Share
Embed
Data Transformation in Digdag
ワークフローエンジンのDigdagを使ったELT、特にT(Transform)に関する問題について、Digdagのジョブ定義をうまく活用しながら解決する方法について、TimeTree社の取り組みをご紹介します。
また、弊社のようにデータ基盤チームがまだないスタートアップでのTransfomの難しさとの向き合い方も、一例としてお話しします。
Yusaku Omasa
April 06, 2022
Transcript
62 slides
-
もくじ - TimeTreeのご紹介 (1 min) - Transform (5 min) -
Transform 傾向と対策 in Digdag (10 min) - ⼩さな会社でTransformを運⽤する (4 min) -
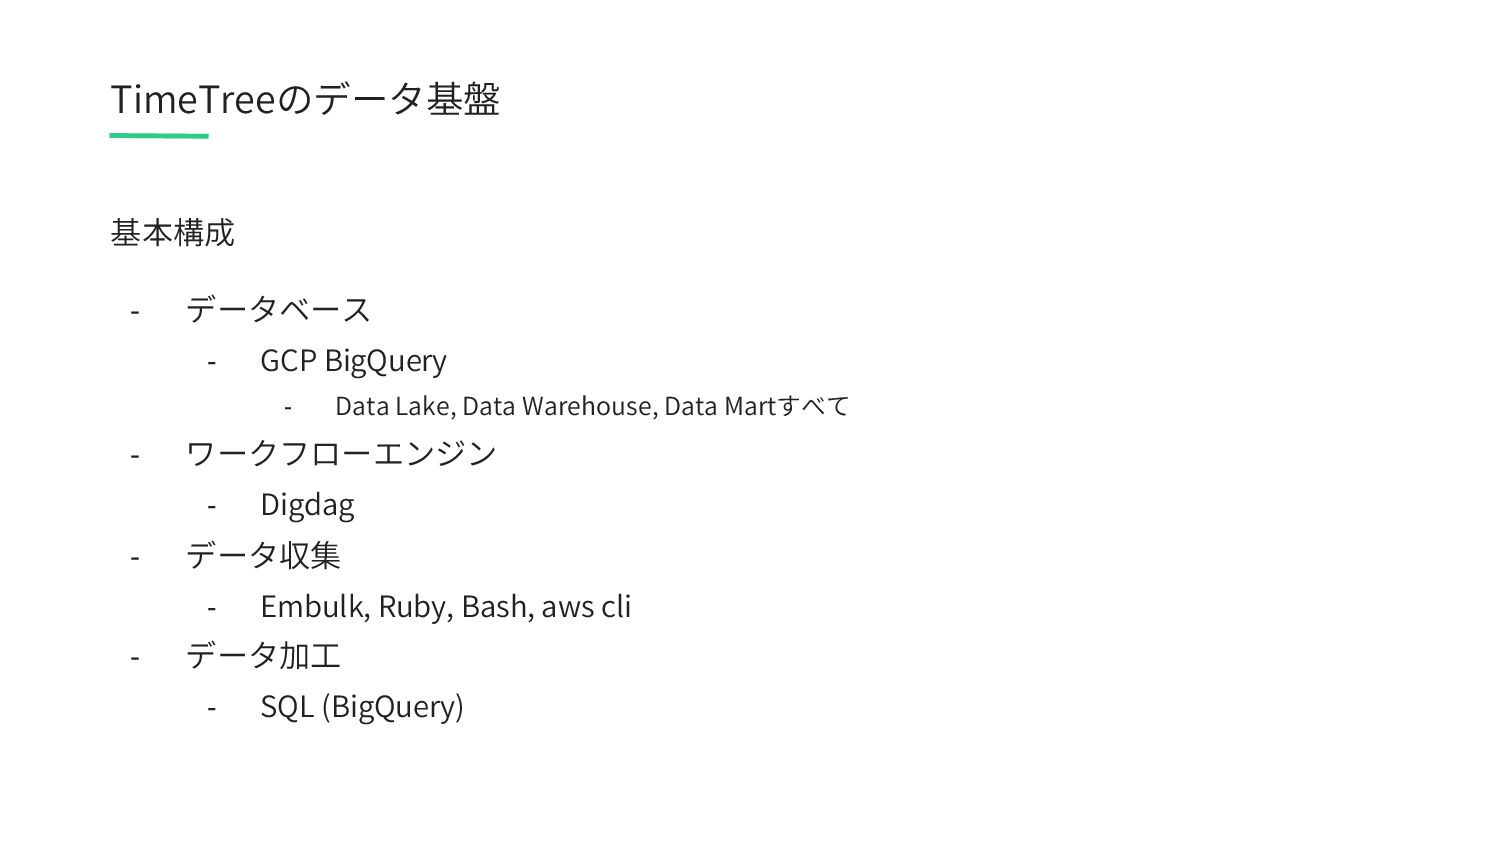
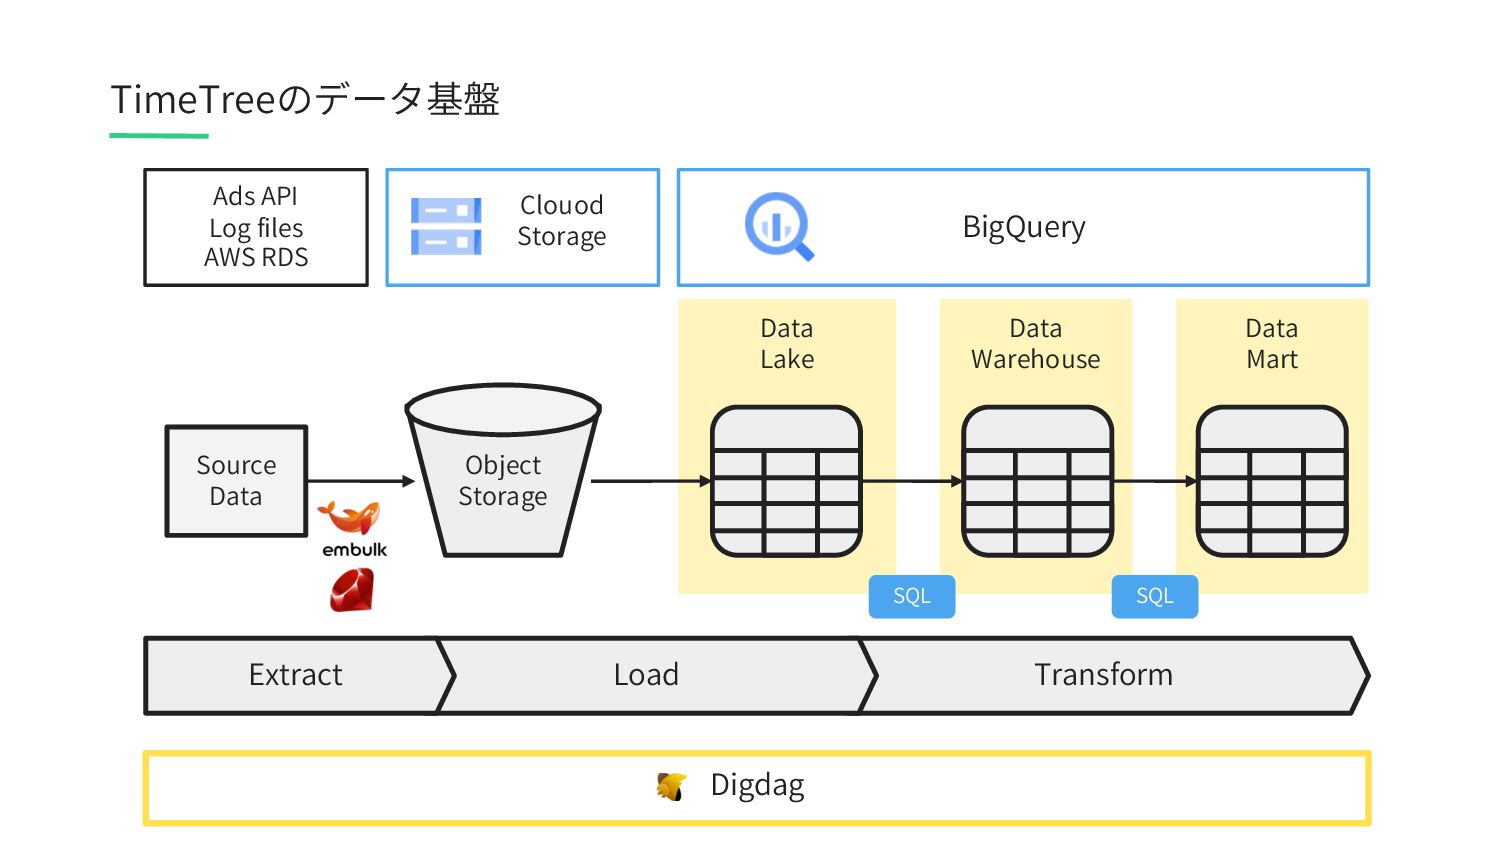
基本構成 - データベース - GCP BigQuery - Data Lake, Data
Warehouse, Data Martすべて - ワークフローエンジン - Digdag - データ収集 - Embulk, Ruby, Bash, aws cli - データ加⼯ - SQL (BigQuery) TimeTreeのデータ基盤 -
Digdag TimeTreeのデータ基盤 BigQuery Data Mart Data Warehouse Data Lake Transform
Load Extract Object Storage Clouod Storage Ads API Log files AWS RDS Source Data SQL SQL -
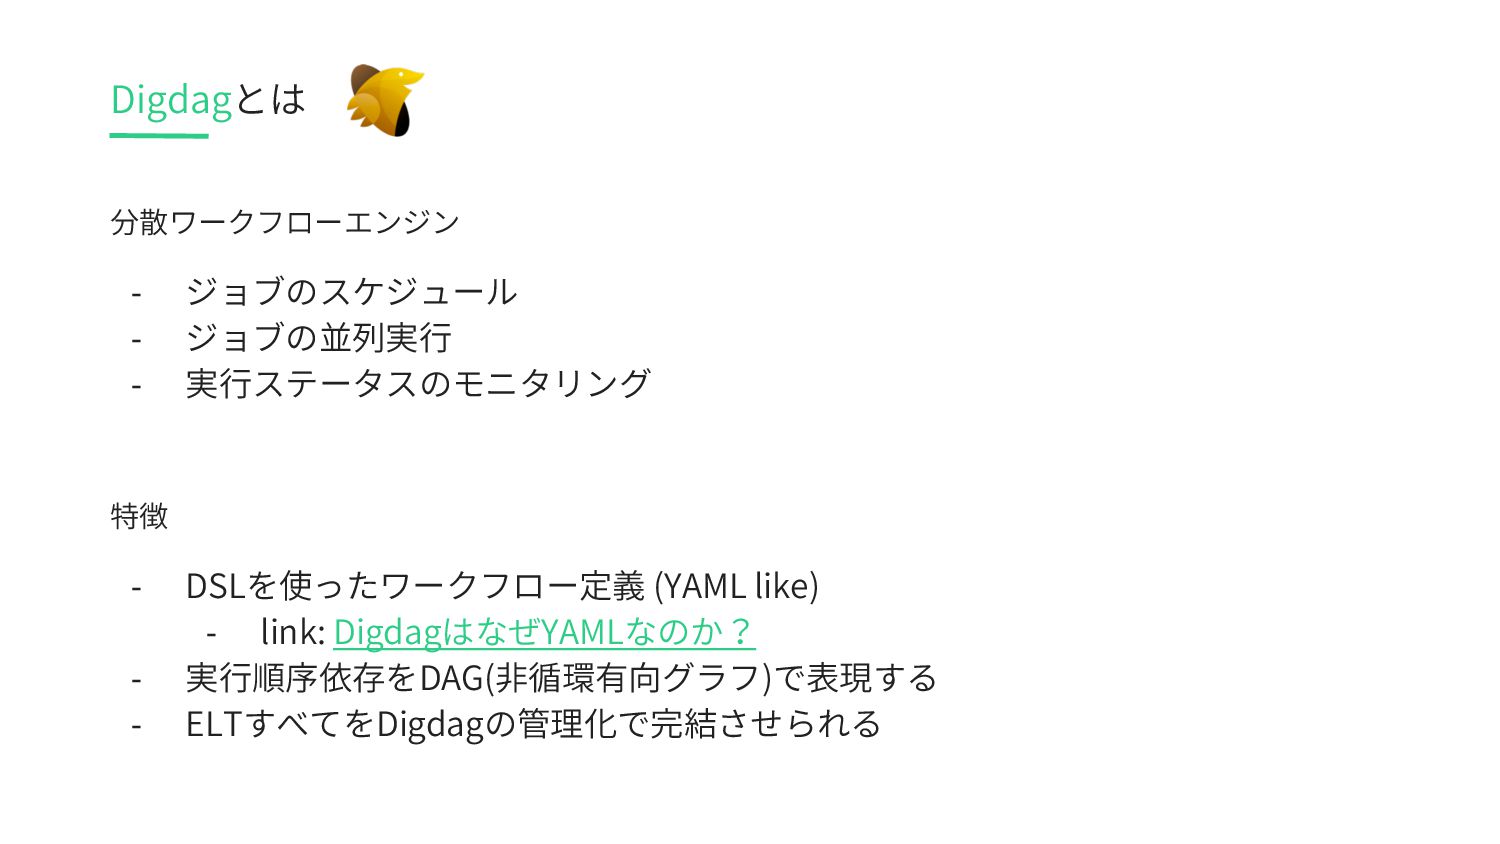
Digdagとは 分散ワークフローエンジン - ジョブのスケジュール - ジョブの並列実⾏ - 実⾏ステータスのモニタリング 特徴 -
DSLを使ったワークフロー定義 (YAML like) - link: DigdagはなぜYAMLなのか? - 実⾏順序依存をDAG(⾮循環有向グラフ)で表現する - ELTすべてをDigdagの管理化で完結させられる -
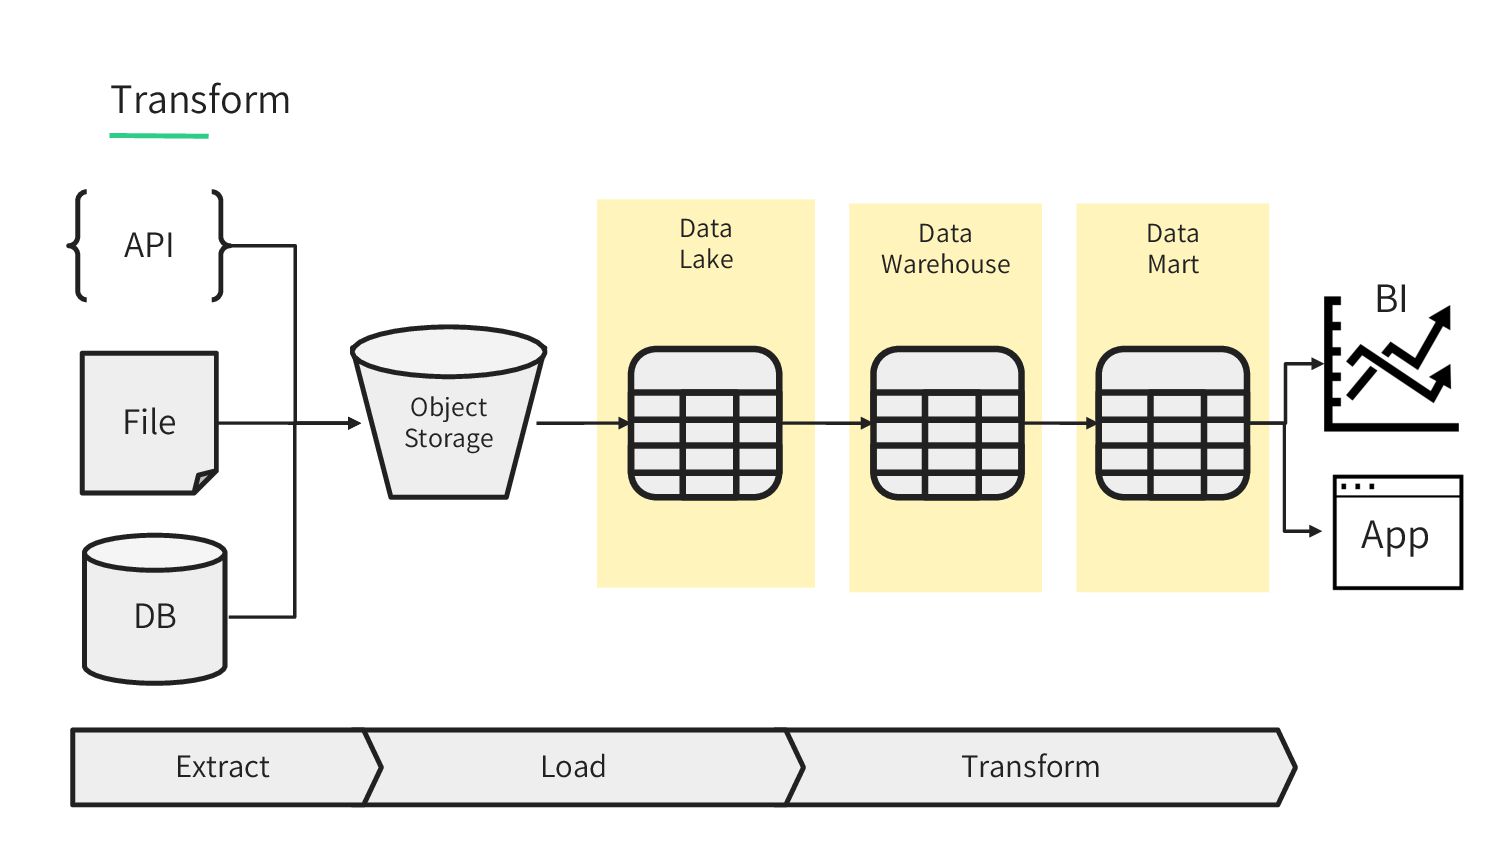
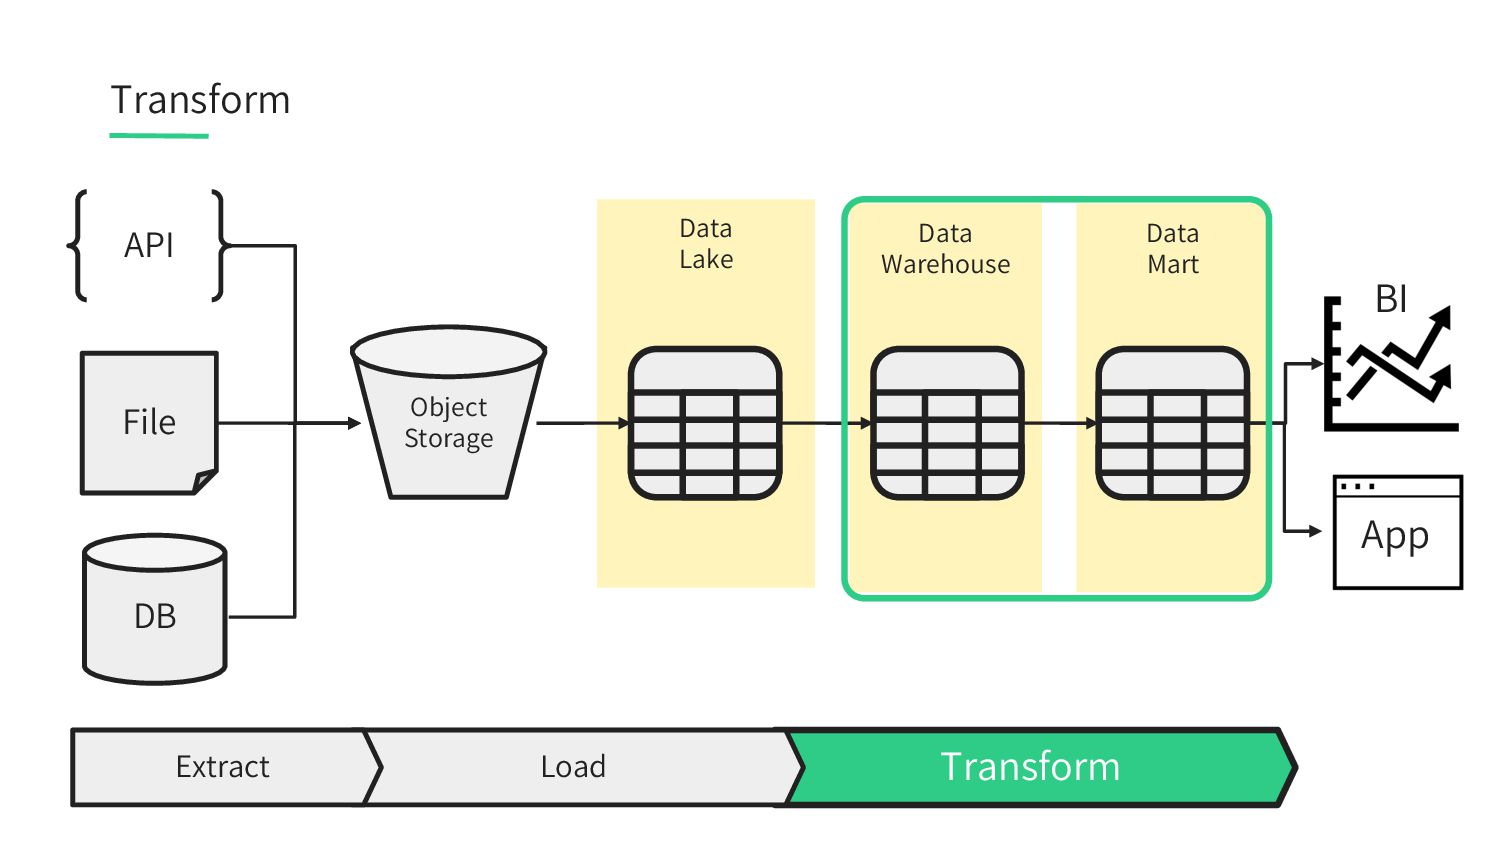
Transform ELTとは - Extract: データを抽出 - Load: データ基盤にデータをロード - Transform:
データ加⼯・テーブル変形 Transformは、データ基盤における「3層構造」のうち、 Data Warehouse(DWH) / Data Martを⽣成する部分になる -
Data Mart Data Warehouse Data Lake App File API DB
BI Transform Load Extract Object Storage Transform -
Transform Data Mart Data Warehouse Data Lake App BI Load
Extract Object Storage File API DB Transform -
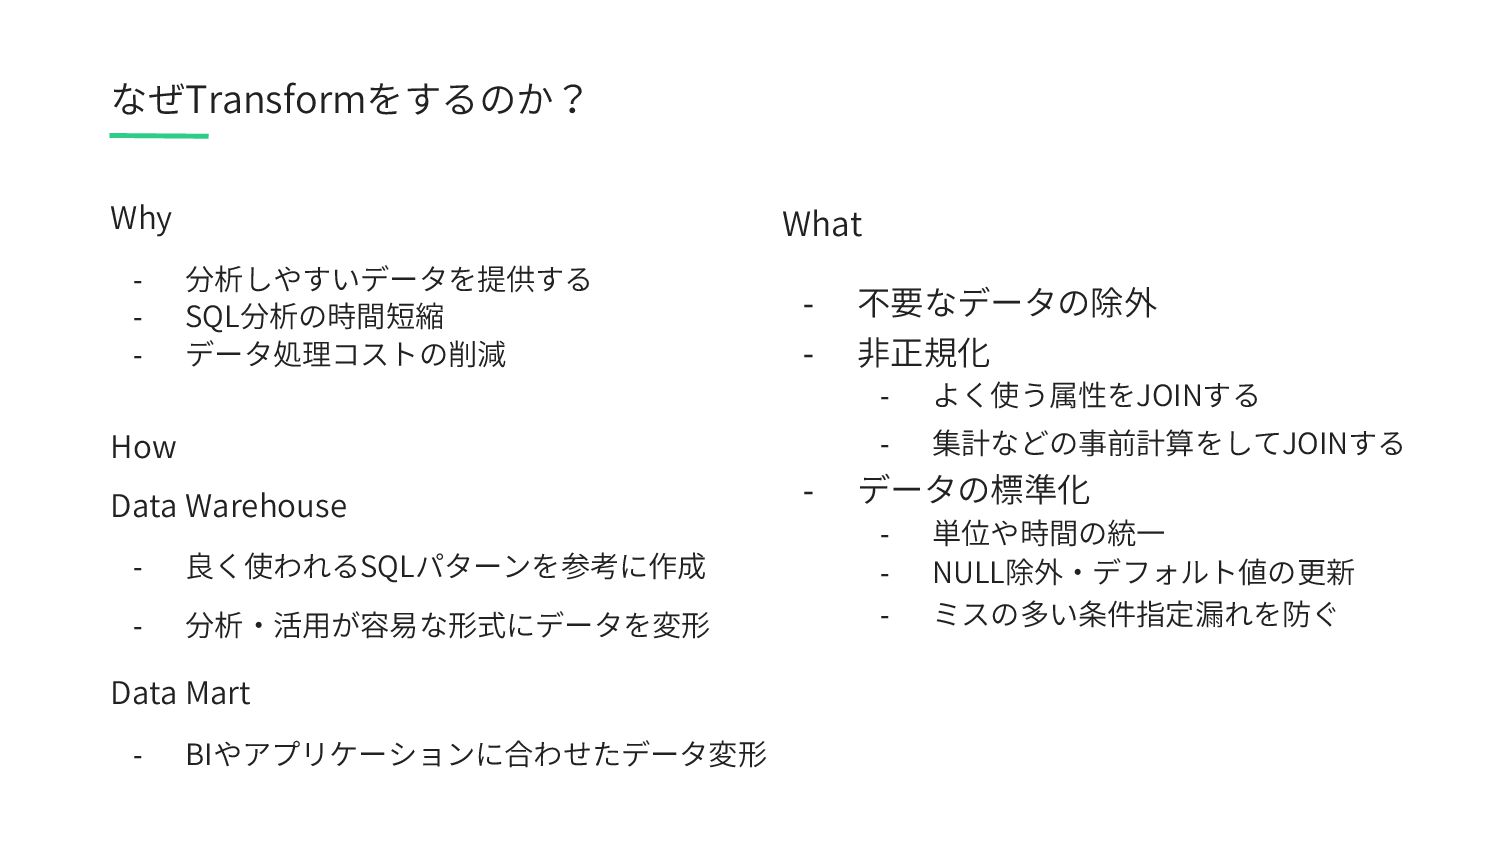
なぜTransformをするのか? What - 不要なデータの除外 - ⾮正規化 - よく使う属性をJOINする - 集計などの事前計算をしてJOINする
- データの標準化 - 単位や時間の統⼀ - NULL除外・デフォルト値の更新 - ミスの多い条件指定漏れを防ぐ Why - 分析しやすいデータを提供する - SQL分析の時間短縮 - データ処理コストの削減 How Data Warehouse - 良く使われるSQLパターンを参考に作成 - 分析・活⽤が容易な形式にデータを変形 Data Mart - BIやアプリケーションに合わせたデータ変形 -
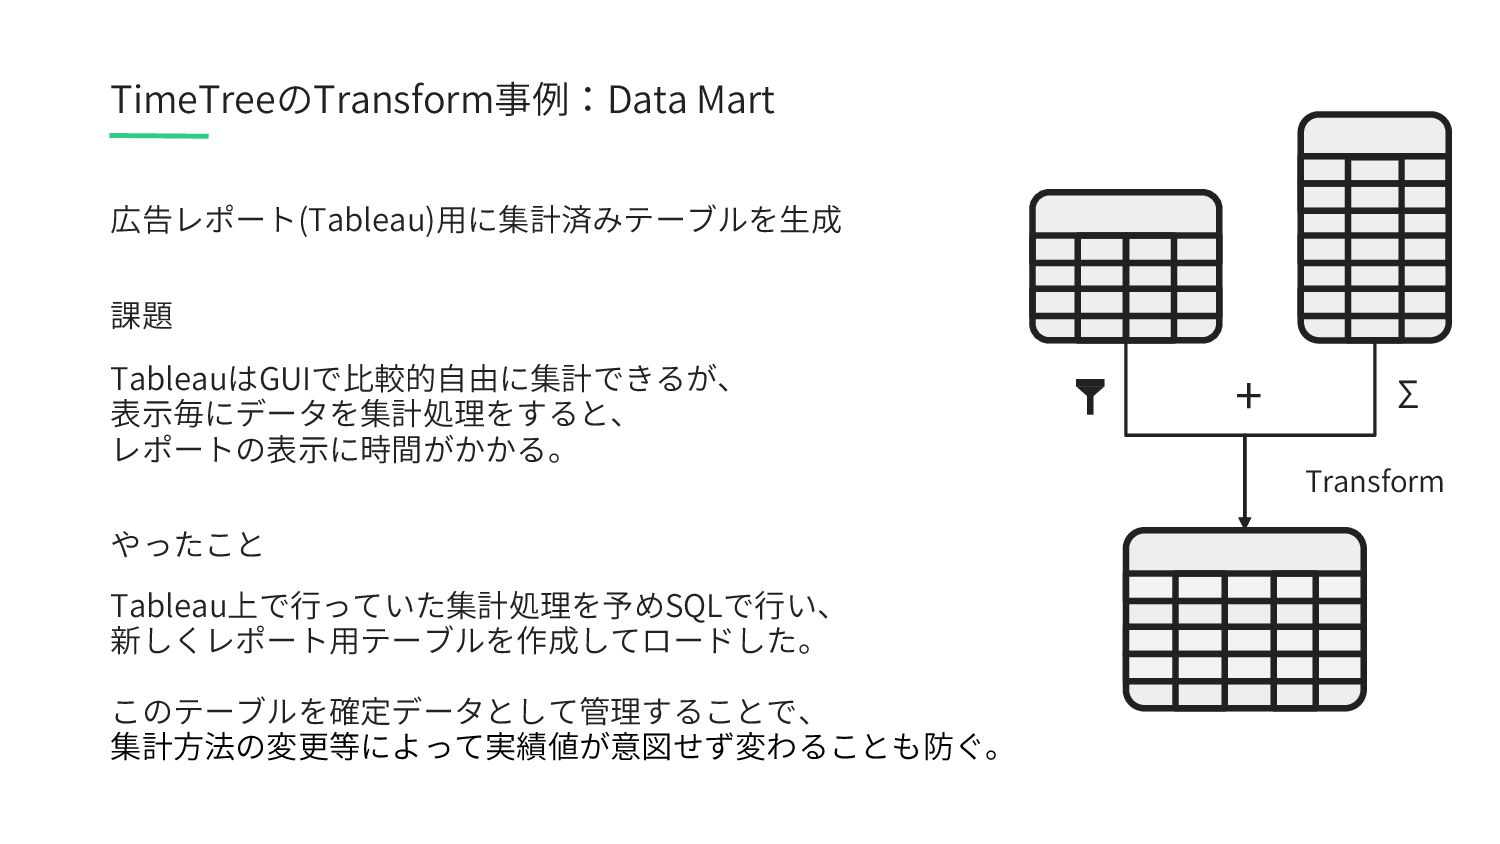
TimeTreeのTransform事例:Data Mart 広告レポート(Tableau)⽤に集計済みテーブルを⽣成 課題 TableauはGUIで⽐較的⾃由に集計できるが、 表⽰毎にデータを集計処理をすると、 レポートの表⽰に時間がかかる。 やったこと Tableau上で⾏っていた集計処理を予めSQLで⾏い、 新しくレポート⽤テーブルを作成してロードした。
このテーブルを確定データとして管理することで、 集計⽅法の変更等によって実績値が意図せず変わることも防ぐ。 Transform Σ + -
データの依存関係を複雑化する - Transformで使うデータは依存関係を持つ - DWH / Data Martで多段の依存関係も⽣じる - データが密結合になりやすい
- 疎結合を維持することで保守しやすくなるが... 重要なデータほど良く使われ、依存関係が増えていく - ユーザーの属性(ディメンション) - 購買データ(トランザクション) …etc Transformがもたらすもの -
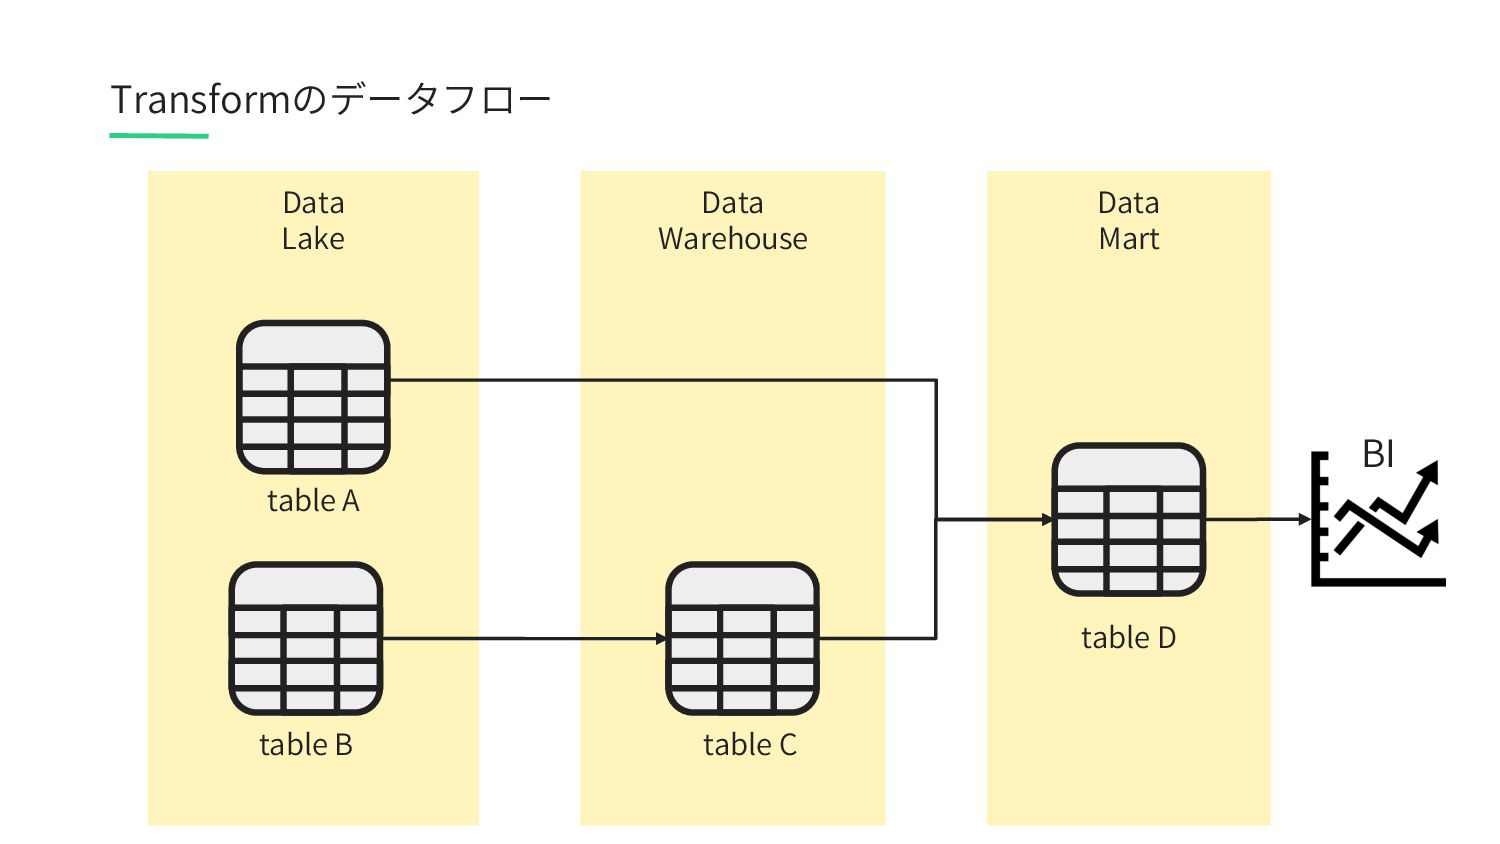
Data Lake Data Warehouse Data Mart Transformのデータフロー table A table
B table C table D BI -
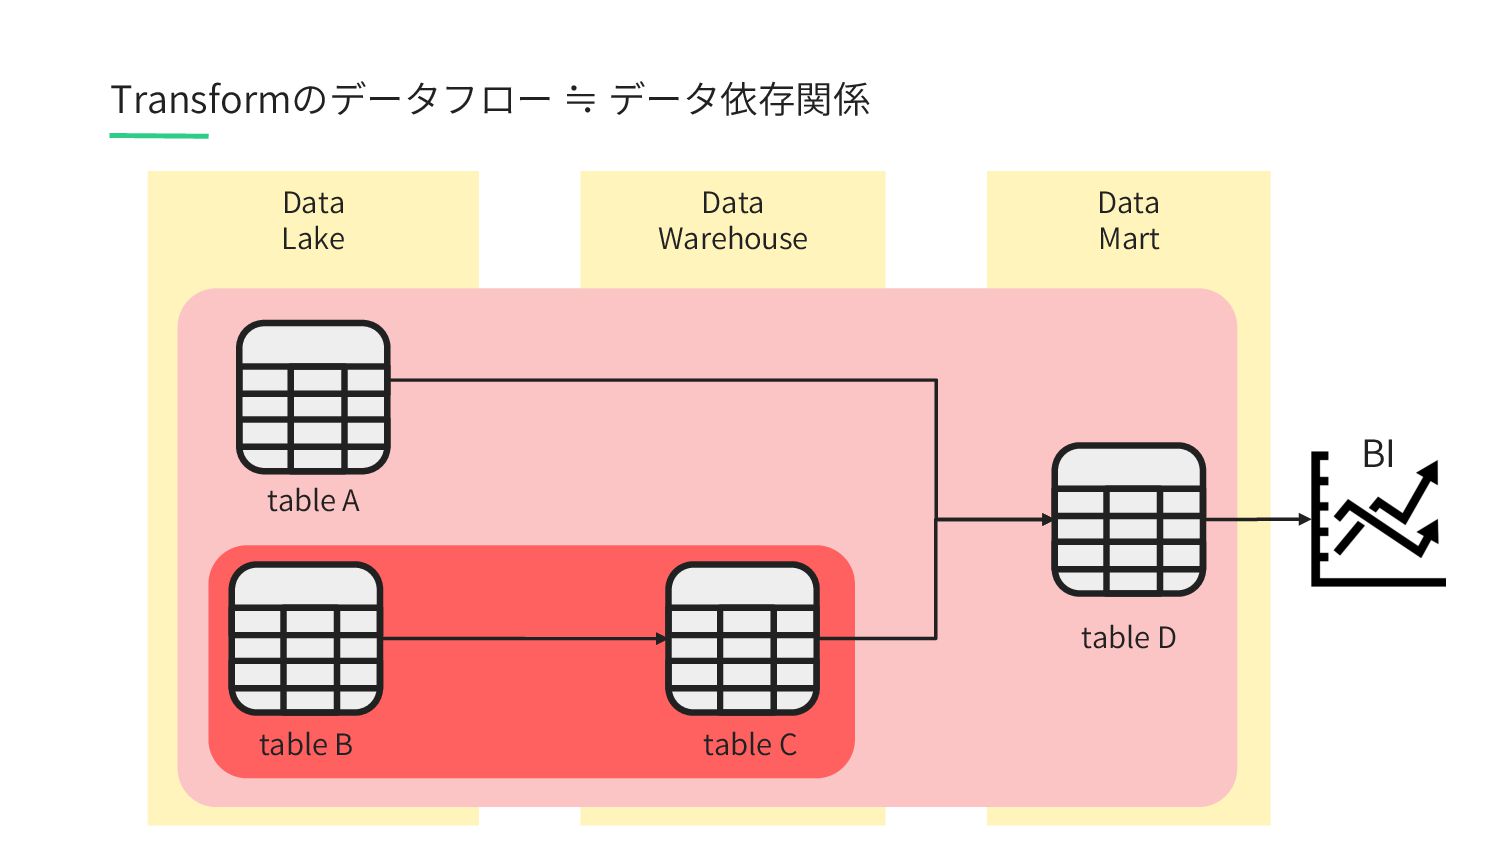
Data Lake Data Warehouse Data Mart Transformのデータフロー ≒ データ依存関係 table
A table B table C table D BI -
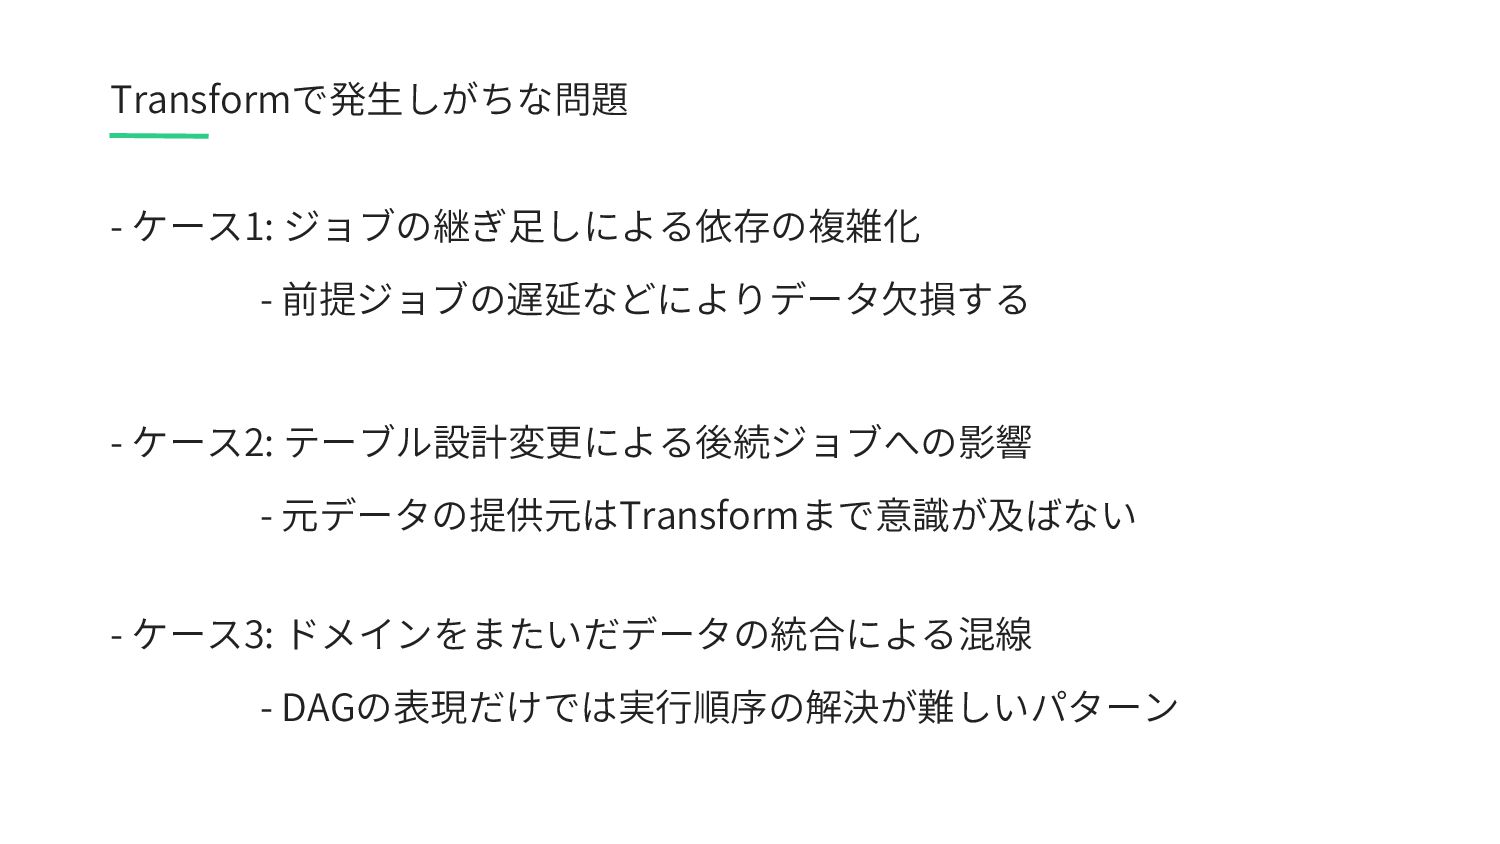
- ケース1: ジョブの継ぎ⾜しによる依存の複雑化 - 前提ジョブの遅延などによりデータ⽋損する - ケース2: テーブル設計変更による後続ジョブへの影響 - 元データの提供元はTransformまで意識が及ばない
- ケース3: ドメインをまたいだデータの統合による混線 - DAGの表現だけでは実⾏順序の解決が難しいパターン Transformで発⽣しがちな問題 -
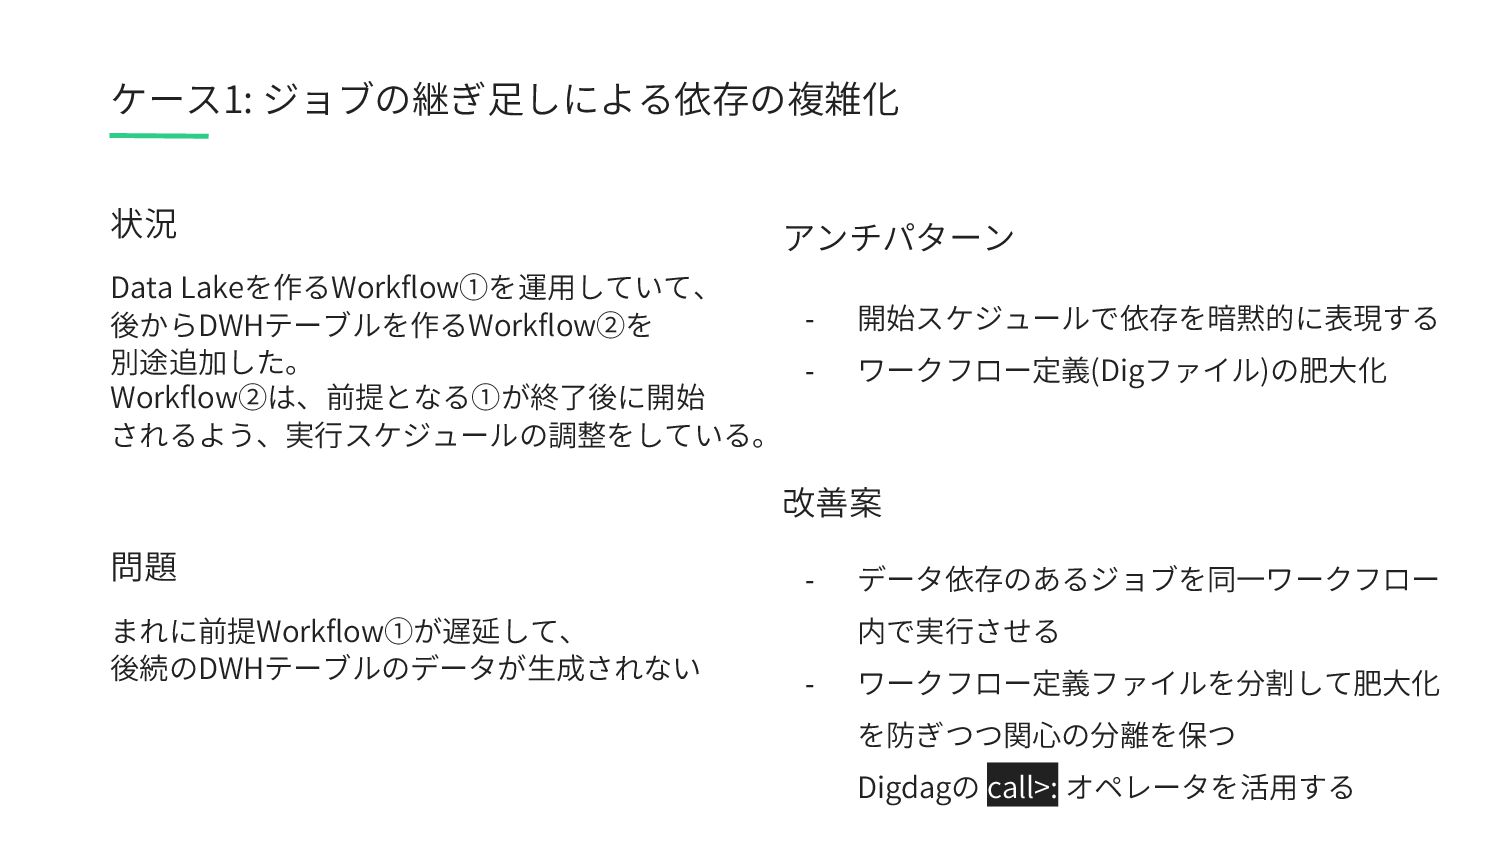
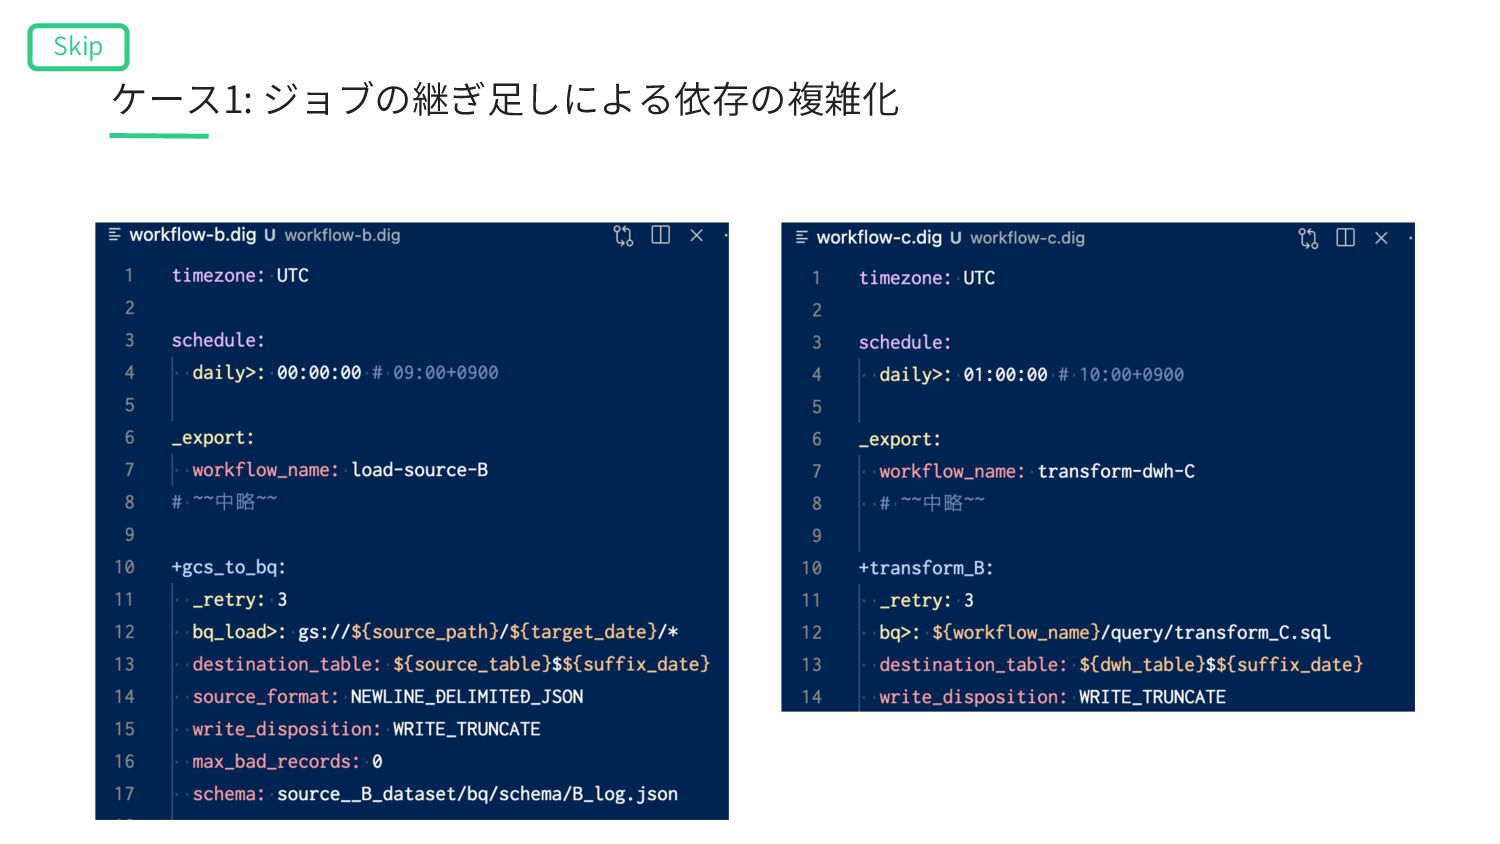
状況 Data Lakeを作るWorkflow①を運⽤していて、 後からDWHテーブルを作るWorkflow②を 別途追加した。 Workflow②は、前提となる①が終了後に開始 されるよう、実⾏スケジュールの調整をしている。 問題 まれに前提Workflow①が遅延して、 後続のDWHテーブルのデータが⽣成されない
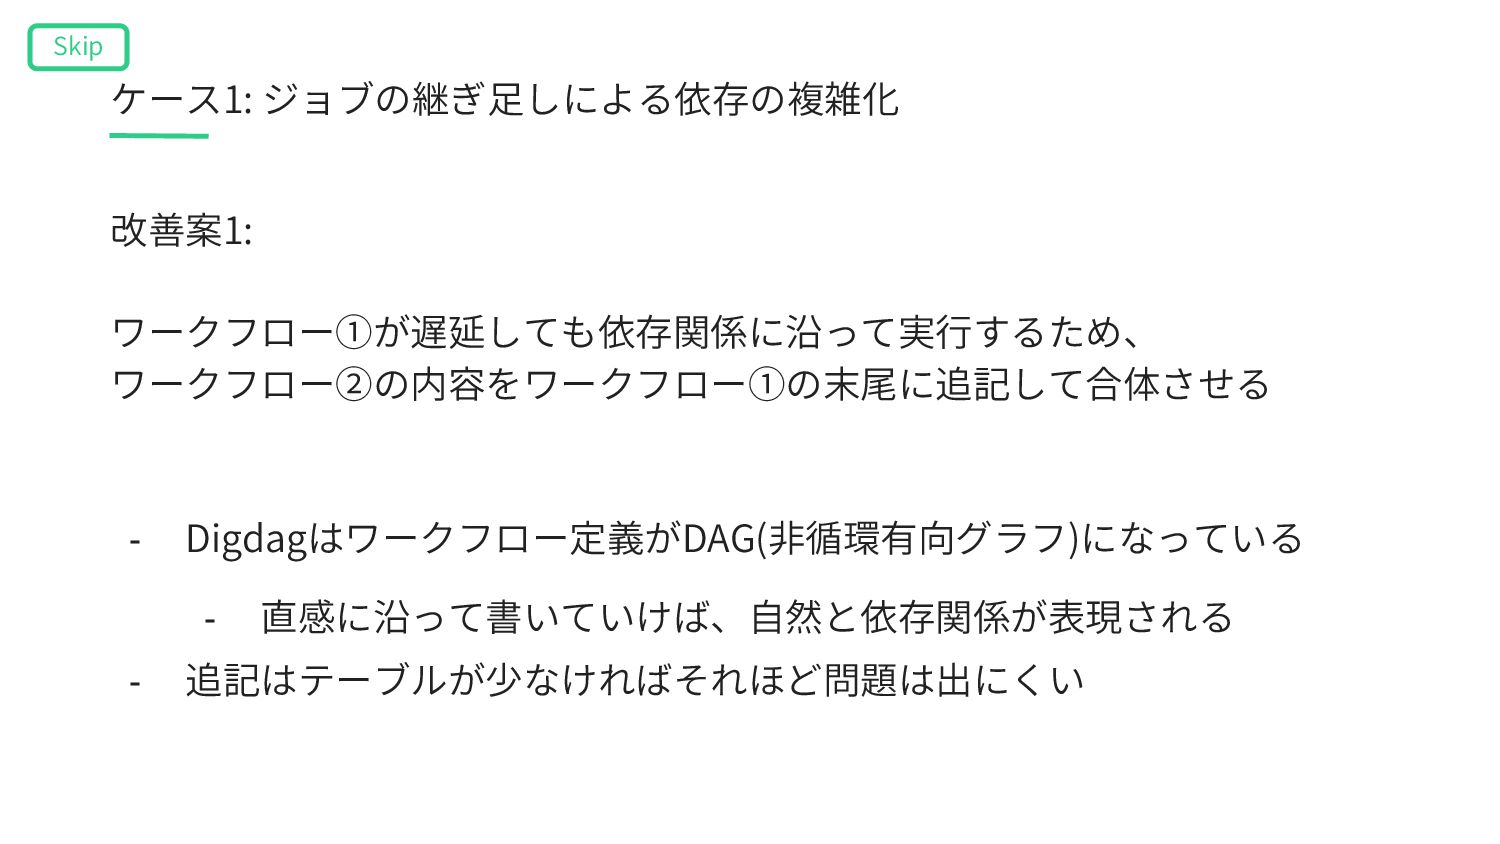
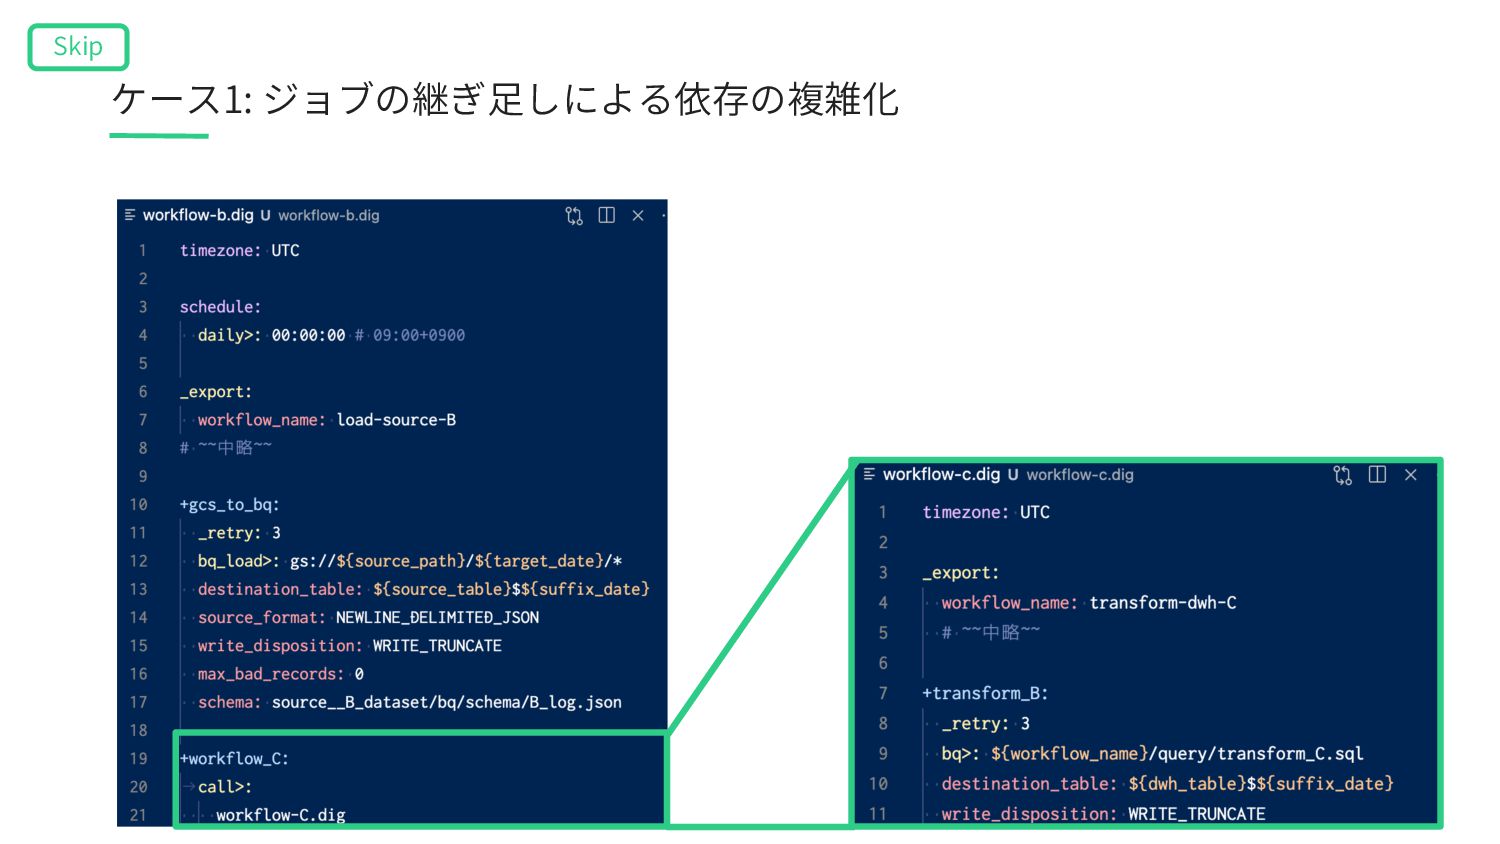
ケース1: ジョブの継ぎ⾜しによる依存の複雑化 アンチパターン - 開始スケジュールで依存を暗黙的に表現する - ワークフロー定義(Digファイル)の肥⼤化 改善案 - データ依存のあるジョブを同⼀ワークフロー 内で実⾏させる - ワークフロー定義ファイルを分割して肥⼤化 を防ぎつつ関⼼の分離を保つ Digdagの call>: オペレータを活⽤する -
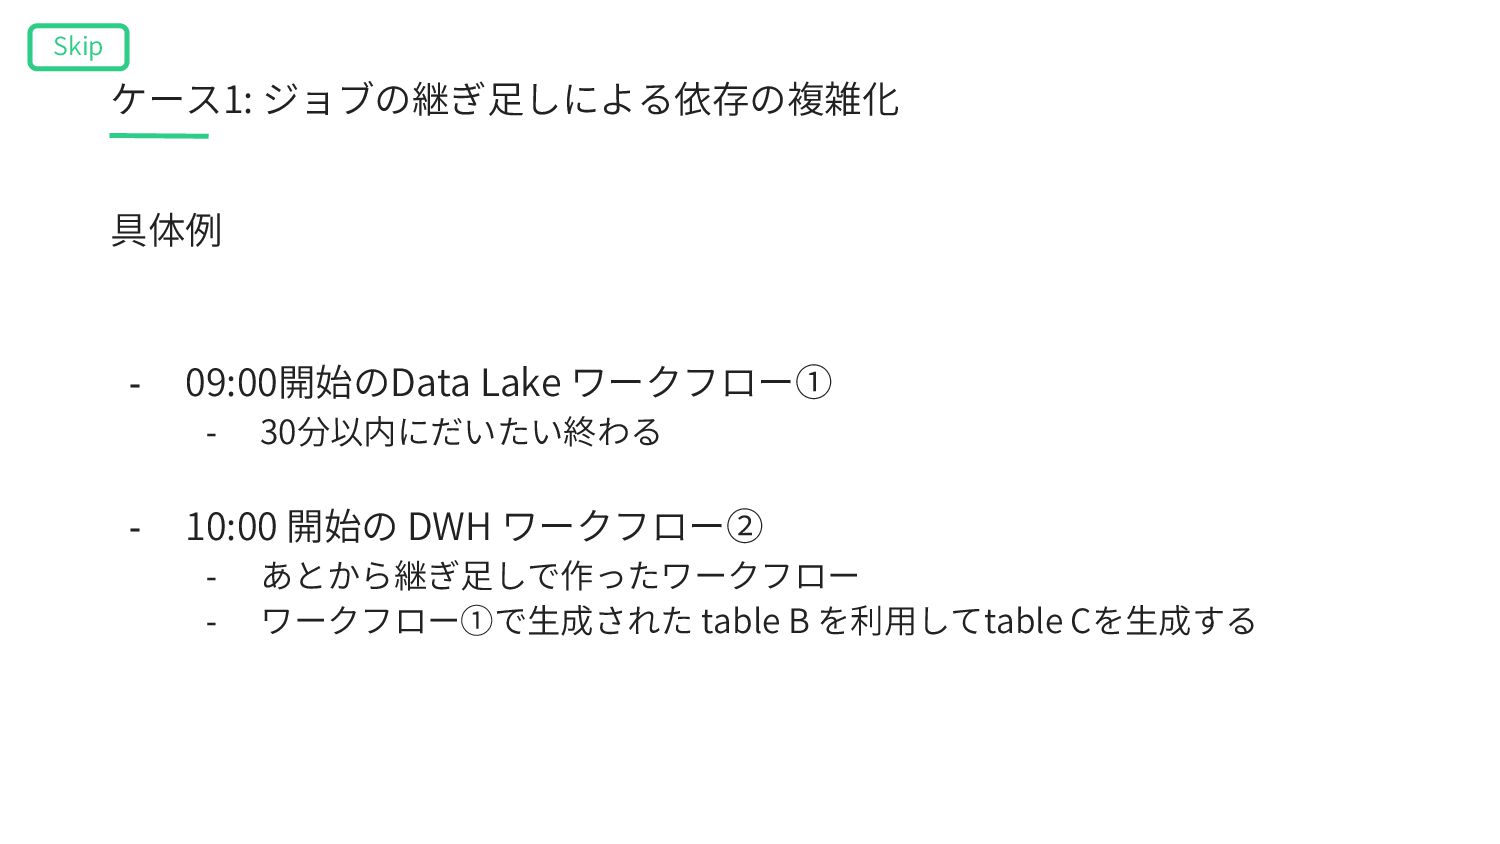
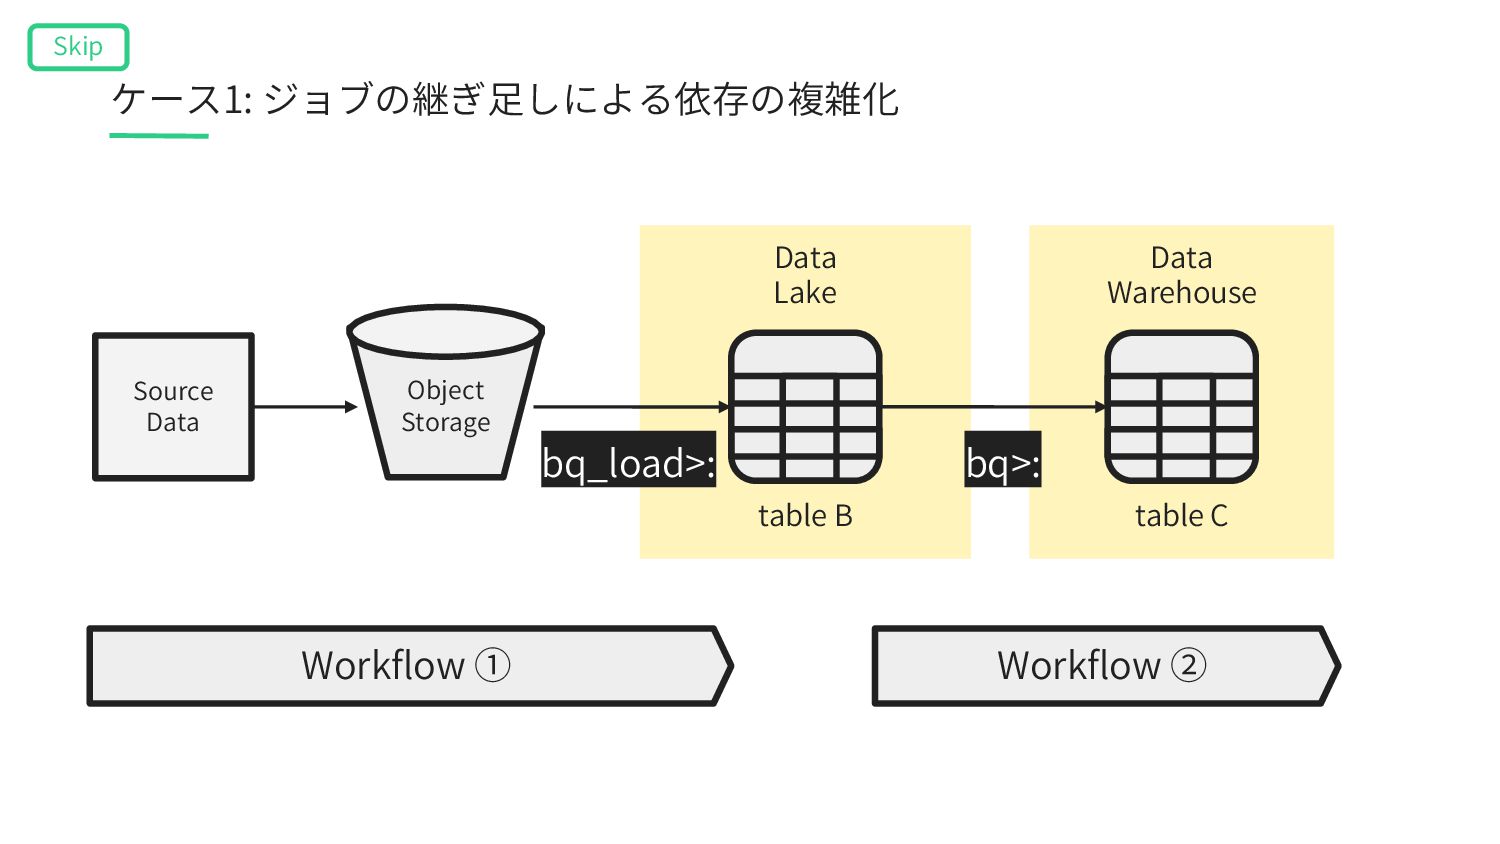
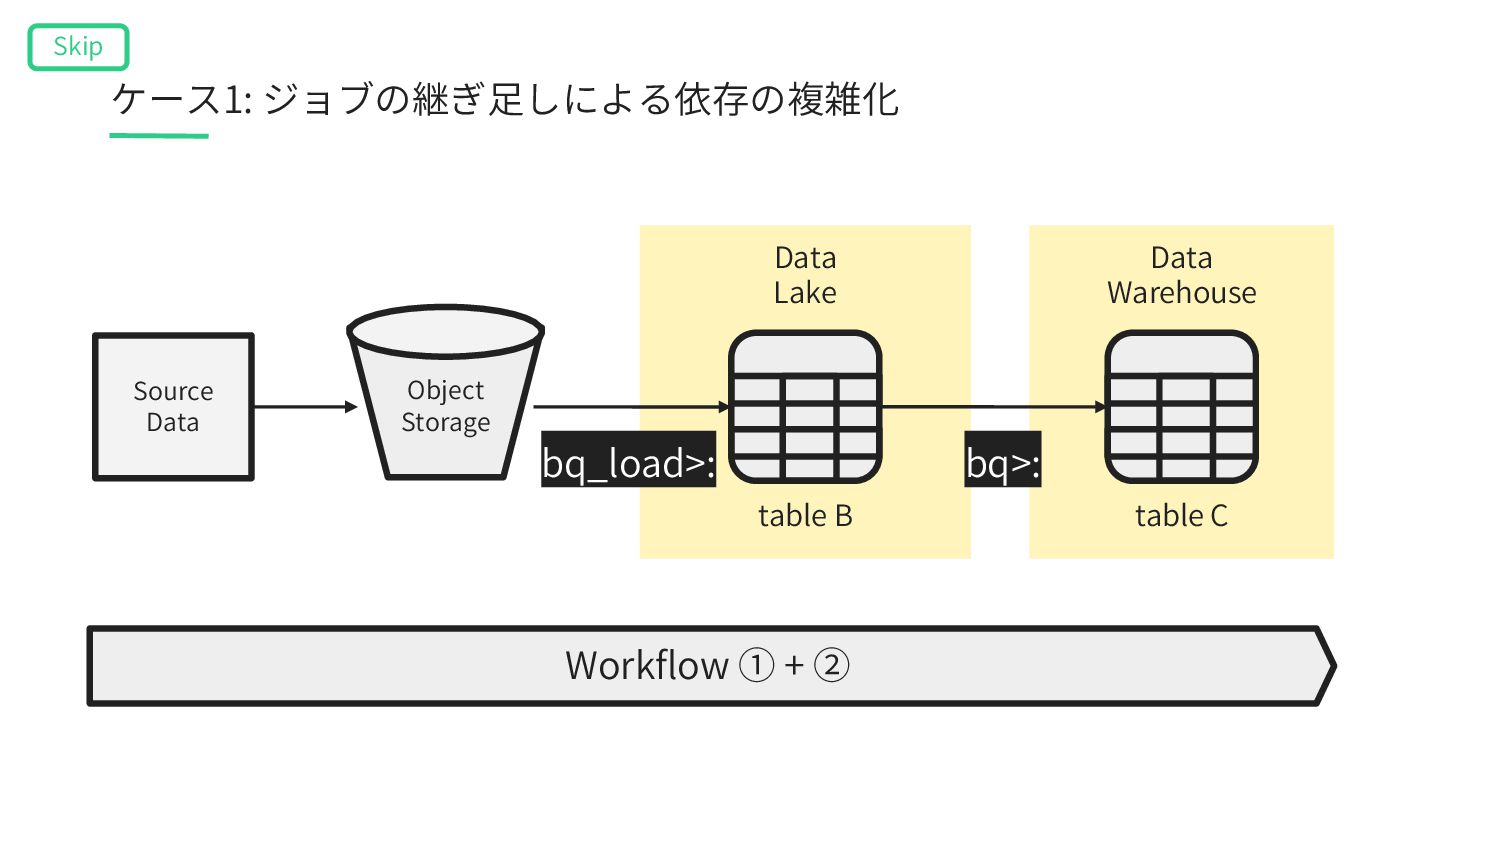
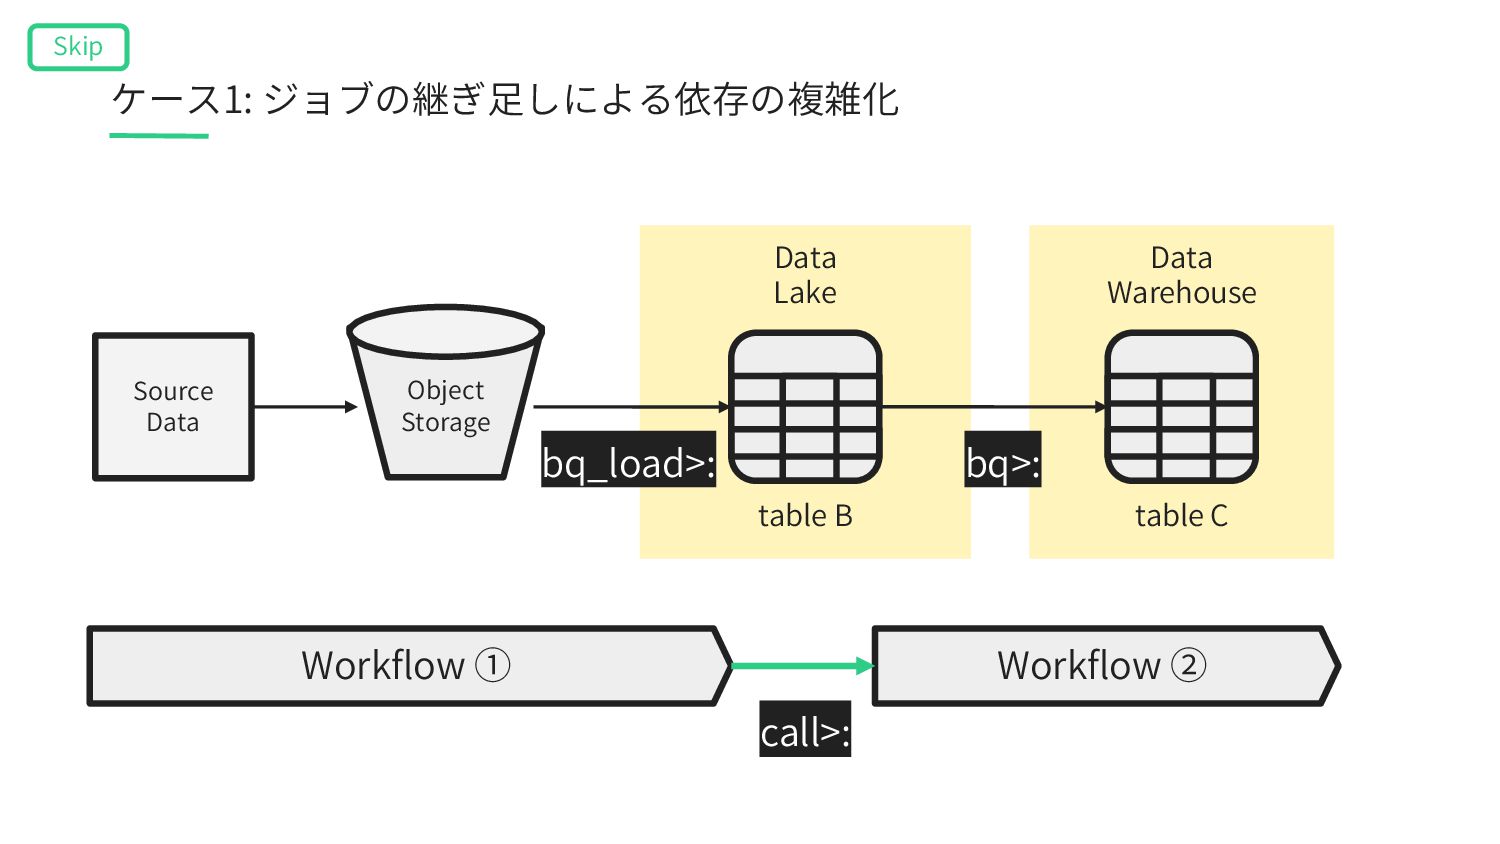
具体例 - 09:00開始のData Lake ワークフロー① - 30分以内にだいたい終わる - 10:00 開始の
DWH ワークフロー② - あとから継ぎ⾜しで作ったワークフロー - ワークフロー①で⽣成された table B を利⽤してtable Cを⽣成する ケース1: ジョブの継ぎ⾜しによる依存の複雑化 Skip -
Data Lake Data Warehouse table B table C Source Data
bq>: bq_load>: Object Storage Workflow ① Workflow ② ケース1: ジョブの継ぎ⾜しによる依存の複雑化 Skip -
Workflow ① + ② Data Lake Data Warehouse table B
table C Source Data bq>: bq_load>: Object Storage Skip ケース1: ジョブの継ぎ⾜しによる依存の複雑化 -
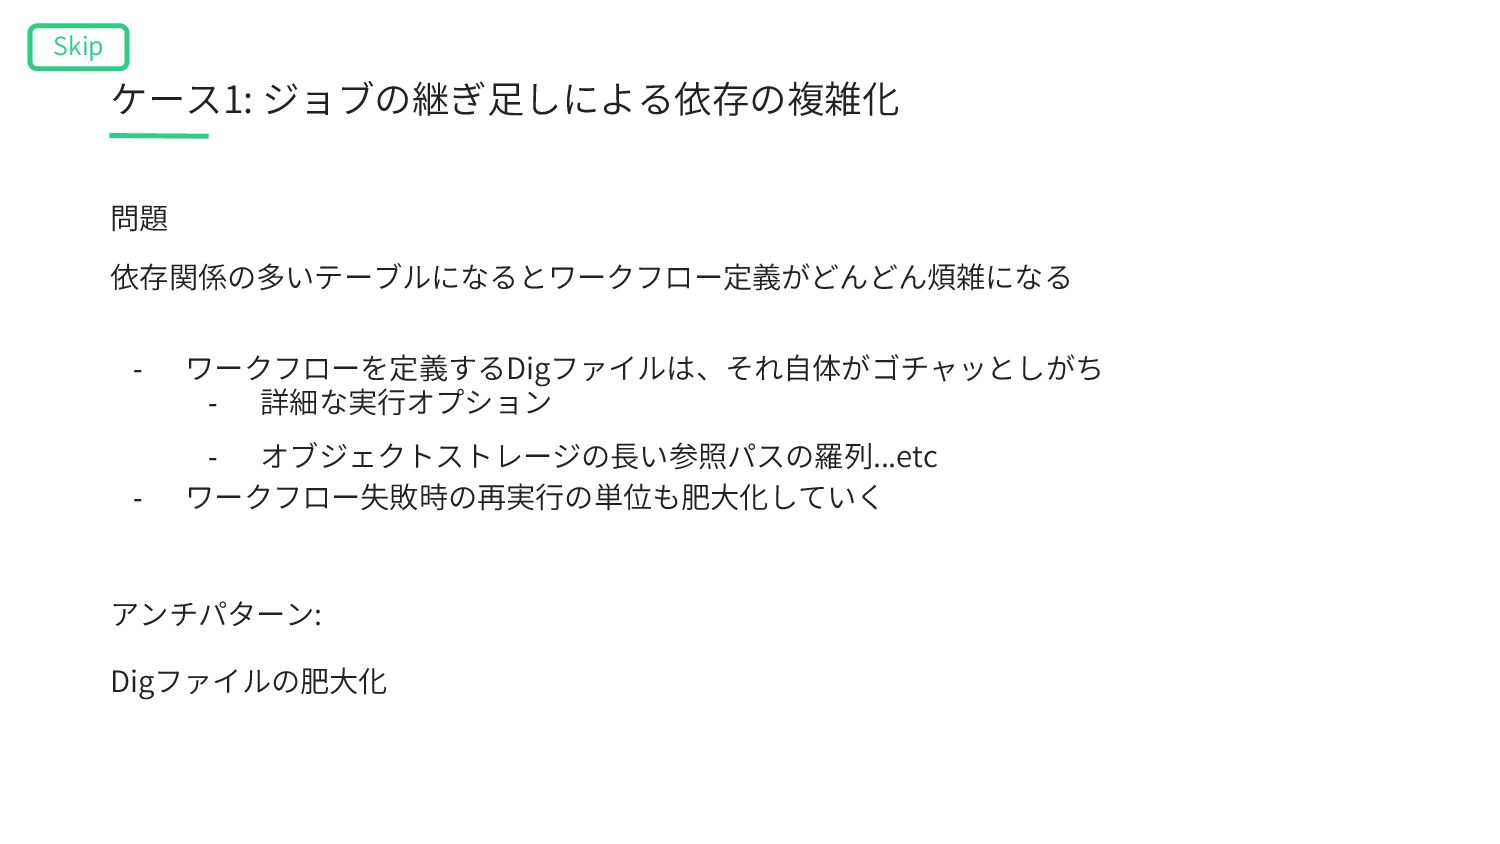
問題 依存関係の多いテーブルになるとワークフロー定義がどんどん煩雑になる - ワークフローを定義するDigファイルは、それ⾃体がゴチャッとしがち - 詳細な実⾏オプション - オブジェクトストレージの⻑い参照パスの羅列...etc - ワークフロー失敗時の再実⾏の単位も肥⼤化していく
アンチパターン: Digファイルの肥⼤化 Skip ケース1: ジョブの継ぎ⾜しによる依存の複雑化 -
改善案2: ワークフロー定義を分けたまま、 call>: オペレータを使って、ワークフロー間の依存を表現する - ワークフロー定義を分割して「関⼼と分離」を保てる - 定義が分割されているので、個別に実⾏することもできる call>: Digファイルで定義されたワークフローを呼び出すオペレータ。
Digdagの _export: で指定した環境変数などは引き継がれない。 Skip ケース1: ジョブの継ぎ⾜しによる依存の複雑化 -
Data Lake Data Warehouse table B table C Source Data
bq>: bq_load>: Object Storage Workflow ① Workflow ② call>: Skip ケース1: ジョブの継ぎ⾜しによる依存の複雑化 -
改善案の限界 これらは関⼼を分離できるだけであって、依存の複雑化は解消できない - 依存をなくすにはデータの参照をやめるしかない - table C を作る限り table B
との依存はなくならない call>: で表現しきれないケースもある - ワークフローごとに起動スケジュールを分けたいケース - JSTのデータは0時に、UTCのデータは9時にELTするなど - JSTとUTCのデータをまとめて9時にELTするのであれば問題ない ケース1: ジョブの継ぎ⾜しによる依存の複雑化 -
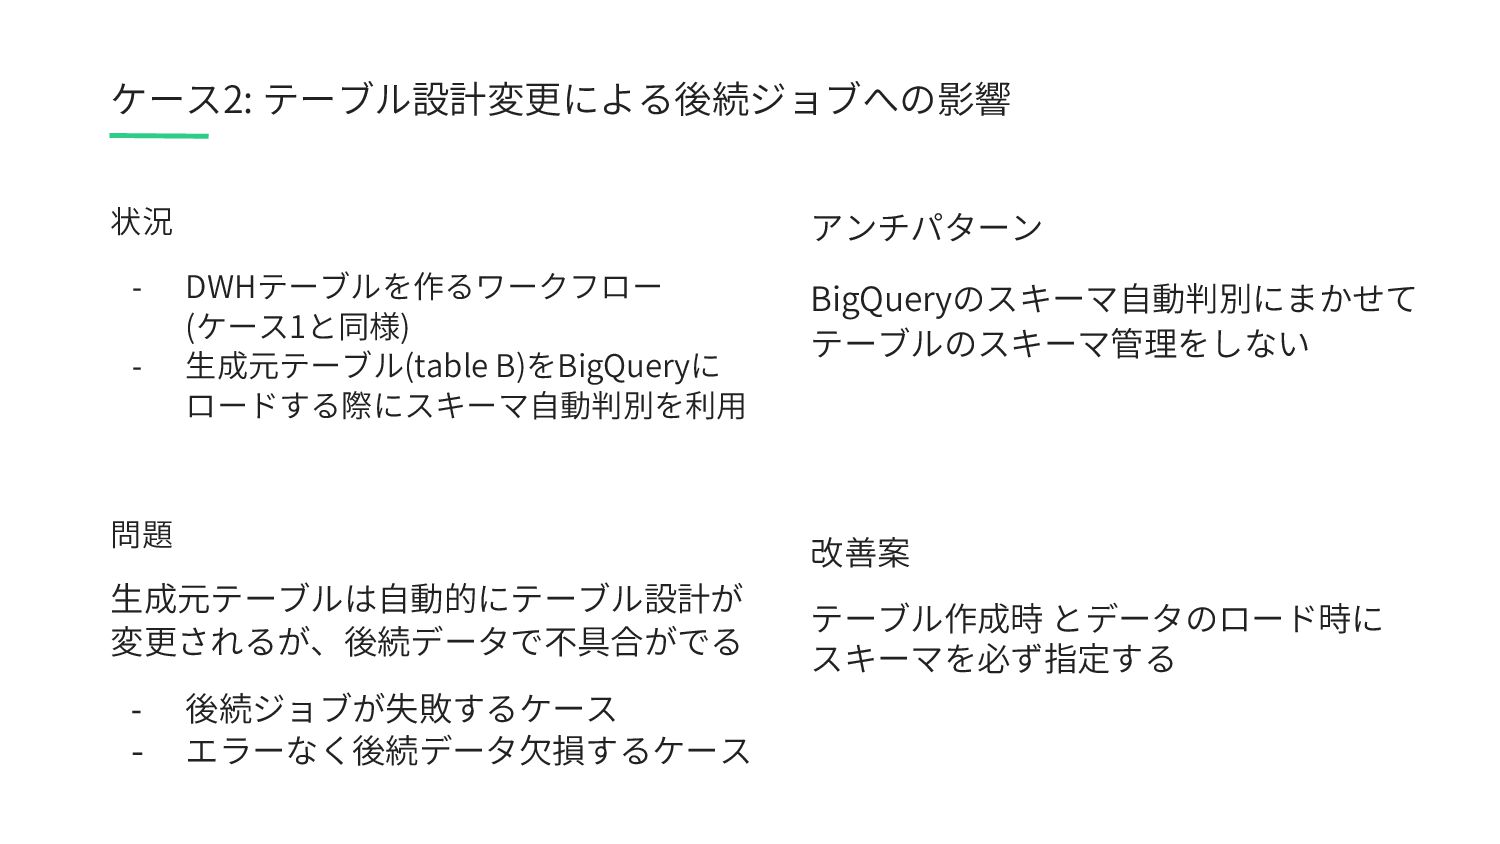
状況 - DWHテーブルを作るワークフロー (ケース1と同様) - ⽣成元テーブル(table B)をBigQueryに ロードする際にスキーマ⾃動判別を利⽤ 問題 ⽣成元テーブルは⾃動的にテーブル設計が
変更されるが、後続データで不具合がでる - 後続ジョブが失敗するケース - エラーなく後続データ⽋損するケース アンチパターン BigQueryのスキーマ⾃動判別にまかせて テーブルのスキーマ管理をしない 改善案 テーブル作成時 とデータのロード時に スキーマを必ず指定する ケース2: テーブル設計変更による後続ジョブへの影響 -
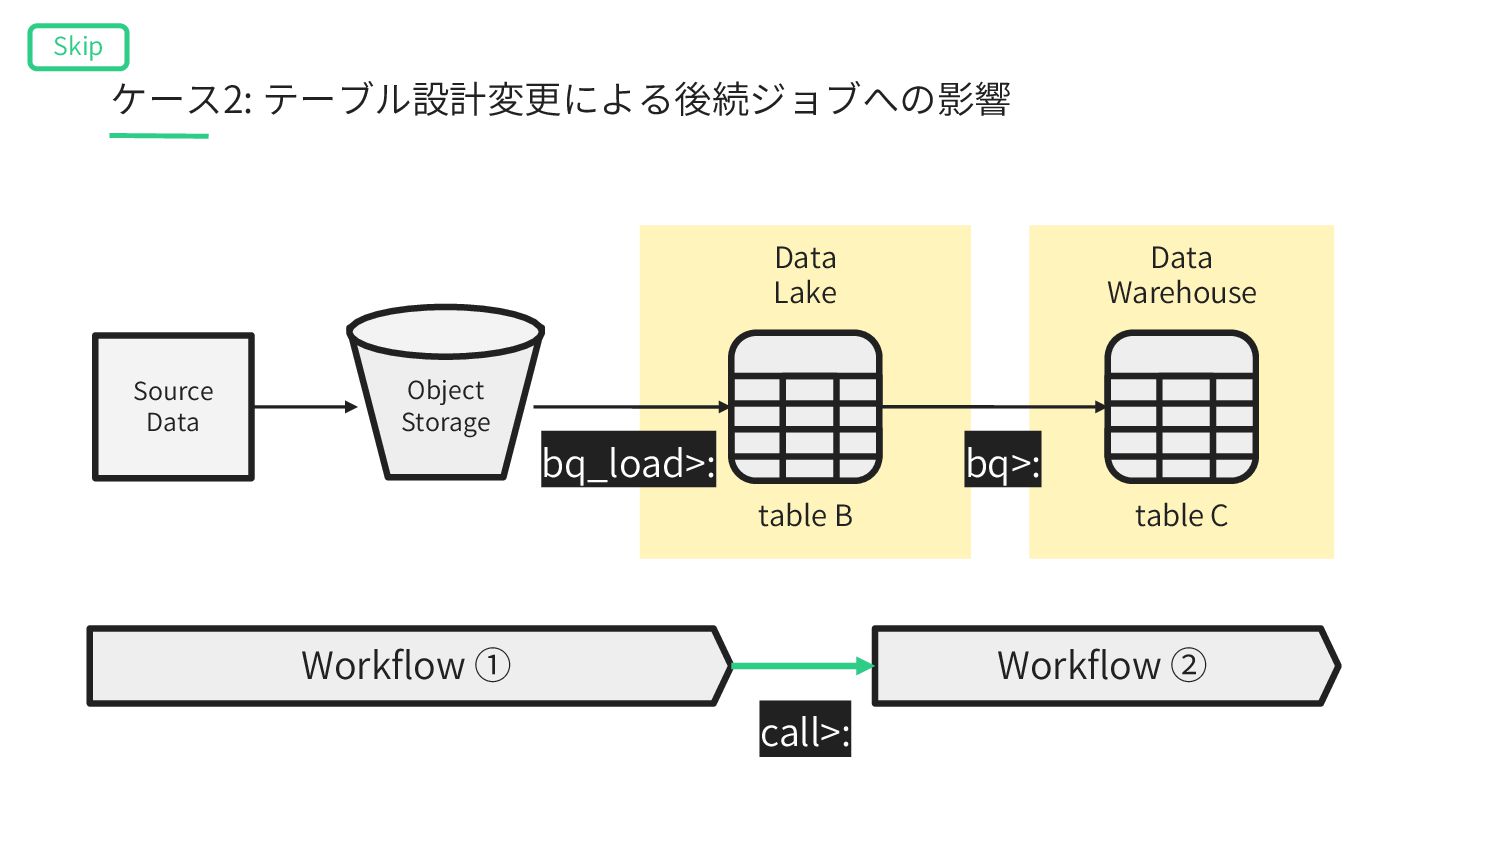
Data Lake Data Warehouse table B table C Source Data
bq>: bq_load>: Object Storage Workflow ① Workflow ② call>: ケース2: テーブル設計変更による後続ジョブへの影響 Skip -
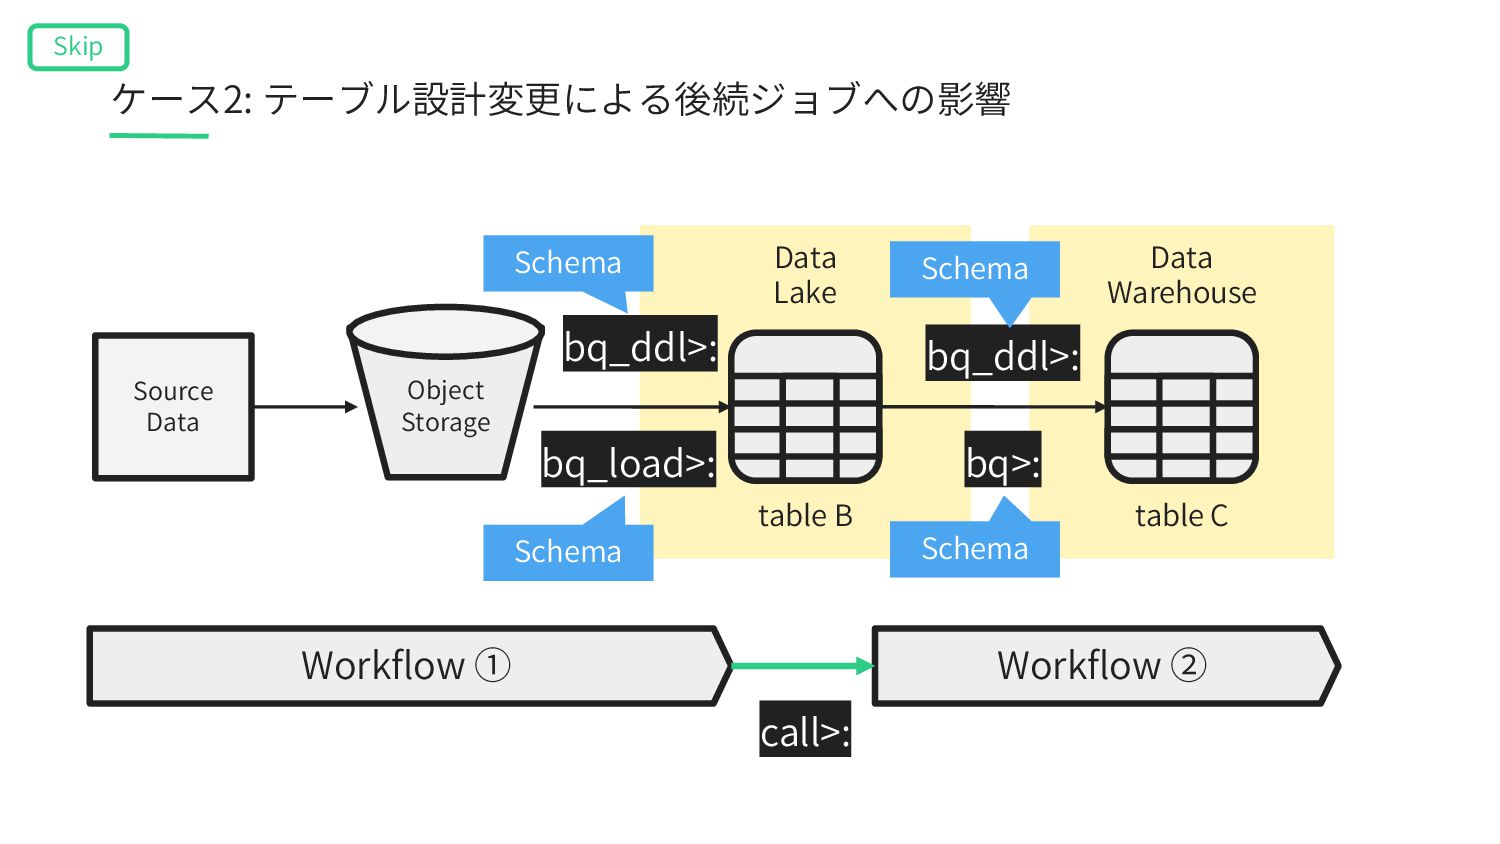
Data Lake Data Warehouse table B table C Source Data
bq>: bq_load>: Object Storage Workflow ① Workflow ② call>: bq_ddl>: bq_ddl>: ケース2: テーブル設計変更による後続ジョブへの影響 Skip Schema Schema Schema Schema -
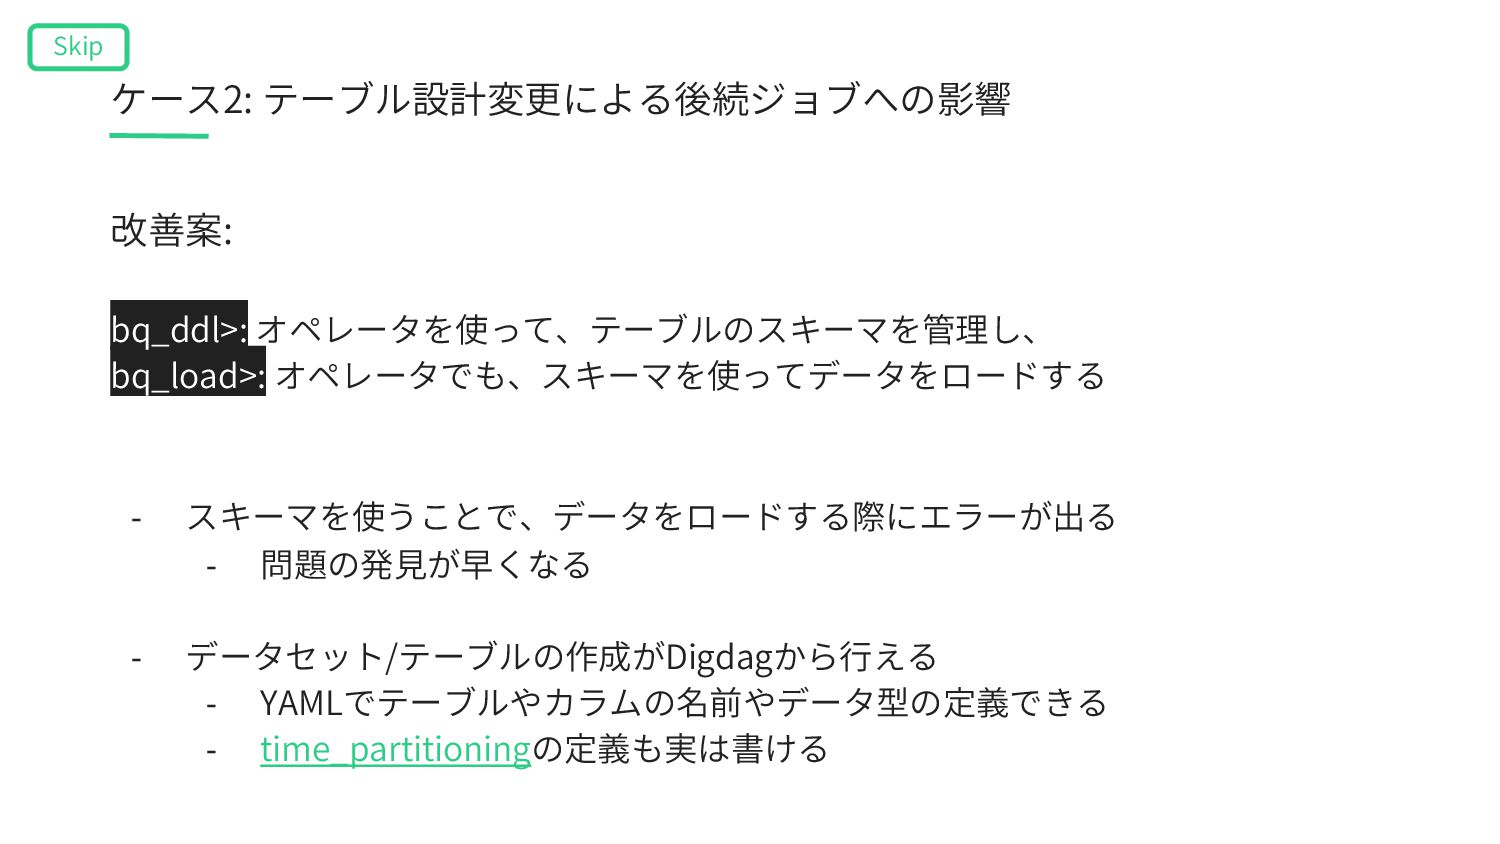
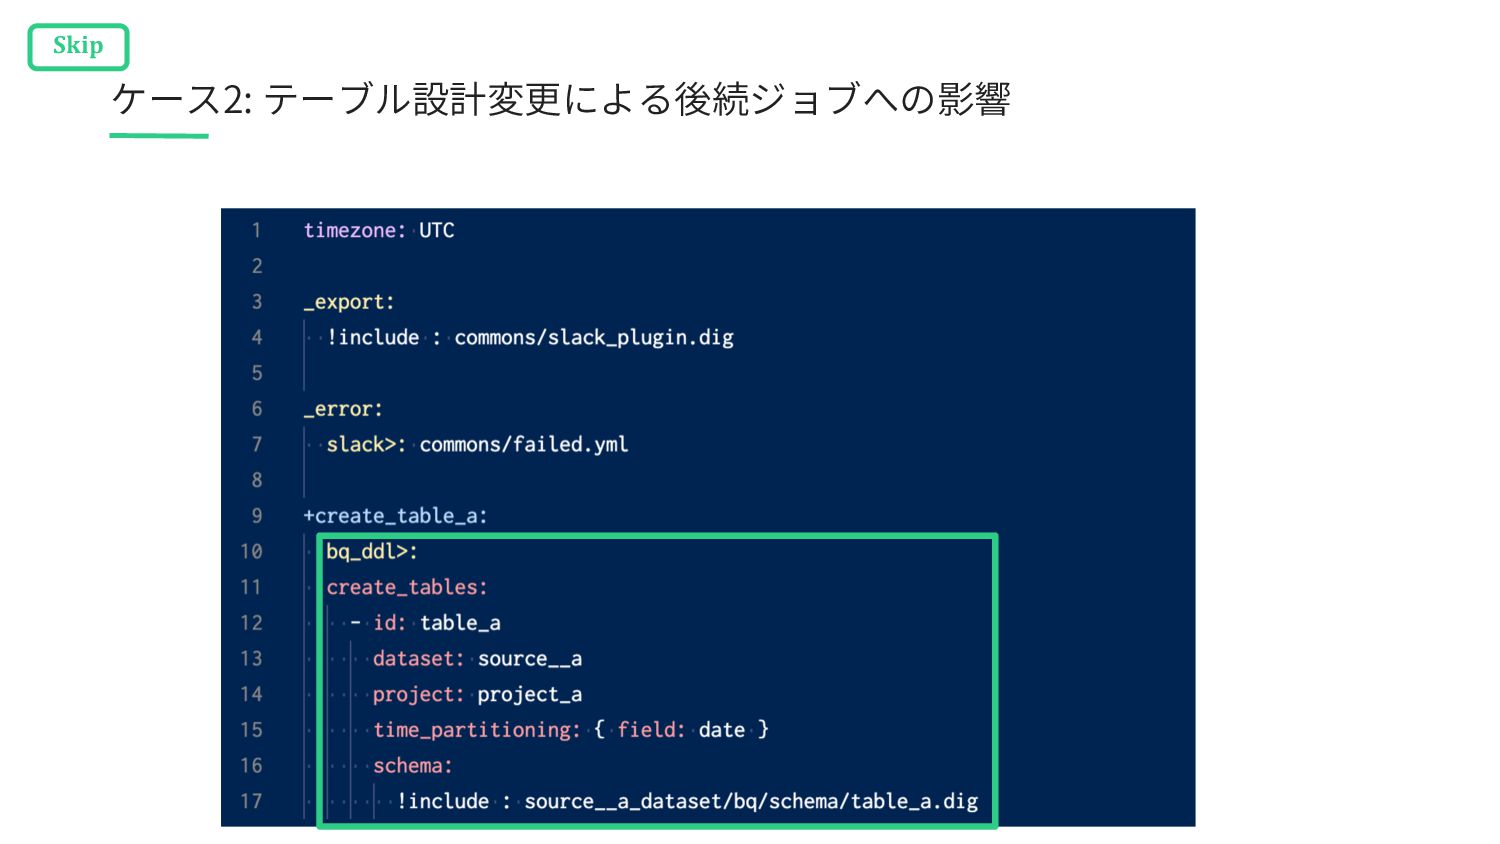
改善案: bq_ddl>: オペレータを使って、テーブルのスキーマを管理し、 bq_load>: オペレータでも、スキーマを使ってデータをロードする - スキーマを使うことで、データをロードする際にエラーが出る - 問題の発⾒が早くなる -
データセット/テーブルの作成がDigdagから⾏える - YAMLでテーブルやカラムの名前やデータ型の定義できる - time_partitioningの定義も実は書ける ケース2: テーブル設計変更による後続ジョブへの影響 Skip -
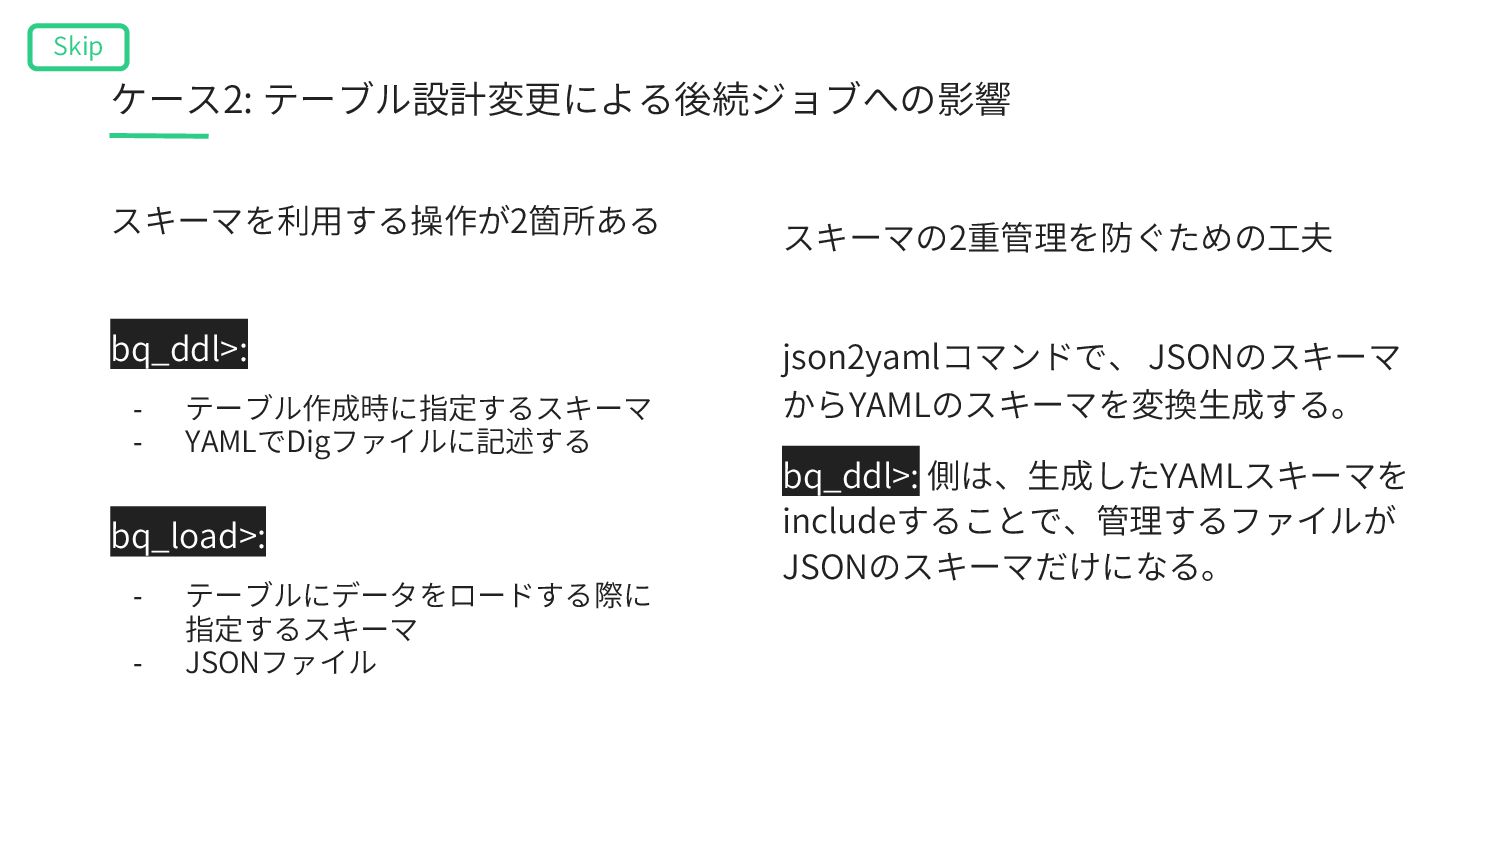
スキーマを利⽤する操作が2箇所ある bq_ddl>: - テーブル作成時に指定するスキーマ - YAMLでDigファイルに記述する bq_load>: - テーブルにデータをロードする際に 指定するスキーマ
- JSONファイル ケース2: テーブル設計変更による後続ジョブへの影響 Skip スキーマの2重管理を防ぐための⼯夫 json2yamlコマンドで、 JSONのスキーマ からYAMLのスキーマを変換⽣成する。 bq_ddl>: 側は、⽣成したYAMLスキーマを includeすることで、管理するファイルが JSONのスキーマだけになる。 -
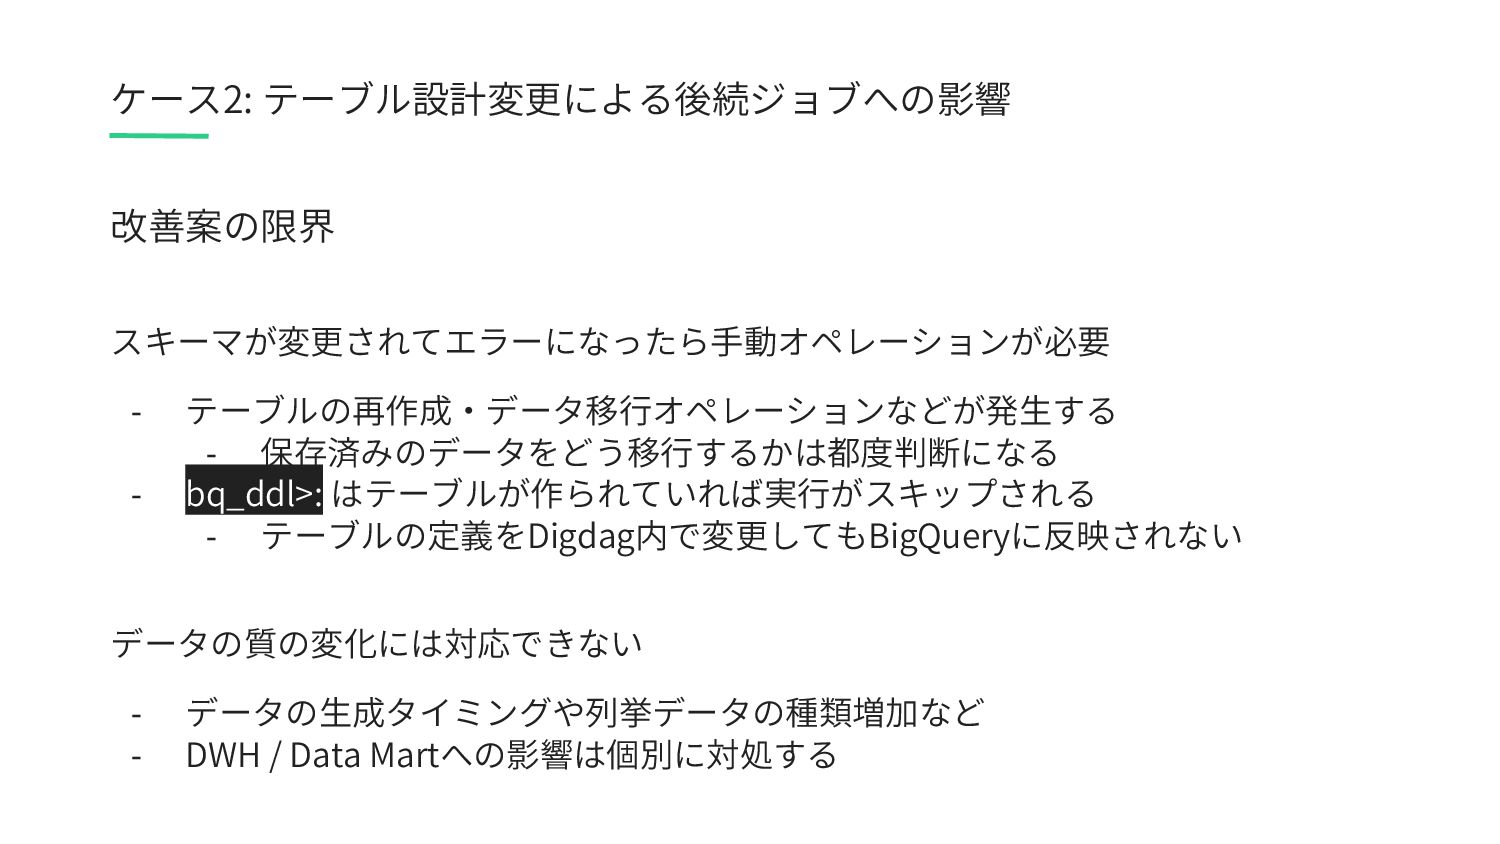
改善案の限界 スキーマが変更されてエラーになったら⼿動オペレーションが必要 - テーブルの再作成・データ移⾏オペレーションなどが発⽣する - 保存済みのデータをどう移⾏するかは都度判断になる - bq_ddl>: はテーブルが作られていれば実⾏がスキップされる -
テーブルの定義をDigdag内で変更してもBigQueryに反映されない データの質の変化には対応できない - データの⽣成タイミングや列挙データの種類増加など - DWH / Data Martへの影響は個別に対処する ケース2: テーブル設計変更による後続ジョブへの影響 -
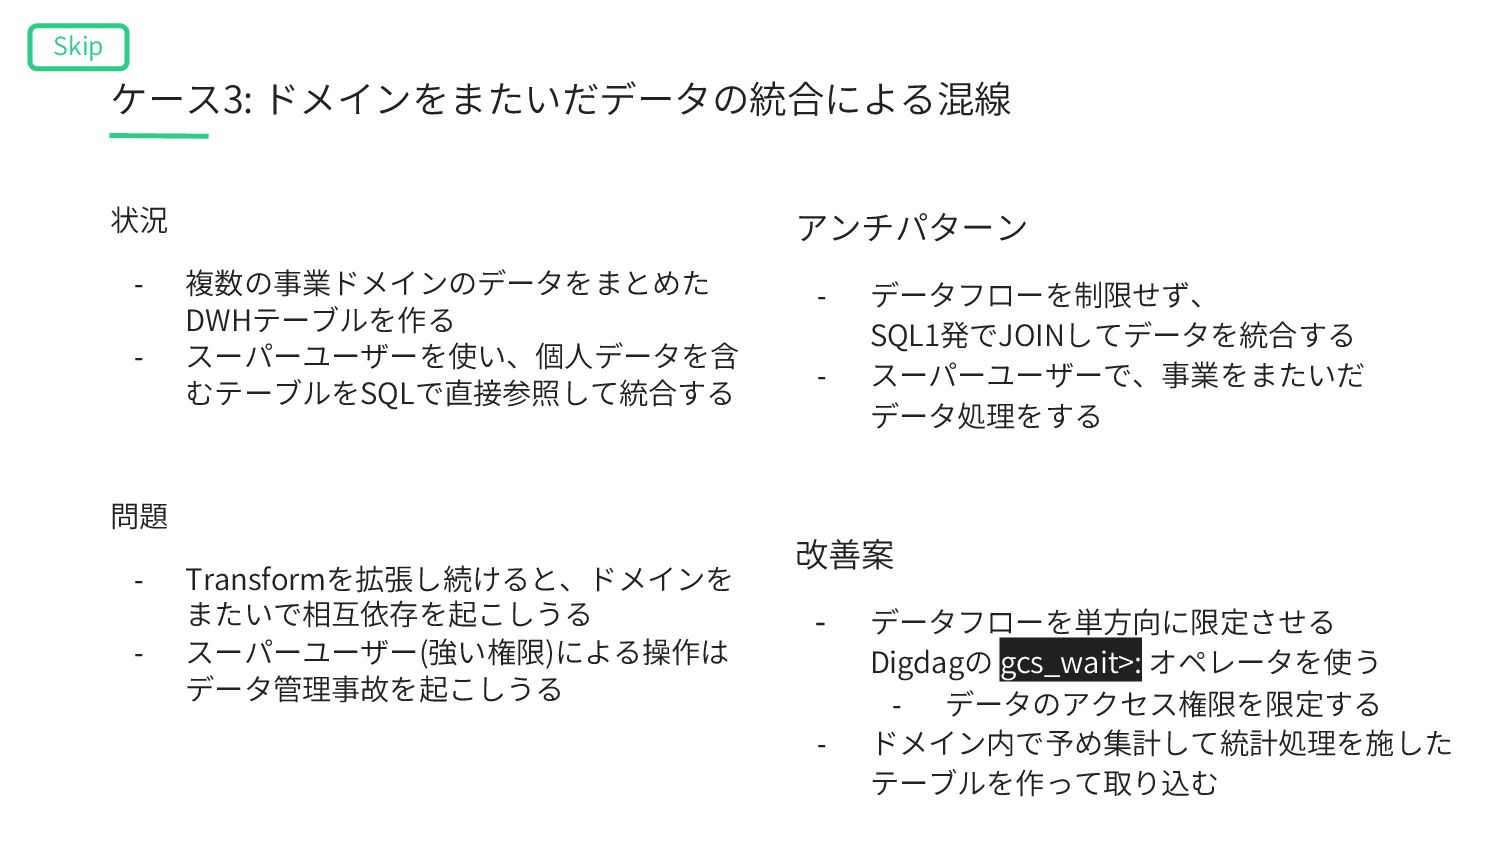
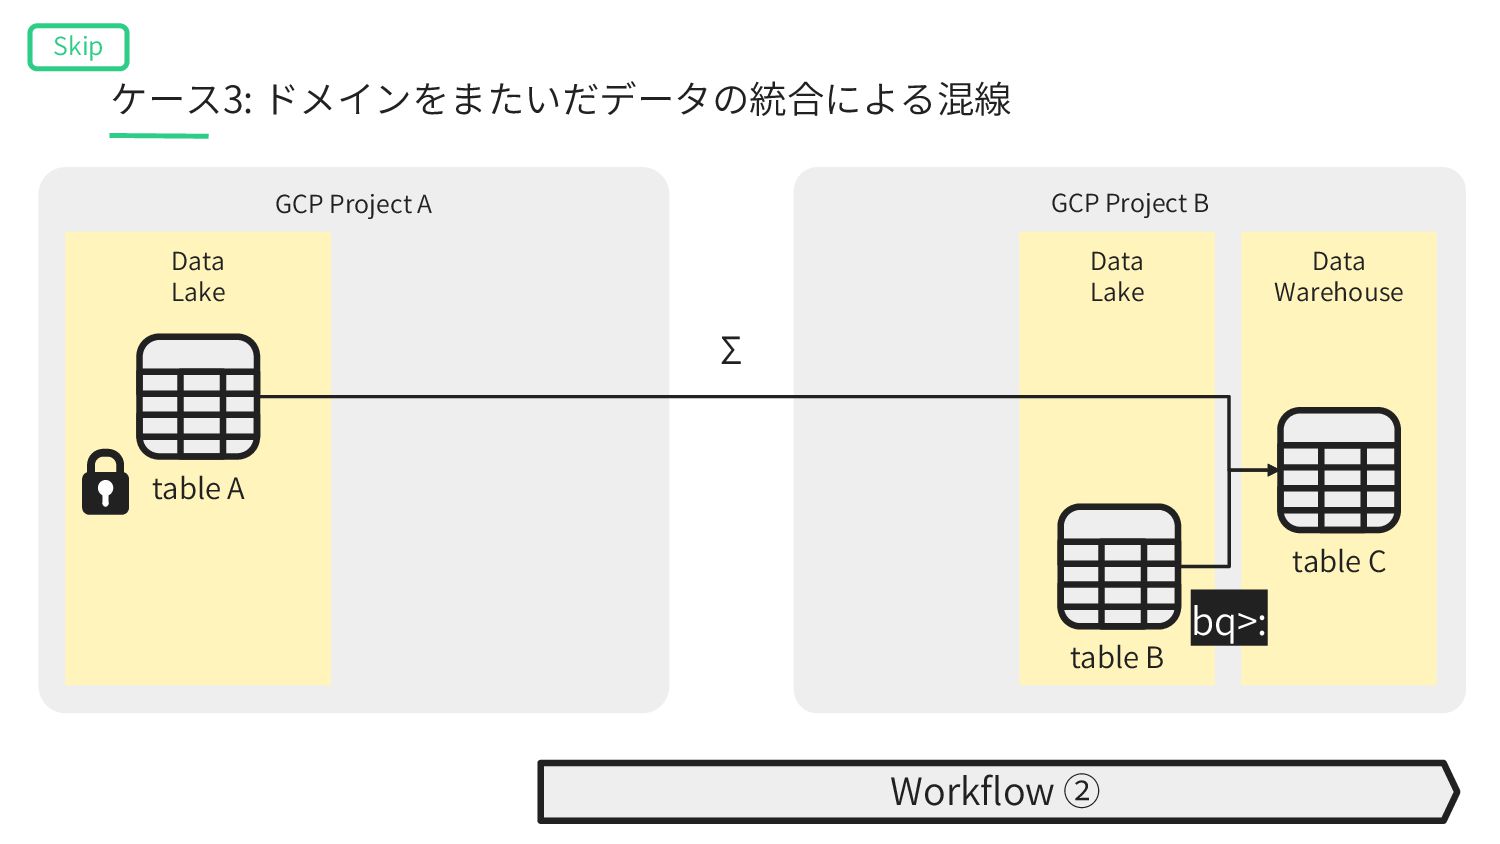
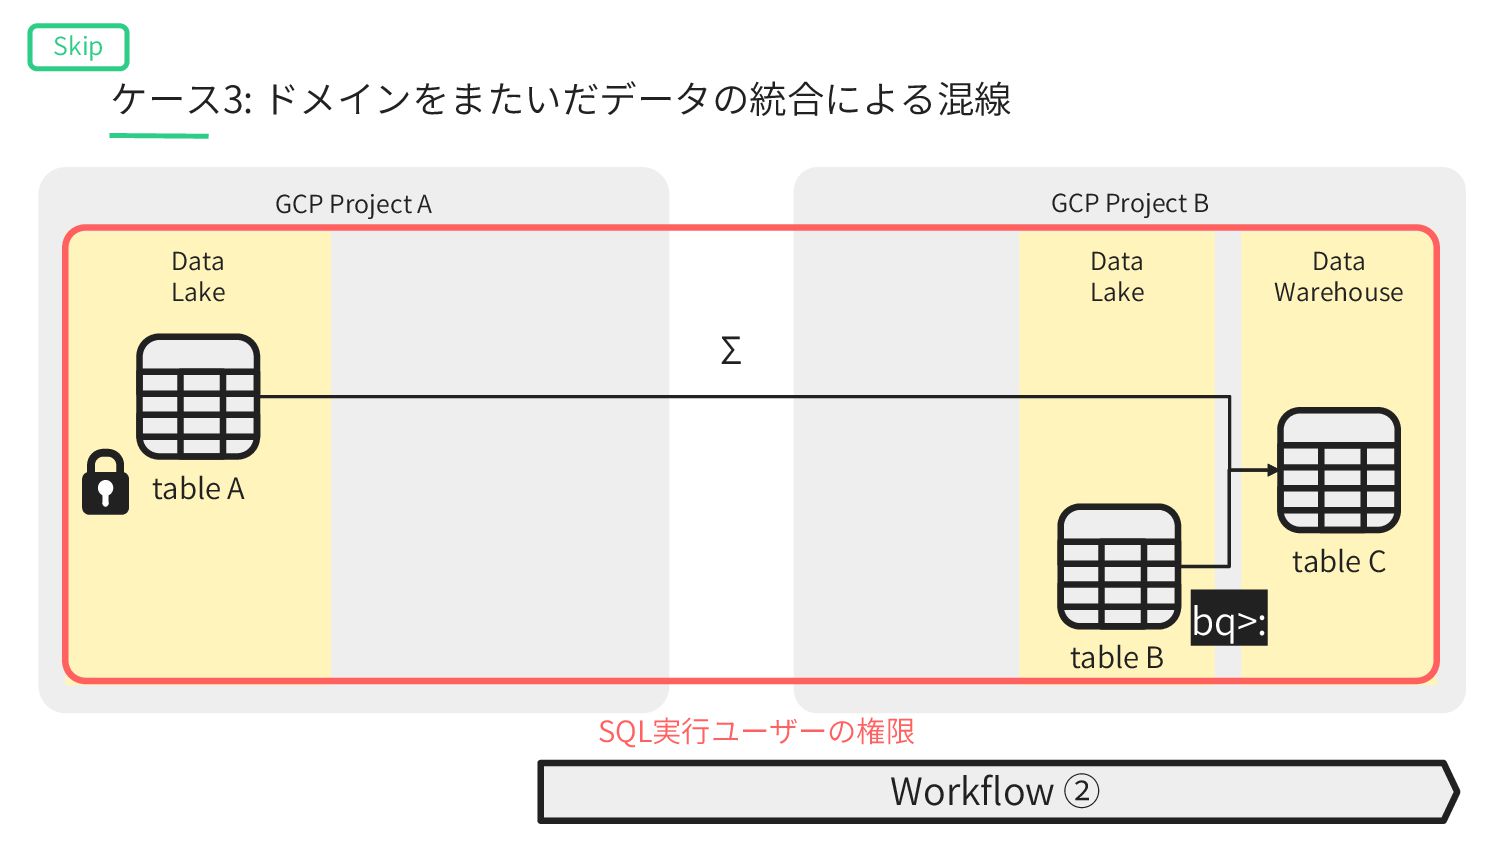
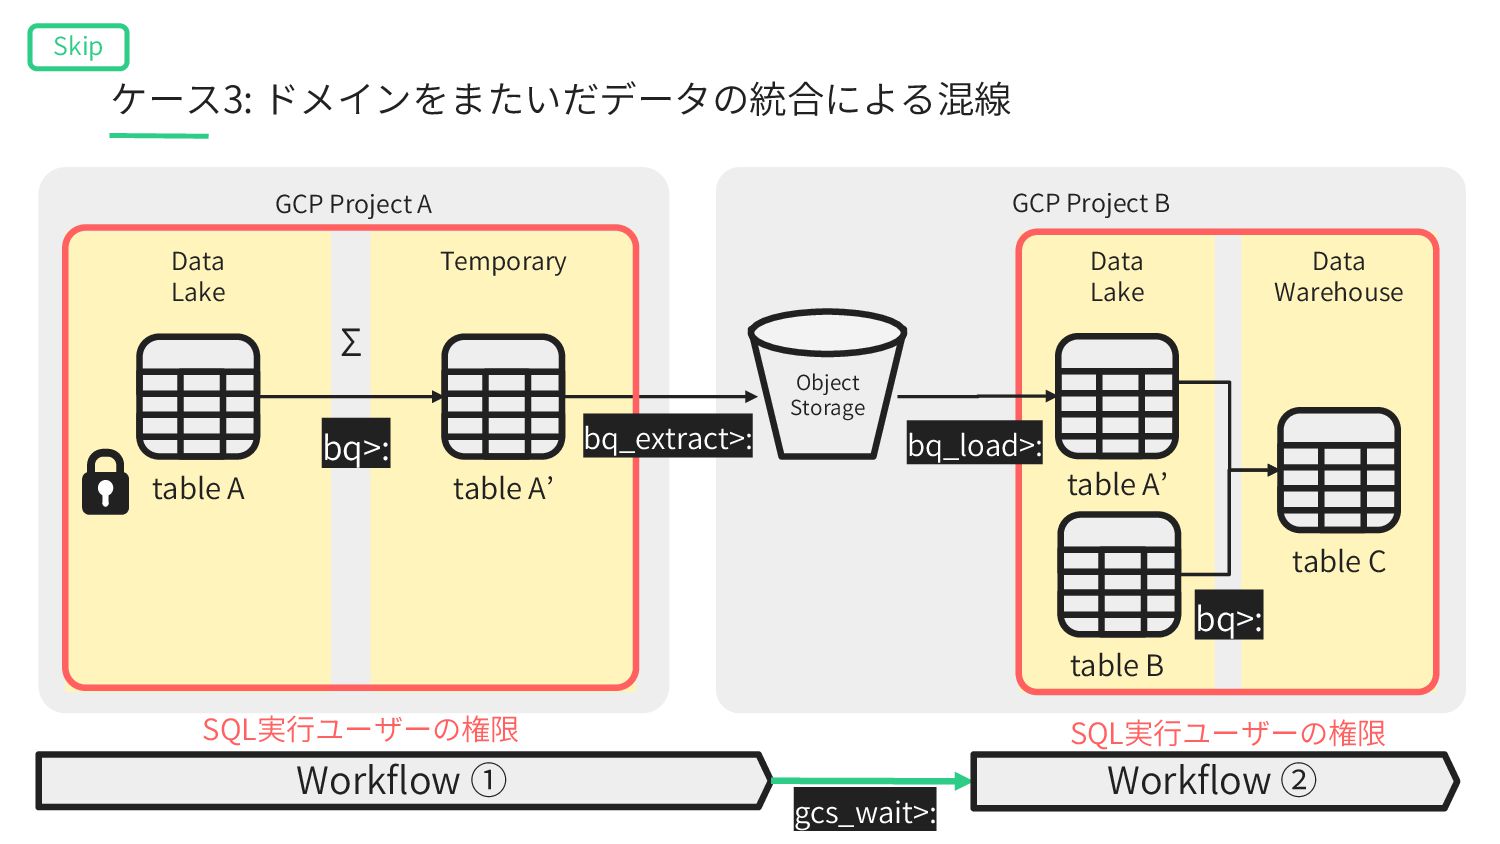
状況 - 複数の事業ドメインのデータをまとめた DWHテーブルを作る - スーパーユーザーを使い、個⼈データを含 むテーブルをSQLで直接参照して統合する 問題 - Transformを拡張し続けると、ドメインを
またいで相互依存を起こしうる - スーパーユーザー(強い権限)による操作は データ管理事故を起こしうる アンチパターン - データフローを制限せず、 SQL1発でJOINしてデータを統合する - スーパーユーザーで、事業をまたいだ データ処理をする 改善案 - データフローを単⽅向に限定させる Digdagの gcs_wait>: オペレータを使う - データのアクセス権限を限定する - ドメイン内で予め集計して統計処理を施した テーブルを作って取り込む ケース3: ドメインをまたいだデータの統合による混線 Skip -
具体例 - DWH ワークフロー② - Data Lake aとData Lake bのデータを統合するDWHテーブルを作る
- aとbは別のドメインでGCPのProjectも別になっている - aのデータは個⼈データが含まれているため、統計処理をしてから統合する - 両ProjectのBigQueryの権限を持ったスーパーユーザーでSQL1発でする ケース3: ドメインをまたいだデータの統合による混線 Skip -
GCP Project A GCP Project B Data Lake table B
Data Warehouse table C Workflow ② bq>: Σ Data Lake table A ケース3: ドメインをまたいだデータの統合による混線 Skip -
GCP Project A GCP Project B Data Lake table B
Data Warehouse table C Workflow ② bq>: Σ Data Lake table A SQL実⾏ユーザーの権限 ケース3: ドメインをまたいだデータの統合による混線 Skip -
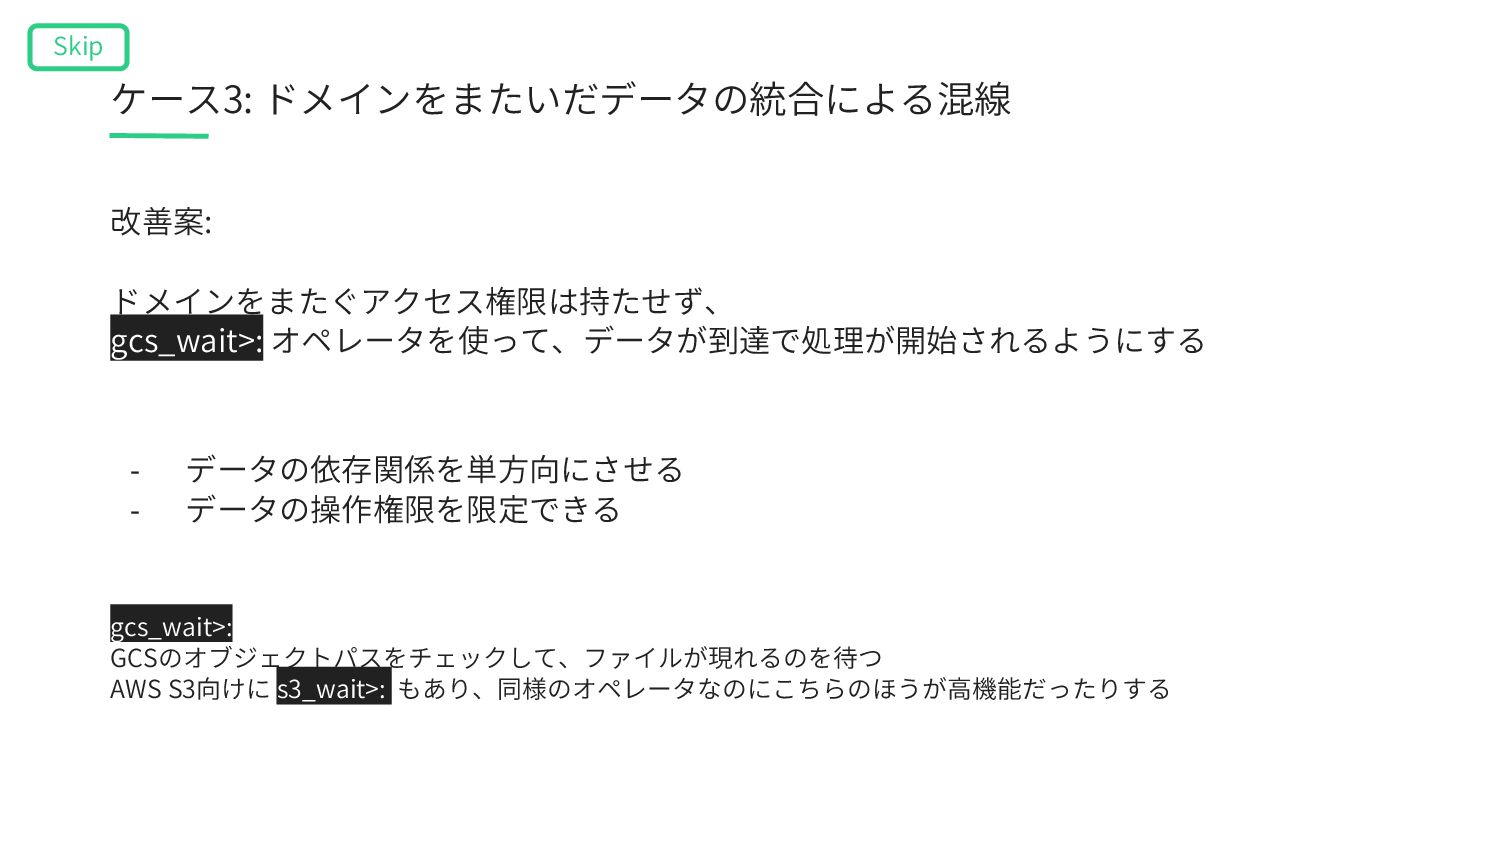
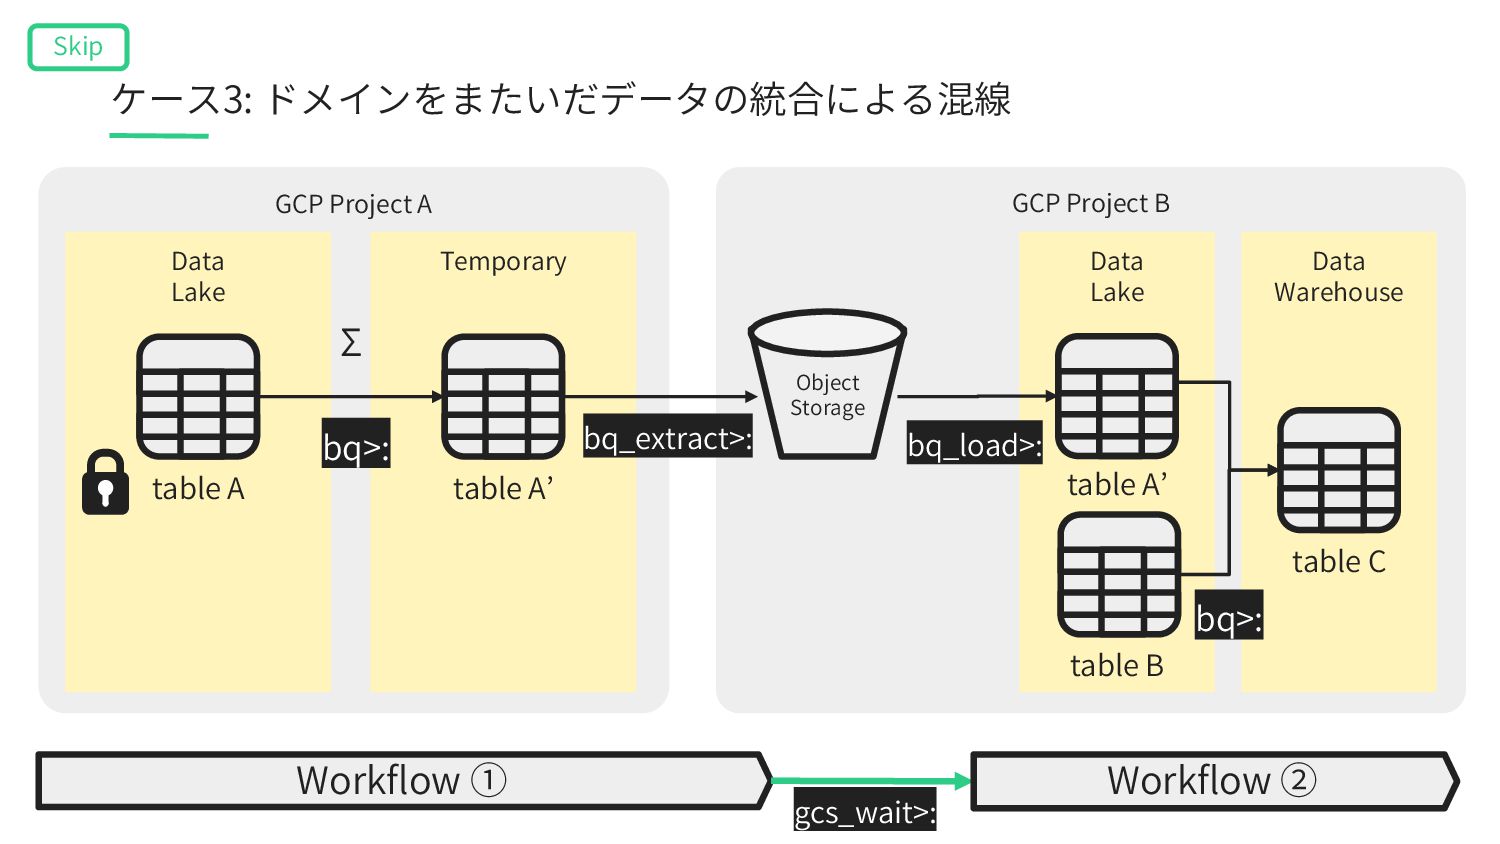
改善案: ドメインをまたぐアクセス権限は持たせず、 gcs_wait>: オペレータを使って、データが到達で処理が開始されるようにする - データの依存関係を単⽅向にさせる - データの操作権限を限定できる gcs_wait>: GCSのオブジェクトパスをチェックして、ファイルが現れるのを待つ
AWS S3向けに s3_wait>: もあり、同様のオペレータなのにこちらのほうが⾼機能だったりする ケース3: ドメインをまたいだデータの統合による混線 Skip -
GCP Project B Data Lake GCP Project A Temporary table
A’ table B Data Warehouse table C Data Lake Workflow ① table A’ gcs_wait>: Workflow ② bq_extract>: table A bq>: bq>: Σ bq_load>: Object Storage ケース3: ドメインをまたいだデータの統合による混線 Skip -
GCP Project B GCP Project A Temporary Data Lake Data
Lake table A’ table B Data Warehouse table C Workflow ① table A’ gcs_wait>: Workflow ② table A bq>: bq>: Σ Object Storage SQL実⾏ユーザーの権限 SQL実⾏ユーザーの権限 bq_extract>: ケース3: ドメインをまたいだデータの統合による混線 Skip bq_load>: -
問題が起きてからデータ復旧するとオペレーションが⼤変になるので、 問題発⽣前に兆候を掴むための⼯夫をする - ワークフローごとに想定実⾏時間で設定する - Digdagの sla: で想定の実⾏時間を設定 - 設定値を超えたらアラートをSlackに⾶ばすことができる
- ワークフローの外形監視 - Digdag内部のエラーなど、SLAやFailで通知できないケースもありうる - Healthchecks.ioでワークフローの外形監視するなど 問題はできるだけ事前に防ぐ -
変更しないというよりも、変更が⾮常に難しい 要因は、データを管理する場所と使う場所が別であるため - ELTのワークフロー定義を修正するだけでは済まない - データを使う場所は多岐にわたるため、全容の把握が難しい (Redash, Data Portal, GAS…etc)
- 多くのケースで全てに対応できるだけの修正コストが払えない - 結果、公開APIのように後⽅互換をサポートし続けることになる Data Warehouseテーブルの設計は変更しない(つもりでいる) -
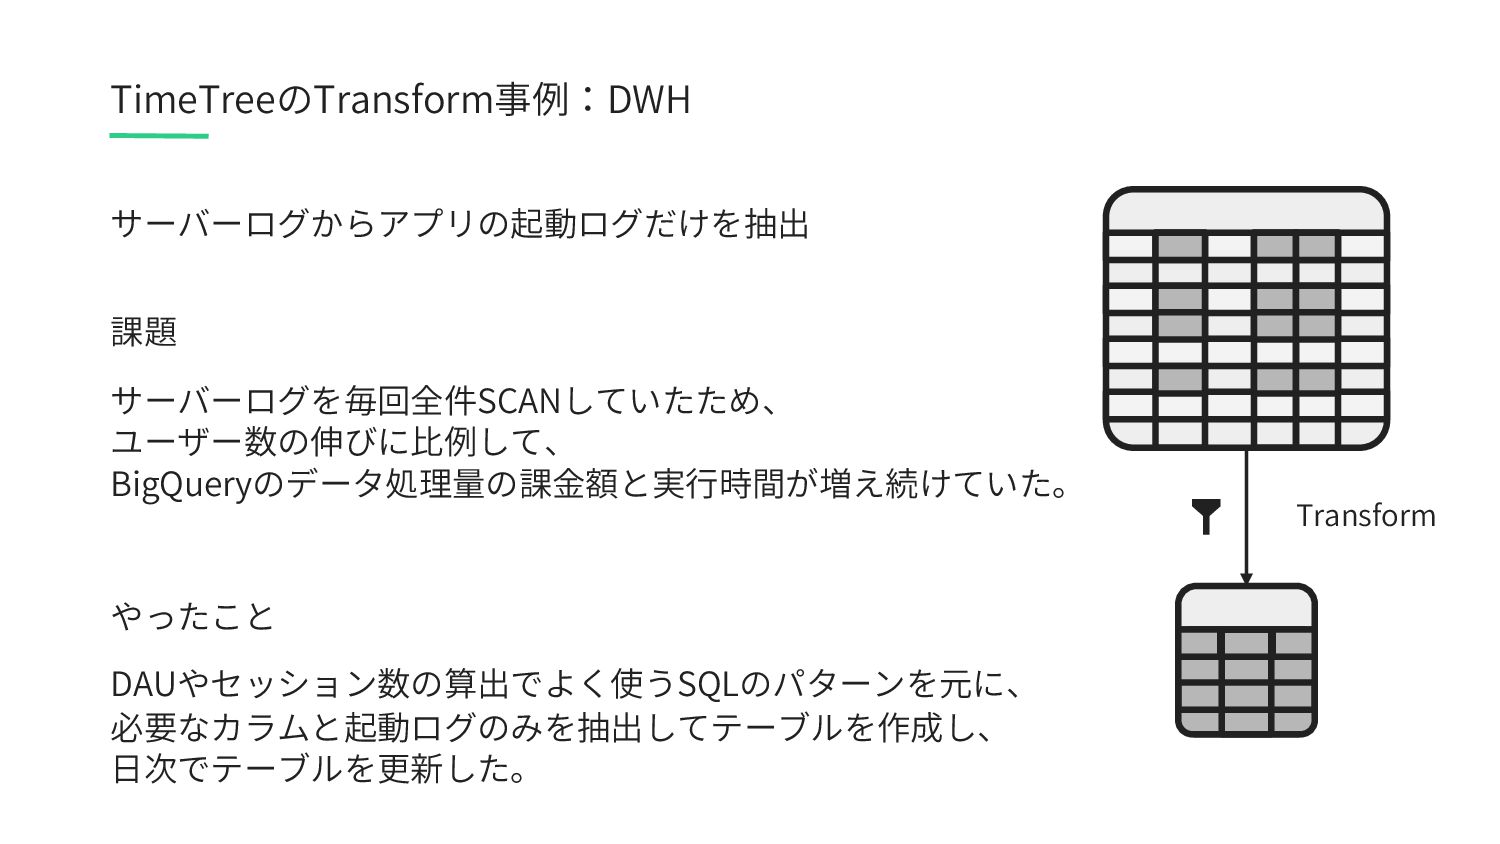
テーブルを作る条件を決めておく Data Warehouse - ユースケースが固まっていて枯れている集計パターンがある場合 - 変更が⾮常に難しいことから、枯れていることが⼤事 - コスト・実⾏時間⾯で集計データを持っておきたい場合 -
Data Lakeを直接SQLで叩くとスキャンするデータ量が 膨⼤になってしまうなど Data Mart - アプリケーション/ BIとして利⽤する形式が決まっている場合 - BIツールは⾼性能だが、事前集計で⾼速に提供できる - レポーティング⽤の確定データを作ることで数字が後からずれることを防ぐ