Share
Embed
名古屋検索勉強会#19
名古屋検索勉強会#19(https://search-nagoya.connpass.com/event/147848/presentation/)の資料です。
情報検索の基礎
20章 ウェブのクローリングとインデックス付け
を解説しています。
INOUE Takahiro
September 21, 2019
Transcript
31 slides
-
この章は何の章? • 以下2つを説明する • Webクロールの難しさ • Webクローラーの仕組みや動き • 具体的には •
20.1 Webクローリングの課題 • 20.2 各課題の対策と、その集⼤大成(分散Webクローラ) • 20.3 インデックス分散の⼿手法 -
基本的なクローラの動き • seed pagesのURLを基に、キューを初期化する • 以下を繰り返す • キューからURLを取得する • URLを基にWebページにアクセスして、
• テキストデータを取得する • URLを取得し、キューに追加する • 前提:web ページが⼗十分にリンクされていること -
シンプルなクローラの課題 • クローラをWebの多⽅方⾯面に配って情報収集したい • 全てのページをインデックスしたいけどできない →何をインデックスするか選択しないといけない • 同じ内容のページ(複製ページ)が⾒見見つかるので、1つに統合したい • スパムやスパイダートラップの対策をしたい
スパイダートラップ:クローラに無限にアクセスをさせたり、クローラを壊したりする罠 • 同じサイトにクロールする際は、⻑⾧長い間隔をあけたい • 定期的に再クロールしたい けど、webは広⼤大なので、ごく⼀一部のページしか再クロールできない ということで、やはり選択と優先順位付の問題が出てくる。 -
20.1.1 クローラの必須機能 • robustness/頑健性 • スパムやスパイダートラップなど、クローラを騙そうとするサイトがあるため、 耐性がなくてはならない。 • 巨⼤大なページ、複製ページ、動的ページも対策しないといけない •
politeness/礼儀正しさ • アクセスが頻繁すぎてはならない • クロールを許可されたページしかクロールしてはならない Webサイトのrobots.txtに明記されていたらそれを守る 明記されていなくてもマナーは守る。 -
20.1.2 他にクローラにあるといい機能 • 分散性 複数サーバで分散処理理できること • スケーラブル性 サーバ追加や帯域追加でスケールアップできること • 性能と効率 システム資源(CPU・ストレージ・N/W)を効率よく使えること • 品質 有⽤用なページを優先して取得できること
• 新鮮さ ページの更更新頻度に合わせてクローリングできること ただしwebは巨⼤大なので、再クロールは⼩小さな領域に絞らなくてはならない • 拡張性 新しいデータ形式・fetchプロトコルが出ても対応できるようにク ローラのアーキテクチャーをモジュール化しておくこと -
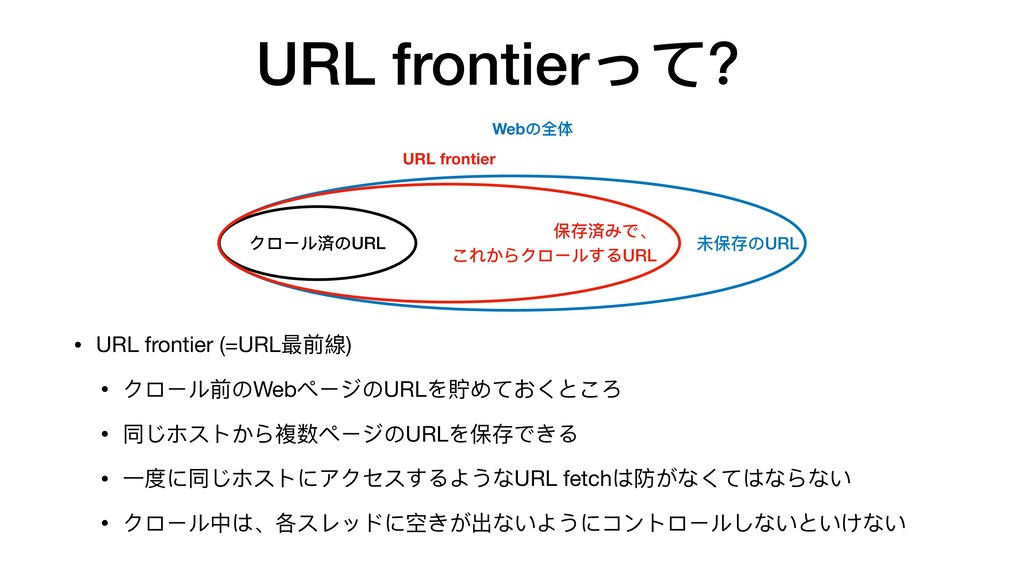
未保存のURL URL frontierって? • URL frontier (=URL最前線) • クロール前のWebページのURLを貯めておくところ •
同じホストから複数ページのURLを保存できる • ⼀一度に同じホストにアクセスするようなURL fetchは防がなくてはならない • クロール中は、各スレッドに空きが出ないようにコントロールしないといけない クロール済のURL 保存済みで、 これからクロールするURL URL frontier Webの全体 -
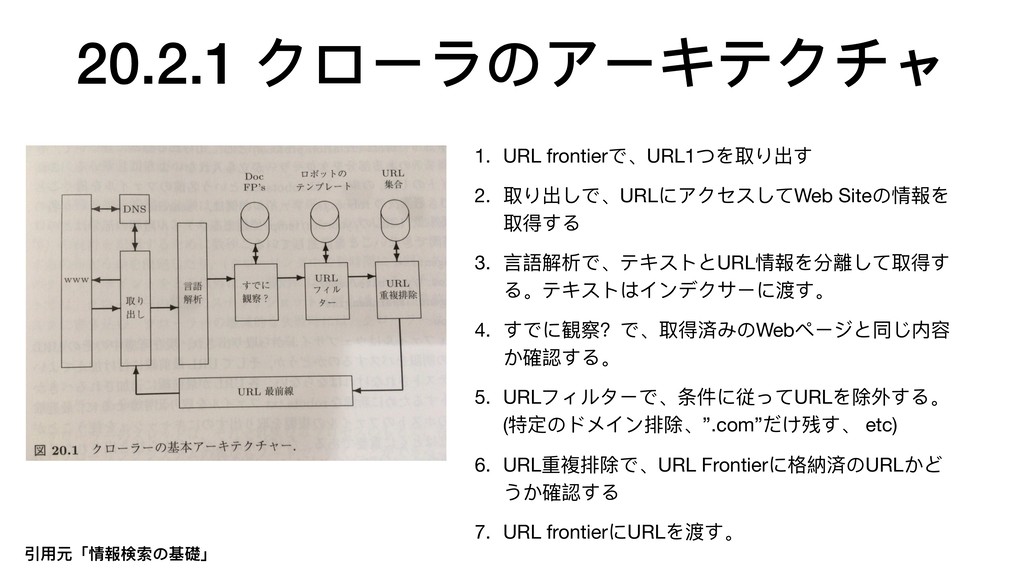
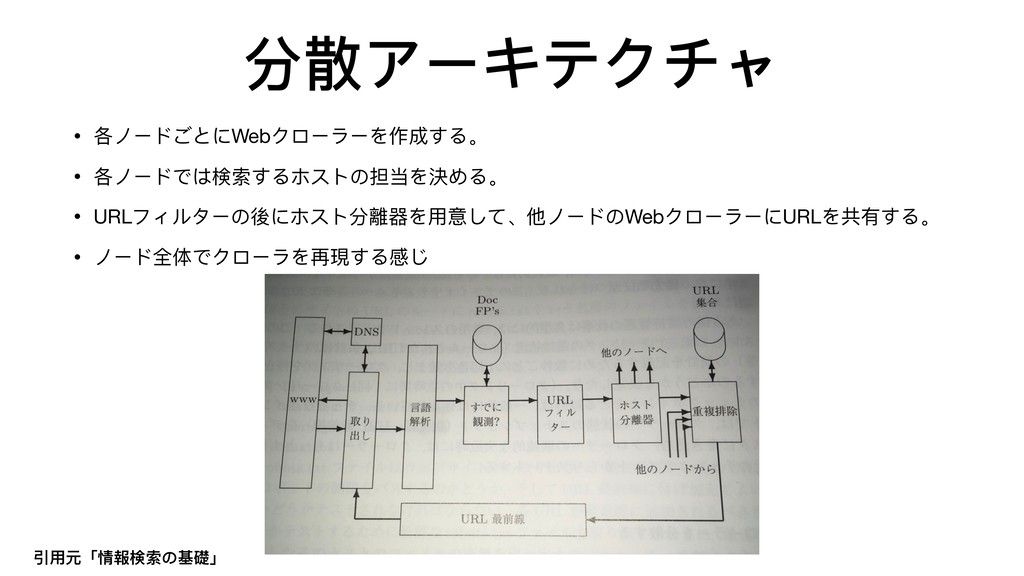
20.2.1 クローラのアーキテクチャ 1. URL frontierで、URL1つを取り出す 2. 取り出しで、URLにアクセスしてWeb Siteの情報を 取得する 3.
⾔言語解析で、テキストとURL情報を分離して取得す る。テキストはインデクサーに渡す。 4. すでに観察?で、取得済みのWebページと同じ内容 か確認する。 5. URLフィルターで、条件に従ってURLを除外する。 (特定のドメイン排除、”.com”だけ残す、 etc) 6. URL重複排除で、URL Frontierに格納済のURLかど うか確認する 7. URL frontierにURLを渡す。 引⽤用元「情報検索の基礎」 -
すでに観察? • Webページがすでに取得済みのものか確認する。 すでに取得済みのものと同じだったらスキップする。 チェックには、ドキュメントのフィンガープリントやシングルを使う • フィンガープリント: Web ページの要約情報。複製かどうかを⾒見見分けるのに使う。 シングルも似たようなもの。詳細は19章参照
• チェックポイント スナップショットをディスクに書き込む 壊滅的な失敗をした時は、チェックポイントからクロールをリスタートす る。 -
ロボット排除プロトコル (robots.txt) • robots.txtはクローラのアクセスを制限するためのプロトコル • 使い⽅方 URLのルートにrobots.txtを置き、以下を記載する。 User-agent: *
Disallow: <directory> ← 指定したディレクトリ以下にはどのagentもアクセスできない User-agent: <robot_name> Disallow: ←ただしrobot_nameというagentだけは、どのディレクトリにもアクセスできる • クローラはrobots.txtを⾒見見て、URLをURL frontierに送っていいかを決める。 クロール先のrobots.txtをキャッシュすることは重要。 →ただ、robots.txtを置いた⼈人の期待していることとは反する(?) • robots.txtのフィルタリングをしてから、Web Siteの取り出しをしなくてはならない。 -
URLの正規化 • URLには相対URLで記載されているものがある。 • 例例 http://mit.eduにアクセスしていて、次のリンクとしてaboutsite.htmlを 取得 →絶対URLでは、http://mit.edu/aboutsite.htmlを示す •
URL分析中は、相対URLを正規化(絶対URL化)しなくてはならない。 -
クローラを分散する • 複数のクロールスレッドを異異なるノードで⾛走らせることが重要 (地理理的に分散したノードなど) 異異なるプロセス・異異なるシステム・異異なるノードでの分散がスケーリングに は重要。 • どのノードがどのエリアを担当するかは、ハッシュ関数やポリシーで決定で きる。 とはいえ、地理理的に近いと有効かどうかはまた別の話なので、検討が必要。
(ヨーロッパのノードにヨーロッパのWebサイトを担当させるのは、N/W経路路 上は有効でないこともある) • -
すでに観察? を分散する時の問題 • すでに観察は、ホスト名などで分割しにくい • 複製⽂文書はホストが異異なっても出てきてしまうので、フィンガープリント 等を別ノードから遠隔呼び出ししないといけない • フィンガープリントには局所性がないので、よく使われるフィンガープリ ントがない。
→キャッシングが使えない。 • 古いフィンガープリントやシングルを削除できないといけない ↓ • URL frontierに、URL+フィンガープリントを保存しないといけない。 -
20.2.2 DNS解決 • Webサーバは唯⼀一のIPアドレス(グローバルIPアドレス)を持っている • URLを取り出した時、DNSサーバに問い合わせてIPアドレスに変換する • DNS解決はボトルネック (複数DNSに分割・分散している関係で、複数の要求が発⽣生し、秒単位の時間がかかる) →DNSキャッシングで改善する
→礼儀正しさの制限があるので、キャッシュのヒット率が制限される • 標準ライブラリの問題 あるクローラがDNSに解決を要求している間、同⼀一ノードの他クローラではDNSが弾かれる →クローラ内にDNSリゾルバーを⽤用意して対応する。 DNSリゾルバーはDNSの解決が終わるまで、他の処理理を時間待ちさせる。 • (リゾルバーの⼀一つ?)メルカトルでは、トライ5回・タイムアウト時間は90秒 (解決まで数⼗十秒かかるホスト名もあるので) -
20.2.3 URL frontier • URL取り出しの順番で考慮すべきこと 1. 頻繁に更更新されるページは、頻繁にクローリングしたい 。 →しかし、ページの品質も考慮したい (スパムページも頻繁に更更新されるので)
2. 礼儀正しさ(短期間で同⼀一ホストに何度もアクセスするのは避けたい) Webページは同⼀一ホスト内の別Webページにリンクすることが多いた め、安易易にクロールすると同⼀一ホストに何度もアクセスしてしまう。 →⼀一般的な解決法:取り出し要求の間隔を⼤大きくする -
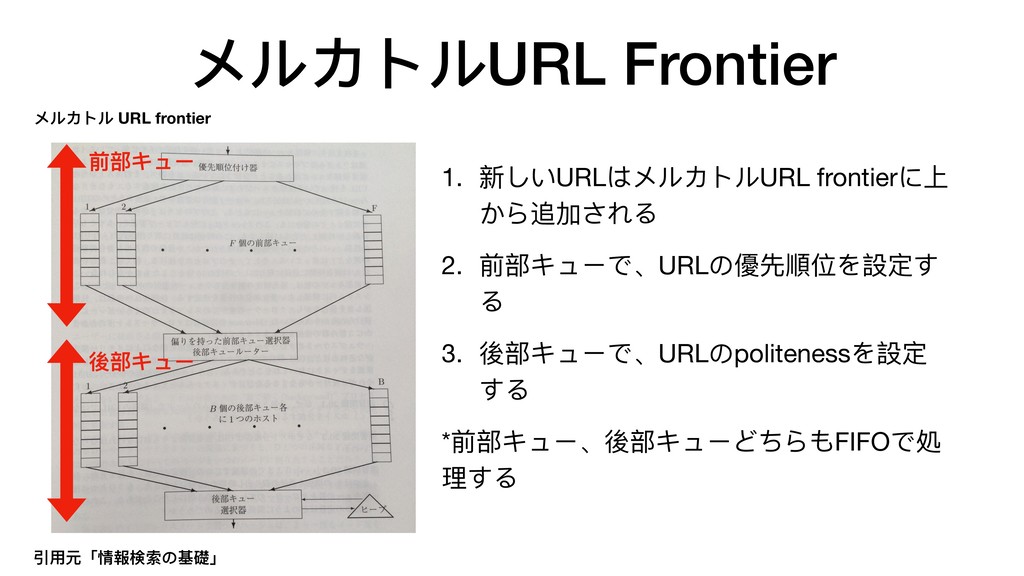
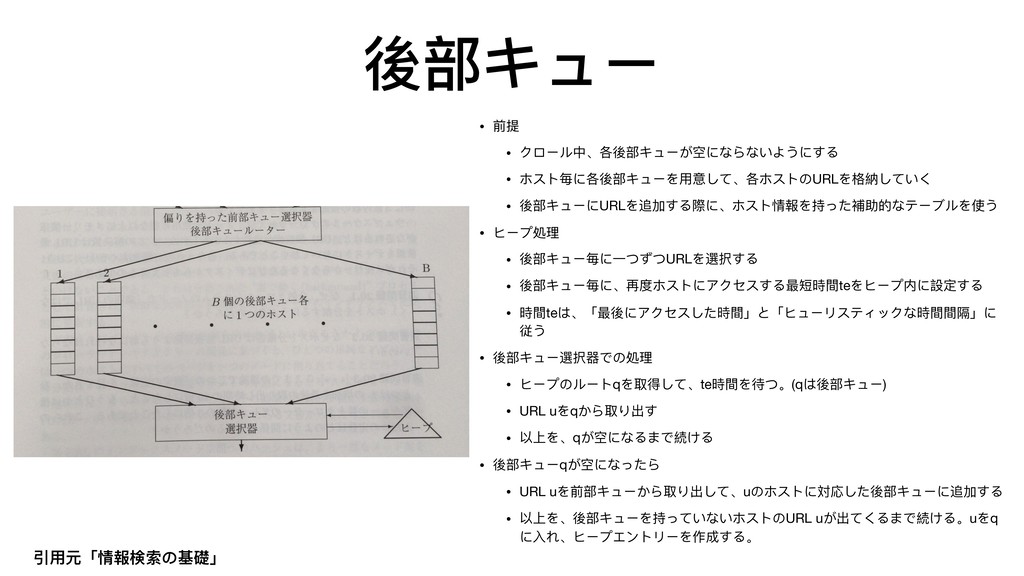
メルカトルURL Frontier 1. 新しいURLはメルカトルURL frontierに上 から追加される 2. 前部キューで、URLの優先順位を設定す る 3.
後部キューで、URLのpolitenessを設定 する *前部キュー、後部キューどちらもFIFOで処 理理する 引⽤用元「情報検索の基礎」 メルカトル URL frontier 前部キュー 後部キュー -
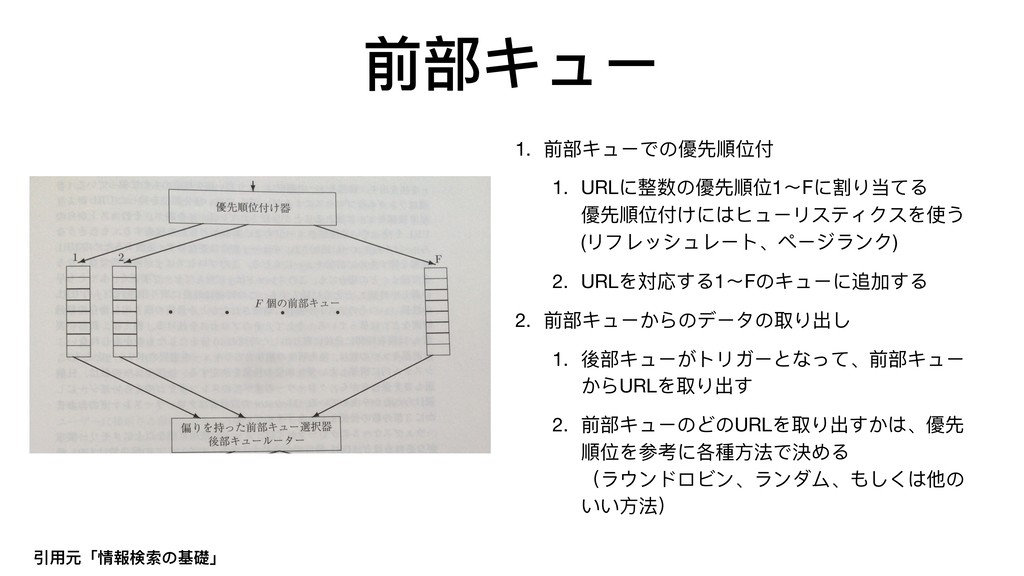
前部キュー 1. 前部キューでの優先順位付 1. URLに整数の優先順位1〜Fに割り当てる 優先順位付けにはヒューリスティクスを使う (リフレッシュレート、ページランク) 2. URLを対応する1〜Fのキューに追加する 2.
前部キューからのデータの取り出し 1. 後部キューがトリガーとなって、前部キュー からURLを取り出す 2. 前部キューのどのURLを取り出すかは、優先 順位を参考に各種⽅方法で決める (ラウンドロビン、ランダム、もしくは他の いい⽅方法) 引⽤用元「情報検索の基礎」 -
後部キュー • 前提 • クロール中、各後部キューが空にならないようにする • ホスト毎に各後部キューを⽤用意して、各ホストのURLを格納していく • 後部キューにURLを追加する際に、ホスト情報を持った補助的なテーブルを使う •
ヒープ処理理 • 後部キュー毎に⼀一つずつURLを選択する • 後部キュー毎に、再度ホストにアクセスする最短時間teをヒープ内に設定する • 時間teは、「最後にアクセスした時間」と「ヒューリスティックな時間間隔」に 従う • 後部キュー選択器器での処理理 • ヒープのルートqを取得して、te時間を待つ。(qは後部キュー) • URL uをqから取り出す • 以上を、qが空になるまで続ける • 後部キューqが空になったら • URL uを前部キューから取り出して、uのホストに対応した後部キューに追加する • 以上を、後部キューを持っていないホストのURL uが出てくるまで続ける。uをq に⼊入れ、ヒープエントリーを作成する。 引⽤用元「情報検索の基礎」 -
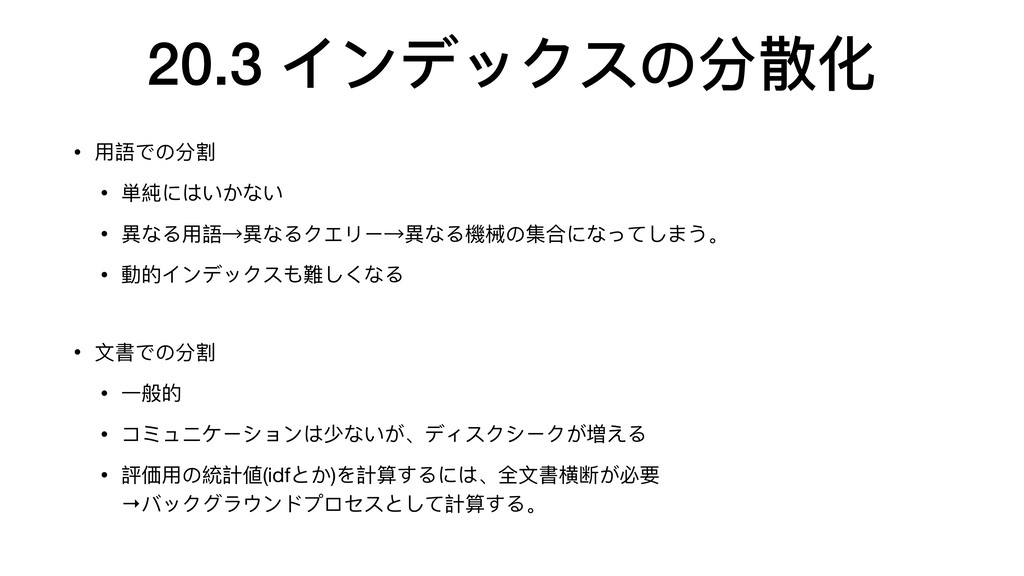
20.3 インデックスの分散化 • ⽤用語での分割 • 単純にはいかない • 異異なる⽤用語→異異なるクエリー→異異なる機械の集合になってしまう。 • 動的インデックスも難しくなる
• ⽂文書での分割 • ⼀一般的 • コミュニケーションは少ないが、ディスクシークが増える • 評価⽤用の統計値(idfとか)を計算するには、全⽂文書横断が必要 →バックグラウンドプロセスとして計算する。 -
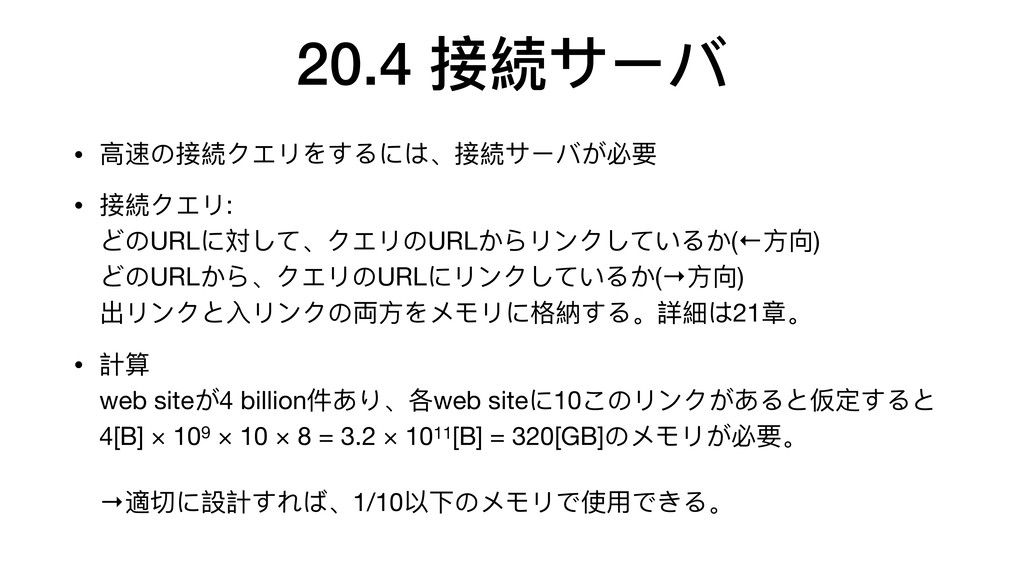
20.4 接続サーバ • ⾼高速の接続クエリをするには、接続サーバが必要 • 接続クエリ: どのURLに対して、クエリのURLからリンクしているか(←⽅方向) どのURLから、クエリのURLにリンクしているか(→⽅方向) 出リンクと⼊入リンクの両⽅方をメモリに格納する。詳細は21章。 •
計算 web siteが4 billion件あり、各web siteに10このリンクがあると仮定すると 4[B] × 109 × 10 × 8 = 3.2 × 10¹¹[B] = 320[GB]のメモリが必要。 →適切に設計すれば、1/10以下のメモリで使⽤用できる。 -
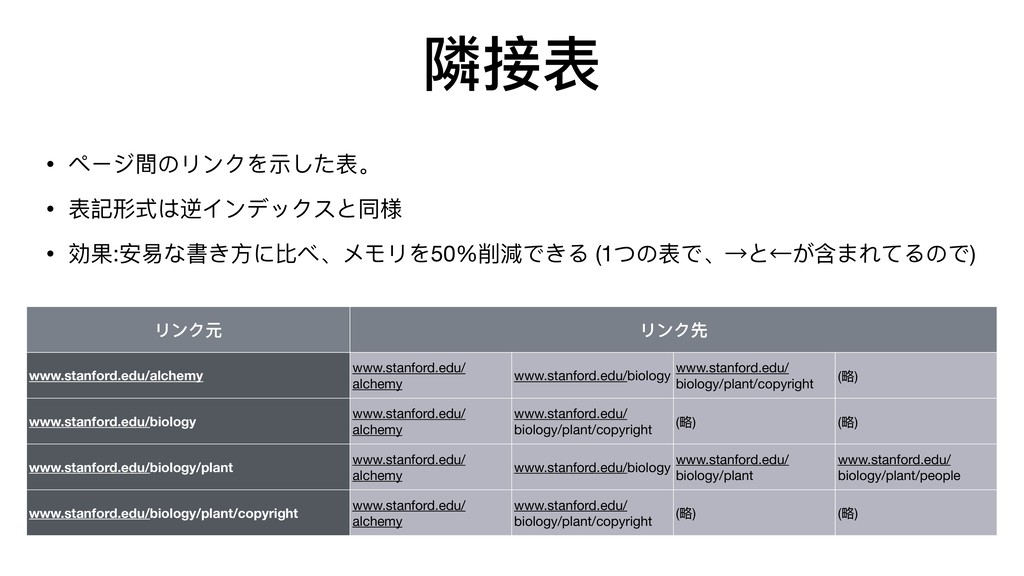
隣接表 • ページ間のリンクを示した表。 • 表記形式は逆インデックスと同様 • 効果:安易易な書き⽅方に⽐比べ、メモリを50%削減できる (1つの表で、→と←が含まれてるので) リンク元 リンク先
www.stanford.edu/alchemy www.stanford.edu/ alchemy www.stanford.edu/biology www.stanford.edu/ biology/plant/copyright (略略) www.stanford.edu/biology www.stanford.edu/ alchemy www.stanford.edu/ biology/plant/copyright (略略) (略略) www.stanford.edu/biology/plant www.stanford.edu/ alchemy www.stanford.edu/biology www.stanford.edu/ biology/plant www.stanford.edu/ biology/plant/people www.stanford.edu/biology/plant/copyright www.stanford.edu/ alchemy www.stanford.edu/ biology/plant/copyright (略略) (略略) -
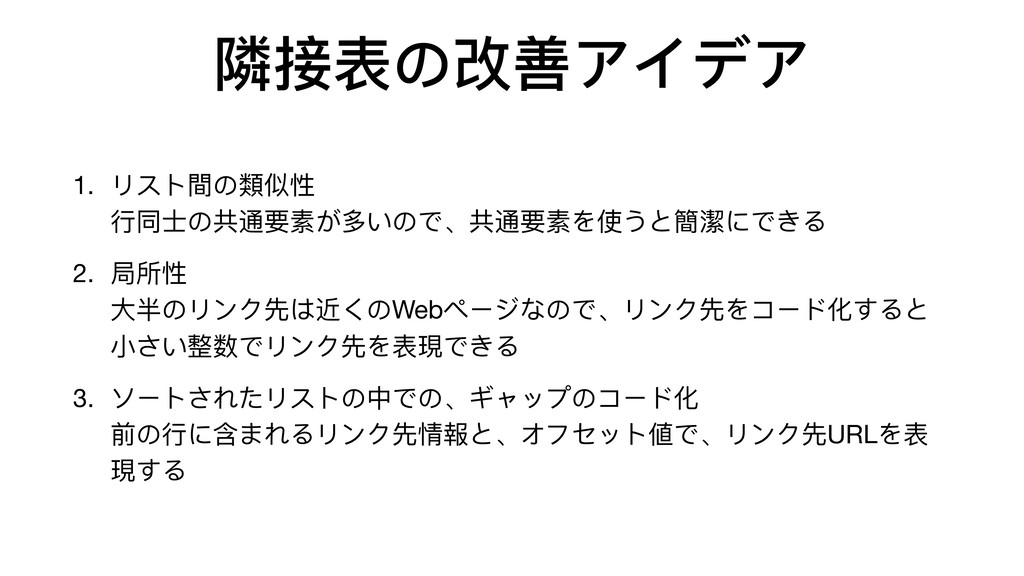
隣接表の改善アイデア 1. リスト間の類類似性 ⾏行行同⼠士の共通要素が多いので、共通要素を使うと簡潔にできる 2. 局所性 ⼤大半のリンク先は近くのWebページなので、リンク先をコード化すると ⼩小さい整数でリンク先を表現できる 3. ソートされたリストの中での、ギャップのコード化
前の⾏行行に含まれるリンク先情報と、オフセット値で、リンク先URLを表 現する -
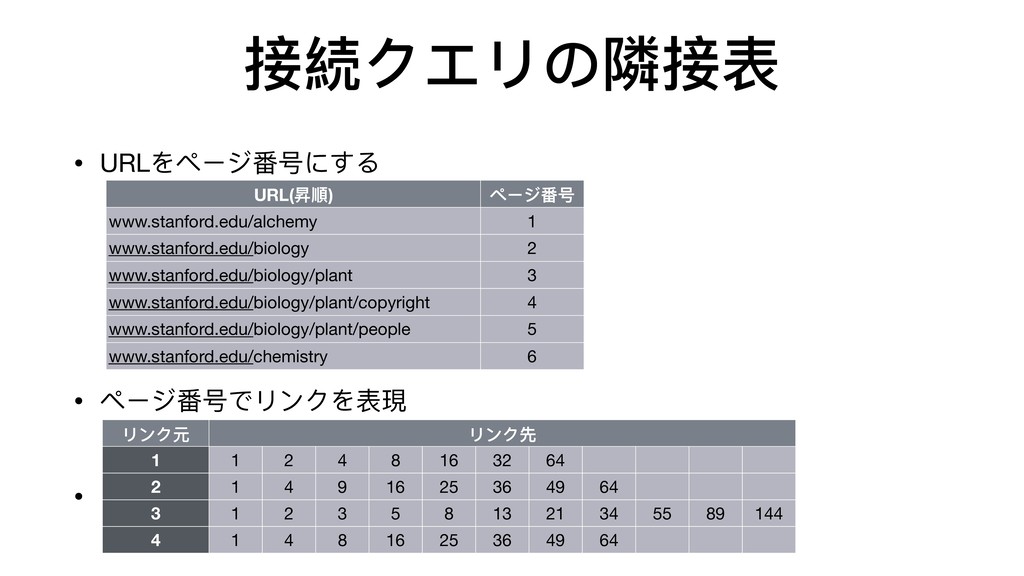
接続クエリの隣接表 • URLをページ番号にする • ページ番号でリンクを表現 • URL(昇順) ページ番号 www.stanford.edu/alchemy 1
www.stanford.edu/biology 2 www.stanford.edu/biology/plant 3 www.stanford.edu/biology/plant/copyright 4 www.stanford.edu/biology/plant/people 5 www.stanford.edu/chemistry 6 リンク元 リンク先 1 1 2 4 8 16 32 64 2 1 4 9 16 25 36 49 64 3 1 2 3 5 8 13 21 34 55 89 144 4 1 4 8 16 25 36 49 64 -
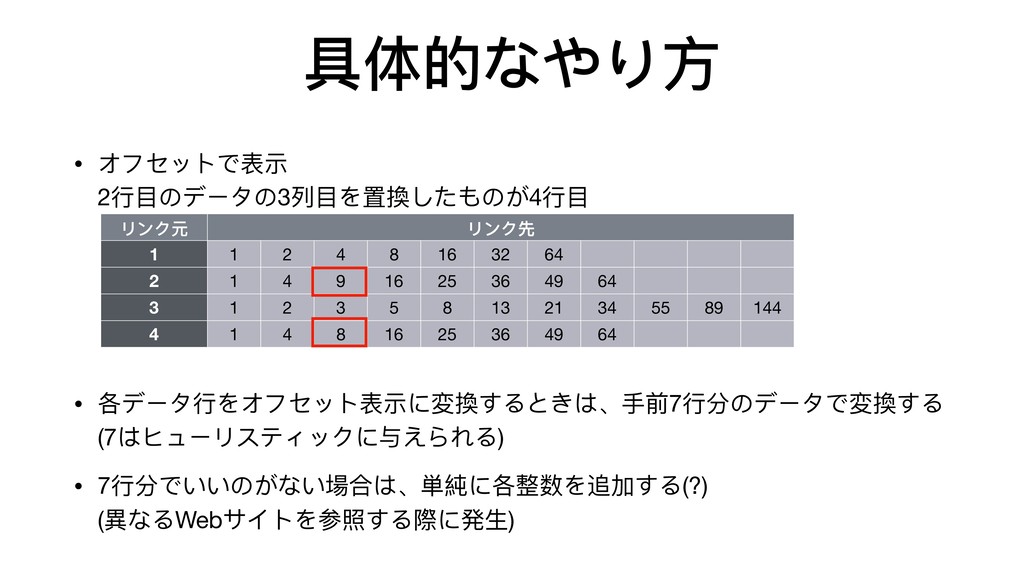
具体的なやり⽅方 • オフセットで表示 2⾏行行⽬目のデータの3列列⽬目を置換したものが4⾏行行⽬目 • 各データ⾏行行をオフセット表示に変換するときは、⼿手前7⾏行行分のデータで変換する (7はヒューリスティックに与えられる) • 7⾏行行分でいいのがない場合は、単純に各整数を追加する(?) (異異なるWebサイトを参照する際に発⽣生)
リンク元 リンク先 1 1 2 4 8 16 32 64 2 1 4 9 16 25 36 49 64 3 1 2 3 5 8 13 21 34 55 89 144 4 1 4 8 16 25 36 49 64 -
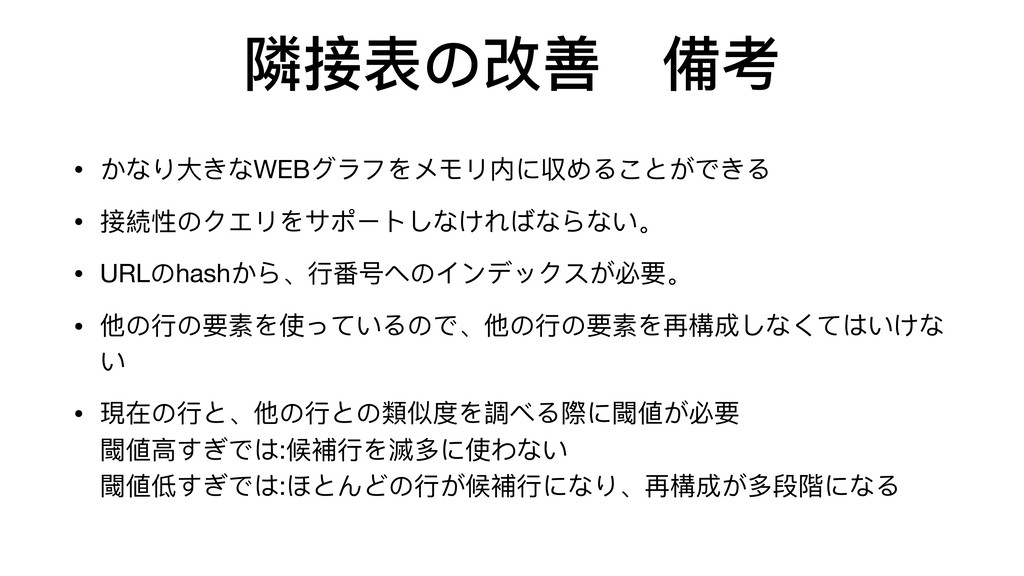
隣接表の改善 備考 • かなり⼤大きなWEBグラフをメモリ内に収めることができる • 接続性のクエリをサポートしなければならない。 • URLのhashから、⾏行行番号へのインデックスが必要。 • 他の⾏行行の要素を使っているので、他の⾏行行の要素を再構成しなくてはいけな い
• 現在の⾏行行と、他の⾏行行との類類似度を調べる際に閾値が必要 閾値⾼高すぎでは:候補⾏行行を滅多に使わない 閾値低すぎでは:ほとんどの⾏行行が候補⾏行行になり、再構成が多段階になる