Share
Embed
いかにして命令の入れ替わりについて心配するのをやめ、メモリモデルを 愛するようになったか(改)
@nullpo_head
kernel/vm探検隊 東京18
https://kernelvm.connpass.com/event/355100/
ハードウェアメモリモデル(Sequential Consistency, TSO, Multicopy atomic weak models, Non-Multicopy atomic weak models)とC++ソフトウェアメモリーモデルの話をしました
Takaya Saeki
August 09, 2025
Transcript
65 slides
-
• メモリモデルについてTSO, Weak, そしてC++ソフトウェアメモリーモデルを解説した • が、思いっきり誤りがあった Special Thanks: @yamasa さん(本当に)
• 誤りがまた見つかると思うので今度は https://fuel.edby.coffee/posts/kvm-mm-teisei に随時訂正をあげます(予定) • 前回のスライドは単純に非公開にしたので今回は訂正先へのリンクを書いた 2 前回の内容を訂正しつつパワーアップし て話します -
6 杞 憂 杞 国 有 下 人 憂 二
天 地 崩 墜 、 身 亡 一 レ 所 レ 寄 、 廃 二 寝 食 一 者 上 。 又 有 下 憂 二 彼 之 所 一 レ 憂 者 上 -
杞(き)の国に、天が落 ち地が崩れて身の置き所 がなくなるのではないか と心配し、夜も寝られず、 食物もろくに食べられな い者がいた。 今週のことわざ(三省堂辞書 編集部)2008/1/28より引用 7 杞
憂 杞 国 有 下 人 憂 二 天 地 崩 墜 、 身 亡 一 レ 所 レ 寄 、 廃 二 寝 食 一 者 上 。 又 有 下 憂 二 彼 之 所 一 レ 憂 者 上 -
8 杞(き)の国に、天が落 ち地が崩れて身の置き所 がなくなるのではないか と心配し、夜も寝られず、 食物もろくに食べられな い者がいた。 今週のことわざ(三省堂辞書 編集部)2008/1/28より引用 杞
憂 杞 国 有 下 人 憂 二 天 地 崩 墜 、 身 亡 一 レ 所 レ 寄 、 廃 二 寝 食 一 者 上 。 又 有 下 憂 二 彼 之 所 一 レ 憂 者 上 天が落ちてきたらどうしよう? -
杞(き)の国に、天が落 ち地が崩れて身の置き所 がなくなるのではないか と心配し、夜も寝られず、 食物もろくに食べられな い者がいた。 今週のことわざ(三省堂辞書 編集部)2008/1/28より引用 杞 憂
杞 国 有 下 人 憂 二 天 地 崩 墜 、 身 亡 一 レ 所 レ 寄 、 廃 二 寝 食 一 者 上 。 又 有 下 憂 二 彼 之 所 一 レ 憂 者 上 9 天が落ちてきたらどうしよう? そんなことを心配する 必要はないのだ -
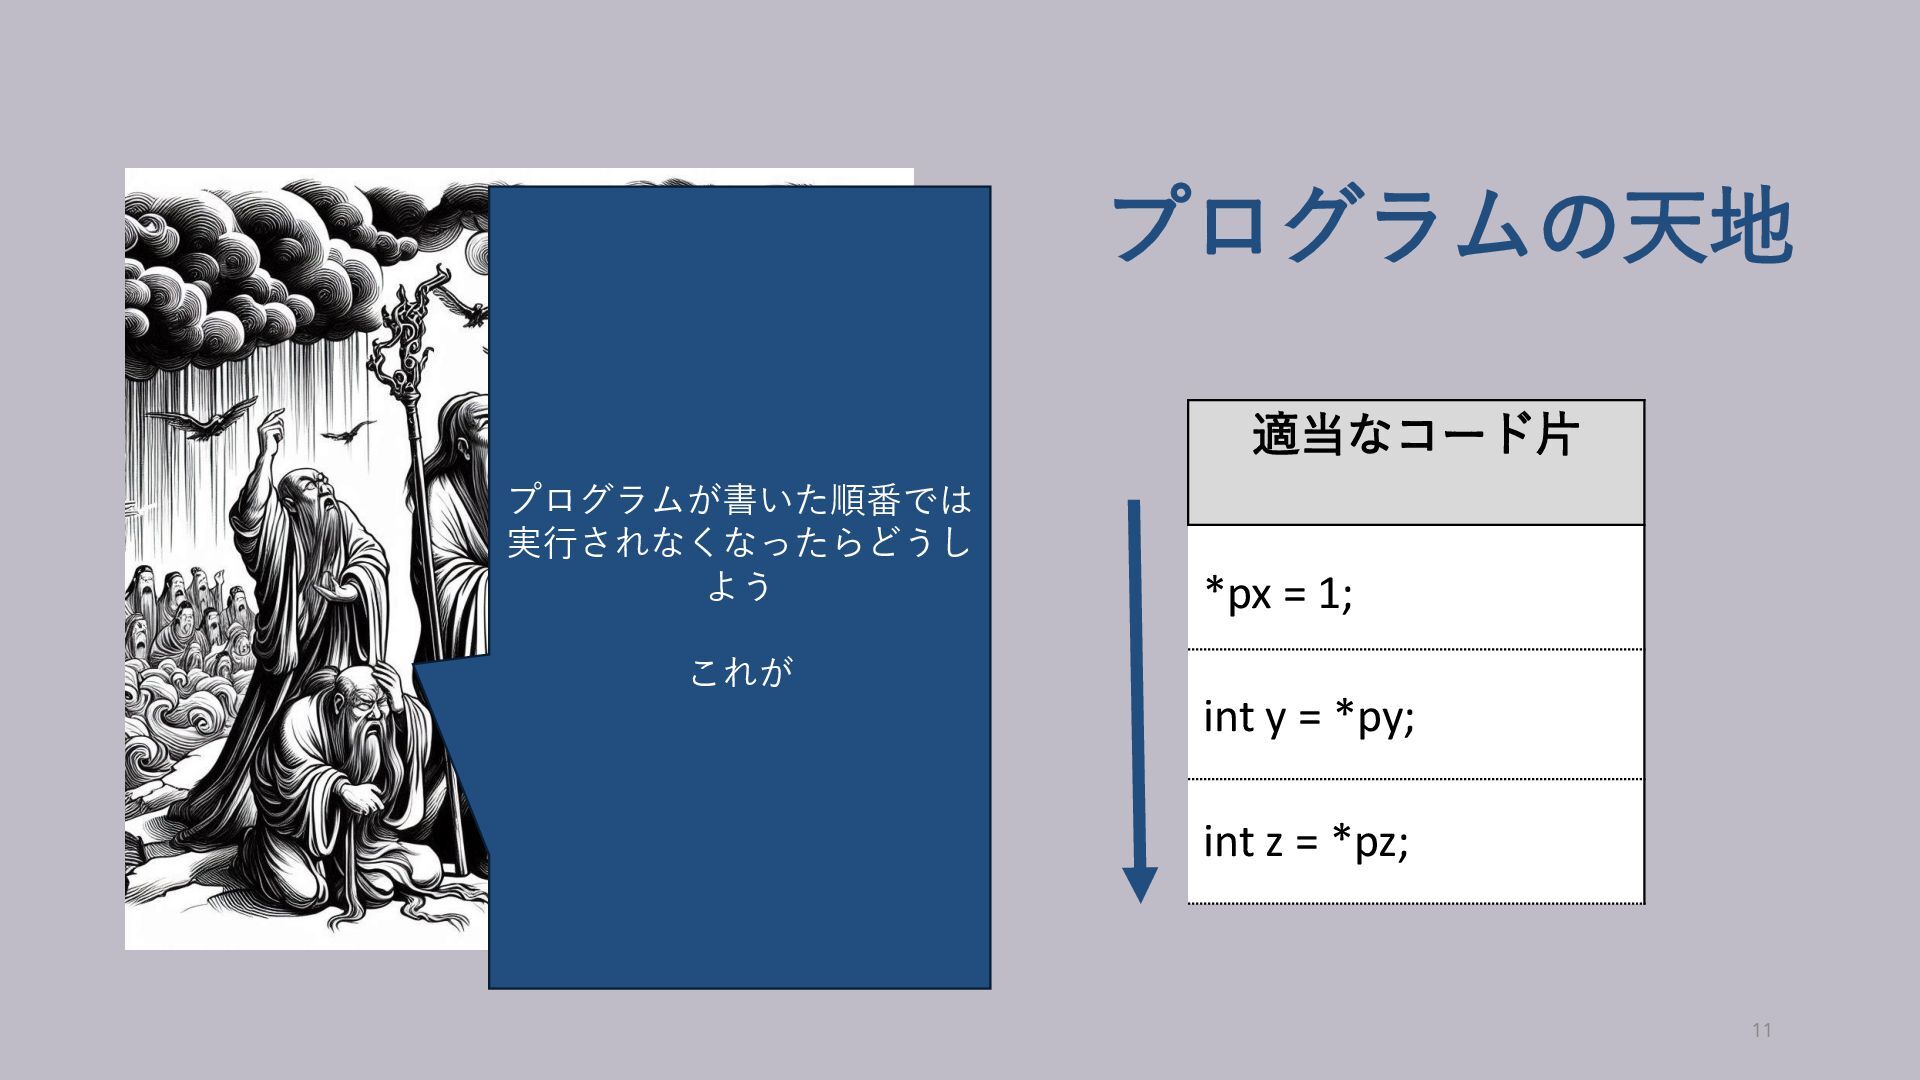
11 プログラムが書いた順番では 実行されなくなったらどうし よう これが 適当なコード片 *px = 1; int
y = *py; int z = *pz; プログラムの天地 -
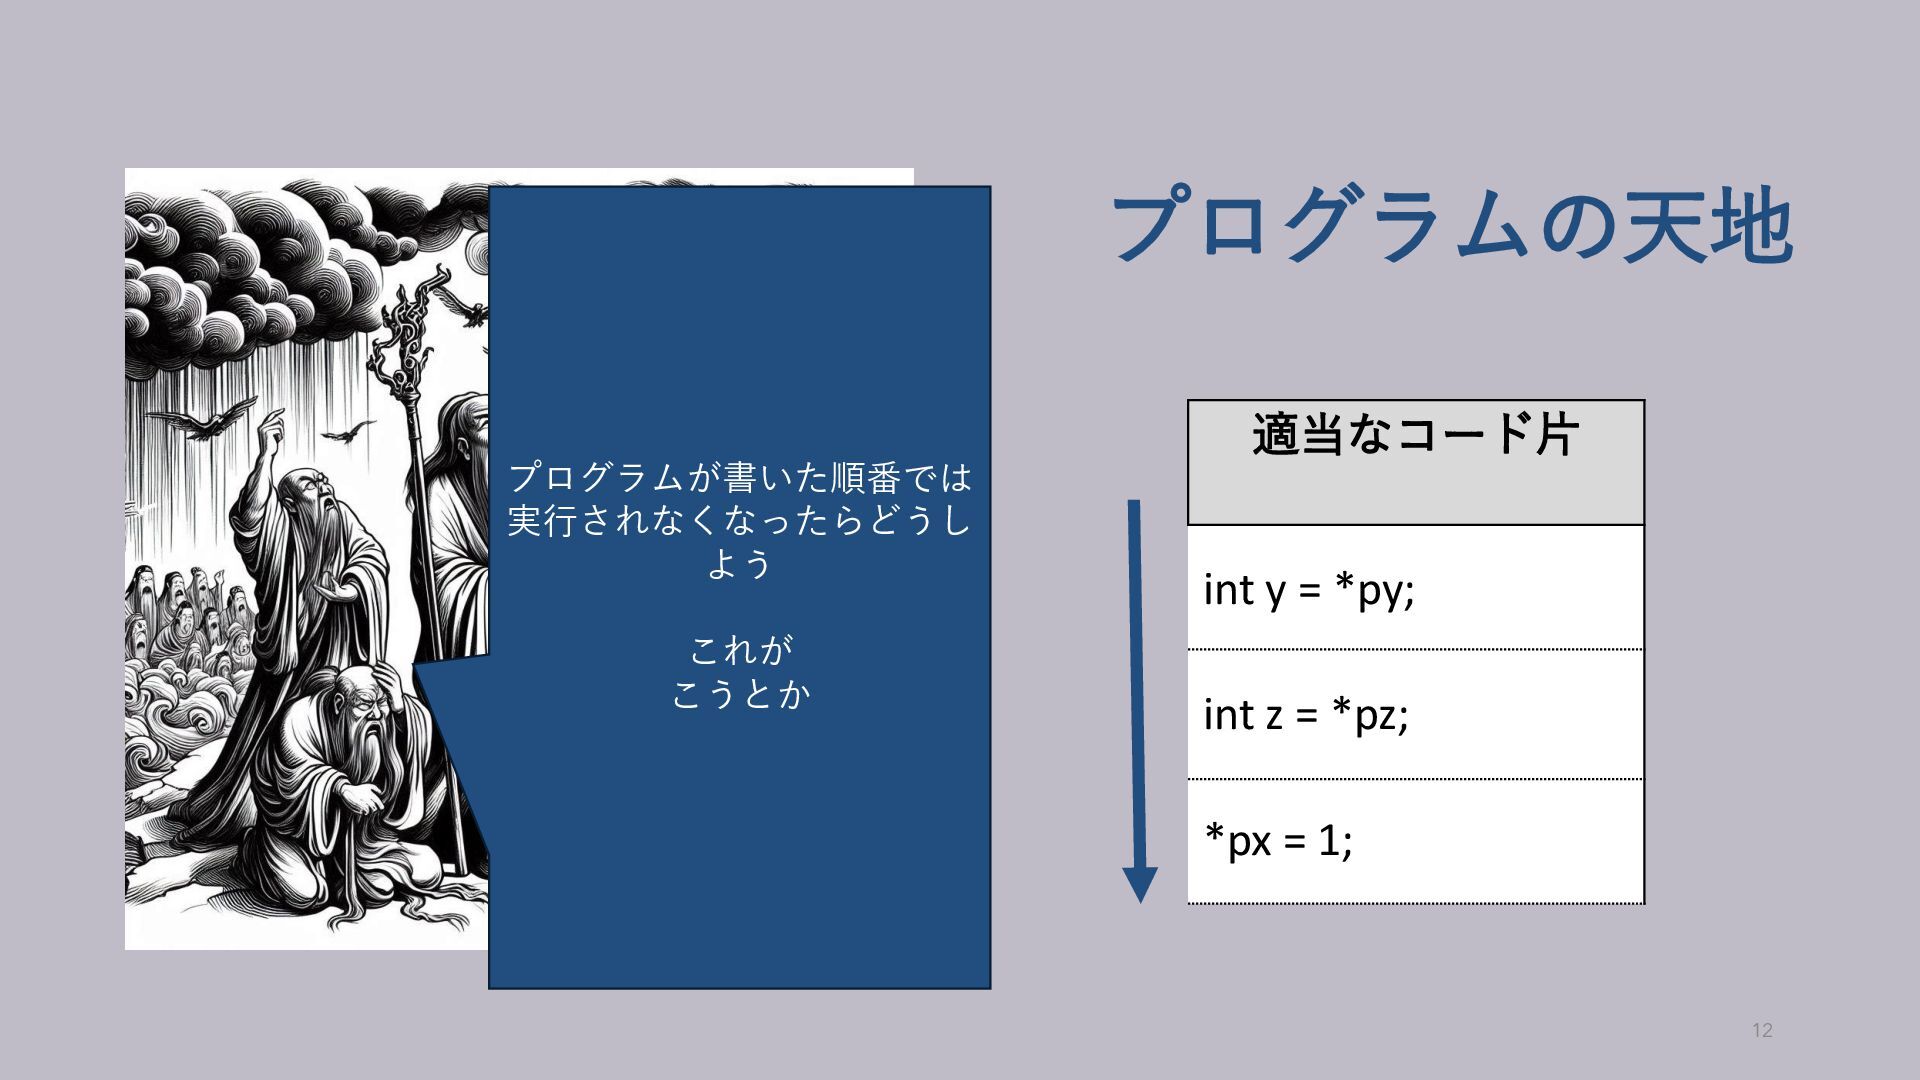
12 プログラムが書いた順番では 実行されなくなったらどうし よう これが こうとか 適当なコード片 *px = 1;
int y = *py; int z = *pz; プログラムの天地 -
13 プログラムが書いた順番では 実行されなくなったらどうし よう これが こうとか 適当なコード片 *px = 1;
int y = *py; int z = *pz; それについては心配してくれ プログラムの天地 -
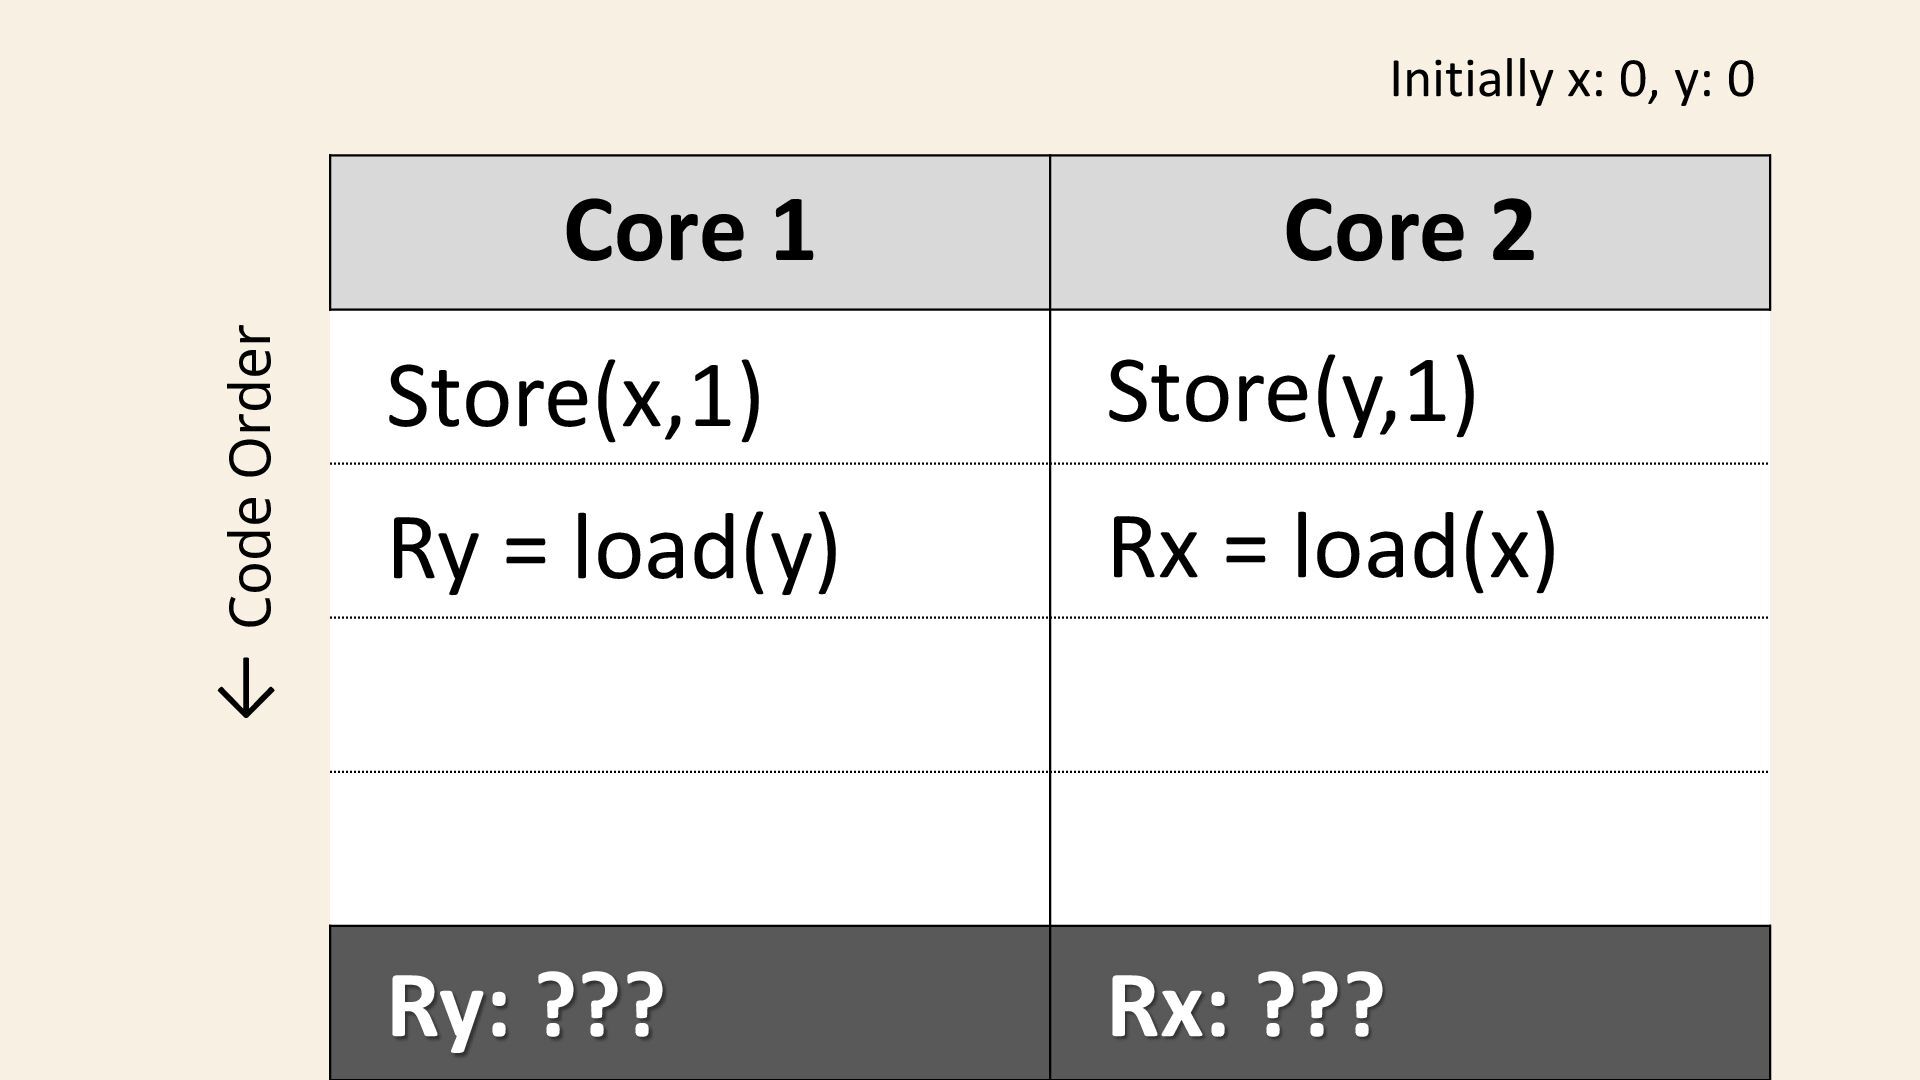
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: ??? Rx: ??? ← Code Order Initially x: 0, y: 0 -
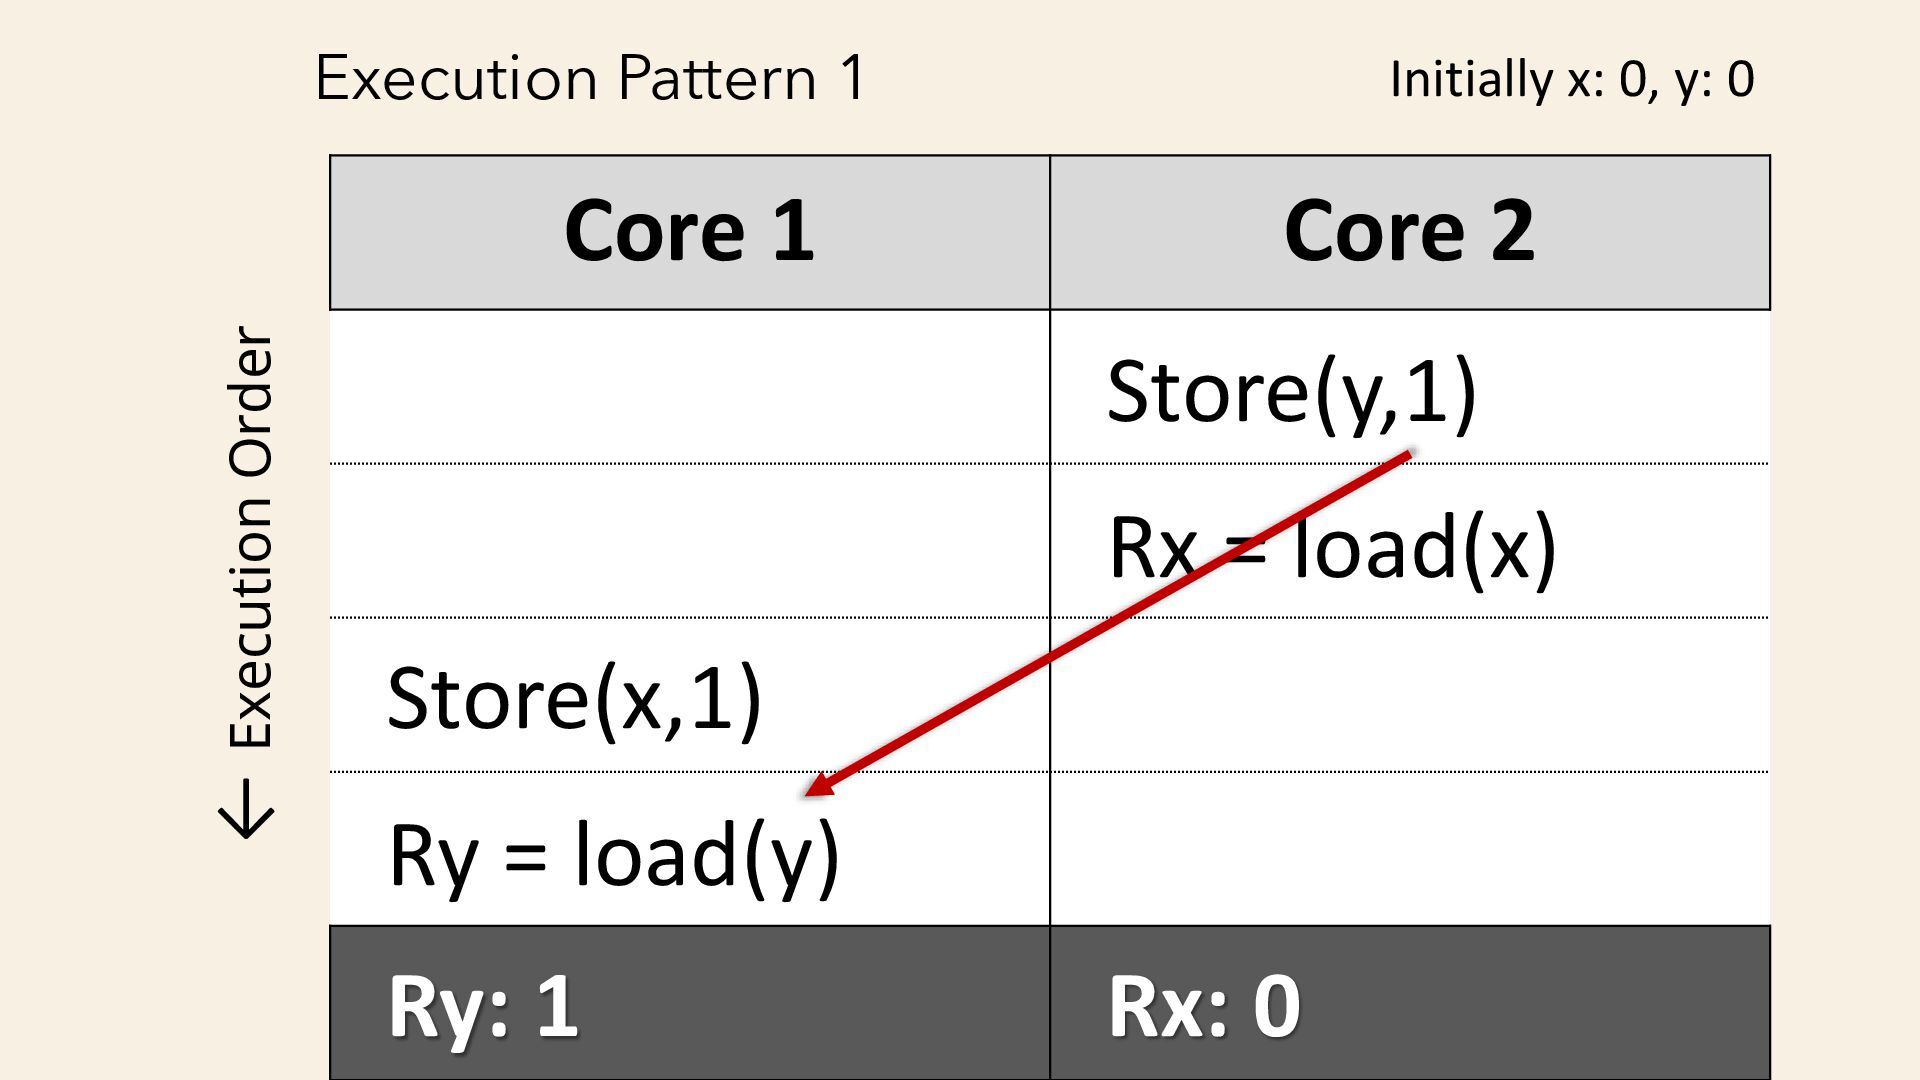
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 1 Rx: 0 Initially x: 0, y: 0 ← Execution Order Execution Pattern 1 -
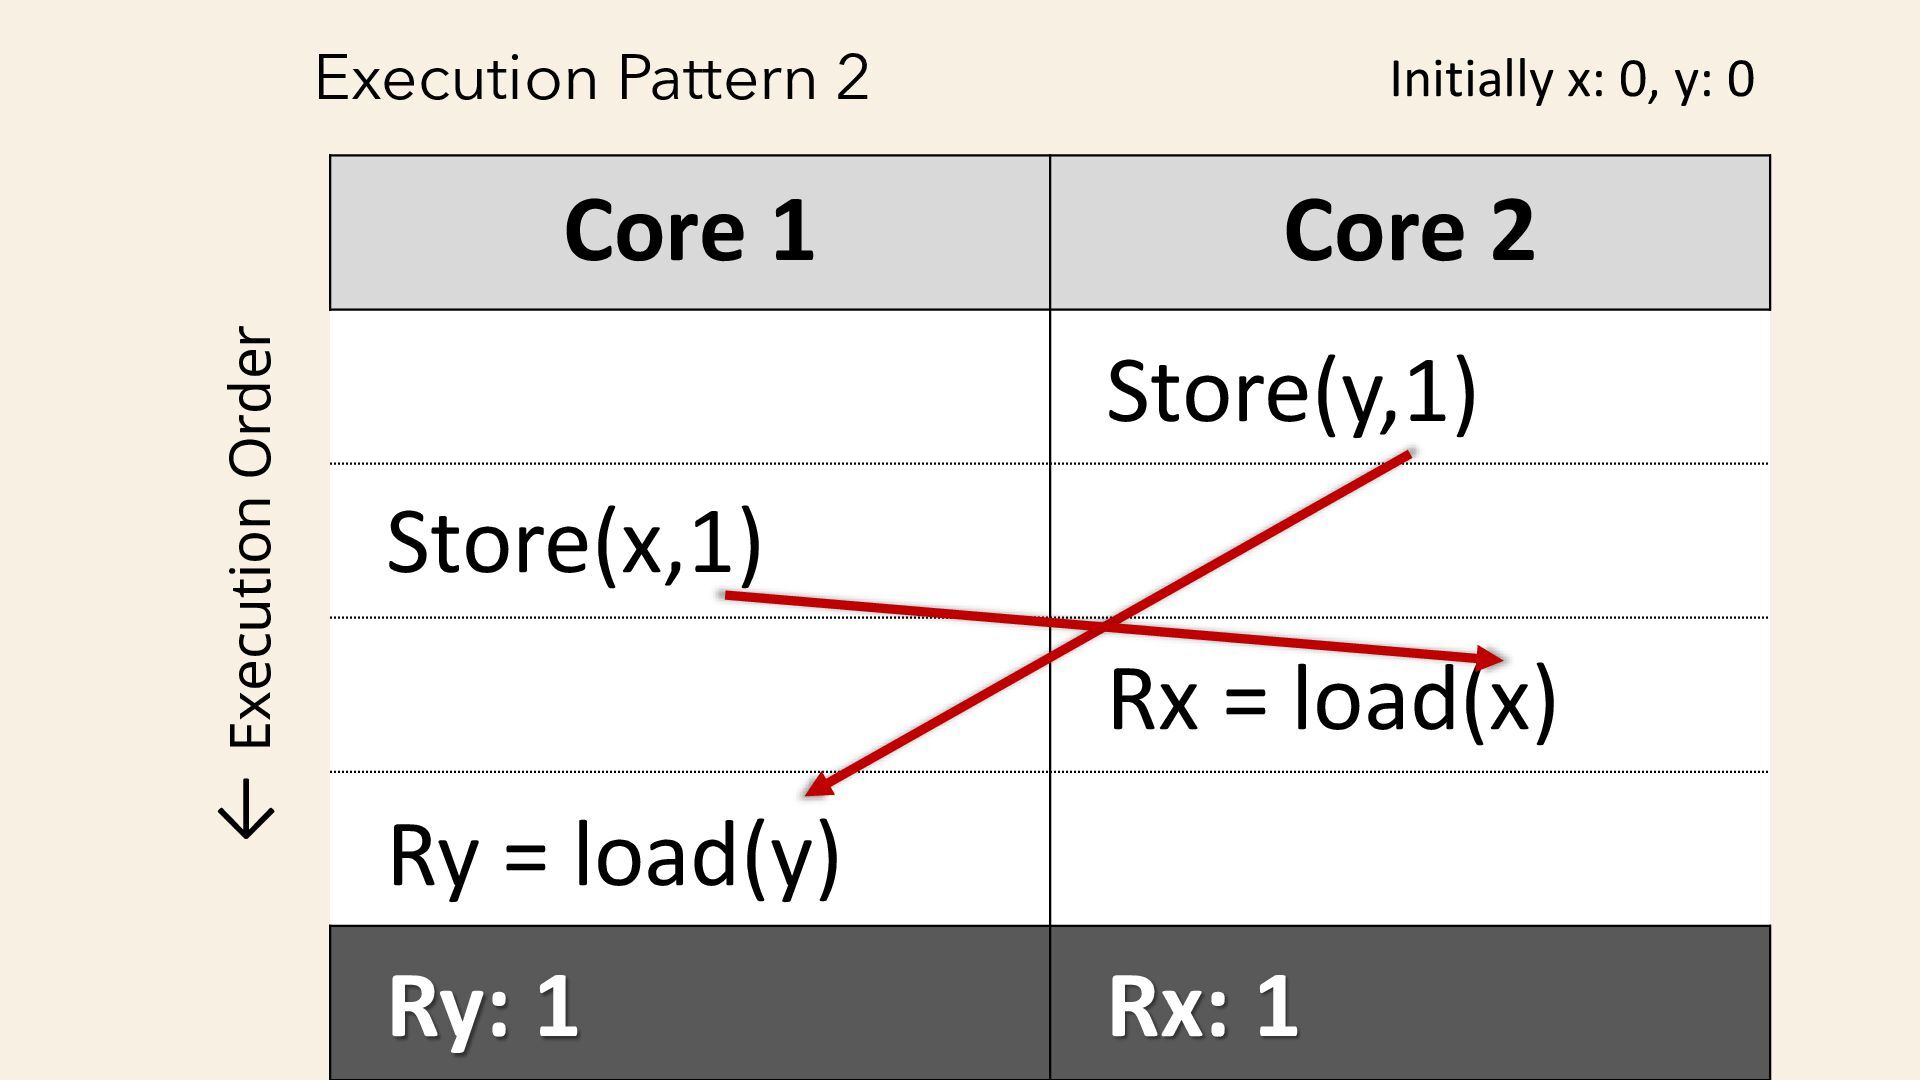
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 1 Rx: 1 ← Execution Order Initially x: 0, y: 0 Execution Pattern 2 -
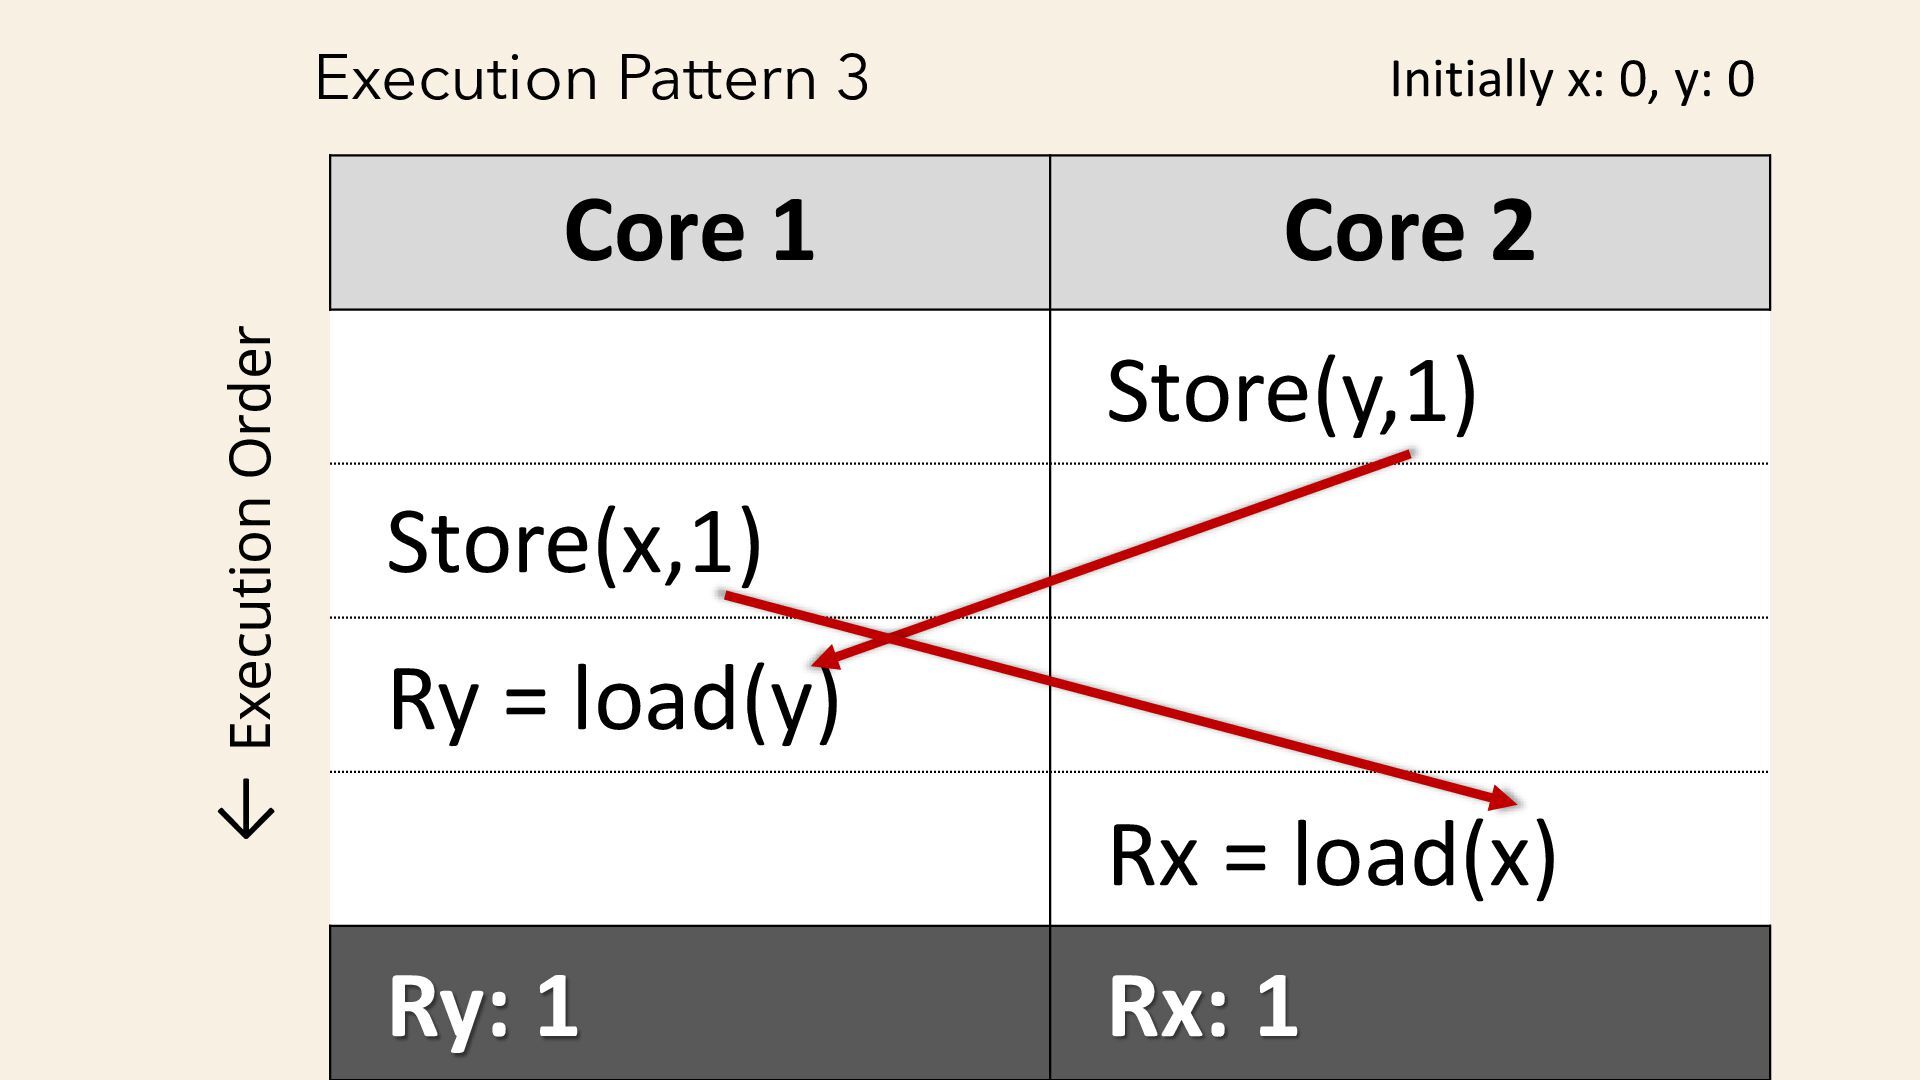
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 1 Rx: 1 ← Execution Order Initially x: 0, y: 0 Execution Pattern 3 -
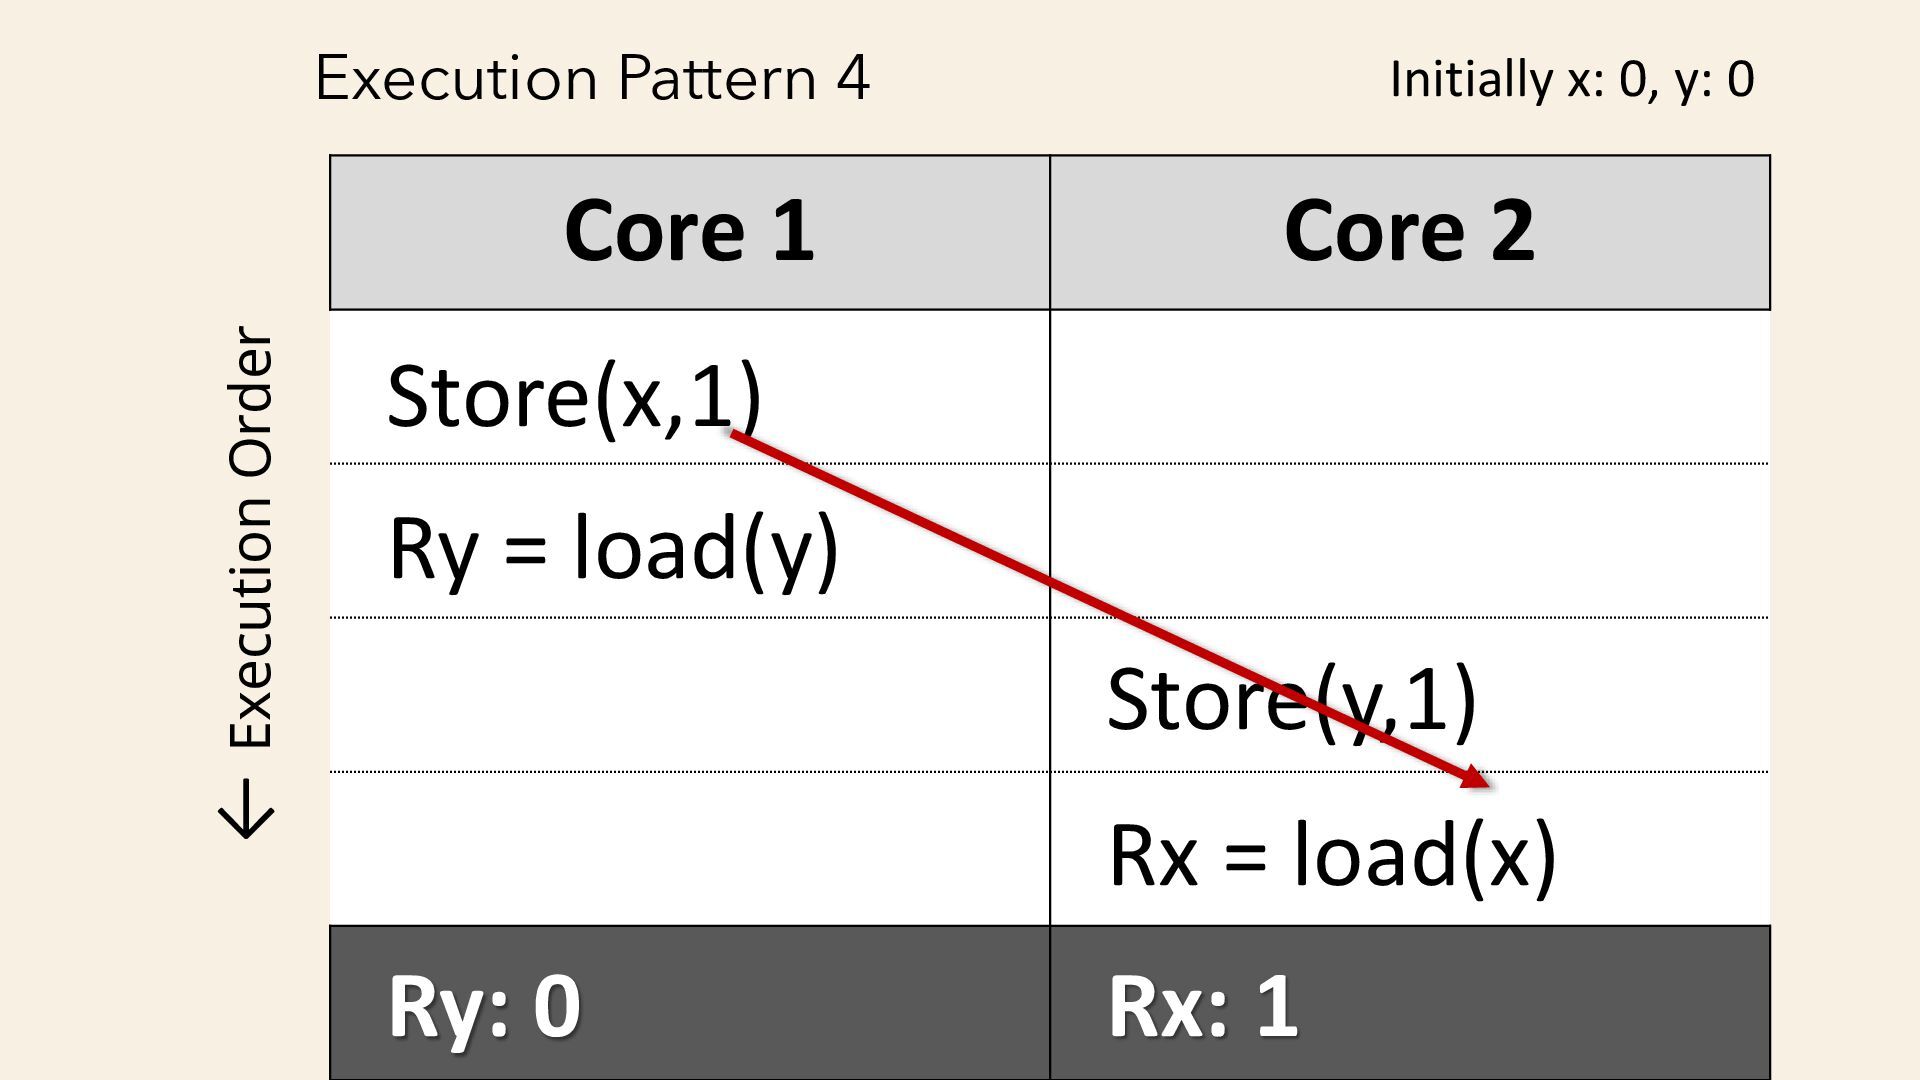
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 0 Rx: 1 ← Execution Order Initially x: 0, y: 0 Execution Pattern 4 -
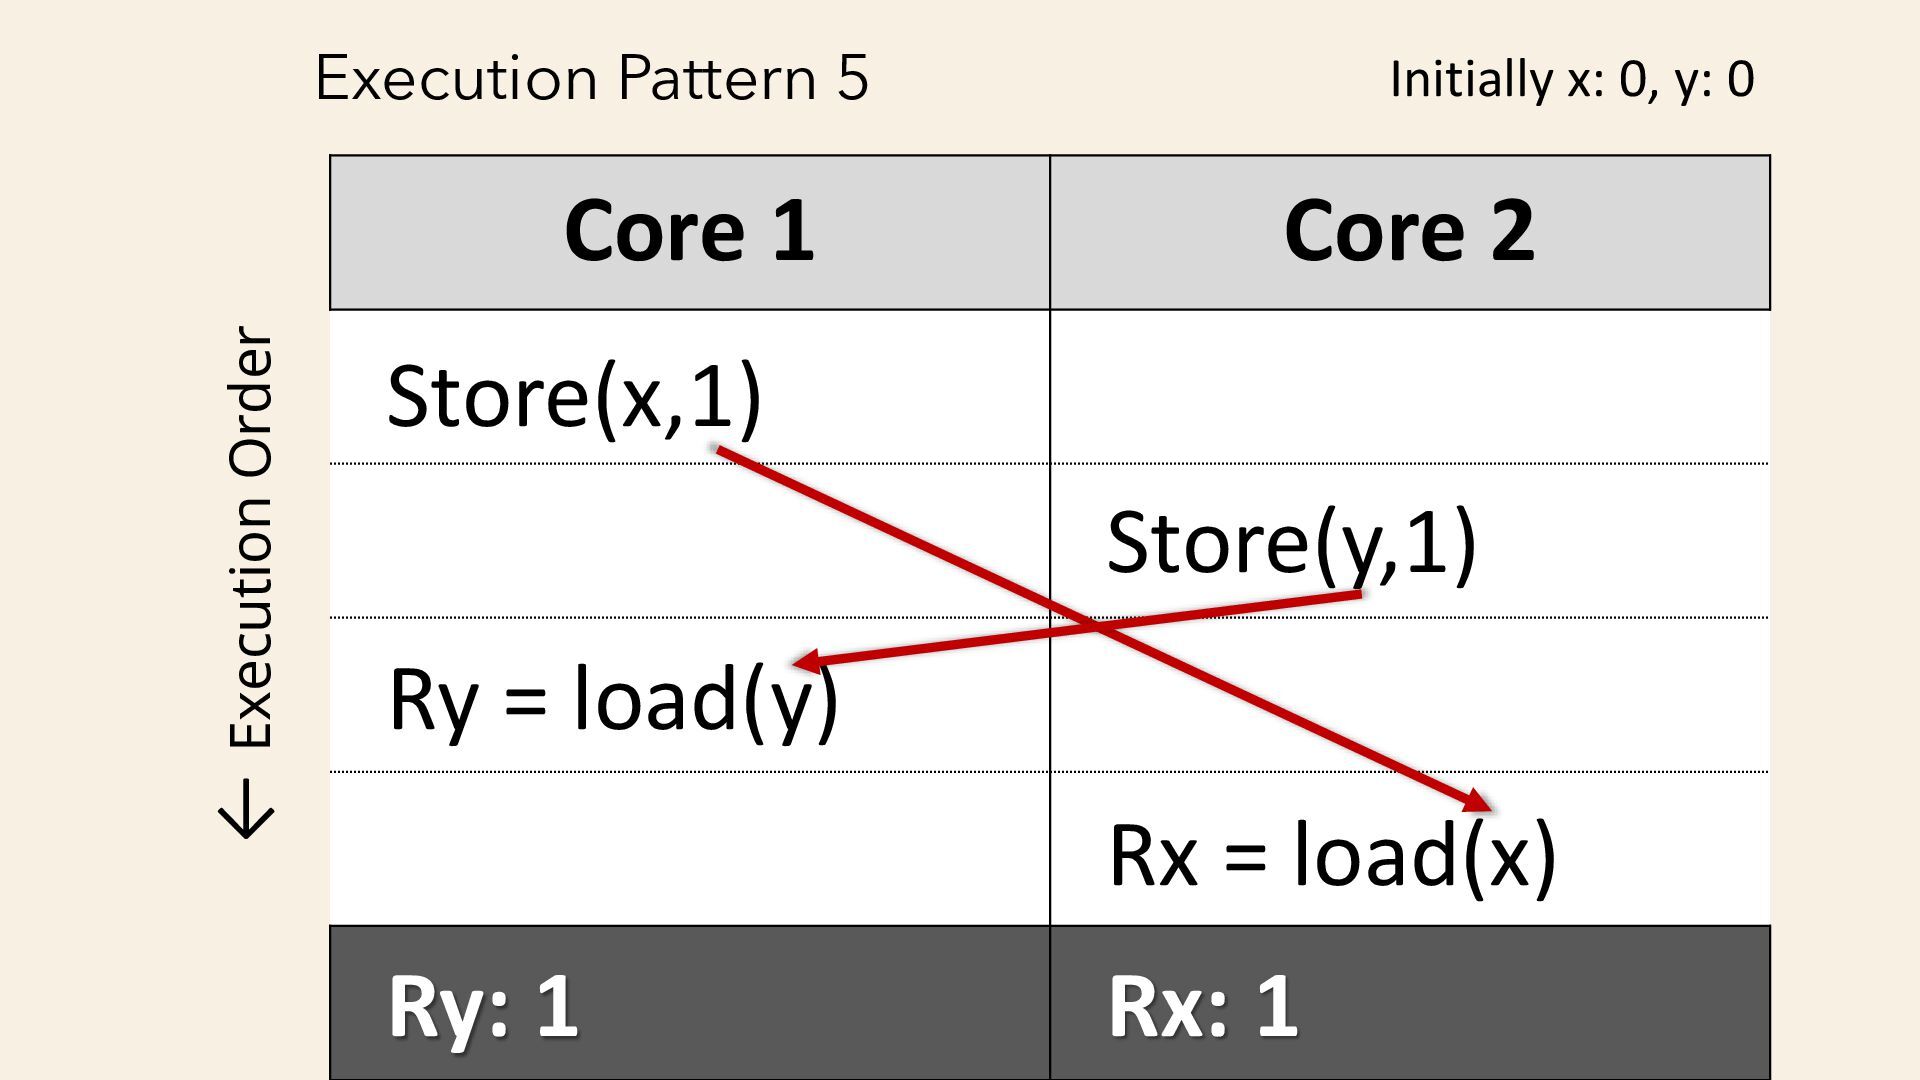
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 1 Rx: 1 ← Execution Order Initially x: 0, y: 0 Execution Pattern 5 -
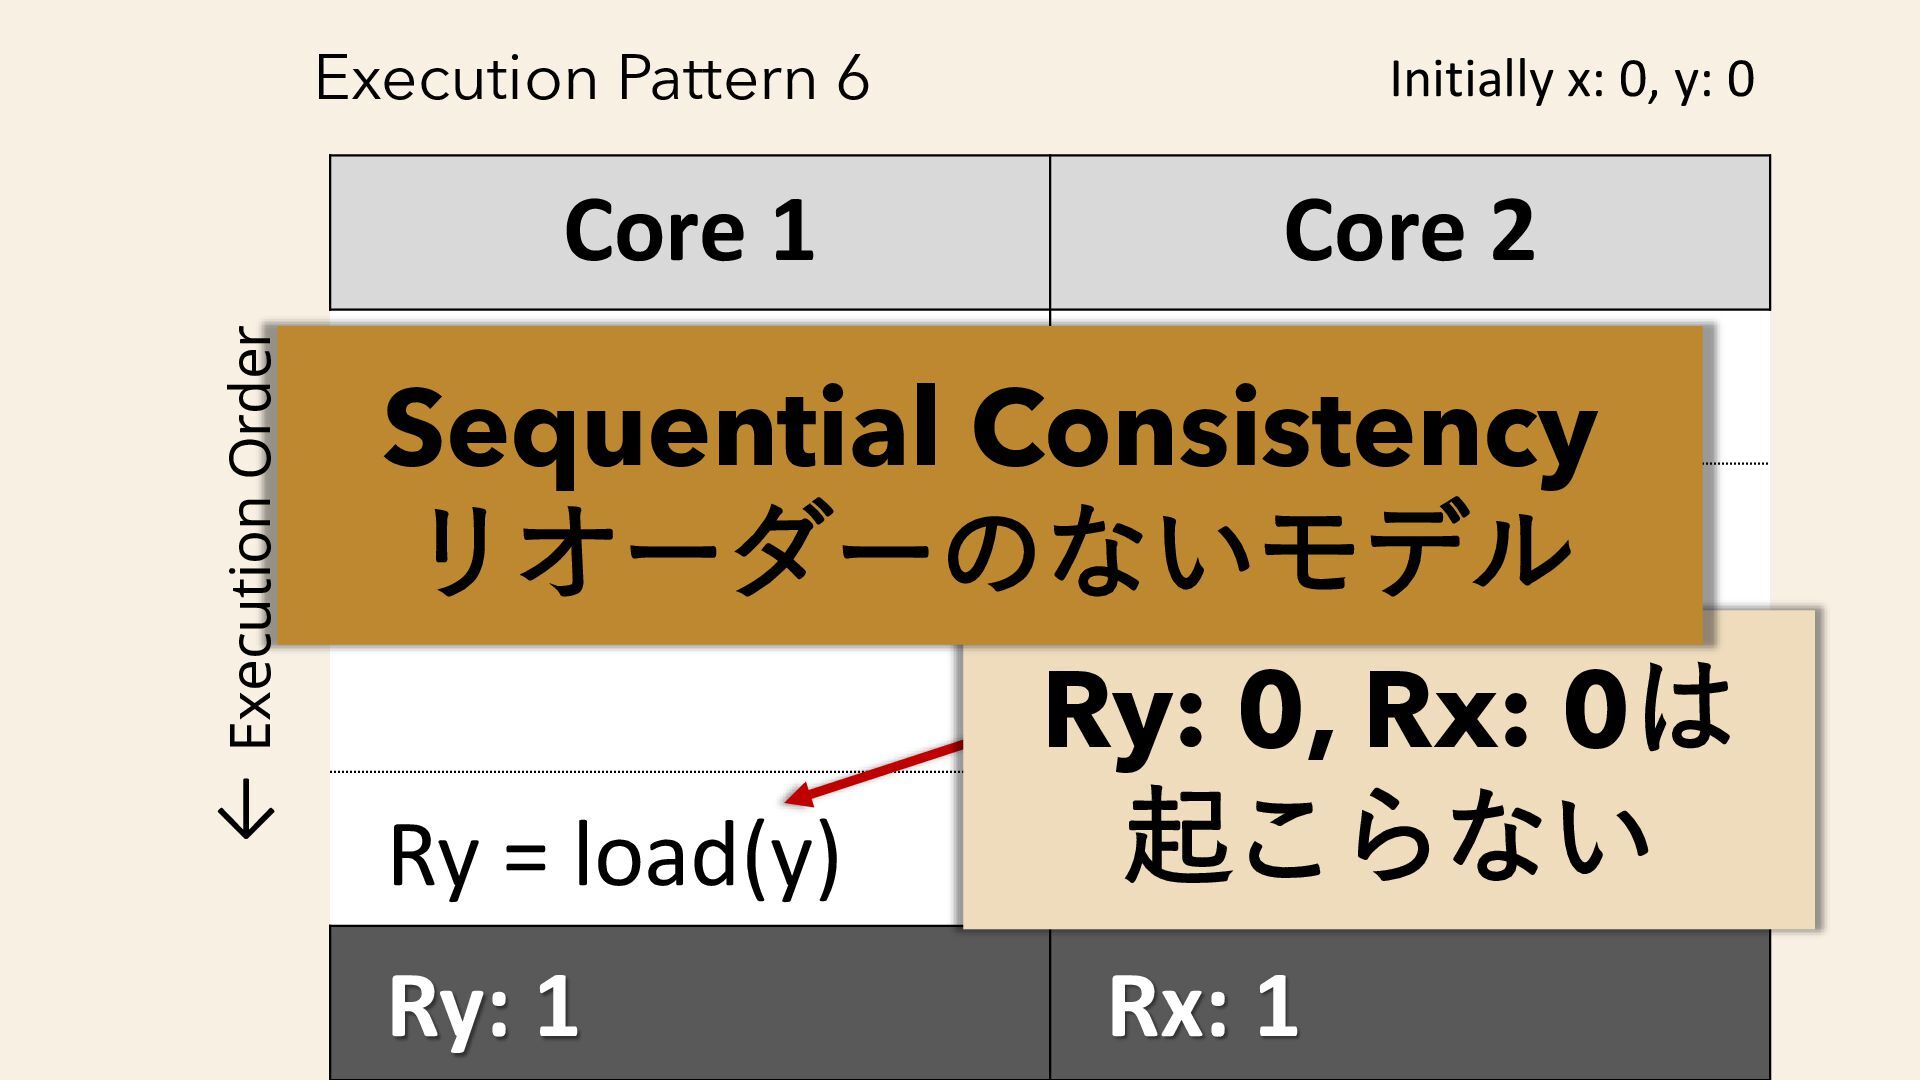
Core 1 Core 2 Ry = load(y) Store(x,1) Rx =
load(x) Store(y,1) Ry: 1 Rx: 1 ← Execution Order Initially x: 0, y: 0 Execution Pattern 6 Ry: 0, Rx: 0は 起こらない Sequential Consistency リオーダーのないモデル -
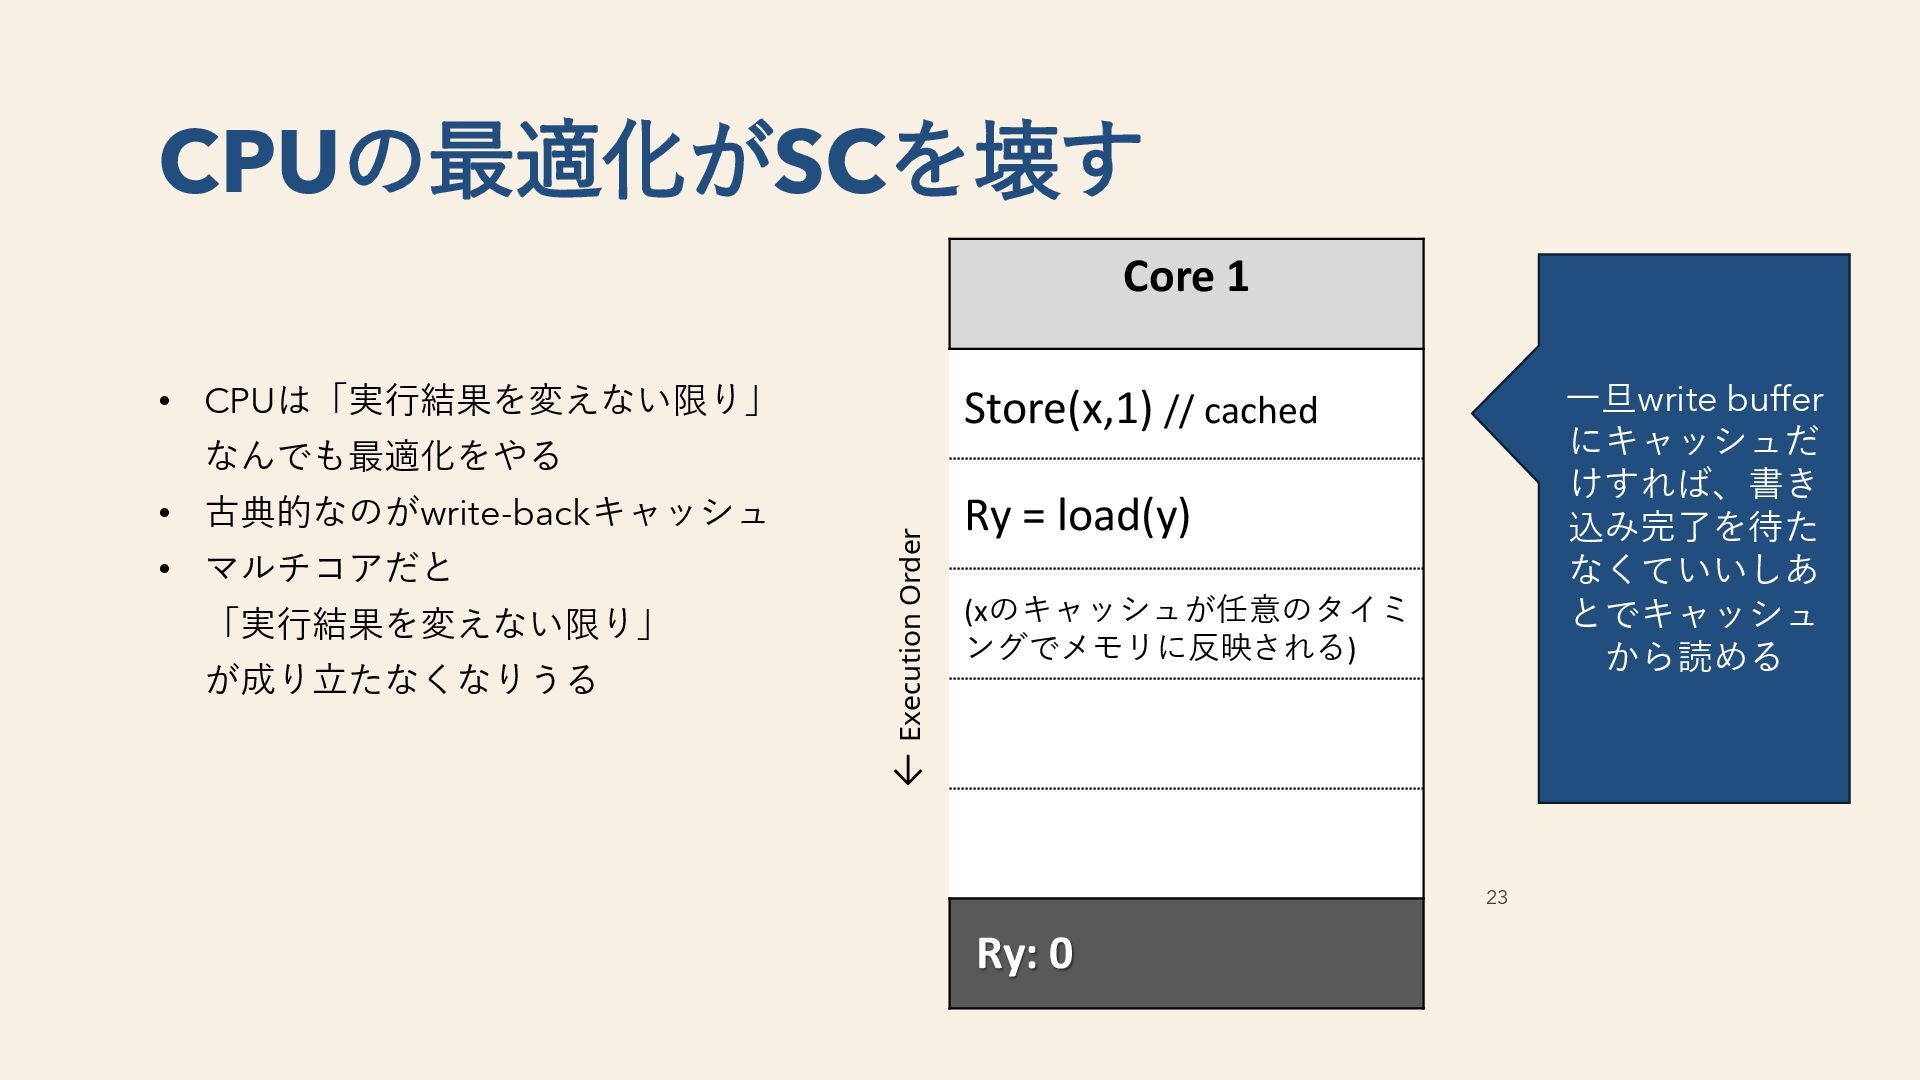
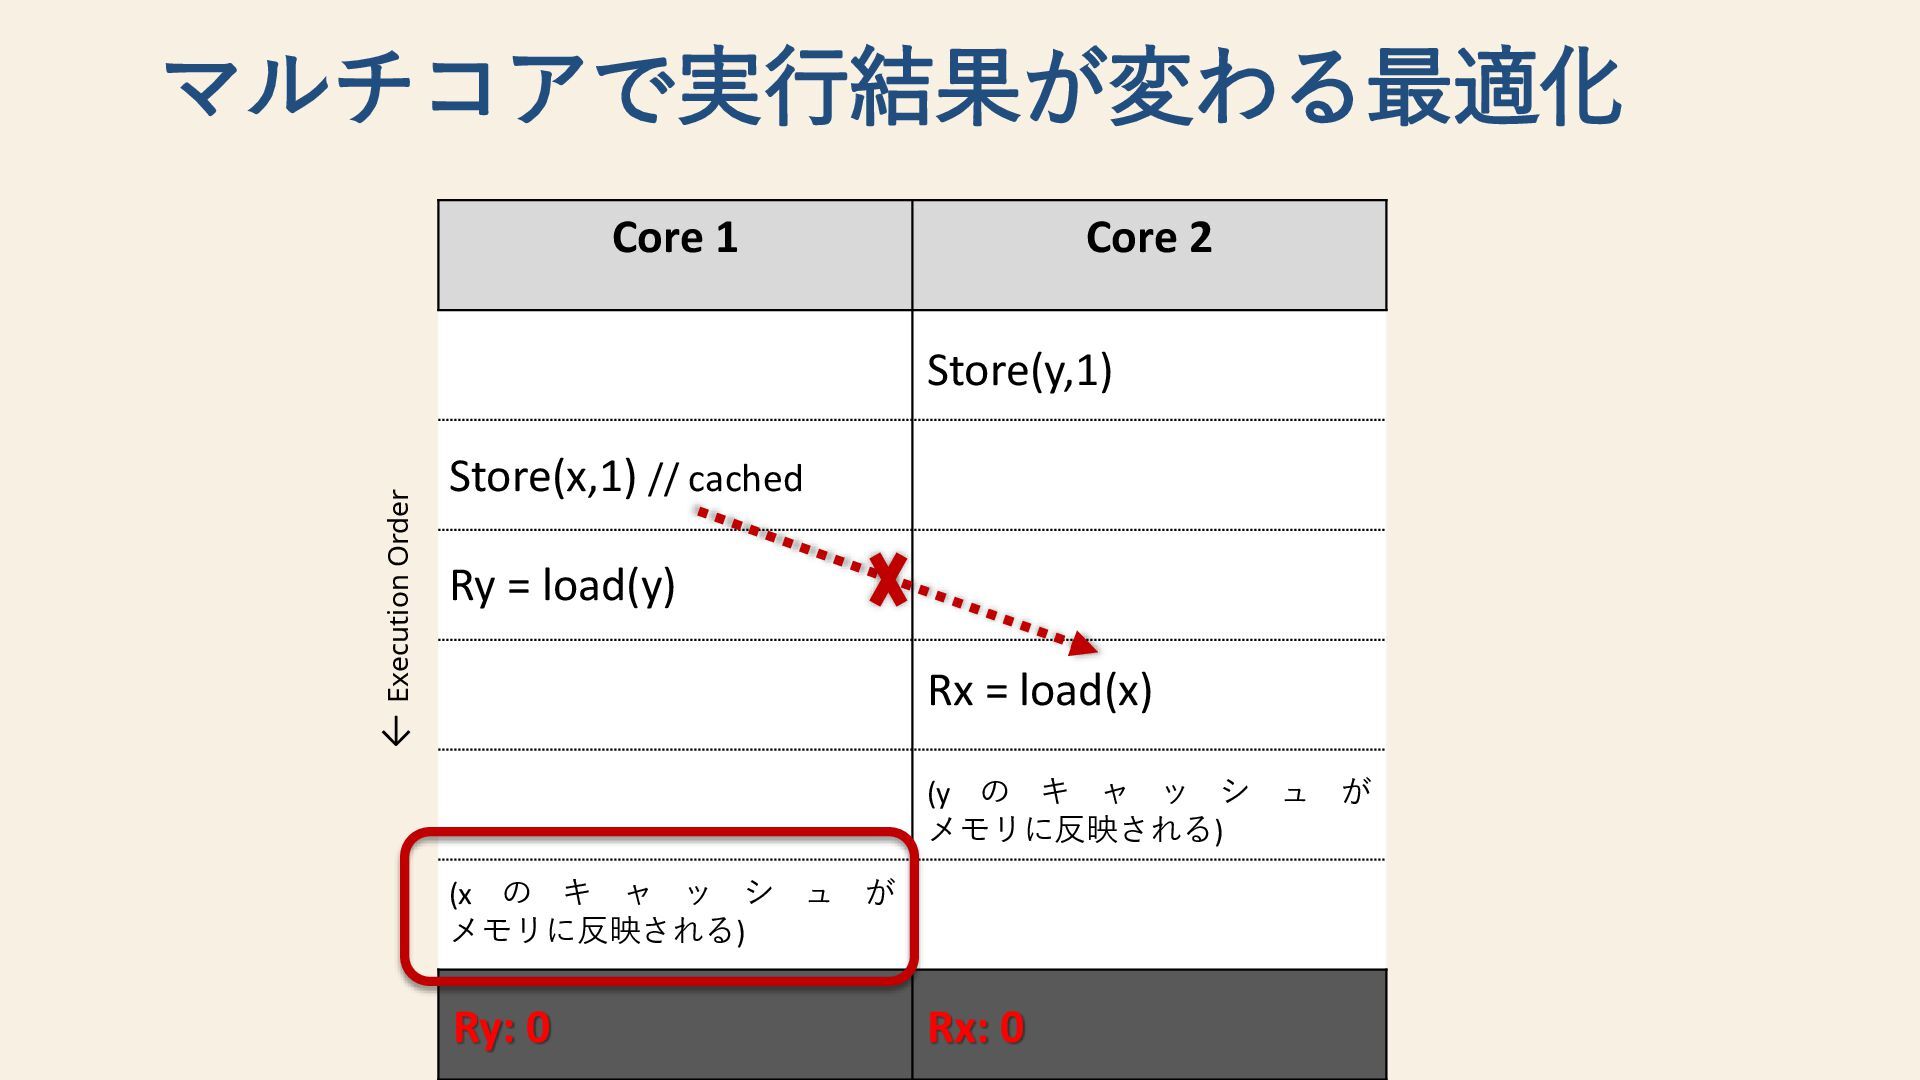
• CPUは「実行結果を変えない限り」 なんでも最適化をやる • 古典的なのがwrite-backキャッシュ • マルチコアだと 「実行結果を変えない限り」 が成り立たなくなりうる 23
CPUの最適化がSCを壊す Core 1 Store(x,1) // cached Ry: 0 ← Execution Order Ry = load(y) (xのキャッシュが任意のタイミ ングでメモリに反映される) 一旦write buffer にキャッシュだ けすれば、書き 込み完了を待た なくていいしあ とでキャッシュ から読める -
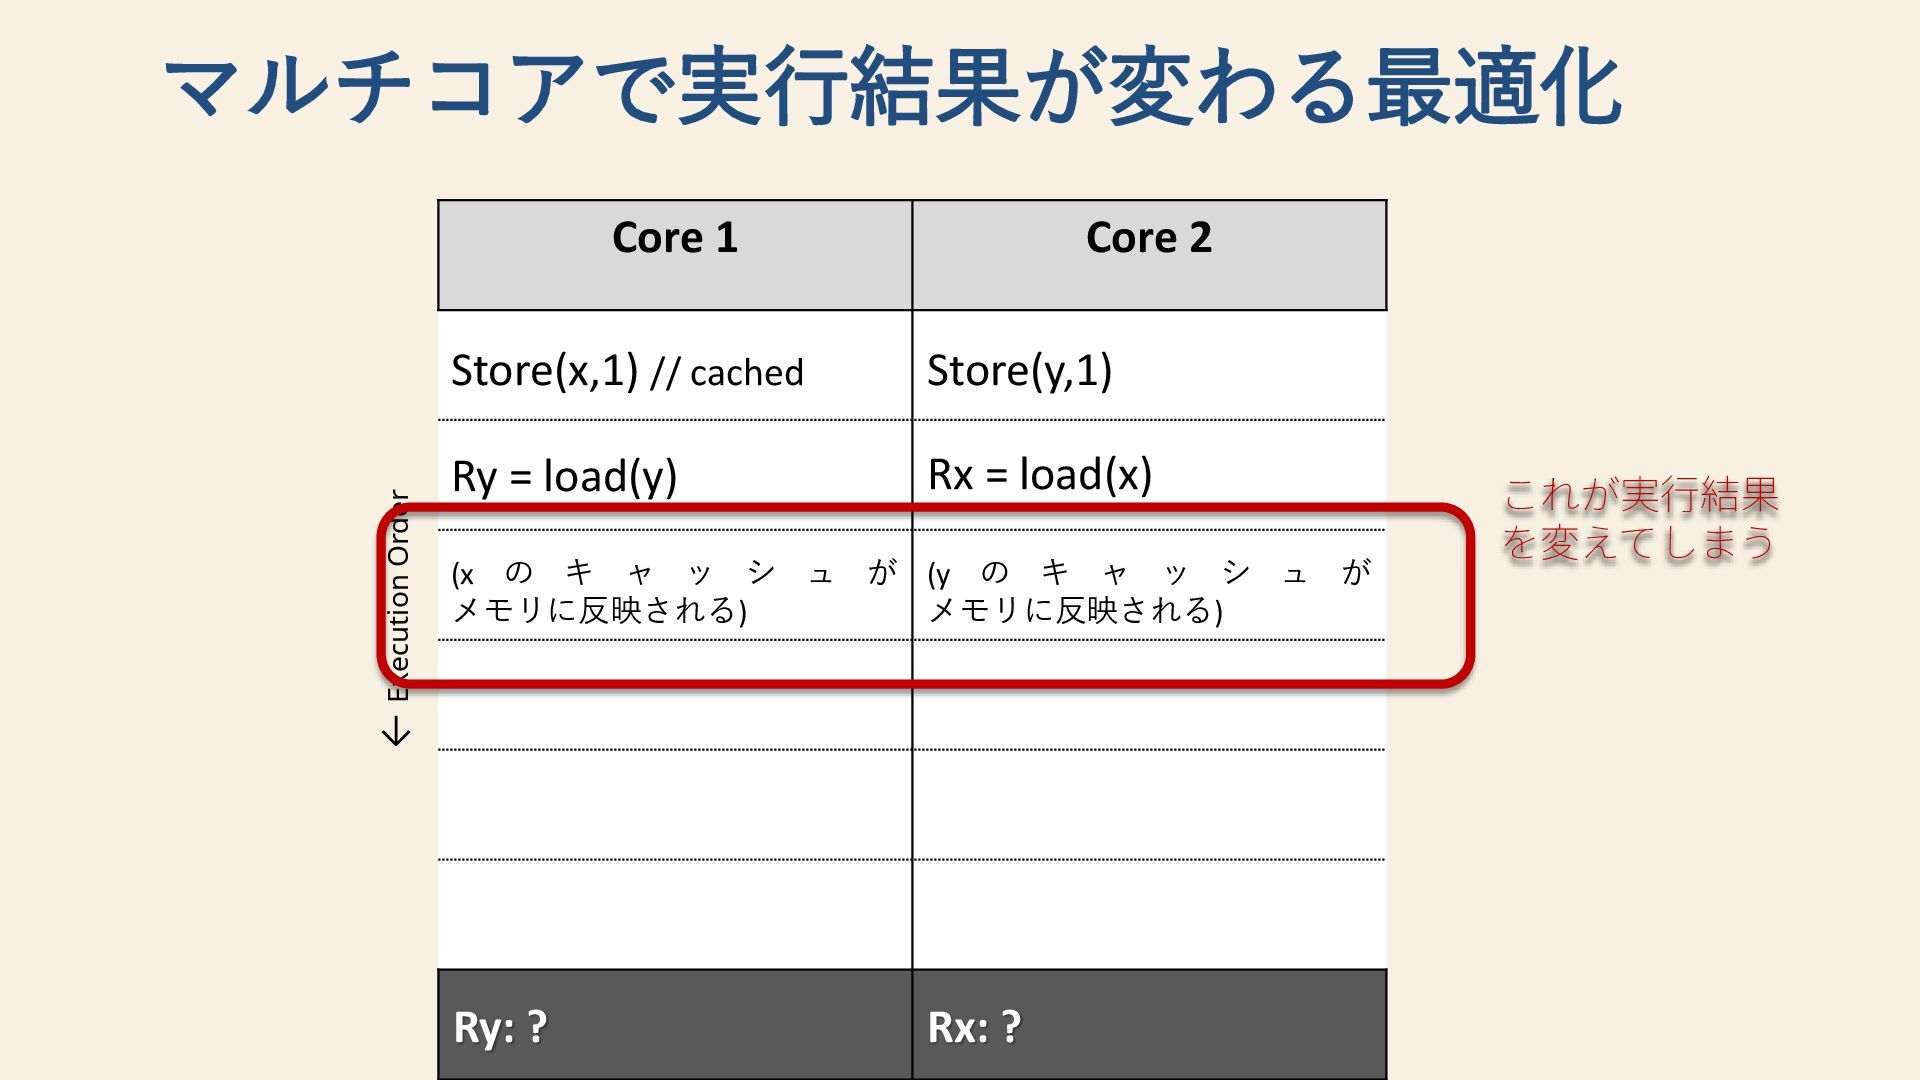
24 マルチコアで実行結果が変わる最適化 Core 1 Core 2 Store(x,1) // cached Rx
= load(x) Store(y,1) Ry: ? Rx: ? ← Execution Order Ry = load(y) (x の キ ャ ッ シ ュ が メモリに反映される) (y の キ ャ ッ シ ュ が メモリに反映される) これが実行結果 を変えてしまう -
25 マルチコアで実行結果が変わる最適化 Core 1 Core 2 Store(x,1) // cached Rx
= load(x) Store(y,1) Ry: 0 Rx: 0 ← Execution Order Ry = load(y) (x の キ ャ ッ シ ュ が メモリに反映される) (y の キ ャ ッ シ ュ が メモリに反映される) -
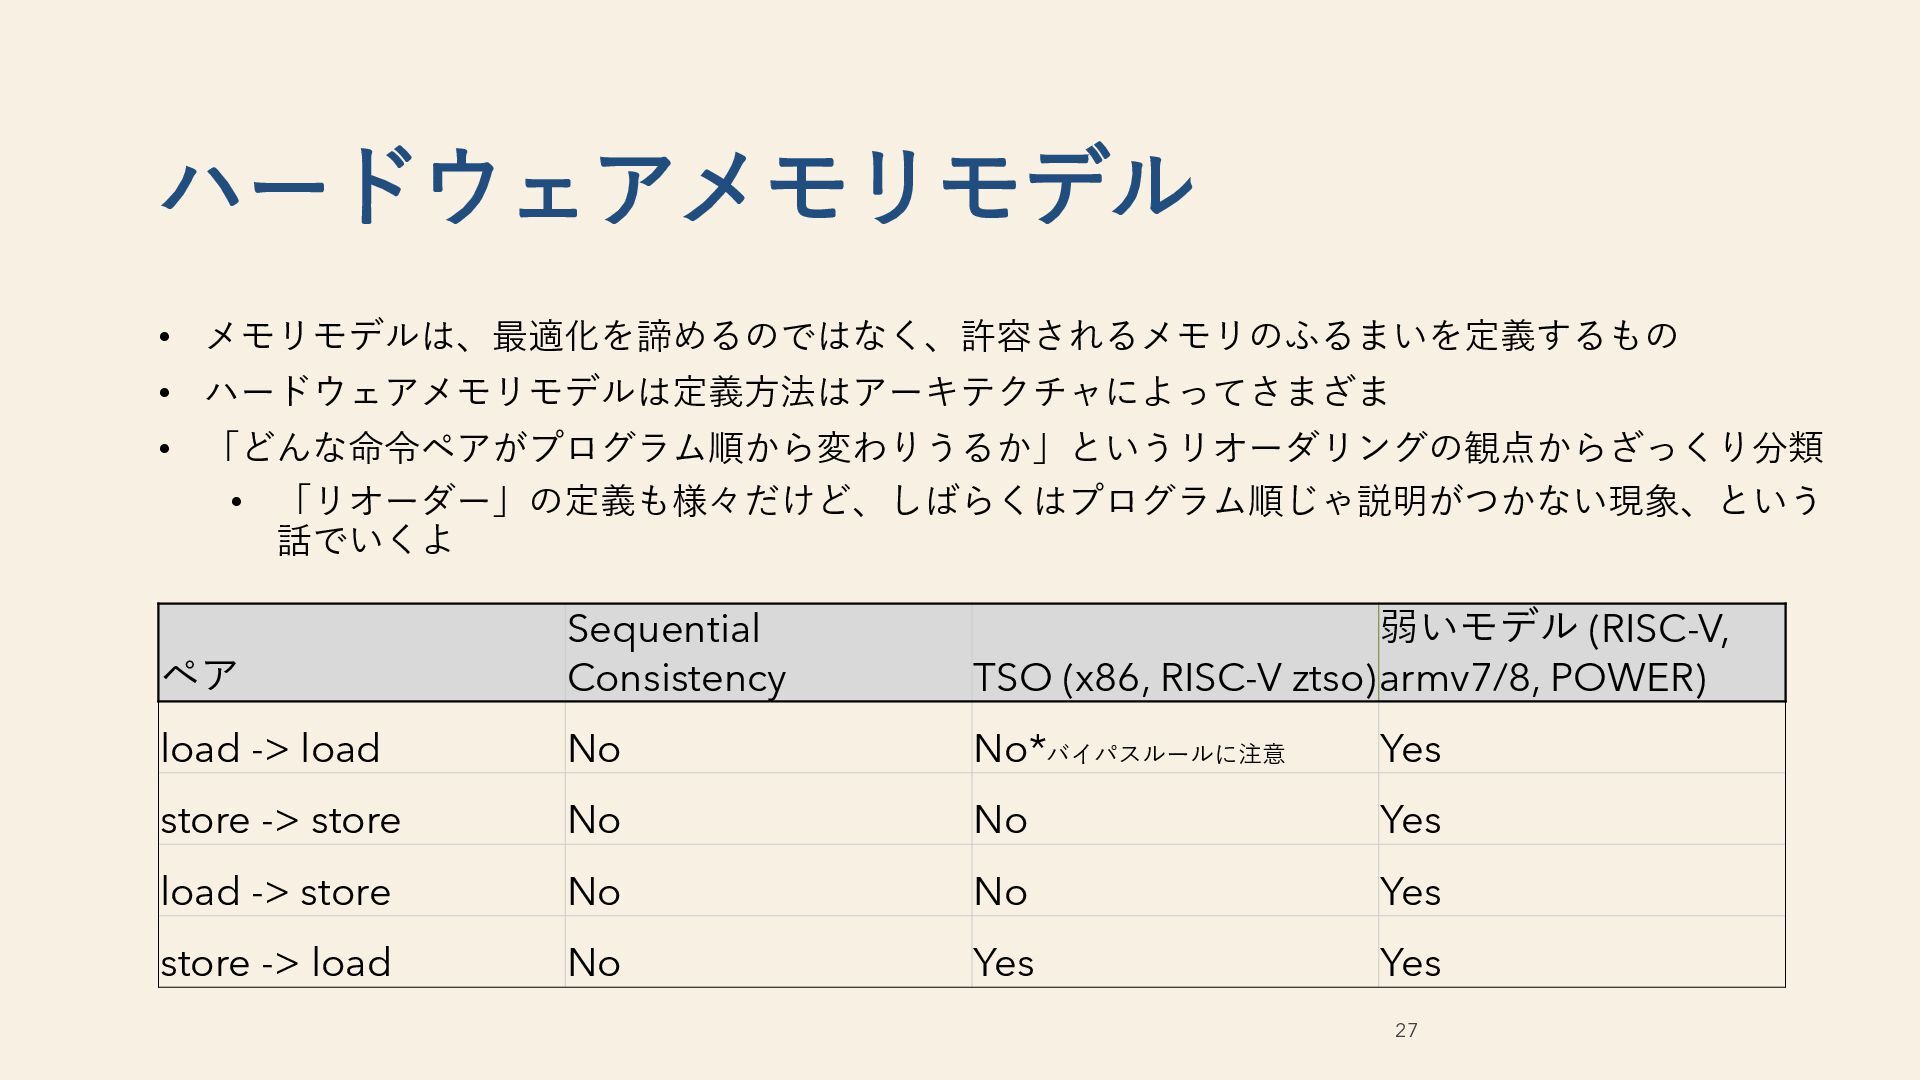
• メモリモデルは、最適化を諦めるのではなく、許容されるメモリのふるまいを定義するもの • ハードウェアメモリモデルは定義方法はアーキテクチャによってさまざま • 「どんな命令ペアがプログラム順から変わりうるか」というリオーダリングの観点からざっくり分類 • 「リオーダー」の定義も様々だけど、しばらくはプログラム順じゃ説明がつかない現象、という 話でいくよ 27
ハードウェアメモリモデル ペア Sequential Consistency TSO (x86, RISC-V ztso) 弱いモデル (RISC-V, armv7/8, POWER) load -> load No No*バイパスルールに注意 Yes store -> store No No Yes load -> store No No Yes store -> load No Yes Yes -
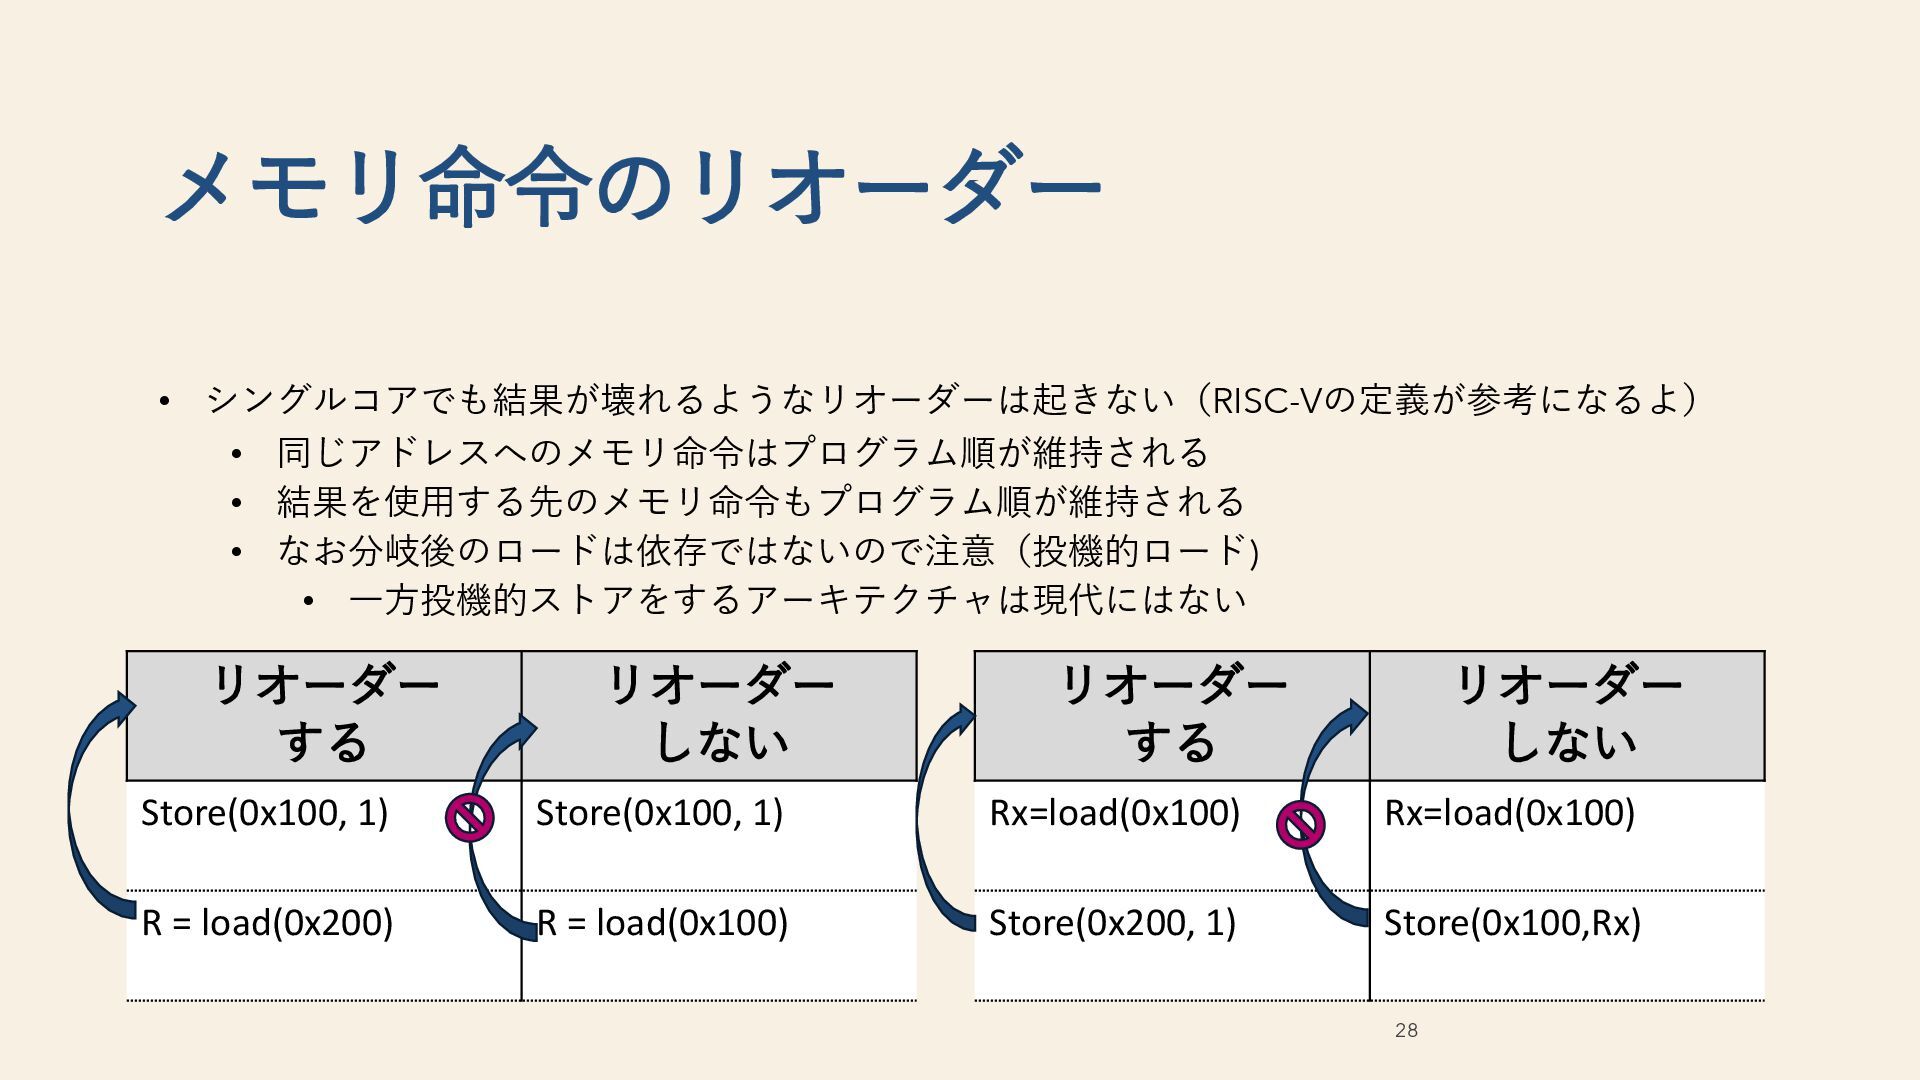
• シングルコアでも結果が壊れるようなリオーダーは起きない(RISC-Vの定義が参考になるよ) • 同じアドレスへのメモリ命令はプログラム順が維持される • 結果を使用する先のメモリ命令もプログラム順が維持される • なお分岐後のロードは依存ではないので注意(投機的ロード) • 一方投機的ストアをするアーキテクチャは現代にはない
28 メモリ命令のリオーダー リオーダー する リオーダー しない Store(0x100, 1) Store(0x100, 1) R = load(0x200) R = load(0x100) リオーダー する リオーダー しない Rx=load(0x100) Rx=load(0x100) Store(0x200, 1) Store(0x100,Rx) -
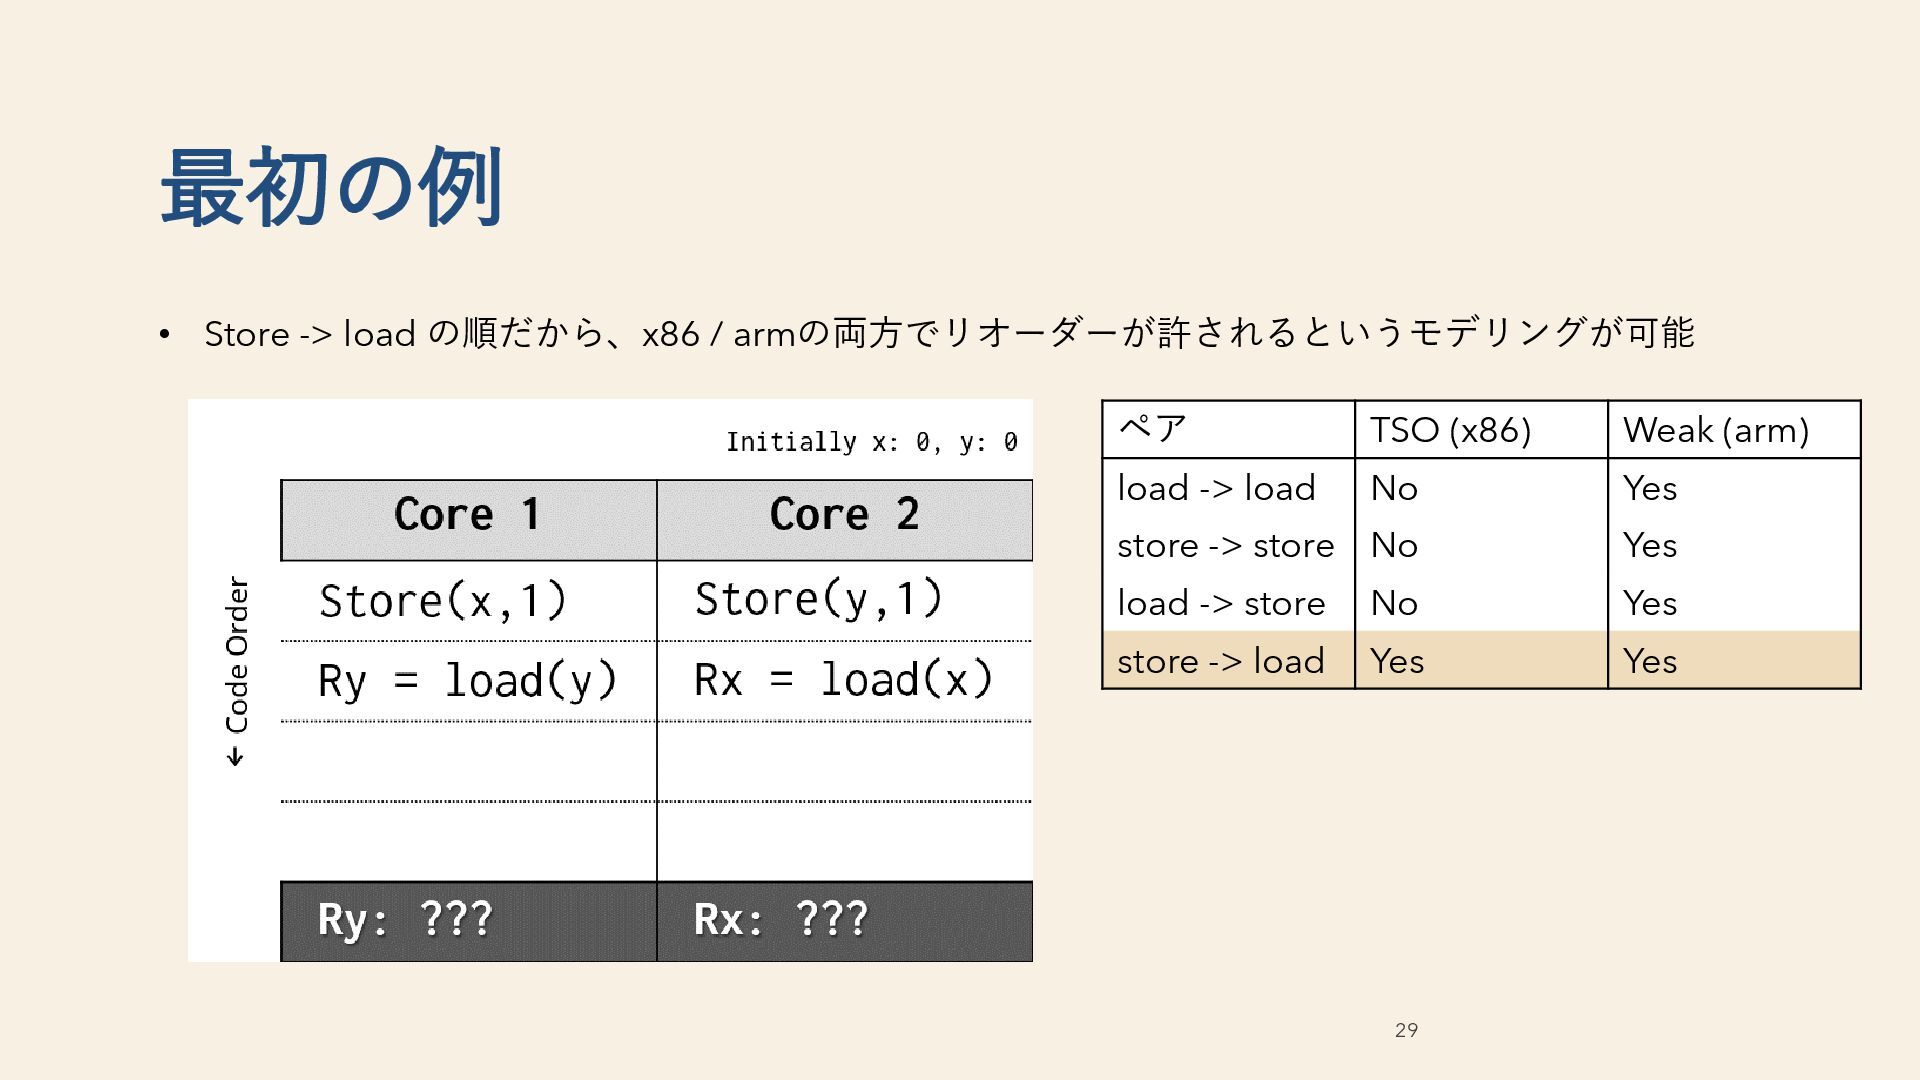
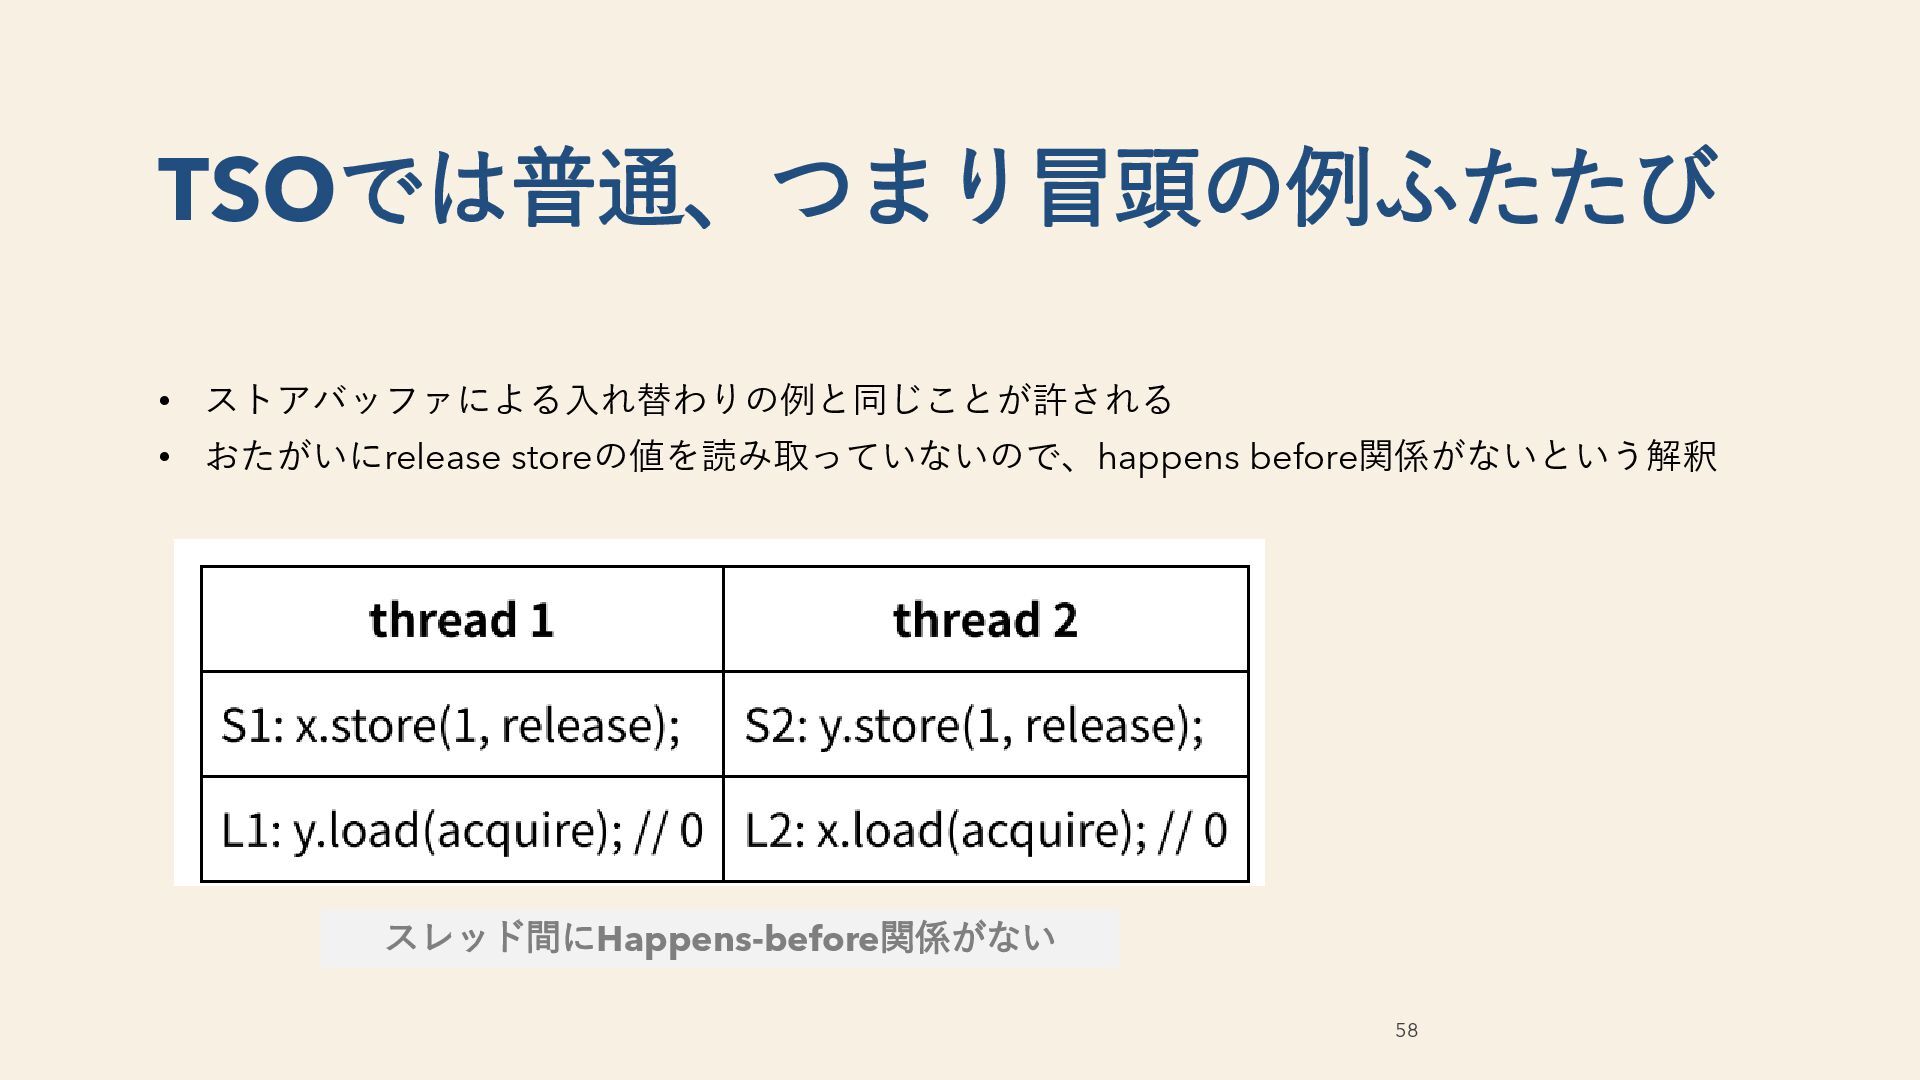
29 最初の例 • Store -> load の順だから、x86 / armの両方でリオーダーが許されるというモデリングが可能 ペア
TSO (x86) Weak (arm) load -> load No Yes store -> store No Yes load -> store No Yes store -> load Yes Yes -
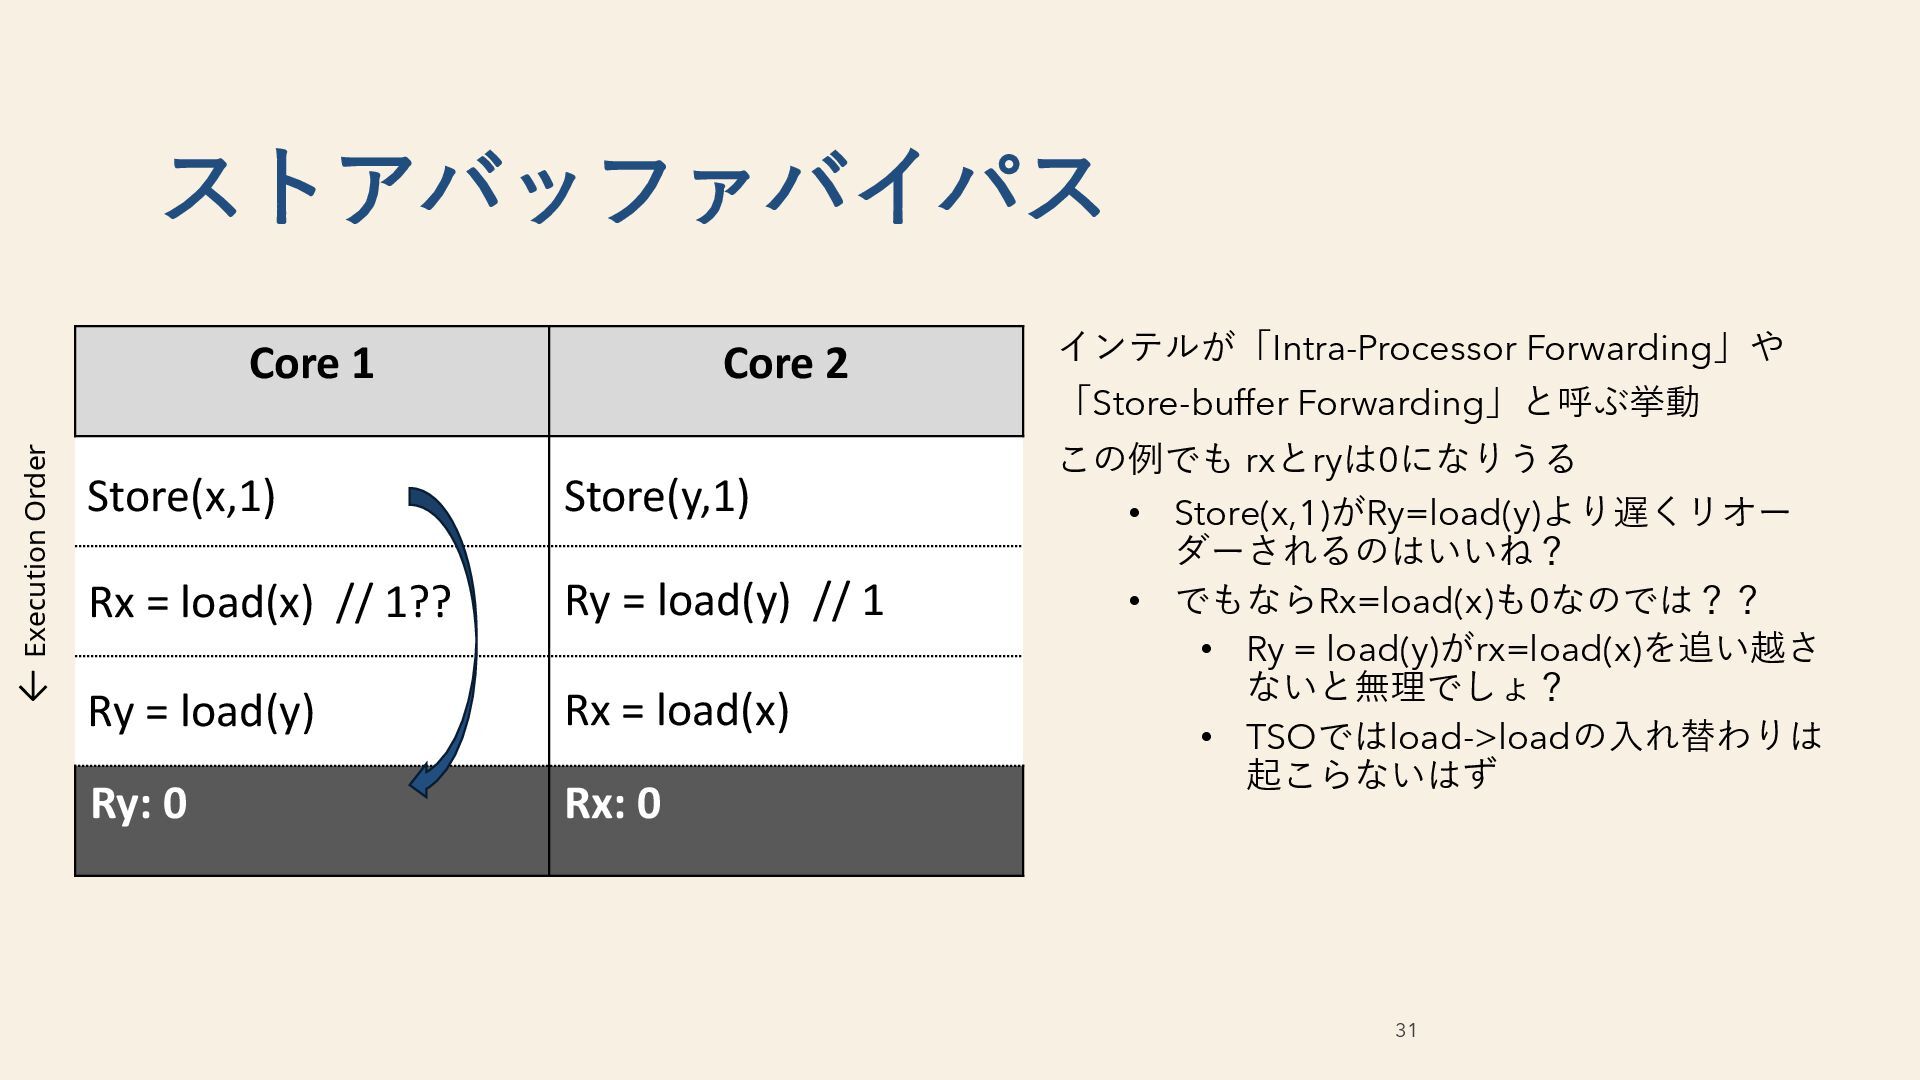
インテルが「Intra-Processor Forwarding」や 「Store-buffer Forwarding」と呼ぶ挙動 この例でも rxとryは0になりうる • Store(x,1)がRy=load(y)より遅くリオー ダーされるのはいいね? •
でもならRx=load(x)も0なのでは?? • Ry = load(y)がrx=load(x)を追い越さ ないと無理でしょ? • TSOではload->loadの入れ替わりは 起こらないはず 31 ストアバッファバイパス Core 1 Core 2 Ry: 0 Rx: 0 Store(x,1) Rx = load(x) Store(y,1) ← Execution Order Ry = load(y) Ry = load(y) // 1 Rx = load(x) // 1?? -
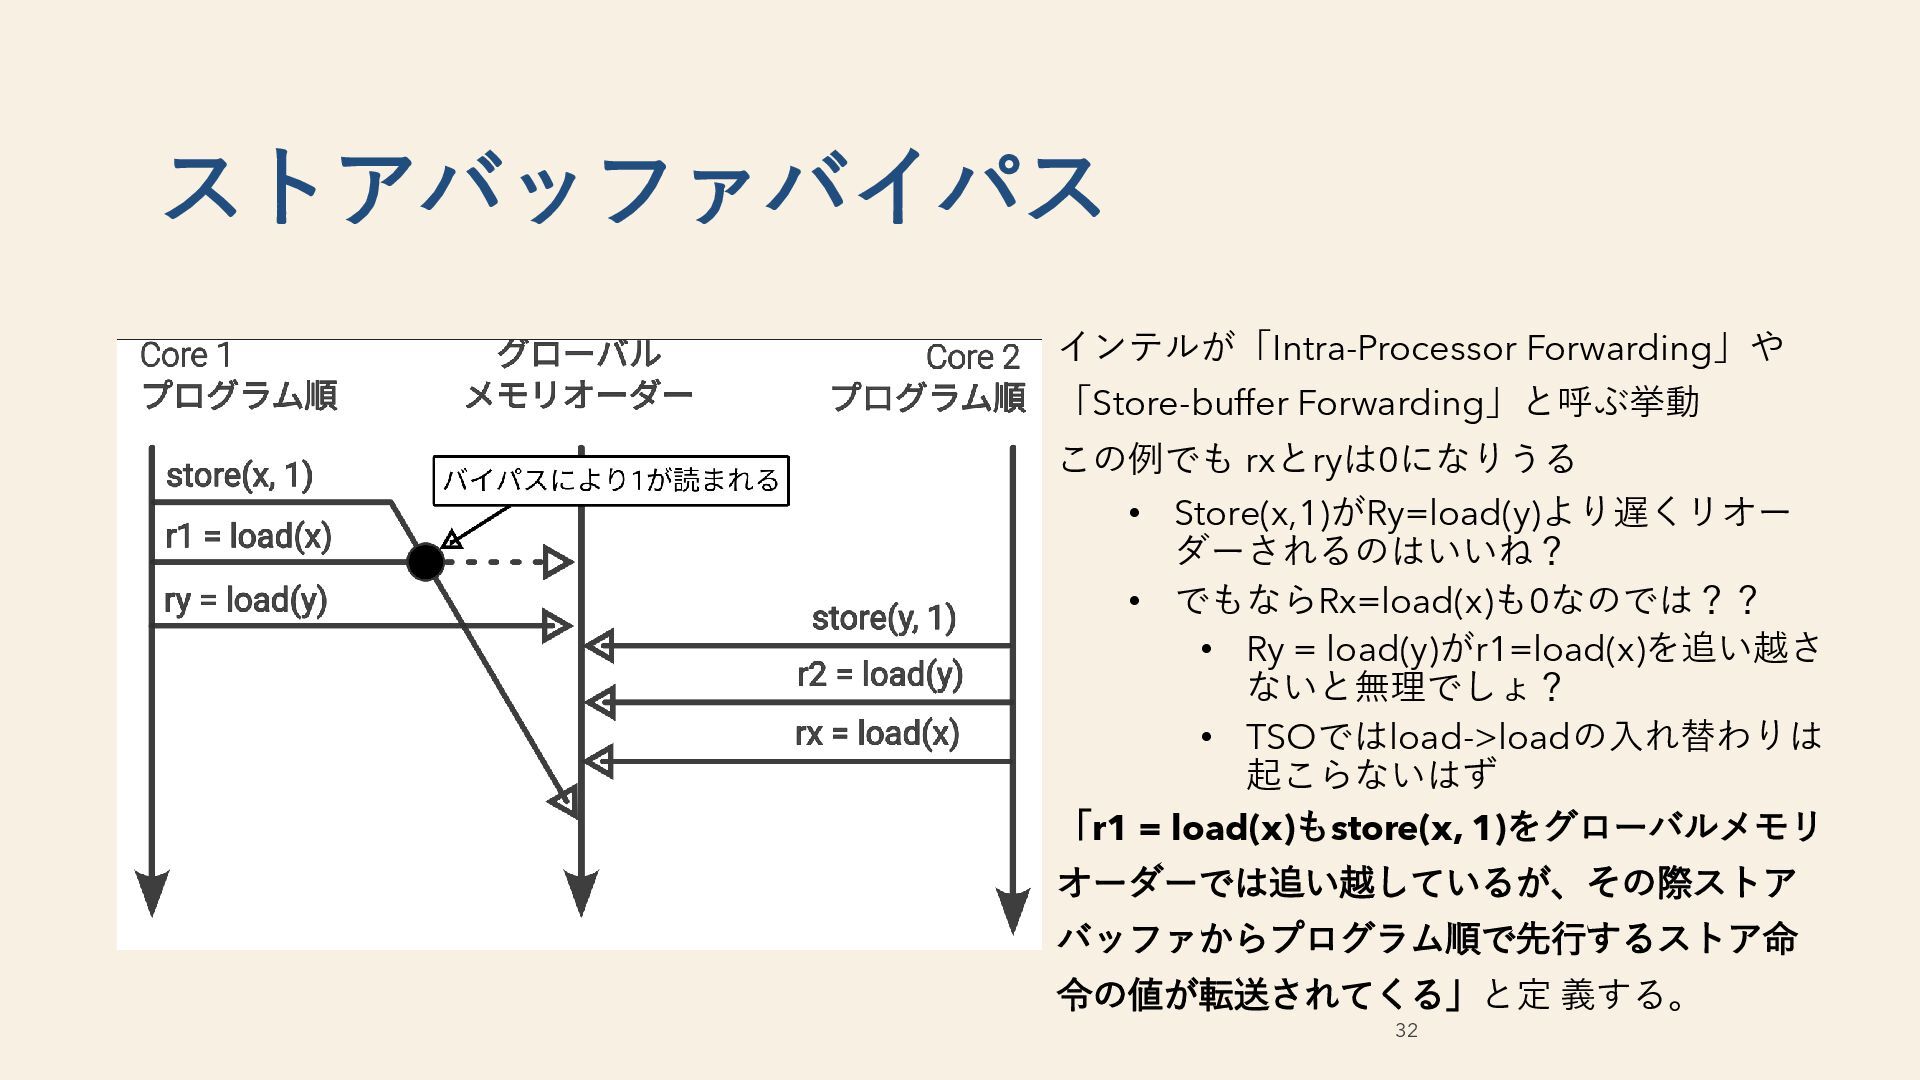
インテルが「Intra-Processor Forwarding」や 「Store-buffer Forwarding」と呼ぶ挙動 この例でも rxとryは0になりうる • Store(x,1)がRy=load(y)より遅くリオー ダーされるのはいいね? •
でもならRx=load(x)も0なのでは?? • Ry = load(y)がr1=load(x)を追い越さ ないと無理でしょ? • TSOではload->loadの入れ替わりは 起こらないはず 「r1 = load(x)もstore(x, 1)をグローバルメモリ オーダーでは追い越しているが、その際ストア バッファからプログラム順で先行するストア命 令の値が転送されてくる」と定 義する。 32 ストアバッファバイパス -
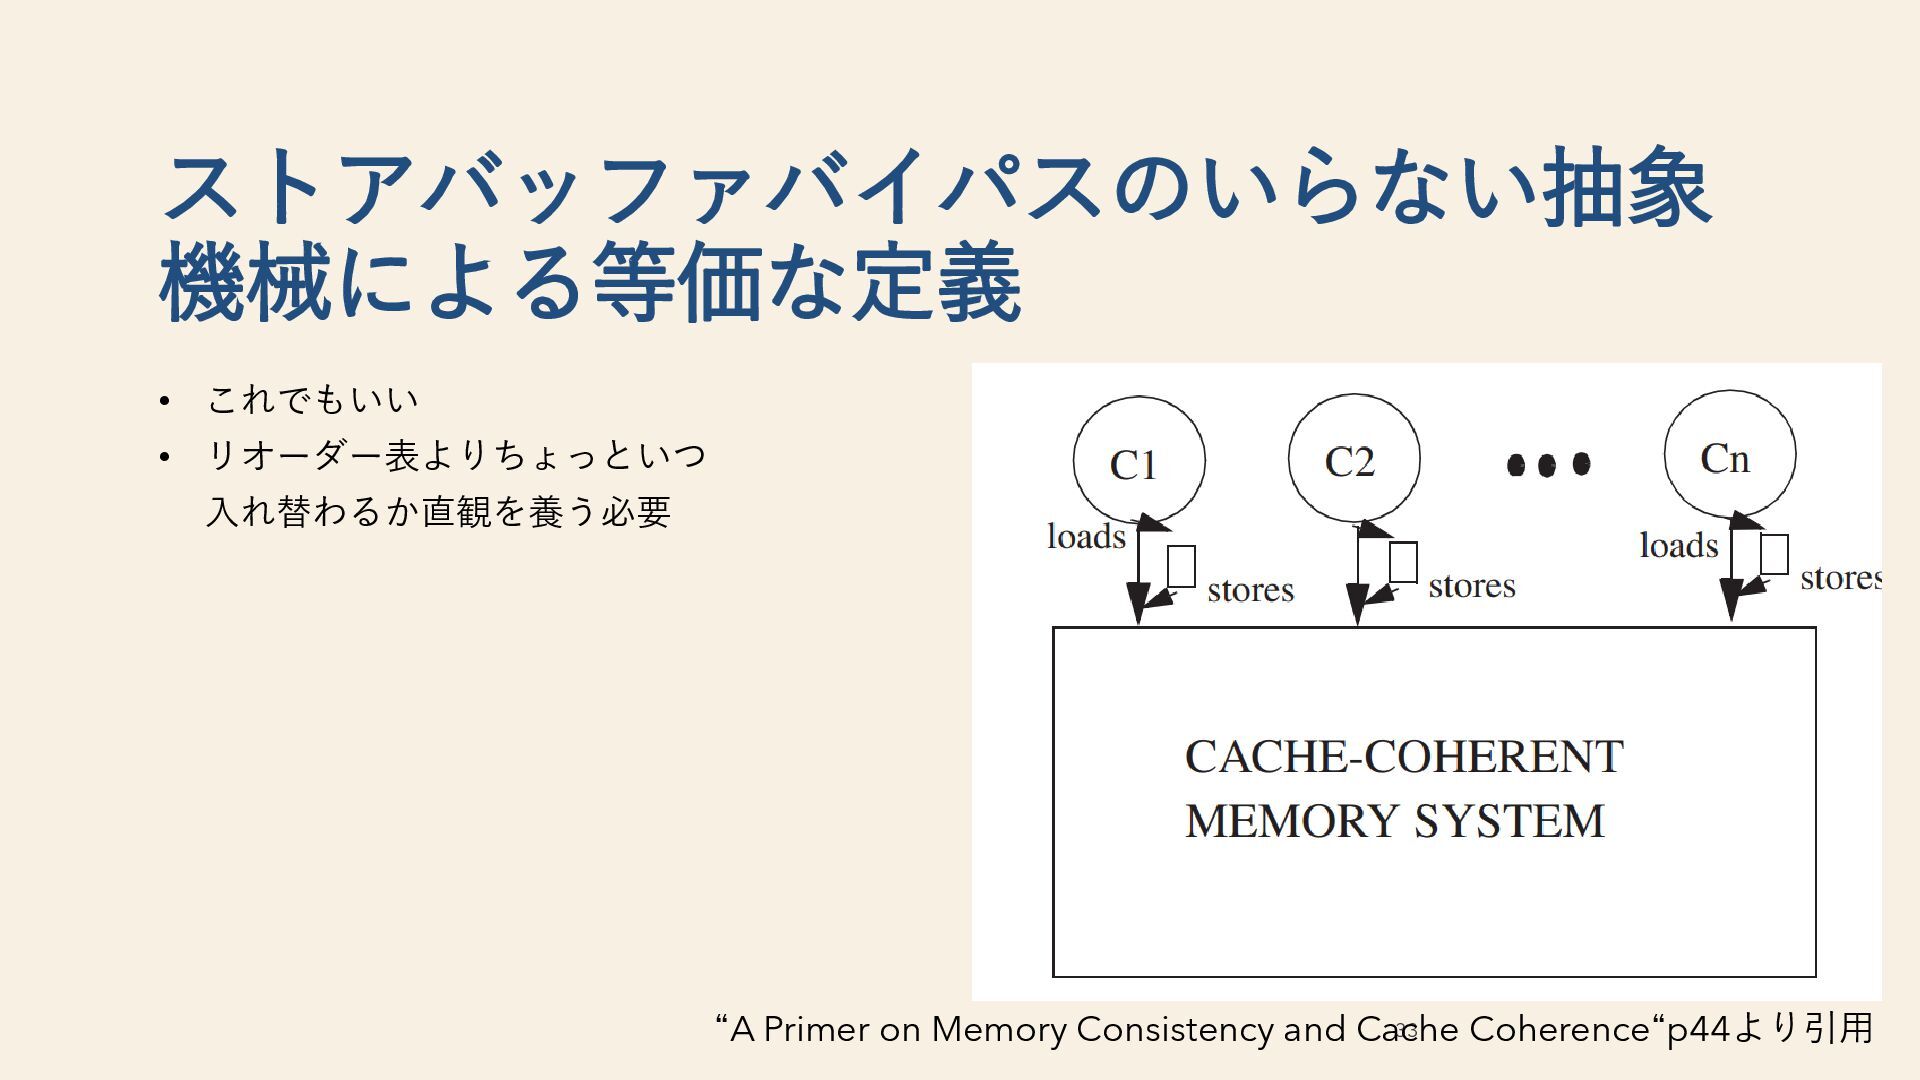
• これでもいい • リオーダー表よりちょっといつ 入れ替わるか直観を養う必要 33 ストアバッファバイパスのいらない抽象 機械による等価な定義 “A Primer
on Memory Consistency and Cache Coherence“p44より引用 -
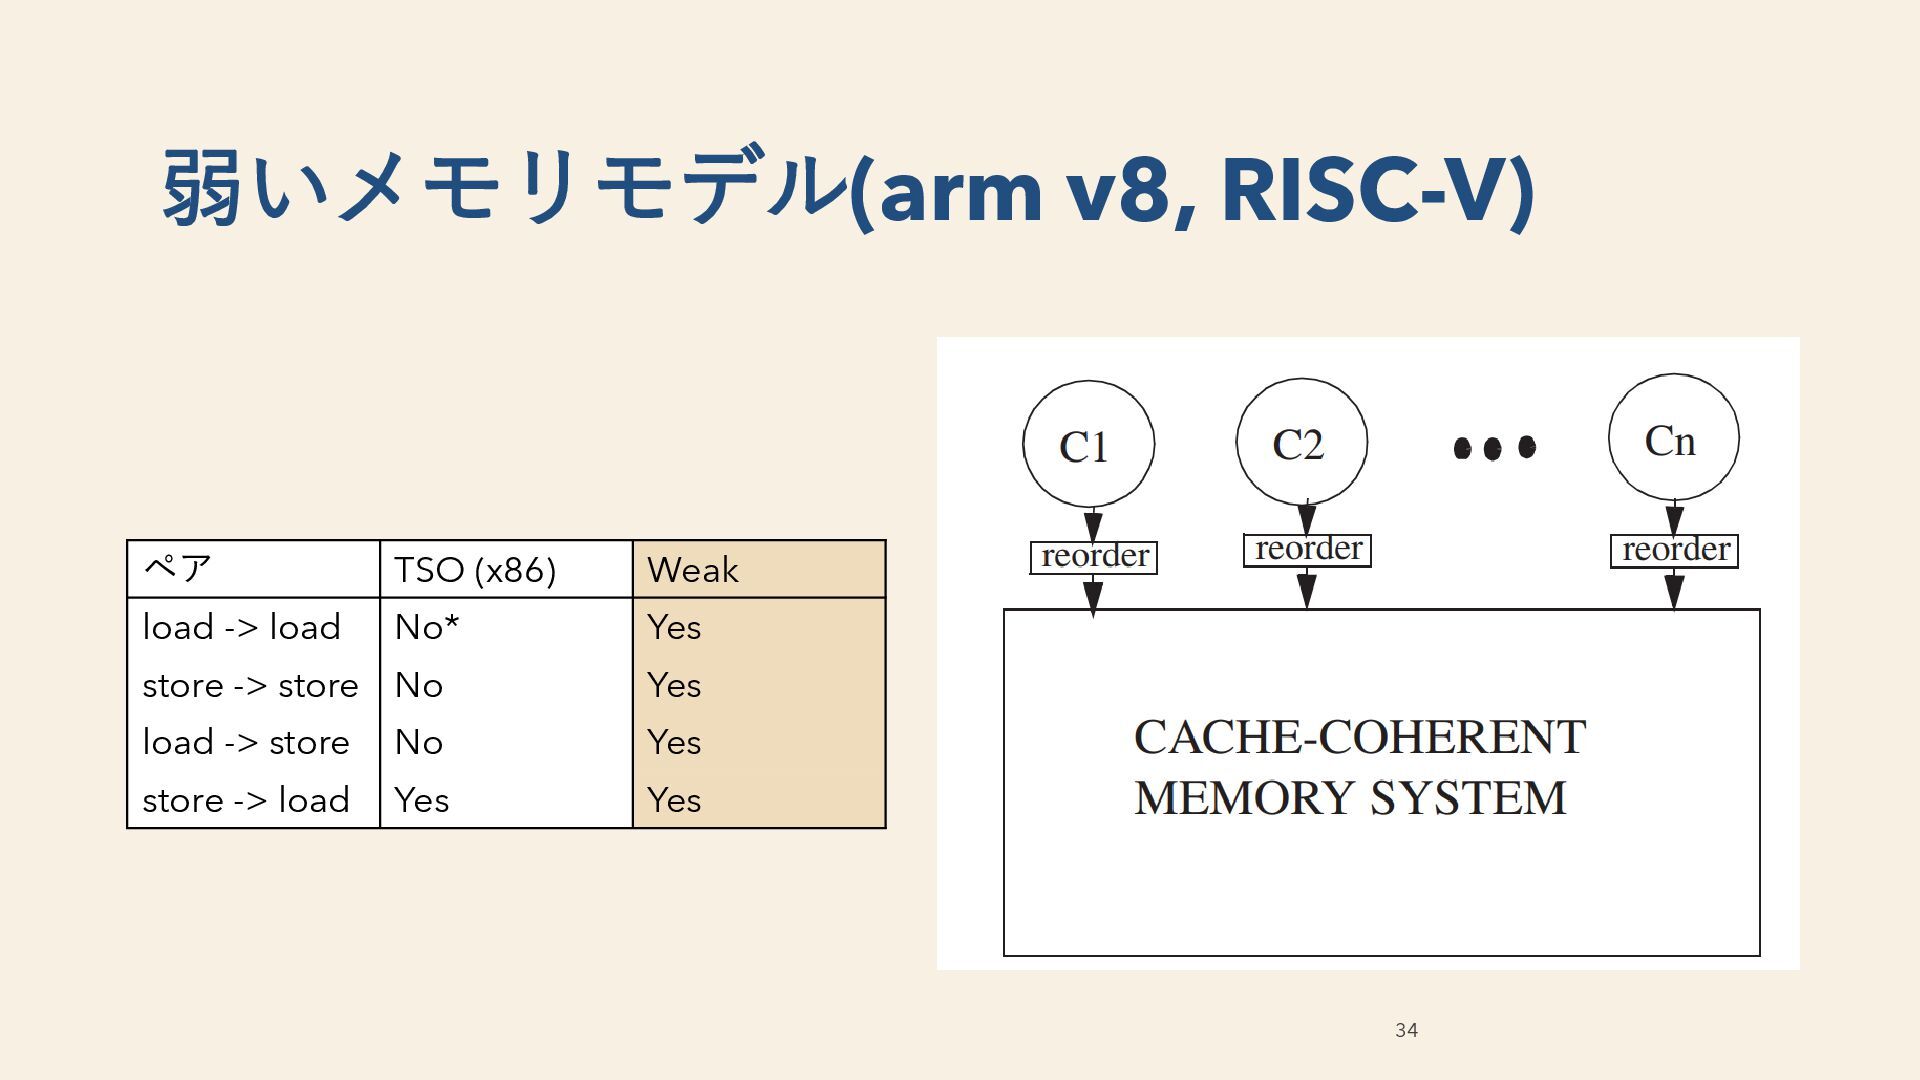
34 弱いメモリモデル(arm v8, RISC-V) ペア TSO (x86) Weak load ->
load No* Yes store -> store No Yes load -> store No Yes store -> load Yes Yes -
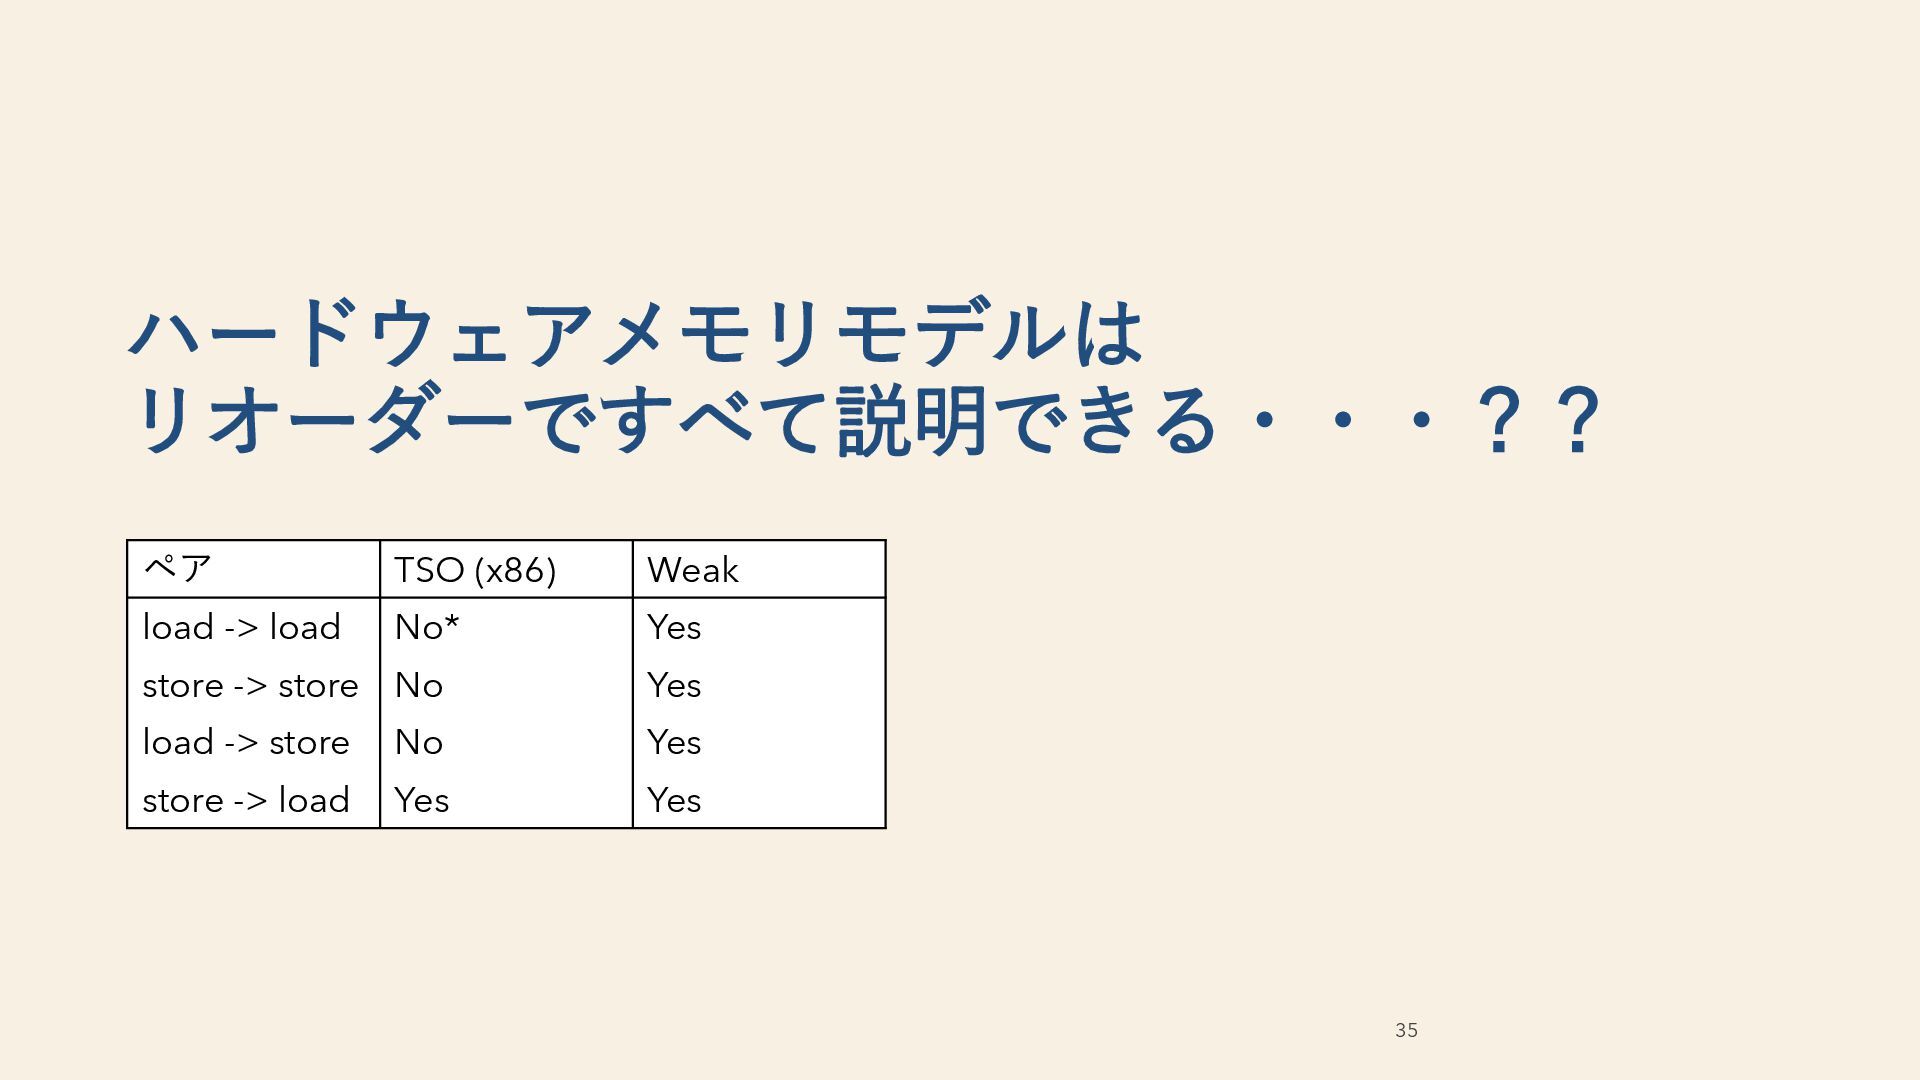
35 ハードウェアメモリモデルは リオーダーですべて説明できる・・・?? ペア TSO (x86) Weak load -> load
No* Yes store -> store No Yes load -> store No Yes store -> load Yes Yes -
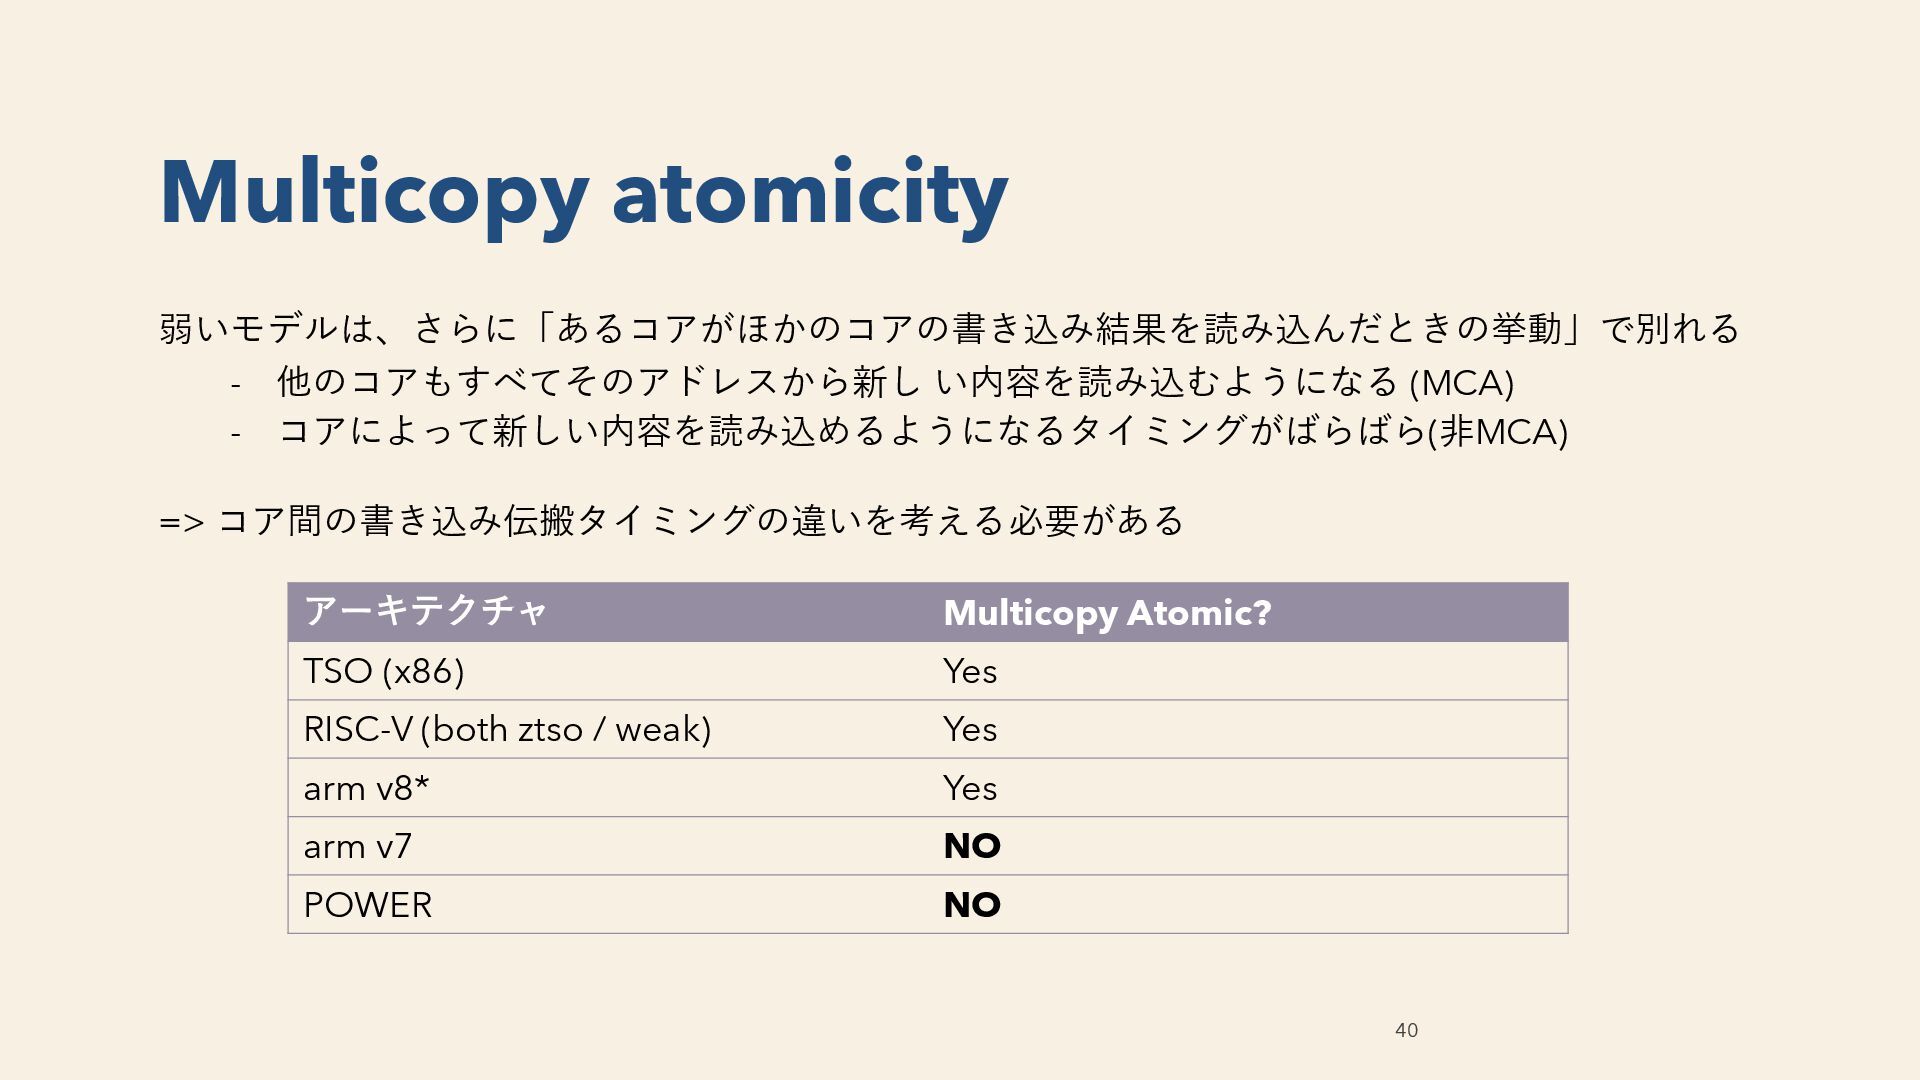
弱いモデルは、さらに「あるコアがほかのコアの書き込み結果を読み込んだときの挙動」で別れる - 他のコアもすべてそのアドレスから新し い内容を読み込むようになる (MCA) - コアによって新しい内容を読み込めるようになるタイミングがばらばら(非MCA) => コア間の書き込み伝搬タイミングの違いを考える必要がある 40
Multicopy atomicity アーキテクチャ Multicopy Atomic? TSO (x86) Yes RISC-V (both ztso / weak) Yes arm v8* Yes arm v7 NO POWER NO -
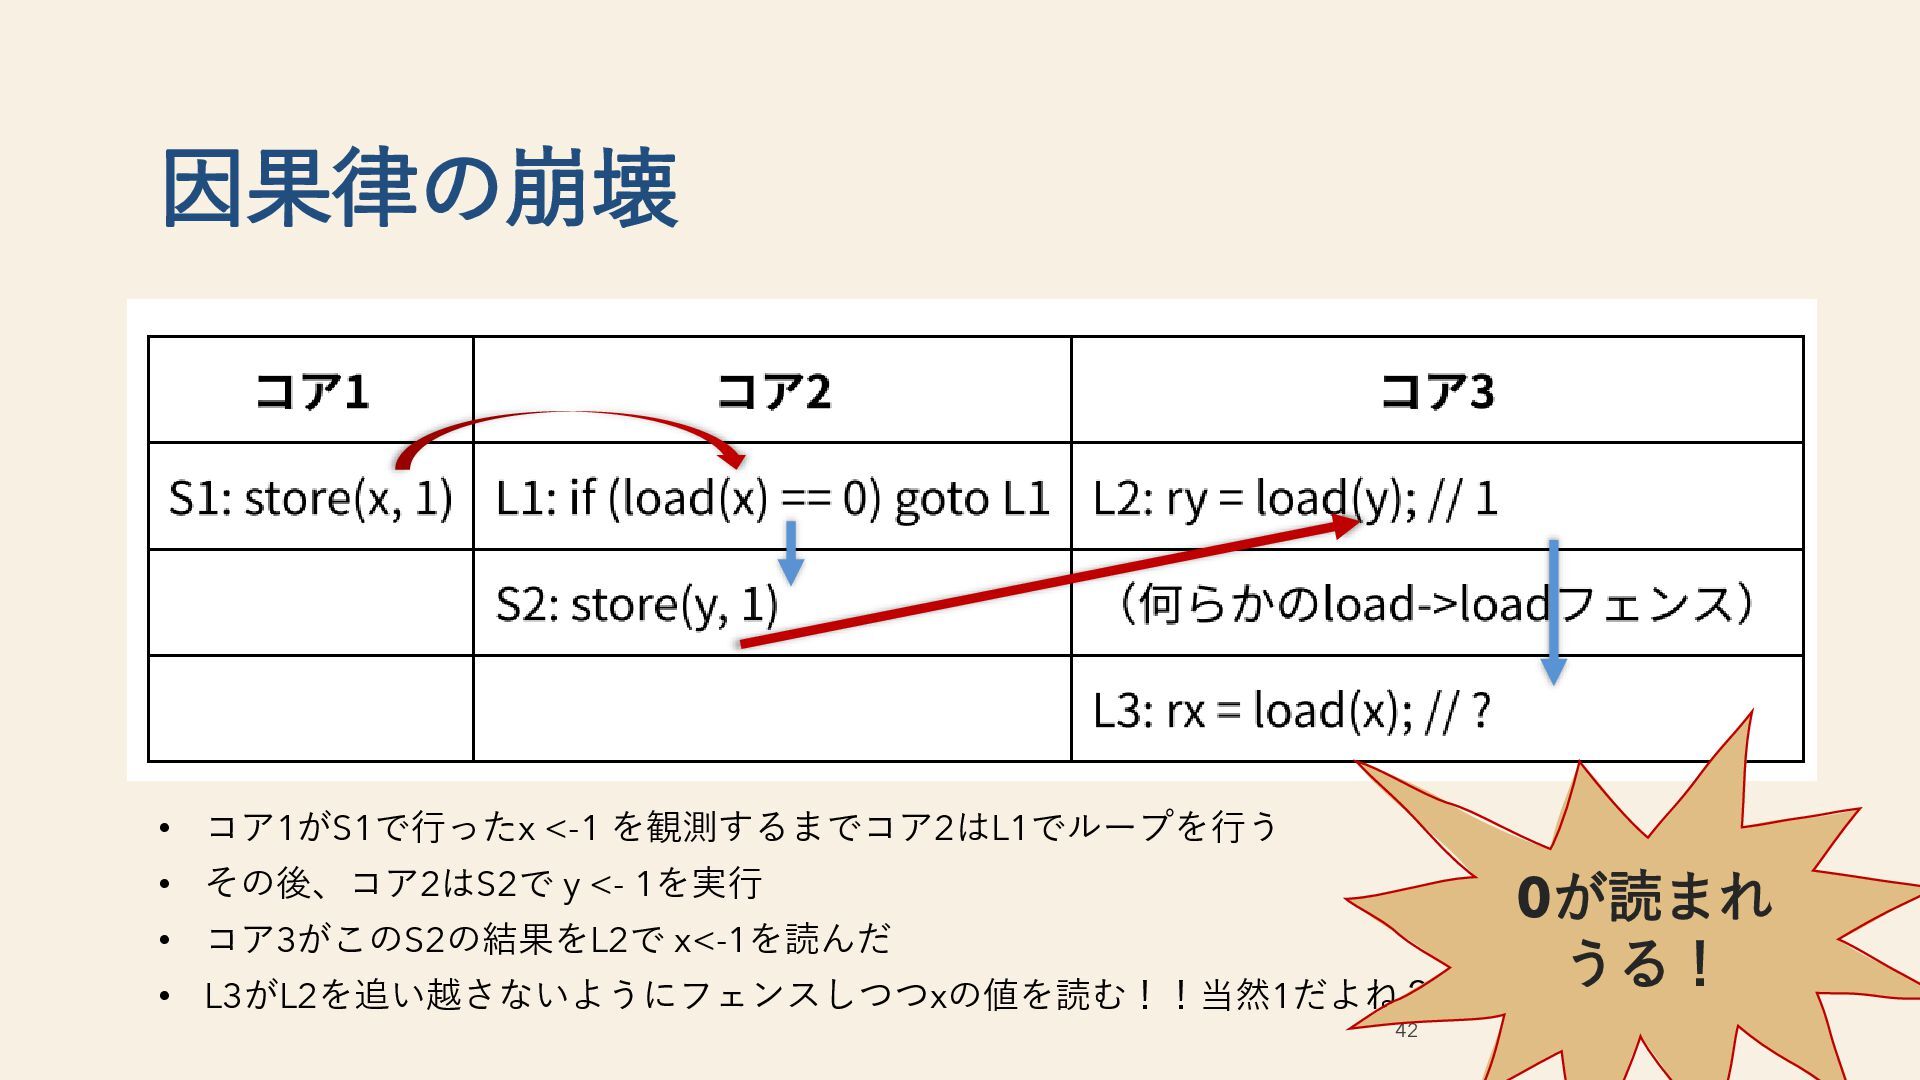
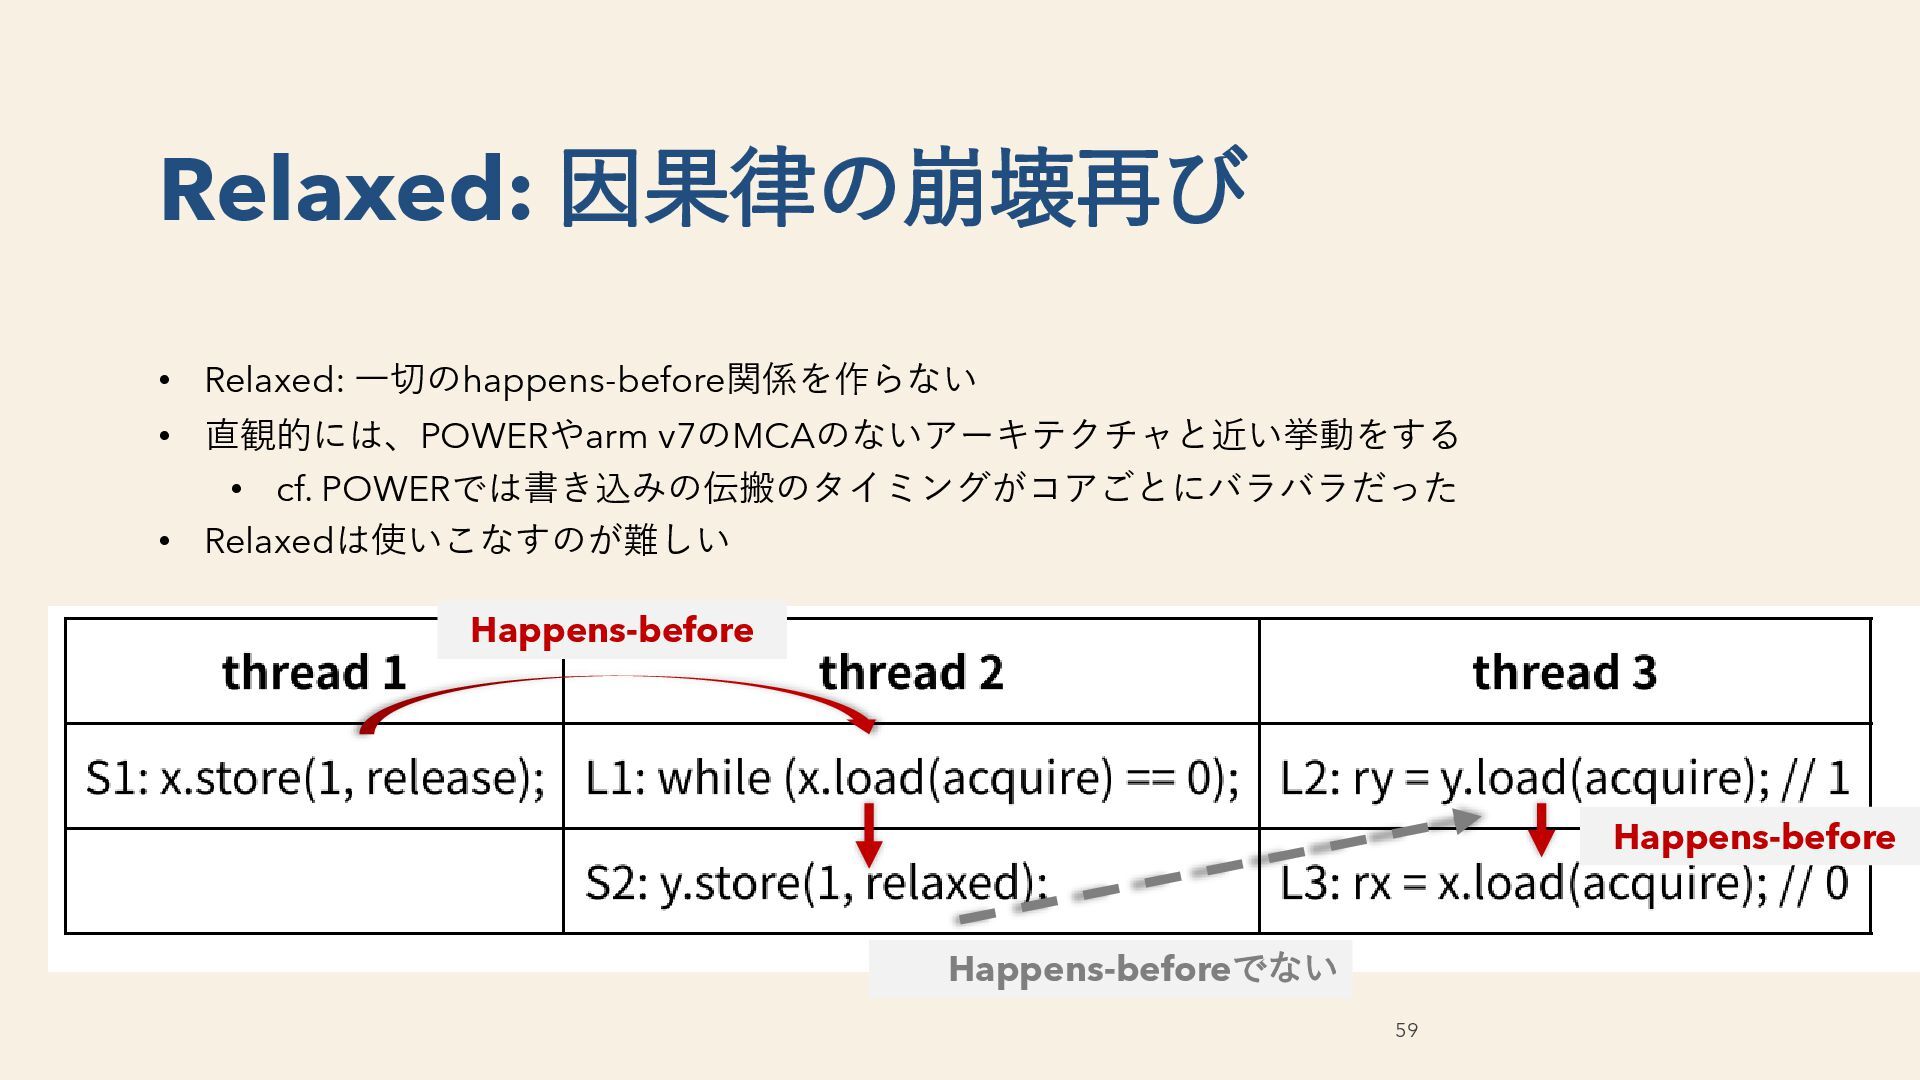
• コア1がS1で行ったx <-1 を観測するまでコア2はL1でループを行う • その後、コア2はS2で y <- 1を実行 •
コア3がこのS2の結果をL2で x<-1を読んだ • L3がL2を追い越さないようにフェンスしつつxの値を読む!!当然1だよね? 42 因果律の崩壊 0が読まれ うる! -
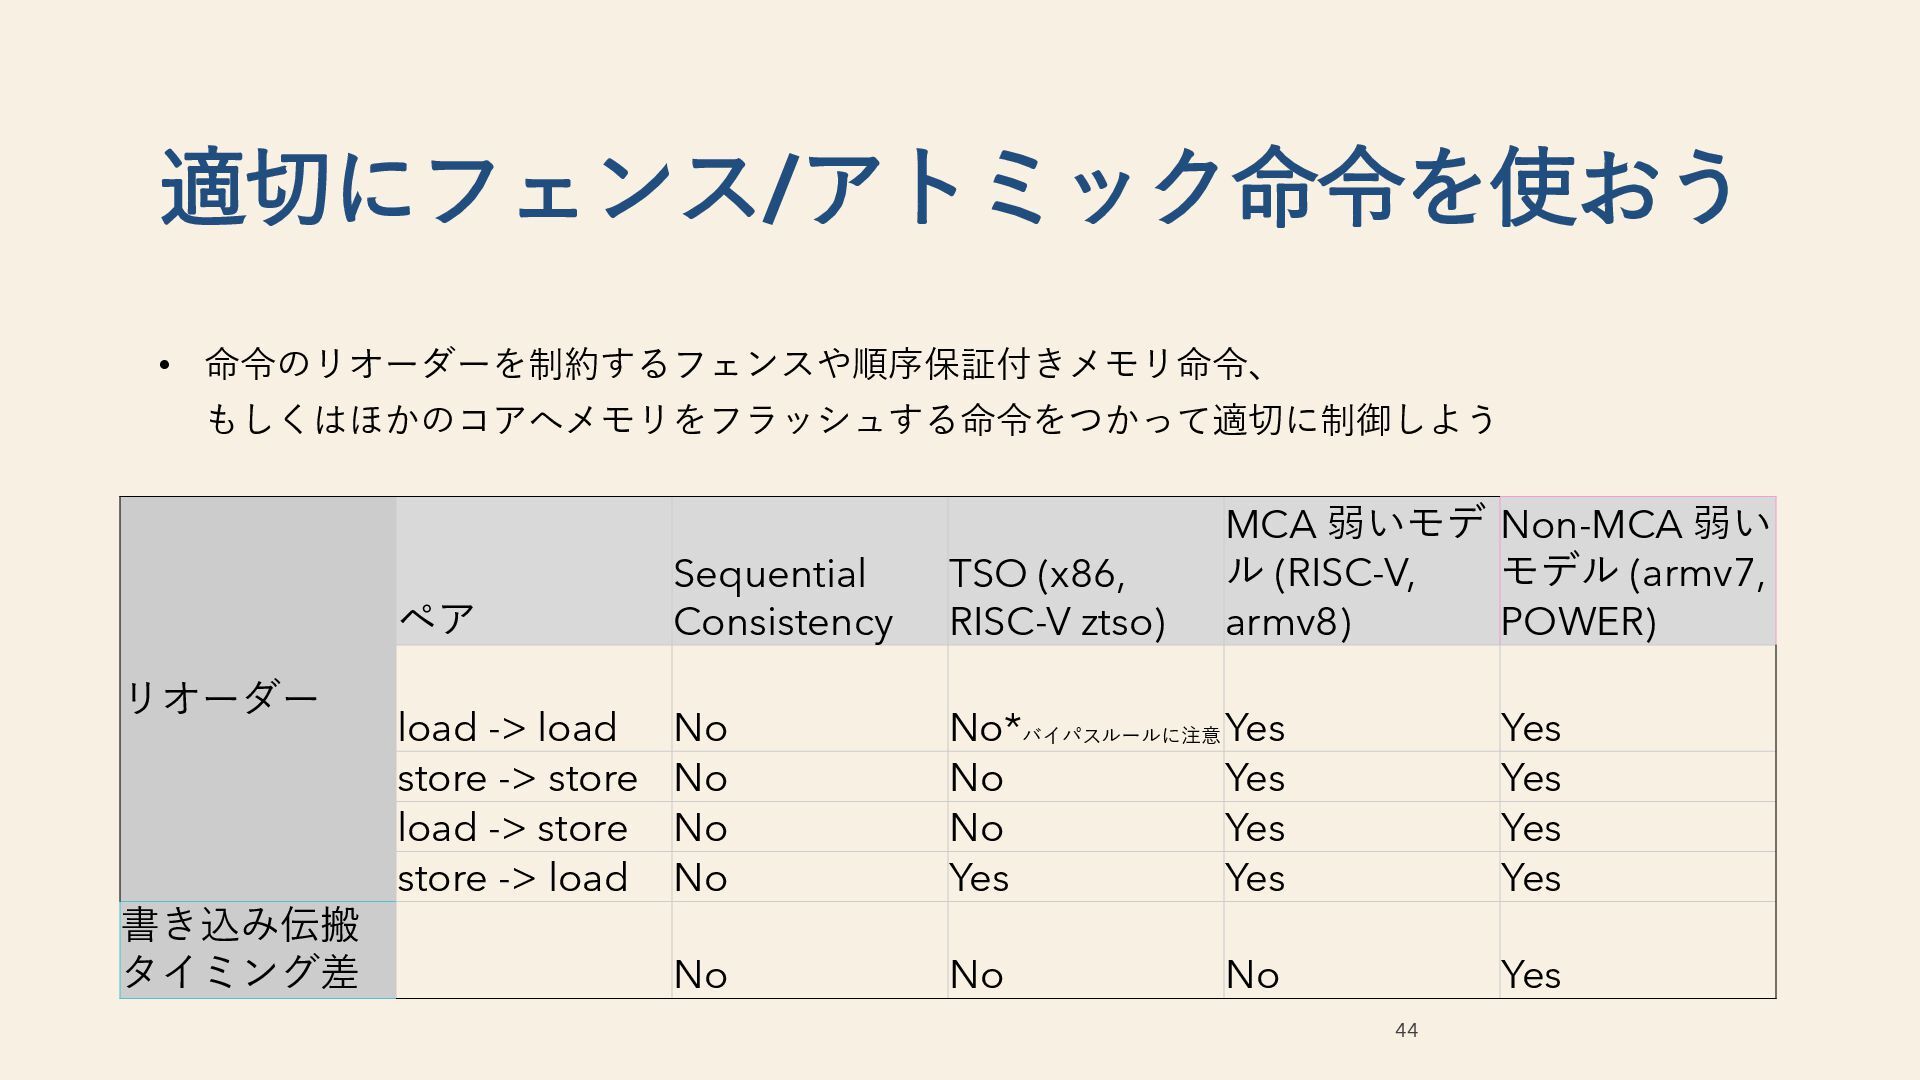
• 命令のリオーダーを制約するフェンスや順序保証付きメモリ命令、 もしくはほかのコアへメモリをフラッシュする命令をつかって適切に制御しよう 44 適切にフェンス/アトミック命令を使おう リオーダー ペア Sequential Consistency TSO
(x86, RISC-V ztso) MCA 弱いモデ ル (RISC-V, armv8) Non-MCA 弱い モデル (armv7, POWER) load -> load No No*バイパスルールに注意 Yes Yes store -> store No No Yes Yes load -> store No No Yes Yes store -> load No Yes Yes Yes 書き込み伝搬 タイミング差 No No No Yes -
ハードウェアメモリモデルと比べ、ふたつコンセプトの追加がある 1. コンパイル時リオーダリング • コンパイラも自由に命令を並べ替えてコンパイルすることがある • X86 (TSO)のCPUであろうと、もとのプログラムからはload->loadの入れ替えさえ起こる 2. Atomic性
• 例えばコンパイラは32bitメモリアクセスを1バイトx4回してもよい • Atomicアクセスを明示する必要がある 49 ソフトウェアメモリモデル -
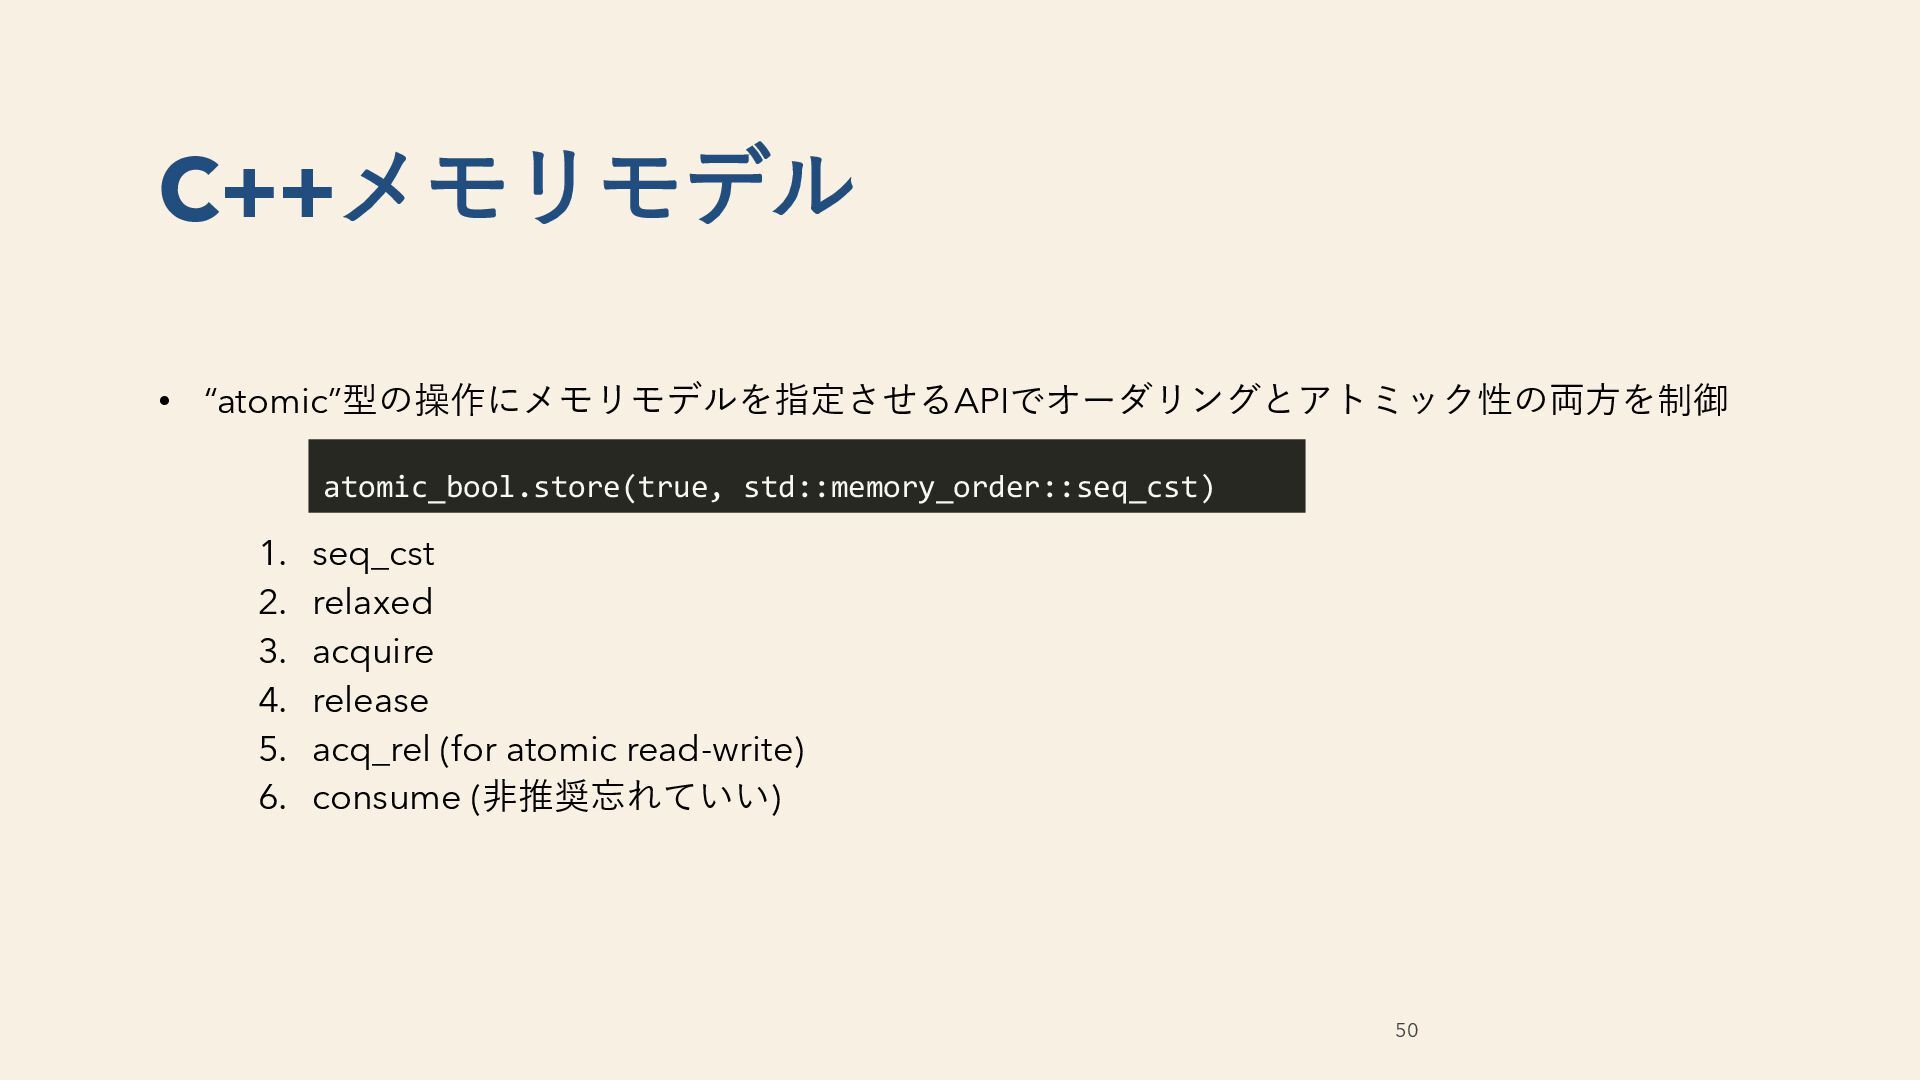
• “atomic”型の操作にメモリモデルを指定させるAPIでオーダリングとアトミック性の両方を制御 1. seq_cst 2. relaxed 3. acquire 4. release
5. acq_rel (for atomic read-write) 6. consume (非推奨忘れていい) 50 C++メモリモデル atomic_bool.store(true, std::memory_order::seq_cst) -
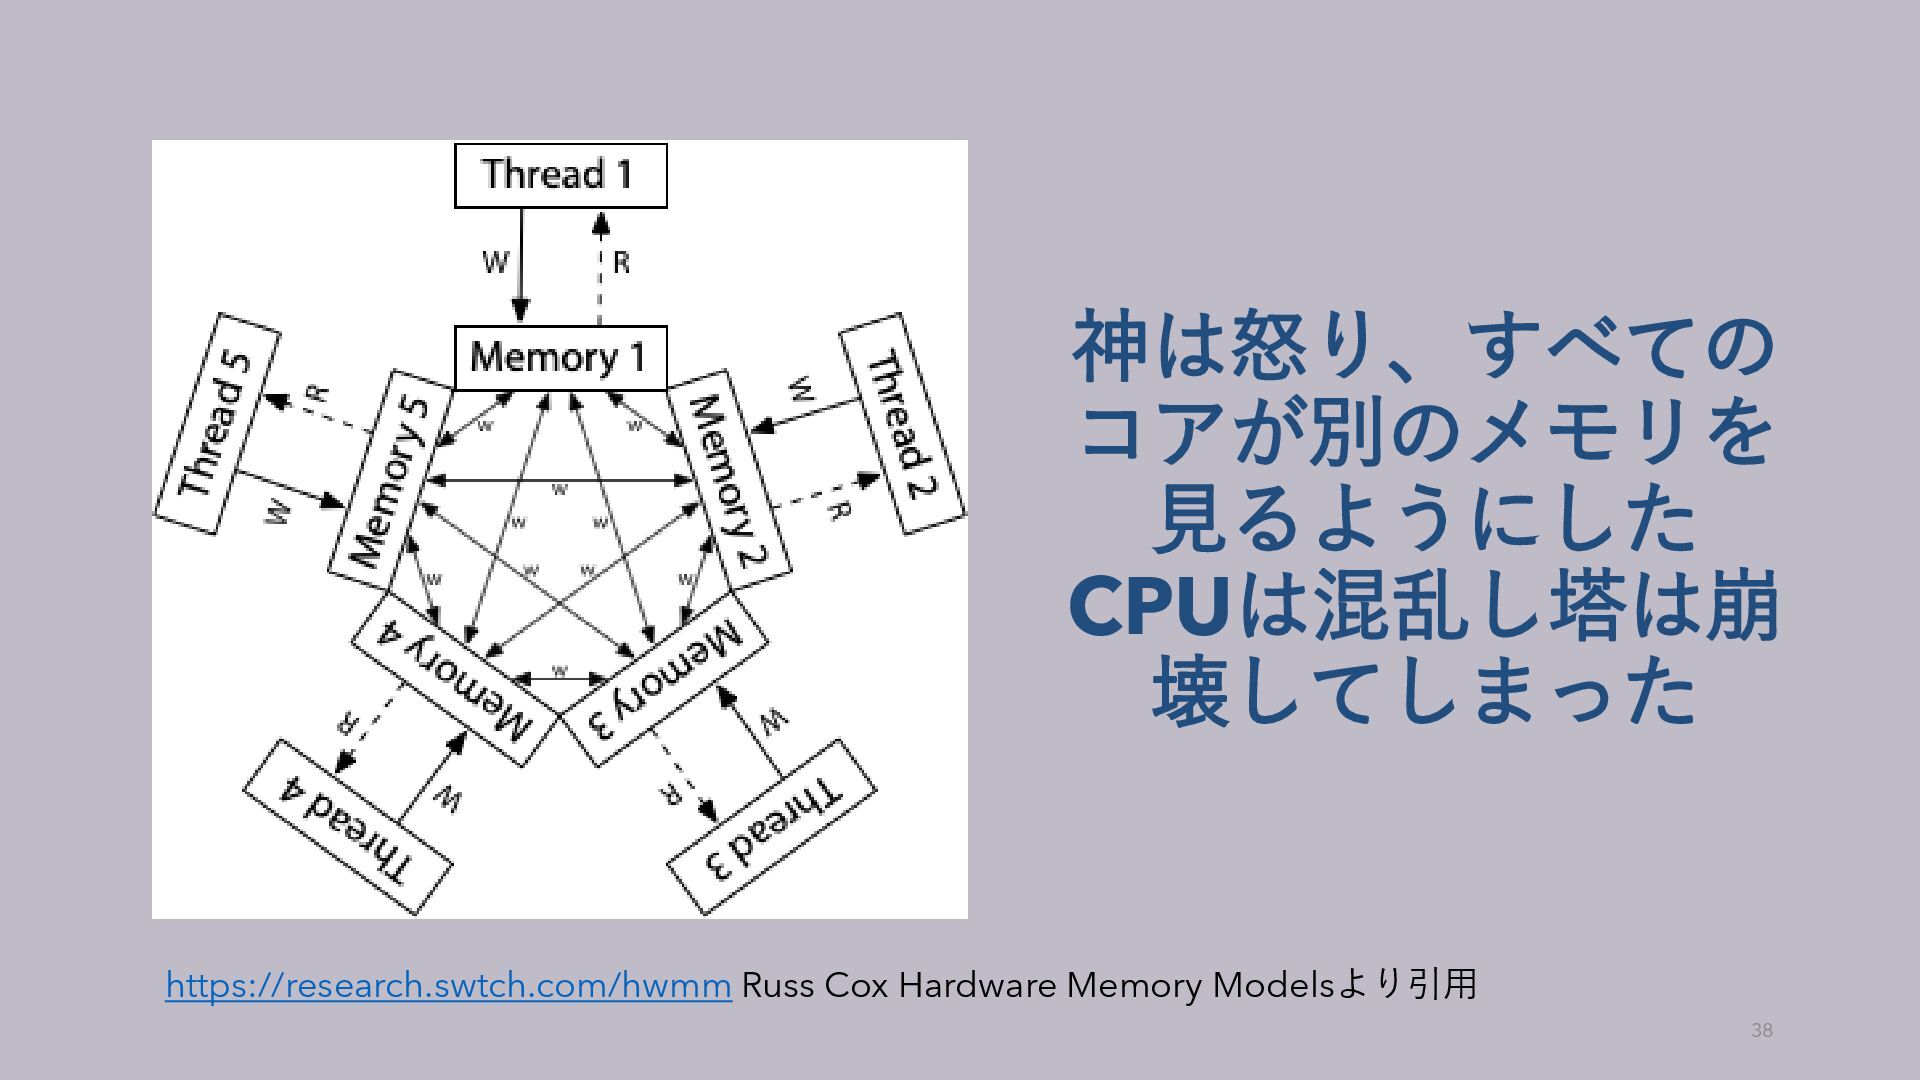
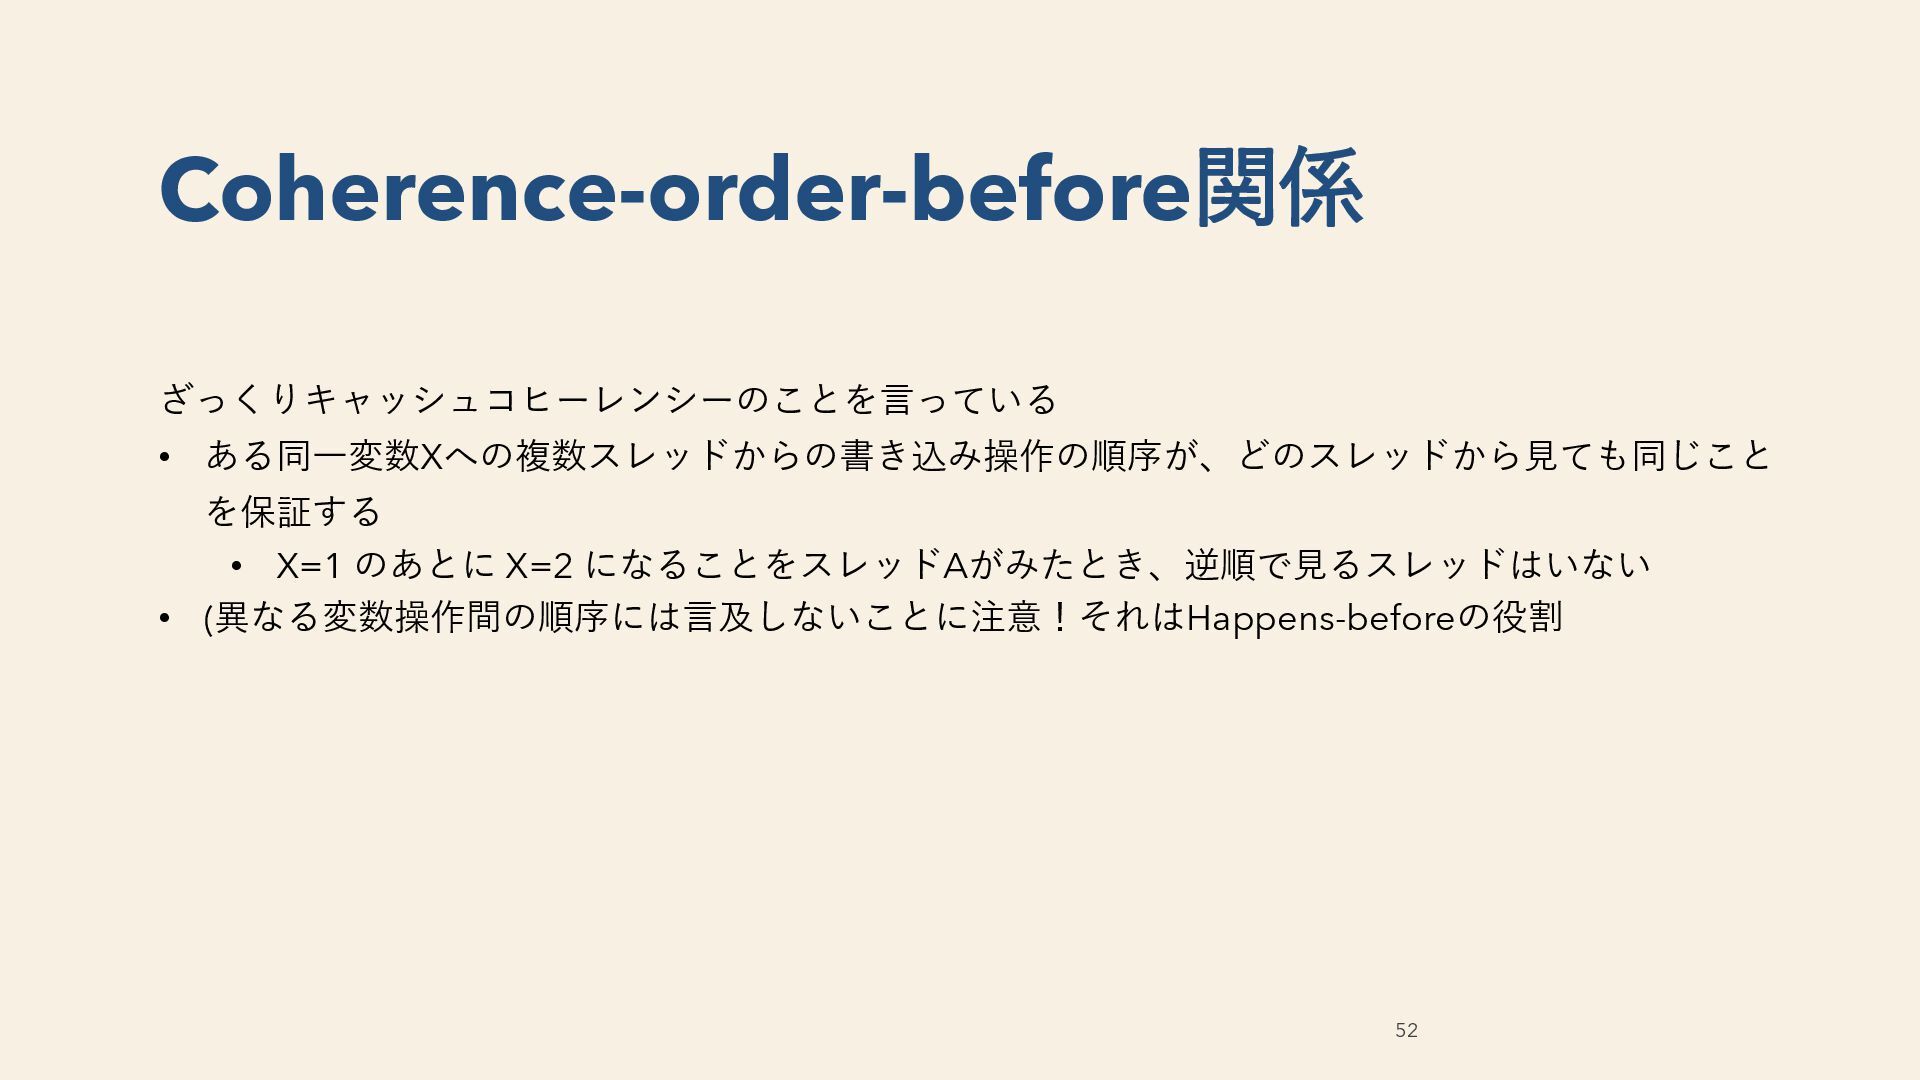
ざっくりキャッシュコヒーレンシーのことを言っている • ある同一変数Xへの複数スレッドからの書き込み操作の順序が、どのスレッドから見ても同じこと を保証する • X=1 のあとに X=2 になることをスレッドAがみたとき、逆順で見るスレッドはいない •
(異なる変数操作間の順序には言及しないことに注意!それはHappens-beforeの役割 52 Coherence-order-before関係 -
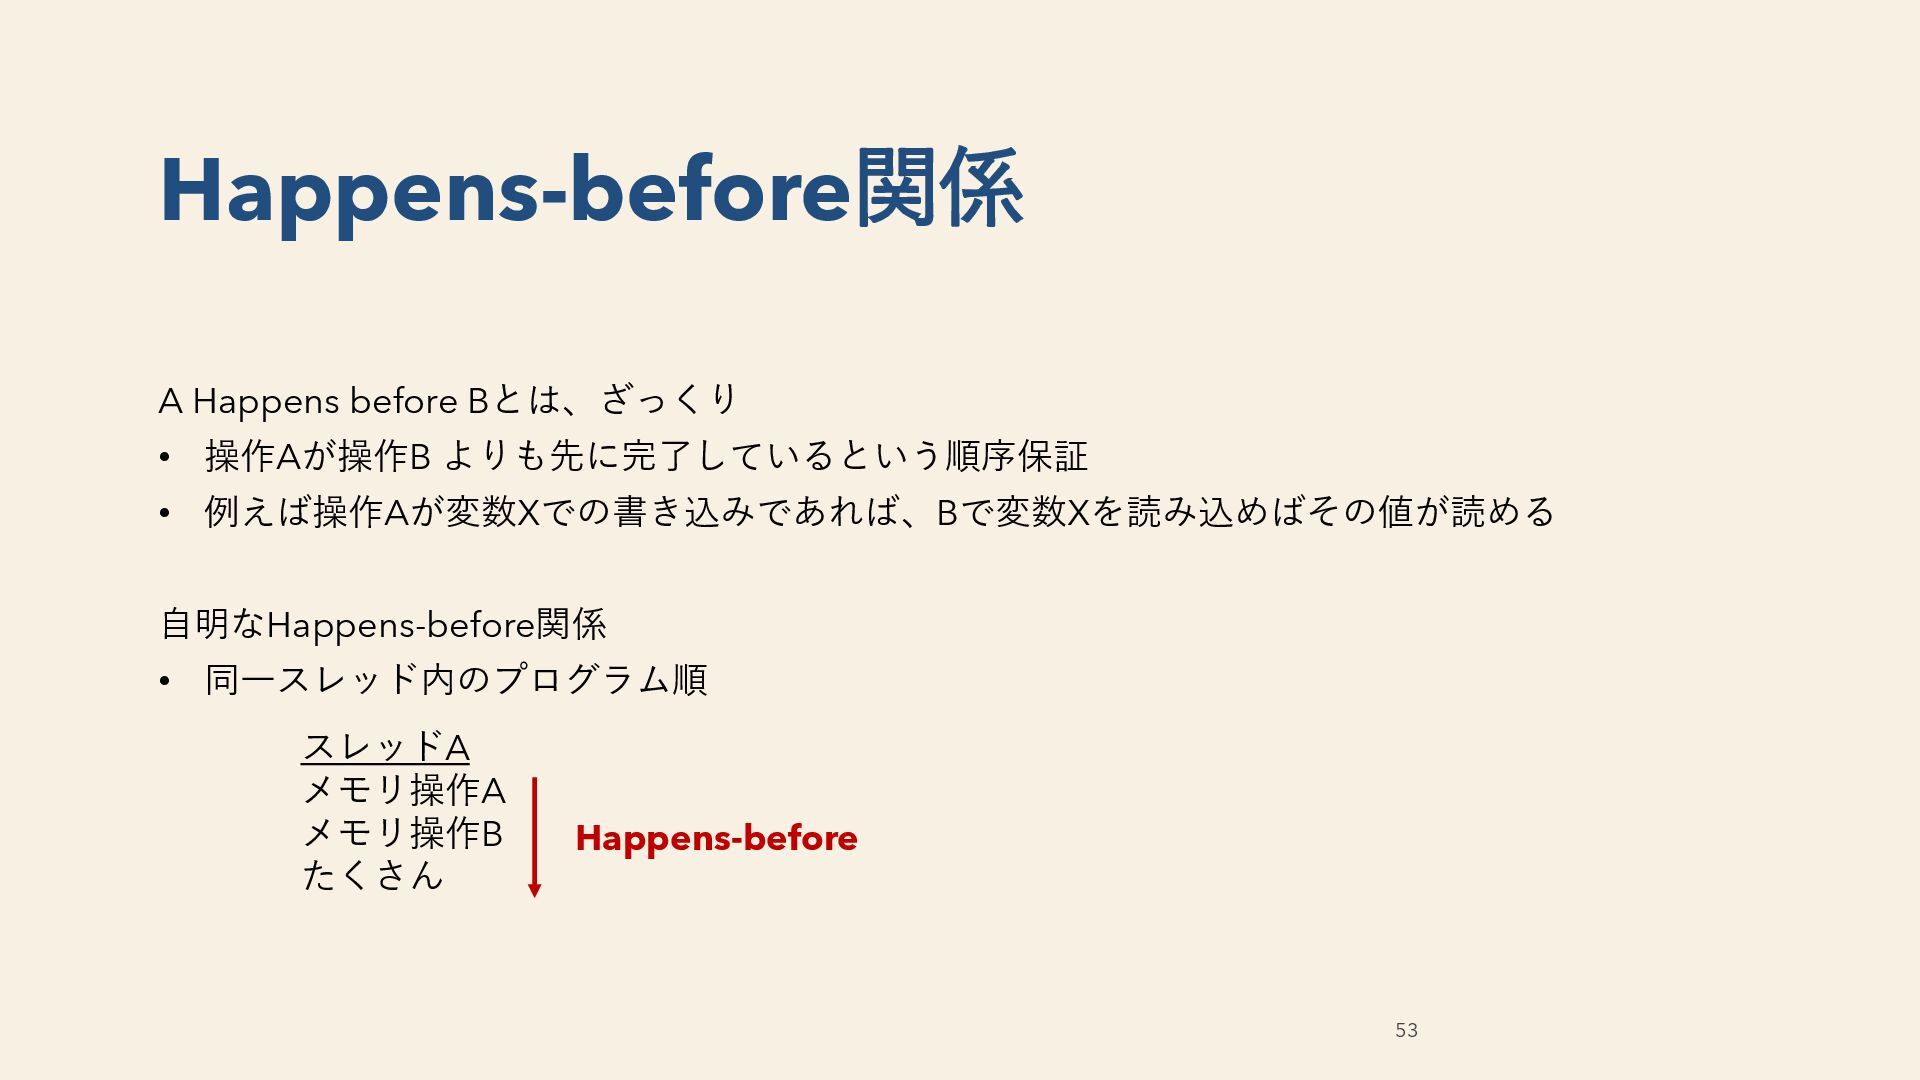
A Happens before Bとは、ざっくり • 操作Aが操作B よりも先に完了しているという順序保証 • 例えば操作Aが変数Xでの書き込みであれば、Bで変数Xを読み込めばその値が読める 自明なHappens-before関係
• 同一スレッド内のプログラム順 53 Happens-before関係 スレッドA メモリ操作A メモリ操作B たくさん Happens-before -
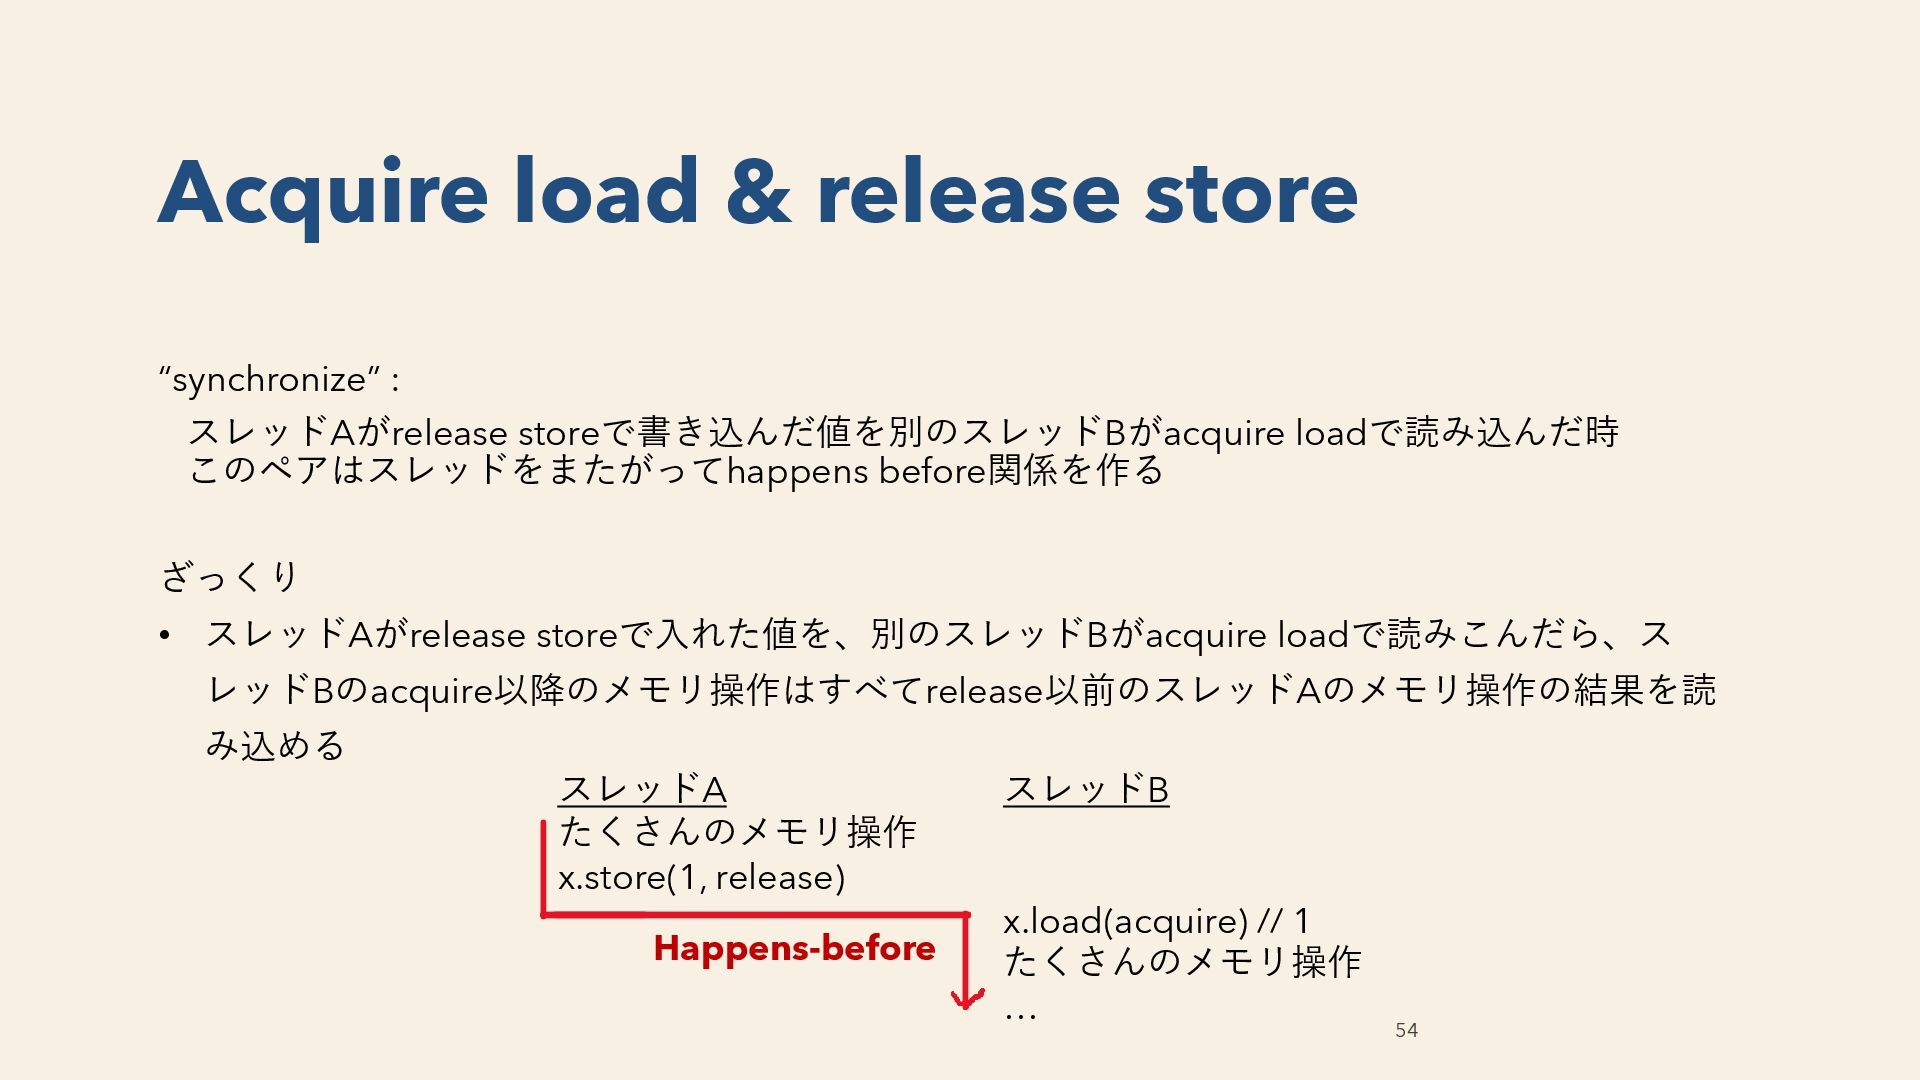
“synchronize” : スレッドAがrelease storeで書き込んだ値を別のスレッドBがacquire loadで読み込んだ時 このペアはスレッドをまたがってhappens before関係を作る ざっくり • スレッドAがrelease
storeで入れた値を、別のスレッドBがacquire loadで読みこんだら、ス レッドBのacquire以降のメモリ操作はすべてrelease以前のスレッドAのメモリ操作の結果を読 み込める 54 Acquire load & release store スレッドA たくさんのメモリ操作 x.store(1, release) スレッドB x.load(acquire) // 1 たくさんのメモリ操作 … Happens-before -
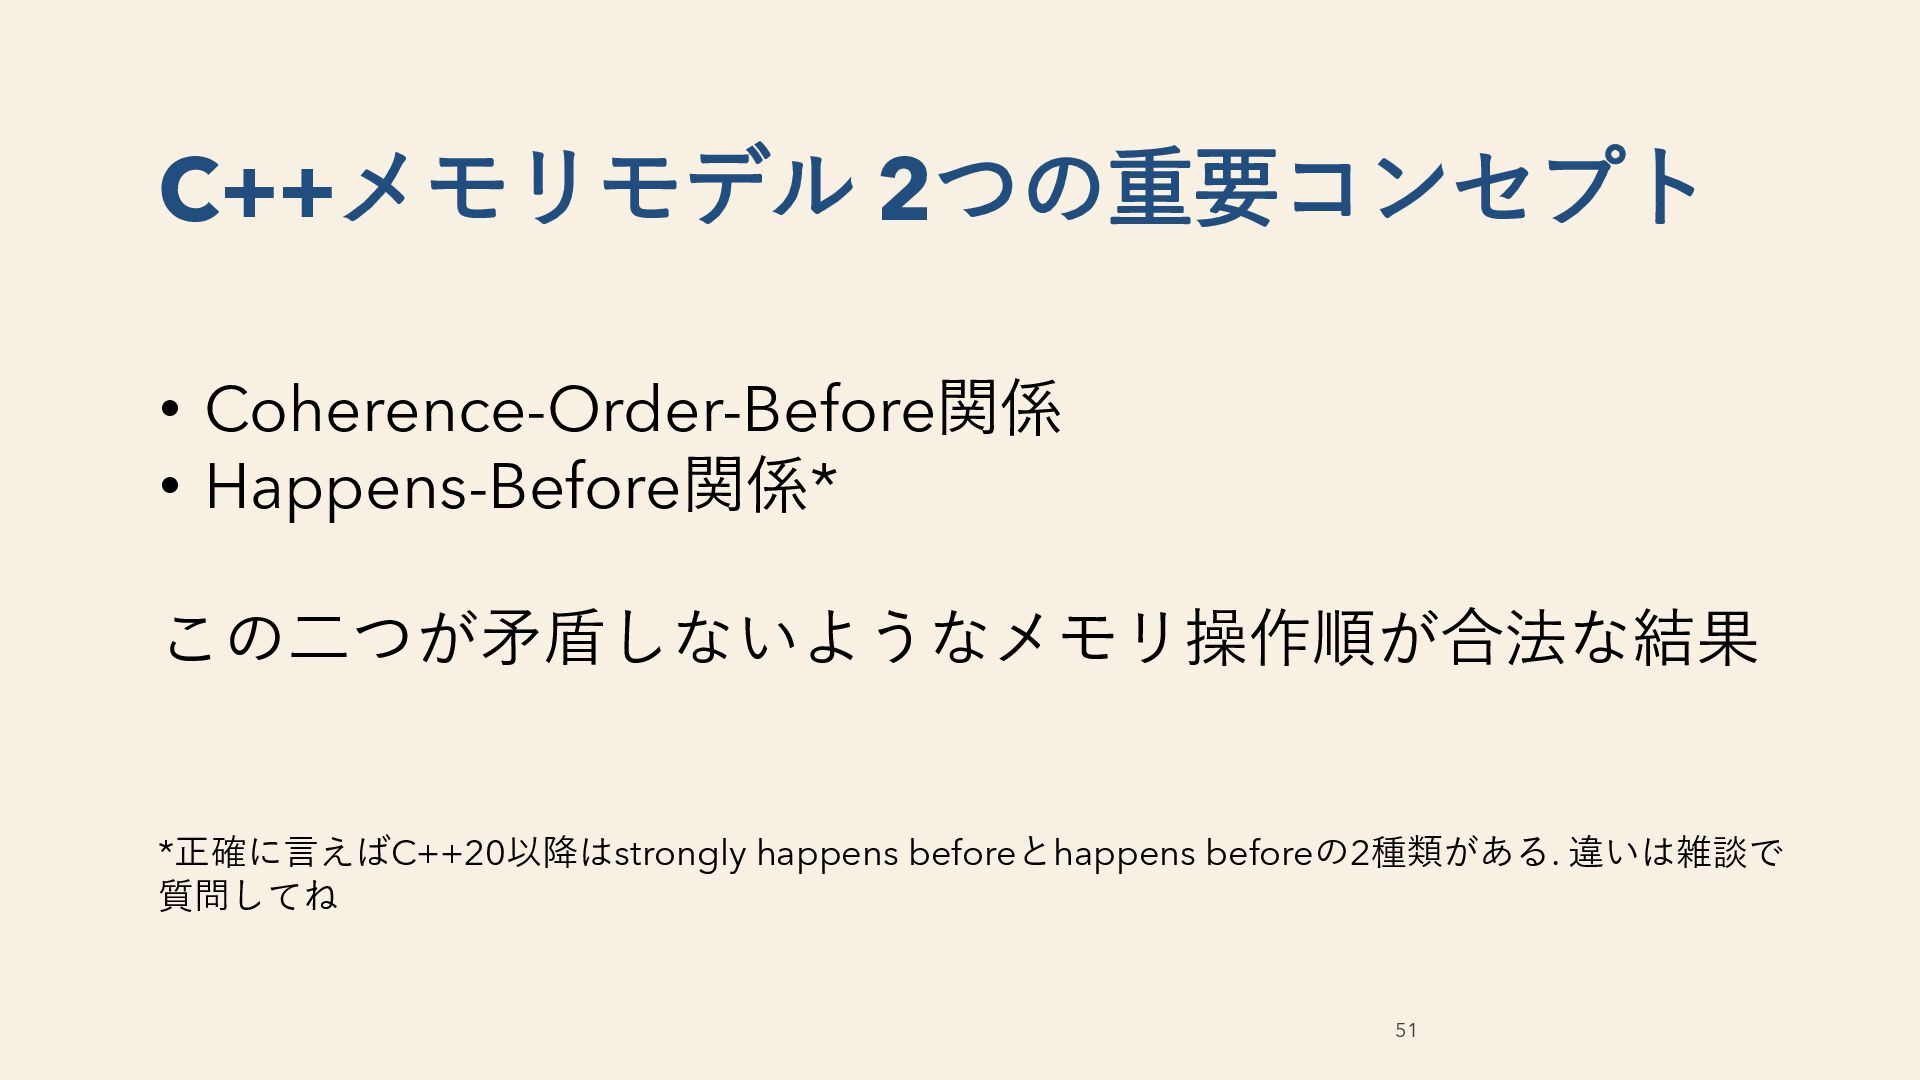
55 C++のメモリオ ー ダ ー だって?あれは単に COHERENCE-BEFORE と HAPPENS-BEFORE の
ニつの半順序が互いに無矛盾であるようなメモリ 操作集合だよ。何か問題でも? (こんな格言はない) -
CPUの挙動と照らし合わせてみよう ポインタを理解するためにこんな歴史を辿った方も多いのではないでしょうか ポインタわからん ➔ ポインタってアドレスのことだったのか!(具体例を用いた直観の養成) ➔ いやポインタってアドレスよりもっと抽象的な概念だわ (抽象化) ➔ うんうんwasmのfunction
table indexポインタもまたポインタだね (別の具体例の理解) C++ memory modelも同じ経緯を僕は辿りました 56 直観を作るとうれしい -
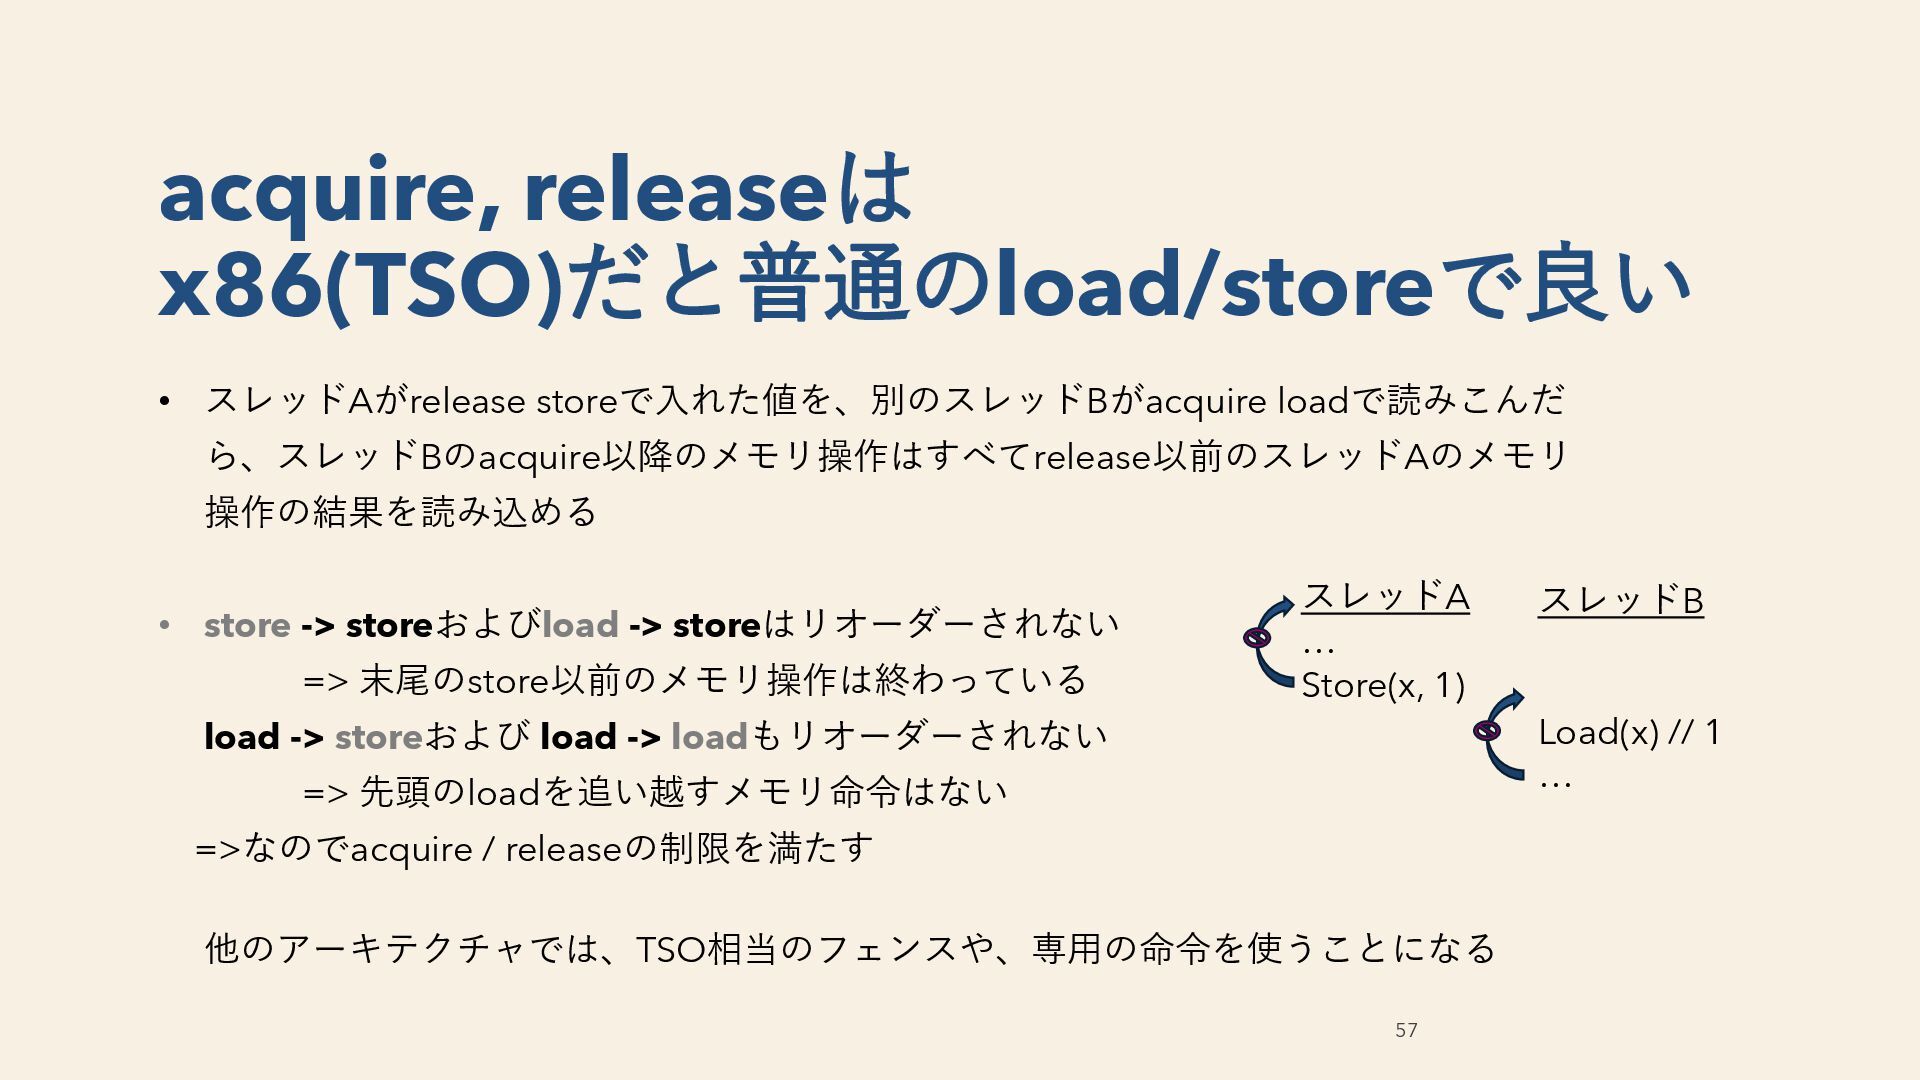
• スレッドAがrelease storeで入れた値を、別のスレッドBがacquire loadで読みこんだ ら、スレッドBのacquire以降のメモリ操作はすべてrelease以前のスレッドAのメモリ 操作の結果を読み込める • store -> storeおよびload
-> storeはリオーダーされない => 末尾のstore以前のメモリ操作は終わっている load -> storeおよび load -> loadもリオーダーされない => 先頭のloadを追い越すメモリ命令はない =>なのでacquire / releaseの制限を満たす 他のアーキテクチャでは、TSO相当のフェンスや、専用の命令を使うことになる 57 acquire, releaseは x86(TSO)だと普通のload/storeで良い スレッドA … Store(x, 1) スレッドB Load(x) // 1 … -
• Relaxed: 一切のhappens-before関係を作らない • 直観的には、POWERやarm v7のMCAのないアーキテクチャと近い挙動をする • cf. POWERでは書き込みの伝搬のタイミングがコアごとにバラバラだった •
Relaxedは使いこなすのが難しい 59 Relaxed: 因果律の崩壊再び Happens-beforeでない Happens-before Happens-before -
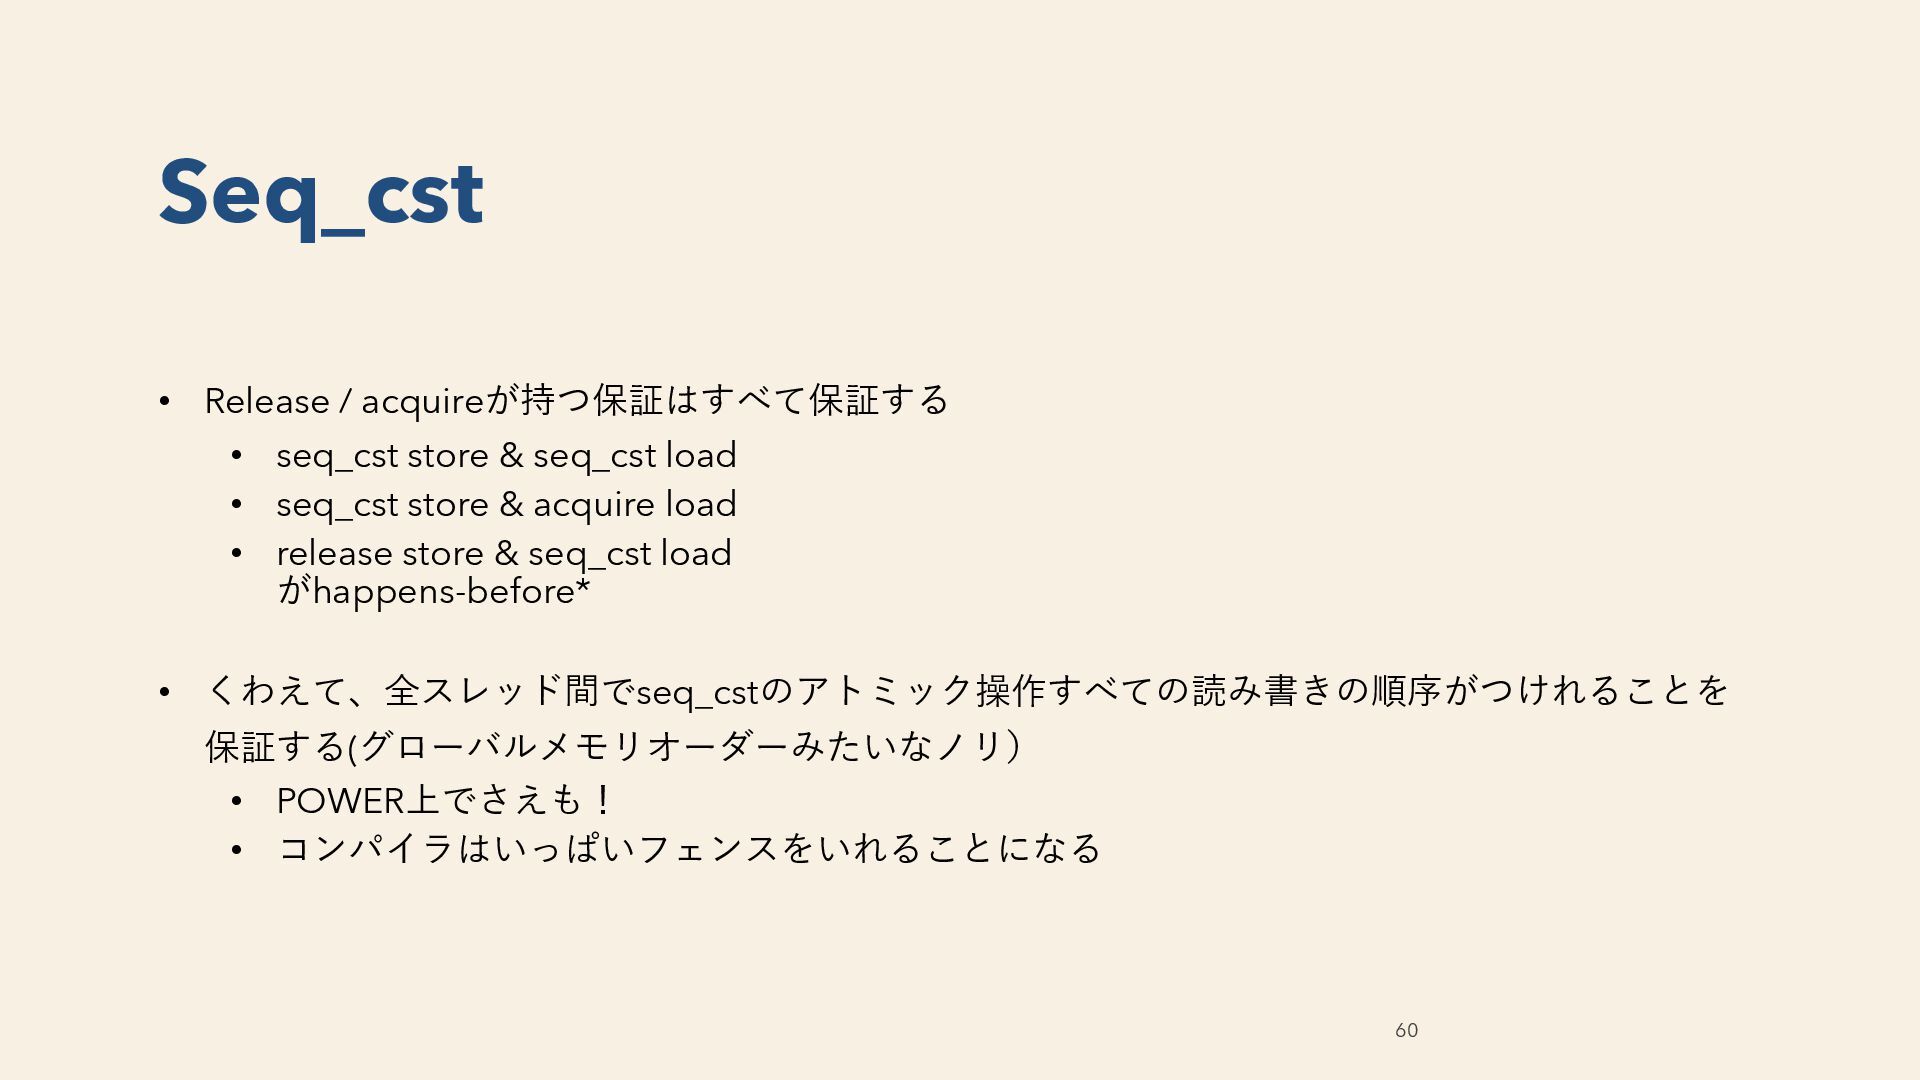
• Release / acquireが持つ保証はすべて保証する • seq_cst store & seq_cst load
• seq_cst store & acquire load • release store & seq_cst load がhappens-before* • くわえて、全スレッド間でseq_cstのアトミック操作すべての読み書きの順序がつけれることを 保証する(グローバルメモリオーダーみたいなノリ) • POWER上でさえも! • コンパイラはいっぱいフェンスをいれることになる 60 Seq_cst -
• Release / acquireが持つ保証はすべて保証する • seq_cst store & seq_cst load
• seq_cst store & acquire load • release store & seq_cst load がhappens-before* • くわえて、全スレッド間でseq_cstのアトミック操作すべての読み書きの順序がつけれることを 保証する(グローバルメモリオーダーみたいなノリ) • POWER上でさえも! • コンパイラはいっぱいフェンスをいれることになる 61 Seq_cst -
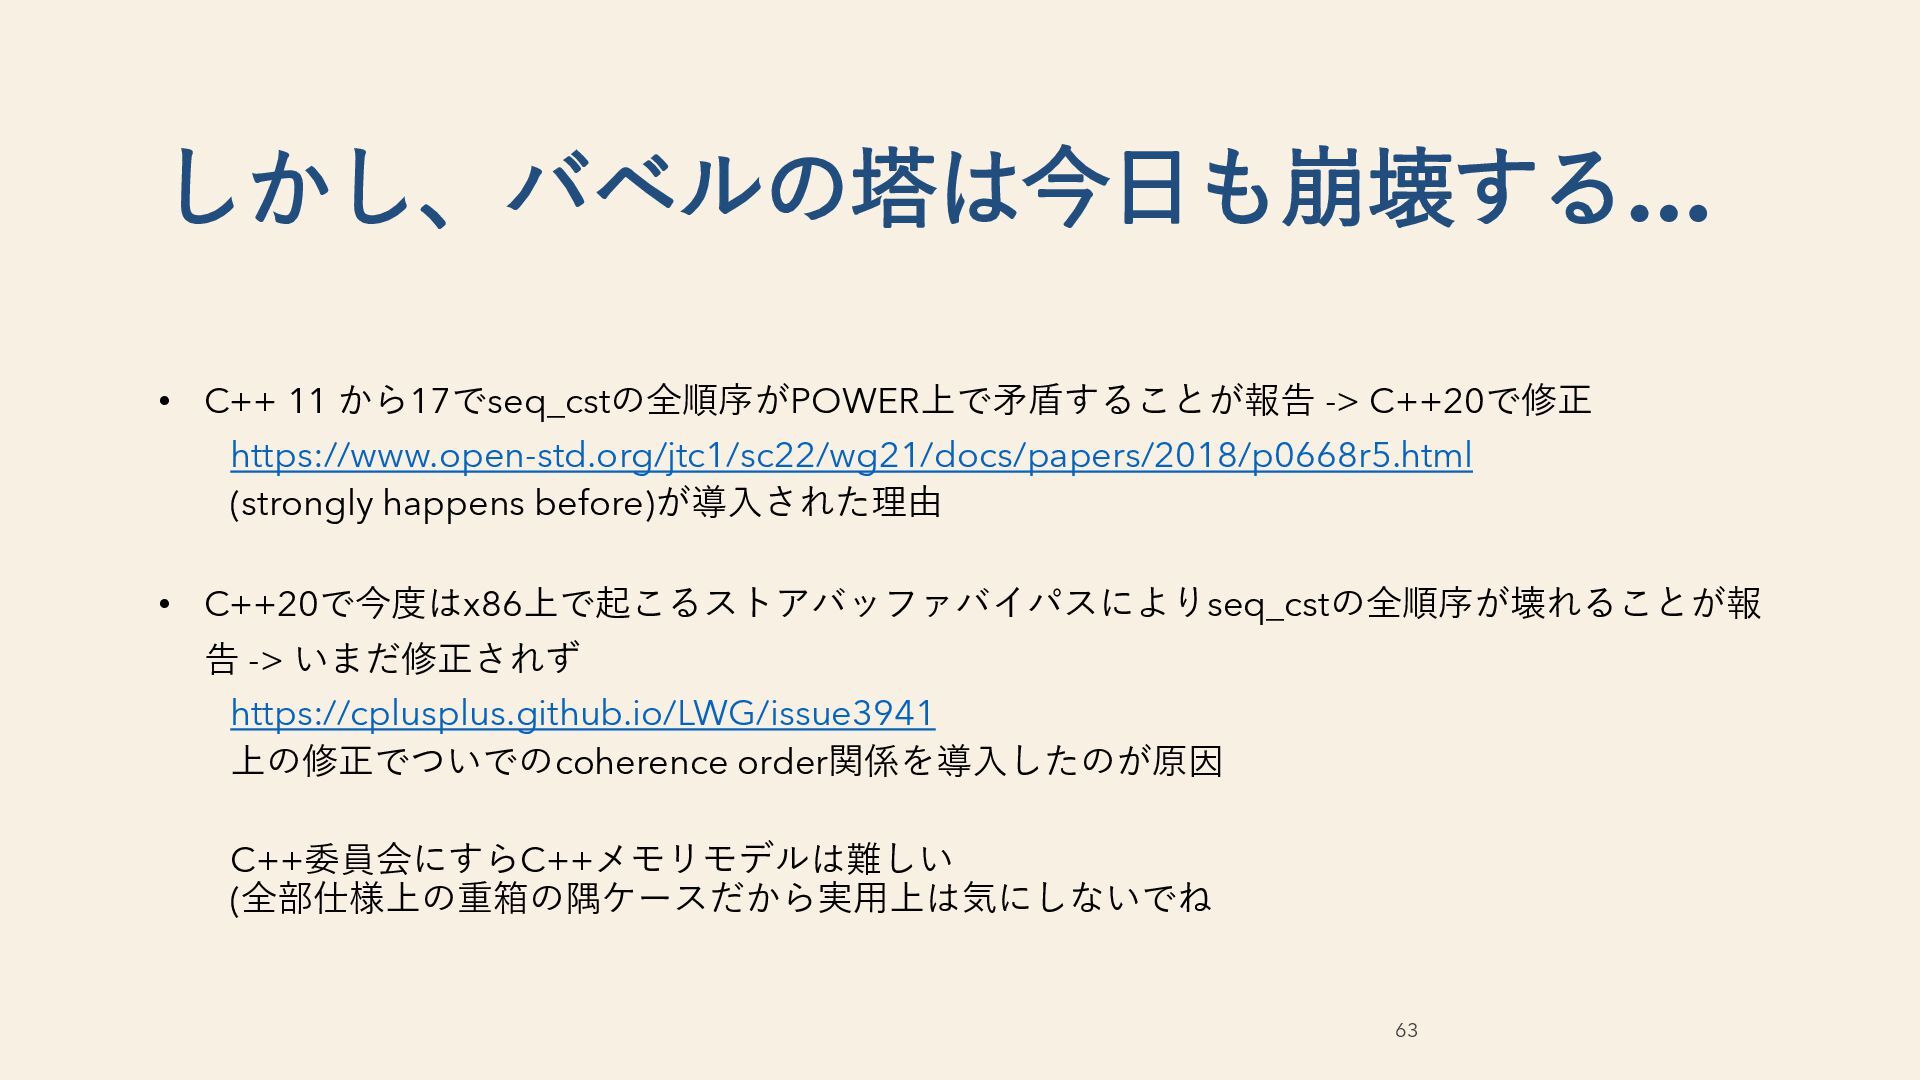
• C++ 11 から17でseq_cstの全順序がPOWER上で矛盾することが報告 -> C++20で修正 https://www.open-std.org/jtc1/sc22/wg21/docs/papers/2018/p0668r5.html (strongly happens before)が導入された理由
• C++20で今度はx86上で起こるストアバッファバイパスによりseq_cstの全順序が壊れることが報 告 -> いまだ修正されず https://cplusplus.github.io/LWG/issue3941 上の修正でついでのcoherence order関係を導入したのが原因 C++委員会にすらC++メモリモデルは難しい (全部仕様上の重箱の隅ケースだから実用上は気にしないでね 63 しかし、バベルの塔は今日も崩壊する… -
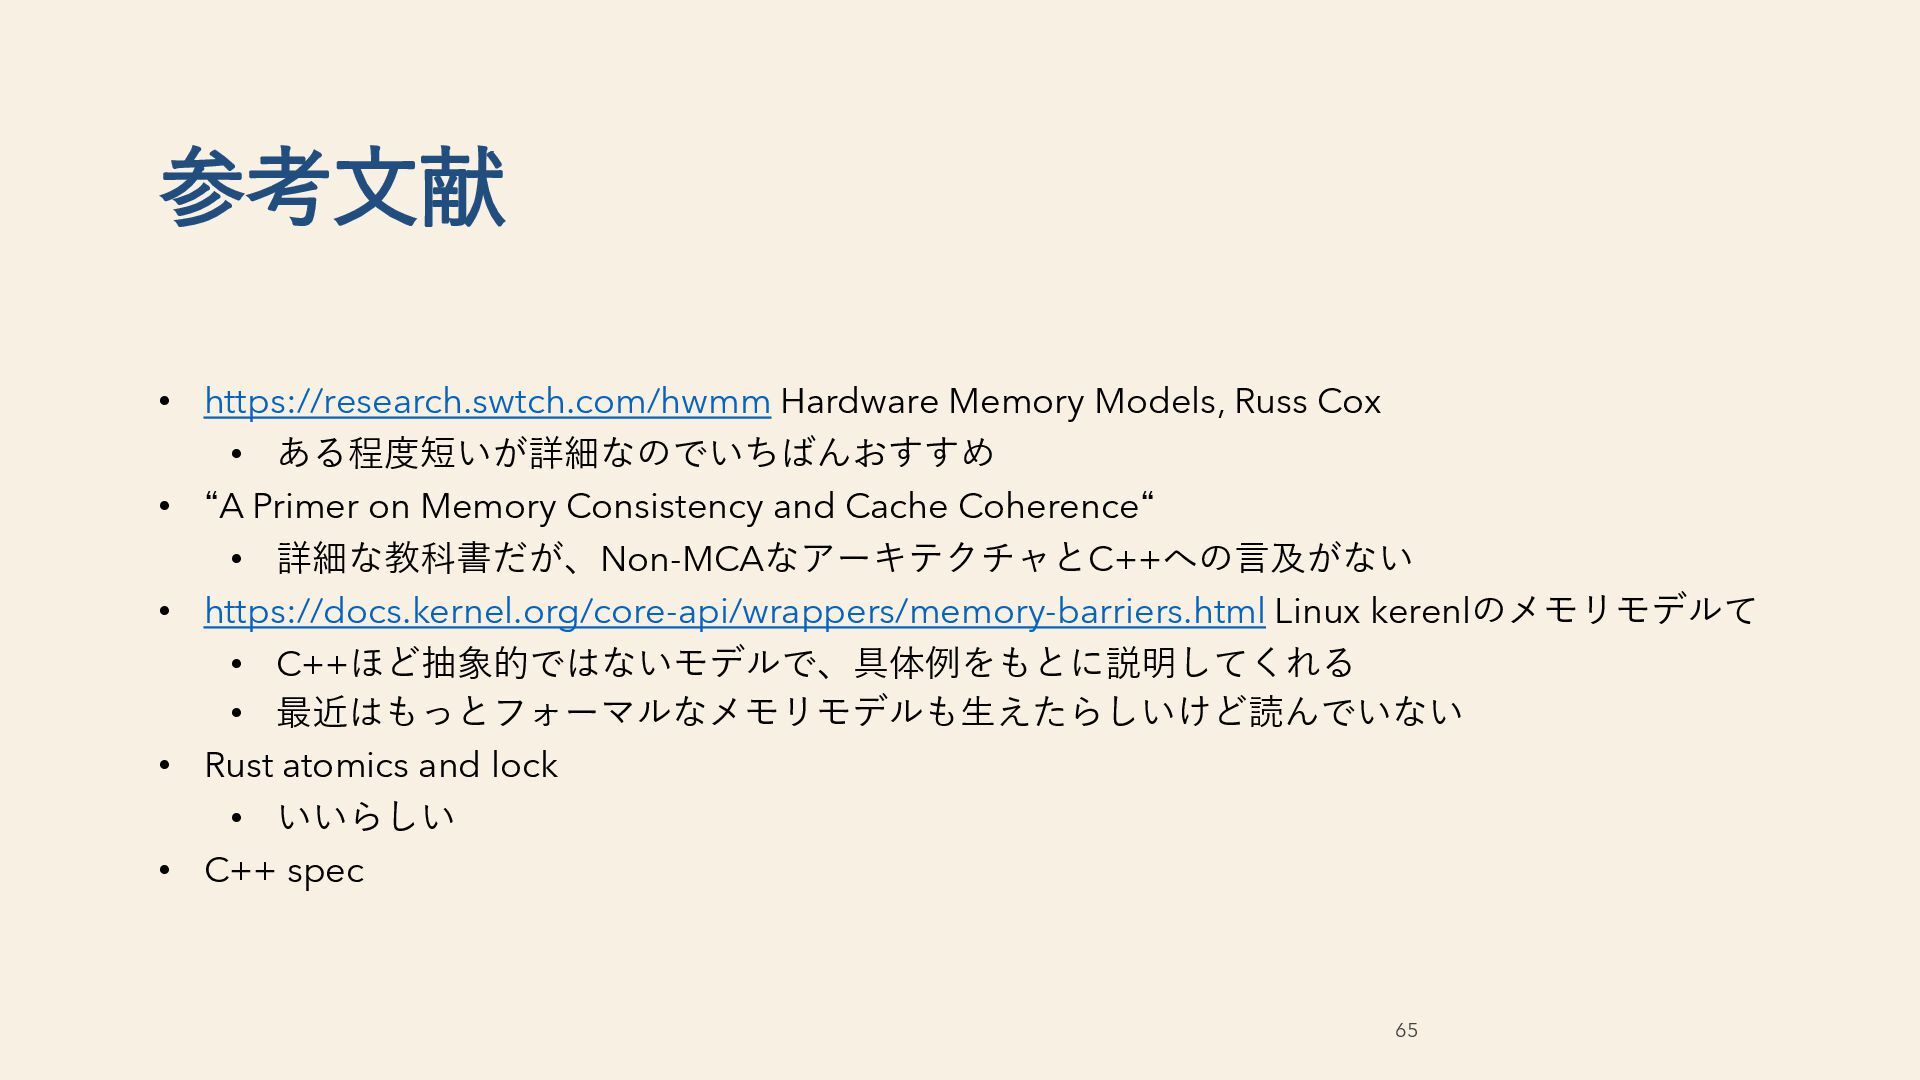
• https://research.swtch.com/hwmm Hardware Memory Models, Russ Cox • ある程度短いが詳細なのでいちばんおすすめ •
“A Primer on Memory Consistency and Cache Coherence“ • 詳細な教科書だが、Non-MCAなアーキテクチャとC++への言及がない • https://docs.kernel.org/core-api/wrappers/memory-barriers.html Linux kerenlのメモリモデルて • C++ほど抽象的ではないモデルで、具体例をもとに説明してくれる • 最近はもっとフォーマルなメモリモデルも生えたらしいけど読んでいない • Rust atomics and lock • いいらしい • C++ spec 65 参考文献