Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
test
Search
aa
June 09, 2026
3
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
test
tre
aa
June 09, 2026
Featured
See All Featured
For a Future-Friendly Web
brad_frost
184
10k
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.8k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
480
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Tell your own story through comics
letsgokoyo
1
1.1k
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
540
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
750
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
Facilitating Awesome Meetings
lara
57
7.2k
Transcript
WEBエージェント用LLM SFT(LoRA)設計ドキュメント Qwen2.5-VL-7B × GMO Cloud B300 × 2台 ×
Singularity LoRA SFT Mind2Web Qwen ChatML形式 マルチモーダル対応 TRL NEC × LLM Infrastructure Team
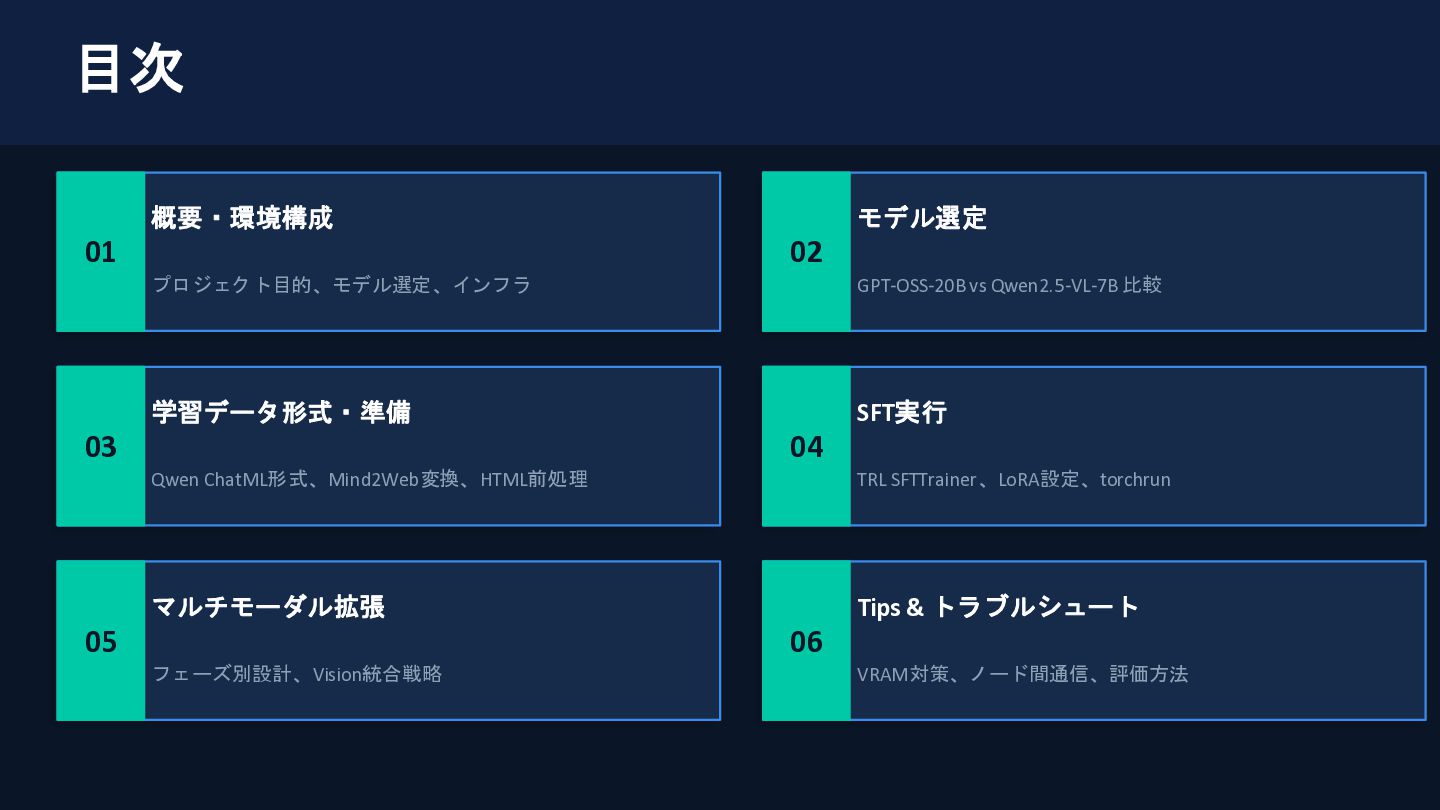
目次 01 概要・環境構成 プロジェクト目的、モデル選定、インフラ 02 モデル選定 GPT-OSS-20B vs Qwen2.5-VL-7B 比較
03 学習データ形式・準備 Qwen ChatML形式、Mind2Web変換、HTML前処理 04 SFT実行 TRL SFTTrainer、LoRA設定、torchrun 05 マルチモーダル拡張 フェーズ別設計、Vision統合戦略 06 Tips & トラブルシュート VRAM対策、ノード間通信、評価方法
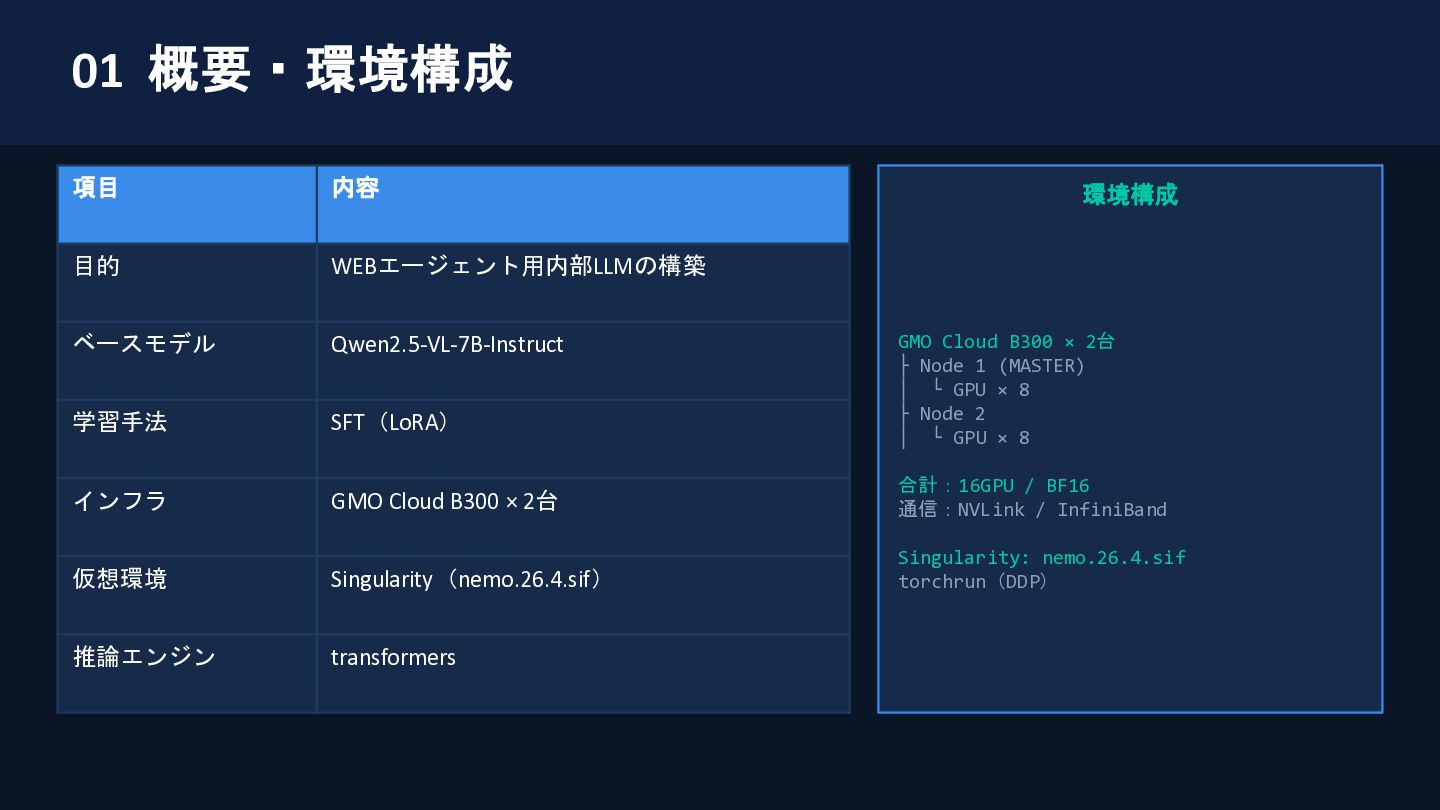
01 概要・環境構成 項目 内容 目的 WEBエージェント用内部LLMの構築 ベースモデル Qwen2.5-VL-7B-Instruct 学習手法 SFT(LoRA)
インフラ GMO Cloud B300 × 2台 仮想環境 Singularity(nemo.26.4.sif) 推論エンジン transformers 環境構成 GMO Cloud B300 × 2台 ├ Node 1 (MASTER) │ └ GPU × 8 ├ Node 2 │ └ GPU × 8 合計:16GPU / BF16 通信:NVLink / InfiniBand Singularity: nemo.26.4.sif torchrun(DDP)
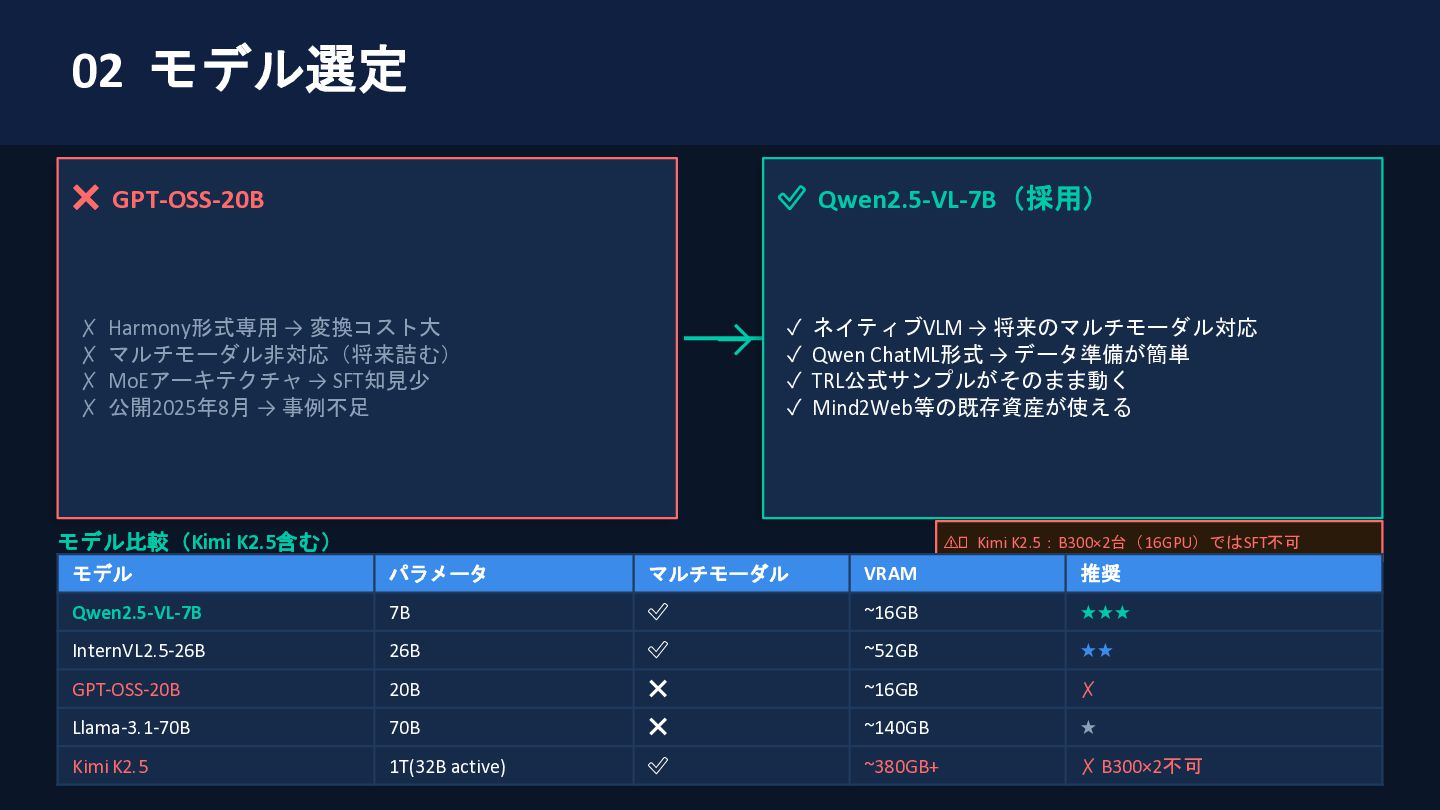
02 モデル選定 ❌ GPT-OSS-20B ✗ Harmony形式専用 → 変換コスト大 ✗ マルチモーダル非対応(将来詰む)
✗ MoEアーキテクチャ → SFT知見少 ✗ 公開2025年8月 → 事例不足 → ✅ Qwen2.5-VL-7B(採用) ✓ ネイティブVLM → 将来のマルチモーダル対応 ✓ Qwen ChatML形式 → データ準備が簡単 ✓ TRL公式サンプルがそのまま動く ✓ Mind2Web等の既存資産が使える モデル比較(Kimi K2.5含む) ⚠️ Kimi K2.5:B300×2台(16GPU)ではSFT不可 モデル パラメータ マルチモーダル VRAM 推奨 Qwen2.5-VL-7B 7B ✅ ~16GB ★★★ InternVL2.5-26B 26B ✅ ~52GB ★★ GPT-OSS-20B 20B ❌ ~16GB ✗ Llama-3.1-70B 70B ❌ ~140GB ★ Kimi K2.5 1T(32B active) ✅ ~380GB+ ✗ B300×2不可
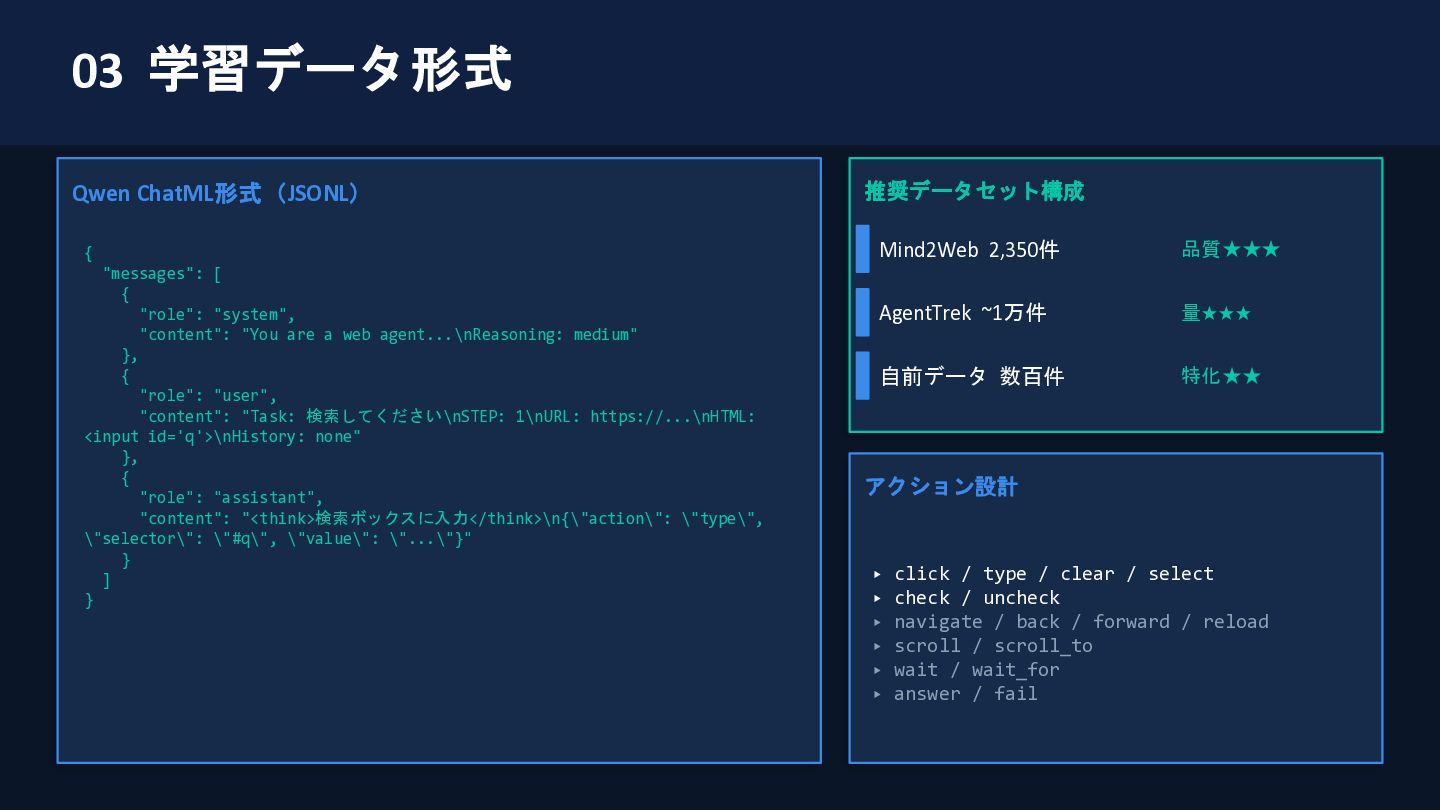
03 学習データ形式 Qwen ChatML形式(JSONL) { "messages": [ { "role": "system",
"content": "You are a web agent...\nReasoning: medium" }, { "role": "user", "content": "Task: 検索してください\nSTEP: 1\nURL: https://...\nHTML: <input id='q'>\nHistory: none" }, { "role": "assistant", "content": "<think>検索ボックスに入力</think>\n{\"action\": \"type\", \"selector\": \"#q\", \"value\": \"...\"}" } ] } 推奨データセット構成 Mind2Web 2,350件 品質★★★ AgentTrek ~1万件 量★★★ 自前データ 数百件 特化★★ アクション設計 ▸ click / type / clear / select ▸ check / uncheck ▸ navigate / back / forward / reload ▸ scroll / scroll_to ▸ wait / wait_for ▸ answer / fail
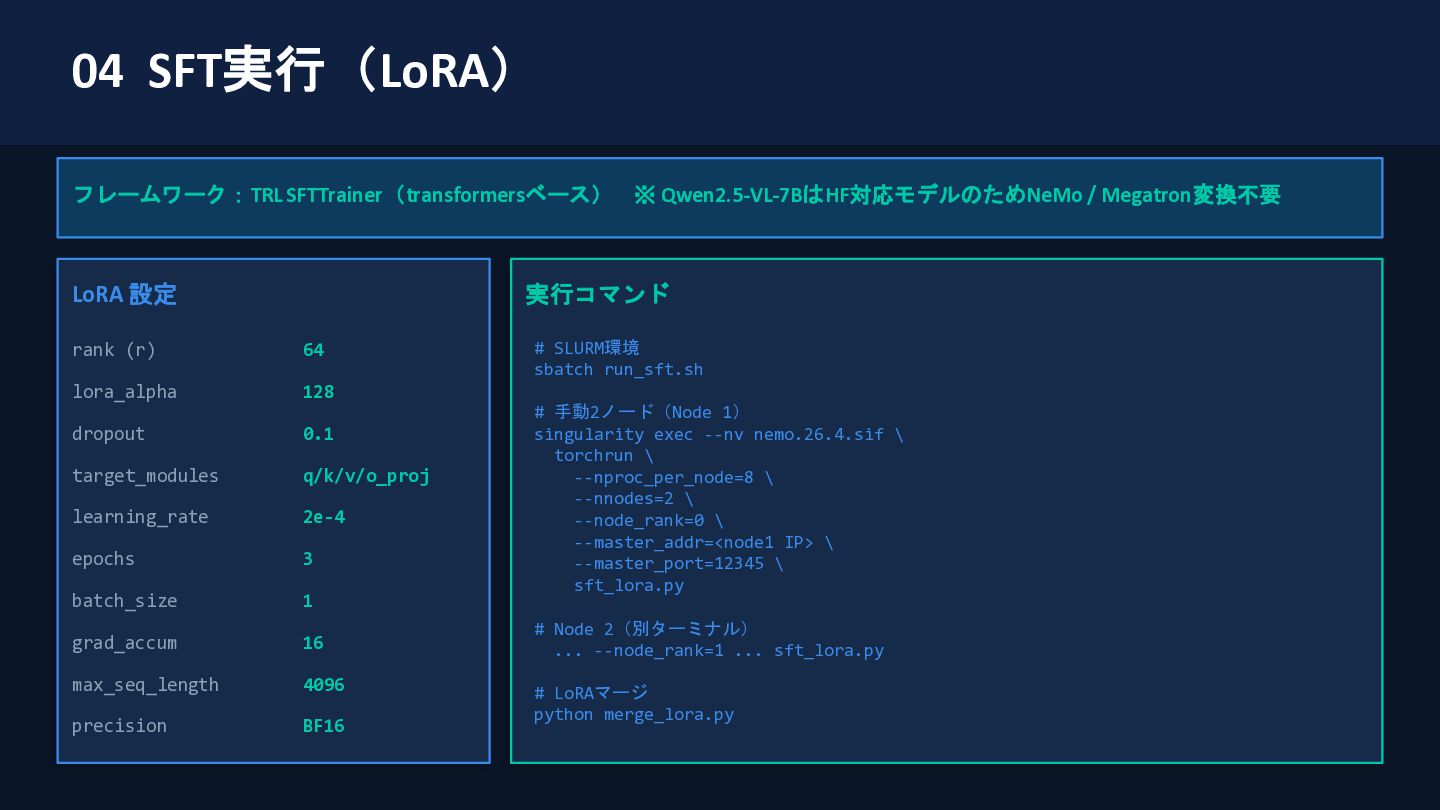
04 SFT実行(LoRA) フレームワーク:TRL SFTTrainer(transformersベース) ※ Qwen2.5-VL-7BはHF対応モデルのためNeMo / Megatron変換不要 LoRA 設定
rank (r) 64 lora_alpha 128 dropout 0.1 target_modules q/k/v/o_proj learning_rate 2e-4 epochs 3 batch_size 1 grad_accum 16 max_seq_length 4096 precision BF16 実行コマンド # SLURM環境 sbatch run_sft.sh # 手動2ノード(Node 1) singularity exec --nv nemo.26.4.sif \ torchrun \ --nproc_per_node=8 \ --nnodes=2 \ --node_rank=0 \ --master_addr=<node1 IP> \ --master_port=12345 \ sft_lora.py # Node 2(別ターミナル) ... --node_rank=1 ... sft_lora.py # LoRAマージ python merge_lora.py
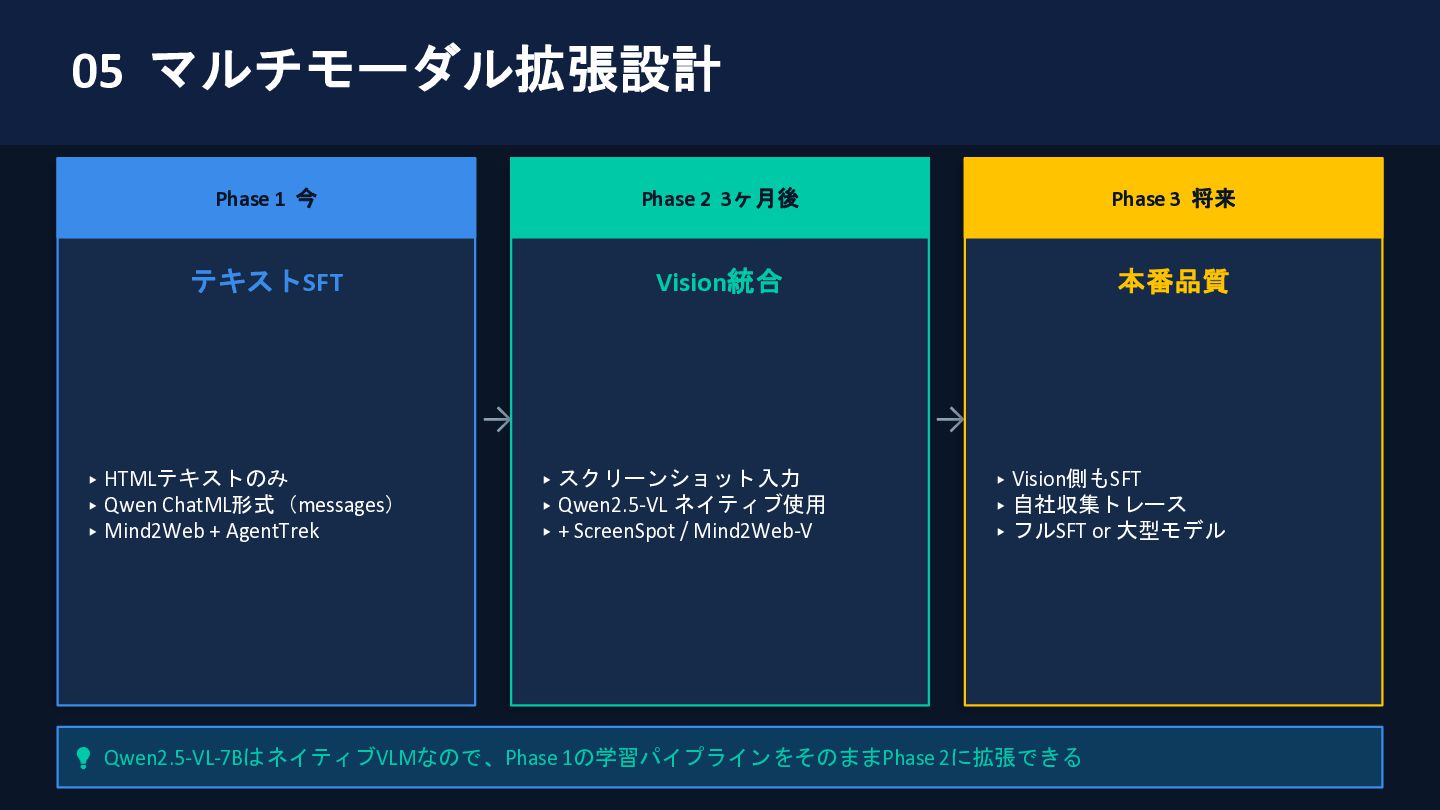
05 マルチモーダル拡張設計 Phase 1 今 テキストSFT ▸ HTMLテキストのみ ▸ Qwen
ChatML形式(messages) ▸ Mind2Web + AgentTrek → Phase 2 3ヶ月後 Vision統合 ▸ スクリーンショット入力 ▸ Qwen2.5-VL ネイティブ使用 ▸ + ScreenSpot / Mind2Web-V → Phase 3 将来 本番品質 ▸ Vision側もSFT ▸ 自社収集トレース ▸ フルSFT or 大型モデル 💡 Qwen2.5-VL-7BはネイティブVLMなので、Phase 1の学習パイプラインをそのままPhase 2に拡張できる
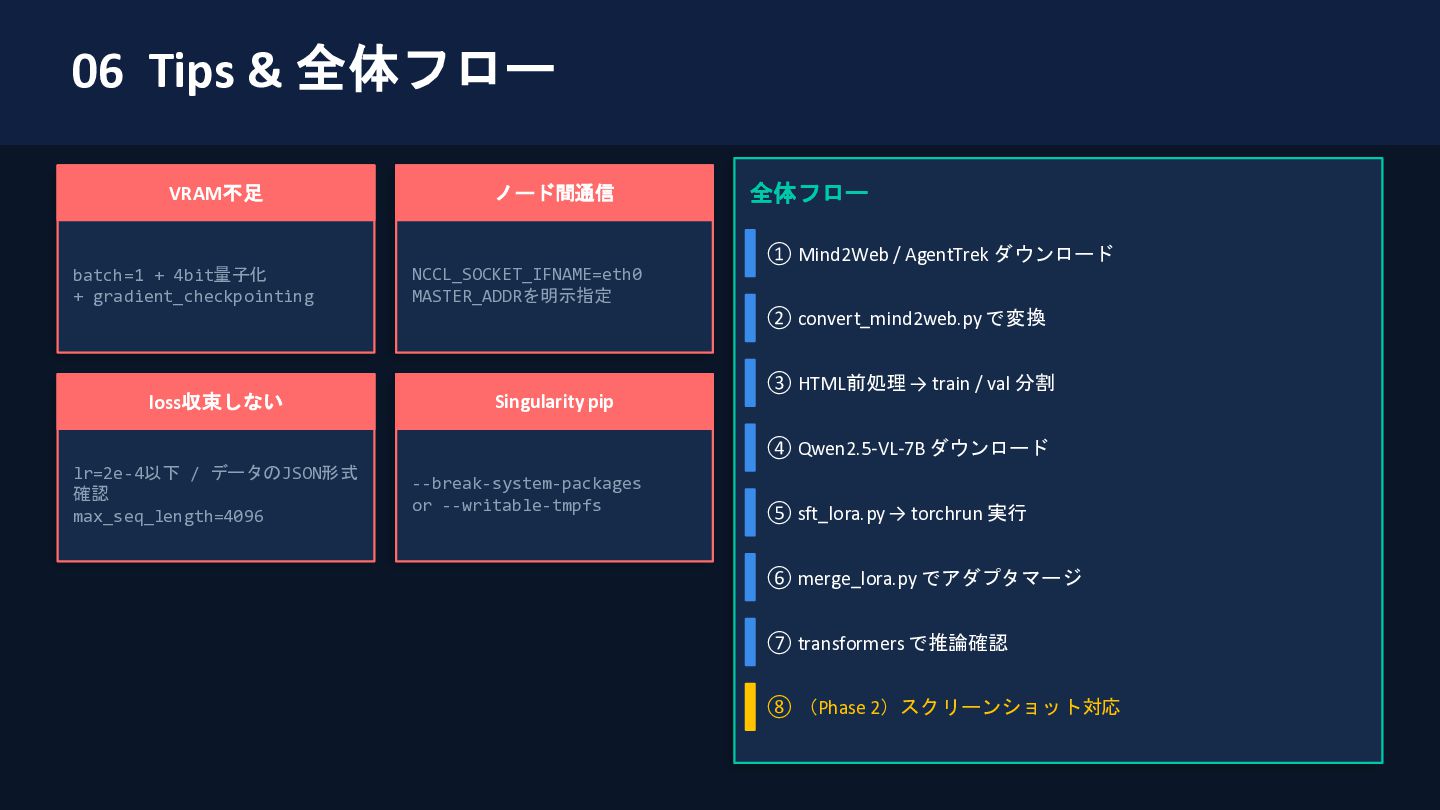
06 Tips & 全体フロー VRAM不足 batch=1 + 4bit量子化 + gradient_checkpointing
ノード間通信 NCCL_SOCKET_IFNAME=eth0 MASTER_ADDRを明示指定 loss収束しない lr=2e-4以下 / データのJSON形式 確認 max_seq_length=4096 Singularity pip --break-system-packages or --writable-tmpfs 全体フロー ① Mind2Web / AgentTrek ダウンロード ② convert_mind2web.py で変換 ③ HTML前処理 → train / val 分割 ④ Qwen2.5-VL-7B ダウンロード ⑤ sft_lora.py → torchrun 実行 ⑥ merge_lora.py でアダプタマージ ⑦ transformers で推論確認 ⑧ (Phase 2)スクリーンショット対応
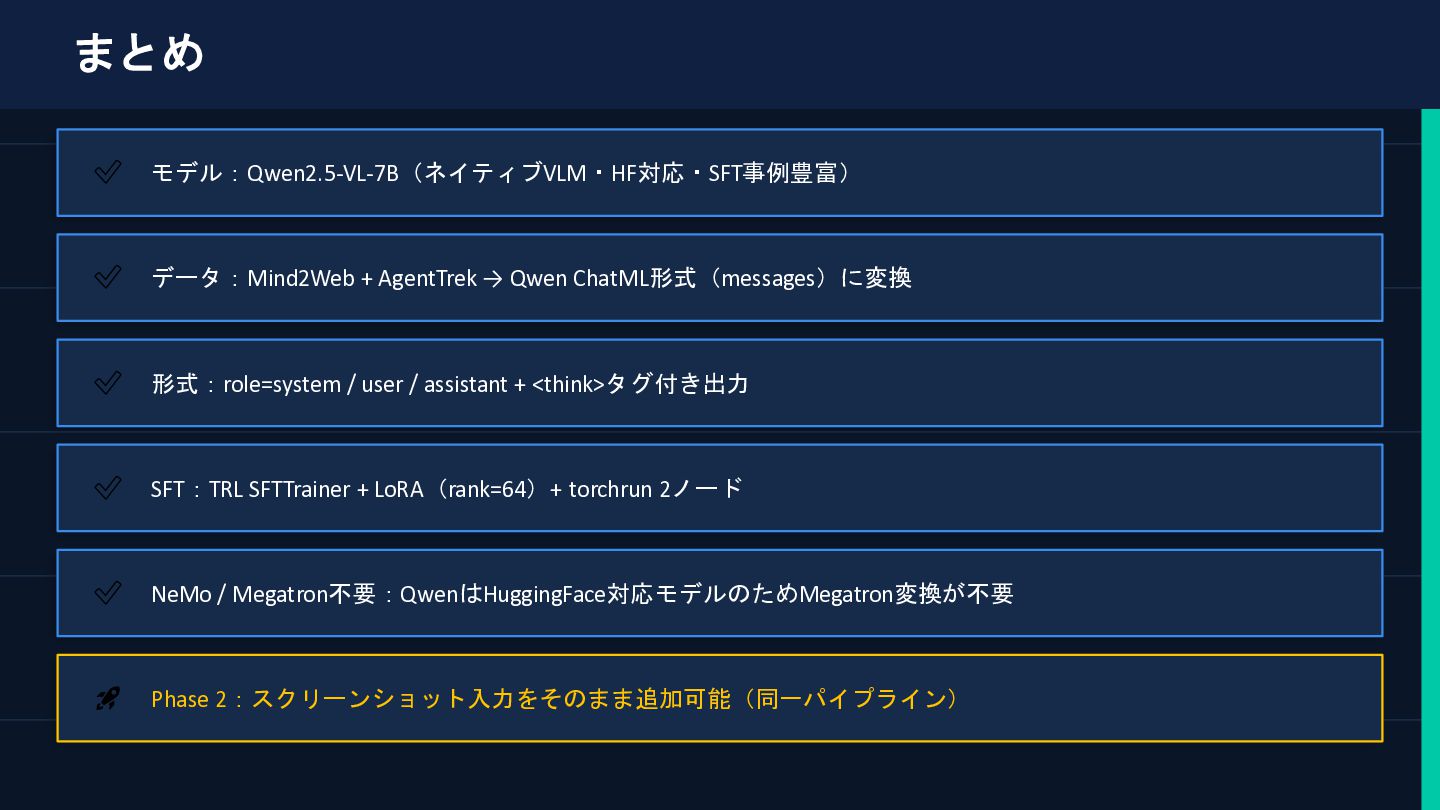
まとめ ✅ モデル:Qwen2.5-VL-7B(ネイティブVLM・HF対応・SFT事例豊富) ✅ データ:Mind2Web + AgentTrek → Qwen ChatML形式(messages)に変換
✅ 形式:role=system / user / assistant + <think>タグ付き出力 ✅ SFT:TRL SFTTrainer + LoRA(rank=64)+ torchrun 2ノード ✅ NeMo / Megatron不要:QwenはHuggingFace対応モデルのためMegatron変換が不要 🚀 Phase 2:スクリーンショット入力をそのまま追加可能(同一パイプライン)


 brad_frost
 signer
 aarron
 apolaine
 inesmontani
 letsgokoyo
 jacobtomlinson
 palkan
 techseoconnect
 scottboms
 aleyda
 lara