Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Model Based Reinforcement Learning
Search
Kandai Watanabe
May 18, 2019
Research
290
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Model Based Reinforcement Learning
Kandai Watanabe
May 18, 2019
Other Decks in Research
See All in Research
20260624 NLP colloquium: 単一のhubテキストがCLIPを壊す:hubnessによる埋め込みの脆弱性特定
de9uch1
2
300
LA-Bench 2025:実験指示から 実行可能手順を生成するためのデータセット/LA-Bench 2025: A Dataset for Generating Executable Experimental Procedures from Experimental Instructions
stktu
0
200
敵対生成プロンプト同時探索による内省型プロンプト最適化
kinoue_smarthr
0
440
【ローカルAIに向き合う展示会vol.2】液体時間定数型モジュールを用いた オリジナルの双方向エンコーダーモデルNexteraBERT 推論速度向上検討並びにダウンストリーム評価
rikkabotan7
0
230
A new deal for disabled people
resolutionfoundation
0
260
XDPerf: A High-Performance Traffic Generator Built with WASM and eBPF
takehaya
1
340
GLIM とMegaParticles:正規分布近似の限界とタイトカップリング&パーティクルフィルタの進展 / GLIM and MegaParticles : Progress of the distribution representation in SLAM
koide3
0
960
CDCL を用いた MILP の厳密解法
imai448
0
300
[最先端NLP勉強会2026] Checklists Are Better Than Reward Models For Aligning Language Models
nzw0301
1
330
Kunai: Toward a Verifier-Safe Layered DSL for Nested Encapsulation Packet Filtering on eBPF
takehaya
1
150
Adapter les bergeries aux fortes chaleurs
institutdelelevage
PRO
0
140
【Zozo Research 技術共有会】三次元領域の現在と展望
mickey_0226
3
680
Featured
See All Featured
Color Theory Basics | Prateek | Gurzu
gurzu
1
490
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
520
Ruling the World: When Life Gets Gamed
codingconduct
0
400
Six Lessons from altMBA
skipperchong
29
4.5k
Fireside Chat
paigeccino
43
4.1k
YesSQL, Process and Tooling at Scale
rocio
174
15k
Git: the NoSQL Database
bkeepers
PRO
433
67k
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
Designing for humans not robots
tammielis
254
26k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Transcript
⾼橋研 Model Based RL勉強会 GPIRL / IOC / MaxEnt 第3回
2019/05/18 GitHub: https://github.com/watakandhi Qiita: https://qiita.com/watakandhi Twitter: https://twitter.com/watakandhi
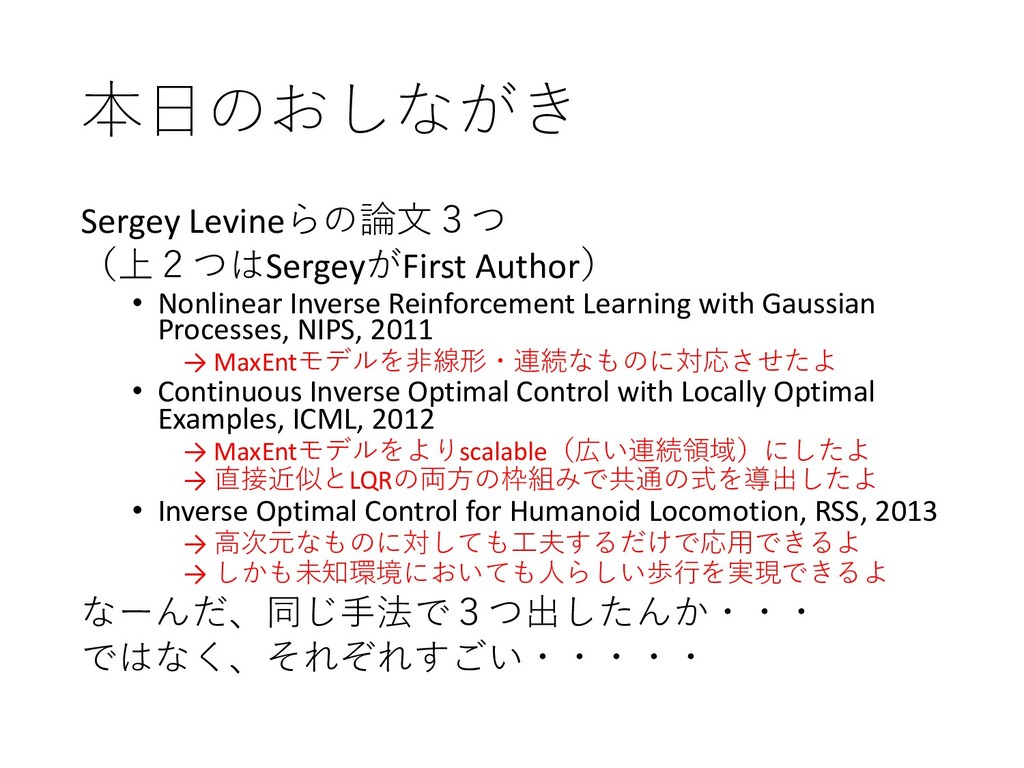
本⽇のおしながき Sergey Levineらの論⽂3つ (上2つはSergeyがFirst Author) • Nonlinear Inverse Reinforcement Learning
with Gaussian Processes, NIPS, 2011 → MaxEntモデルを⾮線形・連続なものに対応させたよ • Continuous Inverse Optimal Control with Locally Optimal Examples, ICML, 2012 → MaxEntモデルをよりscalable(広い連続領域)にしたよ → 直接近似とLQRの両⽅の枠組みで共通の式を導出したよ • Inverse Optimal Control for Humanoid Locomotion, RSS, 2013 → ⾼次元なものに対しても⼯夫するだけで応⽤できるよ → しかも未知環境においても⼈らしい歩⾏を実現できるよ なーんだ、同じ⼿法で3つ出したんか・・・ ではなく、それぞれすごい・・・・・
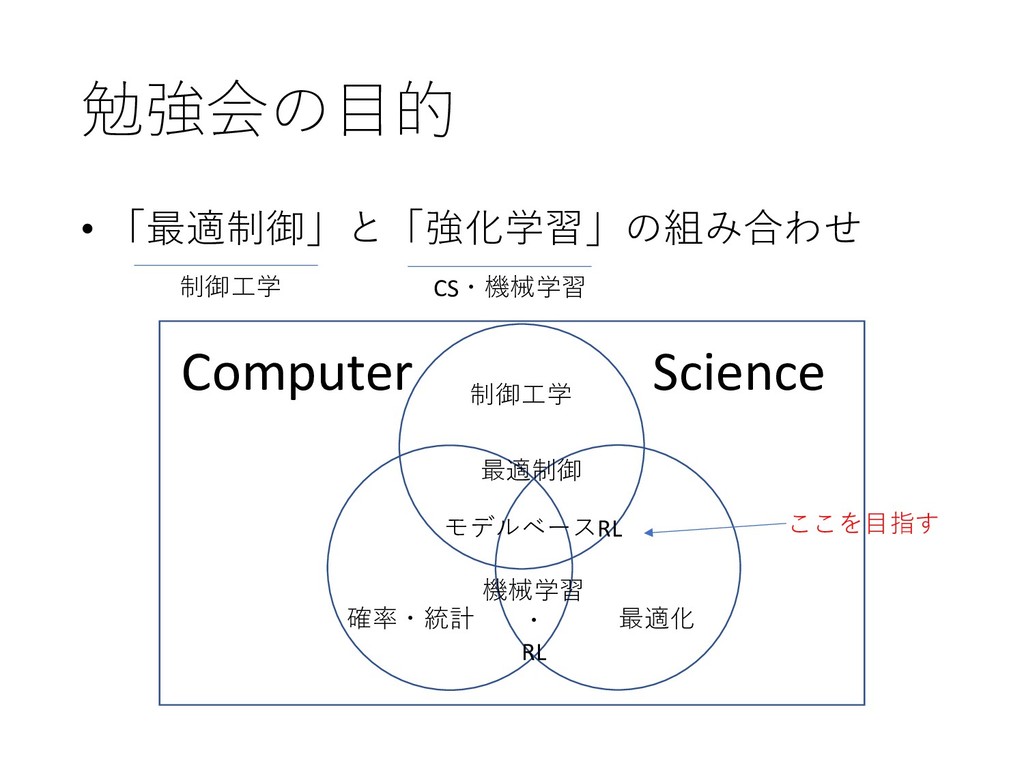
勉強会の⽬的 • 「最適制御」と「強化学習」の組み合わせ 制御⼯学 CS・機械学習 機械学習 ・ RL 確率・統計 最適化
制御⼯学 最適制御 モデルベースRL Computer Science ここを⽬指す
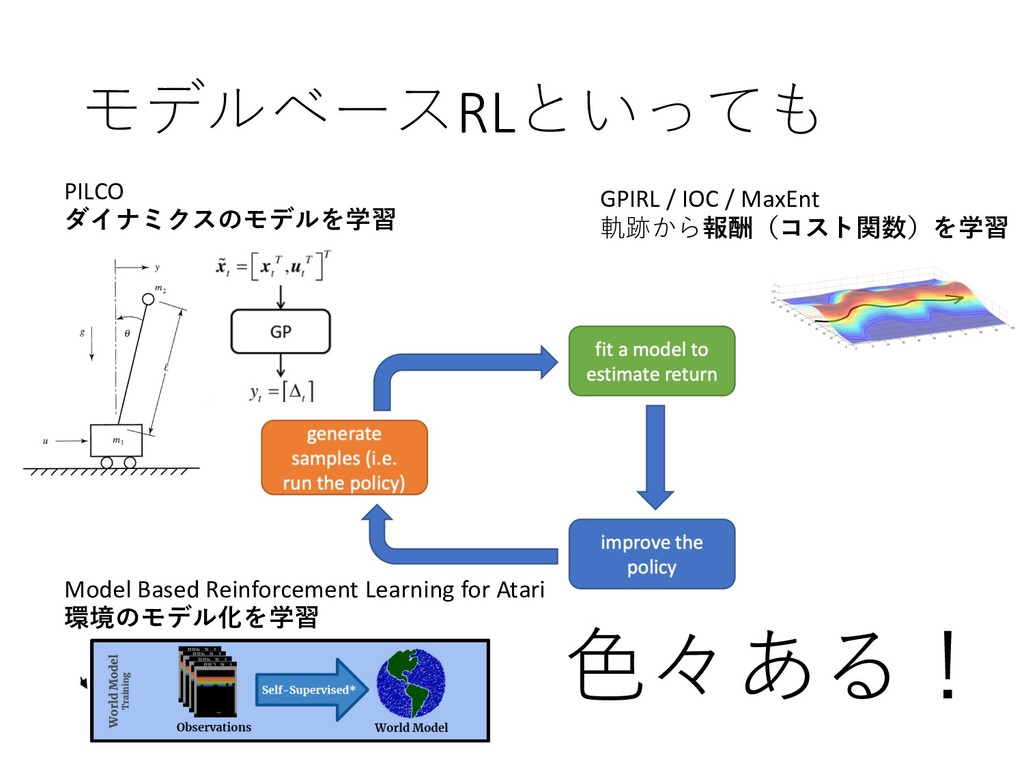
モデルベースRLといっても Model Based Reinforcement Learning for Atari 環境のモデル化を学習 GPIRL /
IOC / MaxEnt 軌跡から報酬(コスト関数)を学習 ⾊々ある! PILCO ダイナミクスのモデルを学習
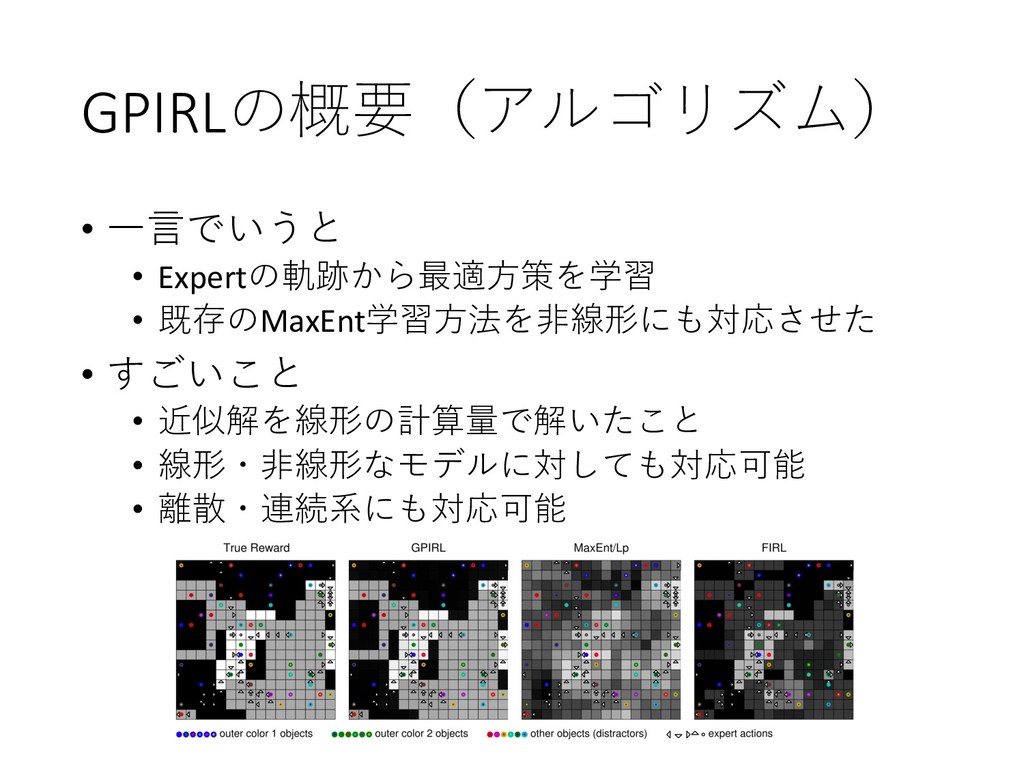
GPIRLの概要(アルゴリズム) • ⼀⾔でいうと • Expertの軌跡から最適⽅策を学習 • 既存のMaxEnt学習⽅法を⾮線形にも対応させた • すごいこと •
近似解を線形の計算量で解いたこと • 線形・⾮線形なモデルに対しても対応可能 • 離散・連続系にも対応可能
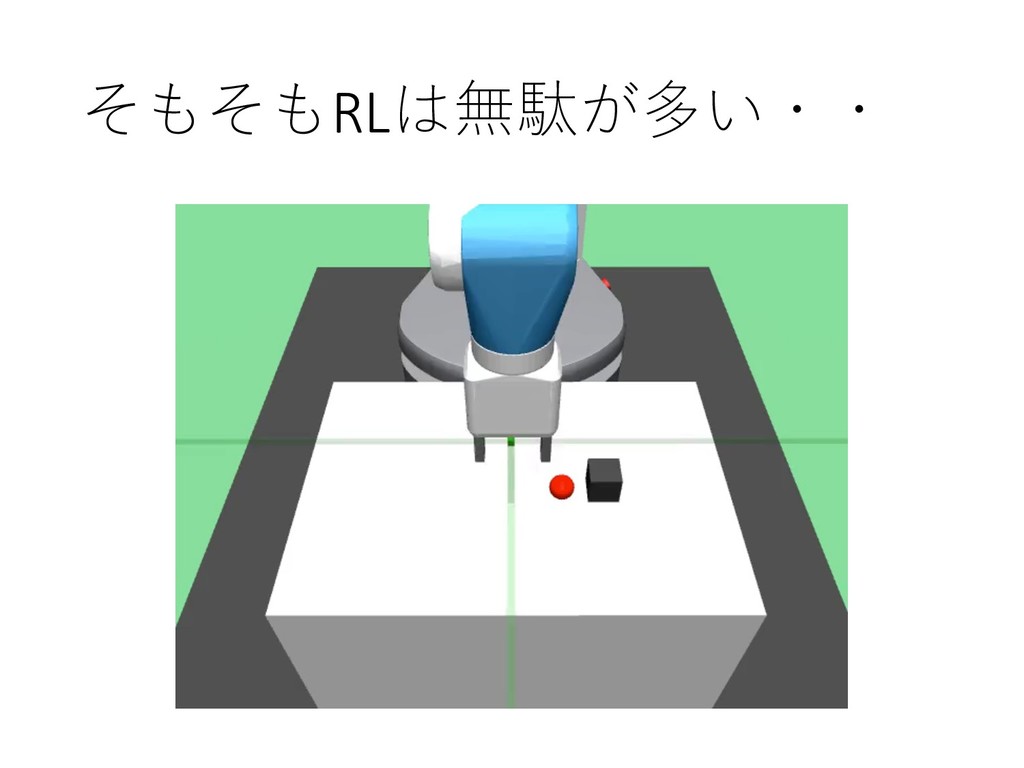
そもそもRLは無駄が多い・・
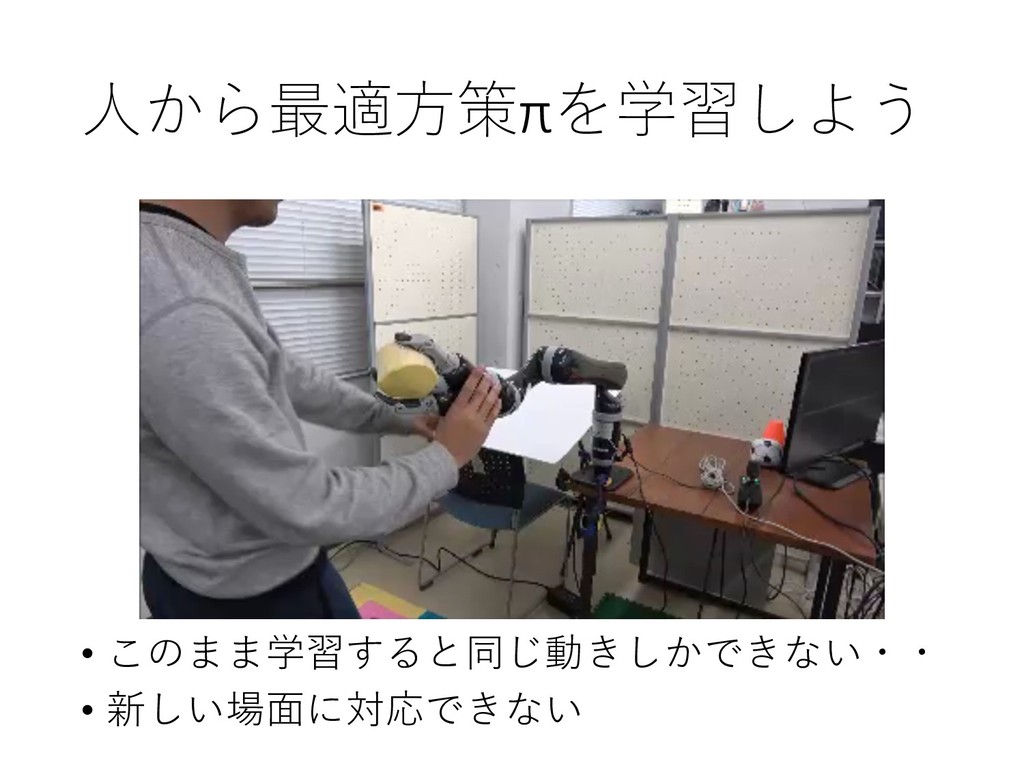
⼈から最適⽅策πを学習しよう • このまま学習すると同じ動きしかできない・・ • 新しい場⾯に対応できない
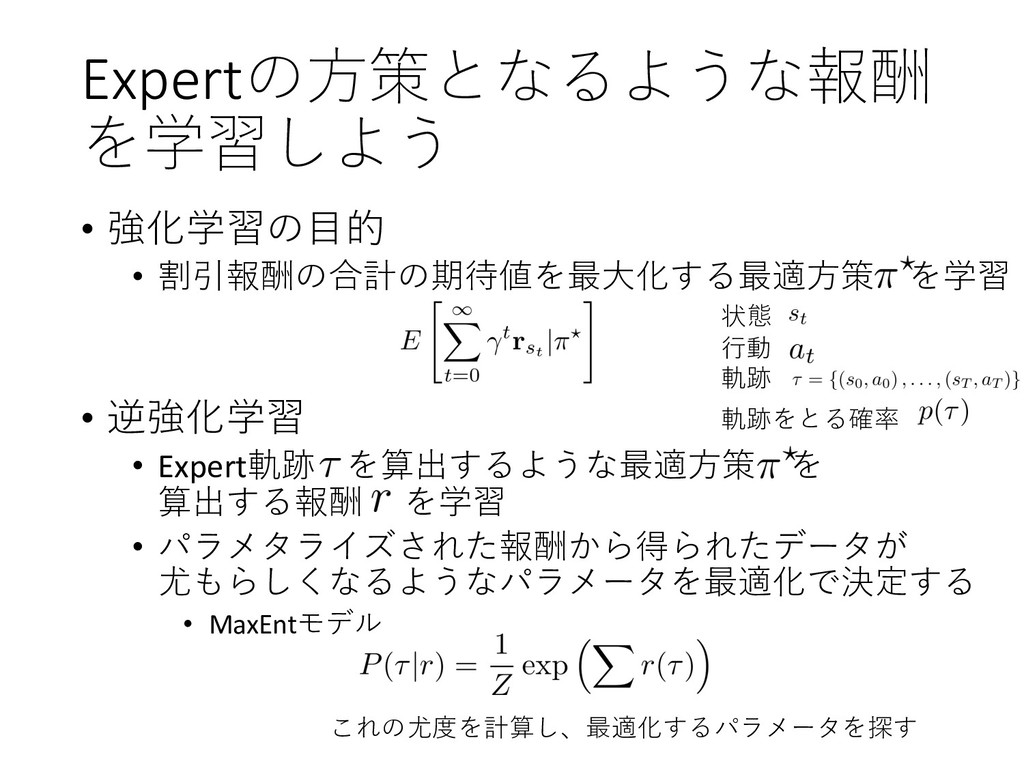
Expertの⽅策となるような報酬 を学習しよう • 強化学習の⽬的 • 割引報酬の合計の期待値を最⼤化する最適⽅策 を学習 • 逆強化学習 •
Expert軌跡 を算出するような最適⽅策 を 算出する報酬 を学習 • パラメタライズされた報酬から得られたデータが 尤もらしくなるようなパラメータを最適化で決定する • MaxEntモデル 軌跡をとる確率 状態 ⾏動 軌跡 これの尤度を計算し、最適化するパラメータを探す
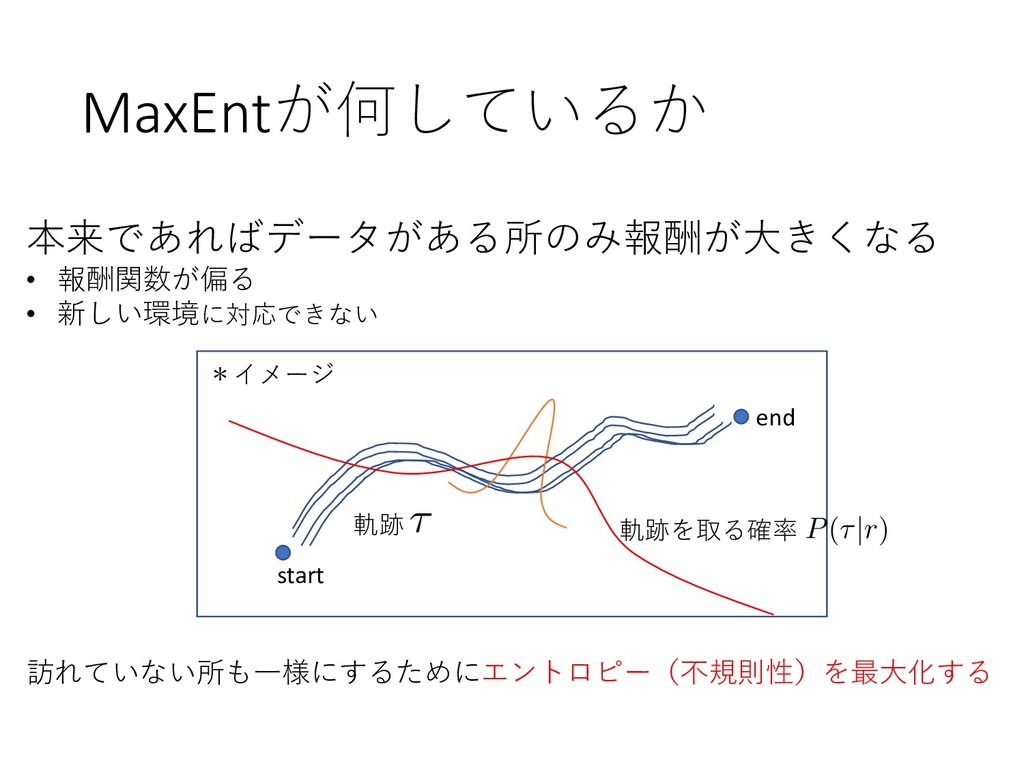
MaxEntが何しているか start end 本来であればデータがある所のみ報酬が⼤きくなる • 報酬関数が偏る • 新しい環境に対応できない 訪れていない所も⼀様にするためにエントロピー(不規則性)を最⼤化する 軌跡
軌跡を取る確率 *イメージ
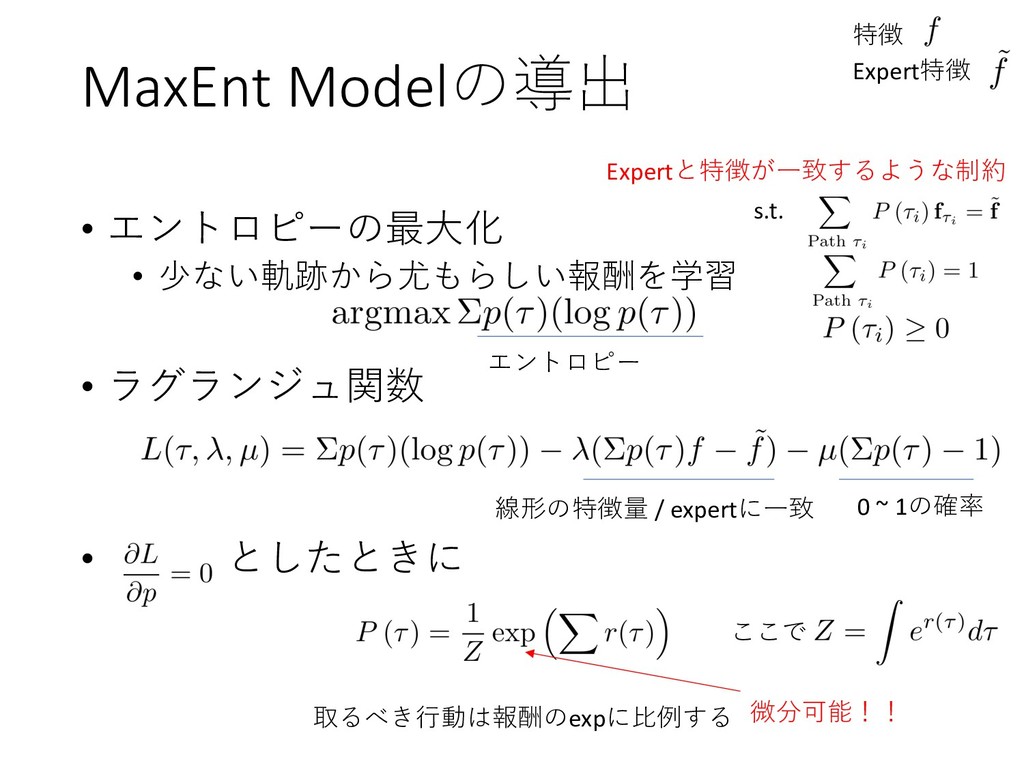
MaxEnt Modelの導出 • エントロピーの最⼤化 • 少ない軌跡から尤もらしい報酬を学習 • ラグランジュ関数 • としたときに
線形の特徴量 / expertに⼀致 ここで 特徴 Expert特徴 0 ~ 1の確率 取るべき⾏動は報酬のexpに⽐例する エントロピー 微分可能!! s.t. Expertと特徴が⼀致するような制約
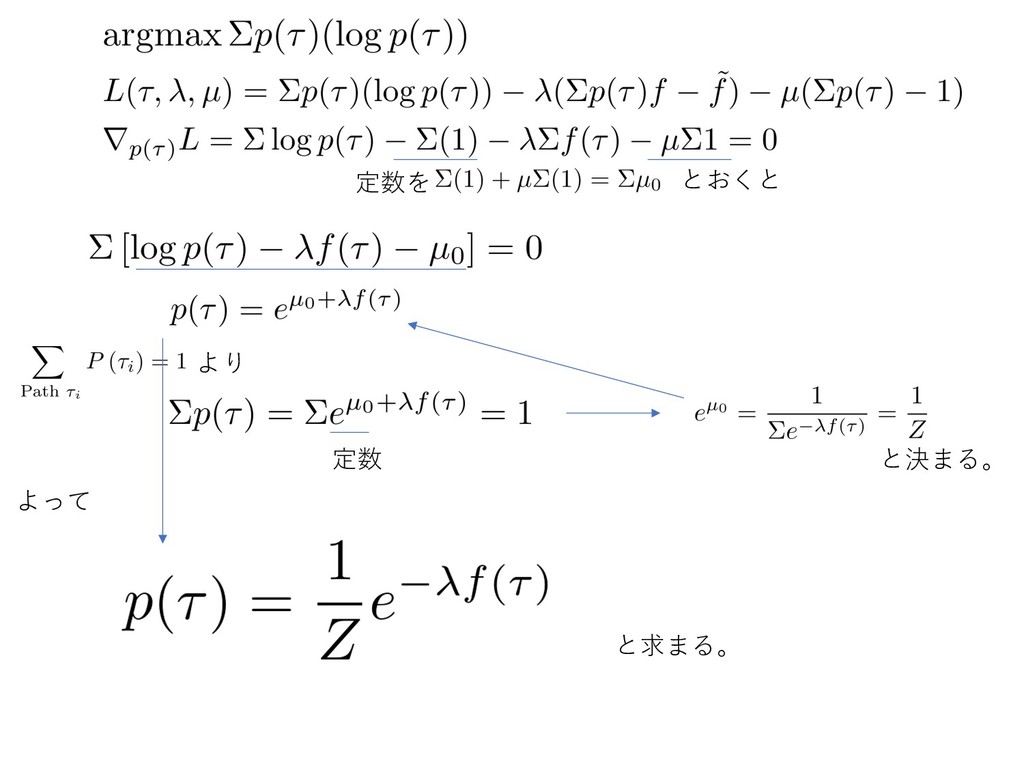
とおくと 定数を より 定数 よって と決まる。 と求まる。
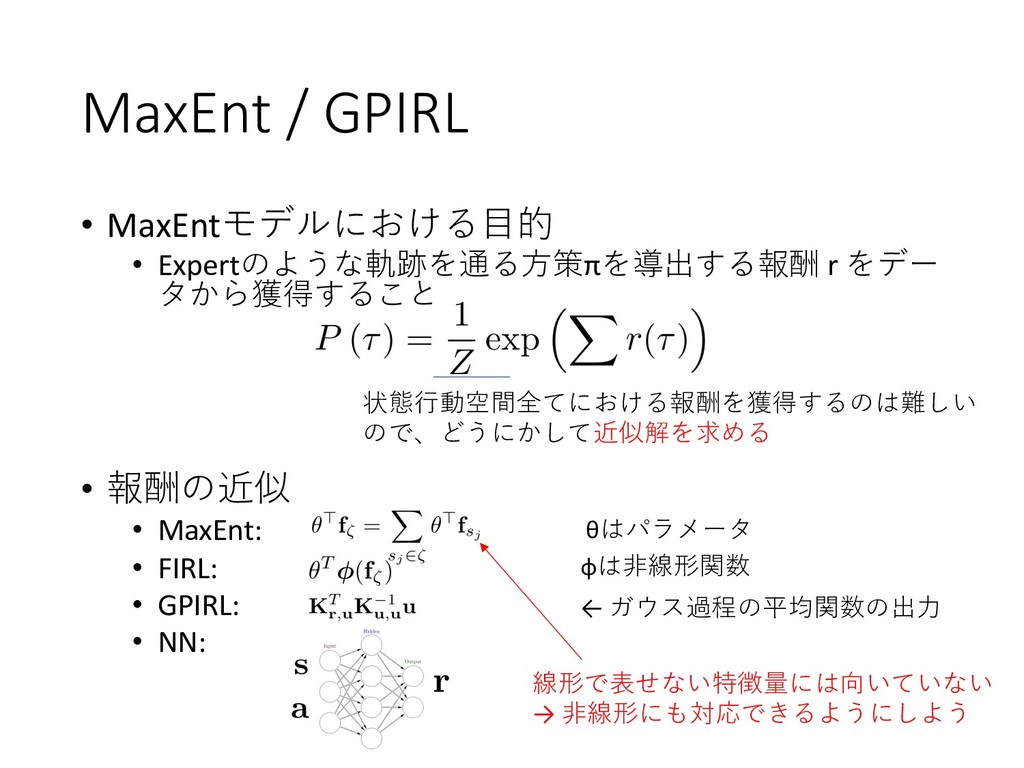
MaxEnt / GPIRL • MaxEntモデルにおける⽬的 • Expertのような軌跡を通る⽅策πを導出する報酬 r をデー タから獲得すること
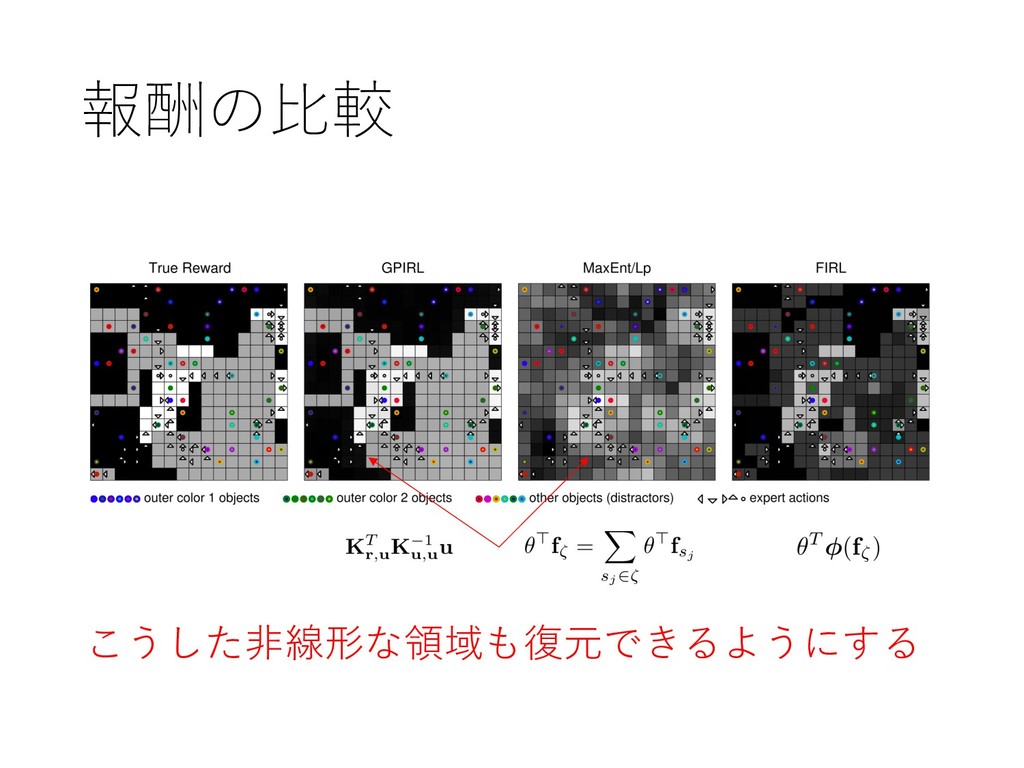
• 報酬の近似 • MaxEnt: • FIRL: • GPIRL: • NN: 状態⾏動空間全てにおける報酬を獲得するのは難しい ので、どうにかして近似解を求める θはパラメータ φは⾮線形関数 ← ガウス過程の平均関数の出⼒ 線形で表せない特徴量には向いていない → ⾮線形にも対応できるようにしよう
報酬の⽐較 こうした⾮線形な領域も復元できるようにする
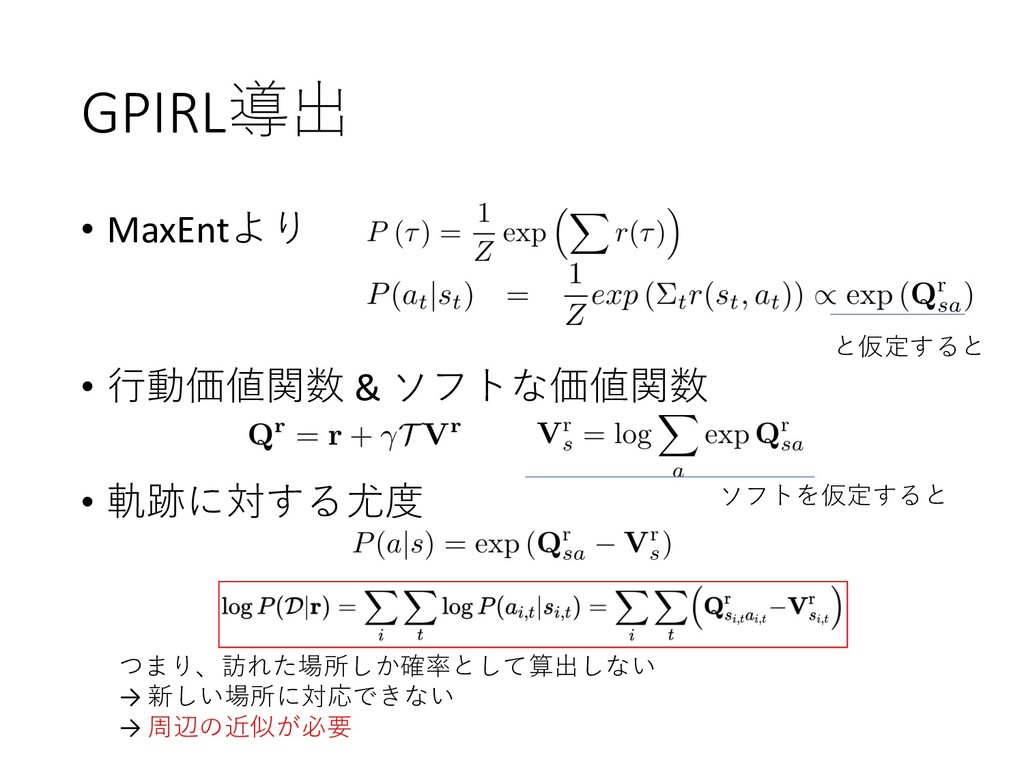
GPIRL導出 • MaxEntより • ⾏動価値関数 & ソフトな価値関数 • 軌跡に対する尤度 つまり、訪れた場所しか確率として算出しない
→ 新しい場所に対応できない → 周辺の近似が必要 と仮定すると ソフトを仮定すると
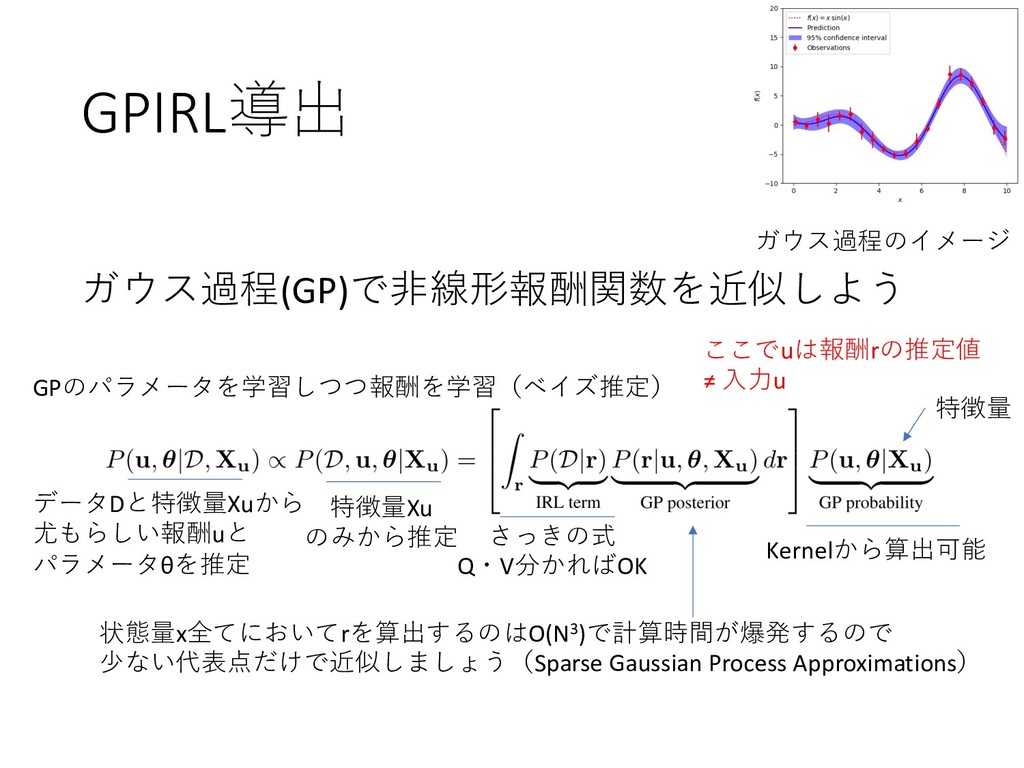
GPIRL導出 ガウス過程(GP)で⾮線形報酬関数を近似しよう ガウス過程のイメージ データDと特徴量Xuから 尤もらしい報酬uと パラメータθを推定 特徴量Xu のみから推定 さっきの式 Q・V分かればOK
Kernelから算出可能 GPのパラメータを学習しつつ報酬を学習(ベイズ推定) 状態量x全てにおいてrを算出するのはO(N3)で計算時間が爆発するので 少ない代表点だけで近似しましょう(Sparse Gaussian Process Approximations) ここでuは報酬rの推定値 ≠ ⼊⼒u 特徴量
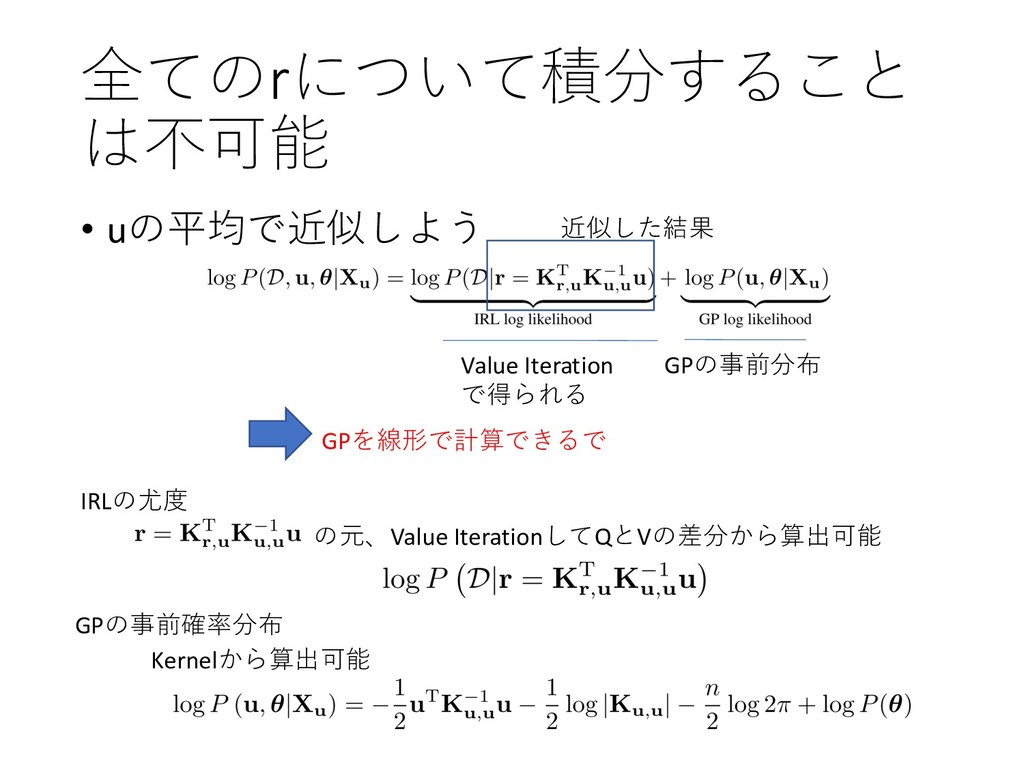
全てのrについて積分すること は不可能 Value Iteration で得られる GPの事前分布 • uの平均で近似しよう GPの事前確率分布 IRLの尤度
の元、Value IterationしてQとVの差分から算出可能 Kernelから算出可能 近似した結果 GPを線形で計算できるで
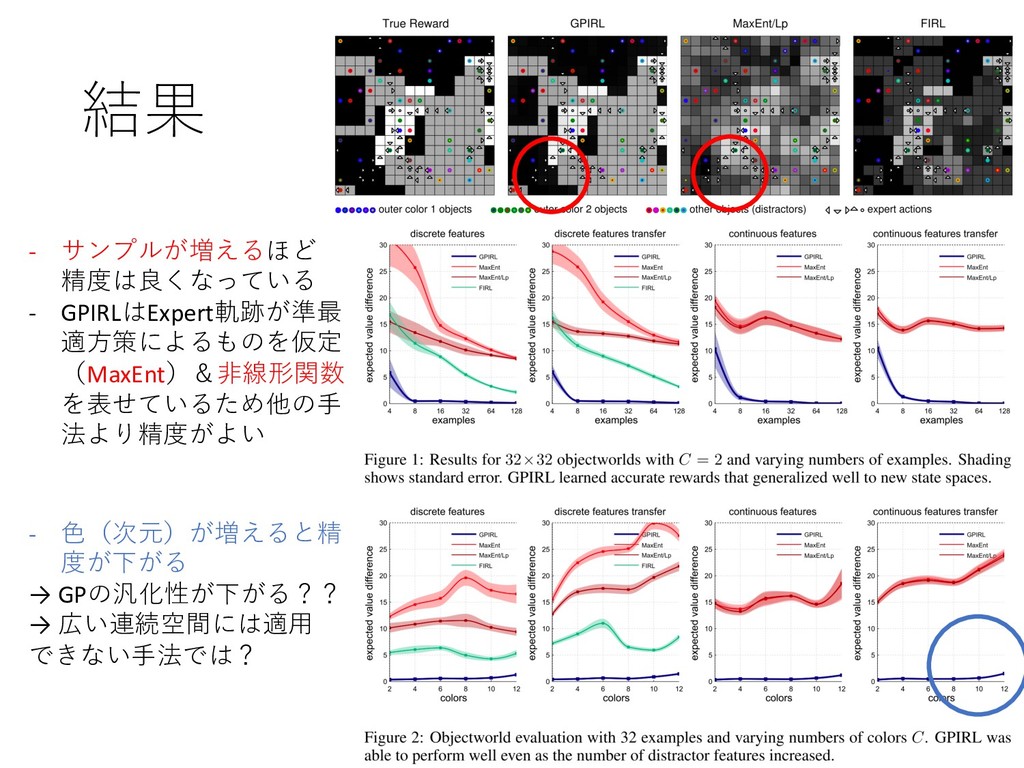
結果 - サンプルが増えるほど 精度は良くなっている - GPIRLはExpert軌跡が準最 適⽅策によるものを仮定 (MaxEnt)&⾮線形関数 を表せているため他の⼿ 法より精度がよい
- ⾊(次元)が増えると精 度が下がる → GPの汎化性が下がる?? → 広い連続空間には適⽤ できない⼿法では?
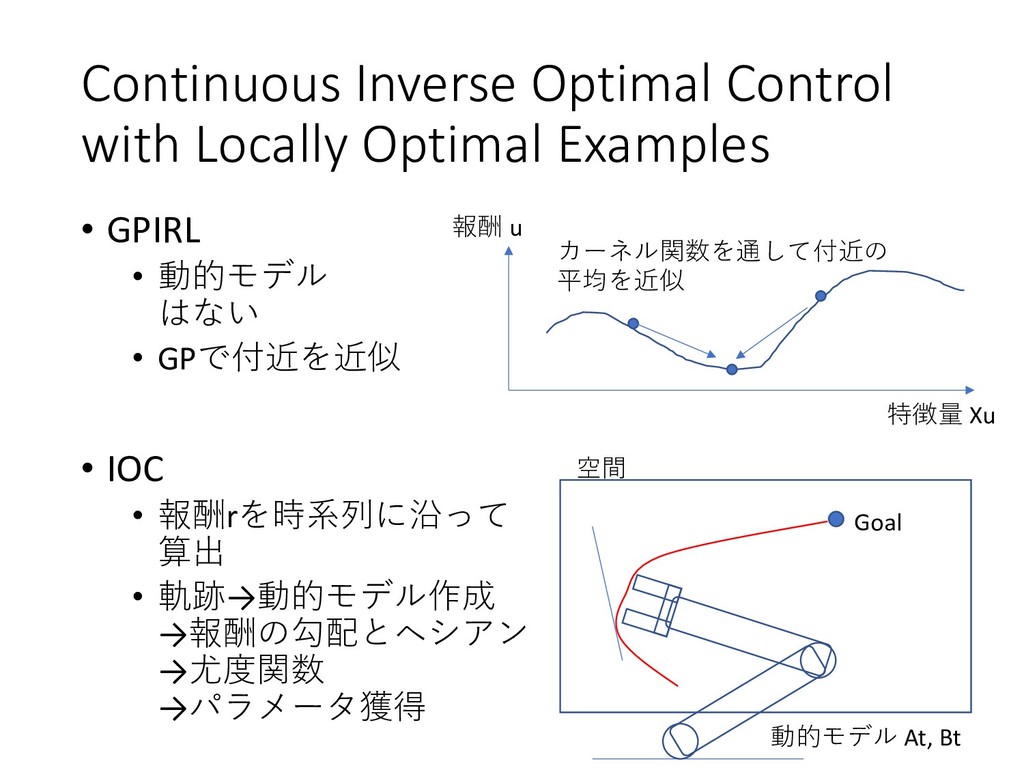
Continuous Inverse Optimal Control with Locally Optimal Examples • GPIRL
• 動的モデル はない • GPで付近を近似 • IOC • 報酬rを時系列に沿って 算出 • 軌跡→動的モデル作成 →報酬の勾配とヘシアン →尤度関数 →パラメータ獲得 特徴量 Xu 報酬 u カーネル関数を通して付近の 平均を近似 Goal 動的モデル At, Bt 空間
ここから 状態s=x, ⾏動a=u
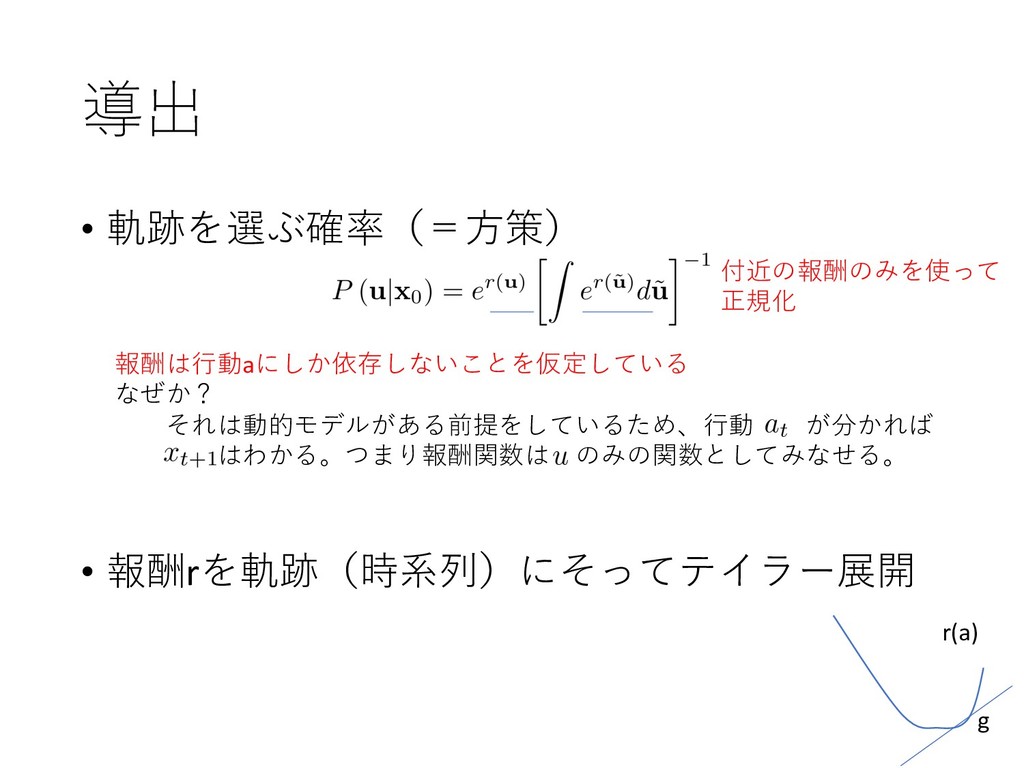
導出 • 軌跡を選ぶ確率(=⽅策) • 報酬rを軌跡(時系列)にそってテイラー展開 r(a) g 報酬は⾏動aにしか依存しないことを仮定している なぜか? それは動的モデルがある前提をしているため、⾏動
が分かれば はわかる。つまり報酬関数は のみの関数としてみなせる。 付近の報酬のみを使って 正規化
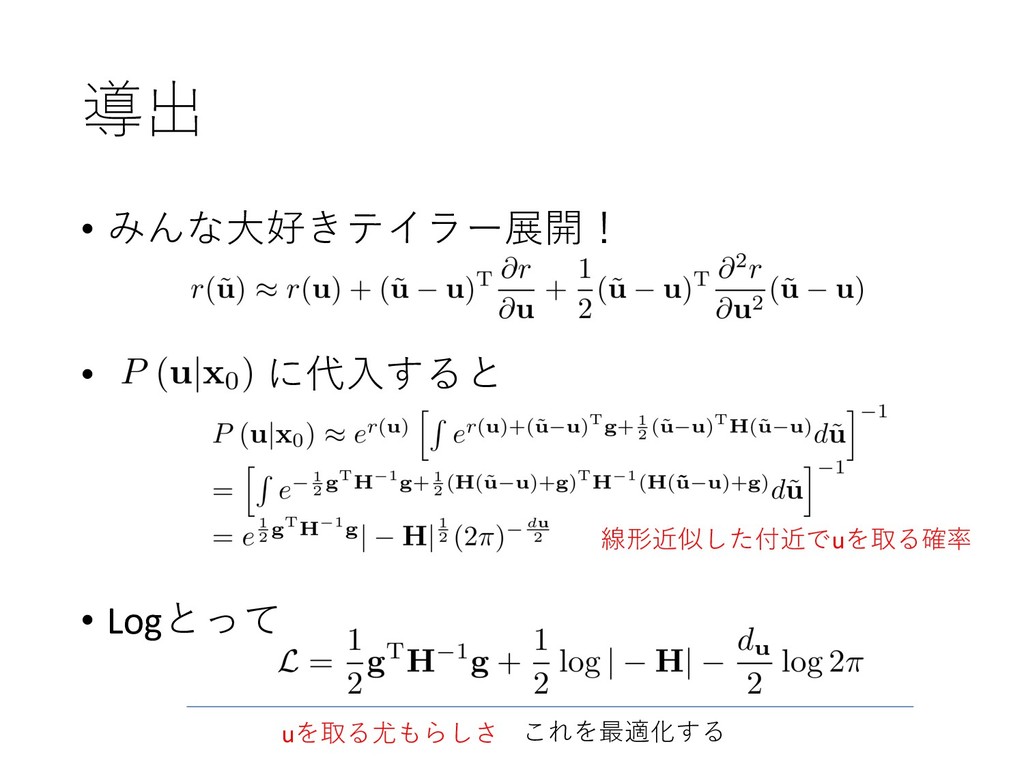
導出 • みんな⼤好きテイラー展開! • に代⼊すると • Logとって これを最適化する 線形近似した付近でuを取る確率 uを取る尤もらしさ
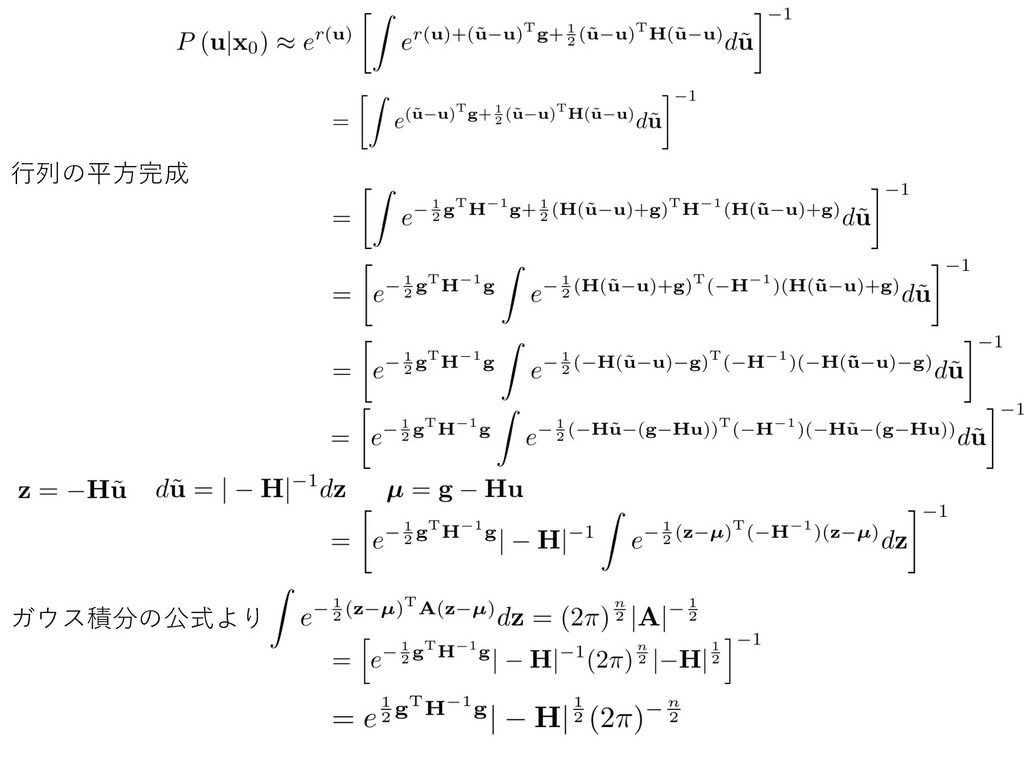
⾏列の平⽅完成 ガウス積分の公式より
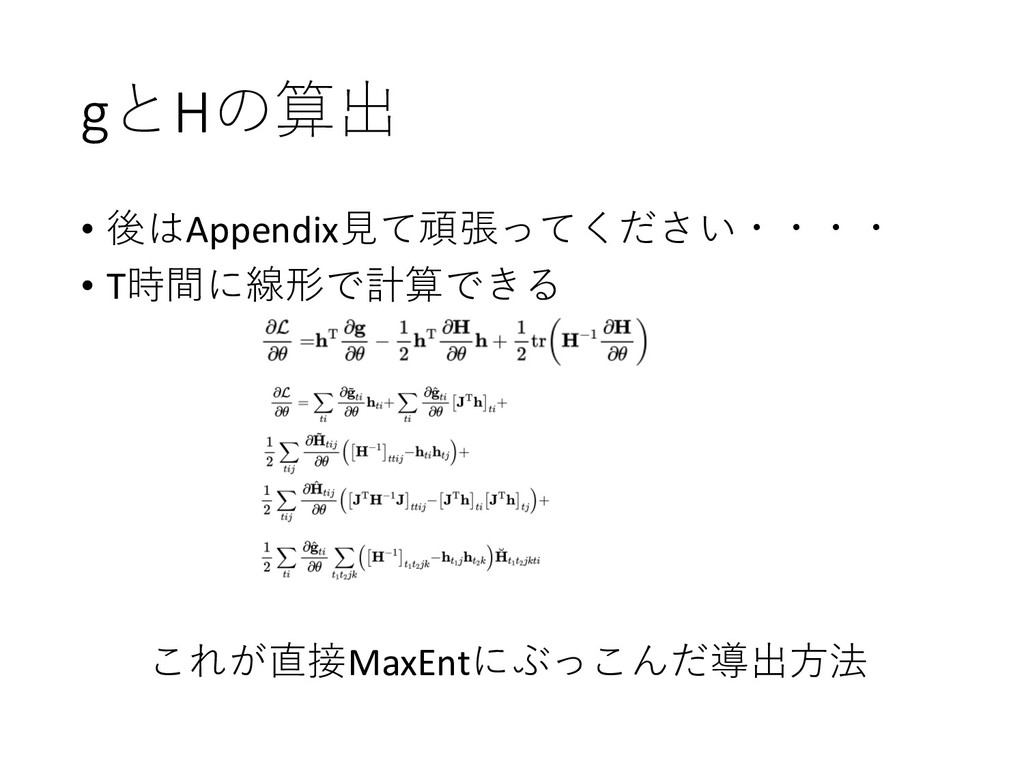
gとHの算出 • 後はAppendix⾒て頑張ってください・・・・ • T時間に線形で計算できる これが直接MaxEntにぶっこんだ導出⽅法
Break
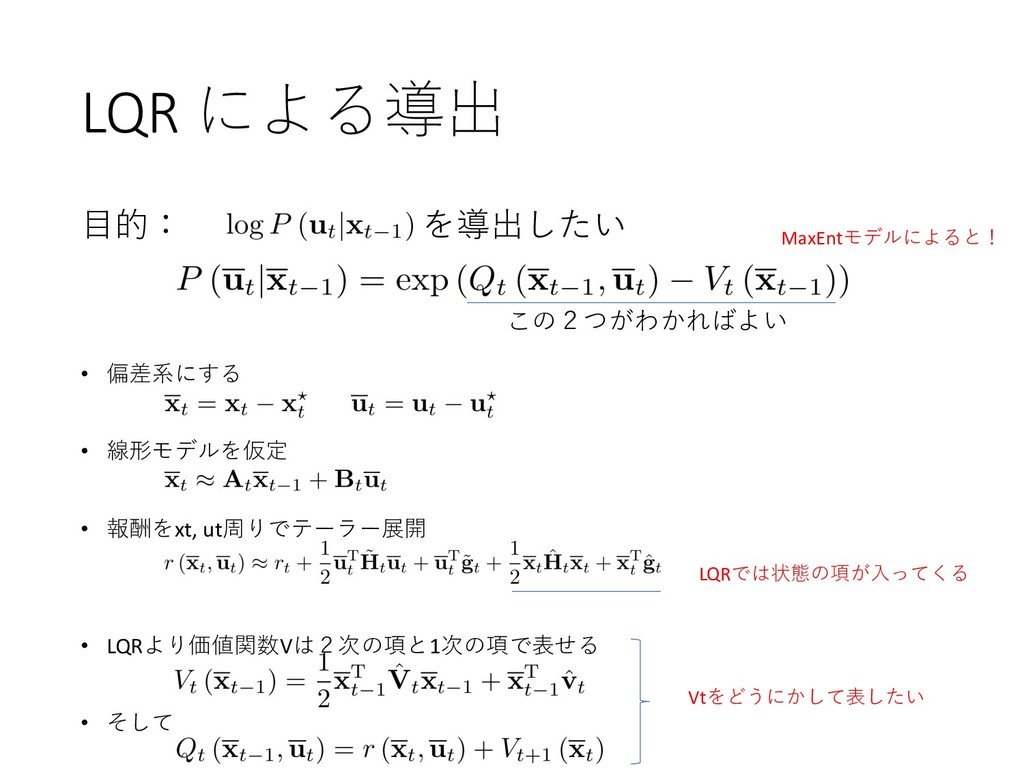
LQR による導出 ⽬的: を導出したい • 偏差系にする • 線形モデルを仮定 • 報酬をxt,
ut周りでテーラー展開 • LQRより価値関数Vは2次の項と1次の項で表せる • そして LQRでは状態の項が⼊ってくる MaxEntモデルによると! この2つがわかればよい Vtをどうにかして表したい
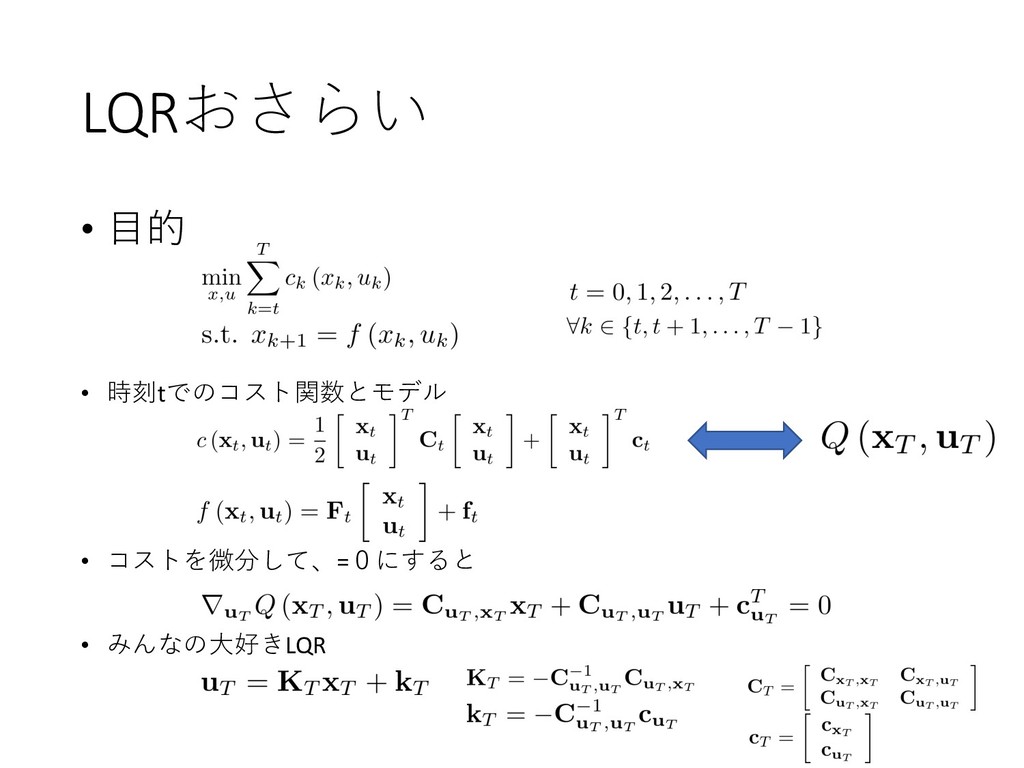
LQRおさらい • ⽬的 • 時刻tでのコスト関数とモデル • コストを微分して、=0にすると • みんなの⼤好きLQR
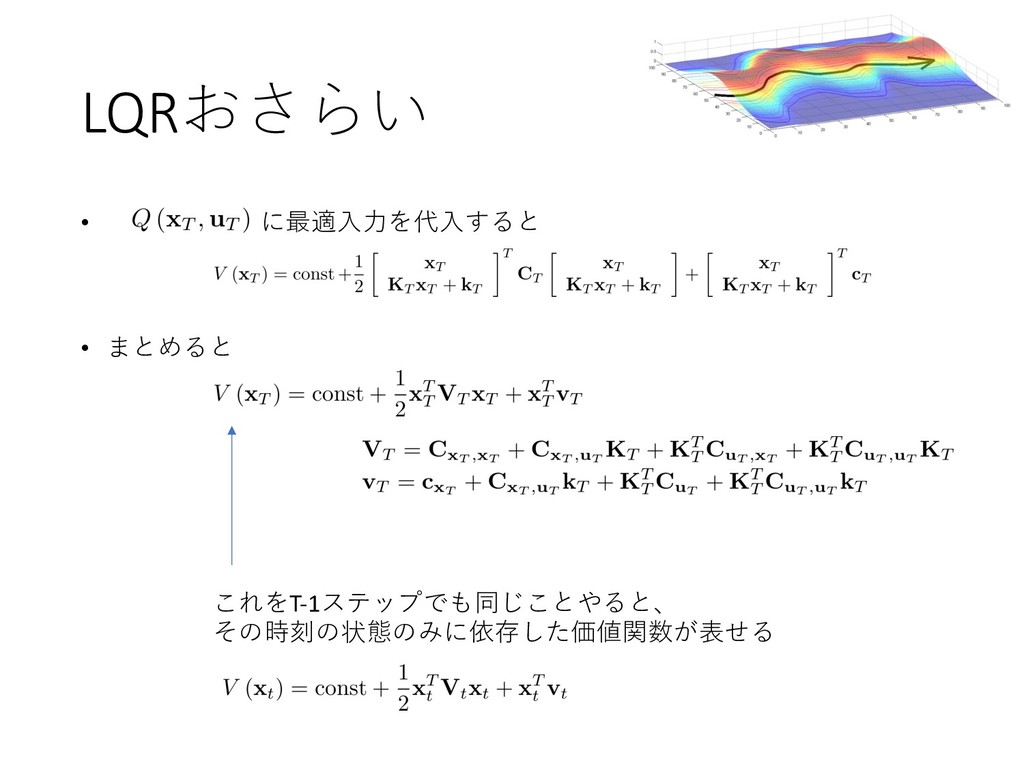
LQRおさらい • に最適⼊⼒を代⼊すると • まとめると これをT-1ステップでも同じことやると、 その時刻の状態のみに依存した価値関数が表せる
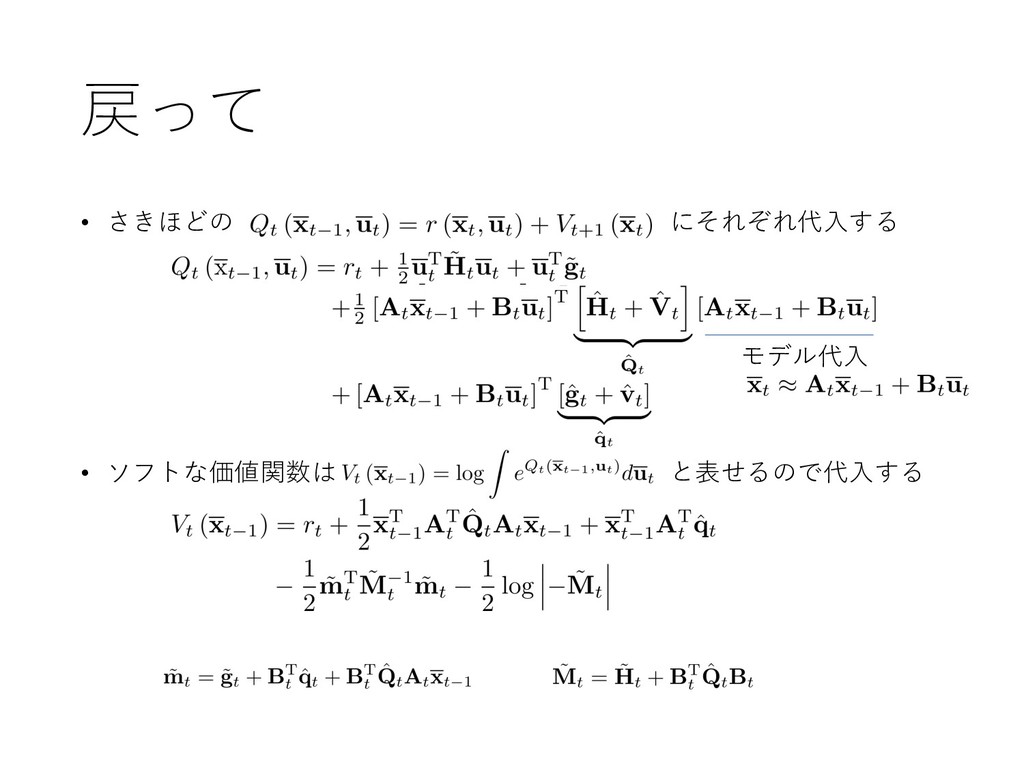
戻って • さきほどの にそれぞれ代⼊する • ソフトな価値関数は と表せるので代⼊する モデル代⼊
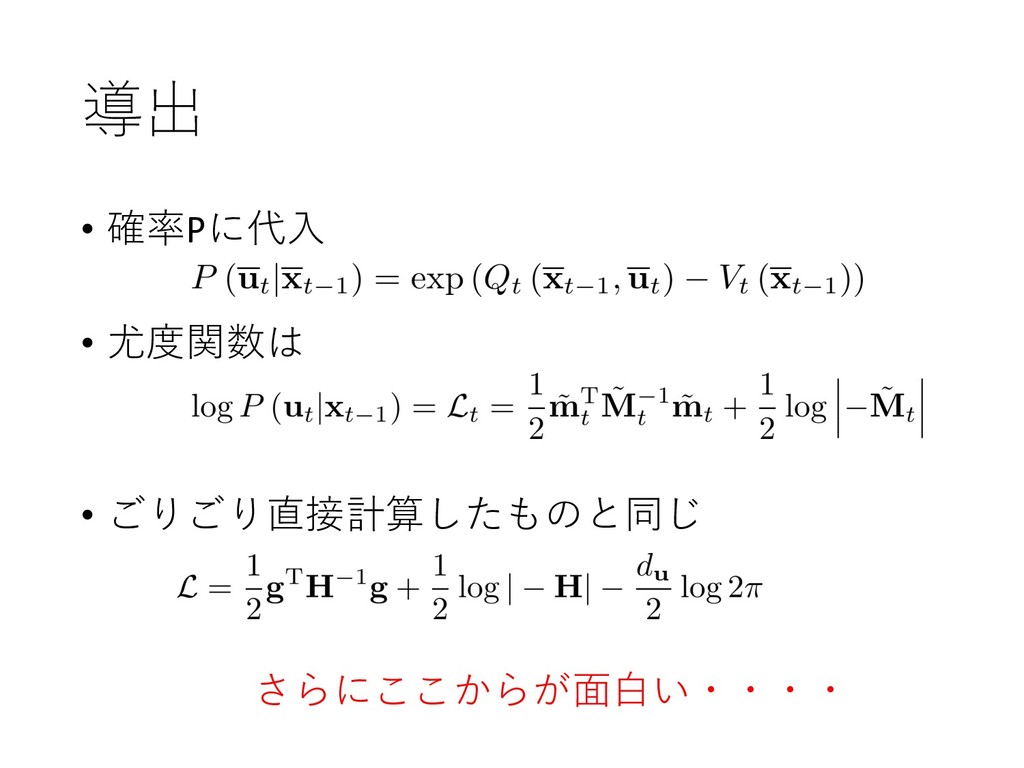
導出 • 確率Pに代⼊ • 尤度関数は • ごりごり直接計算したものと同じ さらにここからが⾯⽩い・・・・
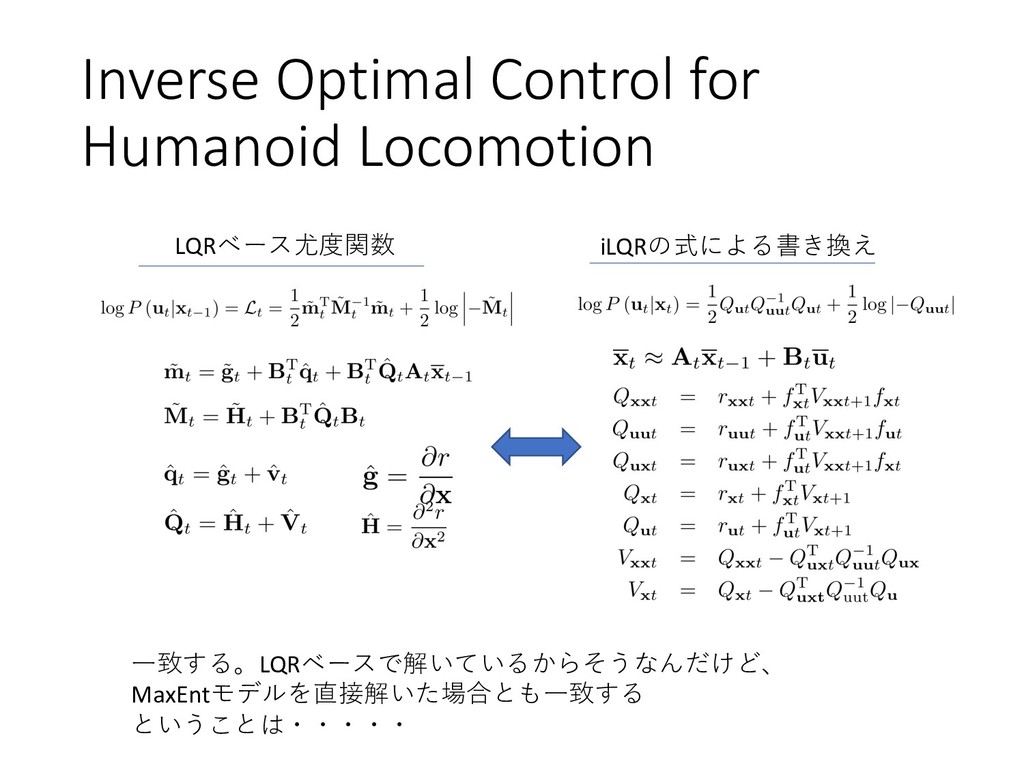
Inverse Optimal Control for Humanoid Locomotion LQRベース尤度関数 iLQRの式による書き換え ⼀致する。LQRベースで解いているからそうなんだけど、 MaxEntモデルを直接解いた場合とも⼀致する
ということは・・・・・
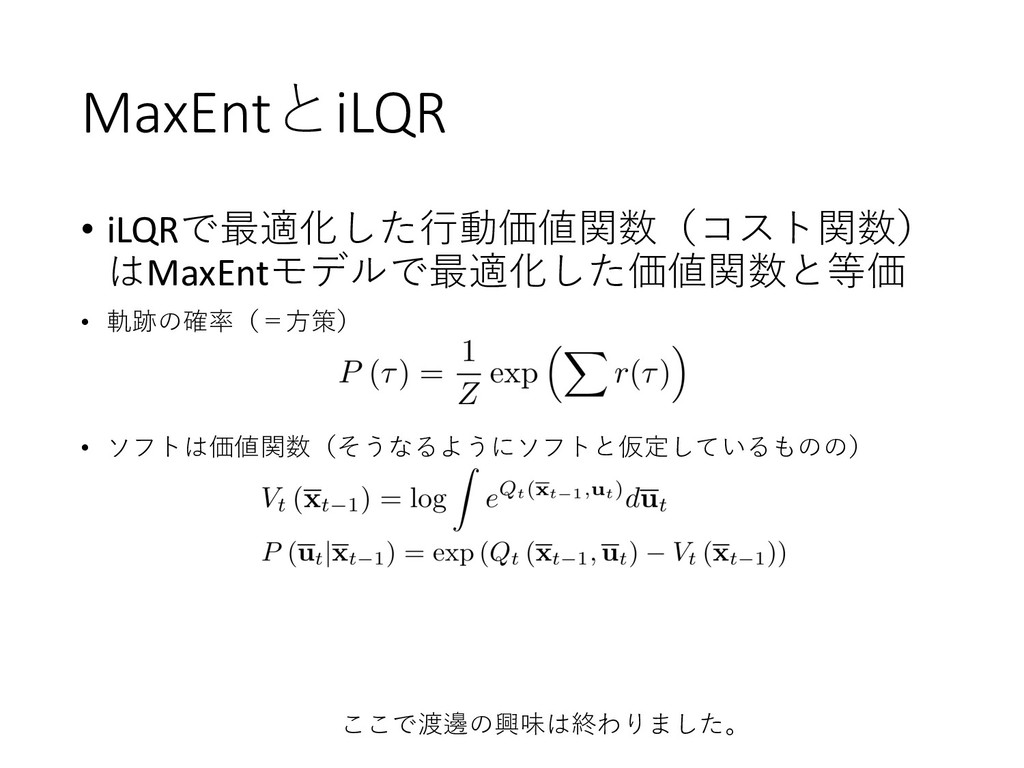
MaxEntとiLQR • iLQRで最適化した⾏動価値関数(コスト関数) はMaxEntモデルで最適化した価値関数と等価 • 軌跡の確率(=⽅策) • ソフトは価値関数(そうなるようにソフトと仮定しているものの) ここで渡邊の興味は終わりました。
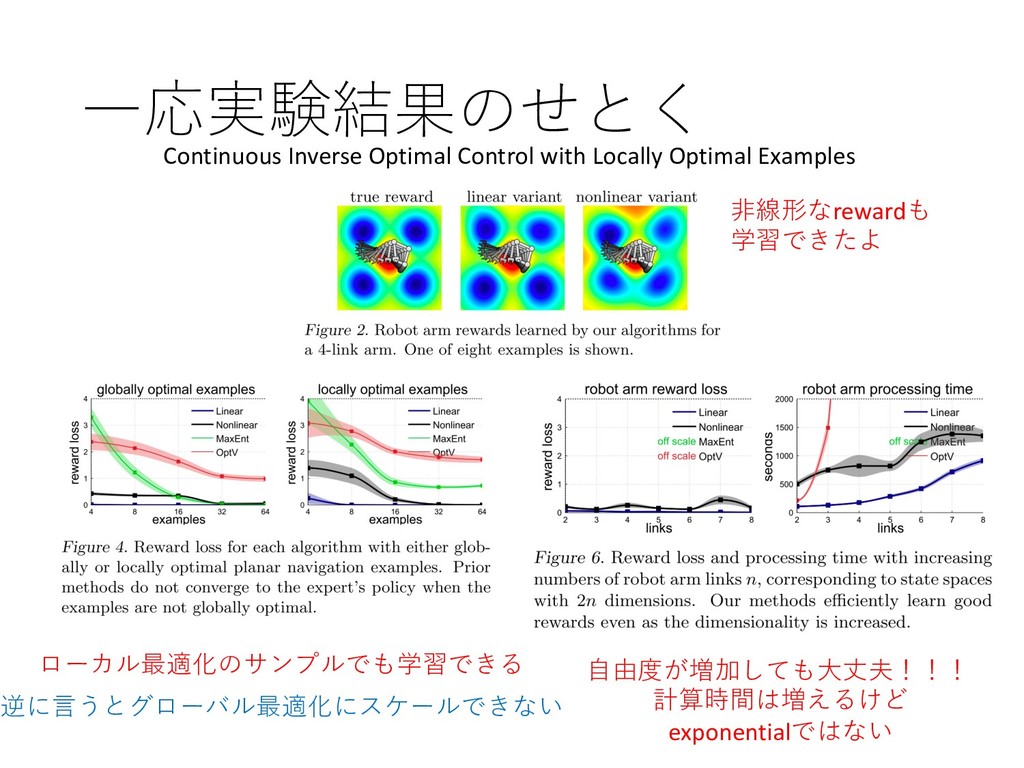
⼀応実験結果のせとく ローカル最適化のサンプルでも学習できる 逆に⾔うとグローバル最適化にスケールできない ⾮線形なrewardも 学習できたよ ⾃由度が増加しても⼤丈夫!!! 計算時間は増えるけど exponentialではない Continuous Inverse
Optimal Control with Locally Optimal Examples
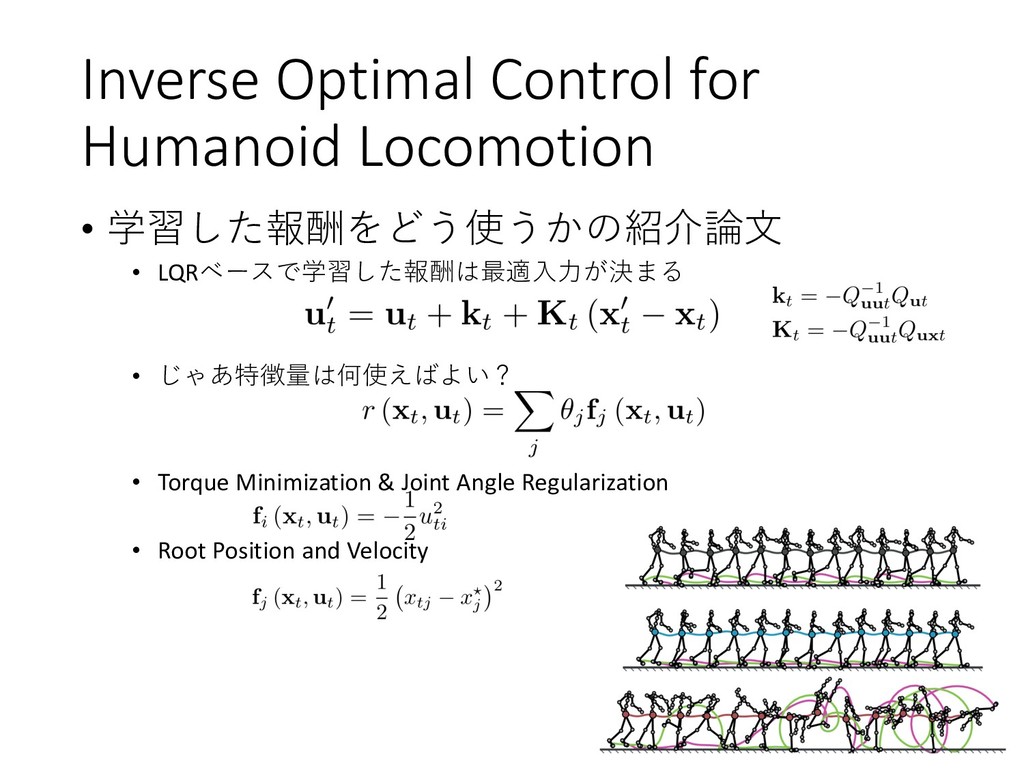
Inverse Optimal Control for Humanoid Locomotion • 学習した報酬をどう使うかの紹介論⽂ • LQRベースで学習した報酬は最適⼊⼒が決まる
• じゃあ特徴量は何使えばよい? • Torque Minimization & Joint Angle Regularization • Root Position and Velocity
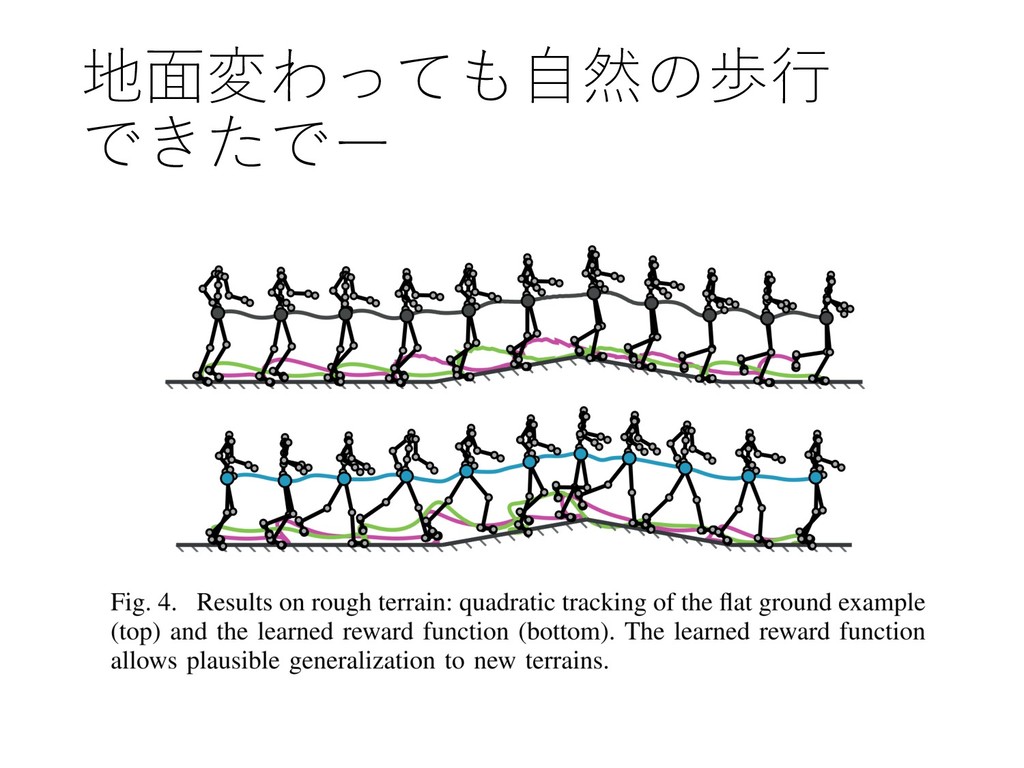
地⾯変わっても⾃然の歩⾏ できたでー
本・論⽂・著者 Rasmussen (PILCOもこの⼈) - GPの使い⼿。モデルベース強化学習の代表格 • Gaussian process dynamic programming
• Gaussian processes in reinforcement learning • Gaussian Processes for Machine Learning • Ziebart & Bagnell • Modeling Purposeful Adaptive Behavior with the Principle ofMaximum Causal Entropy, Ph.D. Thesis • これにMaxEntやIOCの基礎となる理論の導出が載っている


 de9uch1
 stktu
 kinoue_smarthr
 rikkabotan7
 resolutionfoundation
 takehaya
 koide3
 imai448
 nzw0301
 institutdelelevage
 mickey_0226
 gurzu
 nikkihalliwell
 codingconduct
 skipperchong
 paigeccino
 rocio
 bkeepers
 techseoconnect
 tammielis
 jct
 aleyda
 lynnandtonic