Share
Embed
VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs
本資料はSatAI.challengeのサーベイメンバーと共に作成したものです。
SatAI.challengeは、リモートセンシング技術にAIを適用した論文の調査や、より俯瞰した技術トレンドの調査や国際学会のメタサーベイを行う研究グループです。speakerdeckではSatAI.challenge内での勉強会で使用した資料をWeb上で共有しています。
https://x.com/sataichallenge
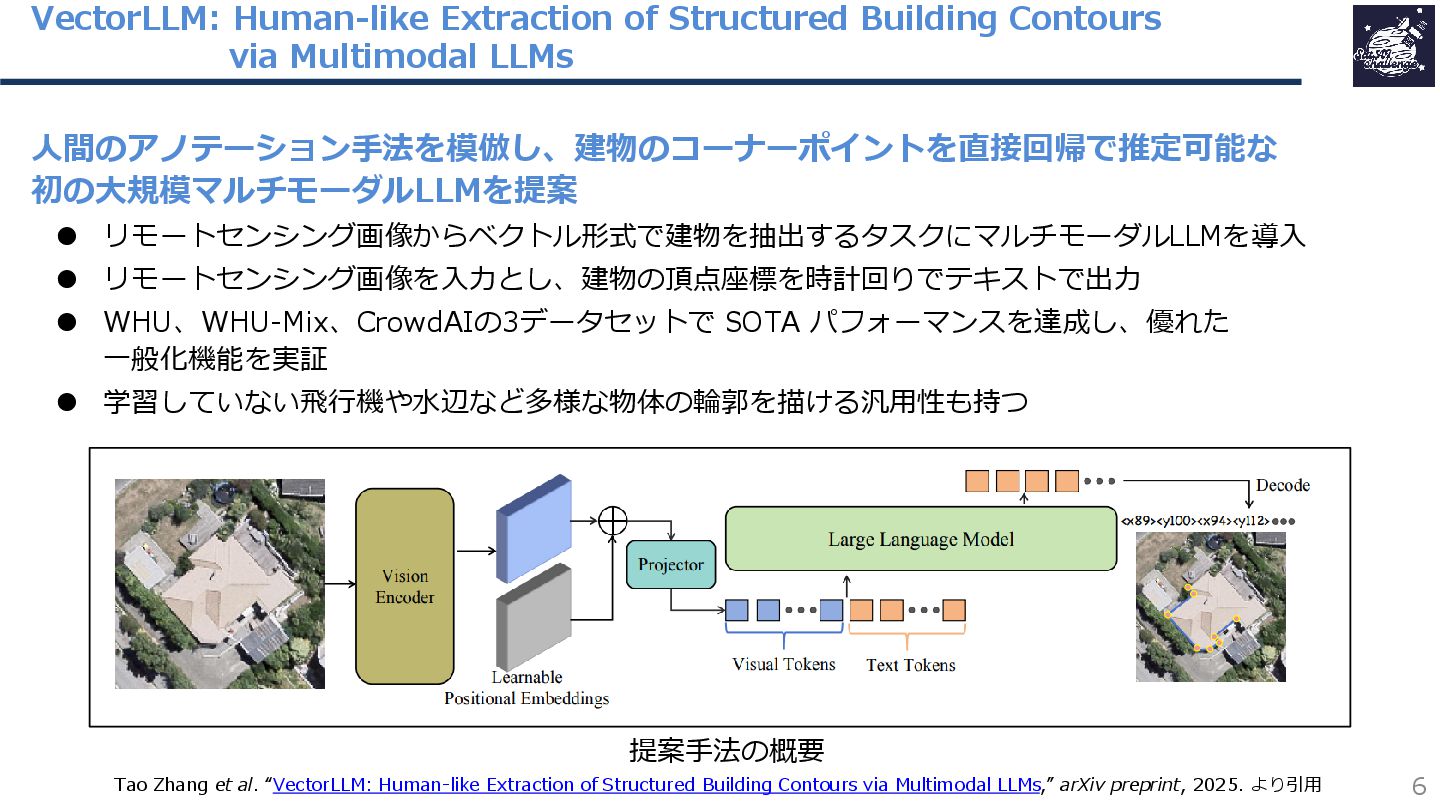
紹介する論文は「VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs」です。この研究では、人間が建物の輪郭を描くときと同様に建物の角を見つけ輪郭を描く手法を、マルチモーダル大規模言語モデルを用いて提案しています。学習を行った建物の輪郭抽出の精度が高いだけではなく、水域や道路といった学習を行っていない他の地物の輪郭も抽出できる汎用性を実現しています。
SatAI.challenge
July 27, 2025
Transcript
34 slides
-
VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs
青木 亮祐 / ぴっかりん(@ra0kley) 1 第15回 SatAI.challenge勉強会 -
目次 2 • 自己紹介スライド • 研究の1ページサマリ紹介 • 研究の背景(Introduction) • 手法について(Method)
• 実験(Experimet) • 結論(Conclusion) • 読んだ感想・思ったこと -
青木 亮祐(ぴっかりん) 株式会社パスコ 研究開発センター 自己紹介 4 X(旧Twitter) GitHub 最近の業務: -
地理空間情報×AIで色々行ったり、その環境整備 - オウンドメディアの編集のお手伝いやイベントの企画など Project PLATEAU ADVOCATE 2025 -
VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs
6 人間のアノテーション手法を模倣し、建物のコーナーポイントを直接回帰で推定可能な 初の大規模マルチモーダルLLMを提案 • リモートセンシング画像からベクトル形式で建物を抽出するタスクにマルチモーダルLLMを導入 • リモートセンシング画像を入力とし、建物の頂点座標を時計回りでテキストで出力 • WHU、WHU-Mix、CrowdAIの3データセットで SOTA パフォーマンスを達成し、優れた 一般化機能を実証 • 学習していない飛行機や水辺など多様な物体の輪郭を描ける汎用性も持つ 提案手法の概要 Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
背景: AIによって建物を抽出する意義と課題 8 • リモートセンシング画像からの建物抽出は都市計画や人口推計、災害評価、地図の更新など 様々なタスクで使われる重要なタスク • AIによって自動的かつ正確に建物を抽出する手法は色々出てきているが 既存手法は複雑な多段階のパイプラインで構成されており、スケーラビリティと実世界への 適用に制限がある
• 最近では、リモートセンシングから地物抽出のタスクでも、SAM(Segmentation Anything Model)が 用いられ始めているが、ファインチューニングしても様々なタスクへの汎用性がない -
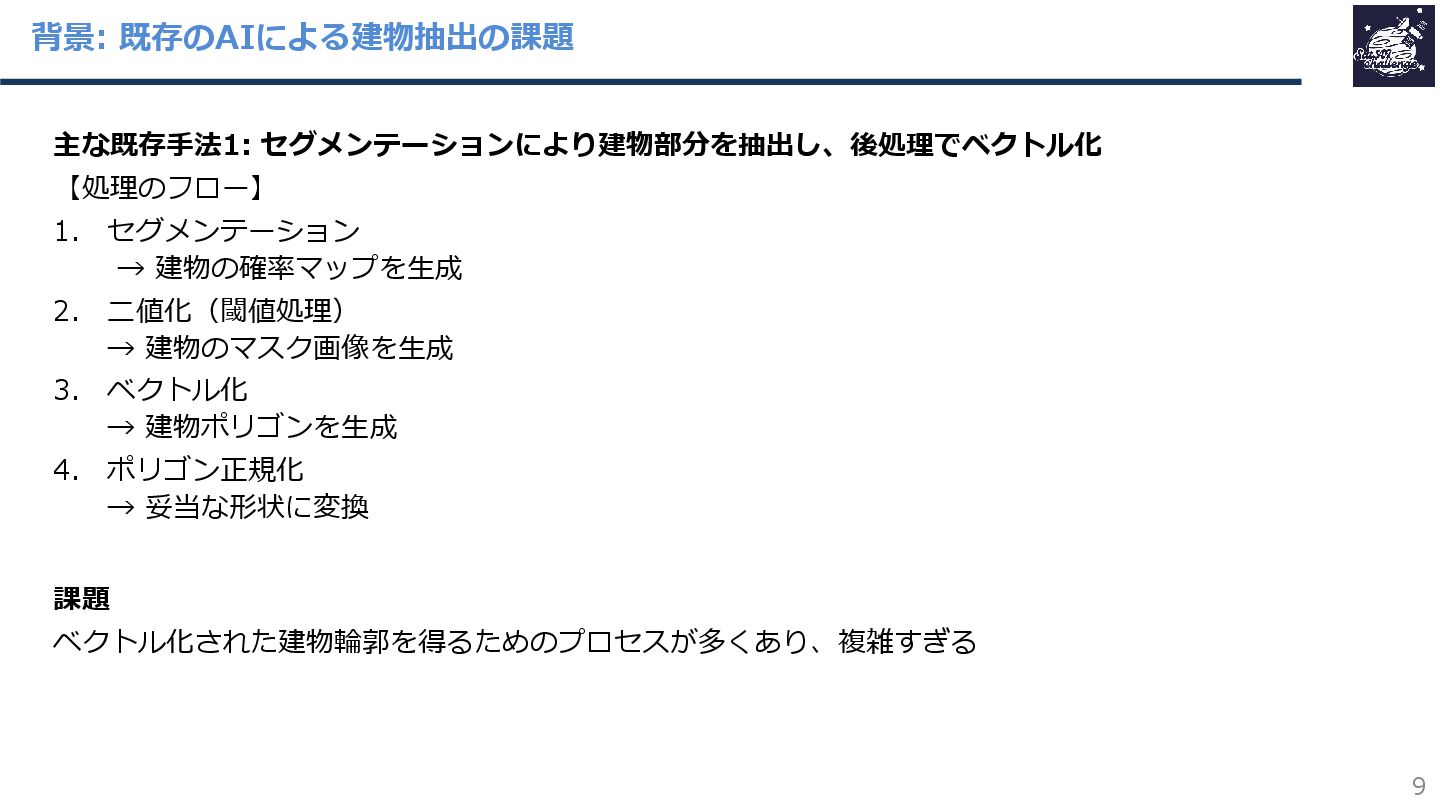
背景: 既存のAIによる建物抽出の課題 9 主な既存手法1: セグメンテーションにより建物部分を抽出し、後処理でベクトル化 【処理のフロー】 1. セグメンテーション → 建物の確率マップを生成
2. 二値化(閾値処理) → 建物のマスク画像を生成 3. ベクトル化 → 建物ポリゴンを生成 4. ポリゴン正規化 → 妥当な形状に変換 課題 ベクトル化された建物輪郭を得るためのプロセスが多くあり、複雑すぎる -
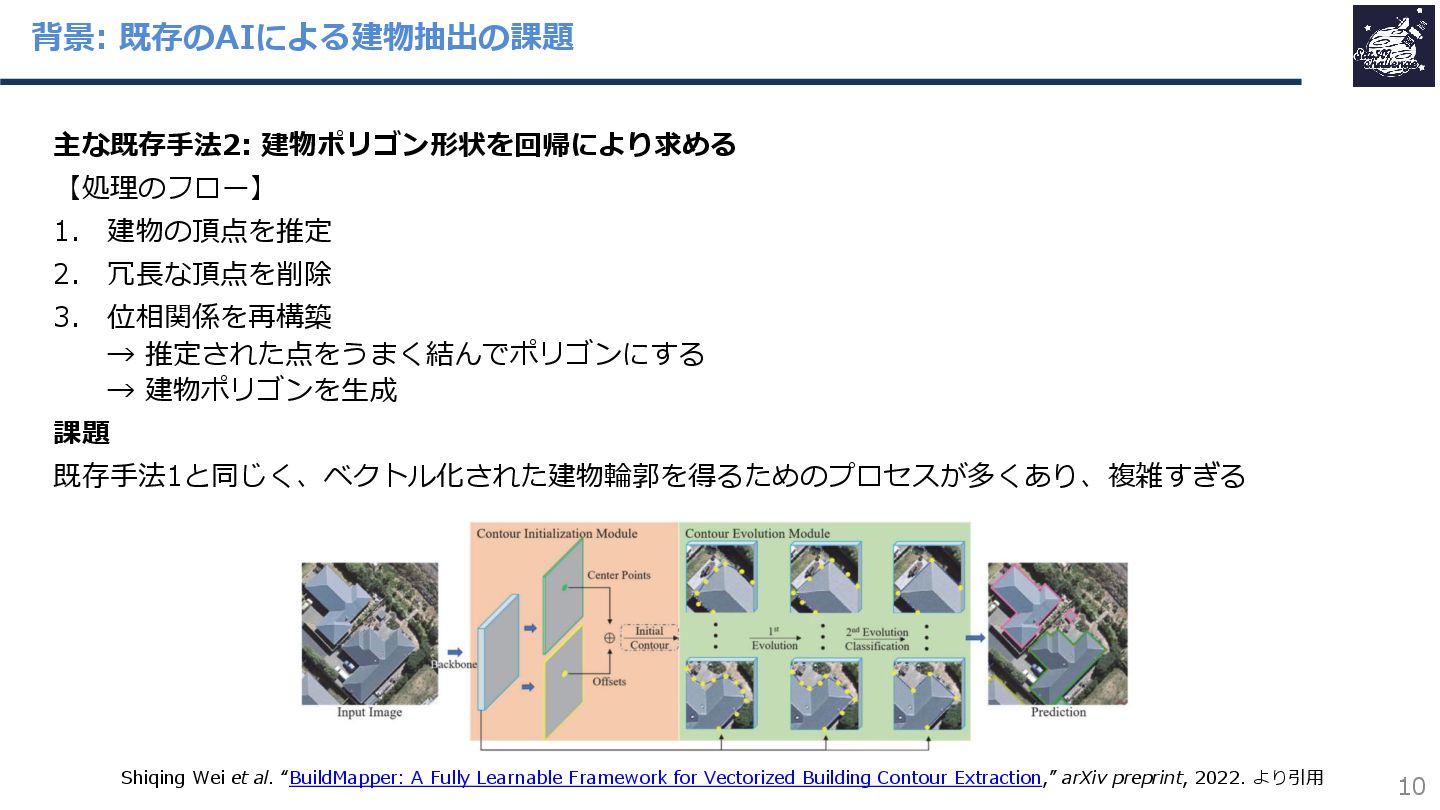
背景: 既存のAIによる建物抽出の課題 10 主な既存手法2: 建物ポリゴン形状を回帰により求める 【処理のフロー】 1. 建物の頂点を推定 2. 冗長な頂点を削除
3. 位相関係を再構築 → 推定された点をうまく結んでポリゴンにする → 建物ポリゴンを生成 課題 既存手法1と同じく、ベクトル化された建物輪郭を得るためのプロセスが多くあり、複雑すぎる Shiqing Wei et al. “BuildMapper: A Fully Learnable Framework for Vectorized Building Contour Extraction,” arXiv preprint, 2022. より引用 -
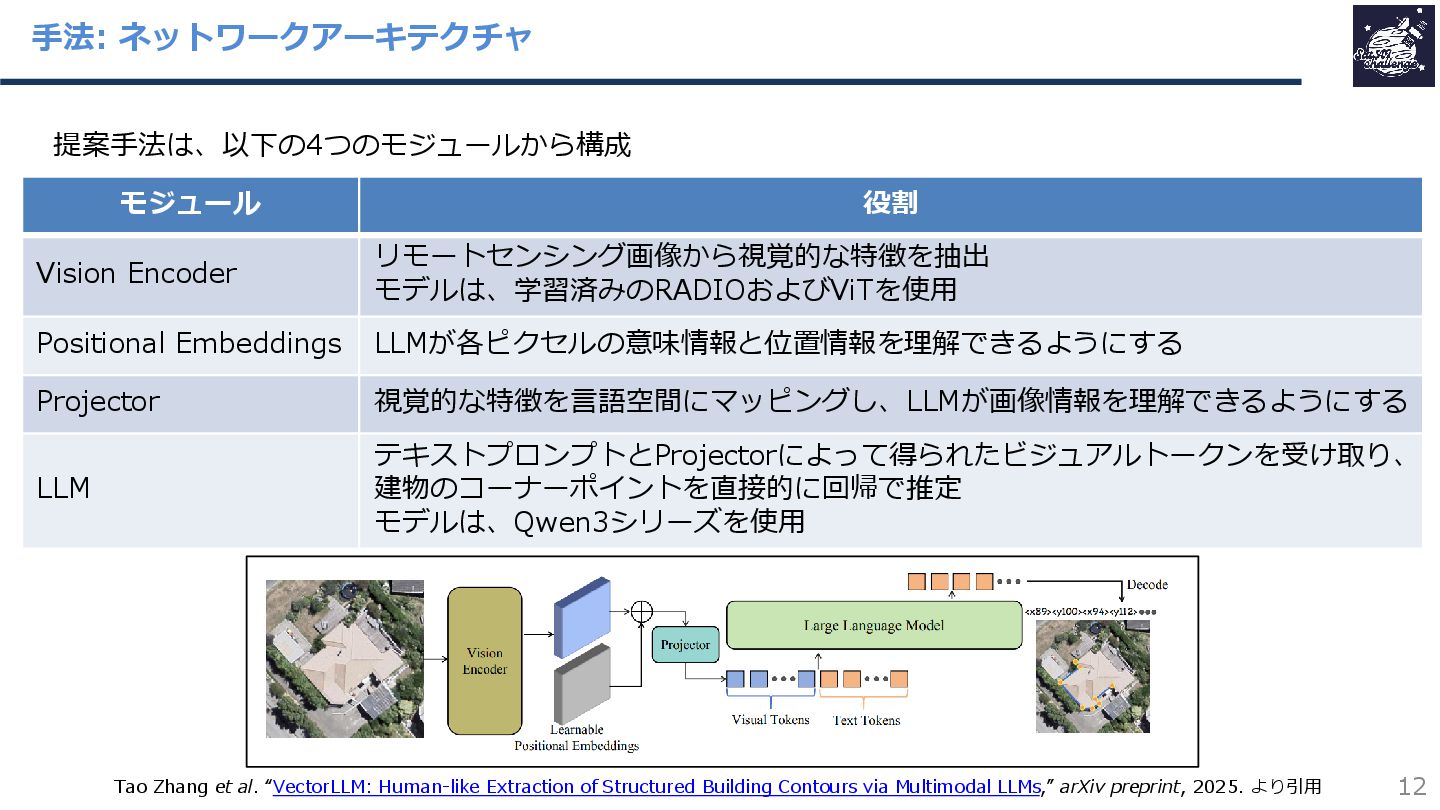
手法: ネットワークアーキテクチャ 12 提案手法は、以下の4つのモジュールから構成 モジュール 役割 Vision Encoder リモートセンシング画像から視覚的な特徴を抽出 モデルは、学習済みのRADIOおよびViTを使用
Positional Embeddings LLMが各ピクセルの意味情報と位置情報を理解できるようにする Projector 視覚的な特徴を言語空間にマッピングし、LLMが画像情報を理解できるようにする LLM テキストプロンプトとProjectorによって得られたビジュアルトークンを受け取り、 建物のコーナーポイントを直接的に回帰で推定 モデルは、Qwen3シリーズを使用 Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
手法: 学習戦略(事前トレーニング) 13 視覚的な特徴をテキスト空間に紐づけるだけでなく、 幾何学的推論能力をLLMに学習させるのが目的 事前学習データ例 “Input: [image]¥n[x85][y32][x160][y63][x135][y122] [x176][y139][x154][y191][x103][y169][x111] [y150][x46][y124][x85][y32].”
損失関数 next-token-prediction loss 工夫点 建物輪郭を描き始める始点をランダムにシャッフル することで、過学習を防ぎ、汎用性を高める Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
手法: 学習戦略(教師ありファインチューニング) 14 ユーザの指示に対応した回答を出力するように学習 学習データ例 既存の建物抽出データセットをVQA形式に再構成し使用 建物の左上隅を始点とし、時計回りに点を並べるように回答 を生成するように学習 “Input: [image]¥nPlease
extract the regular vector contour of the central building in the image, start from the left top corner and in clockwise. Output: [x85][y32][x160][y63][x135][y122][x176][y139] [x154][y191][x103][y169][x111][y150][x46][y124] [x85][y32].” 損失関数 next-token-prediction loss Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
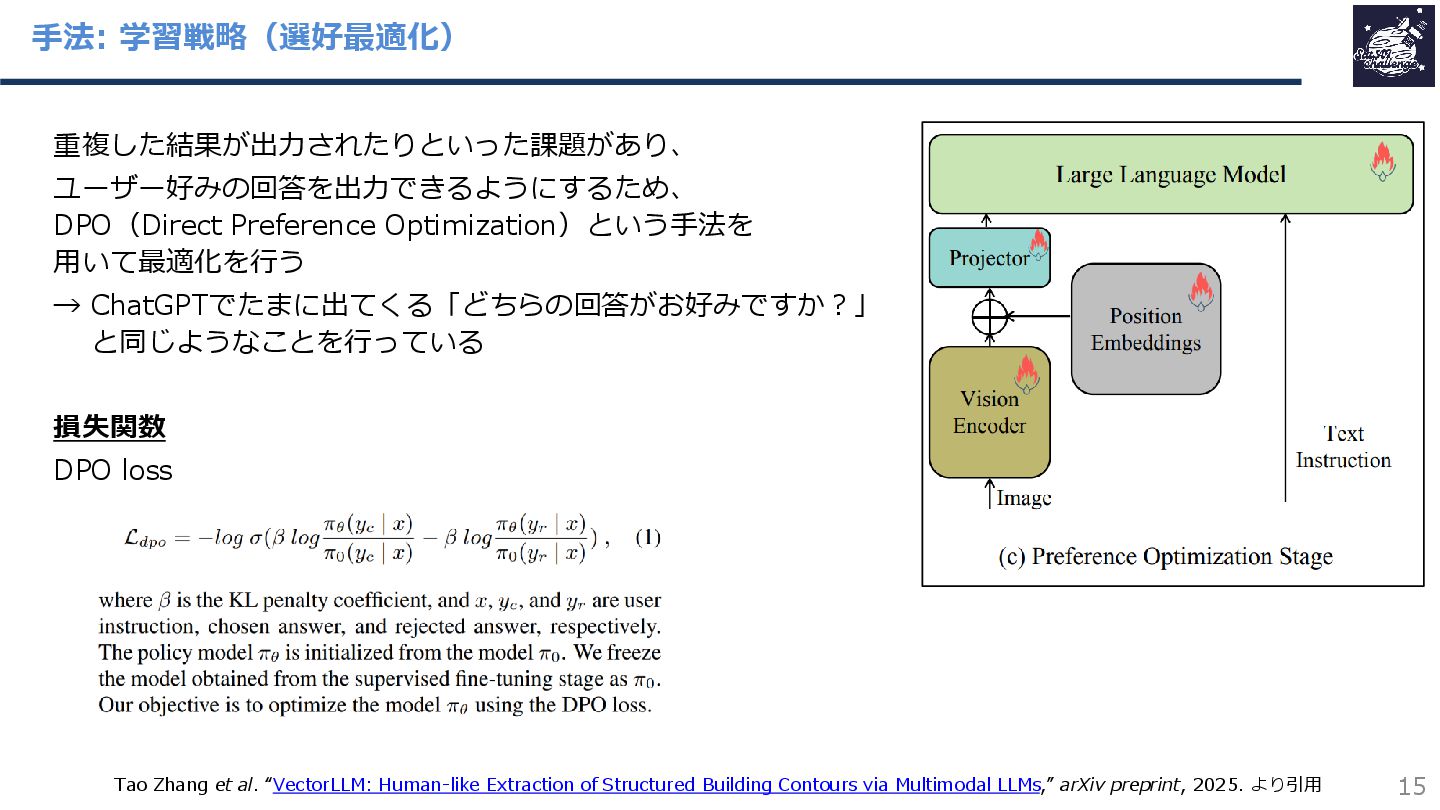
手法: 学習戦略(選好最適化) 15 重複した結果が出力されたりといった課題があり、 ユーザー好みの回答を出力できるようにするため、 DPO(Direct Preference Optimization)という手法を 用いて最適化を行う →
ChatGPTでたまに出てくる「どちらの回答がお好みですか?」 と同じようなことを行っている 損失関数 DPO loss Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
学習データ例 好ましい回答:教師ありファインチューニングモデルの 推論結果でIoU0.8以上のもの 好ましくない回答: IoUが0.8未満の推論結果 わざとランダムに破損させた推論結果 “Input: [image]¥nPlease extract the
regular vector contour of the central building in the image, start from the left top corner and in clockwise. Rejected Answer: [x83][y40][x96][y38][x95][y30][x116] [y26][x121][y49][x111][y51][x112][y58][x106][y60][x115] [y107][x128][y104][x134][y137][x121][y139][x126][y165] [x140][y187][x83][y197][x83][y40] Chosen Answer: [x85][y47][x97][y45][x96][y37][x115] [y34][x120][y55][x111][y57][x112][y64][x107][y65][x115] [y107][x126][y105][x131][y135][x120][y137][x125][y160] [x133][y159][x137][y180][x85][y190][x85][y47].” 手法: 学習戦略(選好最適化) 16 -
手法: 学習戦略(バウンディングボックス アクセス) 17 現状のLLMの課題 画像内の建物の輪郭を描画するように設計されているが、現在のLLMは、トークンの制限により 画像中に100を超える小さな建物があるなどに対応できない 解決策 LサイズのSwin TransformerをバックボーンとしたFCOS(物体検出モデル)にて建物を検出し、
その結果を入力する 背景情報を含めるために、判読されたバウンディングボックスをわずかに拡大させる 入力データの作成 学習時: 教師データの画像からあらかじめ各建物を切り取って、VectorLLMに入力 推論時: 画像中のすべての建物をFCOSで検出し、事前に切り取ってからVectorLLMに入力 -
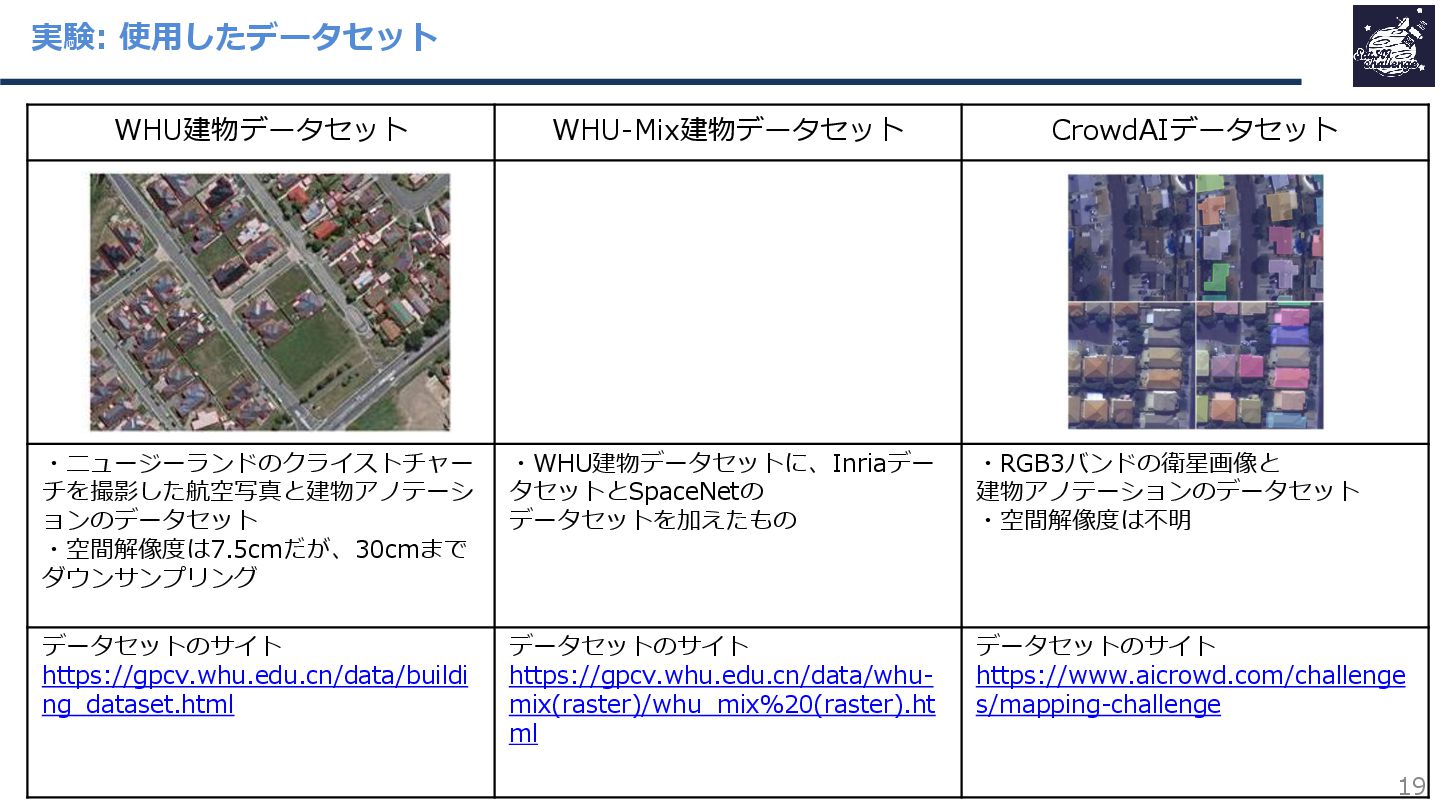
実験: 使用したデータセット 19 WHU建物データセット WHU-Mix建物データセット CrowdAIデータセット ・ニュージーランドのクライストチャー チを撮影した航空写真と建物アノテーシ ョンのデータセット ・空間解像度は7.5cmだが、30cmまで
ダウンサンプリング ・WHU建物データセットに、Inriaデー タセットとSpaceNetの データセットを加えたもの ・RGB3バンドの衛星画像と 建物アノテーションのデータセット ・空間解像度は不明 データセットのサイト https://gpcv.whu.edu.cn/data/buildi ng_dataset.html データセットのサイト https://gpcv.whu.edu.cn/data/whu- mix(raster)/whu_mix%20(raster).ht ml データセットのサイト https://www.aicrowd.com/challenge s/mapping-challenge -
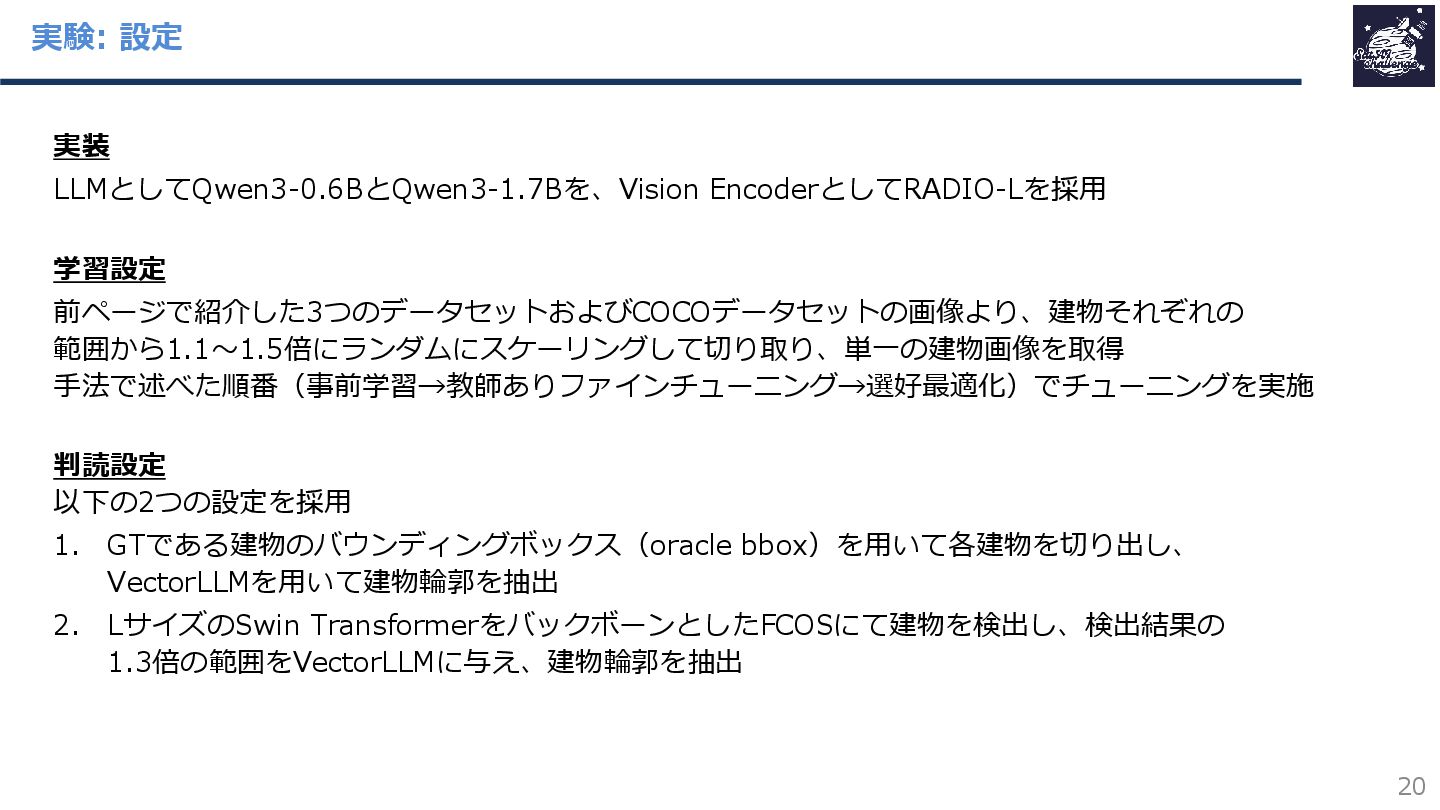
実験: 設定 20 実装 LLMとしてQwen3-0.6BとQwen3-1.7Bを、Vision EncoderとしてRADIO-Lを採用 学習設定 前ページで紹介した3つのデータセットおよびCOCOデータセットの画像より、建物それぞれの 範囲から1.1~1.5倍にランダムにスケーリングして切り取り、単一の建物画像を取得 手法で述べた順番(事前学習→教師ありファインチューニング→選好最適化)でチューニングを実施
判読設定 以下の2つの設定を採用 1. GTである建物のバウンディングボックス(oracle bbox)を用いて各建物を切り出し、 VectorLLMを用いて建物輪郭を抽出 2. LサイズのSwin TransformerをバックボーンとしたFCOSにて建物を検出し、検出結果の 1.3倍の範囲をVectorLLMに与え、建物輪郭を抽出 -
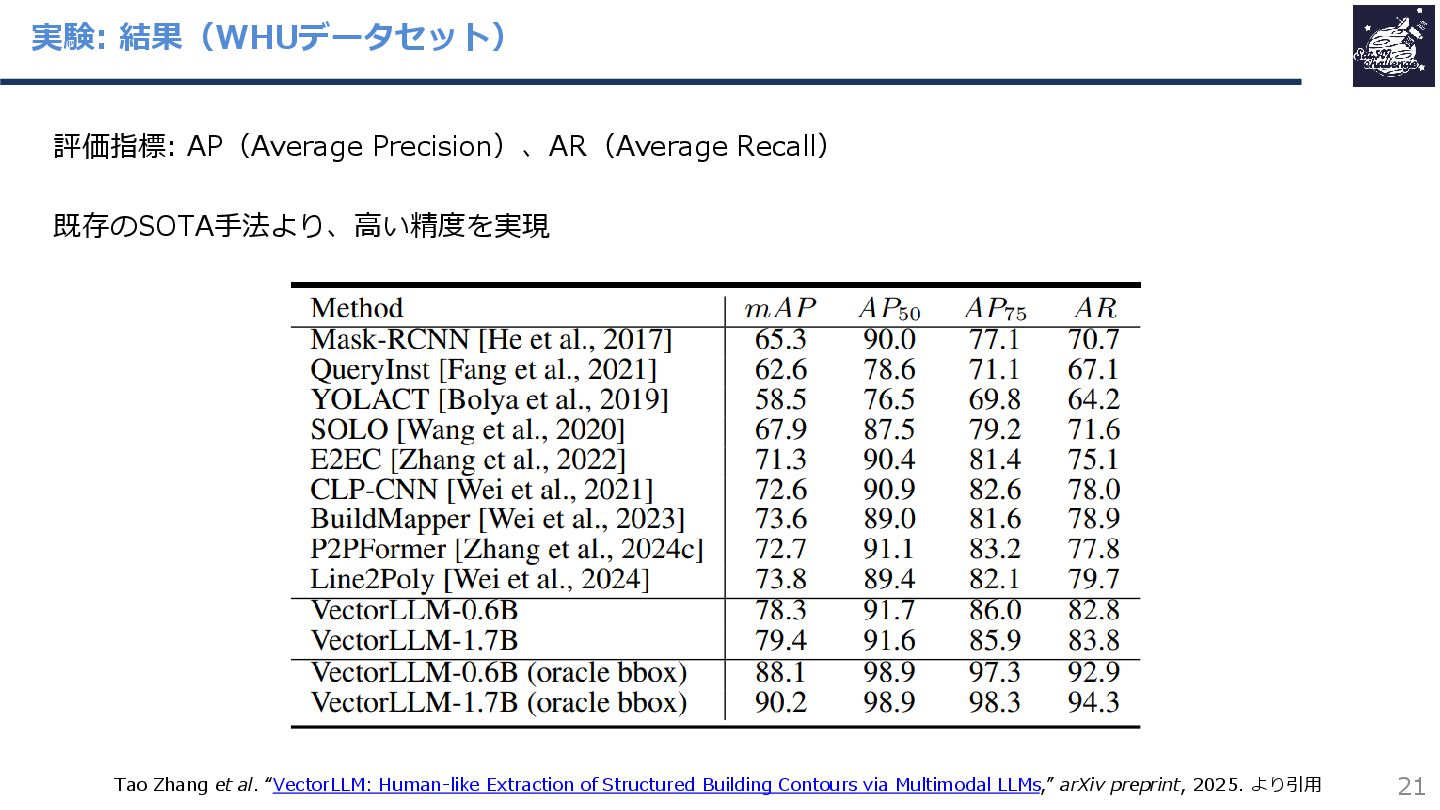
実験: 結果(WHUデータセット) 21 評価指標: AP(Average Precision)、AR(Average Recall) 既存のSOTA手法より、高い精度を実現 Tao Zhang
et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
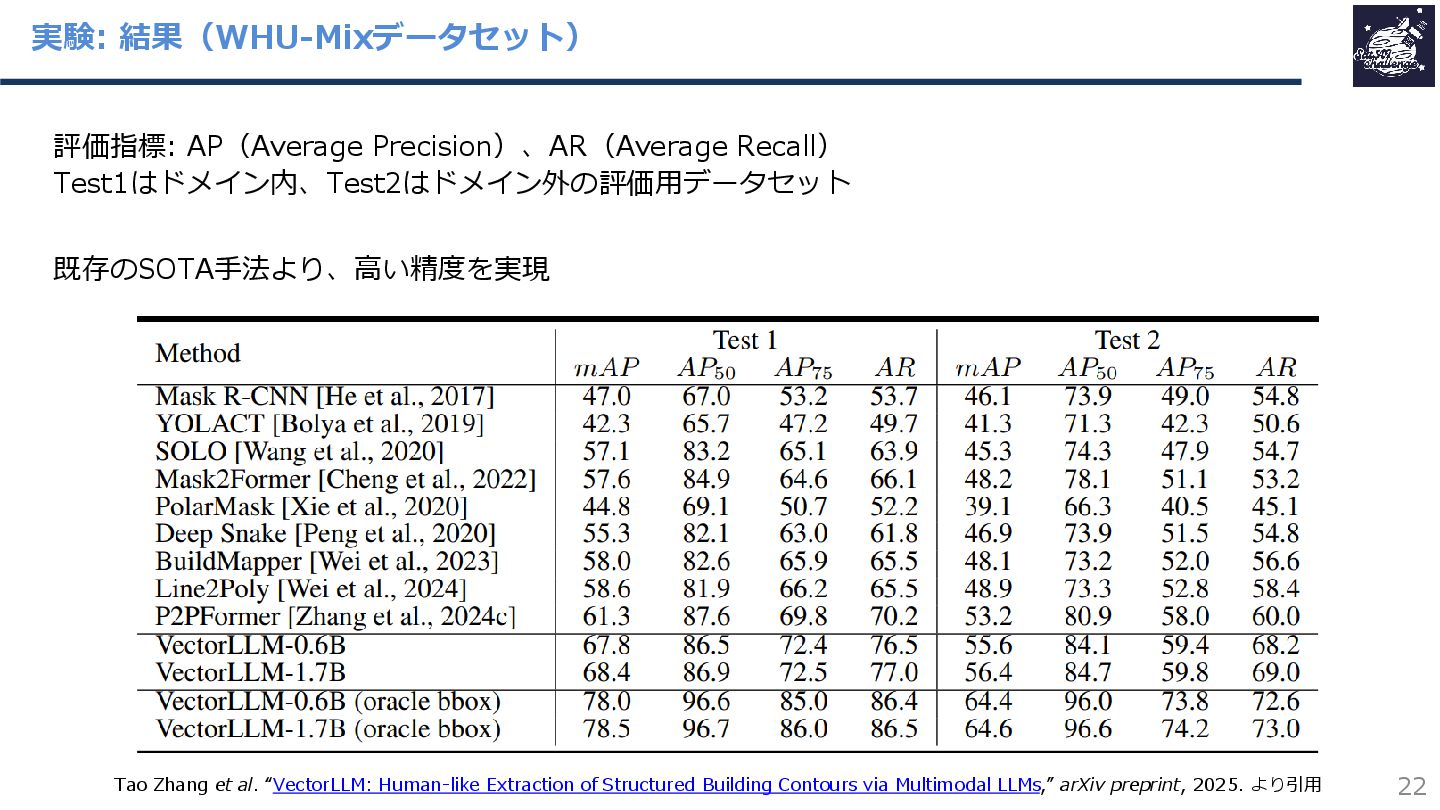
実験: 結果(WHU-Mixデータセット) 22 評価指標: AP(Average Precision)、AR(Average Recall) Test1はドメイン内、Test2はドメイン外の評価用データセット 既存のSOTA手法より、高い精度を実現 Tao
Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
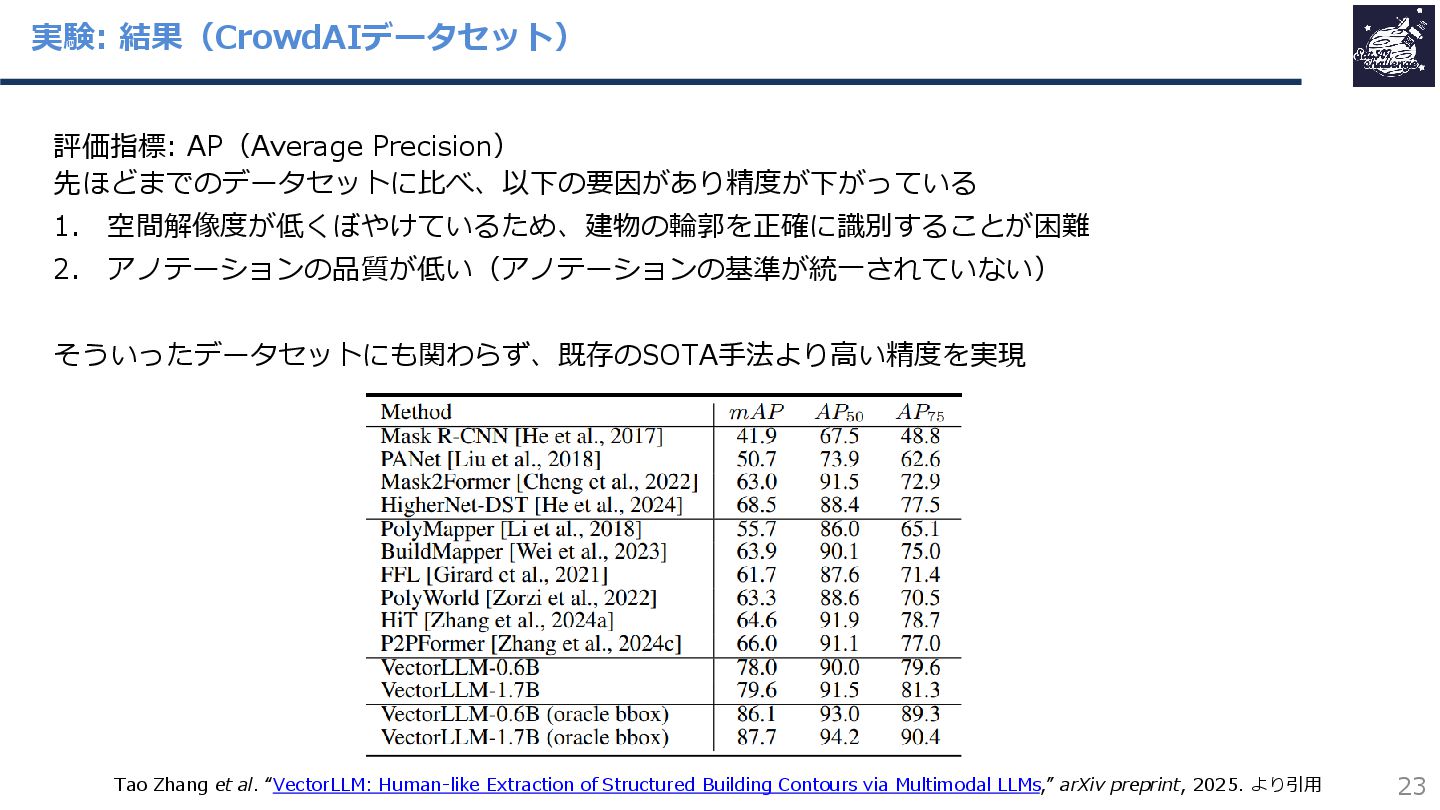
実験: 結果(CrowdAIデータセット) 23 評価指標: AP(Average Precision) 先ほどまでのデータセットに比べ、以下の要因があり精度が下がっている 1. 空間解像度が低くぼやけているため、建物の輪郭を正確に識別することが困難 2.
アノテーションの品質が低い(アノテーションの基準が統一されていない) そういったデータセットにも関わらず、既存のSOTA手法より高い精度を実現 Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
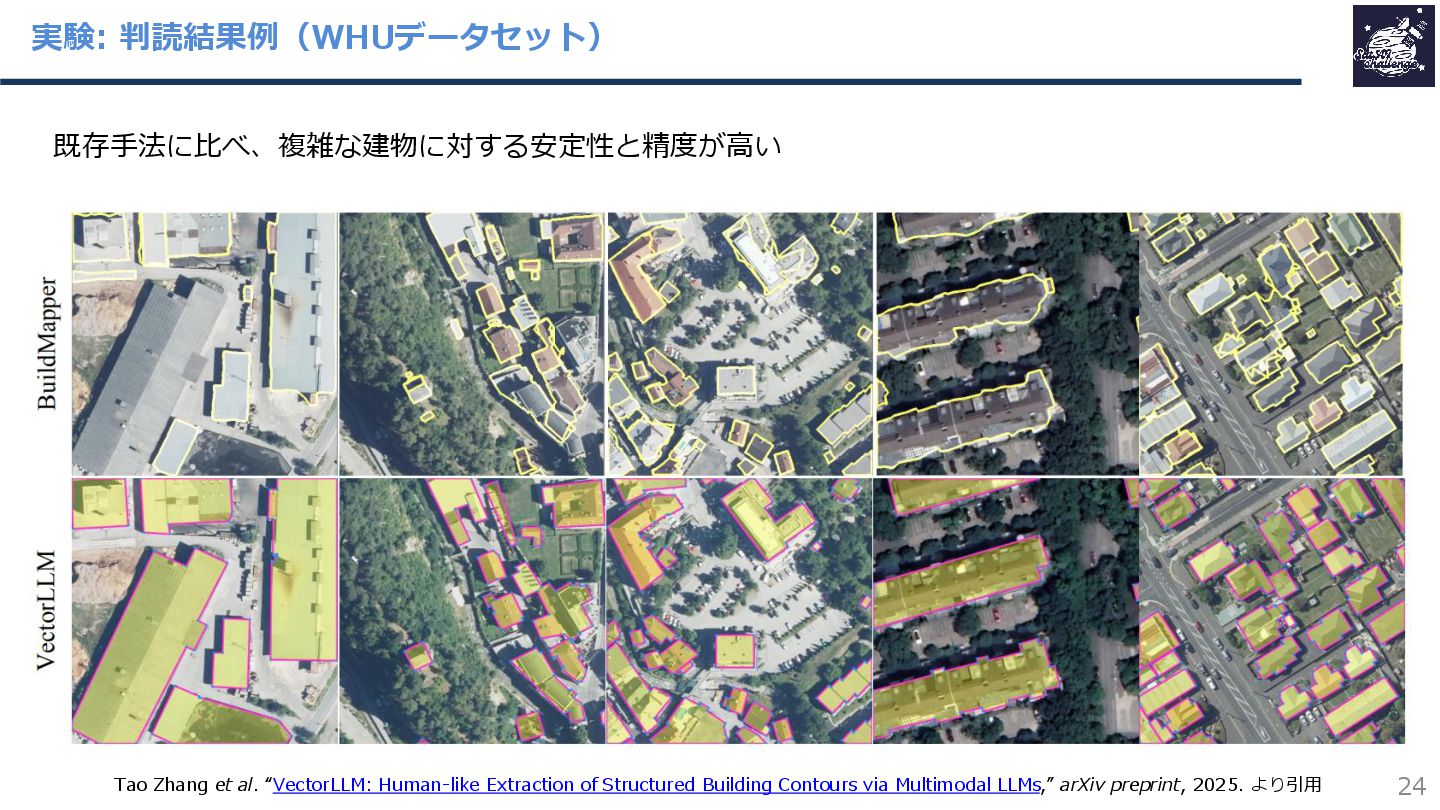
実験: 判読結果例(WHUデータセット) 24 既存手法に比べ、複雑な建物に対する安定性と精度が高い Tao Zhang et al. “VectorLLM: Human-like
Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
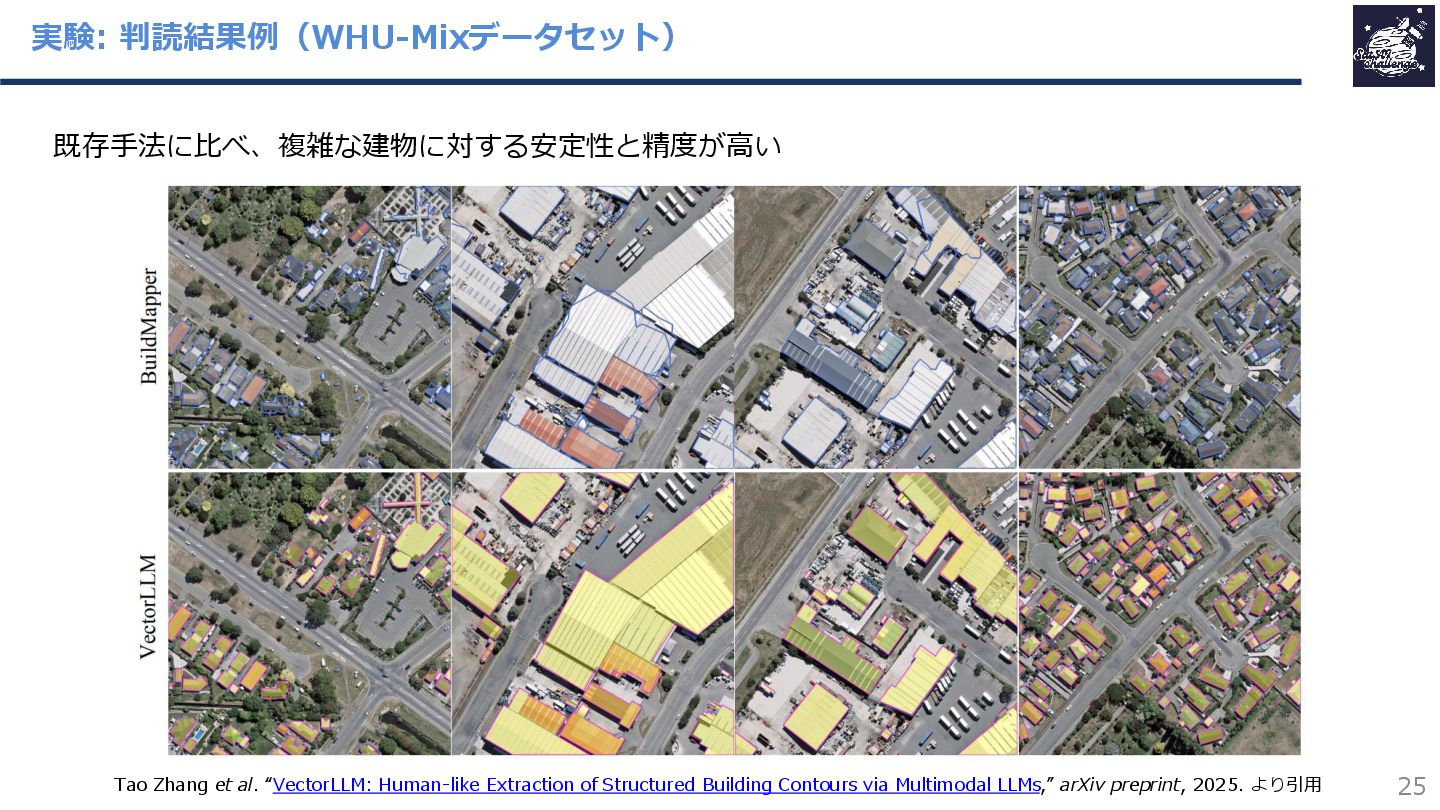
実験: 判読結果例(WHU-Mixデータセット) 25 既存手法に比べ、複雑な建物に対する安定性と精度が高い Tao Zhang et al. “VectorLLM: Human-like
Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
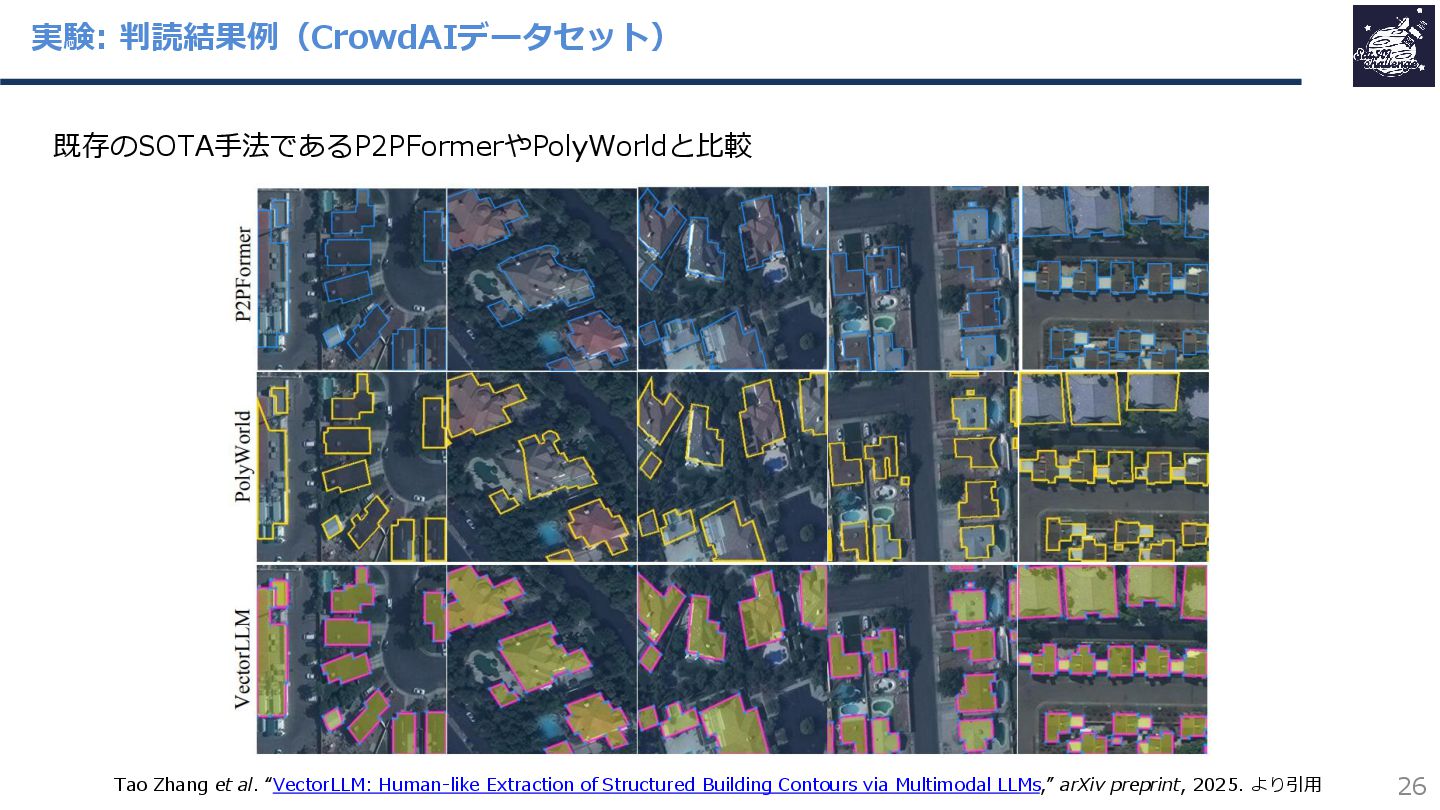
実験: 判読結果例(CrowdAIデータセット) 26 既存のSOTA手法であるP2PFormerやPolyWorldと比較 Tao Zhang et al. “VectorLLM: Human-like
Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
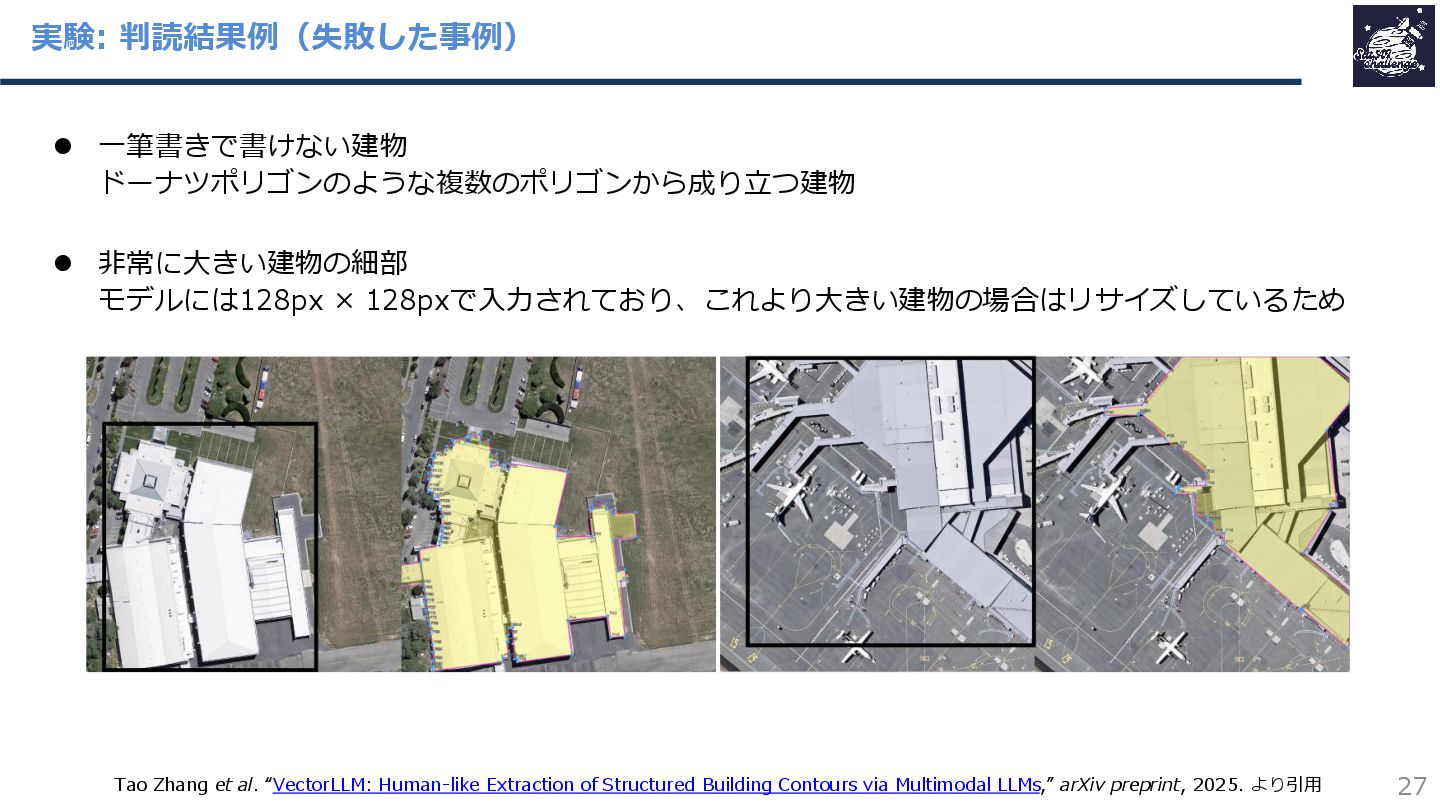
実験: 判読結果例(失敗した事例) 27 ⚫ 一筆書きで書けない建物 ドーナツポリゴンのような複数のポリゴンから成り立つ建物 ⚫ 非常に大きい建物の細部 モデルには128px ×
128pxで入力されており、これより大きい建物の場合はリサイズしているため Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
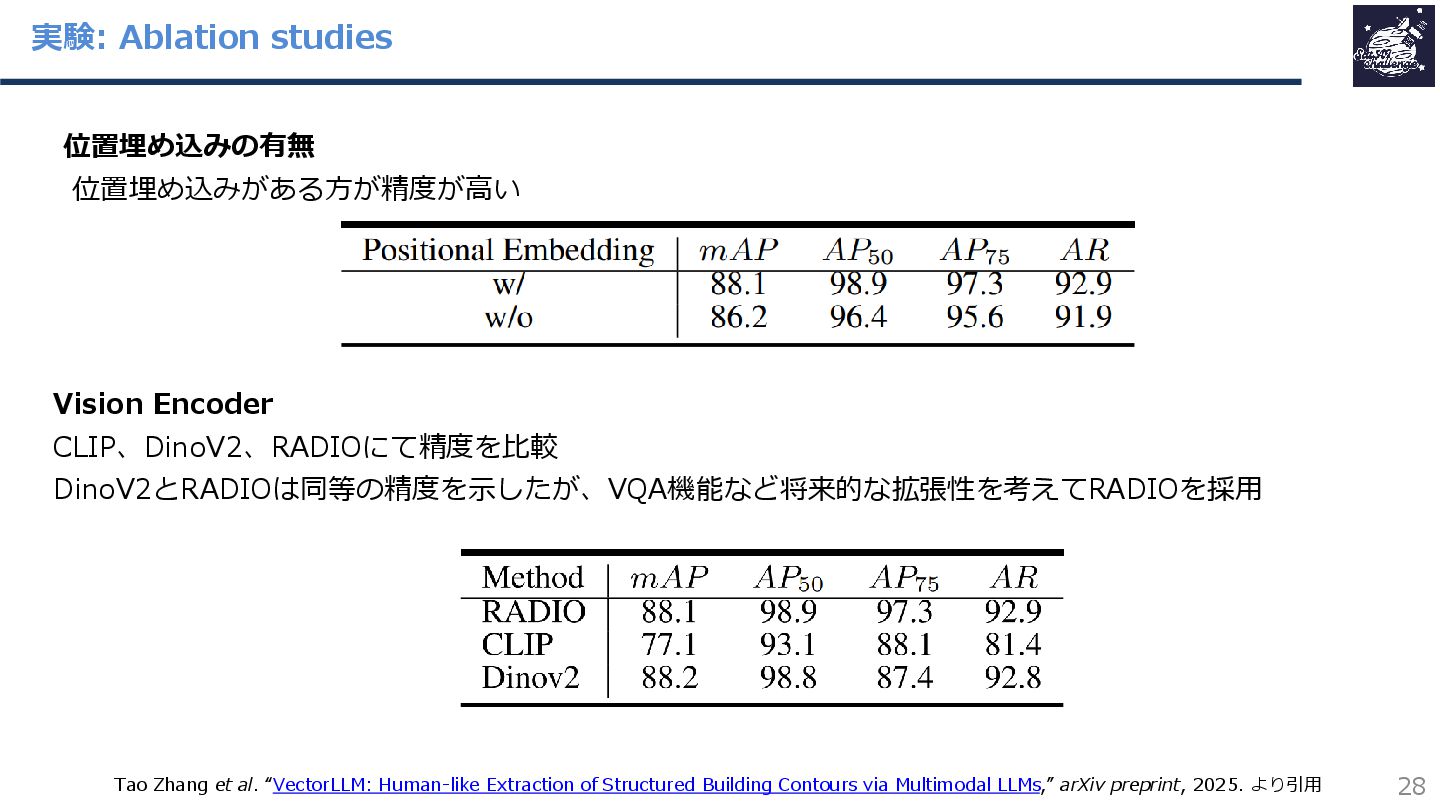
実験: Ablation studies 28 位置埋め込みの有無 位置埋め込みがある方が精度が高い Vision Encoder CLIP、DinoV2、RADIOにて精度を比較 DinoV2とRADIOは同等の精度を示したが、VQA機能など将来的な拡張性を考えてRADIOを採用
Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
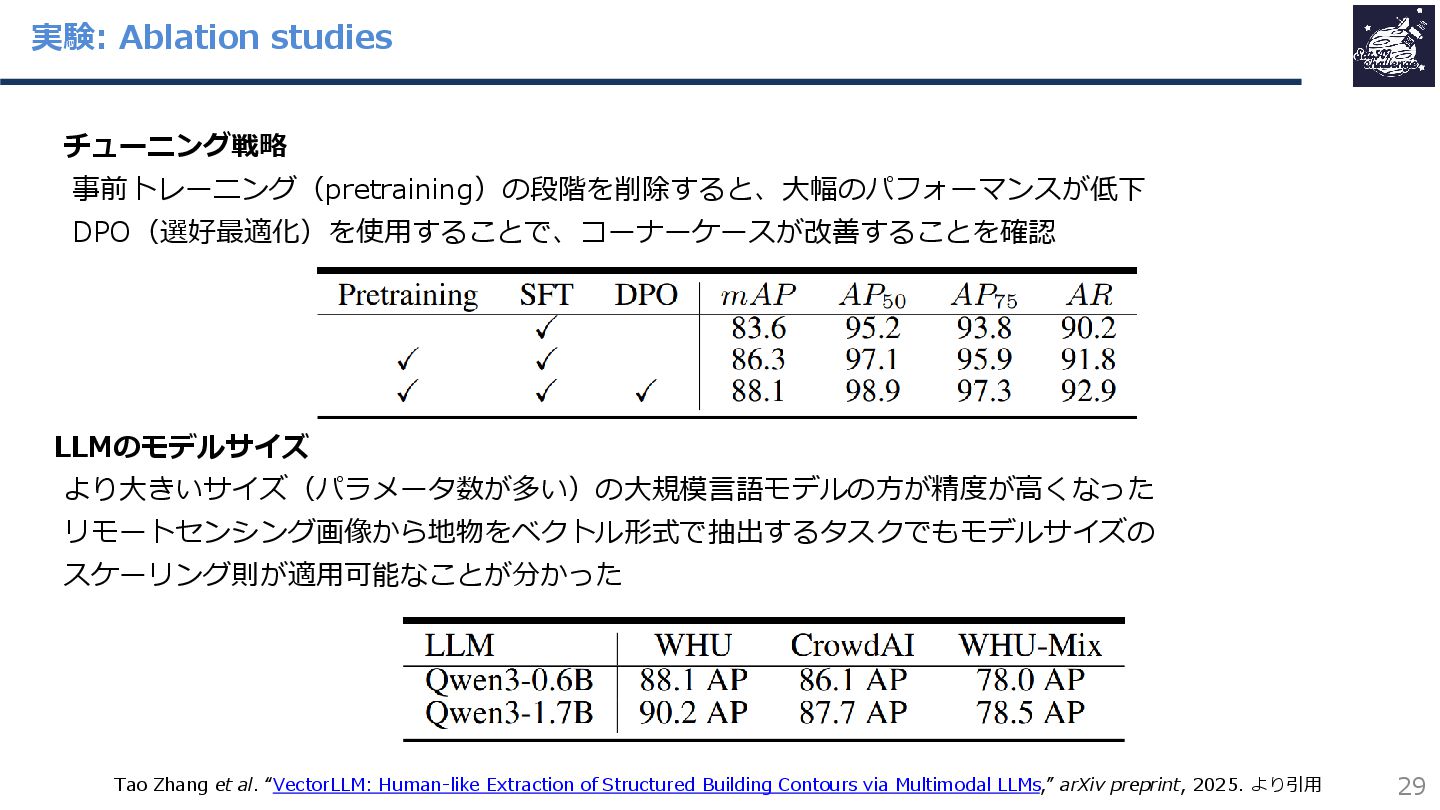
実験: Ablation studies 29 チューニング戦略 事前トレーニング(pretraining)の段階を削除すると、大幅のパフォーマンスが低下 DPO(選好最適化)を使用することで、コーナーケースが改善することを確認 LLMのモデルサイズ より大きいサイズ(パラメータ数が多い)の大規模言語モデルの方が精度が高くなった リモートセンシング画像から地物をベクトル形式で抽出するタスクでもモデルサイズの
スケーリング則が適用可能なことが分かった Tao Zhang et al. “VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
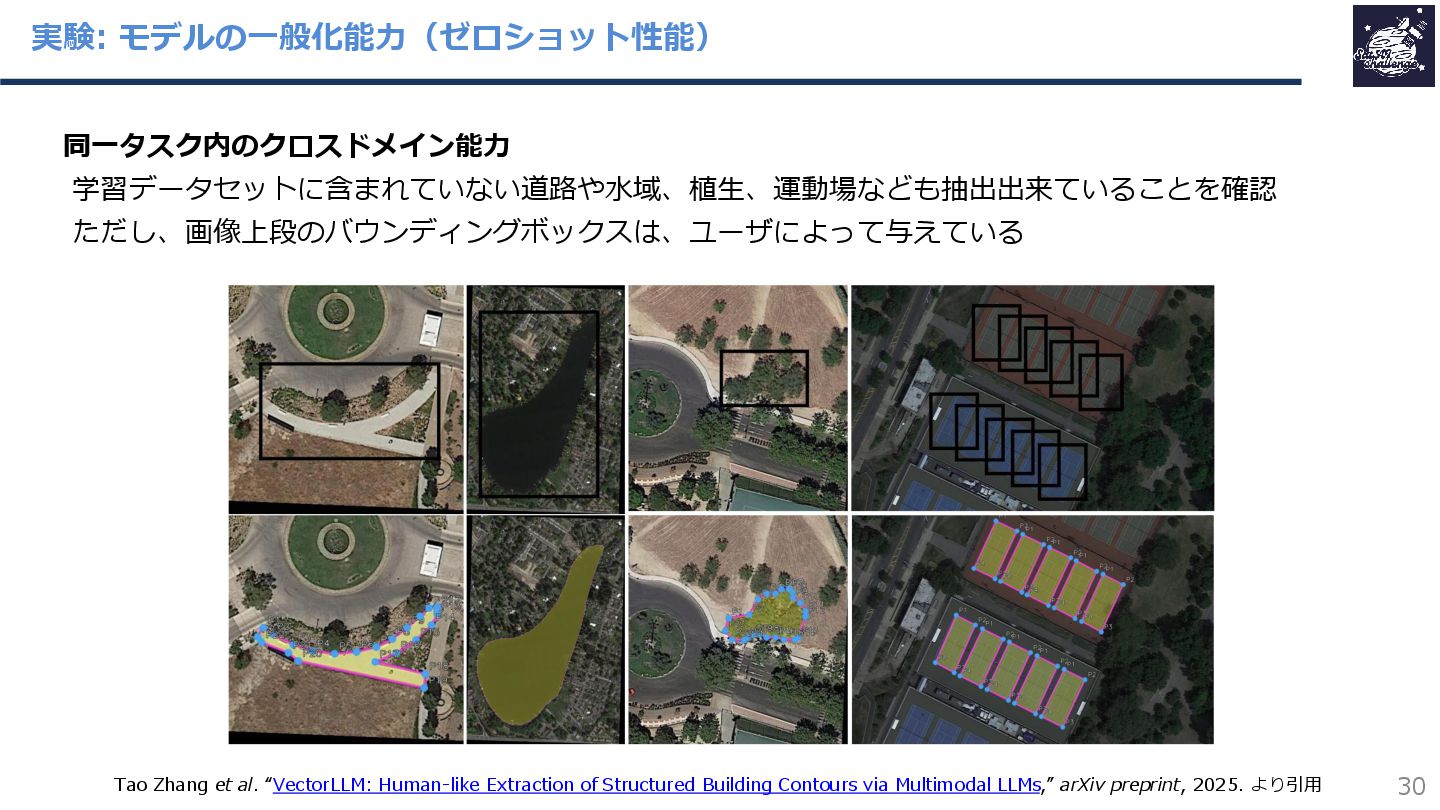
実験: モデルの一般化能力(ゼロショット性能) 30 同一タスク内のクロスドメイン能力 学習データセットに含まれていない道路や水域、植生、運動場なども抽出出来ていることを確認 ただし、画像上段のバウンディングボックスは、ユーザによって与えている Tao Zhang et al.
“VectorLLM: Human-like Extraction of Structured Building Contours via Multimodal LLMs,” arXiv preprint, 2025. より引用 -
結論 32 • リモートセンシング画像から直接ベクトル形式で建物を抽出するタスクに 初のマルチモーダルLLMを提案 • WHU、WHU-Mix、CrowdAIの3データセットで SOTA パフォーマンスを達成 •
優れた一般化機能を持っており、学習していない飛行機や水辺など多様な地物の輪郭を 描けるといったゼロショット性能を示した -
読んだ感想・思ったこと 34 • 大きい建物はスライディングウィンドウで判読していき、判読結果のポリゴンを 融合すれば解決できるのでは? • VectorLLMから派生したモデルにより、将来的に色々な地物がE2Eでベクトル形式で 抽出できそうだが、最終的には物体検出モデルの性能によりそう • 判読にどのくらい時間がかかるか不明なので、実務に適用できるかは今後に期待
• コードとモデルの重みは、オープンソースで公開しますと記載されているが まだ公開されていない?(あるある) → preprintだからかもしれないが