Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
6 年寝ていた Cumo を AI と 3 か月で 叩き起こした話
Search
Watson
November 07, 2026
Technology
66
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
6 年寝ていた Cumo を AI と 3 か月で 叩き起こした話
Watson
November 07, 2026
More Decks by Watson
See All by Watson
クラウドネイティブ時代に 進化し続けるFluentd
watson
0
42
RMagick, migrate to ImageMagick 7 #RubyKaigi #RubyKaigi2019
watson
0
10k
Magick
watson
0
12k
Improve JSON Performance
watson
2
1.1k
fastlane 奮闘記
watson
0
110
How to optimize Ruby internal.
watson
3
3.1k
iOS、AndroidアプリをRubyで
watson
1
520
RubyMotion 2.0
watson
6
2.9k
Differences CRuby/MacRuby/RubyMotion
watson
5
5.8k
Other Decks in Technology
See All in Technology
自治体AIコンタクトセンター、何をどこに任せる?~Amazon Connect Customer +Amazon Bedrockの実践知~ / 20261107 Satoshi Torano
shift_evolve
PRO
1
120
[JAWS Festa 2026]一番いい仕事は、請求書に現れない / jawsfesta2026
sh_fk2
2
420
TSKaigi Sendai 2026 - tsgo時代のTypeScript Playgroundはどう動くか
teamlab
PRO
0
110
並列度を下げたら速くなった — go build の重複コンパイルを実測で見る
tomoaki25
2
990
HQ駆動開発で最高のAI-Contextを作ろう
sansantech
PRO
1
120
分析作業をどこまで任せるか自分で決められる AIネイティブBI『Golden Analytics』が 良さげな話 /golden-analytics-is-ai-native-bi
shinyaa31
0
130
llm-d に入門してみた / Try out llm-d
kota2and3kan
0
100
基本から分かる!AWSセキュリティ運用の考え方と任せ方
cmusudakeisuke
1
460
SSFの現在地 ― CAEP/RISCからAI Identityへ
oidfj
0
300
Kiro Crew 入門 (手を離しても進む仕事) | 目指せ Kiro マスター 11
inariku
PRO
4
650
AX時代の自治体支援リソース再配分と役割分担の再構成:戦略とロードマップ(概要)
sishi2026
0
210
`go get`したらELFが降ってきた件
taiyow
0
190
Featured
See All Featured
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Automating Front-end Workflow
addyosmani
1370
210k
Practical Orchestrator
shlominoach
192
12k
Building a Scalable Design System with Sketch
lauravandoore
464
34k
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
48k
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
550
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
Context Engineering - Making Every Token Count
addyosmani
9
1.3k
[SF Ruby Conf 2025] Rails X
palkan
3
1.5k
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
890
Transcript
大江戸Ruby会議11 / 大江戸フリートークス / 2026-11-08 6 年寝ていた Cumo を AI
と 3 か月で 叩き起こした話 Shizuo Fujita(@watson1978) 株式会社クリアコード Signed-off-by: @watson1978 Co-authored-by: Claude
自己紹介 @watson1978 Shizuo Fujita 株式会社クリアコード Ruby コミッター RMagick メンテナー Fluentd
コミッター oj メンテナー 2025 年 8 月から sonots さんの Cumo を引き 継いでメンテ
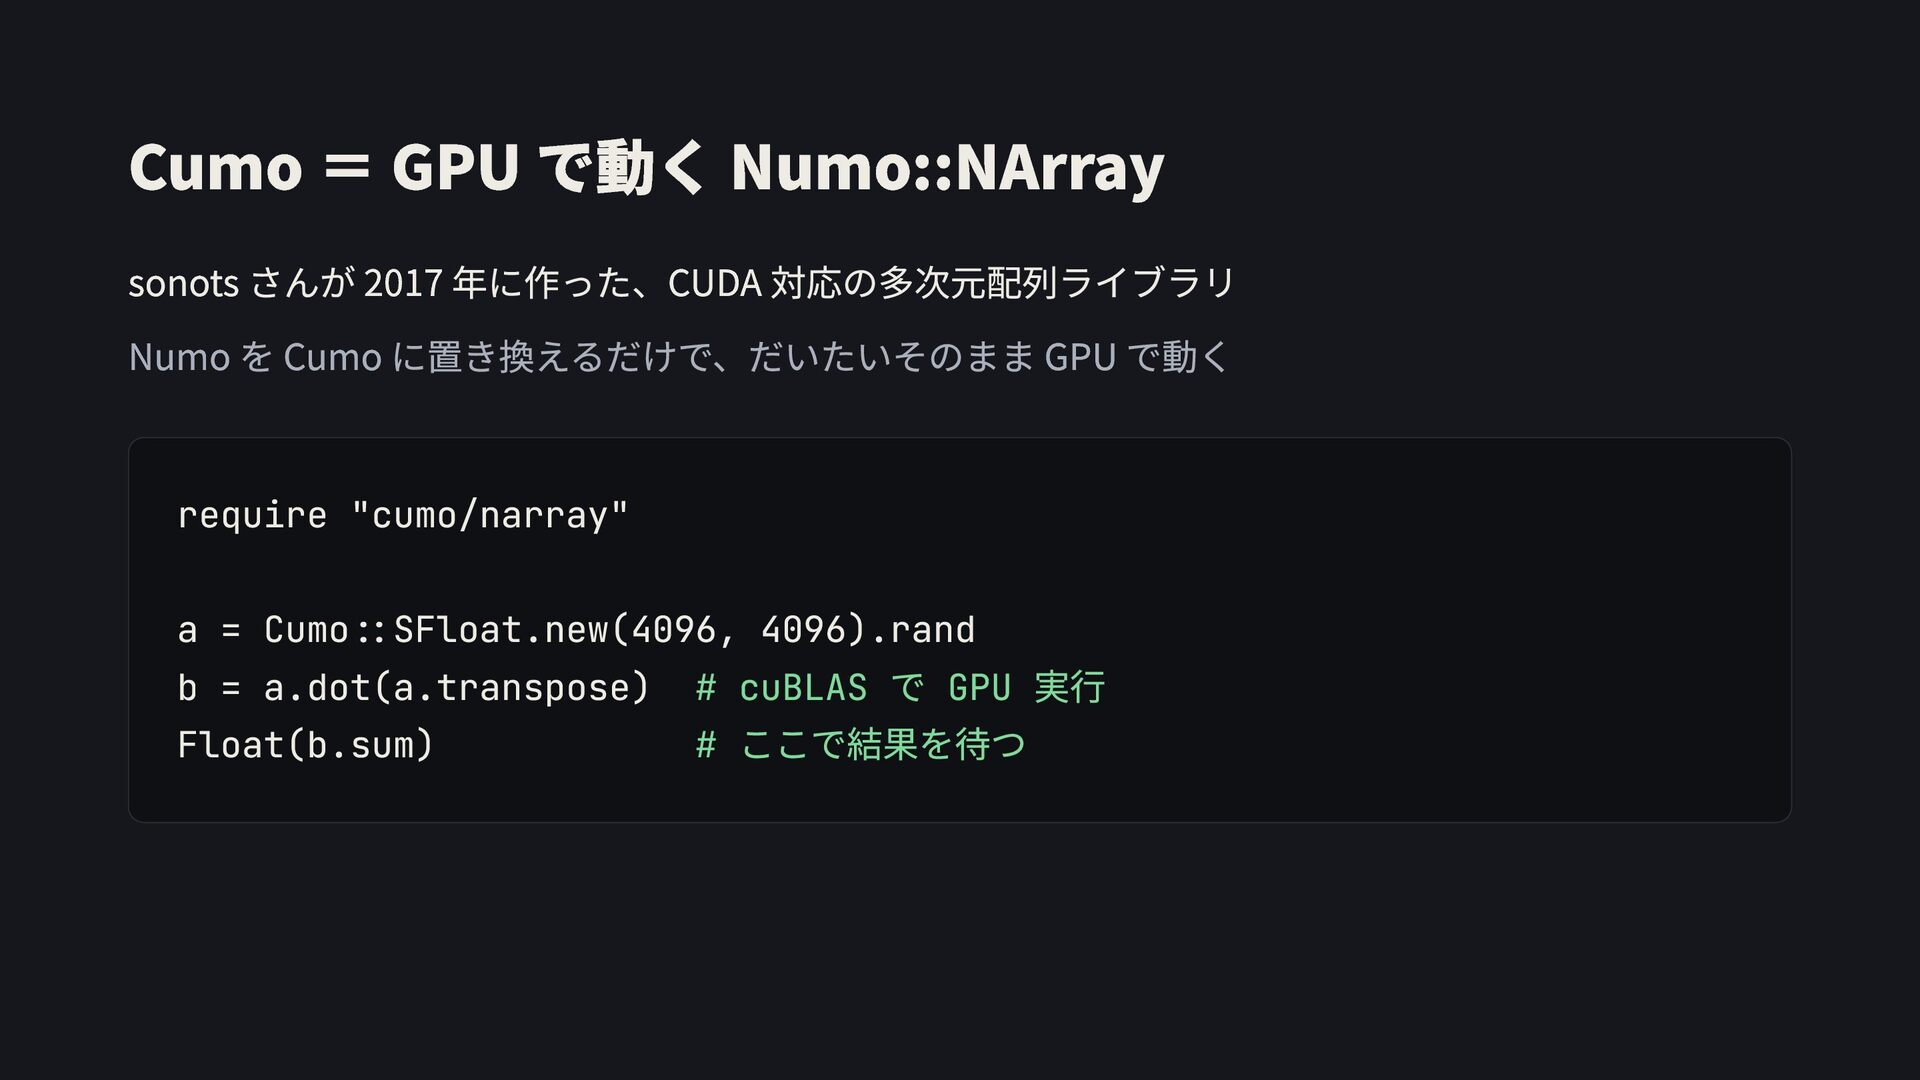
Cumo = GPU で動く Numo::NArray sonots さんが 2017 年に作った、CUDA 対応の多次元配列ライブラリ
Numo を Cumo に置き換えるだけで、だいたいそのまま GPU で動く require "cumo/narray" a = Cumo::SFloat.new(4096, 4096).rand b = a.dot(a.transpose) # cuBLAS GPU Float(b.sum) # で 実行 ここで結果を待つ
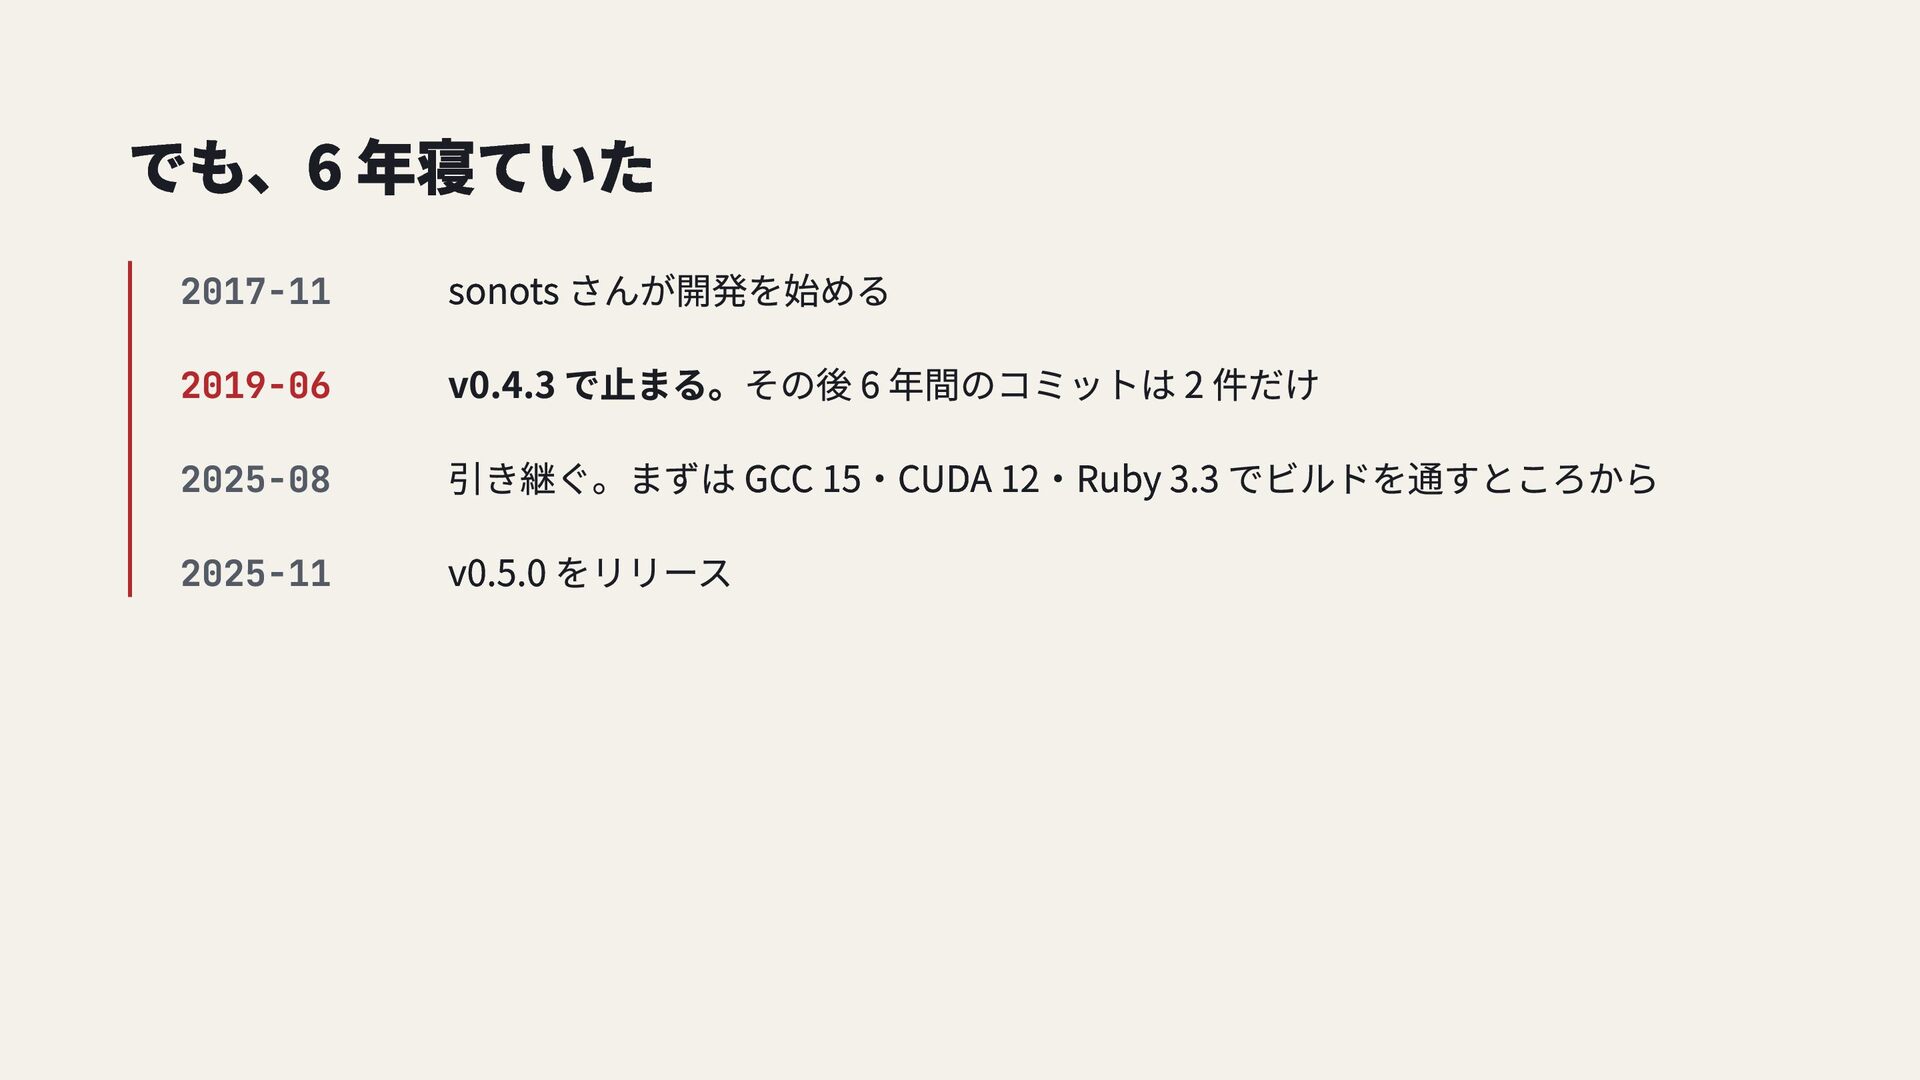
でも、6 年寝ていた 2017-11 2019-06 2025-08 2025-11 sonots さんが開発を始める v0.4.3 で止まる。その後
6 年間のコミットは 2 件だけ 引き継ぐ。まずは GCC 15・CUDA 12・Ruby 3.3 でビルドを通すところから v0.5.0 をリリース
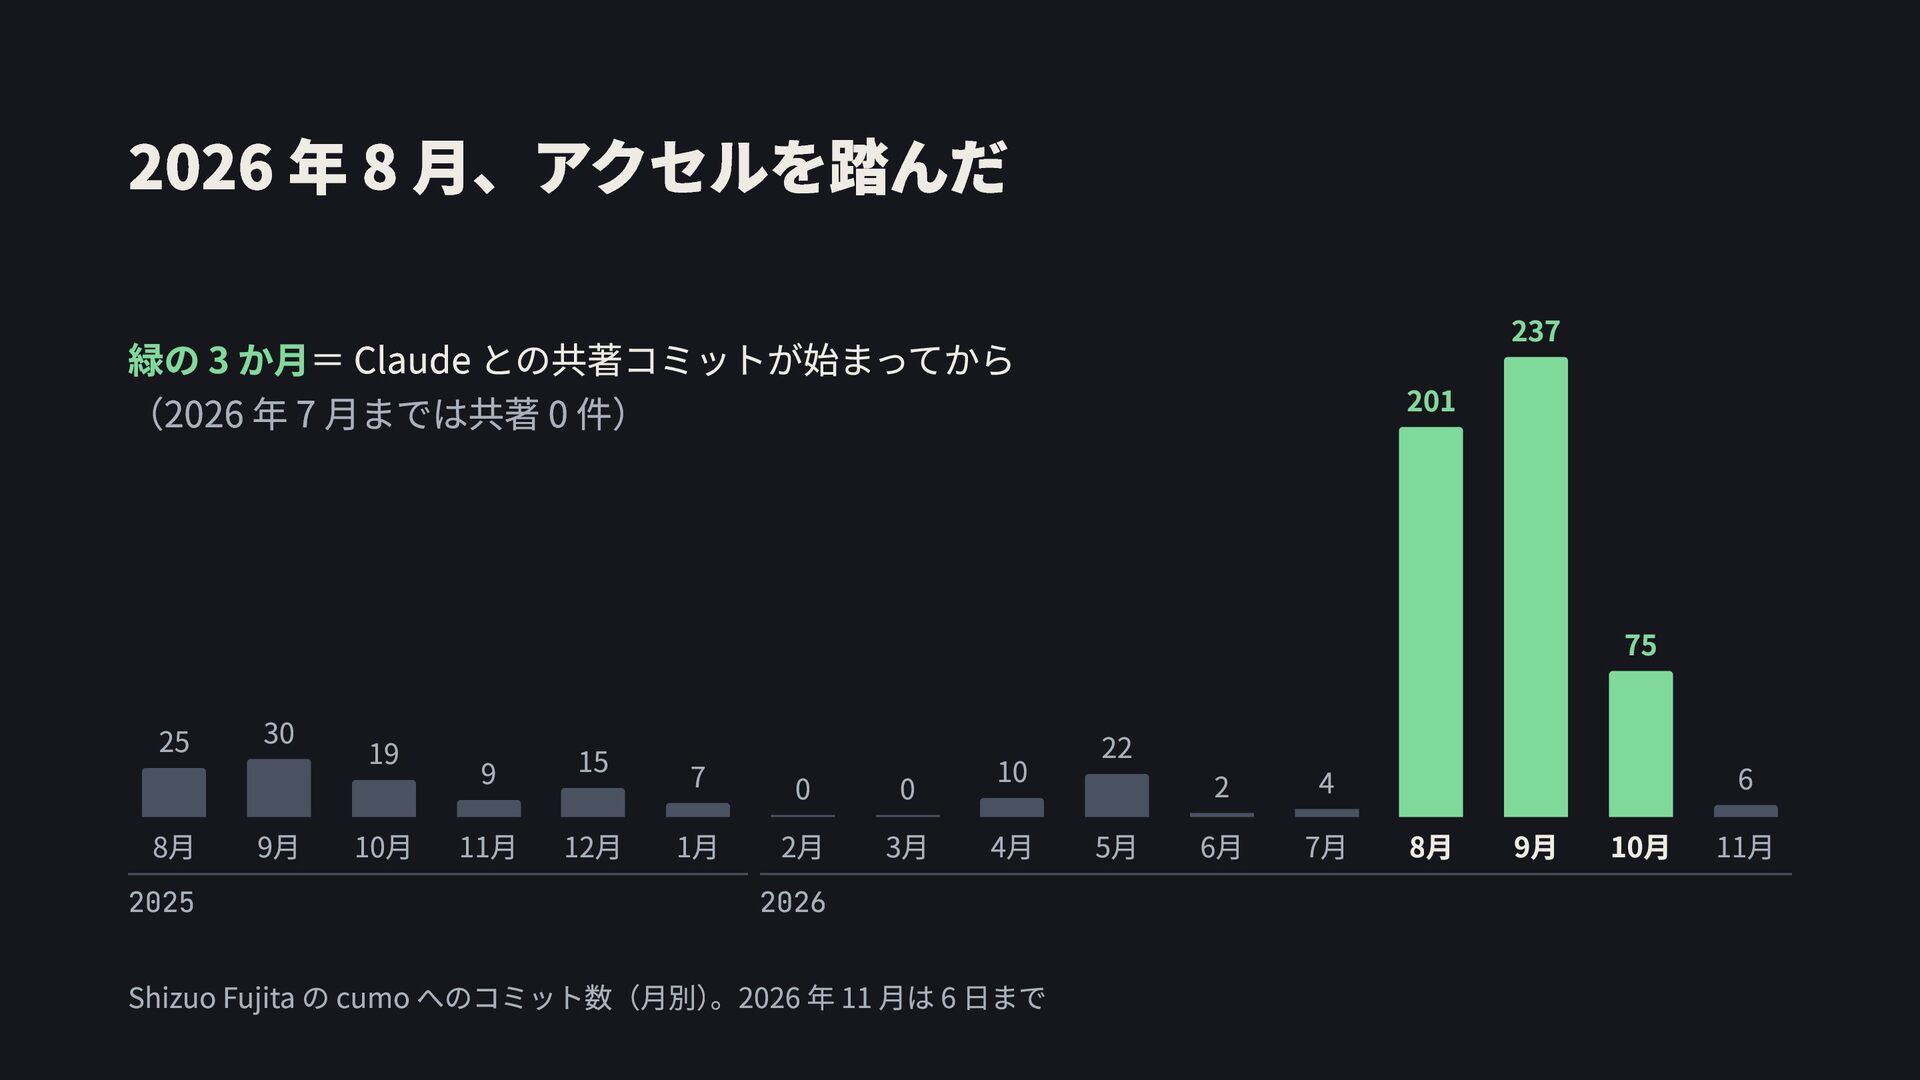
2026 年 8 月、アクセルを踏んだ 緑の 3 か月= Claude との共著コミットが始まってから (2026
年 7 月までは共著 0 件) 201 237 75 25 8月 2025 30 19 15 9 7 9月 10月 11月 12月 1月 0 2月 0 3月 10 4月 2026 Shizuo Fujita の cumo へのコミット数(月別)。2026 年 11 月は 6 日まで 22 5月 2 6月 4 7月 8月 6 9月 10月 11月
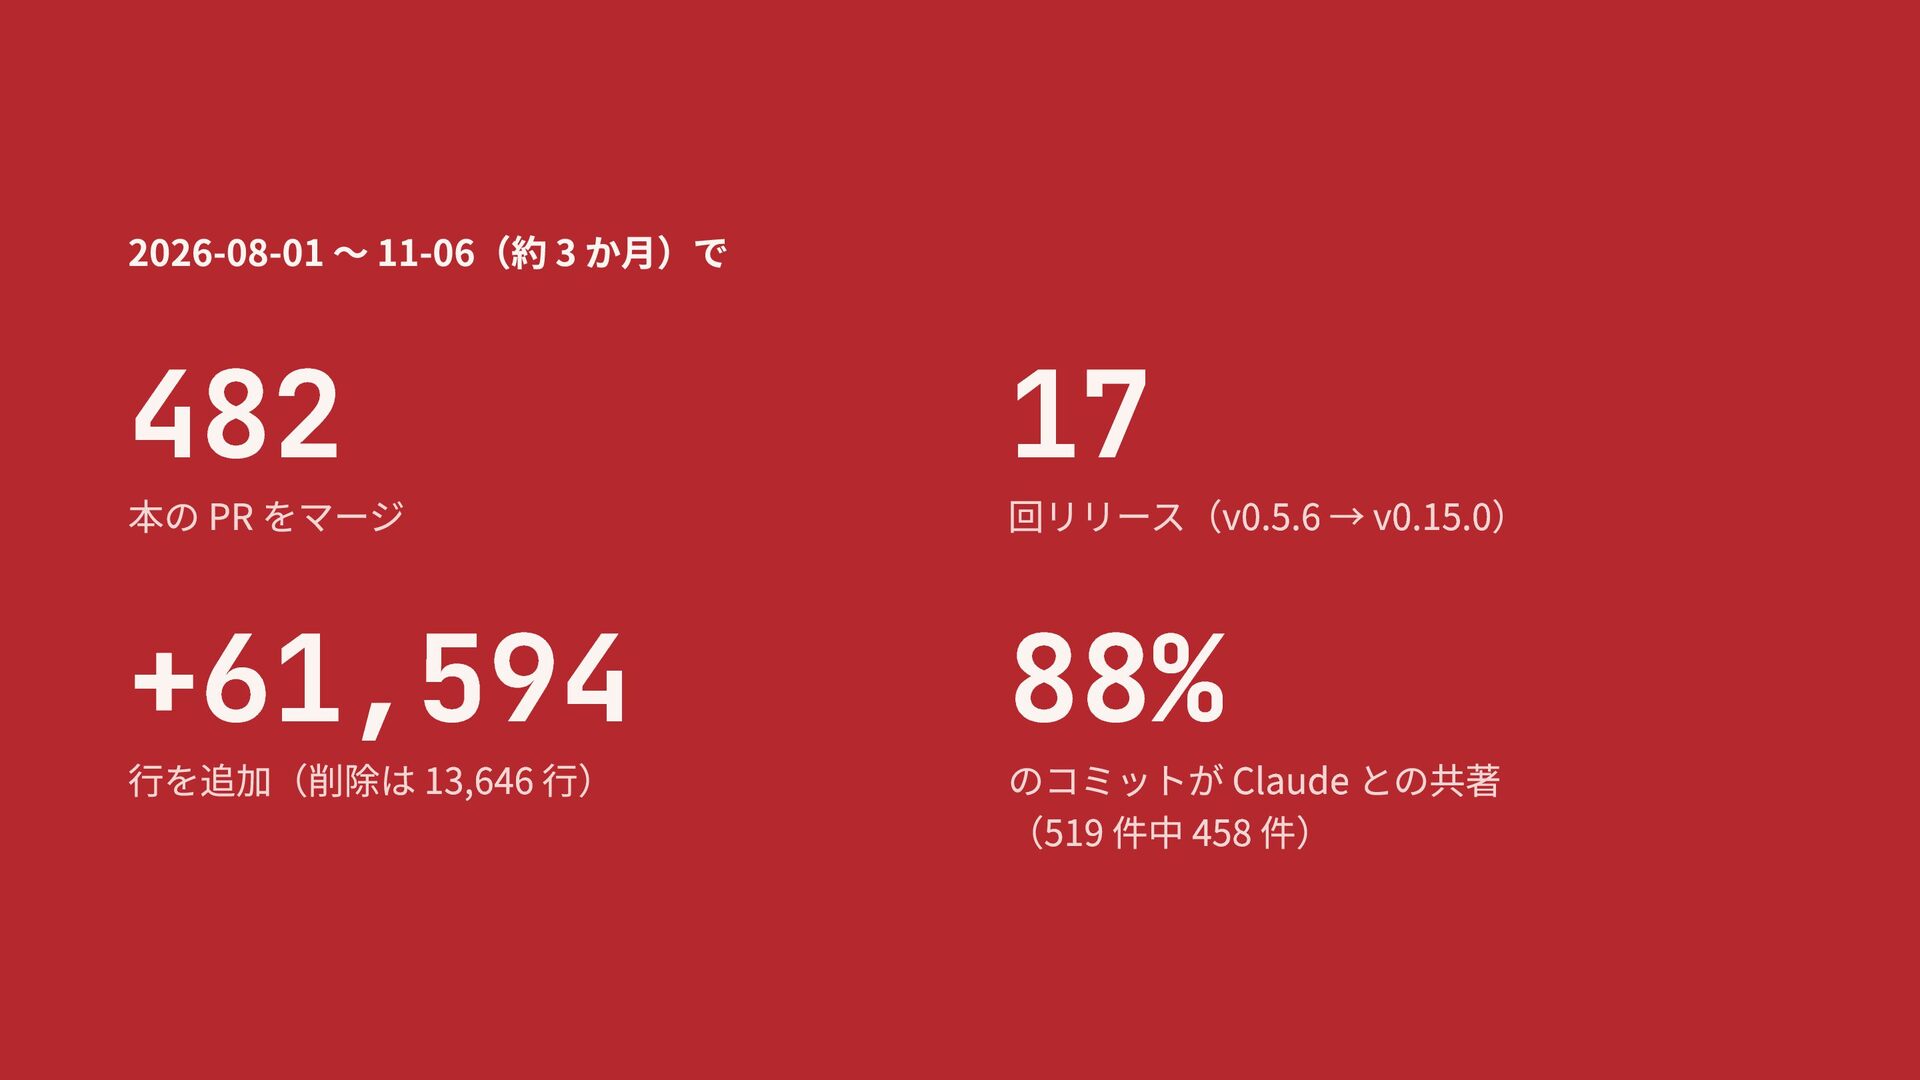
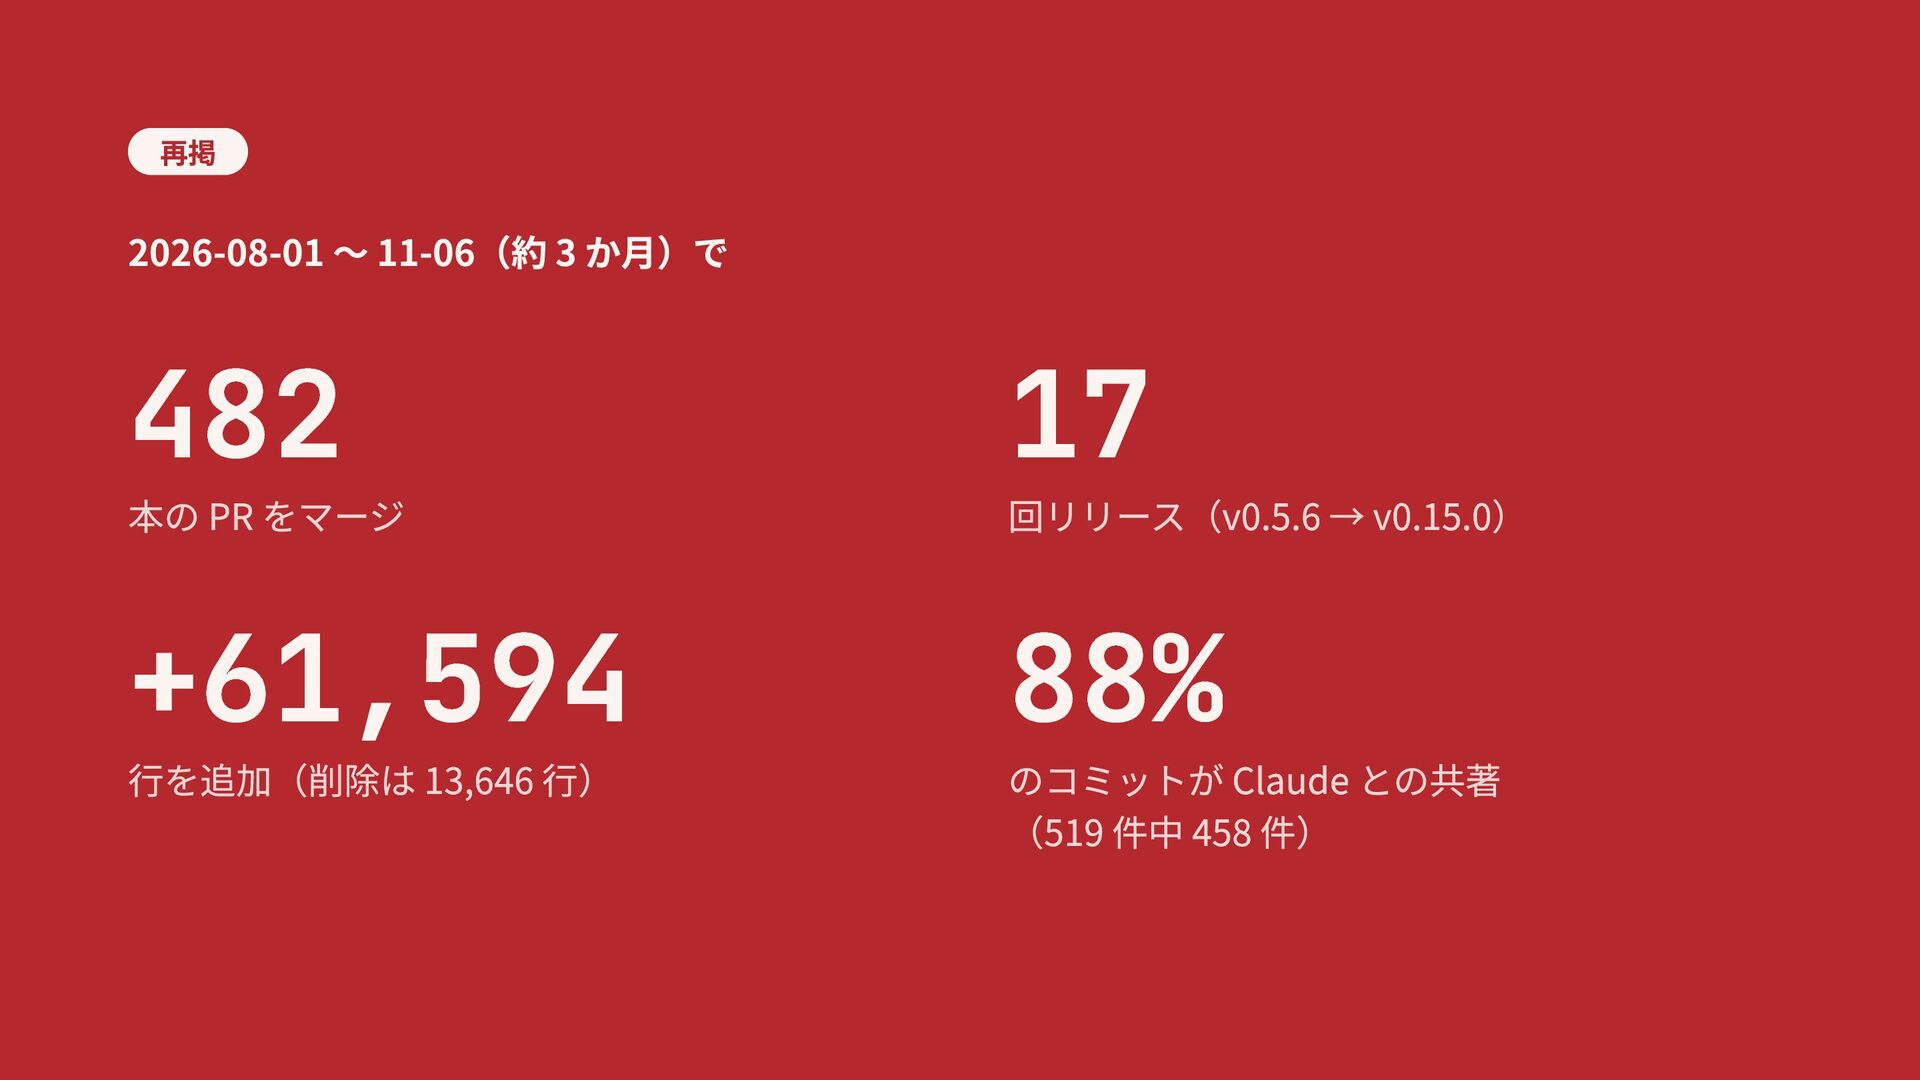
2026-08-01 〜 11-06(約 3 か月)で 482 17 +61,594 88% 本の
PR をマージ 行を追加(削除は 13,646 行) 回リリース(v0.5.6 → v0.15.0) のコミットが Claude との共著 (519 件中 458 件)
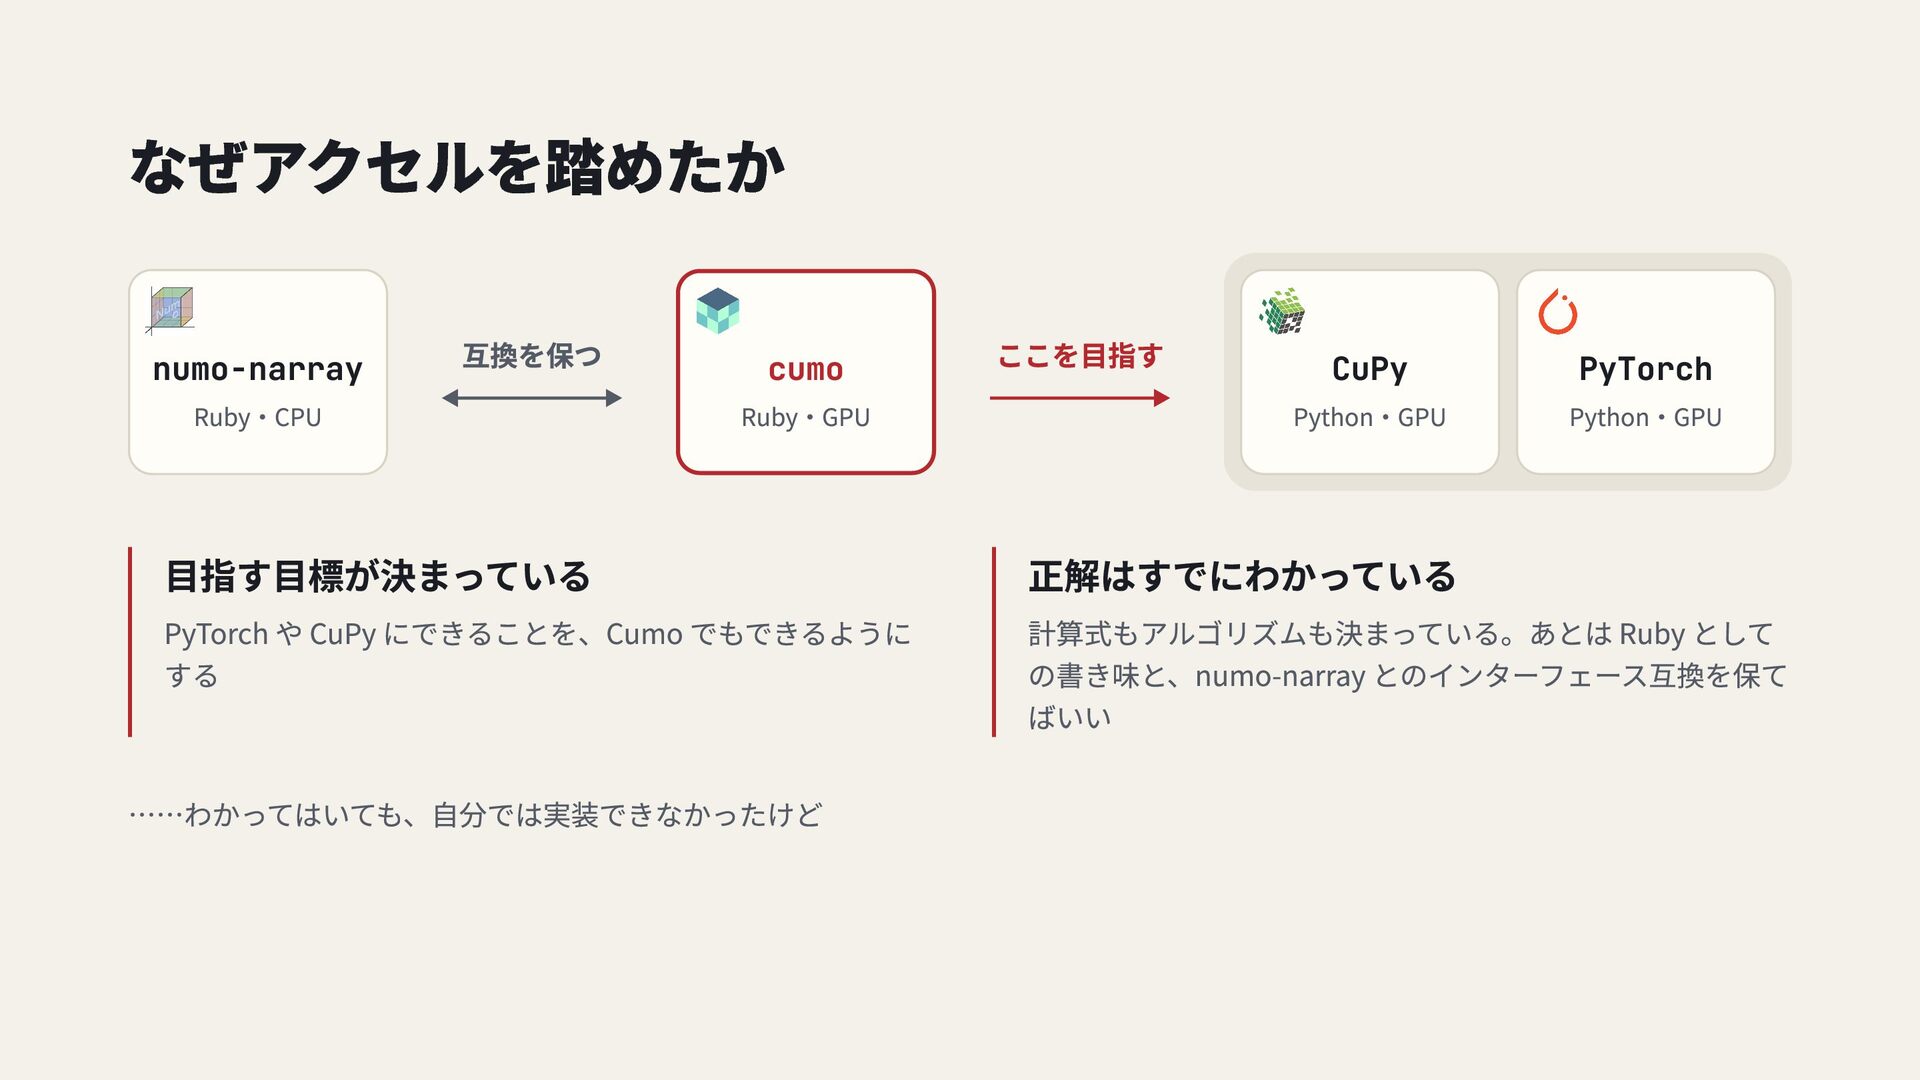
なぜアクセルを踏めたか numo-narray Ruby・CPU 互換を保つ cumo Ruby・GPU 目指す目標が決まっている PyTorch や CuPy
にできることを、Cumo でもできるように する ……わかってはいても、自分では実装できなかったけど ここを目指す CuPy Python・GPU 正解はすでにわかっている PyTorch Python・GPU 計算式もアルゴリズムも決まっている。あとは Ruby として の書き味と、numo-narray とのインターフェース互換を保て ばいい
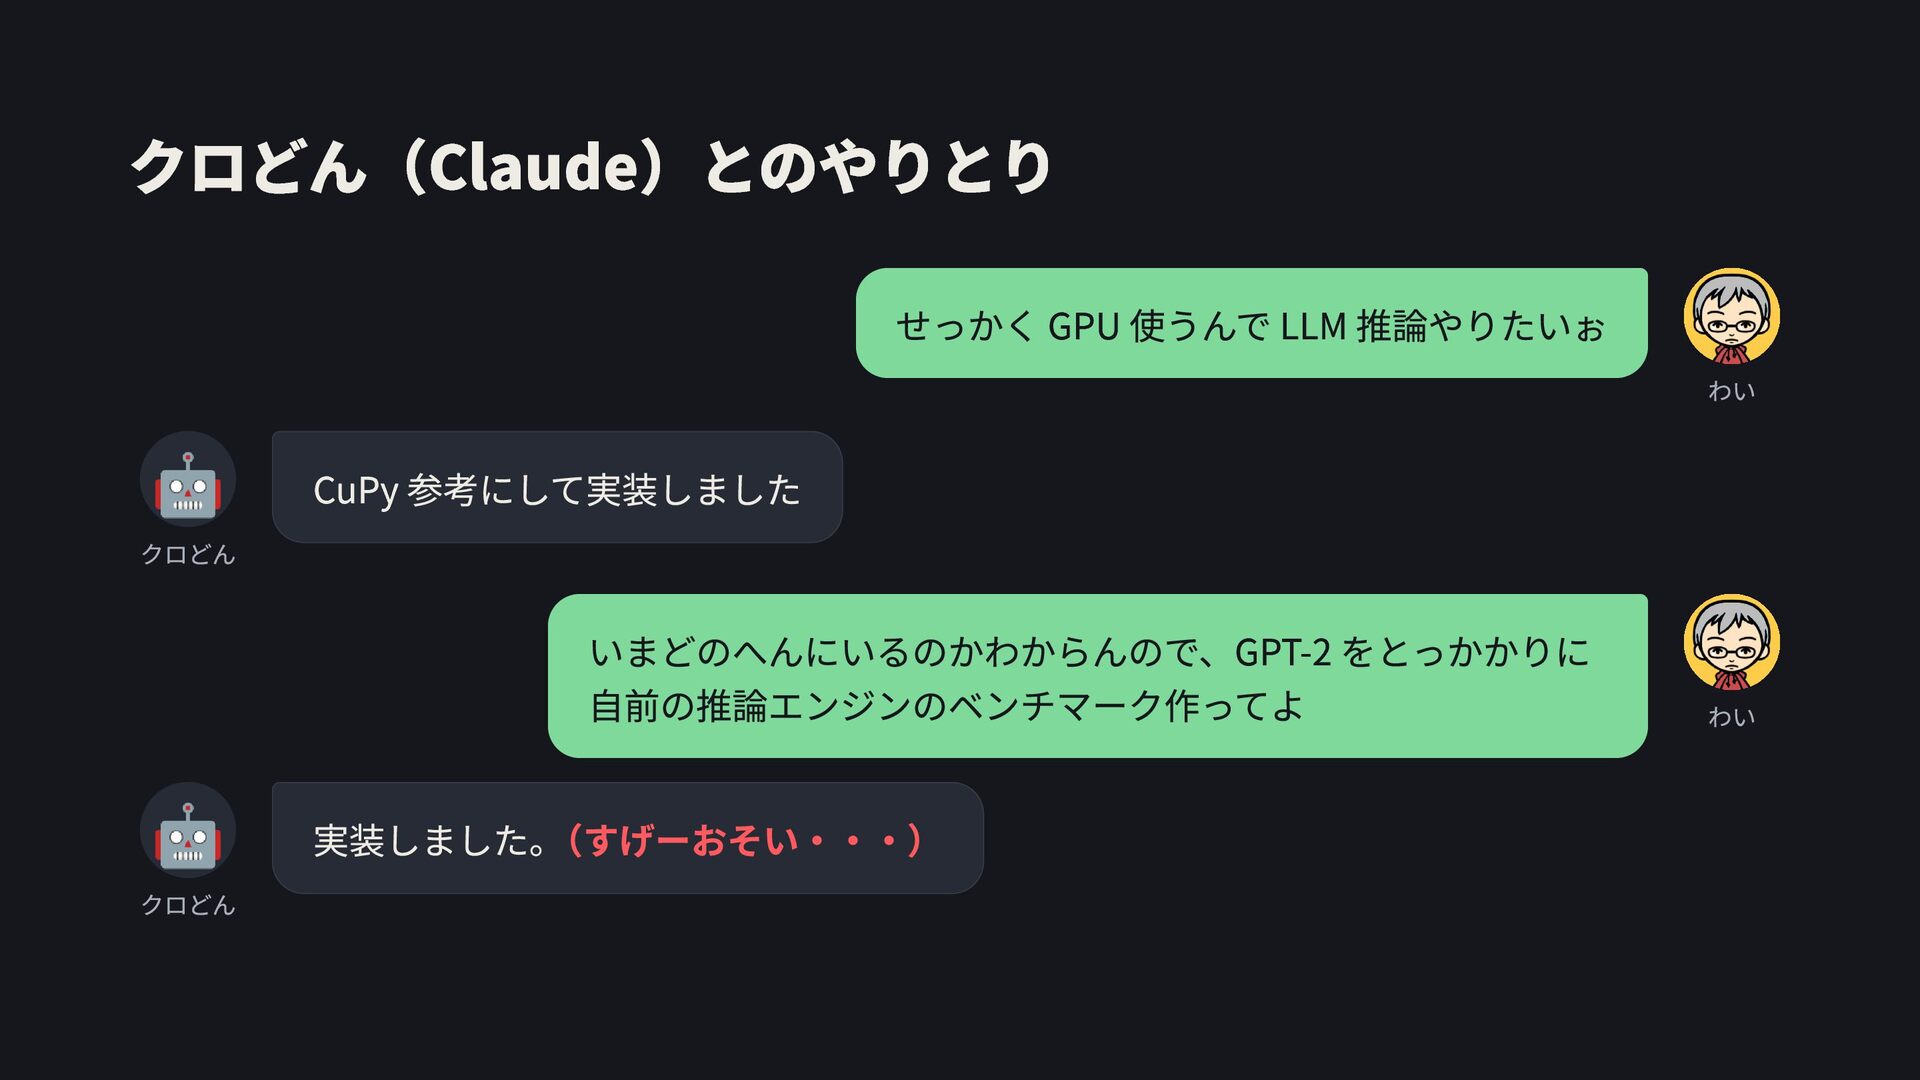
クロどん(Claude)とのやりとり 🤖 CuPy 参考にして実装しました せっかく GPU 使うんで LLM 推論やりたいぉ わい
クロどん いまどのへんにいるのかわからんので、GPT-2 をとっかかりに 自前の推論エンジンのベンチマーク作ってよ 🤖 実装しました。(すげーおそい・・・) クロどん わい
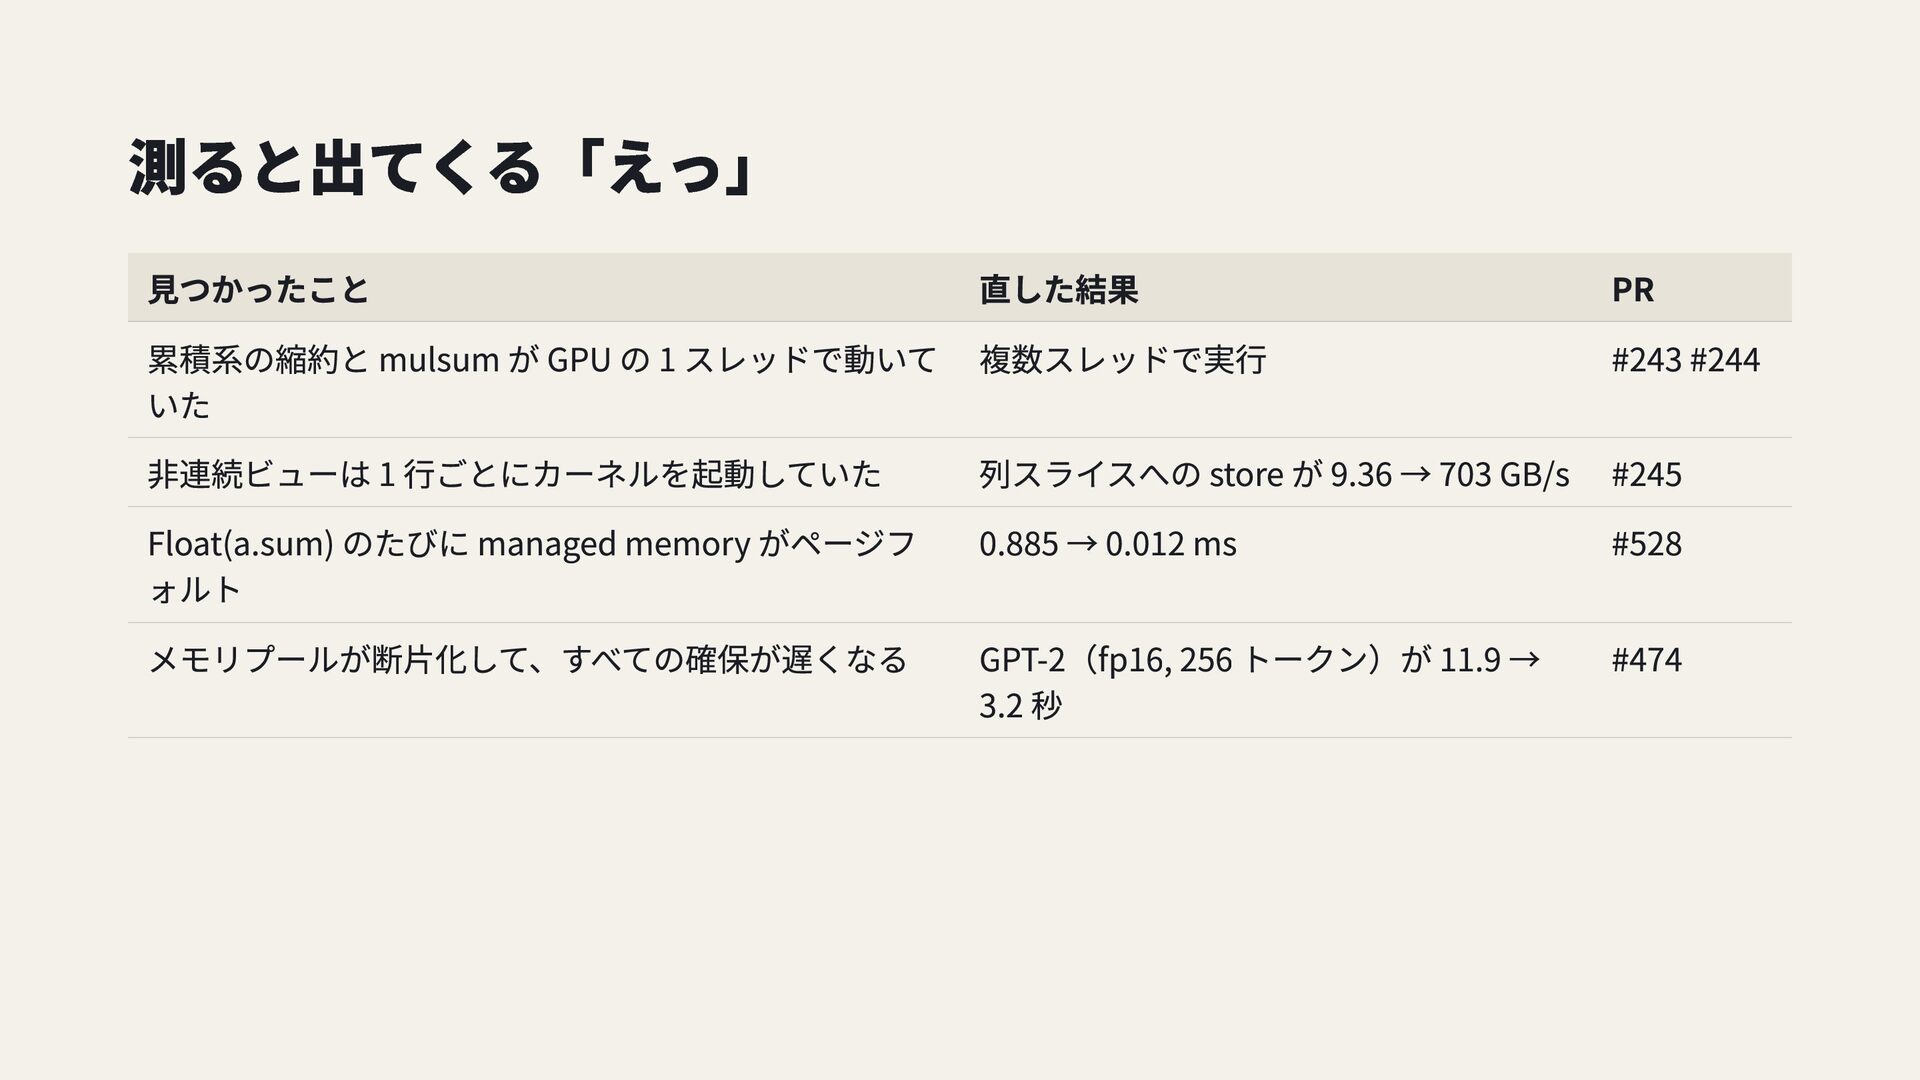
測ると出てくる「えっ」 見つかったこと 直した結果 PR 累積系の縮約と mulsum が GPU の 1
スレッドで動いて 複数スレッドで実行 #243 #244 いた 非連続ビューは 1 行ごとにカーネルを起動していた 列スライスへの store が 9.36 → 703 GB/s #245 Float(a.sum) のたびに managed memory がページフ 0.885 → 0.012 ms #528 ォルト メモリプールが断片化して、すべての確保が遅くなる GPT-2(fp16, 256 トークン)が 11.9 → #474 3.2 秒
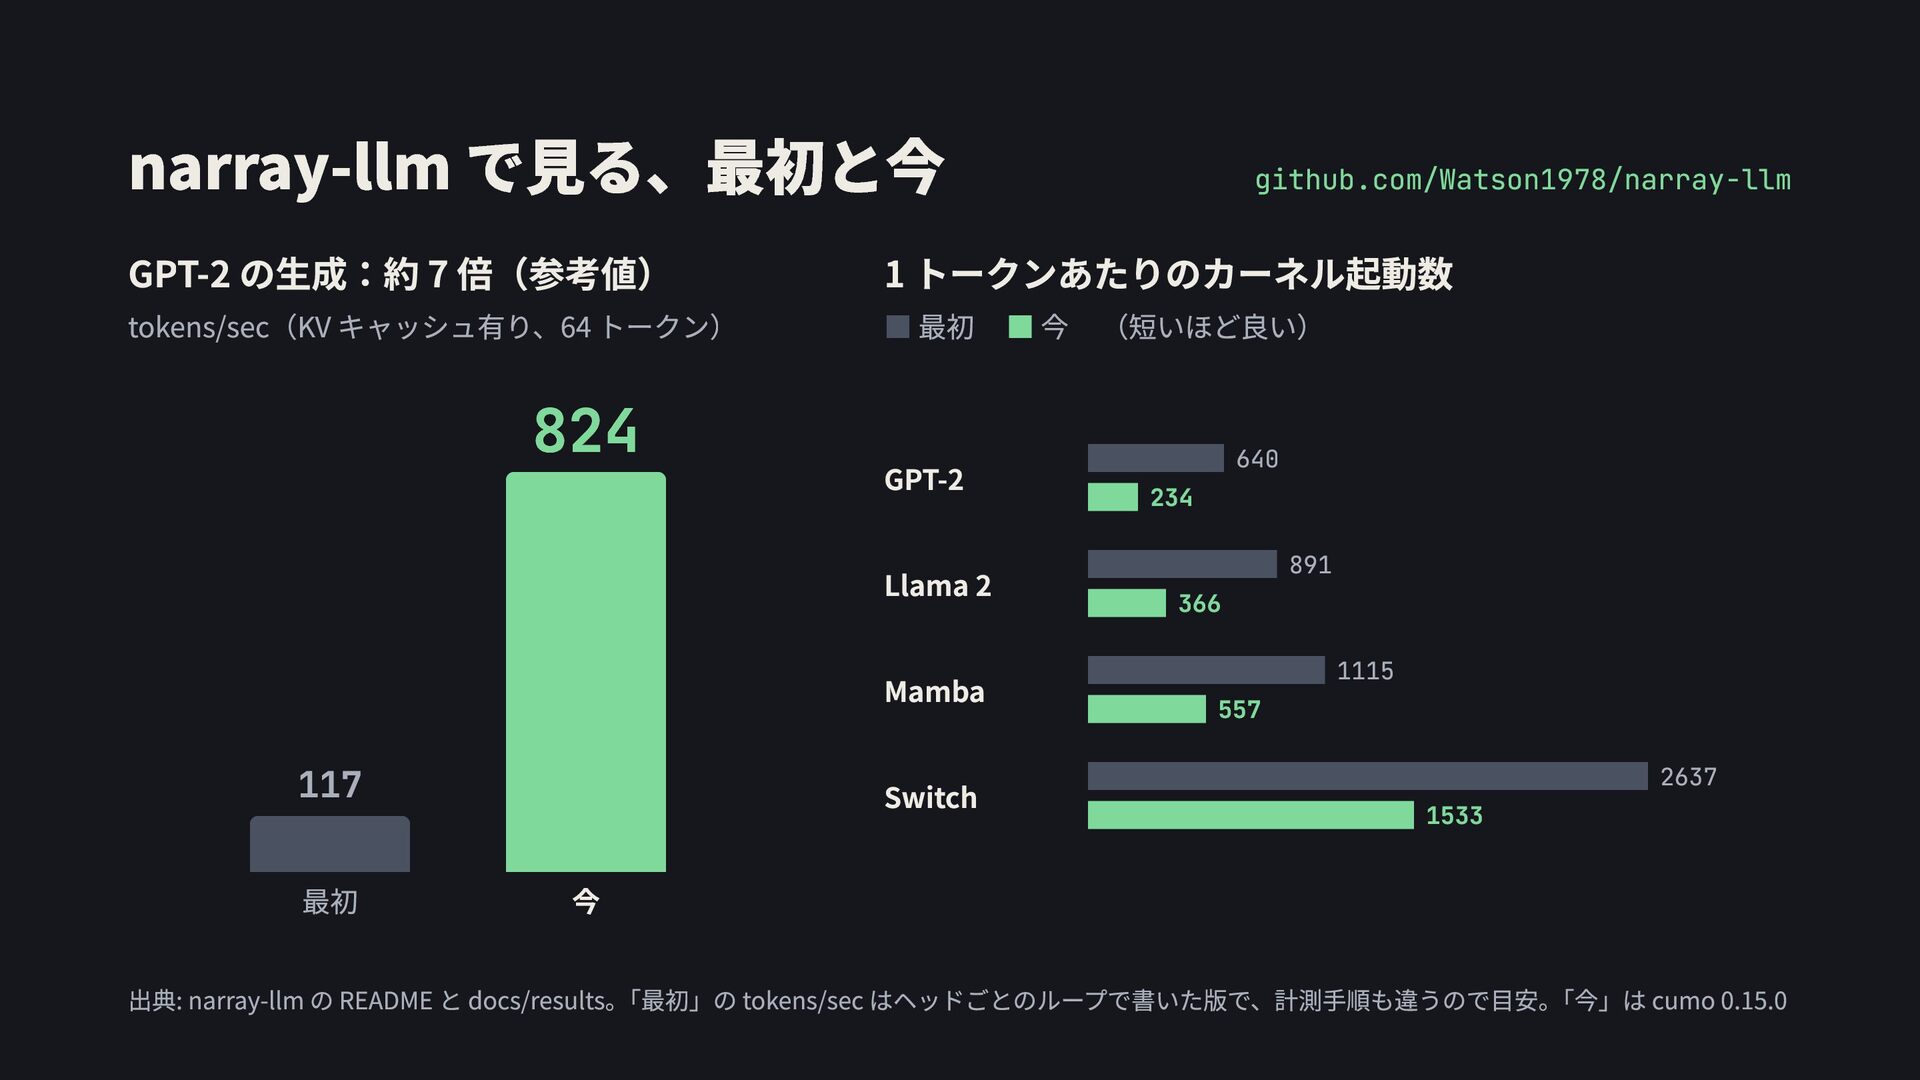
narray-llm で見る、最初と今 GPT-2 の生成:約 7 倍(参考値) tokens/sec(KV キャッシュ有り、64 トークン) 824
1 トークンあたりのカーネル起動数 ▪ 最初 ▪ 今 (短いほど良い) GPT-2 Llama 2 Mamba Switch 117 最初 github.com/Watson1978/narray-llm 640 234 891 366 1115 557 2637 1533 今 出典: narray-llm の README と docs/results。「最初」の tokens/sec はヘッドごとのループで書いた版で、計測手順も違うので目安。「今」は cumo 0.15.0
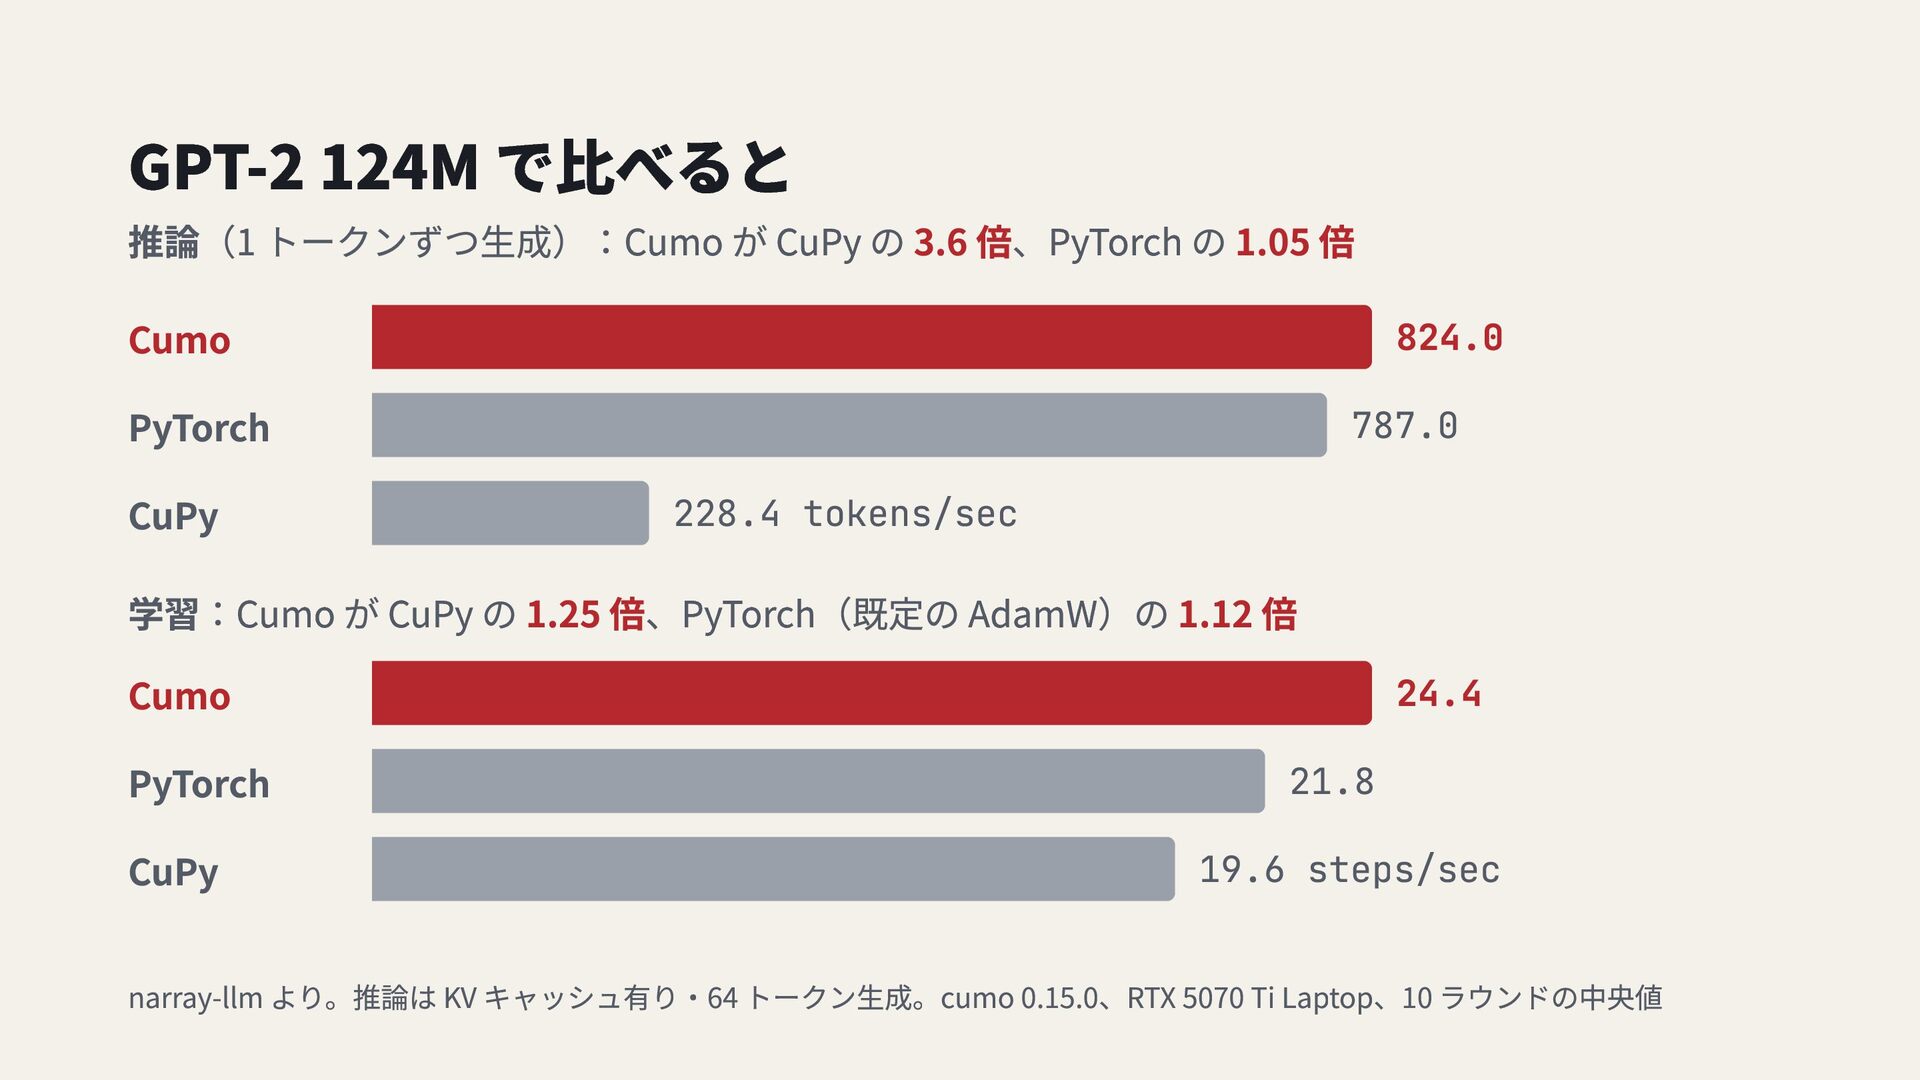
GPT-2 124M で比べると 推論(1 トークンずつ生成):Cumo が CuPy の 3.6 倍、PyTorch
の 1.05 倍 824.0 Cumo 787.0 PyTorch 228.4 tokens/sec CuPy 学習:Cumo が CuPy の 1.25 倍、PyTorch(既定の AdamW)の 1.12 倍 24.4 Cumo 21.8 PyTorch 19.6 steps/sec CuPy narray-llm より。推論は KV キャッシュ有り・64 トークン生成。cumo 0.15.0、RTX 5070 Ti Laptop、10 ラウンドの中央値
再掲 2026-08-01 〜 11-06(約 3 か月)で 482 17 +61,594 88%
本の PR をマージ 行を追加(削除は 13,646 行) 回リリース(v0.5.6 → v0.15.0) のコミットが Claude との共著 (519 件中 458 件)
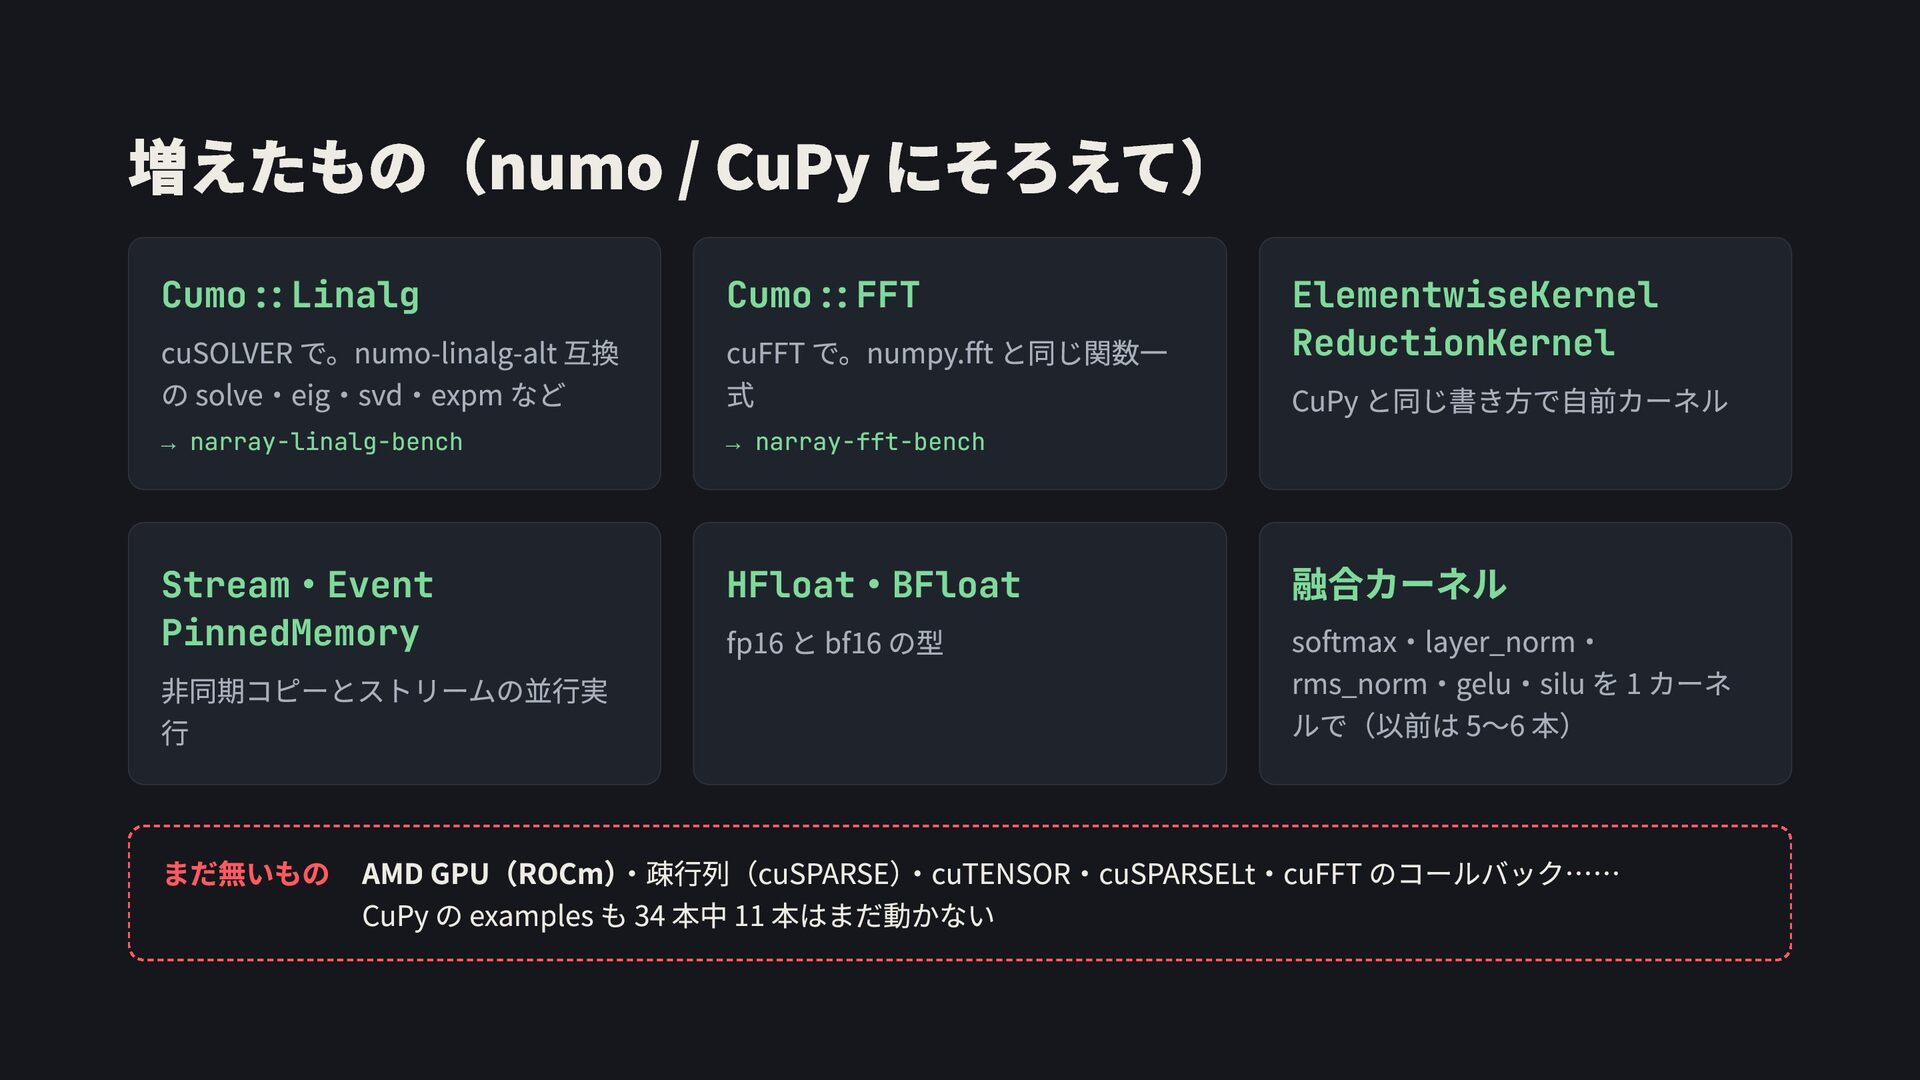
増えたもの(numo / CuPy にそろえて) Cumo::Linalg cuSOLVER で。numo-linalg-alt 互換 の solve・eig・svd・expm
など → narray-linalg-bench ・ Stream Event PinnedMemory 非同期コピーとストリームの並行実 行 Cumo::FFT cuFFT で。numpy.fft と同じ関数一 式 → narray-fft-bench ・ HFloat BFloat fp16 と bf16 の型 ElementwiseKernel ReductionKernel CuPy と同じ書き方で自前カーネル 融合カーネル softmax・layer_norm・ rms_norm・gelu・silu を 1 カーネ ルで(以前は 5〜6 本) まだ無いもの AMD GPU(ROCm)・疎行列(cuSPARSE)・cuTENSOR・cuSPARSELt・cuFFT のコールバック…… CuPy の examples も 34 本中 11 本はまだ動かない
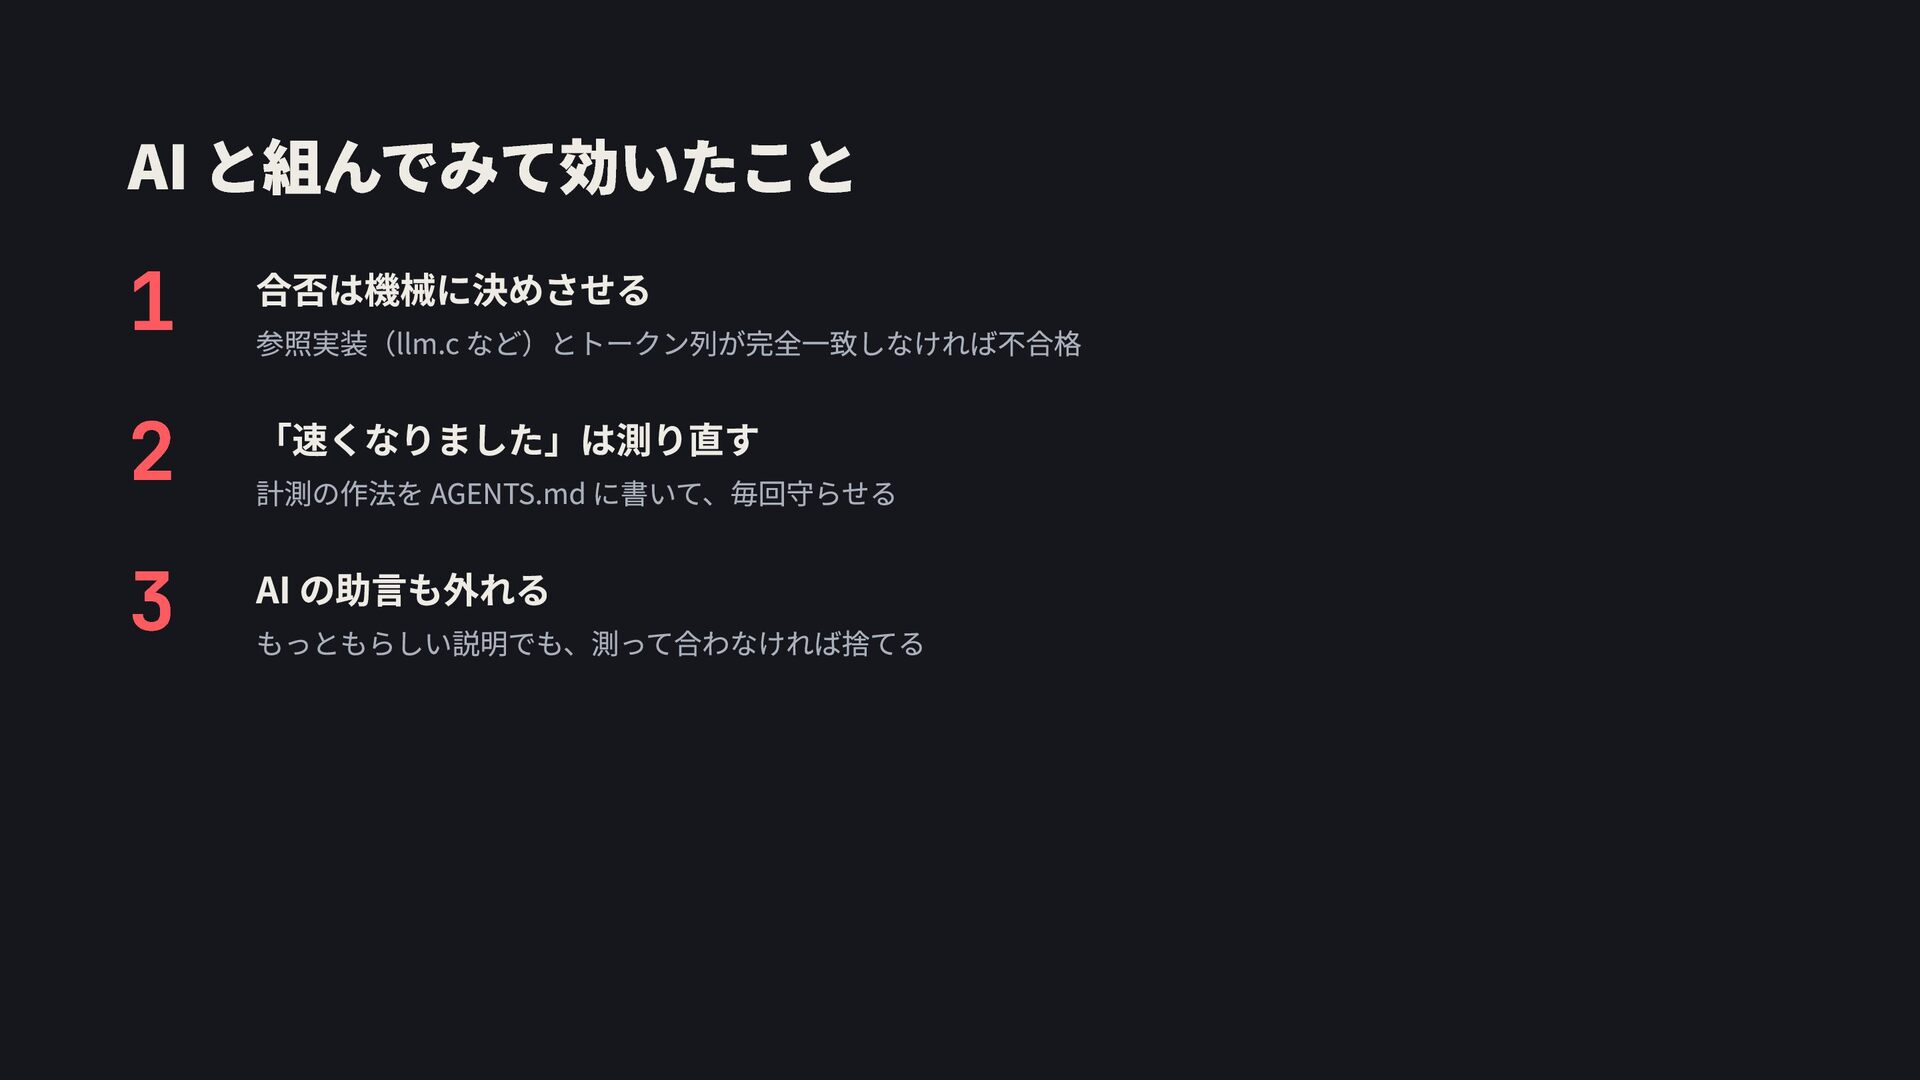
AI と組んでみて効いたこと 1 合否は機械に決めさせる 2 「速くなりました」は測り直す 3 AI の助言も外れる 参照実装(llm.c
など)とトークン列が完全一致しなければ不合格 計測の作法を AGENTS.md に書いて、毎回守らせる もっともらしい説明でも、測って合わなければ捨てる
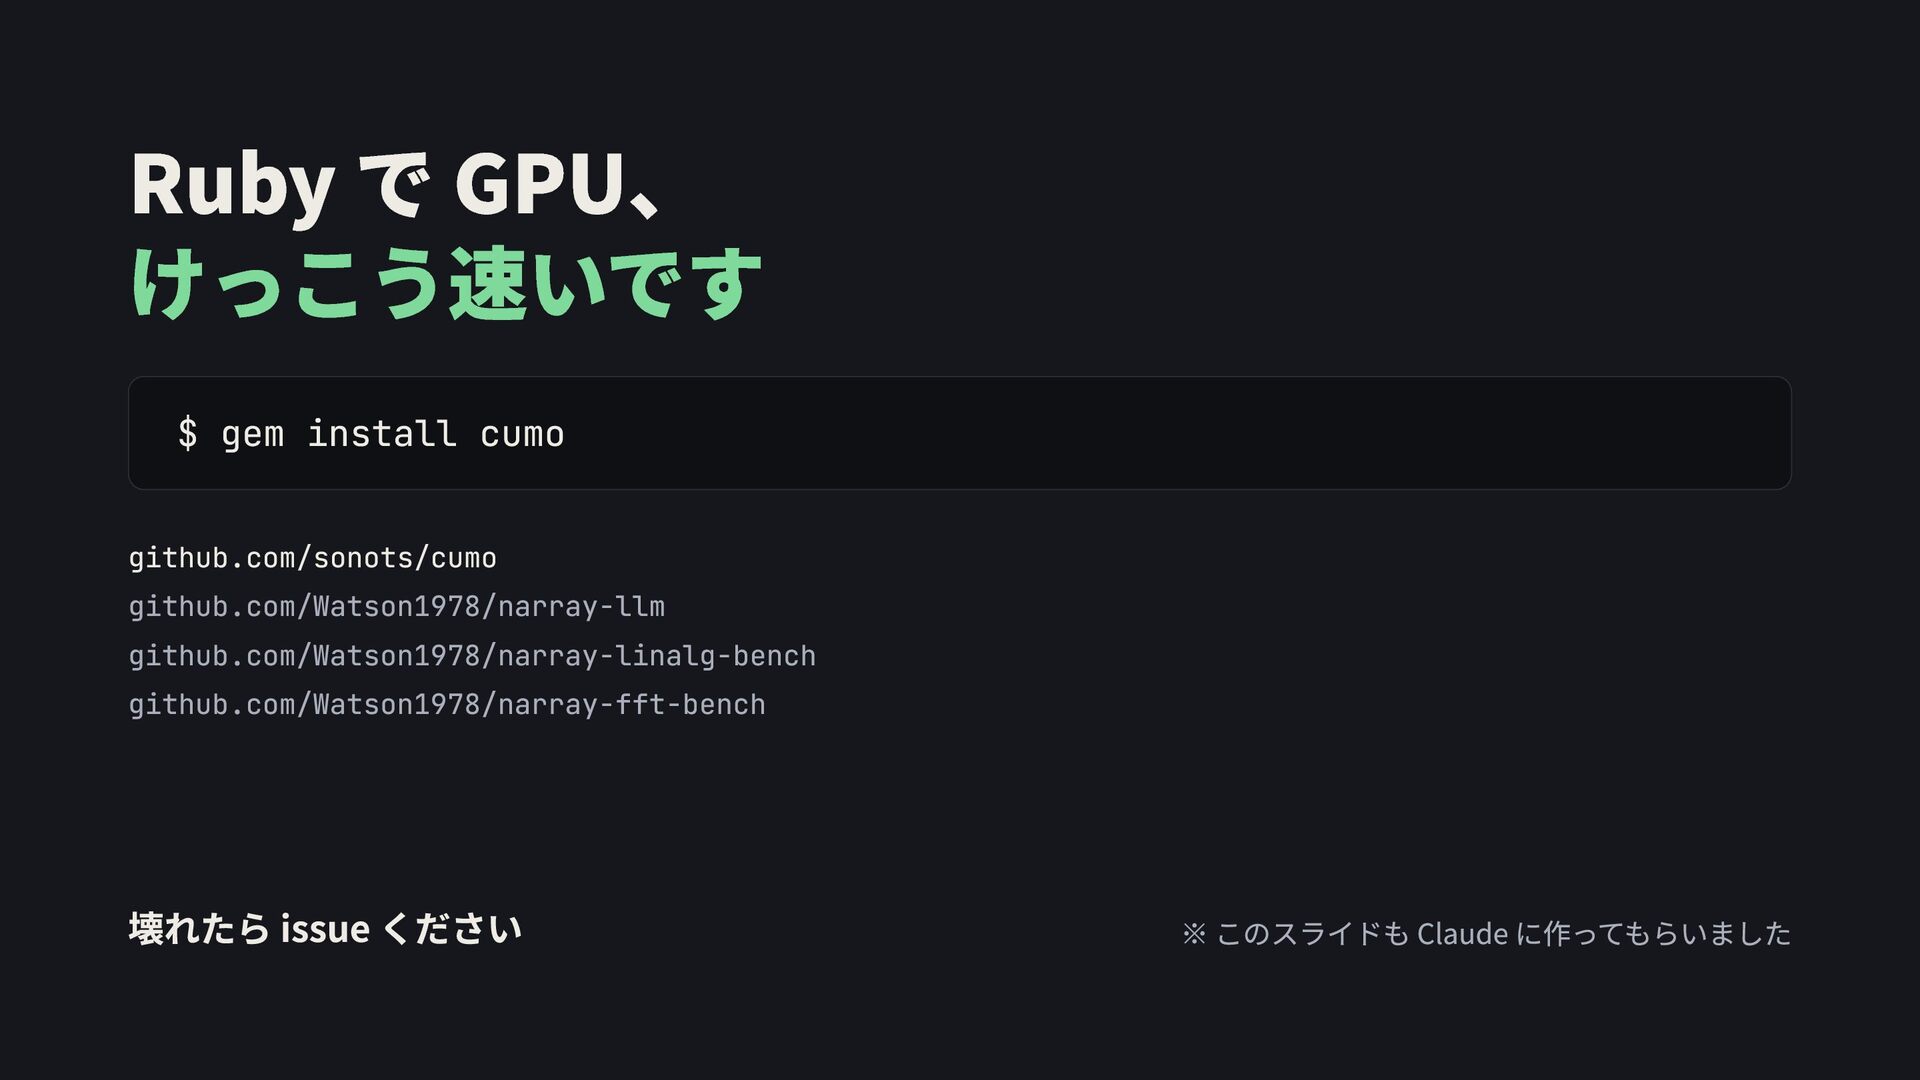
Ruby で GPU、 けっこう速いです $ gem install cumo github.com/sonots/cumo github.com/Watson1978/narray-llm
github.com/Watson1978/narray-linalg-bench github.com/Watson1978/narray-fft-bench 壊れたら issue ください ※ このスライドも Claude に作ってもらいました


 watson
 shift_evolve
 sh_fk2
 teamlab
 tomoaki25
 sansantech
 shinyaa31
 kota2and3kan
 cmusudakeisuke
 oidfj
 inariku
 sishi2026
 taiyow
 axbom
 danielanewman
 addyosmani
 shlominoach
 lauravandoore
 rkaga
 akashhashmi
 joshbly
 palkan
 jnunemaker
 cargoodrich