Share
Embed
Transcript
25 slides
-
How much can language models memorize? John Xavier Morris, Chawin
Sitawarin, Chuan Guo, Narine Kokhlikyan, G. Edward Suh, Alexander M Rush, Kamalika Chaudhuri, Saeed Mahloujifar ICLR 2026 笹野研究室 D2 矢野千紘 -
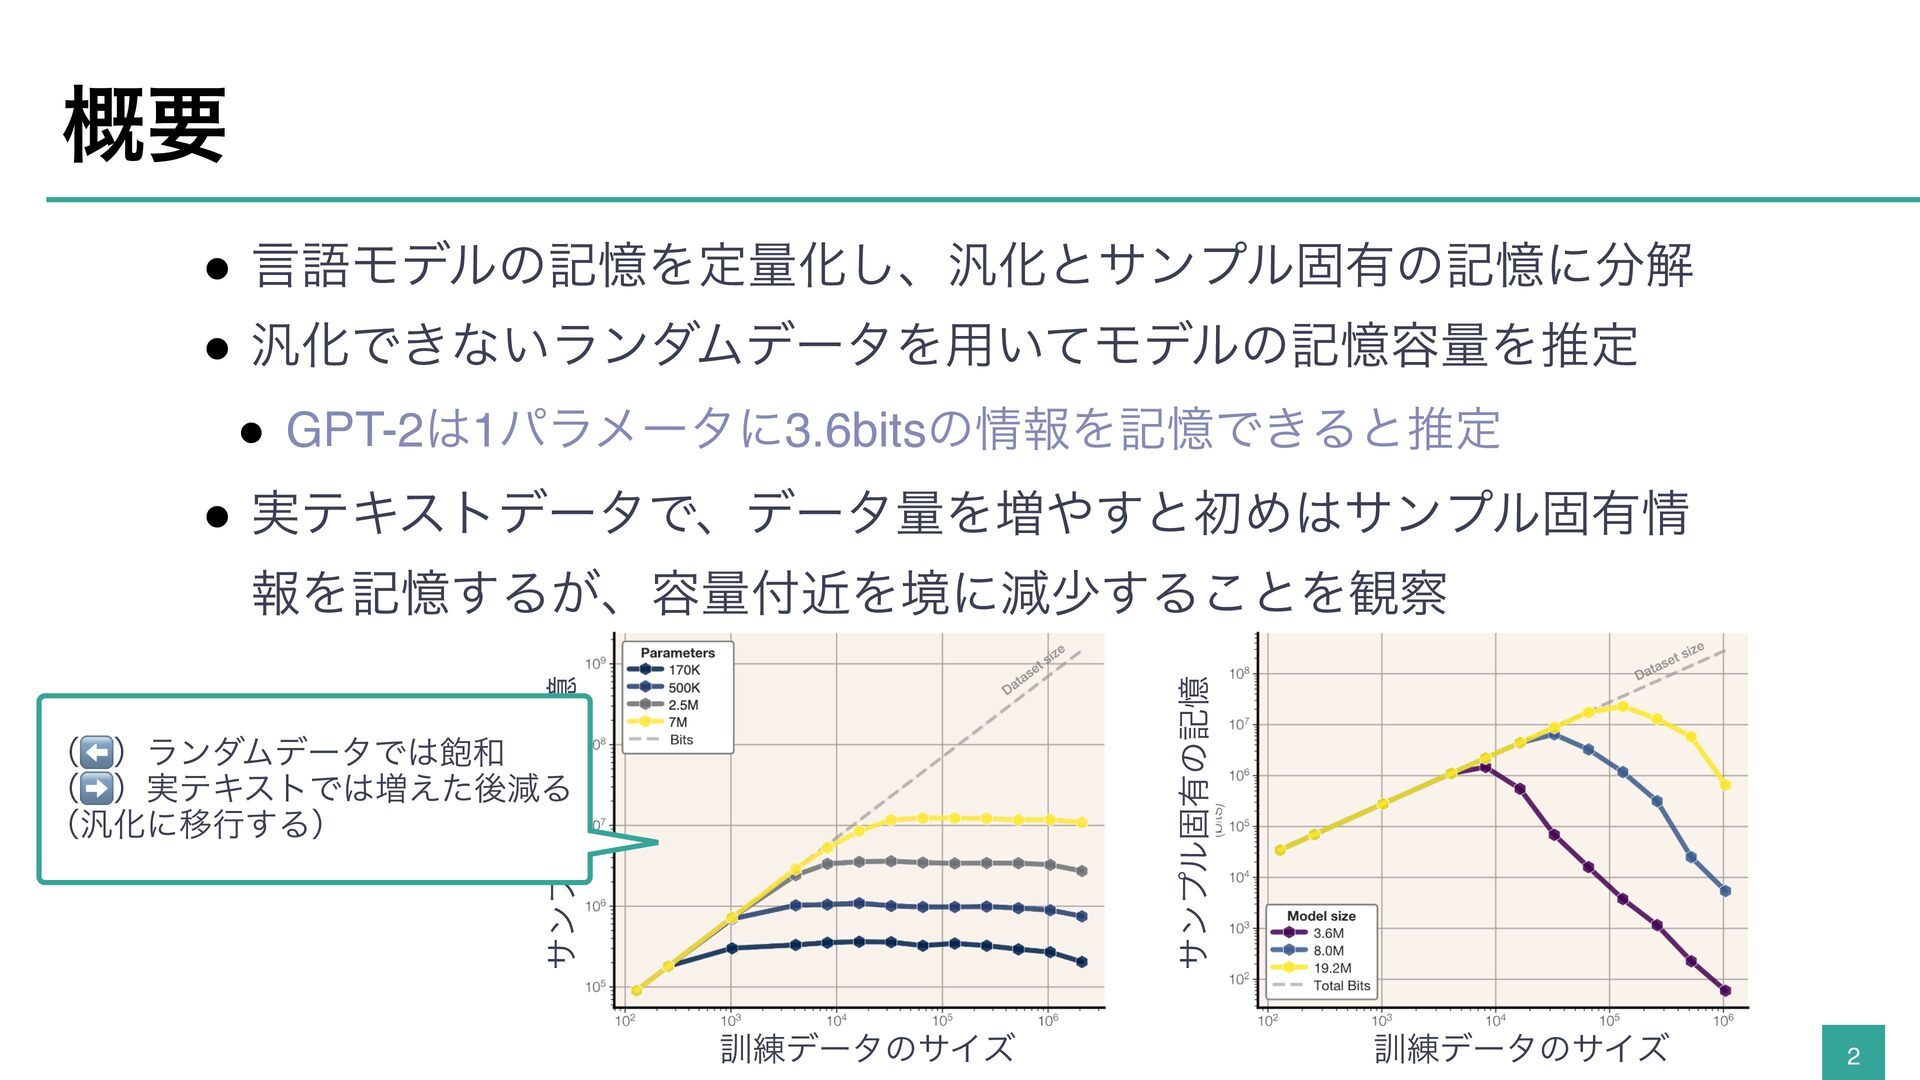
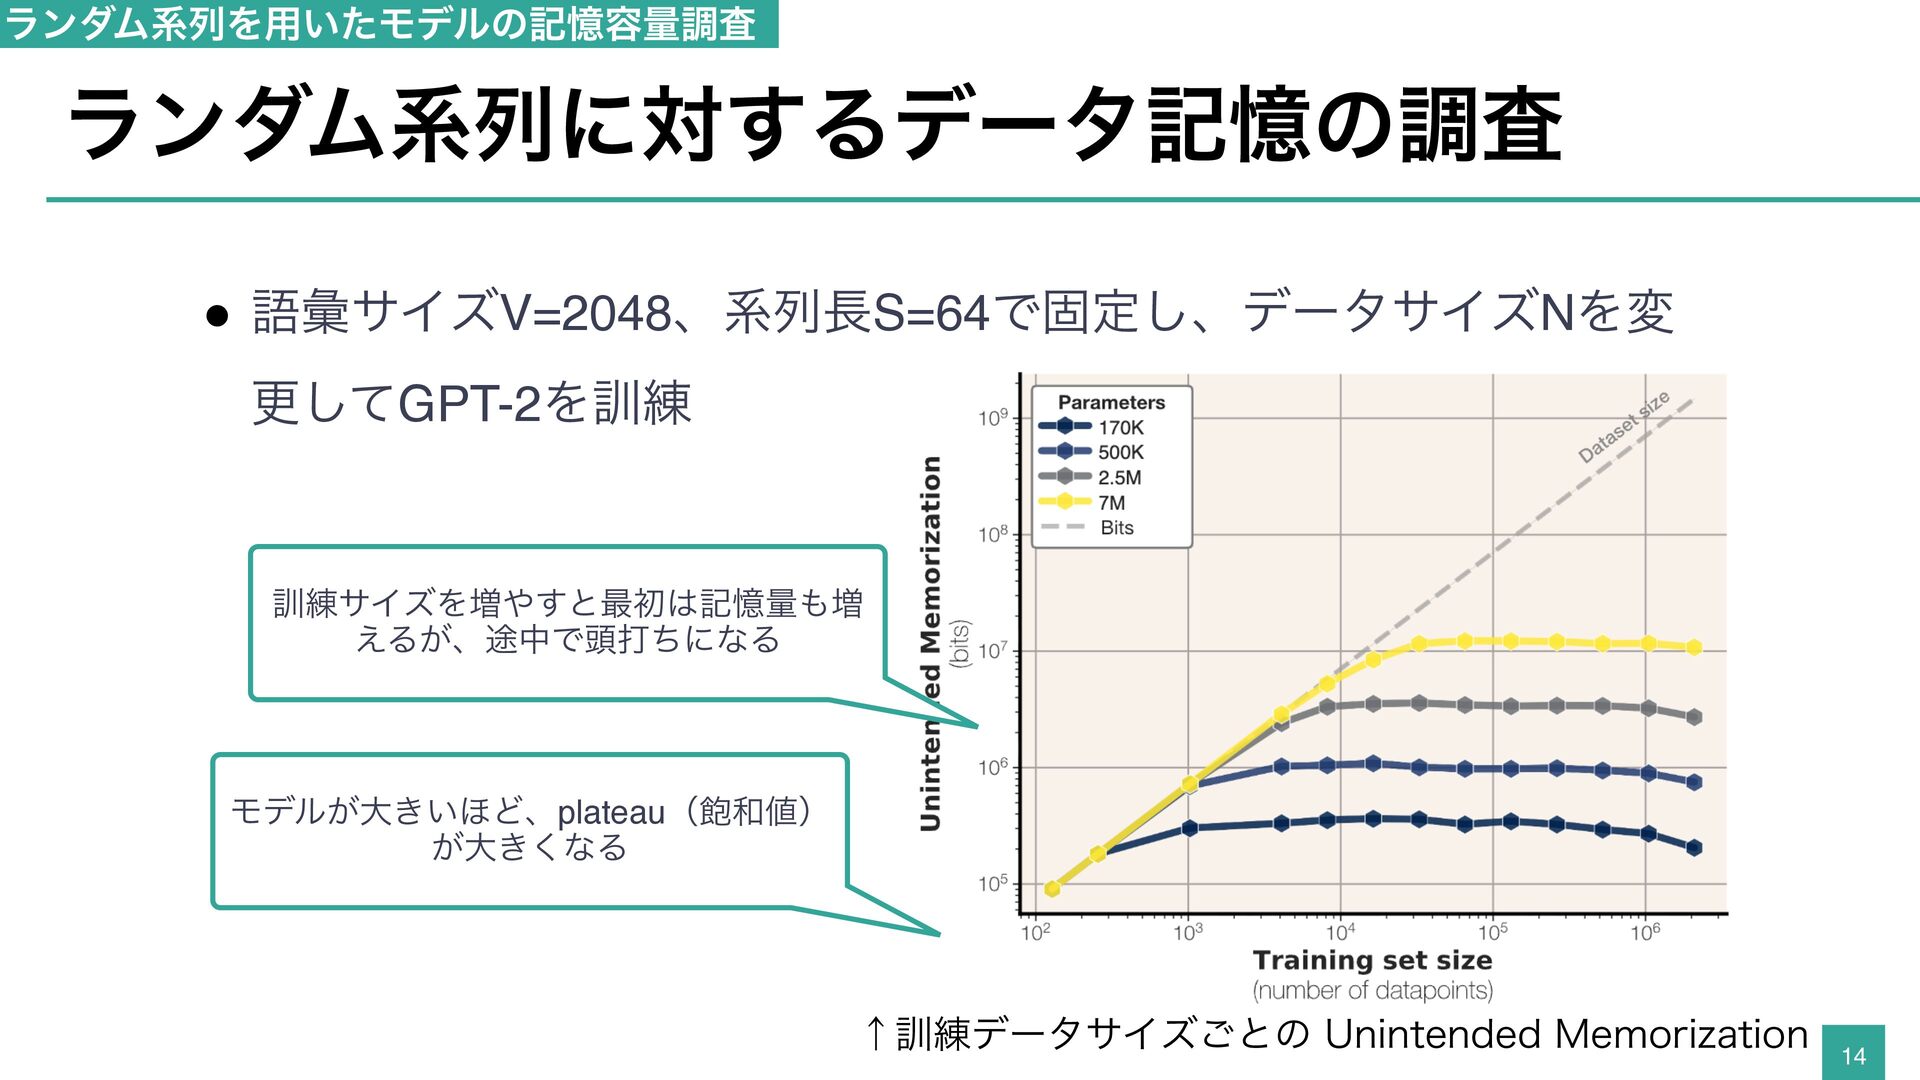
概要 • 言語モデルの記憶を定量化し、汎化とサンプル固有の記憶に分解 • 汎化できないランダムデータを用いてモデルの記憶容量を推定 • GPT-2は1パラメータに3.6bitsの情報を記憶できると推定 • 実テキストデータで、データ量を増やすと初めはサンプル固有情 サンプル固有の記憶
サンプル固有の記憶 報を記憶するが、容量付近を境に減少することを観察 (⬅)ランダムデータでは飽和 (➡)実テキストでは増えた後減る (汎化に移行する) 訓練データのサイズ 訓練データのサイズ 2 -
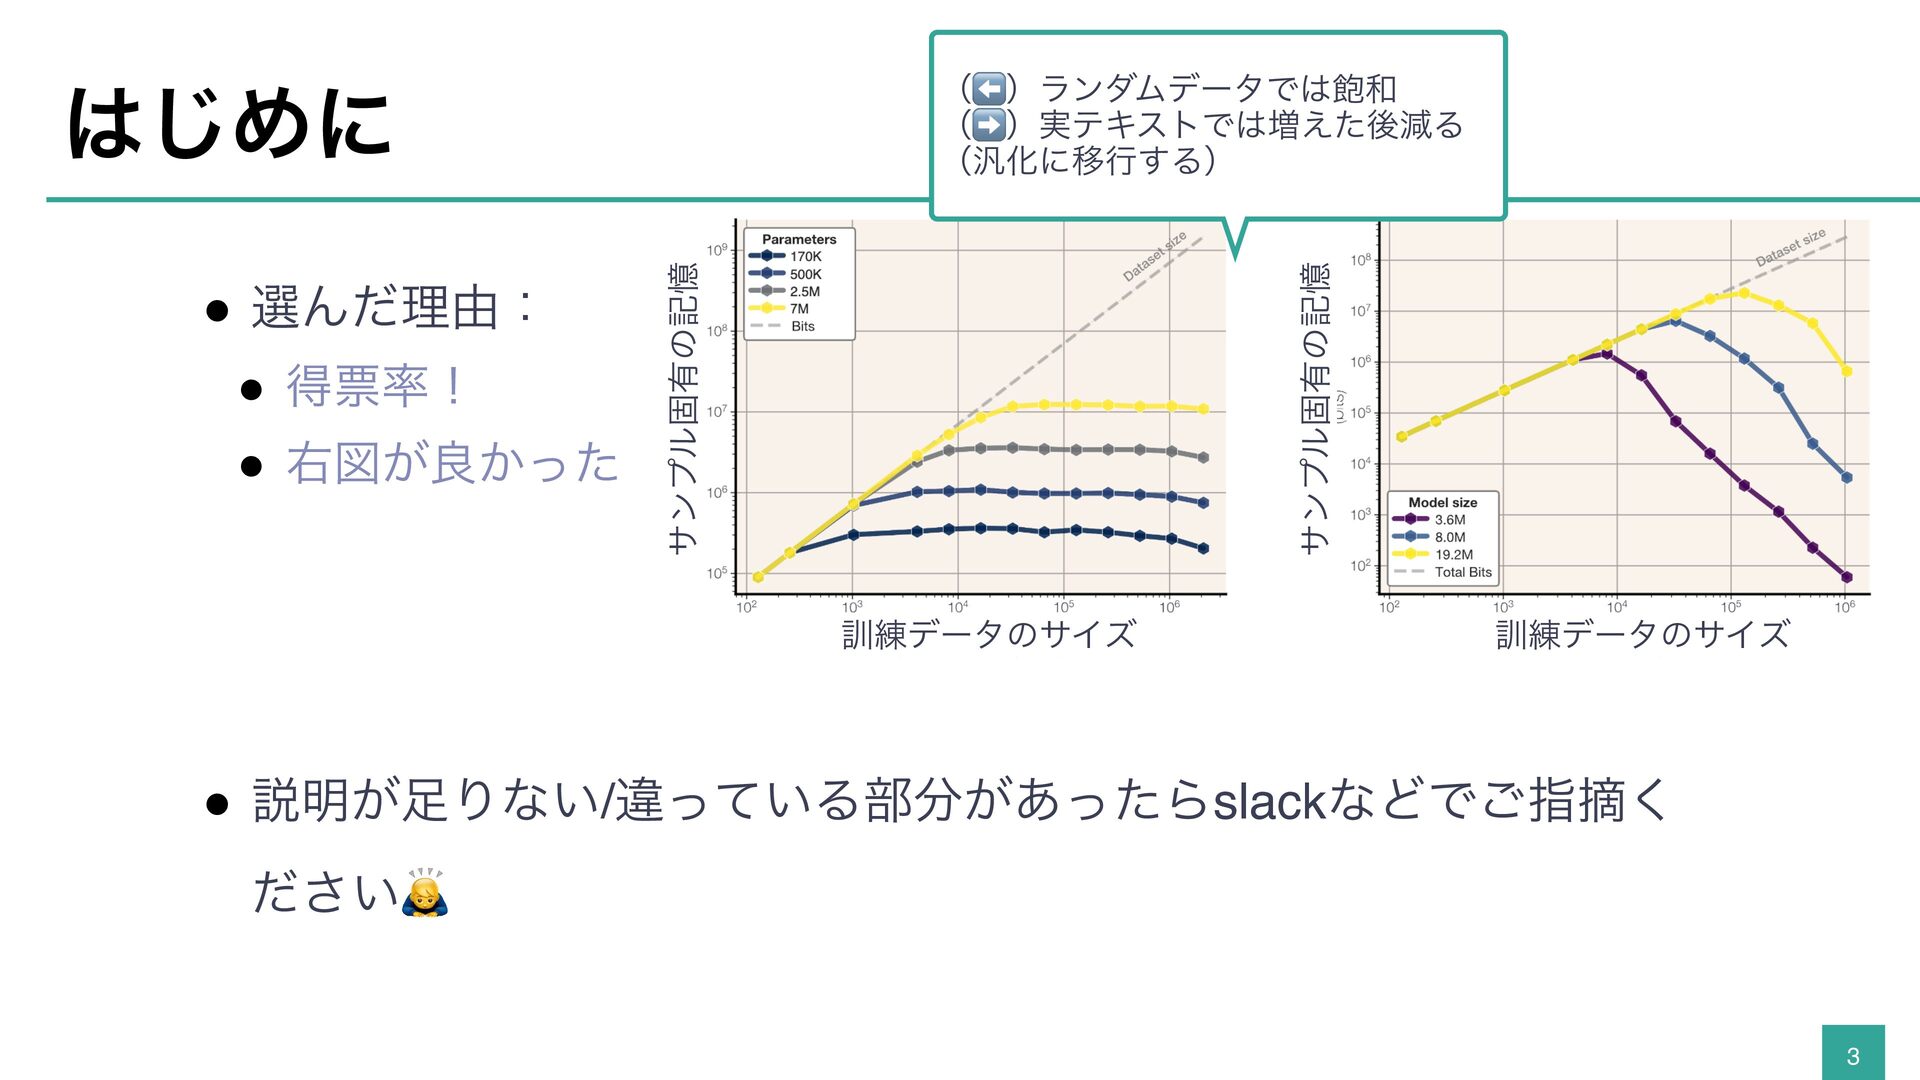
• 選んだ理由: • 得票率! • 右図が良かった サンプル固有の記憶 はじめに サンプル固有の記憶 (⬅)ランダムデータでは飽和
(➡)実テキストでは増えた後減る (汎化に移行する) 訓練データのサイズ 訓練データのサイズ • 説明が足りない/違っている部分があったらslackなどでご指摘く ださい🙇 3 -
導入 汎化とサンプル固有の記憶 • 言語モデルの記憶はgeneralizationとunintended memorizationに区別で きる • generalization(intended memorization):汎化 •
unintended memorization:サンプル固有の記憶 例) • John Smith scored 147 points in the 2019 regional bowling championship. • 構文はgeneralizationによって予測できるが、名前、スコア、年は unintended memorizationによってのみ予測できる 4 -
導入 先行研究とその課題 • 言語モデルが訓練データを「記憶しているか」は従来から研究さ れてきた • データ抽出(Extraction):訓練データをモデルに生成させる • メンバーシップ推論(Membership inference):訓練データのloss
や出力確率を見る • しかし、既存指標では memorization と generalization が混ざっ てしまう • モデルが訓練文を生成できても、単に一般化した結果かもしれない 5 -
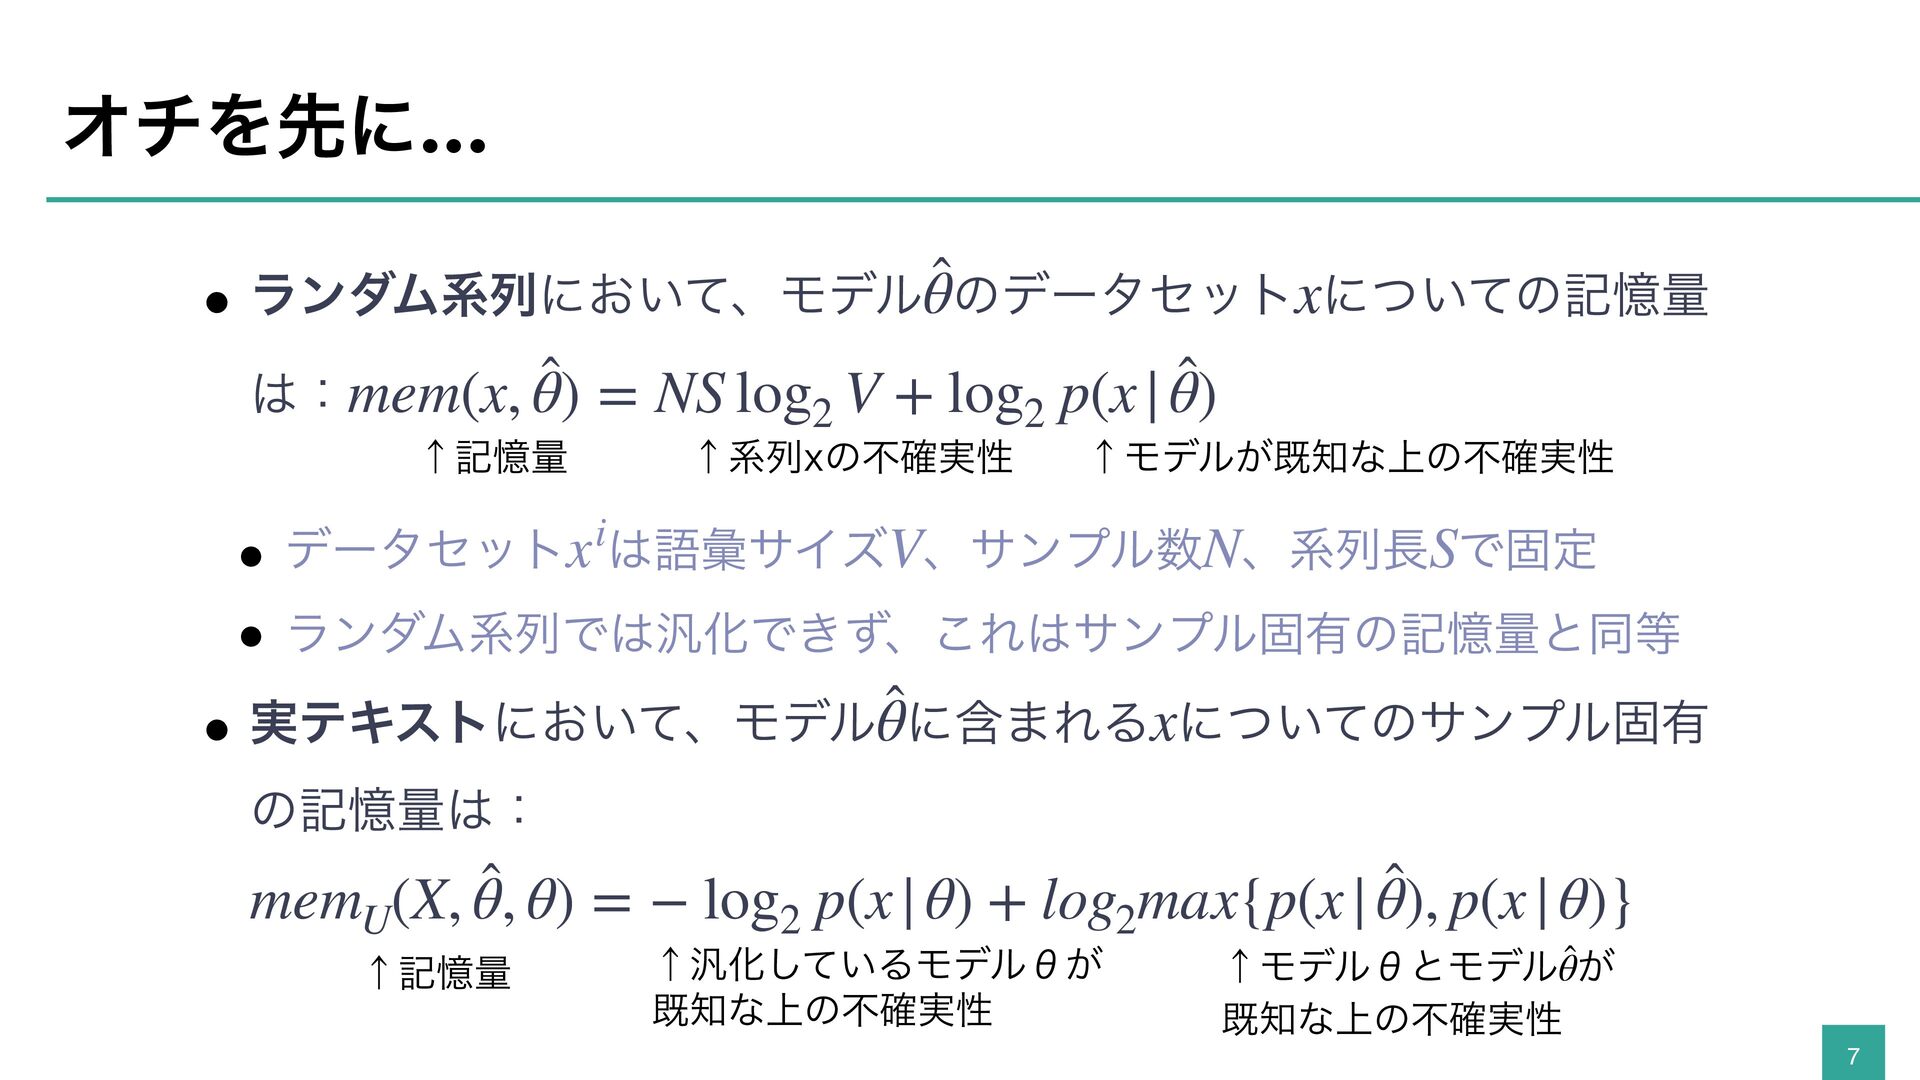
オチを先に… ̂ • ランダム系列において、モデルθのデータセットxについての記憶量 ̂ ̂ は:mem(x, θ) = NS
log2 V + log2 p(x | θ) ↑記憶量 ↑系列xの不確実性 ↑モデルが既知な上の不確実性 i • データセットx は語彙サイズV、サンプル数N、系列長Sで固定 • ランダム系列では汎化できず、これはサンプル固有の記憶量と同等 ̂ • 実テキストにおいて、モデルθに含まれるxについてのサンプル固有 の記憶量は: ̂ ̂ memU(X, θ, θ) = − log2 p(x | θ) + log2max{p(x | θ), p(x | θ)} ↑記憶量 ↑汎化しているモデルθが 既知な上の不確実性 ̂ ↑モデルθとモデルθが 既知な上の不確実性 7 -
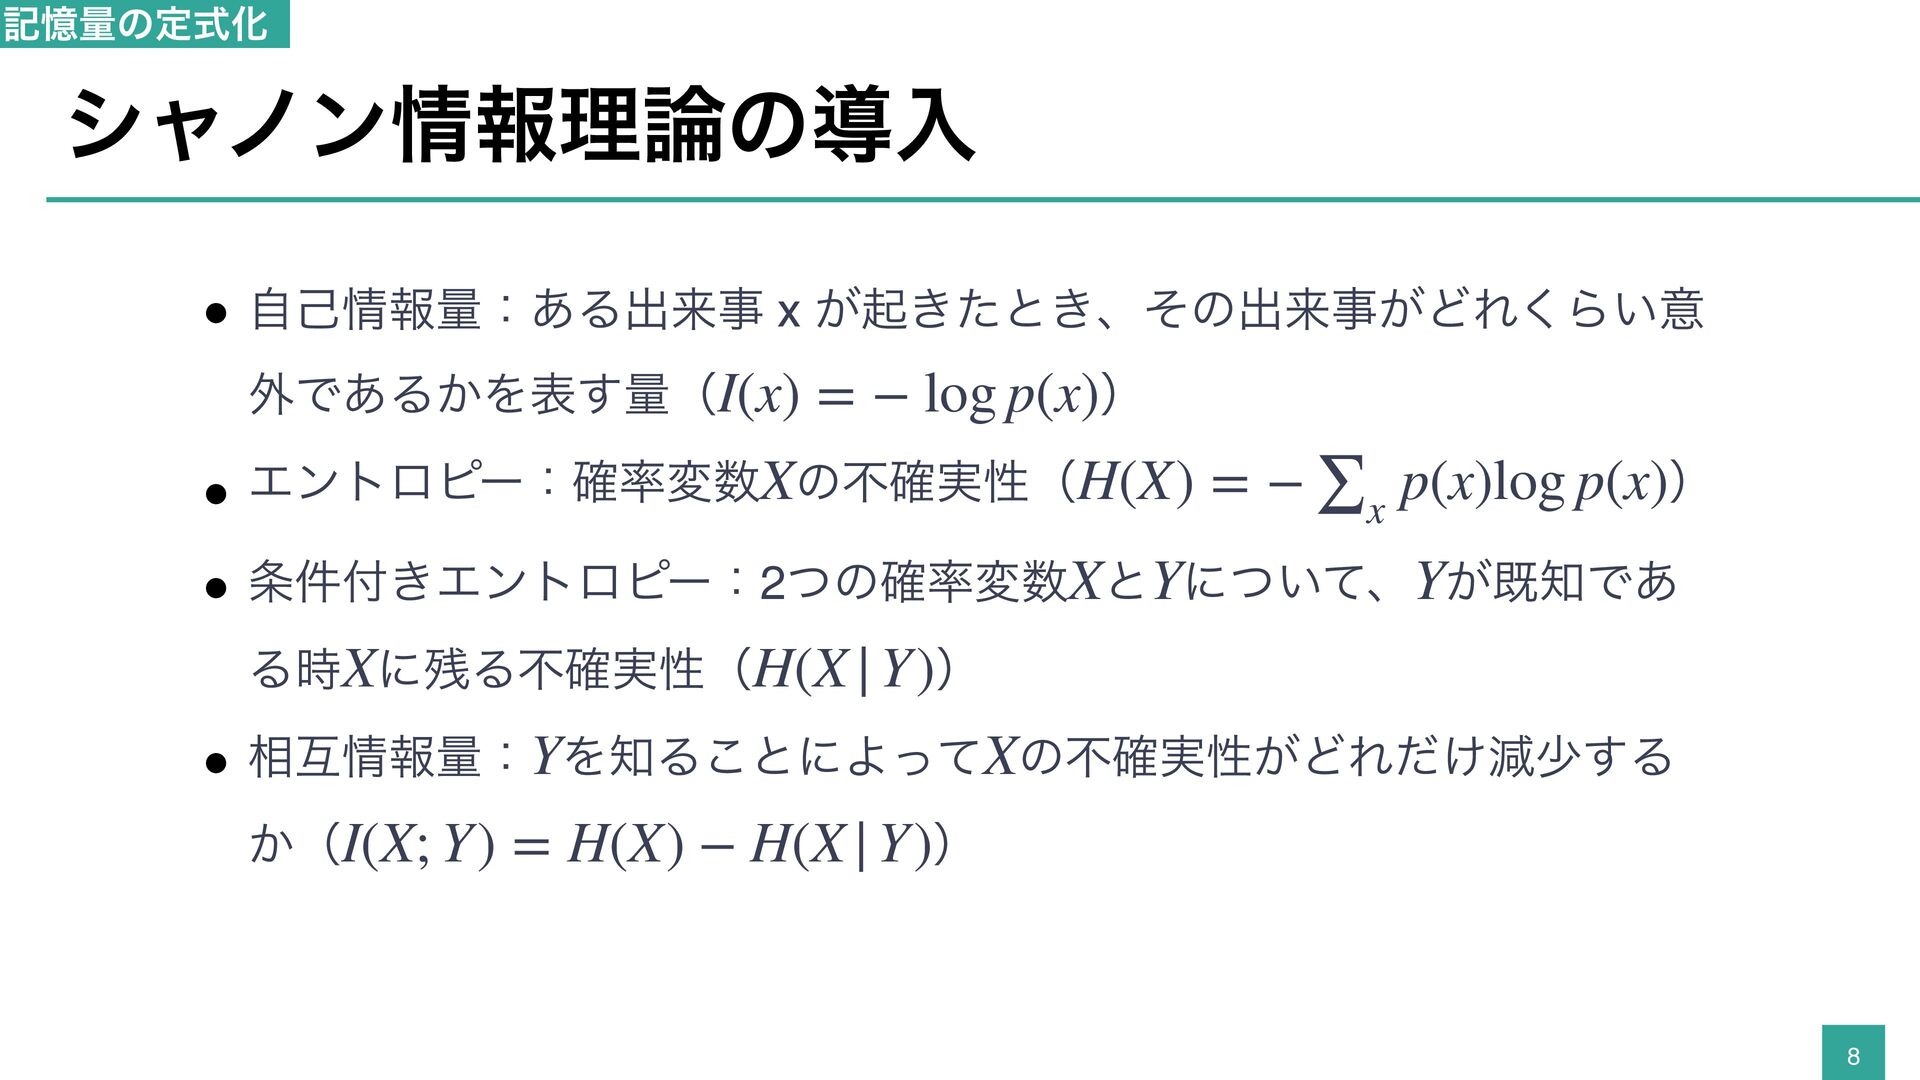
記憶量の定式化 シャノン情報理論の導入 • 自己情報量:ある出来事 x が起きたとき、その出来事がどれくらい意 外であるかを表す量(I(x) = − log
p(x)) • エントロピー:確率変数Xの不確実性(H(X) = − ∑x p(x)log p(x)) • 条件付きエントロピー:2つの確率変数XとYについて、Yが既知であ る時Xに残る不確実性(H(X | Y)) • 相互情報量:Yを知ることによってXの不確実性がどれだけ減少する か(I(X; Y) = H(X) − H(X | Y)) 8 -
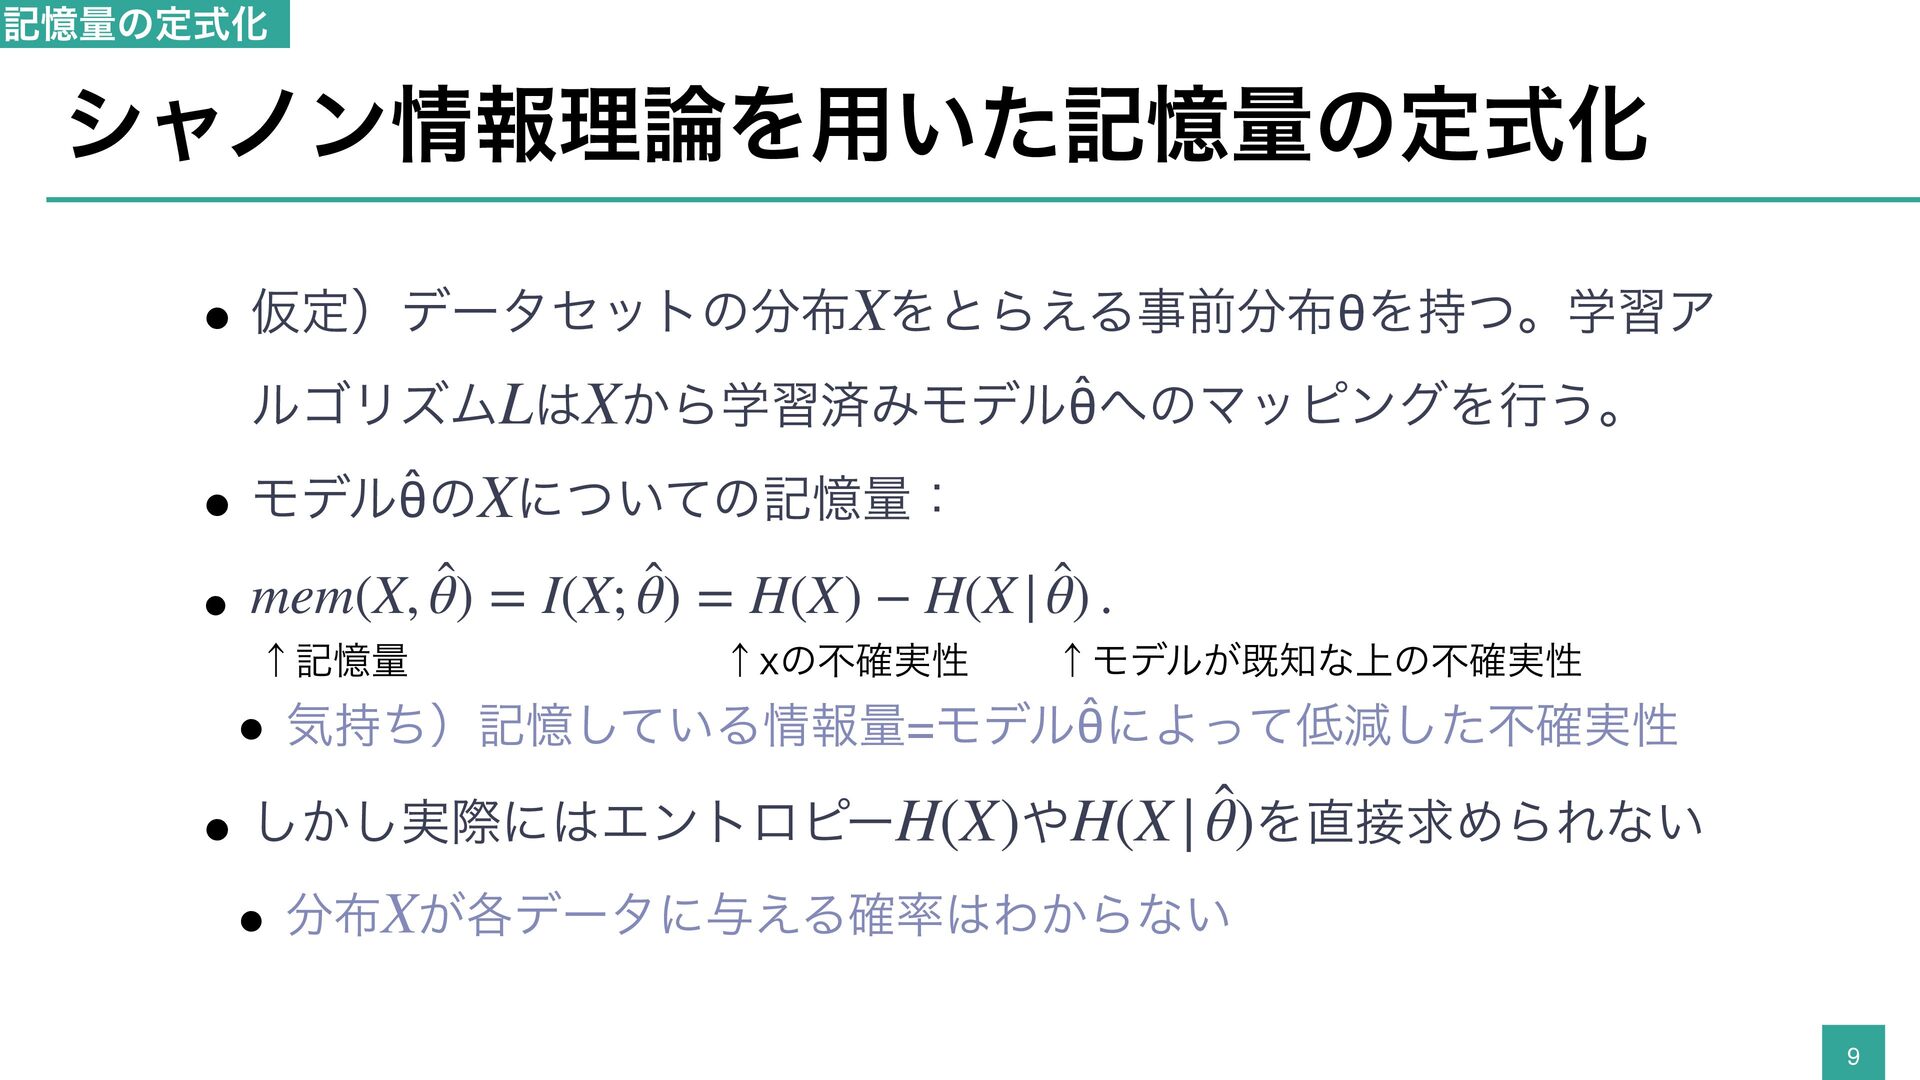
記憶量の定式化 シャノン情報理論を用いた記憶量の定式化 • 仮定)データセットの分布Xをとらえる事前分布θを持つ。学習ア ルゴリズムLはXから学習済みモデルθ̂へのマッピングを行う。 • モデルθ̂のXについての記憶量: ̂ ̂ ̂
• mem(X, θ) = I(X; θ) = H(X) − H(X | θ) . ↑記憶量 ↑xの不確実性 ↑モデルが既知な上の不確実性 • 気持ち)記憶している情報量=モデルθ̂によって低減した不確実性 ̂ • しかし実際にはエントロピーH(X)やH(X | θ)を直接求められない • 分布Xが各データに与える確率はわからない 9 -
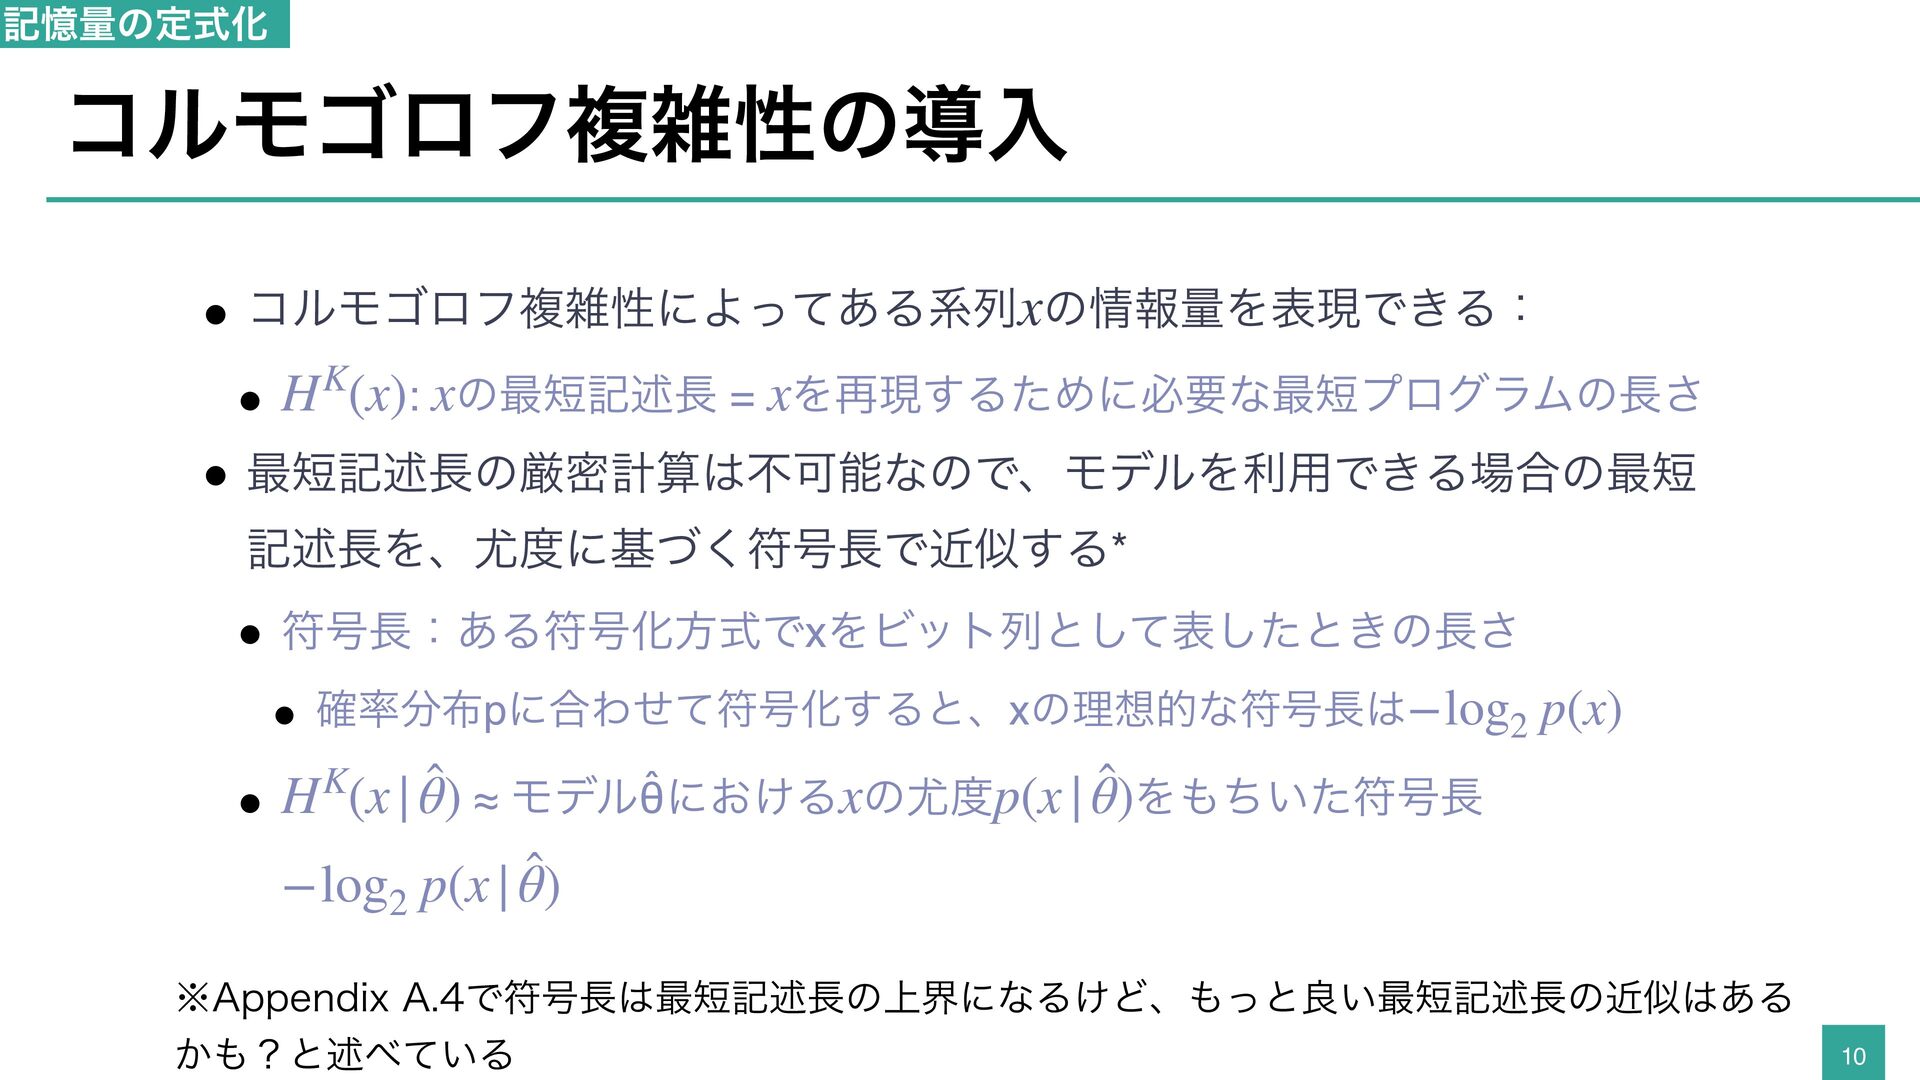
記憶量の定式化 コルモゴロフ複雑性の導入 • コルモゴロフ複雑性によってある系列xの情報量を表現できる: K • H (x): xの最短記述長 =
xを再現するために必要な最短プログラムの長さ • 最短記述長の厳密計算は不可能なので、モデルを利用できる場合の最短 記述長を、尤度に基づく符号長で近似する* • 符号長:ある符号化方式でxをビット列として表したときの長さ • 確率分布pに合わせて符号化すると、xの理想的な符号長は−log2 p(x) ̂ ̂ ̂ • H (x | θ) ≈ モデルθにおけるxの尤度p(x | θ)をもちいた符号長 ̂ −log p(x | θ) K 2 ※Appendix A.4で符号長は最短記述長の上界になるけど、もっと良い最短記述長の近似はある かも?と述べている 10 -
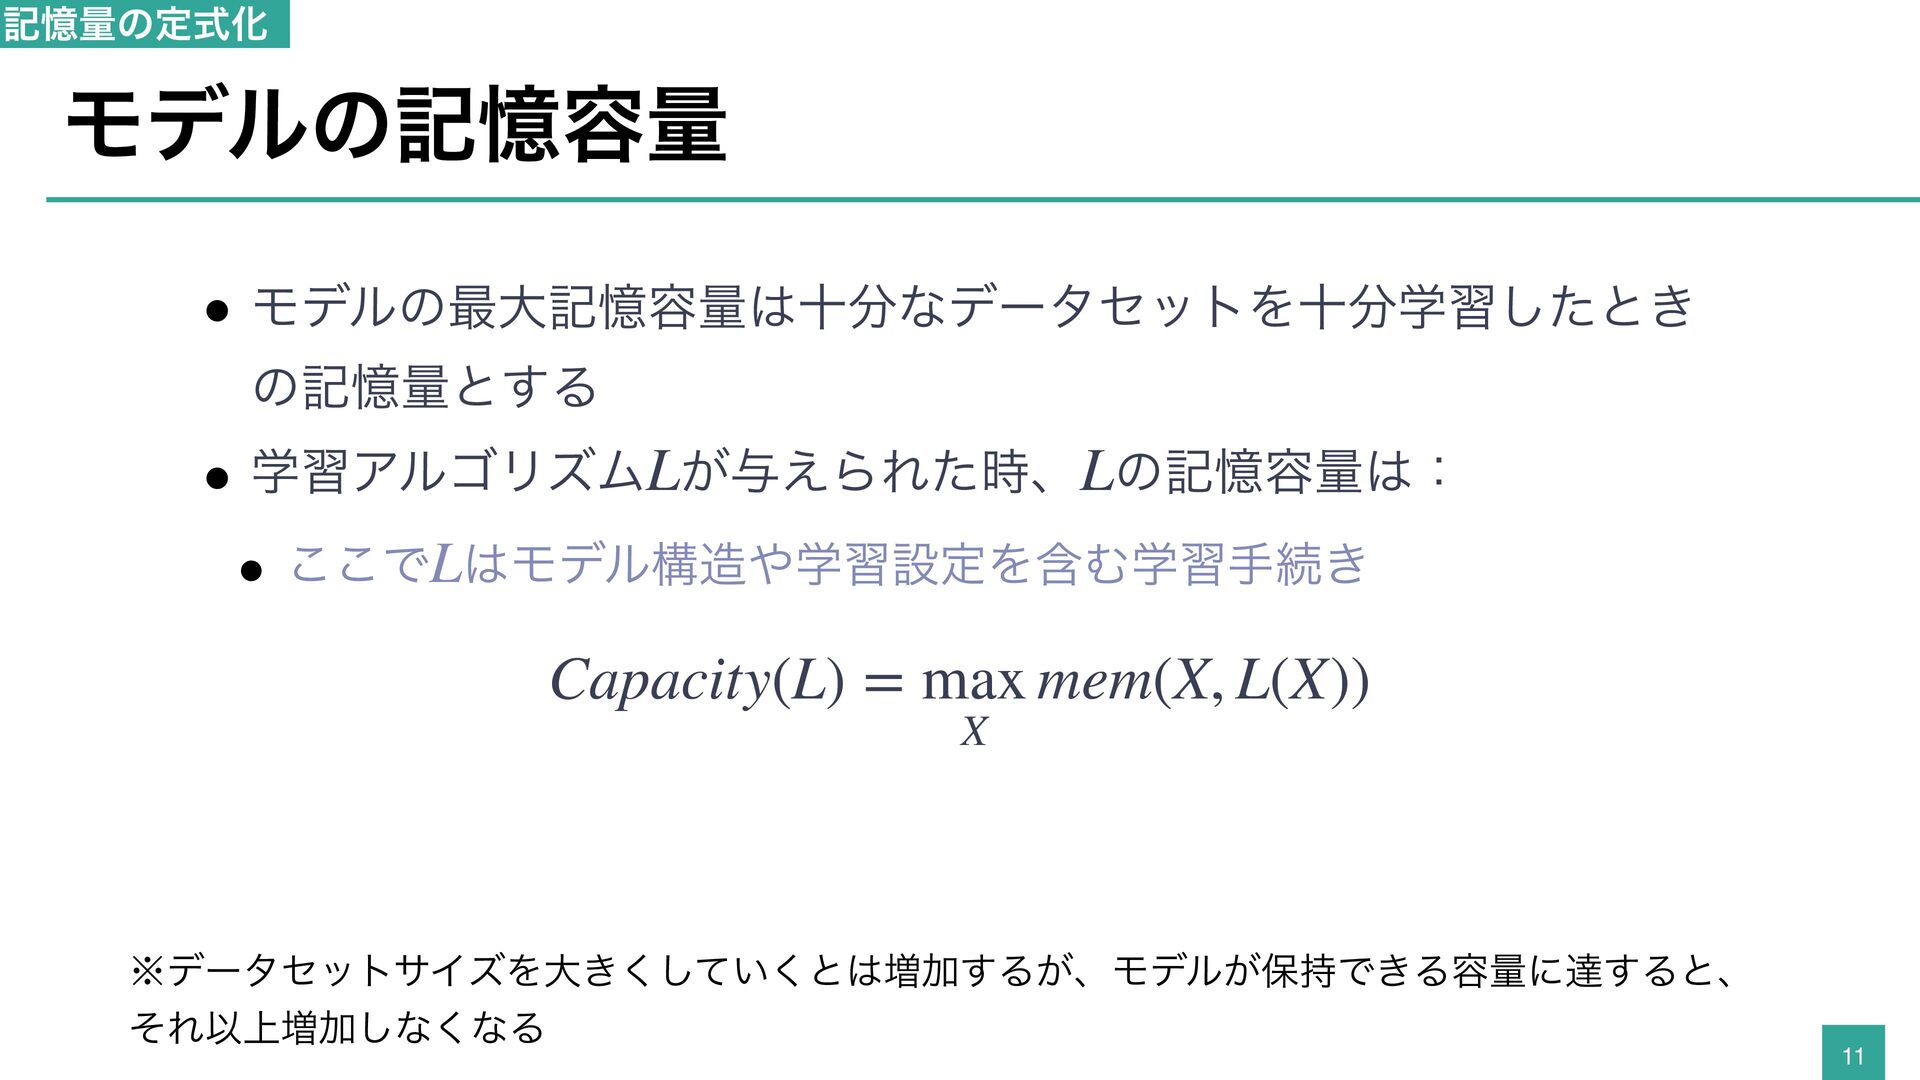
記憶量の定式化 モデルの記憶容量 • モデルの最大記憶容量は十分なデータセットを十分学習したとき の記憶量とする • 学習アルゴリズムLが与えられた時、Lの記憶容量は: • ここでLはモデル構造や学習設定を含む学習手続き Capacity(L)
= max mem(X, L(X)) X ※データセットサイズを大きくしていくとは増加するが、モデルが保持できる容量に達すると、 それ以上増加しなくなる 11 -
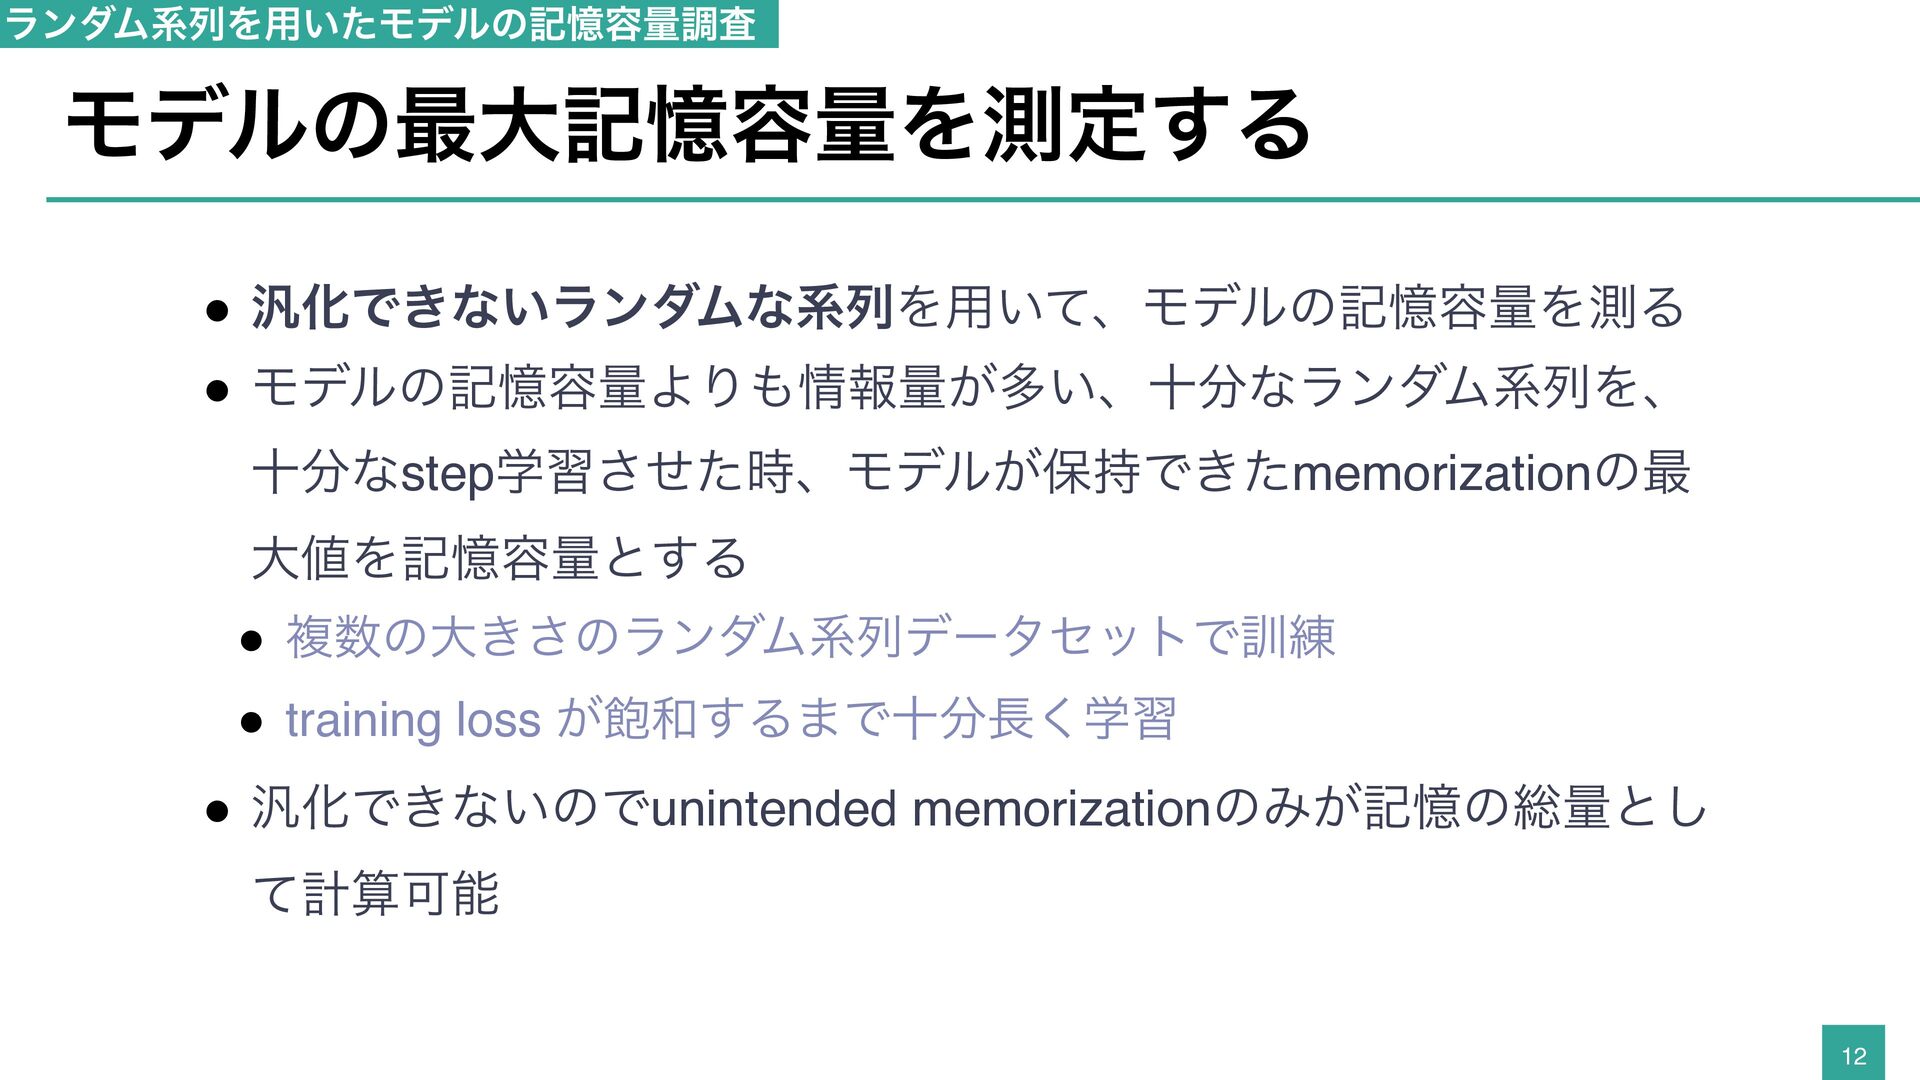
ランダム系列を用いたモデルの記憶容量調査 モデルの最大記憶容量を測定する • 汎化できないランダムな系列を用いて、モデルの記憶容量を測る • モデルの記憶容量よりも情報量が多い、十分なランダム系列を、 十分なstep学習させた時、モデルが保持できたmemorizationの最 大値を記憶容量とする • 複数の大きさのランダム系列データセットで訓練
• training loss が飽和するまで十分長く学習 • 汎化できないのでunintended memorizationのみが記憶の総量とし て計算可能 12 -
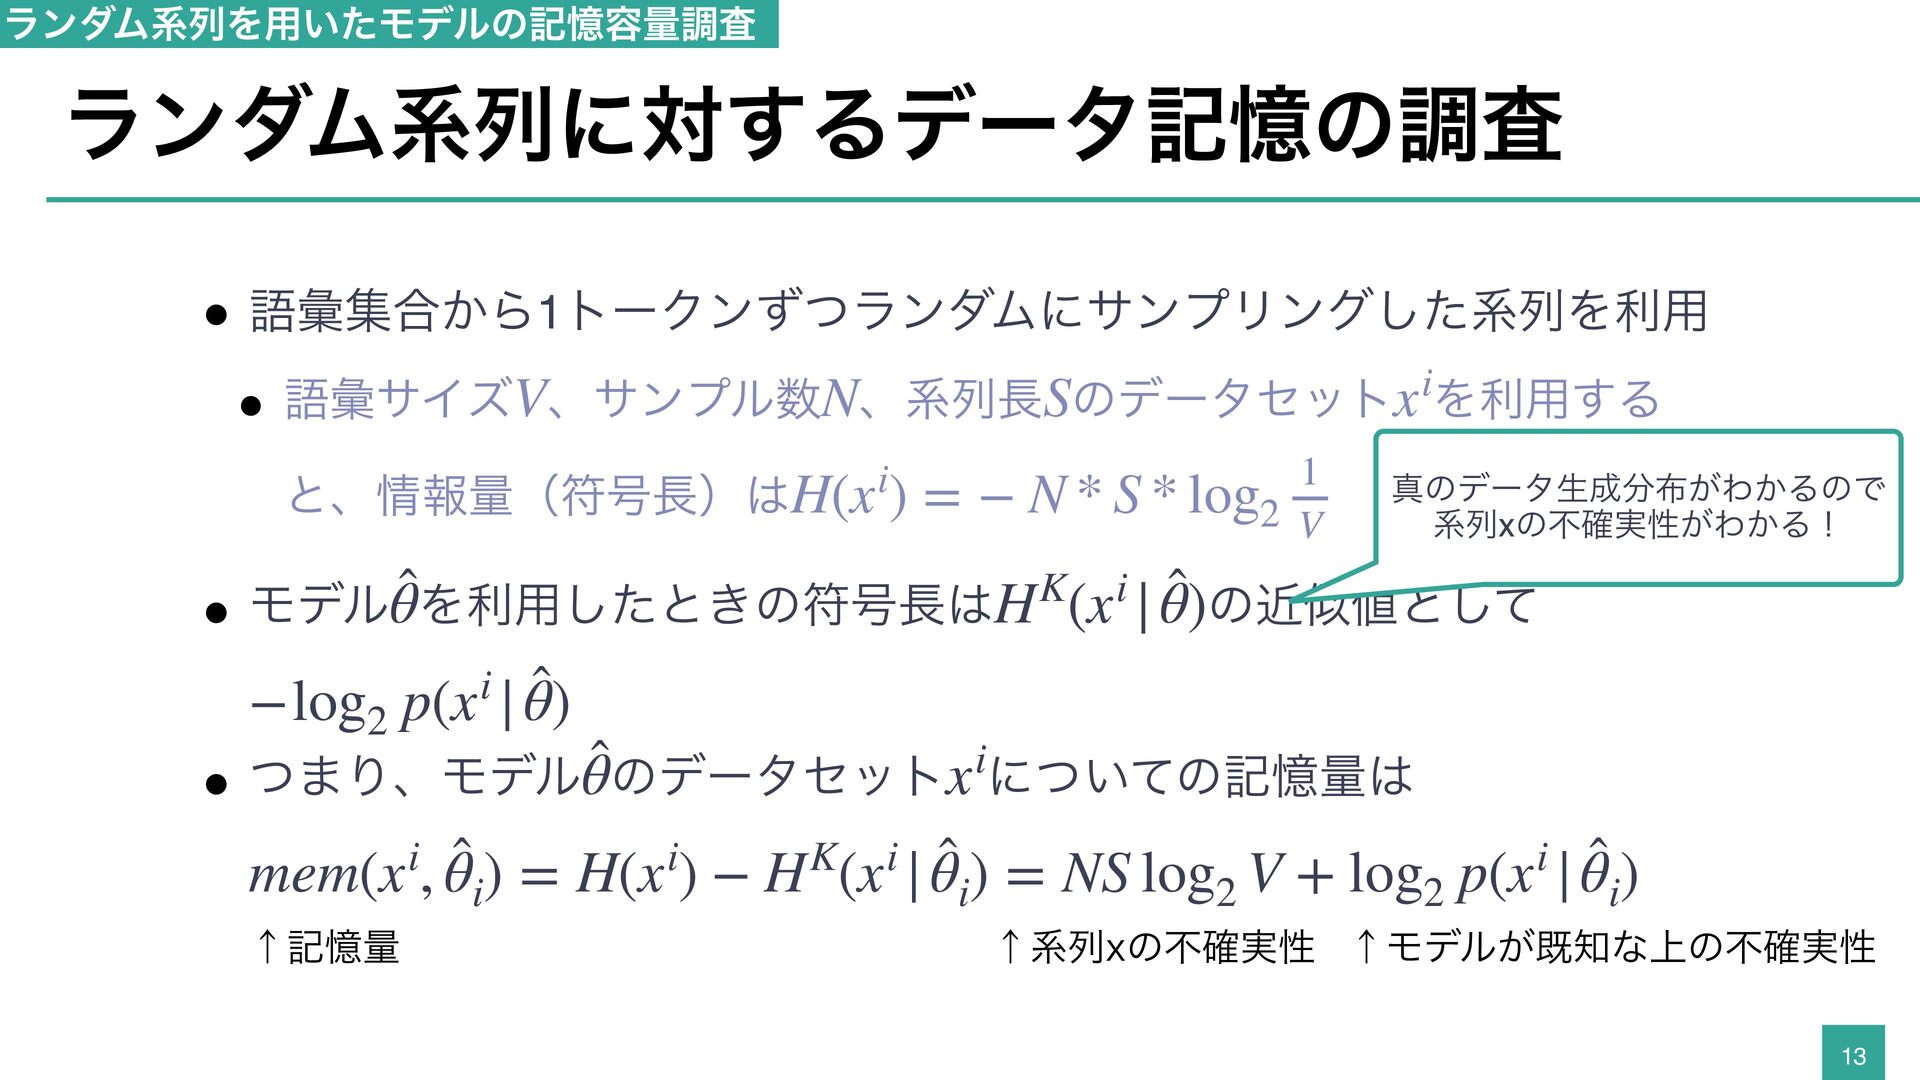
ランダム系列を用いたモデルの記憶容量調査 ランダム系列に対するデータ記憶の調査 • 語彙集合から1トークンずつランダムにサンプリングした系列を利用 i • 語彙サイズV、サンプル数N、系列長Sのデータセットx を利用する 1 と、情報量(符号長)はH(x
) = − N * S * log2 V i 真のデータ生成分布がわかるので 系列xの不確実性がわかる! K i ̂ ̂ • モデルθを利用したときの符号長はH (x | θ)の近似値として ̂ | −log2 p(x θ) i i ̂ • つまり、モデルθのデータセットx についての記憶量は i K i i ̂ ̂ mem(x , θ ) = H(x ) − H (x | θ ) = NS log V + log p(x | θ ̂ ) i ↑記憶量 i i 2 2 i ↑系列xの不確実性 ↑モデルが既知な上の不確実性 13 -
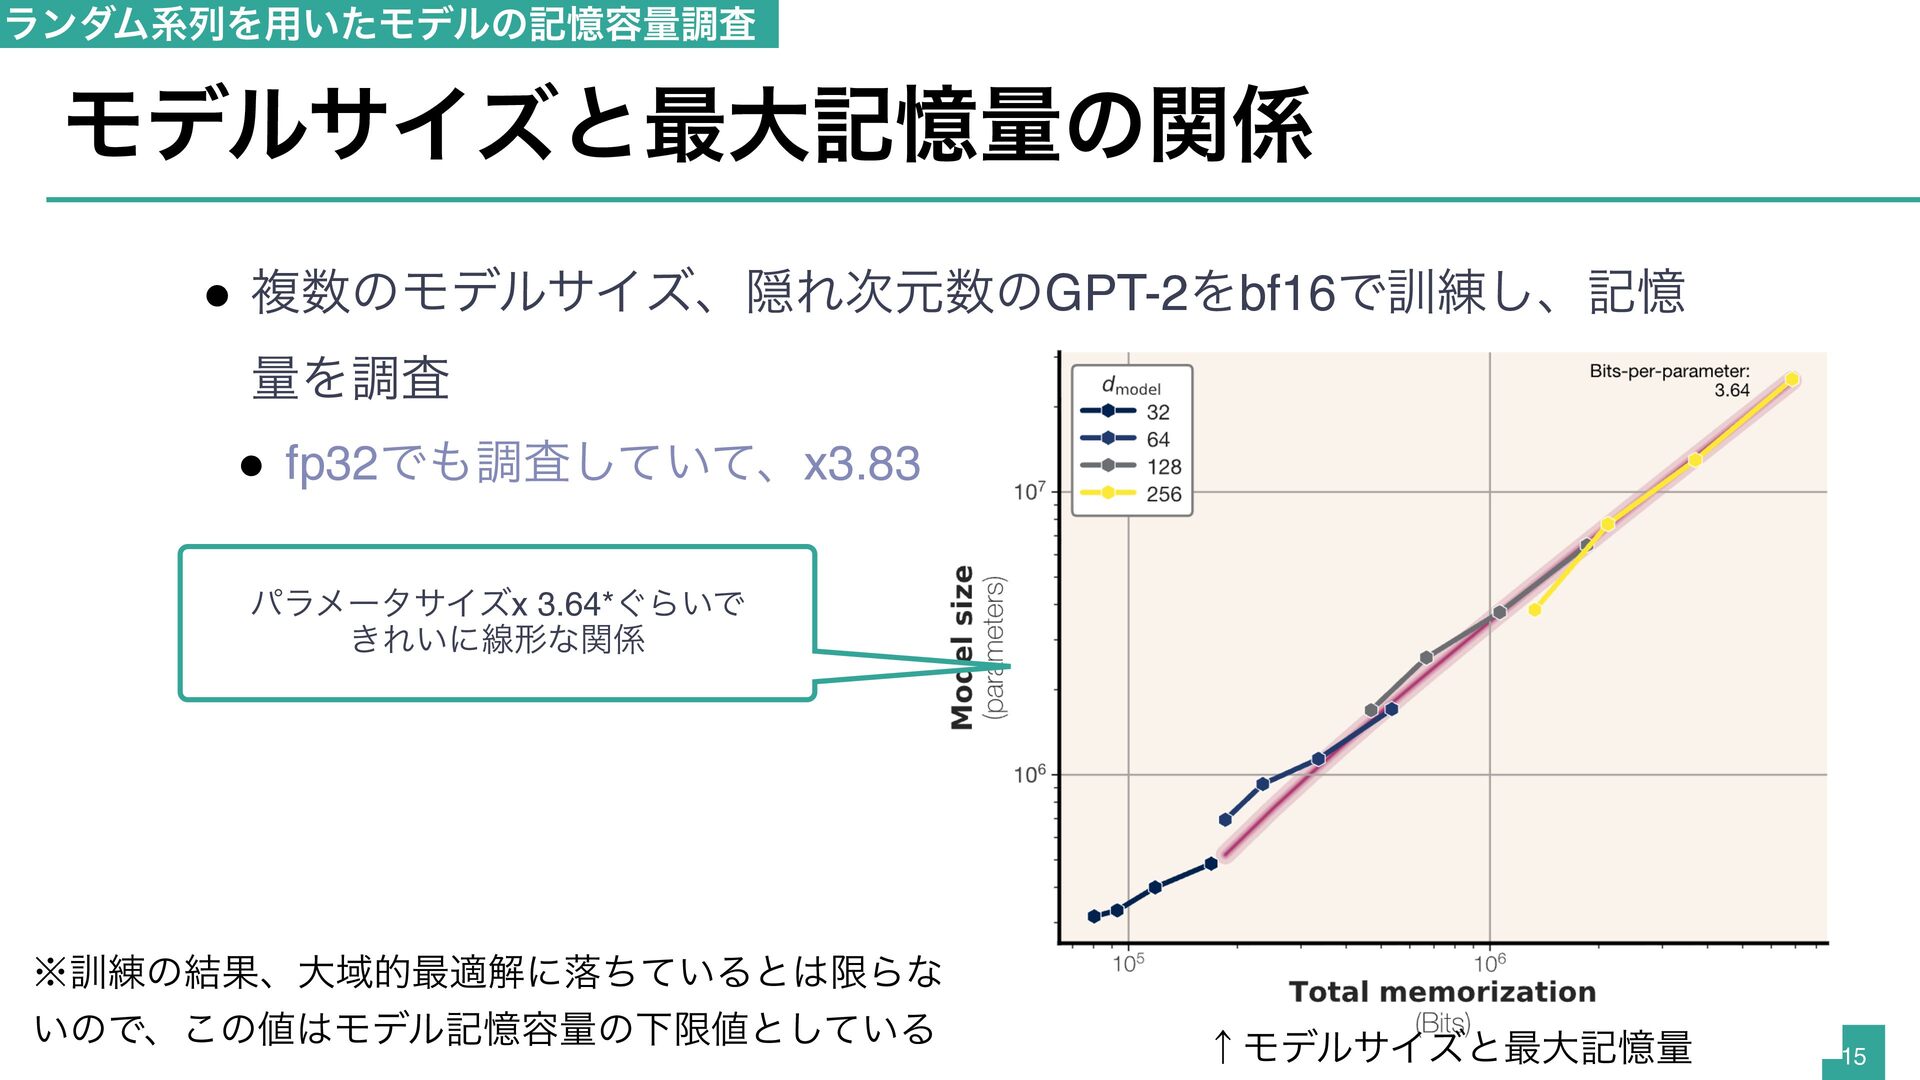
ランダム系列を用いたモデルの記憶容量調査 モデルサイズと最大記憶量の関係 • 複数のモデルサイズ、隠れ次元数のGPT-2をbf16で訓練し、記憶 量を調査 • fp32でも調査していて、x3.83 パラメータサイズx 3.64*ぐらいで きれいに線形な関係
※訓練の結果、大域的最適解に落ちているとは限らな いので、この値はモデル記憶容量の下限値としている ↑モデルサイズと最大記憶量 15 -
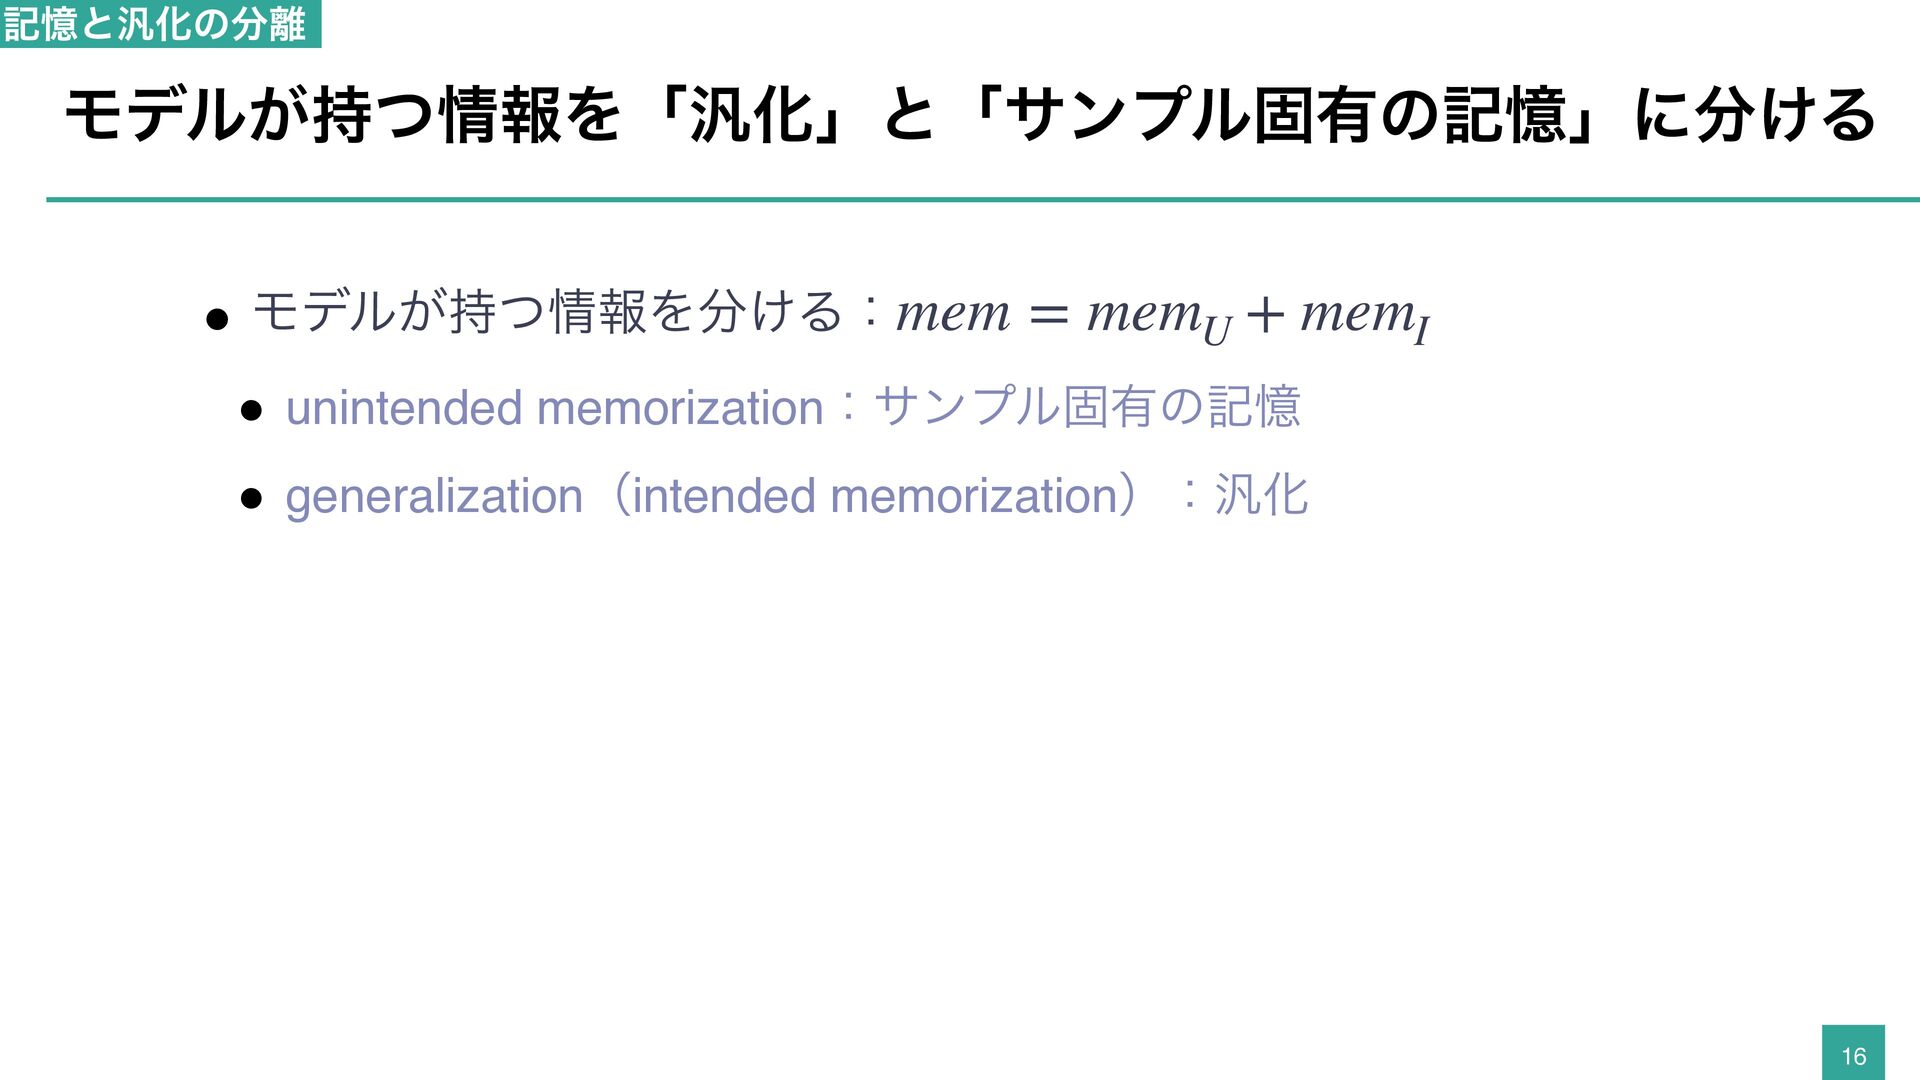
記憶と汎化の分離 モデルが持つ情報を「汎化」と「サンプル固有の記憶」に分ける • モデルが持つ情報を分ける:mem = memU + memI • unintended
memorization:サンプル固有の記憶 • generalization(intended memorization):汎化 16 -
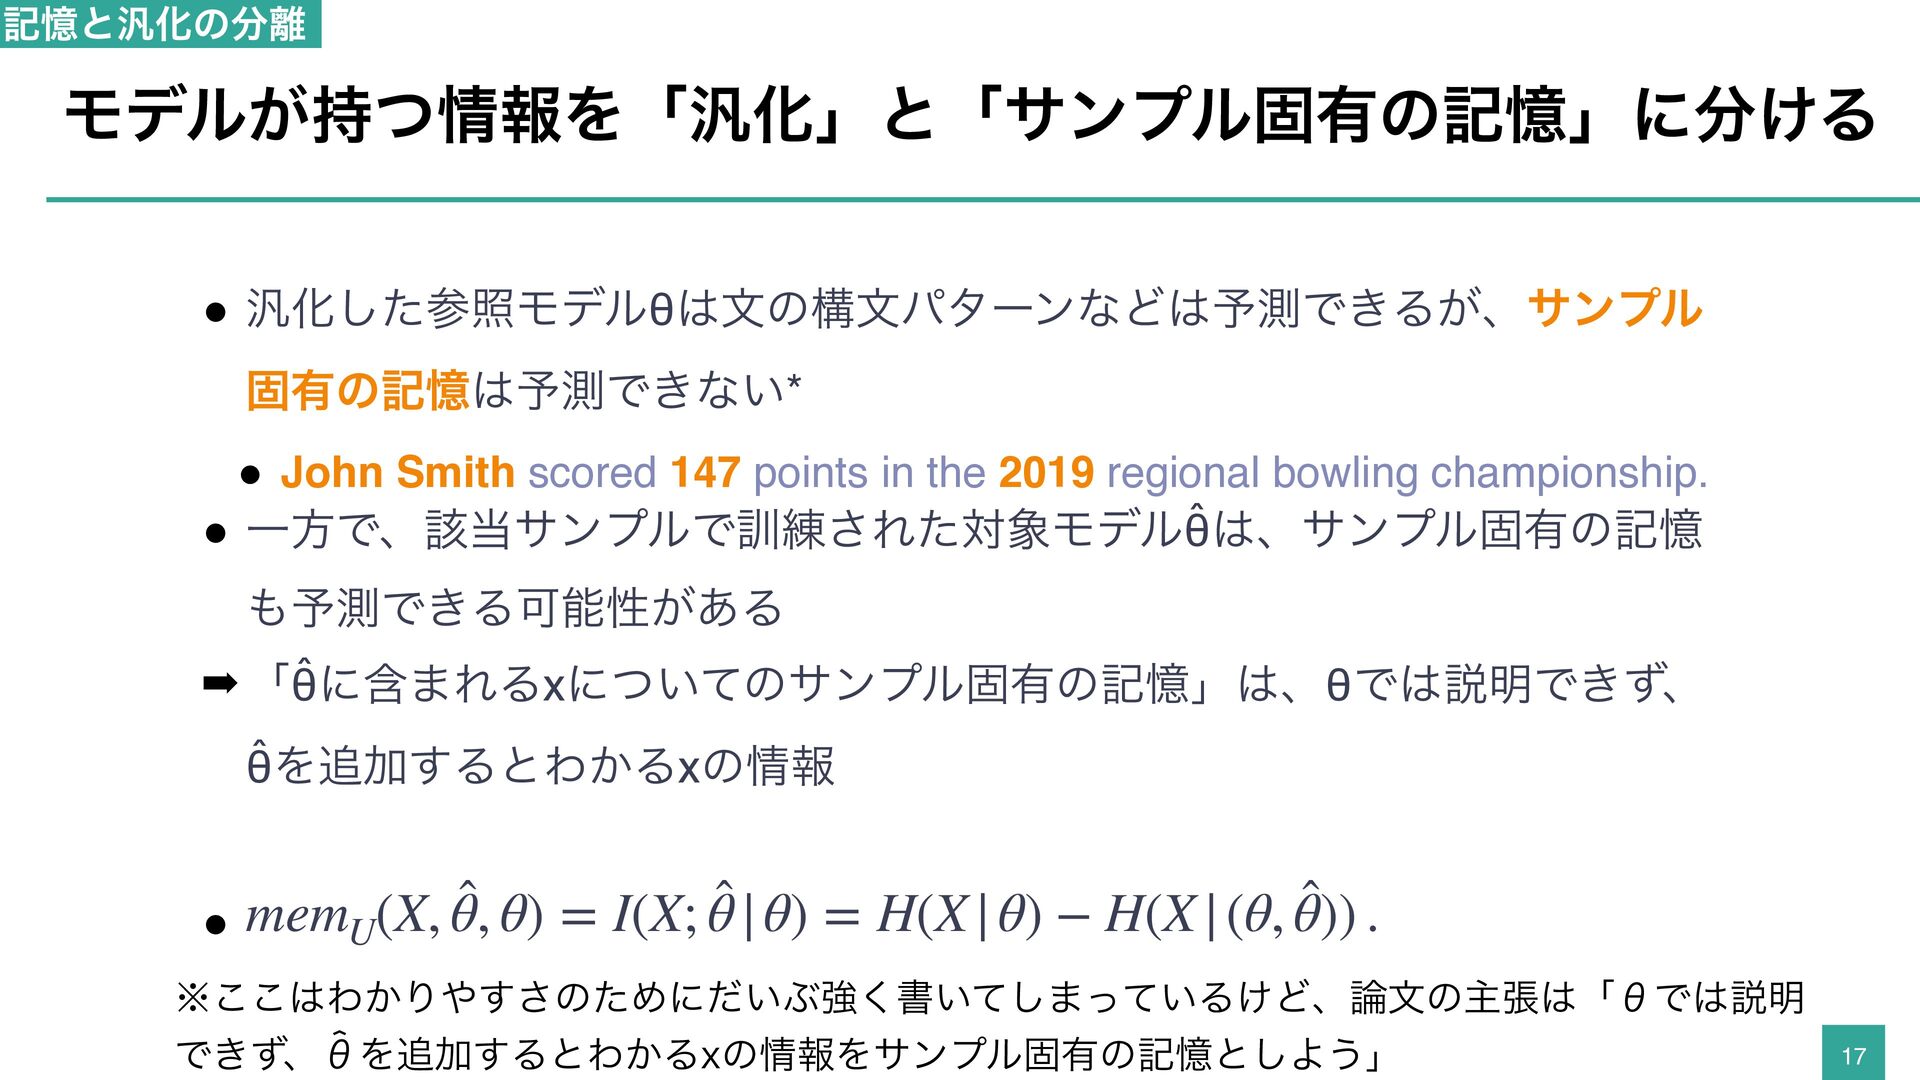
記憶と汎化の分離 モデルが持つ情報を「汎化」と「サンプル固有の記憶」に分ける • 汎化した参照モデルθは文の構文パターンなどは予測できるが、サンプル 固有の記憶は予測できない* • John Smith scored 147
points in the 2019 regional bowling championship. • 一方で、該当サンプルで訓練された対象モデルθ̂は、サンプル固有の記憶 も予測できる可能性がある ➡ 「θ̂に含まれるxについてのサンプル固有の記憶」は、θでは説明できず、 θ̂を追加するとわかるxの情報 ̂ ̂ ̂ | | | mem (X, θ, θ) = I(X; θ θ) = H(X θ) − H(X (θ, θ)) . • U ※ここはわかりやすさのためにだいぶ強く書いてしまっているけど、論文の主張は「θでは説明 できず、θ̂を追加するとわかるxの情報をサンプル固有の記憶としよう」 17 -
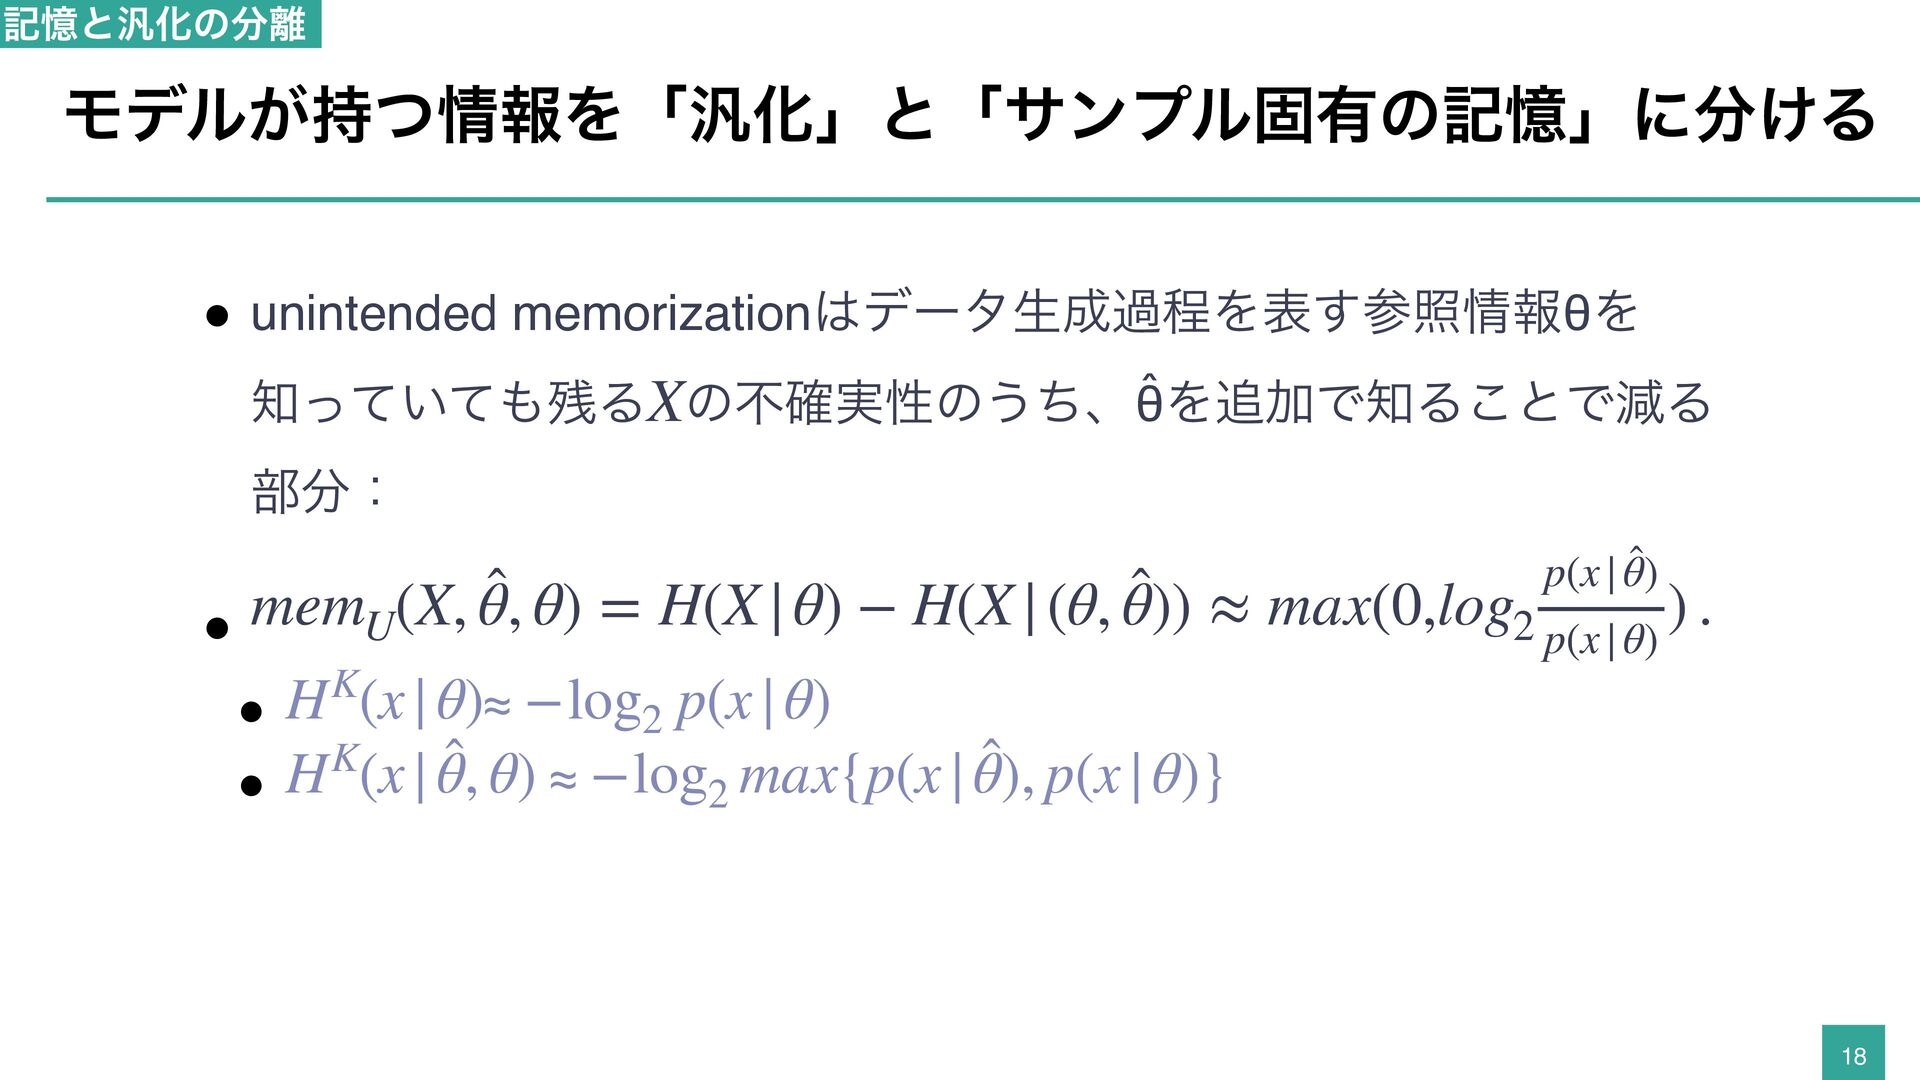
記憶と汎化の分離 モデルが持つ情報を「汎化」と「サンプル固有の記憶」に分ける • unintended memorizationはデータ生成過程を表す参照情報θを 知っていても残るXの不確実性のうち、θ̂を追加で知ることで減る 部分: p(x | θ)̂
̂ ̂ | | mem (X, θ, θ) = H(X θ) − H(X (θ, θ)) ≈ max(0,log ) . U 2 • p(x | θ) K • H (x | θ)≈ −log2 p(x | θ) K ̂ ̂ • H (x | θ, θ) ≈ −log2 max{p(x | θ), p(x | θ)} 18 -
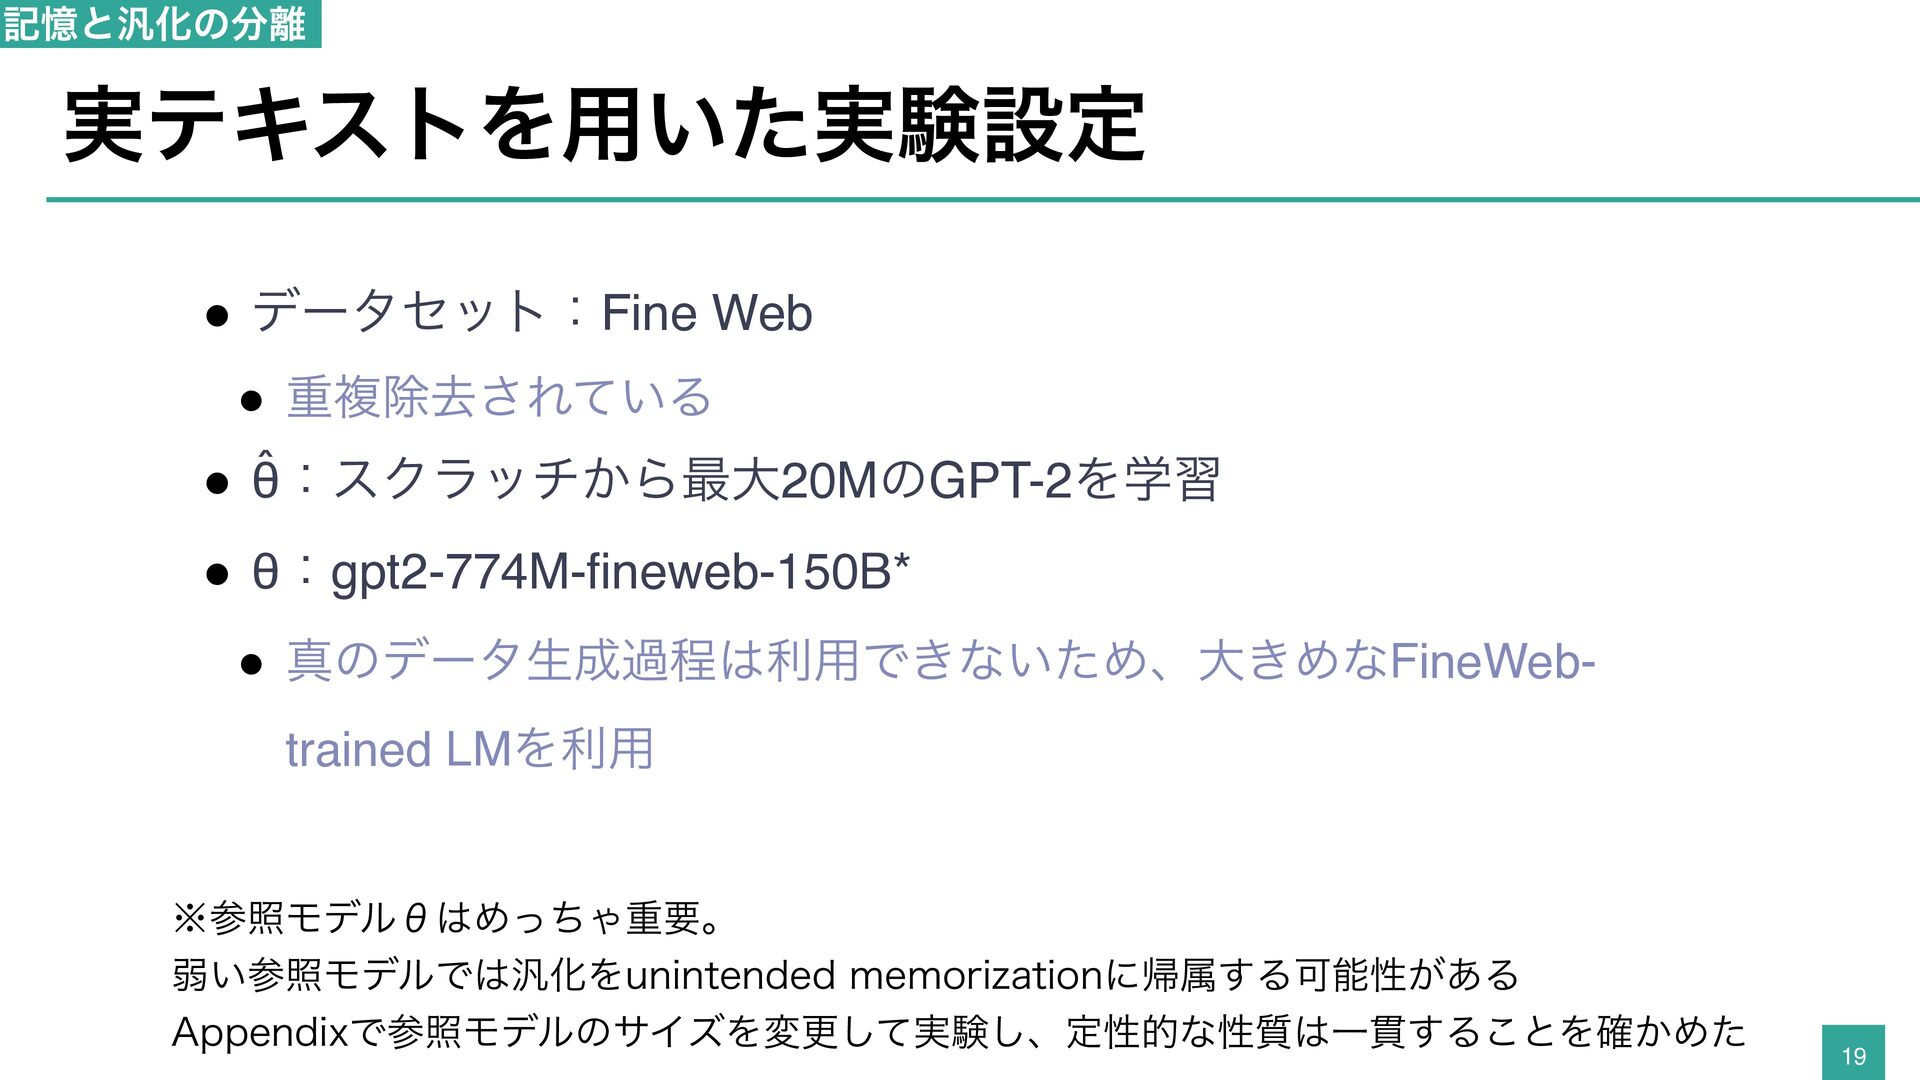
記憶と汎化の分離 実テキストを用いた実験設定 • データセット:Fine Web • 重複除去されている • θ̂:スクラッチから最大20MのGPT-2を学習 •
θ:gpt2-774M- neweb-150B* • 真のデータ生成過程は利用できないため、大きめなFineWebtrained LMを利用 fi ※参照モデルθはめっちゃ重要。 弱い参照モデルでは汎化をunintended memorizationに帰属する可能性がある Appendixで参照モデルのサイズを変更して実験し、定性的な性質は一貫することを確かめた 19 -
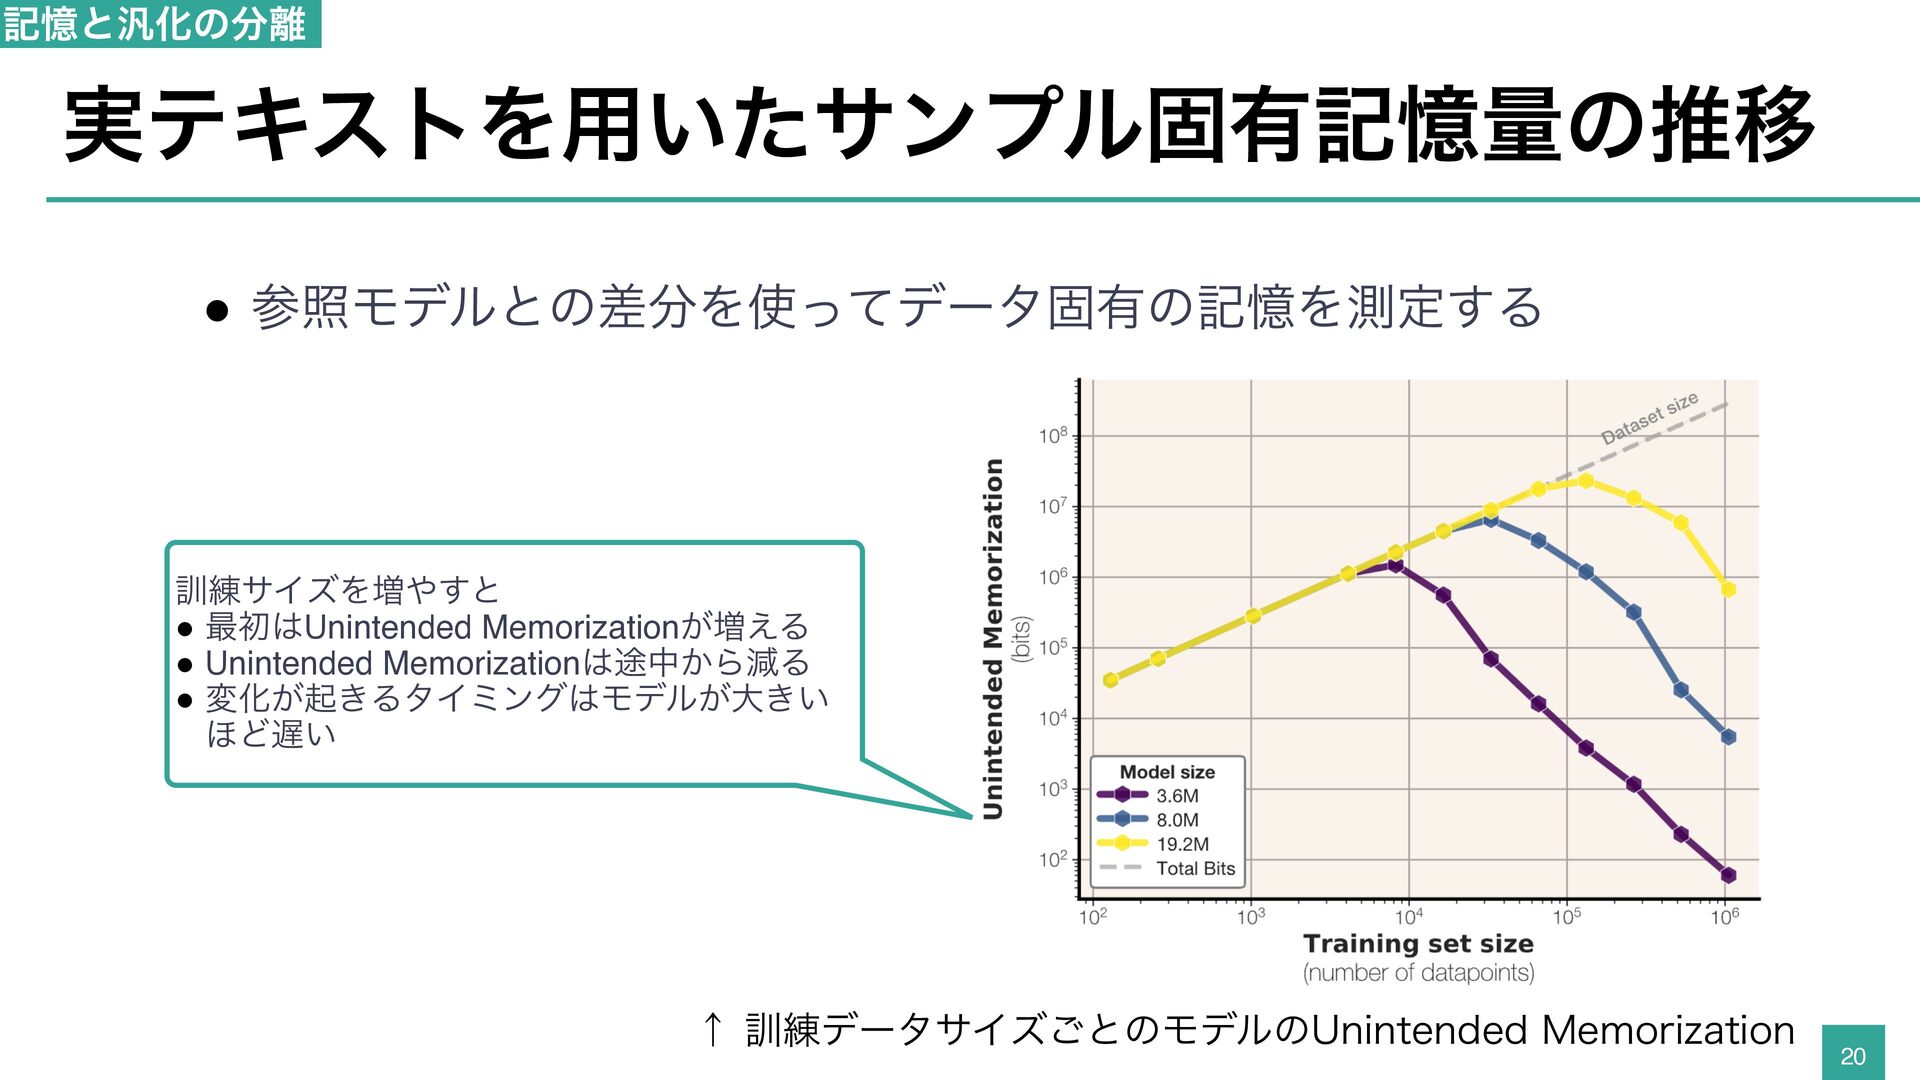
記憶と汎化の分離 実テキストを用いたサンプル固有記憶量の推移 • 参照モデルとの差分を使ってデータ固有の記憶を測定する 訓練サイズを増やすと • 最初はUnintended Memorizationが増える • Unintended
Memorizationは途中から減る • 変化が起きるタイミングはモデルが大きい ほど遅い ↑ 訓練データサイズごとのモデルのUnintended Memorization 20 -
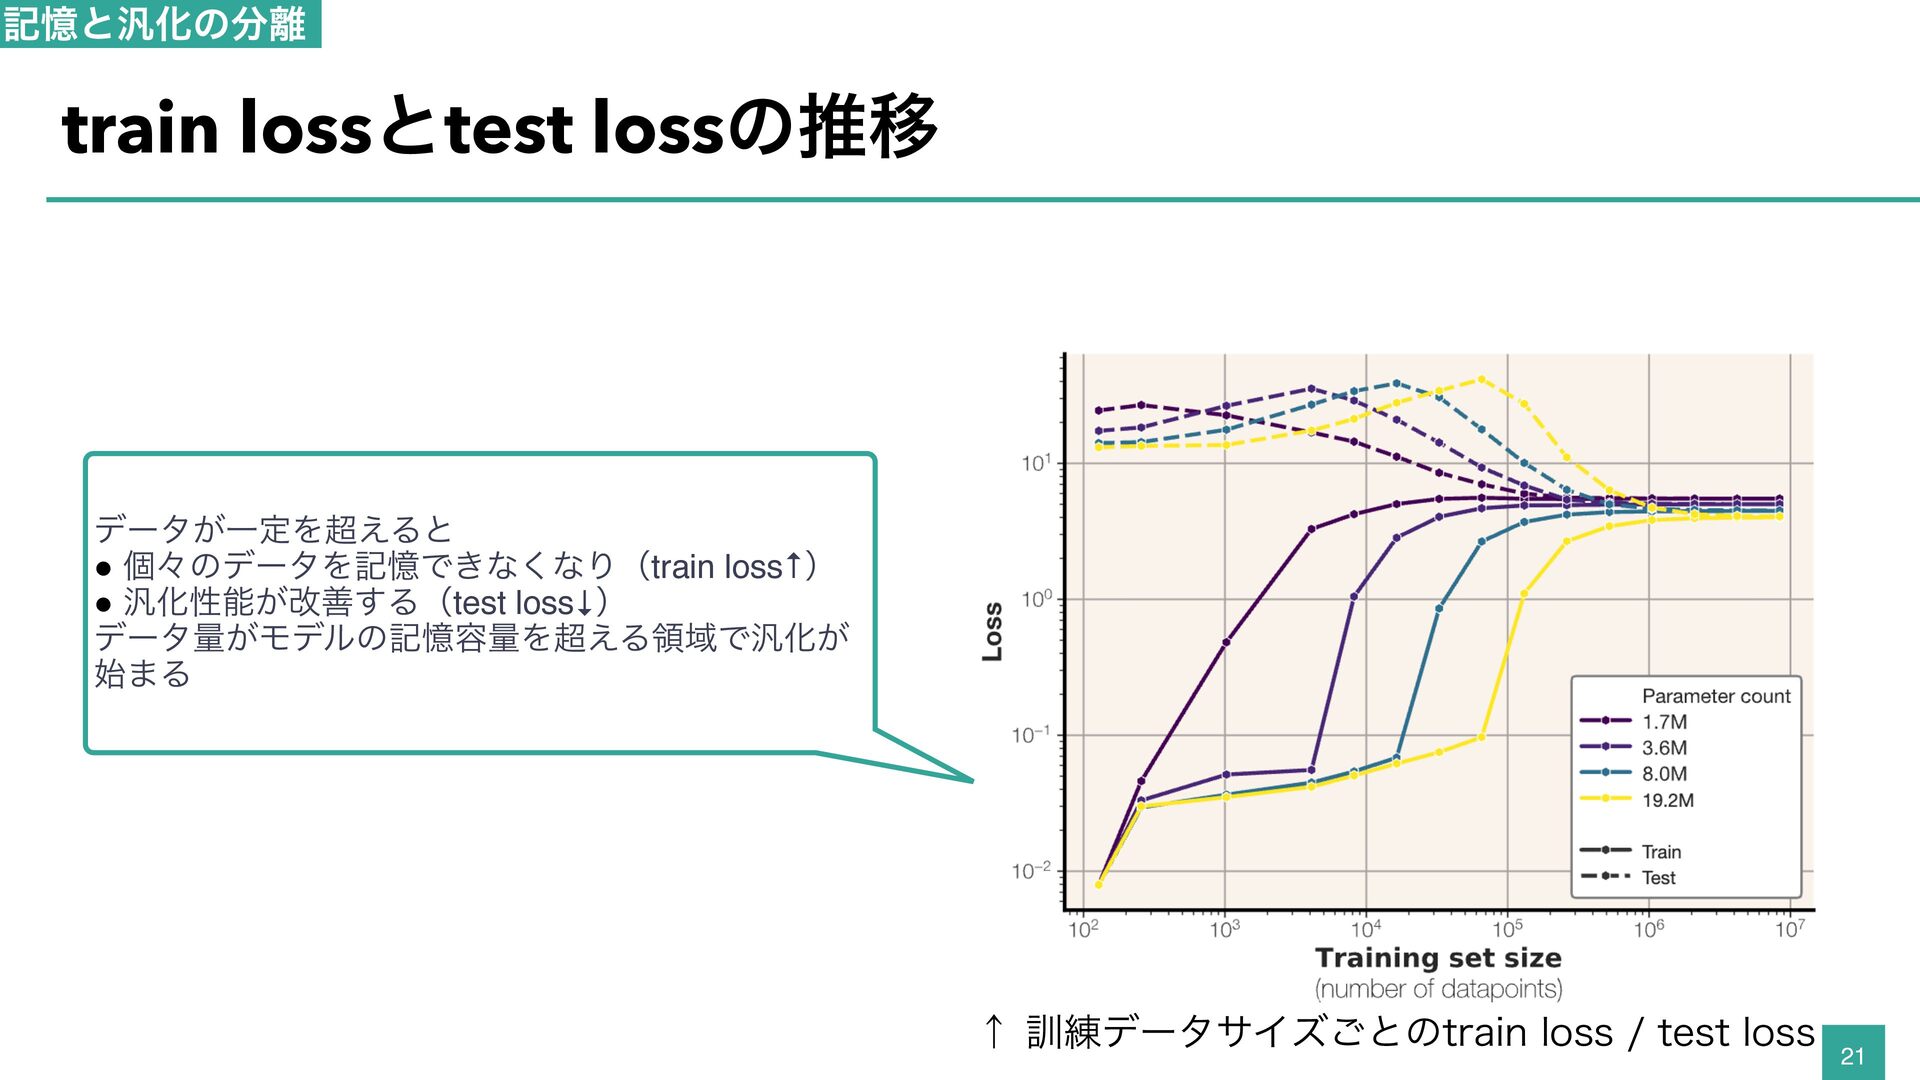
記憶と汎化の分離 train lossとtest lossの推移 データが一定を超えると • 個々のデータを記憶できなくなり(train loss↑) • 汎化性能が改善する(test
loss↓) データ量がモデルの記憶容量を超える領域で汎化が 始まる ↑ 訓練データサイズごとのtrain loss / test loss 21 -
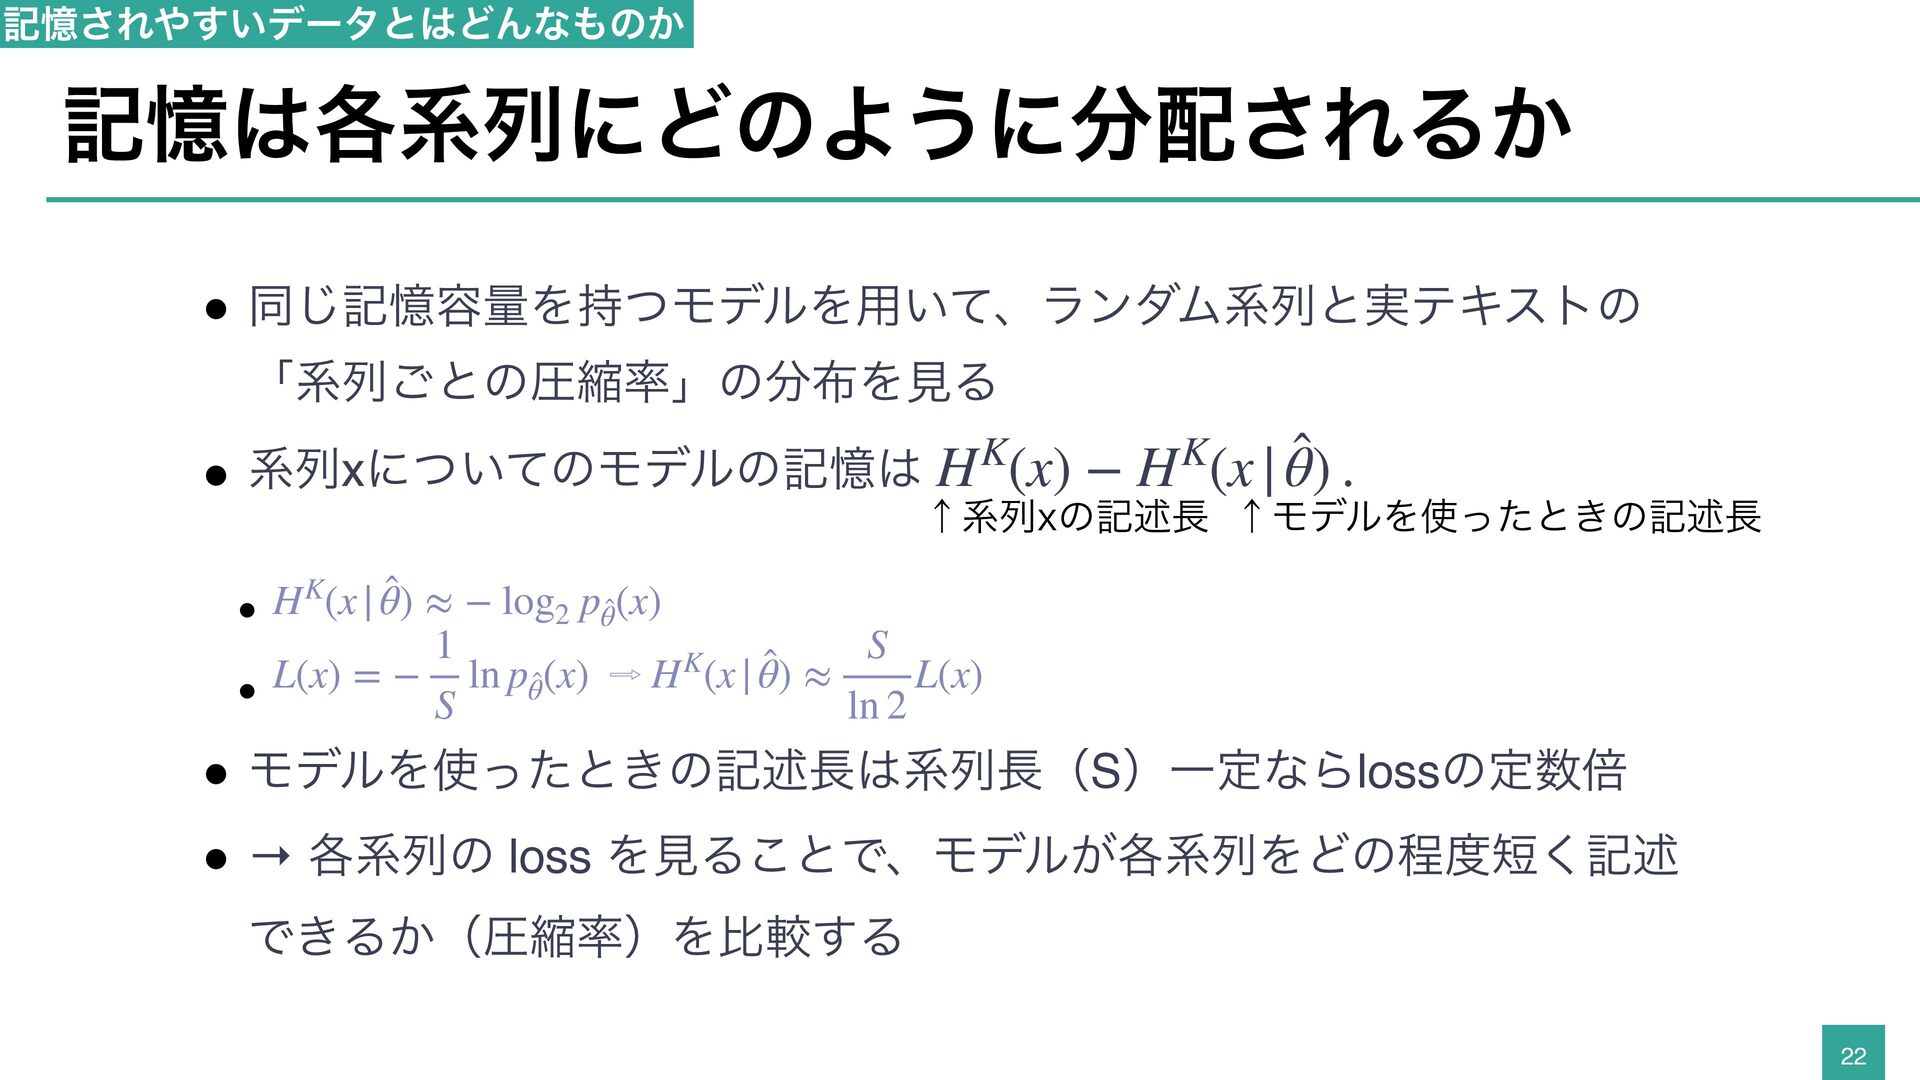
記憶されやすいデータとはどんなものか 記憶は各系列にどのように分配されるか • 同じ記憶容量を持つモデルを用いて、ランダム系列と実テキストの 「系列ごとの圧縮率」の分布を見る ̂ • 系列xについてのモデルの記憶は H (x)
− H (x | θ) . K K ↑系列xの記述長 ↑モデルを使ったときの記述長 ̂ | H (x θ) ≈ − log2 pθ(x) ̂ • 1 S K ̂ | L(x) = − ln p (x) H (x θ) ≈ L(x) ⇨ ̂ θ • S ln 2 K • モデルを使ったときの記述長は系列長(S)一定ならlossの定数倍 • → 各系列の loss を見ることで、モデルが各系列をどの程度短く記述 できるか(圧縮率)を比較する 22 -
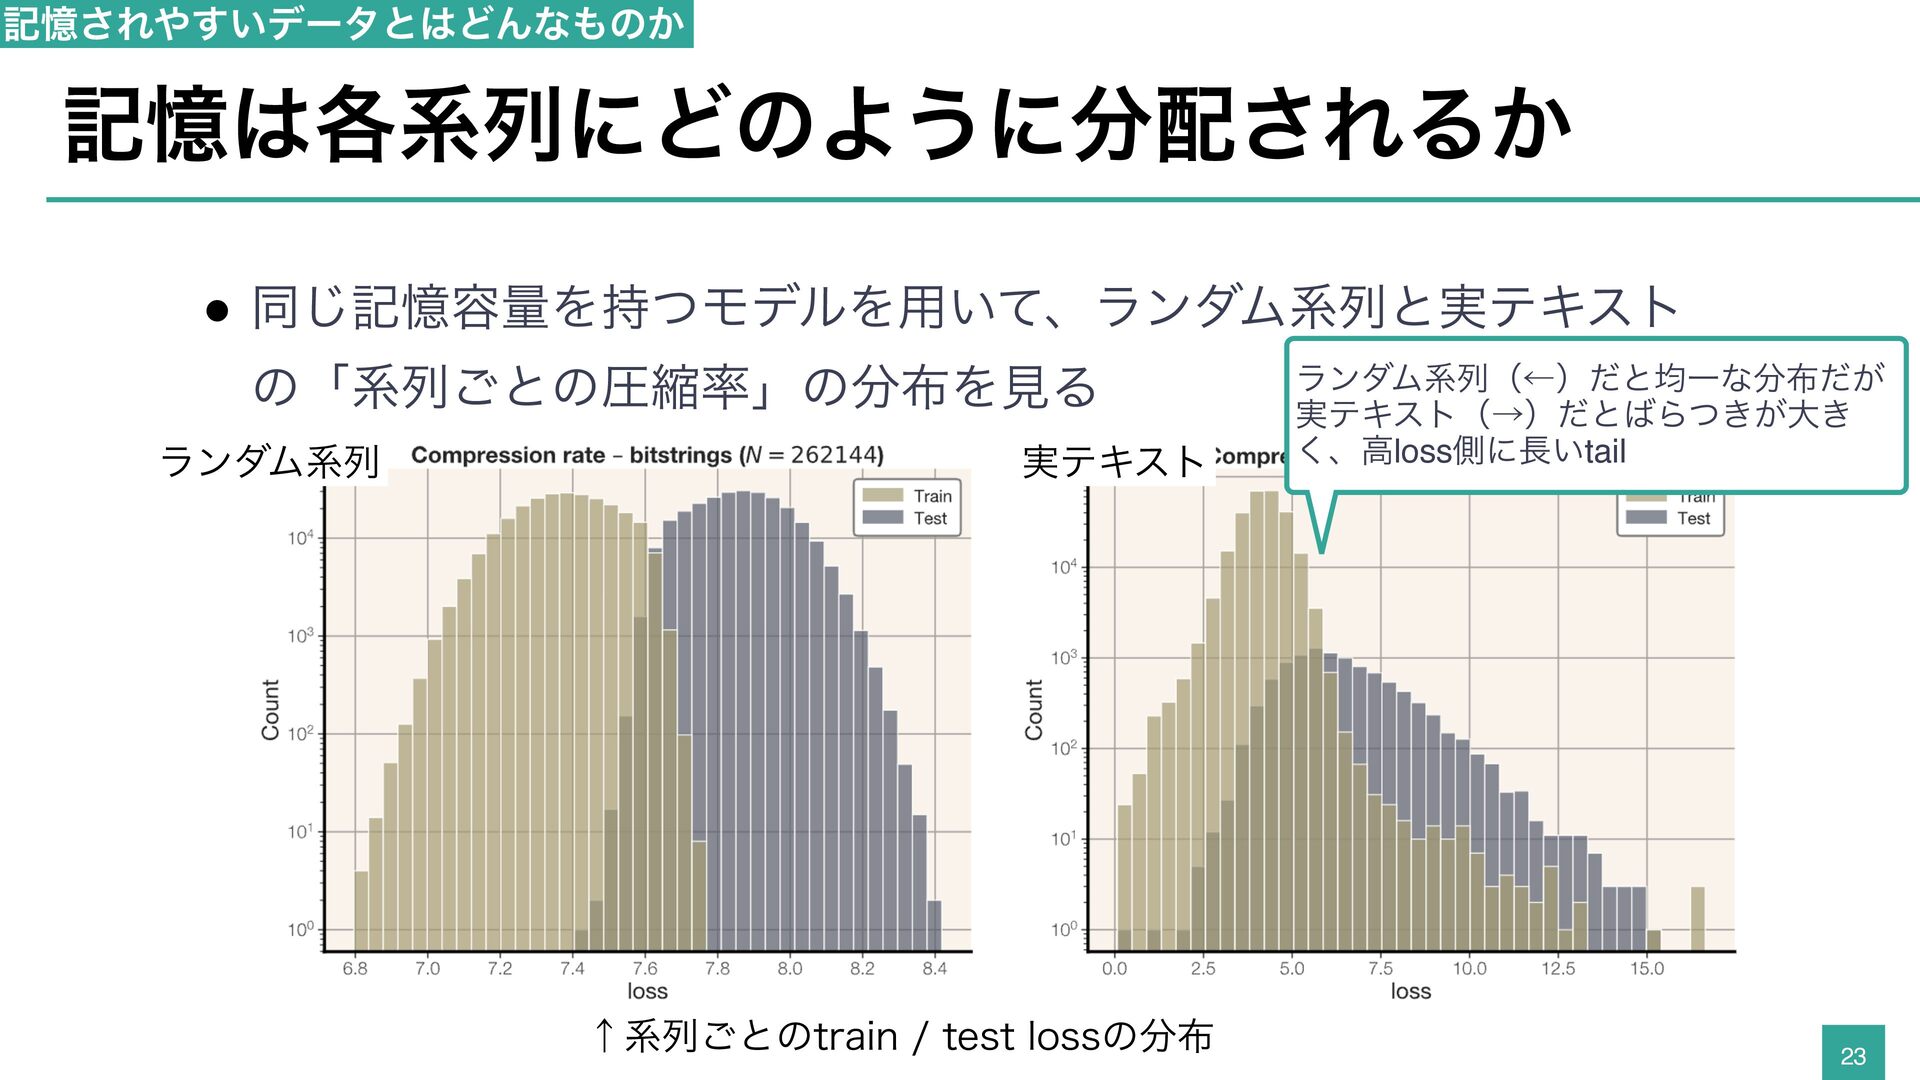
記憶されやすいデータとはどんなものか 記憶は各系列にどのように分配されるか • 同じ記憶容量を持つモデルを用いて、ランダム系列と実テキスト の「系列ごとの圧縮率」の分布を見る ランダム系列 実テキスト ↑系列ごとのtrain / test
lossの分布 ランダム系列(←)だと均一な分布だが 実テキスト(→)だとばらつきが大き く、高loss側に長いtail 23 -
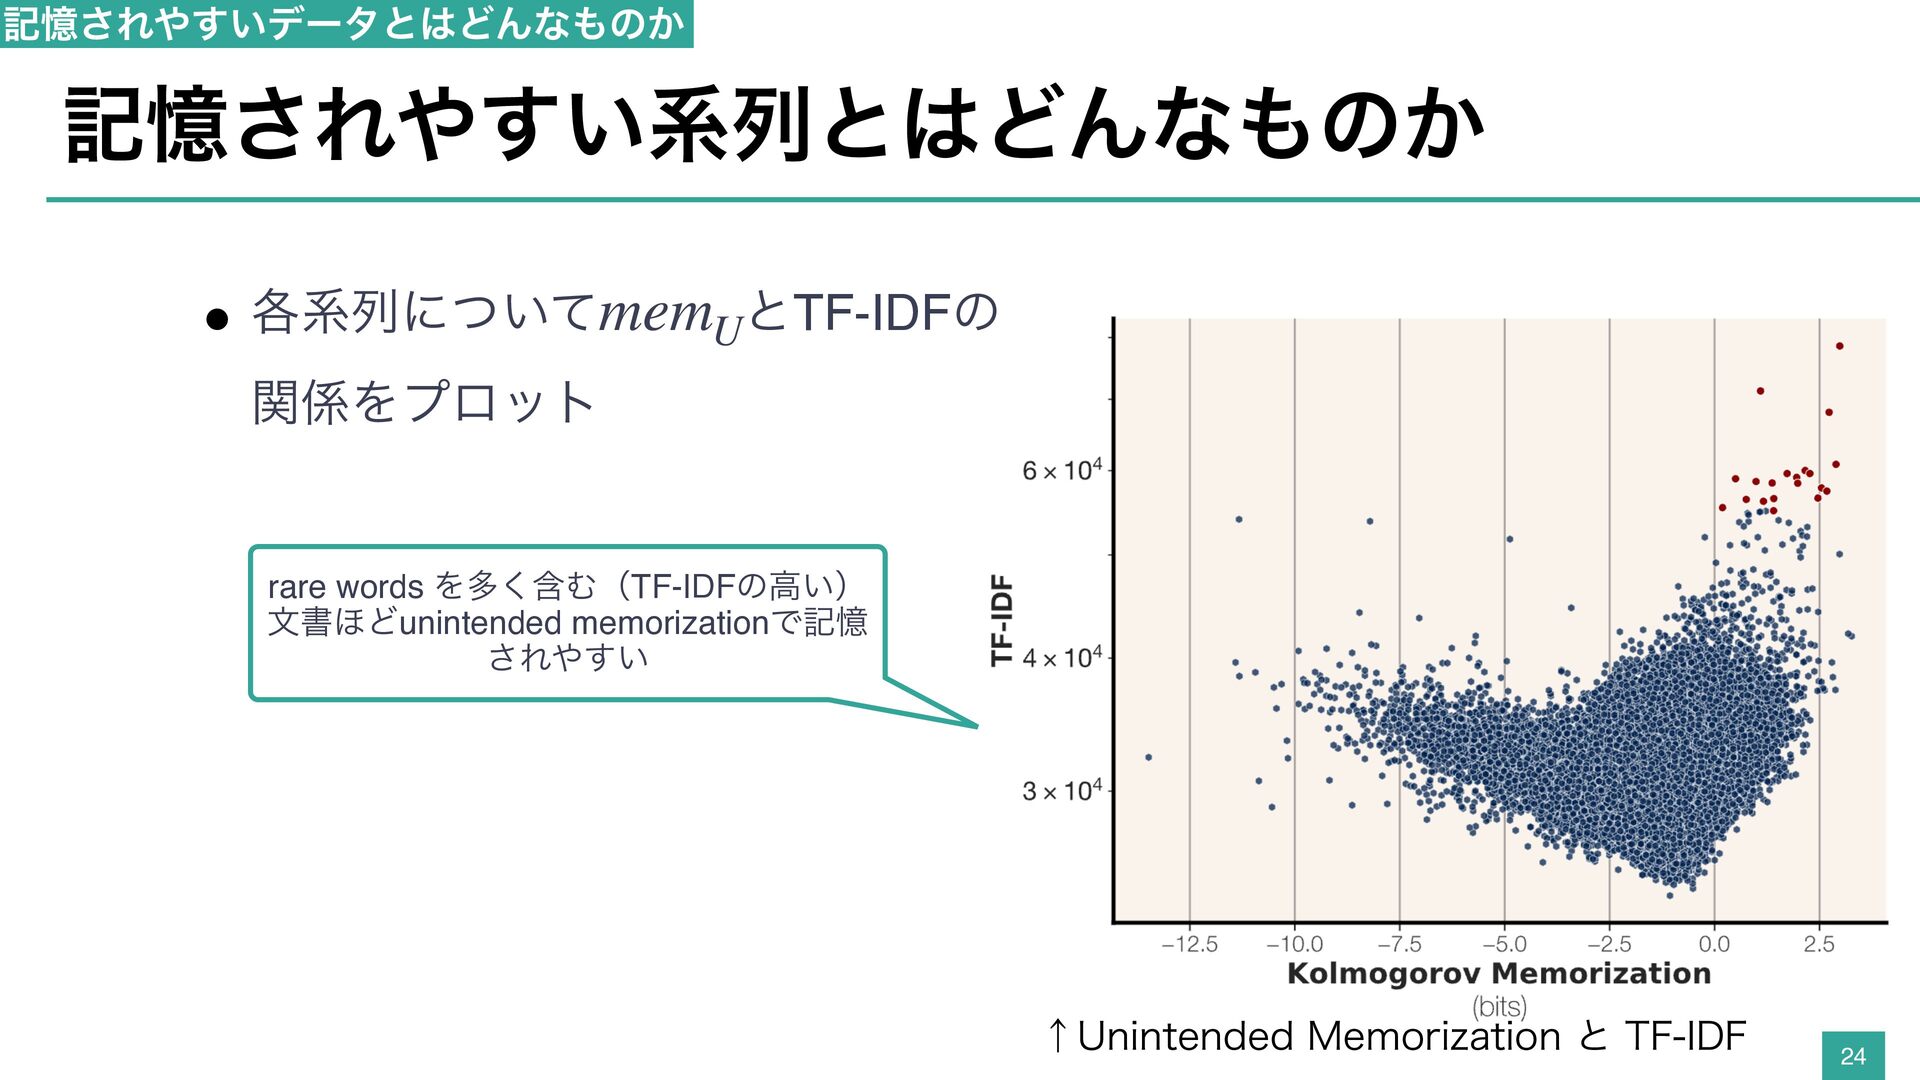
記憶されやすいデータとはどんなものか 記憶されやすい系列とはどんなものか • 各系列についてmemUとTF-IDFの 関係をプロット rare words を多く含む(TF-IDFの高い) 文書ほどunintended memorizationで記憶
されやすい ↑Unintended Memorization と TF-IDF 24 -
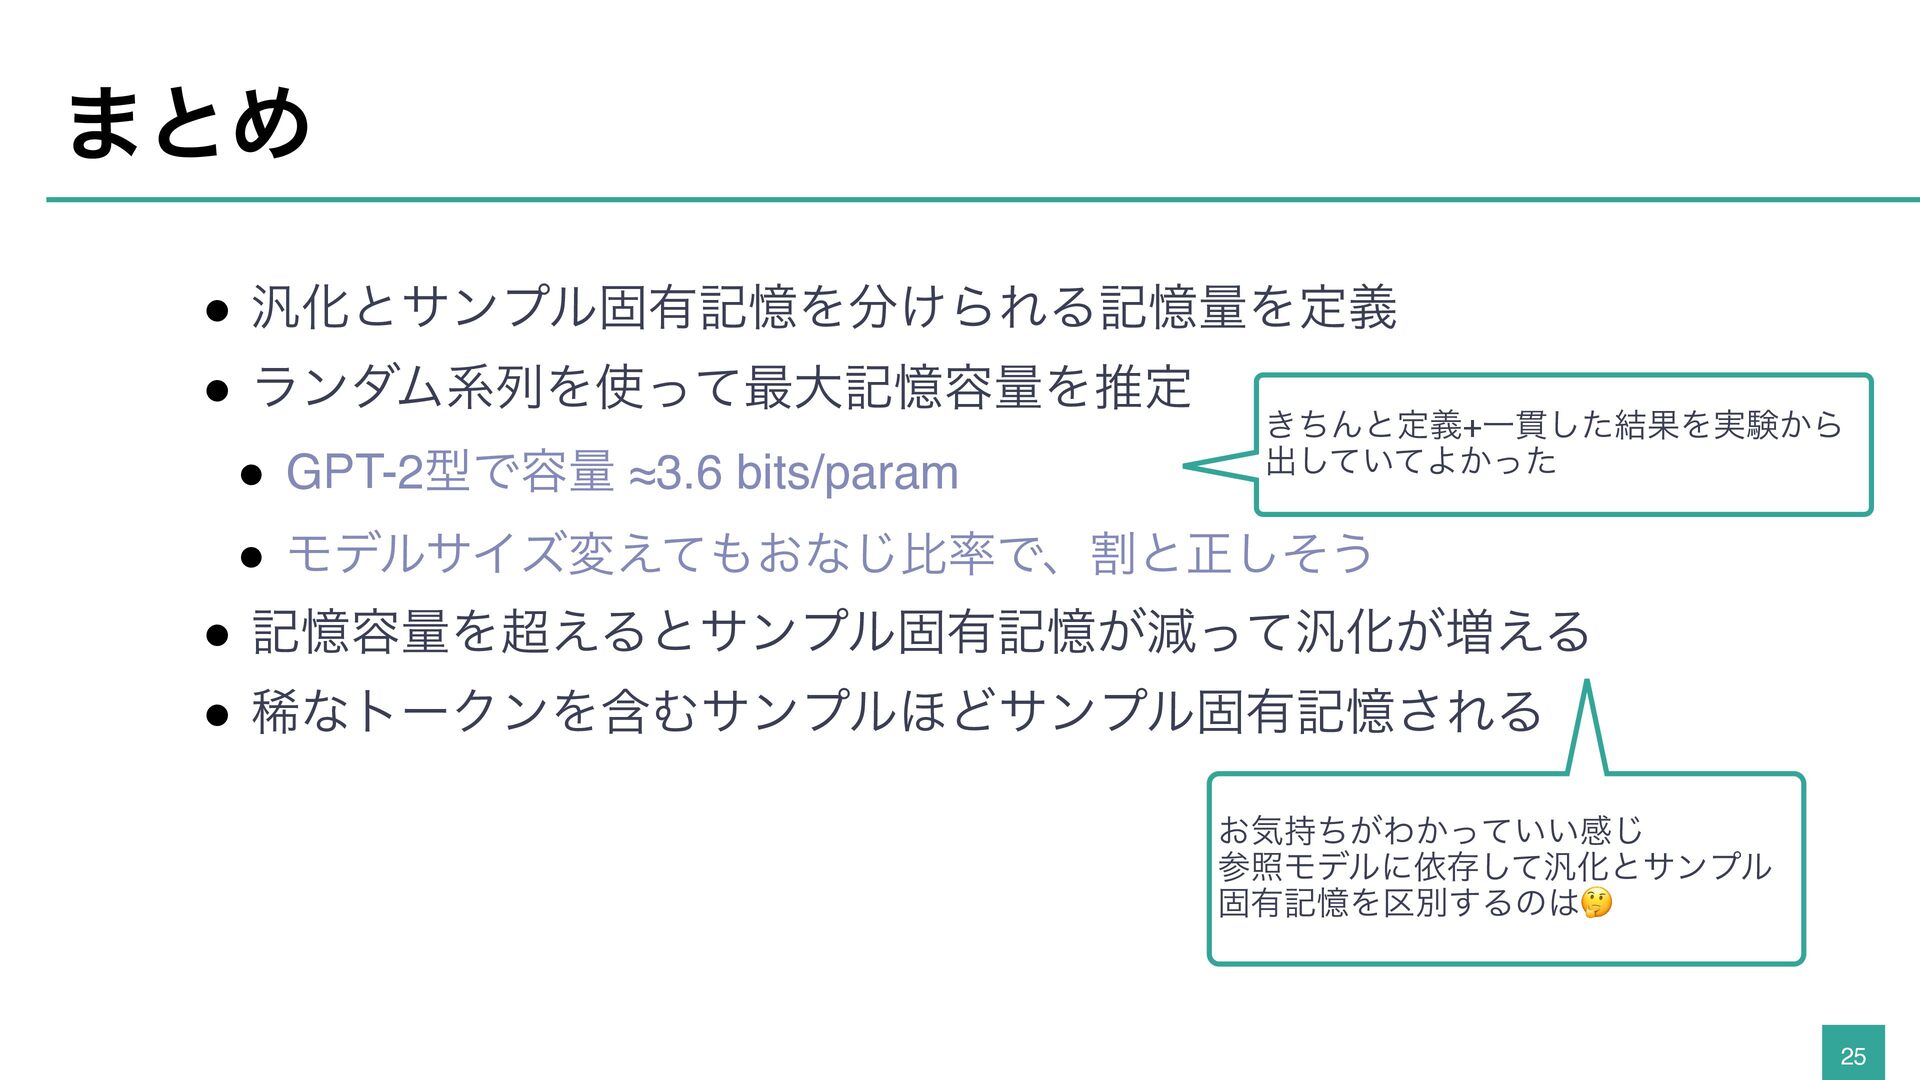
まとめ • 汎化とサンプル固有記憶を分けられる記憶量を定義 • ランダム系列を使って最大記憶容量を推定 • GPT-2型で容量 ≈3.6 bits/param きちんと定義+一貫した結果を実験から
出していてよかった • モデルサイズ変えてもおなじ比率で、割と正しそう • 記憶容量を超えるとサンプル固有記憶が減って汎化が増える • 稀なトークンを含むサンプルほどサンプル固有記憶される お気持ちがわかっていい感じ 参照モデルに依存して汎化とサンプル 固有記憶を区別するのは🤔 25