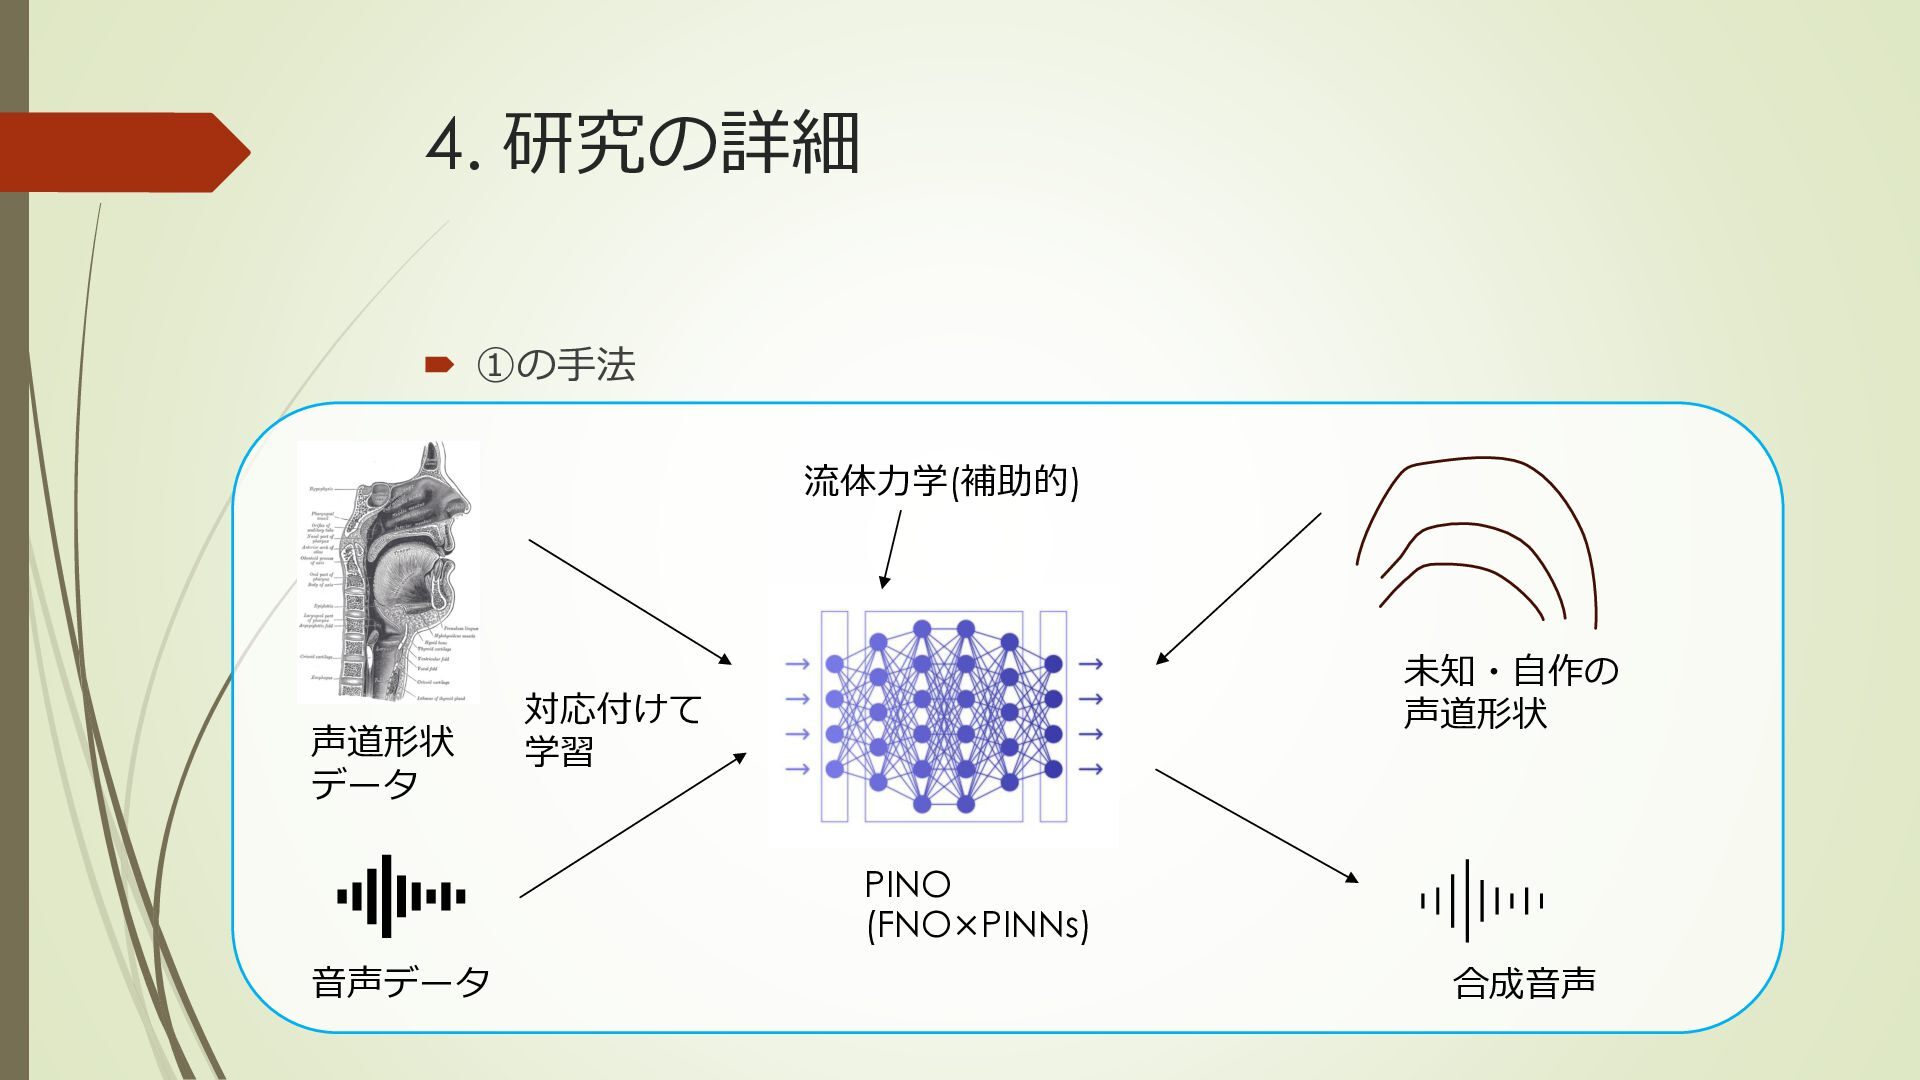
rtMRIやEMAのデータセットから、機械学習を用いた物理シミュレーションで音声合成する、というテーマです。
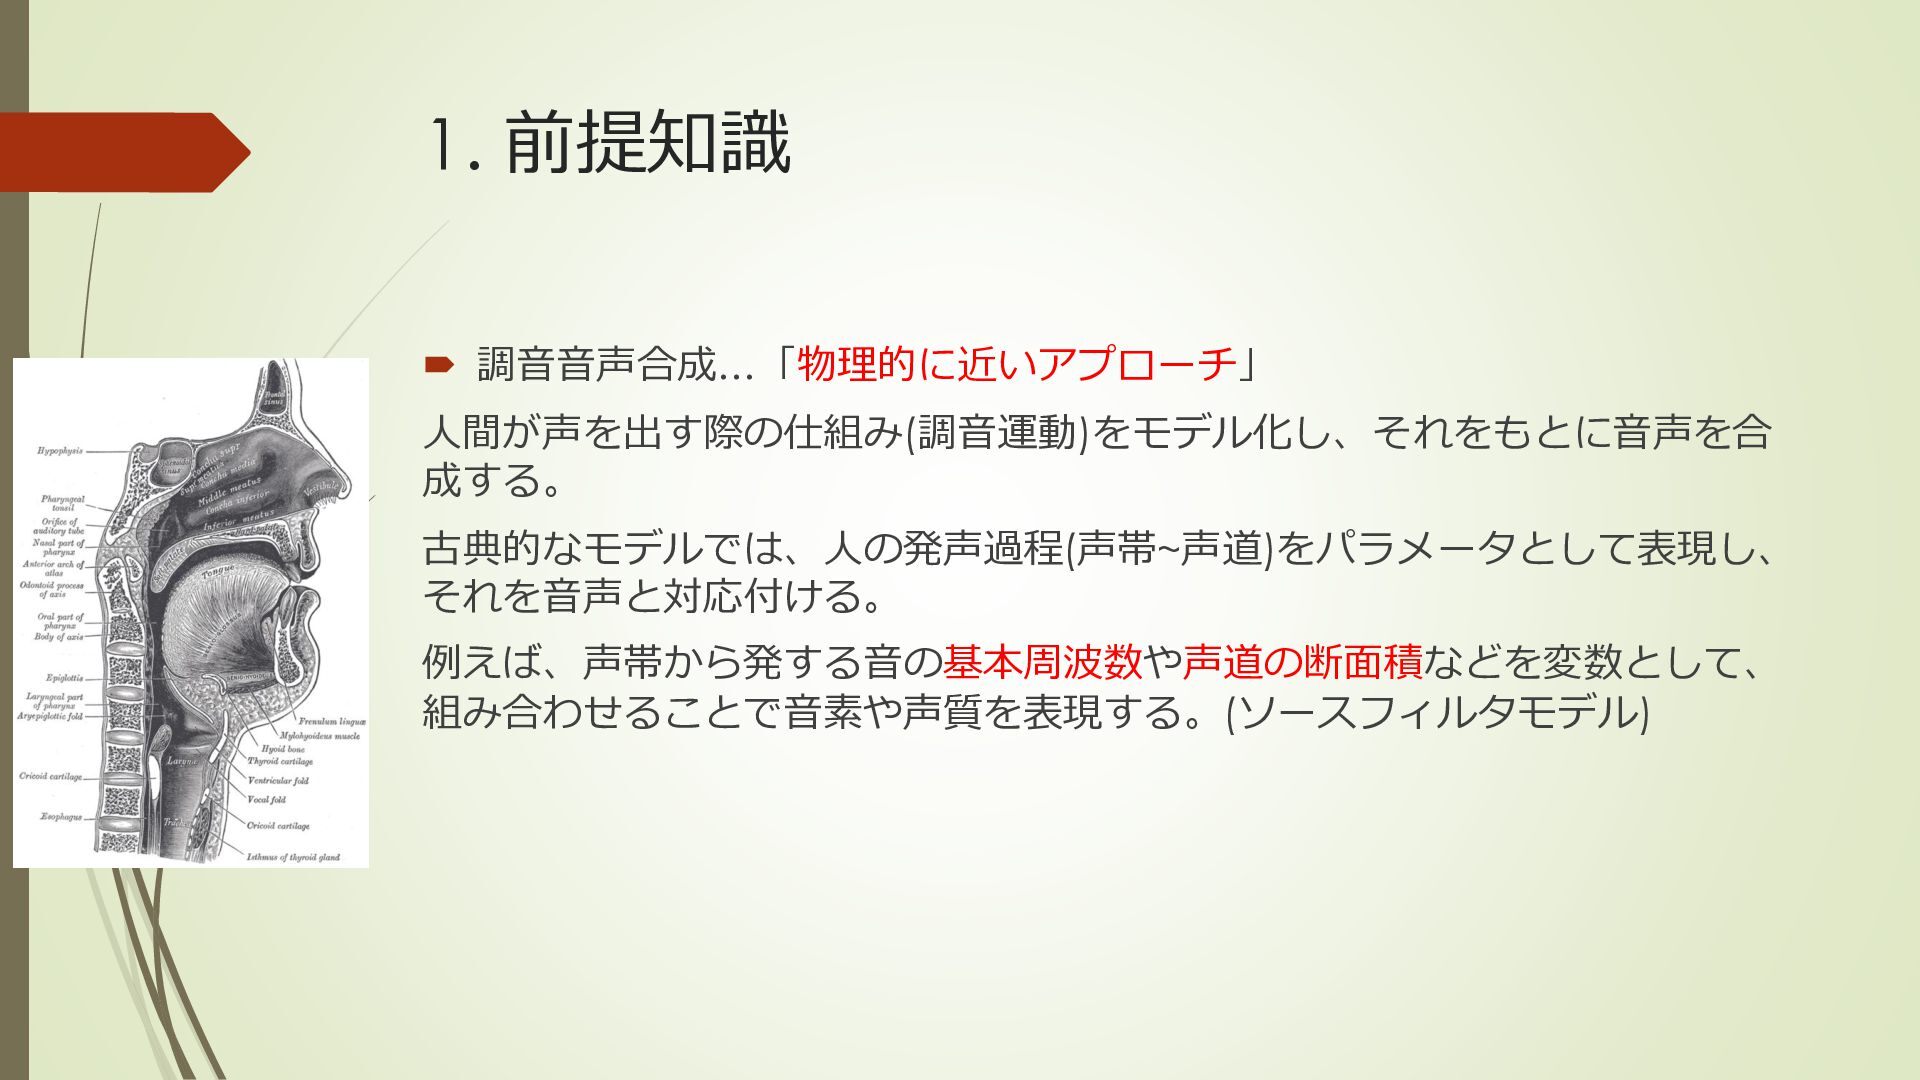
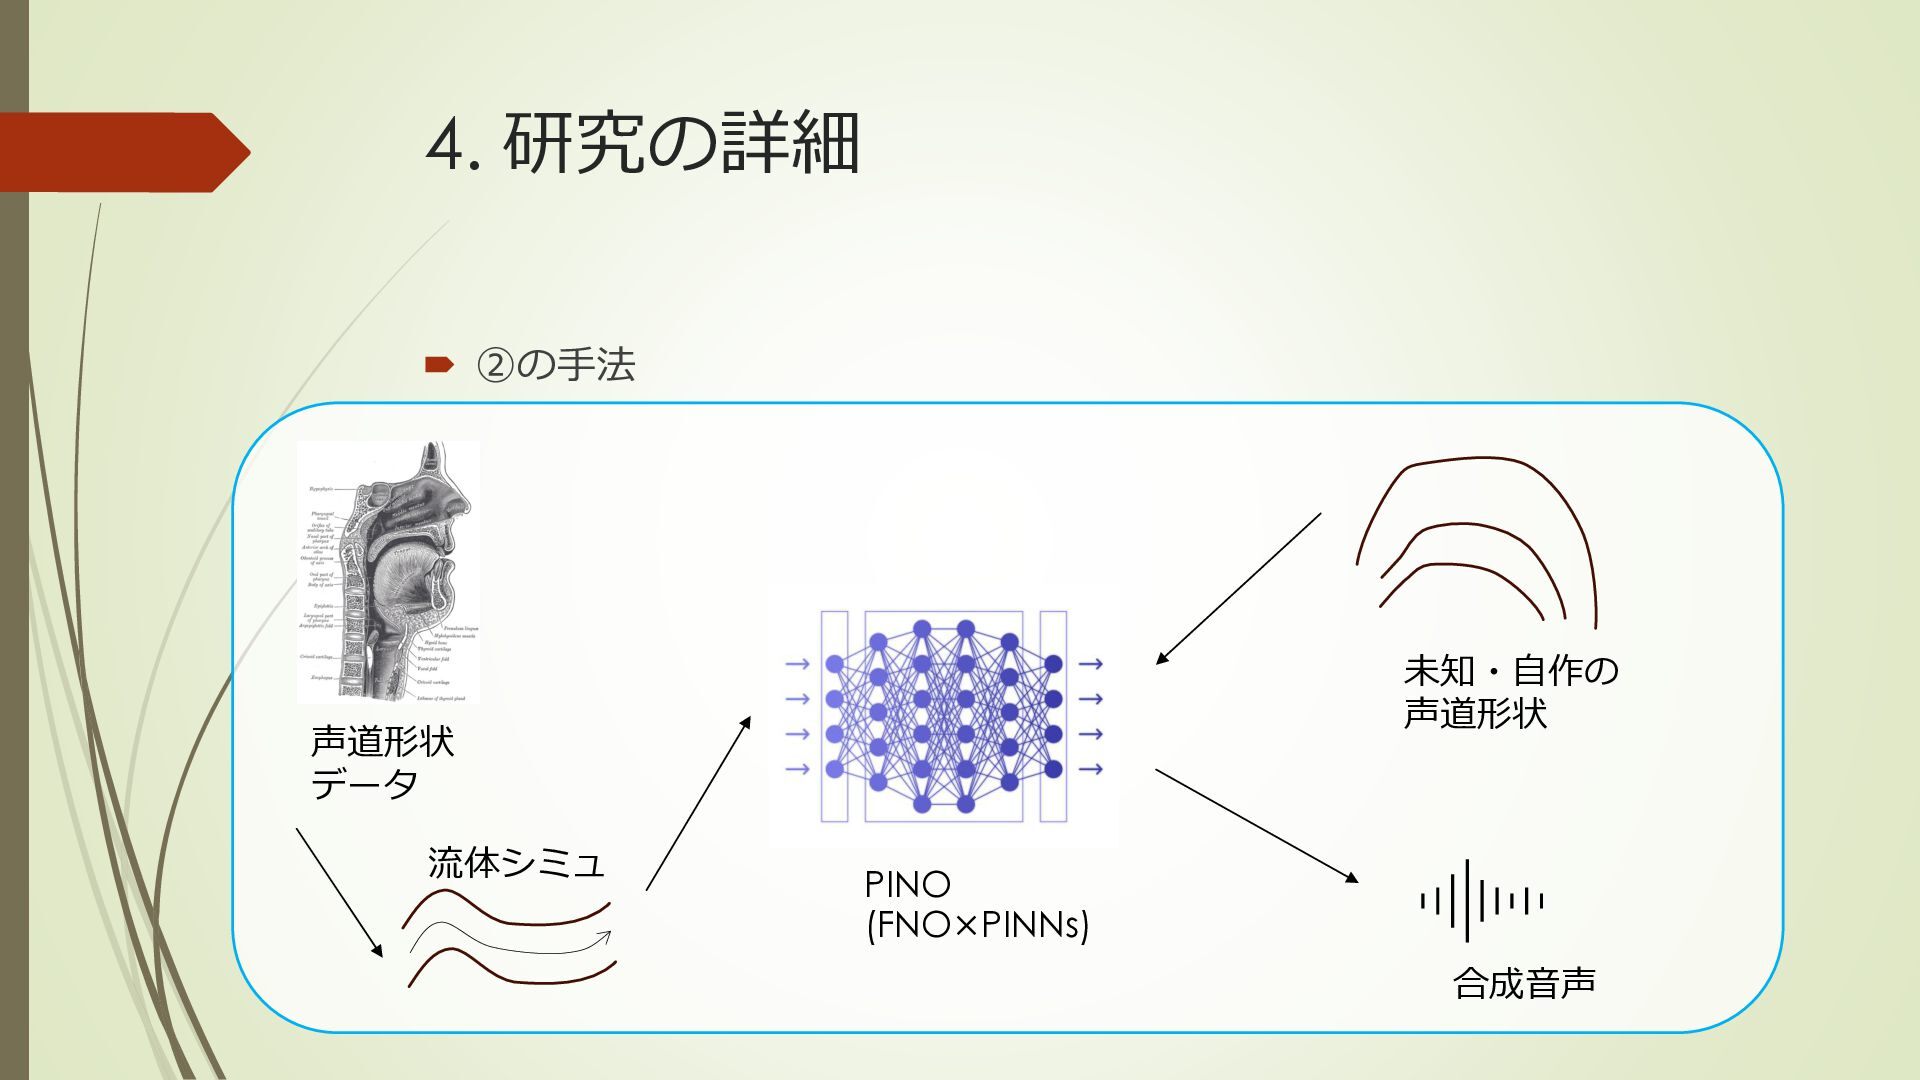
声道形状の画像を加工(フーリエ変換など)して滑らかな管としてみなし、流体シミュレーションで音声を合成します。
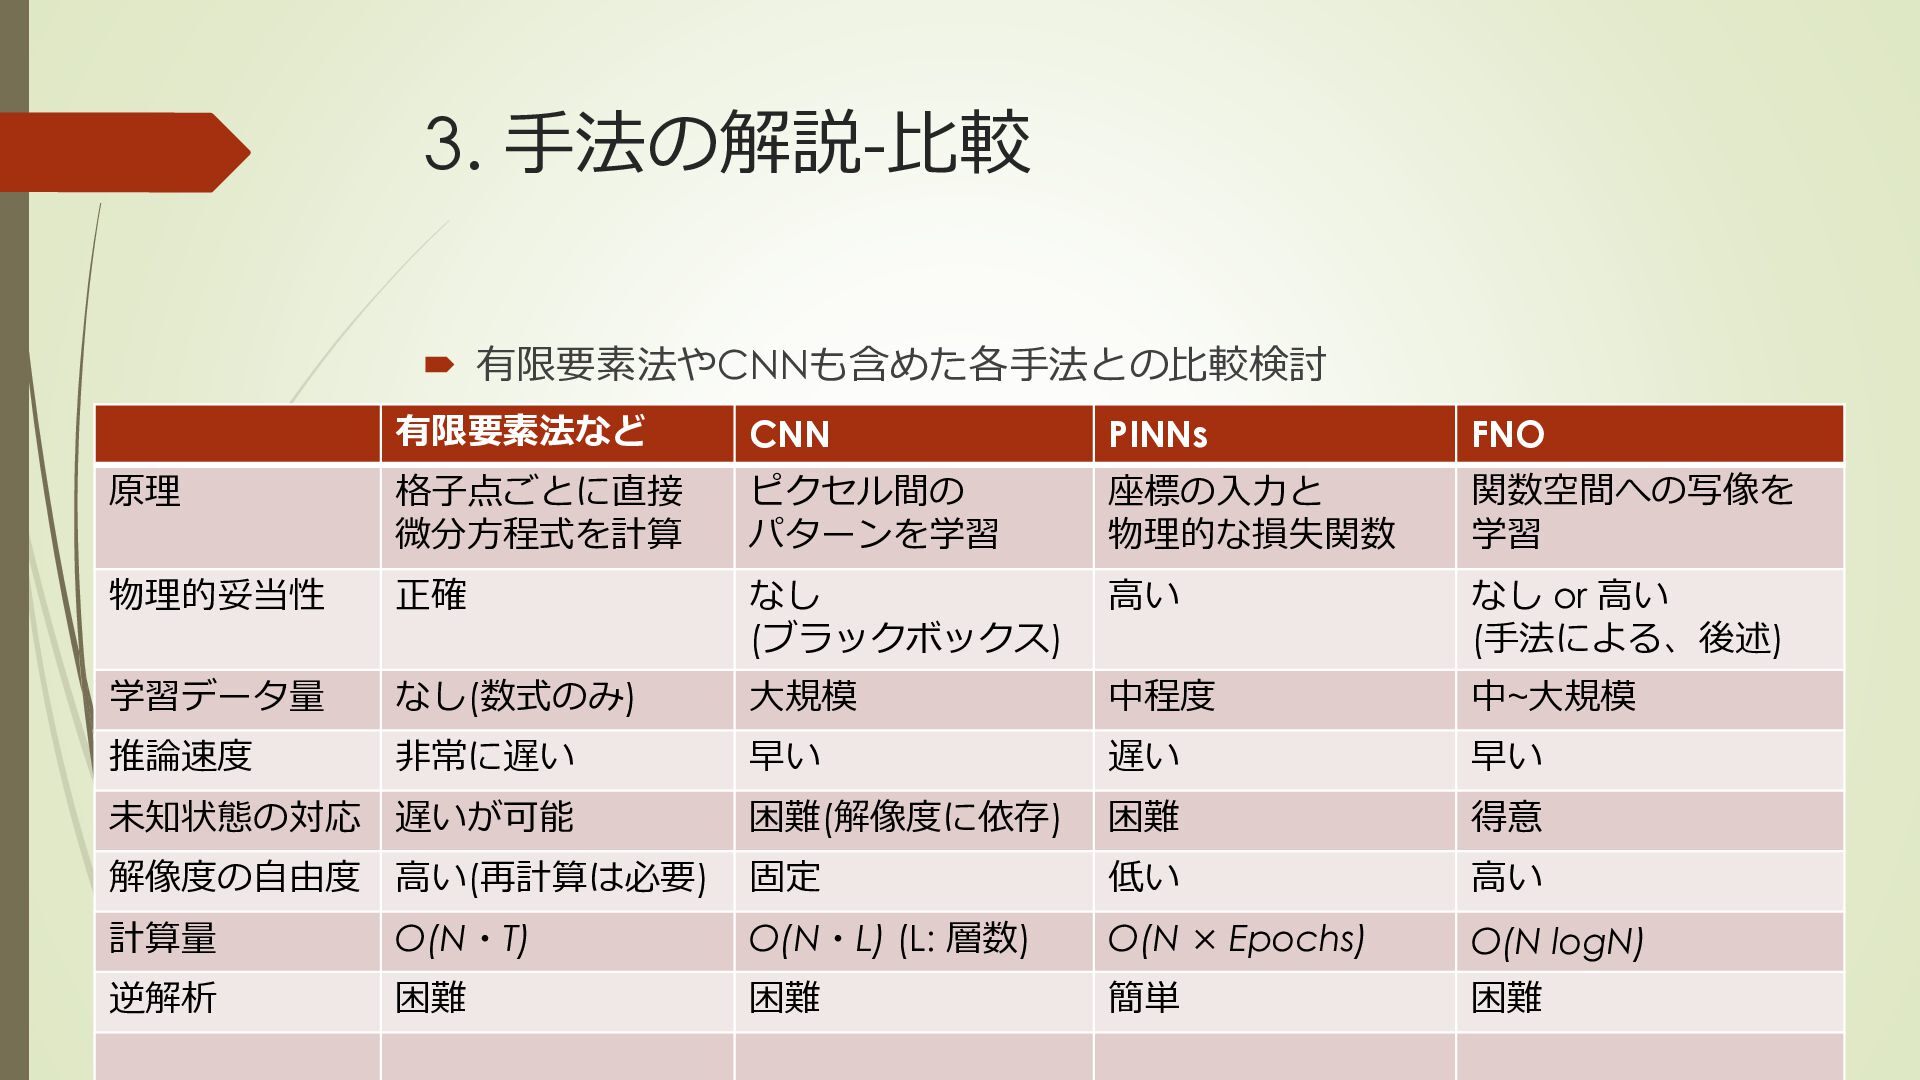
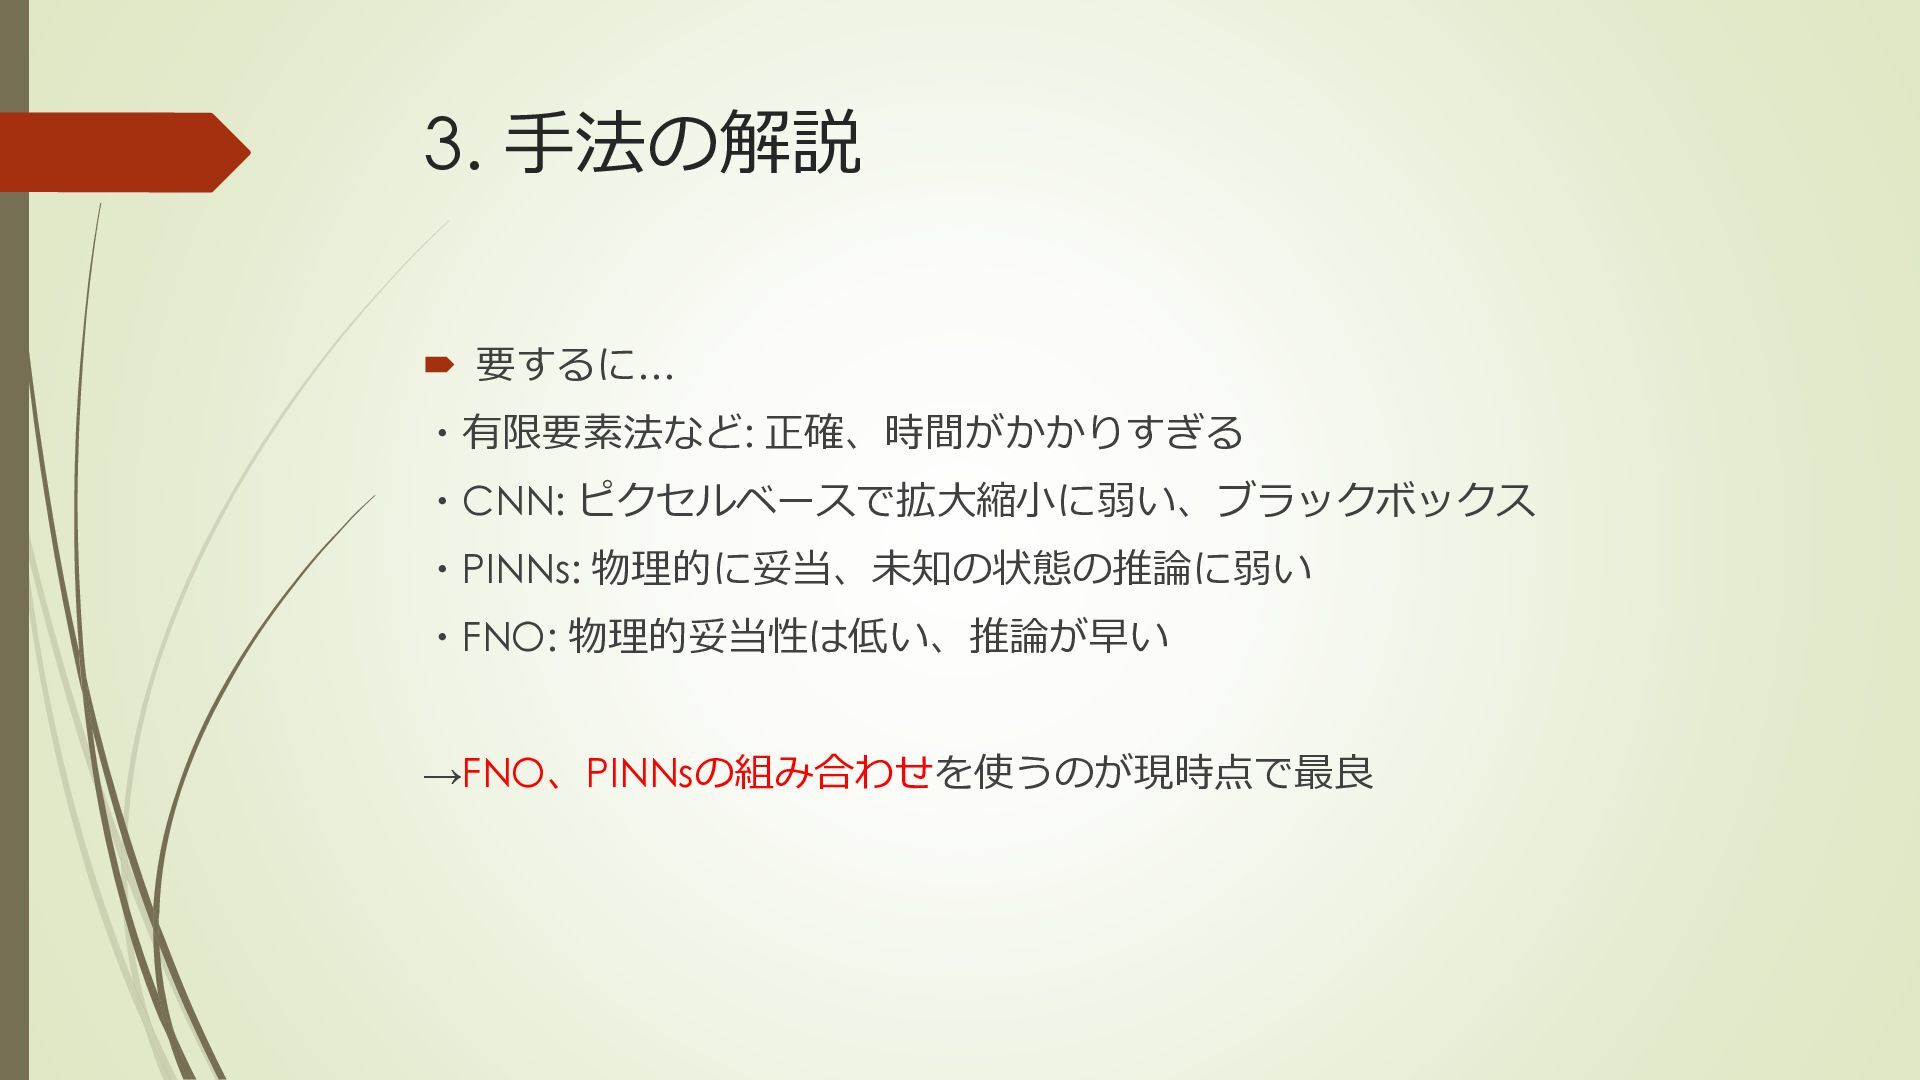
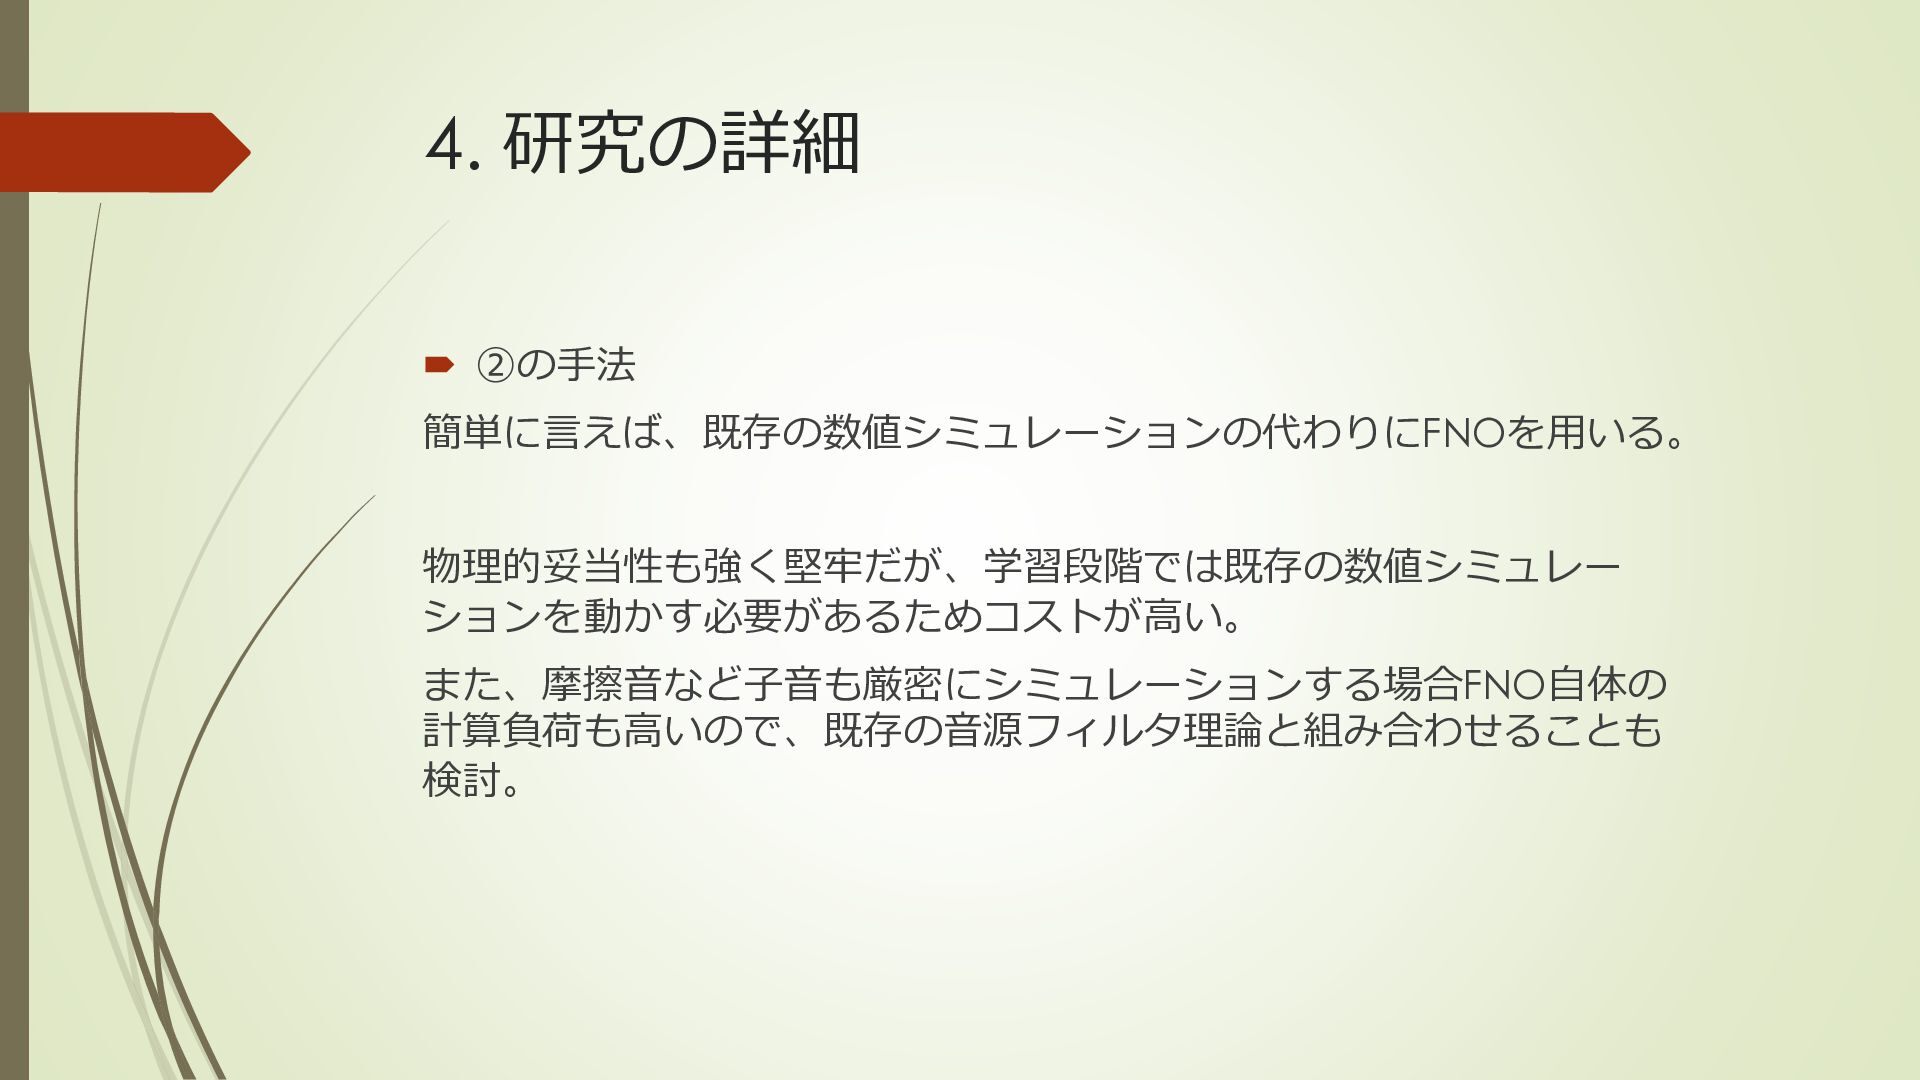
シミュレーションでは時間がかかる有限要素法などではなく、FNO及びPINNsを用いて高速化し、リアルタイム性を担保できればと考えています。
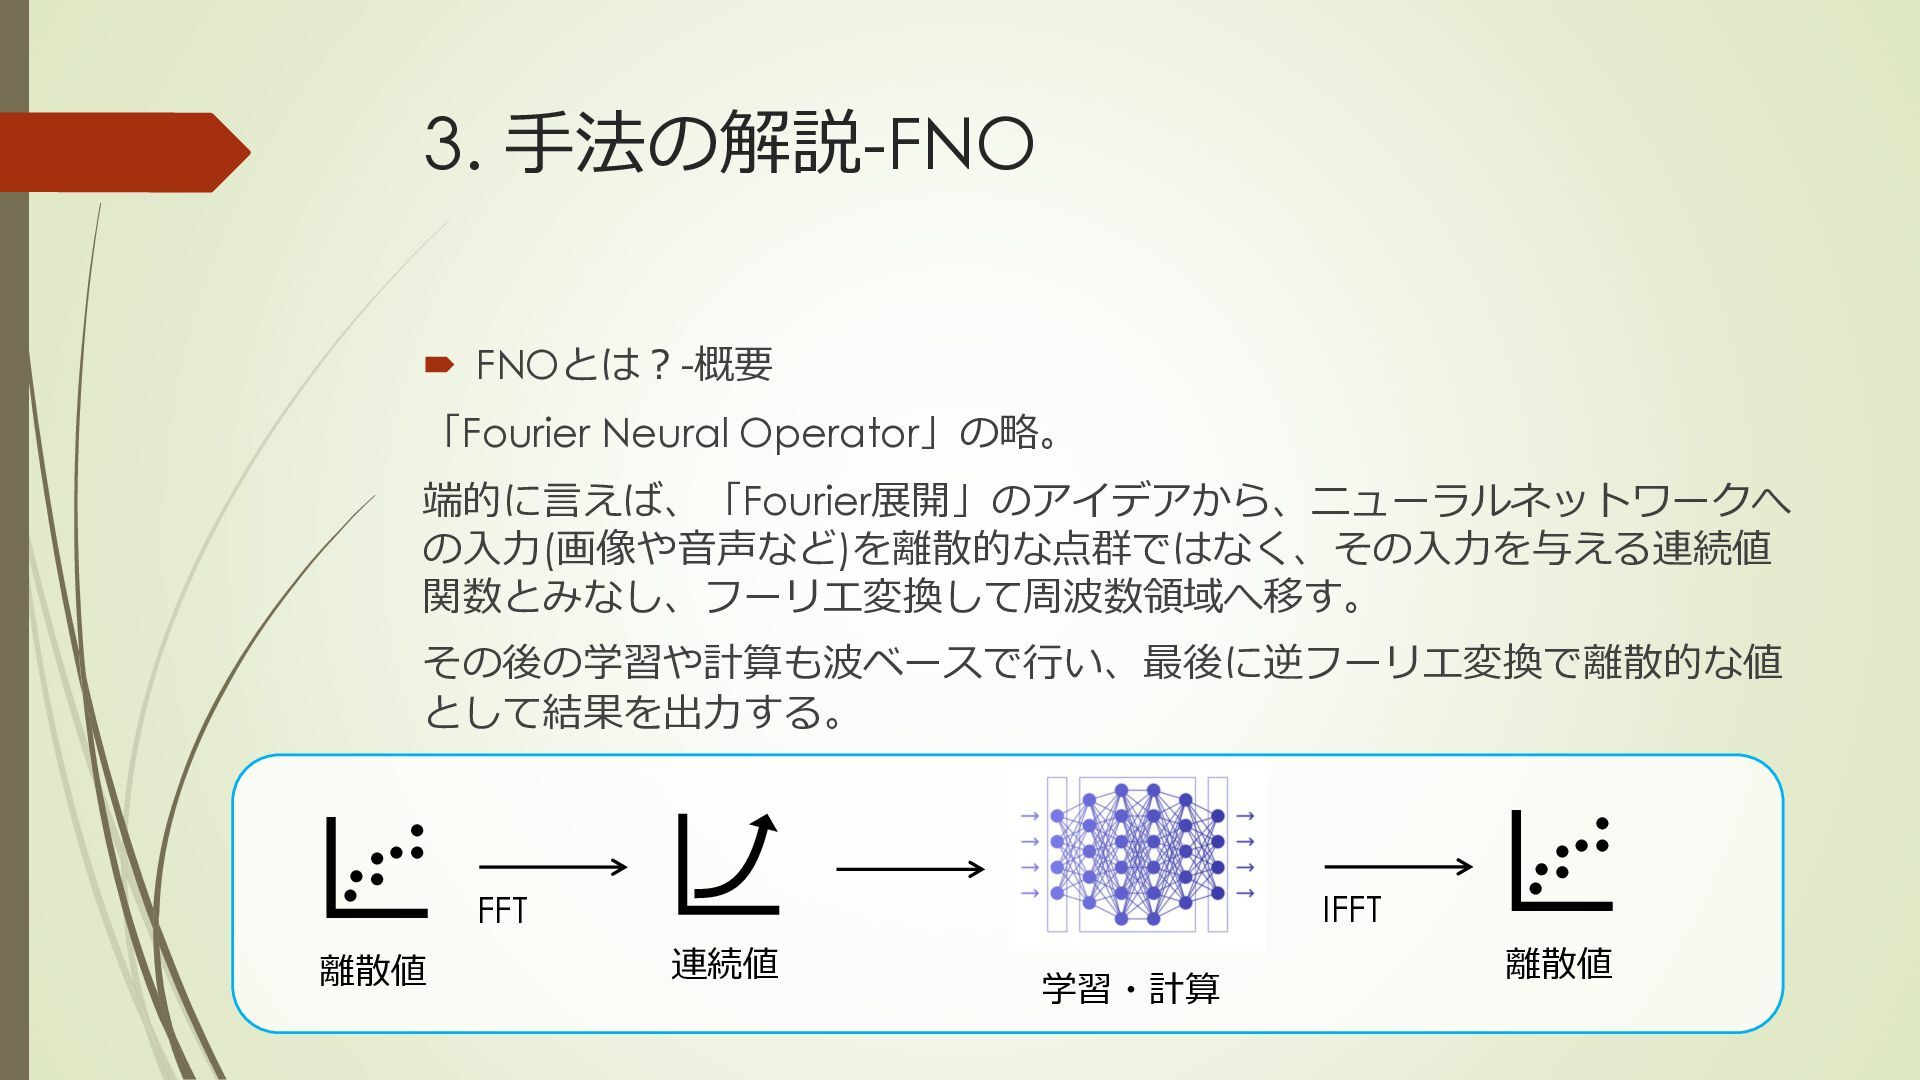
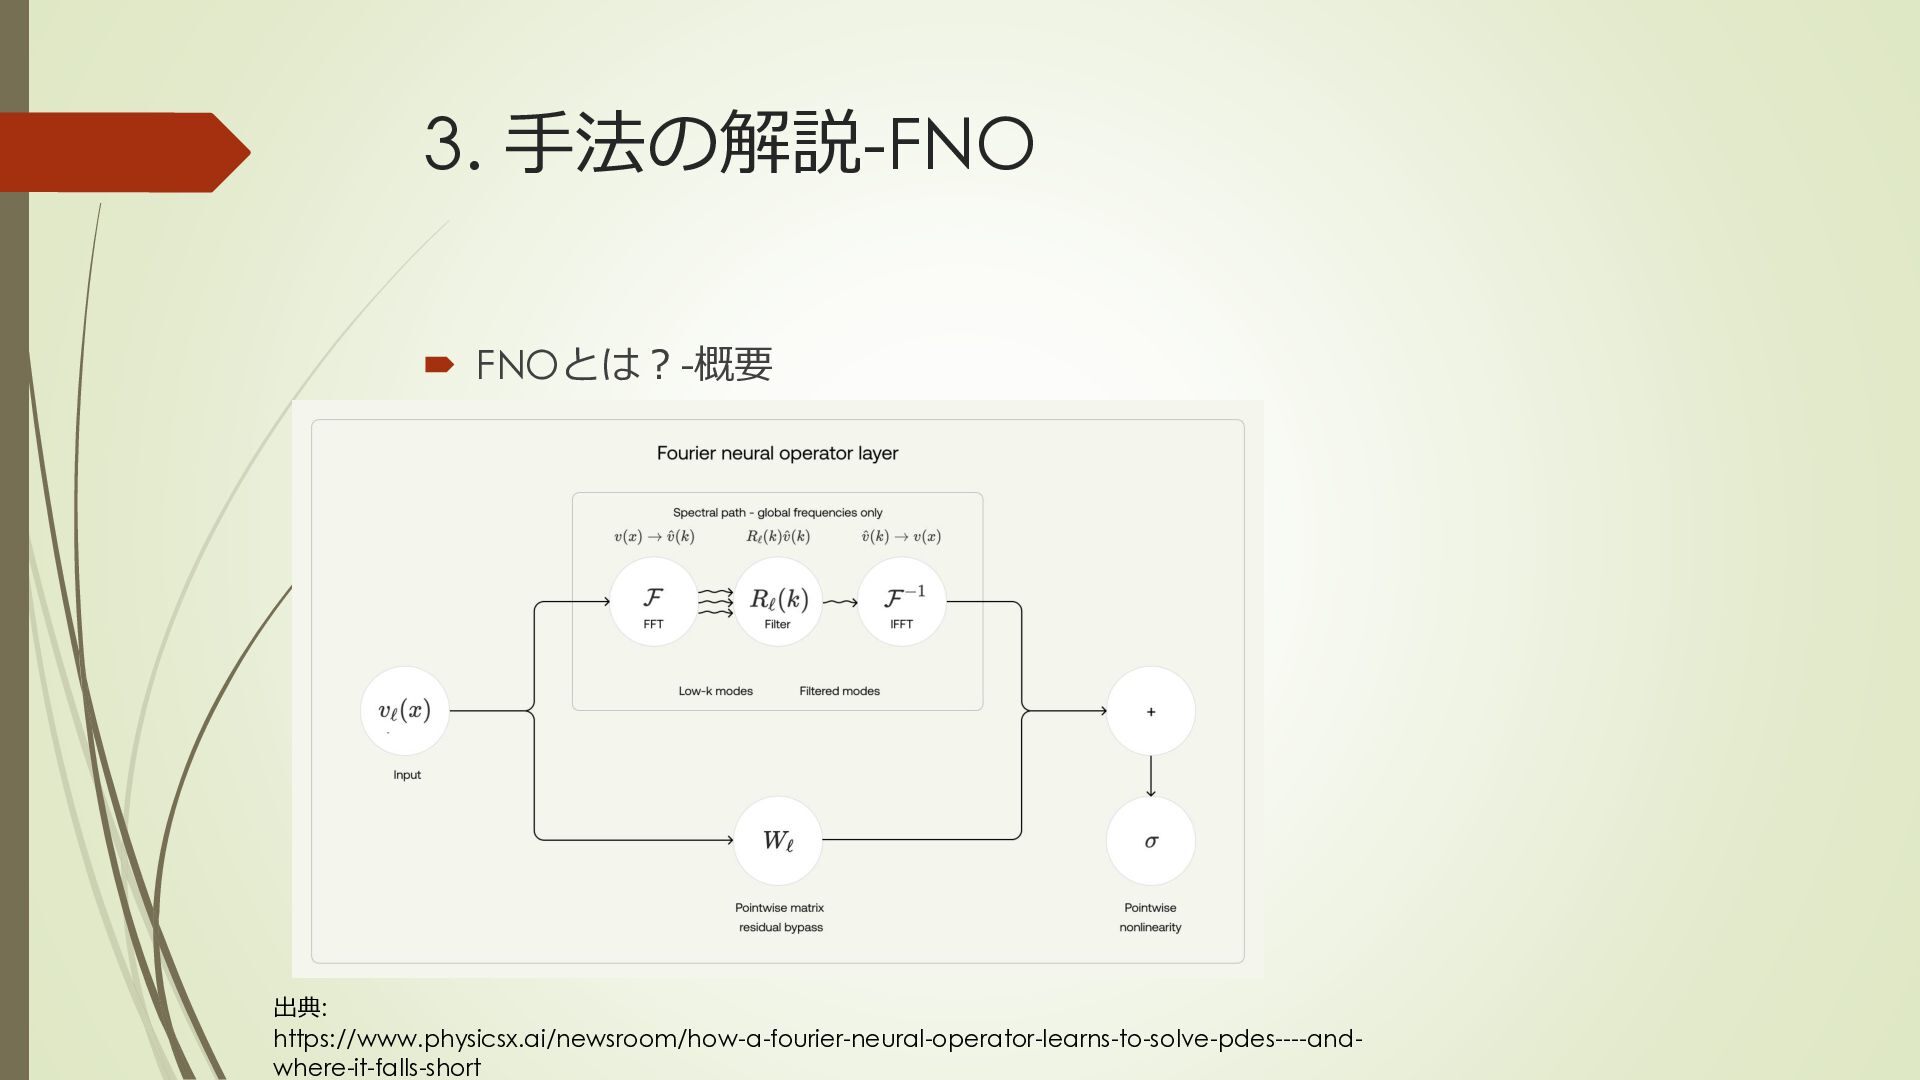
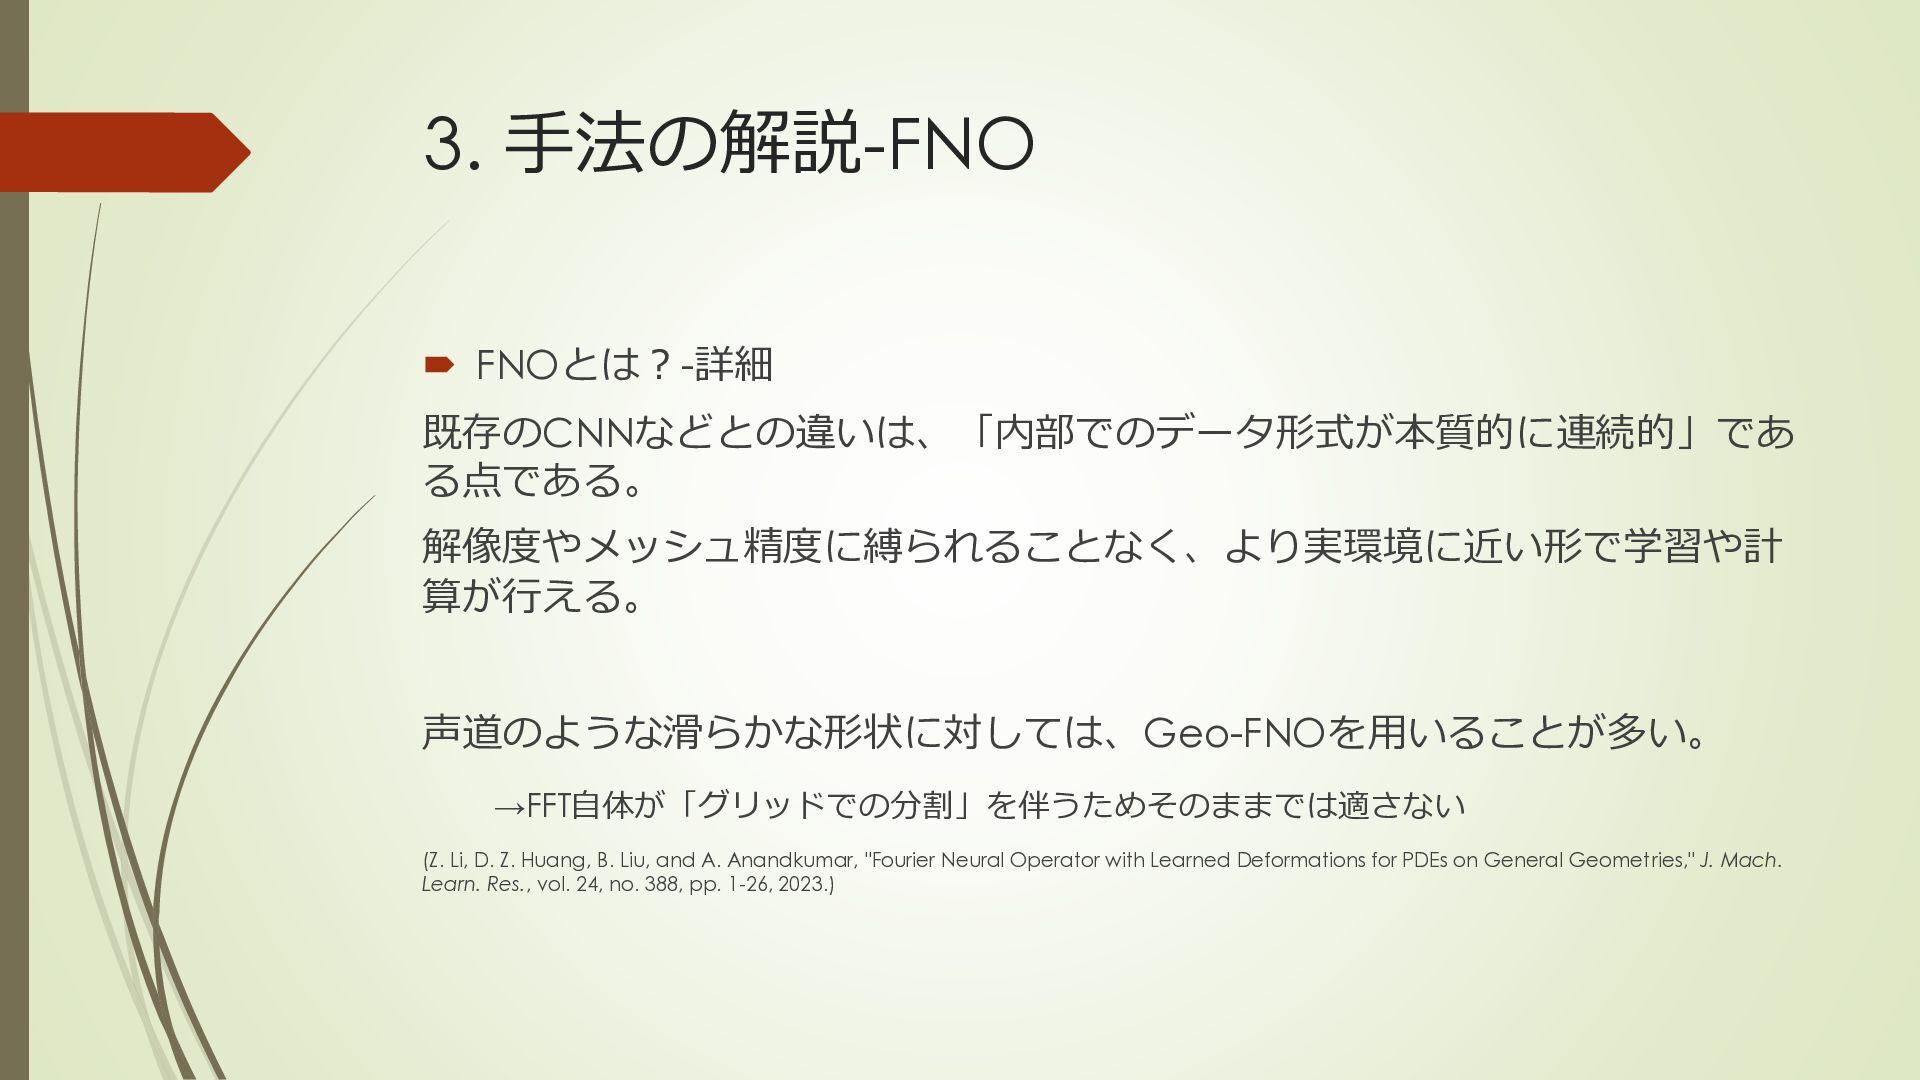
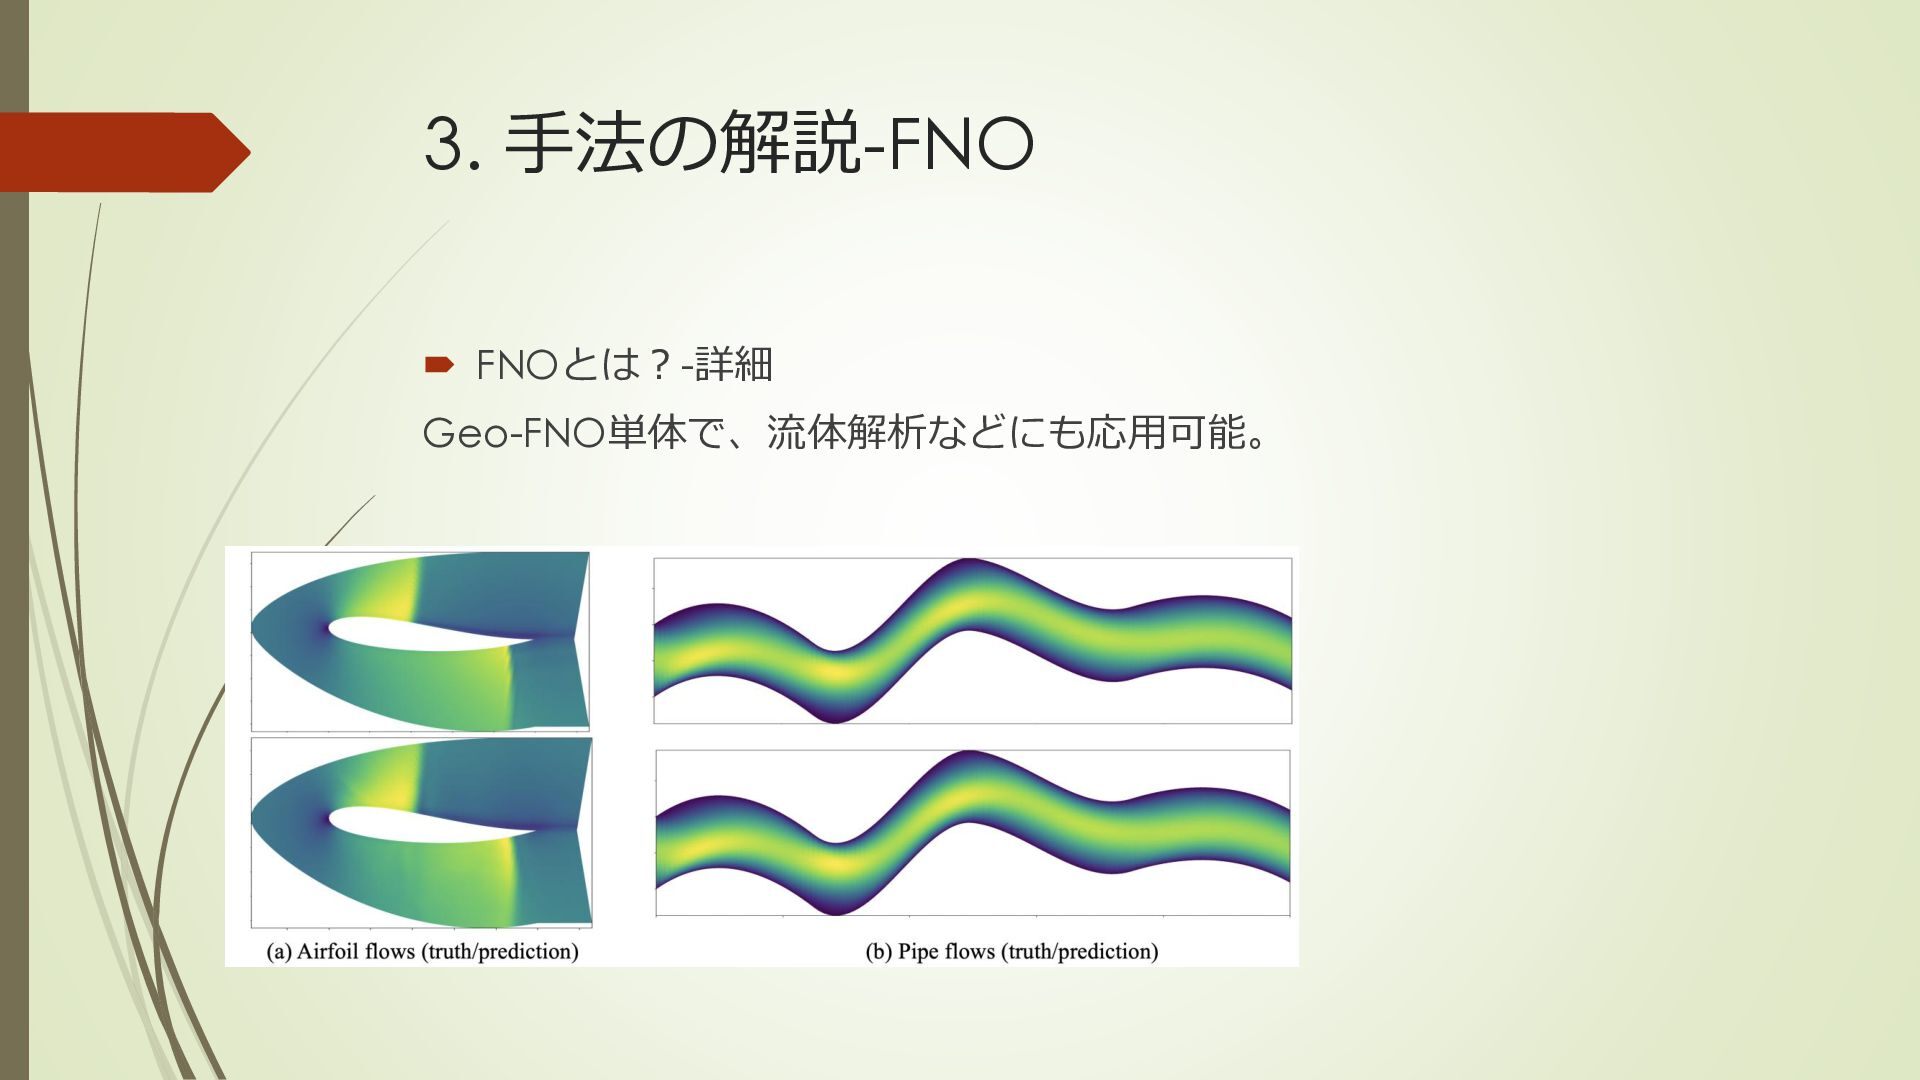
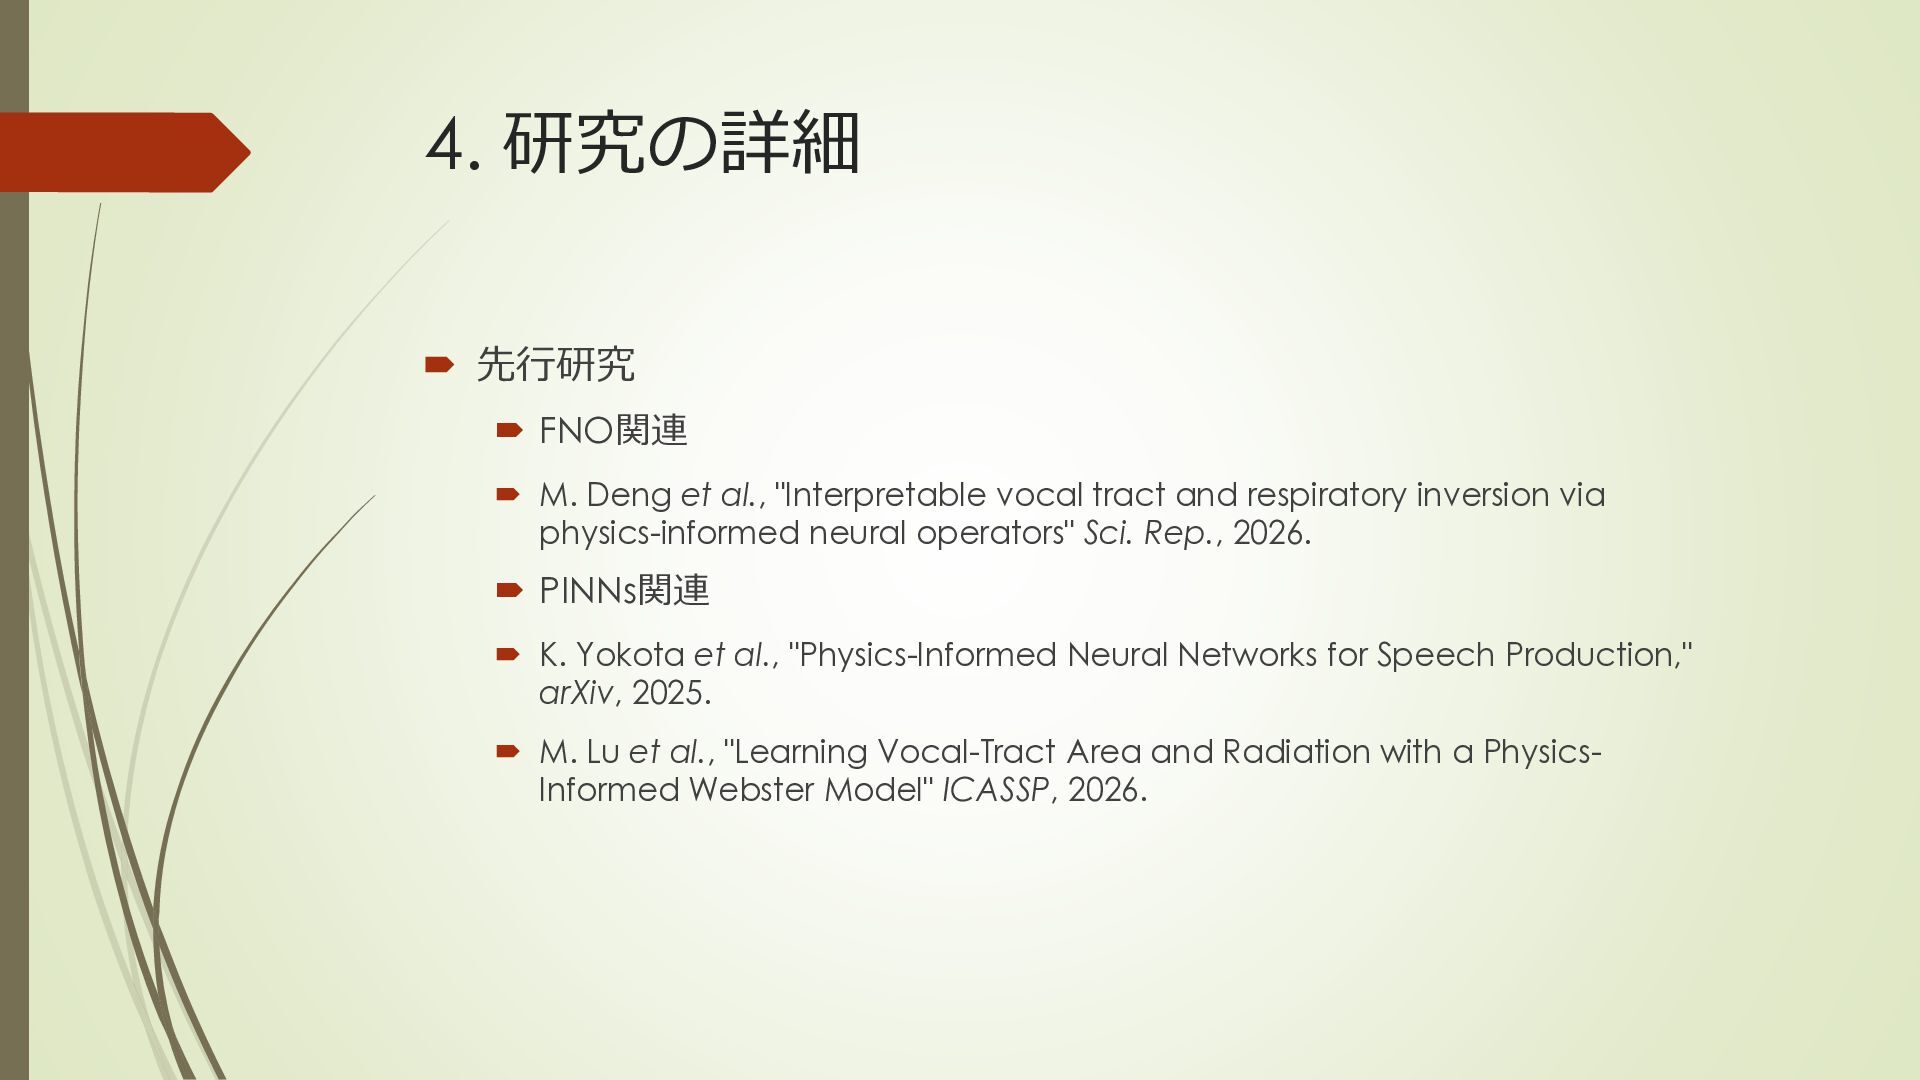
FNOは端的に言えば、学習データや入力を画像や音声などの離散値ではなく、連続値として扱う手法です。離散値のデータをフーリエ変換して無限次元をもつ波の集まりとみなすことで、解像度に依存しない機械学習の手法となります。これを応用したGeo-FNOは偏微分方程式のソルバーとして扱え、流体シミュレーションに使用した例があります。
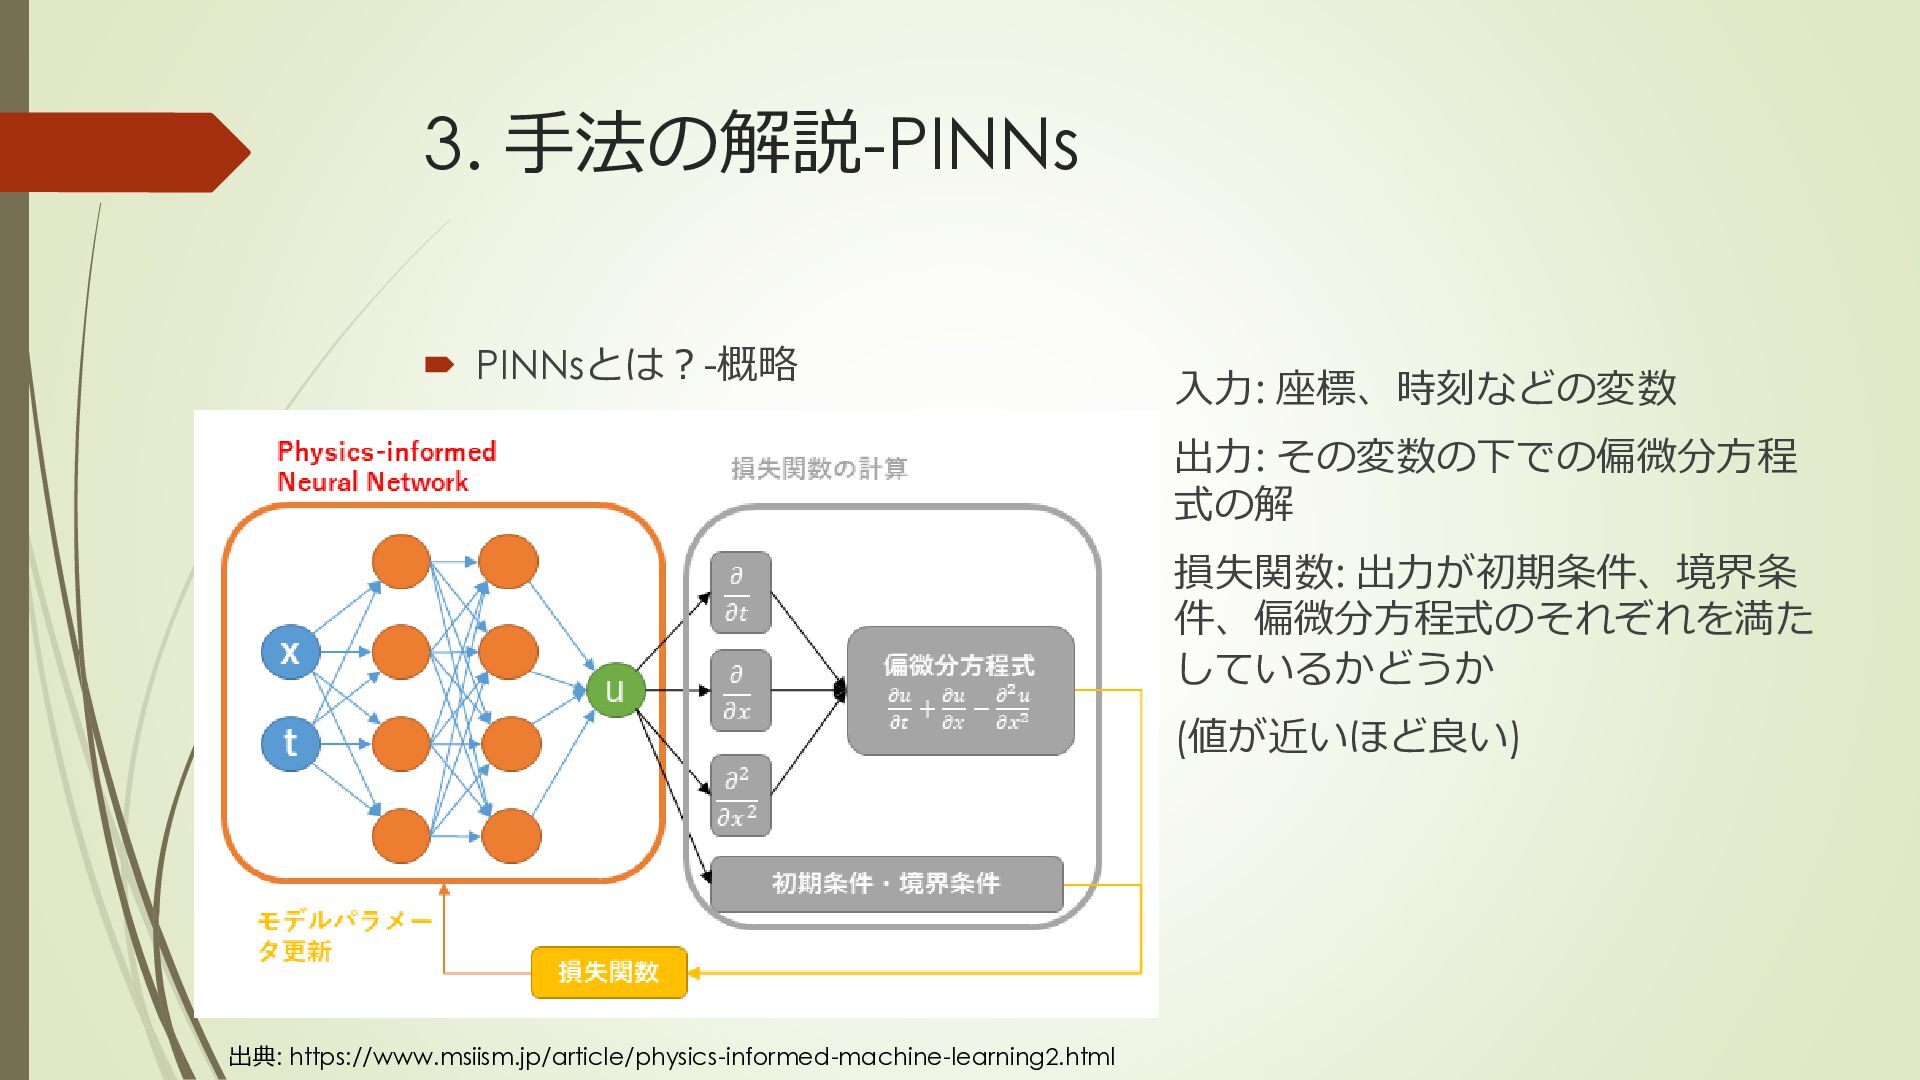
PINNsは損失関数の計算の中に物理法則を記述する偏微分方程式を入れ込むことで、物理的に矛盾しない範囲での学習を行う手法です。これを物理シミュレーションベースの音声合成に使用した先行研究はありますが、一次元モデルに限られます。
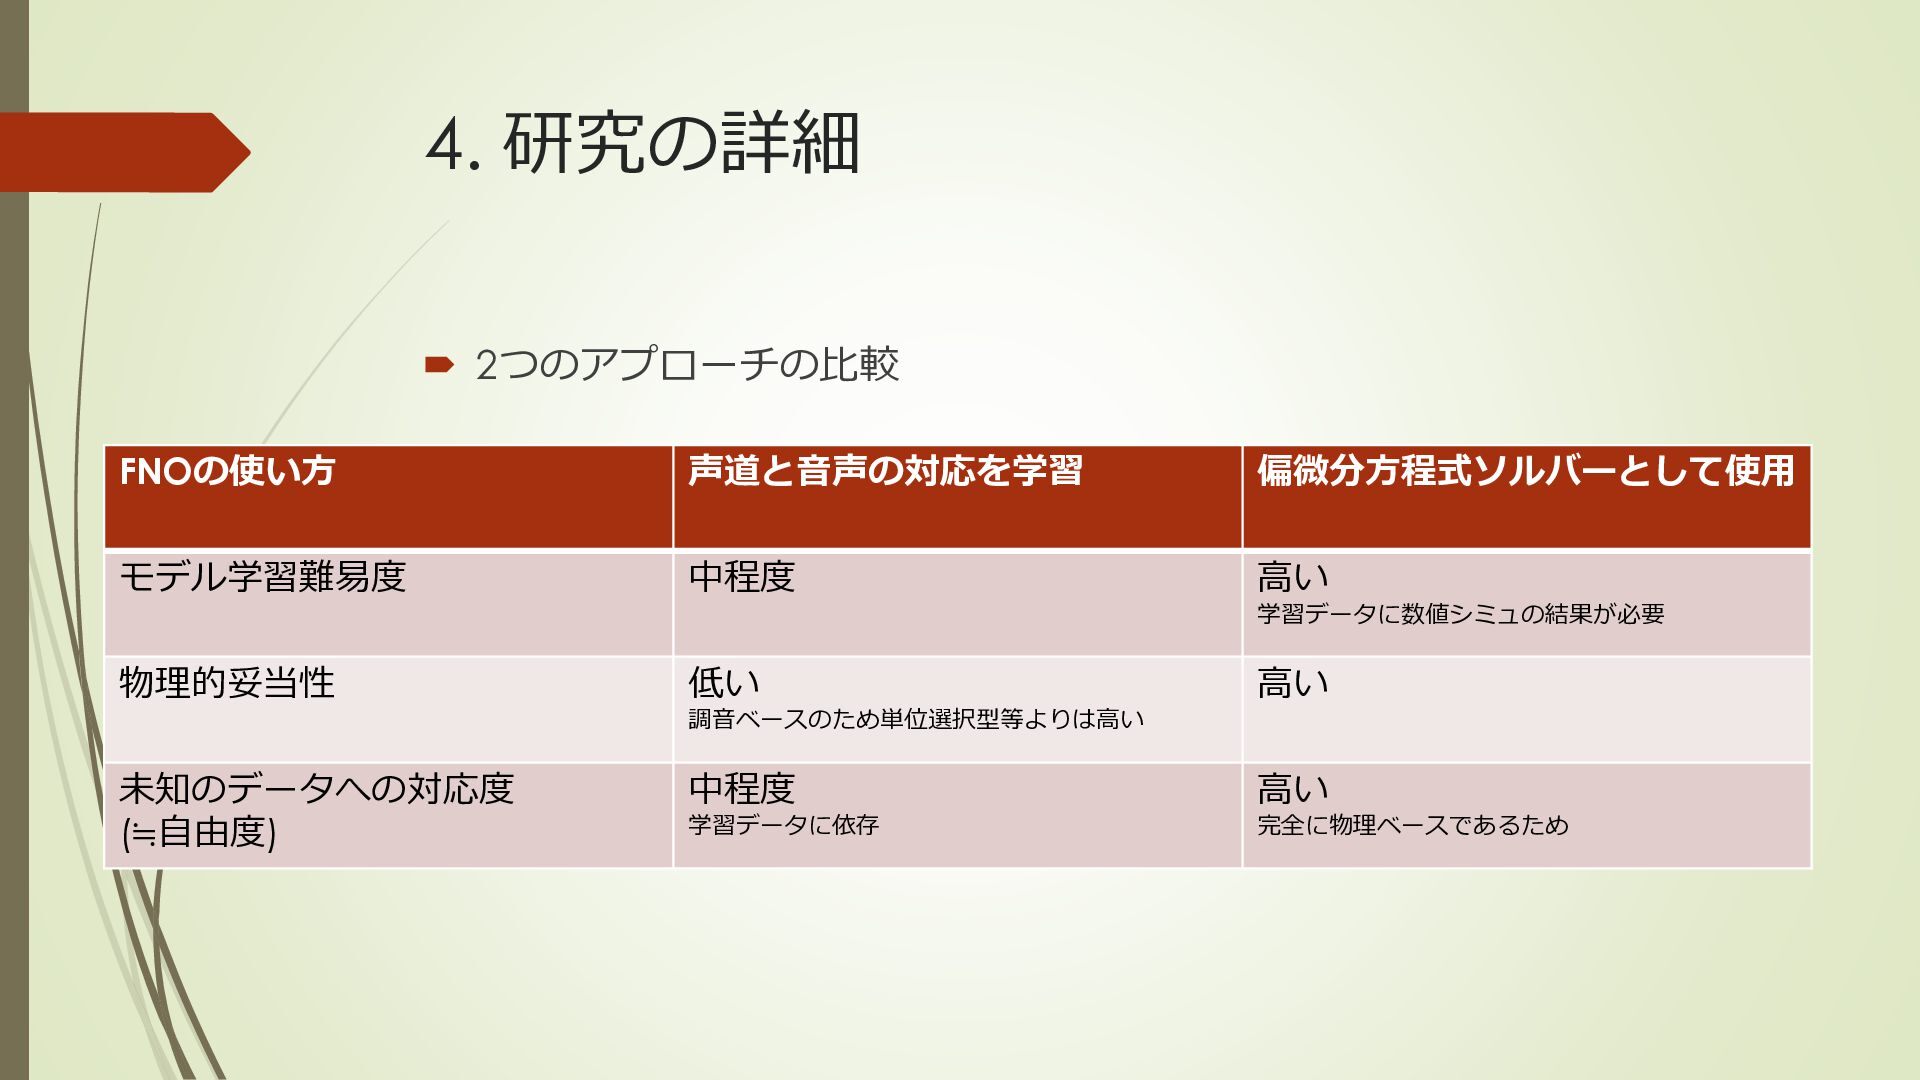
もしマシンスペックなどの問題で流体シミュレーションが難しい場合、声道の動画像と音声の対応付けを学習させることでもほぼ同じことが可能ではないか?と考えています。


 bitkey
 pfn
 puhitaku
 akhino
 occhi
 camiha
 onk
 iktakahiro
 y0hgi
 glaforge
 yamad
 satoshi7
 davidcarrasco
 lara
 nmsamuel
 apolaine
 jonoalderson
 techseoconnect
 madoxten
 cromwellryan
 chriscoyier
 shlominoach
 sarafernandez
 axbom