Share
Embed
Transcript
33 slides
-
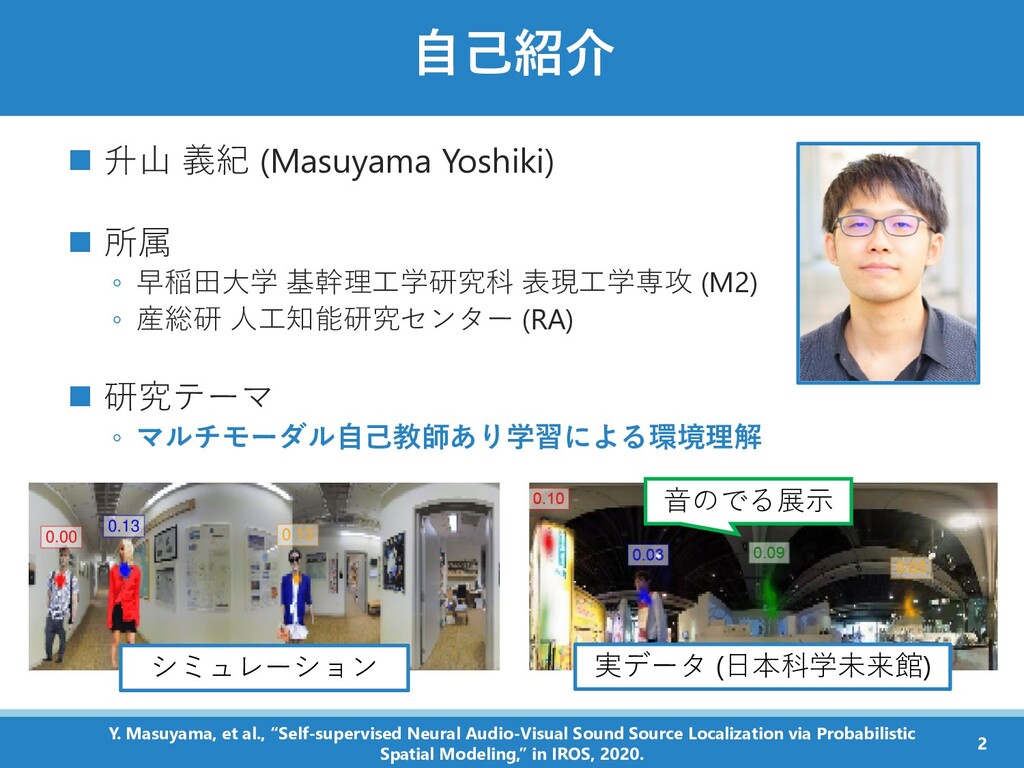
自己紹介 ◼ 升山 義紀 (Masuyama Yoshiki) ◼ 所属 ◦ 早稲田大学
基幹理工学研究科 表現工学専攻 (M2) ◦ 産総研 人工知能研究センター (RA) ◼ 研究テーマ ◦ マルチモーダル自己教師あり学習による環境理解 シミュレーション 実データ (日本科学未来館) 音のでる展示 2 Y. Masuyama, et al., “Self-supervised Neural Audio-Visual Sound Source Localization via Probabilistic Spatial Modeling,” in IROS, 2020. -
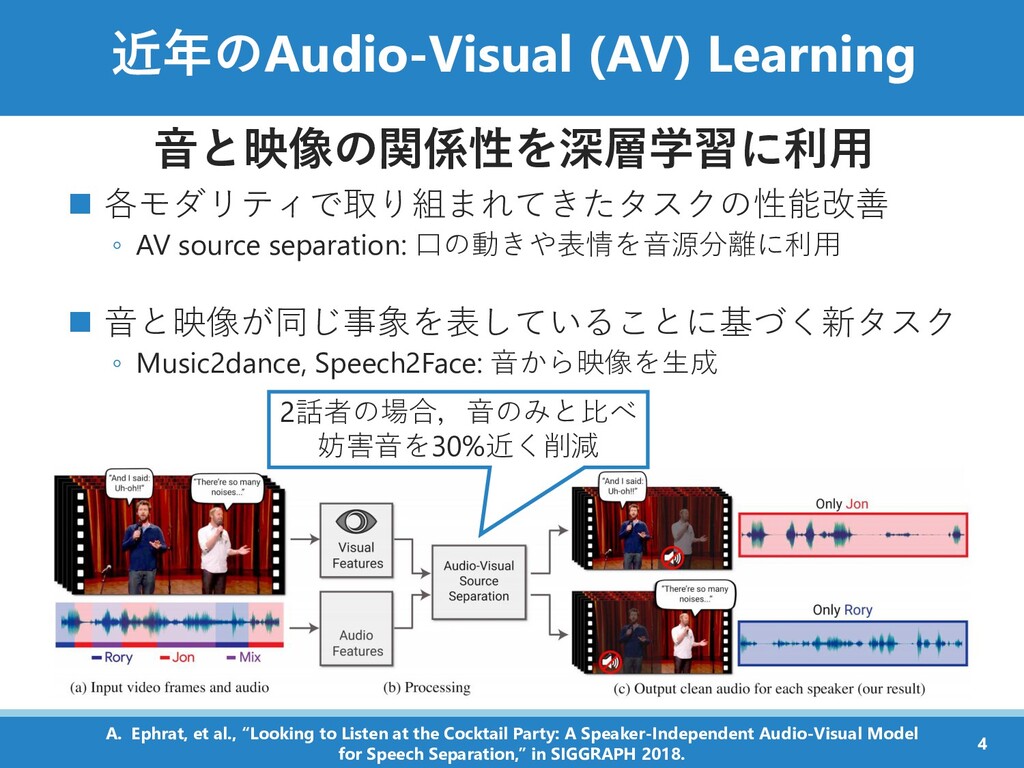
近年のAudio-Visual (AV) Learning 音と映像の関係性を深層学習に利用 ◼ 各モダリティで取り組まれてきたタスクの性能改善 ◦ AV source separation:
口の動きや表情を音源分離に利用 ◼ 音と映像が同じ事象を表していることに基づく新タスク ◦ Music2dance, Speech2Face: 音から映像を生成 2話者の場合,音のみと比べ 妨害音を30%近く削減 4 A. Ephrat, et al., “Looking to Listen at the Cocktail Party: A Speaker-Independent Audio-Visual Model for Speech Separation,” in SIGGRAPH 2018. -
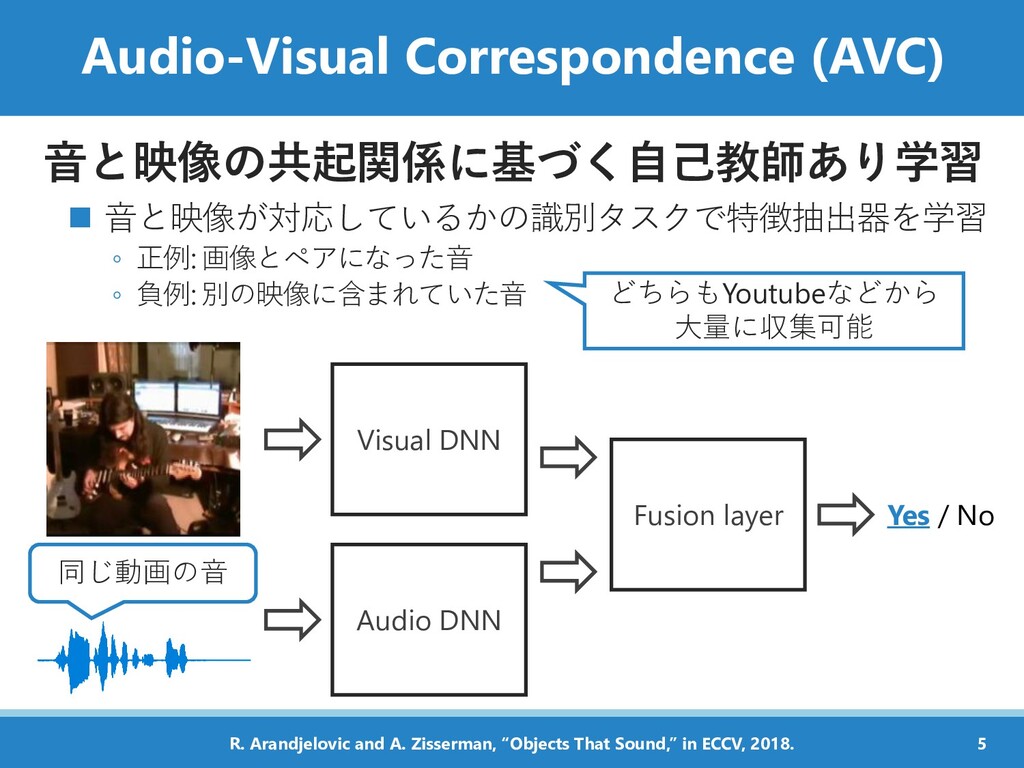
Audio-Visual Correspondence (AVC) 音と映像の共起関係に基づく自己教師あり学習 ◼ 音と映像が対応しているかの識別タスクで特徴抽出器を学習 ◦ 正例: 画像とペアになった音 ◦
負例: 別の映像に含まれていた音 どちらもYoutubeなどから 大量に収集可能 Visual DNN Audio DNN Fusion layer Yes / No 同じ動画の音 5 R. Arandjelovic and A. Zisserman, “Objects That Sound,” in ECCV, 2018. -
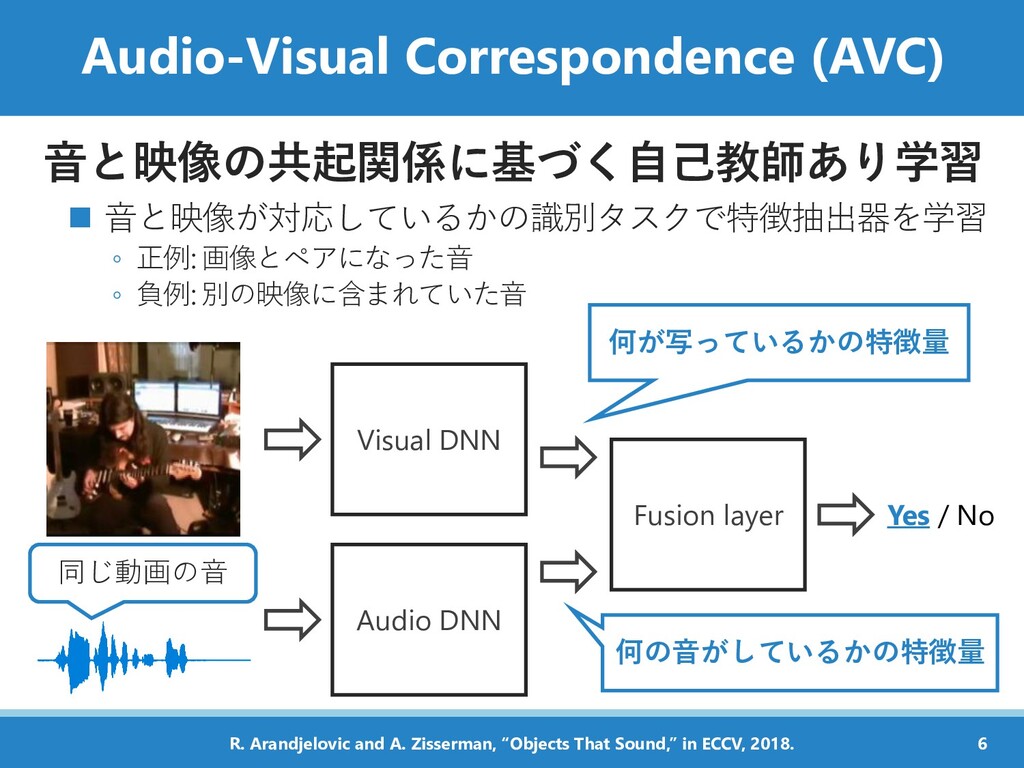
Audio-Visual Correspondence (AVC) 音と映像の共起関係に基づく自己教師あり学習 ◼ 音と映像が対応しているかの識別タスクで特徴抽出器を学習 ◦ 正例: 画像とペアになった音 ◦
負例: 別の映像に含まれていた音 何の音がしているかの特徴量 Visual DNN Audio DNN Fusion layer Yes / No 同じ動画の音 何が写っているかの特徴量 6 R. Arandjelovic and A. Zisserman, “Objects That Sound,” in ECCV, 2018. -
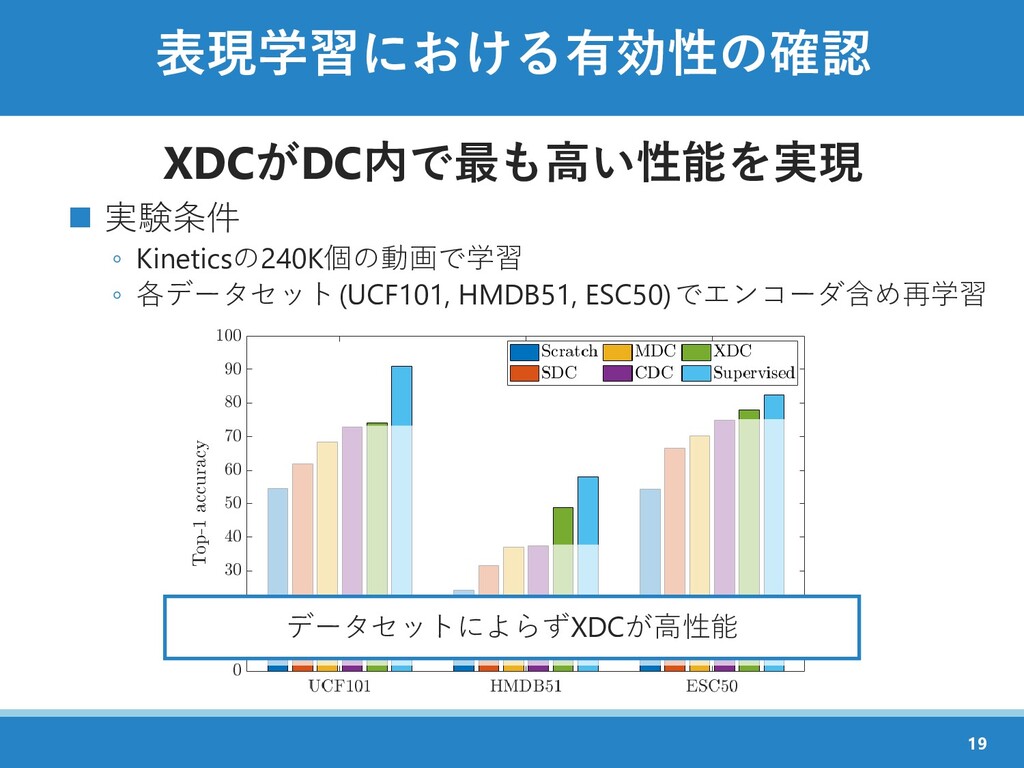
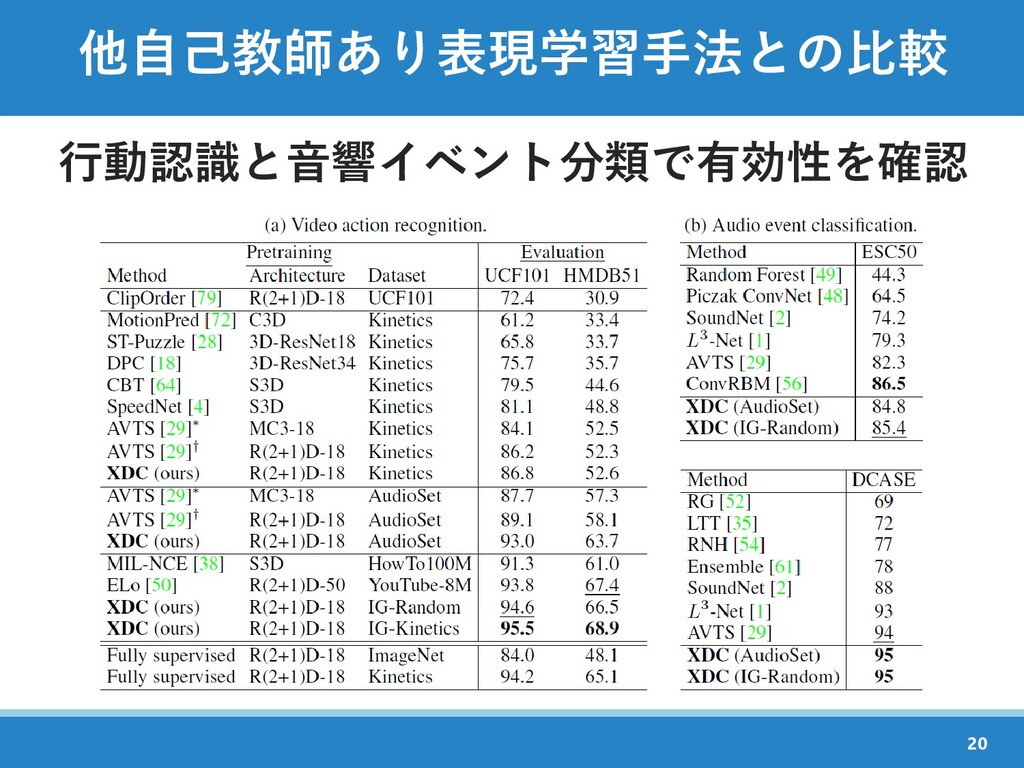
NeurIPS2020でのAudio-Visual Learning 自己教師あり学習に関する発表多数 ◼ 自己教師あり学習 ◦ Self-Supervised Learning by Cross-Modal
Audio-Video Clustering ◦ Labelling Unlabelled Videos from Scratch with Multi-Modal Self- Supervision ◦ Learning Representations from Audio-Visual Spatial Alignment ◦ Self-Supervised MultiModal Versatile Networks ◦ Discriminative Sounding Objects Localization via Self-supervised Audiovisual Matching ◼ 応用 ◦ See, Hear, Explore: Curiosity via Audio-Visual Association ◦ Audeo: Audio Generation for a Silent Performance Video 7 -
NeurIPS2020でのAudio-Visual Learning 自己教師あり学習に関する発表多数 ◼ 自己教師あり学習 ◦ Self-Supervised Learning by Cross-Modal
Audio-Video Clustering ◦ Labelling Unlabelled Videos from Scratch with Multi-Modal Self- Supervision ◦ Learning Representations from Audio-Visual Spatial Alignment ◦ Self-Supervised MultiModal Versatile Networks ◦ Discriminative Sounding Objects Localization via Self-supervised Audiovisual Matching ◼ 応用 ◦ See, Hear, Explore: Curiosity via Audio-Visual Association ◦ Audeo: Audio Generation for a Silent Performance Video クラスタリングによる学習 8 -
NeurIPS2020でのAudio-Visual Learning 自己教師あり学習に関する発表多数 ◼ 自己教師あり学習 ◦ Self-Supervised Learning by Cross-Modal
Audio-Video Clustering ◦ Labelling Unlabelled Videos from Scratch with Multi-Modal Self- Supervision ◦ Learning Representations from Audio-Visual Spatial Alignment ◦ Self-Supervised MultiModal Versatile Networks ◦ Discriminative Sounding Objects Localization via Self-supervised Audiovisual Matching ◼ 応用 ◦ See, Hear, Explore: Curiosity via Audio-Visual Association ◦ Audeo: Audio Generation for a Silent Performance Video AVCの拡張 9 -
NeurIPS2020でのAudio-Visual Learning 自己教師あり学習に関する発表多数 ◼ 自己教師あり学習 ◦ Self-Supervised Learning by Cross-Modal
Audio-Video Clustering ◦ Labelling Unlabelled Videos from Scratch with Multi-Modal Self- Supervision ◦ Learning Representations from Audio-Visual Spatial Alignment ◦ Self-Supervised MultiModal Versatile Networks ◦ Discriminative Sounding Objects Localization via Self-supervised Audiovisual Matching ◼ 応用 ◦ See, Hear, Explore: Curiosity via Audio-Visual Association ◦ Audeo: Audio Generation for a Silent Performance Video AVCを強化学習へ応用 10 -
Self-Supervised Learning by Cross- Modal Audio-Video Clustering H. Alwassel, D.
Mahajan, B. Korbar, L. Torresani, B. Ghanem and D. Tran 11 -
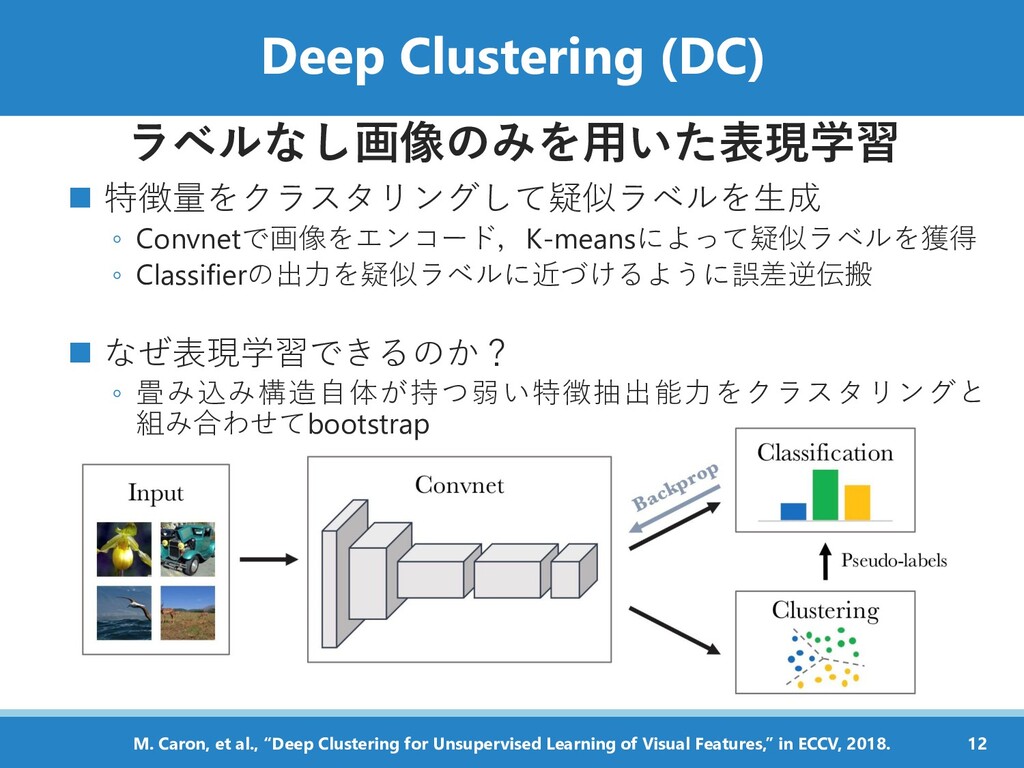
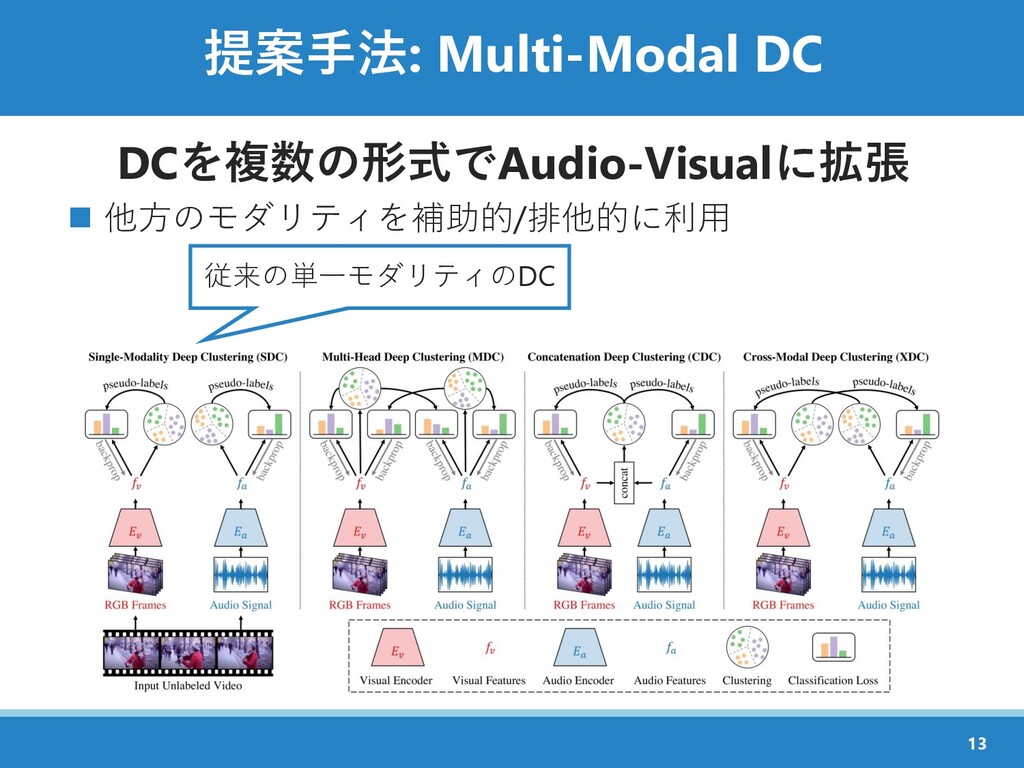
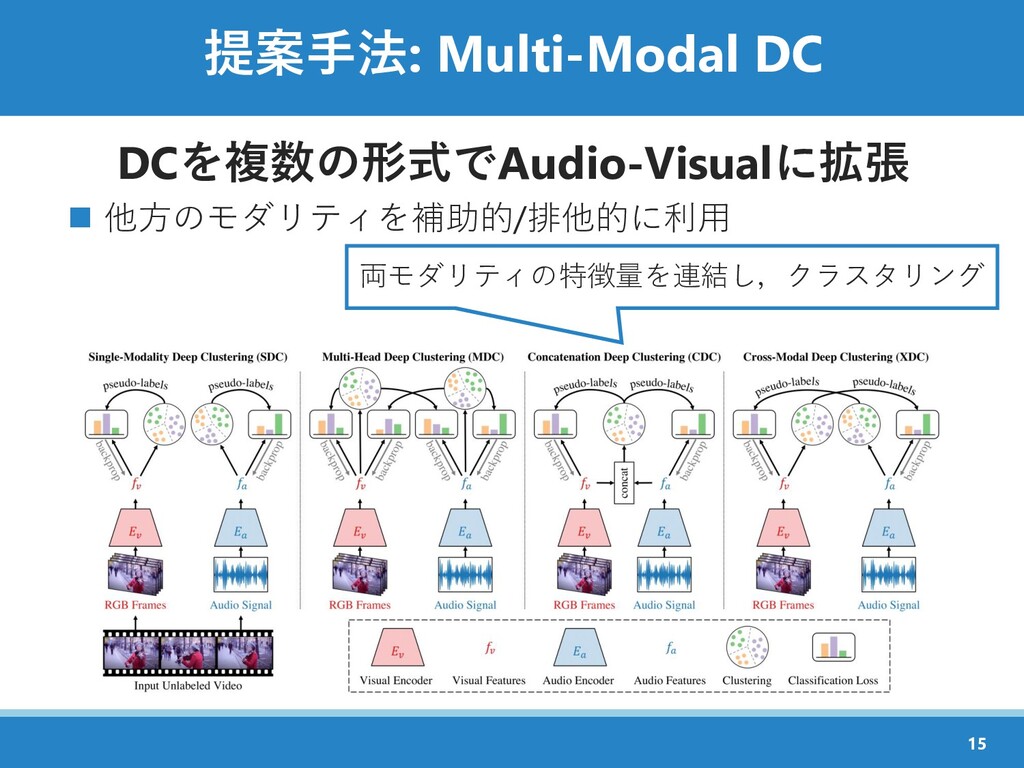
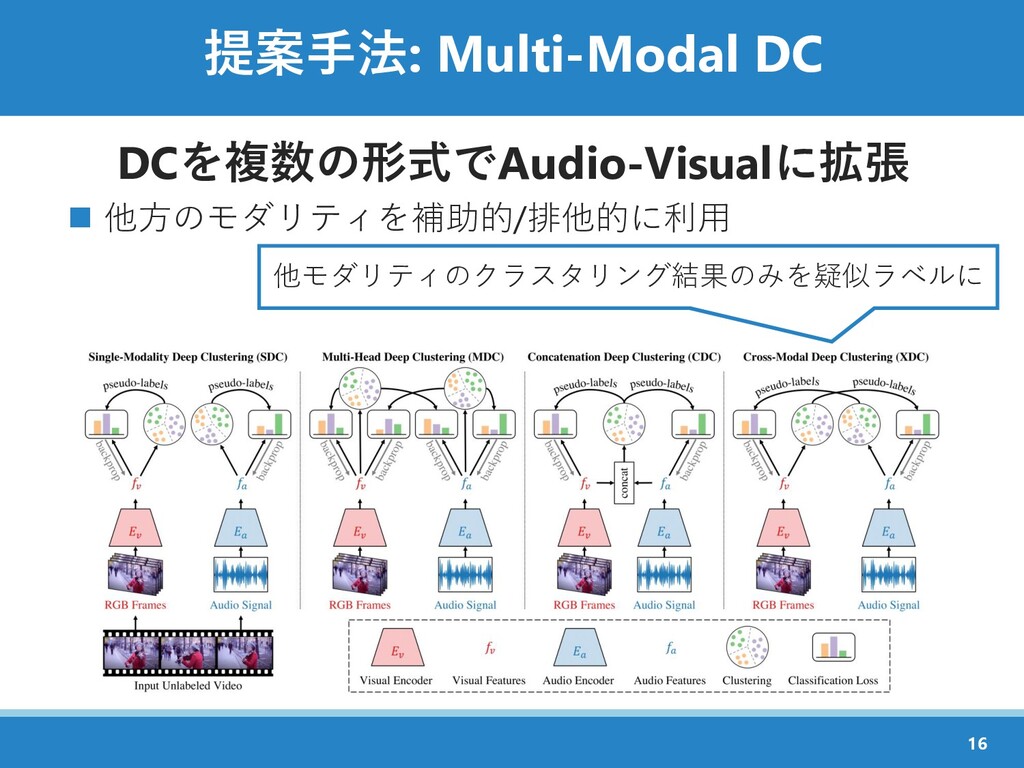
Deep Clustering (DC) ラベルなし画像のみを用いた表現学習 ◼ 特徴量をクラスタリングして疑似ラベルを生成 ◦ Convnetで画像をエンコード,K-meansによって疑似ラベルを獲得 ◦ Classifierの出力を疑似ラベルに近づけるように誤差逆伝搬
◼ なぜ表現学習できるのか? ◦ 畳み込み構造自体が持つ弱い特徴抽出能力をクラスタリングと 組み合わせてbootstrap 12 M. Caron, et al., “Deep Clustering for Unsupervised Learning of Visual Features,” in ECCV, 2018. -
Learning Representations from Audio-Visual Spatial Alignment P. Morgado, Y Li
and N. Vasconcelos 21 -
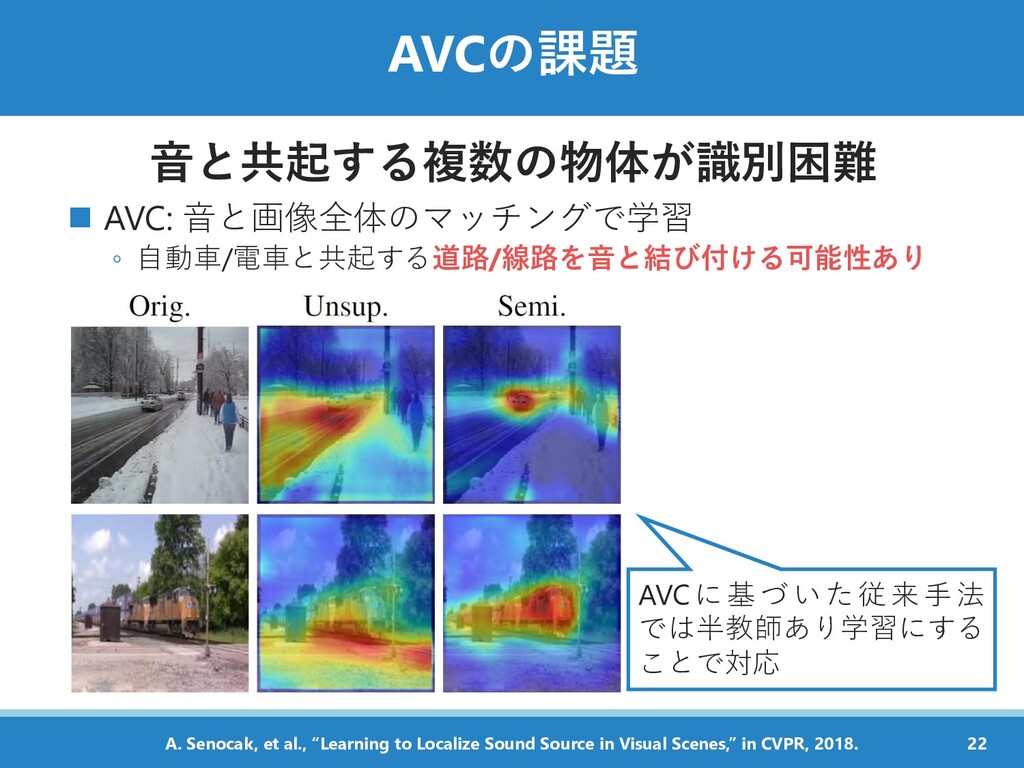
AVCの課題 音と共起する複数の物体が識別困難 ◼ AVC: 音と画像全体のマッチングで学習 ◦ 自動車/電車と共起する道路/線路を音と結び付ける可能性あり AVCに基づいた従来手法 では半教師あり学習にする ことで対応
22 A. Senocak, et al., “Learning to Localize Sound Source in Visual Scenes,” in CVPR, 2018. -
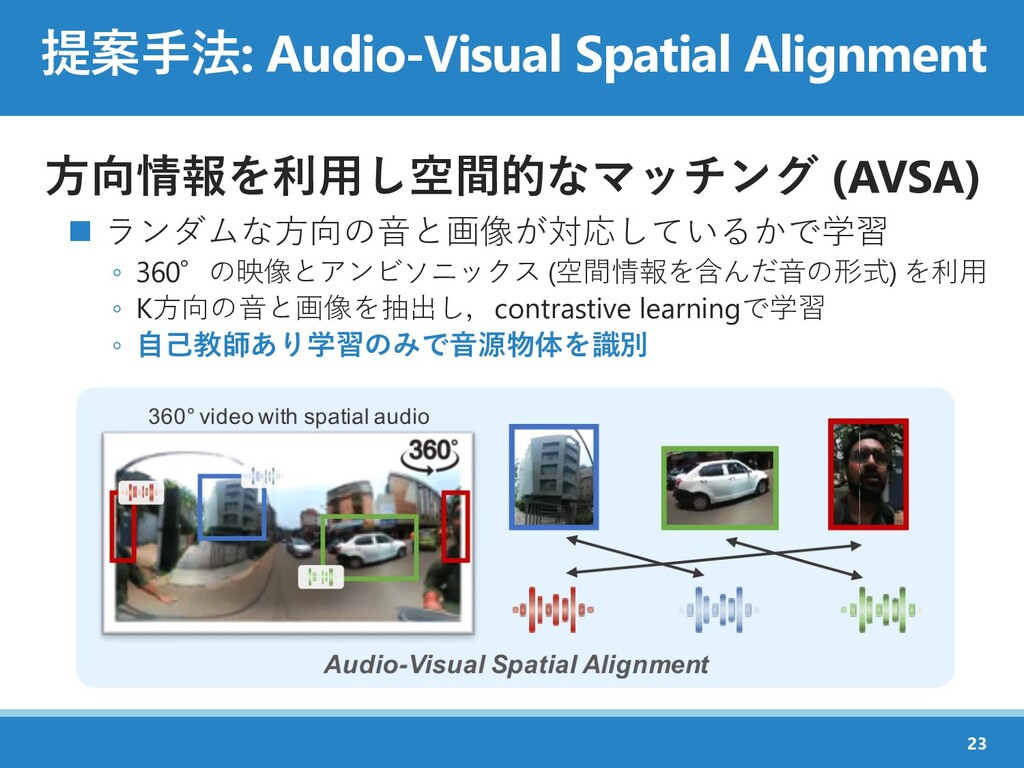
提案手法: Audio-Visual Spatial Alignment 方向情報を利用し空間的なマッチング (AVSA) ◼ ランダムな方向の音と画像が対応しているかで学習 ◦ 360°の映像とアンビソニックス
(空間情報を含んだ音の形式) を利用 ◦ K方向の音と画像を抽出し,contrastive learningで学習 ◦ 自己教師あり学習のみで音源物体を識別 23 -
Transformerで複数方向の特徴量を変換 各方向の音/画像の特徴量を集合として処理 ◼ 特定の方向の音と映像に含まれる情報のズレに対応 ◦ 音: ある方向の音には別の方向の音も混在 ◦ 画像: 特定の方向にはその方向の物体のみ
Transformerで他の方向 の特徴量と照らし合わ せながら,音の特徴量 を画像の特徴量に変換 24 -
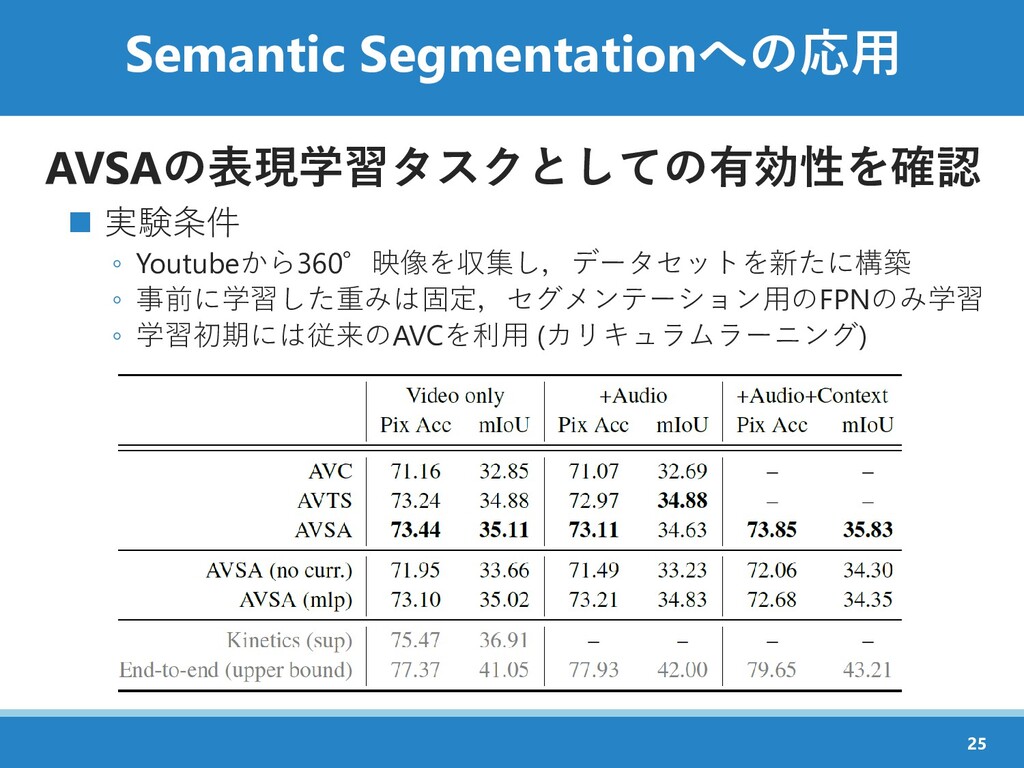
Semantic Segmentationへの応用 AVSAの表現学習タスクとしての有効性を確認 ◼ 実験条件 ◦ Youtubeから360°映像を収集し,データセットを新たに構築 ◦ 事前に学習した重みは固定,セグメンテーション用のFPNのみ学習 ◦
学習初期には従来のAVCを利用 (カリキュラムラーニング) 25 -
See, Hear, Explore: Curiosity via Audio-Visual Association V. Dean, S.
Tulsiani and A. Gupta 26 -
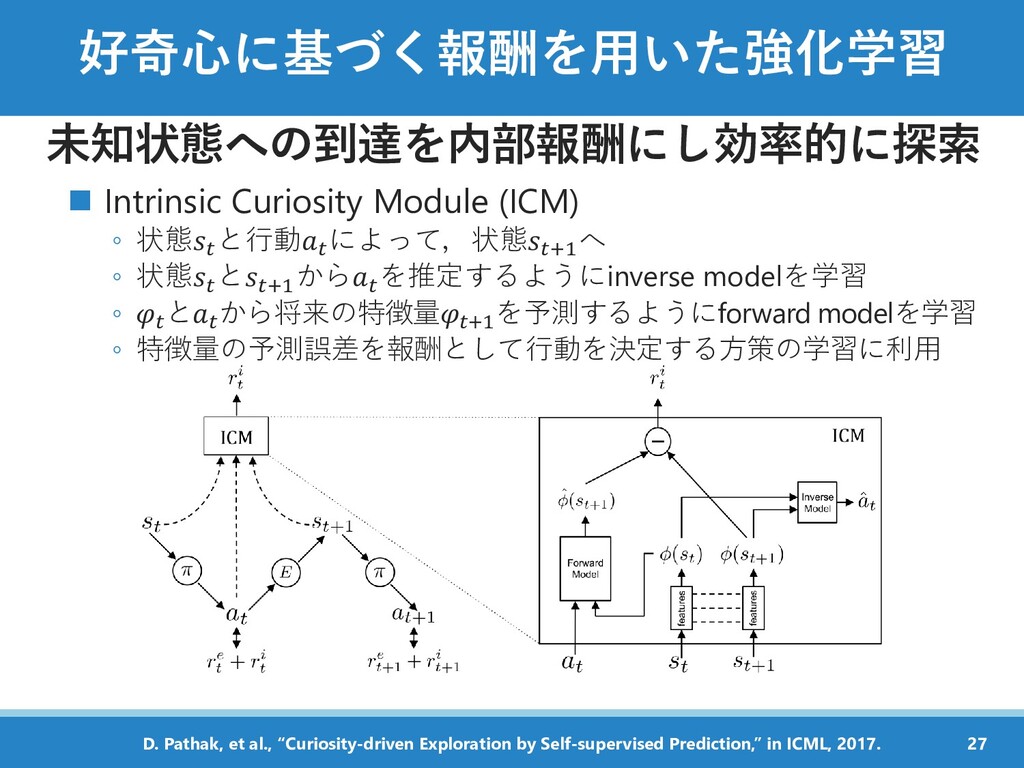
好奇心に基づく報酬を用いた強化学習 未知状態への到達を内部報酬にし効率的に探索 ◼ Intrinsic Curiosity Module (ICM) ◦ 状態 と行動
によって,状態+1 へ ◦ 状態 と+1 から を推定するようにinverse modelを学習 ◦ と から将来の特徴量+1 を予測するようにforward modelを学習 ◦ 特徴量の予測誤差を報酬として行動を決定する方策の学習に利用 27 D. Pathak, et al., “Curiosity-driven Exploration by Self-supervised Prediction,” in ICML, 2017. -
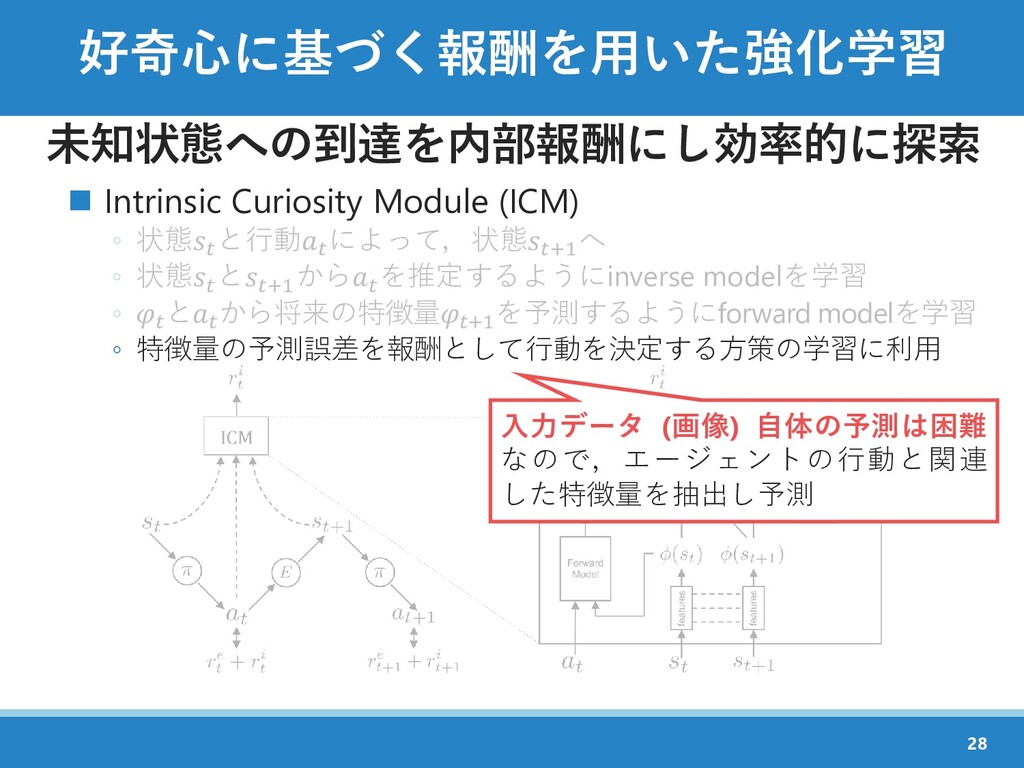
好奇心に基づく報酬を用いた強化学習 未知状態への到達を内部報酬にし効率的に探索 ◼ Intrinsic Curiosity Module (ICM) ◦ 状態 と行動
によって,状態+1 へ ◦ 状態 と+1 から を推定するようにinverse modelを学習 ◦ と から将来の特徴量+1 を予測するようにforward modelを学習 ◦ 特徴量の予測誤差を報酬として行動を決定する方策の学習に利用 入力データ (画像) 自体の予測は困難 なので,エージェントの行動と関連 した特徴量を抽出し予測 28 -
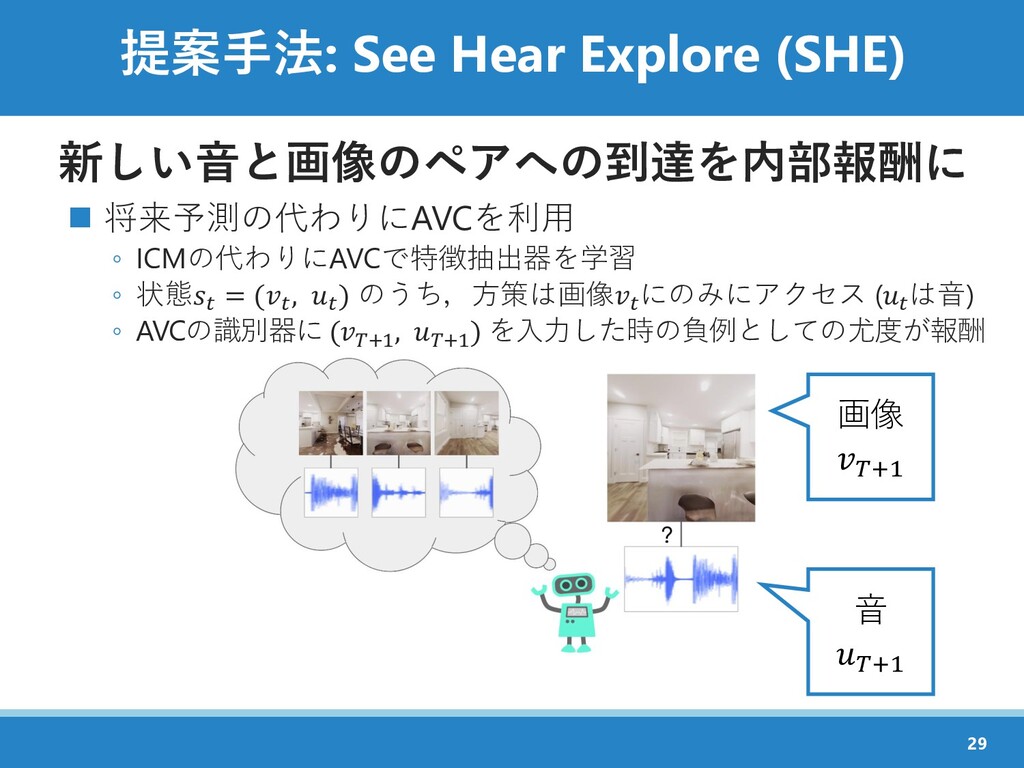
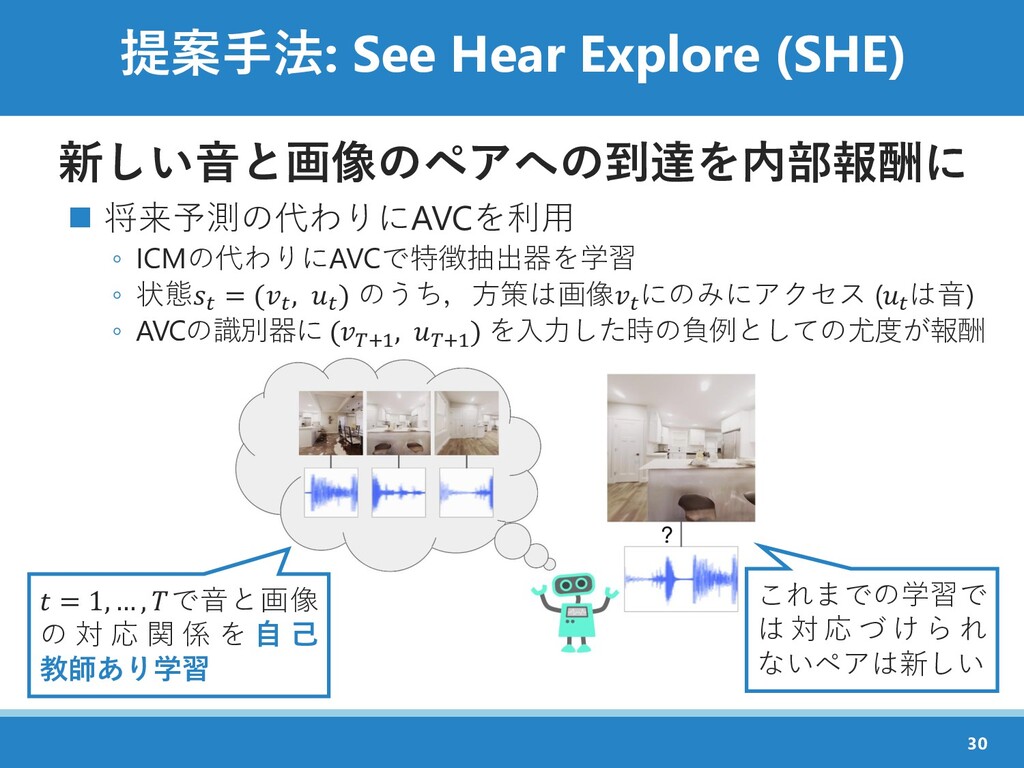
提案手法: See Hear Explore (SHE) 新しい音と画像のペアへの到達を内部報酬に ◼ 将来予測の代わりにAVCを利用 ◦ ICMの代わりにAVCで特徴抽出器を学習
◦ 状態 = ( , ) のうち,方策は画像 にのみにアクセス ( は音) ◦ AVCの識別器に (+1 , +1 ) を入力した時の負例としての尤度が報酬 29 画像 +1 音 +1 -
提案手法: See Hear Explore (SHE) 新しい音と画像のペアへの到達を内部報酬に ◼ 将来予測の代わりにAVCを利用 ◦ ICMの代わりにAVCで特徴抽出器を学習
◦ 状態 = ( , ) のうち,方策は画像 にのみにアクセス ( は音) ◦ AVCの識別器に (+1 , +1 ) を入力した時の負例としての尤度が報酬 = 1, … , で音と画像 の 対 応 関 係 を 自 己 教師あり学習 これまでの学習で は 対 応 づ け ら れ ないペアは新しい 30 -
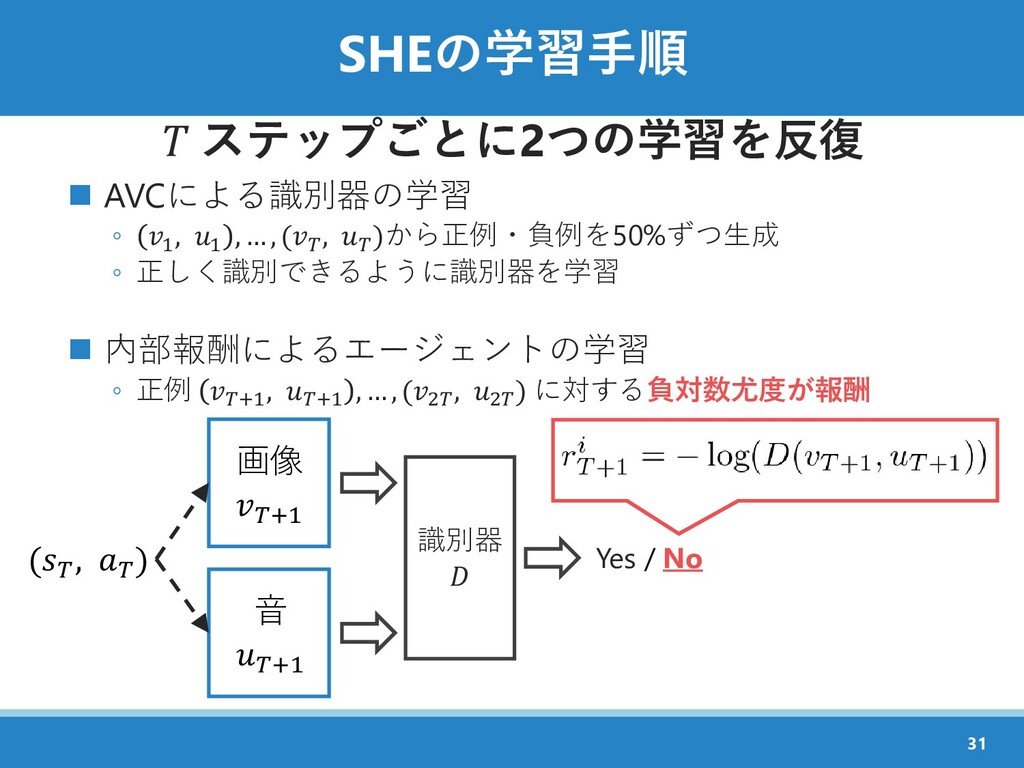
SHEの学習手順 ステップごとに2つの学習を反復 ◼ AVCによる識別器の学習 ◦ 1 , 1 , …,
( , )から正例・負例を50%ずつ生成 ◦ 正しく識別できるように識別器を学習 ◼ 内部報酬によるエージェントの学習 ◦ 正例 +1 , +1 , …, (2 , 2 ) に対する負対数尤度が報酬 画像 +1 音 +1 識別器 Yes / No ( , ) 31 -
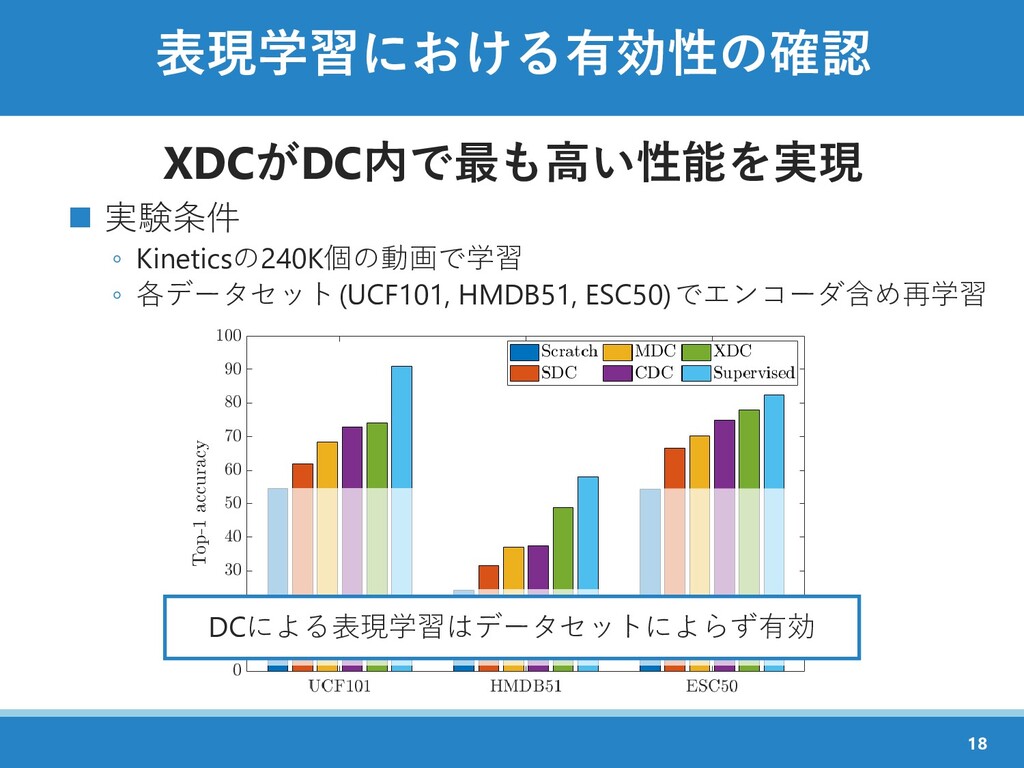
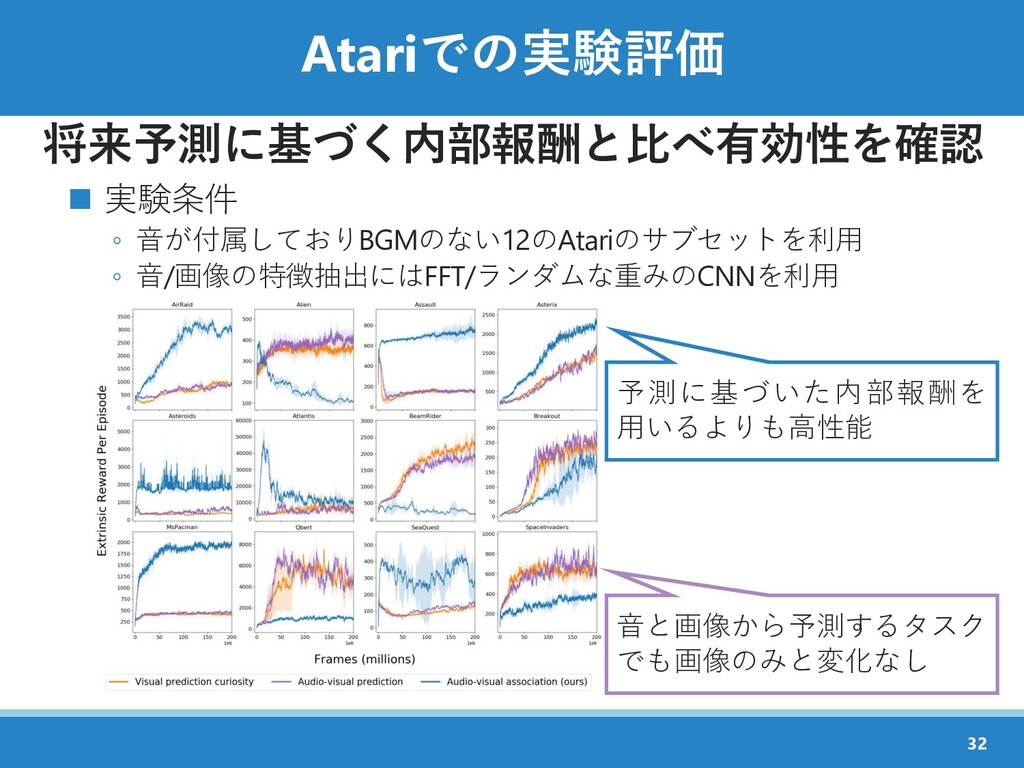
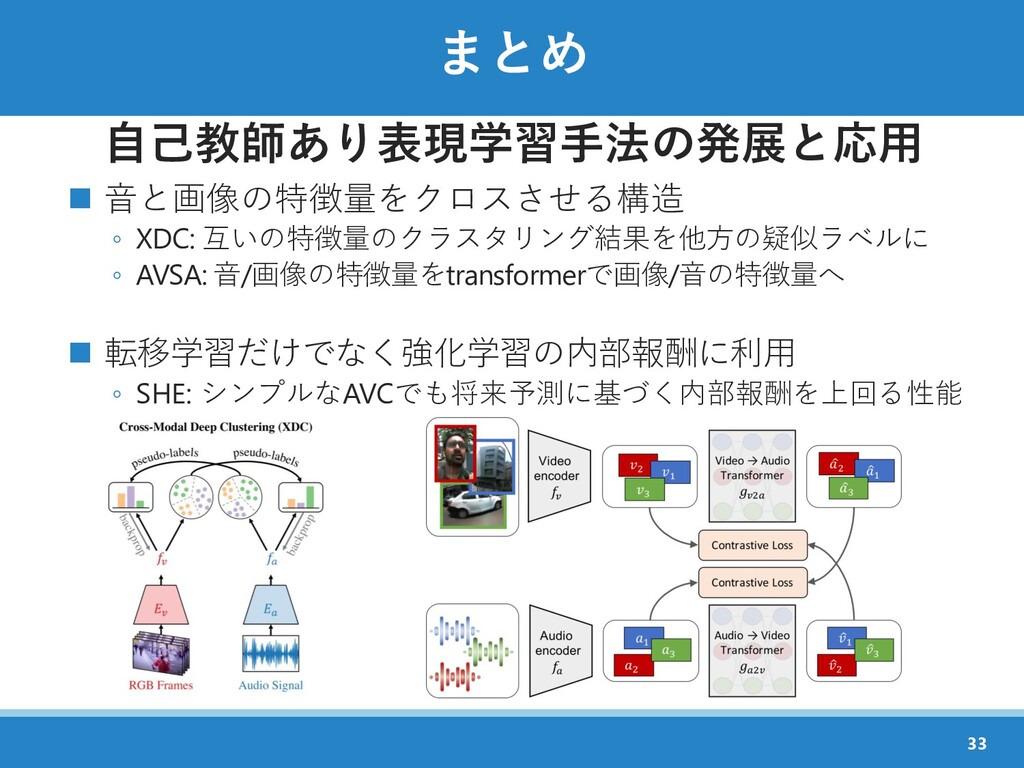
まとめ 自己教師あり表現学習手法の発展と応用 ◼ 音と画像の特徴量をクロスさせる構造 ◦ XDC: 互いの特徴量のクラスタリング結果を他方の疑似ラベルに ◦ AVSA: 音/画像の特徴量をtransformerで画像/音の特徴量へ
◼ 転移学習だけでなく強化学習の内部報酬に利用 ◦ SHE: シンプルなAVCでも将来予測に基づく内部報酬を上回る性能 33