Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
続・機械学習事始め(社内LT)
Search
Yuki Uchiyama
December 25, 2017
74
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
続・機械学習事始め(社内LT)
Yuki Uchiyama
December 25, 2017
Featured
See All Featured
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
HDC tutorial
michielstock
2
960
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Java REST API Framework Comparison - PWX 2021
mraible
34
9.8k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
A Soul's Torment
seathinner
8
3.8k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
800
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.2k
Transcript
続・機械学習事始め 2017/12/22 内山佑樹
Contents 1.今回つくるもの(教師あり学習によるデータ分析) 2.Pythonについてざっくり(DEMO) 3.データ分析の流れ 4.データ分析の実際(DEMO) 5.まとめ
1.今回つくるもの 「教師あり学習」によるデータ分析 ・ある地域の統計情報(年収、人口や平均住宅価格)に基づき、 その地域での「物件の適正価格」を算定するプログラムをつくる。
2.Pythonについてざっくり ・Python3 ・NumPy 数値計算をよしなにやってくれるライブラリ ・Jupyter Notebook 実行結果を記録しながら分析作業を行うためのツール Anacondaを使用してPythonをインストールすると、同時に入ってる。 →DEMO
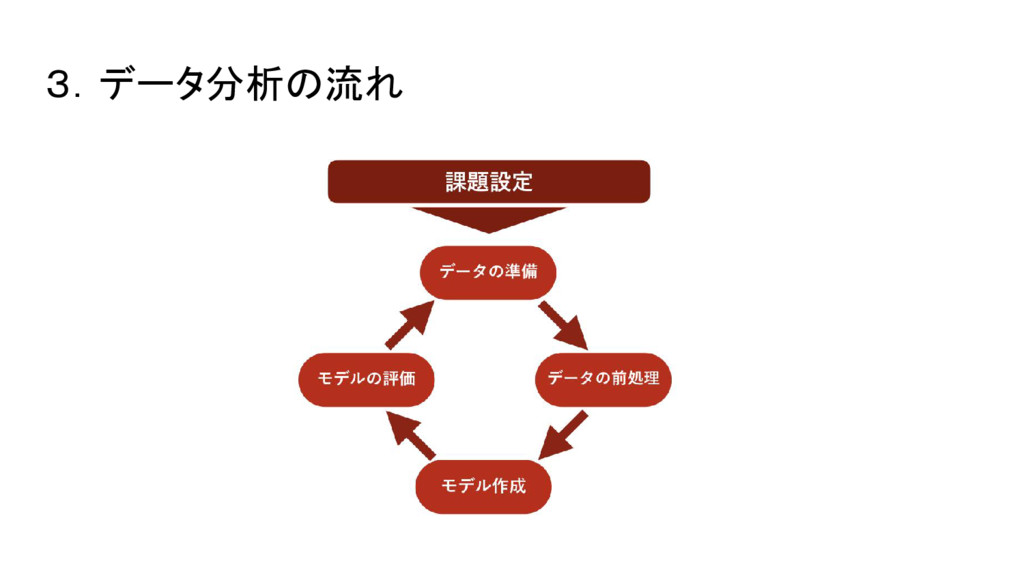
3.データ分析の流れ
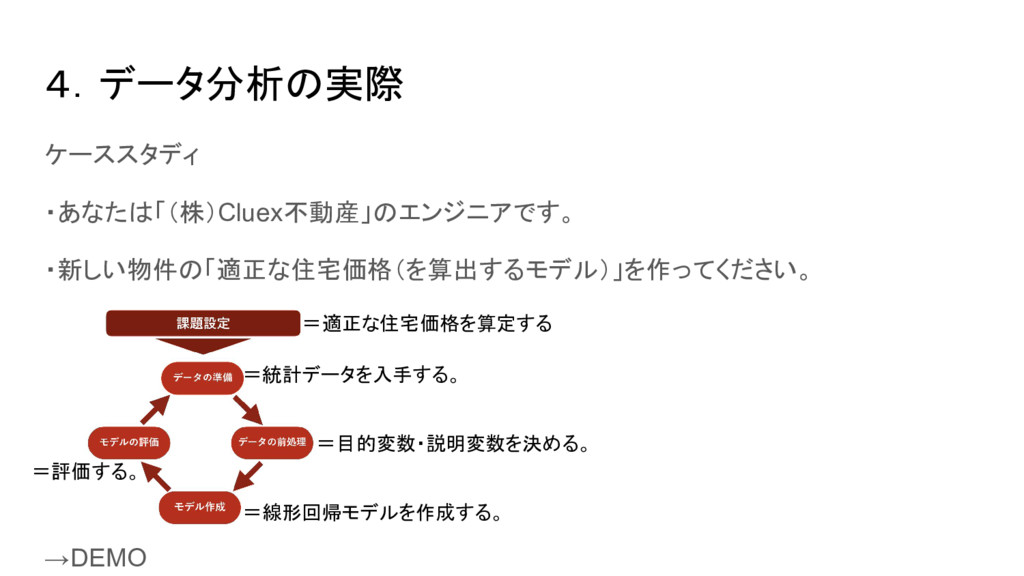
4.データ分析の実際 ケーススタディ ・あなたは「(株)Cluex不動産」のエンジニアです。 ・新しい物件の「適正な住宅価格(を算出するモデル)」を作ってください。 →DEMO =適正な住宅価格を算定する =統計データを入手する。 =目的変数・説明変数を決める。 =線形回帰モデルを作成する。 =評価する。
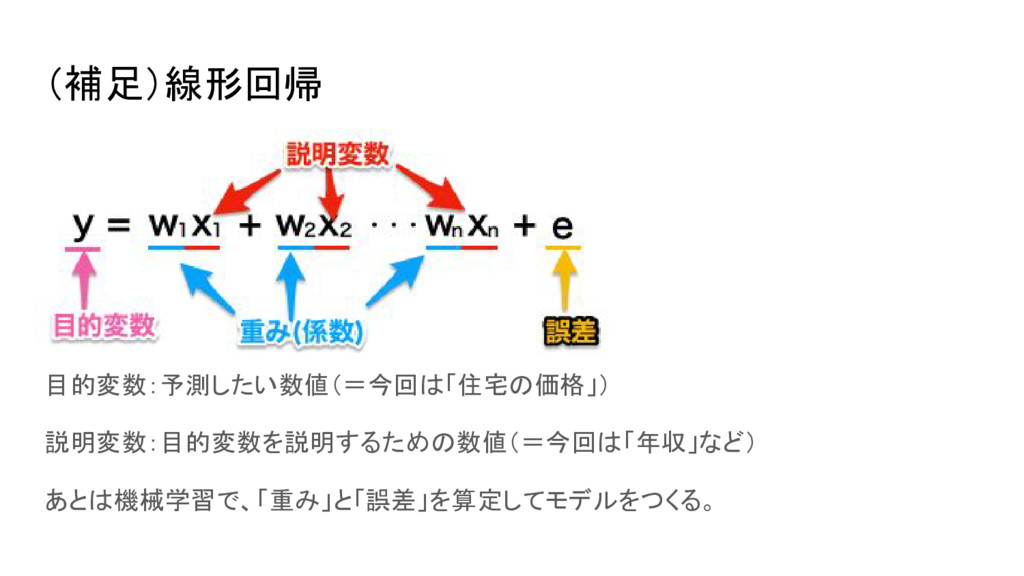
(補足)線形回帰 目的変数:予測したい数値(=今回は「住宅の価格」) 説明変数:目的変数を説明するための数値(=今回は「年収」など) あとは機械学習で、「重み」と「誤差」を算定してモデルをつくる。
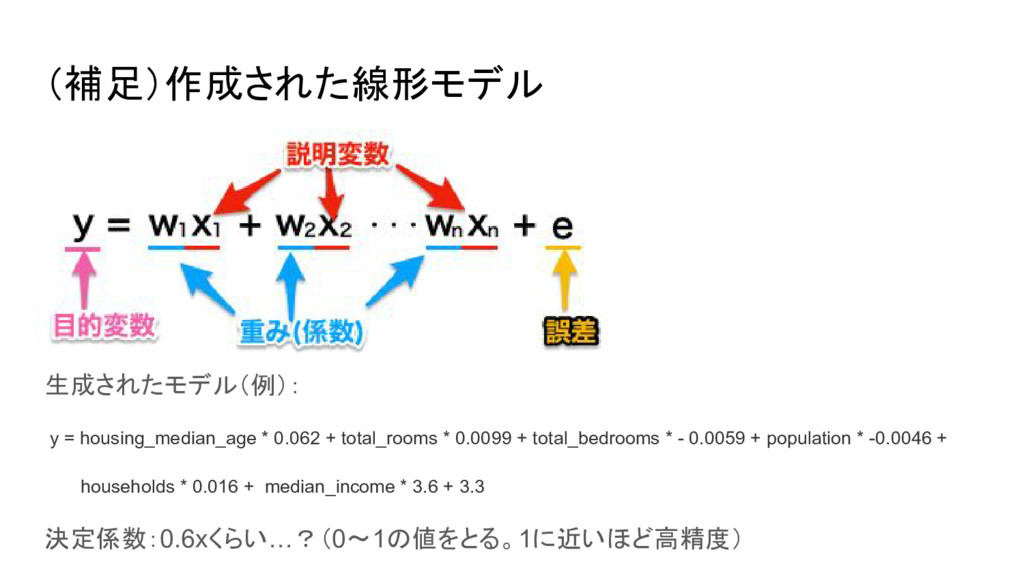
(補足)作成された線形モデル 生成されたモデル(例): y = housing_median_age * 0.062 + total_rooms *
0.0099 + total_bedrooms * - 0.0059 + population * -0.0046 + households * 0.016 + median_income * 3.6 + 3.3 決定係数:0.6xくらい…?(0〜1の値をとる。1に近いほど高精度)
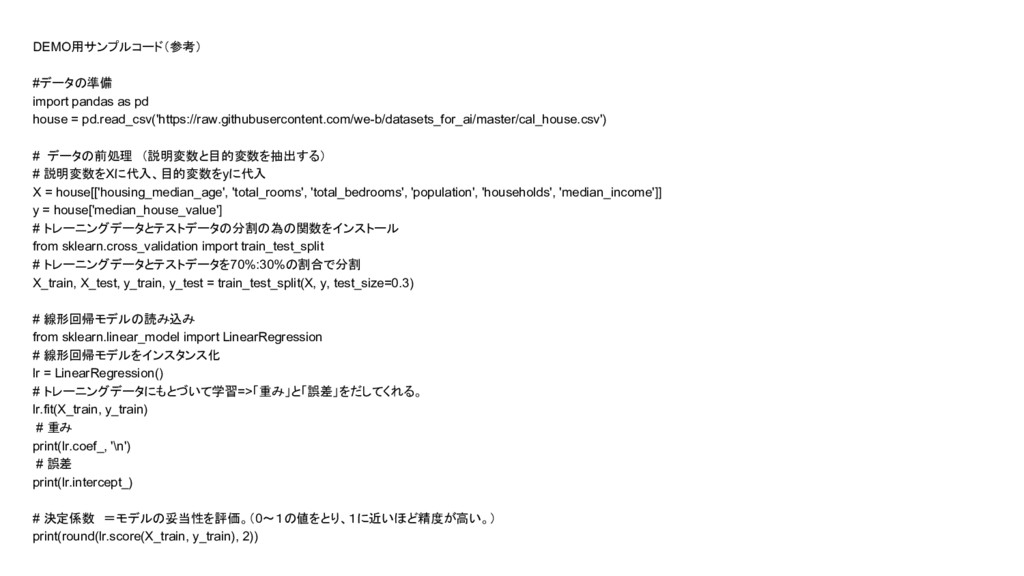
DEMO用サンプルコード(参考) #データの準備 import pandas as pd house = pd.read_csv('https://raw.githubusercontent.com/we-b/datasets_for_ai/master/cal_house.csv') #
データの前処理 (説明変数と目的変数を抽出する) # 説明変数をXに代入、目的変数をyに代入 X = house[['housing_median_age', 'total_rooms', 'total_bedrooms', 'population', 'households', 'median_income']] y = house['median_house_value'] # トレーニングデータとテストデータの分割の為の関数をインストール from sklearn.cross_validation import train_test_split # トレーニングデータとテストデータを70%:30%の割合で分割 X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3) # 線形回帰モデルの読み込み from sklearn.linear_model import LinearRegression # 線形回帰モデルをインスタンス化 lr = LinearRegression() # トレーニングデータにもとづいて学習=>「重み」と「誤差」をだしてくれる。 lr.fit(X_train, y_train) # 重み print(lr.coef_, '\n') # 誤差 print(lr.intercept_) # 決定係数 =モデルの妥当性を評価。(0〜1の値をとり、1に近いほど精度が高い。) print(round(lr.score(X_train, y_train), 2))
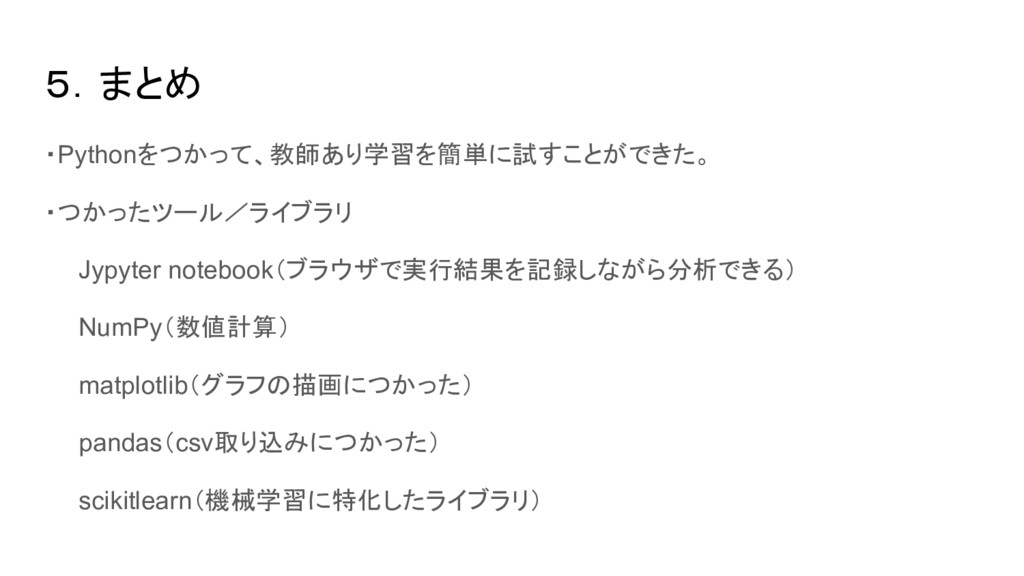
5.まとめ ・Pythonをつかって、教師あり学習を簡単に試すことができた。 ・つかったツール/ライブラリ Jypyter notebook(ブラウザで実行結果を記録しながら分析できる) NumPy(数値計算) matplotlib(グラフの描画につかった) pandas(csv取り込みにつかった) scikitlearn(機械学習に特化したライブラリ)
ご清聴ありがとうございました!!


 addyosmani
 akihiro_kokubo
 sergeychernyshev
 michielstock
 eileencodes
 mraible
 scottboms
 seathinner
 honzajavorek
 aleyda
 soysaucechin