Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
20250515_SeedEverythingな人を救いたい
Search
yuyagi
May 19, 2025
Technology
65
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
20250515_SeedEverythingな人を救いたい
内部の勉強会で使った、Pytorchのseedに関する備忘スライドです
RNGに関してミスしやすいポイントをまとめています
yuyagi
May 19, 2025
Other Decks in Technology
See All in Technology
Reactの設計論
uhyo
14
7.7k
AI時代に顧客へ最速で価値を 届けるための試行錯誤 〜「AI × マネジメント」領域におけるmentoのケース〜
posterkeisuke
0
110
例外の正しい扱い方 そのエラー try-catchして大丈夫?
jinwatanabe
3
450
SQL文一行も書けない人事がCortexもろもろを使って人事業務を楽にしてみる
ponponmikankan
1
210
AI 駆動 Terraform 開発/SRE_BizReach_MIXI_2
visional_engineering_and_design
3
2k
2026-09-09 【sigma_ucj#1】Sigma を IaC 管理したい! / IaC for Sigma
civitaspo
0
110
Claude in Chrome 入門 / Introduction to Claude in Chrome
cielo1985
0
140
アリアドネの糸と、20年ごとの建て替え ── 長尾真『電子図書館』を、伊勢で読み直す / Rereading Makoto Nagao’s "Electronic Library" in Ise
ykiyota
0
150
AIで実装は速くなった。なのにプロダクトは速くならない。職能の壁を越えて価値のフローを設計する
nwiizo
8
7.8k
AIネイティブプロダクトで顧客価値を最大化するプロダクトエンジニアとFDEの協働
righttouch
PRO
0
220
Snowflakeで実現する全社横断の顧客の声(VOC)分析・活用基盤@Snowflake World Tour Tokyo 2026
yuto16
0
160
WAF 運用改善の承認サイクル/SRE_BizReach_MIXI_1
visional_engineering_and_design
2
420
Featured
See All Featured
Mind Mapping
helmedeiros
1
350
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
590
Unsuck your backbone
ammeep
672
58k
End of SEO as We Know It (SMX Advanced Version)
ipullrank
3
4.4k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1k
Discover your Explorer Soul
emna__ayadi
2
1.3k
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
530
4 Signs Your Business is Dying
shpigford
187
23k
Intergalactic Javascript Robots from Outer Space
tanoku
273
27k
The Cult of Friendly URLs
andyhume
79
7k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
The SEO Collaboration Effect
kristinabergwall1
1
550
Transcript
Seed Everythingな人を救いたい Yuyagi
自己紹介 ◆ データサイエンティスト 新規事業/データ活用系プロジェクトを担当 YuYagi ◆ Kagle Master - 信号処理系のコンペ参加が多め(画像、音響、センサ等)
(気分転換に未知のジャンルもやってみたい)
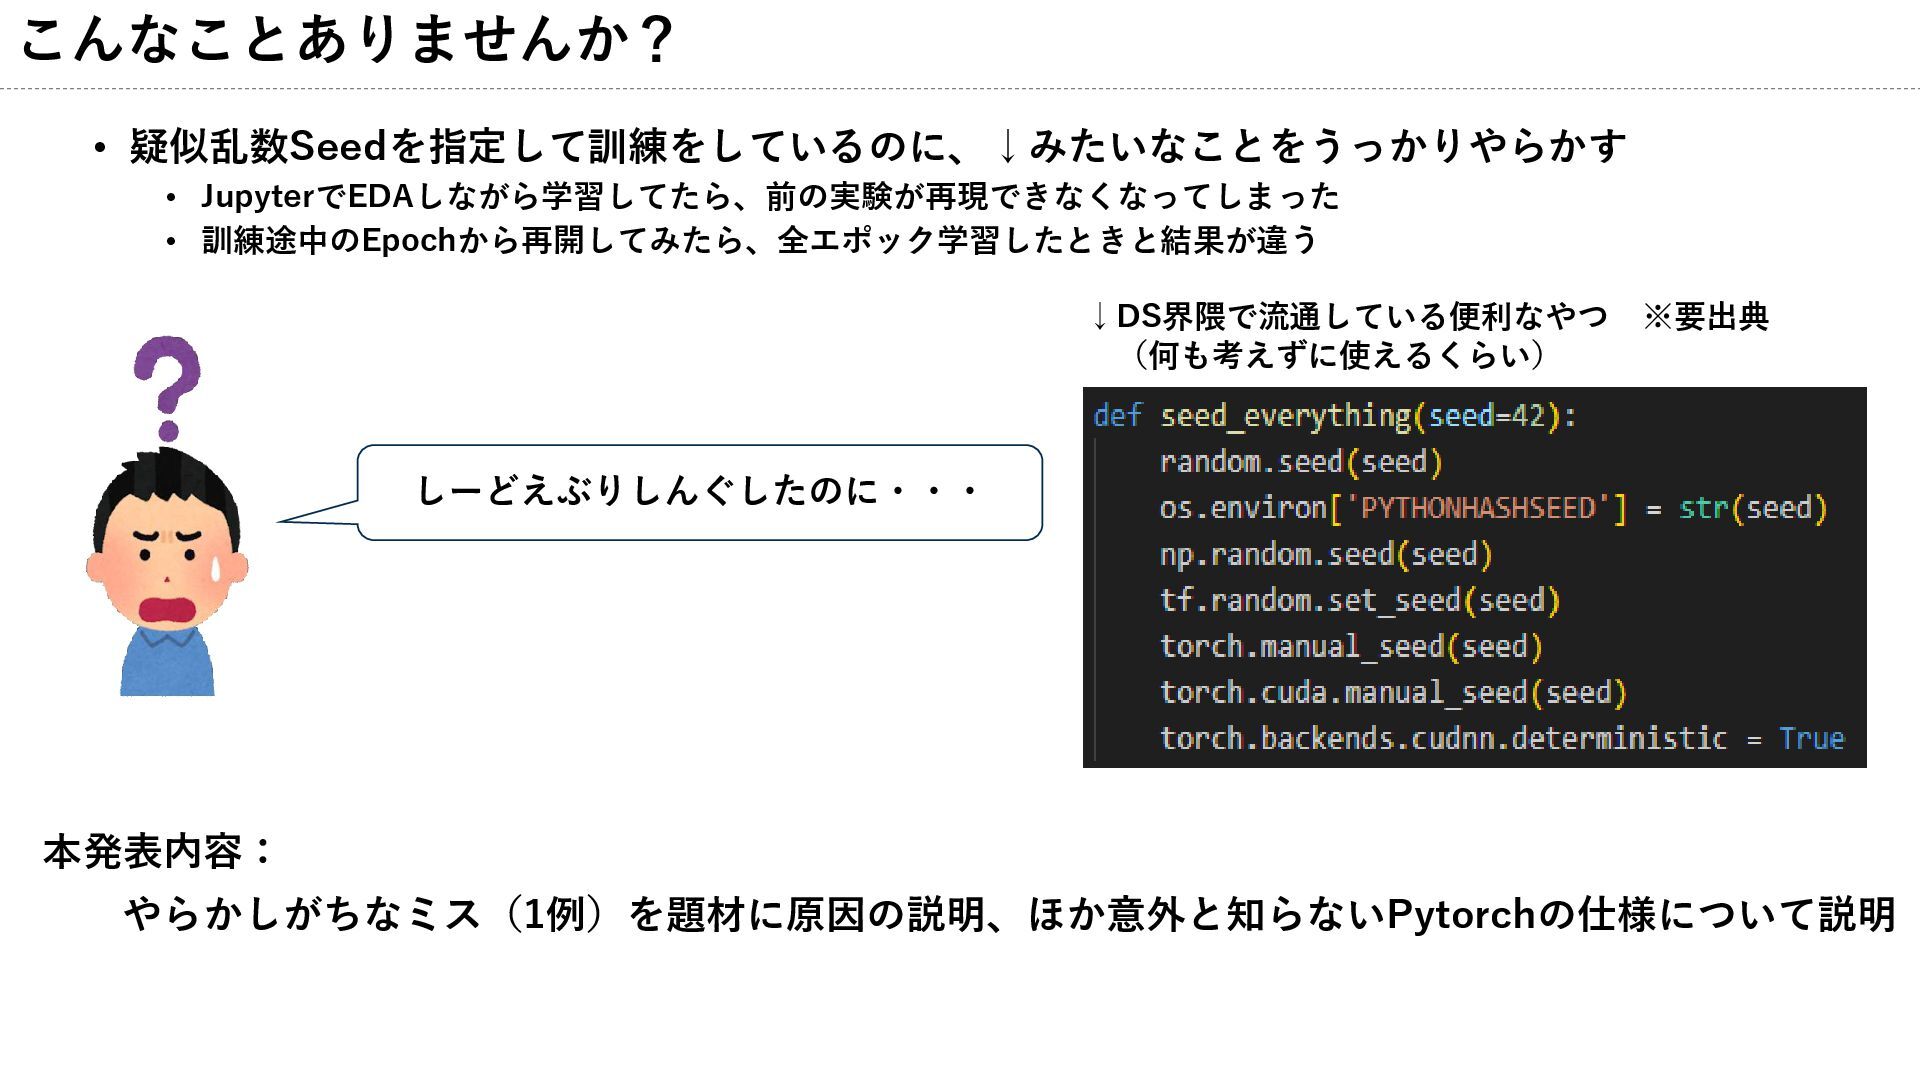
こんなことありませんか? • 疑似乱数Seedを指定して訓練をしているのに、↓みたいなことをうっかりやらかす • JupyterでEDAしながら学習してたら、前の実験が再現できなくなってしまった • 訓練途中のEpochから再開してみたら、全エポック学習したときと結果が違う しーどえぶりしんぐしたのに・・・ ↓DS界隈で流通している便利なやつ ※要出典
(何も考えずに使えるくらい) 本発表内容: やらかしがちなミス(1例)を題材に原因の説明、ほか意外と知らないPytorchの仕様について説明
目次 • 疑似乱数とは? • よくあるミスとその原因 → Epochの途中から再開すると結果が変わってしまう、という例を題材に原因を説明 ・さらなる注意ポイント → DataLoaderのWorker数を増やすと、Workerごとに別のシードが設定される?!
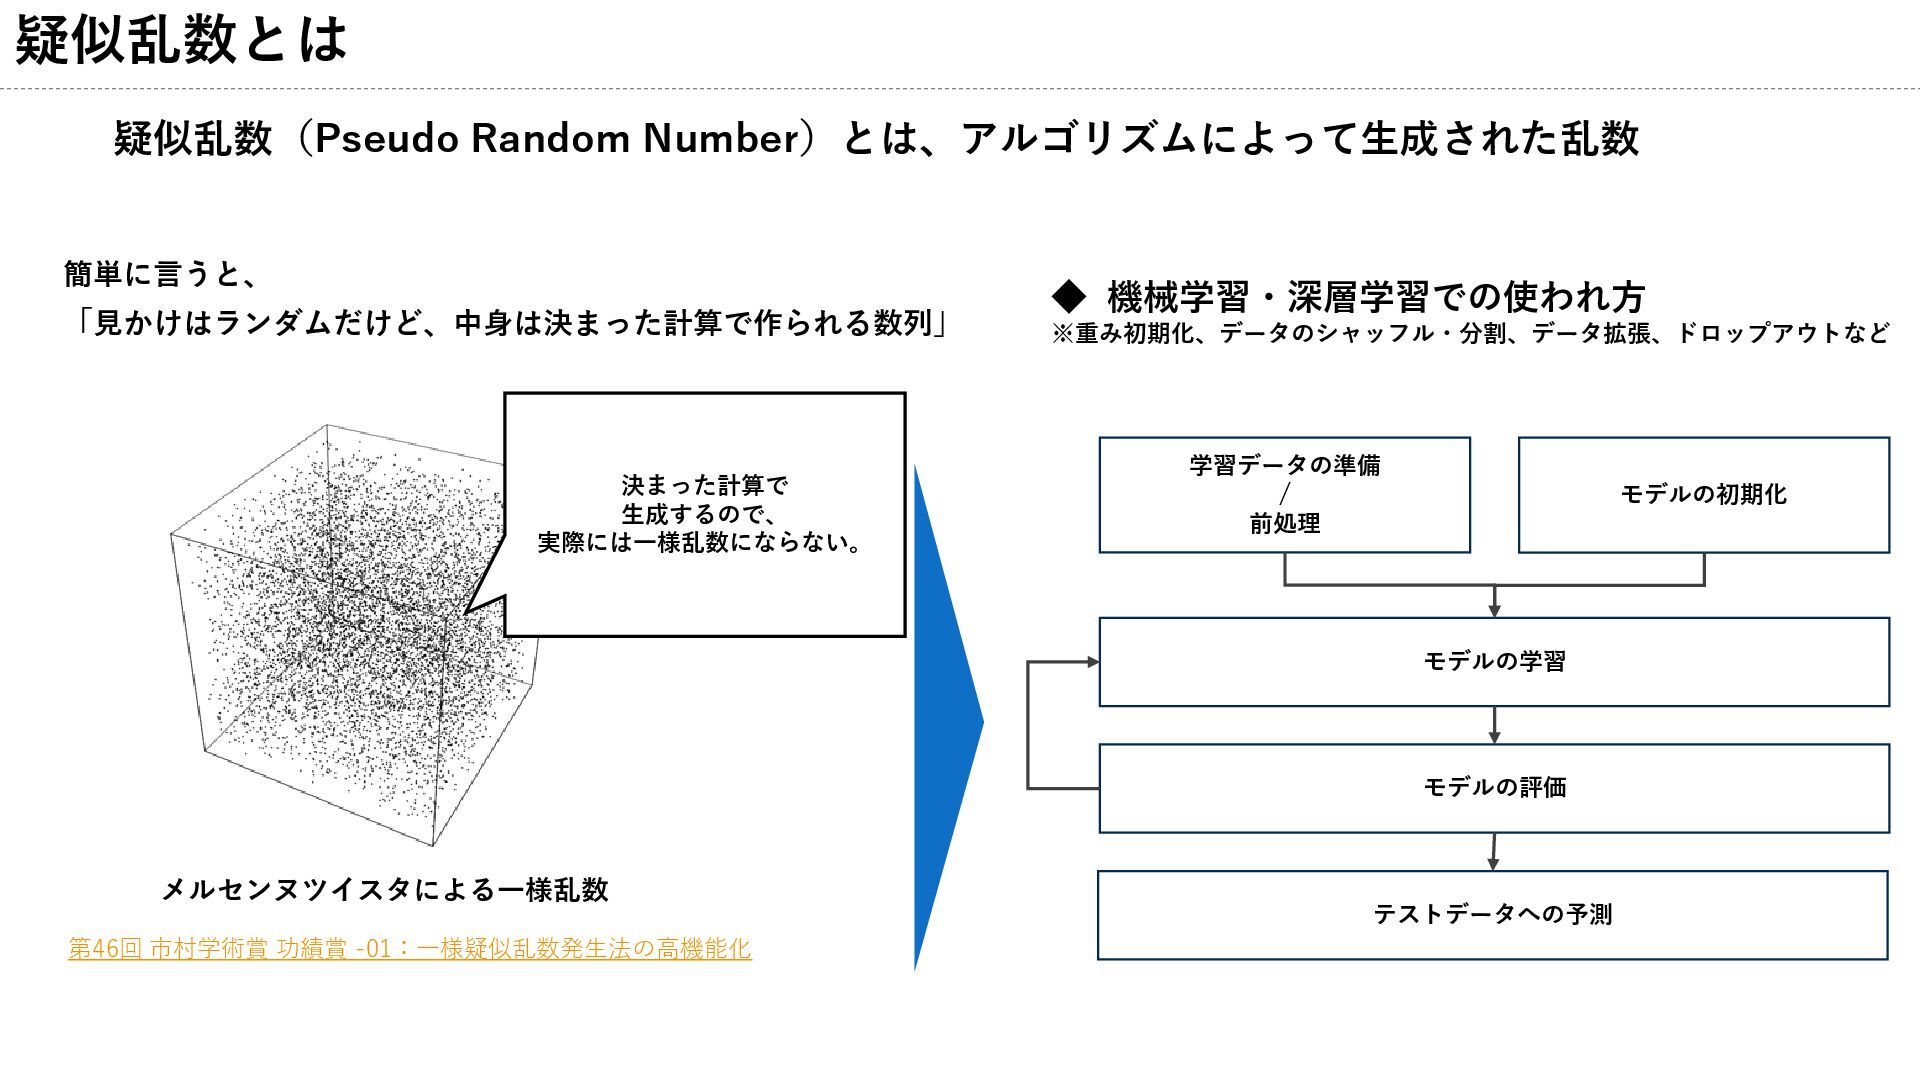
疑似乱数とは 簡単に言うと、 「見かけはランダムだけど、中身は決まった計算で作られる数列」 疑似乱数(Pseudo Random Number)とは、アルゴリズムによって生成された乱数 モデルの初期化 学習データの準備 / 前処理
モデルの学習 モデルの評価 テストデータへの予測 ◆ 機械学習・深層学習での使われ方 ※重み初期化、データのシャッフル・分割、データ拡張、ドロップアウトなど 第46回 市村学術賞 功績賞 -01:一様疑似乱数発生法の高機能化 決まった計算で 生成するので、 実際には一様乱数にならない。 メルセンヌツイスタによる一様乱数
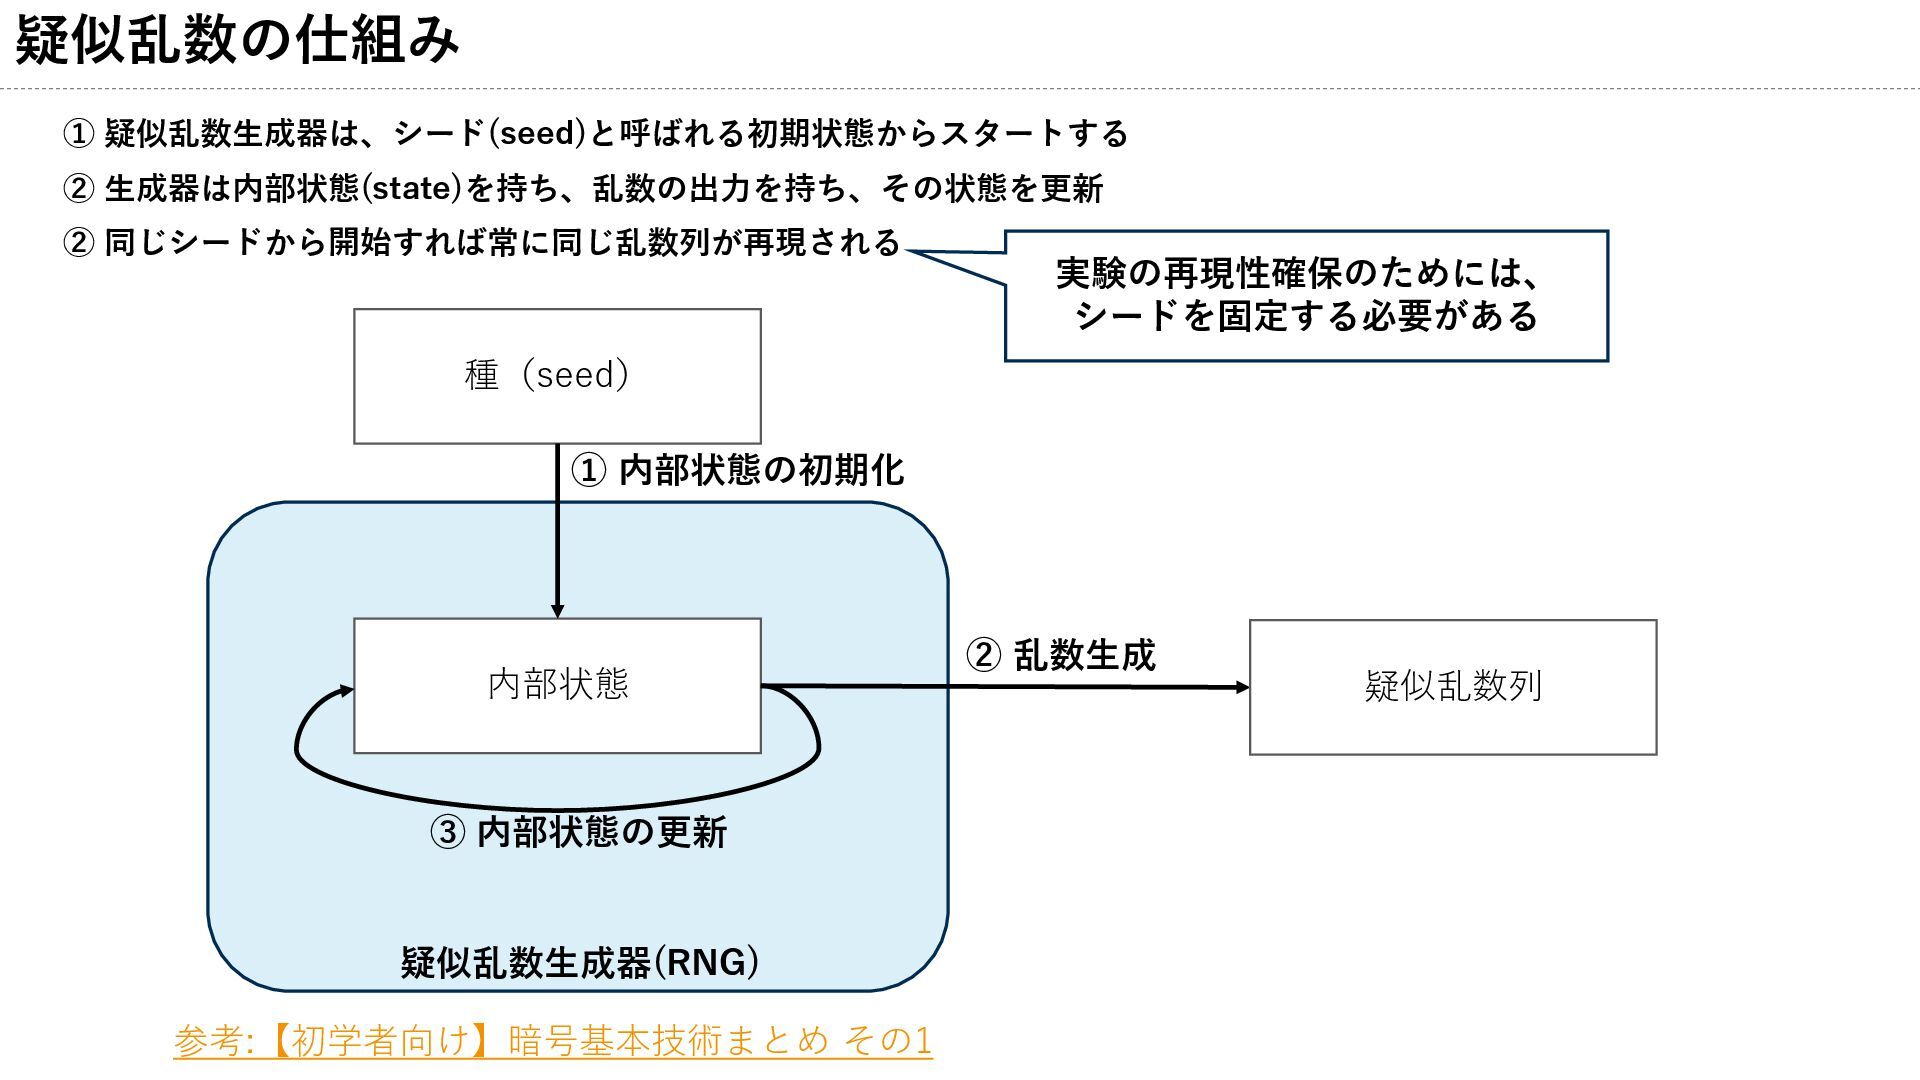
疑似乱数の仕組み ① 疑似乱数生成器は、シード(seed)と呼ばれる初期状態からスタートする ② 生成器は内部状態(state)を持ち、乱数の出力を持ち、その状態を更新 ② 同じシードから開始すれば常に同じ乱数列が再現される 種(seed) 内部状態 疑似乱数列
疑似乱数生成器(RNG) ① 内部状態の初期化 ② 乱数生成 ③ 内部状態の更新 参考:【初学者向け】暗号基本技術まとめ その1 実験の再現性確保のためには、 シードを固定する必要がある
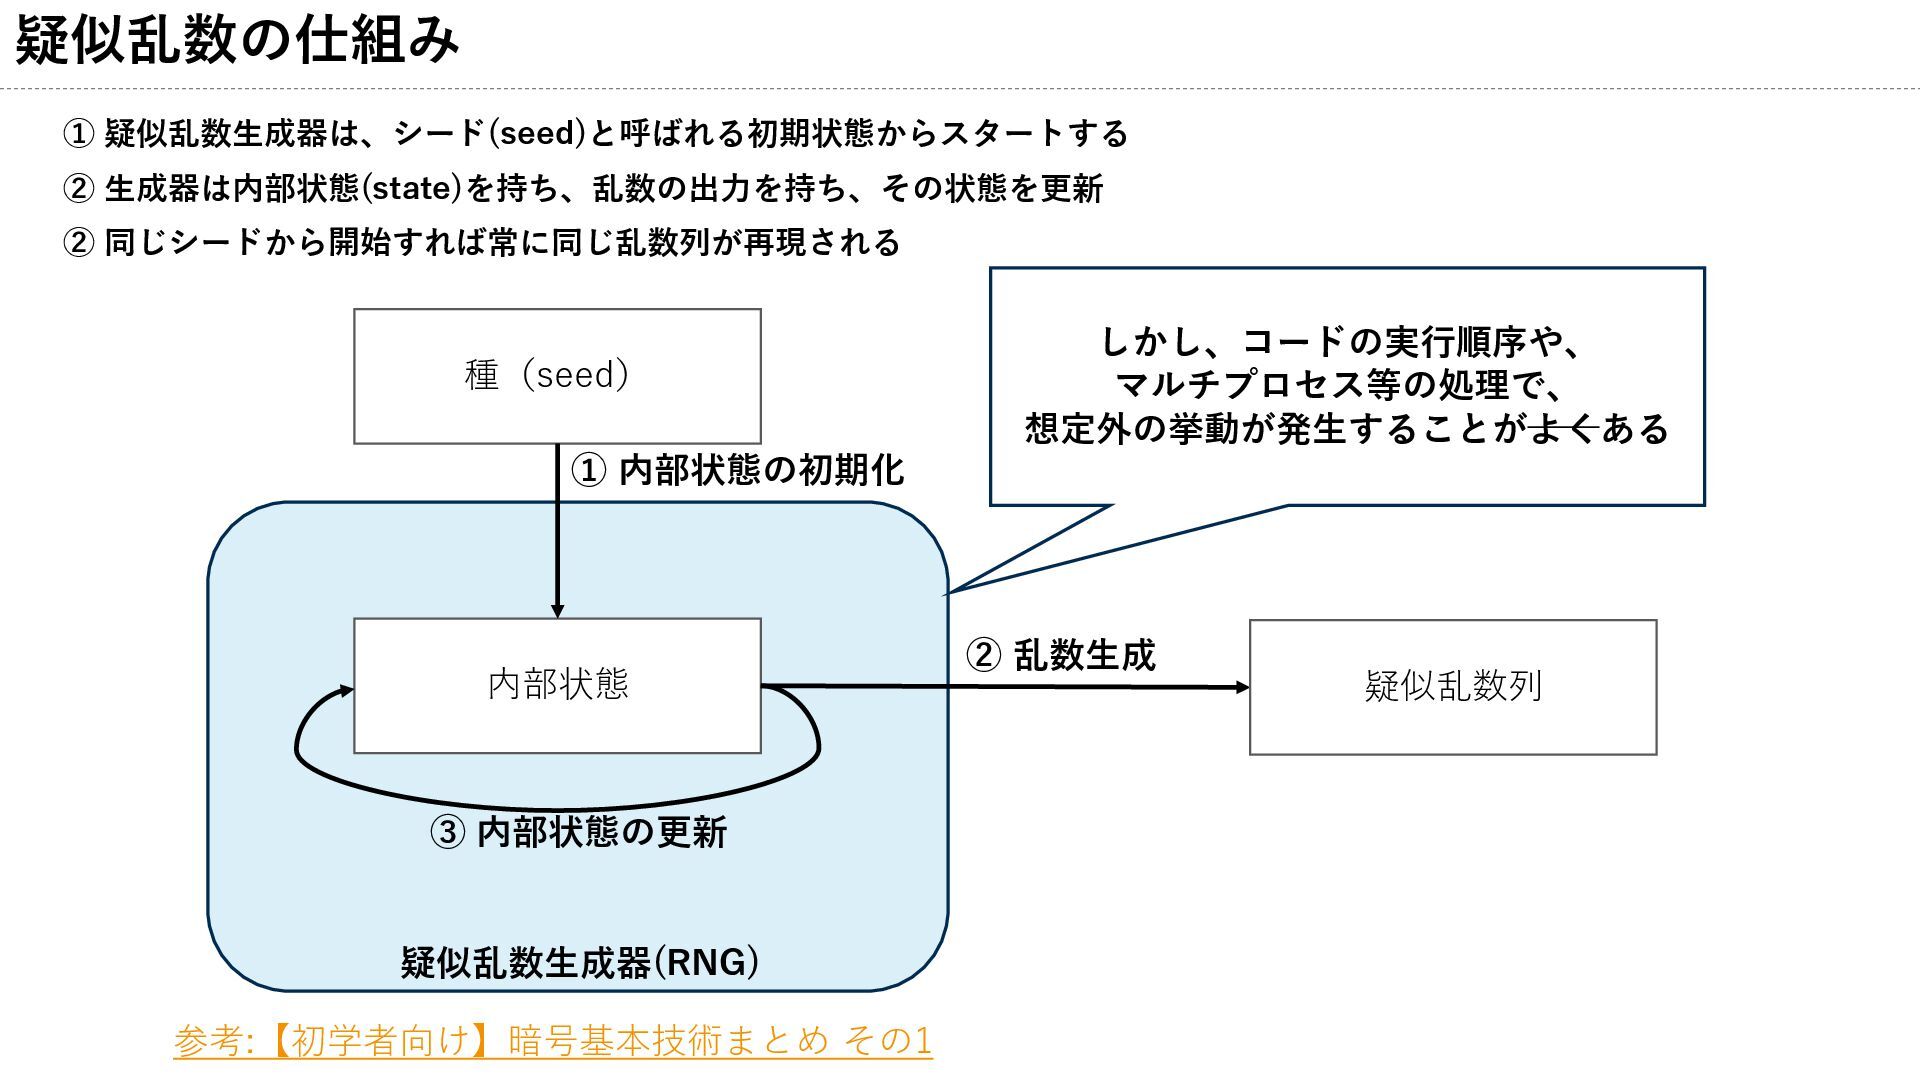
疑似乱数の仕組み 種(seed) 内部状態 疑似乱数列 疑似乱数生成器(RNG) ① 内部状態の初期化 ② 乱数生成 しかし、コードの実行順序や、
マルチプロセス等の処理で、 想定外の挙動が発生することがよくある ③ 内部状態の更新 ① 疑似乱数生成器は、シード(seed)と呼ばれる初期状態からスタートする ② 生成器は内部状態(state)を持ち、乱数の出力を持ち、その状態を更新 ② 同じシードから開始すれば常に同じ乱数列が再現される 参考:【初学者向け】暗号基本技術まとめ その1
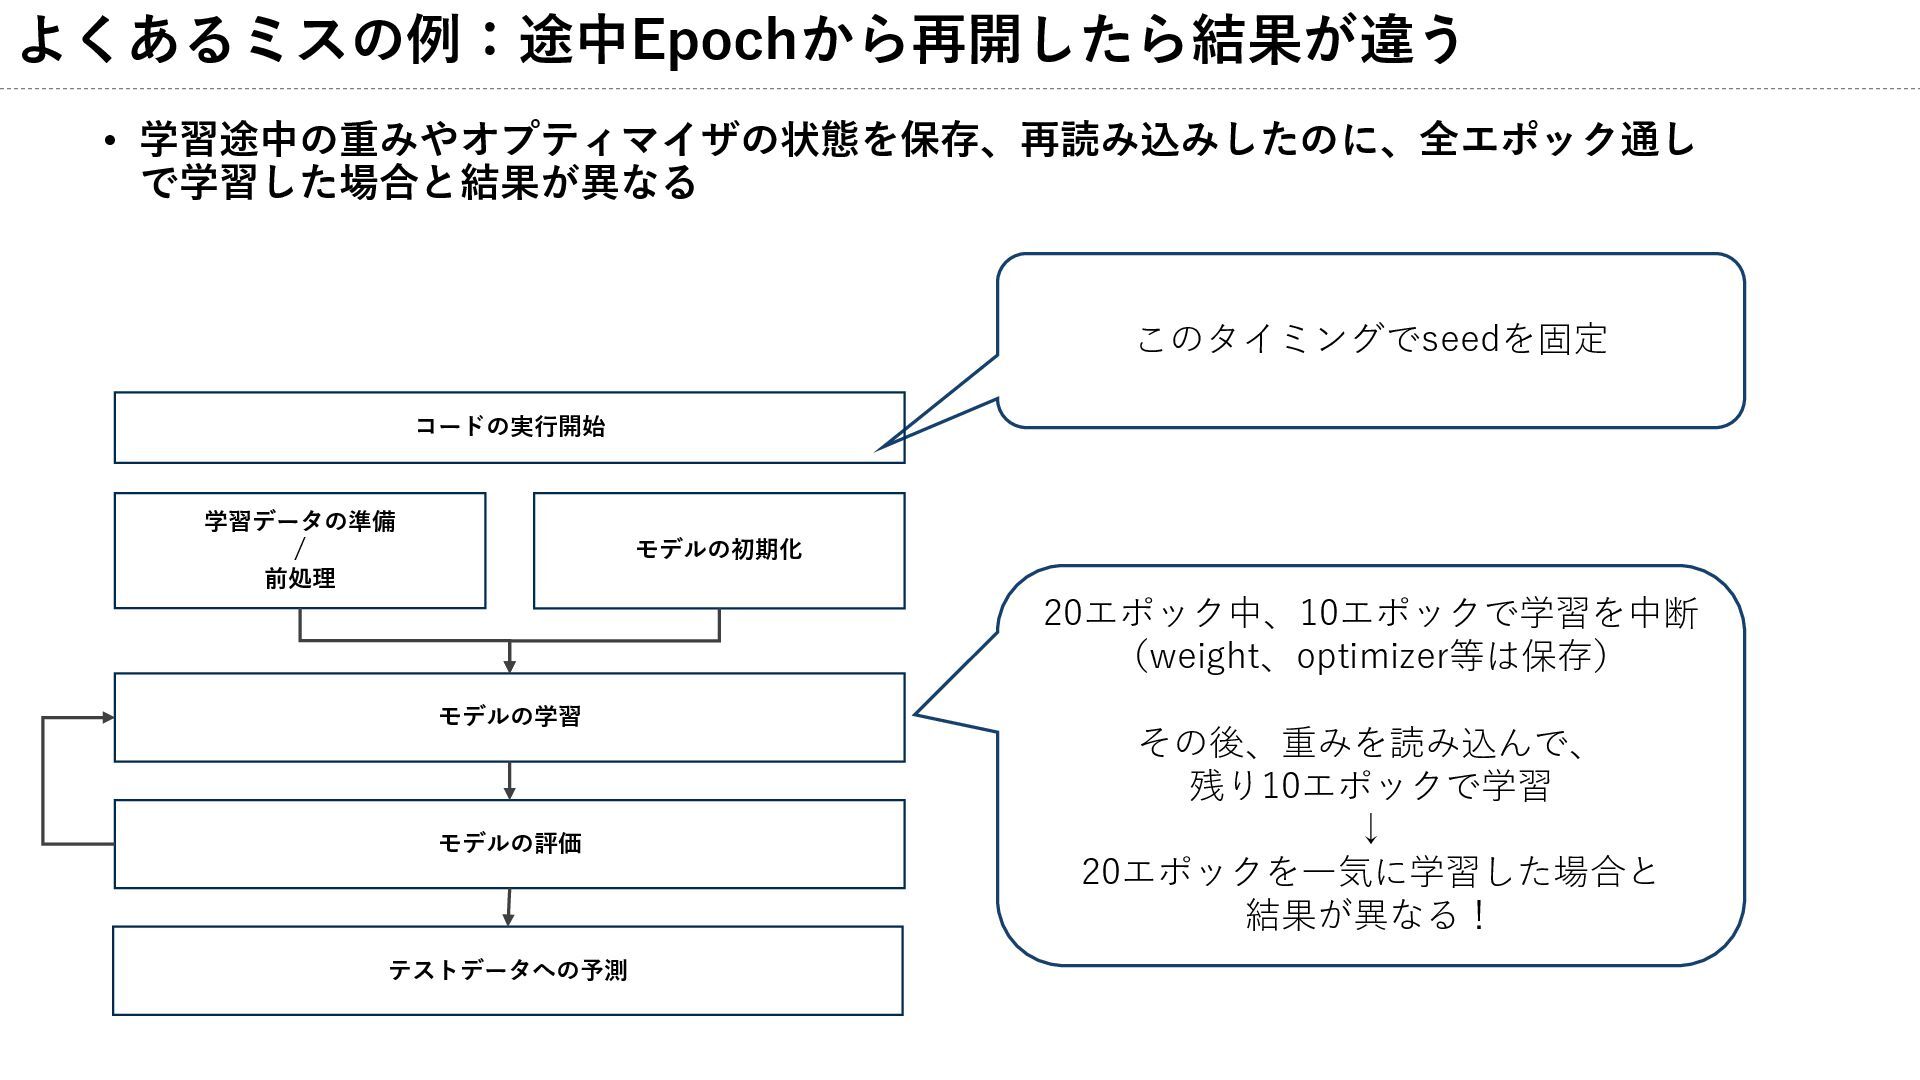
よくあるミスの例:途中Epochから再開したら結果が違う • 学習途中の重みやオプティマイザの状態を保存、再読み込みしたのに、全エポック通し で学習した場合と結果が異なる モデルの初期化 学習データの準備 / 前処理 モデルの学習 モデルの評価
テストデータへの予測 このタイミングでseedを固定 コードの実行開始 20エポック中、10エポックで学習を中断 (weight、optimizer等は保存) その後、重みを読み込んで、 残り10エポックで学習 ↓ 20エポックを一気に学習した場合と 結果が異なる!
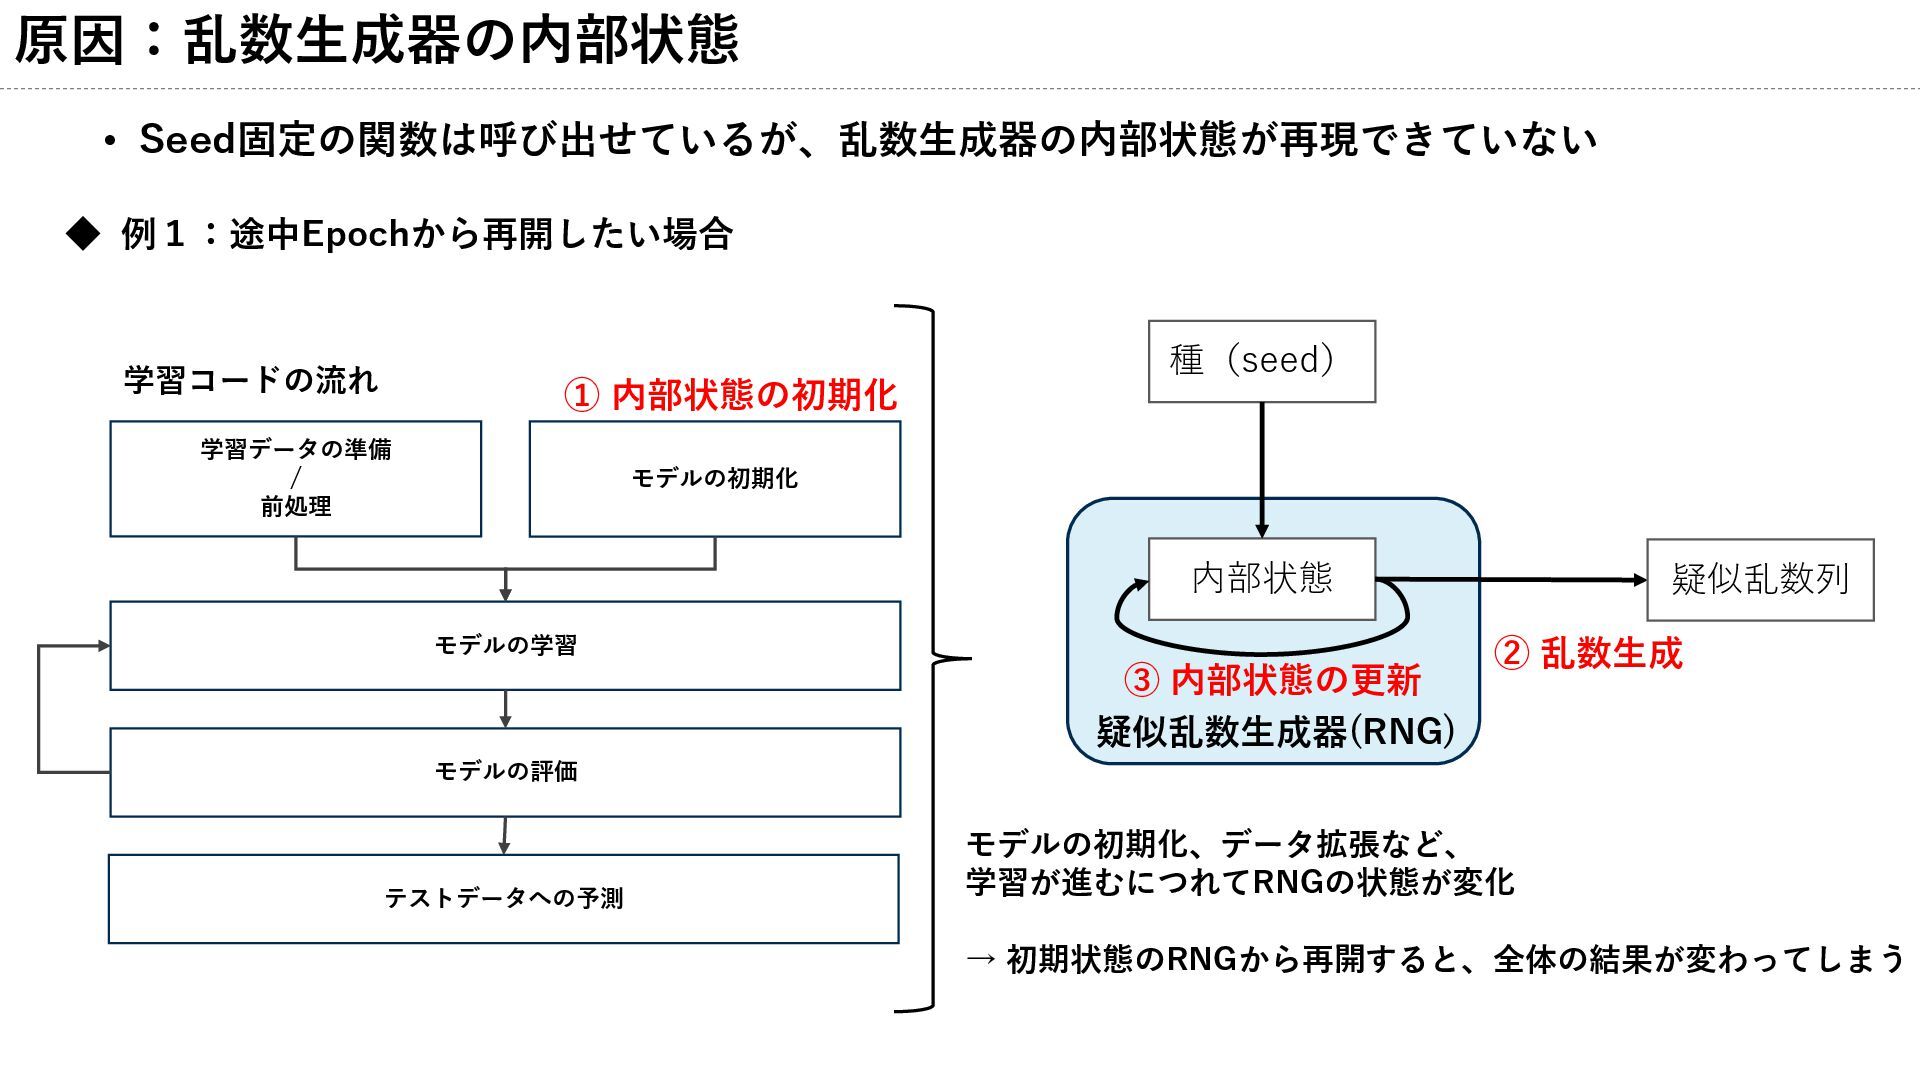
原因:乱数生成器の内部状態 • Seed固定の関数は呼び出せているが、乱数生成器の内部状態が再現できていない モデルの初期化 学習データの準備 / 前処理 モデルの学習 モデルの評価 テストデータへの予測
◆ 例1:途中Epochから再開したい場合 種(seed) 内部状態 疑似乱数列 疑似乱数生成器(RNG) ② 乱数生成 ③ 内部状態の更新 学習コードの流れ ① 内部状態の初期化 モデルの初期化、データ拡張など、 学習が進むにつれてRNGの状態が変化 → 初期状態のRNGから再開すると、全体の結果が変わってしまう
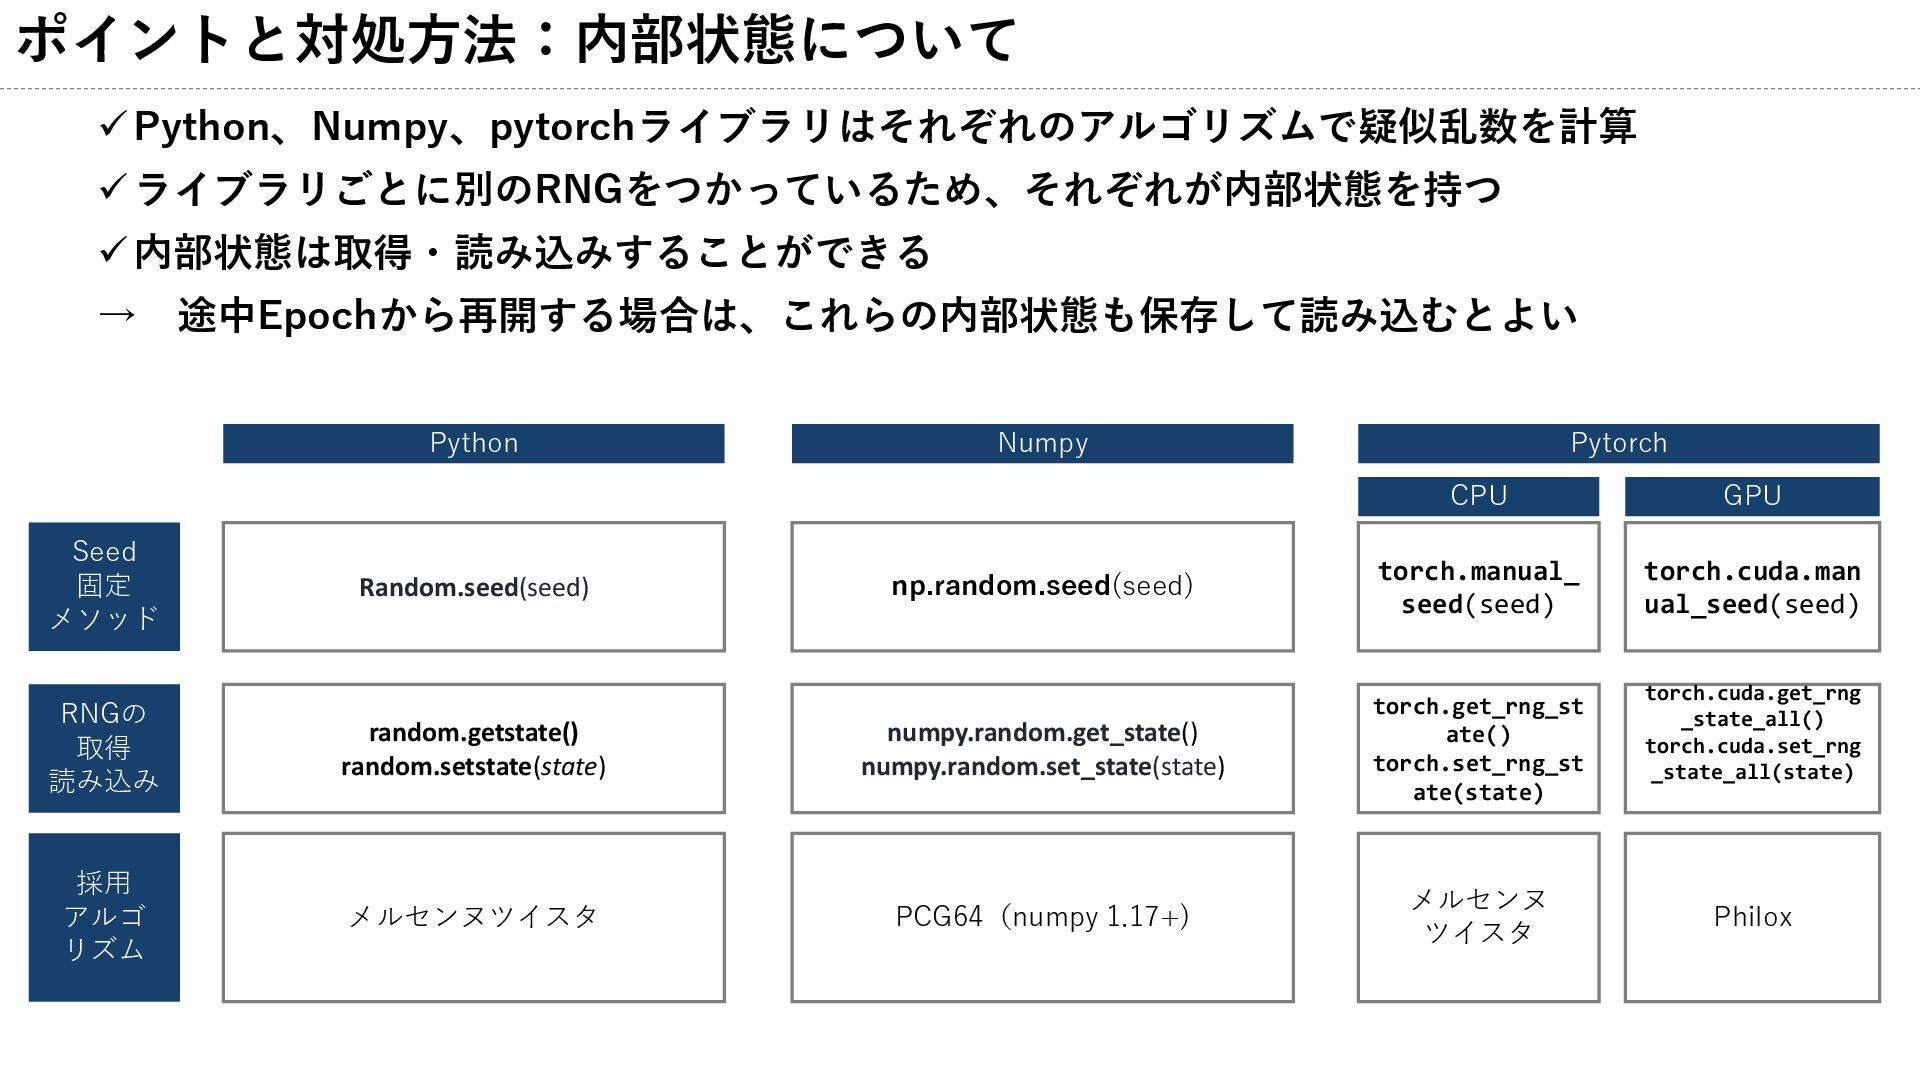
ポイントと対処方法:内部状態について ✓Python、Numpy、pytorchライブラリはそれぞれのアルゴリズムで疑似乱数を計算 ✓ライブラリごとに別のRNGをつかっているため、それぞれが内部状態を持つ ✓内部状態は取得・読み込みすることができる → 途中Epochから再開する場合は、これらの内部状態も保存して読み込むとよい Numpy Python Pytorch Seed
固定 メソッド Random.seed(seed) np.random.seed(seed) torch.manual_ seed(seed) RNGの 取得 読み込み random.getstate() random.setstate(state) numpy.random.get_state() numpy.random.set_state(state) torch.get_rng_st ate() torch.set_rng_st ate(state) 採用 アルゴ リズム メルセンヌツイスタ PCG64(numpy 1.17+) メルセンヌ ツイスタ torch.cuda.man ual_seed(seed) torch.cuda.get_rng _state_all() torch.cuda.set_rng _state_all(state) Philox CPU GPU
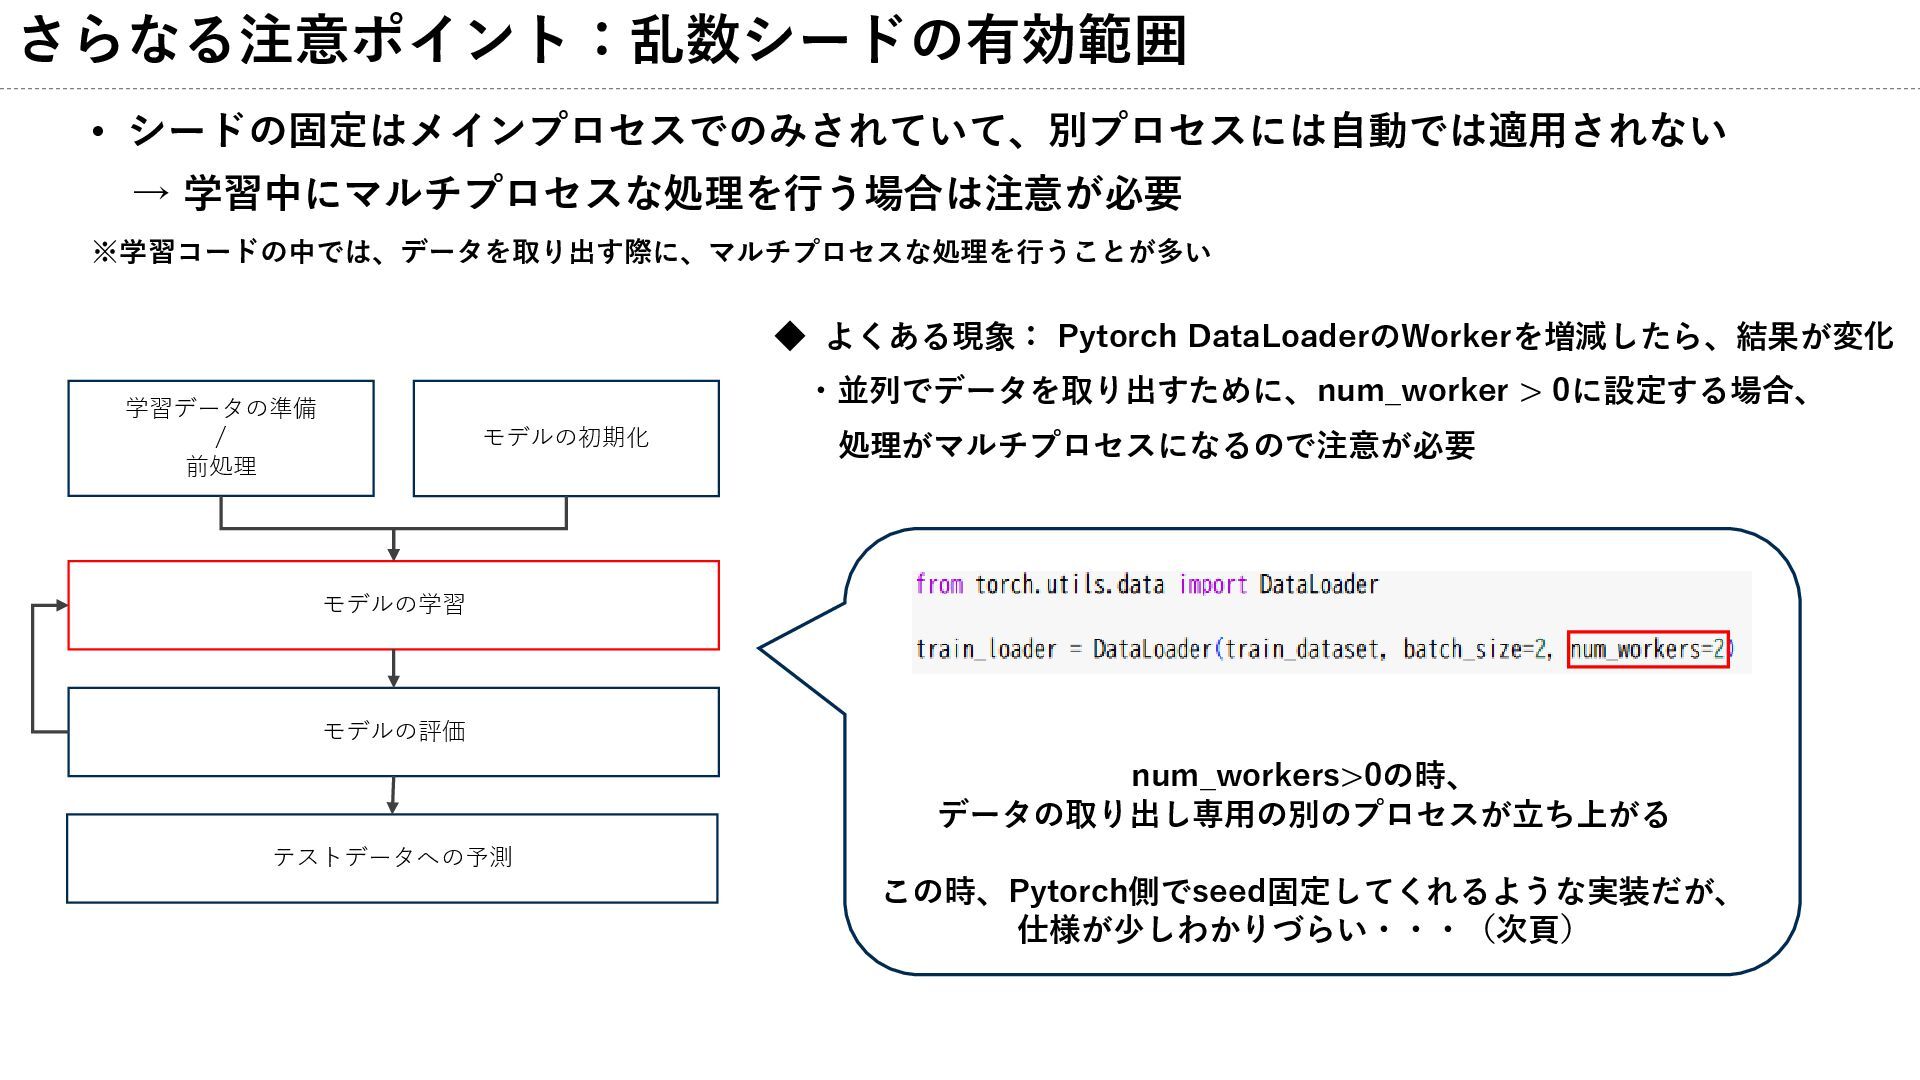
さらなる注意ポイント:乱数シードの有効範囲 • シードの固定はメインプロセスでのみされていて、別プロセスには自動では適用されない → 学習中にマルチプロセスな処理を行う場合は注意が必要 ※学習コードの中では、データを取り出す際に、マルチプロセスな処理を行うことが多い ◆ よくある現象: Pytorch DataLoaderのWorkerを増減したら、結果が変化
・並列でデータを取り出すために、num_worker > 0に設定する場合、 処理がマルチプロセスになるので注意が必要 . num_workers>0の時、 データの取り出し専用の別のプロセスが立ち上がる この時、Pytorch側でseed固定してくれるような実装だが、 仕様が少しわかりづらい・・・(次頁) モデルの初期化 学習データの準備 / 前処理 モデルの学習 モデルの評価 テストデータへの予測
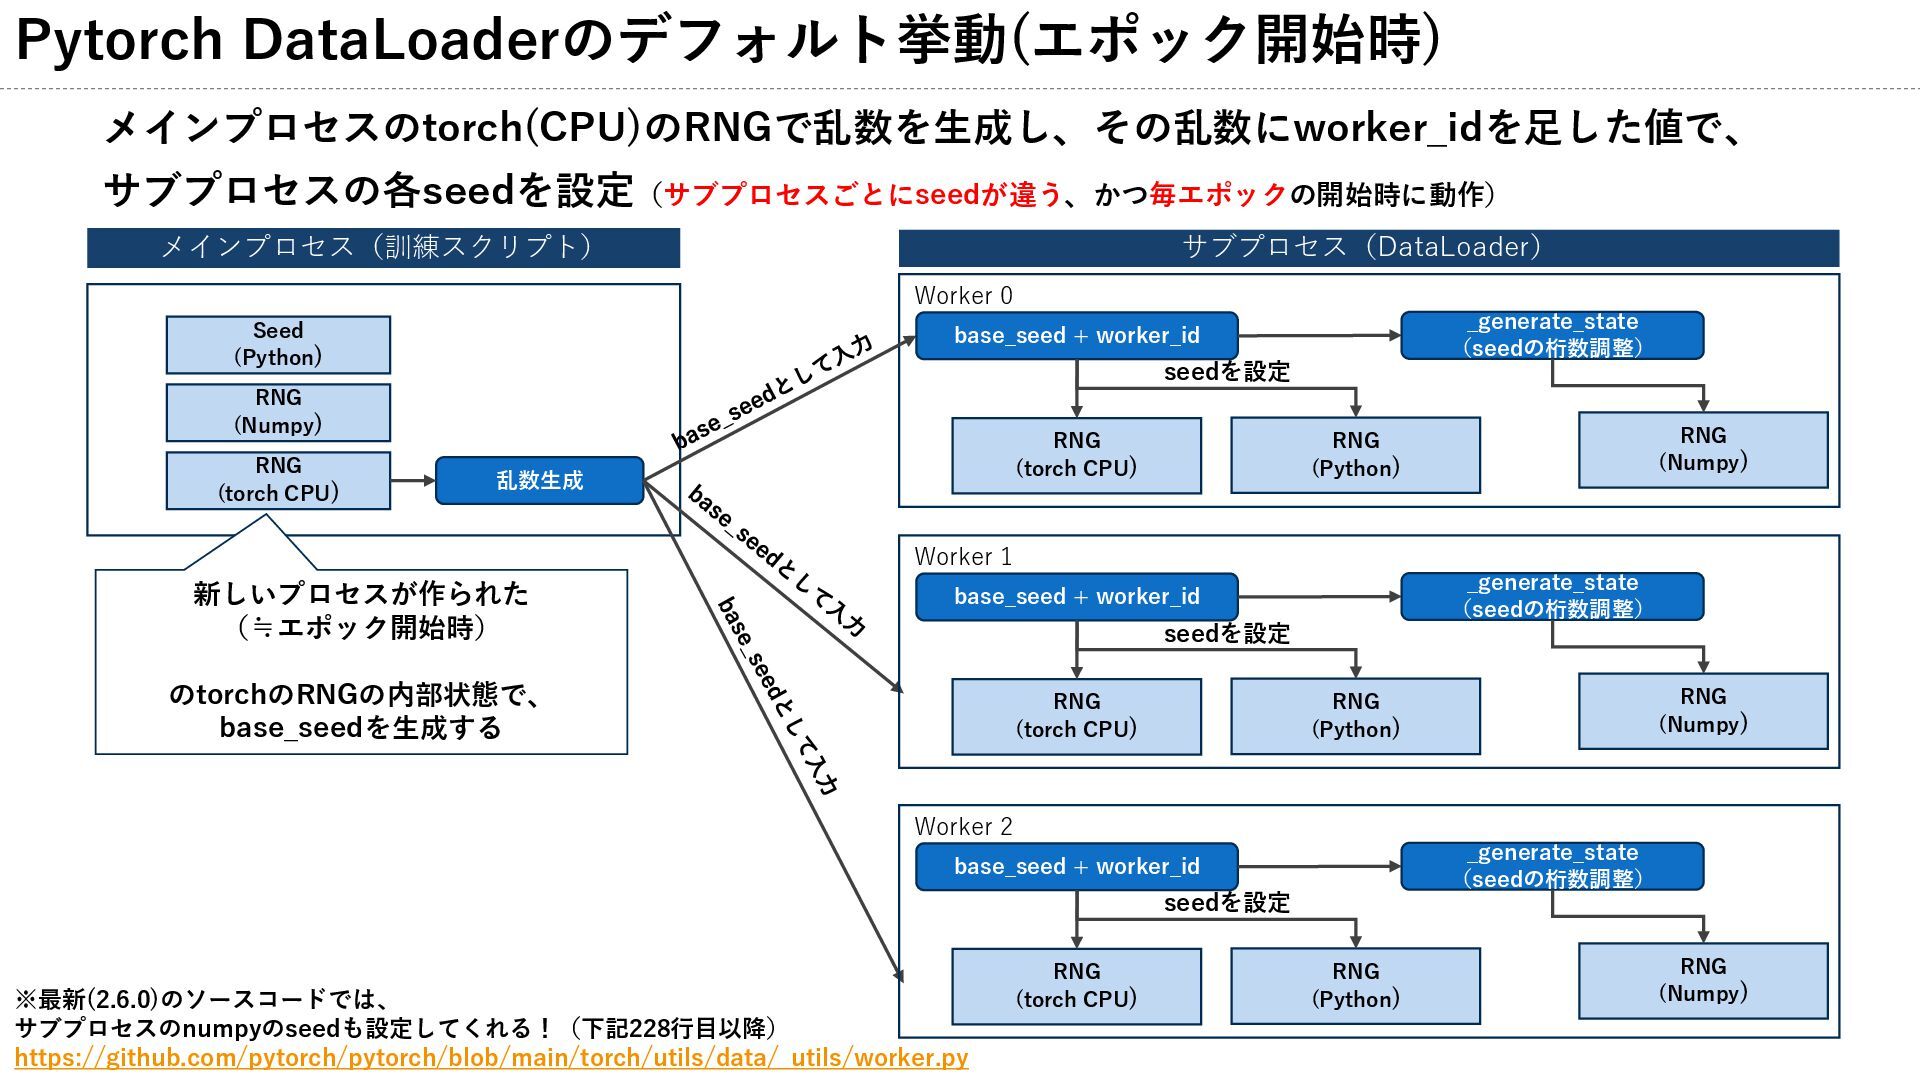
Pytorch DataLoaderのデフォルト挙動(エポック開始時) メインプロセスのtorch(CPU)のRNGで乱数を生成し、その乱数にworker_idを足した値で、 サブプロセスの各seedを設定(サブプロセスごとにseedが違う、かつ毎エポックの開始時に動作) Worker 0 メインプロセス(訓練スクリプト) サブプロセス(DataLoader) Seed (Python)
RNG (Numpy) RNG (torch CPU) RNG (Python) RNG (Numpy) RNG (torch CPU) 乱数生成 base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) Worker 1 RNG (Python) RNG (Numpy) RNG (torch CPU) base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) Worker 2 RNG (Python) RNG (Numpy) RNG (torch CPU) base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) ※最新(2.6.0)のソースコードでは、 サブプロセスのnumpyのseedも設定してくれる!(下記228行目以降) https://github.com/pytorch/pytorch/blob/main/torch/utils/data/_utils/worker.py 新しいプロセスが作られた (≒エポック開始時) のtorchのRNGの内部状態で、 base_seedを生成する
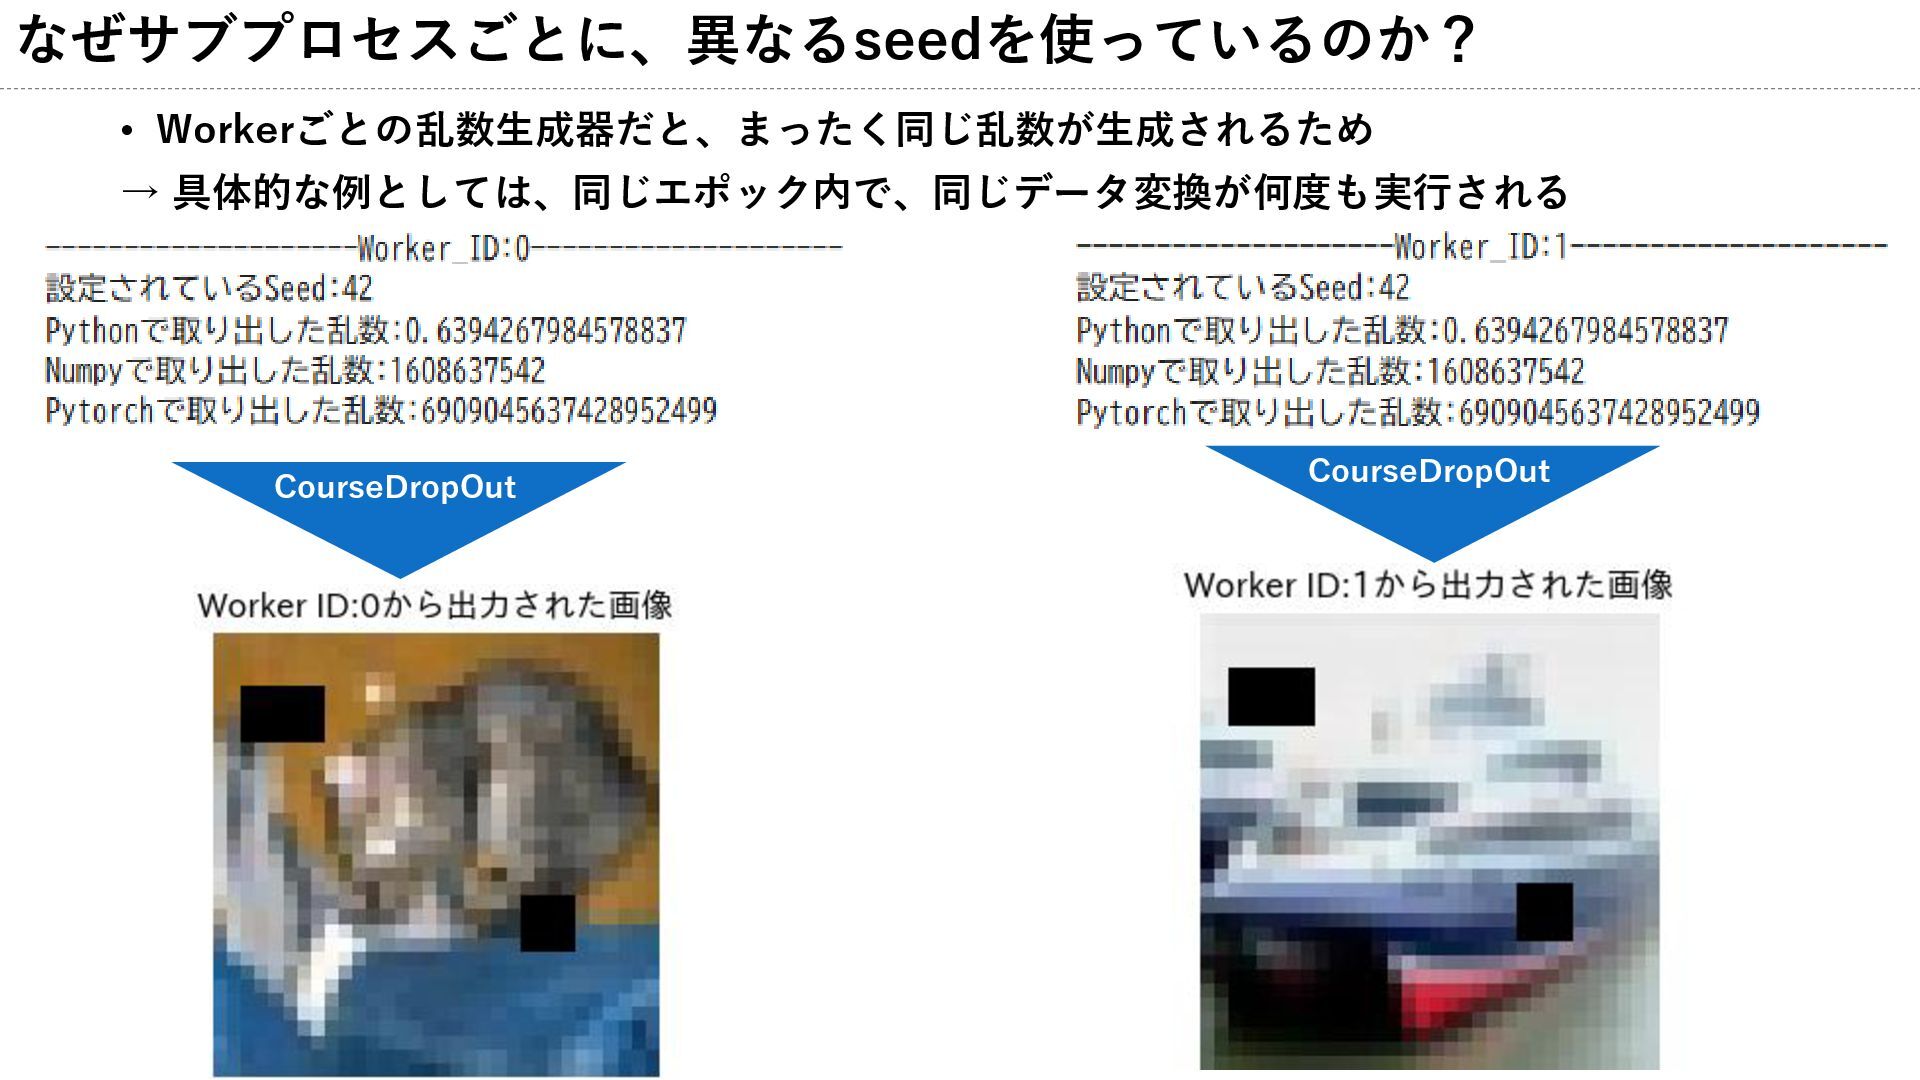
なぜサブプロセスごとに、異なるseedを使っているのか? • Workerごとの乱数生成器だと、まったく同じ乱数が生成されるため → 具体的な例としては、同じエポック内で、同じデータ変換が何度も実行される CourseDropOut CourseDropOut
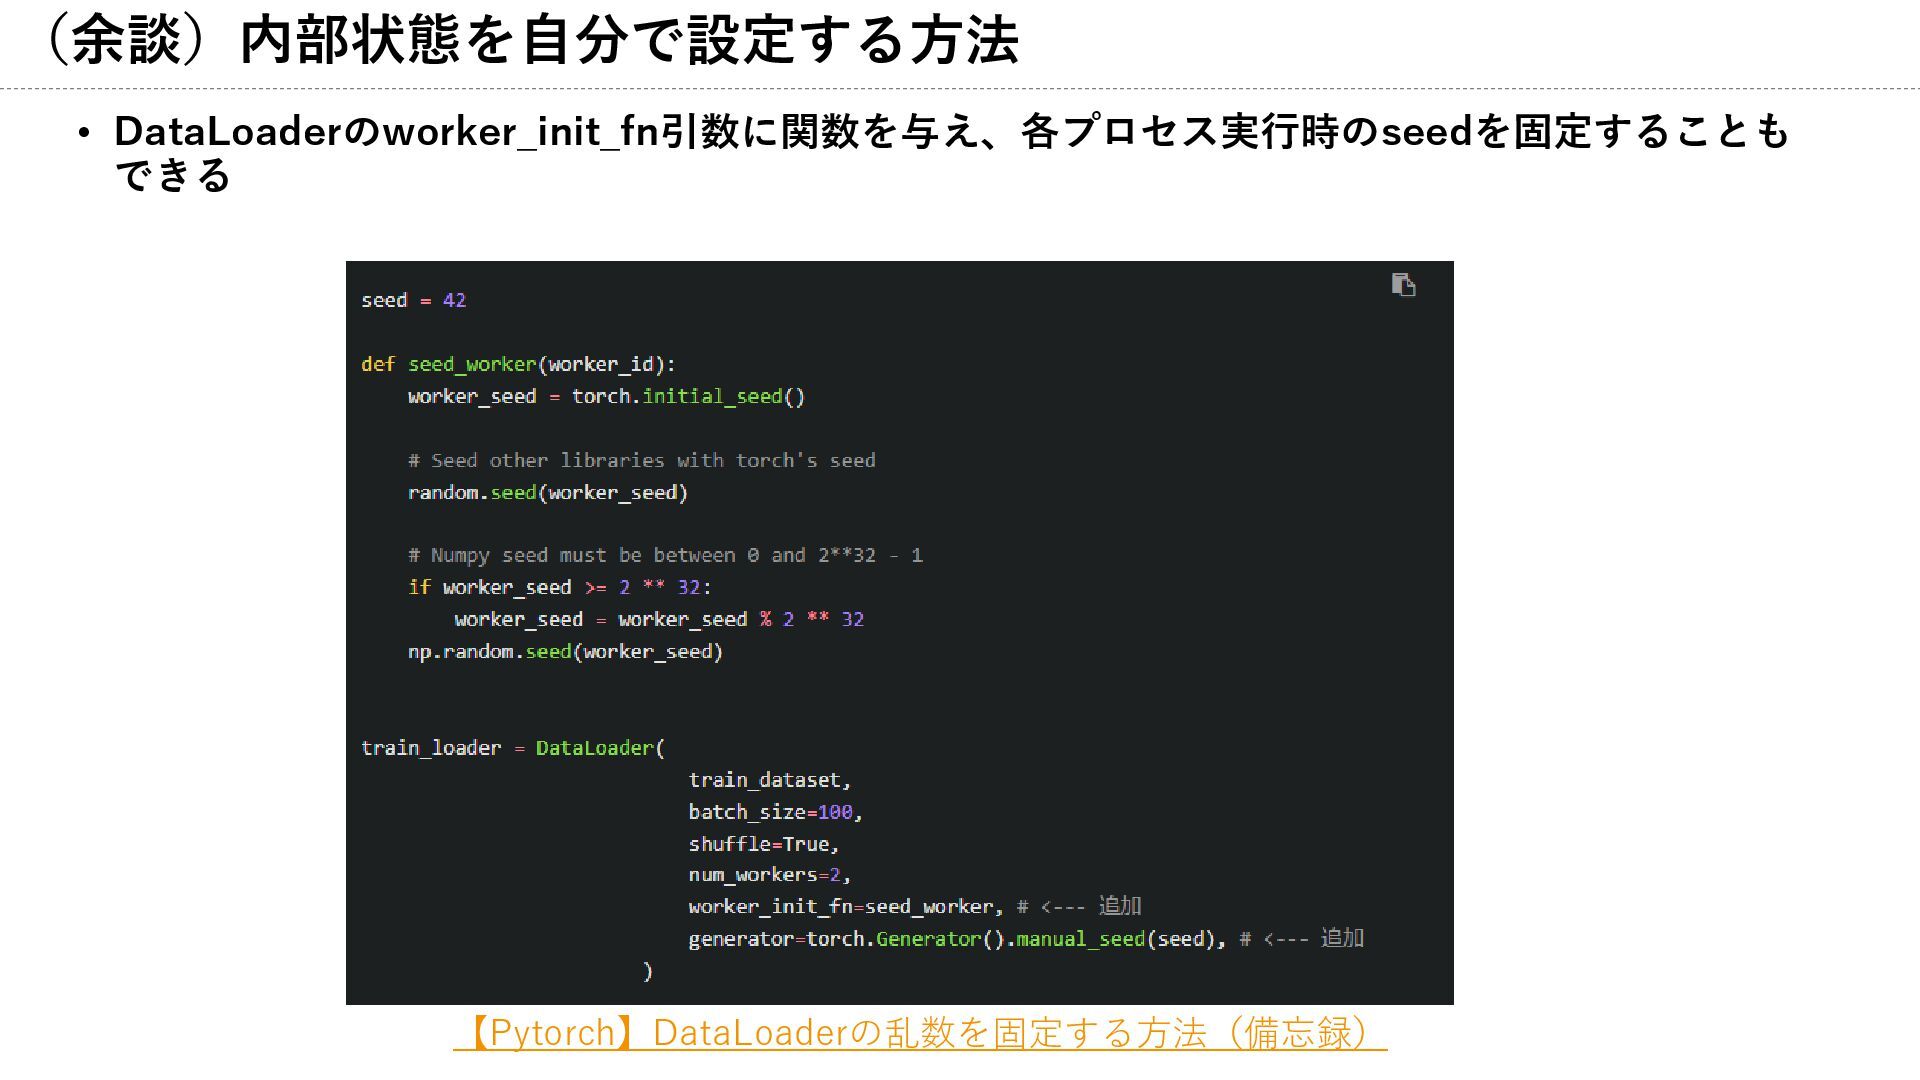
(余談)内部状態を自分で設定する方法 • DataLoaderのworker_init_fn引数に関数を与え、各プロセス実行時のseedを固定することも できる 【Pytorch】DataLoaderの乱数を固定する方法(備忘録)
結局どうするべきか? [単一プロセス(worker=0)] ✓一気通貫で全エポック訓練する場合は、基本的にseed_everythingだけやればOK ※ ただし、乱数生成器の状態が同じになるように気を付ける ✓エポックの途中から訓練する場合は、訓練途中の各ライブラリのRNGを読み込めばOK [マルチプロセスの場合(worker>0)] ✓一気通貫で全エポック訓練する場合は、こちらもseed_everythingだけやればOK ※ workerの設定によっては結果も若干変わるので注意
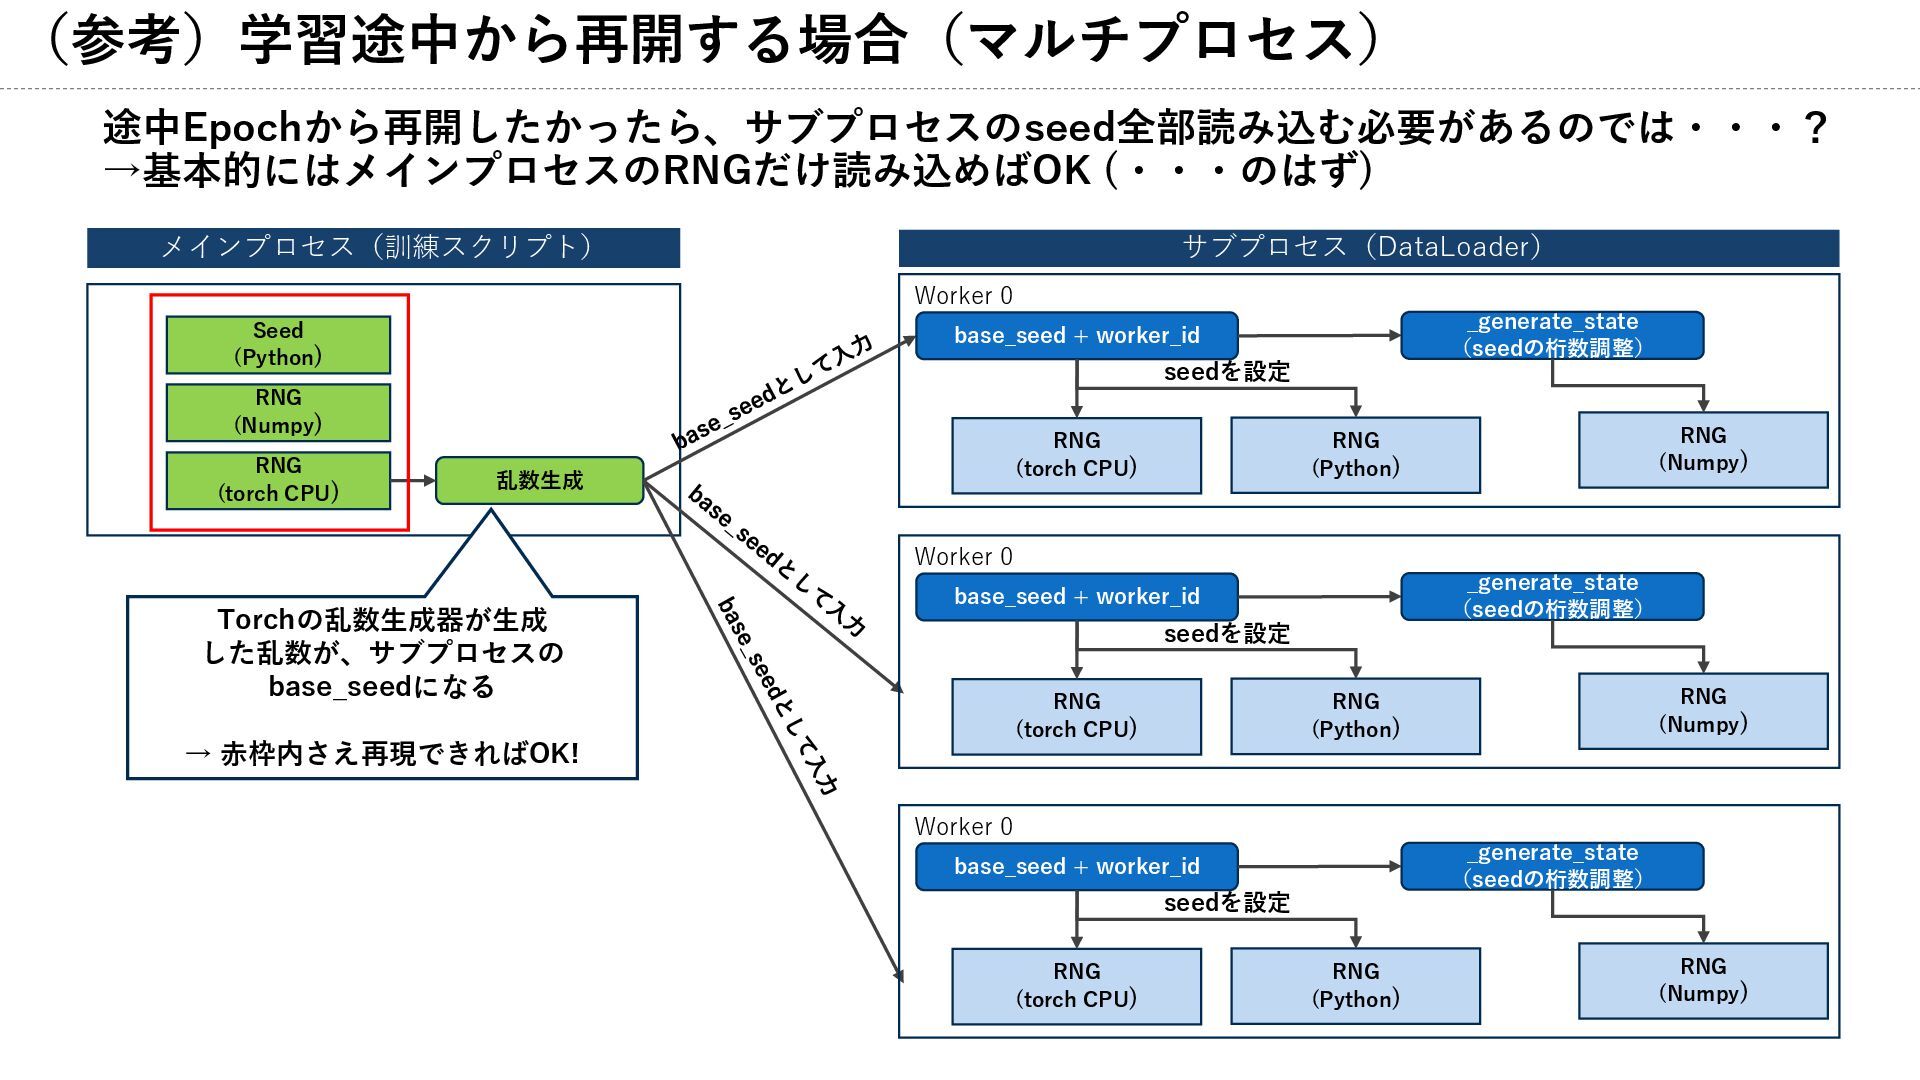
(疑問) 途中Epochから再開したかったら、サブプロセスのseed全部読み込む必要があるのでは・・・? →基本的にはメインプロセスのRNGだけ読み込めばOK (・・・のはず)
(参考)学習途中から再開する場合(マルチプロセス) 途中Epochから再開したかったら、サブプロセスのseed全部読み込む必要があるのでは・・・? →基本的にはメインプロセスのRNGだけ読み込めばOK (・・・のはず) Worker 0 メインプロセス(訓練スクリプト) サブプロセス(DataLoader) Seed (Python)
RNG (Numpy) RNG (torch CPU) RNG (Python) RNG (Numpy) RNG (torch CPU) 乱数生成 base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) Worker 0 RNG (Python) RNG (Numpy) RNG (torch CPU) base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) Worker 0 RNG (Python) RNG (Numpy) RNG (torch CPU) base_seed + worker_id seedを設定 _generate_state (seedの桁数調整) Torchの乱数生成器が生成 した乱数が、サブプロセスの base_seedになる → 赤枠内さえ再現できればOK!
終わりに 読んでいただいてありがとうございました! 実験で試したことを実行できるノートブックです↓ https://github.com/yu-yagi/random_seed_experment


 uhyo
 posterkeisuke
 jinwatanabe
 ponponmikankan
 visional_engineering_and_design
 civitaspo
 cielo1985
 ykiyota
 nwiizo
 righttouch
 yuto16
 helmedeiros
 reverentgeek
 ammeep
 ipullrank
 tammyeverts
 emna__ayadi
 davetheseo
 shpigford
 tanoku
 andyhume
 yeseniaperezcruz
 kristinabergwall1