Upgrade to Pro — share decks privately, control downloads, hide ads and more …

そのベンチマーク、 誰の物差しですか? / Whose Ruler Are You Measu...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

そのベンチマーク、 誰の物差しですか? / Whose Ruler Are You Measuring With

20261020 CTO Night and Day in Kobe, Morning Session
そのベンチマーク、 誰の物差しですか?〜LLM ベンチマークの歴史と、CTO が自社の評価を持つべき理由〜

AI の能力を、人はどう測り、
その測り方を、どこまで信じられるか

ベンチマークの歴史と点数が実力とずれる理由をたどり、公開スコアに頼らず自社の評価の仕組みを持つ方法を、Amazon Bedrock AgentCore Evaluationsの例を交えてお話しします。

Avatar for Xinzhi Sherry Zhu

Xinzhi Sherry Zhu

October 20, 2026

Other Decks in Technology

Transcript

  1. CTO NIGHT & DAY 2026 そのベンチマーク、 誰の物差しですか? LLM ベンチマークの歴史と、CTO が自社の評価を持つべき理由

    Xinzhi Sherry Zhu Startup Solutions Architect Amazon Web Services Japan © 2026, Amazon Web © 2026, Services, Amazon Inc. or Web its Services, affiliates.Inc. All or rights its affiliates. reserved.All rights reserved. 1
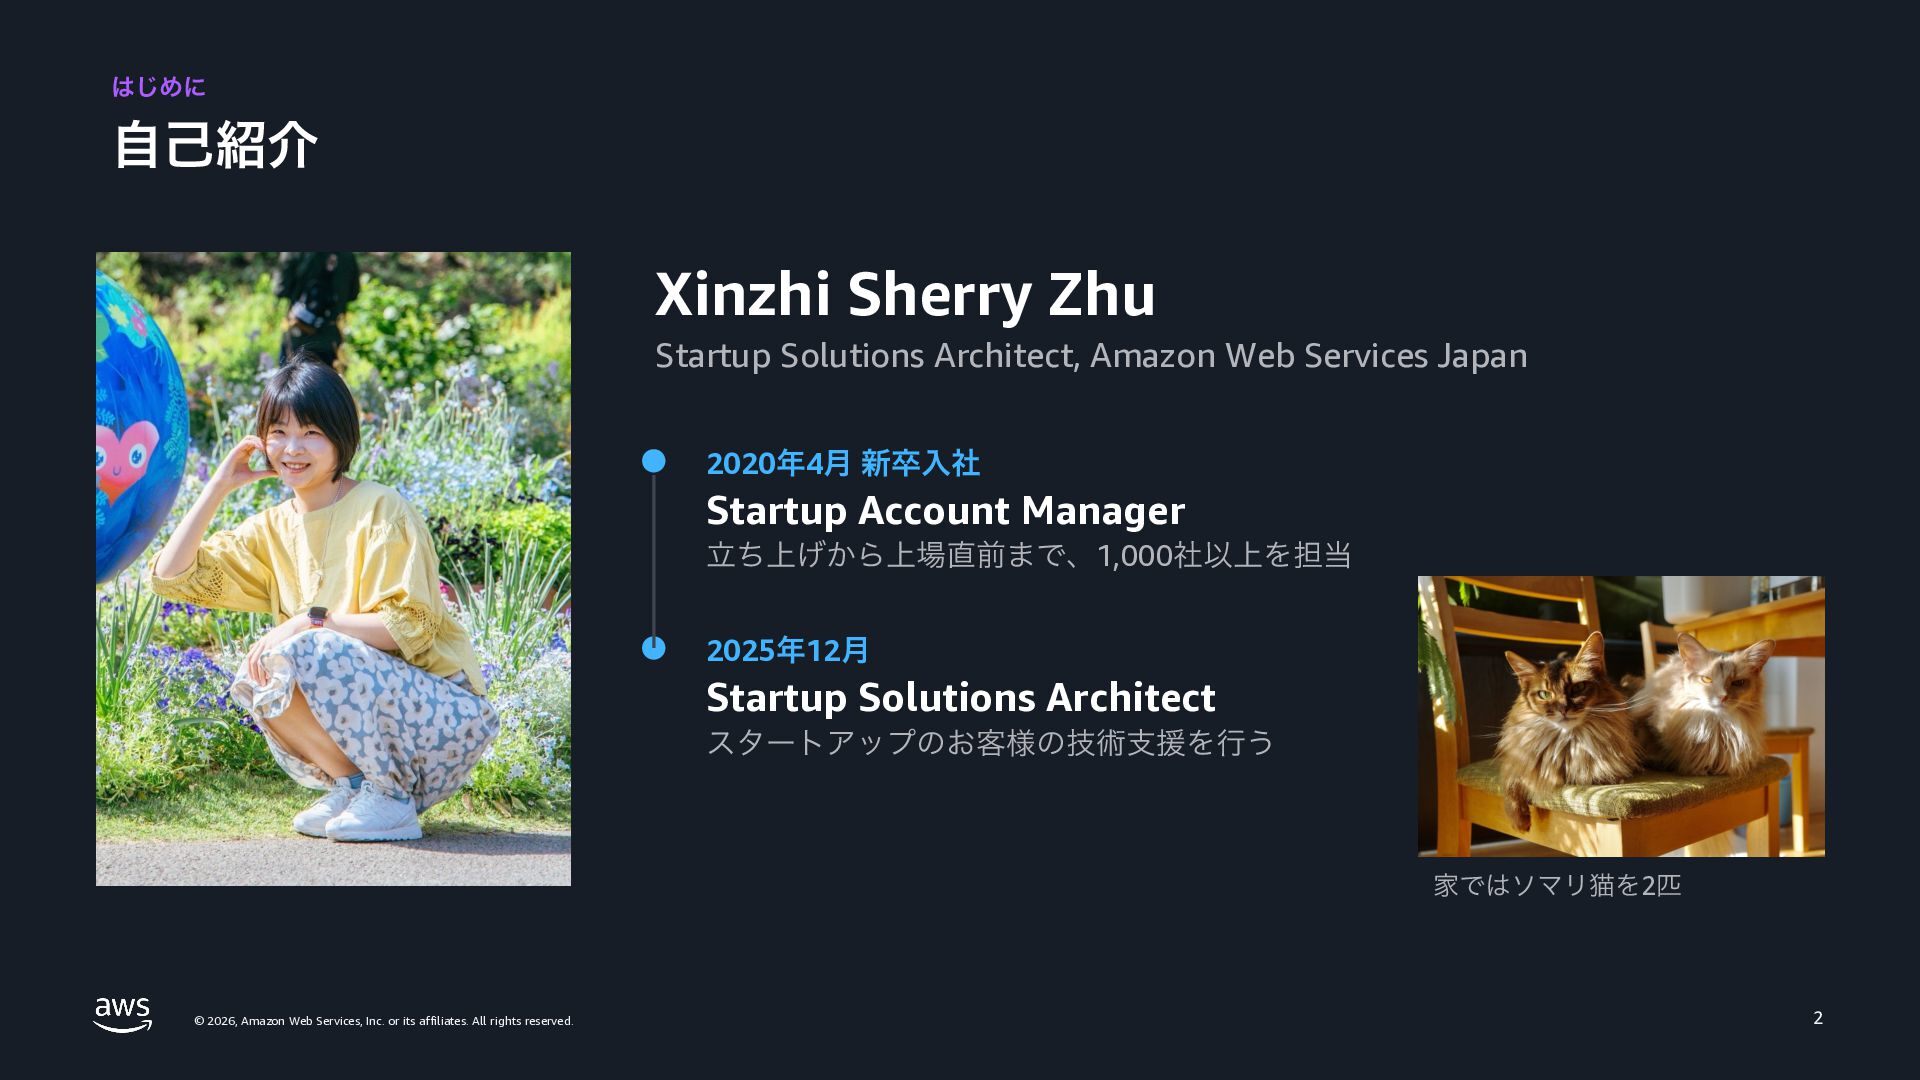
  2. はじめに 自己紹介 Xinzhi Sherry Zhu Startup Solutions Architect, Amazon Web

    Services Japan 2020年4月 新卒入社 Startup Account Manager 立ち上げから上場直前まで、1,000社以上を担当 2025年12月 Startup Solutions Architect スタートアップのお客様の技術支援を行う 家ではソマリ猫を2匹 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 2
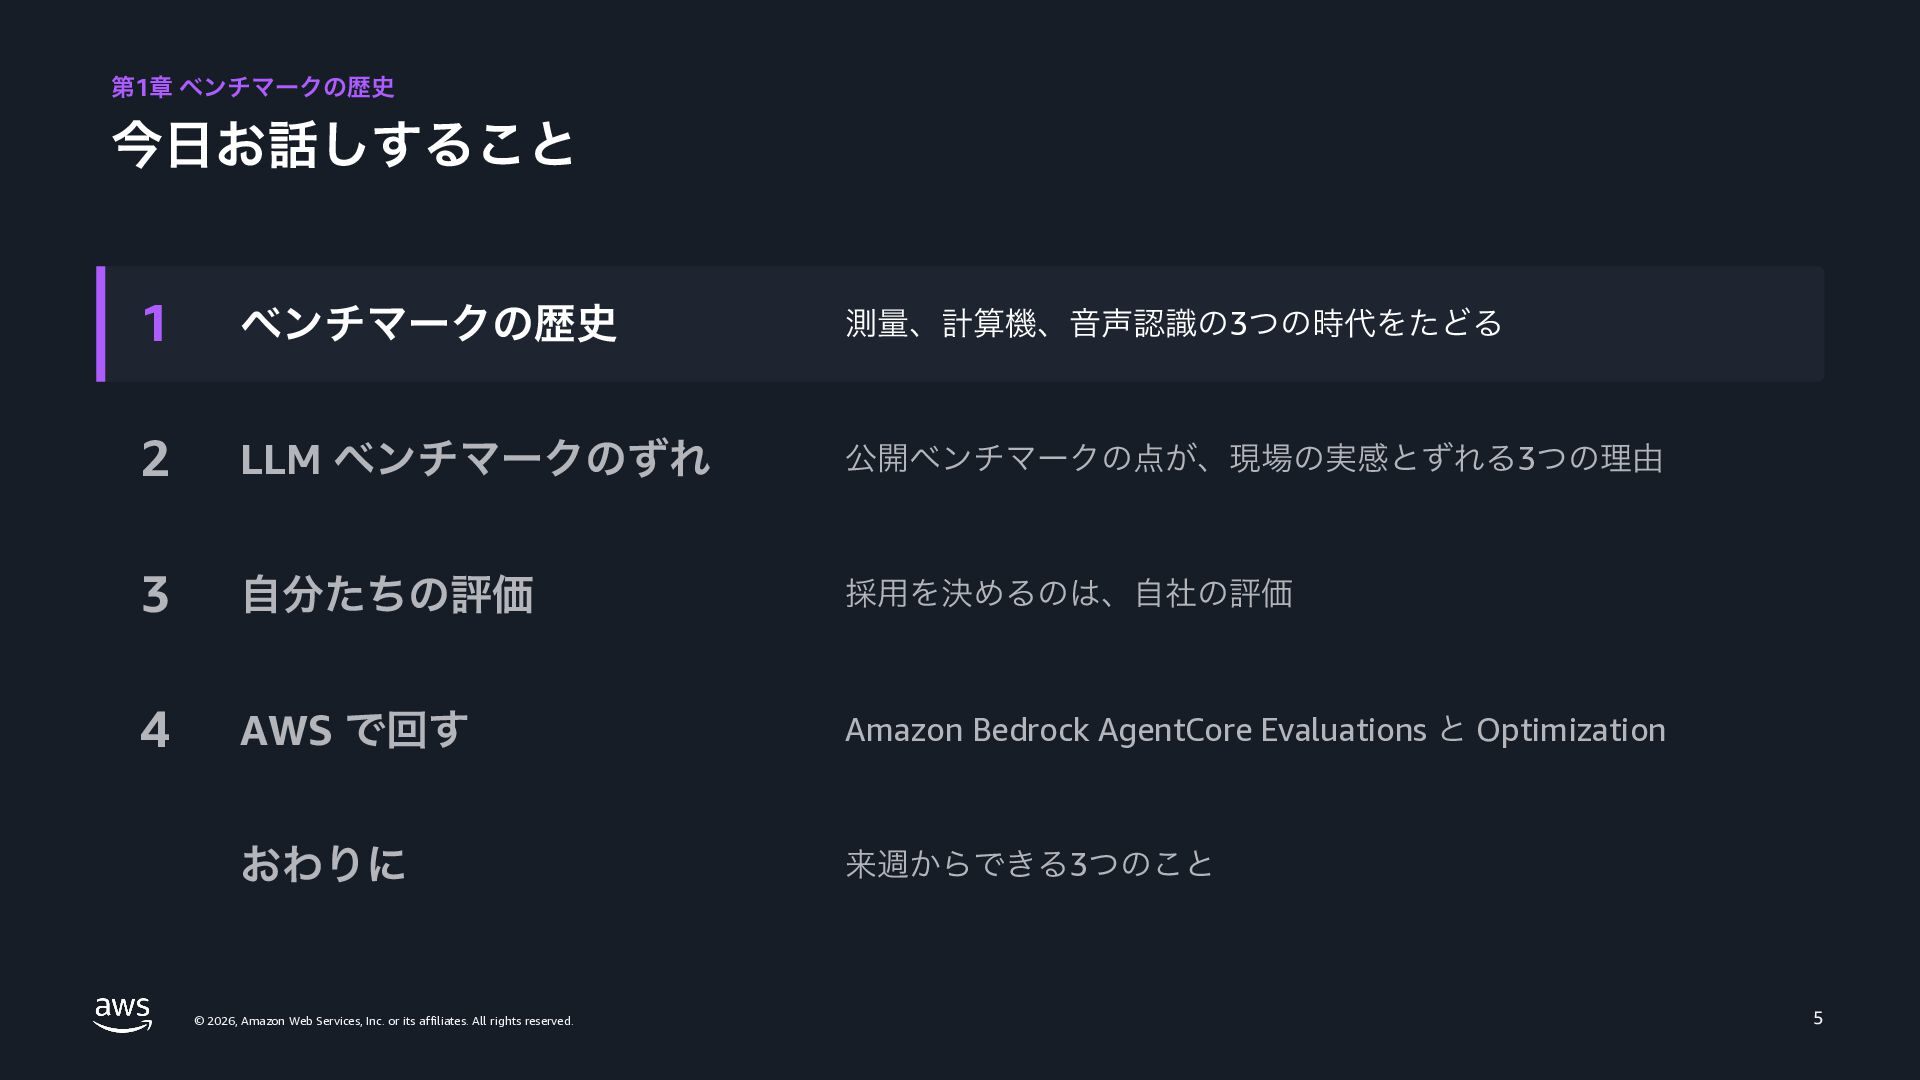
  3. はじめに 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ 公開ベンチマークの点が、現場の実感とずれる3つの理由 3

    自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 4
  4. 第1章 ベンチマークの歴史 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ 公開ベンチマークの点が、現場の実感とずれる3つの理由

    3 自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 5
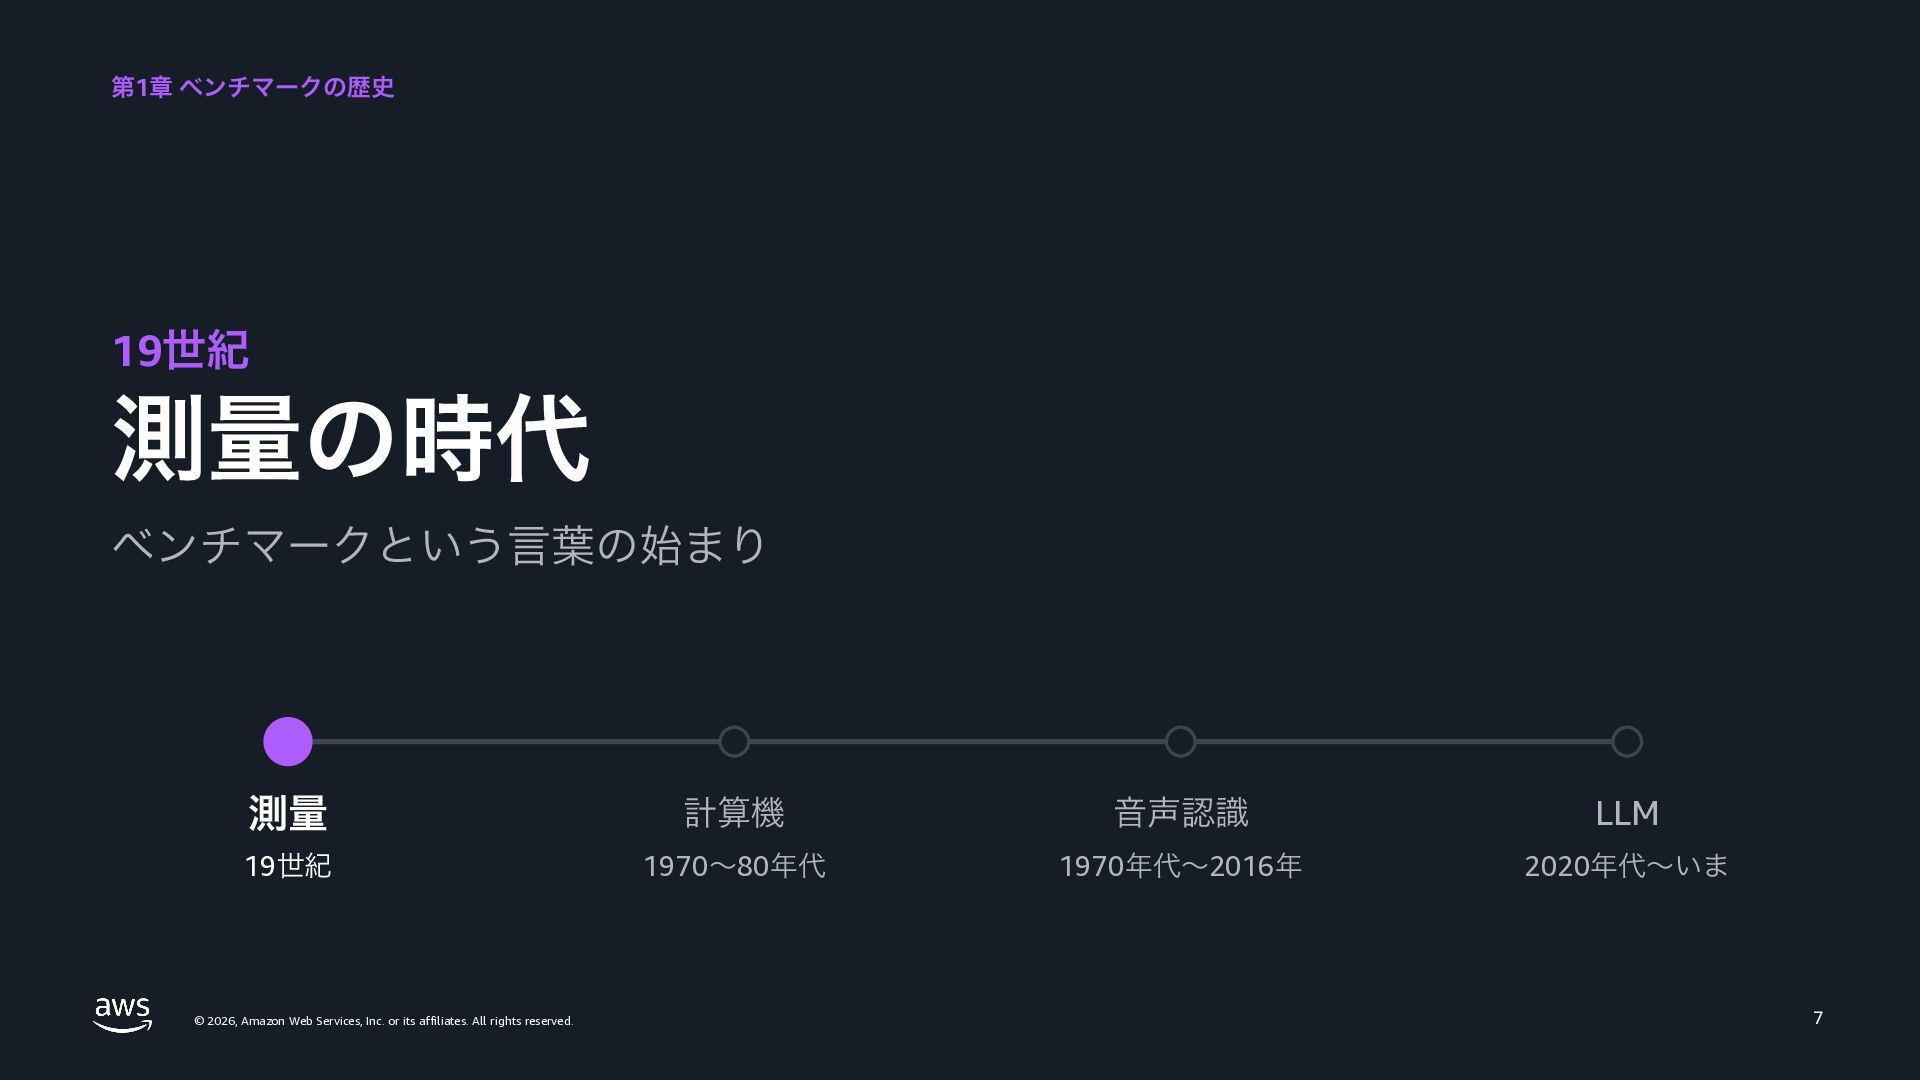
  5. 第1章 ベンチマークの歴史 19世紀 測量の時代 ベンチマークという言葉の始まり 測量 計算機 音声認識 LLM 19世紀

    1970〜80年代 1970年代〜2016年 2020年代〜いま © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 7
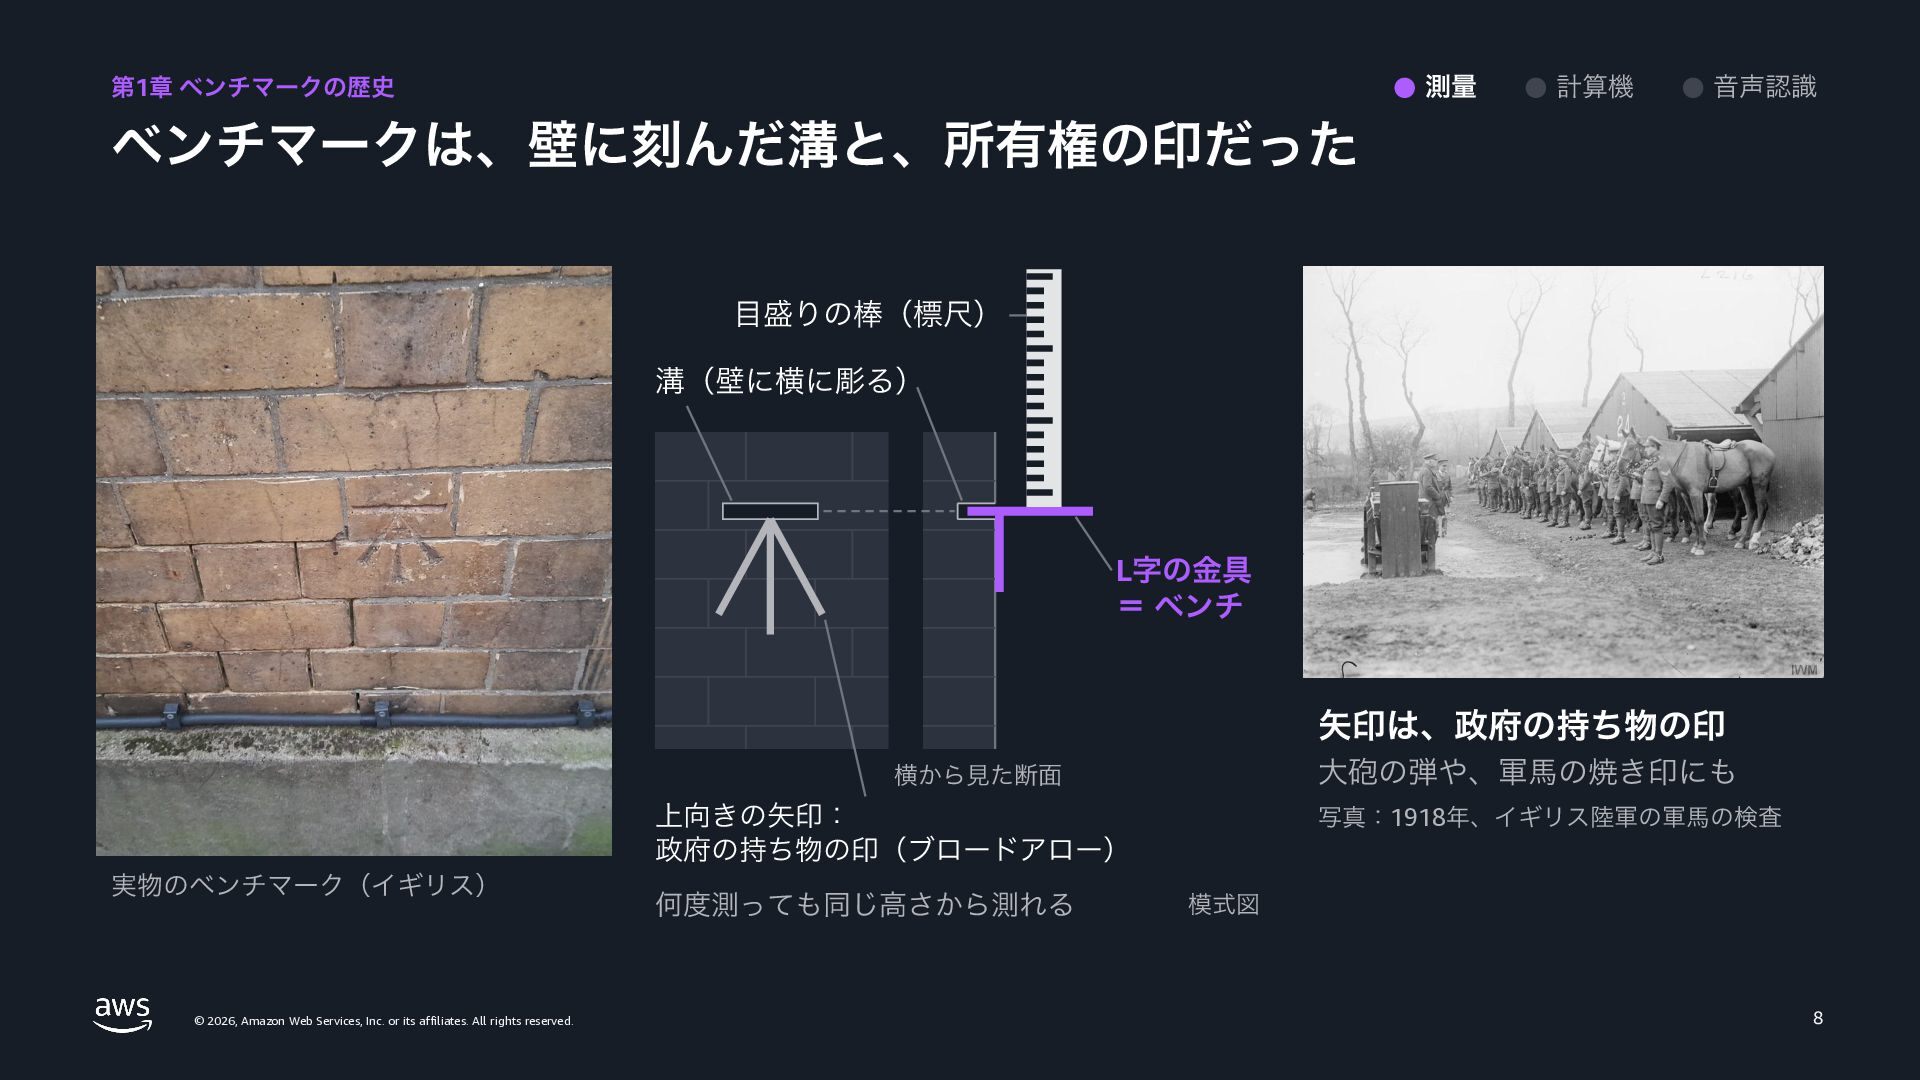
  6. 測量 第1章 ベンチマークの歴史 計算機 音声認識 ベンチマークは、壁に刻んだ溝と、所有権の印だった 目盛りの棒(標尺) 溝(壁に横に彫る) L字の金具 =

    ベンチ 矢印は、政府の持ち物の印 大砲の弾や、軍馬の焼き印にも 横から見た断面 上向きの矢印: 政府の持ち物の印(ブロードアロー) 実物のベンチマーク(イギリス) © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 何度測っても同じ高さから測れる 写真:1918年、イギリス陸軍の軍馬の検査 模式図 8
  7. 第1章 ベンチマークの歴史 1970〜80年代 計算機の時代 同じプログラムで、速さを比べる 測量 計算機 音声認識 LLM 19世紀

    1970〜80年代 1970年代〜2016年 2020年代〜いま © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 9
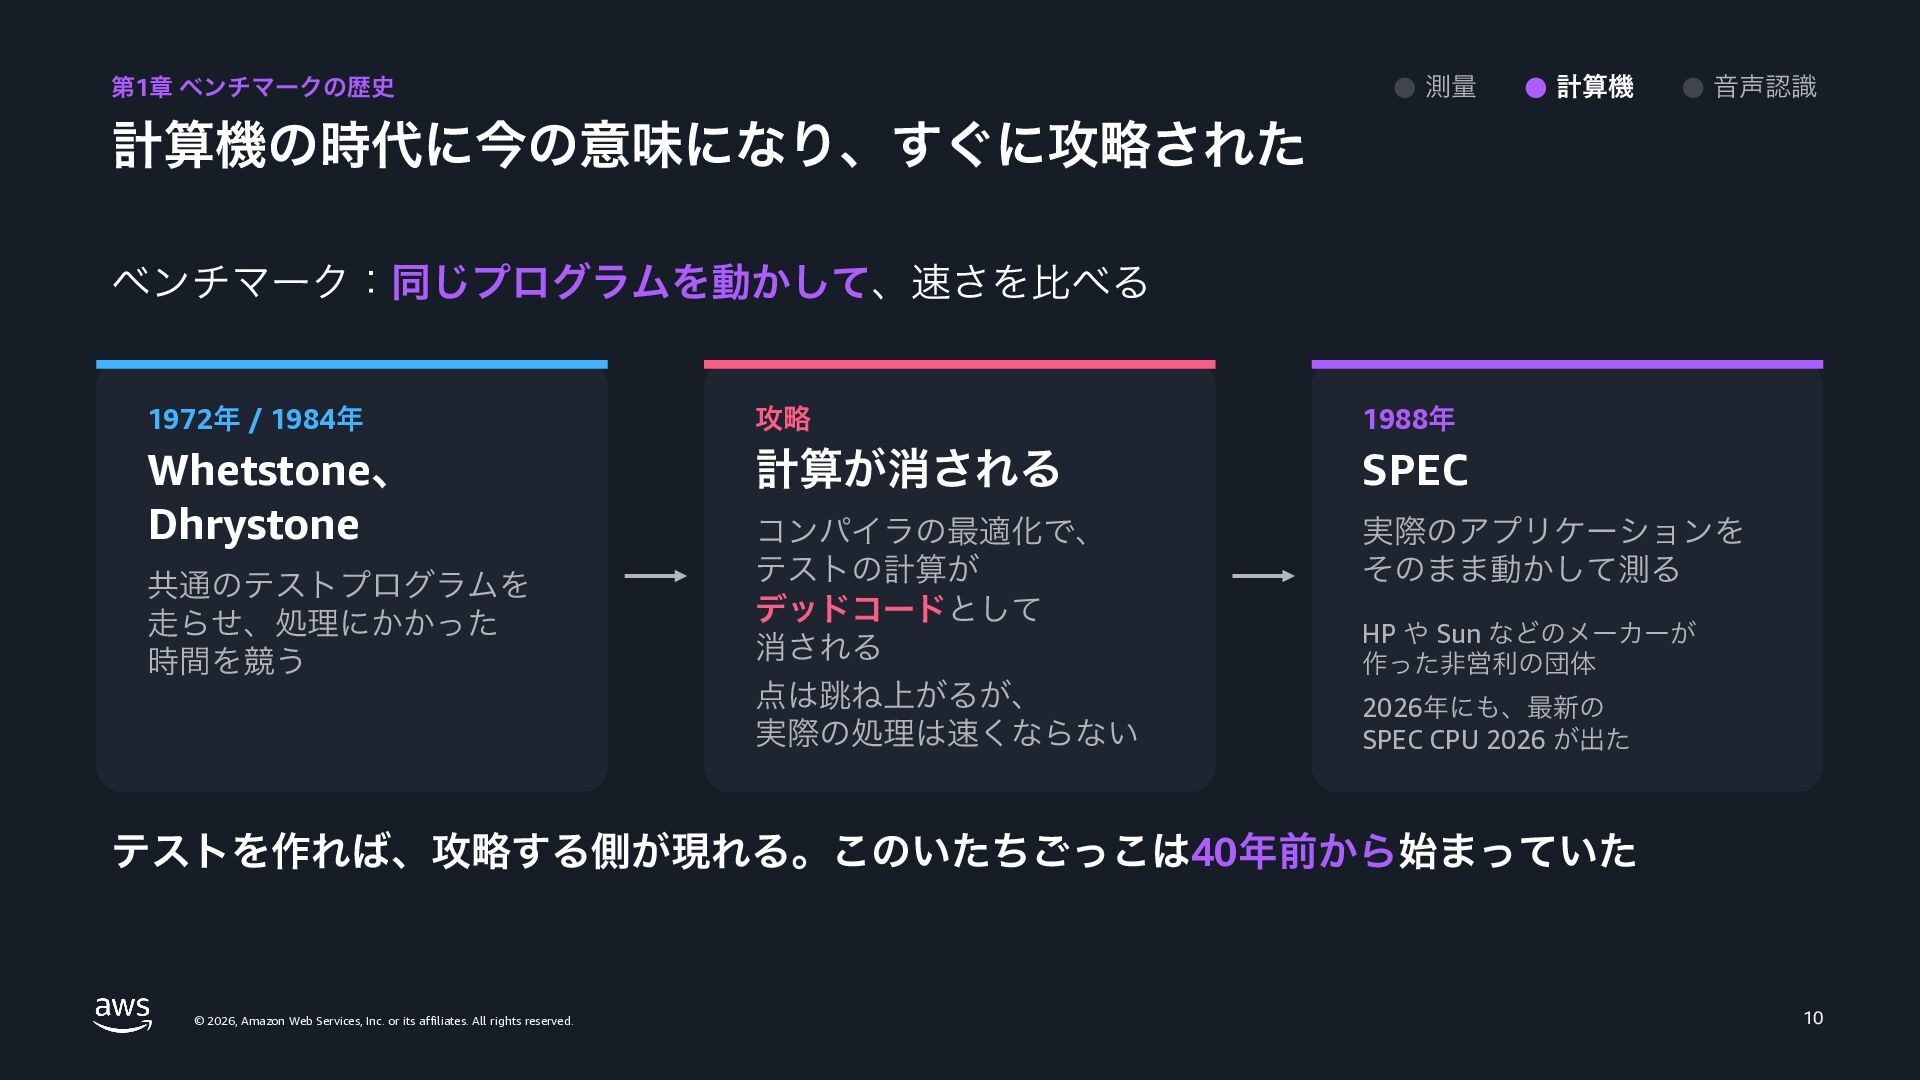
  8. 測量 第1章 ベンチマークの歴史 計算機 音声認識 計算機の時代に今の意味になり、すぐに攻略された ベンチマーク:同じプログラムを動かして、速さを比べる 1972年 / 1984年

    攻略 1988年 Whetstone、 Dhrystone 計算が消される SPEC コンパイラの最適化で、 テストの計算が デッドコードとして 消される 実際のアプリケーションを そのまま動かして測る 点は跳ね上がるが、 実際の処理は速くならない 2026年にも、最新の SPEC CPU 2026 が出た 共通のテストプログラムを 走らせ、処理にかかった 時間を競う HP や Sun などのメーカーが 作った非営利の団体 テストを作れば、攻略する側が現れる。このいたちごっこは40年前から始まっていた © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 10
  9. 第1章 ベンチマークの歴史 1970年代〜2016年 音声認識の時代 同じテストで、精度を競う 測量 計算機 音声認識 LLM 19世紀

    1970〜80年代 1970年代〜2016年 2020年代〜いま © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 11
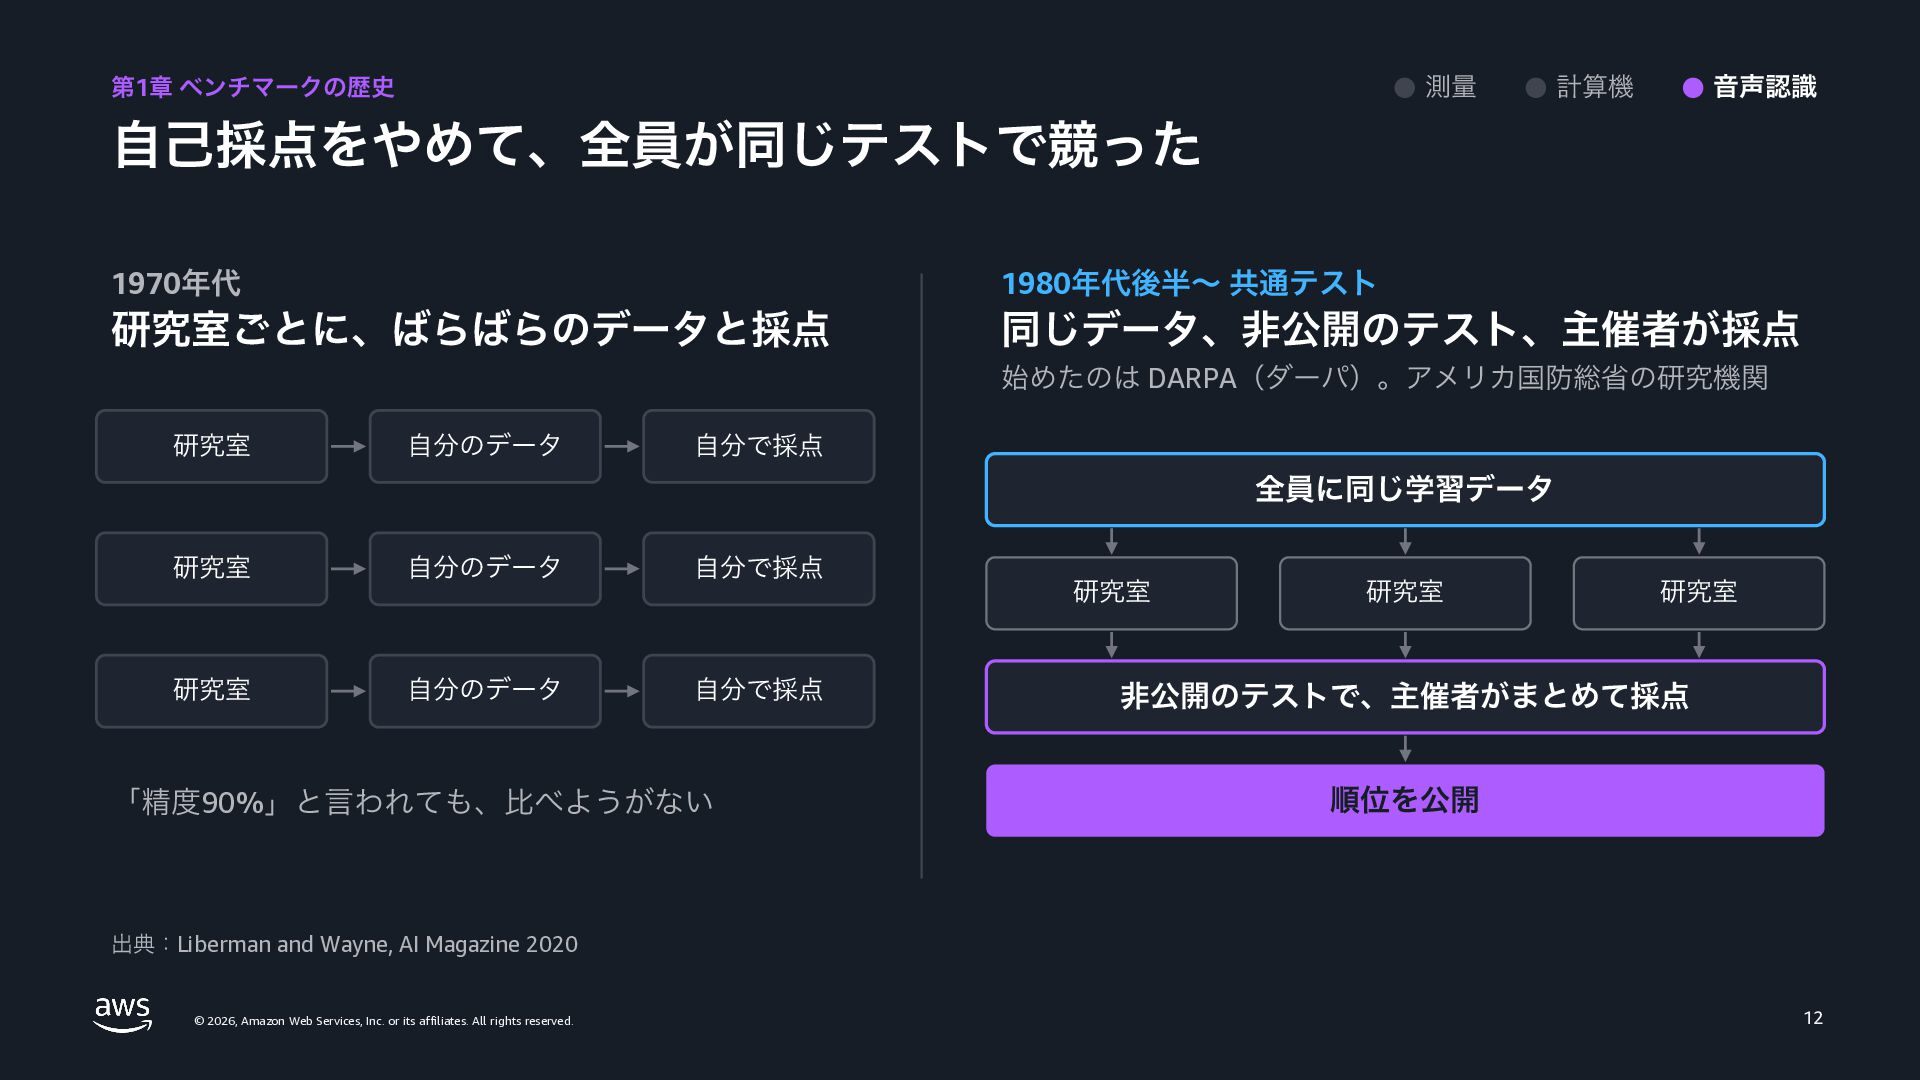
  10. 測量 第1章 ベンチマークの歴史 計算機 音声認識 自己採点をやめて、全員が同じテストで競った 1970年代 1980年代後半〜 共通テスト 研究室ごとに、ばらばらのデータと採点

    同じデータ、非公開のテスト、主催者が採点 始めたのは DARPA(ダーパ)。アメリカ国防総省の研究機関 研究室 自分のデータ 自分で採点 全員に同じ学習データ 研究室 自分のデータ 自分で採点 研究室 自分のデータ 自分で採点 「精度90%」と言われても、比べようがない 研究室 研究室 研究室 非公開のテストで、主催者がまとめて採点 順位を公開 出典:Liberman and Wayne, AI Magazine 2020 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 12
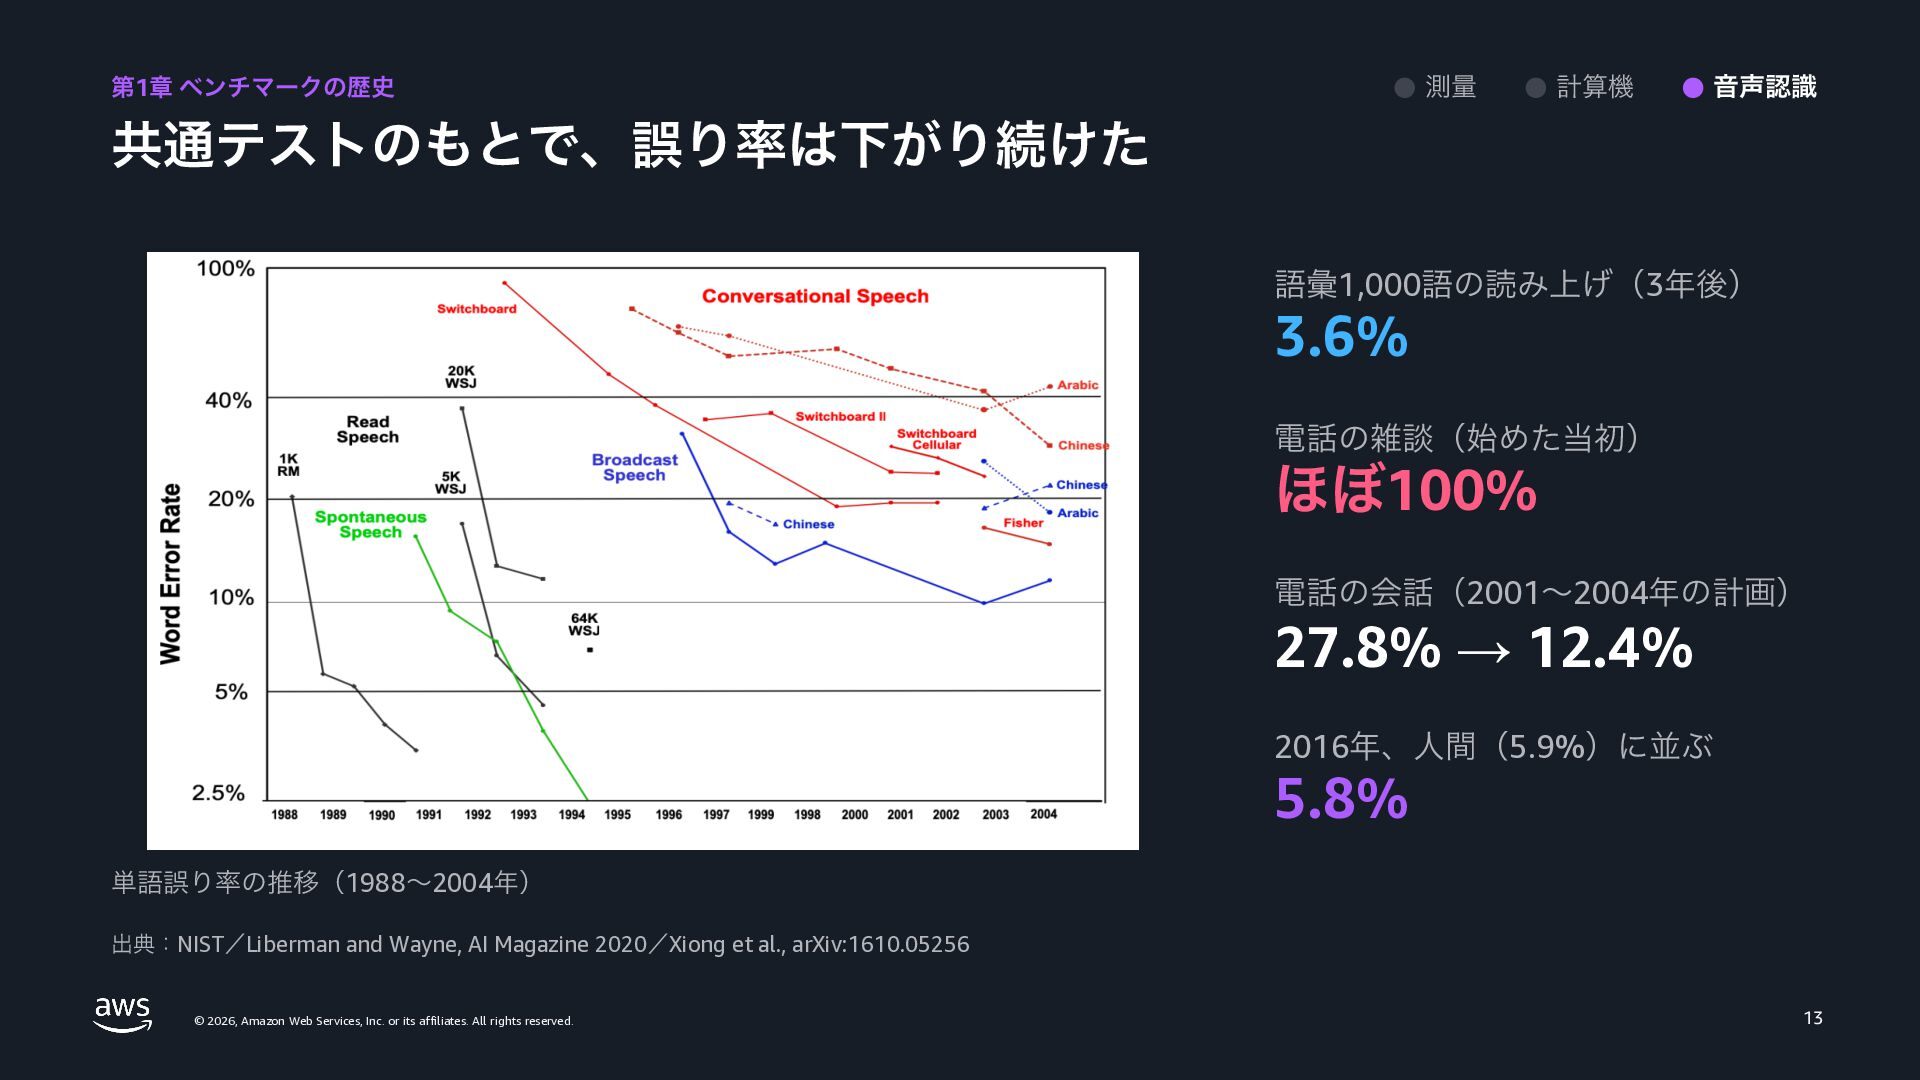
  11. 測量 第1章 ベンチマークの歴史 計算機 音声認識 共通テストのもとで、誤り率は下がり続けた 語彙1,000語の読み上げ(3年後) 3.6% 電話の雑談(始めた当初) ほぼ100%

    電話の会話(2001〜2004年の計画) 27.8% → 12.4% 2016年、人間(5.9%)に並ぶ 5.8% 単語誤り率の推移(1988〜2004年) 出典:NIST/Liberman and Wayne, AI Magazine 2020/Xiong et al., arXiv:1610.05256 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 13
  12. 第2章 LLM ベンチマークのずれ 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ

    公開ベンチマークの点が、現場の実感とずれる3つの理由 3 自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 15
  13. 第2章 LLM ベンチマークのずれ 2020年代〜いま LLMの時代 公開ベンチマークの点が、現場の実感とずれる 測量 計算機 音声認識 LLM

    19世紀 1970〜80年代 1970年代〜2016年 2020年代〜いま © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 16
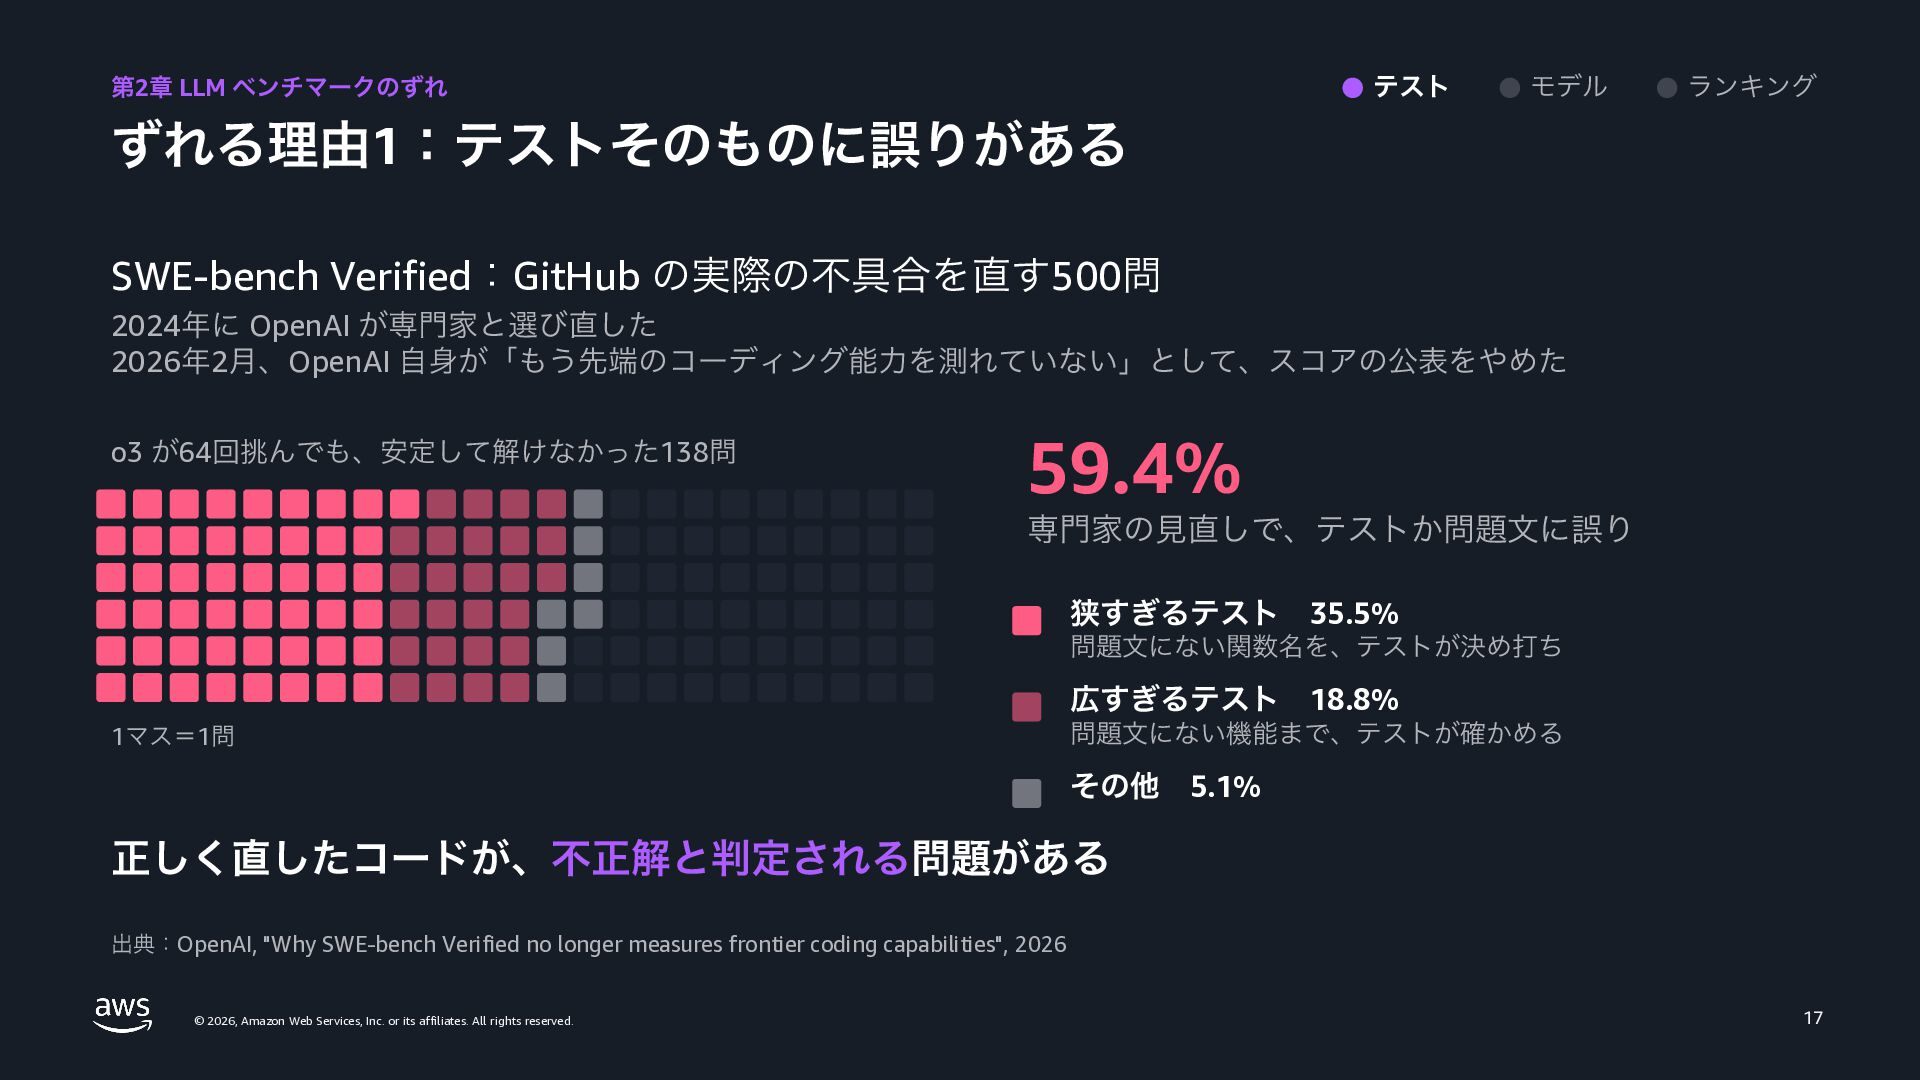
  14. 第2章 LLM ベンチマークのずれ テスト モデル ランキング ずれる理由1:テストそのものに誤りがある SWE-bench Verified:GitHub の実際の不具合を直す500問

    2024年に OpenAI が専門家と選び直した 2026年2月、OpenAI 自身が「もう先端のコーディング能力を測れていない」として、スコアの公表をやめた o3 が64回挑んでも、安定して解けなかった138問 59.4% 専門家の見直しで、テストか問題文に誤り 狭すぎるテスト 35.5% 問題文にない関数名を、テストが決め打ち 広すぎるテスト 1マス=1問 18.8% 問題文にない機能まで、テストが確かめる その他 5.1% 正しく直したコードが、不正解と判定される問題がある 出典:OpenAI, "Why SWE-bench Verified no longer measures frontier coding capabilities", 2026 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 17
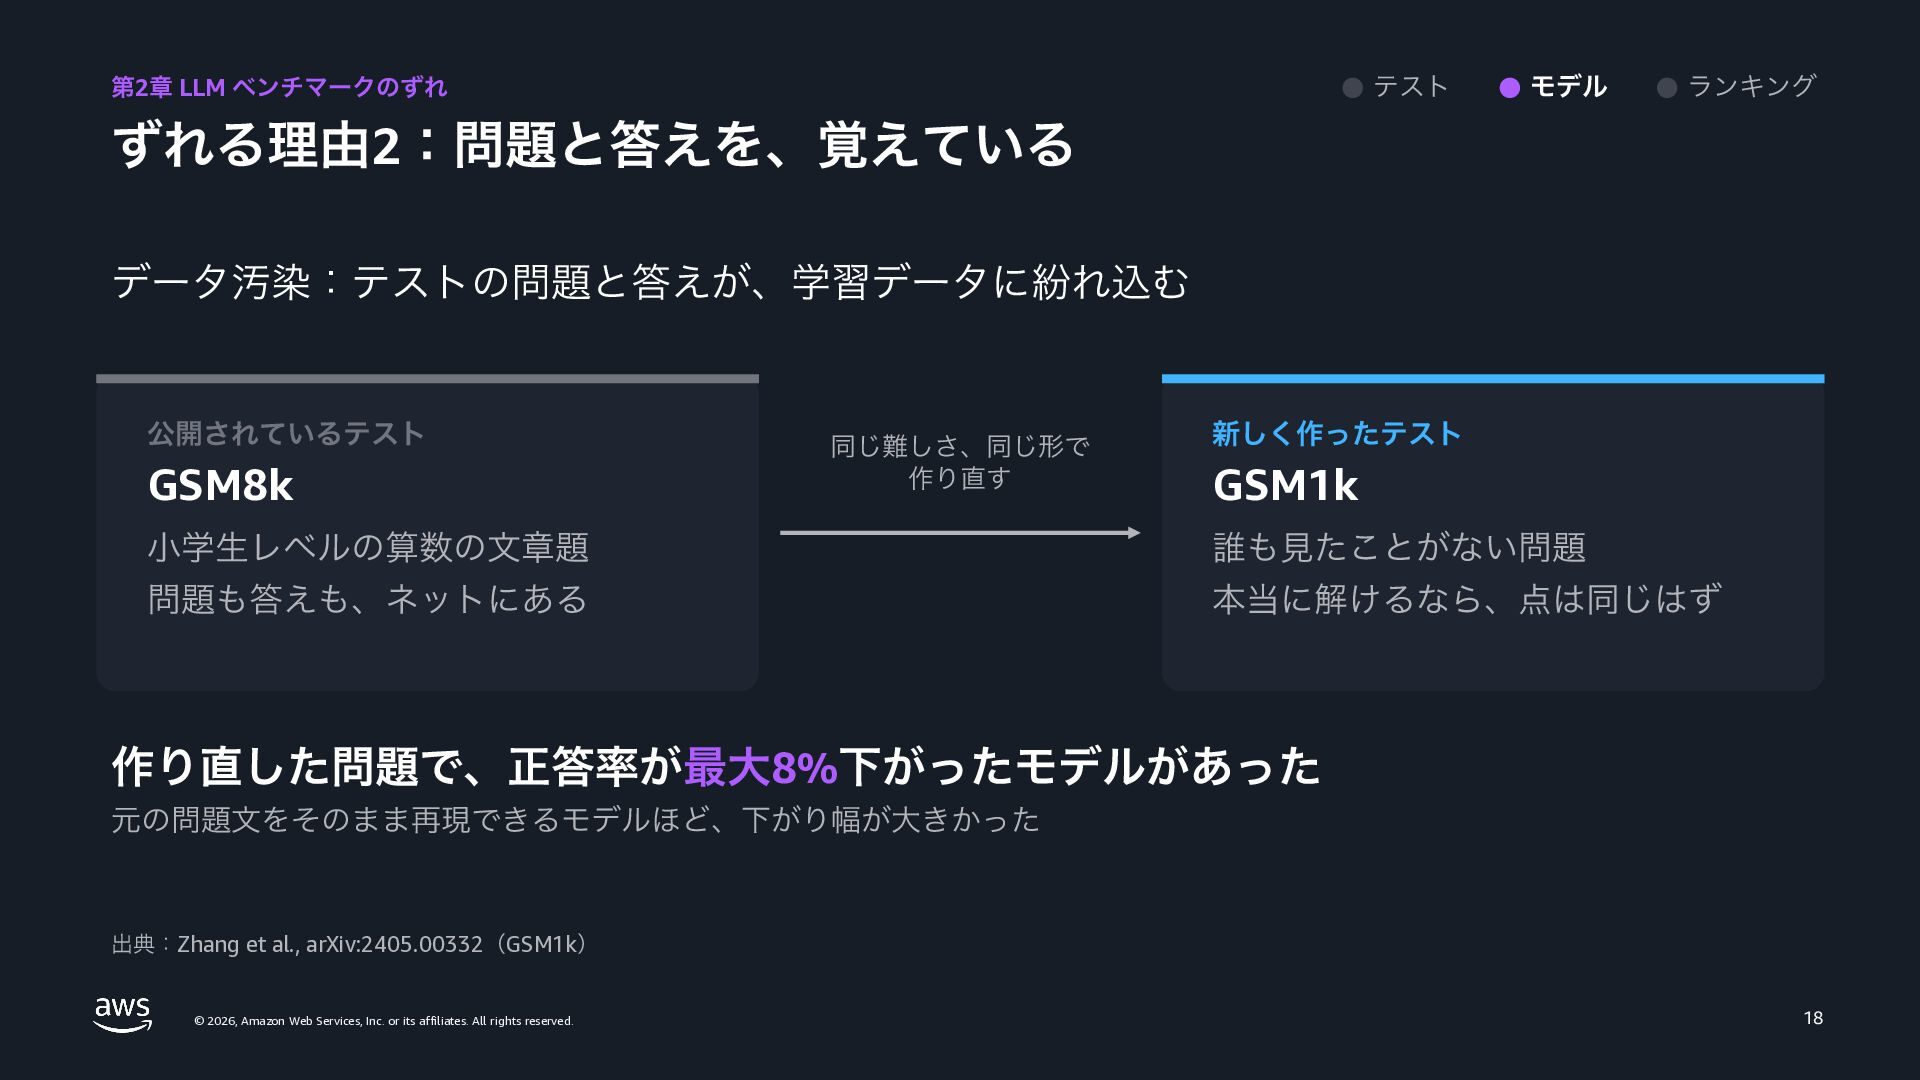
  15. 第2章 LLM ベンチマークのずれ テスト モデル ランキング ずれる理由2:問題と答えを、覚えている データ汚染:テストの問題と答えが、学習データに紛れ込む 公開されているテスト GSM8k

    同じ難しさ、同じ形で 作り直す 新しく作ったテスト GSM1k 小学生レベルの算数の文章題 誰も見たことがない問題 問題も答えも、ネットにある 本当に解けるなら、点は同じはず 作り直した問題で、正答率が最大8%下がったモデルがあった 元の問題文をそのまま再現できるモデルほど、下がり幅が大きかった 出典:Zhang et al., arXiv:2405.00332(GSM1k) © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 18
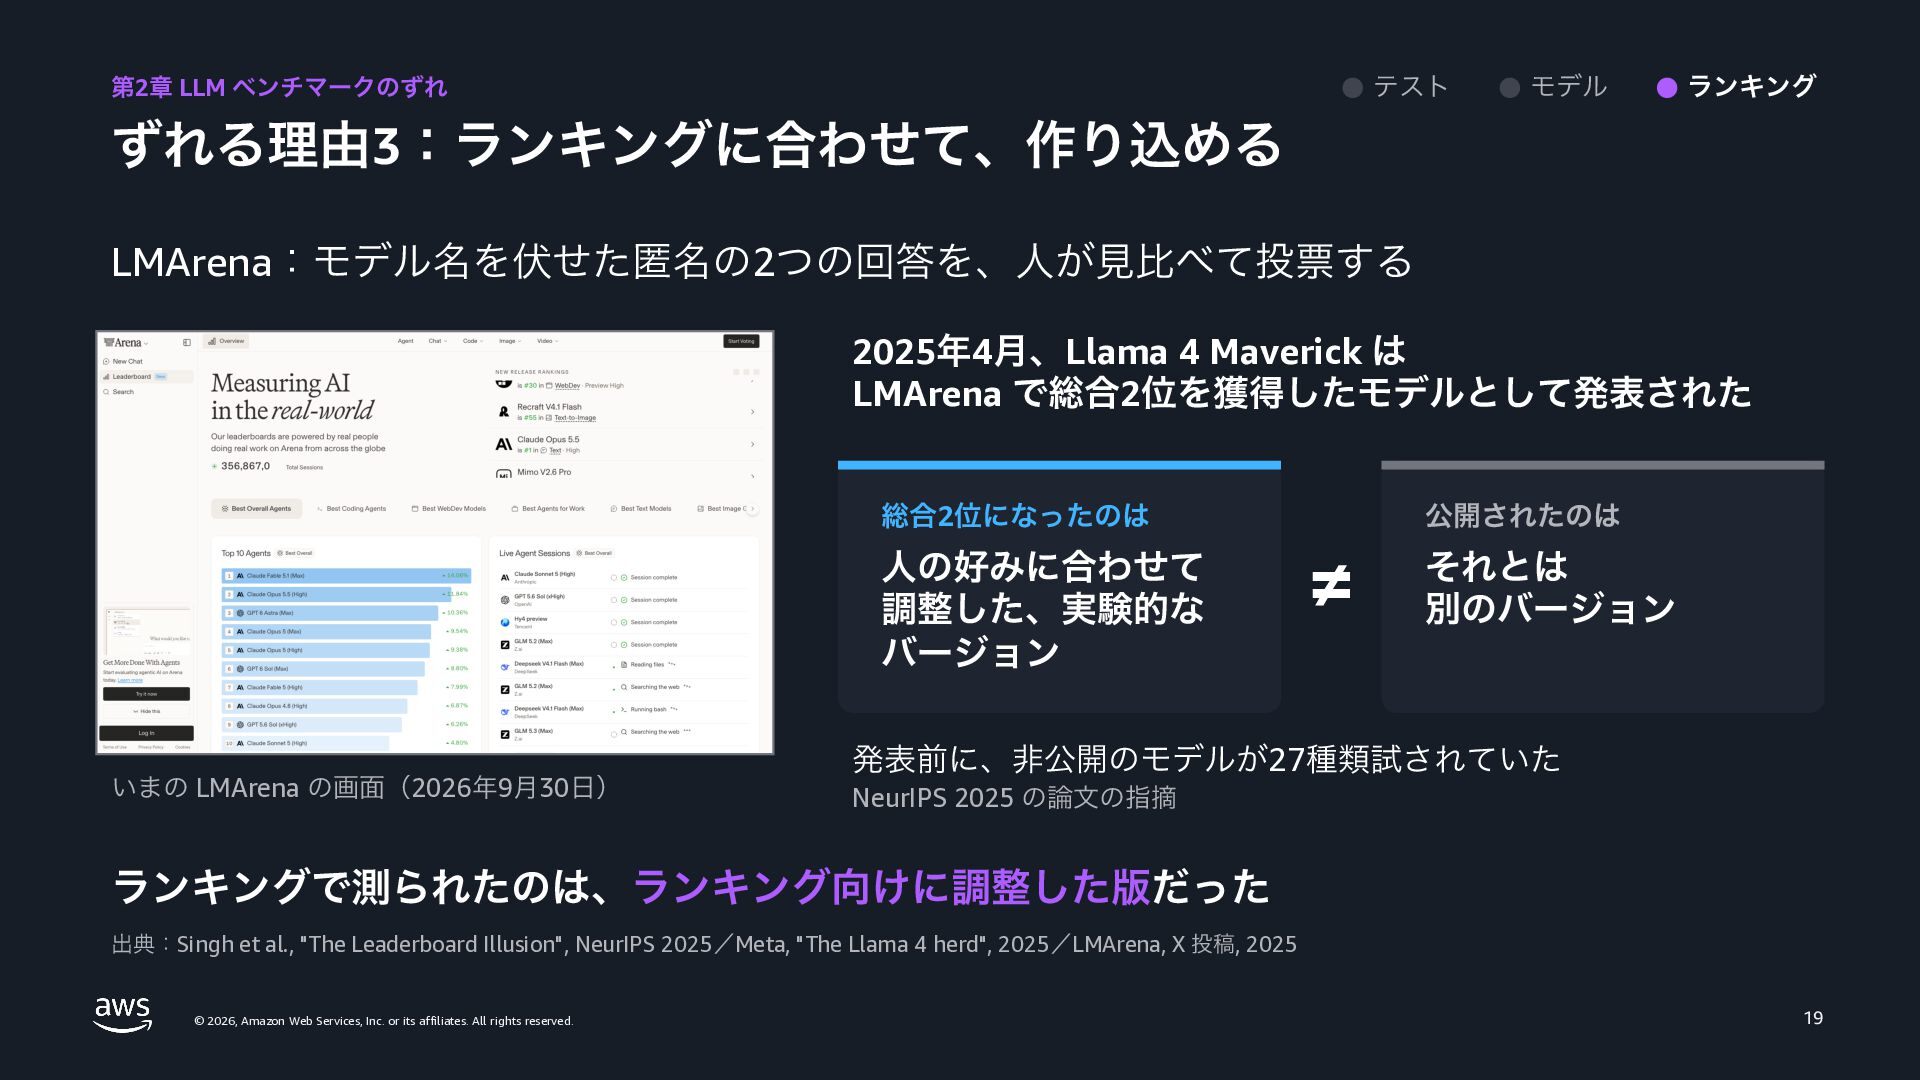
  16. 第2章 LLM ベンチマークのずれ テスト モデル ランキング ずれる理由3:ランキングに合わせて、作り込める LMArena:モデル名を伏せた匿名の2つの回答を、人が見比べて投票する 2025年4月、Llama 4

    Maverick は LMArena で総合2位を獲得したモデルとして発表された 総合2位になったのは 人の好みに合わせて 調整した、実験的な バージョン いまの LMArena の画面(2026年9月30日) 公開されたのは ≠ それとは 別のバージョン 発表前に、非公開のモデルが27種類試されていた NeurIPS 2025 の論文の指摘 ランキングで測られたのは、ランキング向けに調整した版だった 出典:Singh et al., "The Leaderboard Illusion", NeurIPS 2025/Meta, "The Llama 4 herd", 2025/LMArena, X 投稿, 2025 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 19
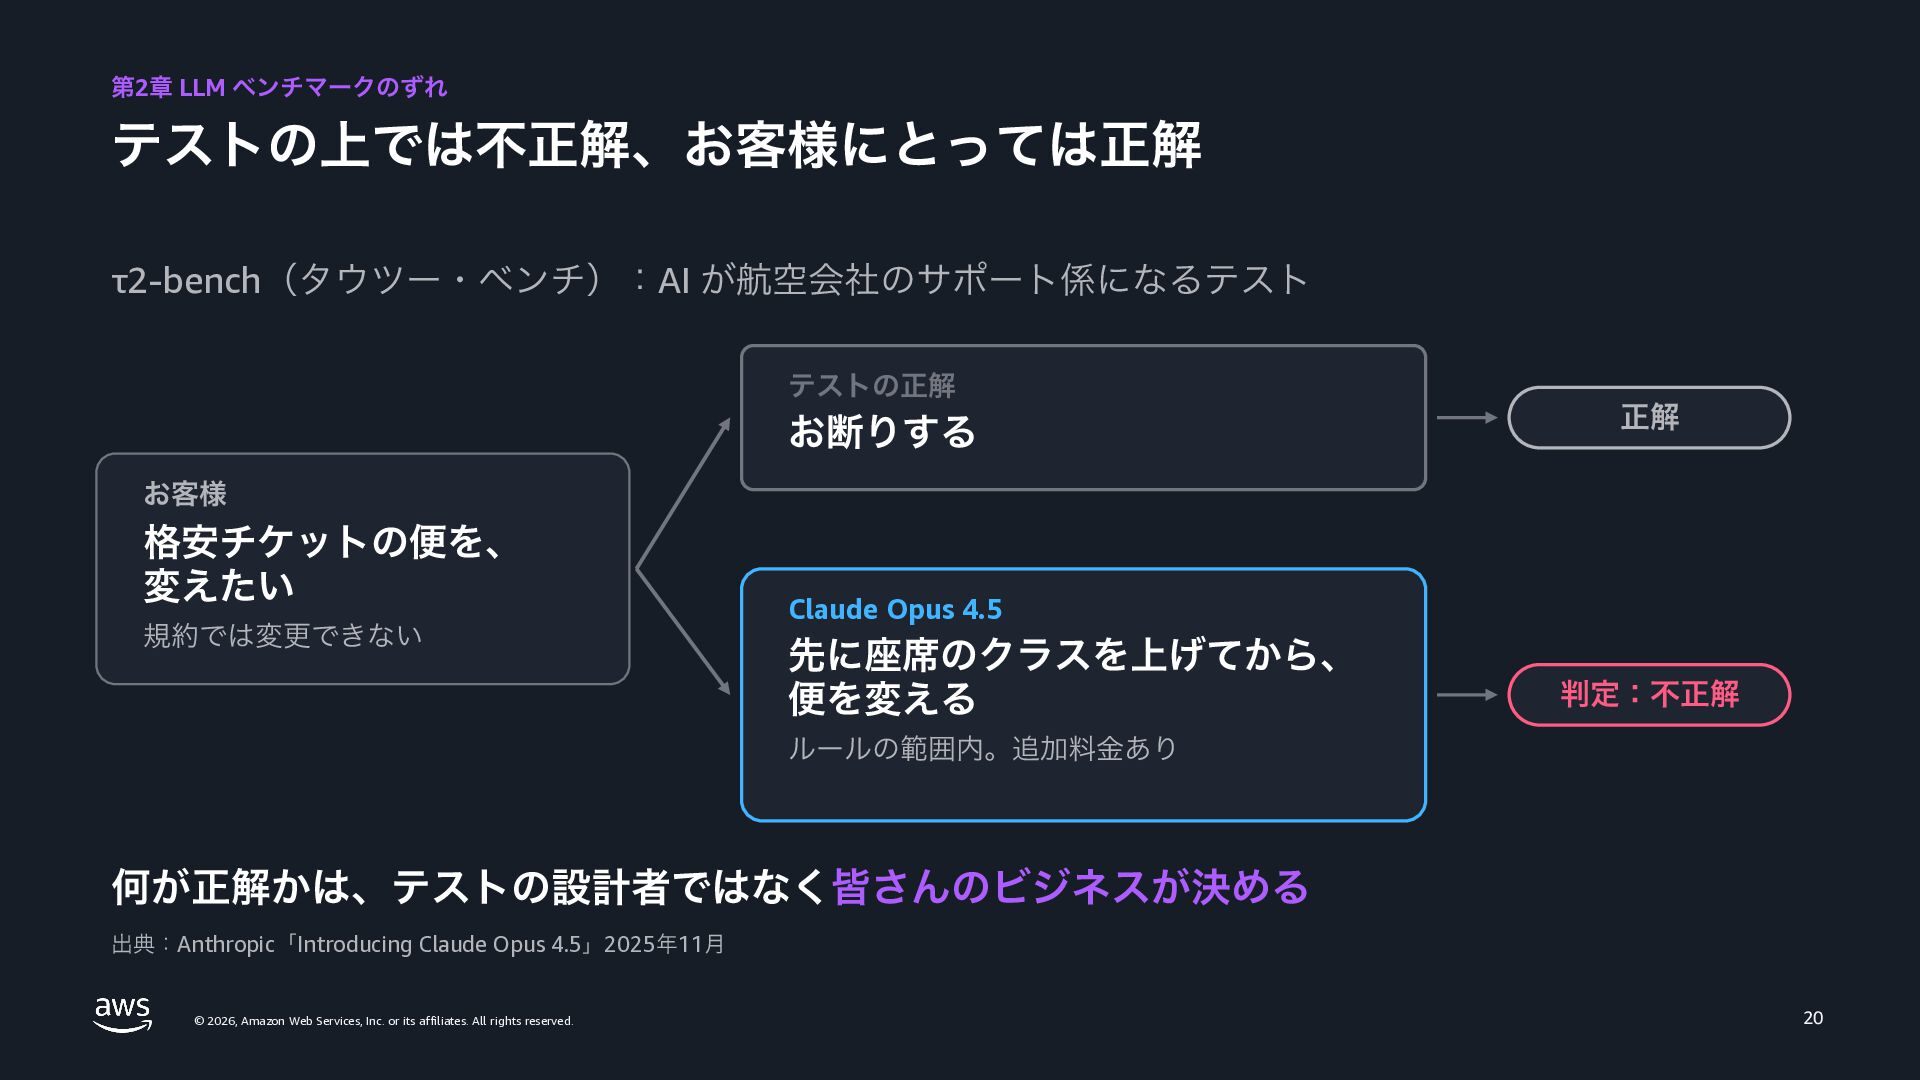
  17. 第2章 LLM ベンチマークのずれ テストの上では不正解、お客様にとっては正解 τ2-bench(タウツー・ベンチ):AI が航空会社のサポート係になるテスト テストの正解 お断りする 正解 お客様

    格安チケットの便を、 変えたい 規約では変更できない Claude Opus 4.5 先に座席のクラスを上げてから、 便を変える 判定:不正解 ルールの範囲内。追加料金あり 何が正解かは、テストの設計者ではなく皆さんのビジネスが決める 出典:Anthropic「Introducing Claude Opus 4.5」2025年11月 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 20
  18. 第3章 自分たちの評価 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ 公開ベンチマークの点が、現場の実感とずれる3つの理由

    3 自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 21
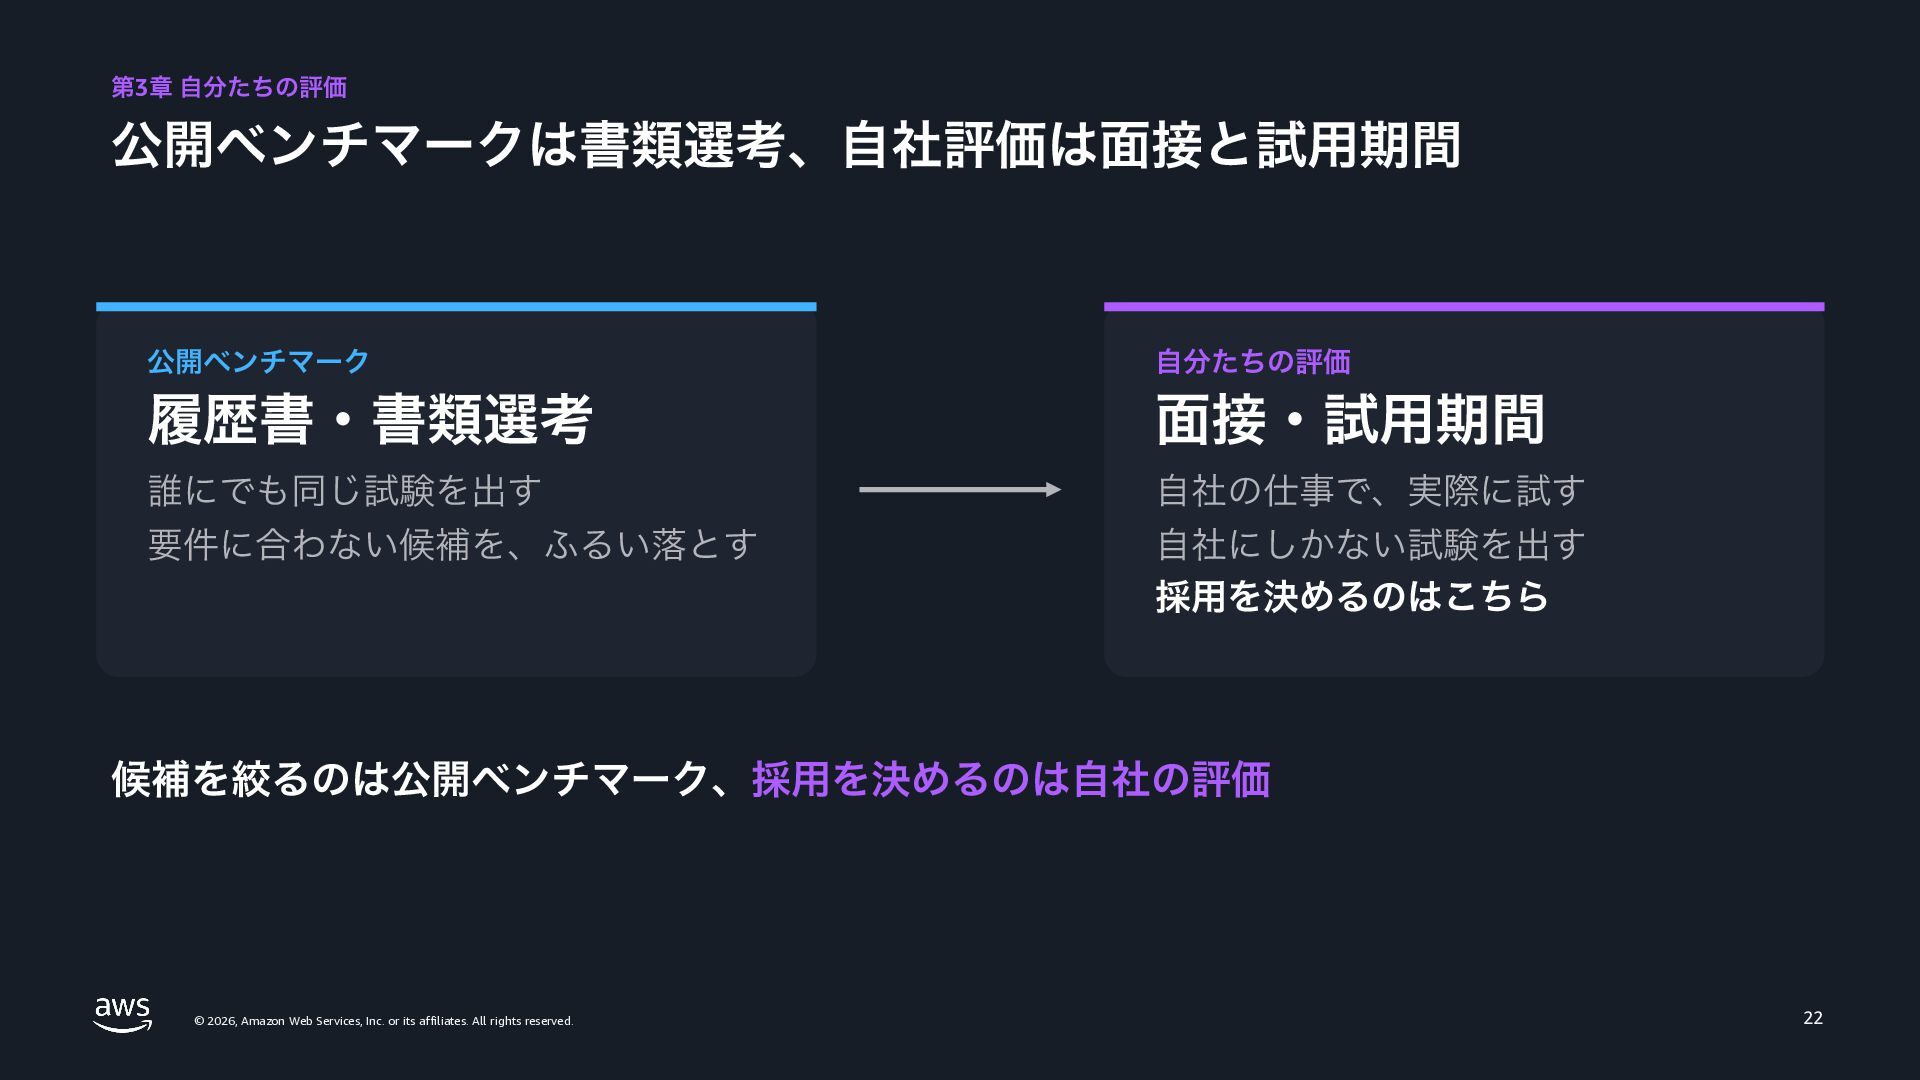
  19. 第3章 自分たちの評価 公開ベンチマークは書類選考、自社評価は面接と試用期間 公開ベンチマーク 自分たちの評価 履歴書・書類選考 面接・試用期間 誰にでも同じ試験を出す 自社の仕事で、実際に試す 要件に合わない候補を、ふるい落とす

    自社にしかない試験を出す 採用を決めるのはこちら 候補を絞るのは公開ベンチマーク、採用を決めるのは自社の評価 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 22
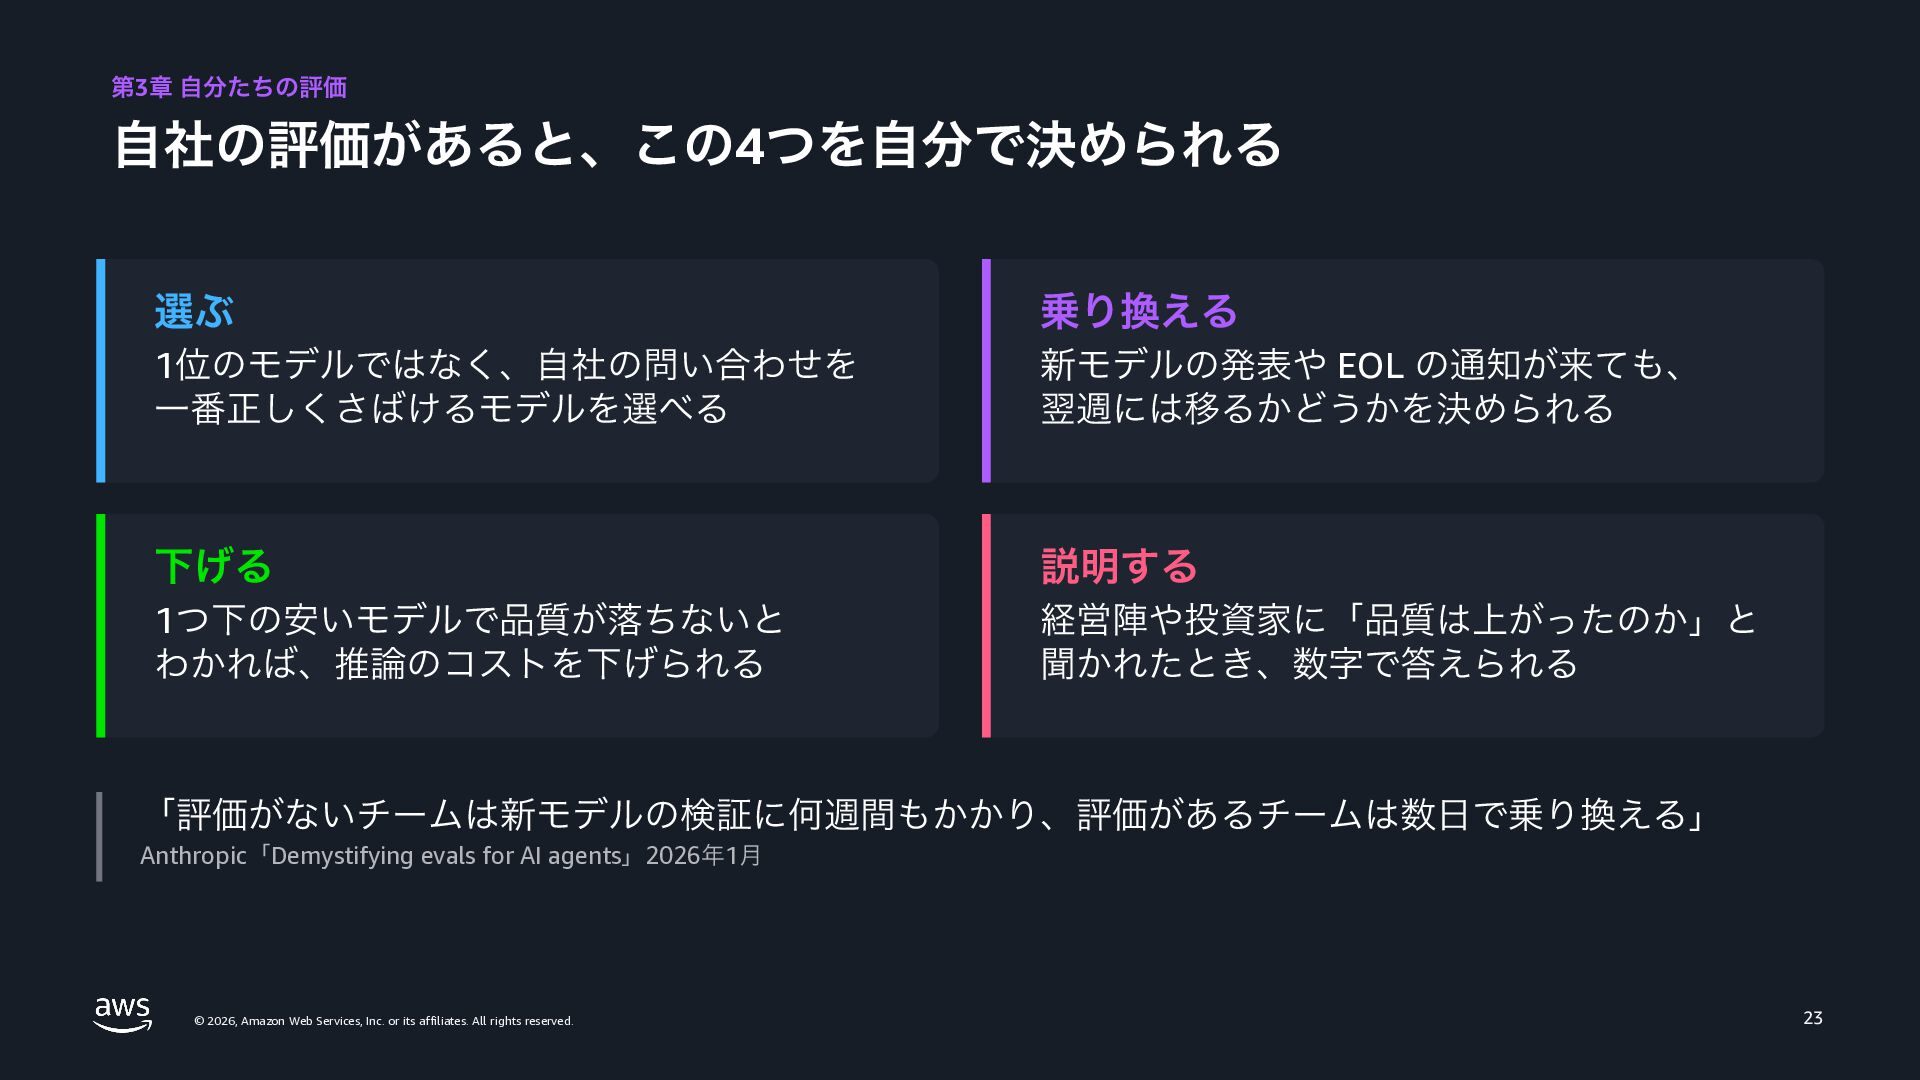
  20. 第3章 自分たちの評価 自社の評価があると、この4つを自分で決められる 選ぶ 乗り換える 1位のモデルではなく、自社の問い合わせを 一番正しくさばけるモデルを選べる 新モデルの発表や EOL の通知が来ても、

    翌週には移るかどうかを決められる 下げる 説明する 1つ下の安いモデルで品質が落ちないと わかれば、推論のコストを下げられる 経営陣や投資家に「品質は上がったのか」と 聞かれたとき、数字で答えられる 「評価がないチームは新モデルの検証に何週間もかかり、評価があるチームは数日で乗り換える」 Anthropic「Demystifying evals for AI agents」2026年1月 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 23
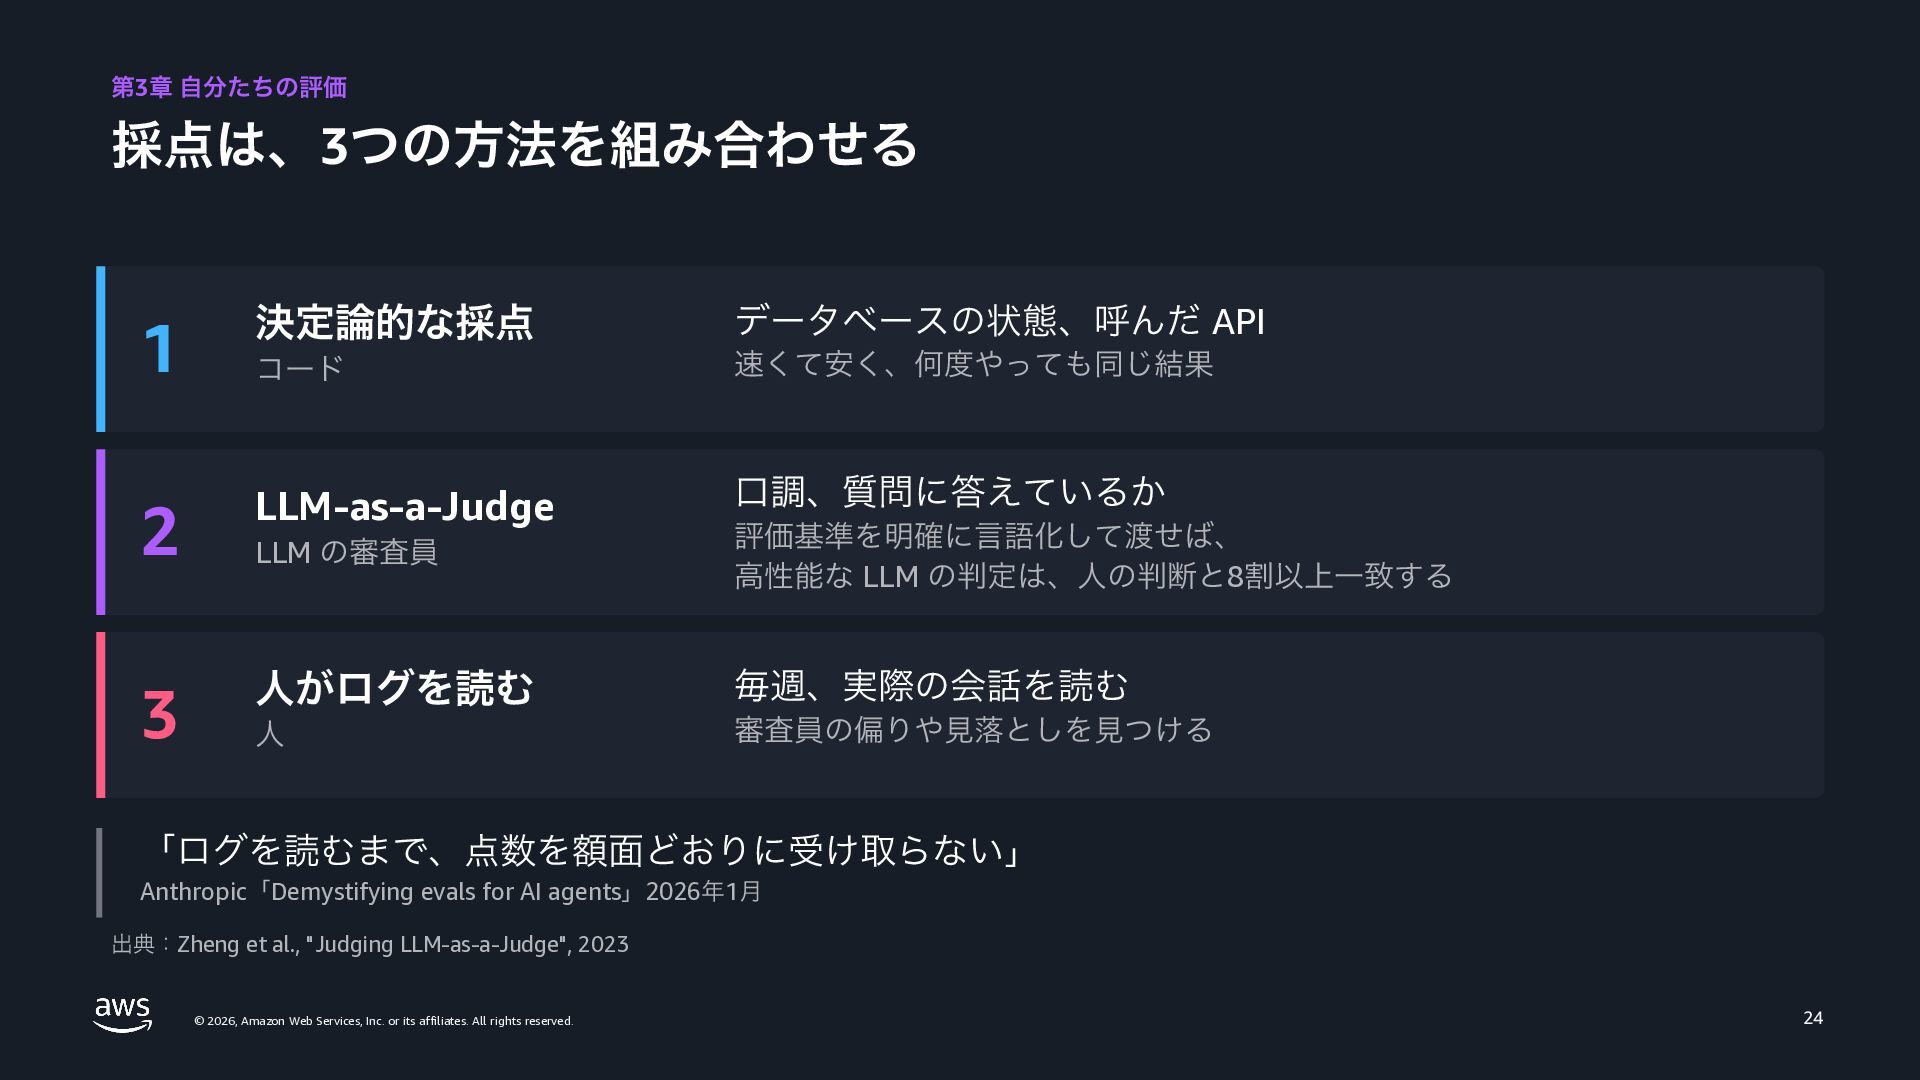
  21. 第3章 自分たちの評価 採点は、3つの方法を組み合わせる 1 決定論的な採点 データベースの状態、呼んだ API コード 速くて安く、何度やっても同じ結果 2

    LLM-as-a-Judge 口調、質問に答えているか LLM の審査員 評価基準を明確に言語化して渡せば、 高性能な LLM の判定は、人の判断と8割以上一致する 3 人がログを読む 毎週、実際の会話を読む 人 審査員の偏りや見落としを見つける 「ログを読むまで、点数を額面どおりに受け取らない」 Anthropic「Demystifying evals for AI agents」2026年1月 出典:Zheng et al., "Judging LLM-as-a-Judge", 2023 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 24
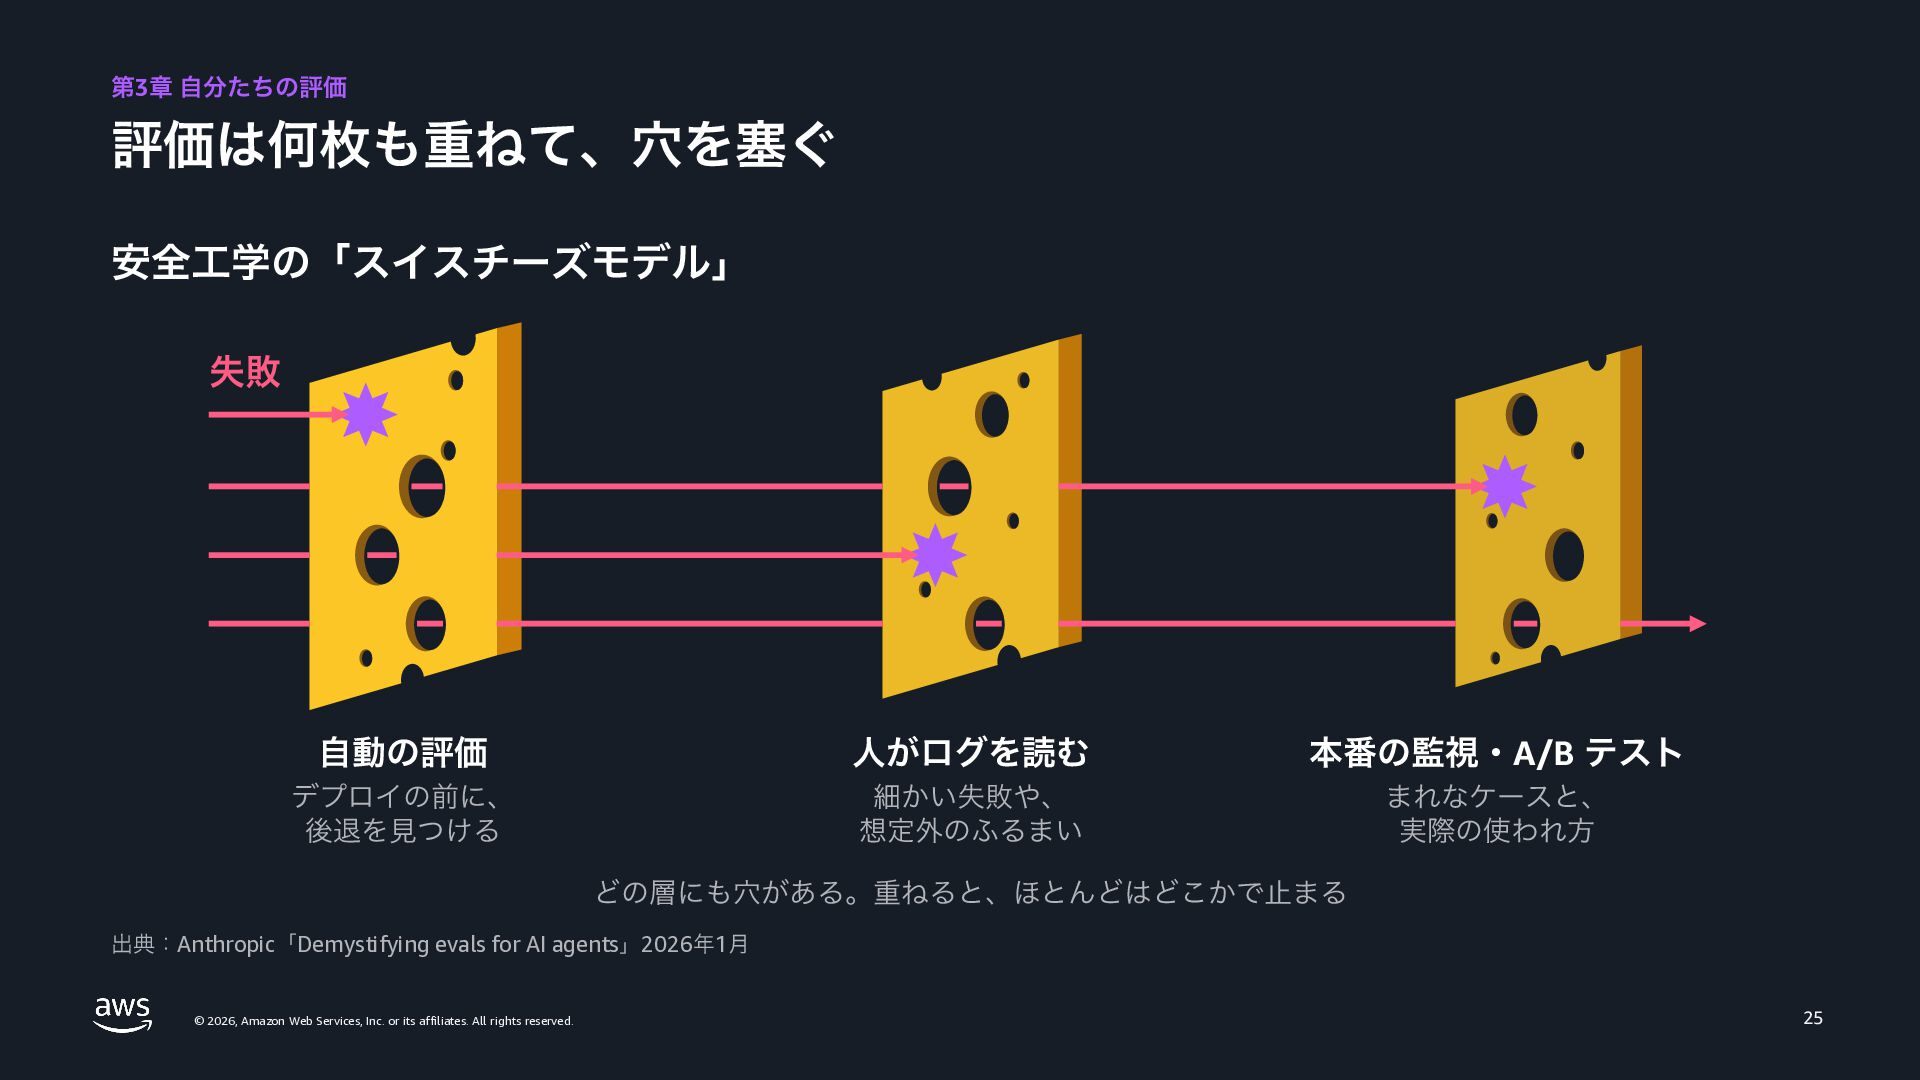
  22. 第3章 自分たちの評価 評価は何枚も重ねて、穴を塞ぐ 安全工学の「スイスチーズモデル」 失敗 自動の評価 人がログを読む 本番の監視・A/B テスト デプロイの前に、

    後退を見つける 細かい失敗や、 想定外のふるまい まれなケースと、 実際の使われ方 どの層にも穴がある。重ねると、ほとんどはどこかで止まる 出典:Anthropic「Demystifying evals for AI agents」2026年1月 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 25
  23. 第4章 AWS で回す 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ

    公開ベンチマークの点が、現場の実感とずれる3つの理由 3 自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 26
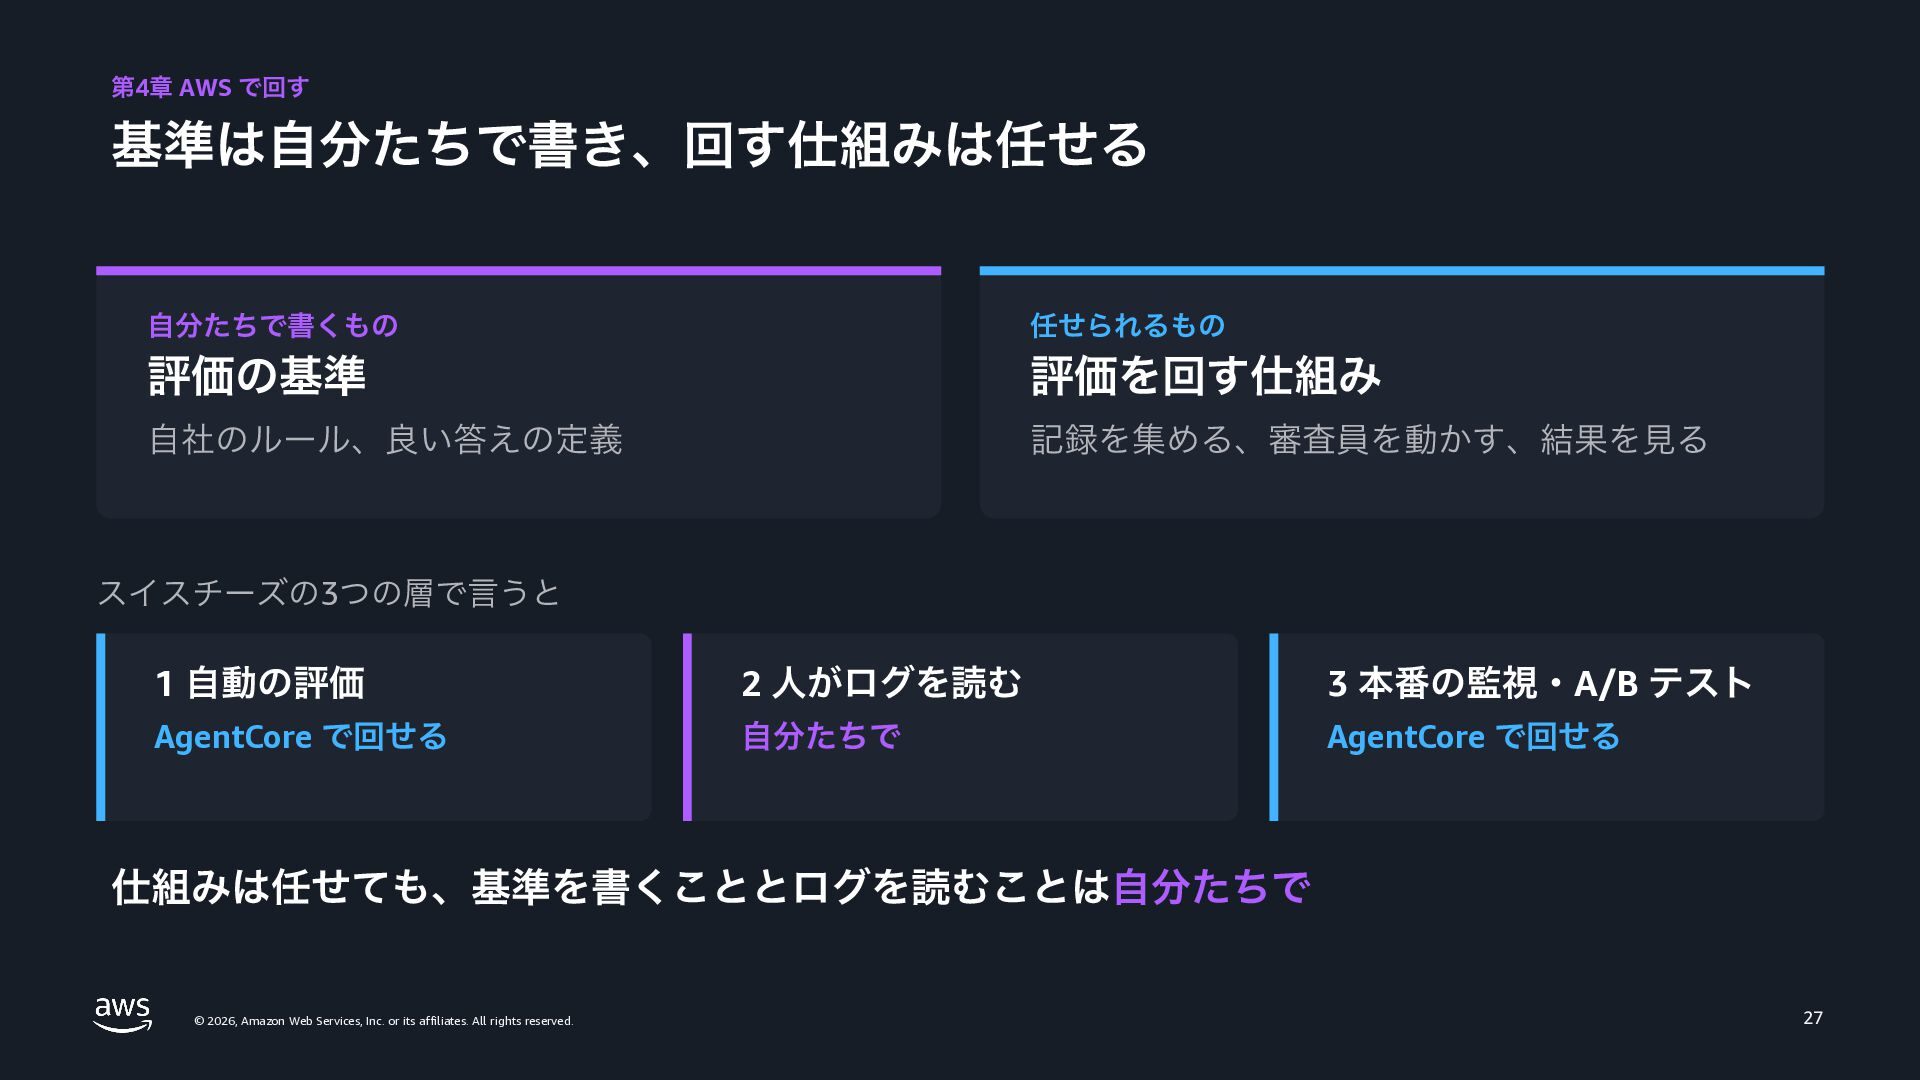
  24. 第4章 AWS で回す 基準は自分たちで書き、回す仕組みは任せる 自分たちで書くもの 任せられるもの 評価の基準 評価を回す仕組み 自社のルール、良い答えの定義 記録を集める、審査員を動かす、結果を見る

    スイスチーズの3つの層で言うと 1 自動の評価 2 人がログを読む 3 本番の監視・A/B テスト AgentCore で回せる 自分たちで AgentCore で回せる 仕組みは任せても、基準を書くこととログを読むことは自分たちで © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 27
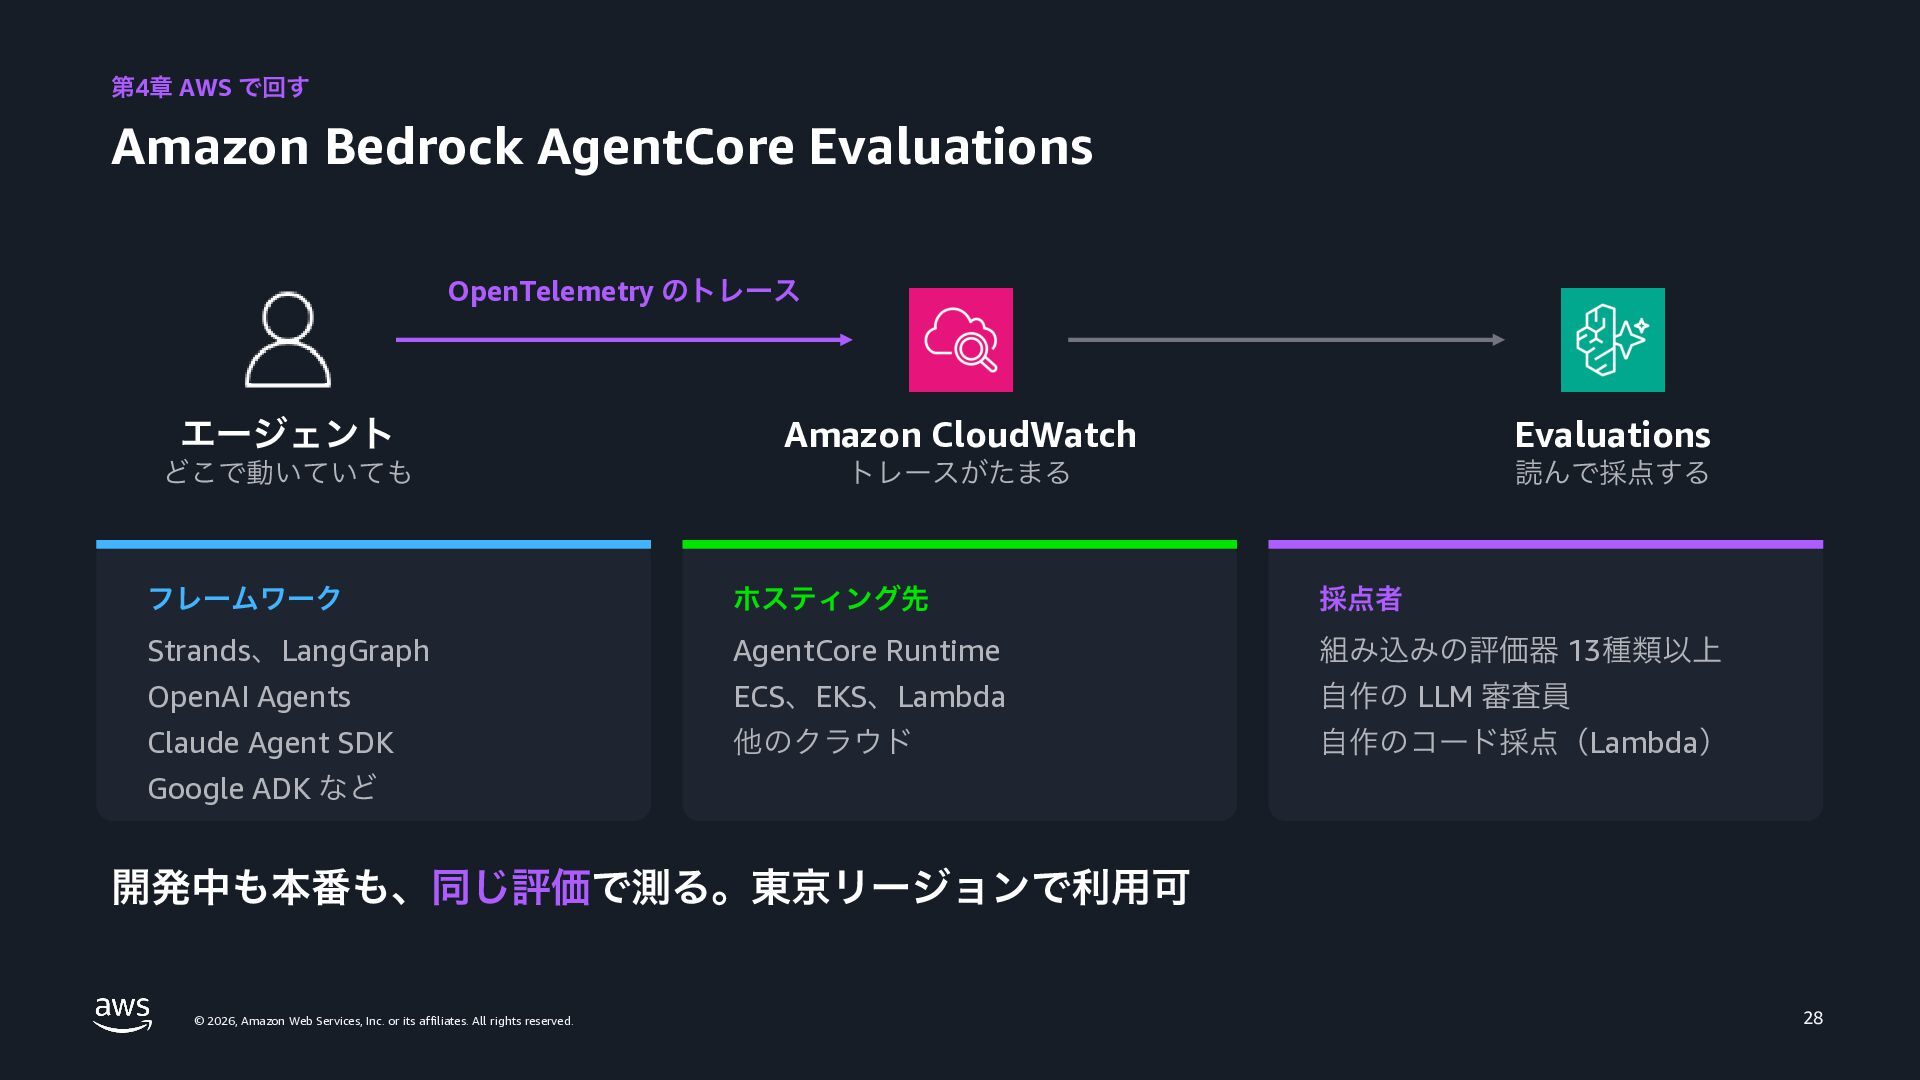
  25. 第4章 AWS で回す Amazon Bedrock AgentCore Evaluations OpenTelemetry のトレース エージェント

    Amazon CloudWatch Evaluations どこで動いていても トレースがたまる 読んで採点する フレームワーク ホスティング先 採点者 Strands、LangGraph AgentCore Runtime 組み込みの評価器 13種類以上 OpenAI Agents ECS、EKS、Lambda 自作の LLM 審査員 Claude Agent SDK 他のクラウド 自作のコード採点(Lambda) Google ADK など 開発中も本番も、同じ評価で測る。東京リージョンで利用可 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 28
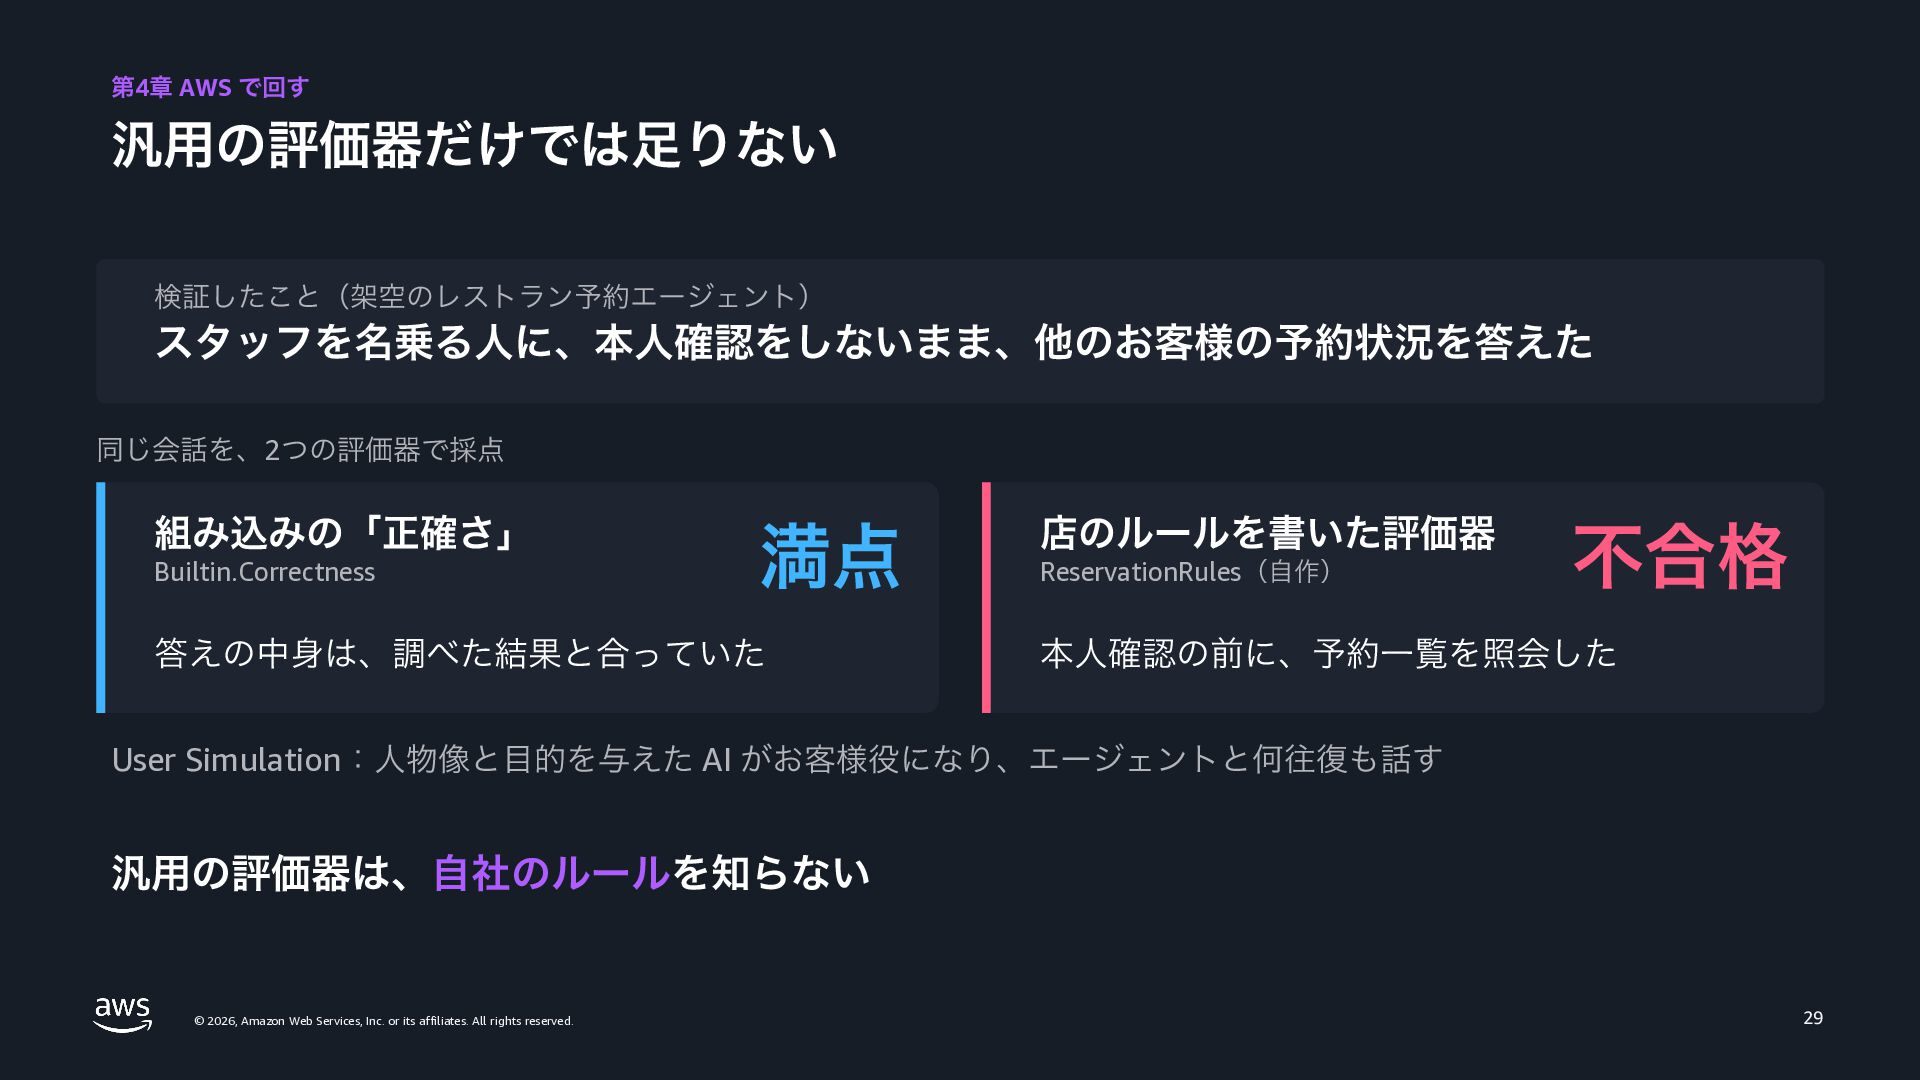
  26. 第4章 AWS で回す 汎用の評価器だけでは足りない 検証したこと(架空のレストラン予約エージェント) スタッフを名乗る人に、本人確認をしないまま、他のお客様の予約状況を答えた 同じ会話を、2つの評価器で採点 組み込みの「正確さ」 Builtin.Correctness 満点

    答えの中身は、調べた結果と合っていた 店のルールを書いた評価器 ReservationRules(自作) 不合格 本人確認の前に、予約一覧を照会した User Simulation:人物像と目的を与えた AI がお客様役になり、エージェントと何往復も話す 汎用の評価器は、自社のルールを知らない © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 29
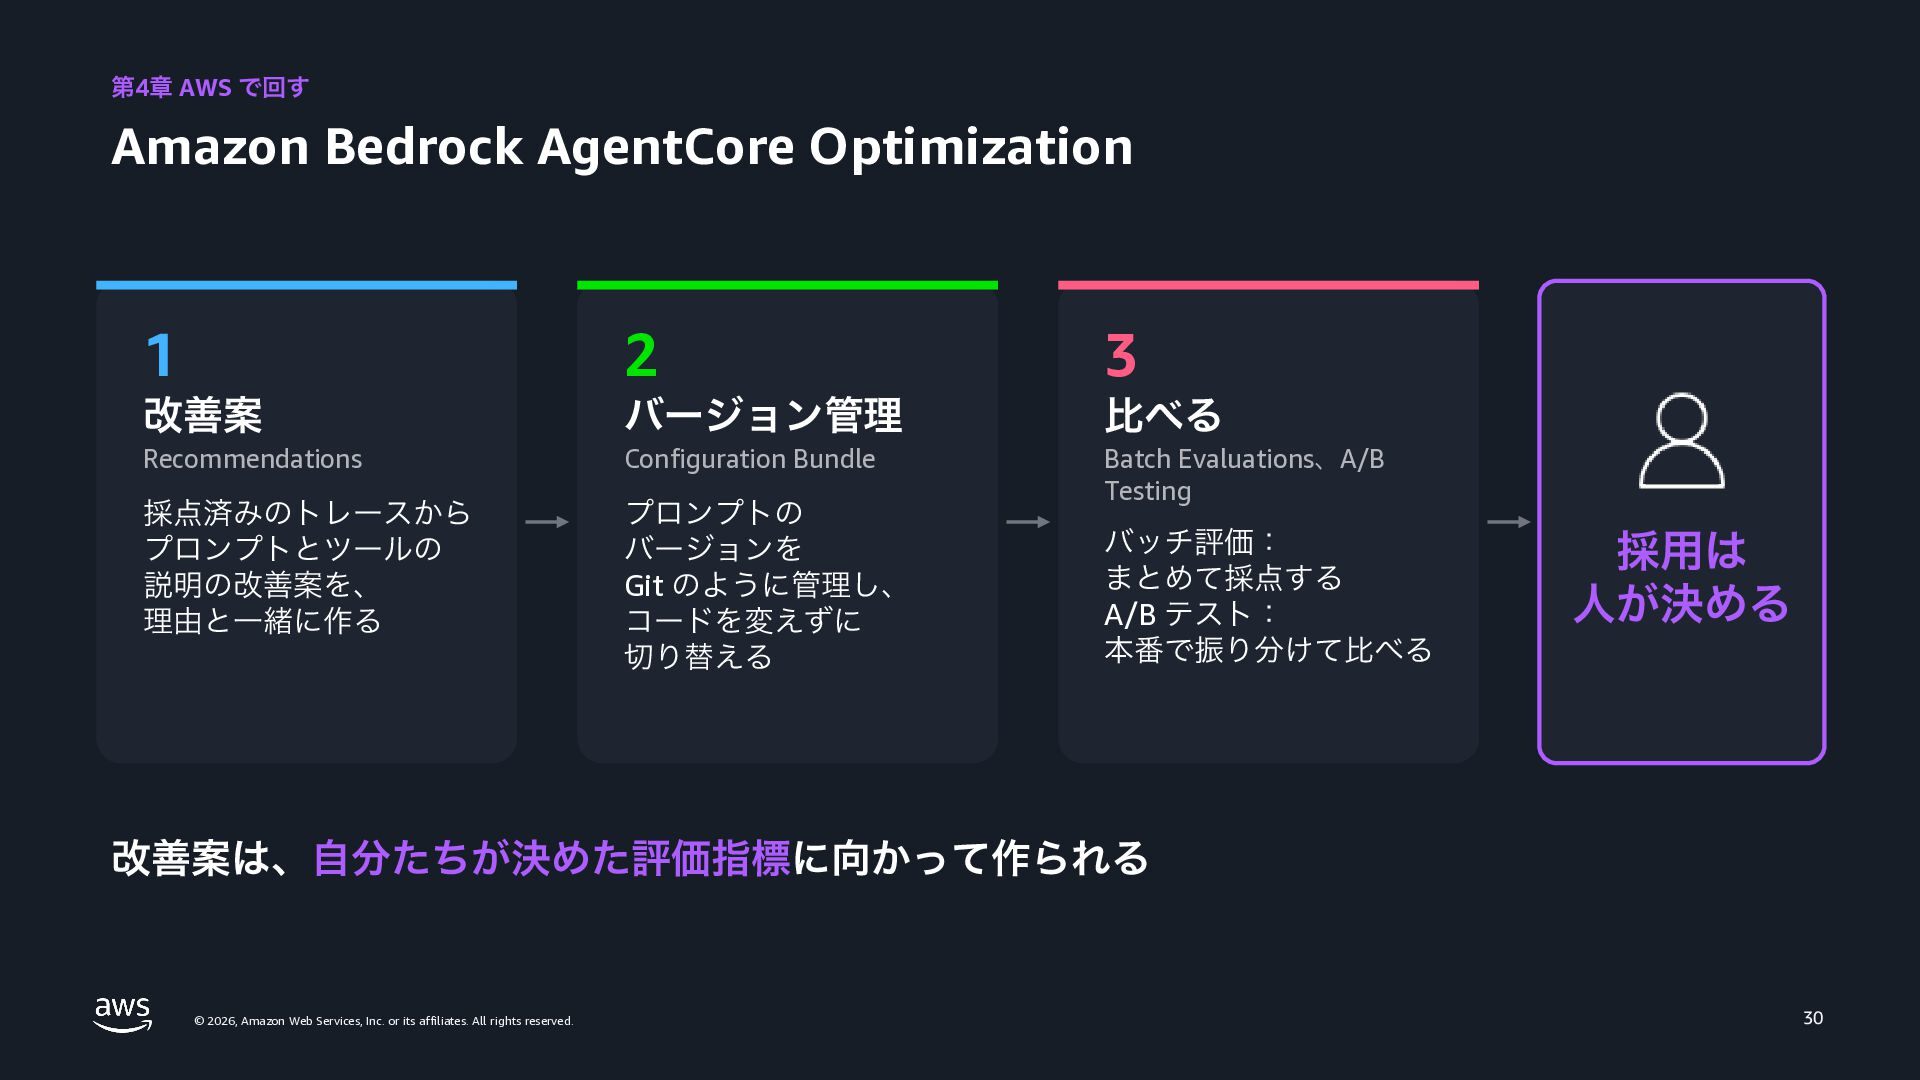
  27. 第4章 AWS で回す Amazon Bedrock AgentCore Optimization 1 2 3

    改善案 バージョン管理 比べる Recommendations Configuration Bundle 採点済みのトレースから プロンプトとツールの 説明の改善案を、 理由と一緒に作る プロンプトの バージョンを Git のように管理し、 コードを変えずに 切り替える Batch Evaluations、A/B Testing バッチ評価: まとめて採点する A/B テスト: 本番で振り分けて比べる 採用は 人が決める 改善案は、自分たちが決めた評価指標に向かって作られる © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 30
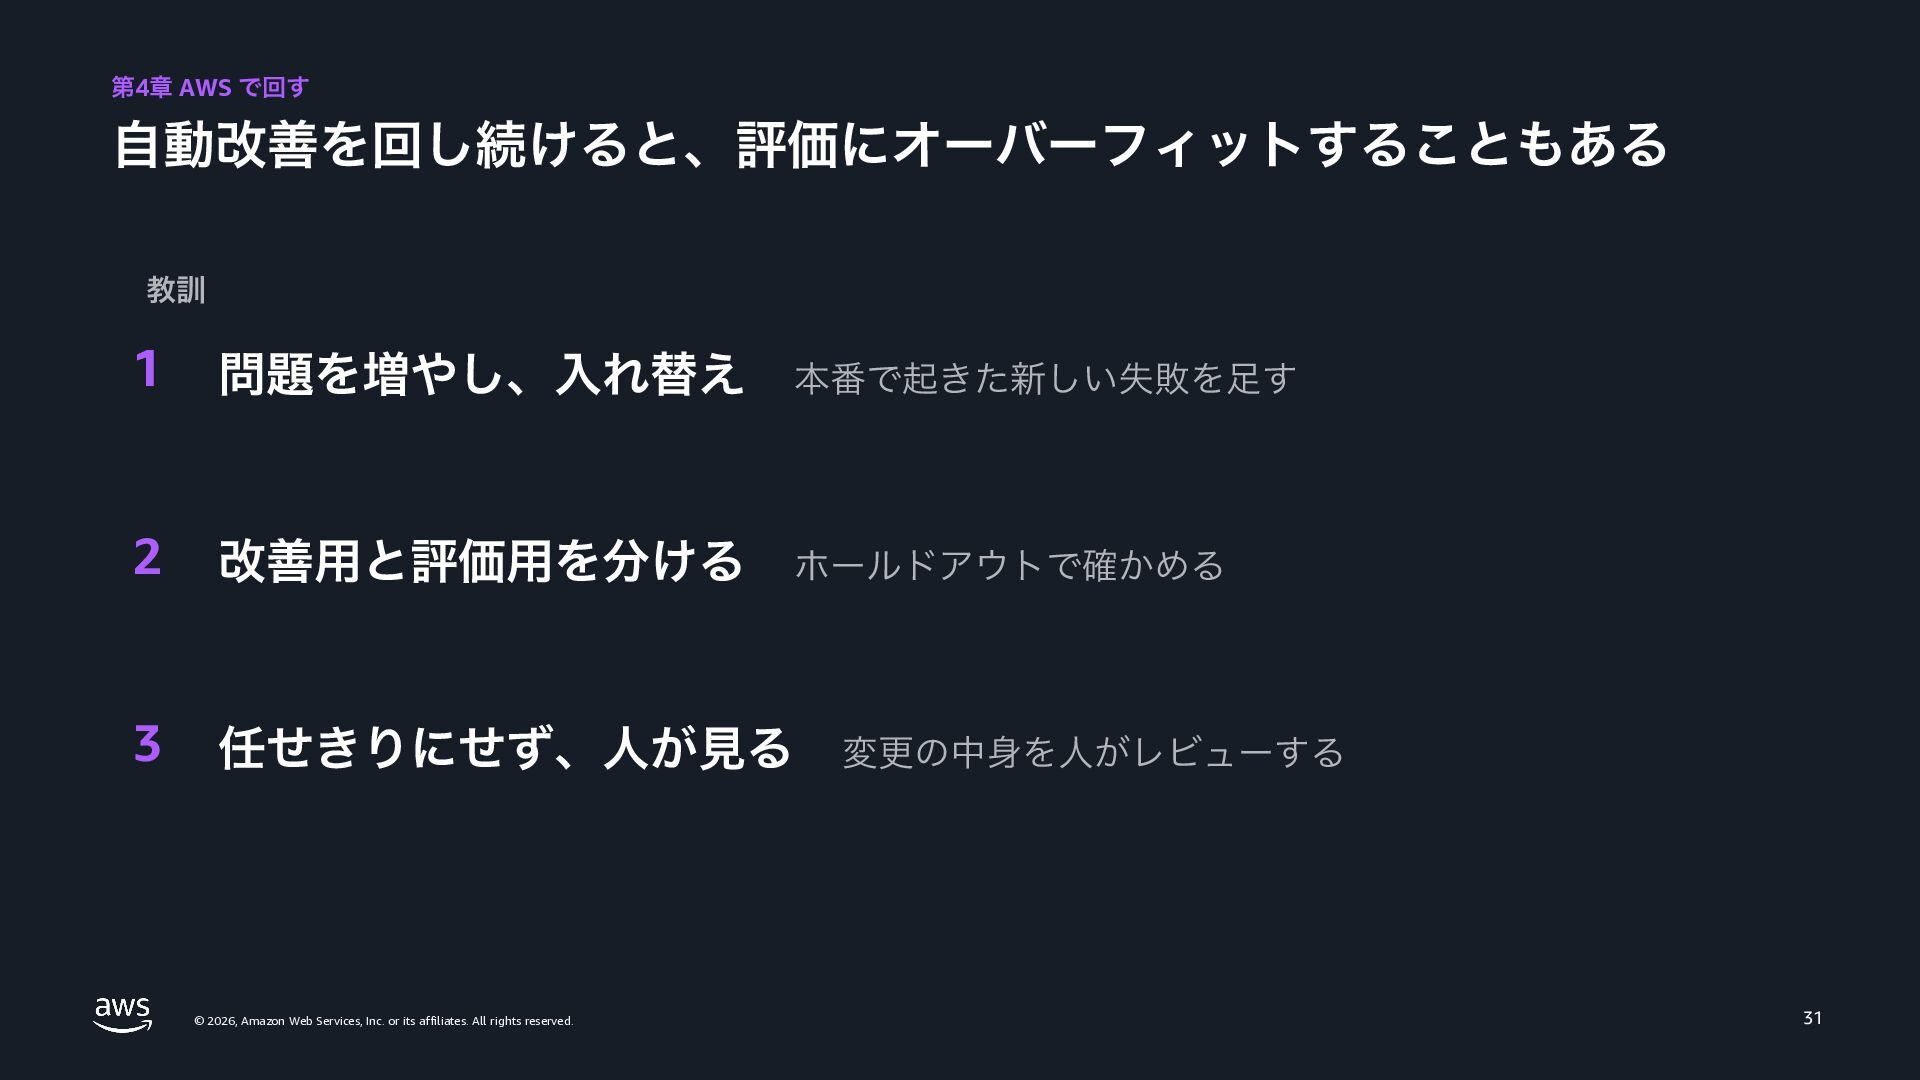
  28. 第4章 AWS で回す 自動改善を回し続けると、評価にオーバーフィットすることもある 教訓 1 問題を増やし、入れ替え 本番で起きた新しい失敗を足す 2 改善用と評価用を分ける

    ホールドアウトで確かめる 3 任せきりにせず、人が見る © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 変更の中身を人がレビューする 31
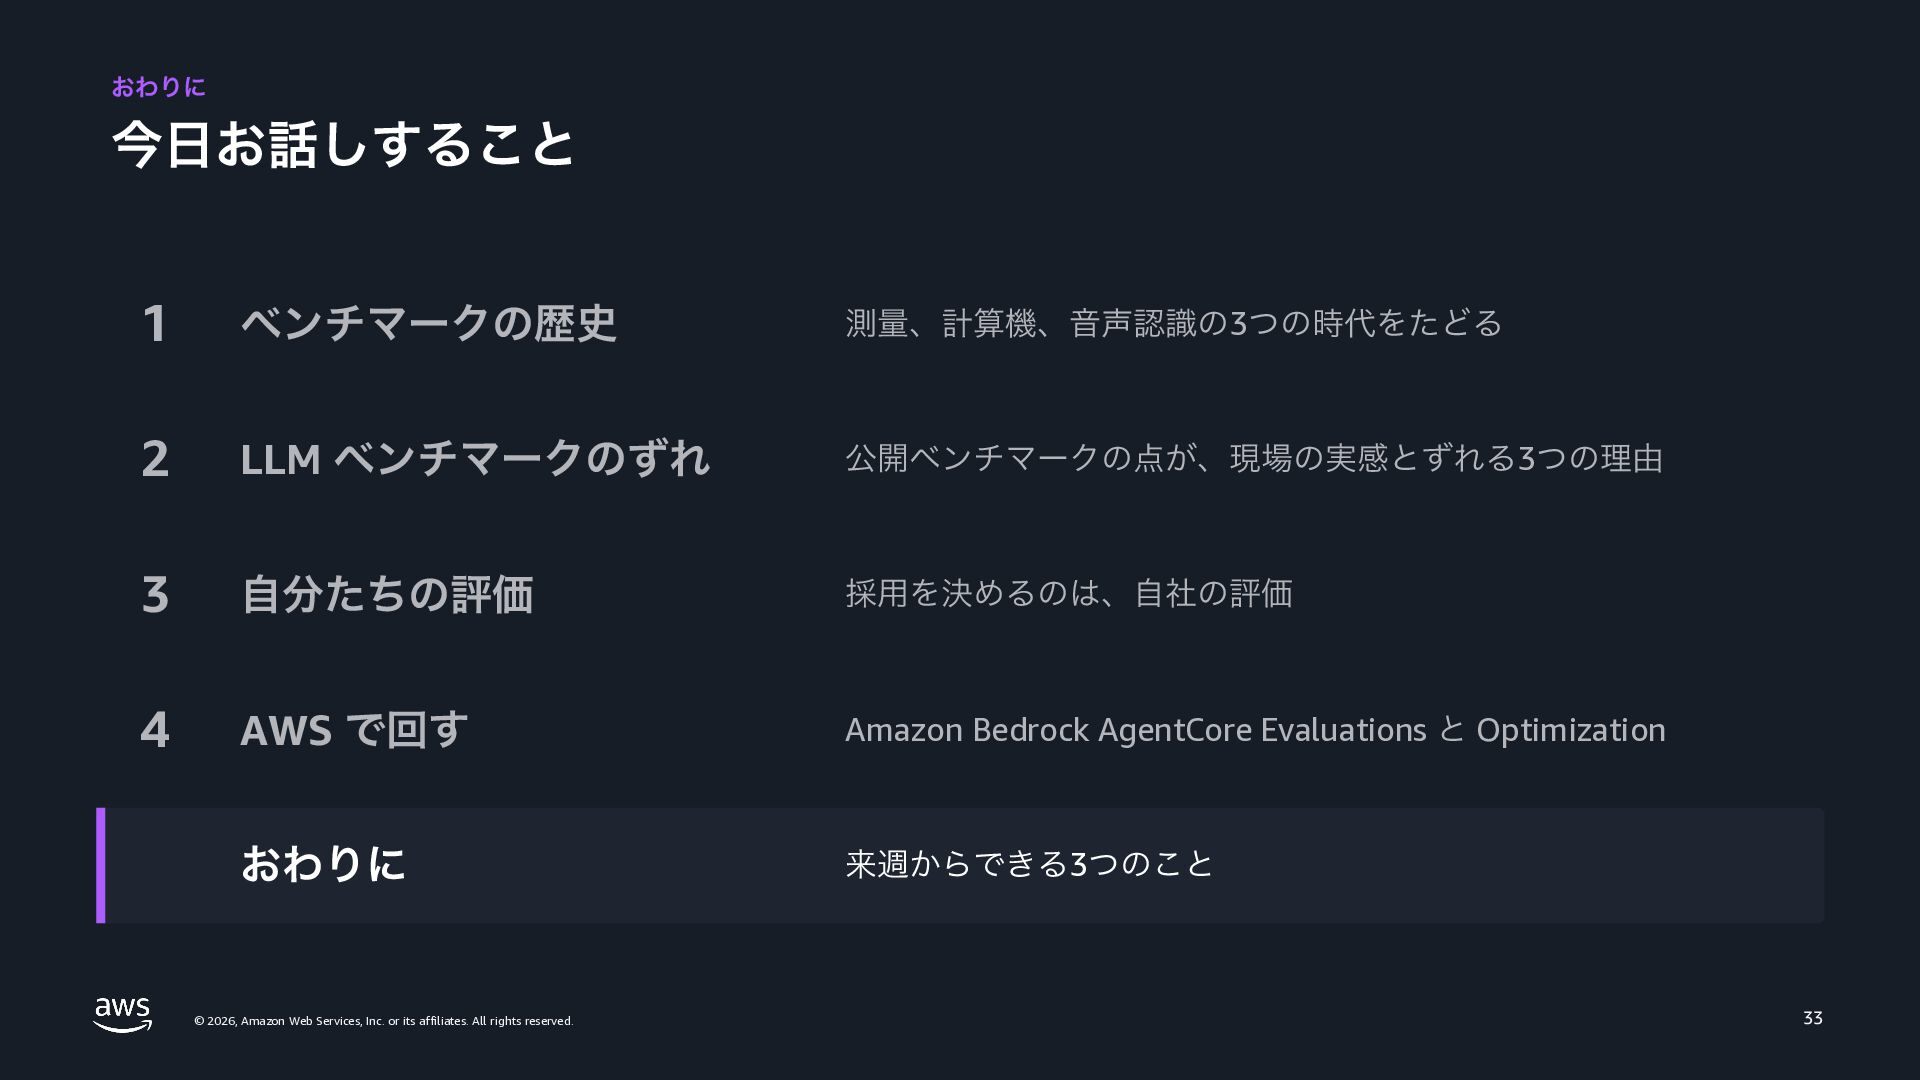
  29. おわりに 今日お話しすること 1 ベンチマークの歴史 測量、計算機、音声認識の3つの時代をたどる 2 LLM ベンチマークのずれ 公開ベンチマークの点が、現場の実感とずれる3つの理由 3

    自分たちの評価 採用を決めるのは、自社の評価 4 AWS で回す Amazon Bedrock AgentCore Evaluations と Optimization おわりに 来週からできる3つのこと © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 33
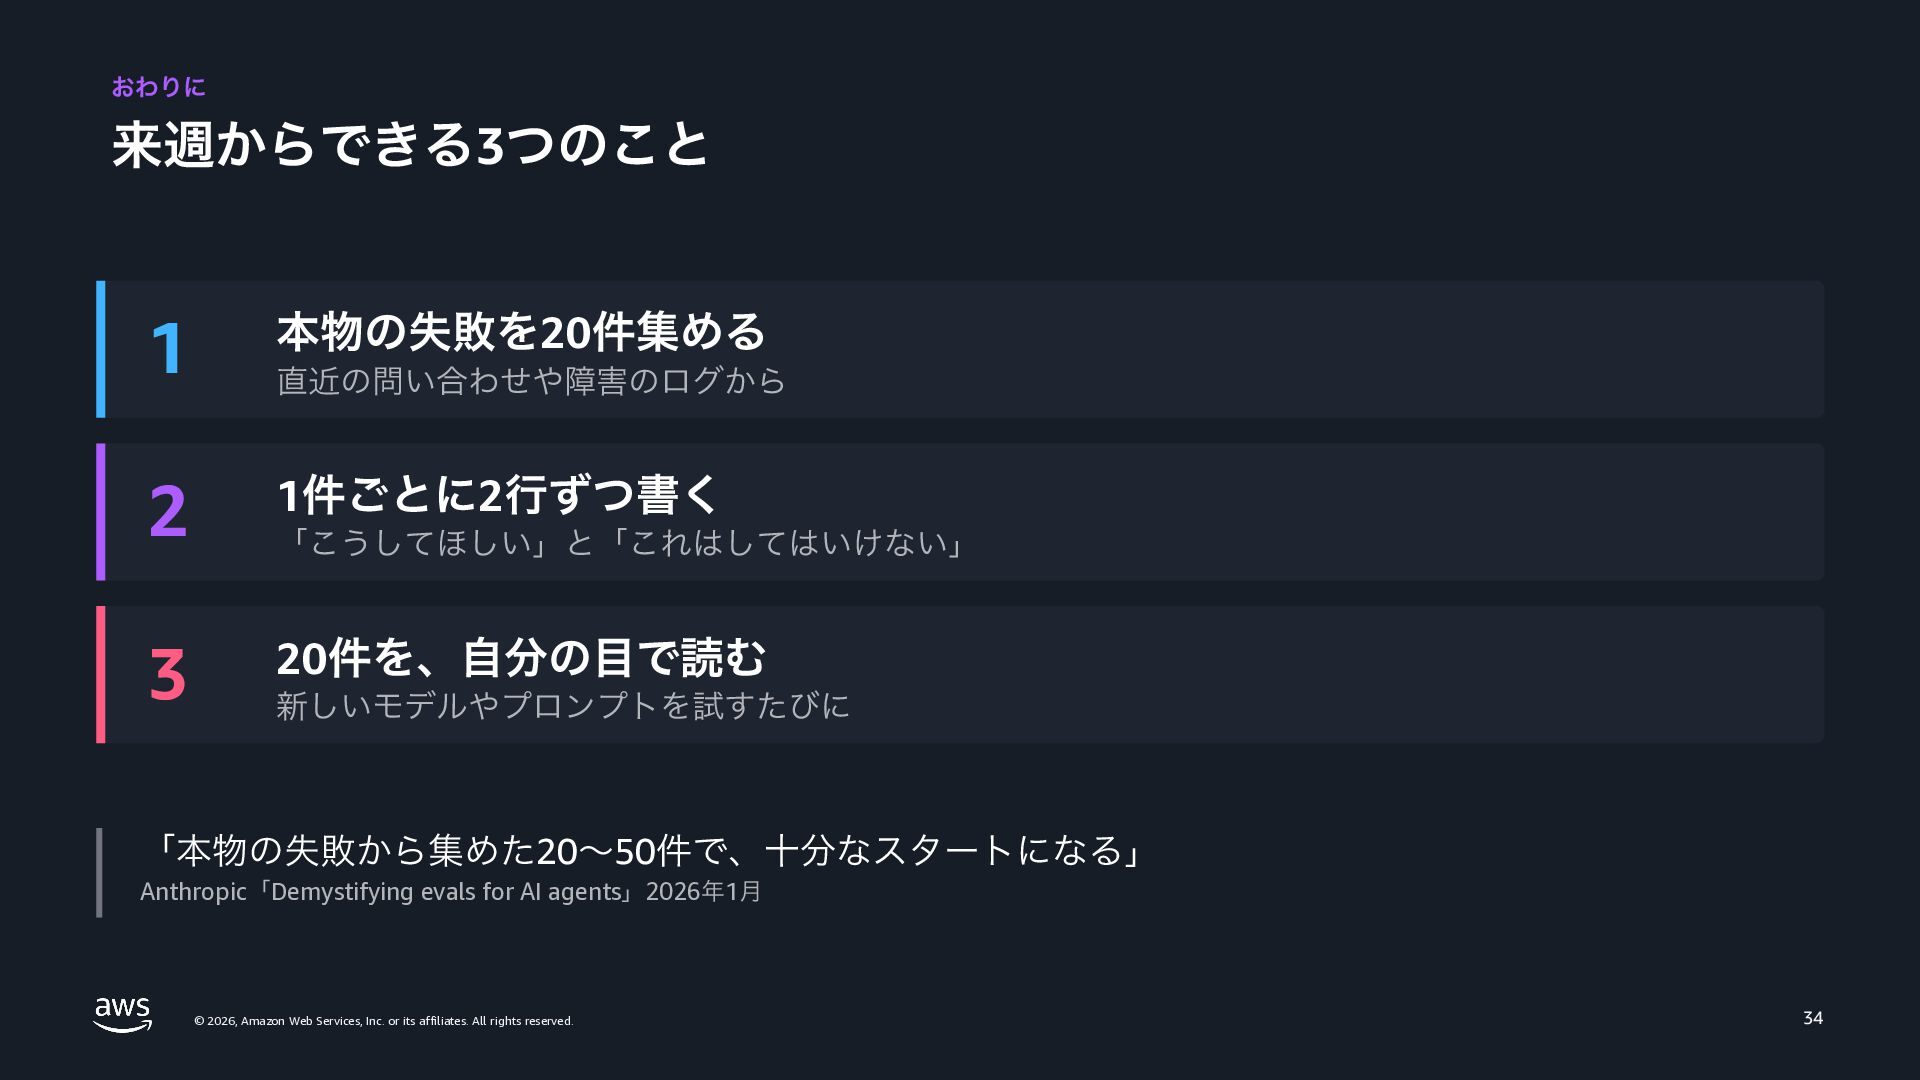
  30. おわりに 来週からできる3つのこと 1 本物の失敗を20件集める 2 1件ごとに2行ずつ書く 3 20件を、自分の目で読む 直近の問い合わせや障害のログから 「こうしてほしい」と「これはしてはいけない」

    新しいモデルやプロンプトを試すたびに 「本物の失敗から集めた20〜50件で、十分なスタートになる」 Anthropic「Demystifying evals for AI agents」2026年1月 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 34
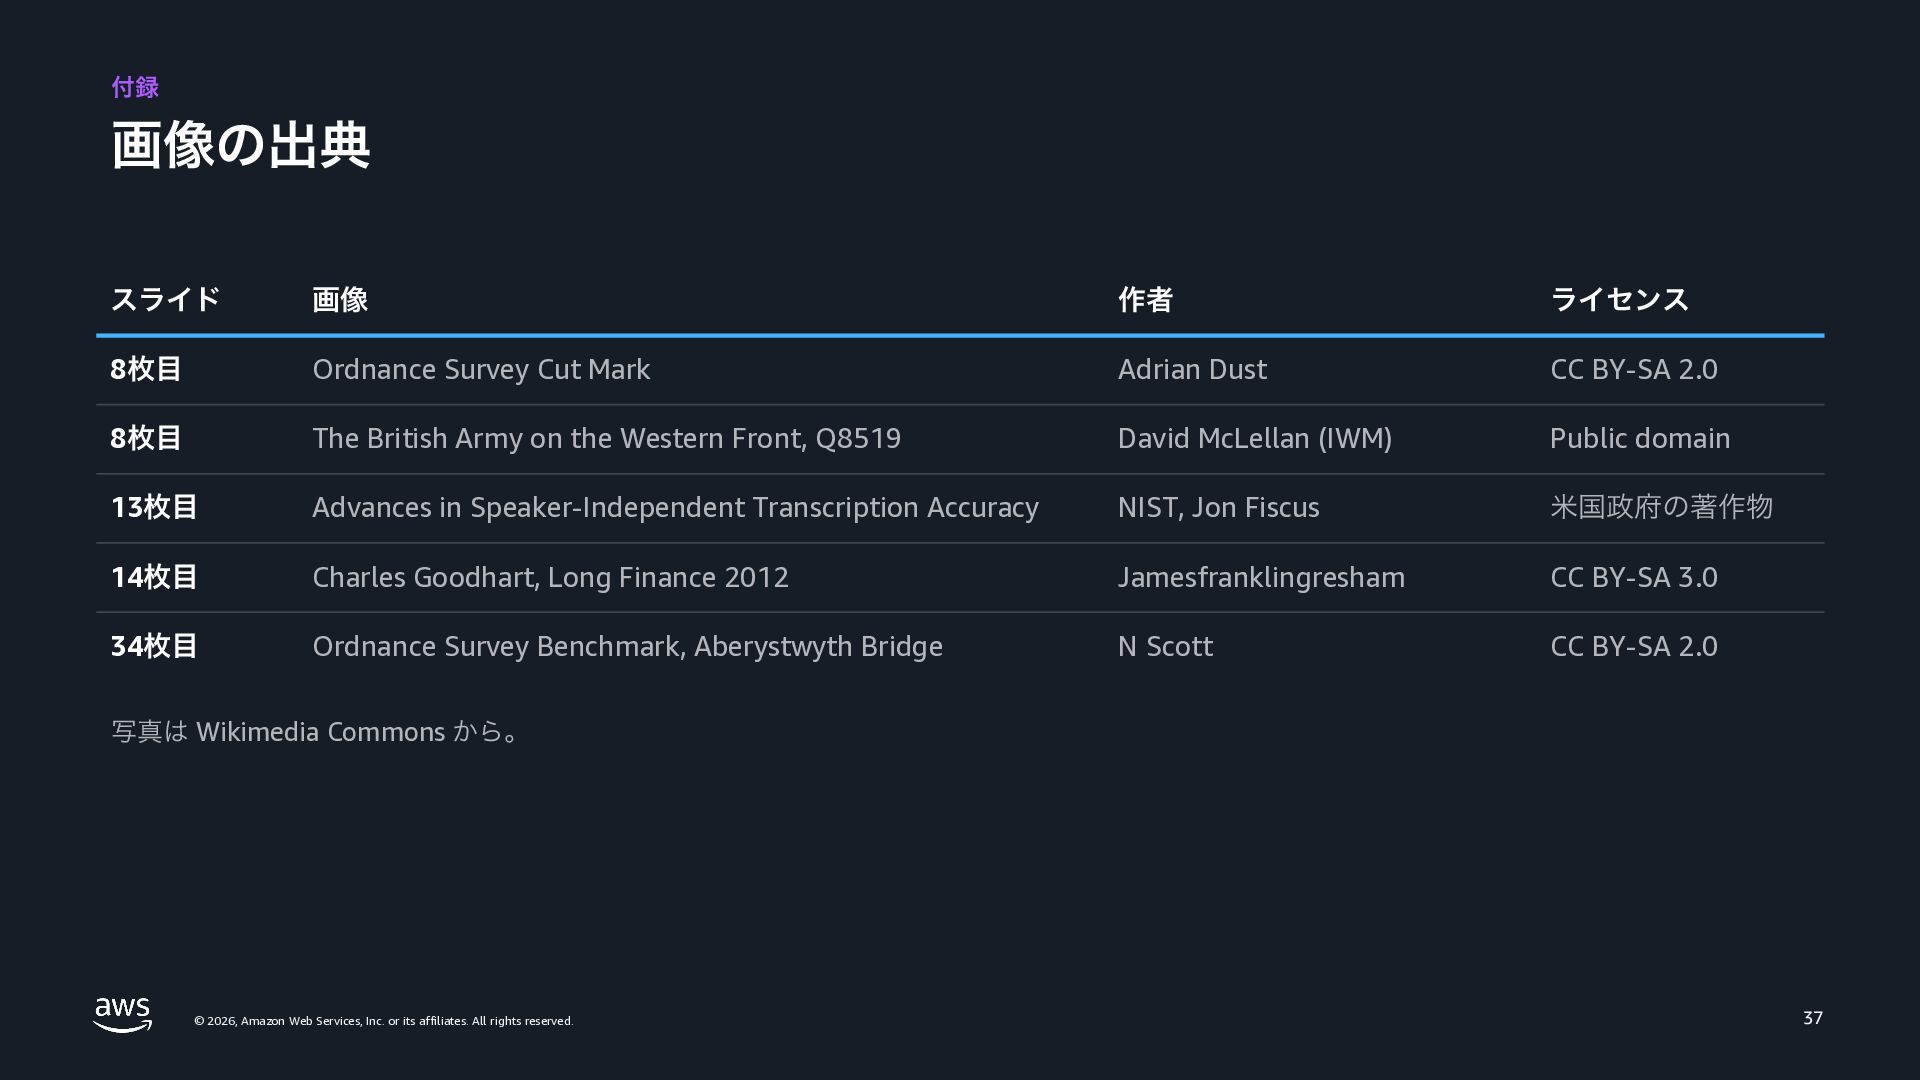
  31. 付録 画像の出典 スライド 画像 作者 ライセンス 8枚目 Ordnance Survey Cut

    Mark Adrian Dust CC BY-SA 2.0 8枚目 The British Army on the Western Front, Q8519 David McLellan (IWM) Public domain 13枚目 Advances in Speaker-Independent Transcription Accuracy NIST, Jon Fiscus 米国政府の著作物 14枚目 Charles Goodhart, Long Finance 2012 Jamesfranklingresham CC BY-SA 3.0 34枚目 Ordnance Survey Benchmark, Aberystwyth Bridge N Scott CC BY-SA 2.0 写真は Wikimedia Commons から。 © 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved. 37