Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Les premiers pas vers Machine Learning

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Zhe LI Zhe LI
April 01, 2016

Les premiers pas vers Machine Learning

Présentation à TTFX Bordeaux

Avatar for Zhe LI

Zhe LI

April 01, 2016

Other Decks in Technology

Transcript

  1. Machine Learning : c’est quoi ?  Émerge dans la

    seconde moitié du XXème siècle du domaine de l’intelligence artificielle  sans être humainement guidés au cours de leur apprentissage, ni explicitement programmés pour gérer telle expérience ou donnée spécifique  Étudier et construire les programmes qui sont capables de :  Comprendre des échantillons de donnée en s’appuyant sur les techniques statistiques  Déterminer la meilleure manière de modéliser les données  Donner certaine prédiction pour les nouvelles données -> Expérience Tâche
  2. Pourquoi maintenant ?  Disponibilité de données massives et variées

     Augmentation des capacités de calcul et de stockage.
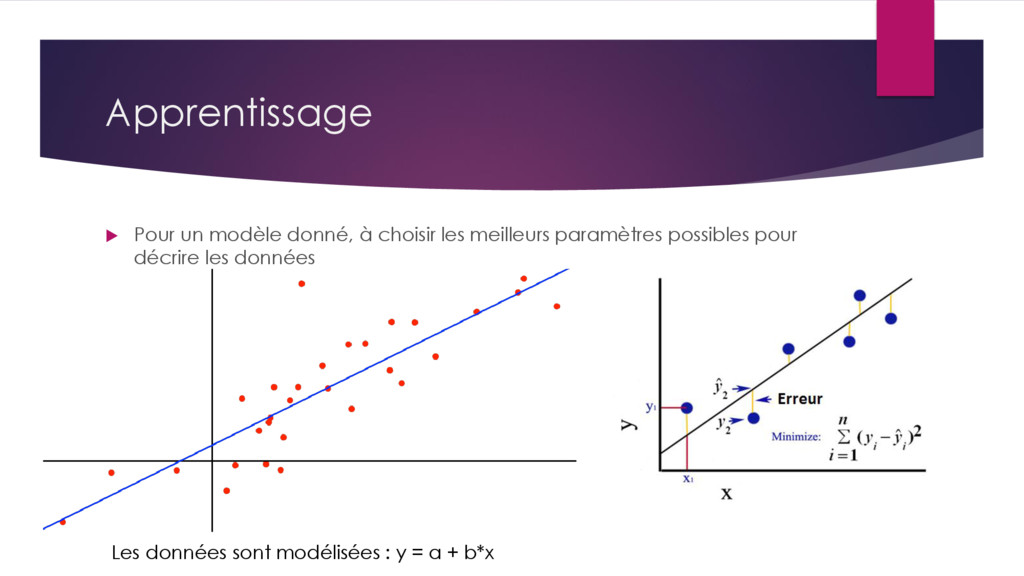
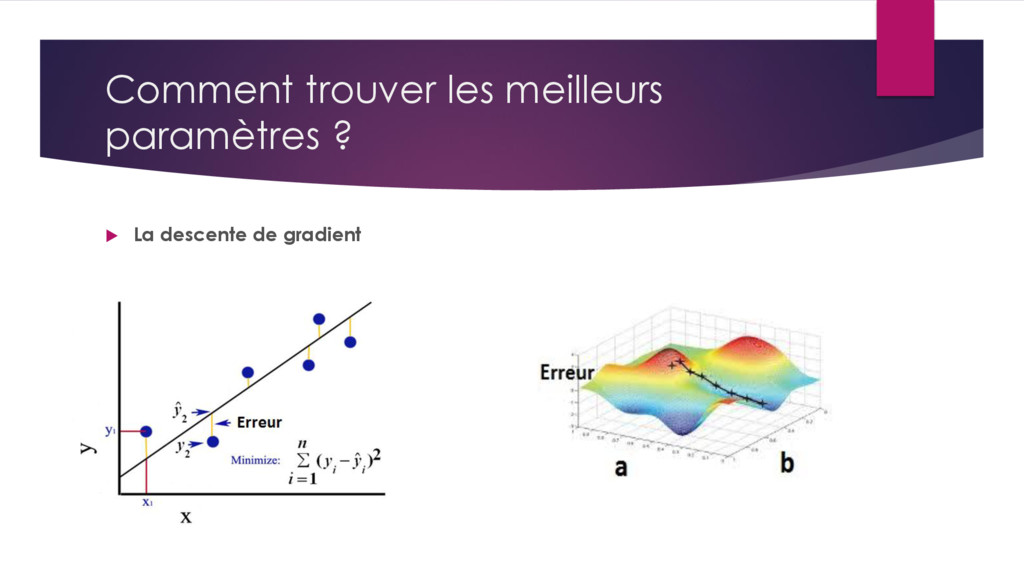
  3. Apprentissage  Pour un modèle donné, à choisir les meilleurs

    paramètres possibles pour décrire les données Les données sont modélisées : y = a + b*x
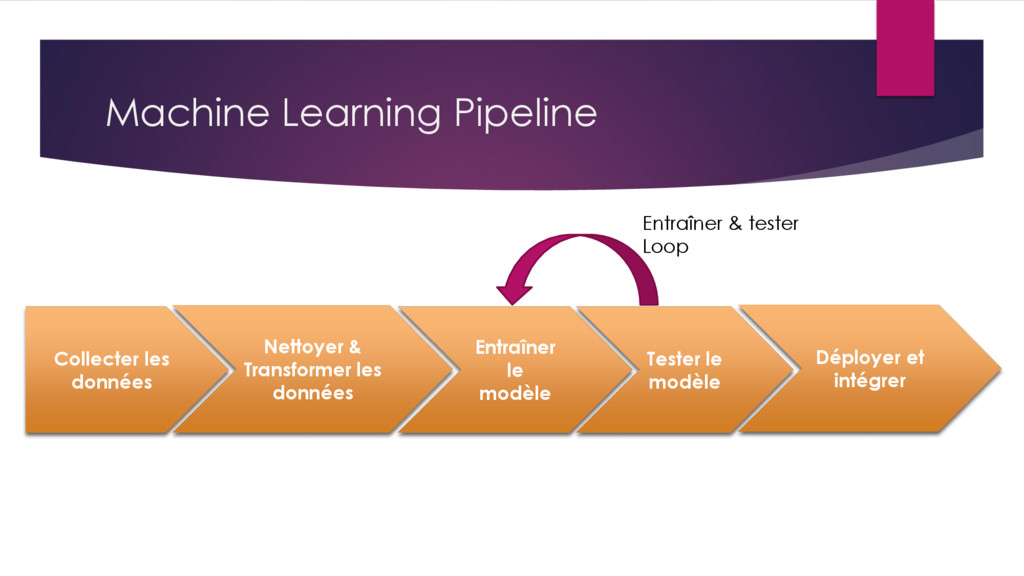
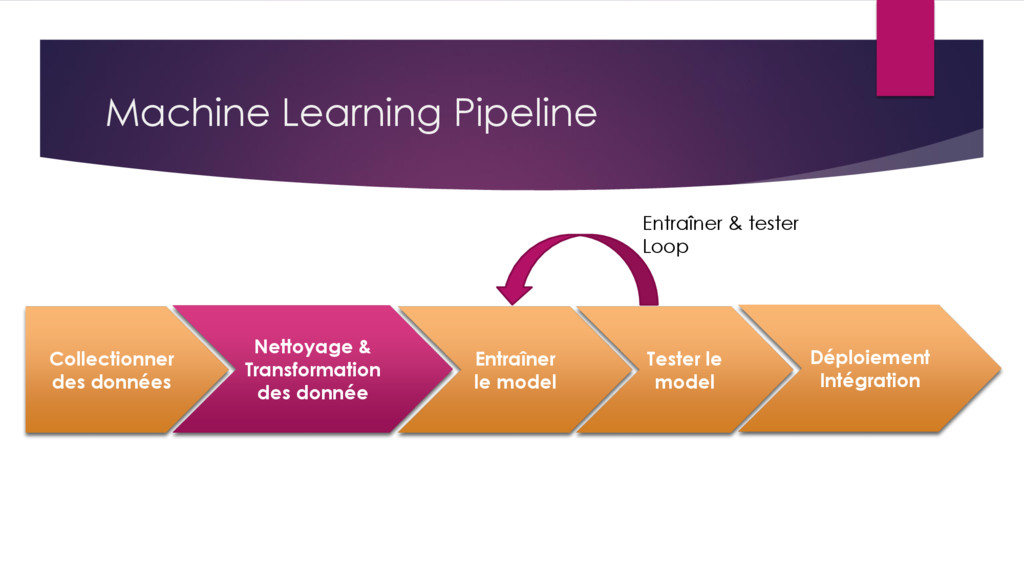
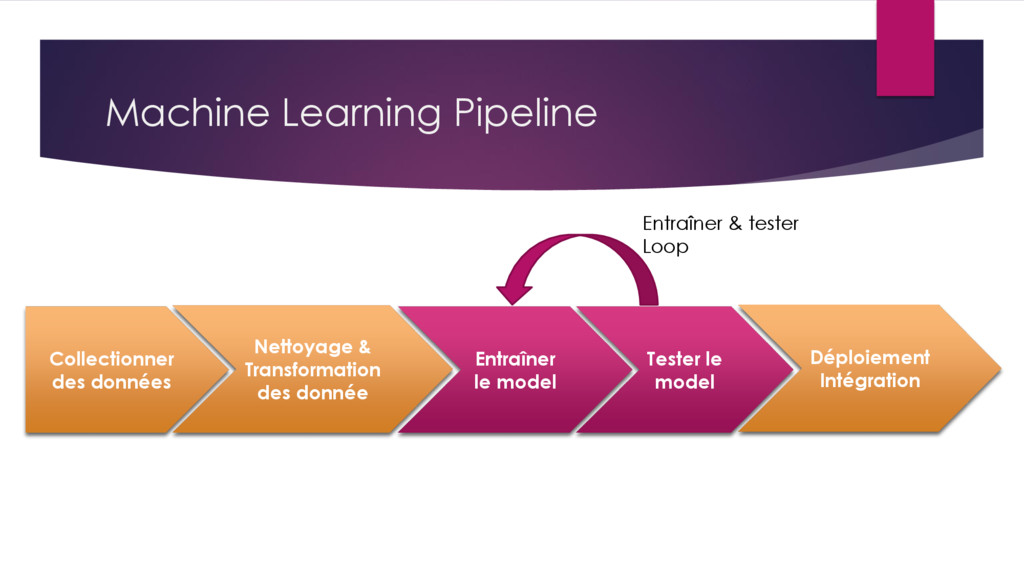
  4. Machine Learning Pipeline Collecter les données Nettoyer & Transformer les

    données Entraîner le modèle Tester le modèle Déployer et intégrer Entraîner & tester Loop
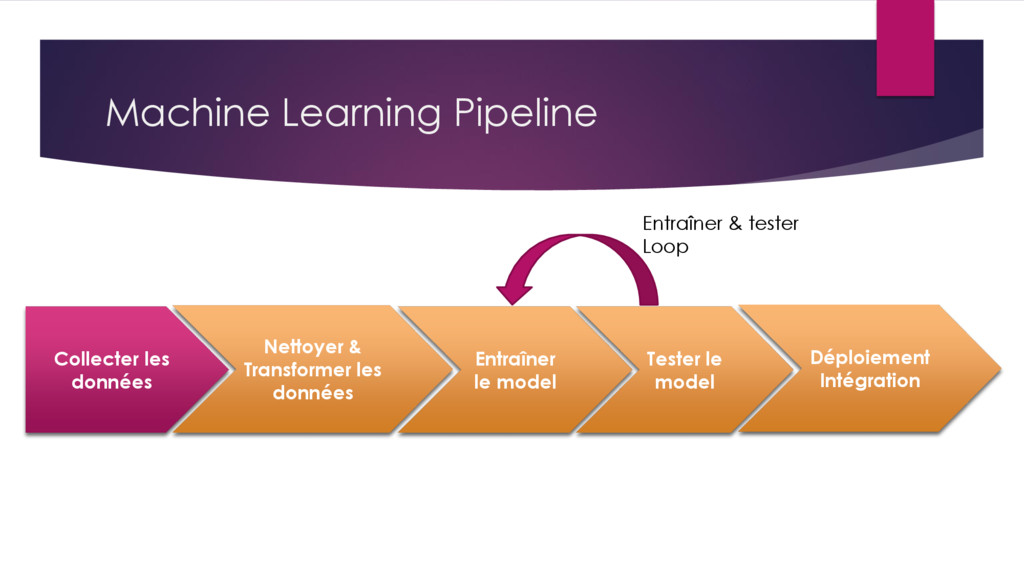
  5. Machine Learning Pipeline Collecter les données Nettoyer & Transformer les

    données Entraîner le model Tester le model Déploiement Intégration Entraîner & tester Loop
  6. Collecte & Stockage des données  Plusieurs possibilités pour collecter

    les données  Récupérer les activités des utilisateurs via les navigateurs, les log et les sensors  Stockage des données  HDFS, S3, MongoDB etc
  7. Machine Learning Pipeline Collectionner des données Nettoyage & Transformation des

    donnée Entraîner le model Tester le model Déploiement Intégration Entraîner & tester Loop
  8. Nettoyage des données  Filtrage des données  Traitement des

    données incomplètes, erronées et corrompues  Agrégation des données
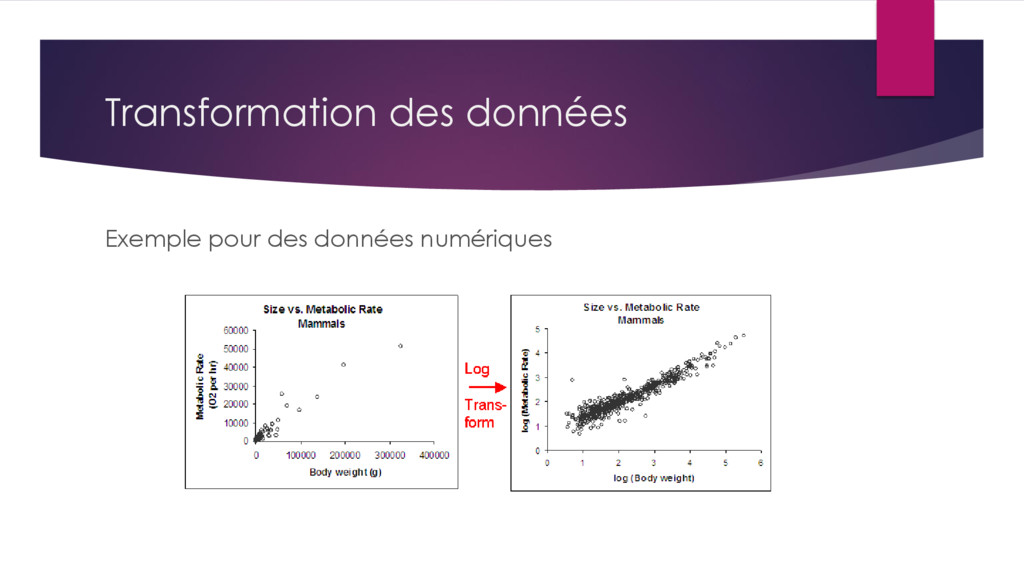
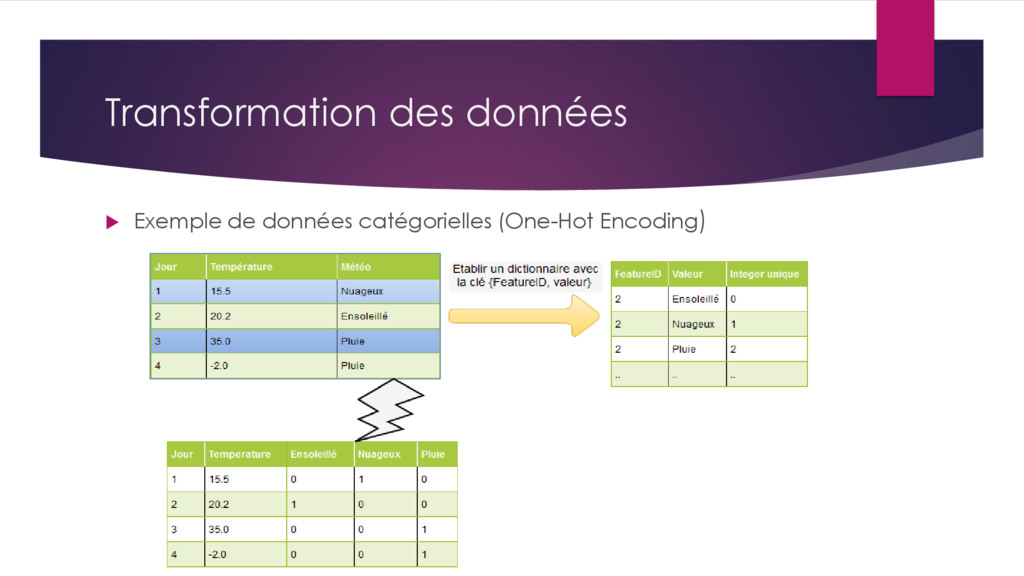
  9. Transformation des données  Création des nouvelles caractéristiques  Normaliser

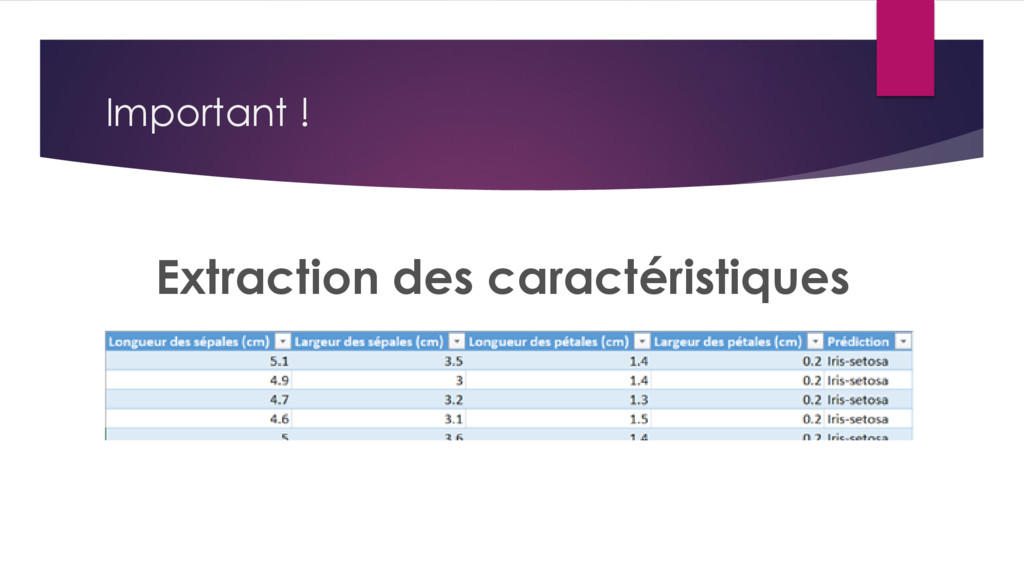
    les données numériques  Extraction des caractéristiques à partir du texte, l’image et l’audio (Stop Words, Stemming…)
  10. Machine Learning Pipeline Collectionner des données Nettoyage & Transformation des

    donnée Entraîner le model Tester le model Déploiement Intégration Entraîner & tester Loop
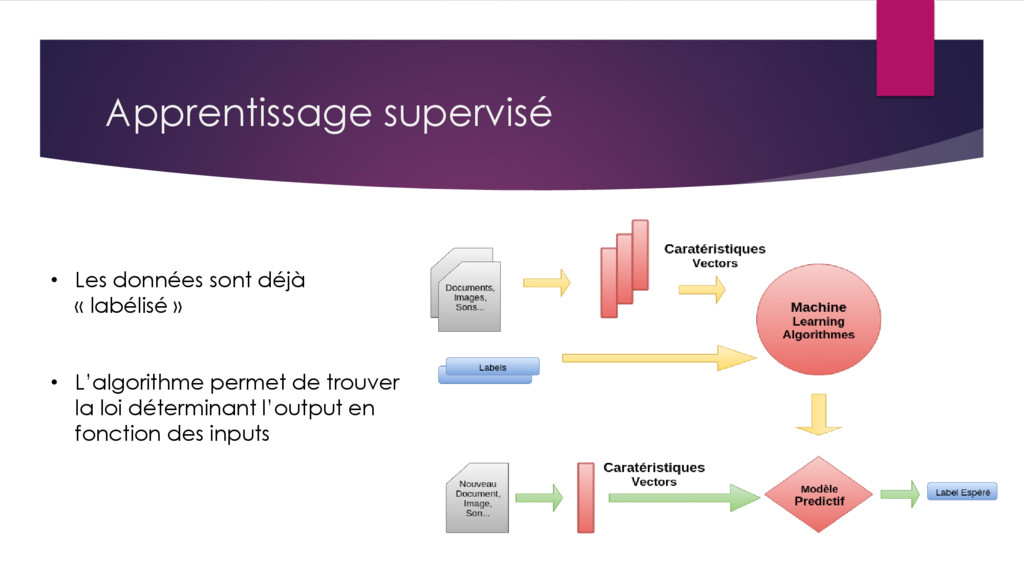
  11. Apprentissage supervisé • Les données sont déjà « labélisé »

    • L’algorithme permet de trouver la loi déterminant l’output en fonction des inputs
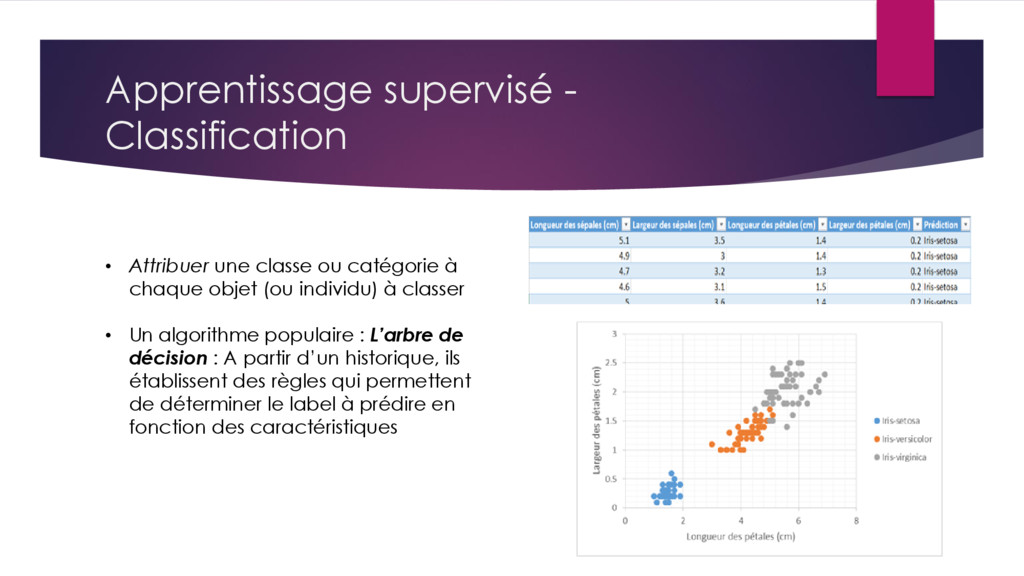
  12. Apprentissage supervisé - Classification • Attribuer une classe ou catégorie

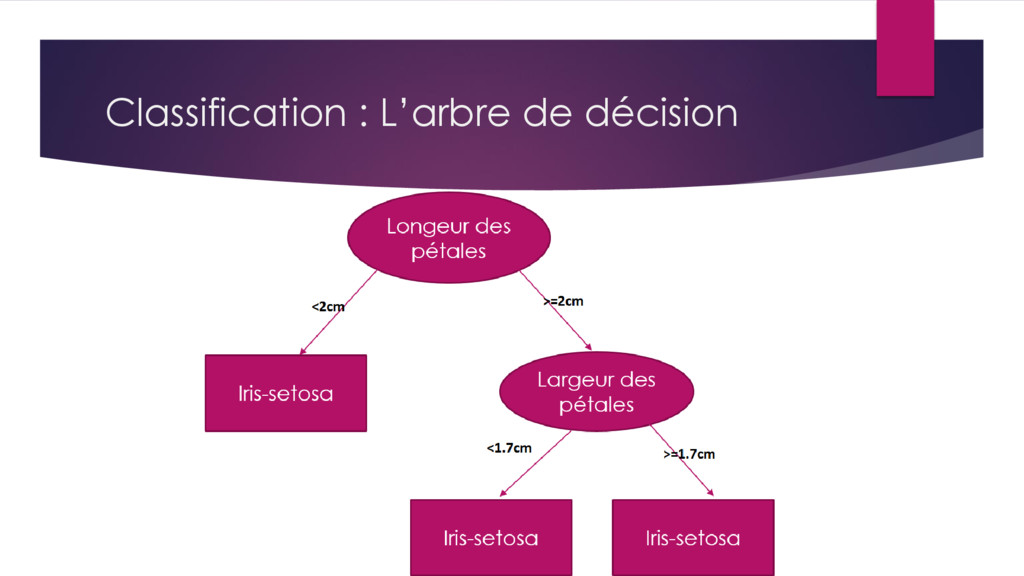
    à chaque objet (ou individu) à classer • Un algorithme populaire : L’arbre de décision : A partir d’un historique, ils établissent des règles qui permettent de déterminer le label à prédire en fonction des caractéristiques
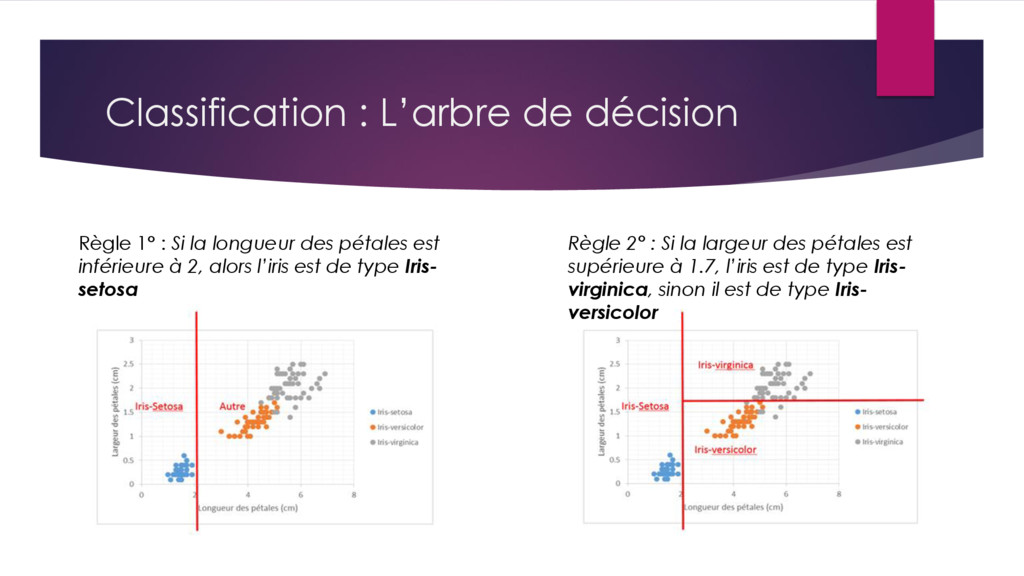
  13. Classification : L’arbre de décision Règle 1° : Si la

    longueur des pétales est inférieure à 2, alors l’iris est de type Iris- setosa Règle 2° : Si la largeur des pétales est supérieure à 1.7, l’iris est de type Iris- virginica, sinon il est de type Iris- versicolor
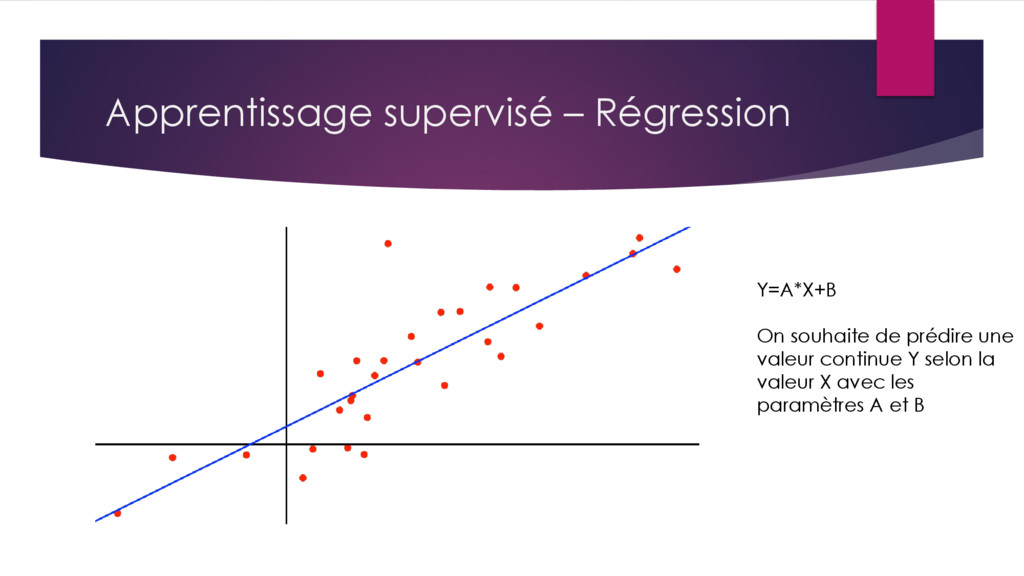
  14. Apprentissage supervisé – Régression Y=A*X+B On souhaite de prédire une

    valeur continue Y selon la valeur X avec les paramètres A et B
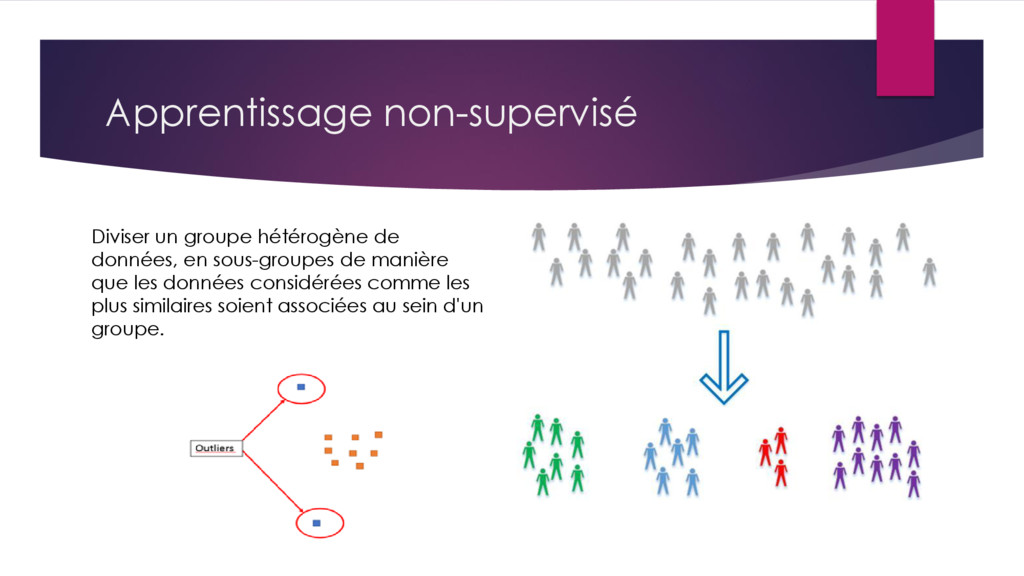
  15. Apprentissage non-supervisé Diviser un groupe hétérogène de données, en sous-groupes

    de manière que les données considérées comme les plus similaires soient associées au sein d'un groupe.
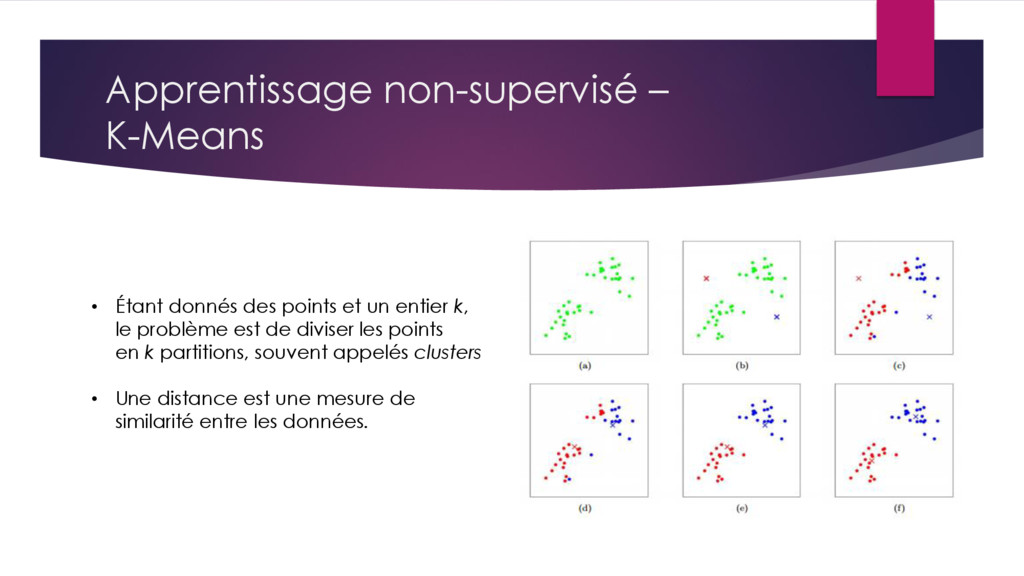
  16. Apprentissage non-supervisé – K-Means • Étant donnés des points et

    un entier k, le problème est de diviser les points en k partitions, souvent appelés clusters • Une distance est une mesure de similarité entre les données.
  17. Apprentissage semi-supervisé  Utiliser un ensemble de données étiquetées et

    non-étiquetés  Un intérêt provient du fait que l'étiquetage de données nécessite l'intervention d'un utilisateur humain. Lorsque les jeux de données deviennent très grands, cette opération peut s'avérer fastidieuse
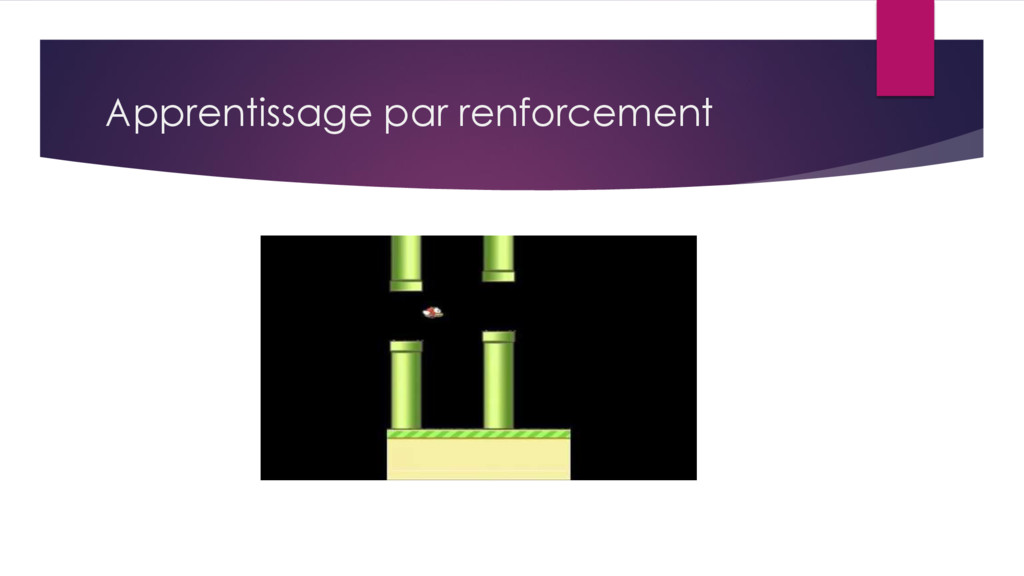
  18. Apprentissage par renforcement  Un ensemble d'états S de l'agent

    dans l'environnement  Un ensemble d'actions A que l'agent peut effectuer  Un ensemble de valeurs scalaires "récompenses" R que l'agent peut obtenir  L’objectif est d’établir une stratégie(Policy) optimale, permettant de maximiser la somme des récompenses
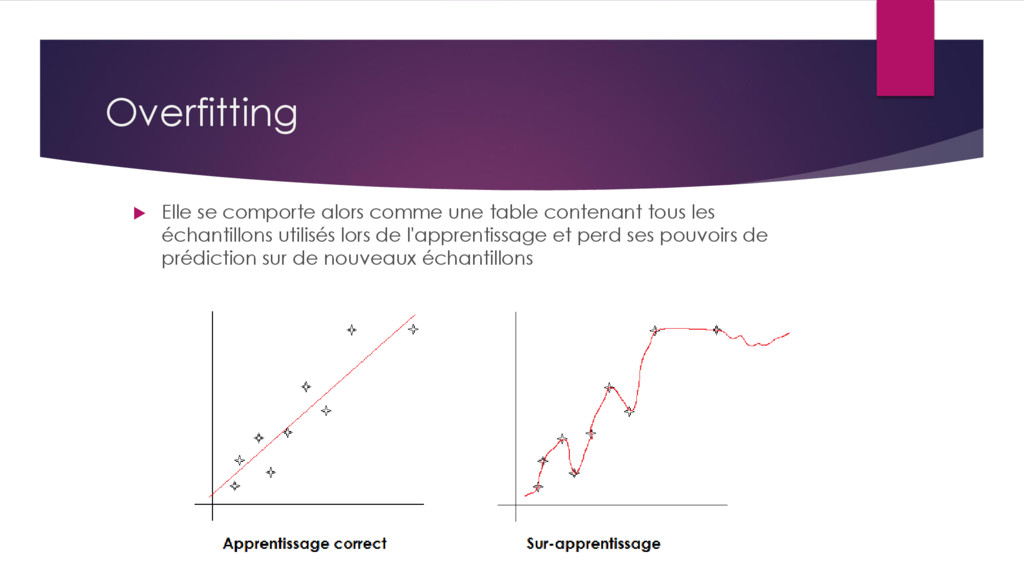
  19. Overfitting  Elle se comporte alors comme une table contenant

    tous les échantillons utilisés lors de l'apprentissage et perd ses pouvoirs de prédiction sur de nouveaux échantillons
  20. Validation  Séparer les données en deux sous-ensembles : l'ensemble

    d'apprentissage et l'ensemble de validation.  L'ensemble d'apprentissage permet de faire évoluer les paramètres.  L'ensemble de validation n'est pas utilisé pour l'apprentissage mais permet de vérifier la pertinence du réseau avec des échantillons qu'il ne connait pas.
  21. Pour apprendre  Dataset public :  http://www.kdnuggets.com/2011/02/free-public-datasets.html  https://archive.ics.uci.edu/ml/datasets.html

     Compétition Kaggle (@arm_gilles)  Des MOOC: Coursera, Edx, Udacity  Github  Beaucoup de paper, articles, livres..  Beaucoup de pratiques 
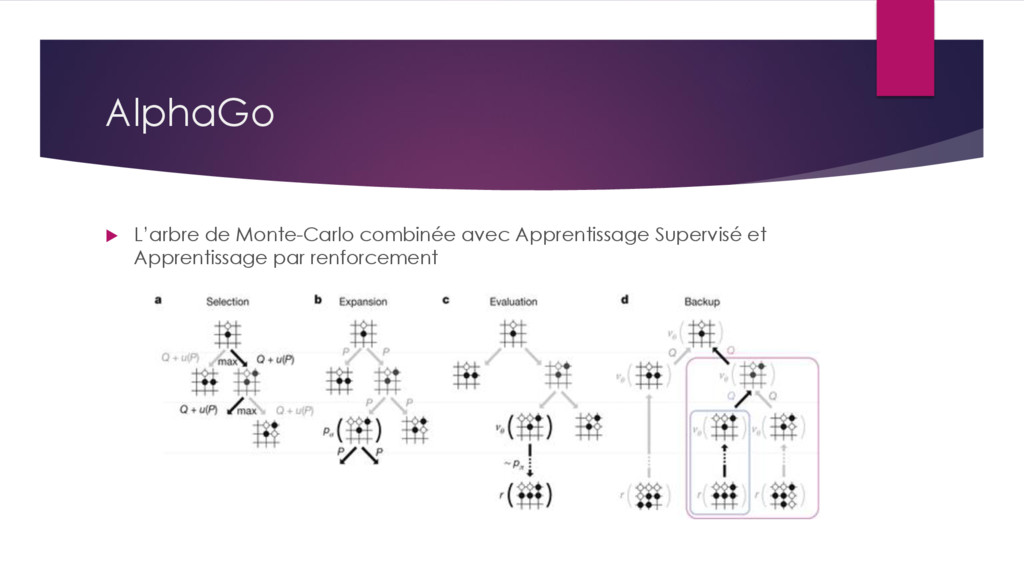
  22. Références  https://blogs.msdn.microsoft.com/mlfrance  “Mastering the game of Go with

    deep neural networks and tree search”  Wikipedia  Beaucoup de papers  https://shapeofdata.wordpress.com/2015/01/24/convolutional-neural- networks/  https://jcrisch.wordpress.com/2015/04/02/les-reseaux-de-neurones/  http://www.nervanasys.com/demystifying-deep-reinforcement-learning/  https://github.com/yenchenlin1994/DeepLearningFlappyBird