Upgrade to Pro — share decks privately, control downloads, hide ads and more …

HotChips 2026 報告会 - MX1 CXL Computational Memor...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Mikiya Michishita Mikiya Michishita
October 10, 2026
51

HotChips 2026 報告会 - MX1 CXL Computational Memory Device

Avatar for Mikiya Michishita

Mikiya Michishita

October 10, 2026

Transcript

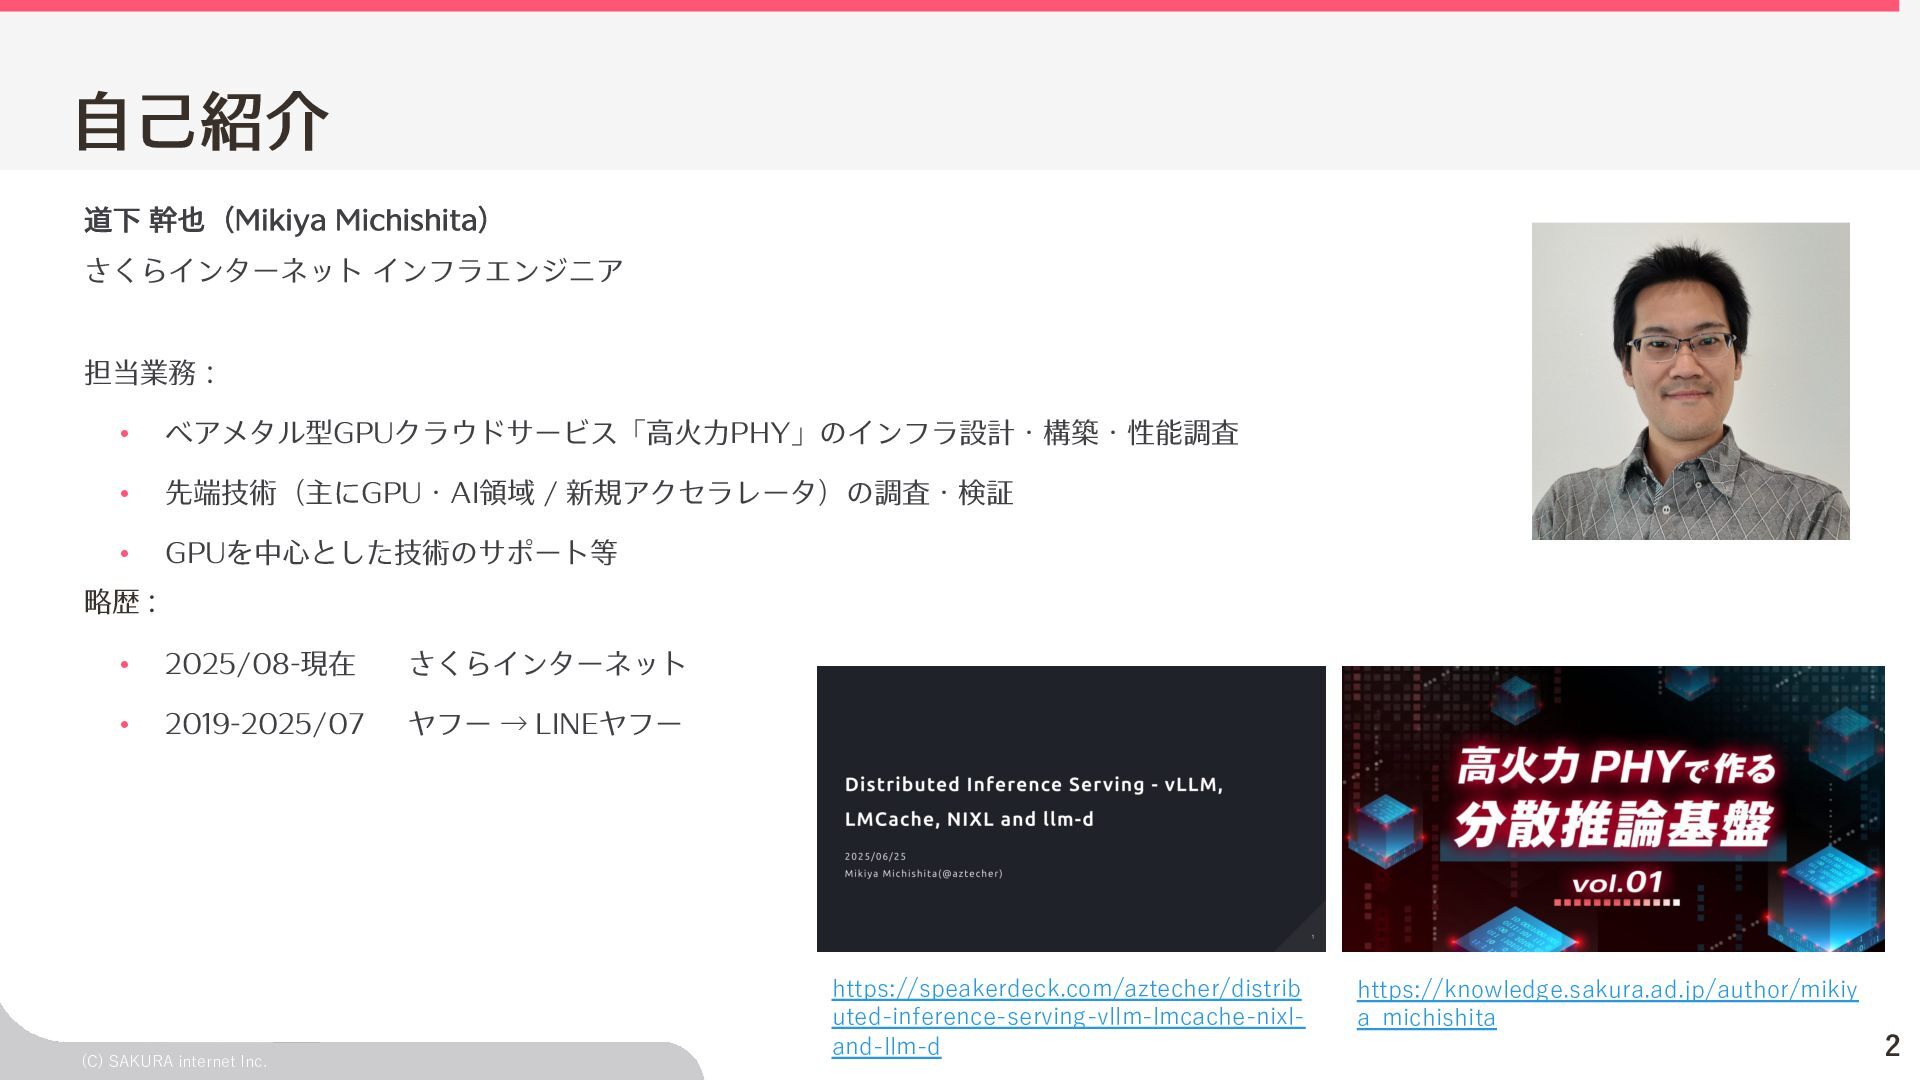
  1. ⾃⼰紹介 道下 幹也(Mikiya Michishita) さくらインターネット インフラエンジニア 担当業務: • ベアメタル型GPUクラウドサービス「⾼⽕⼒PHY」のインフラ設計・構築・性能調査 •

    先端技術(主にGPU・AI領域 / 新規アクセラレータ)の調査・検証 • GPUを中⼼とした技術のサポート等 略歴 : • 2025/08-現在 さくらインターネット • 2019-2025/07 ヤフー → LINEヤフー (C) SAKURA internet Inc. https://speakerdeck.com/aztecher/distrib uted-inference-serving-vllm-lmcache-nixland-llm-d https://knowledge.sakura.ad.jp/author/mikiy a_michishita 2
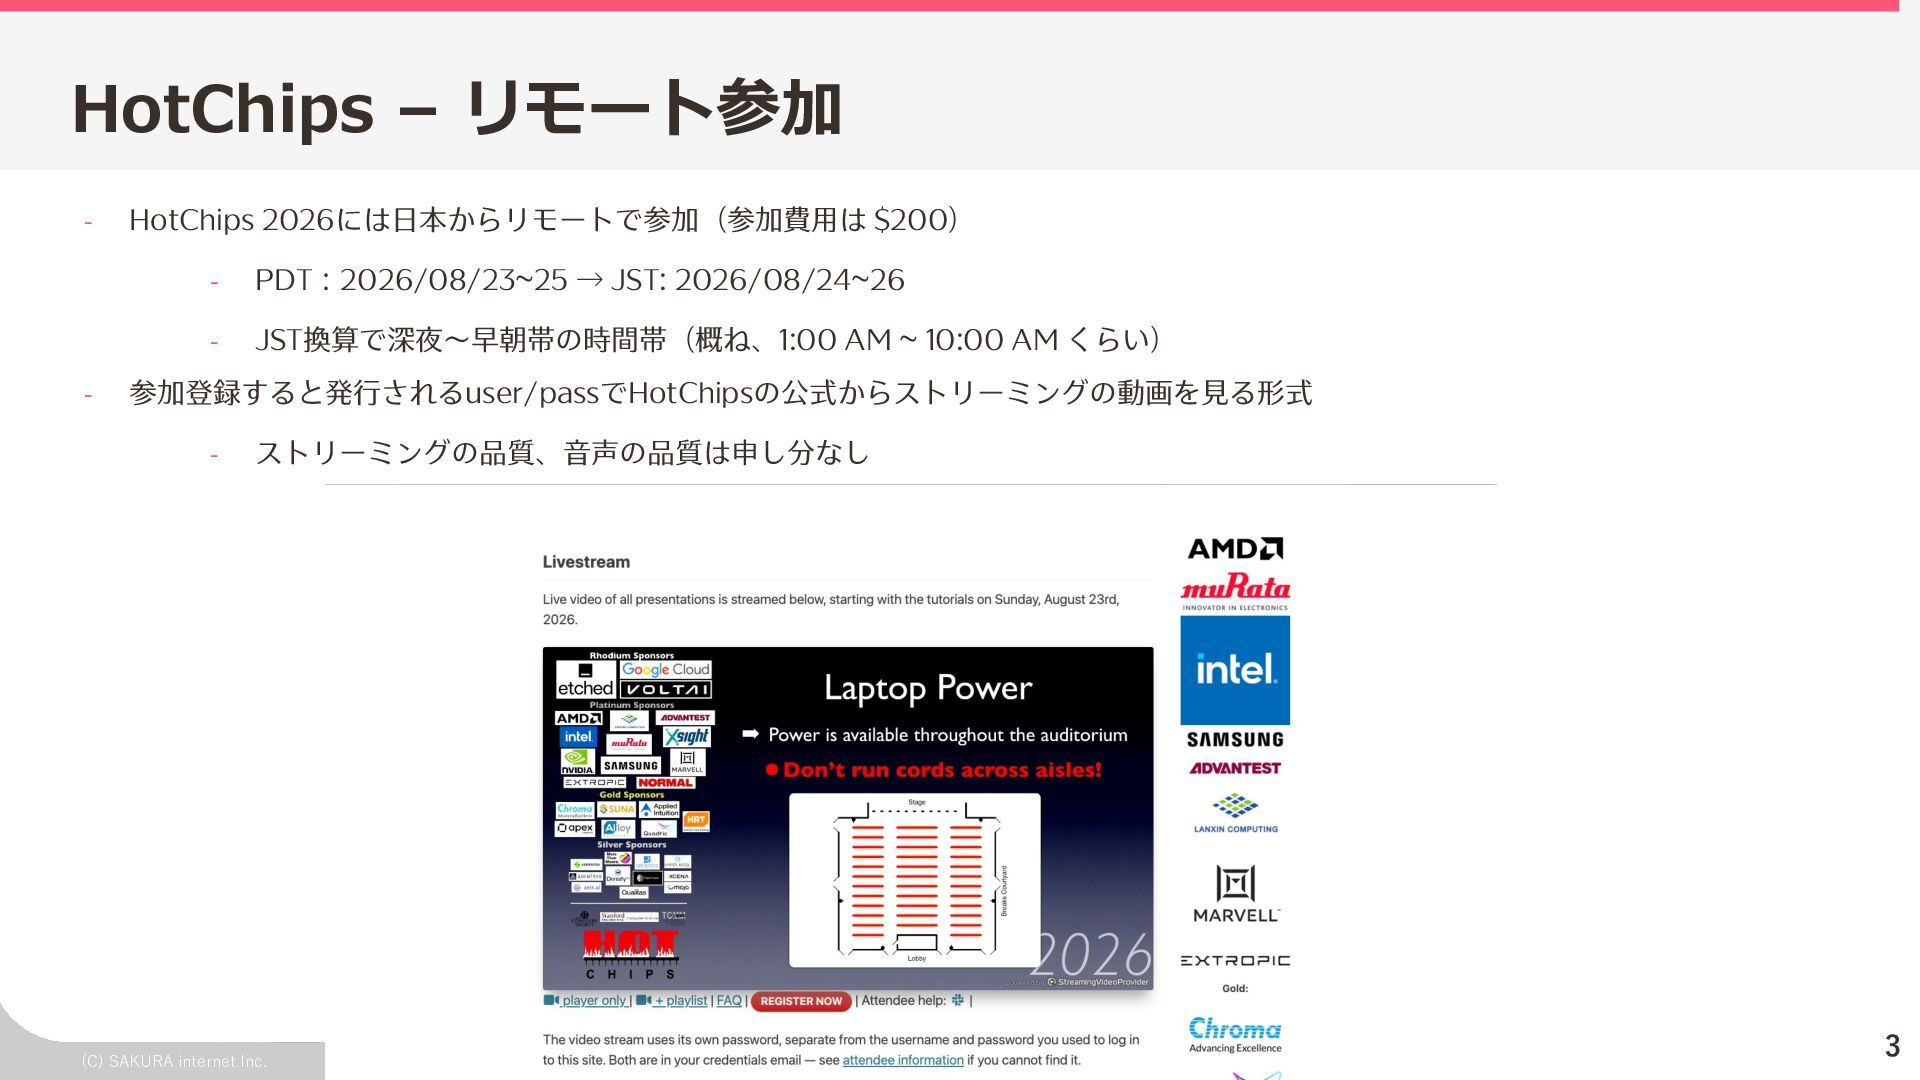
  2. HotChips – リモート参加 - - HotChips 2026には⽇本からリモートで参加(参加費⽤は $200) - PDT:2026/08/23~25

    → JST: 2026/08/24~26 - JST換算で深夜〜早朝帯の時間帯(概ね、1:00 AM ~ 10:00 AM くらい) 参加登録すると発⾏されるuser/passでHotChipsの公式からストリーミングの動画を⾒る形式 - ストリーミングの品質、⾳声の品質は申し分なし (C) SAKURA internet Inc. 3
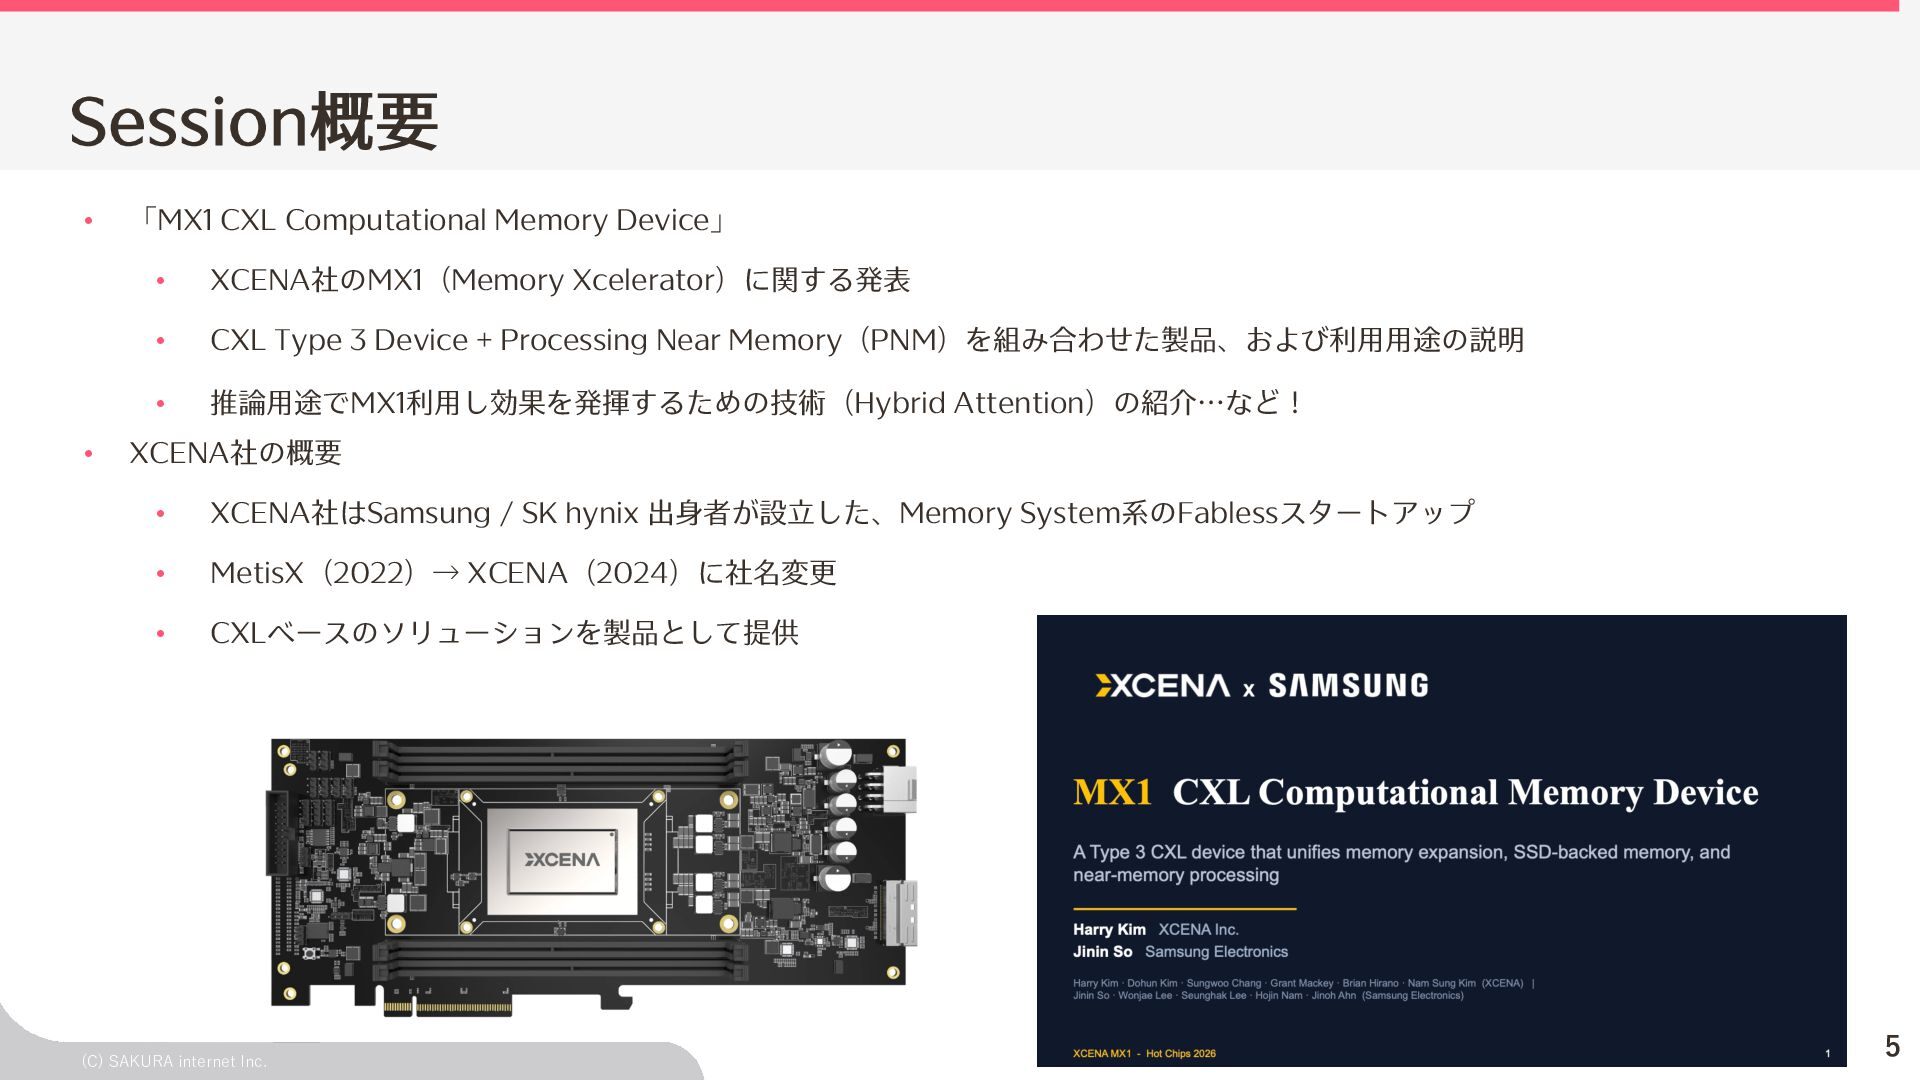
  3. Session概要 • • 「MX1 CXL Computational Memory Device」 • XCENA社のMX1(Memory

    Xcelerator)に関する発表 • CXL Type 3 Device + Processing Near Memory(PNM)を組み合わせた製品、および利⽤⽤途の説明 • 推論⽤途でMX1利⽤し効果を発揮するための技術(Hybrid Attention)の紹介…など! XCENA社の概要 • XCENA社はSamsung / SK hynix 出⾝者が設⽴した、Memory System系のFablessスタートアップ • MetisX(2022)→ XCENA(2024)に社名変更 • CXLベースのソリューションを製品として提供 (C) SAKURA internet Inc. 5
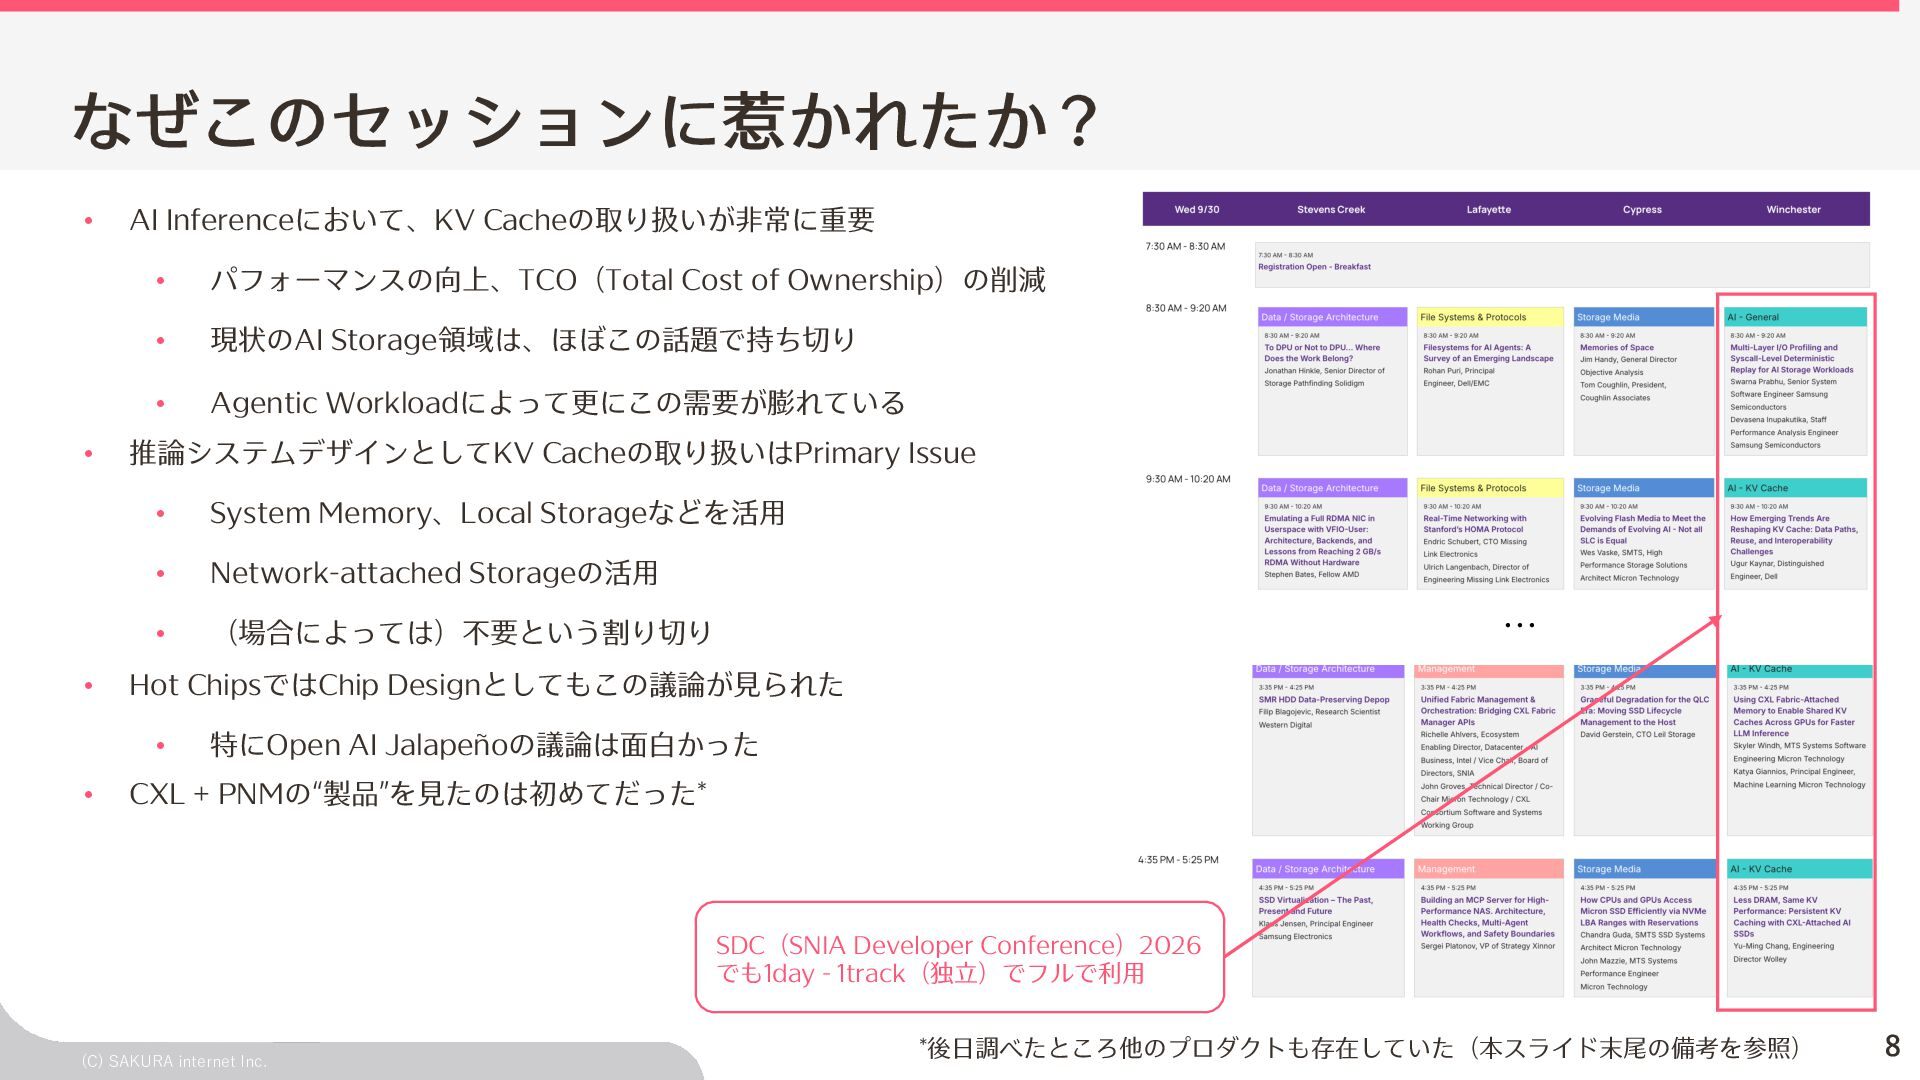
  4. なぜこのセッションに惹かれたか? • • • AI Inferenceにおいて、KV Cacheの取り扱いが⾮常に重要 • パフォーマンスの向上、TCO(Total Cost

    of Ownership)の削減 • 現状のAI Storage領域は、ほぼこの話題で持ち切り • Agentic Workloadによって更にこの需要が膨れている 推論システムデザインとしてKV Cacheの取り扱いはPrimary Issue • System Memory、Local Storageなどを活⽤ • Network-attached Storageの活⽤ • (場合によっては)不要という割り切り Hot ChipsではChip Designとしてもこの議論が⾒られた • • … 特にOpen AI Jalapeñoの議論は⾯⽩かった CXL + PNMの“製品”を⾒たのは初めてだった* SDC(SNIA Developer Conference)2026 でも1day - 1track(独⽴)でフルで利⽤ (C) SAKURA internet Inc. *後⽇調べたところ他のプロダクトも存在していた(本スライド末尾の備考を参照) 8
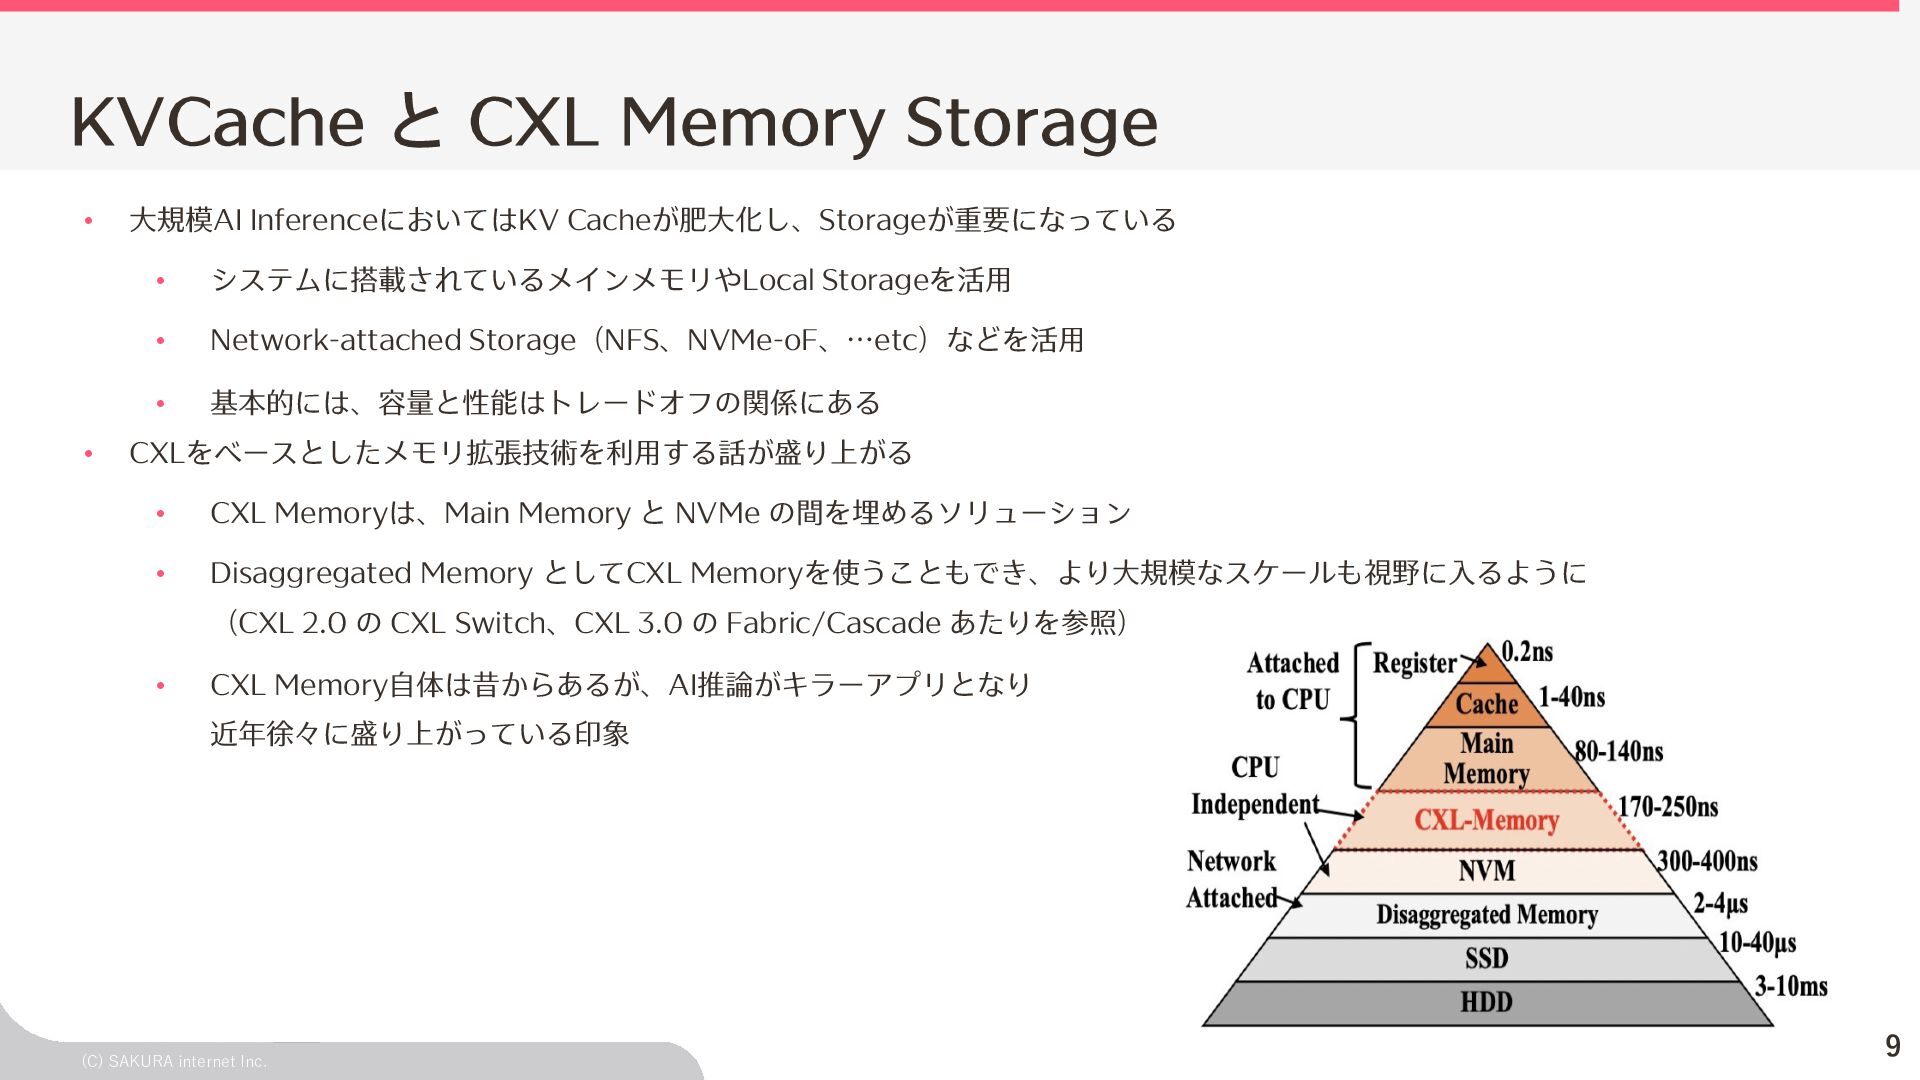
  5. KVCache と CXL Memory Storage • • ⼤規模AI InferenceにおいてはKV Cacheが肥⼤化し、Storageが重要になっている

    • システムに搭載されているメインメモリやLocal Storageを活⽤ • Network-attached Storage(NFS、NVMe-oF、…etc)などを活⽤ • 基本的には、容量と性能はトレードオフの関係にある CXLをベースとしたメモリ拡張技術を利⽤する話が盛り上がる • CXL Memoryは、Main Memory と NVMe の間を埋めるソリューション • Disaggregated Memory としてCXL Memoryを使うこともでき、より⼤規模なスケールも視野に⼊るように (CXL 2.0 の CXL Switch、CXL 3.0 の Fabric/Cascade あたりを参照) • CXL Memory⾃体は昔からあるが、AI推論がキラーアプリとなり 近年徐々に盛り上がっている印象 (C) SAKURA internet Inc. 9
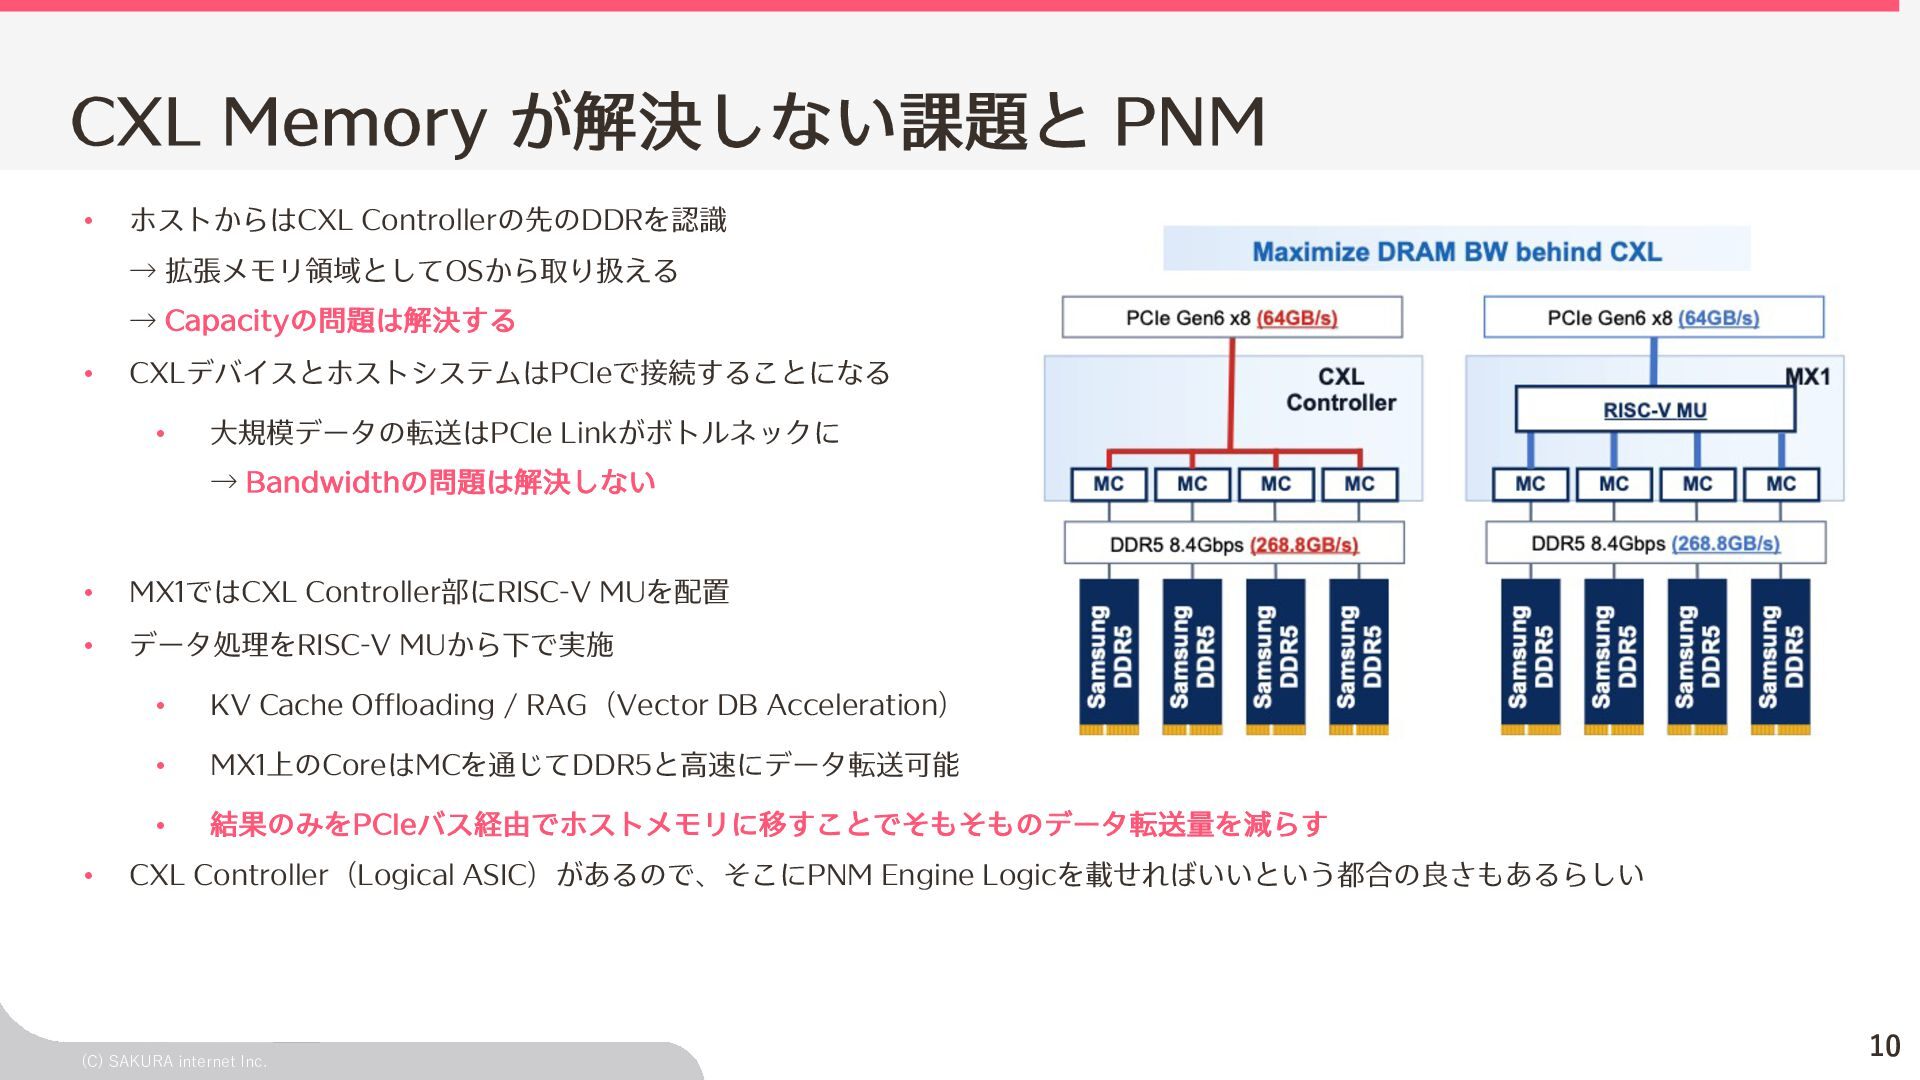
  6. CXL Memory が解決しない課題と PNM • ホストからはCXL Controllerの先のDDRを認識 → 拡張メモリ領域としてOSから取り扱える →

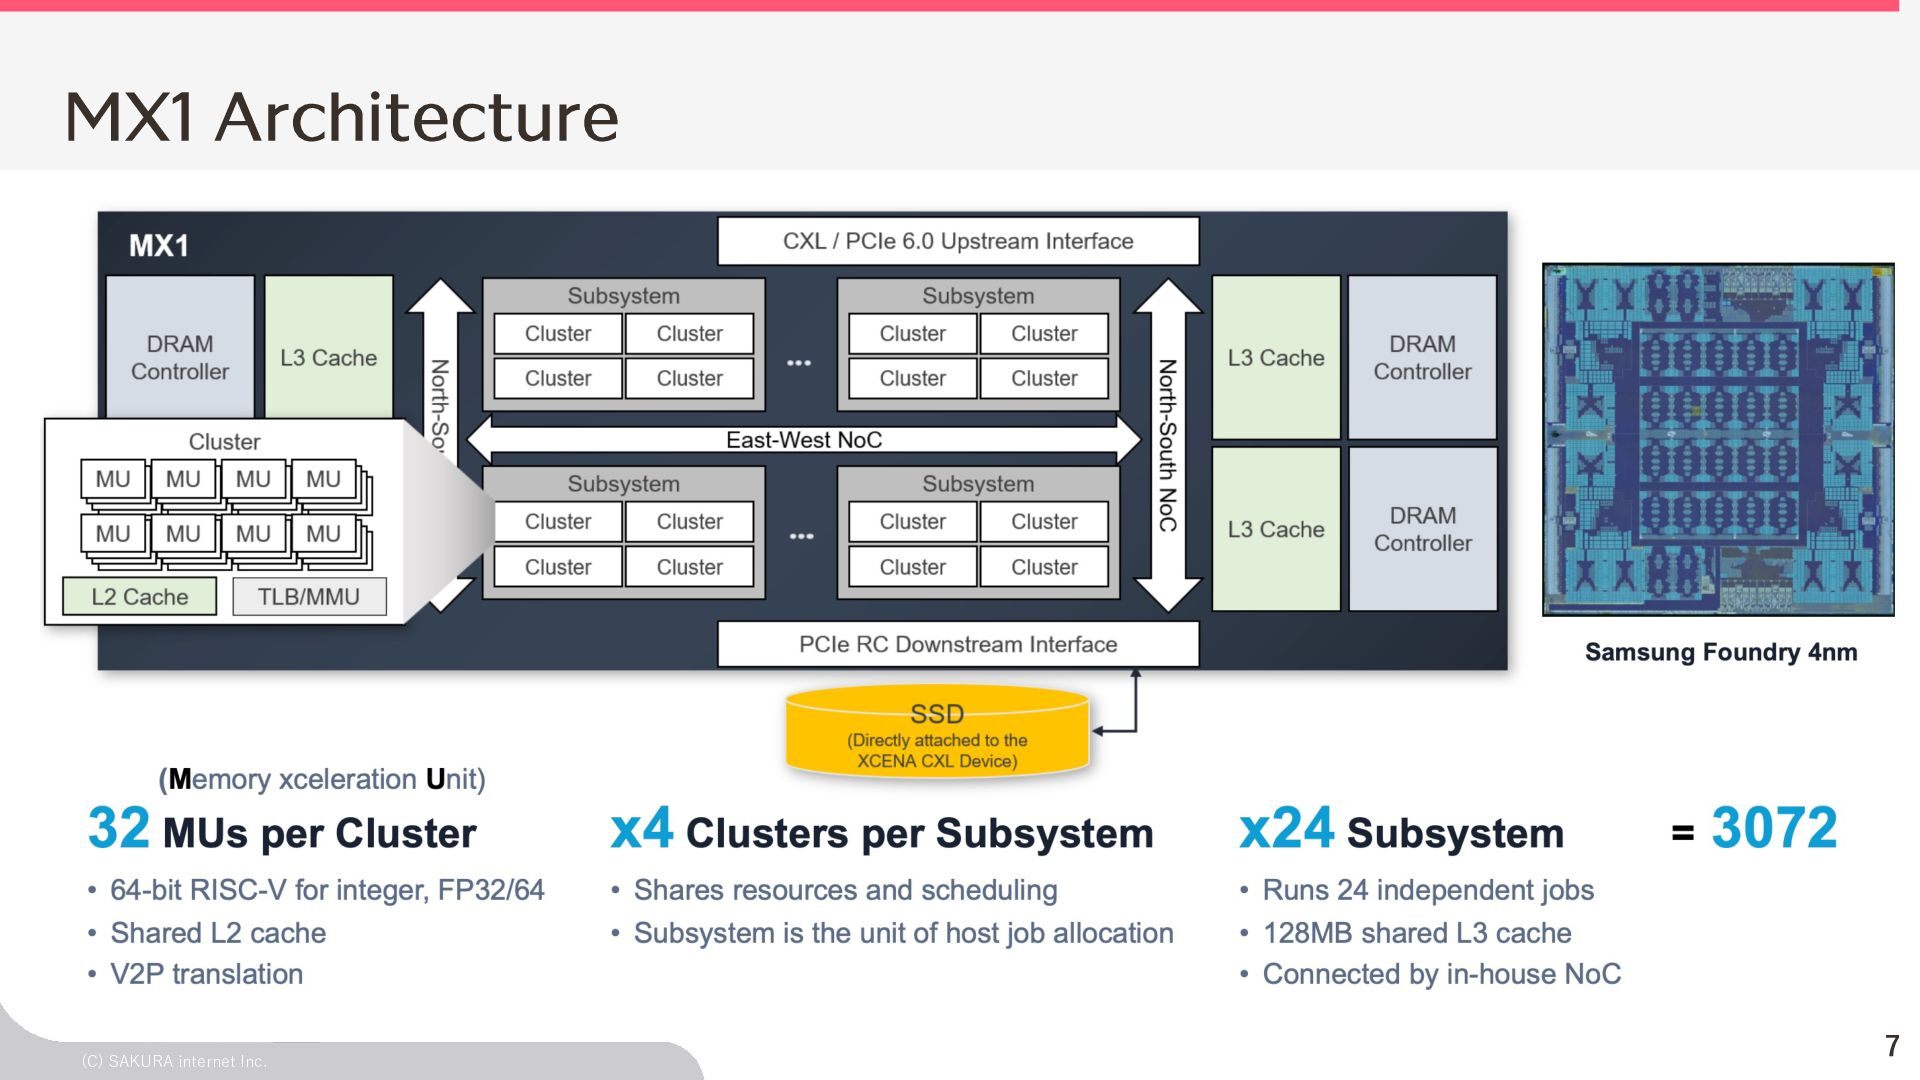
    Capacityの問題は解決する • CXLデバイスとホストシステムはPCIeで接続することになる • ⼤規模データの転送はPCIe Linkがボトルネックに → Bandwidthの問題は解決しない • MX1ではCXL Controller部にRISC-V MUを配置 • データ処理をRISC-V MUから下で実施 • • KV Cache Offloading / RAG(Vector DB Acceleration) • MX1上のCoreはMCを通じてDDR5と⾼速にデータ転送可能 • 結果のみをPCIeバス経由でホストメモリに移すことでそもそものデータ転送量を減らす CXL Controller(Logical ASIC)があるので、そこにPNM Engine Logicを載せればいいという都合の良さもあるらしい (C) SAKURA internet Inc. 10
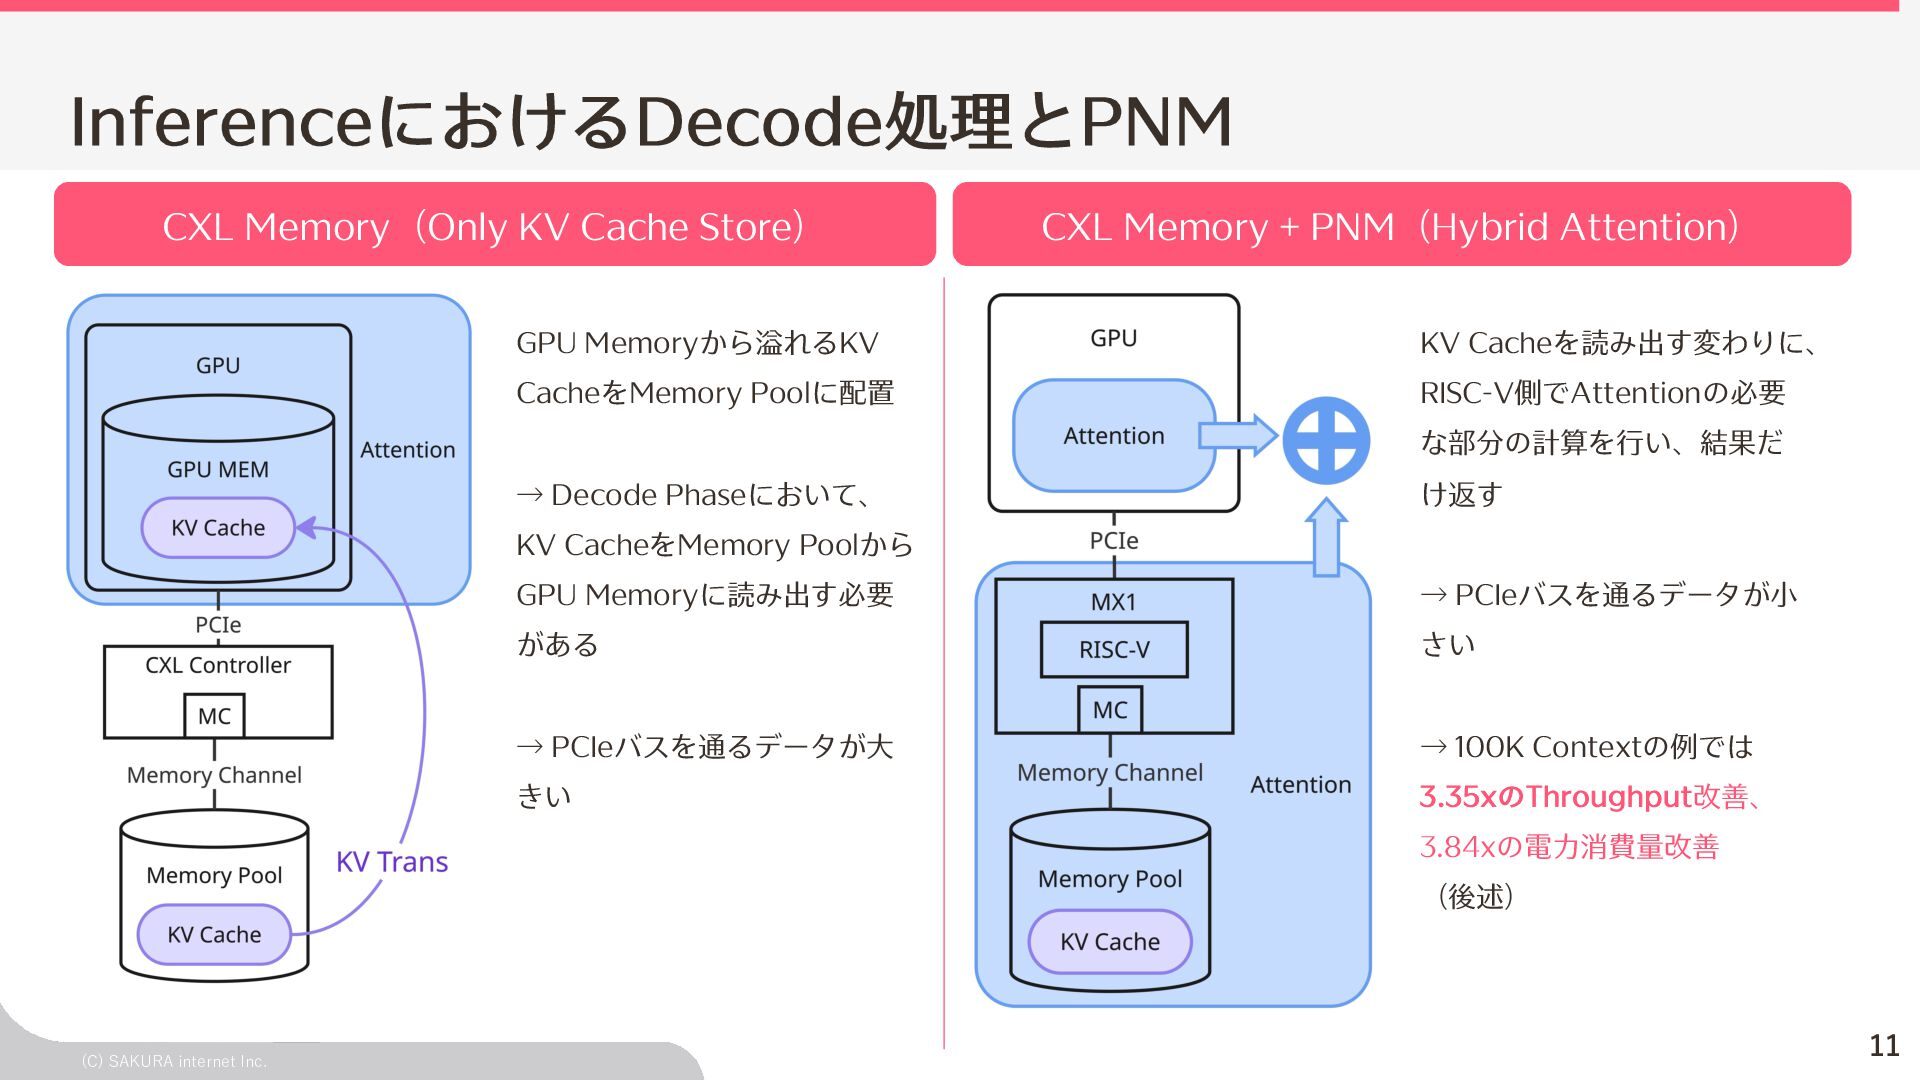
  7. InferenceにおけるDecode処理とPNM CXL Memory(Only KV Cache Store) CXL Memory + PNM(Hybrid

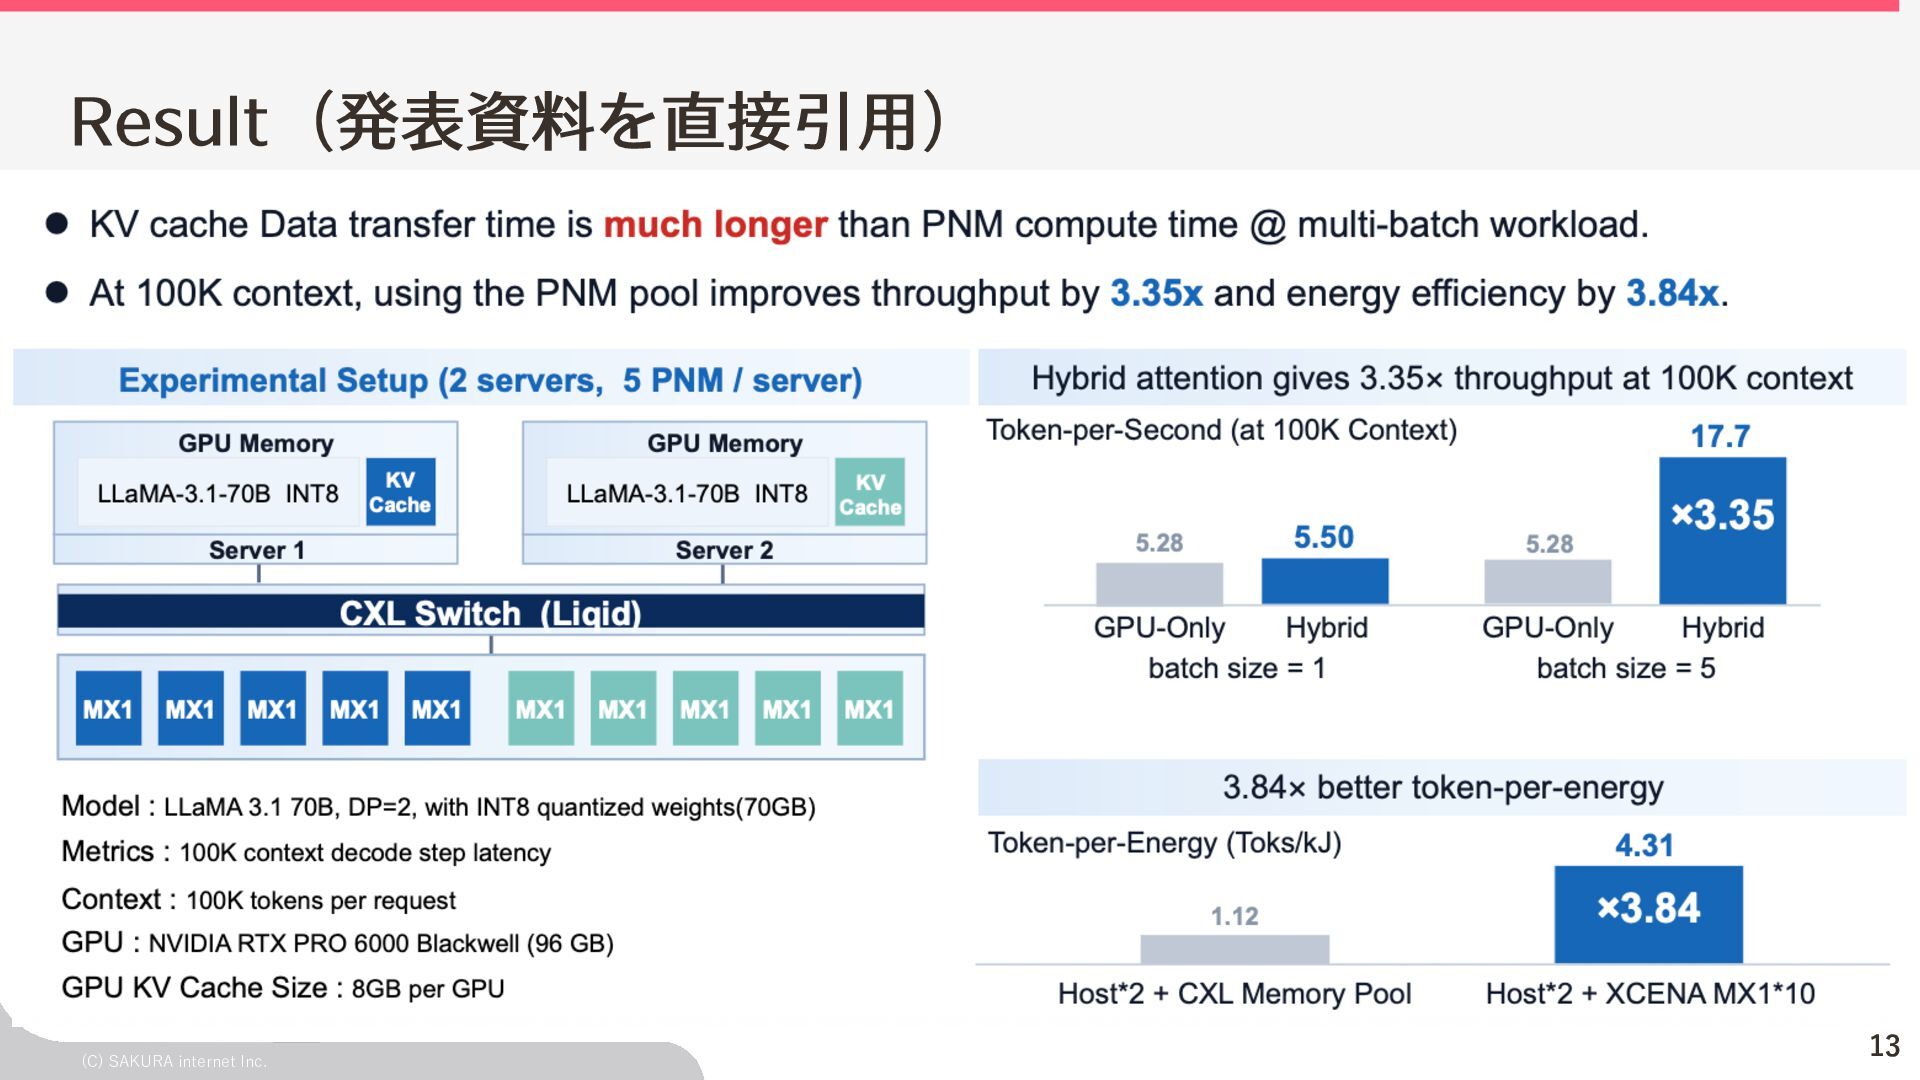
    Attention) GPU Memoryから溢れるKV KV Cacheを読み出す変わりに、 CacheをMemory Poolに配置 RISC-V側でAttentionの必要 な部分の計算を⾏い、結果だ → Decode Phaseにおいて、 け返す KV CacheをMemory Poolから GPU Memoryに読み出す必要 → PCIeバスを通るデータが⼩ がある さい → PCIeバスを通るデータが⼤ → 100K Contextの例では きい 3.35xのThroughput改善、 3.84xの電⼒消費量改善 (後述) (C) SAKURA internet Inc. 11
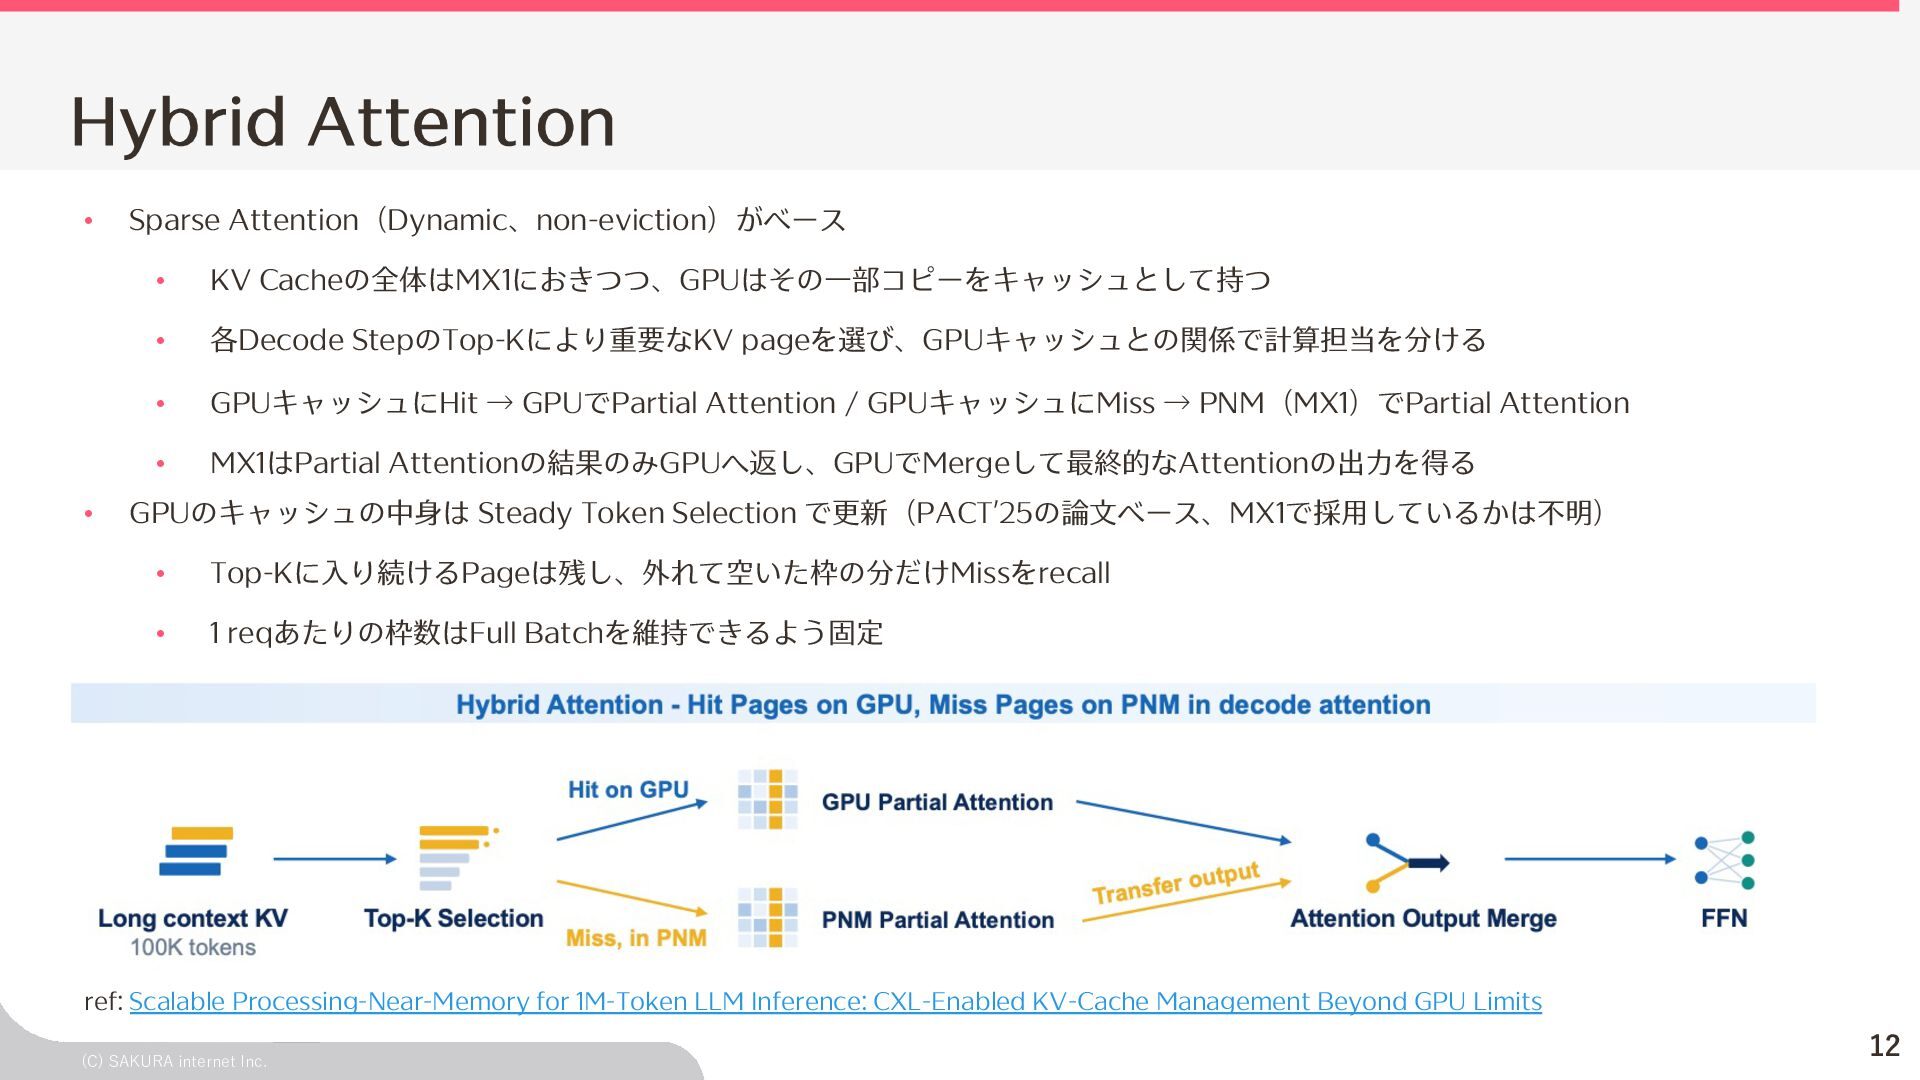
  8. Hybrid Attention • • Sparse Attention(Dynamic、non-eviction)がベース • KV Cacheの全体はMX1におきつつ、GPUはその⼀部コピーをキャッシュとして持つ •

    各Decode StepのTop-Kにより重要なKV pageを選び、GPUキャッシュとの関係で計算担当を分ける • GPUキャッシュにHit → GPUでPartial Attention / GPUキャッシュにMiss → PNM(MX1)でPartial Attention • MX1はPartial Attentionの結果のみGPUへ返し、GPUでMergeして最終的なAttentionの出⼒を得る GPUのキャッシュの中⾝は Steady Token Selection で更新(PACTʼ25の論⽂ベース、MX1で採⽤しているかは不明) • Top-Kに⼊り続けるPageは残し、外れて空いた枠の分だけMissをrecall • 1 reqあたりの枠数はFull Batchを維持できるよう固定 ref: Scalable Processing-Near-Memory for 1M-Token LLM Inference: CXL-Enabled KV-Cache Management Beyond GPU Limits (C) SAKURA internet Inc. 12
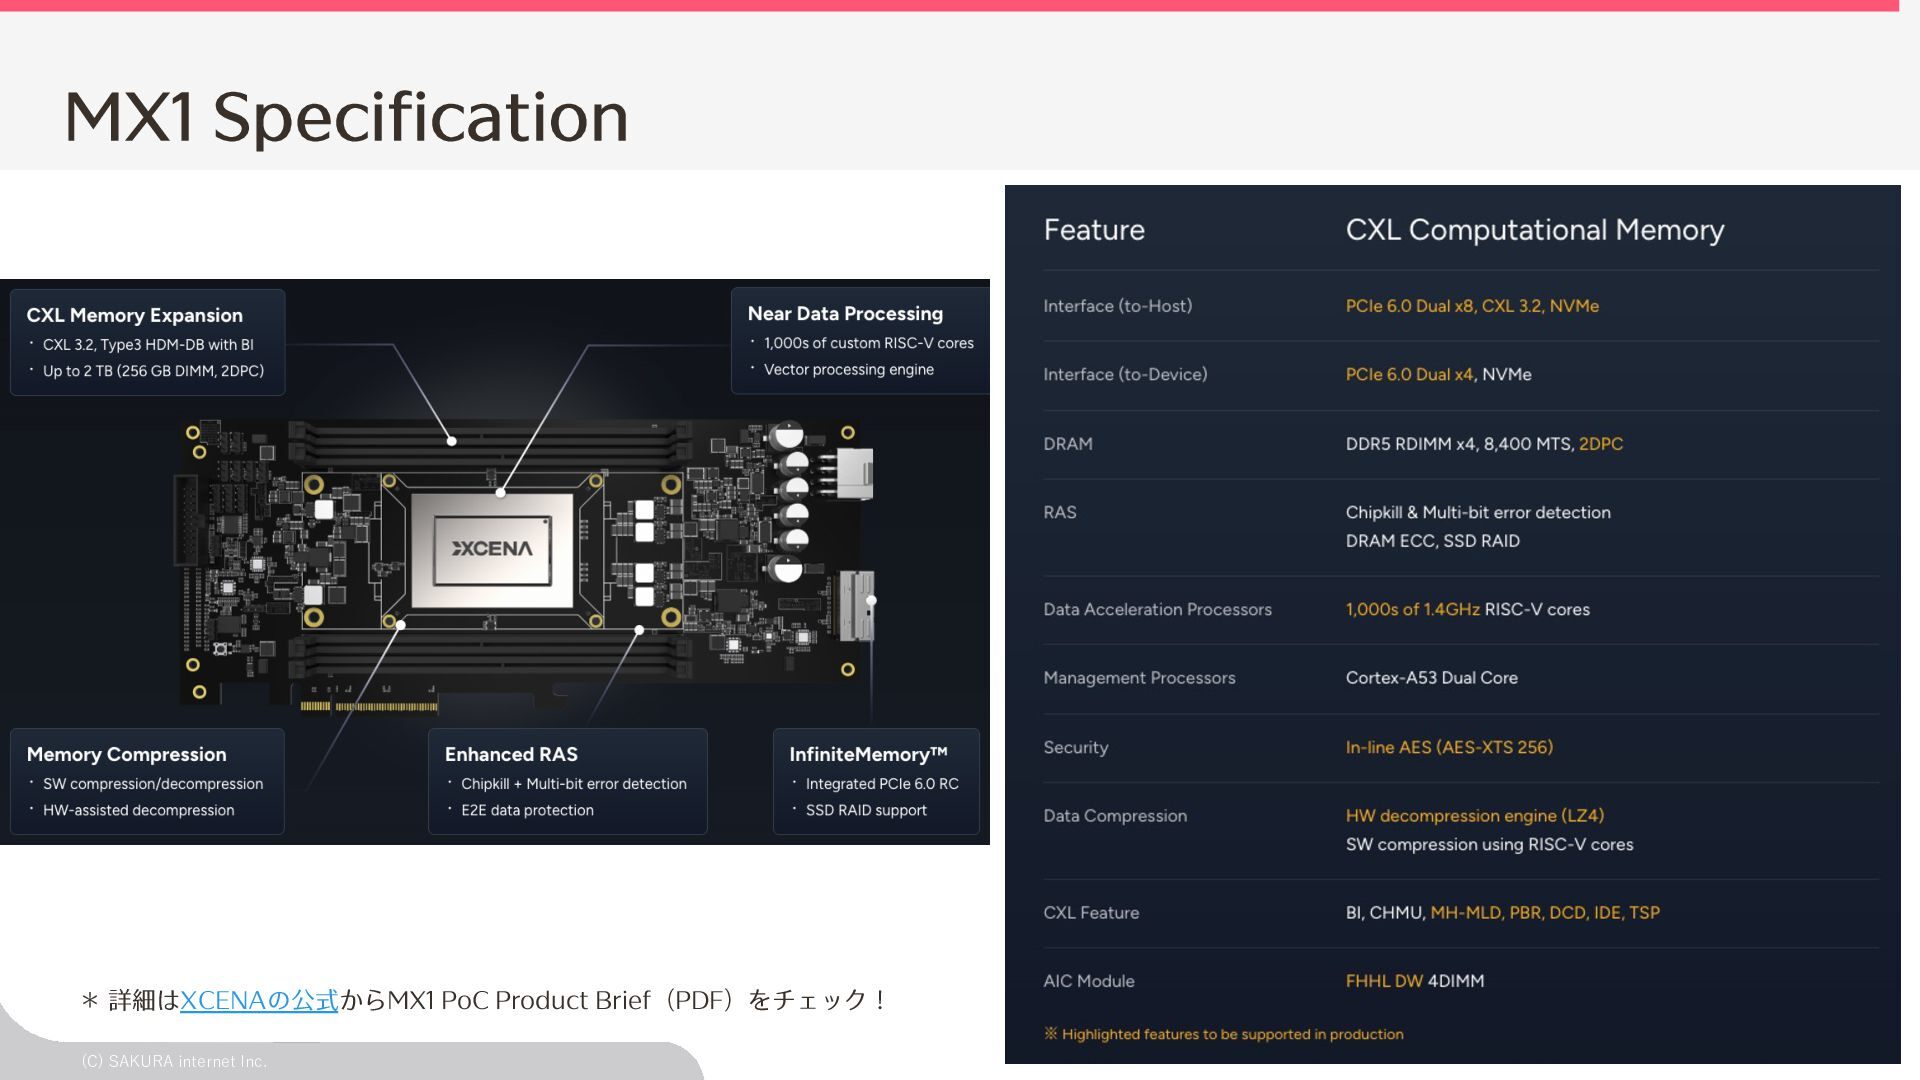
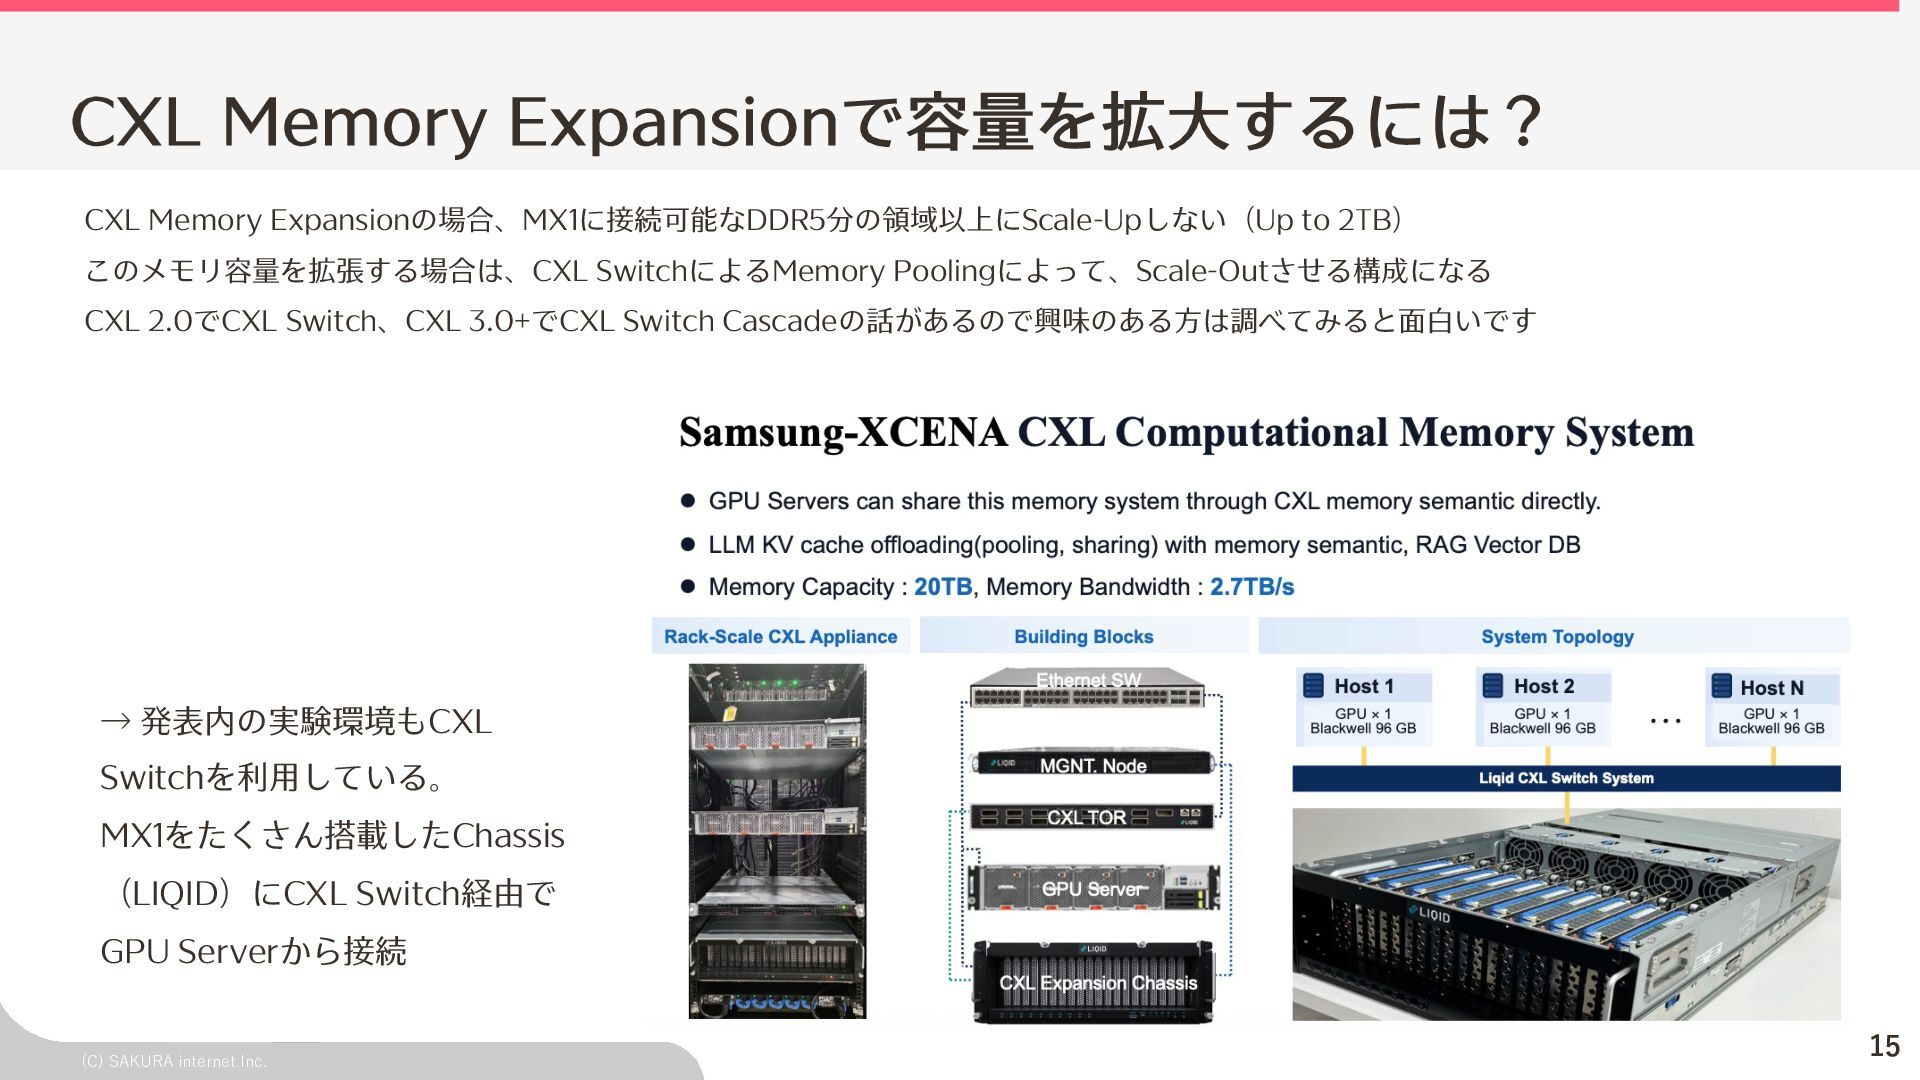
  9. CXL Memory Expansionで容量を拡⼤するには? CXL Memory Expansionの場合、MX1に接続可能なDDR5分の領域以上にScale-Upしない(Up to 2TB) このメモリ容量を拡張する場合は、CXL SwitchによるMemory

    Poolingによって、Scale-Outさせる構成になる CXL 2.0でCXL Switch、CXL 3.0+でCXL Switch Cascadeの話があるので興味のある⽅は調べてみると⾯⽩いです → 発表内の実験環境もCXL Switchを利⽤している。 MX1をたくさん搭載したChassis (LIQID)にCXL Switch経由で GPU Serverから接続 (C) SAKURA internet Inc. 15
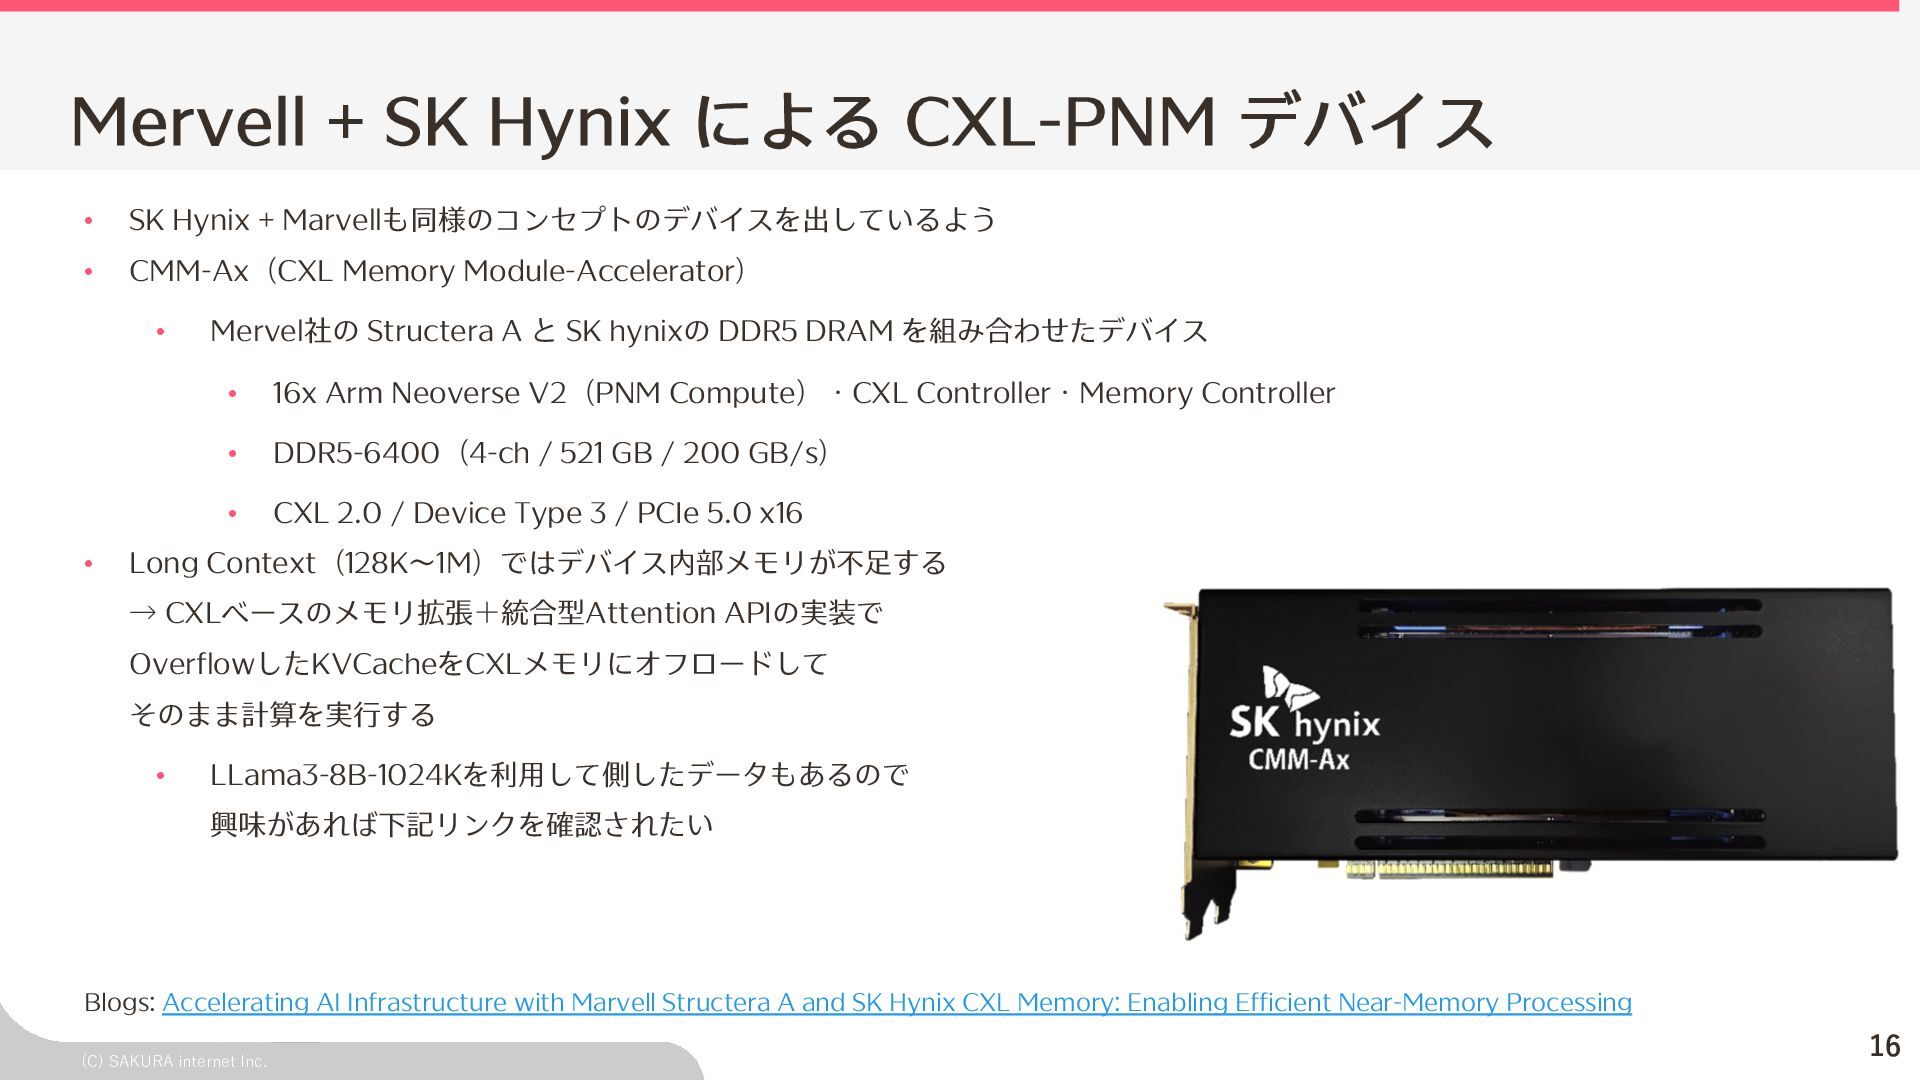
  10. Mervell + SK Hynix による CXL-PNM デバイス • SK Hynix

    + Marvellも同様のコンセプトのデバイスを出しているよう • CMM-Ax(CXL Memory Module-Accelerator) • • Mervel社の Structera A と SK hynixの DDR5 DRAM を組み合わせたデバイス • 16x Arm Neoverse V2(PNM Compute)・CXL Controller・Memory Controller • DDR5-6400(4-ch / 521 GB / 200 GB/s) • CXL 2.0 / Device Type 3 / PCIe 5.0 x16 Long Context(128K〜1M)ではデバイス内部メモリが不⾜する → CXLベースのメモリ拡張+統合型Attention APIの実装で OverflowしたKVCacheをCXLメモリにオフロードして そのまま計算を実⾏する • LLama3-8B-1024Kを利⽤して側したデータもあるので 興味があれば下記リンクを確認されたい Blogs: Accelerating AI Infrastructure with Marvell Structera A and SK Hynix CXL Memory: Enabling Efficient Near-Memory Processing (C) SAKURA internet Inc. 16
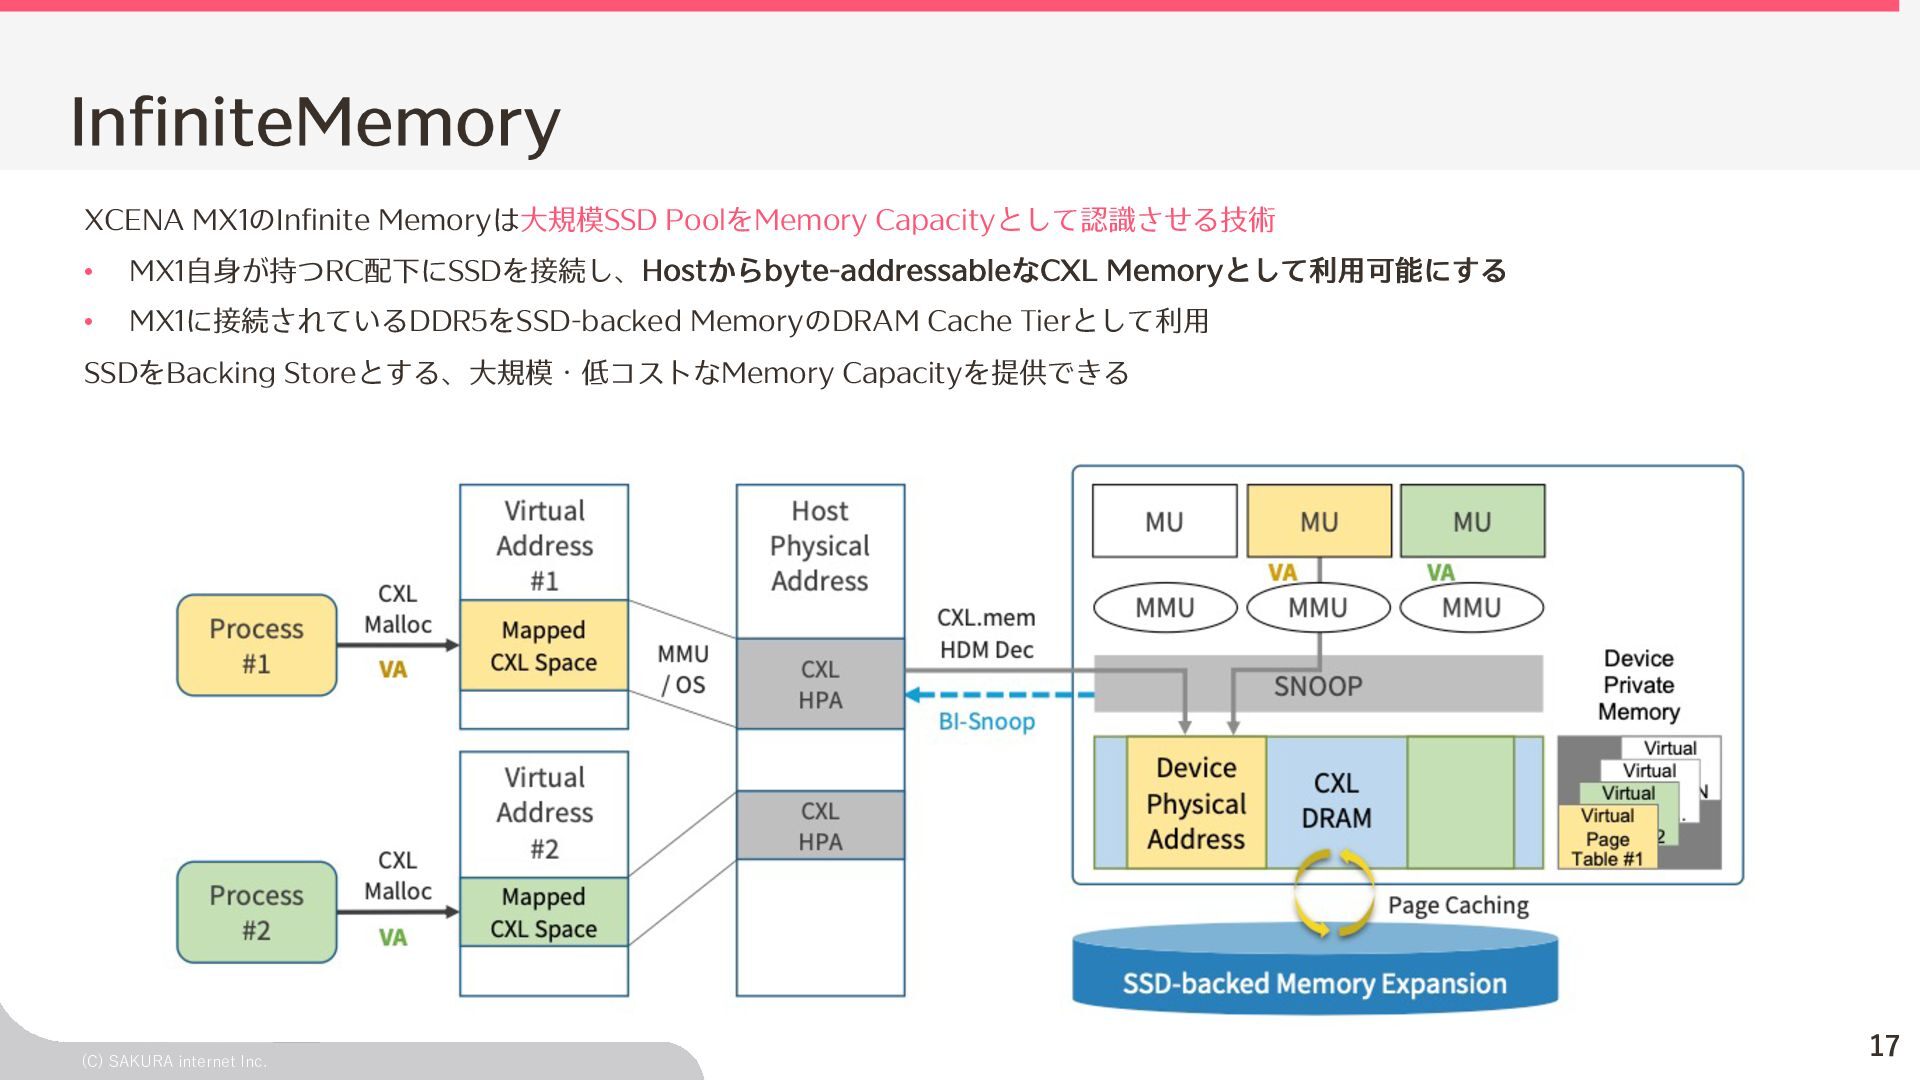
  11. InfiniteMemory XCENA MX1のInfinite Memoryは⼤規模SSD PoolをMemory Capacityとして認識させる技術 • MX1⾃⾝が持つRC配下にSSDを接続し、Hostからbyte-addressableなCXL Memoryとして利⽤可能にする •

    MX1に接続されているDDR5をSSD-backed MemoryのDRAM Cache Tierとして利⽤ SSDをBacking Storeとする、⼤規模・低コストなMemory Capacityを提供できる (C) SAKURA internet Inc. 17
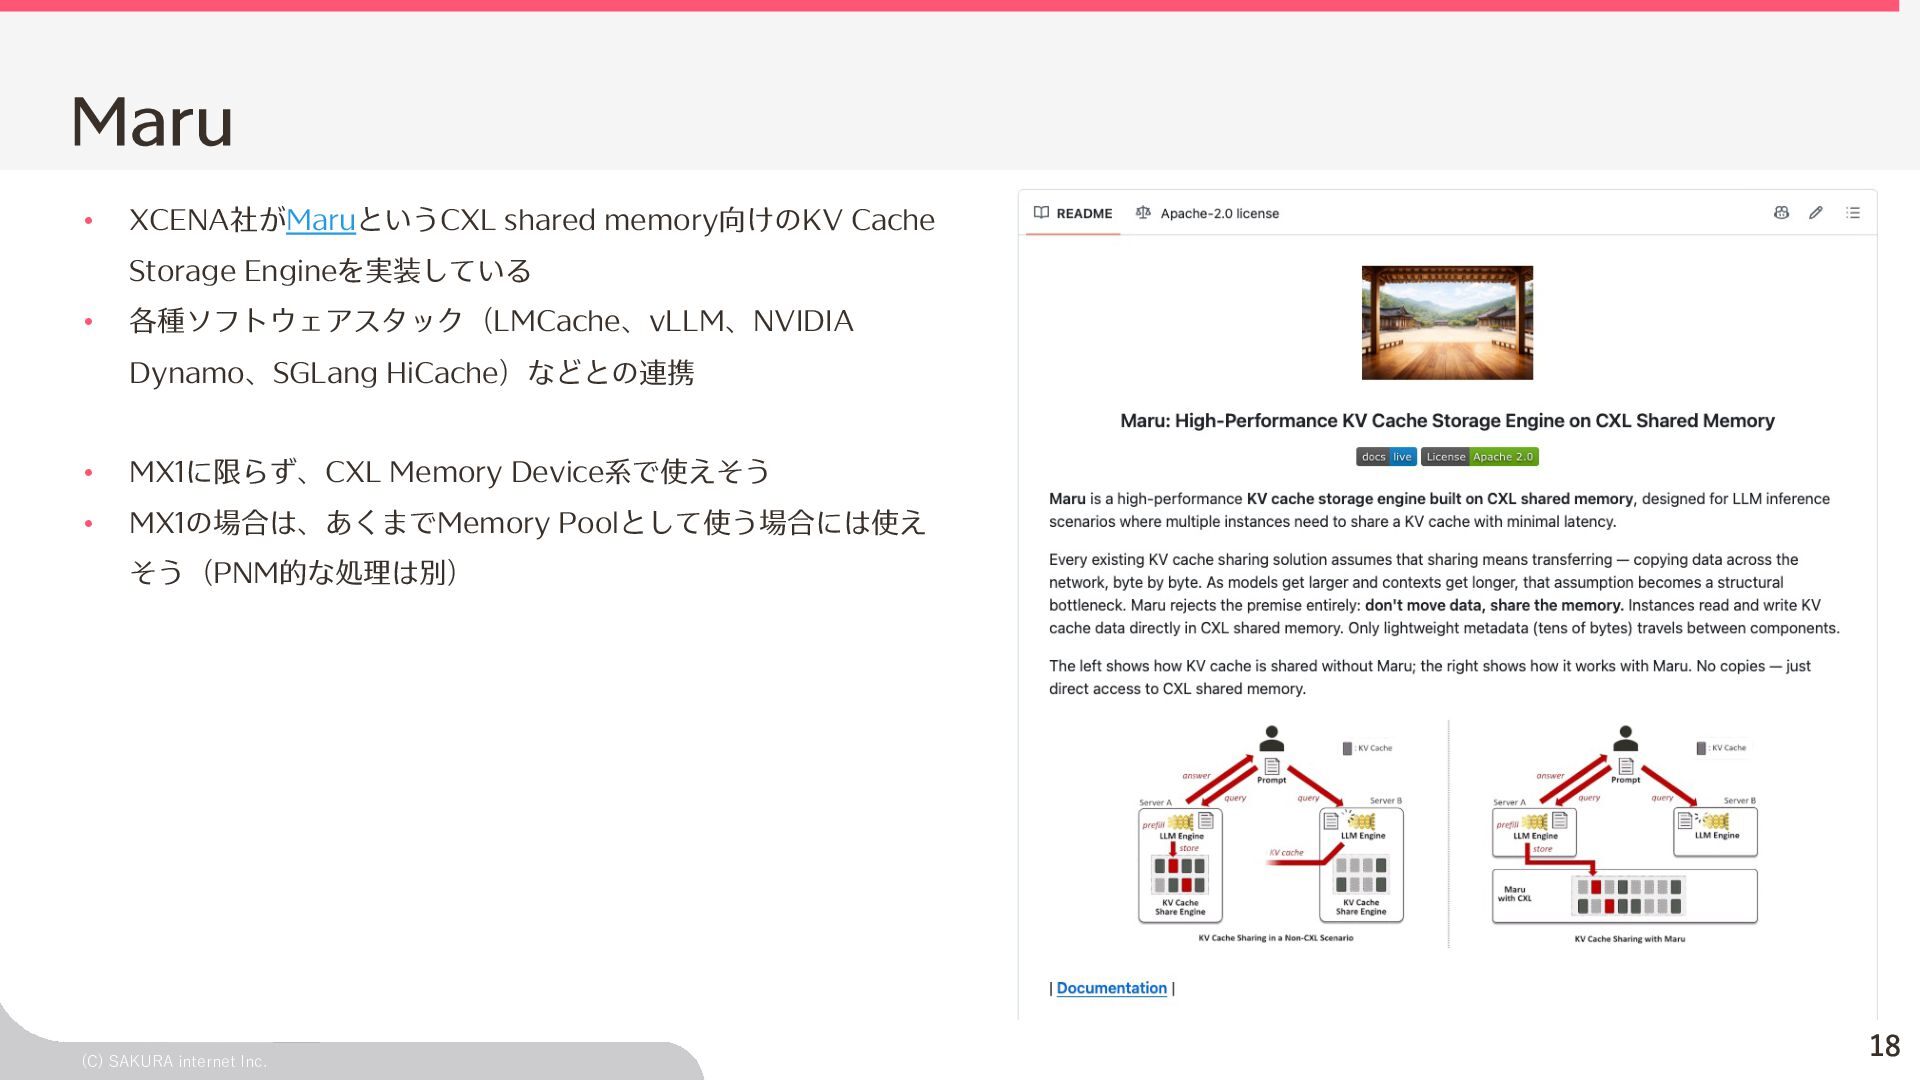
  12. Maru • XCENA社がMaruというCXL shared memory向けのKV Cache Storage Engineを実装している • 各種ソフトウェアスタック(LMCache、vLLM、NVIDIA

    Dynamo、SGLang HiCache)などとの連携 • MX1に限らず、CXL Memory Device系で使えそう • MX1の場合は、あくまでMemory Poolとして使う場合には使え そう(PNM的な処理は別) (C) SAKURA internet Inc. 18
  13. References • XCENA SDK Docs • XCENA InfiniteMemory • How

    We Solved the KV Cache Bottleneck in LLM Inference with CXL Shared Memory • Scalable Processing-Near-Memory for 1M-Token LLM Inference: CXL-Enabled KV-Cache Management Beyond GPU Limits • Accelerating AI Infrastructure with Marvell Structera A and SK Hynix CXL Memory: Enabling Efficient Near-Memory Processing (C) SAKURA internet Inc. 19