Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Apache Beam, Batch, Streaming, Modelos, y otra...

Avatar for borderstark borderstark
November 16, 2016
71

Apache Beam, Batch, Streaming, Modelos, y otra fauna

Avatar for borderstark

borderstark

November 16, 2016

Transcript

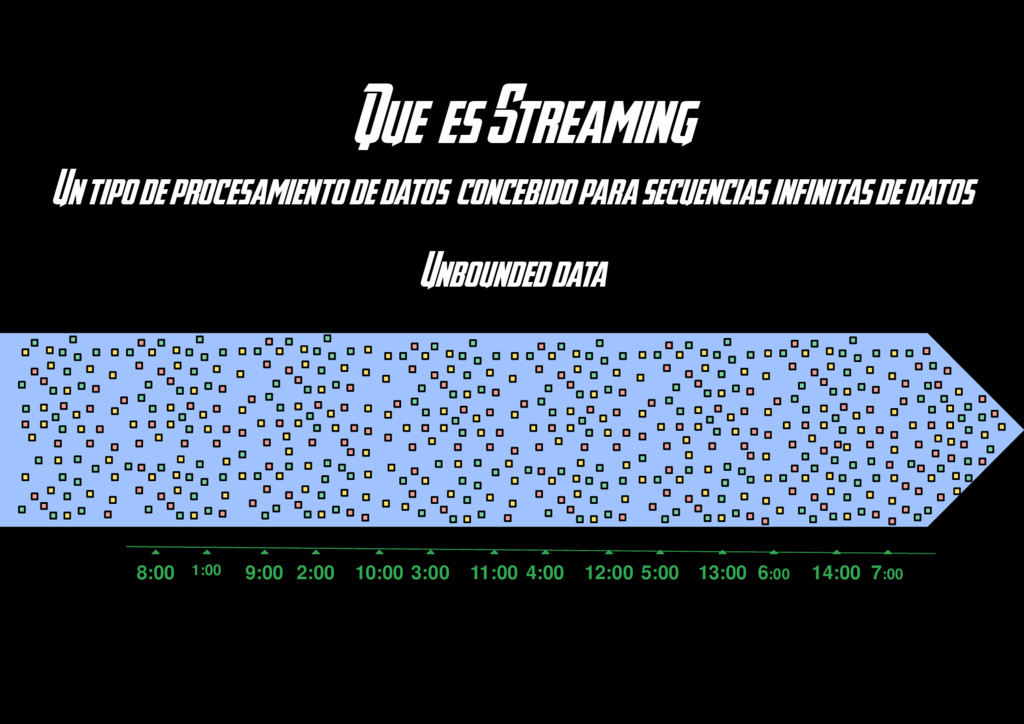
  1. Un tipode procesamientode datos concebidopara secuenciasinfinitasde datos Unbounded data Que

    es Streaming Tuesday 9:00 8:00 14:00 13:00 12:00 11:00 10:00 2:00 1:00 7:00 6:00 5:00 4:00 3:00
  2. 1. Completitud 2. Latencia 3. Coste Objetivos 9:00 8:00 14:00

    13:00 12:00 11:00 10:00 2:00 1:00 7:00 6:00 5:00 4:00 3:00 O(nlogn)
  3. Que se esta calculando? Transformaciones Donde se calculan los eventos?

    Windowing Cuandose generan los resultados? Watermarksy triggers Comose recalculan los resultados? Acumulados What, Where, When& How
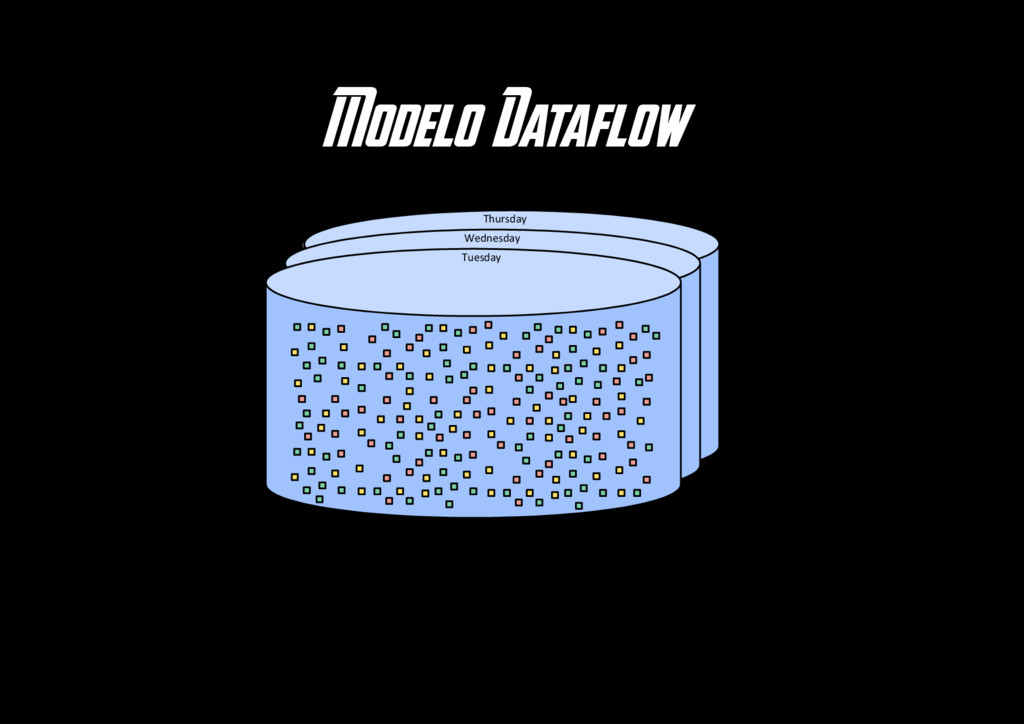
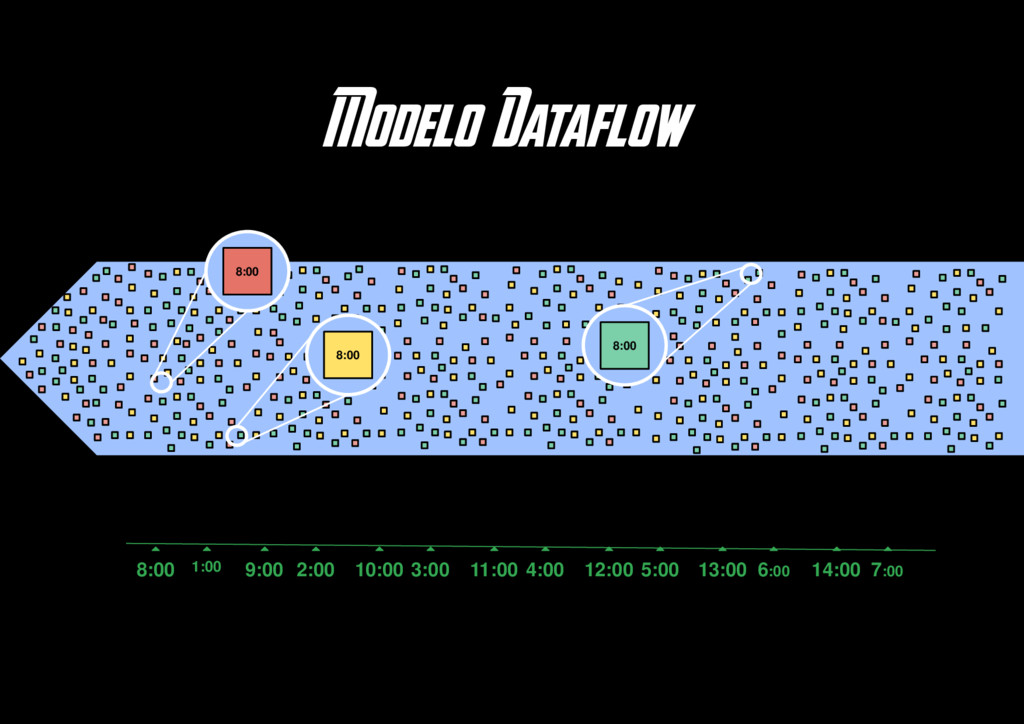
  4. Modelo Dataflow Tuesday Wednesday Thursday 9:00 8:00 14:00 13:00 12:00

    11:00 10:00 2:00 1:00 7:00 6:00 5:00 4:00 3:00 8:00 8:00 8:00
  5. Objetivos Modelo Dataflow 1. Desarrollar codigoeficiente y simple 2. Procesamiento

    en Batchy Streaming 3. Uso de timestampspersonalizados 4. Manejo de datos desordenados
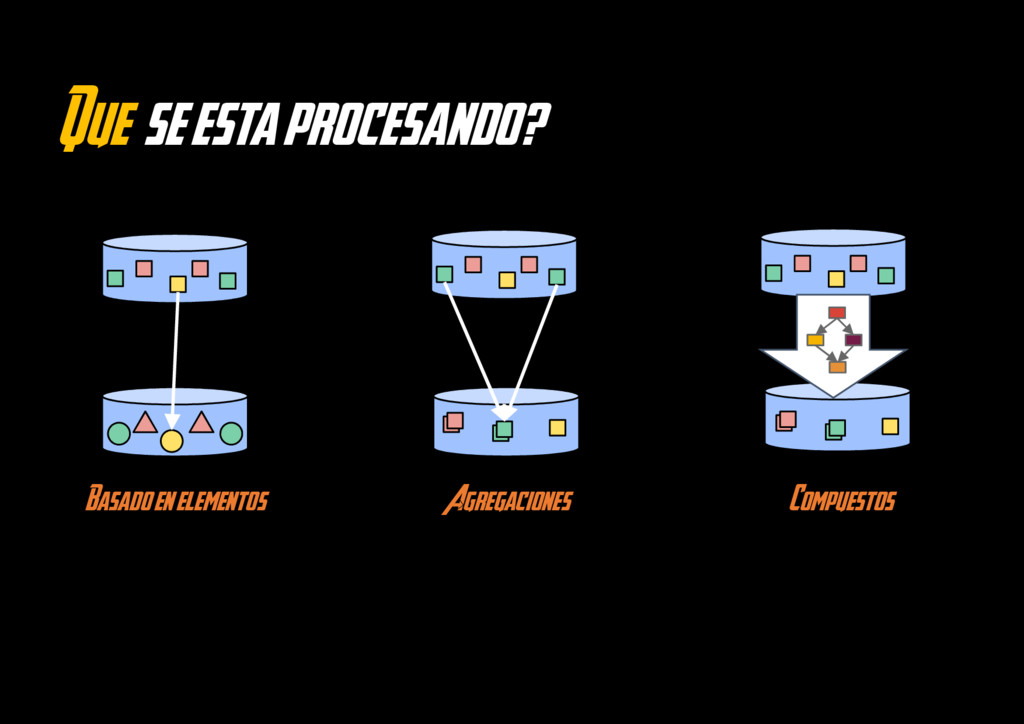
  6. Que se esta procesando? Donde se calculan los eventos? Cuandose

    procesan los eventos? Comose recalculan los resultados? Fundamentos modelo Dataflow
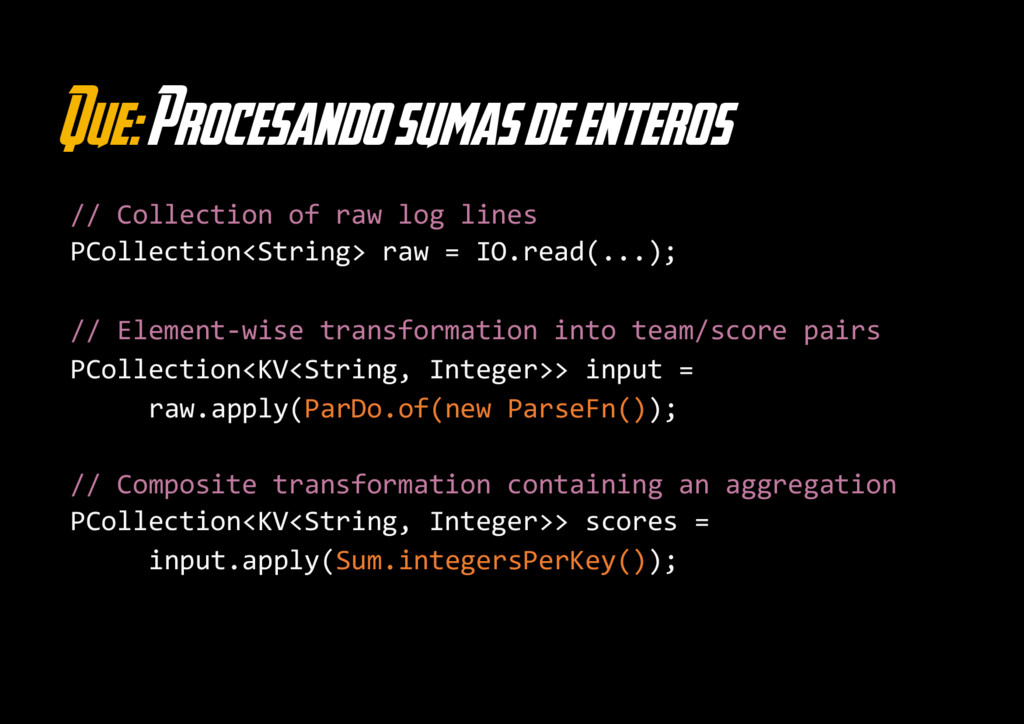
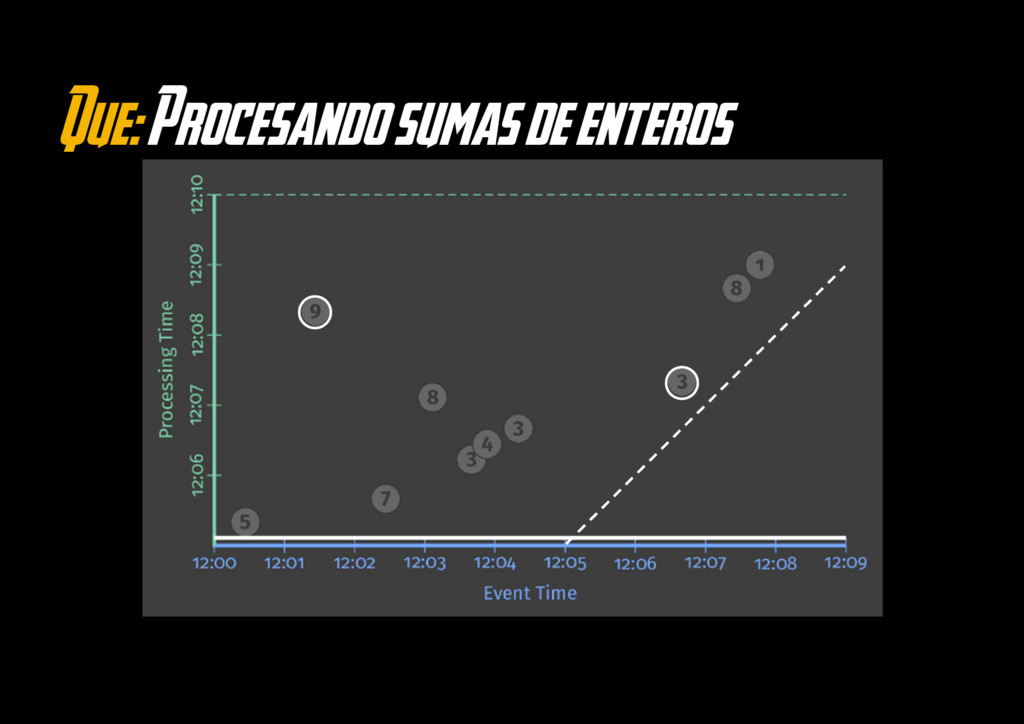
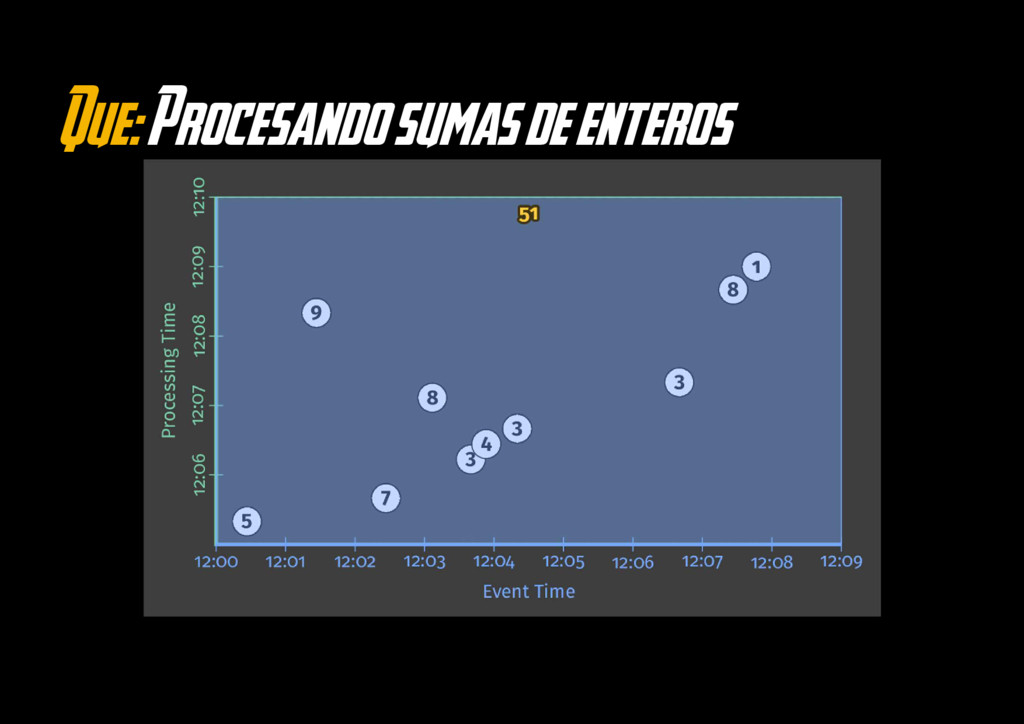
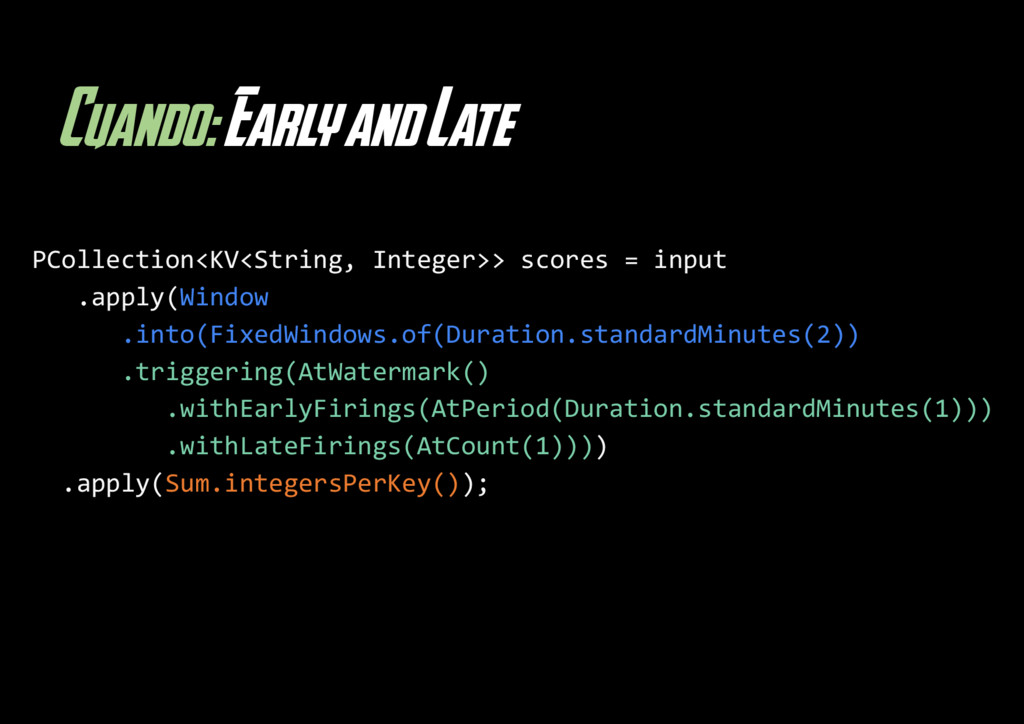
  7. Que:Procesando sumas de enteros // Collection of raw log lines

    PCollection<String> raw = IO.read(...); // Element-wise transformation into team/score pairs PCollection<KV<String, Integer>> input = raw.apply(ParDo.of(new ParseFn()); // Composite transformation containing an aggregation PCollection<KV<String, Integer>> scores = input.apply(Sum.integersPerKey());
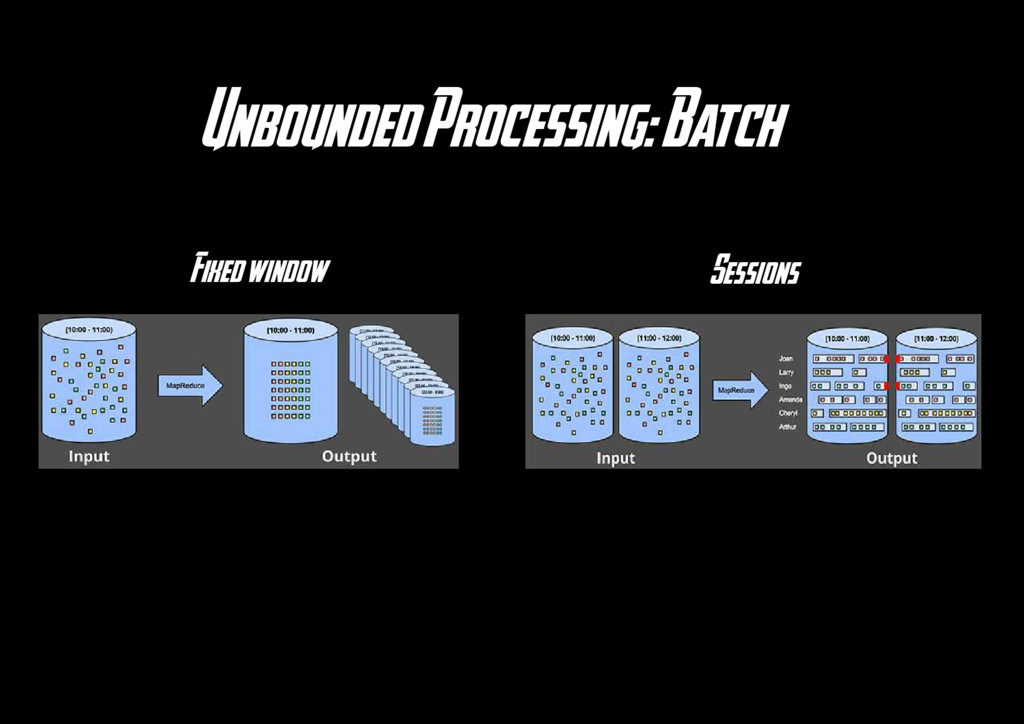
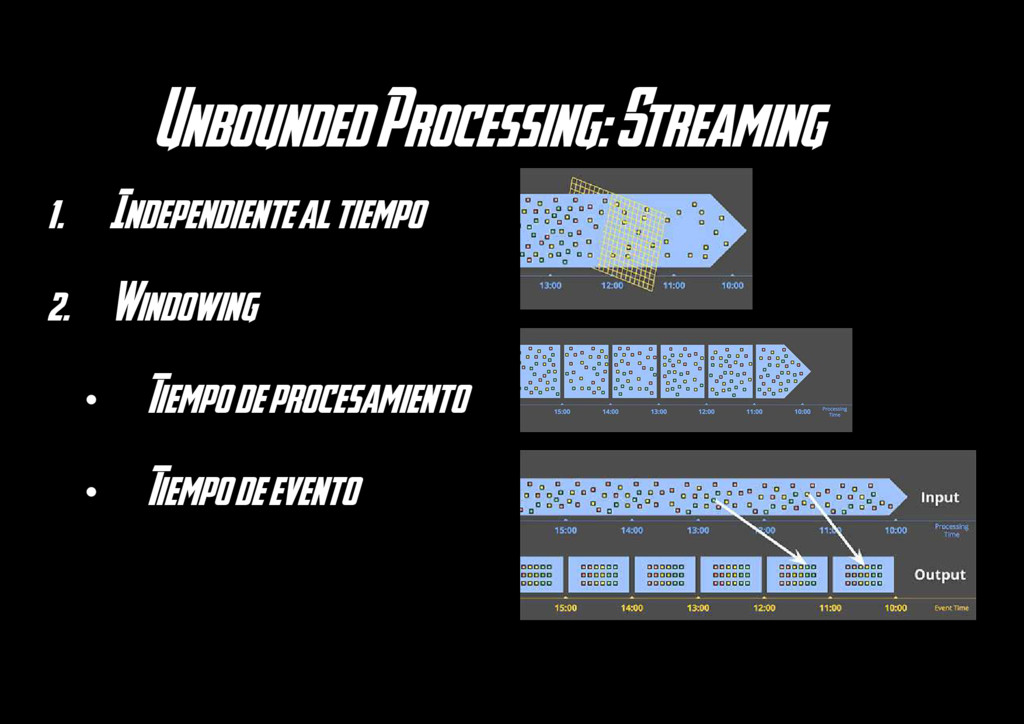
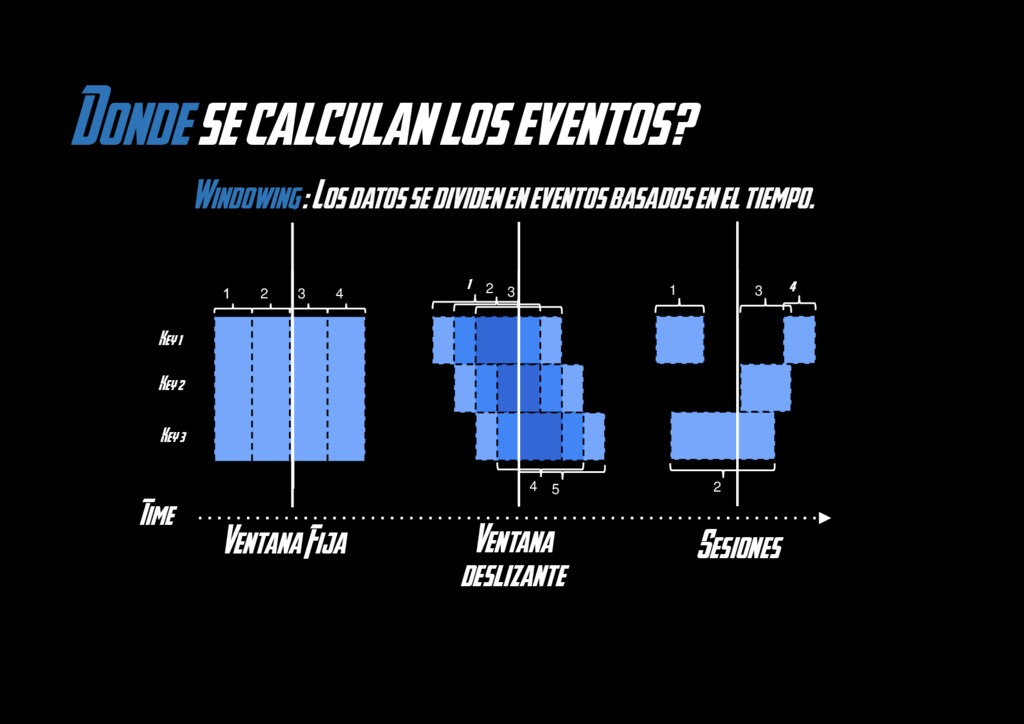
  8. Windowing: Los datos se dividen en eventos basados en el

    tiempo. Ventana Fija Ventana deslizante 1 2 3 5 4 Sesiones 2 4 3 1 Key 2 Key 1 Key 3 Time 2 3 4 Dondese calculan los eventos?
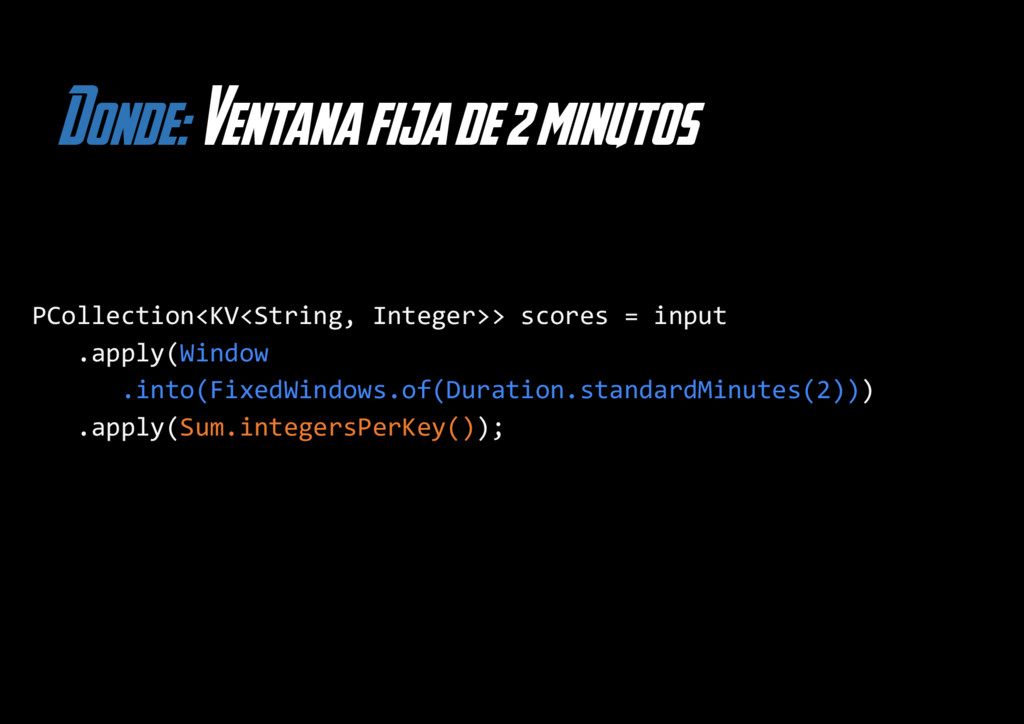
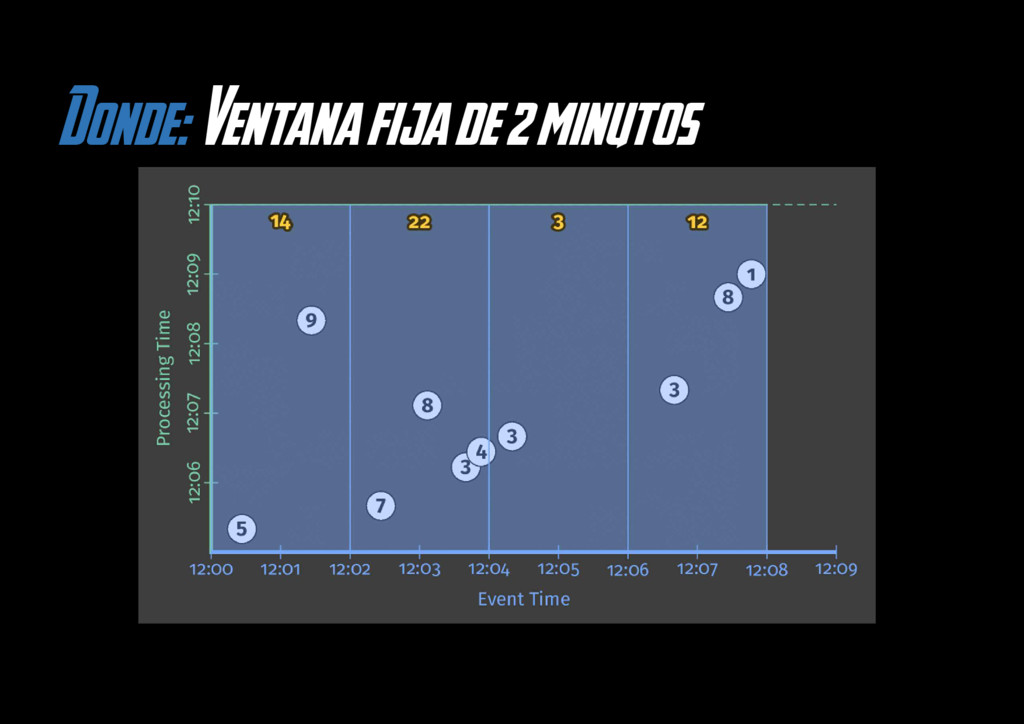
  9. Donde: Ventana fija de 2 minutos PCollection<KV<String, Integer>> scores =

    input .apply(Window .into(FixedWindows.of(Duration.standardMinutes(2))) .apply(Sum.integersPerKey());
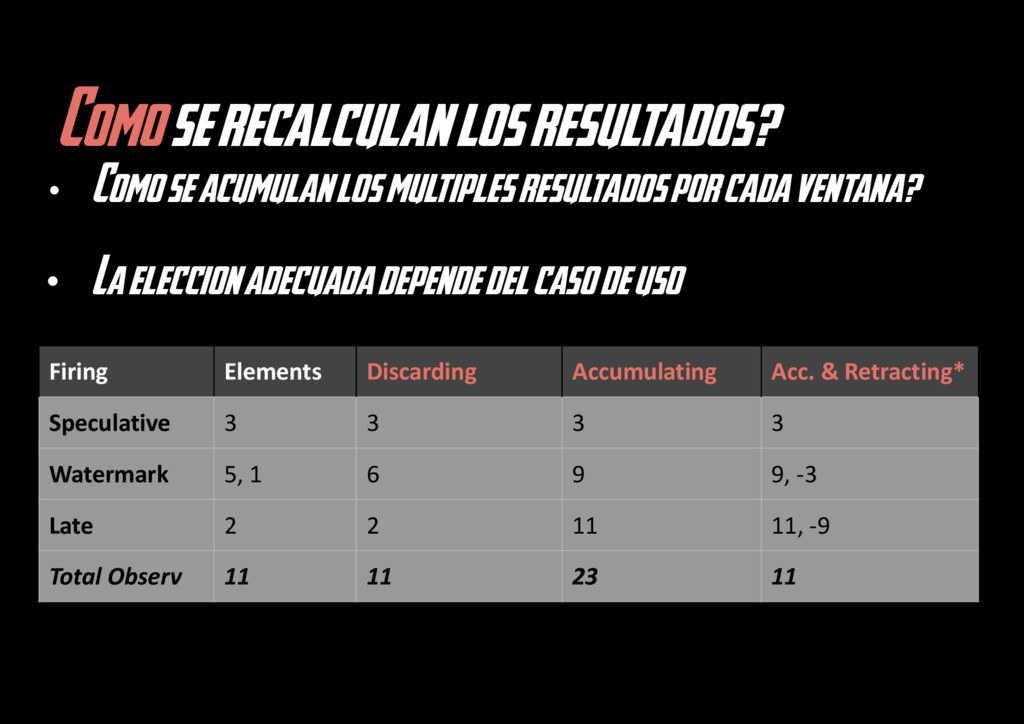
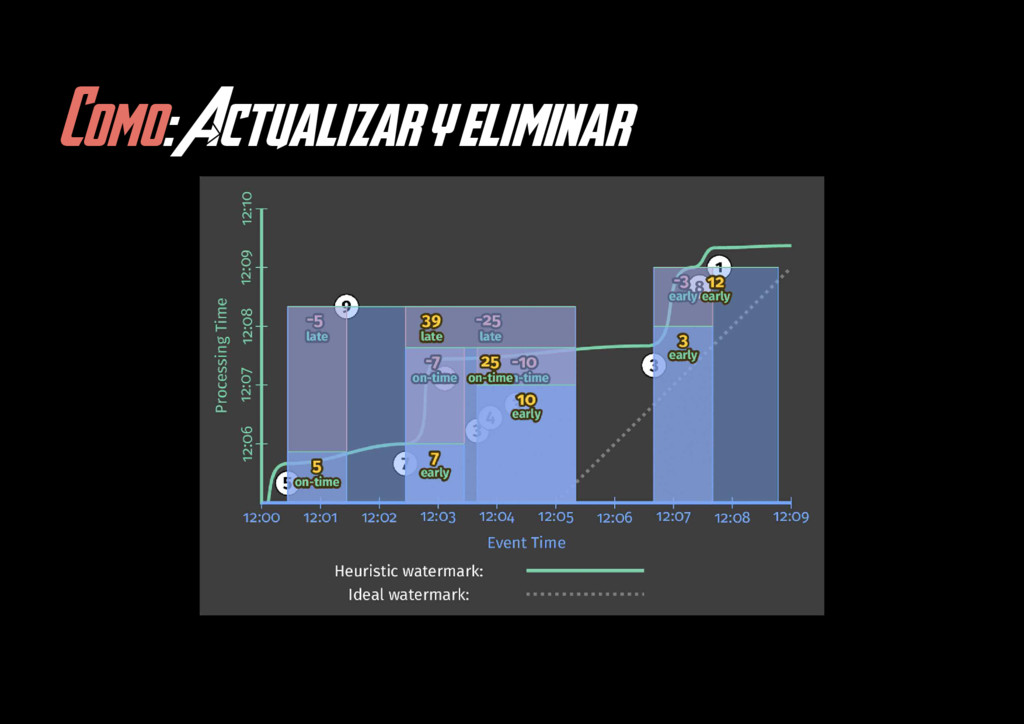
  10. Comose recalculan los resultados? • Como se acumulan los multiplesresultados

    por cada ventana? • La eleccionadecuada depende del caso de uso Firing Elements Speculative 3 Watermark 5, 1 Late 2 Total Observ 11 Discarding 3 6 2 11 Accumulating 3 9 11 23 Acc. & Retracting* 3 9, -3 11, -9 11
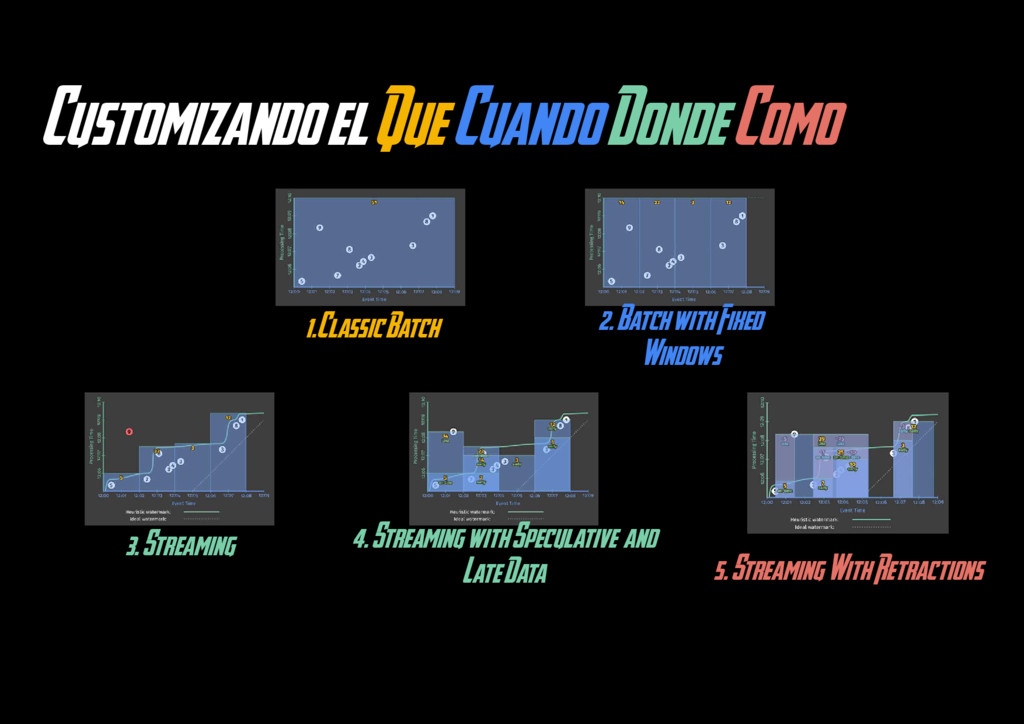
  11. 1.Classic Batch 2. BatchwithFixed Windows 3. Streaming 5. StreamingWithRetractions 4.

    StreamingwithSpeculative and Late Data Customizandoel Que CuandoDonde Como
  12. Que es Apache Beam? 1. Beam: Brtch& strEAM 2. Proyecto

    en Apache Incubatorcedido por Google, A.K.A DataFlow 3. Es un lenguaje para la creacion de ET Ls, procesos de ingesta y de integracion 4. Abstrae el codigo del entorno de ejecucion 5. Pasar de ejecucionBatcha Streaminges muy senicllo
  13. Conceptos BEAM 1. Perfiles • Usuarios Finales • Programadores SDK

    • Programador de RUNNERS 2. Conceptos : • PCollection: Bounded/Unbounded • PTransform: Transformaciones en si mismas • Pipeline: Flujo de datos, grafo aciclico • PipelineRunner: Donde y cuando se ejecuta el proceso
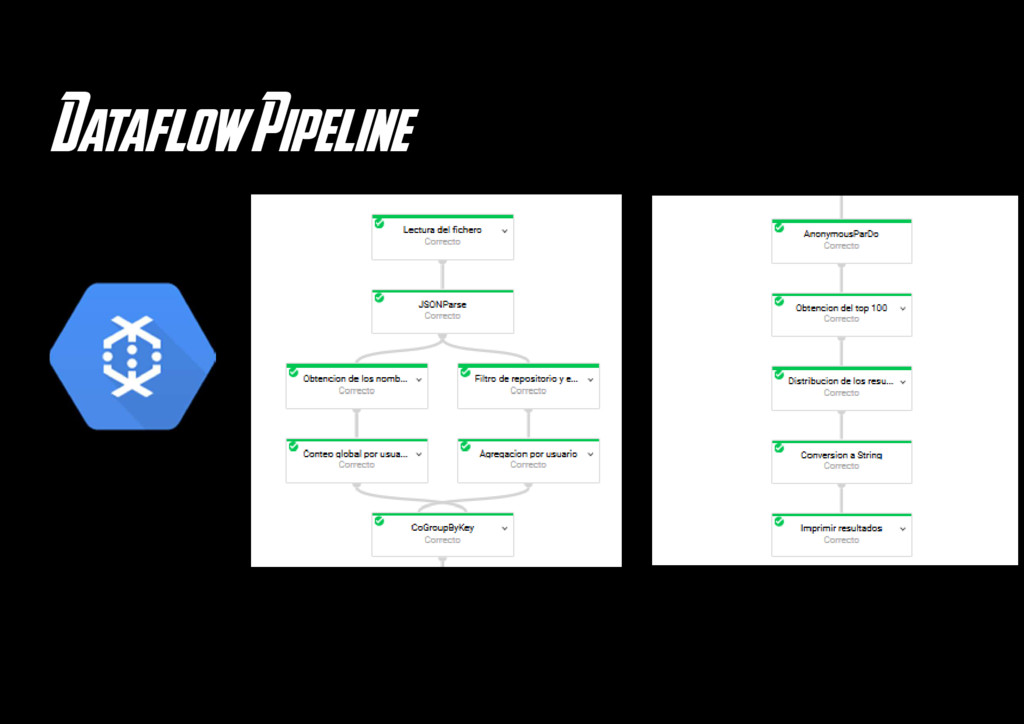
  14. Google Dataflow 1. Servicio Gestionado 2. Elastico 3. Facturado por

    minuto 4. Alto grado de compatibilidad -BEAM es DataFlow. 5. Integracioncon Big Query, PubSub, Cloud Storage...
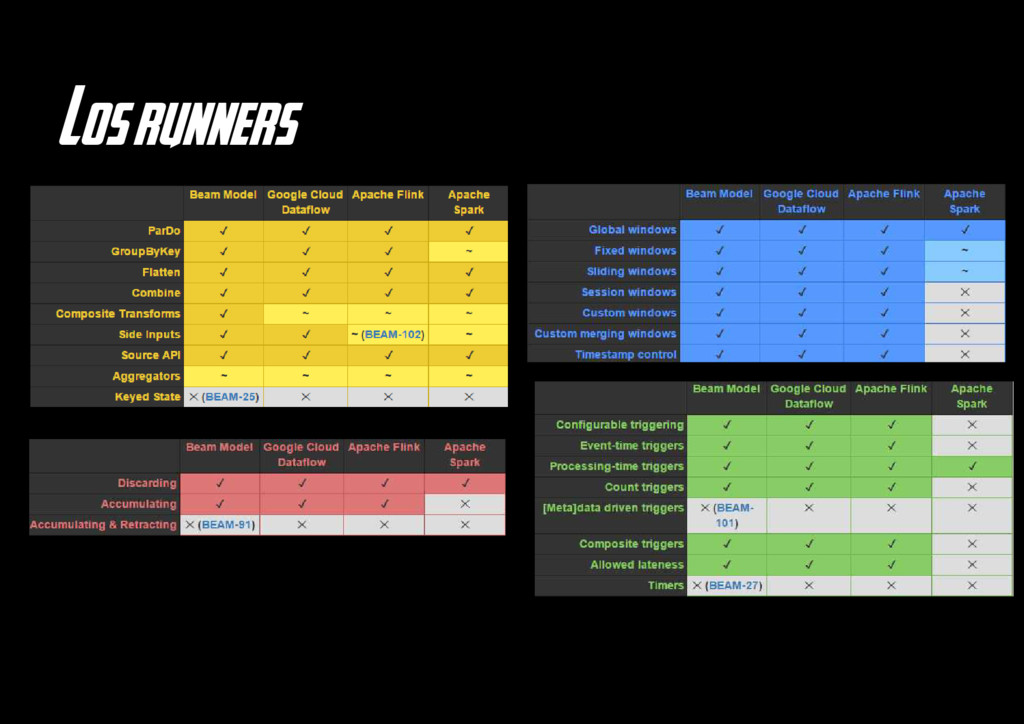
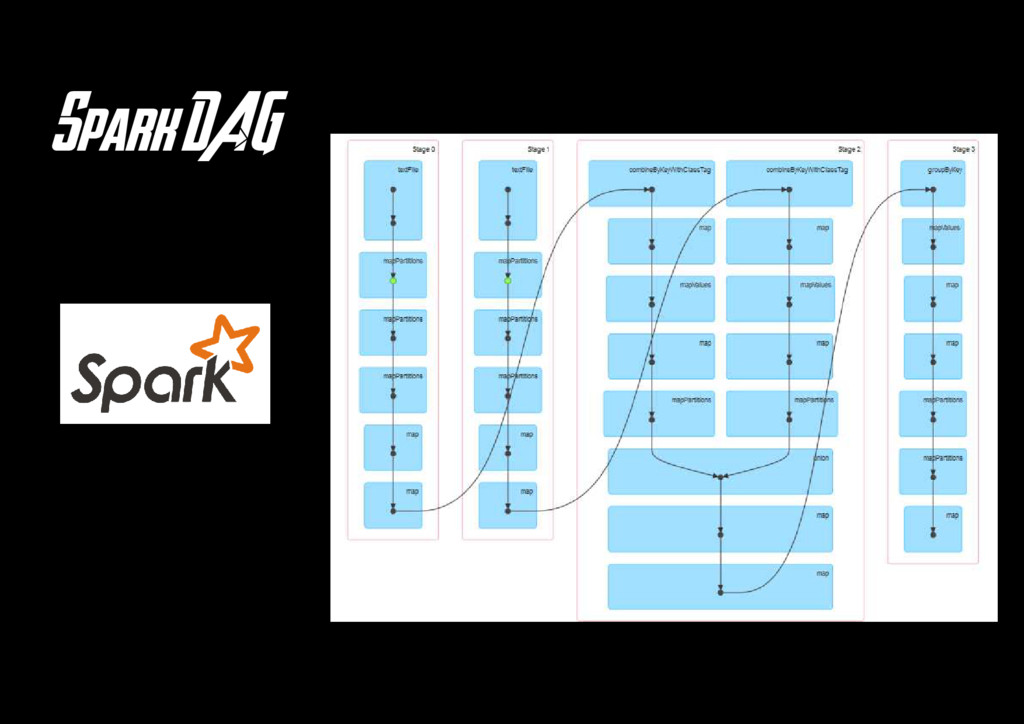
  15. Spark 1. El SparkRunnerpara BEAM ha sido donado por Clouderaa

    Apache. 2. No esta completamente integrado con BEAM 3. Mas rapido que Dataflowen Jobs sencillos 4. JoinSensible
  16. Flink 1. FlinkRunnercreado por los padres del propio Apache Flink,

    Data Artisans 2. Jobs en Streamingmuy rapidos 3. Mejor integrado con BEAM que Spark para operaciones de Windowing y Triggering 4. JoinSensible
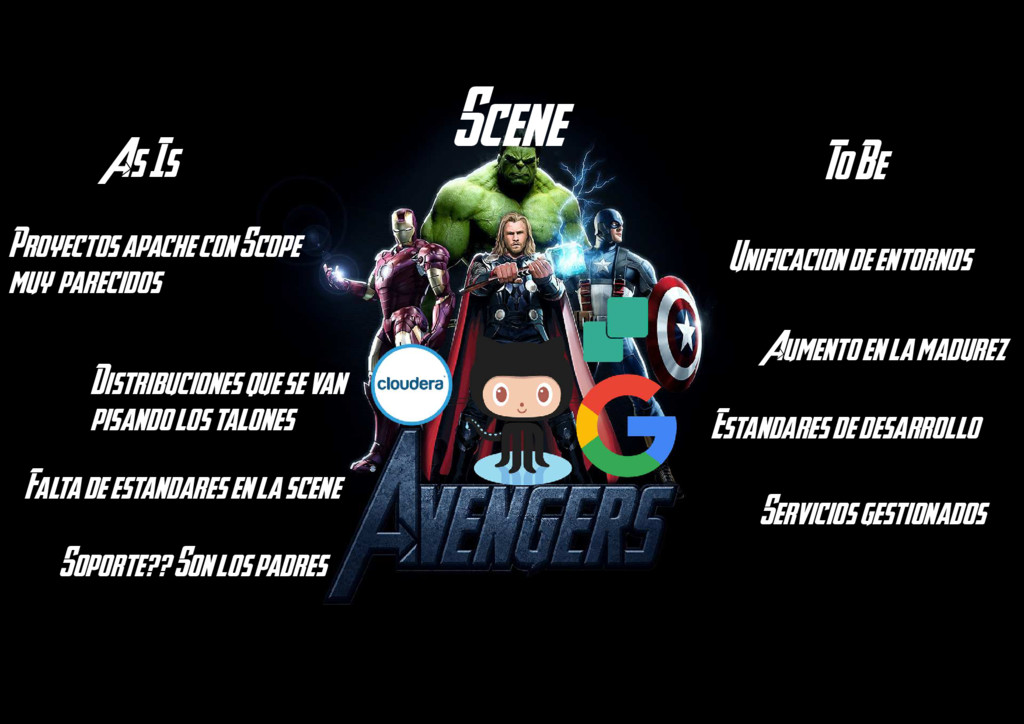
  17. Scene Proyectos apache con Scope muy parecidos Falta de estandaresen

    la scene Distribuciones que se van pisando los talones Soporte?? Son los padres Aumento en la madurez Unificacionde entornos Servicios gestionados As Is To Be Estandaresde desarrollo
  18. 1. API enScala para Spark y Beam 2. Compatible con

    productosGoogle Cloud Newcomers
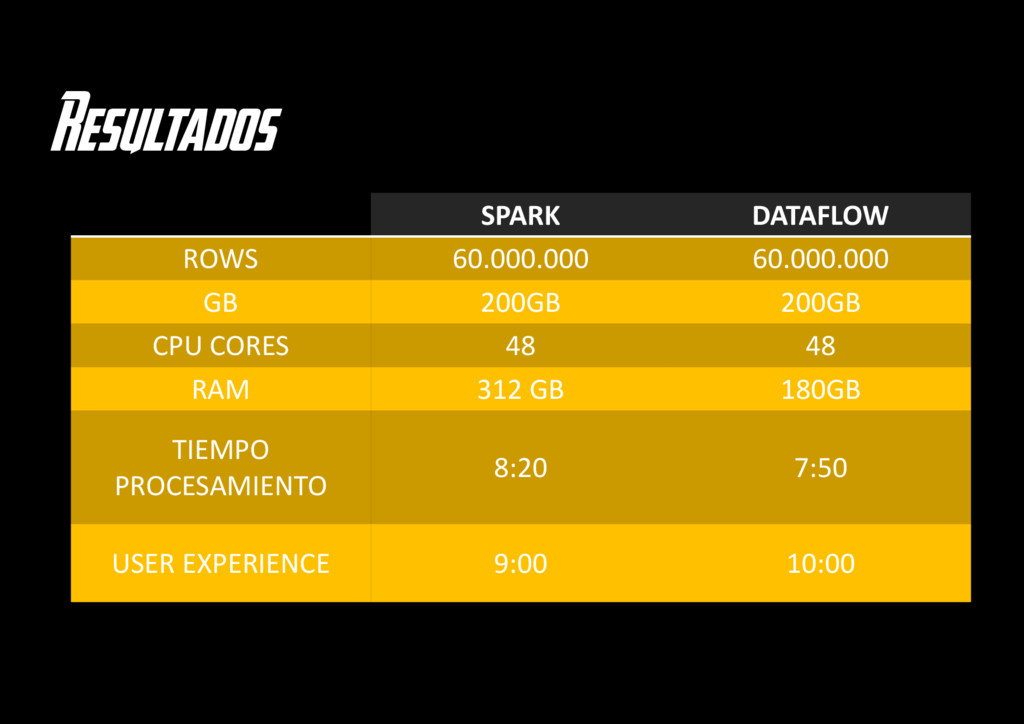
  19. Resultados SPARK DATAFLOW ROWS 60.000.000 60.000.000 GB 200GB 200GB CPU

    CORES 48 48 RAM 312 GB 180GB TIEMPO PROCESAMIENTO 8:20 7:50 USER EXPERIENCE 9:00 10:00
  20. Lo bueno 1. Procesamiento en Batcho en Stramingsin practicamente cambiar

    codigo 2. Diferentes entornos de ejcuciontanto gestionados como propios 3. Proyecto que esta creando mucho Hypeen la comunidad 4. Equipo de contributorsconsolidado
  21. Lo malo 1. Proyecto en IncubatingStatus 2. Poco Soporte 3.

    Runnersno integrados completamente 4. El Streamingesta en la cresta del ciclo del hype 5. Pocos casos de exito vendibles