Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
いくつ知ってる? GoogleのAIたち
Search
Cloud Ace
October 08, 2026
Technology
6
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
いくつ知ってる? GoogleのAIたち
Cloud Ace
October 08, 2026
More Decks by Cloud Ace
See All by Cloud Ace
GCSの署名付きURL、 URLを返せば終わりじゃなかった話
cloudace
0
8
新卒1年目からAI駆動開発:期待と現実、そして気づいたこと
cloudace
0
11
Developer Knowledge MCP でサポート業務を改善する
cloudace
0
6
クラウドエース流AI駆動開発の実践
cloudace
0
13
ソフトウェアDNAとクラウドエージェントのススメ
cloudace
0
150
今年の最難関と思われるProfessional Security Operations Engineer の概要
cloudace
0
32
Gemini CLI x Google Cloud Document MCP で作る Google Cloud クイズボット
cloudace
0
36
魅力的な LT を作りたい
cloudace
0
31
AIエージェントはqじゃなくてwqしよう
cloudace
0
35
Other Decks in Technology
See All in Technology
AgentCoreで実践するハーネスエンジニアリング
yakumo
1
290
おそらく日本で唯一のDevRelインターン生として
husengs7
0
170
今こそ知りたいAmplifyGen2
mkdev10
2
160
Snapshot Testing in Practice: Predictable and Reliable SwiftUI Views
fespinoza
0
150
継続的なAIコスト最適化
bgpat
1
220
生成AIと進める探索的データ分析(2026.10.03 第122回Tokyo.R勉強会)
tatamiya
2
1.4k
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
4
1.2k
自主式軟體工廠
philipz
0
240
More Freedom on the Same Shared GPU Cluster: A Small Team’s Experience with vCluster
nttcom
0
140
予測不能な実行エージェントを安全にサクッと試せるサンドボックス環境の話
sansantech
PRO
0
130
不可逆な意思決定を避けながら10億超の顧客データを AI Ready にするデータ基盤設計
baseballyama
1
160
3つのアプローチで目指す チームを強くするAI駆動開発
thkt
0
130
Featured
See All Featured
Six Lessons from altMBA
skipperchong
29
4.5k
How to make the Groovebox
asonas
2
2.5k
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
860
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
The Invisible Side of Design
smashingmag
301
52k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Color Theory Basics | Prateek | Gurzu
gurzu
1
480
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
510
Writing Fast Ruby
sferik
630
63k
Measuring & Analyzing Core Web Vitals
bluesmoon
9
1k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Tell your own story through comics
letsgokoyo
1
1.1k
Transcript
Jagu'e'r 月末 Tech Lunch #17 いくつ知ってる? GoogleのAIたち Geminiだけじゃない、Google製AIのディープな世界 クラウドエース株式会社 遠藤柊弥
SPEAKER PROFILE 自己紹介 名前 / 所属 遠藤柊弥 / クラウドエース株式会社 第一開発部
普段の業務・ロール 主にフロントエンド領域で上流から下流までやるソフトウェアエンジニア 推しのGoogle製AI Gemini 3.8 Flash(高コスパ、日本語の読み書きが安定している)
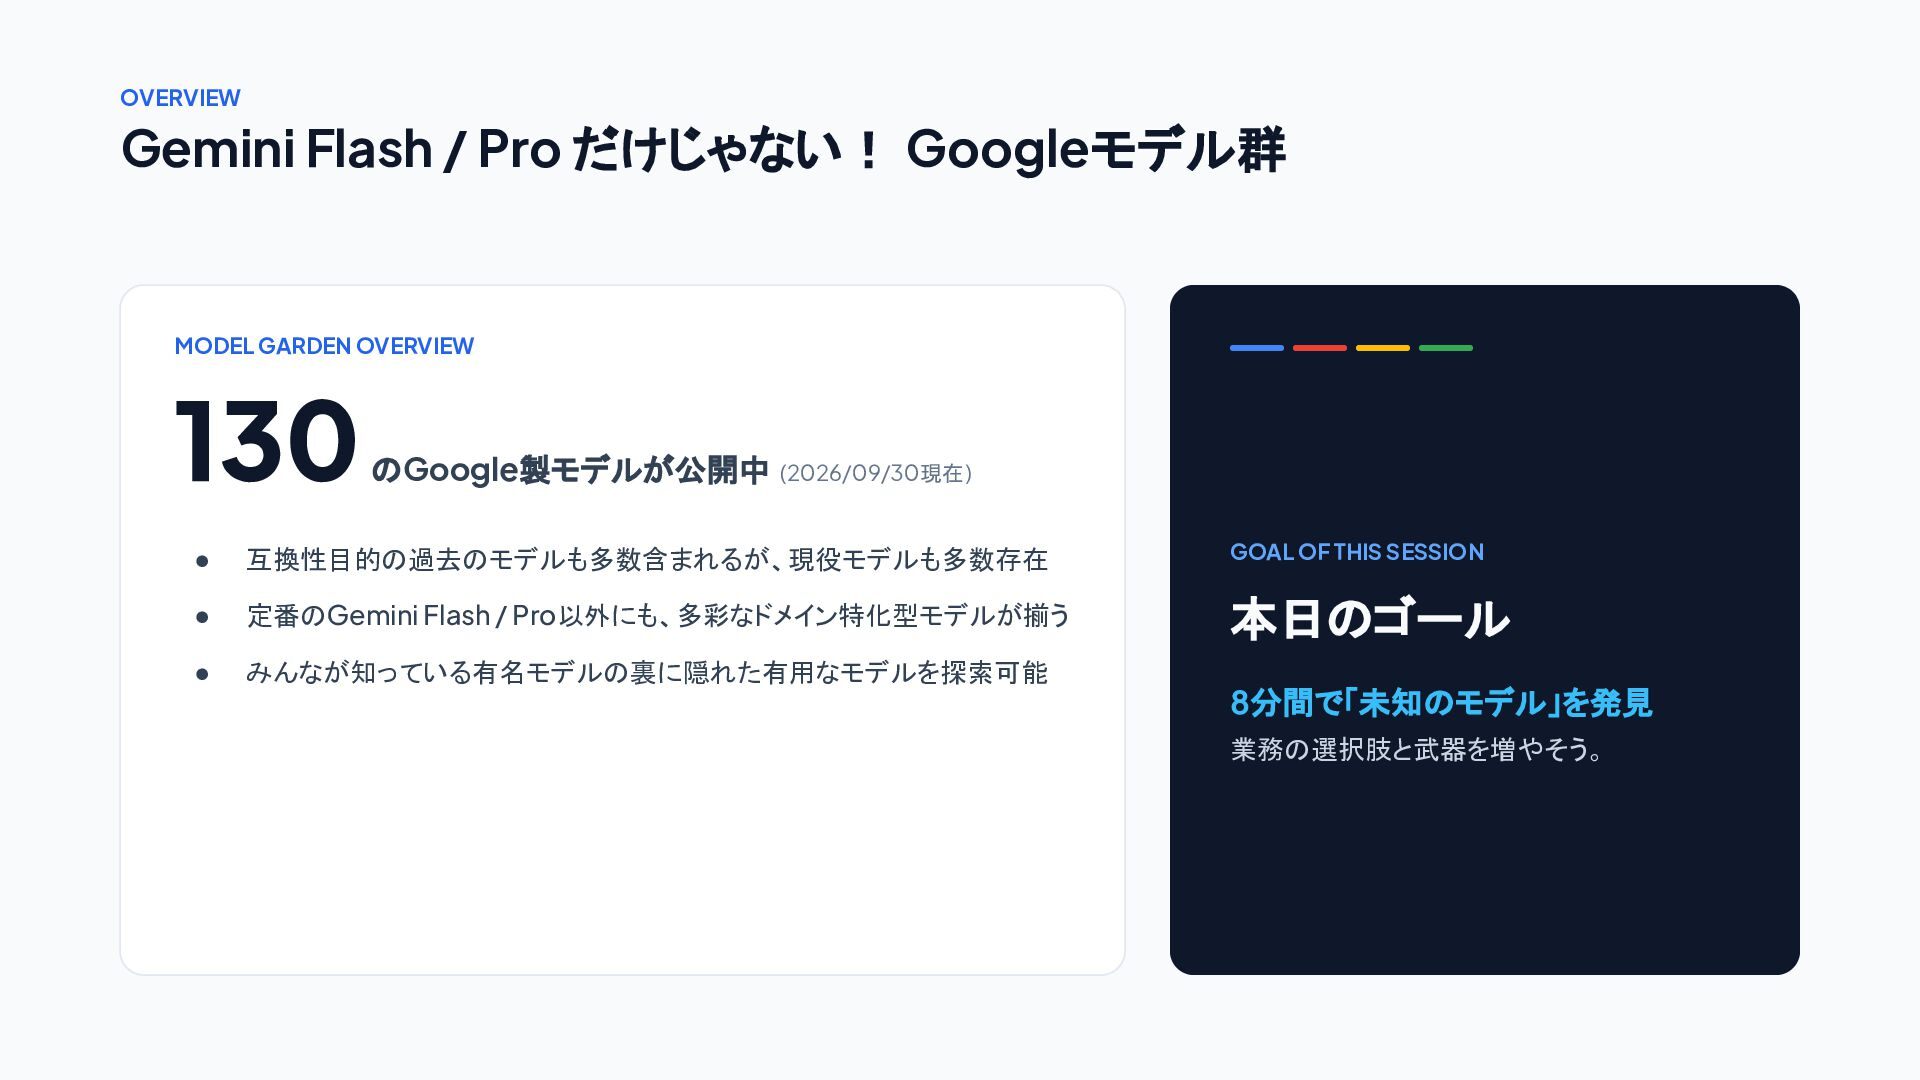
OVERVIEW Gemini Flash / Pro だけじゃない! Googleモデル群 MODEL GARDEN OVERVIEW
130 のGoogle製モデルが公開中 (2026/09/30現在) • 互換性目的の過去のモデルも多数含まれるが、現役モデルも多数存在 GOAL OF THIS SESSION • 定番のGemini Flash / Pro以外にも、多彩なドメイン特化型モデルが揃う 本日のゴール • みんなが知っている有名モデルの裏に隠れた有用なモデルを探索可能 8分間で「未知のモデル」を発見 業務の選択肢と武器を増やそう。
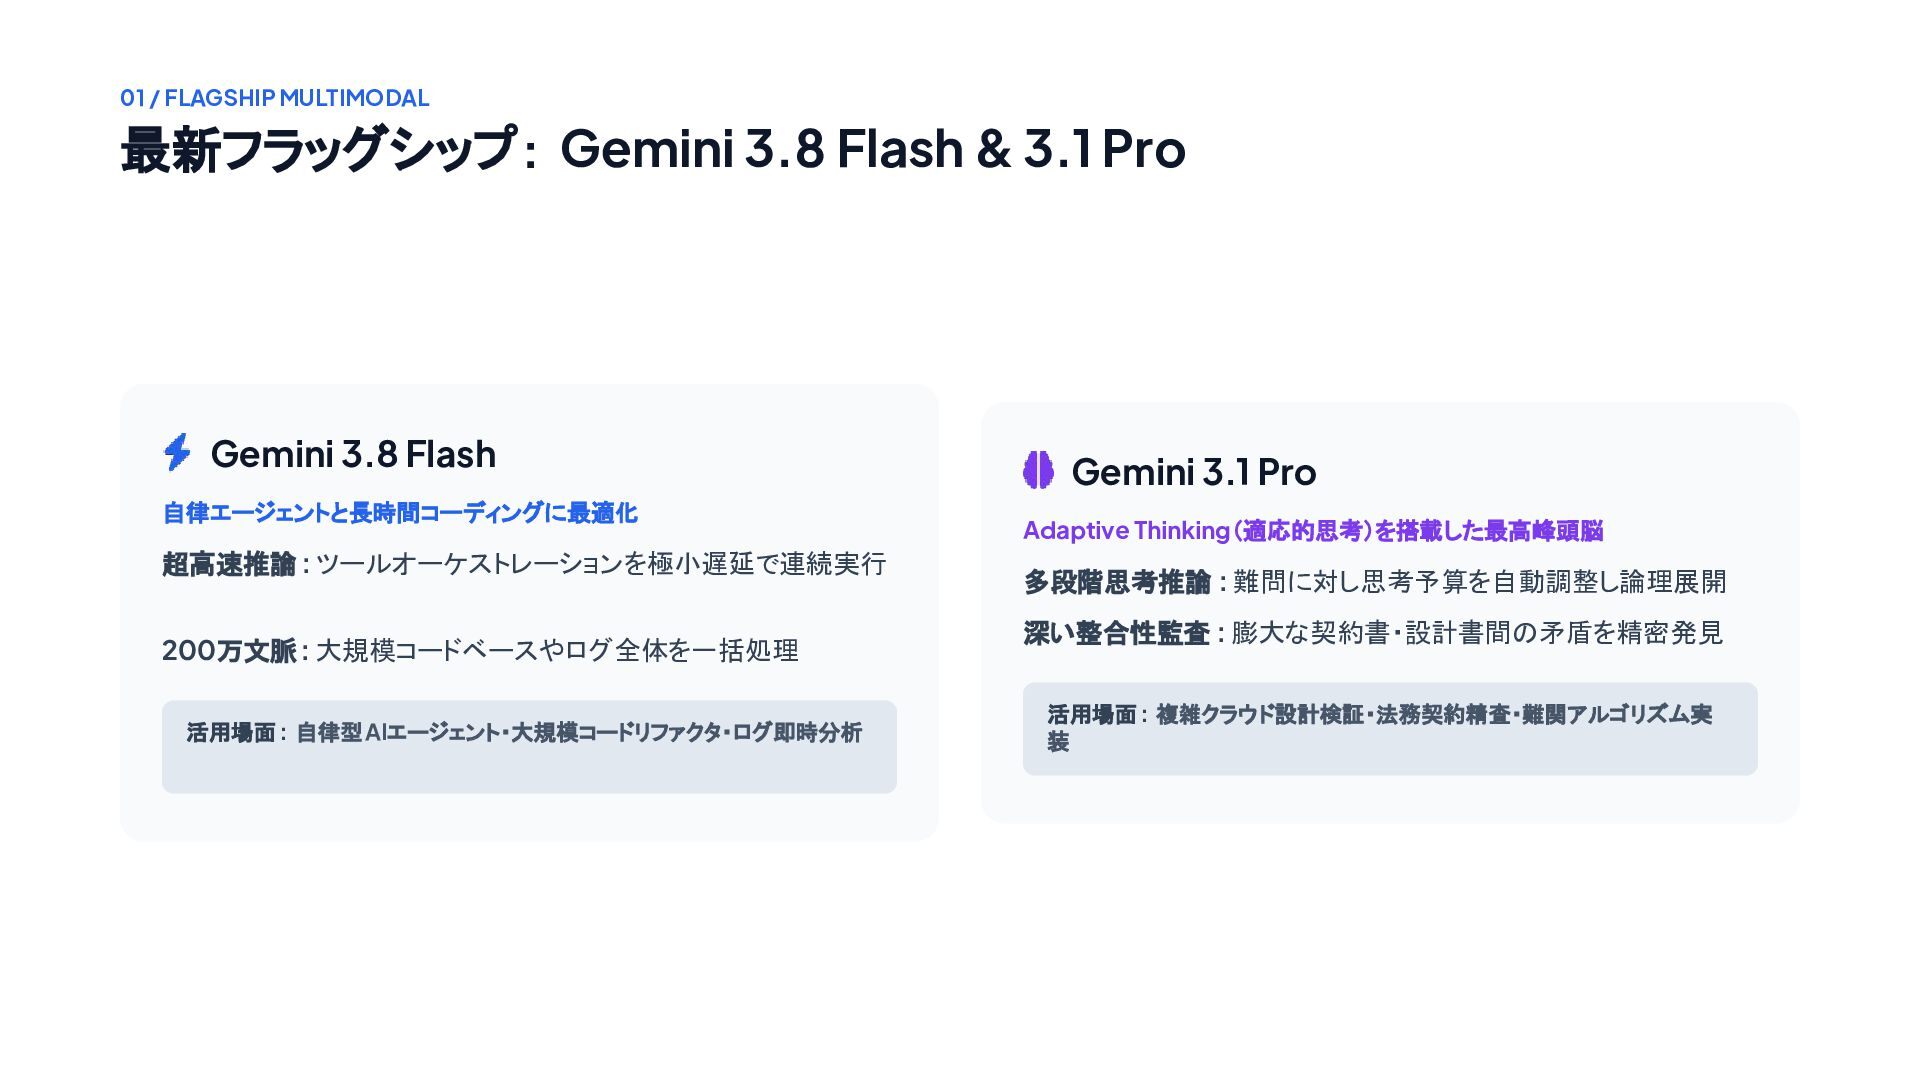
01 / FLAGSHIP MULTIMODAL 最新フラッグシップ: Gemini 3.8 Flash & 3.1
Pro Gemini 3.8 Flash 自律エージェントと長時間コーディングに最適化 超高速推論 : ツールオーケストレーションを極小遅延で連続実行 200万文脈: 大規模コードベースやログ全体を一括処理 活用場面 : 自律型AIエージェント・大規模コードリファクタ・ログ即時分析 Gemini 3.1 Pro Adaptive Thinking(適応的思考)を搭載した最高峰頭脳 多段階思考推論 : 難問に対し思考予算を自動調整し論理展開 深い整合性監査 : 膨大な契約書・設計書間の矛盾を精密発見 活用場面 : 複雑クラウド設計検証・法務契約精査・難関アルゴリズム実 装
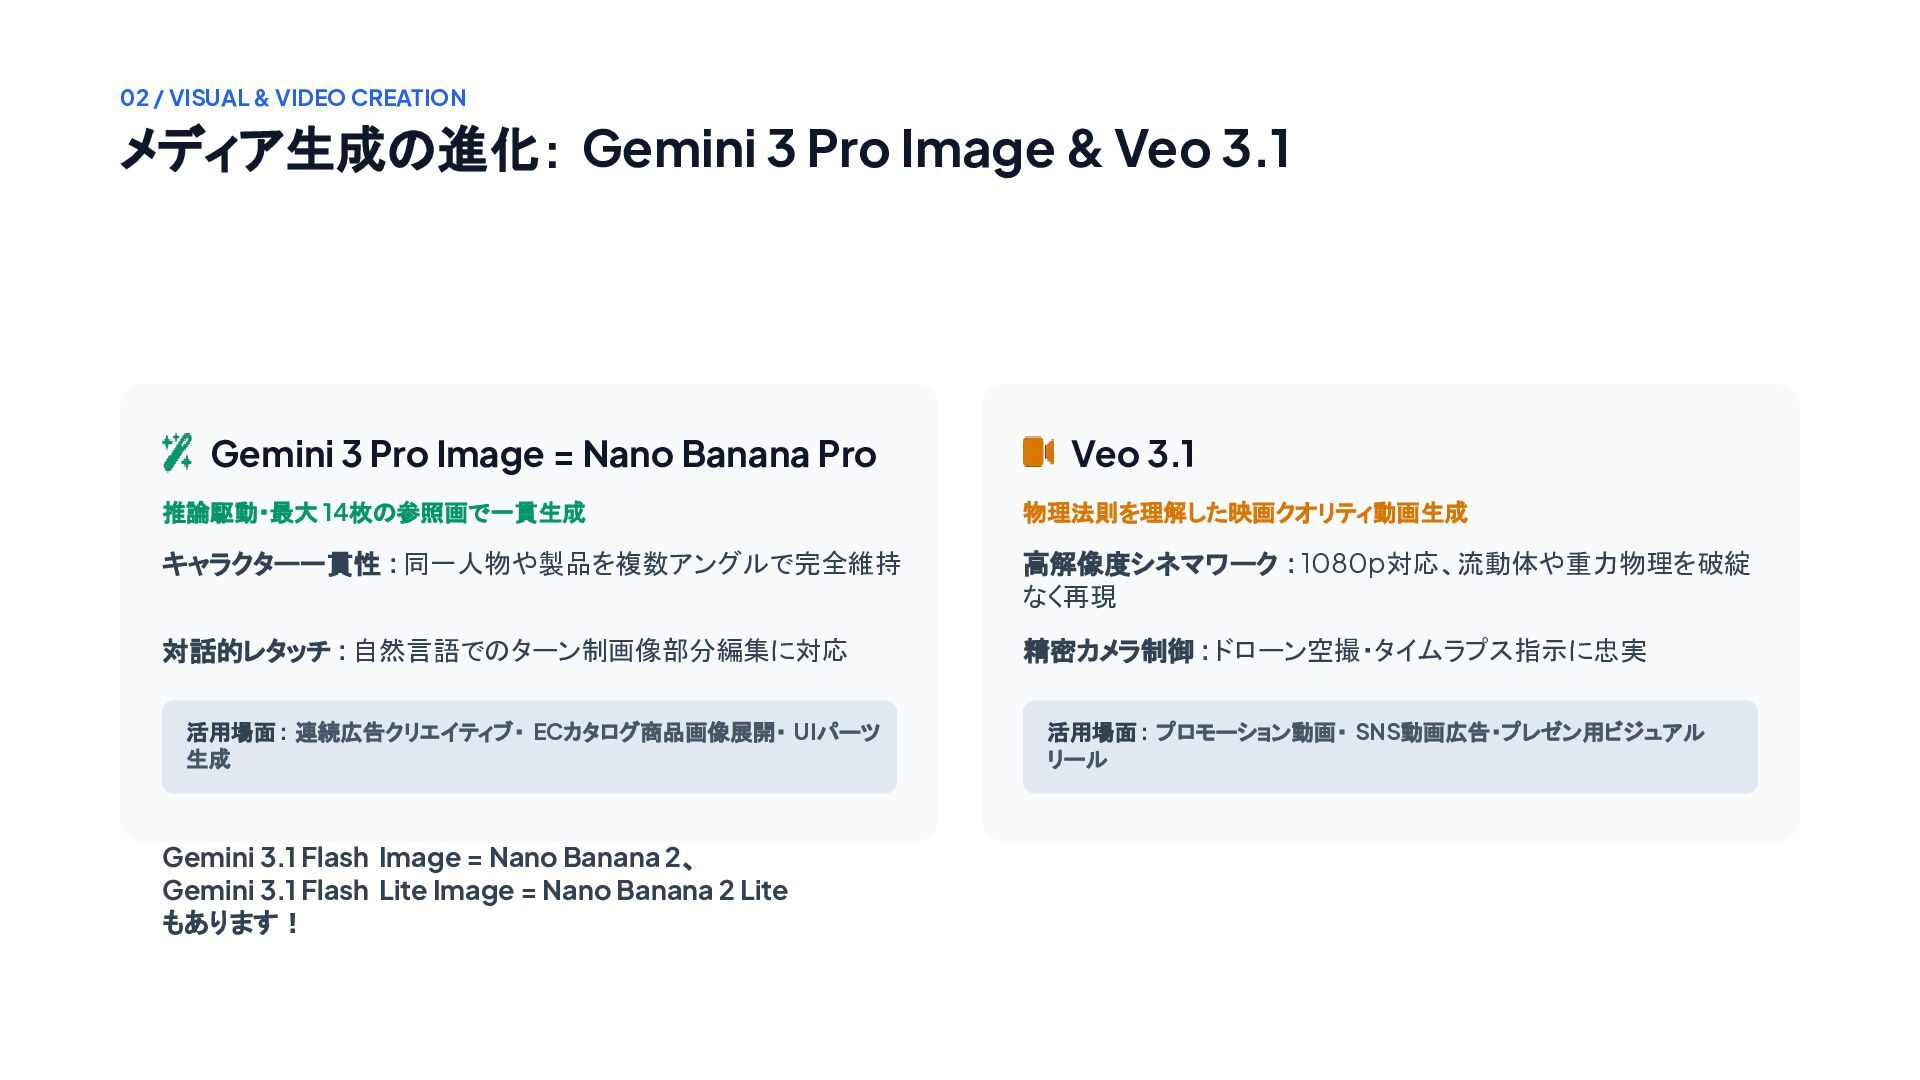
02 / VISUAL & VIDEO CREATION メディア生成の進化: Gemini 3 Pro
Image & Veo 3.1 Gemini 3 Pro Image = Nano Banana Pro Veo 3.1 推論駆動・最大 14枚の参照画で一貫生成 物理法則を理解した映画クオリティ動画生成 キャラクター一貫性 : 同一人物や製品を複数アングルで完全維持 高解像度シネマワーク : 1080p対応、流動体や重力物理を破綻 なく再現 対話的レタッチ : 自然言語でのターン制画像部分編集に対応 精密カメラ制御 : ドローン空撮・タイムラプス指示に忠実 活用場面 : 連続広告クリエイティブ・ ECカタログ商品画像展開・ UIパーツ 生成 Gemini 3.1 Flash Image = Nano Banana 2、 Gemini 3.1 Flash Lite Image = Nano Banana 2 Lite もあります! 活用場面 : プロモーション動画・ SNS動画広告・プレゼン用ビジュアル リール
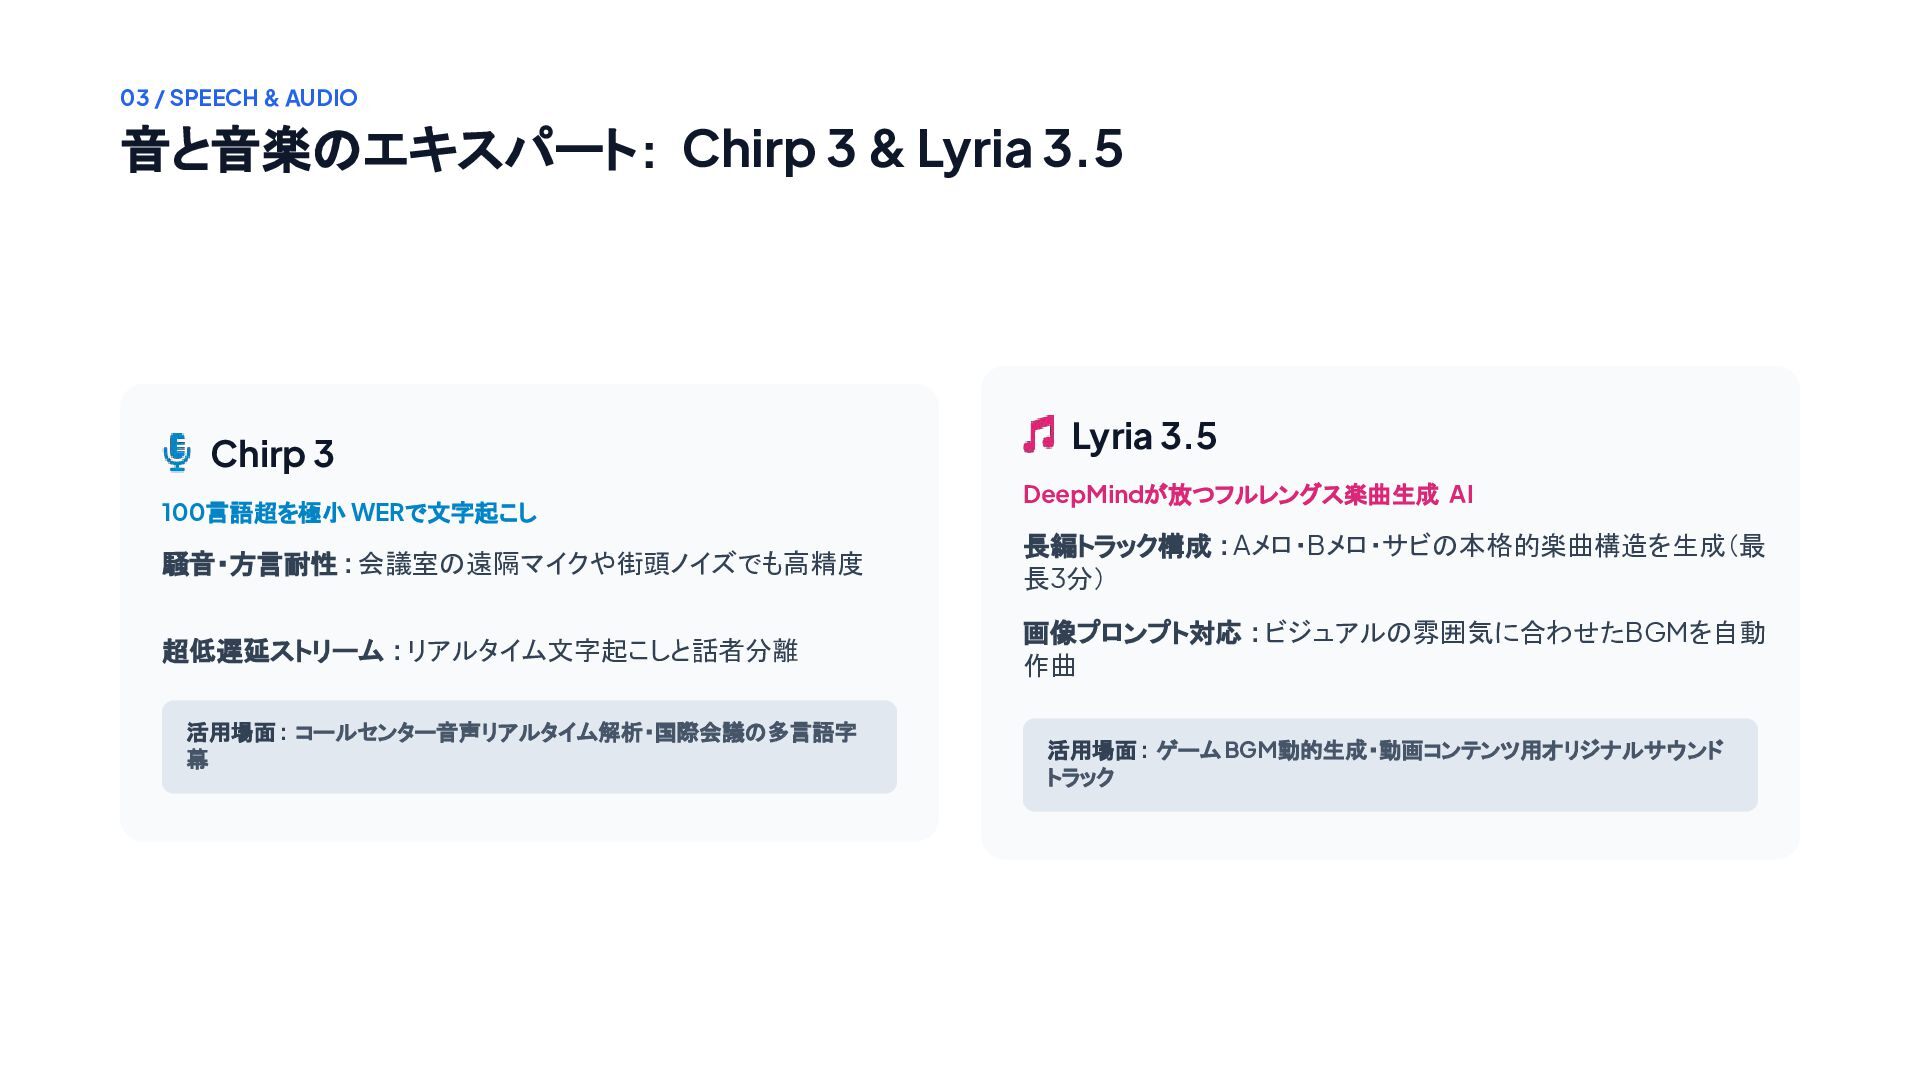
03 / SPEECH & AUDIO 音と音楽のエキスパート: Chirp 3 & Lyria
3.5 Chirp 3 100言語超を極小 WERで文字起こし Lyria 3.5 DeepMindが放つフルレングス楽曲生成 AI 騒音・方言耐性 : 会議室の遠隔マイクや街頭ノイズでも高精度 長編トラック構成 : Aメロ・Bメロ・サビの本格的楽曲構造を生成(最 長3分) 超低遅延ストリーム : リアルタイム文字起こしと話者分離 画像プロンプト対応 : ビジュアルの雰囲気に合わせたBGMを自動 作曲 活用場面 : コールセンター音声リアルタイム解析・国際会議の多言語字 幕 活用場面 : ゲームBGM動的生成・動画コンテンツ用オリジナルサウンド トラック
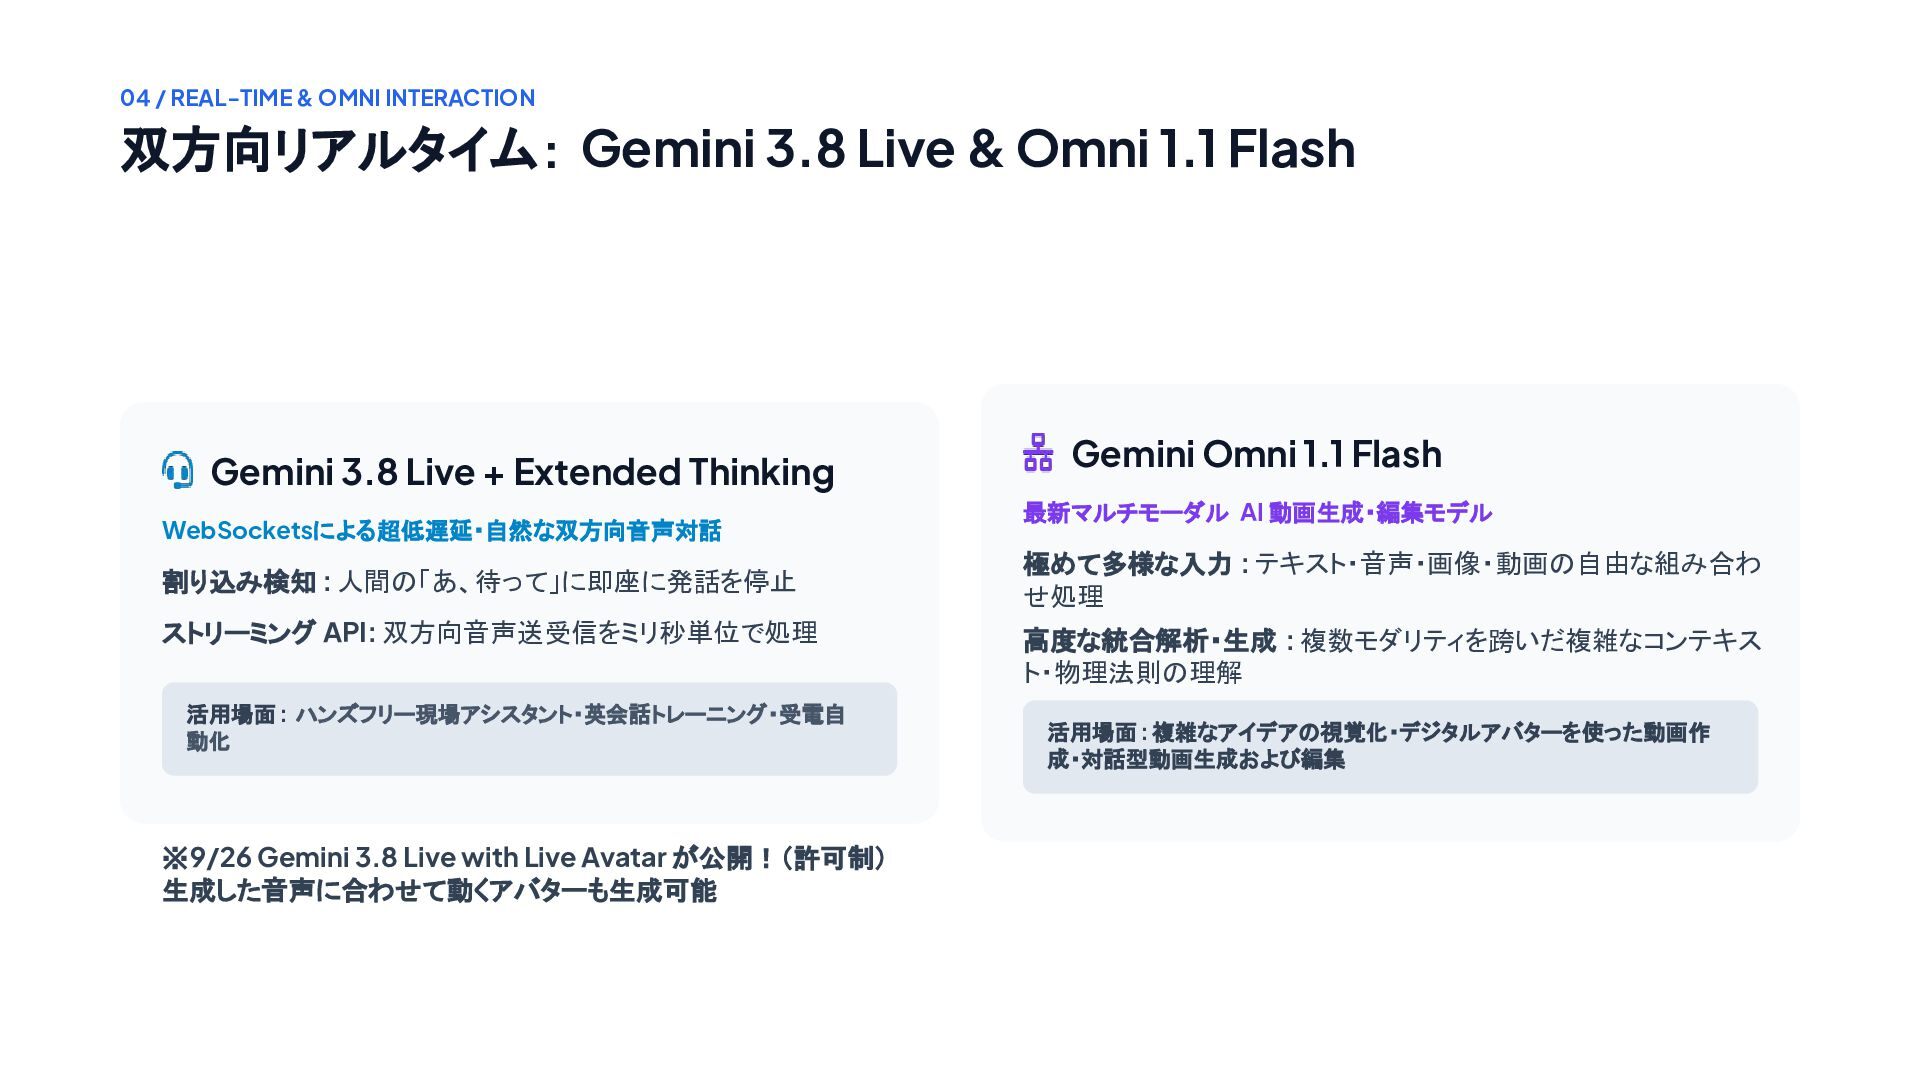
04 / REAL-TIME & OMNI INTERACTION 双方向リアルタイム: Gemini 3.8 Live
& Omni 1.1 Flash Gemini 3.8 Live + Extended Thinking WebSocketsによる超低遅延・自然な双方向音声対話 割り込み検知 : 人間の「あ、待って」に即座に発話を停止 ストリーミング API: 双方向音声送受信をミリ秒単位で処理 活用場面 : ハンズフリー現場アシスタント・英会話トレーニング・受電自 動化 ※9/26 Gemini 3.8 Live with Live Avatar が公開!(許可制) 生成した音声に合わせて動くアバターも生成可能 Gemini Omni 1.1 Flash 最新マルチモーダル AI 動画生成・編集モデル 極めて多様な入力 : テキスト・音声・画像・動画の自由な組み合わ せ処理 高度な統合解析・生成 : 複数モダリティを跨いだ複雑なコンテキス ト・物理法則の理解 活用場面 : 複雑なアイデアの視覚化・デジタルアバターを使った動画作 成・対話型動画生成および編集
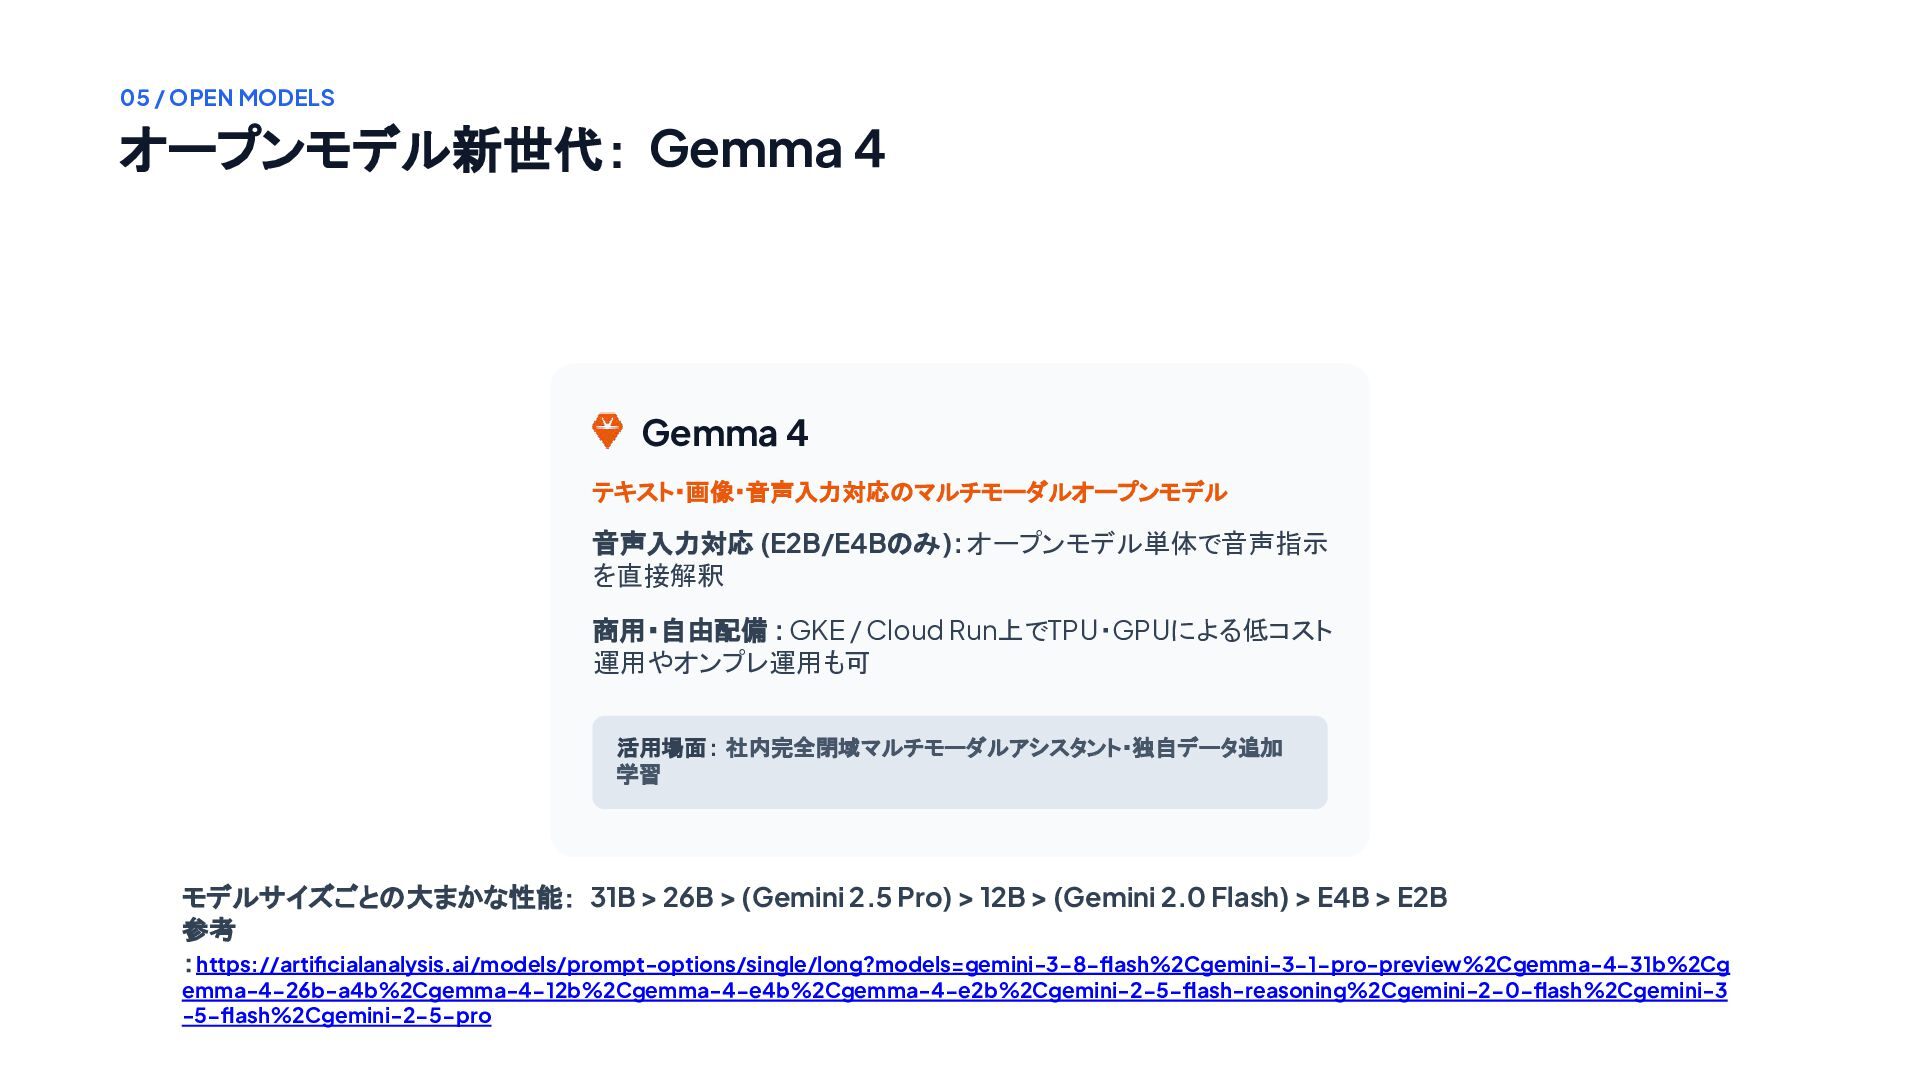
05 / OPEN MODELS オープンモデル新世代: Gemma 4 Gemma 4 テキスト・画像・音声入力対応のマルチモーダルオープンモデル
音声入力対応 (E2B/E4Bのみ): オープンモデル単体で音声指示 を直接解釈 商用・自由配備 : GKE / Cloud Run上でTPU・GPUによる低コスト 運用やオンプレ運用も可 活用場面 : 社内完全閉域マルチモーダルアシスタント・独自データ追加 学習 モデルサイズごとの大まかな性能: 31B > 26B > (Gemini 2.5 Pro) > 12B > (Gemini 2.0 Flash) > E4B > E2B 参考 : https://artificialanalysis.ai/models/prompt-options/single/long?models=gemini-3−8−flash%2Cgemini-3−1−pro-preview%2Cgemma-4−31b%2Cg emma-4−26b-a4b%2Cgemma-4−12b%2Cgemma-4−e4b%2Cgemma-4−e2b%2Cgemini-2−5−flash-reasoning%2Cgemini-2−0−flash%2Cgemini-3 -5−flash%2Cgemini-2−5−pro
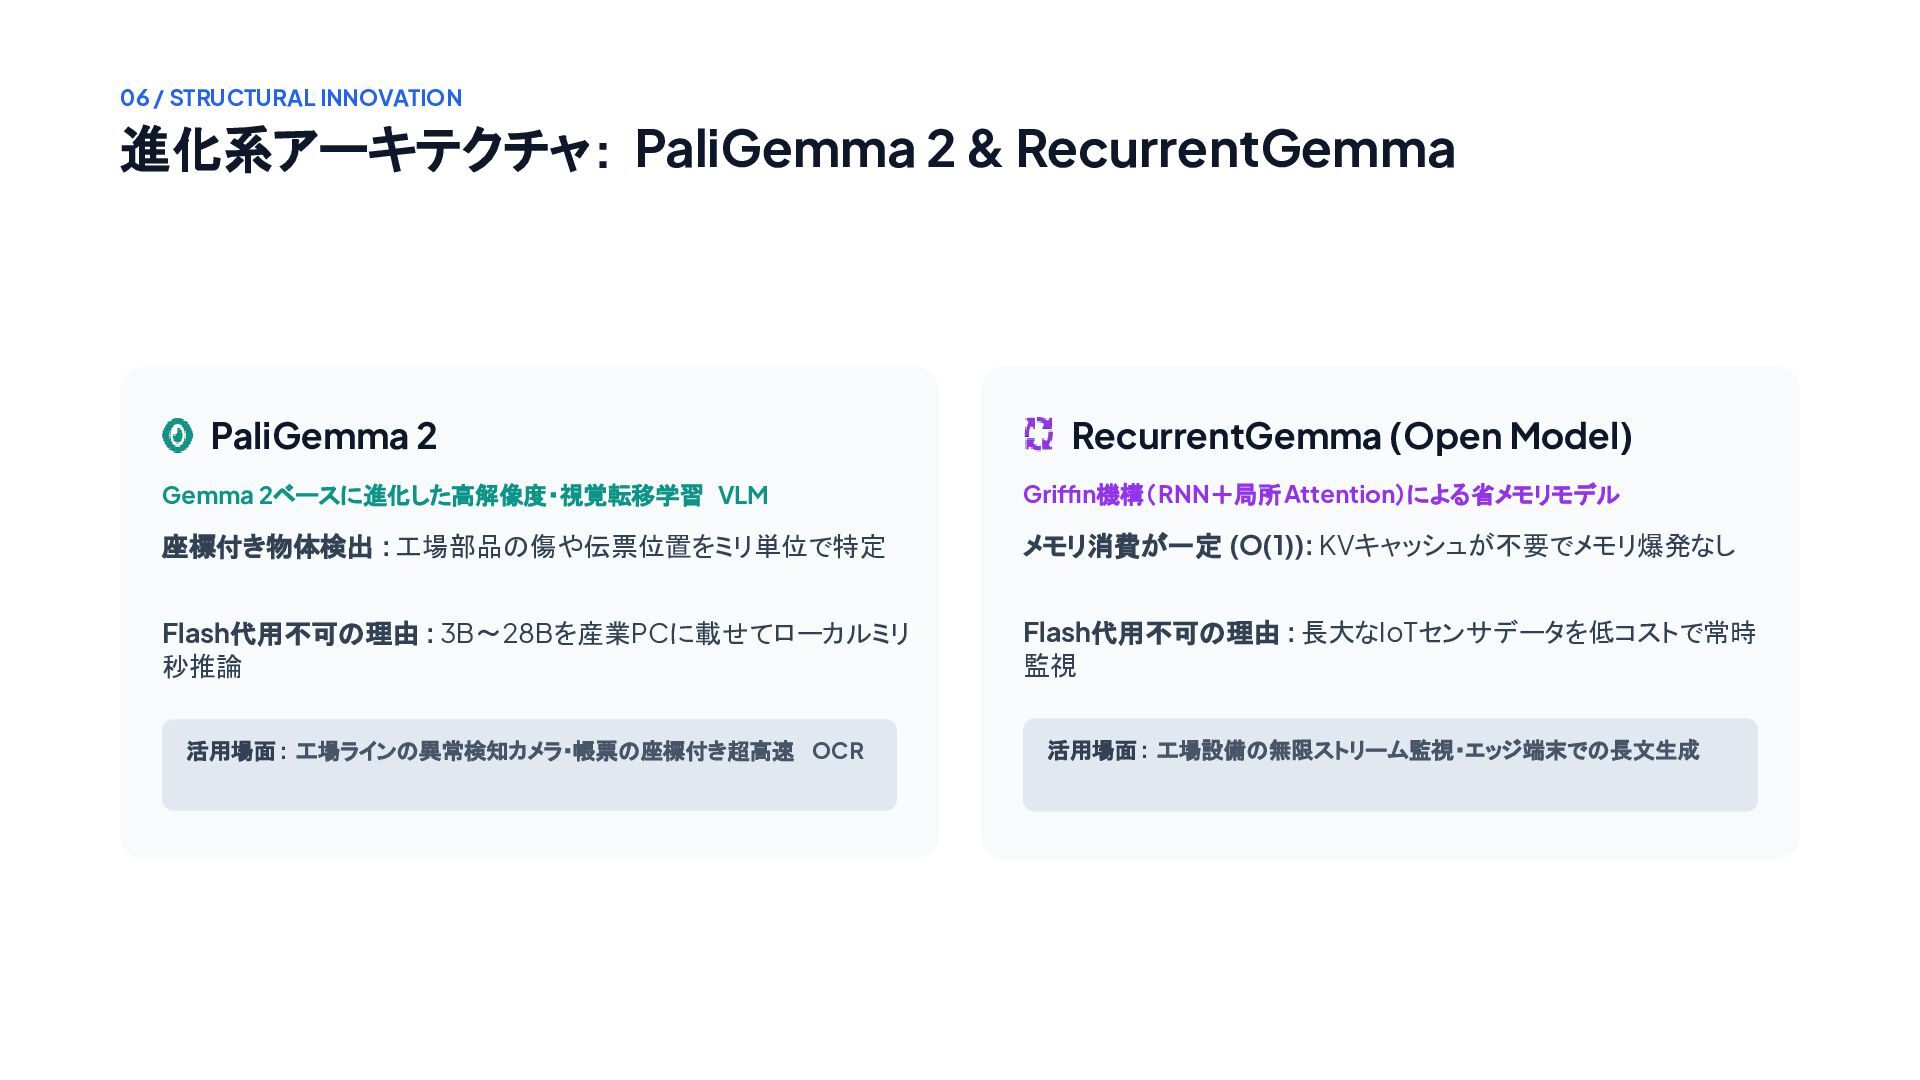
06 / STRUCTURAL INNOVATION 進化系アーキテクチャ: PaliGemma 2 & RecurrentGemma PaliGemma
2 RecurrentGemma (Open Model) Gemma 2ベースに進化した高解像度・視覚転移学習 VLM Griffin機構(RNN+局所Attention)による省メモリモデル 座標付き物体検出 : 工場部品の傷や伝票位置をミリ単位で特定 メモリ消費が一定 (O(1)): KVキャッシュが不要でメモリ爆発なし Flash代用不可の理由 : 3B〜28Bを産業PCに載せてローカルミリ 秒推論 Flash代用不可の理由 : 長大なIoTセンサデータを低コストで常時 監視 活用場面 : 工場ラインの異常検知カメラ・帳票の座標付き超高速 OCR 活用場面 : 工場設備の無限ストリーム監視・エッジ端末での長文生成
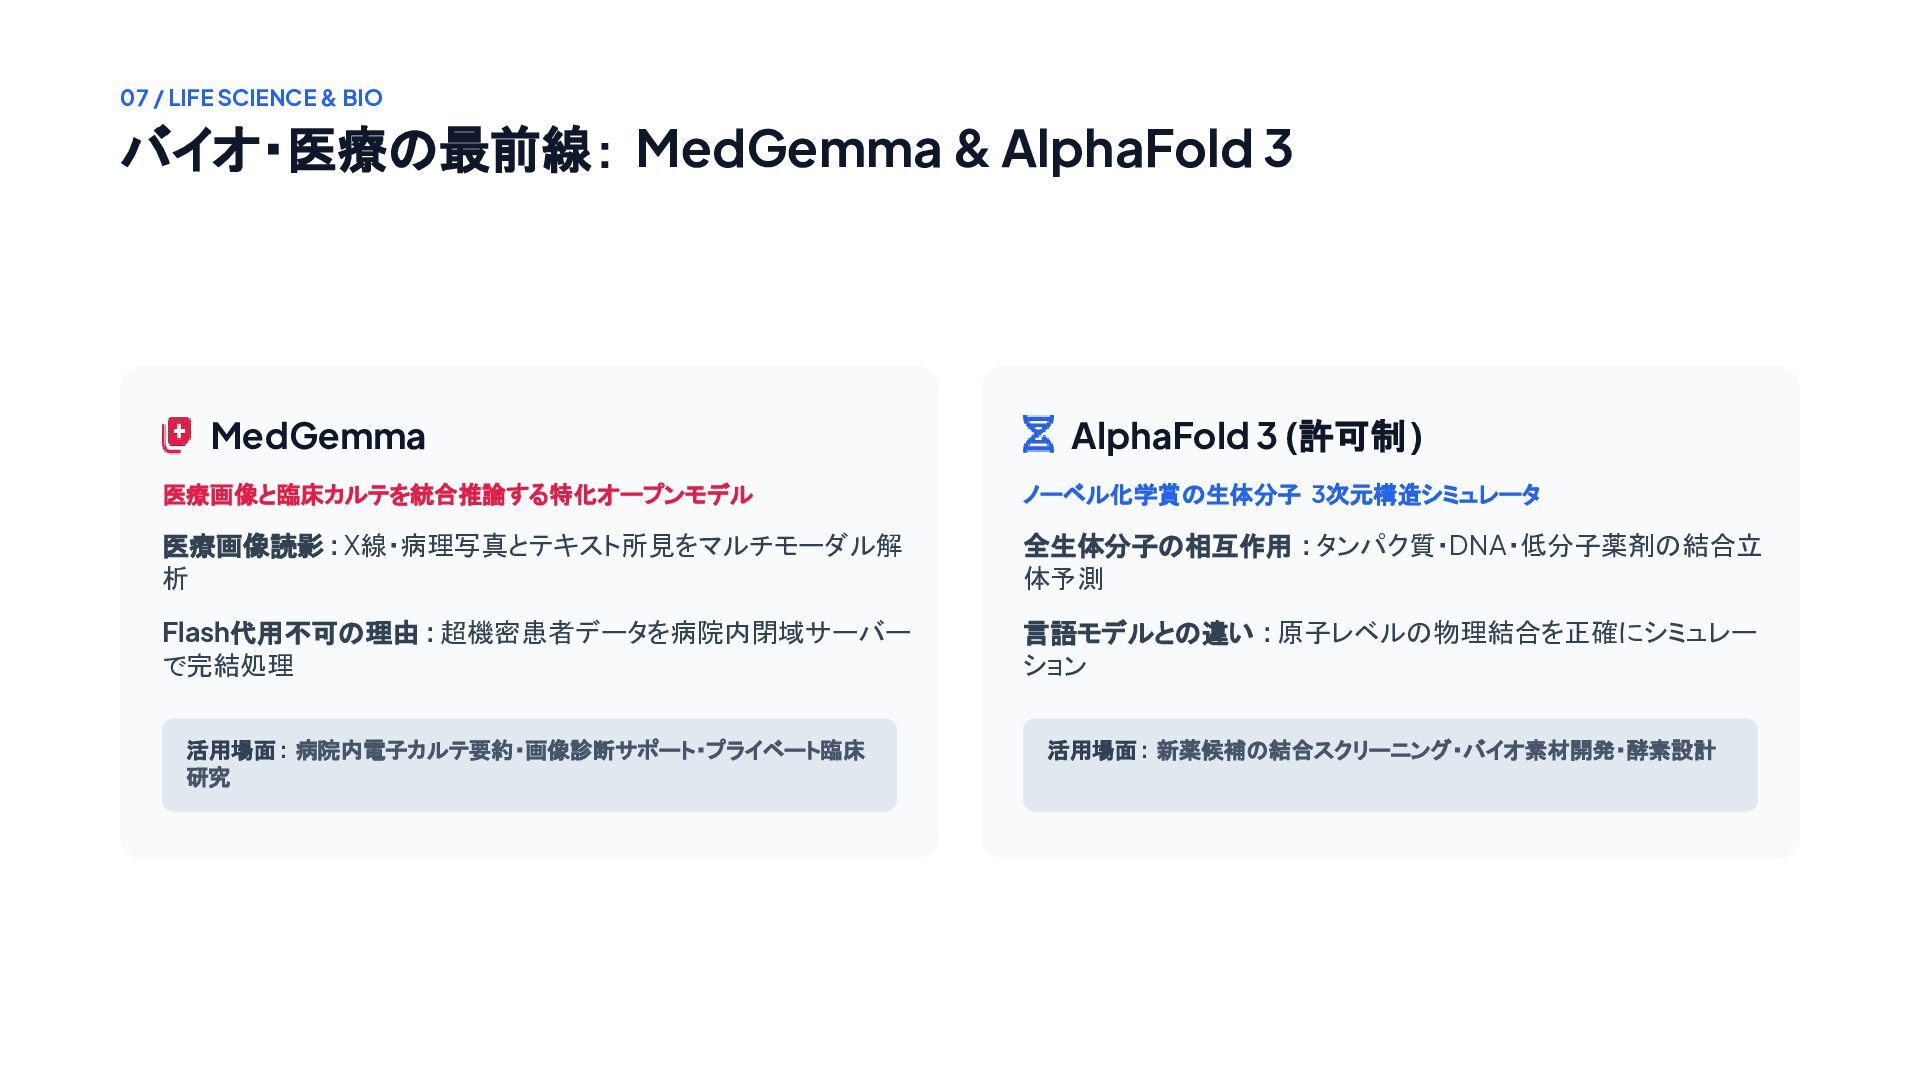
07 / LIFE SCIENCE & BIO バイオ・医療の最前線: MedGemma & AlphaFold
3 MedGemma AlphaFold 3 (許可制) 医療画像と臨床カルテを統合推論する特化オープンモデル ノーベル化学賞の生体分子 3次元構造シミュレータ 医療画像読影 : X線・病理写真とテキスト所見をマルチモーダル解 析 全生体分子の相互作用 : タンパク質・DNA・低分子薬剤の結合立 体予測 Flash代用不可の理由 : 超機密患者データを病院内閉域サーバー で完結処理 言語モデルとの違い : 原子レベルの物理結合を正確にシミュレー ション 活用場面 : 病院内電子カルテ要約・画像診断サポート・プライベート臨床 研究 活用場面 : 新薬候補の結合スクリーニング・バイオ素材開発・酵素設計
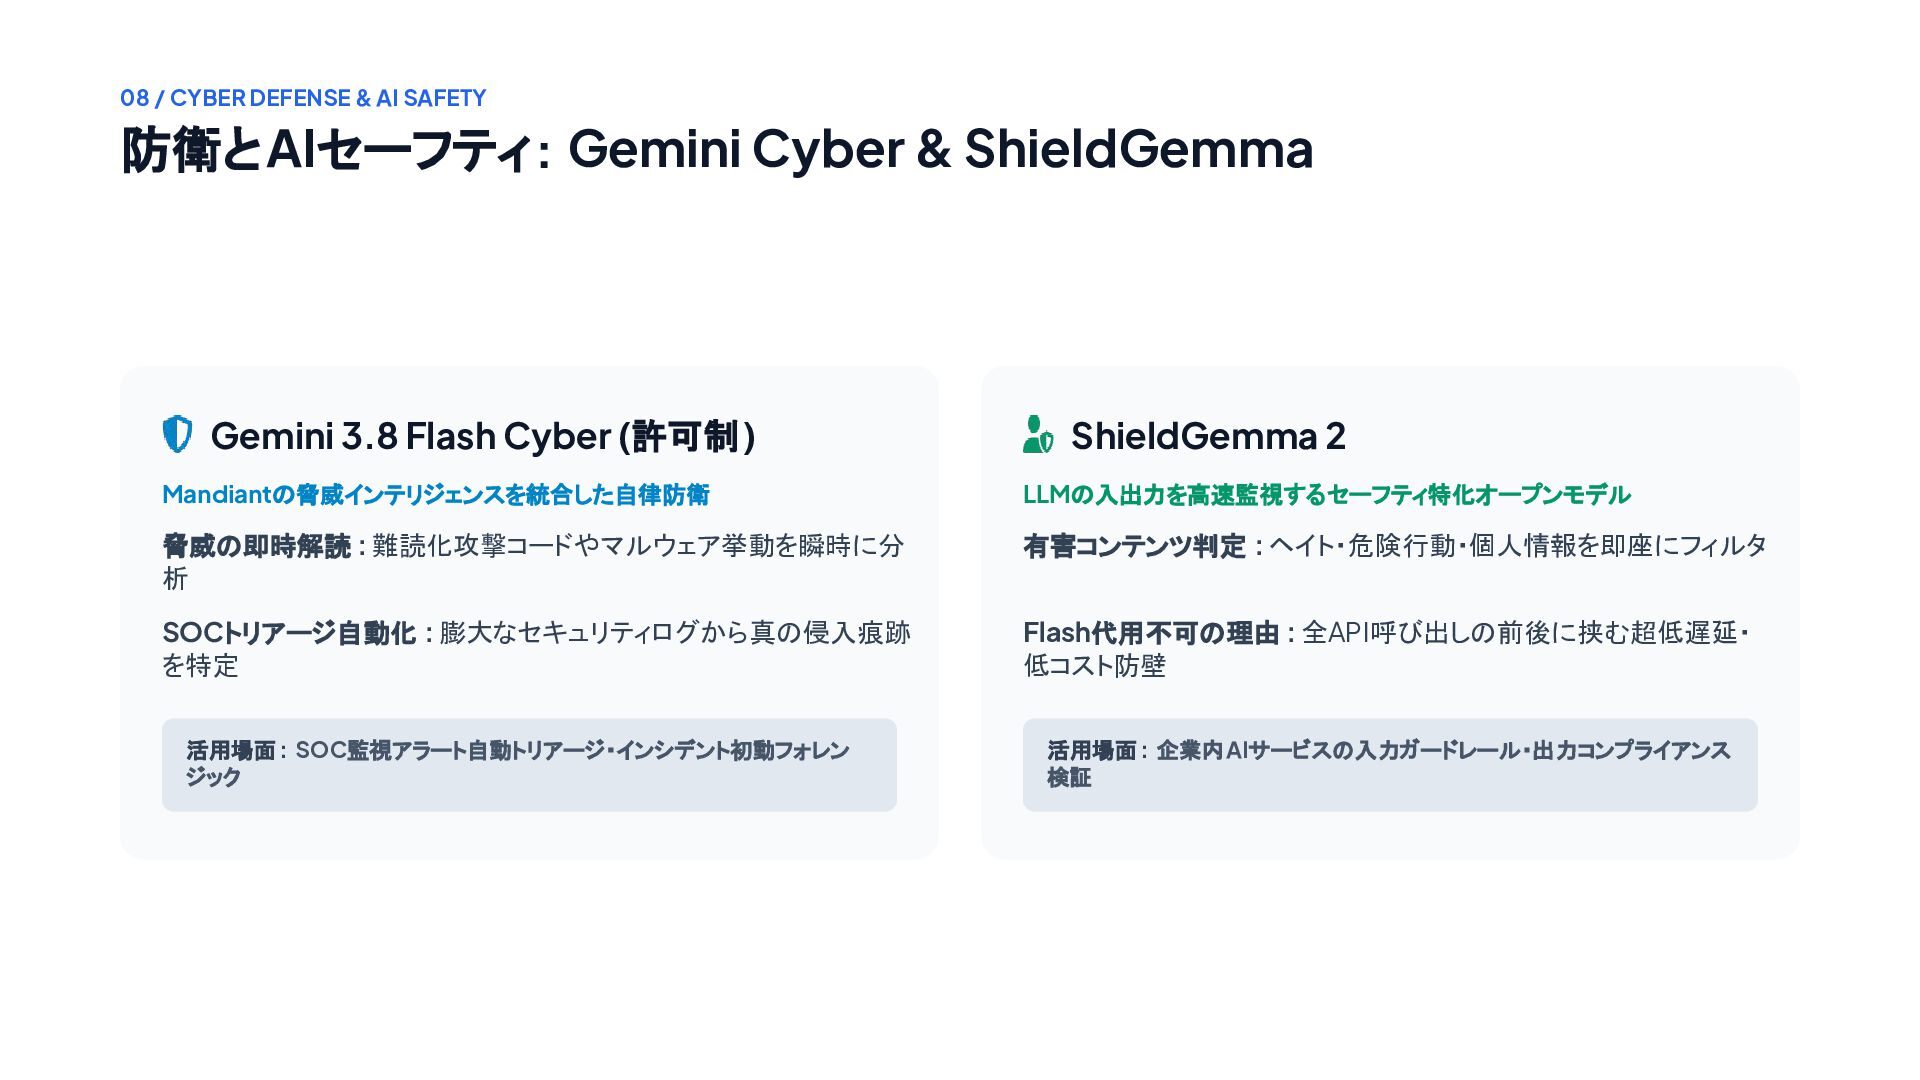
08 / CYBER DEFENSE & AI SAFETY 防衛とAIセーフティ: Gemini Cyber
& ShieldGemma Gemini 3.8 Flash Cyber (許可制) ShieldGemma 2 Mandiantの脅威インテリジェンスを統合した自律防衛 LLMの入出力を高速監視するセーフティ特化オープンモデル 脅威の即時解読 : 難読化攻撃コードやマルウェア挙動を瞬時に分 析 有害コンテンツ判定 : ヘイト・危険行動・個人情報を即座にフィルタ SOCトリアージ自動化 : 膨大なセキュリティログから真の侵入痕跡 を特定 Flash代用不可の理由 : 全API呼び出しの前後に挟む超低遅延・ 低コスト防壁 活用場面 : SOC監視アラート自動トリアージ・インシデント初動フォレン ジック 活用場面 : 企業内AIサービスの入力ガードレール・出力コンプライアンス 検証
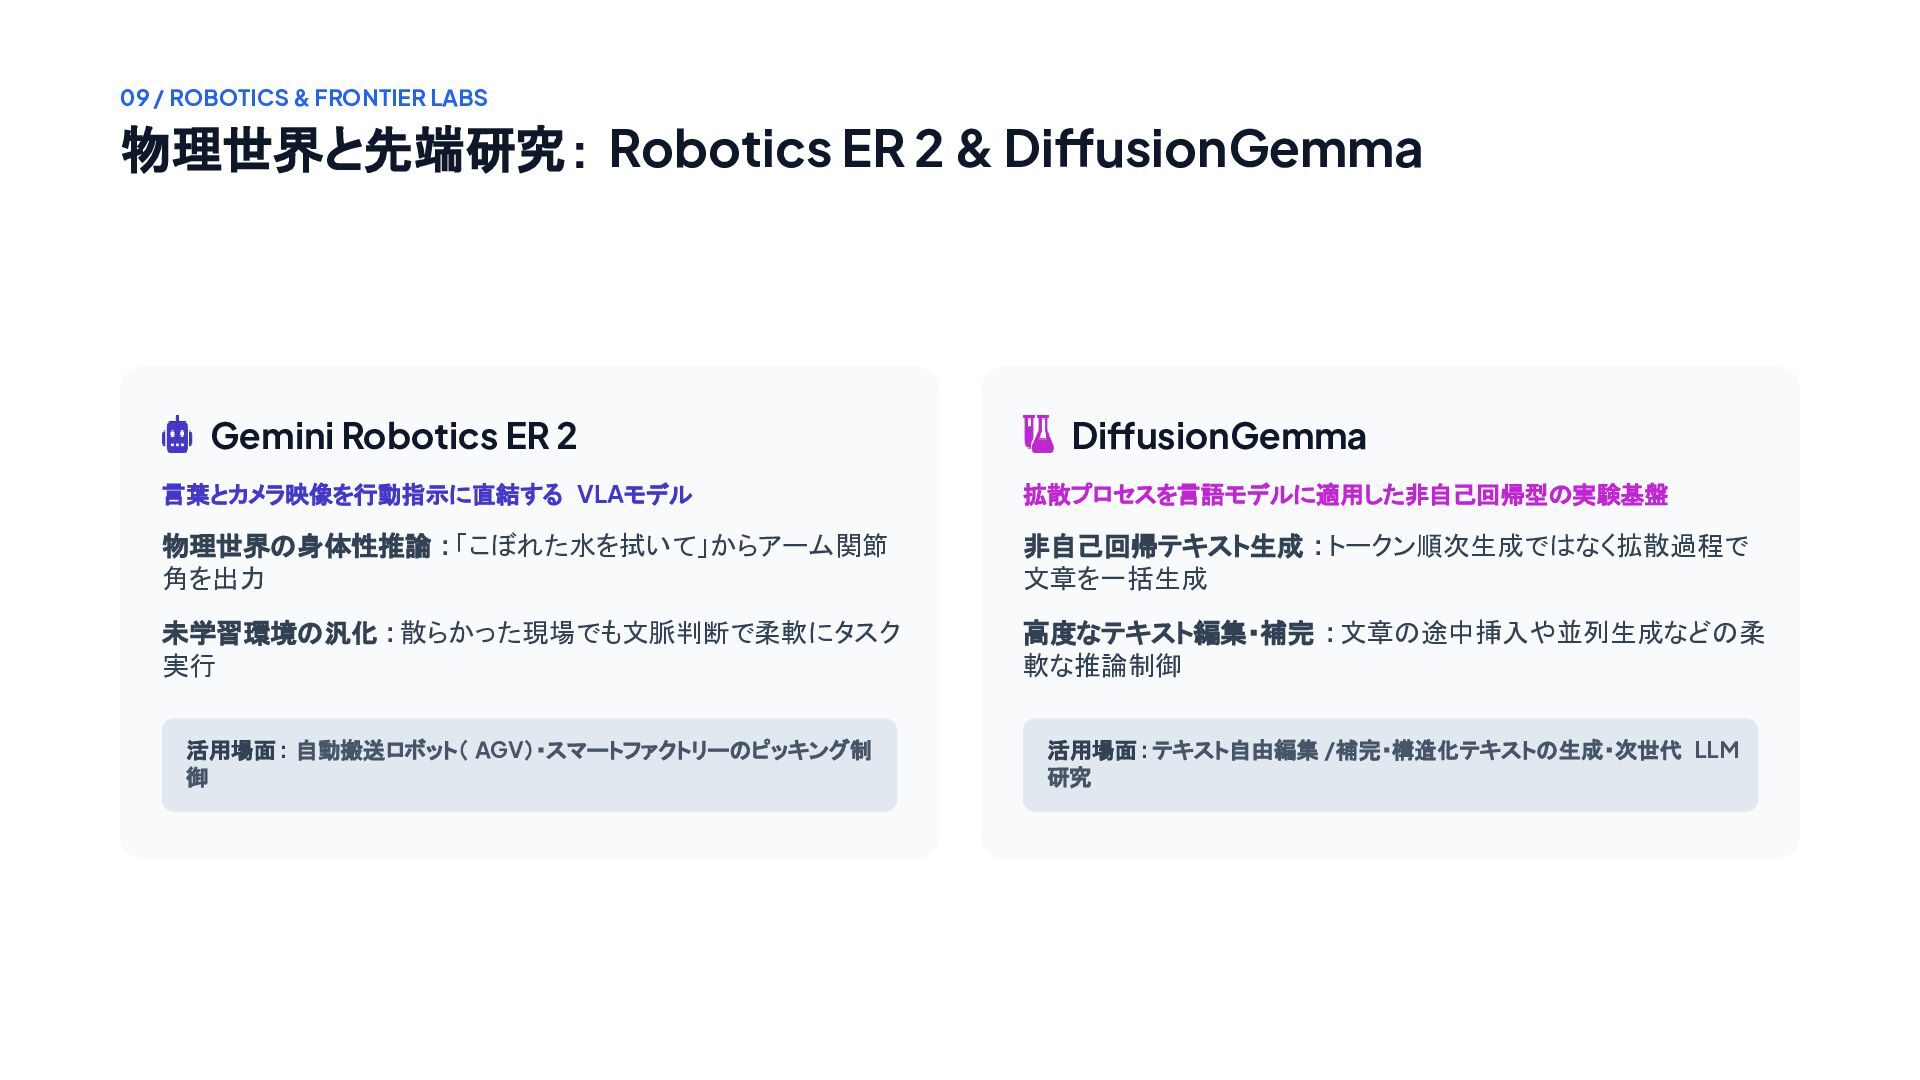
09 / ROBOTICS & FRONTIER LABS 物理世界と先端研究: Robotics ER 2
& DiffusionGemma Gemini Robotics ER 2 DiffusionGemma 言葉とカメラ映像を行動指示に直結する VLAモデル 拡散プロセスを言語モデルに適用した非自己回帰型の実験基盤 物理世界の身体性推論 : 「こぼれた水を拭いて」からアーム関節 角を出力 非自己回帰テキスト生成 : トークン順次生成ではなく拡散過程で 文章を一括生成 未学習環境の汎化 : 散らかった現場でも文脈判断で柔軟にタスク 実行 高度なテキスト編集・補完 : 文章の途中挿入や並列生成などの柔 軟な推論制御 活用場面 : 自動搬送ロボット( AGV)・スマートファクトリーのピッキング制 御 活用場面 : テキスト自由編集 /補完・構造化テキストの生成・次世代 LLM 研究
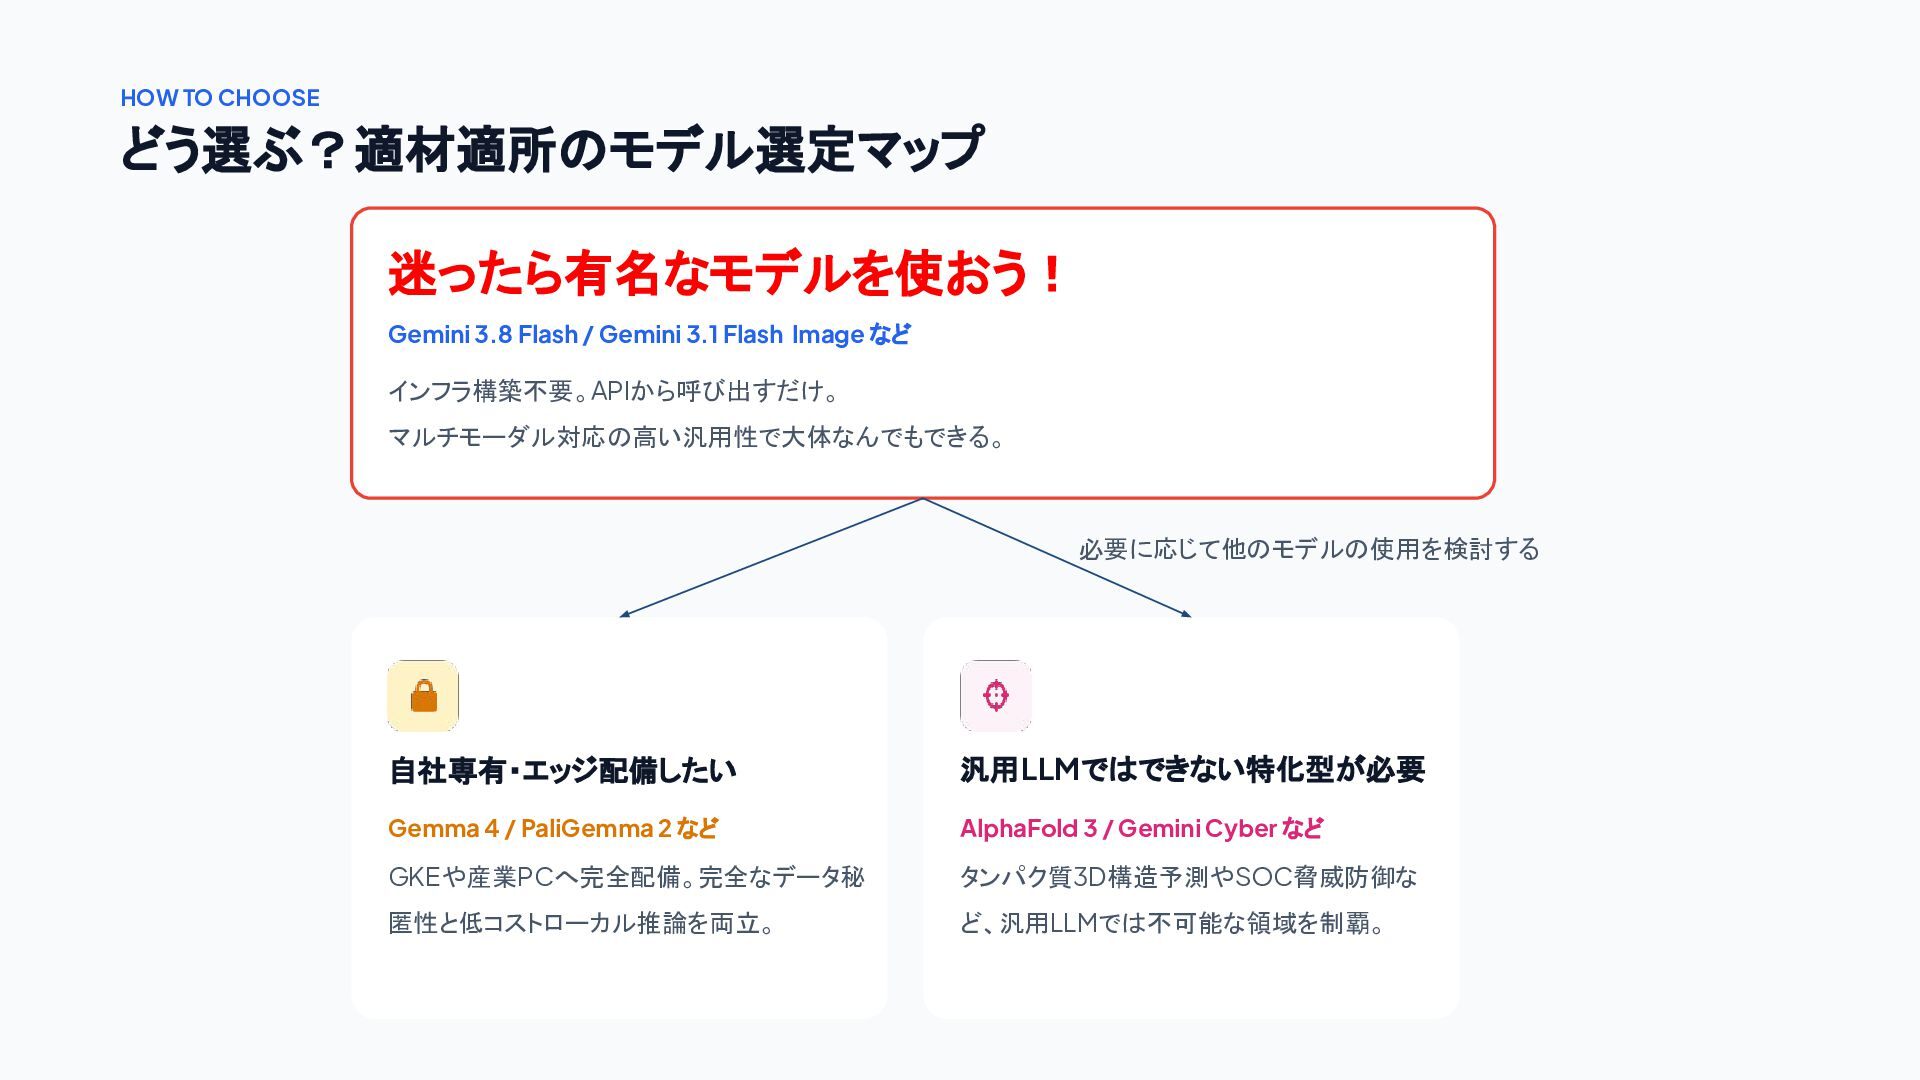
HOW TO CHOOSE どう選ぶ?適材適所のモデル選定マップ 迷ったら有名なモデルを使おう! Gemini 3.8 Flash / Gemini
3.1 Flash Image など インフラ構築不要。APIから呼び出すだけ。 マルチモーダル対応の高い汎用性で大体なんでもできる。 必要に応じて他のモデルの使用を検討する 自社専有・エッジ配備したい 汎用LLMではできない特化型が必要 Gemma 4 / PaliGemma 2 など AlphaFold 3 / Gemini Cyber など GKEや産業PCへ完全配備。完全なデータ秘 タンパク質3D構造予測やSOC脅威防御な 匿性と低コストローカル推論を両立。 ど、汎用LLMでは不可能な領域を制覇。
CONCLUSION Model Gardenを開いて、 新しいAIモデルを試してみよう! ご清聴ありがとうございました!


 cloudace
 yakumo
 husengs7
 mkdev10
 fespinoza
 bgpat
 tatamiya
 recruitengineers
 philipz
 nttcom
 sansantech
 baseballyama
 thkt
 skipperchong
 asonas
 cargoodrich
 destraynor
 smashingmag
 keavy
 gurzu
 tammyeverts
 sferik
 bluesmoon
 twada
 letsgokoyo