Upgrade to Pro — share decks privately, control downloads, hide ads and more …

LLM 101

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

LLM 101

토큰 수준부터 LLM이 어떻게 동작하는지 설명합니다.

Avatar for Leonardo YongUk Kim

Leonardo YongUk Kim

November 01, 2026

More Decks by Leonardo YongUk Kim

Other Decks in Programming

Transcript

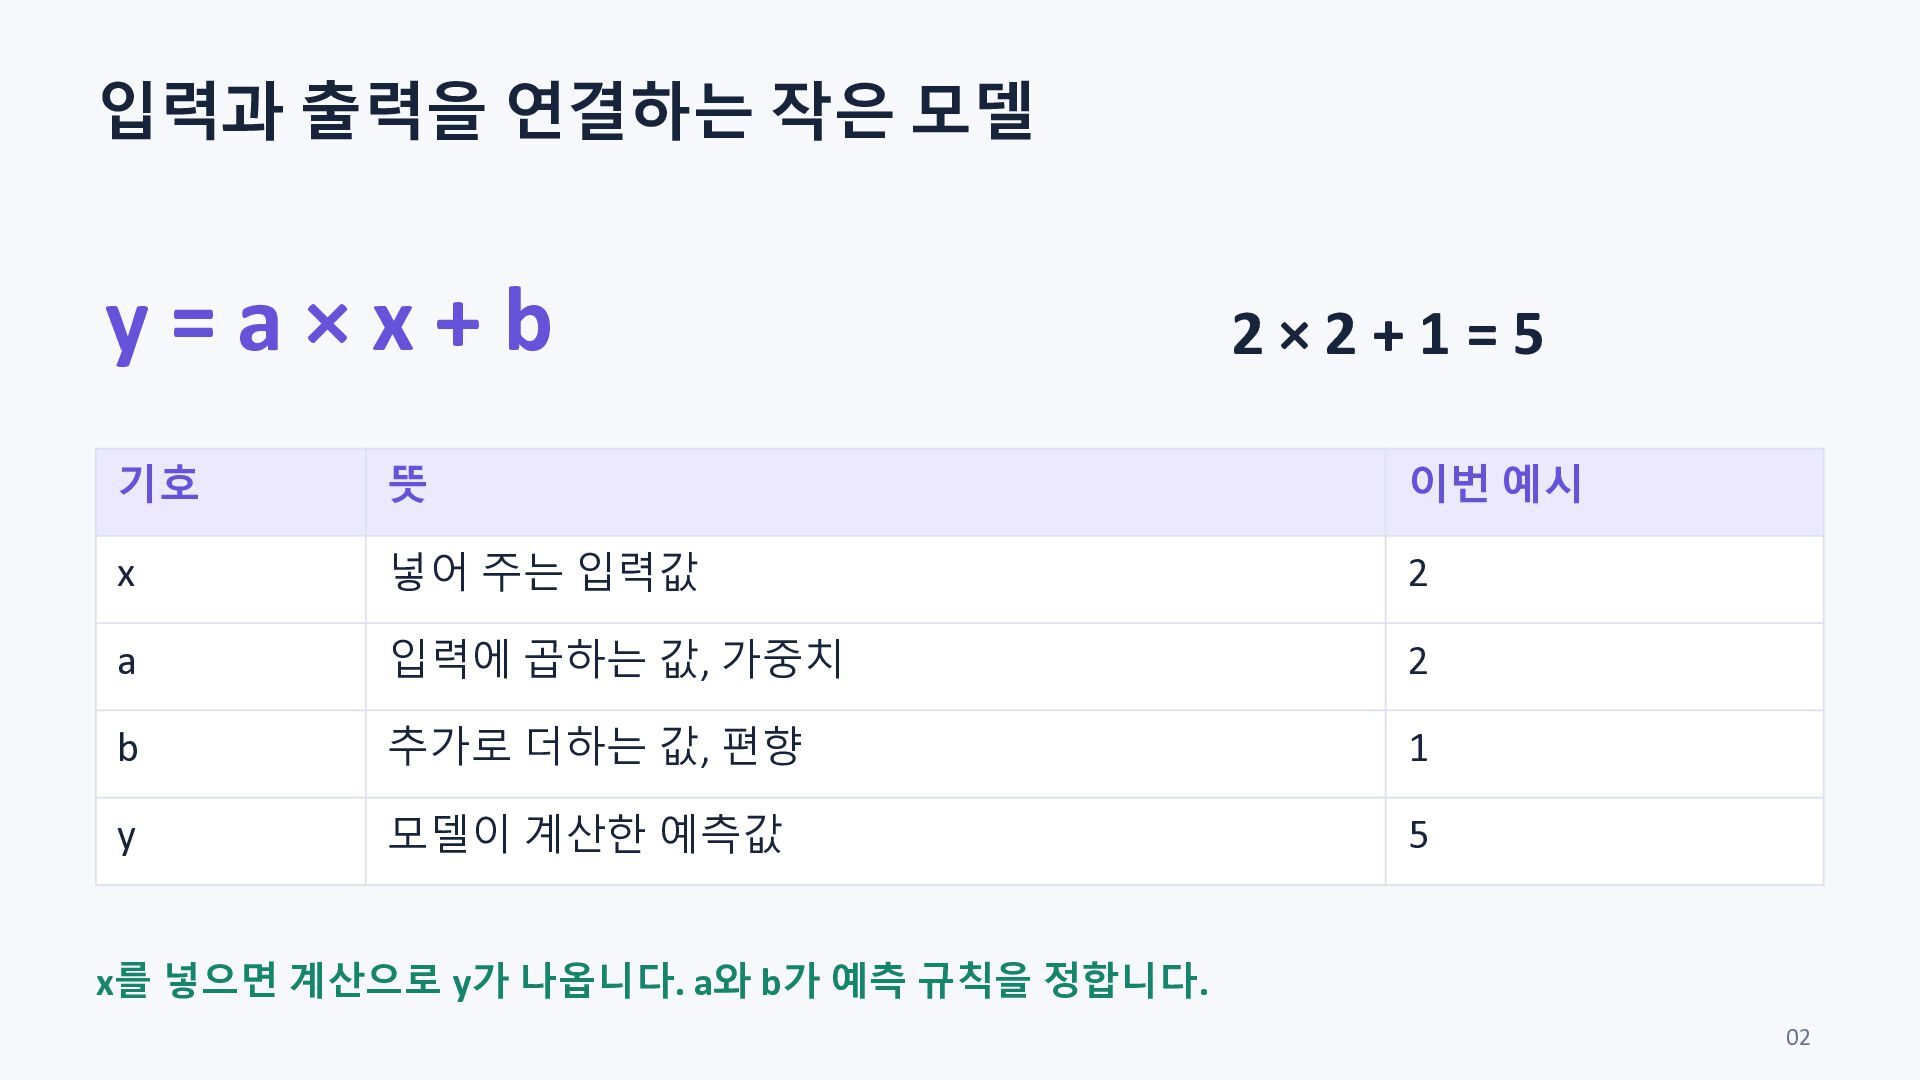
  1. 입력과 출력을 연결하는 작은 모델 y=a×x+b 2×2+1=5 기호 뜻 이번

    예시 x 넣어 주는 입력값 2 a 입력에 곱하는 값, 가중치 2 b 추가로 더하는 값, 편향 1 y 모델이 계산한 예측값 5 x를 넣으면 계산으로 y가 나옵니다. a와 b가 예측 규칙을 정합니다. 02
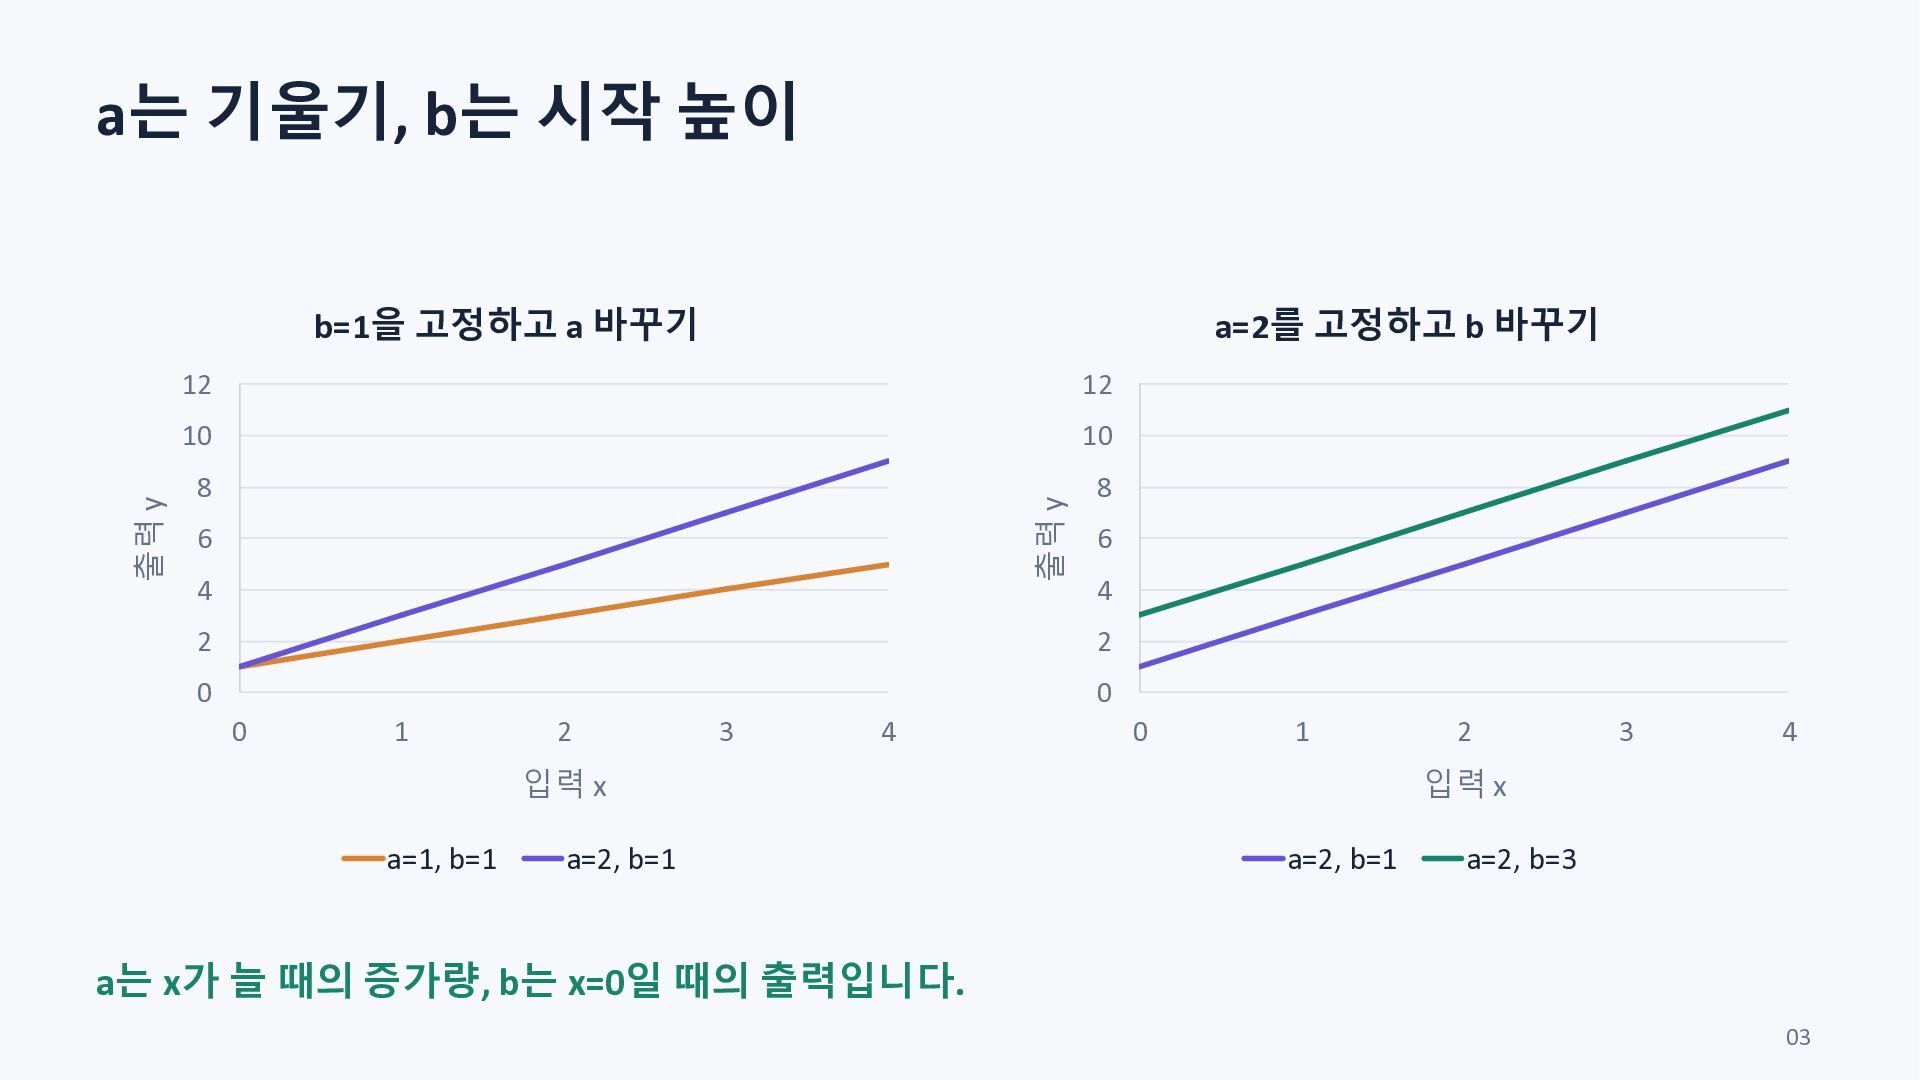
  2. a는 기울기, b는 시작 높이 a=2를 고정하고 b 바꾸기 12

    12 10 10 8 8 출력 y 출력 y b=1을 고정하고 a 바꾸기 6 4 6 4 2 2 0 0 0 1 2 3 4 0 1 입력 x a=1, b=1 a=2, b=1 2 3 4 입력 x a=2, b=1 a=2, b=3 a는 x가 늘 때의 증가량, b는 x=0일 때의 출력입니다. 03
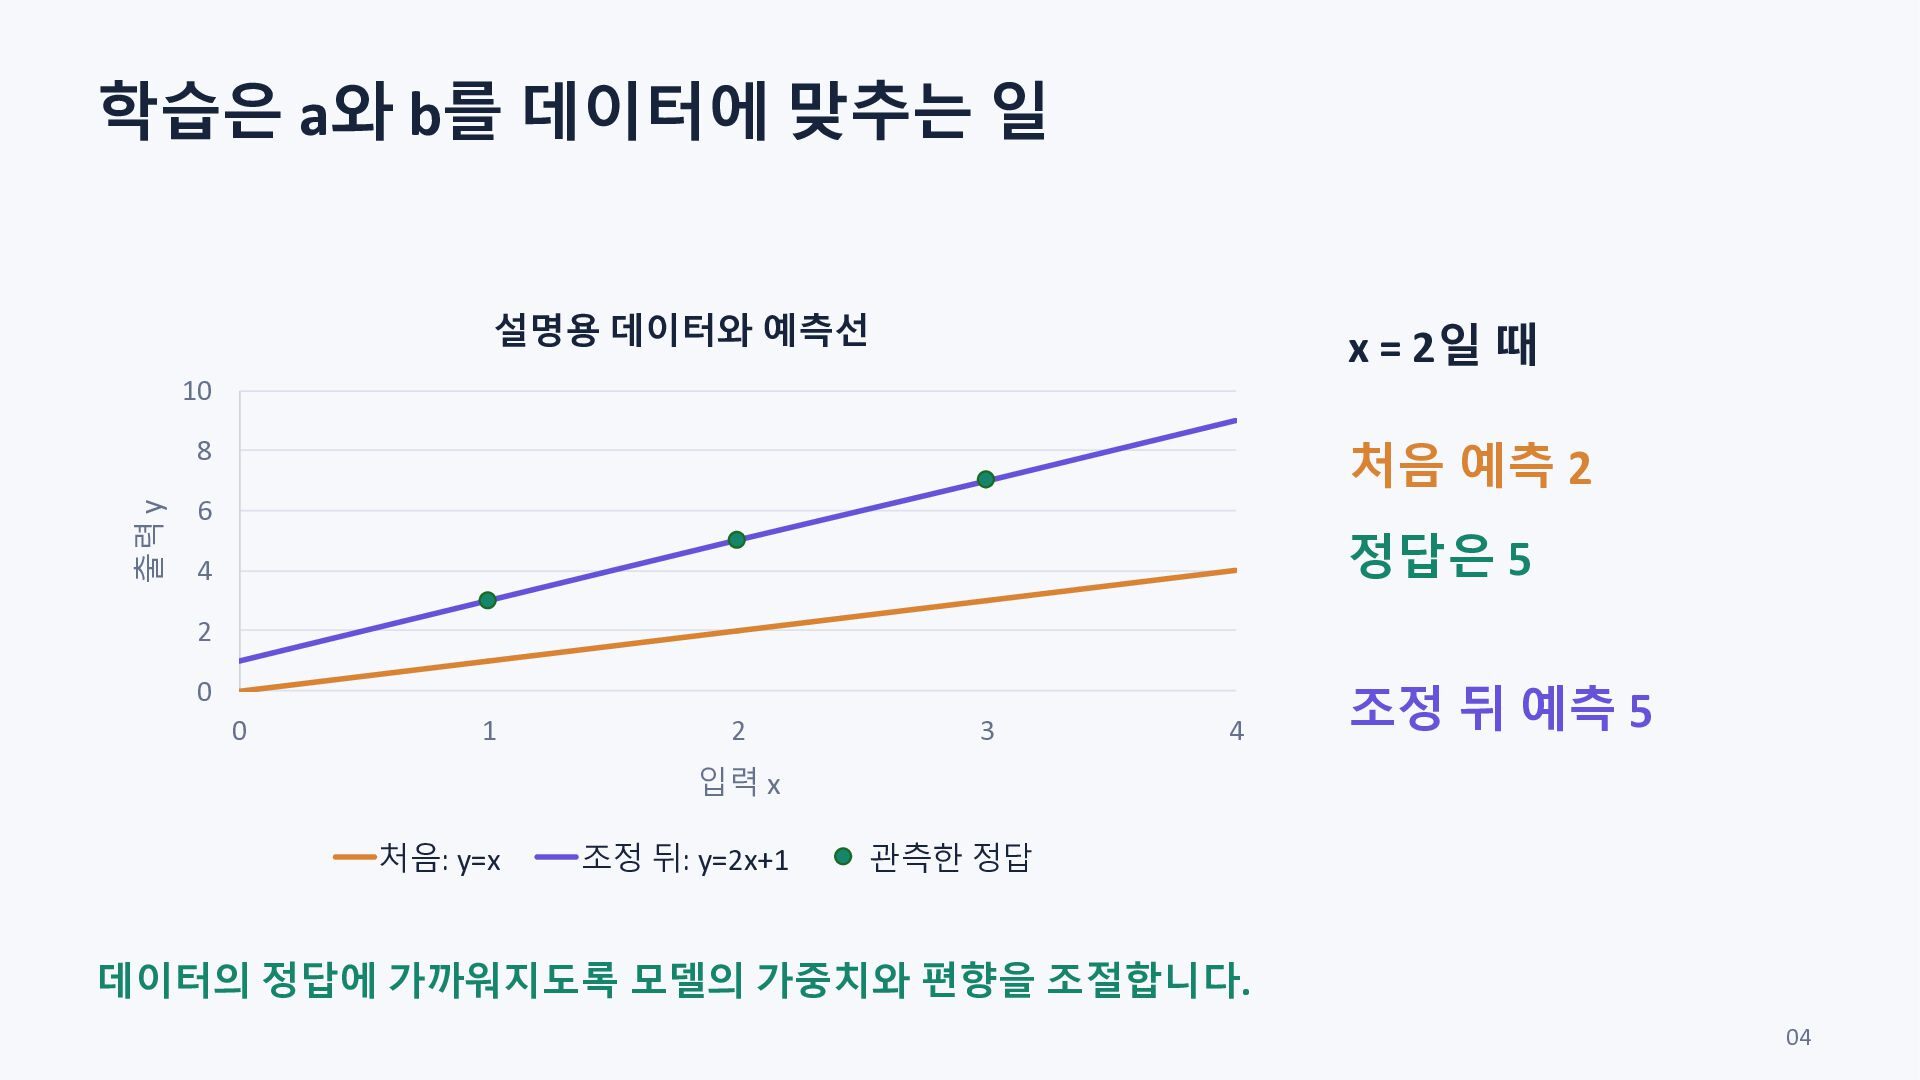
  3. 학습은 a와 b를 데이터에 맞추는 일 설명용 데이터와 예측선 x

    = 2일 때 10 처음 예측 2 출력 y 8 6 정답은 5 4 2 0 0 1 2 3 4 조정 뒤 예측 5 입력 x 처음: y=x 조정 뒤: y=2x+1 관측한 정답 데이터의 정답에 가까워지도록 모델의 가중치와 편향을 조절합니다. 04
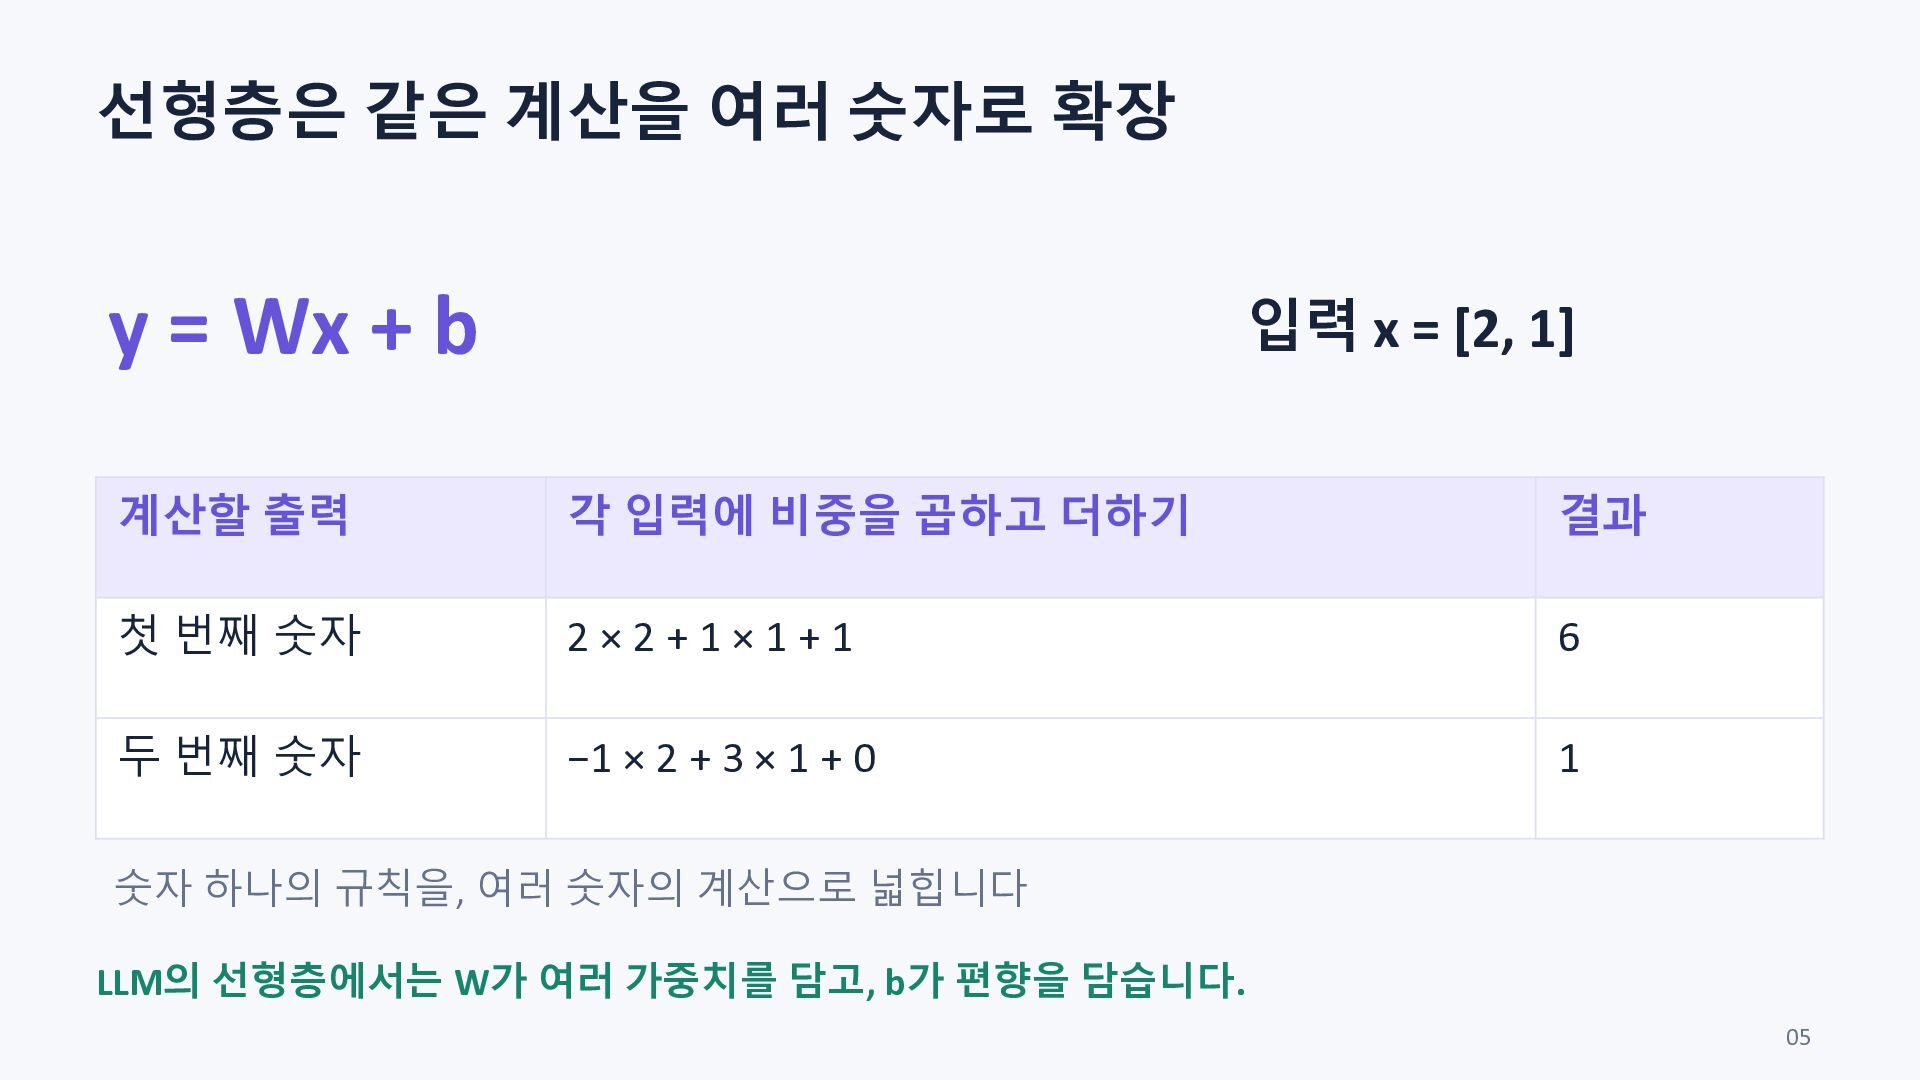
  4. 선형층은 같은 계산을 여러 숫자로 확장 입력 x = [2,

    1] y = Wx + b 계산할 출력 각 입력에 비중을 곱하고 더하기 결과 첫 번째 숫자 2×2+1×1+1 6 두 번째 숫자 −1 × 2 + 3 × 1 + 0 1 숫자 하나의 규칙을, 여러 숫자의 계산으로 넓힙니다 LLM의 선형층에서는 W가 여러 가중치를 담고, b가 편향을 담습니다. 05
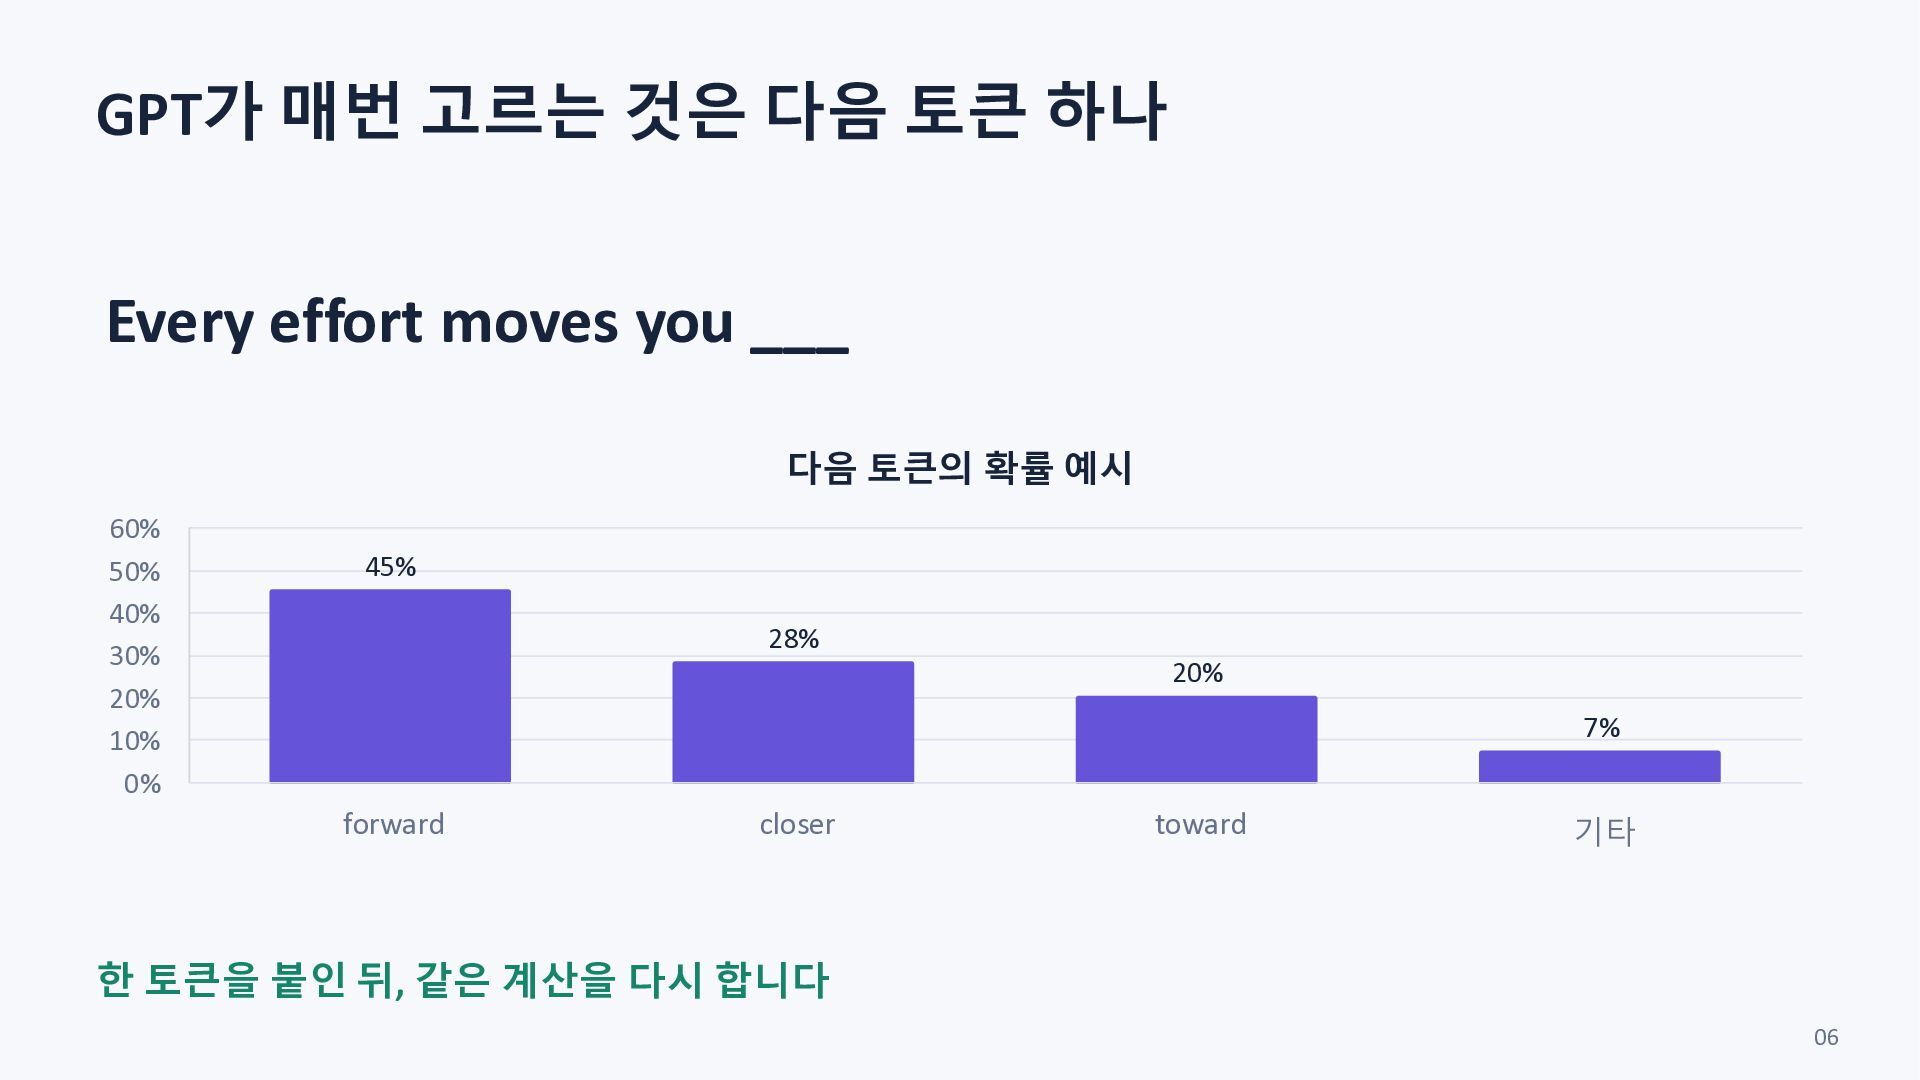
  5. GPT가 매번 고르는 것은 다음 토큰 하나 Every effort moves

    you ___ 다음 토큰의 확률 예시 60% 50% 40% 30% 20% 10% 0% 45% 28% 20% 7% forward closer toward 기타 한 토큰을 붙인 뒤, 같은 계산을 다시 합니다 06
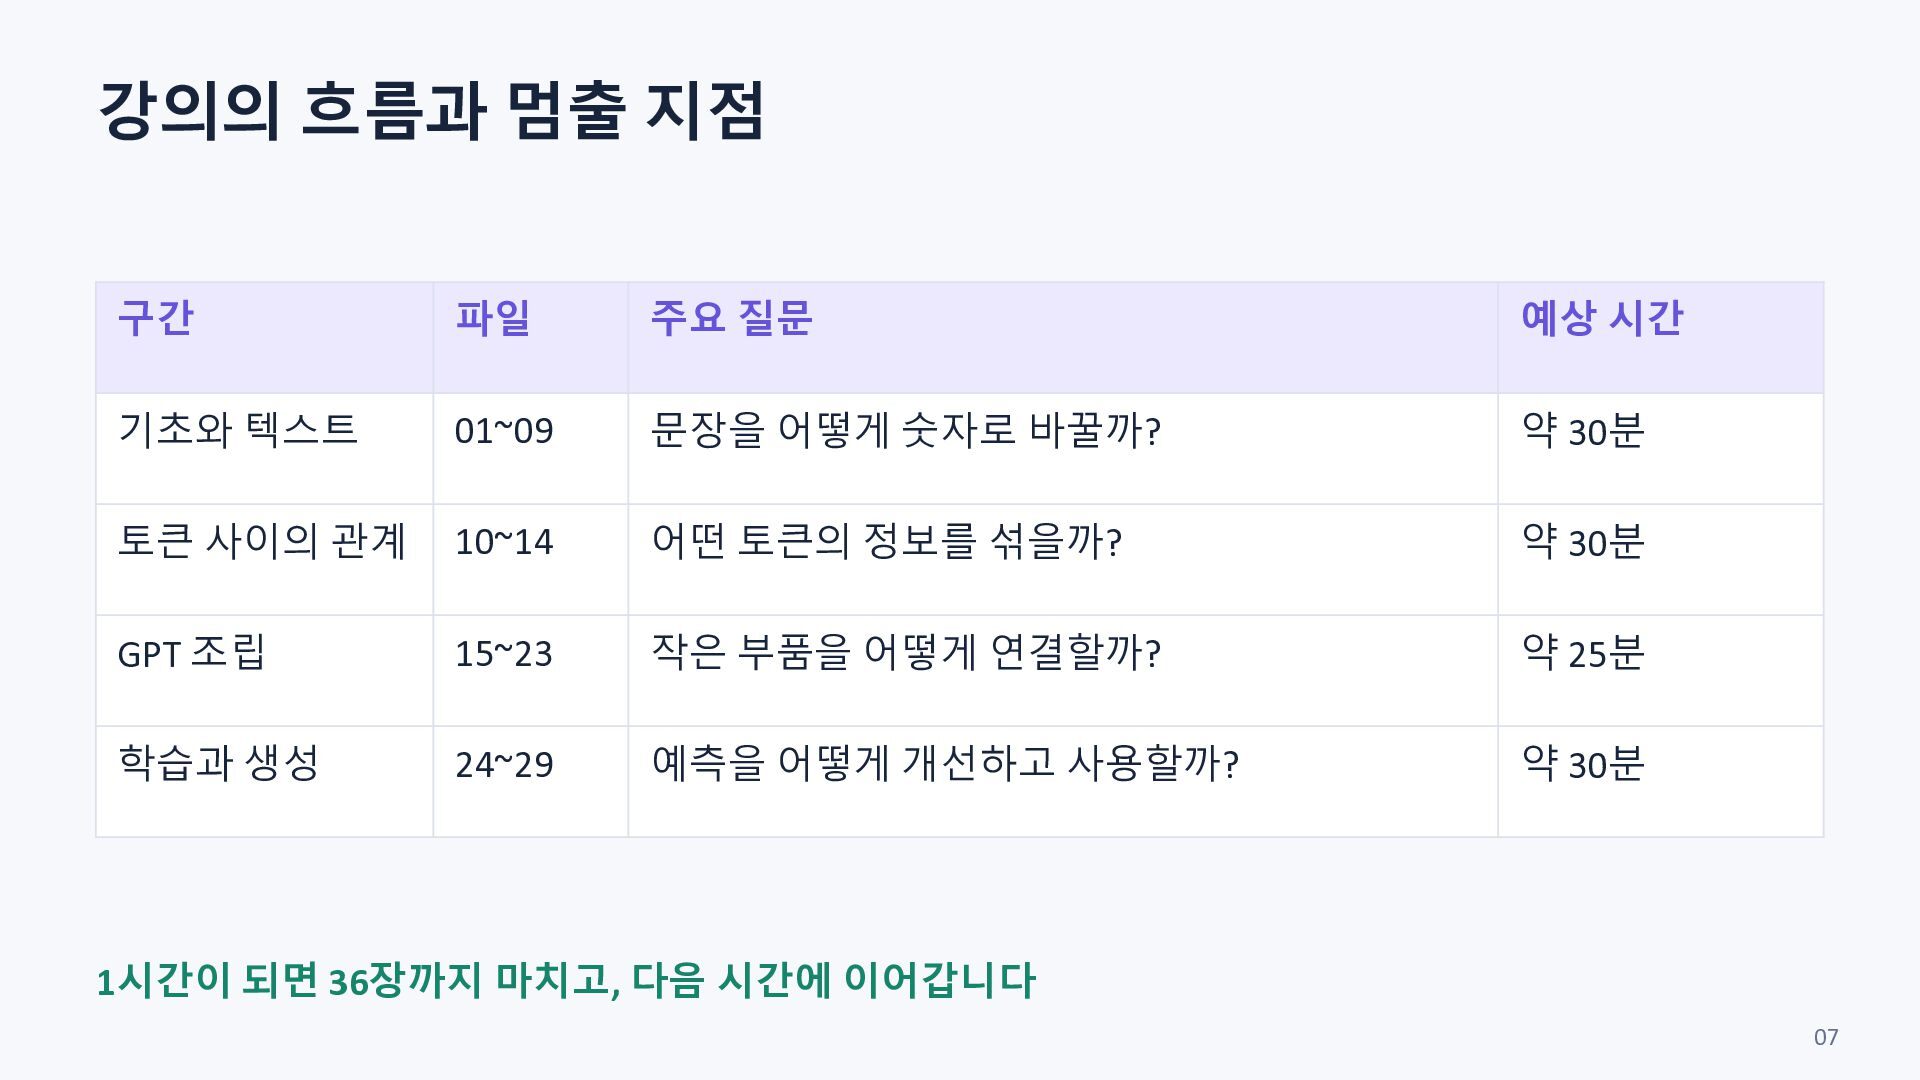
  6. 강의의 흐름과 멈출 지점 구간 파일 주요 질문 예상 시간

    기초와 텍스트 01~09 문장을 어떻게 숫자로 바꿀까? 약 30분 토큰 사이의 관계 10~14 어떤 토큰의 정보를 섞을까? 약 30분 GPT 조립 15~23 작은 부품을 어떻게 연결할까? 약 25분 학습과 생성 24~29 예측을 어떻게 개선하고 사용할까? 약 30분 1시간이 되면 36장까지 마치고, 다음 시간에 이어갑니다 07
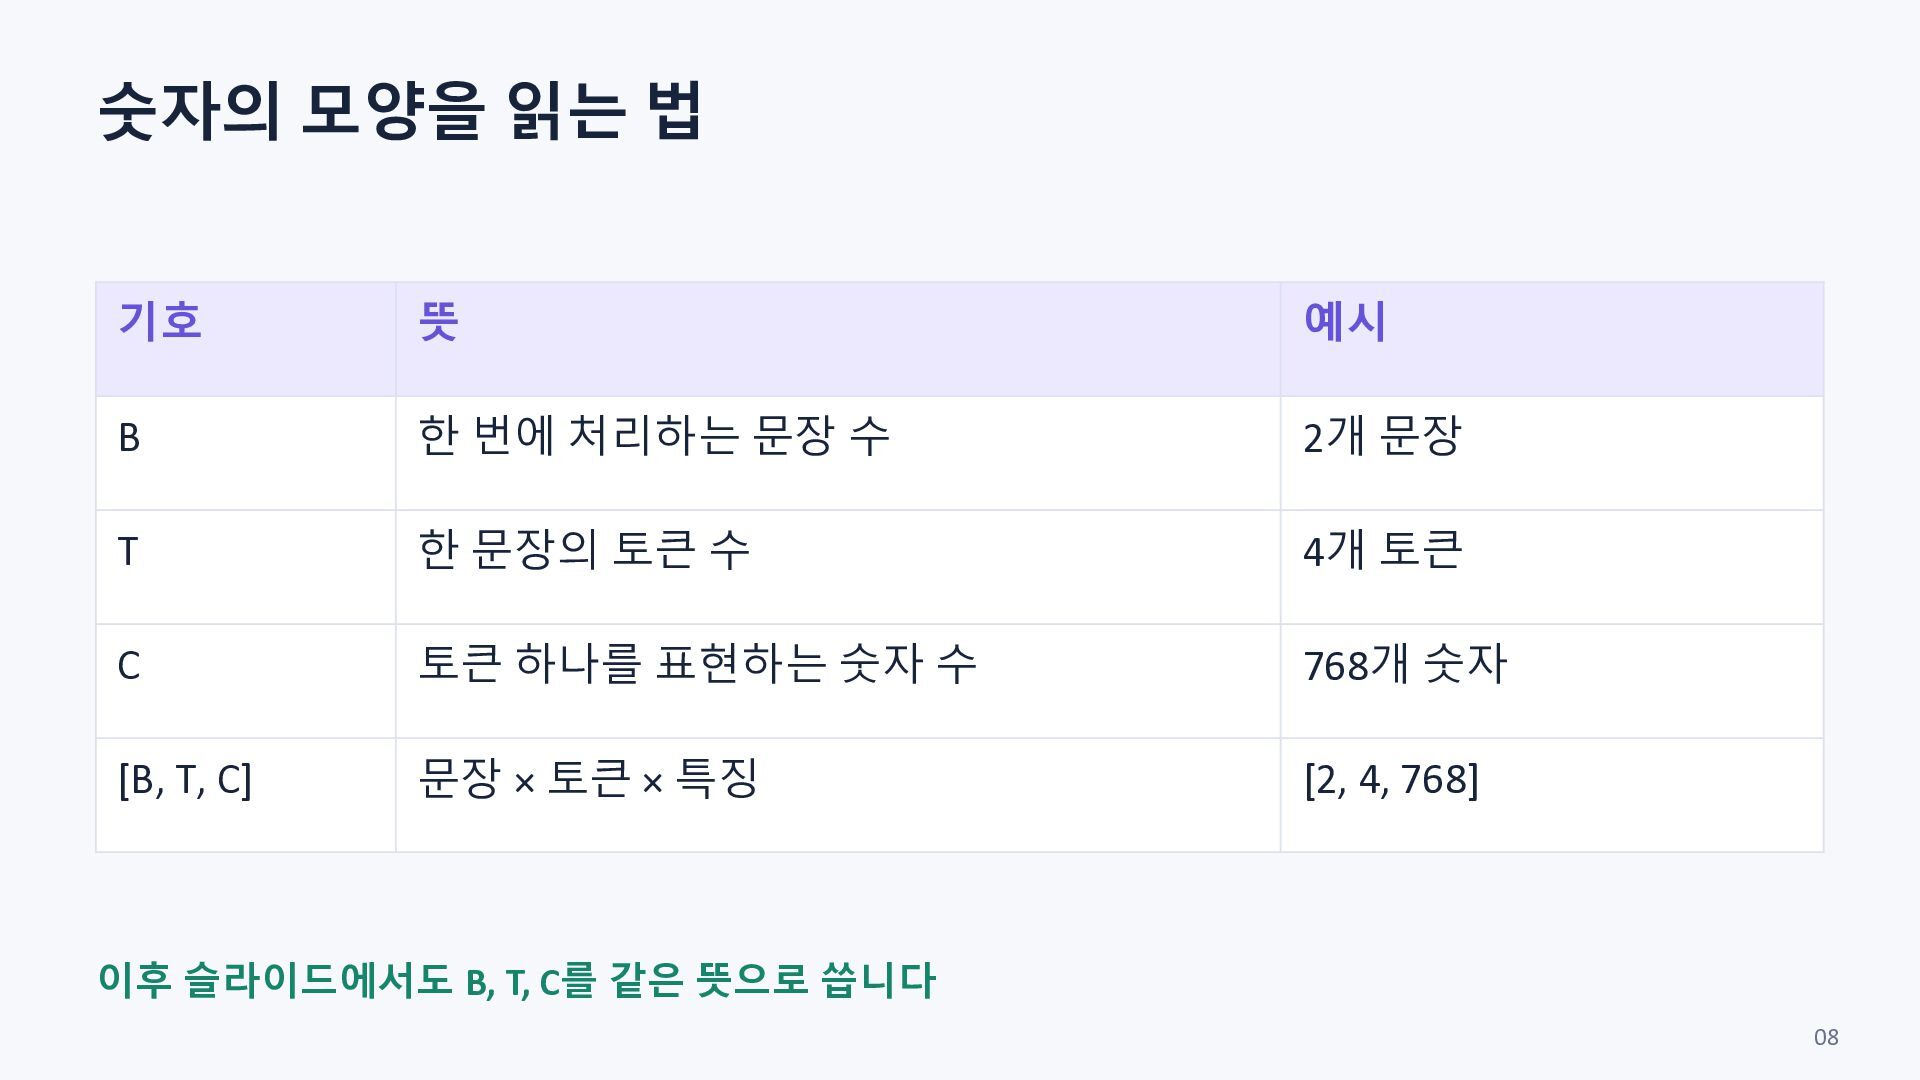
  7. 숫자의 모양을 읽는 법 기호 뜻 예시 B 한 번에

    처리하는 문장 수 2개 문장 T 한 문장의 토큰 수 4개 토큰 C 토큰 하나를 표현하는 숫자 수 768개 숫자 [B, T, C] 문장 × 토큰 × 특징 [2, 4, 768] 이후 슬라이드에서도 B, T, C를 같은 뜻으로 씁니다 08
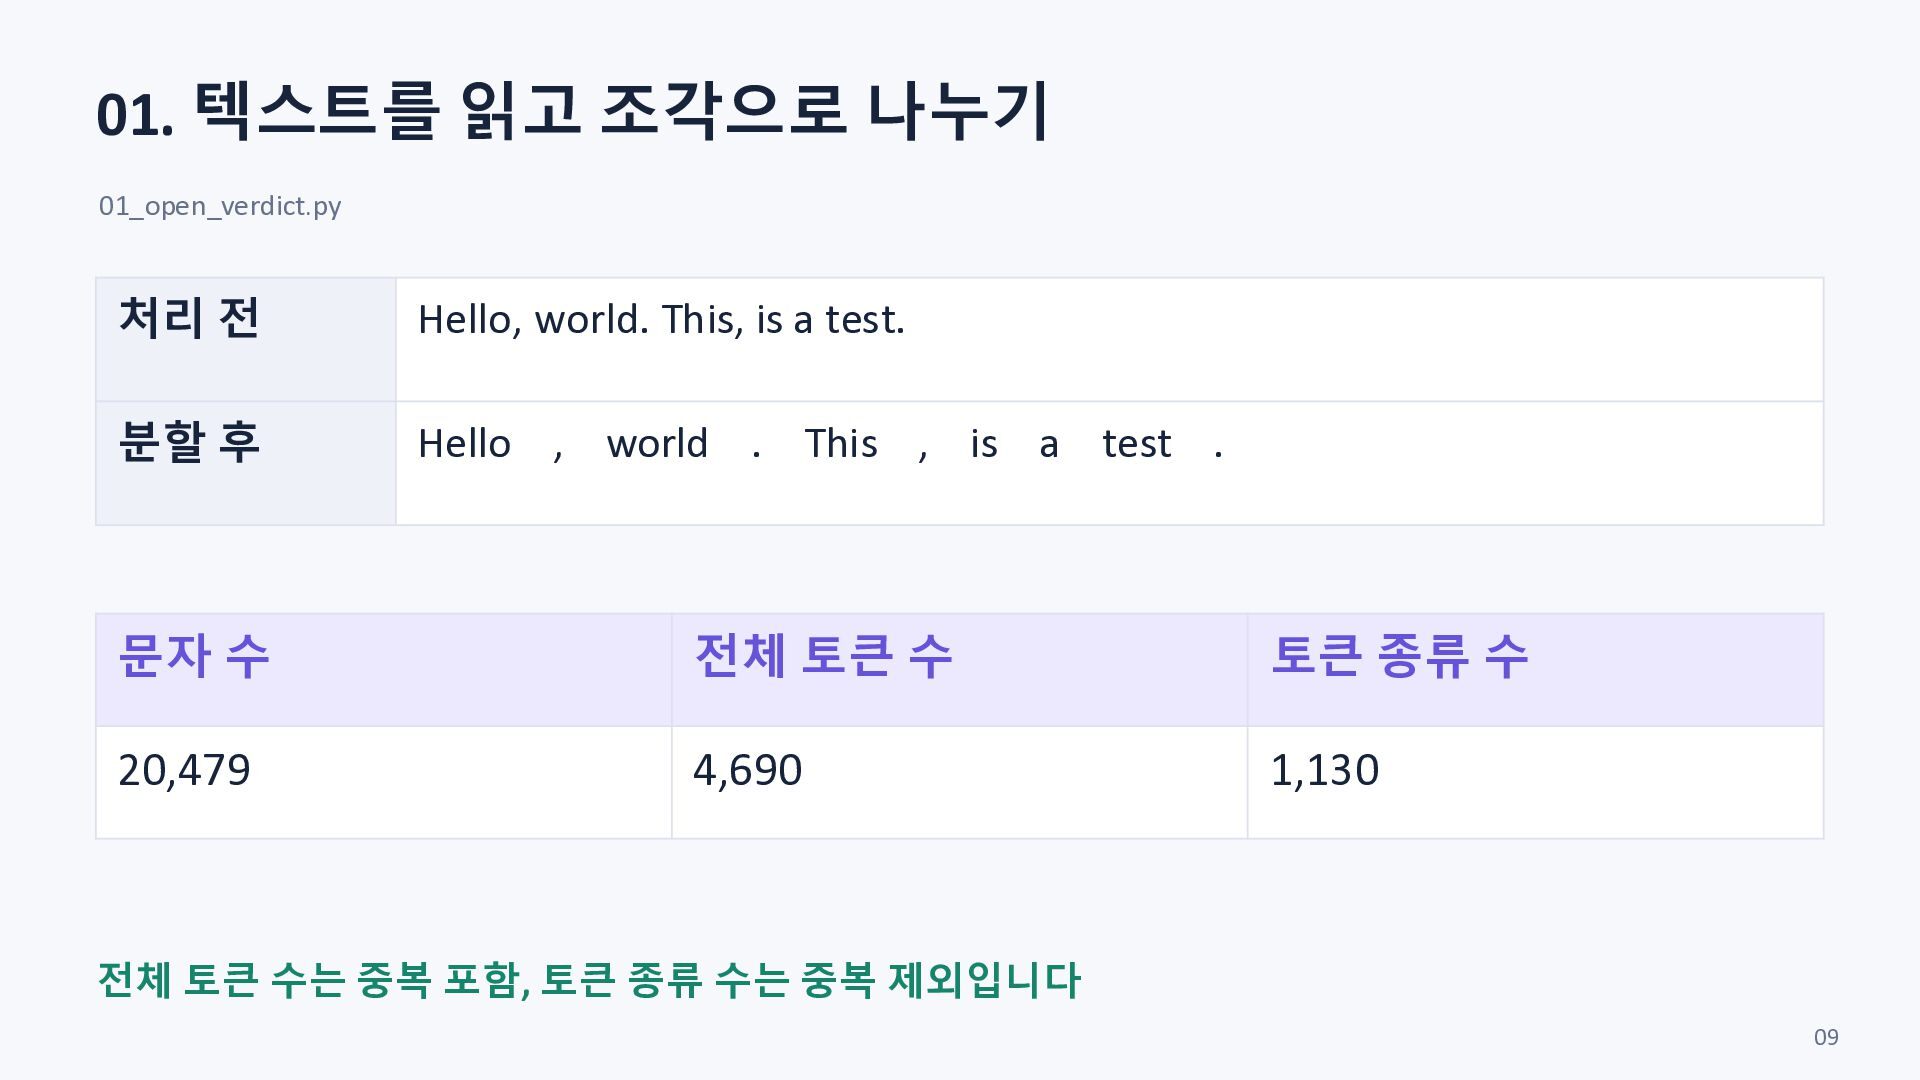
  8. 01. 텍스트를 읽고 조각으로 나누기 01_open_verdict.py 처리 전 Hello, world.

    This, is a test. 분할 후 Hello , world . This , is a test . 문자 수 전체 토큰 수 토큰 종류 수 20,479 4,690 1,130 전체 토큰 수는 중복 포함, 토큰 종류 수는 중복 제외입니다 09
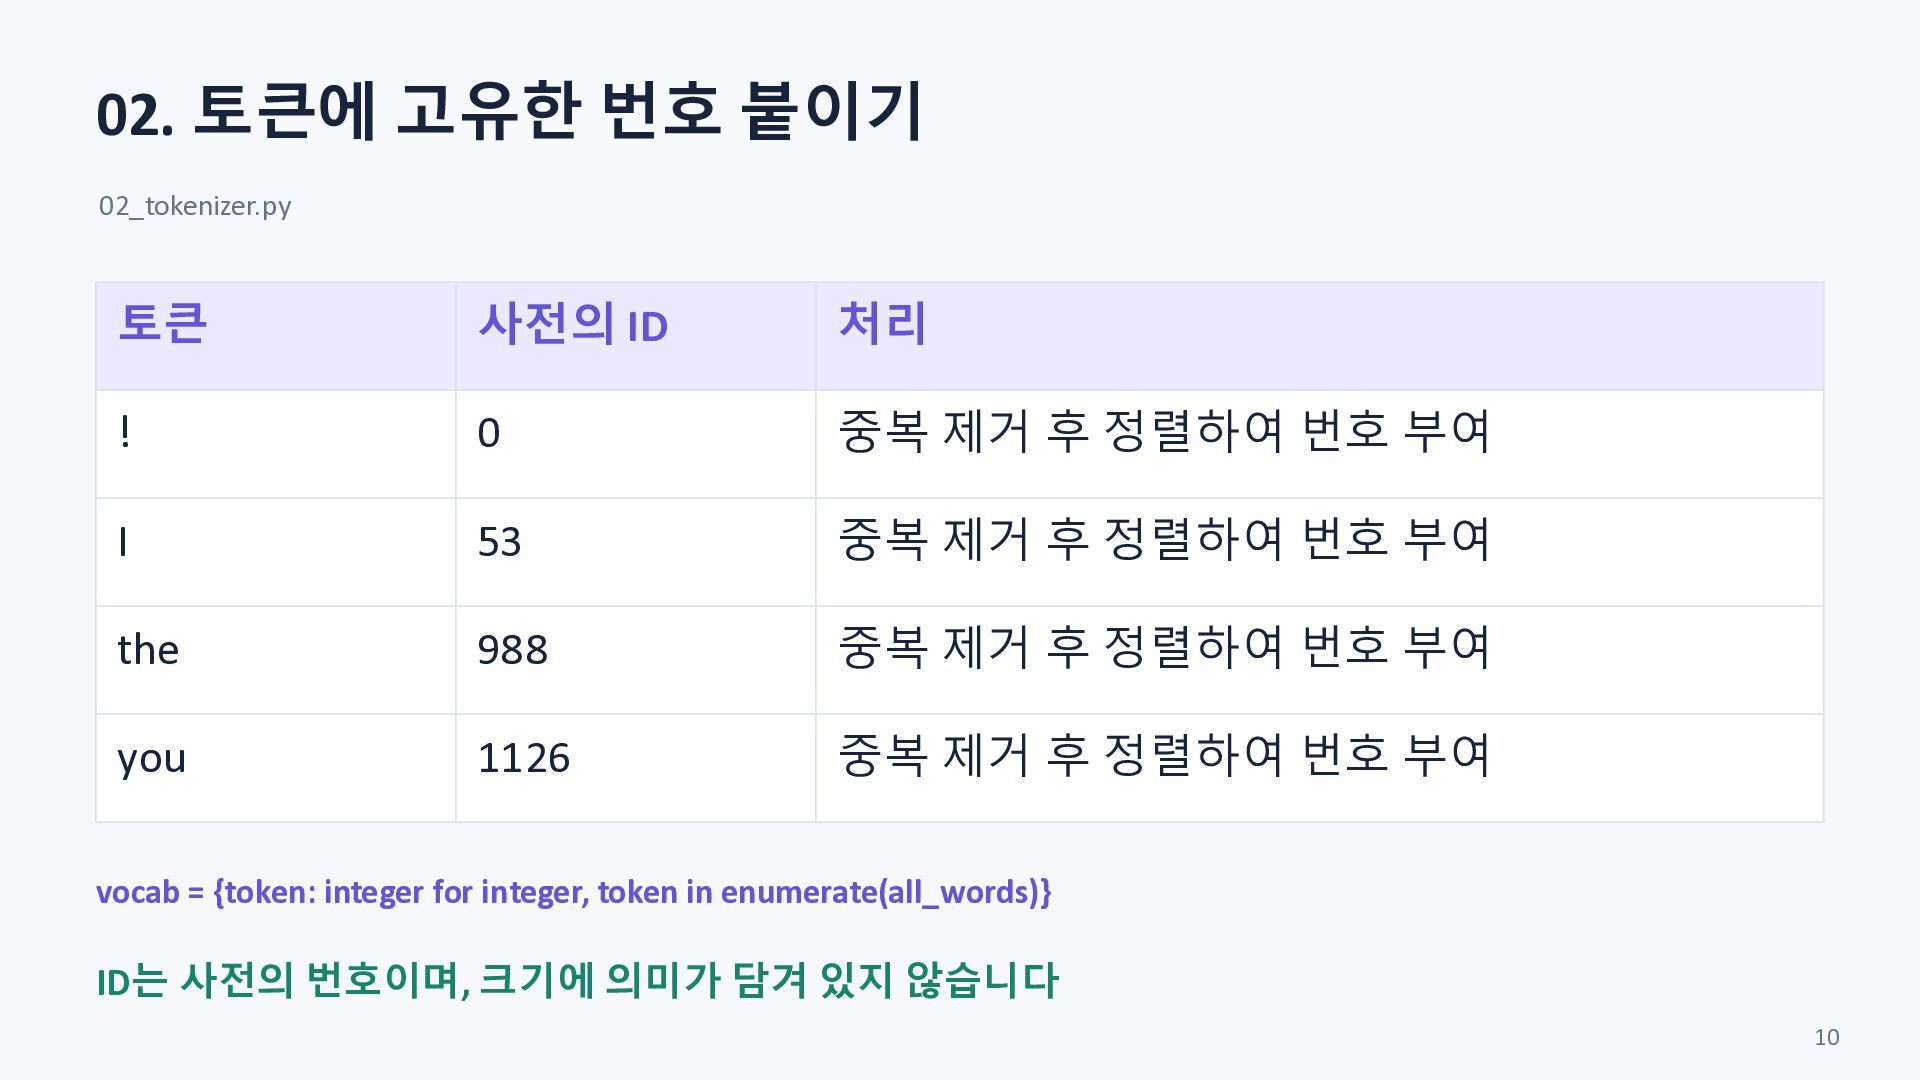
  9. 02. 토큰에 고유한 번호 붙이기 02_tokenizer.py 토큰 사전의 ID 처리

    ! 0 중복 제거 후 정렬하여 번호 부여 I 53 중복 제거 후 정렬하여 번호 부여 the 988 중복 제거 후 정렬하여 번호 부여 you 1126 중복 제거 후 정렬하여 번호 부여 vocab = {token: integer for integer, token in enumerate(all_words)} ID는 사전의 번호이며, 크기에 의미가 담겨 있지 않습니다 10
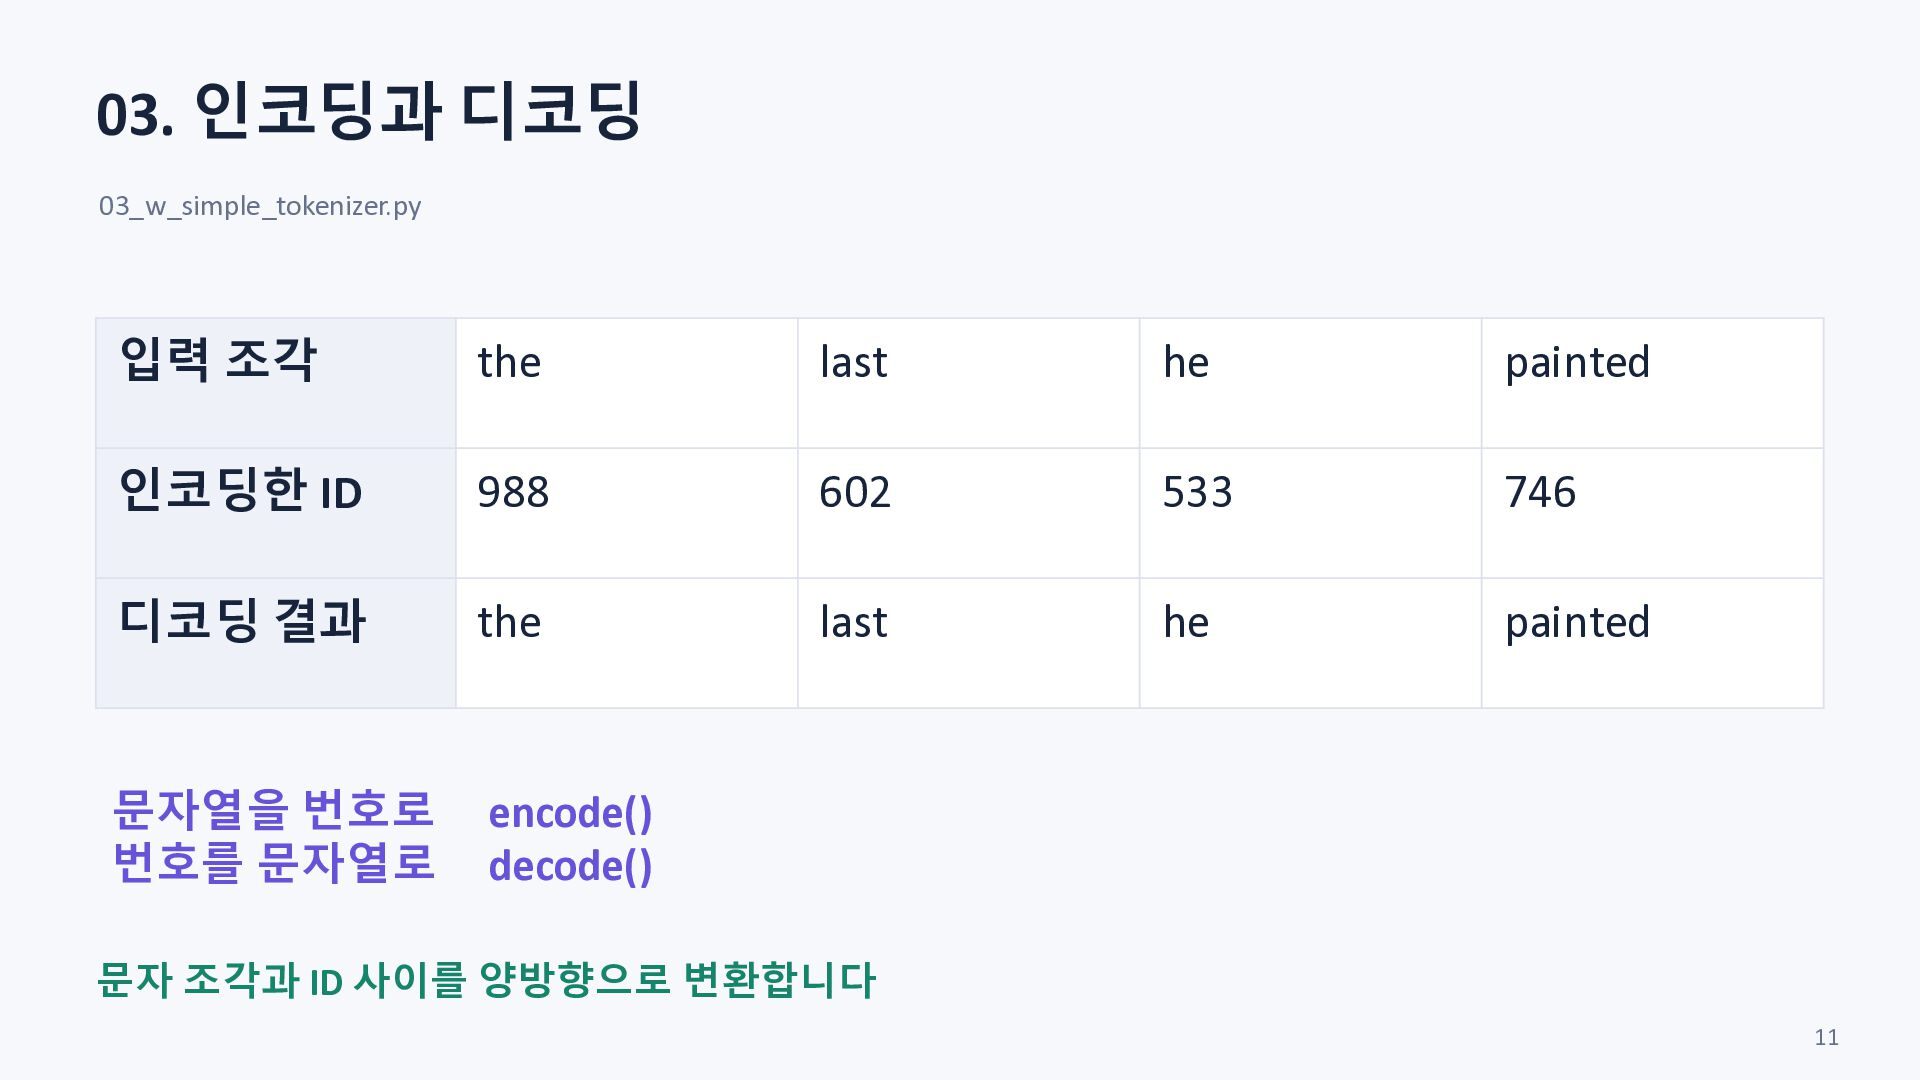
  10. 03. 인코딩과 디코딩 03_w_simple_tokenizer.py 입력 조각 the last he painted

    인코딩한 ID 988 602 533 746 디코딩 결과 the last he painted 문자열을 번호로 번호를 문자열로 encode() decode() 문자 조각과 ID 사이를 양방향으로 변환합니다 11
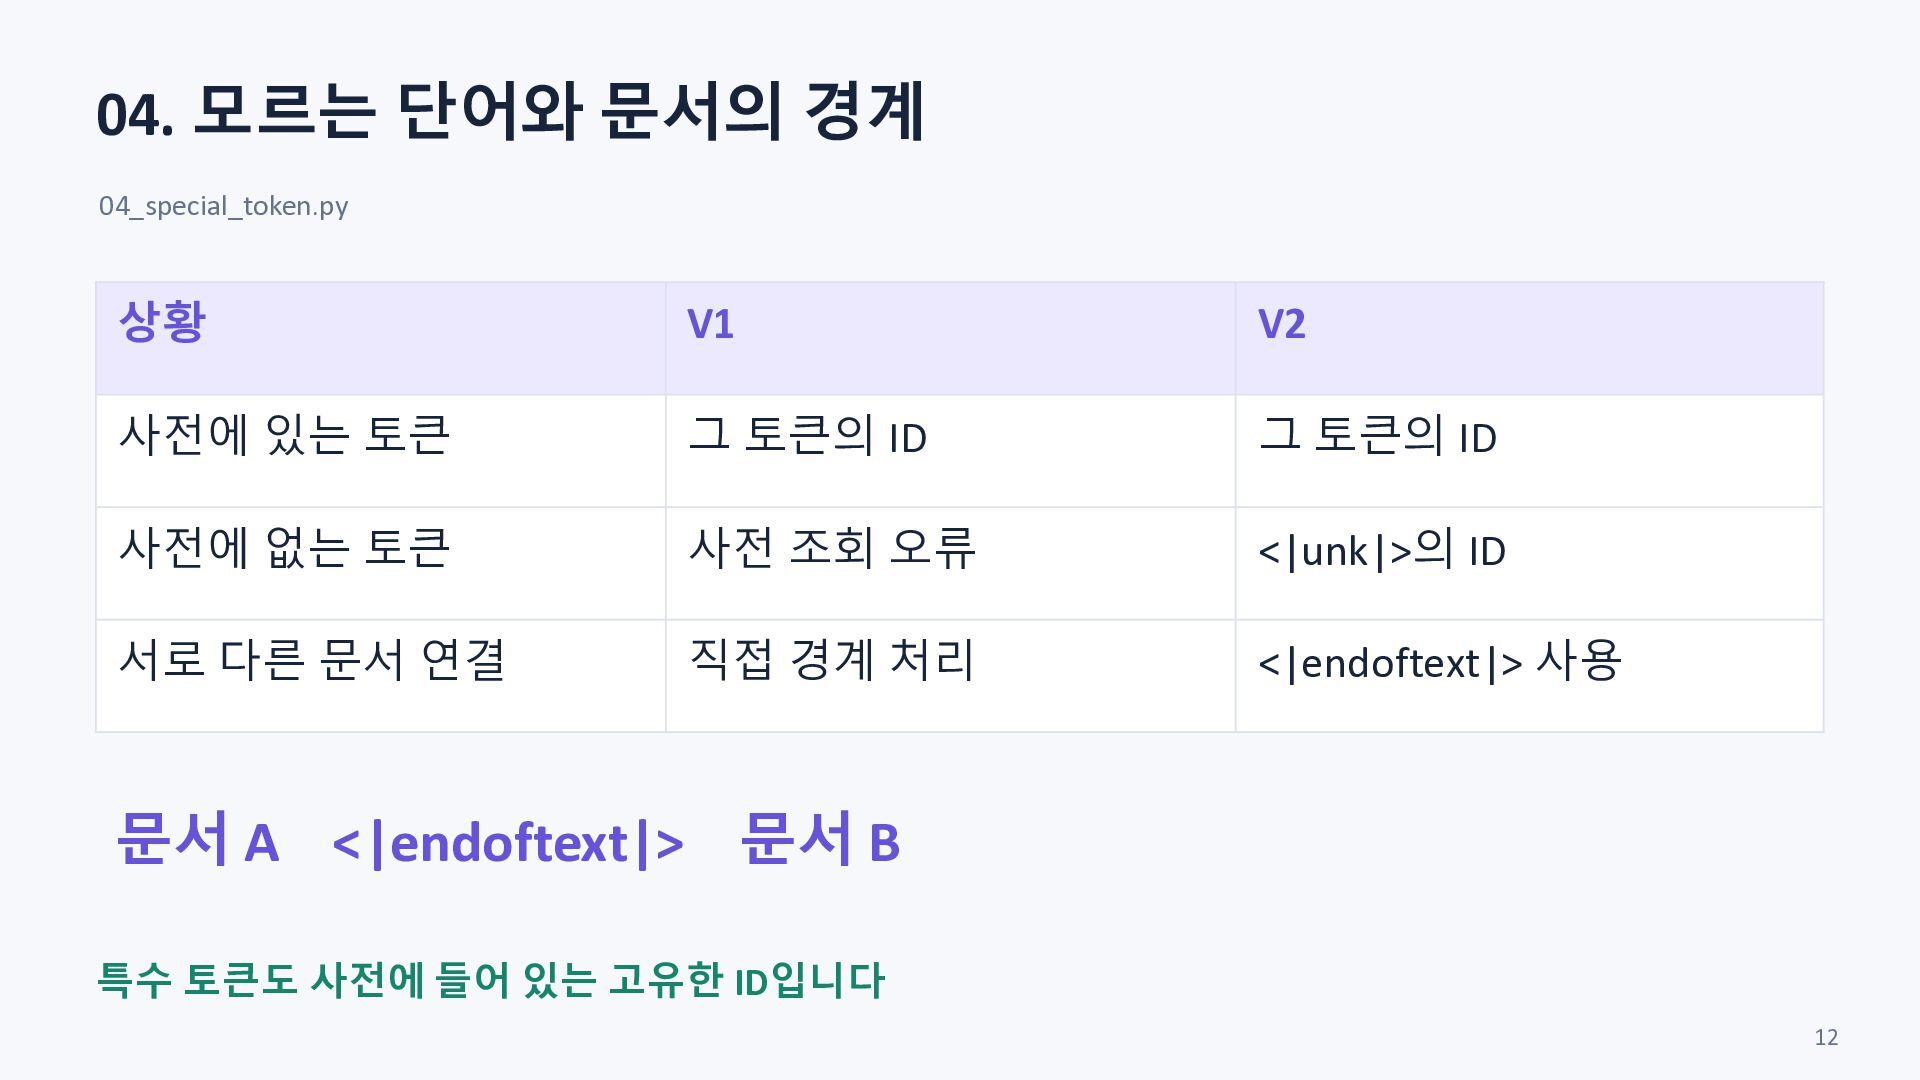
  11. 04. 모르는 단어와 문서의 경계 04_special_token.py 상황 V1 V2 사전에

    있는 토큰 그 토큰의 ID 그 토큰의 ID 사전에 없는 토큰 사전 조회 오류 <|unk|>의 ID 서로 다른 문서 연결 직접 경계 처리 <|endoftext|> 사용 문서 A <|endoftext|> 문서 B 특수 토큰도 사전에 들어 있는 고유한 ID입니다 12
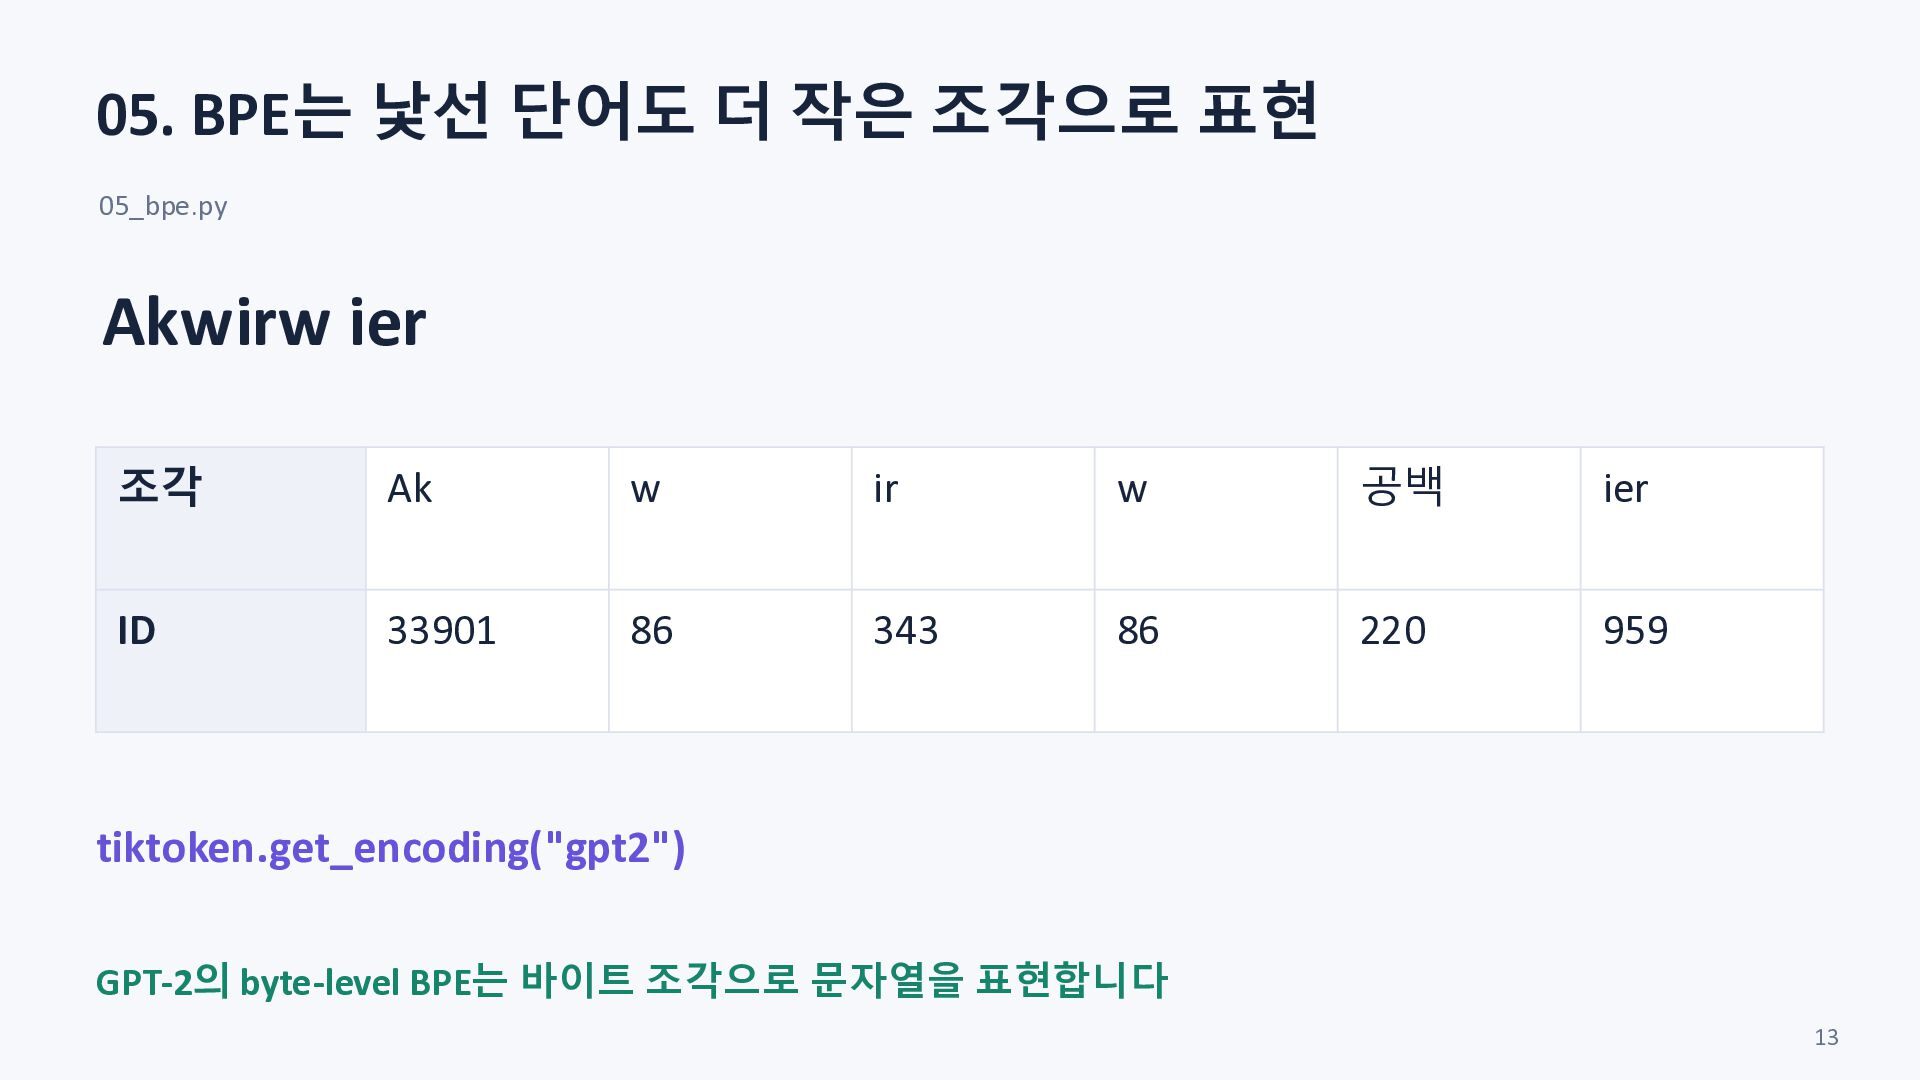
  12. 05. BPE는 낯선 단어도 더 작은 조각으로 표현 05_bpe.py Akwirw

    ier 조각 Ak w ir w 공백 ier ID 33901 86 343 86 220 959 tiktoken.get_encoding("gpt2") GPT-2의 byte-level BPE는 바이트 조각으로 문자열을 표현합니다 13
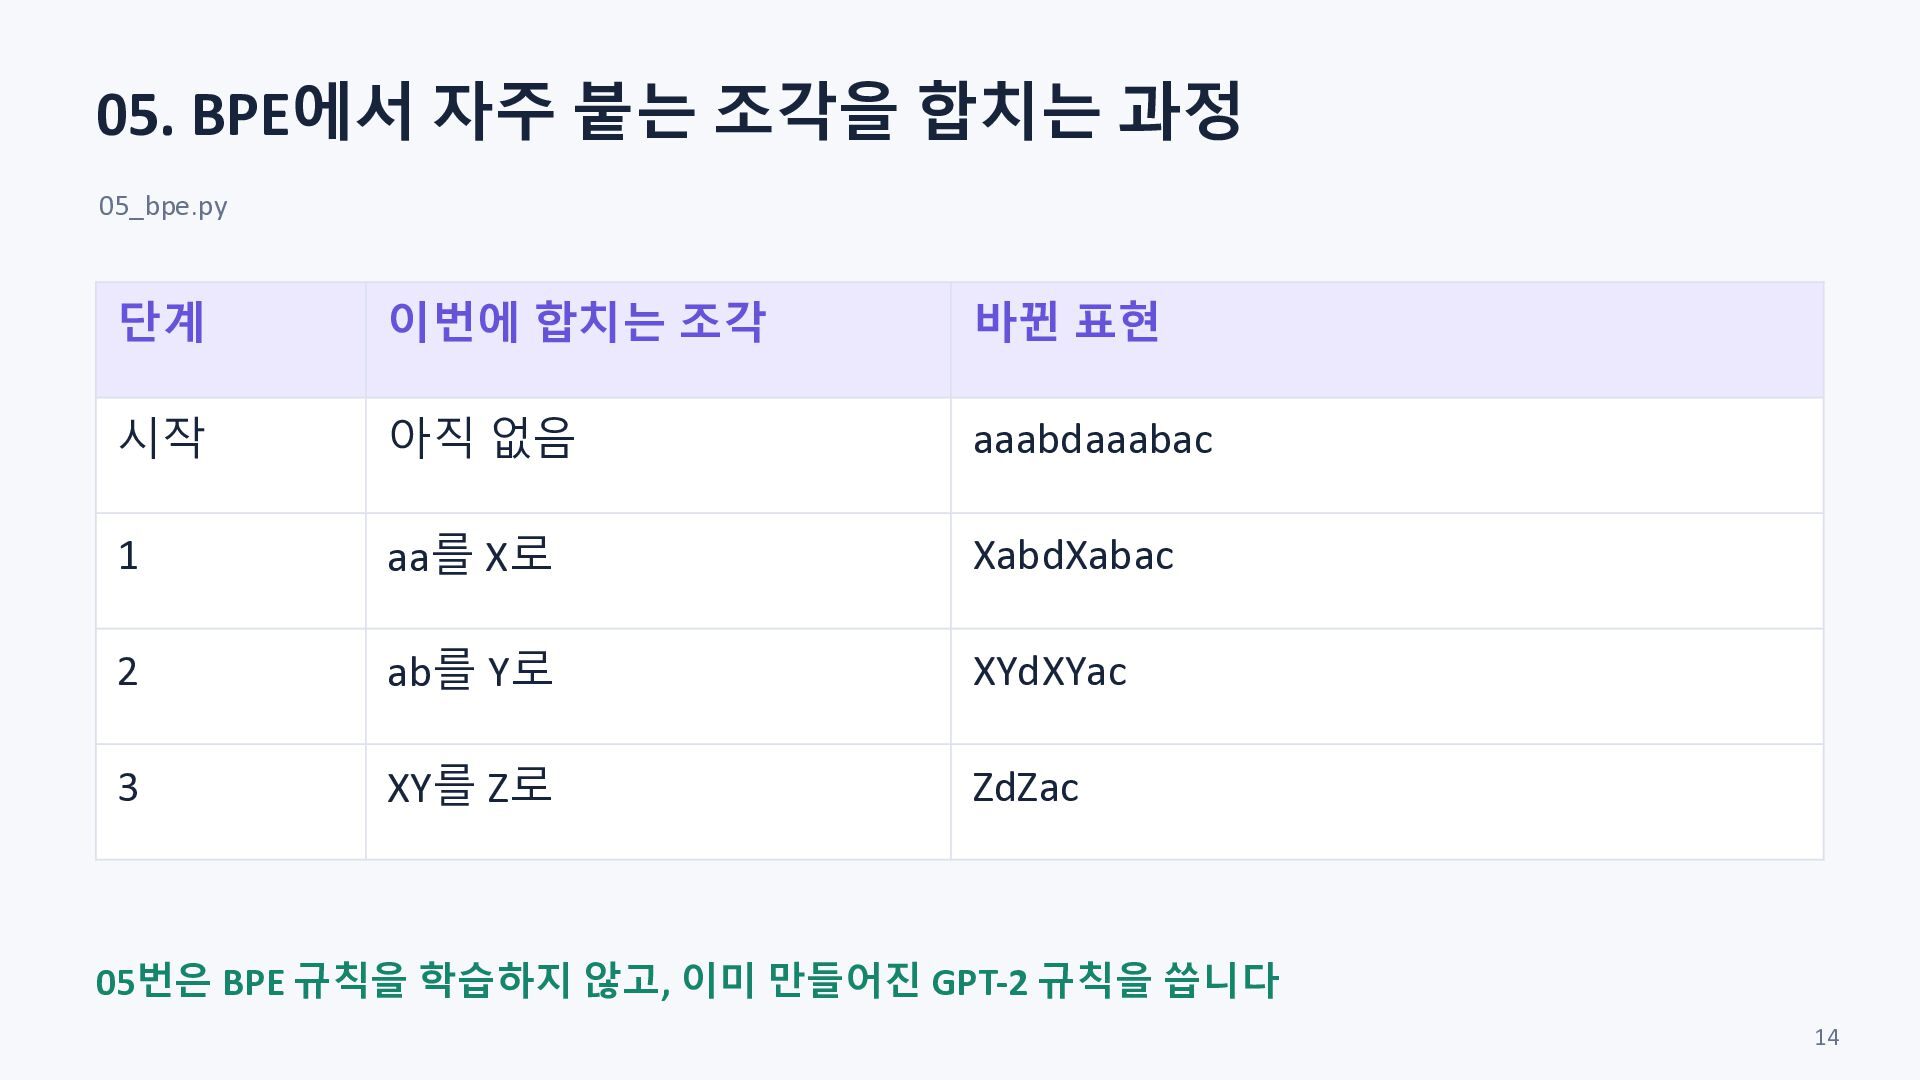
  13. 05. BPE에서 자주 붙는 조각을 합치는 과정 05_bpe.py 단계 이번에

    합치는 조각 바뀐 표현 시작 아직 없음 aaabdaaabac 1 aa를 X로 XabdXabac 2 ab를 Y로 XYdXYac 3 XY를 Z로 ZdZac 05번은 BPE 규칙을 학습하지 않고, 이미 만들어진 GPT-2 규칙을 씁니다 14
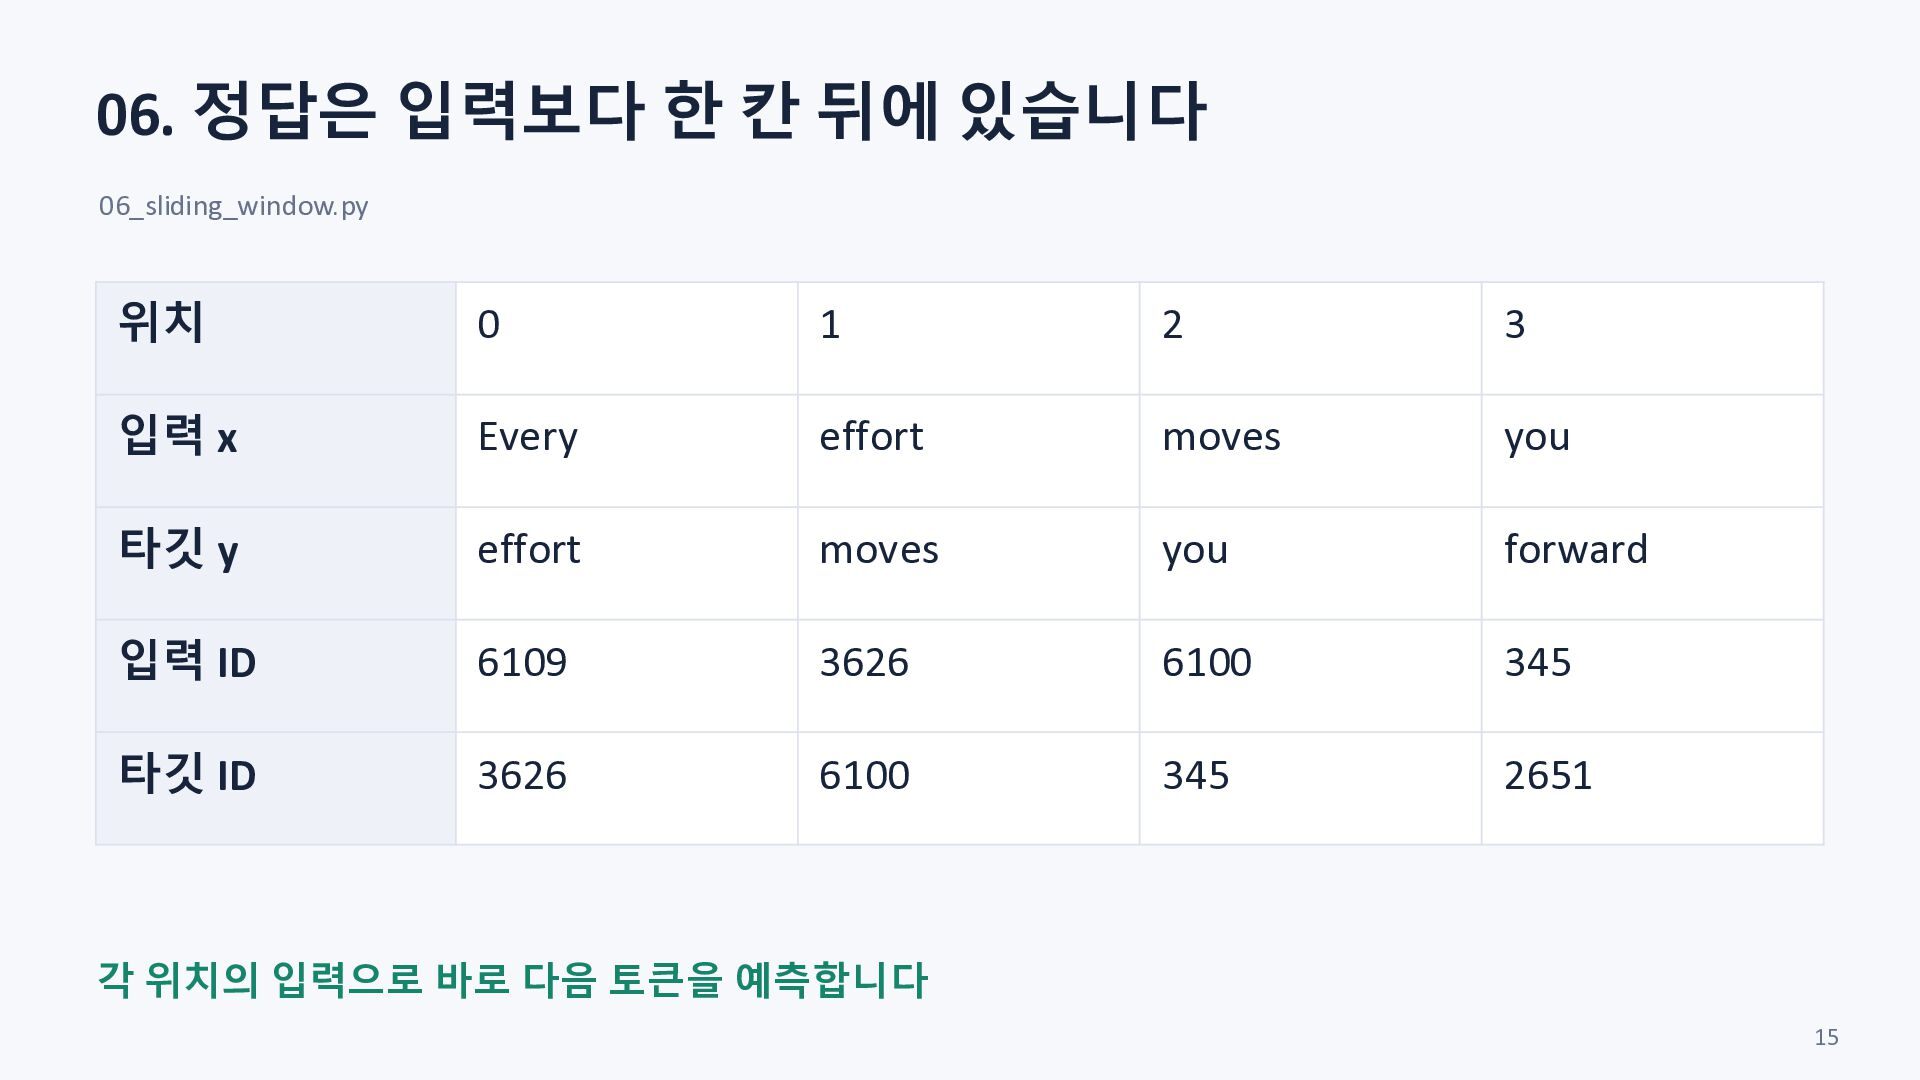
  14. 06. 정답은 입력보다 한 칸 뒤에 있습니다 06_sliding_window.py 위치 0

    1 2 3 입력 x Every effort moves you 타깃 y effort moves you forward 입력 ID 6109 3626 6100 345 타깃 ID 3626 6100 345 2651 각 위치의 입력으로 바로 다음 토큰을 예측합니다 15
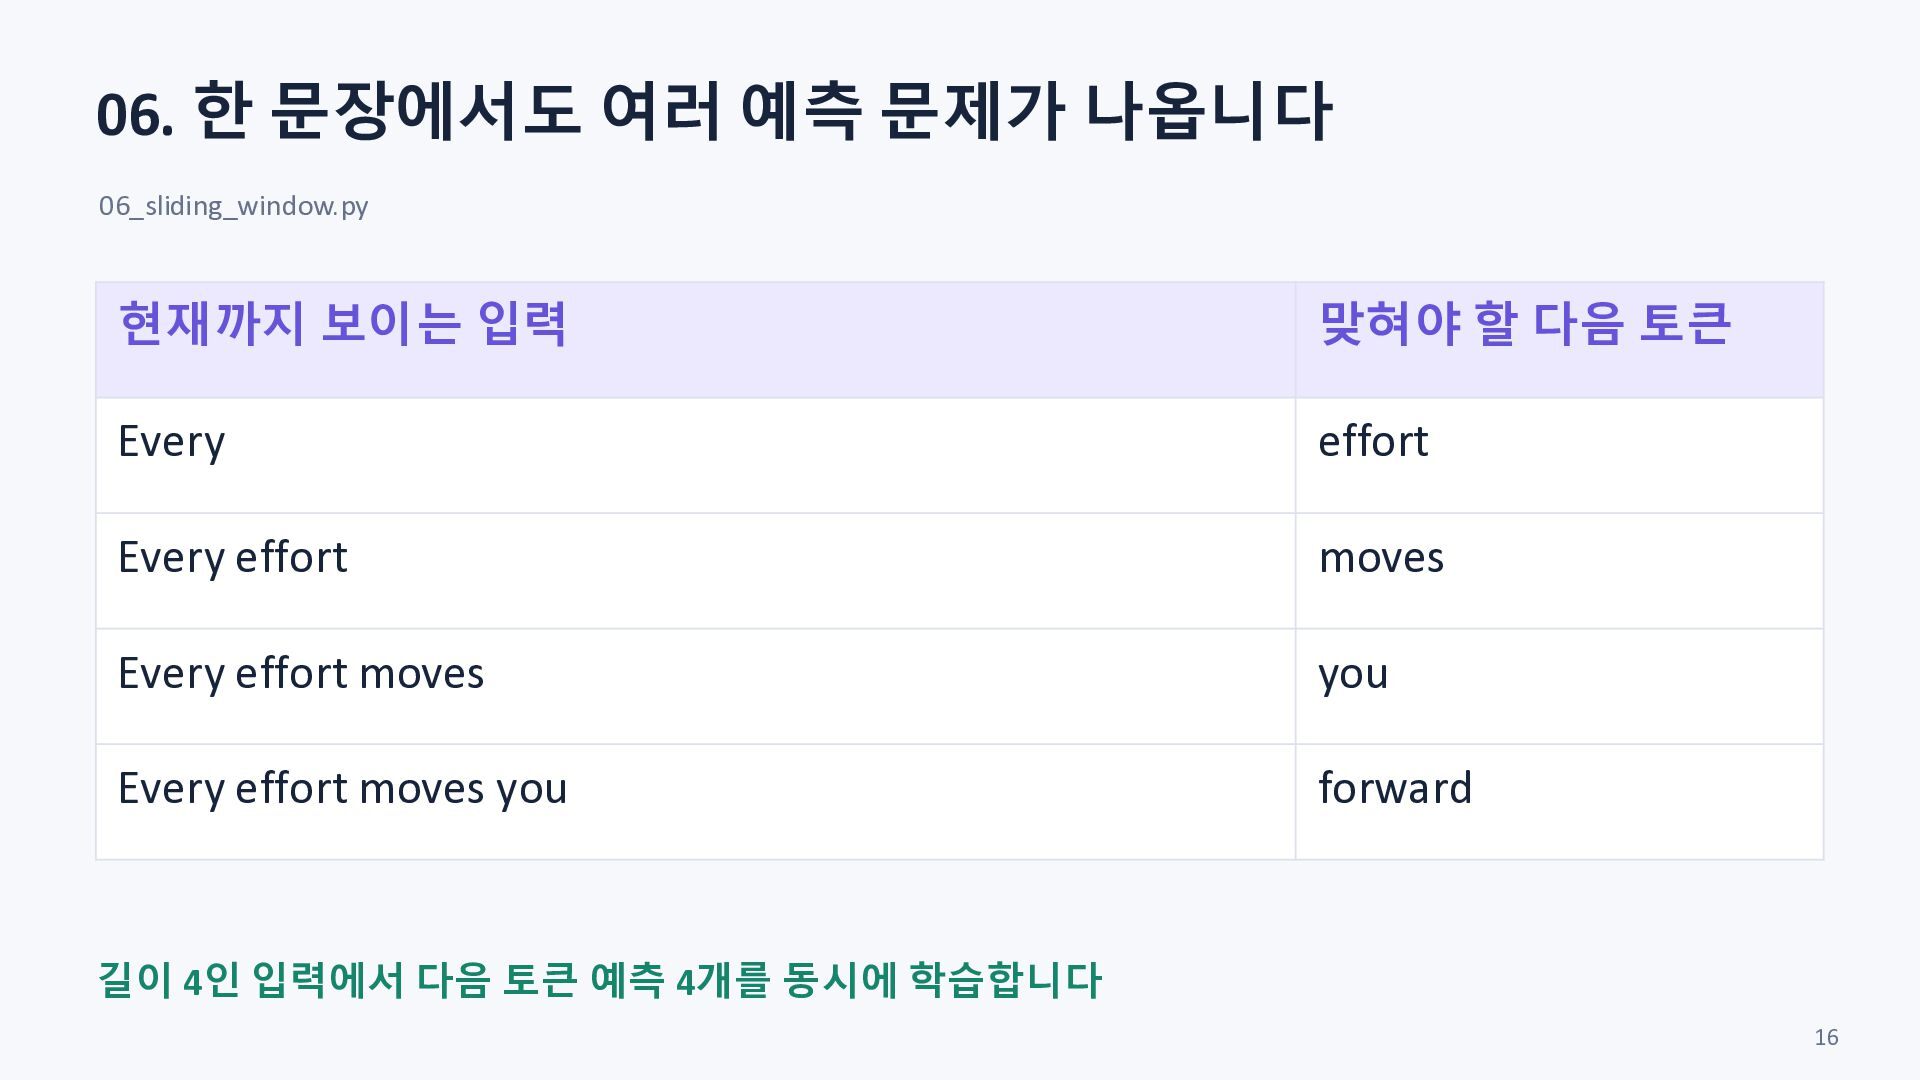
  15. 06. 한 문장에서도 여러 예측 문제가 나옵니다 06_sliding_window.py 현재까지 보이는

    입력 맞혀야 할 다음 토큰 Every effort Every effort moves Every effort moves you Every effort moves you forward 길이 4인 입력에서 다음 토큰 예측 4개를 동시에 학습합니다 16
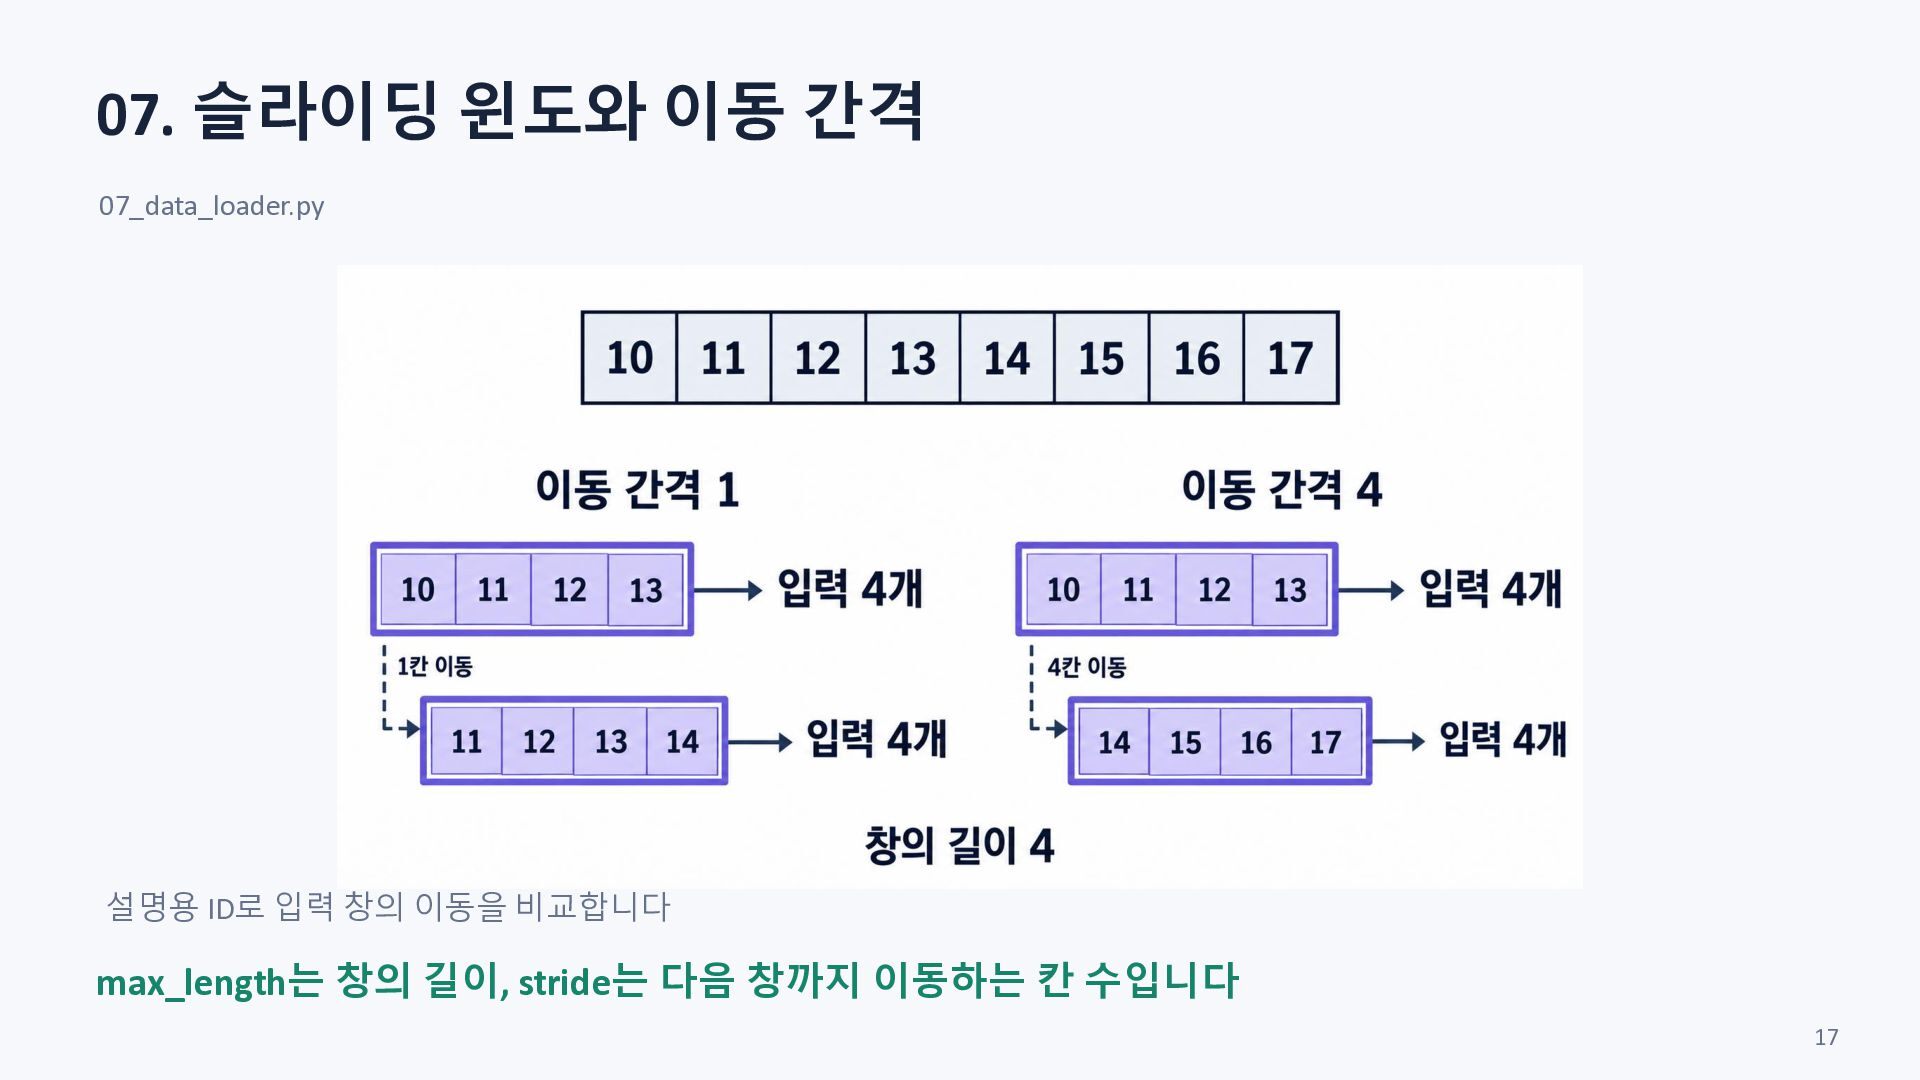
  16. 07. 슬라이딩 윈도와 이동 간격 07_data_loader.py 설명용 ID로 입력 창의

    이동을 비교합니다 max_length는 창의 길이, stride는 다음 창까지 이동하는 칸 수입니다 17
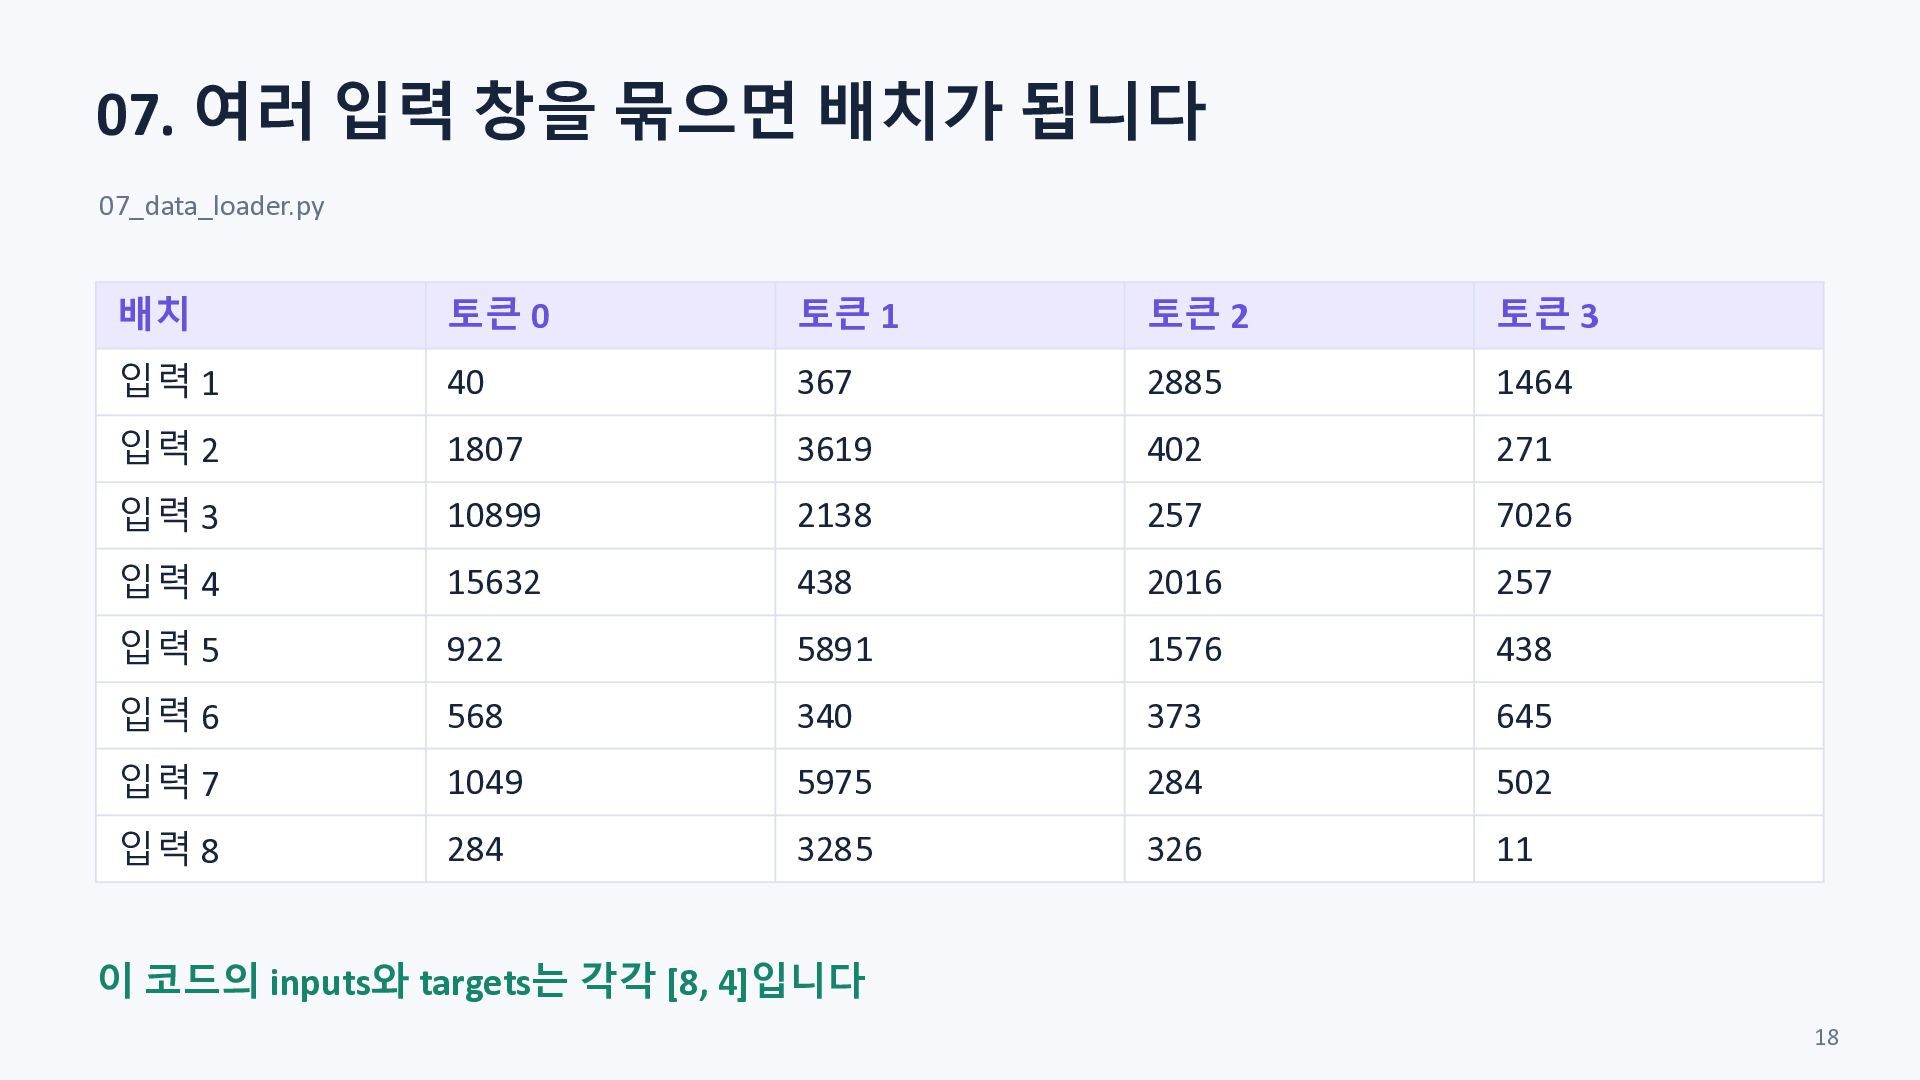
  17. 07. 여러 입력 창을 묶으면 배치가 됩니다 07_data_loader.py 배치 토큰

    0 토큰 1 토큰 2 토큰 3 입력 1 40 367 2885 1464 입력 2 1807 3619 402 271 입력 3 10899 2138 257 7026 입력 4 15632 438 2016 257 입력 5 922 5891 1576 438 입력 6 568 340 373 645 입력 7 1049 5975 284 502 입력 8 284 3285 326 11 이 코드의 inputs와 targets는 각각 [8, 4]입니다 18
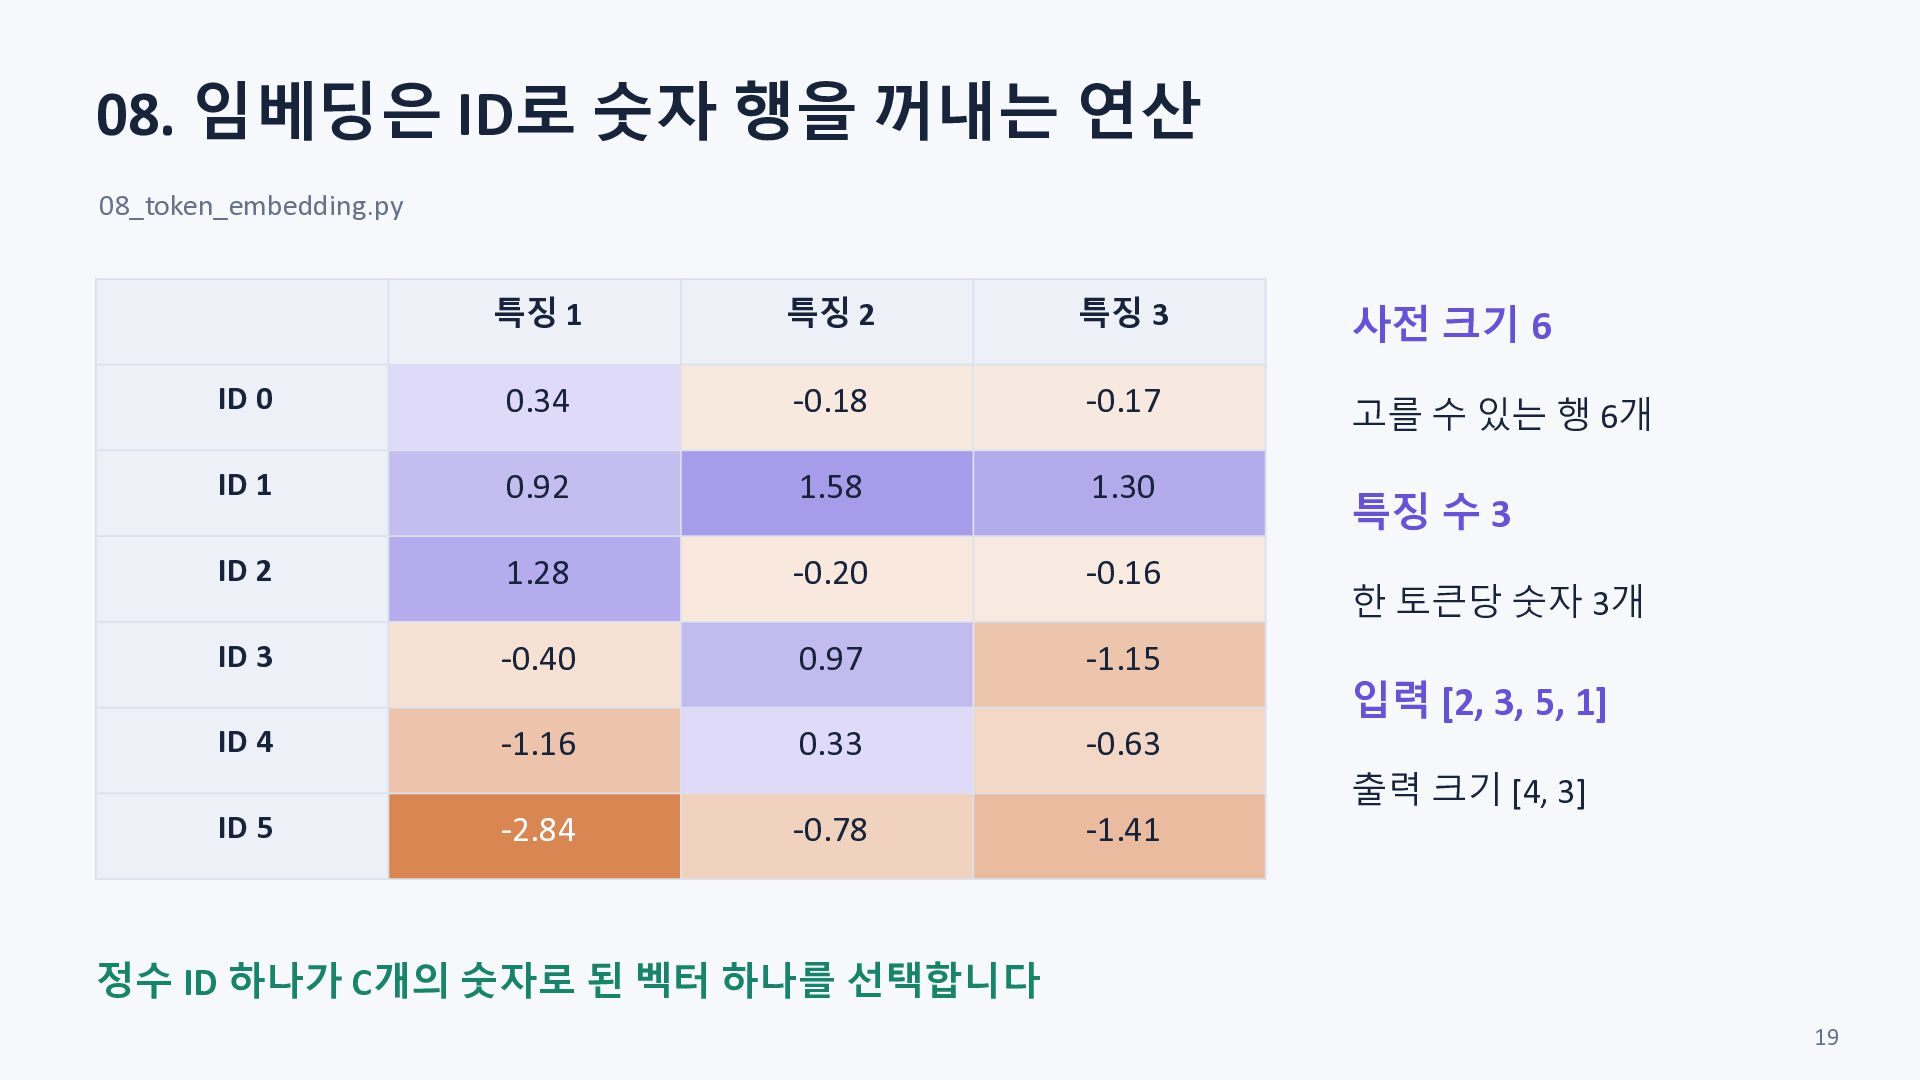
  18. 08. 임베딩은 ID로 숫자 행을 꺼내는 연산 08_token_embedding.py 특징 1

    특징 2 특징 3 사전 크기 6 ID 0 0.34 -0.18 -0.17 고를 수 있는 행 6개 ID 1 0.92 1.58 1.30 특징 수 3 ID 2 1.28 -0.20 -0.16 ID 3 -0.40 0.97 -1.15 ID 4 -1.16 0.33 -0.63 -2.84 -0.78 -1.41 ID 5 한 토큰당 숫자 3개 입력 [2, 3, 5, 1] 출력 크기 [4, 3] 정수 ID 하나가 C개의 숫자로 된 벡터 하나를 선택합니다 19
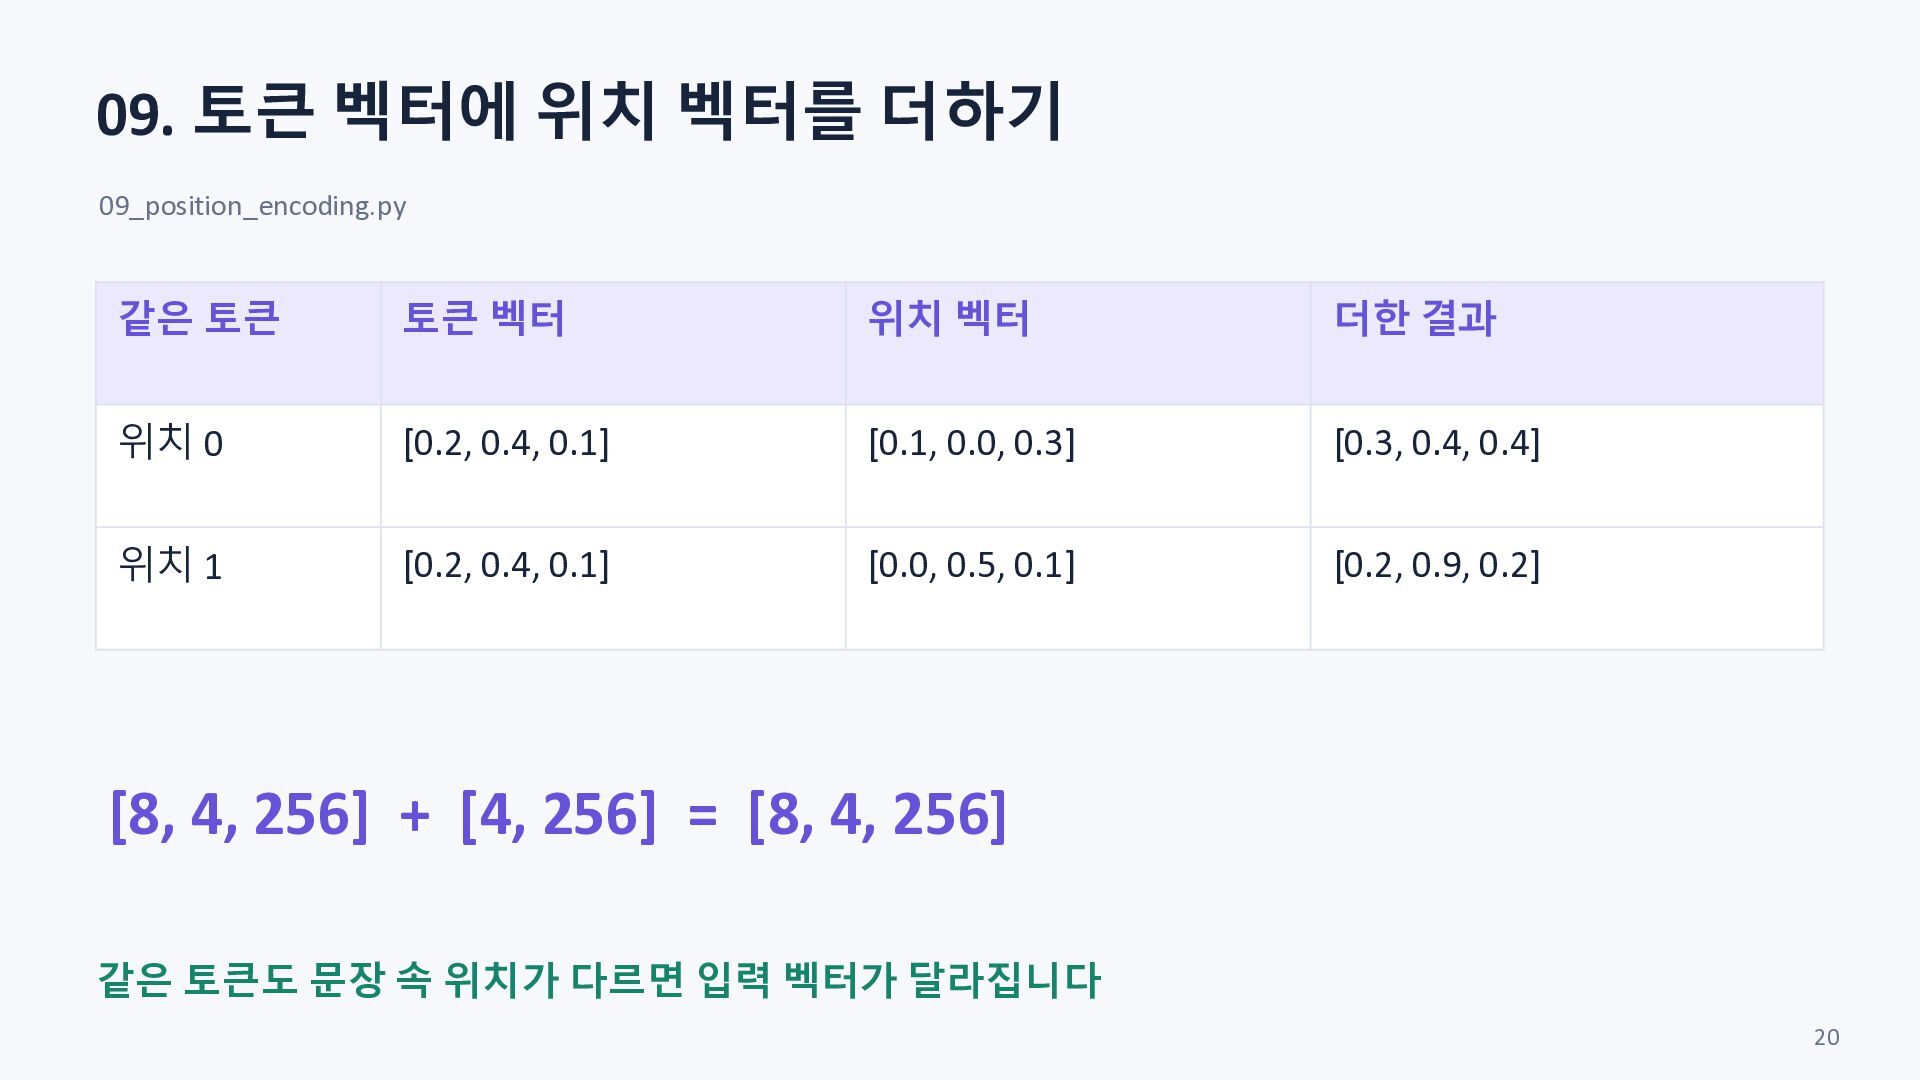
  19. 09. 토큰 벡터에 위치 벡터를 더하기 09_position_encoding.py 같은 토큰 토큰

    벡터 위치 벡터 더한 결과 위치 0 [0.2, 0.4, 0.1] [0.1, 0.0, 0.3] [0.3, 0.4, 0.4] 위치 1 [0.2, 0.4, 0.1] [0.0, 0.5, 0.1] [0.2, 0.9, 0.2] [8, 4, 256] + [4, 256] = [8, 4, 256] 같은 토큰도 문장 속 위치가 다르면 입력 벡터가 달라집니다 20
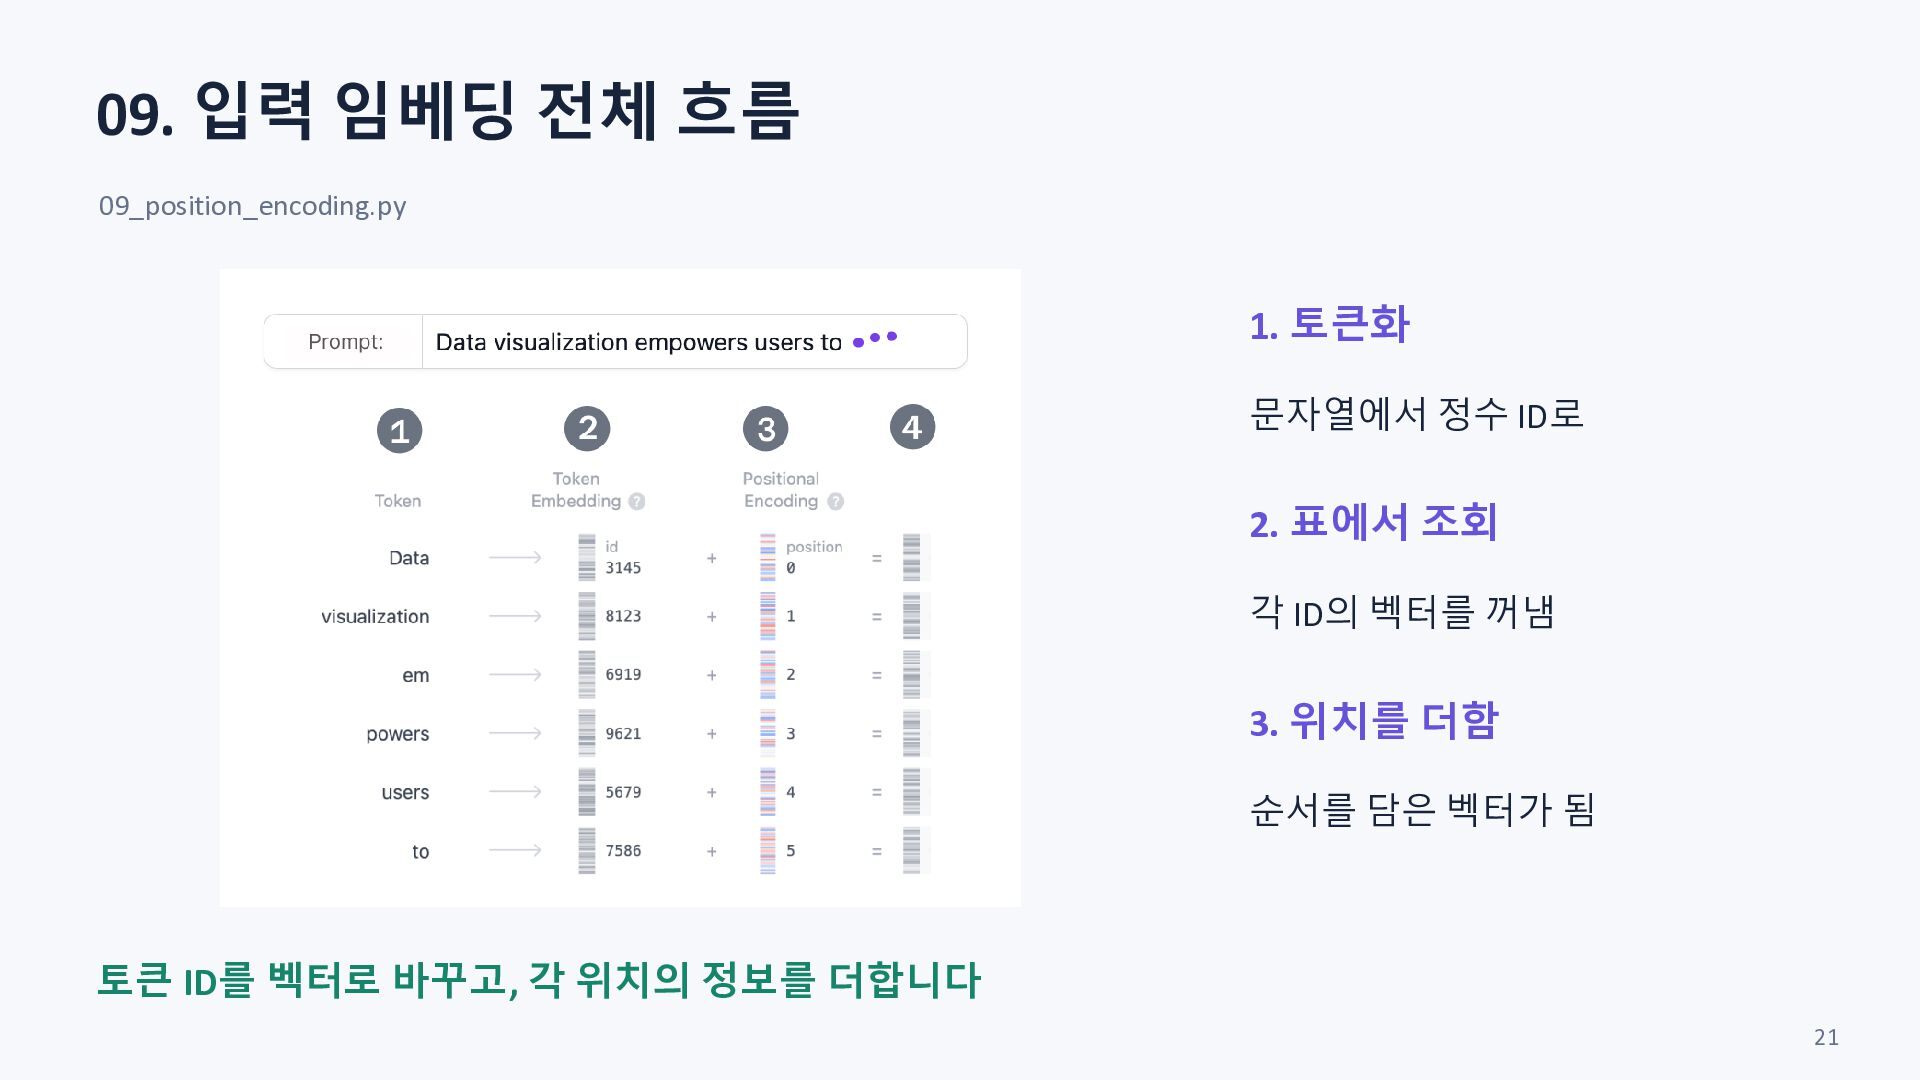
  20. 09. 입력 임베딩 전체 흐름 09_position_encoding.py 1. 토큰화 문자열에서 정수

    ID로 2. 표에서 조회 각 ID의 벡터를 꺼냄 3. 위치를 더함 순서를 담은 벡터가 됨 토큰 ID를 벡터로 바꾸고, 각 위치의 정보를 더합니다 21
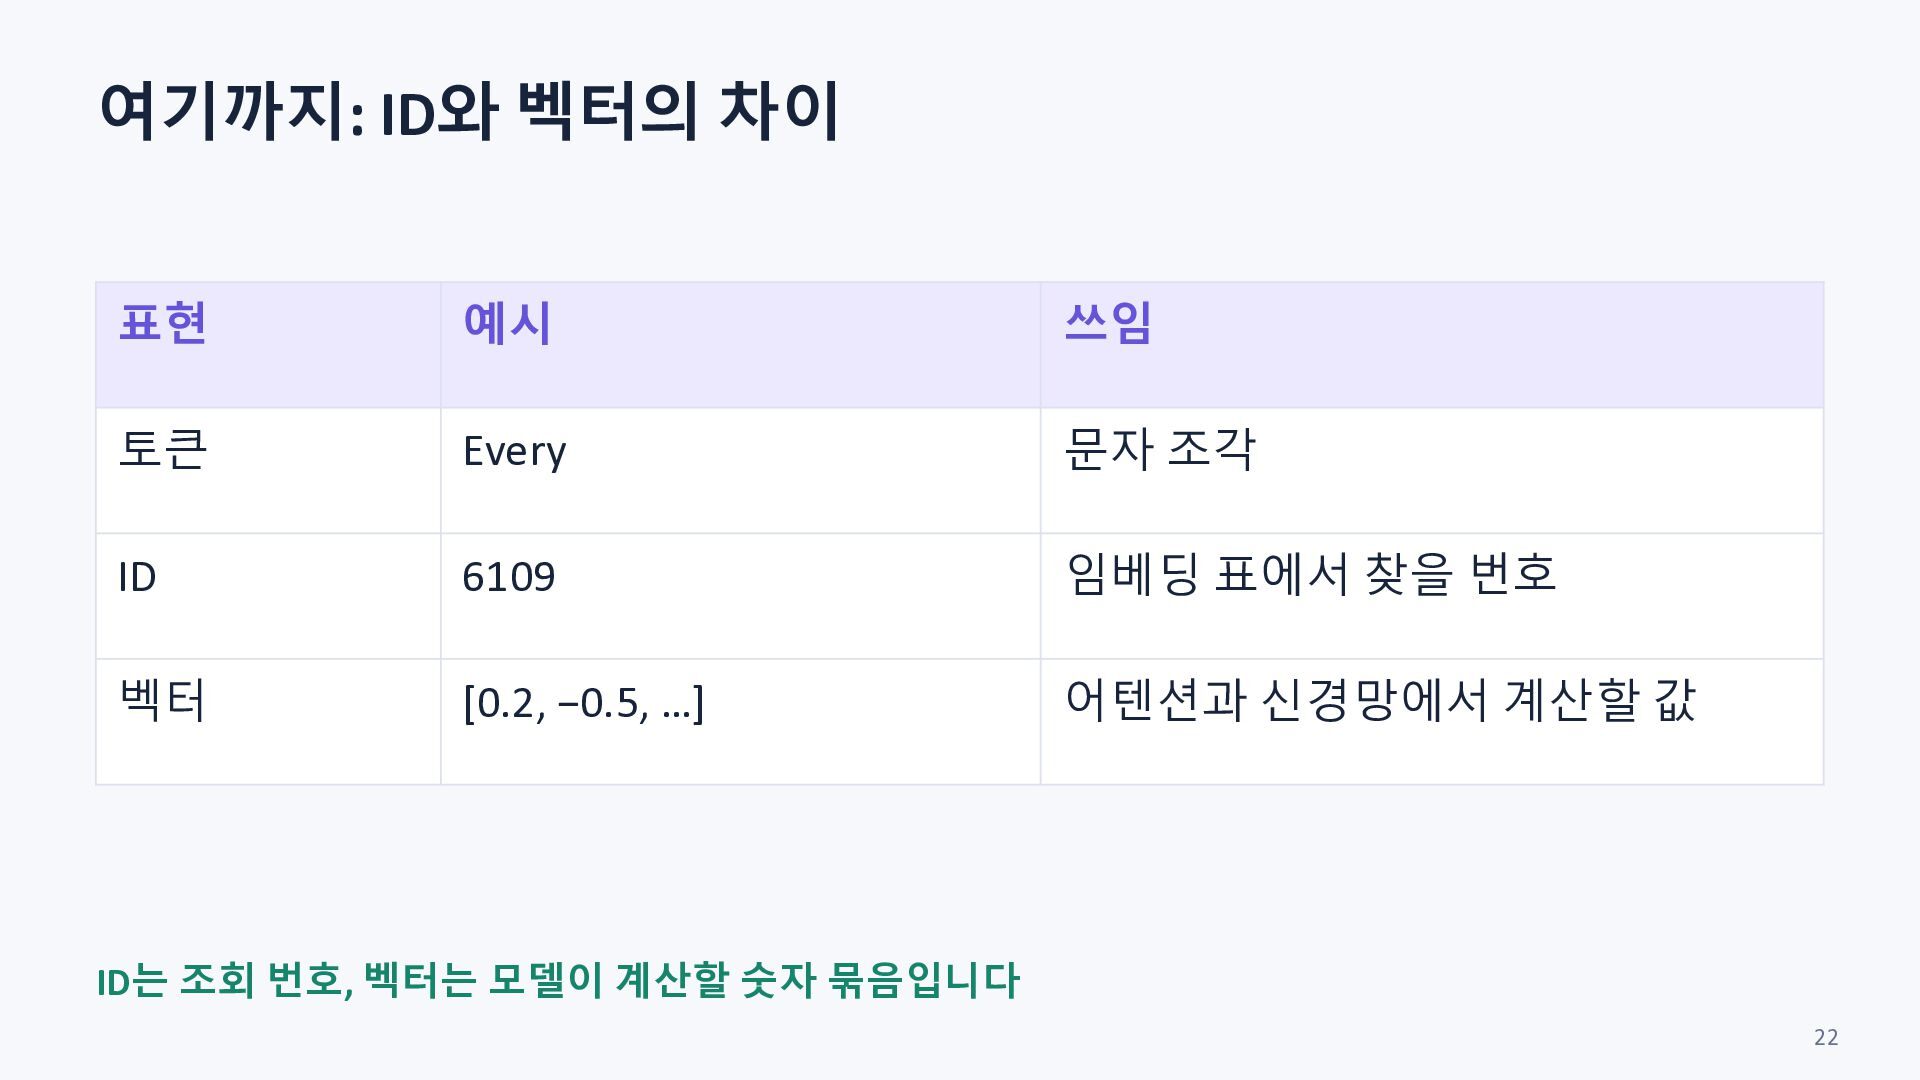
  21. 여기까지: ID와 벡터의 차이 표현 예시 쓰임 토큰 Every 문자

    조각 ID 6109 임베딩 표에서 찾을 번호 벡터 [0.2, −0.5, …] 어텐션과 신경망에서 계산할 값 ID는 조회 번호, 벡터는 모델이 계산할 숫자 묶음입니다 22
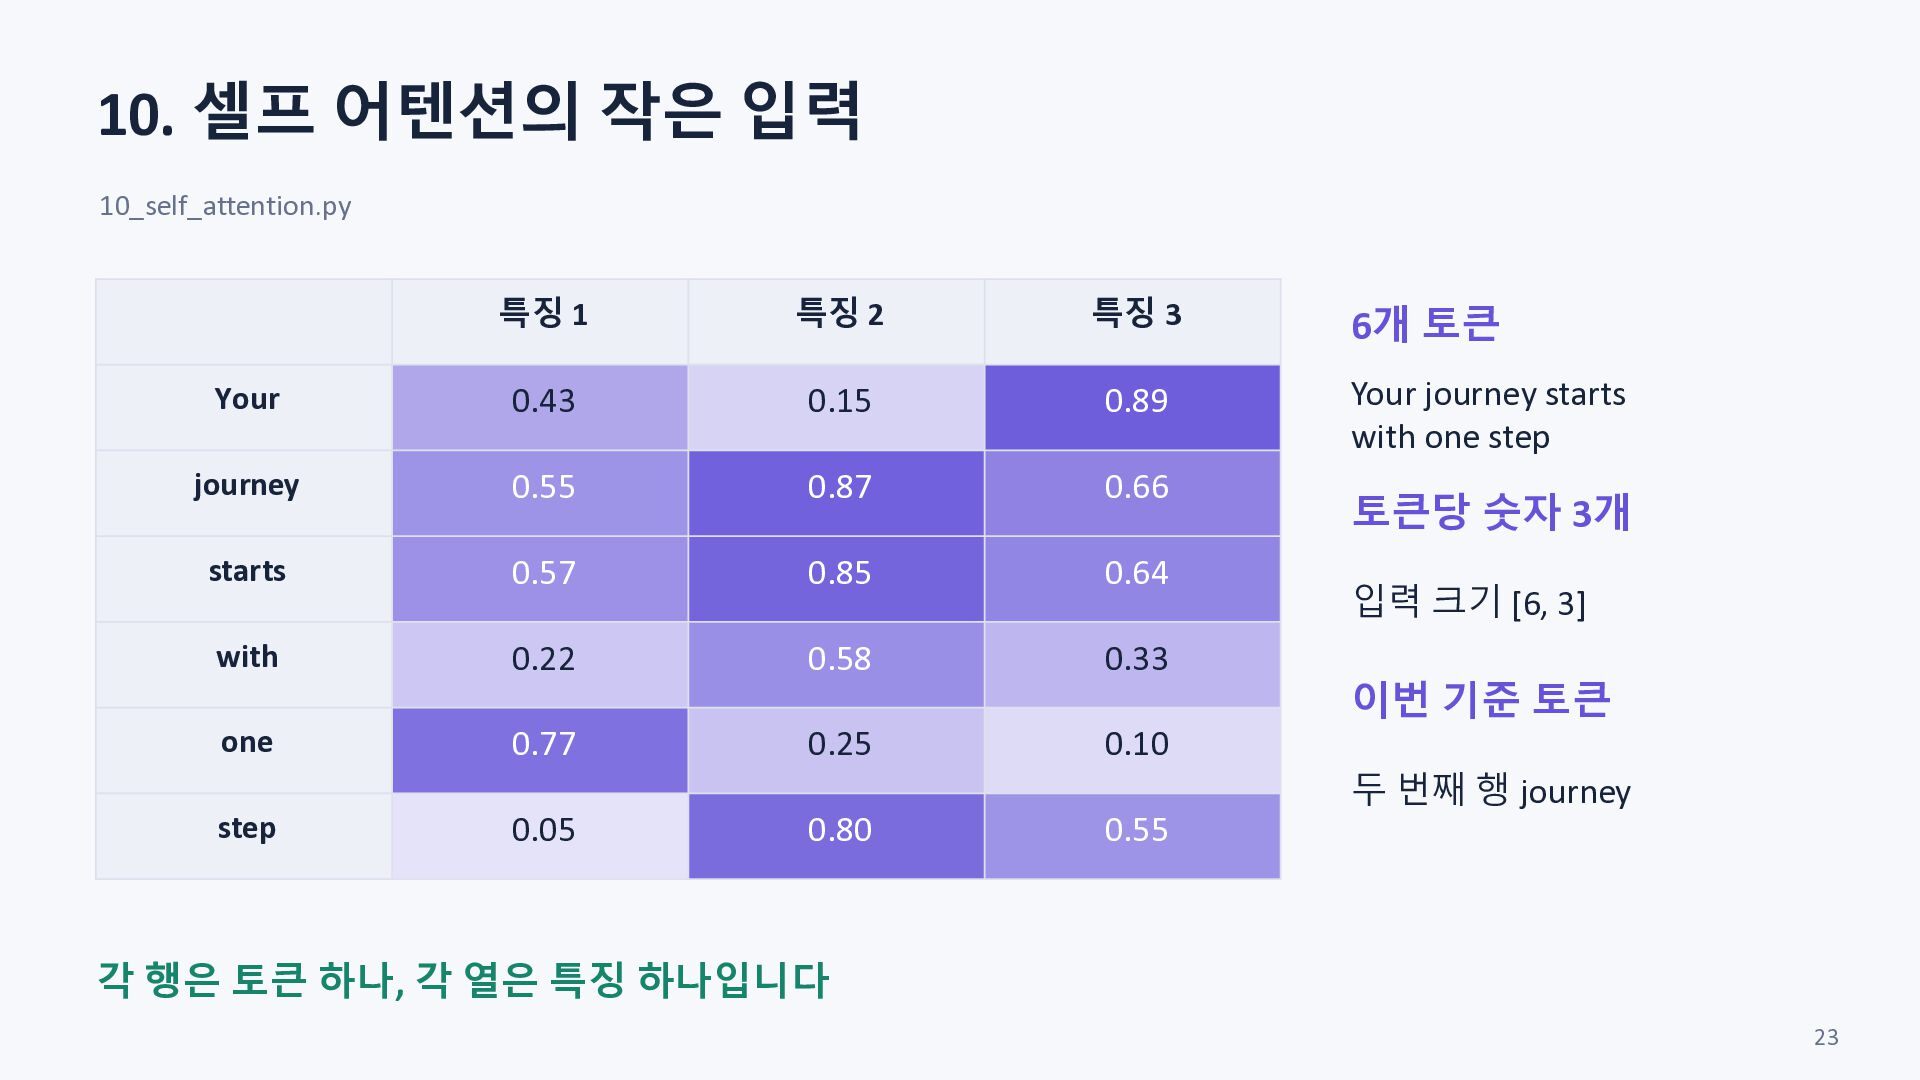
  22. 10. 셀프 어텐션의 작은 입력 10_self_attention.py 특징 1 특징 2

    특징 3 6개 토큰 Your 0.43 0.15 0.89 Your journey starts with one step journey 0.55 0.87 0.66 토큰당 숫자 3개 starts 0.57 0.85 0.64 with 0.22 0.58 0.33 one 0.77 0.25 0.10 0.05 0.80 0.55 step 입력 크기 [6, 3] 이번 기준 토큰 두 번째 행 journey 각 행은 토큰 하나, 각 열은 특징 하나입니다 23
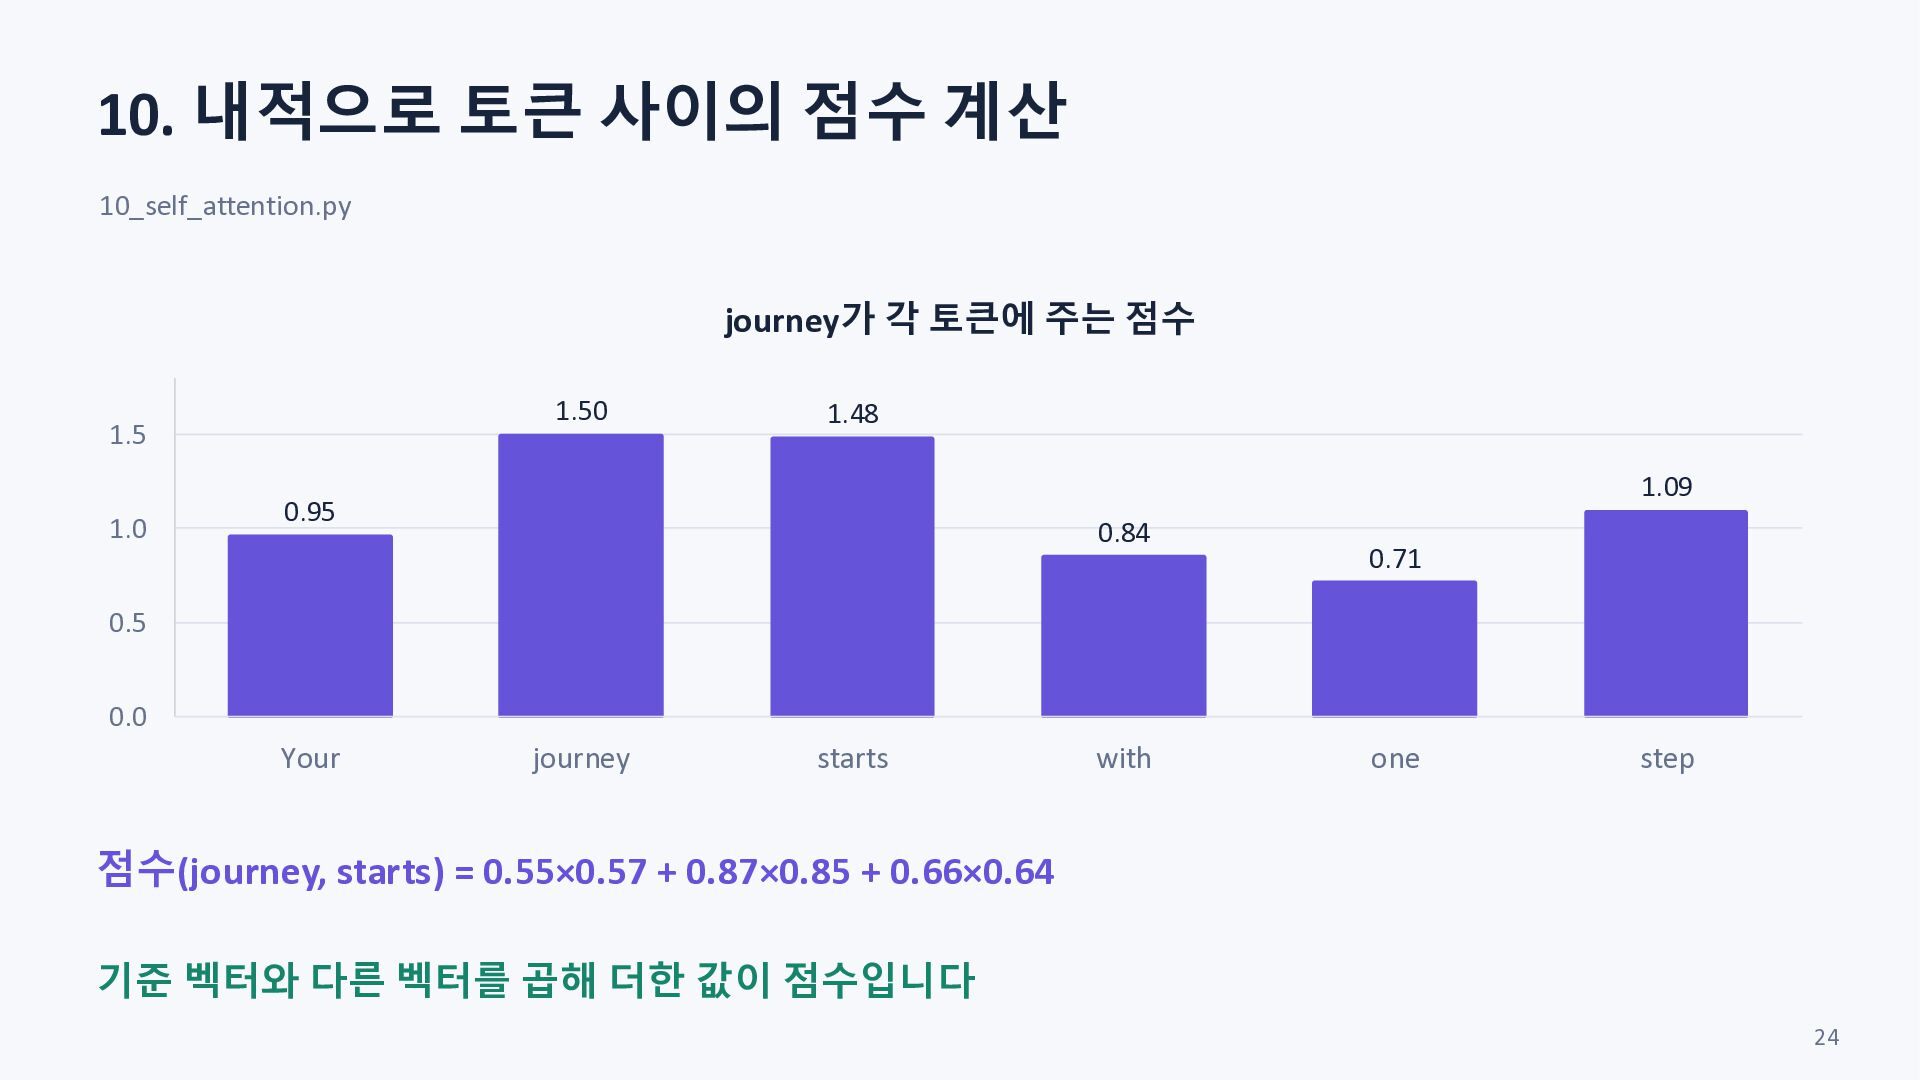
  23. 10. 내적으로 토큰 사이의 점수 계산 10_self_attention.py journey가 각 토큰에

    주는 점수 1.50 1.5 1.0 1.48 1.09 0.95 0.84 0.71 0.5 0.0 Your journey starts with one step 점수(journey, starts) = 0.55×0.57 + 0.87×0.85 + 0.66×0.64 기준 벡터와 다른 벡터를 곱해 더한 값이 점수입니다 24
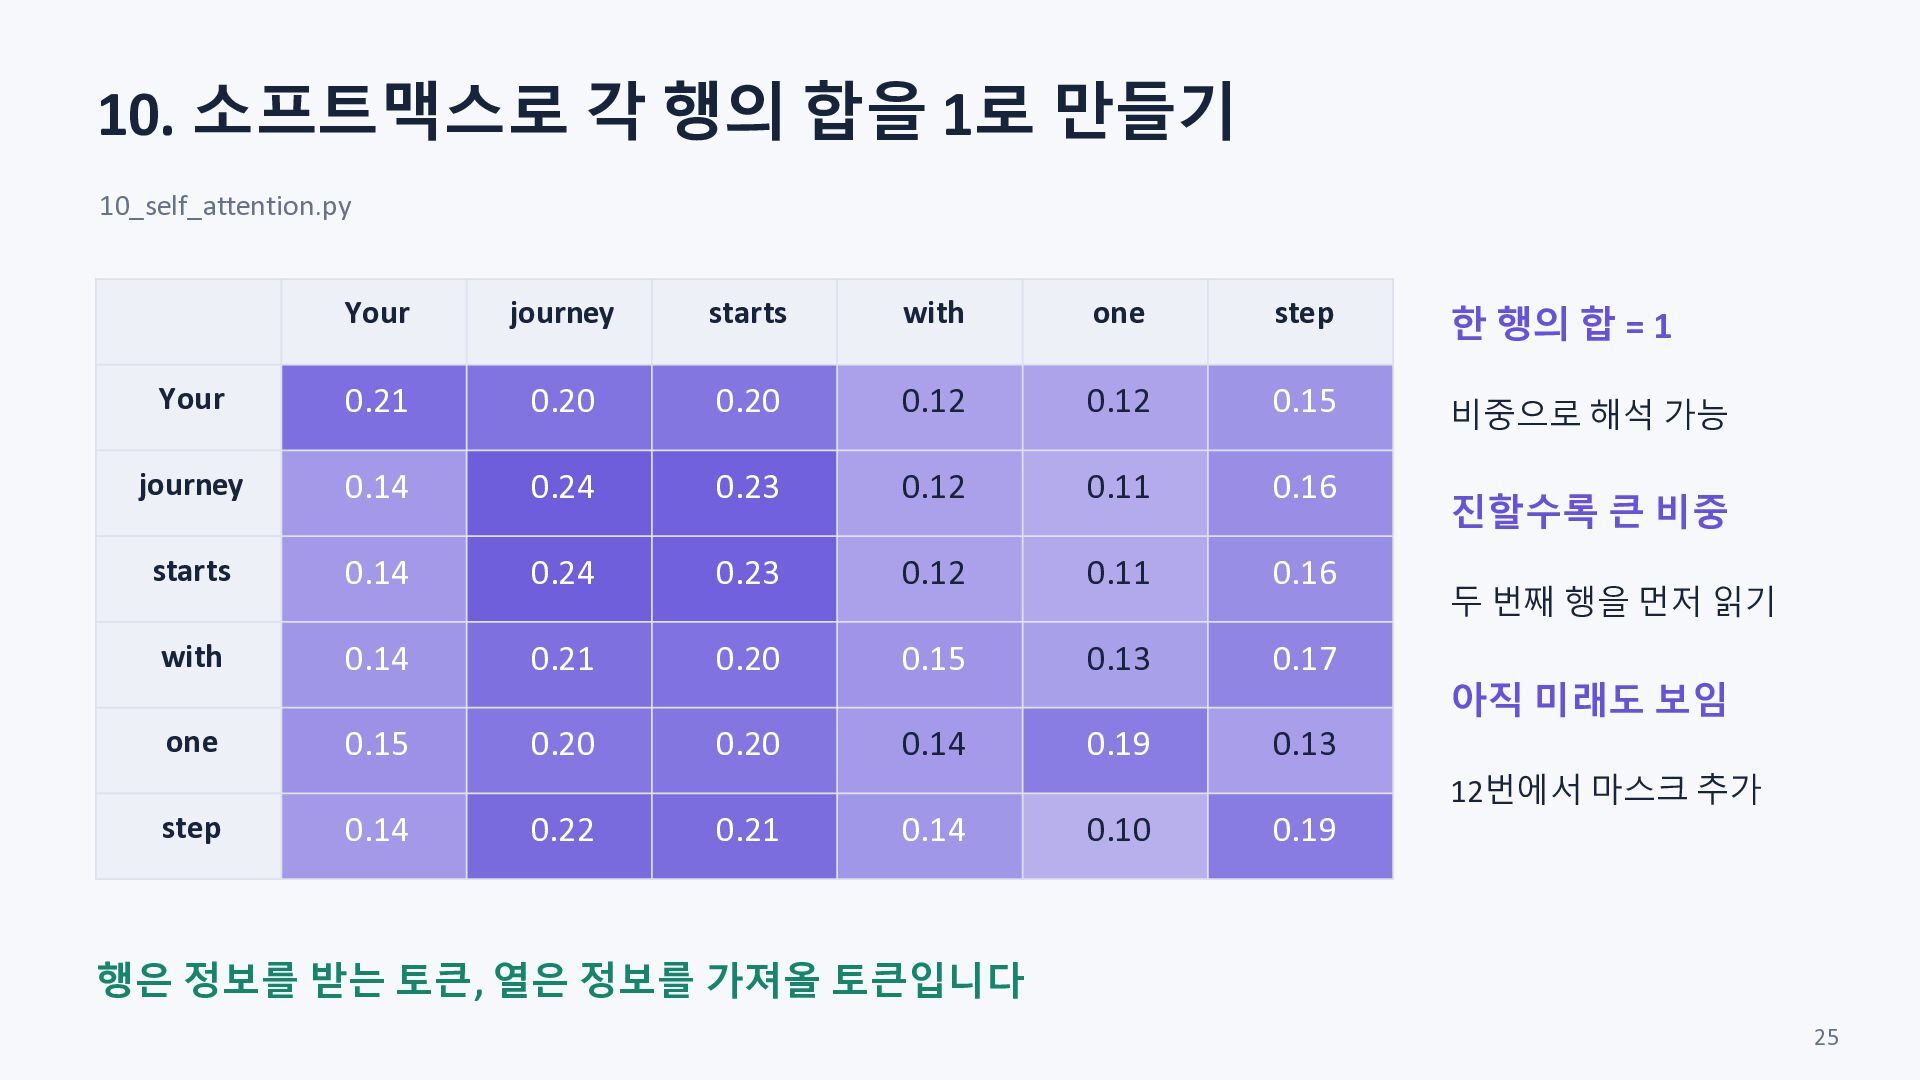
  24. 10. 소프트맥스로 각 행의 합을 1로 만들기 10_self_attention.py Your journey

    starts with one step 한 행의 합 = 1 Your 0.21 0.20 0.20 0.12 0.12 0.15 비중으로 해석 가능 journey 0.14 0.24 0.23 0.12 0.11 0.16 진할수록 큰 비중 starts 0.14 0.24 0.23 0.12 0.11 0.16 with 0.14 0.21 0.20 0.15 0.13 0.17 one 0.15 0.20 0.20 0.14 0.19 0.13 두 번째 행을 먼저 읽기 아직 미래도 보임 12번에서 마스크 추가 step 0.14 0.22 0.21 0.14 0.10 0.19 행은 정보를 받는 토큰, 열은 정보를 가져올 토큰입니다 25
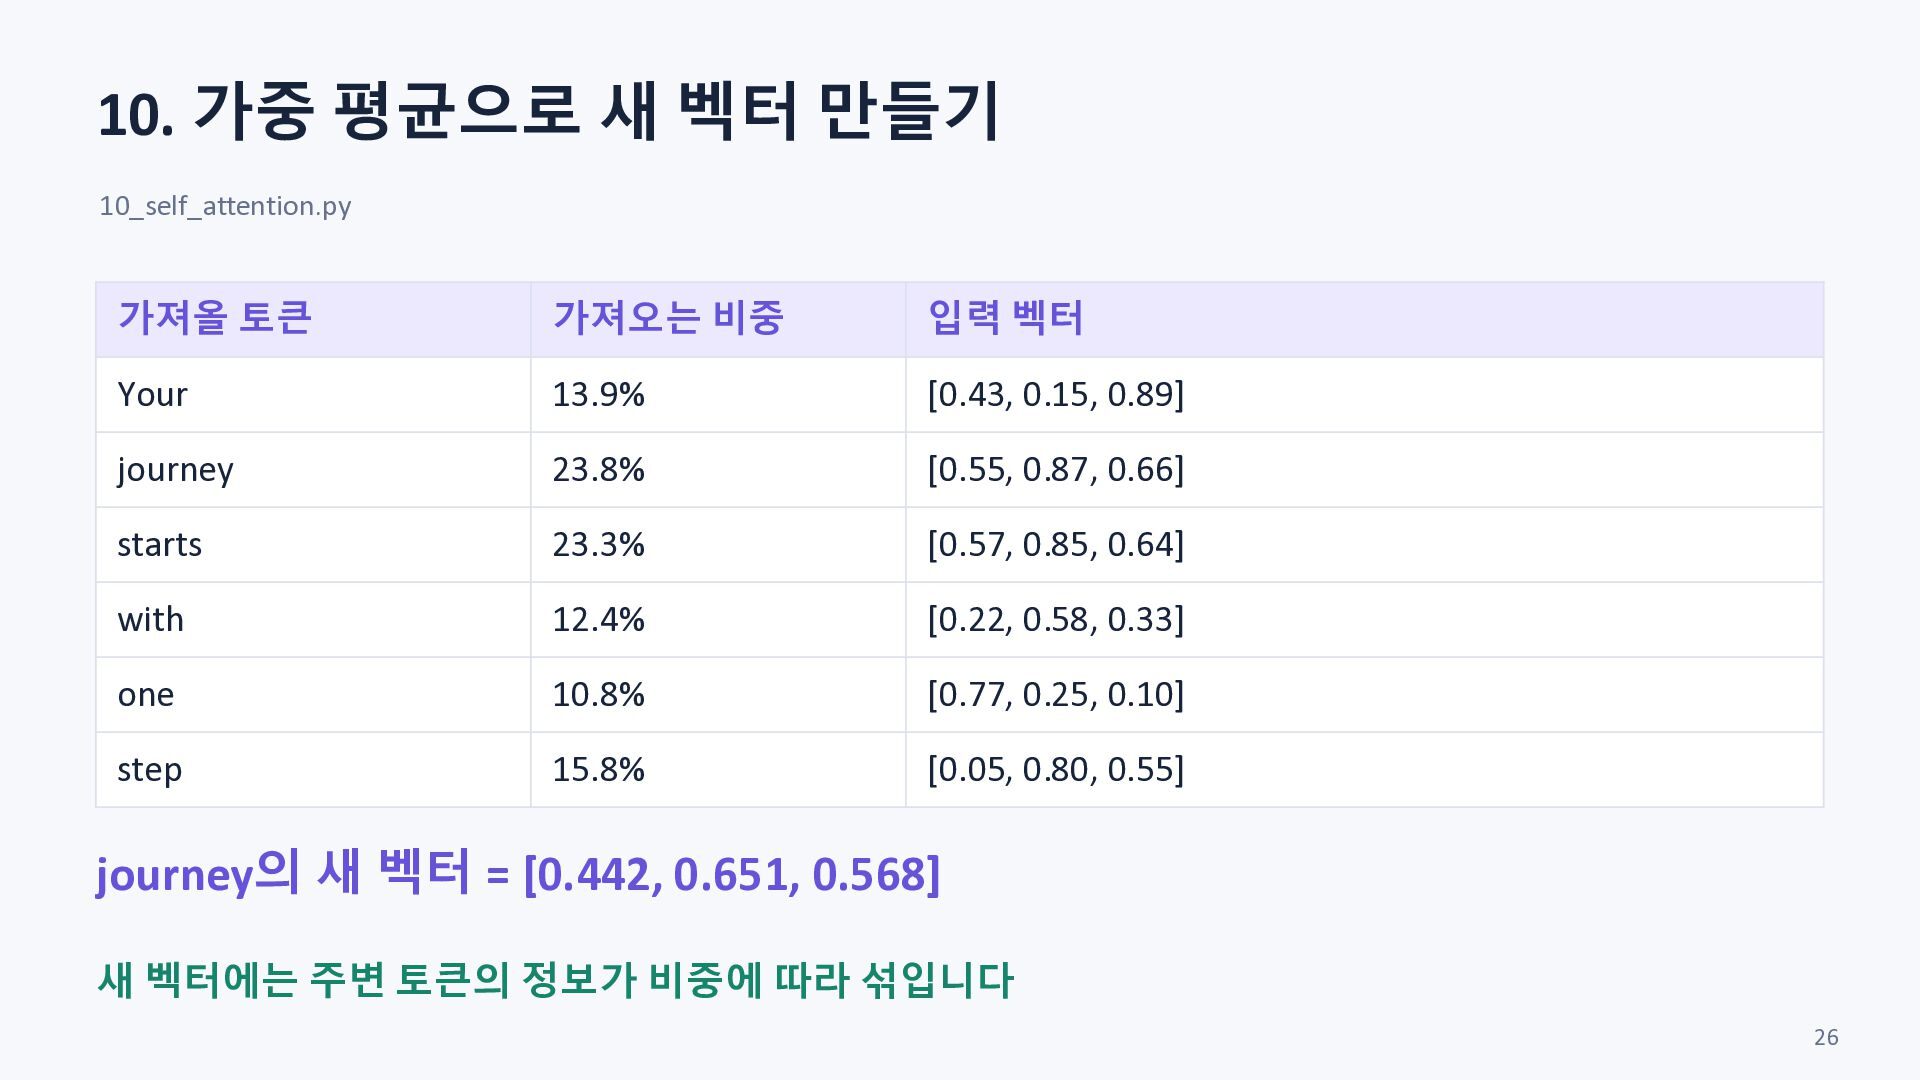
  25. 10. 가중 평균으로 새 벡터 만들기 10_self_attention.py 가져올 토큰 가져오는

    비중 입력 벡터 Your 13.9% [0.43, 0.15, 0.89] journey 23.8% [0.55, 0.87, 0.66] starts 23.3% [0.57, 0.85, 0.64] with 12.4% [0.22, 0.58, 0.33] one 10.8% [0.77, 0.25, 0.10] step 15.8% [0.05, 0.80, 0.55] journey의 새 벡터 = [0.442, 0.651, 0.568] 새 벡터에는 주변 토큰의 정보가 비중에 따라 섞입니다 26
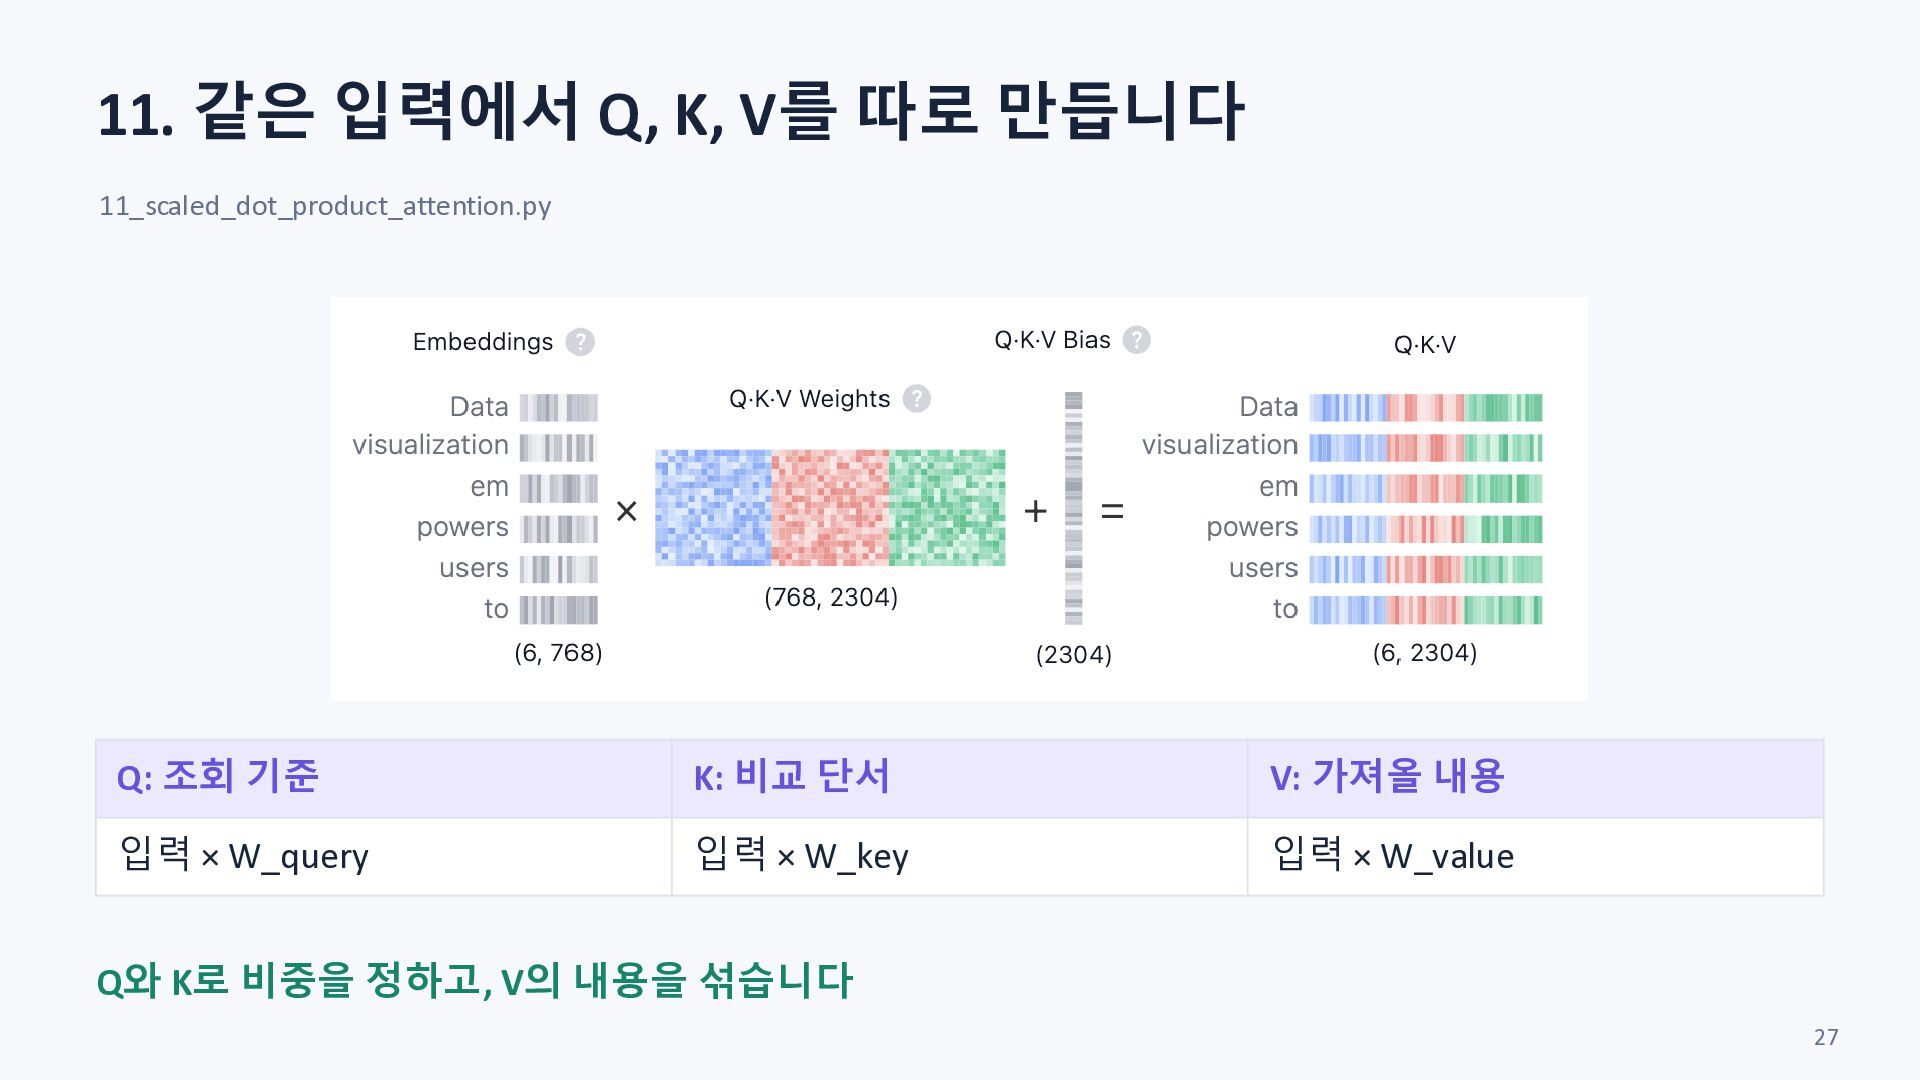
  26. 11. 같은 입력에서 Q, K, V를 따로 만듭니다 11_scaled_dot_product_attention.py Q:

    조회 기준 K: 비교 단서 V: 가져올 내용 입력 × W_query 입력 × W_key 입력 × W_value Q와 K로 비중을 정하고, V의 내용을 섞습니다 27
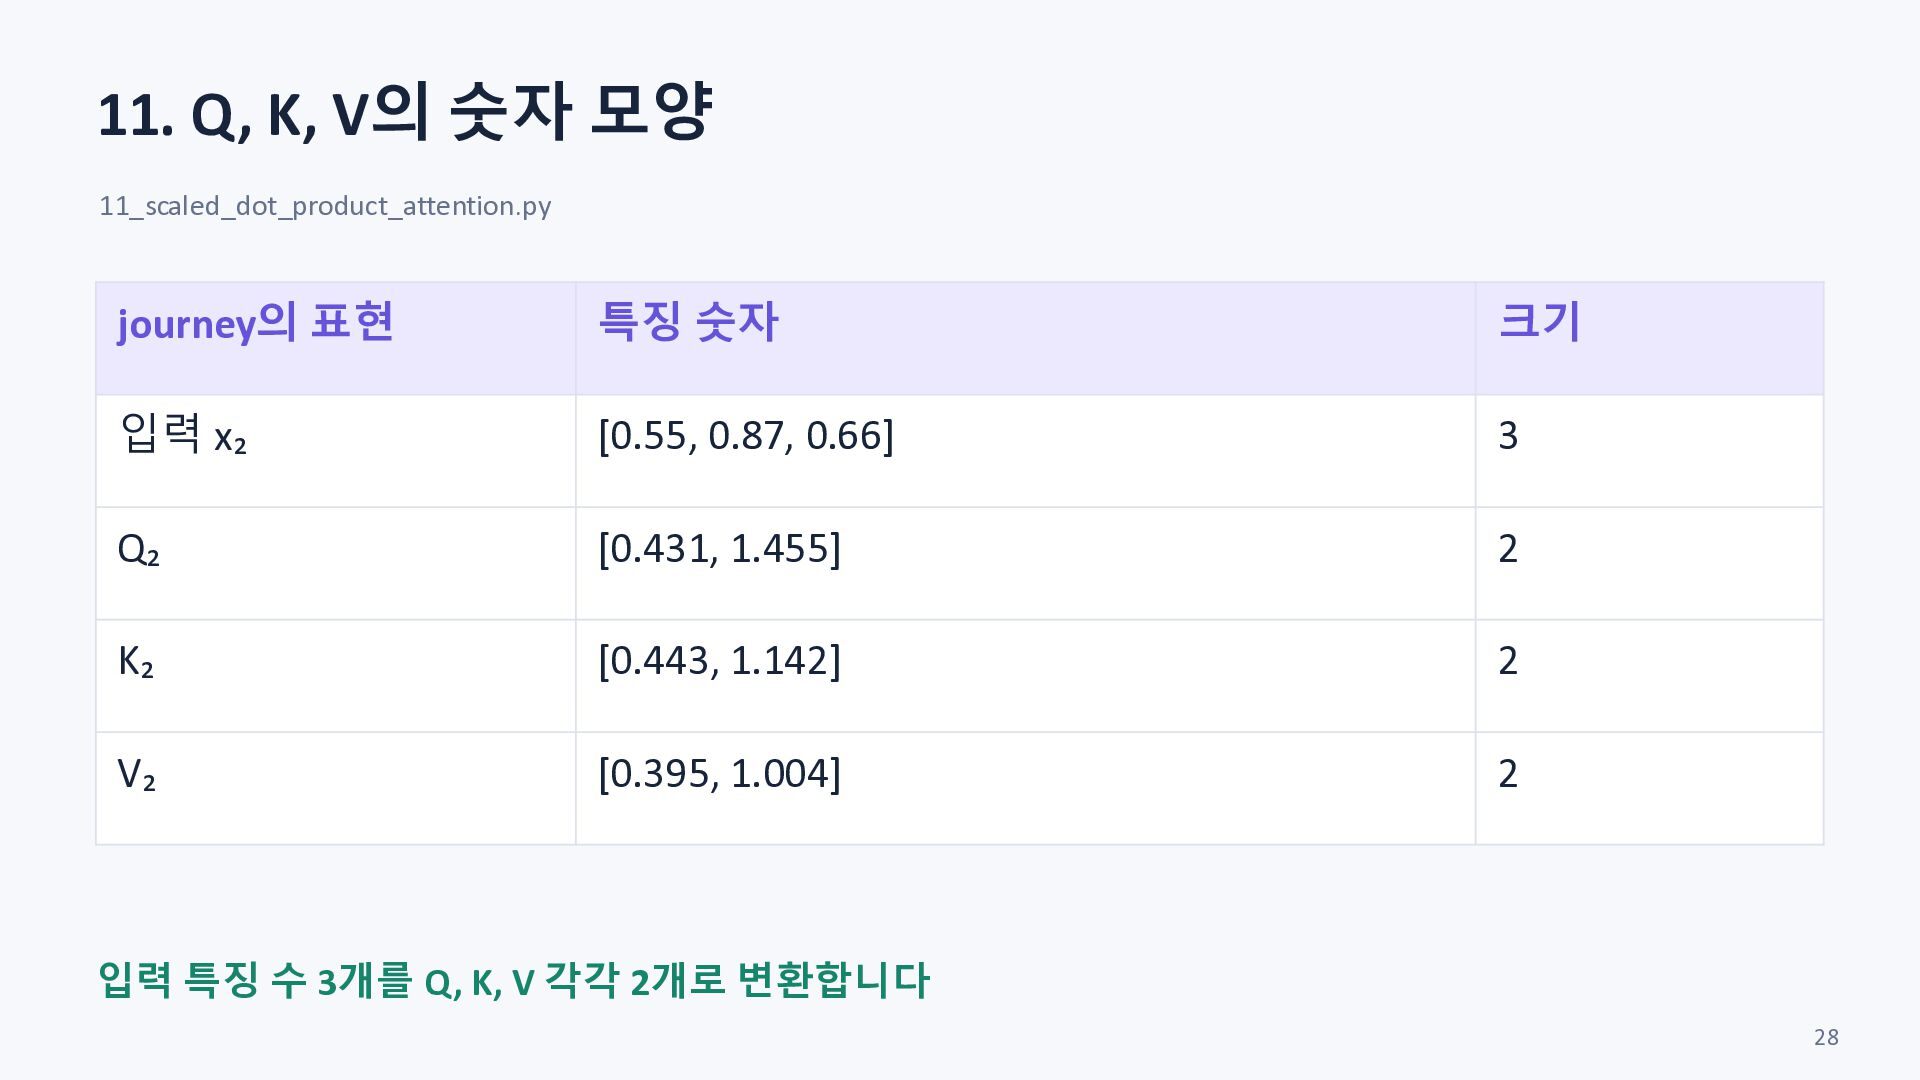
  27. 11. Q, K, V의 숫자 모양 11_scaled_dot_product_attention.py journey의 표현 특징

    숫자 크기 입력 x₂ [0.55, 0.87, 0.66] 3 Q₂ [0.431, 1.455] 2 K₂ [0.443, 1.142] 2 V₂ [0.395, 1.004] 2 입력 특징 수 3개를 Q, K, V 각각 2개로 변환합니다 28
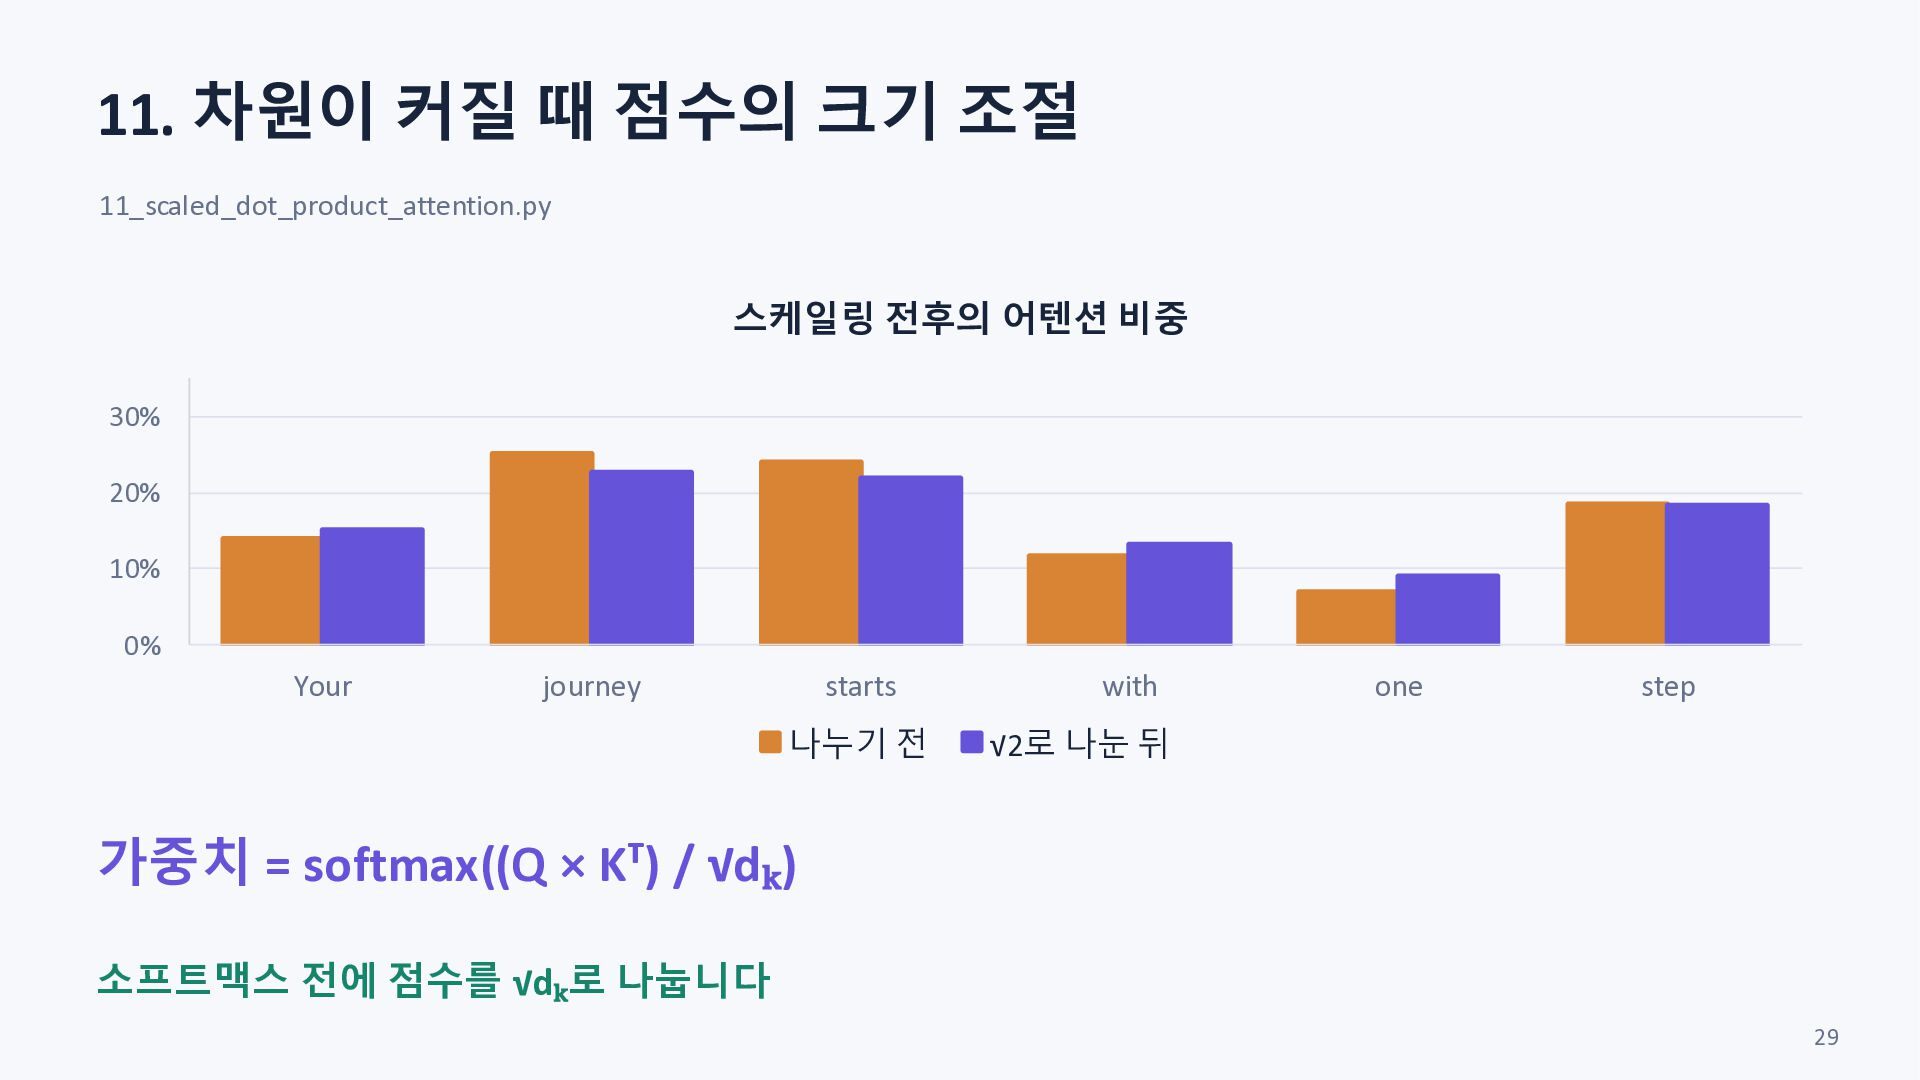
  28. 11. 차원이 커질 때 점수의 크기 조절 11_scaled_dot_product_attention.py 스케일링 전후의

    어텐션 비중 30% 20% 10% 0% Your journey starts 나누기 전 with one step √2로 나눈 뒤 가중치 = softmax((Q × Kᵀ) / √dₖ) 소프트맥스 전에 점수를 √dₖ로 나눕니다 29
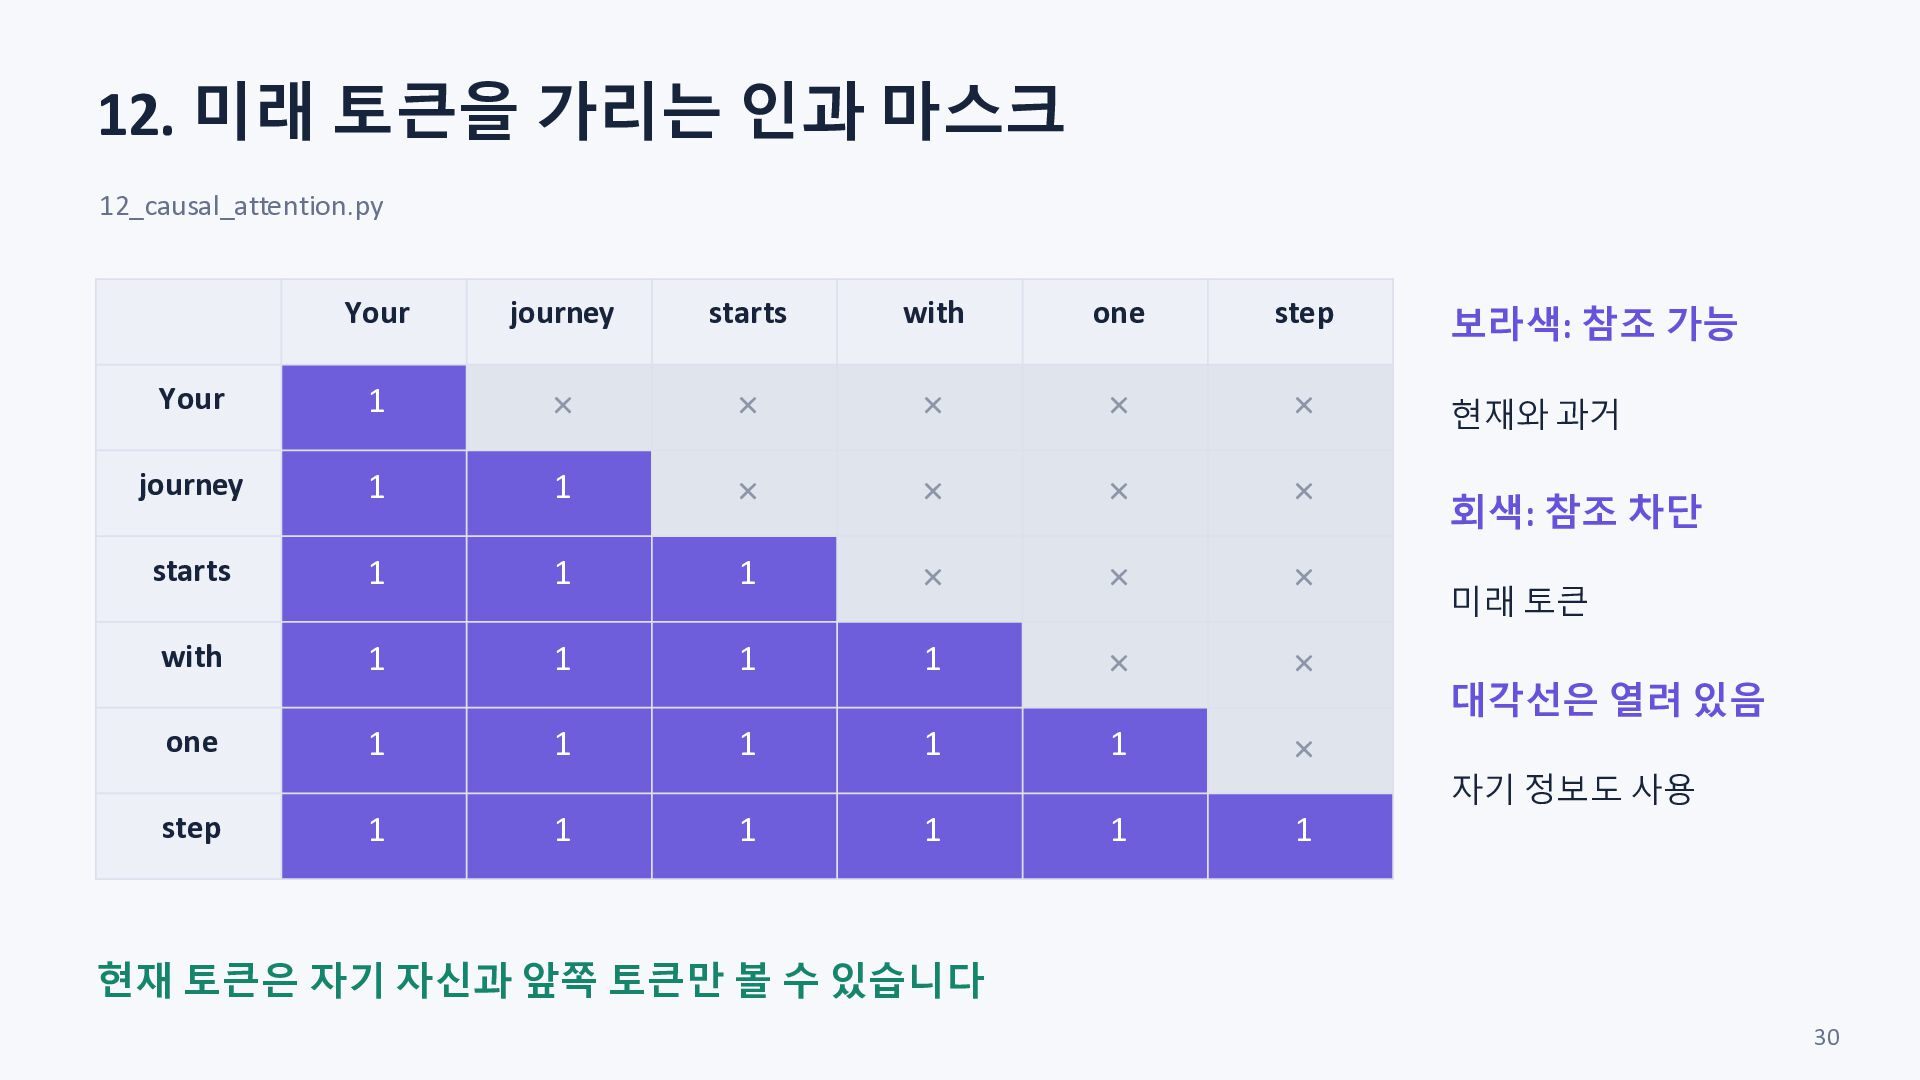
  29. 12. 미래 토큰을 가리는 인과 마스크 12_causal_attention.py Your journey starts

    with one step 보라색: 참조 가능 Your 1 × × × × × 현재와 과거 journey 1 1 × × × × 회색: 참조 차단 starts 1 1 1 × × × with 1 1 1 1 × × one 1 1 1 1 1 × step 1 1 1 1 1 미래 토큰 대각선은 열려 있음 자기 정보도 사용 1 현재 토큰은 자기 자신과 앞쪽 토큰만 볼 수 있습니다 30
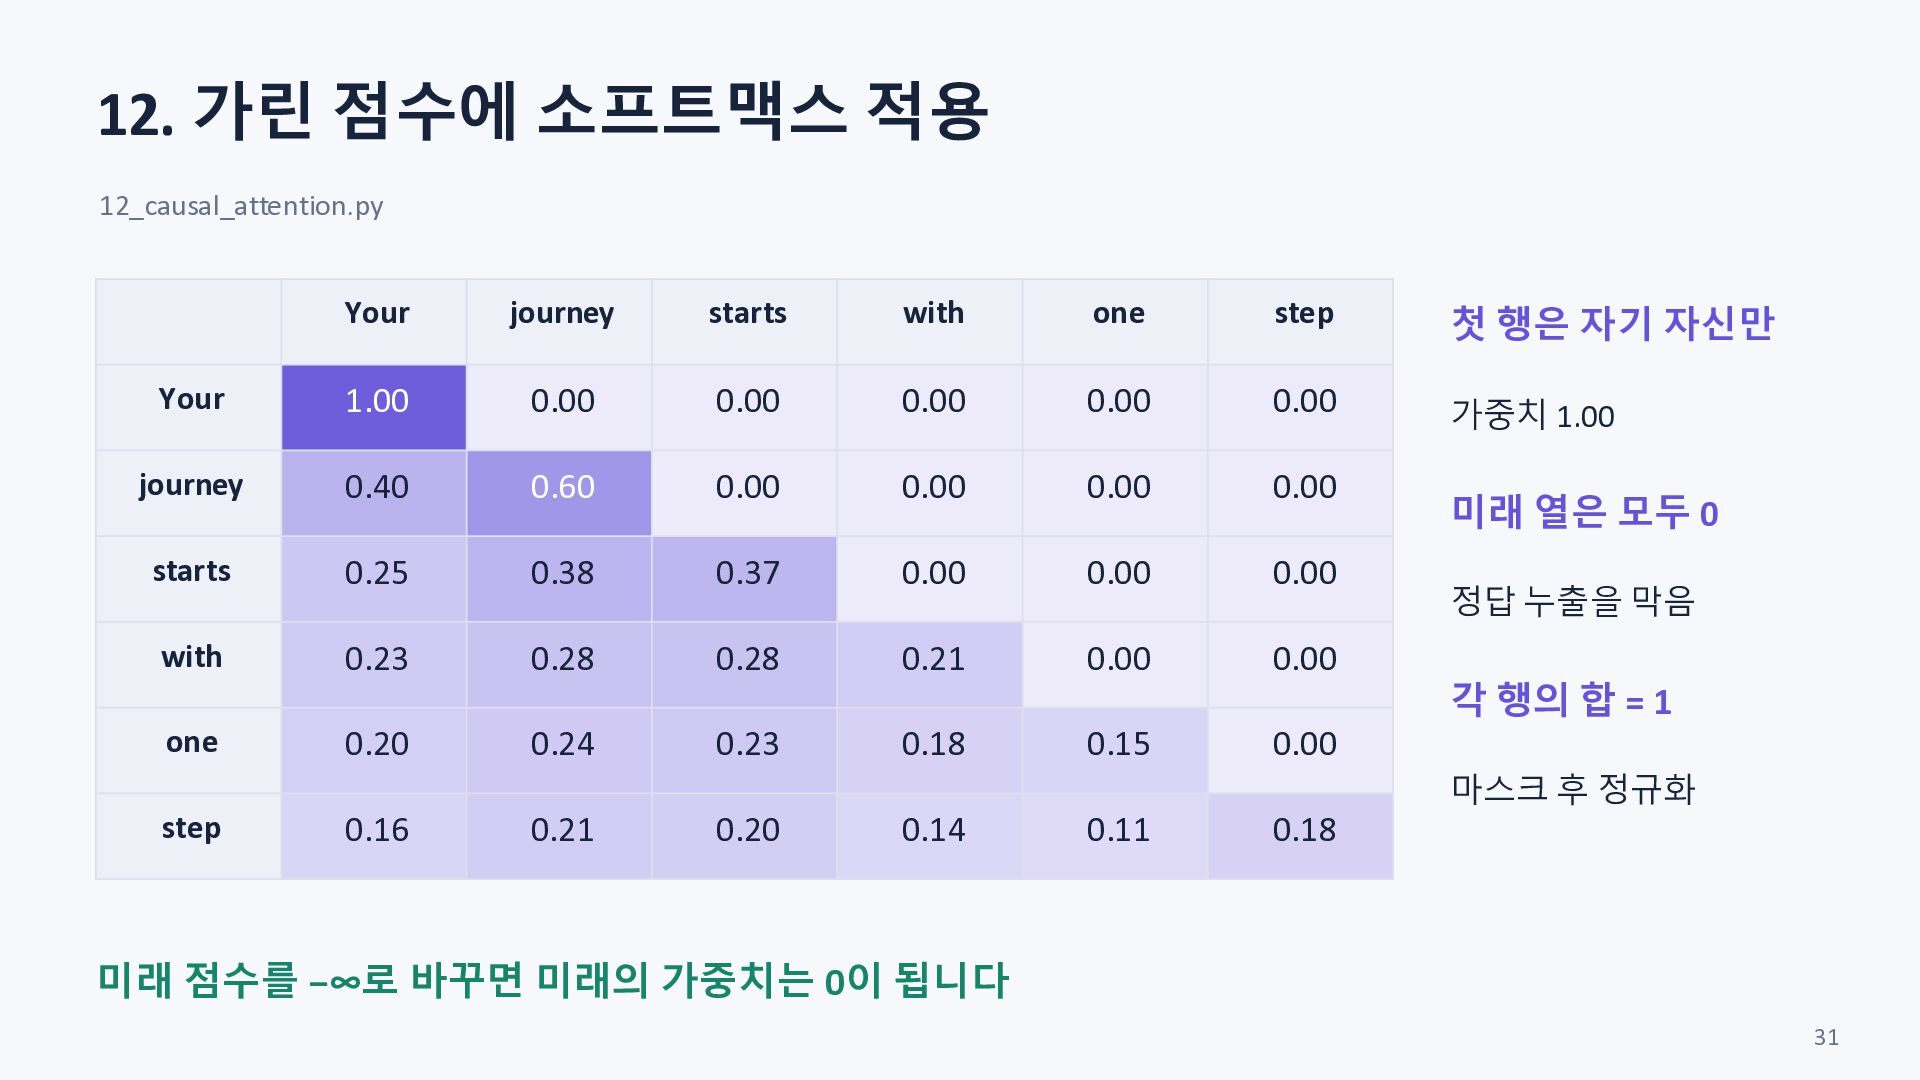
  30. 12. 가린 점수에 소프트맥스 적용 12_causal_attention.py Your journey starts with

    one step 첫 행은 자기 자신만 Your 1.00 0.00 0.00 0.00 0.00 0.00 가중치 1.00 journey 0.40 0.60 0.00 0.00 0.00 0.00 미래 열은 모두 0 starts 0.25 0.38 0.37 0.00 0.00 0.00 with 0.23 0.28 0.28 0.21 0.00 0.00 one 0.20 0.24 0.23 0.18 0.15 0.00 정답 누출을 막음 각 행의 합 = 1 마스크 후 정규화 step 0.16 0.21 0.20 0.14 0.11 0.18 미래 점수를 −∞로 바꾸면 미래의 가중치는 0이 됩니다 31
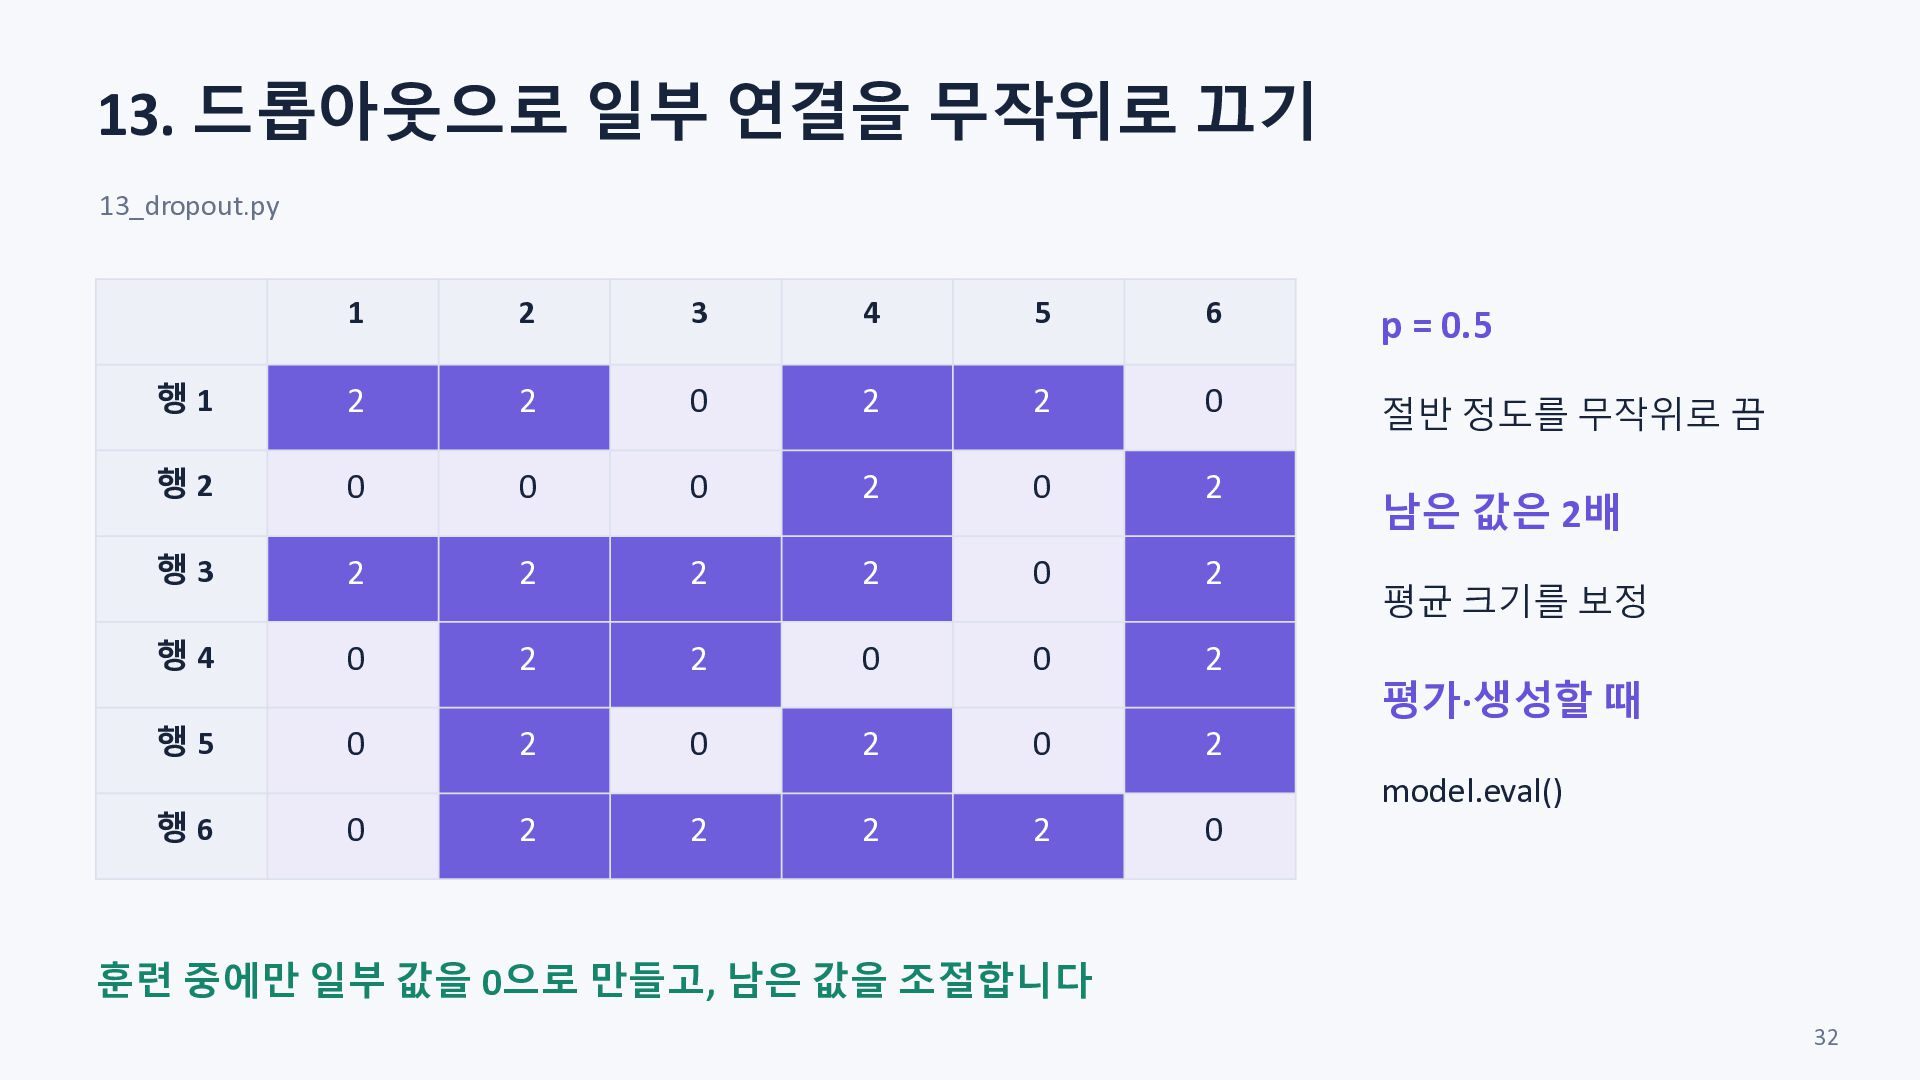
  31. 13. 드롭아웃으로 일부 연결을 무작위로 끄기 13_dropout.py 1 2 3

    4 5 6 p = 0.5 행1 2 2 0 2 2 0 절반 정도를 무작위로 끔 행2 0 0 0 2 0 2 남은 값은 2배 행3 2 2 2 2 0 2 행4 0 2 2 0 0 2 행5 0 2 0 2 0 2 행6 평균 크기를 보정 평가·생성할 때 model.eval() 0 2 2 2 2 0 훈련 중에만 일부 값을 0으로 만들고, 남은 값을 조절합니다 32
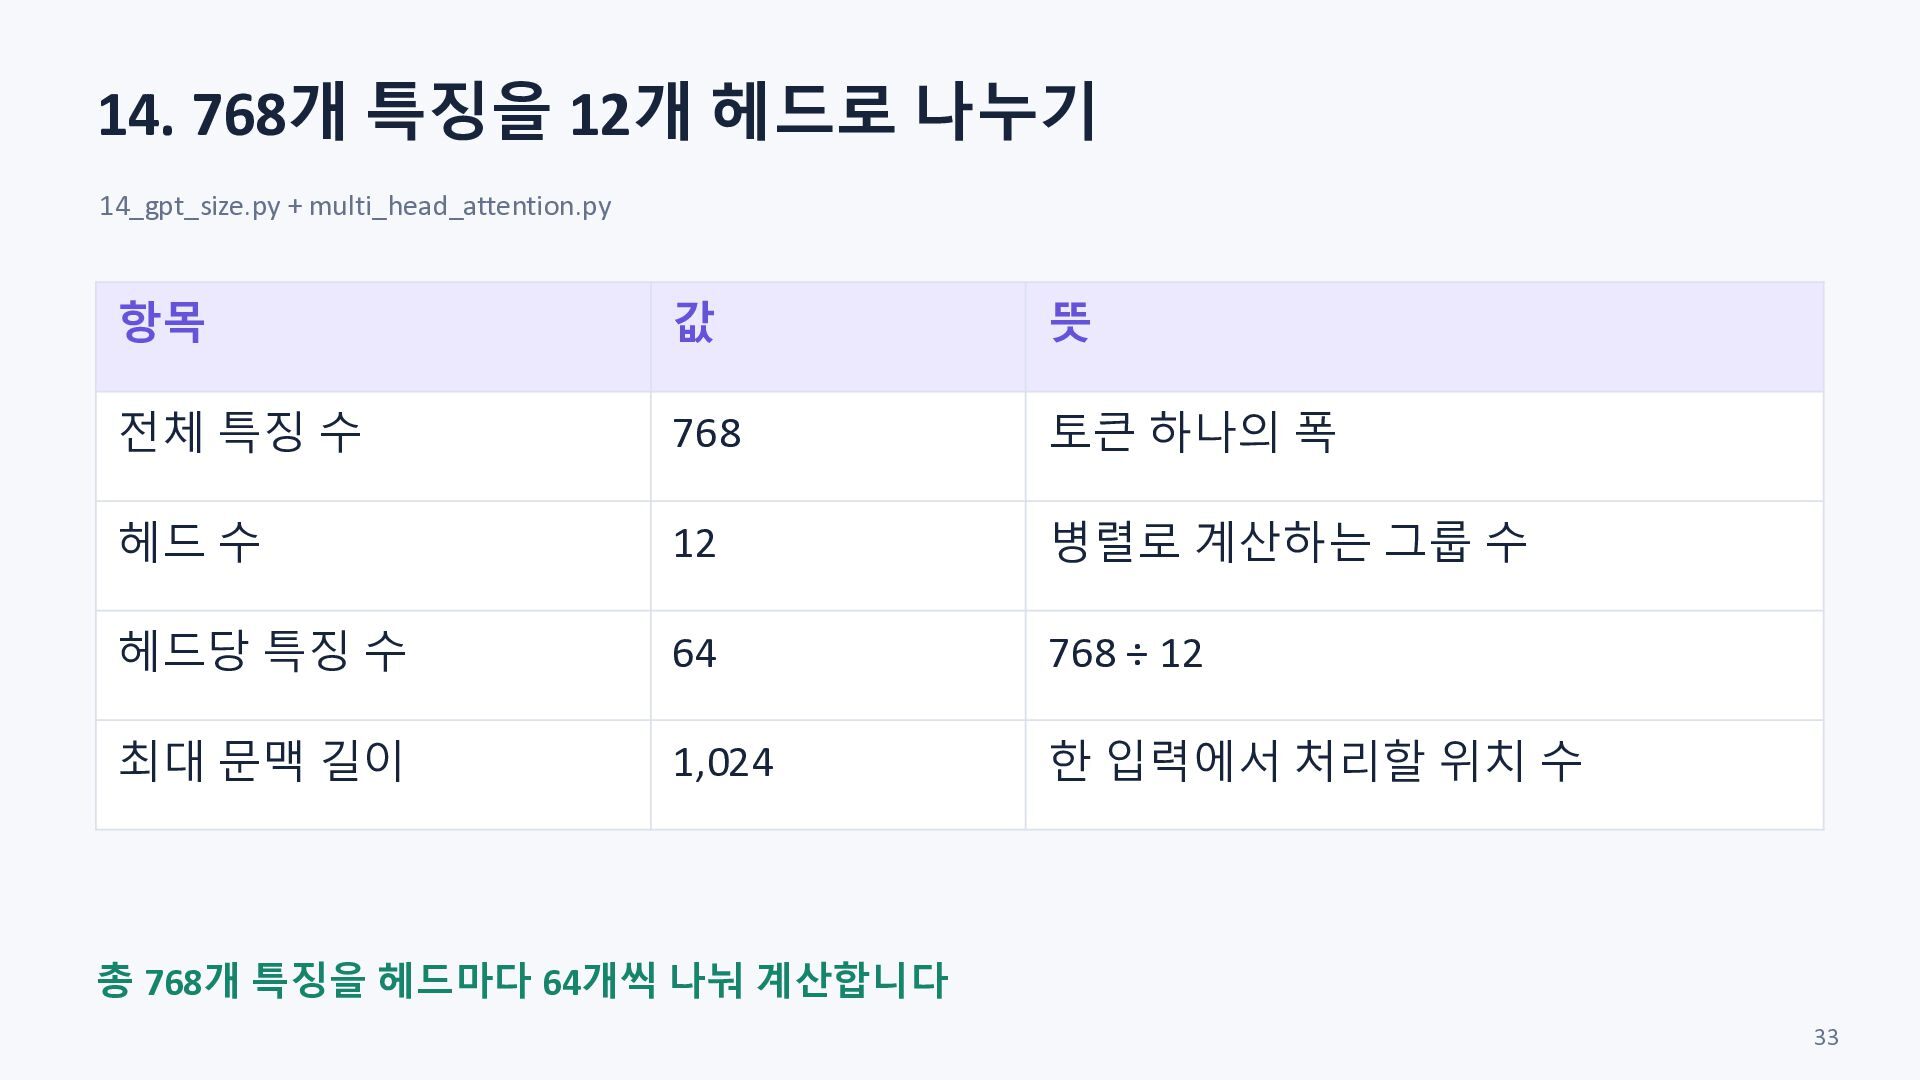
  32. 14. 768개 특징을 12개 헤드로 나누기 14_gpt_size.py + multi_head_attention.py 항목

    값 뜻 전체 특징 수 768 토큰 하나의 폭 헤드 수 12 병렬로 계산하는 그룹 수 헤드당 특징 수 64 768 ÷ 12 최대 문맥 길이 1,024 한 입력에서 처리할 위치 수 총 768개 특징을 헤드마다 64개씩 나눠 계산합니다 33
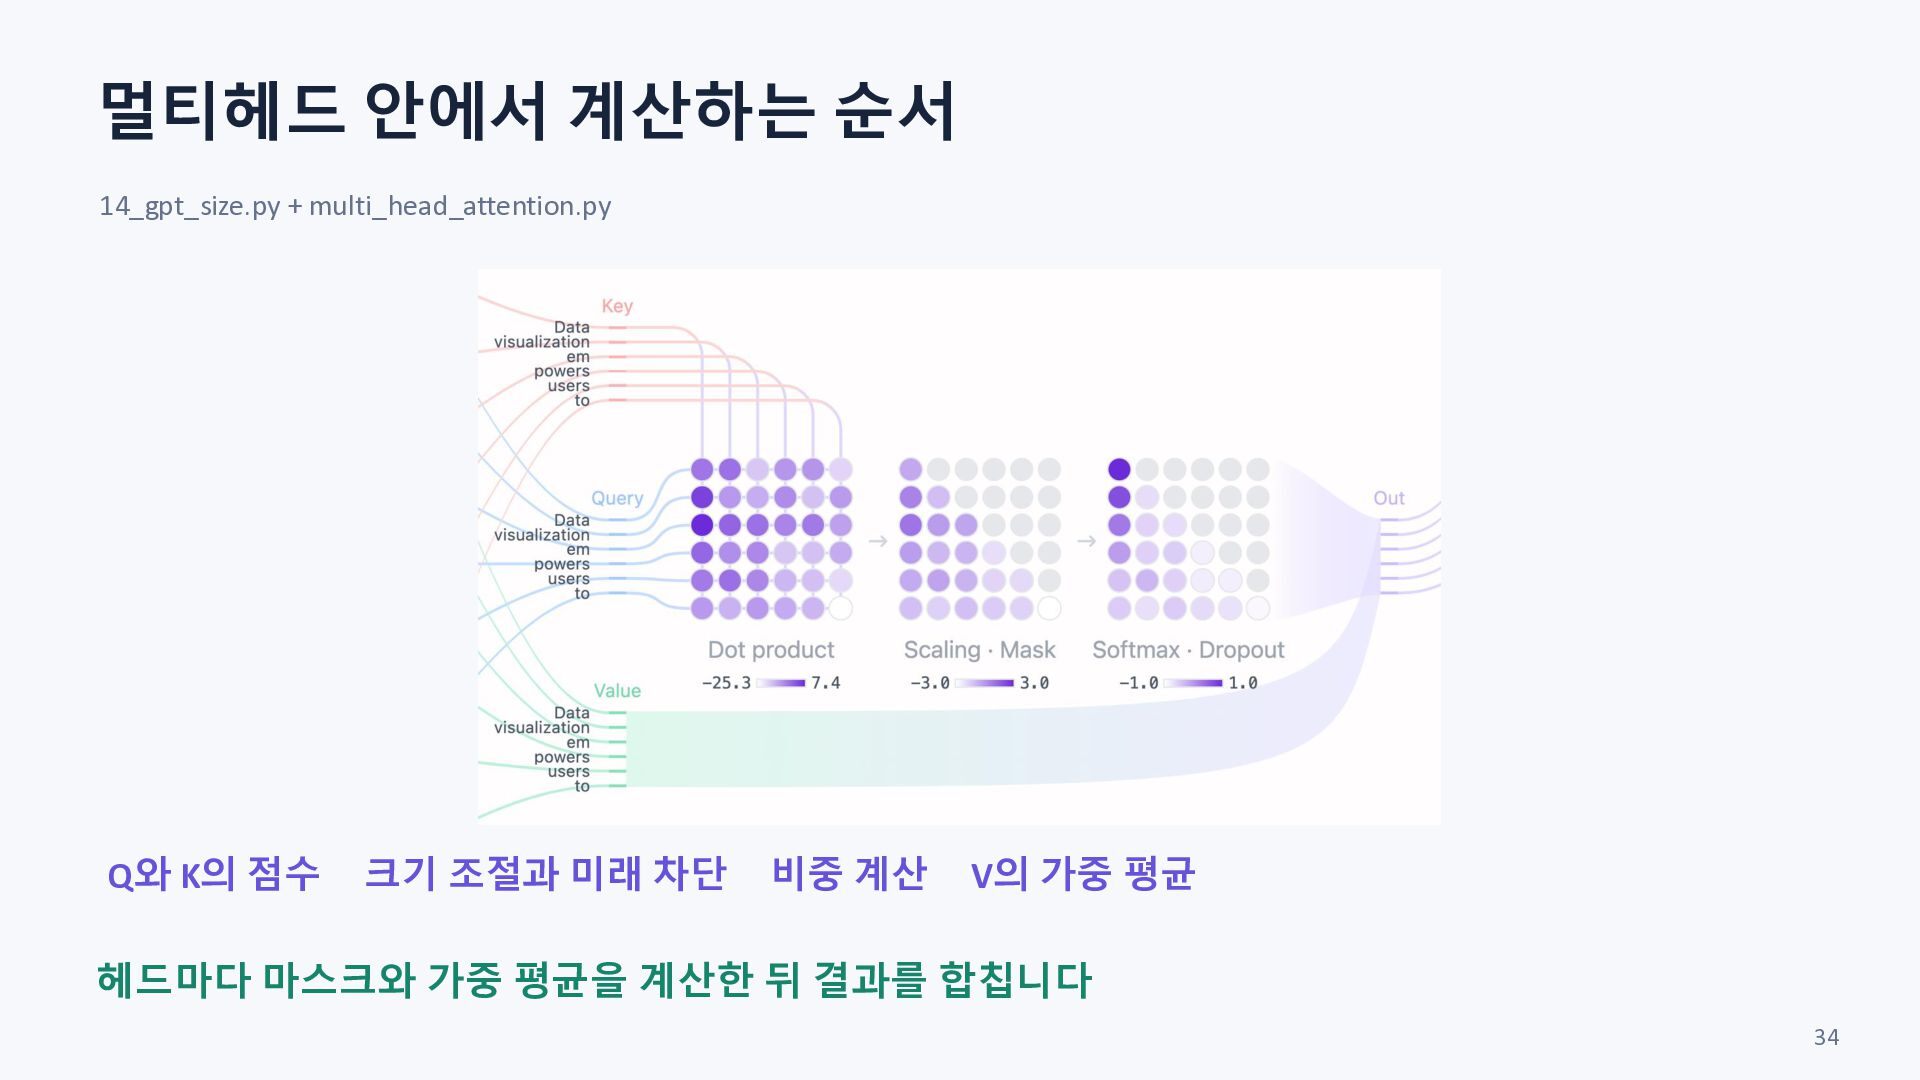
  33. 멀티헤드 안에서 계산하는 순서 14_gpt_size.py + multi_head_attention.py Q와 K의 점수

    크기 조절과 미래 차단 비중 계산 V의 가중 평균 헤드마다 마스크와 가중 평균을 계산한 뒤 결과를 합칩니다 34
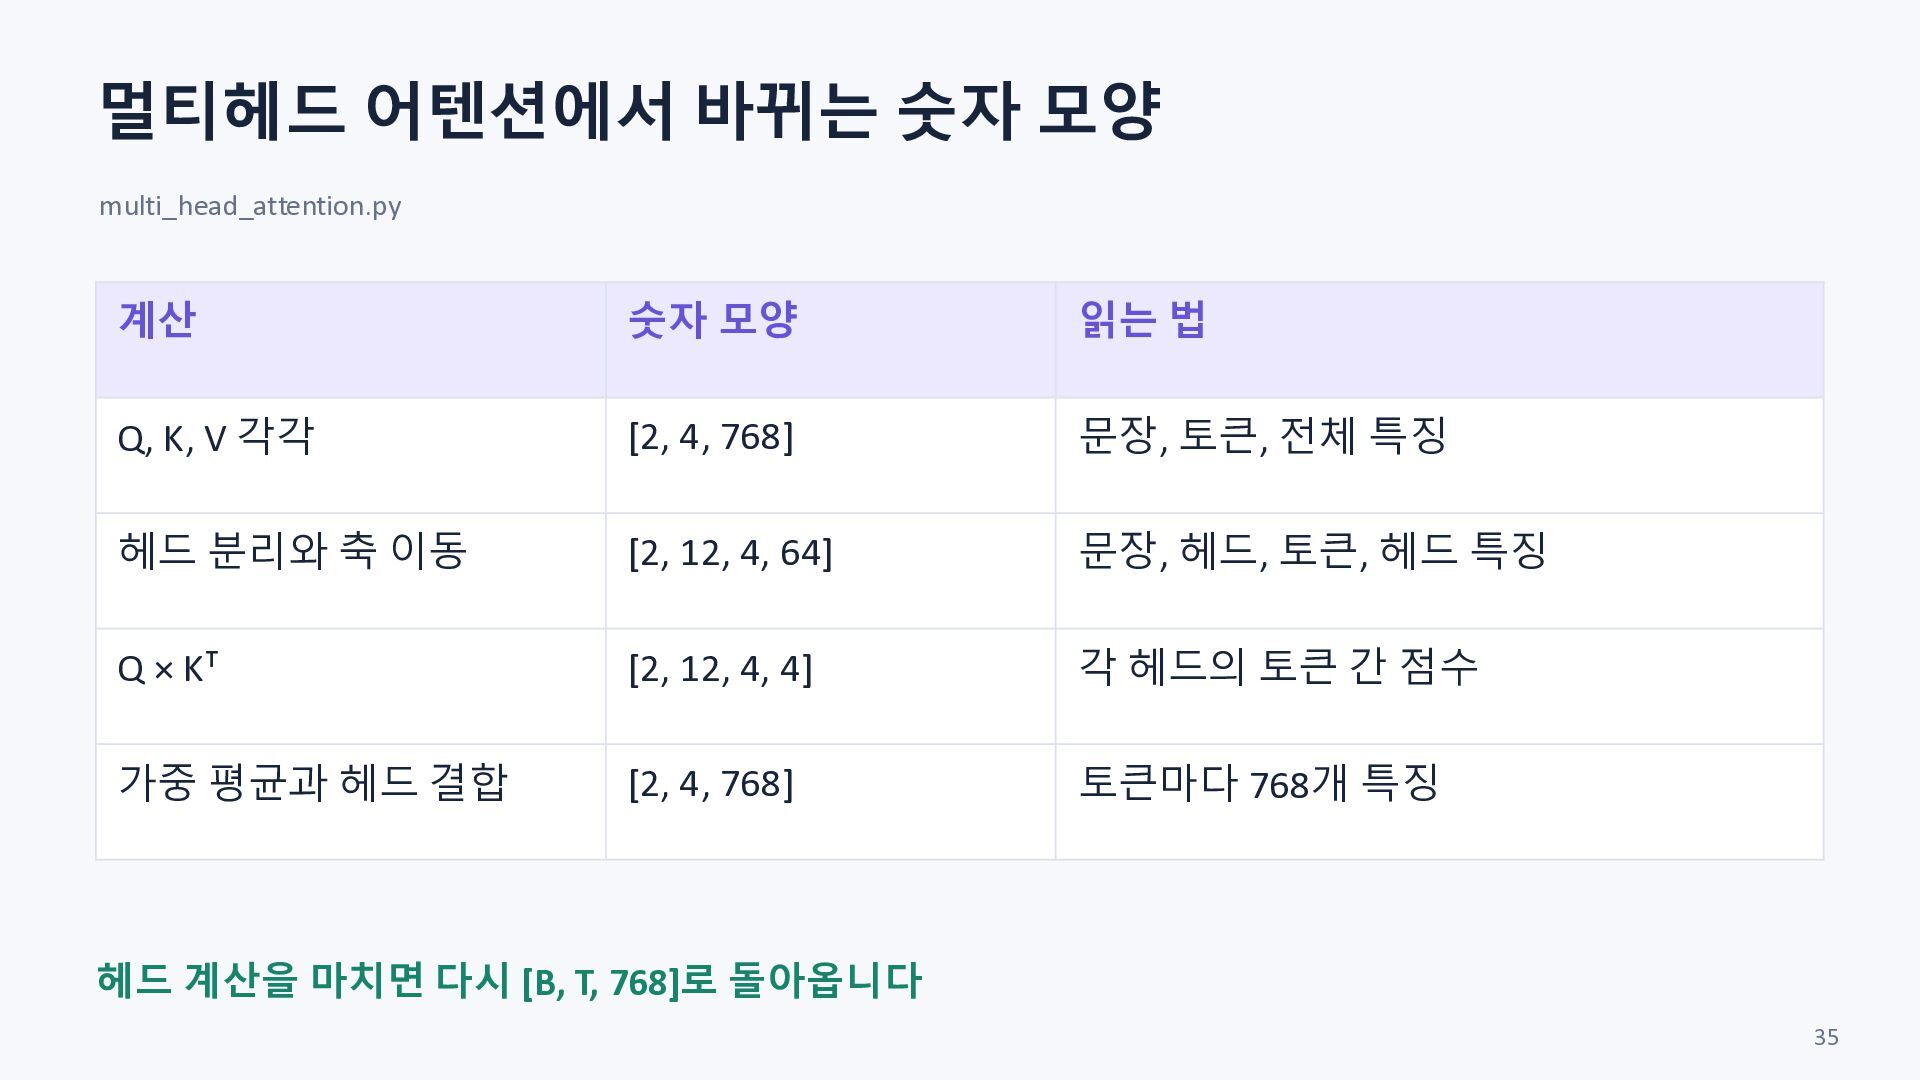
  34. 멀티헤드 어텐션에서 바뀌는 숫자 모양 multi_head_attention.py 계산 숫자 모양 읽는

    법 Q, K, V 각각 [2, 4, 768] 문장, 토큰, 전체 특징 헤드 분리와 축 이동 [2, 12, 4, 64] 문장, 헤드, 토큰, 헤드 특징 Q × Kᵀ [2, 12, 4, 4] 각 헤드의 토큰 간 점수 가중 평균과 헤드 결합 [2, 4, 768] 토큰마다 768개 특징 헤드 계산을 마치면 다시 [B, T, 768]로 돌아옵니다 35
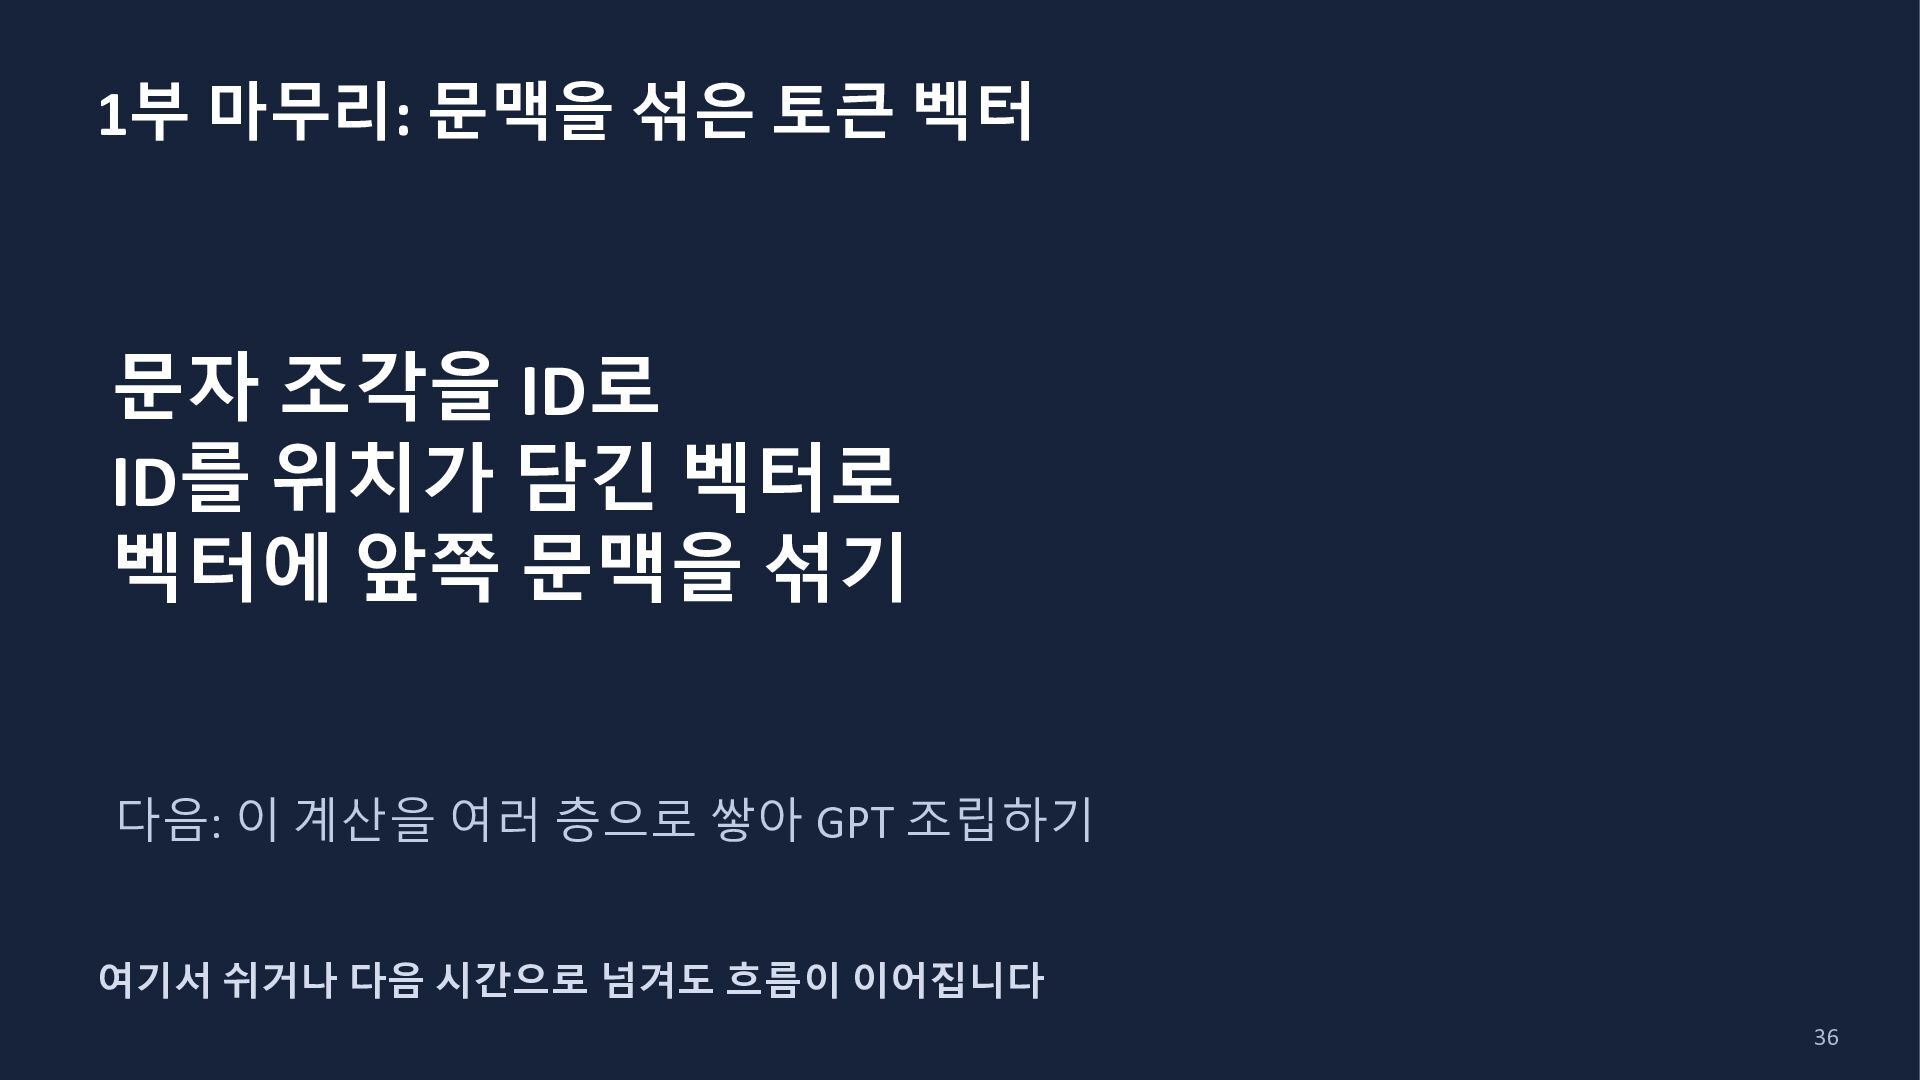
  35. 1부 마무리: 문맥을 섞은 토큰 벡터 문자 조각을 ID로 ID를

    위치가 담긴 벡터로 벡터에 앞쪽 문맥을 섞기 다음: 이 계산을 여러 층으로 쌓아 GPT 조립하기 여기서 쉬거나 다음 시간으로 넘겨도 흐름이 이어집니다 36
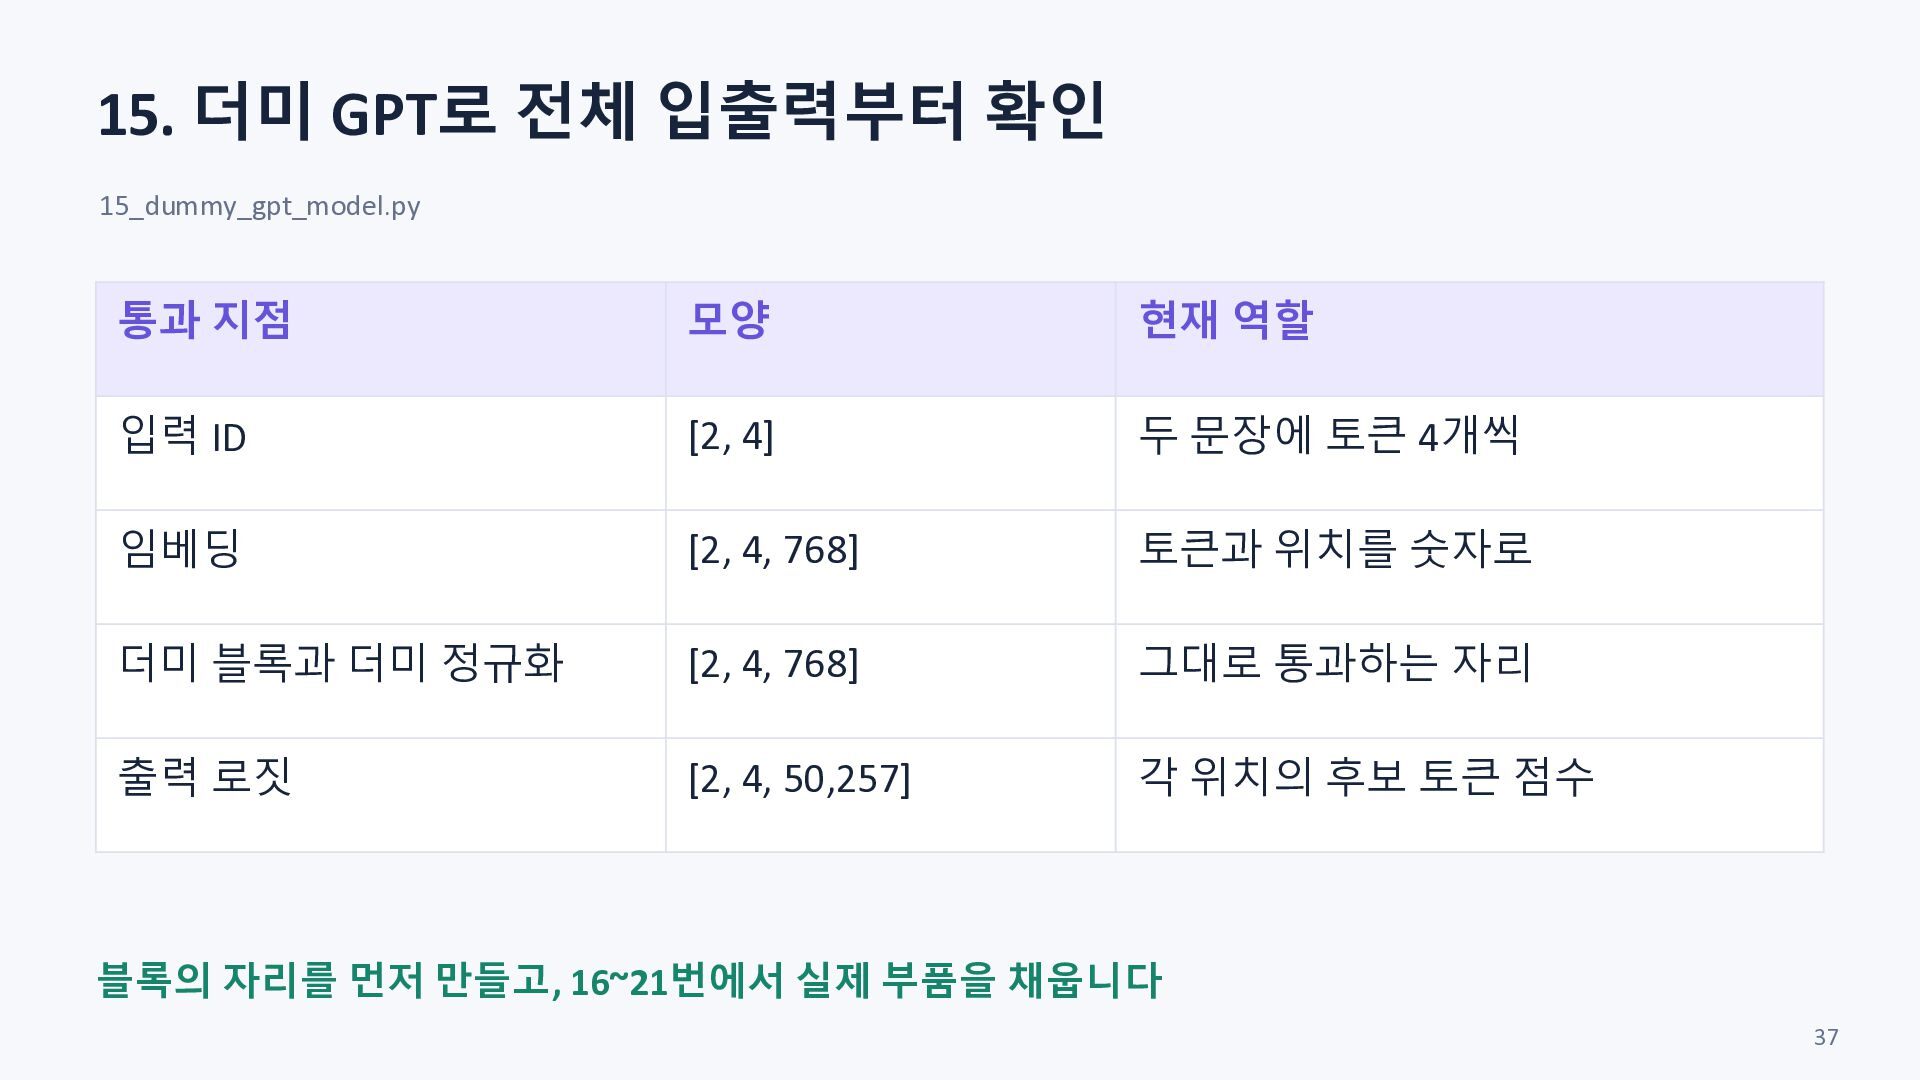
  36. 15. 더미 GPT로 전체 입출력부터 확인 15_dummy_gpt_model.py 통과 지점 모양

    현재 역할 입력 ID [2, 4] 두 문장에 토큰 4개씩 임베딩 [2, 4, 768] 토큰과 위치를 숫자로 더미 블록과 더미 정규화 [2, 4, 768] 그대로 통과하는 자리 출력 로짓 [2, 4, 50,257] 각 위치의 후보 토큰 점수 블록의 자리를 먼저 만들고, 16~21번에서 실제 부품을 채웁니다 37
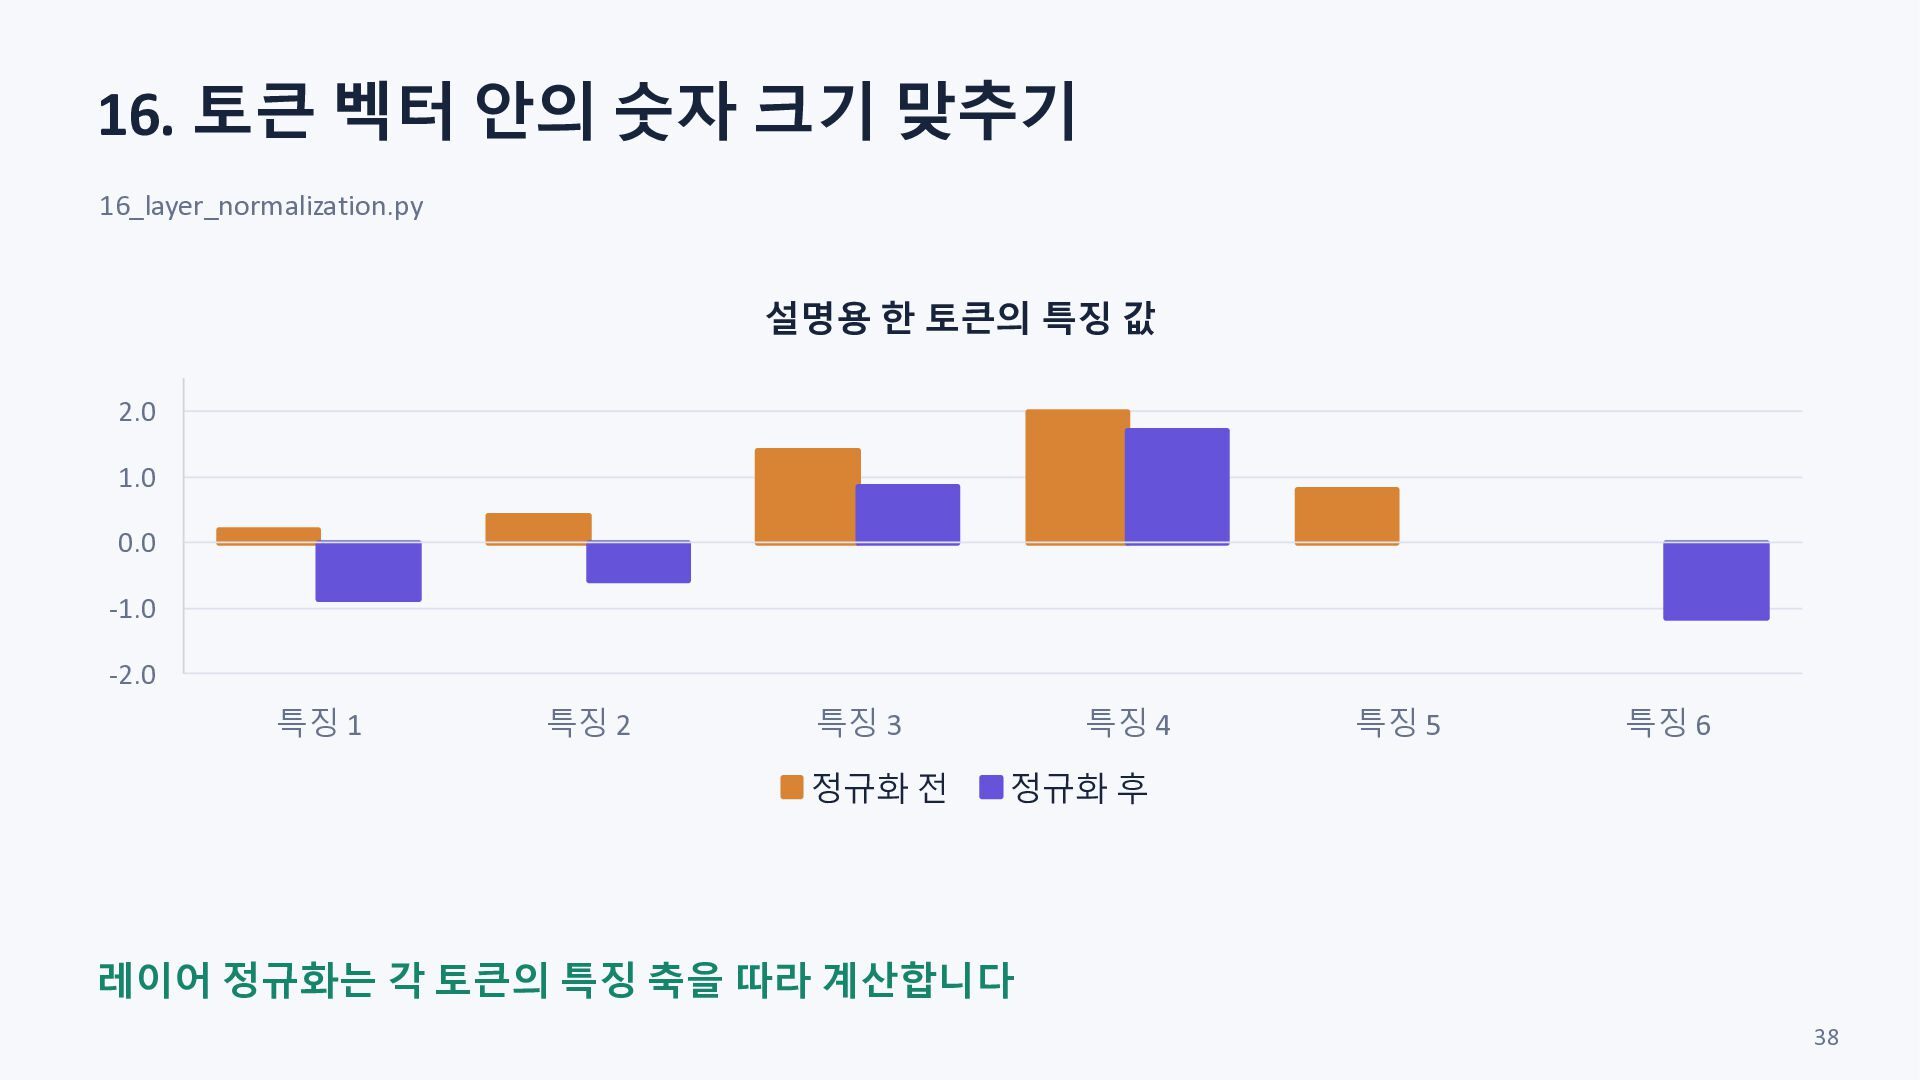
  37. 16. 토큰 벡터 안의 숫자 크기 맞추기 16_layer_normalization.py 설명용 한

    토큰의 특징 값 2.0 1.0 0.0 -1.0 -2.0 특징 1 특징 2 특징 3 정규화 전 특징 4 특징 5 특징 6 정규화 후 레이어 정규화는 각 토큰의 특징 축을 따라 계산합니다 38
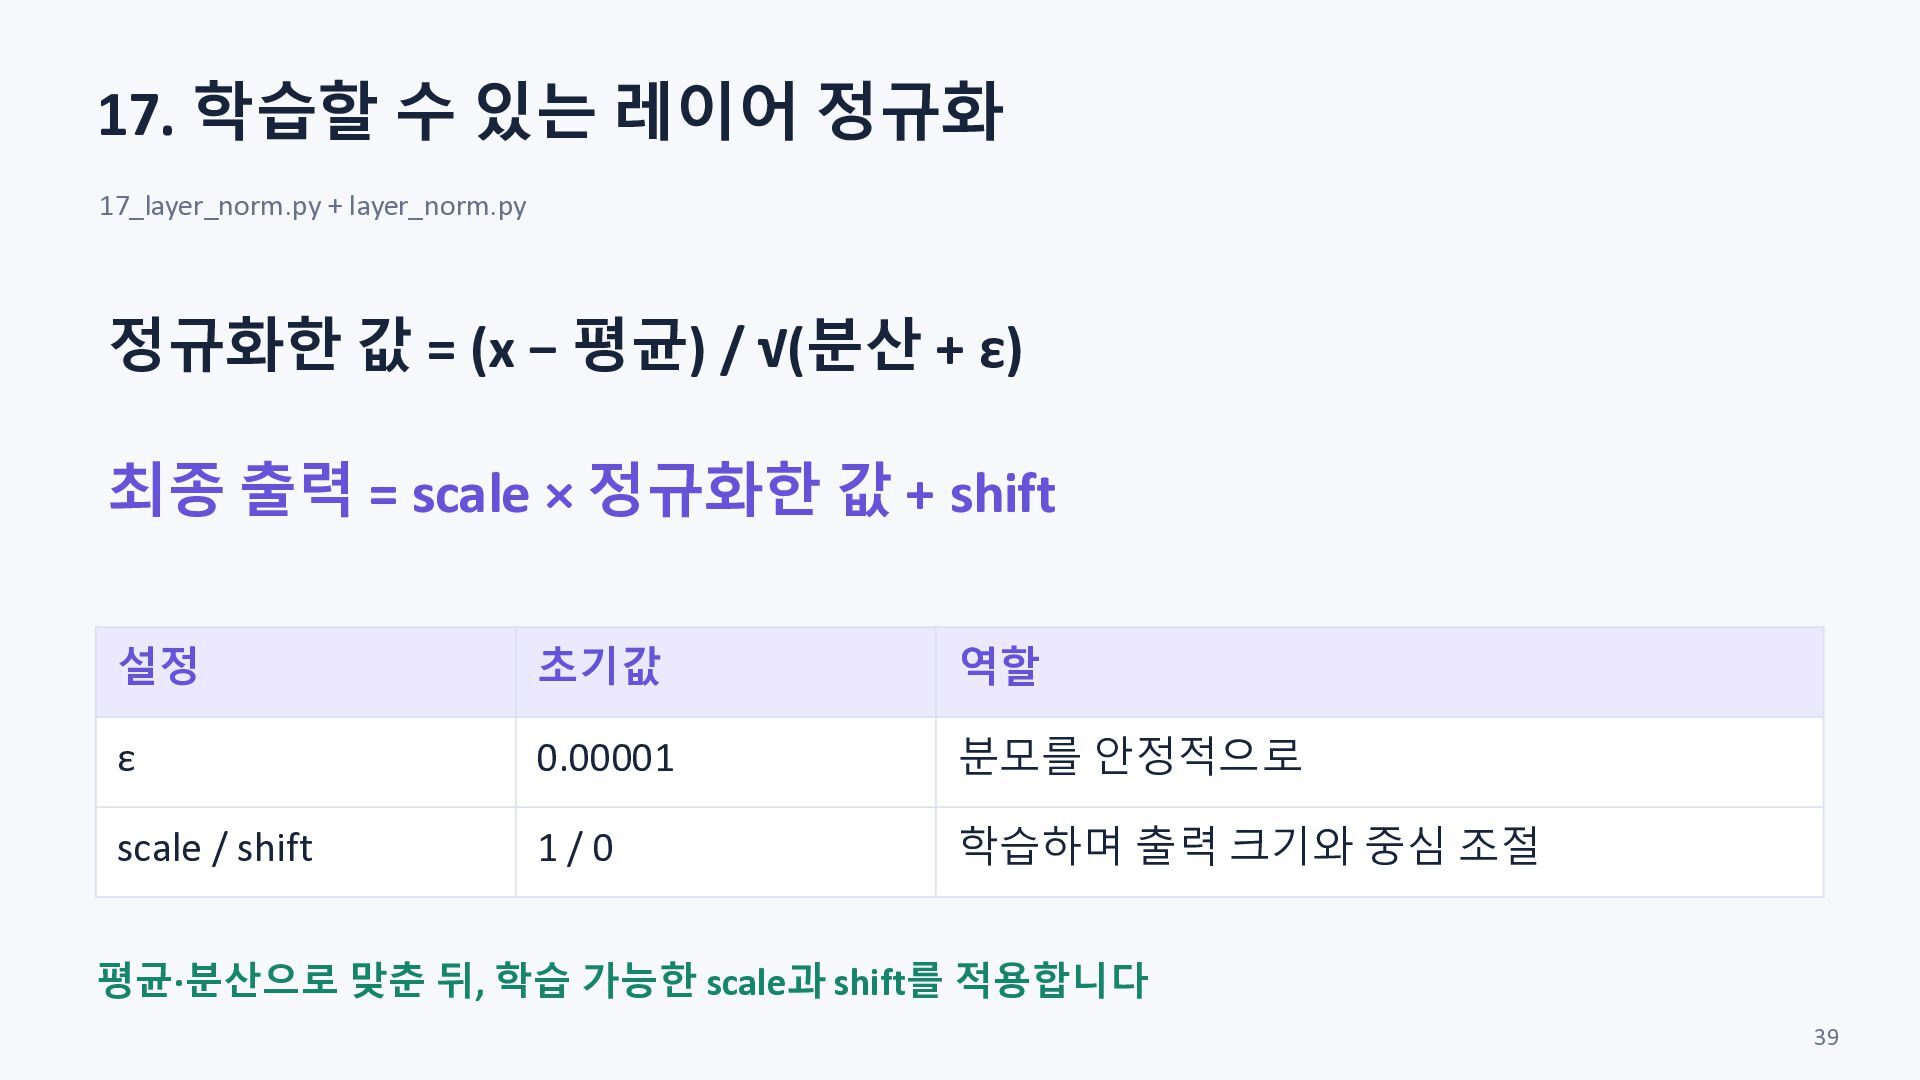
  38. 17. 학습할 수 있는 레이어 정규화 17_layer_norm.py + layer_norm.py 정규화한

    값 = (x − 평균) / √(분산 + ε) 최종 출력 = scale × 정규화한 값 + shift 설정 초기값 역할 ε 0.00001 분모를 안정적으로 scale / shift 1/0 학습하며 출력 크기와 중심 조절 평균·분산으로 맞춘 뒤, 학습 가능한 scale과 shift를 적용합니다 39
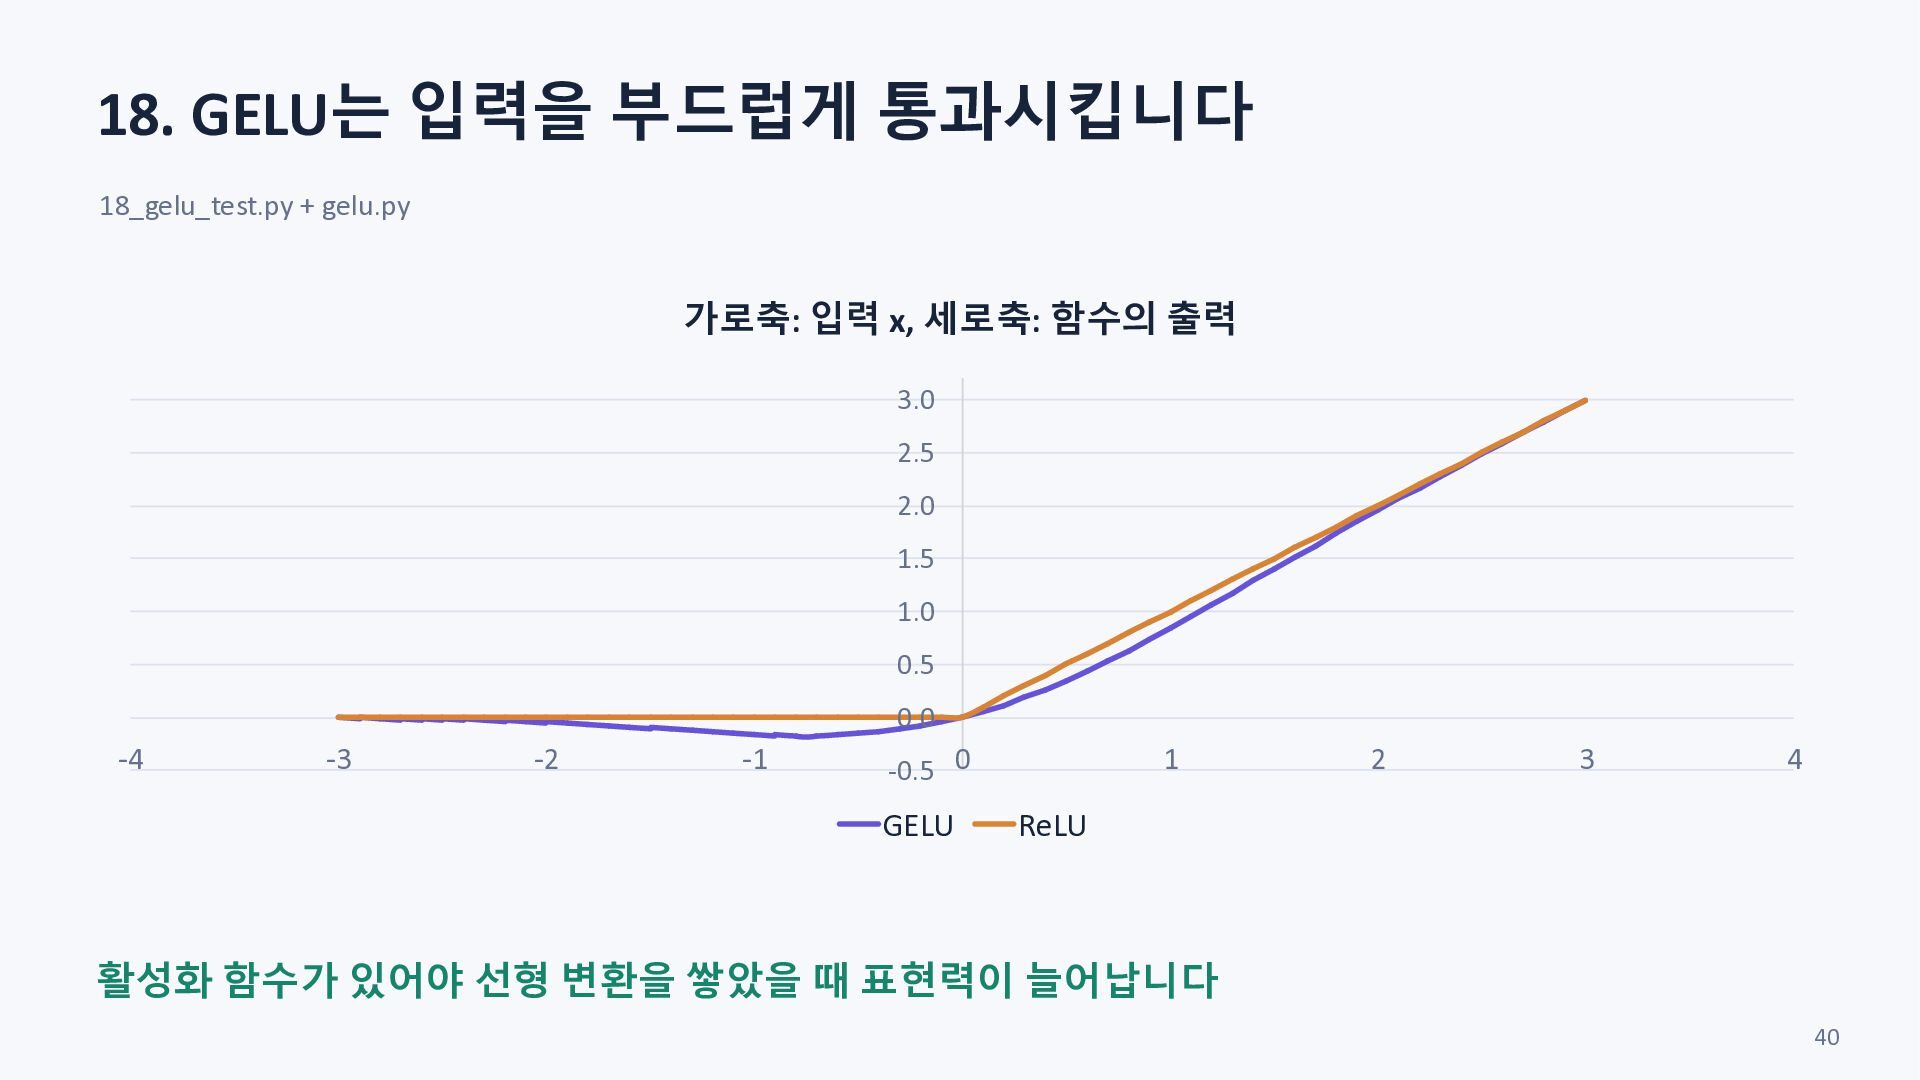
  39. 18. GELU는 입력을 부드럽게 통과시킵니다 18_gelu_test.py + gelu.py 가로축: 입력

    x, 세로축: 함수의 출력 3.0 2.5 2.0 1.5 1.0 0.5 0.0 -4 -3 -2 -1 -0.5 0 GELU 1 2 3 4 ReLU 활성화 함수가 있어야 선형 변환을 쌓았을 때 표현력이 늘어납니다 40
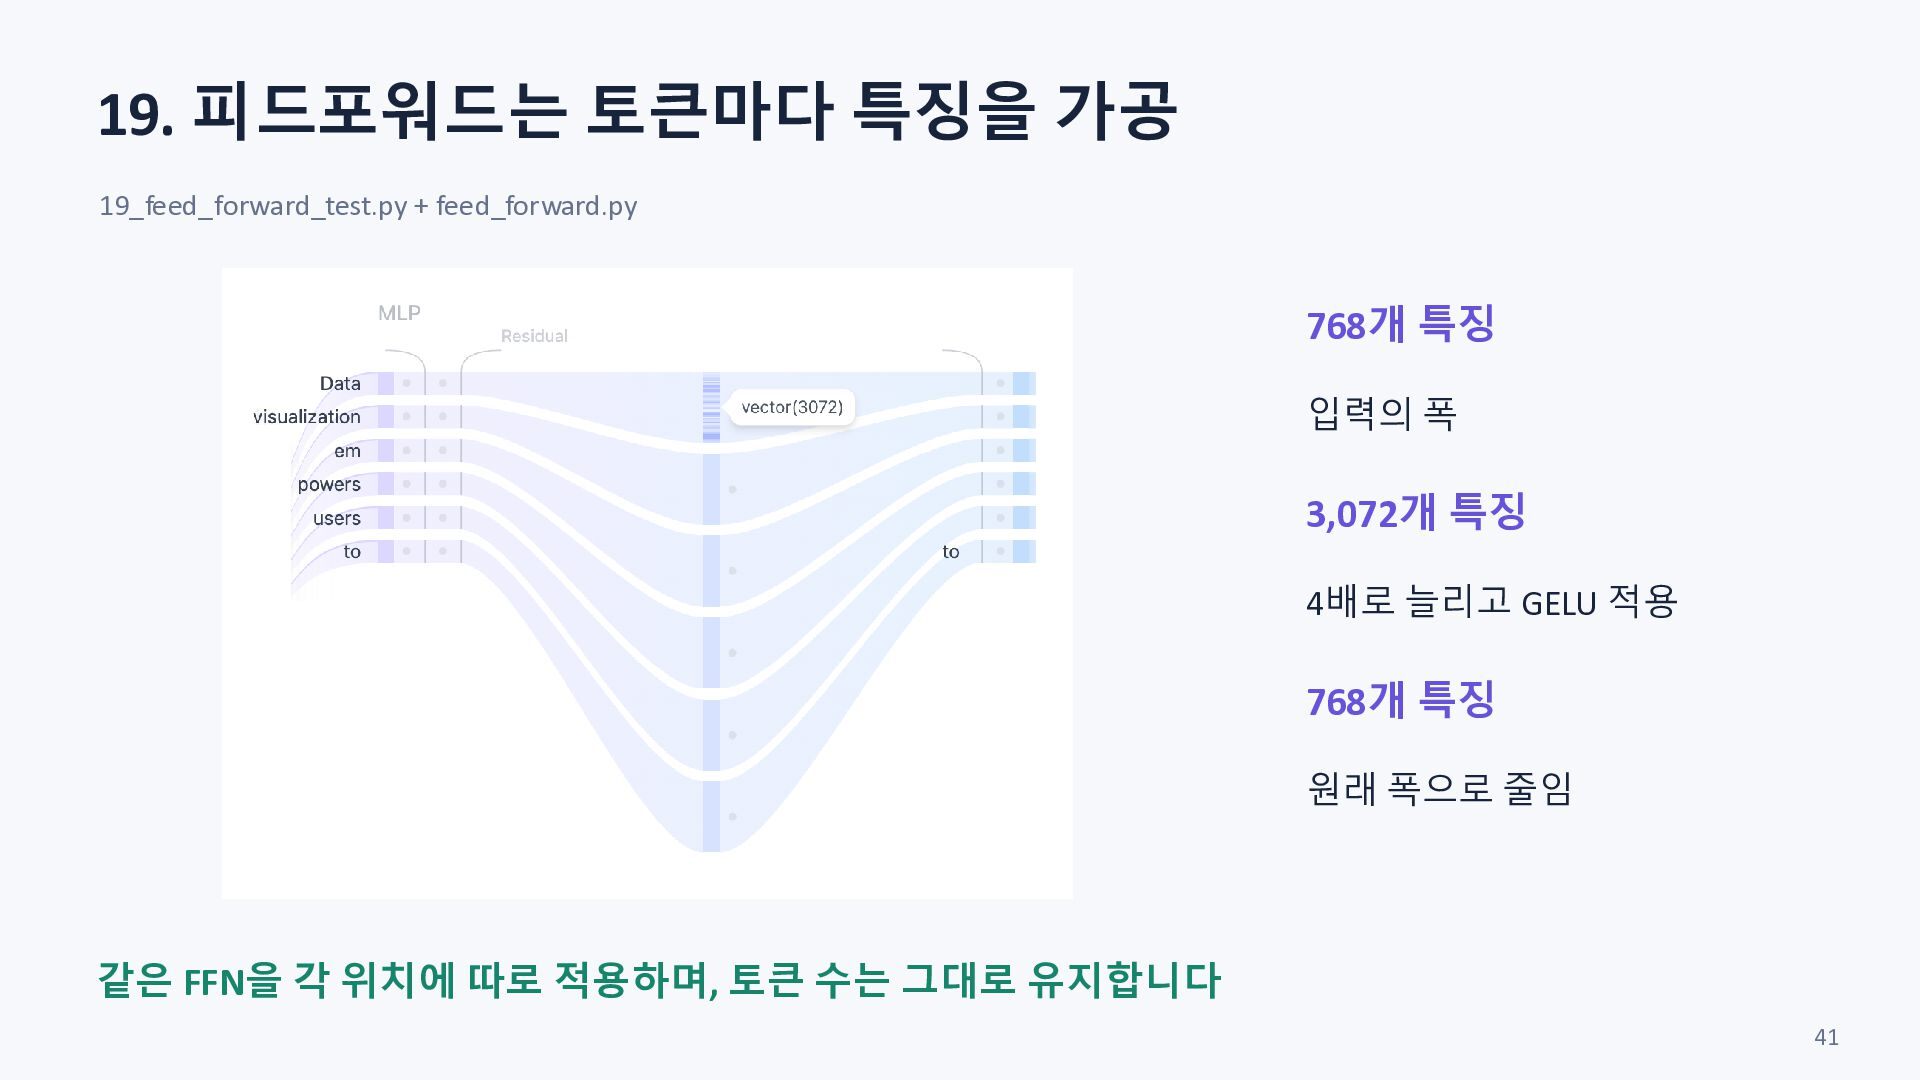
  40. 19. 피드포워드는 토큰마다 특징을 가공 19_feed_forward_test.py + feed_forward.py 768개 특징

    입력의 폭 3,072개 특징 4배로 늘리고 GELU 적용 768개 특징 원래 폭으로 줄임 같은 FFN을 각 위치에 따로 적용하며, 토큰 수는 그대로 유지합니다 41
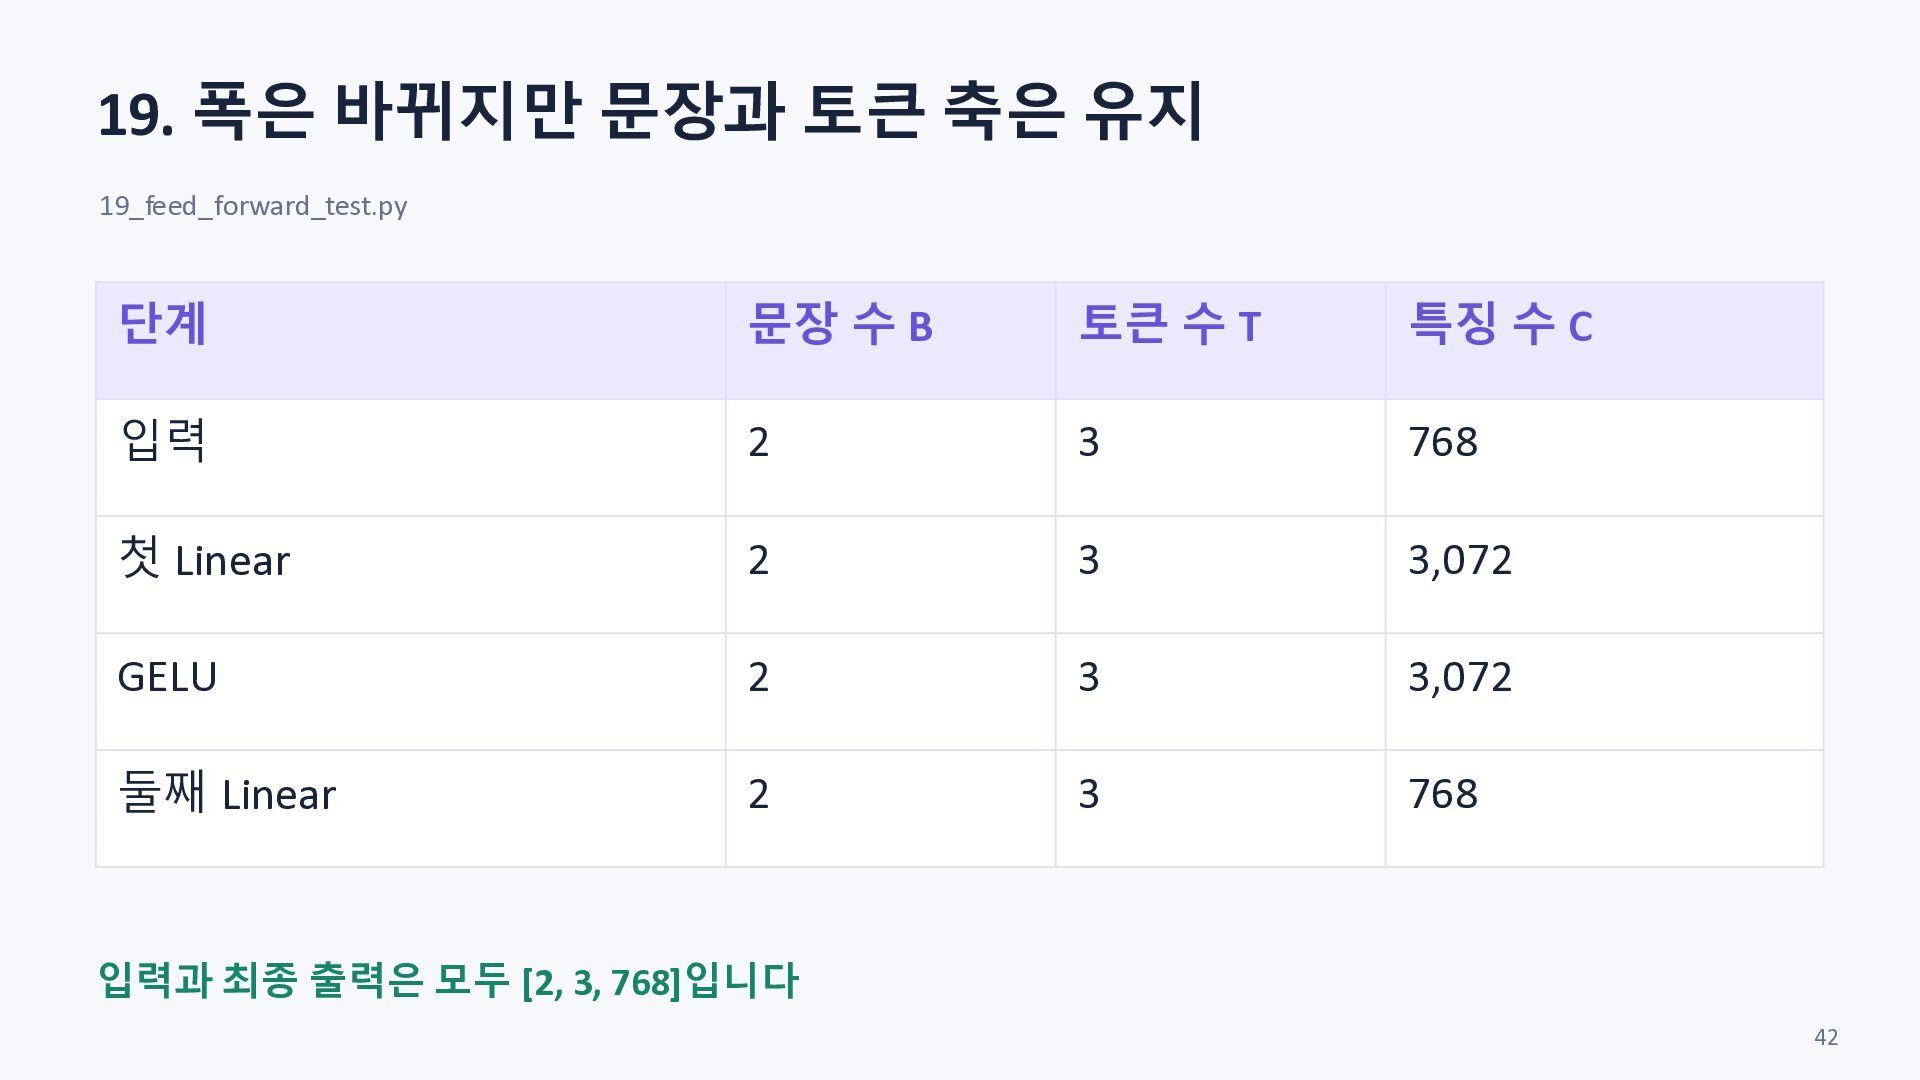
  41. 19. 폭은 바뀌지만 문장과 토큰 축은 유지 19_feed_forward_test.py 단계 문장

    수 B 토큰 수 T 특징 수 C 입력 2 3 768 첫 Linear 2 3 3,072 GELU 2 3 3,072 둘째 Linear 2 3 768 입력과 최종 출력은 모두 [2, 3, 768]입니다 42
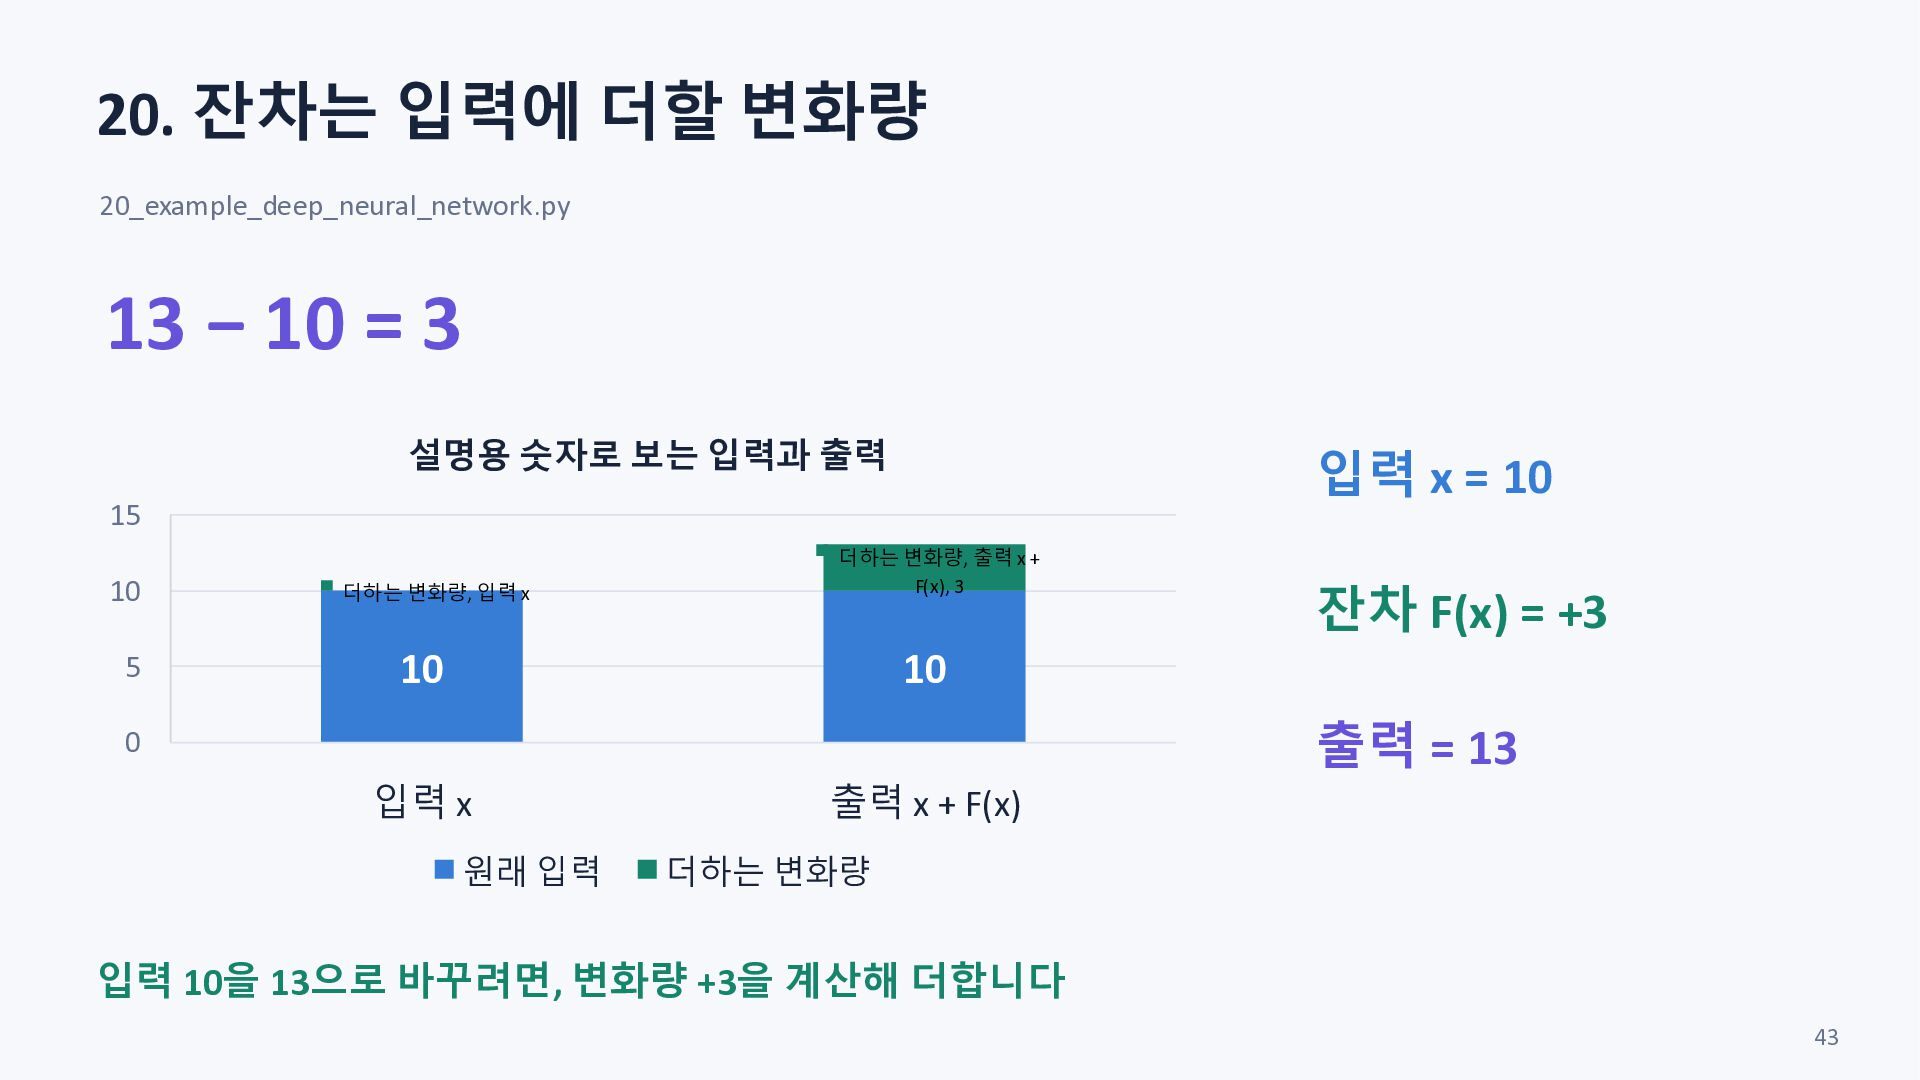
  42. 20. 잔차는 입력에 더할 변화량 20_example_deep_neural_network.py 13 − 10 =

    3 설명용 숫자로 보는 입력과 출력 입력 x = 10 15 10 5 더하는 변화량, 입력 x 더하는 변화량, 출력 x + F(x), 3 10 잔차 F(x) = +3 10 0 입력 x 원래 입력 출력 x + F(x) 출력 = 13 더하는 변화량 입력 10을 13으로 바꾸려면, 변화량 +3을 계산해 더합니다 43
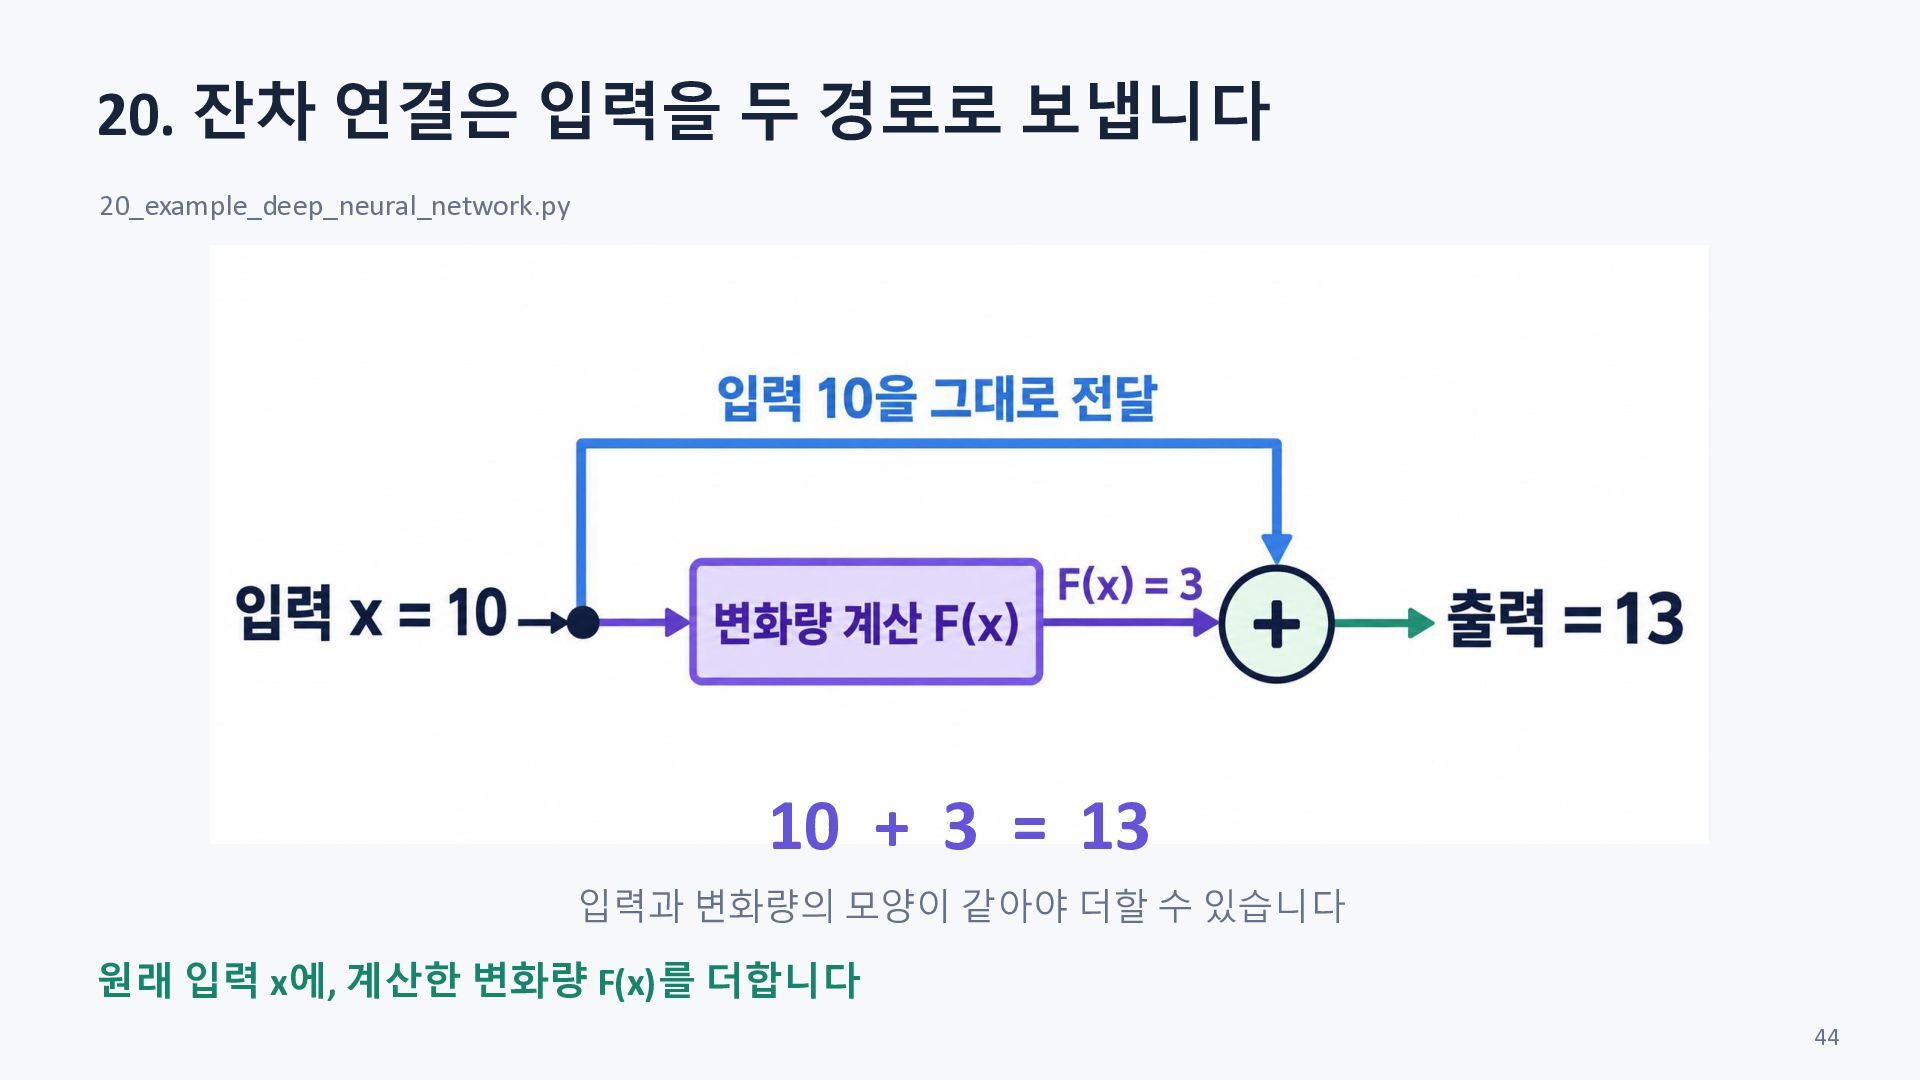
  43. 20. 잔차 연결은 입력을 두 경로로 보냅니다 20_example_deep_neural_network.py 10 +

    3 = 13 입력과 변화량의 모양이 같아야 더할 수 있습니다 원래 입력 x에, 계산한 변화량 F(x)를 더합니다 44
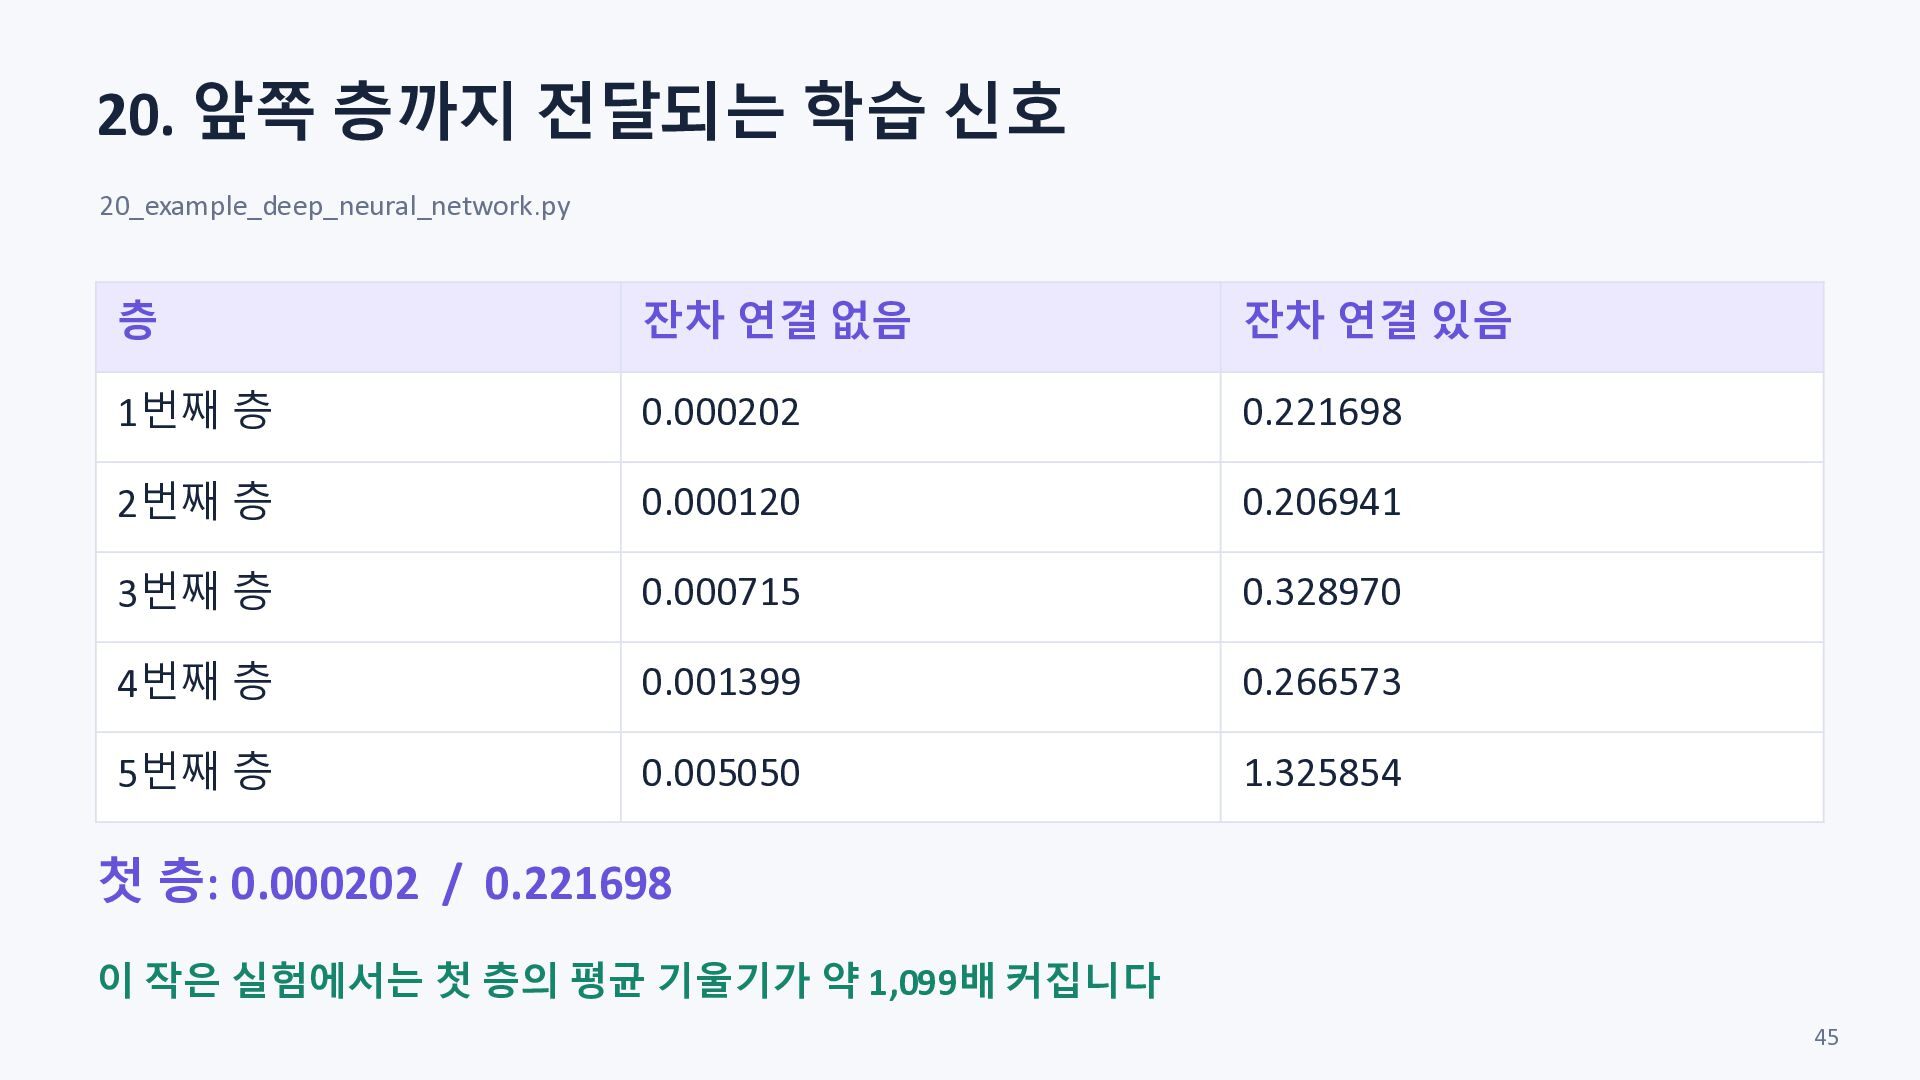
  44. 20. 앞쪽 층까지 전달되는 학습 신호 20_example_deep_neural_network.py 층 잔차 연결

    없음 잔차 연결 있음 1번째 층 0.000202 0.221698 2번째 층 0.000120 0.206941 3번째 층 0.000715 0.328970 4번째 층 0.001399 0.266573 5번째 층 0.005050 1.325854 첫 층: 0.000202 / 0.221698 이 작은 실험에서는 첫 층의 평균 기울기가 약 1,099배 커집니다 45
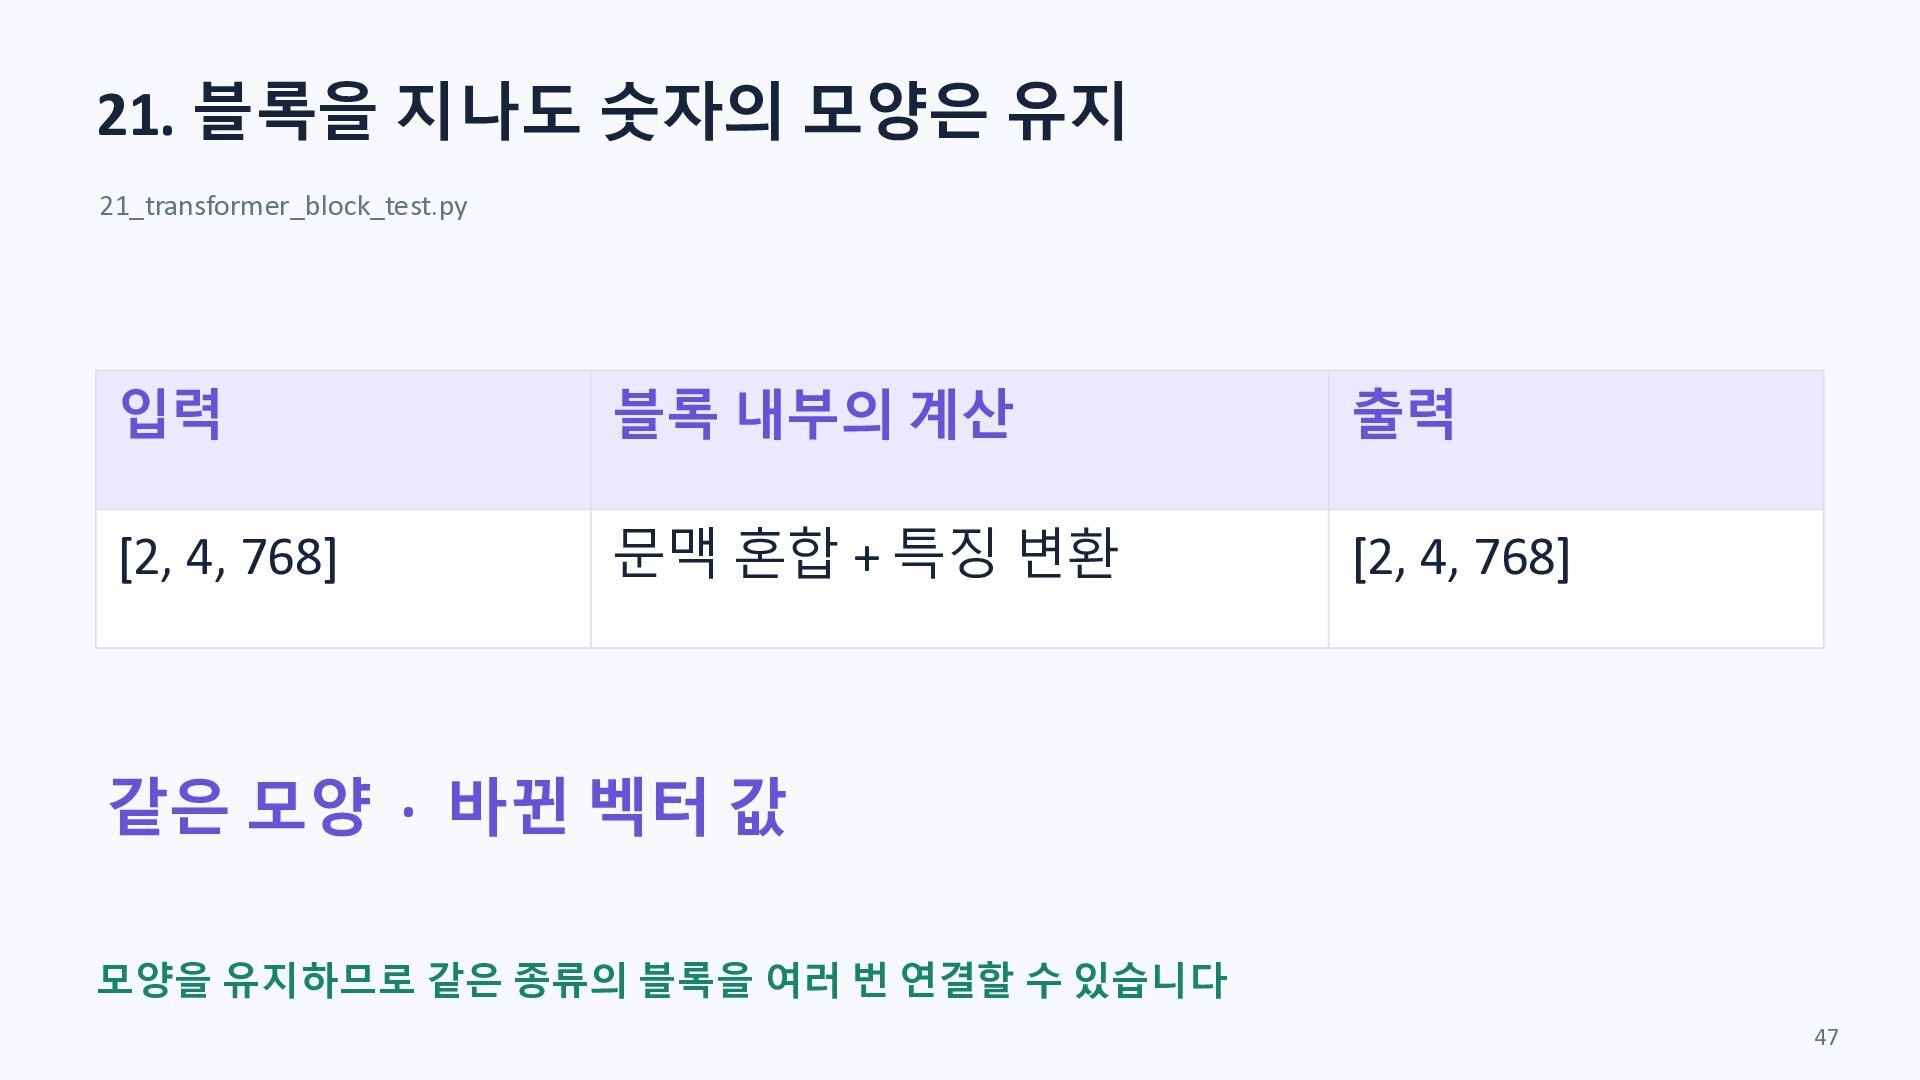
  45. 21. 블록을 지나도 숫자의 모양은 유지 21_transformer_block_test.py 입력 블록 내부의

    계산 출력 [2, 4, 768] 문맥 혼합 + 특징 변환 [2, 4, 768] 같은 모양 · 바뀐 벡터 값 모양을 유지하므로 같은 종류의 블록을 여러 번 연결할 수 있습니다 47
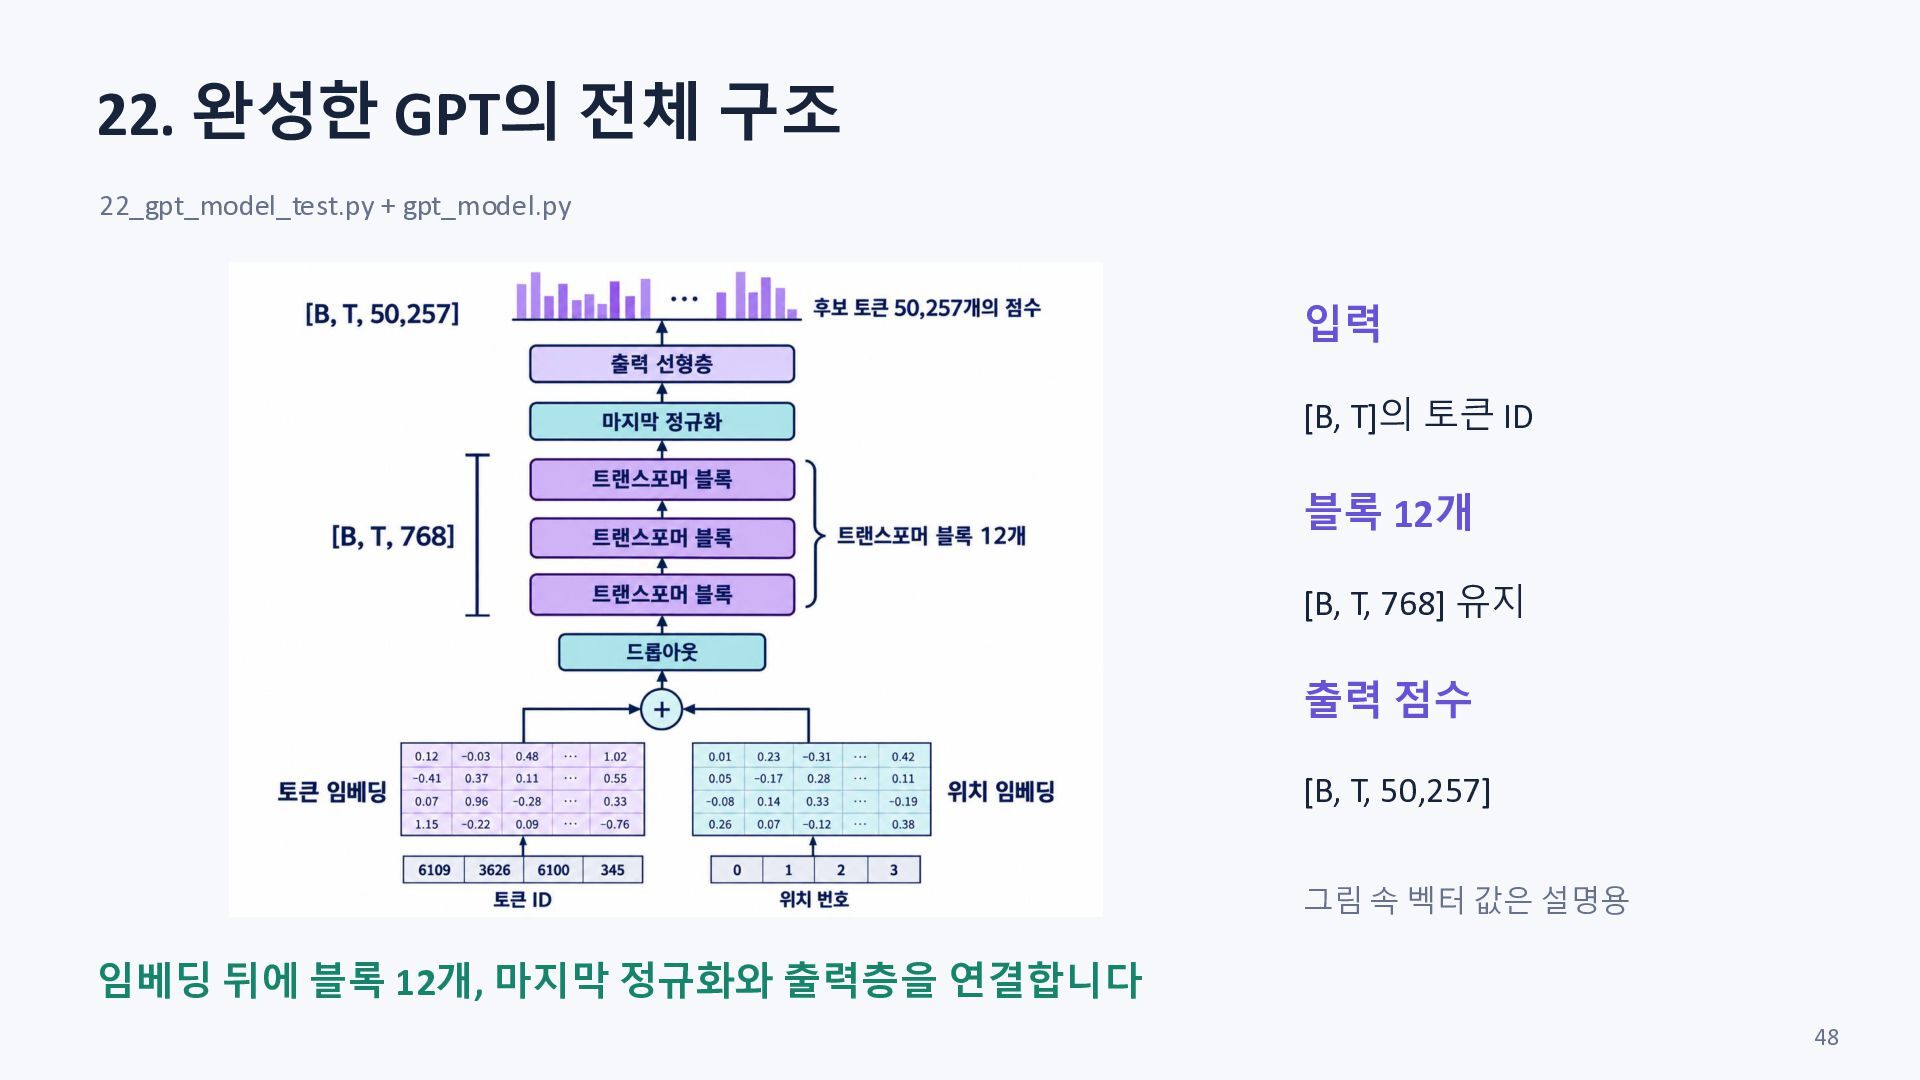
  46. 22. 완성한 GPT의 전체 구조 22_gpt_model_test.py + gpt_model.py 입력 [B,

    T]의 토큰 ID 블록 12개 [B, T, 768] 유지 출력 점수 [B, T, 50,257] 그림 속 벡터 값은 설명용 임베딩 뒤에 블록 12개, 마지막 정규화와 출력층을 연결합니다 48
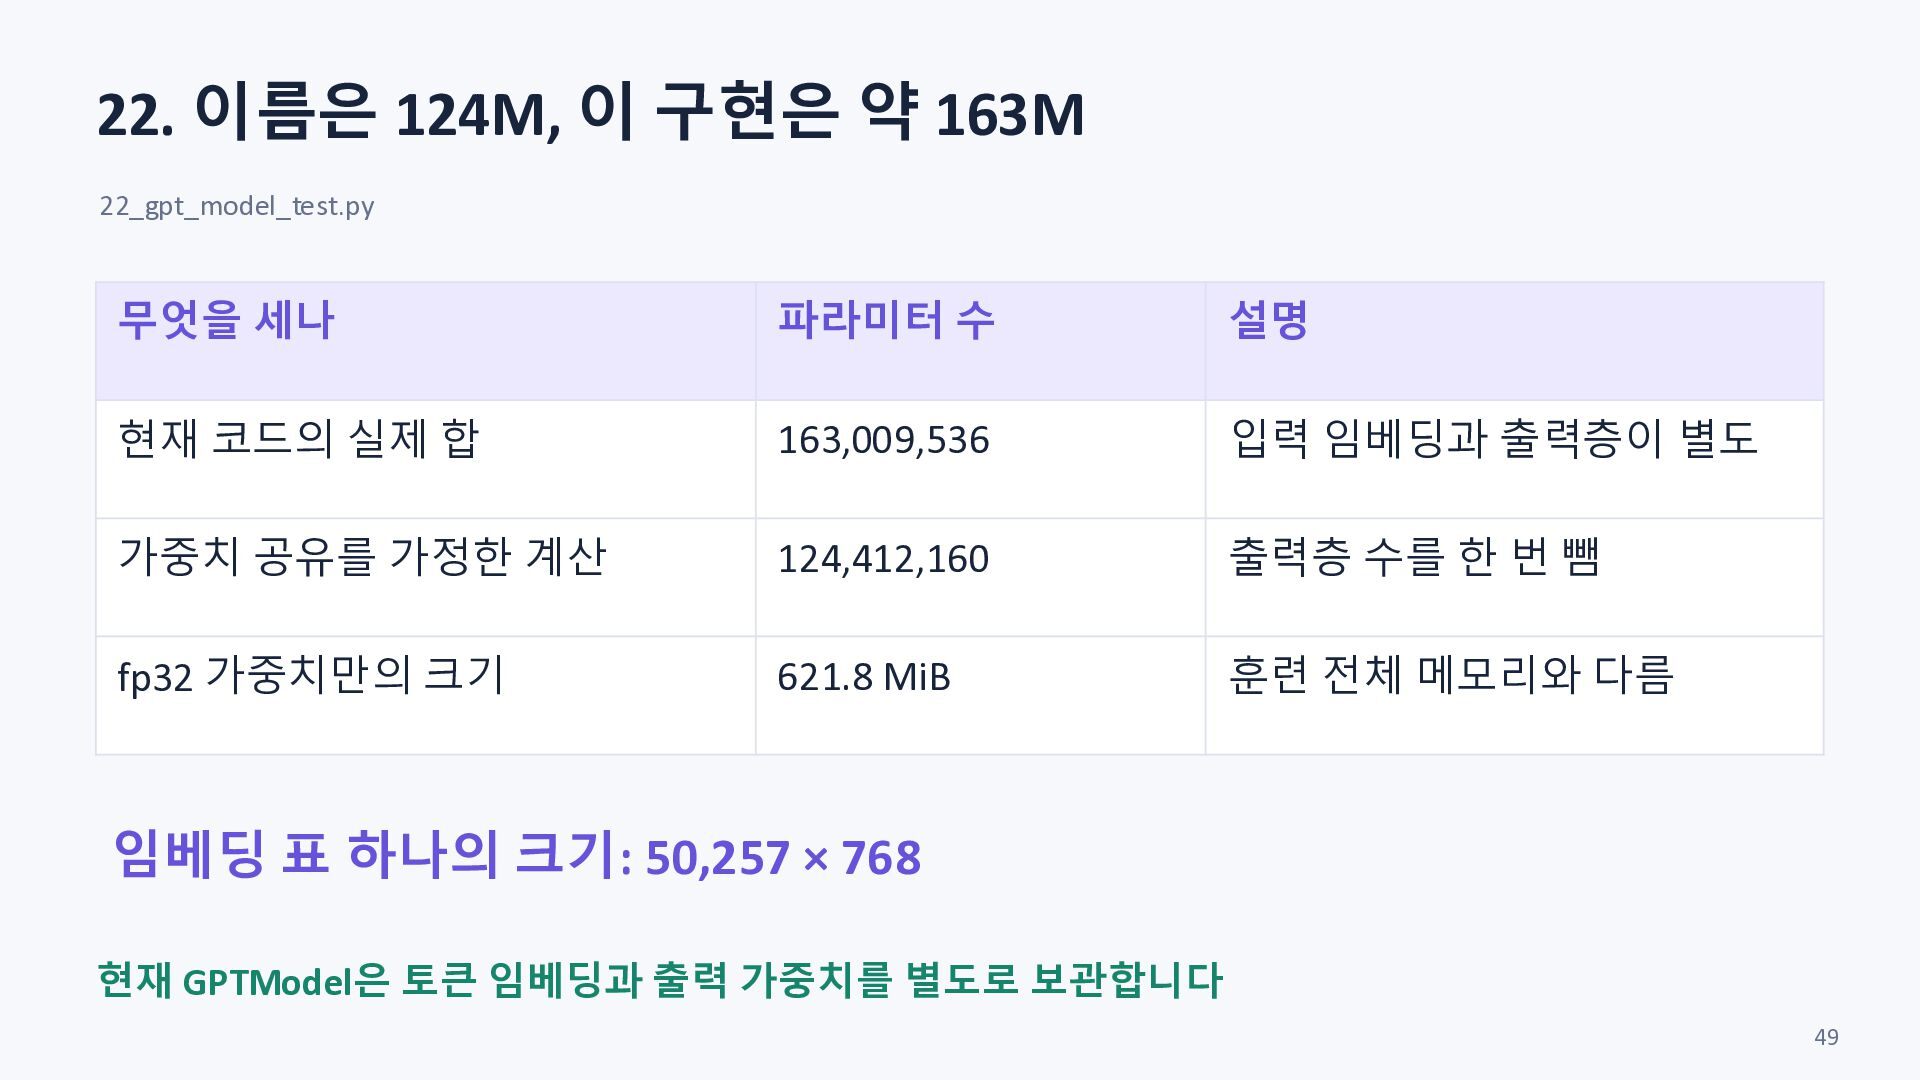
  47. 22. 이름은 124M, 이 구현은 약 163M 22_gpt_model_test.py 무엇을 세나

    파라미터 수 설명 현재 코드의 실제 합 163,009,536 입력 임베딩과 출력층이 별도 가중치 공유를 가정한 계산 124,412,160 출력층 수를 한 번 뺌 fp32 가중치만의 크기 621.8 MiB 훈련 전체 메모리와 다름 임베딩 표 하나의 크기: 50,257 × 768 현재 GPTModel은 토큰 임베딩과 출력 가중치를 별도로 보관합니다 49
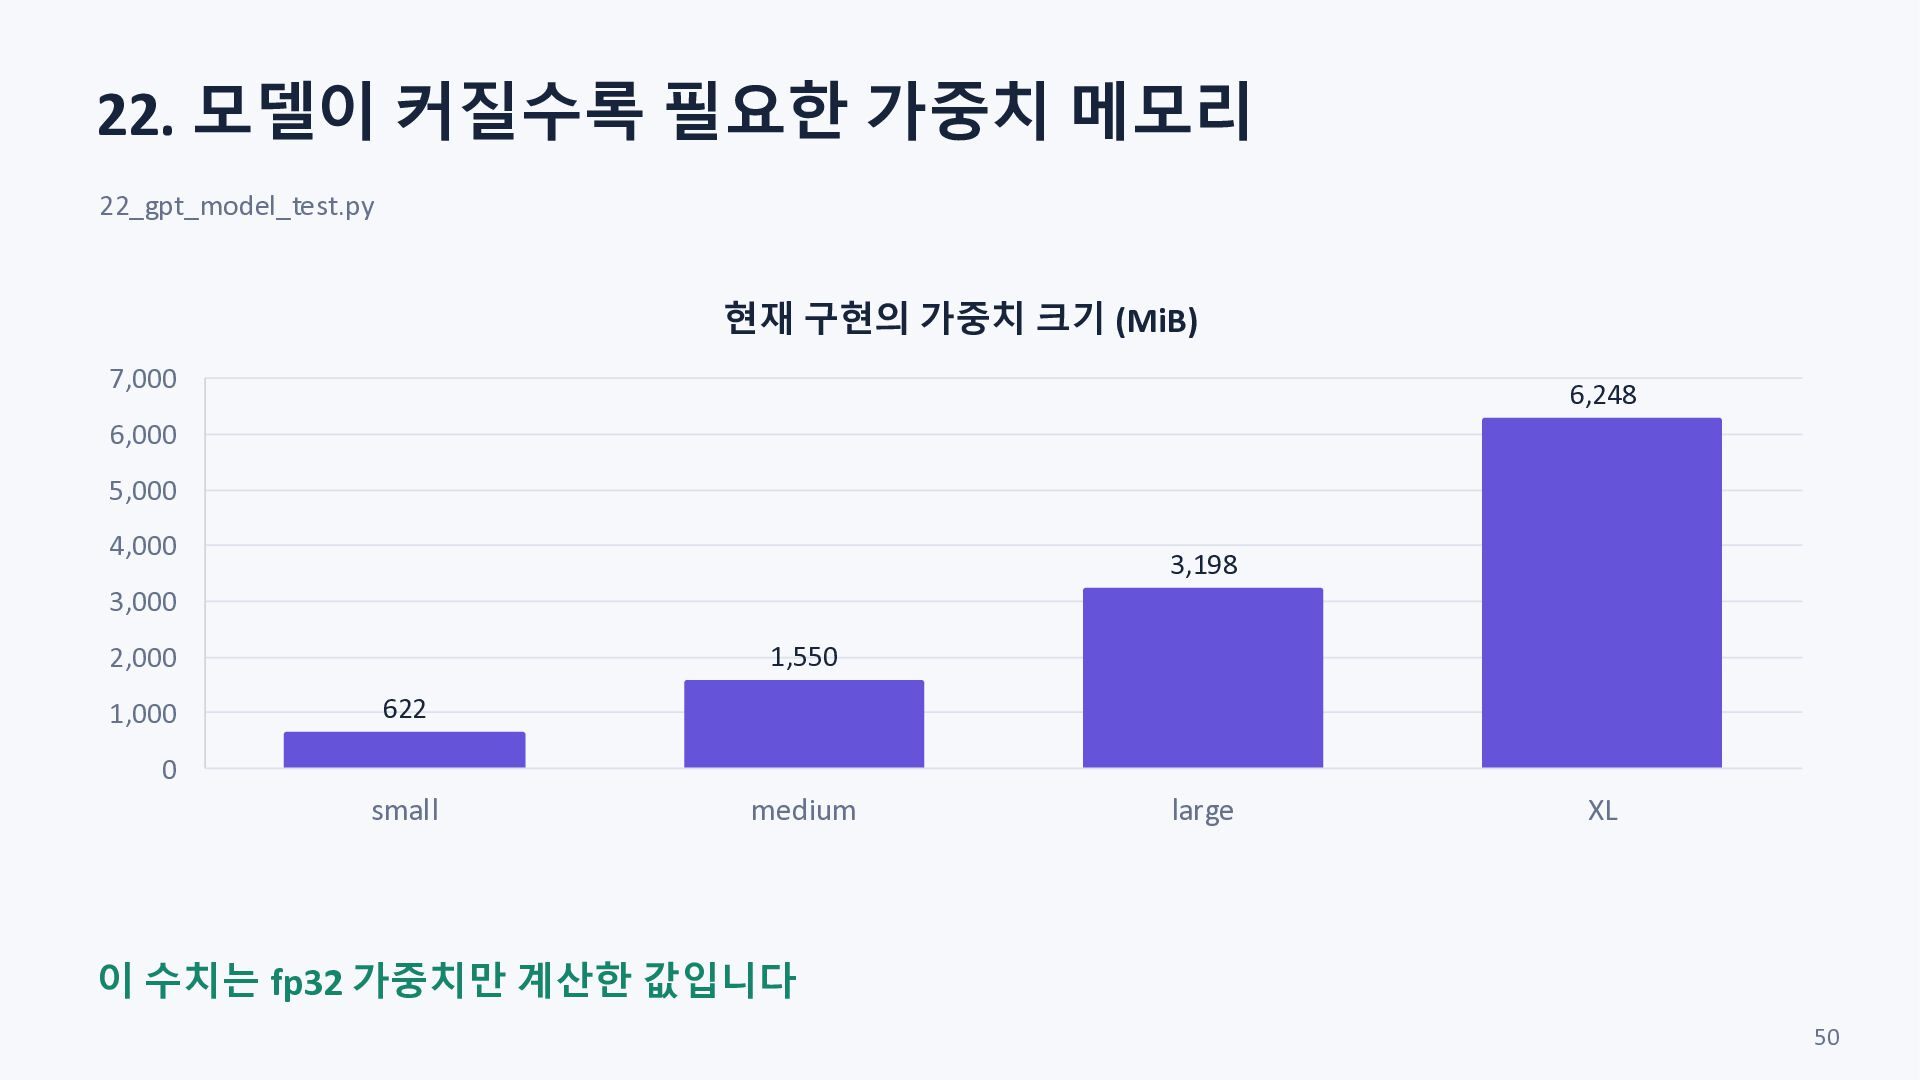
  48. 22. 모델이 커질수록 필요한 가중치 메모리 22_gpt_model_test.py 현재 구현의 가중치

    크기 (MiB) 7,000 6,248 6,000 5,000 4,000 3,198 3,000 1,550 2,000 1,000 622 0 small medium large XL 이 수치는 fp32 가중치만 계산한 값입니다 50
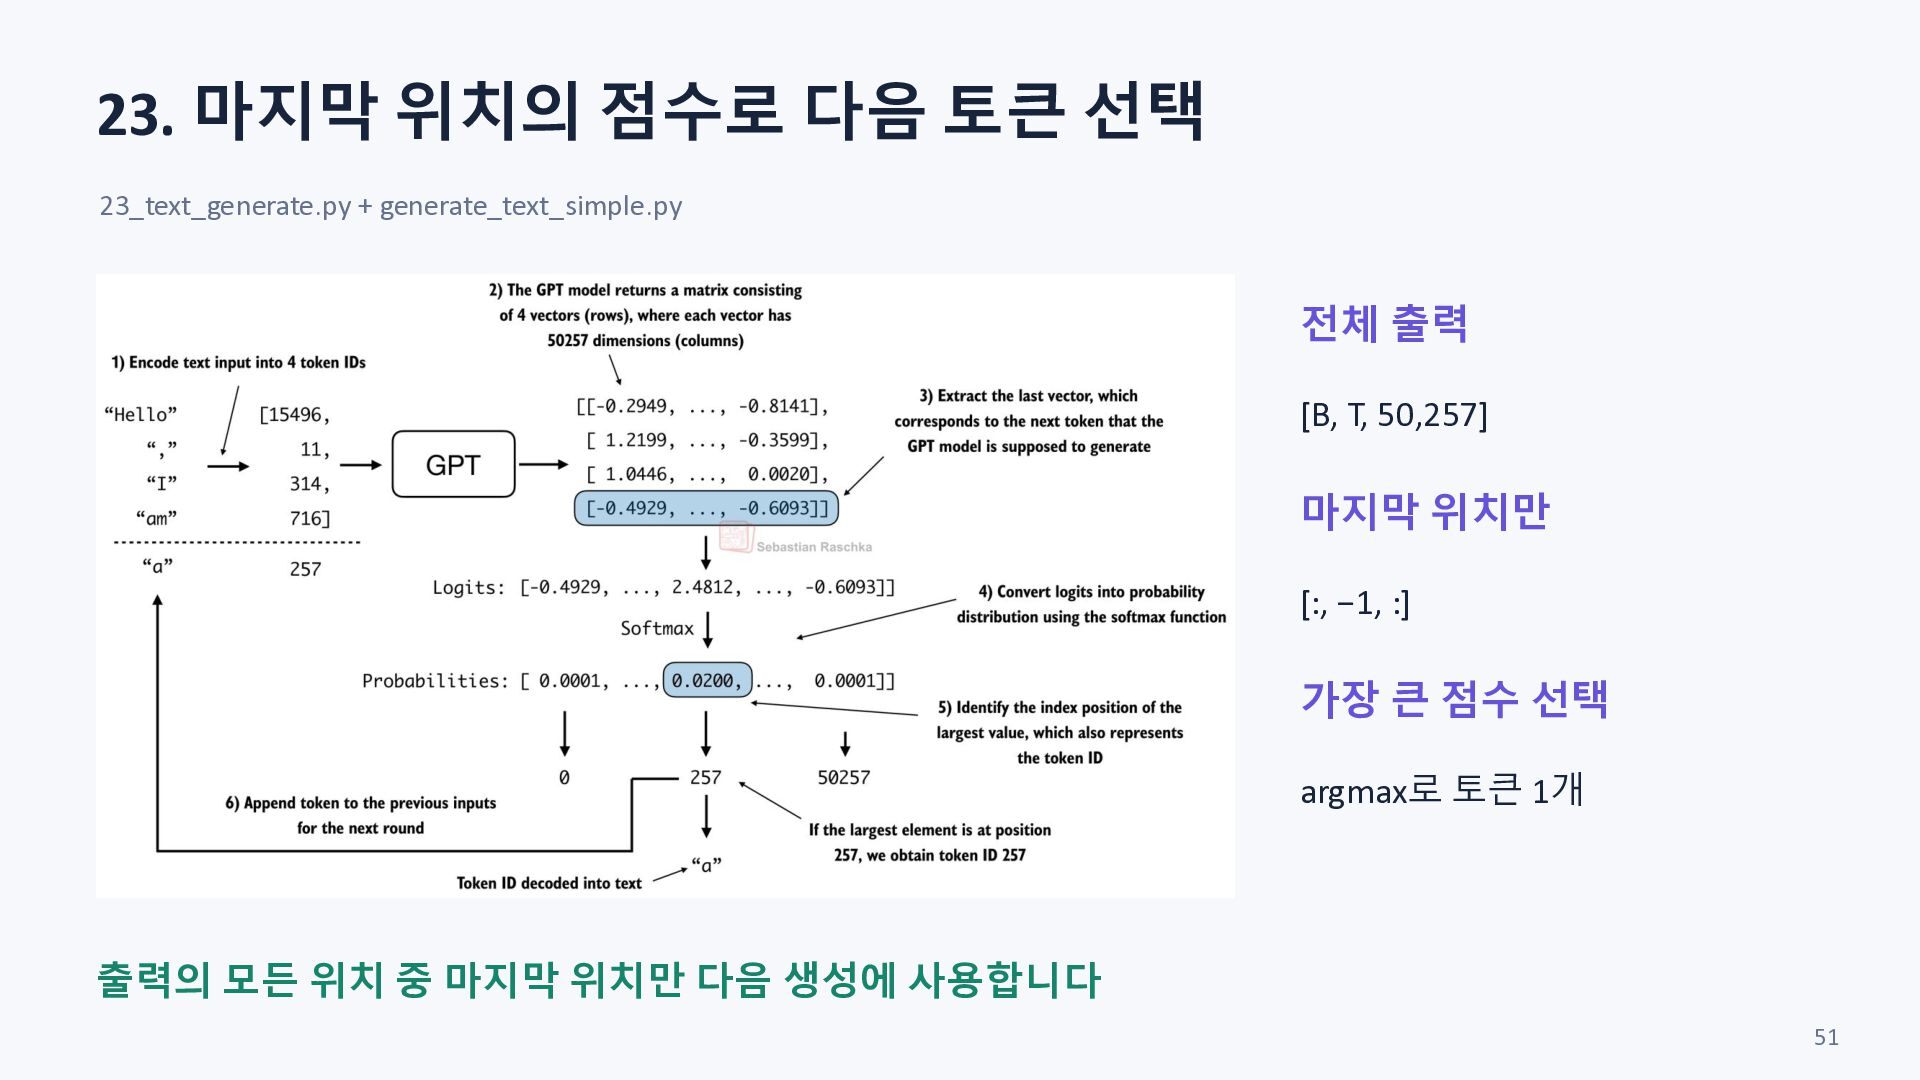
  49. 23. 마지막 위치의 점수로 다음 토큰 선택 23_text_generate.py + generate_text_simple.py

    전체 출력 [B, T, 50,257] 마지막 위치만 [:, −1, :] 가장 큰 점수 선택 argmax로 토큰 1개 출력의 모든 위치 중 마지막 위치만 다음 생성에 사용합니다 51
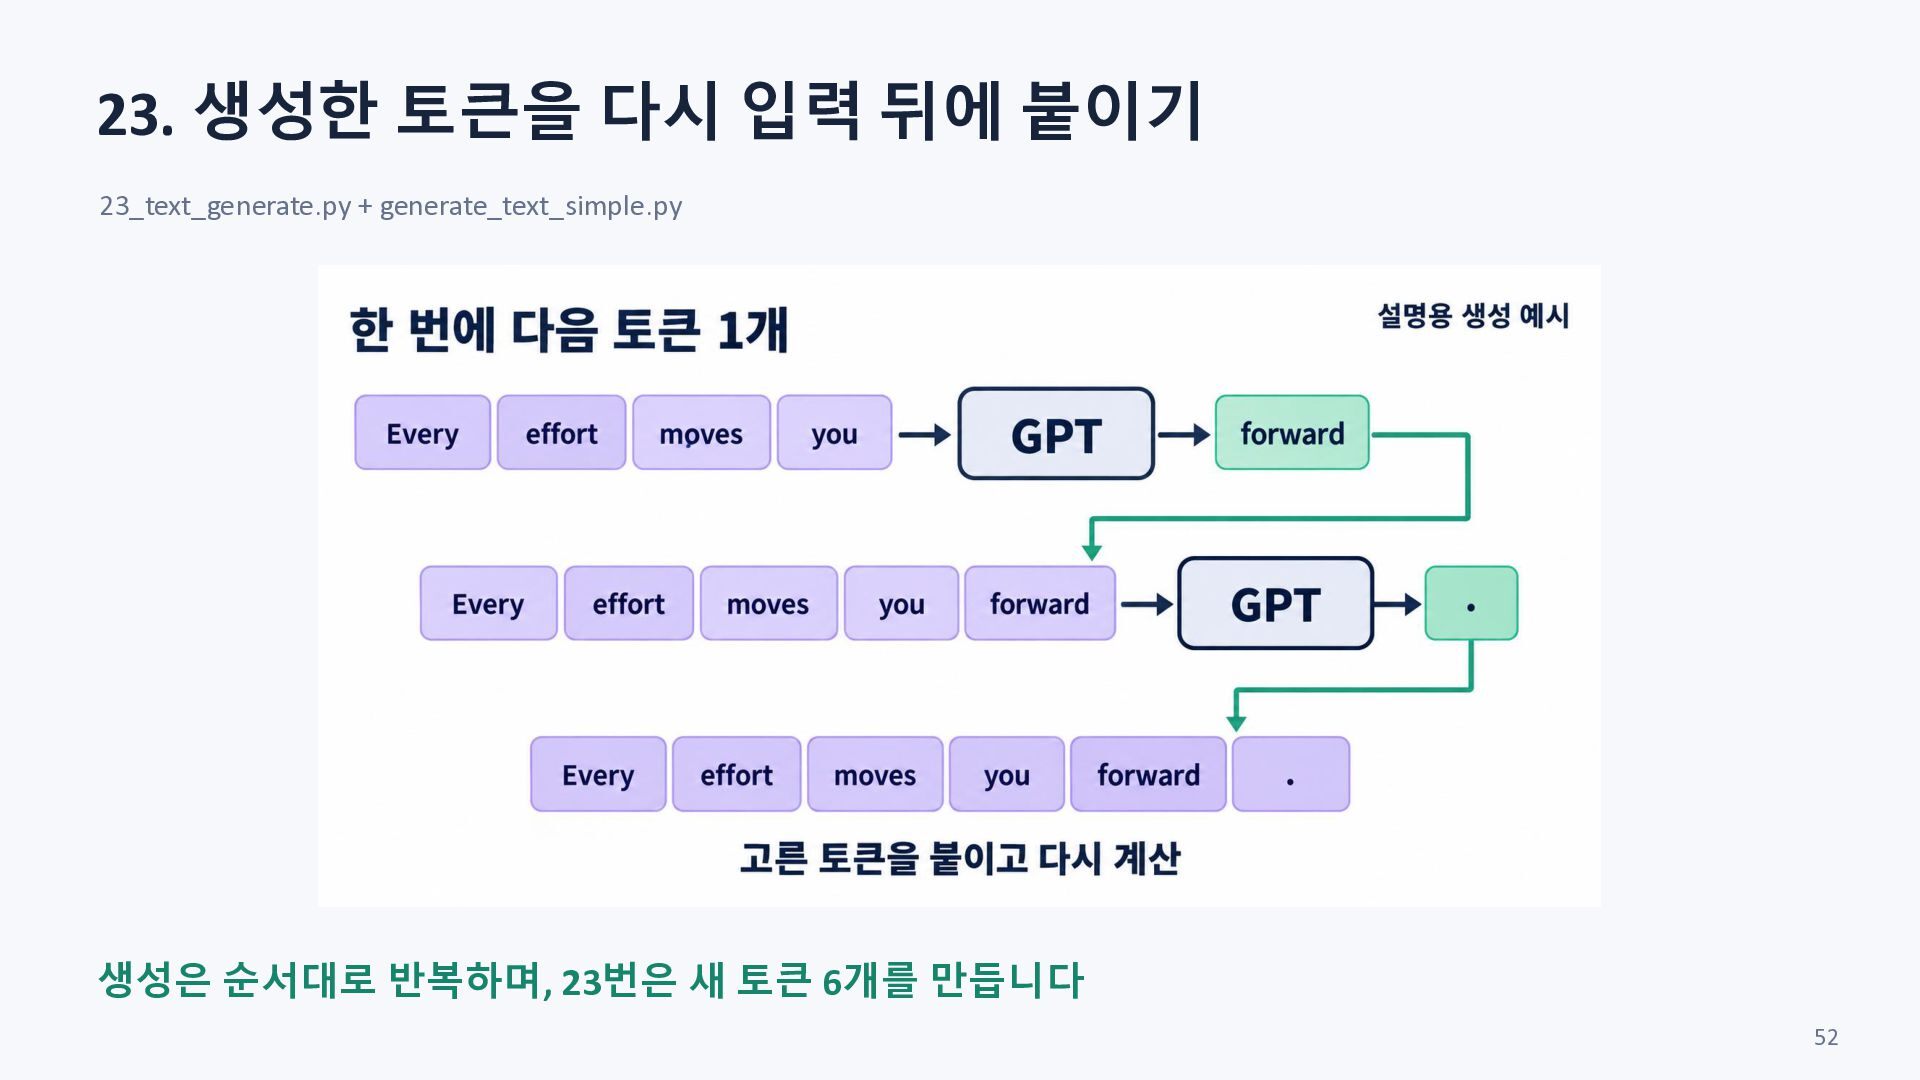
  50. 23. 생성한 토큰을 다시 입력 뒤에 붙이기 23_text_generate.py + generate_text_simple.py

    생성은 순서대로 반복하며, 23번은 새 토큰 6개를 만듭니다 52
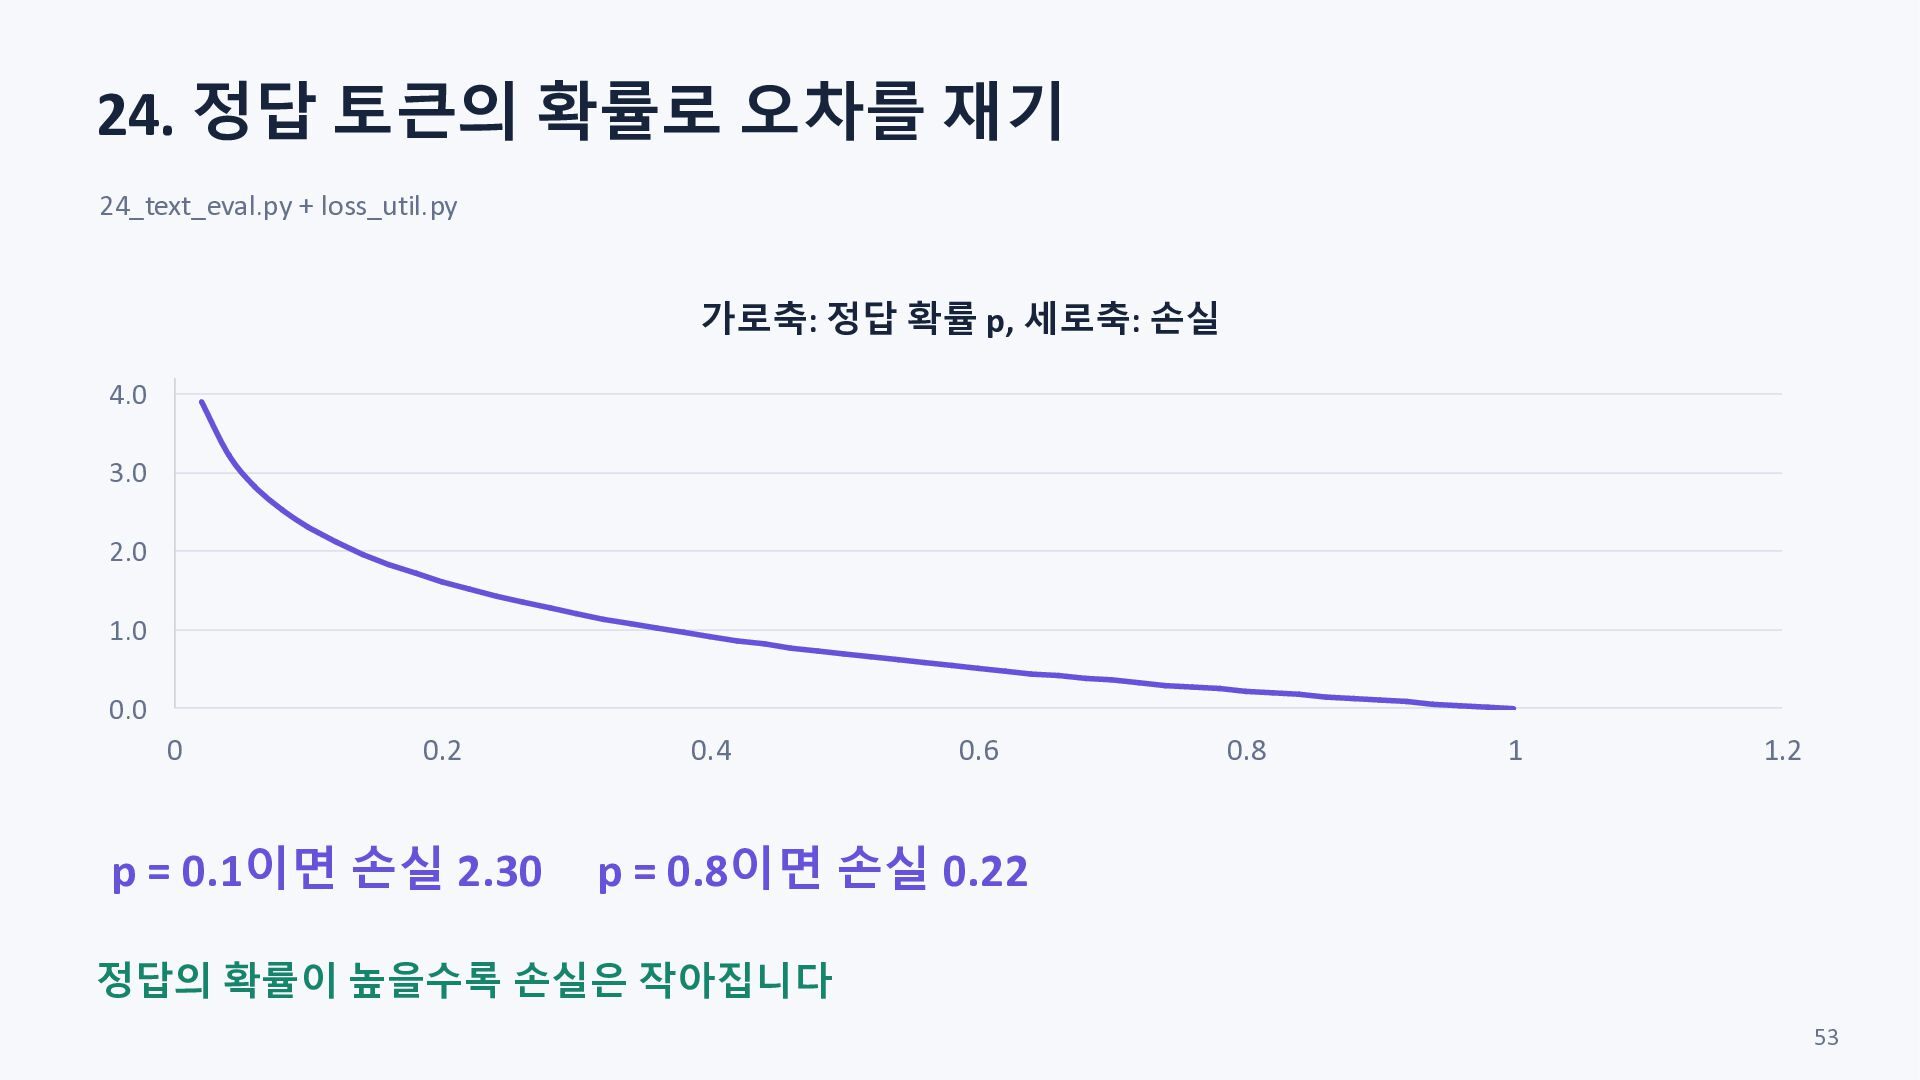
  51. 24. 정답 토큰의 확률로 오차를 재기 24_text_eval.py + loss_util.py 가로축:

    정답 확률 p, 세로축: 손실 4.0 3.0 2.0 1.0 0.0 0 0.2 p = 0.1이면 손실 2.30 0.4 0.6 0.8 1 1.2 p = 0.8이면 손실 0.22 정답의 확률이 높을수록 손실은 작아집니다 53
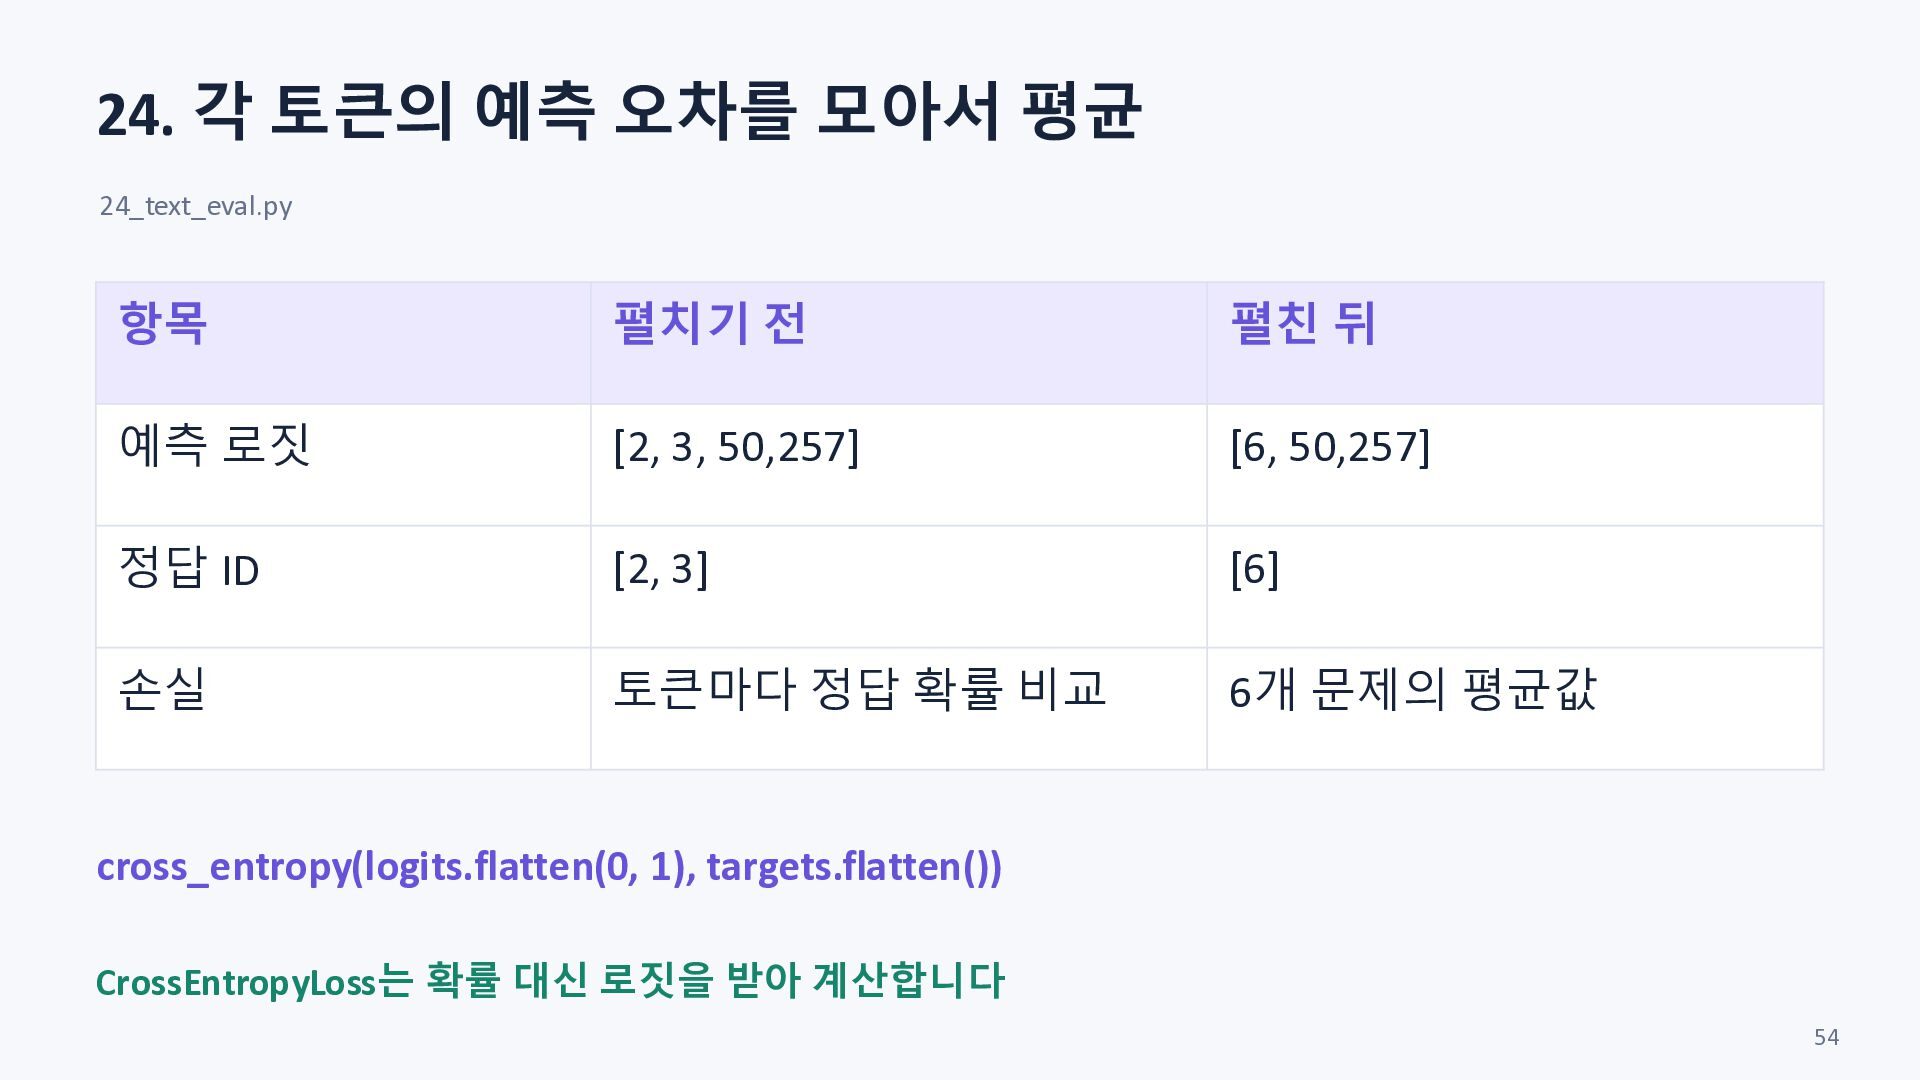
  52. 24. 각 토큰의 예측 오차를 모아서 평균 24_text_eval.py 항목 펼치기

    전 펼친 뒤 예측 로짓 [2, 3, 50,257] [6, 50,257] 정답 ID [2, 3] [6] 손실 토큰마다 정답 확률 비교 6개 문제의 평균값 cross_entropy(logits.flatten(0, 1), targets.flatten()) CrossEntropyLoss는 확률 대신 로짓을 받아 계산합니다 54
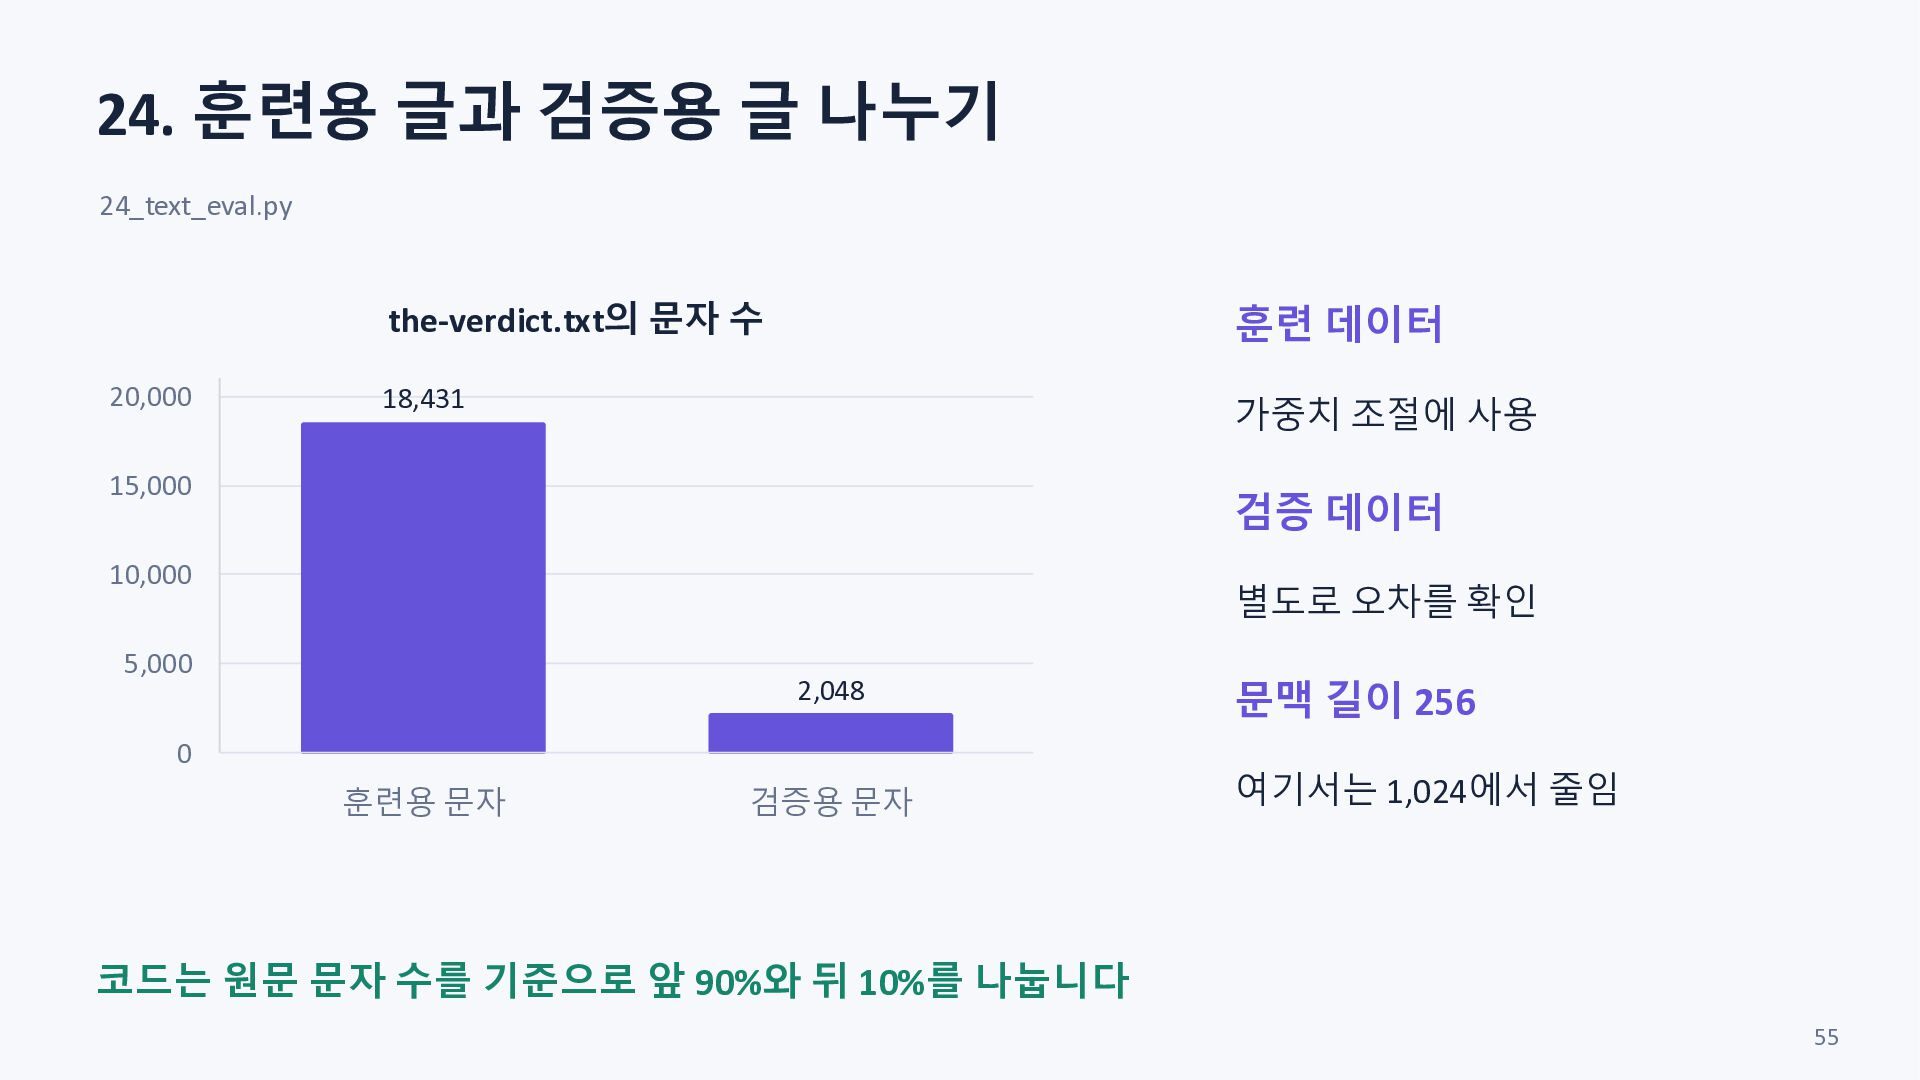
  53. 24. 훈련용 글과 검증용 글 나누기 24_text_eval.py 20,000 the-verdict.txt의 문자

    수 훈련 데이터 18,431 가중치 조절에 사용 15,000 검증 데이터 10,000 별도로 오차를 확인 5,000 2,048 0 훈련용 문자 검증용 문자 문맥 길이 256 여기서는 1,024에서 줄임 코드는 원문 문자 수를 기준으로 앞 90%와 뒤 10%를 나눕니다 55
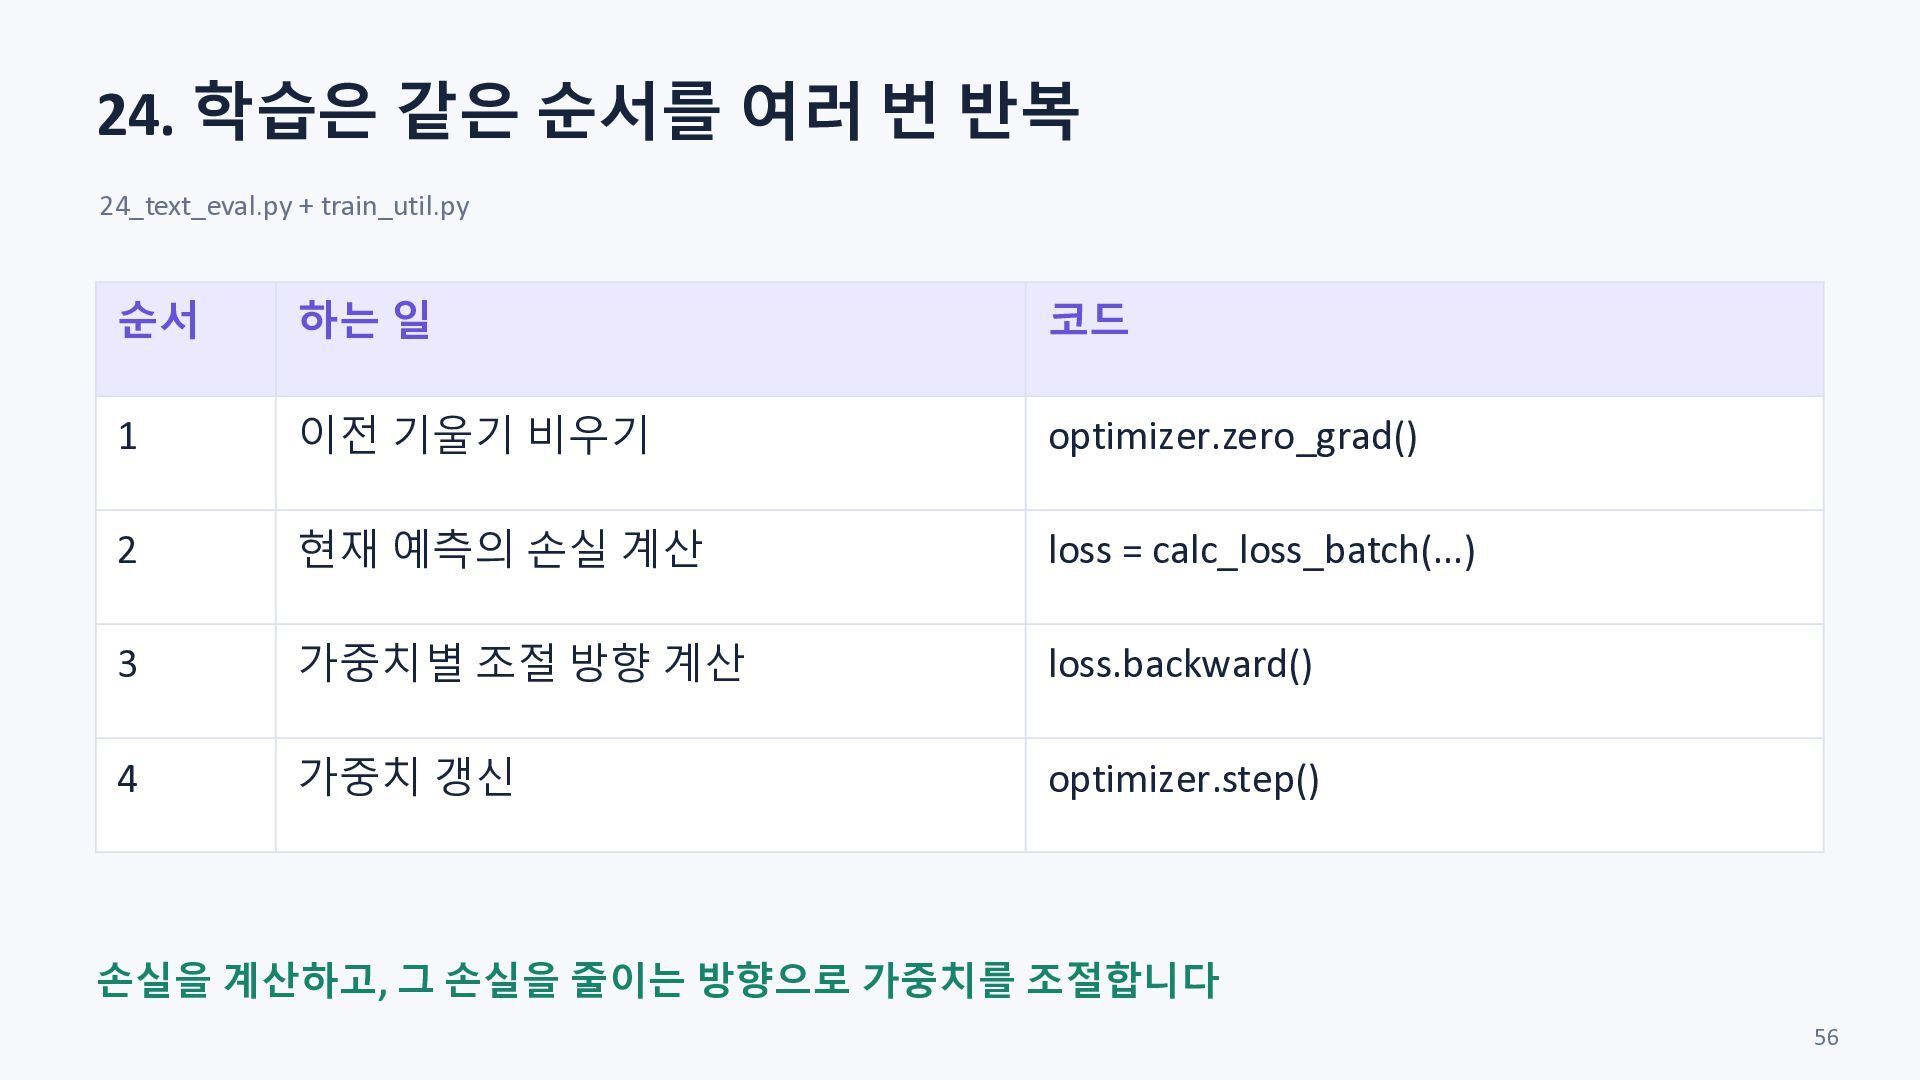
  54. 24. 학습은 같은 순서를 여러 번 반복 24_text_eval.py + train_util.py

    순서 하는 일 코드 1 이전 기울기 비우기 optimizer.zero_grad() 2 현재 예측의 손실 계산 loss = calc_loss_batch(...) 3 가중치별 조절 방향 계산 loss.backward() 4 가중치 갱신 optimizer.step() 손실을 계산하고, 그 손실을 줄이는 방향으로 가중치를 조절합니다 56
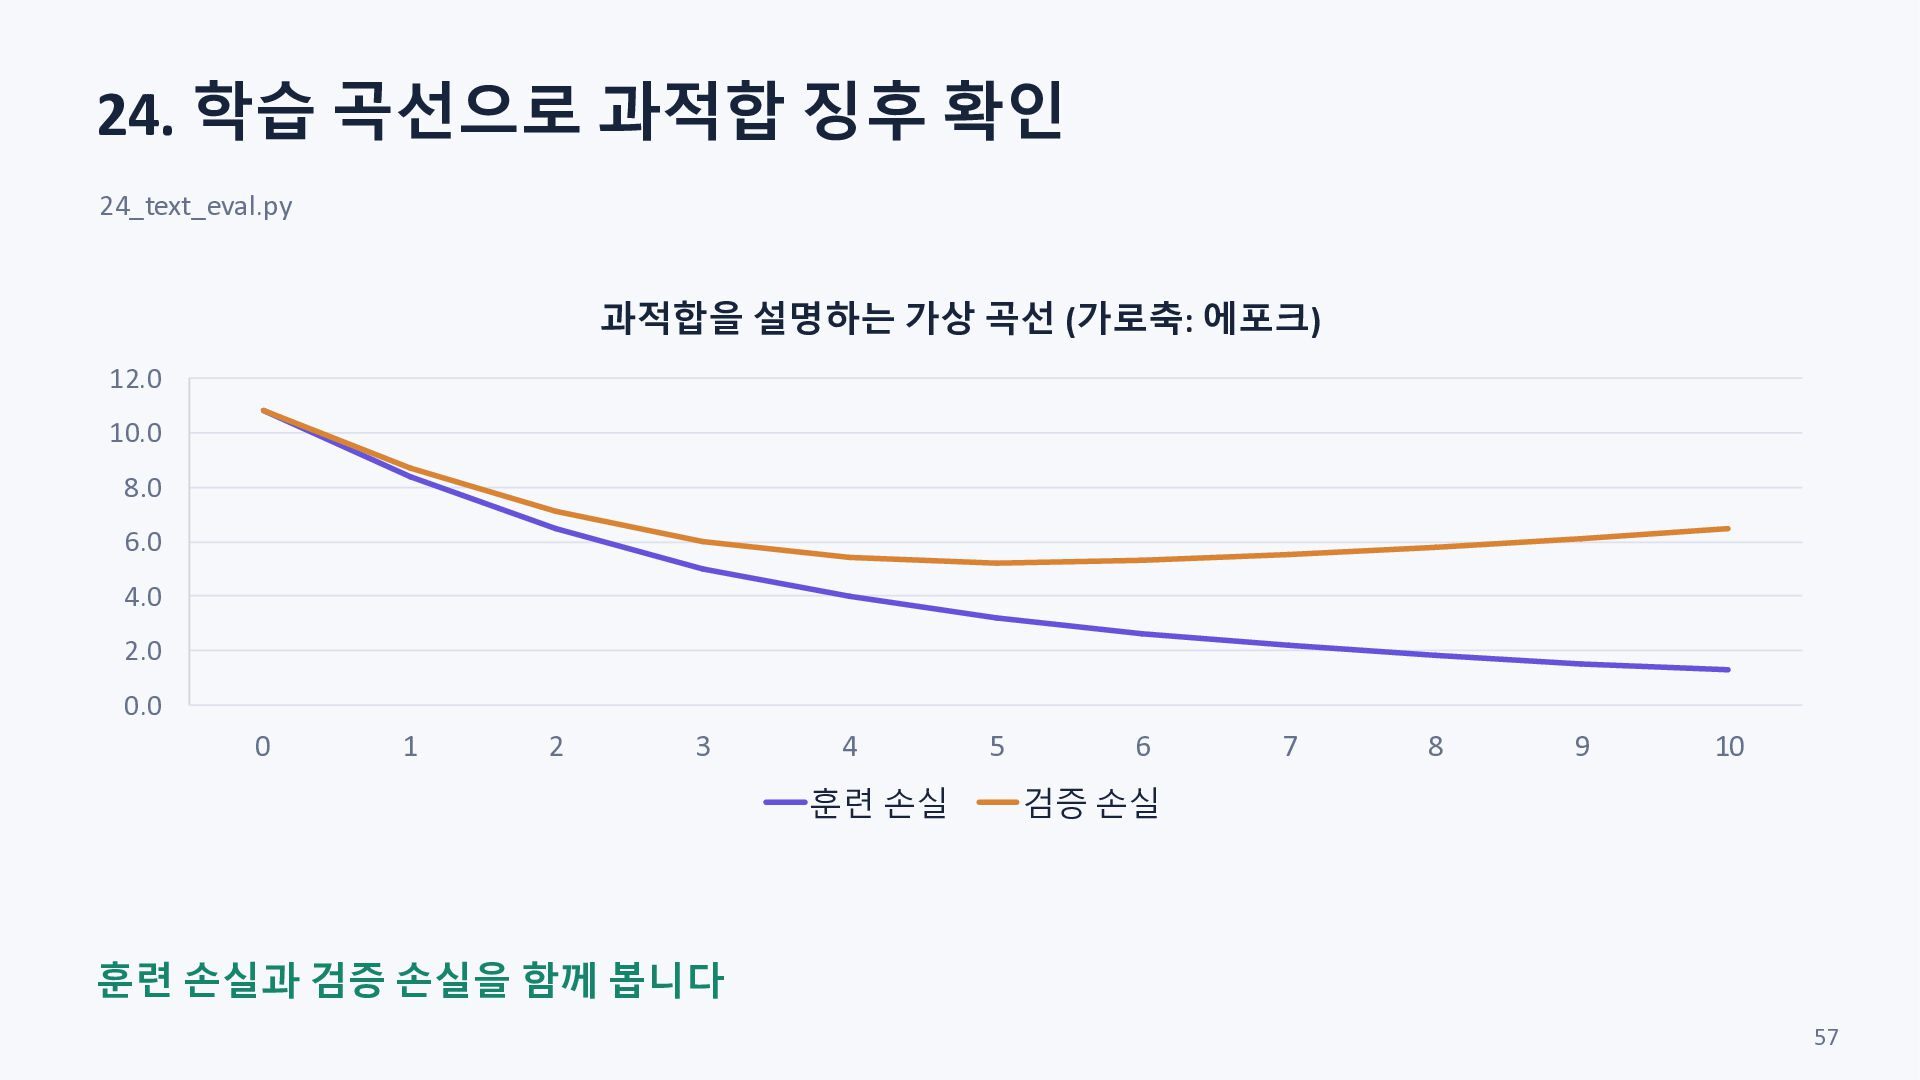
  55. 24. 학습 곡선으로 과적합 징후 확인 24_text_eval.py 과적합을 설명하는 가상

    곡선 (가로축: 에포크) 12.0 10.0 8.0 6.0 4.0 2.0 0.0 0 1 2 3 4 훈련 손실 5 6 7 8 9 10 검증 손실 훈련 손실과 검증 손실을 함께 봅니다 57
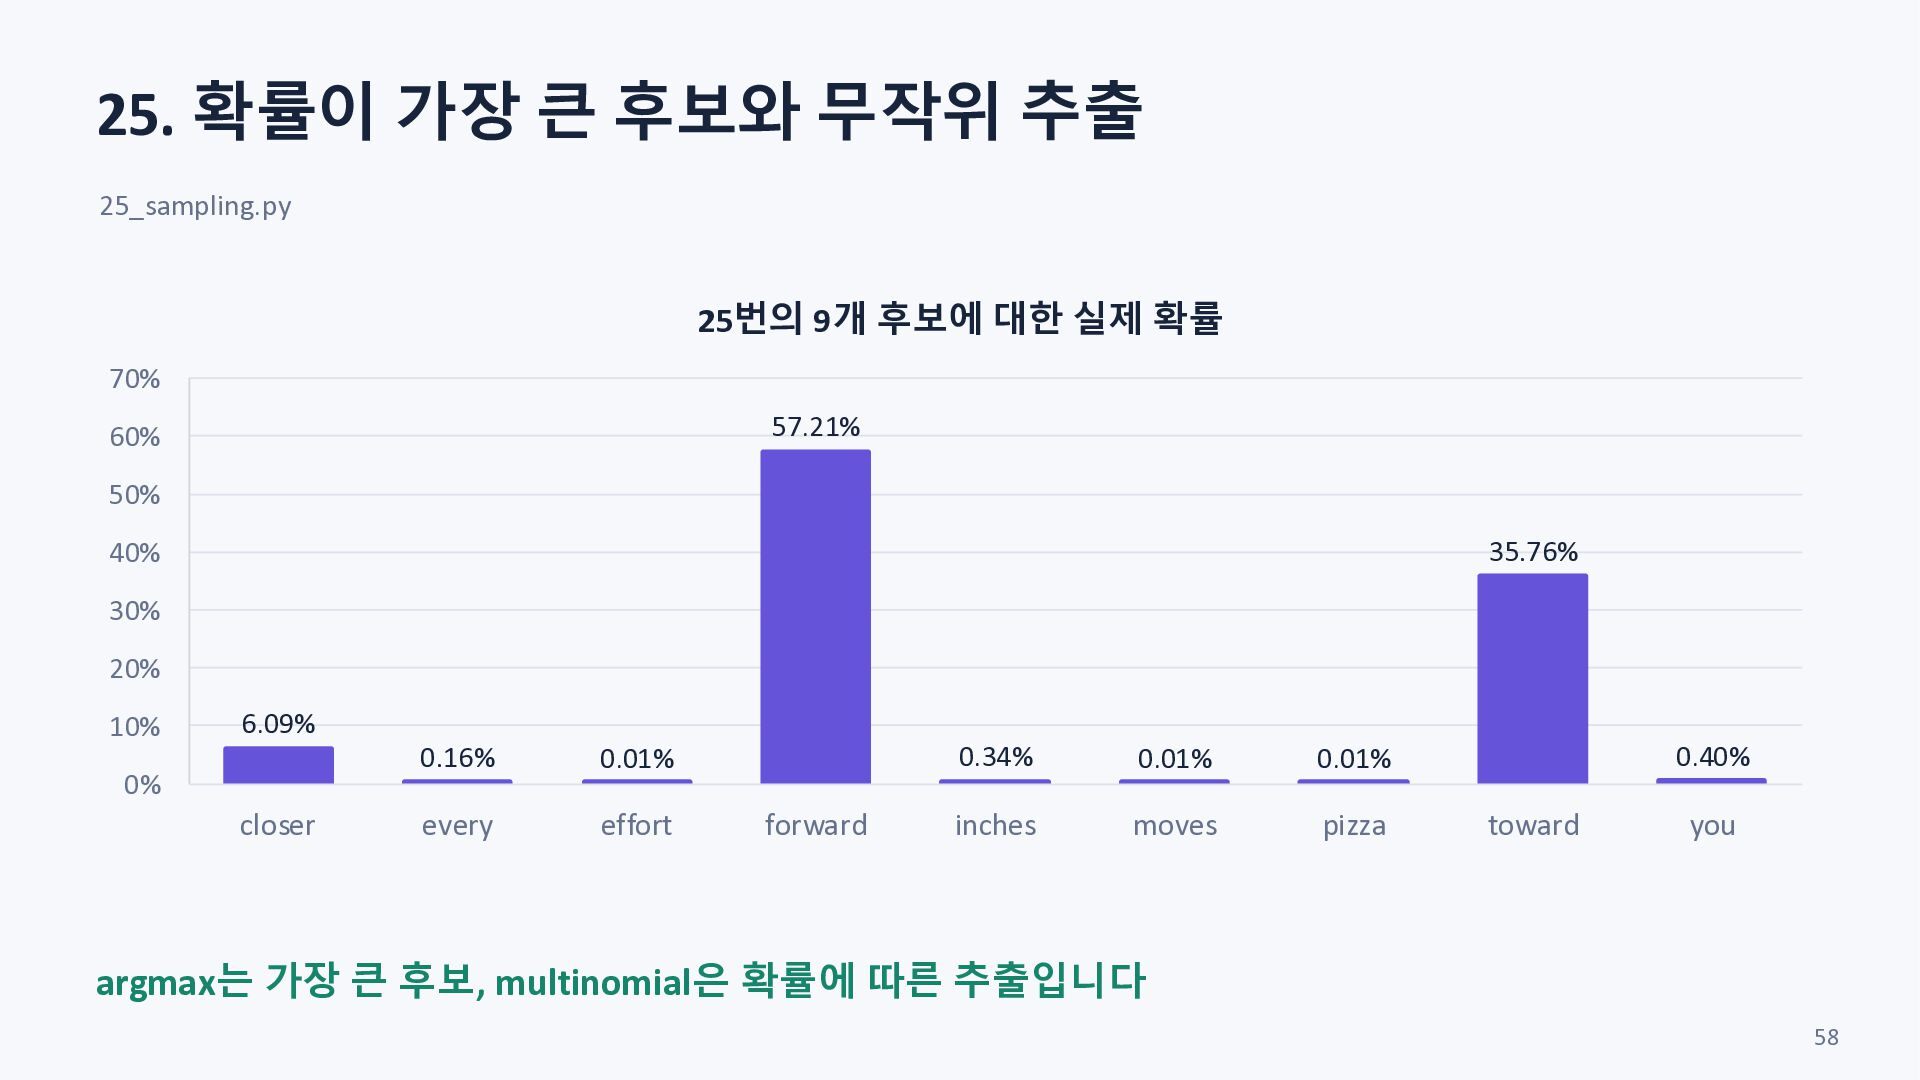
  56. 25. 확률이 가장 큰 후보와 무작위 추출 25_sampling.py 25번의 9개

    후보에 대한 실제 확률 70% 57.21% 60% 50% 35.76% 40% 30% 20% 10% 6.09% 0% closer 0.16% 0.01% every effort forward 0.34% 0.01% 0.01% inches moves pizza 0.40% toward you argmax는 가장 큰 후보, multinomial은 확률에 따른 추출입니다 58
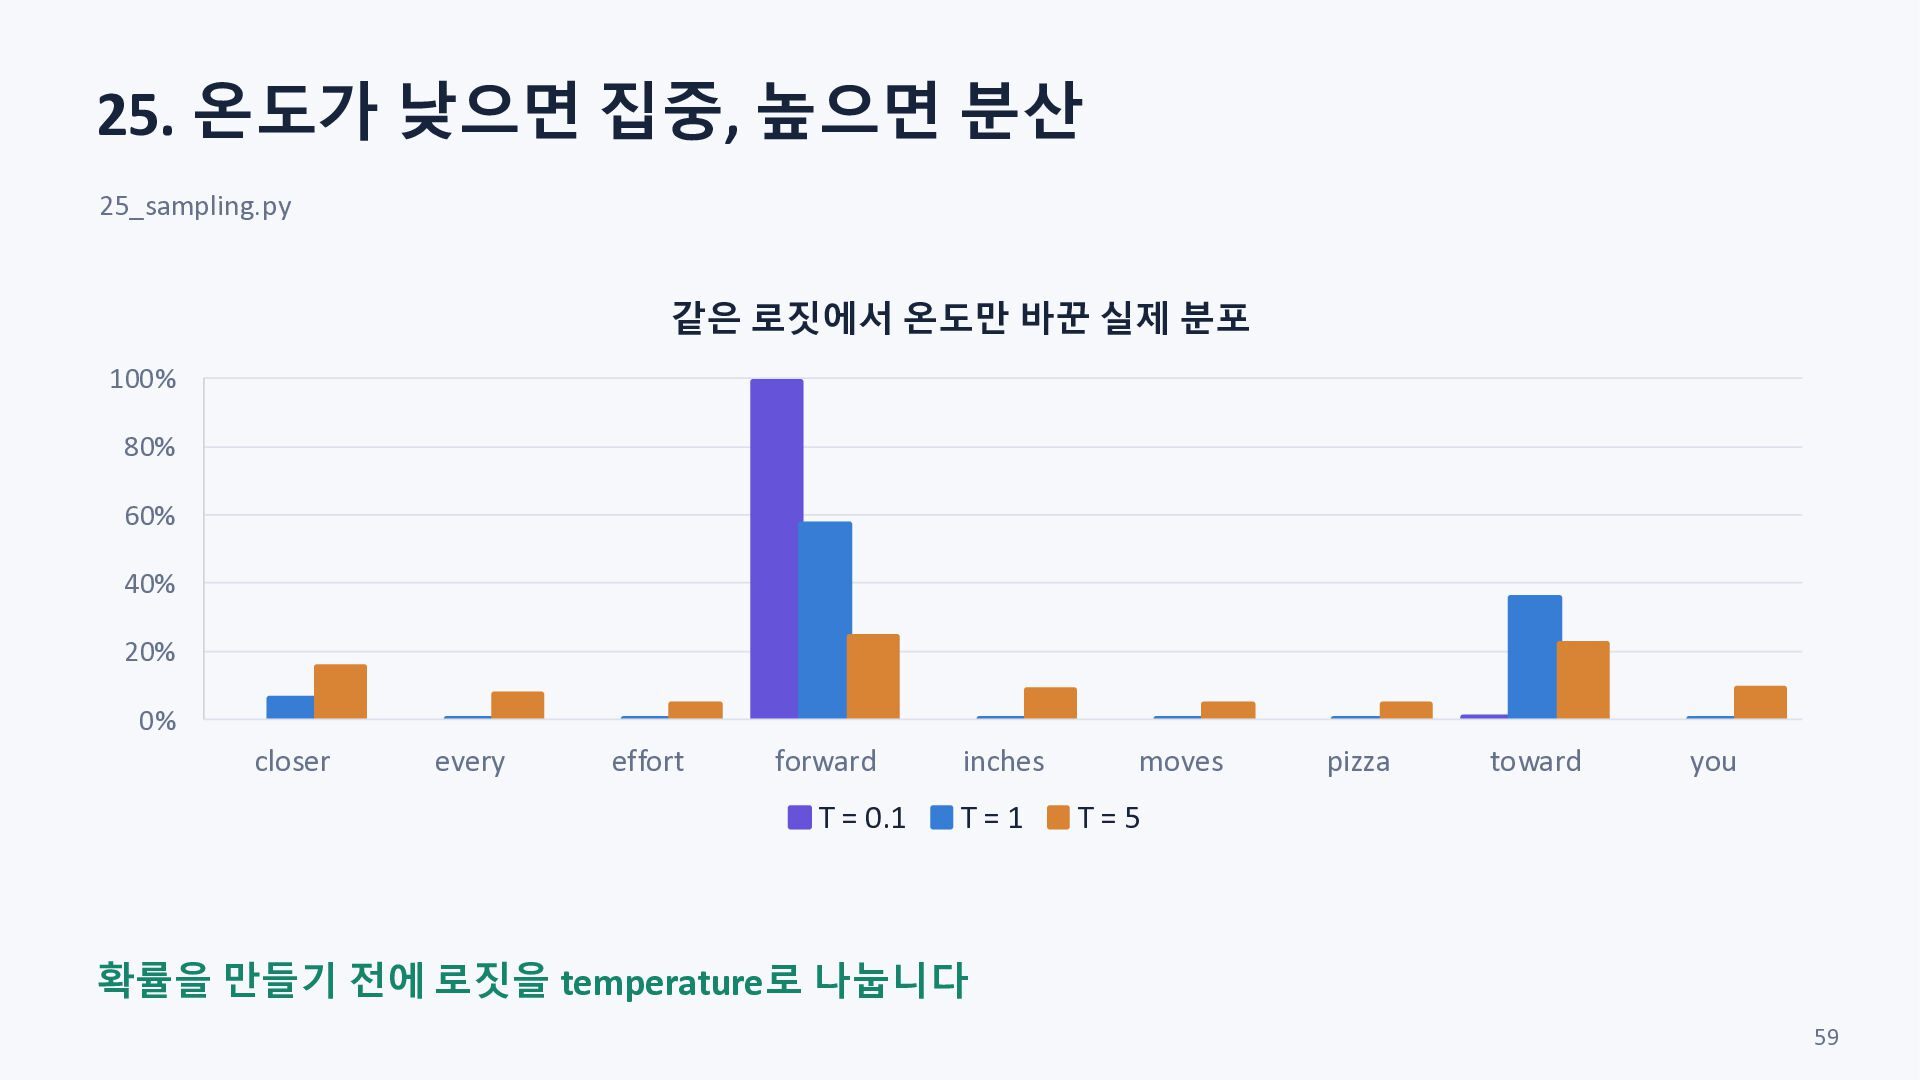
  57. 25. 온도가 낮으면 집중, 높으면 분산 25_sampling.py 같은 로짓에서 온도만

    바꾼 실제 분포 100% 80% 60% 40% 20% 0% closer every effort forward T = 0.1 inches T=1 moves pizza toward you T=5 확률을 만들기 전에 로짓을 temperature로 나눕니다 59
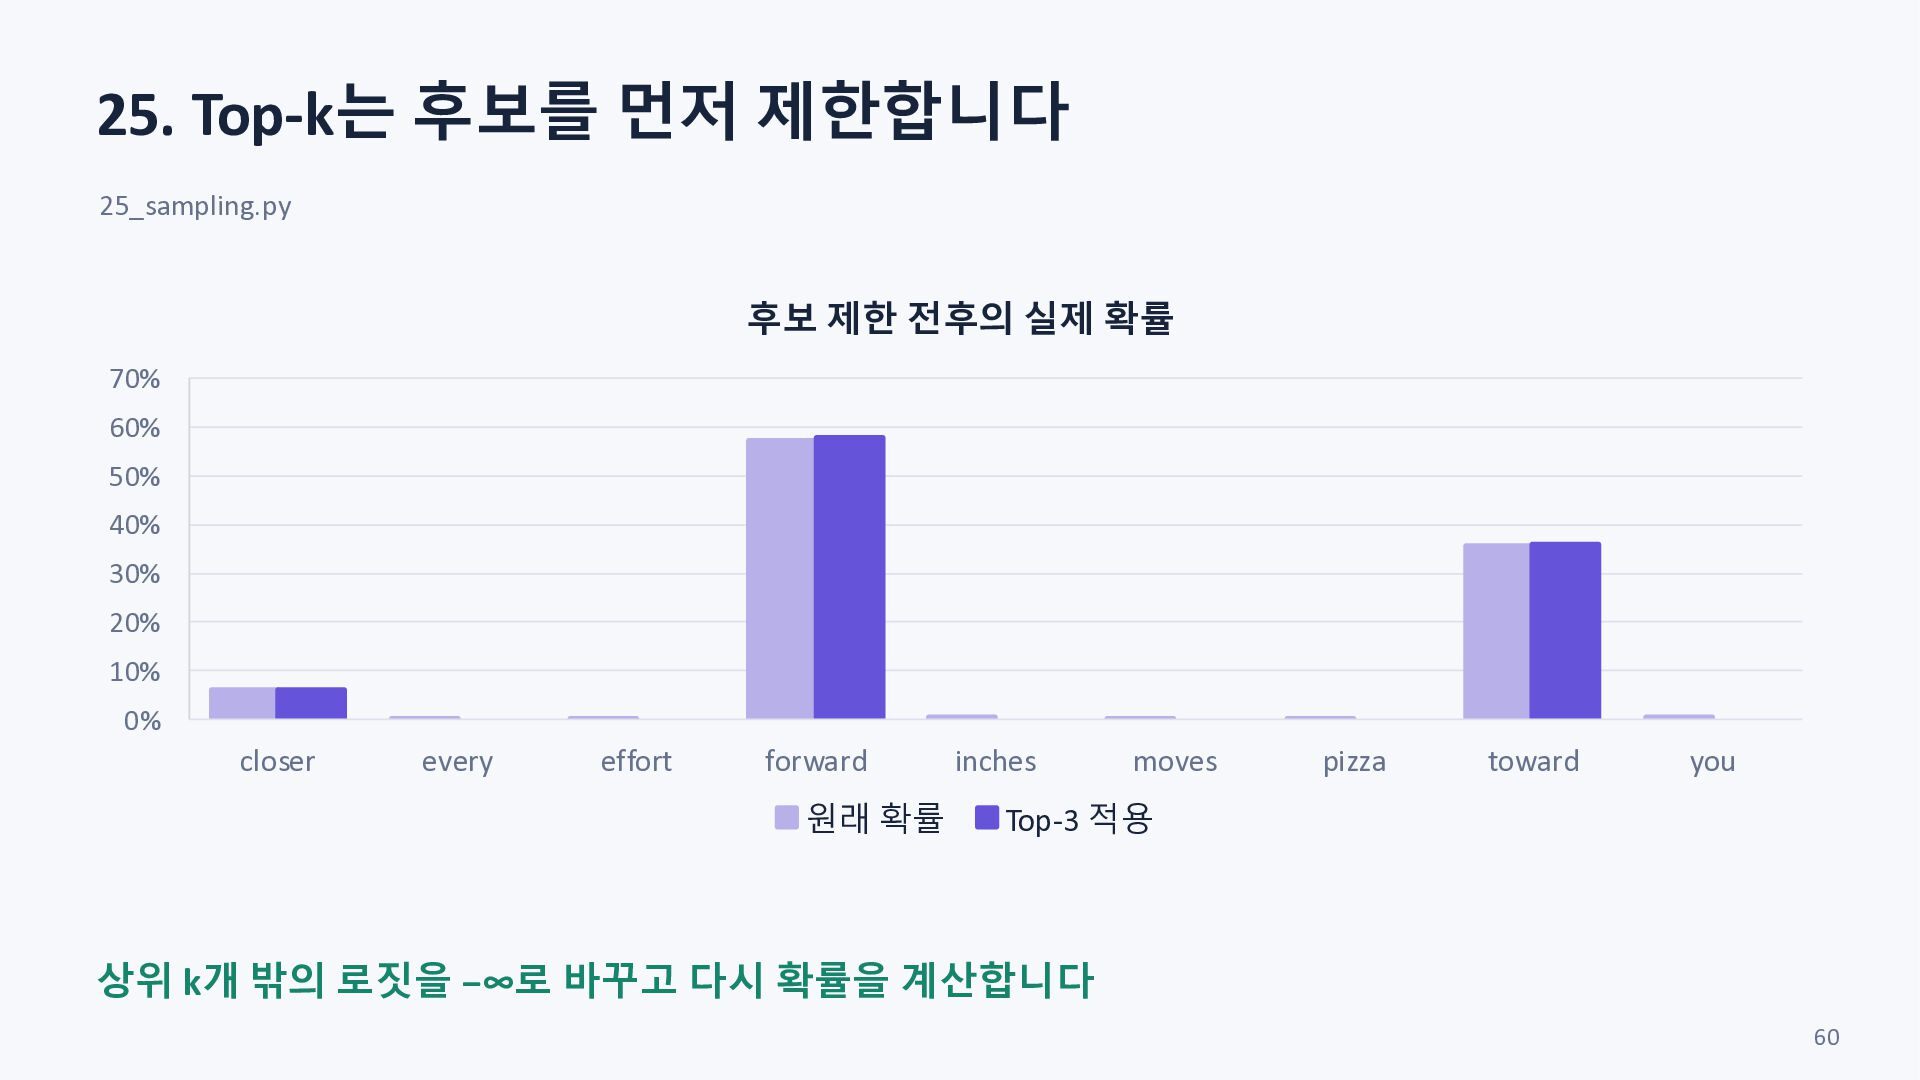
  58. 25. Top-k는 후보를 먼저 제한합니다 25_sampling.py 후보 제한 전후의 실제

    확률 70% 60% 50% 40% 30% 20% 10% 0% closer every effort forward 원래 확률 inches moves pizza toward you Top-3 적용 상위 k개 밖의 로짓을 −∞로 바꾸고 다시 확률을 계산합니다 60
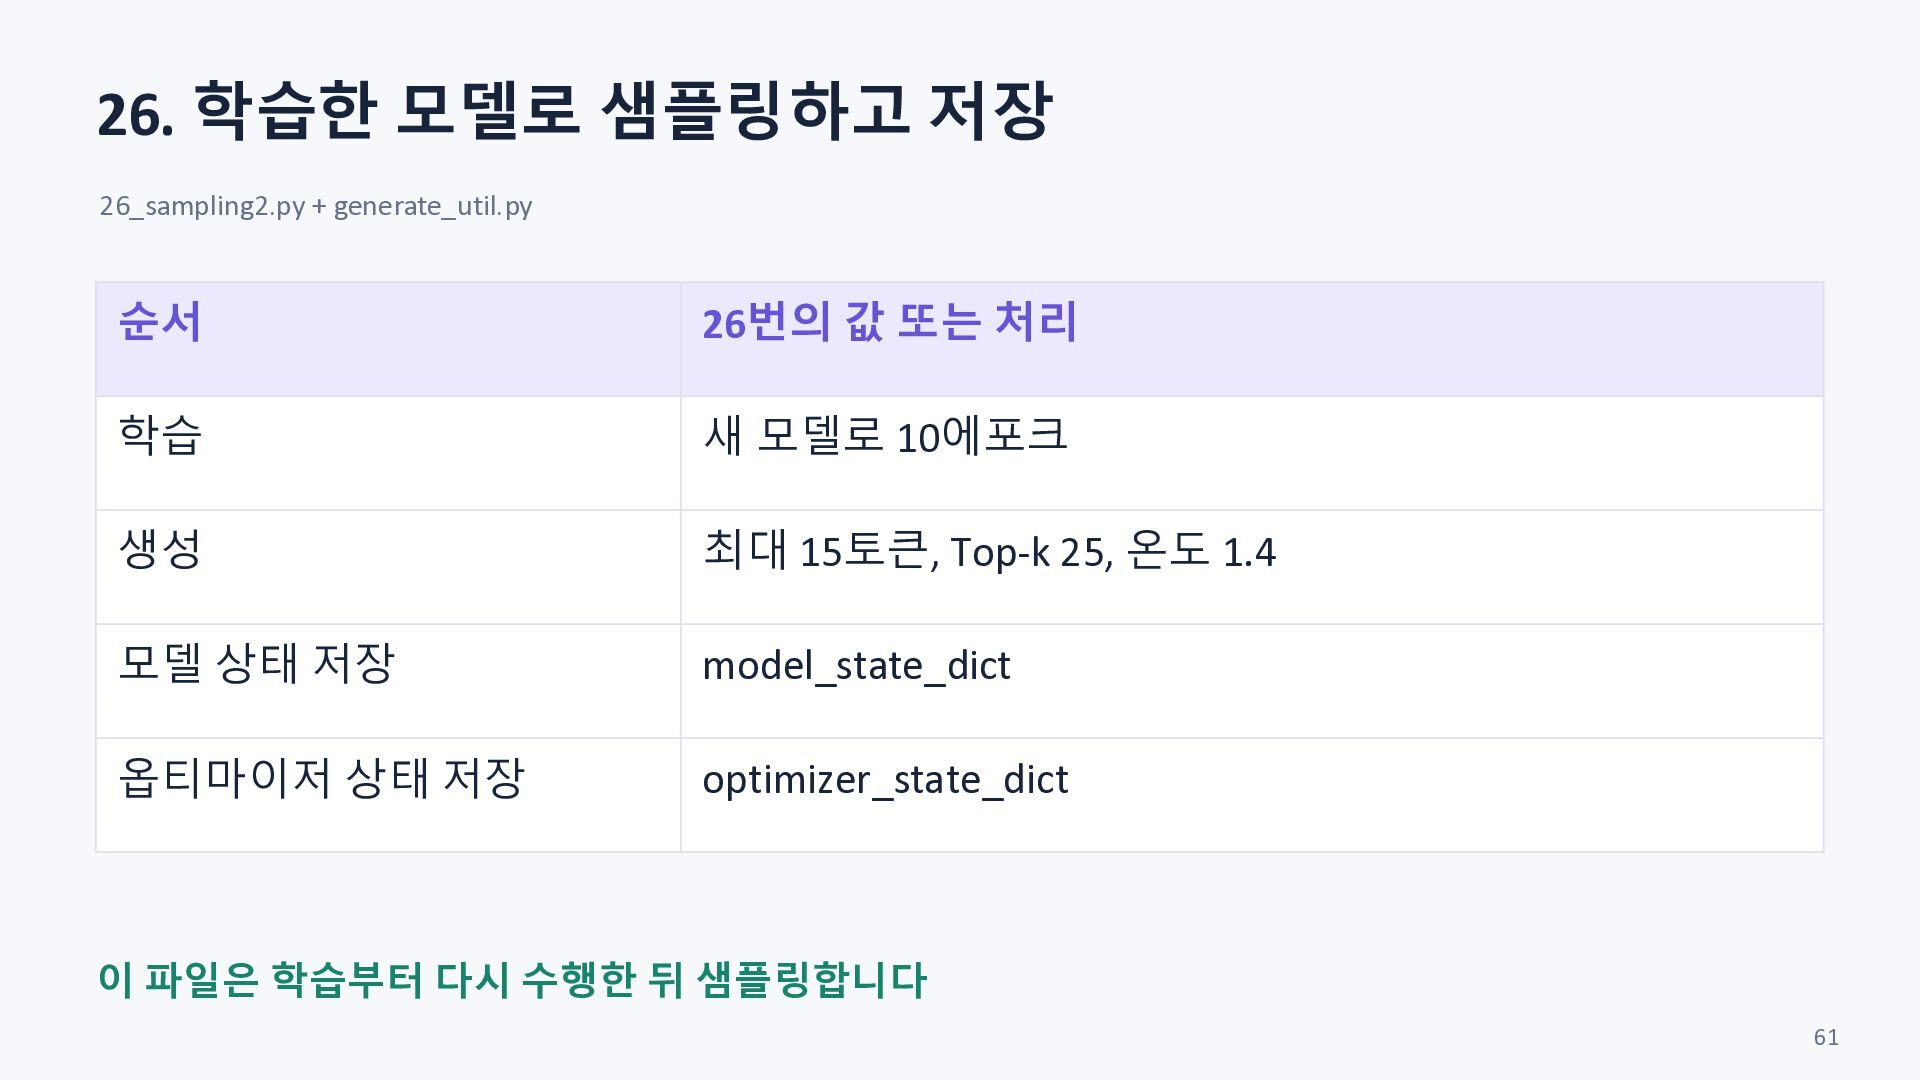
  59. 26. 학습한 모델로 샘플링하고 저장 26_sampling2.py + generate_util.py 순서 26번의

    값 또는 처리 학습 새 모델로 10에포크 생성 최대 15토큰, Top-k 25, 온도 1.4 모델 상태 저장 model_state_dict 옵티마이저 상태 저장 optimizer_state_dict 이 파일은 학습부터 다시 수행한 뒤 샘플링합니다 61
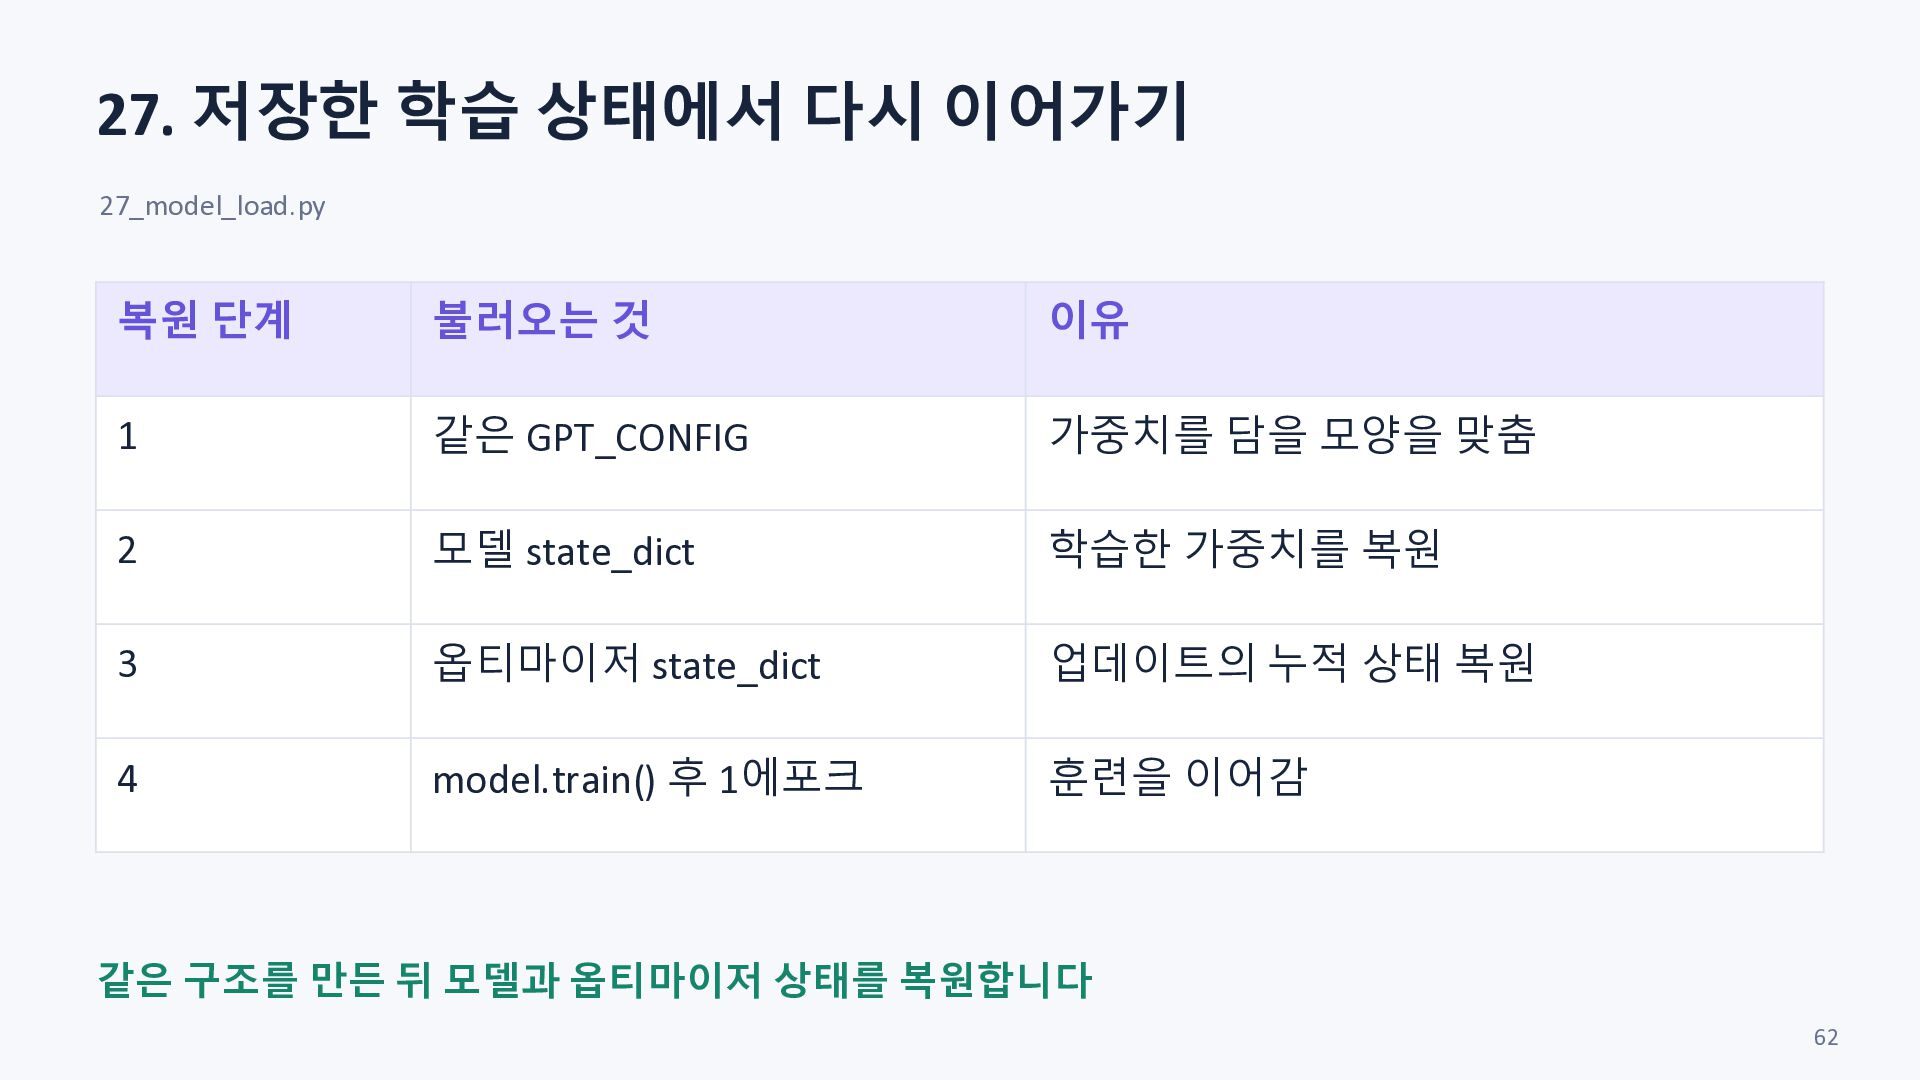
  60. 27. 저장한 학습 상태에서 다시 이어가기 27_model_load.py 복원 단계 불러오는

    것 이유 1 같은 GPT_CONFIG 가중치를 담을 모양을 맞춤 2 모델 state_dict 학습한 가중치를 복원 3 옵티마이저 state_dict 업데이트의 누적 상태 복원 4 model.train() 후 1에포크 훈련을 이어감 같은 구조를 만든 뒤 모델과 옵티마이저 상태를 복원합니다 62
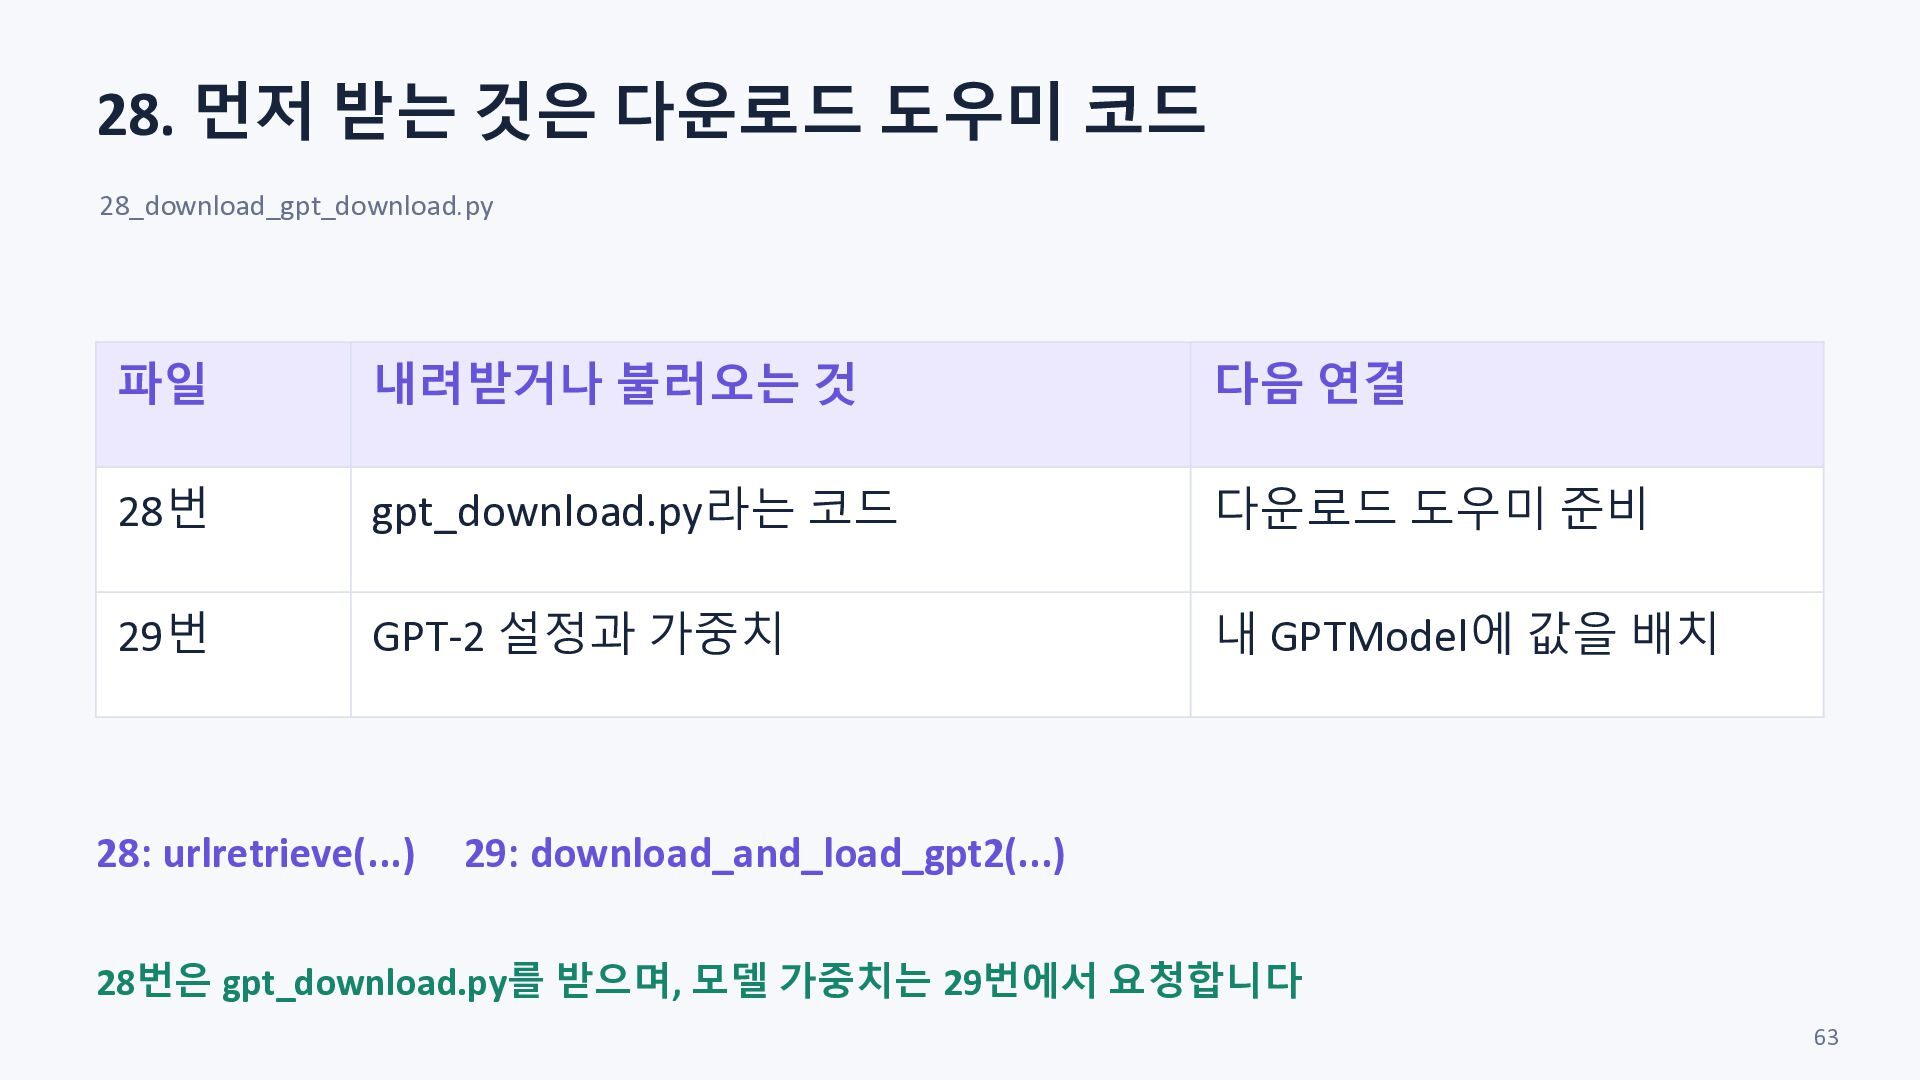
  61. 28. 먼저 받는 것은 다운로드 도우미 코드 28_download_gpt_download.py 파일 내려받거나

    불러오는 것 다음 연결 28번 gpt_download.py라는 코드 다운로드 도우미 준비 29번 GPT-2 설정과 가중치 내 GPTModel에 값을 배치 28: urlretrieve(...) 29: download_and_load_gpt2(...) 28번은 gpt_download.py를 받으며, 모델 가중치는 29번에서 요청합니다 63
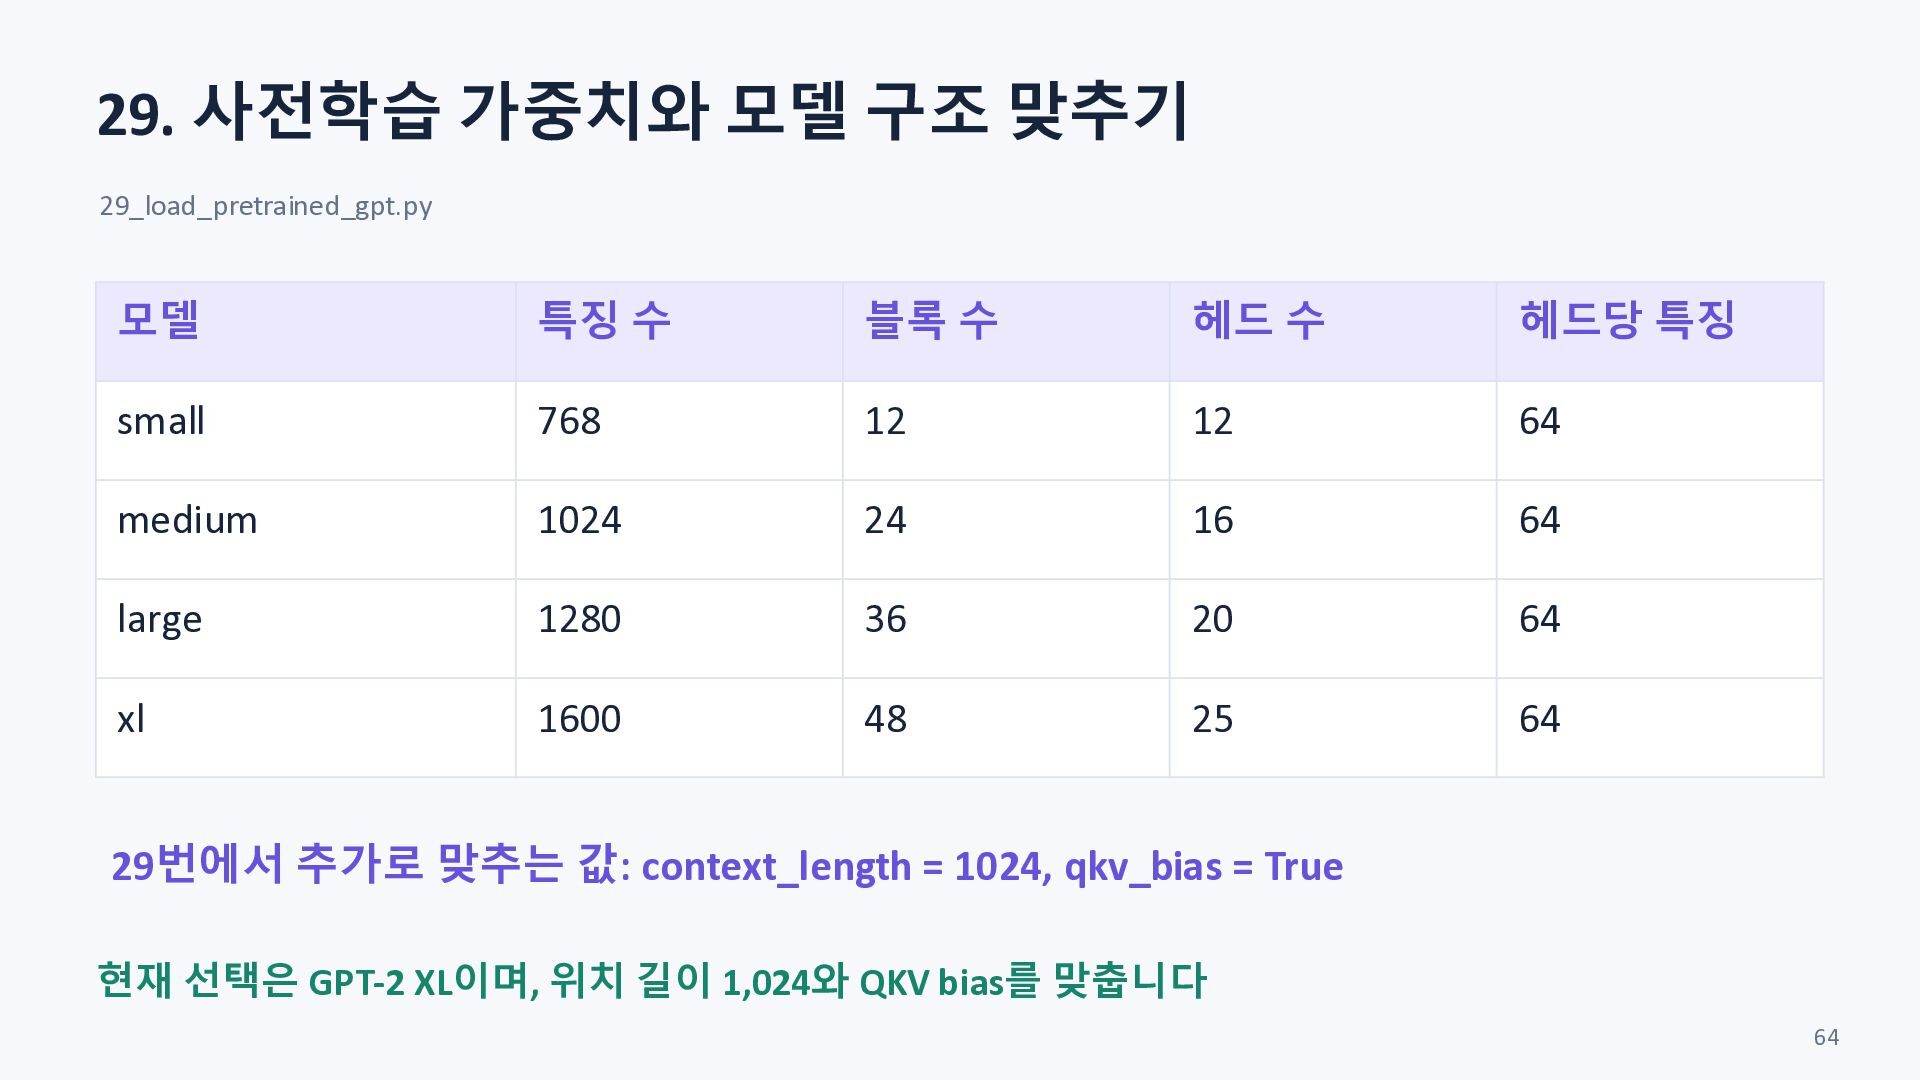
  62. 29. 사전학습 가중치와 모델 구조 맞추기 29_load_pretrained_gpt.py 모델 특징 수

    블록 수 헤드 수 헤드당 특징 small 768 12 12 64 medium 1024 24 16 64 large 1280 36 20 64 xl 1600 48 25 64 29번에서 추가로 맞추는 값: context_length = 1024, qkv_bias = True 현재 선택은 GPT-2 XL이며, 위치 길이 1,024와 QKV bias를 맞춥니다 64
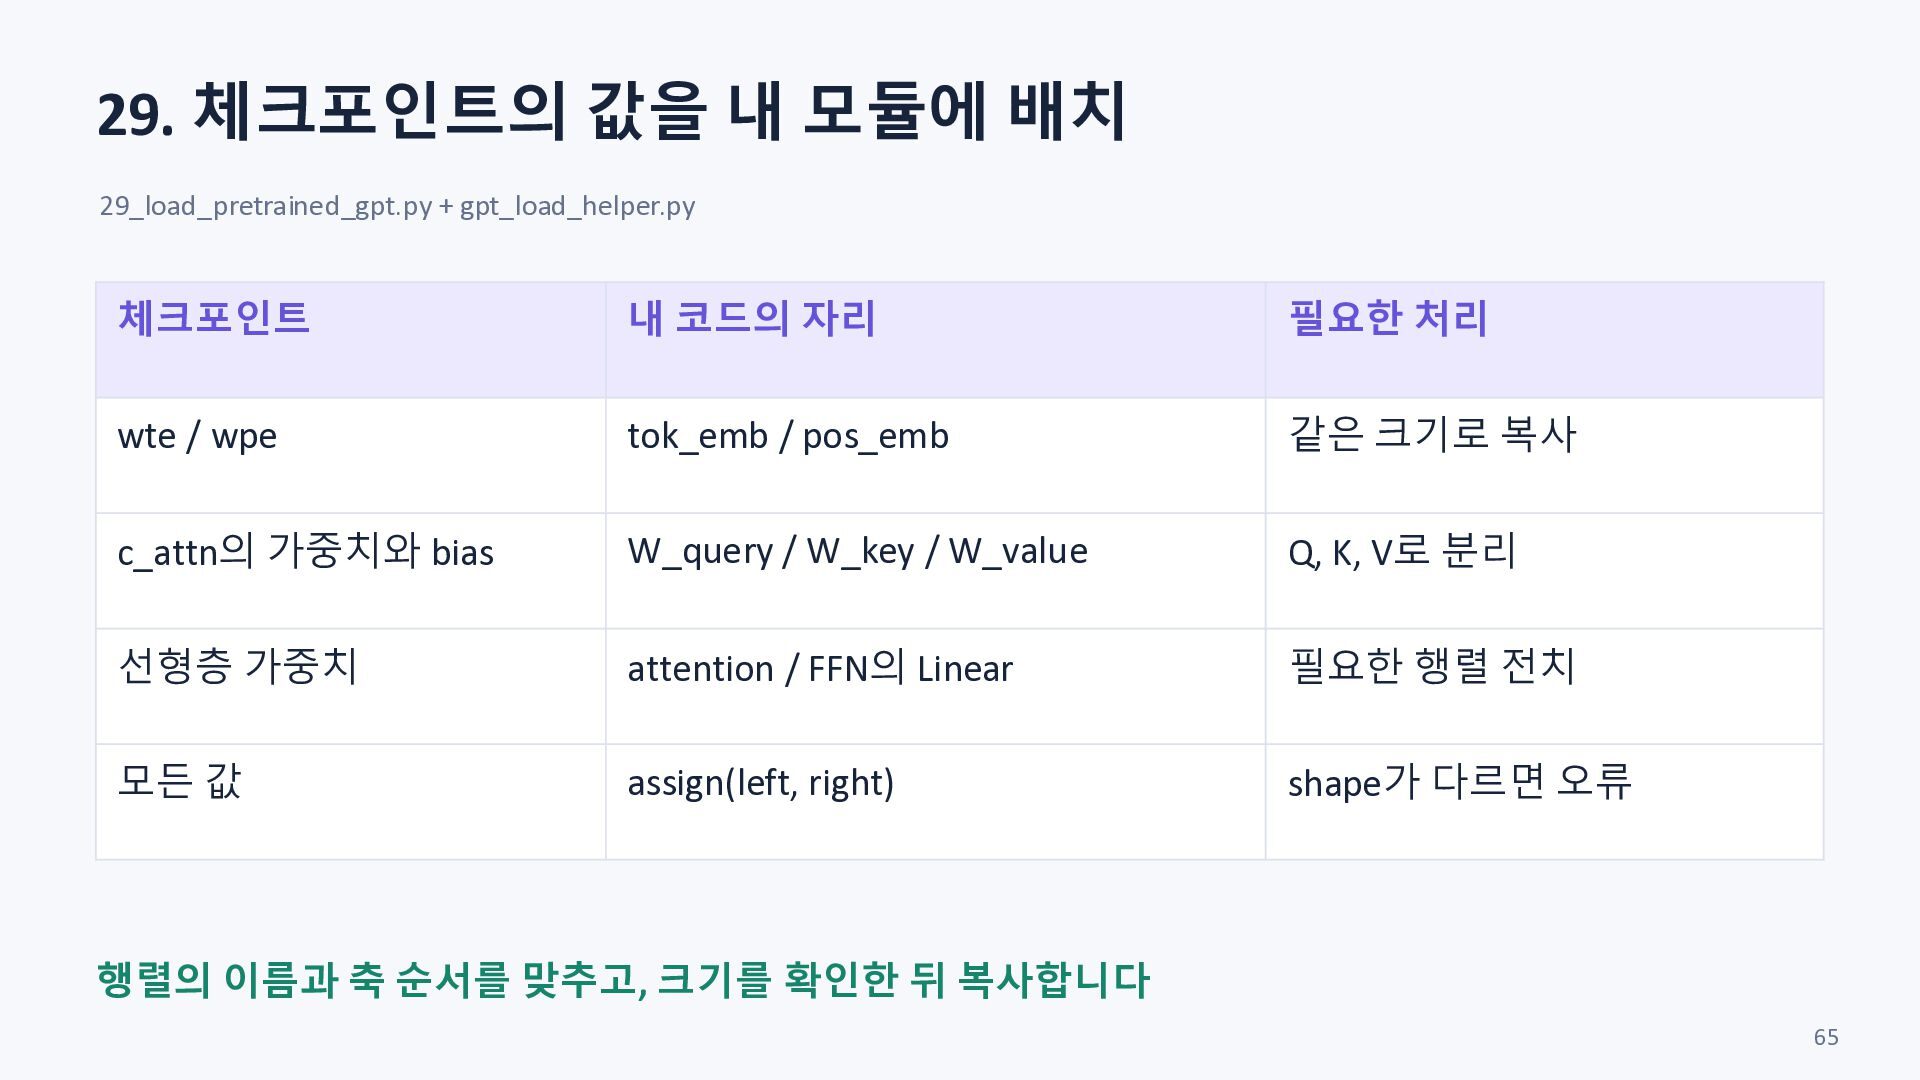
  63. 29. 체크포인트의 값을 내 모듈에 배치 29_load_pretrained_gpt.py + gpt_load_helper.py 체크포인트

    내 코드의 자리 필요한 처리 wte / wpe tok_emb / pos_emb 같은 크기로 복사 c_attn의 가중치와 bias W_query / W_key / W_value Q, K, V로 분리 선형층 가중치 attention / FFN의 Linear 필요한 행렬 전치 모든 값 assign(left, right) shape가 다르면 오류 행렬의 이름과 축 순서를 맞추고, 크기를 확인한 뒤 복사합니다 65
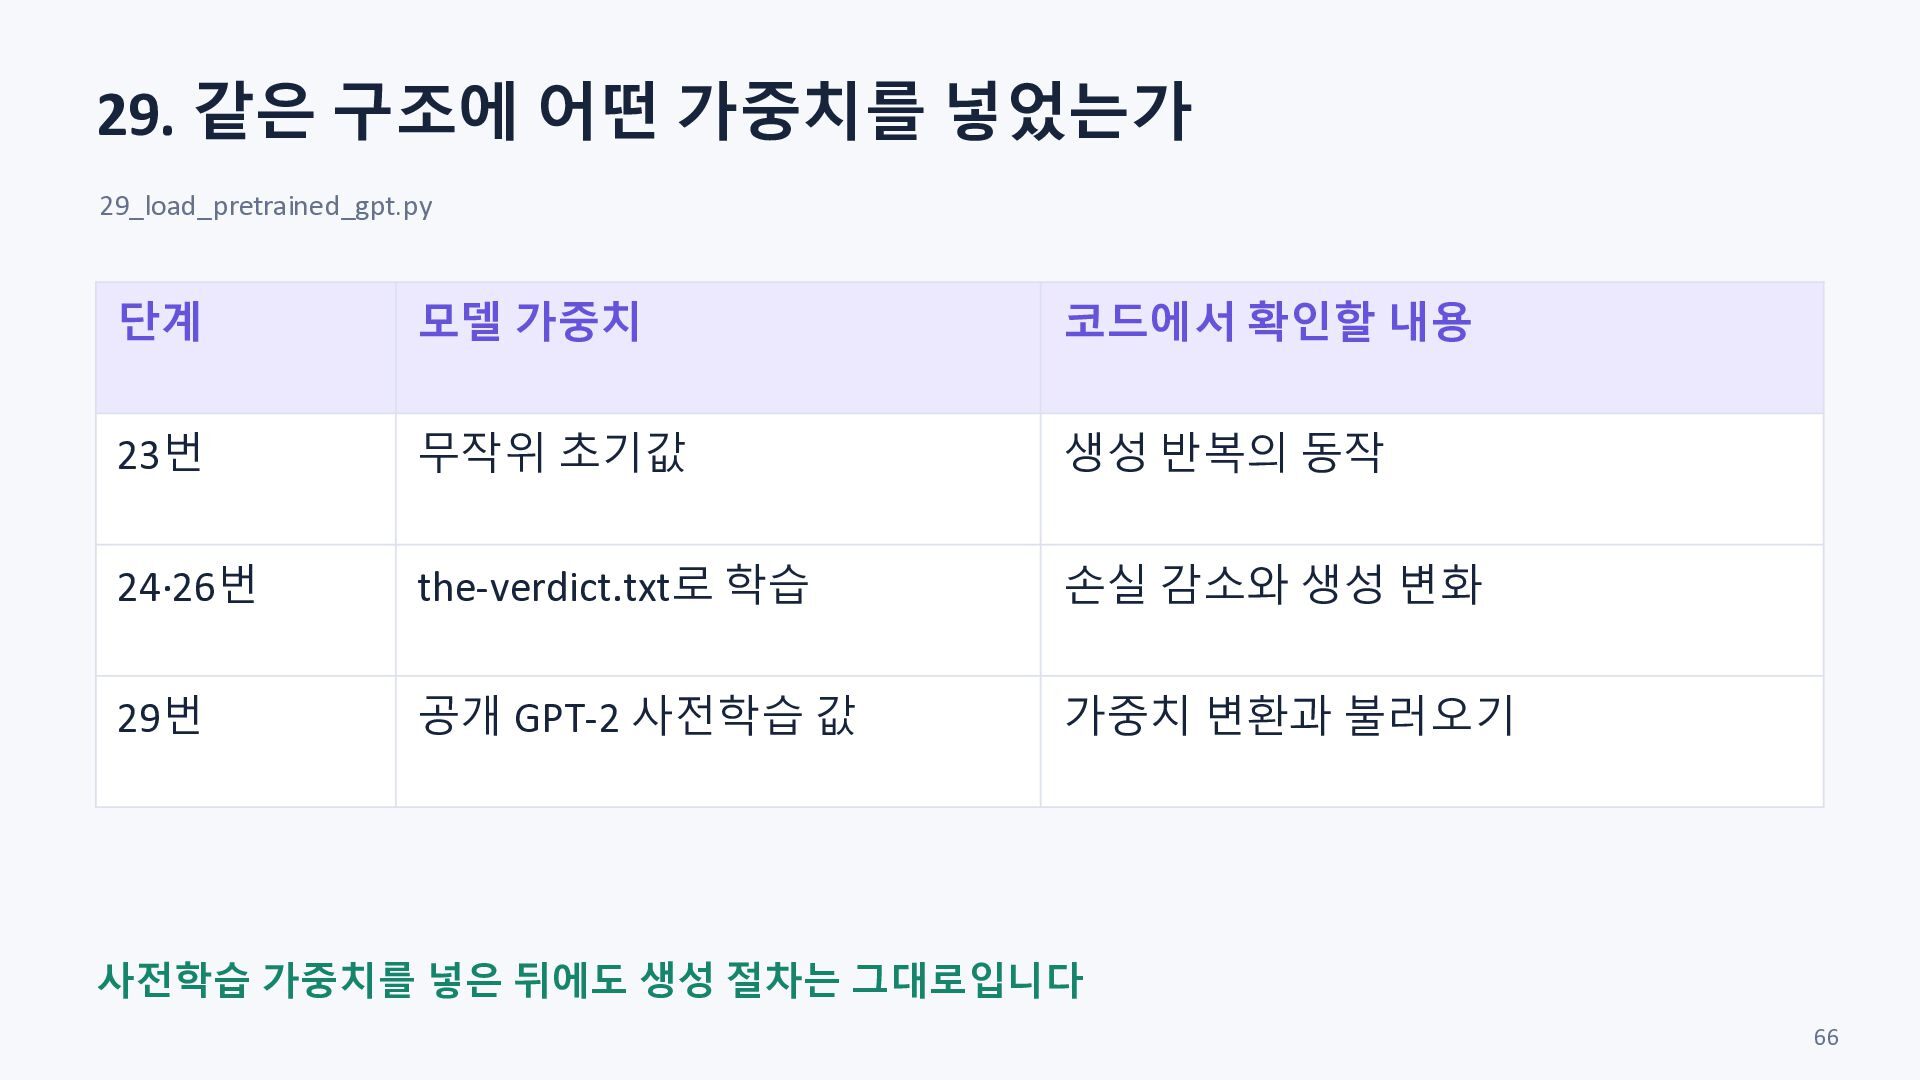
  64. 29. 같은 구조에 어떤 가중치를 넣었는가 29_load_pretrained_gpt.py 단계 모델 가중치

    코드에서 확인할 내용 23번 무작위 초기값 생성 반복의 동작 24·26번 the-verdict.txt로 학습 손실 감소와 생성 변화 29번 공개 GPT-2 사전학습 값 가중치 변환과 불러오기 사전학습 가중치를 넣은 뒤에도 생성 절차는 그대로입니다 66
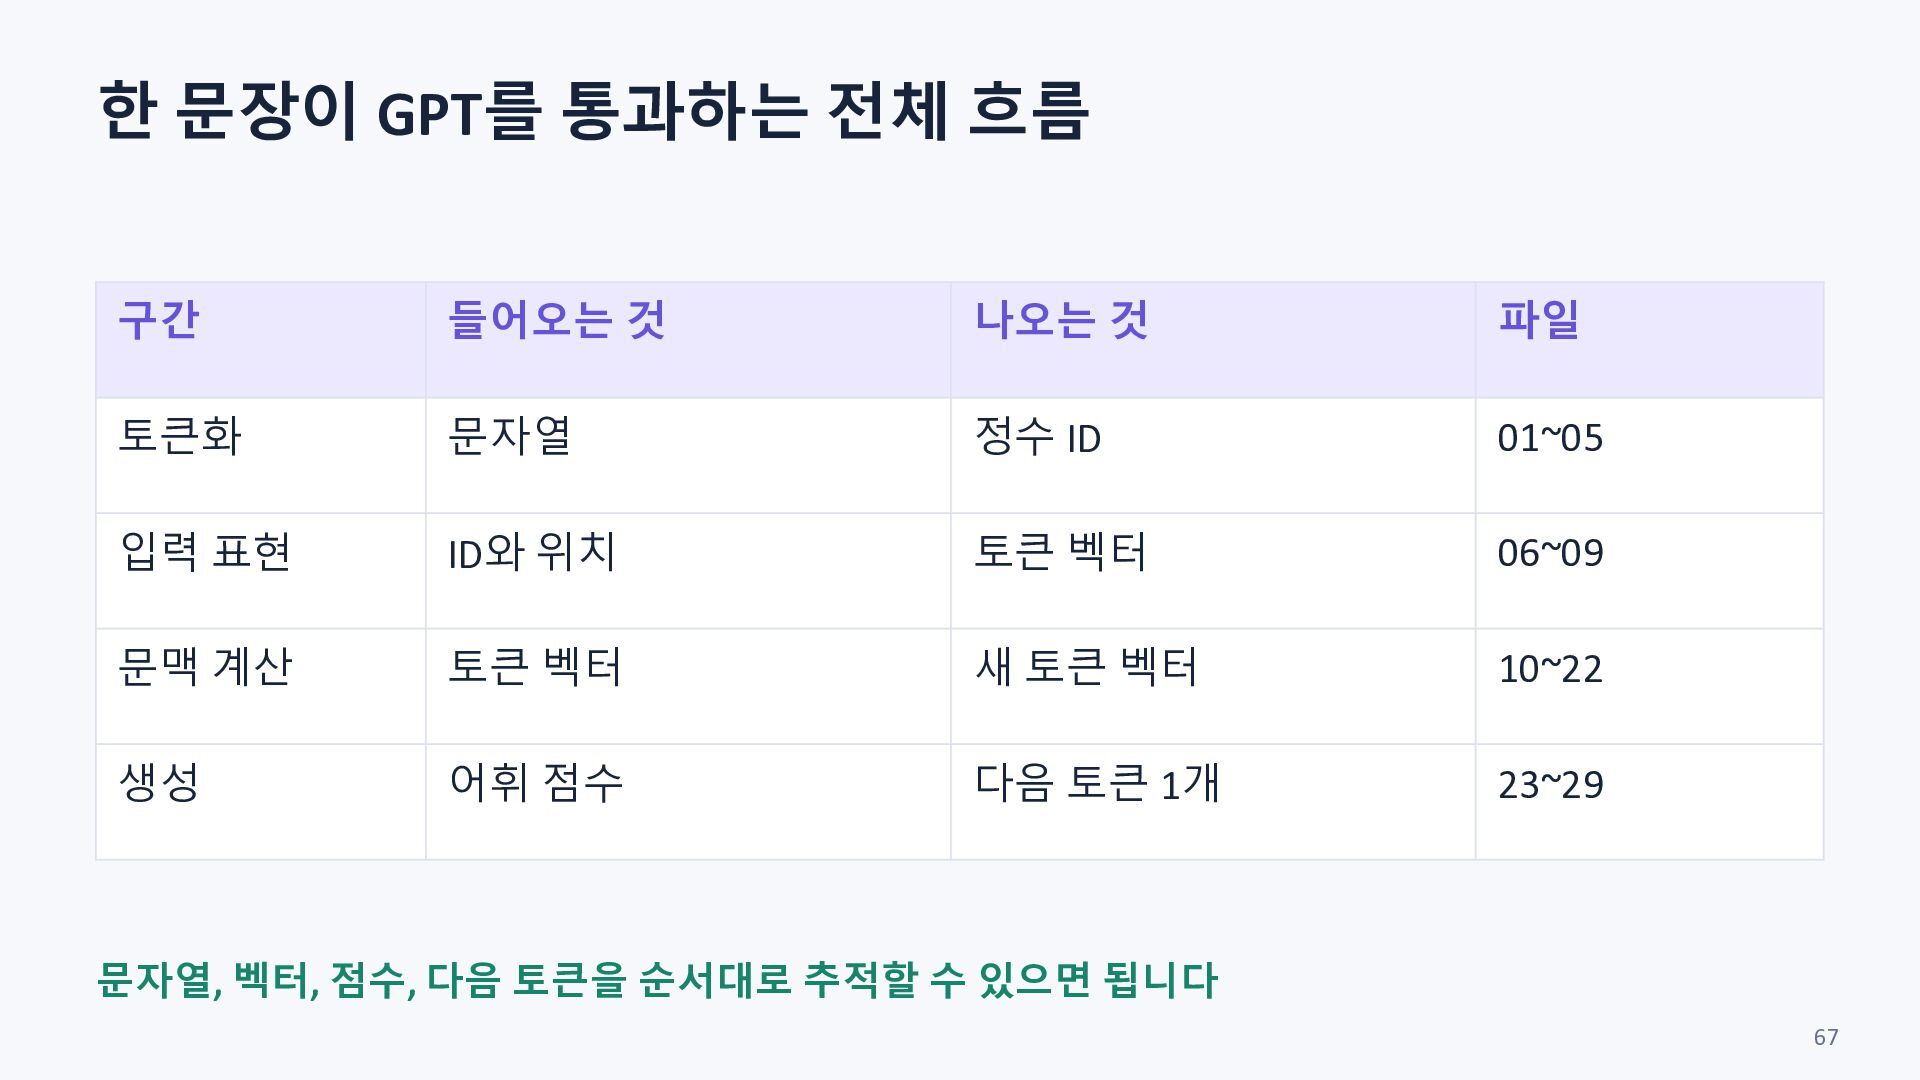
  65. 한 문장이 GPT를 통과하는 전체 흐름 구간 들어오는 것 나오는

    것 파일 토큰화 문자열 정수 ID 01~05 입력 표현 ID와 위치 토큰 벡터 06~09 문맥 계산 토큰 벡터 새 토큰 벡터 10~22 생성 어휘 점수 다음 토큰 1개 23~29 문자열, 벡터, 점수, 다음 토큰을 순서대로 추적할 수 있으면 됩니다 67
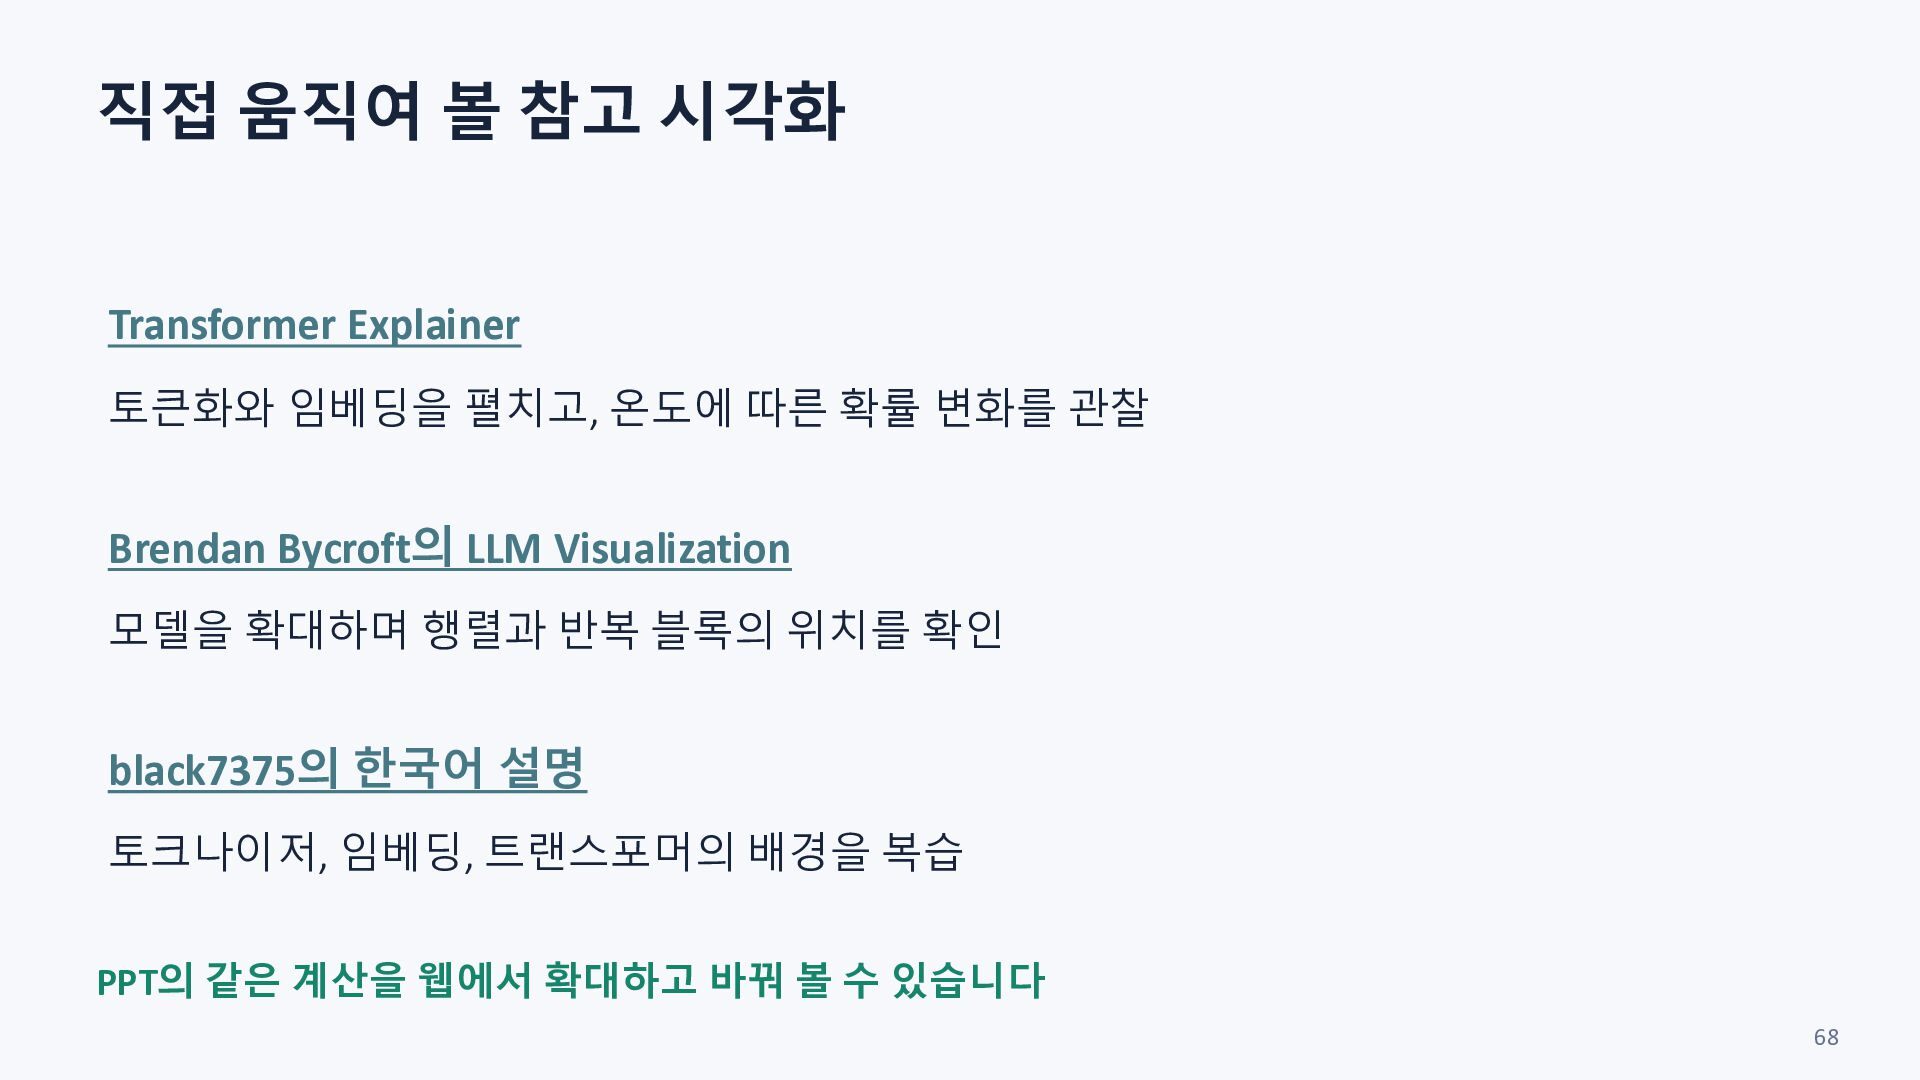
  66. 직접 움직여 볼 참고 시각화 Transformer Explainer 토큰화와 임베딩을 펼치고,

    온도에 따른 확률 변화를 관찰 Brendan Bycroft의 LLM Visualization 모델을 확대하며 행렬과 반복 블록의 위치를 확인 black7375의 한국어 설명 토크나이저, 임베딩, 트랜스포머의 배경을 복습 PPT의 같은 계산을 웹에서 확대하고 바꿔 볼 수 있습니다 68
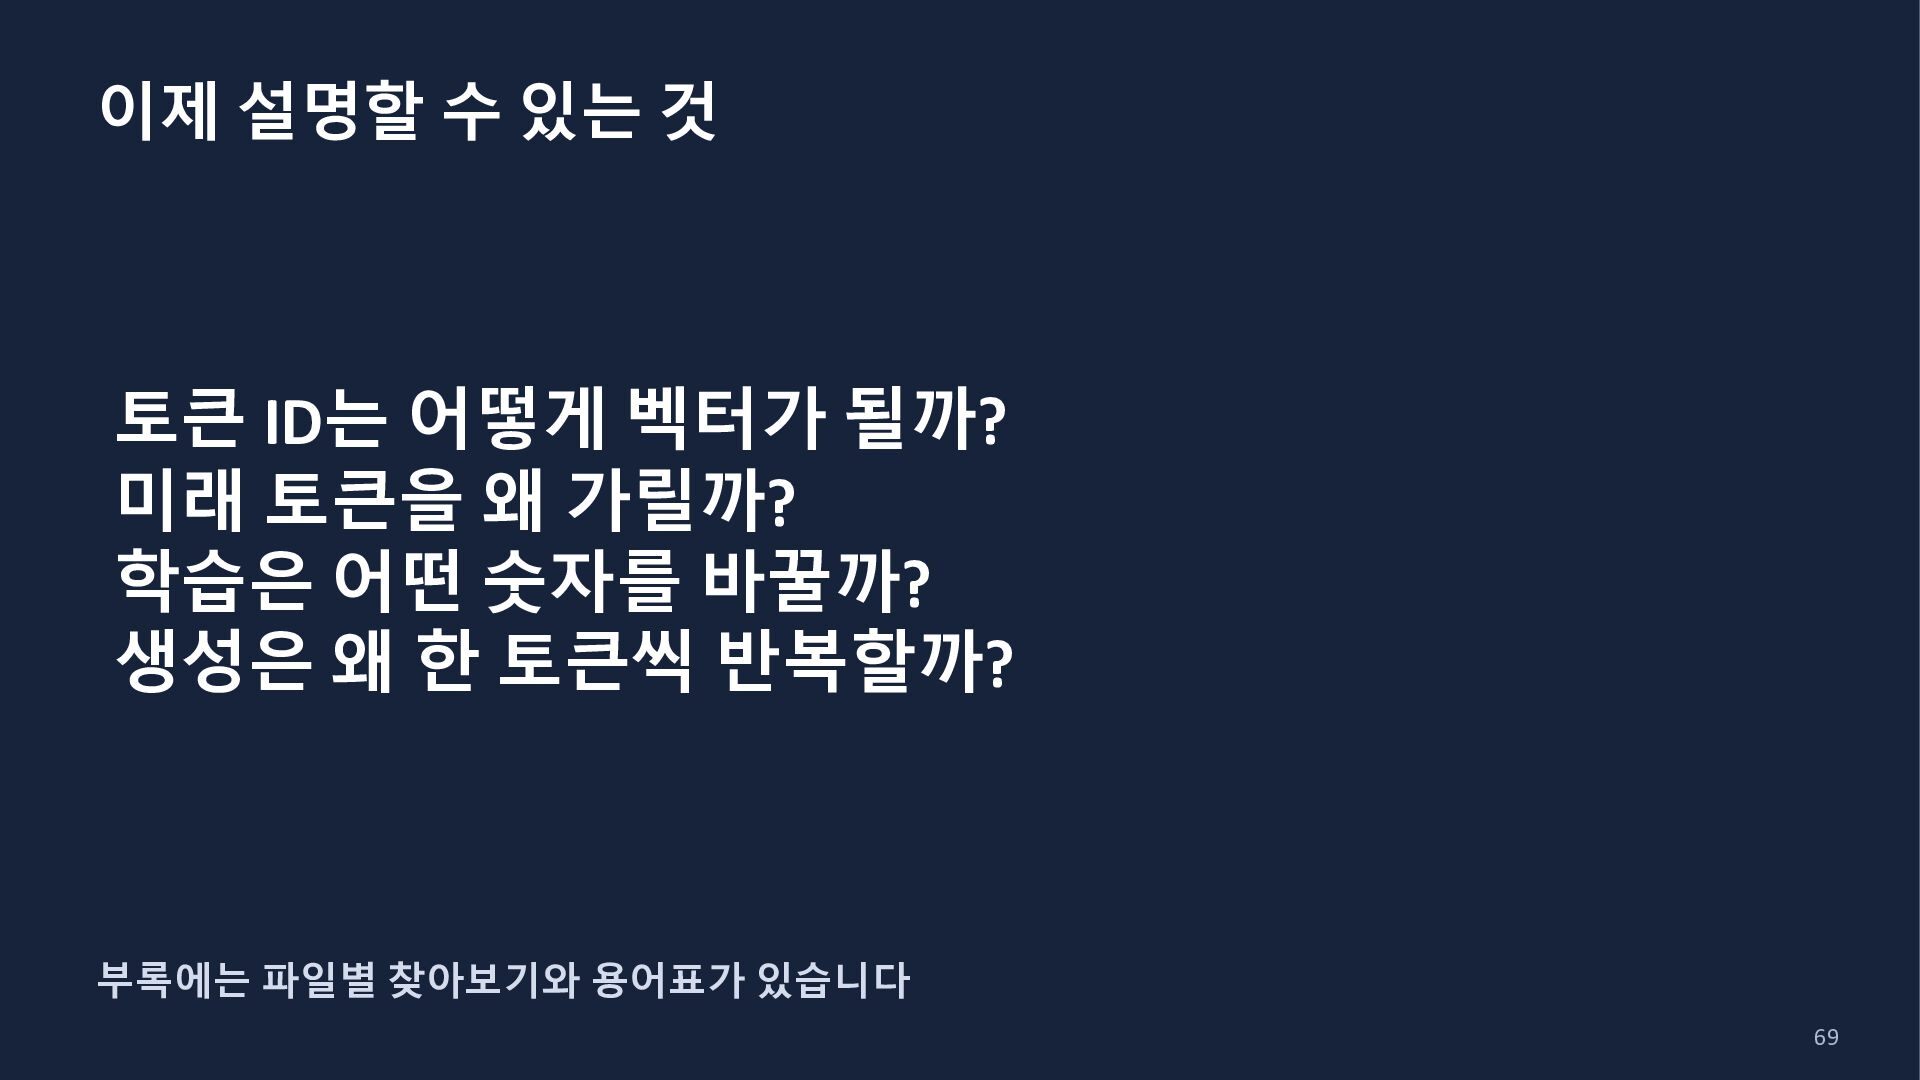
  67. 이제 설명할 수 있는 것 토큰 ID는 어떻게 벡터가 될까?

    미래 토큰을 왜 가릴까? 학습은 어떤 숫자를 바꿀까? 생성은 왜 한 토큰씩 반복할까? 부록에는 파일별 찾아보기와 용어표가 있습니다 69
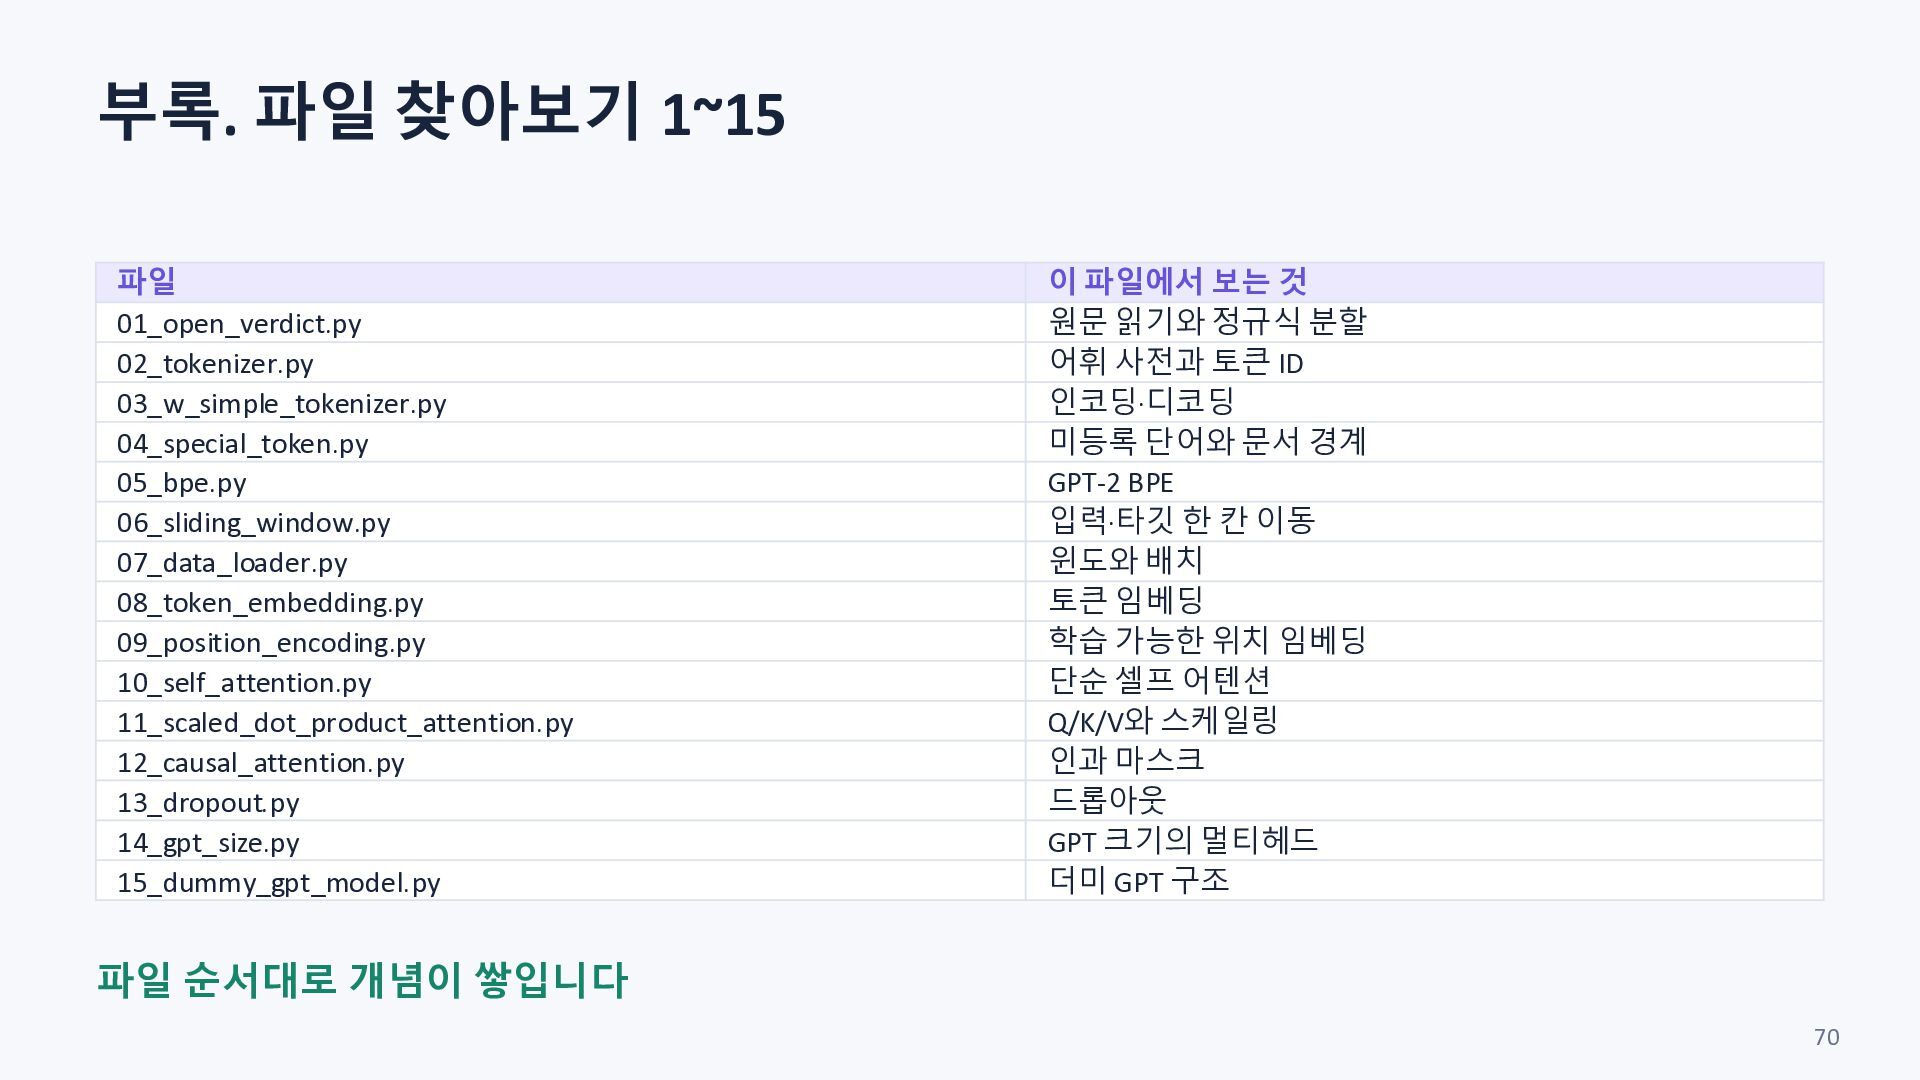
  68. 부록. 파일 찾아보기 1~15 파일 01_open_verdict.py 02_tokenizer.py 03_w_simple_tokenizer.py 04_special_token.py 05_bpe.py

    06_sliding_window.py 07_data_loader.py 08_token_embedding.py 09_position_encoding.py 10_self_attention.py 11_scaled_dot_product_attention.py 12_causal_attention.py 13_dropout.py 14_gpt_size.py 15_dummy_gpt_model.py 이 파일에서 보는 것 원문 읽기와 정규식 분할 어휘 사전과 토큰 ID 인코딩·디코딩 미등록 단어와 문서 경계 GPT-2 BPE 입력·타깃 한 칸 이동 윈도와 배치 토큰 임베딩 학습 가능한 위치 임베딩 단순 셀프 어텐션 Q/K/V와 스케일링 인과 마스크 드롭아웃 GPT 크기의 멀티헤드 더미 GPT 구조 파일 순서대로 개념이 쌓입니다 70
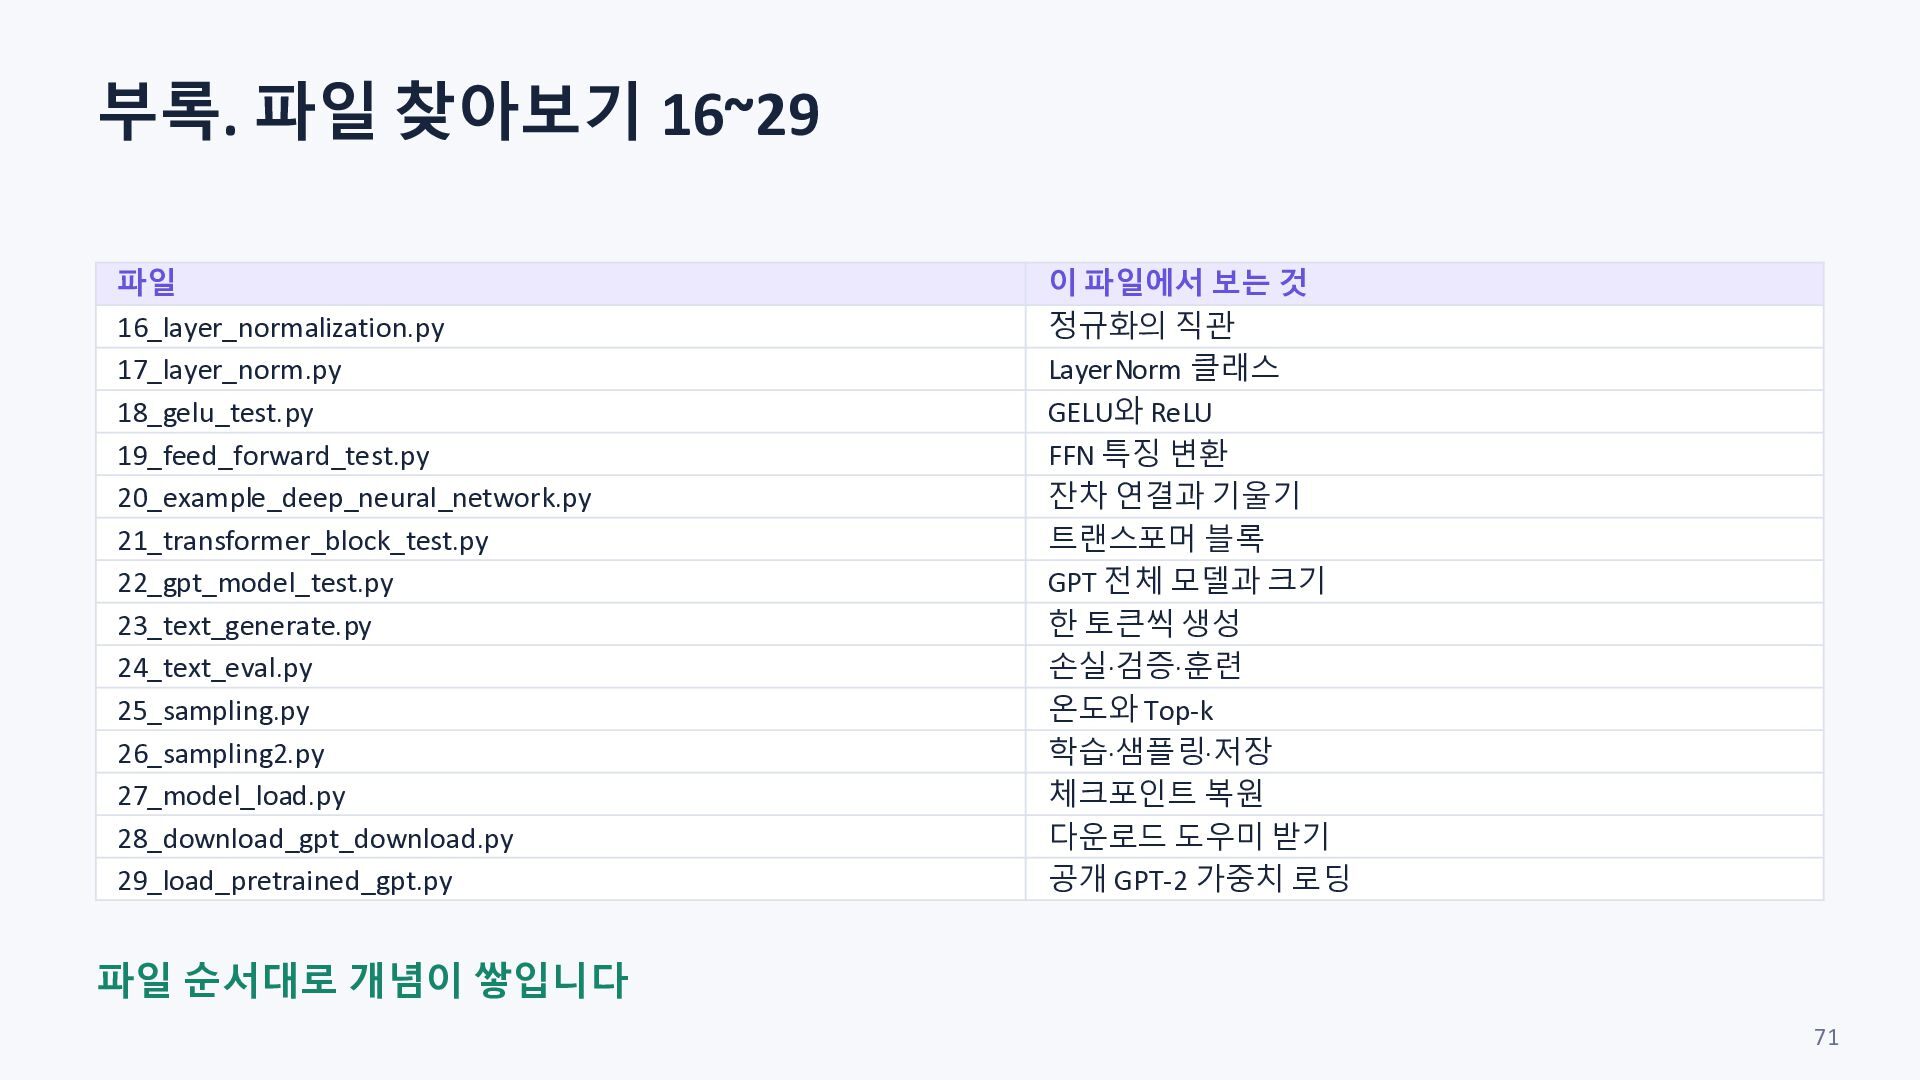
  69. 부록. 파일 찾아보기 16~29 파일 16_layer_normalization.py 17_layer_norm.py 18_gelu_test.py 19_feed_forward_test.py 20_example_deep_neural_network.py

    21_transformer_block_test.py 22_gpt_model_test.py 23_text_generate.py 24_text_eval.py 25_sampling.py 26_sampling2.py 27_model_load.py 28_download_gpt_download.py 29_load_pretrained_gpt.py 이 파일에서 보는 것 정규화의 직관 LayerNorm 클래스 GELU와 ReLU FFN 특징 변환 잔차 연결과 기울기 트랜스포머 블록 GPT 전체 모델과 크기 한 토큰씩 생성 손실·검증·훈련 온도와 Top-k 학습·샘플링·저장 체크포인트 복원 다운로드 도우미 받기 공개 GPT-2 가중치 로딩 파일 순서대로 개념이 쌓입니다 71
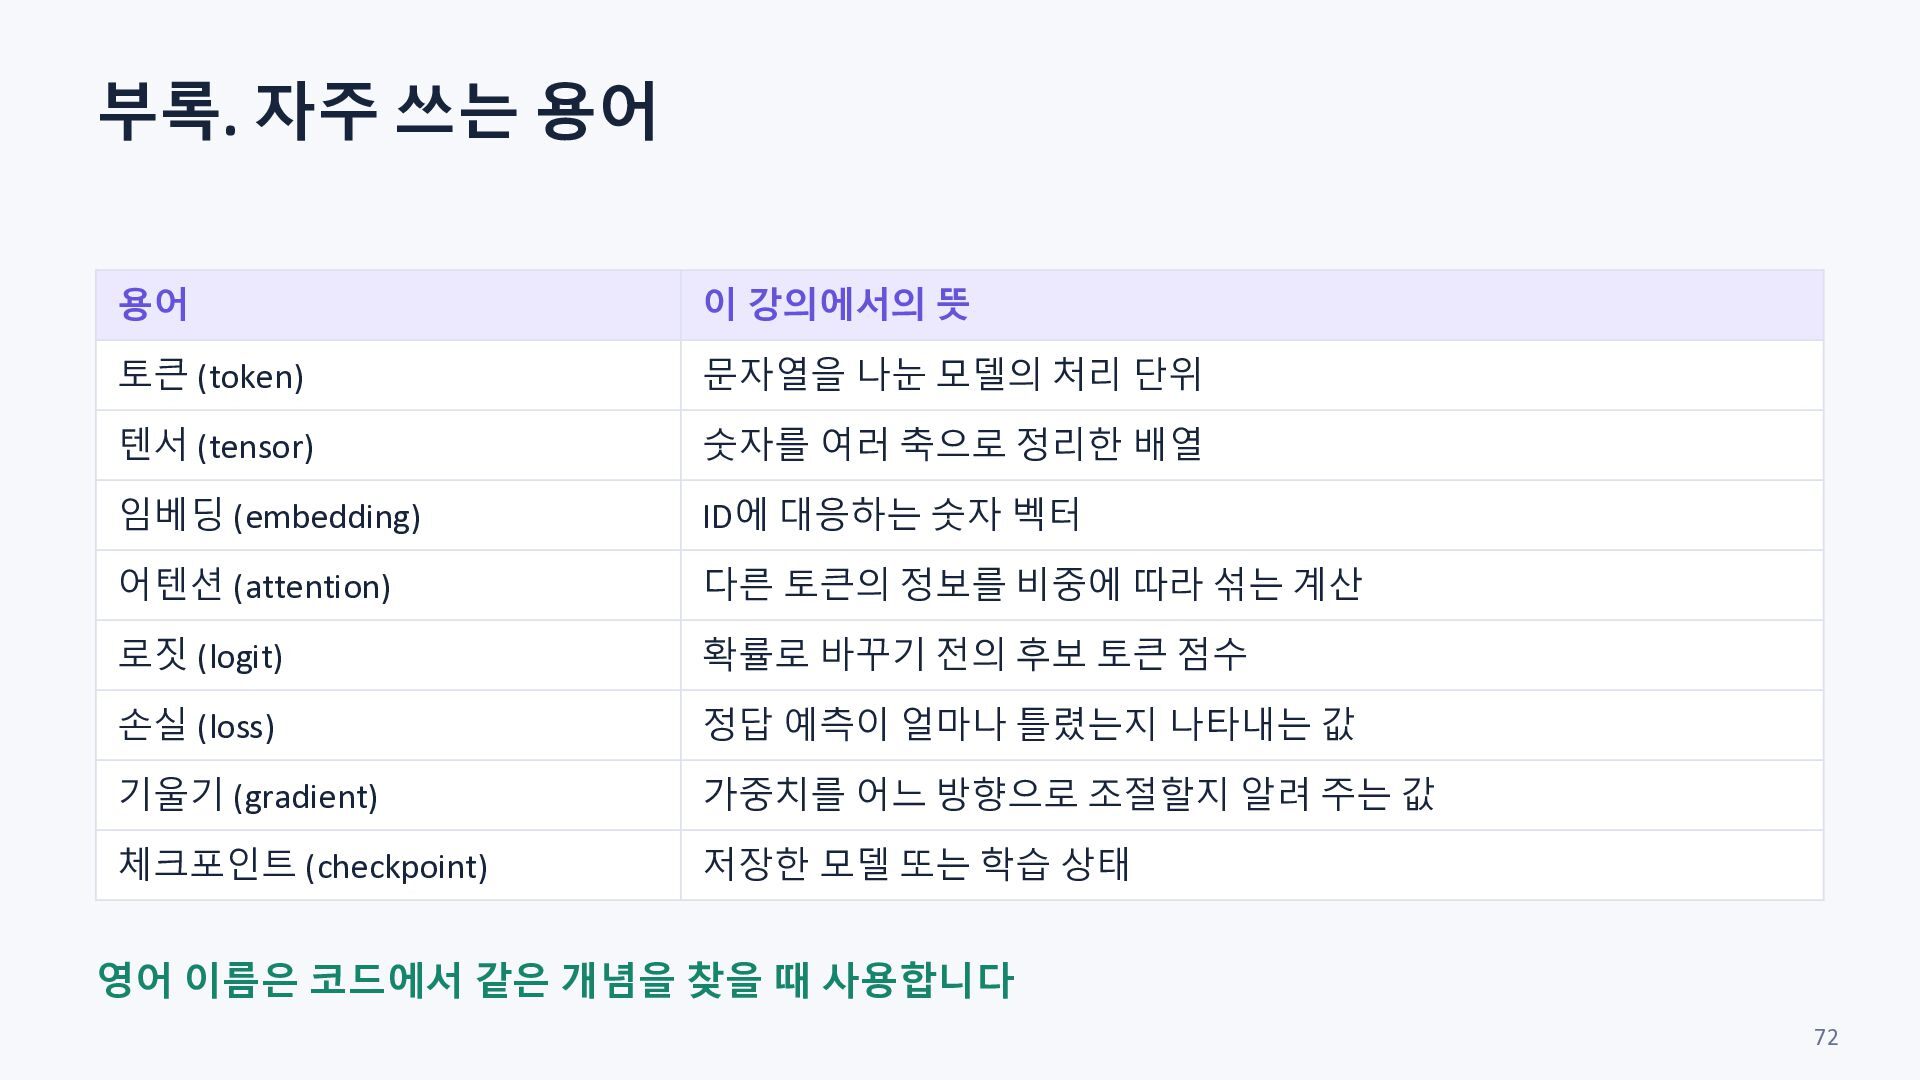
  70. 부록. 자주 쓰는 용어 용어 이 강의에서의 뜻 토큰 (token)

    문자열을 나눈 모델의 처리 단위 텐서 (tensor) 숫자를 여러 축으로 정리한 배열 임베딩 (embedding) ID에 대응하는 숫자 벡터 어텐션 (attention) 다른 토큰의 정보를 비중에 따라 섞는 계산 로짓 (logit) 확률로 바꾸기 전의 후보 토큰 점수 손실 (loss) 정답 예측이 얼마나 틀렸는지 나타내는 값 기울기 (gradient) 가중치를 어느 방향으로 조절할지 알려 주는 값 체크포인트 (checkpoint) 저장한 모델 또는 학습 상태 영어 이름은 코드에서 같은 개념을 찾을 때 사용합니다 72
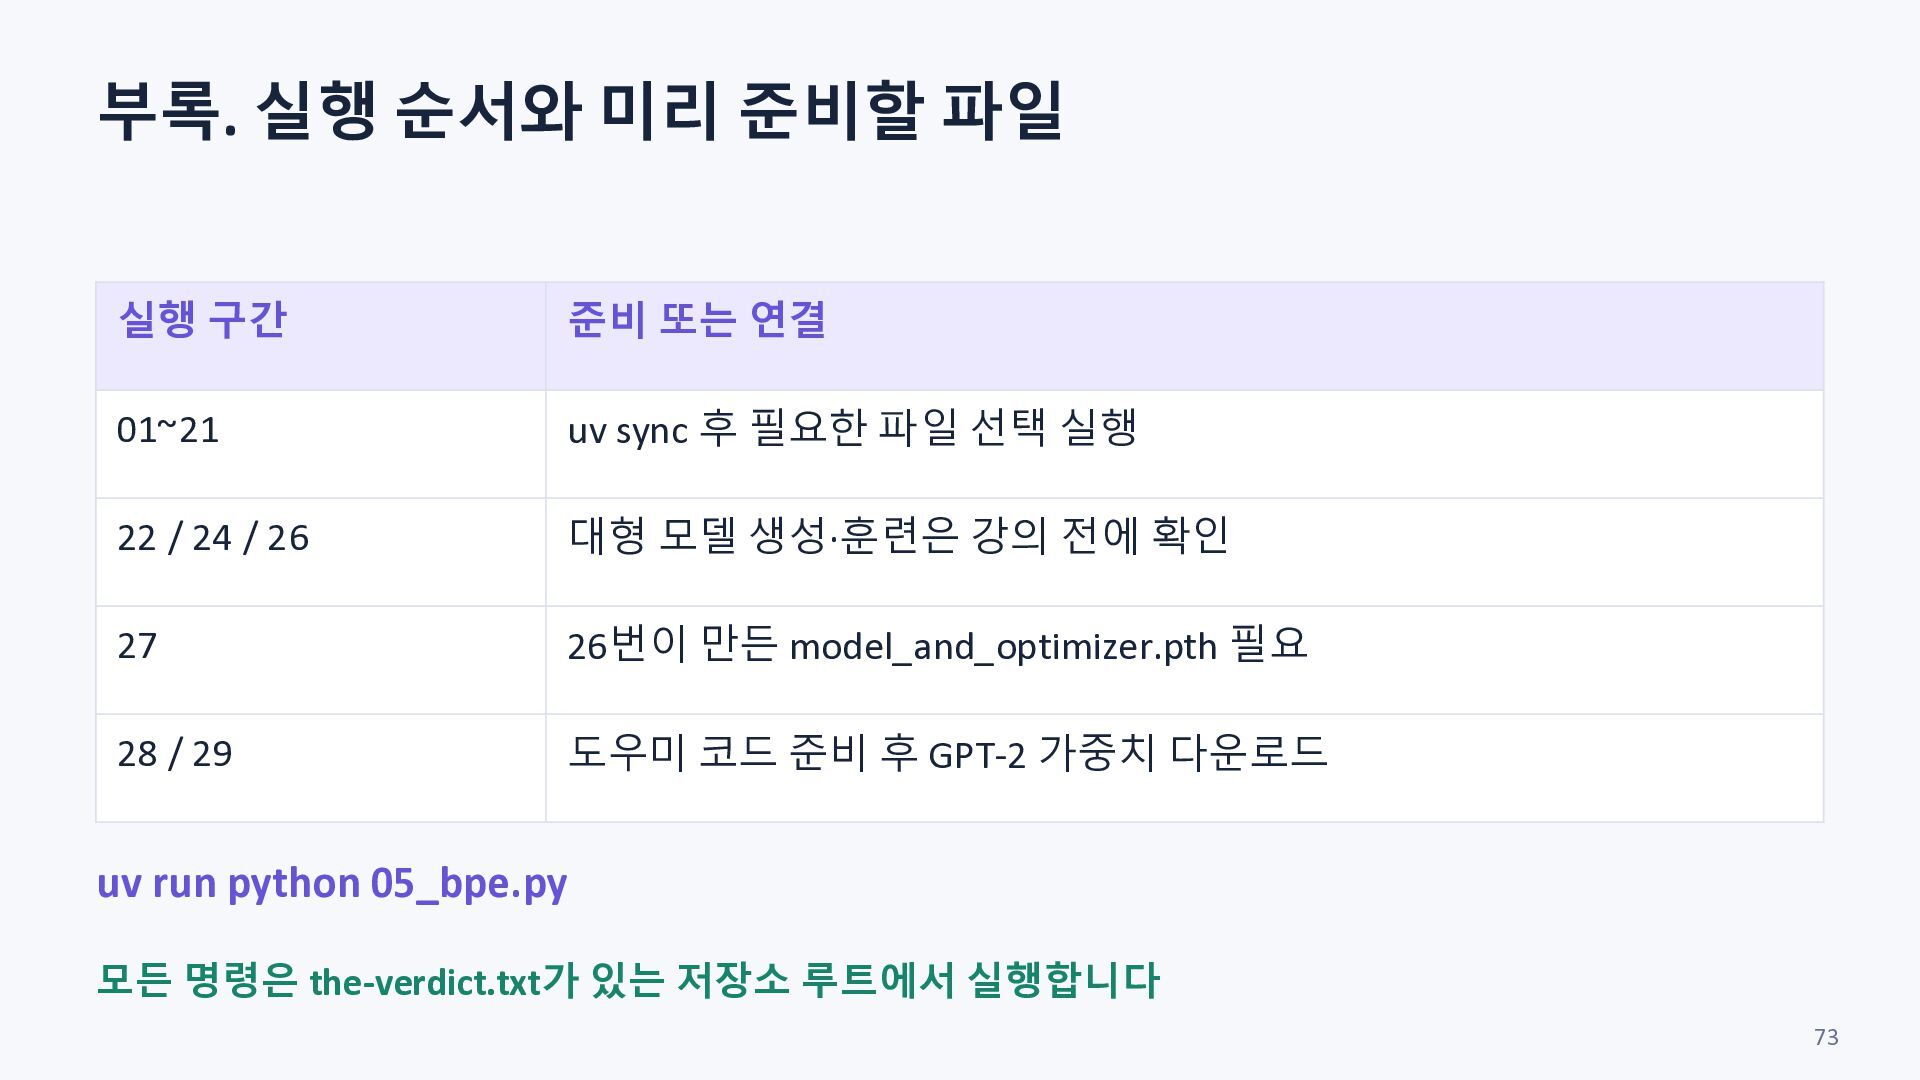
  71. 부록. 실행 순서와 미리 준비할 파일 실행 구간 준비 또는

    연결 01~21 uv sync 후 필요한 파일 선택 실행 22 / 24 / 26 대형 모델 생성·훈련은 강의 전에 확인 27 26번이 만든 model_and_optimizer.pth 필요 28 / 29 도우미 코드 준비 후 GPT-2 가중치 다운로드 uv run python 05_bpe.py 모든 명령은 the-verdict.txt가 있는 저장소 루트에서 실행합니다 73