Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Web Scraping con Requests y Beautiful

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Diego Allen Diego Allen
November 28, 2015

Web Scraping con Requests y Beautiful

Charla sobre web scraping en el PyDay Villarica, Paraguay 2015

Avatar for Diego Allen

Diego Allen

November 28, 2015

Other Decks in Programming

Transcript

  1. Web Scraping Web Scraping es una técnica utilizada para extraer

    información de sitios web. Librería HTTP + Librería para parsear el DOM - Descargar páginas web - Extraer datos de las páginas descargadas
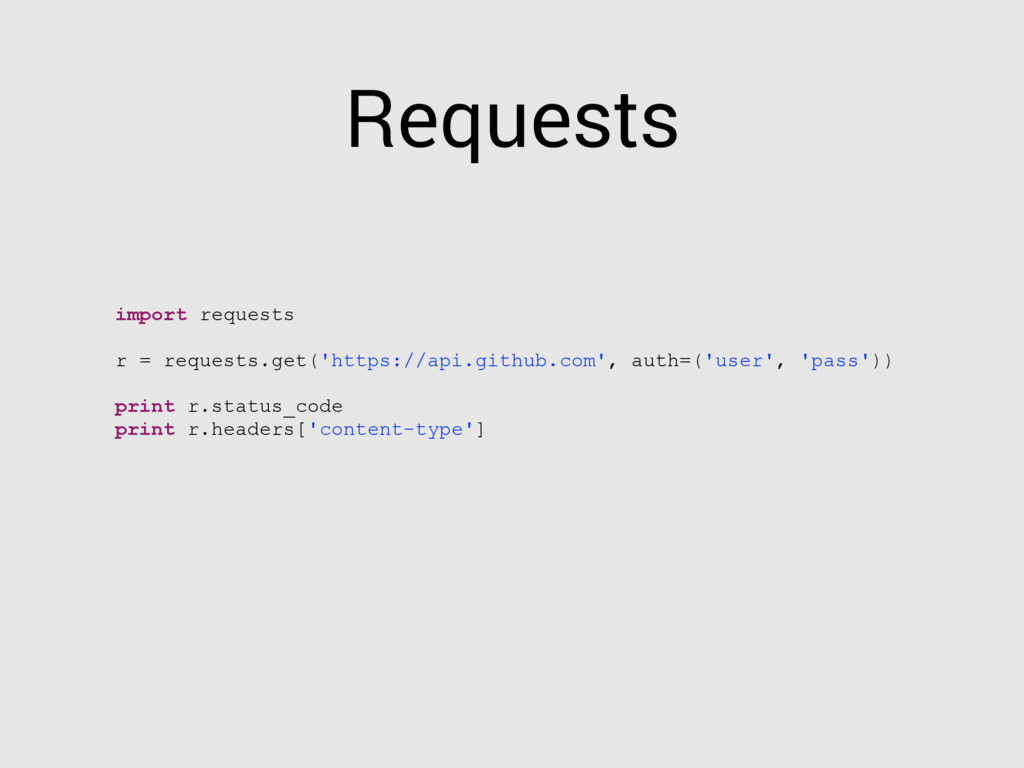
  2. Requests • HTTP para humanos • Un reemplazo a los

    modulos HTTP de la librería standard • Requests fue desarrollado bajo los principios del PEP 20. Instalación: pip install requests Documentación: http://docs.python-requests.org/en/latest/
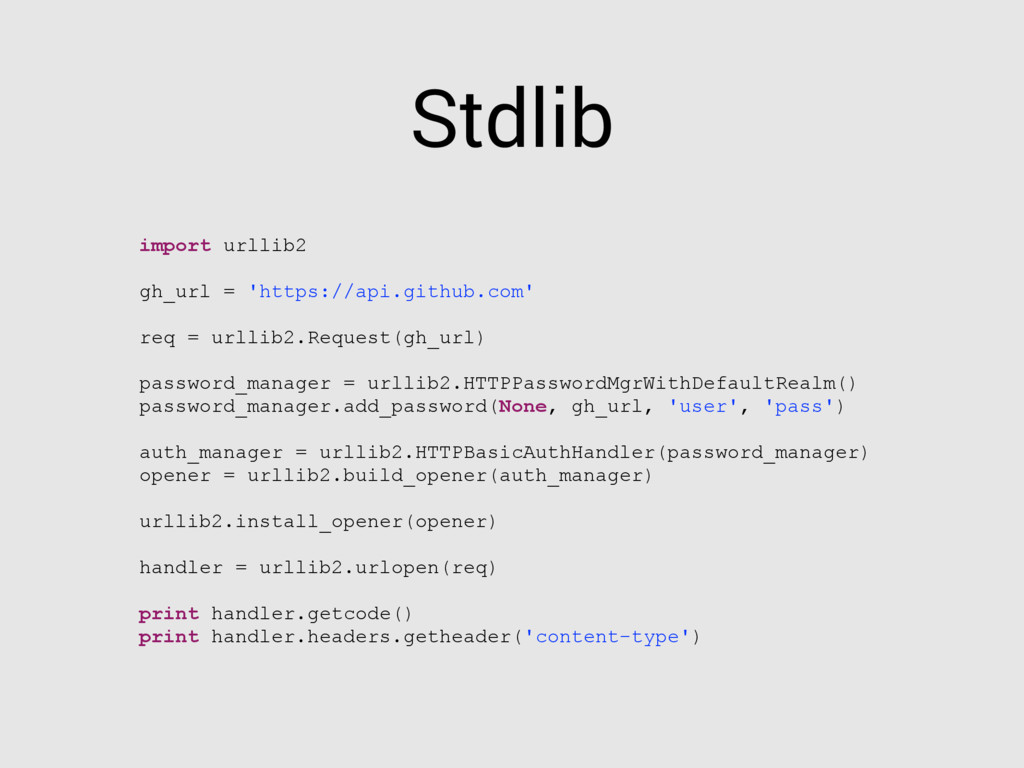
  3. Stdlib import urllib2 gh_url = 'https://api.github.com' req = urllib2.Request(gh_url) password_manager

    = urllib2.HTTPPasswordMgrWithDefaultRealm() password_manager.add_password(None, gh_url, 'user', 'pass') auth_manager = urllib2.HTTPBasicAuthHandler(password_manager) opener = urllib2.build_opener(auth_manager) urllib2.install_opener(opener) handler = urllib2.urlopen(req) print handler.getcode() print handler.headers.getheader('content-type')
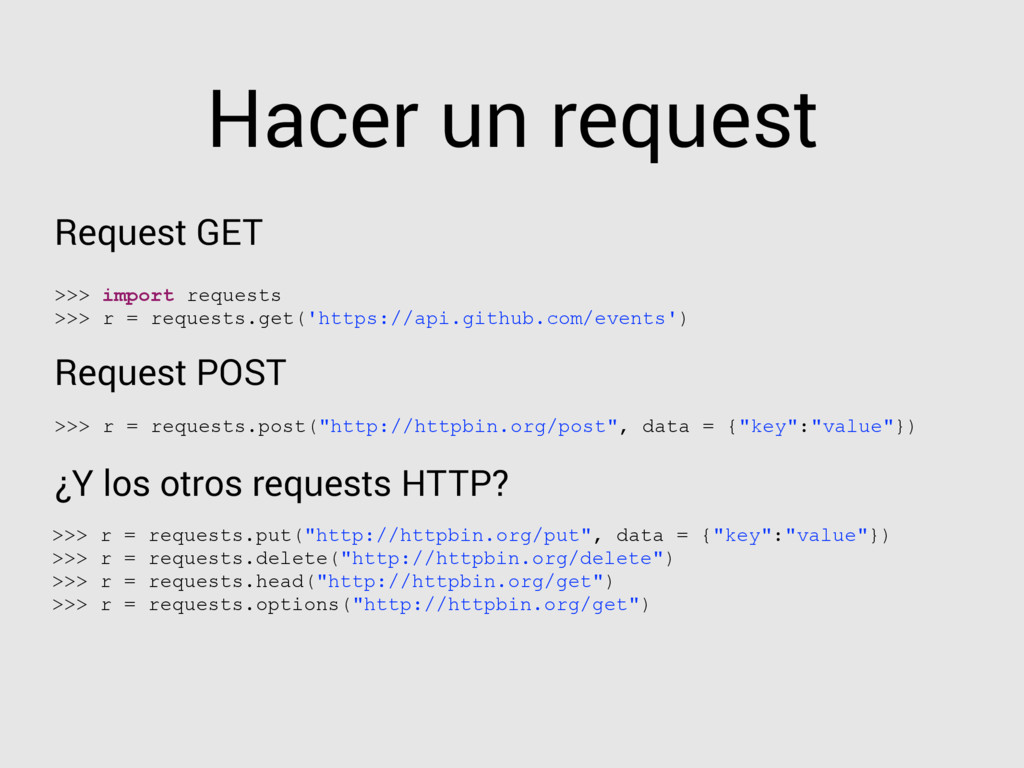
  4. Hacer un request >>> import requests >>> r = requests.get('https://api.github.com/events')

    Request GET Request POST >>> r = requests.post("http://httpbin.org/post", data = {"key":"value"}) ¿Y los otros requests HTTP? >>> r = requests.put("http://httpbin.org/put", data = {"key":"value"}) >>> r = requests.delete("http://httpbin.org/delete") >>> r = requests.head("http://httpbin.org/get") >>> r = requests.options("http://httpbin.org/get")
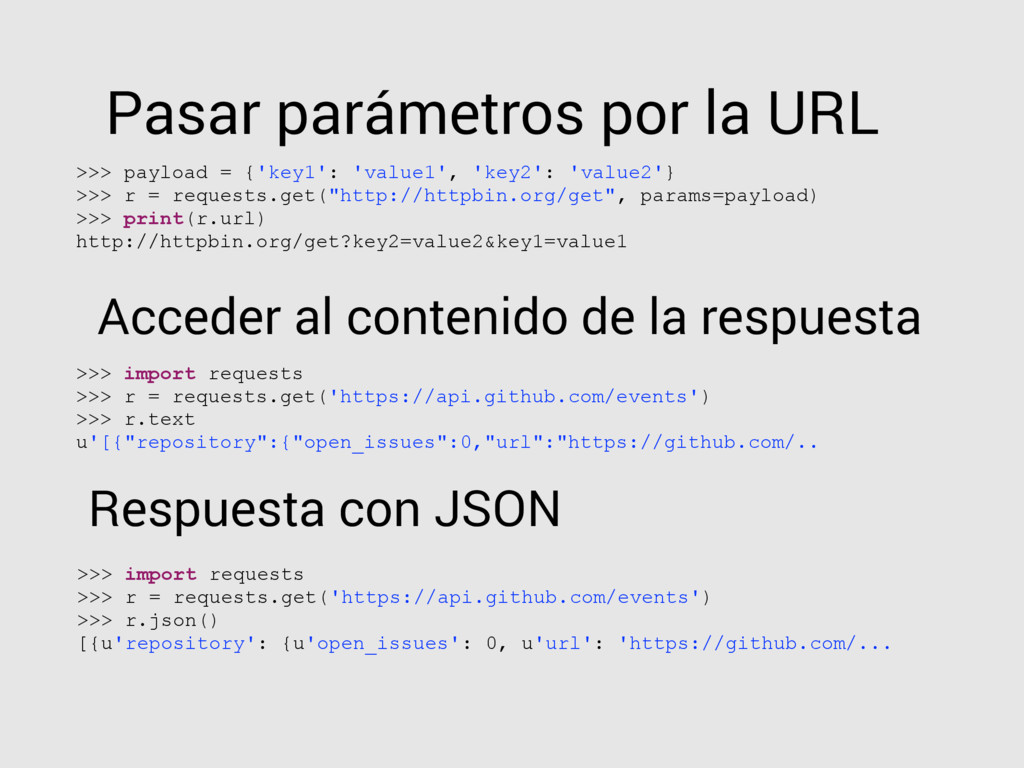
  5. Pasar parámetros por la URL >>> payload = {'key1': 'value1',

    'key2': 'value2'} >>> r = requests.get("http://httpbin.org/get", params=payload) >>> print(r.url) http://httpbin.org/get?key2=value2&key1=value1 Acceder al contenido de la respuesta >>> import requests >>> r = requests.get('https://api.github.com/events') >>> r.text u'[{"repository":{"open_issues":0,"url":"https://github.com/.. Respuesta con JSON >>> import requests >>> r = requests.get('https://api.github.com/events') >>> r.json() [{u'repository': {u'open_issues': 0, u'url': 'https://github.com/...
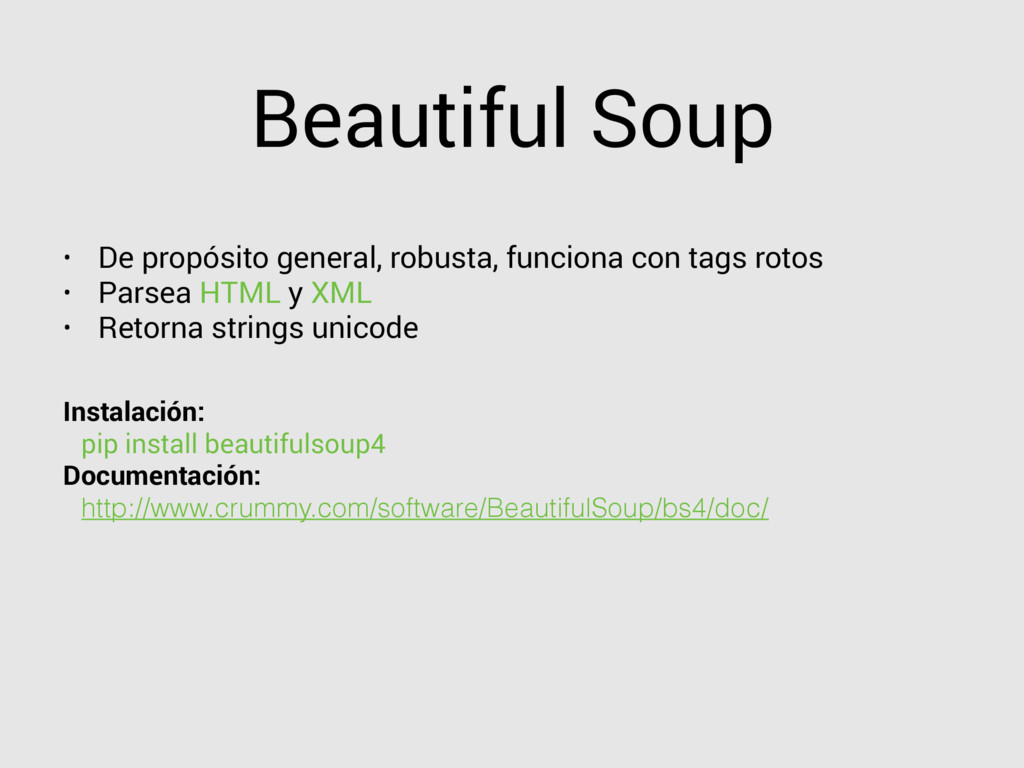
  6. Beautiful Soup • De propósito general, robusta, funciona con tags

    rotos • Parsea HTML y XML • Retorna strings unicode Instalación: pip install beautifulsoup4 Documentación: http://www.crummy.com/software/BeautifulSoup/bs4/doc/
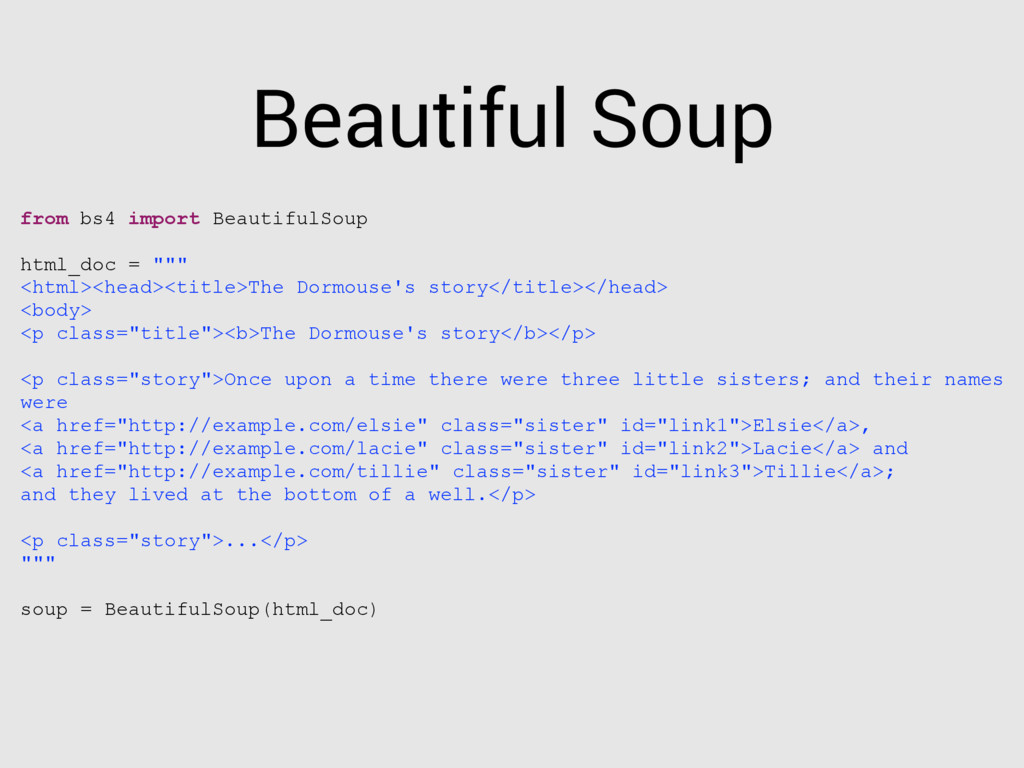
  7. Beautiful Soup from bs4 import BeautifulSoup html_doc = """ <html><head><title>The

    Dormouse's story</title></head> <body> <p class="title"><b>The Dormouse's story</b></p> <p class="story">Once upon a time there were three little sisters; and their names were <a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>, <a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and <a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>; and they lived at the bottom of a well.</p> <p class="story">...</p> """ soup = BeautifulSoup(html_doc)
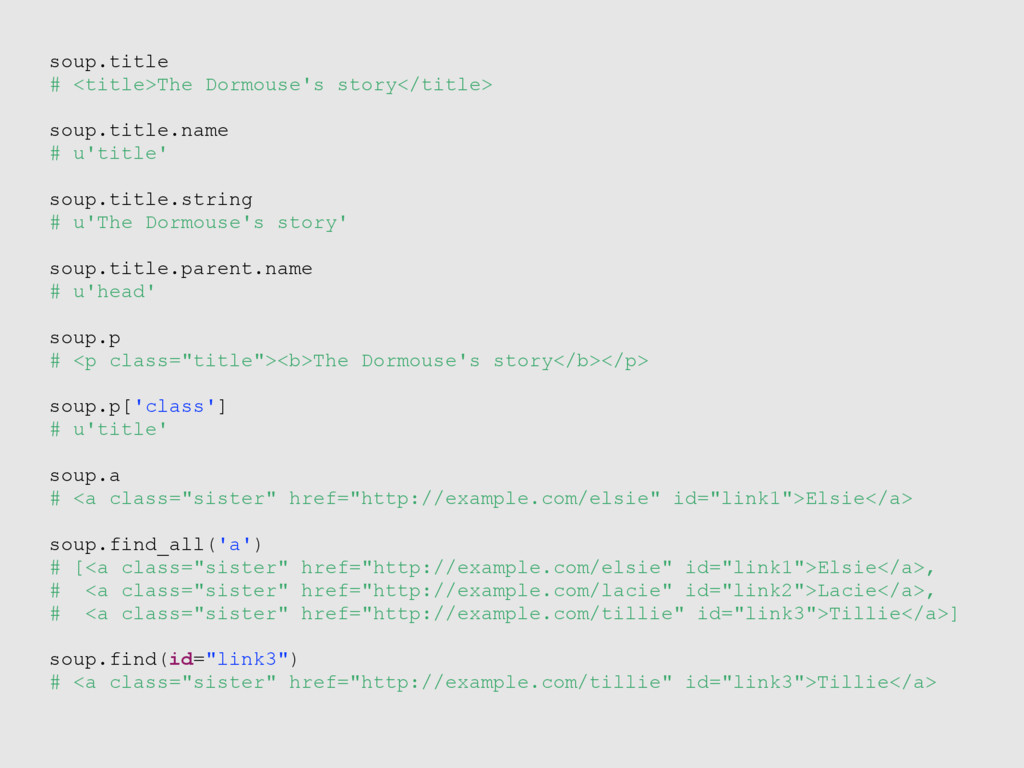
  8. soup.title # <title>The Dormouse's story</title> soup.title.name # u'title' soup.title.string #

    u'The Dormouse's story' soup.title.parent.name # u'head' soup.p # <p class="title"><b>The Dormouse's story</b></p> soup.p['class'] # u'title' soup.a # <a class="sister" href="http://example.com/elsie" id="link1">Elsie</a> soup.find_all('a') # [<a class="sister" href="http://example.com/elsie" id="link1">Elsie</a>, # <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, # <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>] soup.find(id="link3") # <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>
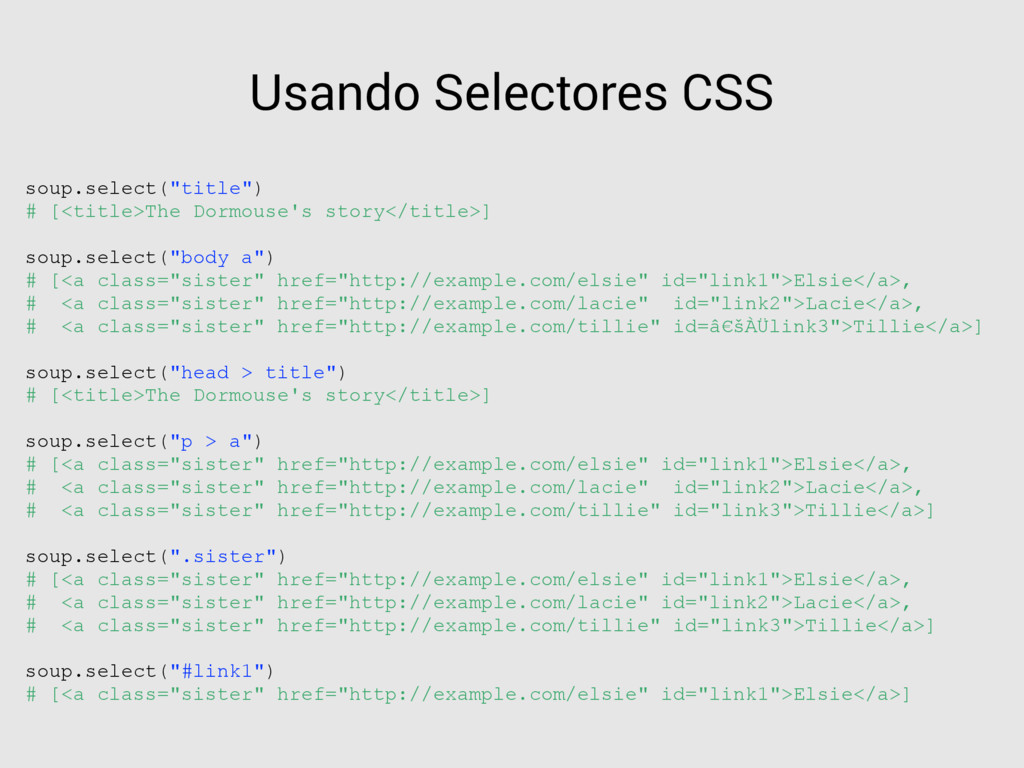
  9. soup.select("title") # [<title>The Dormouse's story</title>] soup.select("body a") # [<a class="sister"

    href="http://example.com/elsie" id="link1">Elsie</a>, # <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, # <a class="sister" href="http://example.com/tillie" id=‚ÀÜlink3">Tillie</a>] soup.select("head > title") # [<title>The Dormouse's story</title>] soup.select("p > a") # [<a class="sister" href="http://example.com/elsie" id="link1">Elsie</a>, # <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, # <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>] soup.select(".sister") # [<a class="sister" href="http://example.com/elsie" id="link1">Elsie</a>, # <a class="sister" href="http://example.com/lacie" id="link2">Lacie</a>, # <a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>] soup.select("#link1") # [<a class="sister" href="http://example.com/elsie" id="link1">Elsie</a>] Usando Selectores CSS