Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Scraping: 10 mistakes to avoid @ Breizhcamp 2016
Search
Fabien Vauchelles
March 24, 2016
Science
240
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Scraping: 10 mistakes to avoid @ Breizhcamp 2016
From website, to storage, learn webscraping
#webscraping #tricks
Fabien Vauchelles
March 24, 2016
More Decks by Fabien Vauchelles
See All by Fabien Vauchelles
[StartupCourse/18] Discover Machine Learning
fabienvauchelles
0
96
[StartupCourse/01] Gérer sa carrière @ Polytech Paris Sud 2016
fabienvauchelles
0
81
[StartupCourse/02] Monter Une Startup @ Polytech Paris Sud 2016
fabienvauchelles
0
79
[StartupCourse/03] De l'idée au produit @ Polytech Paris Sud 2016
fabienvauchelles
0
54
Other Decks in Science
See All in Science
20260410_SystemsThinking
takusamar
1
160
Visual Linear Algebra - Lecture at Shosen Grande
hiranabe
0
590
自社のレビュー履歴からAIコードレビュアーをつくる方法
estie
0
580
プレイがつなぐ研究と社会:市⺠‧クリエイター‧SF作家による実践を通じて
hayataka88
1
110
[第67回 CV勉強会@関東] CV × Scientific Figures / kantoCV 67th CVPR 2026
lychee1223
0
240
プロジェクト「Azayaka」のSARの数式とジオメトリ
syuchimu
0
470
サンプル対応のない複数遺伝子発現プロファイルに対するテンソル分解型統合解析の要約
tagtag
PRO
0
260
データベース09: 実体関連モデル上の一貫性制約
trycycle
PRO
0
1.9k
HOLO: Homography-Guided Pose Estimator Network for Fine-Grained Visual Localization on SD Maps
tomoaki0705
0
150
Cross-Media Technologies, Information Science and Human-Information Interaction
signer
PRO
3
33k
暗号解読における量子計算の展望
neutron63zf
0
260
不動産業界における業界特化のデータ整備とAI活用 ─Vertical DataとVertical AI─
estie
1
1k
Featured
See All Featured
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
540
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
How to train your dragon (web standard)
notwaldorf
97
6.8k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Statistics for Hackers
jakevdp
799
230k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.3k
Code Reviewing Like a Champion
maltzj
528
40k
From π to Pie charts
rasagy
1
380
Game over? The fight for quality and originality in the time of robots
wayneb77
1
290
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
1
340
Intergalactic Javascript Robots from Outer Space
tanoku
273
27k
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
290
Transcript
Fabien VAUCHELLES zelros.com /
[email protected]
/ @fabienv http://bit.ly/breizhscraping (24/03/2016)
FABIEN VAUCHELLES Developer for 16 years CTO of Expert in
data extraction (scraping) Creator of Scrapoxy.io
What is Scraping
“Scraping is to transform human-readable webpage into machine-readable data.” Neo
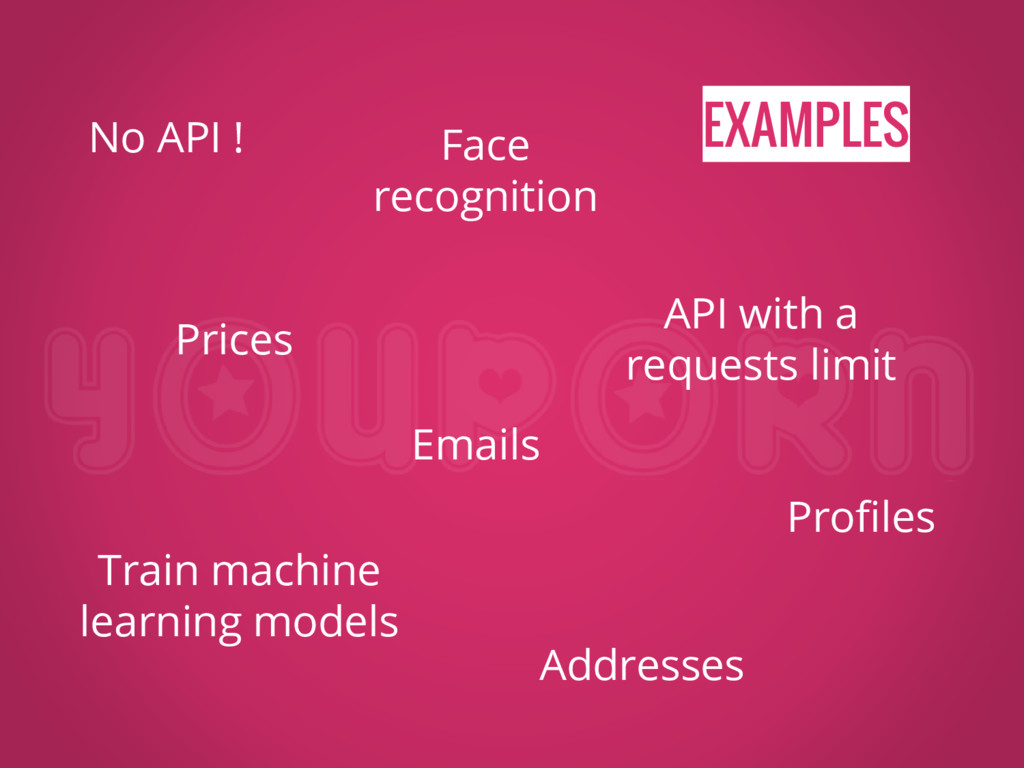
Why do we do Scraping
EXAMPLES No API ! API with a requests limit Prices
Emails Profiles Train machine learning models Addresses Face recognition
“I used Scraping to create my clients list !” Walter
White
FORGET THE LAW 1.
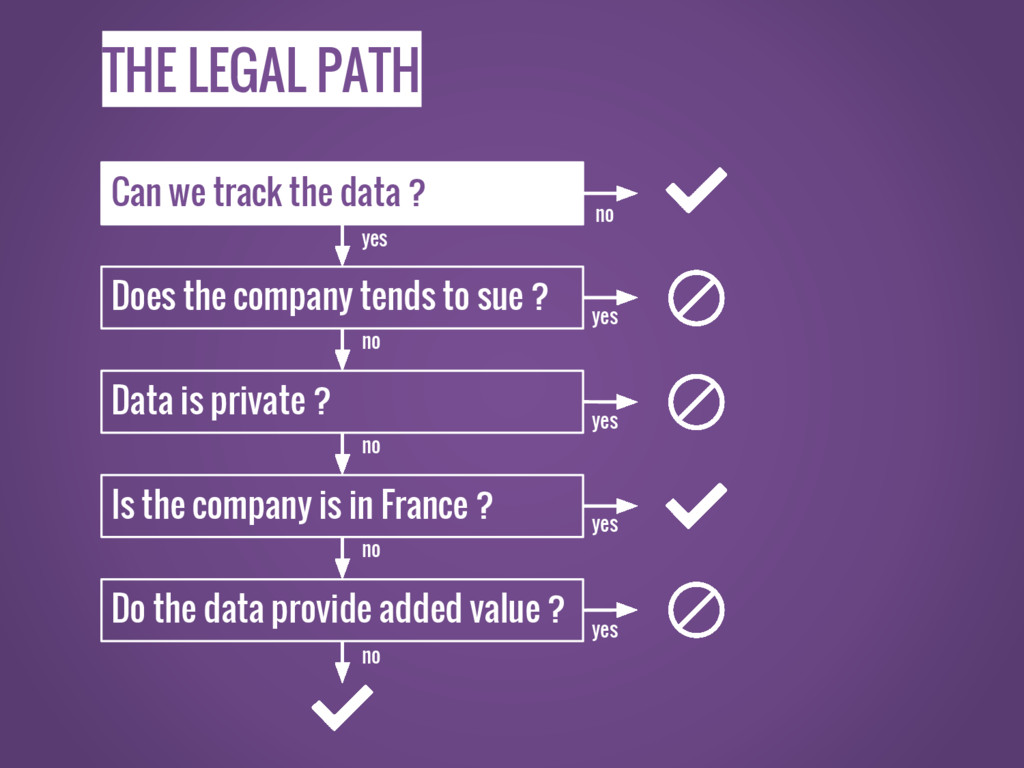
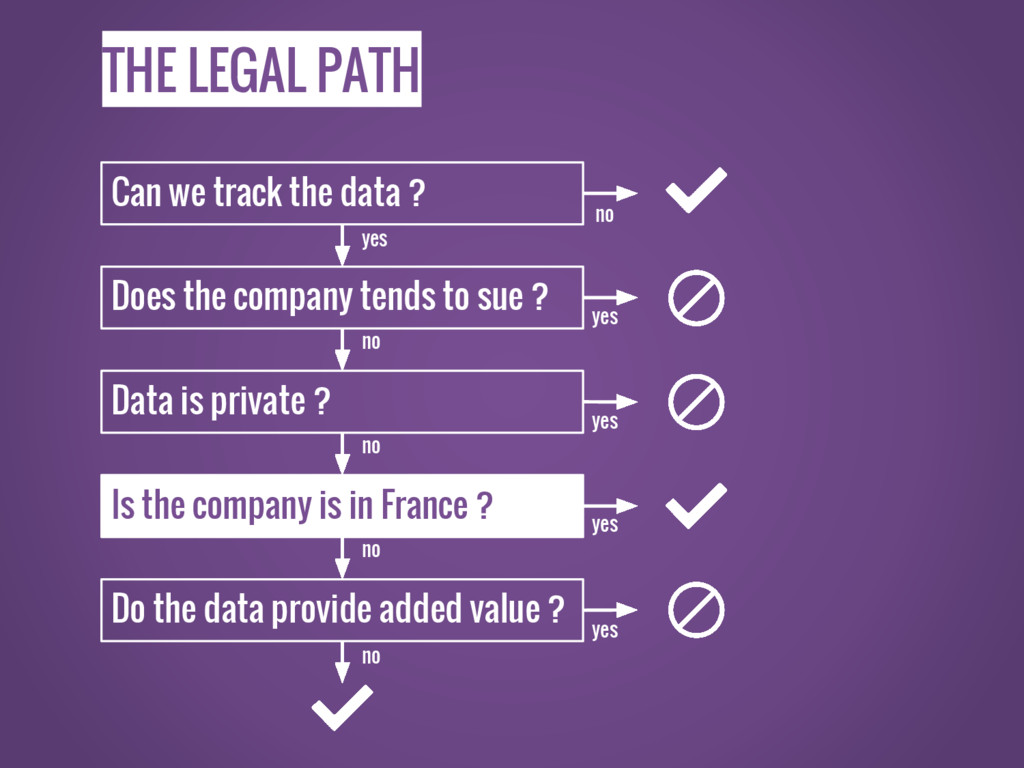
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
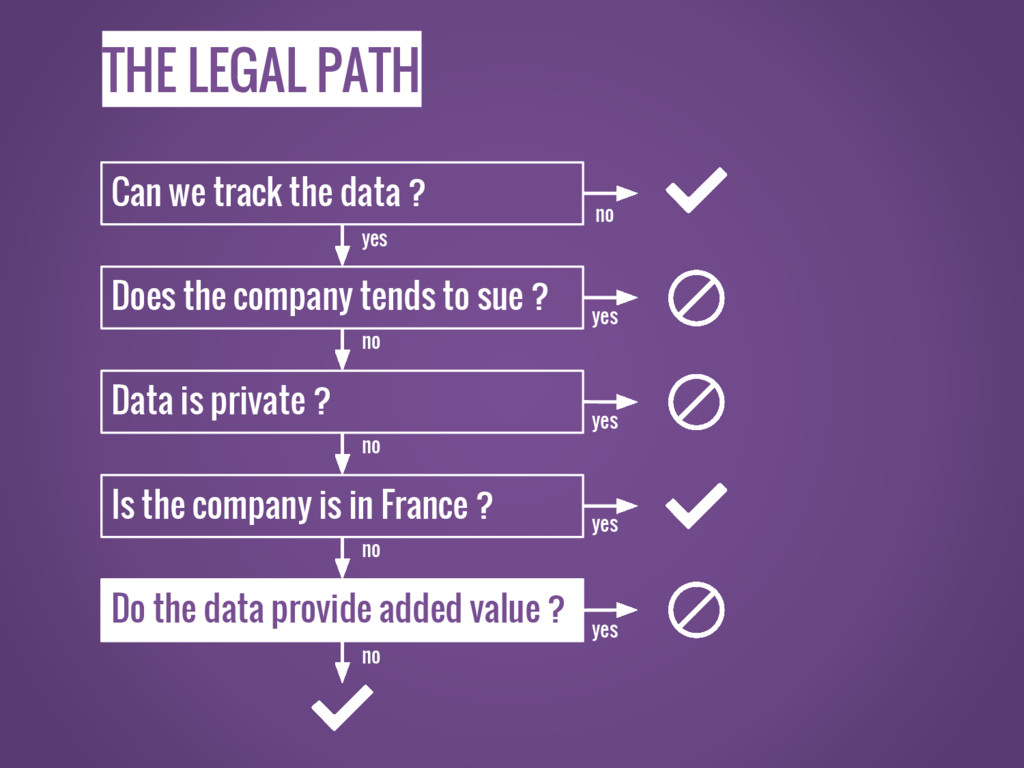
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
RUBBER DUCK E-MARKET LET’S STUDY THE
BUILD YOUR OWN SCRIPT 2.
USE A FRAMEWORK Limit concurrents request by site Limit speed
Change user agent Follow redirects Export results to CSV or JSON etc. Only 15 minutes to extract structured data !
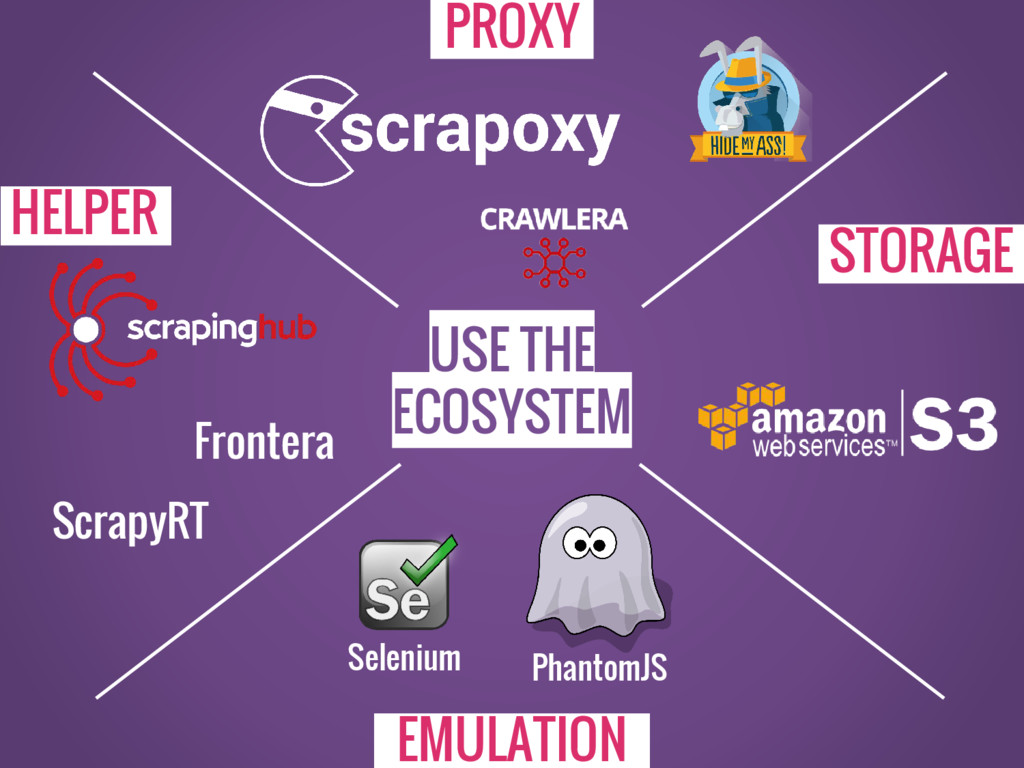
USE THE ECOSYSTEM Frontera ScrapyRT PhantomJS Selenium PROXY EMULATION HELPER
STORAGE
RUSH ON THE FIRST DATA SOURCE 3.
FIND THE EXPORT BUTTON
TAKE TIME TO FIND DATA
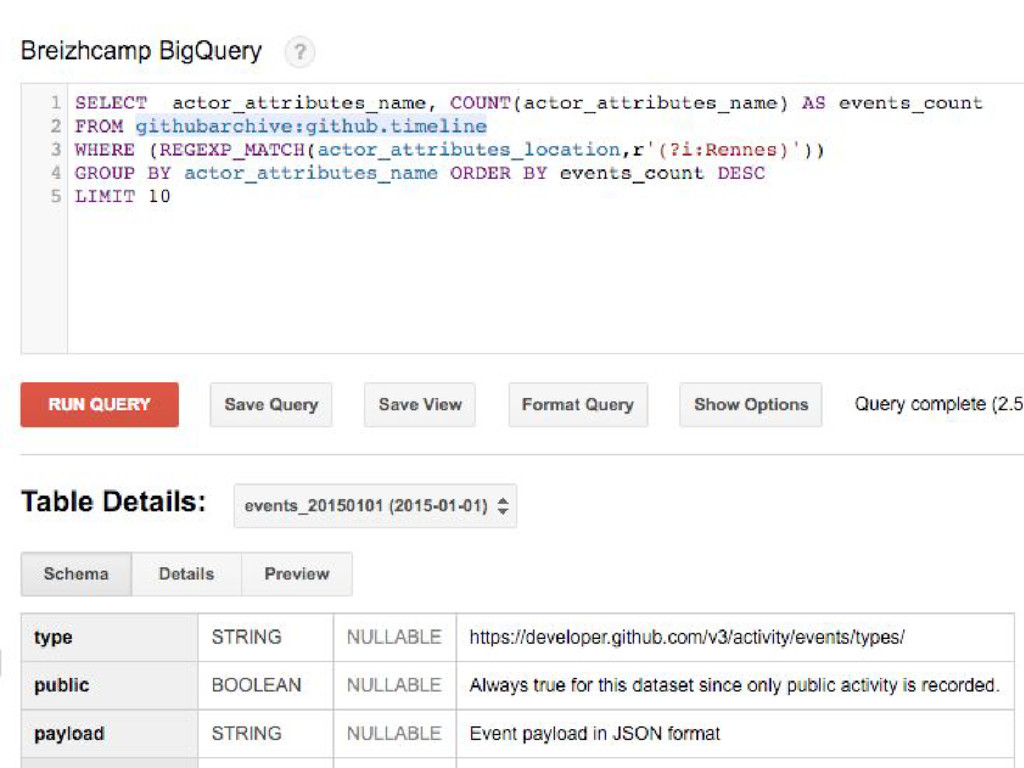
How to find a developer on Rennes
#1. GO TO BREIZHCAMP
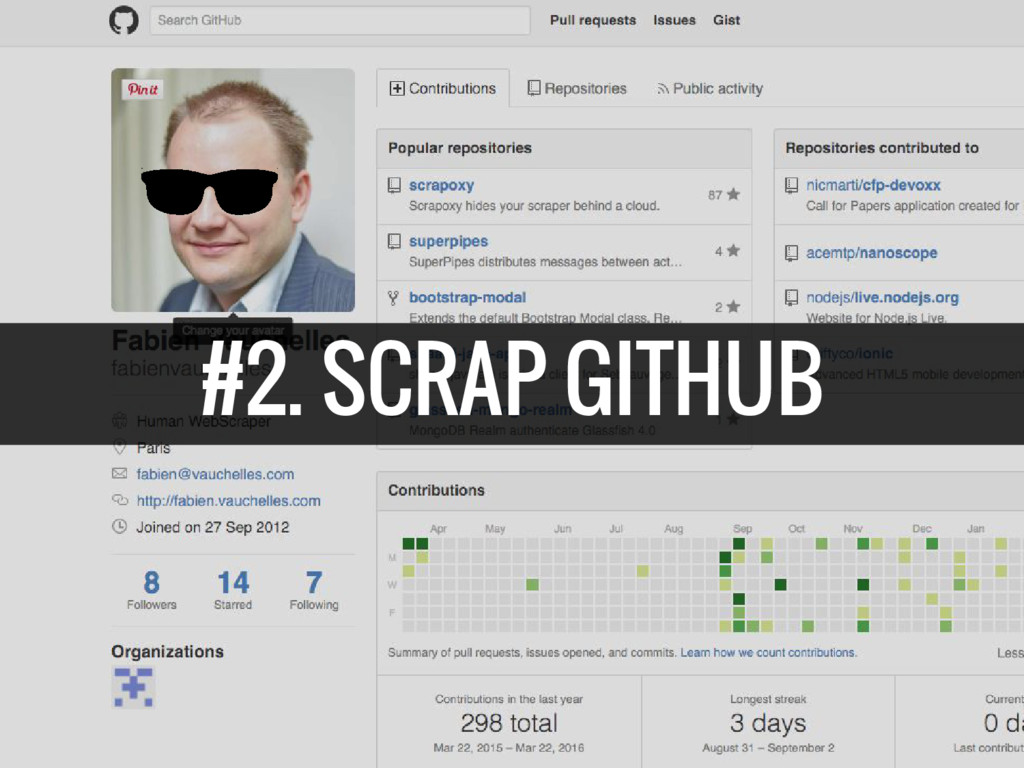
#2. SCRAP GITHUB
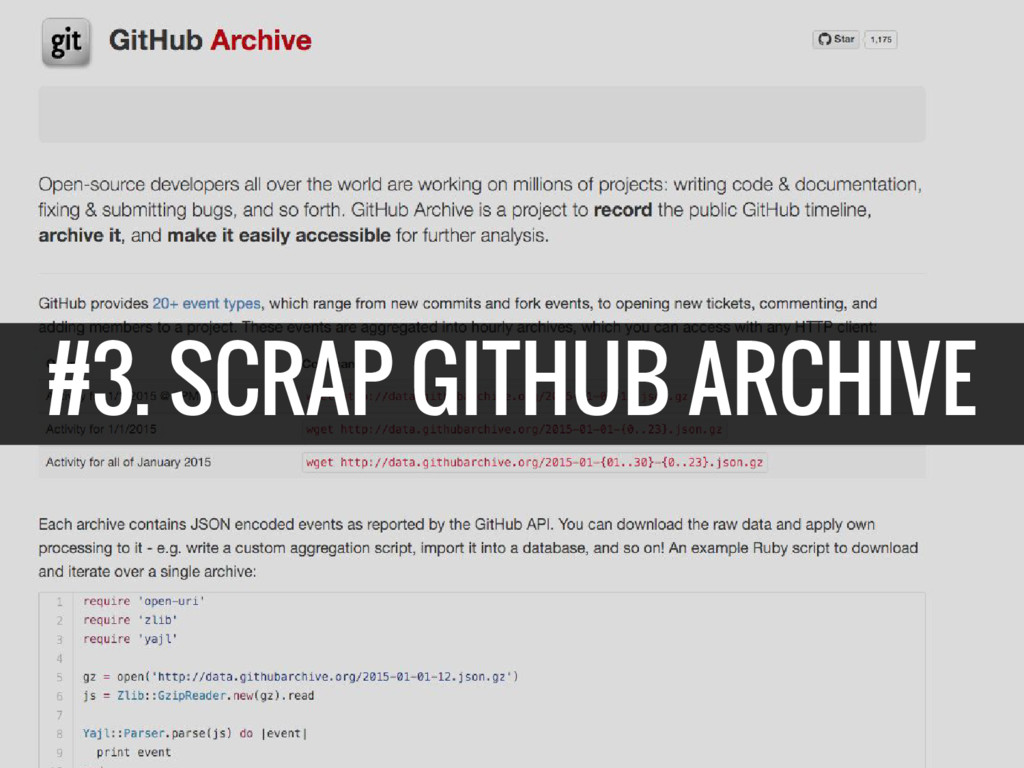
#3. SCRAP GITHUB ARCHIVE
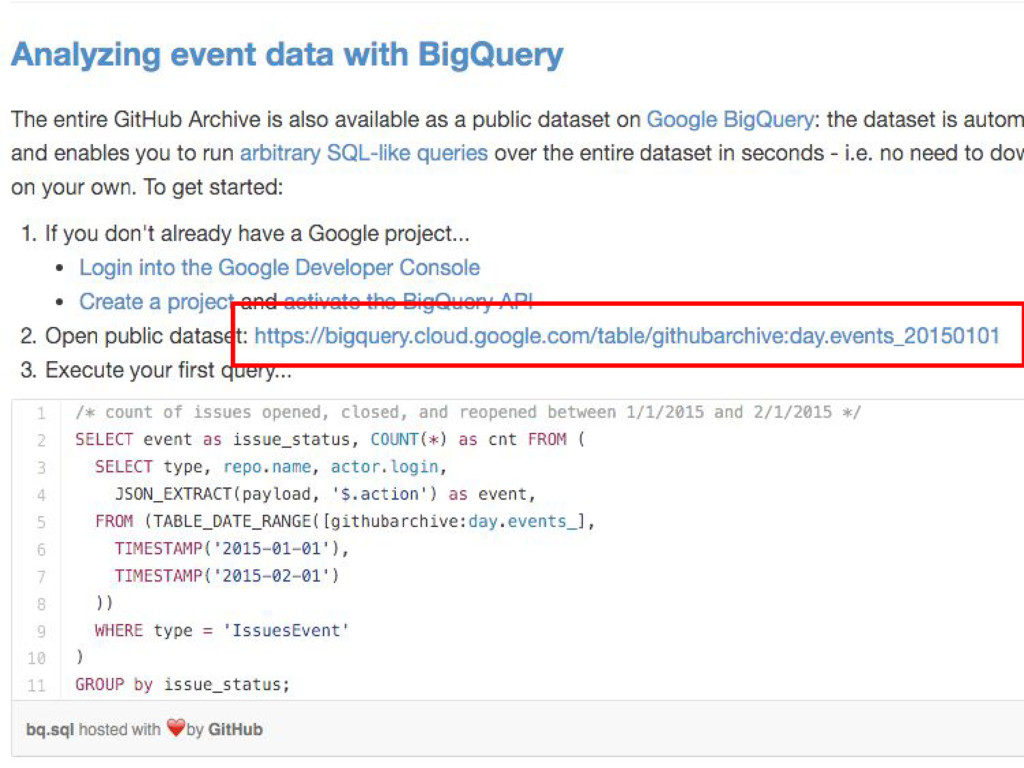
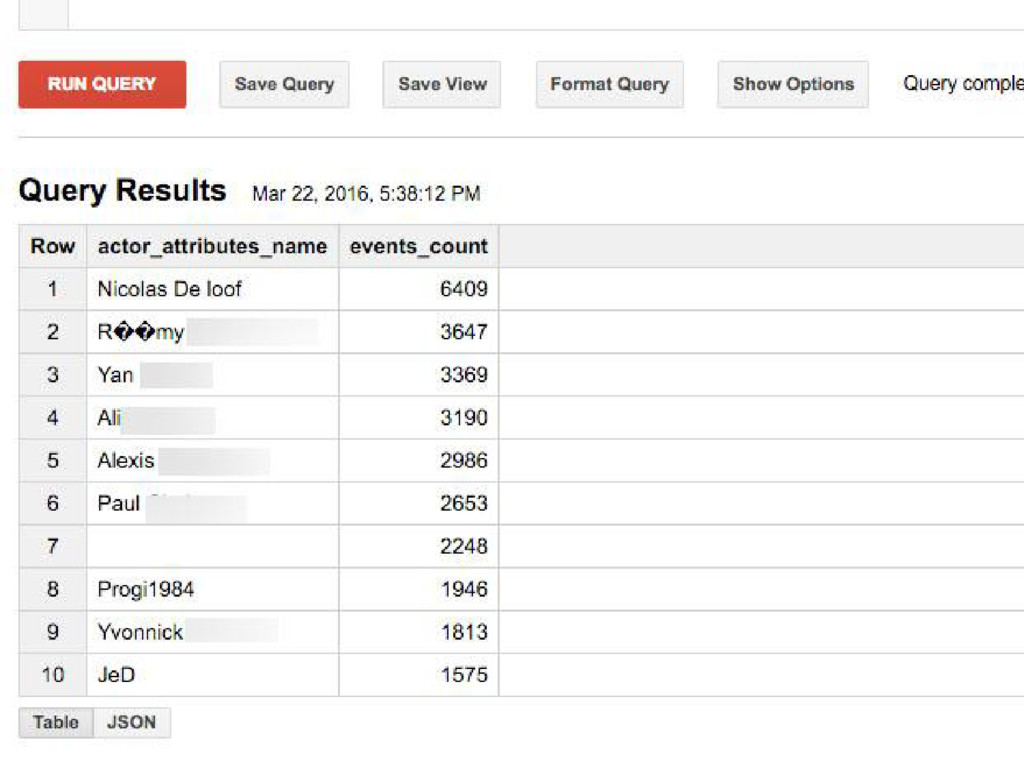
#4. USE GOOGLE BIG QUERY
None
None
None
KEEP THE DEFAULT USER-AGENT 4.
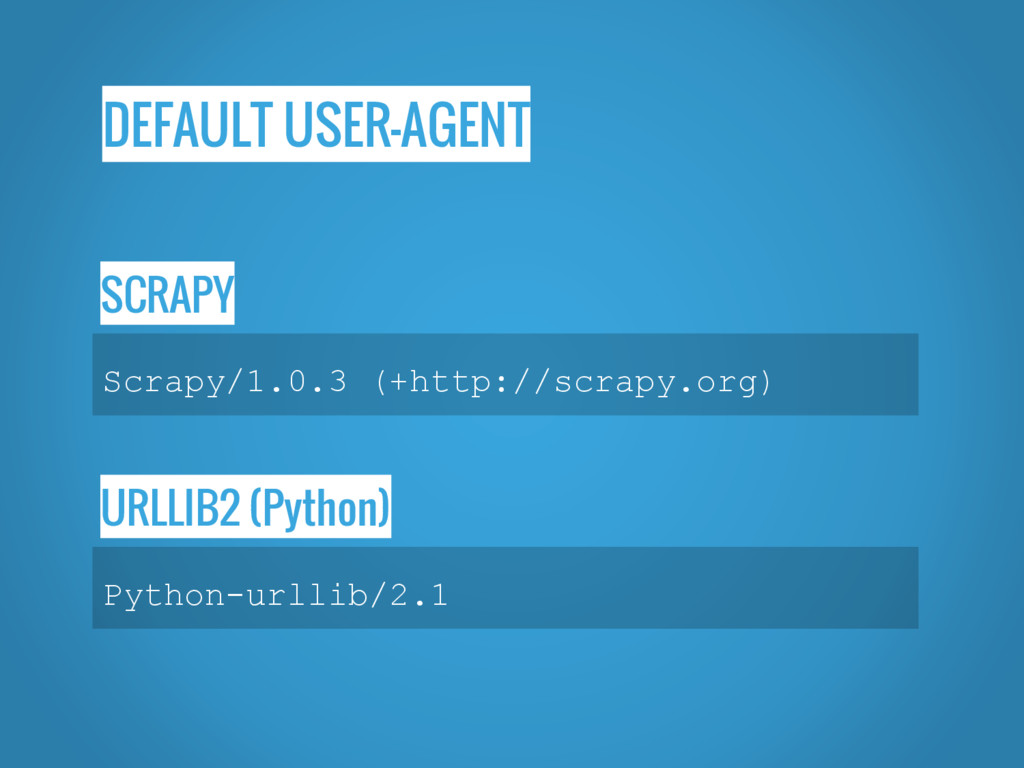
DEFAULT USER-AGENT SCRAPY Scrapy/1.0.3 (+http://scrapy.org) URLLIB2 (Python) Python-urllib/2.1
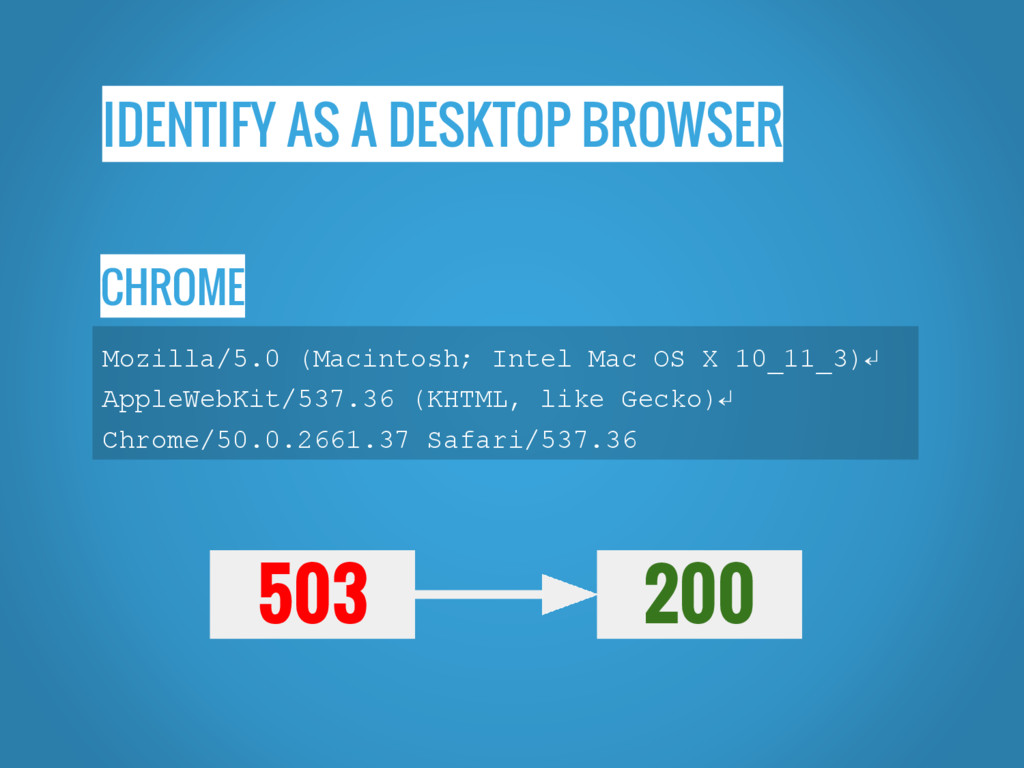
IDENTIFY AS A DESKTOP BROWSER CHROME Mozilla/5.0 (Macintosh; Intel Mac
OS X 10_11_3)↵ AppleWebKit/537.36 (KHTML, like Gecko)↵ Chrome/50.0.2661.37 Safari/537.36 200 503
SCRAP WITH YOUR DSL ACCESS 5.
BLACKLISTED
What is Blacklisting
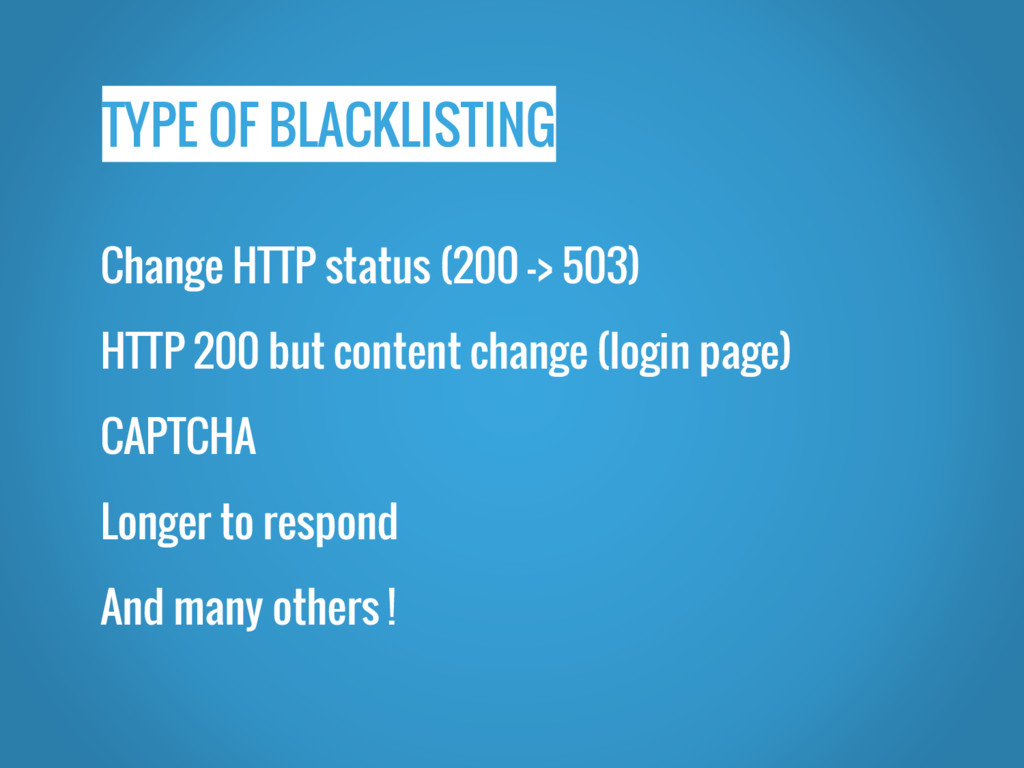
TYPE OF BLACKLISTING Change HTTP status (200 -> 503) HTTP
200 but content change (login page) CAPTCHA Longer to respond And many others !
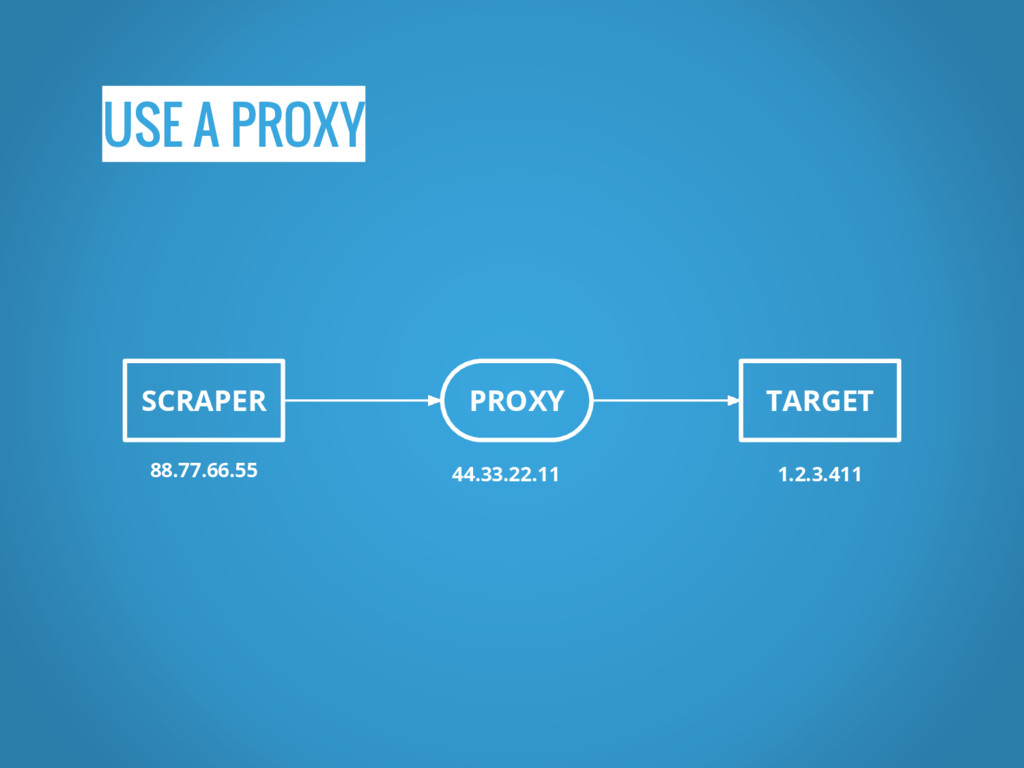
USE A PROXY SCRAPER PROXY TARGET 88.77.66.55 44.33.22.11 1.2.3.411
TYPE OF PROXIES PUBLIC PRIVATE
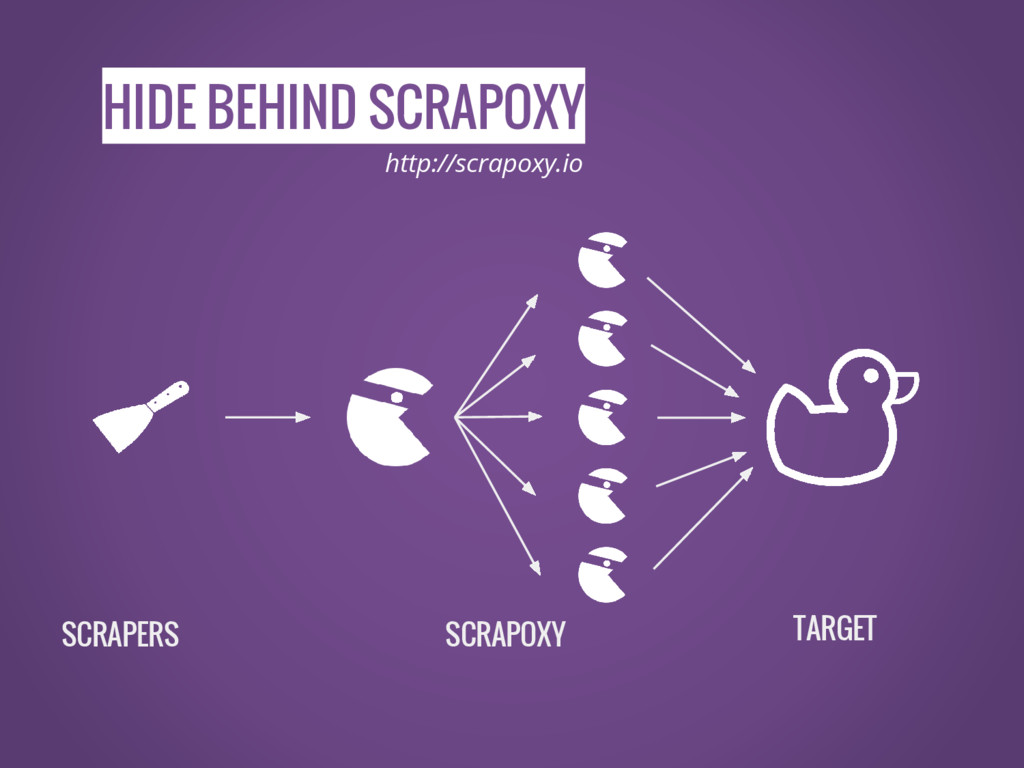
HIDE BEHIND SCRAPOXY SCRAPERS SCRAPOXY TARGET http://scrapoxy.io
TRIGGER ALERTS ON THE REMOTE SITE 6.
STAY OFF THE RADAR
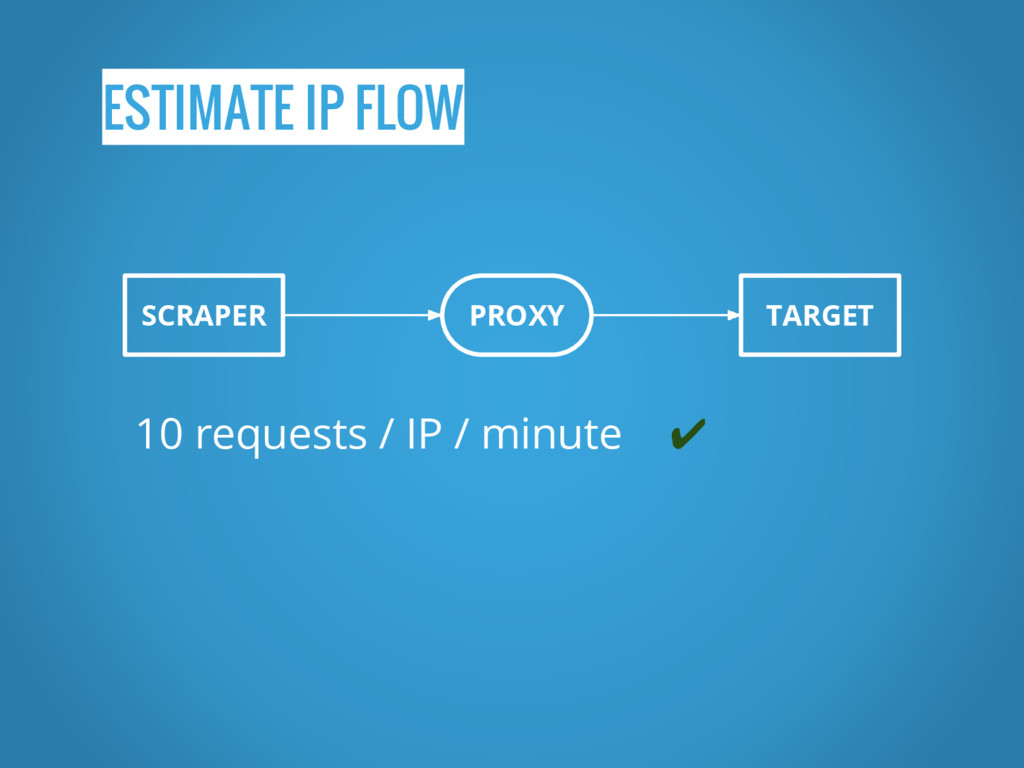
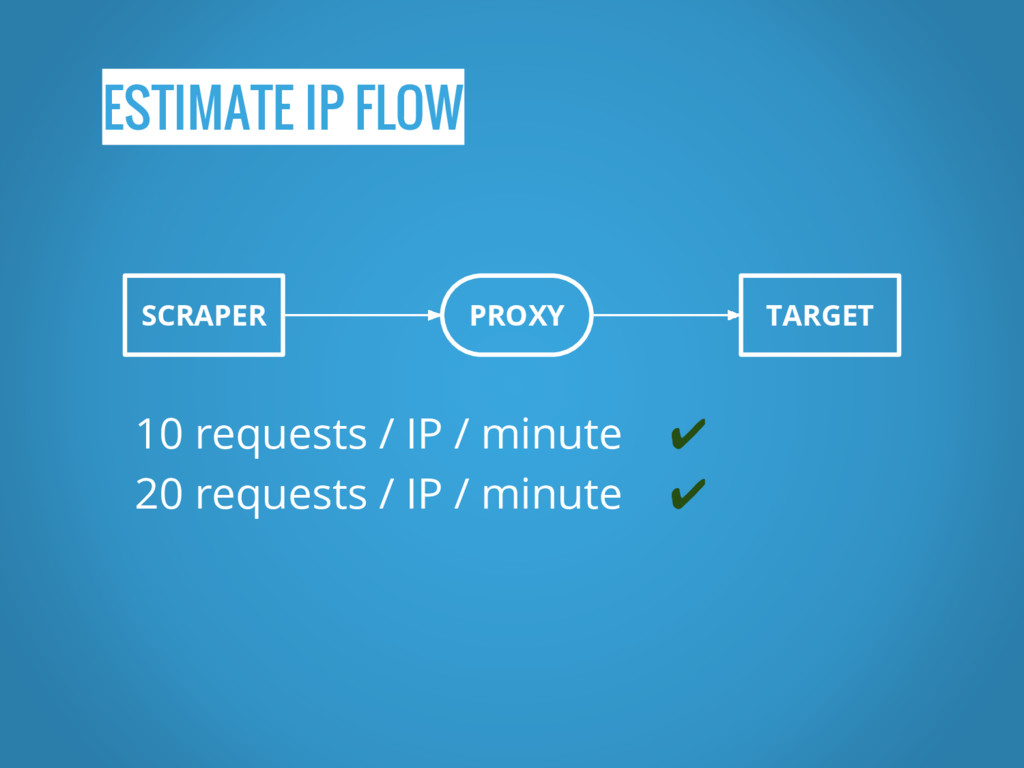
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔ 20 requests / IP / minute ✔
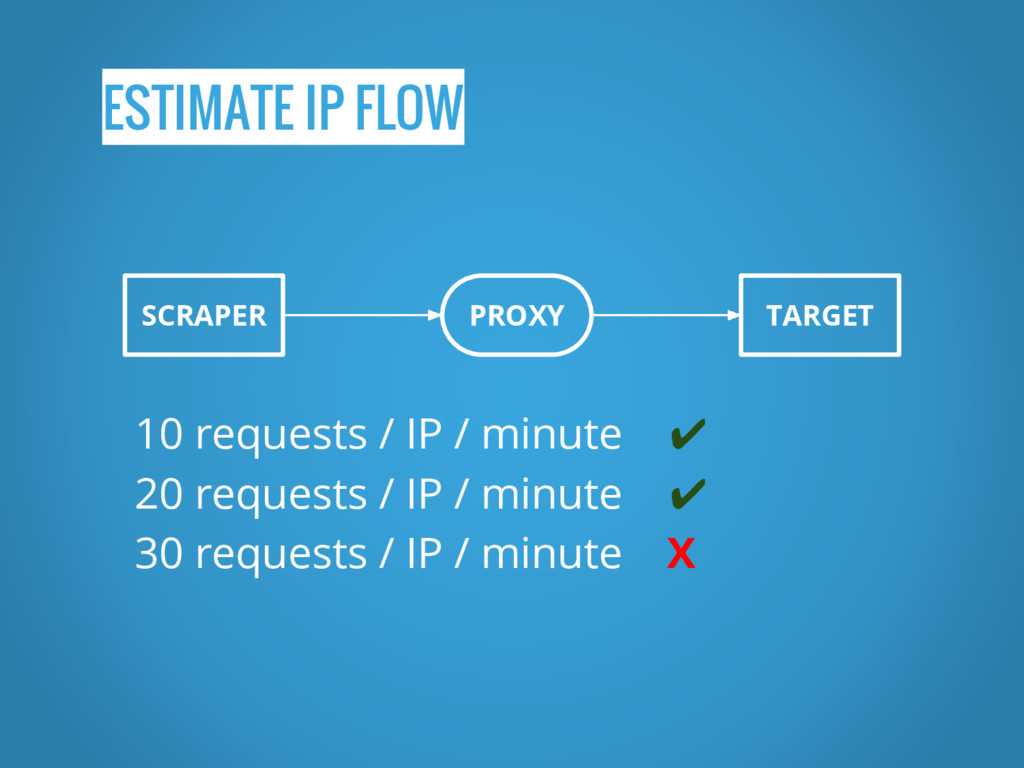
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔ 20 requests / IP / minute ✔ 30 requests / IP / minute X
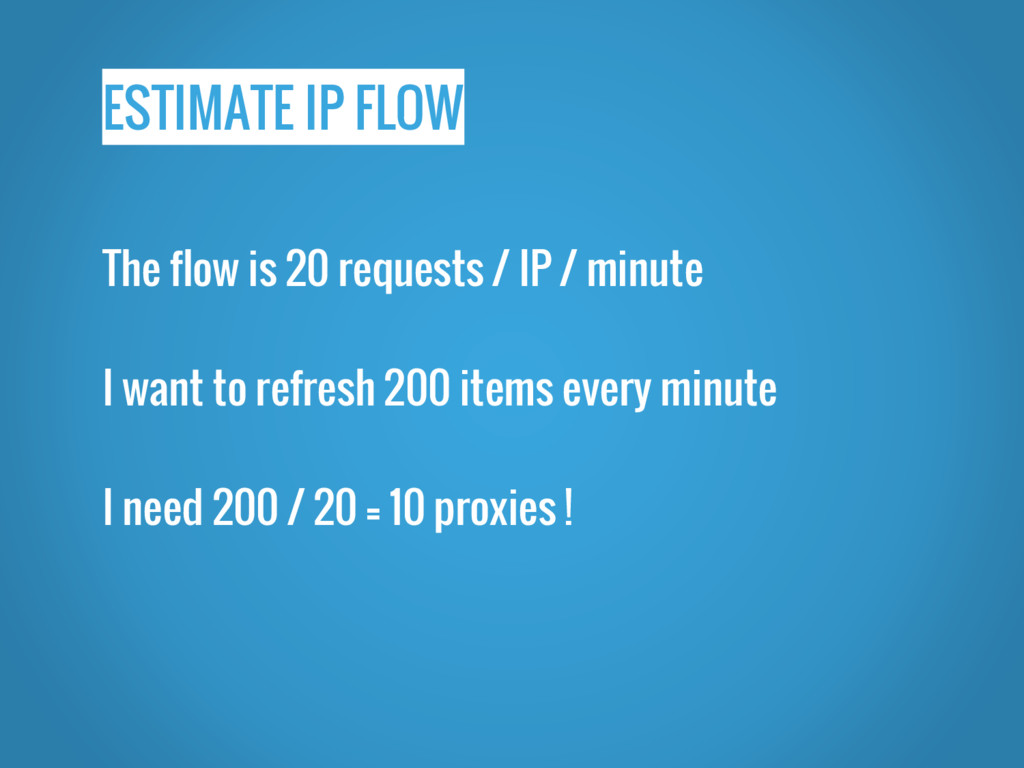
ESTIMATE IP FLOW The flow is 20 requests / IP
/ minute I want to refresh 200 items every minute I need 200 / 20 = 10 proxies !
MIX UP SCRAPER AND CRAWLER 7.
SCRAPERS ARE NOT CRAWLERS
FOCUS ON ESSENTIAL
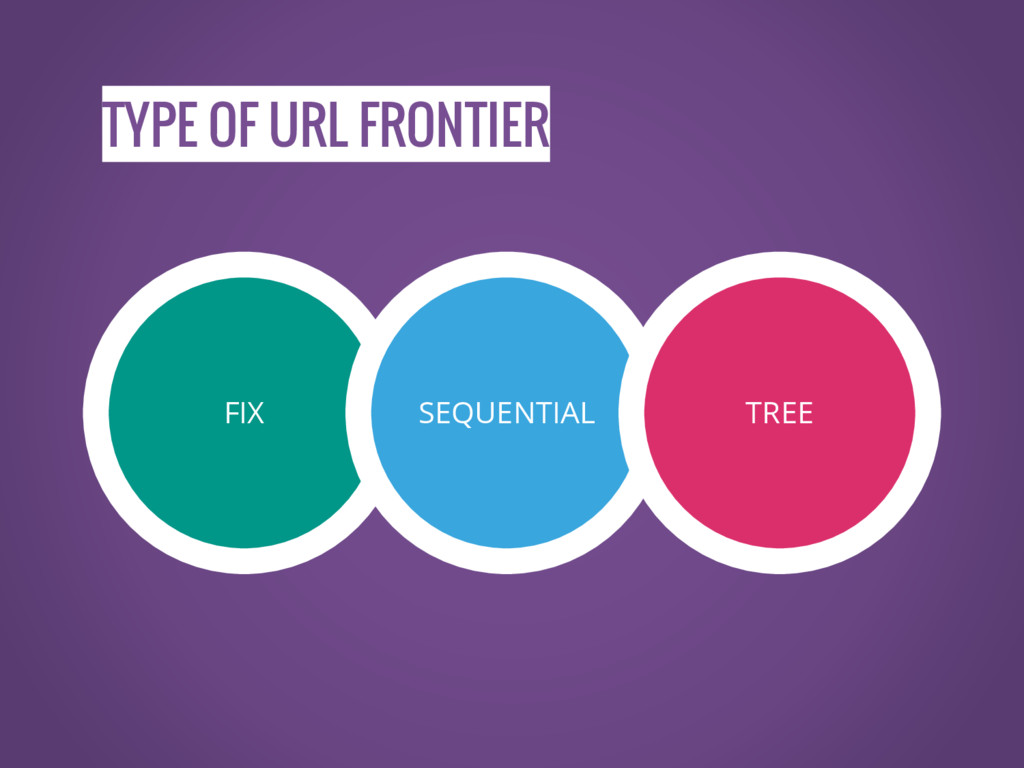
What is the URL frontier
URL frontier is the list of URL to fetch.
TYPE OF URL FRONTIER FIX SEQUENTIAL TREE
STORE ONLY PARSED RESULTS 8.
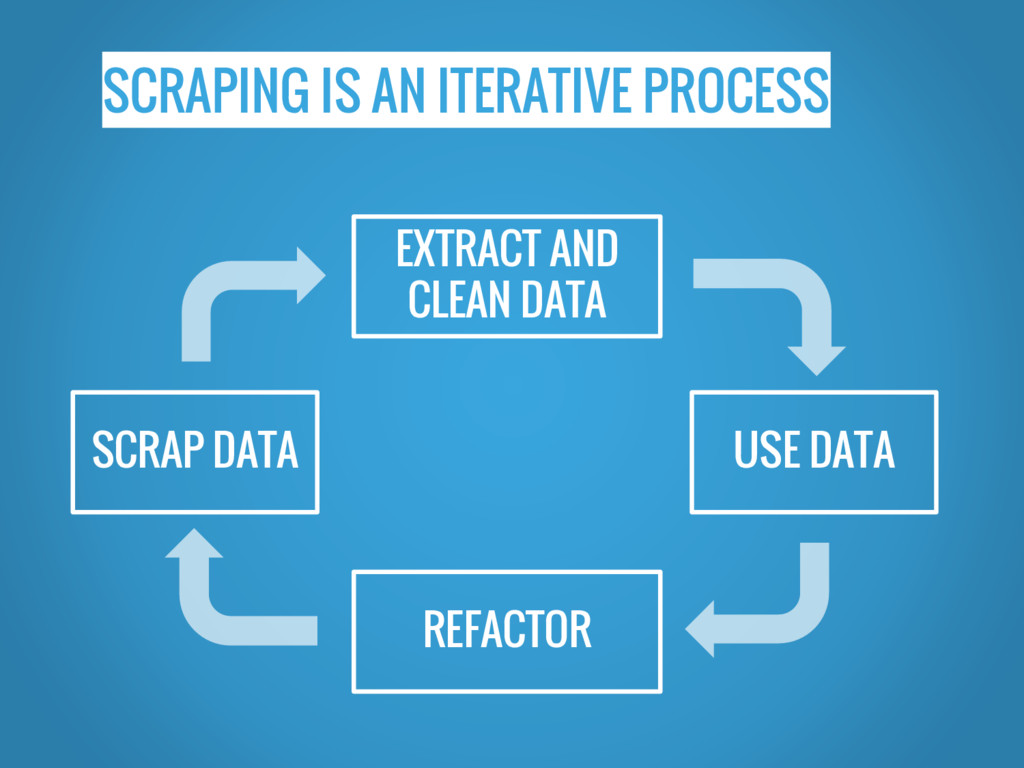
SCRAPING IS AN ITERATIVE PROCESS EXTRACT AND CLEAN DATA SCRAP
DATA USE DATA REFACTOR
SCRAP EVERYTHING... AGAIN ?
STORE FULL HTML PAGE
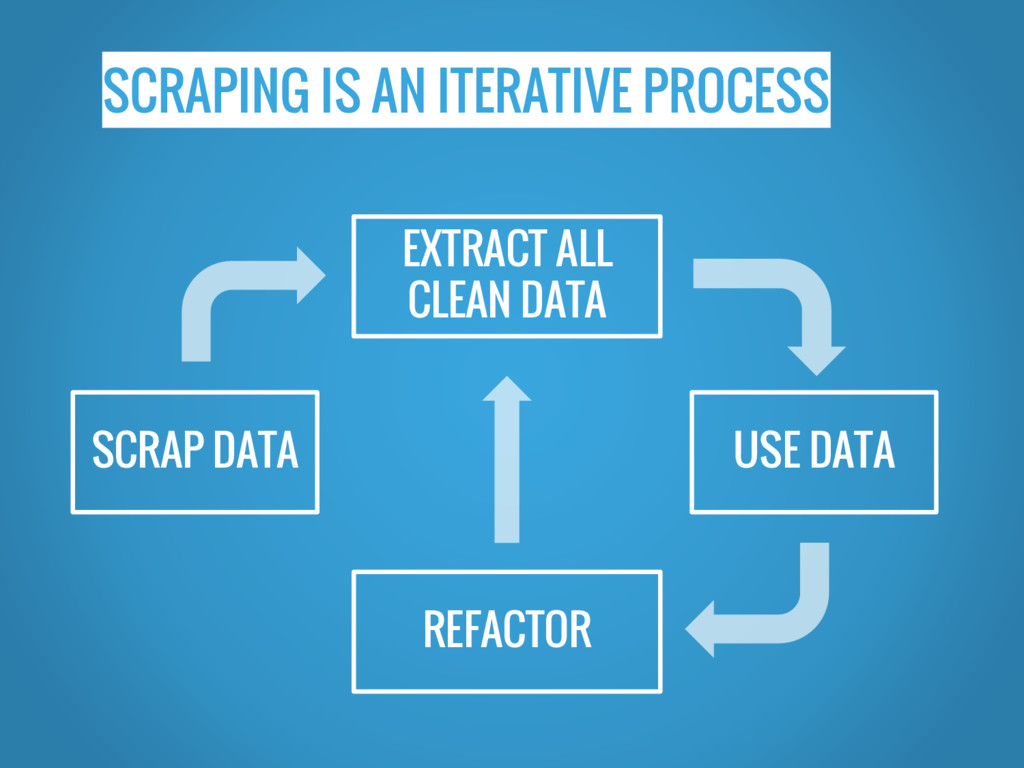
SCRAPING IS AN ITERATIVE PROCESS EXTRACT ALL CLEAN DATA SCRAP
DATA USE DATA REFACTOR
STORE WEBPAGE ONE BY ONE 9.
STORAGE CAN’T MANAGE MILLIONS OF SMALL FILES !
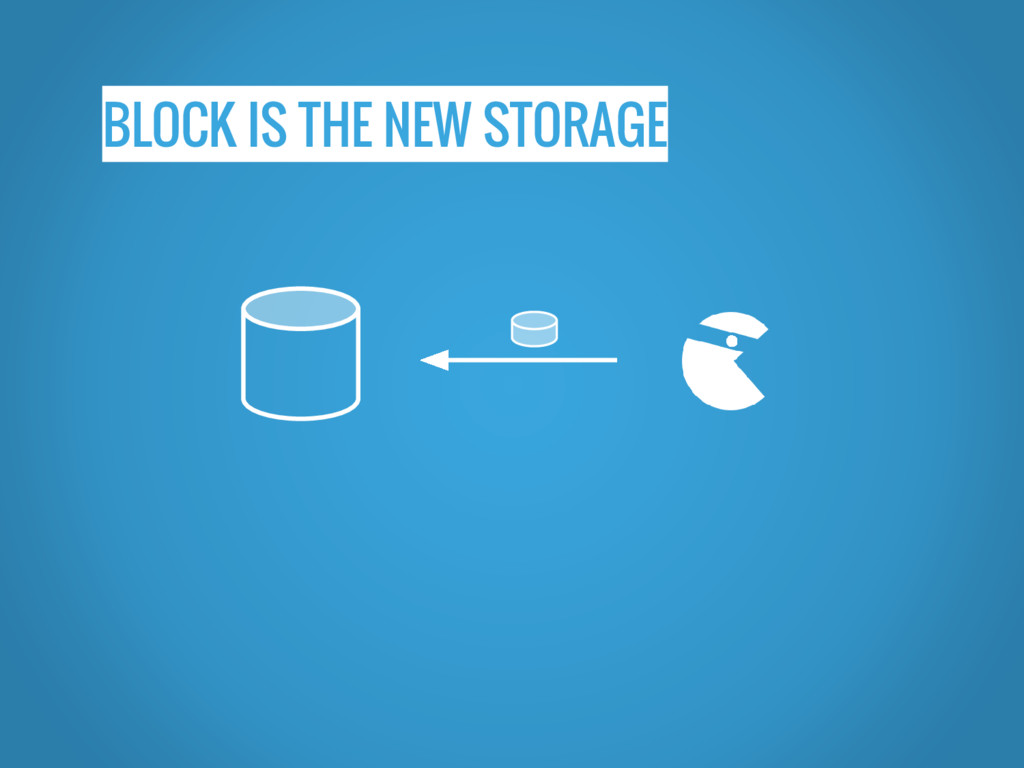
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
STORE HTML IN 128 MO ZIPPED FILES
PARSING IS SIMPLE ! 10.
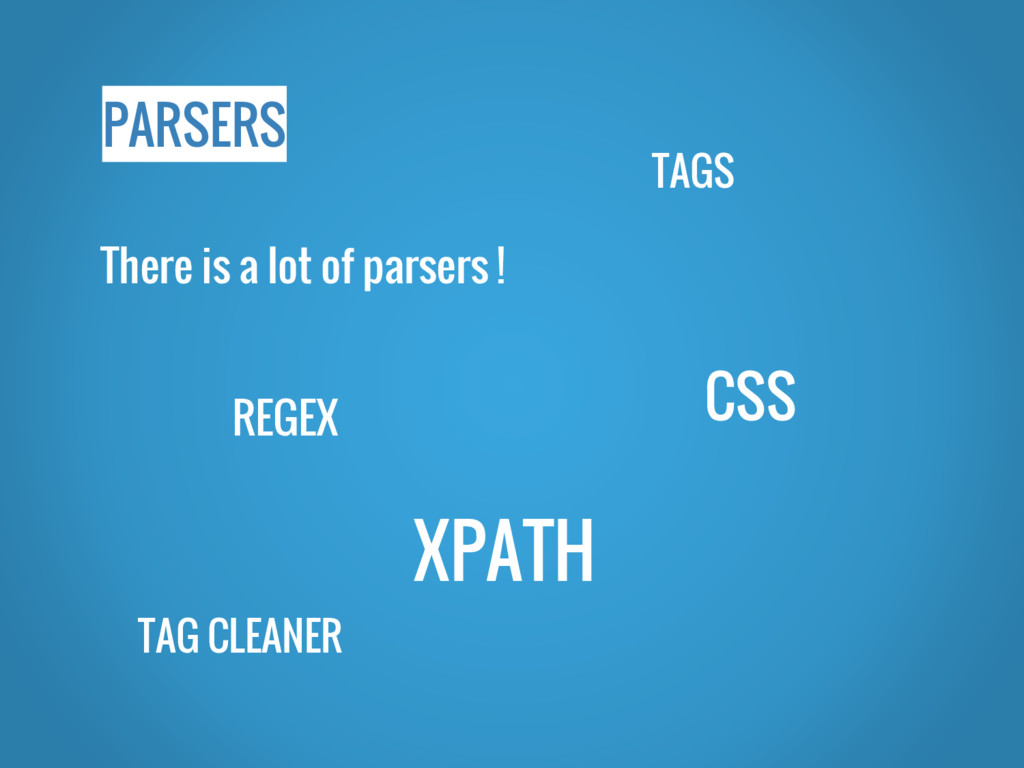
PARSERS There is a lot of parsers ! XPATH CSS
REGEX TAGS TAG CLEANER
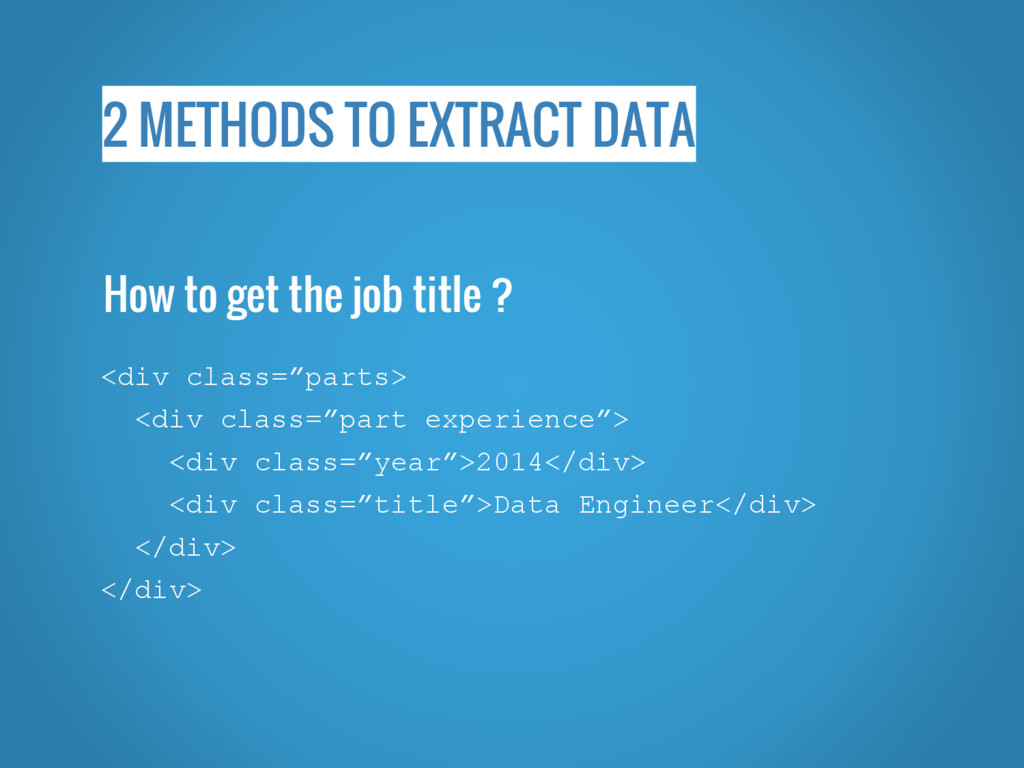
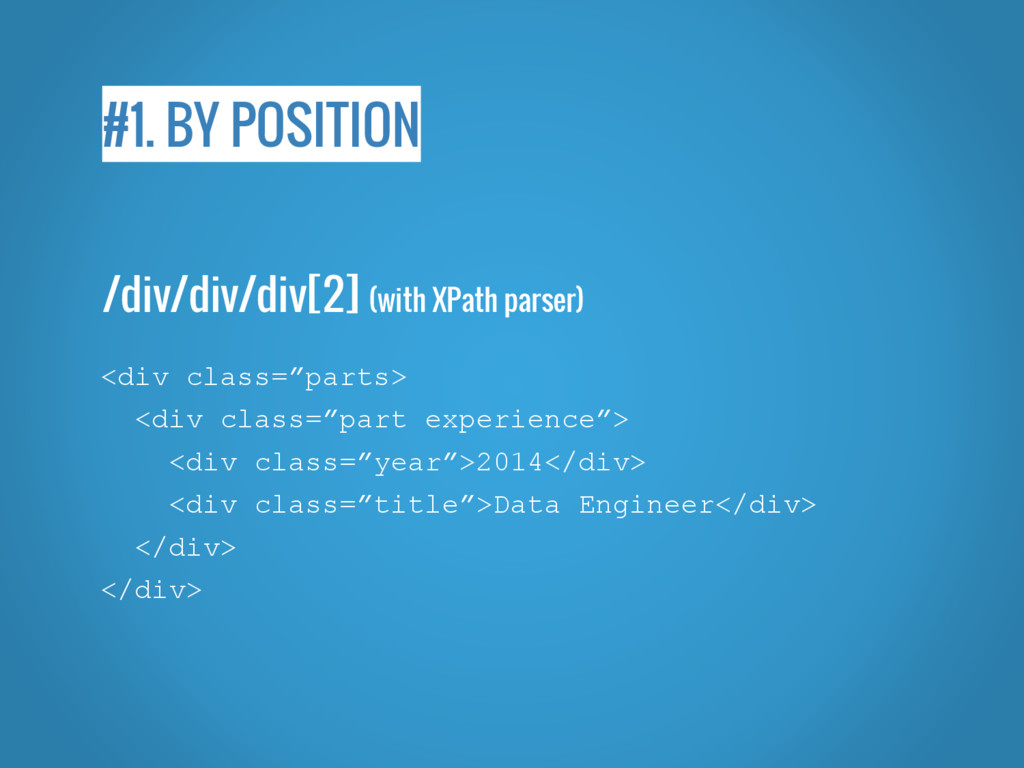
2 METHODS TO EXTRACT DATA <div class=”parts> <div class=”part experience”>
<div class=”year”>2014</div> <div class=”title”>Data Engineer</div> </div> </div> How to get the job title ?
#1. BY POSITION <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”title”>Data Engineer</div> </div> </div> /div/div/div[2] (with XPath parser)
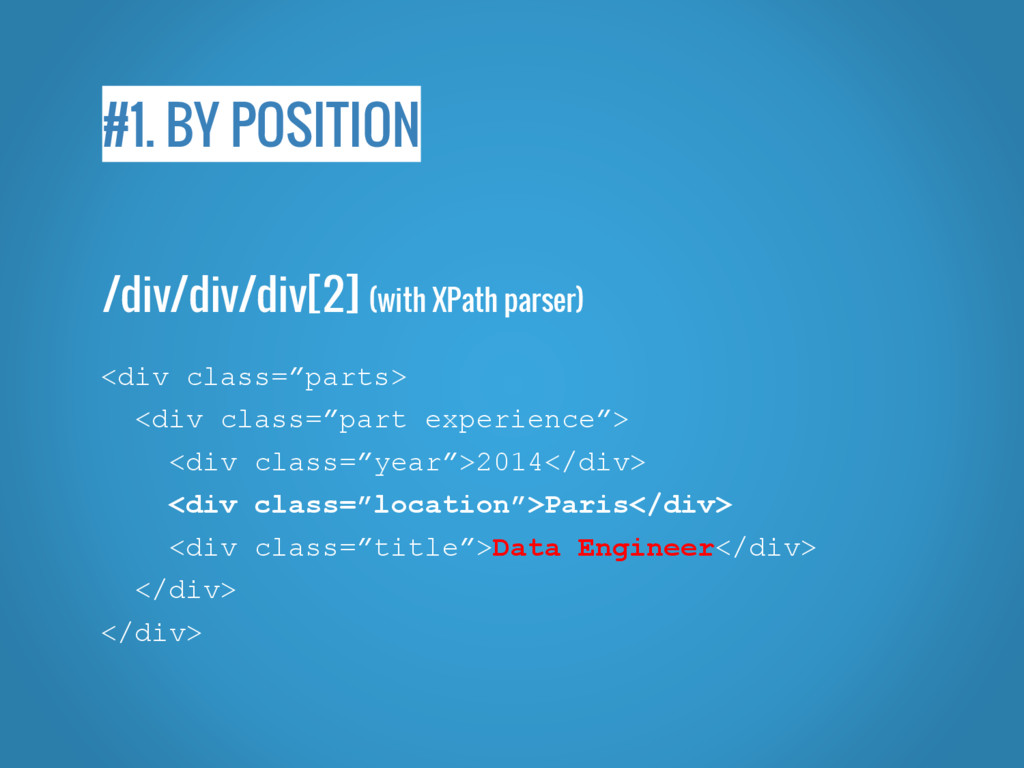
#1. BY POSITION <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”location”>Paris</div> <div class=”title”>Data Engineer</div> </div> </div> /div/div/div[2] (with XPath parser)
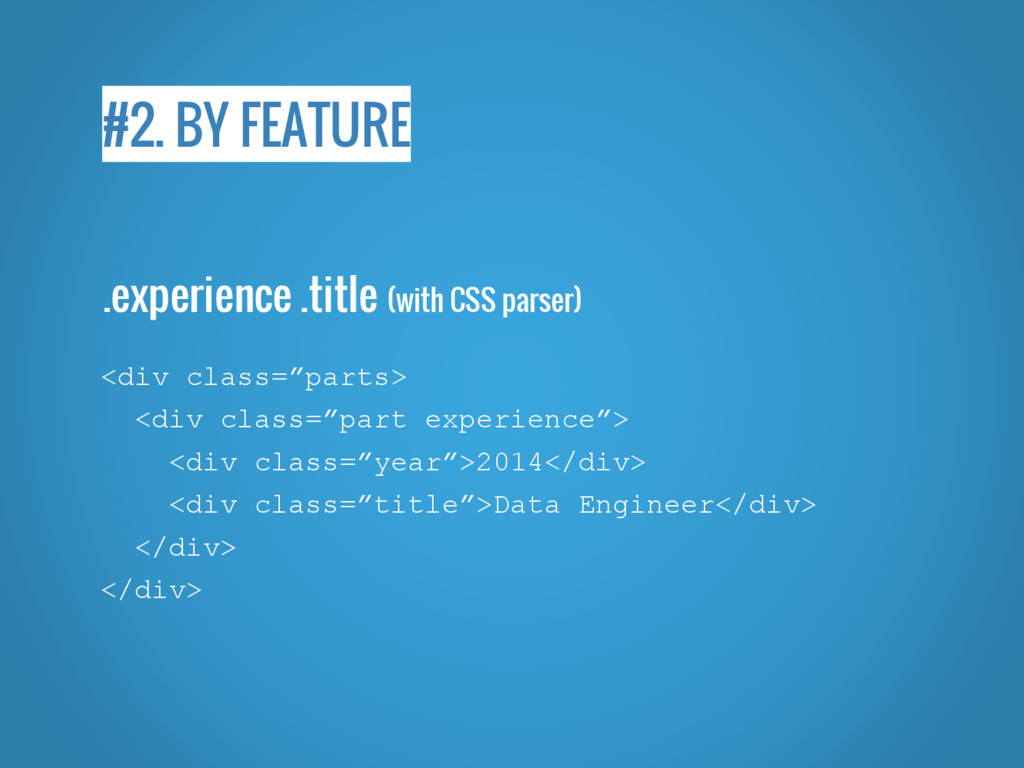
#2. BY FEATURE <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”title”>Data Engineer</div> </div> </div> .experience .title (with CSS parser)
LET’S RECAP !
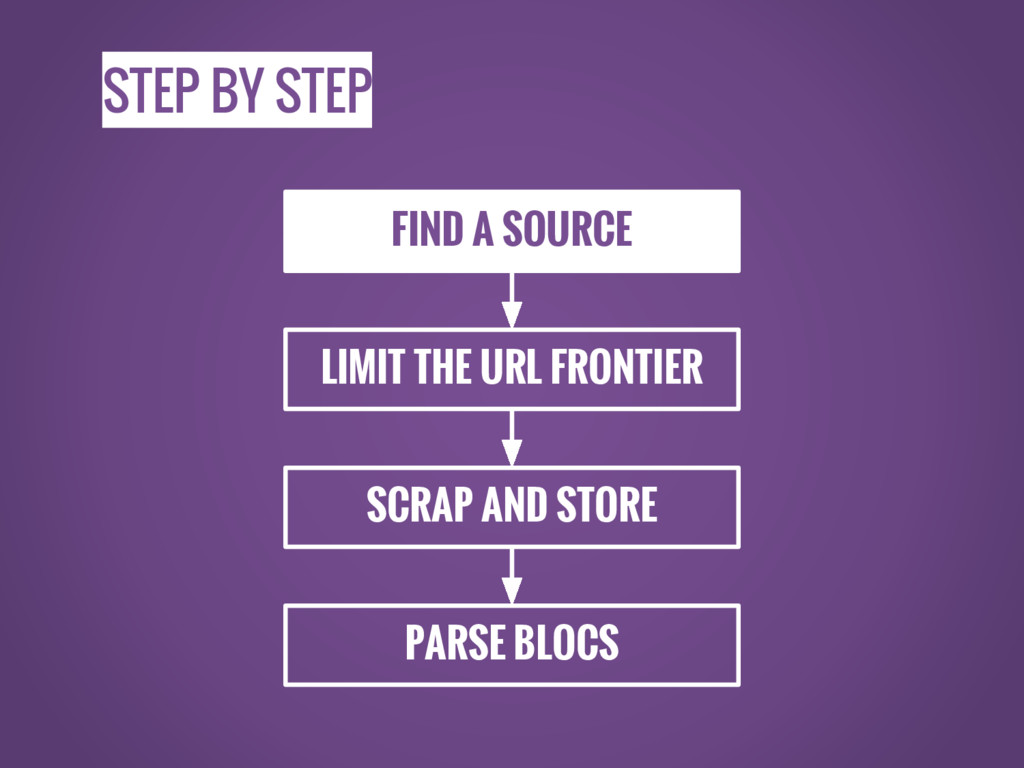
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
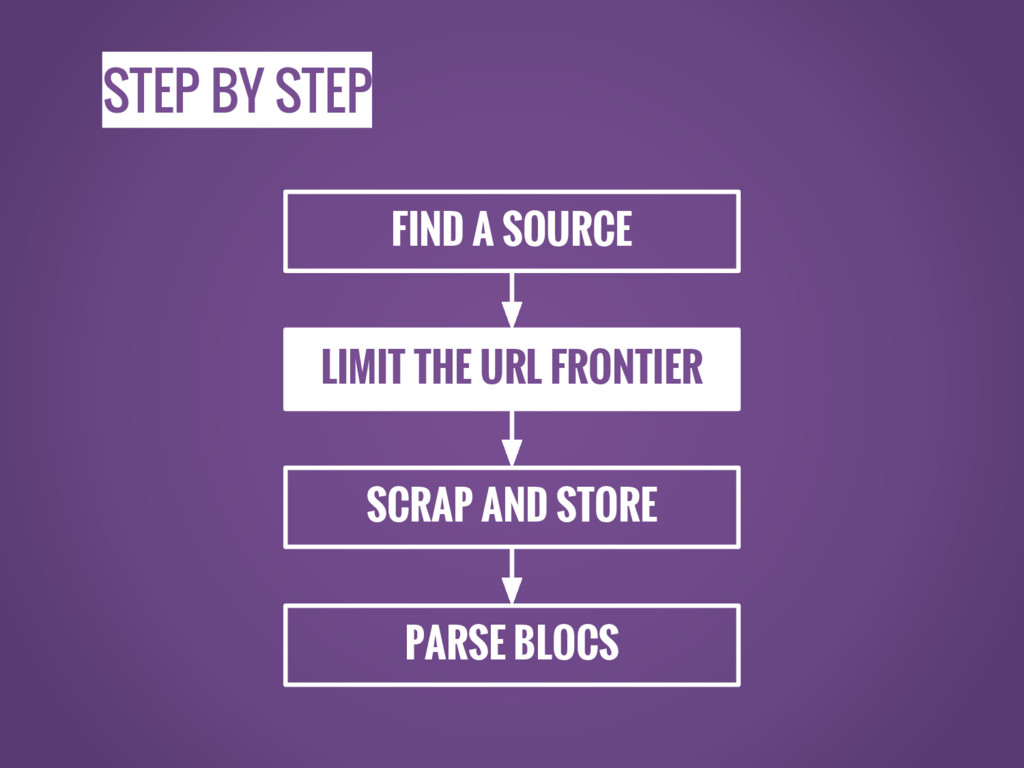
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
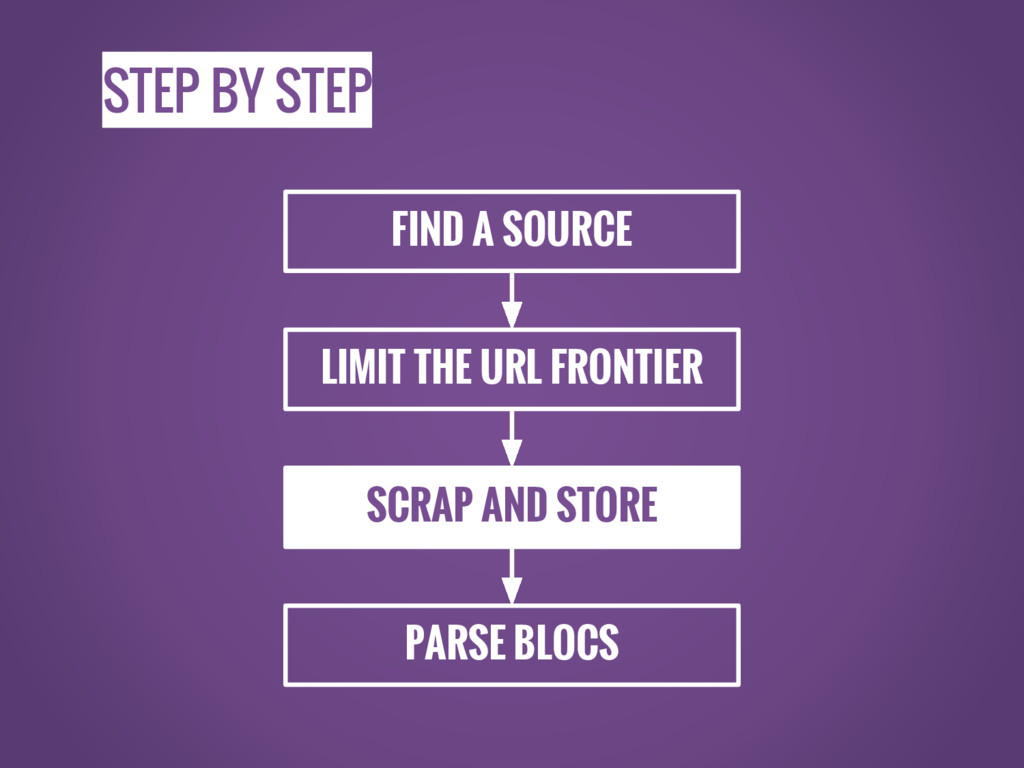
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
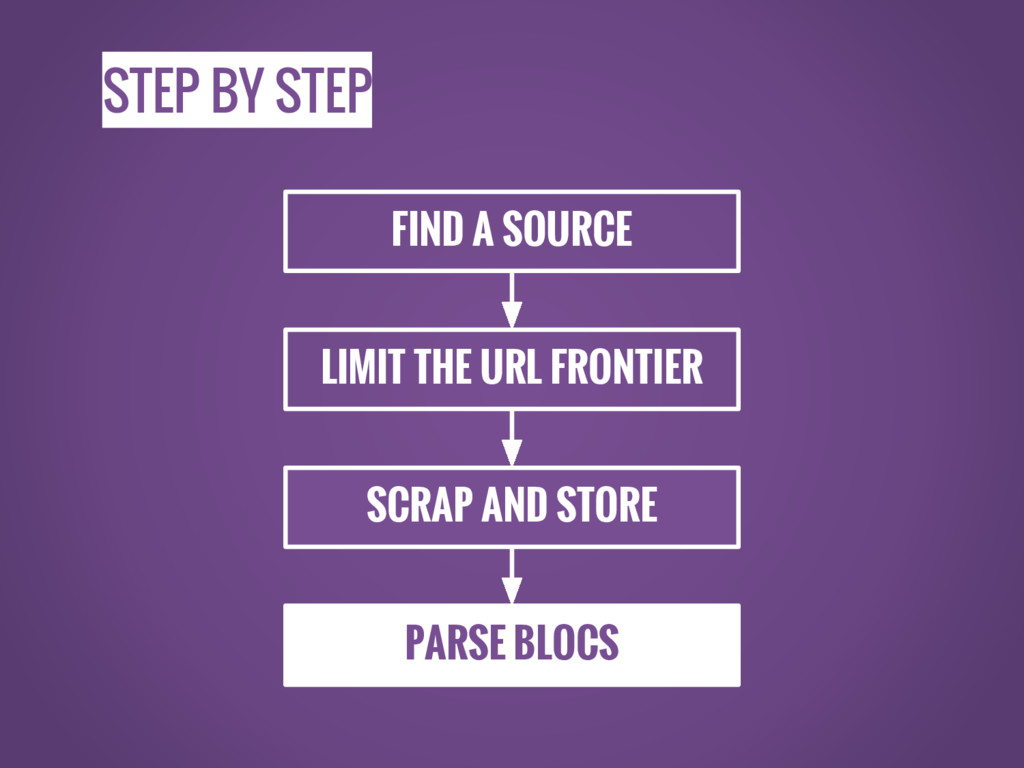
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
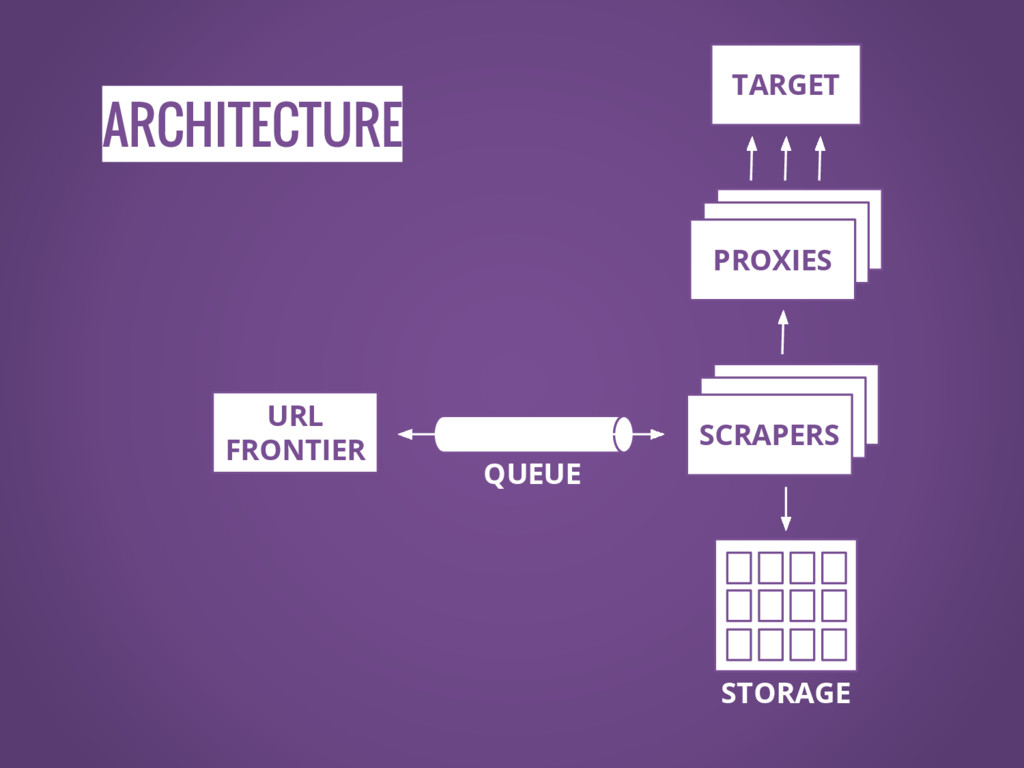
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS
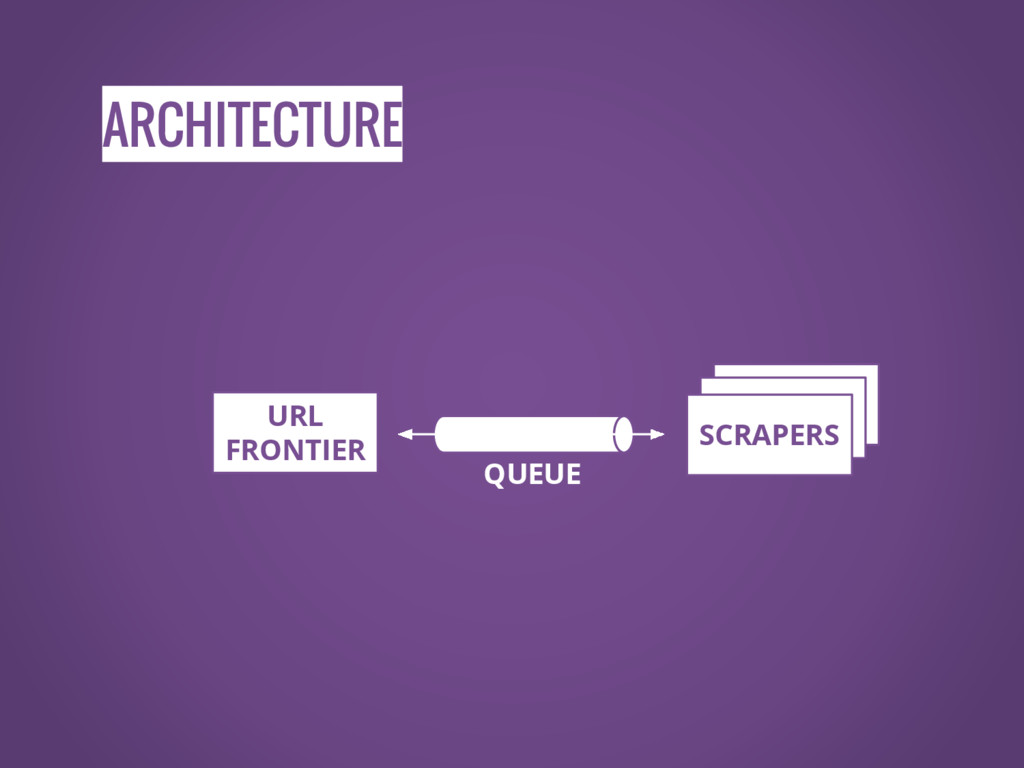
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS URL FRONTIER QUEUE
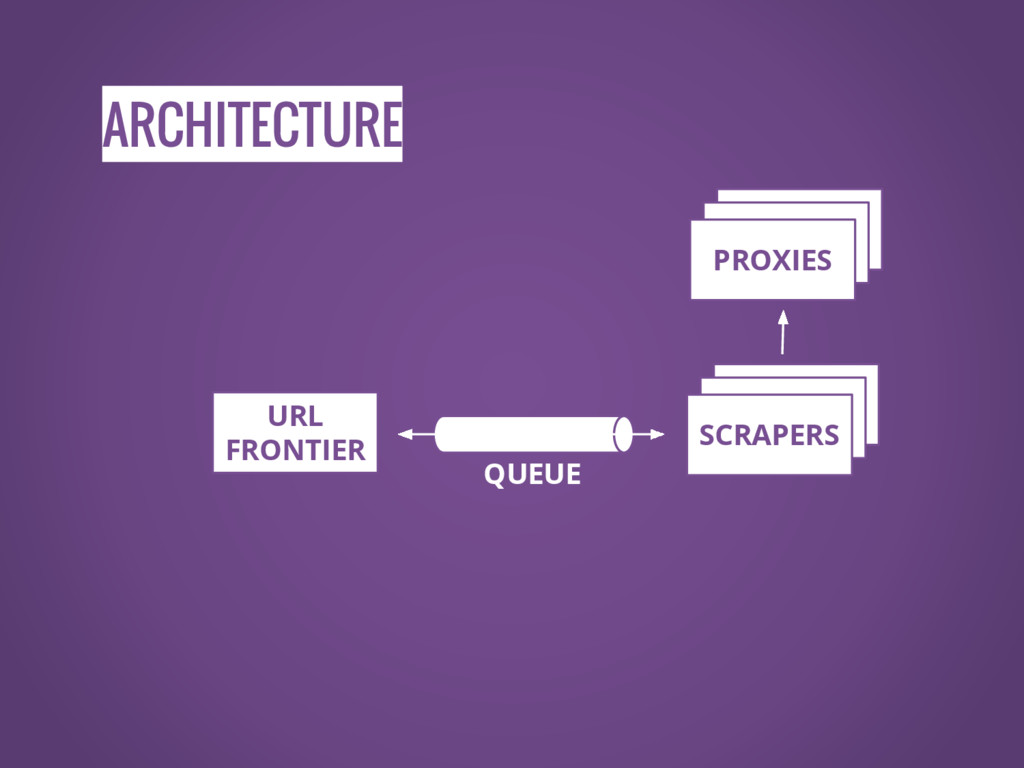
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER QUEUE
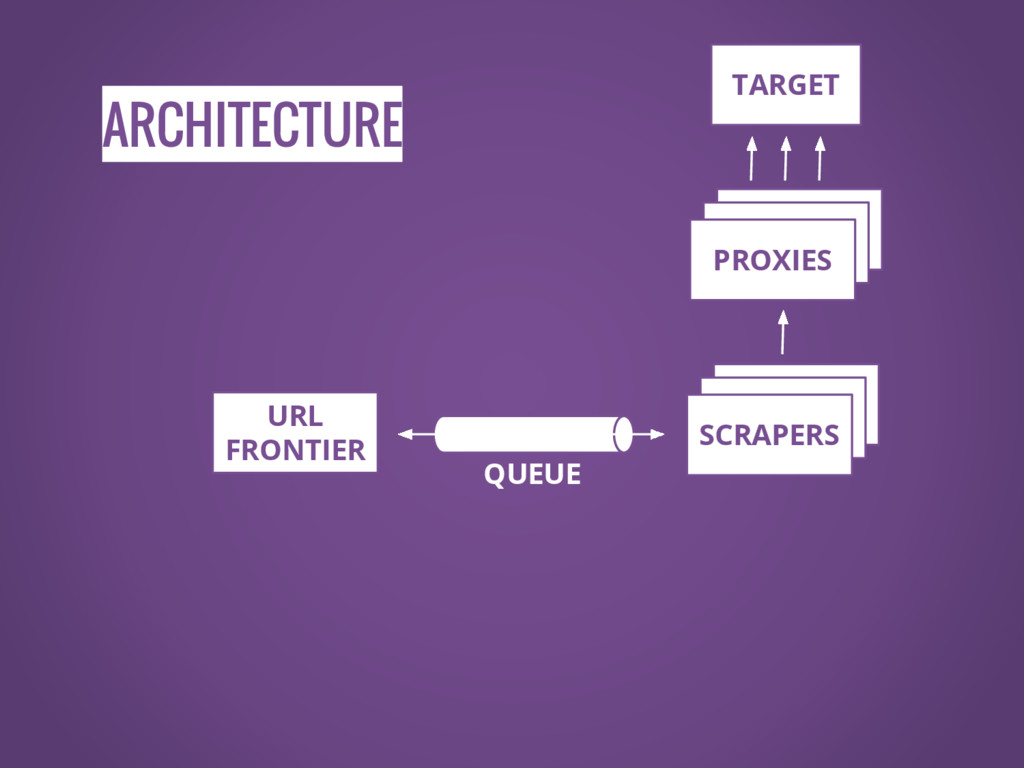
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER TARGET
QUEUE
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER STORAGE
TARGET QUEUE
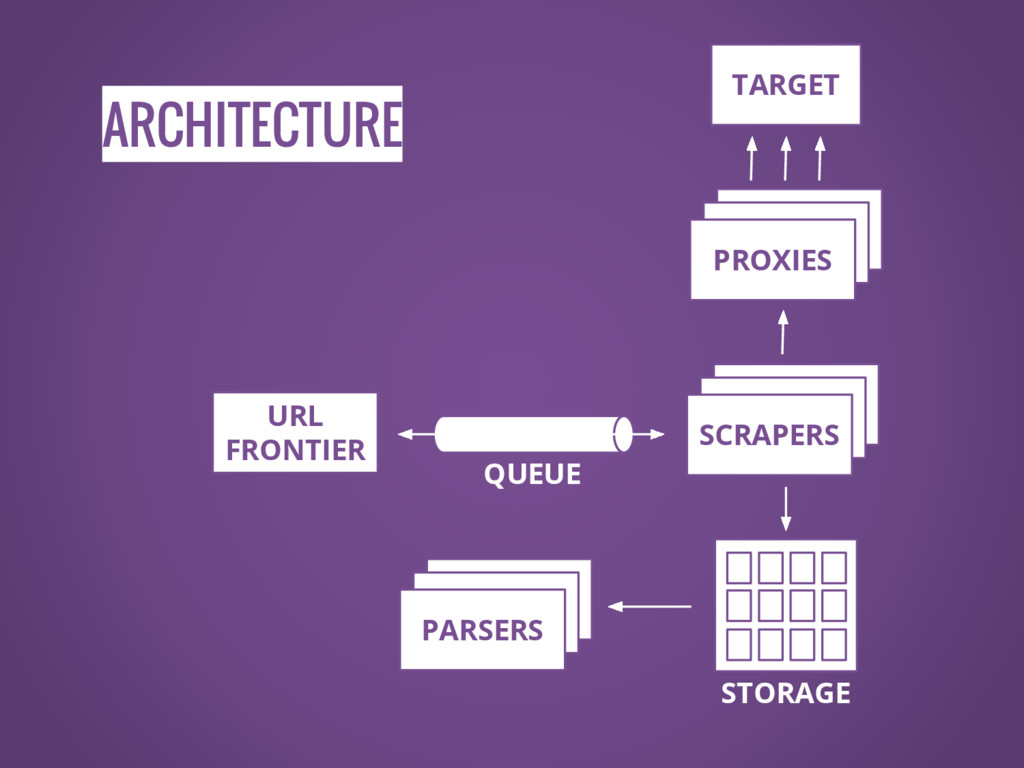
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER SCRAPERS
SCRAPERS PARSERS STORAGE TARGET QUEUE
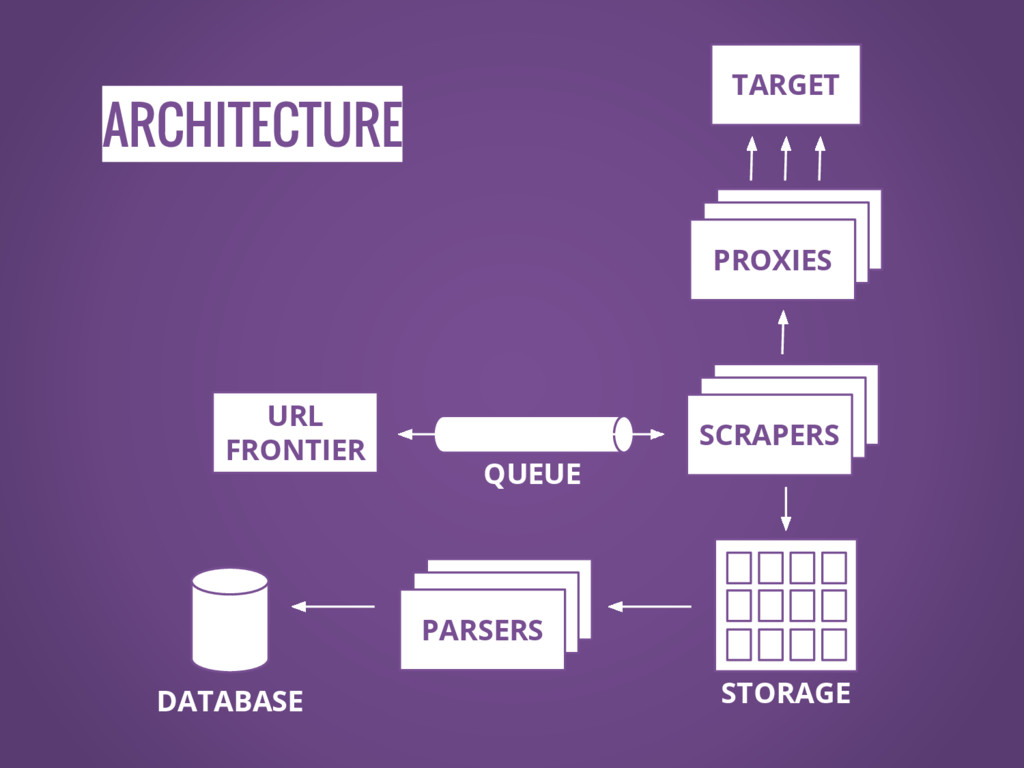
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER SCRAPERS
SCRAPERS PARSERS STORAGE DATABASE TARGET QUEUE
Fabien VAUCHELLES zelros.com /
[email protected]
/ @fabienv http://bit.ly/breizhscraping The best
opensource proxy for Scraping !


 fabienvauchelles
 takusamar
 hiranabe
 estie
 hayataka88
 lychee1223
 syuchimu
 tagtag
 trycycle
 tomoaki0705
 signer
 neutron63zf
 marktimemedia
 panda_program
 notwaldorf
 lindahogenes
 jakevdp
 szymonslowik
 maltzj
 rasagy
 wayneb77
 helenjbeal
 tanoku
 ryanjones