Upgrade to Pro — share decks privately, control downloads, hide ads and more …

20211124_雲勉_オンライン_勉強会_.pdf

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →
Avatar for fukuta fukuta
November 24, 2021

 20211124_雲勉_オンライン_勉強会_.pdf

Avatar for fukuta

fukuta

November 24, 2021

More Decks by fukuta

Other Decks in Technology

Transcript

  1. アイレットご紹介 – 会社概要 3 ◼ 社名 アイレット株式会社 ◼ 所在地 〒105-6307

    東京都港区⻁ノ⾨1-23-1 ⻁ノ⾨ヒルズ森タワー7F 設⽴2003年10⽉15⽇ ◼ 資本⾦ 7,000万円 ◼ 代表者名 岩永充正 ◼ 従業員数 682名(2021年4⽉末時点) ◼ 事業内容 ITコンサルティング、システム開発、 システム保守・運⽤、 サーバハウジング・ホスティング ◼ 主要株主 KDDI株式会社
  2. アイレットご紹介 – AWS APNパートナー 4 cloudpackは、Amazon Elastic Compute Cloud (Amazon

    EC2)やAmazon Simple Storage Service (Amazon S3)をはじめとするAWSの各種プロダクトを利⽤する際の導⼊・設計から運⽤保 守を含んだフルマネージドのサービスを提供し、バックアップや24時間365⽇の監視/障害対応、技術 的な問い合わせに対するサポートなどを⾏っております。 2013年6⽉4⽇には、AWSパートナーネットワーク(APN)において、⽇本初のAPNプレミアティア コンサルティングパートナーの⼀社として認定されたのをはじめ、その後9年連続で認定されていま す。 『APNプレミアティアコンサルティングパートナー』はAPNプログラムの中で最上位のパートナーで あり、厳しいクライテリアを満たしたパートナーのみが選出され、世界で128社のみが認定されてい ます。9年連続で認定された⽇本企業としては、cloudpack(アイレット)と株式会社野村総合研究所 の2社のみとなります。 11
  3. アイレットご紹介 – APN Consulting Partner of the Year 2019 –

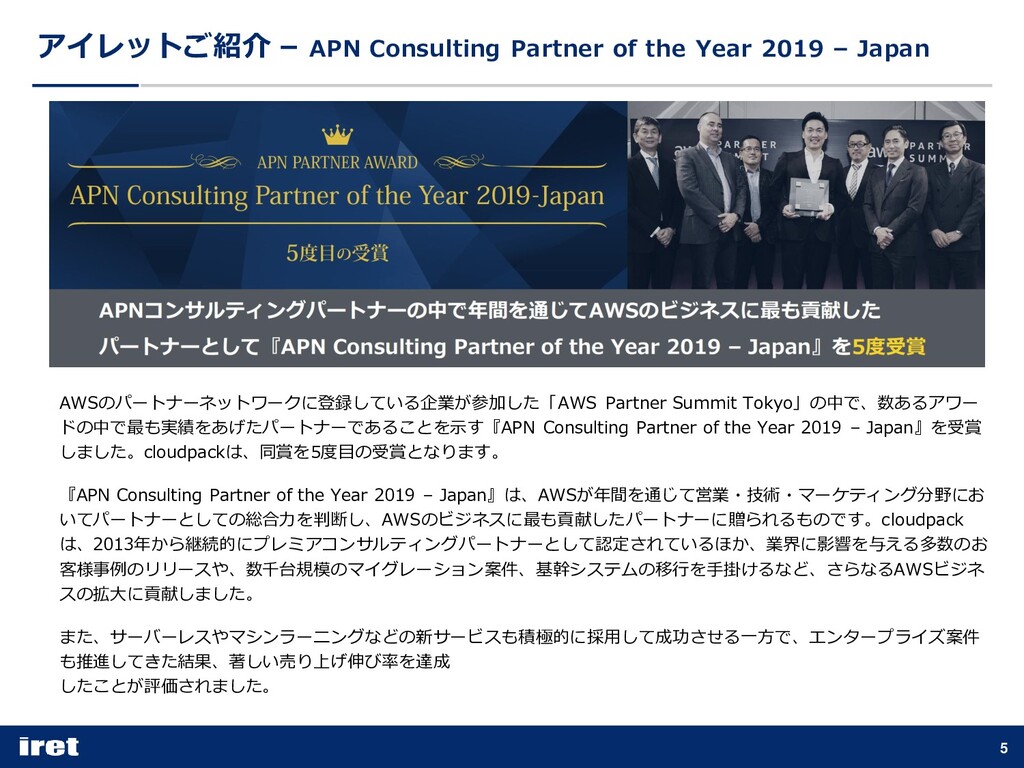
    Japan 5 AWSのパートナーネットワークに登録している企業が参加した「AWS Partner Summit Tokyo」の中で、数あるアワー ドの中で最も実績をあげたパートナーであることを⽰す『APN Consulting Partner of the Year 2019 – Japan』を受賞 しました。cloudpackは、同賞を5度⽬の受賞となります。 『APN Consulting Partner of the Year 2019 – Japan』は、AWSが年間を通じて営業・技術・マーケティング分野にお いてパートナーとしての総合⼒を判断し、AWSのビジネスに最も貢献したパートナーに贈られるものです。cloudpack は、2013年から継続的にプレミアコンサルティングパートナーとして認定されているほか、業界に影響を与える多数のお 客様事例のリリースや、数千台規模のマイグレーション案件、基幹システムの移⾏を⼿掛けるなど、さらなるAWSビジネ スの拡⼤に貢献しました。 また、サーバーレスやマシンラーニングなどの新サービスも積極的に採⽤して成功させる⼀⽅で、エンタープライズ案件 も推進してきた結果、著しい売り上げ伸び率を達成 したことが評価されました。
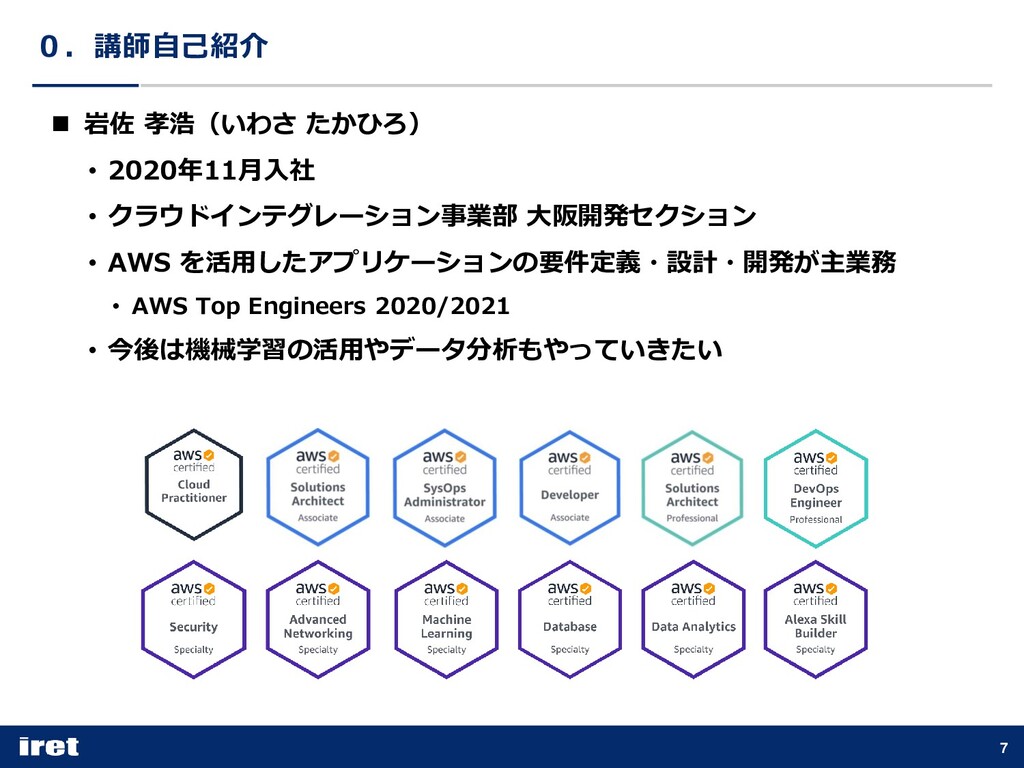
  4. 0.講師自己紹介 ◼ 岩佐 孝浩(いわさ たかひろ) • 2020年11月入社 • クラウドインテグレーション事業部 大阪開発セクション

    • AWS を活用したアプリケーションの要件定義・設計・開発が主業務 • AWS Top Engineers 2020/2021 • 今後は機械学習の活用やデータ分析もやっていきたい 7
  5. アジェンダ 0. 自己紹介 1. はじめに(19:05~19:05) 2. Graph DB 概要 (19:05~19:20)

    3. Neptune 概要 (19:20~19:35) 4. Gremlin による Graph Data の探索 (19:35~19:50) 5. 参考リソース (19:50~19:50) 6. 質疑応答(19:50~20:00) 8
  6. 1.はじめに ◼ 前提 • Graph Database (以降 Graph DB) に興味がある

    • Amazon Neptune に興味がある • Relational Database (以降 RDB), AWS の基礎知識がある ◼ 目的 • Graph DB の概要を理解する • Amazon Neptune の概要を理解する • Apache TinkerPop Gremlin によるデータ探索の概要を理解する ◼ 免責 • iret のプロジェクト事例紹介ではありません。 • ボリュームが多いかもしれないので、少し駆け足で進めます。 • スピーカー含め、全員で Graph DB の理解を深める機会になれば幸いで す。 10
  7. 2030年までにかなり浸透すると、個人的に考えています。 ◼ クラウドの急速な普及 ⚫ 大企業のクラウド移行が進展 ⚫ 中小企業もクラウド移行が加速しそう ◼ ビッグデータの蓄積 ⚫

    クラウドを利用することで、TB~PBのデータを高い可用性・耐久性を安 価に実現可能 ⚫ オンプレよりも気軽にデータを蓄積可能 ◼ データの蓄積から活用へ ⚫ 蓄積されたビッグデータを可視化したり、Graph DB を構築する等、 データの活用が進展 2.Graph DB 概要 – なぜ今 Graph DB なのか 12
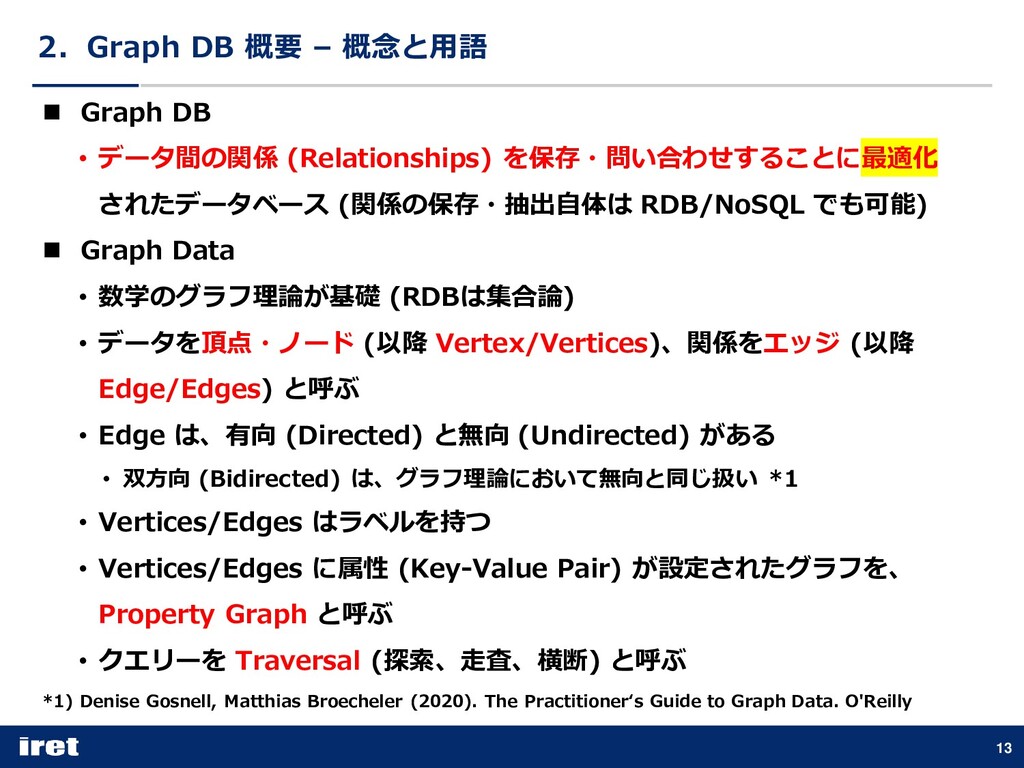
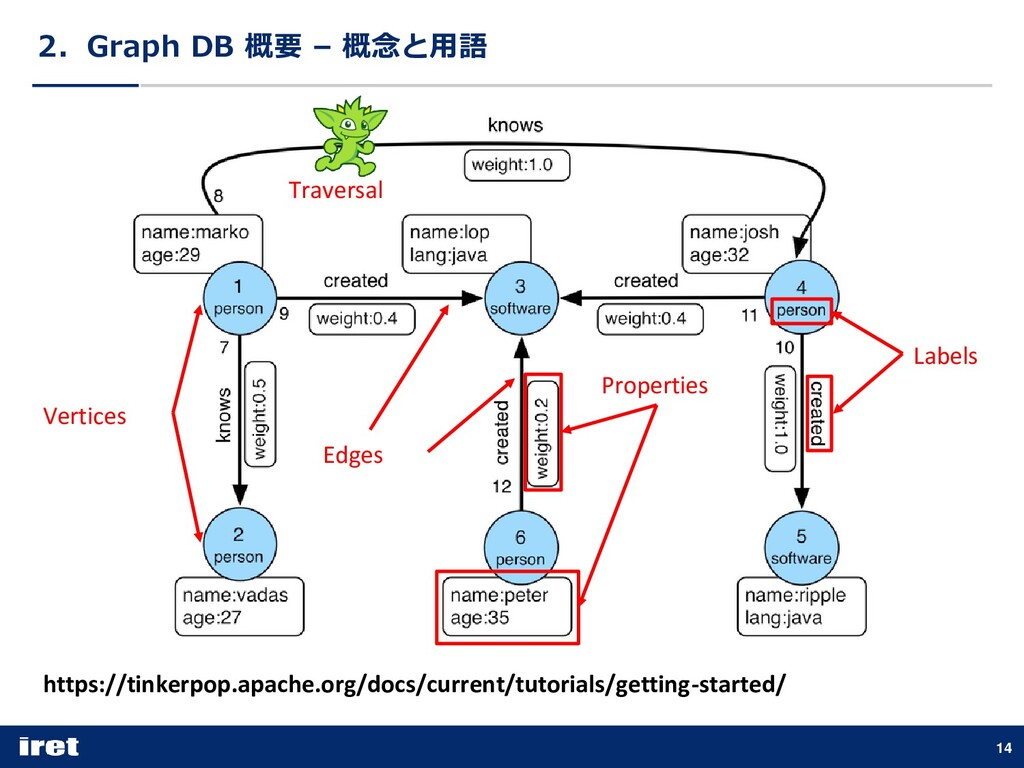
  8. ◼ Graph DB • データ間の関係 (Relationships) を保存・問い合わせすることに最適化 されたデータベース (関係の保存・抽出自体は RDB/NoSQL

    でも可能) ◼ Graph Data • 数学のグラフ理論が基礎 (RDBは集合論) • データを頂点・ノード (以降 Vertex/Vertices)、関係をエッジ (以降 Edge/Edges) と呼ぶ • Edge は、有向 (Directed) と無向 (Undirected) がある • 双方向 (Bidirected) は、グラフ理論において無向と同じ扱い *1 • Vertices/Edges はラベルを持つ • Vertices/Edges に属性 (Key-Value Pair) が設定されたグラフを、 Property Graph と呼ぶ • クエリーを Traversal (探索、走査、横断) と呼ぶ 2.Graph DB 概要 – 概念と用語 13 *1) Denise Gosnell, Matthias Broecheler (2020). The Practitioner‘s Guide to Graph Data. O'Reilly
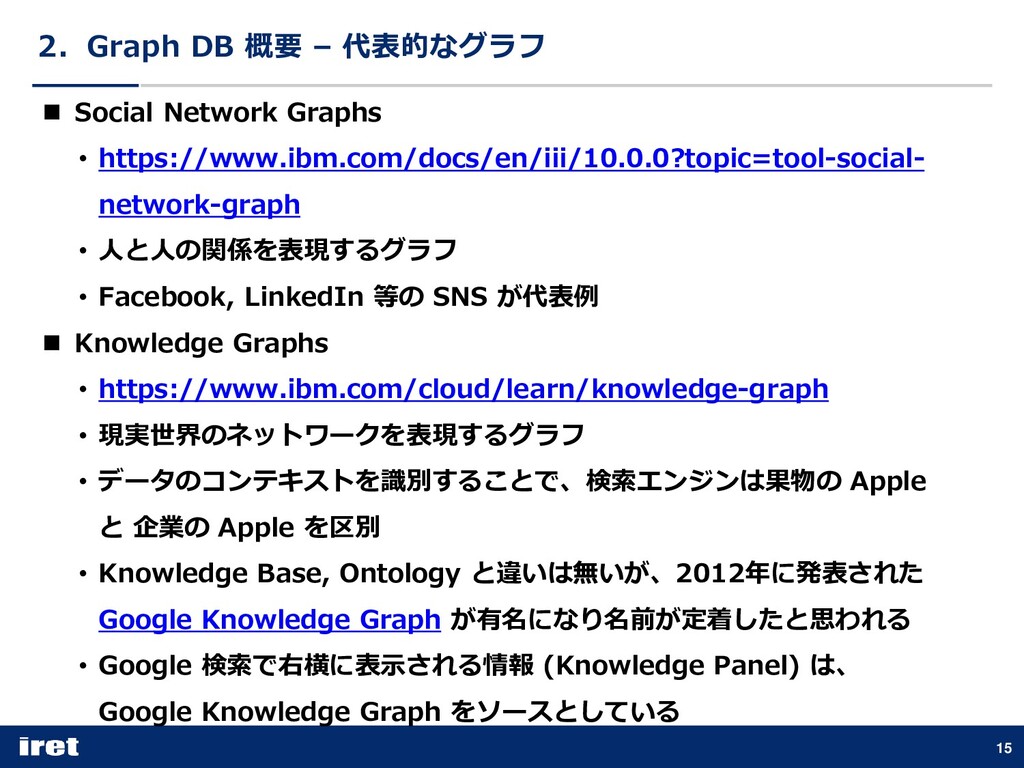
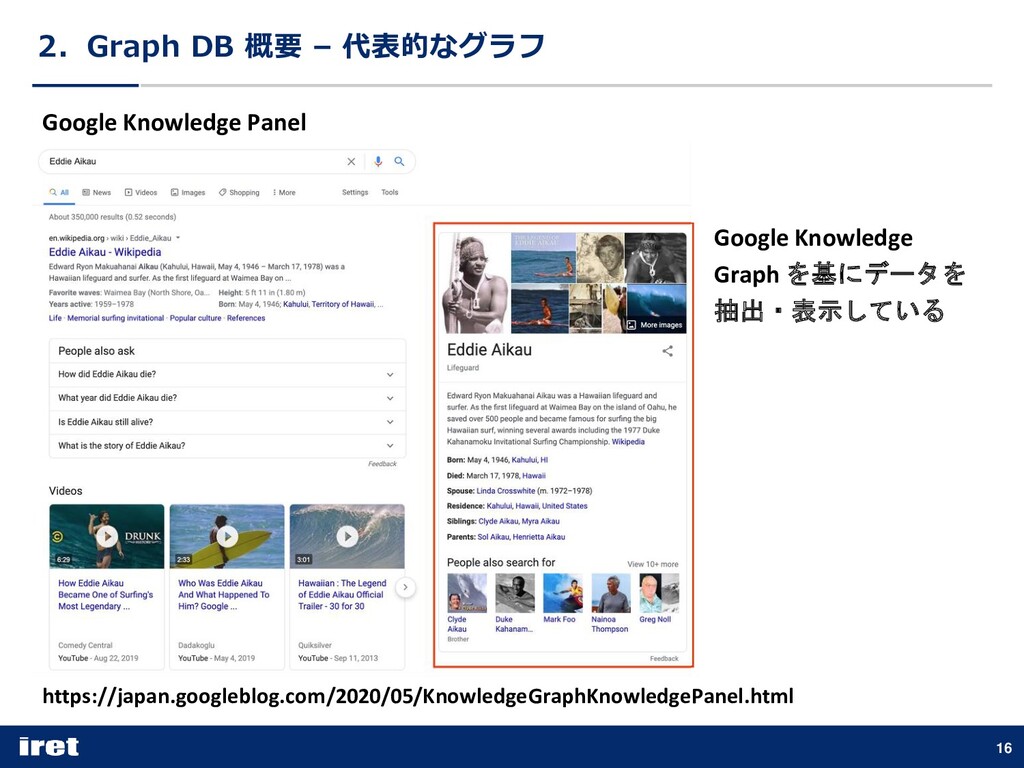
  9. 2.Graph DB 概要 – 代表的なグラフ 15 ◼ Social Network Graphs

    • https://www.ibm.com/docs/en/iii/10.0.0?topic=tool-social- network-graph • 人と人の関係を表現するグラフ • Facebook, LinkedIn 等の SNS が代表例 ◼ Knowledge Graphs • https://www.ibm.com/cloud/learn/knowledge-graph • 現実世界のネットワークを表現するグラフ • データのコンテキストを識別することで、検索エンジンは果物の Apple と 企業の Apple を区別 • Knowledge Base, Ontology と違いは無いが、2012年に発表された Google Knowledge Graph が有名になり名前が定着したと思われる • Google 検索で右横に表示される情報 (Knowledge Panel) は、 Google Knowledge Graph をソースとしている
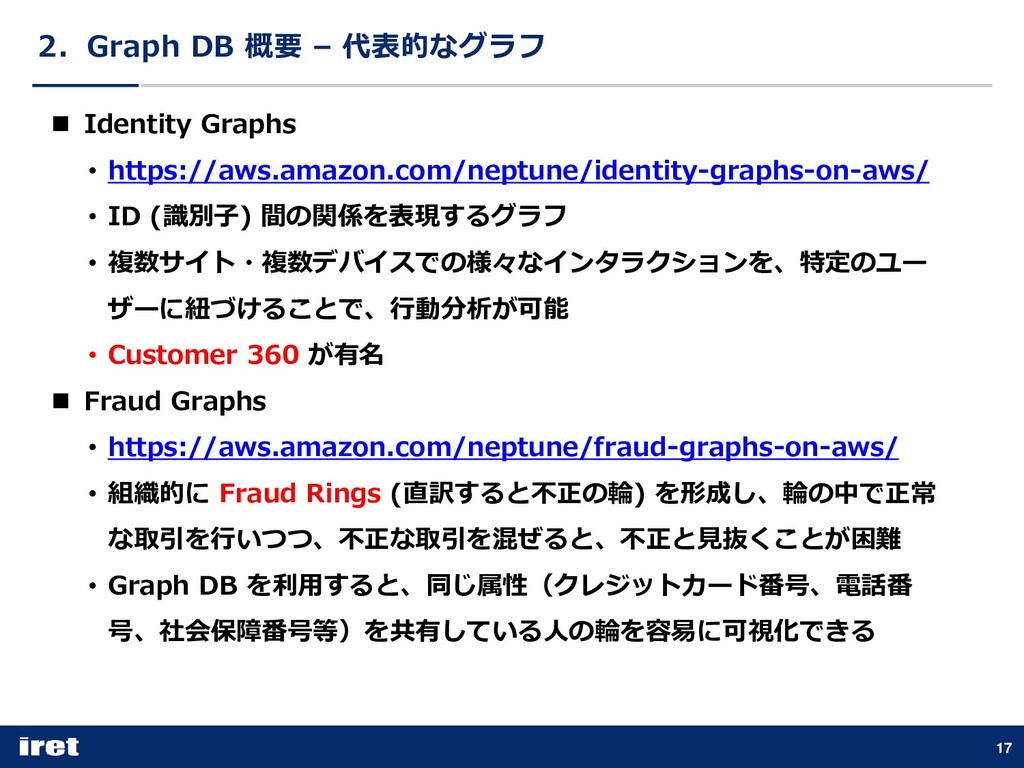
  10. 2.Graph DB 概要 – 代表的なグラフ 17 ◼ Identity Graphs •

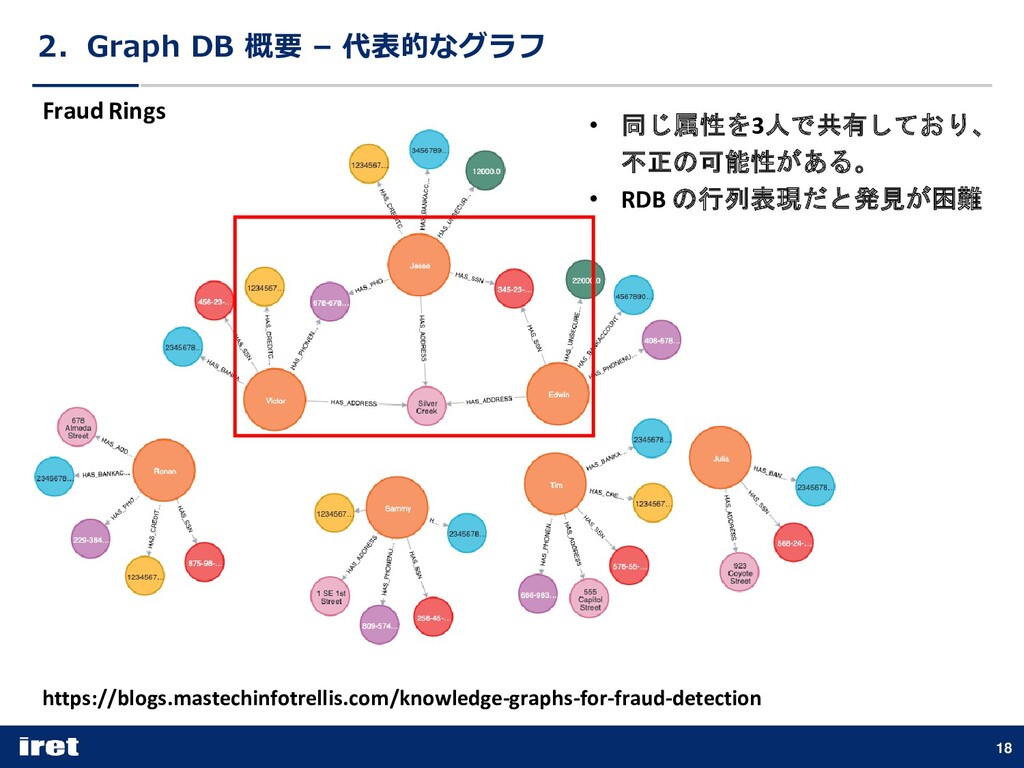
    https://aws.amazon.com/neptune/identity-graphs-on-aws/ • ID (識別子) 間の関係を表現するグラフ • 複数サイト・複数デバイスでの様々なインタラクションを、特定のユー ザーに紐づけることで、行動分析が可能 • Customer 360 が有名 ◼ Fraud Graphs • https://aws.amazon.com/neptune/fraud-graphs-on-aws/ • 組織的に Fraud Rings (直訳すると不正の輪) を形成し、輪の中で正常 な取引を行いつつ、不正な取引を混ぜると、不正と見抜くことが困難 • Graph DB を利用すると、同じ属性(クレジットカード番号、電話番 号、社会保障番号等)を共有している人の輪を容易に可視化できる
  11. 2.Graph DB 概要 – 代表的なグラフ 18 Fraud Rings • 同じ属性を3人で共有しており、

    不正の可能性がある。 • RDB の行列表現だと発見が困難 https://blogs.mastechinfotrellis.com/knowledge-graphs-for-fraud-detection
  12. 2.Graph DB 概要 – 事例 19 ◼ パナマ文書解析 • 2016年にパナマの法律事務所から膨大な内部資料が流出

    • International Consortium of Investigative Journalists (ICIJ:国 際調査報道ジャーナリスト連合) が Graph DB を利用した解析をサポー ト • ICIJ のパナマ文書に関する公式サイト • まだ解析が続いているようです • Forbes の記事 (Why Panama Papers Journalists Use Graph Databases)
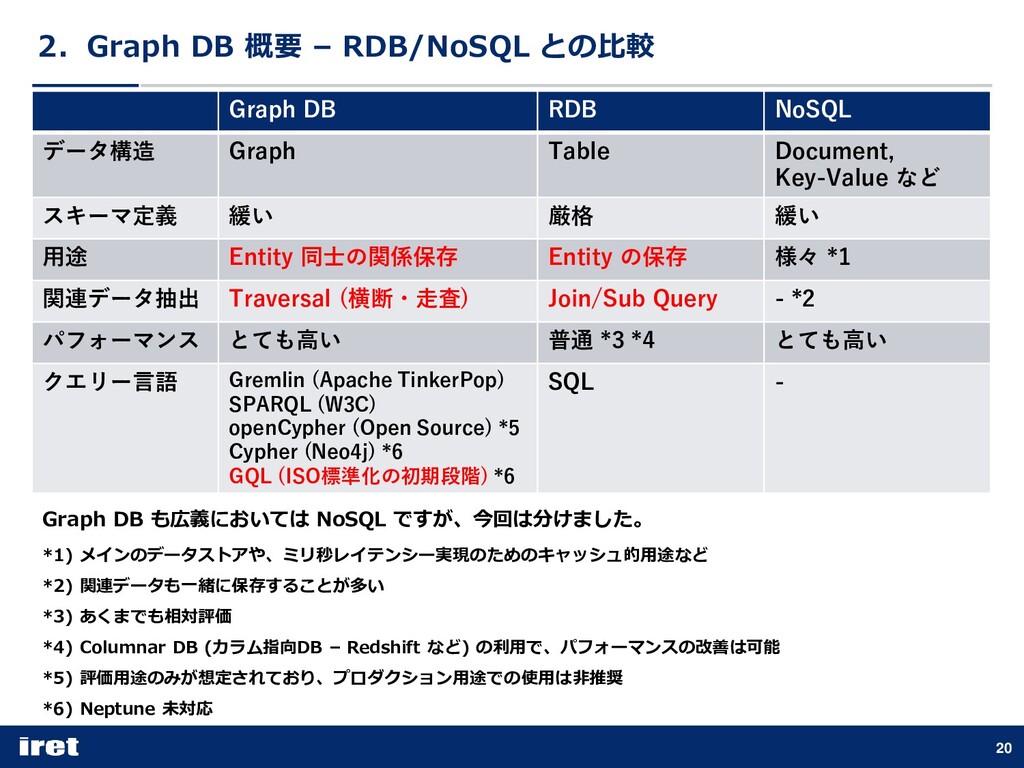
  13. 2.Graph DB 概要 – RDB/NoSQL との比較 20 Graph DB RDB

    NoSQL データ構造 Graph Table Document, Key-Value など スキーマ定義 緩い 厳格 緩い 用途 Entity 同士の関係保存 Entity の保存 様々 *1 関連データ抽出 Traversal (横断・走査) Join/Sub Query - *2 パフォーマンス とても高い 普通 *3 *4 とても高い クエリー言語 Gremlin (Apache TinkerPop) SPARQL (W3C) openCypher (Open Source) *5 Cypher (Neo4j) *6 GQL (ISO標準化の初期段階) *6 SQL - Graph DB も広義においては NoSQL ですが、今回は分けました。 *1) メインのデータストアや、ミリ秒レイテンシー実現のためのキャッシュ的用途など *2) 関連データも一緒に保存することが多い *3) あくまでも相対評価 *4) Columnar DB (カラム指向DB – Redshift など) の利用で、パフォーマンスの改善は可能 *5) 評価用途のみが想定されており、プロダクション用途での使用は非推奨 *6) Neptune 未対応
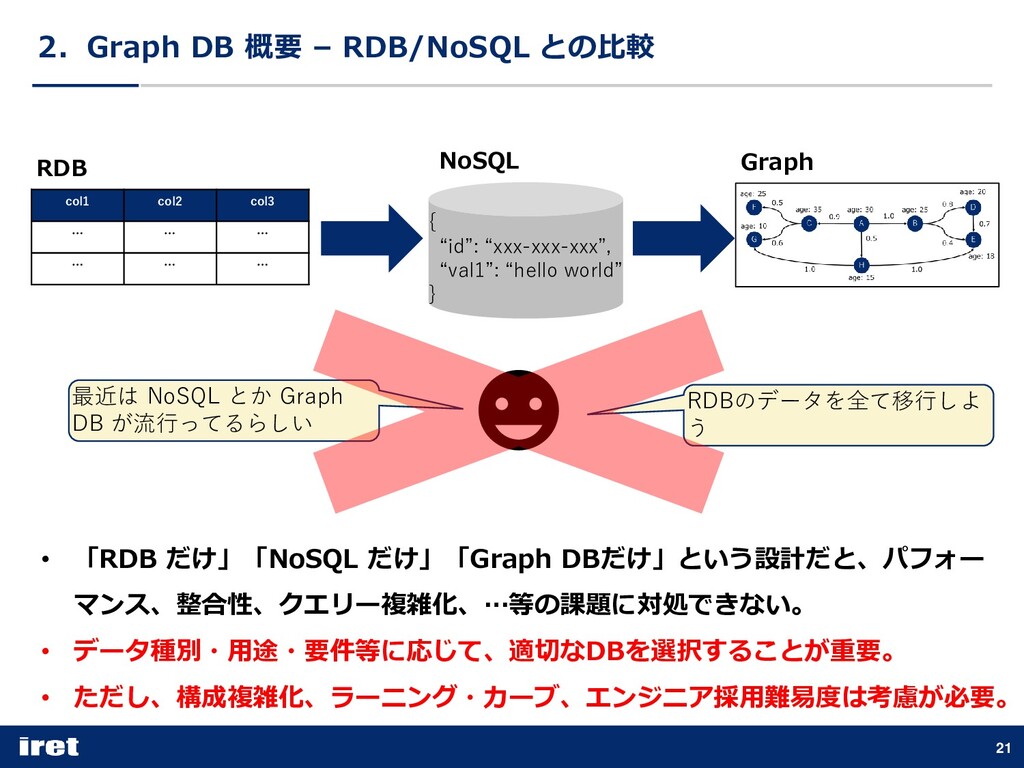
  14. 2.Graph DB 概要 – RDB/NoSQL との比較 21 col1 col2 col3

    … … … … … … RDB { “id”: “xxx-xxx-xxx”, “val1”: “hello world” } NoSQL Graph 最近は NoSQL とか Graph DB が流行ってるらしい RDBのデータを全て移行しよ う • 「RDB だけ」「NoSQL だけ」「Graph DBだけ」という設計だと、パフォー マンス、整合性、クエリー複雑化、…等の課題に対処できない。 • データ種別・用途・要件等に応じて、適切なDBを選択することが重要。 • ただし、構成複雑化、ラーニング・カーブ、エンジニア採用難易度は考慮が必要。
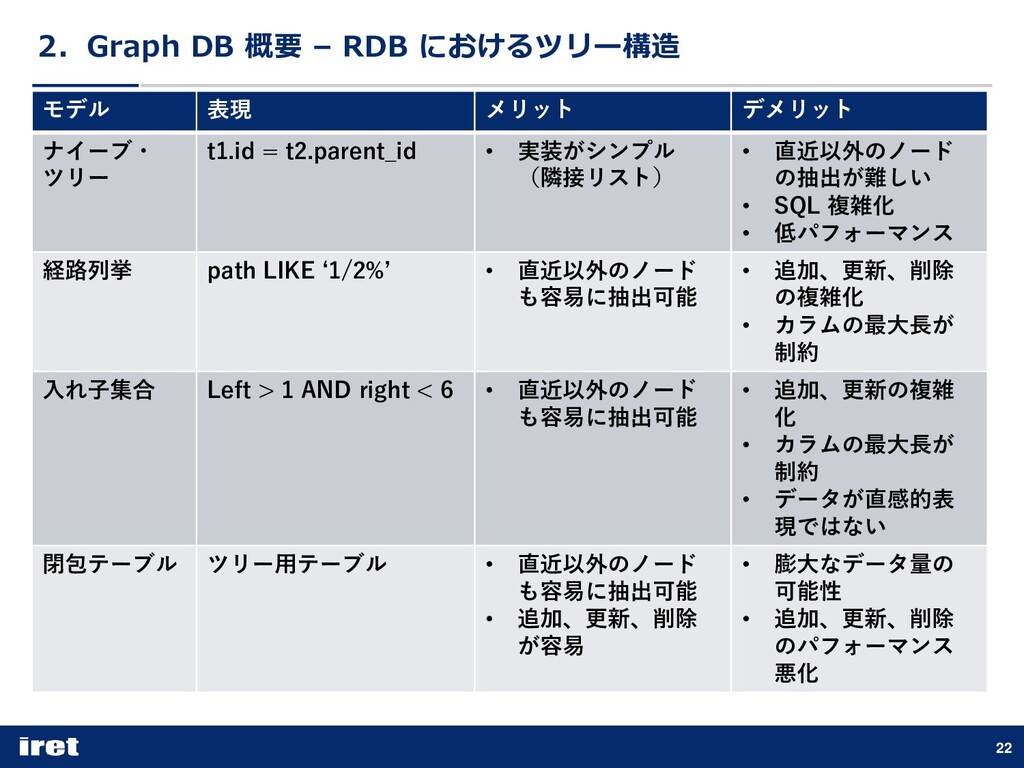
  15. 2.Graph DB 概要 – RDB におけるツリー構造 22 モデル 表現 メリット

    デメリット ナイーブ・ ツリー t1.id = t2.parent_id • 実装がシンプル (隣接リスト) • 直近以外のノード の抽出が難しい • SQL 複雑化 • 低パフォーマンス 経路列挙 path LIKE ‘1/2%’ • 直近以外のノード も容易に抽出可能 • 追加、更新、削除 の複雑化 • カラムの最大長が 制約 入れ子集合 Left > 1 AND right < 6 • 直近以外のノード も容易に抽出可能 • 追加、更新の複雑 化 • カラムの最大長が 制約 • データが直感的表 現ではない 閉包テーブル ツリー用テーブル • 直近以外のノード も容易に抽出可能 • 追加、更新、削除 が容易 • 膨大なデータ量の 可能性 • 追加、更新、削除 のパフォーマンス 悪化
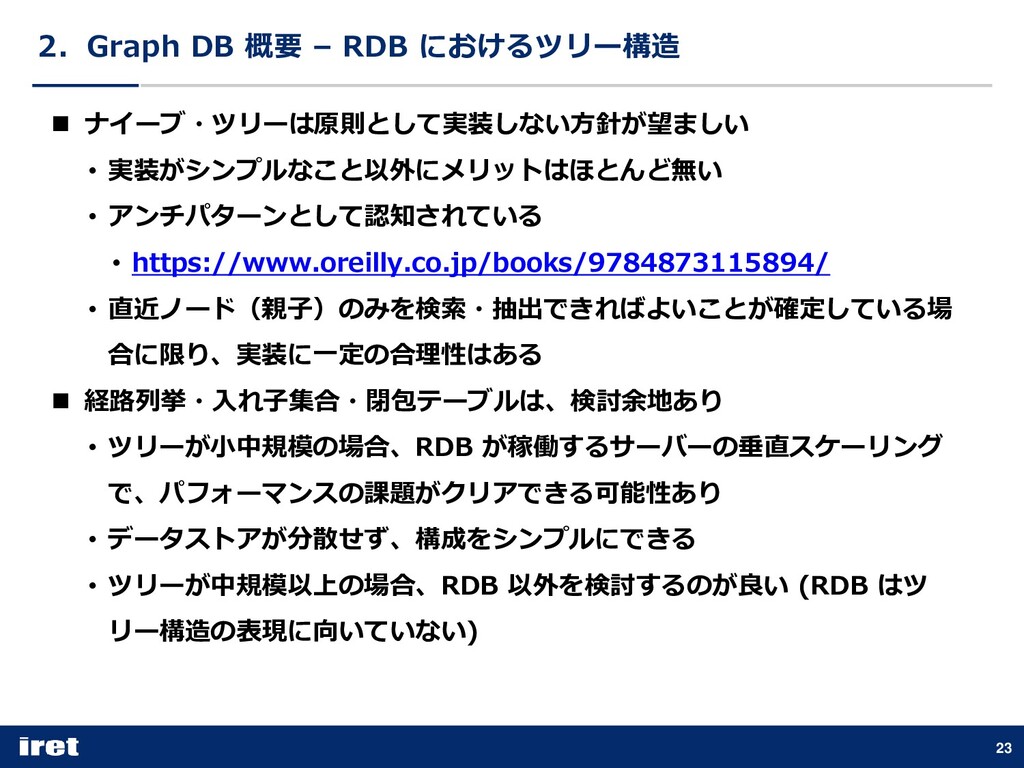
  16. 2.Graph DB 概要 – RDB におけるツリー構造 23 ◼ ナイーブ・ツリーは原則として実装しない方針が望ましい •

    実装がシンプルなこと以外にメリットはほとんど無い • アンチパターンとして認知されている • https://www.oreilly.co.jp/books/9784873115894/ • 直近ノード(親子)のみを検索・抽出できればよいことが確定している場 合に限り、実装に一定の合理性はある ◼ 経路列挙・入れ子集合・閉包テーブルは、検討余地あり • ツリーが小中規模の場合、RDB が稼働するサーバーの垂直スケーリング で、パフォーマンスの課題がクリアできる可能性あり • データストアが分散せず、構成をシンプルにできる • ツリーが中規模以上の場合、RDB 以外を検討するのが良い (RDB はツ リー構造の表現に向いていない)
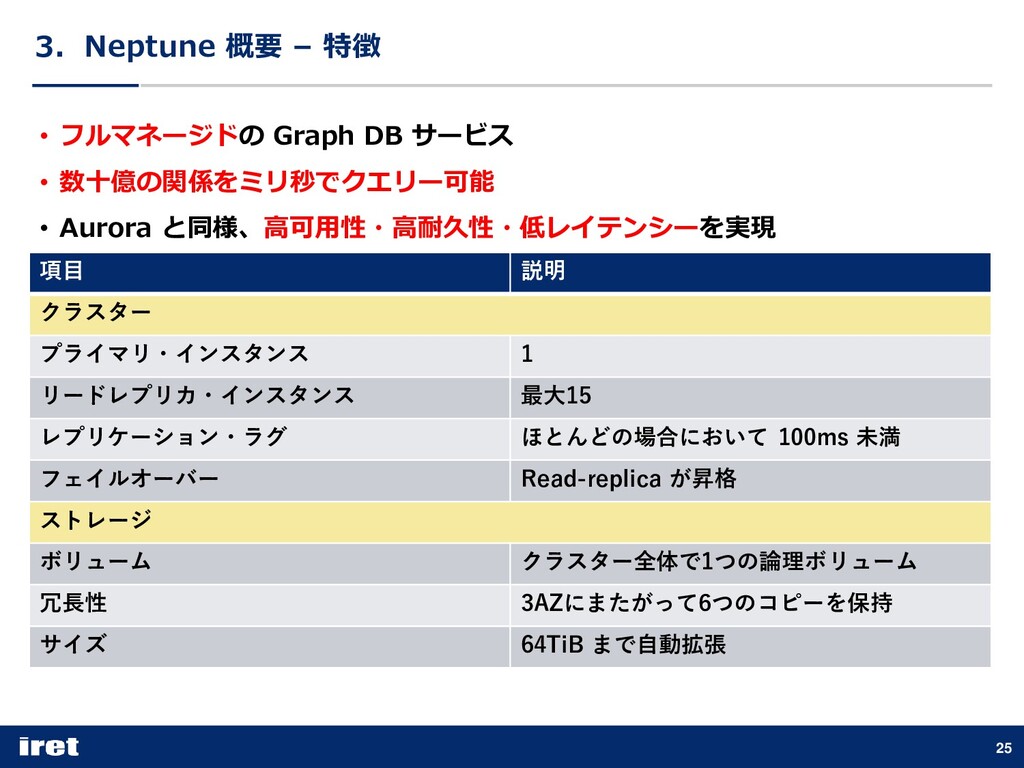
  17. 3.Neptune 概要 – 特徴 項目 説明 クラスター プライマリ・インスタンス 1 リードレプリカ・インスタンス

    最大15 レプリケーション・ラグ ほとんどの場合において 100ms 未満 フェイルオーバー Read-replica が昇格 ストレージ ボリューム クラスター全体で1つの論理ボリューム 冗長性 3AZにまたがって6つのコピーを保持 サイズ 64TiB まで自動拡張 • フルマネージドの Graph DB サービス • 数十億の関係をミリ秒でクエリー可能 • Aurora と同様、高可用性・高耐久性・低レイテンシーを実現 25
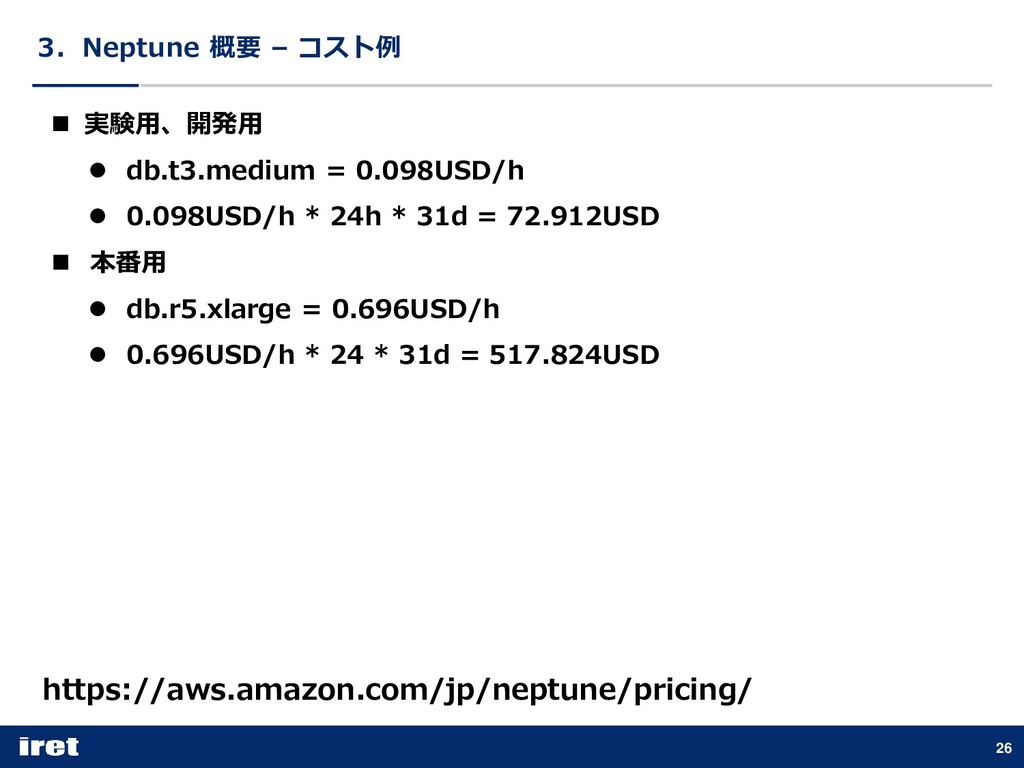
  18. 3.Neptune 概要 – コスト例 26 ◼ 実験用、開発用 ⚫ db.t3.medium =

    0.098USD/h ⚫ 0.098USD/h * 24h * 31d = 72.912USD ◼ 本番用 ⚫ db.r5.xlarge = 0.696USD/h ⚫ 0.696USD/h * 24 * 31d = 517.824USD https://aws.amazon.com/jp/neptune/pricing/
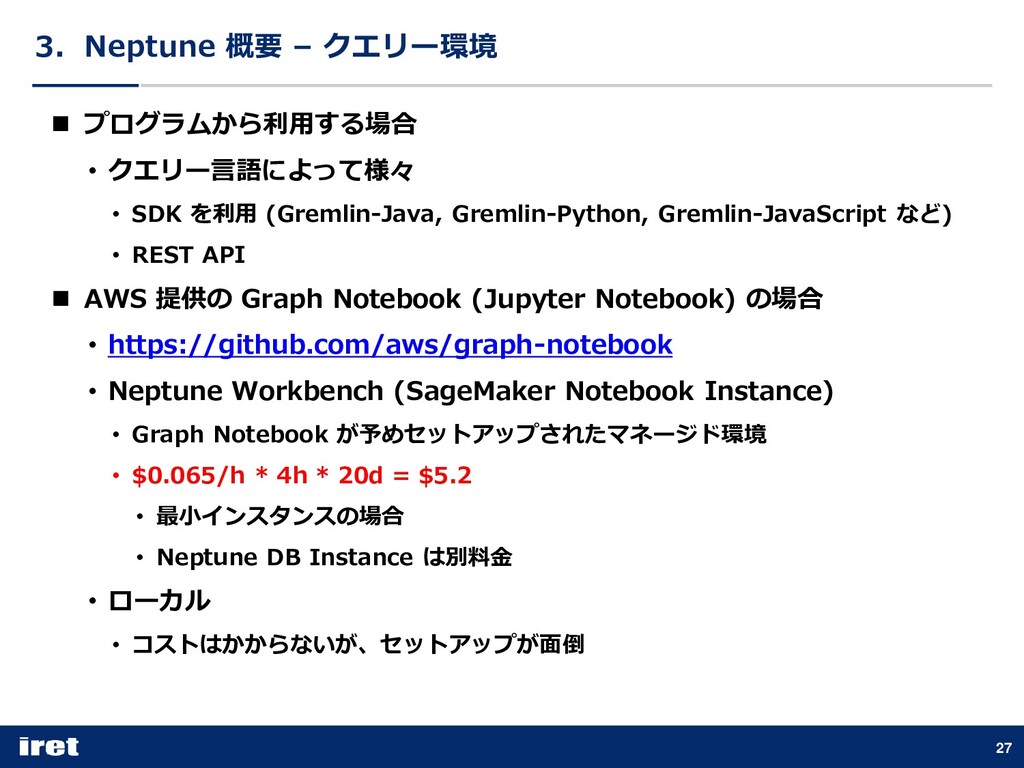
  19. 3.Neptune 概要 – クエリー環境 ◼ プログラムから利用する場合 • クエリー言語によって様々 • SDK

    を利用 (Gremlin-Java, Gremlin-Python, Gremlin-JavaScript など) • REST API ◼ AWS 提供の Graph Notebook (Jupyter Notebook) の場合 • https://github.com/aws/graph-notebook • Neptune Workbench (SageMaker Notebook Instance) • Graph Notebook が予めセットアップされたマネージド環境 • $0.065/h * 4h * 20d = $5.2 • 最小インスタンスの場合 • Neptune DB Instance は別料金 • ローカル • コストはかからないが、セットアップが面倒 27
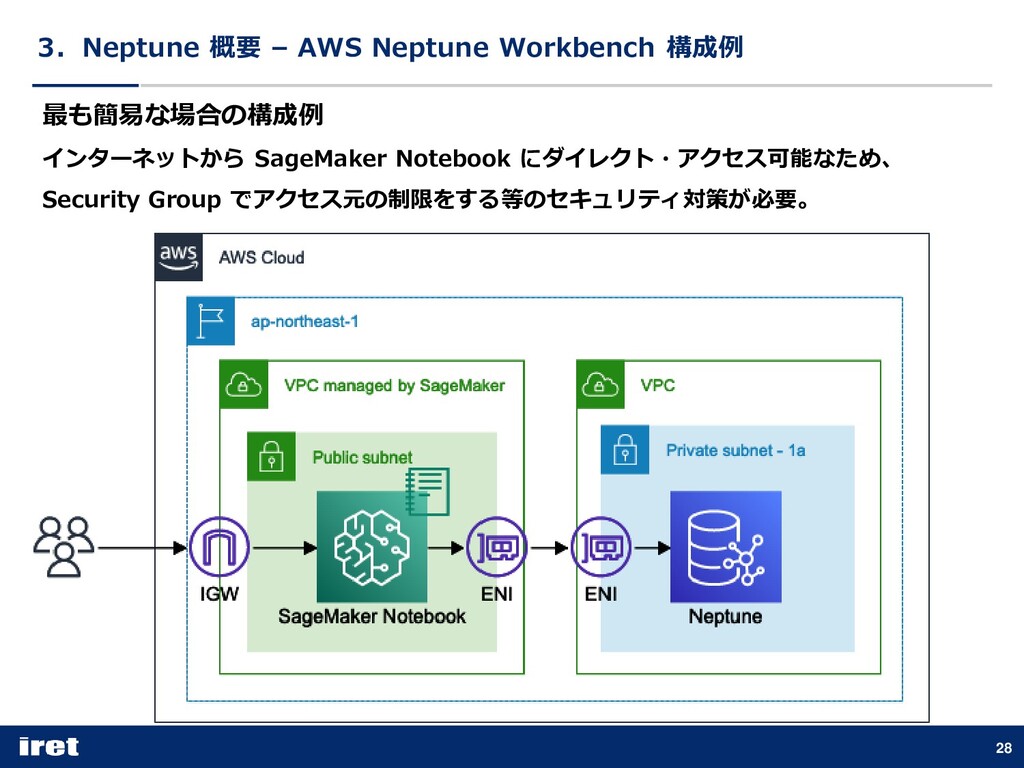
  20. 3.Neptune 概要 – AWS Neptune Workbench 構成例 28 最も簡易な場合の構成例 インターネットから

    SageMaker Notebook にダイレクト・アクセス可能なため、 Security Group でアクセス元の制限をする等のセキュリティ対策が必要。
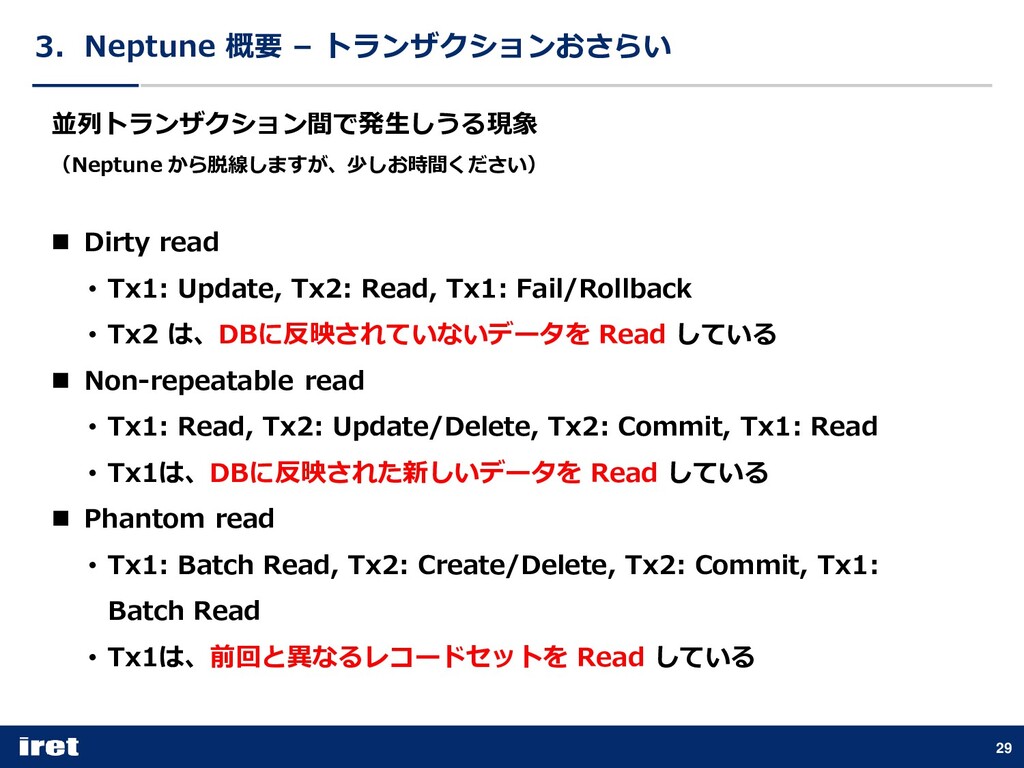
  21. 3.Neptune 概要 – トランザクションおさらい 並列トランザクション間で発生しうる現象 (Neptune から脱線しますが、少しお時間ください) ◼ Dirty read

    • Tx1: Update, Tx2: Read, Tx1: Fail/Rollback • Tx2 は、DBに反映されていないデータを Read している ◼ Non-repeatable read • Tx1: Read, Tx2: Update/Delete, Tx2: Commit, Tx1: Read • Tx1は、DBに反映された新しいデータを Read している ◼ Phantom read • Tx1: Batch Read, Tx2: Create/Delete, Tx2: Commit, Tx1: Batch Read • Tx1は、前回と異なるレコードセットを Read している 29
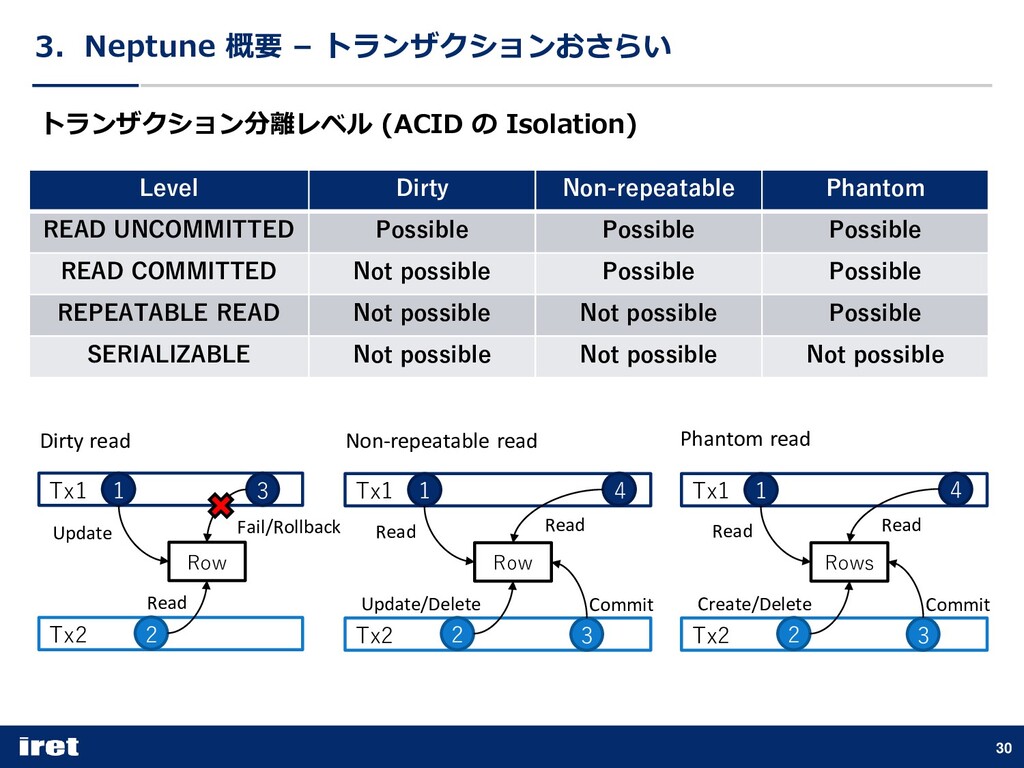
  22. 3.Neptune 概要 – トランザクションおさらい トランザクション分離レベル (ACID の Isolation) 30 Level

    Dirty Non-repeatable Phantom READ UNCOMMITTED Possible Possible Possible READ COMMITTED Not possible Possible Possible REPEATABLE READ Not possible Not possible Possible SERIALIZABLE Not possible Not possible Not possible Tx1 Tx2 1 Update Read Fail/Rollback Row 2 3 Tx1 Tx2 1 Read Update/Delete Commit Row 2 3 4 Read Tx1 Tx2 1 Read Create/Delete Commit Rows 2 3 4 Read Dirty read Non-repeatable read Phantom read
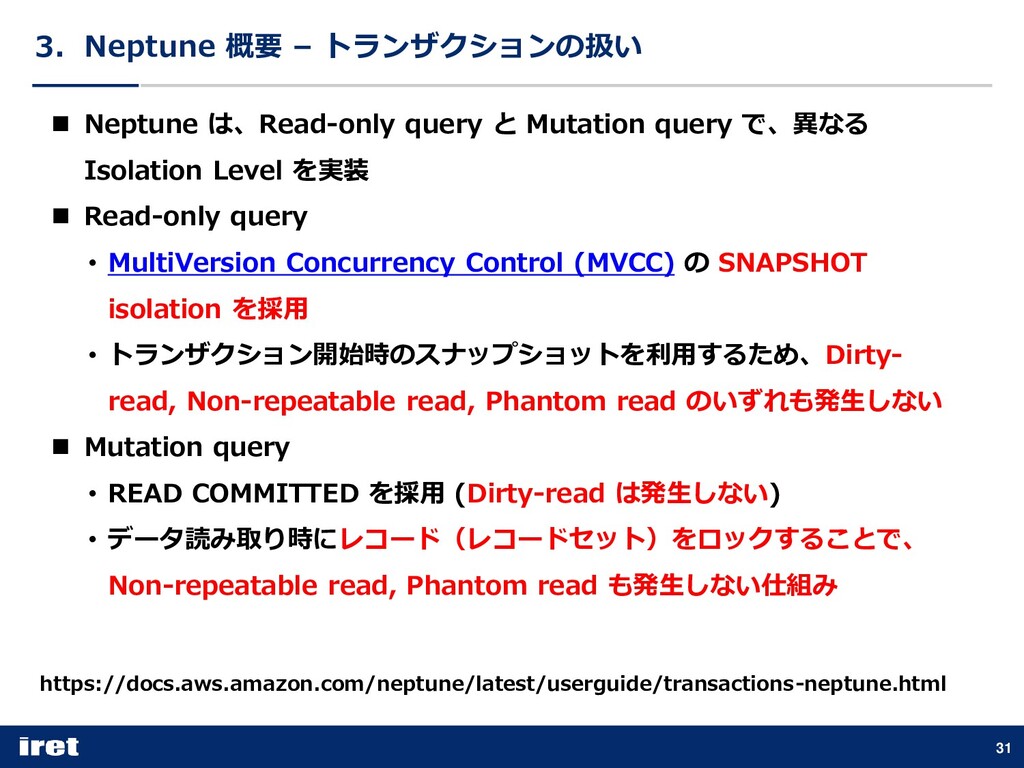
  23. 3.Neptune 概要 – トランザクションの扱い ◼ Neptune は、Read-only query と Mutation

    query で、異なる Isolation Level を実装 ◼ Read-only query • MultiVersion Concurrency Control (MVCC) の SNAPSHOT isolation を採用 • トランザクション開始時のスナップショットを利用するため、Dirty- read, Non-repeatable read, Phantom read のいずれも発生しない ◼ Mutation query • READ COMMITTED を採用 (Dirty-read は発生しない) • データ読み取り時にレコード(レコードセット)をロックすることで、 Non-repeatable read, Phantom read も発生しない仕組み 31 https://docs.aws.amazon.com/neptune/latest/userguide/transactions-neptune.html
  24. 4.Gremlin による Graph Data の探索 – Gremlin とは ◼ Apache

    TinkerPop • https://tinkerpop.apache.org/ • Apache TinkerPop is an open source, vendor-agnostic, graph computing framework… • Graph DB (OLTP) / Graph 分析システム (OLAP) 向けフレーム ワーク(オープンソース, ベンダー非依存) ◼ Gremlin • https://tinkerpop.apache.org/gremlin.html • Gremlin is the graph traversal language of Apache TinkerPop. • Gremlin は TinkerPop が提供するグラフ探索言語 33
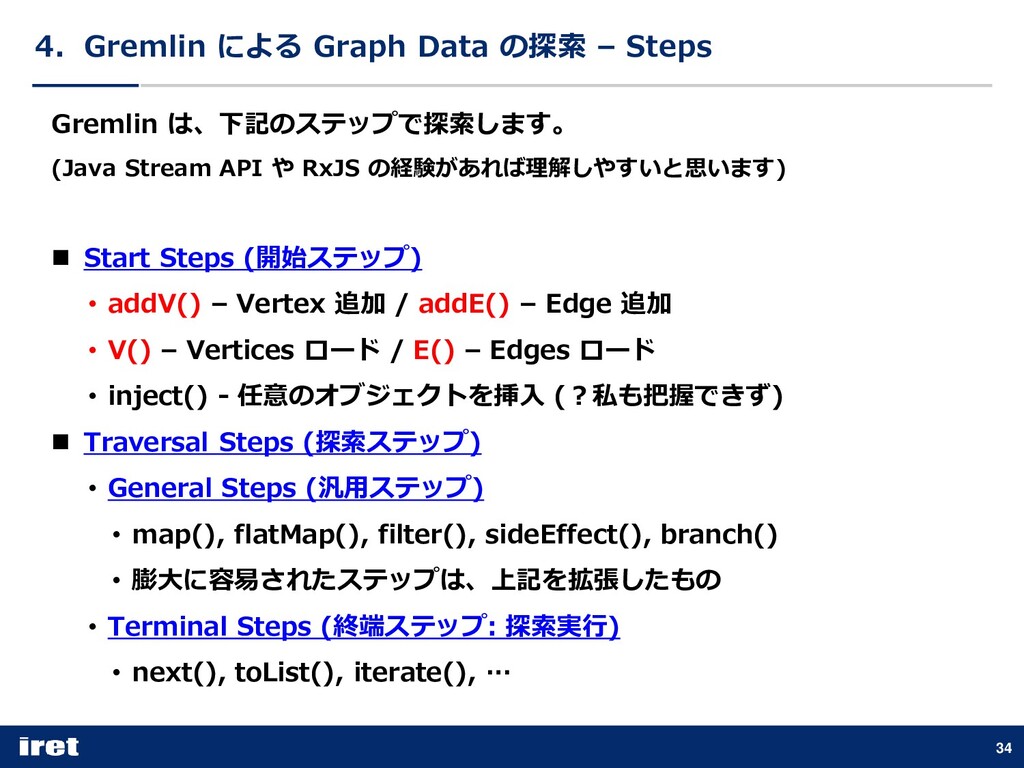
  25. 4.Gremlin による Graph Data の探索 – Steps Gremlin は、下記のステップで探索します。 (Java

    Stream API や RxJS の経験があれば理解しやすいと思います) ◼ Start Steps (開始ステップ) • addV() – Vertex 追加 / addE() – Edge 追加 • V() – Vertices ロード / E() – Edges ロード • inject() - 任意のオブジェクトを挿入 (?私も把握できず) ◼ Traversal Steps (探索ステップ) • General Steps (汎用ステップ) • map(), flatMap(), filter(), sideEffect(), branch() • 膨大に容易されたステップは、上記を拡張したもの • Terminal Steps (終端ステップ: 探索実行) • next(), toList(), iterate(), … 34
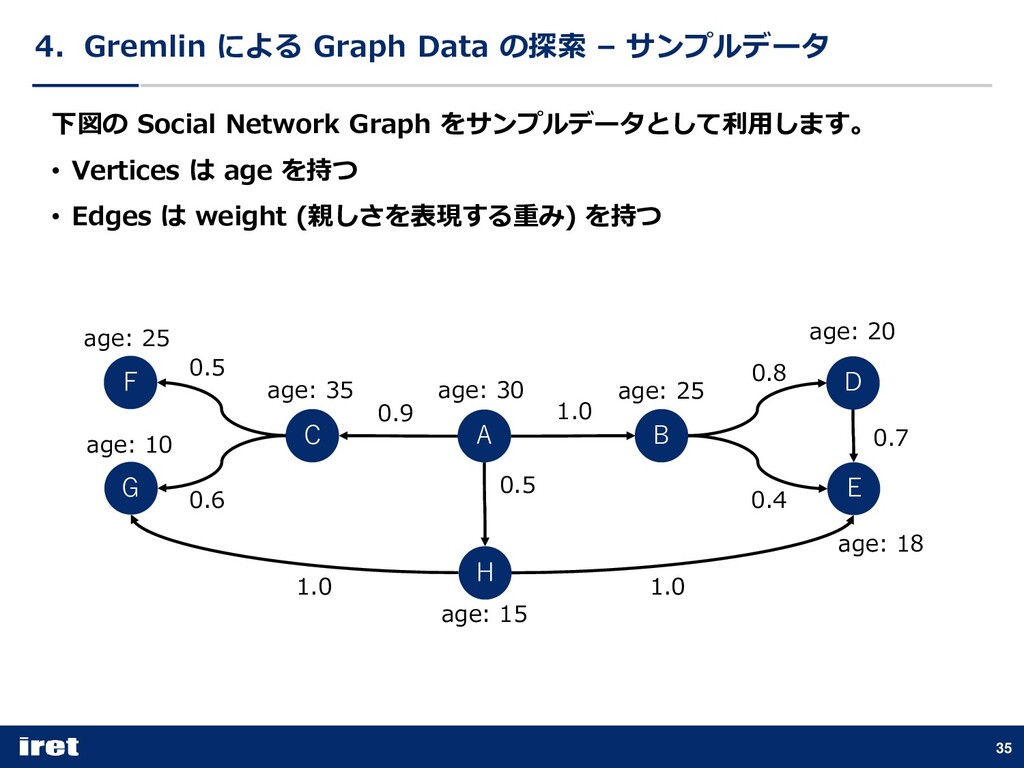
  26. 4.Gremlin による Graph Data の探索 – サンプルデータ 35 下図の Social

    Network Graph をサンプルデータとして利用します。 • Vertices は age を持つ • Edges は weight (親しさを表現する重み) を持つ A B 1.0 0.8 0.9 C D E F G H 1.0 0.4 0.7 0.5 0.6 0.5 1.0 age: 30 age: 25 age: 20 age: 35 age: 25 age: 10 age: 18 age: 15
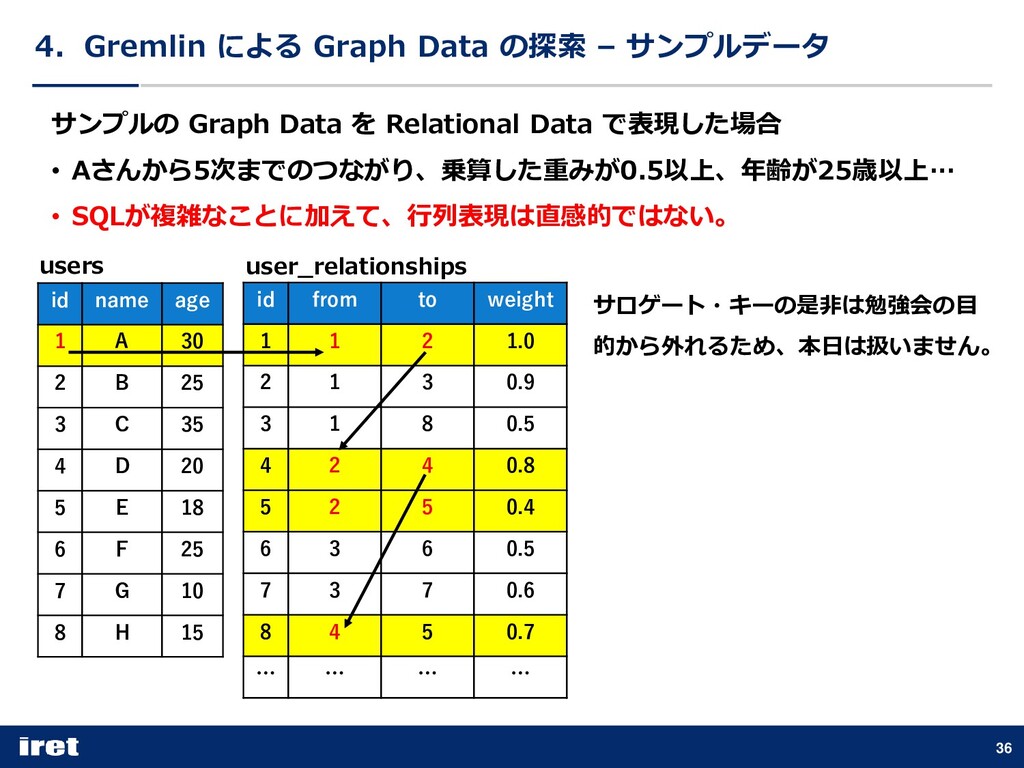
  27. 4.Gremlin による Graph Data の探索 – サンプルデータ 36 id name

    age 1 A 30 2 B 25 3 C 35 4 D 20 5 E 18 6 F 25 7 G 10 8 H 15 id from to weight 1 1 2 1.0 2 1 3 0.9 3 1 8 0.5 4 2 4 0.8 5 2 5 0.4 6 3 6 0.5 7 3 7 0.6 8 4 5 0.7 … … … … users user_relationships サロゲート・キーの是非は勉強会の目 的から外れるため、本日は扱いません。 サンプルの Graph Data を Relational Data で表現した場合 • Aさんから5次までのつながり、乗算した重みが0.5以上、年齢が25歳以上… • SQLが複雑なことに加えて、行列表現は直感的ではない。
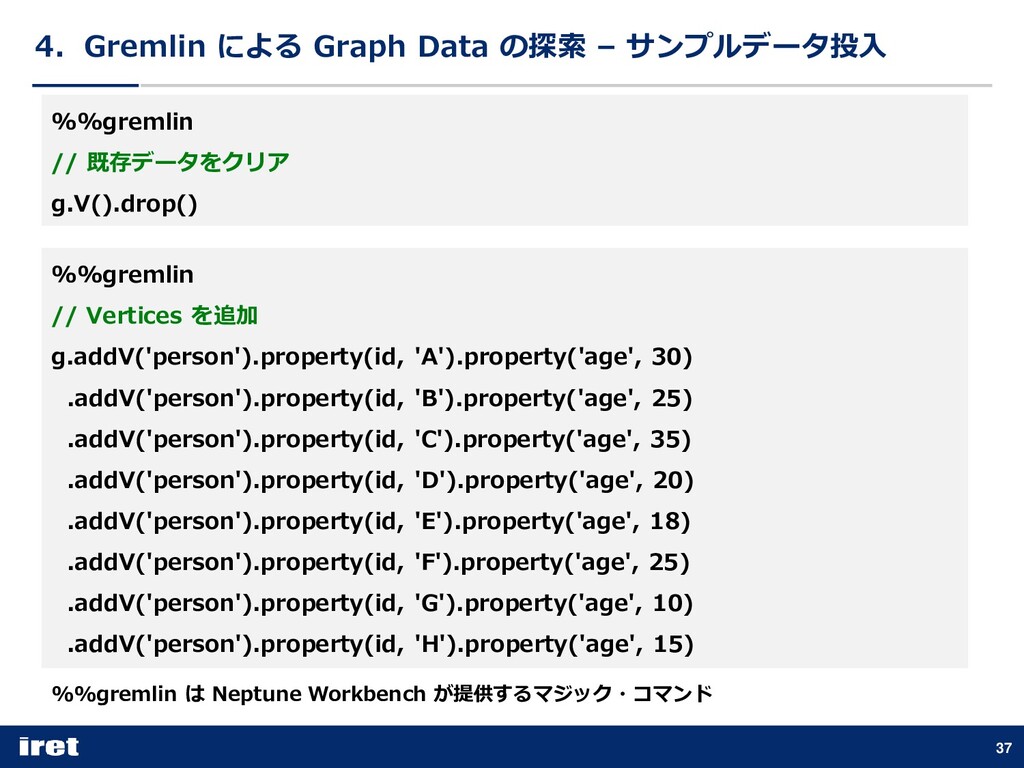
  28. 4.Gremlin による Graph Data の探索 – サンプルデータ投入 %%gremlin // 既存データをクリア

    g.V().drop() 37 %%gremlin // Vertices を追加 g.addV('person').property(id, 'A').property('age', 30) .addV('person').property(id, 'B').property('age', 25) .addV('person').property(id, 'C').property('age', 35) .addV('person').property(id, 'D').property('age', 20) .addV('person').property(id, 'E').property('age', 18) .addV('person').property(id, 'F').property('age', 25) .addV('person').property(id, 'G').property('age', 10) .addV('person').property(id, 'H').property('age', 15) %%gremlin は Neptune Workbench が提供するマジック・コマンド
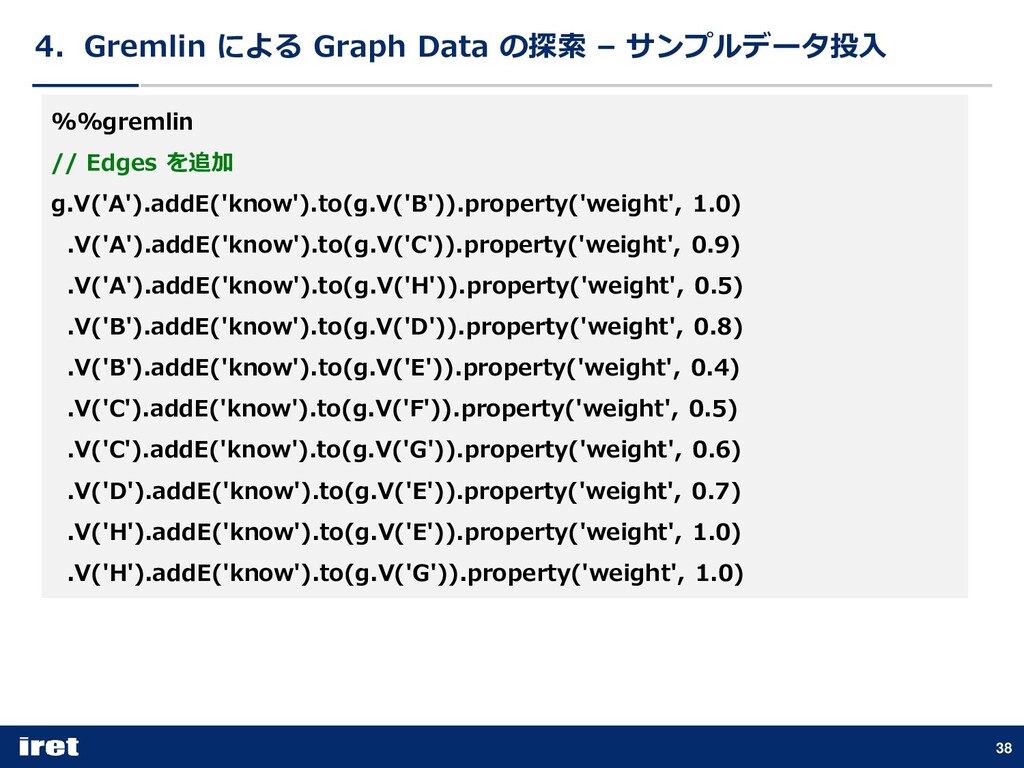
  29. 4.Gremlin による Graph Data の探索 – サンプルデータ投入 %%gremlin // Edges

    を追加 g.V('A').addE('know').to(g.V('B')).property('weight', 1.0) .V('A').addE('know').to(g.V('C')).property('weight', 0.9) .V('A').addE('know').to(g.V('H')).property('weight', 0.5) .V('B').addE('know').to(g.V('D')).property('weight', 0.8) .V('B').addE('know').to(g.V('E')).property('weight', 0.4) .V('C').addE('know').to(g.V('F')).property('weight', 0.5) .V('C').addE('know').to(g.V('G')).property('weight', 0.6) .V('D').addE('know').to(g.V('E')).property('weight', 0.7) .V('H').addE('know').to(g.V('E')).property('weight', 1.0) .V('H').addE('know').to(g.V('G')).property('weight', 1.0) 38
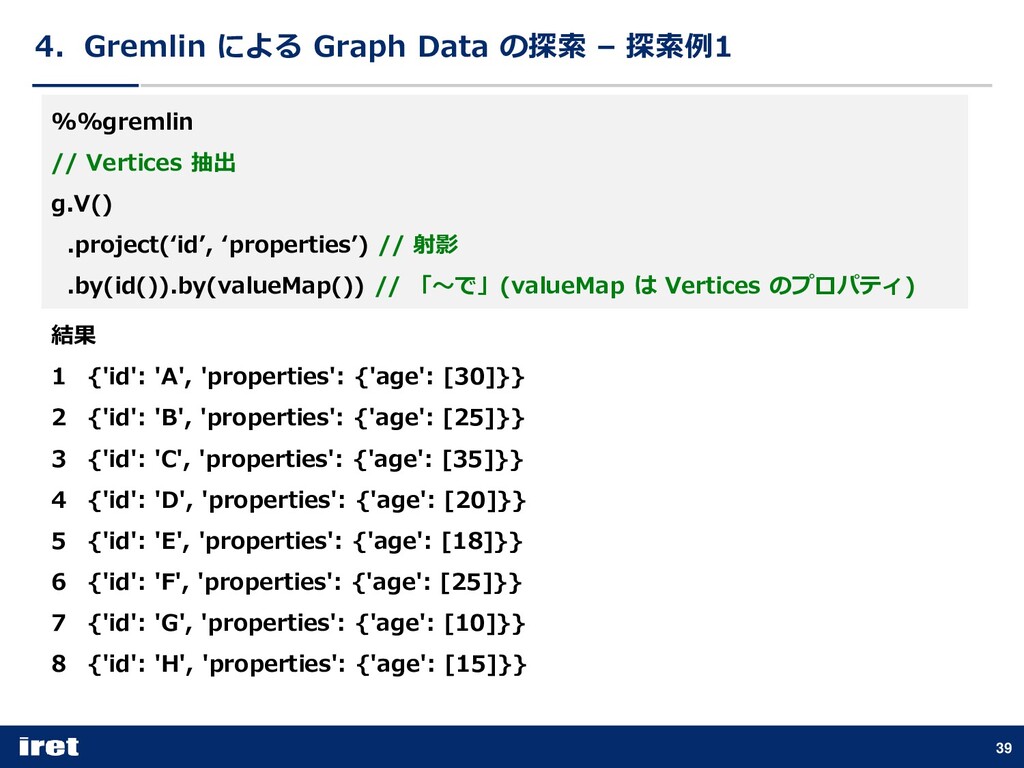
  30. 4.Gremlin による Graph Data の探索 – 探索例1 %%gremlin // Vertices

    抽出 g.V() .project(‘id’, ‘properties’) // 射影 .by(id()).by(valueMap()) // 「~で」(valueMap は Vertices のプロパティ) 39 結果 1 {'id': 'A', 'properties': {'age': [30]}} 2 {'id': 'B', 'properties': {'age': [25]}} 3 {'id': 'C', 'properties': {'age': [35]}} 4 {'id': 'D', 'properties': {'age': [20]}} 5 {'id': 'E', 'properties': {'age': [18]}} 6 {'id': 'F', 'properties': {'age': [25]}} 7 {'id': 'G', 'properties': {'age': [10]}} 8 {'id': 'H', 'properties': {'age': [15]}}
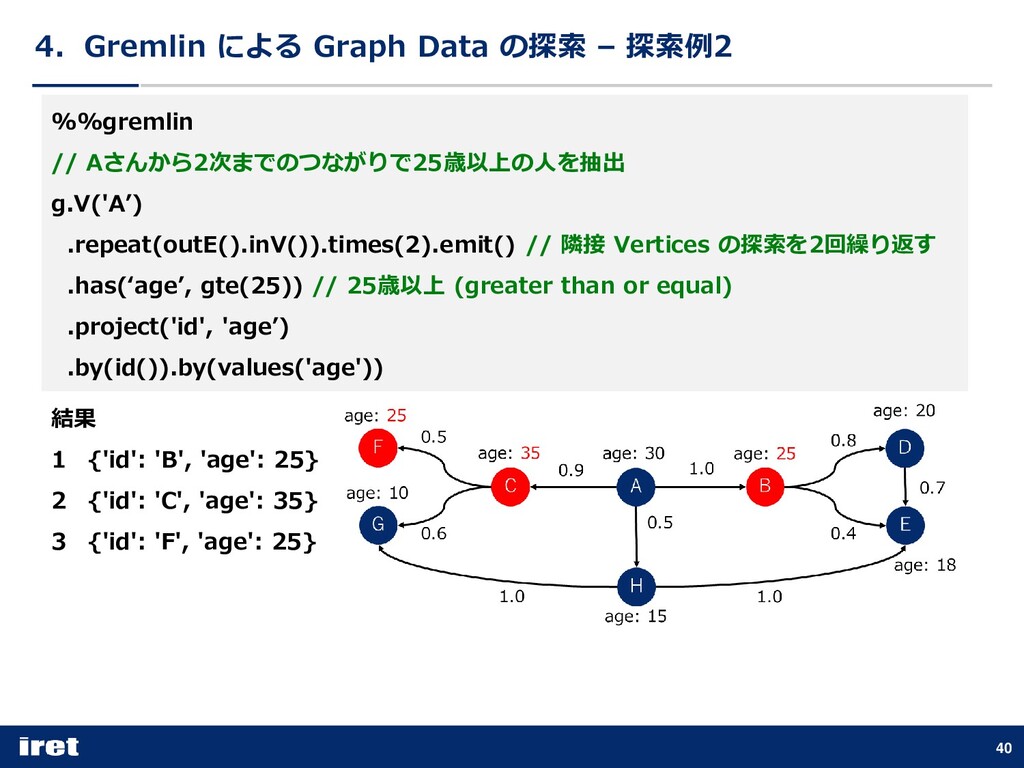
  31. 4.Gremlin による Graph Data の探索 – 探索例2 %%gremlin // Aさんから2次までのつながりで25歳以上の人を抽出

    g.V('A’) .repeat(outE().inV()).times(2).emit() // 隣接 Vertices の探索を2回繰り返す .has(‘age’, gte(25)) // 25歳以上 (greater than or equal) .project('id', 'age’) .by(id()).by(values('age')) 40 結果 1 {'id': 'B', 'age': 25} 2 {'id': 'C', 'age': 35} 3 {'id': 'F', 'age': 25}
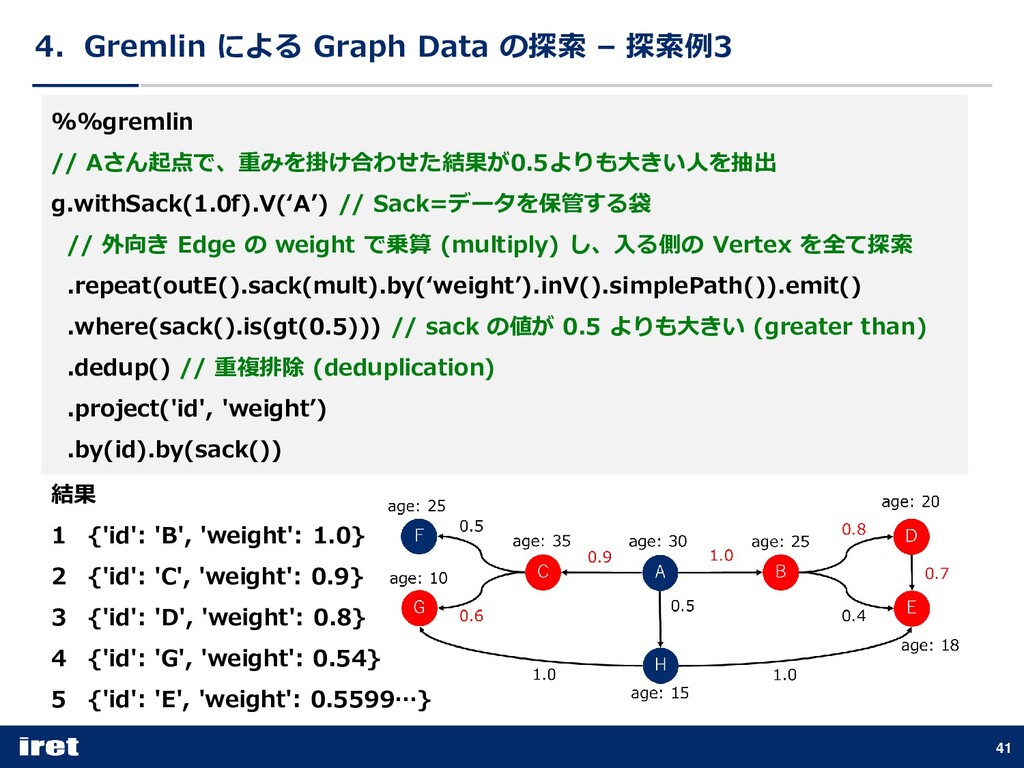
  32. 4.Gremlin による Graph Data の探索 – 探索例3 %%gremlin // Aさん起点で、重みを掛け合わせた結果が0.5よりも大きい人を抽出

    g.withSack(1.0f).V(‘A’) // Sack=データを保管する袋 // 外向き Edge の weight で乗算 (multiply) し、入る側の Vertex を全て探索 .repeat(outE().sack(mult).by(‘weight’).inV().simplePath()).emit() .where(sack().is(gt(0.5))) // sack の値が 0.5 よりも大きい (greater than) .dedup() // 重複排除 (deduplication) .project('id', 'weight’) .by(id).by(sack()) 41 結果 1 {'id': 'B', 'weight': 1.0} 2 {'id': 'C', 'weight': 0.9} 3 {'id': 'D', 'weight': 0.8} 4 {'id': 'G', 'weight': 0.54} 5 {'id': 'E', 'weight': 0.5599…}
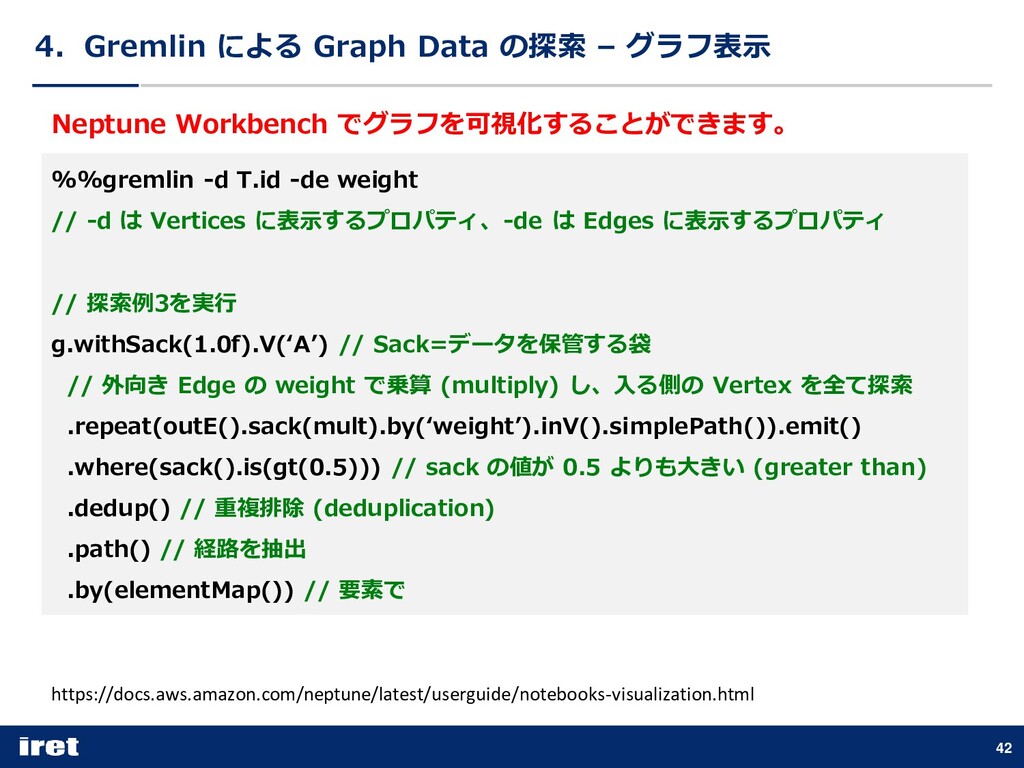
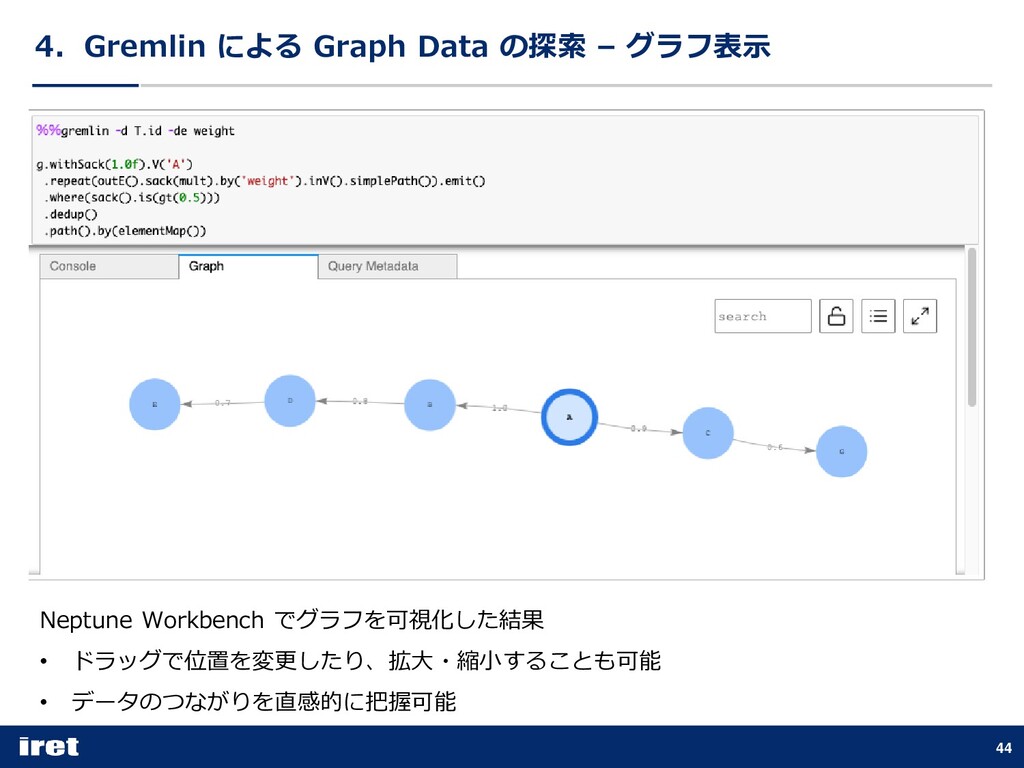
  33. 4.Gremlin による Graph Data の探索 – グラフ表示 %%gremlin -d T.id

    -de weight // -d は Vertices に表示するプロパティ、-de は Edges に表示するプロパティ // 探索例3を実行 g.withSack(1.0f).V(‘A’) // Sack=データを保管する袋 // 外向き Edge の weight で乗算 (multiply) し、入る側の Vertex を全て探索 .repeat(outE().sack(mult).by(‘weight’).inV().simplePath()).emit() .where(sack().is(gt(0.5))) // sack の値が 0.5 よりも大きい (greater than) .dedup() // 重複排除 (deduplication) .path() // 経路を抽出 .by(elementMap()) // 要素で 42 Neptune Workbench でグラフを可視化することができます。 https://docs.aws.amazon.com/neptune/latest/userguide/notebooks-visualization.html
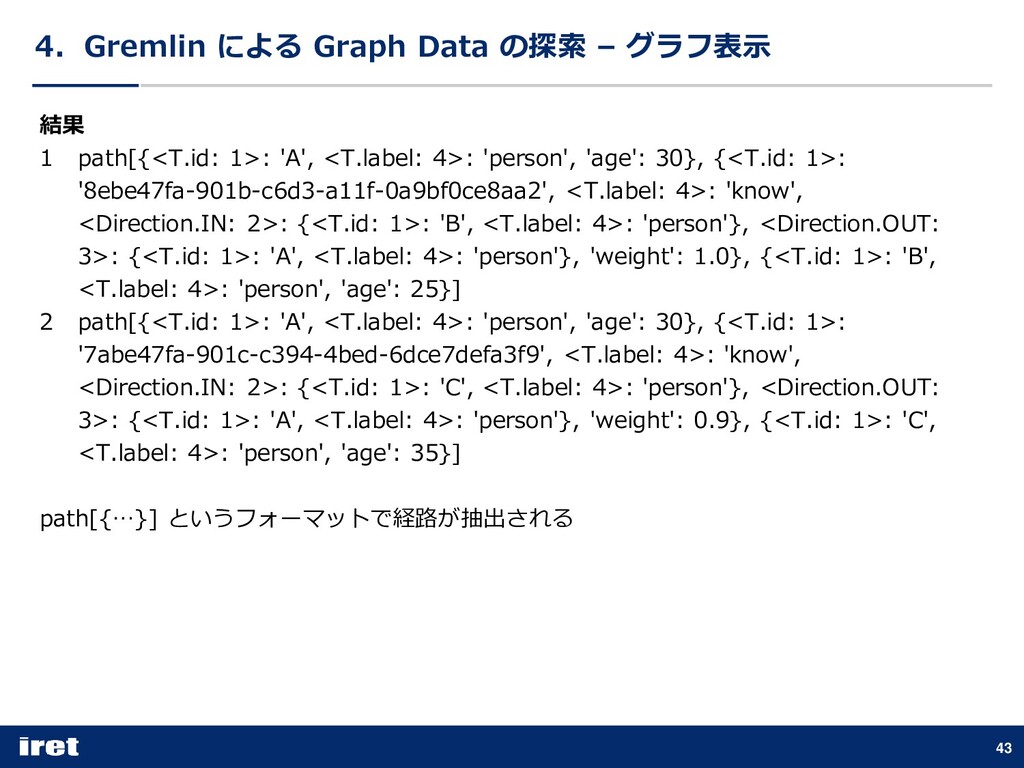
  34. 4.Gremlin による Graph Data の探索 – グラフ表示 43 結果 1

    path[{<T.id: 1>: 'A', <T.label: 4>: 'person', 'age': 30}, {<T.id: 1>: '8ebe47fa-901b-c6d3-a11f-0a9bf0ce8aa2', <T.label: 4>: 'know', <Direction.IN: 2>: {<T.id: 1>: 'B', <T.label: 4>: 'person'}, <Direction.OUT: 3>: {<T.id: 1>: 'A', <T.label: 4>: 'person'}, 'weight': 1.0}, {<T.id: 1>: 'B', <T.label: 4>: 'person', 'age': 25}] 2 path[{<T.id: 1>: 'A', <T.label: 4>: 'person', 'age': 30}, {<T.id: 1>: '7abe47fa-901c-c394-4bed-6dce7defa3f9', <T.label: 4>: 'know', <Direction.IN: 2>: {<T.id: 1>: 'C', <T.label: 4>: 'person'}, <Direction.OUT: 3>: {<T.id: 1>: 'A', <T.label: 4>: 'person'}, 'weight': 0.9}, {<T.id: 1>: 'C', <T.label: 4>: 'person', 'age': 35}] path[{…}] というフォーマットで経路が抽出される
  35. 4.Gremlin による Graph Data の探索 – グラフ表示 44 Neptune Workbench
    でグラフを可視化した結果 • ドラッグで位置を変更したり、拡⼤・縮小することも可能 • データのつながりを直感的に把握可能
  36. 4.Gremlin による Graph Data の探索 – Sample Notebook 45 本日使用したサンプルは、GitHub
    で公開しています。 https://github.com/iwstkhr/amazon-neptune-workbench-gremlin-sample
  37. 5. 参考リソース 47 ◼ Apache TinkerPop • https://tinkerpop.apache.org/ • https://tinkerpop.apache.org/docs/current/tutorials/getting-started/

    • https://tinkerpop.apache.org/gremlin.html • https://tinkerpop.apache.org/docs/3.5.1/reference/ ◼ The Practitioner's Guide to Graph Data • https://www.oreilly.com/library/view/the-practitioners-guide/9781492044062/ ◼ Amazon Neptune • https://aws.amazon.com/jp/neptune/pricing/ • https://github.com/aws/graph-notebook • https://docs.aws.amazon.com/neptune/latest/userguide/transactions-neptune.html • https://docs.aws.amazon.com/neptune/latest/userguide/notebooks-visualization.html ◼ 代表的なグラフ • https://www.ibm.com/docs/en/iii/10.0.0?topic=tool-social-network-graph • https://www.ibm.com/cloud/learn/knowledge-graph • https://japan.googleblog.com/2020/05/KnowledgeGraphKnowledgePanel.html • https://aws.amazon.com/jp/neptune/identity-graphs-on-aws/ • https://aws.amazon.com/jp/neptune/fraud-graphs-on-aws/ • https://blogs.mastechinfotrellis.com/knowledge-graphs-for-fraud-detection ◼ その他 • https://www.forbes.com/sites/metabrown/2016/04/30/why-panama-papers-journalists-use-graph- databases/?sh=125d97a61746 • https://www.icij.org/investigations/panama-papers/ • https://en.wikipedia.org/wiki/Multiversion_concurrency_control