Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SQL Server ボトルネック箇所特定とチューニングの実演 / SQL Server an...
Search
it-ito
April 20, 2019
Programming
830
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SQL Server ボトルネック箇所特定とチューニングの実演 / SQL Server analyze bottleneck and tuning
第17回 SQL Server 2019勉強会
https://sqlserver.connpass.com/event/125485/
it-ito
April 20, 2019
Other Decks in Programming
See All in Programming
AIに “答え“を書かせるのを やめてみた
___akari11
0
120
Event is what happens
moro
2
780
気持ちぃ〜角丸 Squircle
ryu1013
0
310
月間100万人のサービス刷新で、 技術選定をHonoに振り切った話
yutobara
8
6.6k
パズルゲームの作り方 / how to make puzzle games
kaityo256
PRO
2
290
APNsからLive Activityを開始する話
yumnumm
0
170
Kotlinの15年とServer-Side Kotlin
n_takehata
1
150
コーディング自動化の次へ。人の介入をゼロにするファクトリーとサポートAIによる実践
timakin
5
3.6k
Unity6 URPによる海底をテーマにしたVJシステムの解説 | Unity Shader 完全に理解した 勉強会
gam0022
0
370
Starting & Sustaining Code-Based E2E Testing for Non-Coding QA Teams( #jasstniigata )
teyamagu
PRO
1
1k
Railsのためのパスキー実践入門 〜マルチテナントSaaSでの意思決定〜
utakaha
2
560
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
Featured
See All Featured
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Optimising Largest Contentful Paint
csswizardry
37
4k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
820
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
A Tale of Four Properties
chriscoyier
163
24k
WENDY [Excerpt]
tessaabrams
14
40k
A designer walks into a library…
pauljervisheath
211
25k
Redefining SEO in the New Era of Traffic Generation
szymonslowik
1
480
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
330
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
750
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
Transcript
SQL Server ボトルネック箇所特定と チューニングの実演 Twitter@_itito_
最近見たサメ映画
今日の話の流れ • 簡単な構造のデータベースを2種類用意 • クエリを動かすと同じ結果なのに片方のパ フォーマンスが悪い • パフォーマンスが悪い原因を見てみる
使用するデータベース • 公開されているStackOverFlowのデータベースを 改造して使用 – https://www.brentozar.com/archive/2015/10/how-to- download-the-stack-overflow-database-via-bittorrent/ • Large: current
312GB database as of 2018/12 • Medium: 50GB database as of 2014 • Small: 10GB database as of 2010 ←今回はこれを使用
• 次のクエリを含むストアド[PerformanceTest] – 2009/01/01より前に登録したユーザーの数を抽 出するクエリ – 8月31日に登録した人のコメントを抽出するクエリ – ユーザーID30000の人のコメントを抽出するクエリ –
上記の合計実行時間を出すクエリ 使用するクエリ
実演 実際に2つのDBで実行してみる • ApexSqlCompleteでタブを色付けしてます – 緑:問題ないDB – 赤:問題あるDB (プレゼン用に入れてみましたが これ入れると少し重くなりますね)
今回の調べ方 • とりあえずクエリストアを見てみよう • クエリストア – SQL Server 2016から使える機能 –
パフォーマンスチェックやクエリプランの矯正が可能 – 事前に有効化しておく必要あり
実演 クエリストアを確認 • 実行時間で並び替えるとPerformanceTestの ストアドの中で「 8月31日に登録した人のコメ ントを抽出するクエリ」が突出している • 実行計画に大きな違いがある?
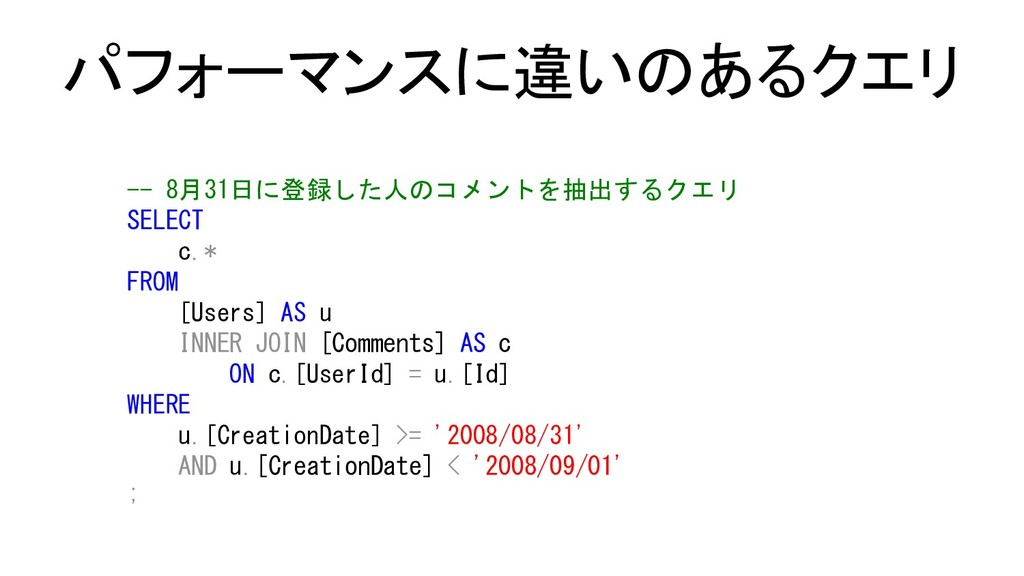
パフォーマンスに違いのあるクエリ -- 8月31日に登録した人のコメントを抽出するクエリ SELECT c.* FROM [Users] AS u INNER
JOIN [Comments] AS c ON c.[UserId] = u.[Id] WHERE u.[CreationDate] >= '2008/08/31' AND u.[CreationDate] < '2008/09/01' ;
実行計画見るときに使えるツール • ApexSQL Plan – https://www.apexsql.com/sql-tools-plan.aspx – 第15回 SQL Server
2019勉強会で紹介されていました • SentryOne Plan Explorer – https://www.sentryone.com/plan-explorer – 第16回 SQL Server 2019勉強会で紹介されていました – 私が今日使っているのはこっち
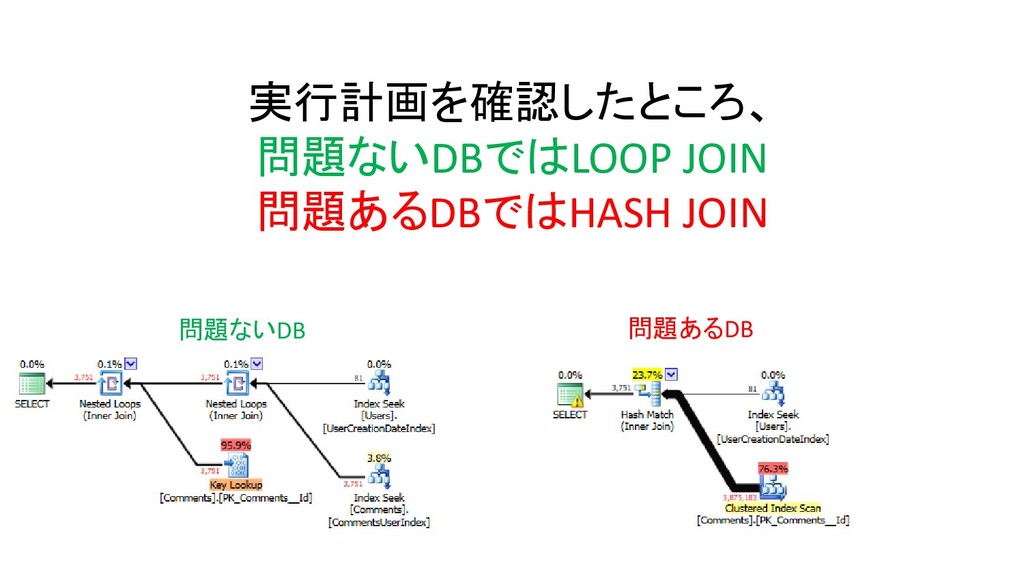
実行計画を確認したところ、 問題ないDBではLOOP JOIN 問題あるDBではHASH JOIN 問題ないDB 問題あるDB
基本的なJOIN(LOOP, MERGE, HASH)の動きを 確認してみる
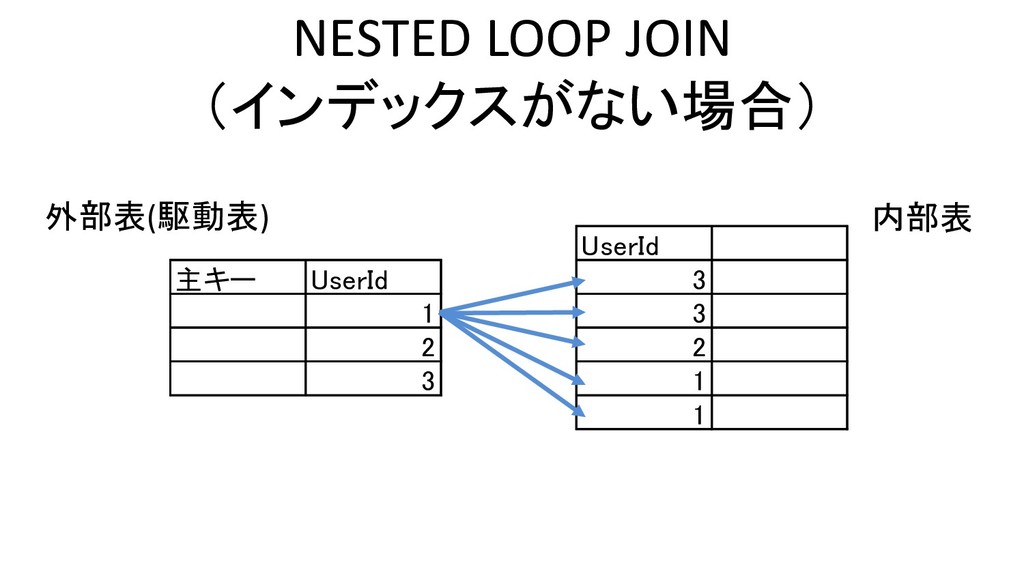
NESTED LOOP JOIN (インデックスがない場合) UserId 主キー UserId 3 1 3
2 2 3 1 1 外部表(駆動表) 内部表
NESTED LOOP JOIN (インデックスがない場合) UserId 主キー UserId 3 1 3
2 2 3 1 1 内部表 外部表(駆動表) 動きとしてはプログラムのfor文の動き 非常に効率が悪い
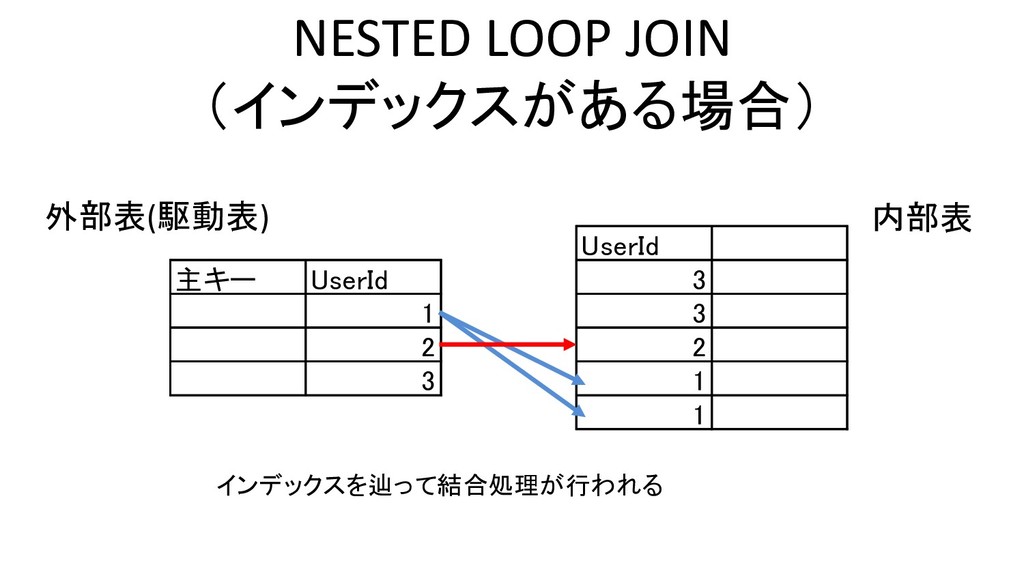
NESTED LOOP JOIN (インデックスがある場合) UserId 主キー UserId 3 1 3
2 2 3 1 1 内部表 外部表(駆動表) インデックスを辿って結合処理が行われる
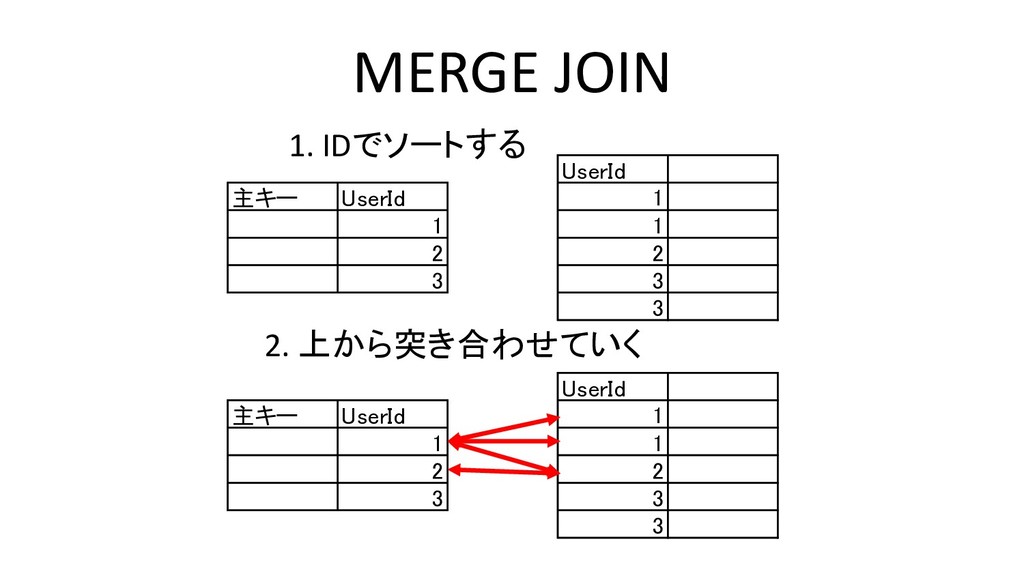
MERGE JOIN UserId 主キー UserId 1 1 1 2 2
3 3 3 1. IDでソートする UserId 主キー UserId 1 1 1 2 2 3 3 3 2. 上から突き合わせていく
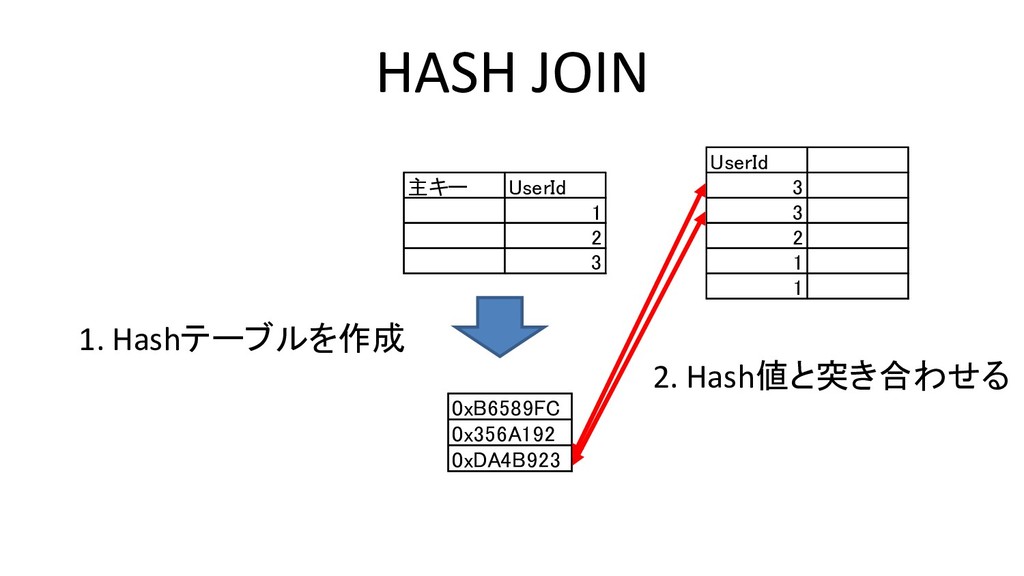
HASH JOIN UserId 主キー UserId 3 1 3 2 2
3 1 1 1. Hashテーブルを作成 0xB6589FC 0x356A192 0xDA4B923 2. Hash値と突き合わせる
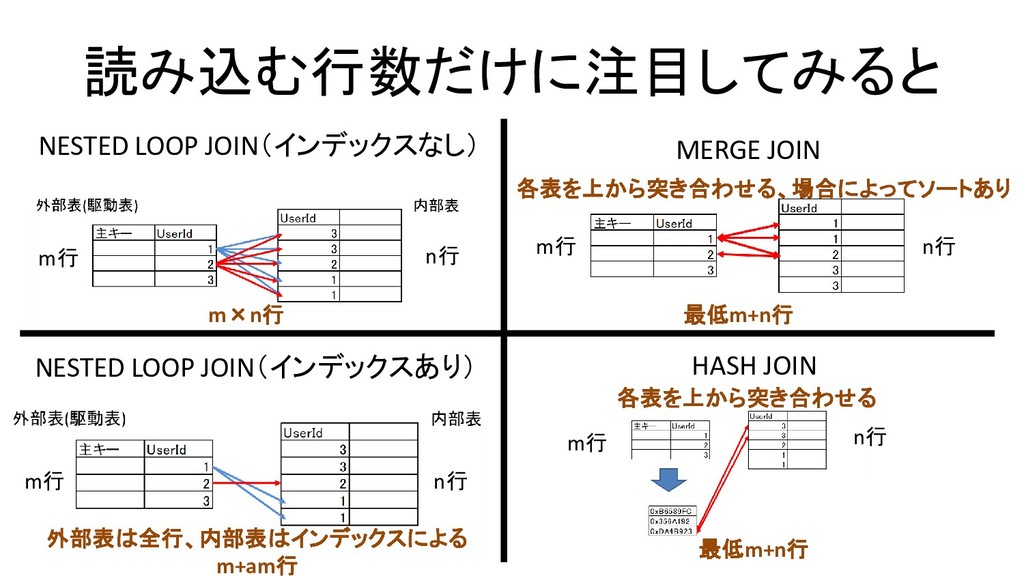
読み込む行数だけに注目してみると NESTED LOOP JOIN(インデックスなし) NESTED LOOP JOIN(インデックスあり) MERGE JOIN HASH
JOIN m行 m行 m行 m行 n行 m×n行 外部表は全行、内部表はインデックスによる m+am行 最低m+n行 最低m+n行 n行 n行 n行 各表を上から突き合わせる、場合によってソートあり 各表を上から突き合わせる
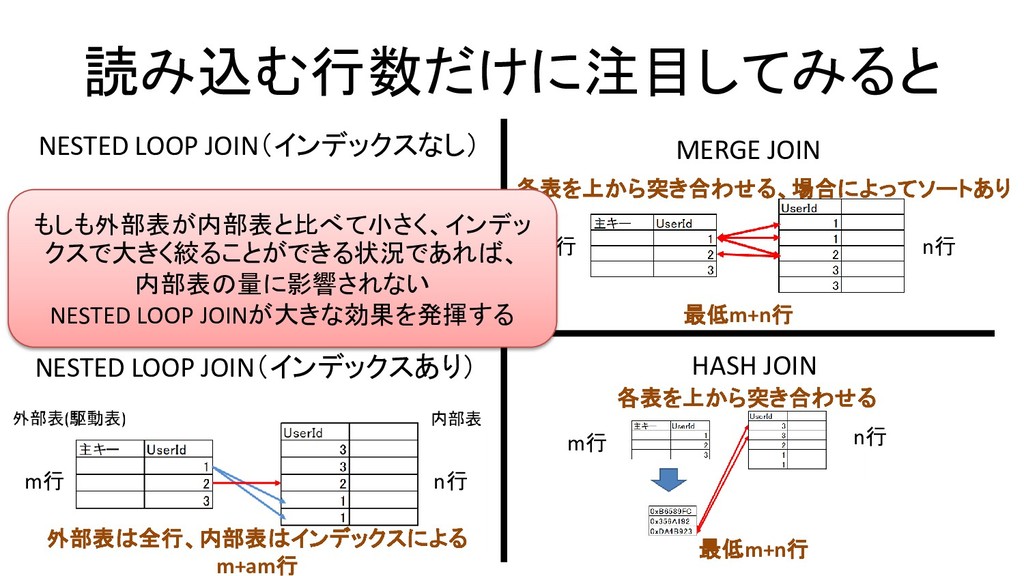
読み込む行数だけに注目してみると NESTED LOOP JOIN(インデックスなし) NESTED LOOP JOIN(インデックスあり) MERGE JOIN HASH
JOIN m行 m行 m行 m行 n行 m×n行 外部表は全行、内部表はインデックスによる m+am行 最低m+n行 最低m+n行 n行 n行 n行 各表を上から突き合わせる、場合によってソートあり 各表を上から突き合わせる もしも外部表が内部表と比べて小さく、インデッ クスで大きく絞ることができる状況であれば、 内部表の量に影響されない NESTED LOOP JOINが大きな効果を発揮する
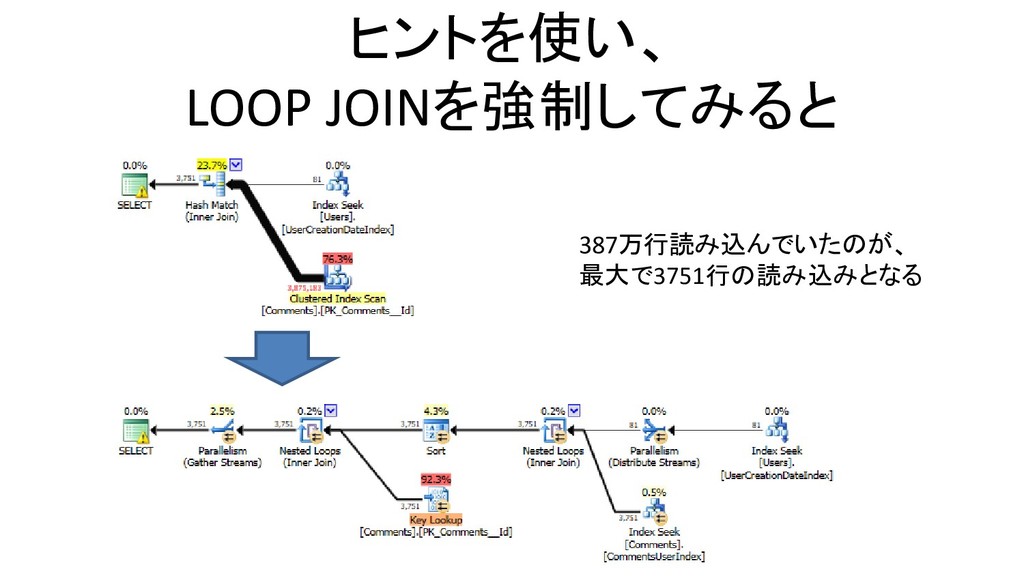
ヒントを使い、 LOOP JOINを強制してみると 387万行読み込んでいたのが、 最大で3751行の読み込みとなる
強制は基本的には避けるべきであり 自然に適したJOINを選んでほしい JOINの種類が異なった原因は 何か?
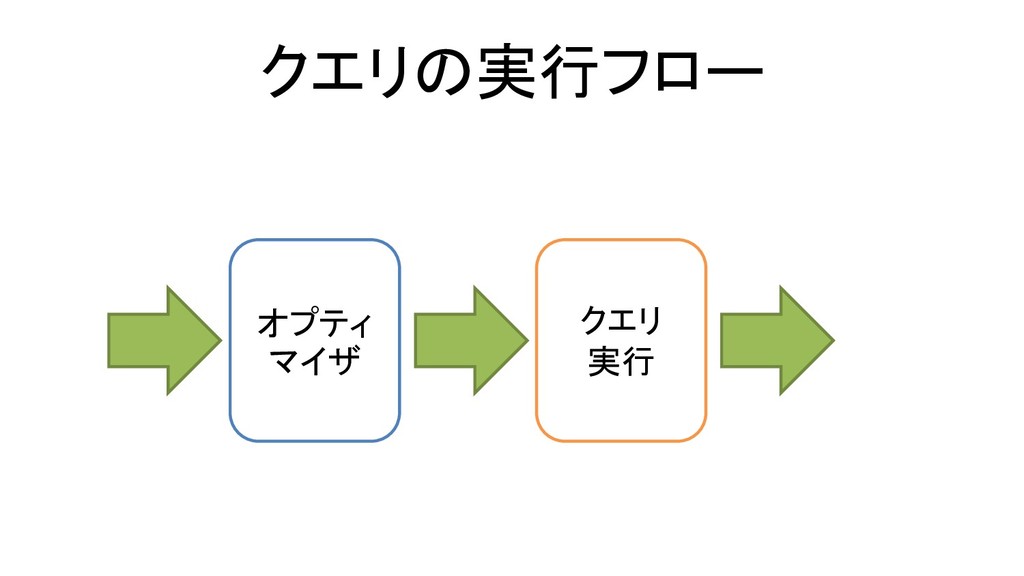
クエリの実行フロー オプティ マイザ クエリ 実行
クエリの実行フロー オプティ マイザ クエリ 実行 推定実行計画 実際の実行計画
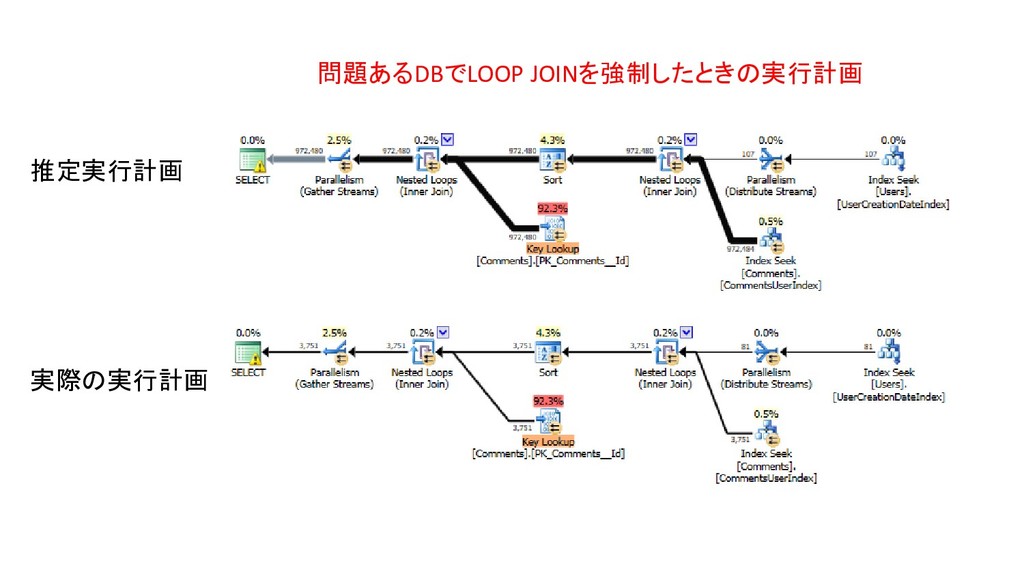
パフォーマンスの悪いDBの 推定実行計画と実際の実行計画を 比較してみる
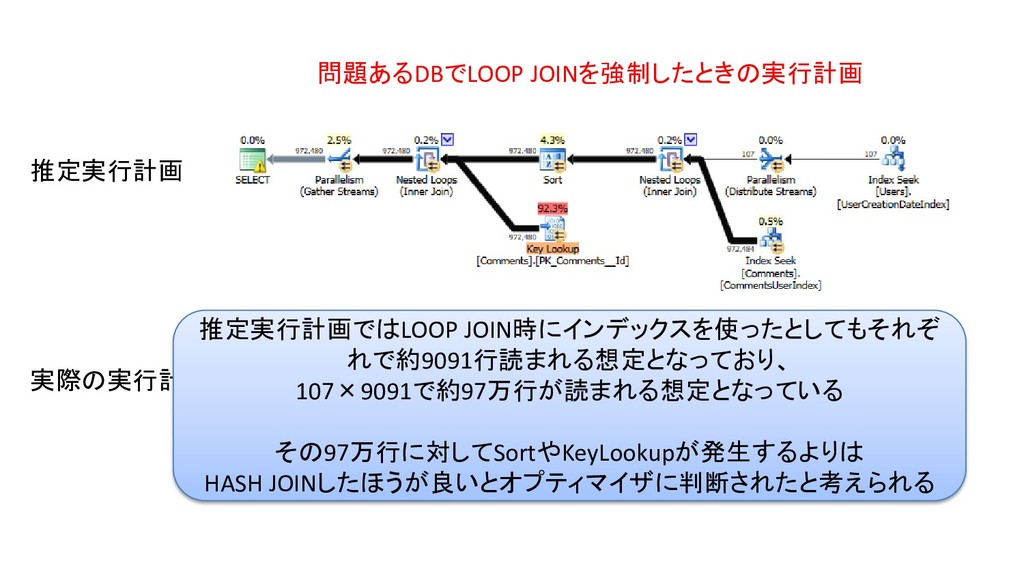
問題あるDBでLOOP JOINを強制したときの実行計画 推定実行計画 実際の実行計画
問題あるDBでLOOP JOINを強制したときの実行計画 推定実行計画 実際の実行計画 推定実行計画ではLOOP JOIN時にインデックスを使ったとしてもそれぞ れで約9091行読まれる想定となっており、 107×9091で約97万行が読まれる想定となっている その97万行に対してSortやKeyLookupが発生するよりは HASH
JOINしたほうが良いとオプティマイザに判断されたと考えられる
インデックスを使った時の 推定行数が多くなってしまったのは なぜか ↓ 統計情報
統計情報とは • 「テーブルやインデックス内で、どんな値が、 どんな頻度で出現するのかをまとめた情報」 (https://www.atmarkit.co.jp/ait/articles/1703 /13/news001.html)
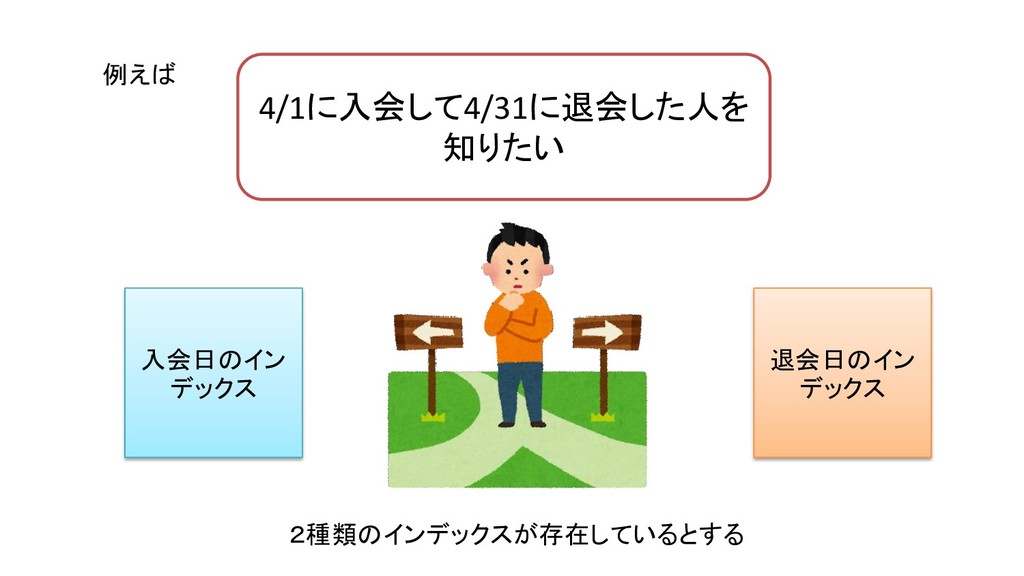
4/1に入会して4/31に退会した人を 知りたい 入会日のイン デックス 退会日のイン デックス 2種類のインデックスが存在しているとする 例えば
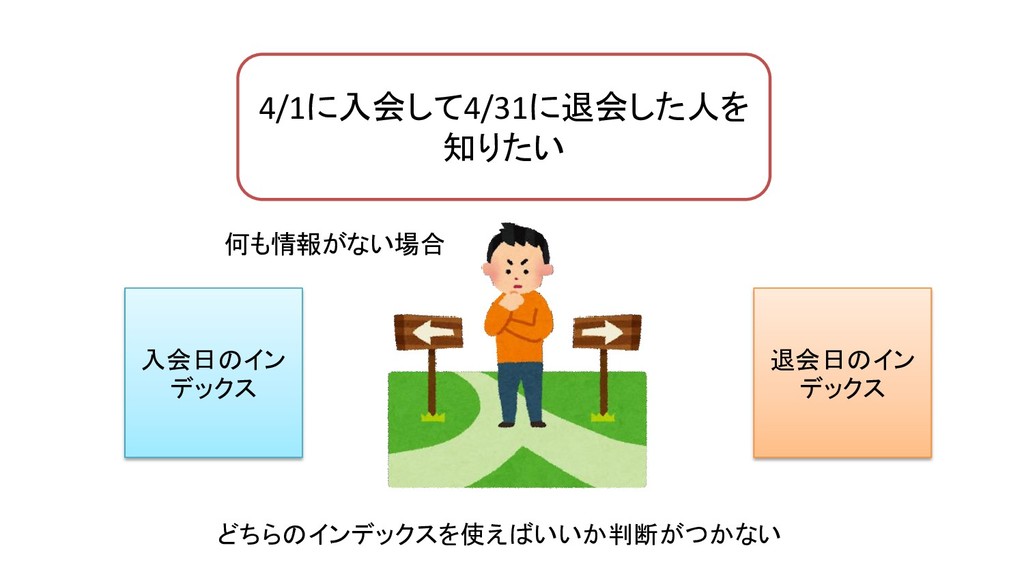
4/1に入会して4/31に退会した人を 知りたい 入会日のイン デックス 退会日のイン デックス どちらのインデックスを使えばいいか判断がつかない 何も情報がない場合
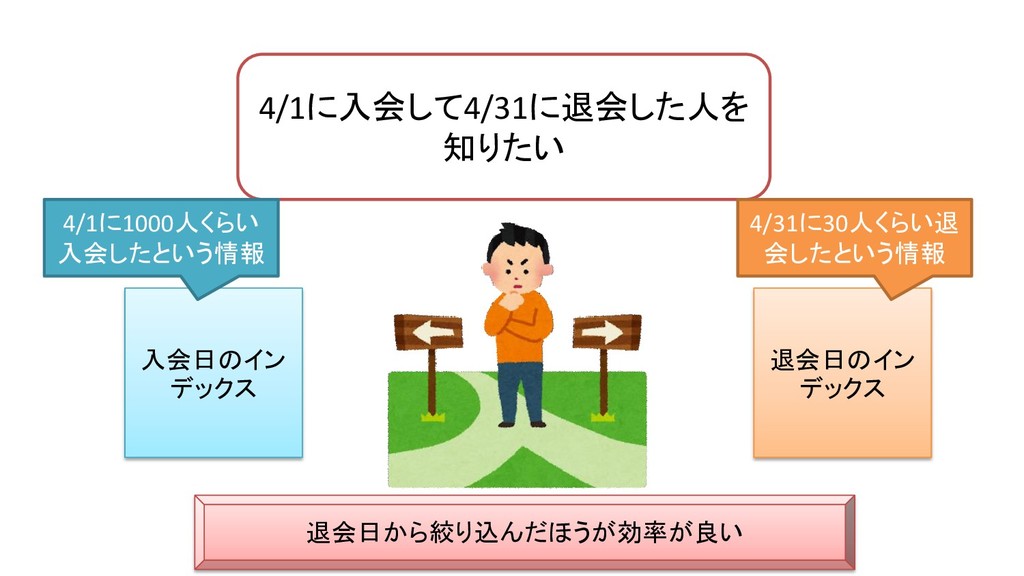
4/1に入会して4/31に退会した人を 知りたい 入会日のイン デックス 退会日のイン デックス 4/1に1000人くらい 入会したという情報 4/31に30人くらい退 会したという情報
退会日から絞り込んだほうが効率が良い
統計情報を見る方法 • A. SSMSから確認 – https://docs.microsoft.com/ja-jp/sql/relational- databases/statistics/view-statistics- properties?view=sql-server-2017 • B.
DBCC SHOW_STATISTICS
実際に見てみる
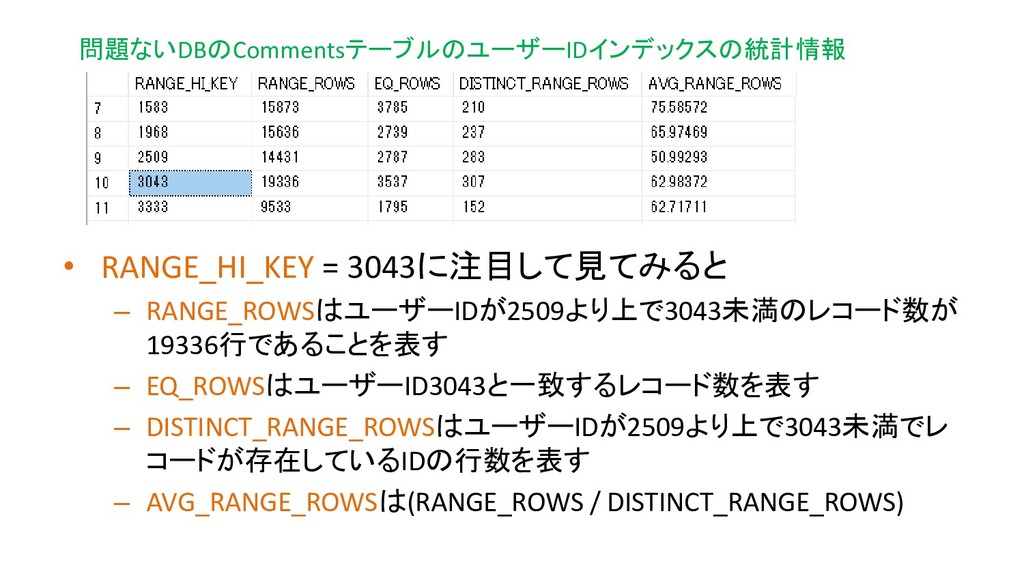
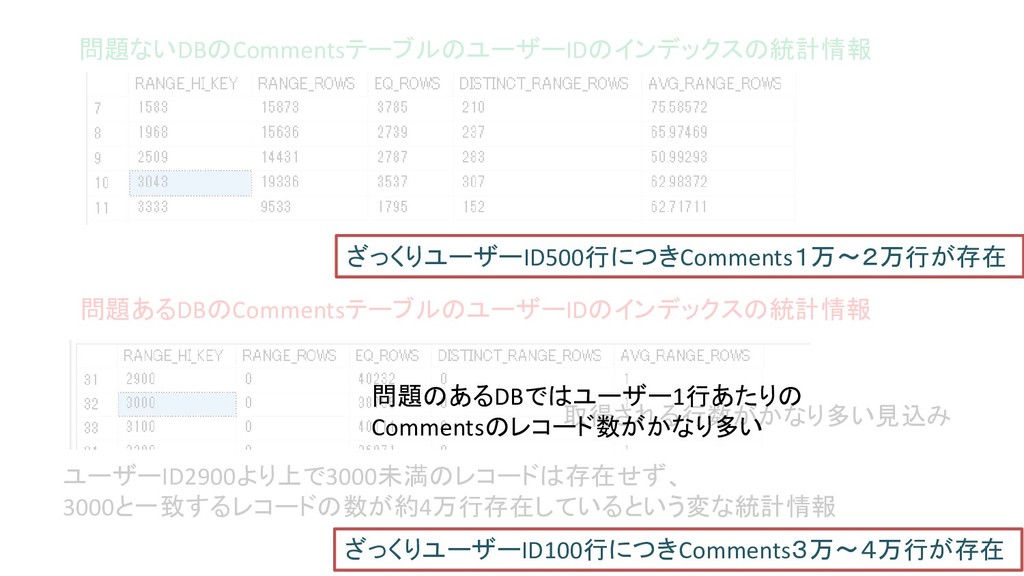
• RANGE_HI_KEY = 3043に注目して見てみると – RANGE_ROWSはユーザーIDが2509より上で3043未満のレコード数が 19336行であることを表す – EQ_ROWSはユーザーID3043と一致するレコード数を表す –
DISTINCT_RANGE_ROWSはユーザーIDが2509より上で3043未満でレ コードが存在しているIDの行数を表す – AVG_RANGE_ROWSは(RANGE_ROWS / DISTINCT_RANGE_ROWS) 問題ないDBのCommentsテーブルのユーザーIDインデックスの統計情報
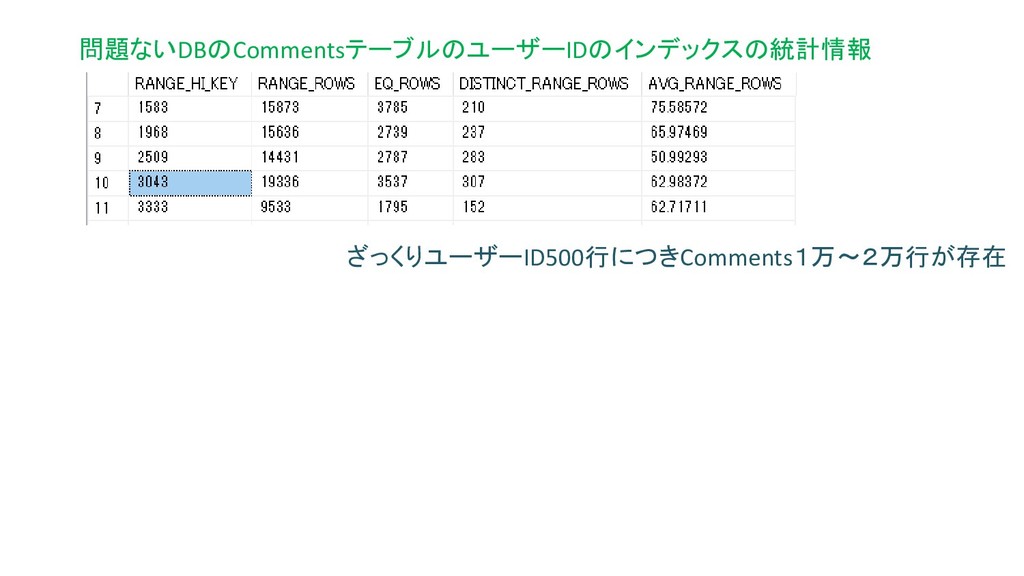
問題ないDBのCommentsテーブルのユーザーIDのインデックスの統計情報 ざっくりユーザーID500行につきComments1万~2万行が存在
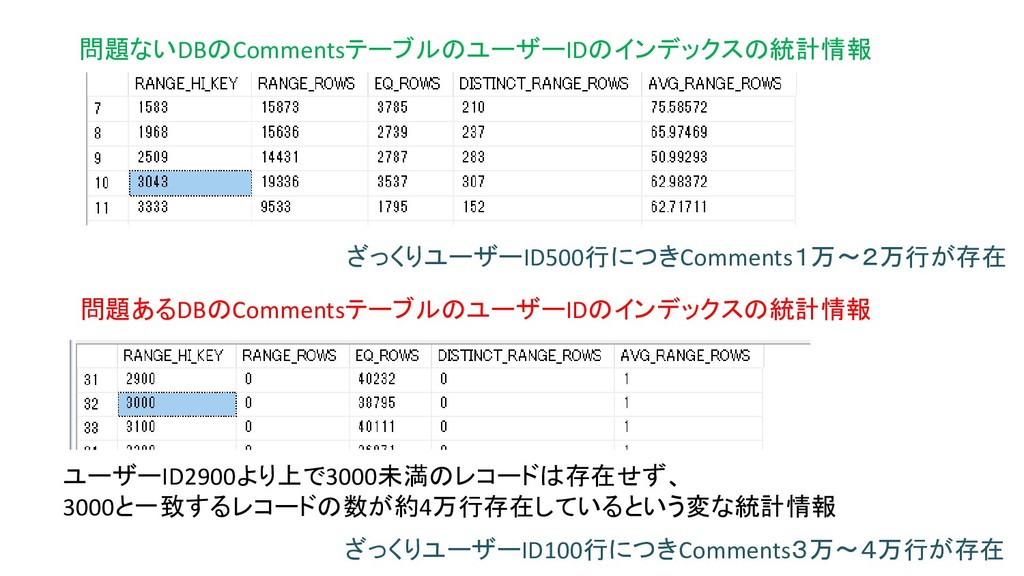
問題ないDBのCommentsテーブルのユーザーIDのインデックスの統計情報 問題あるDBのCommentsテーブルのユーザーIDのインデックスの統計情報 ユーザーID2900より上で3000未満のレコードは存在せず、 3000と一致するレコードの数が約4万行存在しているという変な統計情報 ざっくりユーザーID500行につきComments1万~2万行が存在 ざっくりユーザーID100行につきComments3万~4万行が存在
問題ないDBのCommentsテーブルのユーザーIDのインデックスの統計情報 問題あるDBのCommentsテーブルのユーザーIDのインデックスの統計情報 ユーザーID2900より上で3000未満のレコードは存在せず、 3000と一致するレコードの数が約4万行存在しているという変な統計情報 取得される行数がかなり多い見込み 問題のあるDBではユーザー1行あたりの Commentsのレコード数がかなり多い ざっくりユーザーID500行につきComments1万~2万行が存在 ざっくりユーザーID100行につきComments3万~4万行が存在
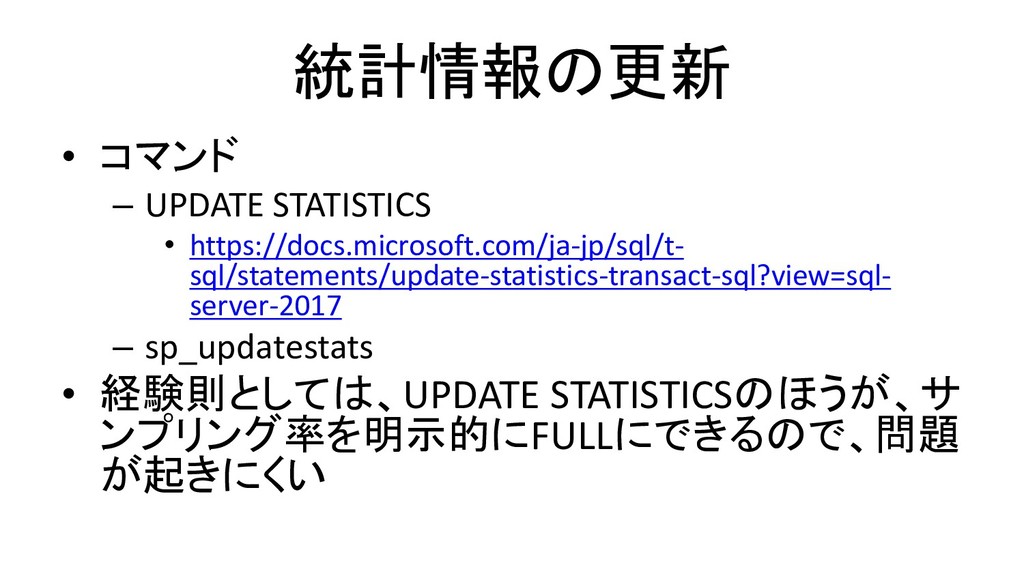
統計情報の更新 • コマンド – UPDATE STATISTICS • https://docs.microsoft.com/ja-jp/sql/t- sql/statements/update-statistics-transact-sql?view=sql- server-2017
– sp_updatestats • 経験則としては、UPDATE STATISTICSのほうが、サ ンプリング率を明示的にFULLにできるので、問題 が起きにくい
統計情報を更新し直して動かして みる
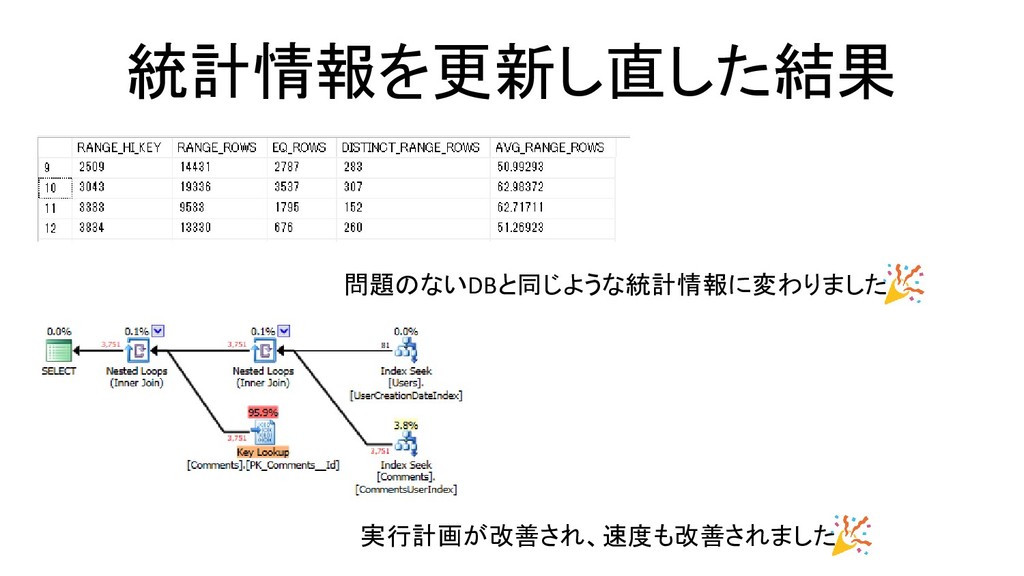
統計情報を更新し直した結果 問題のないDBと同じような統計情報に変わりました 実行計画が改善され、速度も改善されました
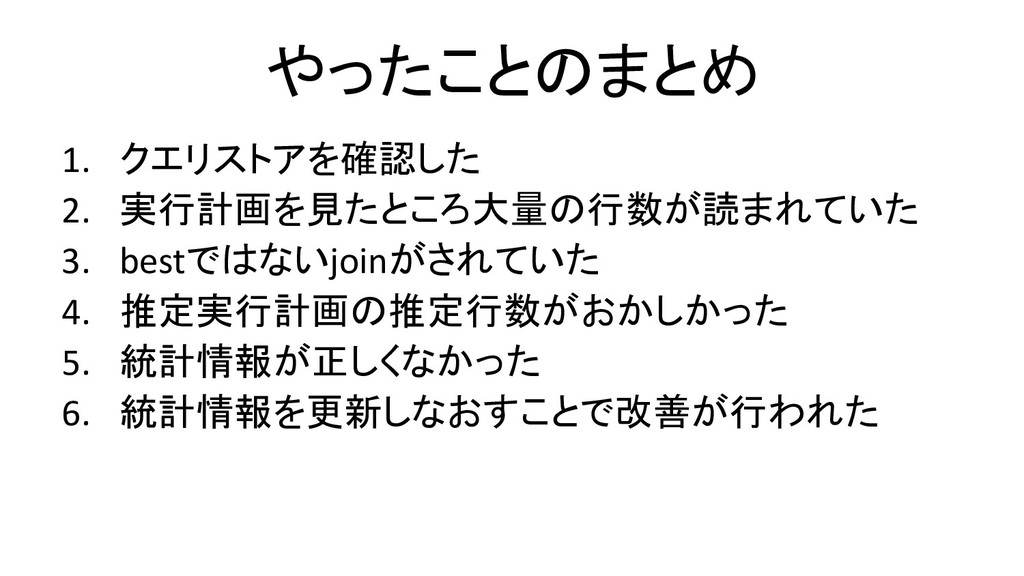
やったことのまとめ 1. クエリストアを確認した 2. 実行計画を見たところ大量の行数が読まれていた 3. bestではないjoinがされていた 4. 推定実行計画の推定行数がおかしかった 5.
統計情報が正しくなかった 6. 統計情報を更新しなおすことで改善が行われた
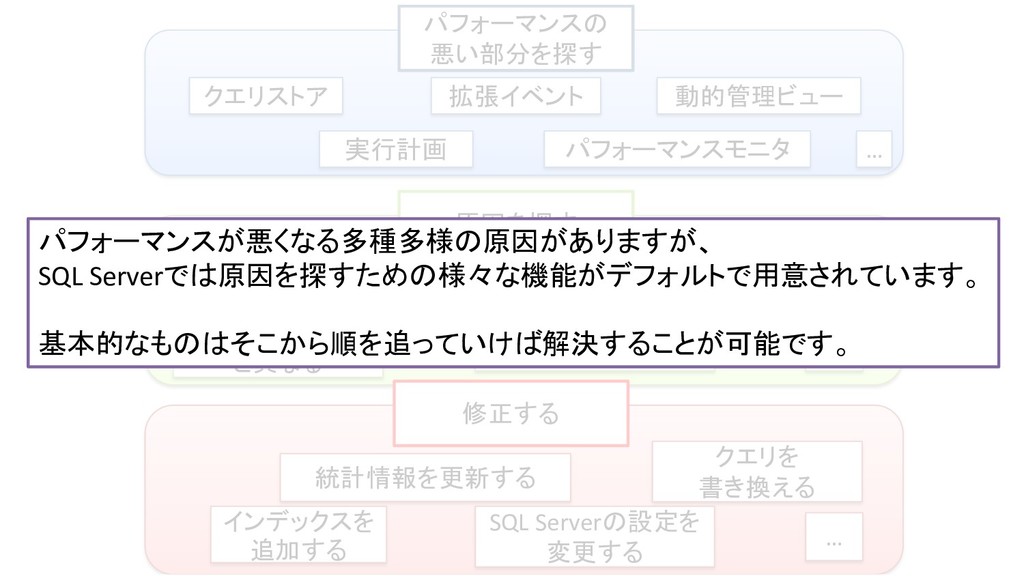
パフォーマンスの 悪い部分を探す クエリストア 実行計画 拡張イベント パフォーマンスモニタ 動的管理ビュー … 原因を探す 実行計画が想定
と異なる IOでwaitが発生している ロックされている n+1問題 … 修正する クエリを 書き換える 統計情報を更新する SQL Serverの設定を 変更する インデックスを 追加する …
パフォーマンスの 悪い部分を探す クエリストア 実行計画 拡張イベント パフォーマンスモニタ 動的管理ビュー … 原因を探す 実行計画が想定
と異なる IOでwaitが発生している ロックされている n+1問題 … 修正する クエリを 書き換える 統計情報を更新する SQL Serverの設定を 変更する インデックスを 追加する … パフォーマンスが悪くなる多種多様の原因がありますが、 SQL Serverでは原因を探すための様々な機能がデフォルトで用意されています。 基本的なものはそこから順を追っていけば解決することが可能です。
以上です ご清聴ありがとうございました


 ___akari11
 moro
 ryu1013
 yutobara
 kaityo256
 yumnumm
 n_takehata
 timakin
 gam0022
 teyamagu
 utakaha
 kishida
 keithpitt
 csswizardry
 marcoroth
 geshan
 chriscoyier
 tessaabrams
 pauljervisheath
 szymonslowik
 afnizarnur
 tmiket
 inesmontani
 charlesmeaden