Share
Embed
その広告配信システムは正しく動いているのか? #TechMar
Tech x Marketing meetup #5 サイトリライアビリティエンジニアリング
https://techxmarketing.connpass.com/event/189979/
jewel12
October 05, 2020
Transcript
34 slides
-
@jewel_x12 • 株式会社VOYAGE GROUP / ◦ インターネット広告配信事業 ◦ fluct 沖縄支社メンバー
• 主にアプリケーション開発や新卒採用のお手伝い • SRE チームではない ◦ SRE チームメンバーじゃない自分がなぜここにいるのか …… -
fluct の SRE チームは解散した • fluct の SREチーム ◦ Service
Reliability Engineering ◦ サービスの信頼性を高め、システム的な事情で広告が見られなくなる状態を減らす ◦ デプロイ環境やモニタリングの整備など、サービスを安定させるための仕組みを作っていた • 信頼性の向上には fluct メンバー全員の知識が必要 ◦ 広告が表示されない理由は低レイヤーの問題からアプリケーションコードのバグまで多岐にわたる • SRE チームは 2019 年に解散 ◦ サービスの信頼性を高めるのは みんなの責務とした Engineers in VOYAGE にも詳しい話が書いてあります -
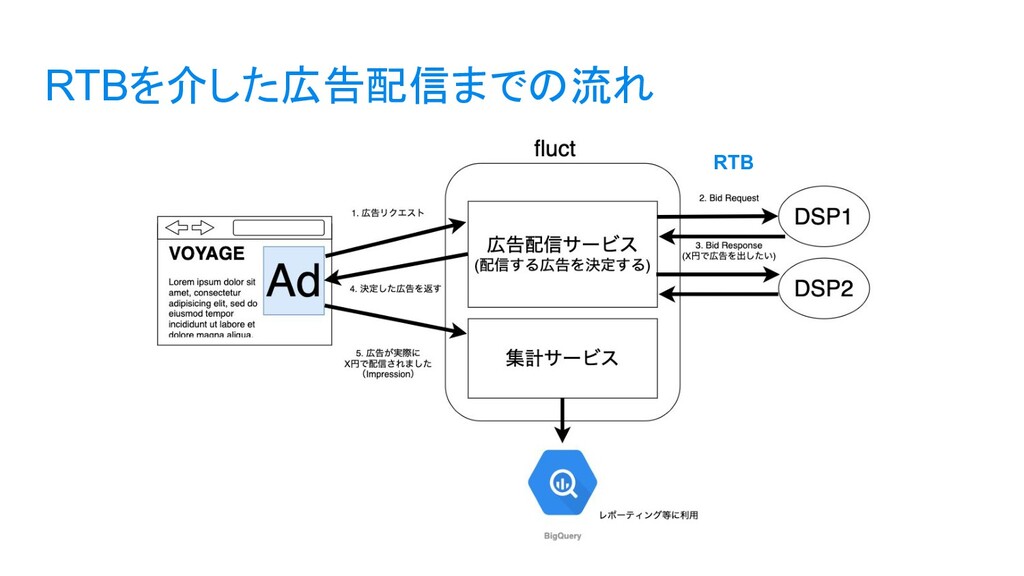
fluct について • インターネット広告配信業者 ◦ SSP (Supply Side Platform) をやっている
◦ https://corp.fluct.jp/ • メディアのインプレッション価値の最大化をミッションとしている ◦ インプレッションとは広告を表示すること ◦ 例えば「広告枠にどのような広告を配信するとメディアの広告収益が上がるのか」を考えている • RTB (Real Time Bidding) もやっている ◦ 広告リクエストごとにオークションを行い、最も配信単価の高い広告を流す ◦ 広告を出すために入札する側を DSP(Demand Side Platform)という ▪ SSP はオークションを開催する側 -
fluct の規模感 • SSP を始めてから 12,000 以上のメディアやアプリに導入されている • 月間で数百億のリクエストを捌く •
広告配信が全て止まるようなインシデントがあったとき ◦ メディアの広告収入が止まったり、メディアの表示自体ができなくなることも ◦ 影響範囲が大きい!! -
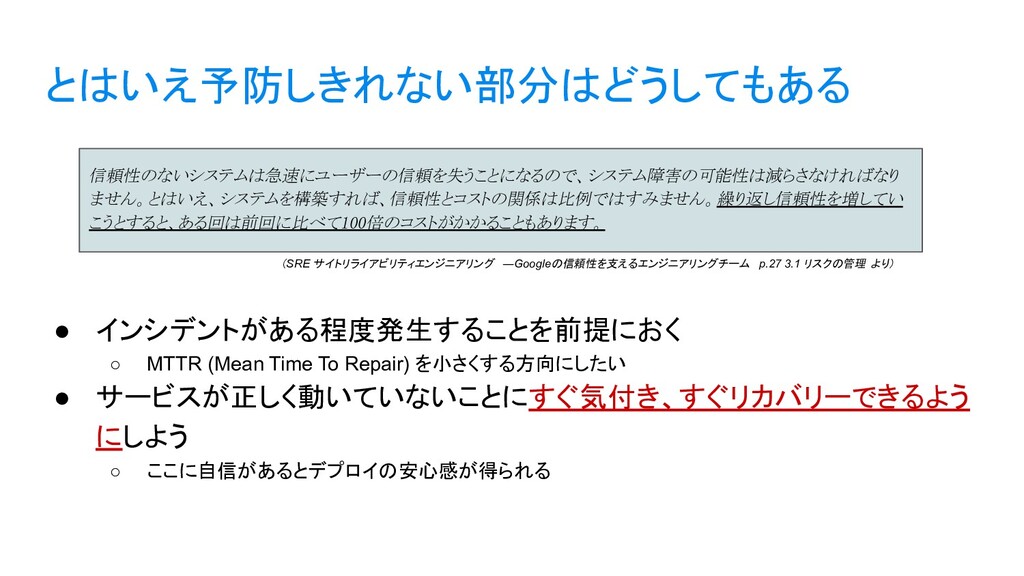
信頼性のないシステムは急速にユーザーの信頼を失うことになるので、システム障害の可能性は減らさなければなり ません。とはいえ、システムを構築すれば、信頼性とコストの関係は比例ではすみません。繰り返し信頼性を増してい こうとすると、ある回は前回に比べて100倍のコストがかかることもあります。 とはいえ予防しきれない部分はどうしてもある • インシデントがある程度発生することを前提におく ◦ MTTR (Mean Time
To Repair) を小さくする方向にしたい • サービスが正しく動いていないことにすぐ気付き、すぐリカバリーできるよう にしよう ◦ ここに自信があるとデプロイの安心感が得られる (SRE サイトリライアビリティエンジニアリング ―Googleの信頼性を支えるエンジニアリングチーム p.27 3.1 リスクの管理 より) -
そのサービスは正しく動いているか? • 正しくとは? ◦ サービスが価値を産んでいること ▪ ビジネス的な指標に異常がないか ▪ エンドユーザーがサービスを使えているか •
価値を生んでいるかはサービスメトリクスを見る ◦ サービスメトリクス ▪ ここではサービスがユーザーに与えている価値を計測したもの とする ◦ 「ビジネスKPI」や「ビジネスKPIに紐づく技術指標」に近い(入門 監視 p.65 5章 ビジネスを監視す る) ▪ 滞在しているユーザー数・コメント投稿数など -
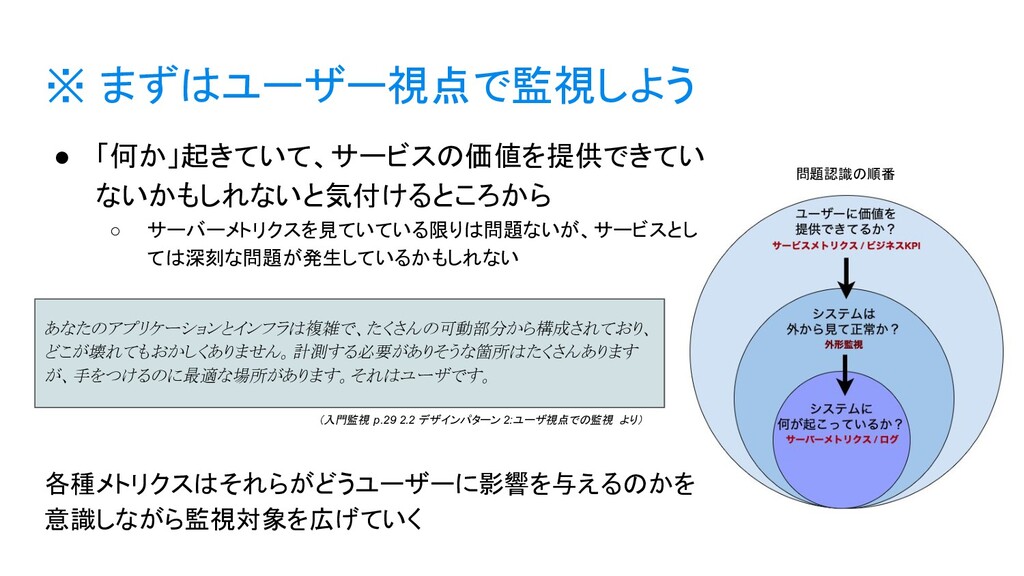
※ まずはユーザー視点で監視しよう • 「何か」起きていて、サービスの価値を提供できてい ないかもしれないと気付けるところから ◦ サーバーメトリクスを見ていている限りは問題ないが、サービスとし ては深刻な問題が発生しているかもしれない 各種メトリクスはそれらがどうユーザーに影響を与えるのかを 意識しながら監視対象を広げていく
あなたのアプリケーションとインフラは複雑で、たくさんの可動部分から構成されており、 どこが壊れてもおかしくありません。計測する必要がありそうな箇所はたくさんあります が、手をつけるのに最適な場所があります。それはユーザです。 (入門監視 p.29 2.2 デザインパターン 2:ユーザ視点での監視 より) 問題認識の順番 -
fluct のサービスは正しく動いているか? • fluct のユーザー ◦ 広告が表示される人 ◦ 広告配信レポートを見るメディア ◦
RTB で bid してくる DSP • fluct のサービスメトリクス ◦ インプレッション数 ◦ 広告配信による売上 ◦ RTB の bid 数, 約定金額 -
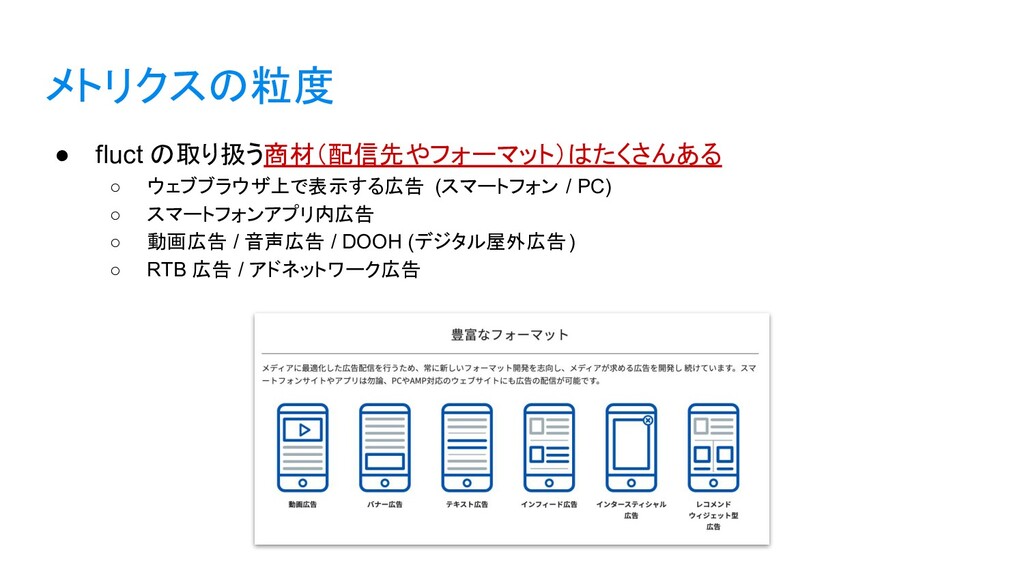
メトリクスの粒度 • fluct の取り扱う商材(配信先やフォーマット)はたくさんある ◦ ウェブブラウザ上で表示する広告 (スマートフォン / PC) ◦
スマートフォンアプリ内広告 ◦ 動画広告 / 音声広告 / DOOH (デジタル屋外広告) ◦ RTB 広告 / アドネットワーク広告 -
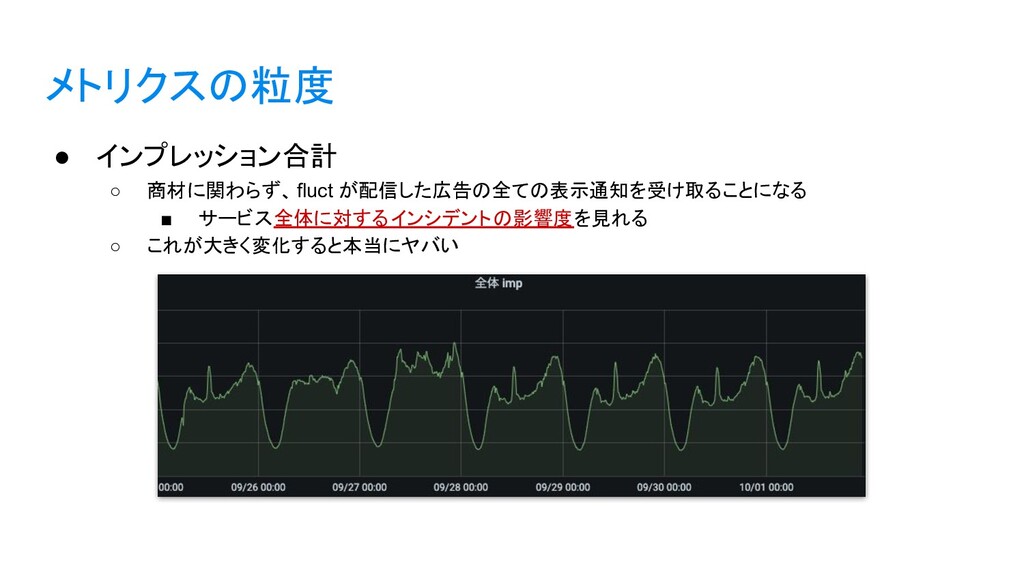
メトリクスの粒度 • 多くの商材は全体インプレッションに埋もれてしまう ◦ 異常に気付かないままになってしまう • 新しい商材も伸ばしていきたい ◦ インシデントがよく発生する商材は使いたくない ◦
安定して広告配信することで、メディアの信頼を得つつ伸ばしていきたい • メトリクスを多角的に見ていく必要がある ざっくりこれくらいを 数個の商材が占める -
前半のまとめ • サービスをすぐにリカバリーできるようにしたい ◦ サービスメトリクスを見て「何か問題が発生していること」に早く気付きたい • fluct は商材が多いので、多角的なメトリクスの取得が必要 • 後半は
◦ サービスメトリクスを監視の中身について説明します -
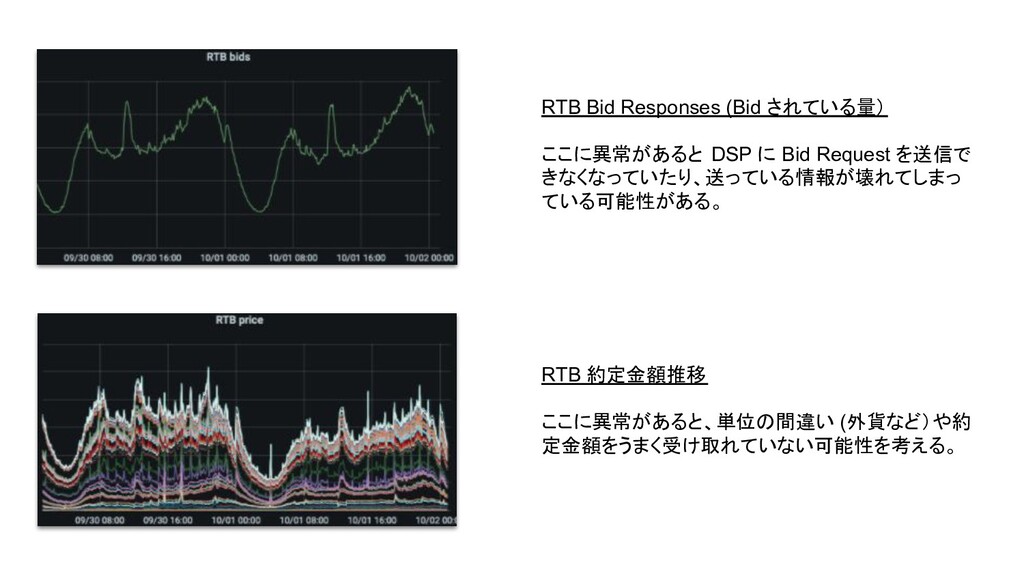
RTB Bid Responses (Bid されている量) ここに異常があると DSP に Bid Request
を送信で きなくなっていたり、送っている情報が壊れてしまっ ている可能性がある。 RTB 約定金額推移 ここに異常があると、単位の間違い (外貨など)や約 定金額をうまく受け取れていない可能性を考える。 -
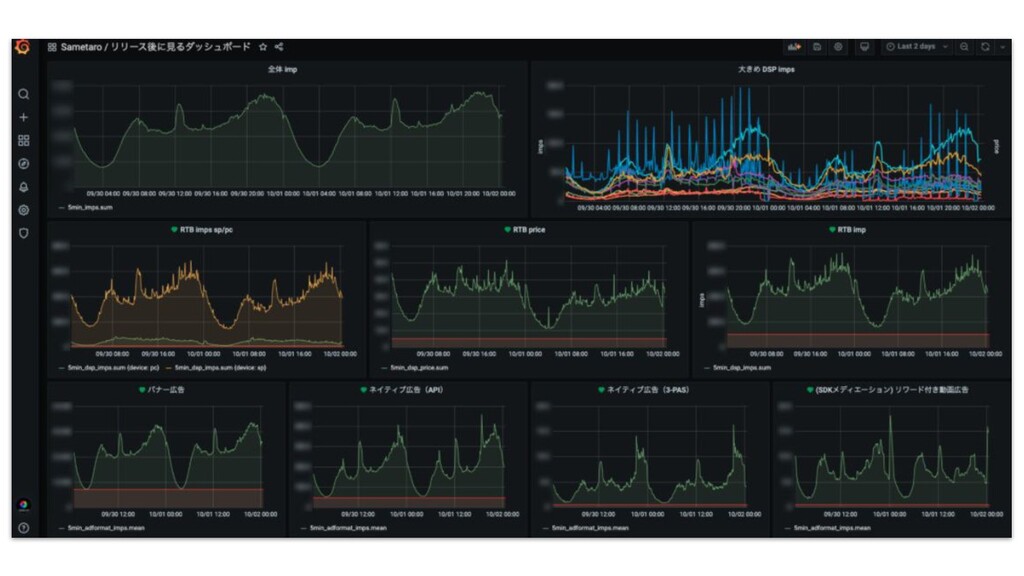
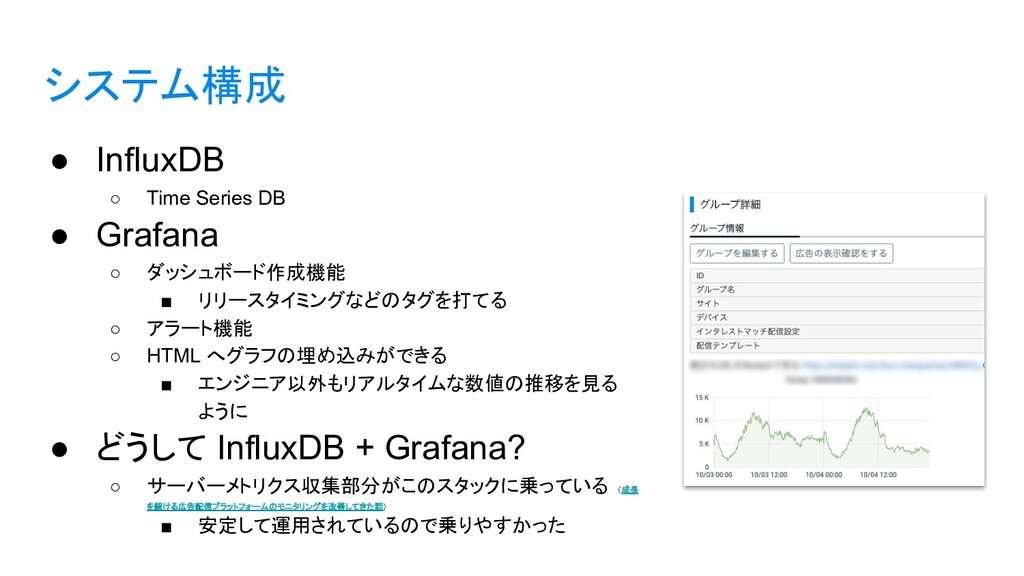
システム構成 • InfluxDB ◦ Time Series DB • Grafana ◦
ダッシュボード作成機能 ▪ リリースタイミングなどのタグを打てる ◦ アラート機能 ◦ HTML へグラフの埋め込みができる ▪ エンジニア以外もリアルタイムな数値の推移を見る ように • どうして InfluxDB + Grafana? ◦ サーバーメトリクス収集部分がこのスタックに乗っている (成長 を続ける広告配信プラットフォームのモニタリングを改善してきた話) ▪ 安定して運用されているので乗りやすかった -
作るときに考えたこと • 対象メトリクスの選定 ◦ 過去のインシデントから、可視化できていたら素早く気付けたであろうメトリクスを選択 • アラートに頼るのではなく、デプロイ時は必要なメトリクスを人が見てほしい ◦ 今の仕組みのアラートは完璧ではない ▪
しきい値を設定してアラート通知を出すのみ ▪ 何がどれくらい変化したらアラート通知するか?という部分を決めきれていない • すでに存在するサービスメトリクスでも、デプロイ内容によっては粒度が荒すぎるケー スもある ◦ fluct のエンジニアとして、自分のデプロイがサービスに悪影響を及ぼしていないか?と意識できる 人であってほしい気持ちもある(気持ち) ▪ この意識が無いと、デプロイフローの改善等に興味が向かないのでは? -
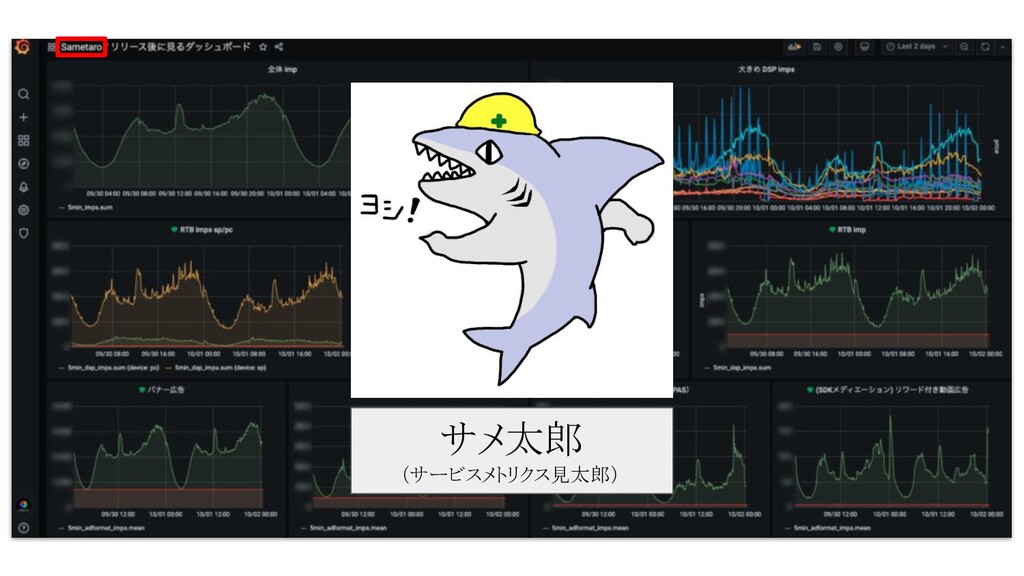
作るときに考えたこと • サメ太郎自体の異常に気付けること ◦ データポイントが一定時間存在しない場合は気付けるようにしてある • メトリクスを追加しやすく ◦ 必要であれば誰でも追加できるようにしたい •
メトリクス投入先は変えやすく ◦ 監視SaaSを使ってもいい -
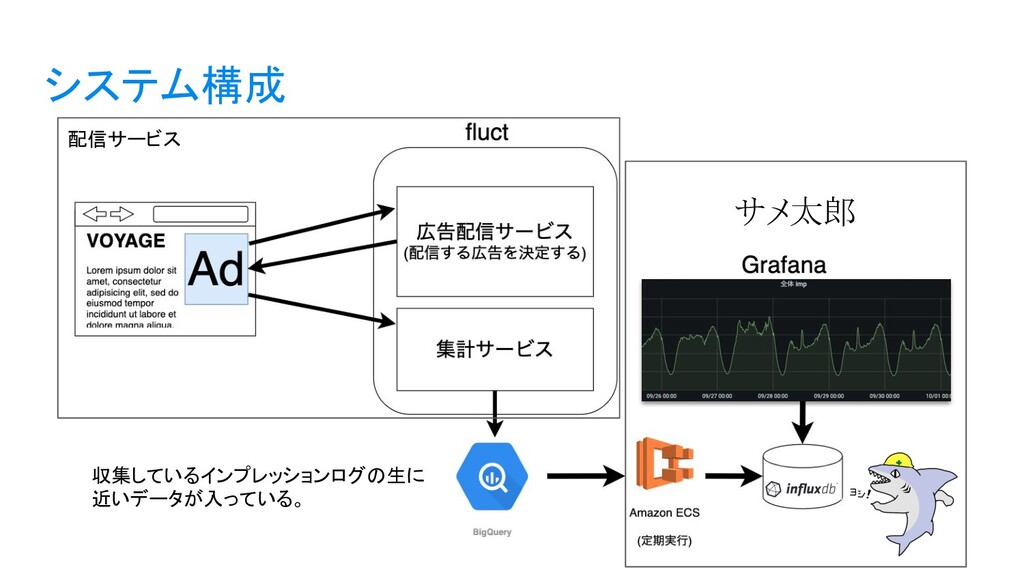
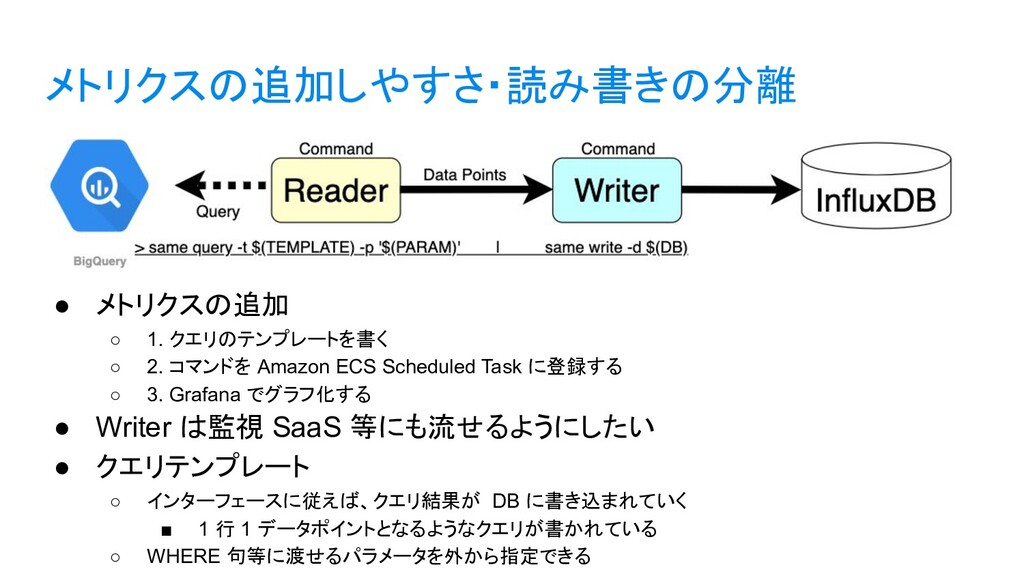
メトリクスの追加しやすさ・読み書きの分離 • メトリクスの追加 ◦ 1. クエリのテンプレートを書く ◦ 2. コマンドを Amazon
ECS Scheduled Task に登録する ◦ 3. Grafana でグラフ化する • Writer は監視 SaaS 等にも流せるようにしたい • クエリテンプレート ◦ インターフェースに従えば、クエリ結果が DB に書き込まれていく ▪ 1 行 1 データポイントとなるようなクエリが書かれている ◦ WHERE 句等に渡せるパラメータを外から指定できる -
メトリクスの追加しやすさ・読み書きの分離 SELECT d.timestamp `timestamp`, -- データポイントの時間 [ STRUCT<measurement string, value
float64>("dsp_imps", d.imps), STRUCT<measurement string, value float64>("dsp_price", d.price) ] `points`, -- 書き込み先とデータ(dsp_imps というシリーズに d.imps を書き込む) [ STRUCT<tag string, value string>("dsp_name", d.dsp_name), STRUCT<tag string, value string>("demand_type", d.demand_type), ] `tags` -- データポイントに付与するタグ FROM d -- 単位時間あたりで集計したサブクエリやビューを指定する テンプレート例(コマンドで指定しているパラメータも使える) -
インシデント発生時の行動パターン • 既存のサービスメトリクスで気付けるとき ◦ 1. グラフに異常を見つける ◦ 2. デプロイタグから関連するマージコミットを探す ◦
3. リバートして良いか考える ▪ 多くのデプロイはリバートのしやすさを考えている ◦ 4. 切り戻して回復したのを確認する ◦ 5. ポストモーテム • 現在収集しているメトリクスで気付けなかったケースでは、可能ならポスト モーテム後にグラフの追加 ◦ 新しいメトリクスの切り方を考える -
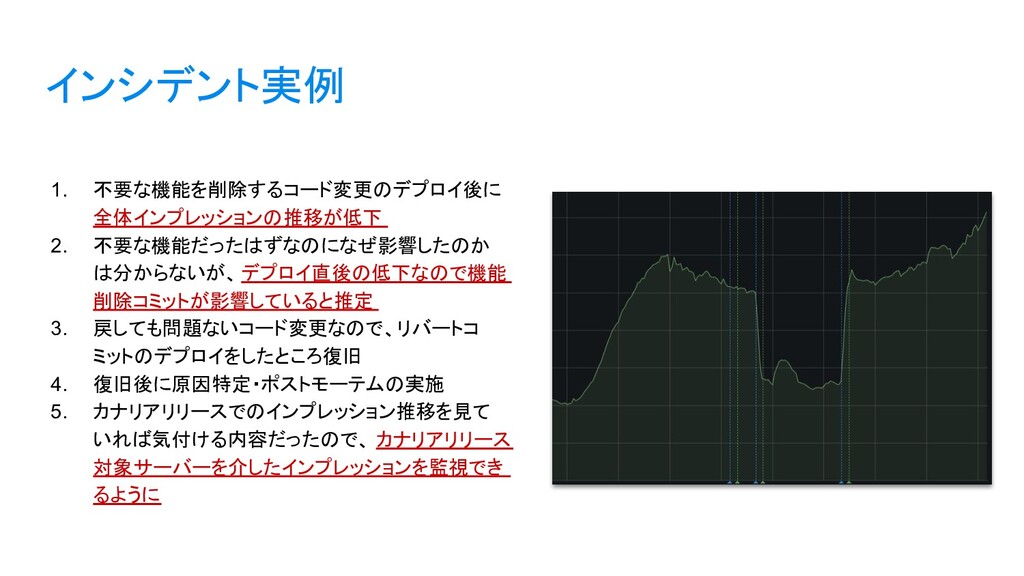
インシデント実例 1. 不要な機能を削除するコード変更のデプロイ後に 全体インプレッションの推移が低下 2. 不要な機能だったはずなのになぜ影響したのか は分からないが、デプロイ直後の低下なので機能 削除コミットが影響していると推定 3. 戻しても問題ないコード変更なので、リバートコ
ミットのデプロイをしたところ復旧 4. 復旧後に原因特定・ポストモーテムの実施 5. カナリアリリースでのインプレッション推移を見て いれば気付ける内容だったので、 カナリアリリース 対象サーバーを介したインプレッションを監視でき るように -
課題 • 自動的な異常検知をやりたい ◦ 人間の目で見きれない、もっと細かい粒度での異常検知 ▪ 例えば全メディアでのサービスメトリクスを対象にして、問題があれば通知したい ◦ 変動のトレンドが読みにくいものもある ▪
変動が大きいのでうまく検知できないかもしれない(アラートだらけになる) ◦ 粒度が小さすぎるとデータ量が足りない ▪ データがある程度集まった粒度のみ異常検知アラートを出すといった機能が必要 -
続・本当にサービスが動いているとは • 「インプレッションが出ているのを確認していれば、システムがユーザーに 価値を提供できている」と言い切ることはまだできない • どういう広告枠にどんな広告を出すのか?も機能のひとつ ◦ 例: 子供も見るメディアにアルコールの広告を出さない ▪
広告はメディアのブランディングや風評にも関わってくるので「インプレッション・売上が出てい るから良い」だけではない • どんな広告が実際に出ているのか把握することも進めています -
まとめ • サービスに何か問題が起きているとき、すぐにリカバリーできるような仕組 みを準備できないか考えよう ◦ 必要なもの ▪ 早く気付く ▪ 早く正常な状態に戻せる
▪ 正常な状態に戻ったことが分かる • 何か問題が起こってないか気付くためにユーザーに価値を提供できている か監視しよう ◦ ビジネスKPIを定期的に見るところから始められる • fluct ではサービス特性を考慮した粒度でのサービスメトリクスを収集し、可 視化する仕組みを整えました