Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ECCV2026読み会
Search
KeiichiIto1978
October 24, 2026
160
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ECCV2026読み会
第68回 コンピュータビジョン勉強会@関東 ECCV2026読み会の登壇資料です。
KeiichiIto1978
October 24, 2026
Transcript
24 slides
ECCV2026における オンライン動画解析系論文の紹介 CV勉強会 ECCV2026 読み会 株式会社アダコテック 伊藤 桂一
自己紹介 学生時代は、産業技術総合研究所で卒業研究を実施。 その縁で、AIST認定ベンチャーに入社。 その後、25年以上AIの研究開発に従事。 主に取り組んだ研究開発事例 ・GAによる光学機器の自動調整、半導体設計の最適化 ・動画/静止画/センサ/音の異常検知 2012年 弊社創業と同時に入社 2014年
現職 Confidential & Proprietary |
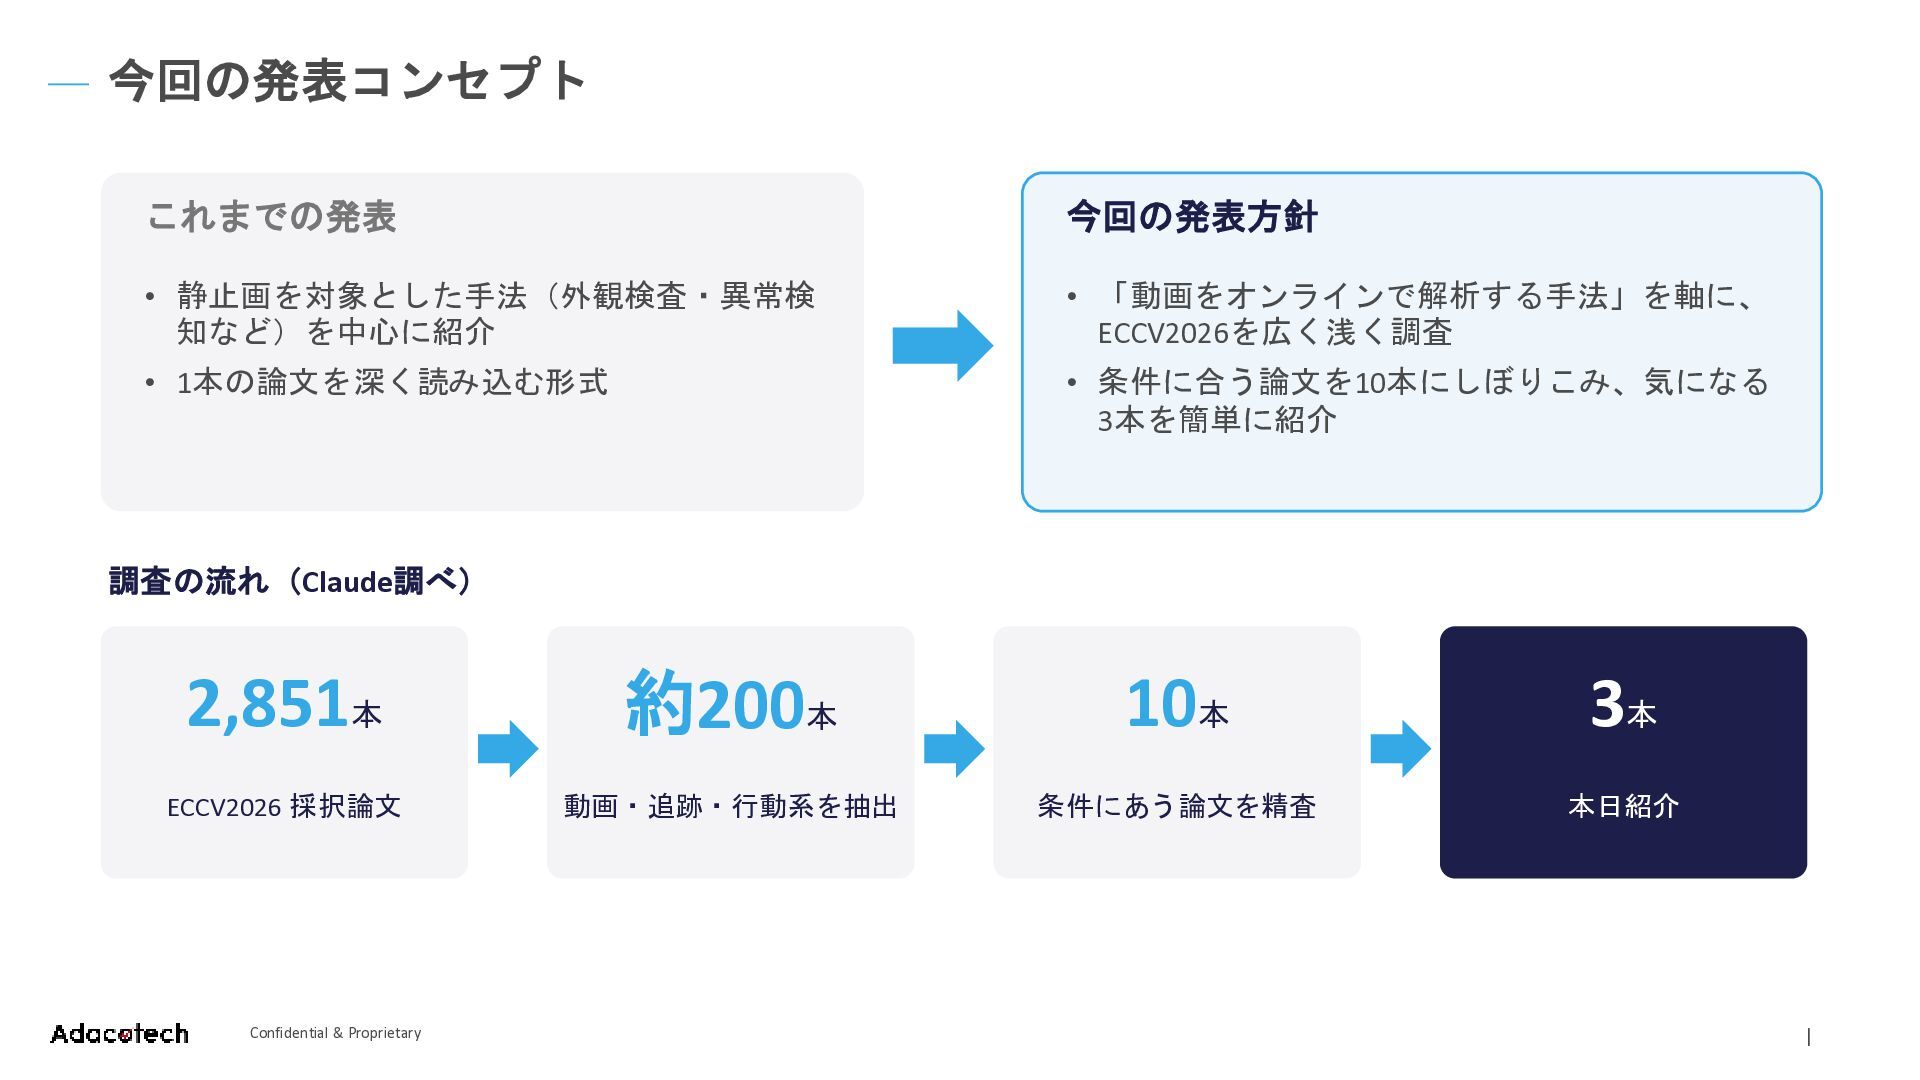
今回の発表コンセプト これまでの発表 今回の発表方針 • 静止画を対象とした手法(外観検査・異常検 知など)を中心に紹介 • 「動画をオンラインで解析する手法」を軸に、 ECCV2026を広く浅く調査 •
1本の論文を深く読み込む形式 • 条件に合う論文を10本にしぼりこみ、気になる 3本を簡単に紹介 調査の流れ(Claude調べ) 2,851本 約200本 10本 3本 ECCV2026 採択論文 動画・追跡・行動系を抽出 条件にあう論文を精査 本日紹介 Confidential & Proprietary |
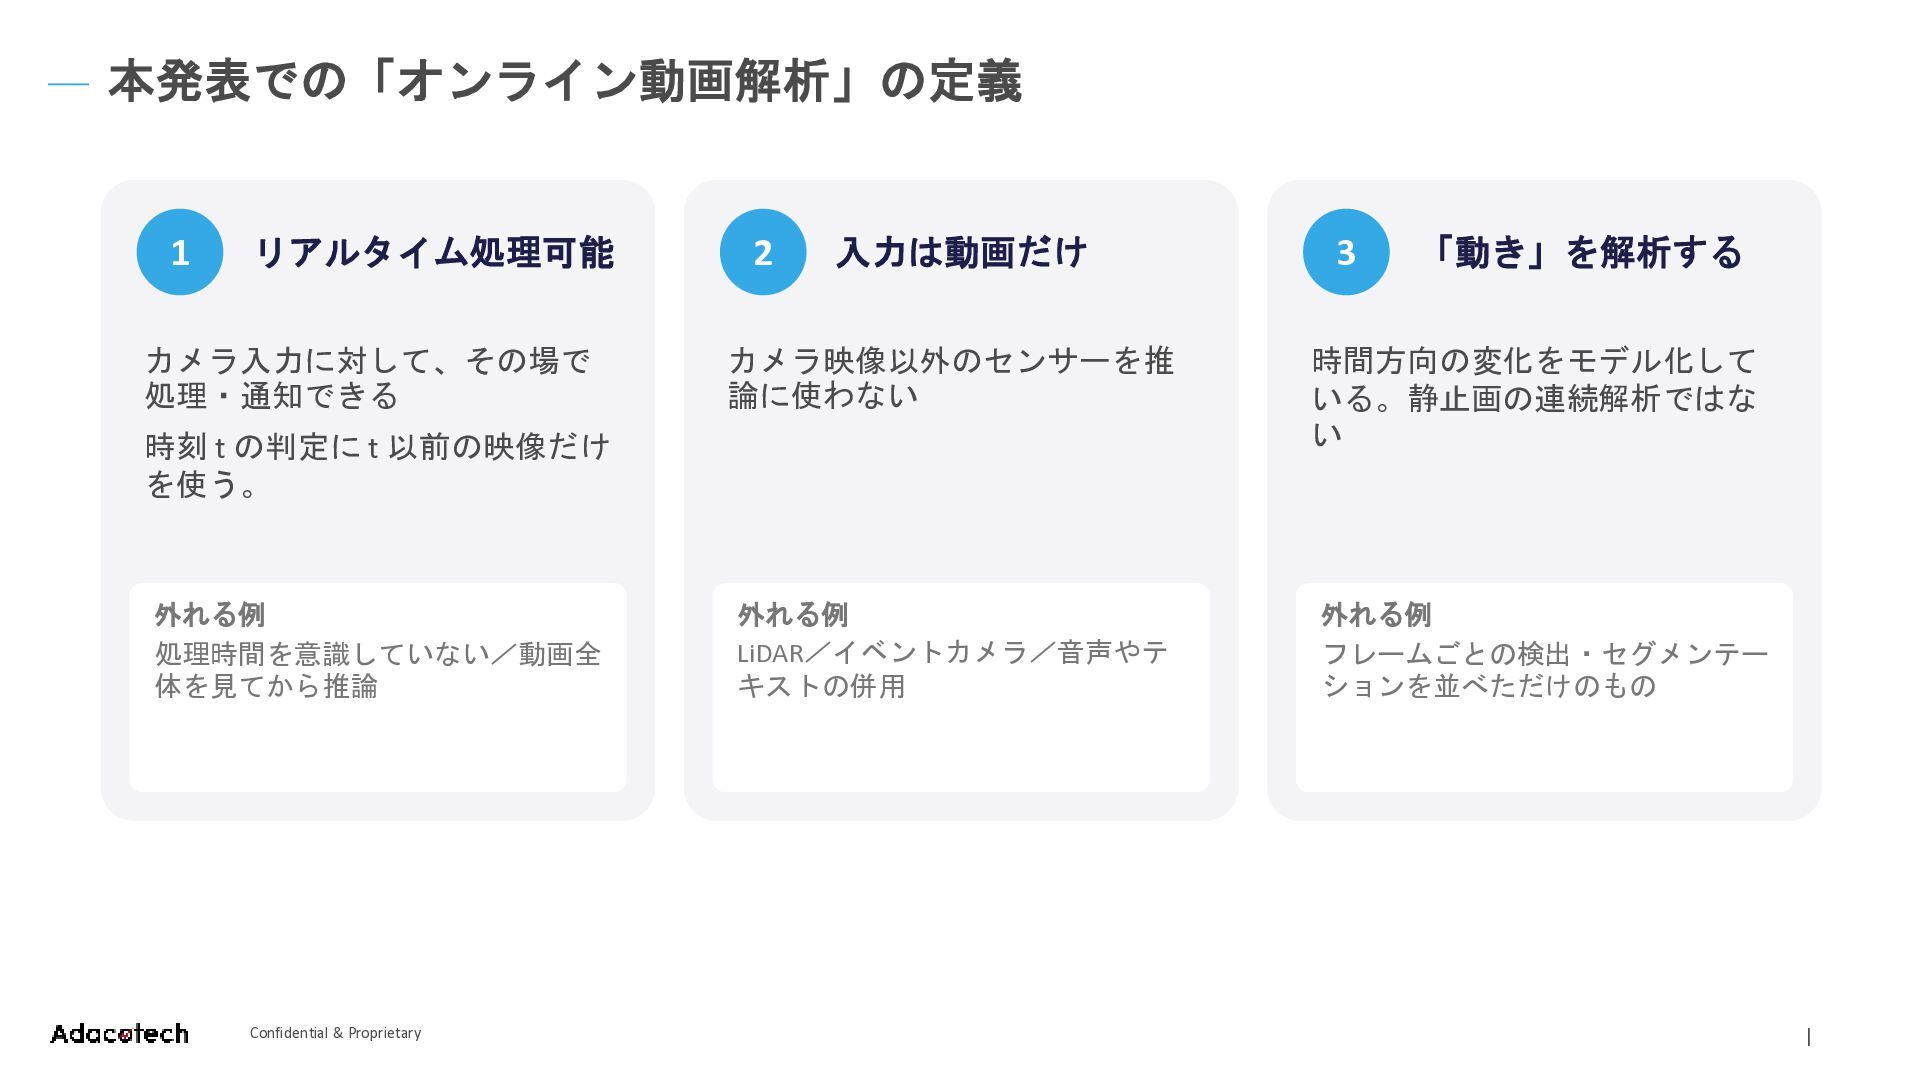
本発表での「オンライン動画解析」の定義 1 リアルタイム処理可能 カメラ入力に対して、その場で 処理・通知できる 2 入力は動画だけ Confidential & Proprietary
「動き」を解析する カメラ映像以外のセンサーを推 論に使わない 時間方向の変化をモデル化して いる。静止画の連続解析ではな い 外れる例 LiDAR/イベントカメラ/音声やテ キストの併用 外れる例 フレームごとの検出・セグメンテー ションを並べただけのもの 時刻 t の判定に t 以前の映像だけ を使う。 外れる例 処理時間を意識していない/動画全 体を見てから推論 3 |
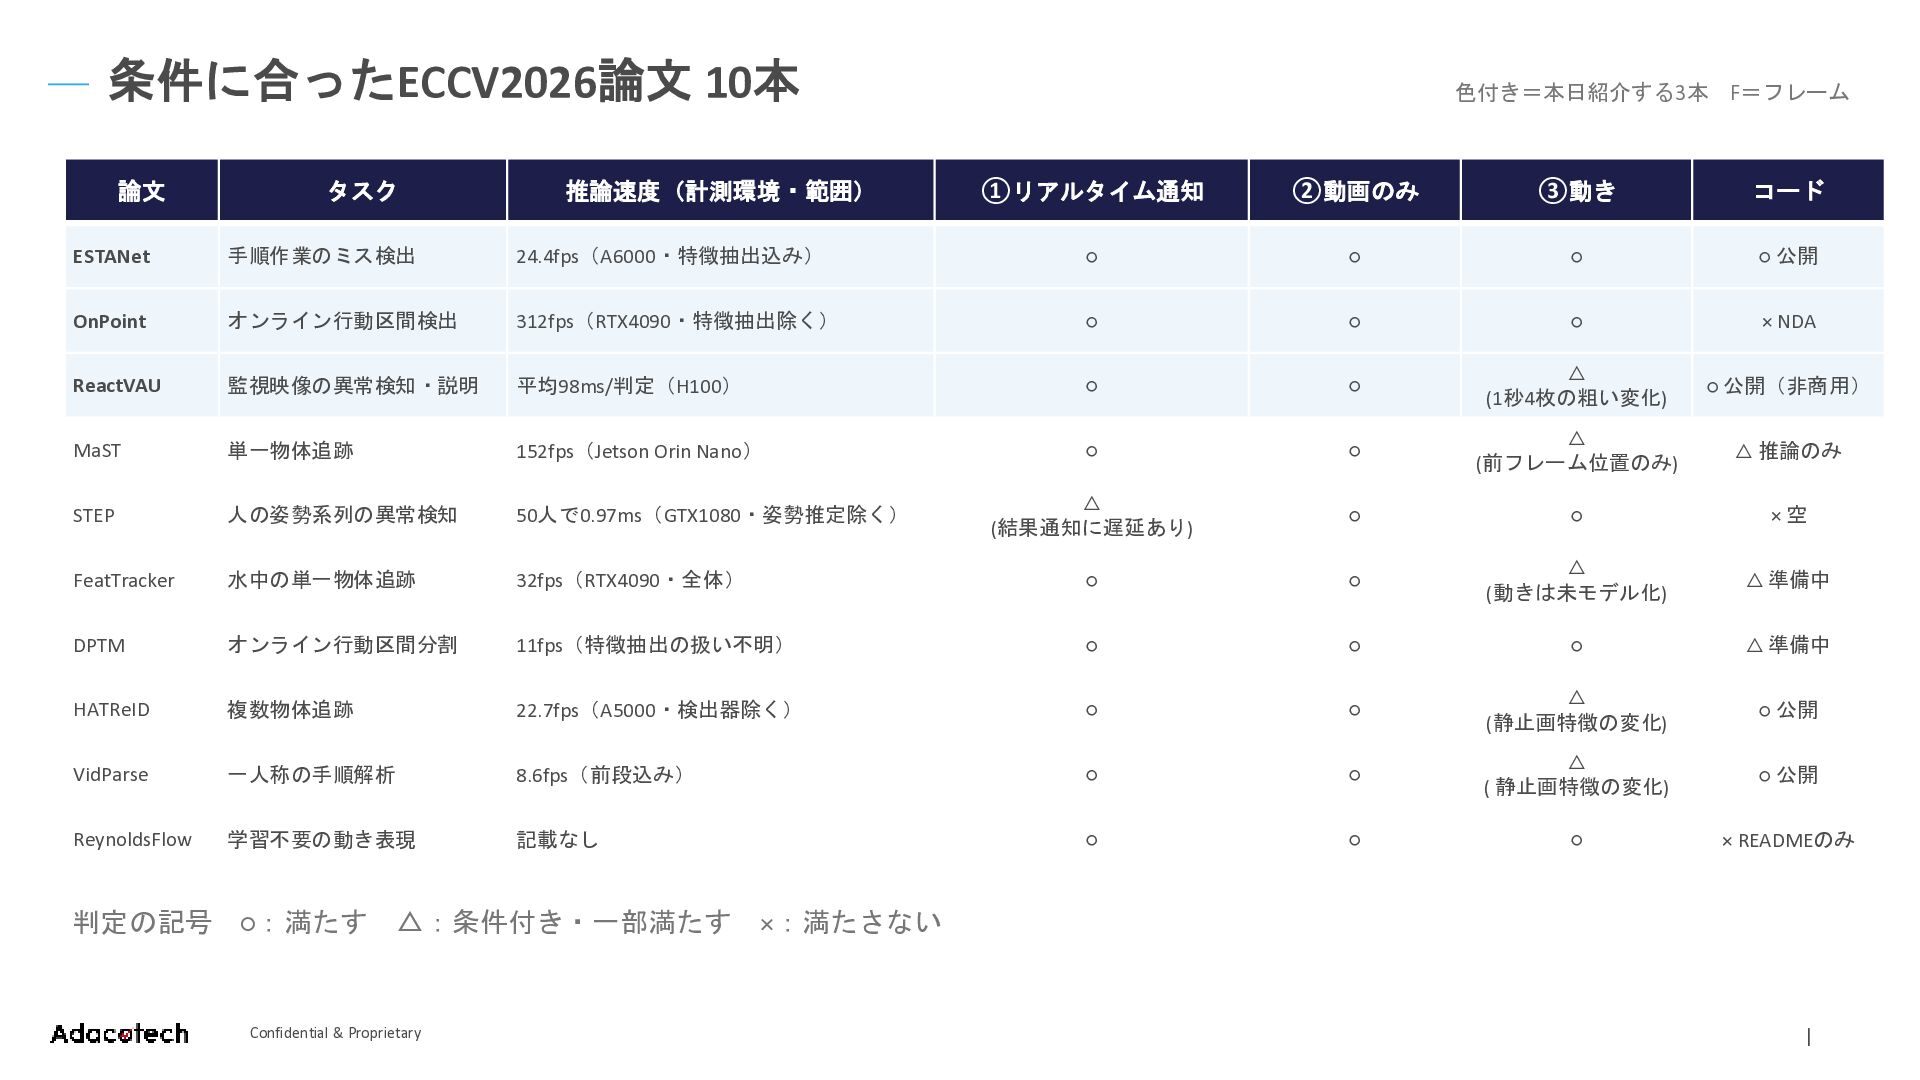
条件に合ったECCV2026論文 10本 論文 タスク 推論速度(計測環境・範囲) 色付き=本日紹介する3本 F=フレーム ①リアルタイム通知 ②動画のみ ③動き
コード ESTANet 手順作業のミス検出 24.4fps(A6000・特徴抽出込み) ◦ ◦ ◦ ◦ 公開 OnPoint オンライン行動区間検出 312fps(RTX4090・特徴抽出除く) ◦ ◦ ◦ × NDA ReactVAU 監視映像の異常検知・説明 平均98ms/判定(H100) ◦ ◦ △ (1秒4枚の粗い変化) ◦ 公開(非商用) MaST 単一物体追跡 152fps(Jetson Orin Nano) ◦ ◦ △ (前フレーム位置のみ) △ 推論のみ STEP 人の姿勢系列の異常検知 50人で0.97ms(GTX1080・姿勢推定除く) △ (結果通知に遅延あり) ◦ ◦ ×空 FeatTracker 水中の単一物体追跡 32fps(RTX4090・全体) ◦ ◦ △ (動きは未モデル化) △ 準備中 DPTM オンライン行動区間分割 11fps(特徴抽出の扱い不明) ◦ ◦ ◦ △ 準備中 HATReID 複数物体追跡 22.7fps(A5000・検出器除く) ◦ ◦ △ (静止画特徴の変化) ◦ 公開 VidParse 一人称の手順解析 8.6fps(前段込み) ◦ ◦ △ ( 静止画特徴の変化) ◦ 公開 ReynoldsFlow 学習不要の動き表現 記載なし ◦ ◦ ◦ × READMEのみ 判定の記号 ◦:満たす △:条件付き・一部満たす ×:満たさない Confidential & Proprietary |
紹介 1/3 手順作業のミス検出 ESTANet: Efficient Online Error Detection in Procedural
Videos via Prediction Inconsistency Shih-Po Lee ほか(Honda Research Institute USA / Northeastern University) ECCV 2026 arXiv:2606.25317 Code: github.com/robert80203/ESTANet
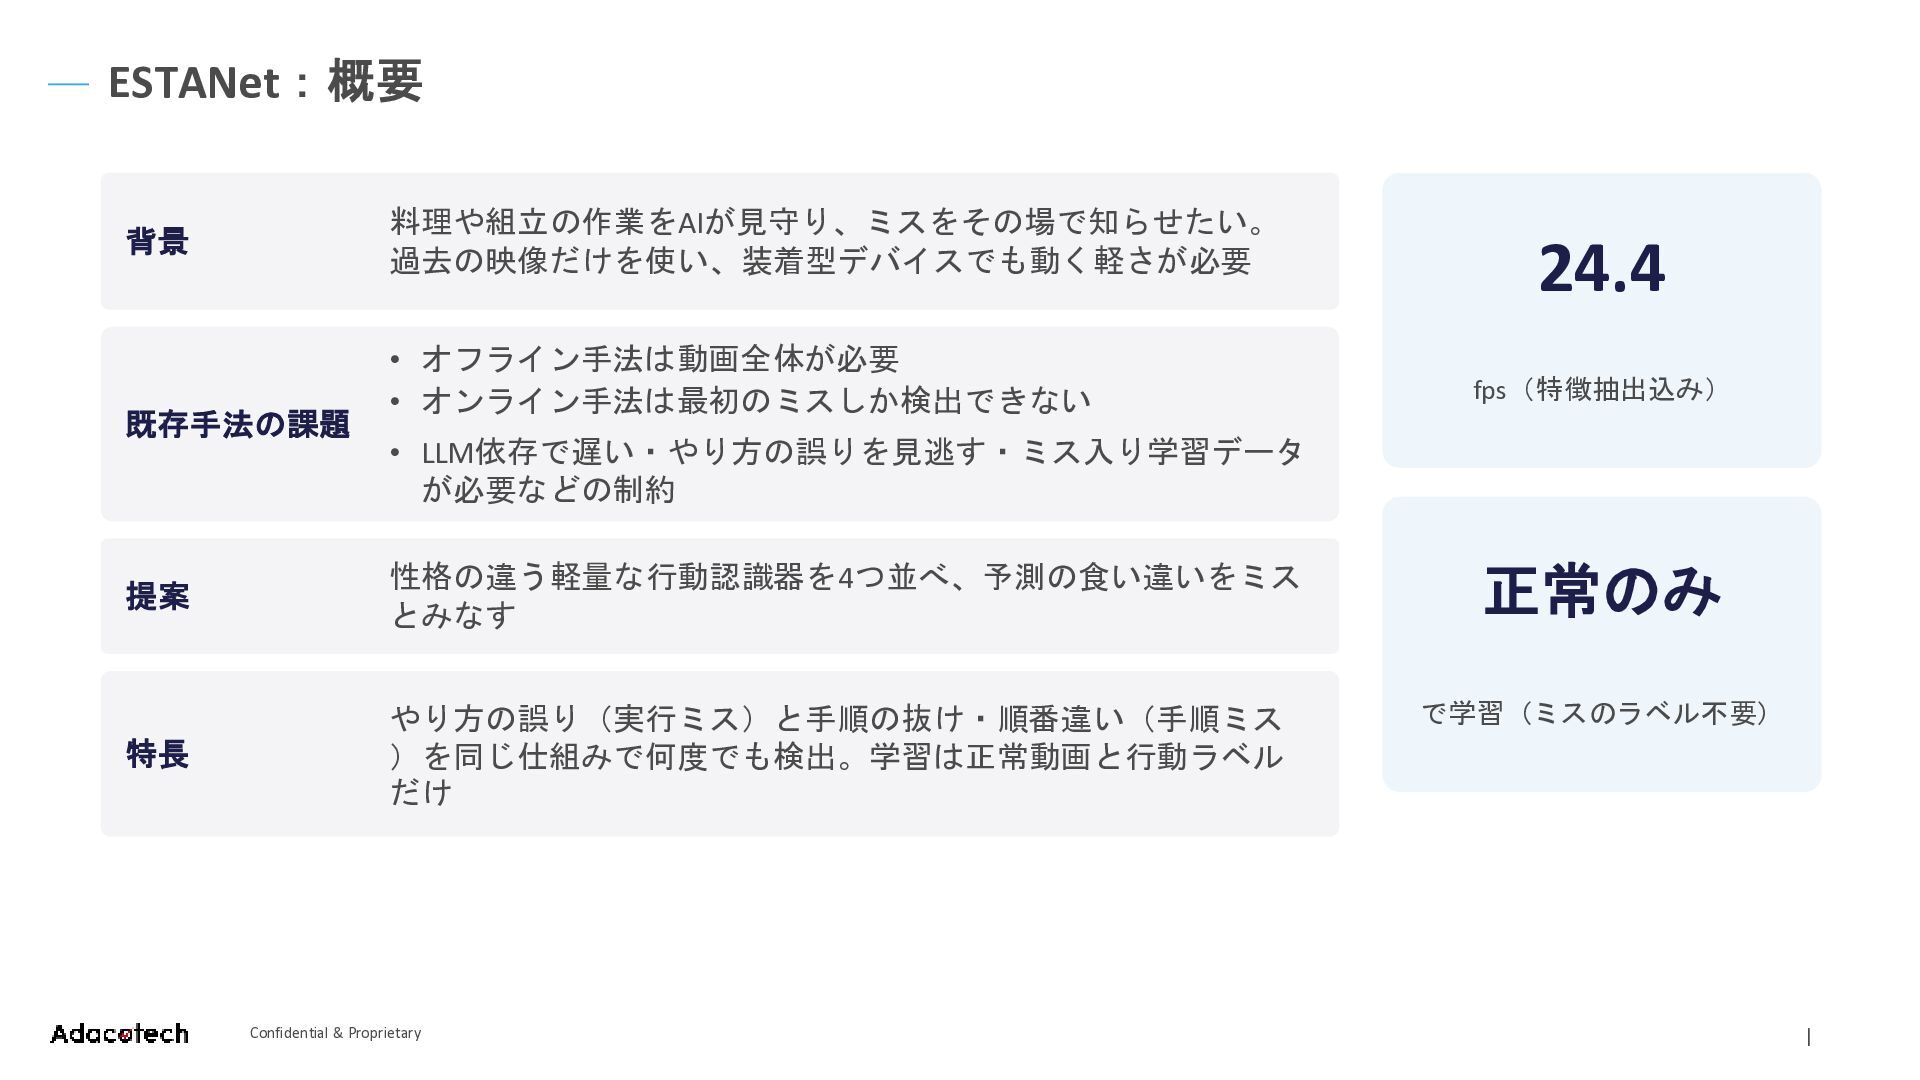
ESTANet:概要 料理や組立の作業をAIが見守り、ミスをその場で知らせたい。 過去の映像だけを使い、装着型デバイスでも動く軽さが必要 背景 既存手法の課題 • オフライン手法は動画全体が必要 • オンライン手法は最初のミスしか検出できない 24.4
fps(特徴抽出込み) • LLM依存で遅い・やり方の誤りを見逃す・ミス入り学習データ が必要などの制約 提案 性格の違う軽量な行動認識器を4つ並べ、予測の食い違いをミス とみなす 正常のみ で学習(ミスのラベル不要) 特長 やり方の誤り(実行ミス)と手順の抜け・順番違い(手順ミス )を同じ仕組みで何度でも検出。学習は正常動画と行動ラベル だけ Confidential & Proprietary |
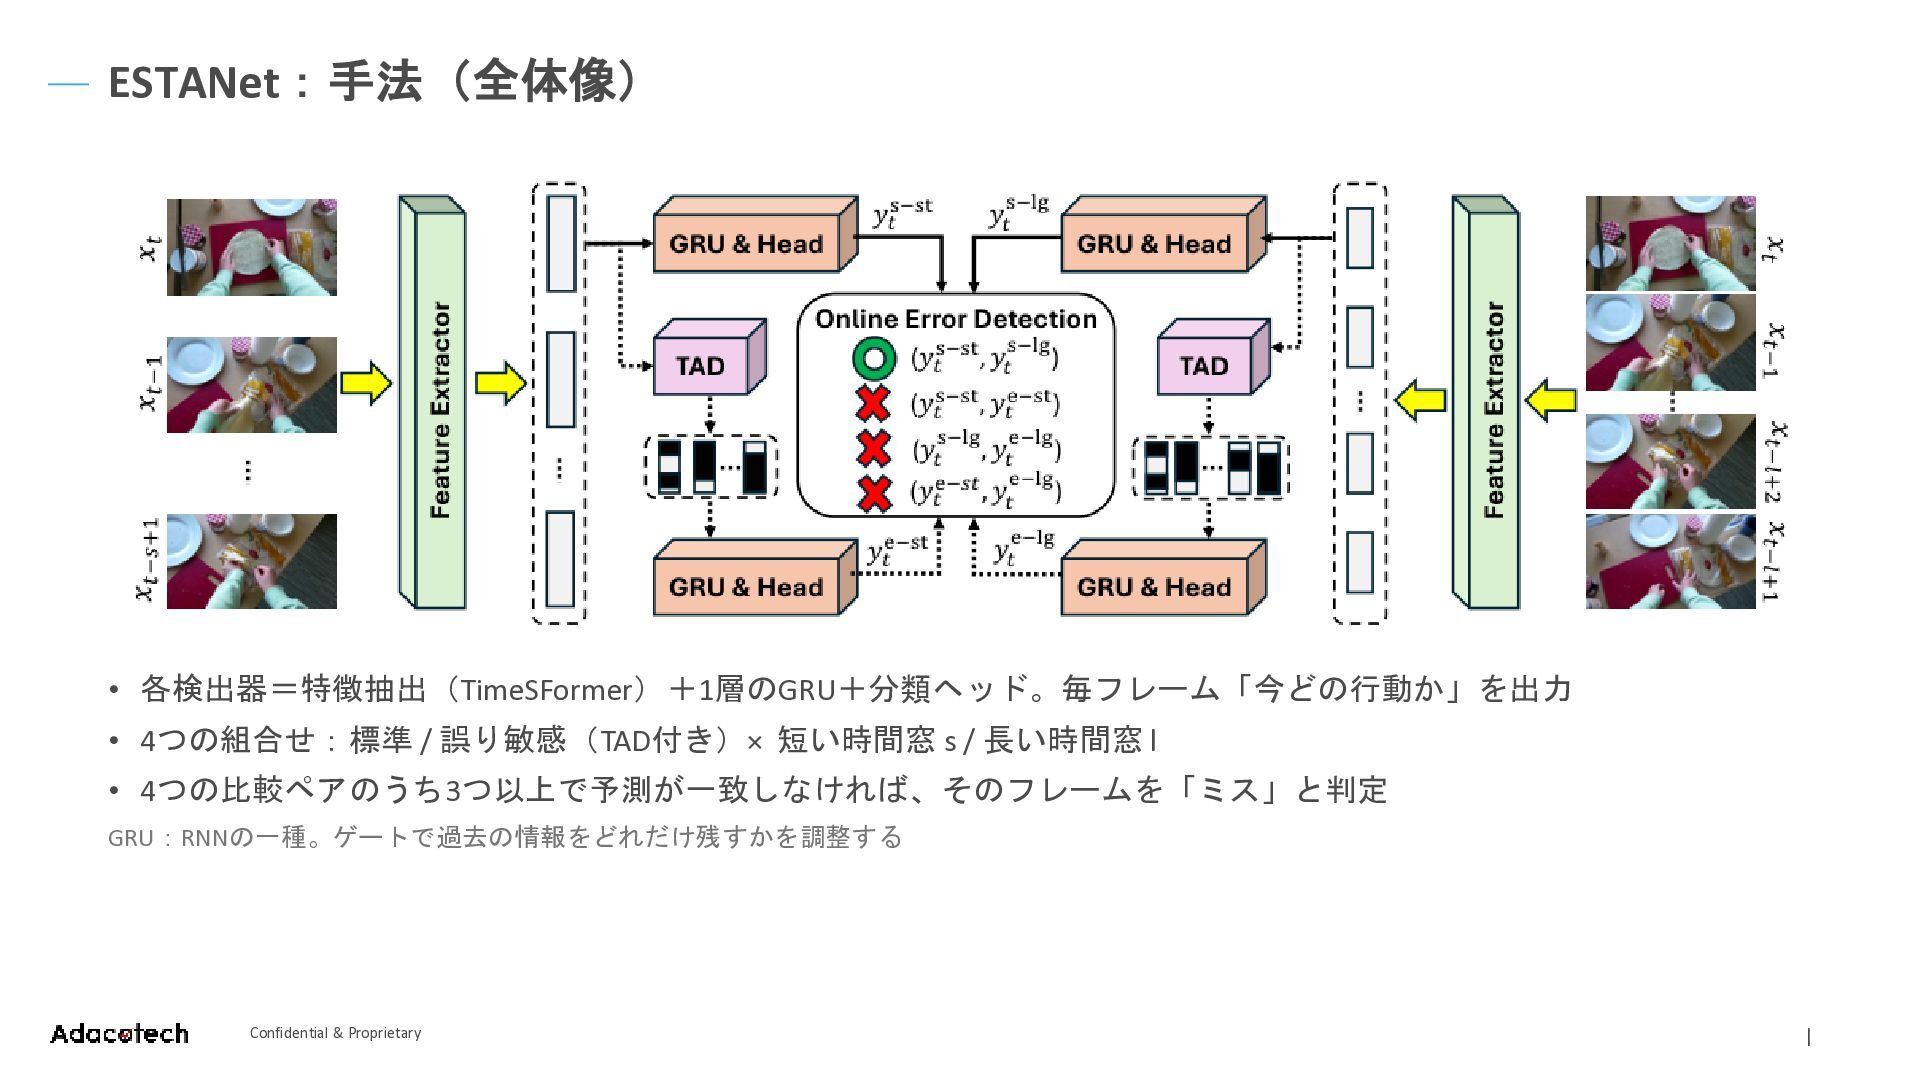
ESTANet:手法(全体像) • 各検出器=特徴抽出(TimeSFormer)+1層のGRU+分類ヘッド。毎フレーム「今どの行動か」を出力 • 4つの組合せ:標準 / 誤り敏感(TAD付き)× 短い時間窓 s /
長い時間窓 l • 4つの比較ペアのうち3つ以上で予測が一致しなければ、そのフレームを「ミス」と判定 GRU:RNNの一種。ゲートで過去の情報をどれだけ残すかを調整する Confidential & Proprietary |
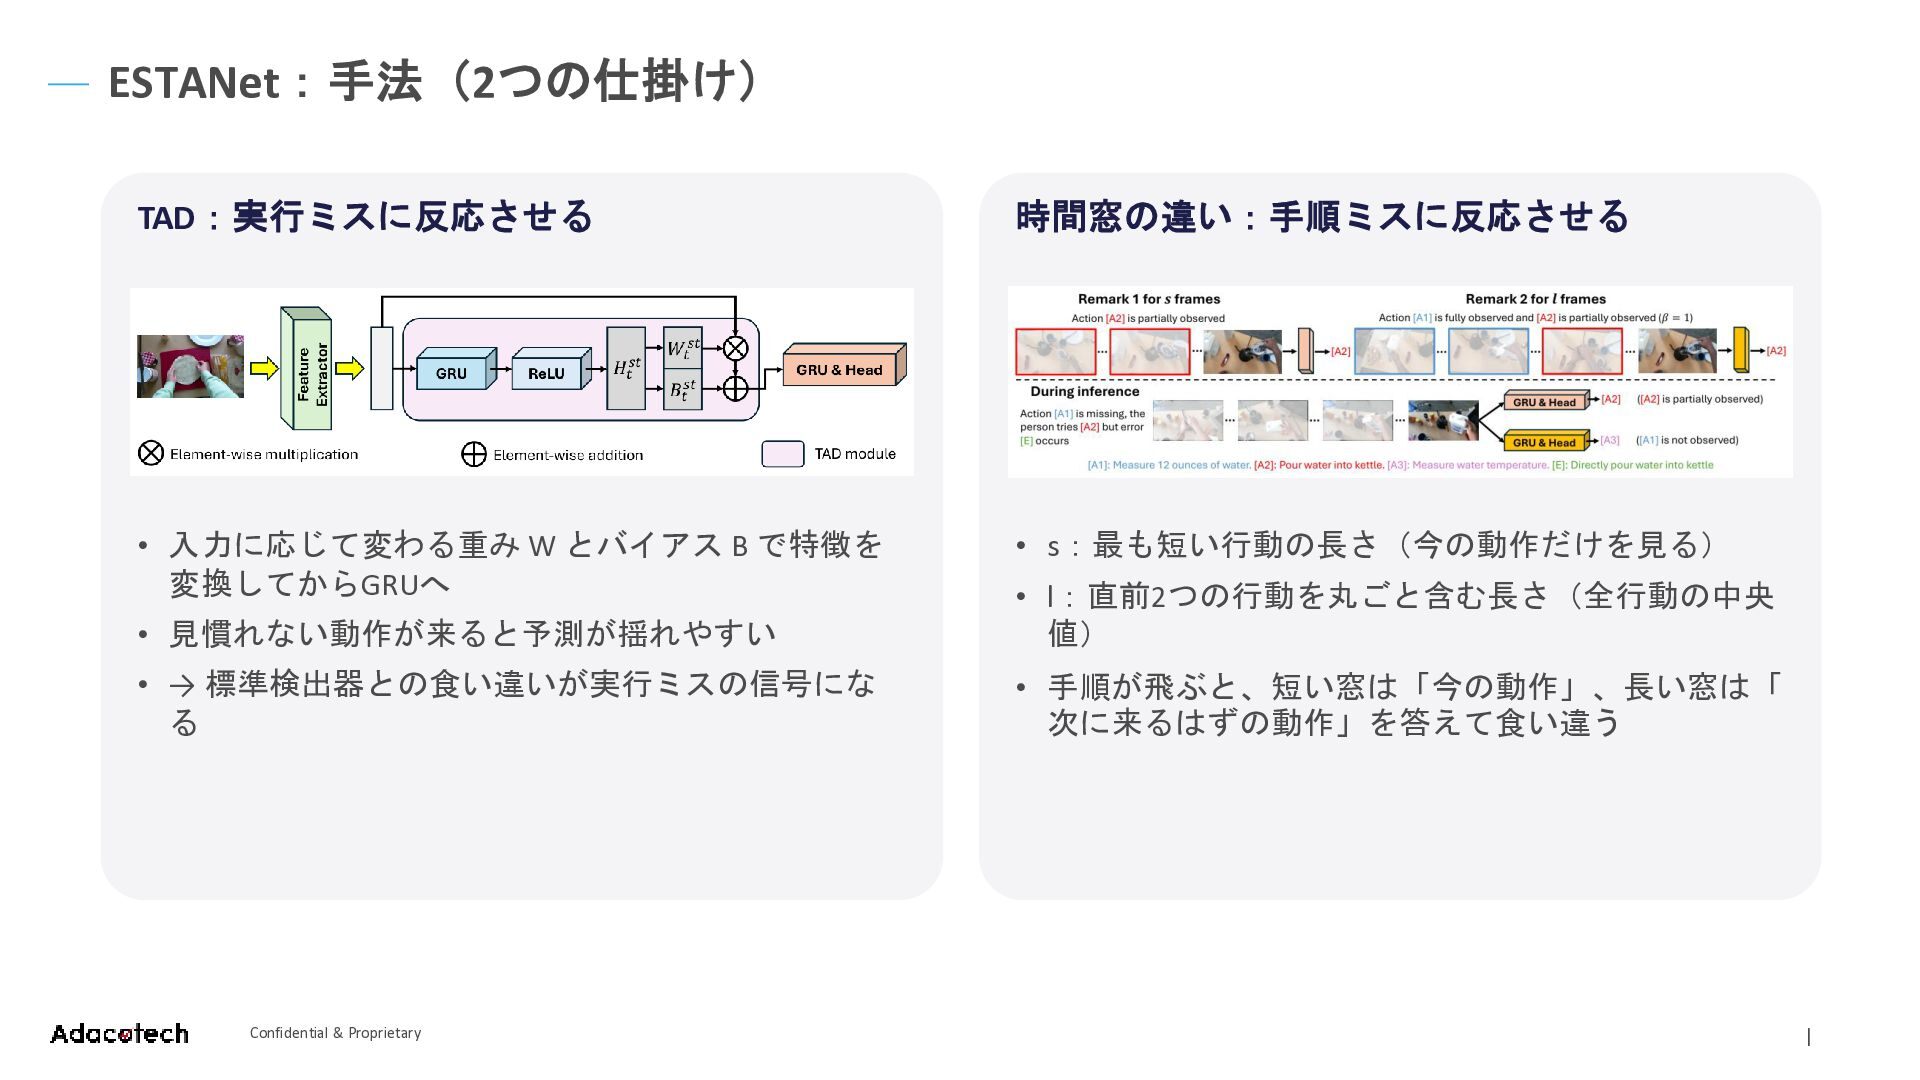
ESTANet:手法(2つの仕掛け) TAD:実行ミスに反応させる 時間窓の違い:手順ミスに反応させる • 入力に応じて変わる重み W とバイアス B で特徴を 変換してからGRUへ
• s:最も短い行動の長さ(今の動作だけを見る) • 見慣れない動作が来ると予測が揺れやすい • l:直前2つの行動を丸ごと含む長さ(全行動の中央 値) • → 標準検出器との食い違いが実行ミスの信号にな る • 手順が飛ぶと、短い窓は「今の動作」、長い窓は「 次に来るはずの動作」を答えて食い違う Confidential & Proprietary |
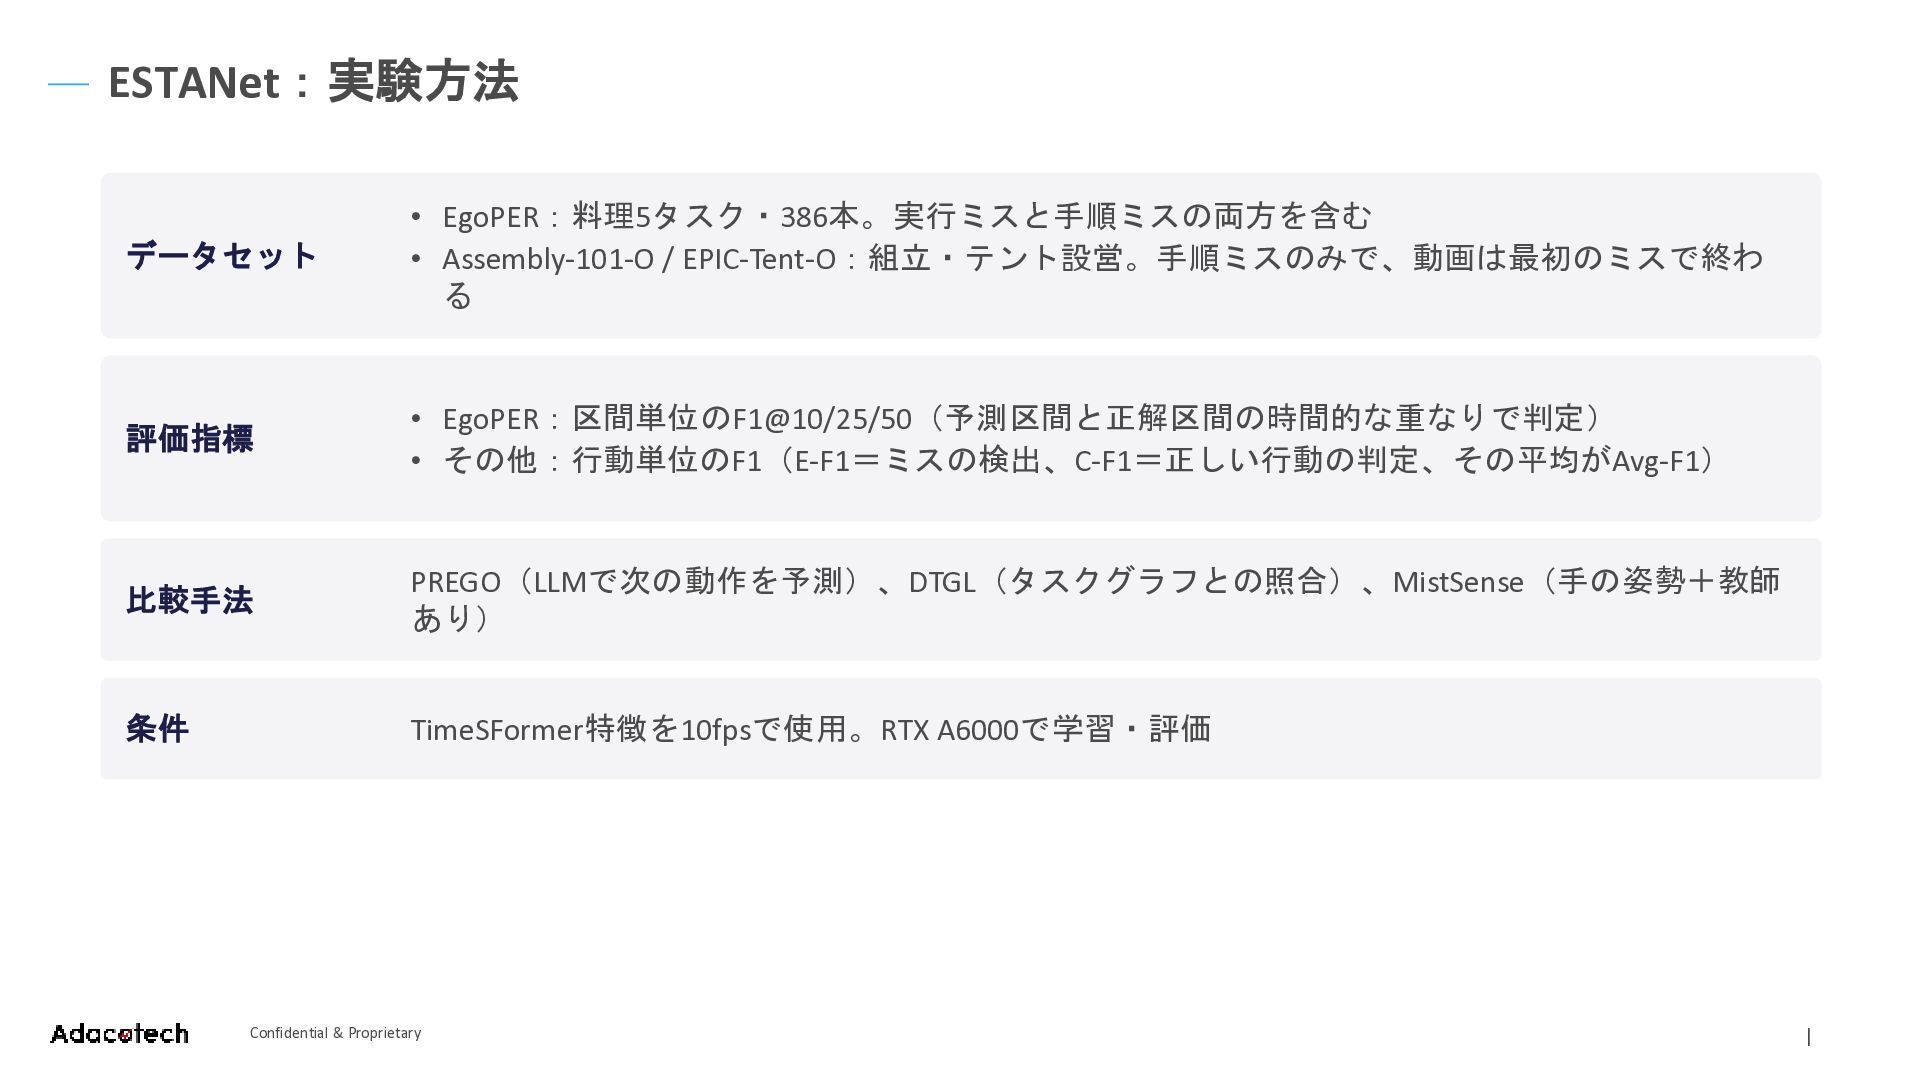
ESTANet:実験方法 データセット • EgoPER:料理5タスク・386本。実行ミスと手順ミスの両方を含む • Assembly-101-O / EPIC-Tent-O:組立・テント設営。手順ミスのみで、動画は最初のミスで終わ る 評価指標
• EgoPER:区間単位のF1@10/25/50(予測区間と正解区間の時間的な重なりで判定) • その他:行動単位のF1(E-F1=ミスの検出、C-F1=正しい行動の判定、その平均がAvg-F1) 比較手法 PREGO(LLMで次の動作を予測)、DTGL(タスクグラフとの照合)、MistSense(手の姿勢+教師 あり) 条件 TimeSFormer特徴を10fpsで使用。RTX A6000で学習・評価 Confidential & Proprietary |
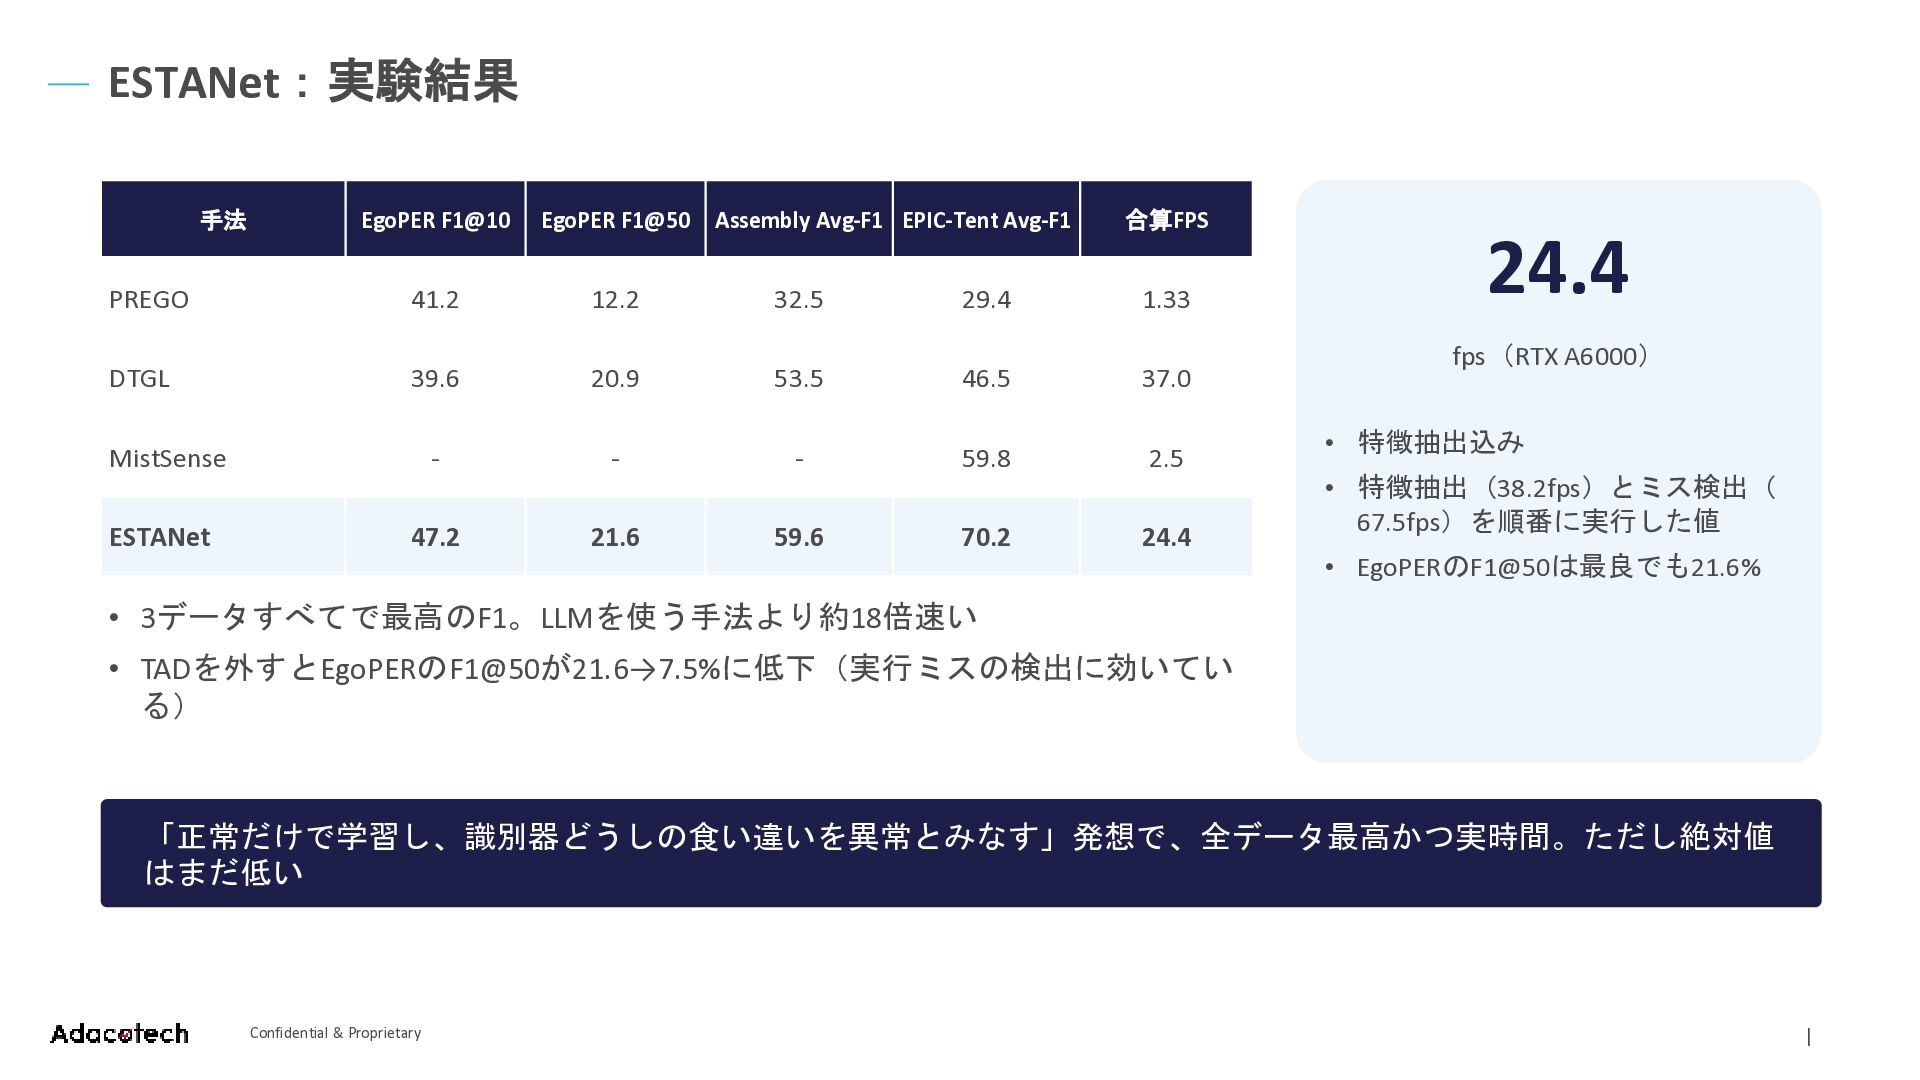
ESTANet:実験結果 手法 Assembly Avg-F1 EPIC-Tent Avg-F1 合算FPS EgoPER F1@10 EgoPER
F1@50 PREGO 41.2 12.2 32.5 29.4 1.33 DTGL 39.6 20.9 53.5 46.5 37.0 MistSense - - - 59.8 2.5 ESTANet 47.2 21.6 59.6 70.2 24.4 24.4 fps(RTX A6000) • 特徴抽出込み • 特徴抽出(38.2fps)とミス検出( 67.5fps)を順番に実行した値 • EgoPERのF1@50は最良でも21.6% • 3データすべてで最高のF1。LLMを使う手法より約18倍速い • TADを外すとEgoPERのF1@50が21.6→7.5%に低下(実行ミスの検出に効いてい る) 「正常だけで学習し、識別器どうしの食い違いを異常とみなす」発想で、全データ最高かつ実時間。ただし絶対値 はまだ低い Confidential & Proprietary |
紹介 2/3 オンラインの行動区間検出 OnPoint: Offline-to-Online Multi-Level Distillation for PointSupervised Online
Temporal Action Localization Sakib Reza ほか(Northeastern University / Dolby Laboratories / Georgia Tech) ECCV 2026 arXiv:2607.00289 Code: NDAのため非公開(プロジェクトページに再実装ガイドあり)
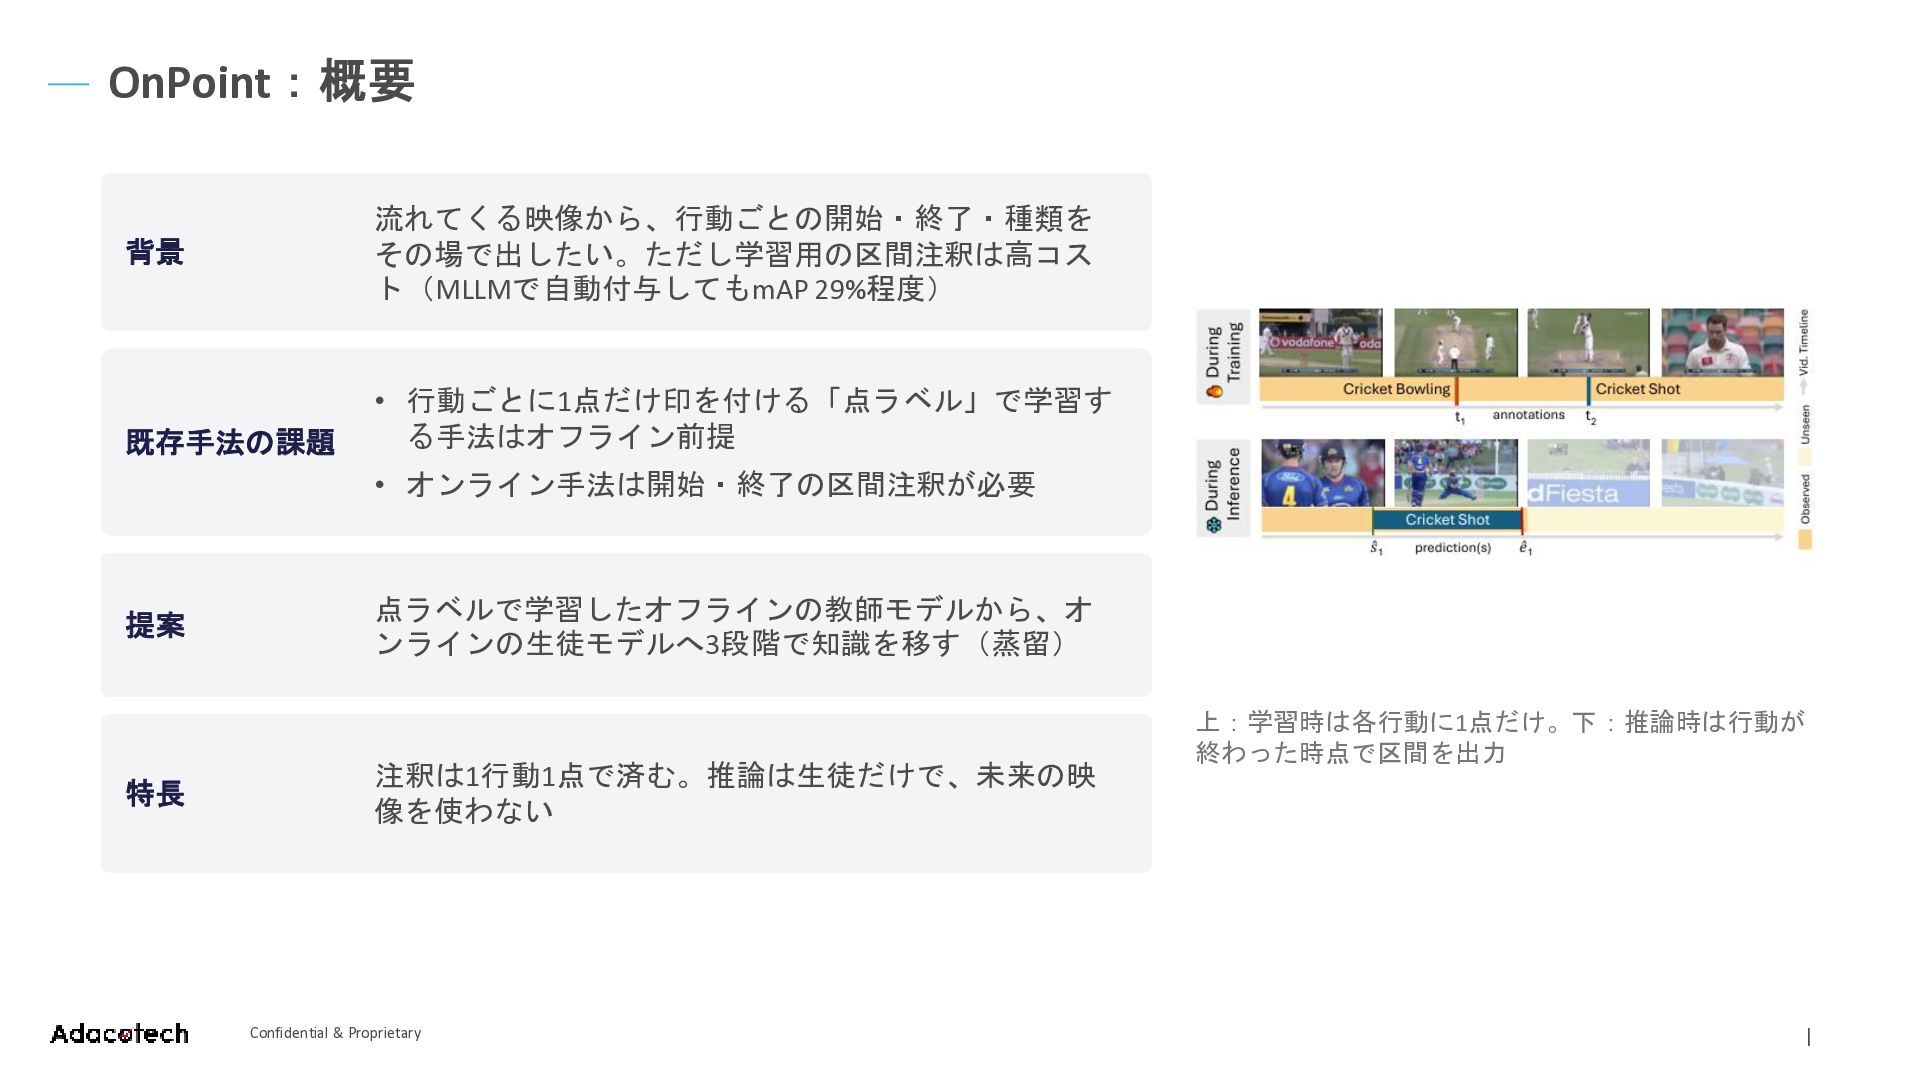
OnPoint:概要 流れてくる映像から、行動ごとの開始・終了・種類を その場で出したい。ただし学習用の区間注釈は高コス ト(MLLMで自動付与してもmAP 29%程度) 背景 既存手法の課題 • 行動ごとに1点だけ印を付ける「点ラベル」で学習す る手法はオフライン前提
• オンライン手法は開始・終了の区間注釈が必要 提案 特長 点ラベルで学習したオフラインの教師モデルから、オ ンラインの生徒モデルへ3段階で知識を移す(蒸留) 注釈は1行動1点で済む。推論は生徒だけで、未来の映 像を使わない Confidential & Proprietary 上:学習時は各行動に1点だけ。下:推論時は行動が 終わった時点で区間を出力 |
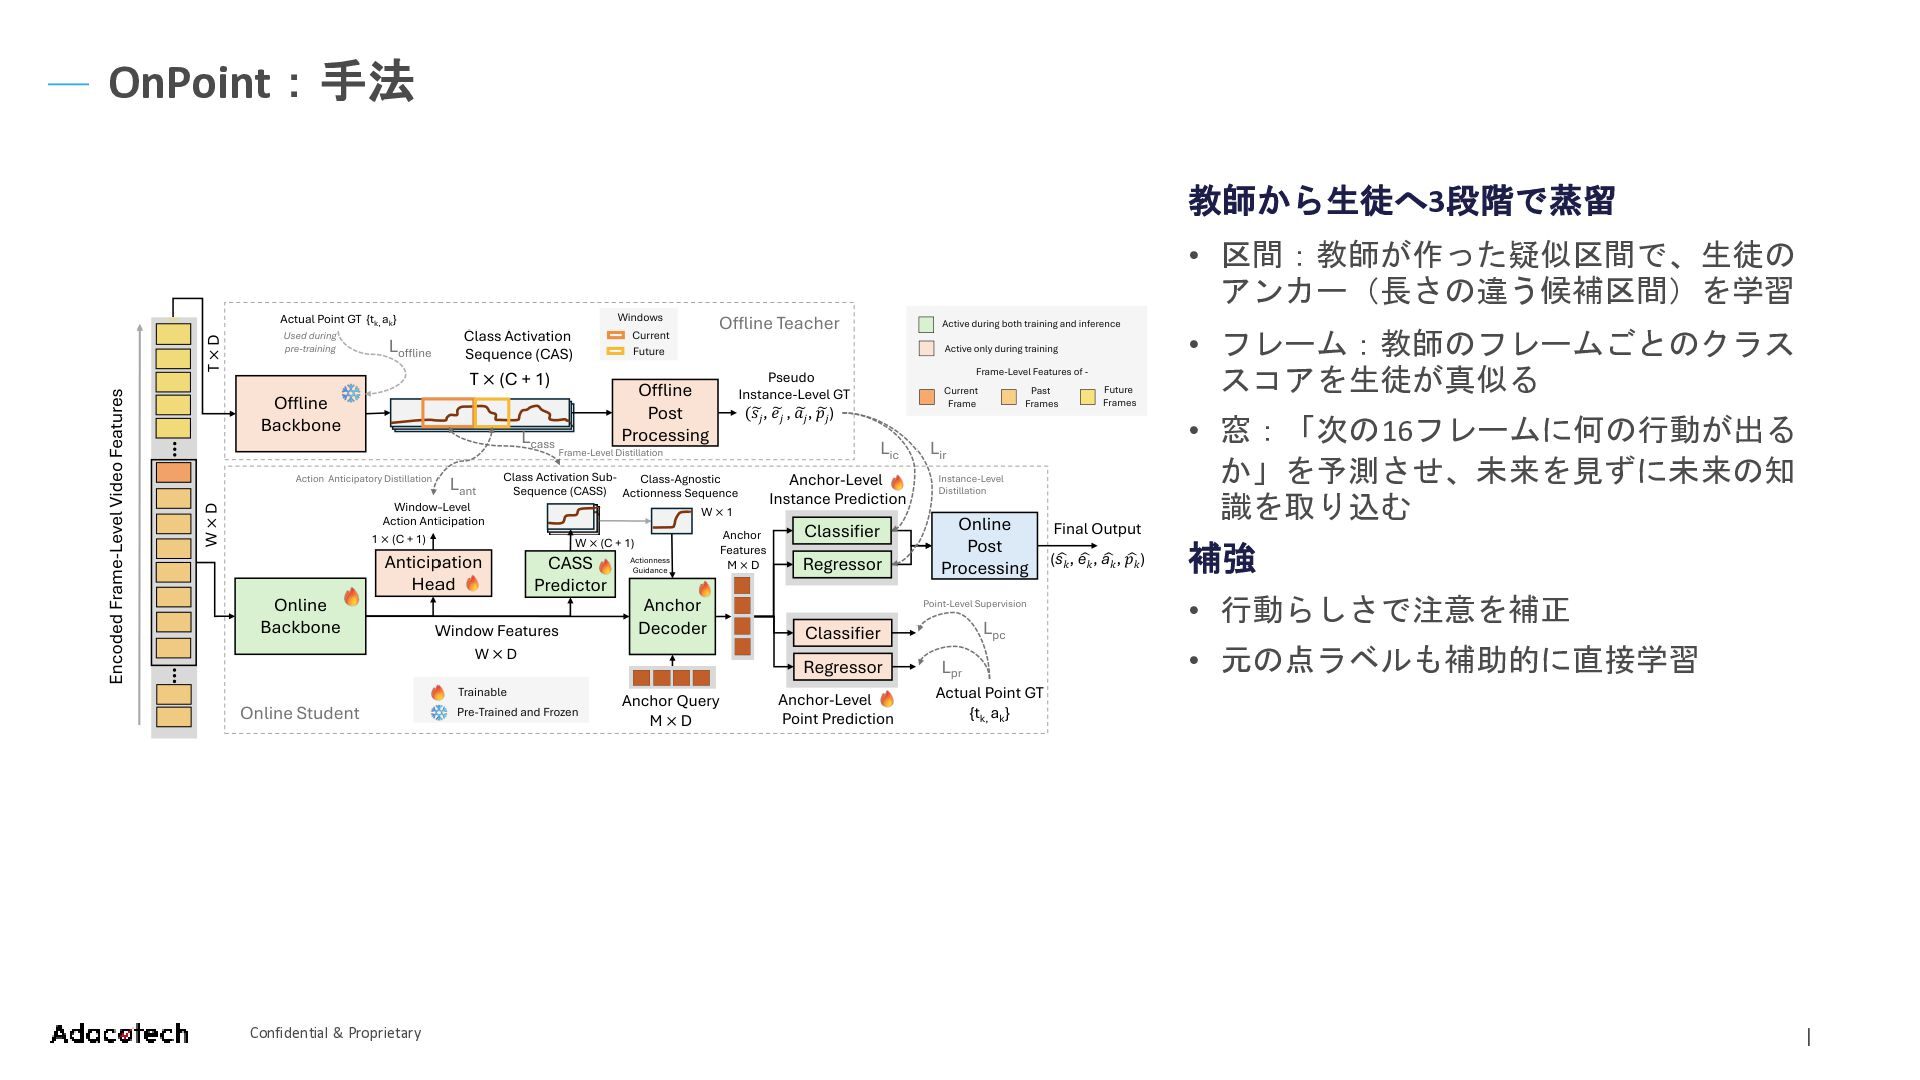
OnPoint:手法 教師から生徒へ3段階で蒸留 • 区間:教師が作った疑似区間で、生徒の アンカー(長さの違う候補区間)を学習 • フレーム:教師のフレームごとのクラス スコアを生徒が真似る • 窓:「次の16フレームに何の行動が出る
か」を予測させ、未来を見ずに未来の知 識を取り込む 補強 • 行動らしさで注意を補正 • 元の点ラベルも補助的に直接学習 Confidential & Proprietary |
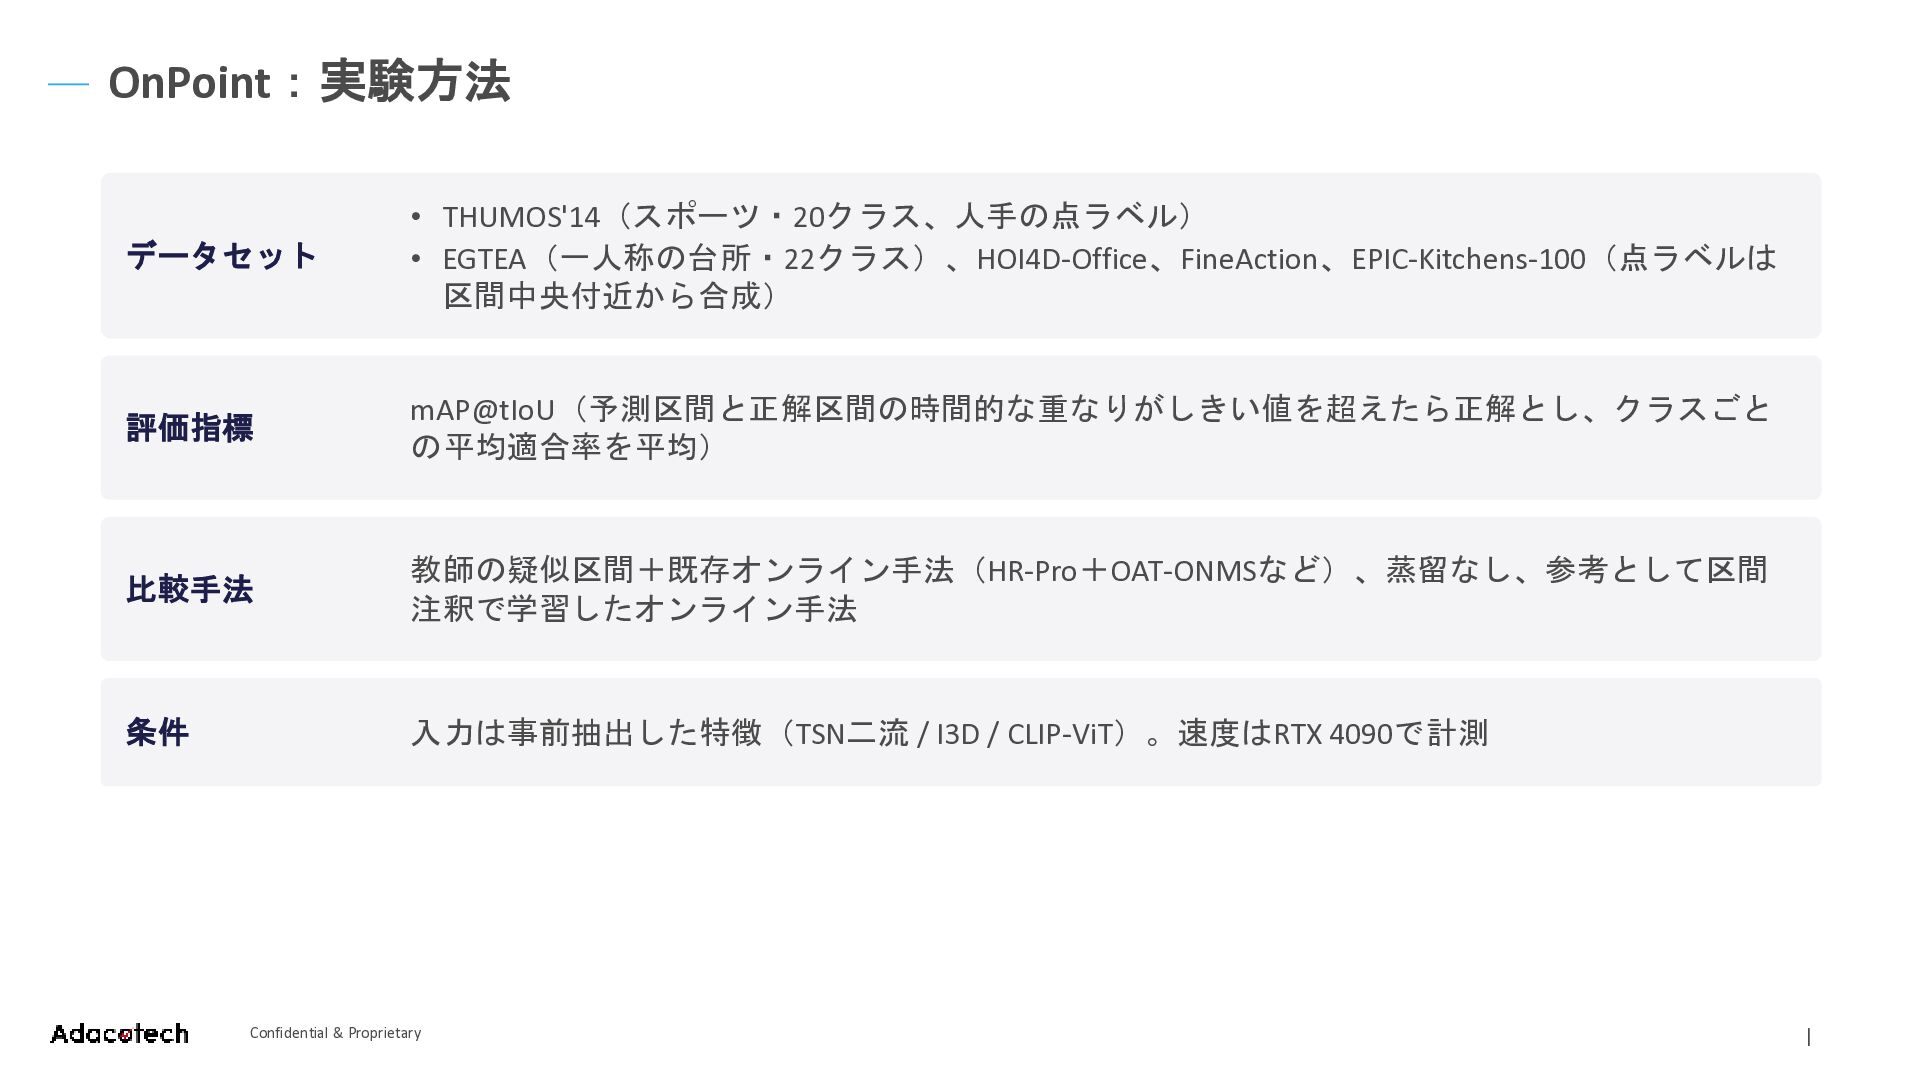
OnPoint:実験方法 データセット • THUMOS'14(スポーツ・20クラス、人手の点ラベル) • EGTEA(一人称の台所・22クラス)、HOI4D-Office、FineAction、EPIC-Kitchens-100(点ラベルは 区間中央付近から合成) 評価指標 mAP@tIoU(予測区間と正解区間の時間的な重なりがしきい値を超えたら正解とし、クラスごと の平均適合率を平均)
比較手法 教師の疑似区間+既存オンライン手法(HR-Pro+OAT-ONMSなど)、蒸留なし、参考として区間 注釈で学習したオンライン手法 条件 入力は事前抽出した特徴(TSN二流 / I3D / CLIP-ViT)。速度はRTX 4090で計測 Confidential & Proprietary |
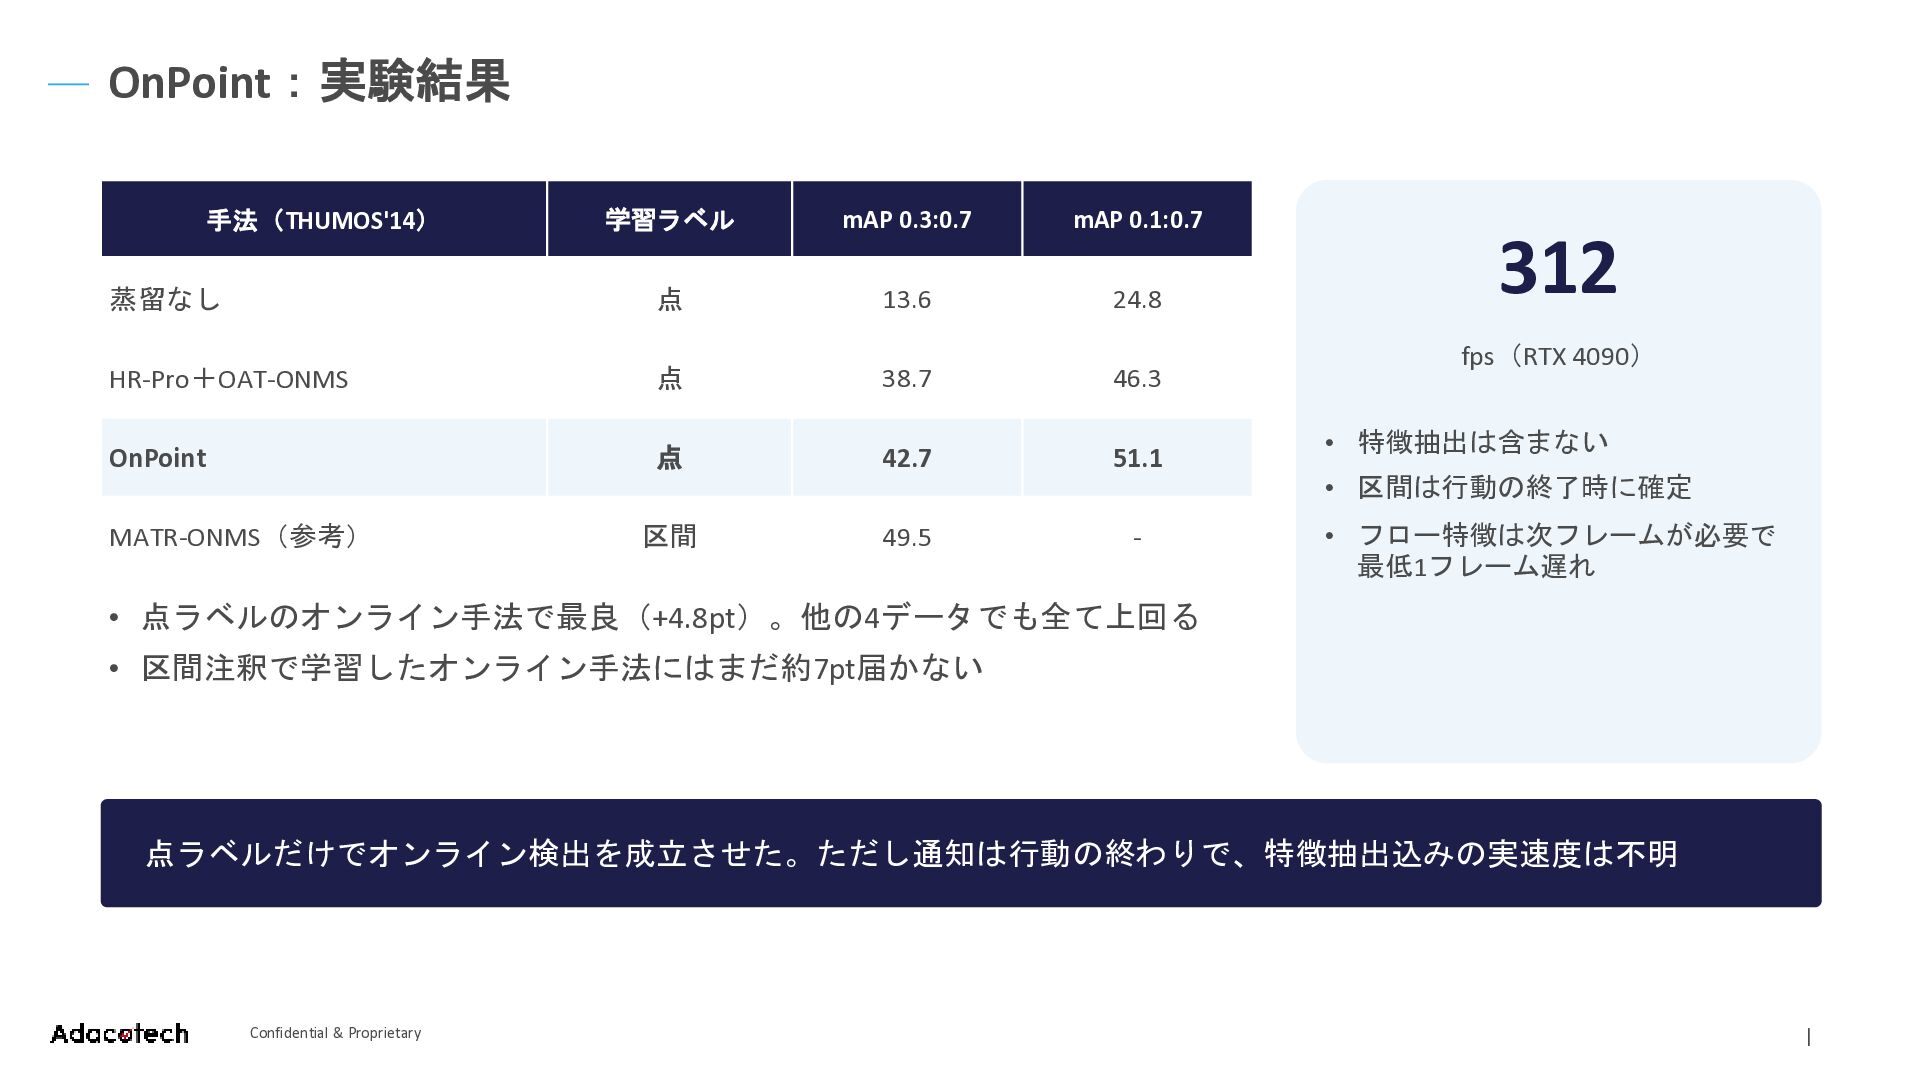
OnPoint:実験結果 手法(THUMOS'14) 学習ラベル mAP 0.3:0.7 mAP 0.1:0.7 蒸留なし 点 13.6
24.8 HR-Pro+OAT-ONMS 点 38.7 46.3 OnPoint 点 42.7 51.1 MATR-ONMS(参考) 区間 49.5 - 312 fps(RTX 4090) • 特徴抽出は含まない • 区間は行動の終了時に確定 • フロー特徴は次フレームが必要で 最低1フレーム遅れ • 点ラベルのオンライン手法で最良(+4.8pt)。他の4データでも全て上回る • 区間注釈で学習したオンライン手法にはまだ約7pt届かない 点ラベルだけでオンライン検出を成立させた。ただし通知は行動の終わりで、特徴抽出込みの実速度は不明 Confidential & Proprietary |
紹介 3/3 監視映像の異常検知と説明 ReactVAU: A Slow-Fast Decoupled Framework for Streaming
Video Anomaly Understanding Chia-Hui Chen ほか(National Tsing Hua University / NVIDIA) ECCV 2026 arXiv:2609.07941 Code: github.com/huiyuiui/ReactVAU-code(NVIDIA非商用ライセンス)
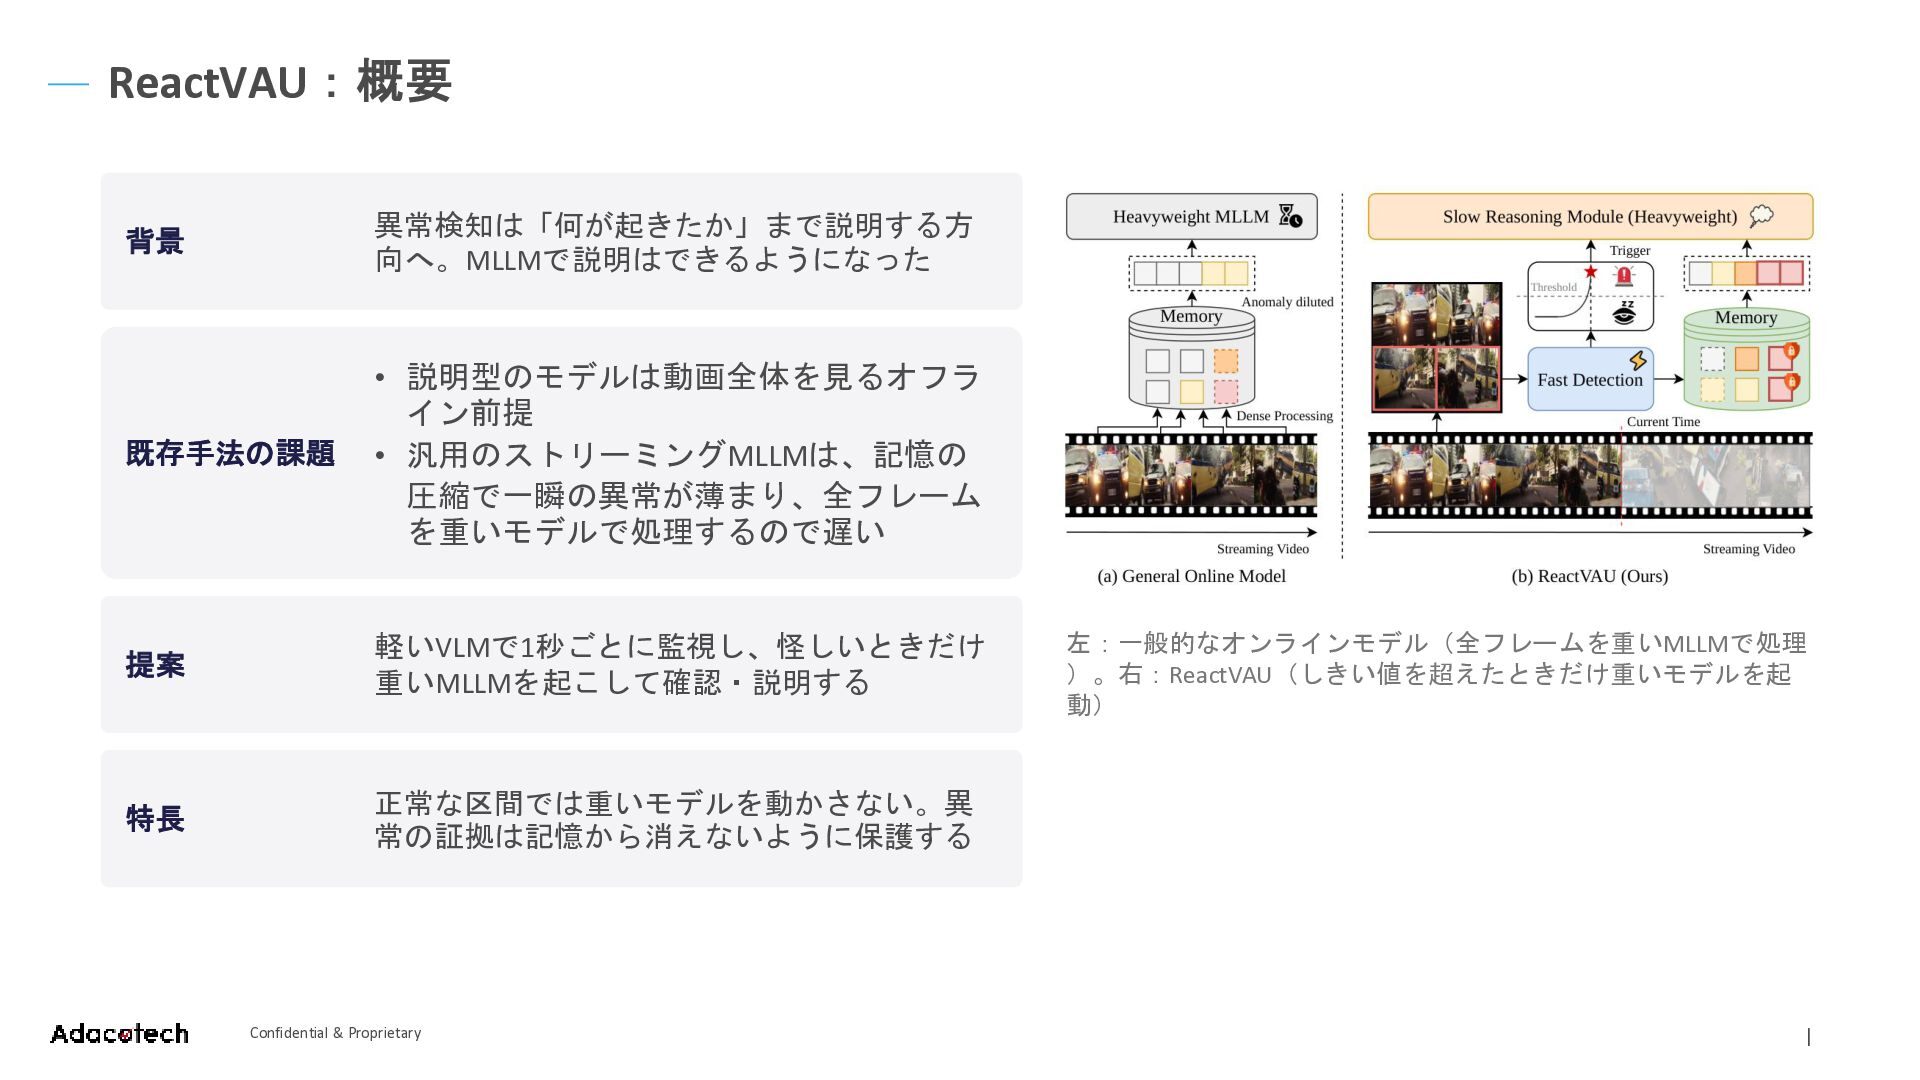
ReactVAU:概要 背景 異常検知は「何が起きたか」まで説明する方 向へ。MLLMで説明はできるようになった 既存手法の課題 • 説明型のモデルは動画全体を見るオフラ イン前提 • 汎用のストリーミングMLLMは、記憶の
圧縮で一瞬の異常が薄まり、全フレーム を重いモデルで処理するので遅い 提案 軽いVLMで1秒ごとに監視し、怪しいときだけ 重いMLLMを起こして確認・説明する 特長 正常な区間では重いモデルを動かさない。異 常の証拠は記憶から消えないように保護する Confidential & Proprietary 左:一般的なオンラインモデル(全フレームを重いMLLMで処理 )。右:ReactVAU(しきい値を超えたときだけ重いモデルを起 動) |
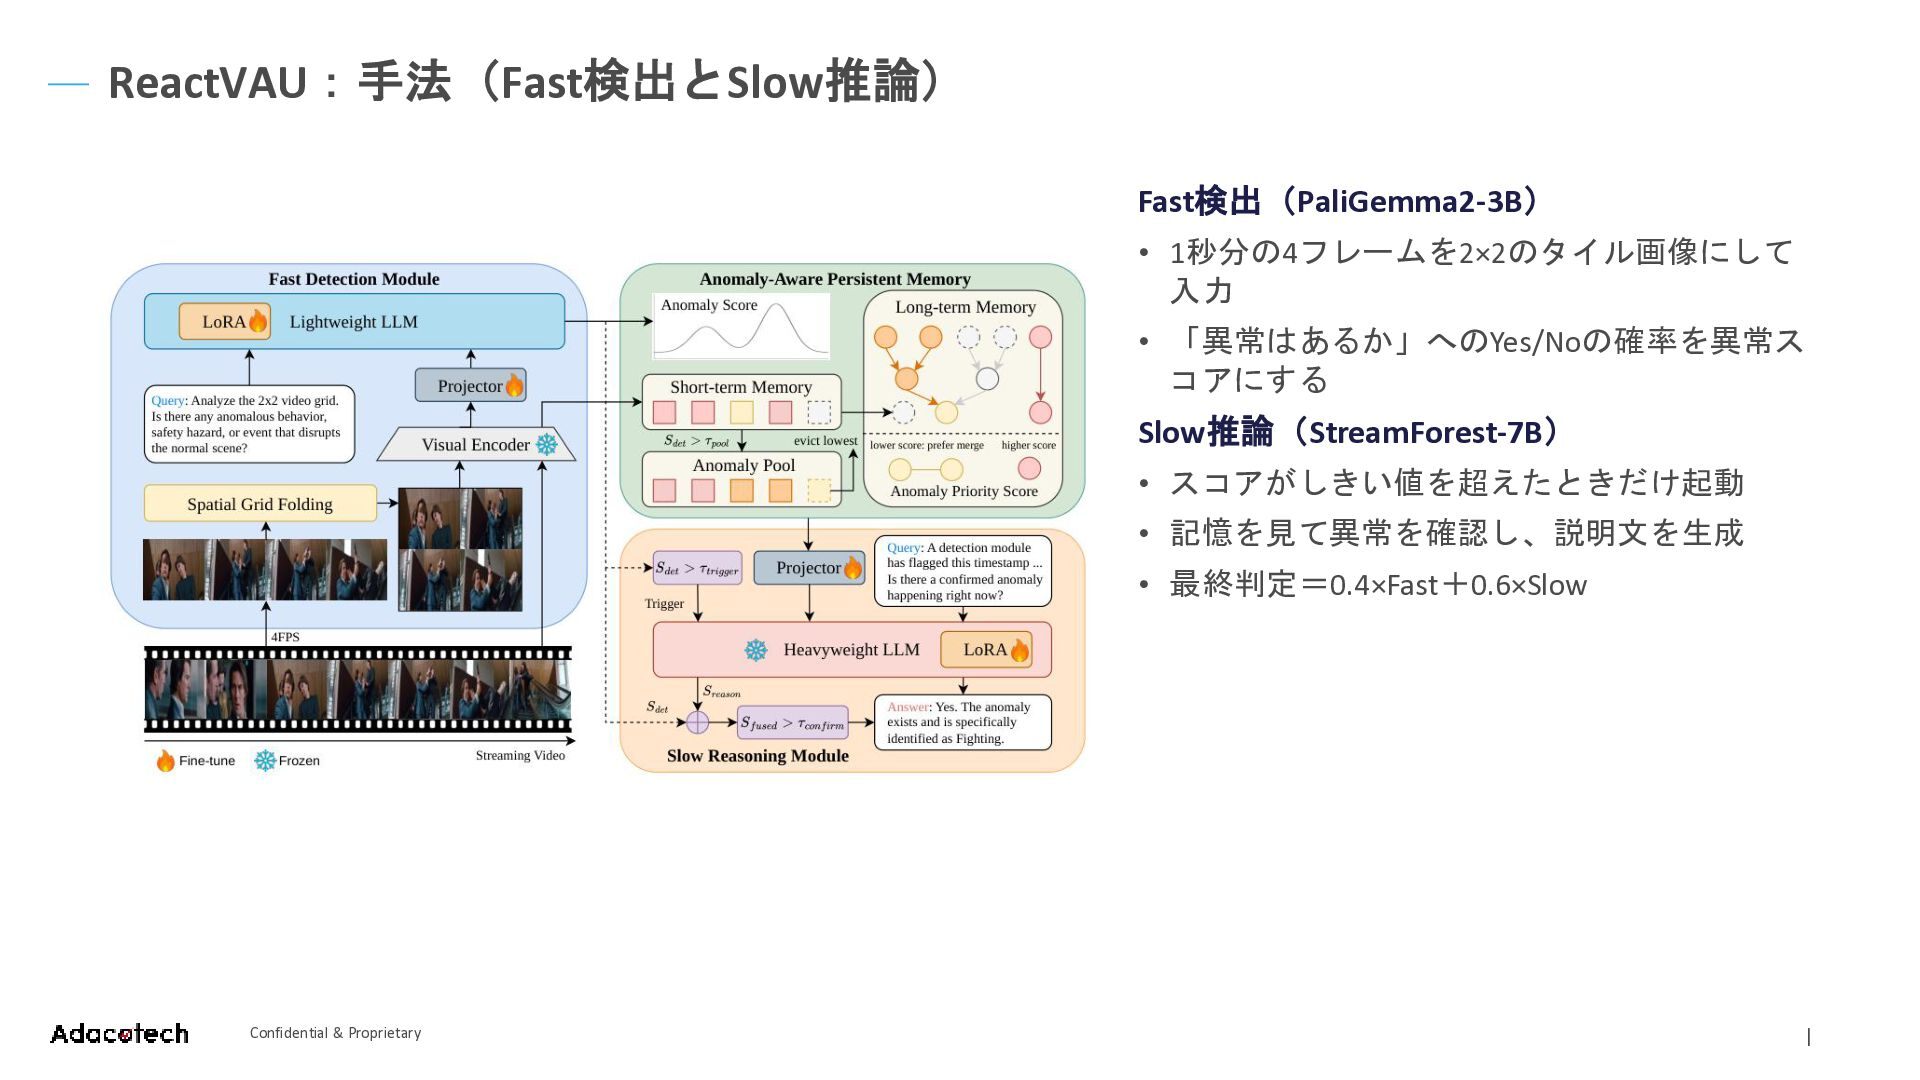
ReactVAU:手法(Fast検出とSlow推論) Fast検出(PaliGemma2-3B) • 1秒分の4フレームを2×2のタイル画像にして 入力 • 「異常はあるか」へのYes/Noの確率を異常ス コアにする Slow推論(StreamForest-7B) •
スコアがしきい値を超えたときだけ起動 • 記憶を見て異常を確認し、説明文を生成 • 最終判定=0.4×Fast+0.6×Slow Confidential & Proprietary |
ReactVAU:手法(異常を忘れない記憶 AAPM) 1 異常優先度スコア 長期記憶で、異常スコアの高い 区間ほど統合・圧縮されにくく する 2 異常プール 怪しいフレームを最大8枚、細部
を残したまま保持する 3 動的な密サンプリング 正常時は1秒に1フレームだけ記 憶を更新。怪しいときは4フレー ムすべてを取り込む ポイント • 重いモデルが休んでいる間も、視覚エンコーダとFast検出は常に動き、記憶を更新し続ける • Slowの起動判定は1秒単位。しきい値を超えている間は毎秒起動していると読める(本文に抑制の記述なし) Confidential & Proprietary |
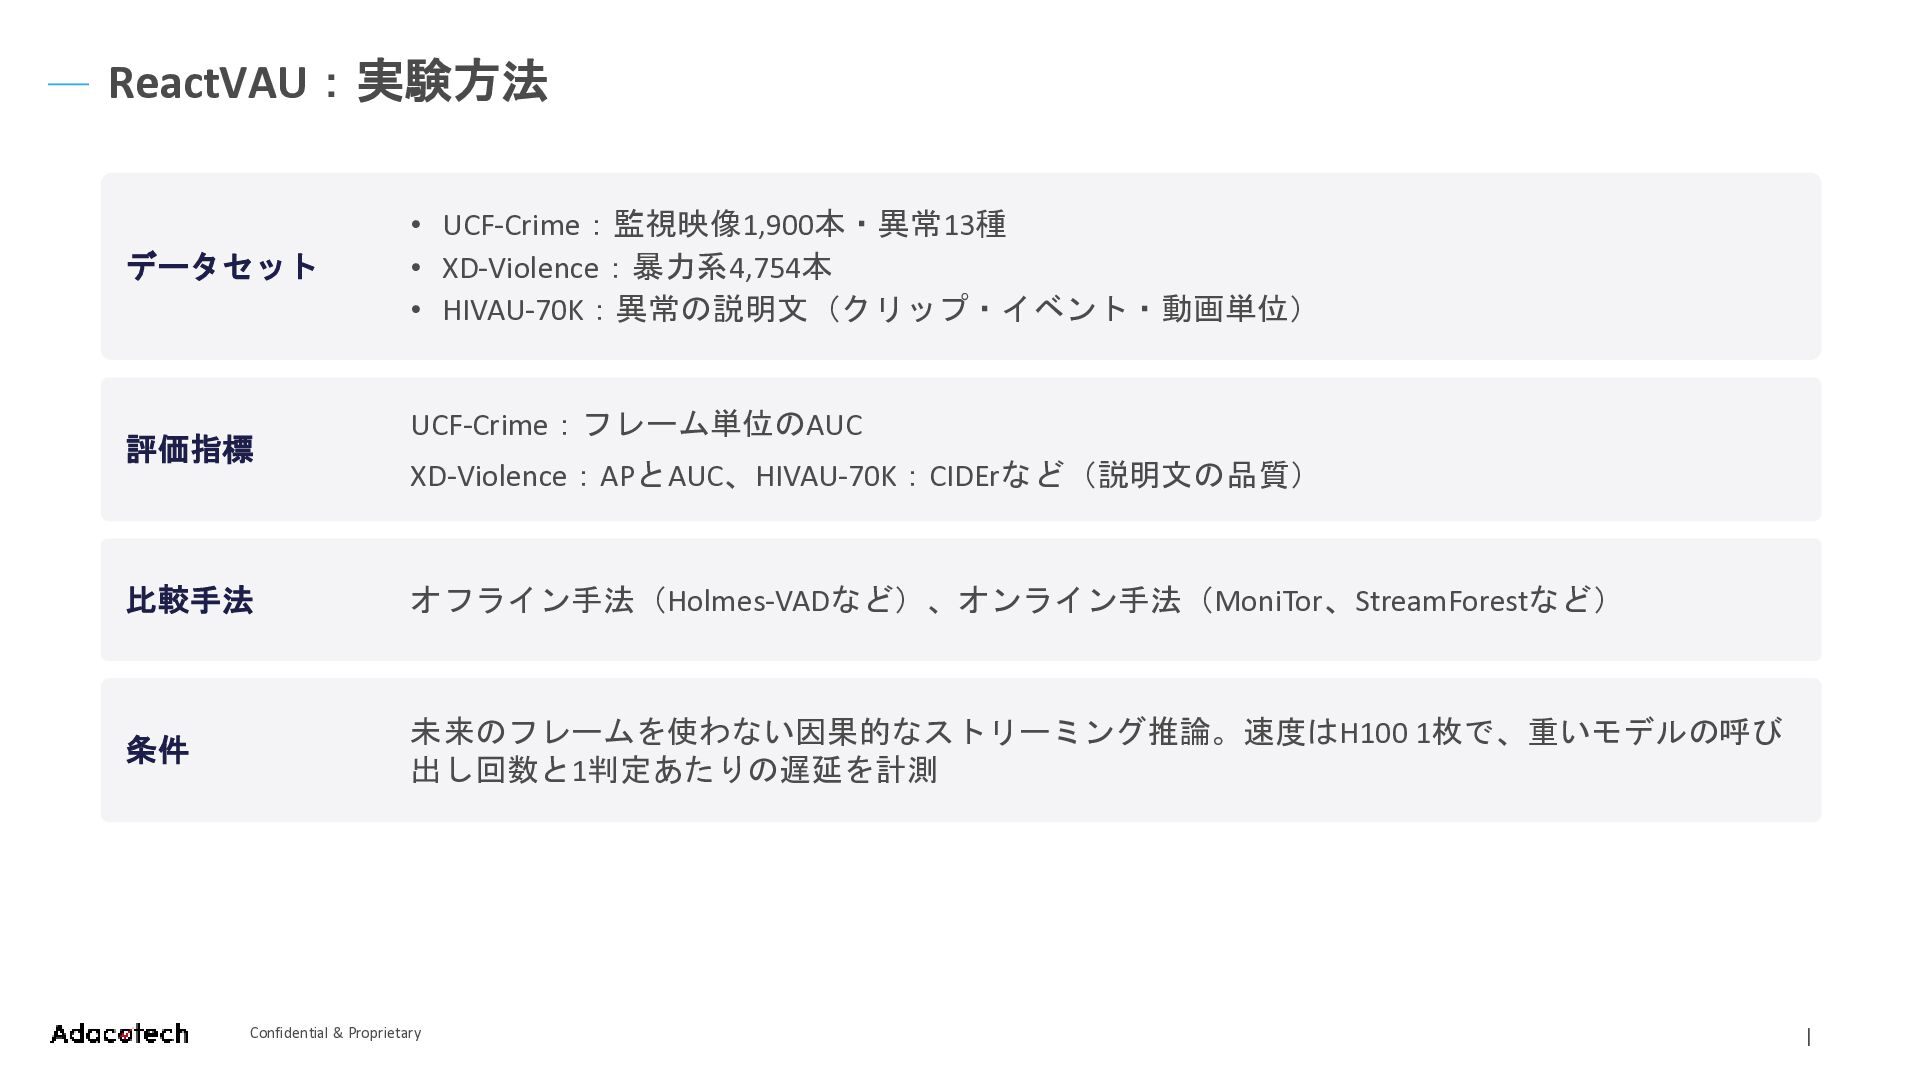
ReactVAU:実験方法 データセット 評価指標 • UCF-Crime:監視映像1,900本・異常13種 • XD-Violence:暴力系4,754本 • HIVAU-70K:異常の説明文(クリップ・イベント・動画単位) UCF-Crime:フレーム単位のAUC
XD-Violence:APとAUC、HIVAU-70K:CIDErなど(説明文の品質) 比較手法 オフライン手法(Holmes-VADなど)、オンライン手法(MoniTor、StreamForestなど) 条件 未来のフレームを使わない因果的なストリーミング推論。速度はH100 1枚で、重いモデルの呼び 出し回数と1判定あたりの遅延を計測 Confidential & Proprietary |
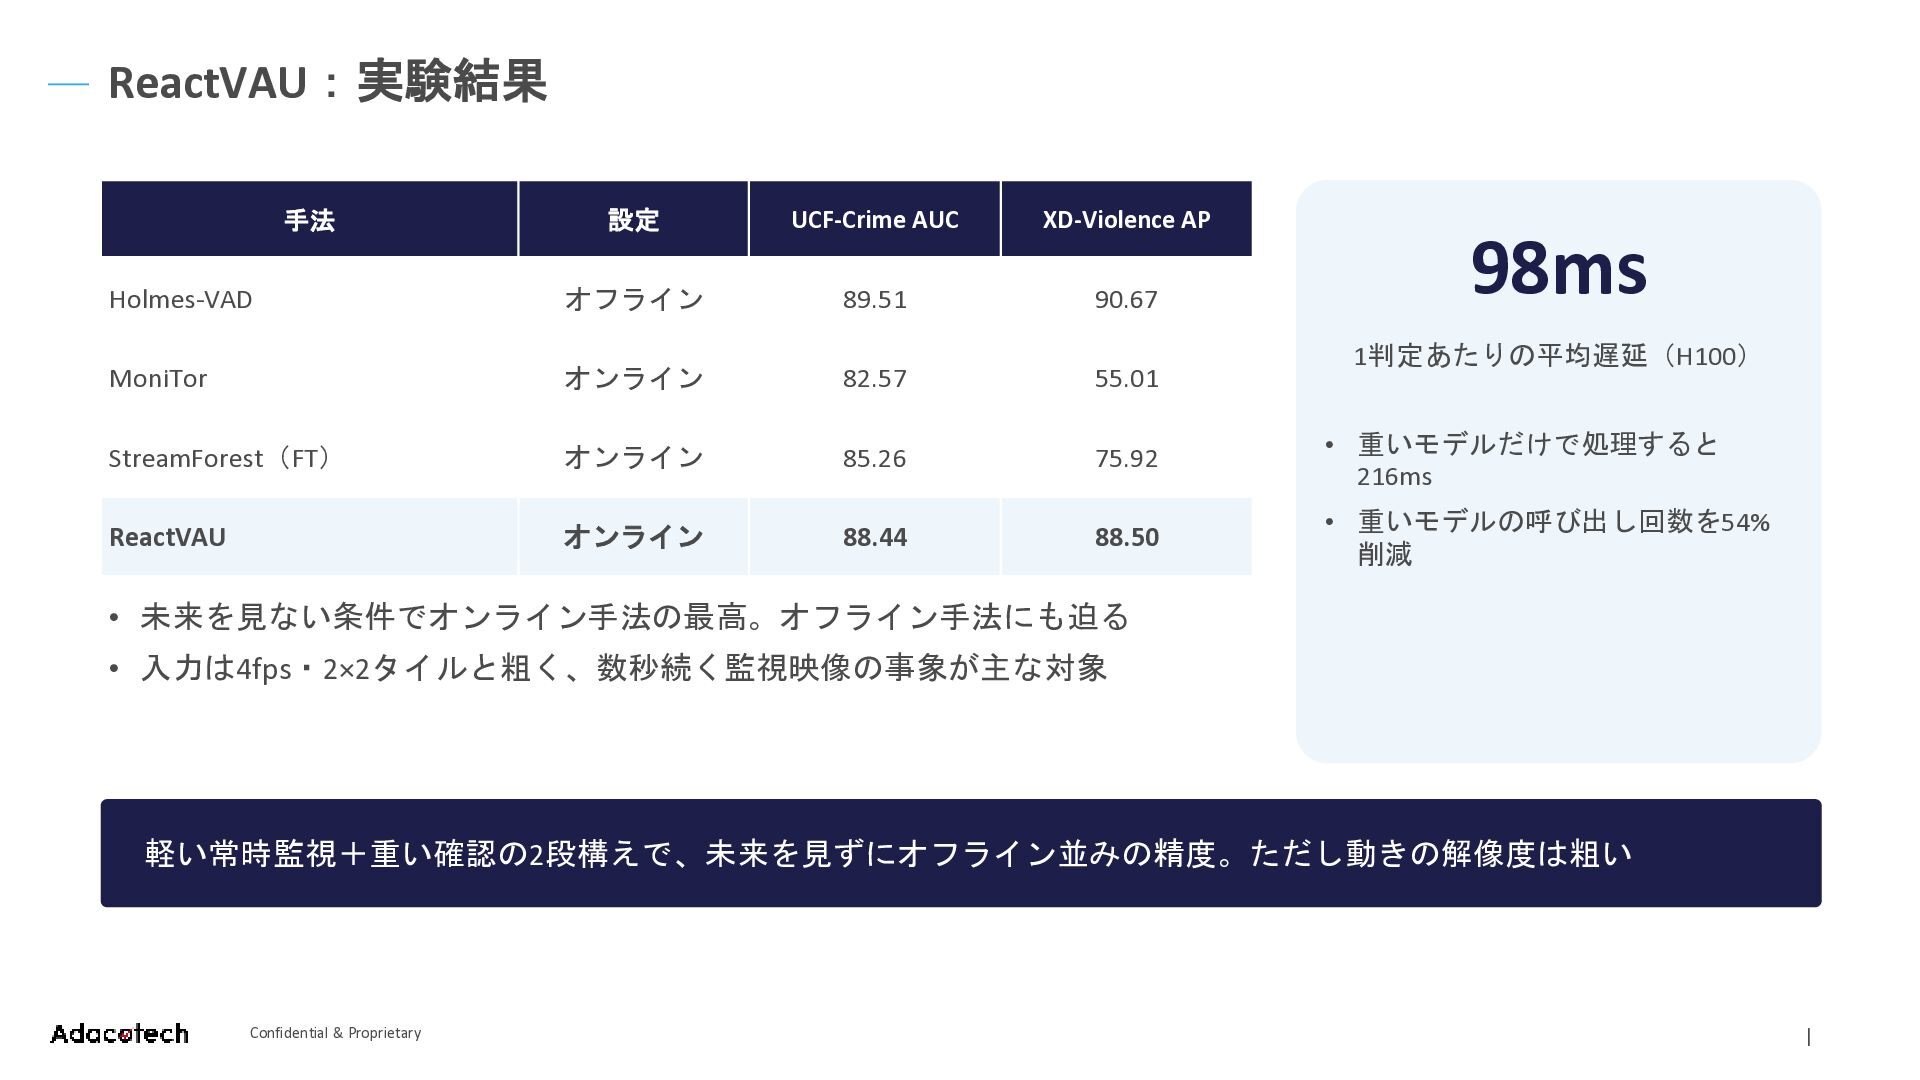
ReactVAU:実験結果 手法 設定 UCF-Crime AUC XD-Violence AP Holmes-VAD オフライン 89.51
90.67 MoniTor オンライン 82.57 55.01 StreamForest(FT) オンライン 85.26 75.92 • 重いモデルだけで処理すると 216ms ReactVAU オンライン 88.44 88.50 • 重いモデルの呼び出し回数を54% 削減 98ms 1判定あたりの平均遅延(H100) • 未来を見ない条件でオンライン手法の最高。オフライン手法にも迫る • 入力は4fps・2×2タイルと粗く、数秒続く監視映像の事象が主な対象 軽い常時監視+重い確認の2段構えで、未来を見ずにオフライン並みの精度。ただし動きの解像度は粗い Confidential & Proprietary |
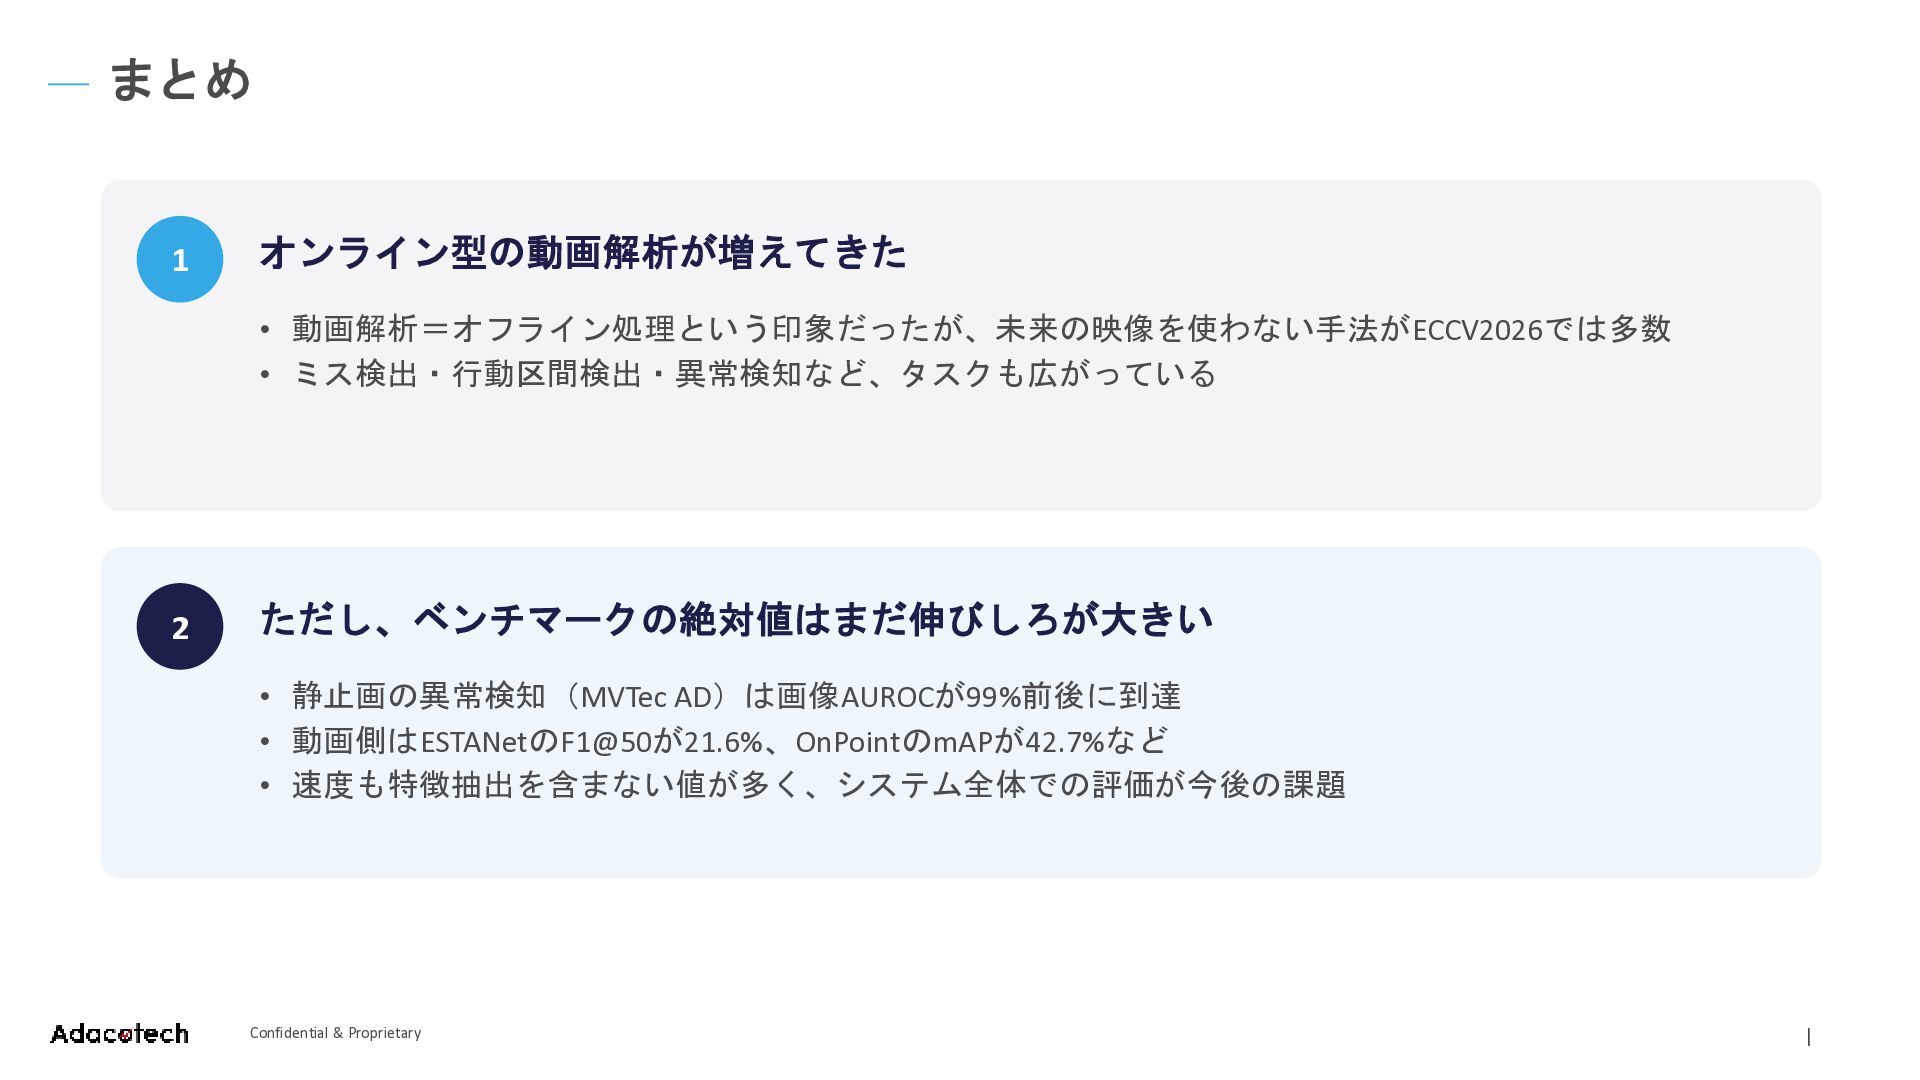
まとめ 1 オンライン型の動画解析が増えてきた • 動画解析=オフライン処理という印象だったが、未来の映像を使わない手法がECCV2026では多数 • ミス検出・行動区間検出・異常検知など、タスクも広がっている 2 ただし、ベンチマークの絶対値はまだ伸びしろが大きい •
静止画の異常検知(MVTec AD)は画像AUROCが99%前後に到達 • 動画側はESTANetのF1@50が21.6%、OnPointのmAPが42.7%など • 速度も特徴抽出を含まない値が多く、システム全体での評価が今後の課題 Confidential & Proprietary |
Thank you very much for your time!! ご関心をお持ちの方はお気軽にこちらまでご連絡ください。 Email :
[email protected]
TEL: 03-4346-4171 https://adacotech.co.jp/
More Decks by KeiichiIto1978
See All by KeiichiIto1978
20260618_CVPR読み会.pdf
keiichiito1978
0
180
20260208_第66回 コンピュータビジョン勉強会
keiichiito1978
0
710
20250916_第65回 コンピュータビジョン勉強会
keiichiito1978
0
190
CVPR勉強会後半
keiichiito1978
0
690
AnomalyNCD Towards Novel Anomaly Class Discovery in Industrial Scenarios
keiichiito1978
0
66
Featured
See All Featured
Site-Speed That Sticks
csswizardry
13
1.6k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.2k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.3k
The World Runs on Bad Software
bkeepers
PRO
72
12k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
6
930
WCS-LA-2024
lcolladotor
0
1k
GraphQLとの向き合い方2022年版
quramy
50
15k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
990
What the history of the web can teach us about the future of AI
inesmontani
PRO
3
810
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
560
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Building AI with AI
inesmontani
PRO
1
1.4k


 keiichiito1978
 csswizardry
 aleyda
 bkeepers
 marcoroth
 lcolladotor
 quramy
 katarinadahlin
 inesmontani
 nikkihalliwell
 bermonpainter