Share
Embed
20260208_第66回 コンピュータビジョン勉強会
KeiichiIto1978
February 08, 2026
Transcript
20 slides
-
| 1 第66回 コンピュータビジョン勉強会@関東 WorldPrediction A Benchmark for High-levelWorld Modeling
and Long-horizon Procedural Planning Delong Chen, Willy Chung, Yejin Bang, Ziwei Ji, Pascale Fung -
| 6 やる夫で学ぶ WorldPrediction A Benchmark for High-levelWorld Modeling and
Long-horizon Procedural Planning Delong Chen, Willy Chung, Yejin Bang, Ziwei Ji, Pascale Fung 「今更『世界の予測』かお? 動画生成AIならSoraとかでもも う完璧じゃないかお? この論文、読む必要あるか?」 「その考えが甘いんだろ、常識 的に考えて。ピクセル生成で出 来ることと、因果関係を理解し て計画でることは別物だ。 Meta FAIRと香港科技大の 『 WorldPrediction 』で現実をみ せてやる」 -
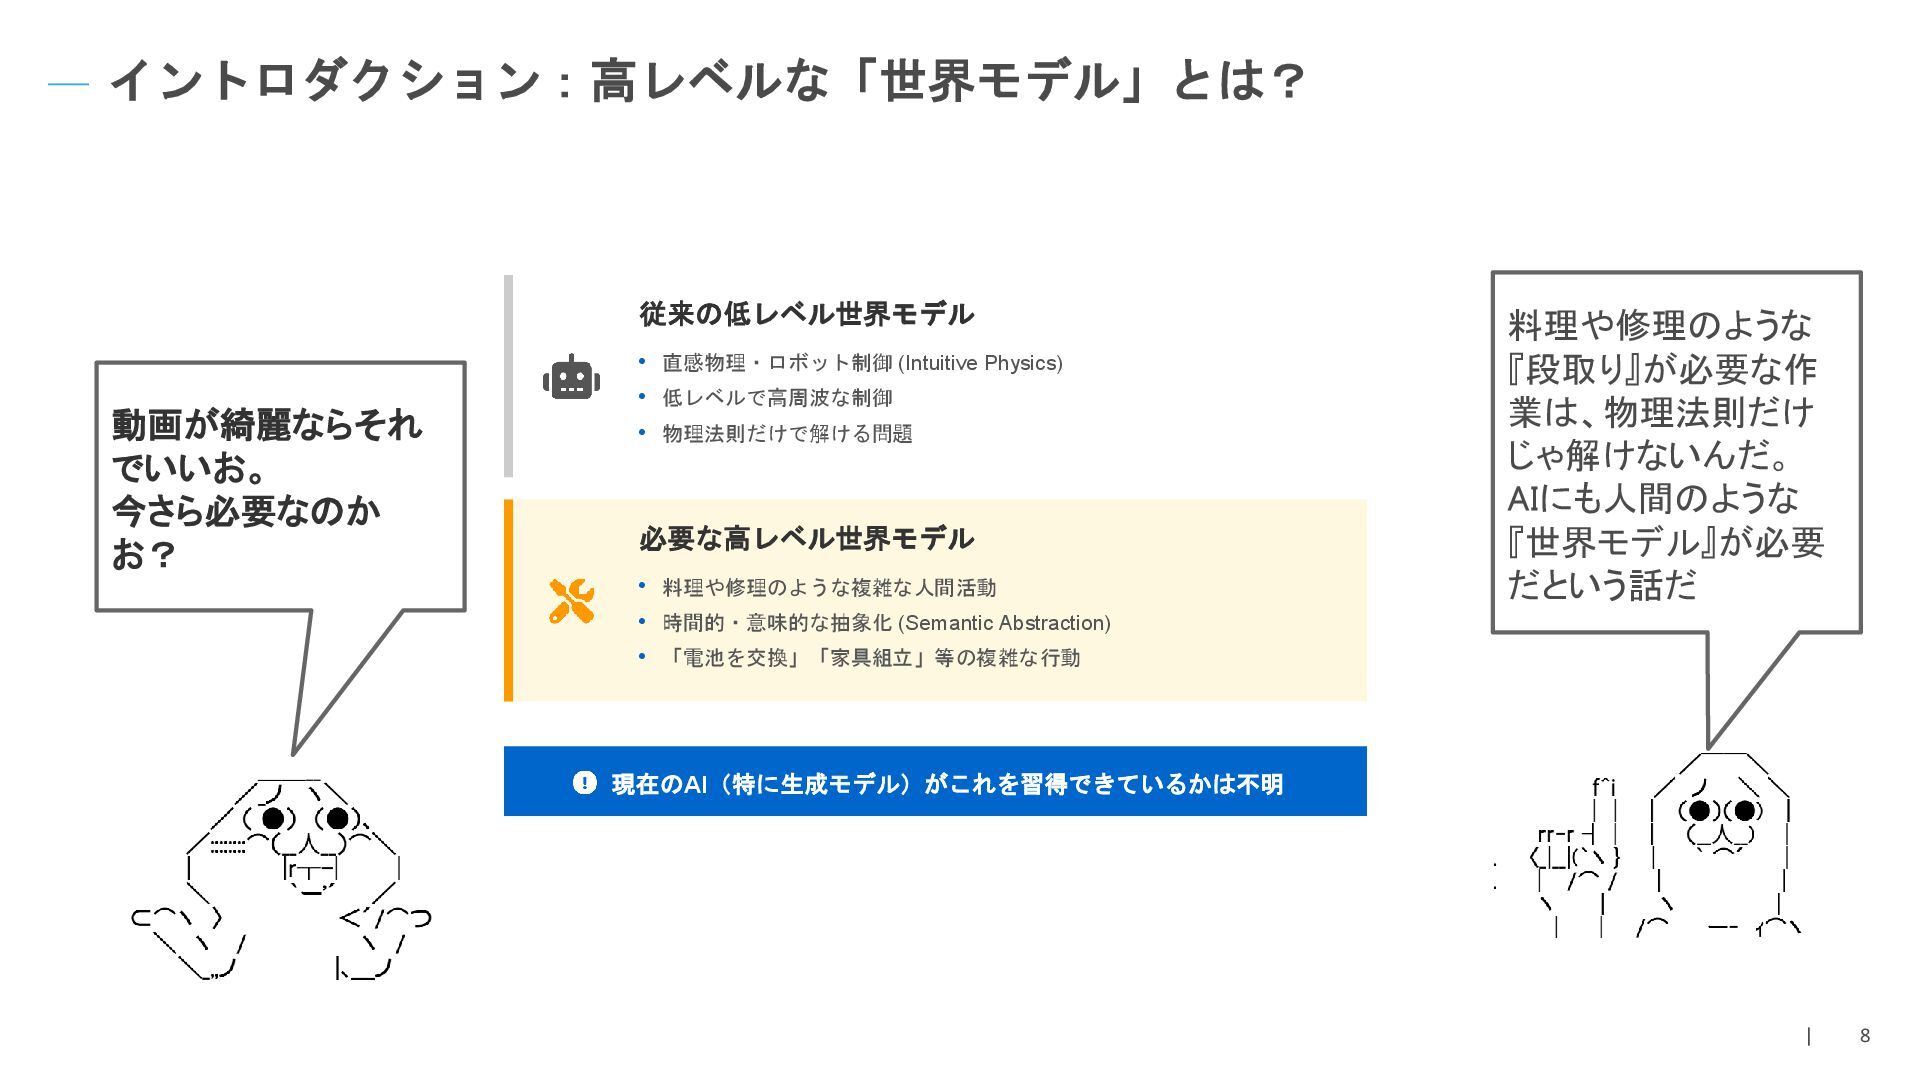
| 8 イントロダクション:高レベルな「世界モデル」とは? 従来の低レベル世界モデル • 直感物理・ロボット制御 (Intuitive Physics) • 低レベルで高周波な制御
• 物理法則だけで解ける問題 必要な高レベル世界モデル • 料理や修理のような複雑な人間活動 • 時間的・意味的な抽象化 (Semantic Abstraction) • 「電池を交換」「家具組立」等の複雑な行動 現在のAI(特に生成モデル)がこれを習得できているかは不明 動画が綺麗ならそれ でいいお。 今さら必要なのか お? 料理や修理のような 『段取り』が必要な作 業は、物理法則だけ じゃ解けないんだ。 AIにも人間のような 『世界モデル』が必要 だという話だ -
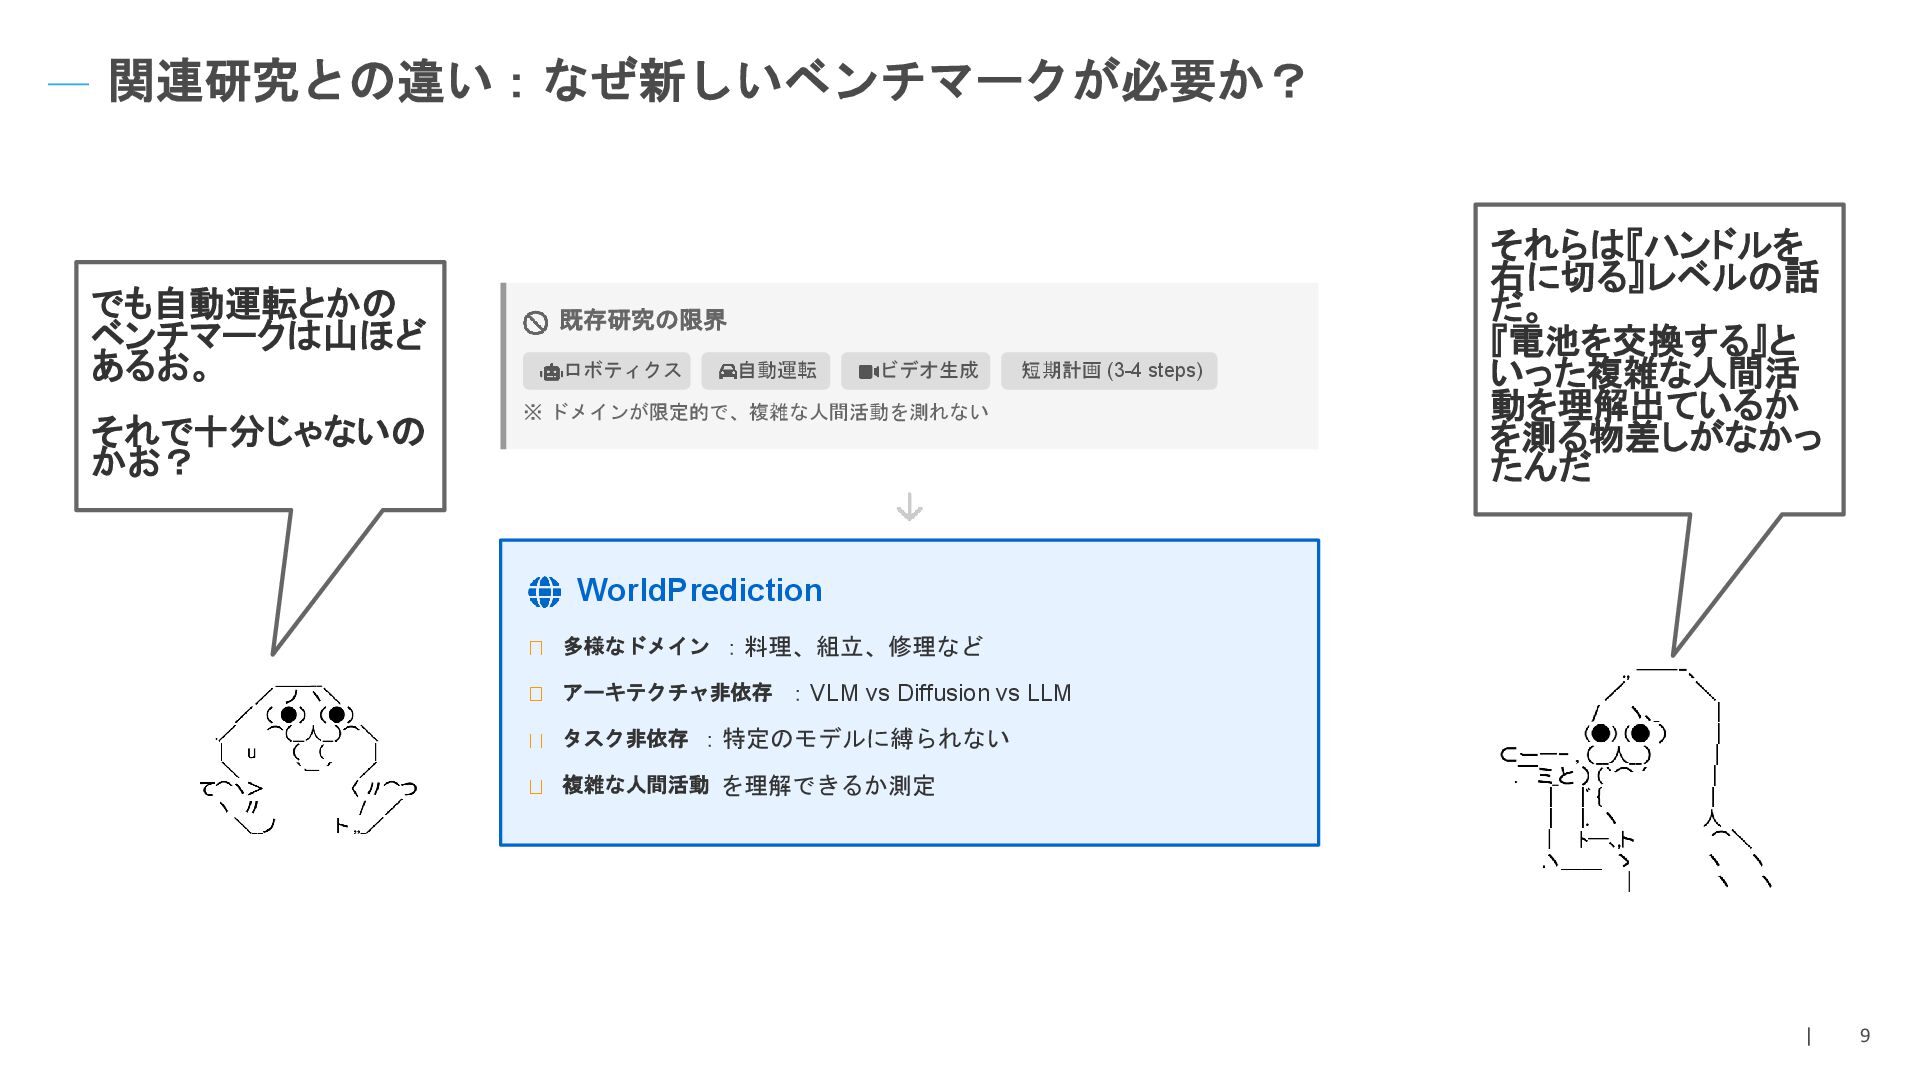
| 9 関連研究との違い:なぜ新しいベンチマークが必要か? 既存研究の限界 ロボティクス 自動運転 ビデオ生成 短期計画 (3-4 steps)
※ ドメインが限定的で、複雑な人間活動を測れない WorldPrediction 多様なドメイン :料理、組立、修理など アーキテクチャ非依存 :VLM vs Diffusion vs LLM タスク非依存 :特定のモデルに縛られない 複雑な人間活動 を理解できるか測定 でも自動運転とかの ベンチマークは山ほど あるお。 それで十分じゃないの かお? それらは『ハンドルを 右に切る』レベルの話 だ。 『電池を交換する』と いった複雑な人間活 動を理解出ているか を測る物差しがなかっ たんだ -
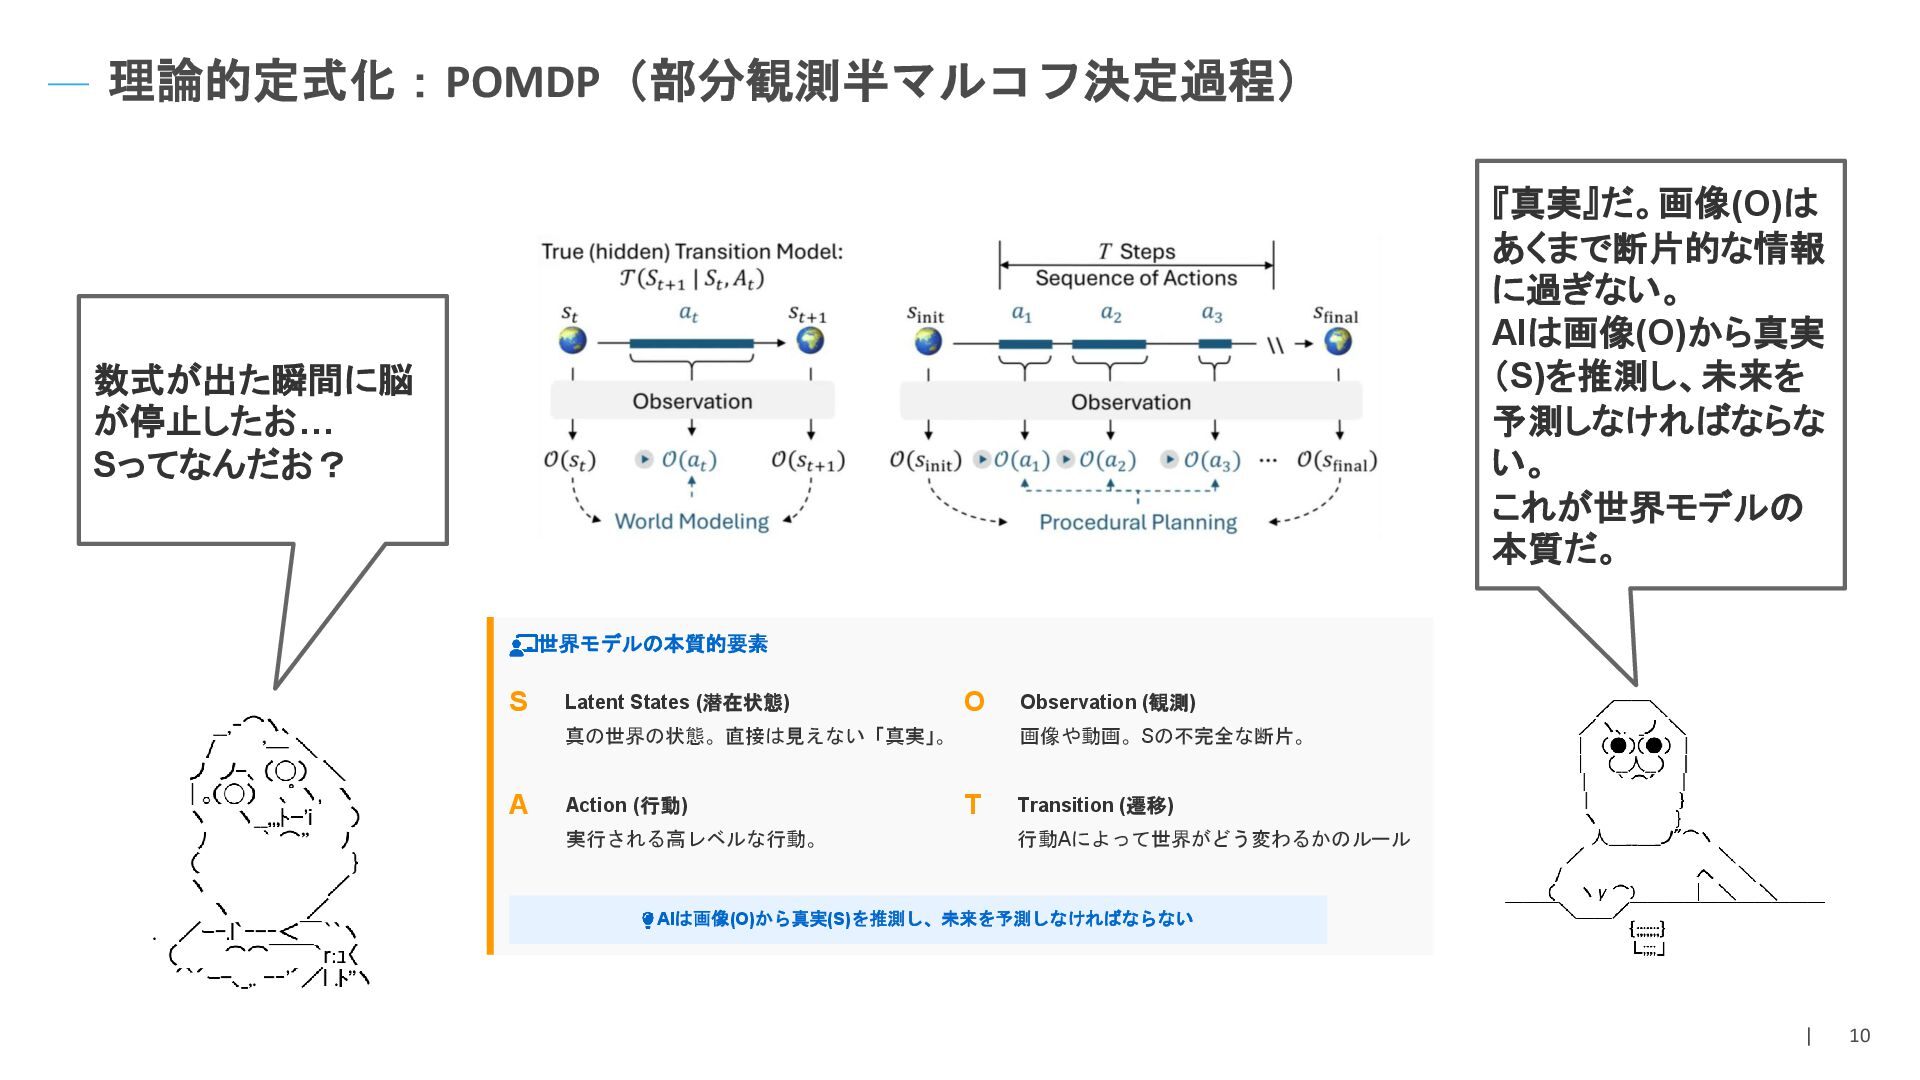
| 10 理論的定式化:POMDP(部分観測半マルコフ決定過程) 世界モデルの本質的要素 S Latent States (潜在状態) 真の世界の状態。直接は見えない「真実」。 O
Observation (観測) 画像や動画。Sの不完全な断片。 A Action (行動) 実行される高レベルな行動。 T Transition (遷移) 行動Aによって世界がどう変わるかのルール AIは画像(O)から真実(S)を推測し、未来を予測しなければならない 数式が出た瞬間に脳 が停止したお… Sってなんだお? 『真実』だ。画像(O)は あくまで断片的な情報 に過ぎない。 AIは画像(O)から真実 (S)を推測し、未来を 予測しなければならな い。 これが世界モデルの 本質だ。 -
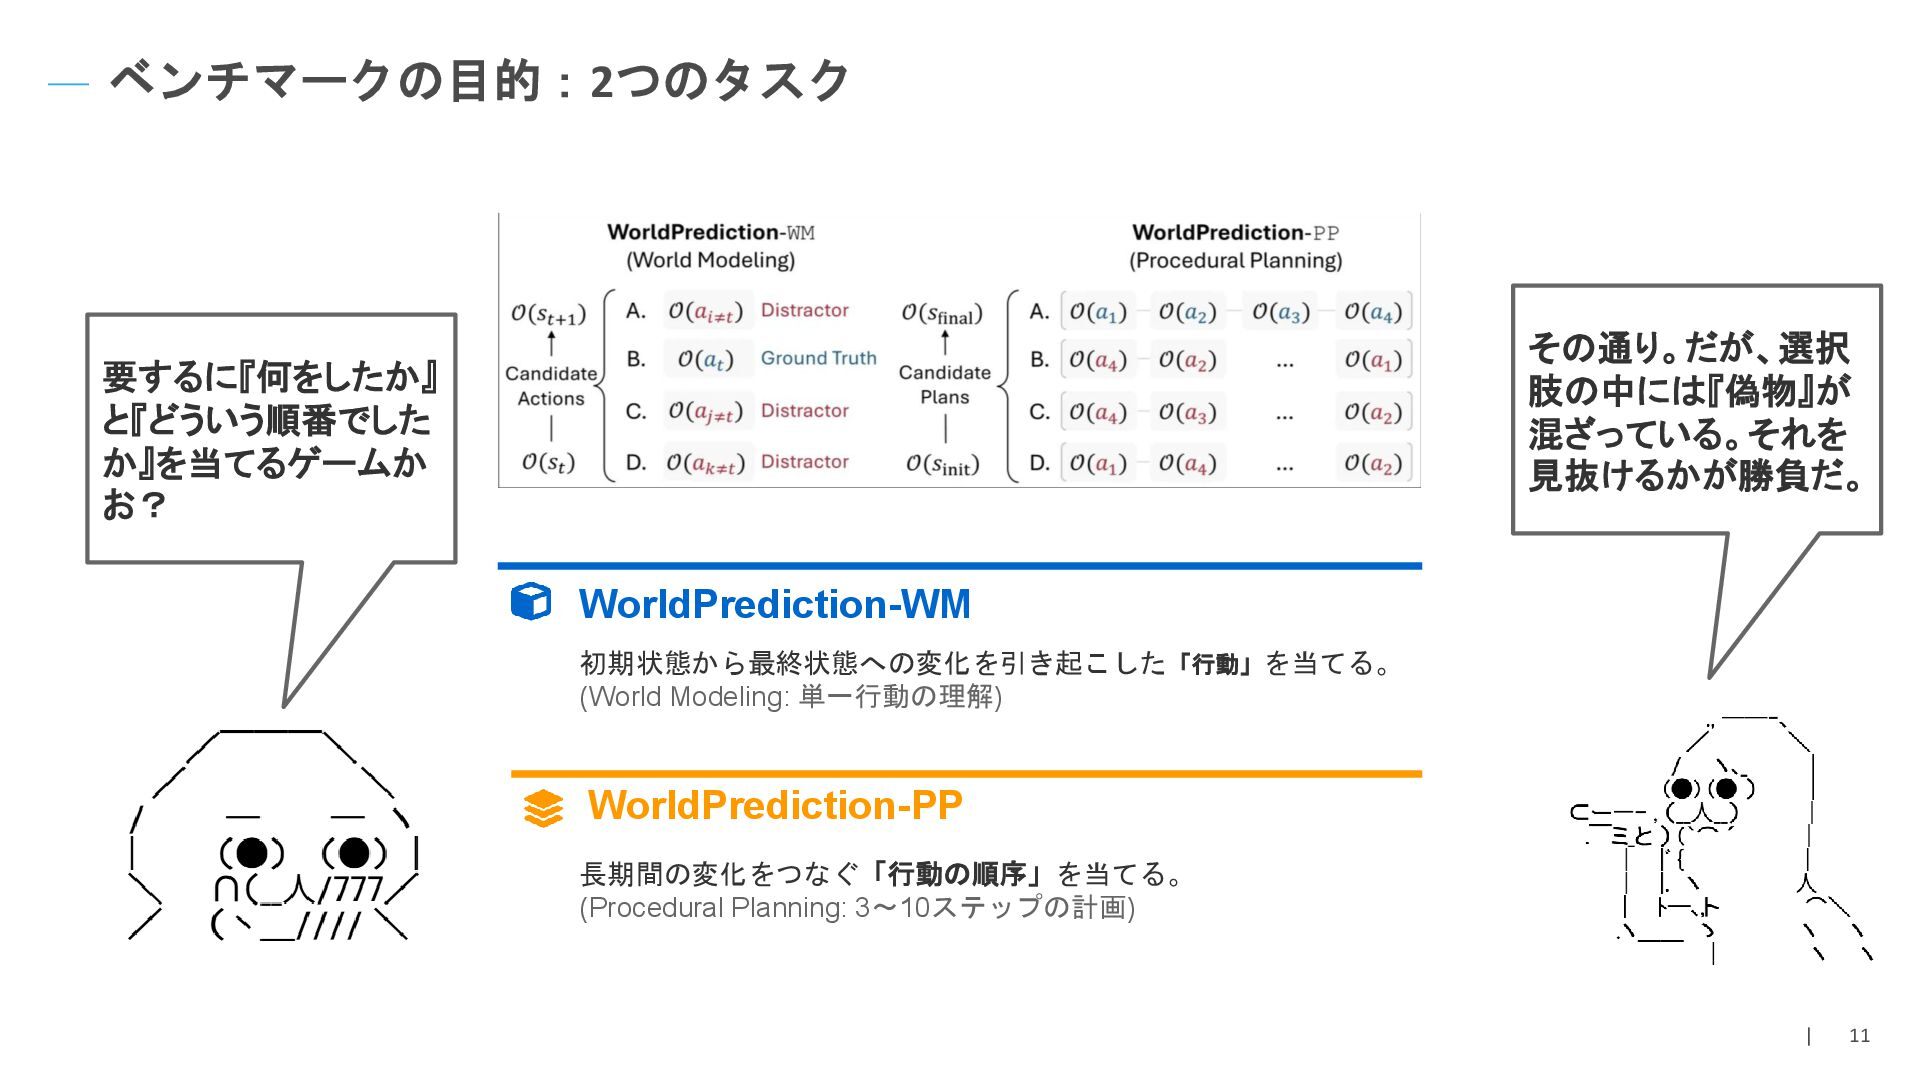
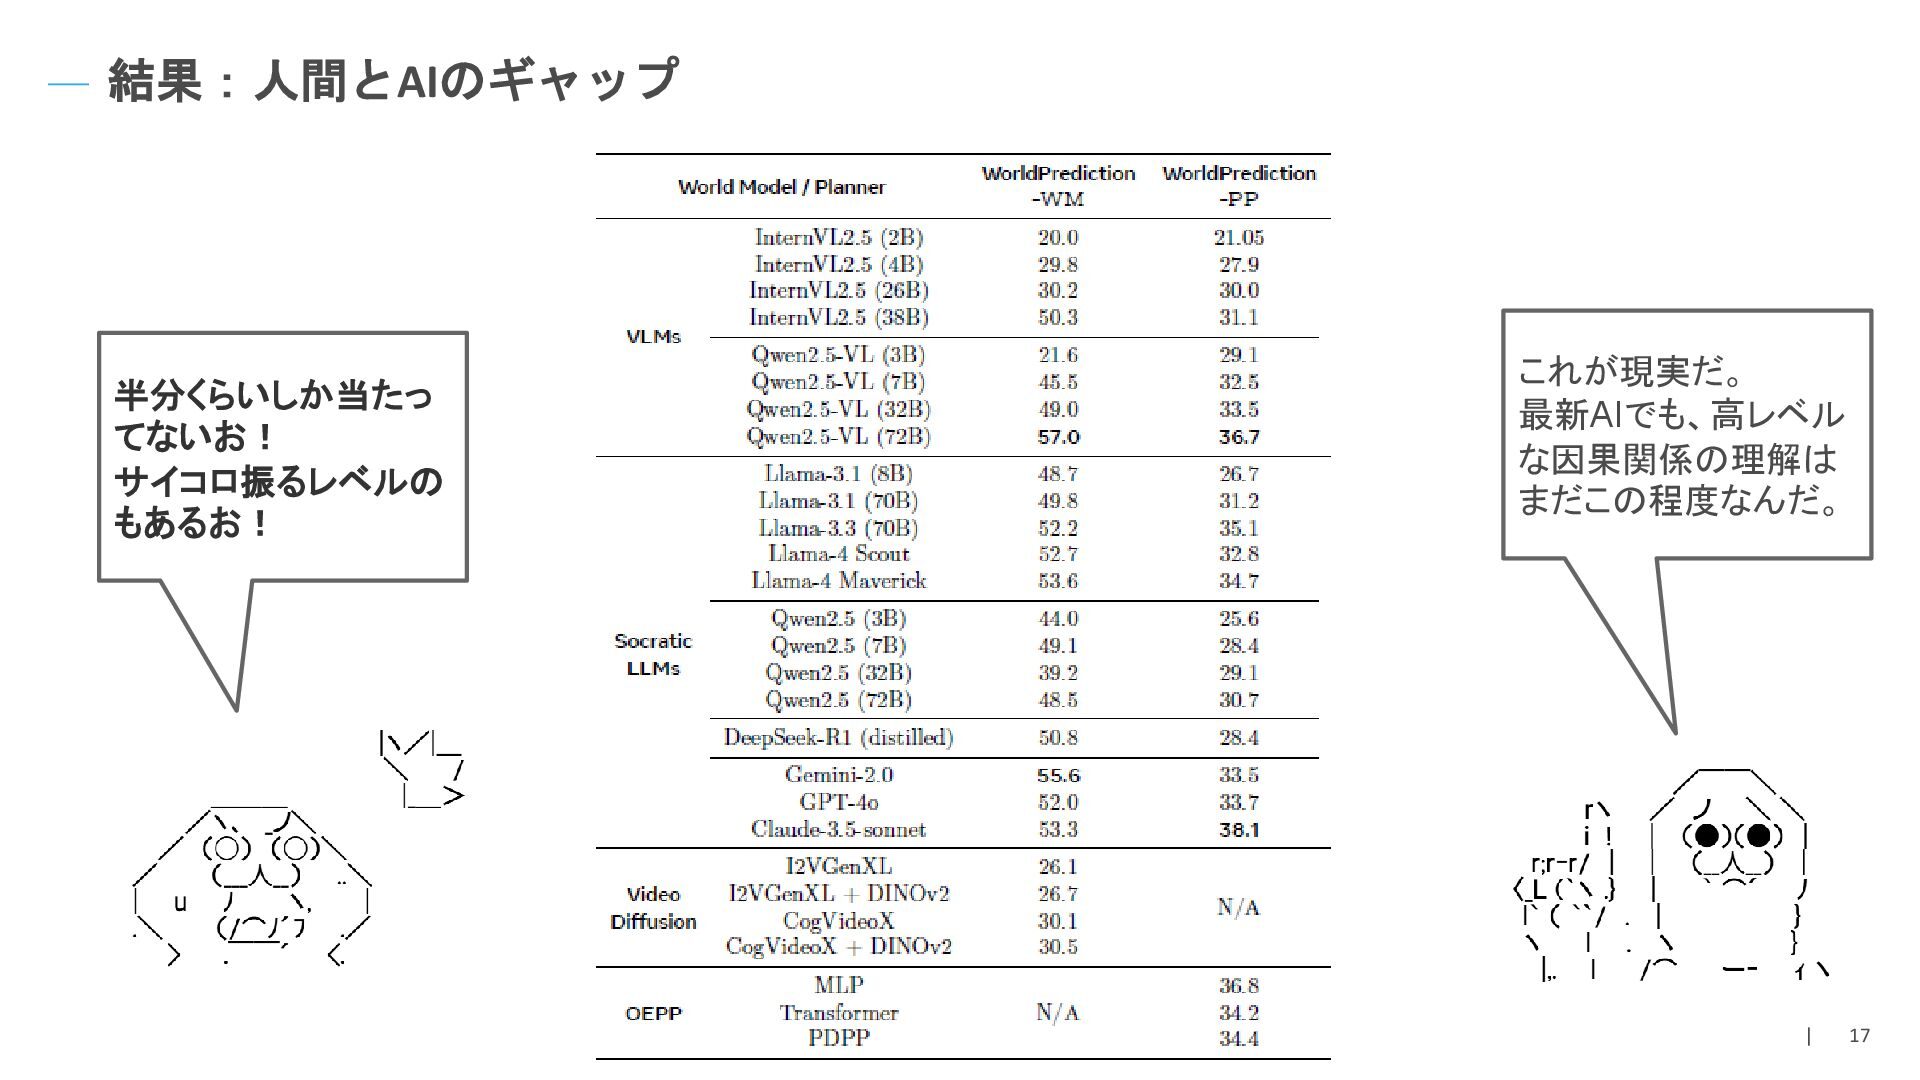
| 11 ベンチマークの目的:2つのタスク WorldPrediction-WM 初期状態から最終状態への変化を引き起こした「行動」を当てる。 (World Modeling: 単一行動の理解) WorldPrediction-PP 長期間の変化をつなぐ「行動の順序」を当てる。
(Procedural Planning: 3〜10ステップの計画) 要するに『何をしたか』 と『どういう順番でした か』を当てるゲームか お? その通り。だが、選択 肢の中には『偽物』が 混ざっている。それを 見抜けるかが勝負だ。 -
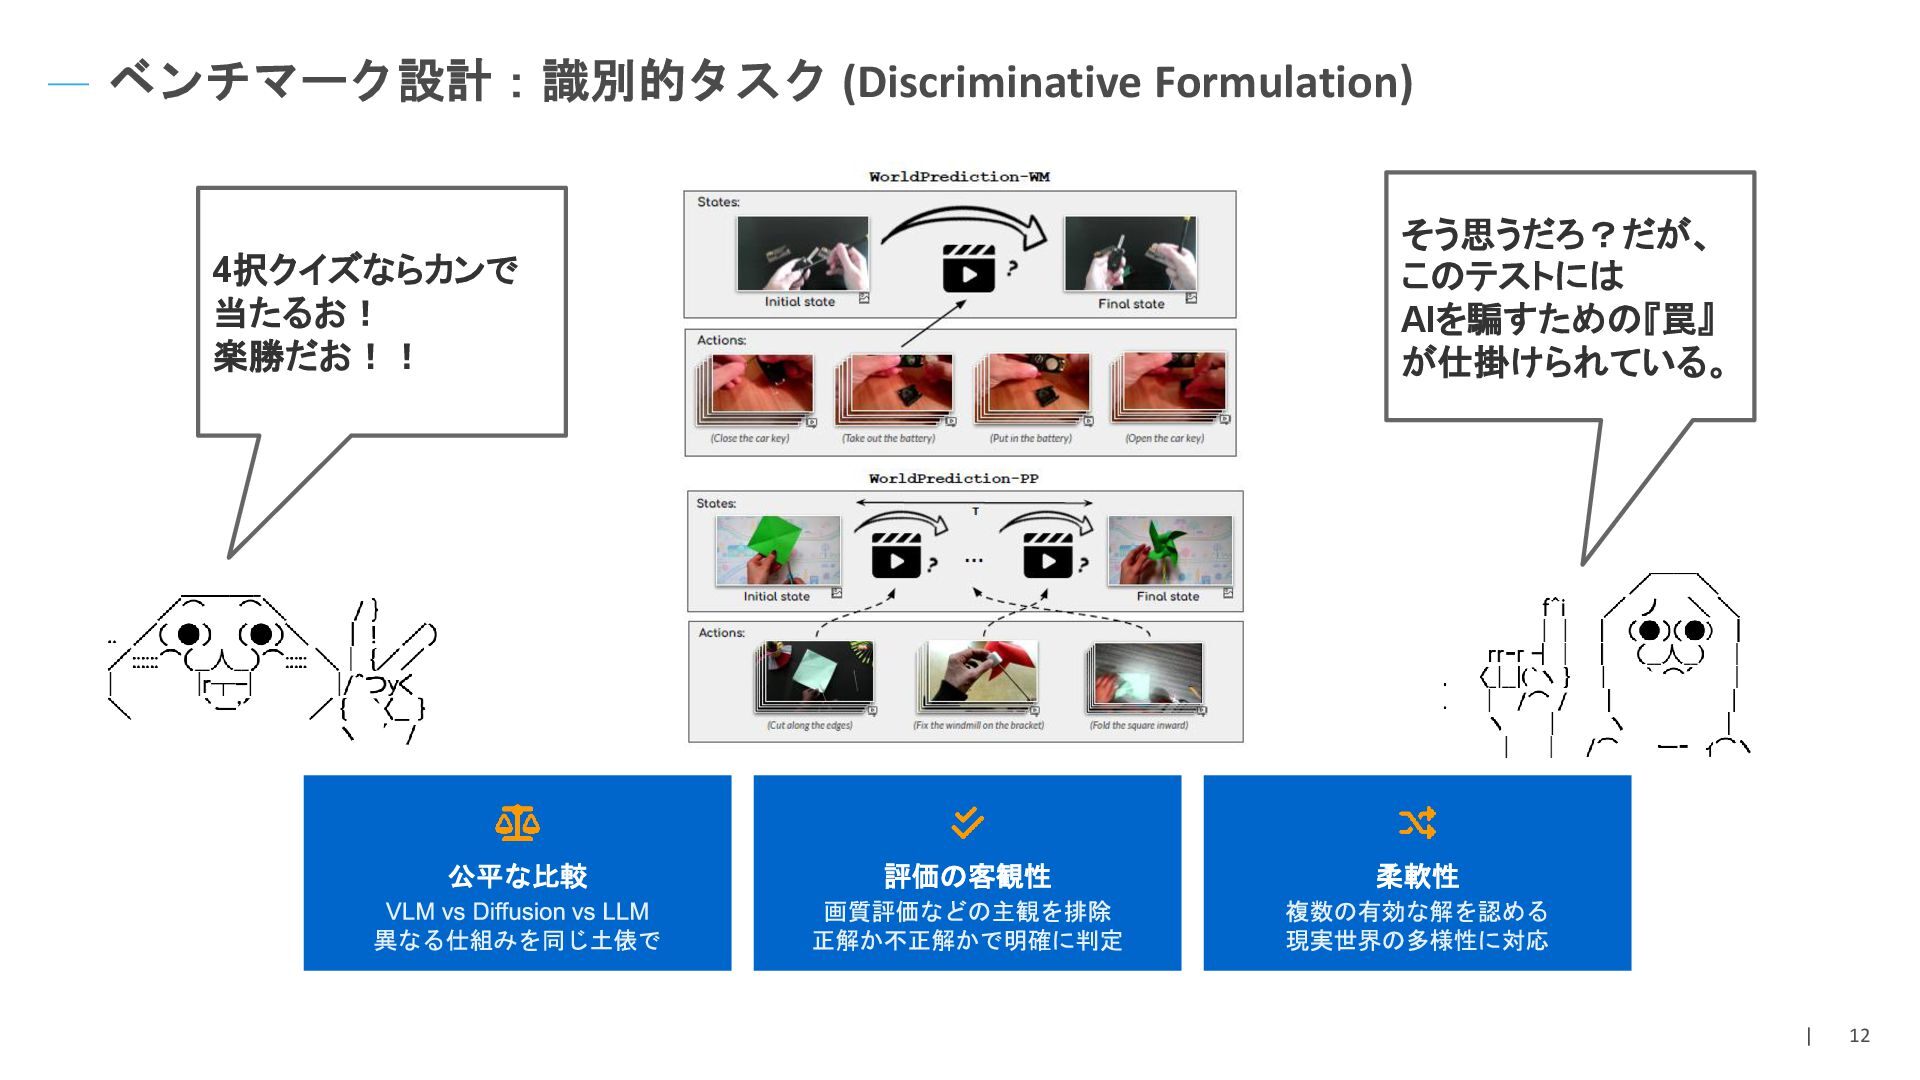
| 12 ベンチマーク設計:識別的タスク (Discriminative Formulation) 公平な比較 評価の客観性 柔軟性 4択クイズならカンで 当たるお!
楽勝だお!! そう思うだろ?だが、 このテストには AIを騙すための『罠』 が仕掛けられている。 -
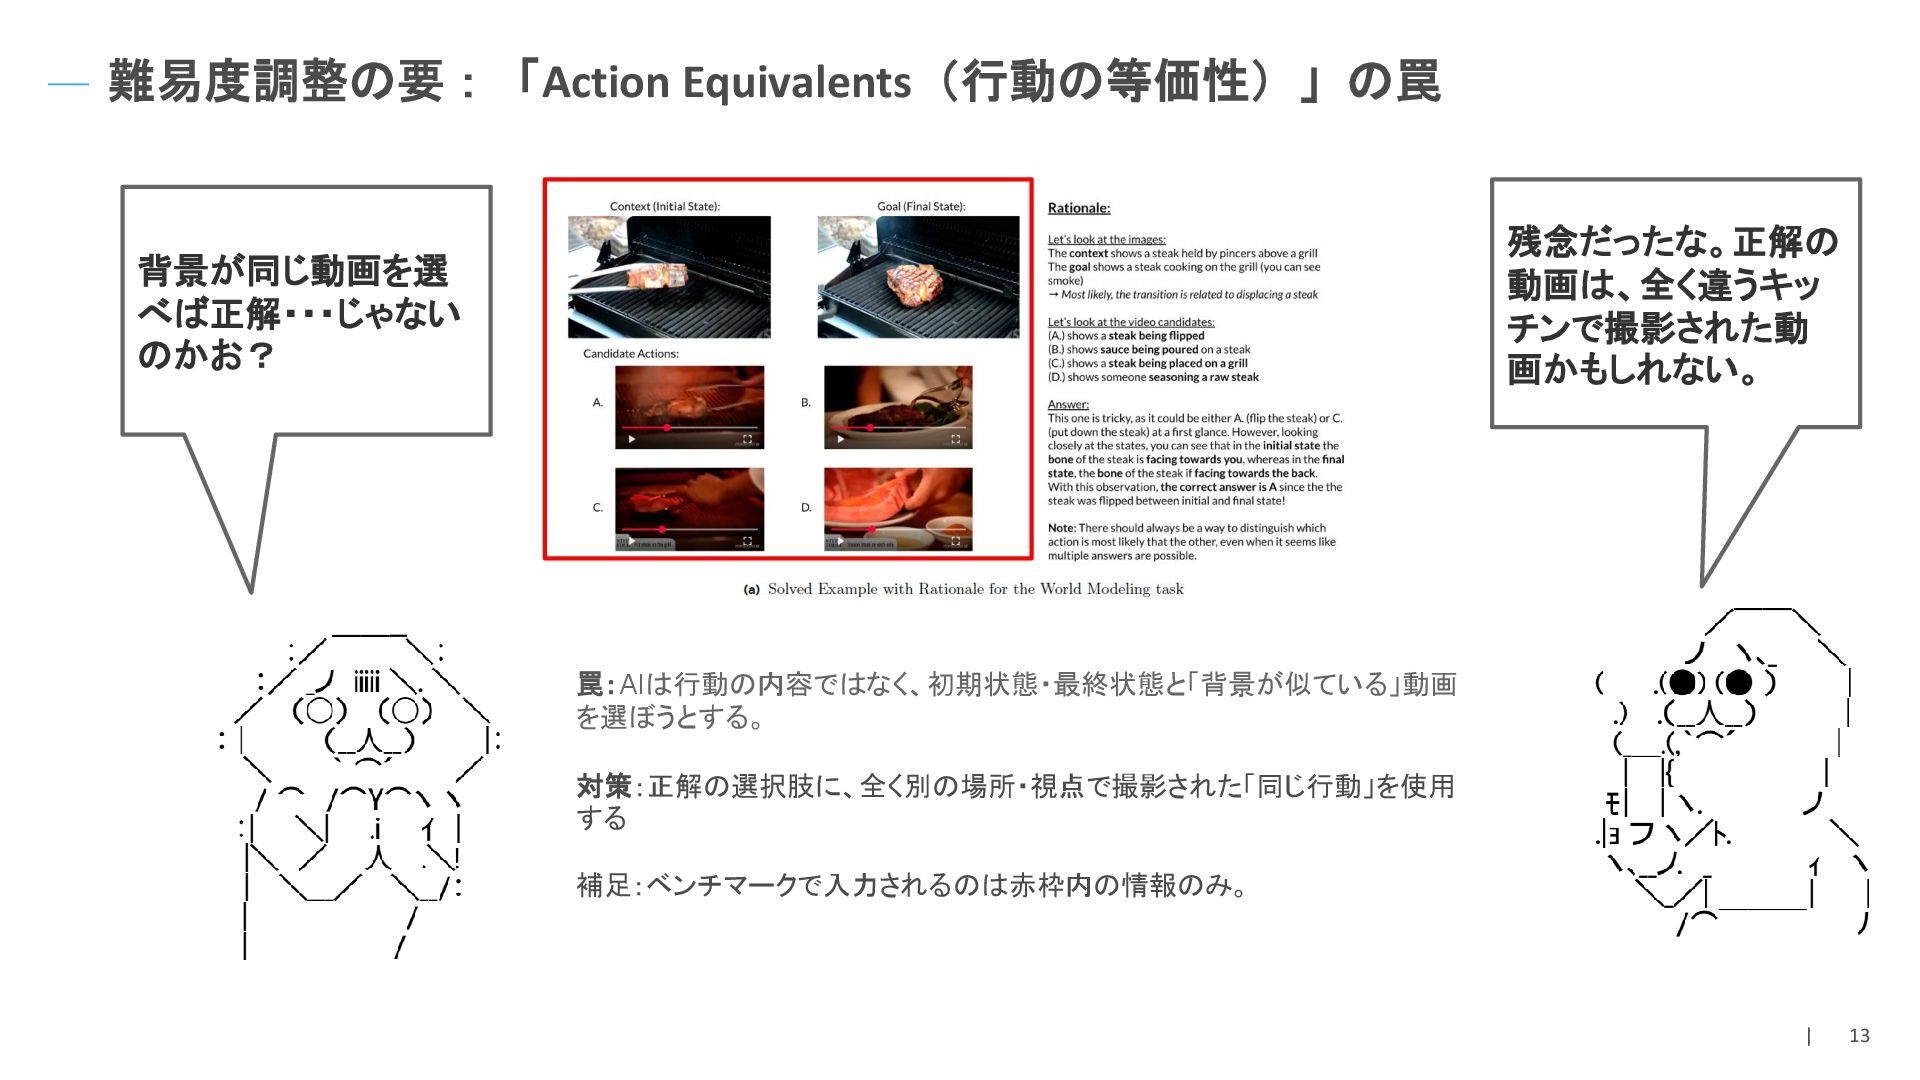
| 13 難易度調整の要:「Action Equivalents(行動の等価性)」の罠 罠:AIは行動の内容ではなく、初期状態・最終状態と「背景が似ている」動画 を選ぼうとする。 対策:正解の選択肢に、全く別の場所・視点で撮影された「同じ行動」を使用 する 補足:ベンチマークで入力されるのは赤枠内の情報のみ。 背景が同じ動画を選
べば正解・・・じゃない のかお? 残念だったな。正解の 動画は、全く違うキッ チンで撮影された動 画かもしれない。 -
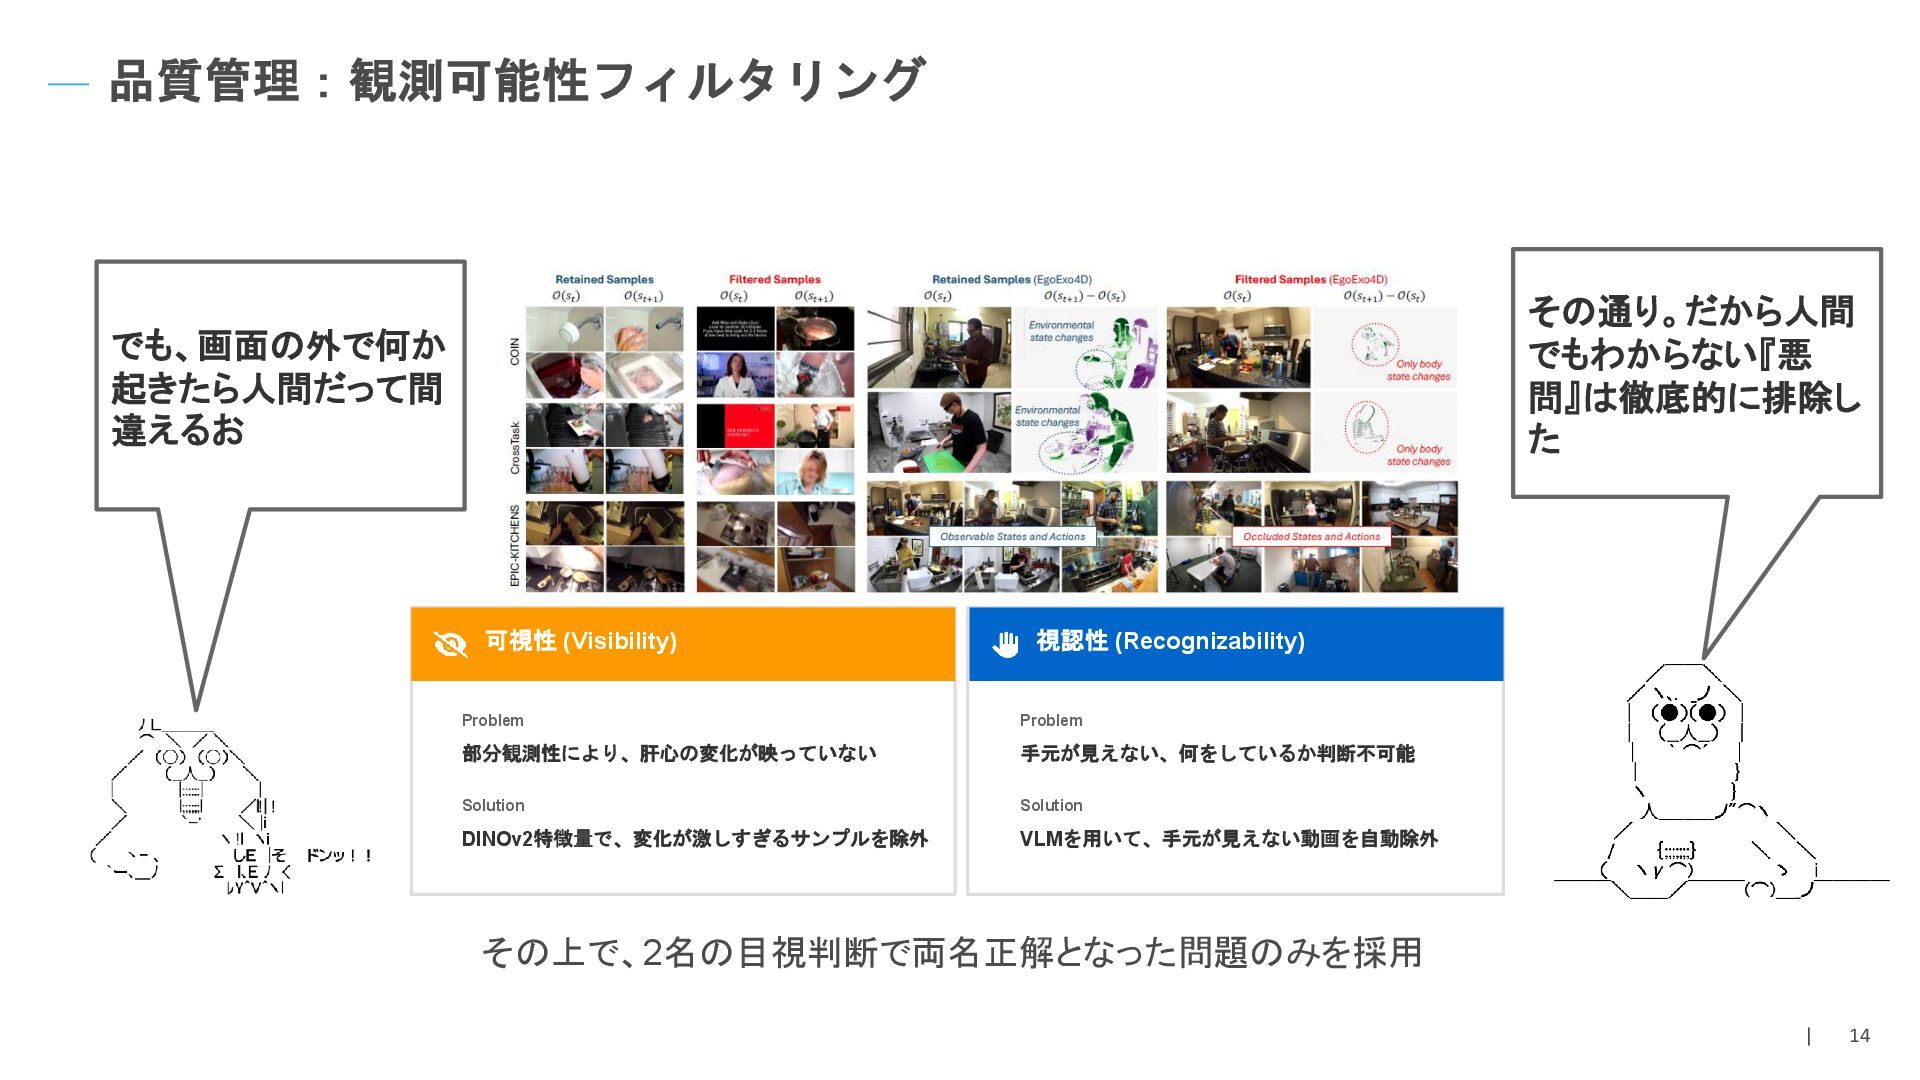
| 14 品質管理:観測可能性フィルタリング でも、画面の外で何か 起きたら人間だって間 違えるお その通り。だから人間 でもわからない『悪 問』は徹底的に排除し た
可視性 (Visibility) Problem 部分観測性により、肝心の変化が映っていない Solution DINOv2特徴量で、変化が激しすぎるサンプルを除外 視認性 (Recognizability) Problem 手元が見えない、何をしているか判断不可能 Solution VLMを用いて、手元が見えない動画を自動除外 その上で、2名の目視判断で両名正解となった問題のみを採用 -
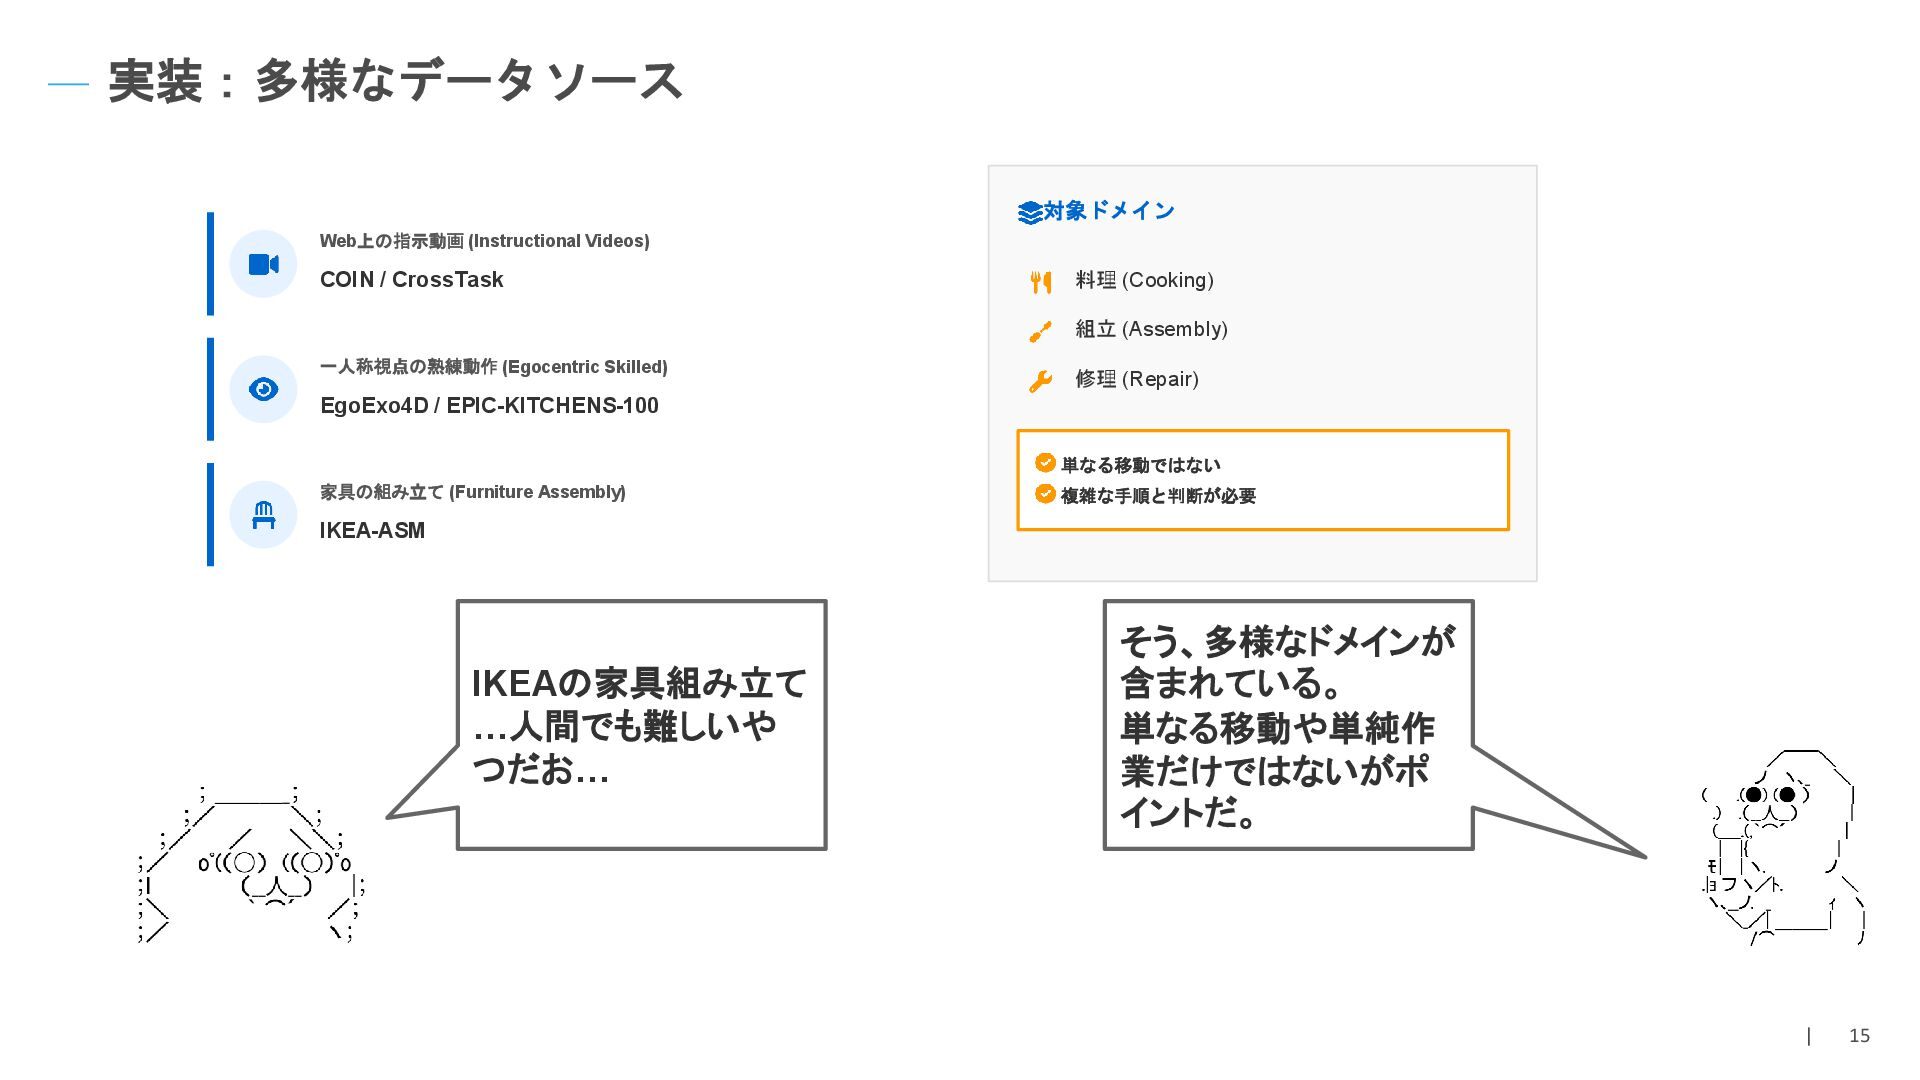
| 15 実装:多様なデータソース Web上の指示動画 (Instructional Videos) COIN / CrossTask 一人称視点の熟練動作
(Egocentric Skilled) EgoExo4D / EPIC-KITCHENS-100 家具の組み立て (Furniture Assembly) IKEA-ASM 対象ドメイン 料理 (Cooking) 組立 (Assembly) 修理 (Repair) 単なる移動ではない 複雑な手順と判断が必要 IKEAの家具組み立て …人間でも難しいや つだお… そう、多様なドメインが 含まれている。 単なる移動や単純作 業だけではないがポ イントだ。 -
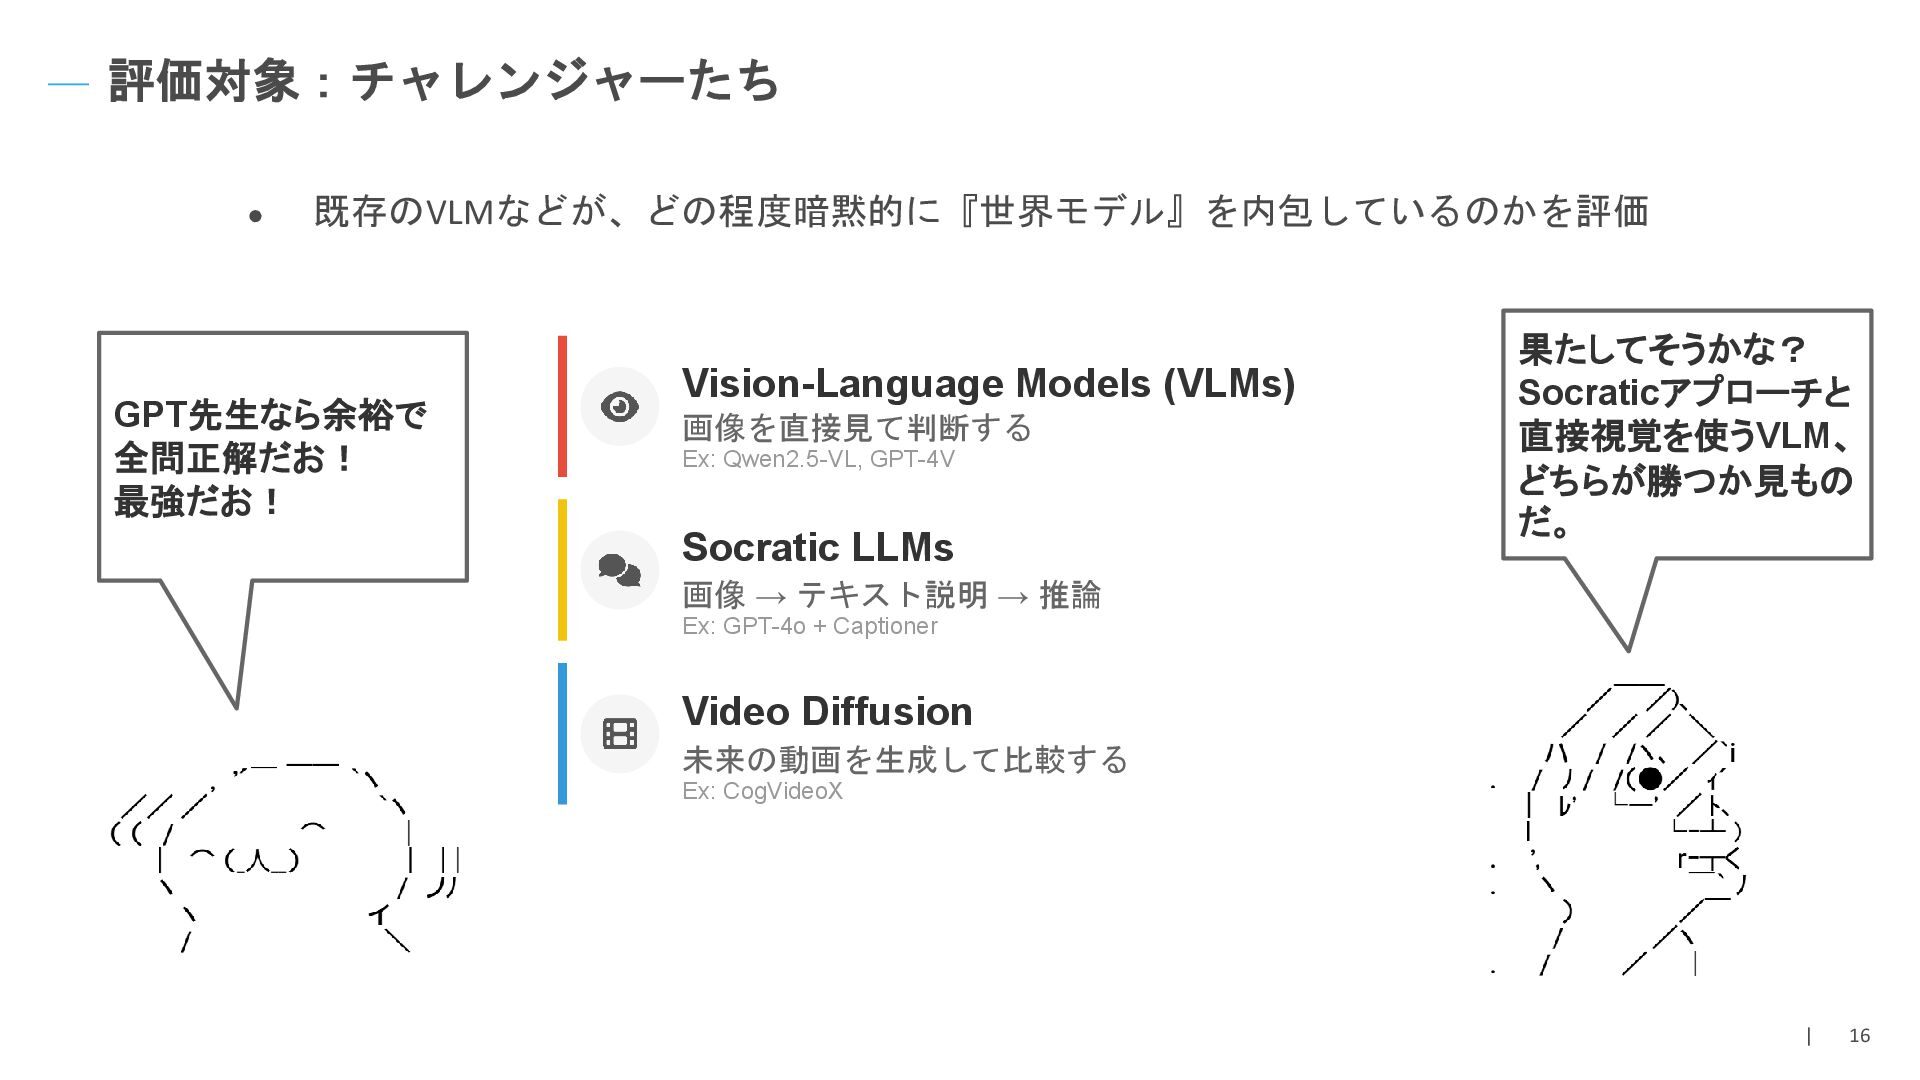
| 16 評価対象:チャレンジャーたち • 既存のVLMなどが、どの程度暗黙的に『世界モデル』を内包しているのかを評価 Vision-Language Models (VLMs) 画像を直接見て判断する Ex:
Qwen2.5-VL, GPT-4V Socratic LLMs 画像 → テキスト説明 → 推論 Ex: GPT-4o + Captioner Video Diffusion 未来の動画を生成して比較する Ex: CogVideoX GPT先生なら余裕で 全問正解だお! 最強だお! 果たしてそうかな? Socraticアプローチと 直接視覚を使うVLM、 どちらが勝つか見もの だ。 -
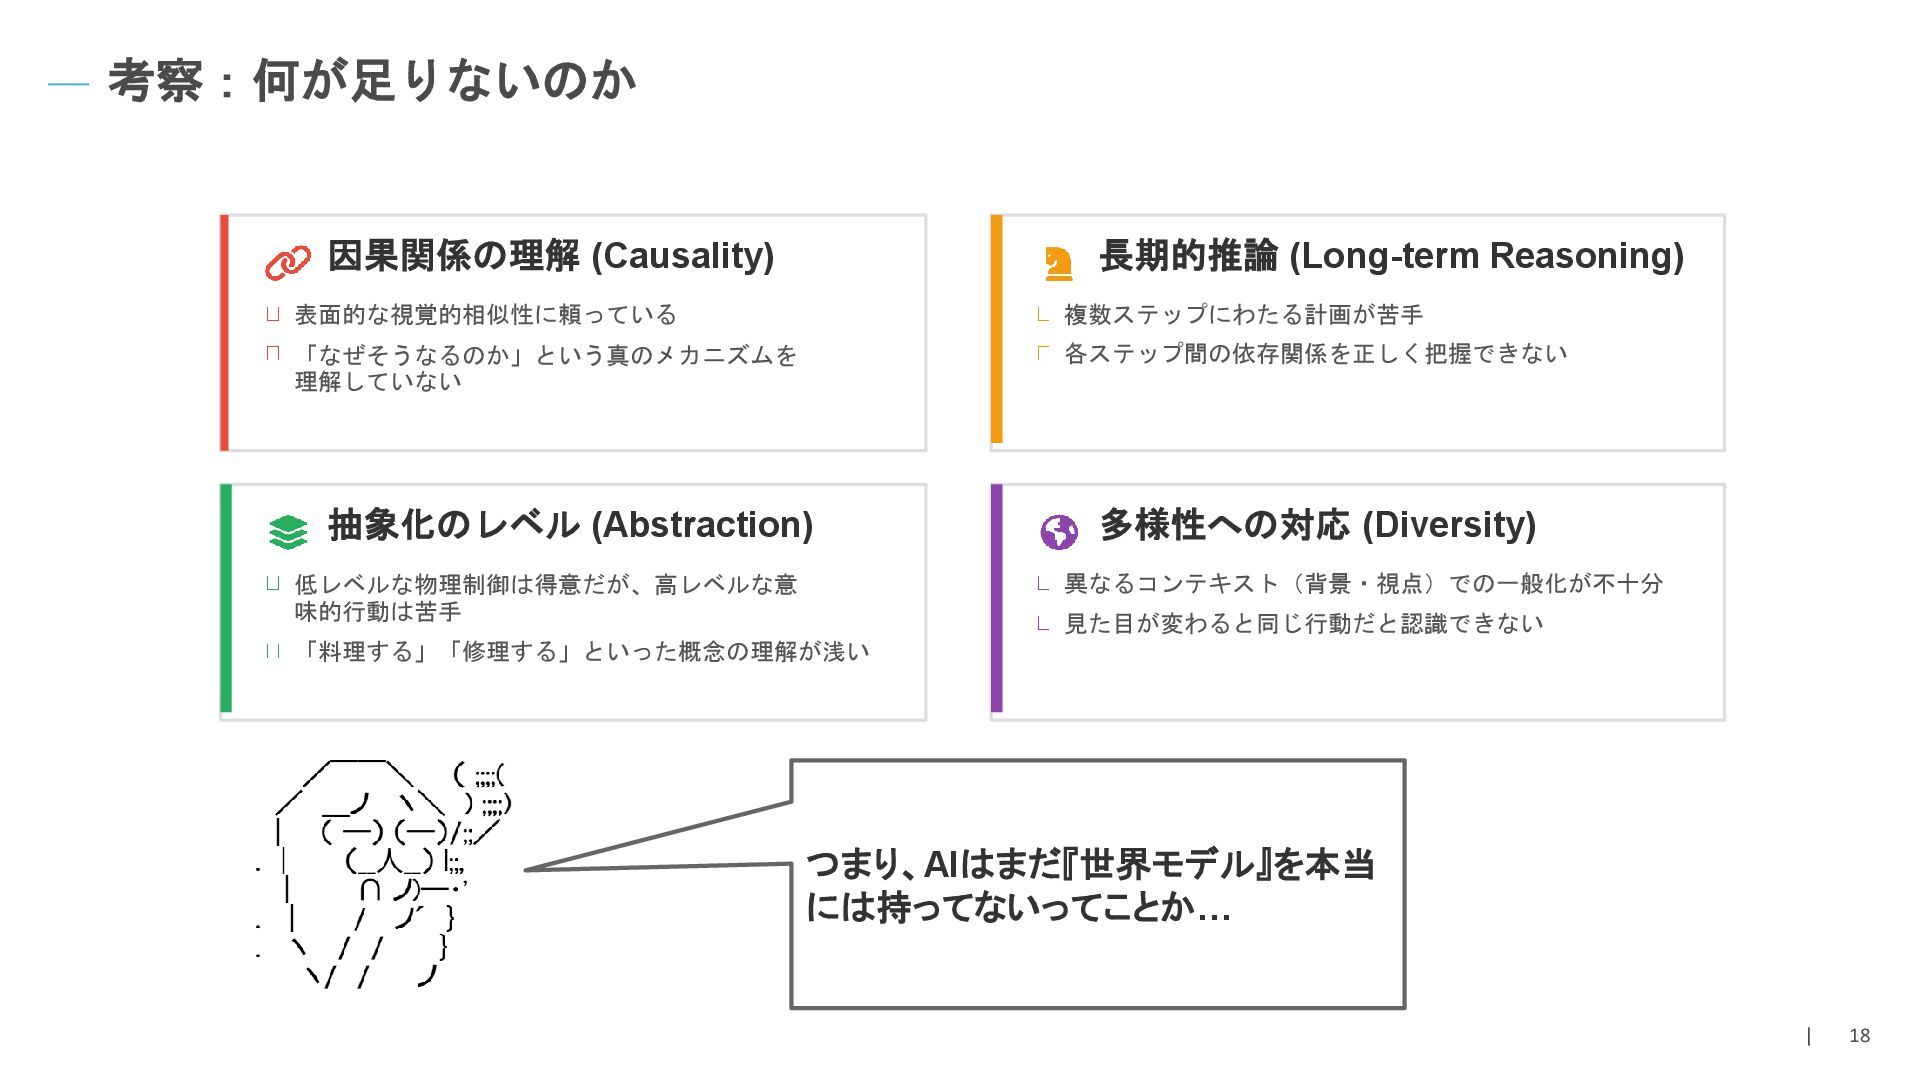
| 18 考察:何が足りないのか 因果関係の理解 (Causality) 表面的な視覚的相似性に頼っている 「なぜそうなるのか」という真のメカニズムを 理解していない
長期的推論 (Long-term Reasoning) 複数ステップにわたる計画が苦手 各ステップ間の依存関係を正しく把握できない 抽象化のレベル (Abstraction) 低レベルな物理制御は得意だが、高レベルな意 味的行動は苦手 「料理する」「修理する」といった概念の理解が浅い 多様性への対応 (Diversity) 異なるコンテキスト(背景・視点)での一般化が不十分 見た目が変わると同じ行動だと認識できない つまり、AIはまだ『世界モデル』を本当 には持ってないってことか… -
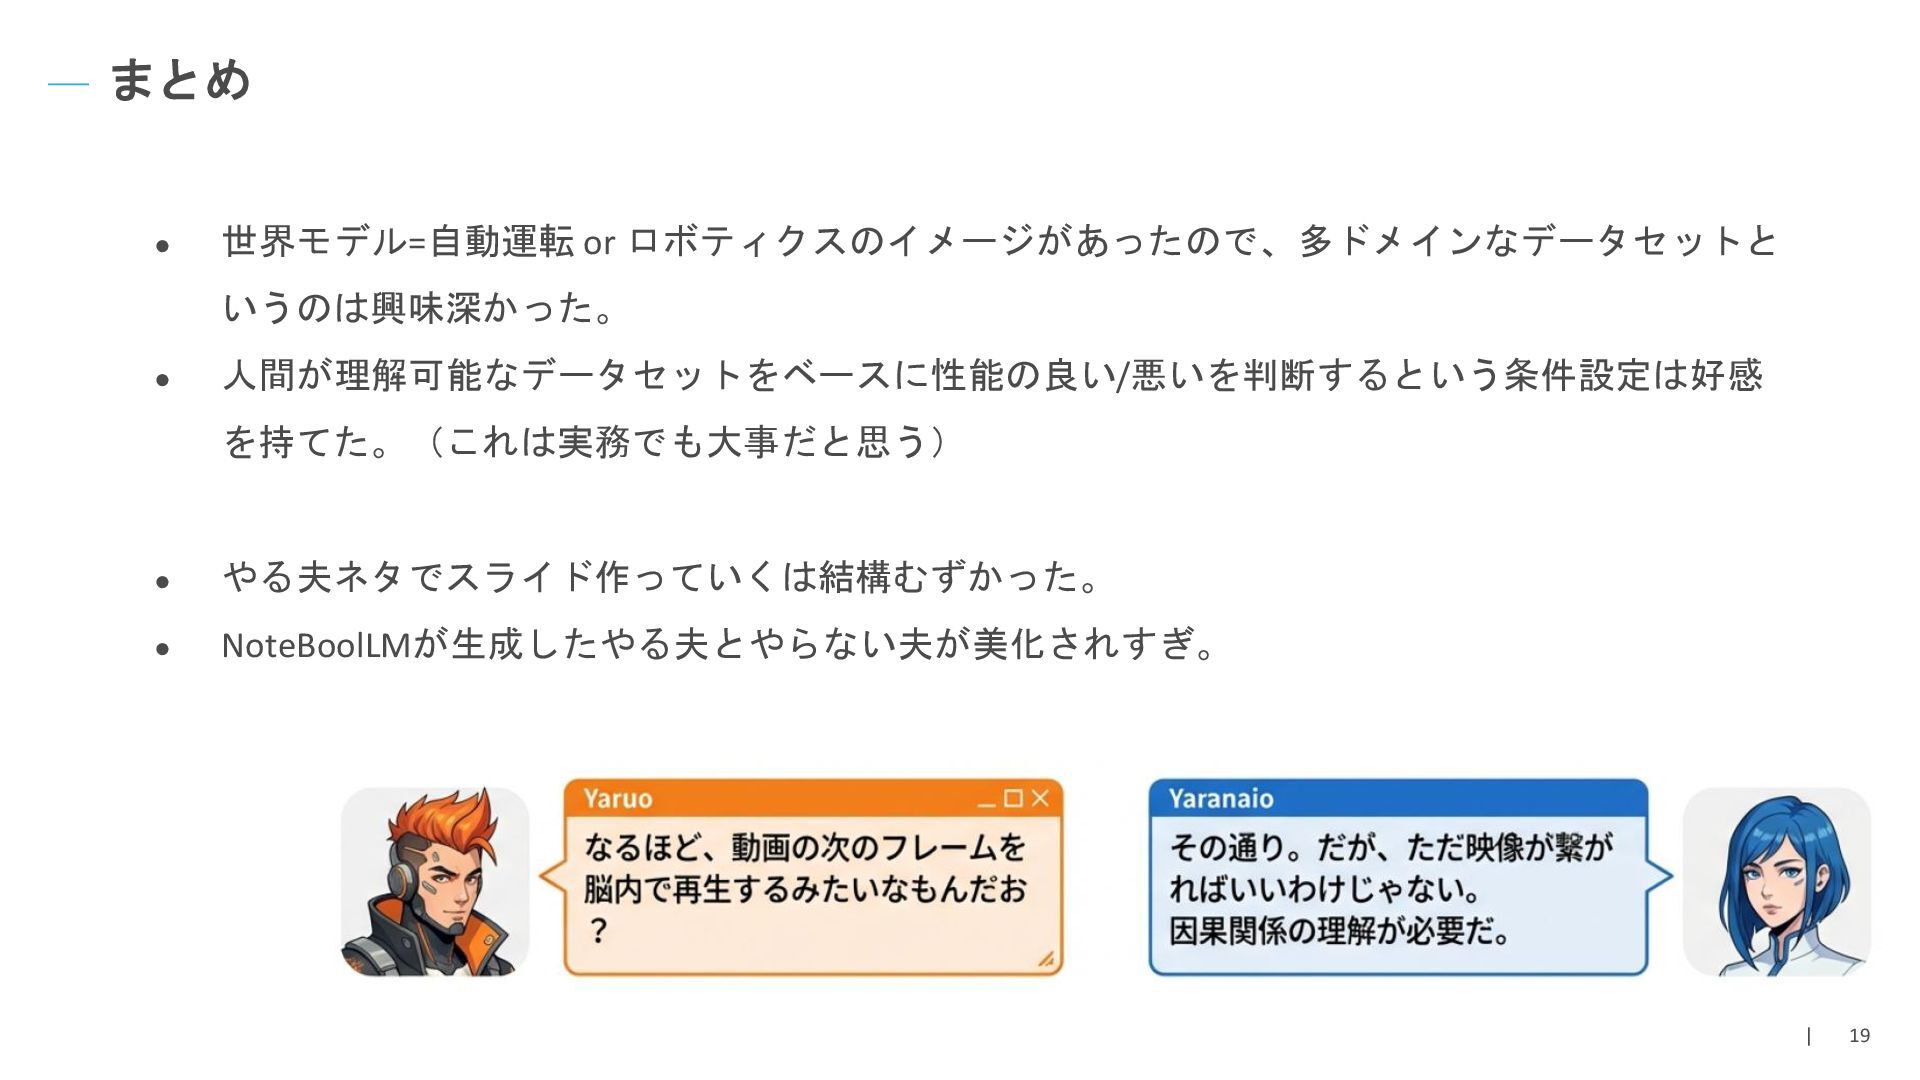
| 19 まとめ • 世界モデル=自動運転 or ロボティクスのイメージがあったので、多ドメインなデータセットと いうのは興味深かった。 • 人間が理解可能なデータセットをベースに性能の良い/悪いを判断するという条件設定は好感
を持てた。(これは実務でも大事だと思う) • やる夫ネタでスライド作っていくは結構むずかった。 • NoteBoolLMが生成したやる夫とやらない夫が美化されすぎ。