Share
Embed
スクラム・アジャイル関連文献とスクラムオントロジーでLLM Wiki作る:SROと用語集で紡ぐ概念・用語の抽出
monotalk.xyz
October 23, 2026
Transcript
24 slides
-
👤 自己紹介 • 名前:櫻井健(@monotalk_xyz) • 現在地・出身地:東京都大田区在住・福島県いわき市出身 • 所属・役割:MCD3 Inc. /
建設SaaS 🏗️ のスクラムマスター • 関心・活動: – 常磐アジャイルに存在すること – 日本酒 – 🍶 にいだしぜんしゅ|仁井田本家 – 🍶 伯楽星 | 新澤醸造店 -
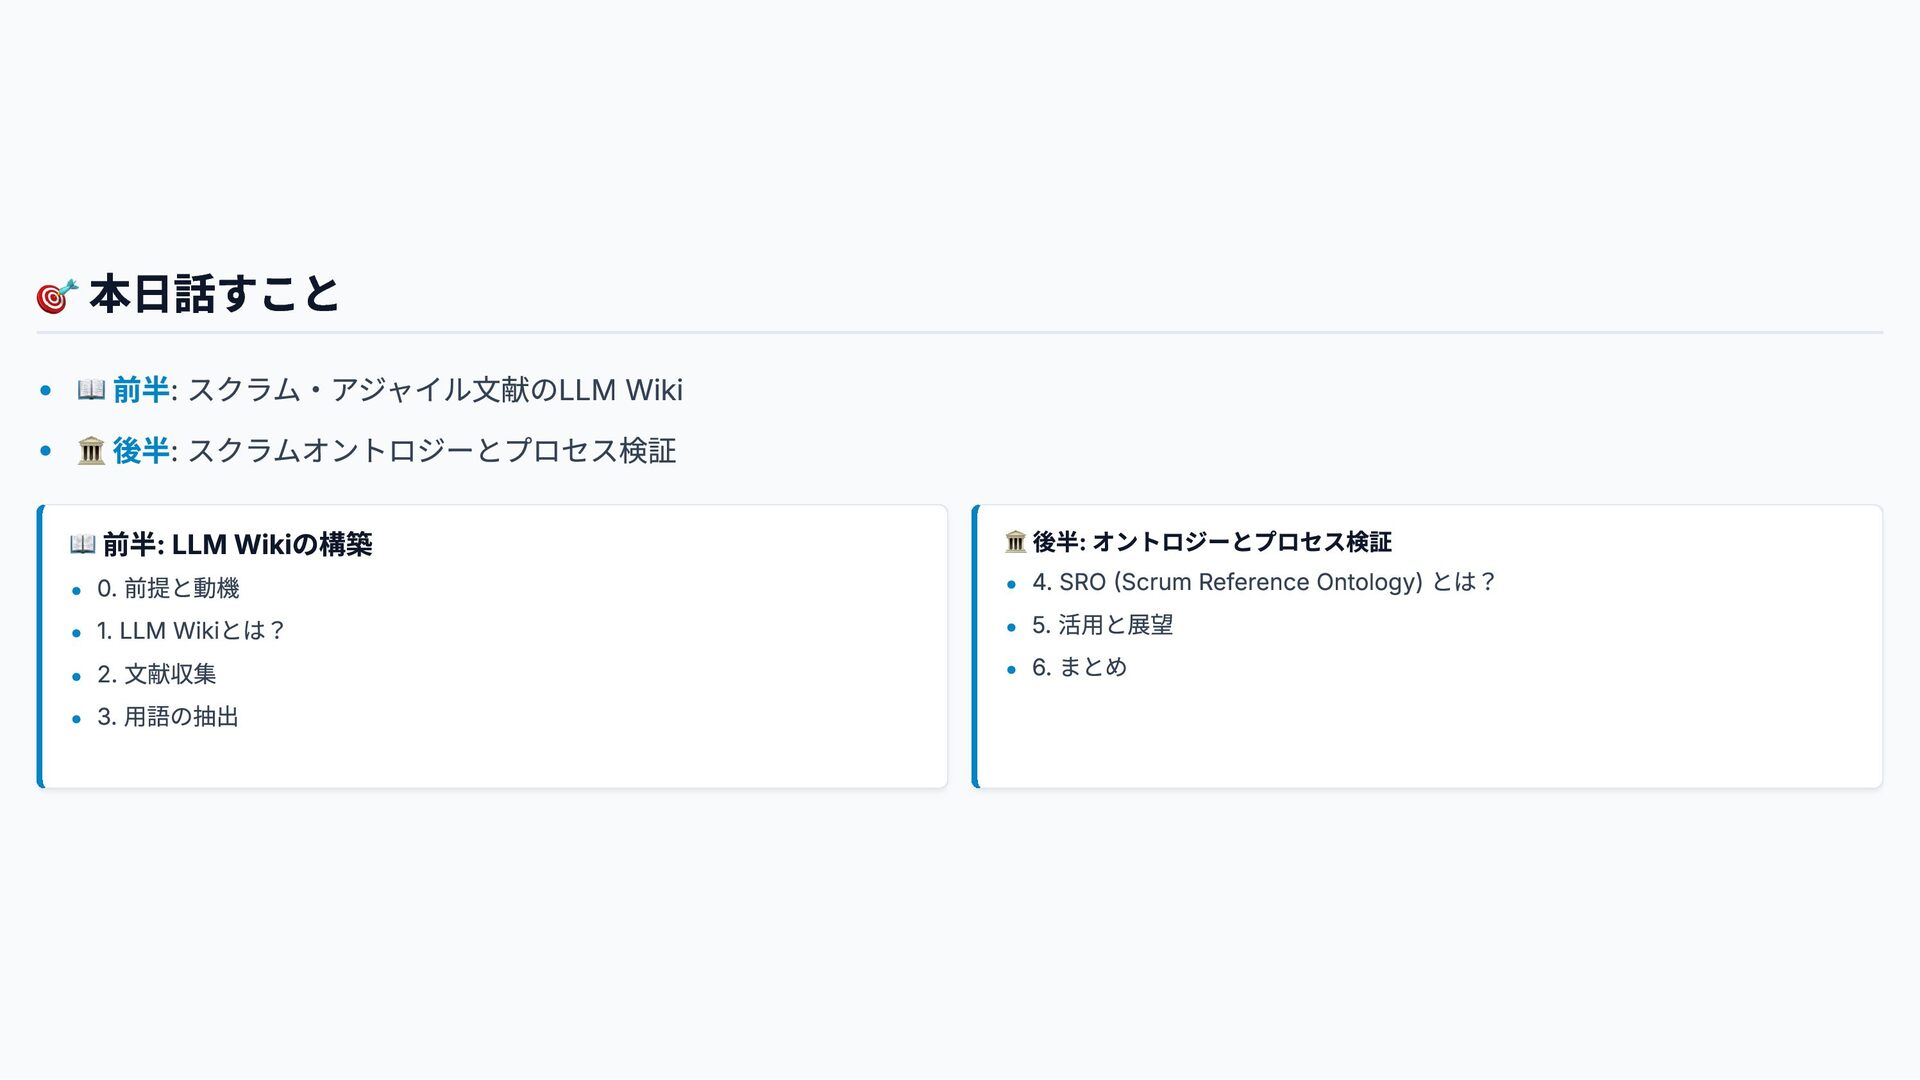
🎯 本日話すこと • 📖 前半: スクラム・アジャイル文献のLLM Wiki • 🏛️ 後半:
スクラムオントロジーとプロセス検証 📖 前半: LLM Wikiの構築 • 0. 前提と動機 • 1. LLM Wikiとは? • 2. 文献収集 • 3. 用語の抽出 🏛️ 後半: オントロジーとプロセス検証 • 4. SRO (Scrum Reference Ontology) とは? • 5. 活用と展望 • 6. まとめ -
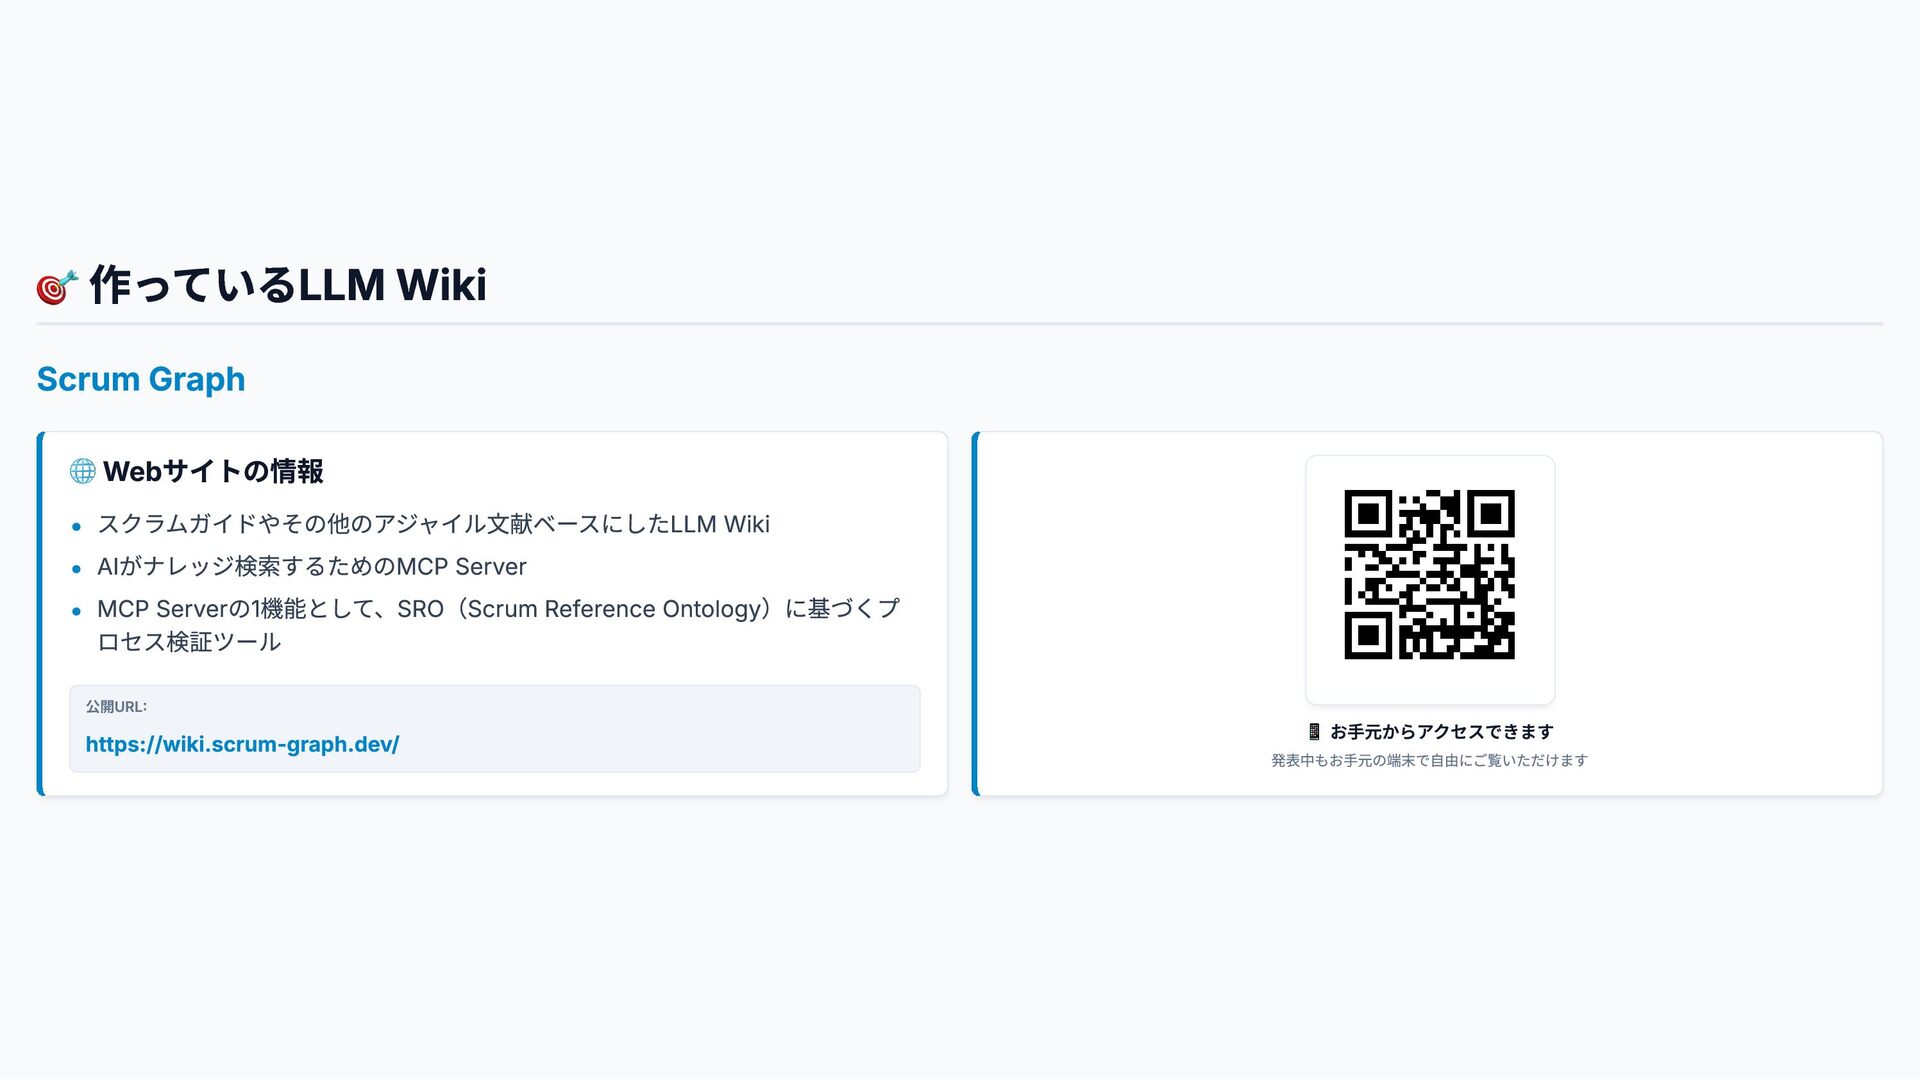
🎯 作っているLLM Wiki Scrum Graph 🌐 Webサイトの情報 • スクラムガイドやその他のアジャイル文献ベースにしたLLM Wiki
• AIがナレッジ検索するためのMCP Server • MCP Serverの1機能として、SRO(Scrum Reference Ontology)に基づくプ ロセス検証ツール 公開URL: https://wiki.scrum-graph.dev/ 📱 お手元からアクセスできます 発表中もお手元の端末で自由にご覧いただけます -
🧭 0. LLM Wikiを作るモチベーション • スクラムチームの新規立ち上げ時(2024年ごろ): – チームのジュニアメンバーがAIチャットにスクラムの質問して、回答を他のメンバー共有しているのを観測 – 立ち上げの支援をしていた立場としては、AIのハルシネーションが怖い
• そのときに思ったこと: – 文献の出所がしっかりしたスクラム・アジャイルのナレッジベースがあり、そこからAIが回答を返す仕組みがあると良さそう -
📚 1. LLM Wikiとは? (1/2) • 2026年4月にXでBuzzったGist: – llm-wiki.md •
従来のRAG(検索拡張生成)のように毎回ドキュメントからナレッジを合成するのではなく、 ドキュメントを登録、更新、削除した時にLLMがナレッジを自律的に構築・更新するという仕組み -
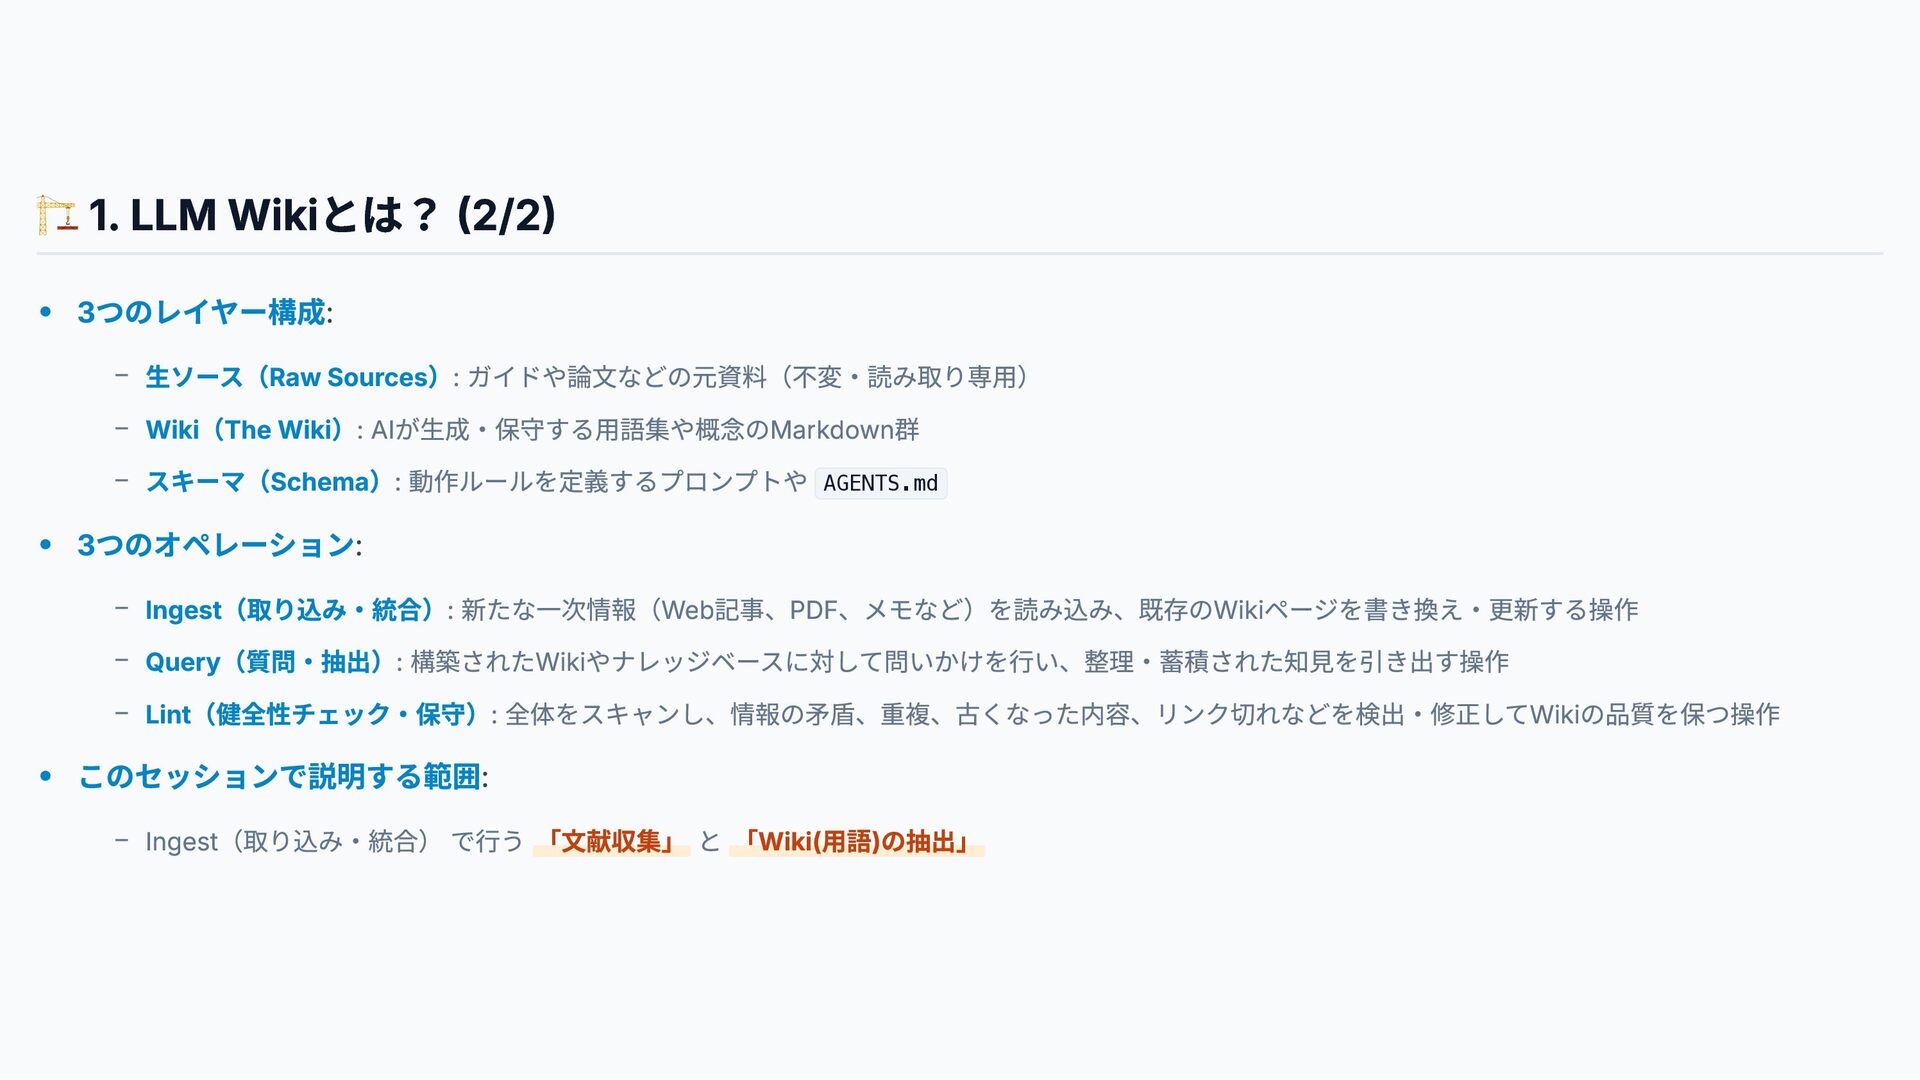
🏗️ 1. LLM Wikiとは? (2/2) • 3つのレイヤー構成: – 生ソース(Raw Sources):
ガイドや論文などの元資料(不変・読み取り専用) – Wiki(The Wiki): AIが生成・保守する用語集や概念のMarkdown群 – スキーマ(Schema): 動作ルールを定義するプロンプトや AGENTS.md • 3つのオペレーション: – Ingest(取り込み・統合): 新たな一次情報(Web記事、PDF、メモなど)を読み込み、既存のWikiページを書き換え・更新する操作 – Query(質問・抽出): 構築されたWikiやナレッジベースに対して問いかけを行い、整理・蓄積された知見を引き出す操作 – Lint(健全性チェック・保守): 全体をスキャンし、情報の矛盾、重複、古くなった内容、リンク切れなどを検出・修正してWikiの品質を保つ操作 • このセッションで説明する範囲: – Ingest(取り込み・統合) で行う 「文献収集」 と 「Wiki(用語)の抽出」 -
💭 2. 文献収集 (1/3) 当初の目論見と直面した課題 → 当初の目論見: • スクラムガイドを軸にプロンプトを作り、AIでリサーチすれば有用な文献は収集できると想定 →
試した手法: • Gemini Deep Researchでリサーチし、Gemini SparkでGoogleスプレッドシートにストック → 直面した課題: • 検索プロンプトが思いつかなくなり、プロンプトを考えるのに疲弊する • ライセンスのファクトチェック(二次利用可否の確認)が煩雑 • 抽出できたWikiが辞書的な解説にとどまり、なにか足りない -
🚧 2. 文献収集 (2/3) スクラムチーム立ち上げ時の観測結果をふりかえる → なぜ、ジュニアメンバーはチャットでAIに質問していたのか?: • 実際どうやればいいのか?(How)を知りたい •
なぜそのルールがあるのか?本当に効果があるのか?(Why)を知りたい -
🎯 2. 文献収集 (3/3) 文献の収集方法を変更。スクラムガイドを「文単位」で実証研究と紐付ける → アプローチを変える: • スクラムガイドをセンテンス(文単位・全301文)に分解 •
分解したセンテンス単位で、論文検索APIでライセンスを指定して論文取得 • 論文に対して「スクラムガイドのセンテンスを検証した実証研究か?」を確認して、「支持」「条件付き(落とし穴や副作用がある)」 と分類する • 対応づけした文献を構造化して管理 → 得られた効果: • 根拠つきでスクラムガイドのWhy,Howを回答できる情報が集まる -
🏷️ 3. 用語の抽出 (1/3) どのように用語を抽出するか? → 当初の目論見: • llm-wiki.md をベースにAIスキルを作れば、自律的に用語が抽出・整理されると想定
→ 直面した課題: • 用語の乱立: 表記揺れで類似の別ページが生成(例: Developer と Developers ) • 孤立した用語の増加: 他ページからリンクされない孤立用語ページが多数生まれる -
🔄 3. 用語の抽出 (2/3) 解決策:人間が定義済みの用語を「アンカー」にする → 解決策1:SRO(Scrum Reference Ontology)の概念を利用: •
SROの概念を用語の上位レベルとして利用、検索やリンク付与時に優先スコアリング → 解決策2:『Scrum Guide Reordered(日本語版)』: • スクラムガイドをトピック・キーワード別に再編成したドキュメント(Stefan Wolpers氏作成 / Ryuzeeさん邦訳) • キーワードをアンカーとして利用可能 • スクラムガイドの文と、トピック・キーワードの逆引きができる → 解決策3:ガイド文献の公式用語集を活用: • Scrum Guide Expansion Pack / EBM Guide / The Flow System Guide / Kanban Guide 2025 等の公式用語集を抽出 -
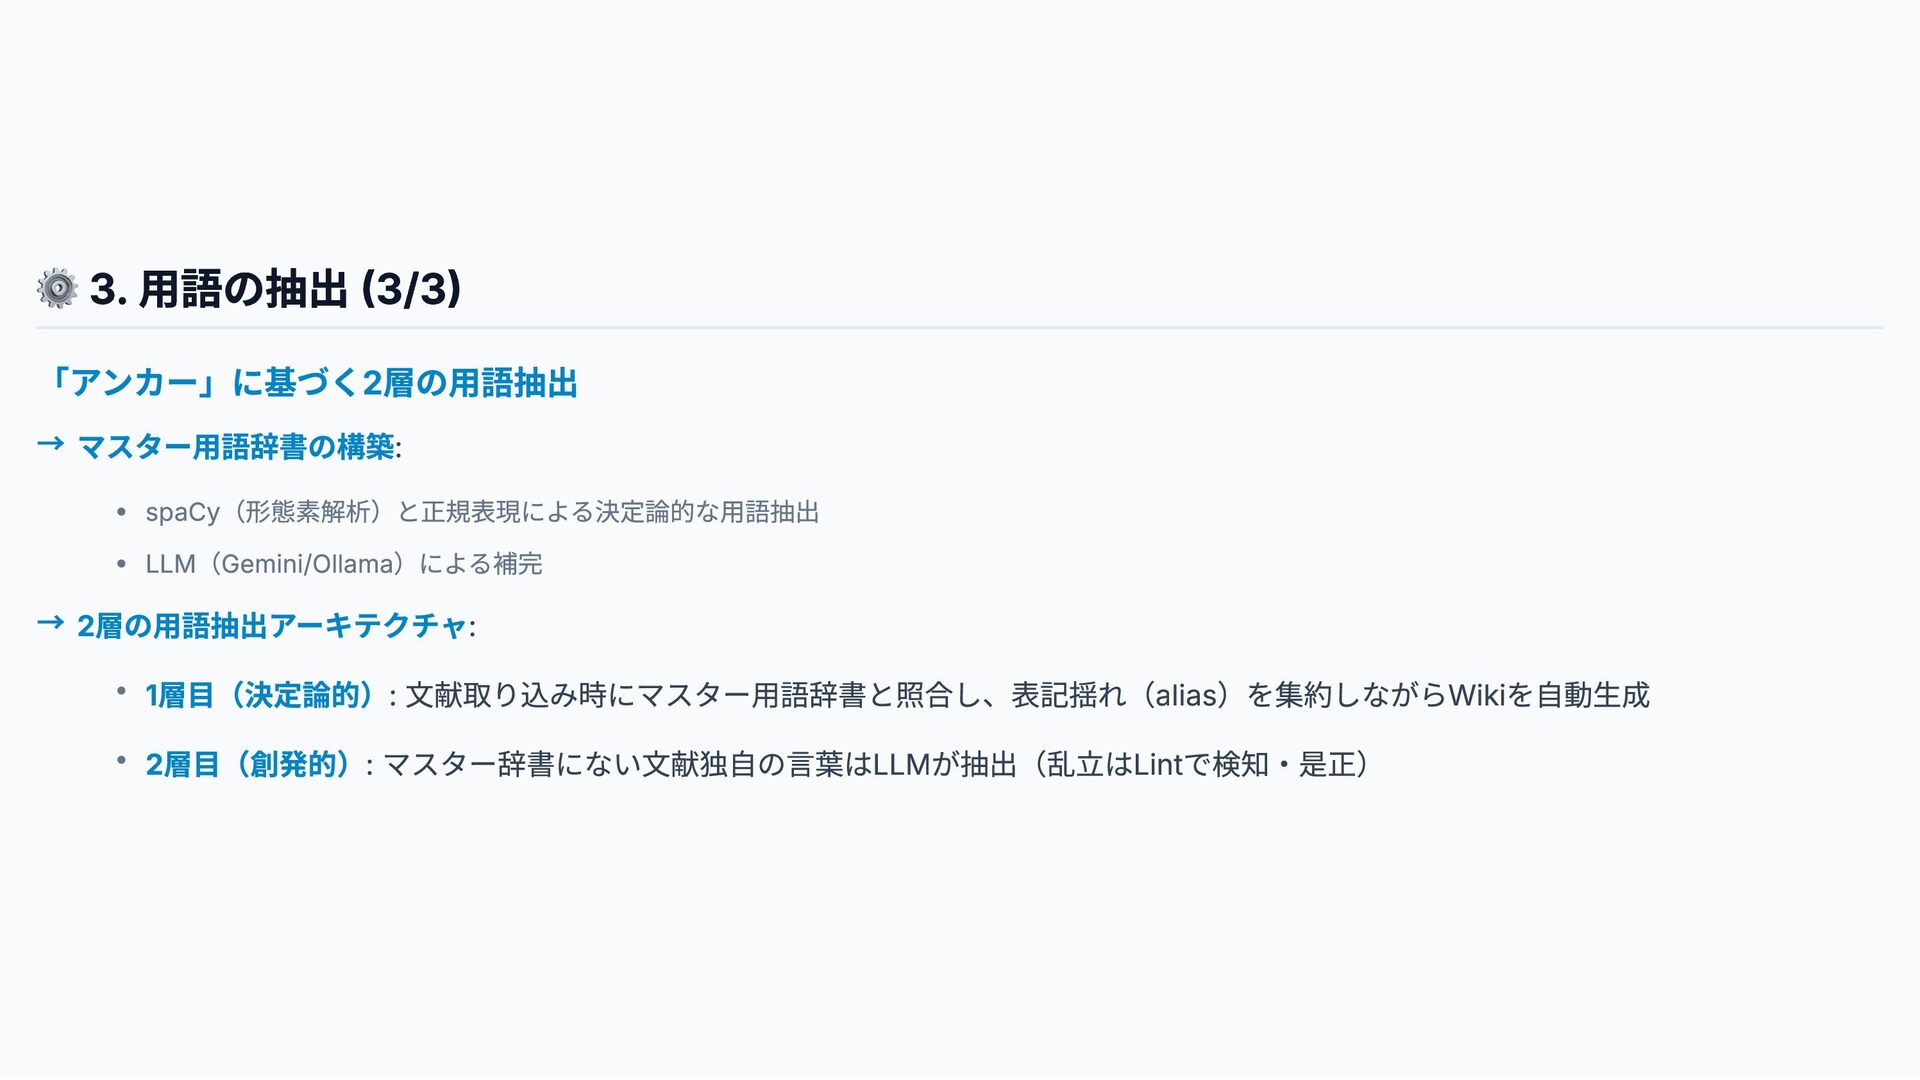
⚙️ 3. 用語の抽出 (3/3) 「アンカー」に基づく2層の用語抽出 → マスター用語辞書の構築: • spaCy(形態素解析)と正規表現による決定論的な用語抽出 •
LLM(Gemini/Ollama)による補完 → 2層の用語抽出アーキテクチャ: • 1層目(決定論的): 文献取り込み時にマスター用語辞書と照合し、表記揺れ(alias)を集約しながらWikiを自動生成 • 2層目(創発的): マスター辞書にない文献独自の言葉はLLMが抽出(乱立はLintで検知・是正) -
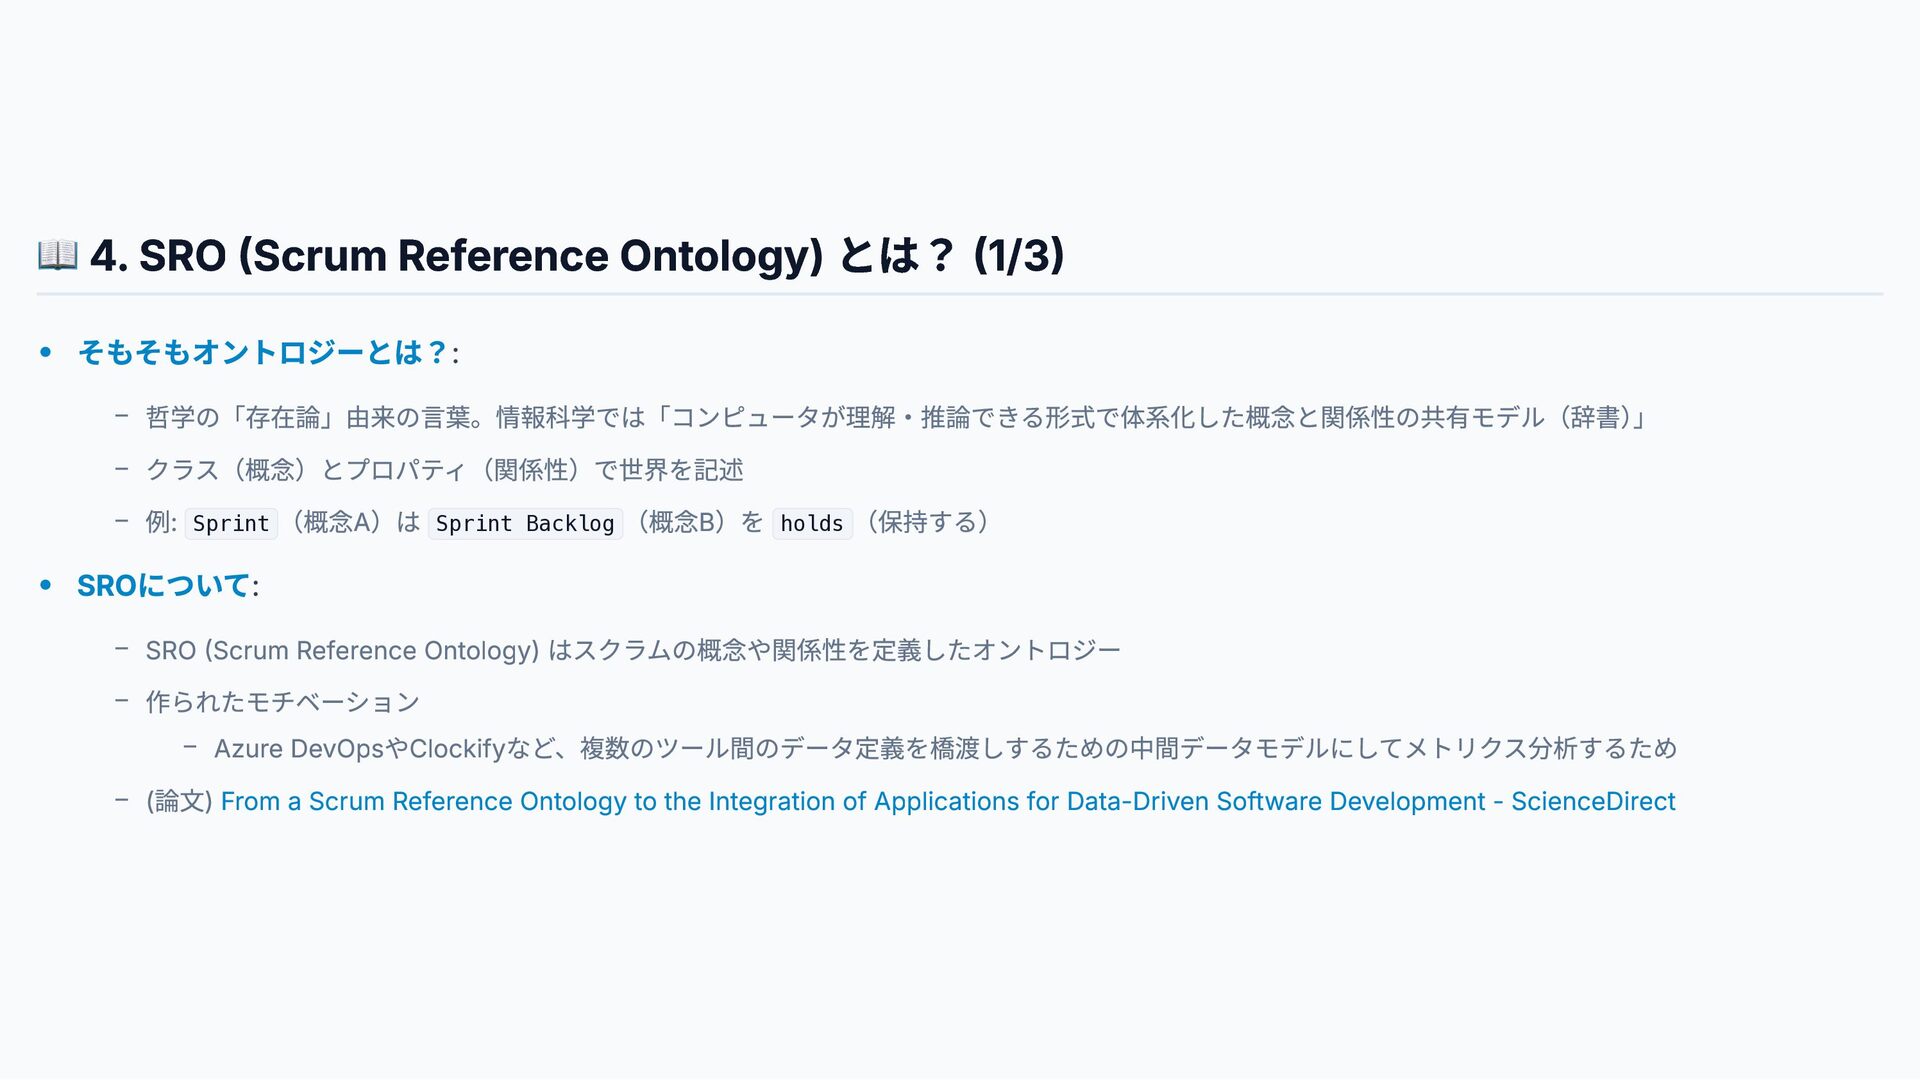
📖 4. SRO (Scrum Reference Ontology) とは? (1/3) • そもそもオントロジーとは?:
– 哲学の「存在論」由来の言葉。情報科学では「コンピュータが理解・推論できる形式で体系化した概念と関係性の共有モデル(辞書)」 – クラス(概念)とプロパティ(関係性)で世界を記述 – 例: Sprint (概念A)は Sprint Backlog (概念B)を holds (保持する) • SROについて: – SRO (Scrum Reference Ontology) はスクラムの概念や関係性を定義したオントロジー – 作られたモチベーション – Azure DevOpsやClockifyなど、複数のツール間のデータ定義を橋渡しするための中間データモデルにしてメトリクス分析するため – (論文) From a Scrum Reference Ontology to the Integration of Applications for Data-Driven Software Development - ScienceDirect -
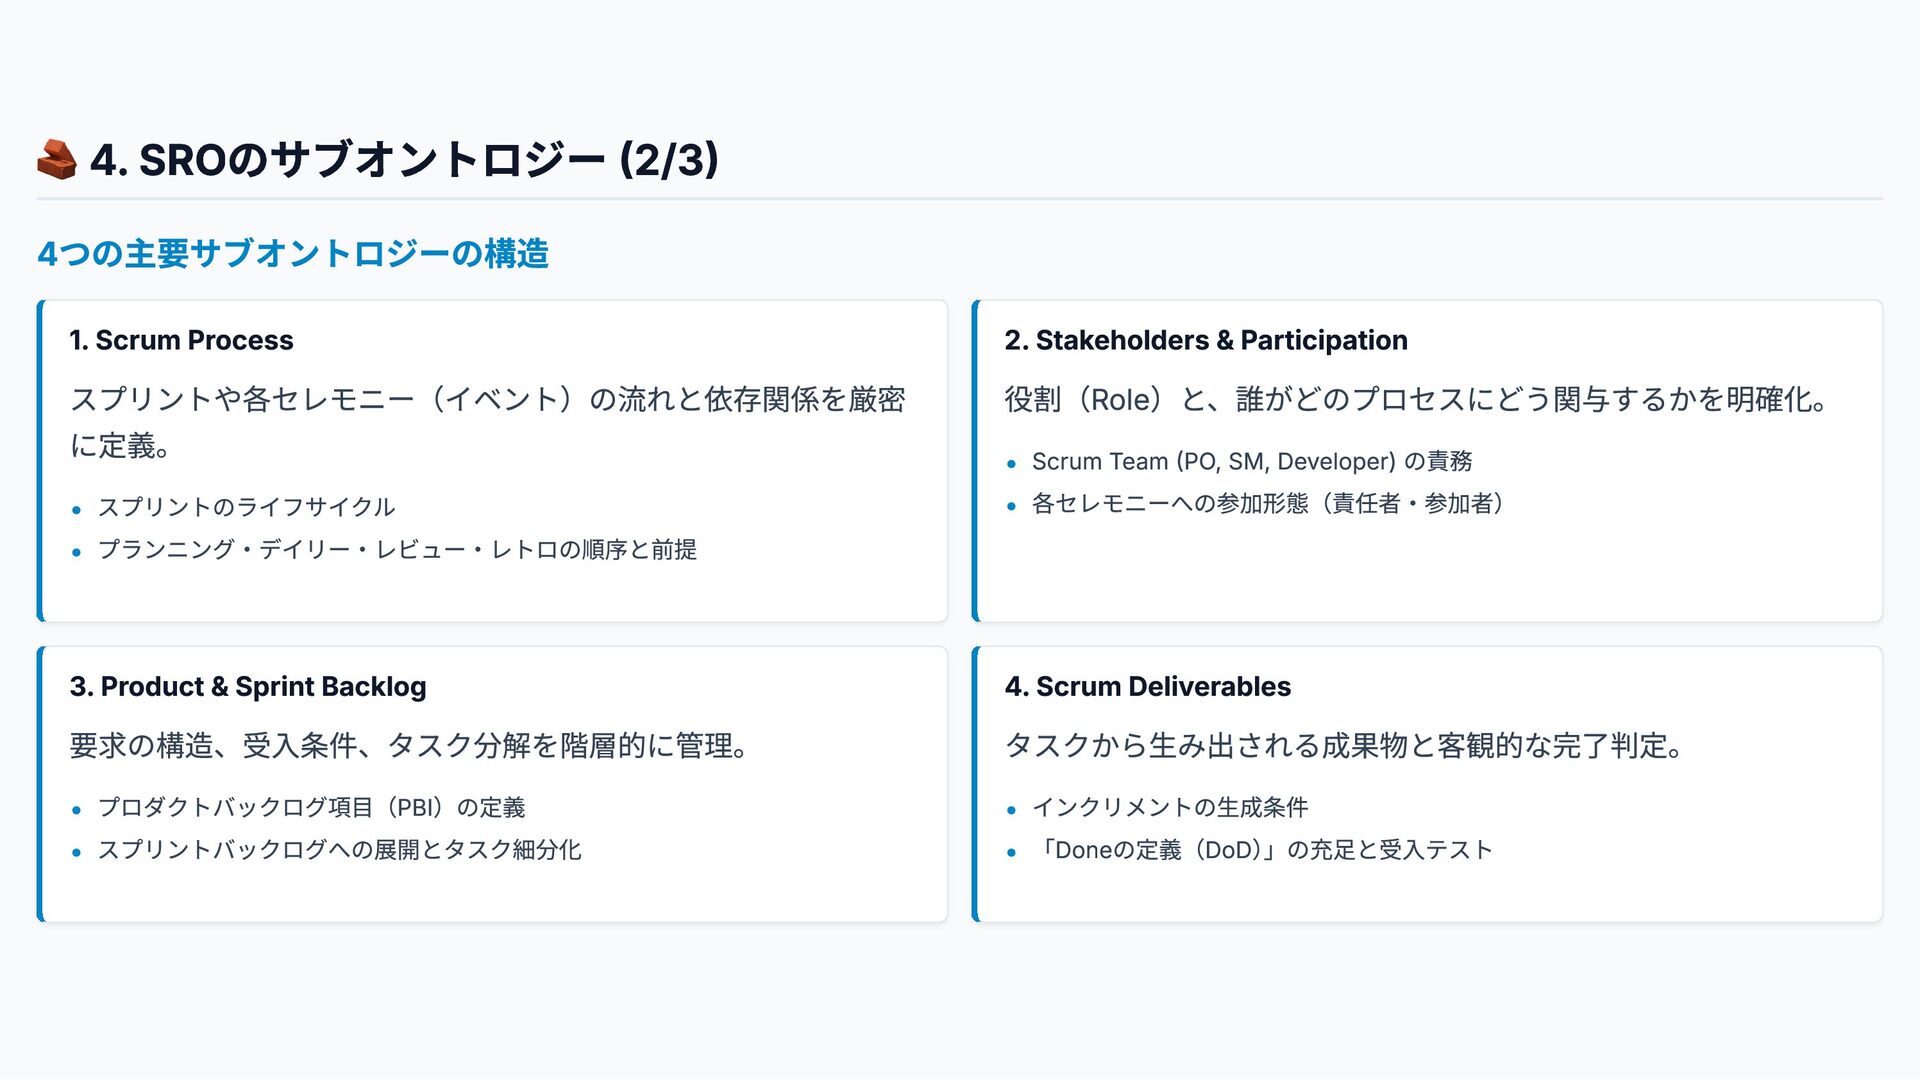
🧱 4. SROのサブオントロジー (2/3) 4つの主要サブオントロジーの構造 1. Scrum Process スプリントや各セレモニー(イベント)の流れと依存関係を厳密 に定義。
• スプリントのライフサイクル • プランニング・デイリー・レビュー・レトロの順序と前提 2. Stakeholders & Participation 役割(Role)と、誰がどのプロセスにどう関与するかを明確化。 • Scrum Team (PO, SM, Developer) の責務 • 各セレモニーへの参加形態(責任者・参加者) 3. Product & Sprint Backlog 4. Scrum Deliverables • プロダクトバックログ項目(PBI)の定義 • スプリントバックログへの展開とタスク細分化 • インクリメントの生成条件 • 「Doneの定義(DoD)」の充足と受入テスト 要求の構造、受入条件、タスク分解を階層的に管理。 タスクから生み出される成果物と客観的な完了判定。 -
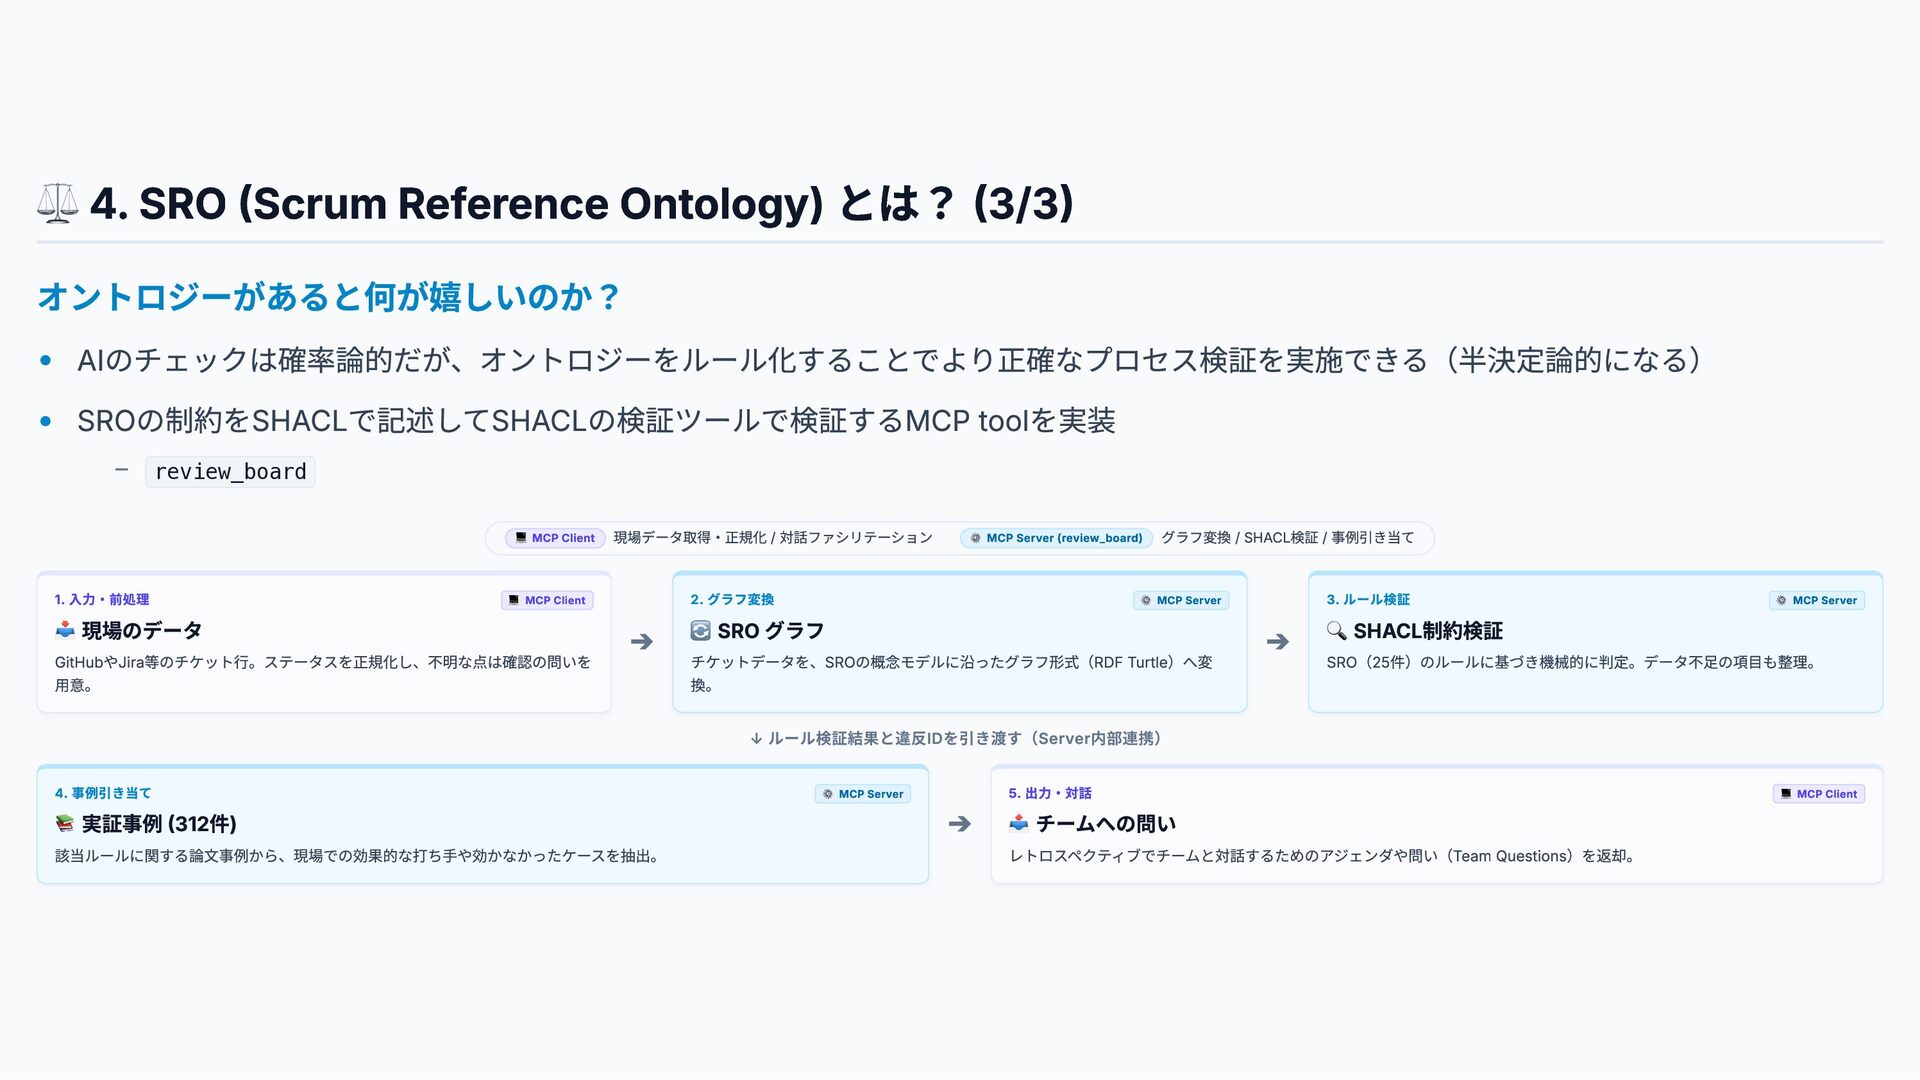
⚖️ 4. SRO (Scrum Reference Ontology) とは? (3/3) オントロジーがあると何が嬉しいのか? •
AIのチェックは確率論的だが、オントロジーをルール化することでより正確なプロセス検証を実施できる(半決定論的になる) • SROの制約をSHACLで記述してSHACLの検証ツールで検証するMCP toolを実装 – review_board 💻 MCP Client 1. 入力・前処理 📥 現場のデータ 現場データ取得・正規化 / 対話ファシリテーション 2. グラフ変換 💻 MCP Client GitHubやJira等のチケット行。ステータスを正規化し、不明な点は確認の問いを ⚙️ MCP Server (review_board) ➔ 用意。 グラフ変換 / SHACL検証 / 事例引き当て 3. ルール検証 ⚙️ MCP Server 🔄 SRO グラフ チケットデータを、SROの概念モデルに沿ったグラフ形式(RDF Turtle)へ変 換。 ➔ 🔍 SHACL制約検証 ⚙️ MCP Server SRO(25件)のルールに基づき機械的に判定。データ不足の項目も整理。 ↓ ルール検証結果と違反IDを引き渡す(Server内部連携) 4. 事例引き当て 📚 実証事例 (312件) 該当ルールに関する論文事例から、現場での効果的な打ち手や効かなかったケースを抽出。 5. 出力・対話 ⚙️ MCP Server ➔ 📤 チームへの問い レトロスペクティブでチームと対話するためのアジェンダや問い(Team Questions)を返却。 💻 MCP Client -
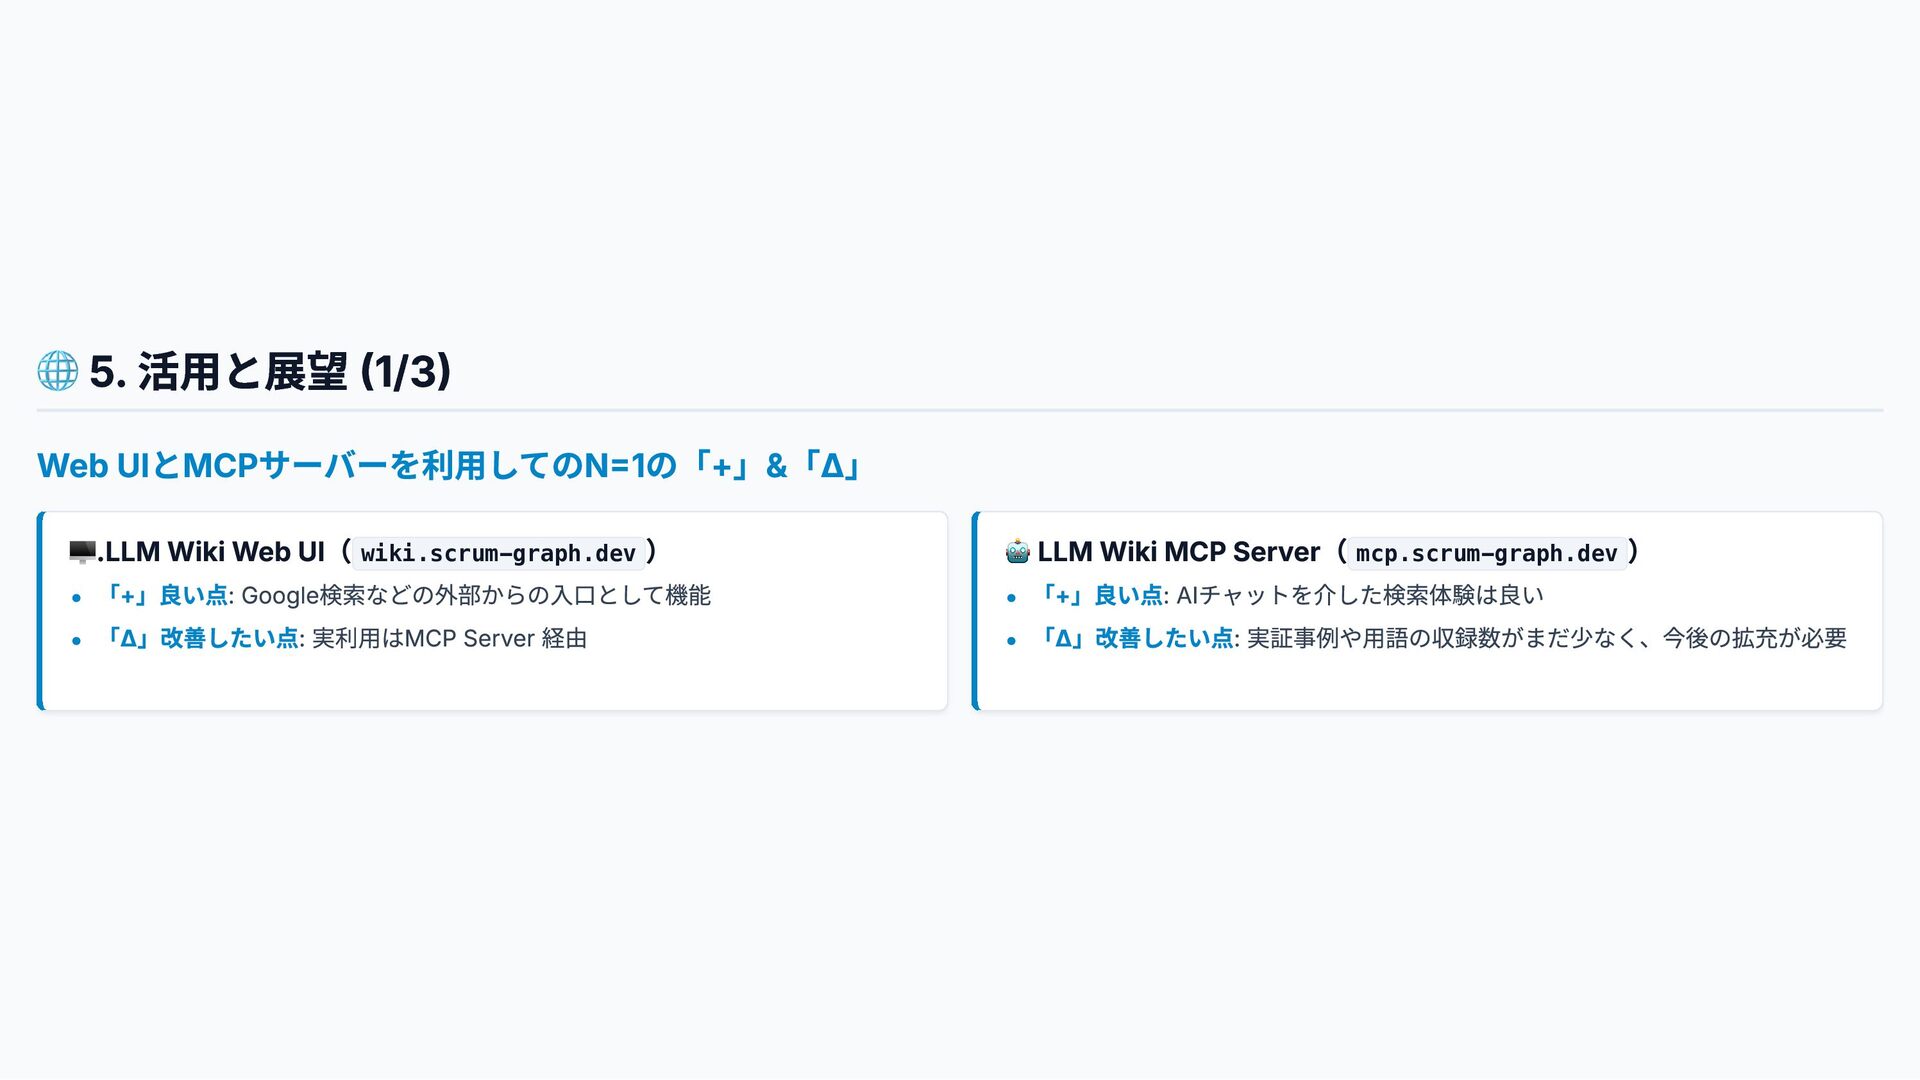
🌐 5. 活用と展望 (1/3) Web UIとMCPサーバーを利用してのN=1の「+」&「Δ」 🖥️.LLM Wiki Web UI(
wiki.scrum-graph.dev ) • 「+」良い点: Google検索などの外部からの入口として機能 • 「Δ」改善したい点: 実利用はMCP Server 経由 🤖 LLM Wiki MCP Server( mcp.scrum-graph.dev ) • 「+」良い点: AIチャットを介した検索体験は良い • 「Δ」改善したい点: 実証事例や用語の収録数がまだ少なく、今後の拡充が必要 -
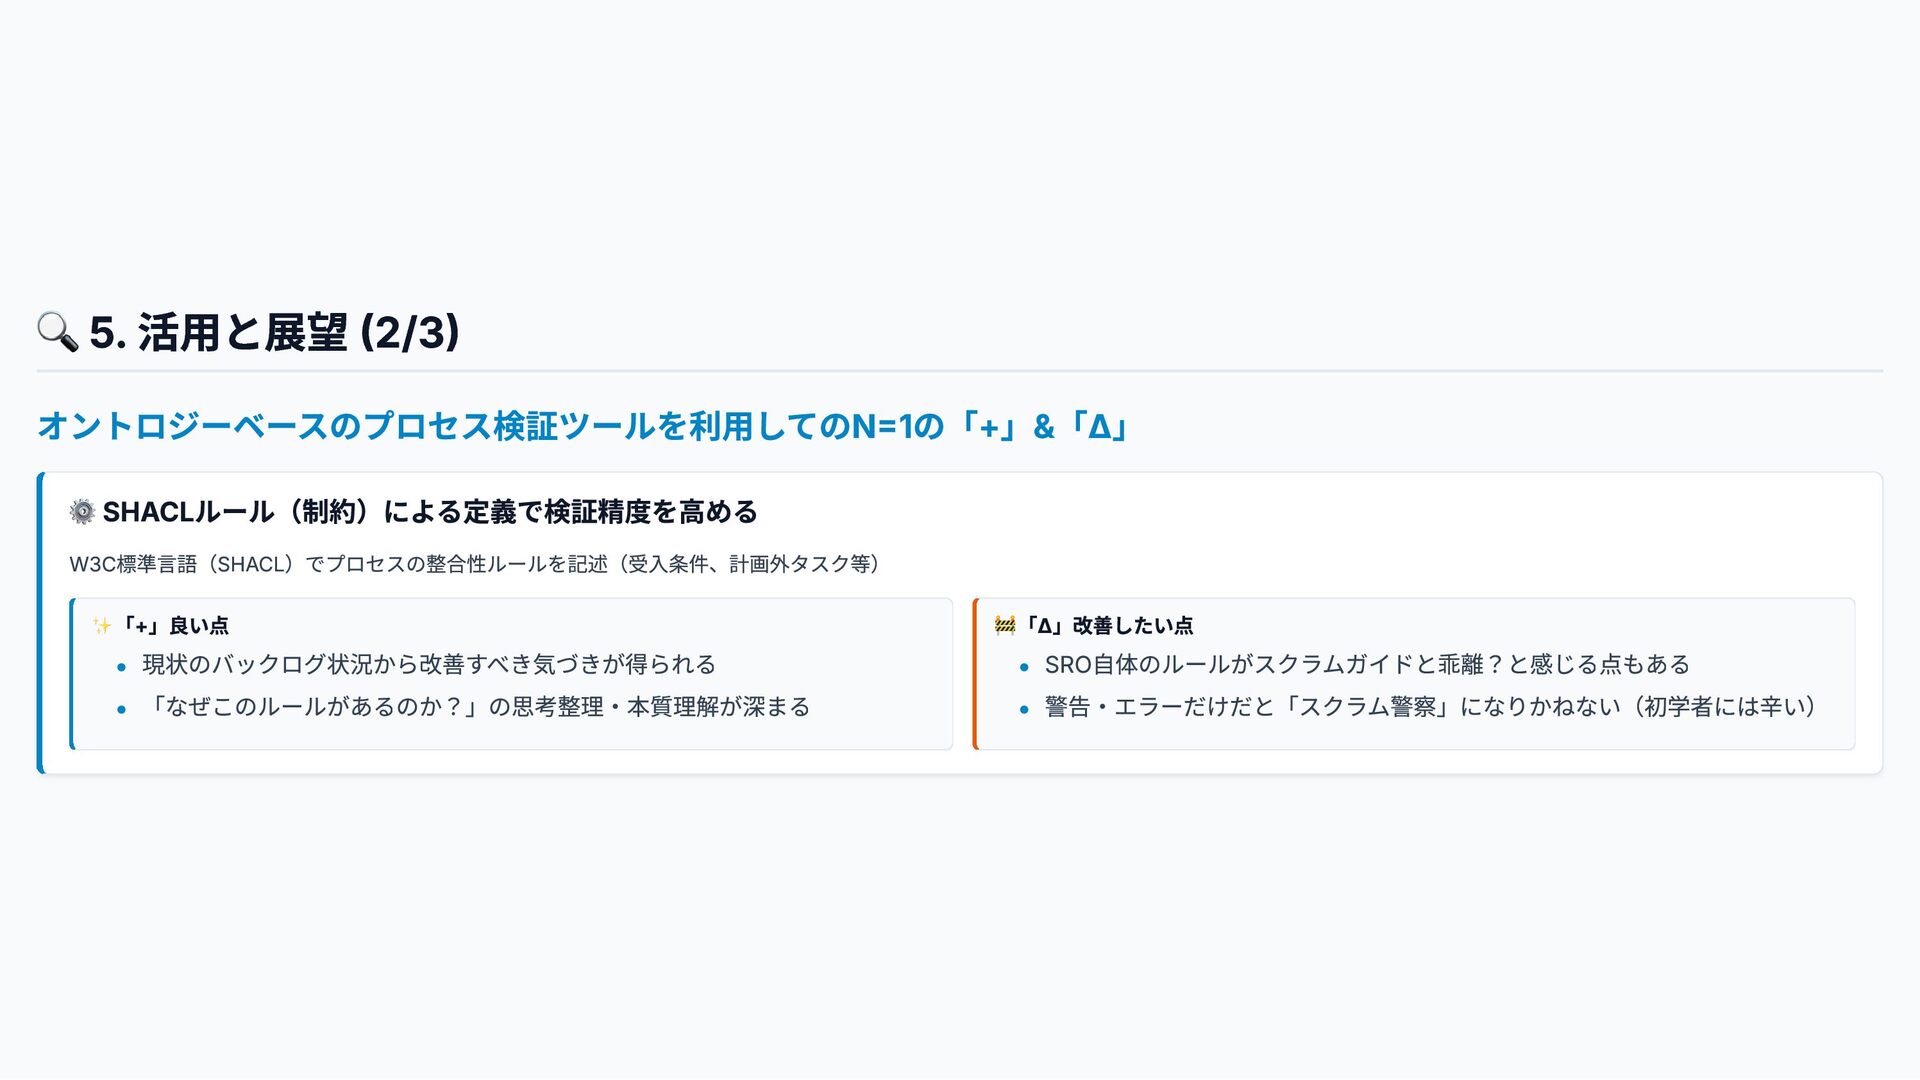
🔍 5. 活用と展望 (2/3) オントロジーベースのプロセス検証ツールを利用してのN=1の「+」&「Δ」 ⚙️ SHACLルール(制約)による定義で検証精度を高める W3C標準言語(SHACL)でプロセスの整合性ルールを記述(受入条件、計画外タスク等) ✨ 「+」良い点
• 現状のバックログ状況から改善すべき気づきが得られる • 「なぜこのルールがあるのか?」の思考整理・本質理解が深まる 🚧 「Δ」改善したい点 • SRO自体のルールがスクラムガイドと乖離?と感じる点もある • 警告・エラーだけだと「スクラム警察」になりかねない(初学者には辛い) -
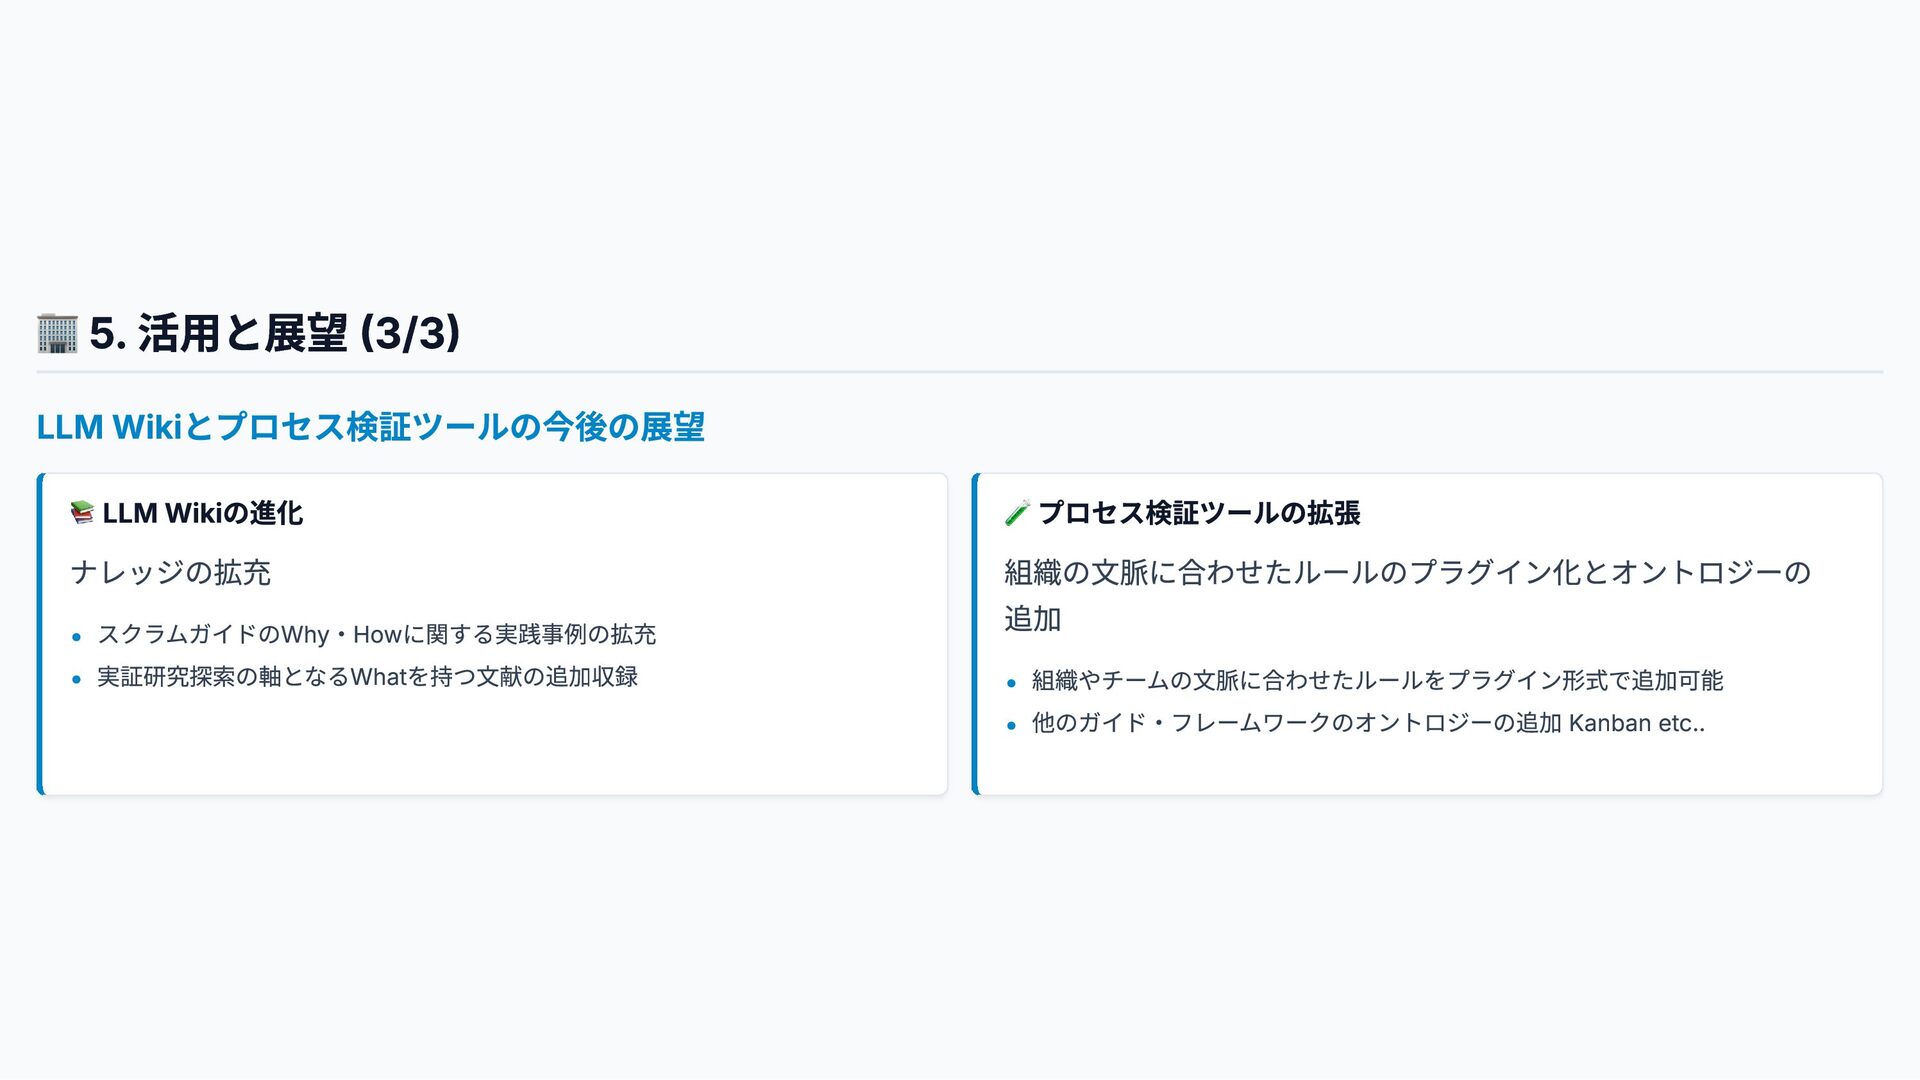
🏢 5. 活用と展望 (3/3) LLM Wikiとプロセス検証ツールの今後の展望 📚 LLM Wikiの進化 ナレッジの拡充
• スクラムガイドのWhy・Howに関する実践事例の拡充 • 実証研究探索の軸となるWhatを持つ文献の追加収録 🧪 プロセス検証ツールの拡張 組織の文脈に合わせたルールのプラグイン化とオントロジーの 追加 • 組織やチームの文脈に合わせたルールをプラグイン形式で追加可能 • 他のガイド・フレームワークのオントロジーの追加 Kanban etc.. -
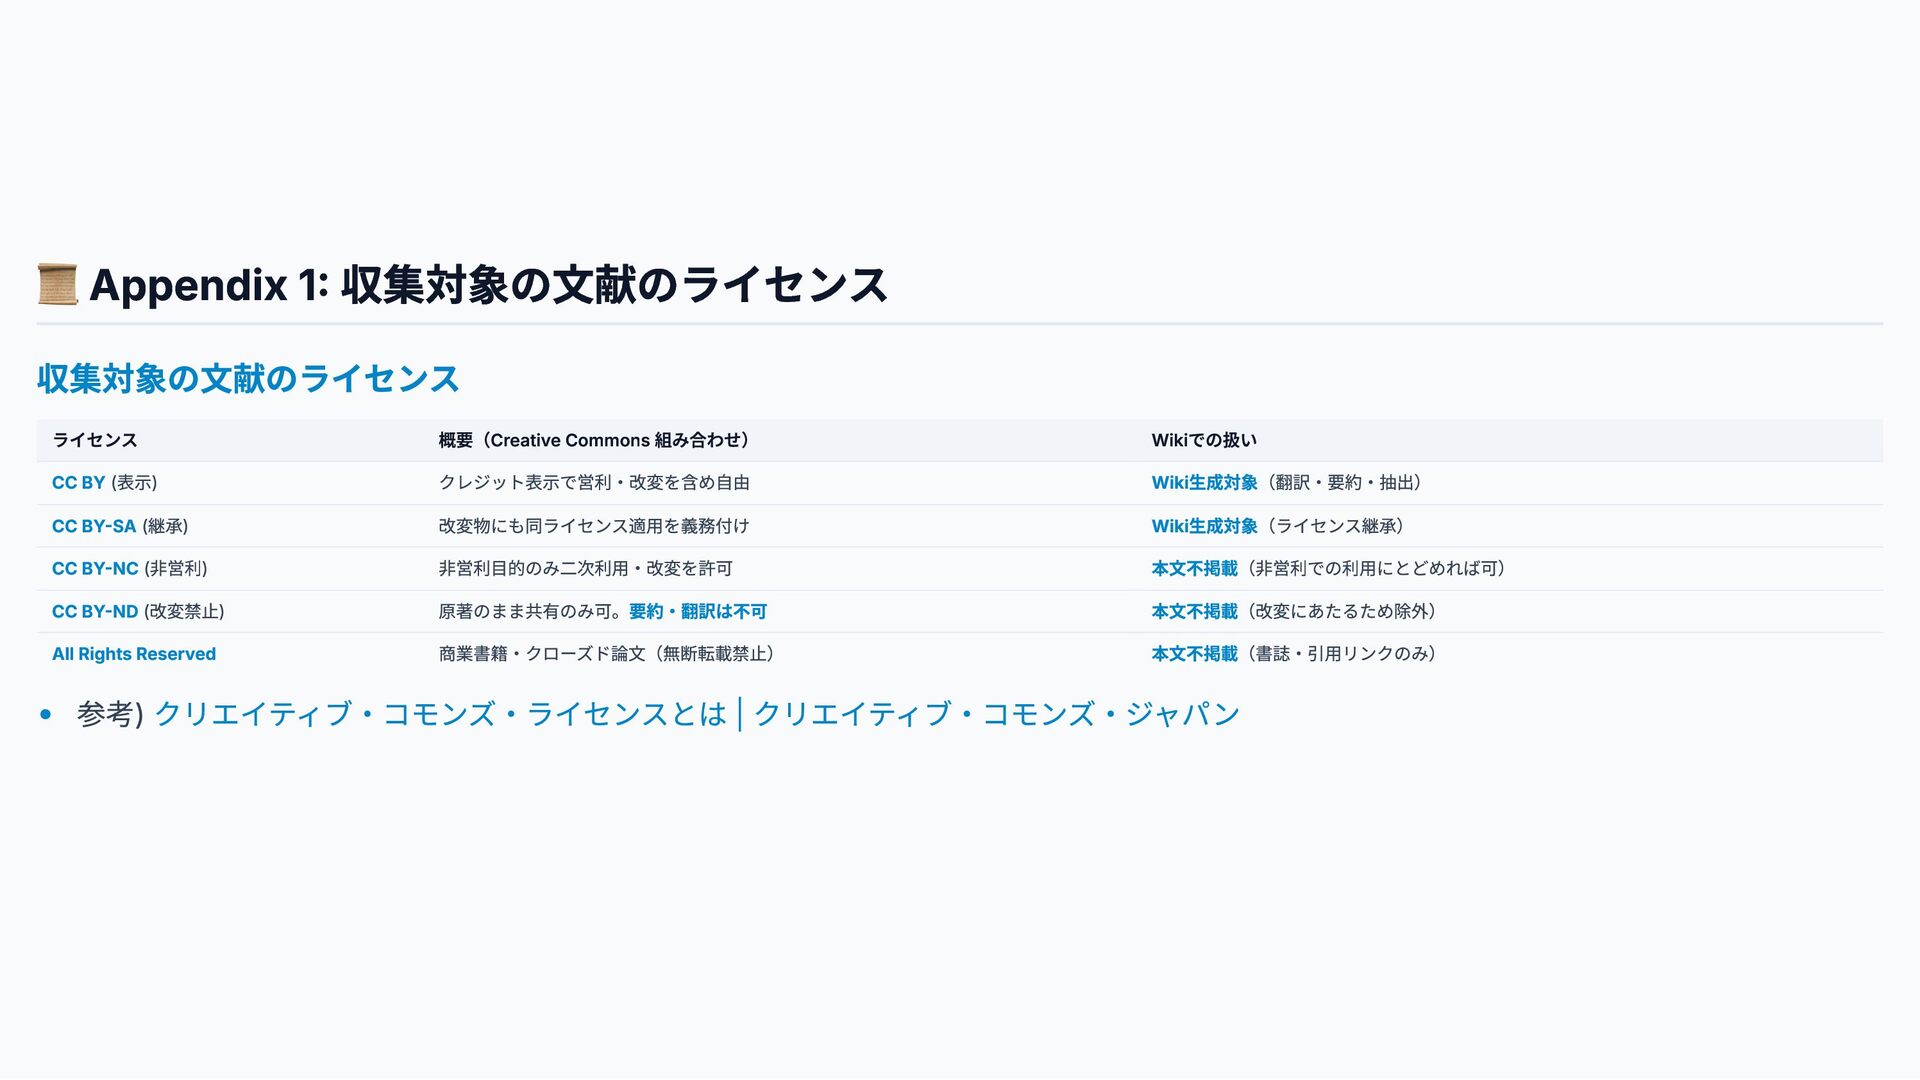
📜 Appendix 1: 収集対象の文献のライセンス 収集対象の文献のライセンス ライセンス CC BY (表示) CC
BY-SA (継承) CC BY-NC (非営利) CC BY-ND (改変禁止) All Rights Reserved 概要(Creative Commons 組み合わせ) クレジット表示で営利・改変を含め自由 改変物にも同ライセンス適用を義務付け 非営利目的のみ二次利用・改変を許可 原著のまま共有のみ可。要約・翻訳は不可 商業書籍・クローズド論文(無断転載禁止) Wikiでの扱い Wiki生成対象(翻訳・要約・抽出) Wiki生成対象(ライセンス継承) 本文不掲載(非営利での利用にとどめれば可) 本文不掲載(改変にあたるため除外) 本文不掲載(書誌・引用リンクのみ) • 参考) クリエイティブ・コモンズ・ライセンスとは | クリエイティブ・コモンズ・ジャパン -
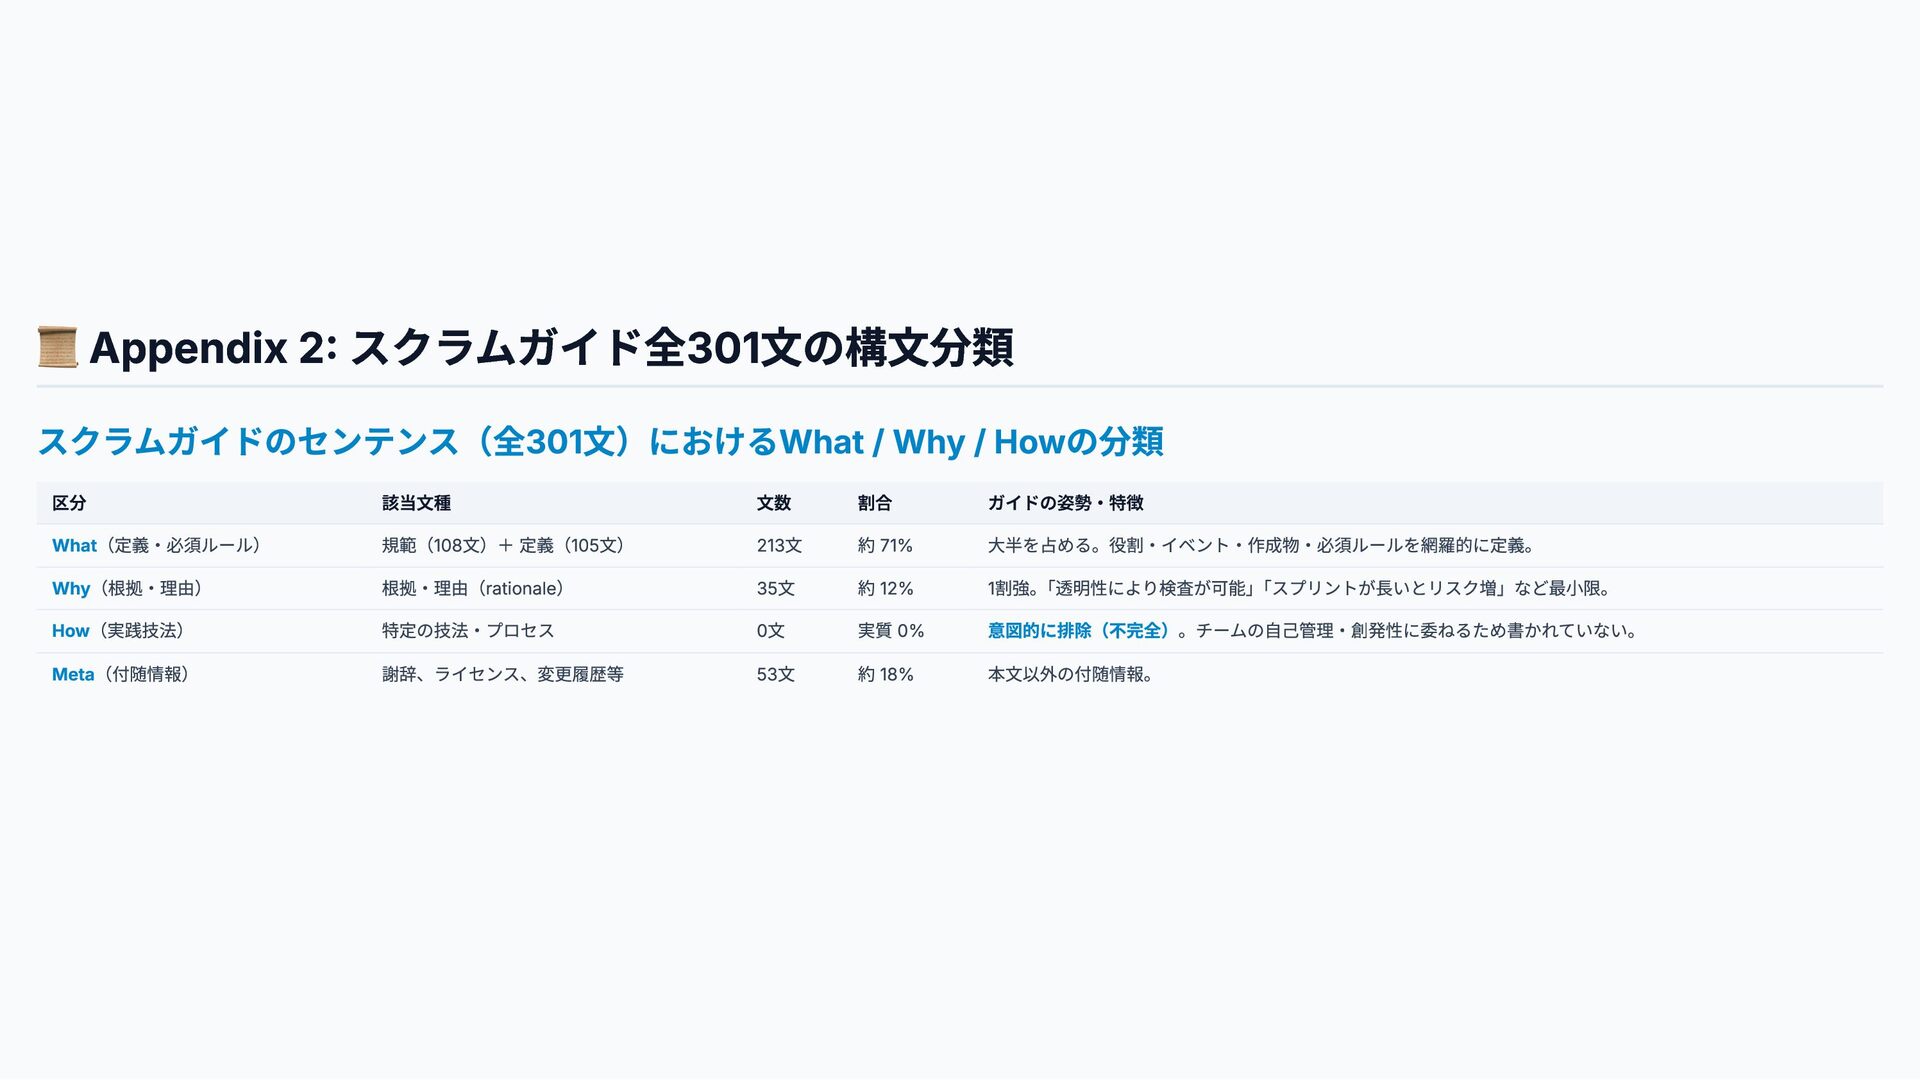
📜 Appendix 2: スクラムガイド全301文の構文分類 スクラムガイドのセンテンス(全301文)におけるWhat / Why / Howの分類 区分
What(定義・必須ルール) Why(根拠・理由) How(実践技法) Meta(付随情報) 該当文種 規範(108文)+ 定義(105文) 根拠・理由(rationale) 特定の技法・プロセス 謝辞、ライセンス、変更履歴等 文数 213文 35文 0文 53文 割合 約 71% 約 12% 実質 0% 約 18% ガイドの姿勢・特徴 大半を占める。役割・イベント・作成物・必須ルールを網羅的に定義。 1割強。「透明性により検査が可能」「スプリントが長いとリスク増」など最小限。 意図的に排除(不完全)。チームの自己管理・創発性に委ねるため書かれていない。 本文以外の付随情報。 -
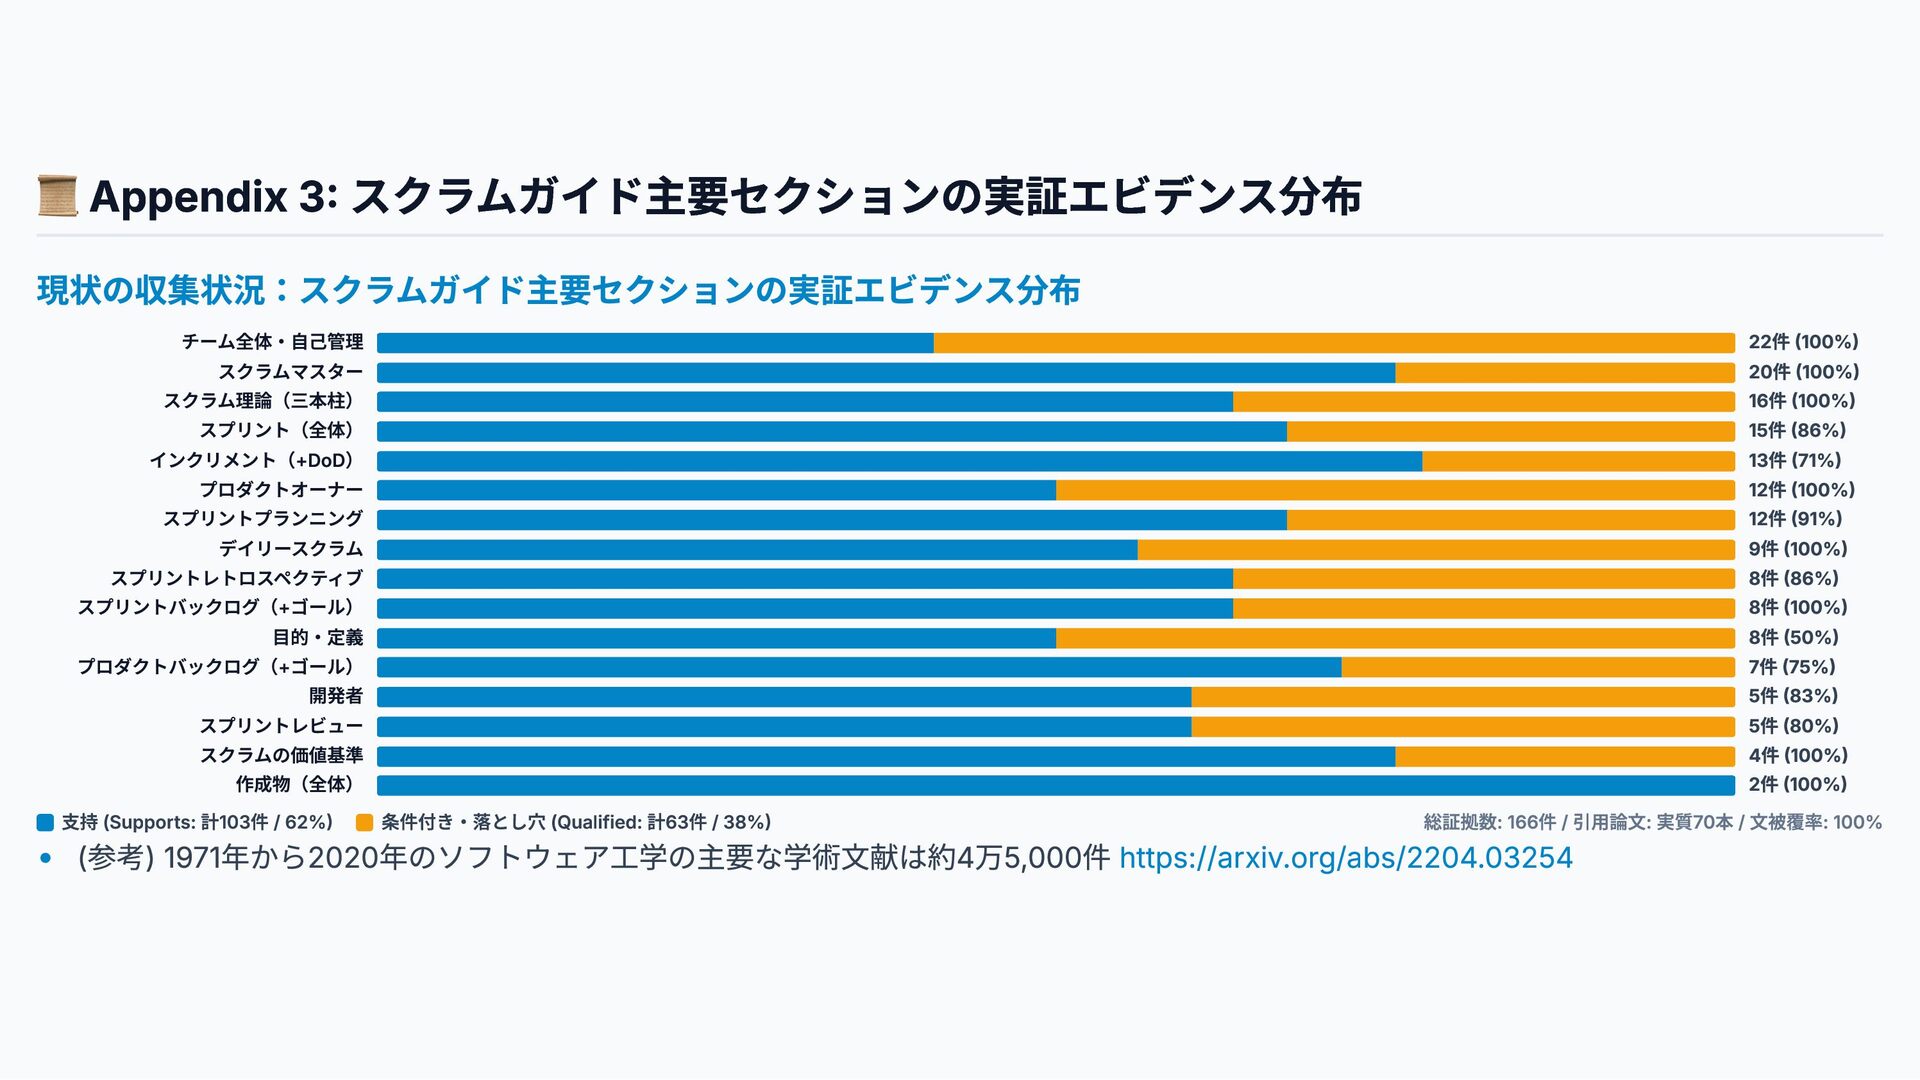
📜 Appendix 3: スクラムガイド主要セクションの実証エビデンス分布 現状の収集状況:スクラムガイド主要セクションの実証エビデンス分布 チーム全体・自己管理 22件 (100%) スクラムマスター 20件
(100%) スクラム理論(三本柱) 16件 (100%) スプリント(全体) 15件 (86%) インクリメント(+DoD) 13件 (71%) プロダクトオーナー 12件 (100%) スプリントプランニング 12件 (91%) デイリースクラム 9件 (100%) スプリントレトロスペクティブ 8件 (86%) スプリントバックログ(+ゴール) 8件 (100%) 目的・定義 8件 (50%) プロダクトバックログ(+ゴール) 7件 (75%) 開発者 5件 (83%) スプリントレビュー 5件 (80%) スクラムの価値基準 4件 (100%) 作成物(全体) 2件 (100%) 支持 (Supports: 計103件 / 62%) 条件付き・落とし穴 (Qualified: 計63件 / 38%) 総証拠数: 166件 / 引用論文: 実質70本 / 文被覆率: 100% • (参考) 1971年から2020年のソフトウェア工学の主要な学術文献は約4万5,000件 https://arxiv.org/abs/2204.03254