Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
老王教你配电脑.pdf
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
loveorchids
August 31, 2018
Technology
51
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
老王教你配电脑.pdf
loveorchids
August 31, 2018
Other Decks in Technology
See All in Technology
DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修
colopl
0
120
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
0
180
フィンテック養成勉強会#68
finengine
0
110
PHPカンファレンス関西の招待状 / Invitation to PHP Conference Kansai
ykanoh
0
200
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
730
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
200
「Docker Desktop不要の時代」は 来たのか?
ueponx
0
820
宣言型部分更新は何を解決しどこへ向かうのか
shuta13
1
470
React改造してみた
tsukina_7mochi
0
110
Browser Spec: Testing Hotwire with Ruby
takahashim
1
130
事業成長とデータ活用を止めないためのマネジメントへ挑戦
hiracky16
0
400
専門領域のAIをどう評価するか
bengo4com
2
280
Featured
See All Featured
From π to Pie charts
rasagy
1
400
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
750
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
A Tale of Four Properties
chriscoyier
163
24k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
How STYLIGHT went responsive
nonsquared
100
6.3k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
450
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
630
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.3k
Transcript
老王教 配 你 电脑
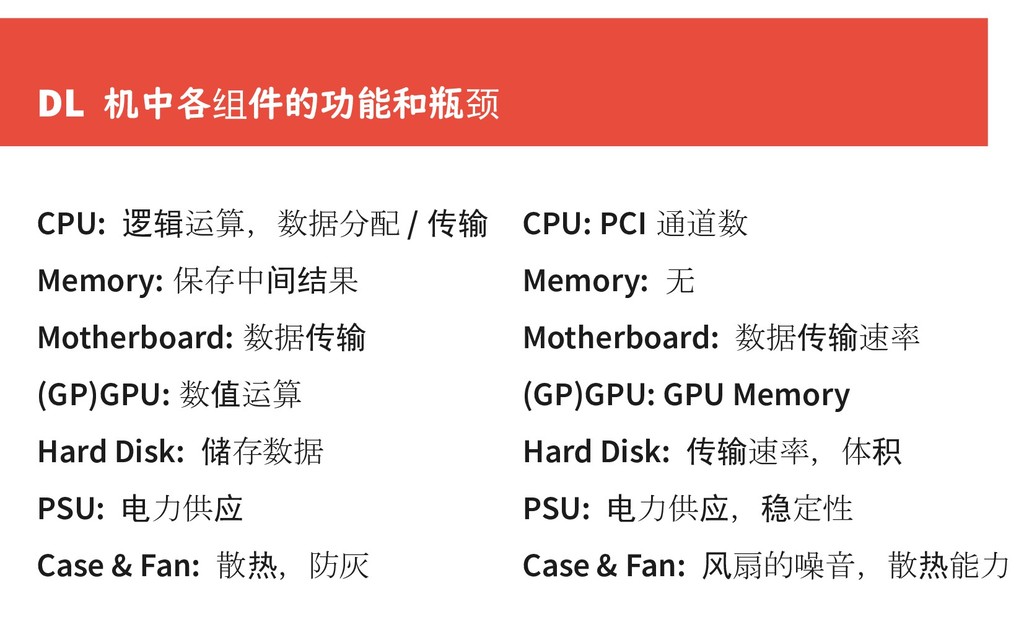
DL 机中各 件的功能和瓶 组 颈 CPU: 运算,数据分配 逻辑 / 传输
Memory: 保存中 果 间结 Motherboard: 数据传输 (GP)GPU: 数 运算 值 Hard Disk: 存数据 储 PSU: 力供 电 应 Case & Fan: 散 ,防灰 热 CPU: PCI 通道数 Memory: 无 Motherboard: 数据 速率 传输 (GP)GPU: GPU Memory Hard Disk: 速率,体 传输 积 PSU: 力供 , 定性 电 应 稳 Case & Fan: 扇的噪音,散 能力 风 热
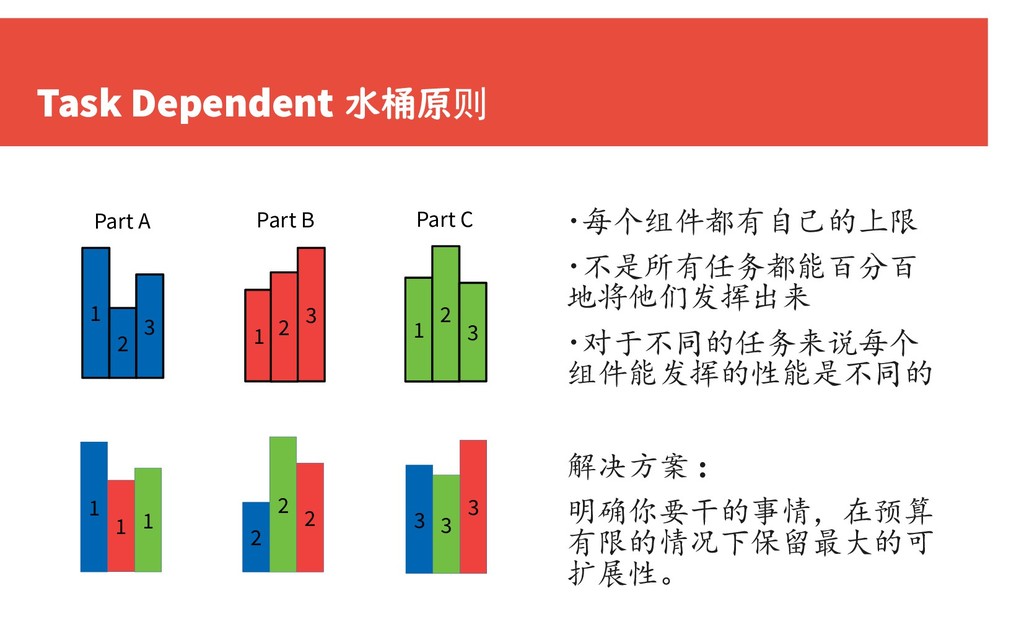
Task Dependent 水桶原则 每个组件都有自己的上限 ・ 不是所有任务都能百分百 ・ 地将他们发挥出来 对于不同的任务来说每个 ・
组件能发挥的性能是不同的 解决方案 : 明确你要干的事情,在预算 有限的情况下保留最大的可 扩展性。 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3 Part A Part B Part C
想定 业务 常 的 : 见 问题 我要做什么(数据分析,自然 言, 像
, 等) 别 语 图 识 视频 我的瓶 在哪里? 颈 我期望的速度是多少?
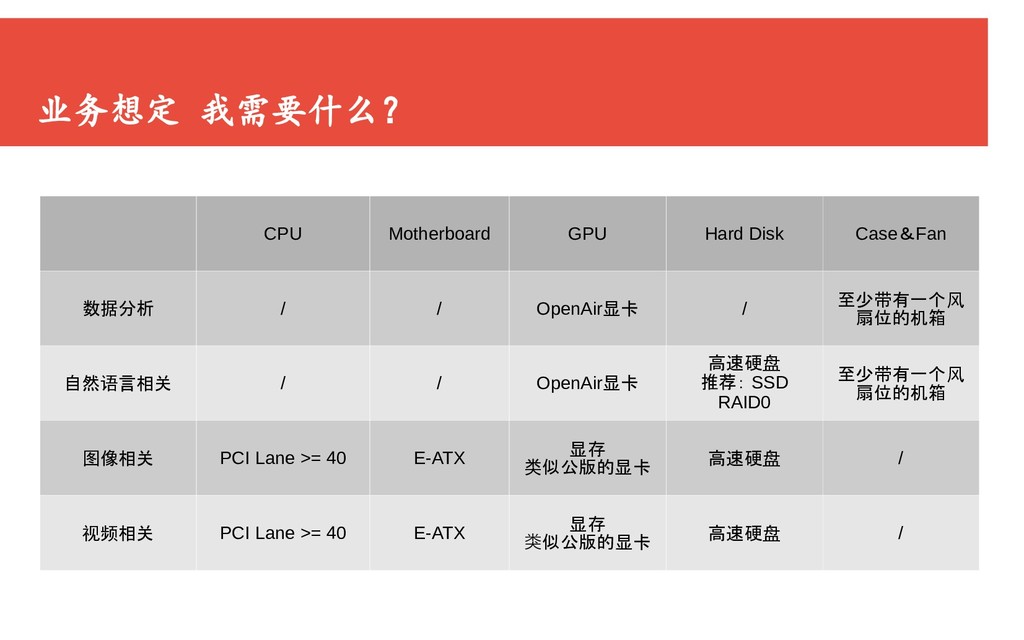
业务想定 我需要什么? CPU Motherboard GPU Hard Disk Case&Fan 数据分析 /
/ OpenAir 卡 显 / 至少 有一个 带 风 扇位的机箱 自然 言相关 语 / / OpenAir 卡 显 高速硬盘 推荐: SSD RAID0 至少 有一个 带 风 扇位的机箱 像相关 图 PCI Lane >= 40 E-ATX 存 显 似公版的 卡 类 显 高速硬盘 / 相关 视频 PCI Lane >= 40 E-ATX 存 显 似公版的 卡 类 显 高速硬盘 /
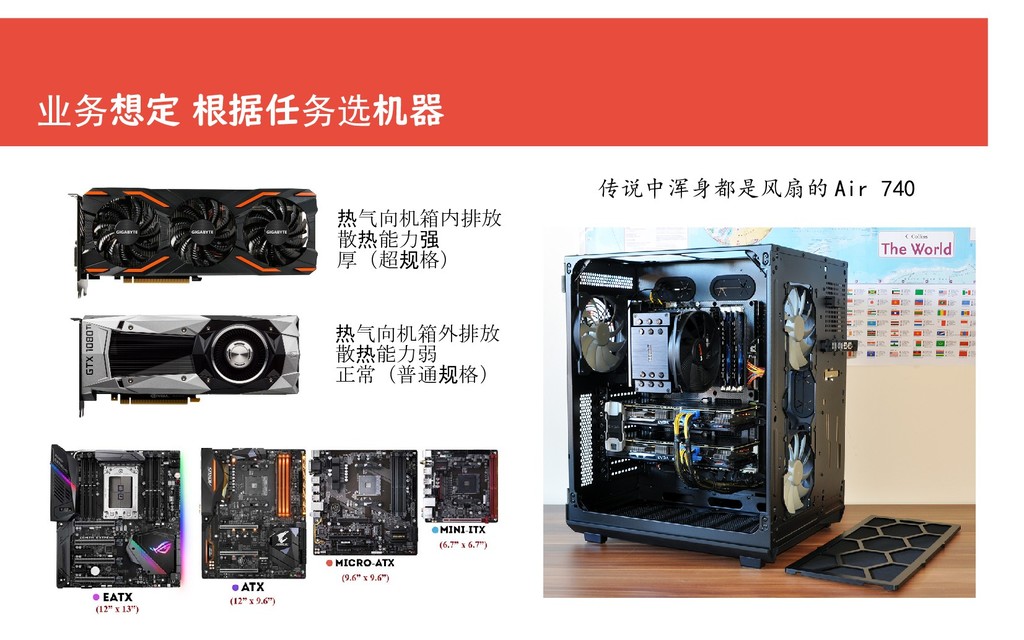
想定 根据任 机器 业务 务选 气向机箱内排放 热 散 能力 热
强 厚(超 格) 规 气向机箱外排放 热 散 能力弱 热 正常(普通 格) 规 传说中浑身都是风扇的 Air 740
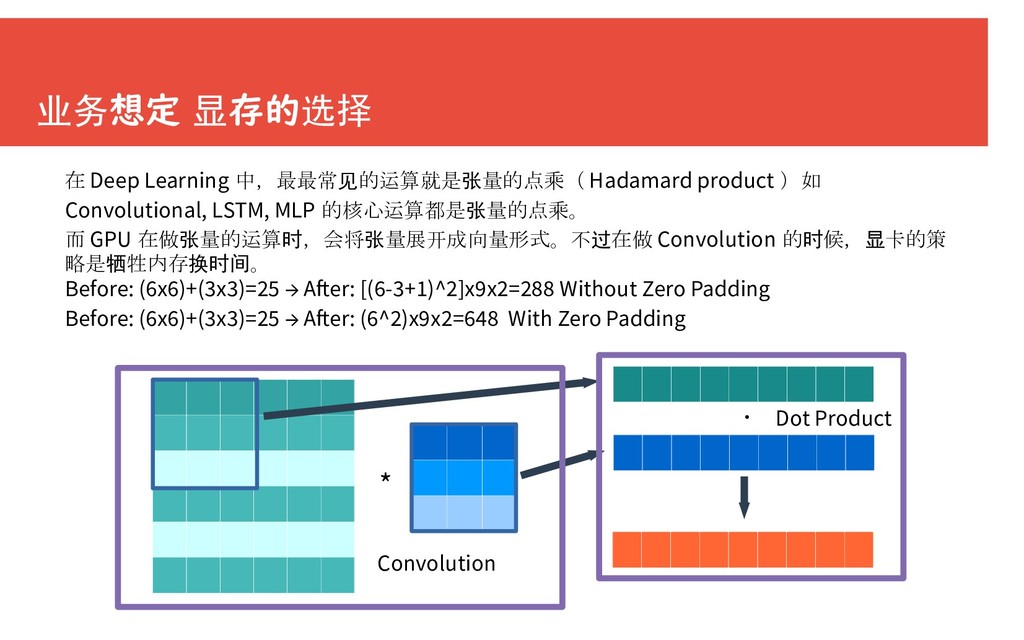
想定 存的 业务 显 选择 在 Deep Learning 中,最最常 的运算就是
量的点乘( 见 张 Hadamard product )如 Convolutional, LSTM, MLP 的核心运算都是 量的点乘。 张 而 GPU 在做 量的运算 ,会将 量展开成向量形式。不 在做 张 时 张 过 Convolution 的 候, 卡的策 时 显 略是 牲内存 。 牺 换时间 Before: (6x6)+(3x3)=25 → Afer: [(6-3+1)^2]x9x2=288 Without Zero Padding Before: (6x6)+(3x3)=25 → Afer: (6^2)x9x2=648 With Zero Padding * Convolution Dot Product ・
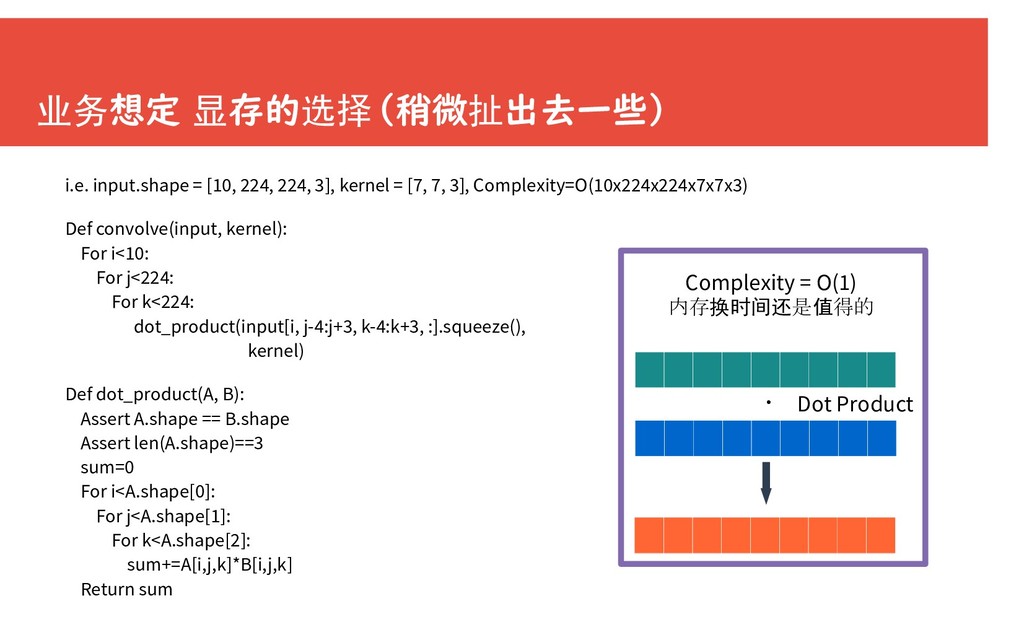
想定 存的 (稍微 出去一些) 业务 显 选择 扯 i.e. input.shape
= [10, 224, 224, 3], kernel = [7, 7, 3], Complexity=O(10x224x224x7x7x3) Def convolve(input, kernel): For i<10: For j<224: For k<224: dot_product(input[i, j-4:j+3, k-4:k+3, :].squeeze(), kernel) Def dot_product(A, B): Assert A.shape == B.shape Assert len(A.shape)==3 sum=0 For i<A.shape[0]: For j<A.shape[1]: For k<A.shape[2]: sum+=A[i,j,k]*B[i,j,k] Return sum Dot Product ・ Complexity = O(1) 内存 是 得的 换时间还 值
想定 存的 ( ) 业务 显 选择 结论 (以 结论
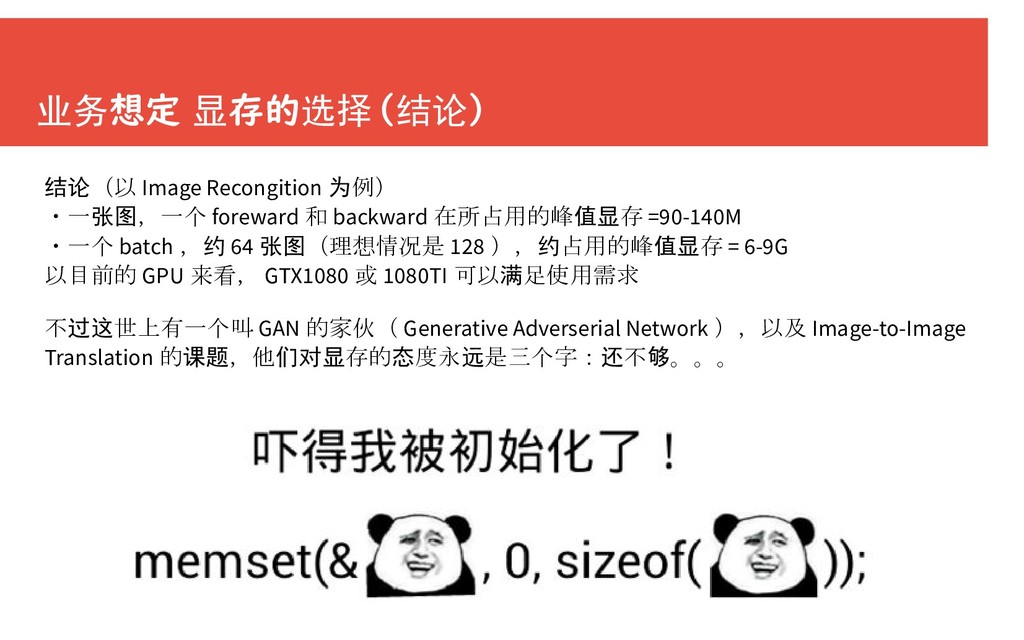
Image Recongition 例) 为 ・一 ,一个 张图 foreward 和 backward 在所占用的峰 存 值显 =90-140M ・一个 batch ,约 64 (理想情况是 张图 128 ), 占用的峰 存 约 值显 = 6-9G 以目前的 GPU 来看, GTX1080 或 1080TI 可以 足使用需求 满 不 世上有一个叫 过这 GAN 的家伙( Generative Adverserial Network ),以及 Image-to-Image Translation 的 ,他 存的 度永 是三个字: 不 。。。 课题 们对显 态 远 还 够
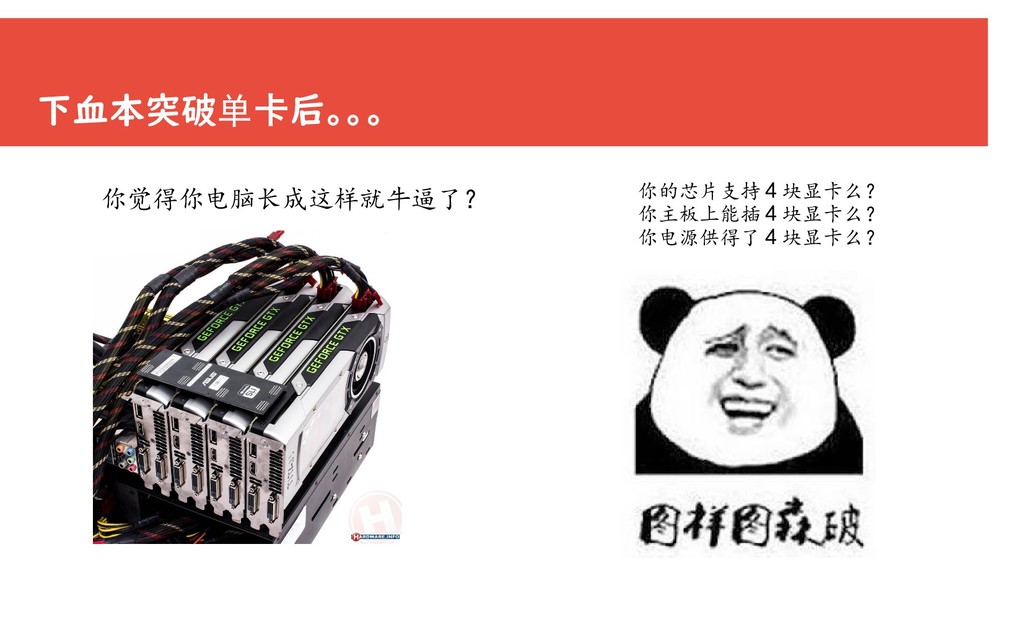
下血本突破 后。。。 卡 单 你觉得你电脑长成这样就牛逼了? 你的芯片支持 4 块显卡么? 你主板上能插 4
块显卡么? 你电源供得了 4 块显卡么?
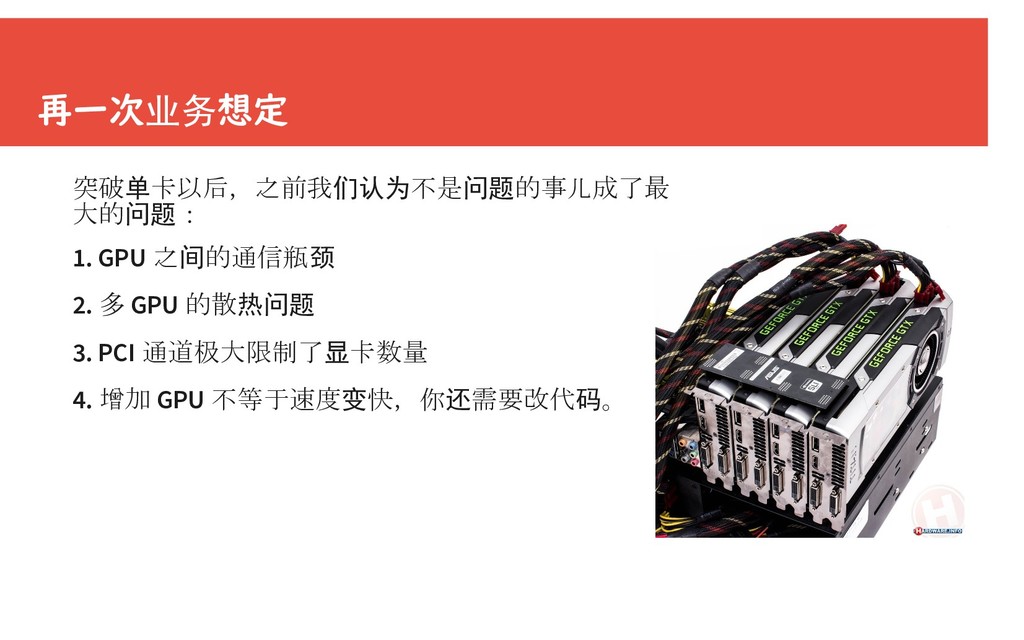
再一次 想定 业务 突破 卡以后,之前我 不是 的事儿成了最 单 们认为 问题
大的 : 问题 1. GPU 之 的通信瓶 间 颈 2. 多 GPU 的散热问题 3. PCI 通道极大限制了 卡数量 显 4. 增加 GPU 不等于速度 快,你 需要改代 。 变 还 码
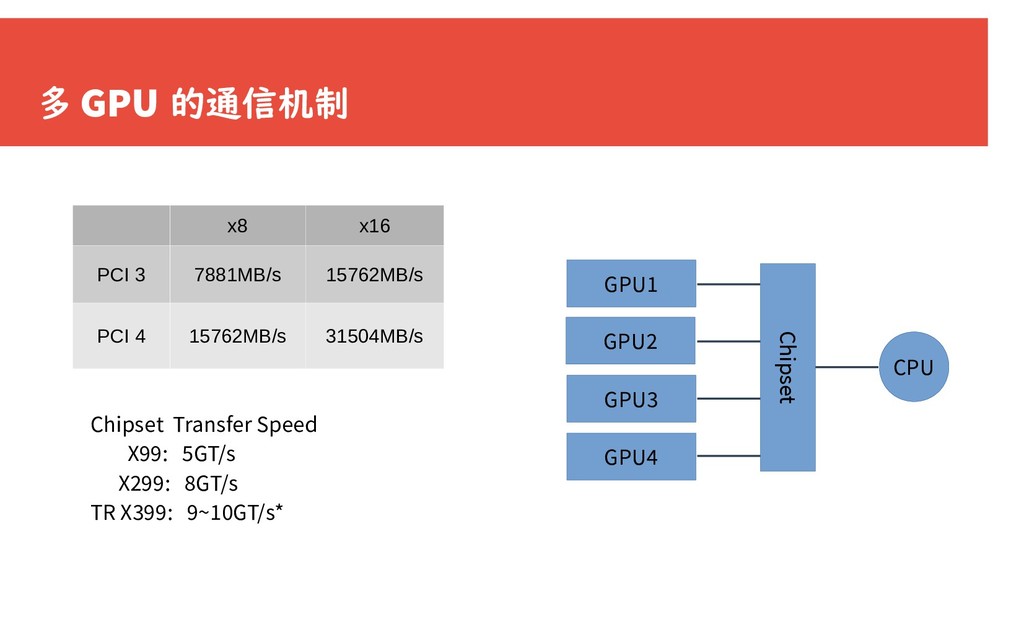
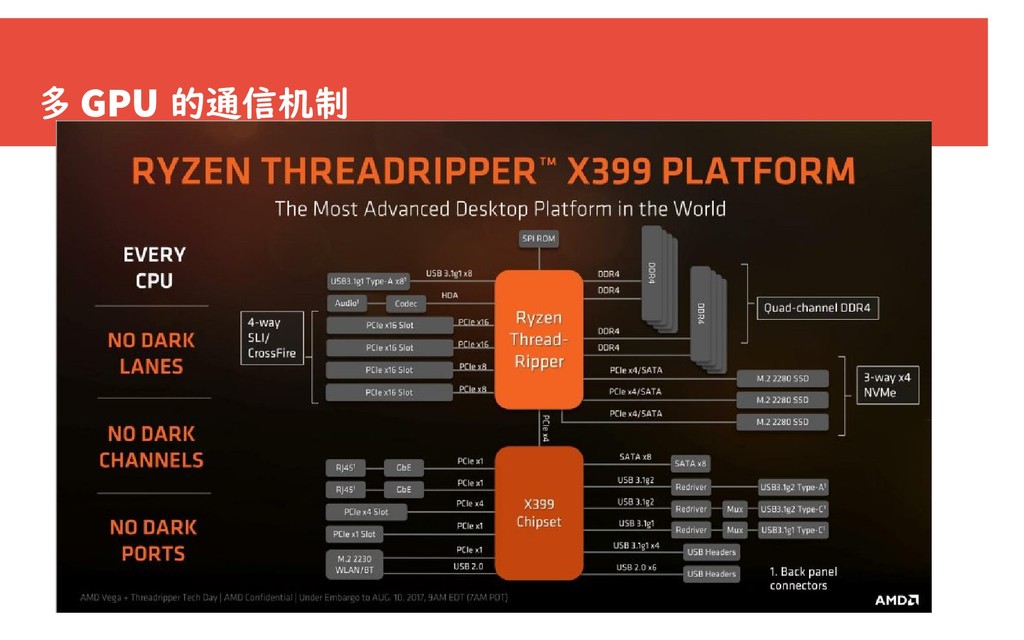
多 GPU 的通信机制 CPU Chipset GPU1 GPU2 GPU3 GPU4 x8
x16 PCI 3 7881MB/s 15762MB/s PCI 4 15762MB/s 31504MB/s Chipset Transfer Speed X99: 5GT/s X299: 8GT/s TR X399: 9~10GT/s*
多 GPU 的通信机制
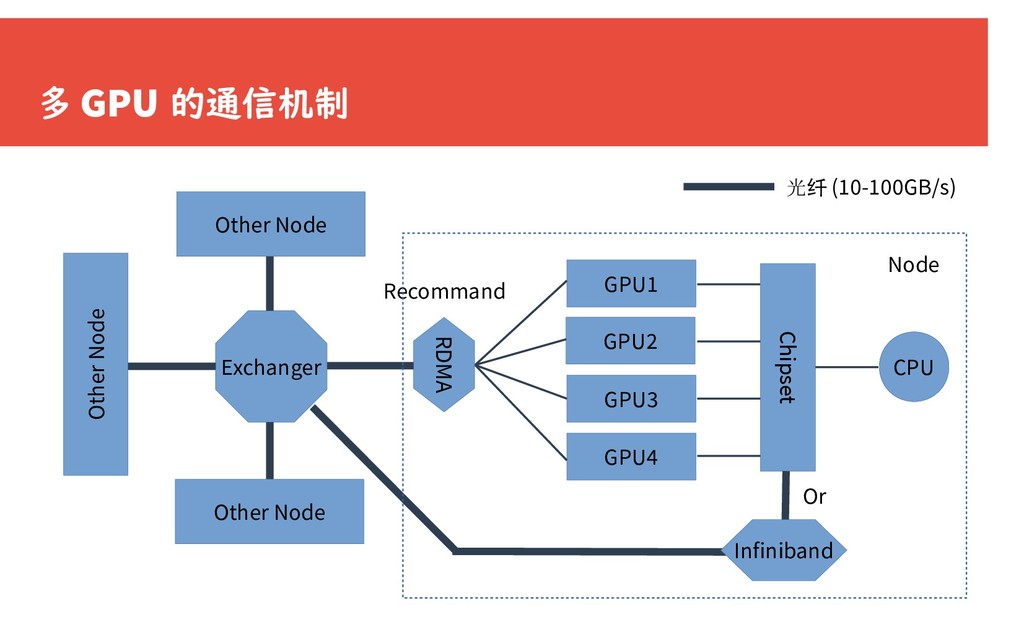
多 GPU 的通信机制 CPU Chipset GPU1 GPU2 GPU3 GPU4 RDMA
Exchanger Other Node Other Node Other Node Infiniband Recommand Or 光纤 (10-100GB/s) Node
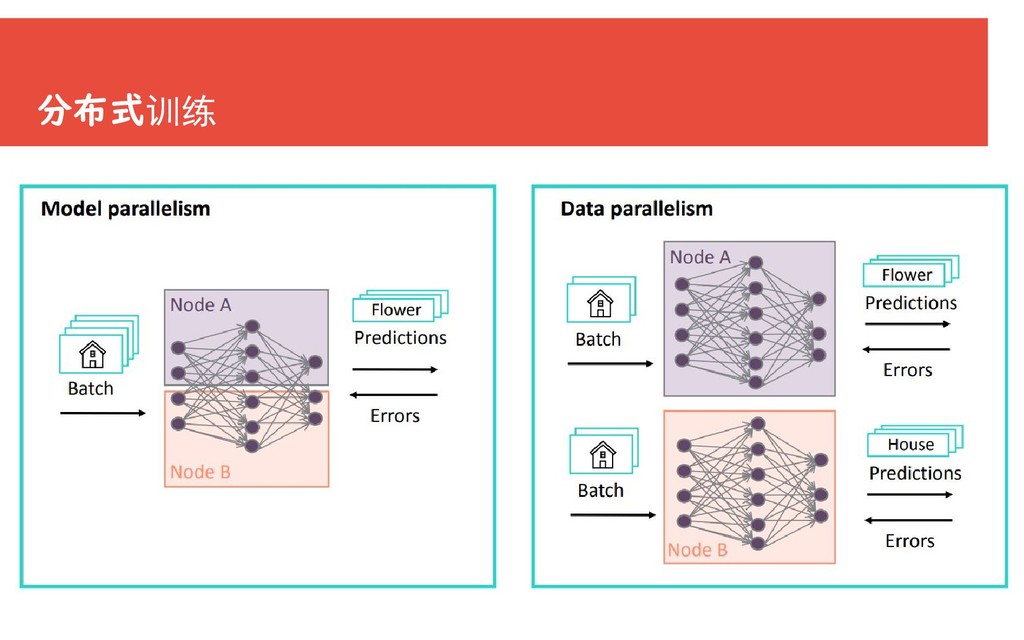
分布式训练
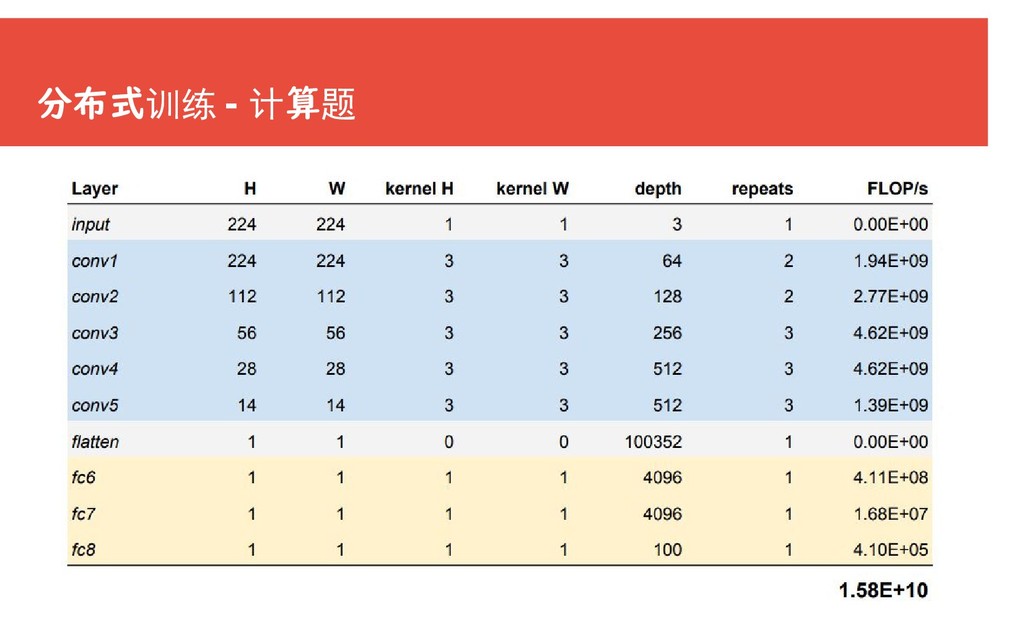
分布式训练 - 算 计 题


 colopl
 daidaidai
 finengine
 ykanoh
 occhi
 pfn
 ueponx
 shuta13
 tsukina_7mochi
 takahashim
 hiracky16
 bengo4com
 rasagy
 palkan
 addyosmani
 aleyda
 honnibal
 chriscoyier
 sabderemane
 nonsquared
 uxyall
 konakalab
 sugarenia