Share
Embed
SQL Server Performance Tuning Essentials
p2sk
August 23, 2023
Transcript
253 slides
-
対象者 • ⽇頃SQL Server / Azure SQL Databaseを使って開発・運⽤・ 管理などを⾏っており、単⼀または全体的なクエリパフォーマ ンスやサーバーのCPU⾼負荷状態に悩んでいる⼈
• CPU負荷を削減することで、クラウドで稼働中のDBをスケール ダウン/スケールインしてコストカットしたい⼈ -
前提条件 • SQLの使⽤経験 • SQL Serverの使⽤経験 • SQL ServerのPaaSの使⽤経験 (Azure/AWS/GCP)
• SQL Server Management Studio (SSMS)の使⽤経験 -
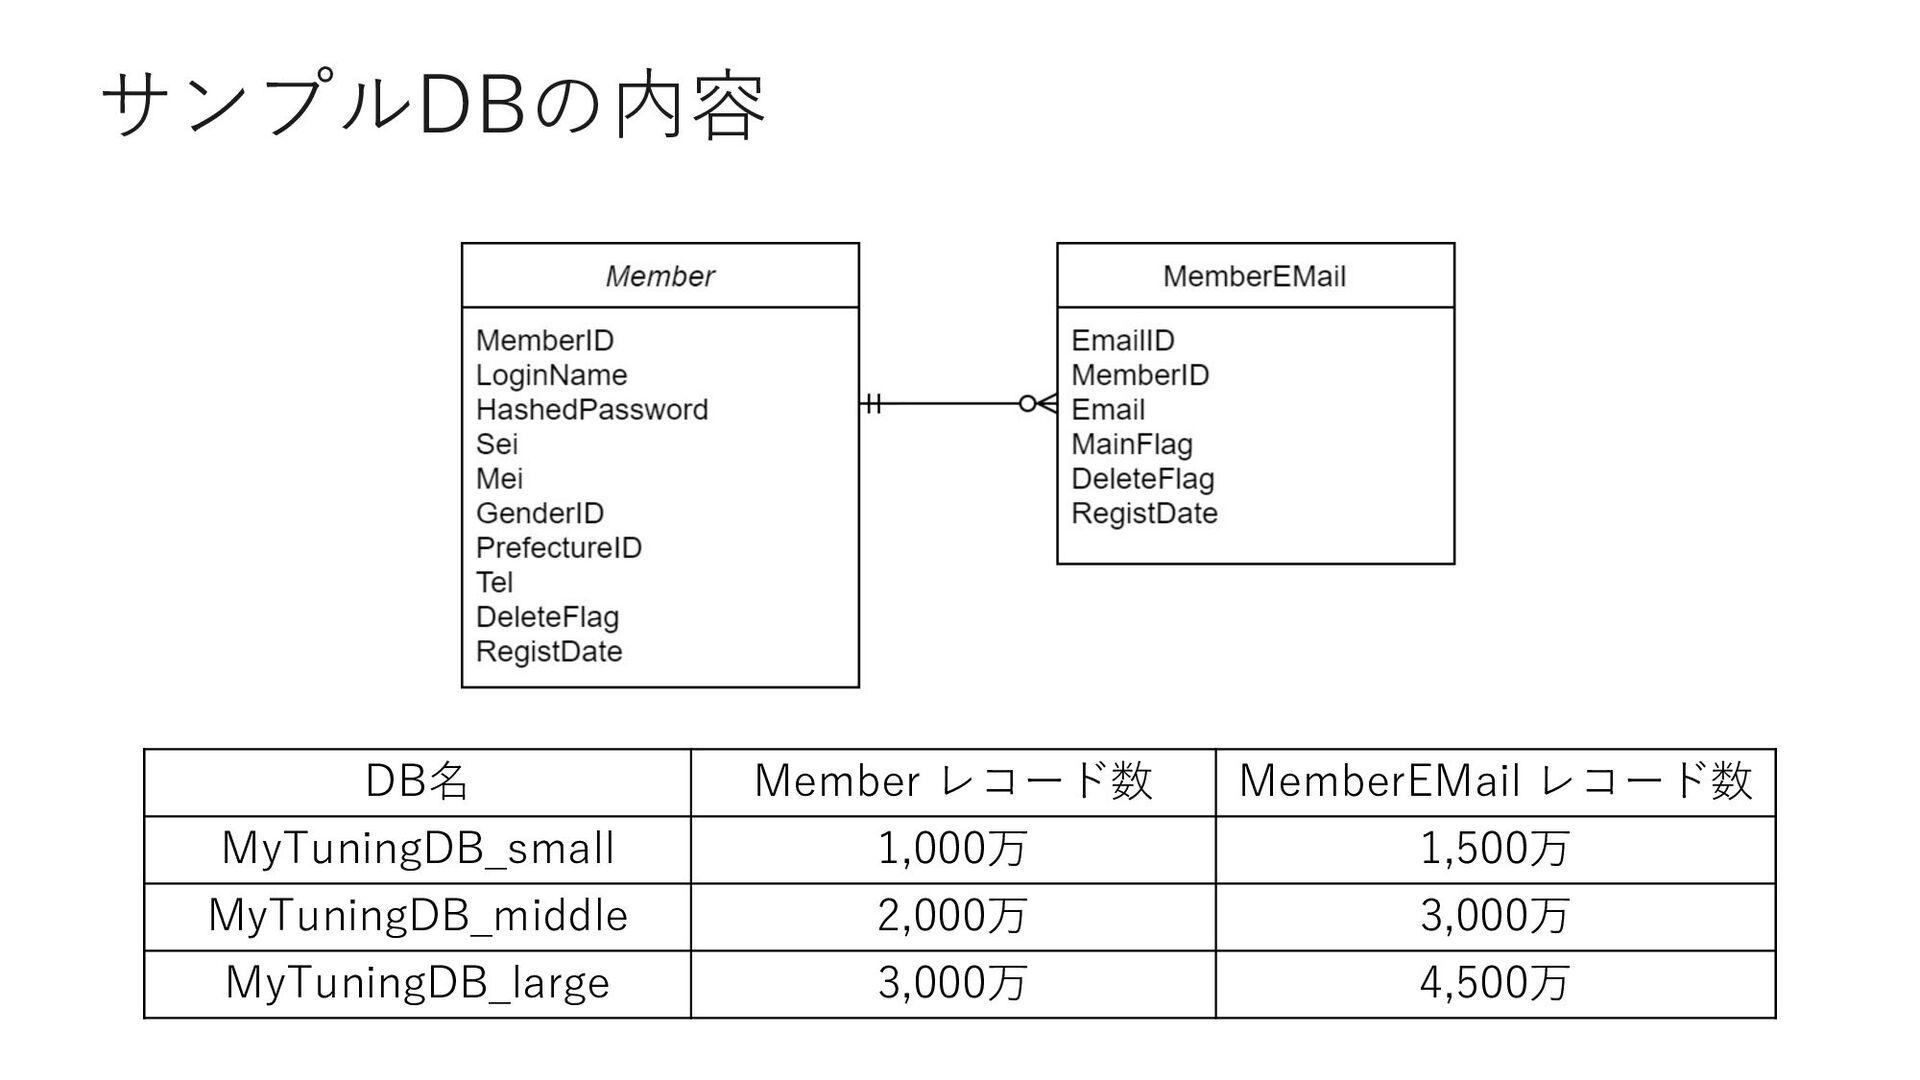
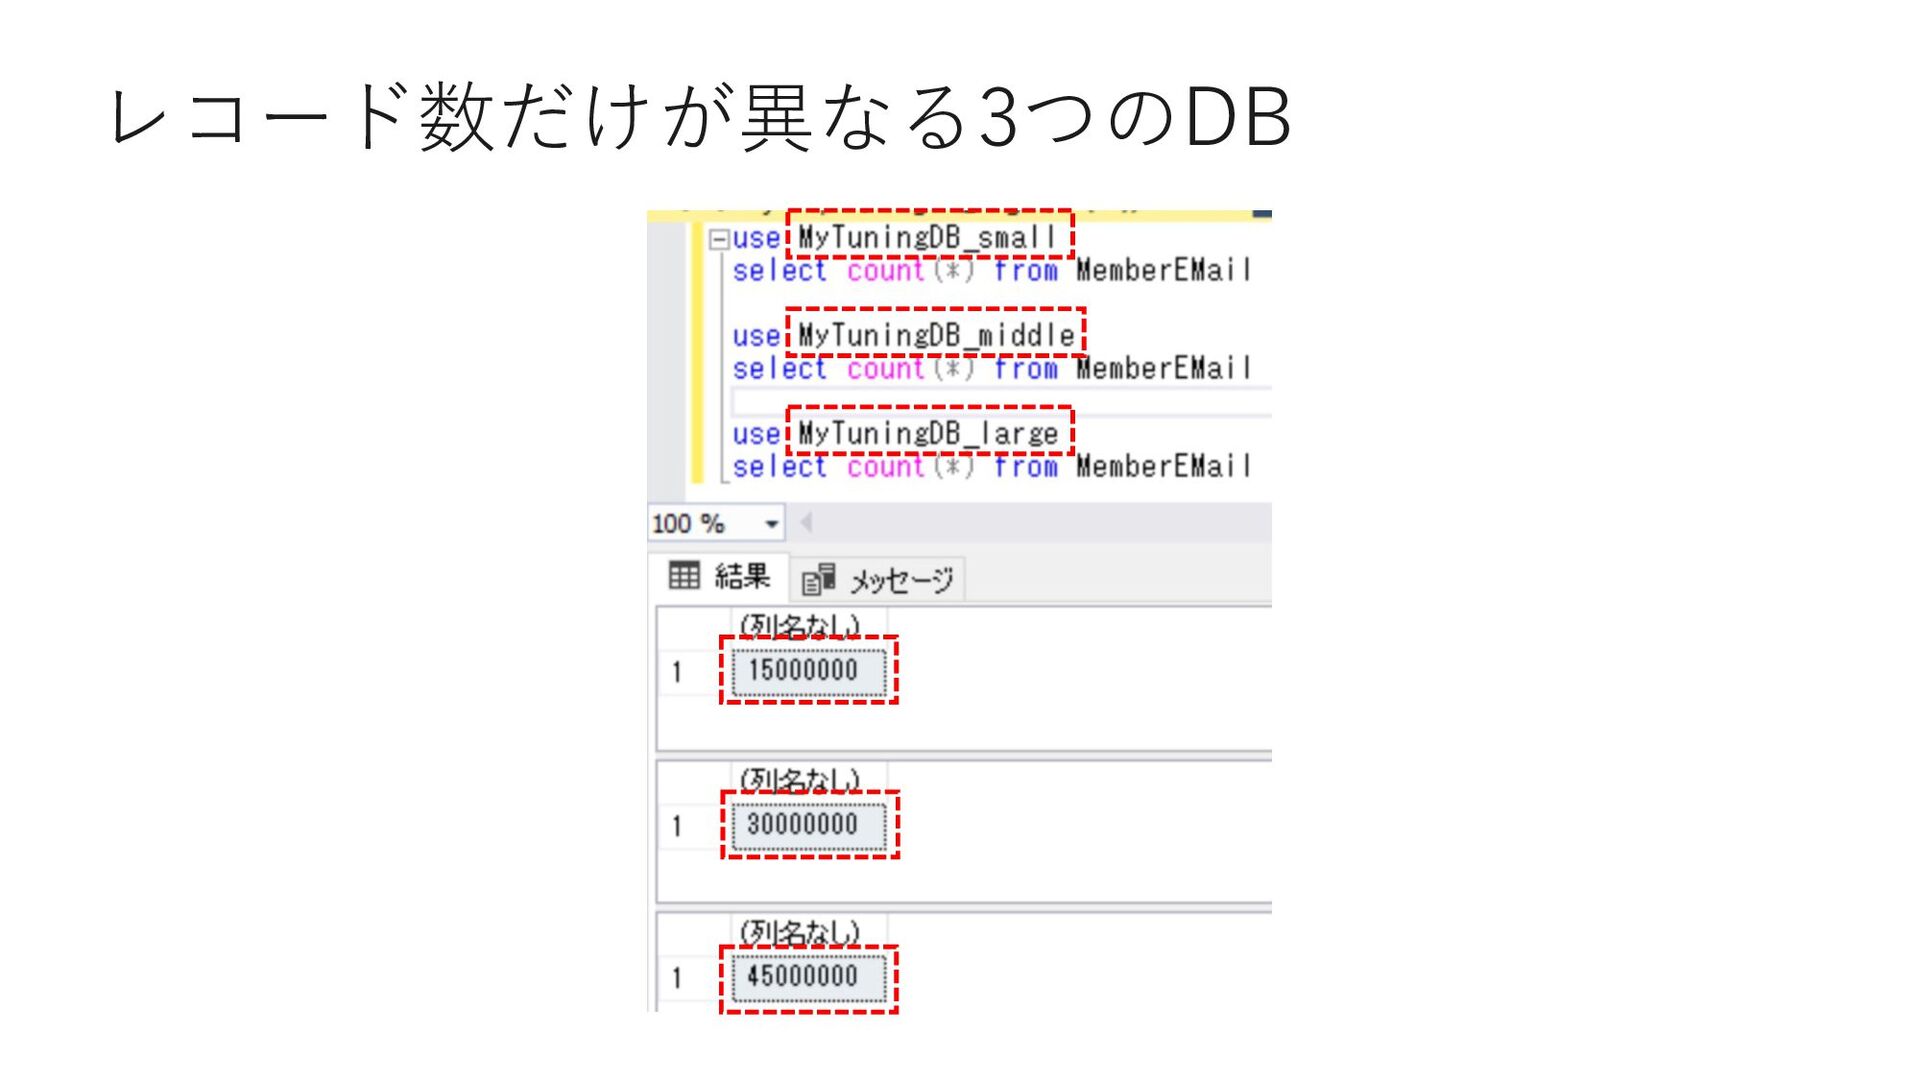
サンプルDBの内容 DB名 Member レコード数 MemberEMail レコード数 MyTuningDB_small 1,000万 1,500万 MyTuningDB_middle
2,000万 3,000万 MyTuningDB_large 3,000万 4,500万 -
サンプルDBについて • SQL Server 2019以降でリストア可能 • ⽤途:サンプルDBを使ってクエリチューニングを体感してもらう • データはすべてランダムに⽣成したデータ •
電話番号やメールアドレスはランダムだが、実在の可能性がある ため別⽤途での使⽤は禁⽌ -
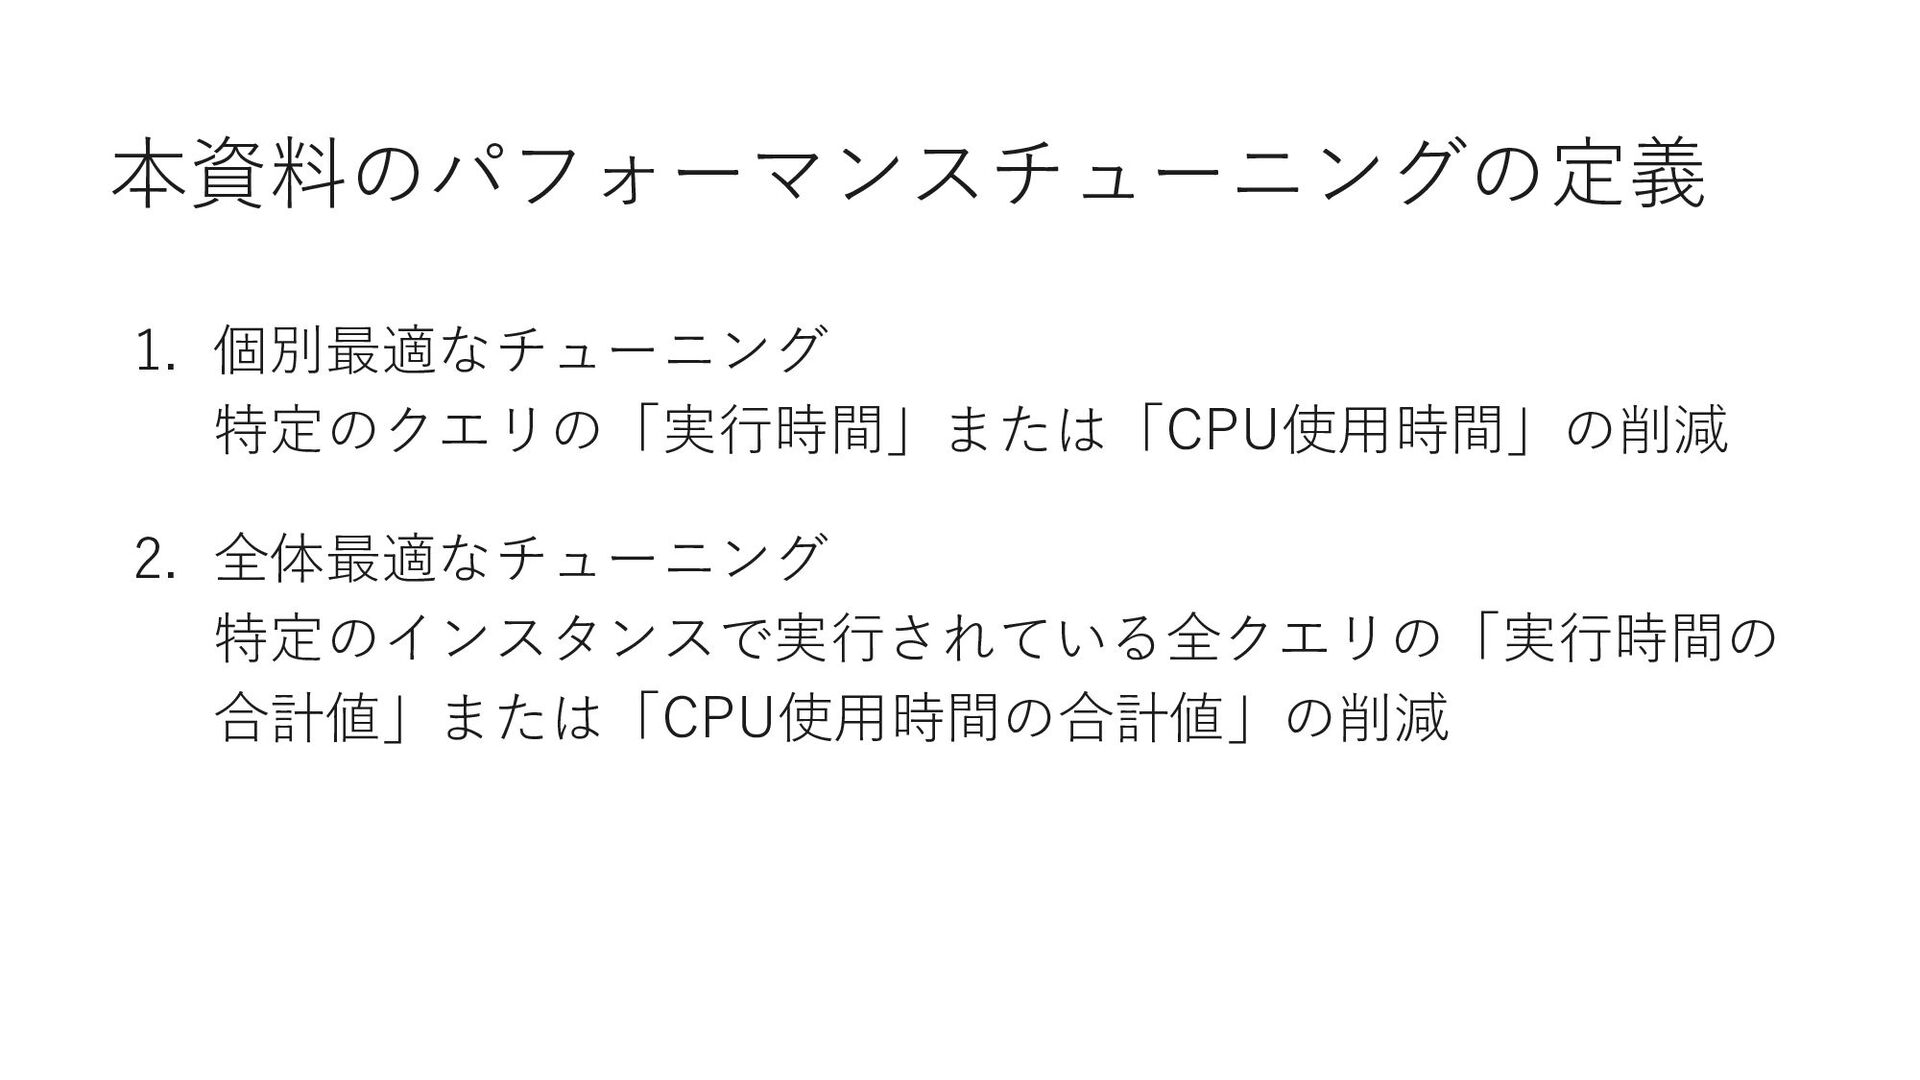
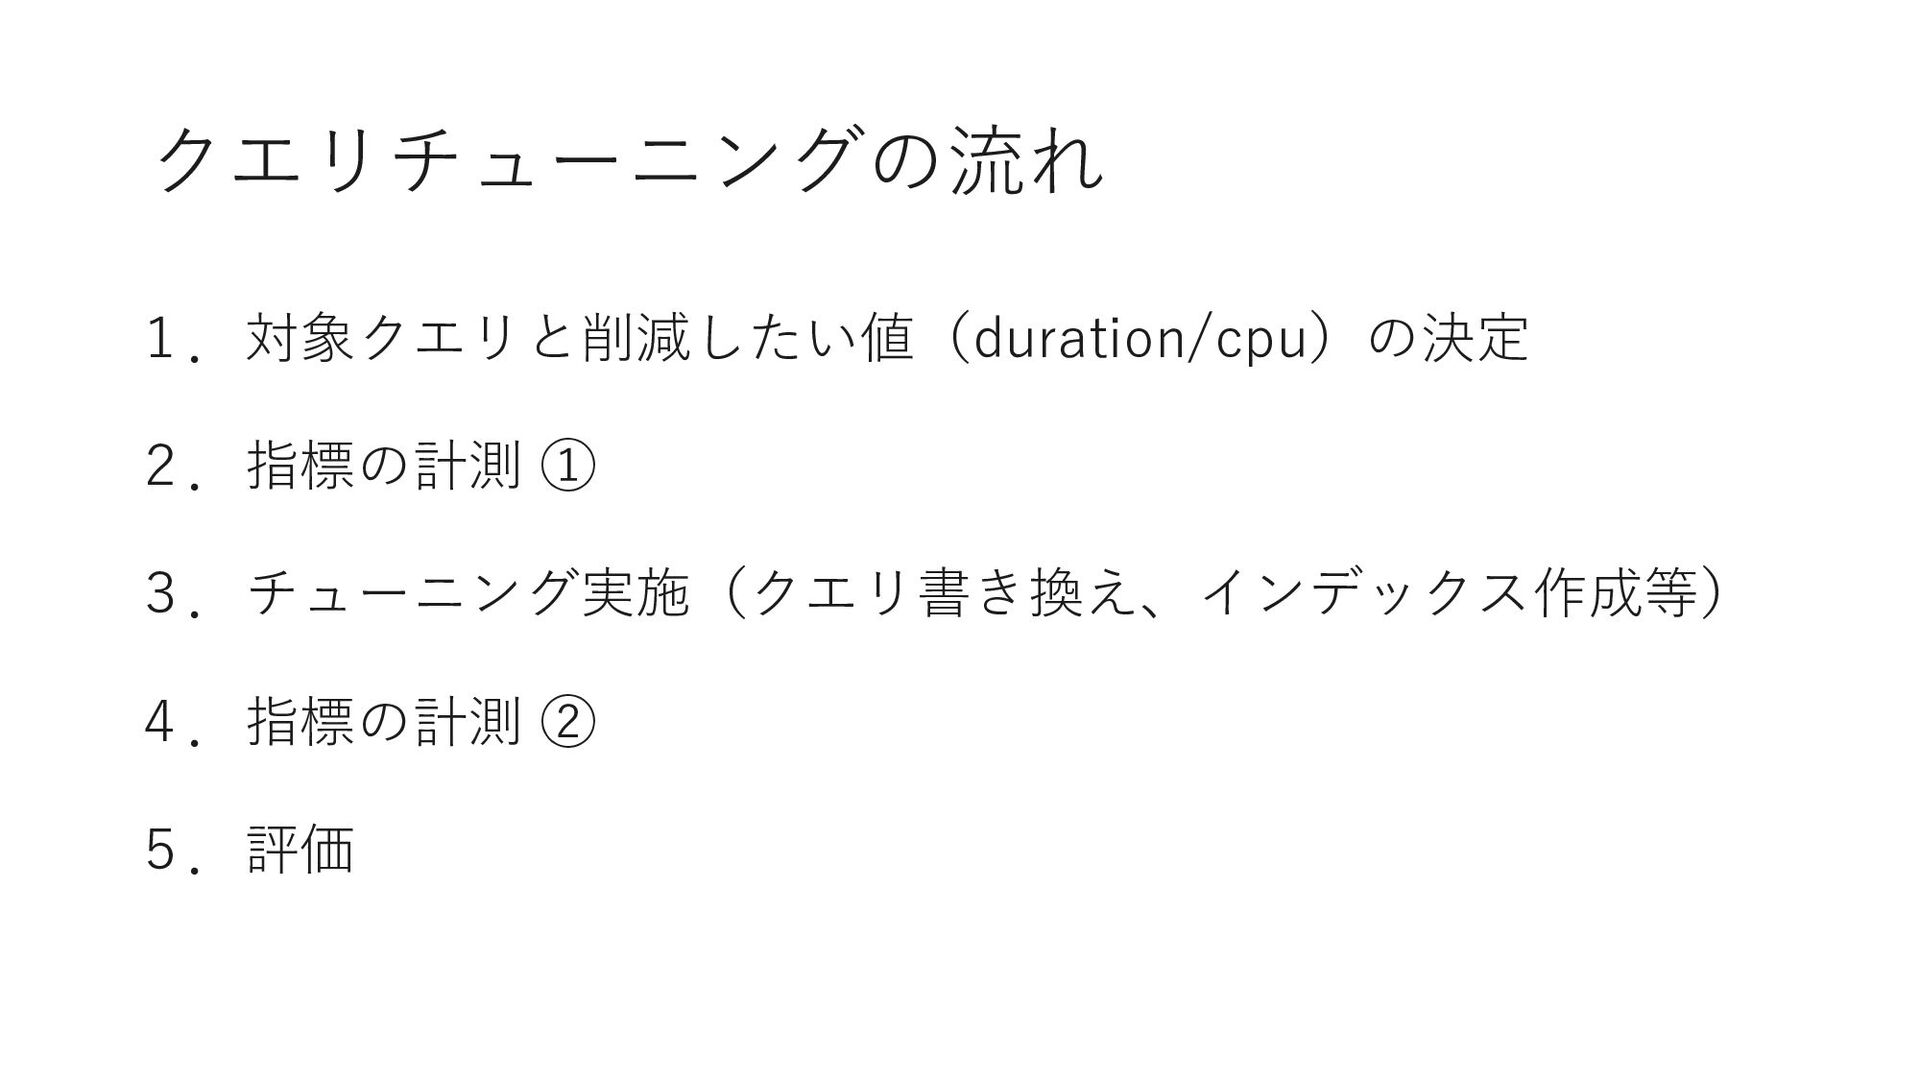
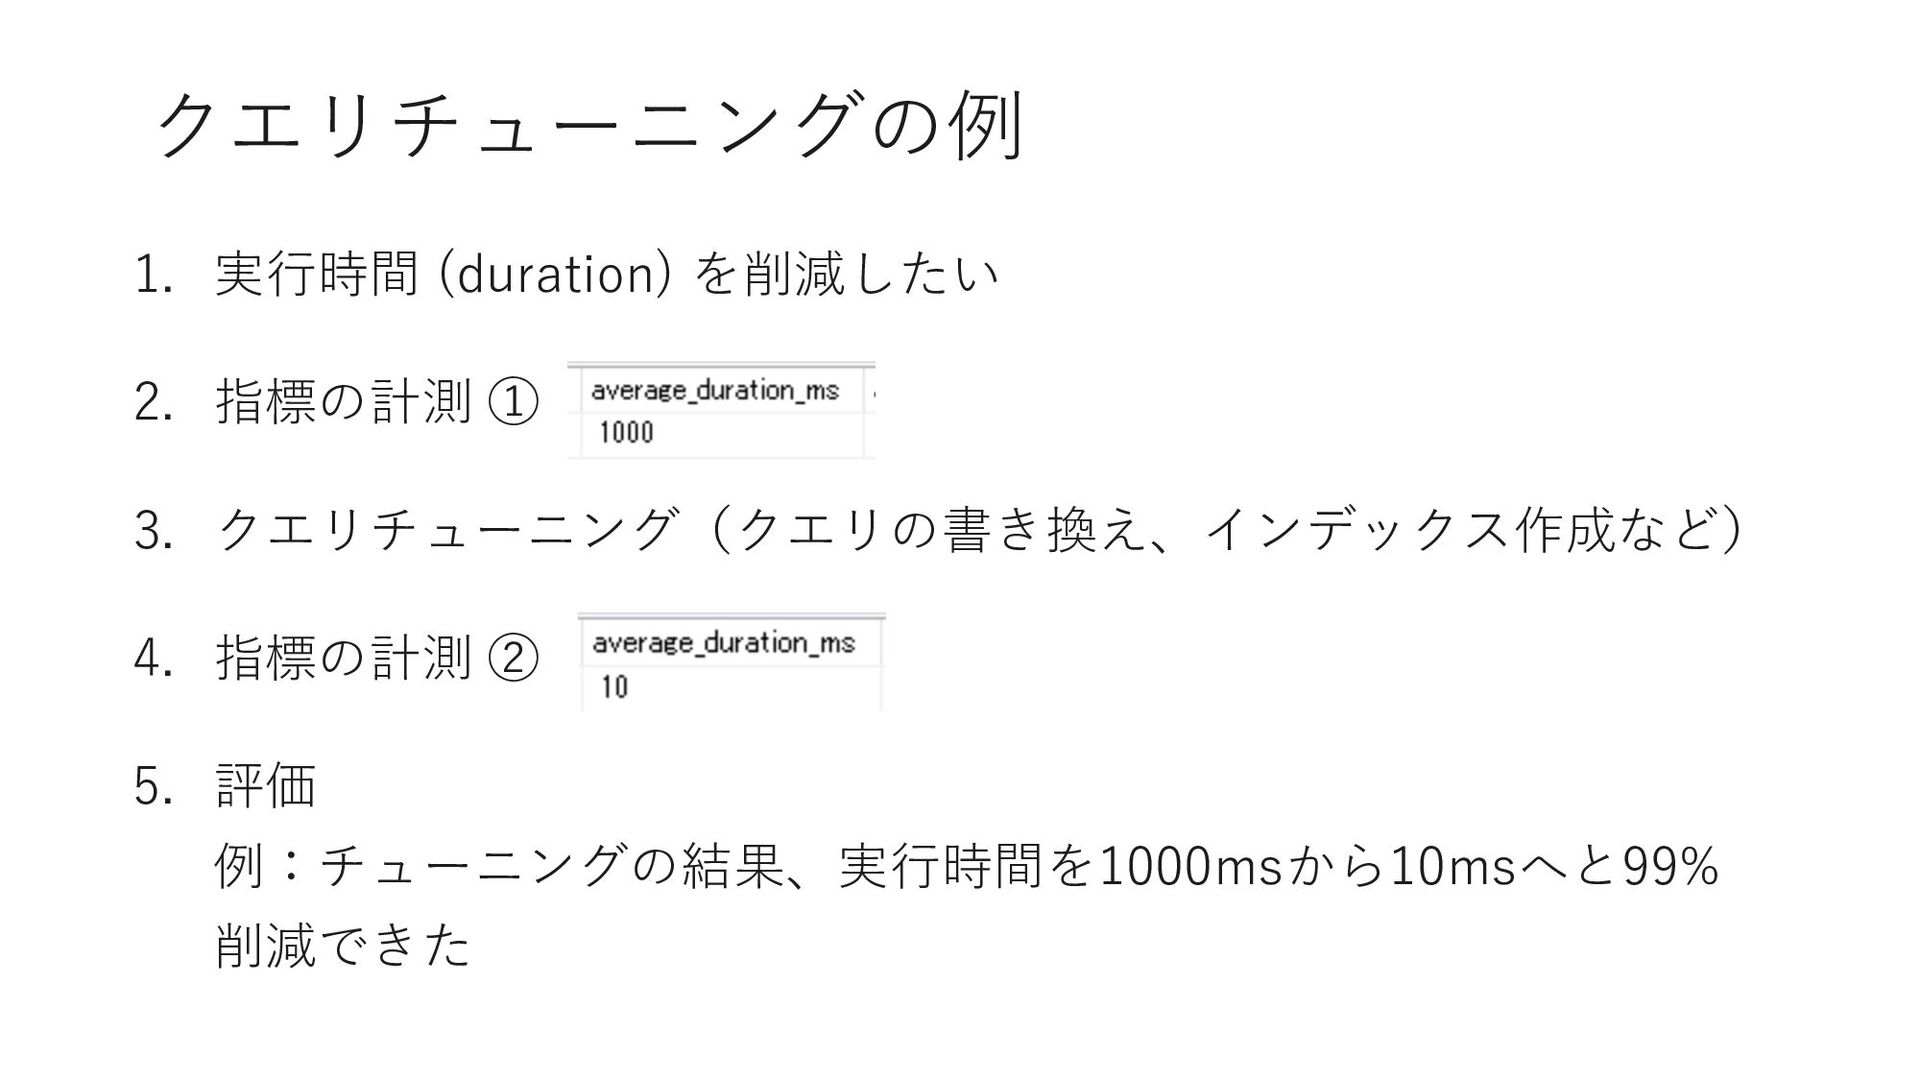
クエリチューニングの例 1. 実⾏時間 (duration) を削減したい 2. 指標の計測 ① 3. クエリチューニング(クエリの書き換え、インデックス作成など)
4. 指標の計測 ② 5. 評価 例:チューニングの結果、実⾏時間を1000msから10msへと99% 削減できた -
なぜsys.dm_exec_query_statsを使うのか? • プロダクション環境ではさまざまなパラメータでクエリが実⾏ • パラメータによって実⾏時間が⼤幅に変化するケースもある 例)リリース前の⼿動での検証時は「where col1 = 1」で1秒だったが、リリース後は 「where
col1 = 2」が指定されることが多く、この場合だと10秒かかる。 • sys.dm_exec_query_statsを使えば、プロダクション環境で指定 されるさまざまなパラメータによって実⾏された実際の duration/cpuを取得できる • プロダクション環境でのチューニングの評価⽅法として妥当 -
注意点① durationとcpuは⼤きく違う場合も • duration >> cpu ロック競合などで待たされる時間が多いと、この関係になる • duration <<
cpu 並列クエリの場合はcpu時間のほうが⼤きくなることがある • duration/cpuは個別に把握することが⼤事 -
• コストとは • あるスペックのマシンでそのクエリを実⾏した場合に想定さ れる実⾏時間 • コストが⾼くても「実⾏時間が⻑そうだとSQL Serverが思っ ている」ということまでしかわからない •
基本的にはコストが低いほどduration/cpuも低いが、コストが 下がってもduration/cpuが増えることもある ⇒ 指標として不適当 注意点② 評価の指標にコスト値は使わない -
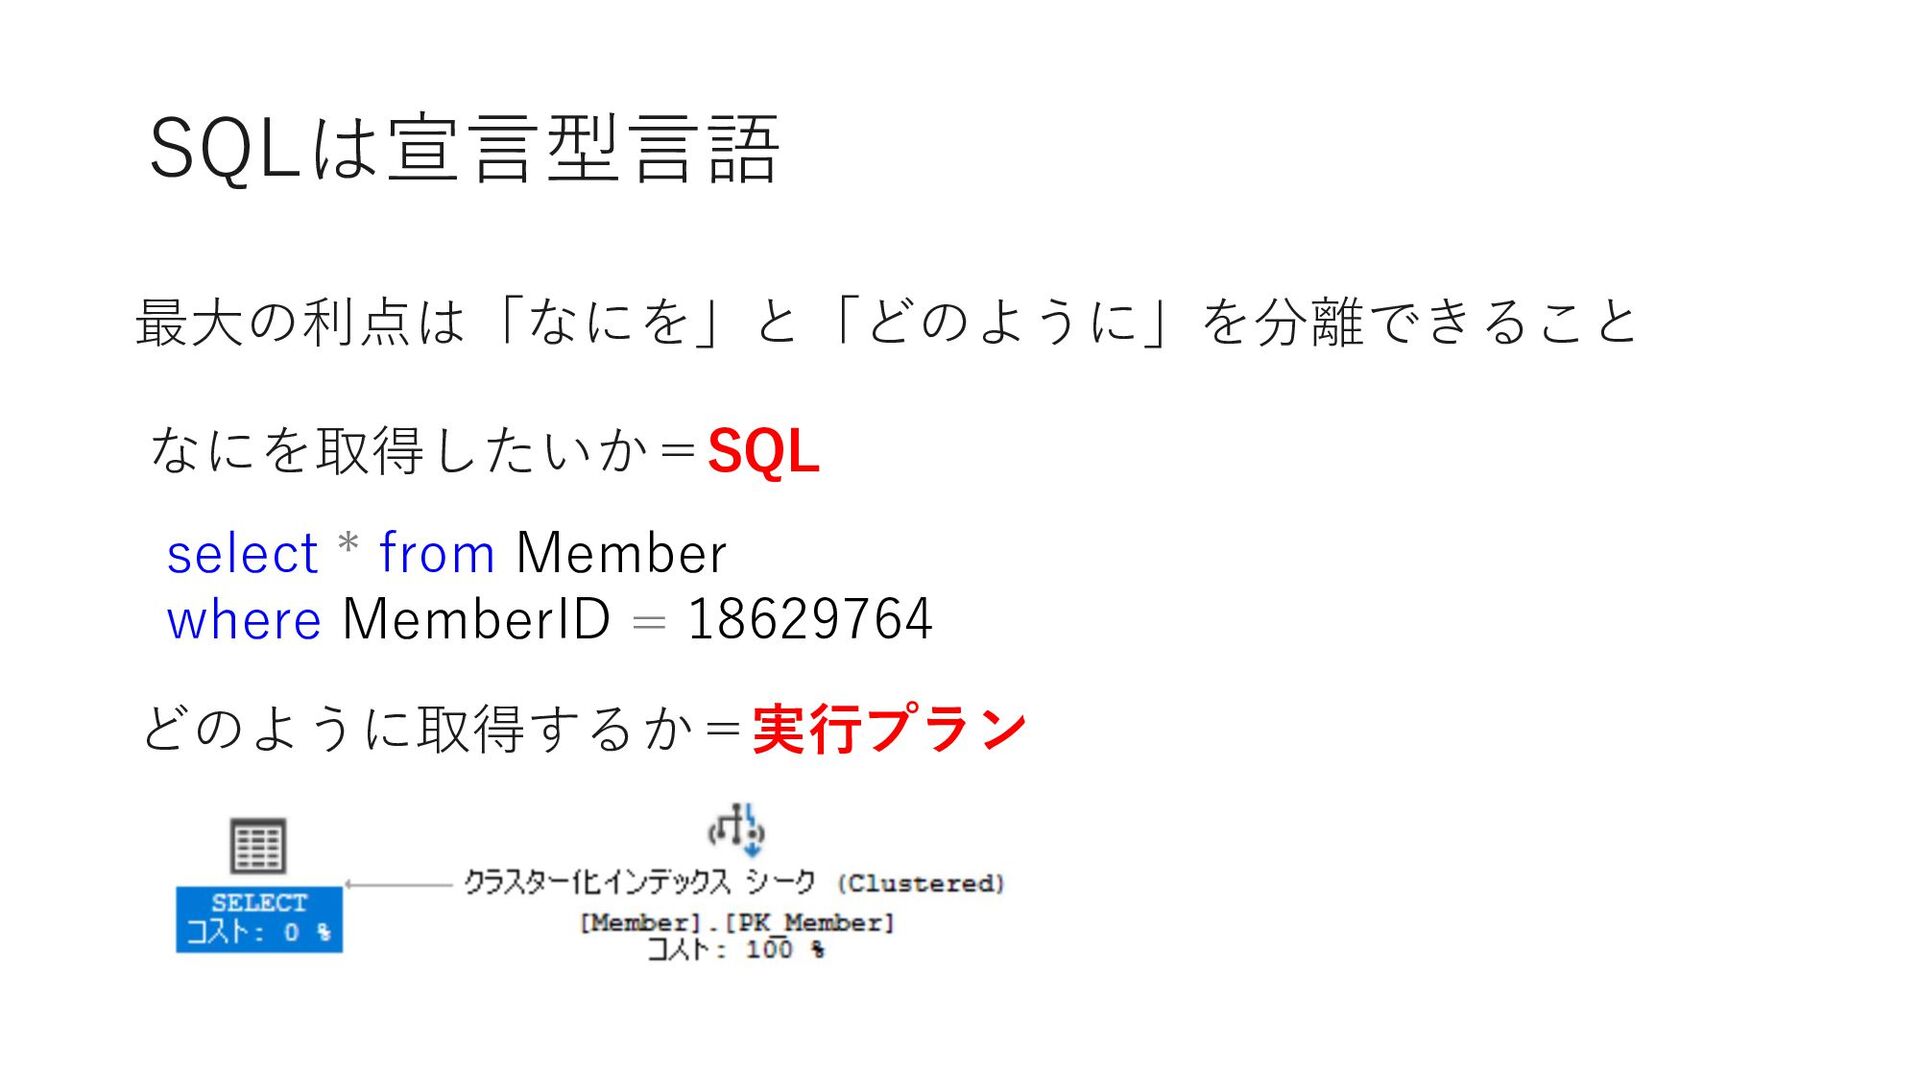
SQLは宣⾔型⾔語 最⼤の利点は「なにを」と「どのように」を分離できること select * from Member where MemberID = 18629764
なにを取得したいか=SQL どのように取得するか=実⾏プラン -
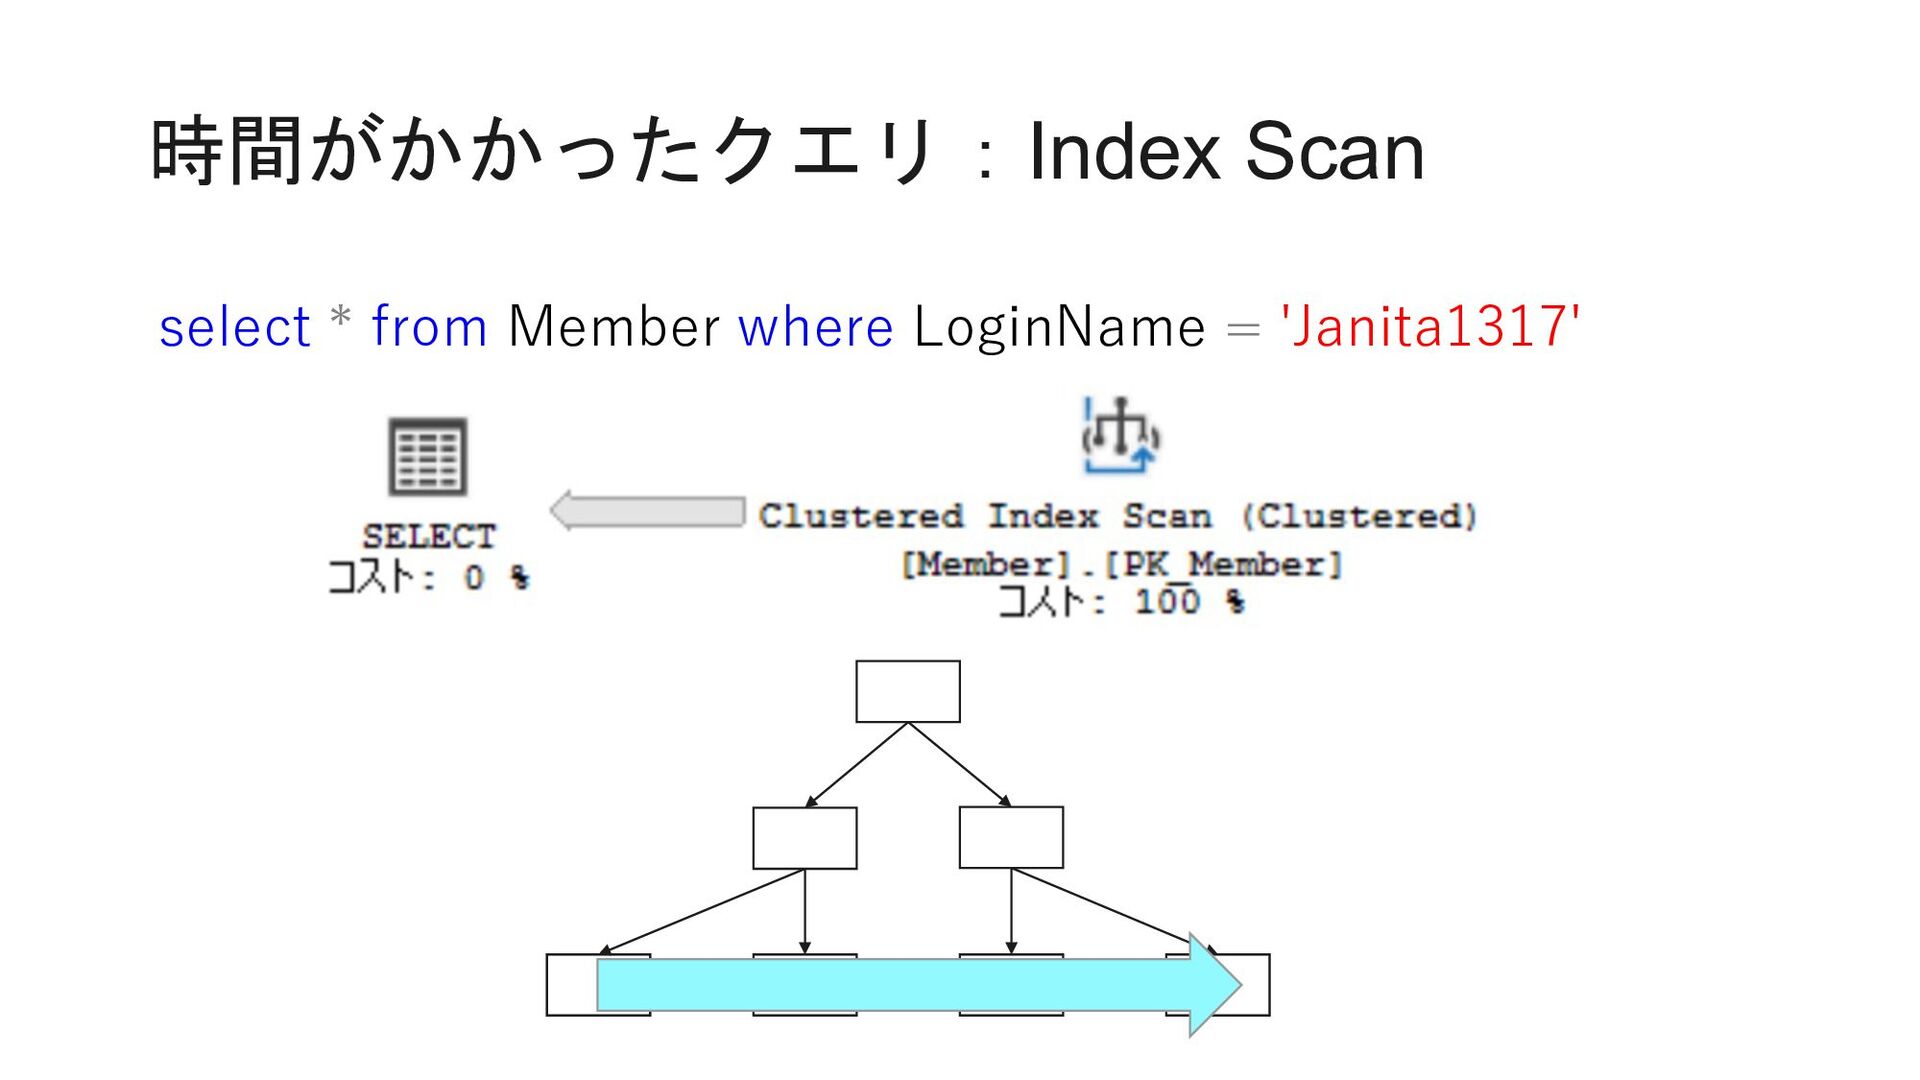
durationの差と実⾏プランの違い • インデックス効いてる • select * from [Member] where LoginName
= 'HunterGreen45744363' • インデックス効いてない • select * from [Member] with(index(PK_Member)) where LoginName = 'HunterGreen45744363ʼ -
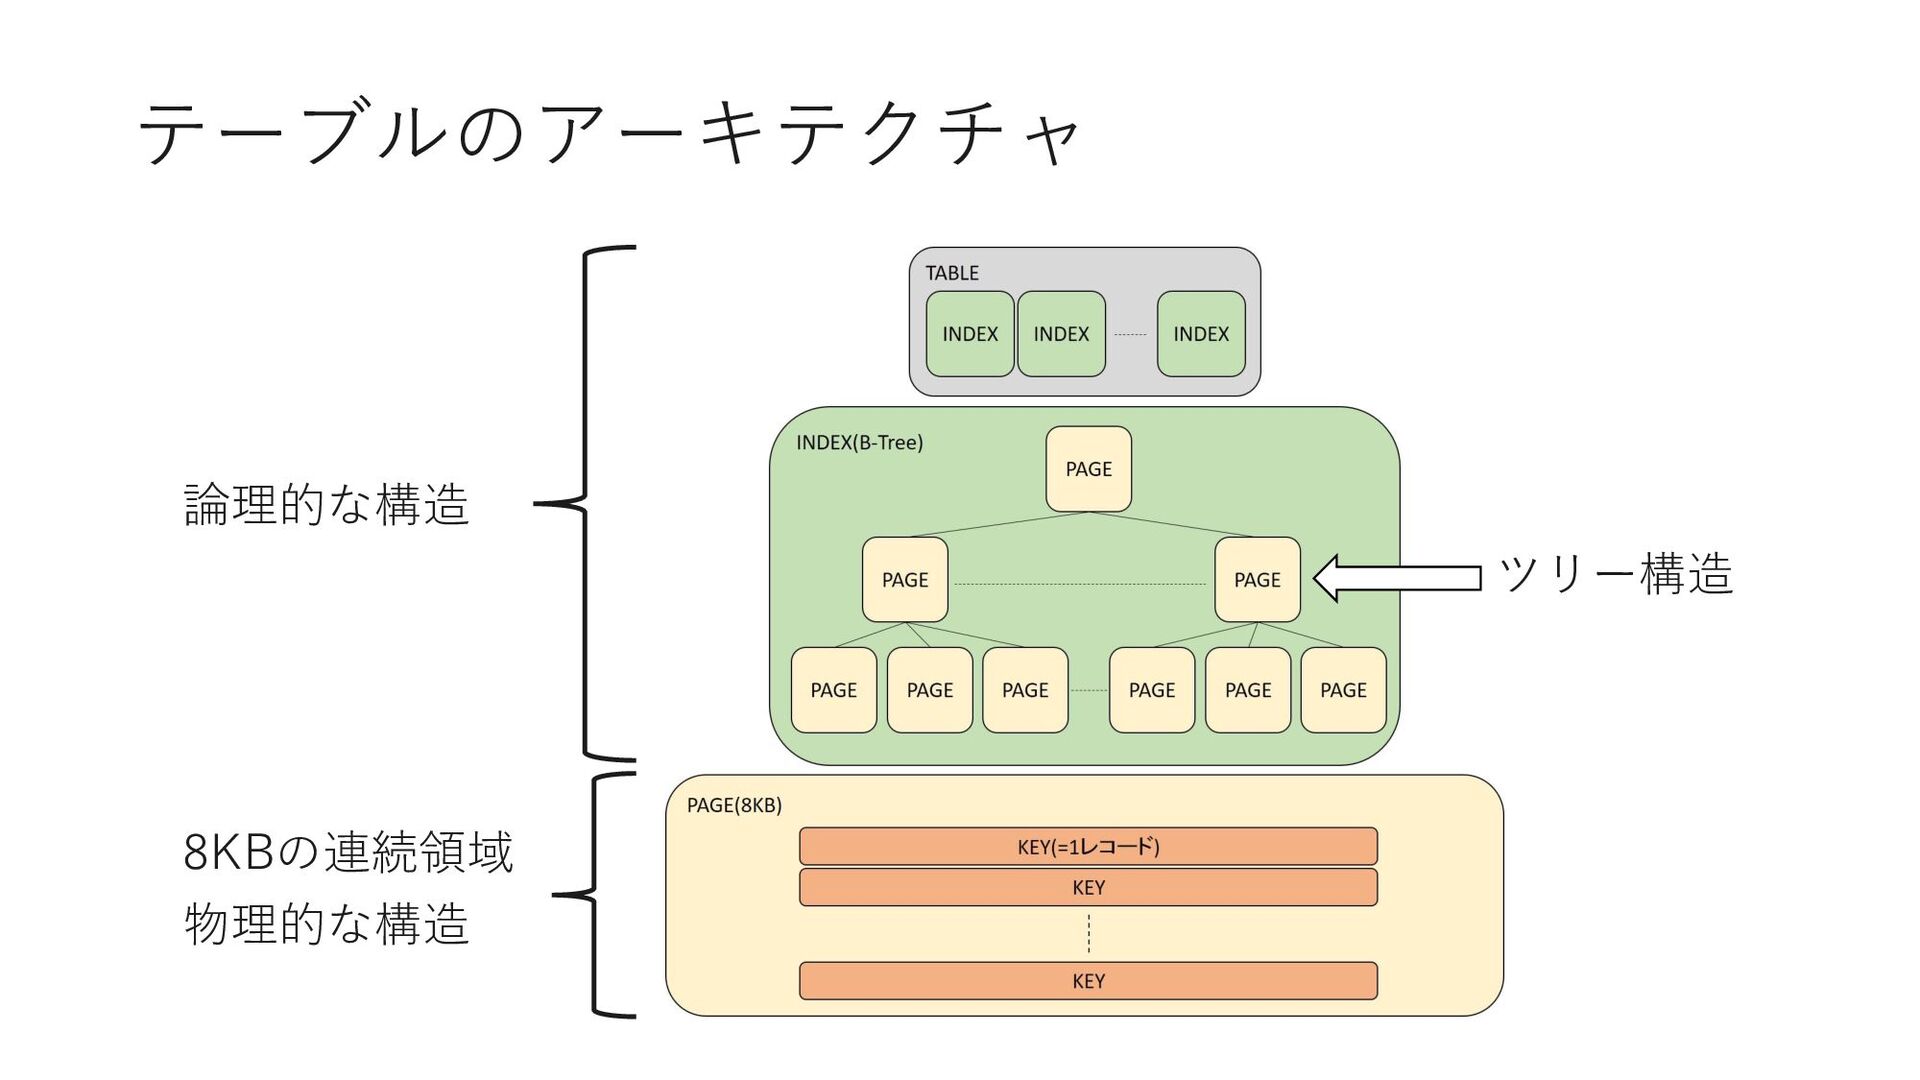
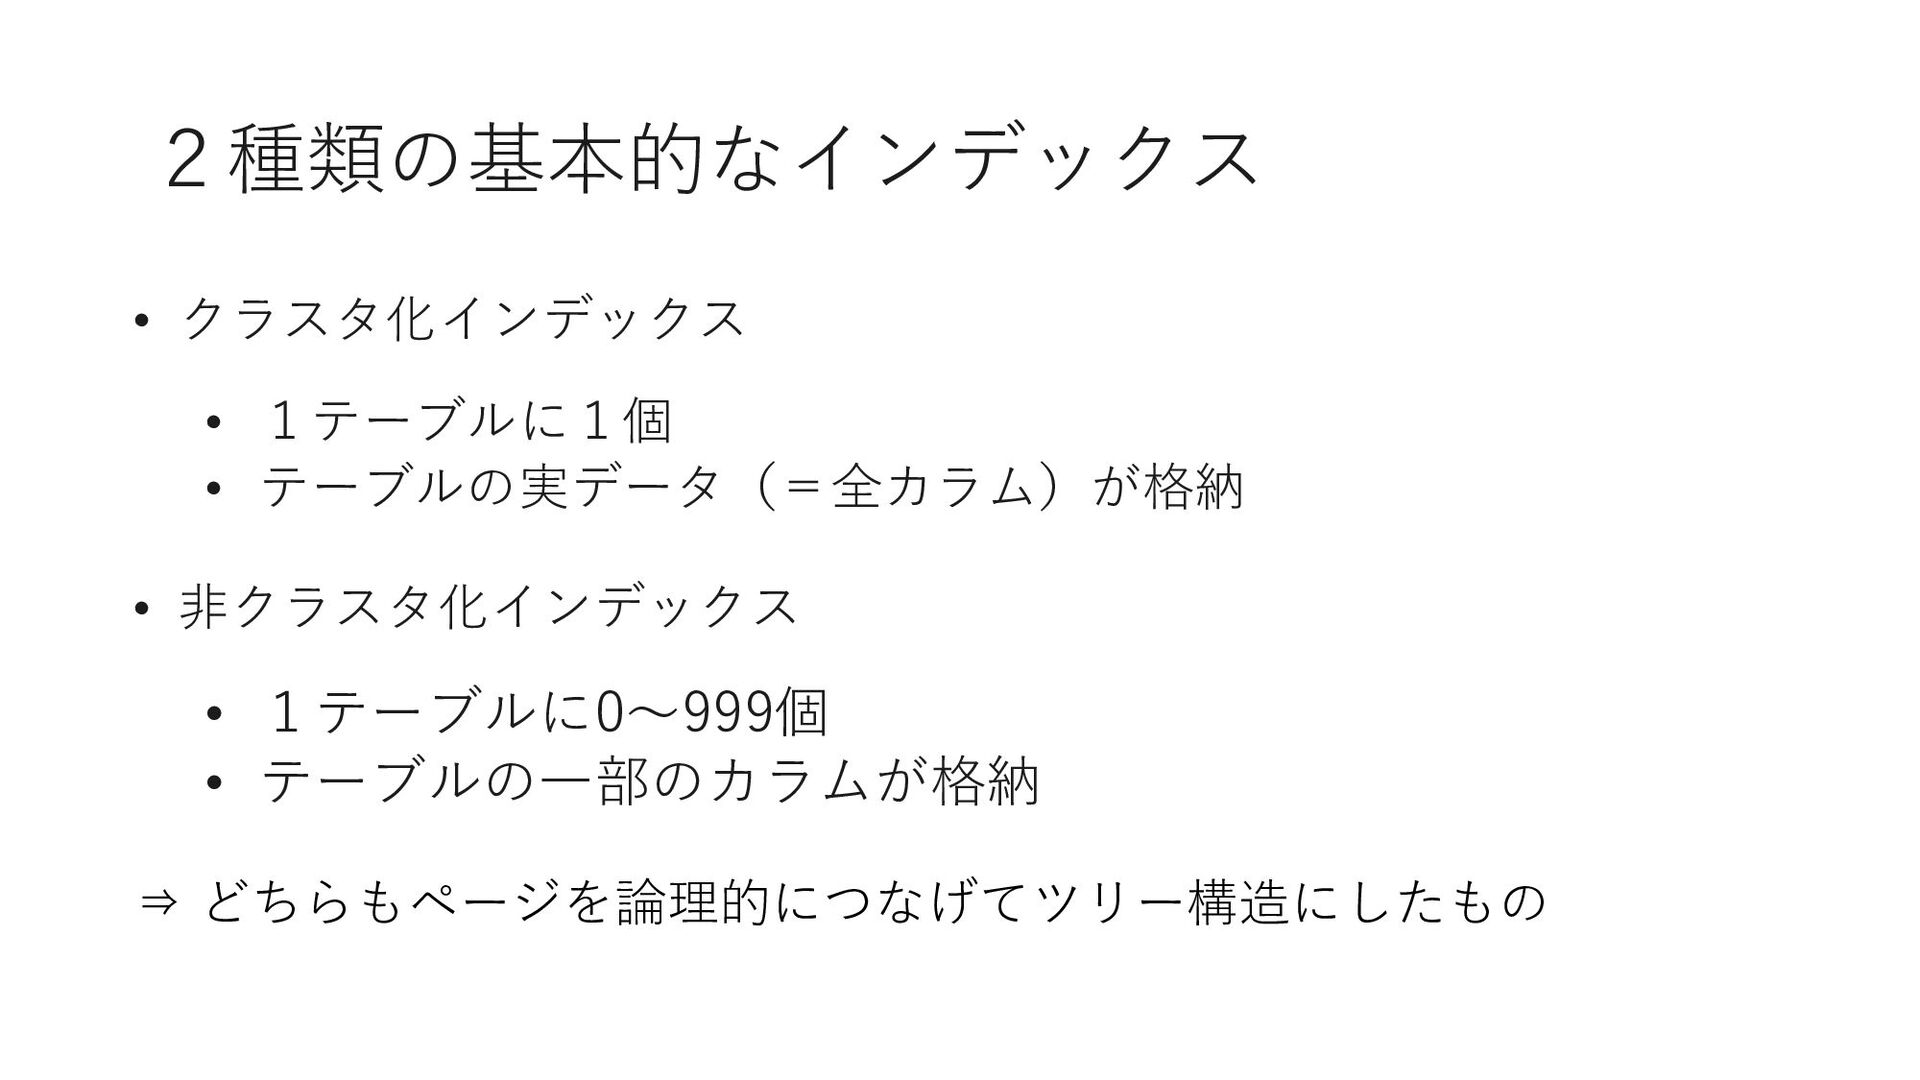
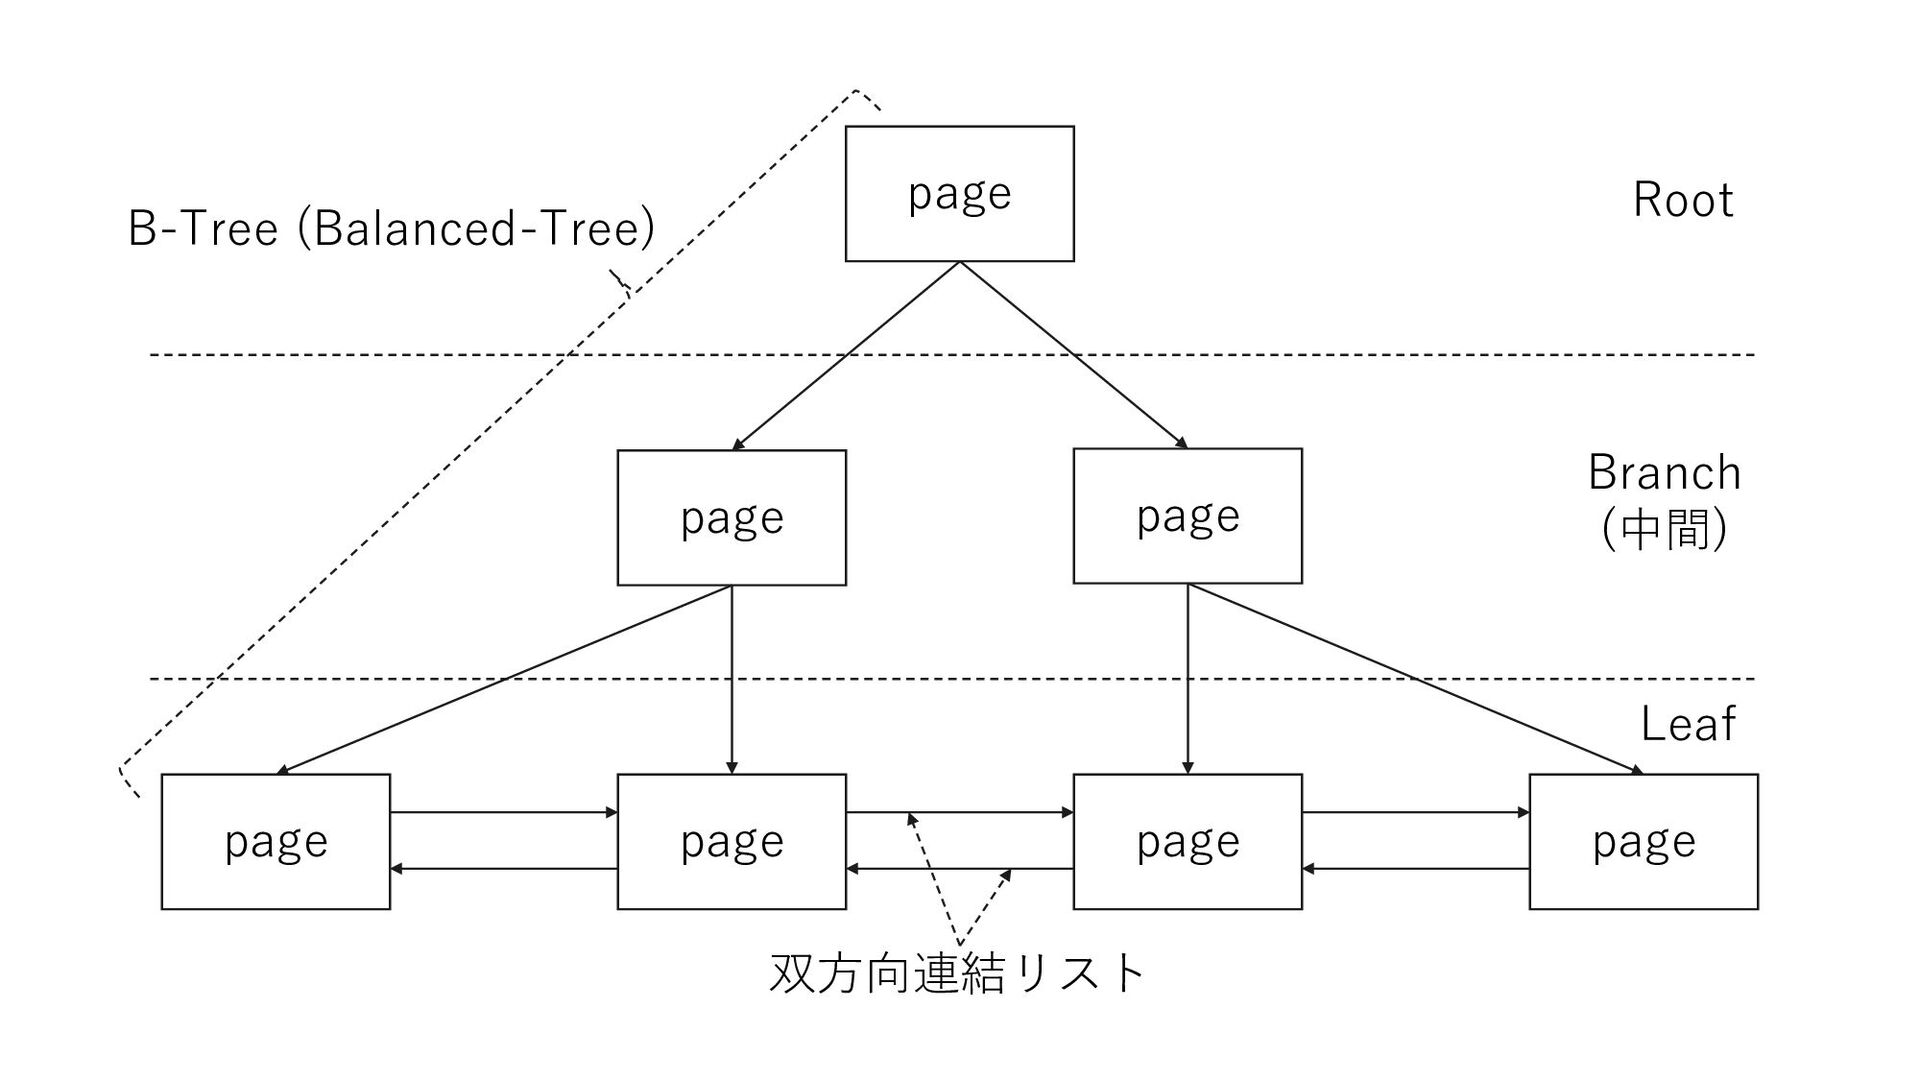
2種類の基本的なインデックス • クラスタ化インデックス • 1テーブルに1個 • テーブルの実データ(=全カラム)が格納 • ⾮クラスタ化インデックス •
1テーブルに0〜999個 • テーブルの⼀部のカラムが格納 ⇒ どちらもページを論理的につなげてツリー構造にしたもの -
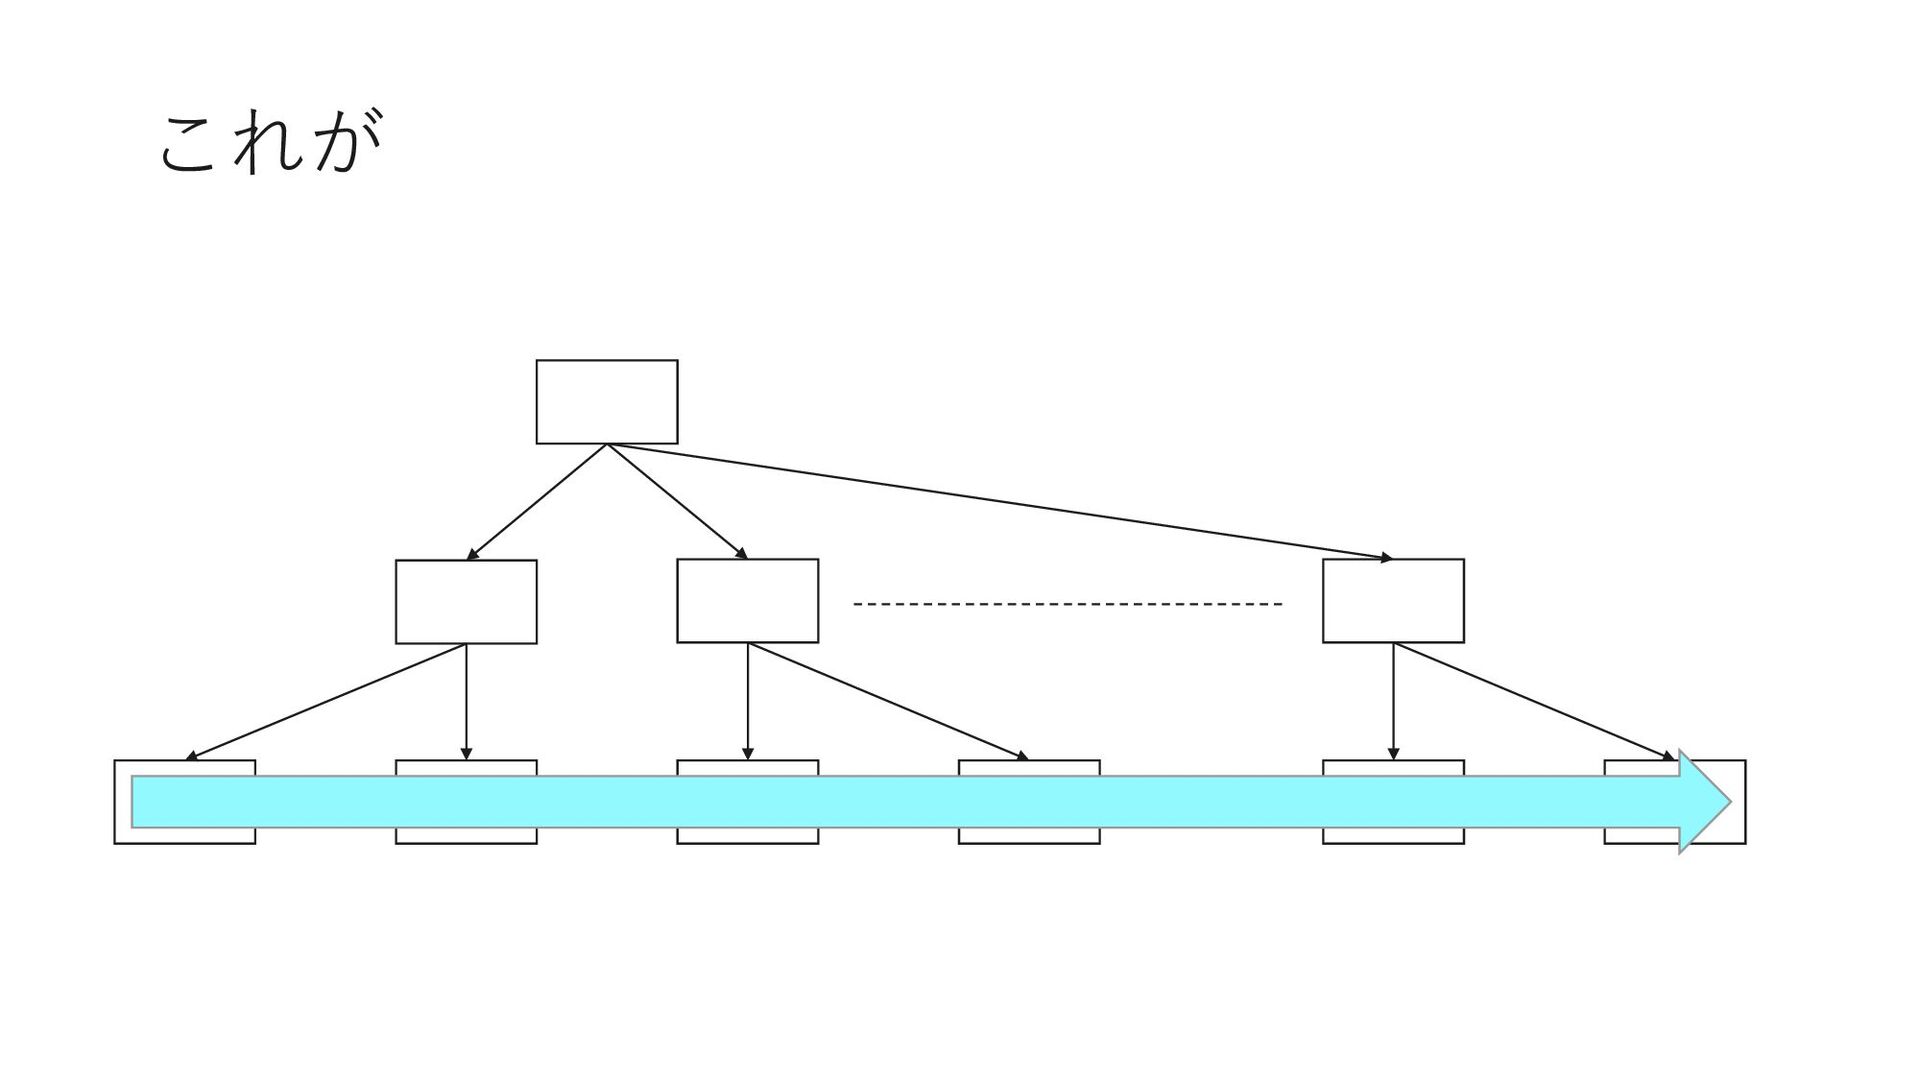
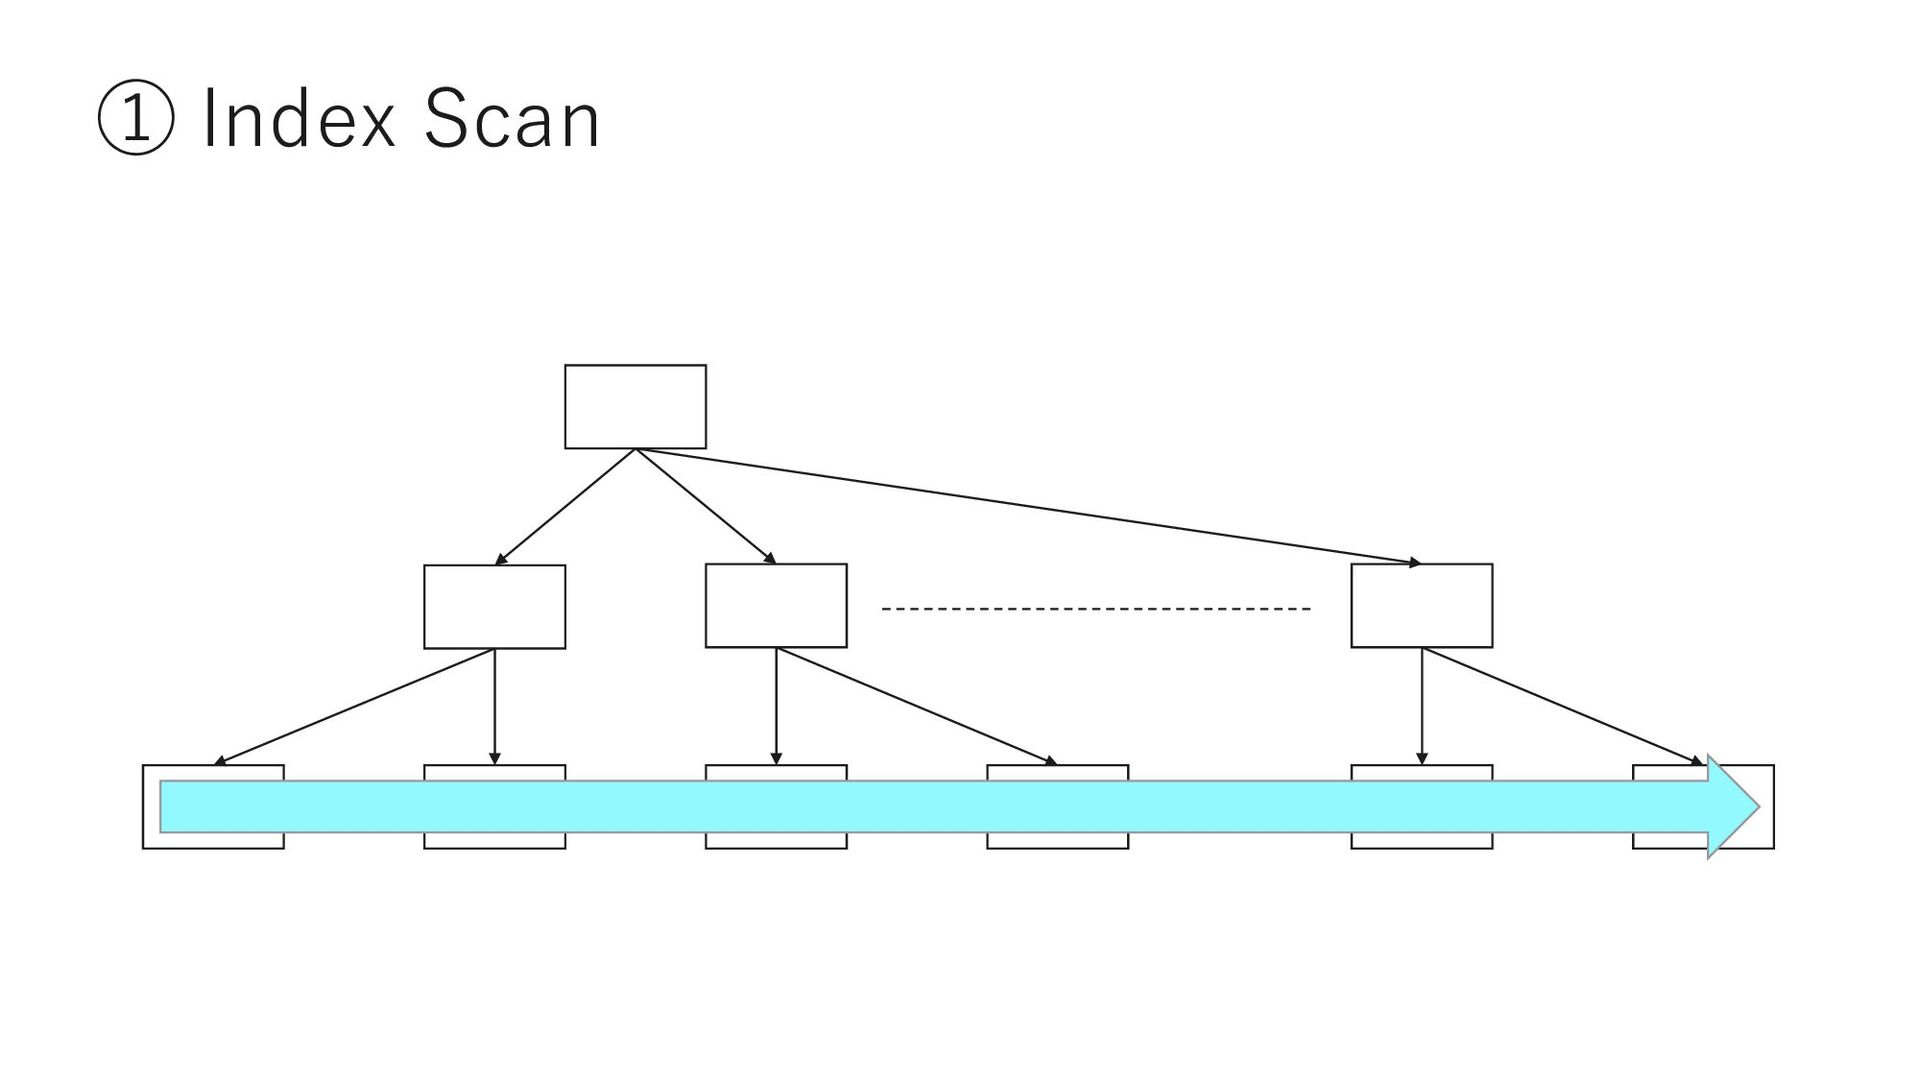
page page page page page page page 双⽅向連結リスト B-Tree (Balanced-Tree)
Root Branch (中間) Leaf -
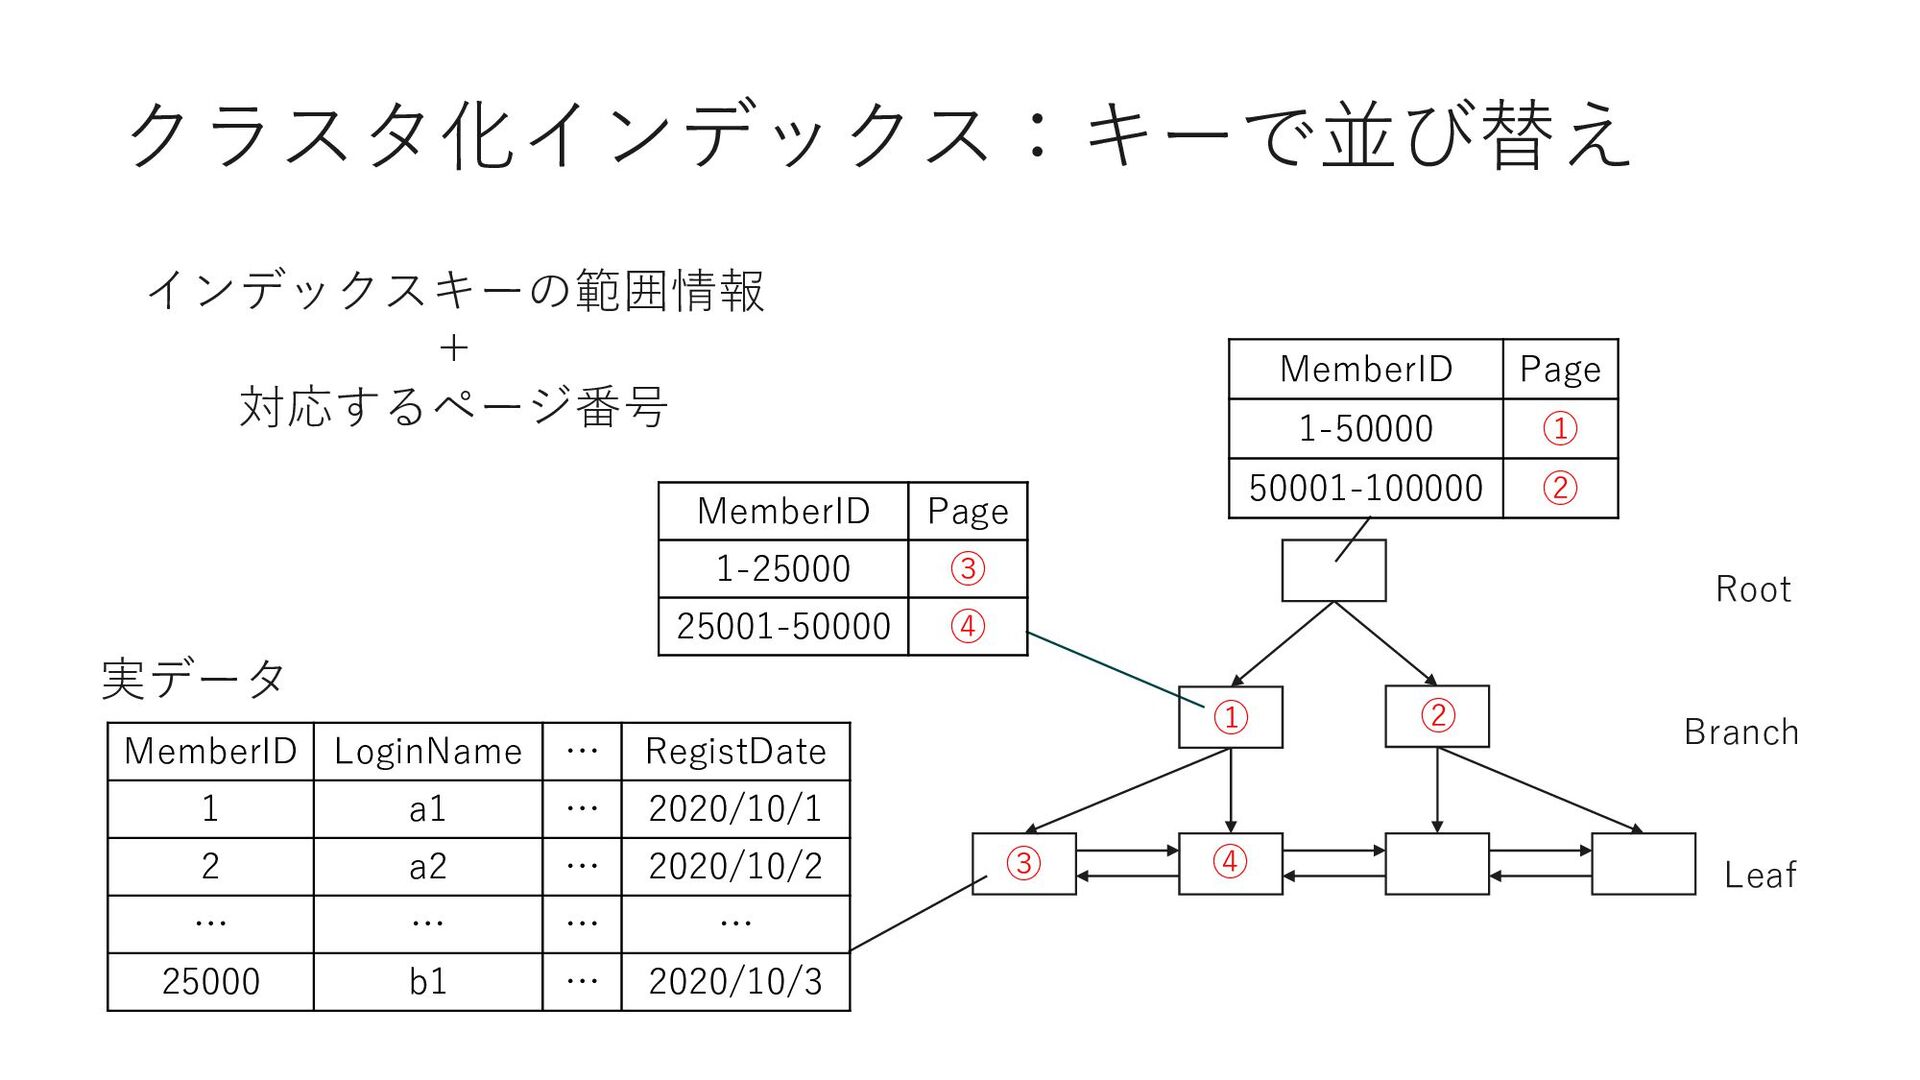
クラスタ化インデックスの定義 [MemberID]で並び替えられたツリー構造になっている ALTER TABLE [dbo].[Member] ADD CONSTRAINT [PK_Member] PRIMARY KEY
CLUSTERED ( [MemberID] ASC ) -
クラスタ化インデックス:キーで並び替え Root Branch Leaf 実データ インデックスキーの範囲情報 + 対応するページ番号 MemberID Page
1-50000 ① 50001-100000 ② ① ② MemberID Page 1-25000 ③ 25001-50000 ④ ③ ④ MemberID LoginName … RegistDate 1 a1 … 2020/10/1 2 a2 … 2020/10/2 … … … … 25000 b1 … 2020/10/3 -
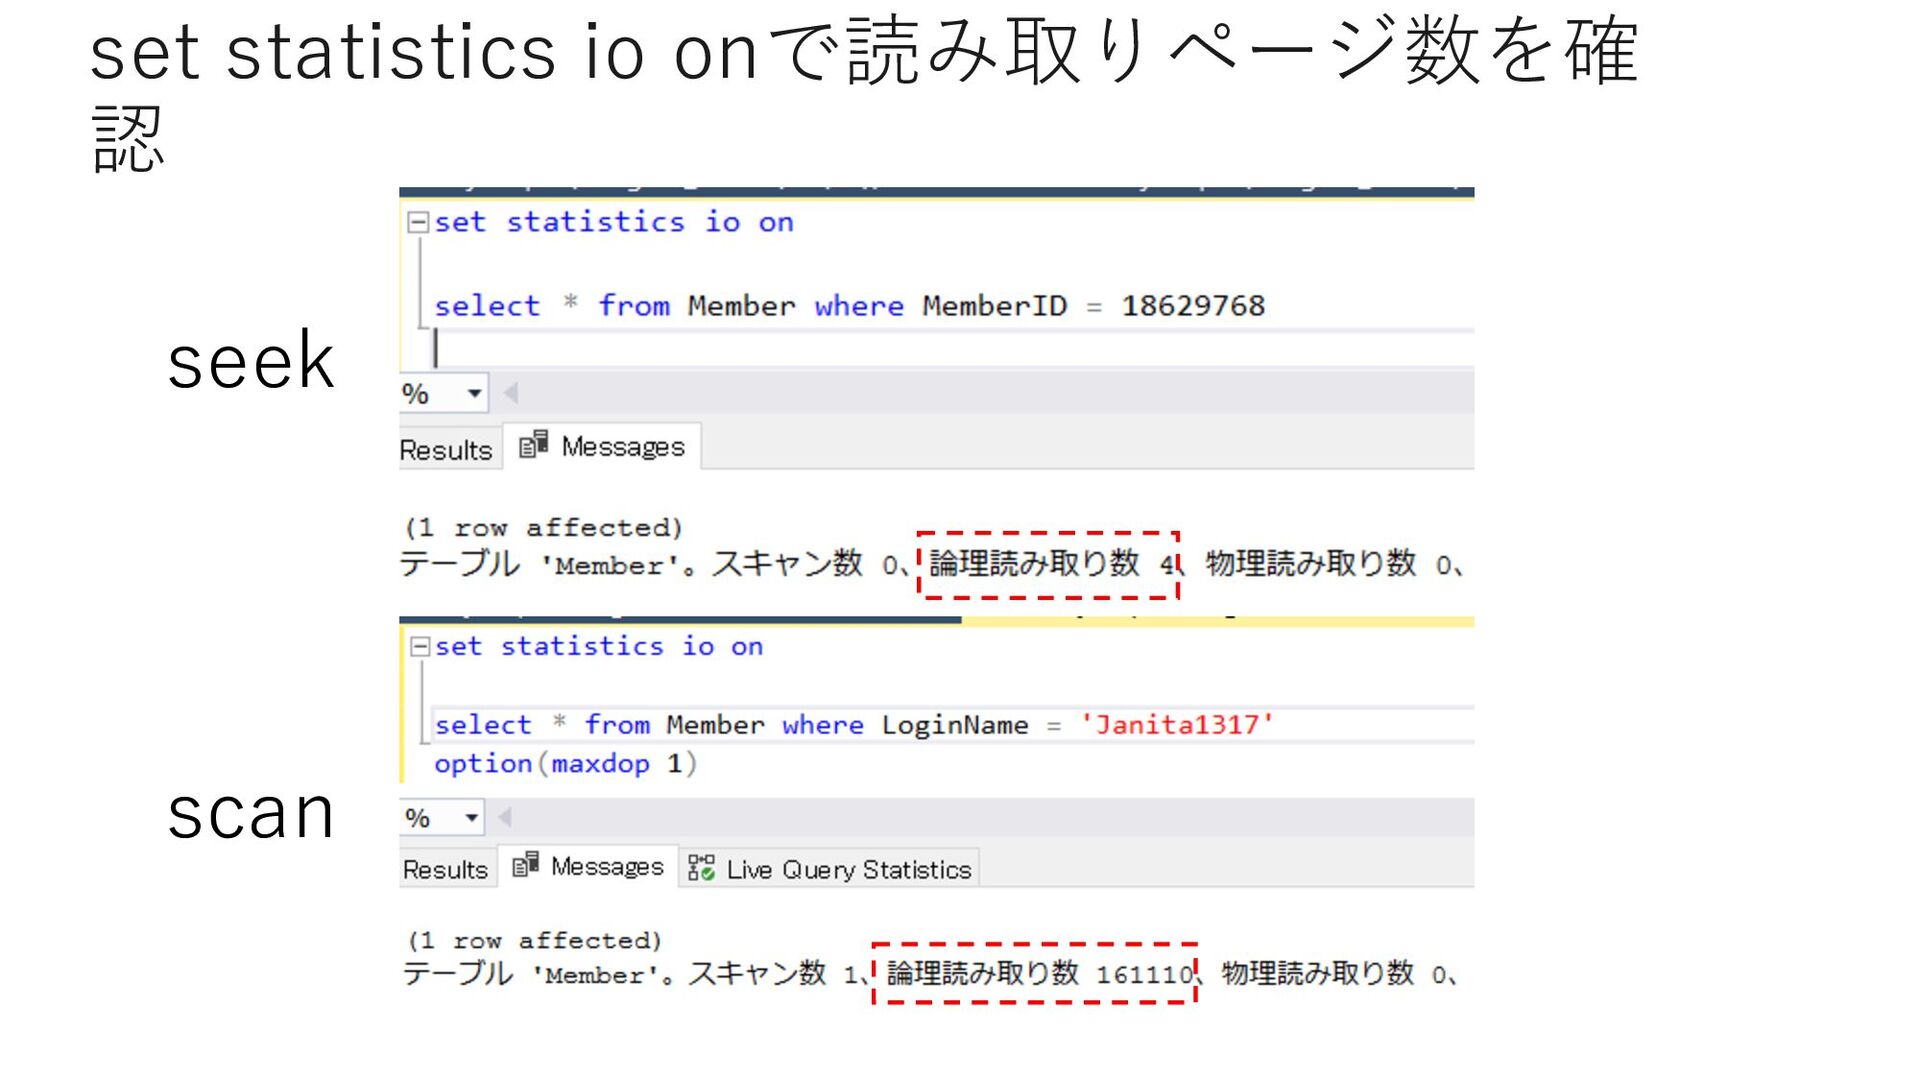
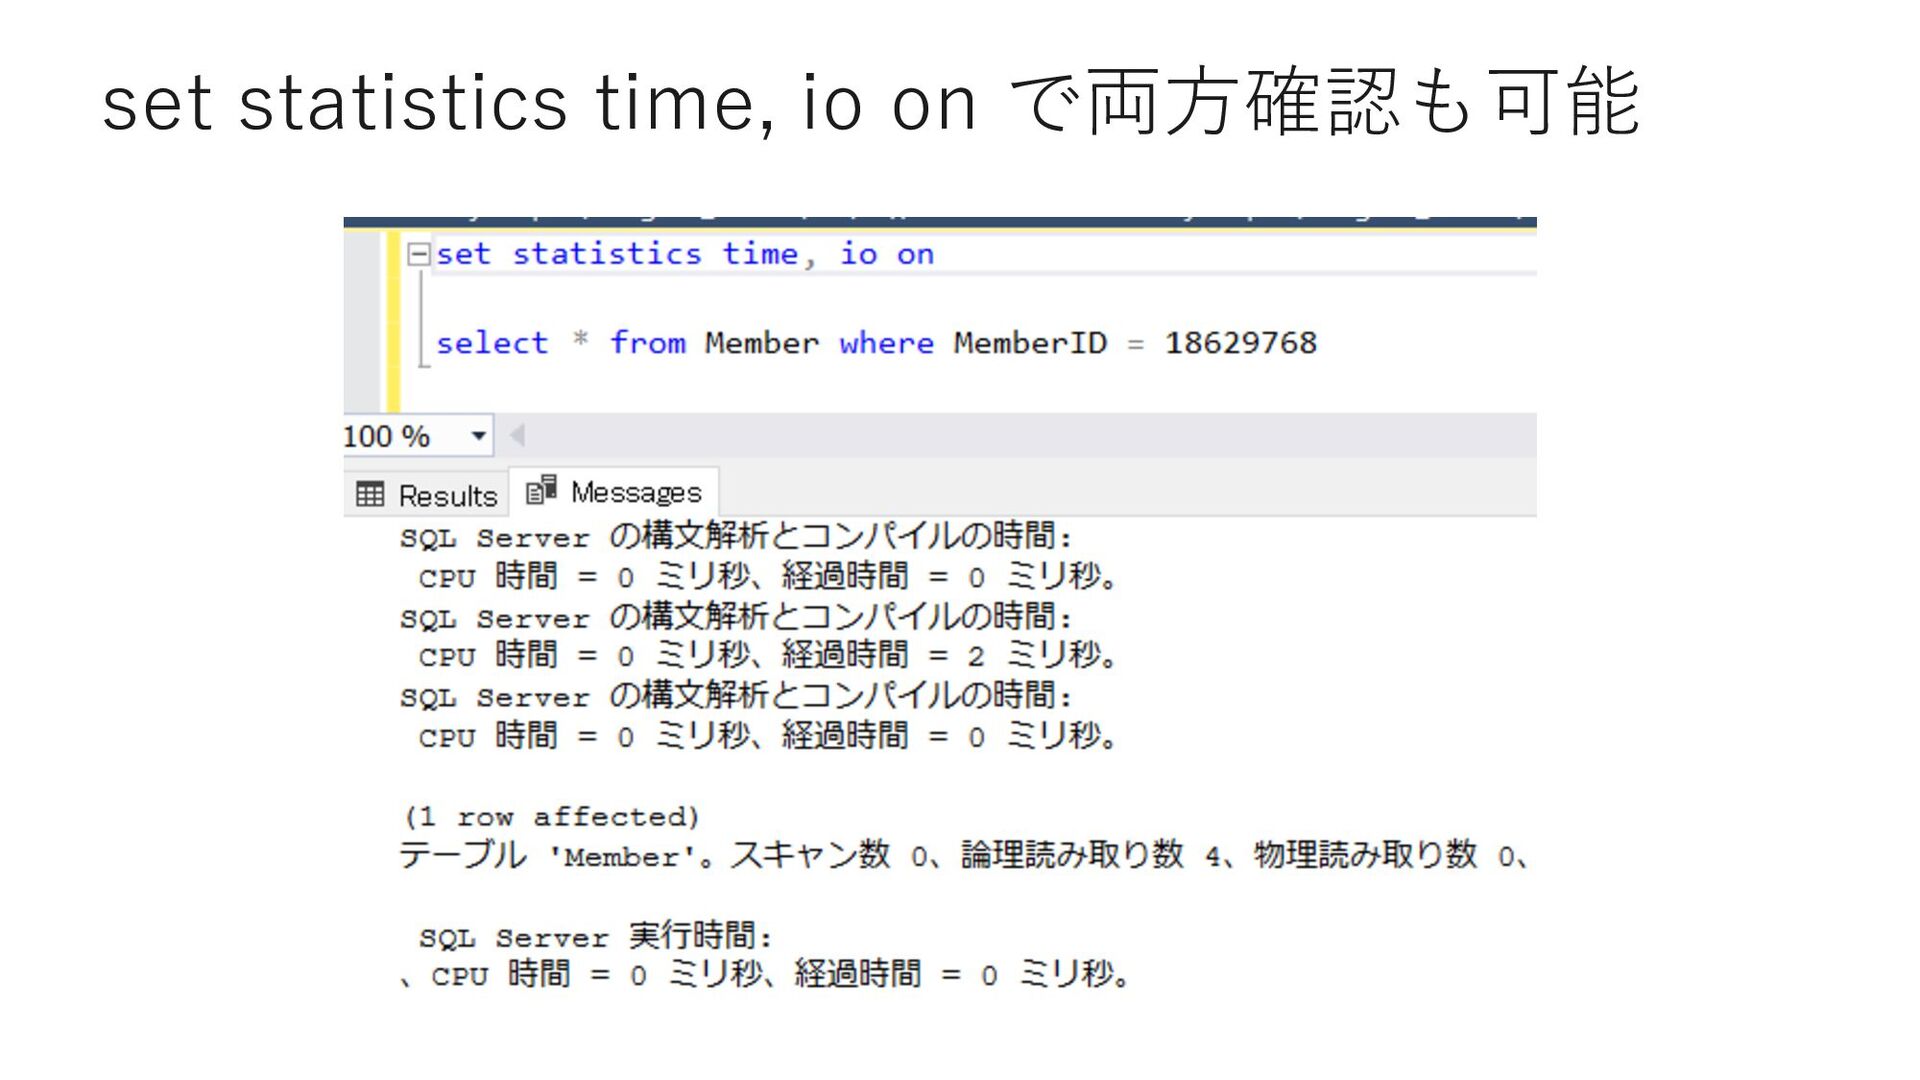
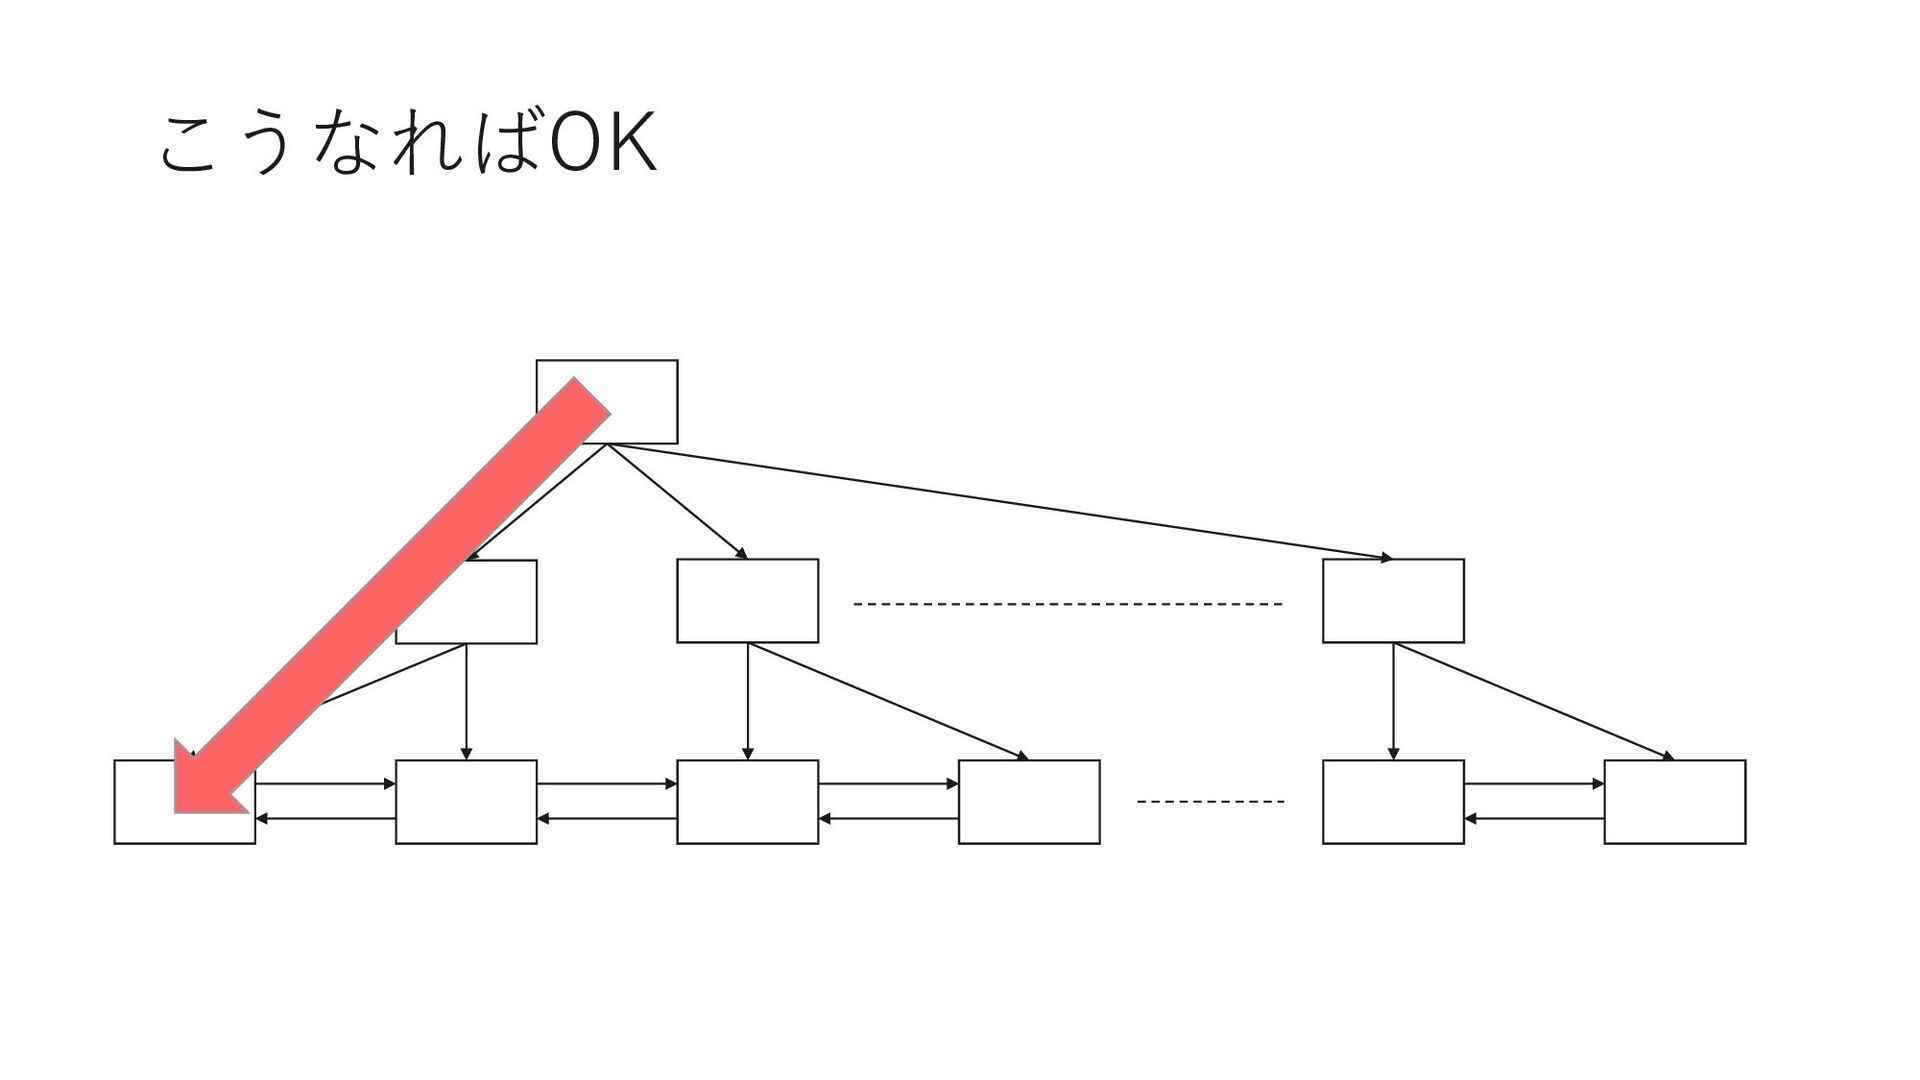
ひとつずつ実⾏してみよう select * from Member where MemberID = 18629768 select
* from Member where LoginName = 'Janita1317' どちらも使われるインデックスは同じ ⇒ インデックスはどう使われたのか? -
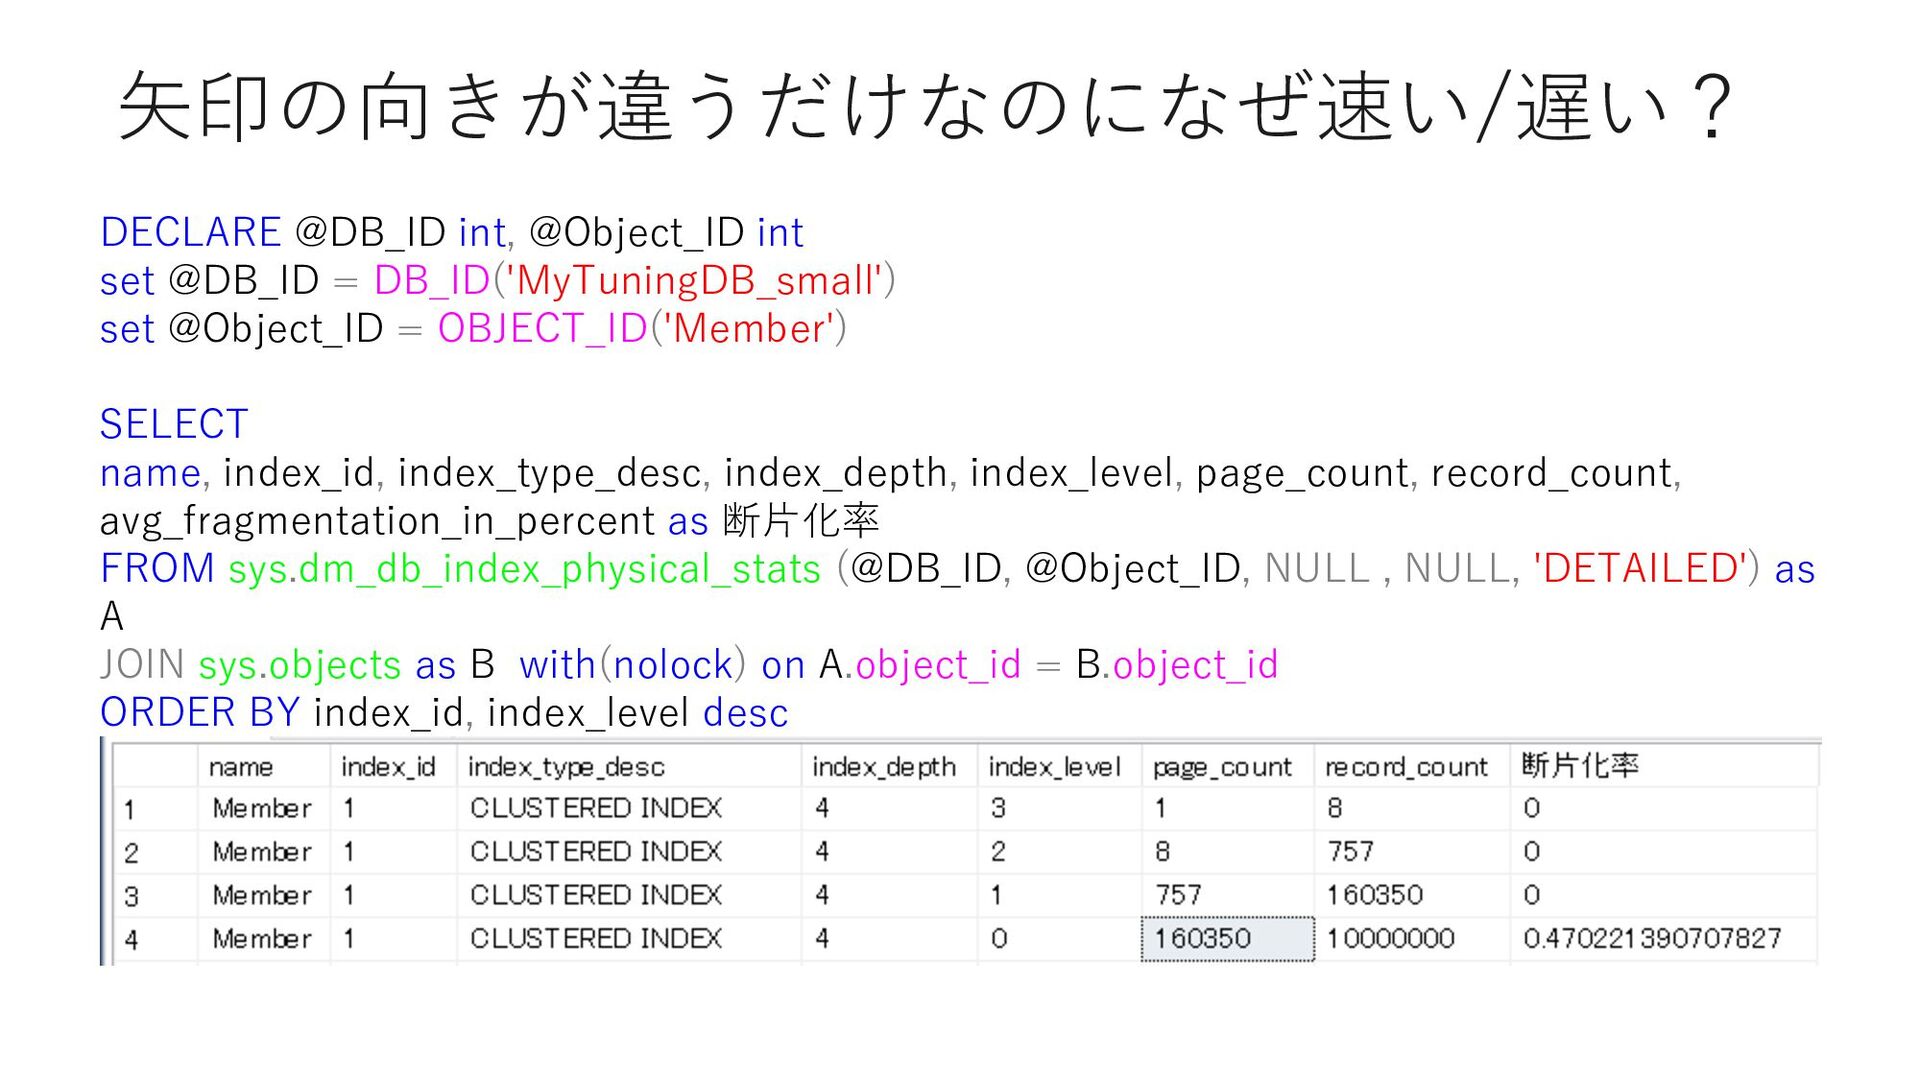
⽮印の向きが違うだけなのになぜ速い/遅い? DECLARE @DB_ID int, @Object_ID int set @DB_ID = DB_ID('MyTuningDB_small')
set @Object_ID = OBJECT_ID('Member') SELECT name, index_id, index_type_desc, index_depth, index_level, page_count, record_count, avg_fragmentation_in_percent as 断⽚化率 FROM sys.dm_db_index_physical_stats (@DB_ID, @Object_ID, NULL , NULL, 'DETAILED') as A JOIN sys.objects as B with(nolock) on A.object_id = B.object_id ORDER BY index_id, index_level desc -
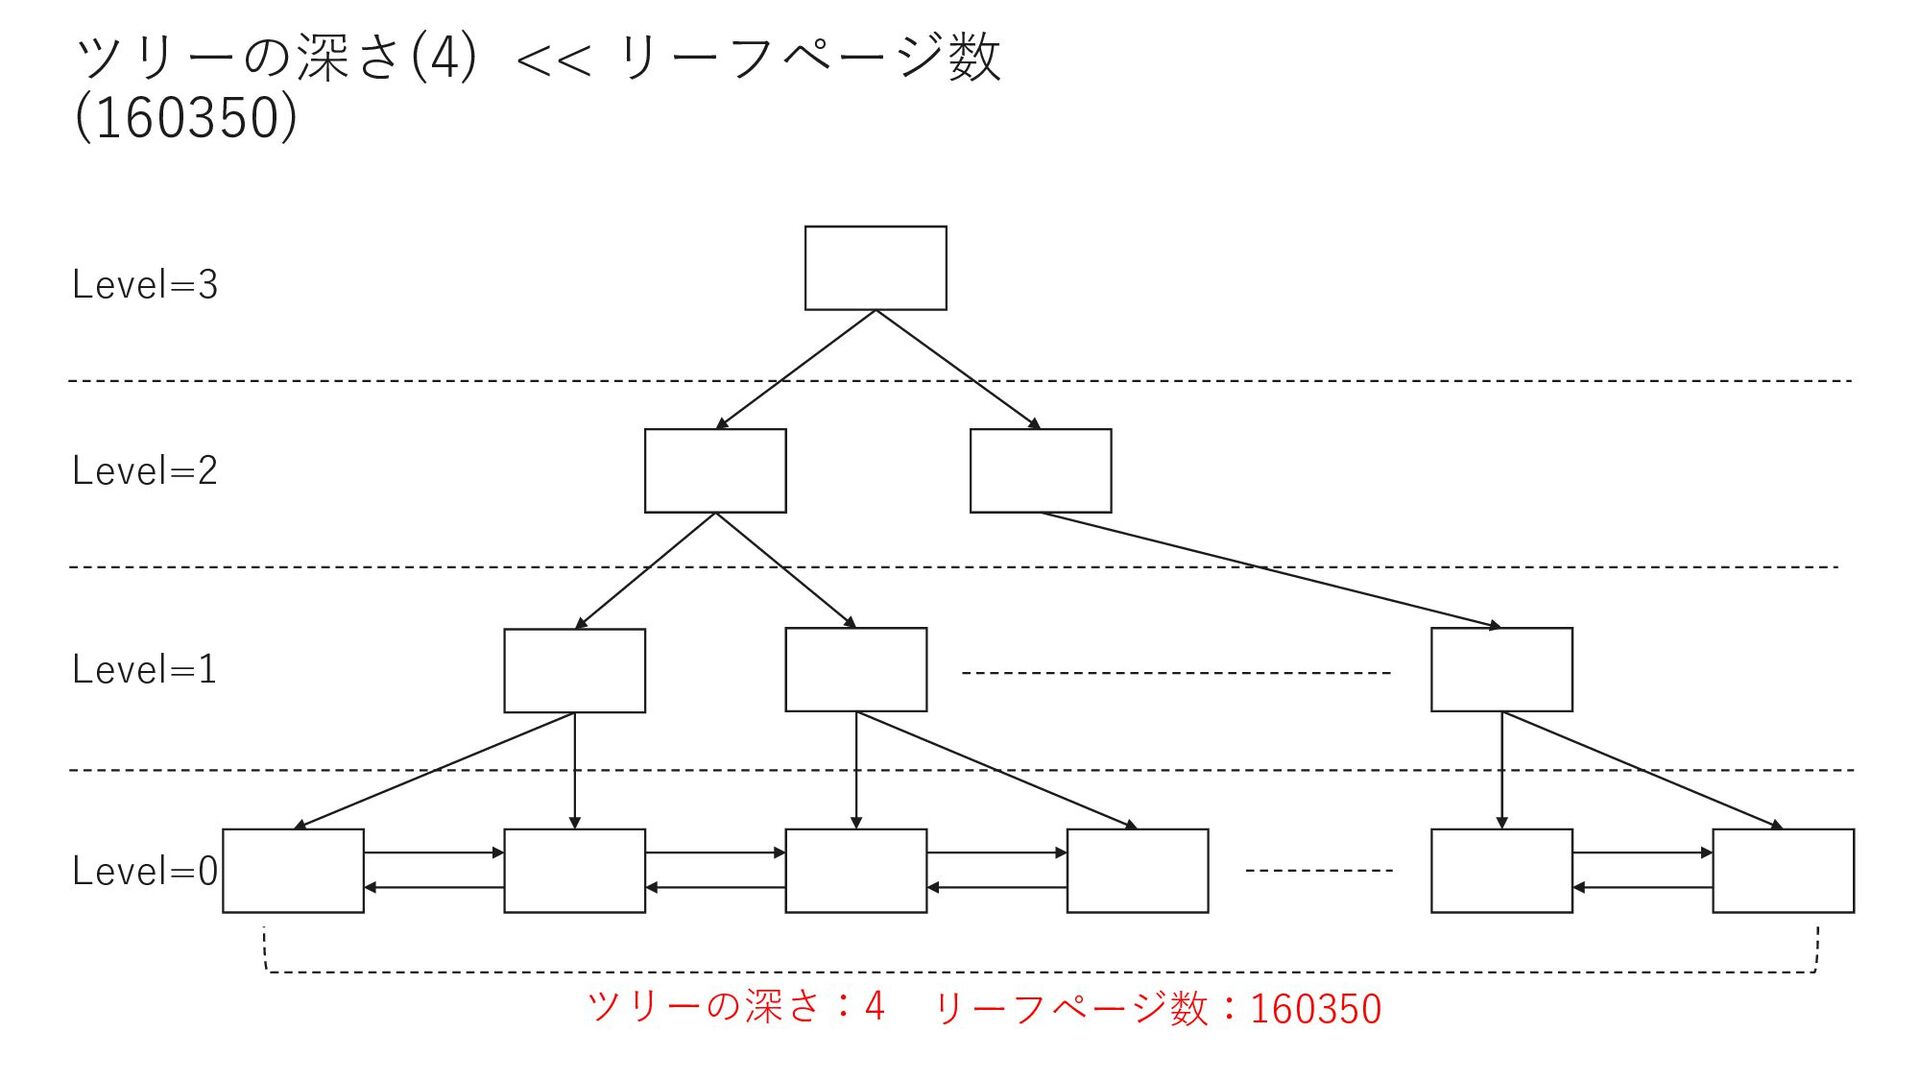
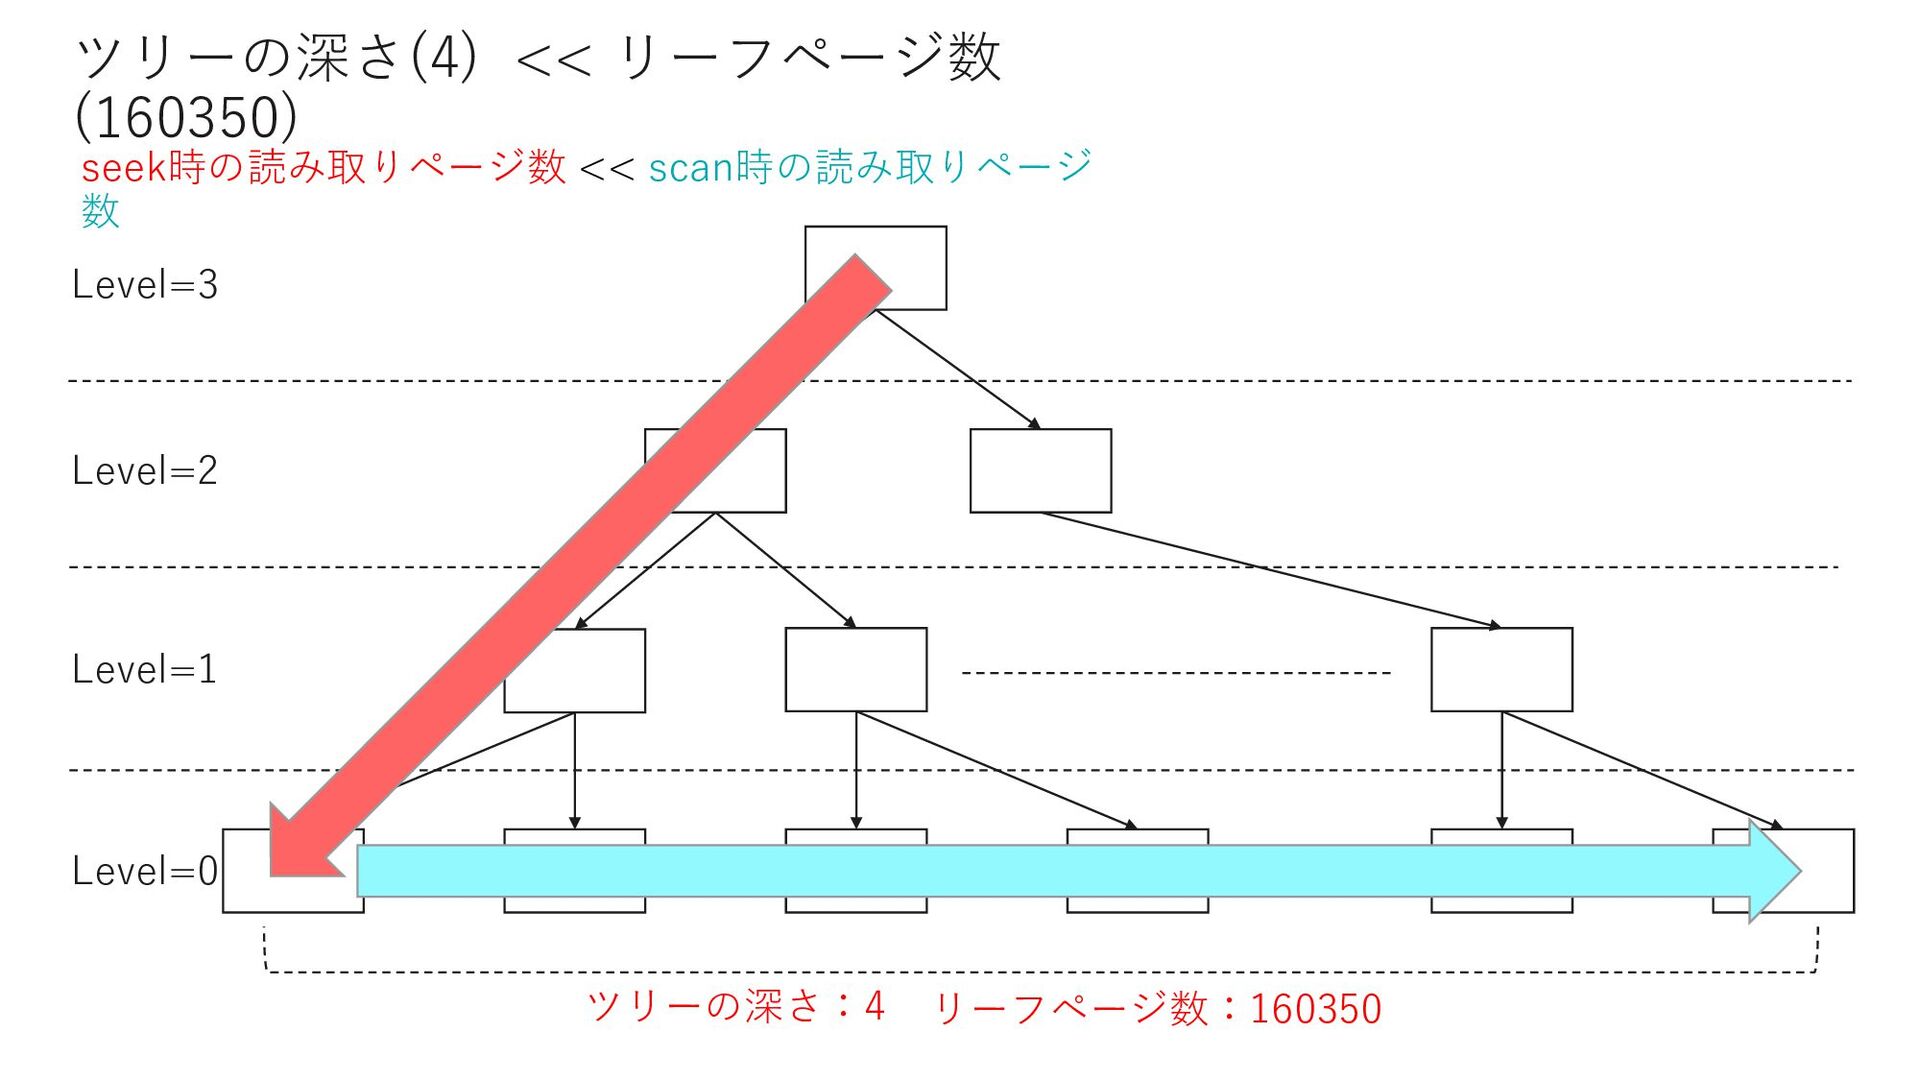
ツリーの深さ(4) << リーフページ数 (160350) リーフページ数:160350 ツリーの深さ:4 Level=2 Level=1 Level=0 Level=3
seek時の読み取りページ数 << scan時の読み取りページ 数 -
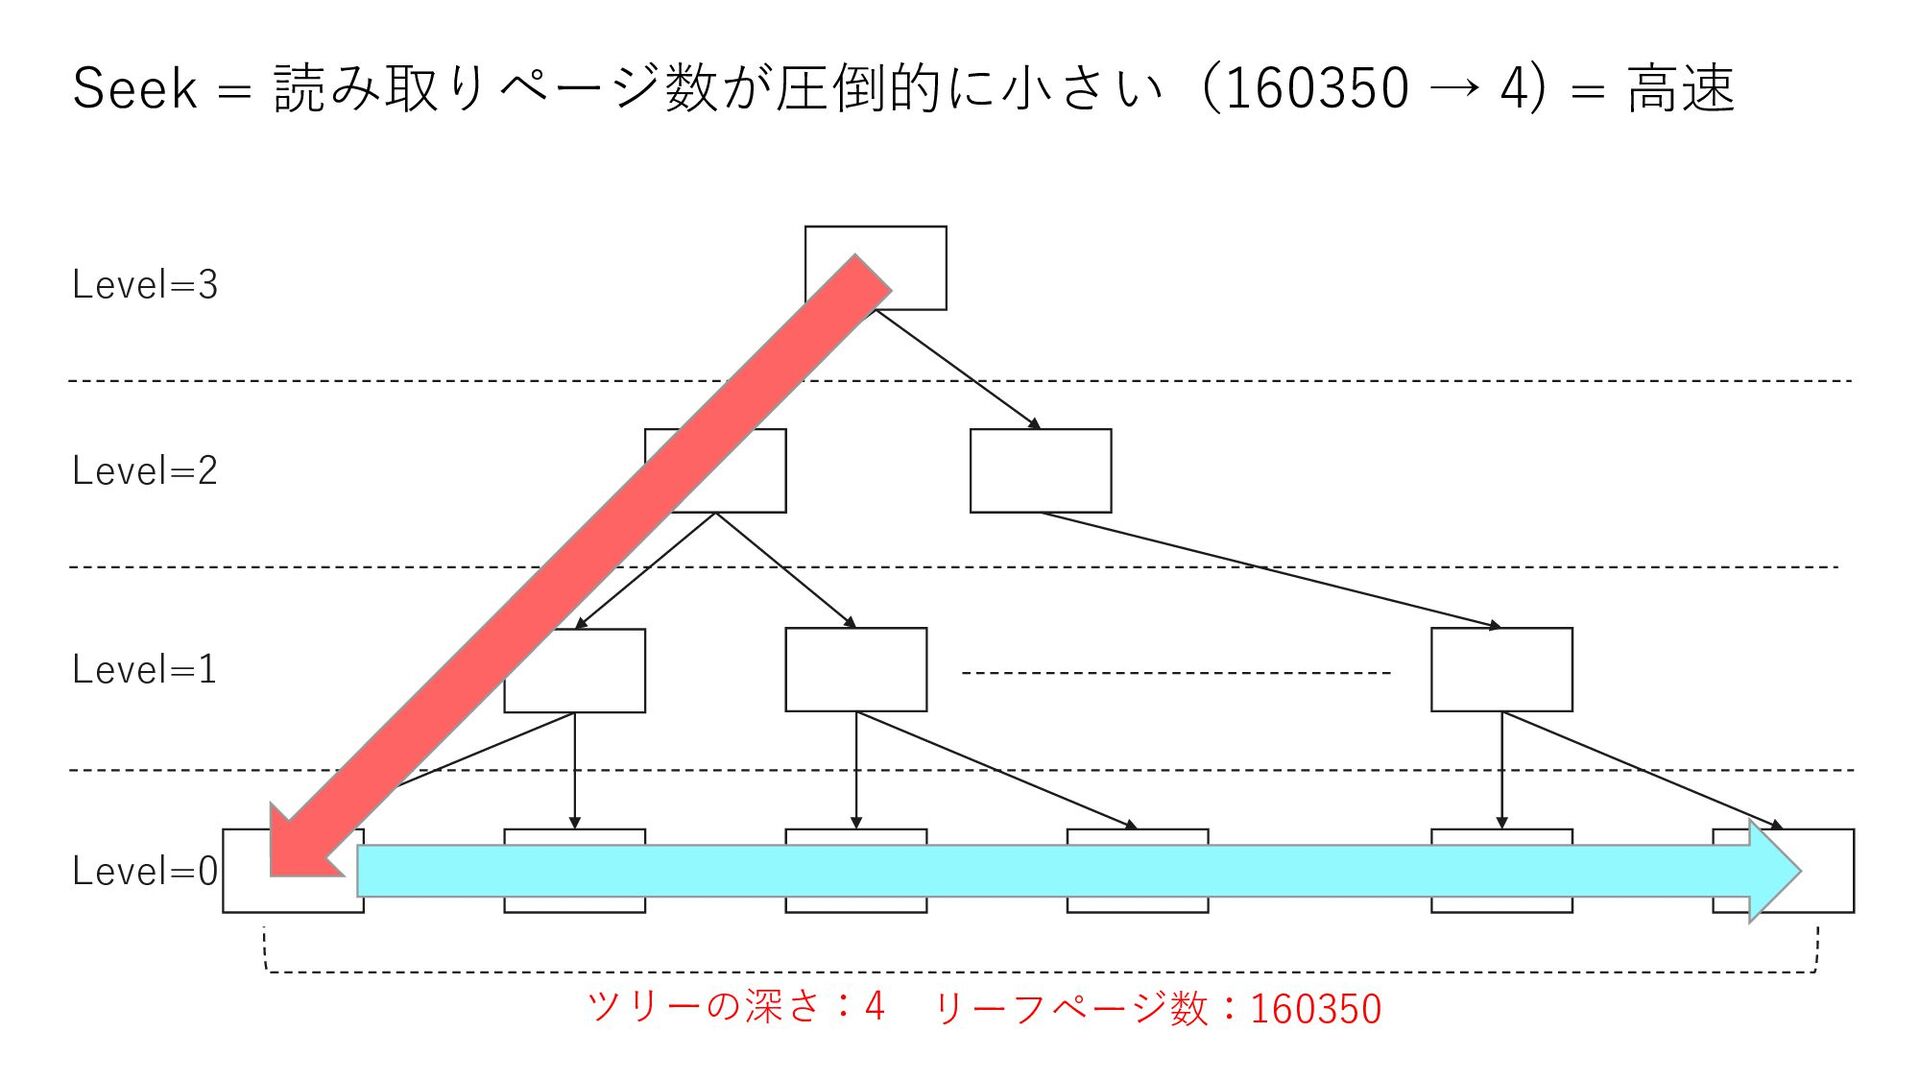
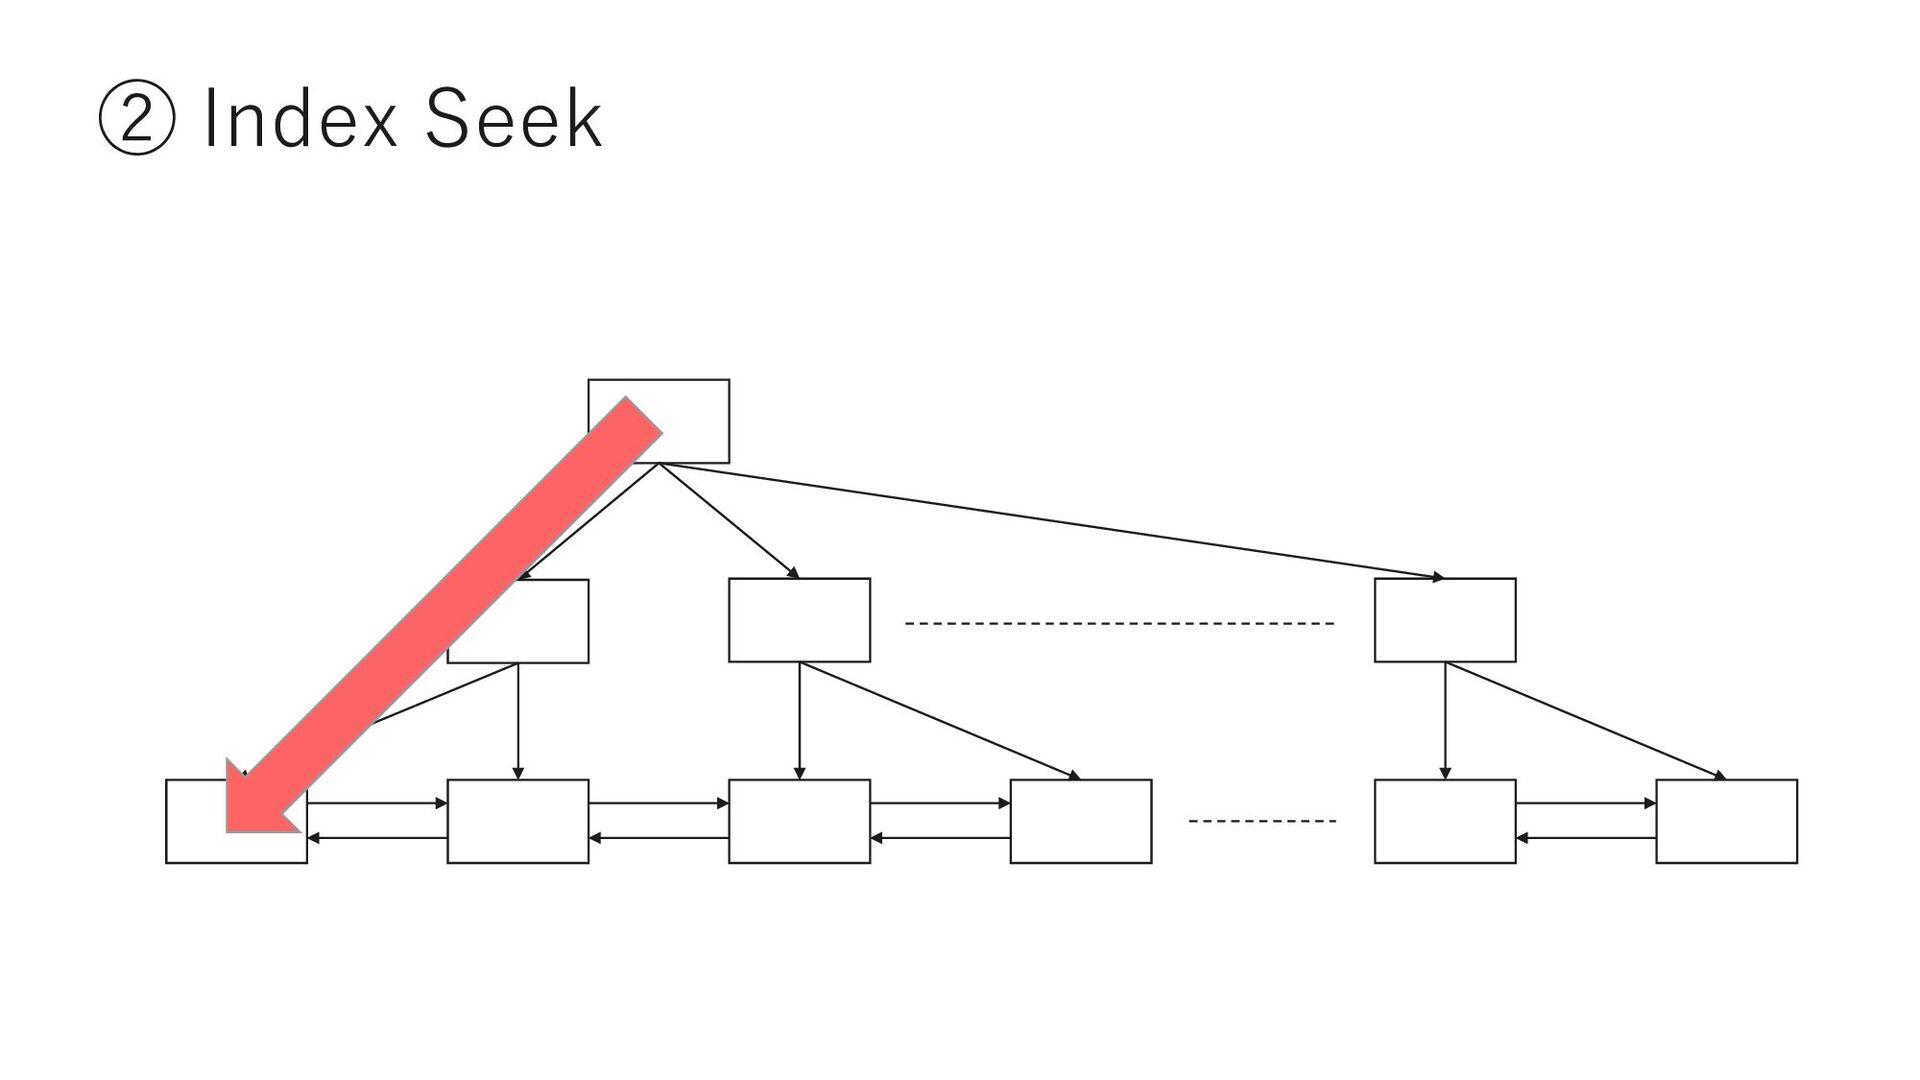
Seek = 読み取りページ数が圧倒的に⼩さい(160350 → 4) = ⾼速 リーフページ数:160350 ツリーの深さ:4 Level=2
Level=1 Level=0 Level=3 -
インデックスが効く(=seek)条 件 例:「インデックスの並び順」=「where句で指定した条件」 ALTER TABLE [dbo].[Member] ADD CONSTRAINT [PK_Member] PRIMARY
KEY CLUSTERED ( [MemberID] ASC ) 効く:select * from Member where MemberID = 18629768 効かない:select * from Member where LoginName = 'Janita1317' インデックス≠万能薬 -
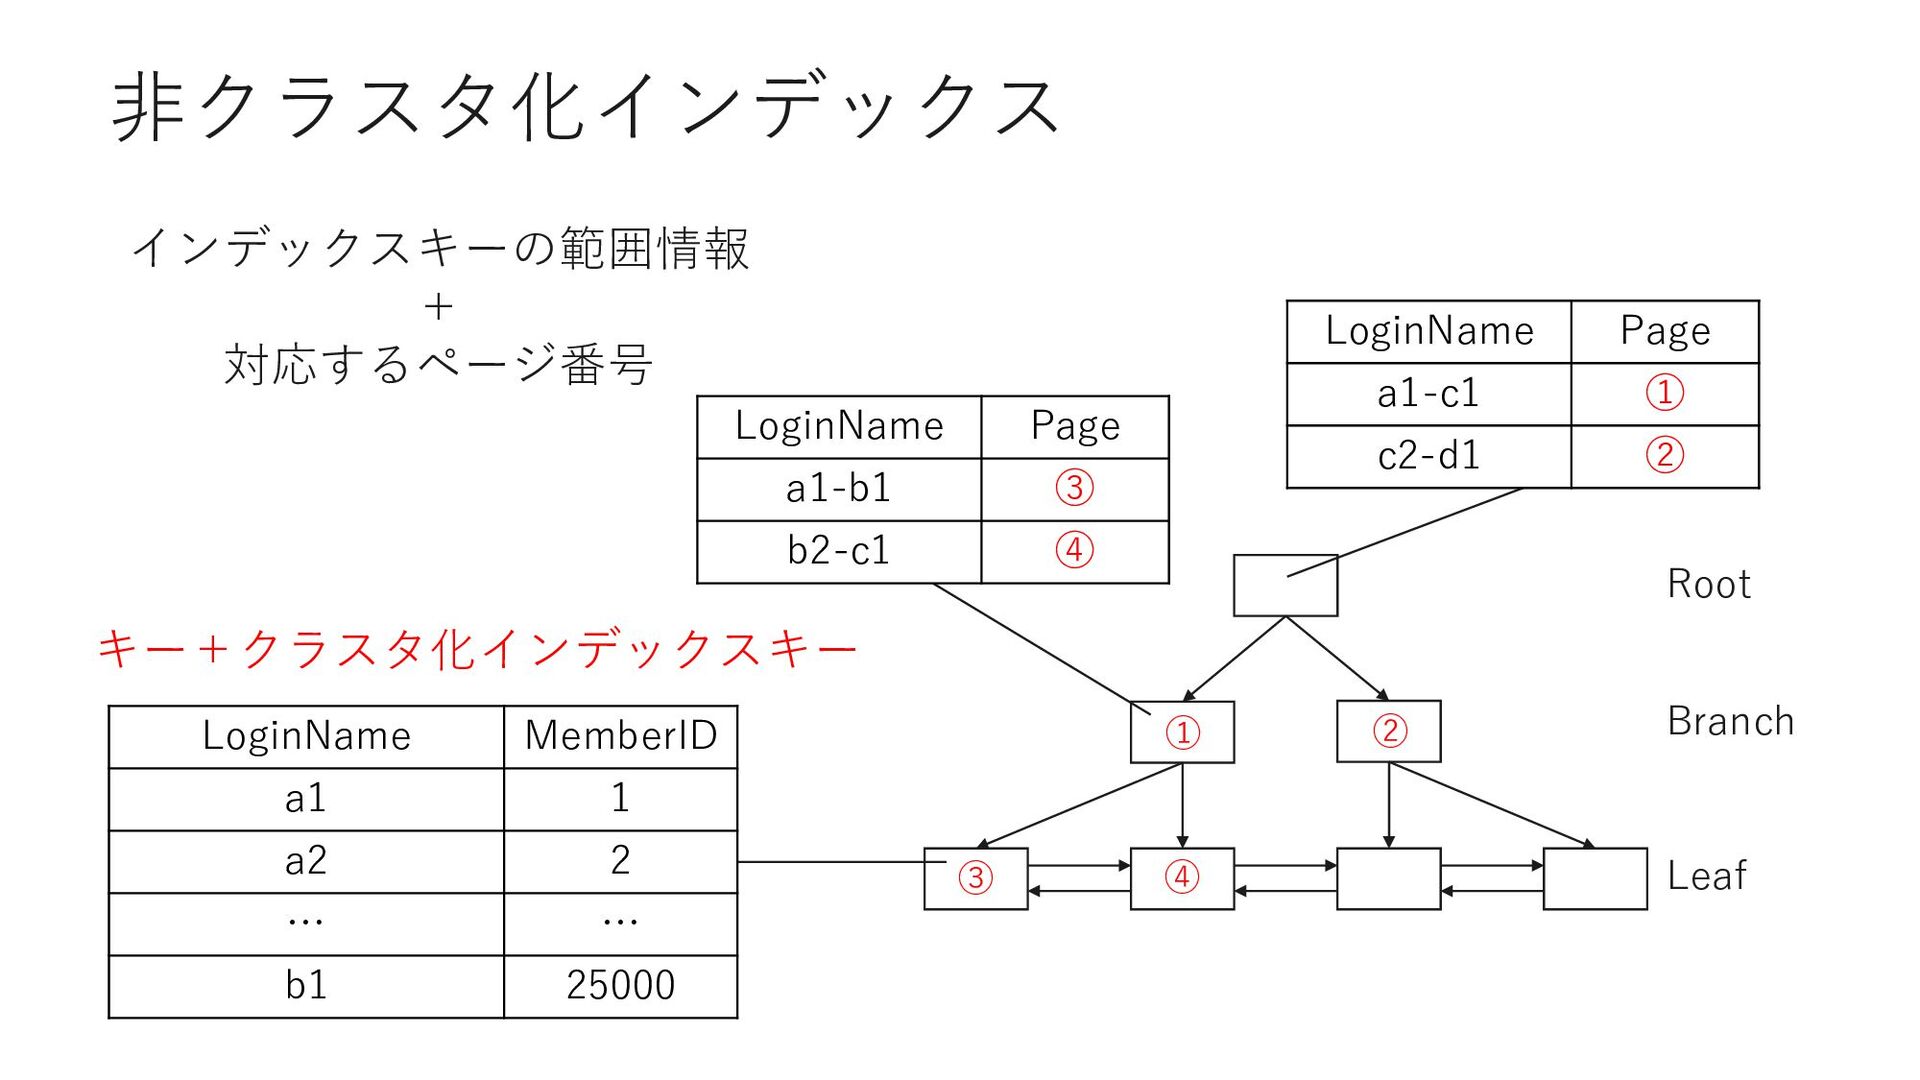
⾮クラスタ化インデックス Root Branch Leaf キー+クラスタ化インデックスキー インデックスキーの範囲情報 + 対応するページ番号 LoginName Page
a1-c1 ① c2-d1 ② ① ② LoginName Page a1-b1 ③ b2-c1 ④ ③ ④ LoginName MemberID a1 1 a2 2 … … b1 25000 -
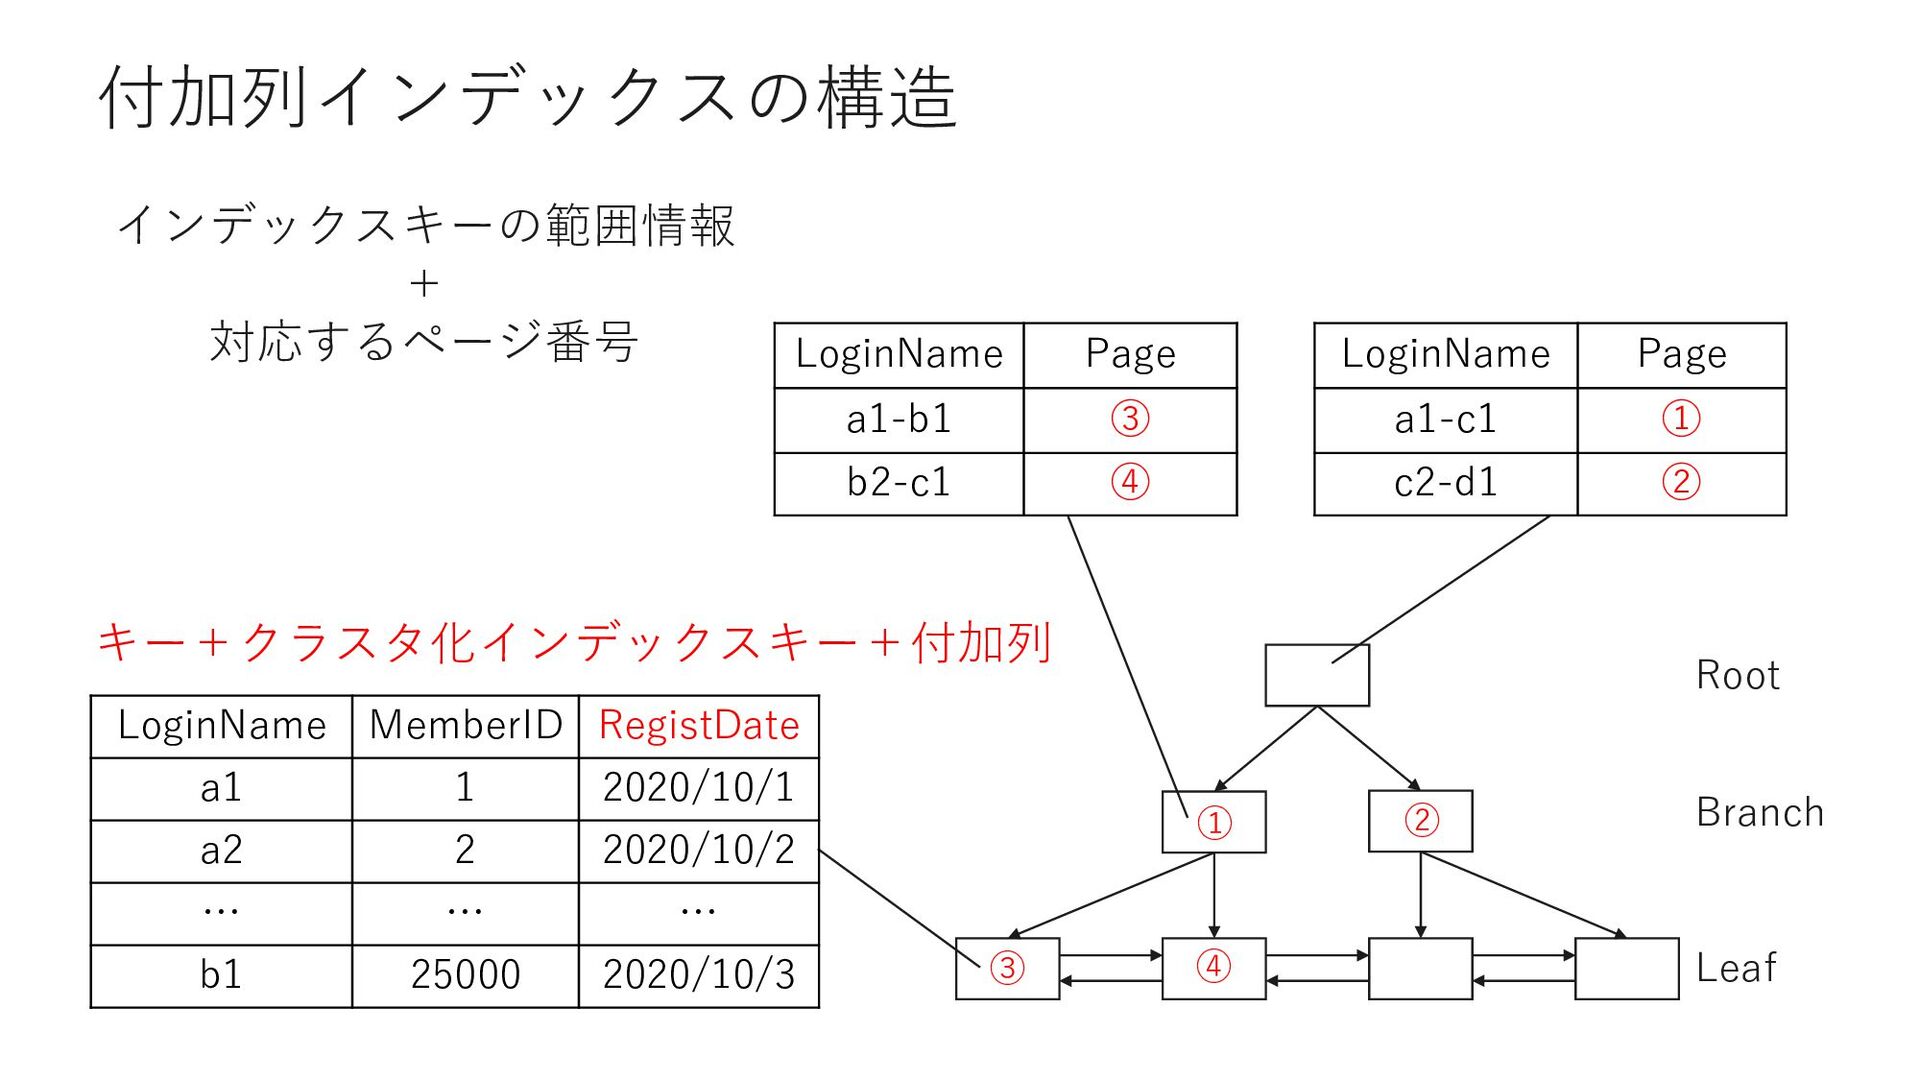
付加列インデックスの構造 Root Branch Leaf キー+クラスタ化インデックスキー+付加列 インデックスキーの範囲情報 + 対応するページ番号 LoginName Page
a1-c1 ① c2-d1 ② ① ② LoginName Page a1-b1 ③ b2-c1 ④ ③ ④ LoginName MemberID RegistDate a1 1 2020/10/1 a2 2 2020/10/2 … … … b1 25000 2020/10/3 -
複合インデックス CREATE NONCLUSTERED INDEX [IX_Member_Sei_PrefectureID] ON [dbo].[Member] ( [Sei] ASC,
[PrefectureID] ASC ) 複合インデックス = 複数のカラムをインデックスキーに指定 -
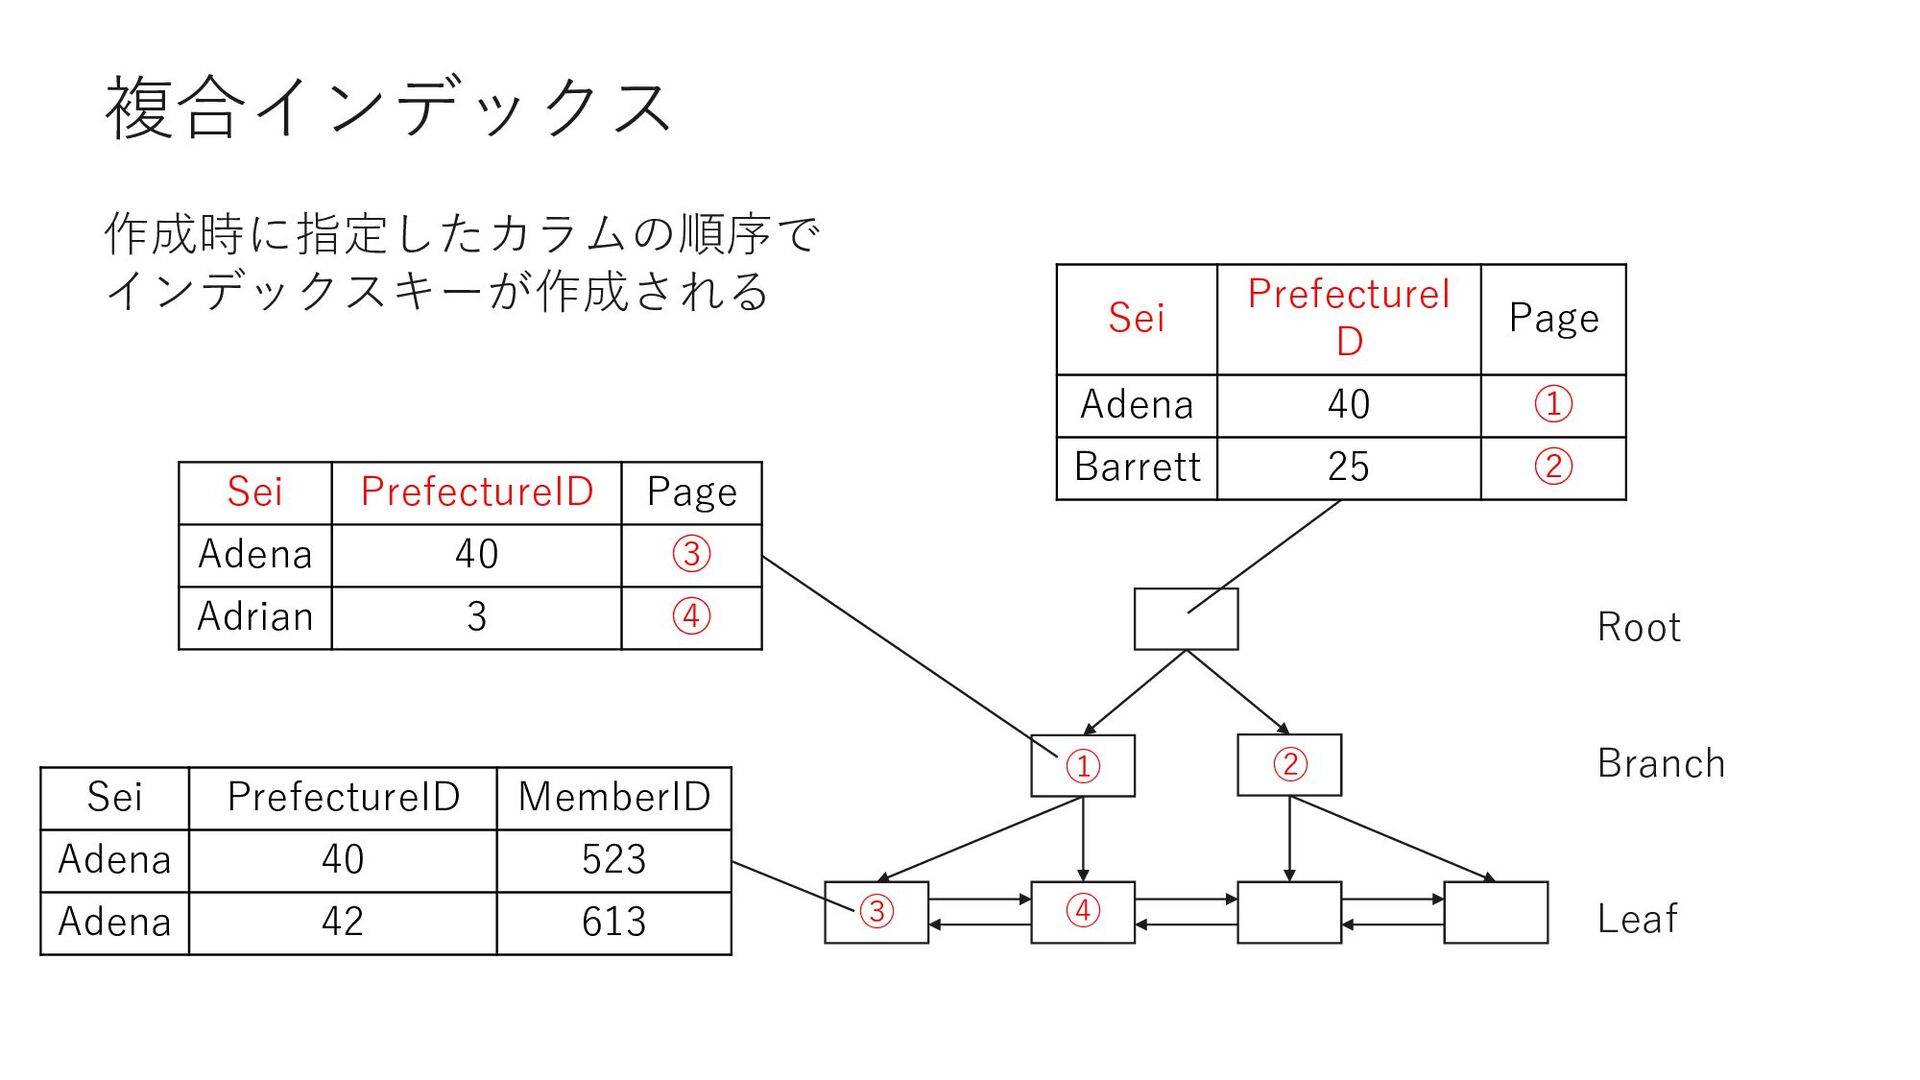
複合インデックス Root Branch Leaf ① ② ③ ④ Sei PrefectureI
D Page Adena 40 ① Barrett 25 ② Sei PrefectureID Page Adena 40 ③ Adrian 3 ④ Sei PrefectureID MemberID Adena 40 523 Adena 42 613 作成時に指定したカラムの順序で インデックスキーが作成される -
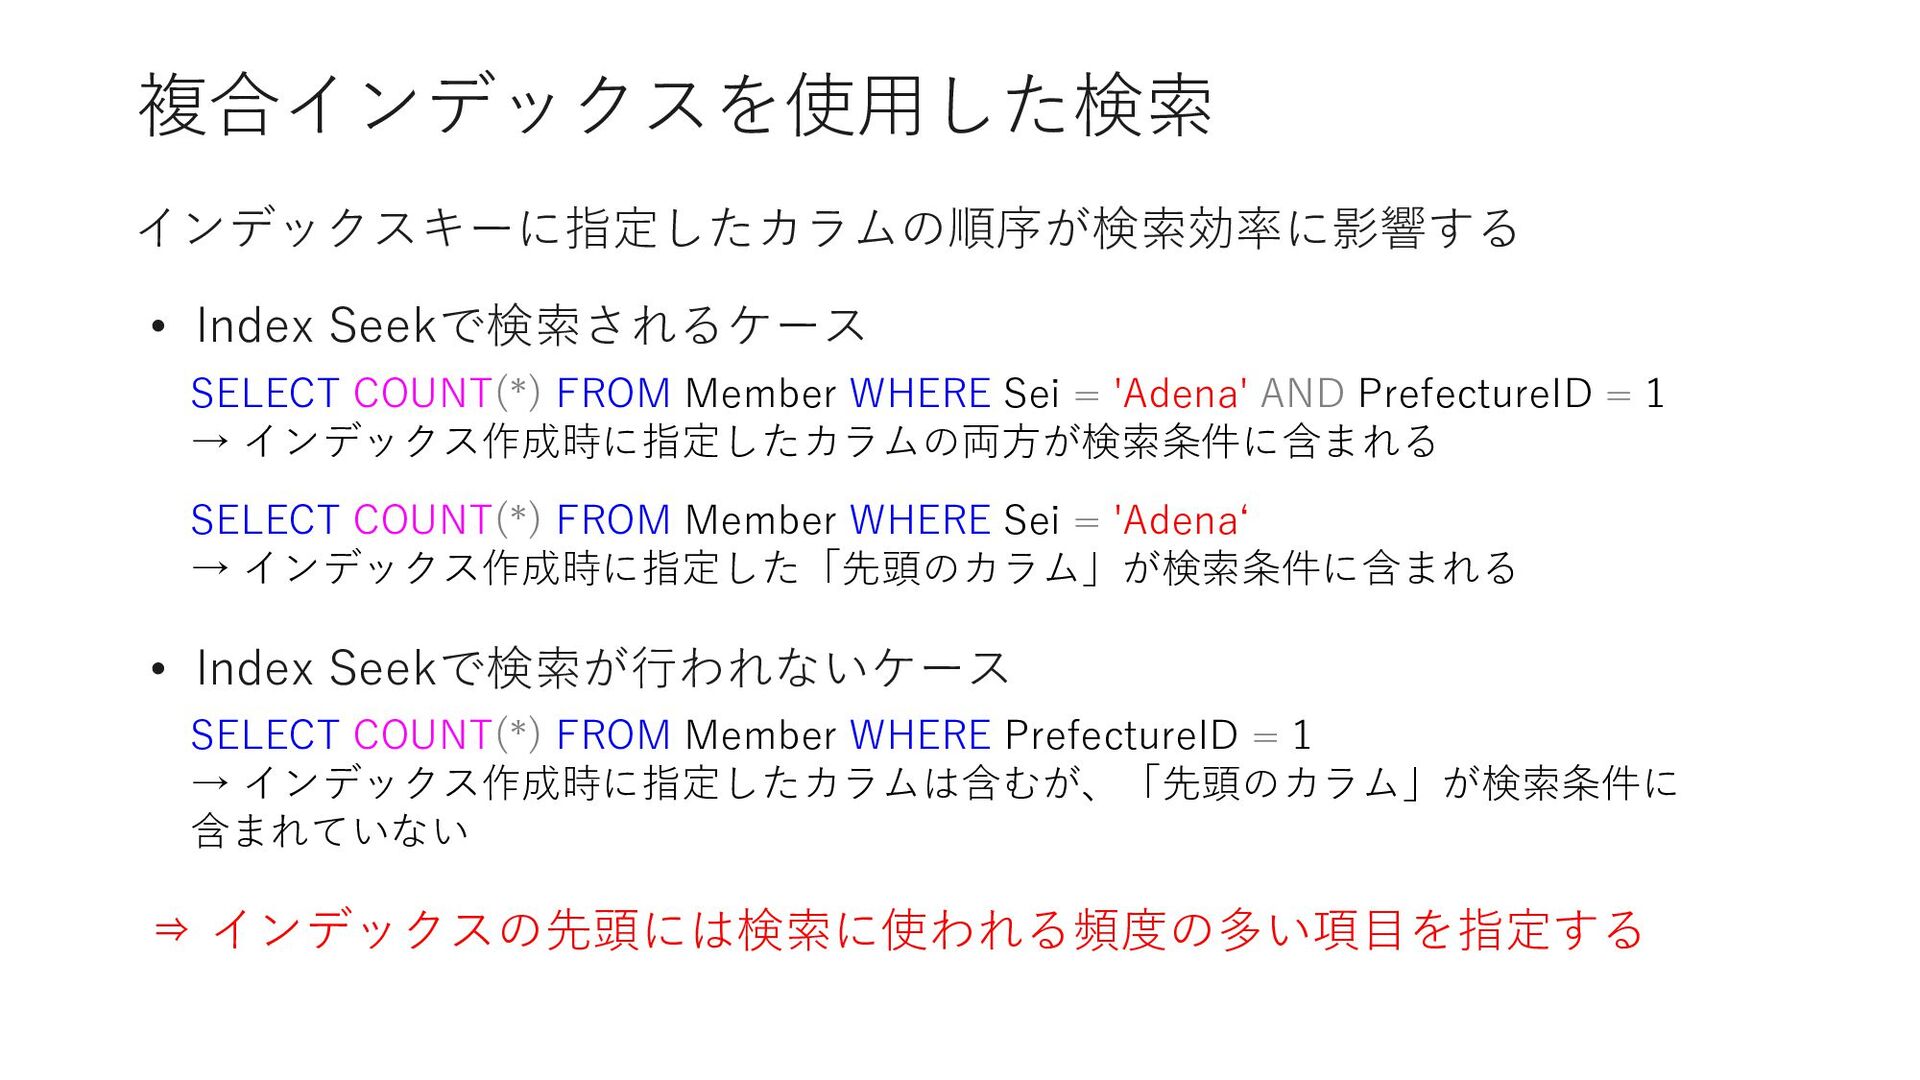
複合インデックスを使⽤した検索 インデックスキーに指定したカラムの順序が検索効率に影響する SELECT COUNT(*) FROM Member WHERE Sei = 'Adena'
AND PrefectureID = 1 → インデックス作成時に指定したカラムの両⽅が検索条件に含まれる SELECT COUNT(*) FROM Member WHERE Sei = 'Adenaʻ → インデックス作成時に指定した「先頭のカラム」が検索条件に含まれる SELECT COUNT(*) FROM Member WHERE PrefectureID = 1 → インデックス作成時に指定したカラムは含むが、「先頭のカラム」が検索条件に 含まれていない • Index Seekで検索されるケース • Index Seekで検索が⾏われないケース ⇒ インデックスの先頭には検索に使われる頻度の多い項⽬を指定する -
LoginName MemberID RegistDate a1 1 2020/10/1 a2 2 2020/10/2 …
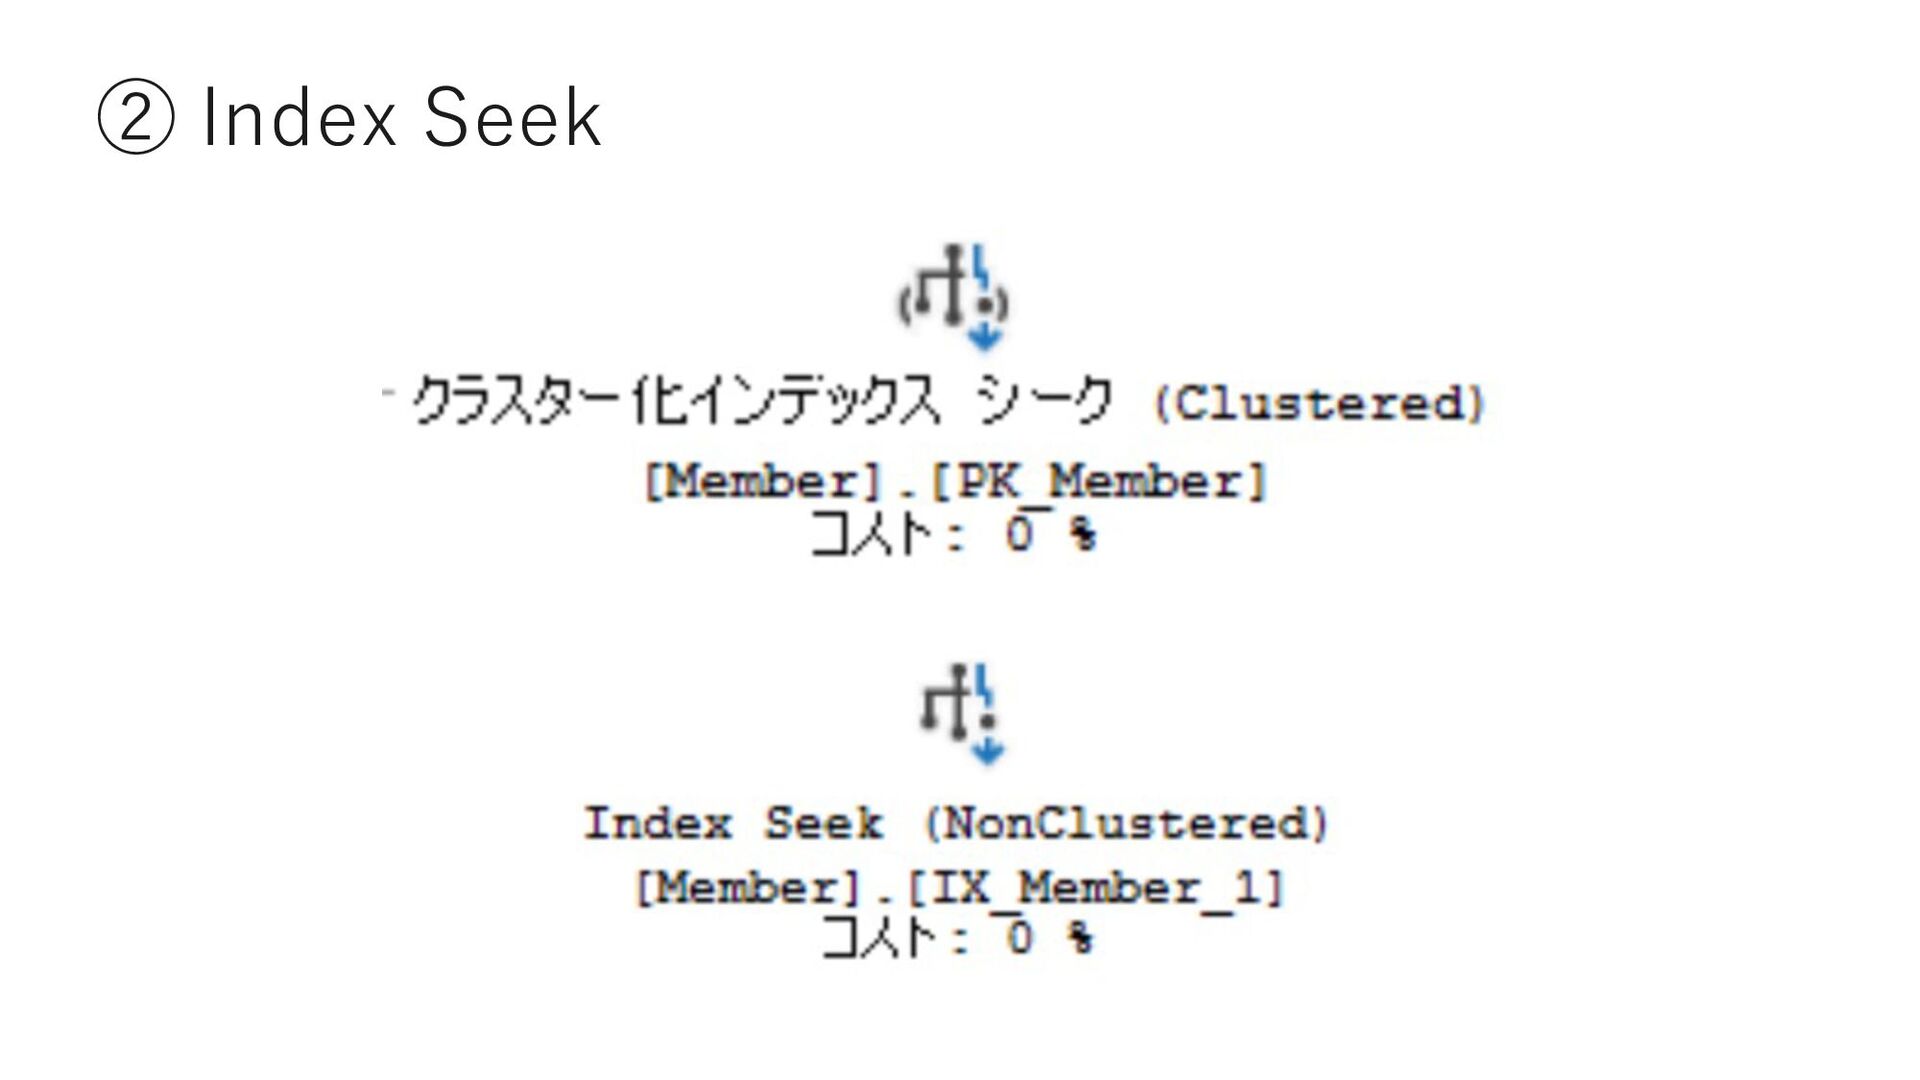
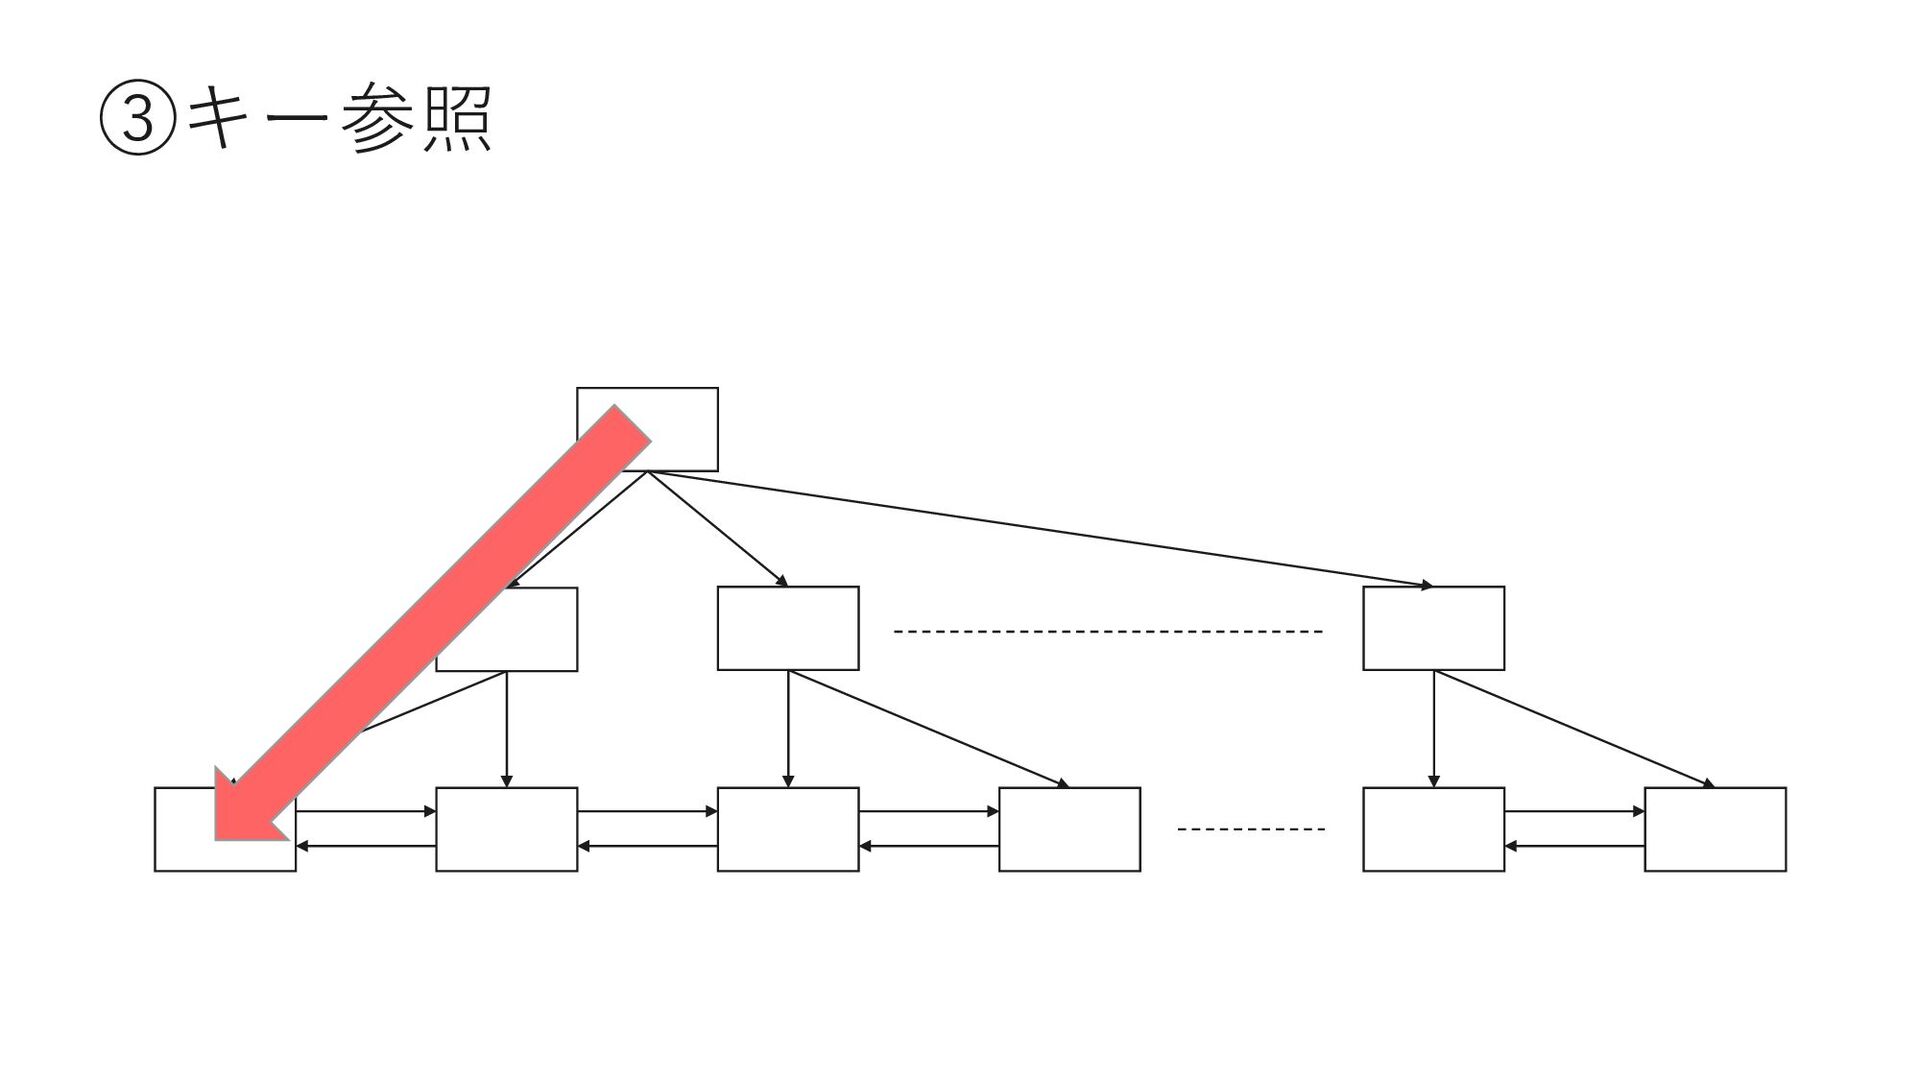
… … b1 25000 2020/10/3 SELECT LoginName, RegistDate, Sei FROM Member WHERE LoginName = 'b1' リーフページに[Sei]が無い ⾮クラスタ化インデックス 実データ MemberID LoginName … Sei 1 a1 … Asai 2 a2 … Tanaka … … … … 25000 b1 … Yokota クラスタ化インデックス キー参照 (MemberID = 25000でIndex Seek) -
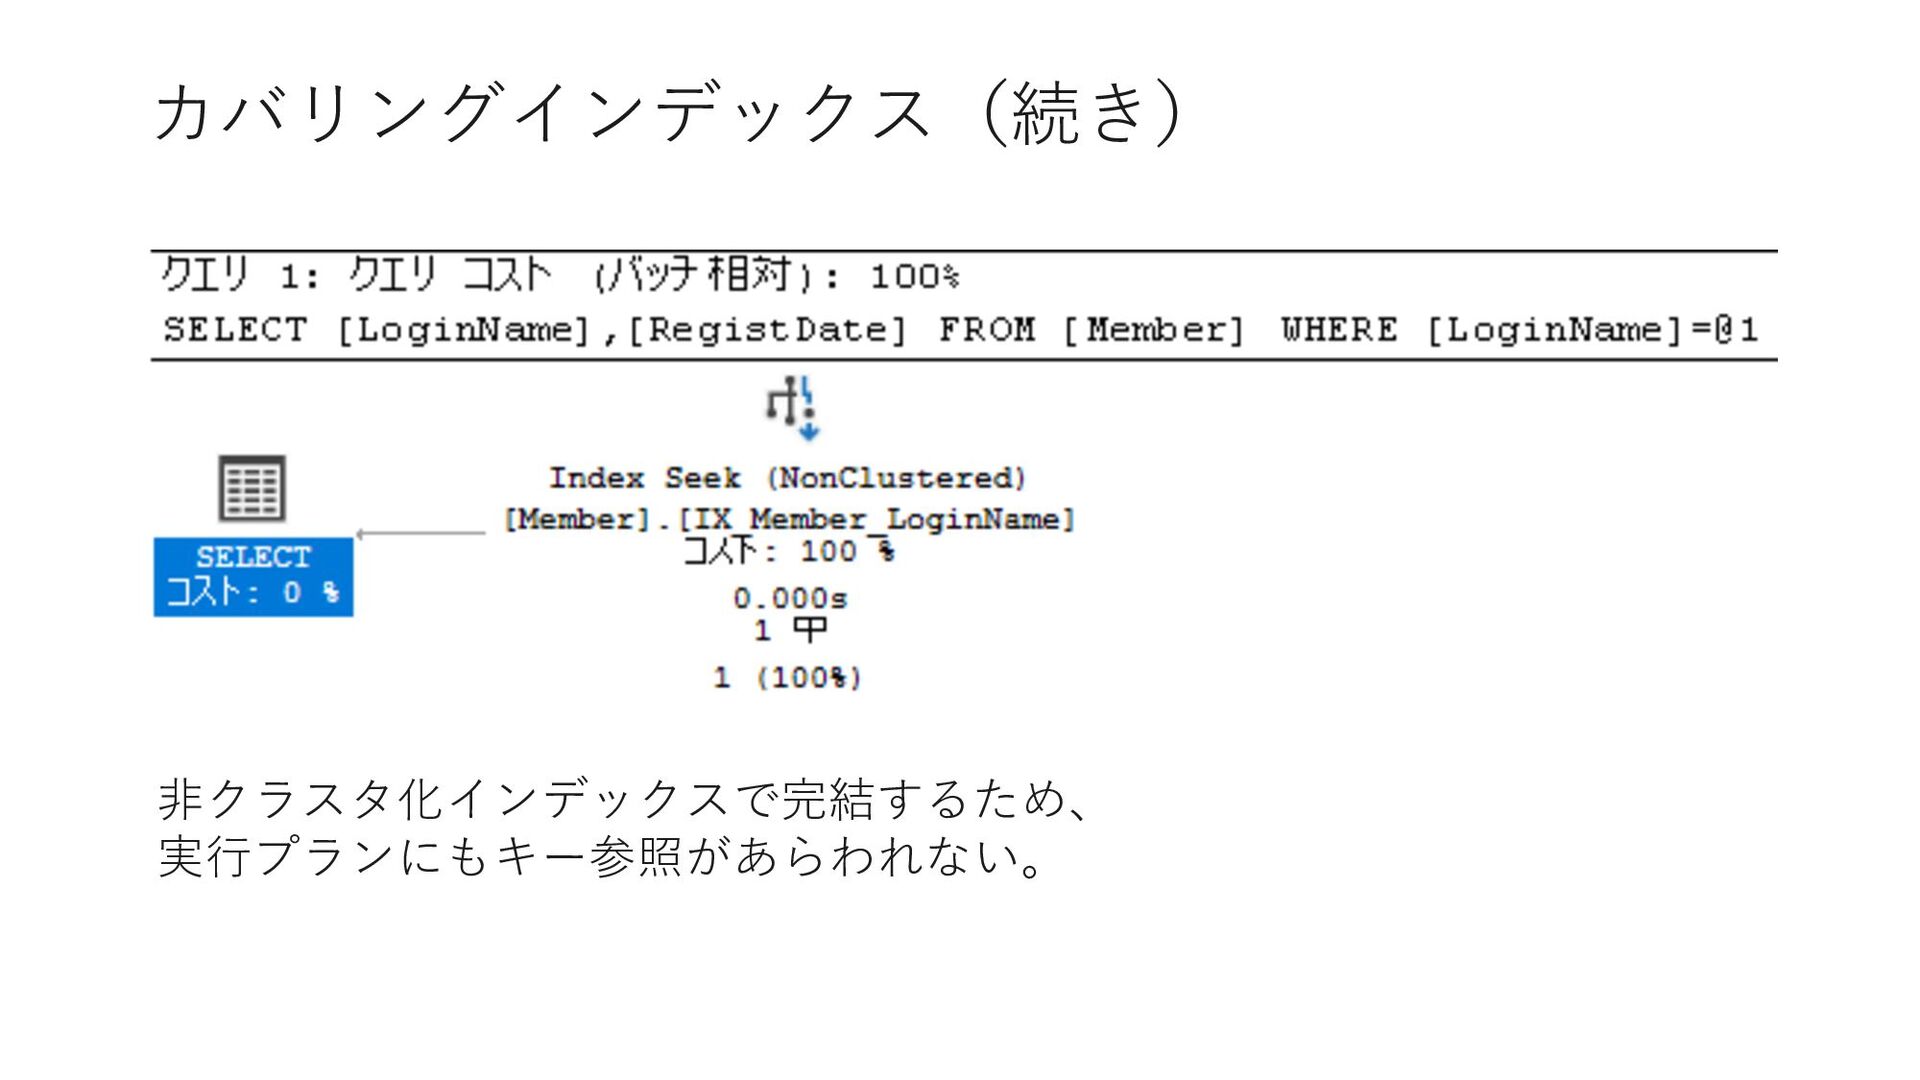
カバリングインデックス • 上記ようなインデックスが作成されている場合 CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName]
ASC) INCLUDE (RegistDate) キー参照が発⽣しないインデックスを「カバリングインデックス」 SELECT LoginName, RegistDate FROM Member WHERE LoginName = 'Tawny265167' インデックスキー インデックスキー INCLUDE カラム クエリに必要なカラムをカバーするインデックスになっている =カバリングインデックス -
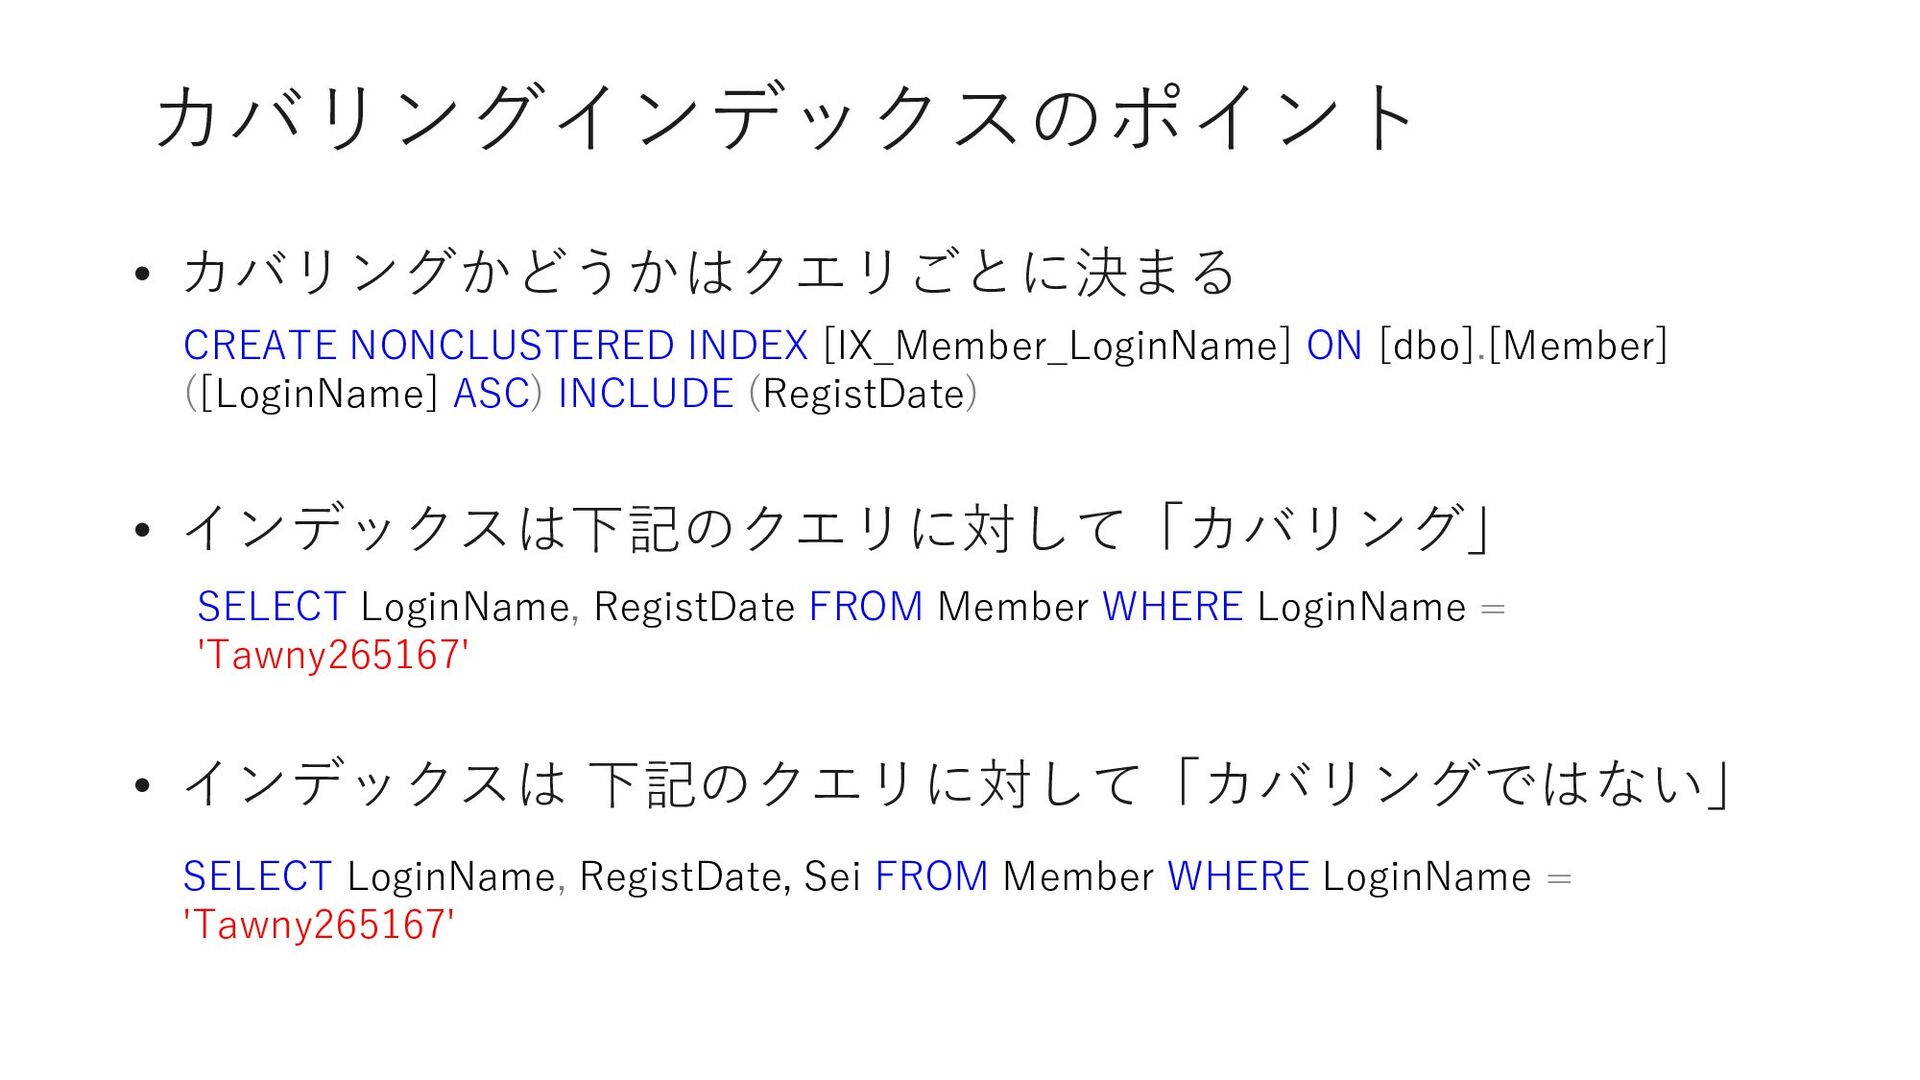
カバリングインデックスのポイント • カバリングかどうかはクエリごとに決まる • インデックスは下記のクエリに対して「カバリング」 • インデックスは 下記のクエリに対して「カバリングではない」 CREATE NONCLUSTERED
INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName] ASC) INCLUDE (RegistDate) SELECT LoginName, RegistDate FROM Member WHERE LoginName = 'Tawny265167' SELECT LoginName, RegistDate, Sei FROM Member WHERE LoginName = 'Tawny265167' -
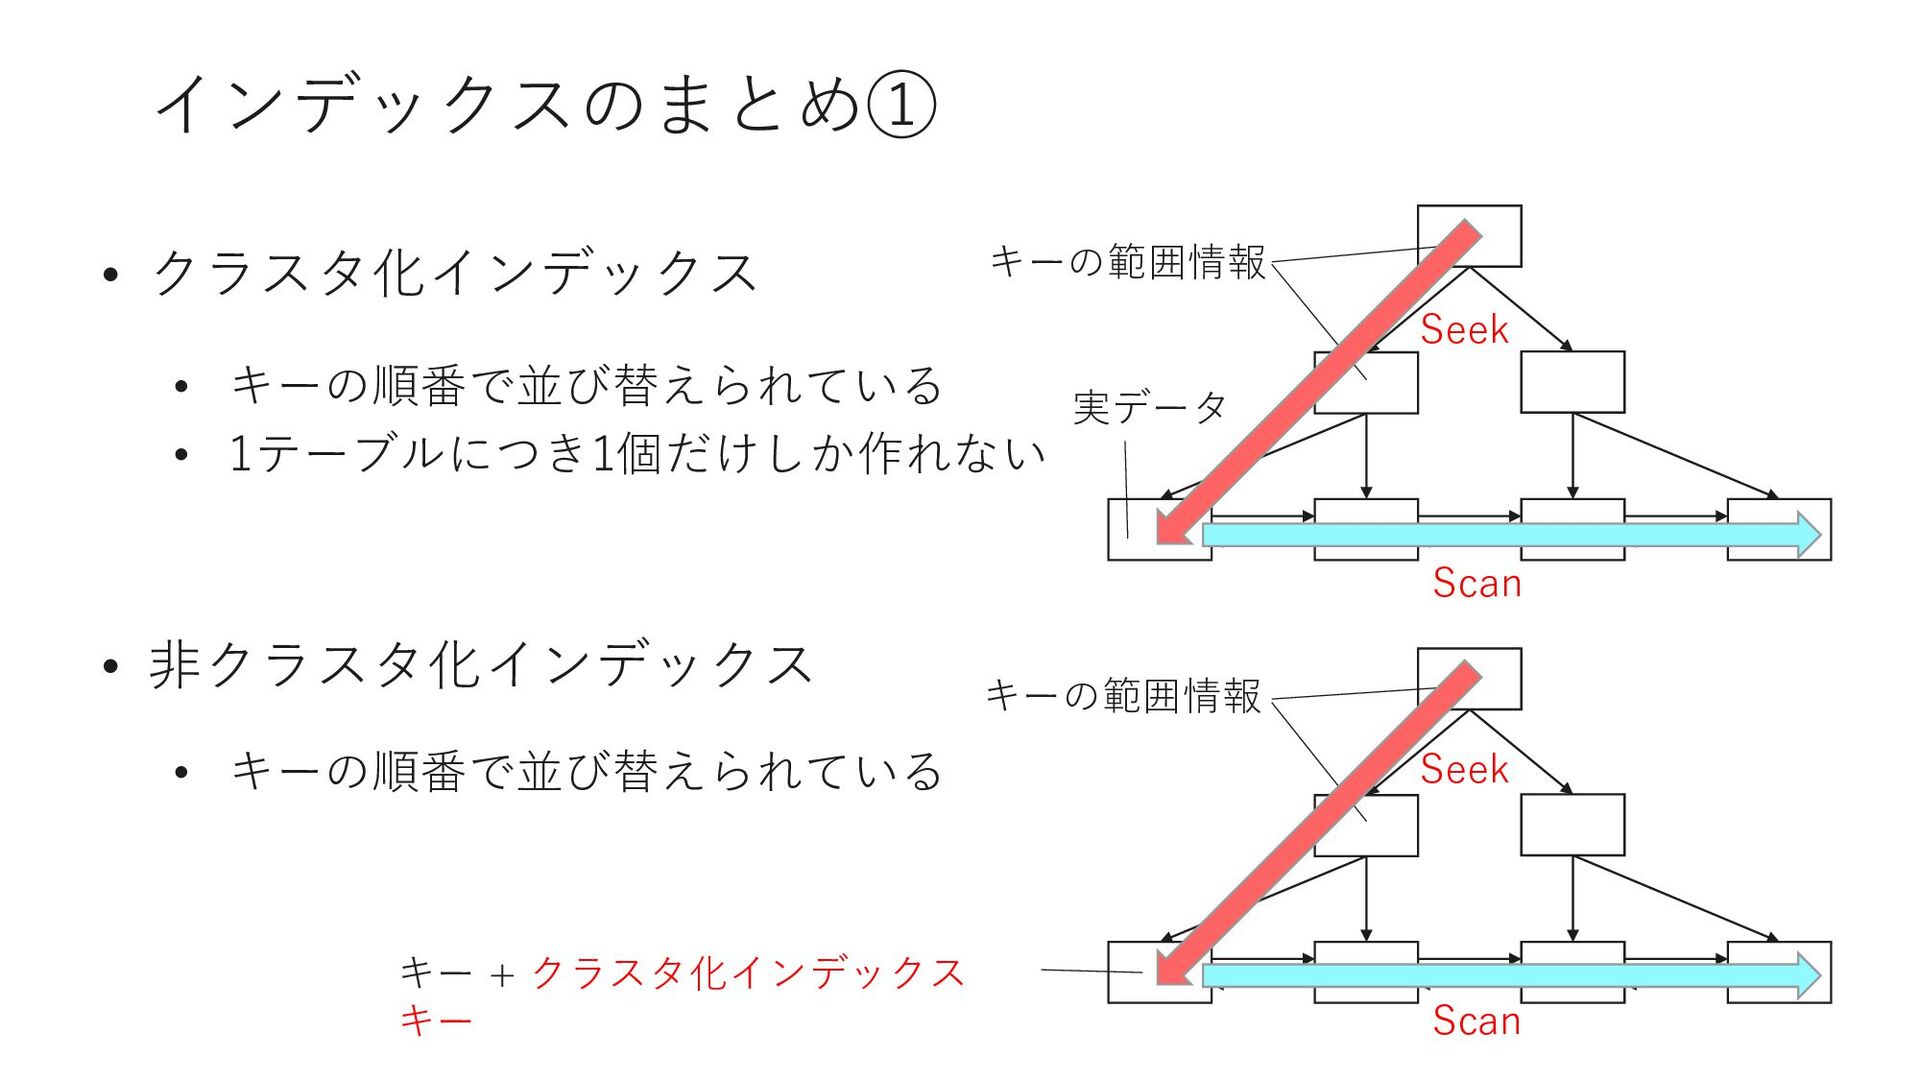
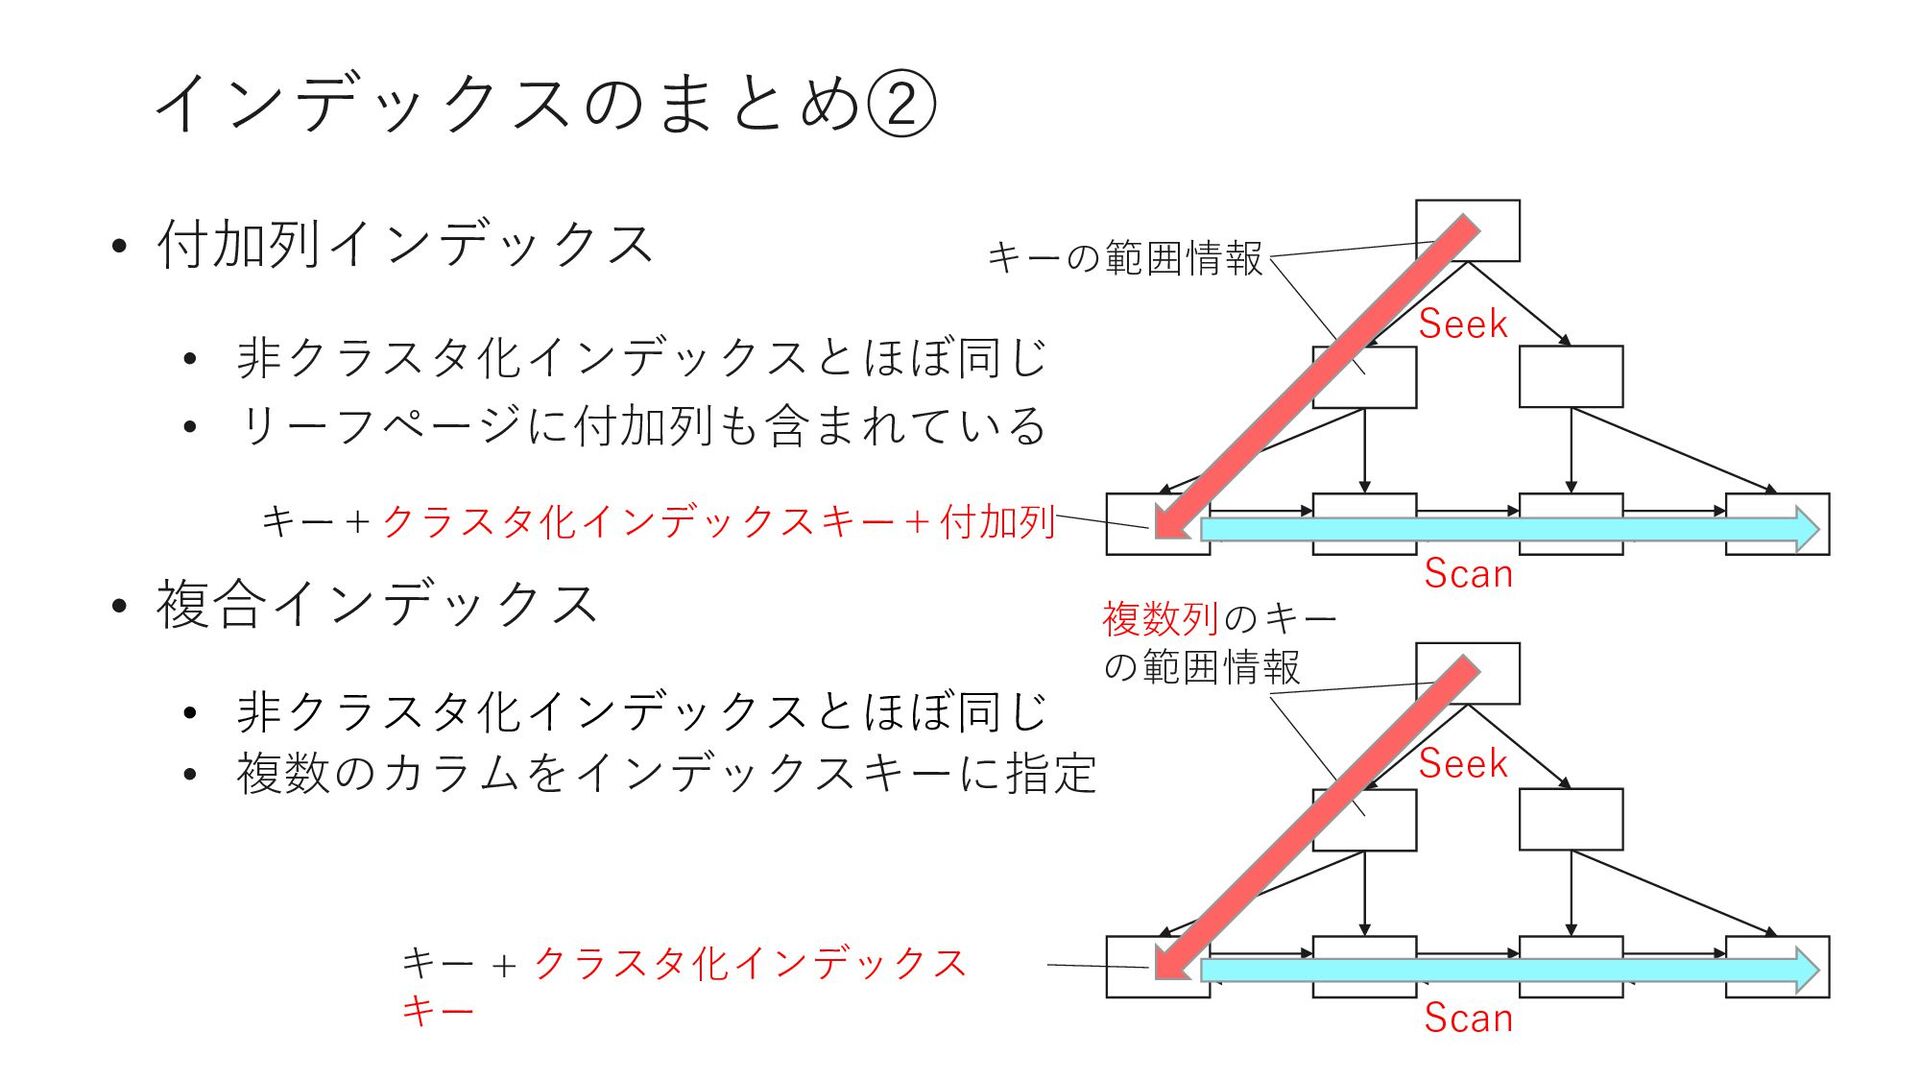
インデックスのまとめ① • クラスタ化インデックス • キーの順番で並び替えられている • 1テーブルにつき1個だけしか作れない • ⾮クラスタ化インデックス •
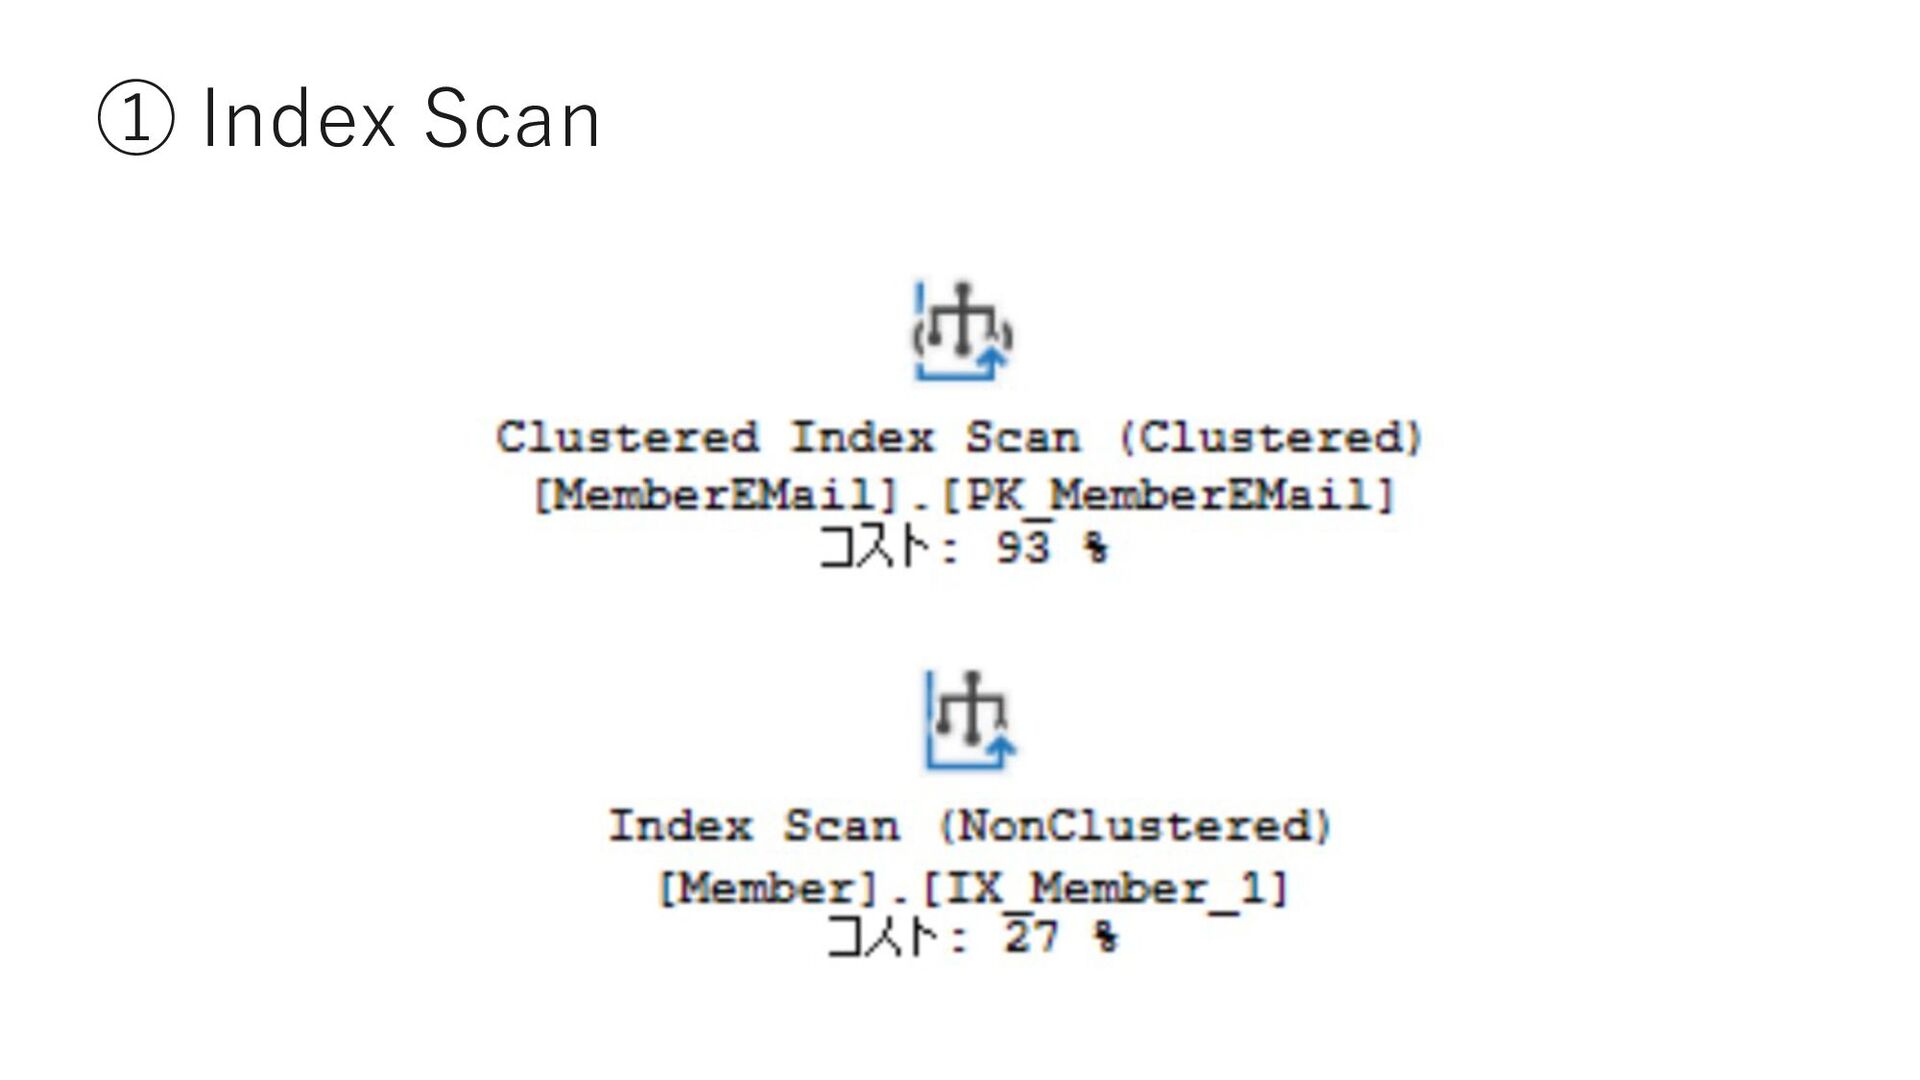
キーの順番で並び替えられている キーの範囲情報 キーの範囲情報 実データ キー + クラスタ化インデックス キー Seek Scan Seek Scan -
• 付加列インデックス • ⾮クラスタ化インデックスとほぼ同じ • リーフページに付加列も含まれている • 複合インデックス • ⾮クラスタ化インデックスとほぼ同じ
• 複数のカラムをインデックスキーに指定 キー+クラスタ化インデックスキー+付加列 インデックスのまとめ② キーの範囲情報 複数列のキー の範囲情報 Seek Scan Seek Scan キー + クラスタ化インデックス キー -
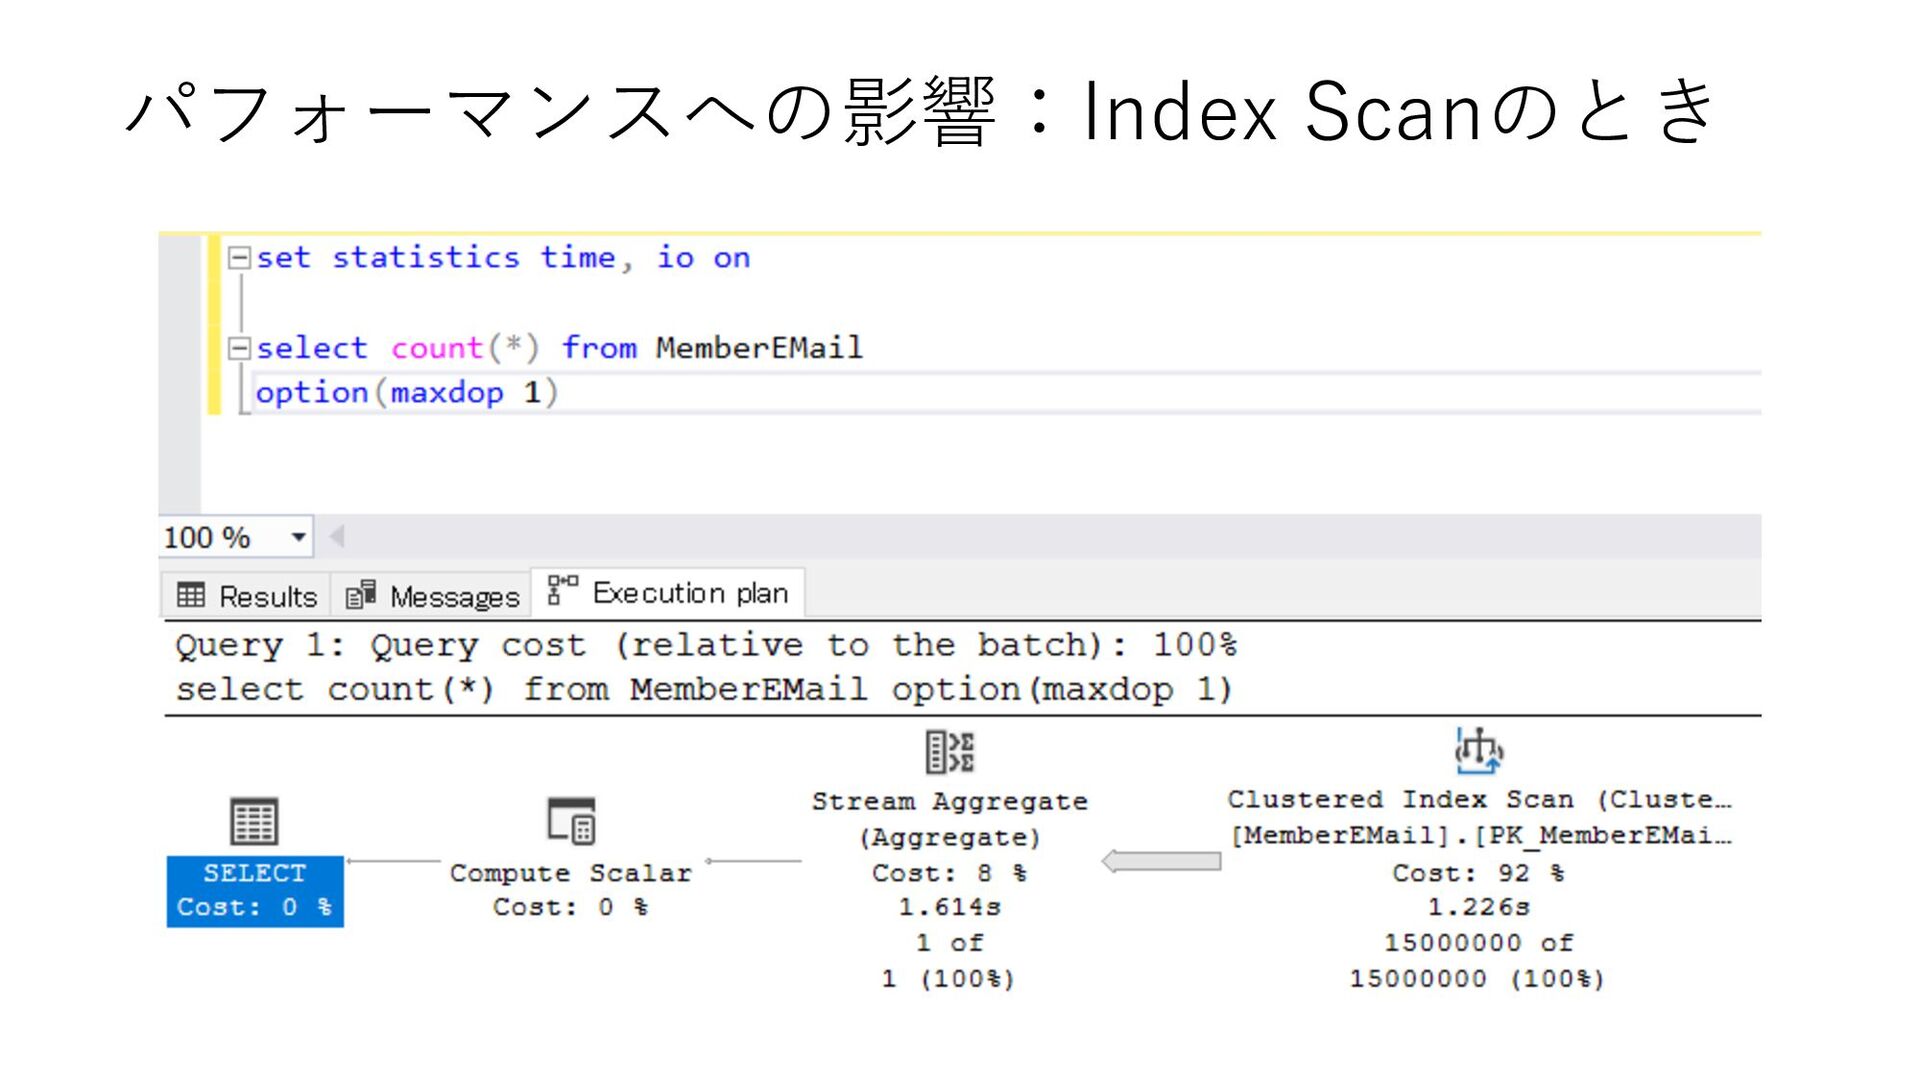
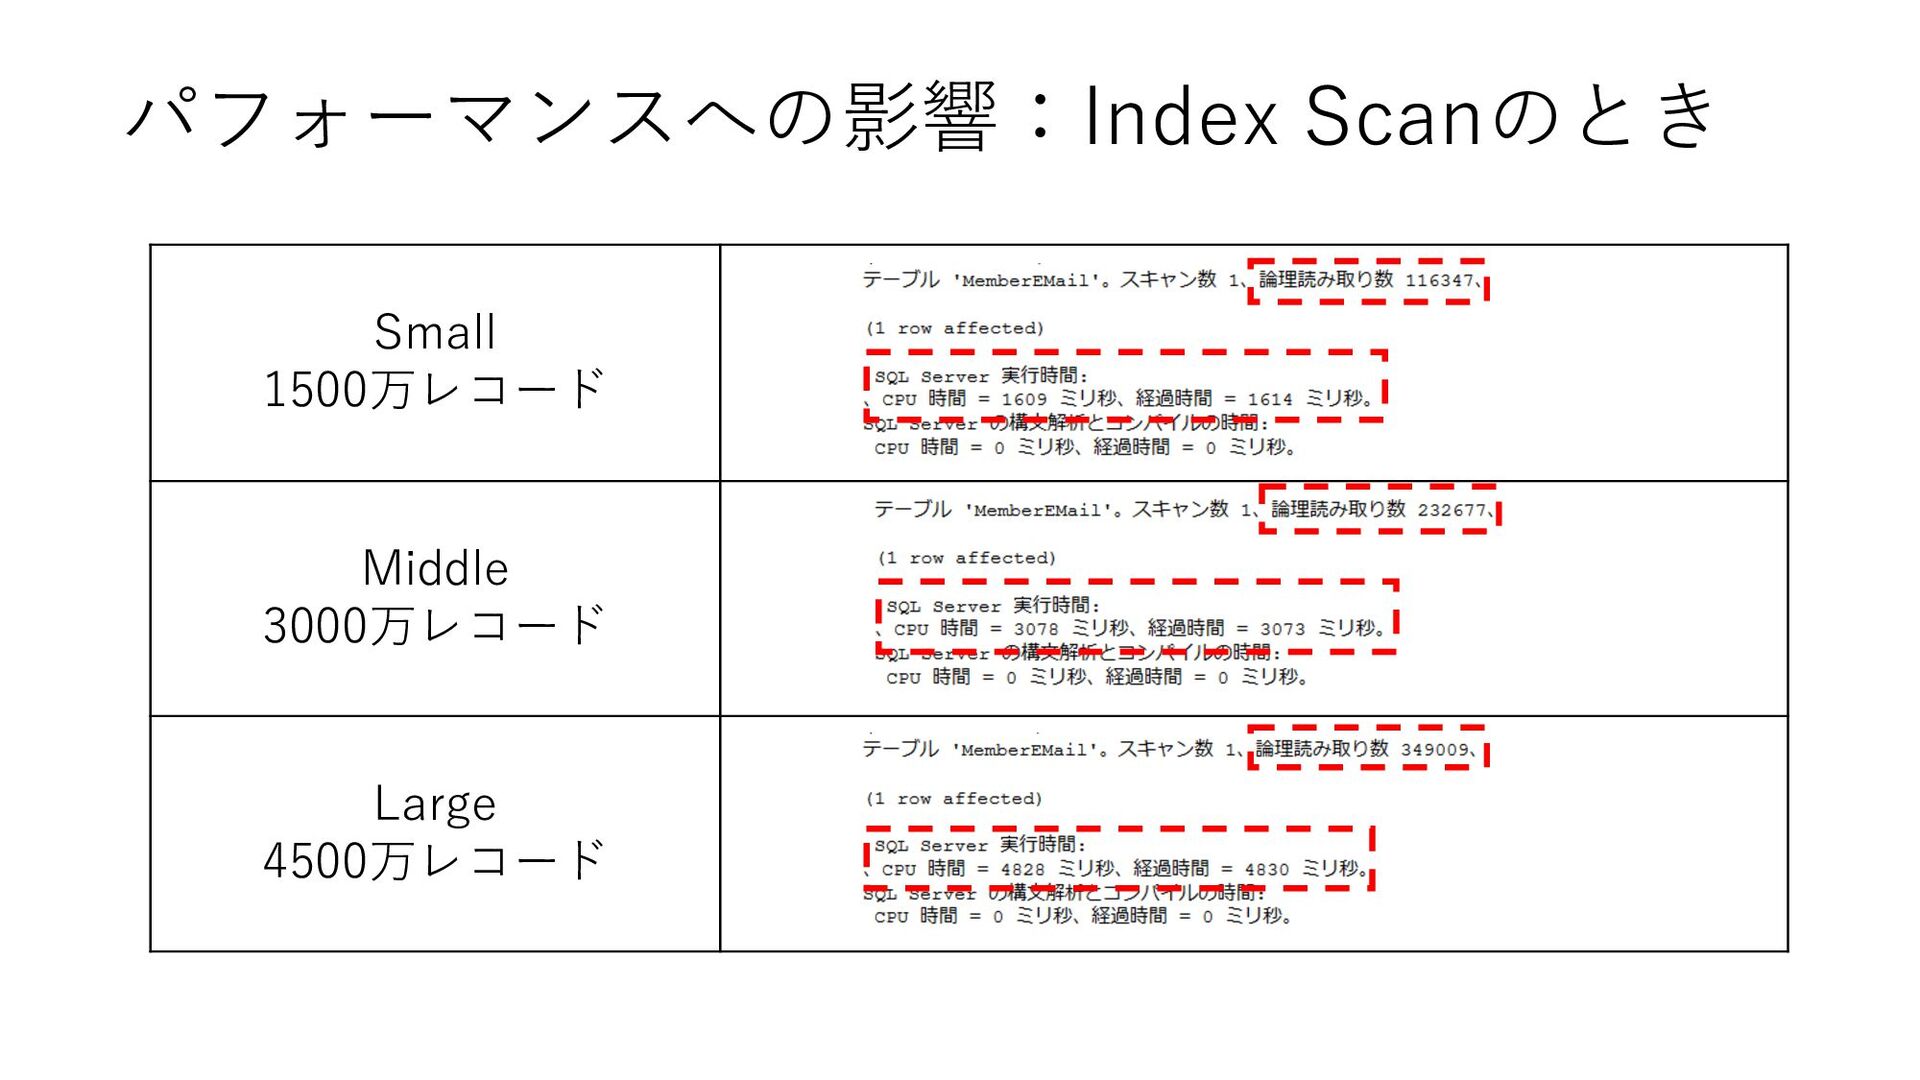
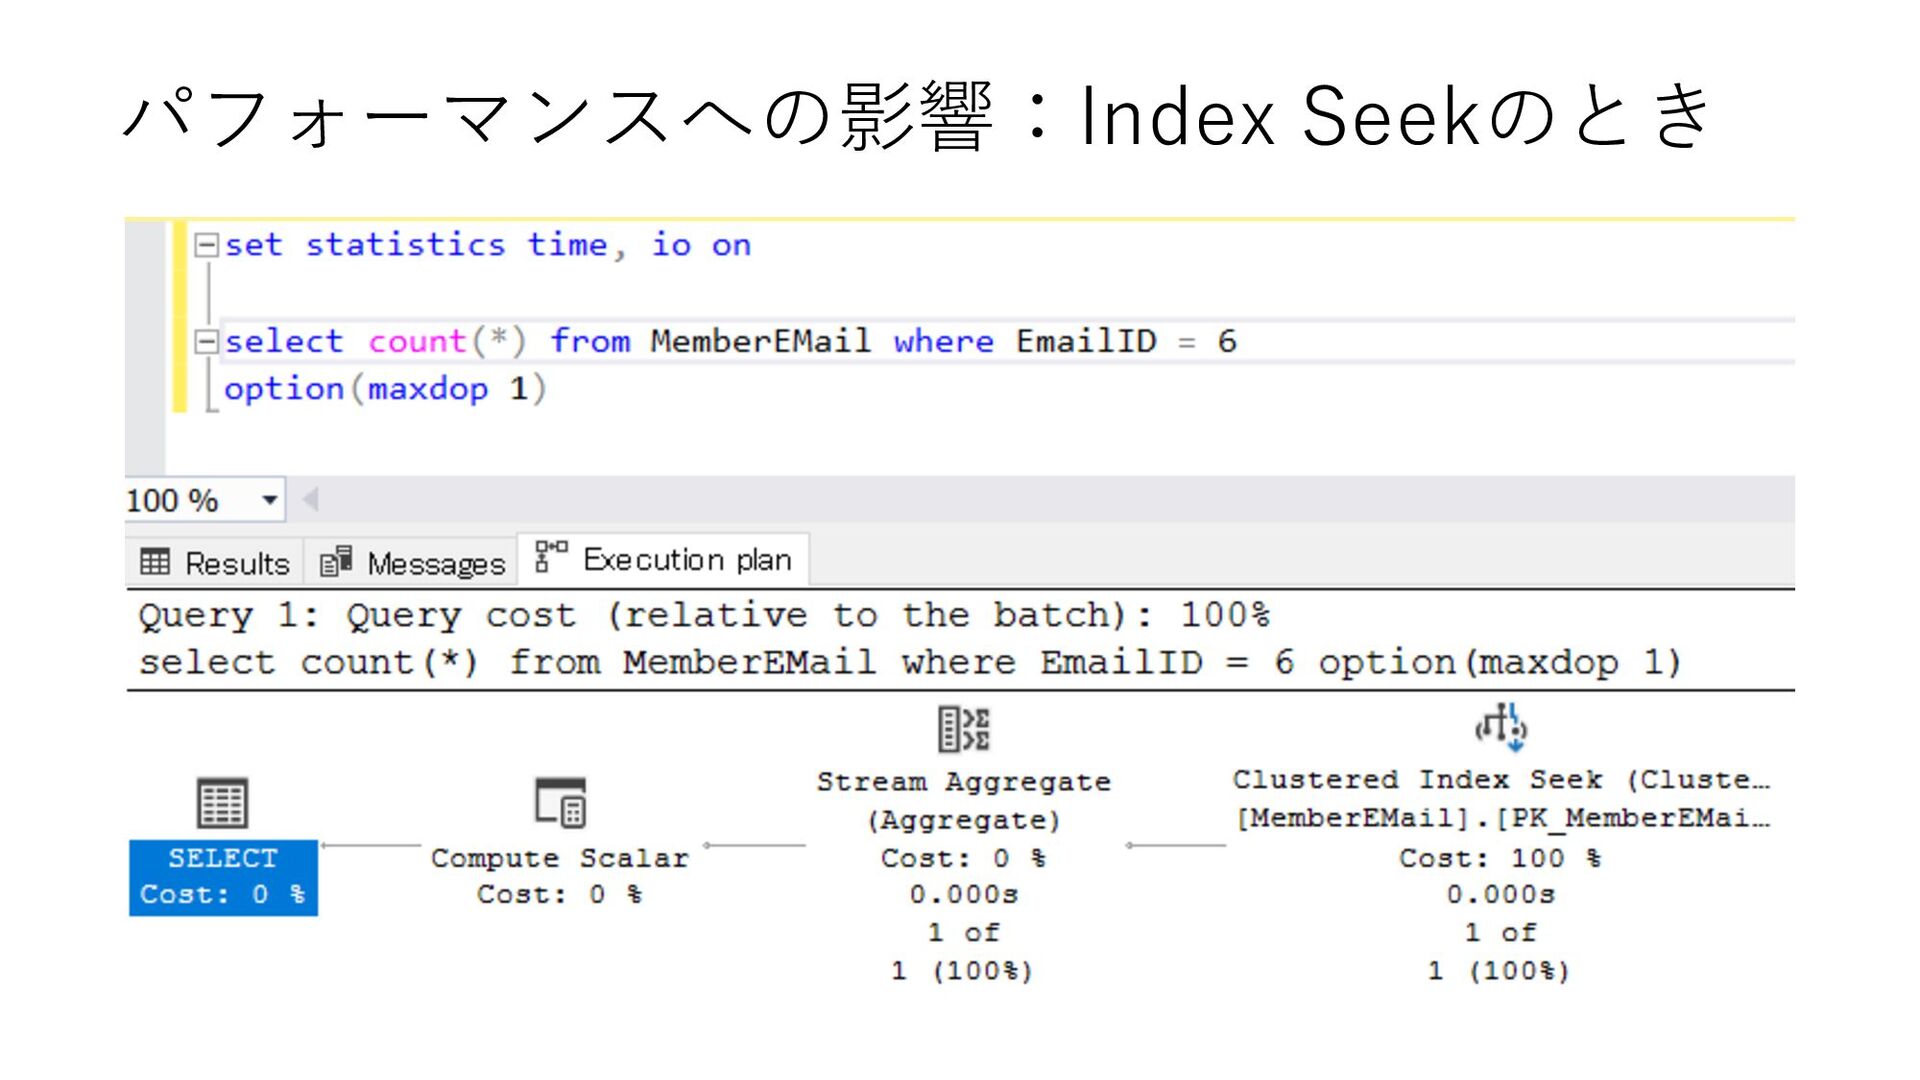
Seek vs Scan • Seekが有利なとき • レコードを⼤幅に絞り込めるとき • Scanが有利なときやScanしか使われないとき •
レコード数が少ないテーブル • count(*)などの集計処理で全件⾛査が必要なとき -
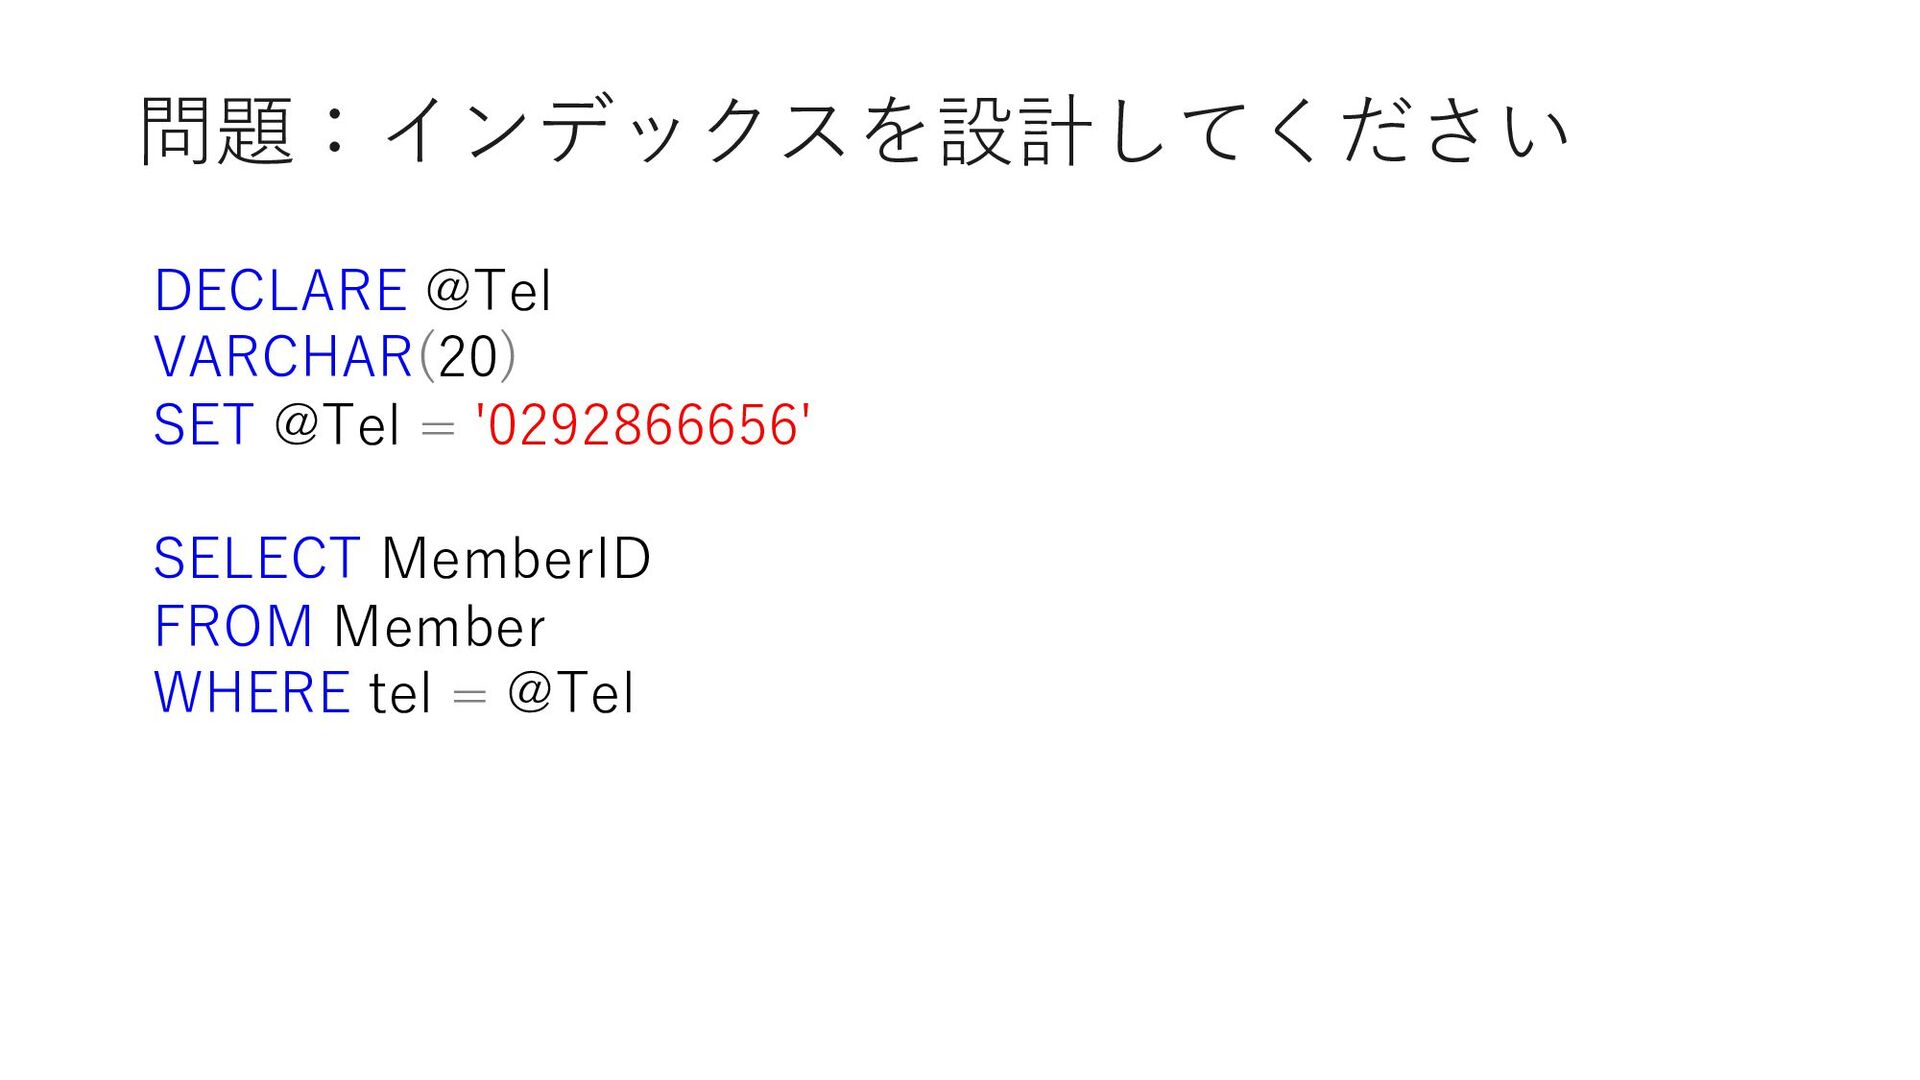
問題:インデックスを設計してください DECLARE @Tel VARCHAR(20) SET @Tel = '0292866656' SELECT MemberID
FROM Member WHERE tel = @Tel -
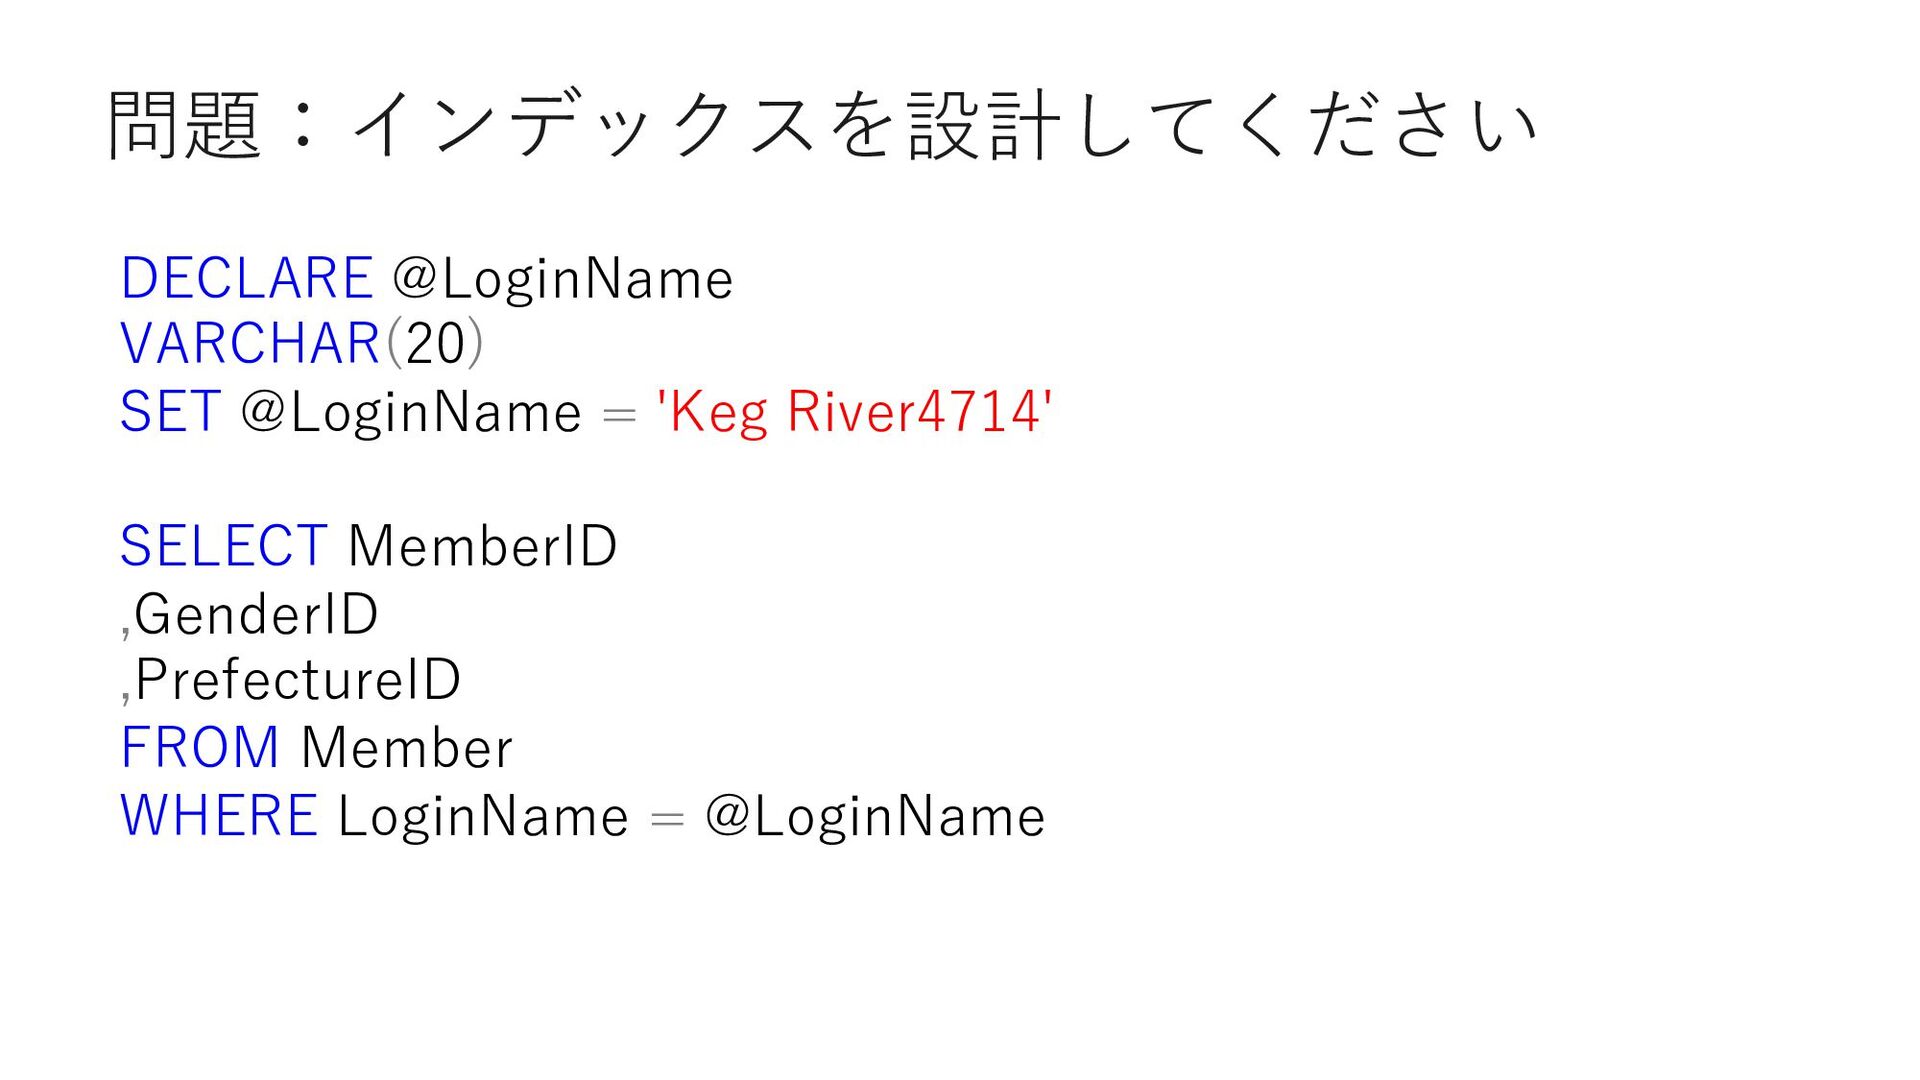
問題:インデックスを設計してください DECLARE @LoginName VARCHAR(20) SET @LoginName = 'Keg River4714' SELECT
MemberID ,GenderID ,PrefectureID FROM Member WHERE LoginName = @LoginName -
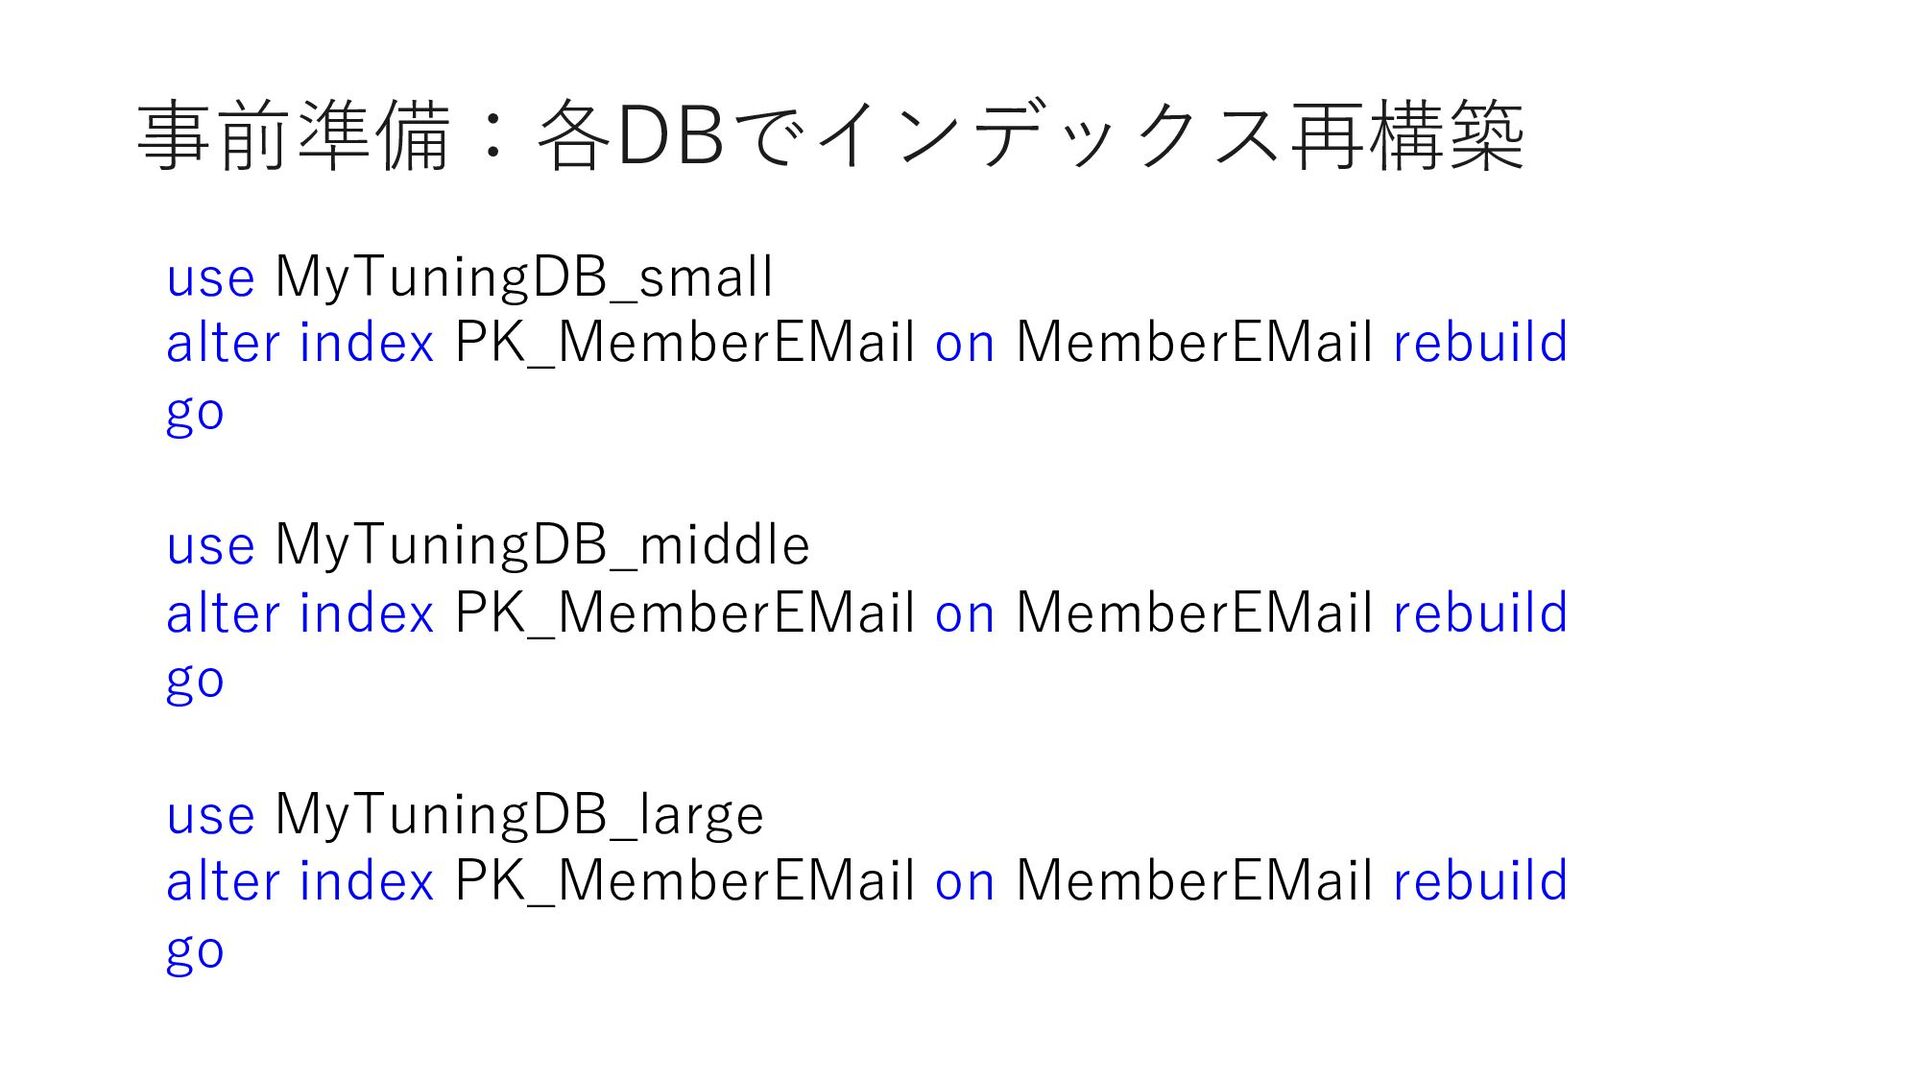
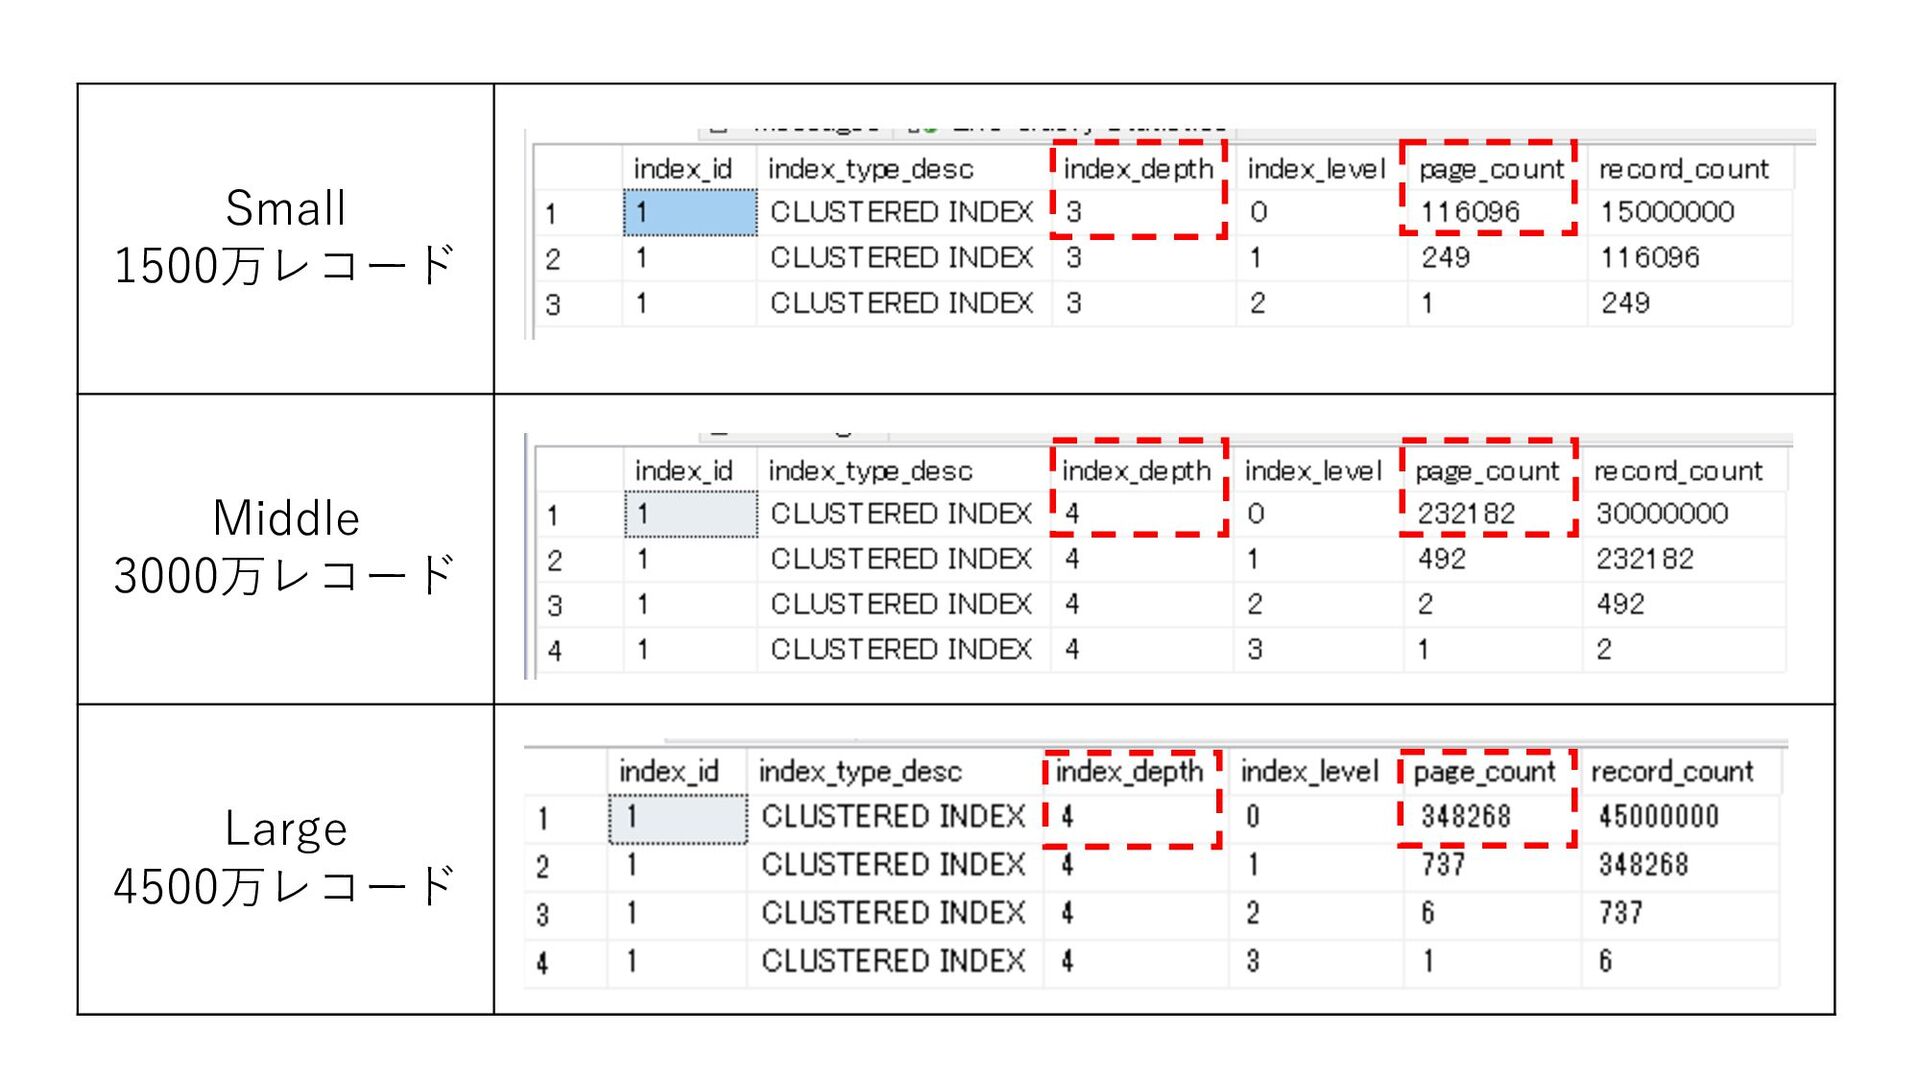
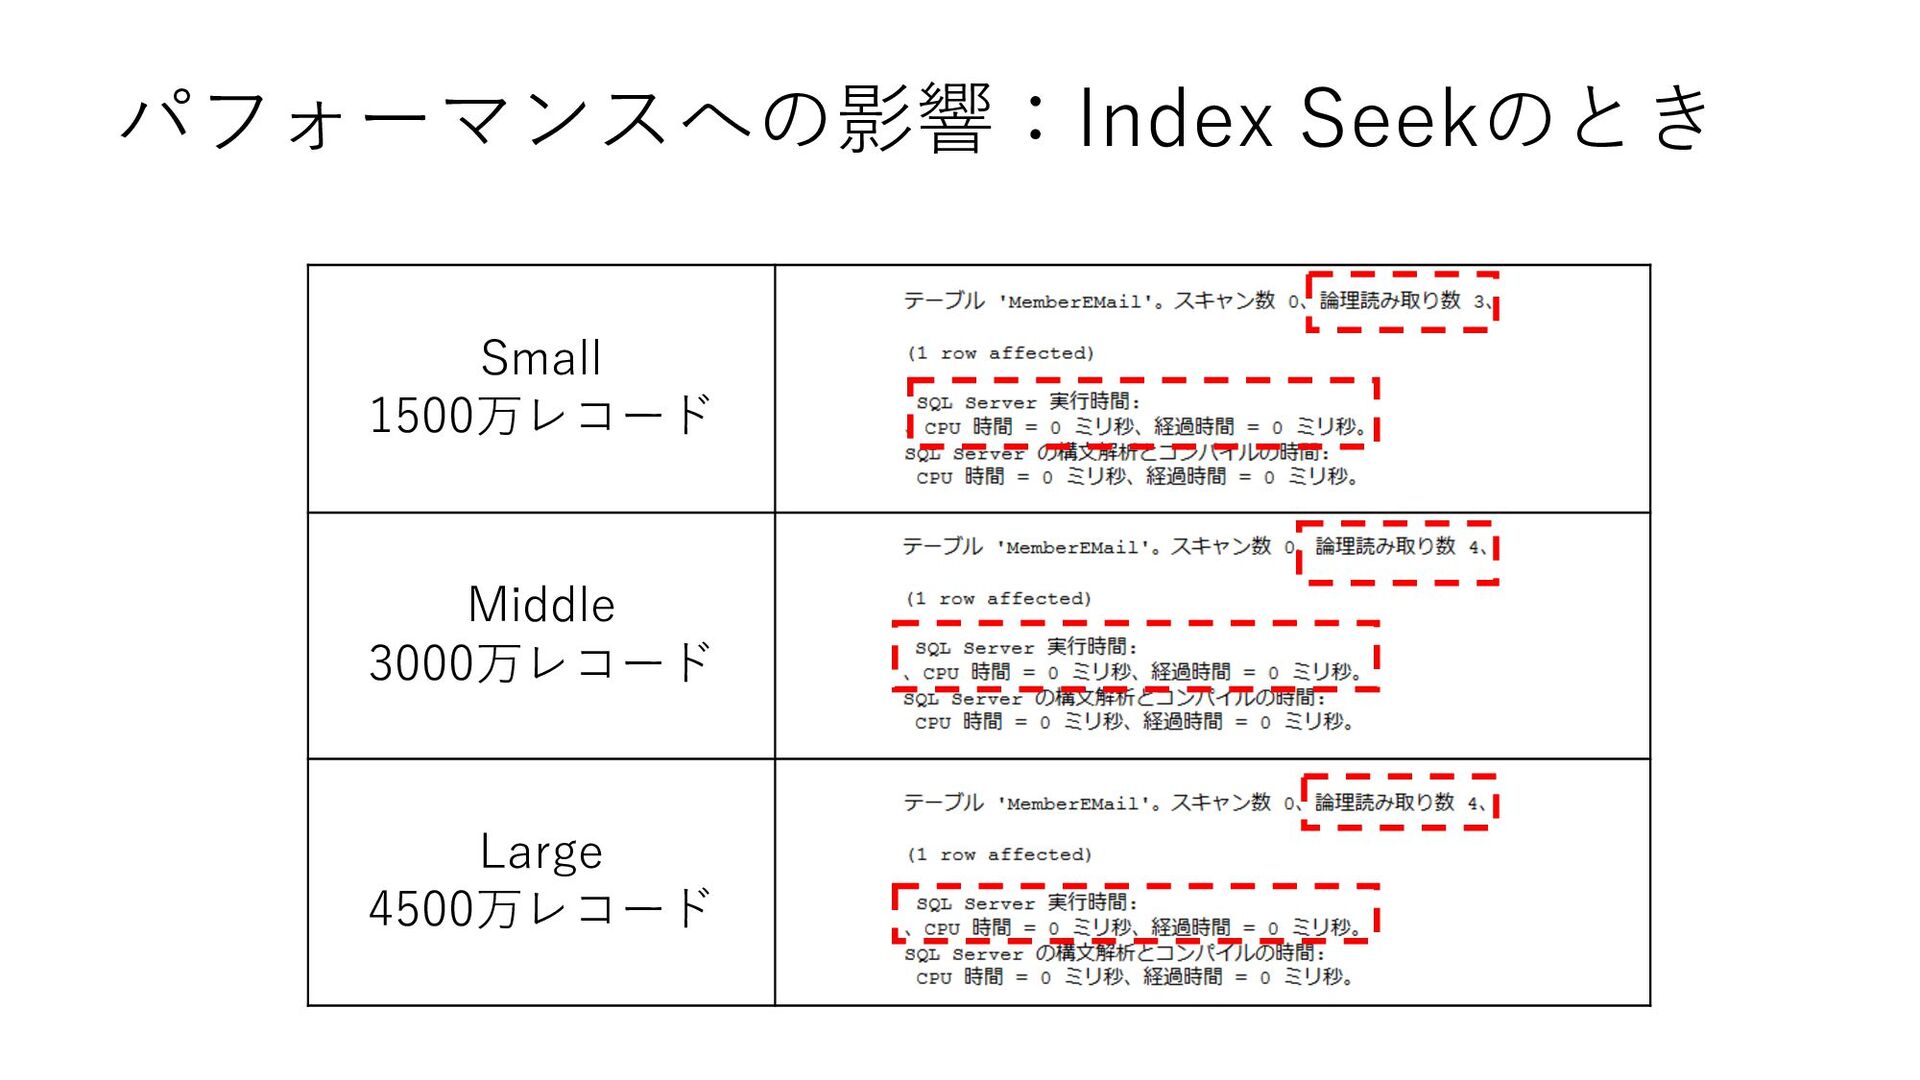
事前準備:各DBでインデックス再構築 use MyTuningDB_small alter index PK_MemberEMail on MemberEMail rebuild go
use MyTuningDB_middle alter index PK_MemberEMail on MemberEMail rebuild go use MyTuningDB_large alter index PK_MemberEMail on MemberEMail rebuild go -
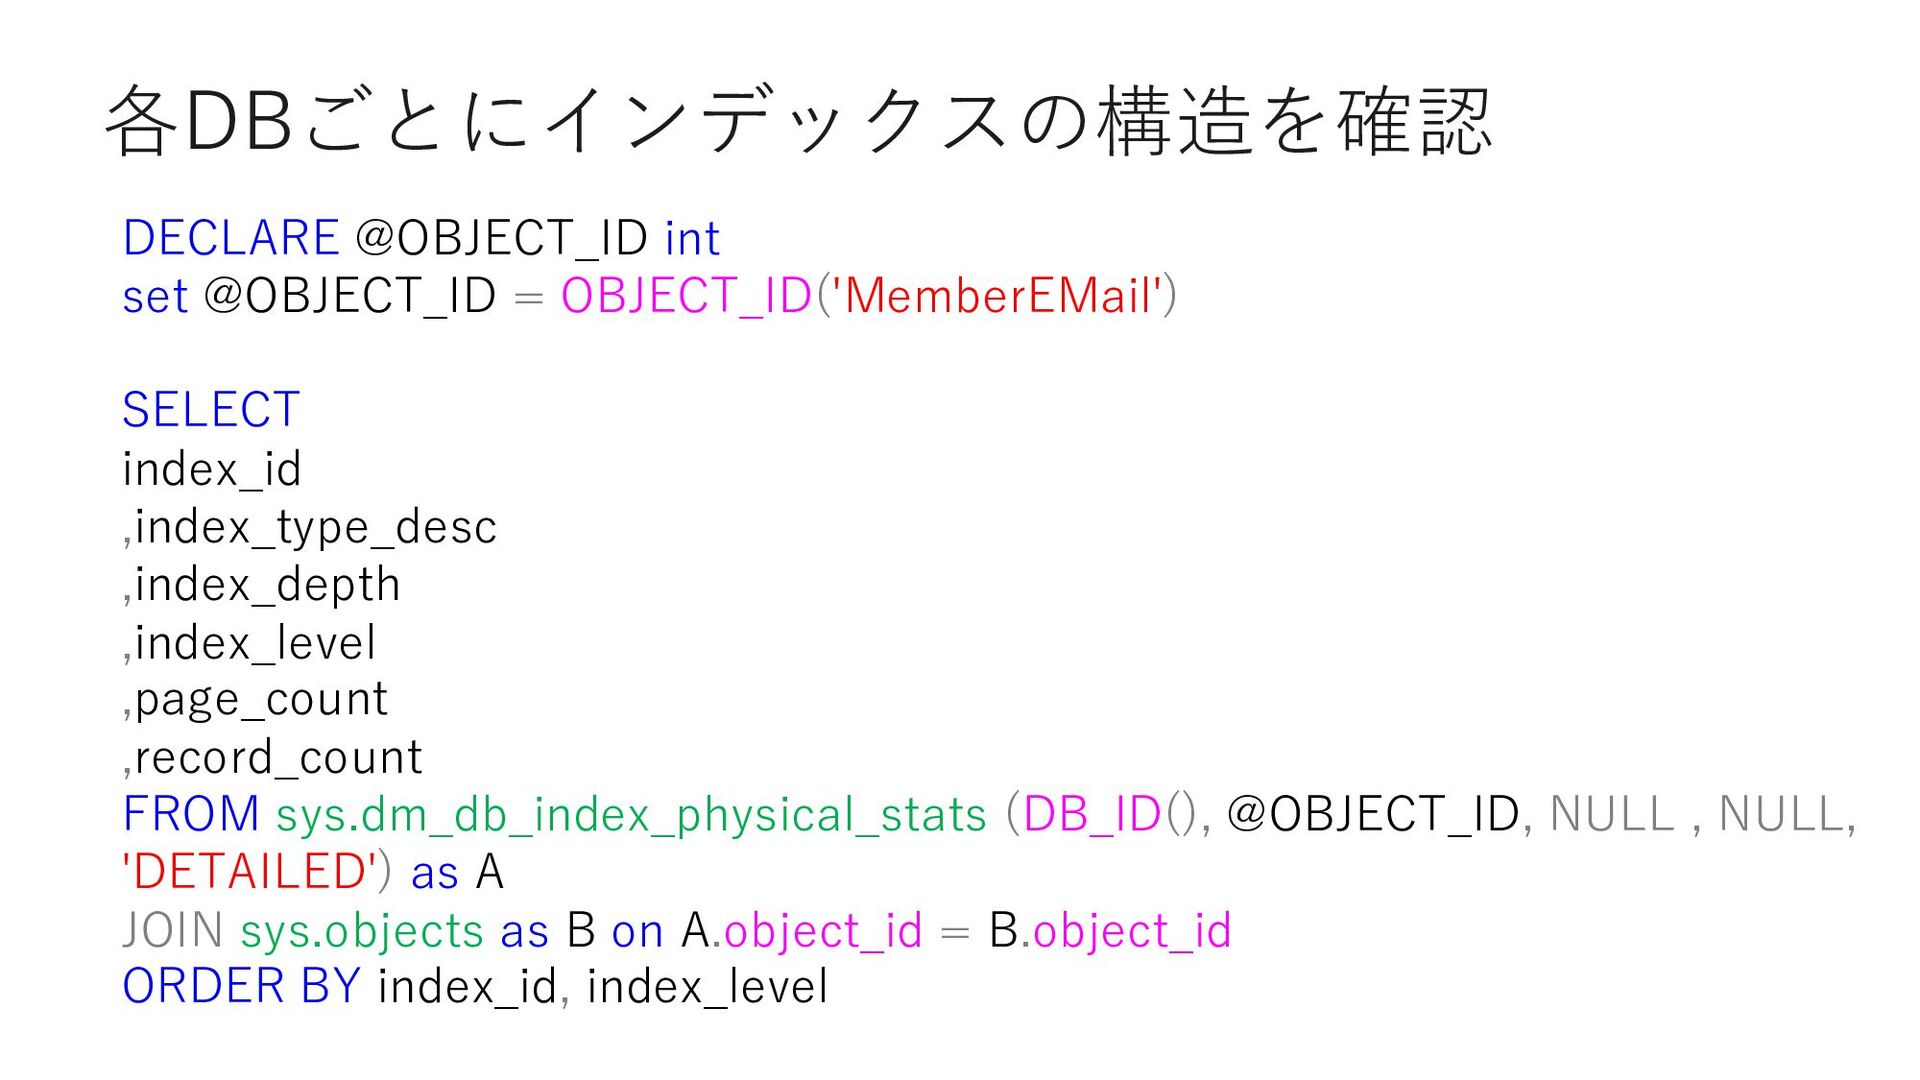
各DBごとにインデックスの構造を確認 DECLARE @OBJECT_ID int set @OBJECT_ID = OBJECT_ID('MemberEMail') SELECT index_id
,index_type_desc ,index_depth ,index_level ,page_count ,record_count FROM sys.dm_db_index_physical_stats (DB_ID(), @OBJECT_ID, NULL , NULL, 'DETAILED') as A JOIN sys.objects as B on A.object_id = B.object_id ORDER BY index_id, index_level -
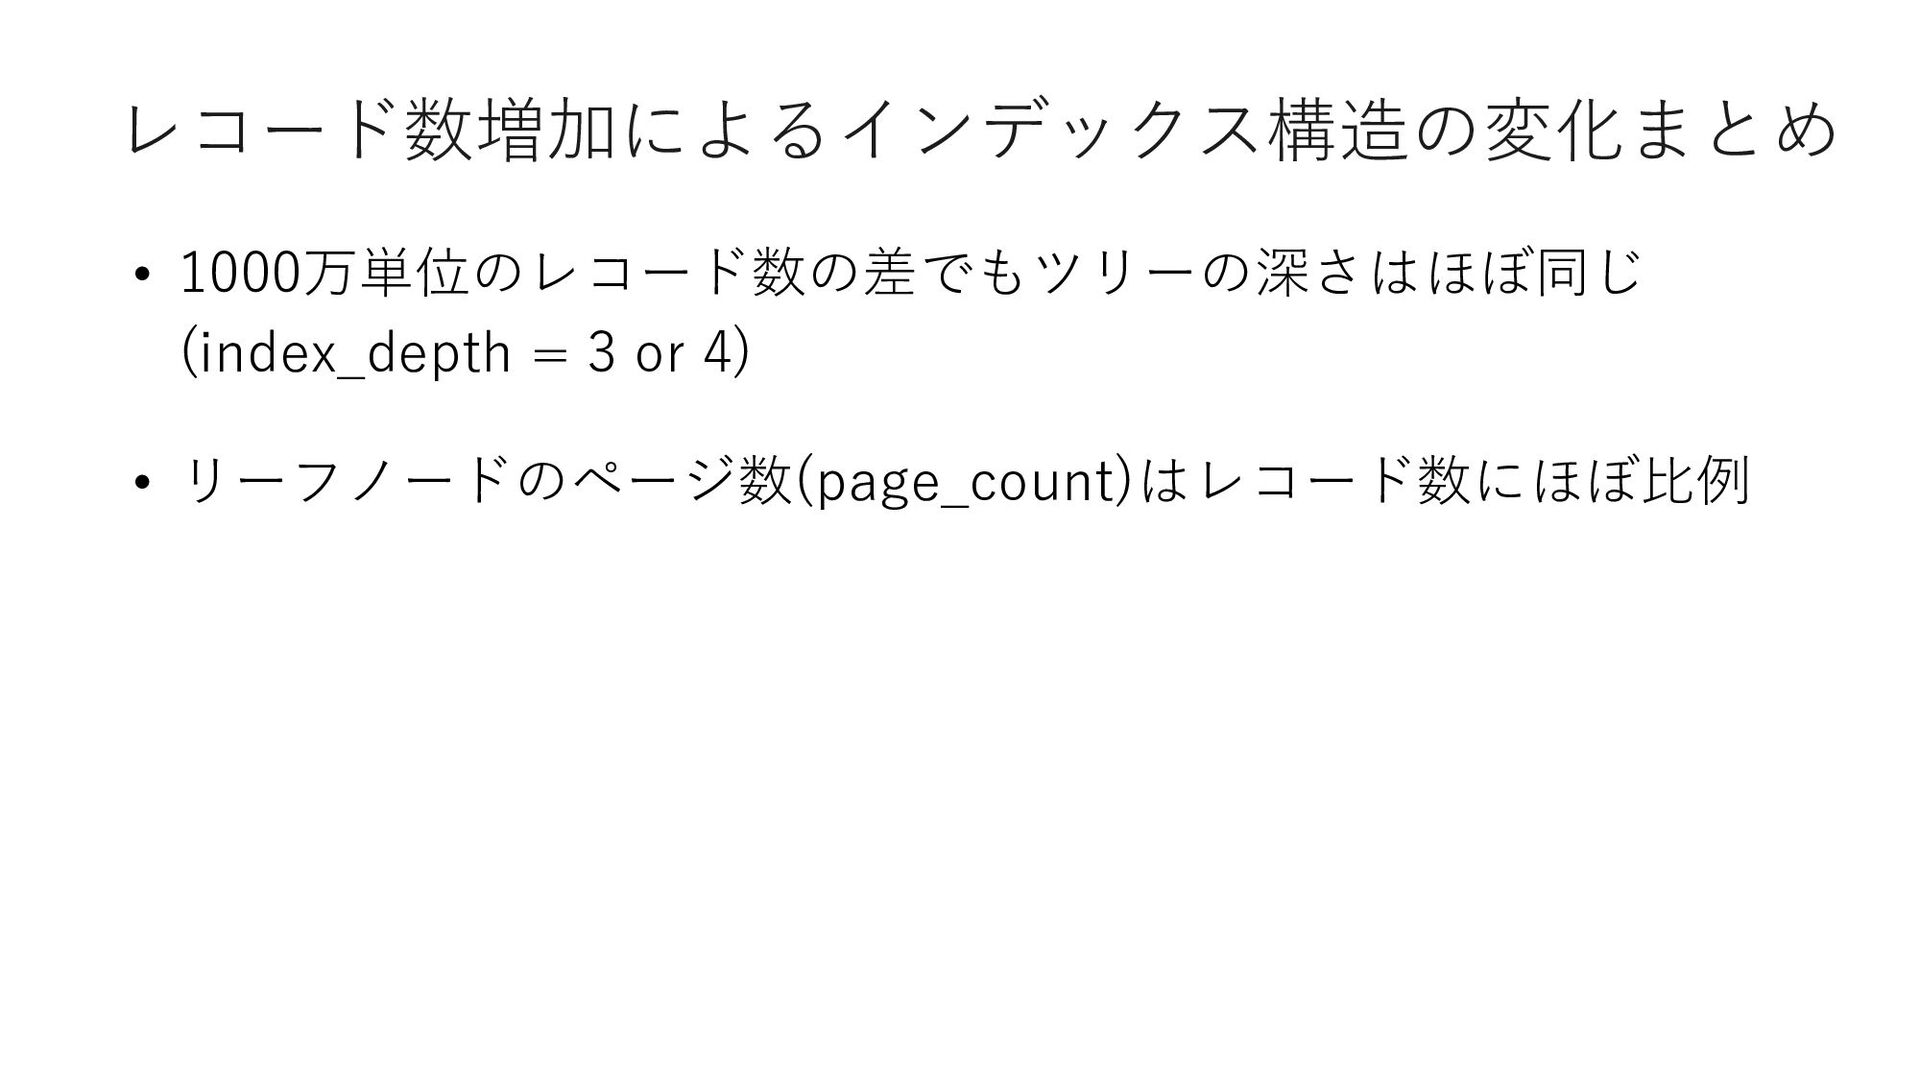
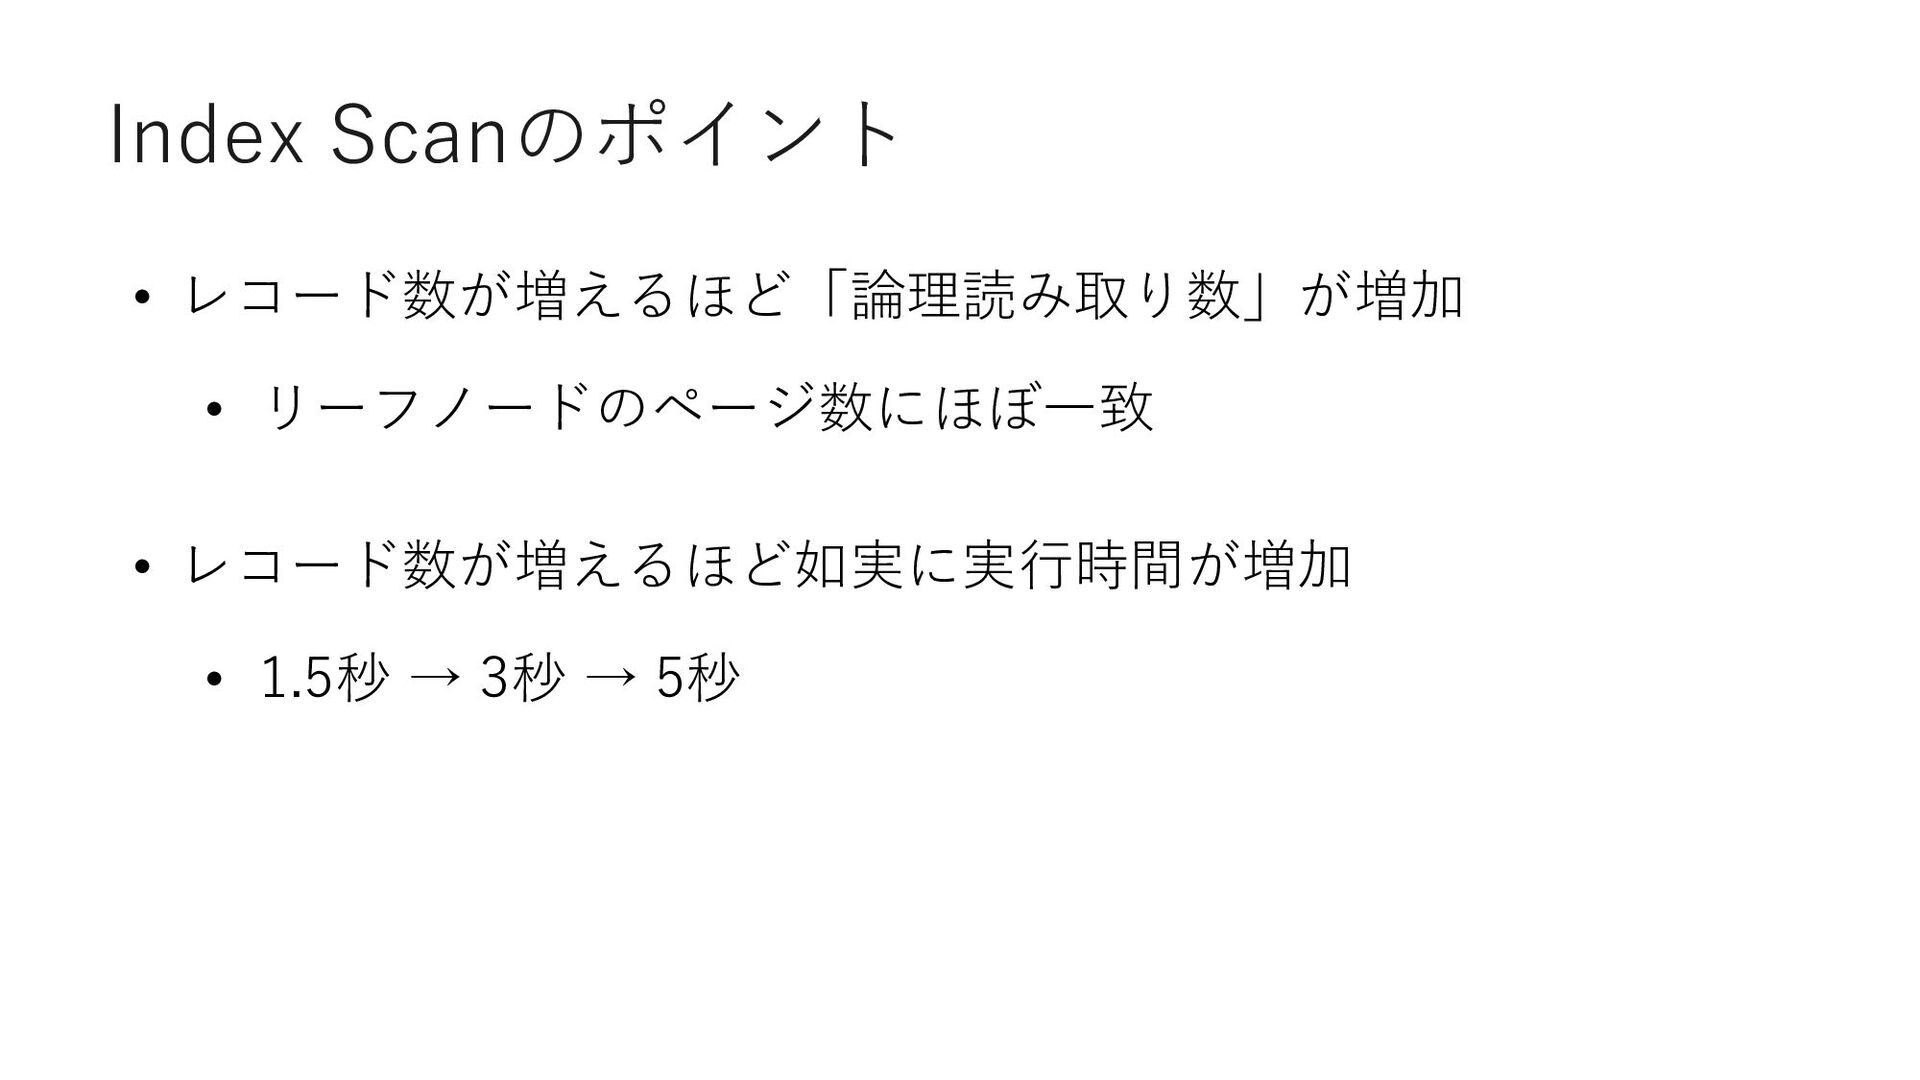
パフォーマンスへの影響のまとめ • データ量増加に伴うクエリ実⾏時間の変化を推定するときに • 「そのクエリの実⾏はScanなのか、Seekなのか」を 理解しておくことがとても重要 • 信頼度が低い推定 • 「データ量が増えたから遅くなった/遅くなりそう」
• 信頼度が⾼い推定 • 「データ量が増えてもSeek処理なので速度は変わらないはず」 • 「データ量が増えるとScan処理なので徐々に遅くなっていく懸念 がある」 -
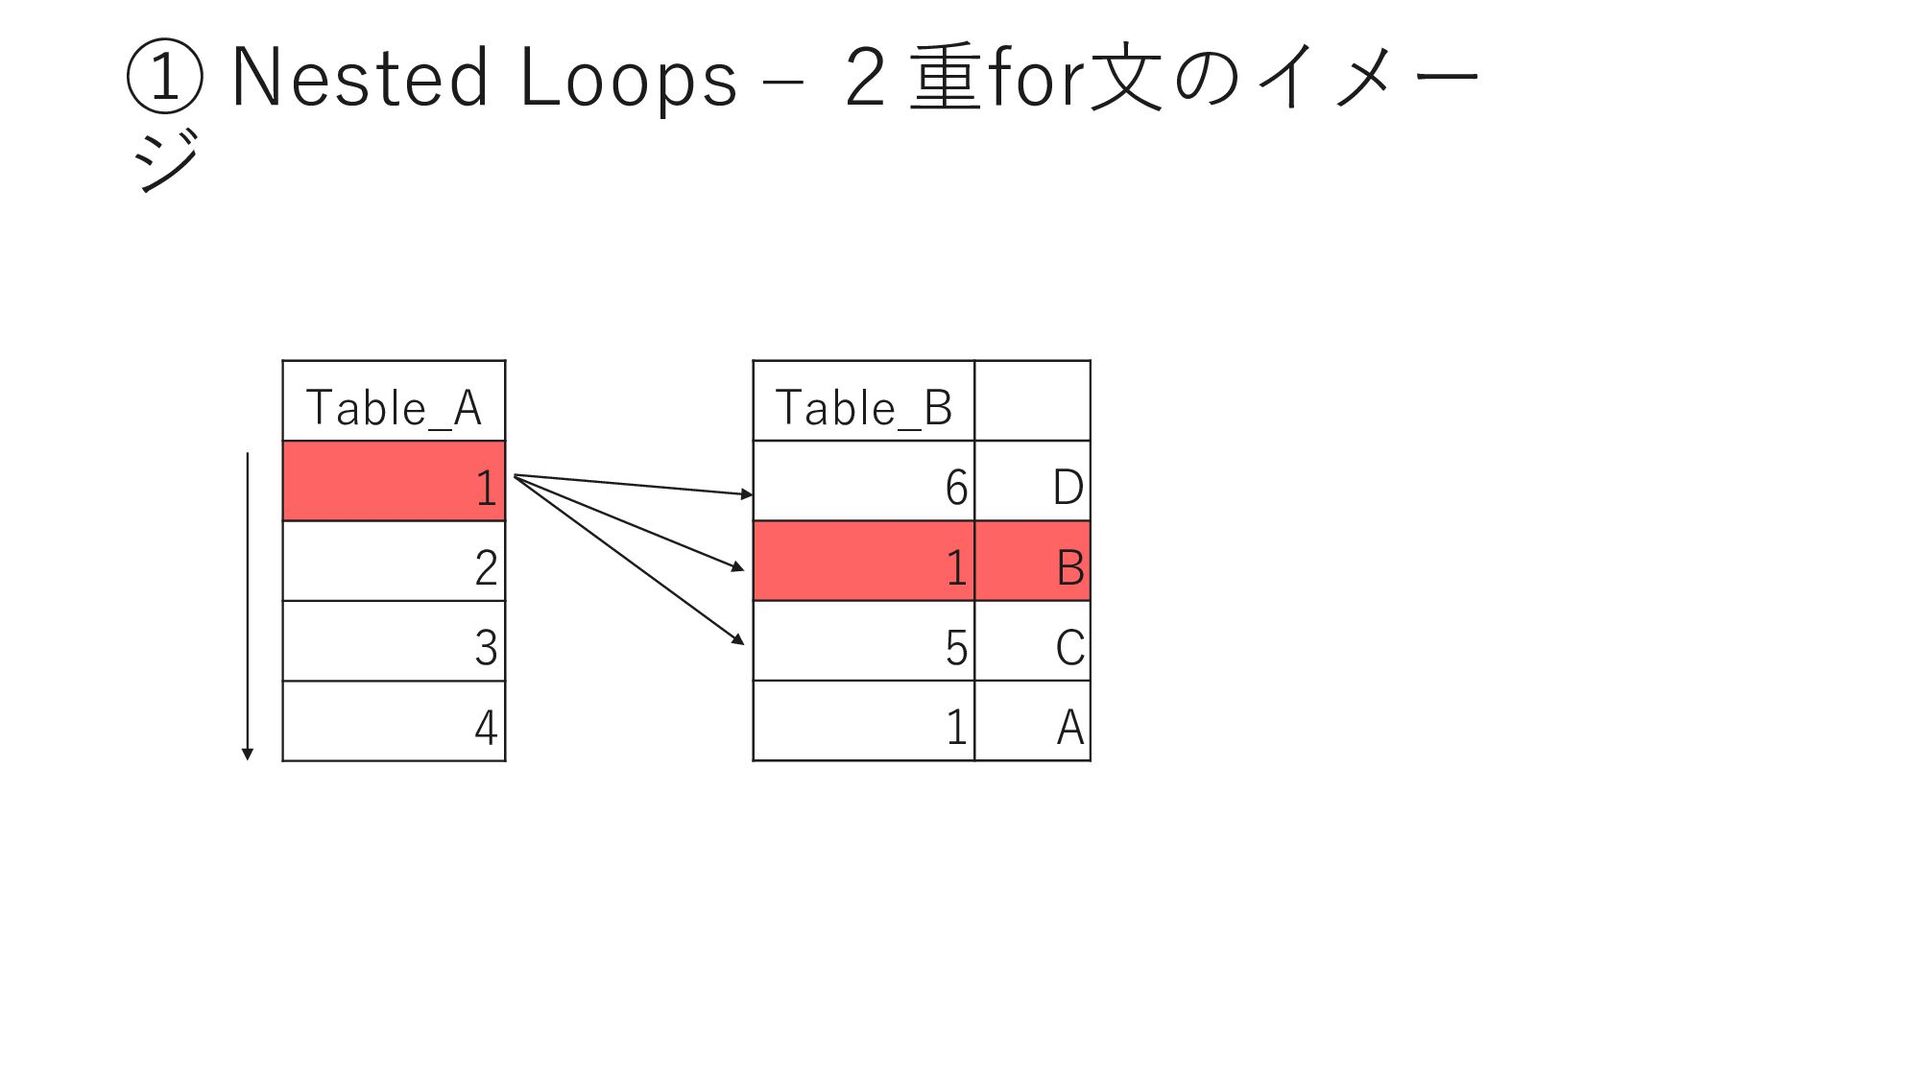
実⾏プランの基本的な演算⼦まとめ • データへのアクセス⽅法 • Scan / Seek / キー参照 •
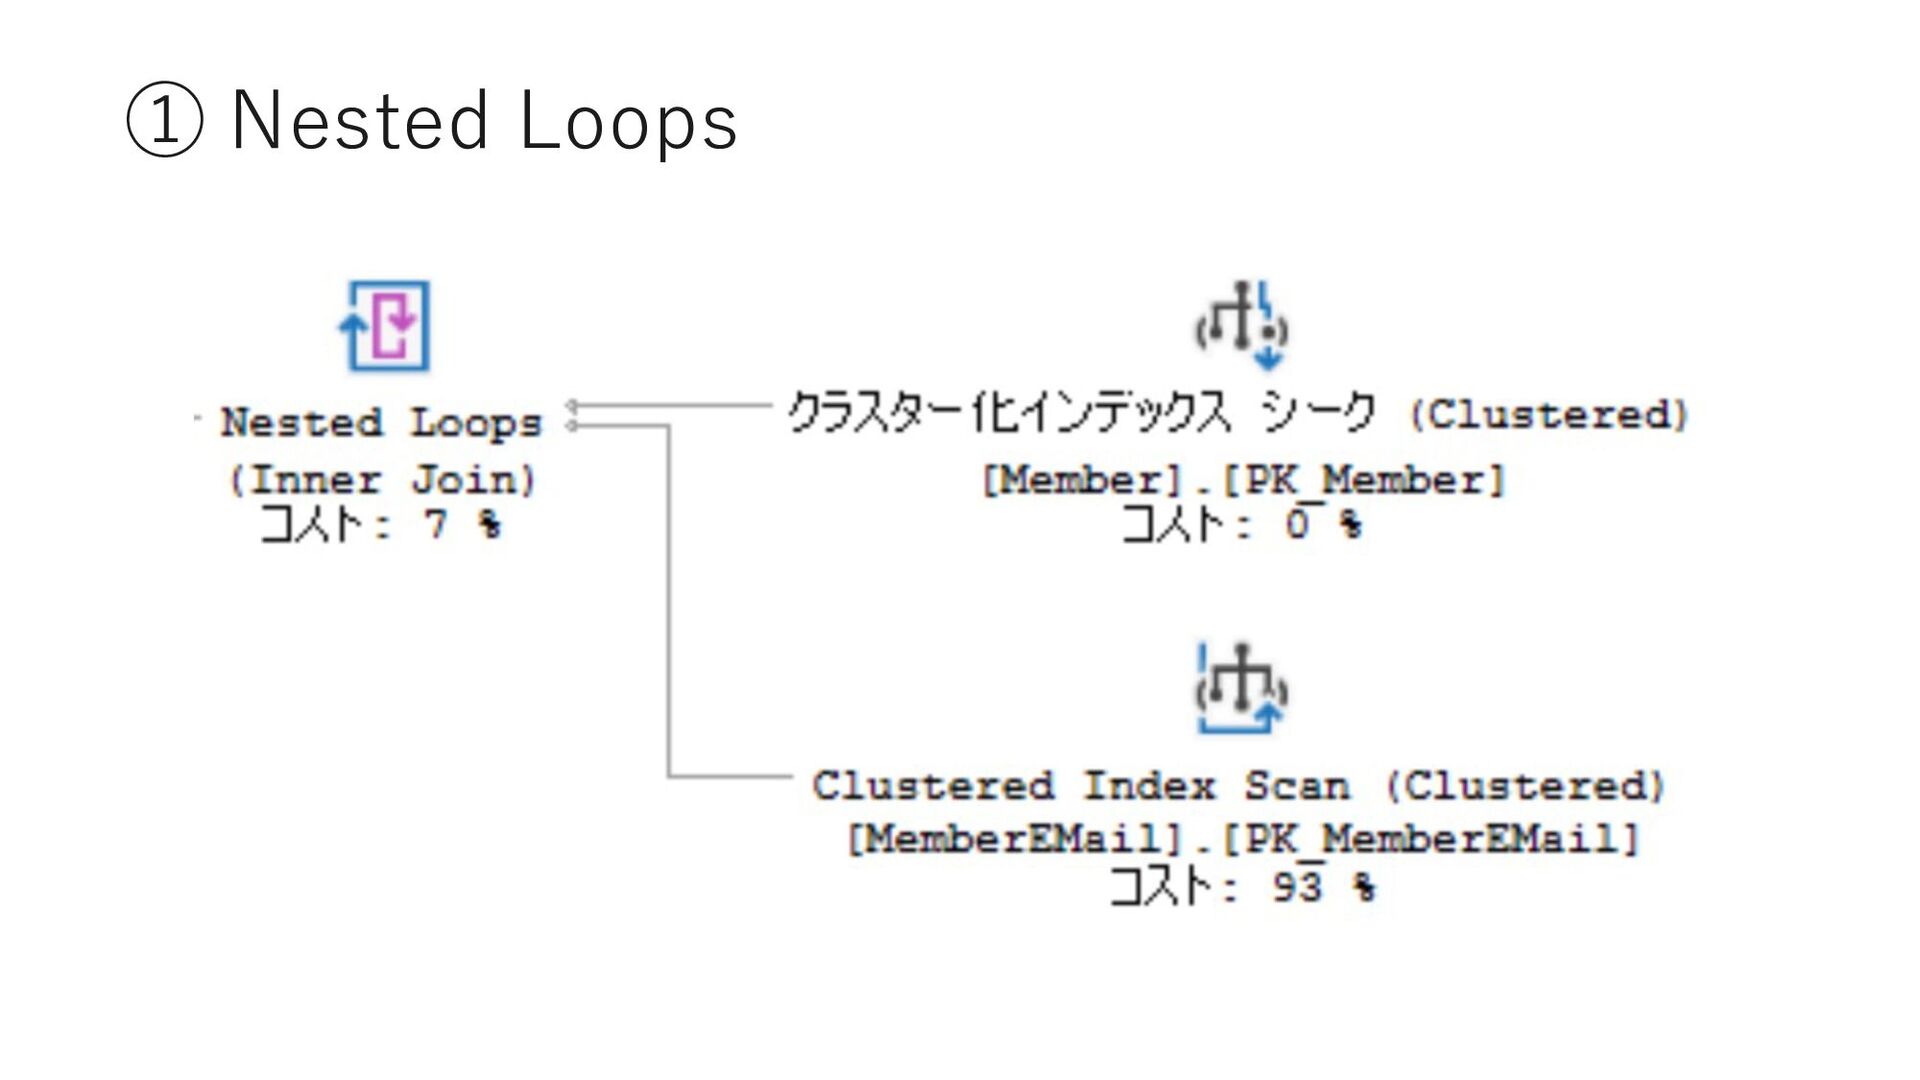
結合⽅法 • Nested Loops / Hash Match / Merge Join • 並び替え • Sort 他にもたくさんあるが、ボトルネックはこの中のどれかである場合 が多い -
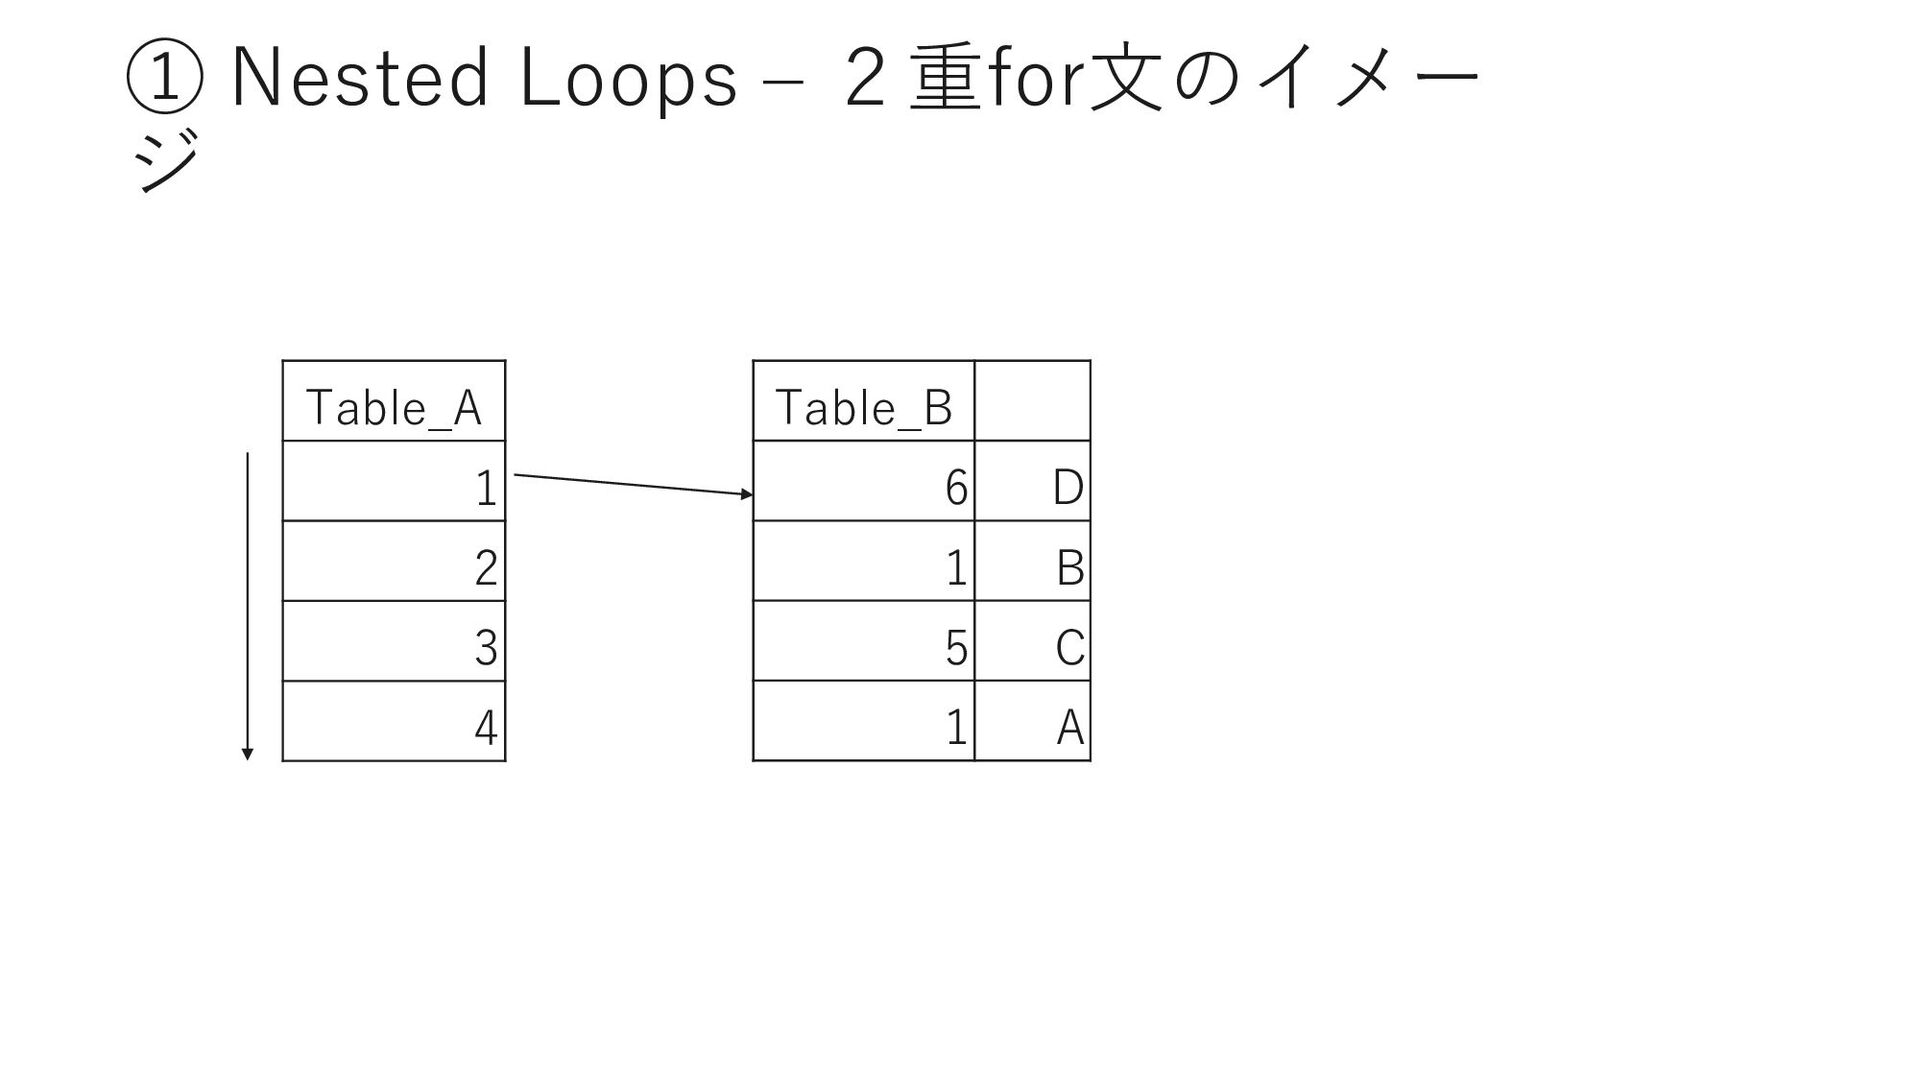
① Nested Loops ‒ 2重for⽂のイメー ジ Table_A 1 2 3
4 Table_B 6 D 1 B 5 C 1 A -
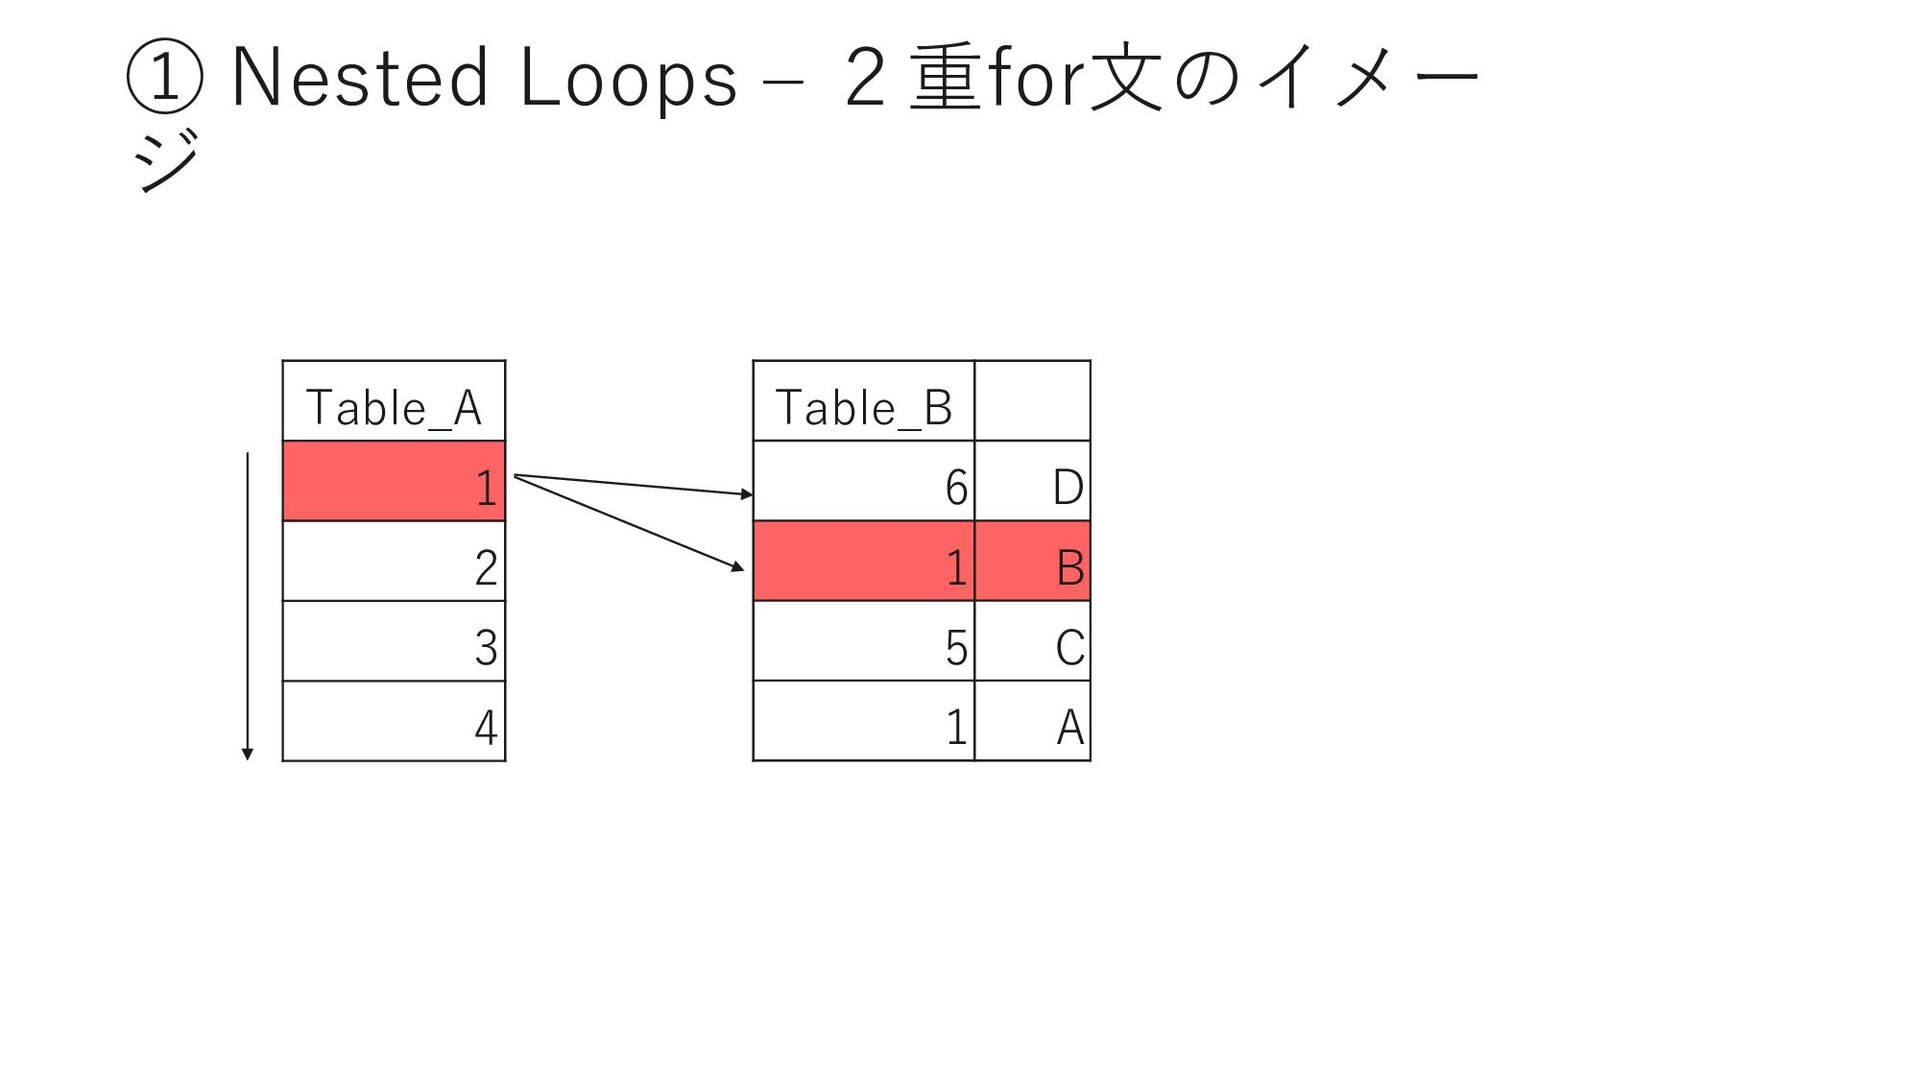
① Nested Loops ‒ 2重for⽂のイメー ジ Table_A 1 2 3
4 Table_B 6 D 1 B 5 C 1 A -
① Nested Loops ‒ 2重for⽂のイメー ジ Table_A 1 2 3
4 Table_B 6 D 1 B 5 C 1 A -
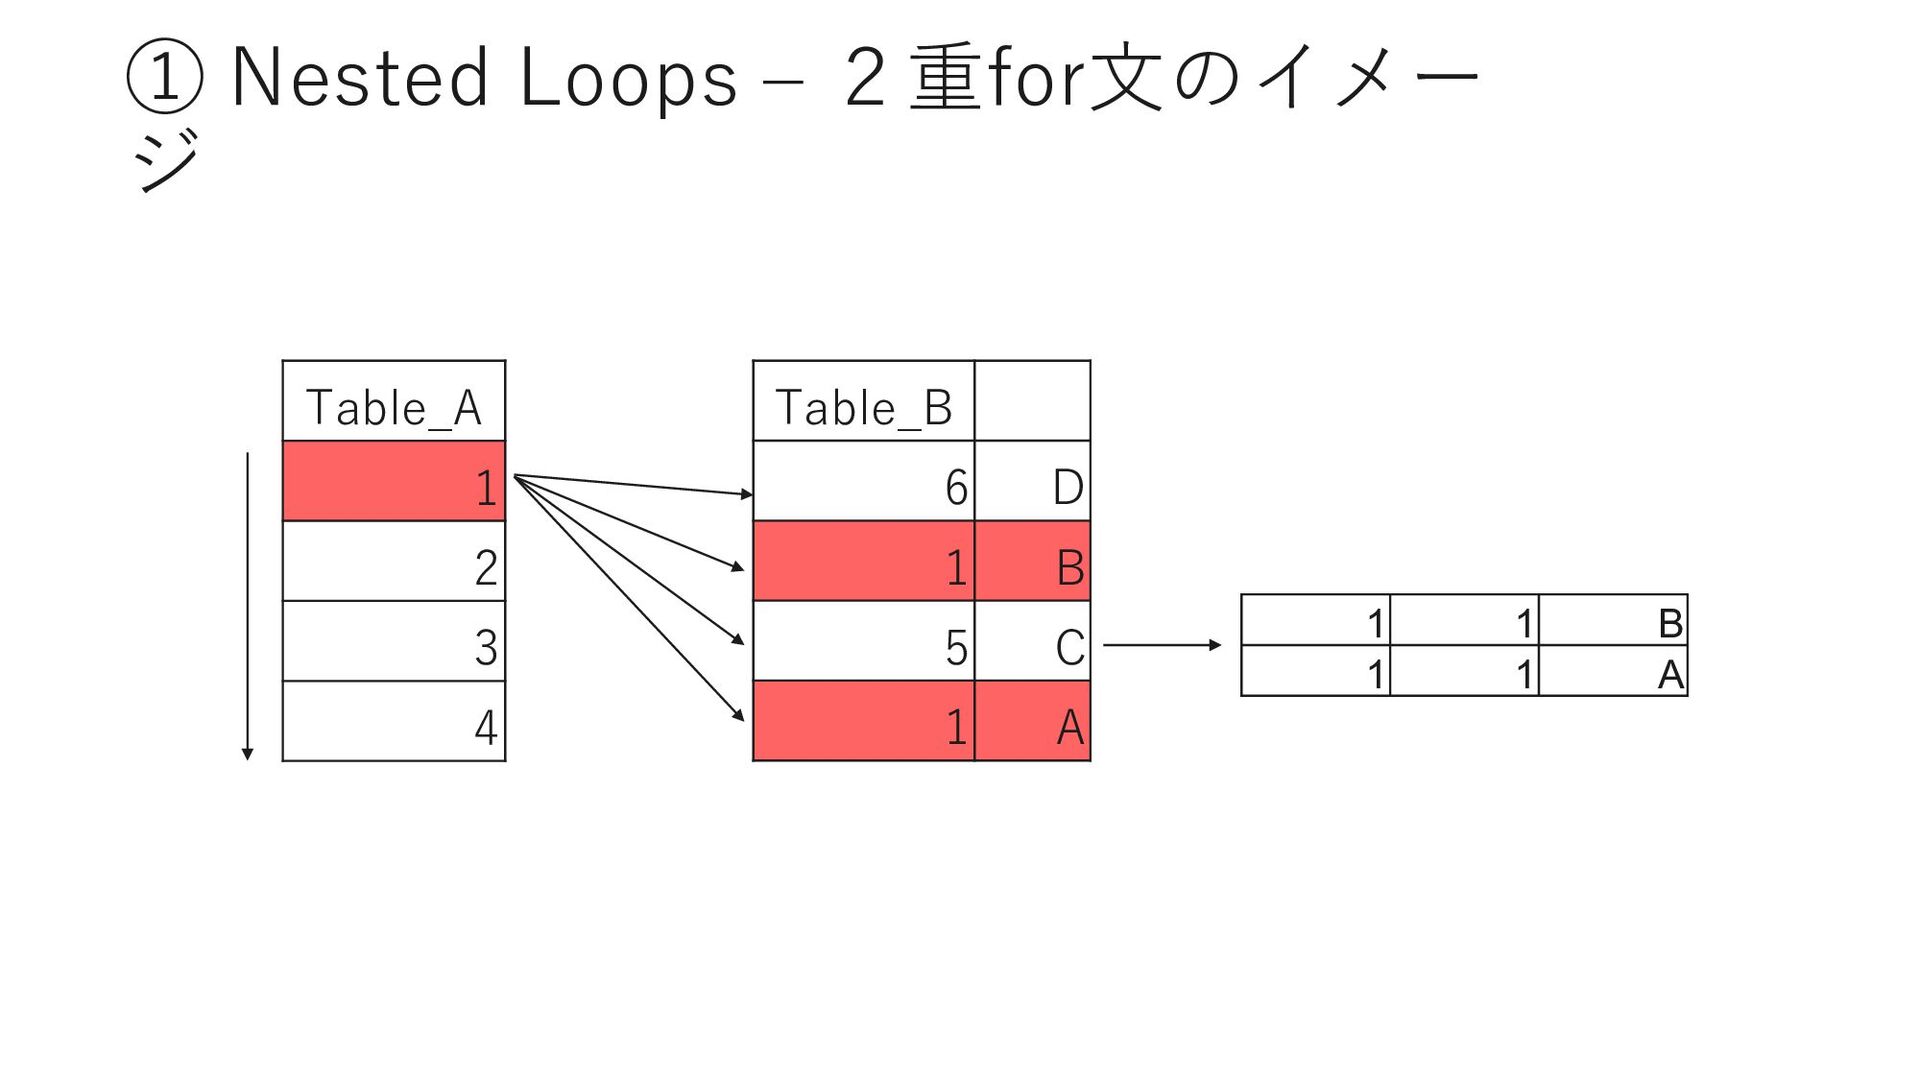
① Nested Loops ‒ 2重for⽂のイメー ジ Table_A 1 2 3
4 Table_B 6 D 1 B 5 C 1 A 1 1 B 1 1 A -
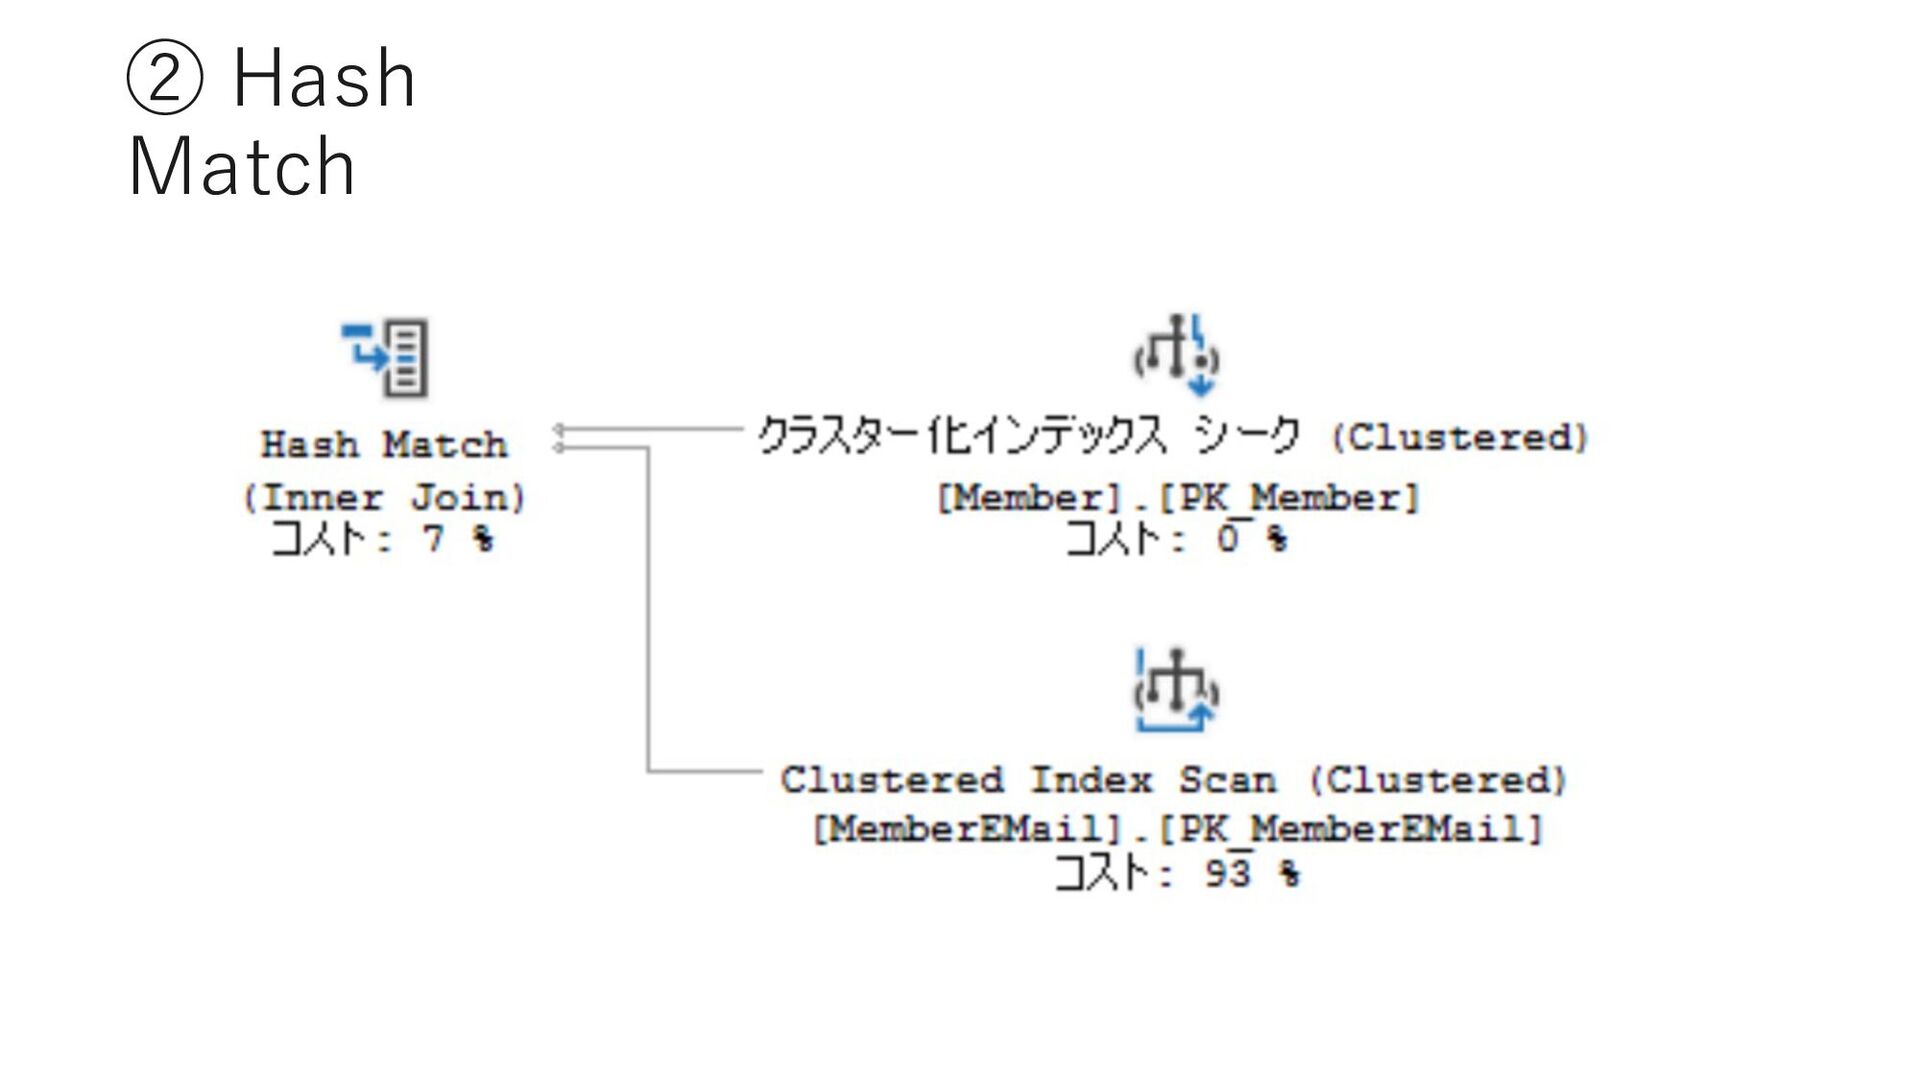
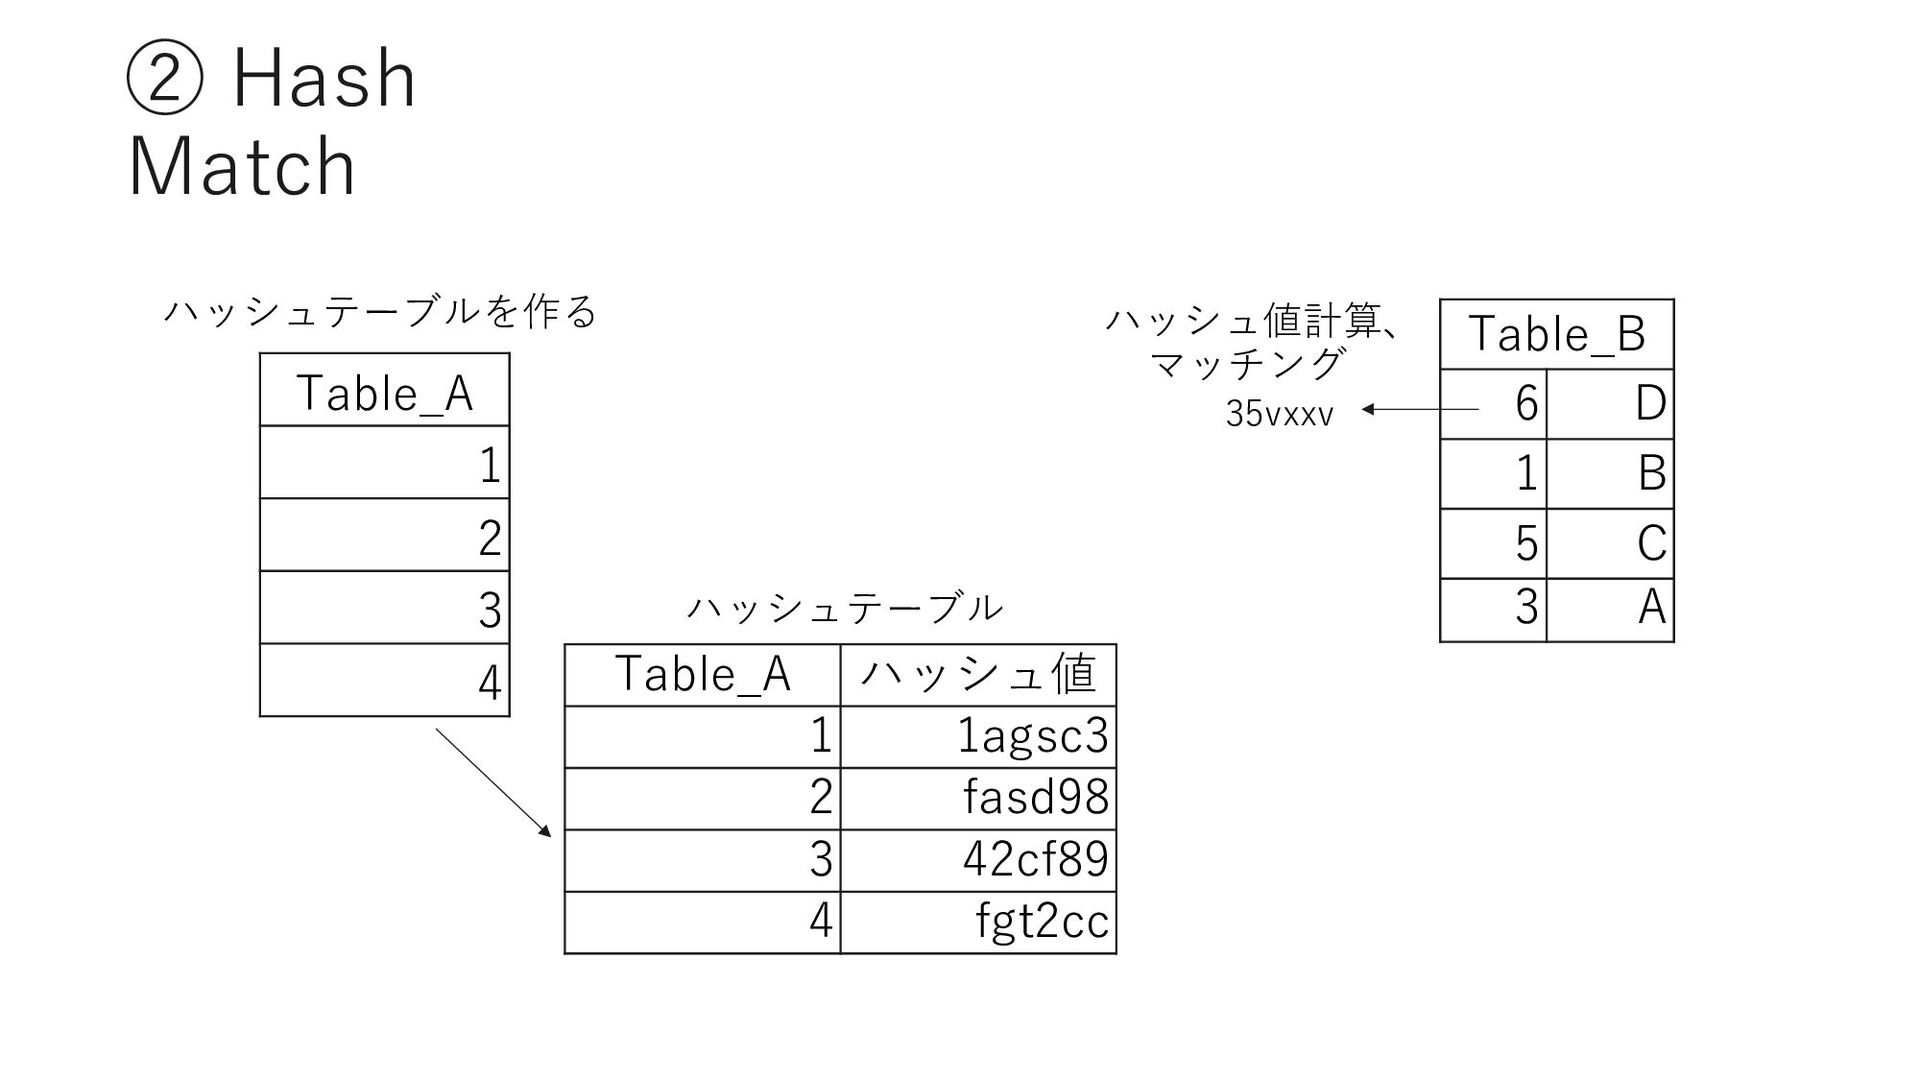
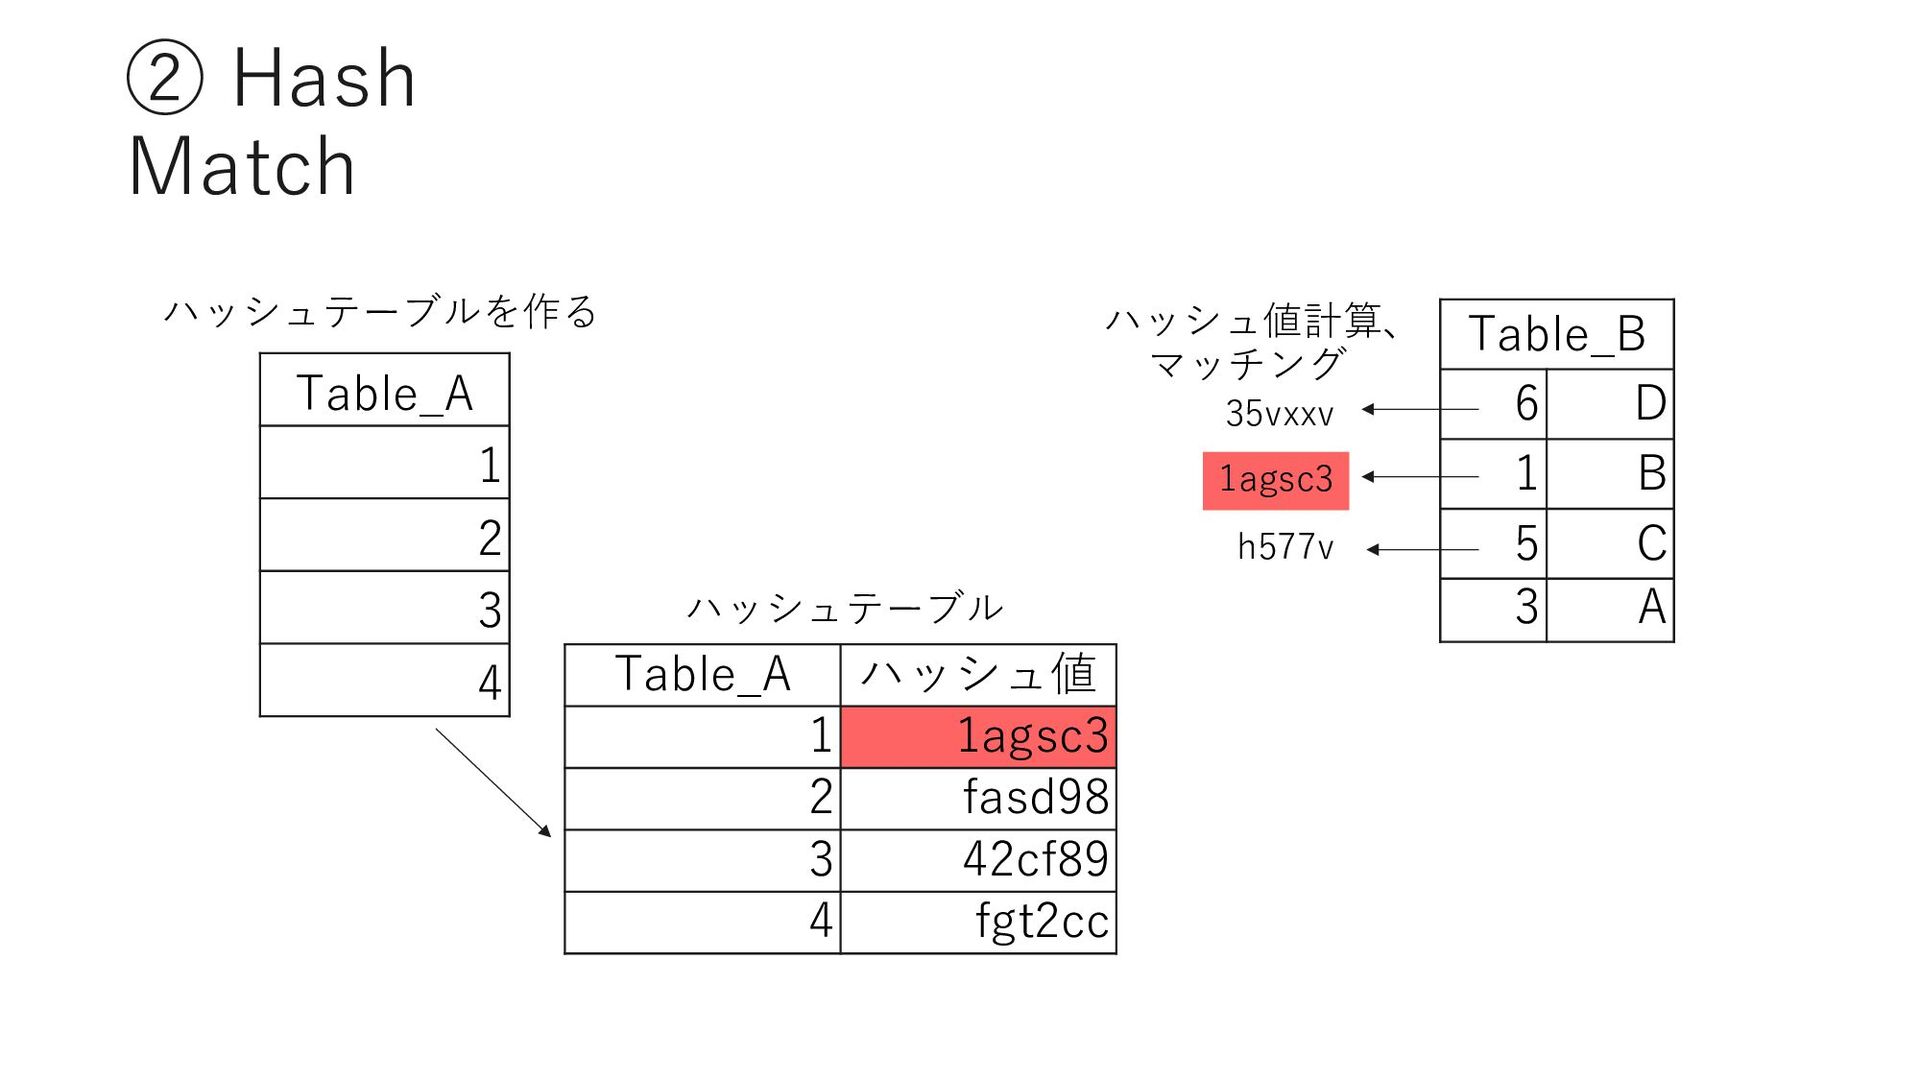
② Hash Match Table_A 1 2 3 4 ハッシュテーブルを作る Table_A
ハッシュ値 1 1agsc3 2 fasd98 3 42cf89 4 fgt2cc ハッシュテーブル Table_B 6 D 1 B 5 C 3 A 35vxxv ハッシュ値計算、 マッチング -
② Hash Match Table_A 1 2 3 4 ハッシュテーブルを作る Table_A
ハッシュ値 1 1agsc3 2 fasd98 3 42cf89 4 fgt2cc ハッシュテーブル Table_B 6 D 1 B 5 C 3 A 35vxxv 1agsc3 ハッシュ値計算、 マッチング h577v -
② Hash Match Table_A 1 2 3 4 ハッシュテーブルを作る Table_A
ハッシュ値 1 1agsc3 2 fasd98 3 42cf89 4 fgt2cc ハッシュテーブル Table_B 6 D 1 B 5 C 3 A 35vxxv 1agsc3 h577v 42cf89 1 1 B 3 3 A ハッシュ値計算、 マッチング -
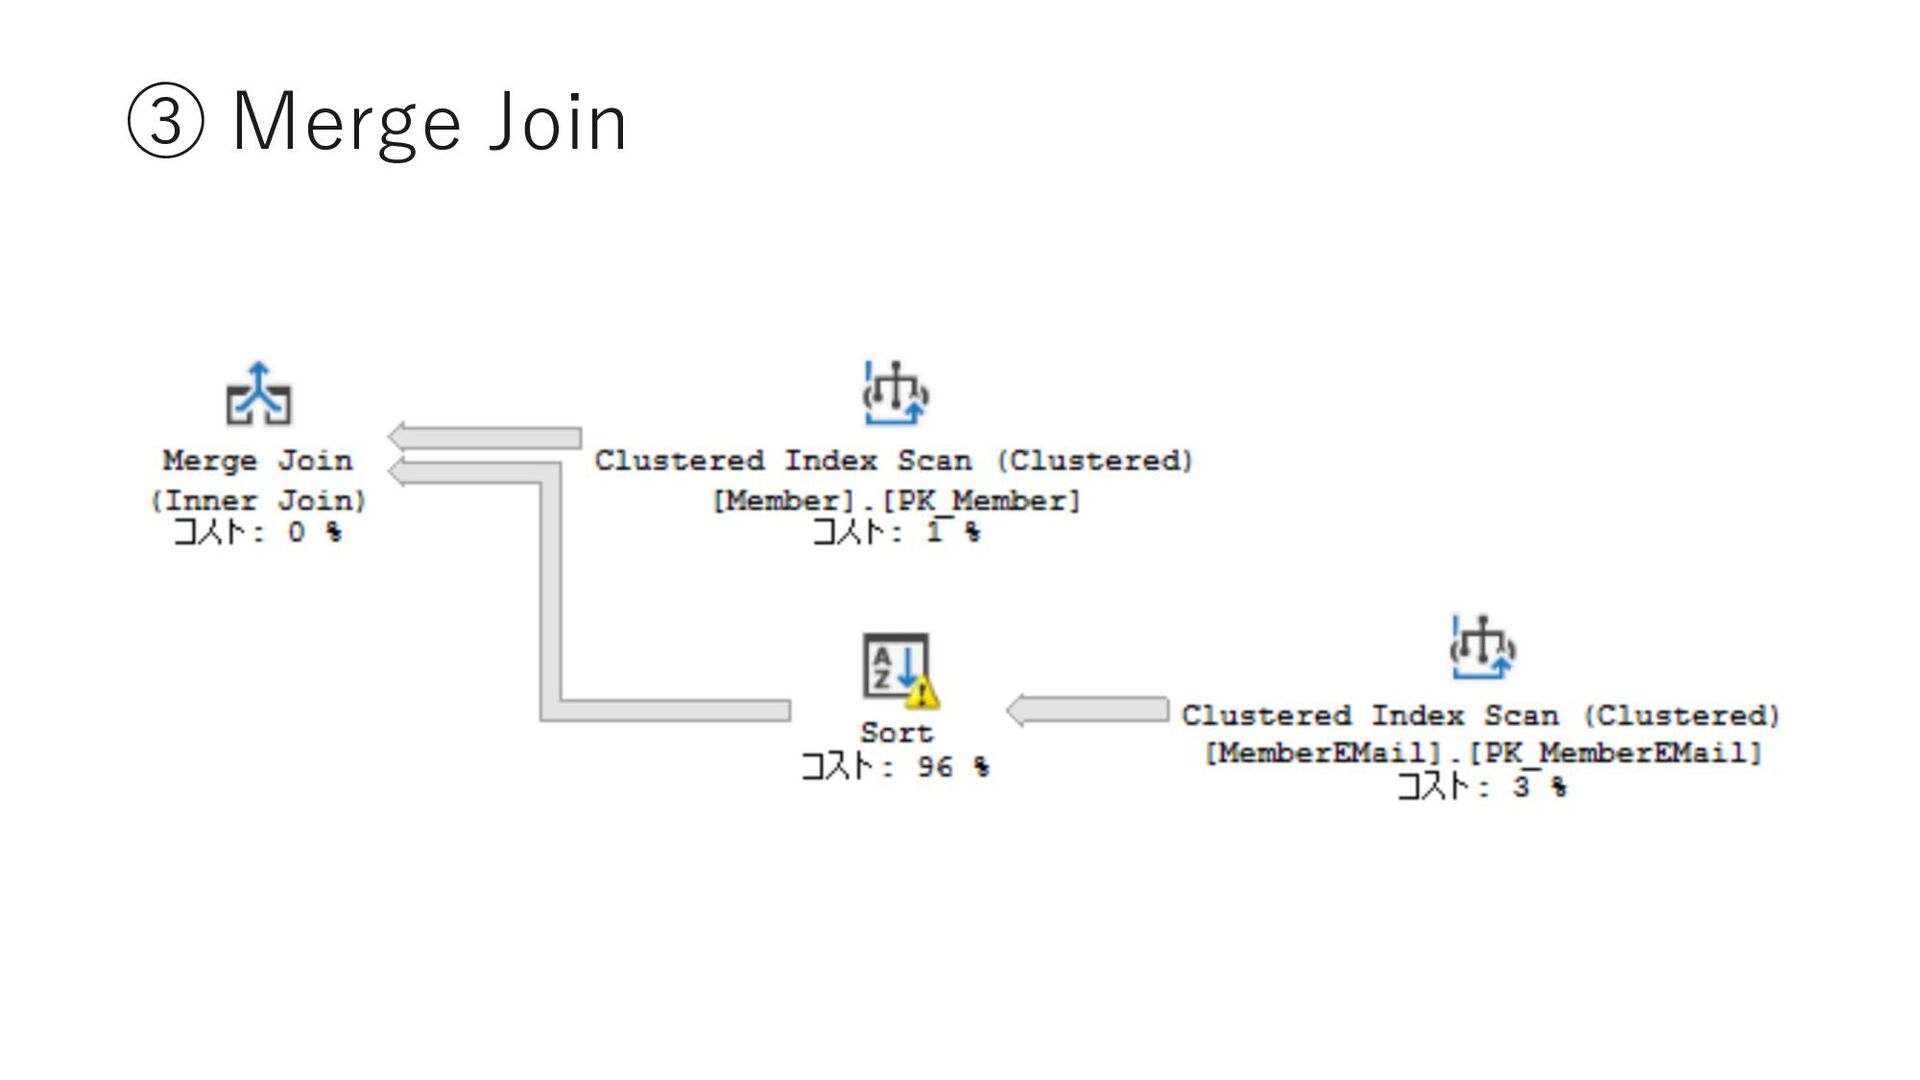
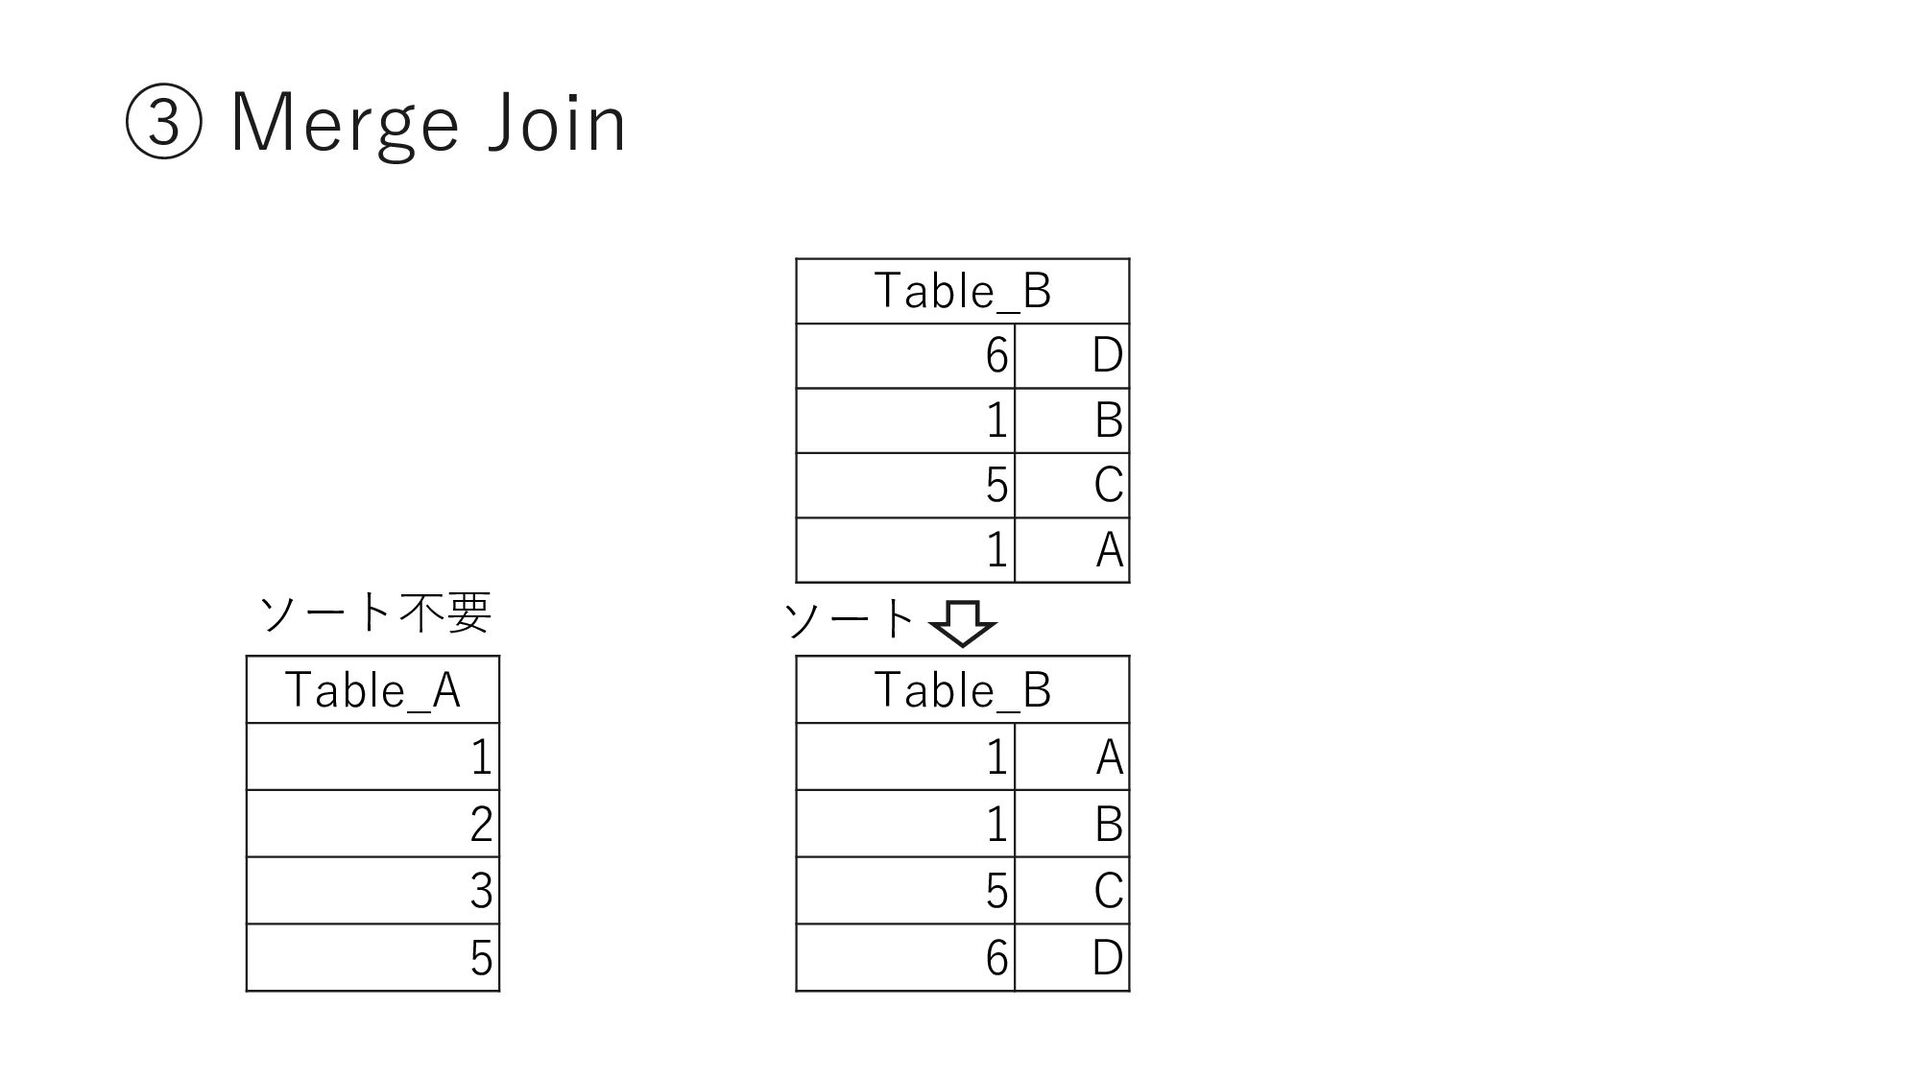
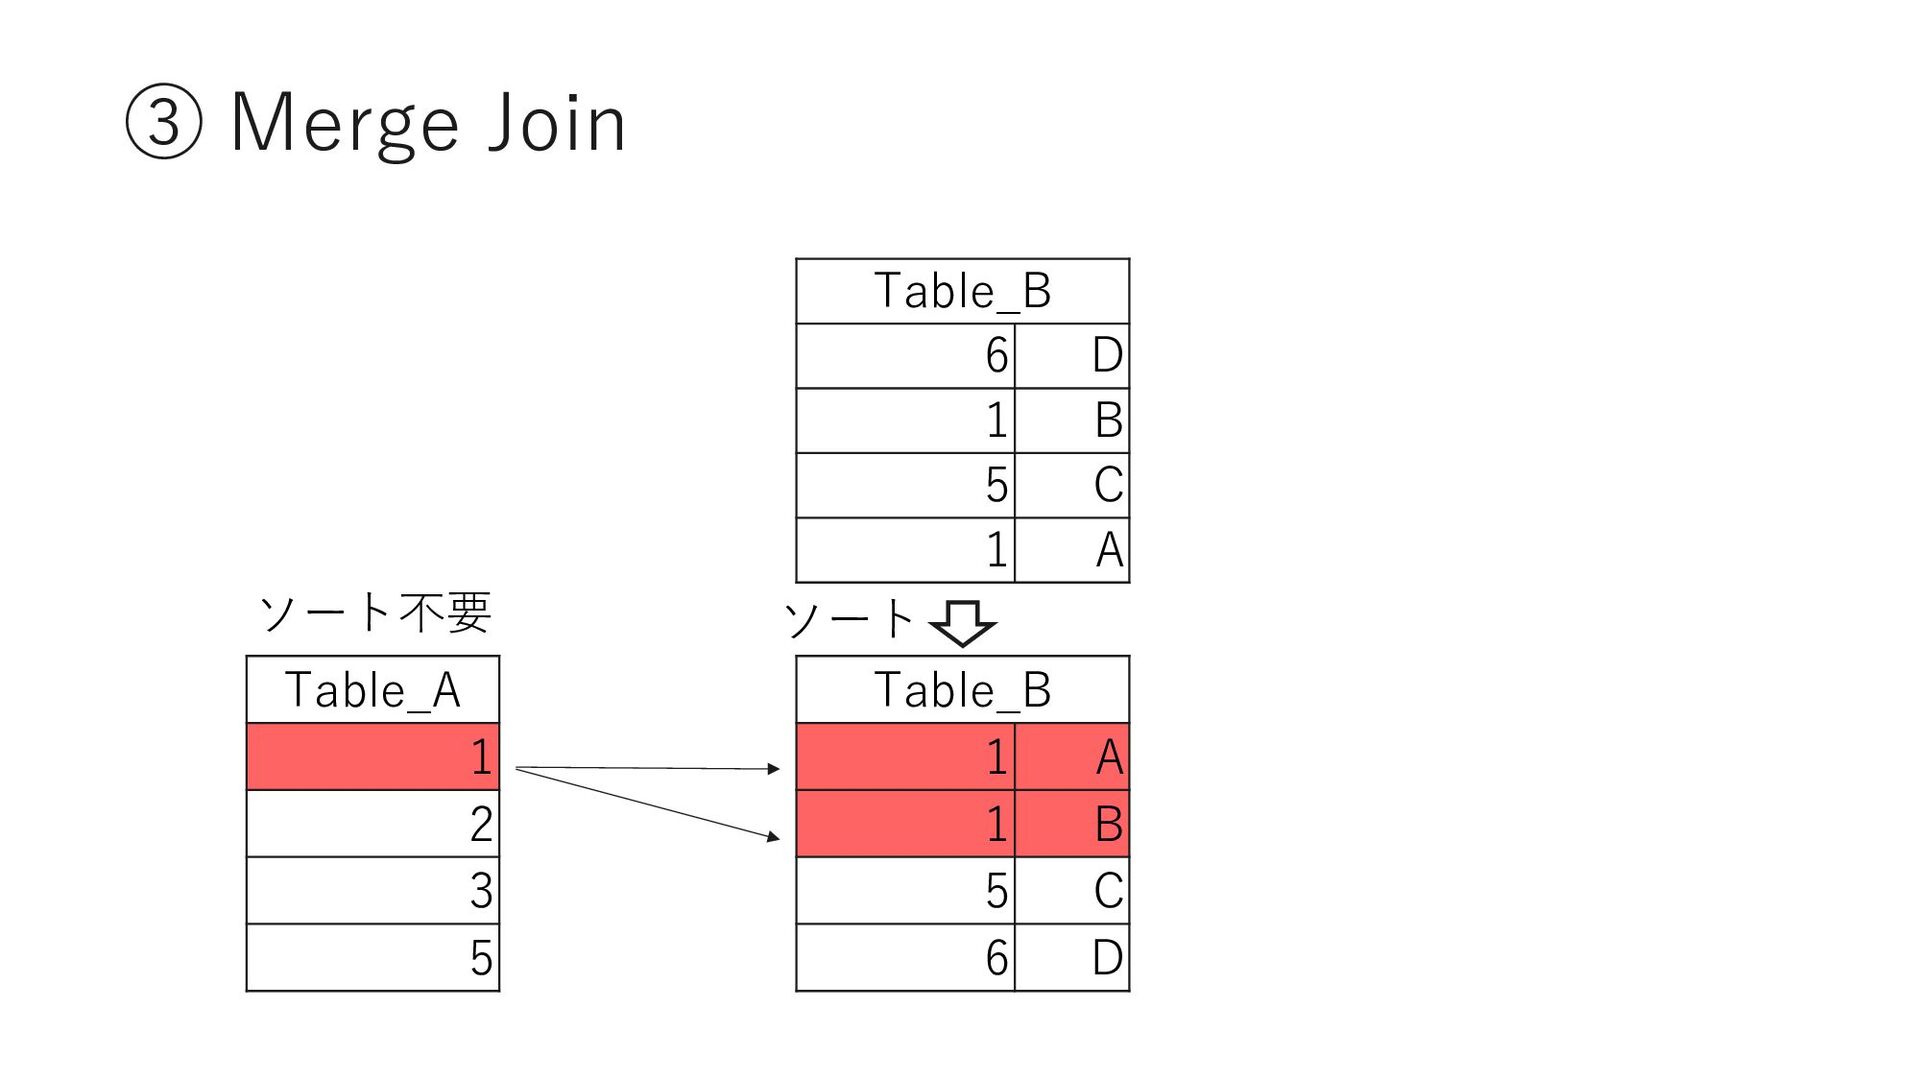
③ Merge Join Table_B 6 D 1 B 5 C
1 A Table_A 1 2 3 5 Table_B 1 A 1 B 5 C 6 D ソート不要 ソート -
③ Merge Join Table_B 6 D 1 B 5 C
1 A Table_A 1 2 3 5 Table_B 1 A 1 B 5 C 6 D ソート不要 ソート -
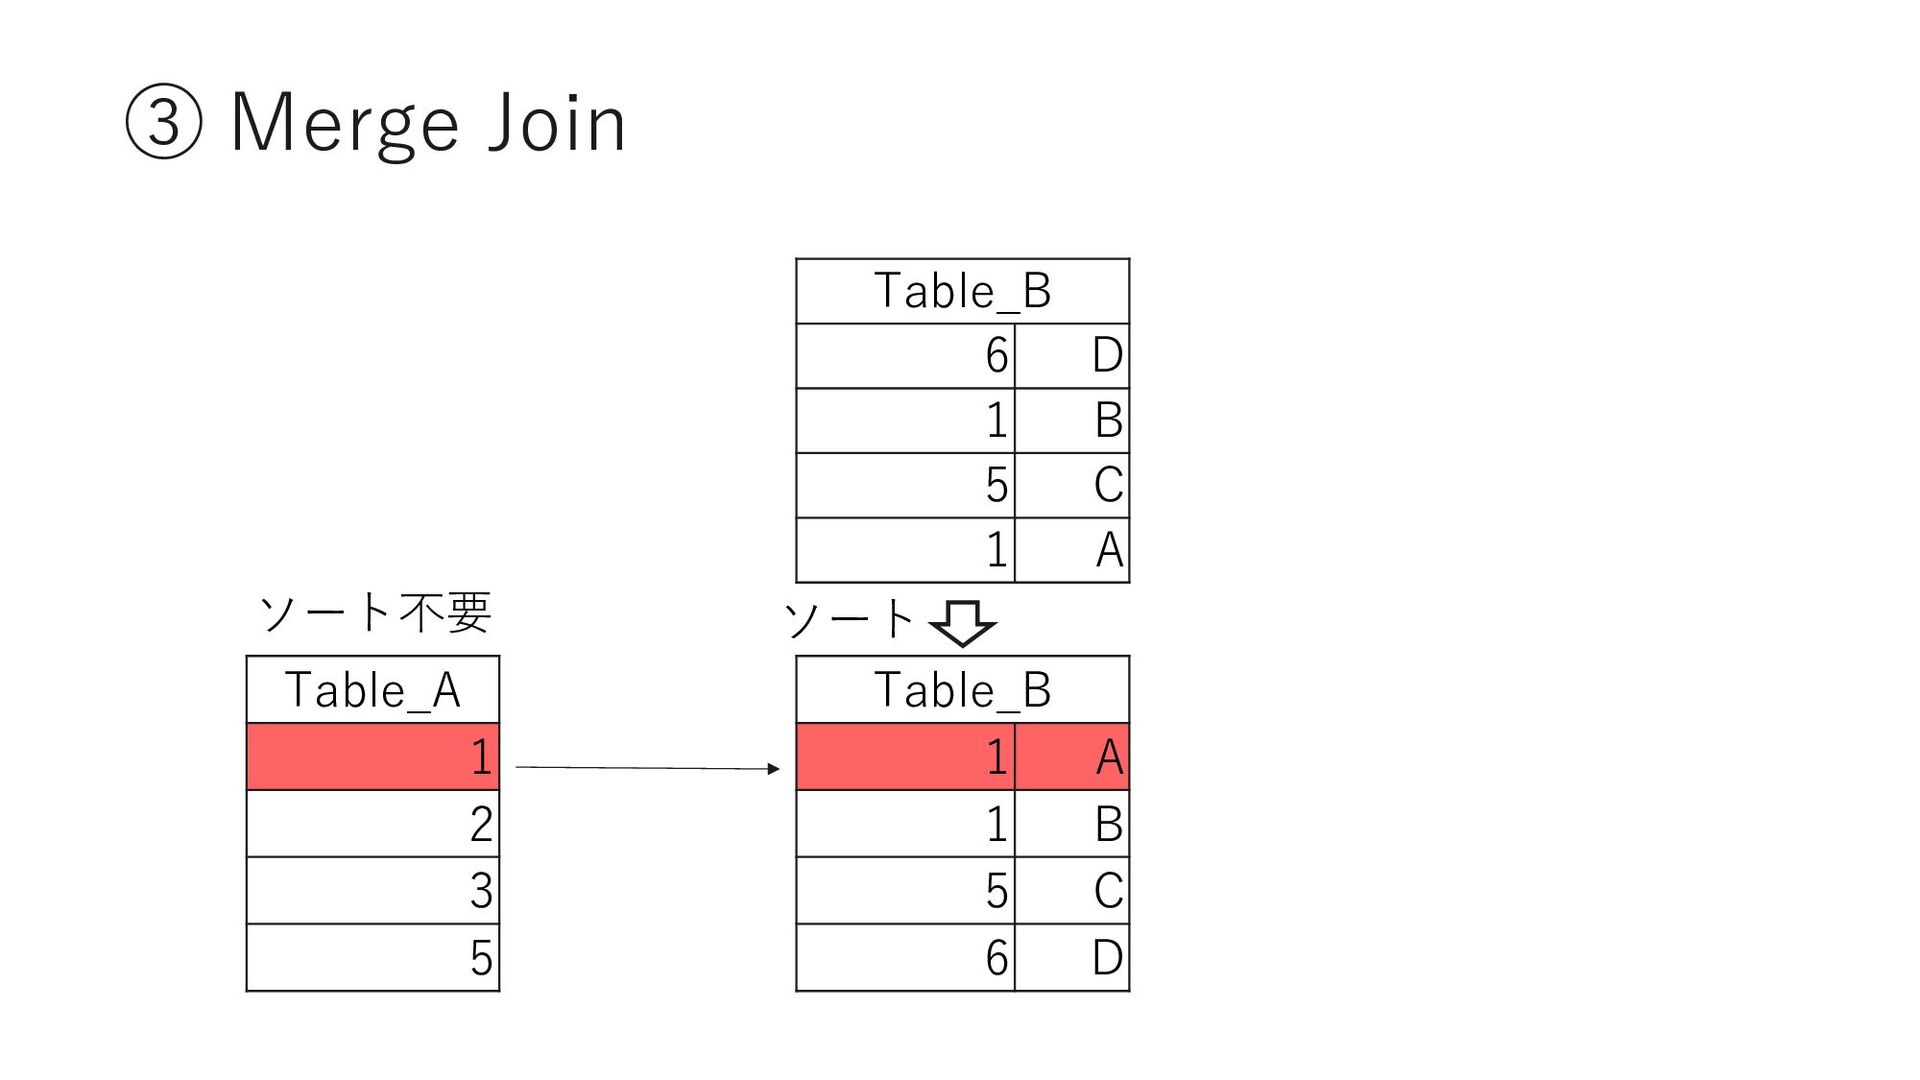
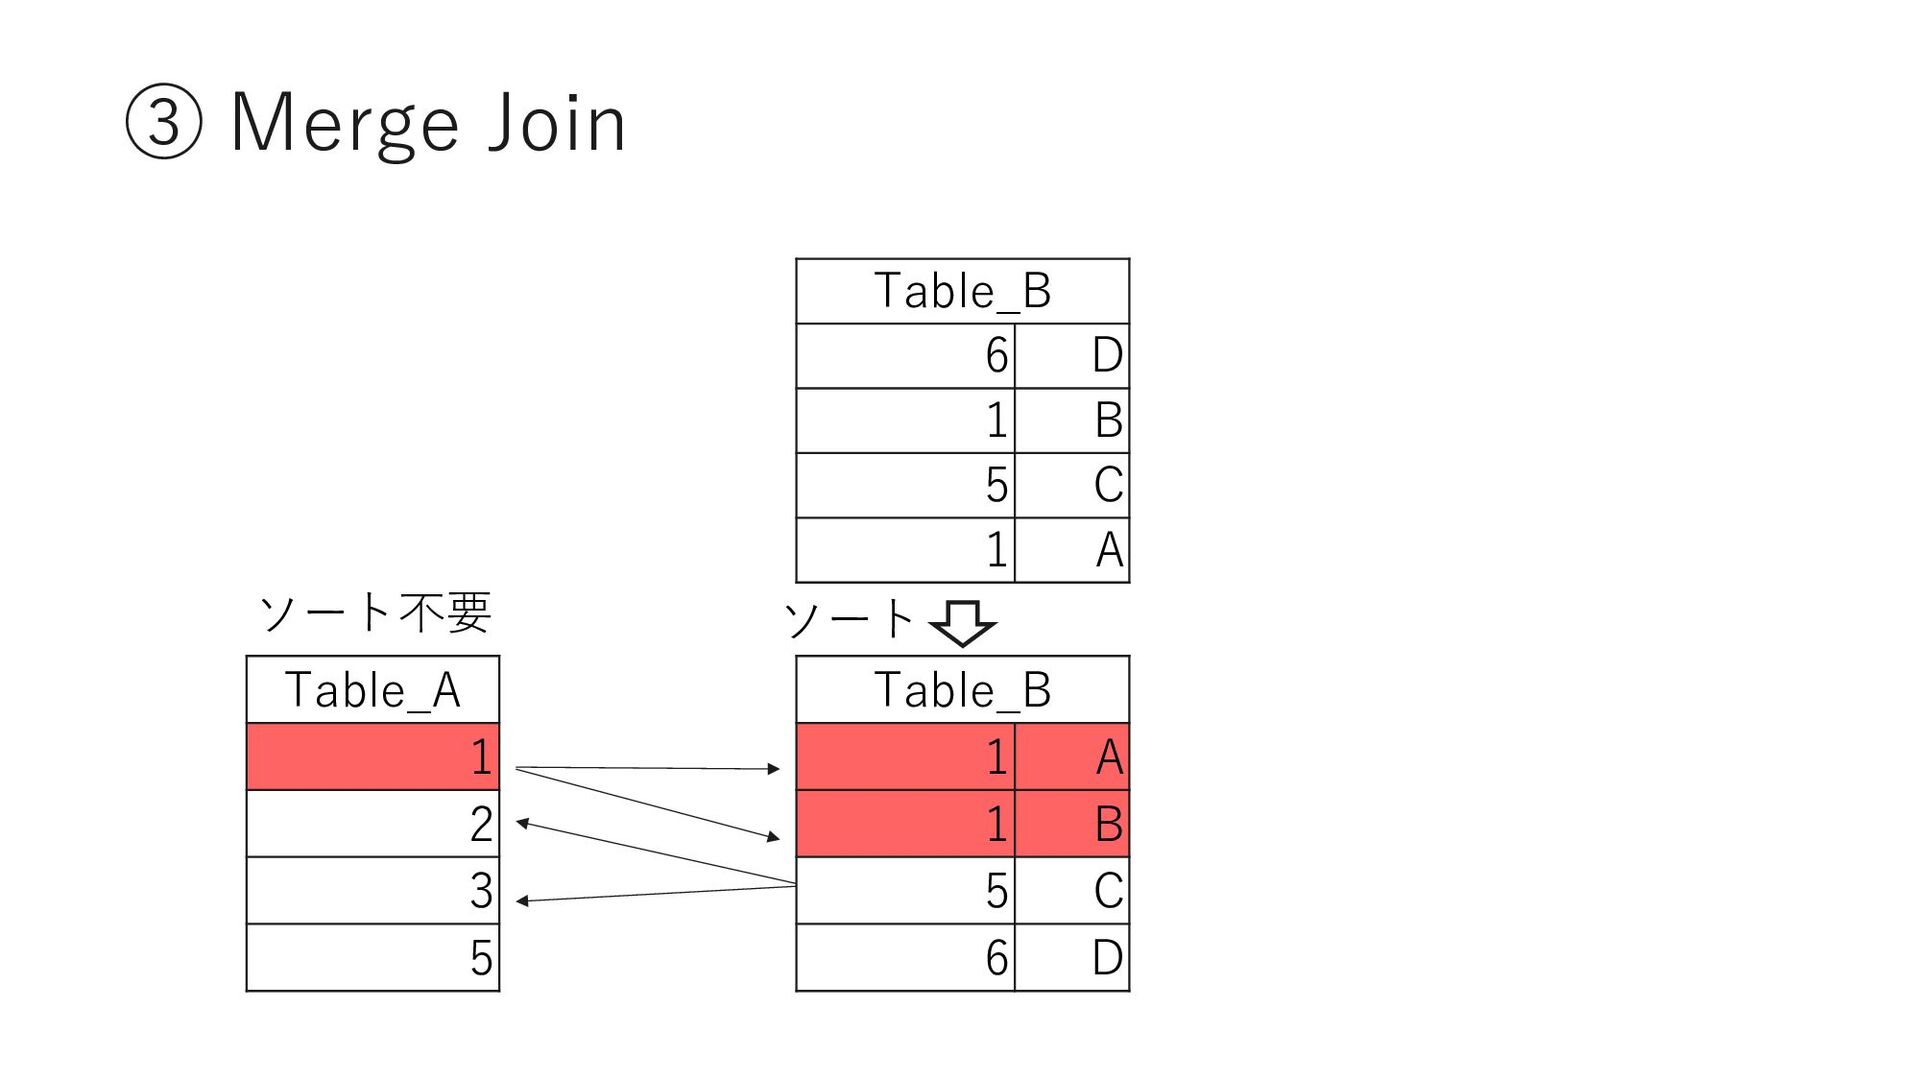
③ Merge Join Table_B 6 D 1 B 5 C
1 A Table_A 1 2 3 5 Table_B 1 A 1 B 5 C 6 D ソート不要 ソート -
③ Merge Join Table_B 6 D 1 B 5 C
1 A Table_A 1 2 3 5 Table_B 1 A 1 B 5 C 6 D ソート不要 ソート -
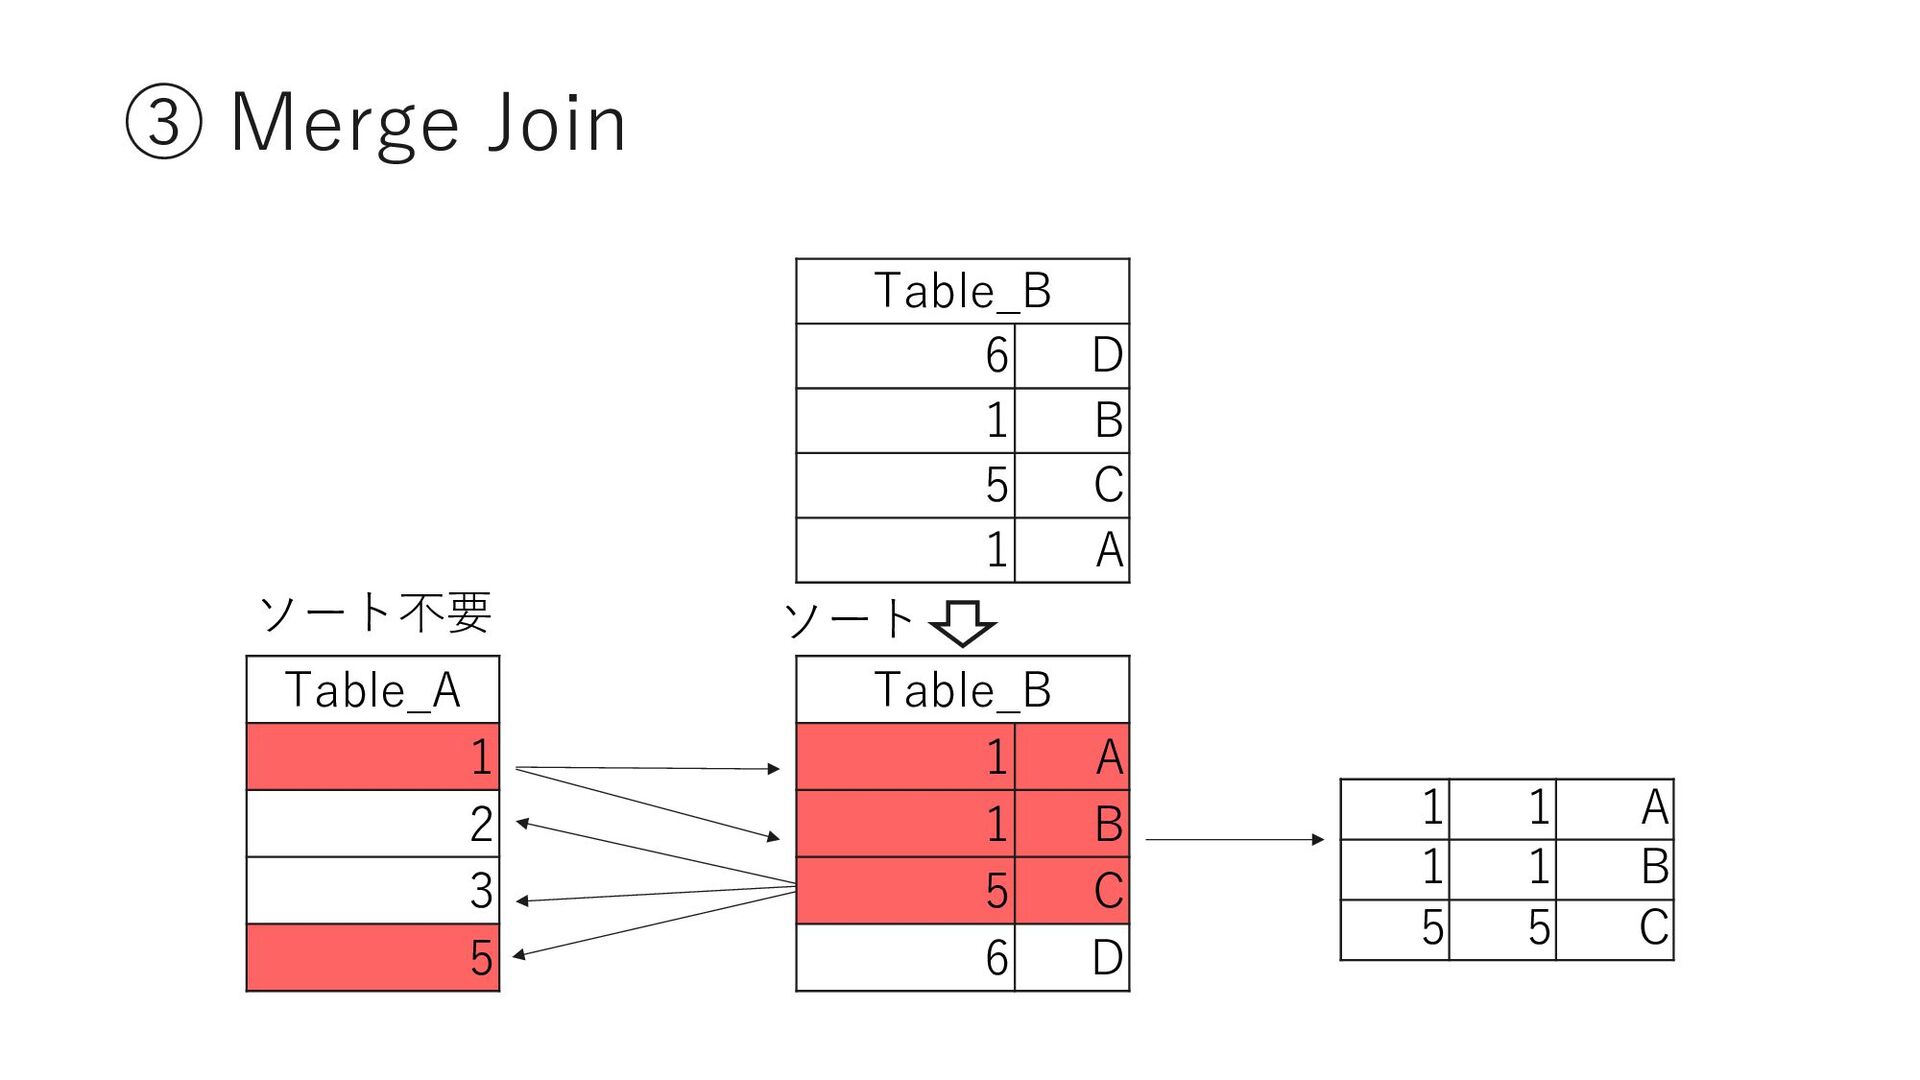
③ Merge Join Table_B 6 D 1 B 5 C
1 A Table_A 1 2 3 5 Table_B 1 A 1 B 5 C 6 D ソート不要 1 1 A 1 1 B 5 5 C ソート -
JOINの使い分け • 基本的にSQL Server側が最適な結合⽅法を判断する • JOINする2テーブルのサイズやインデックスの有無で最適な⽅法が違う • Nested Loops •
⼩さめのデータセットや where句でレコード数が⼤幅に絞り込めるとき向き • Merge Join / Hash Match • ⼤規模テーブル同⼠でレコード数が絞り込めないとき向き • メモリ消費⼤。場合によってはtempDBへの物理書き込み発⽣で速度低下 -
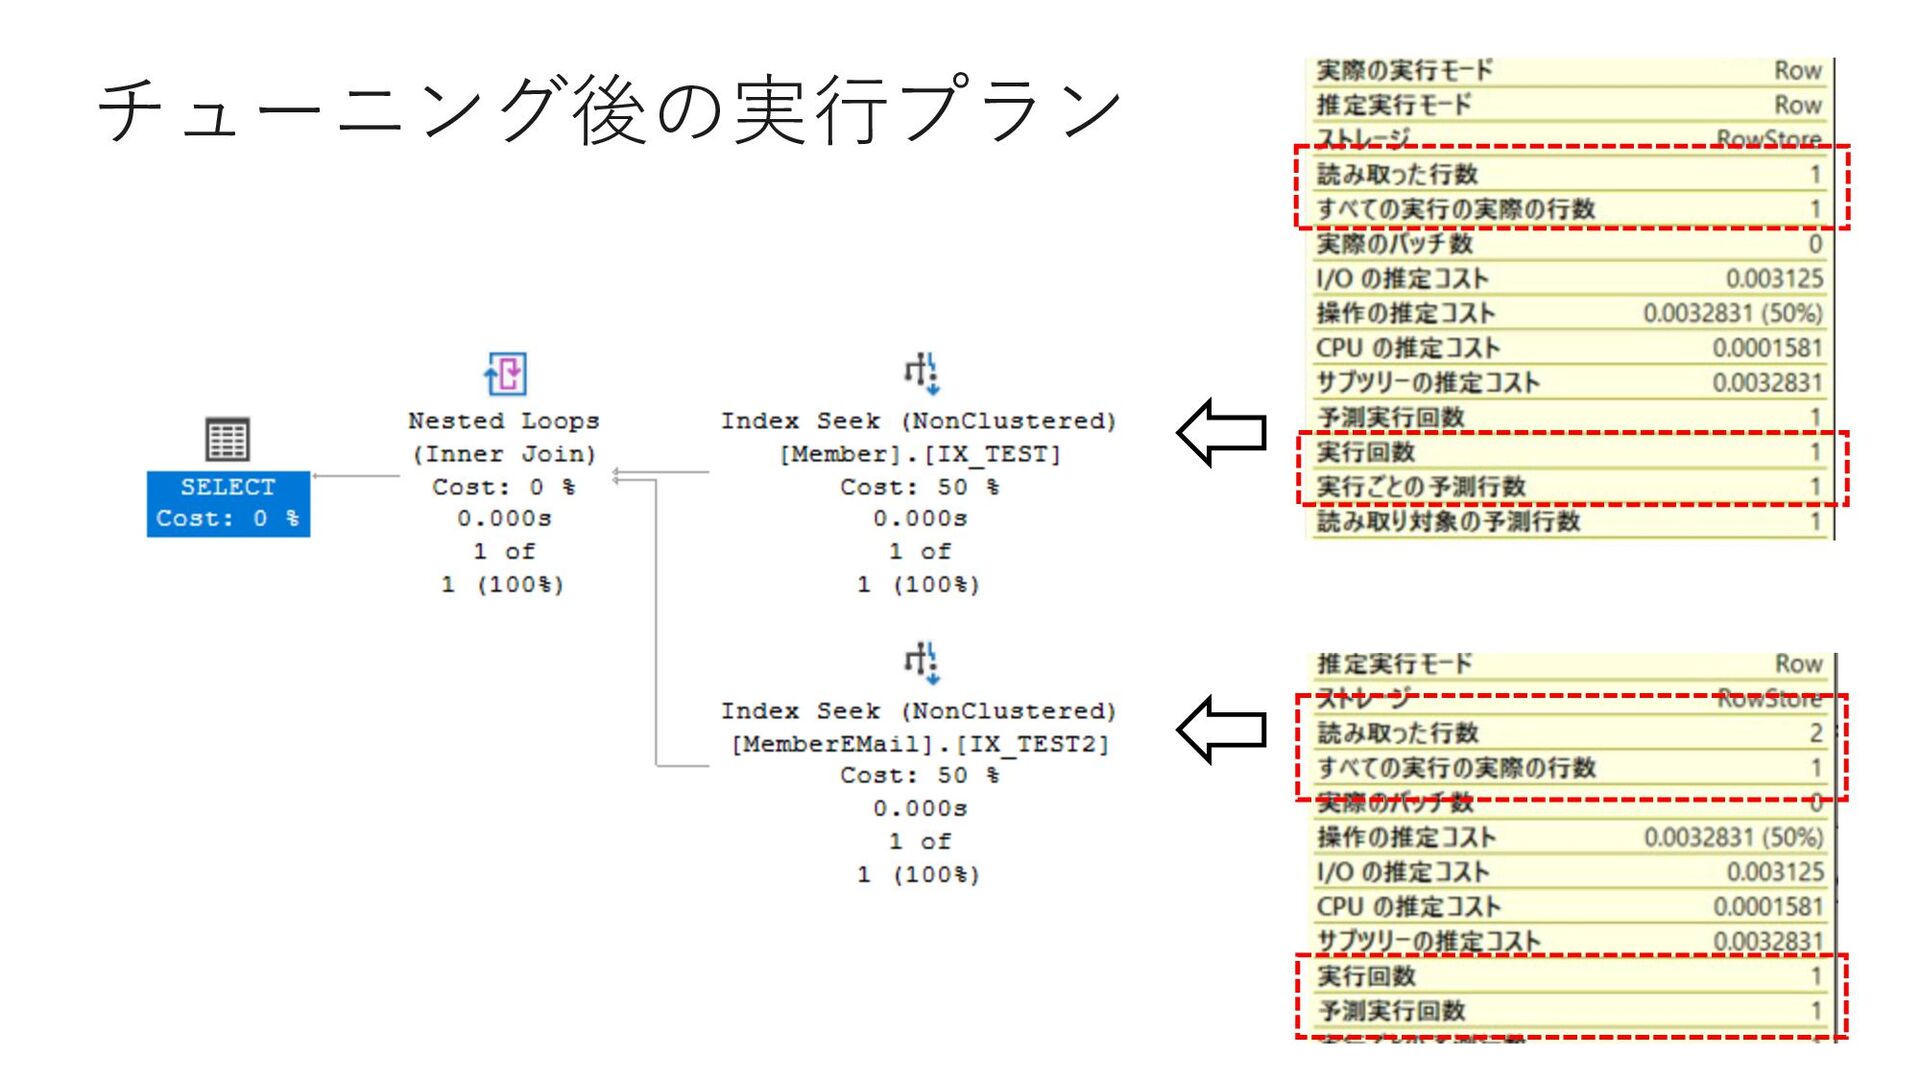
実⾏プランで⾒るべきポイント① • シーク述語 • Index Seek時にレコードを絞り込む条件 • 述語 • リーフページ⾛査時にレコードを絞り込む条件
• オブジェクト • ⾛査対象のクラスタ化インデックス/⾮クラスタ化インデックス/ヒー プ -
実⾏プランで⾒るべきポイント② • 予測⾏数 / 実際の⾏数 / およびその差 • 予測実⾏回数 /
実際の実⾏回数 / およびその差 • 予測と実際の乖離が⼤きく、実⾏時間が⻑い場合は他に最適なプランが 存在する可能性がある -
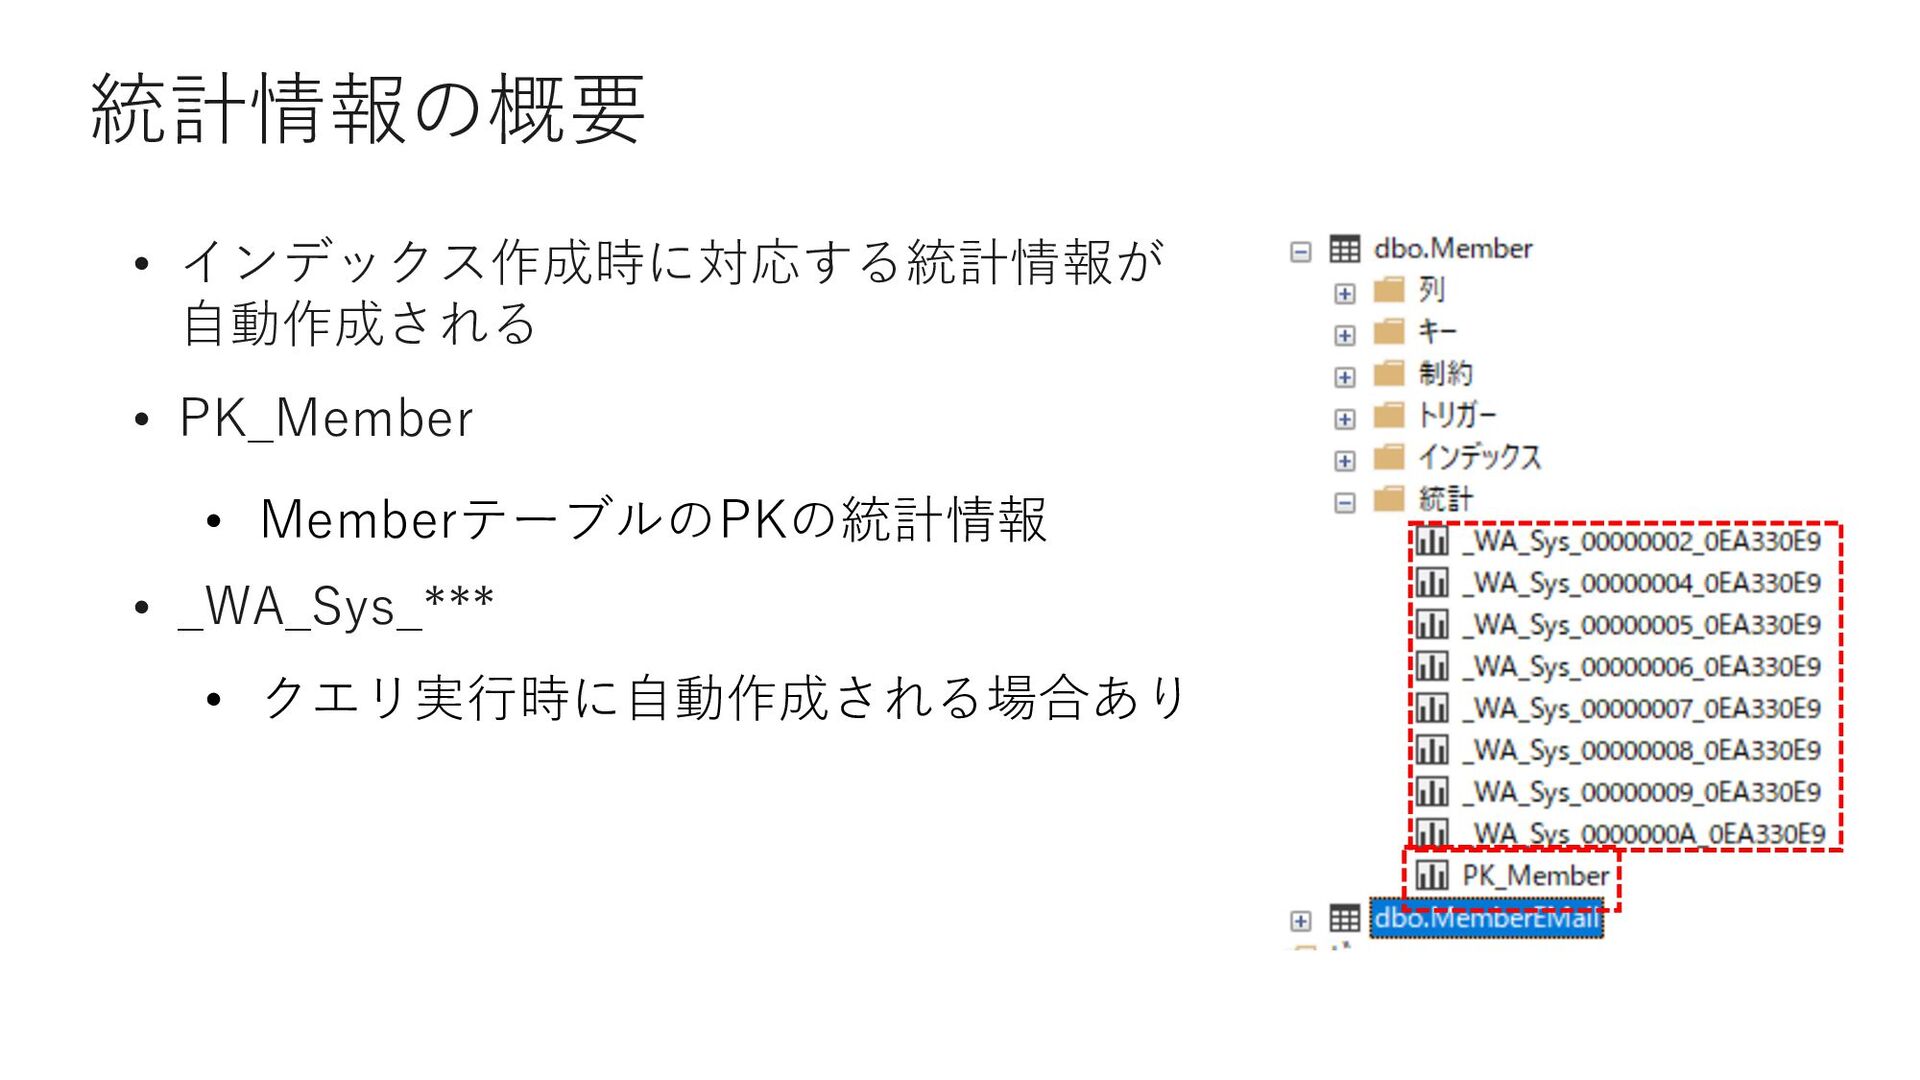
• インデックス作成時に対応する統計情報が ⾃動作成される • PK_Member • MemberテーブルのPKの統計情報 • _WA_Sys_*** •
クエリ実⾏時に⾃動作成される場合あり 統計情報の概要 -
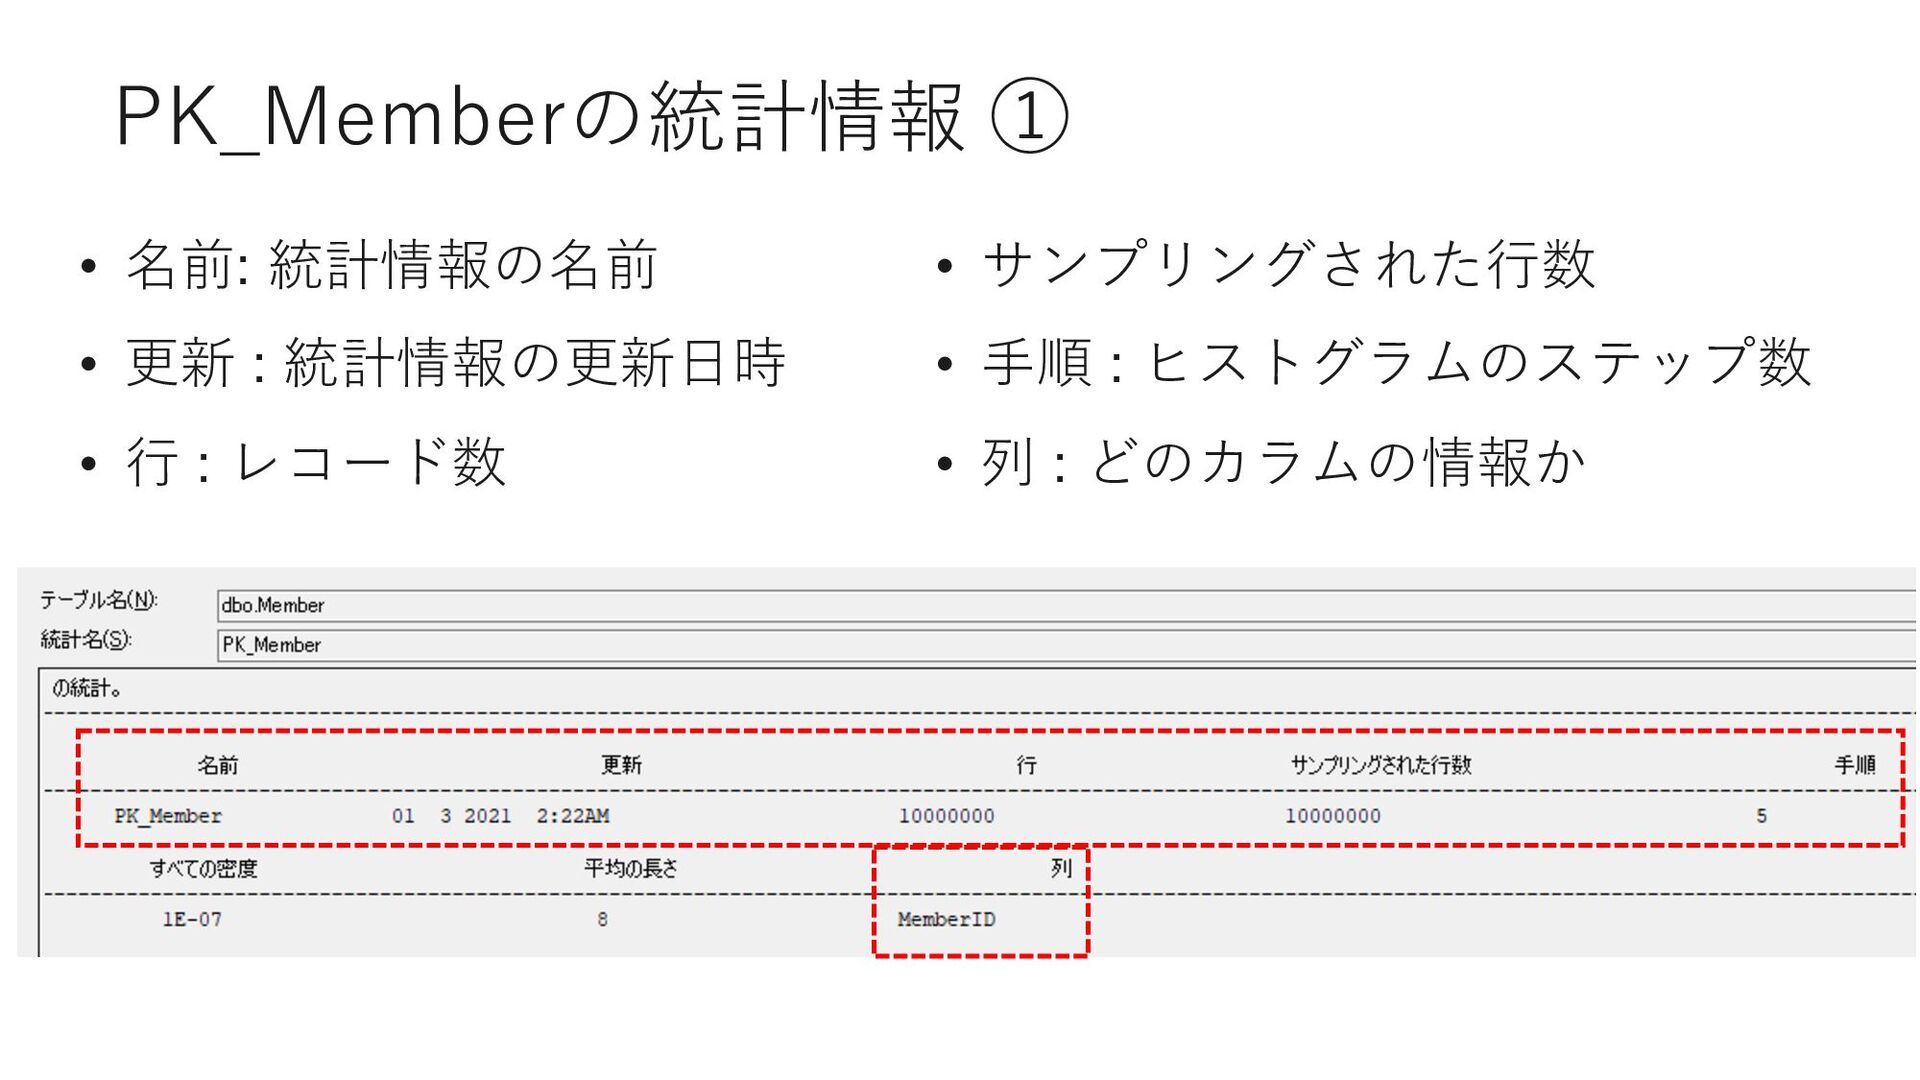
PK_Memberの統計情報 ① • 名前: 統計情報の名前 • 更新 : 統計情報の更新⽇時 •
⾏ : レコード数 • サンプリングされた⾏数 • ⼿順 : ヒストグラムのステップ数 • 列 : どのカラムの情報か -
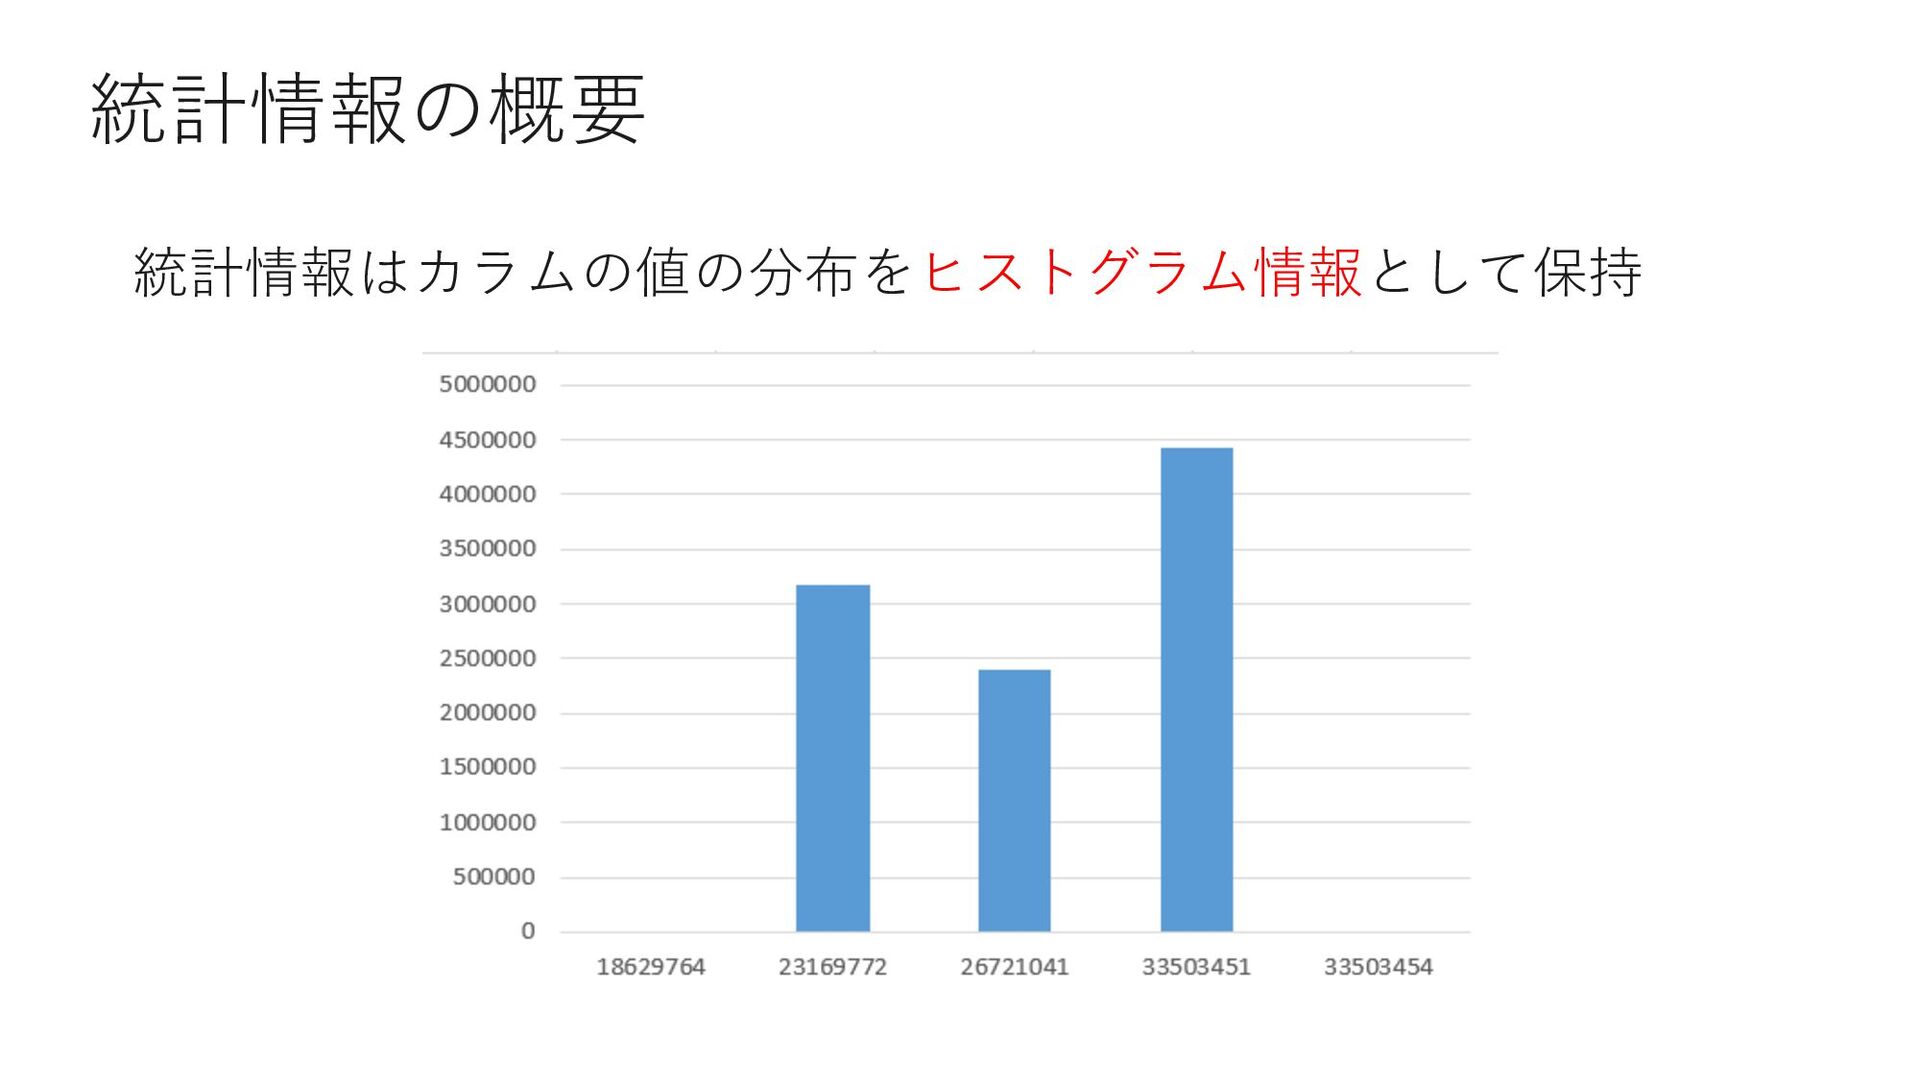
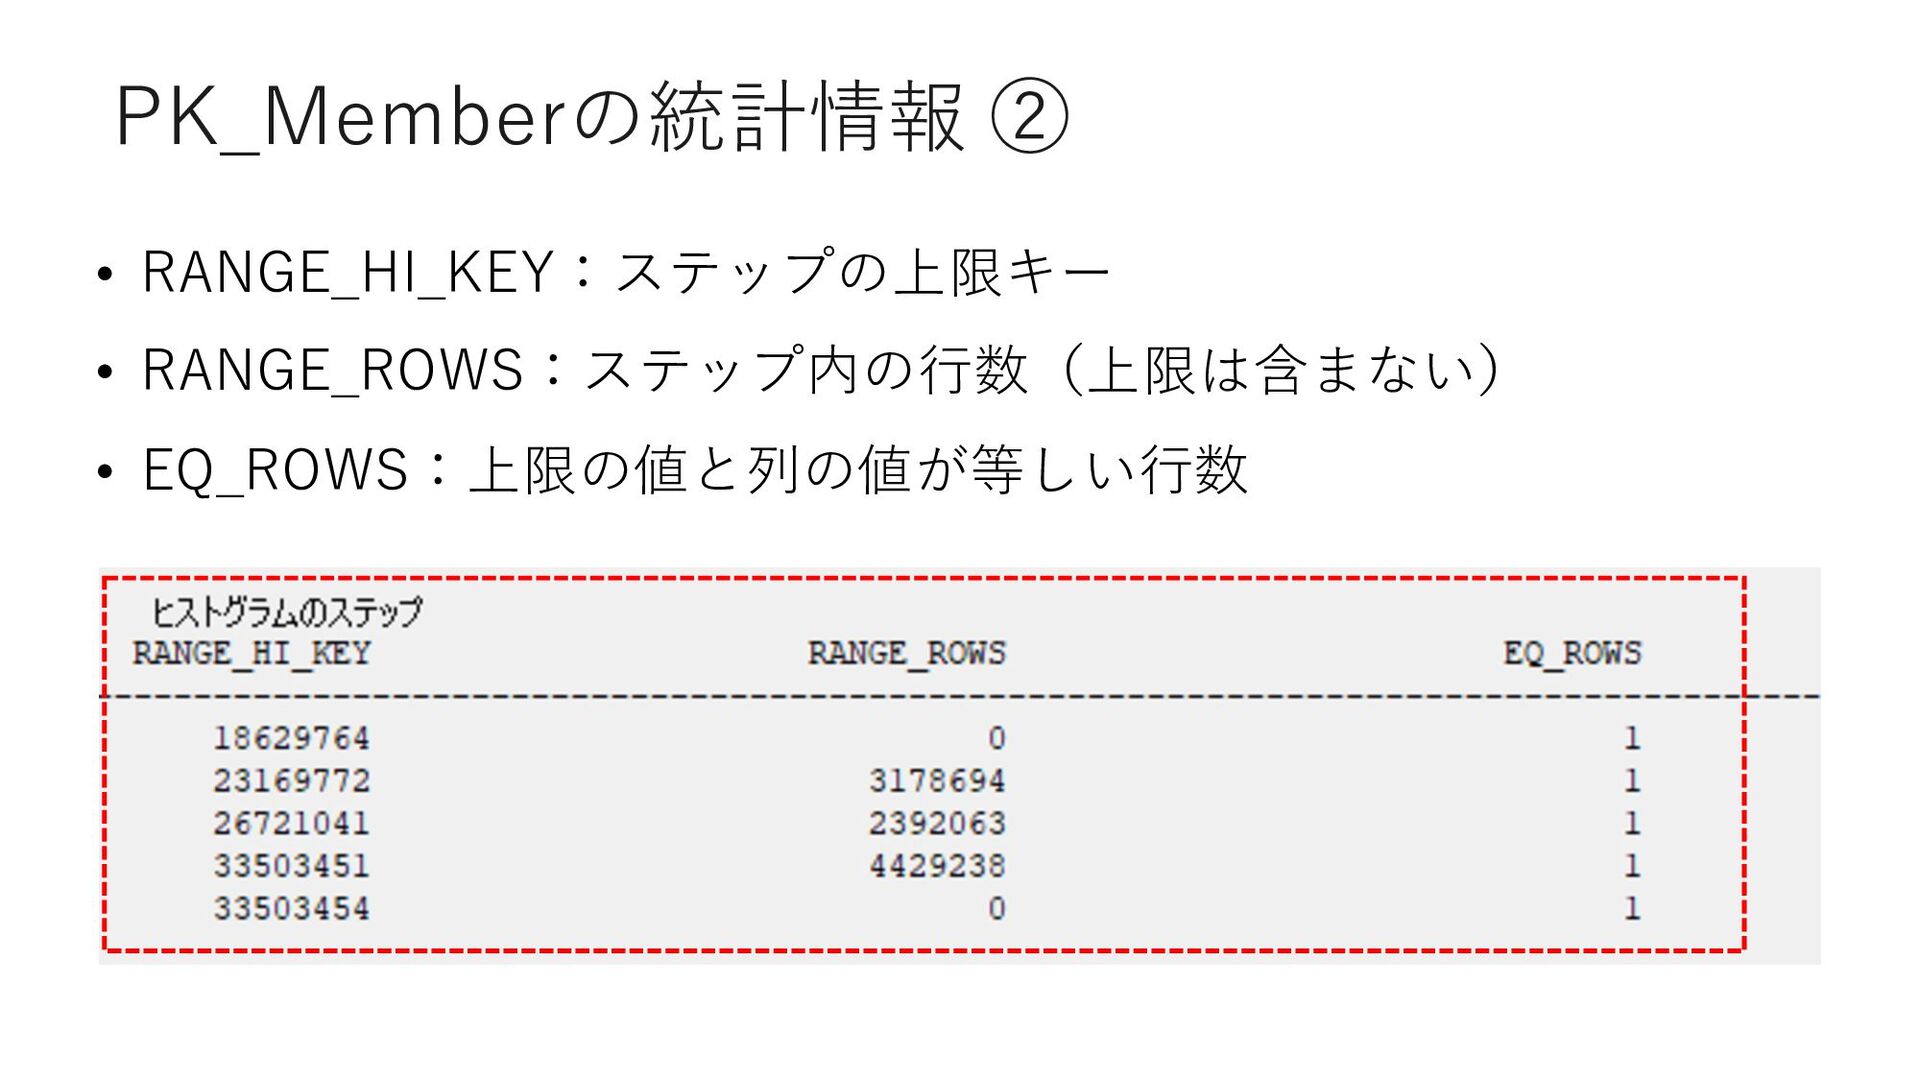
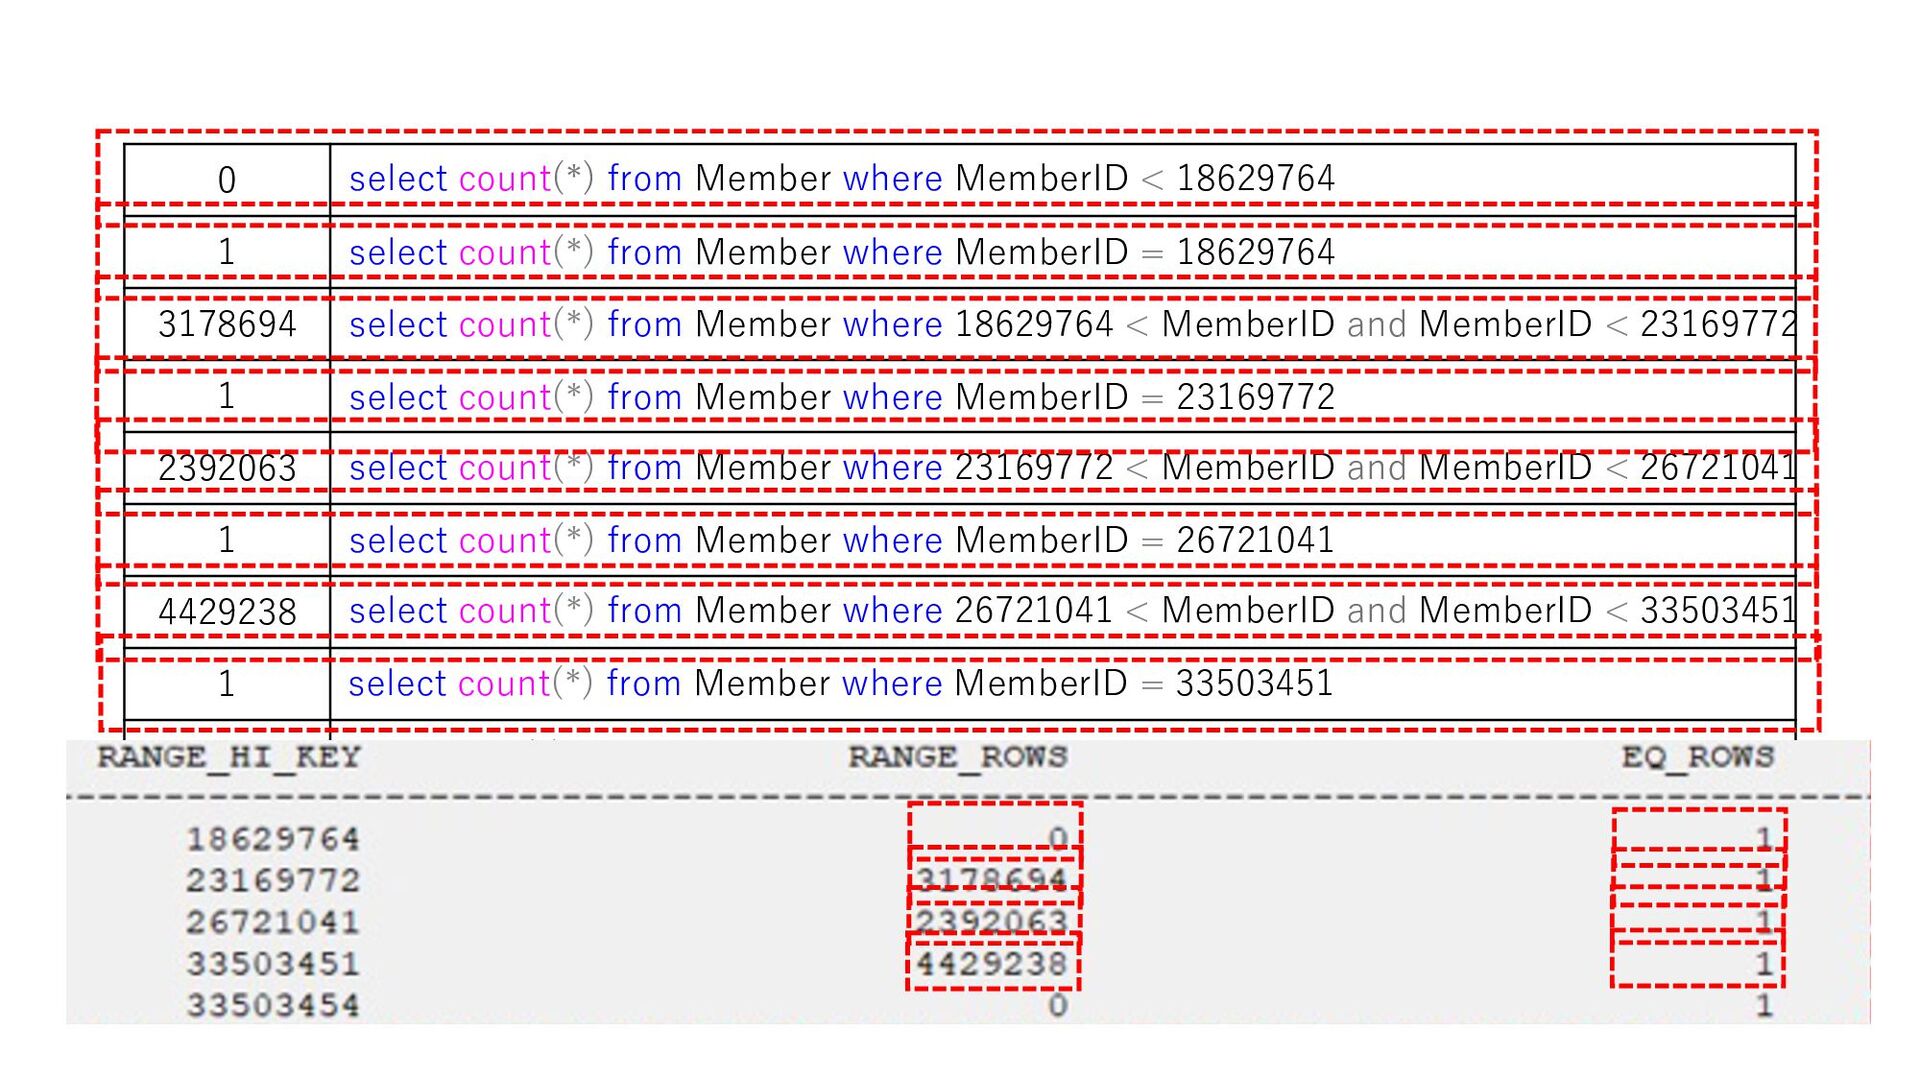
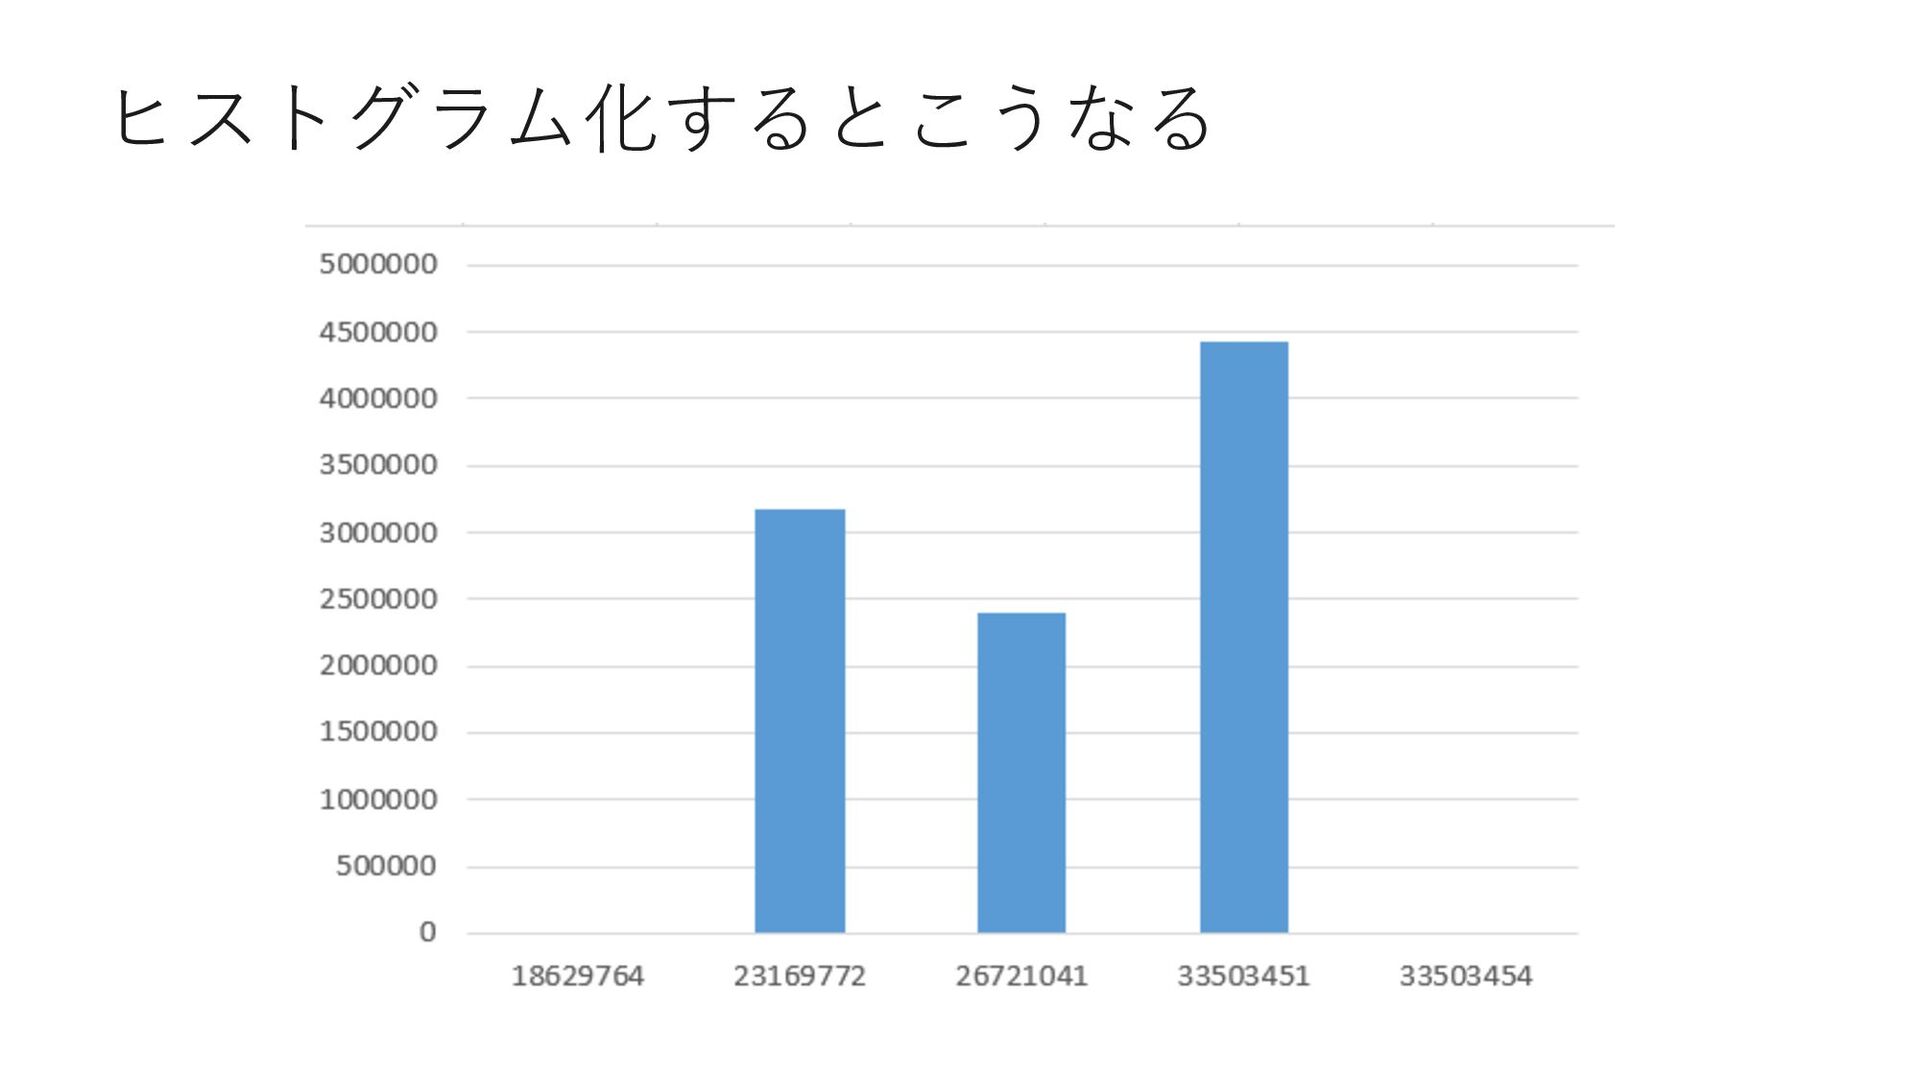
0 1 3178694 1 2392063 1 4429238 1 0 1
0 select count(*) from Member where MemberID < 18629764 select count(*) from Member where MemberID = 18629764 select count(*) from Member where 18629764 < MemberID and MemberID < 23169772 select count(*) from Member where MemberID = 23169772 select count(*) from Member where 23169772 < MemberID and MemberID < 26721041 select count(*) from Member where MemberID = 26721041 select count(*) from Member where 26721041 < MemberID and MemberID < 33503451 select count(*) from Member where MemberID = 33503451 select count(*) from Member where 33503451 < MemberID and MemberID < 33503454 select count(*) from Member where 33503454 = MemberID select count(*) from Member where 33503454 < MemberID -
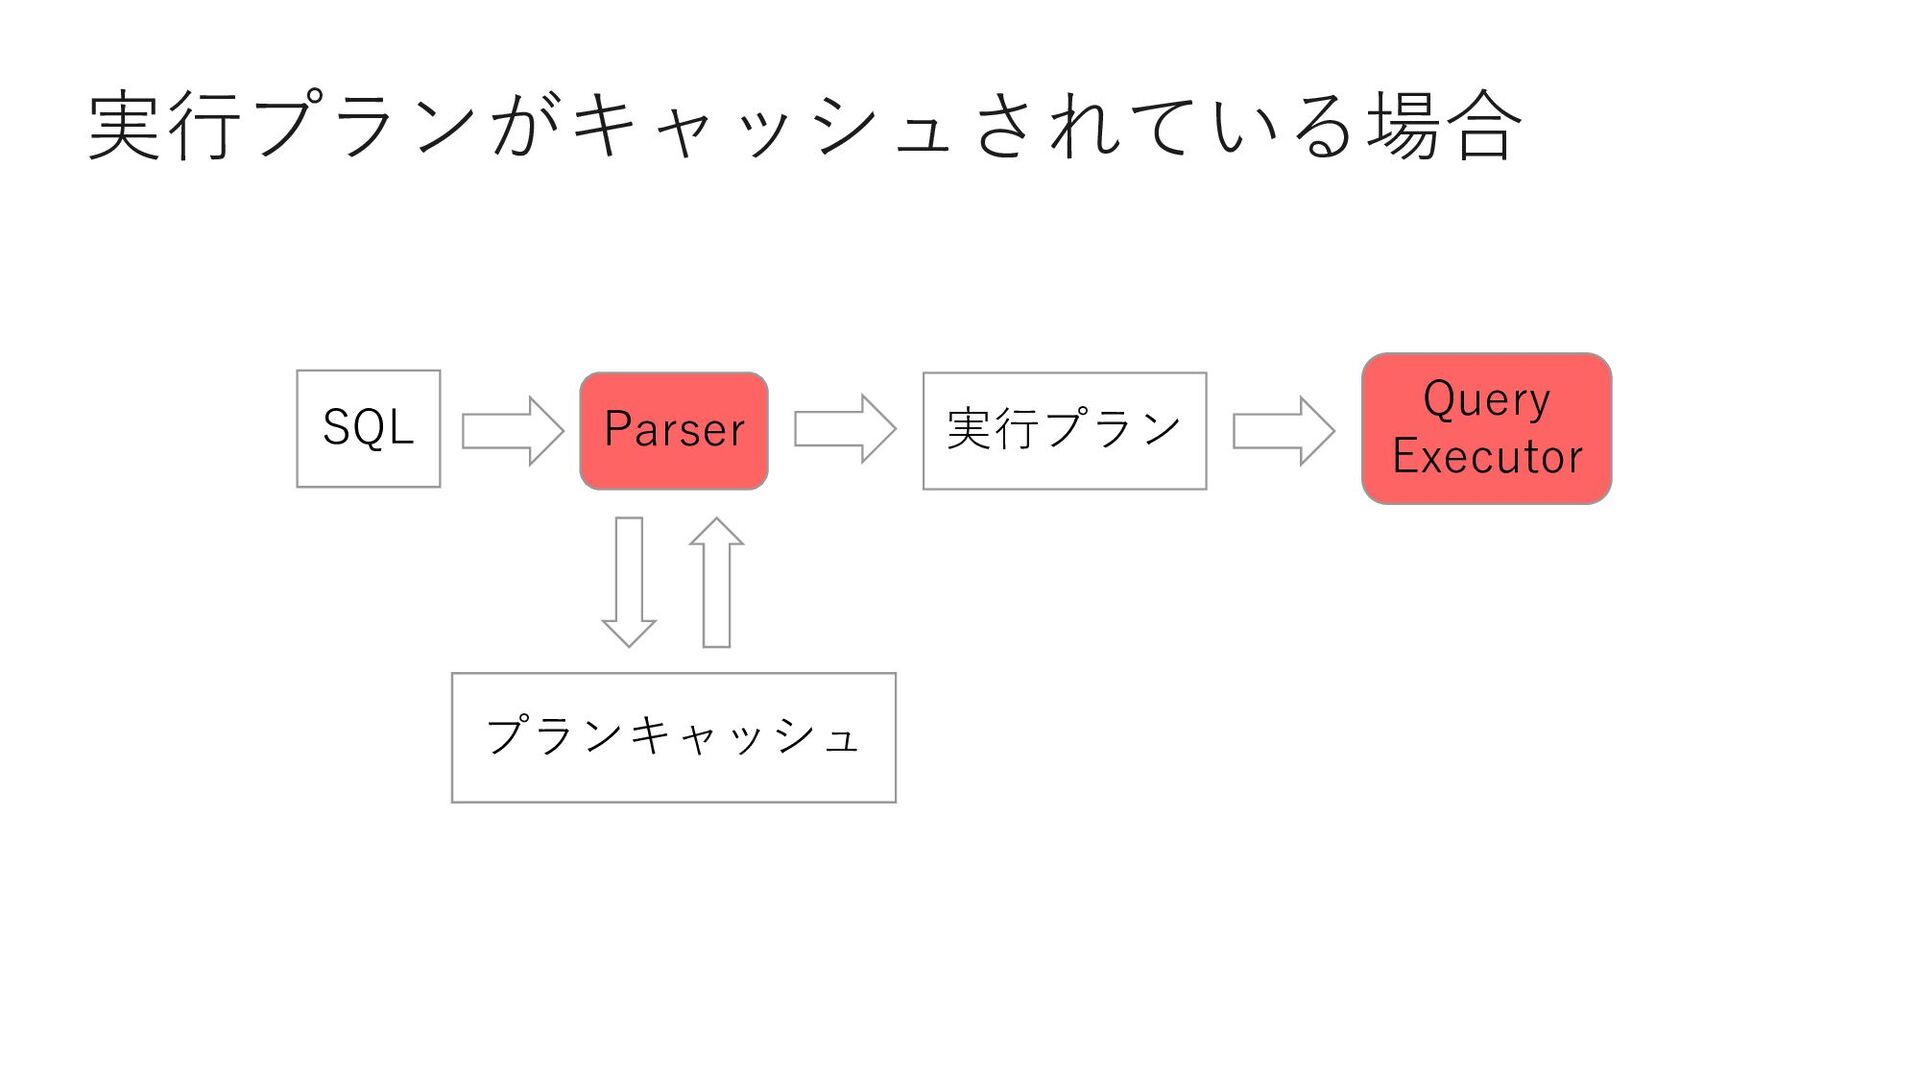
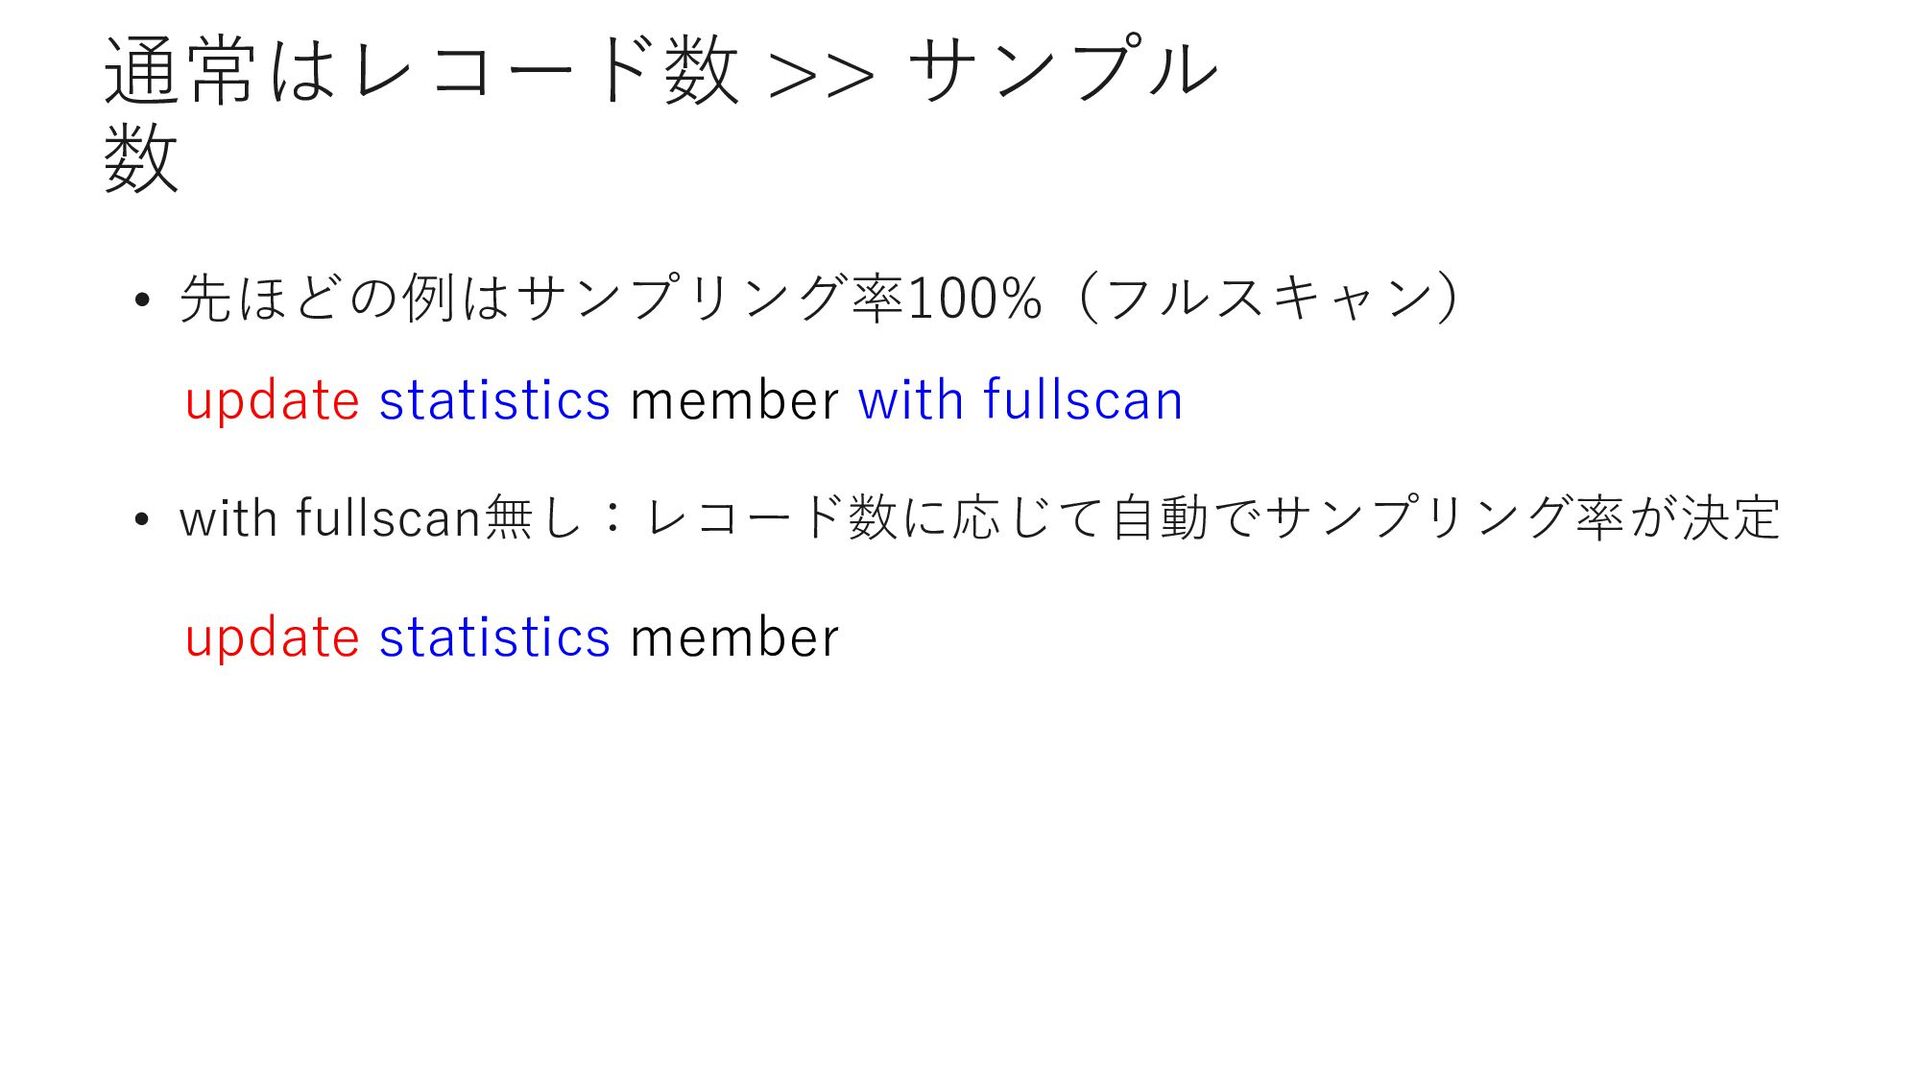
通常はレコード数 >> サンプル 数 • 先ほどの例はサンプリング率100%(フルスキャン) update statistics member update
statistics member with fullscan • with fullscan無し:レコード数に応じて⾃動でサンプリング率が決定 -
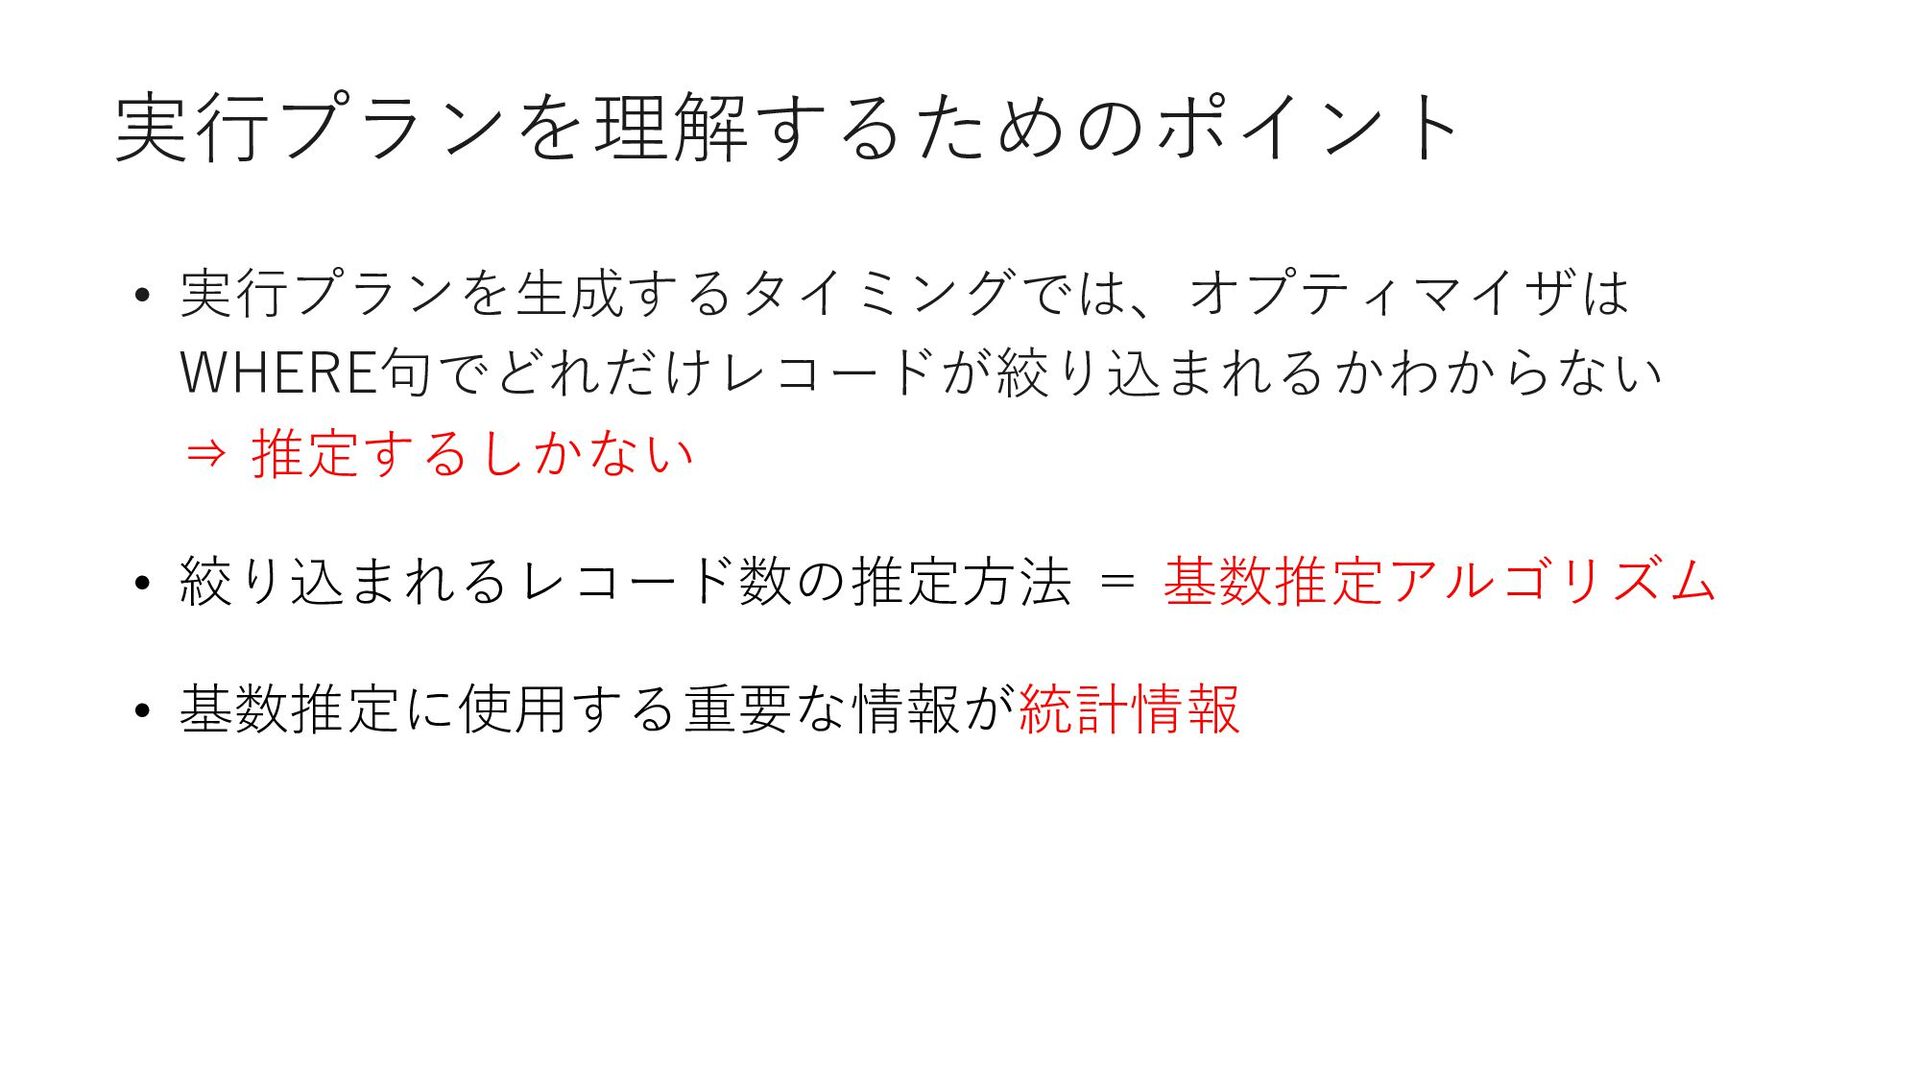
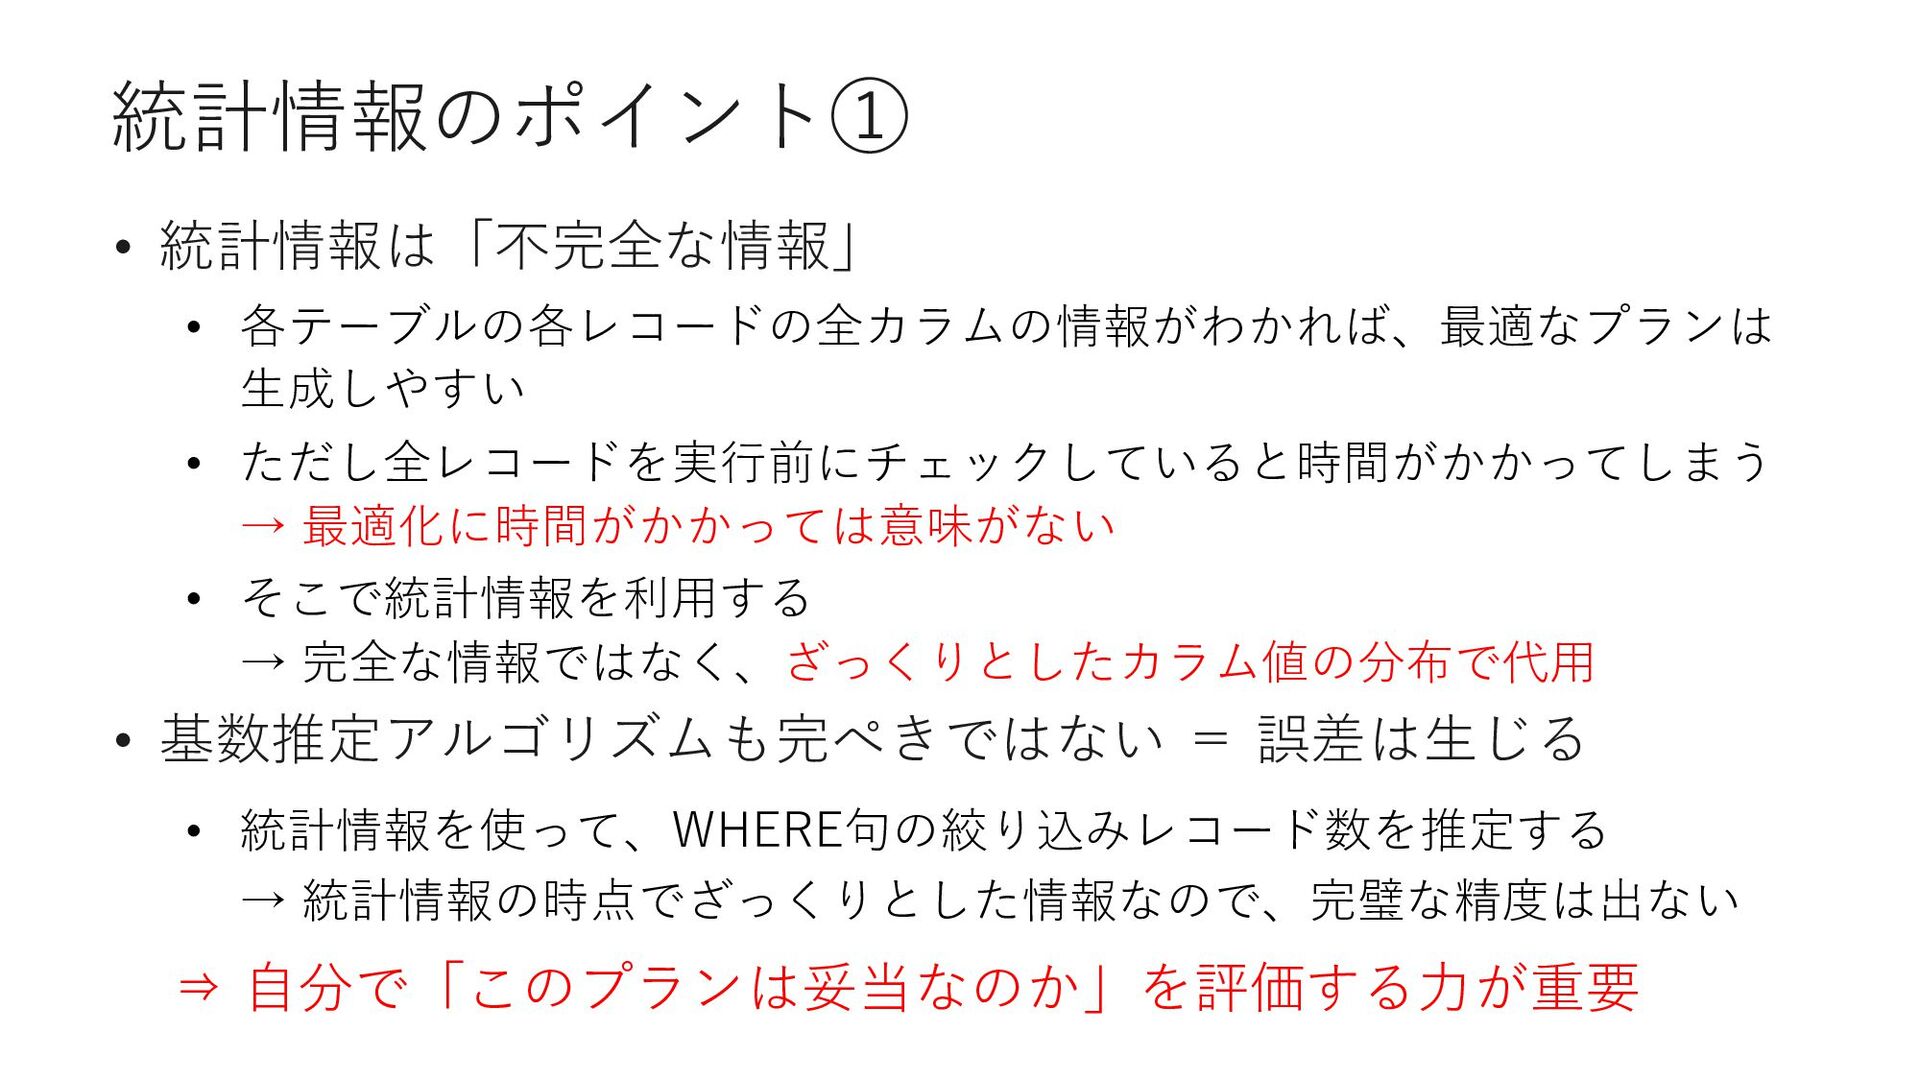
統計情報のポイント① • 統計情報は「不完全な情報」 • 各テーブルの各レコードの全カラムの情報がわかれば、最適なプランは ⽣成しやすい • ただし全レコードを実⾏前にチェックしていると時間がかかってしまう → 最適化に時間がかかっては意味がない
• そこで統計情報を利⽤する → 完全な情報ではなく、ざっくりとしたカラム値の分布で代⽤ • 基数推定アルゴリズムも完ぺきではない = 誤差は⽣じる • 統計情報を使って、WHERE句の絞り込みレコード数を推定する → 統計情報の時点でざっくりとした情報なので、完璧な精度は出ない ⇒ ⾃分で「このプランは妥当なのか」を評価する⼒が重要 -
統計情報についてのまとめ • オプティマイザの仕事は最⾼のプランを⾒つけることではなく、 限られた時間で「良いプラン」を⽣成すること • オプティマイザは実⾏プランを⽣成する際に統計情報を利⽤ • 統計情報はざっくりとしたカラムの分布をヒストグラムで保持 • 諸条件により最適でないプランが⽣成される場合もある
• 統計情報のサンプリング数 • 統計情報の更新⽇時 • 基数推定アルゴリズムの限界 -
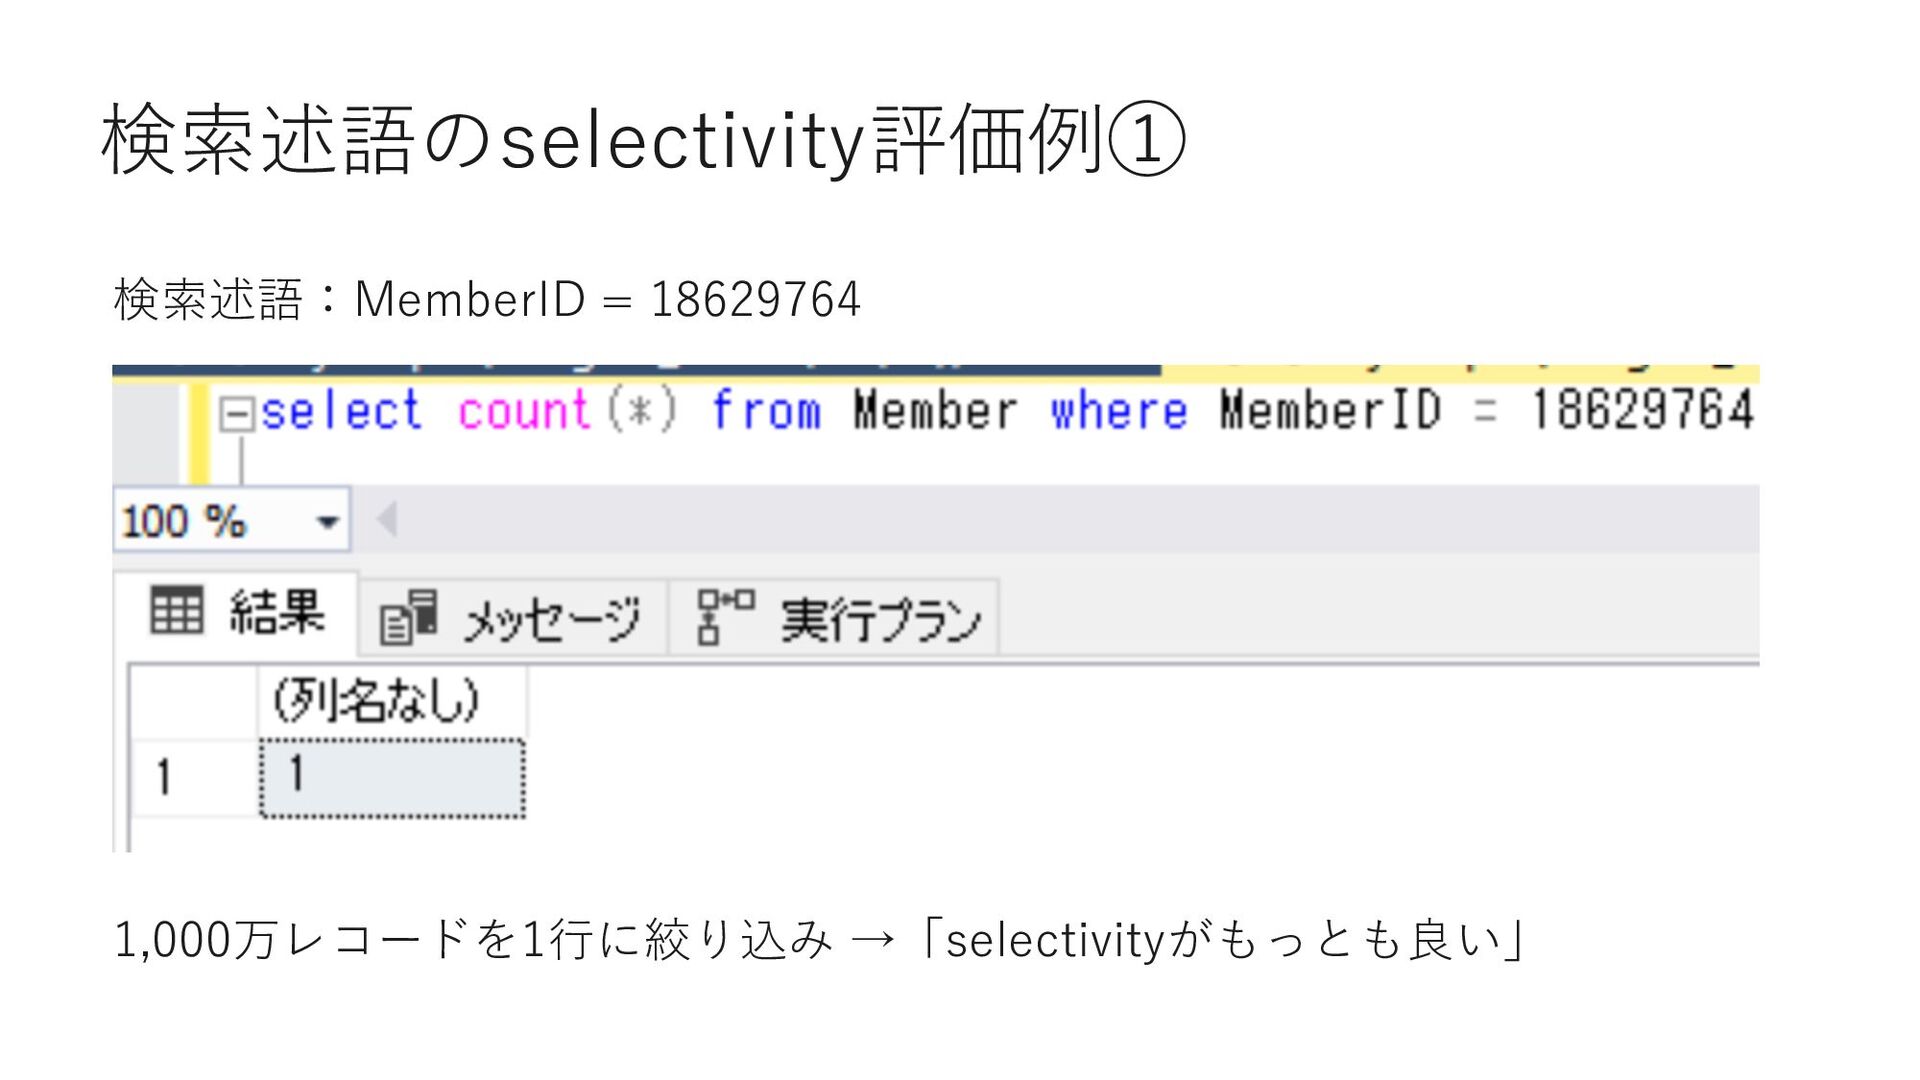
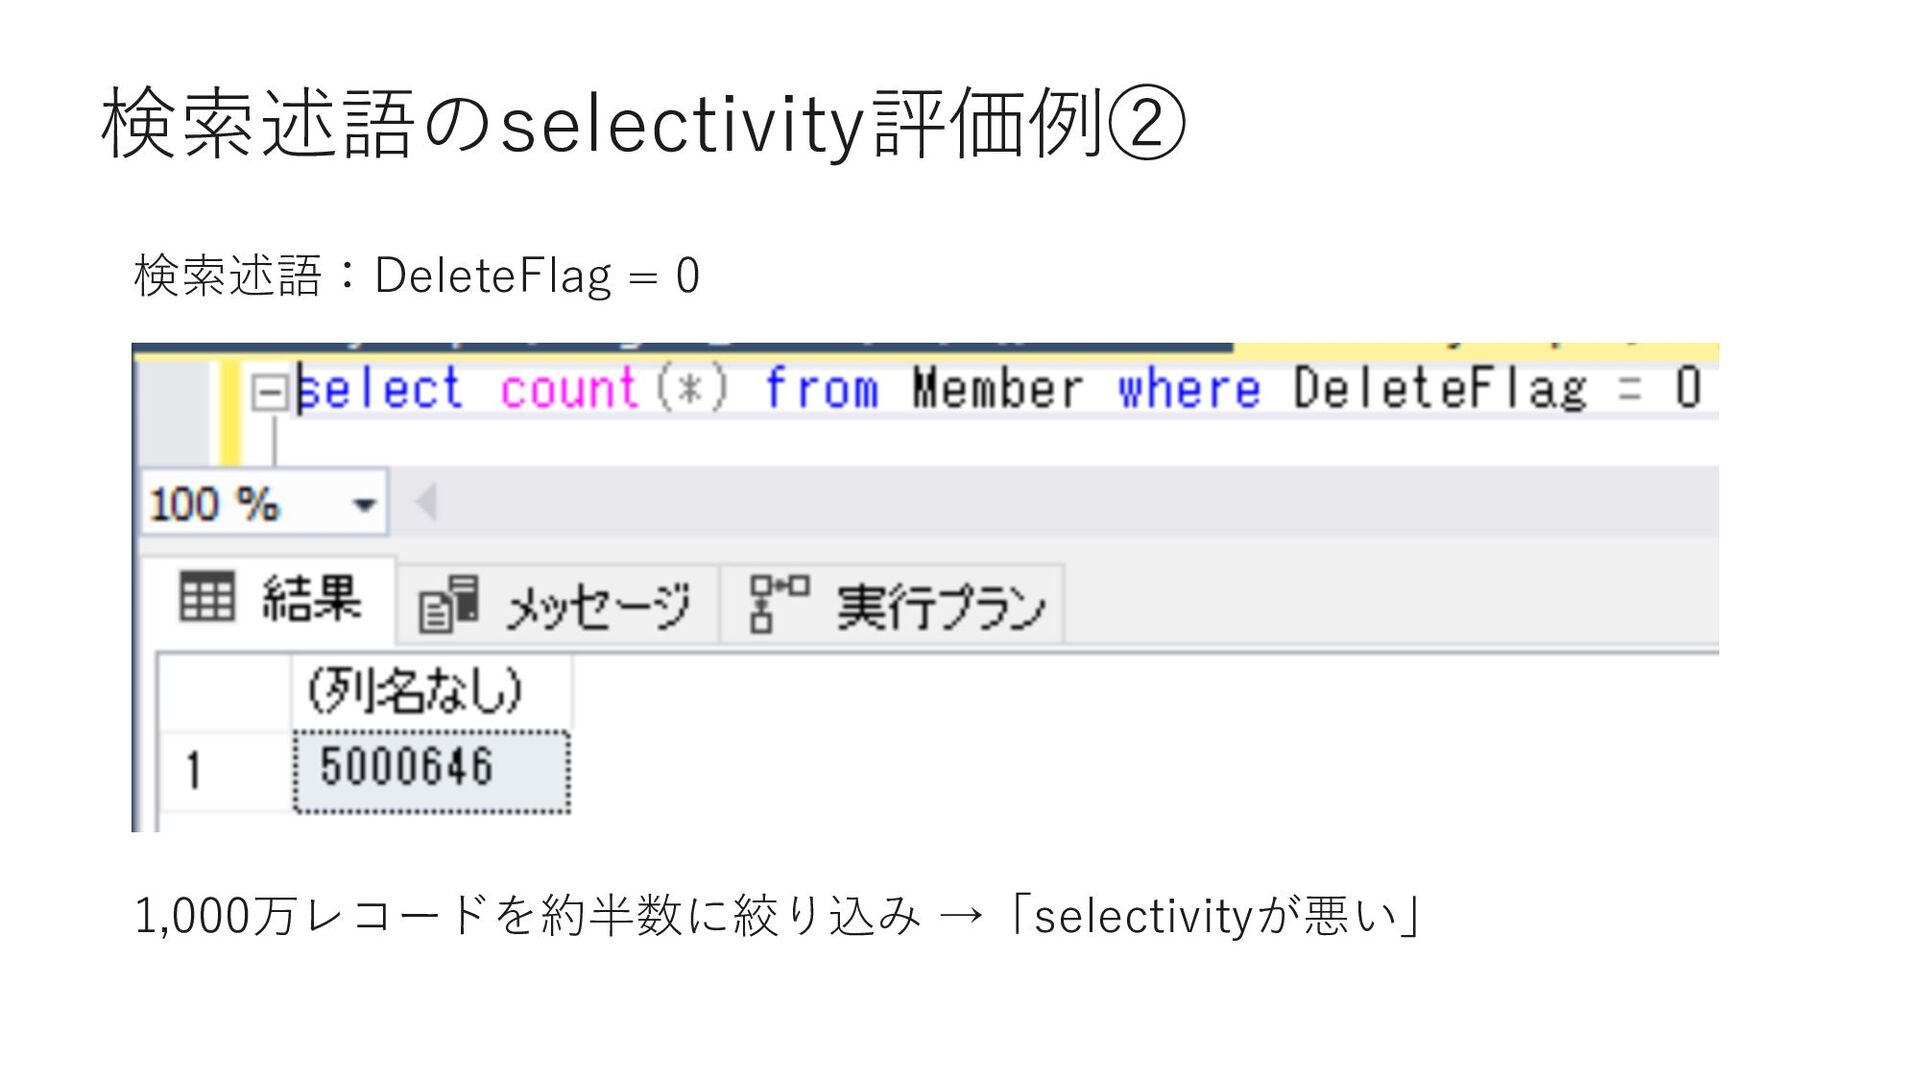
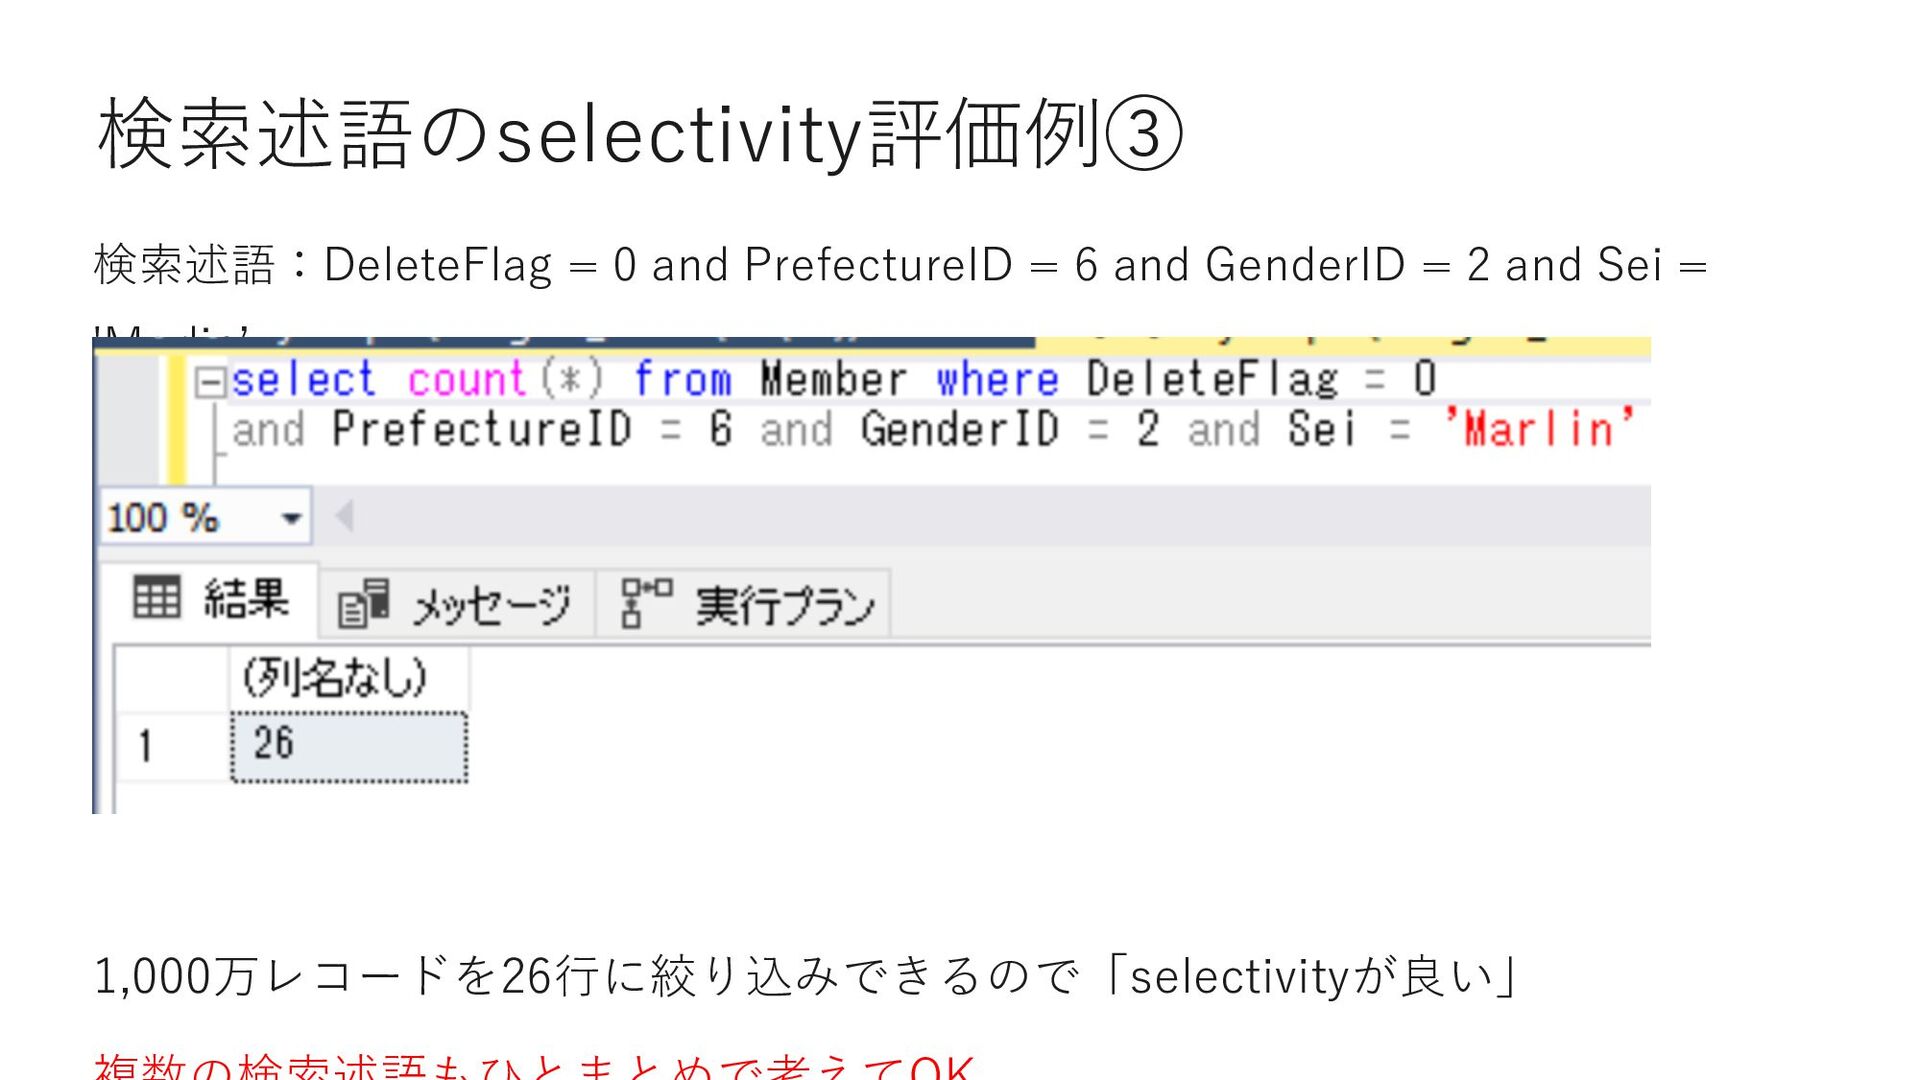
検索述語のselectivity評価例③ 検索述語:DeleteFlag = 0 and PrefectureID = 6 and GenderID
= 2 and Sei = 'Marlinʼ 1,000万レコードを26⾏に絞り込みできるので「selectivityが良い」 -
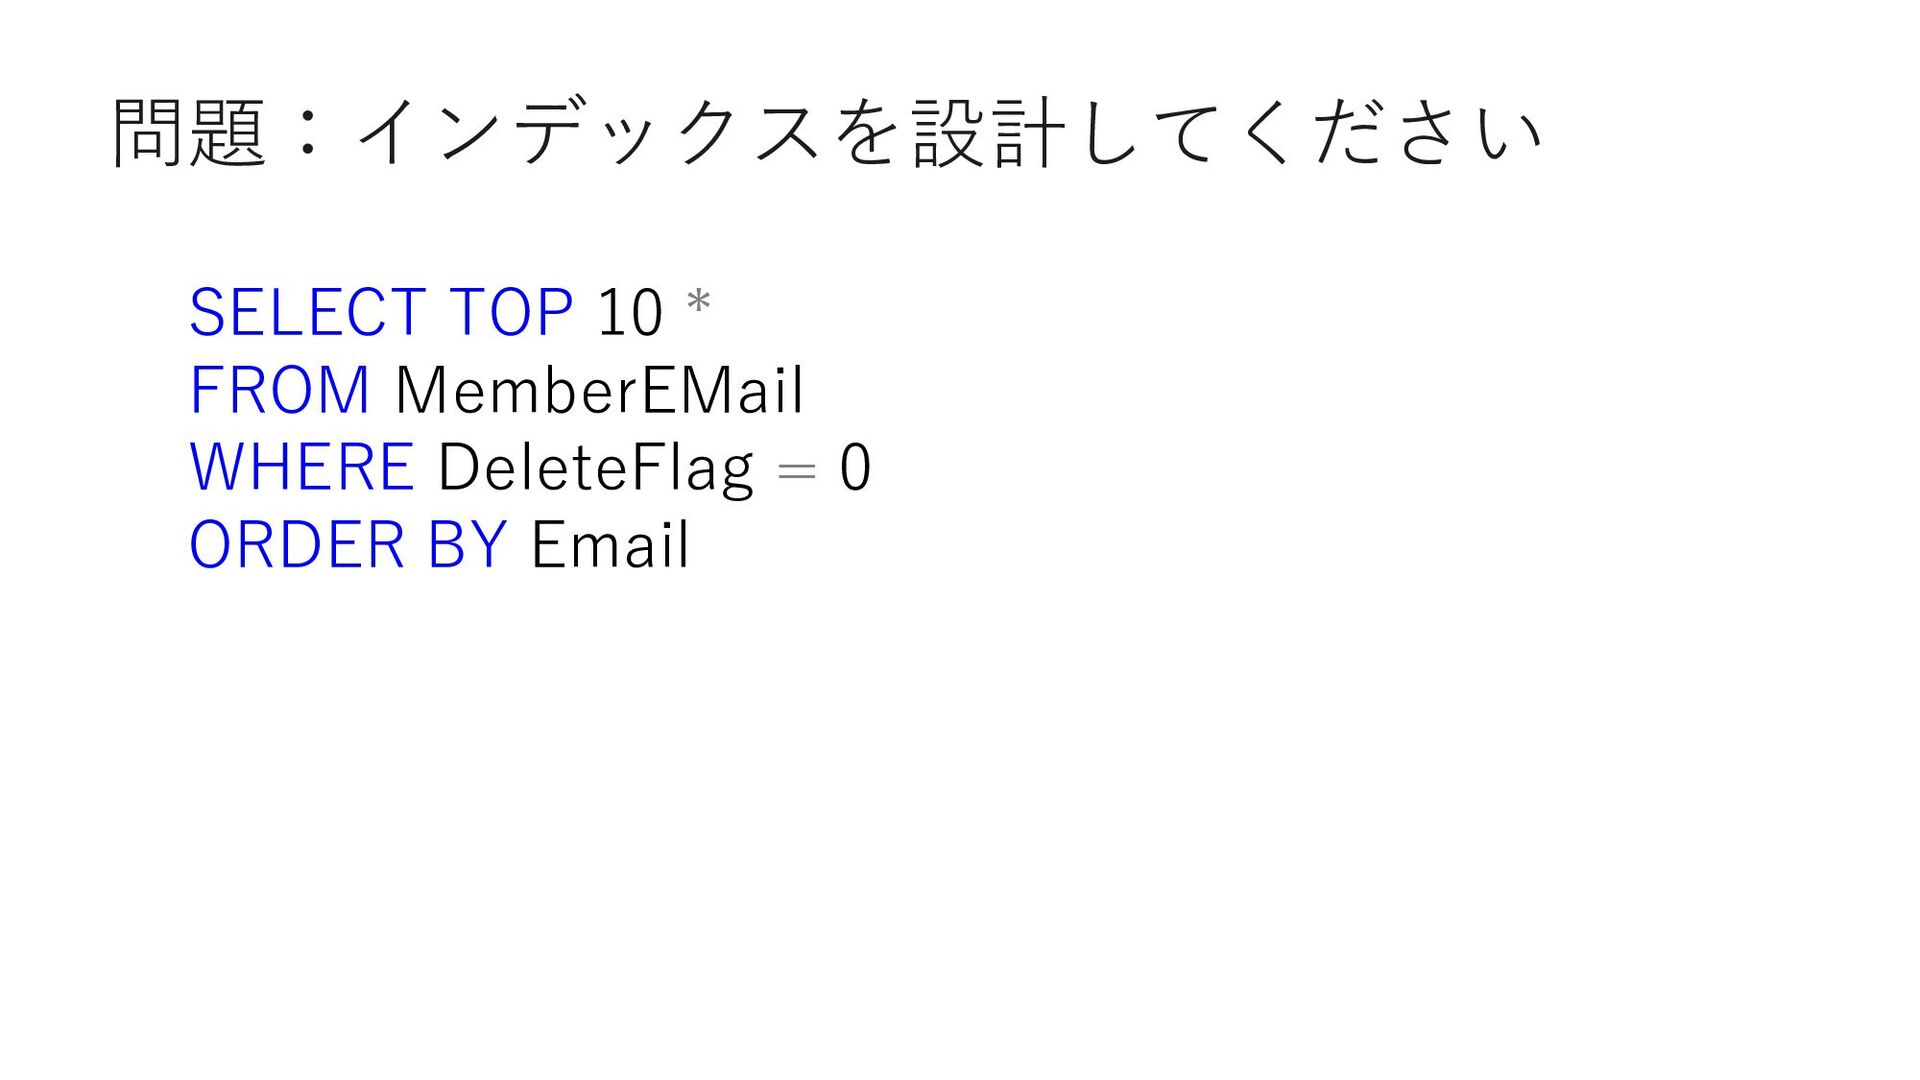
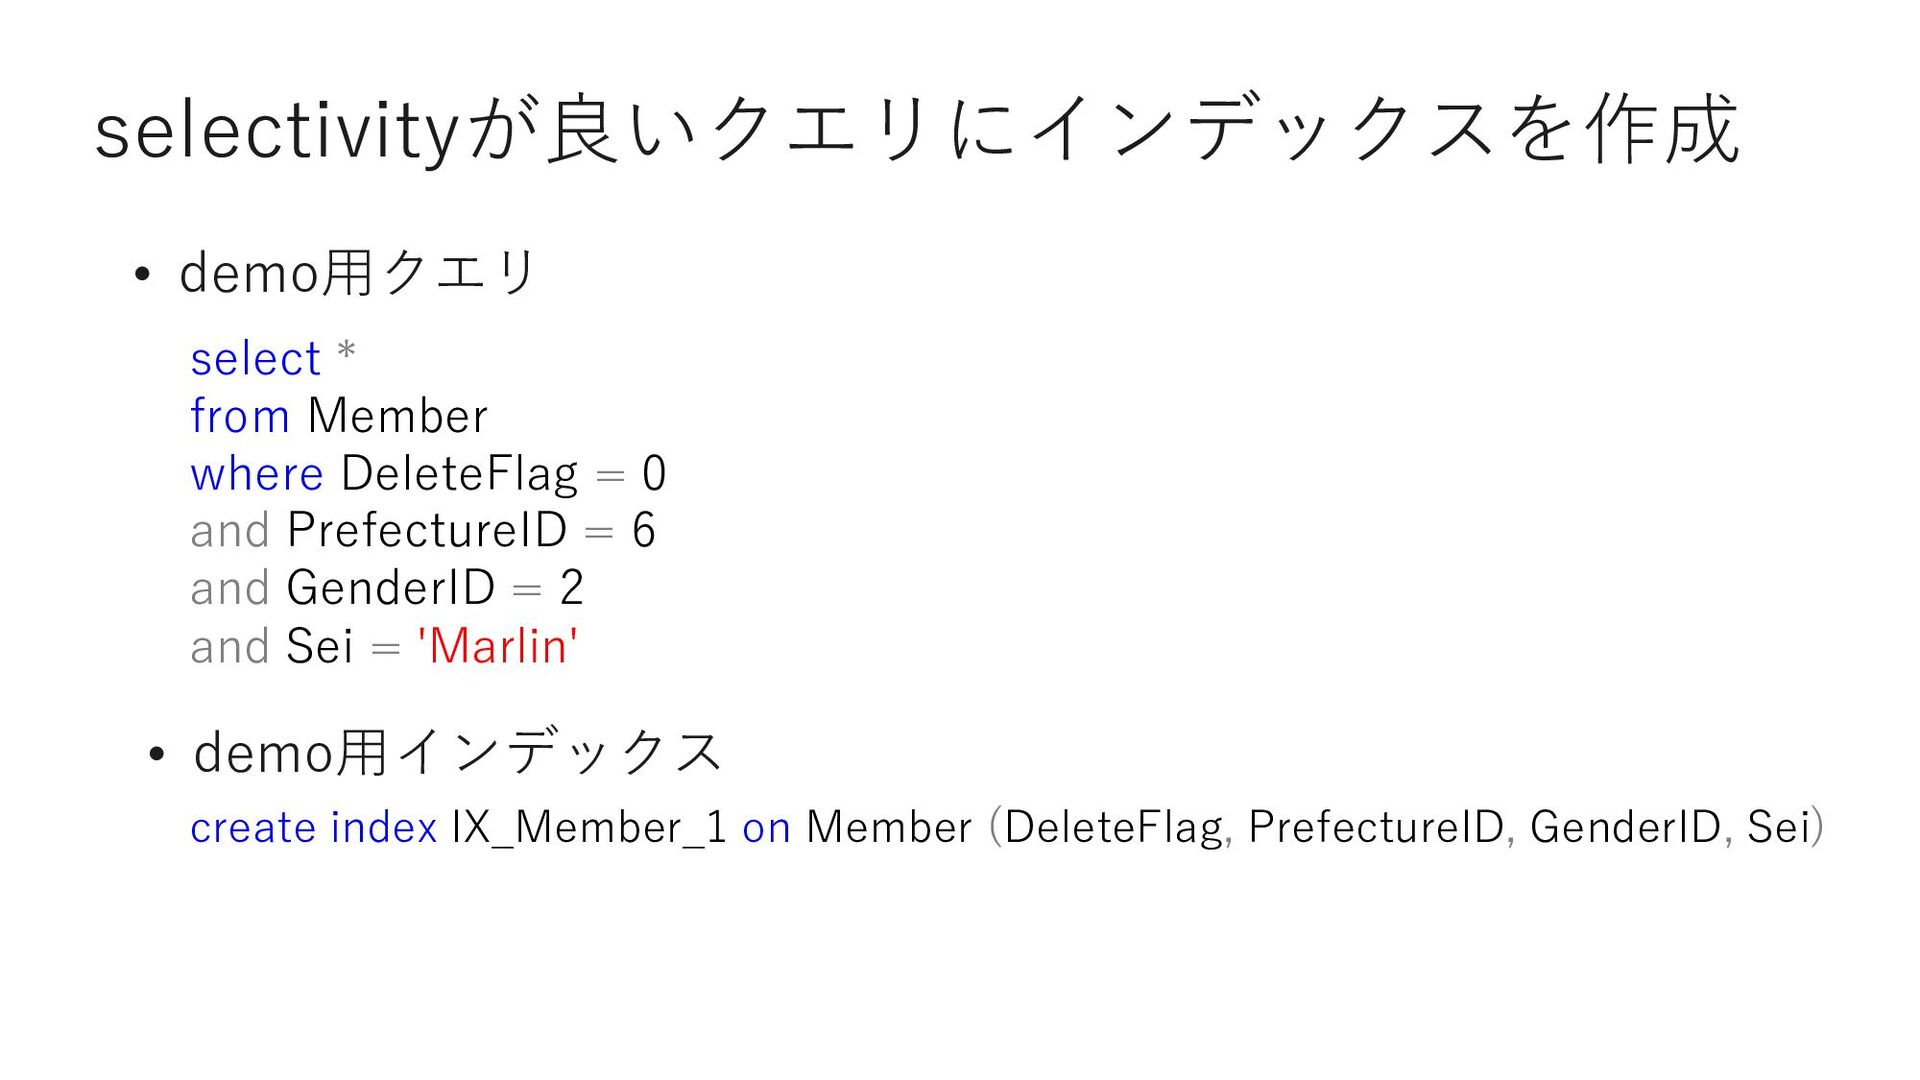
selectivityが良いクエリにインデックスを作成 • demo⽤クエリ select * from Member where DeleteFlag =
0 and PrefectureID = 6 and GenderID = 2 and Sei = 'Marlin' create index IX_Member_1 on Member (DeleteFlag, PrefectureID, GenderID, Sei) • demo⽤インデックス -
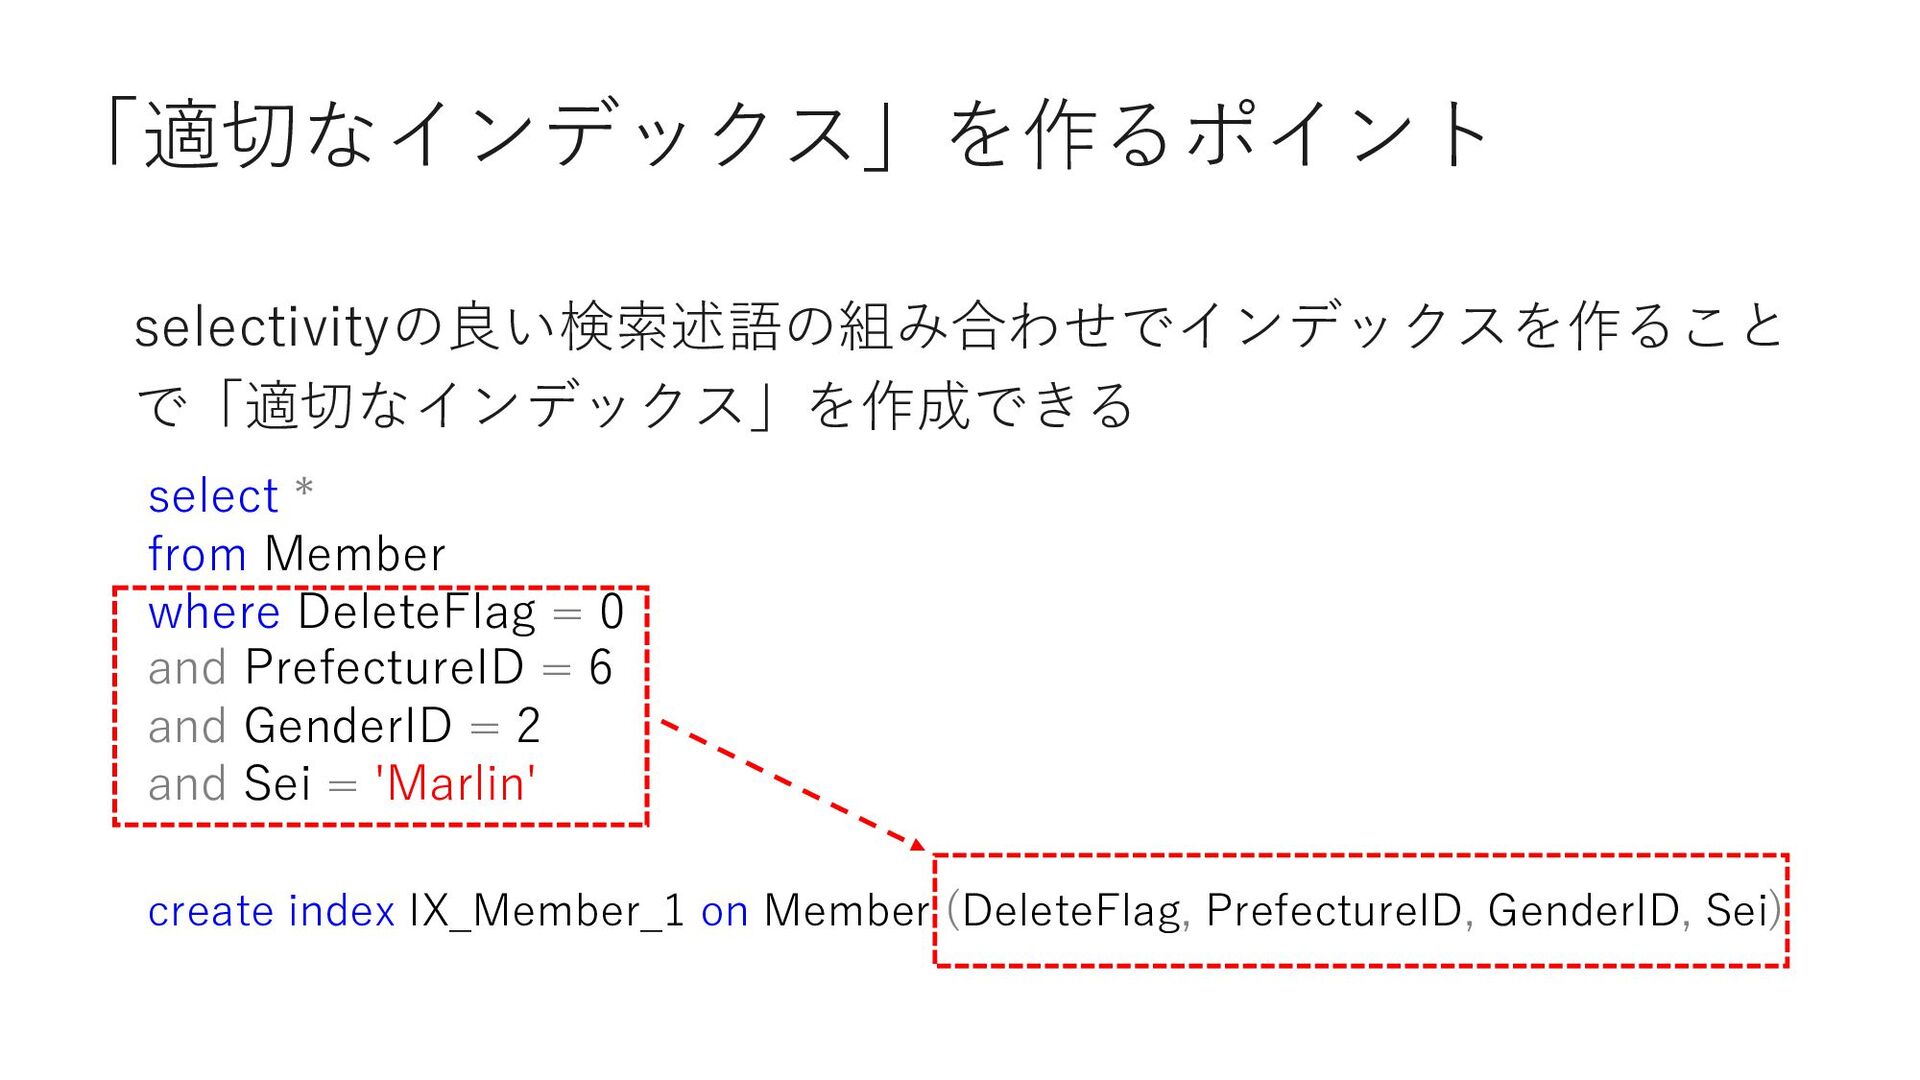
「適切なインデックス」を作るポイント selectivityの良い検索述語の組み合わせでインデックスを作ること で「適切なインデックス」を作成できる select * from Member where DeleteFlag =
0 and PrefectureID = 6 and GenderID = 2 and Sei = 'Marlin' create index IX_Member_1 on Member (DeleteFlag, PrefectureID, GenderID, Sei) -
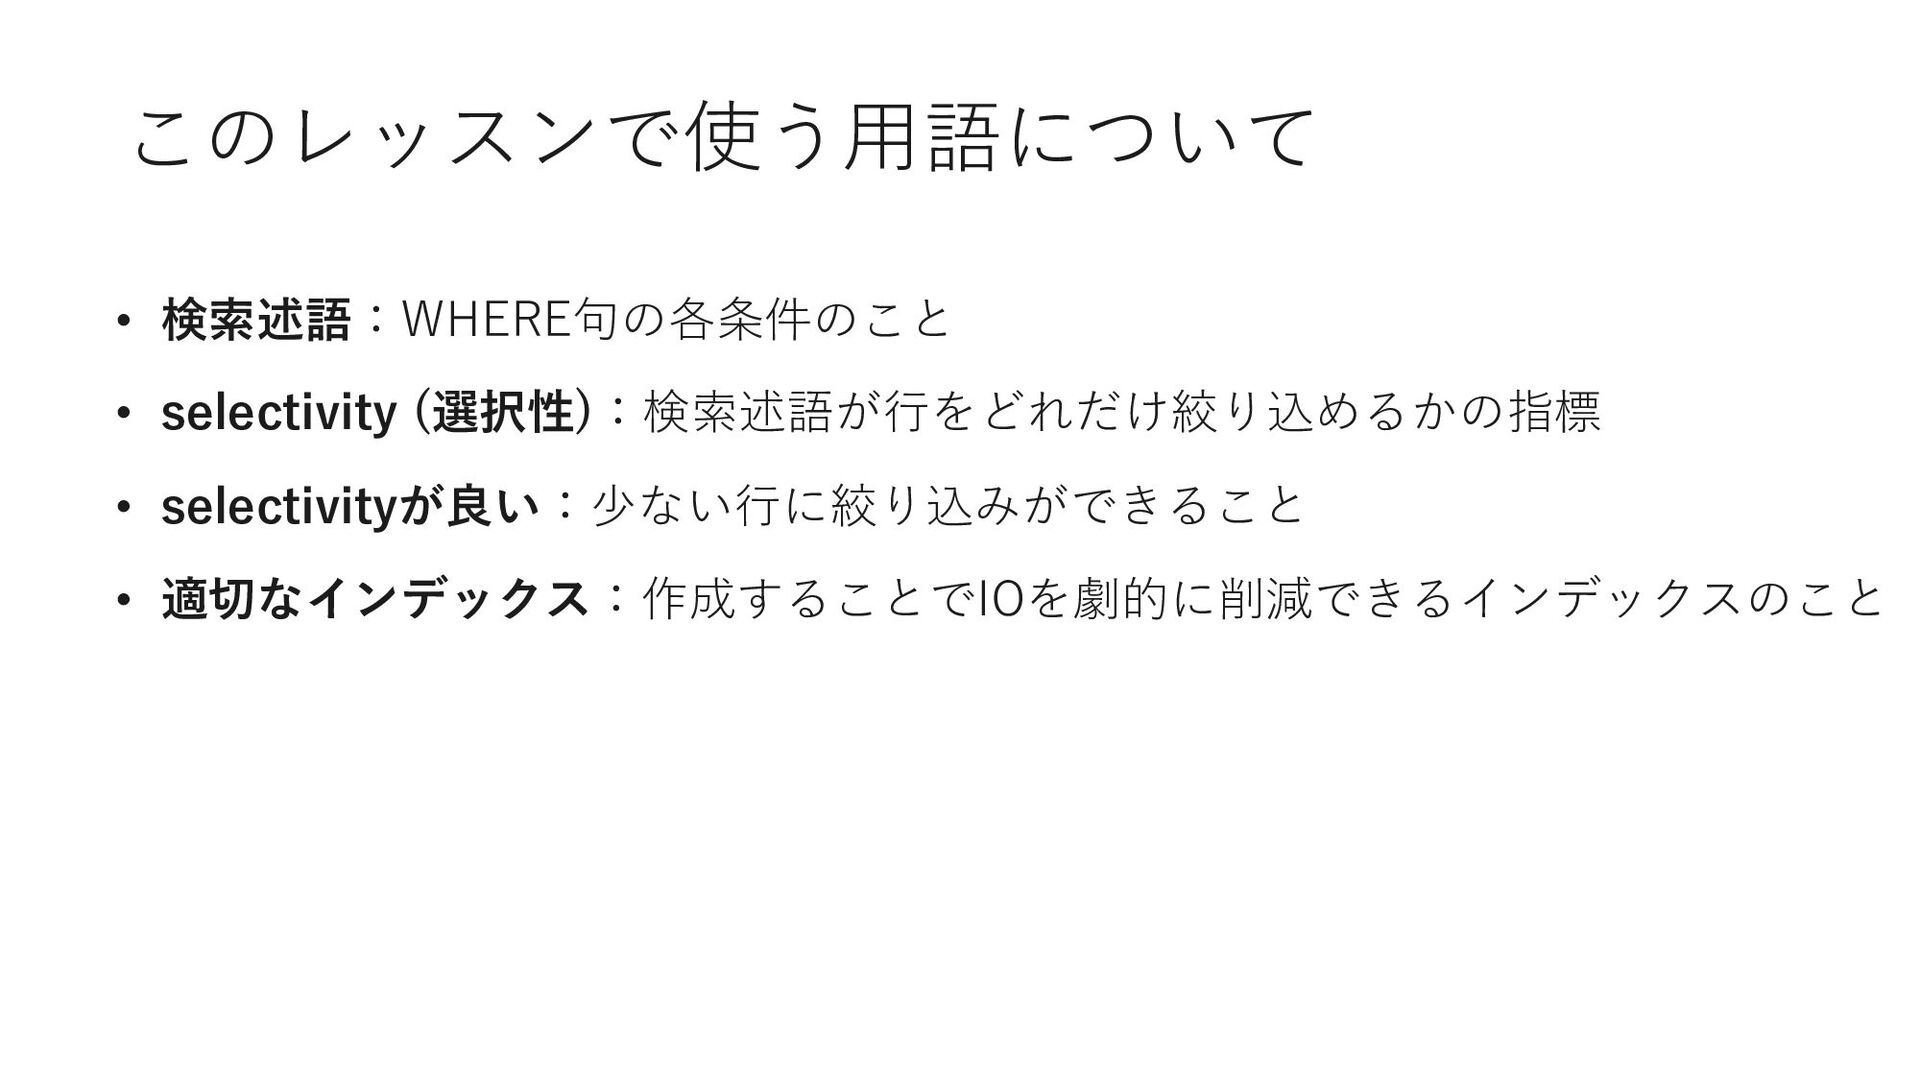
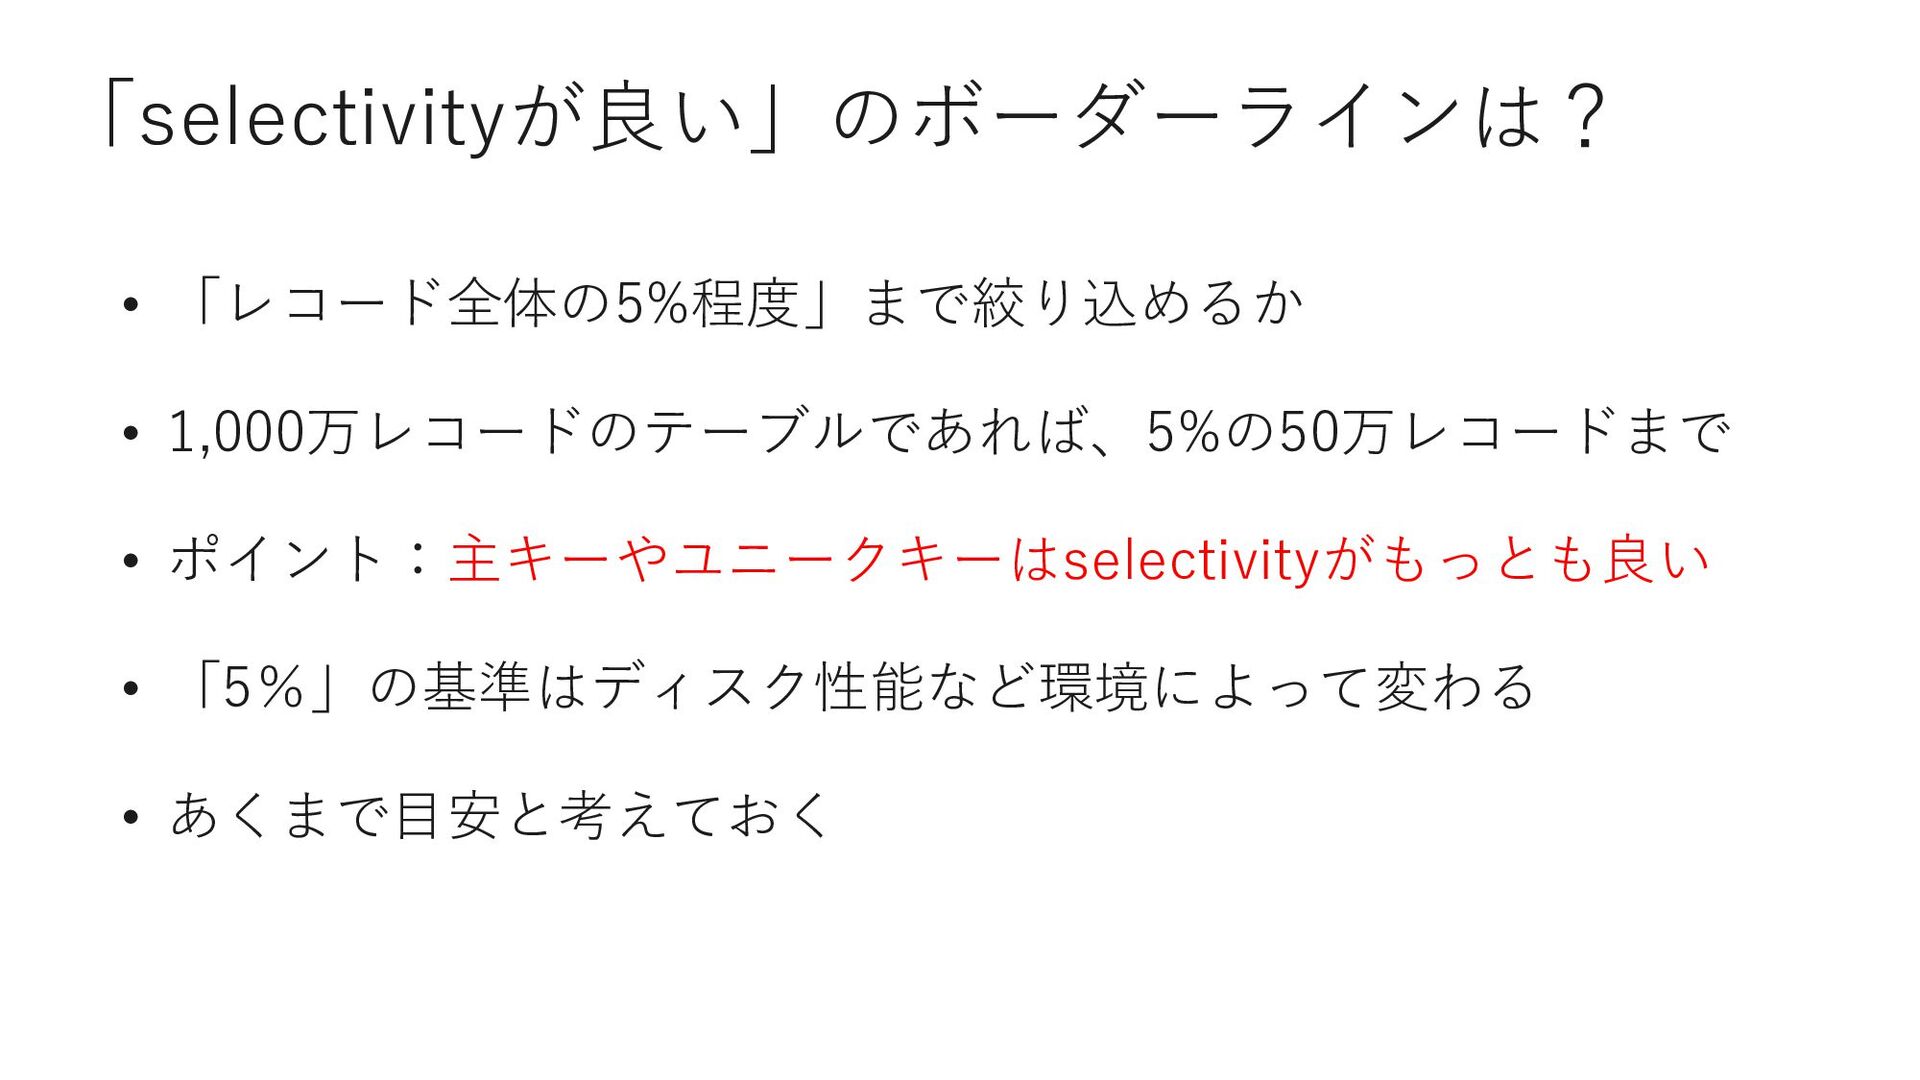
まとめ • ⾼速なクエリ = selectivityの良い検索述語 + 適切なインデック ス • クエリチューニングの際は以下の2点を確認
• selectivityの良い検索述語があるか • 適切なインデックスが存在するか -
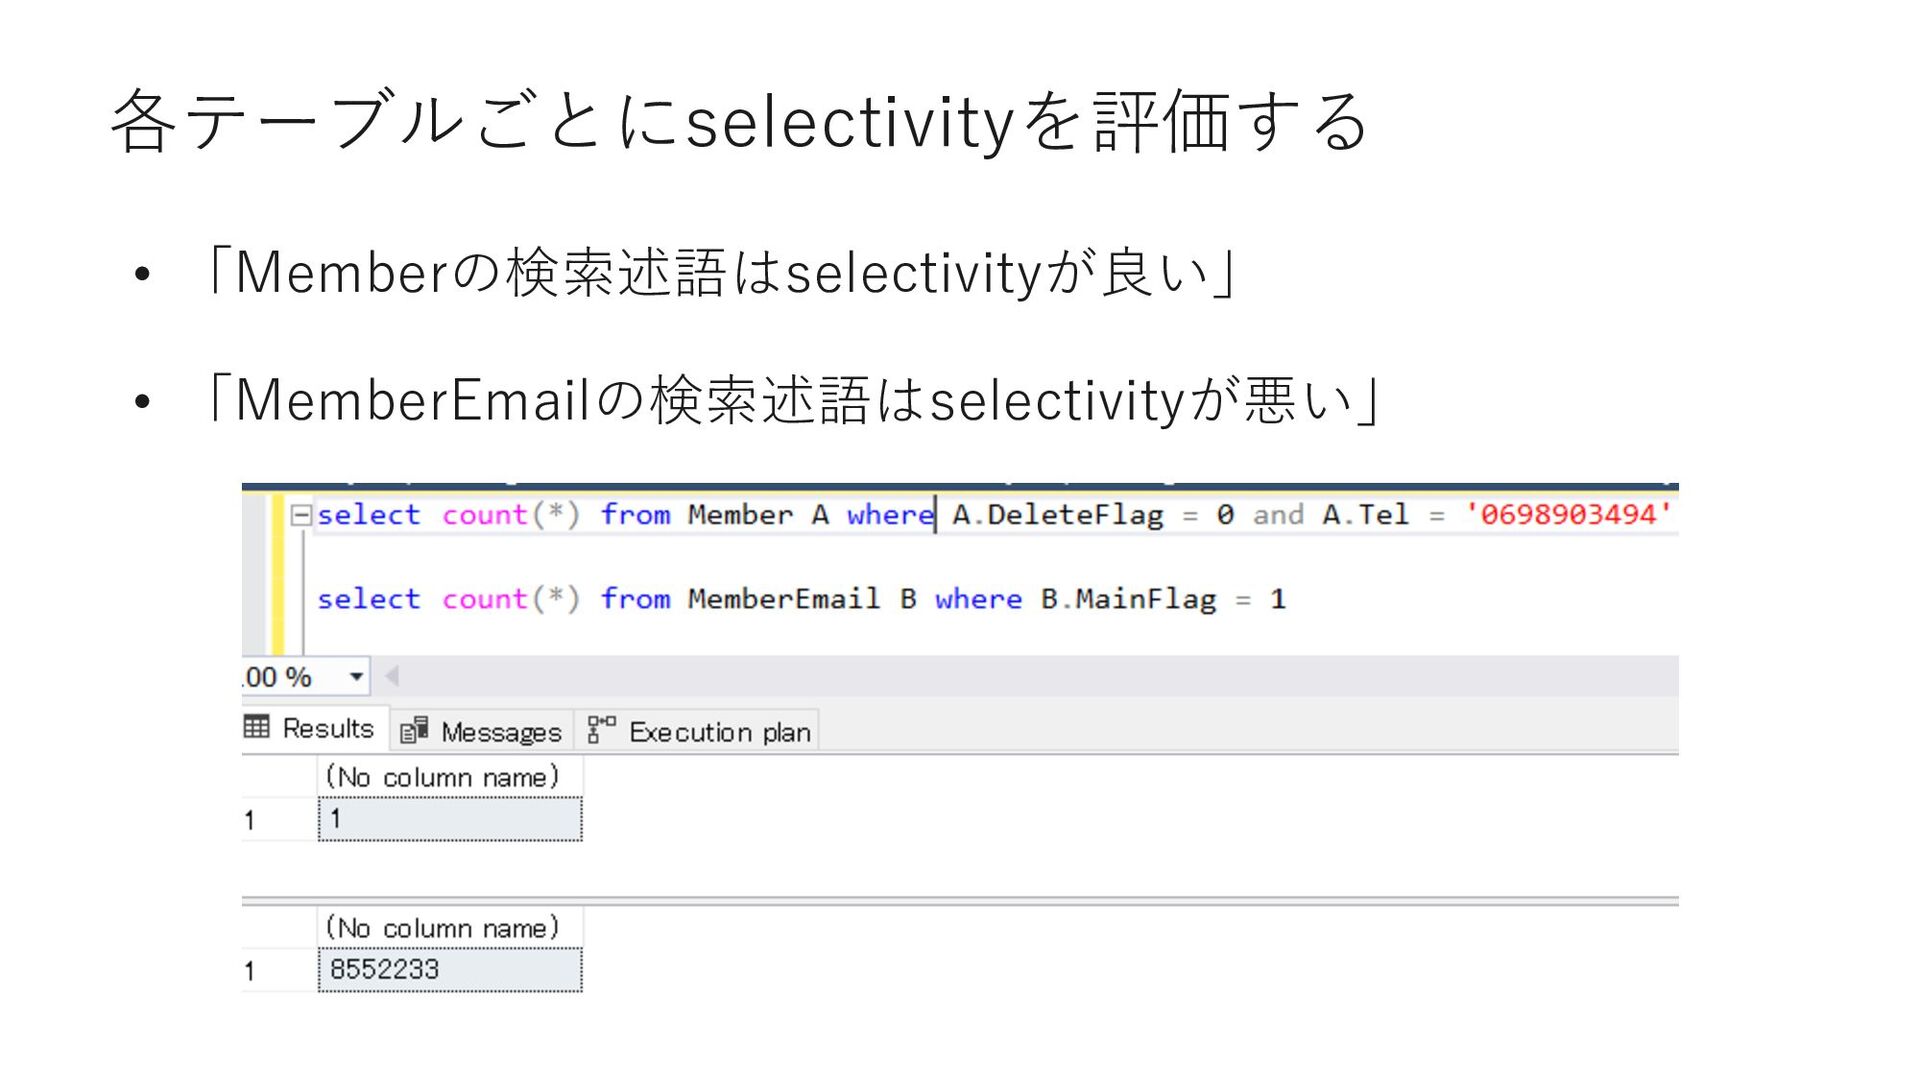
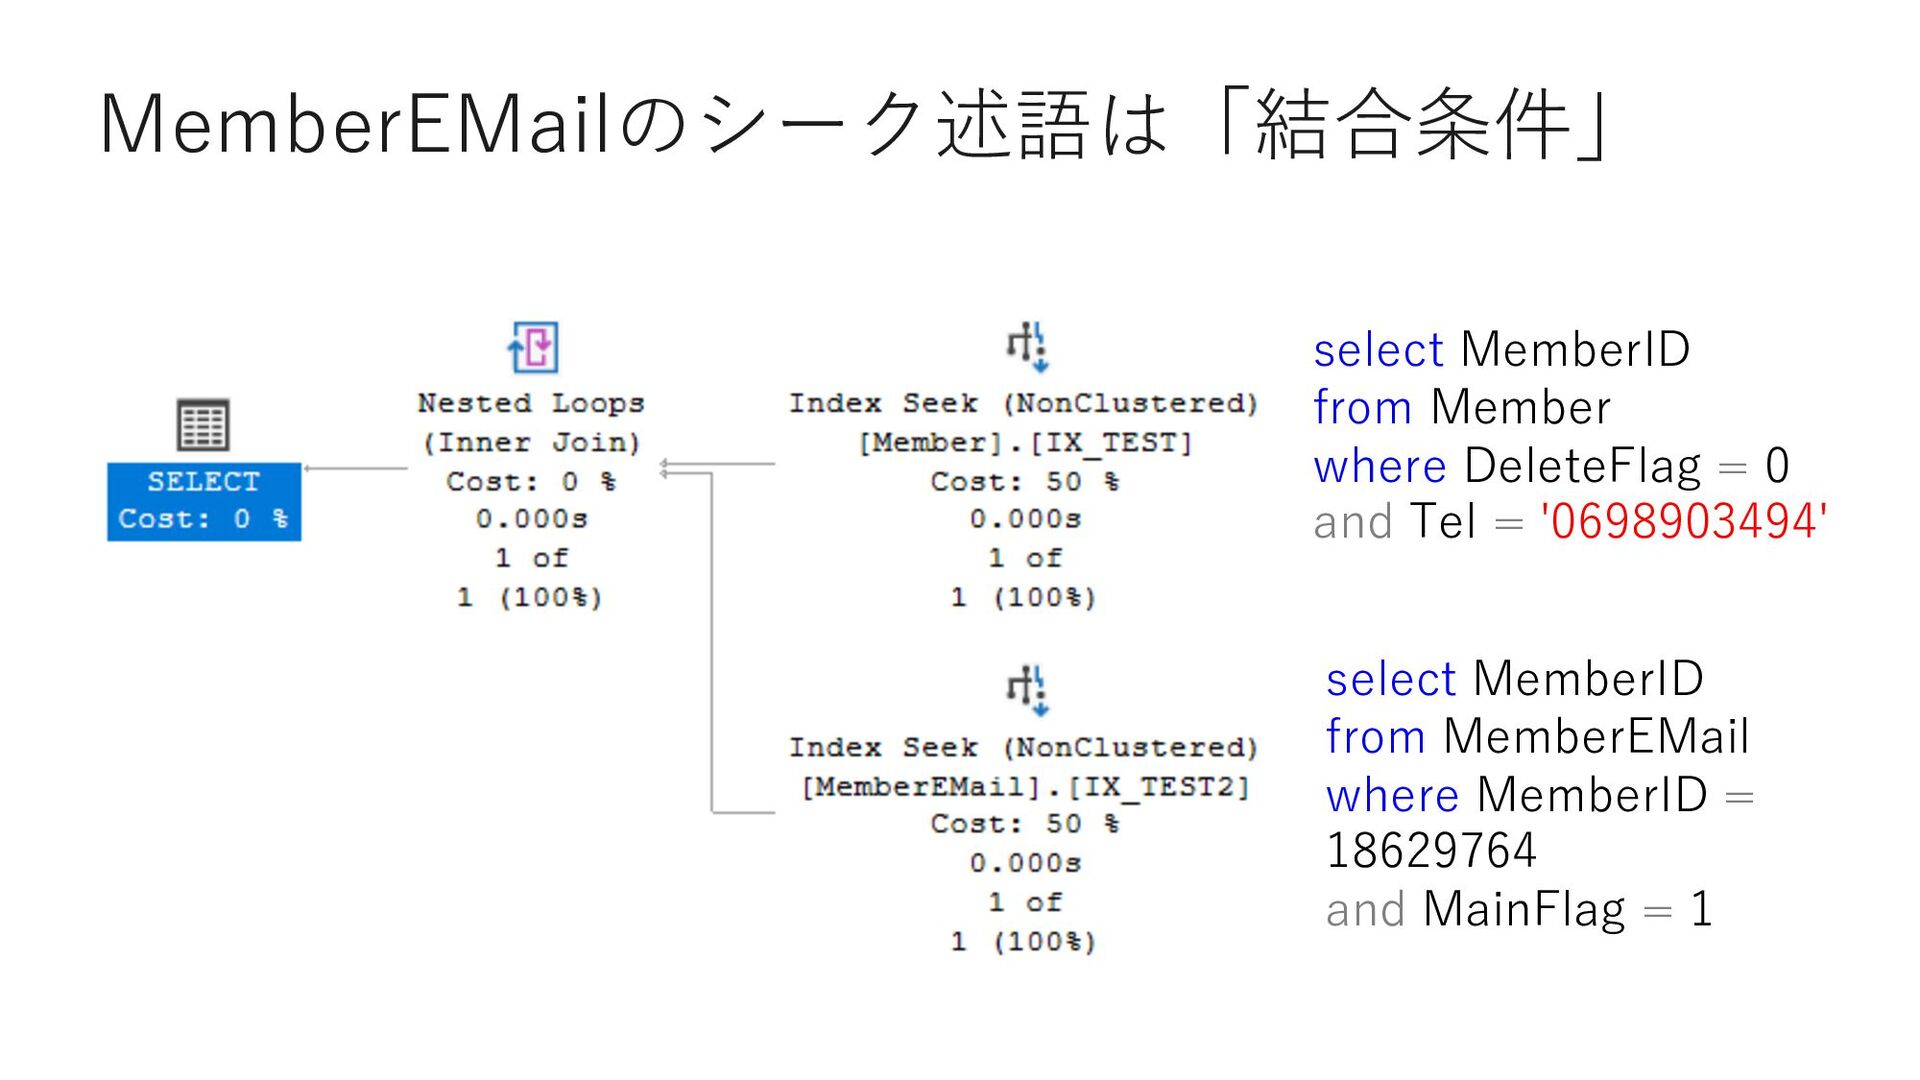
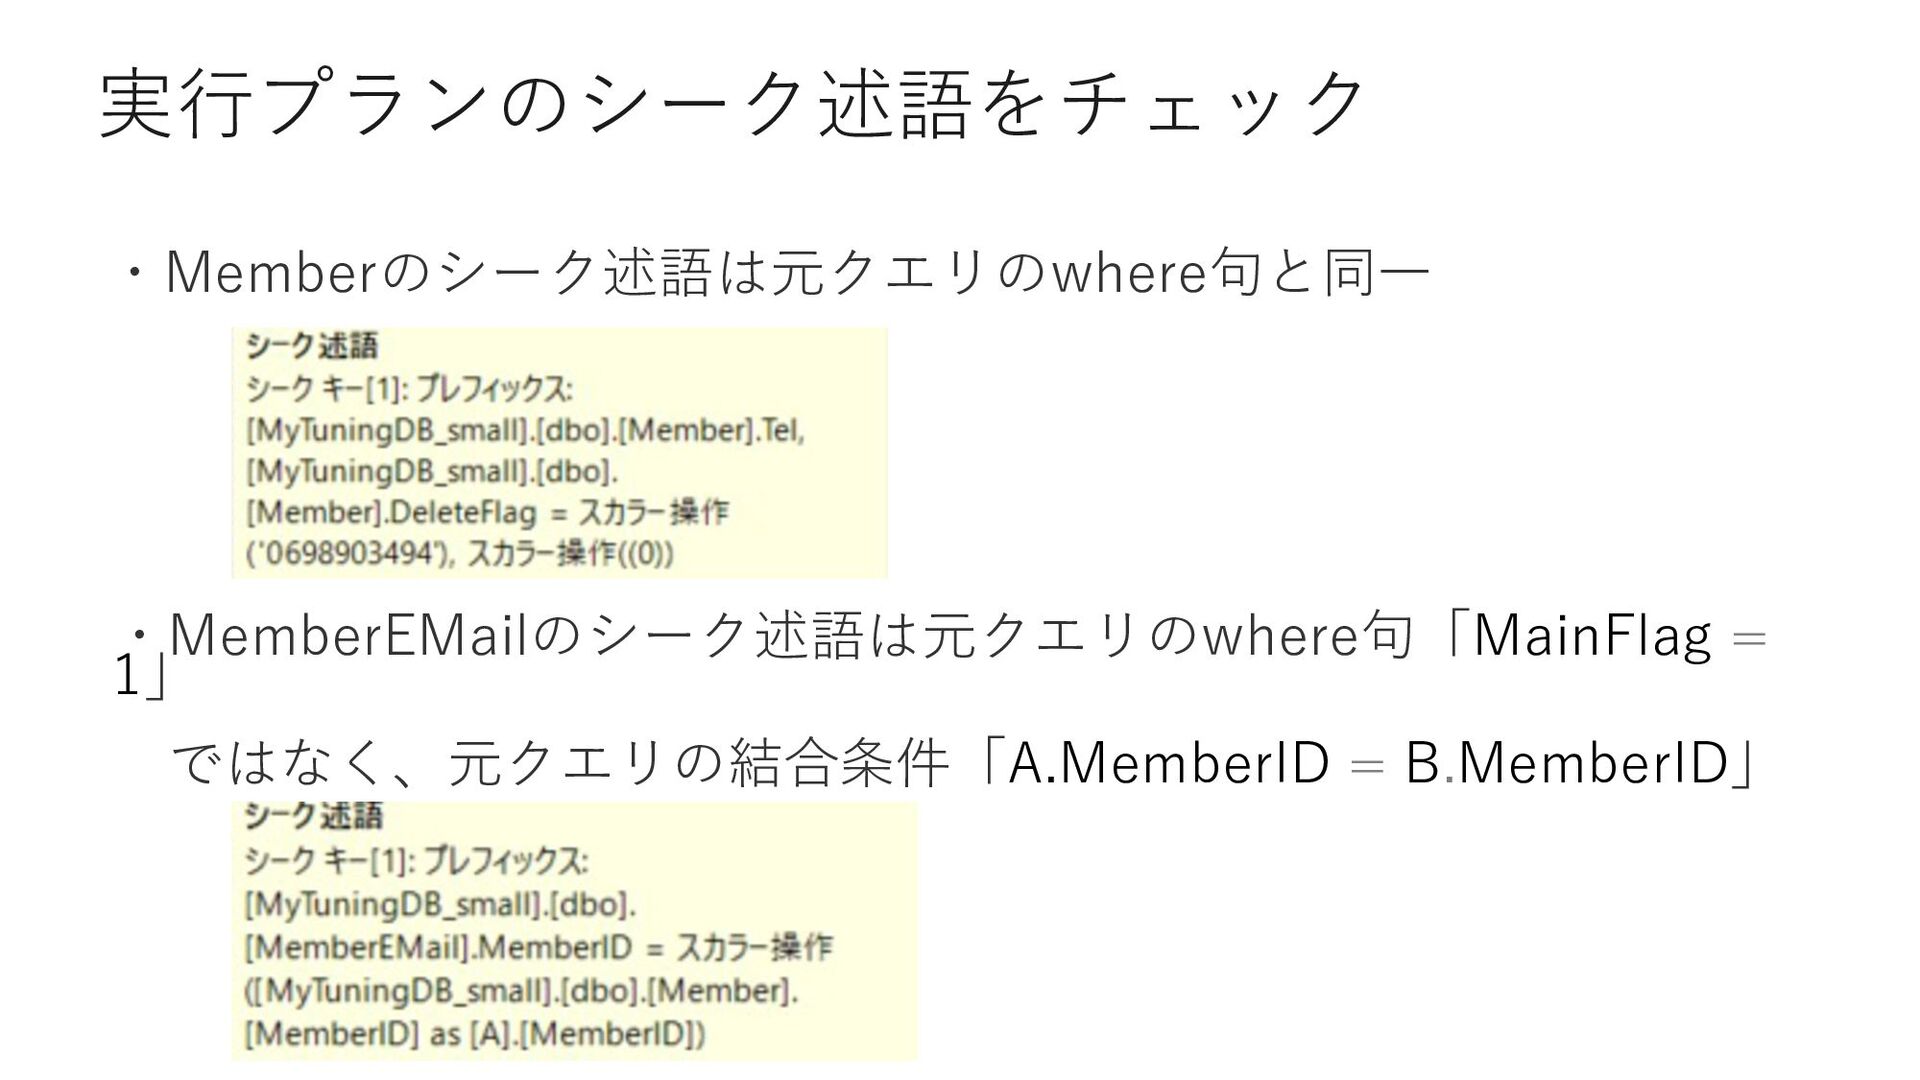
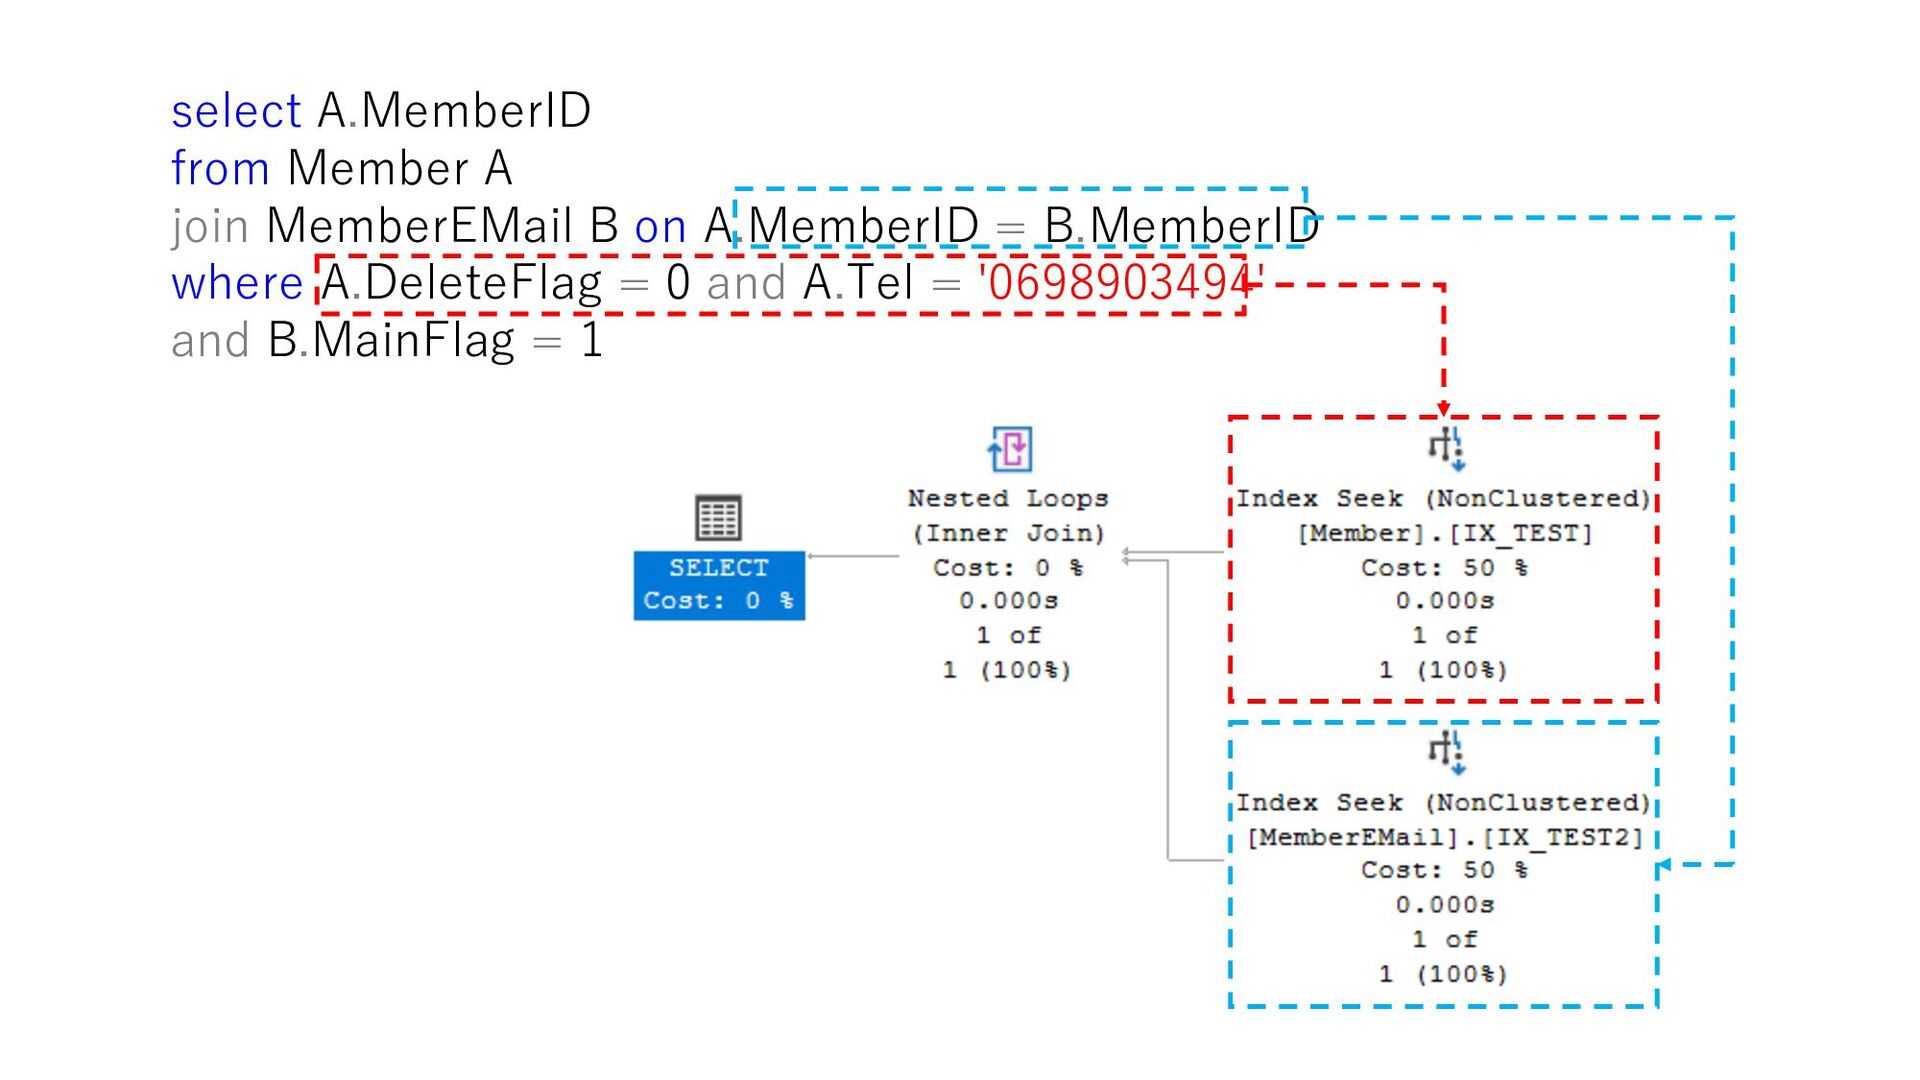
MemberEMailのシーク述語は「結合条件」 select MemberID from Member where DeleteFlag = 0 and
Tel = '0698903494' select MemberID from MemberEMail where MemberID = 18629764 and MainFlag = 1 -
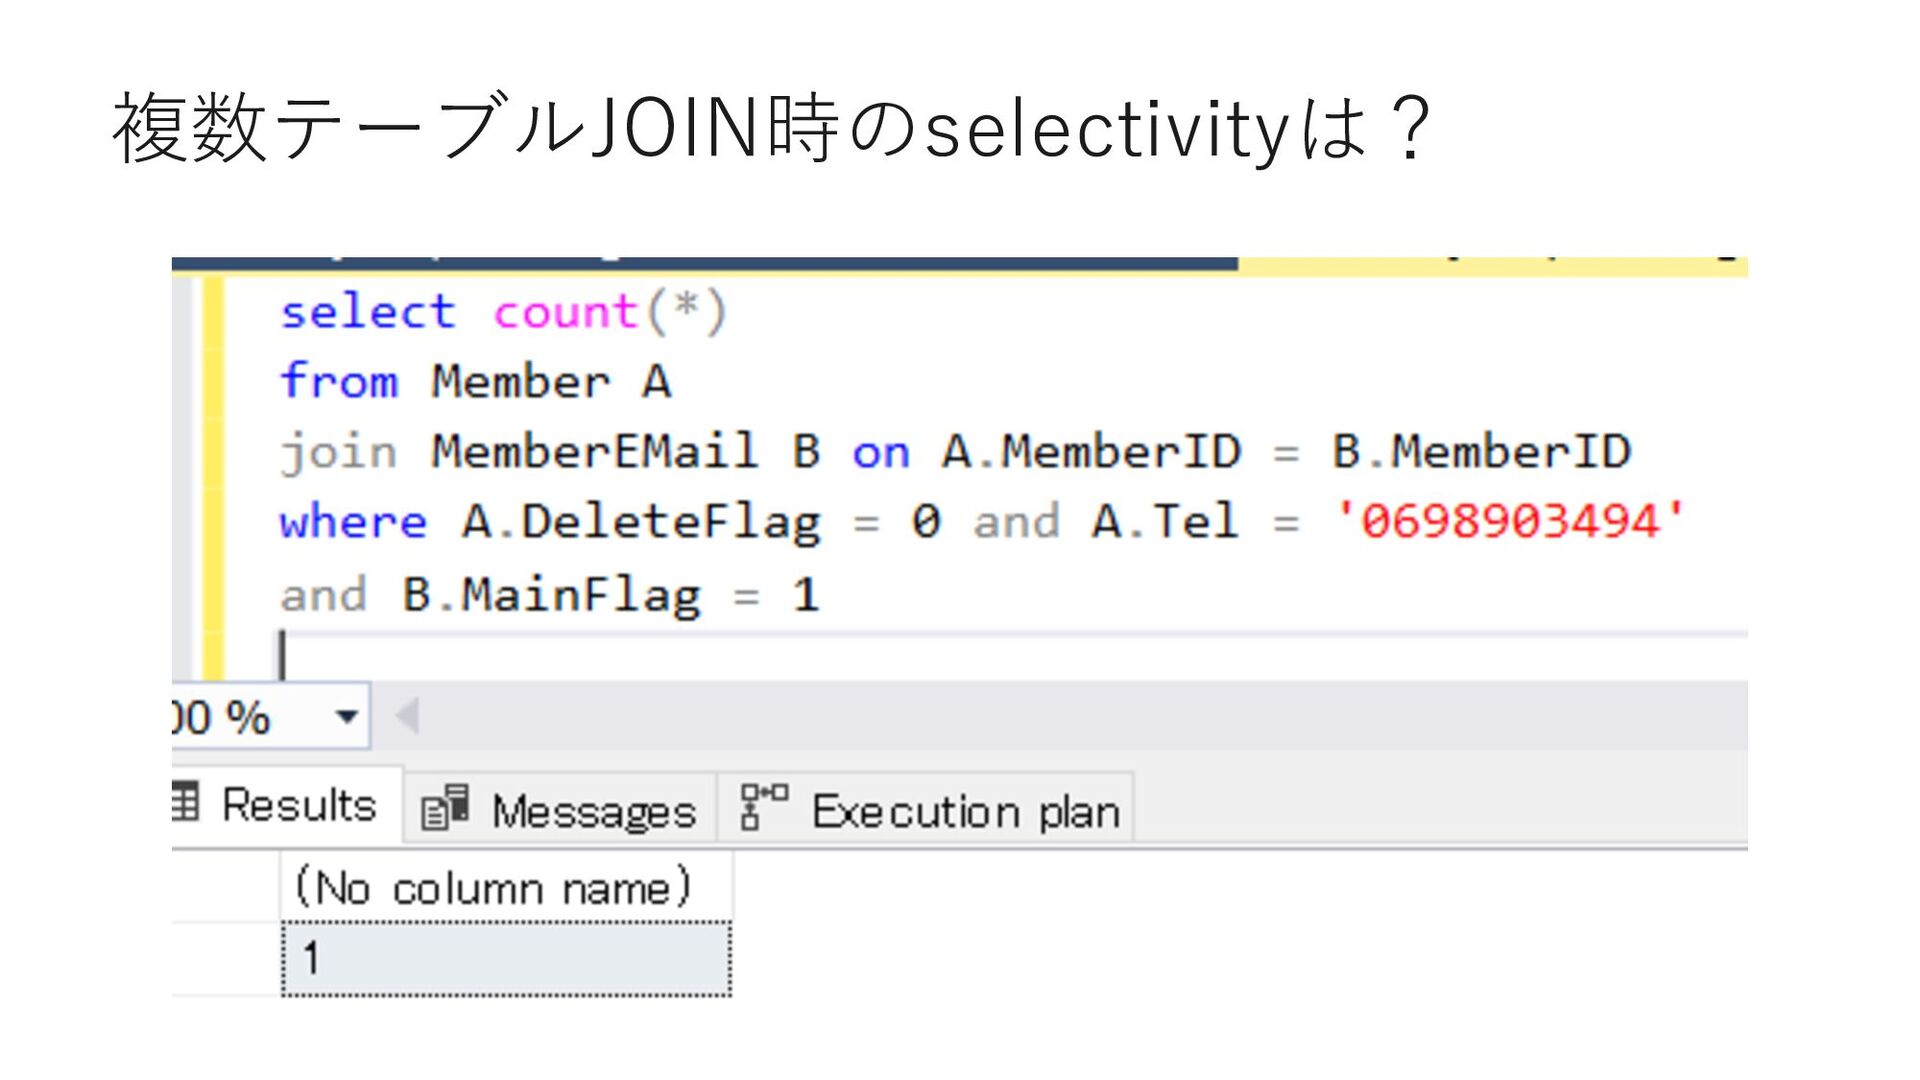
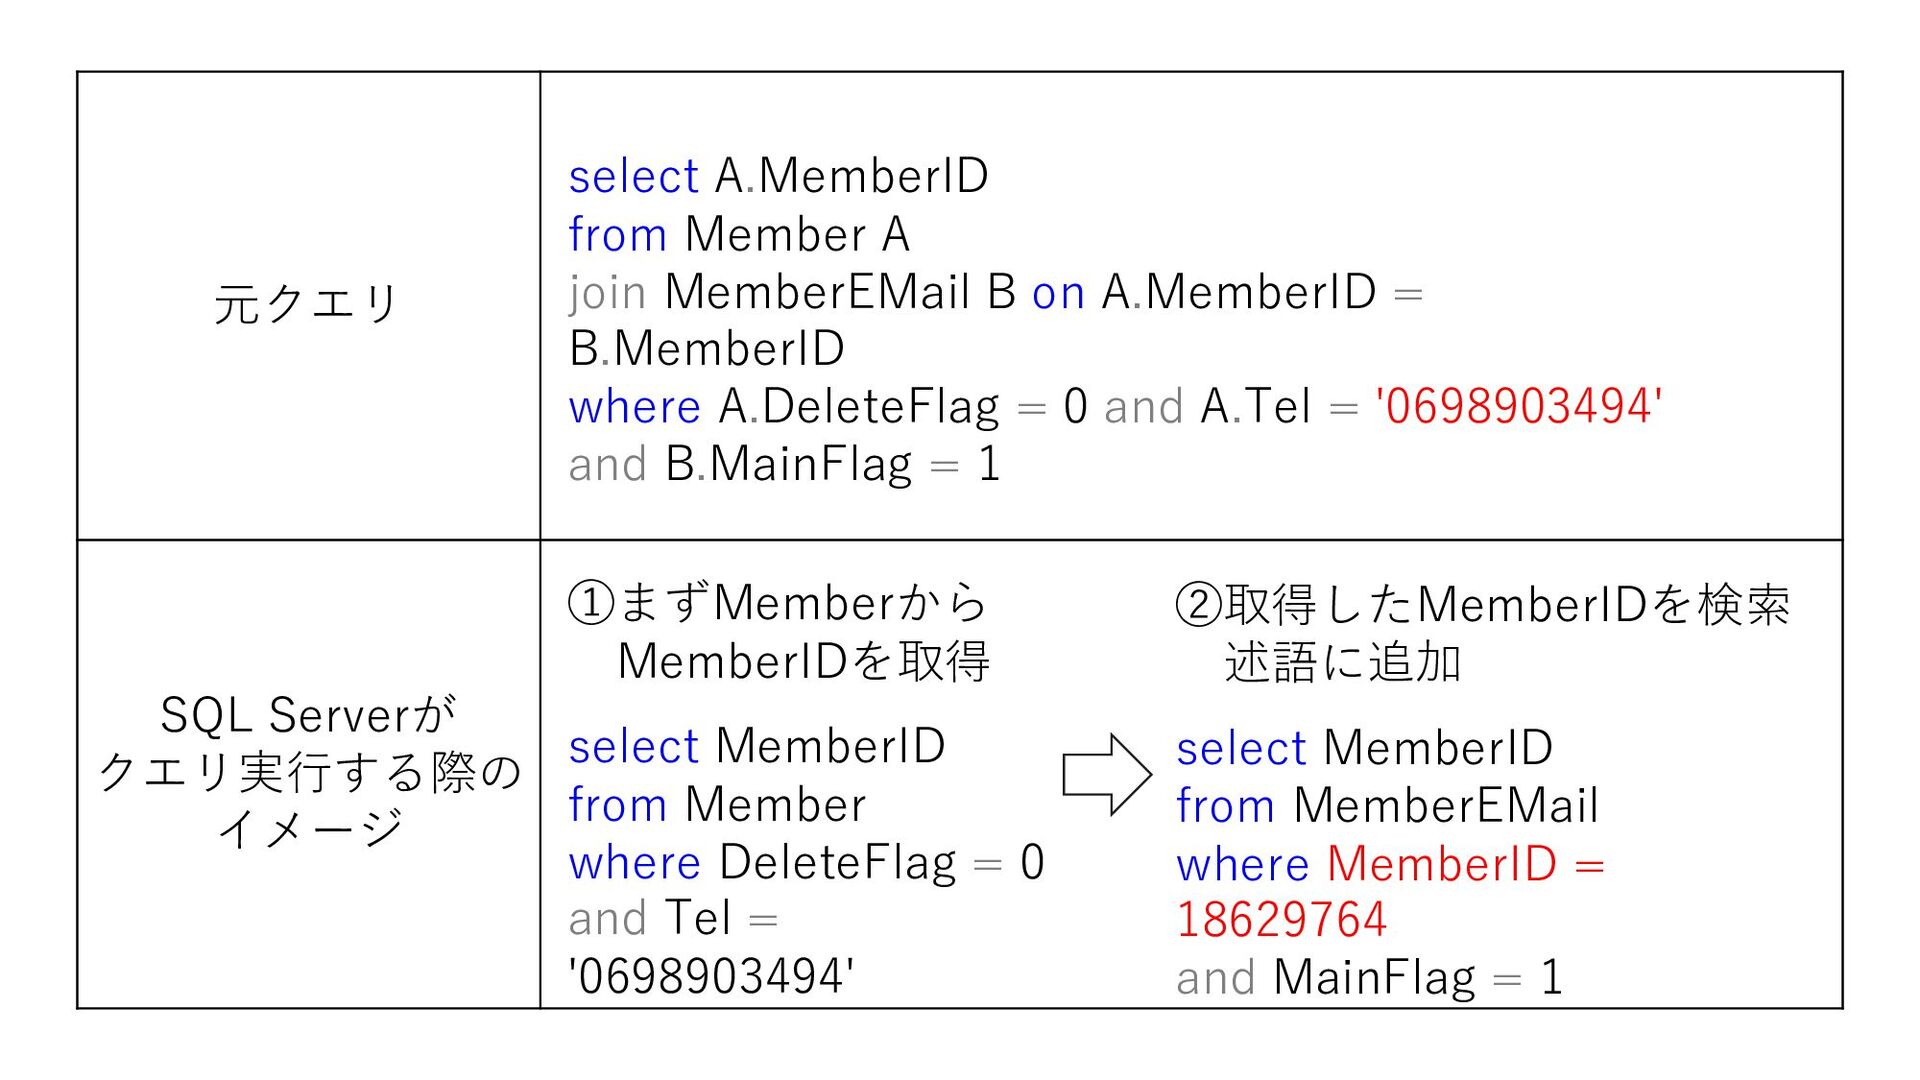
元クエリ SQL Serverが クエリ実⾏する際の イメージ select A.MemberID from Member A
join MemberEMail B on A.MemberID = B.MemberID where A.DeleteFlag = 0 and A.Tel = '0698903494' and B.MainFlag = 1 select MemberID from Member where DeleteFlag = 0 and Tel = '0698903494' select MemberID from MemberEMail where MemberID = 18629764 and MainFlag = 1 ①まずMemberから MemberIDを取得 ②取得したMemberIDを検索 述語に追加 -
select A.MemberID from Member A join MemberEMail B on A.MemberID
= B.MemberID where A.DeleteFlag = 0 and A.Tel = '0698903494' and B.MainFlag = 1 -
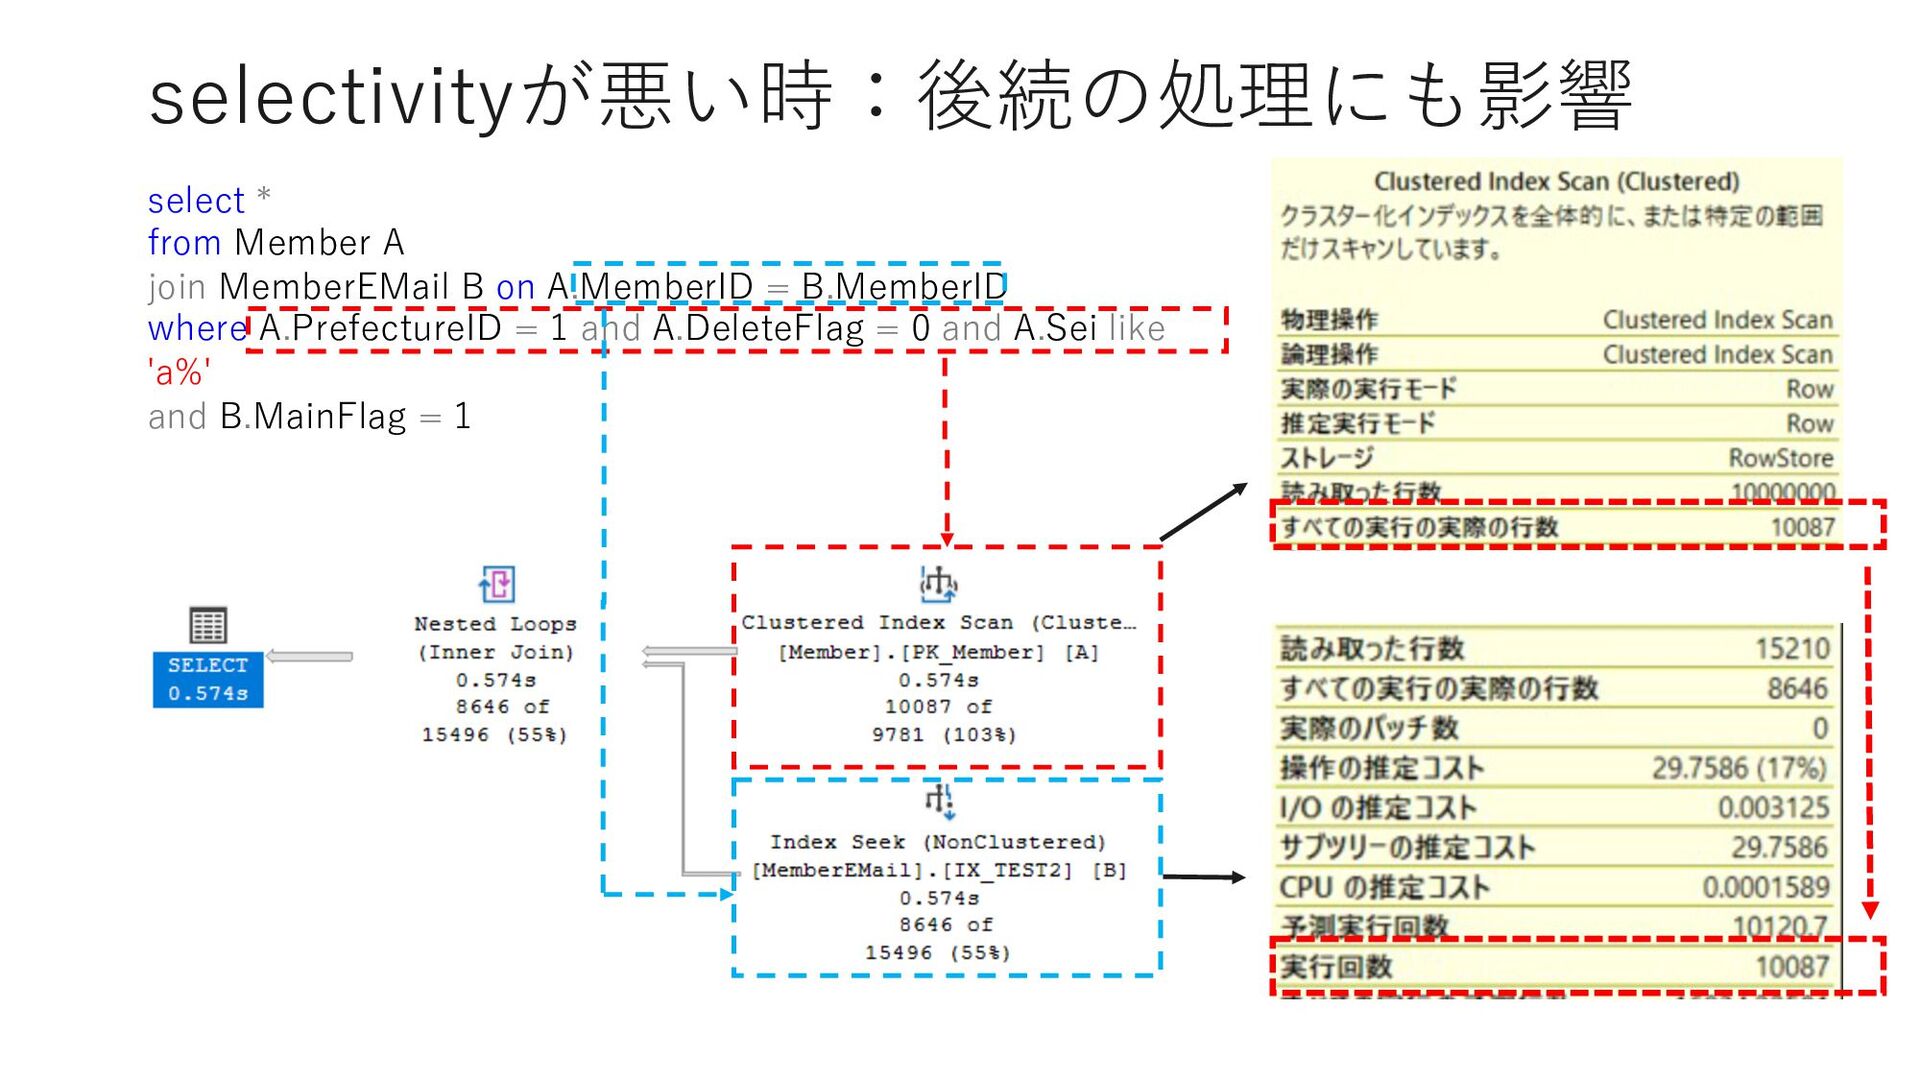
selectivityが悪い時:後続の処理にも影響 select * from Member A join MemberEMail B on
A.MemberID = B.MemberID where A.PrefectureID = 1 and A.DeleteFlag = 0 and A.Sei like 'a%' and B.MainFlag = 1 -
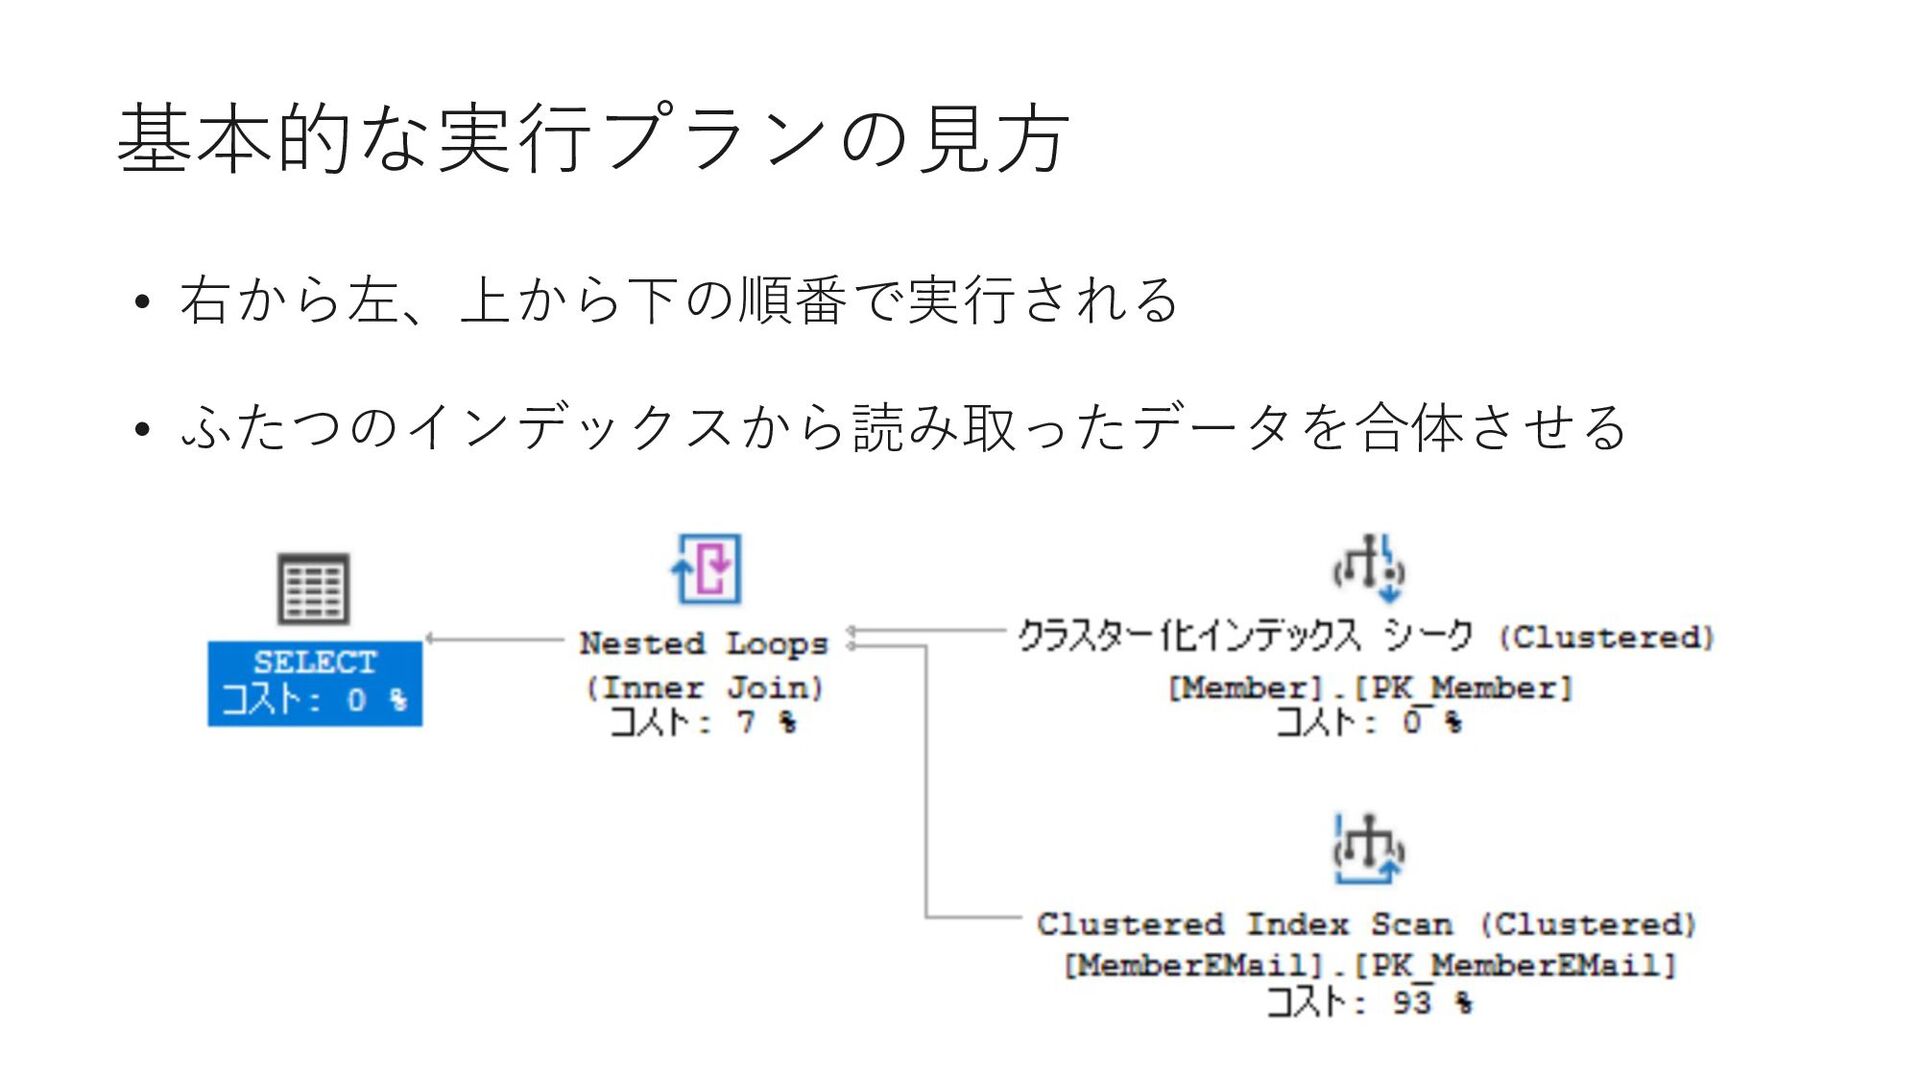
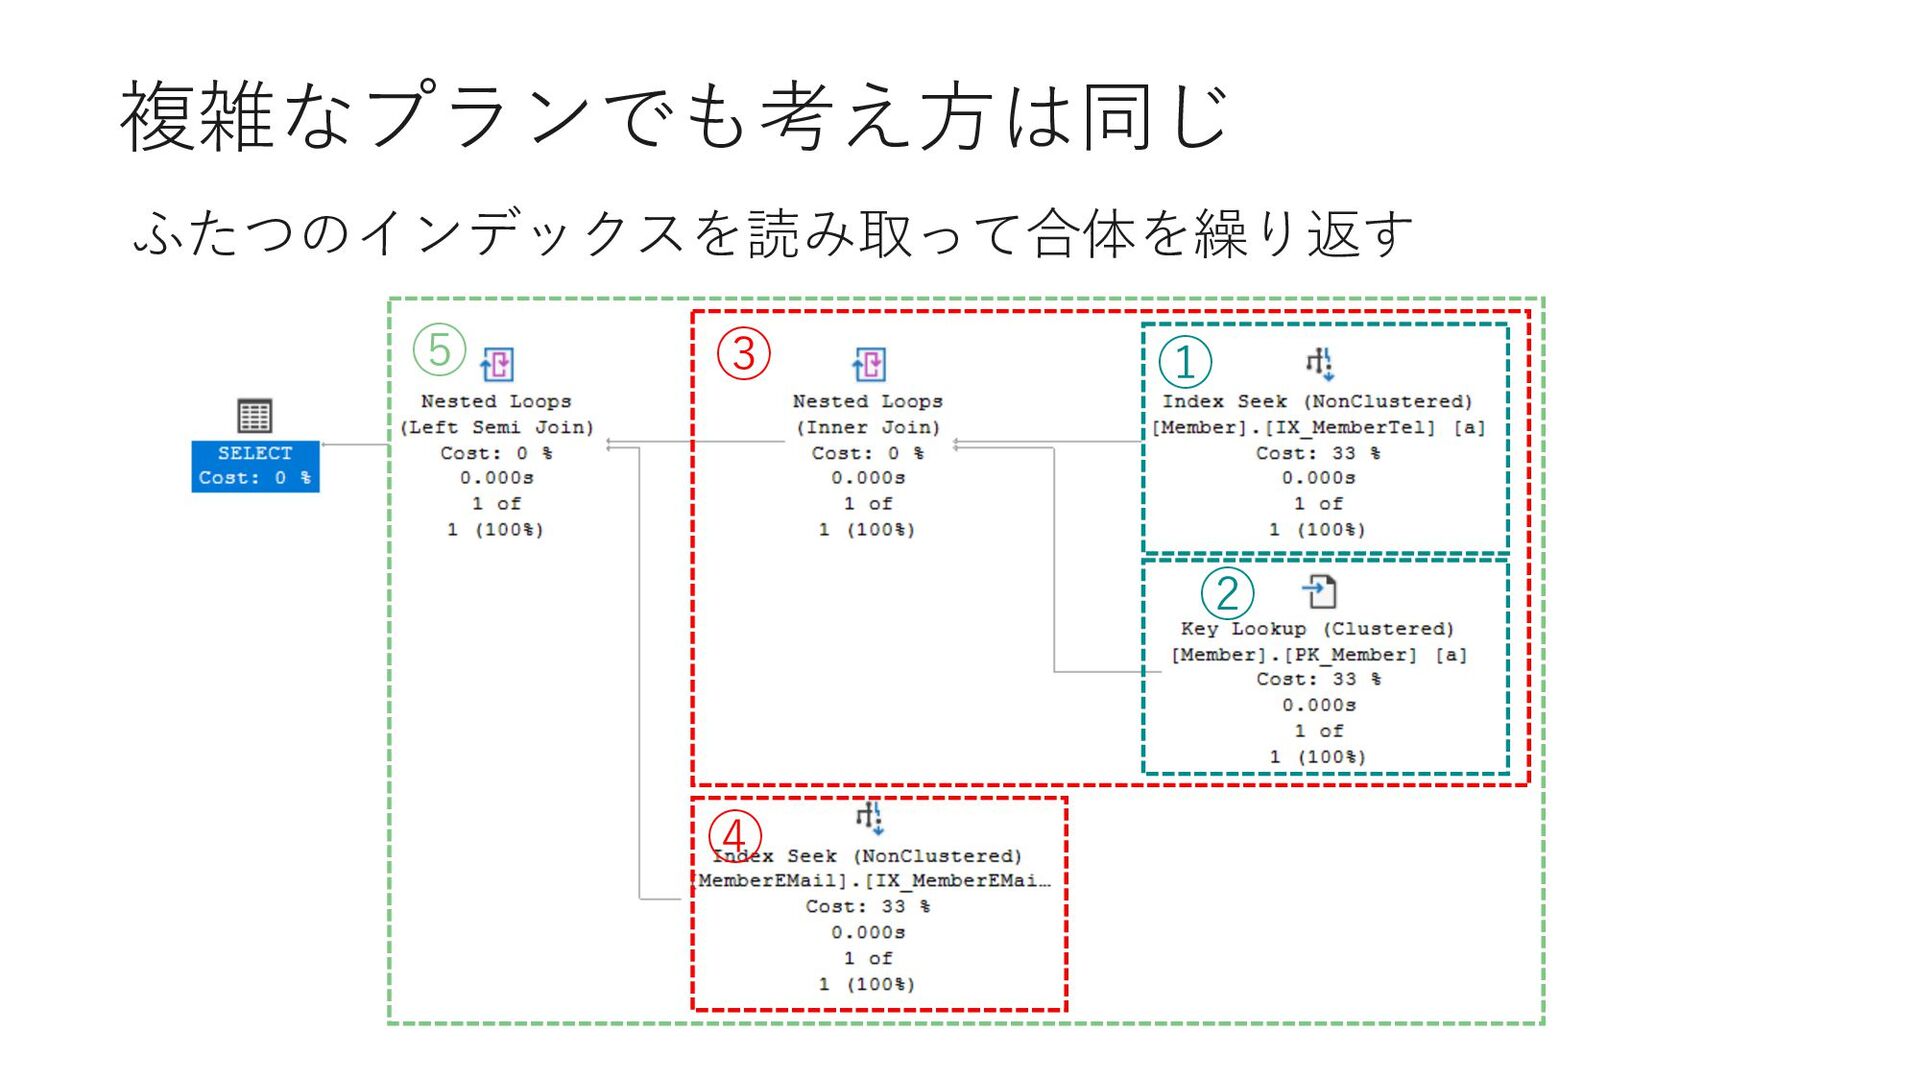
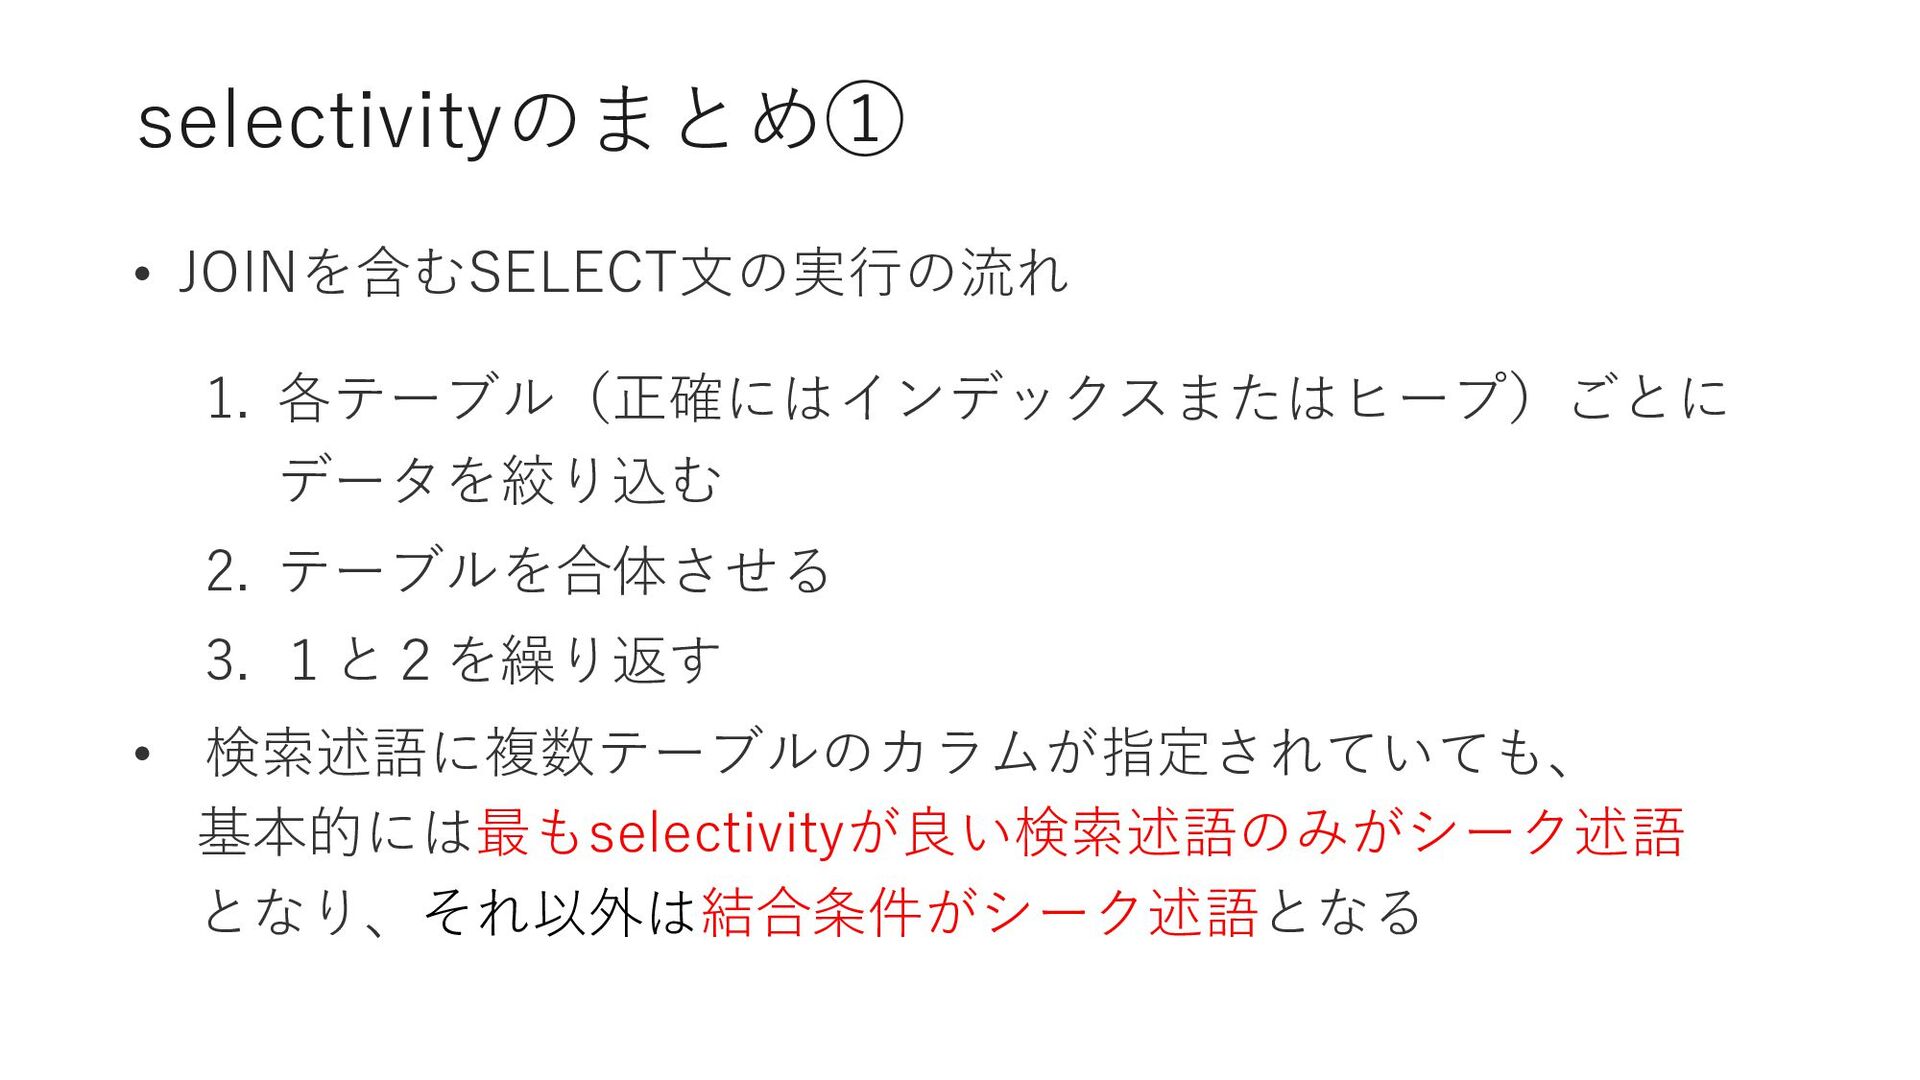
selectivityのまとめ① • JOINを含むSELECT⽂の実⾏の流れ 1. 各テーブル(正確にはインデックスまたはヒープ)ごとに データを絞り込む 2. テーブルを合体させる 3. 1と2を繰り返す
• 検索述語に複数テーブルのカラムが指定されていても、 基本的には最もselectivityが良い検索述語のみがシーク述語 となり、それ以外は結合条件がシーク述語となる -
selectivityのまとめ② • もっともselectivityが良い検索述語による絞り込みレコード数は、 その後の各結合処理の実⾏回数(≒レコード数)へと 影響が伝搬していく • selectivityが良い → パフォーマンス的な好影響が伝搬していく •
selectivityが悪い → パフォーマンス的な悪影響が伝搬していく -
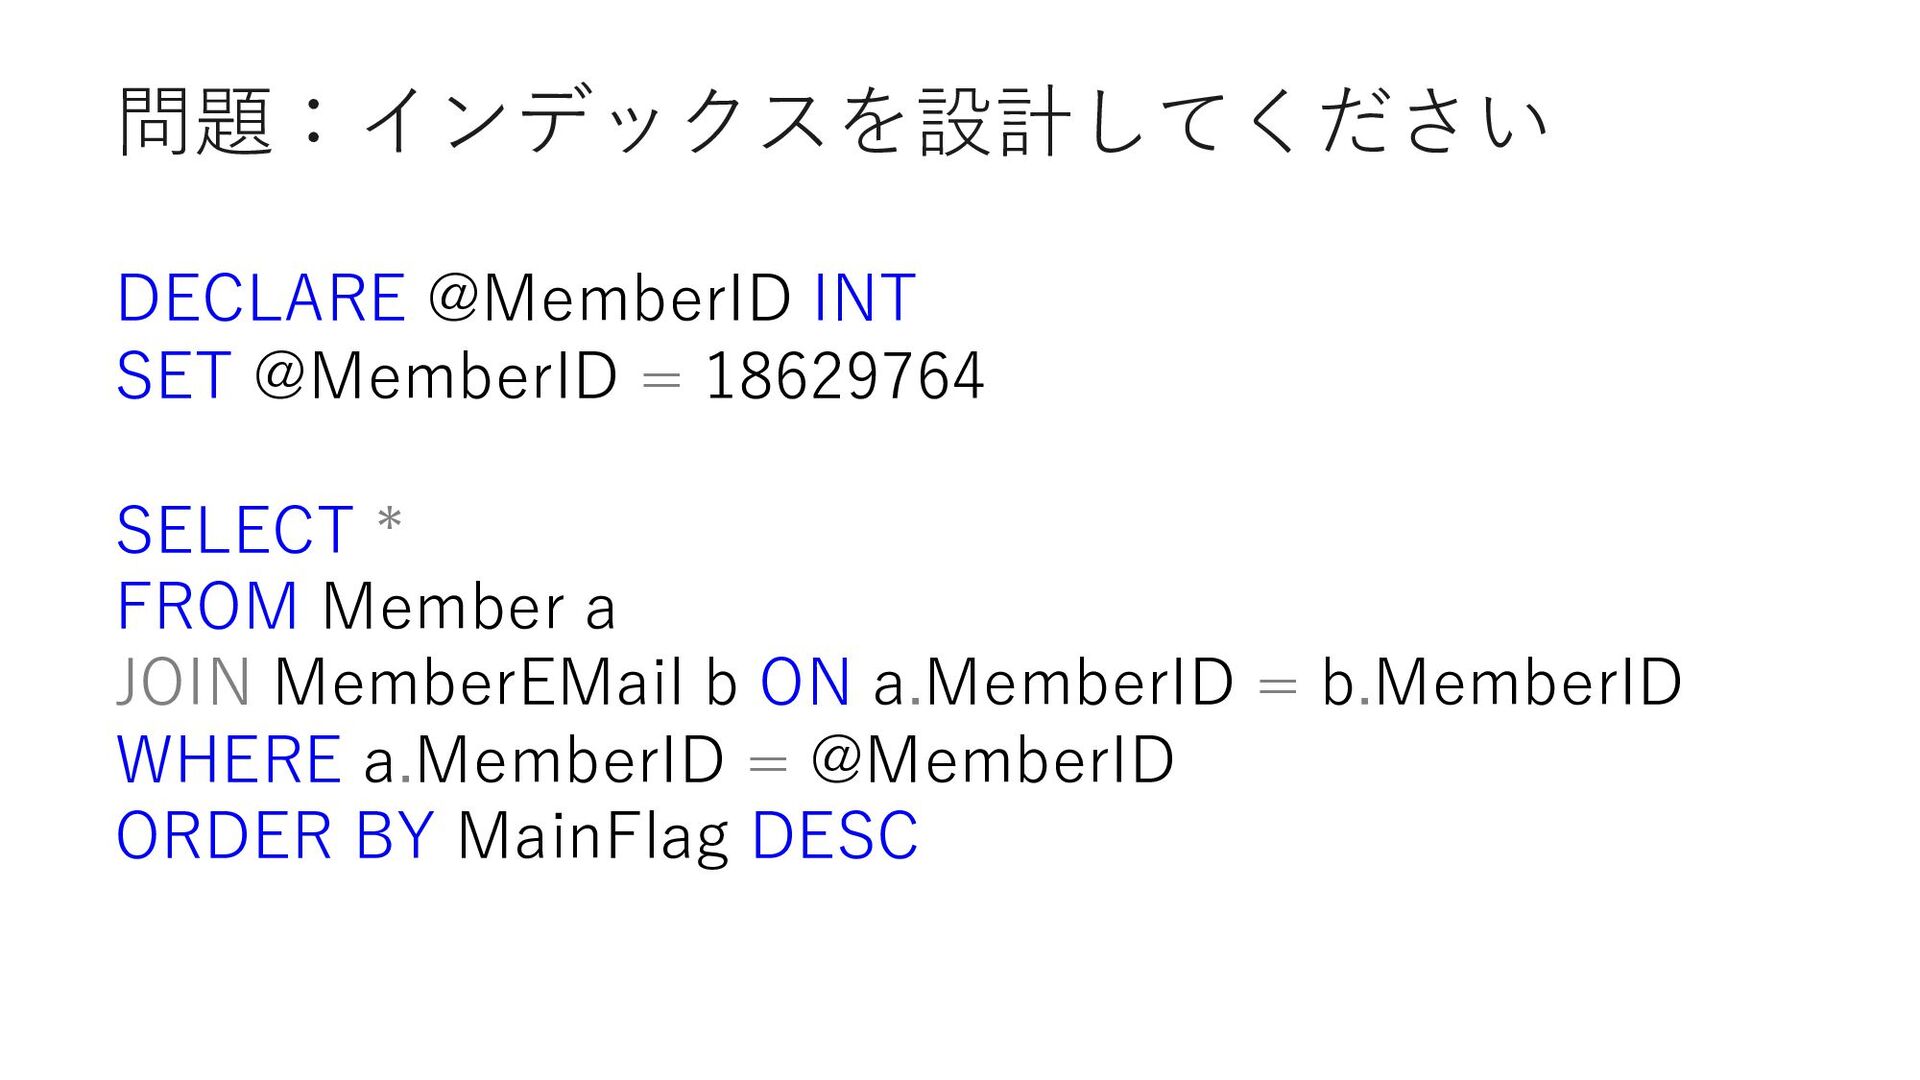
問題:インデックスを設計してください DECLARE @MemberID INT SET @MemberID = 18629764 SELECT *
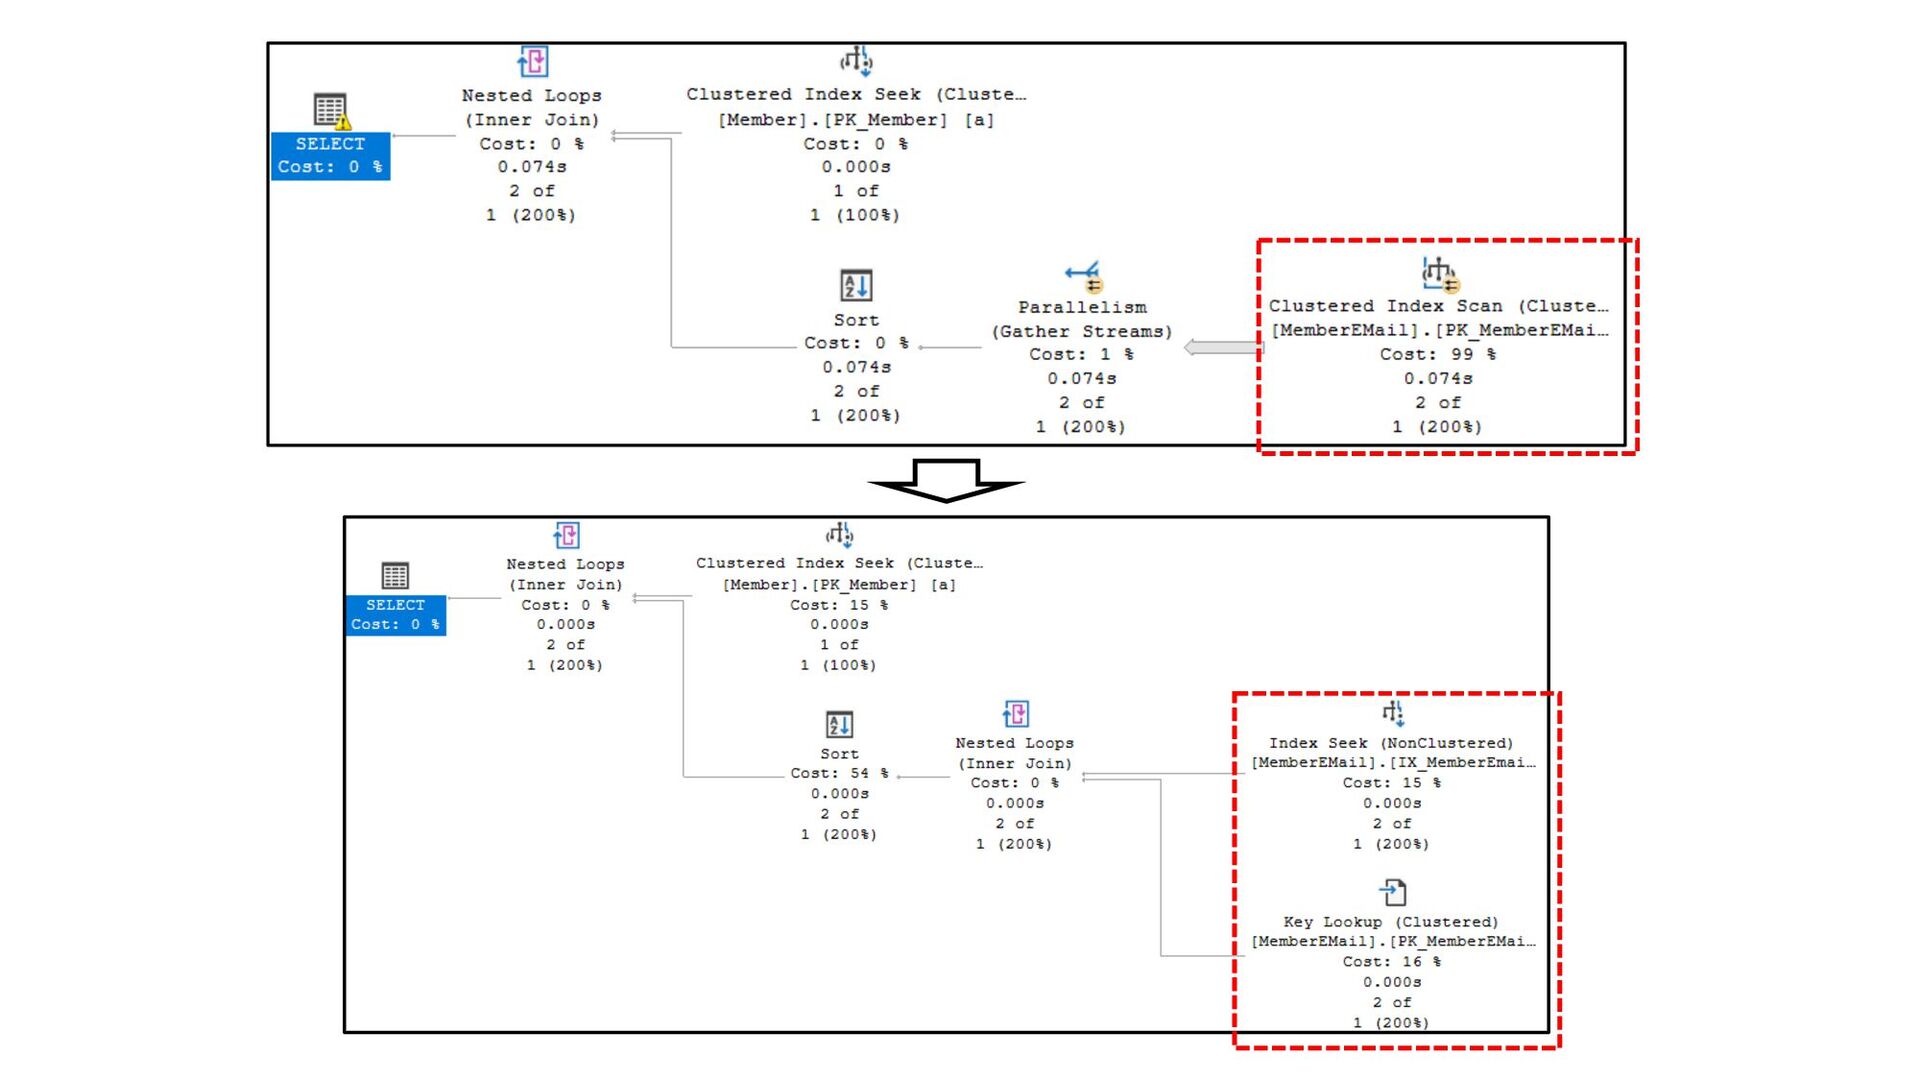
FROM Member a JOIN MemberEMail b ON a.MemberID = b.MemberID WHERE a.MemberID = @MemberID ORDER BY MainFlag DESC -
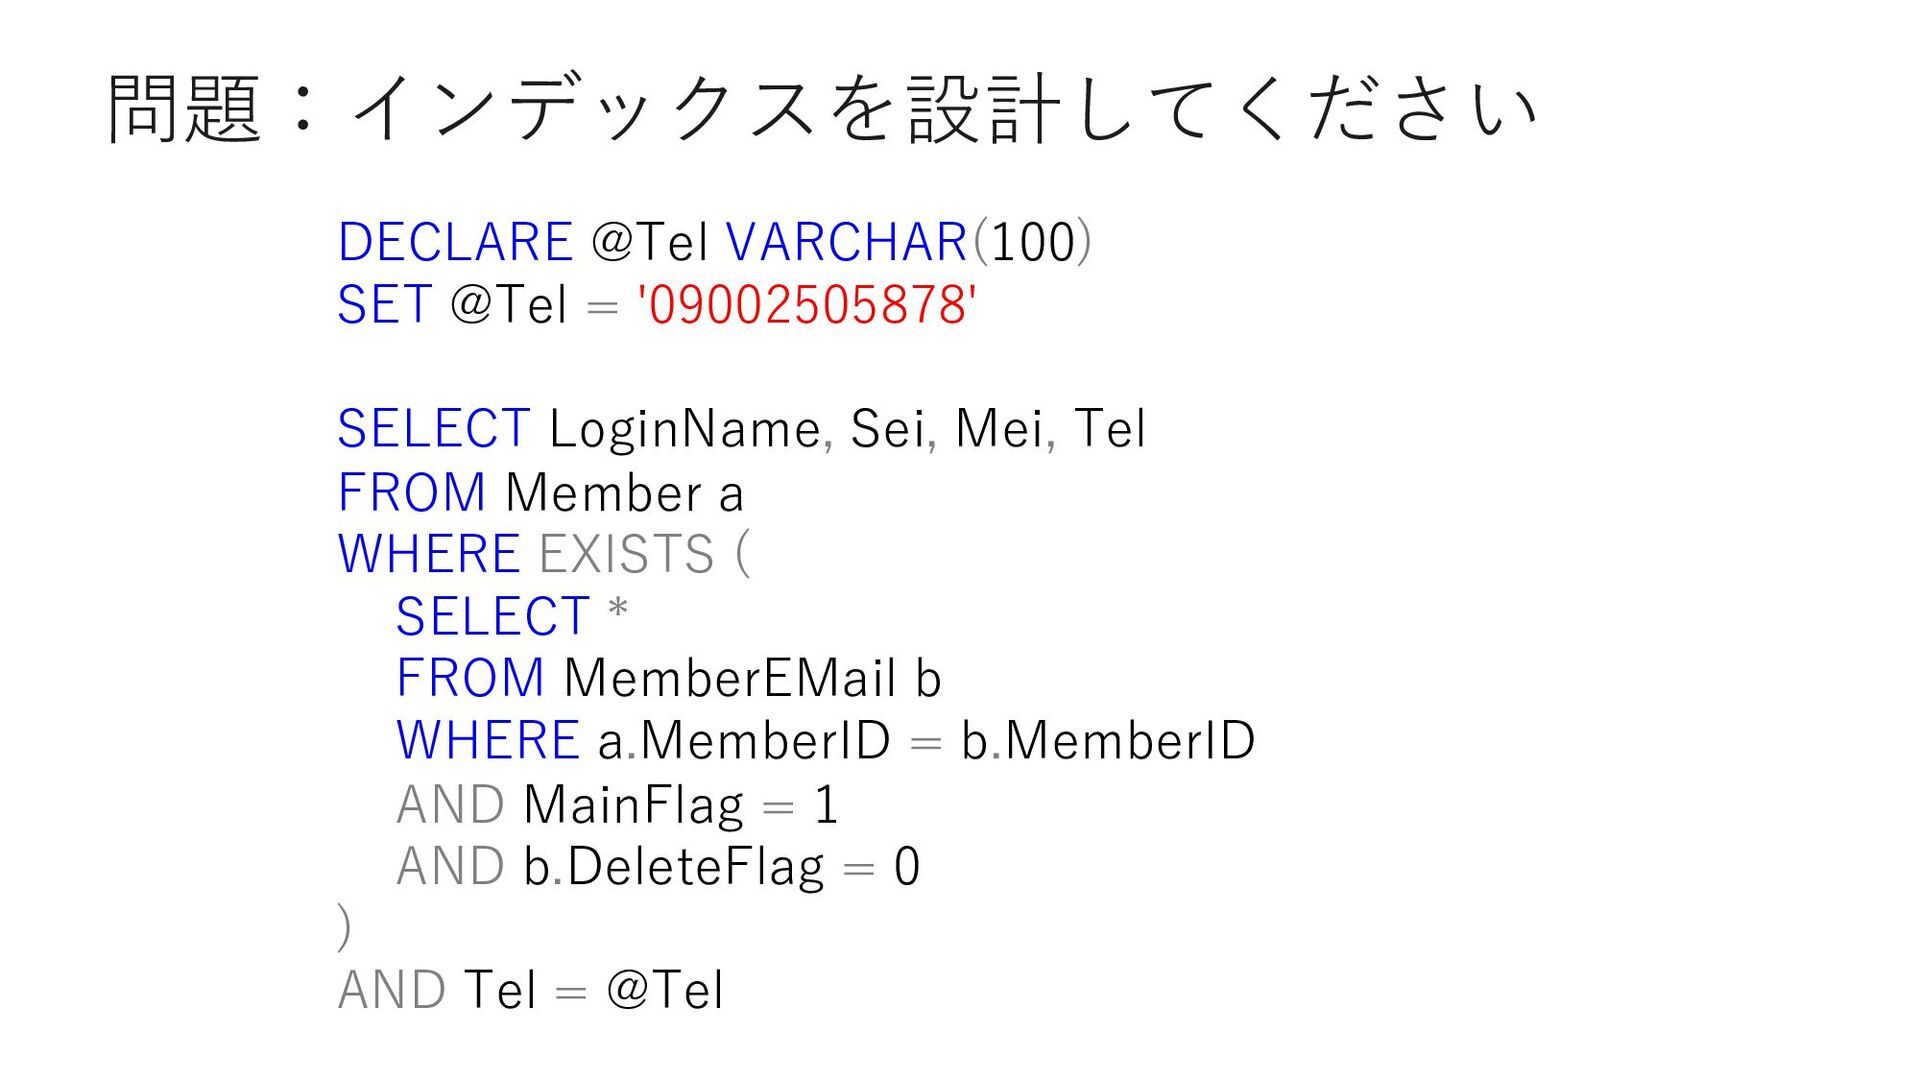
問題:インデックスを設計してください DECLARE @Tel VARCHAR(100) SET @Tel = '09002505878' SELECT LoginName,
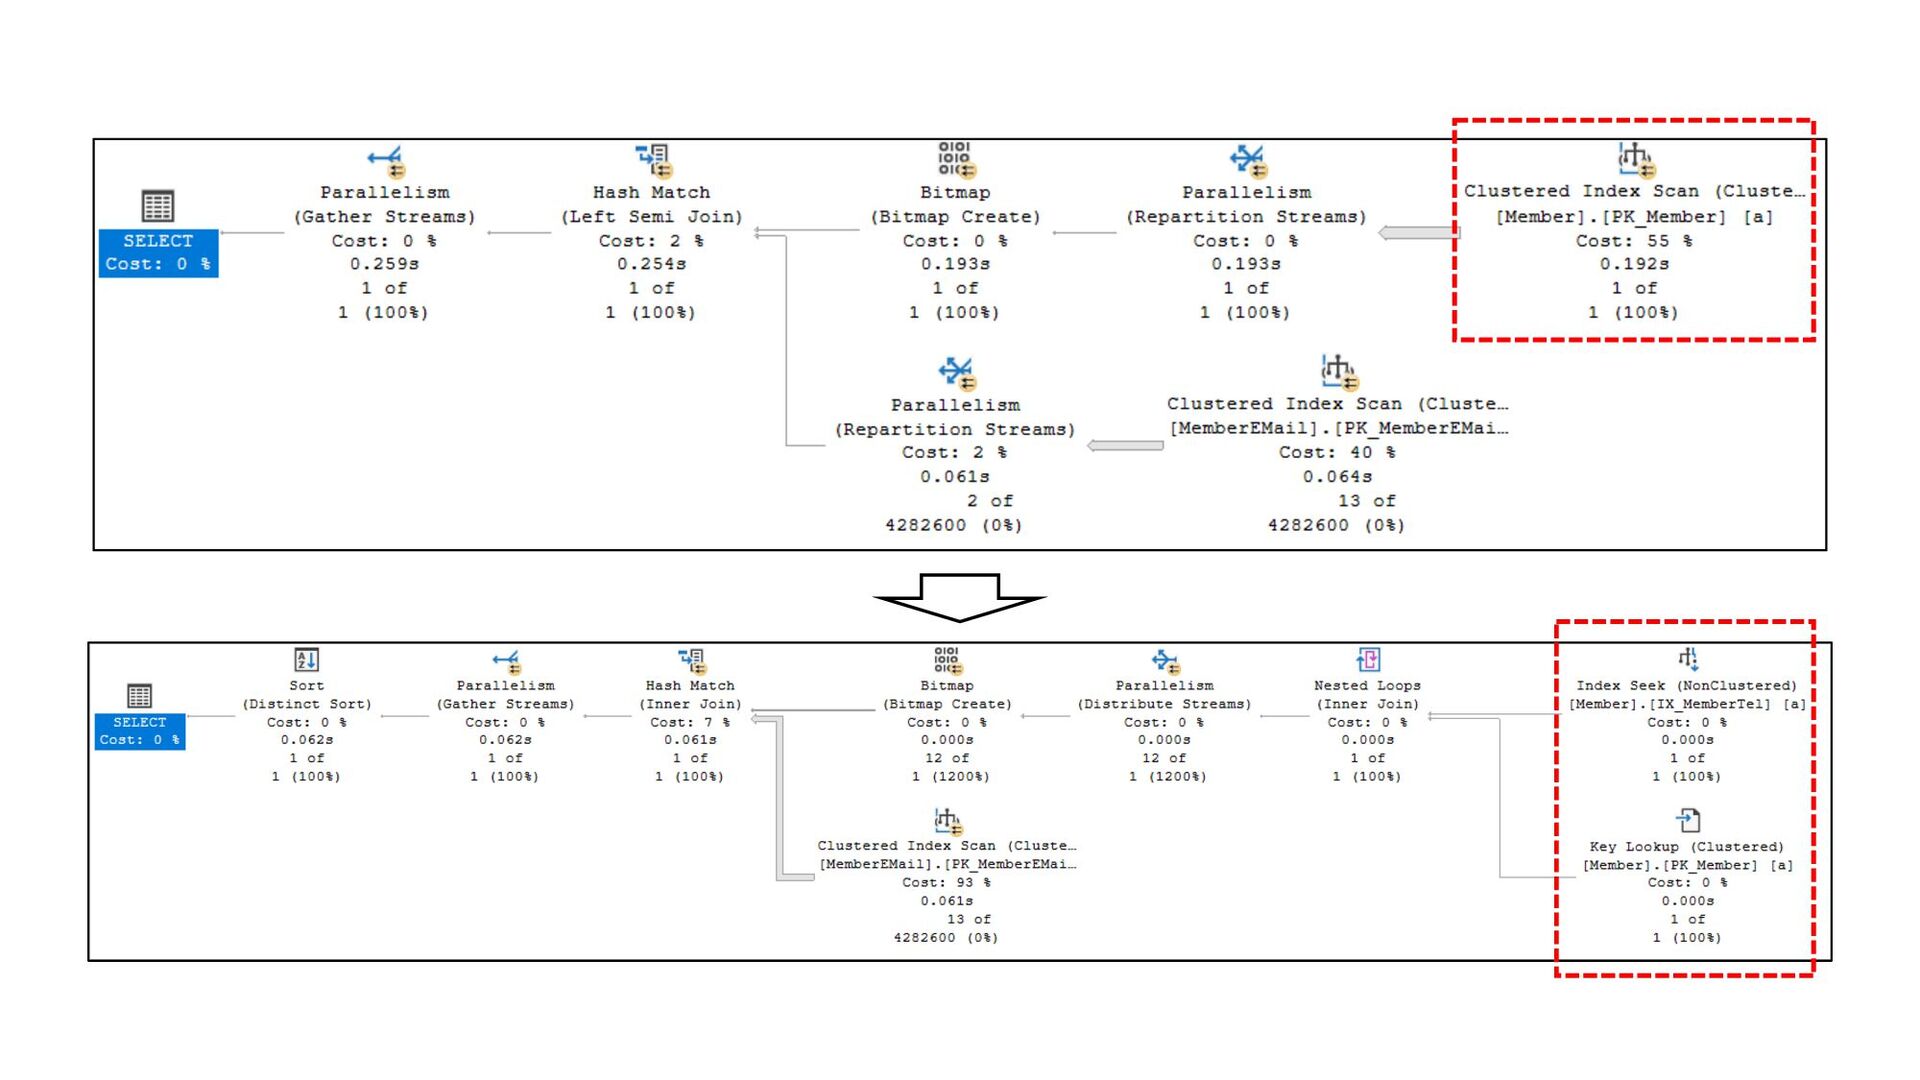
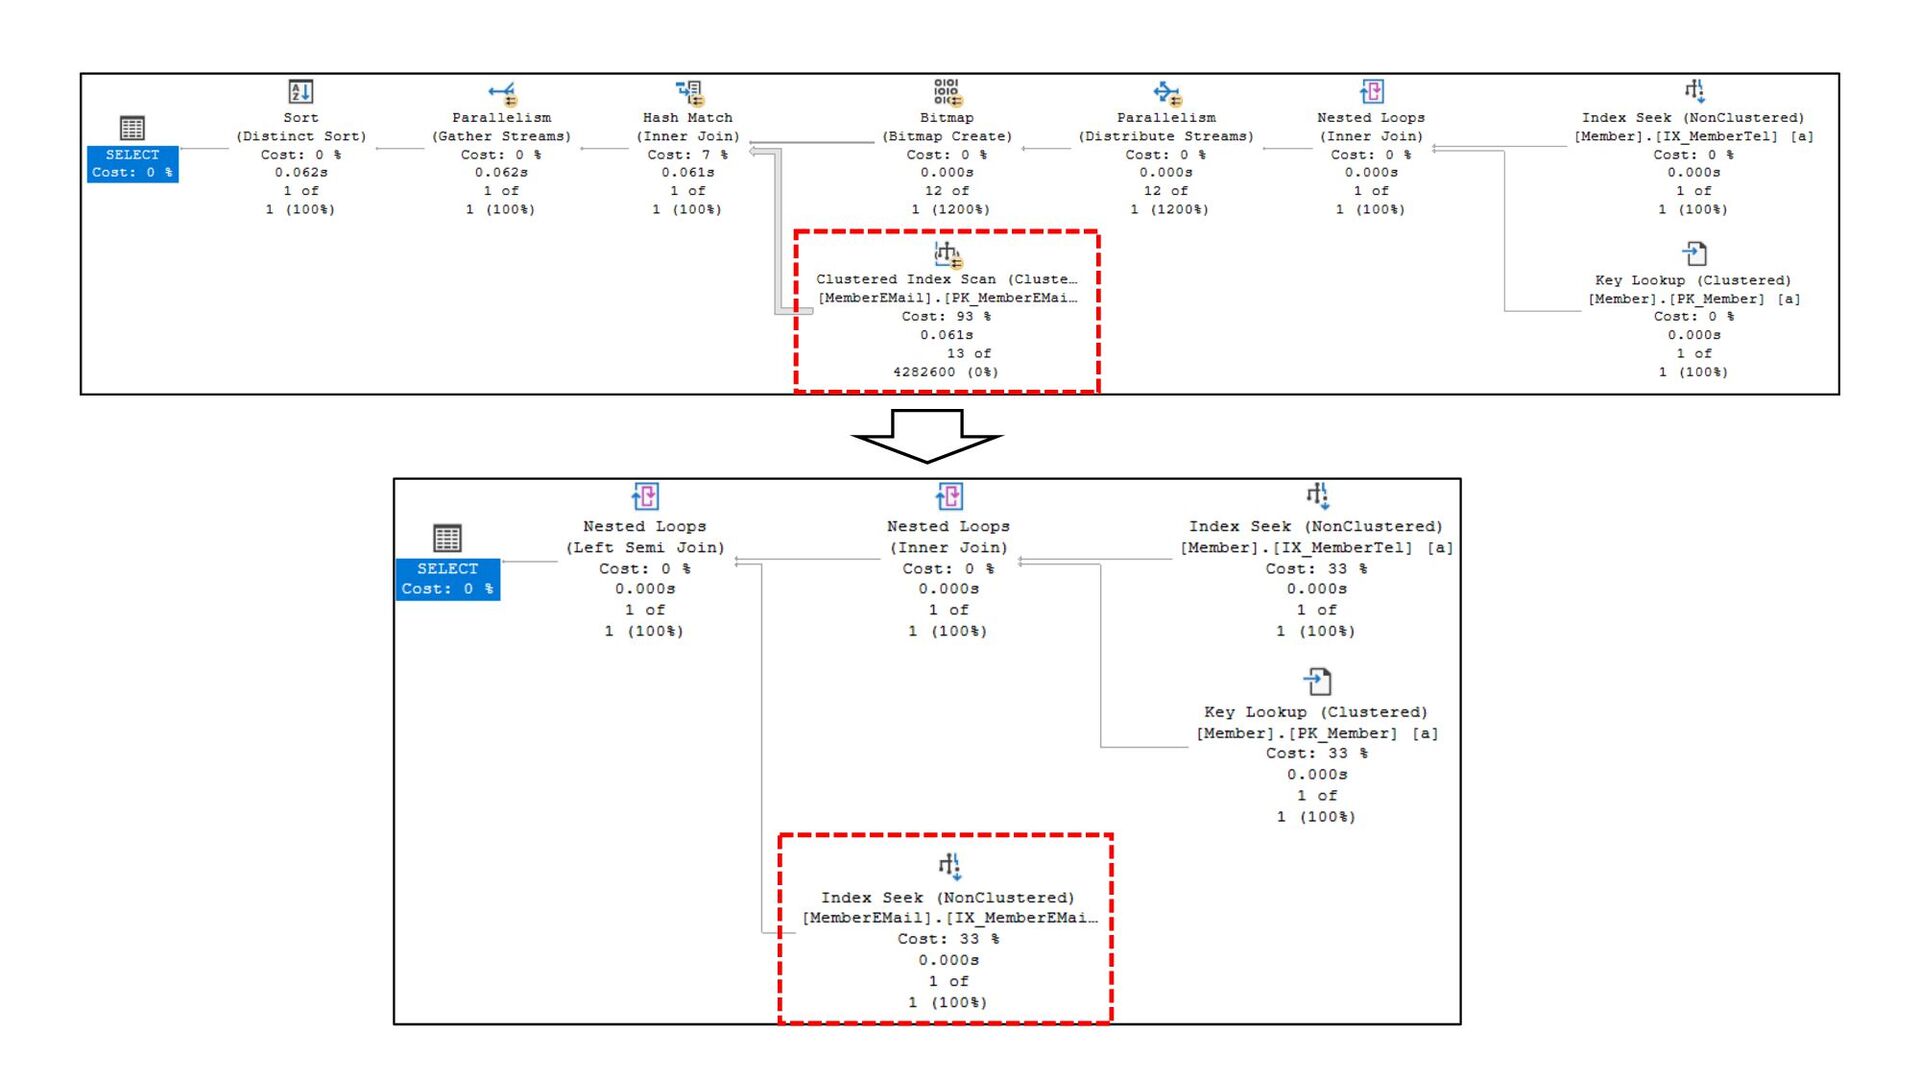
Sei, Mei, Tel FROM Member a WHERE EXISTS ( SELECT * FROM MemberEMail b WHERE a.MemberID = b.MemberID AND MainFlag = 1 AND b.DeleteFlag = 0 ) AND Tel = @Tel -
インデックス設計のポイント • とりあえず実⾏して「実際の実⾏プラン」をチェックする • 「ボトルネックはどこか」という観点で実⾏プランを⾒る • インデックスをひとつずつ作成していく • プラン確認 →
インデックス作成 → プラン確認 をチューニング完了まで繰り返す -
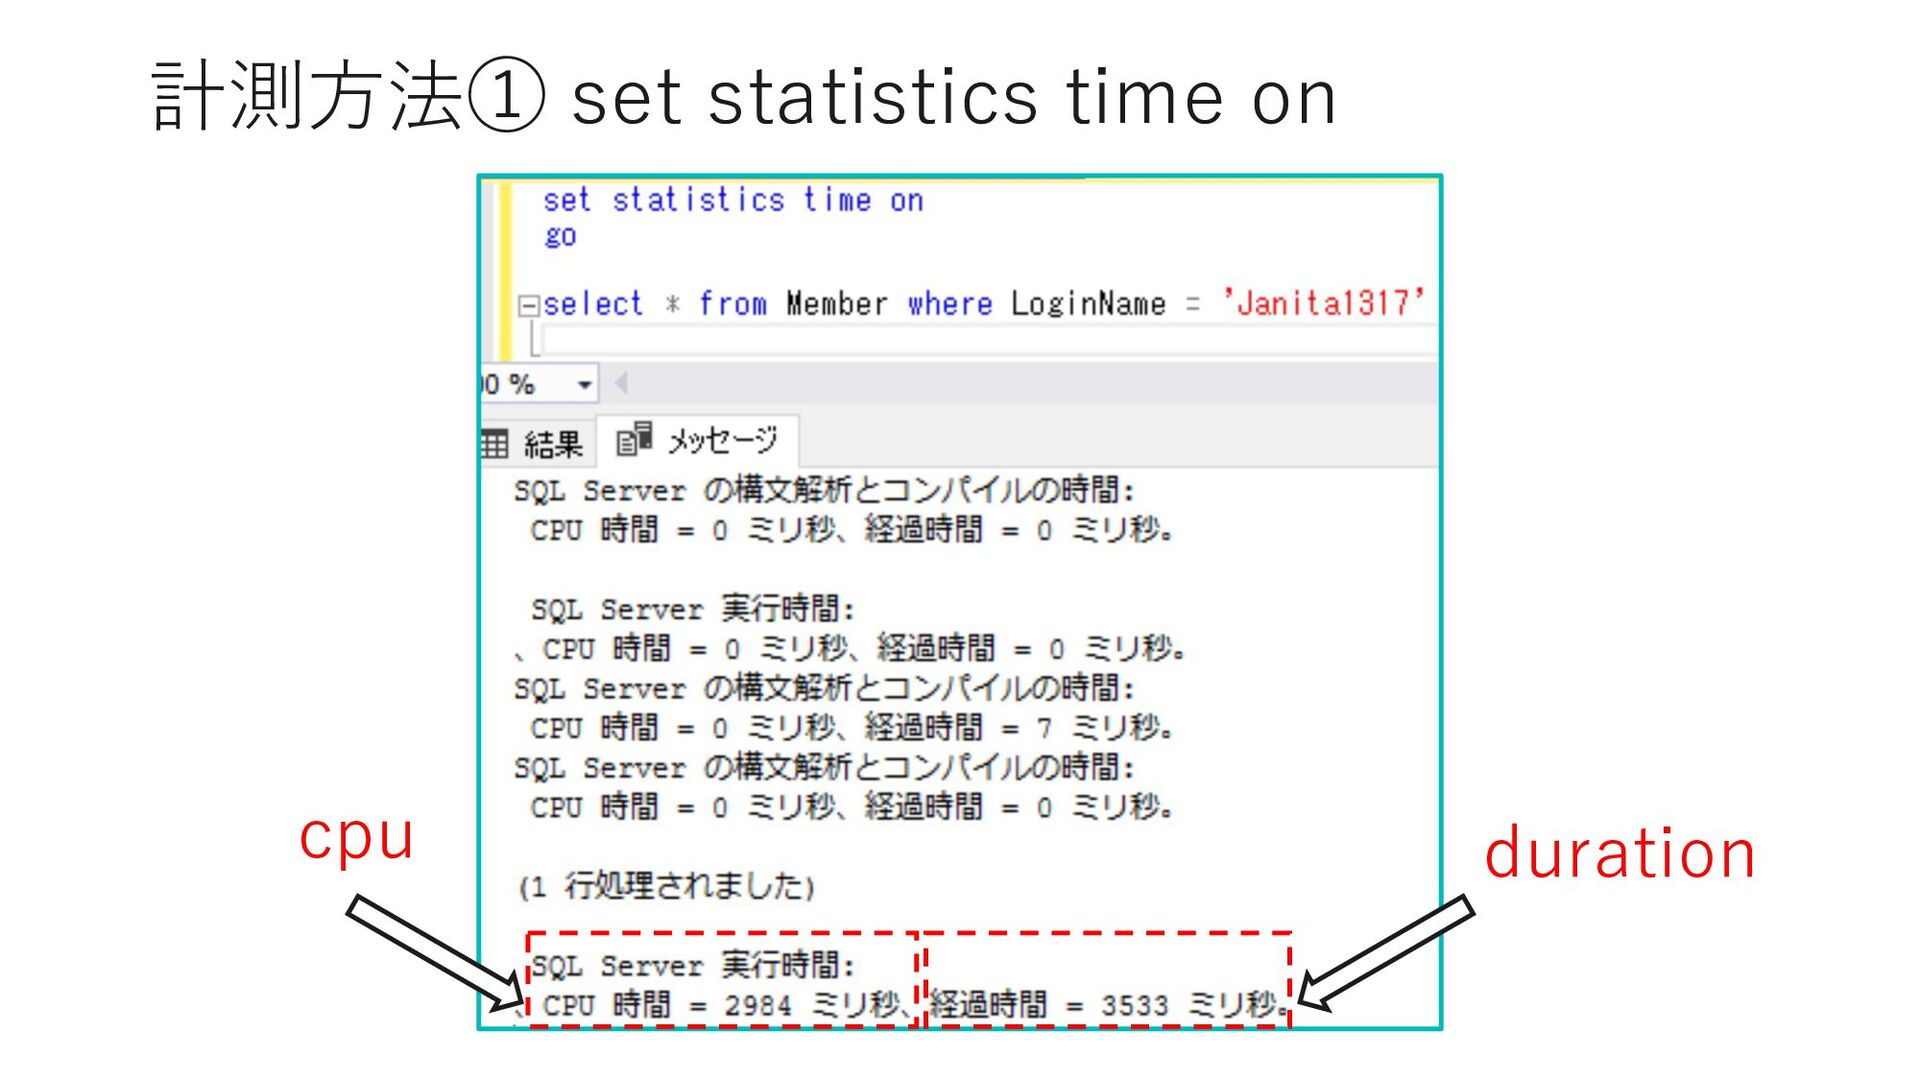
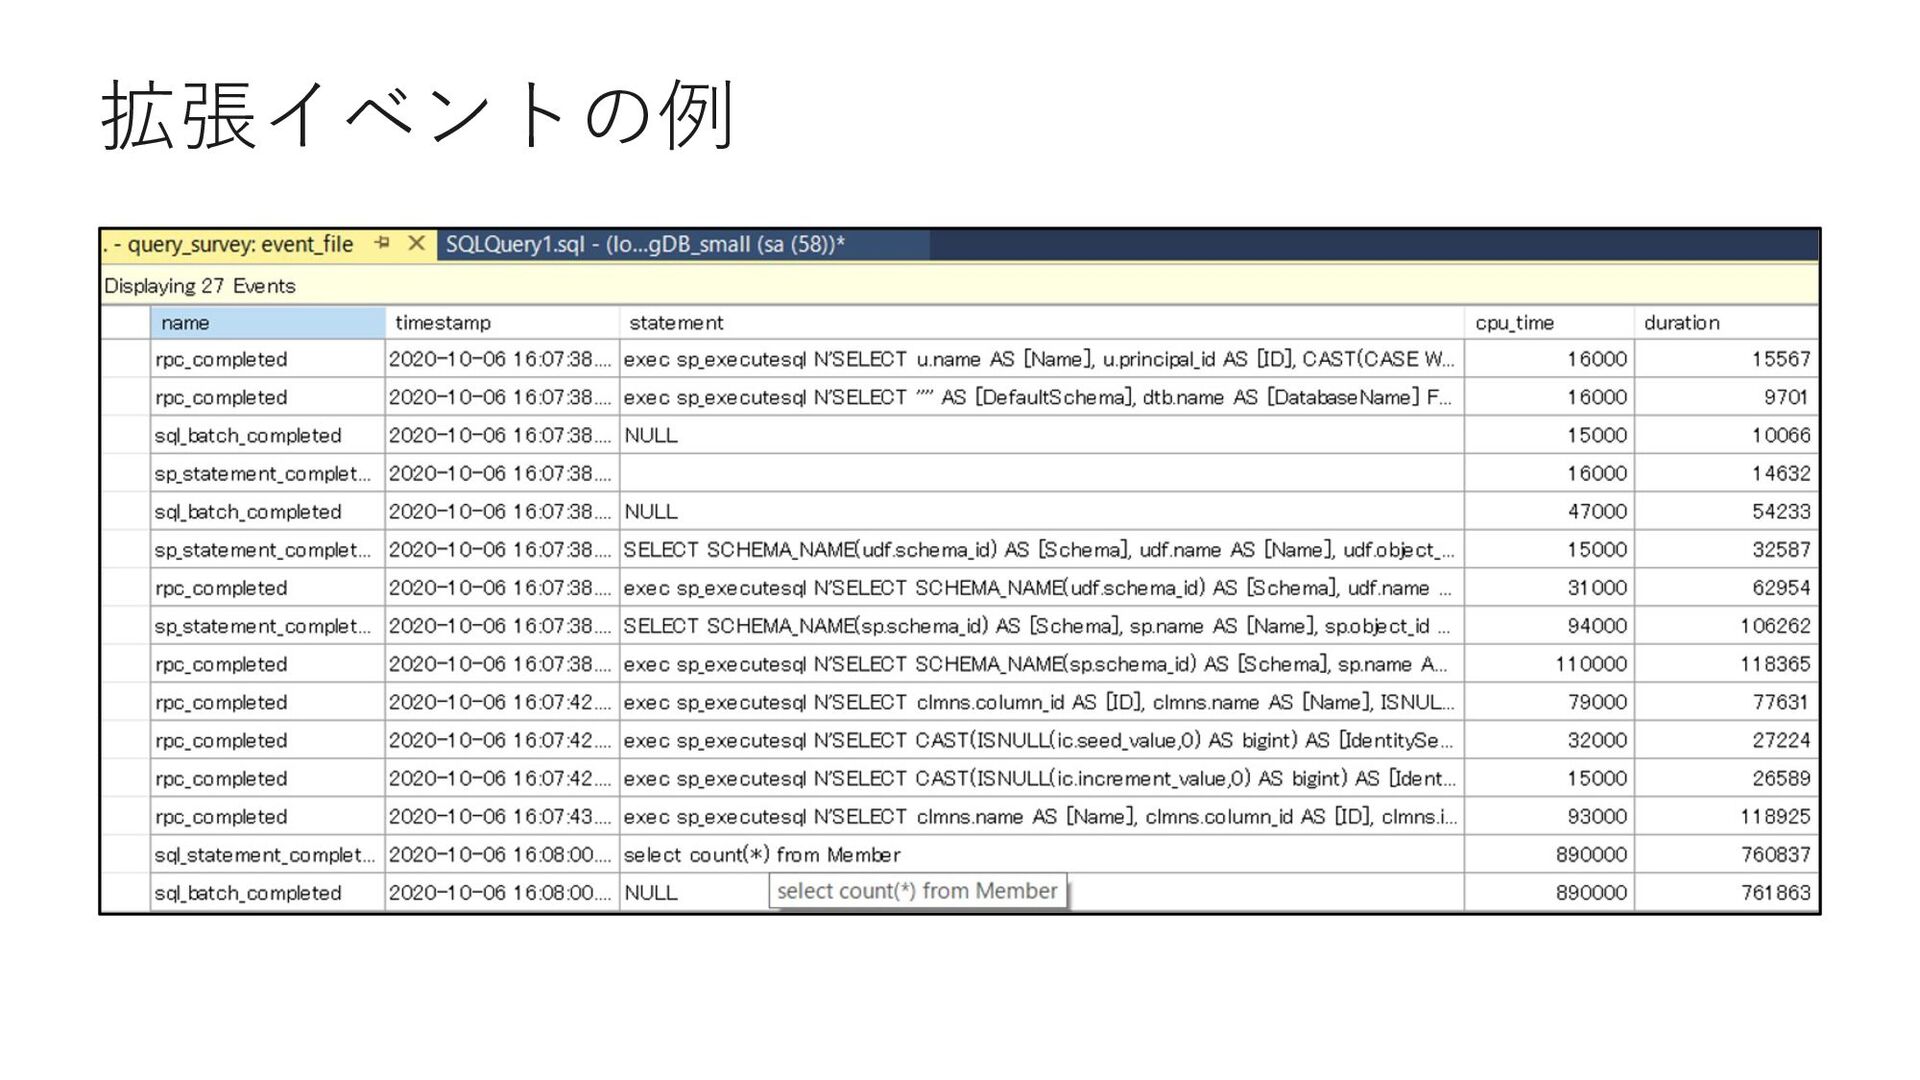
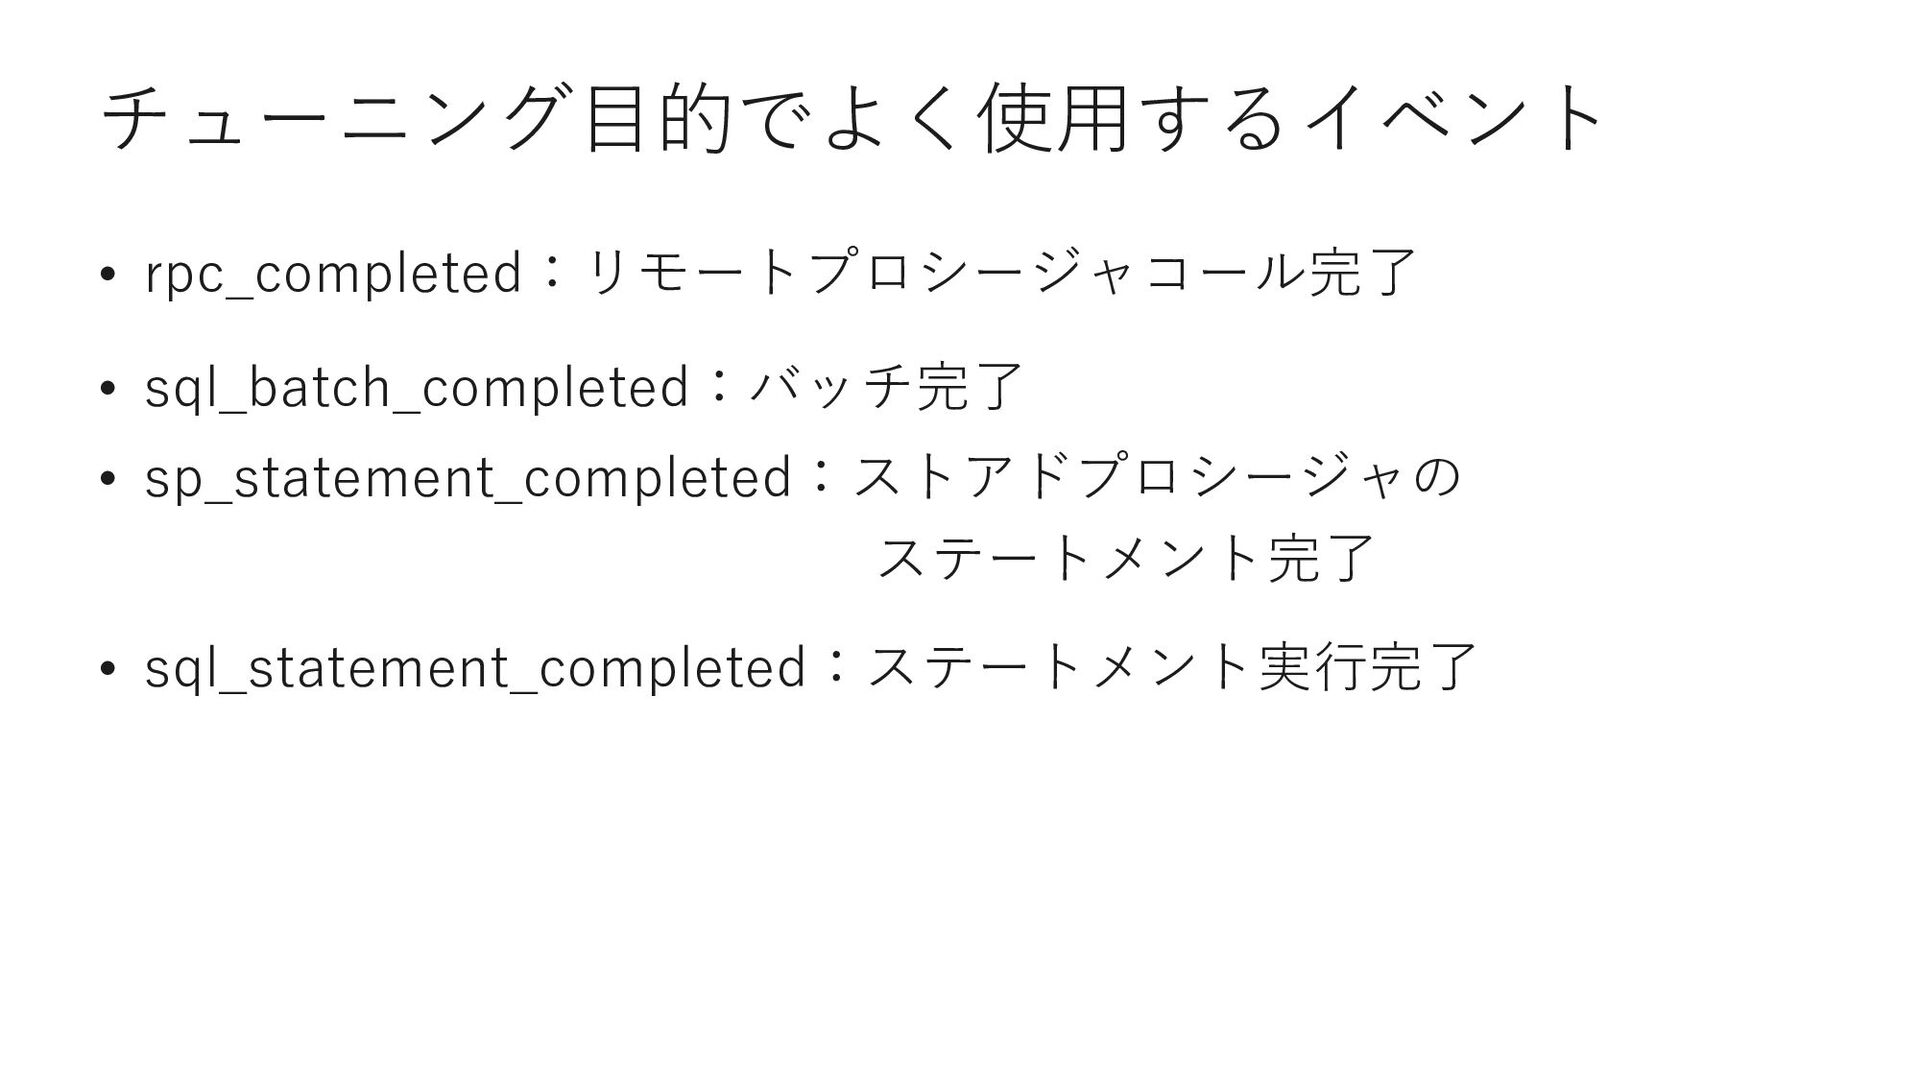
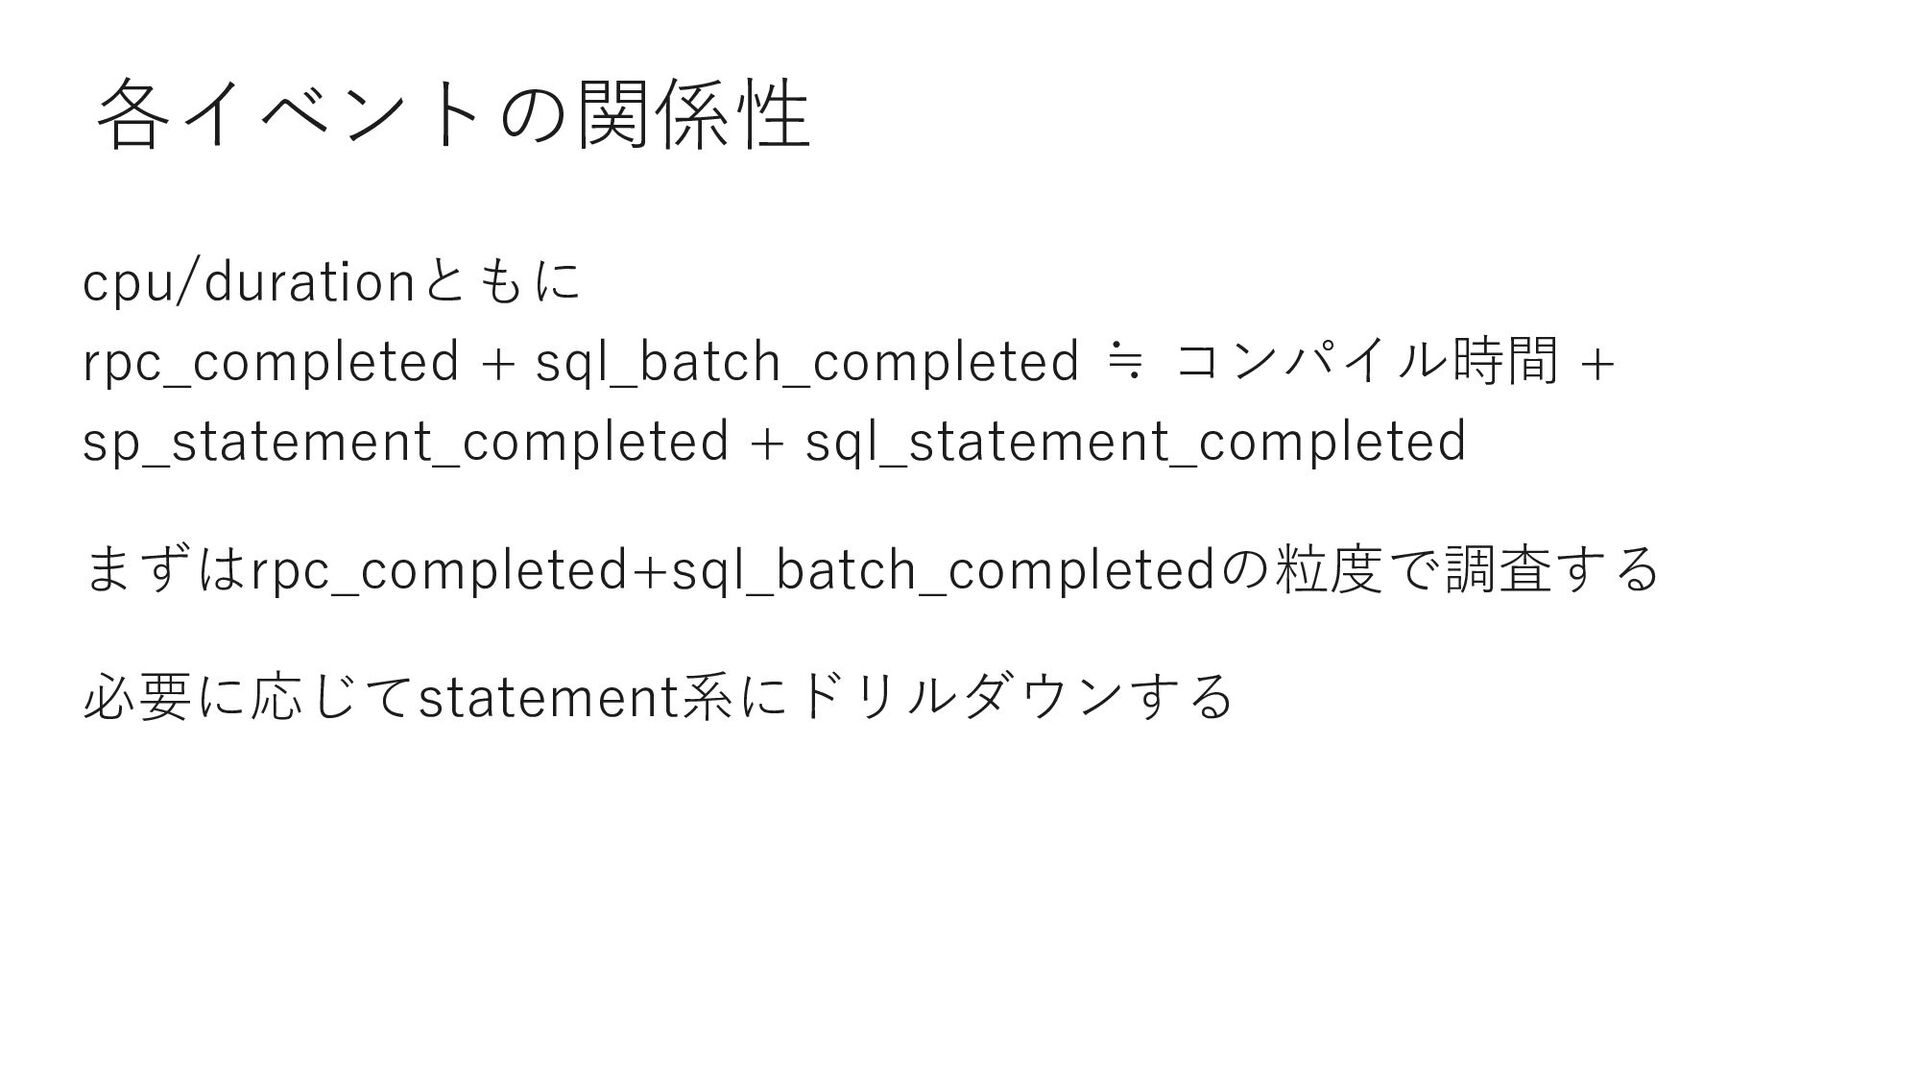
各イベントの関係性 cpu/durationともに rpc_completed + sql_batch_completed ≒ コンパイル時間 + sp_statement_completed +
sql_statement_completed まずはrpc_completed+sql_batch_completedの粒度で調査する 必要に応じてstatement系にドリルダウンする -
DMV(Dynamic Management View)とは • サーバーの情報が格納されたViewのこと。沢⼭種類がある • sys.dm_exec_query_stats ⇒ クエリの実⾏統計(cpu/durationなど)をキャッシュ •
累積値なので、2回情報を取得して差分をとれば該当時間帯の 各クエリのcpuやdurationの合計値を取得できる ⇒ 降順に並び替えると、cpu負荷をかけているクエリを⾒つけ るといったことが可能 -
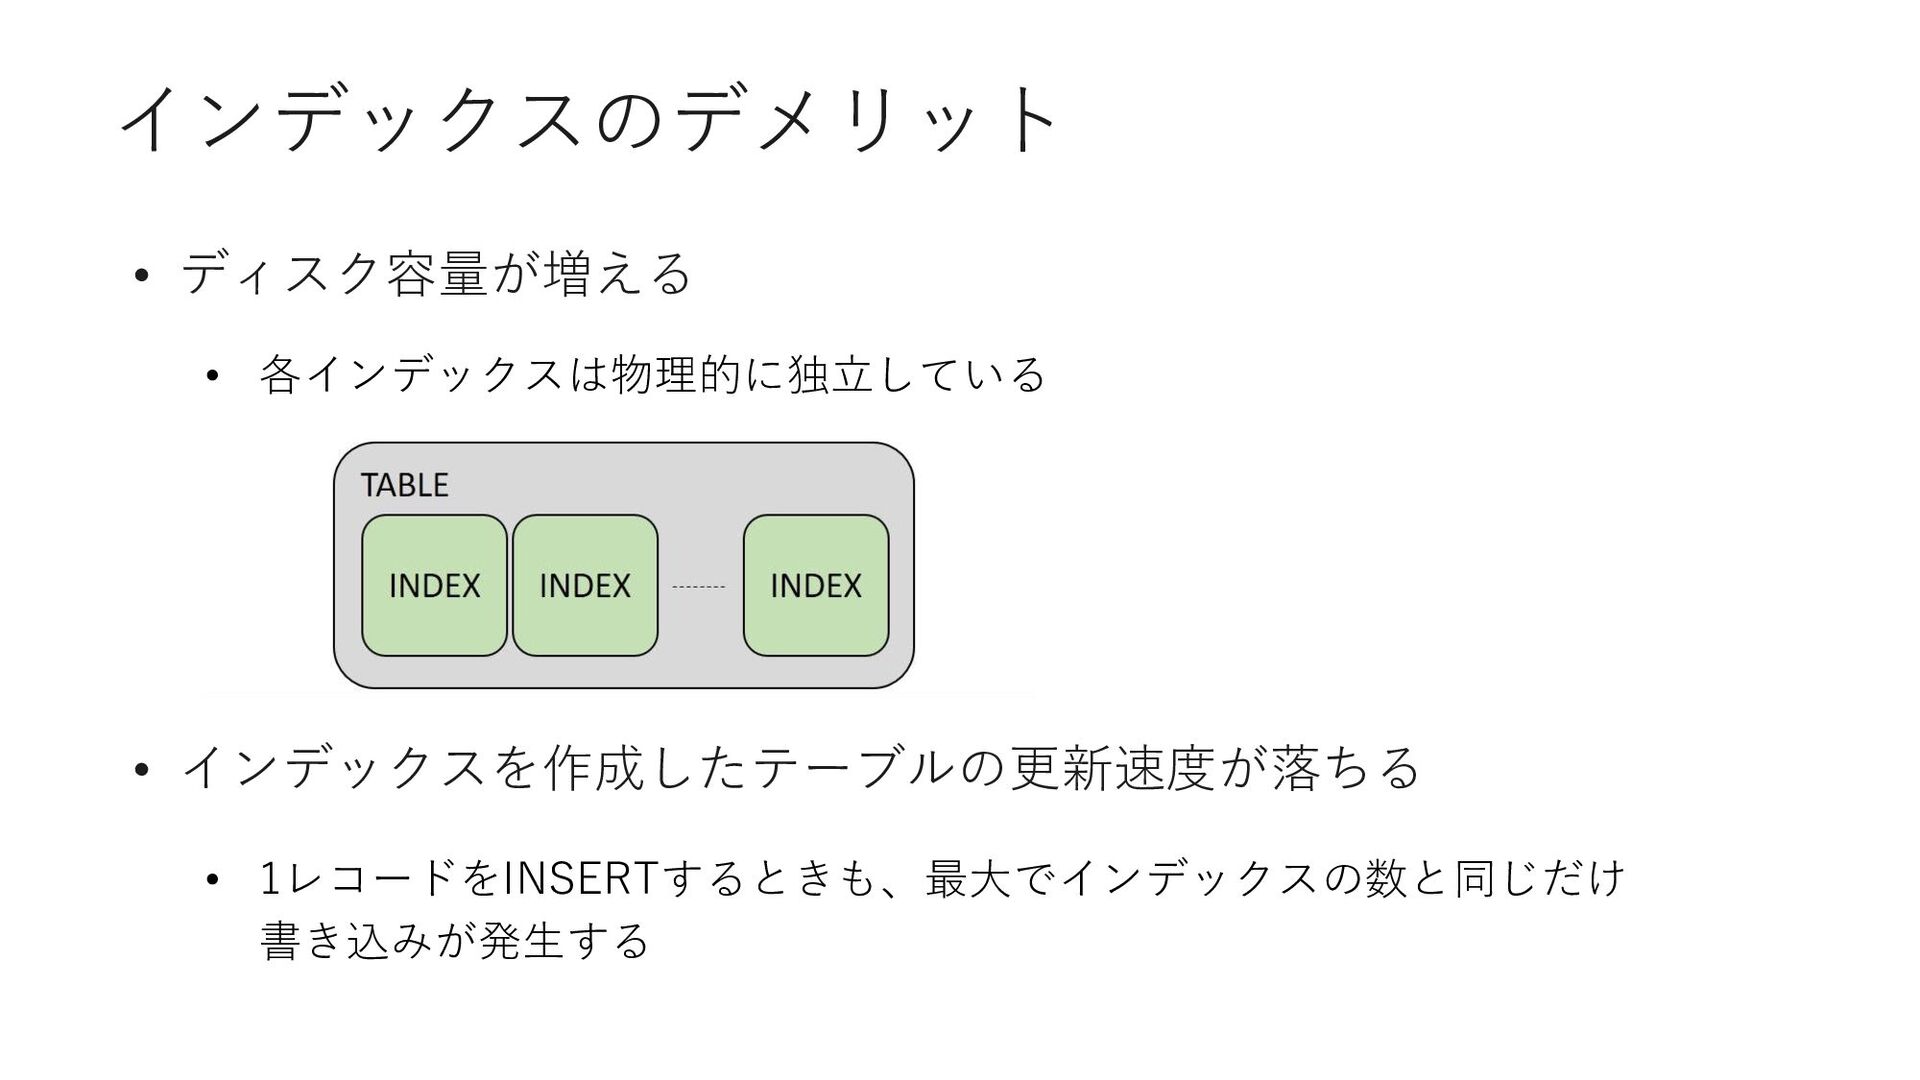
テーブルに作成すべきインデックスの数は? • ⼀般的にインデックスが増えるほど • 読み取りは⾼速になる • 更新は低速になる ⇒ 明確な答えはない •
あるテーブルAに作成すべき最適なインデックスは 「テーブルAを参照する全クエリの総実⾏時間を最⼩化する インデックスの組み合わせ」 -
インデックス作成のアンチパターン 各クエリごとに最適なインデックスを作成する ⇒ 似たインデックスが⼤量に作成される CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member]
( [LoginName] ASC ) INCLUDE (RegistDate) CREATE NONCLUSTERED INDEX [IX_Member_LoginName2] ON [dbo].[Member] ( [LoginName] ASC ) INCLUDE (Sei, Mei) CREATE NONCLUSTERED INDEX [IX_Member_LoginName3] ON [dbo].[Member] ( [LoginName] ASC, [RegistDate] ASC ) INCLUDE (Sei, Mei) CREATE NONCLUSTERED INDEX [IX_Member_LoginName4] ON [dbo].[Member] ( [LoginName] ASC ) INCLUDE (DeleteFlag) -
CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ( [LoginName] ASC )
INCLUDE (RegistDate) CREATE NONCLUSTERED INDEX [IX_Member_LoginName2] ON [dbo].[Member] ( [LoginName] ASC ) INCLUDE (Sei, Mei) CREATE NONCLUSTERED INDEX [IX_Member_LoginName3] ON [dbo].[Member] ( [LoginName] ASC, [RegistDate] ASC ) INCLUDE (Sei, Mei) CREATE NONCLUSTERED INDEX [IX_Member_LoginName4] ON [dbo].[Member] ( [LoginName] ASC ) INCLUDE (DeleteFlag) CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ( [LoginName] ASC , [RegistDate] ASC ) INCLUDE (RegistDate, Sei, Mei, DeleteFlag) -
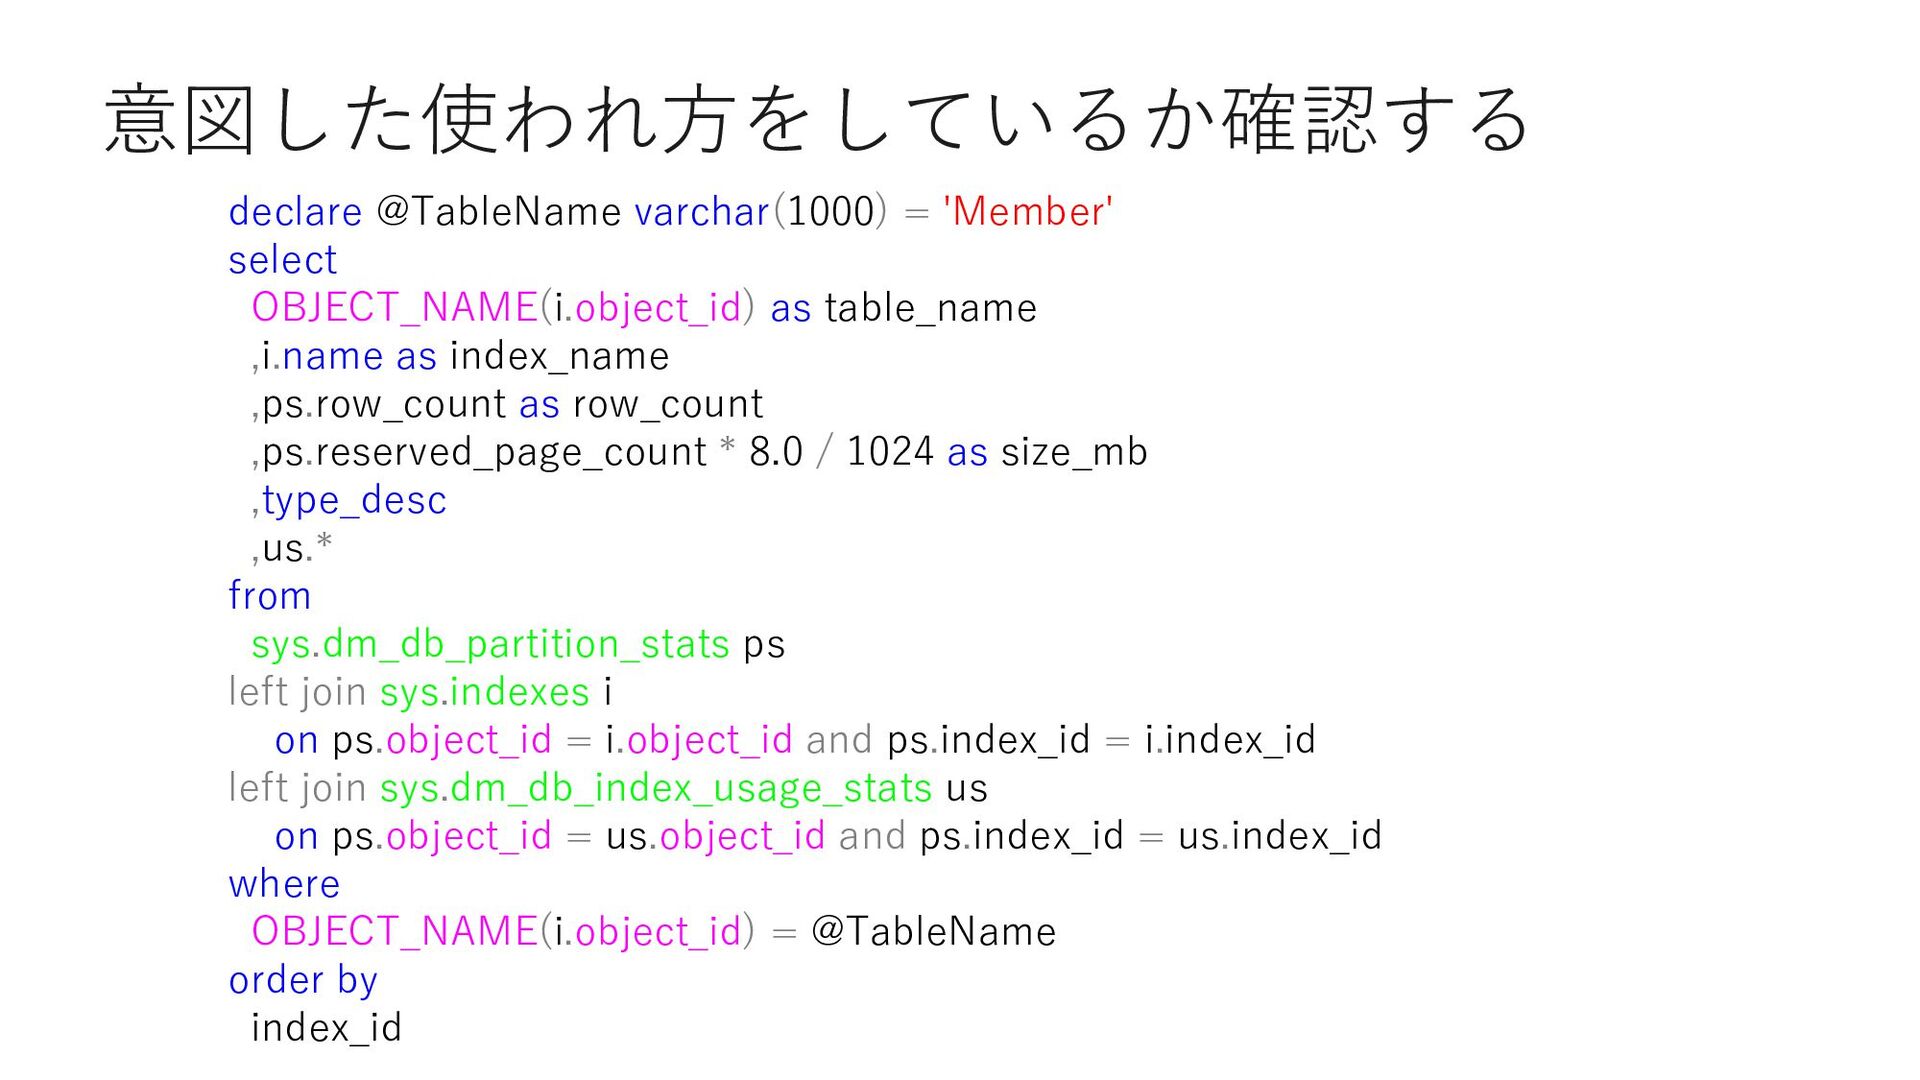
意図した使われ⽅をしているか確認する declare @TableName varchar(1000) = 'Member' select OBJECT_NAME(i.object_id) as table_name
,i.name as index_name ,ps.row_count as row_count ,ps.reserved_page_count * 8.0 / 1024 as size_mb ,type_desc ,us.* from sys.dm_db_partition_stats ps left join sys.indexes i on ps.object_id = i.object_id and ps.index_id = i.index_id left join sys.dm_db_index_usage_stats us on ps.object_id = us.object_id and ps.index_id = us.index_id where OBJECT_NAME(i.object_id) = @TableName order by index_id -
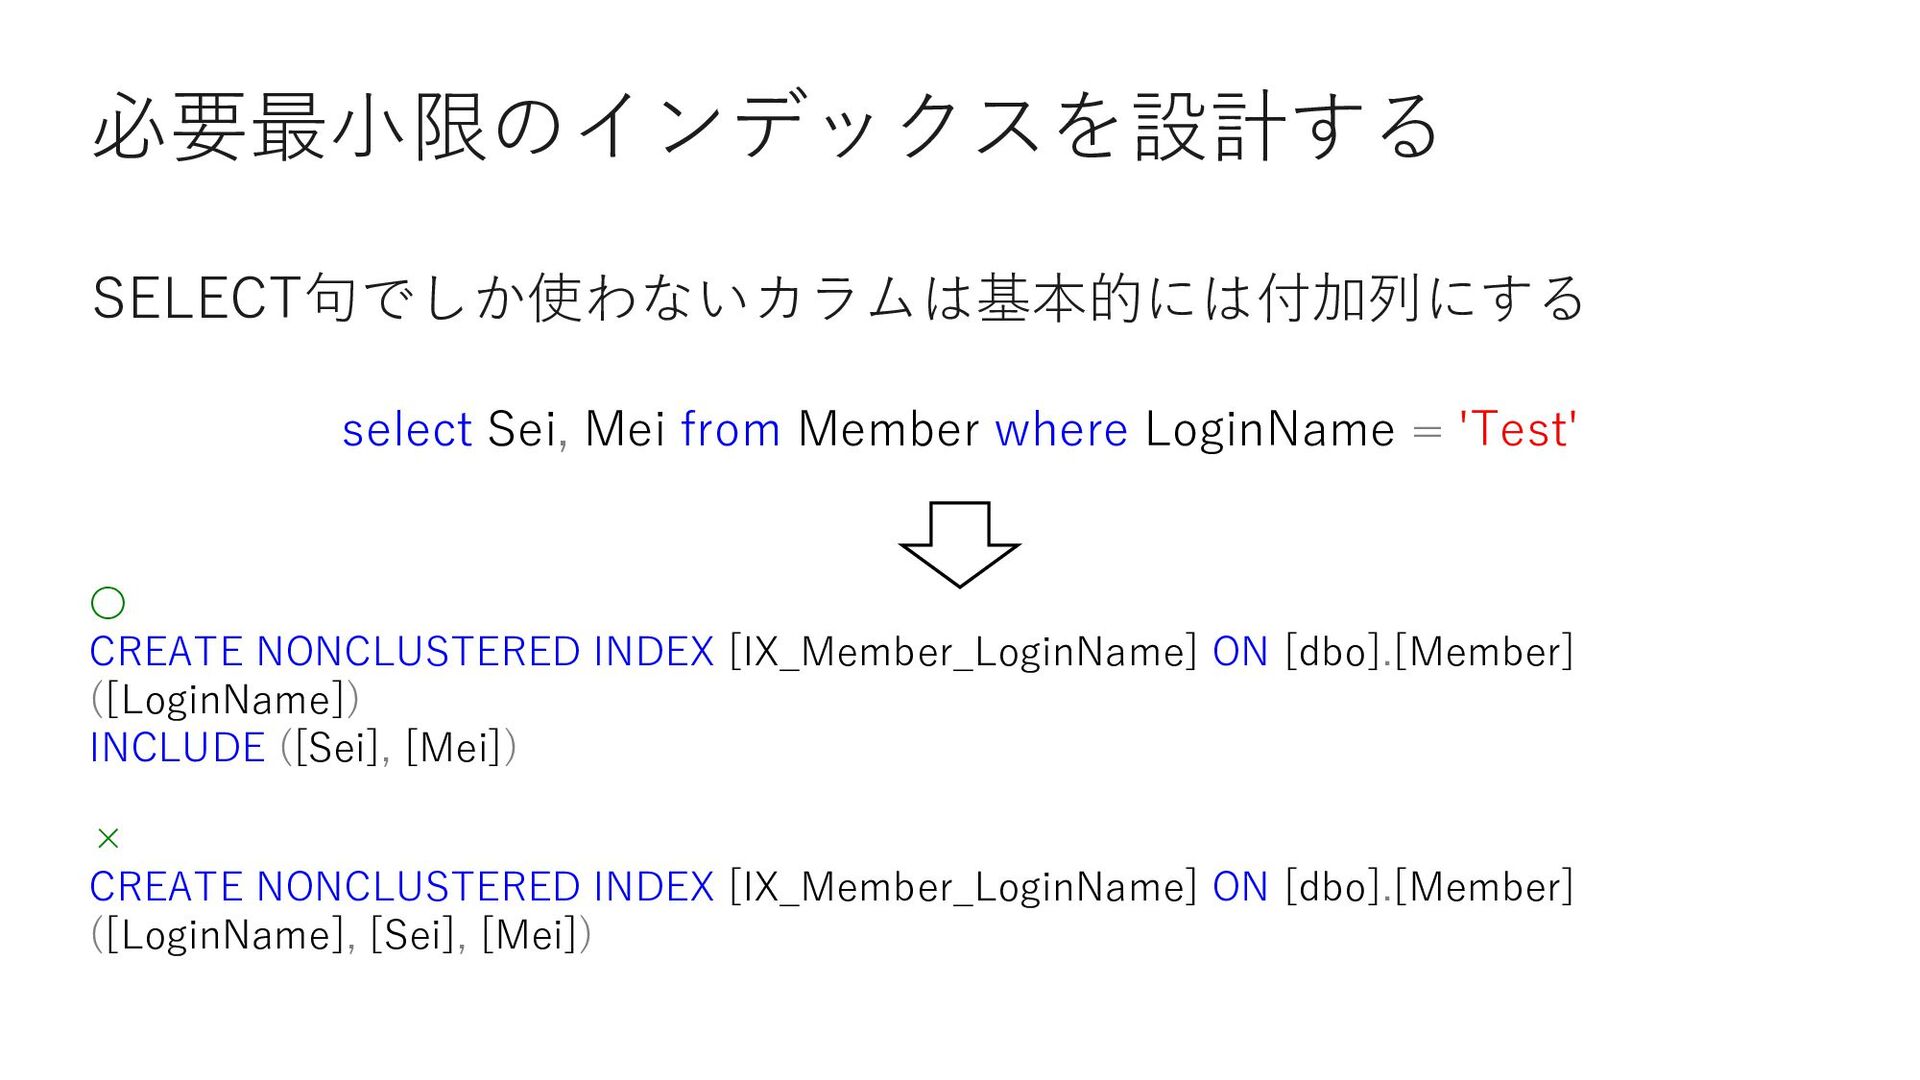
必要最⼩限のインデックスを設計する SELECT句でしか使わないカラムは基本的には付加列にする select Sei, Mei from Member where LoginName =
'Test' 〇 CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName]) INCLUDE ([Sei], [Mei]) × CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName], [Sei], [Mei]) -
なぜSELECT⽤カラムは付加列か? ・付加列として加えておいた⽅がインデックスに拡張性がある select top 10 Sei, Mei from Member where
LoginName like 'Te%' and DeleteFlag = 1 • 例えば、上記のクエリを使った処理を 新しくリリースした場合を考慮する -
付加列にしたインデックスの場合 ・既存のインデックスを⼀度DROPして作り直せばOK CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName]) INCLUDE
([Sei], [Mei]) CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName], [DeleteFlag]) INCLUDE ([Sei], [Mei]) ・ひとつのインデックスで2種類のクエリに対応可能 -
CREATE NONCLUSTERED INDEX [IX_Memaber_LoginName] ON [dbo].[Member] ([LoginName], [DeleteFlag]) INCLUDE ([Sei],
[Mei]) select Sei, Mei from Member where LoginName like 'Te%' and DeleteFlag = 1 select Sei, Mei from Member where LoginName = 'Test' -
付加列にしないインデックスの場合 • 追加で別のインデックスを作るしかなくなる CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName],
[Sei], [Mei]) CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName], [DeleteFlag], [Sei], [Mei]) • このインデックスにまとめようとするのはNG。なぜか? -
• インデックスを修正する時点でプロダクション環境で 実⾏されている全クエリを把握するのは難しい CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName],
[Sei], [Mei]) select * from Member where LoginName = 'Test' and Sei = 'aaa' and Mei = 'bbb' • この既存インデックスだけみると、下記のようなクエリが すでに実⾏されていると考えるのが妥当 ・よってインデックスを増やすしかなくなる -
• 結果的に以下のふたつのインデックスを作成する必要が出てくる CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName], [Sei],
[Mei]) CREATE NONCLUSTERED INDEX [IX_Member_LoginName2] ON [dbo].[Member] ([LoginName], [DeleteFlag], [Sei], [Mei]) • 無駄な容量や更新時のコスト増につながる -
・⼀般化:良いselectivityが得られる最⼩カラム構成をとる 例:MemberテーブルはLoginNameでUniqueとなる性質がある ↓これが0レコード select LoginName from Member group by LoginName
having count(*) > 1 select Sei, Mei from Member where LoginName = 'Test' and DeleteFlag = 1 CREATE NONCLUSTERED INDEX [IX_Member_LoginName] ON [dbo].[Member] ([LoginName]) INCLUDE ([Sei], [Mei], [DeleteFlag]) ・したがって、上記のクエリのインデックスは下記でOK -
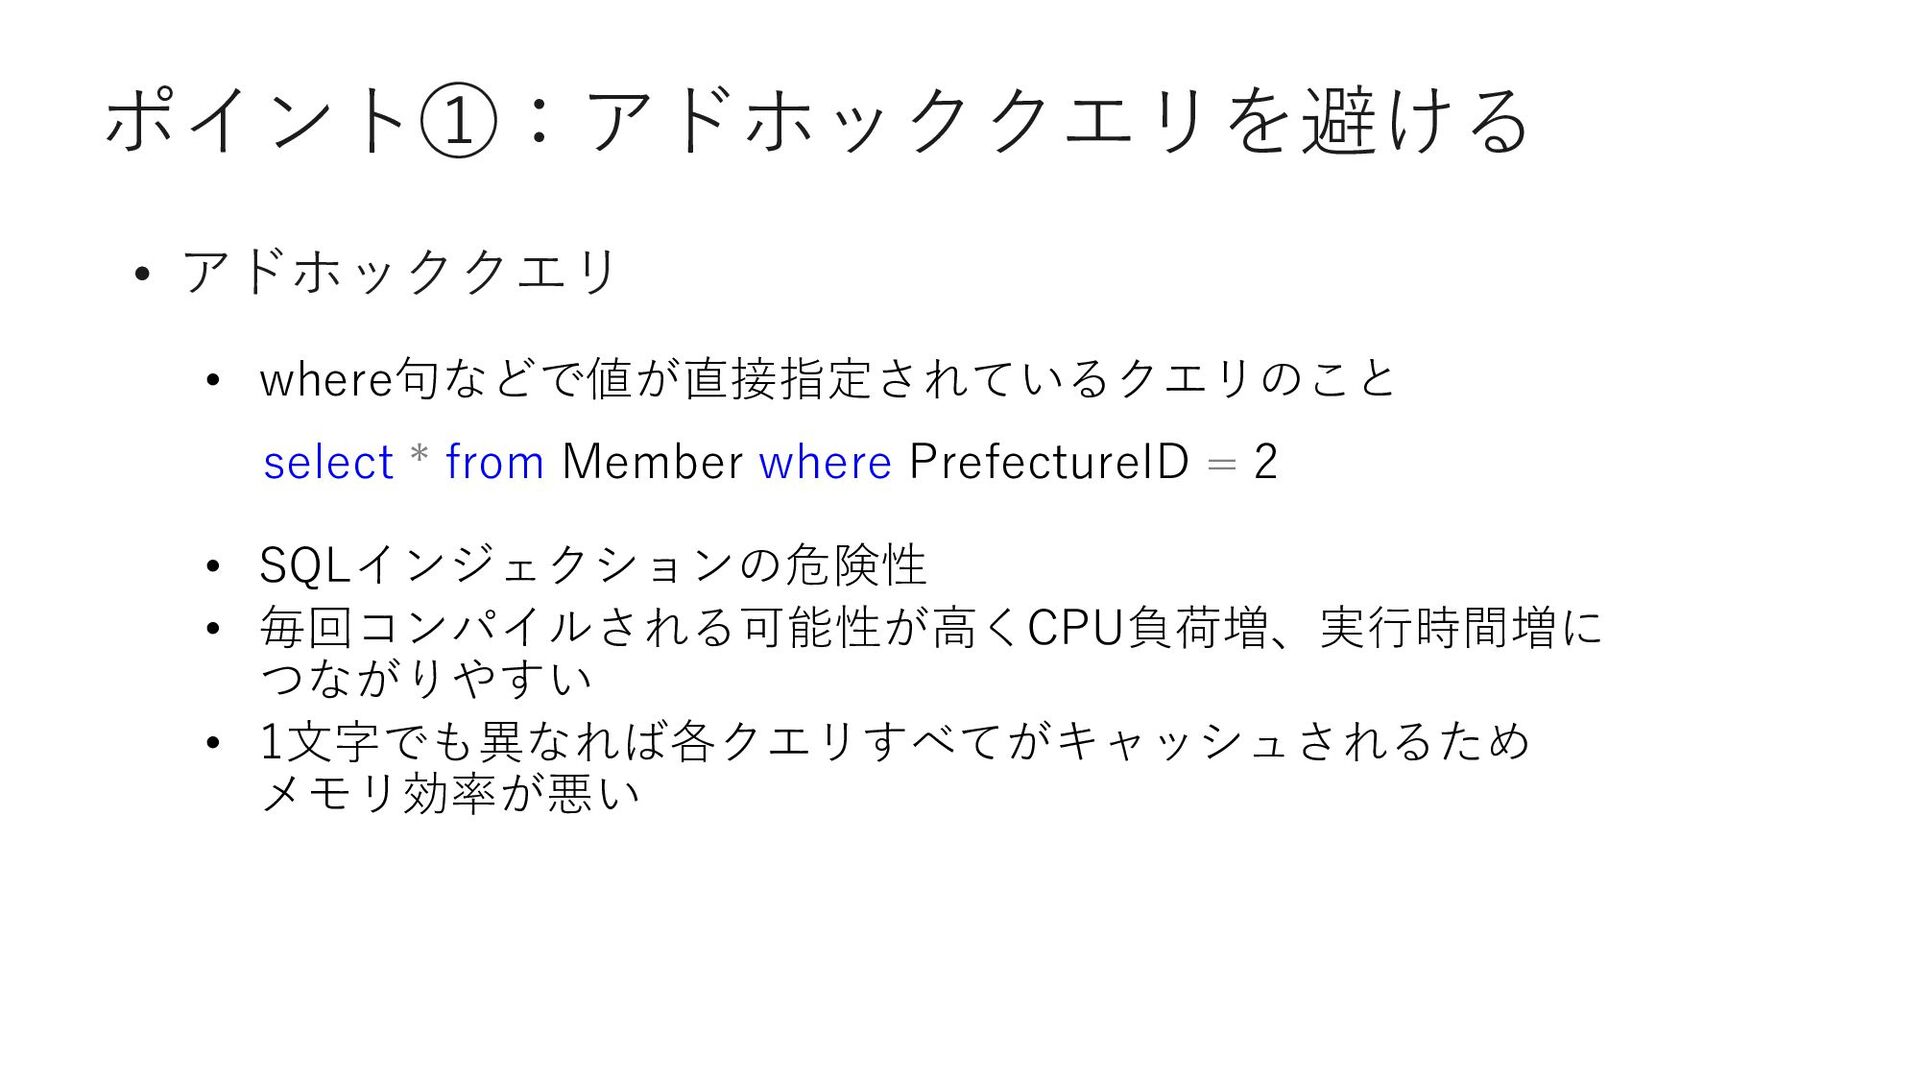
ポイント①:アドホッククエリを避ける • アドホッククエリ • where句などで値が直接指定されているクエリのこと • SQLインジェクションの危険性 • 毎回コンパイルされる可能性が⾼くCPU負荷増、実⾏時間増に つながりやすい
• 1⽂字でも異なれば各クエリすべてがキャッシュされるため メモリ効率が悪い select * from Member where PrefectureID = 2 -
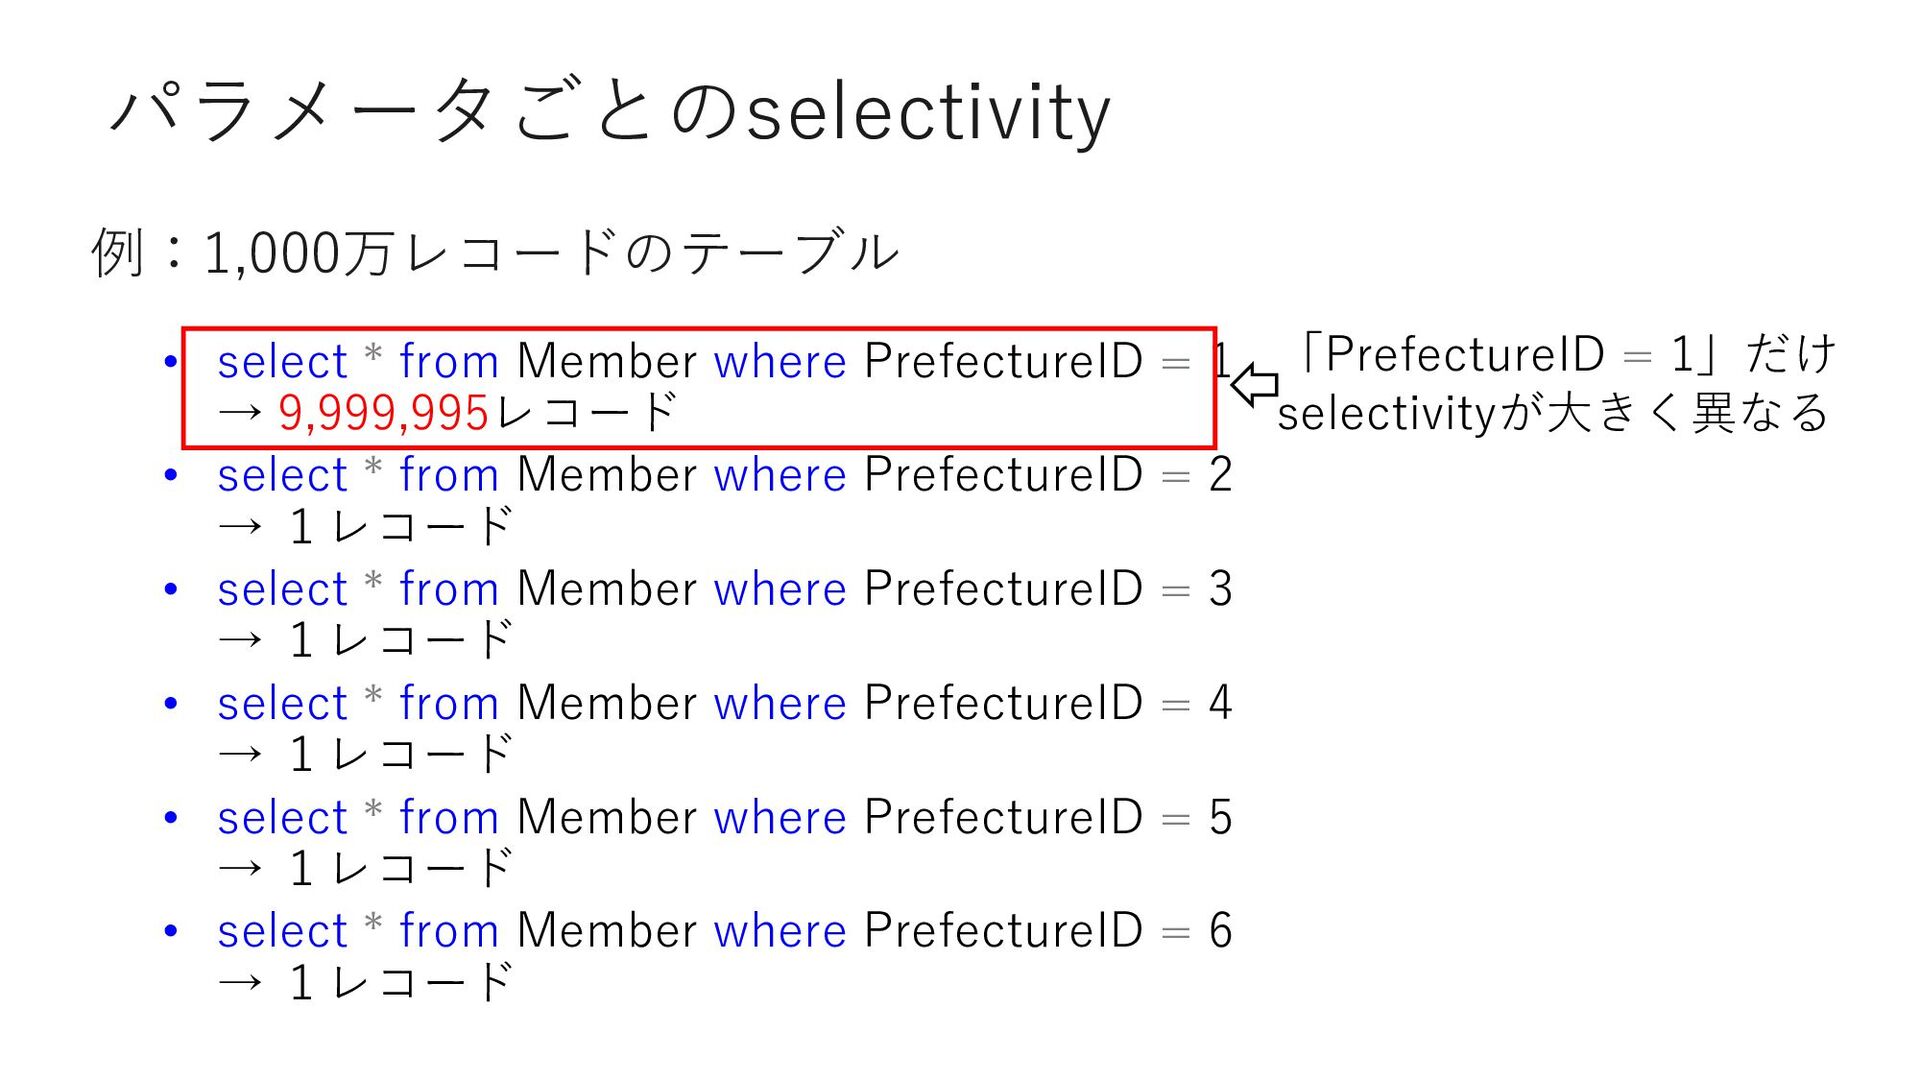
パラメータごとのselectivity 例:1,000万レコードのテーブル • select * from Member where PrefectureID =
1 → 9,999,995レコード • select * from Member where PrefectureID = 2 → 1レコード • select * from Member where PrefectureID = 3 → 1レコード • select * from Member where PrefectureID = 4 → 1レコード • select * from Member where PrefectureID = 5 → 1レコード • select * from Member where PrefectureID = 6 → 1レコード 「PrefectureID = 1」だけ selectivityが⼤きく異なる -
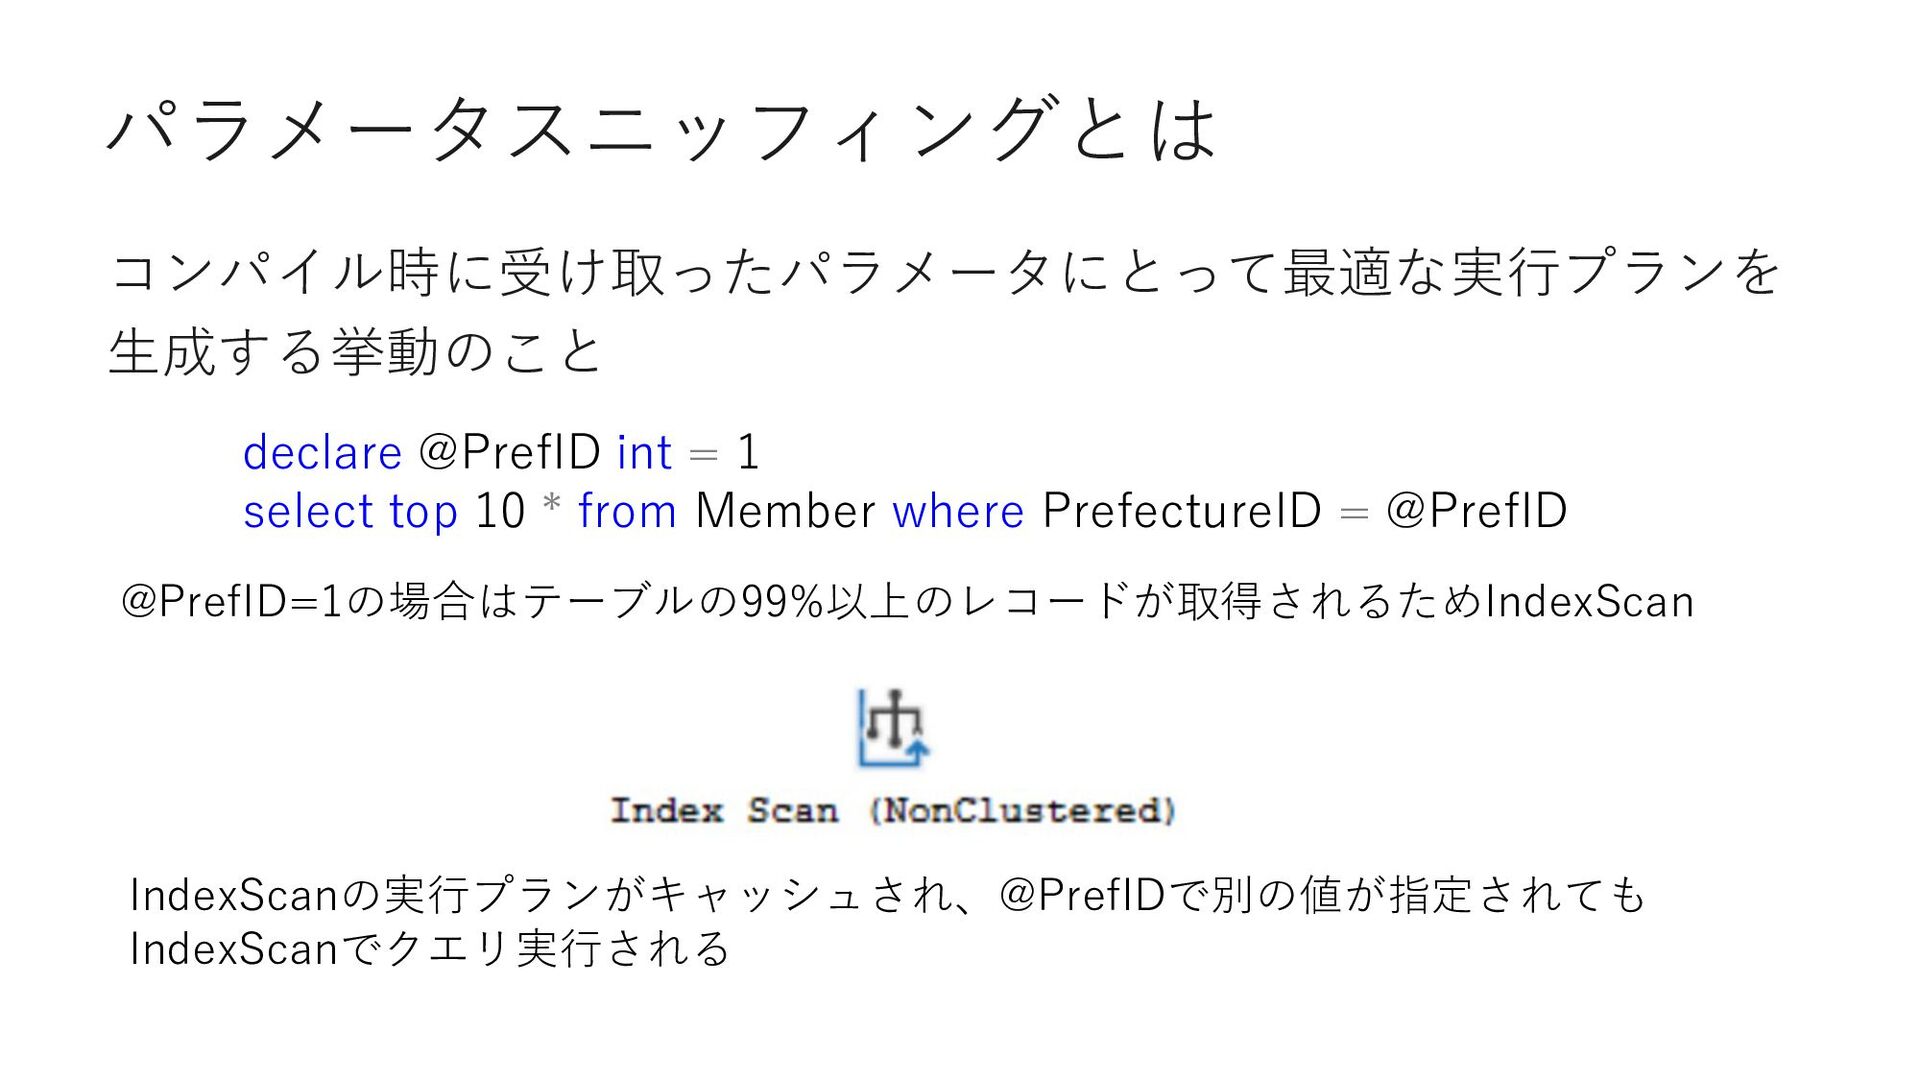
パラメータスニッフィングとは コンパイル時に受け取ったパラメータにとって最適な実⾏プランを ⽣成する挙動のこと declare @PrefID int = 1 select top
10 * from Member where PrefectureID = @PrefID IndexScanの実⾏プランがキャッシュされ、@PrefIDで別の値が指定されても IndexScanでクエリ実⾏される @PrefID=1の場合はテーブルの99%以上のレコードが取得されるためIndexScan -
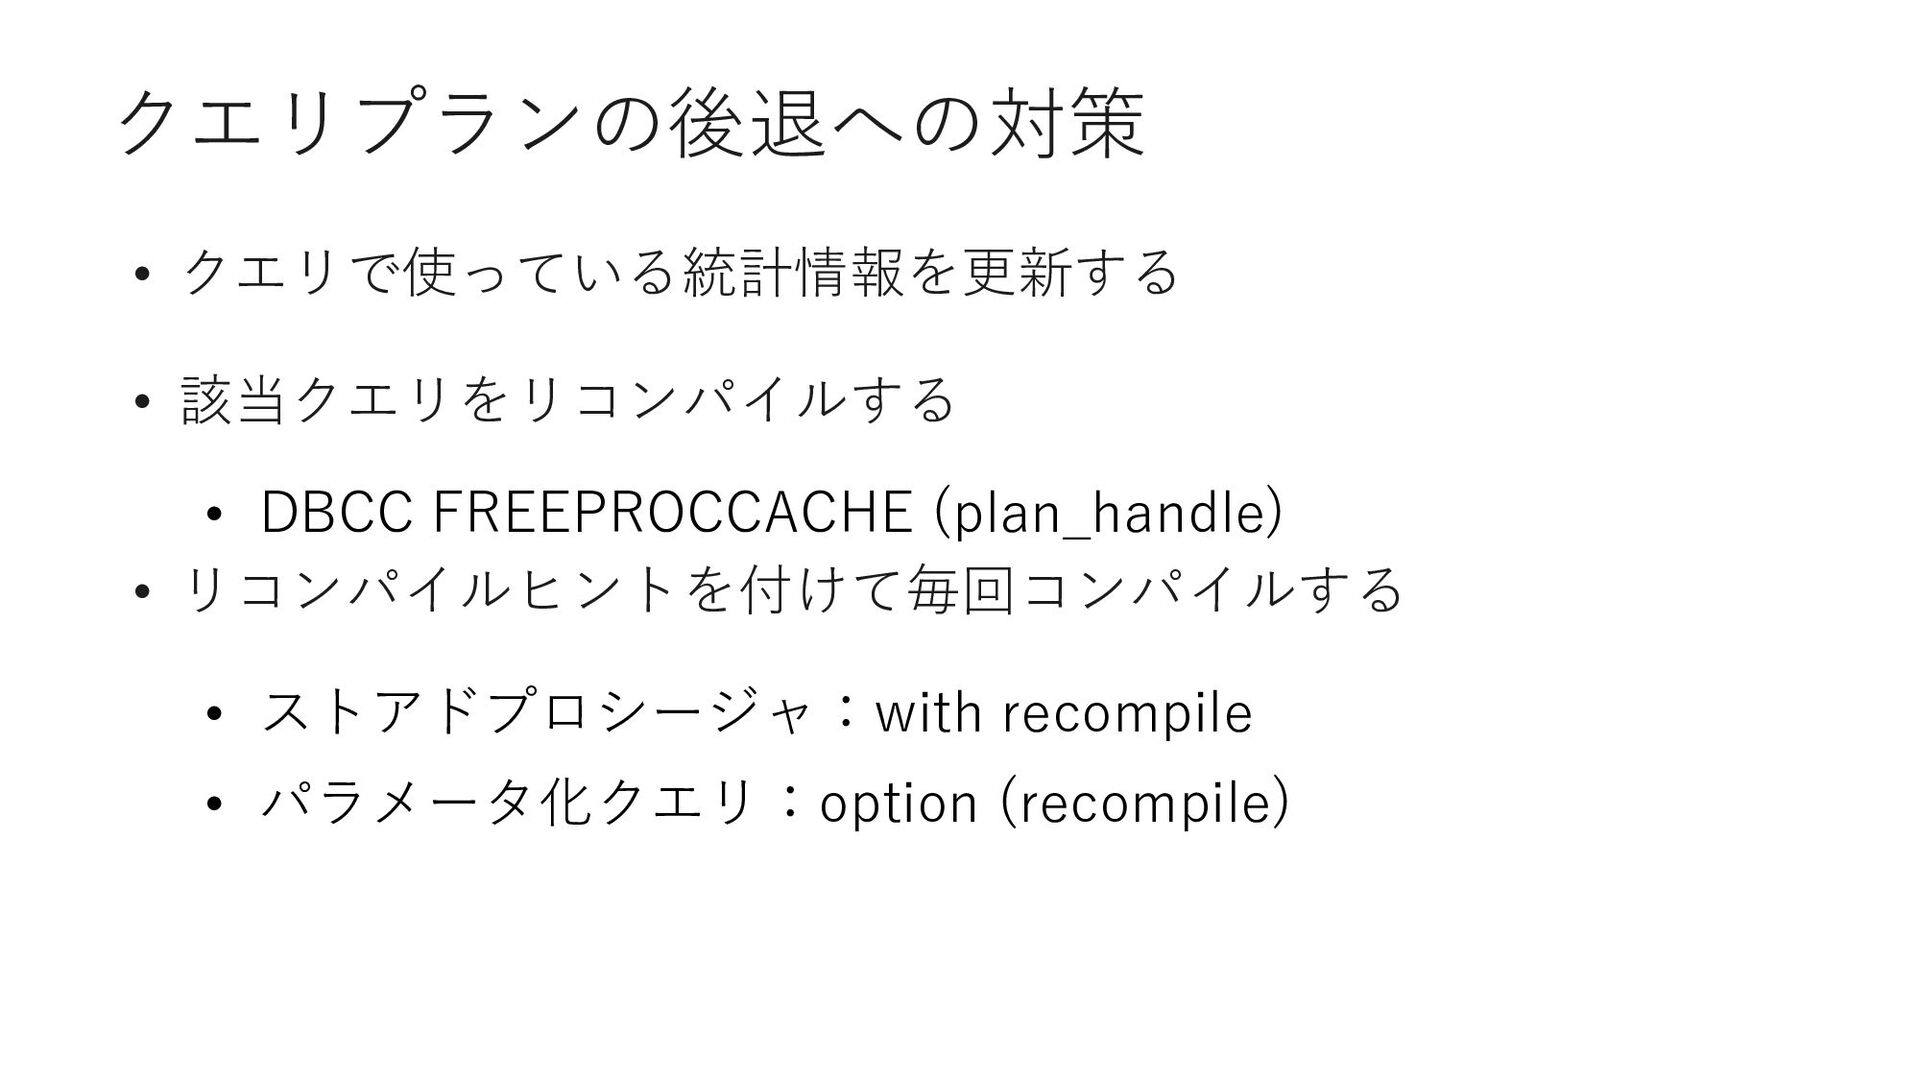
クエリプランの後退への対策 • クエリで使っている統計情報を更新する • 該当クエリをリコンパイルする • DBCC FREEPROCCACHE (plan_handle) •
リコンパイルヒントを付けて毎回コンパイルする • ストアドプロシージャ:with recompile • パラメータ化クエリ:option (recompile) -
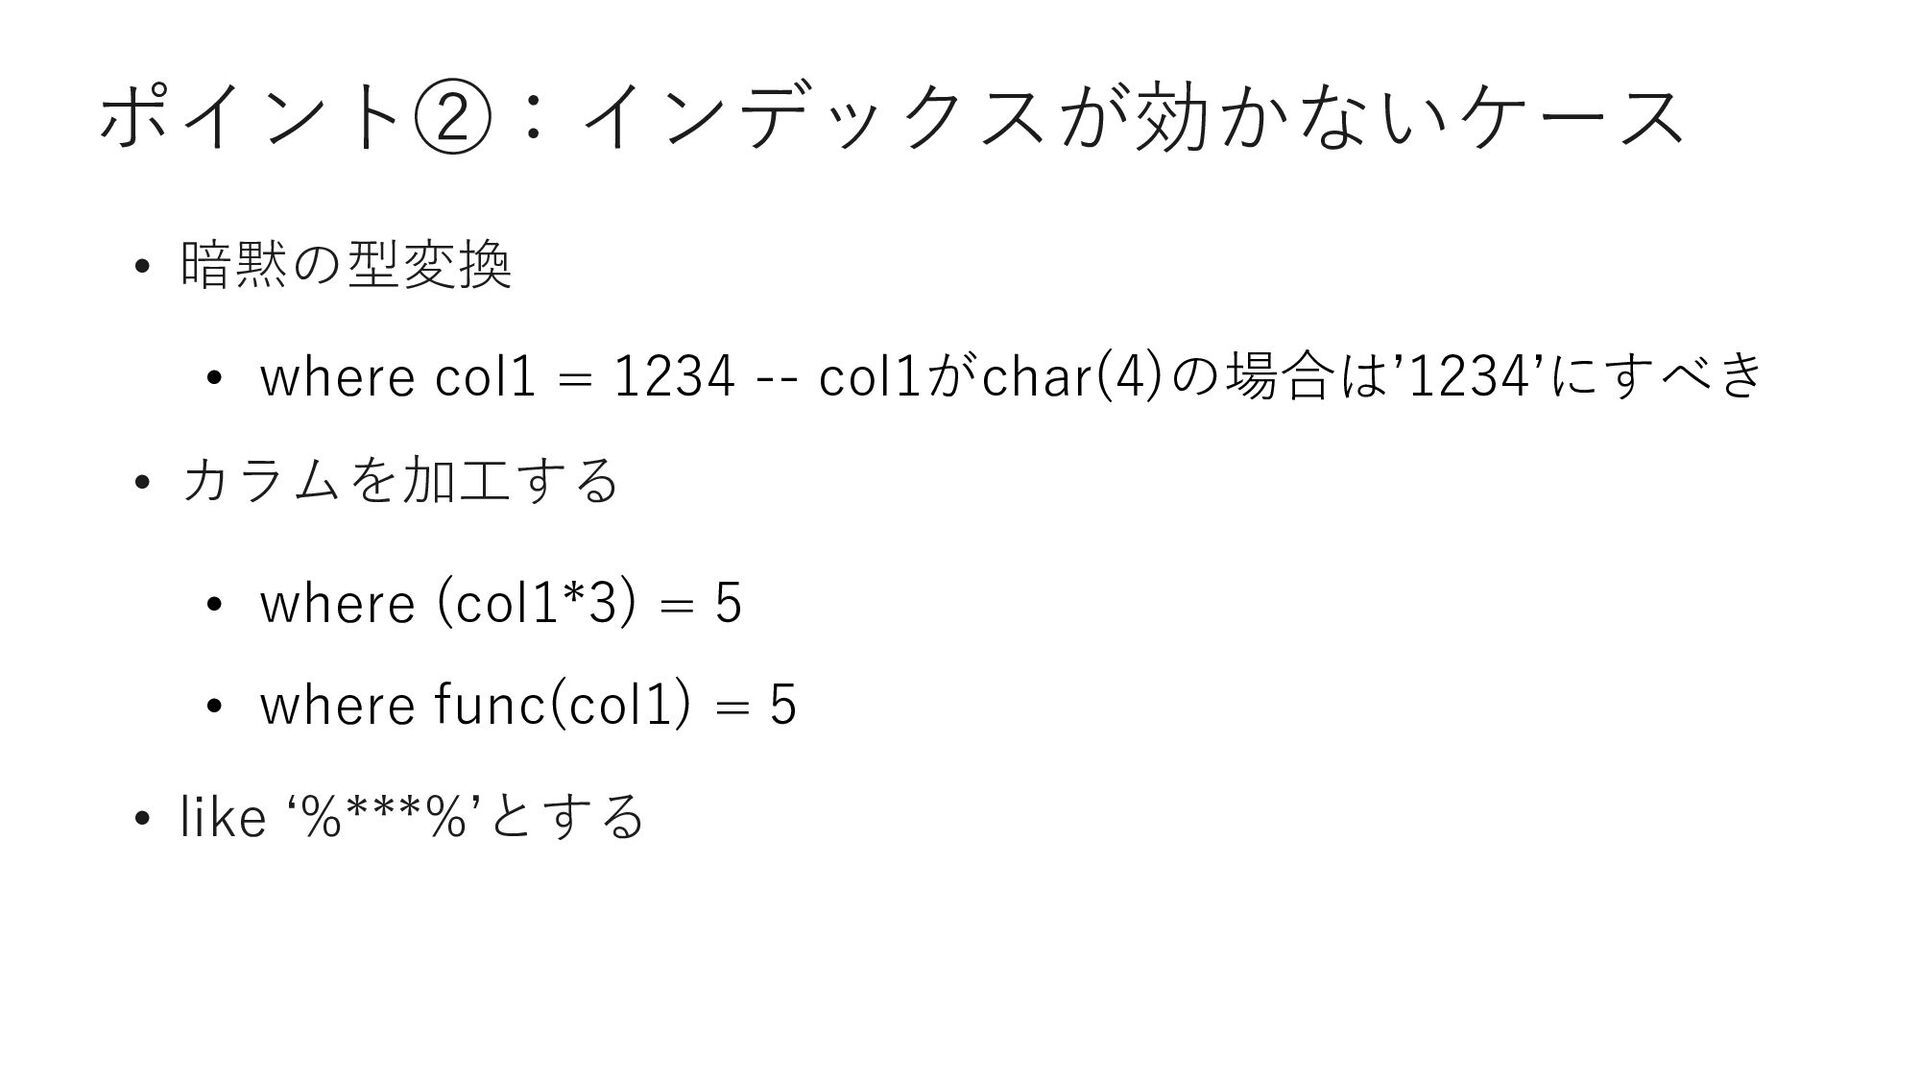
ポイント②:インデックスが効かないケース • 暗黙の型変換 • where col1 = 1234 -- col1がchar(4)の場合はʼ1234ʼにすべき
• カラムを加⼯する • where (col1*3) = 5 • where func(col1) = 5 • like ʻ%***%ʼとする -
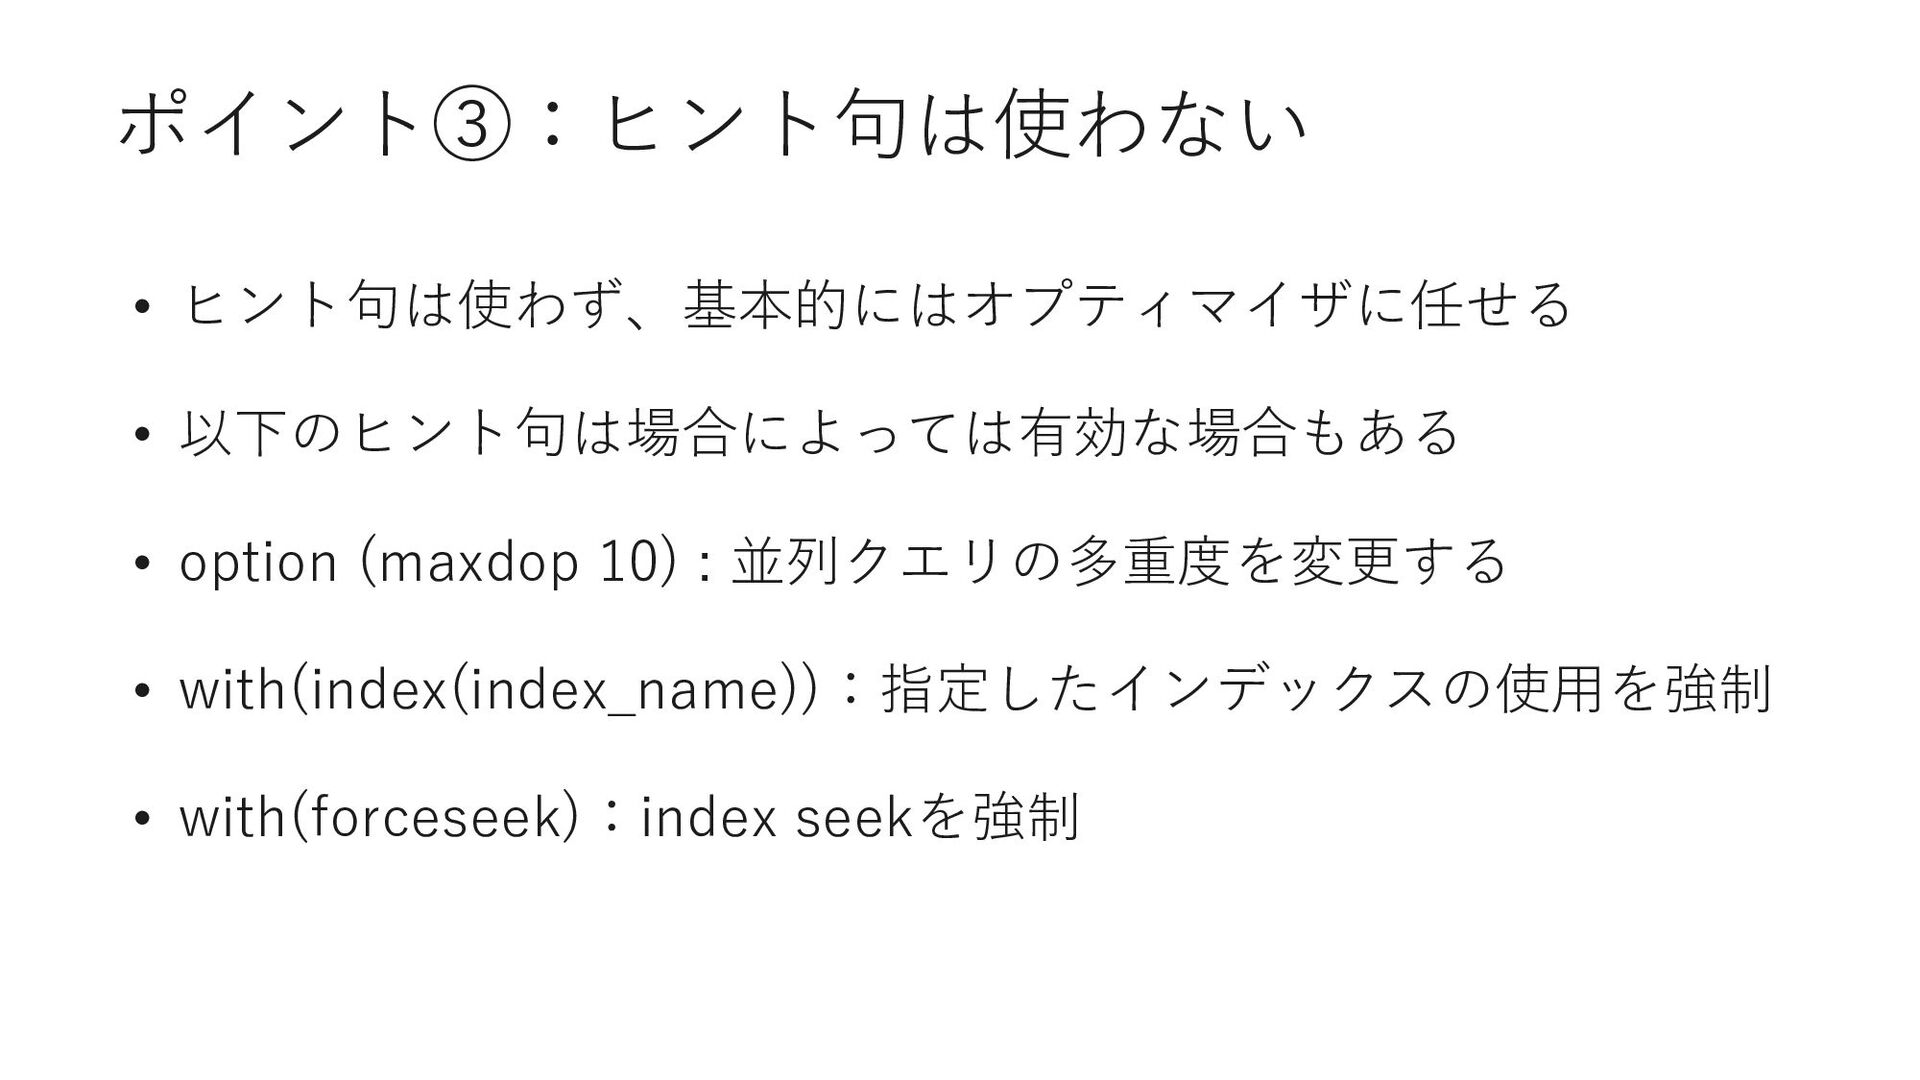
ポイント③:ヒント句は使わない • ヒント句は使わず、基本的にはオプティマイザに任せる • 以下のヒント句は場合によっては有効な場合もある • option (maxdop 10) :
並列クエリの多重度を変更する • with(index(index_name)):指定したインデックスの使⽤を強制 • with(forceseek):index seekを強制 -
問題:全体最適な観点でインデックスを再設計 してください ① CREATE INDEX [IX_Member_Tel] ON [Member] ([tel]) INCLUDE
([RegistDate]) ② CREATE INDEX [IX_Member_LoginName] ON [Member] ([LoginName]) INCLUDE ([Sei], [Mei]) ③ CREATE INDEX [IX_Member_LoginName2] ON [Member] ([LoginName]) INCLUDE ([GenderID], [PrefectureID]) ④ CREATE INDEX [IX_Member_DeleteFlag_RegistDate] ON [Member] ([DeleteFlag], [RegistDate]) ⑤ CREATE INDEX [IX_Member_LoginName_HashedPassword] ON [Member] ([LoginName], [HashedPassword]) INCLUDE ([DeleteFlag]) ⑥ -
解説① ① + ⑥ CREATE INDEX [IX_Member_Tel_DeleteFlag] ON [Member] ([tel],
[DeleteFlag]) INCLUDE ([RegistDate]) ① CREATE INDEX [IX_Member_Tel] ON [Member] ([tel]) INCLUDE ([RegistDate]) ⑥ CREATE INDEX [IX_Member_Tel_DeleteFlag] ON[Member] ([tel], [DeleteFlag]) -
解説② ② + ③ + ⑤ CREATE INDEX [IX_Member_LoginName] ON
[Member] ([LoginName], [HashedPassword]) INCLUDE ([Sei], [Mei], [GenderID], [PrefectureID], [DeleteFlag]) ② CREATE INDEX [IX_Member_LoginName] ON [Member] ([LoginName]) INCLUDE ([Sei], [Mei]) ③ CREATE INDEX [IX_Member_LoginName2] ON [Member] ([LoginName]) INCLUDE ([GenderID], [PrefectureID]) ⑤ CREATE INDEX [IX_Member_LoginName_HashedPassword] ON [Member] ([LoginName], [HashedPassword]) INCLUDE ([DeleteFlag]) -
最終的な回答 ① + ⑥ CREATE INDEX [IX_Member_Tel_DeleteFlag] ON [Member] ([tel],
[DeleteFlag]) INCLUDE ([RegistDate]) ② + ③ + ⑤ CREATE INDEX [IX_Member_LoginName] ON [Member] ([LoginName], [HashedPassword]) INCLUDE ([Sei], [Mei], [GenderID], [PrefectureID], [DeleteFlag]) ④ CREATE INDEX [IX_Member_DeleteFlag_RegistDate] ON [Member] ([DeleteFlag], [RegistDate])