Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Relevance Filtering for Embedding-based Retrieval
Search
Hiroki_Iida
May 24, 2025
Research
150
3
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Relevance Filtering for Embedding-based Retrieval
IR-READING 2025春
Hiroki_Iida
May 24, 2025
More Decks by Hiroki_Iida
See All by Hiroki_Iida
SCOTT: Self-Consistent Chain-of-Thought Distillation
meshidenn
0
700
Match Your Words! A Study of LexicalMatching in Neural Information Retrieval
meshidenn
0
280
COIL: Revisit Exact Lexical Match in Information Retrieval with Contextualized Inverted List
meshidenn
1
550
CEQE- Contextualized Embeddings for Query Expansion.
meshidenn
0
320
ACL2019網羅的サーベイ報告会-iida発表
meshidenn
0
130
What the vec
meshidenn
1
450
Other Decks in Research
See All in Research
SOTAのさらに先へ:厳しい推論制約下での高性能モデルのPost-Training
analokmaus
0
1.6k
進化?迷走?CasualConc ファミリーアプリの現在地 @ 英語コーパス学会 2026
casualconc
0
140
横浜市長(山中氏)の言動にかかる第三者による調査報告書
sishi2026
0
580
高性能計算機クラスタを用いた大規模点群処理による森林の単木抽出と構造解析
kentaitakura
1
140
ros2-perf-multihost: Automated Coordination Framework for Objective Architecture Evaluation in Distributed Systems
takasehideki
0
130
TESSERA: Temporal Embeddings of Surface Spectra for Earth Representation and Analysis
satai
2
110
シングルチャネルマルチトーカー音声認識の進展
ryomasumura
0
330
COMETAを用いたデータ民主化運動の歴史
sazimai
0
270
ハードウェア研究で国際トップ会議を目指す!IROS 2027での論文採択を目指して
ayatokanada
7
4k
モデル評価を効率的にする方法
ftakahashi
0
180
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
780
2026年 オープンキャンパス 研究室紹介
junkurihara
0
230
Featured
See All Featured
Fantastic passwords and where to find them - at NoRuKo
philnash
52
4k
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
300
A Modern Web Designer's Workflow
chriscoyier
699
190k
End of SEO as We Know It (SMX Advanced Version)
ipullrank
3
4.4k
Exploring anti-patterns in Rails
aemeredith
4
520
The browser strikes back
jonoalderson
0
1.8k
Become a Pro
speakerdeck
PRO
31
6.3k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
250
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
A designer walks into a library…
pauljervisheath
211
25k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Transcript
Relevance Filtering for Embedding-based Retrieval Authors: Nicholas Rossi, Juexin Lin,
Feng Liu, Zhen Yang, Tony Lee, Alessandro Magnani, Ciya Liao CIKM '24: Applied Research Papers IR READING 2025春 紹介者: (株) UZABASE 飯田 大貴 特に断りがない限り、図表は本論文からの引用です 1
自己紹介 ▪ 名前:飯田 大貴(IR Readingには度々参加させてもらっています) ▪ 所属:(株) ユーザベース • 経済情報基盤を活用して、経営のスピードを上げる情報プラットフォーム
「スピーダ」を提供 ▪ 業務内容:プロダクト横断の検索 /分類モデルの構築とサービスの構築・運用 ▪ インターン等興味あるかたはお声がけください https://www.uzabase.com/jp/ https://www.uzabase.com/jp/info/20241220-corp_jp/ 2
概要と読んだ理由 ▪ 概要:検索結果をPrecision-Recall高く足切りするために、スコアリングの変換関数を提 案 ▪ 読んだ理由:簡易な足切り方法を知りたかった。 Applied系の論文読んでみたかった。 3
論文が対象とする課題と解決方針 ▪ 無関係な検索結果を表示しないようにして、検索体験を向上させたい ▪ そのため、いい感じに無関係な検索結果をフィルタしたい ▪ しかし、ベクトル検索で用いられる類似度(特に cos類似度)は、しきい値 として用いることが難しい ▪
なぜなら、対照学習を用いて学習されているため、クエリに対して相対的なスコアにな る ▪ そのため、cos類似度を絶対的なスコアに変換したい 4
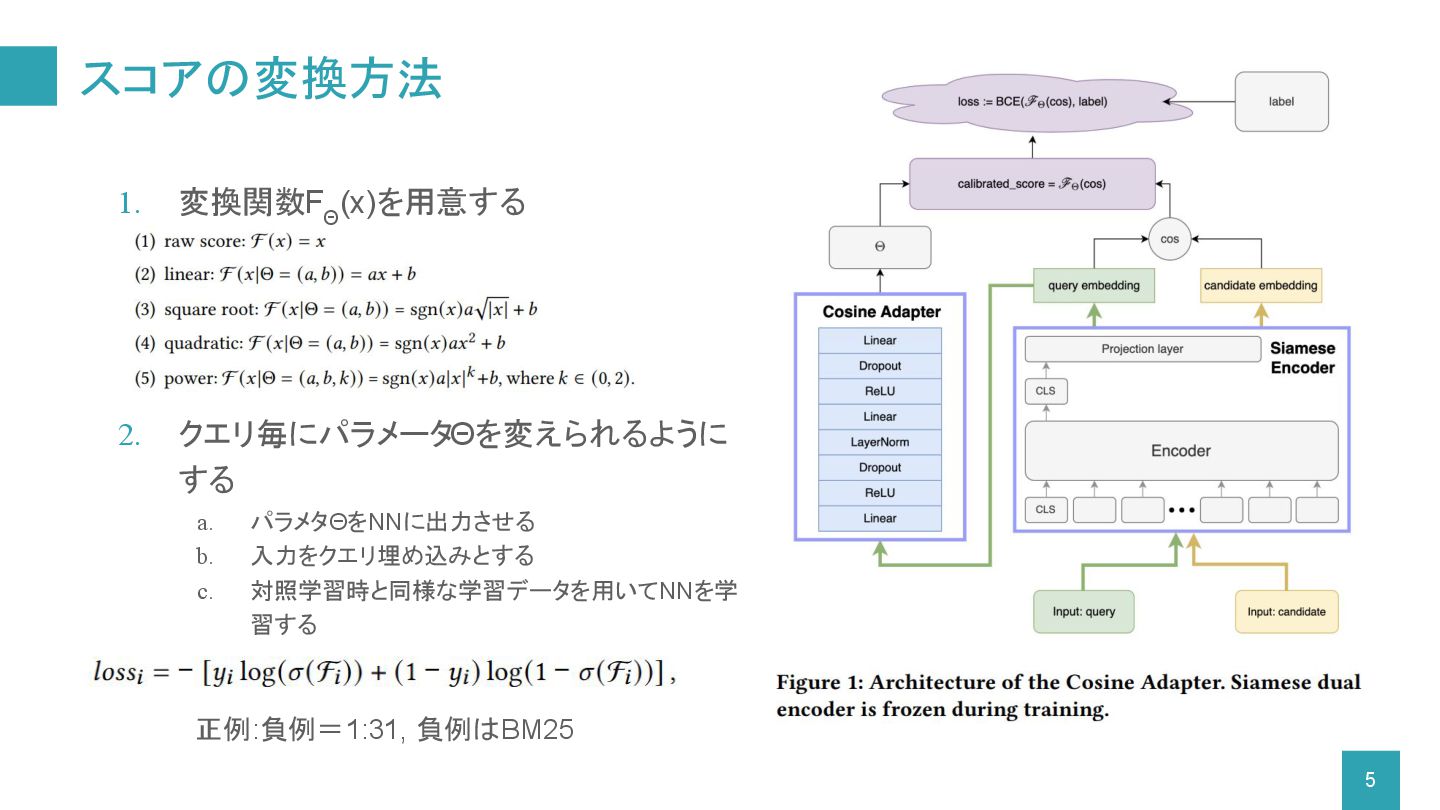
スコアの変換方法 1. 変換関数F Θ (x)を用意する 2. クエリ毎にパラメータΘを変えられるように する a. パラメタΘをNNに出力させる
b. 入力をクエリ埋め込みとする c. 対照学習時と同様な学習データを用いてNNを学 習する 正例:負例=1:31, 負例はBM25 5
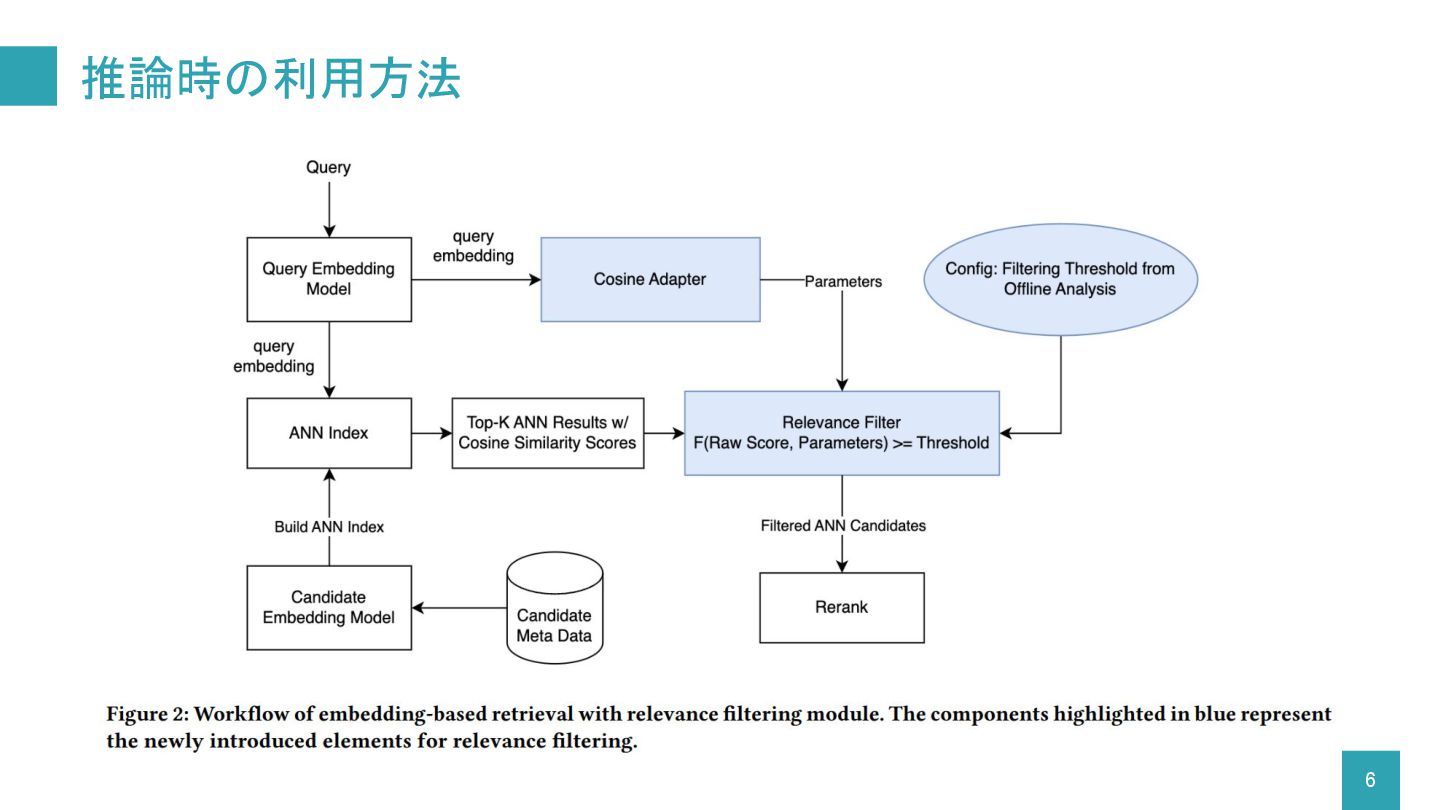
推論時の利用方法 6
実験:MSMARCO ▪ PR AUCとMRRが改善 ▪ K=1000でP@R95とFilter%改善 ▪ Null%*について • K=1000で改善し、K=10では改悪。一
つも正例が登場しないクエリが、K=10 では30%だが、K=1000で1%であるた め • powerでnull、かつraw scoreがnullで はない場合において、70%は正例が top10にない ▪ 先行手法のChoppy#より良い。正 例が一つしかない場合が多いデー タであるため、削り過ぎている 提案手法 提案手法 *あるしきい値*で検索結果が返ってこなくなる度合い。しきい値は 5.2.3よりP@R95で決めたと推察 # Transformeベースの学習でしきい値を決める手法 7
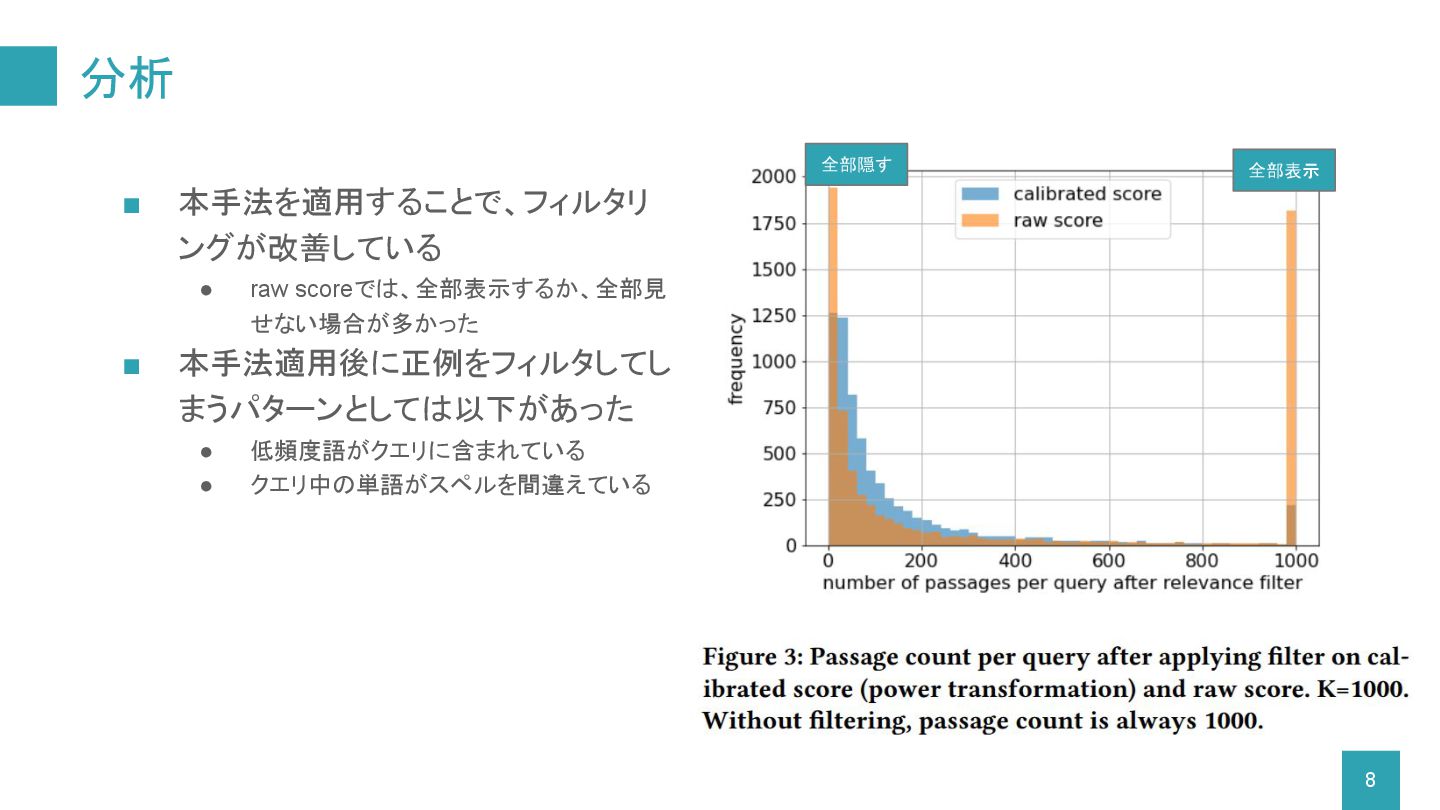
分析 ▪ 本手法を適用することで、フィルタリ ングが改善している • raw scoreでは、全部表示するか、全部見 せない場合が多かった ▪ 本手法適用後に正例をフィルタしてし
まうパターンとしては以下があった • 低頻度語がクエリに含まれている • クエリ中の単語がスペルを間違えている 全部表示 全部隠す 8
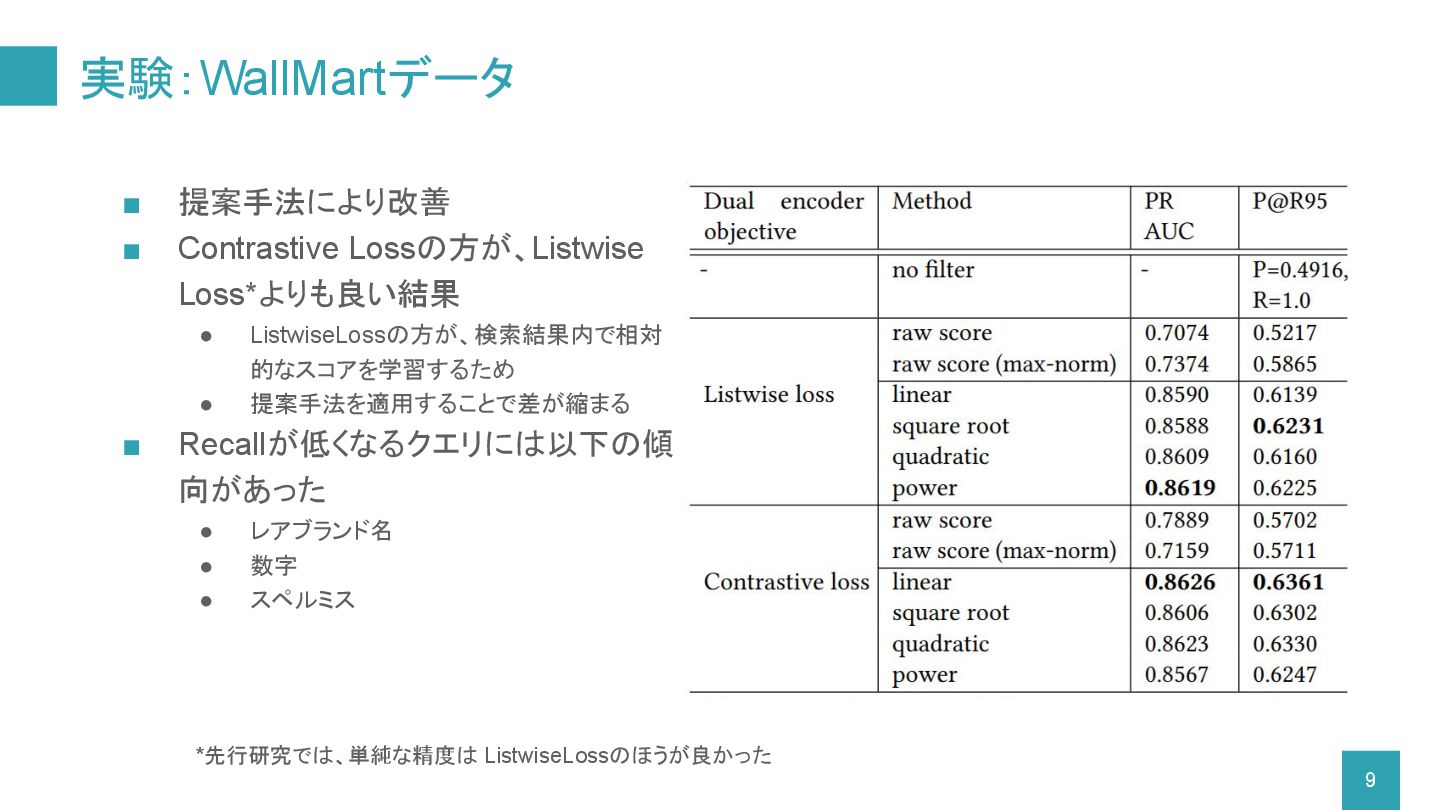
実験:WallMartデータ ▪ 提案手法により改善 ▪ Contrastive Lossの方が、Listwise Loss*よりも良い結果 • ListwiseLossの方が、検索結果内で相対 的なスコアを学習するため
• 提案手法を適用することで差が縮まる ▪ Recallが低くなるクエリには以下の傾 向があった • レアブランド名 • 数字 • スペルミス *先行研究では、単純な精度は ListwiseLossのほうが良かった 9
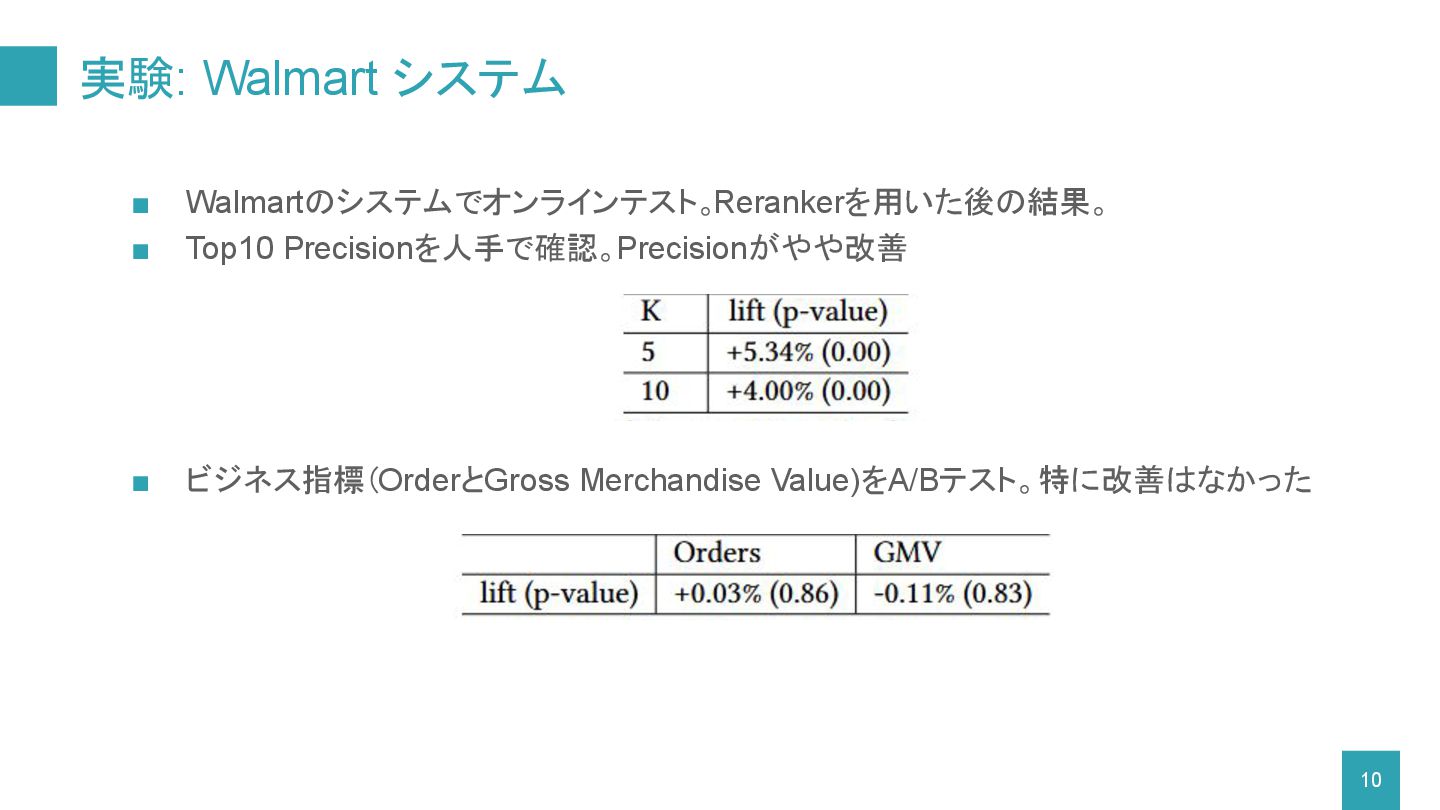
実験: Walmart システム ▪ Walmartのシステムでオンラインテスト。Rerankerを用いた後の結果。 ▪ Top10 Precisionを人手で確認。Precisionがやや改善 ▪ ビジネス指標(OrderとGross
Merchandise Value)をA/Bテスト。特に改善はなかった 10
事例: Walmart システム ▪ 無関係だったものが、フィルタされている ▪ FilterしてからRerankしているので、10位のやや関係ある商品は出現していると思われ る 11
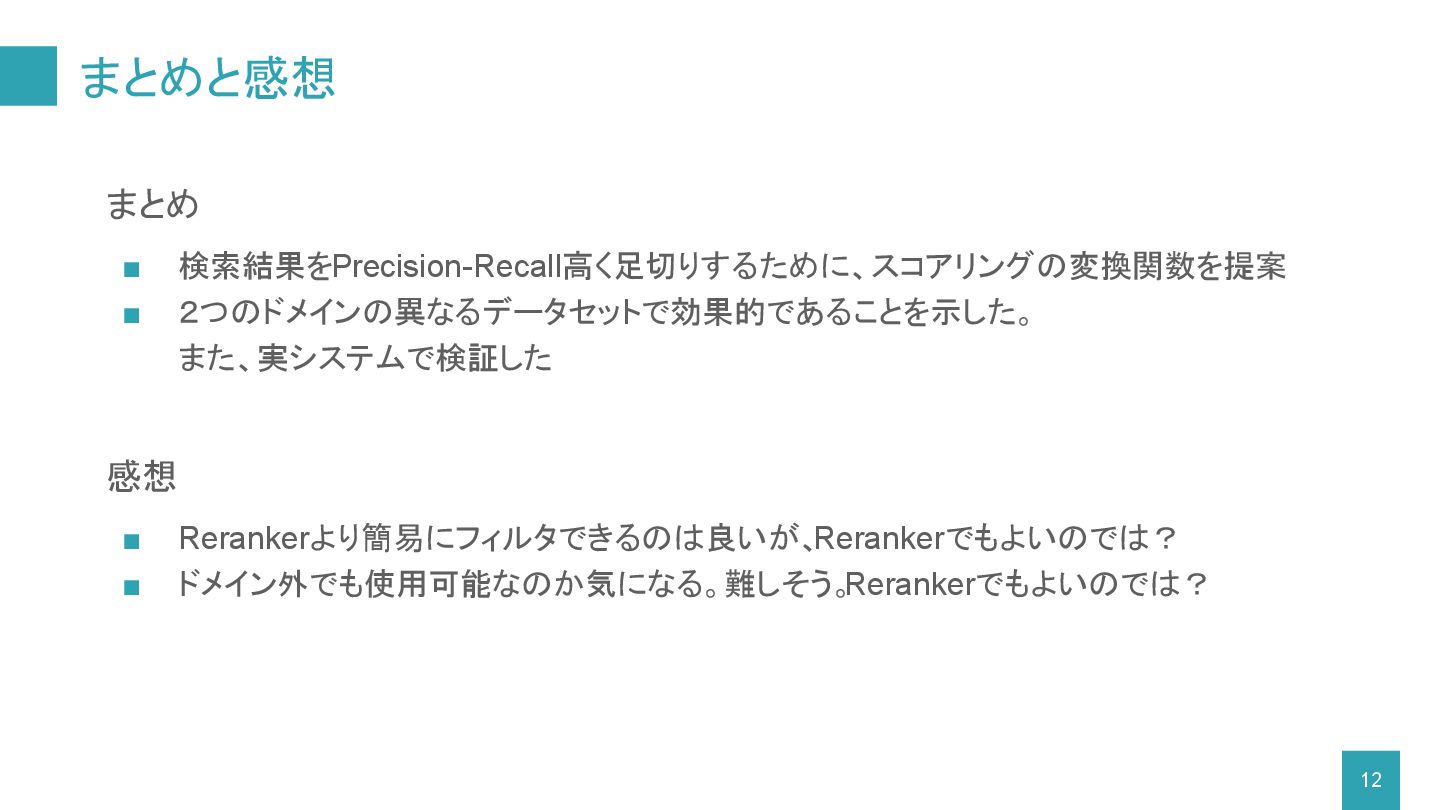
まとめと感想 まとめ ▪ 検索結果をPrecision-Recall高く足切りするために、スコアリングの変換関数を提案 ▪ 2つのドメインの異なるデータセットで効果的であることを示した。 また、実システムで検証した 感想 ▪ Rerankerより簡易にフィルタできるのは良いが、
Rerankerでもよいのでは? ▪ ドメイン外でも使用可能なのか気になる。難しそう。 Rerankerでもよいのでは? 12


 meshidenn
 analokmaus
 casualconc
 sishi2026
 kentaitakura
 takasehideki
 satai
 ryomasumura
 sazimai
 ayatokanada
 ftakahashi
 ontheslope
 junkurihara
 philnash
 stephenakadiri
 chriscoyier
 ipullrank
 aemeredith
 jonoalderson
 speakerdeck
 twada
 stuffmc
 hatefulcrawdad
 pauljervisheath
 mongodb