Share
Embed
Transcript
54 slides
-
elasticsearch. Motor de busca e além Lições aprendidas criando Tu
Proximo Trabajo. -
Miguel Gallardo Mais de 10 anos de experiência como desenvolvedor,
com um salário. Fanático por computador desde os 7 anos de idade. Desenvolvedor desde os 13 anos de idade. Eu sempre estou buscando melhorar minhas habilidades, me tornei um programador poliglota que trabalha em várias linguagens de programação e múltiplos paradigmas de desenvolvimento. -
Miguel Gallardo Mais de 10 anos de experiência como desenvolvedor,
com um salário. Fanático por computador desde os 7 anos de idade. Desenvolvedor desde os 13 anos de idade. Eu sempre estou buscando melhorar minhas habilidades, me tornei um programador poliglota que trabalha em várias linguagens de programação e múltiplos paradigmas de desenvolvimento. -
6 anos Search the web using Google! 10 results Google
Search I'm feeling lucky We've moved. New site at google.com About the Google Stanford Project Get Google! updates monthly! your e-mail Subscribe Archive Copyright ©1997-8 Stanford University -
• 52.069 empregados (Q2 2014) • renda: ~US$ 60 bilhões
• Valor de mercado: ~US$ 392 bilhões • +4 milhões de servidores • 120 bilhões buscas por mês • Adsense, Gmail, google maps, street view, youtube, android, chrome, etc ¿Google? -
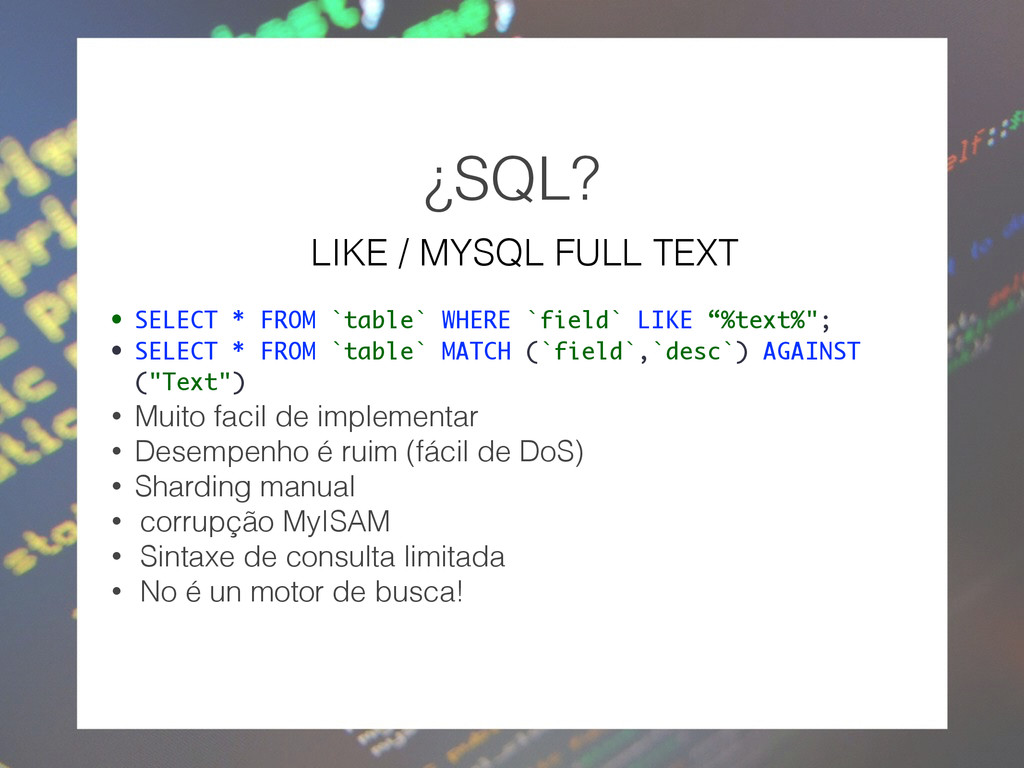
LIKE / MYSQL FULL TEXT • SELECT * FROM `table`
WHERE `field` LIKE “%text%"; • SELECT * FROM `table` MATCH (`field`,`desc`) AGAINST ("Text") • Muito facil de implementar • Desempenho é ruim (fácil de DoS) • Sharding manual • corrupção MyISAM • Sintaxe de consulta limitada • No é un motor de busca! ¿SQL? -
• Launched 2006 • ~3 milhões de avisos • ~1000
fuentes de avisos • “SasaIndex” • RIP 2010 GoSasa -
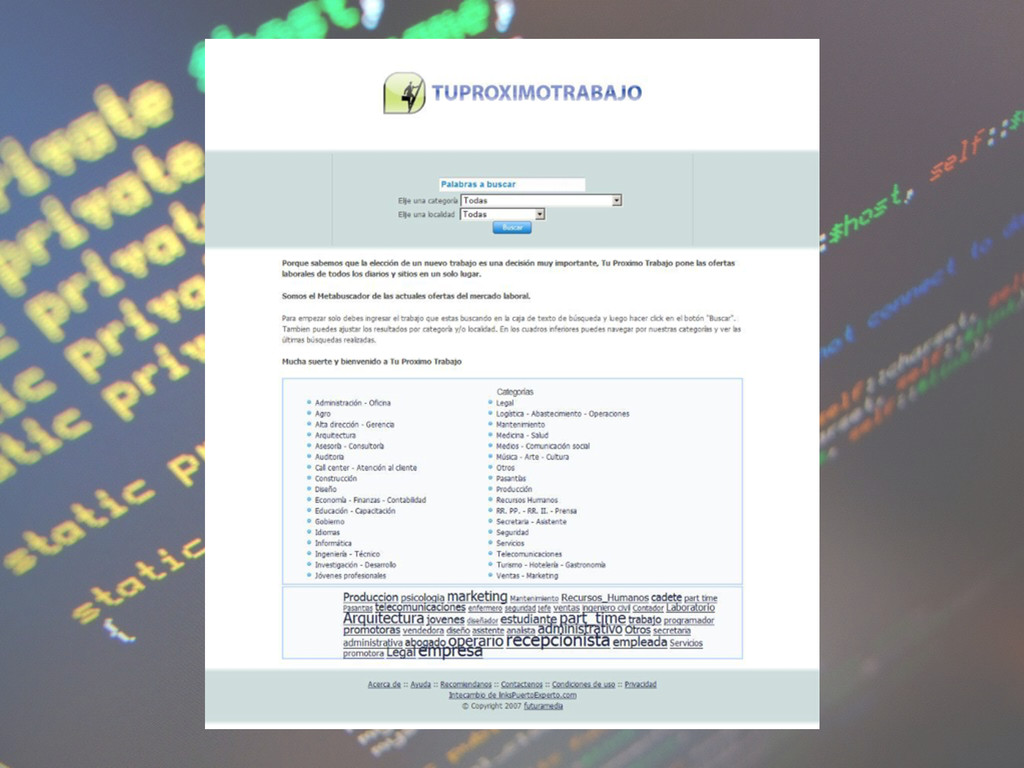
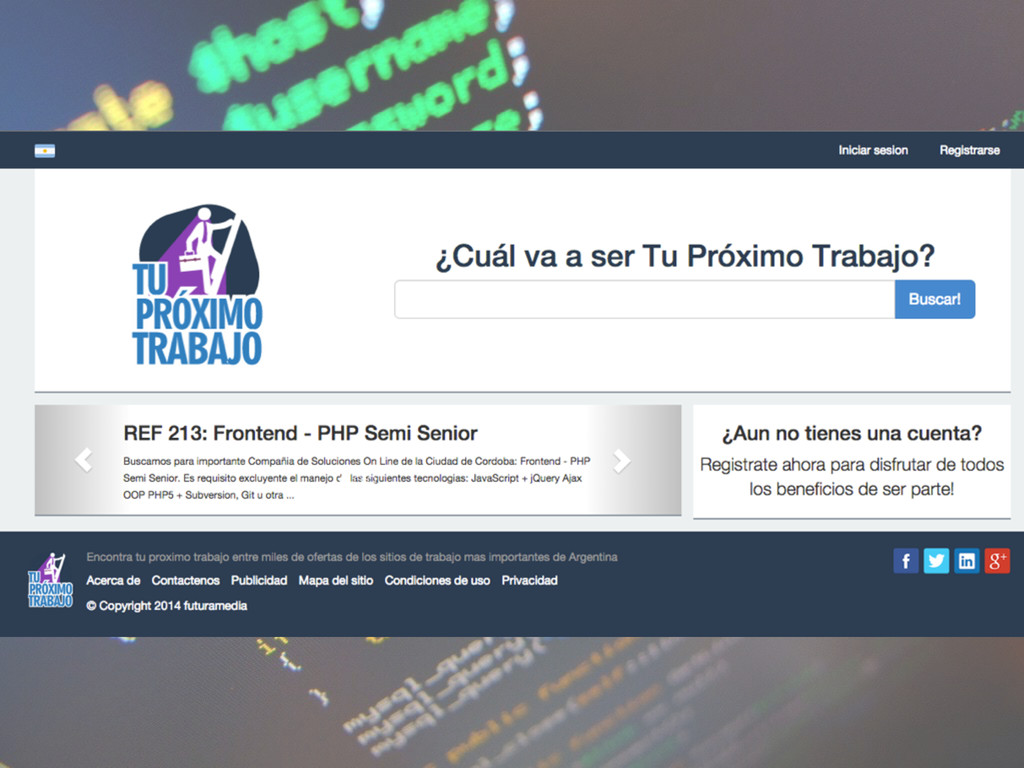
• Lançado 2007 • 9 milhões ofertas de empregos histórico
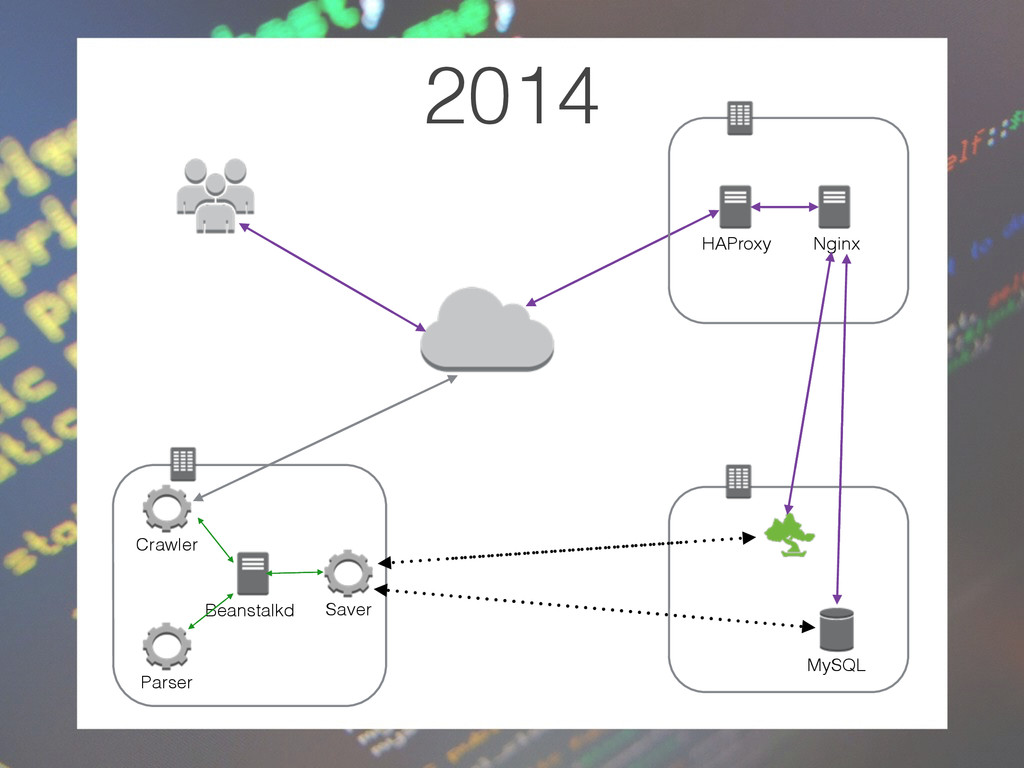
• 200K ofertas de emprego atuais • 80K visitas mensal • 1º motor de busca de emprego na Argentina * Tu Próximo Trabajo -
Sphinx é um servidor de pesquisa de texto completo de
código aberto, projetado a partir do zero com o desempenho, relevância (aka a qualidade da pesquisa), e simplicidade de integração em mente. -
• Alta velocidade de indexação (10~15 MB/s em uma •
CPU) • Alta velocidade de pesquisa (500+ queries/sec) • Alta escalabilidade: Craigslist.org • 300 milhões de consultas/dia • 15 clusters • BoardReader.com: +16 bilhões de documentos indexados em 37 máquinas. • Fala protocolo MySQL -
• Não é em tempo real! Reindexação de dados completo
(2008) • Configuração da velha escola (.conf files) • Configuração de cluster complexo • Velha escola • difícil de instalar, configurar e escalabilidade • Protocolo proprietário • Não de esquema livre -
“Solr é uma plataforma de pesquisa de código aberto do
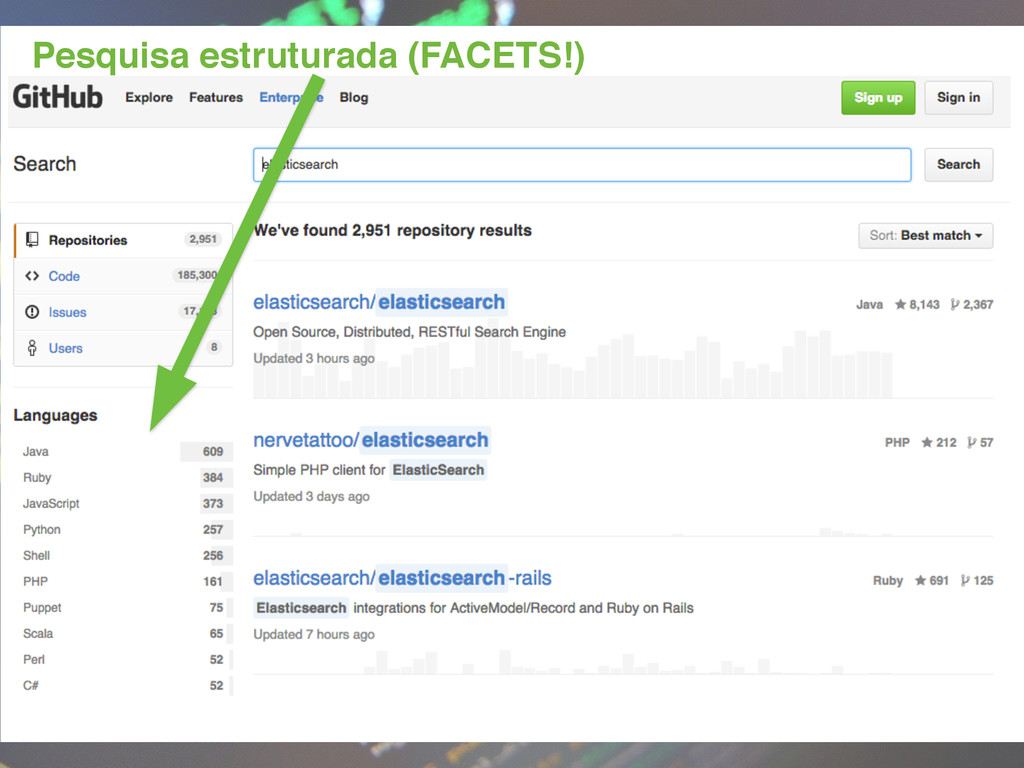
projeto Apache Lucene. Suas principais características incluem pesquisa de texto completo, bateu destacando, pesquisa facetada, clustering dinâmica, integração de banco de dados e de documentos ricos (por exemplo, Word, PDF). Pesquisa distribuída e replicação do índice, Solr é altamente escalável.” Solr/Lucene -
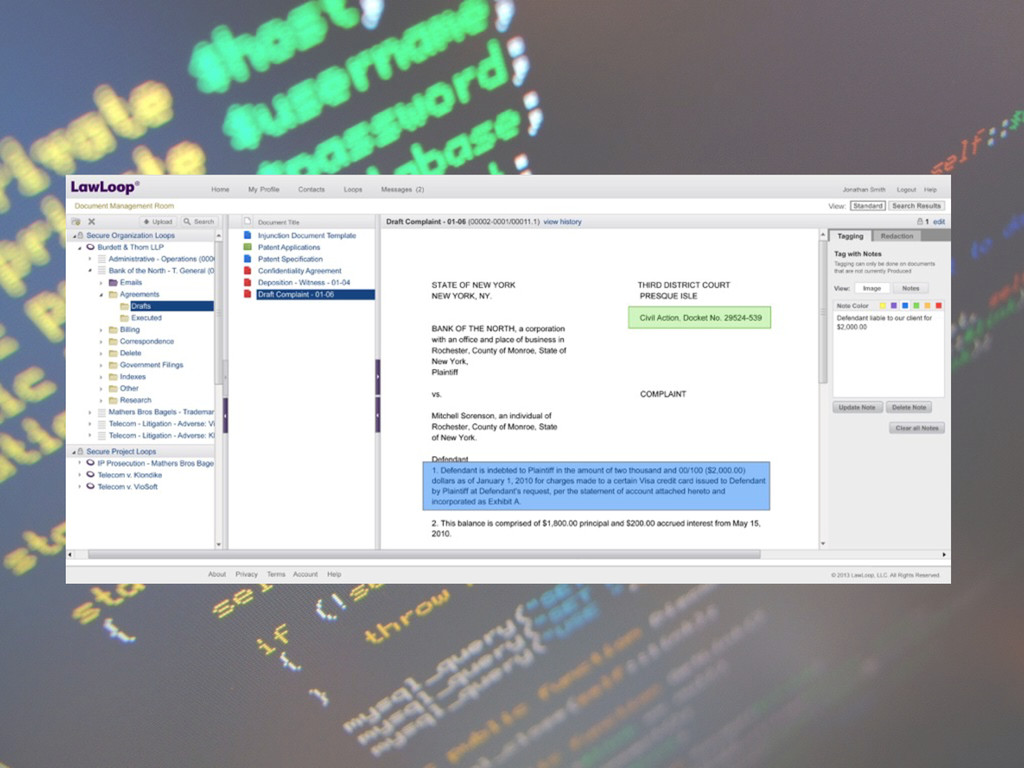
Um Sistema de Gestão de Documentos intuitiva, criada por advogados
para advogados • servidor backend: php • Clientes: ruby, java, net • MySQL para dados. MongoDB para arquivos e documentos -
Elasticsearch é um motor de pesquisa e análise flexível e
poderoso, distribuido, em tempo real e código aberto. -
Elasticsearch é um motor de pesquisa e análise flexível e
poderoso, distribuido, em tempo real e código aberto. • JSON • RESTful API • “Schema free” -
Elasticsearch é um motor de pesquisa e análise flexível e
poderoso, distribuido, em tempo real e código aberto. • Master nodes & data nodes; • Réplicas e fragmentos automáticas • Transporte assíncrona entre nodos -
Elasticsearch é um motor de pesquisa e análise flexível e
poderoso, distribuido, em tempo real e código aberto. • Flush cada 1 segundo -
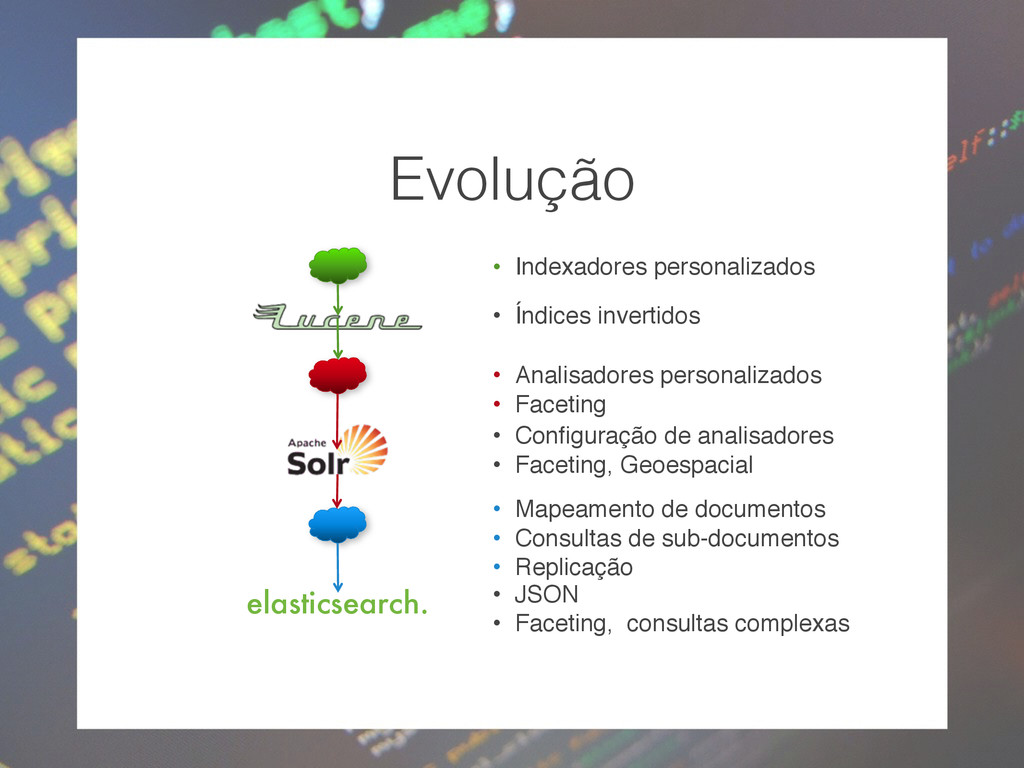
elasticsearch. Evolução • Indexadores personalizados • Índices invertidos • Analisadores
personalizados • Faceting • Configuração de analisadores • Faceting, Geoespacial • Mapeamento de documentos • Consultas de sub-documentos • Replicação • JSON • Faceting, consultas complexas -
Pesquisando 50 milhões de locais em tempo real? Foursquare faz
isso usando ElasticSearch Pesquisa 20TB de dados usando ElasticSearch, incluindo 1,3 bilhões de arquivos e 130 bilhões de linhas de código Usa ElasticSearch para fornecer resultados imediatos e relevantes para a sua plataforma de distribuição de áudio em linha atingindo 180 milhões de pessoas Usa ElasticSearch para fornecer resultados de mais de 20 milhões de produtos, um segundo depois de um artigo foi publicado já está disponível nos resultados Usa ElasticSearch para fornecer resultados de 25 milhões de usuários por dia. 70 milhões de documentos indexados. 215 GB de Dados -
Conceitos • Cluster Um grupo de nodos compartilhando o mesmo
conjunto de índices • Node Uma instância ElasticSearch em execução (processo JVM) • Index ≈ MySQL database Um conjunto de documentos de possivelmente diferentes tipos Armazenado em um ou mais fragmentos • Type ≈ MySQL Table um conjunto de documentos em um índice que compartilham o mesmo esquema • Shard Um índice Lucene, alocado em um nodo -
como instalar? 1. Faça o download e extrair: http://www.elasticsearch.org/download/ 2.
$ bin/elasticsearch Debian/Ubuntu 1. apt-get install elasticsearch RPM 1. yum install elasticsearch -
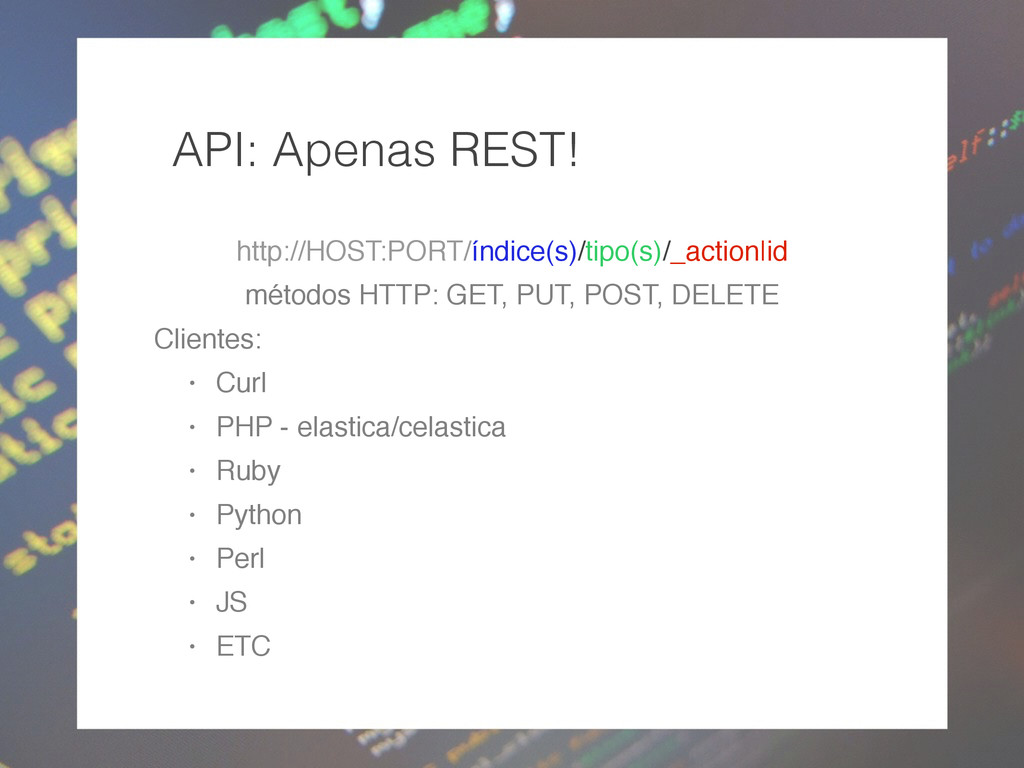
API: Apenas REST! http://HOST:PORT/índice(s)/tipo(s)/_action|id métodos HTTP: GET, PUT, POST, DELETE
Clientes: • Curl • PHP - elastica/celastica • Ruby • Python • Perl • JS • ETC -
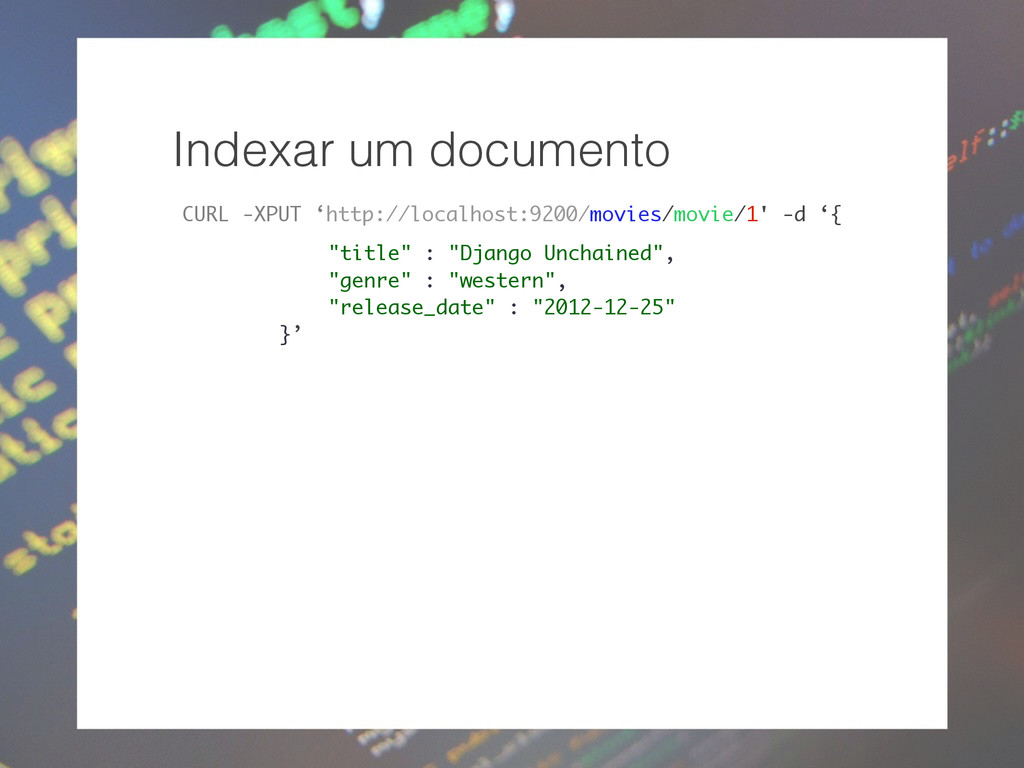
Indexar um documento CURL -XPUT ‘http://localhost:9200/movies/movie/1' -d ‘{ "title" :
"Django Unchained", "genre" : "western", "release_date" : "2012-12-25" }’ -
Atualizar um documento CURL -XPUT ‘http://localhost:9200/movies/movie/1' -d ‘{ "director" :
{ "lastname" : "Tarantino", "firstname" : "Quentin" }, "actors" : [ { "lastname" : "Foxx", "firstname" : "Jamie" }, { "lastname" : "Waltz", "firstname" : "Christoph" }, { "lastname" : "Tarantino", "firstname" : "Quentin" }, ] }’ -
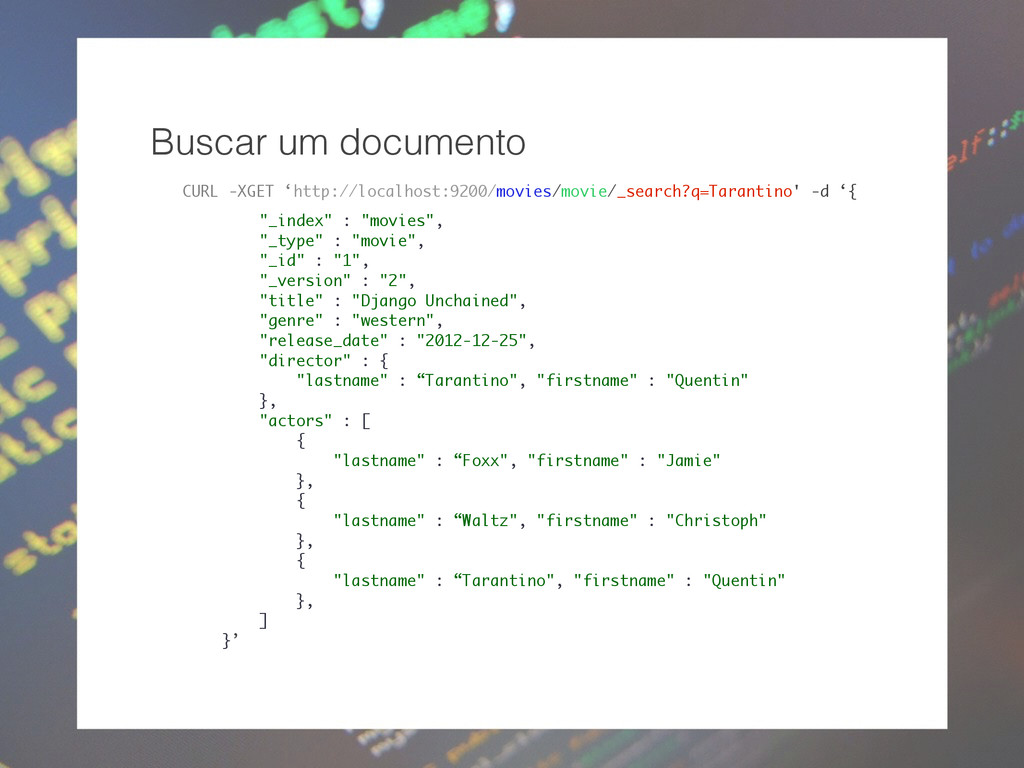
Buscar um documento CURL -XGET ‘http://localhost:9200/movies/movie/_search?q=Tarantino' -d ‘{ "_index" :
"movies", "_type" : "movie", "_id" : "1", "_version" : "2", "title" : "Django Unchained", "genre" : "western", "release_date" : "2012-12-25", "director" : { "lastname" : “Tarantino", "firstname" : "Quentin" }, "actors" : [ { "lastname" : “Foxx", "firstname" : "Jamie" }, { "lastname" : “Waltz", "firstname" : "Christoph" }, { "lastname" : “Tarantino", "firstname" : "Quentin" }, ] }’ -
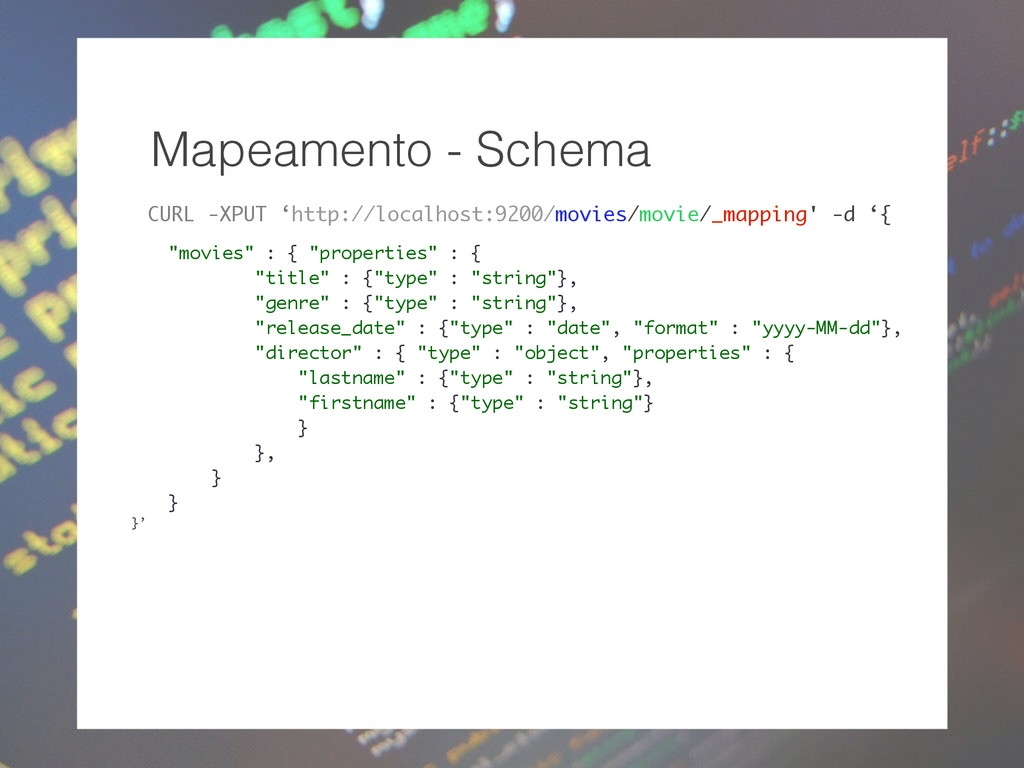
Mapeamento - Schema CURL -XPUT ‘http://localhost:9200/movies/movie/_mapping' -d ‘{ "movies" :
{ "properties" : { "title" : {"type" : "string"}, "genre" : {"type" : "string"}, "release_date" : {"type" : "date", "format" : "yyyy-MM-dd"}, "director" : { "type" : "object", "properties" : { "lastname" : {"type" : "string"}, "firstname" : {"type" : "string"} } }, } } }’ -
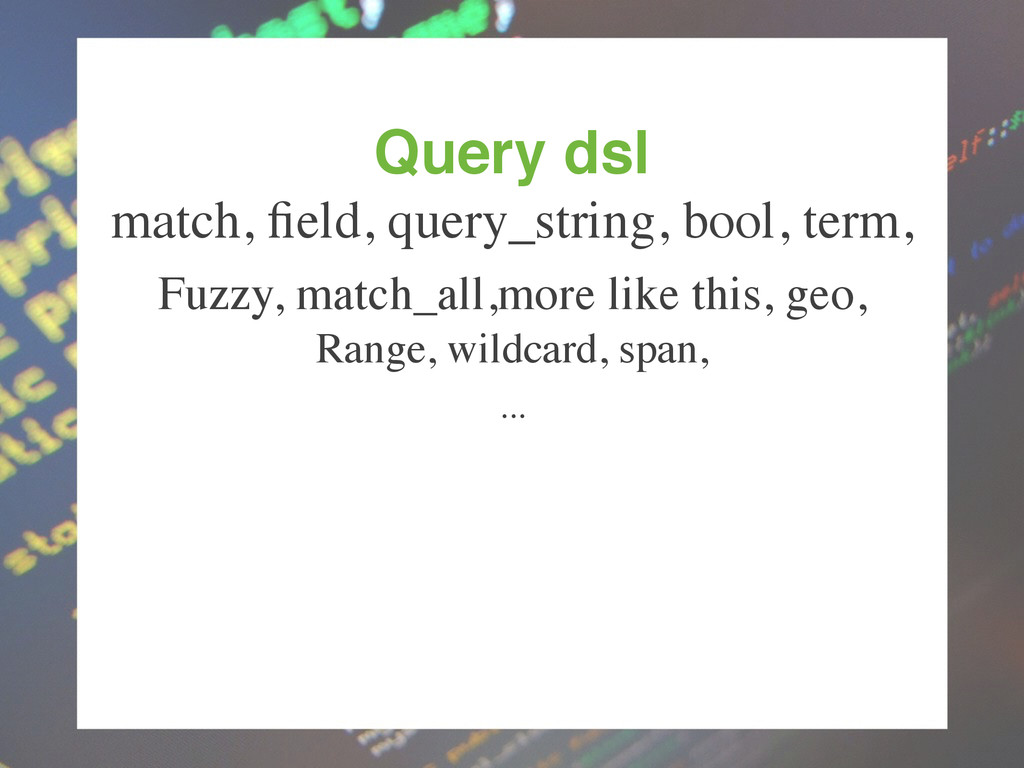
Query dsl match, field, query_string, bool, term, Fuzzy, match_all,more like
this, geo, Range, wildcard, span, ... -
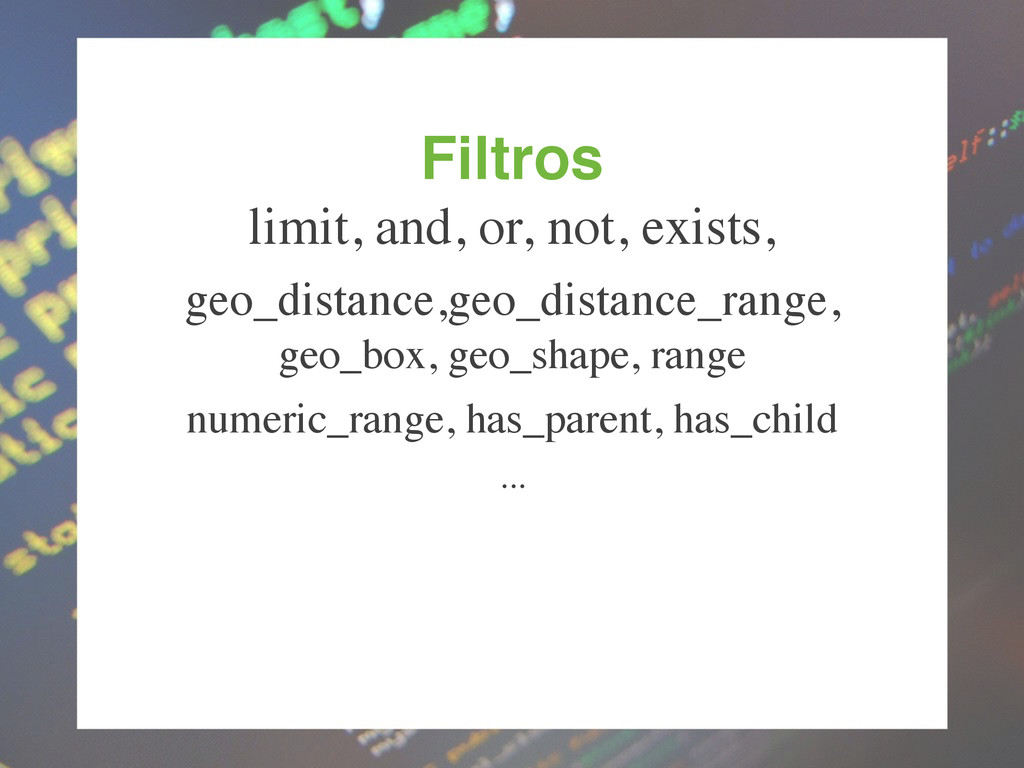
Filtros limit, and, or, not, exists, geo_distance,geo_distance_range, geo_box, geo_shape, range
numeric_range, has_parent, has_child ... -
Rivers Um River é um serviço pluggable funcionando dentro elasticsearch
conjunto puxando dados (ou sendo empurrado com os dados) que é, então, indexada no cluster. • CouchDB • rabbitmq • twitter • wikipedia • MongoDB • JDBC -
Percolator A consulta pode ser salvo como um documento em
elasticsearch, qualquer nova coador documento correspondente será adicionado ao http:// HOST:PORT/índice(s)/tipo(s)/_percolate. -
Logstash Logstash ajuda a tirar logs e outros dados de
eventos de tempo com base de qualquer sistema e armazená-lo em um único lugar para transformação e processamento adicional.