Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
作れることと、作るべきことは違う: 生成AI時代のデータ基盤とプロダクト思考 - Data E...
Search
MonotaRO
PRO
October 01, 2026
48
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
作れることと、作るべきことは違う: 生成AI時代のデータ基盤とプロダクト思考 - Data Engineering Summit 2026
MonotaRO
PRO
October 01, 2026
More Decks by MonotaRO
See All by MonotaRO
AIでSDLCは変わろうとしている では、人と組織をどう再設計すべきか
monotaro
PRO
0
300
モノタロウにおけるSREの現在地:モダナイゼーションの過程で変化していく組織に、SREはどう向き合ったか
monotaro
PRO
2
820
AIと共に、組織をどう進化させるか?
monotaro
PRO
1
470
ビジネスを駆動するアーキテクチャへ ~AI-Agentという新しいアクター
monotaro
PRO
2
17k
事業成長を支えるためのデータ アーキテクチャの取り組み - Data Engineering Summit
monotaro
PRO
0
770
AIと共に進化するモノタロウ - AI駆動開発 Conference Autumn 2025
monotaro
PRO
8
4.5k
映えないObservability
monotaro
PRO
3
1k
Datadogを活用した マイクロサービスの可観測性向上 ~モノタロウの導入効果と実践ノウハウ~
monotaro
PRO
0
430
FastAPIの魔法をgRPC/Connect RPCへ
monotaro
PRO
1
2.8k
Featured
See All Featured
Crafting Experiences
bethany
1
380
Building Adaptive Systems
keathley
44
3.2k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
580
[RailsConf 2023] Rails as a piece of cake
palkan
59
7.1k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.3k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
350
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
Prompt Engineering for Job Search
mfonobong
0
490
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
510
Transcript
Data Engineering Summit 2026 作れることと、作るべきことは違う: 生成AI時代のデータ基盤とプロダクト思考 © 2024 MonotaRO Co.,
Ltd.
自己紹介 斎藤貴文 株式会社MonotaRO プラットフォームエンジニアリング部門 データ基盤G マネージャー 前職ではWebメディアにおけるデータ基盤構築・運用を担当。 2022年にMonotaROに入社。データマネジメントのチームを経て 今のデータ基盤のシステム開発の部署でマネージャーとアーキテクトを担当。 2
モノタロウについて © 2024 MonotaRO Co., Ltd.
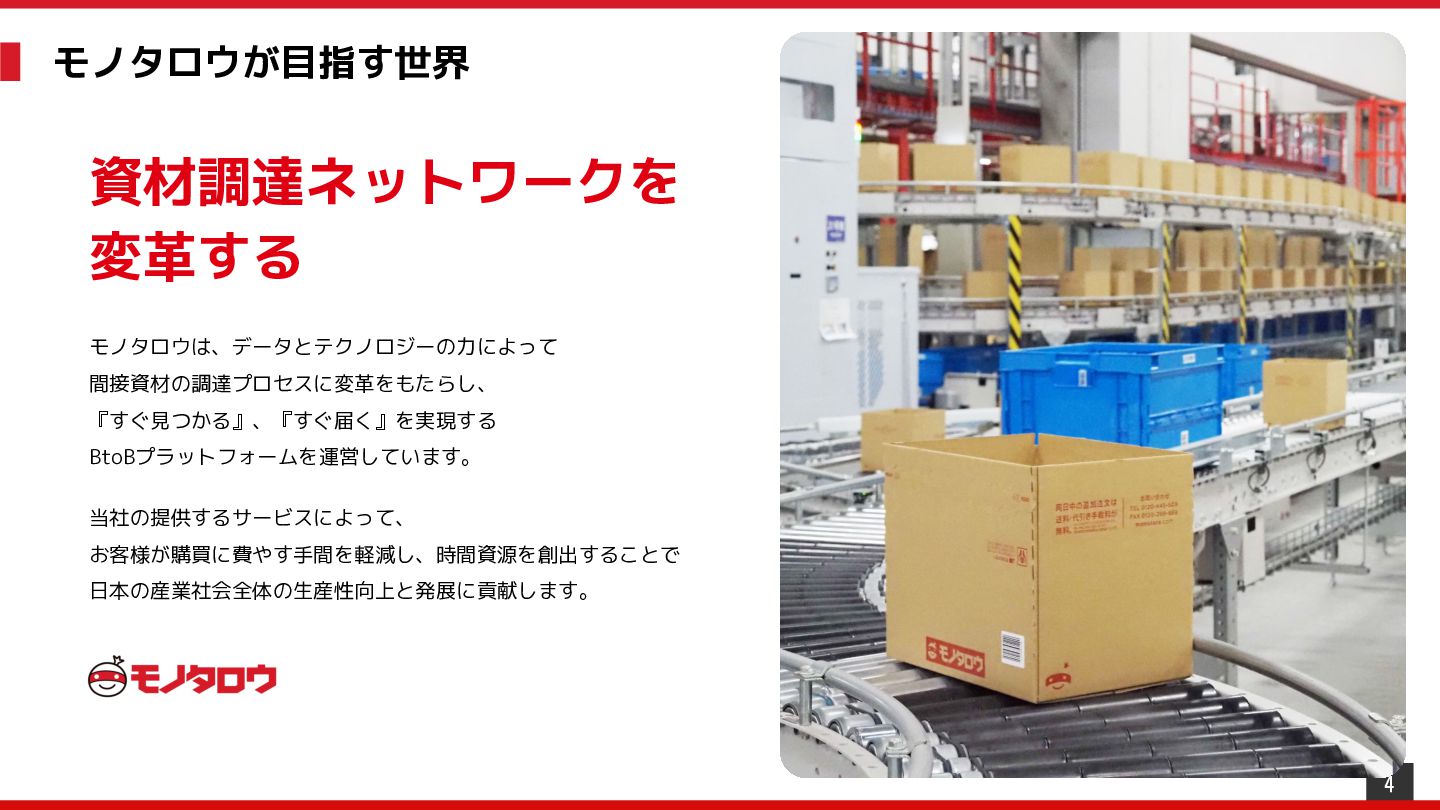
モノタロウが目指す世界 資材調達ネットワークを 変革する モノタロウは、データとテクノロジーの力によって 間接資材の調達プロセスに変革をもたらし、 『すぐ見つかる』、『すぐ届く』を実現する BtoBプラットフォームを運営しています。 当社の提供するサービスによって、 お客様が購買に費やす手間を軽減し、時間資源を創出することで 日本の産業社会全体の生産性向上と発展に貢献します。
4
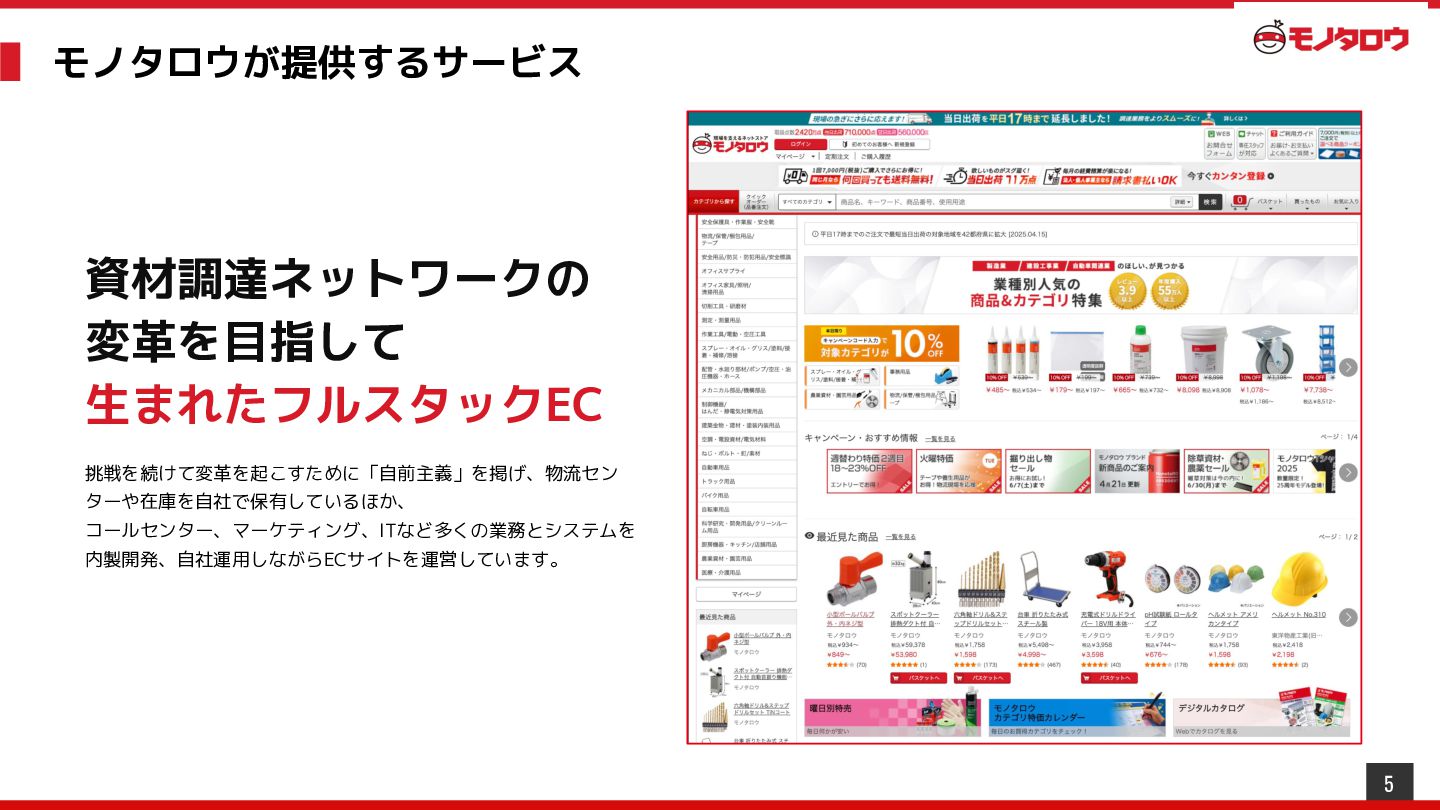
モノタロウが提供するサービス 資材調達ネットワークの 変革を目指して 生まれたフルスタックEC 挑戦を続けて変革を起こすために「自前主義」を掲げ、物流セン ターや在庫を自社で保有しているほか、 コールセンター、マーケティング、ITなど多くの業務とシステムを 内製開発、自社運用しながらECサイトを運営しています。 5
モノタロウのデータ環境の紹介と 前回の発表の振り返り © 2024 MonotaRO Co., Ltd.
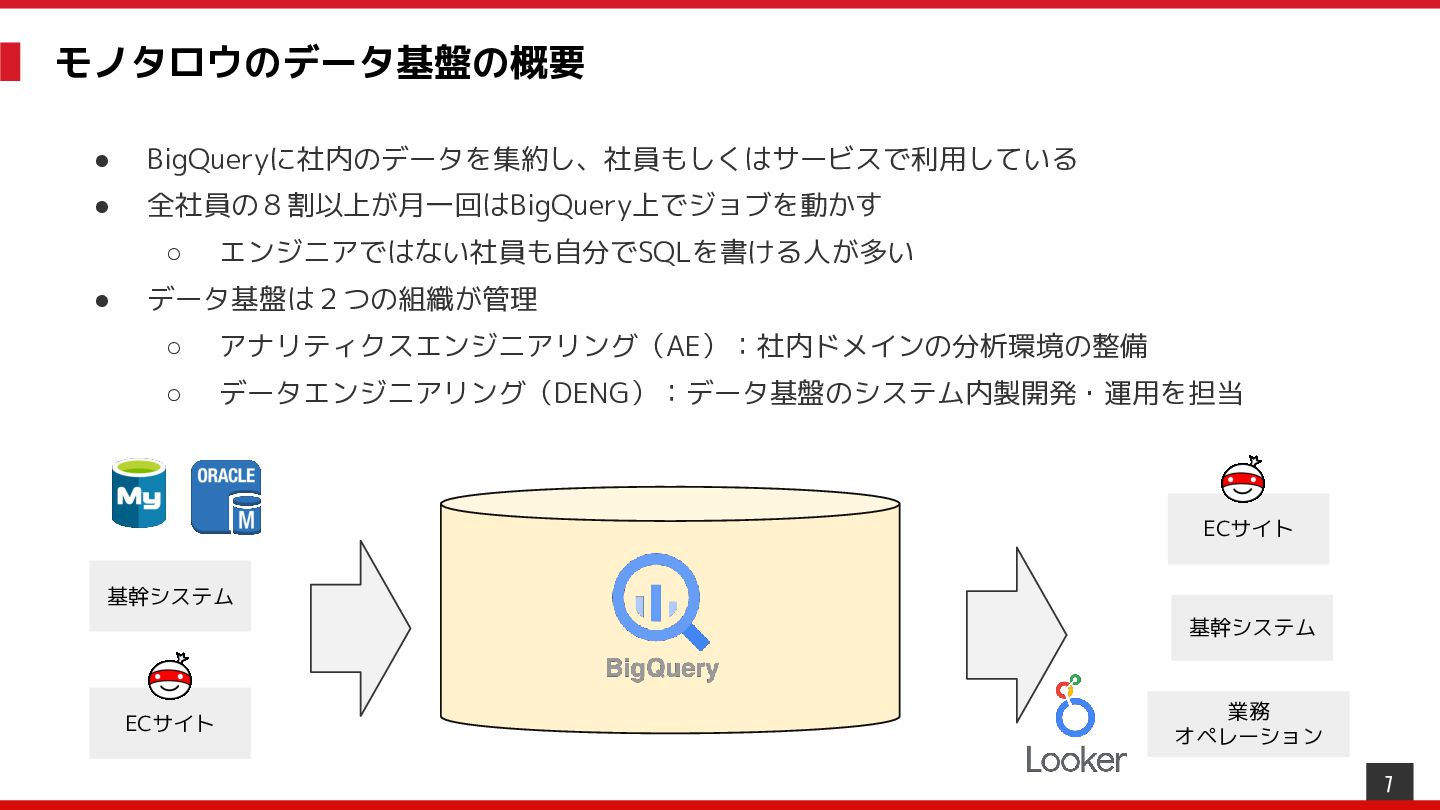
モノタロウのデータ基盤の概要 • BigQueryに社内のデータを集約し、社員もしくはサービスで利用している • 全社員の8割以上が月一回はBigQuery上でジョブを動かす ◦ • エンジニアではない社員も自分でSQLを書ける人が多い データ基盤は2つの組織が管理 ◦
アナリティクスエンジニアリング(AE):社内ドメインの分析環境の整備 ◦ データエンジニアリング(DENG):データ基盤のシステム内製開発・運用を担当 ECサイト 基幹システム 基幹システム ECサイト 業務 オペレーション 7
去年の発表について • 去年のData Engineering Summit 2025においての発表 ◦ 事業成長を支えるためのデータ アーキテクチャの取り組み -
Data Engineering Summit - Speaker Deck • 去年時点での課題 ◦ 事業成長に伴い、データの要求が複雑化 ◦ 部署間のコンテクストの違いが拡大 8
去年の発表について • 「各ドメインが自律的にデータを管理できる」組織作りを目指す ◦ ドメインごとにデータを管理する領域と、 全社的にデータを管理する領域が明確になっている状態 • 手段が目的化していた側面があり方向を修正 ◦ データメッシュという共通認識を作る
◦ アナリティクスエンジニアリングによって 現場の要件を拾い上げる 9
今回お話しすること • 前回の発表からどのように変化したかの報告 • その上で直面したプロダクト開発における課題 • そして、課題を解決するために取り組んでいることを紹介 ※この先に出てくるこれはロボット≒AIのことを表しています 10
去年から今年までに起こったこと © 2024 MonotaRO Co., Ltd.
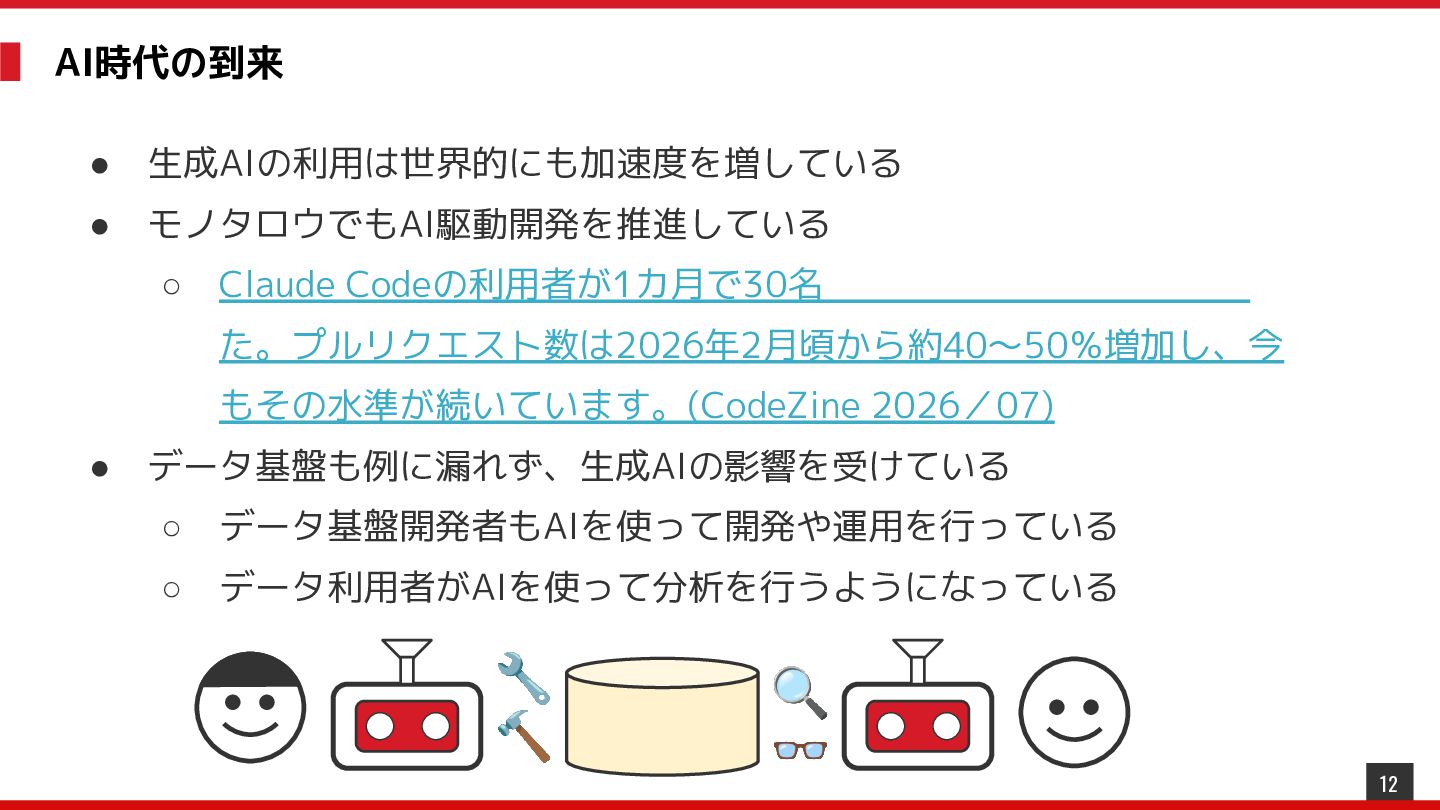
AI時代の到来 • 生成AIの利用は世界的にも加速度を増している • モノタロウでもAI駆動開発を推進している ◦ Claude Codeの利用者が1カ月で30名から100名超に急増しまし た。プルリクエスト数は2026年2月頃から約40〜50%増加し、今 もその水準が続いています。(CodeZine
2026/07) • データ基盤も例に漏れず、生成AIの影響を受けている ◦ データ基盤開発者もAIを使って開発や運用を行っている ◦ データ利用者がAIを使って分析を行うようになっている 🔧 🔨 🔍 👓 12
アナリティクスエンジニアリングの充実 • 去年の発表でお伝えしたアナリティクスエンジニアリングも成果を上げている • • セマンティックレイヤーの整備 ◦ 共通な指標をディメンショナルモデル(LookML)で管理 ◦ 人によって集計が異なることを防止
ダッシュボードカタログの作成 ◦ 社内で構築したダッシュボードをカタログとして用意 ◦ 類似のダッシュボードの乱立を防ぐだけではなく、 社内の分析事例を把握することができるようになる ◦ もちろんアクセス権限を管理することで、情報漏洩は防ぐ AI x AE でモノタロウのデータ基盤は順調に進んでいったのであった。完 13
しかし、そううまくはいかなかった...... © 2024 MonotaRO Co., Ltd.
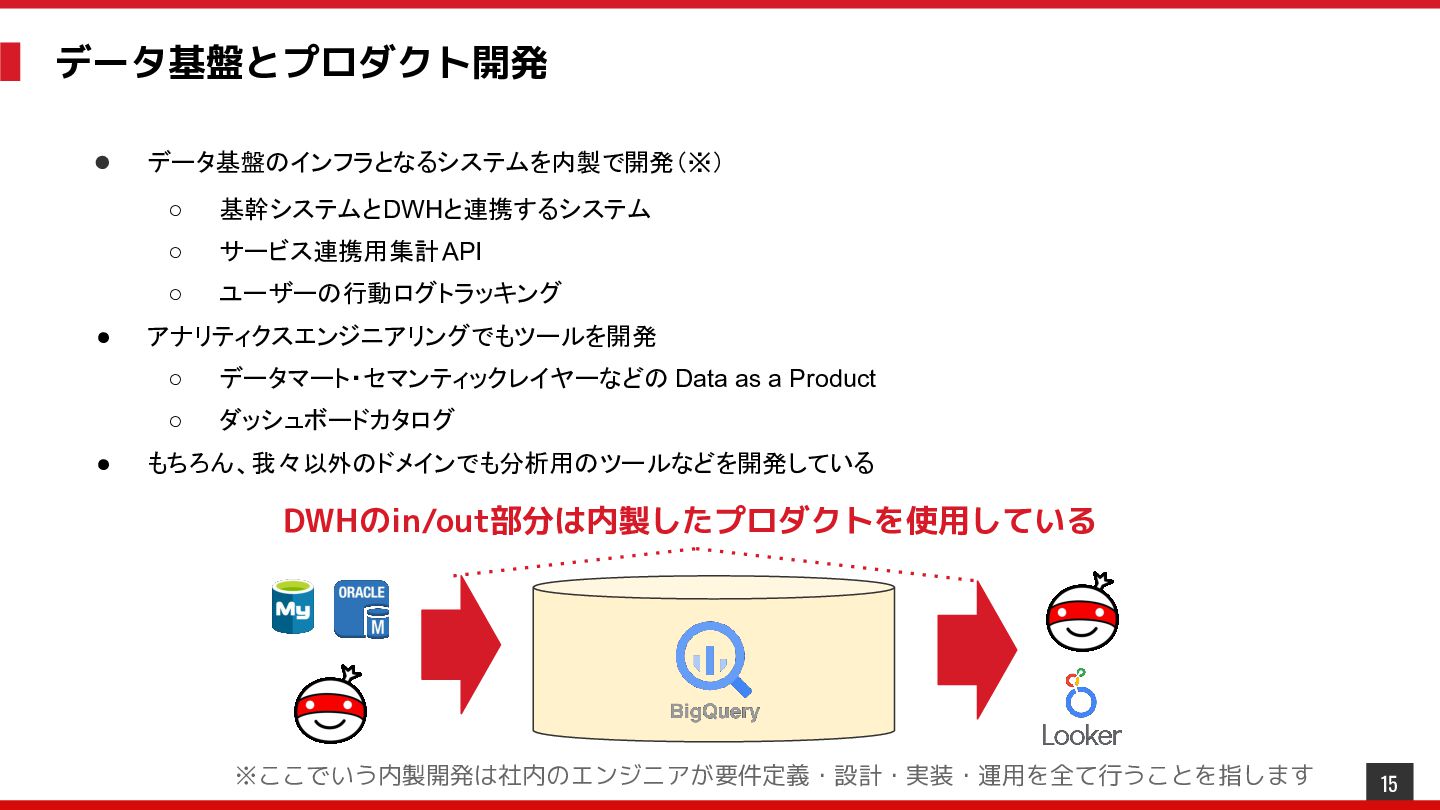
データ基盤とプロダクト開発 • • • データ基盤のインフラとなるシステムを内製で開発(※) ◦ 基幹システムとDWHと連携するシステム ◦ サービス連携用集計 API
◦ ユーザーの行動ログトラッキング アナリティクスエンジニアリングでもツールを開発 ◦ データマート・セマンティックレイヤーなどの Data as a Product ◦ ダッシュボードカタログ もちろん、我々以外のドメインでも分析用のツールなどを開発している DWHのin/out部分は内製したプロダクトを使用している ※ここでいう内製開発は社内のエンジニアが要件定義・設計・実装・運用を全て行うことを指します 15
AI x AEで進むはずだったデータ基盤のプロダクト開発 • AI x AEは追い風になるはずだった ◦ AIによって、設計・実装・運用に関する工数は下げられる ◦
AEによって、要件が開発者に集まり、プロダクトの営業が容易になる • しかし、そううまくはいかなかった...... • 現実的には二つの状態に収束していったのである ◦ 作っているけど、完成しない ◦ 作ったけど、その時にしか使えない それぞれどういう状態になったのか。具体例を紹介します 16
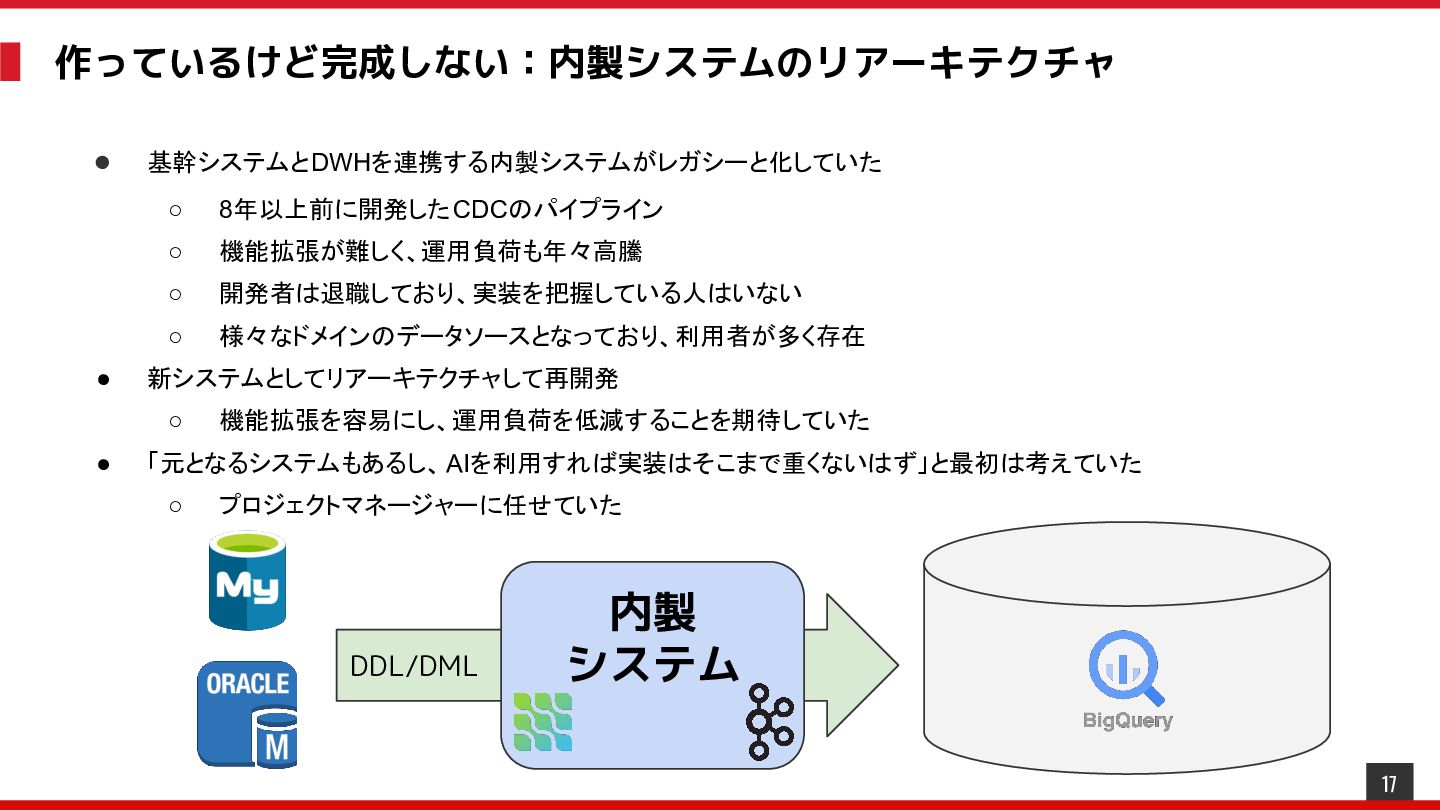
作っているけど完成しない:内製システムのリアーキテクチャ • • 基幹システムとDWHを連携する内製システムがレガシーと化していた ◦ 8年以上前に開発した CDCのパイプライン ◦ 機能拡張が難しく、運用負荷も年々高騰 ◦
開発者は退職しており、実装を把握している人はいない ◦ 様々なドメインのデータソースとなっており、利用者が多く存在 新システムとしてリアーキテクチャして再開発 ◦ • 機能拡張を容易にし、運用負荷を低減することを期待していた 「元となるシステムもあるし、 AIを利用すれば実装はそこまで重くないはず」と最初は考えていた ◦ プロジェクトマネージャーに任せていた DDL/DML 内製 システム 17
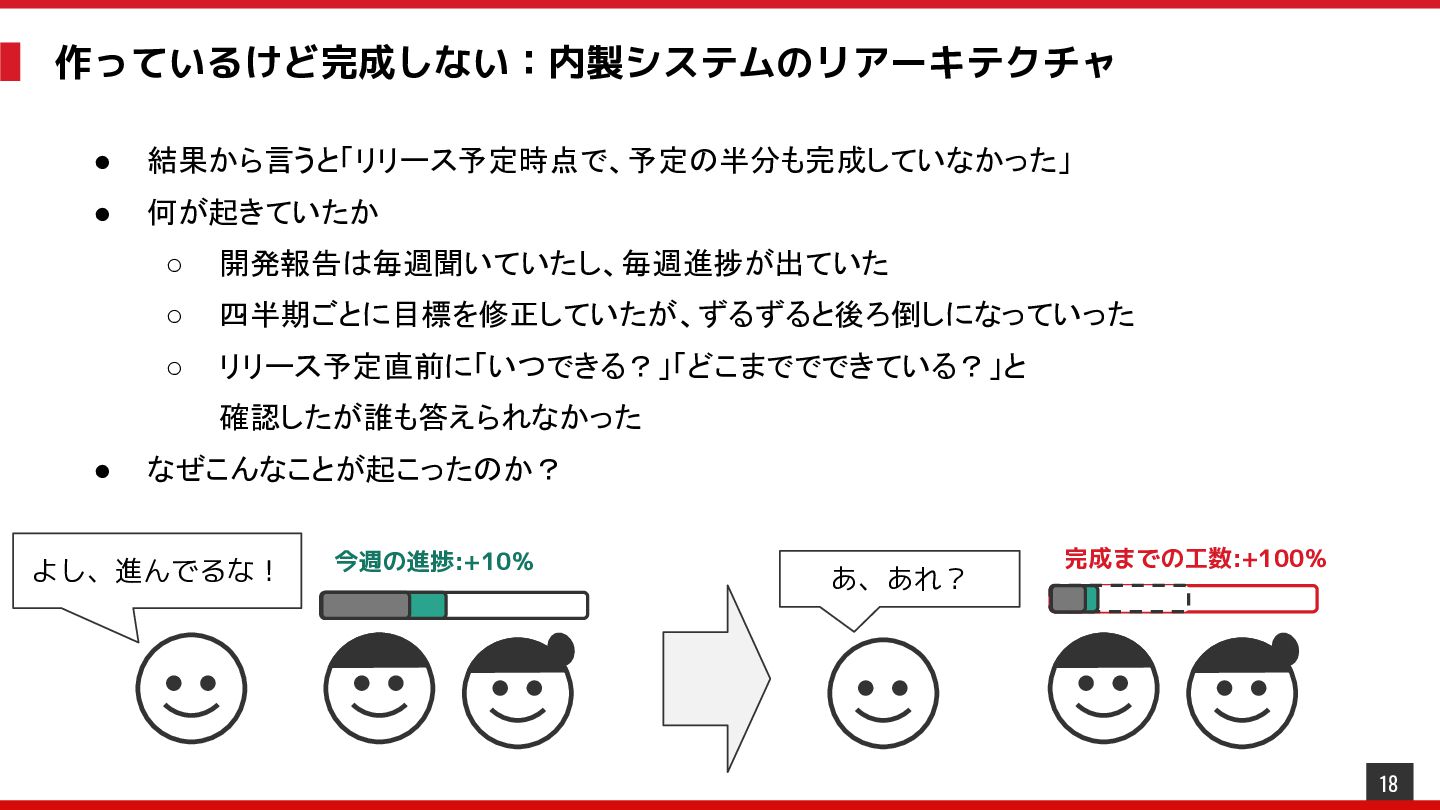
作っているけど完成しない:内製システムのリアーキテクチャ • 結果から言うと「リリース予定時点で、予定の半分も完成していなかった」 • 何が起きていたか ◦ 開発報告は毎週聞いていたし、毎週進捗が出ていた ◦ 四半期ごとに目標を修正していたが、ずるずると後ろ倒しになっていった ◦
リリース予定直前に「いつできる?」「どこまででできている?」と 確認したが誰も答えられなかった • なぜこんなことが起こったのか? よし、進んでるな! 今週の進捗:+10% あ、あれ? 完成までの工数:+100% 18
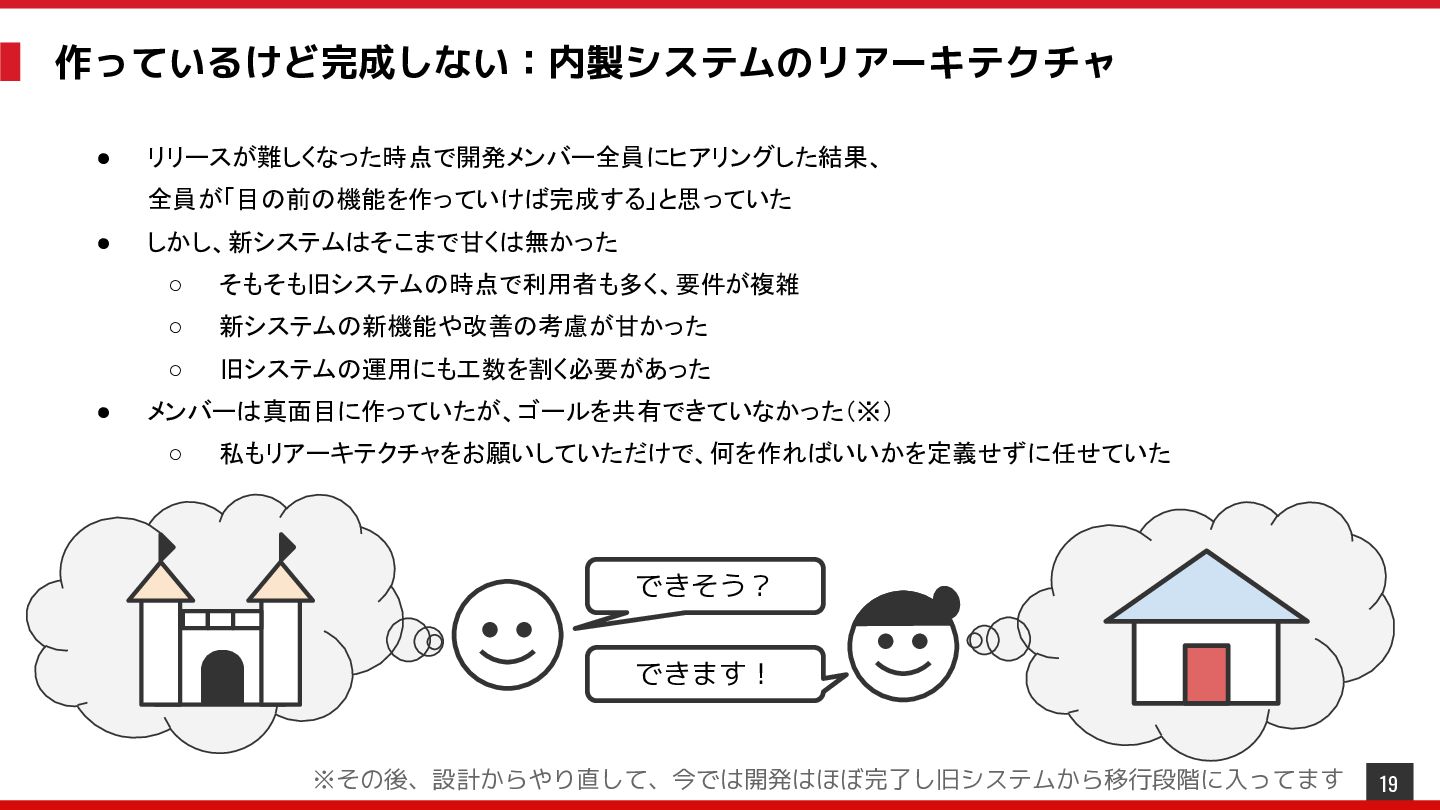
作っているけど完成しない:内製システムのリアーキテクチャ • リリースが難しくなった時点で開発メンバー全員にヒアリングした結果、 全員が「目の前の機能を作っていけば完成する」と思っていた • • しかし、新システムはそこまで甘くは無かった ◦ そもそも旧システムの時点で利用者も多く、要件が複雑 ◦
新システムの新機能や改善の考慮が甘かった ◦ 旧システムの運用にも工数を割く必要があった メンバーは真面目に作っていたが、ゴールを共有できていなかった(※) ◦ 私もリアーキテクチャをお願いしていただけで、何を作ればいいかを定義せずに任せていた できそう? できます! ※その後、設計からやり直して、今では開発はほぼ完了し旧システムから移行段階に入ってます 19
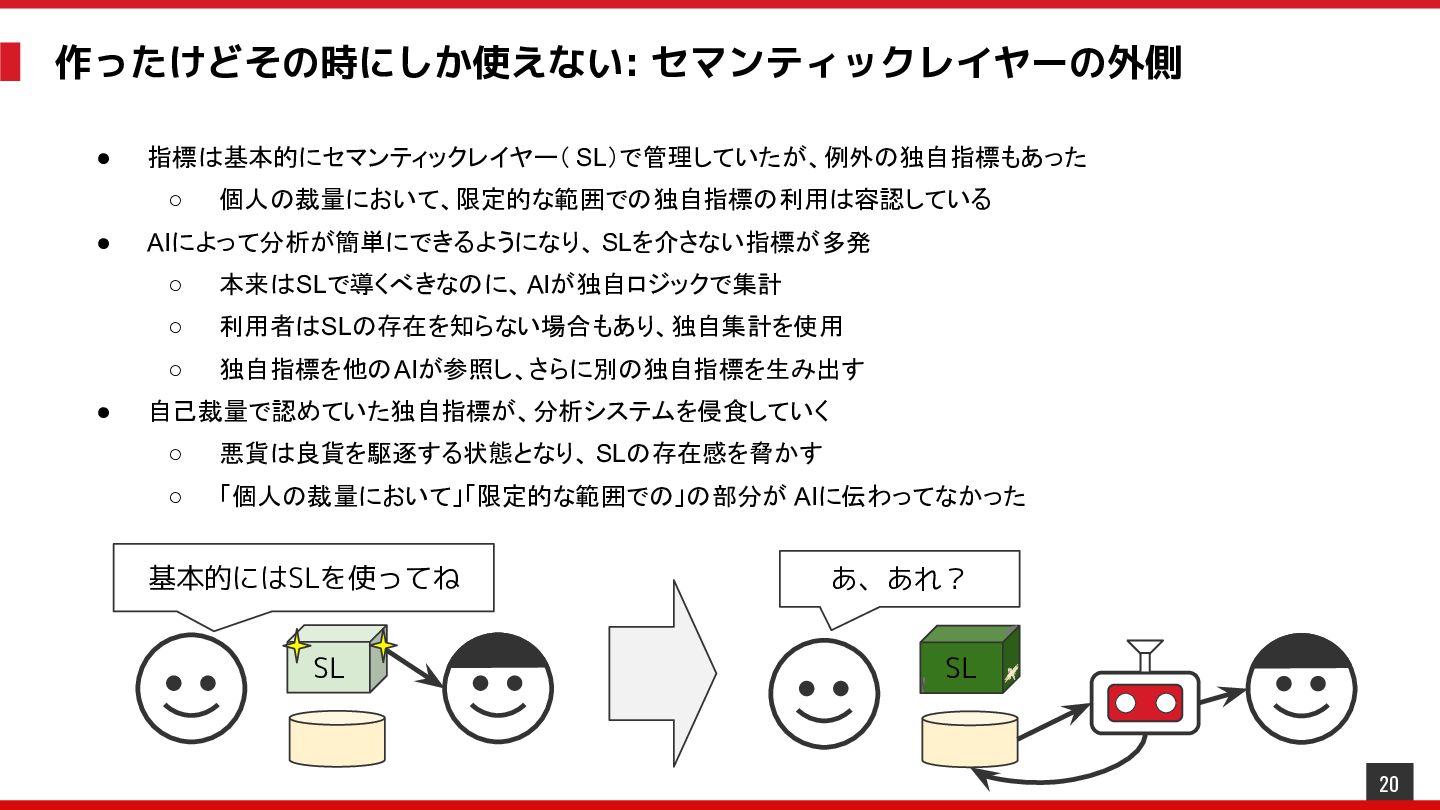
作ったけどその時にしか使えない: セマンティックレイヤーの外側 • 指標は基本的にセマンティックレイヤー( SL)で管理していたが、例外の独自指標もあった ◦ • • 個人の裁量において、限定的な範囲での独自指標の利用は容認している AIによって分析が簡単にできるようになり、
SLを介さない指標が多発 ◦ 本来はSLで導くべきなのに、AIが独自ロジックで集計 ◦ 利用者はSLの存在を知らない場合もあり、独自集計を使用 ◦ 独自指標を他のAIが参照し、さらに別の独自指標を生み出す 自己裁量で認めていた独自指標が、分析システムを侵食していく ◦ 悪貨は良貨を駆逐する状態となり、 SLの存在感を脅かす ◦ 「個人の裁量において」「限定的な範囲での」の部分が AIに伝わってなかった 基本的にはSLを使ってね SL あ、あれ? SL 20
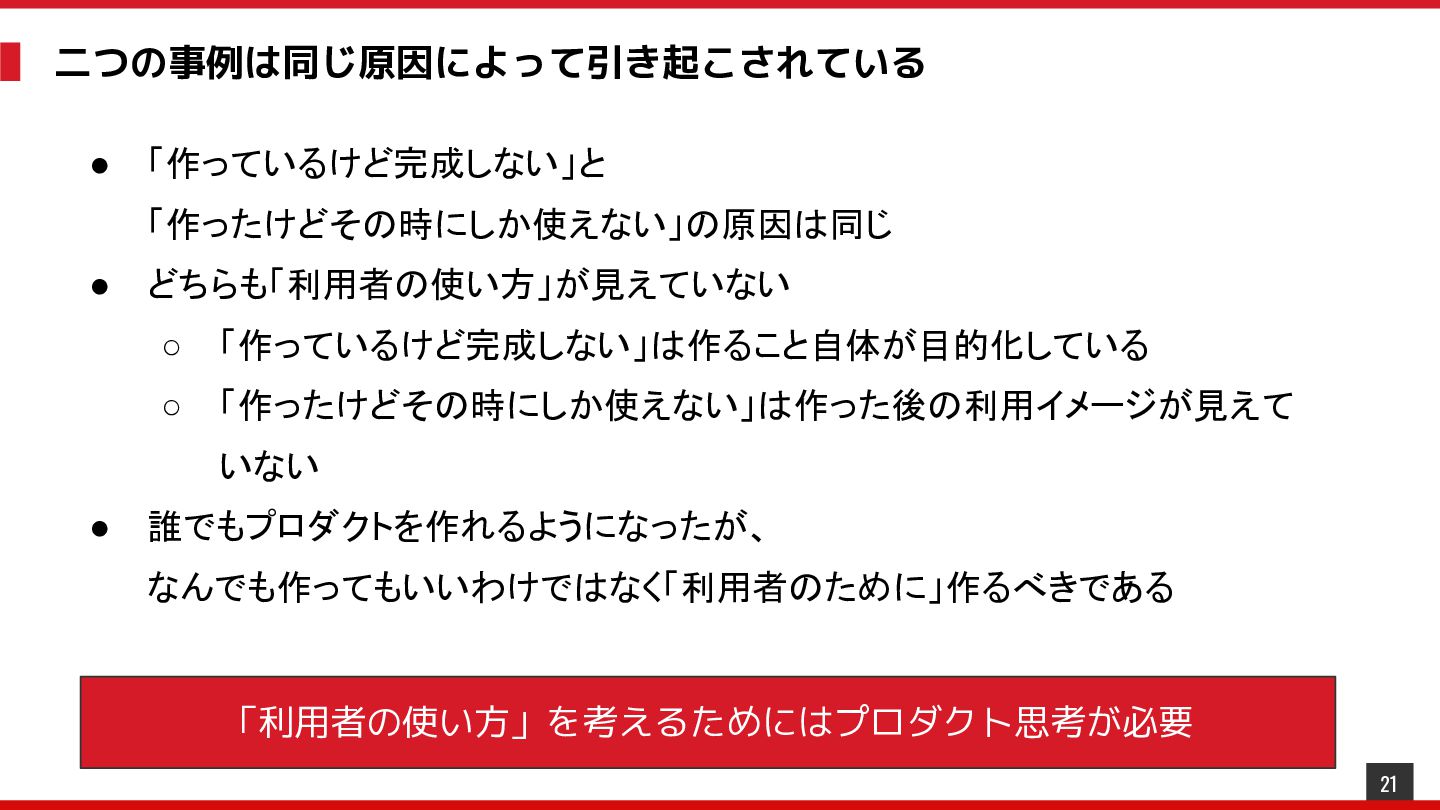
二つの事例は同じ原因によって引き起こされている • 「作っているけど完成しない」と 「作ったけどその時にしか使えない」の原因は同じ • どちらも「利用者の使い方」が見えていない ◦ 「作っているけど完成しない」は作ること自体が目的化している ◦ 「作ったけどその時にしか使えない」は作った後の利用イメージが見えて
いない • 誰でもプロダクトを作れるようになったが、 なんでも作ってもいいわけではなく「利用者のために」作るべきである 「利用者の使い方」を考えるためにはプロダクト思考が必要 21
プロダクト思考 © 2024 MonotaRO Co., Ltd.
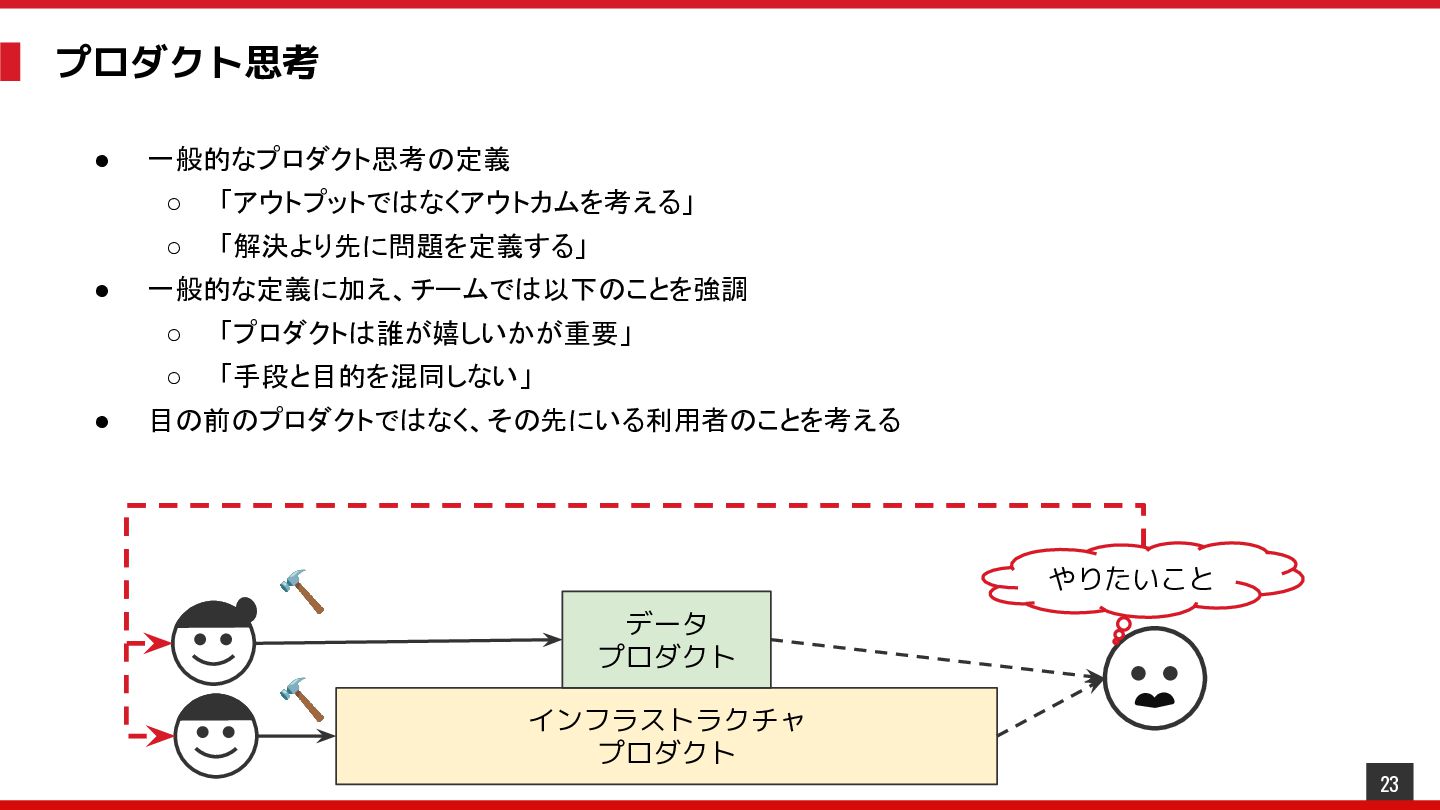
プロダクト思考 • • • 一般的なプロダクト思考の定義 ◦ 「アウトプットではなくアウトカムを考える」 ◦ 「解決より先に問題を定義する」 一般的な定義に加え、チームでは以下のことを強調
◦ 「プロダクトは誰が嬉しいかが重要」 ◦ 「手段と目的を混同しない」 目の前のプロダクトではなく、その先にいる利用者のことを考える 🔨 🔨 やりたいこと データ プロダクト インフラストラクチャ プロダクト 23
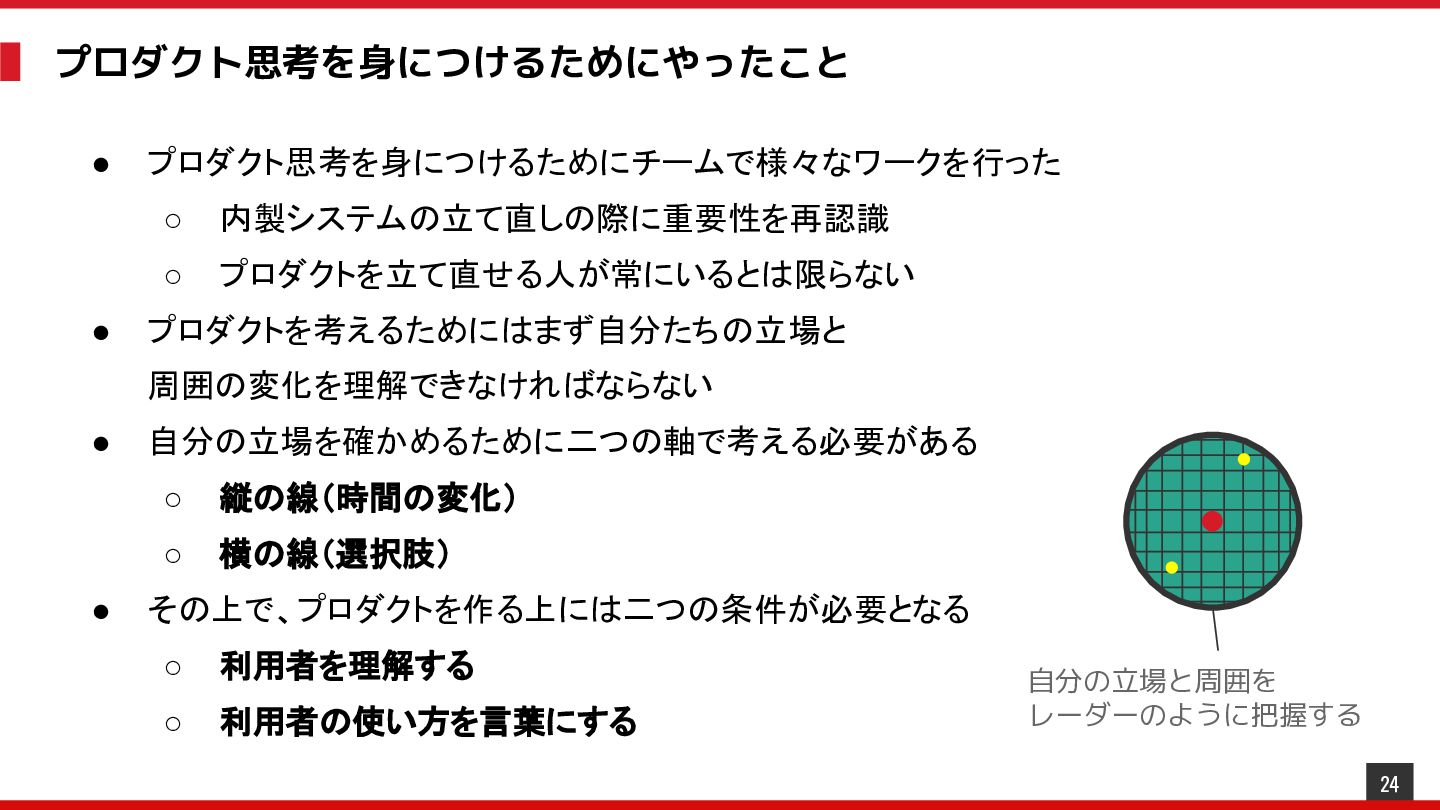
プロダクト思考を身につけるためにやったこと • • プロダクト思考を身につけるためにチームで様々なワークを行った ◦ 内製システムの立て直しの際に重要性を再認識 ◦ プロダクトを立て直せる人が常にいるとは限らない プロダクトを考えるためにはまず自分たちの立場と 周囲の変化を理解できなければならない
• • 自分の立場を確かめるために二つの軸で考える必要がある ◦ 縦の線(時間の変化) ◦ 横の線(選択肢) その上で、プロダクトを作る上には二つの条件が必要となる ◦ 利用者を理解する ◦ 利用者の使い方を言葉にする 自分の立場と周囲を レーダーのように把握する 24
縦の線(時間の変化) • 自分たちが使用している技術が何のために生まれて、何がなくなったのかを 理解できないと自分で何を作ればいいか判断できない • • 縦の線を意識するためにやったこと ◦ 技術書の輪読会や古典論文を紹介 ◦
単に歴史を知るだけではなく、時代背景を考慮して議論することが重要 縦の線を知るために扱った情報 ◦ 現在主に利用している Google Cloudのプロダクトの変遷 ◦ AWS、Snowflake、Databricksなど他社のプロダクトの変遷 ◦ Apache Hadoop, Spark, FlinkなどOSSの変遷 ◦ データエンジニアリングと関係ないエンジニアリングの変遷 📕 25
横の線(選択肢の探索) • 技術の選択肢がないと、自分たちに必要なものを作ることはできない ◦ Lakehouse、Open Table Format、HTAP、Semantic Layerなど 最新の技術動向 •
• ◦ 他社のデータ基盤の事例 ◦ AI Readyなデータ基盤の事例 単に知るだけではなく、自分たちのこととして考え直す ◦ 「弊社のデータ基盤を最新の技術で作り変えるとどうなるか」 ◦ 「弊社では〇〇を導入すべきか/導入すべきではないか」 知っているだけではなく、使えるようにする必要がある 26
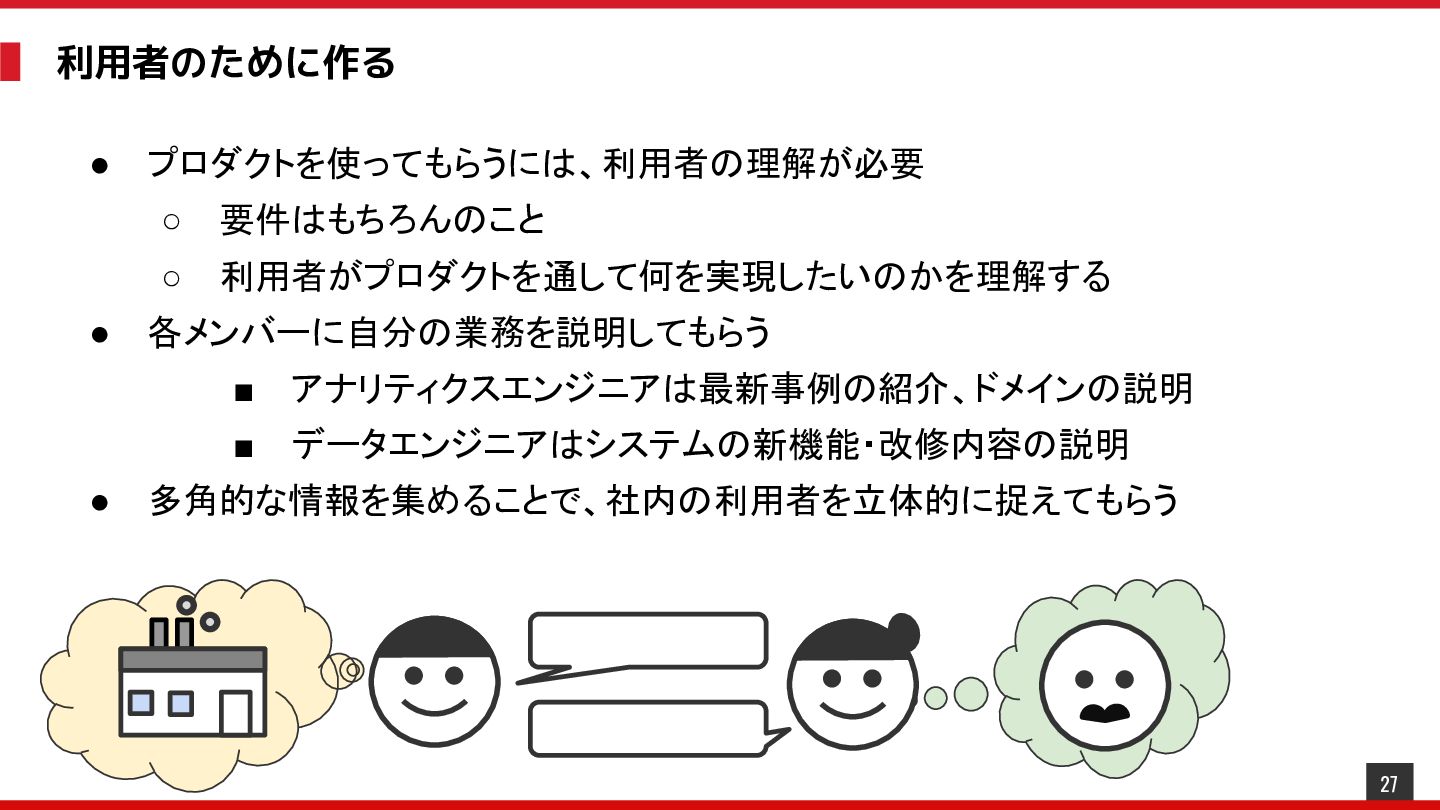
利用者のために作る • • • プロダクトを使ってもらうには、利用者の理解が必要 ◦ 要件はもちろんのこと ◦ 利用者がプロダクトを通して何を実現したいのかを理解する 各メンバーに自分の業務を説明してもらう
▪ アナリティクスエンジニアは最新事例の紹介、ドメインの説明 ▪ データエンジニアはシステムの新機能・改修内容の説明 多角的な情報を集めることで、社内の利用者を立体的に捉えてもらう 27
利用者の使い方を言葉にする • 自分たちが作るものを言葉にできるようにならなければならない ◦ • • • 特にAIは言葉を元に動く Design Docをたくさん書いてもらう
◦ 言語化は量から質に転じる ◦ Why/What/Who/Whereを意識してもらう ◦ Howの質は横の線で担保される AIはDesign Docの良きレビュアー ◦ AIに上手く伝わらないことは、人間にも伝わらない ◦ 個人的にはAIにマルっと書かせることはおすすめしない プロダクトは作り始める前に言葉で作ることができる 📝 プロダクト思考を身につけるためにやってもらい、効果はあったのか!? 28
効果 • 今回の発表を機に、メンバーにヒアリングを行った • 議論の質が変化した ◦ • • 「目的ではなく手段から考えている」ことに自覚的になった 利用者の要件が明確になり、機能の優先度を組み立てられるようになった
◦ 目の前のタスクを捌くのではなく、利用者を意識してやることを決める ◦ 利用者全体を漠然と捉えるのではなく、分類することで要件が具体的になった ◦ 開発方針が変わっても、共通認識があることでメンバー全員の方向が揃いやすくなった まだまだできていないことも多いです ◦ 「具体的に動かさないと分からない」声もあり、「試せる環境」の必要性が増している プロダクトからアウトカムを生み出す組織に移行しつつある 29
まとめ • AI x AEの進捗によって、去年よりもデータマネジメントは進歩した • しかし、作りやすくなったことによる弊害も現れた • • •
◦ 作っているけど、完成しない ◦ 作ったけど、その時にしか使えない どちらも「利用者の使い方」がイメージできているかが重要 ◦ 自分たちの立場(縦の線と横の線) ◦ 利用者を理解する ◦ 利用者の使い方を言葉にする 「自律的にデータを活用できる環境」=「一人一人がプロダクト思考を持っている状態」 ◦ データメッシュでは各ドメインが自分たちでデータマネジメントをする ◦ そのためにはプロダクト思考は、エンジニアだけではなく全員が持つべき考え方 AIによって誰でも簡単に作れる時代だからこそ、 作るべきことを考えられるようにならなければならない 30
興味を持ってくれた方へ • プロダクト開発に興味がある人はこちらからご応募お待ちしています • 見ての通り、まだまだやれていないことばかりです ◦ • 去年も話した通り、データメッシュもやっていきたい 活躍できる余地はたくさんあるので、興味がある方の募集をお待ちしています ソフトウェアエンジニア
(データ基盤) アナリティクスエンジニア 31
© 2020 MonotaRO Co., Ltd. All Rights Reserved. 32


 monotaro
 bethany
 keathley
 mfonobong
 palkan
 smashingmag
 uxyall
 danielanewman
 dugsong
 marcduiker
 addyosmani