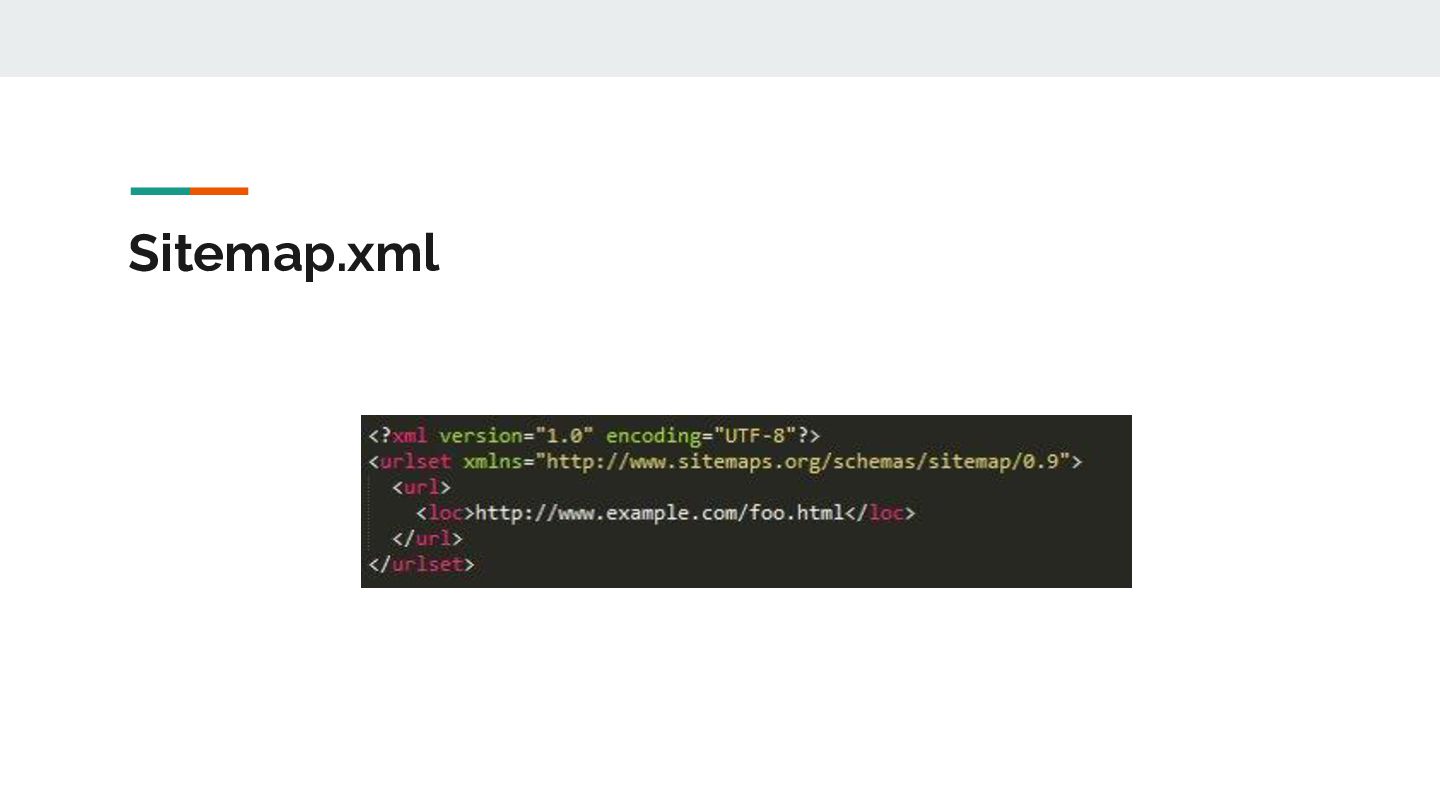
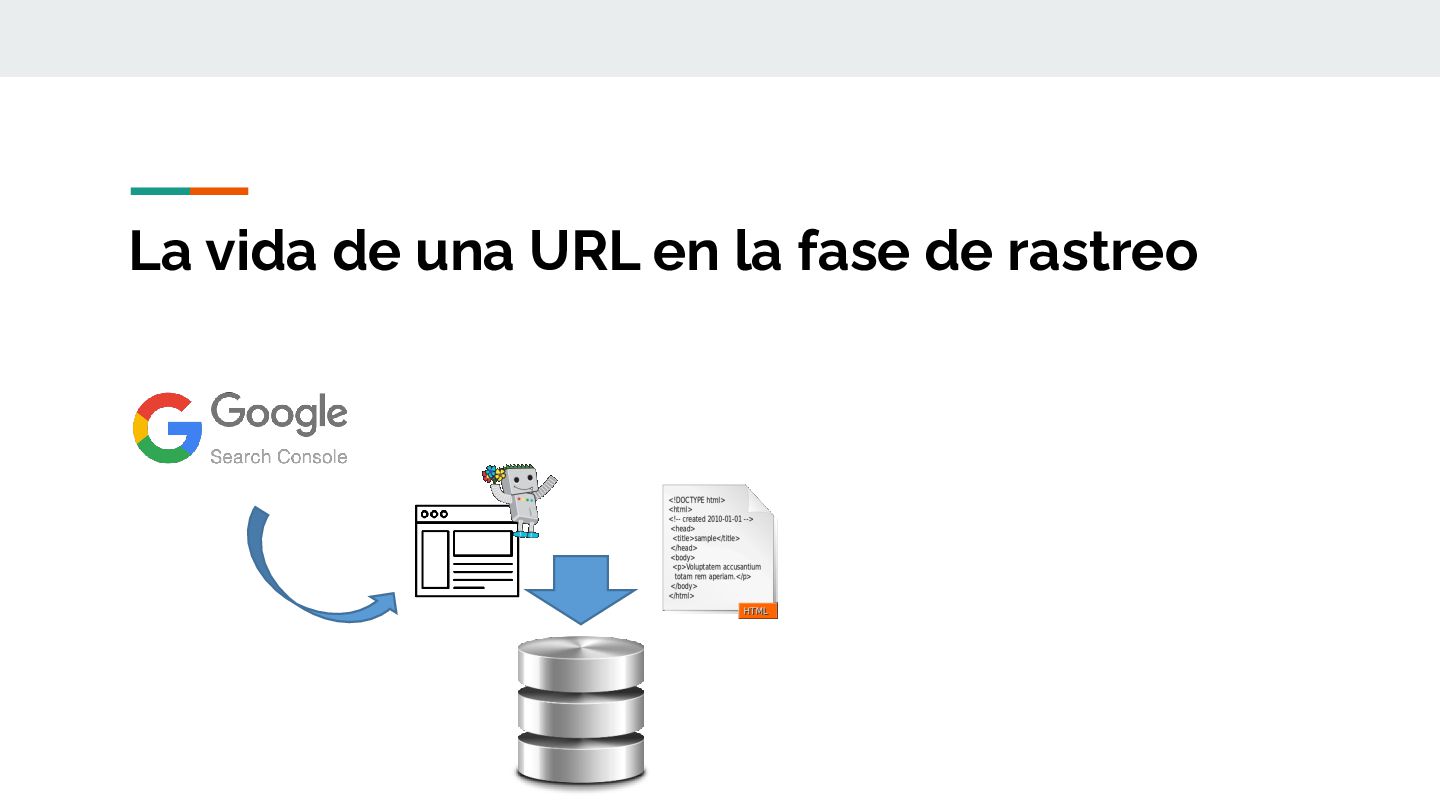
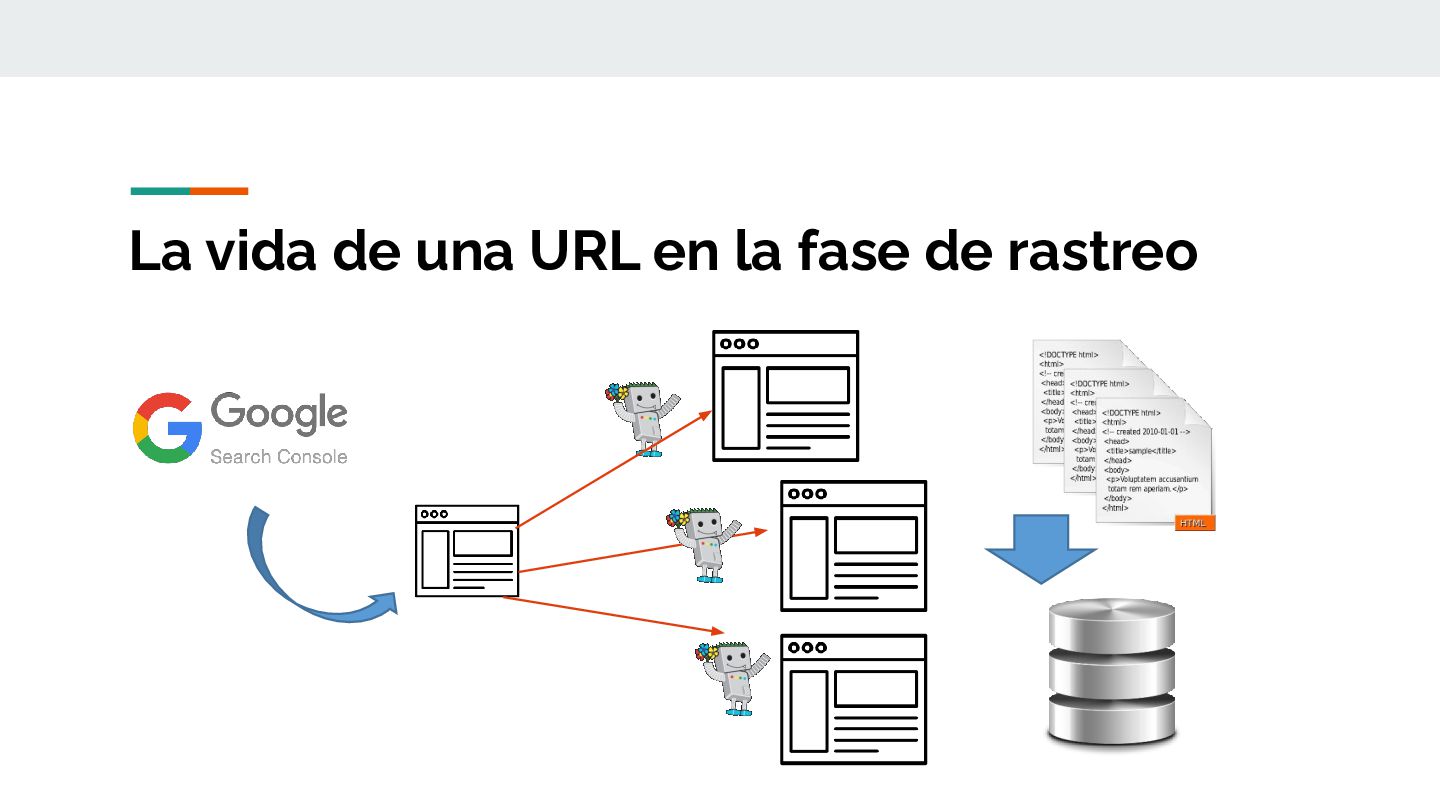
que se pueden enumerar las páginas de tu sitio web para informar a Google y a otros motores de búsqueda sobre la organización del contenido del mismo. Los rastreadores web de los motores de búsqueda leen este archivo para rastrear el sitio de forma más inteligente. Existen 3 extensiones de sitemaps: • Vídeo • Imágenes • Noticias
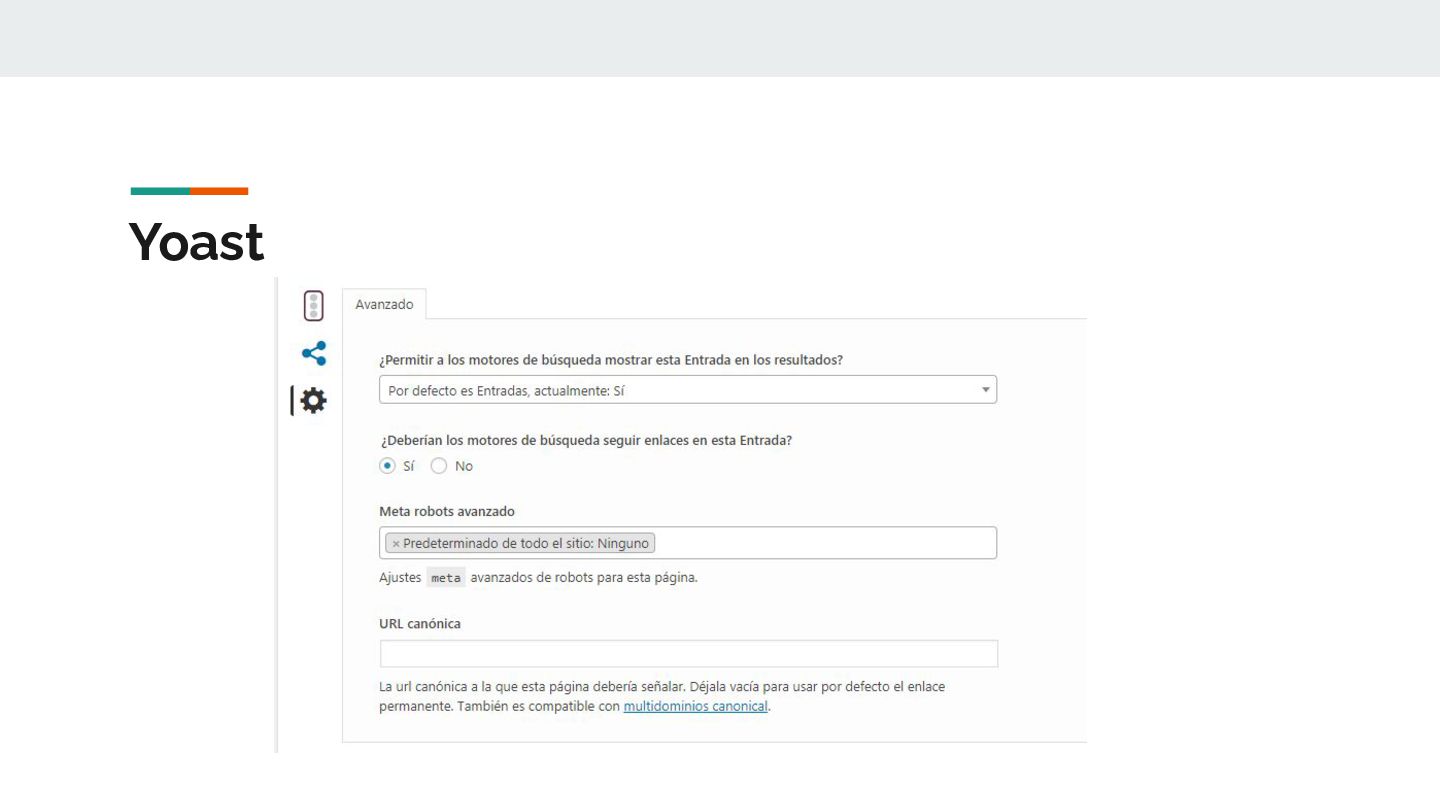
estén en noindex no deben aparecer en el sitemap.xml. Se deben respetar las directivas que aparezcan en el archivo robots.txt. Los archivos de sitemap deben tener la codificación UTF-8 Deben contener las URLs canónicas Comprobar que estas cumplan el estándar RFC-3986 para URIs, el estándar RFC-3987 para IRIs y el estándar XML. El sitemap se debe actualizar cada vez que se cree o se elimine una página.
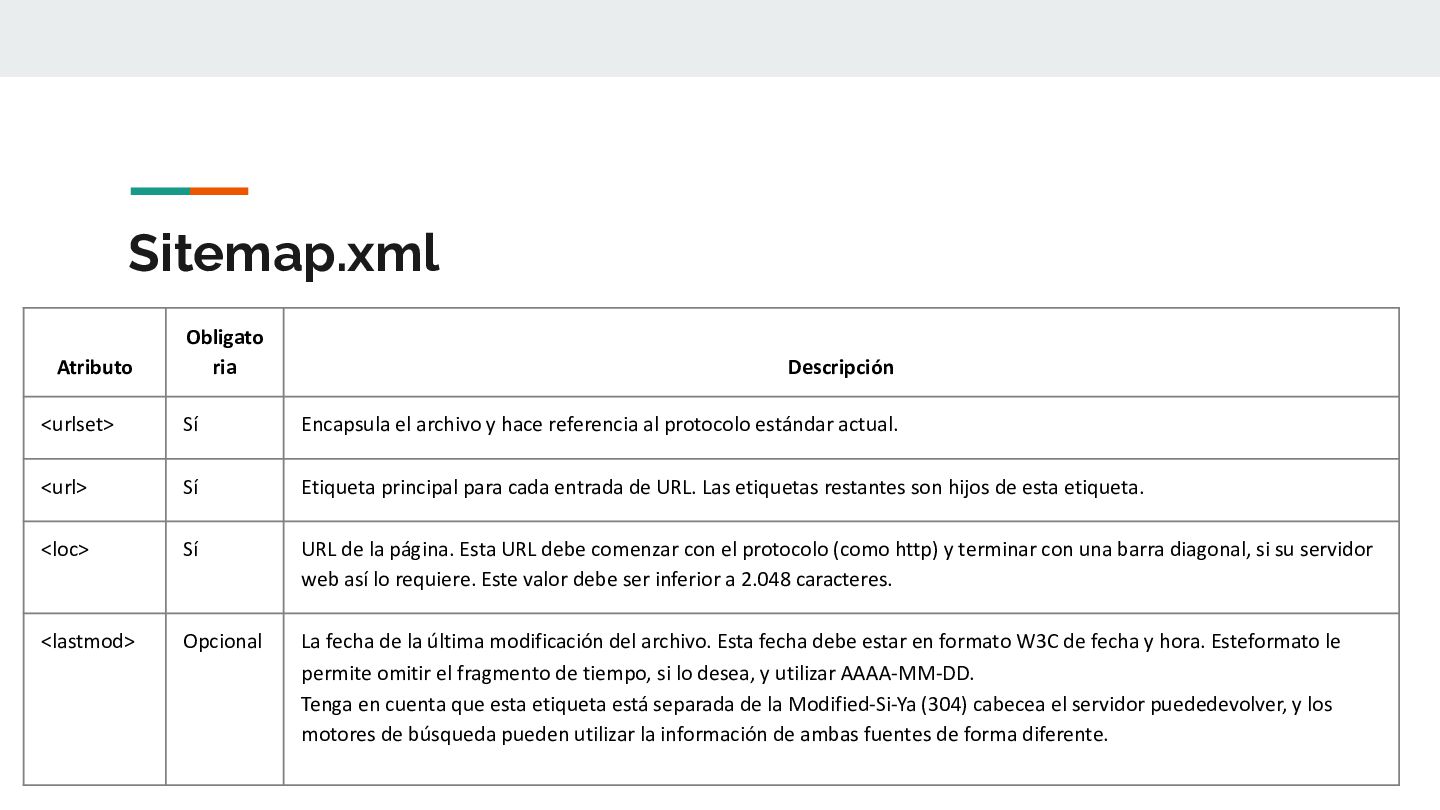
y hace referencia al protocolo estándar actual. <url> Sí Etiqueta principal para cada entrada de URL. Las etiquetas restantes son hijos de esta etiqueta. <loc> Sí URL de la página. Esta URL debe comenzar con el protocolo (como http) y terminar con una barra diagonal, si su servidor web así lo requiere. Este valor debe ser inferior a 2.048 caracteres. <lastmod> Opcional La fecha de la última modificación del archivo. Esta fecha debe estar en formato W3C de fecha y hora. Esteformato le permite omitir el fragmento de tiempo, si lo desea, y utilizar AAAA-MM-DD. Tenga en cuenta que esta etiqueta está separada de la Modified-Si-Ya (304) cabecea el servidor puededevolver, y los motores de búsqueda pueden utilizar la información de ambas fuentes de forma diferente.
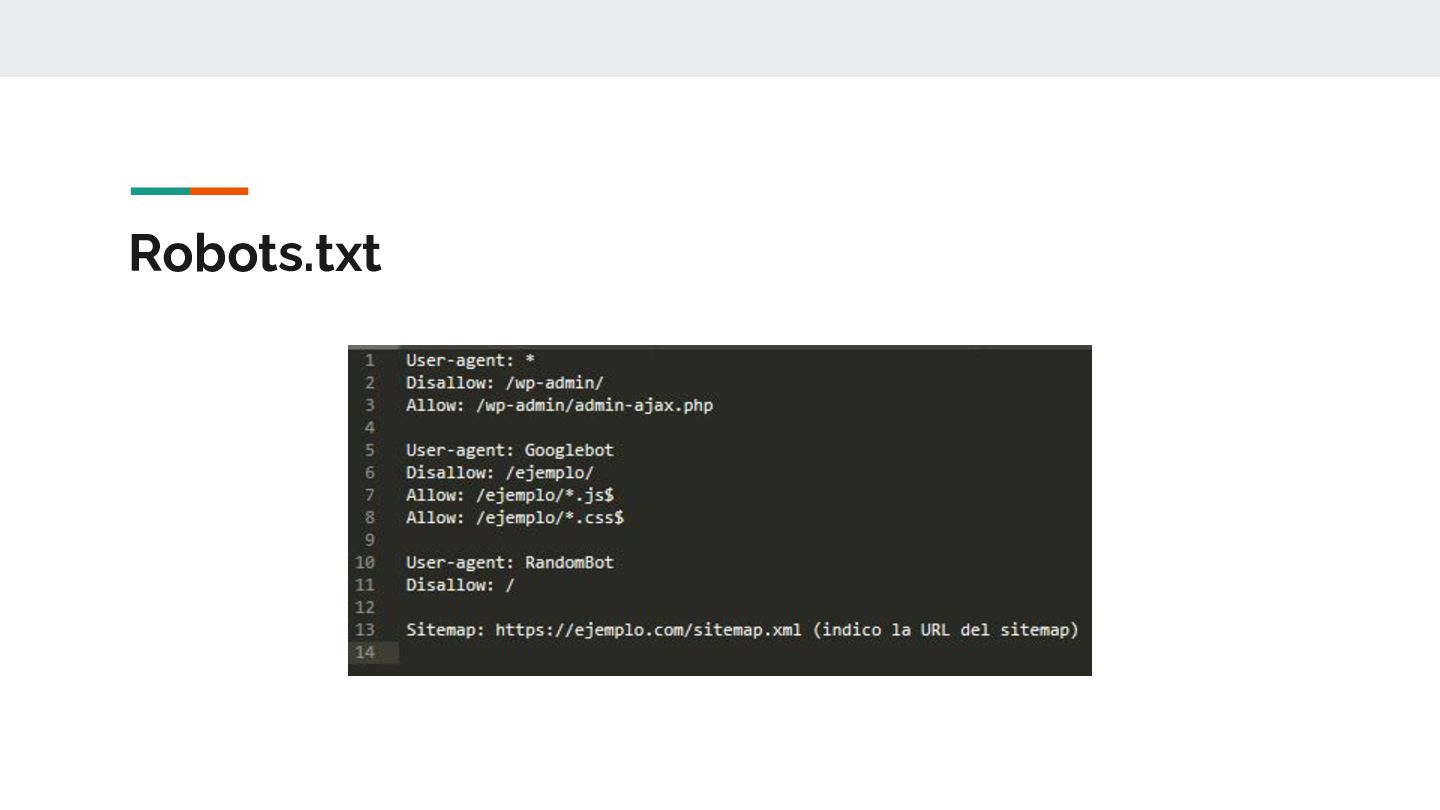
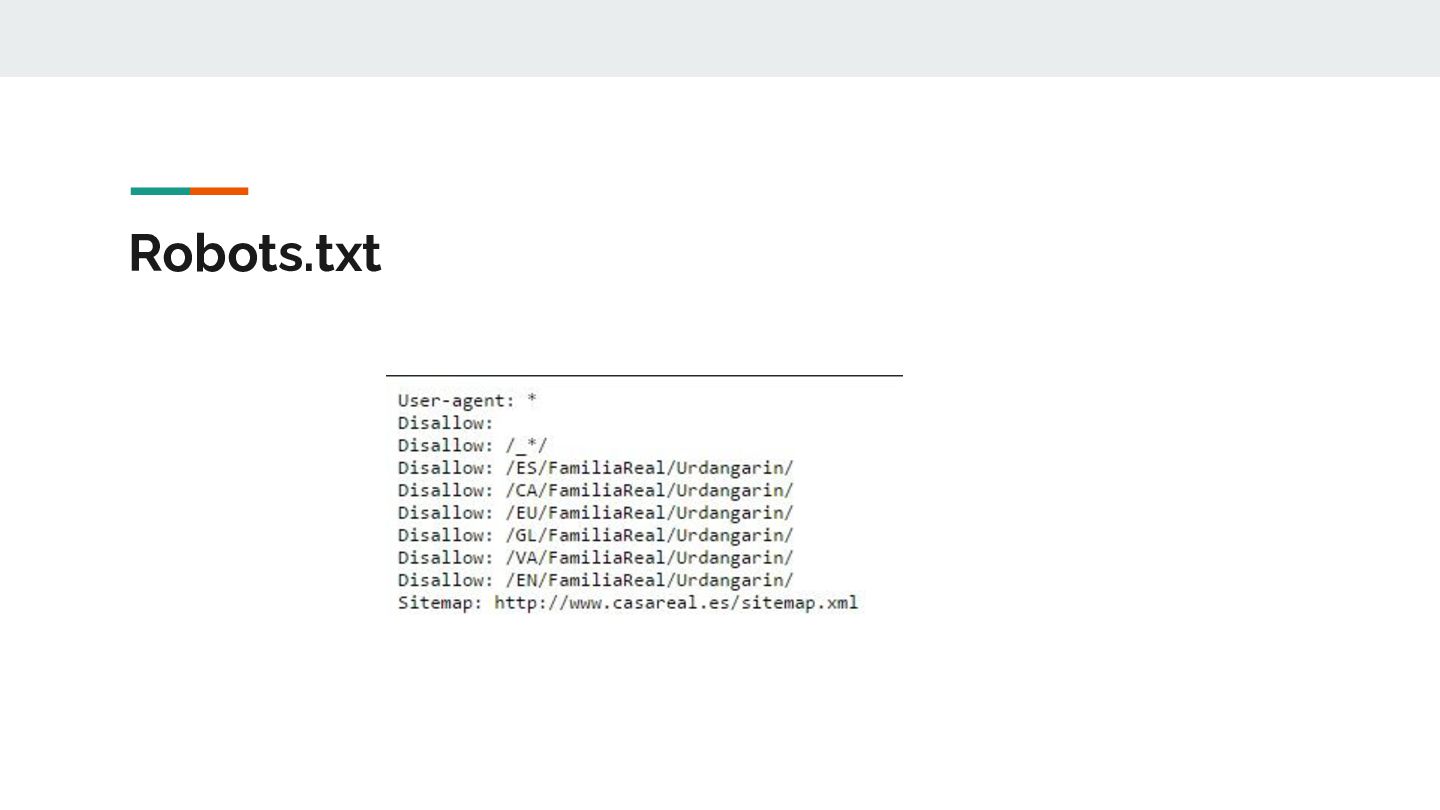
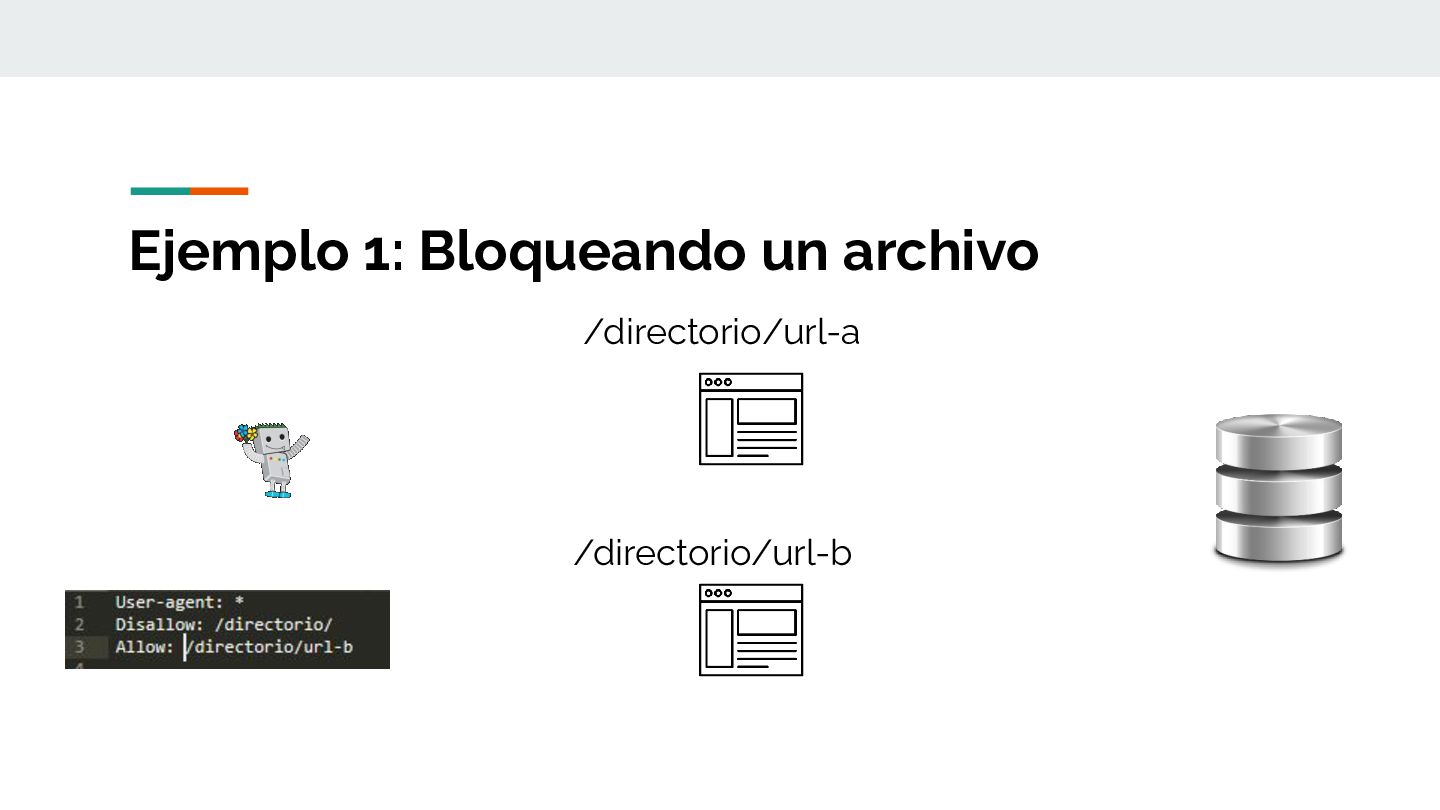
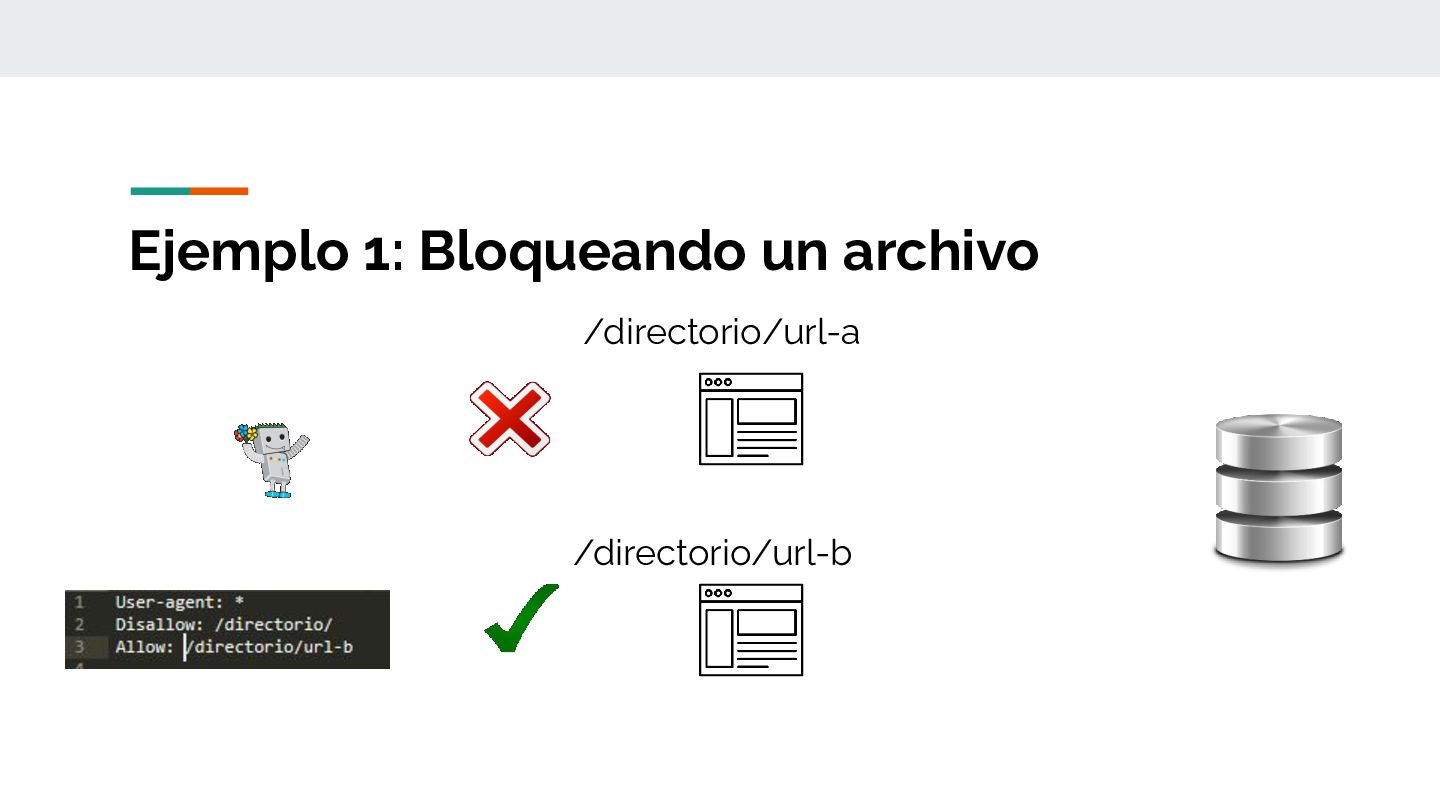
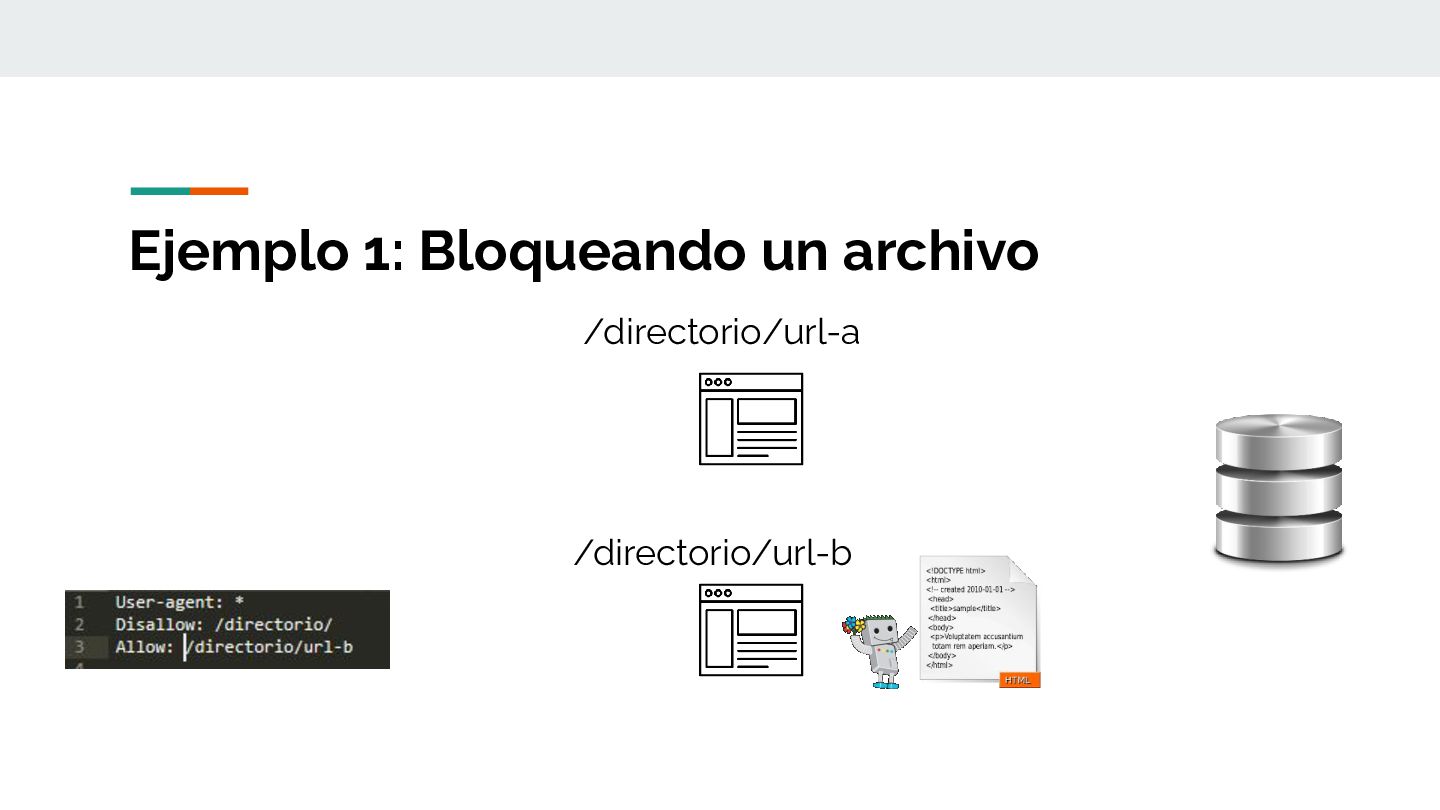
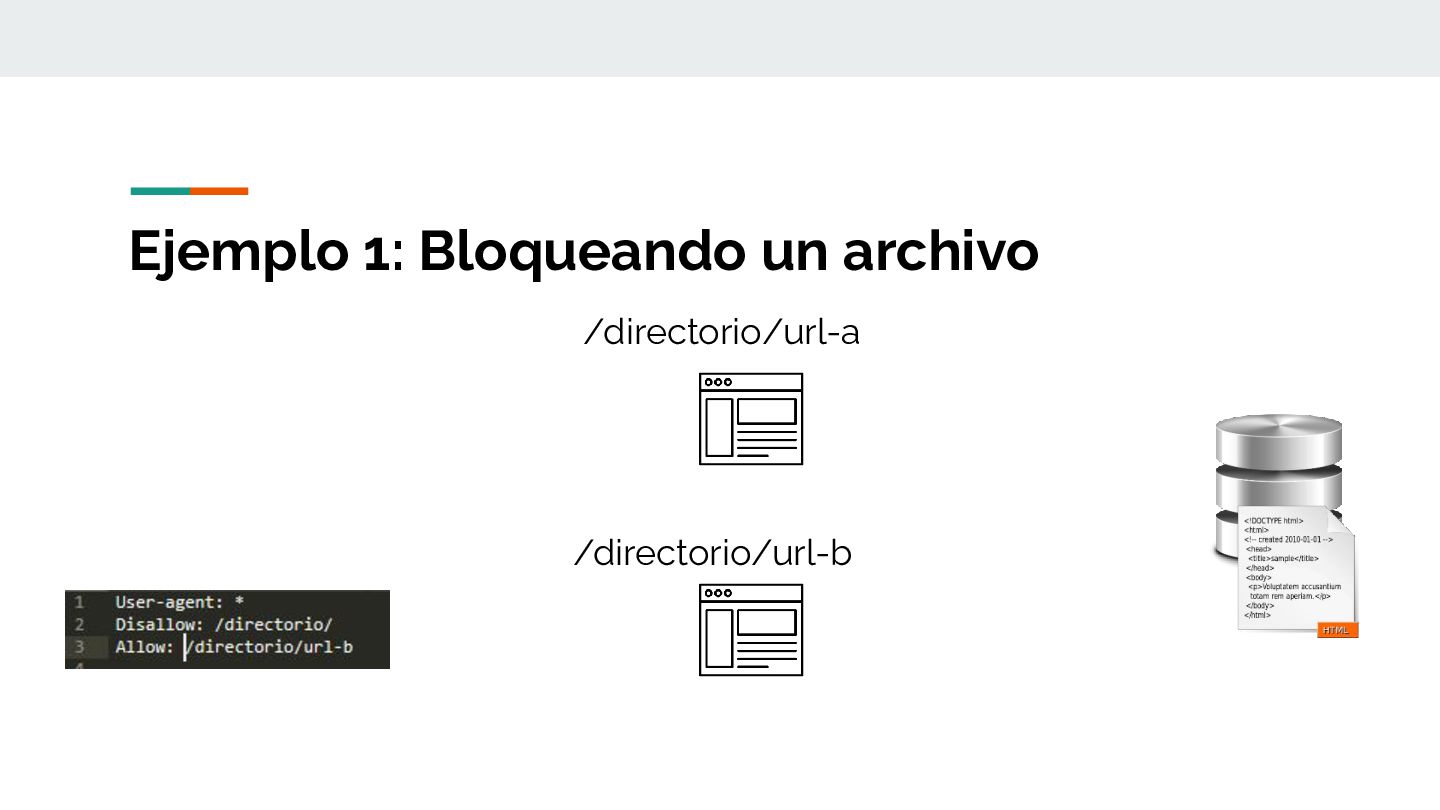
es un archivo en texto plano (.txt) que tiene la función de ofrecer unas directivas a los bots que visitan tu site. Estas directivas pueden ser ignoradas en cualquier momento por ciertos bots por lo que el archivo robots.txt no es la única solución al control de bots, también se puede hacer por .htacces
de cosas: • • • • • • • • User-agent: El bot o el grupo de bots al que afectará la directiva o directivas escritas a continuación. Disallow: La URL o directorios que no queremos que crawlee el bot Allow: La URL o directorios que permitimos crawlear teniendo en cuenta la exclusión generada en un directorio anterior URL del sitemap: URL de la localización del sitemap o del índice de sitemaps #: Para poner un comentario *: Hace referencia a cualquiera $: Para marcar el final de una URL Crawl-delay: el número de segundos que deberá esperar el bot para seguir con el rastreo
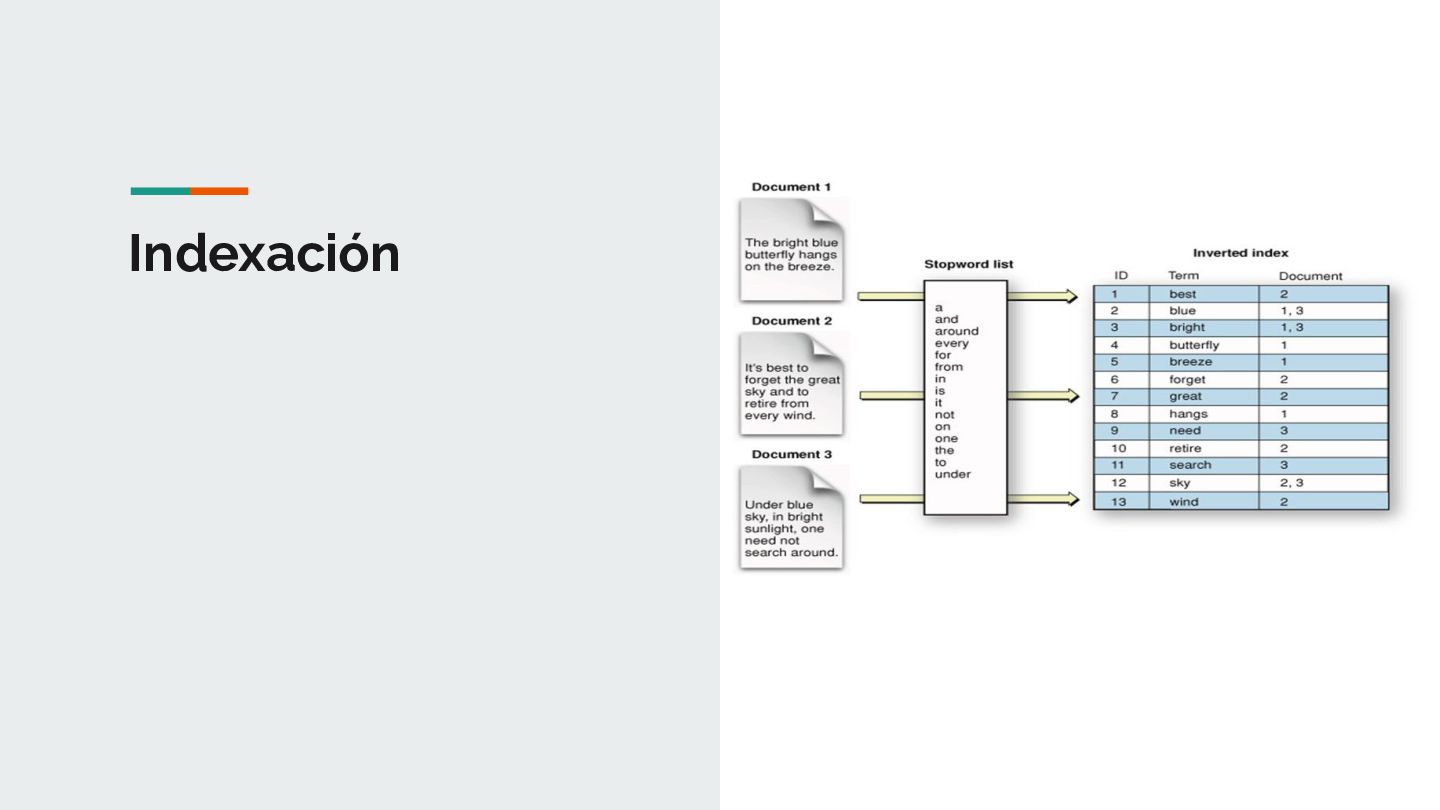
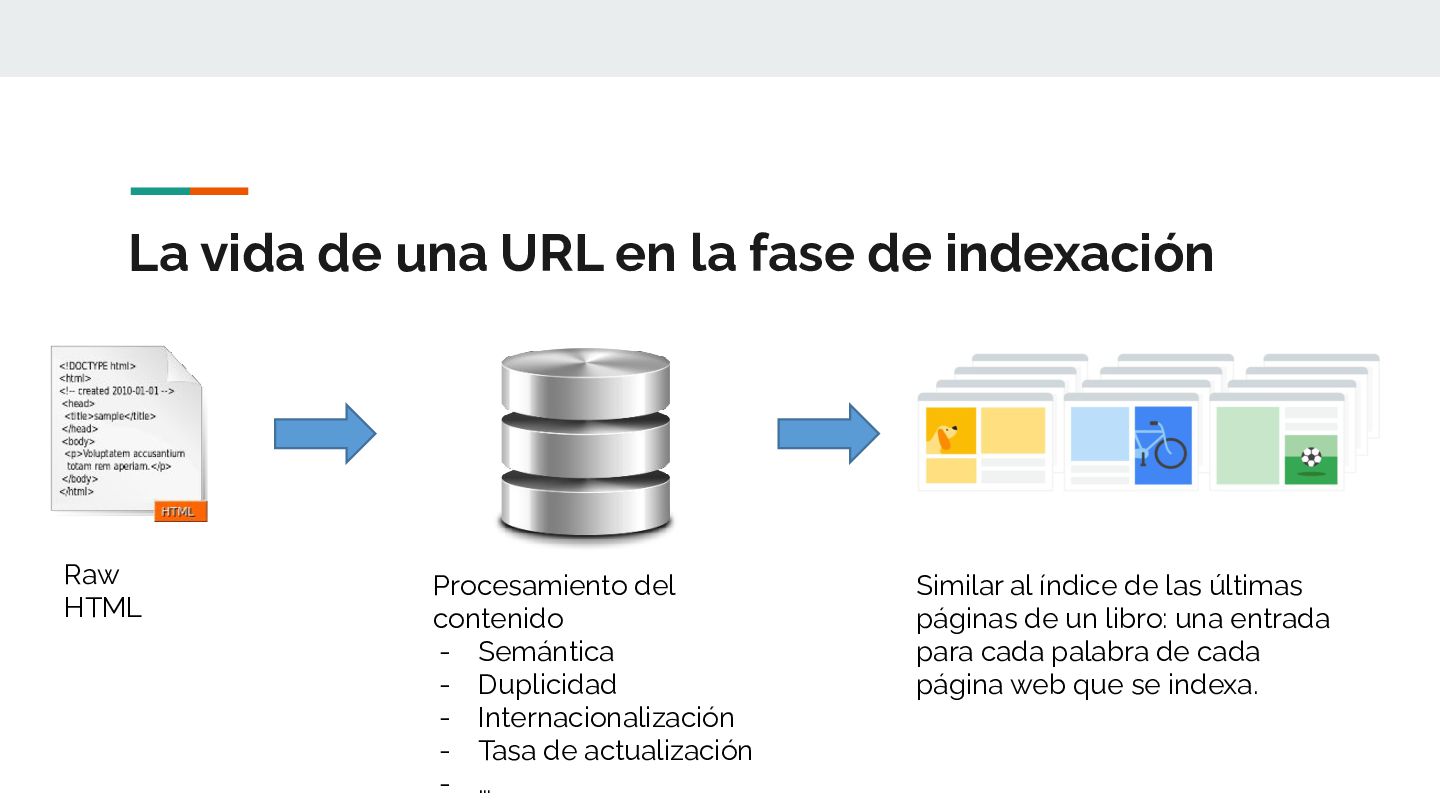
Raw HTML Procesamiento del contenido - Semántica - Duplicidad - Internacionalización - Tasa de actualización - … Similar al índice de las últimas páginas de un libro: una entrada para cada palabra de cada página web que se indexa.
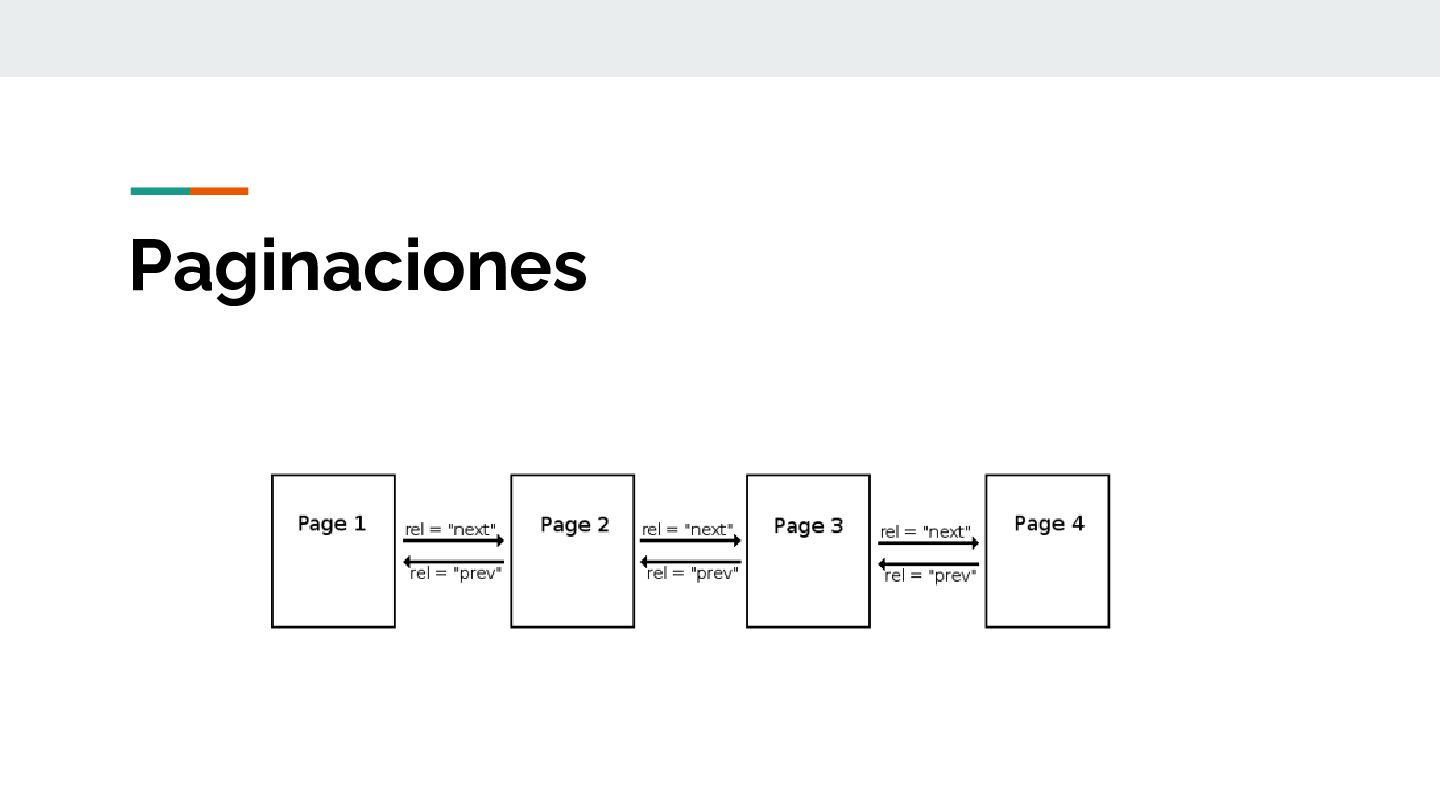
indicar la relación entre las paginaciones. La configuración es: • Para la primera página <link rel=”next” href=”http://ejemplo.com/pagina-2.html” /> • Para las páginas intermedias <link rel=”prev” href=”http://ejemplo.com/pagina.html” /> <link rel=”next” href=”http://ejemplo.com/pagina-3.html” /> • Para la última página <link rel=”prev” href=”http://ejemplo.com/pagina-2.html” />
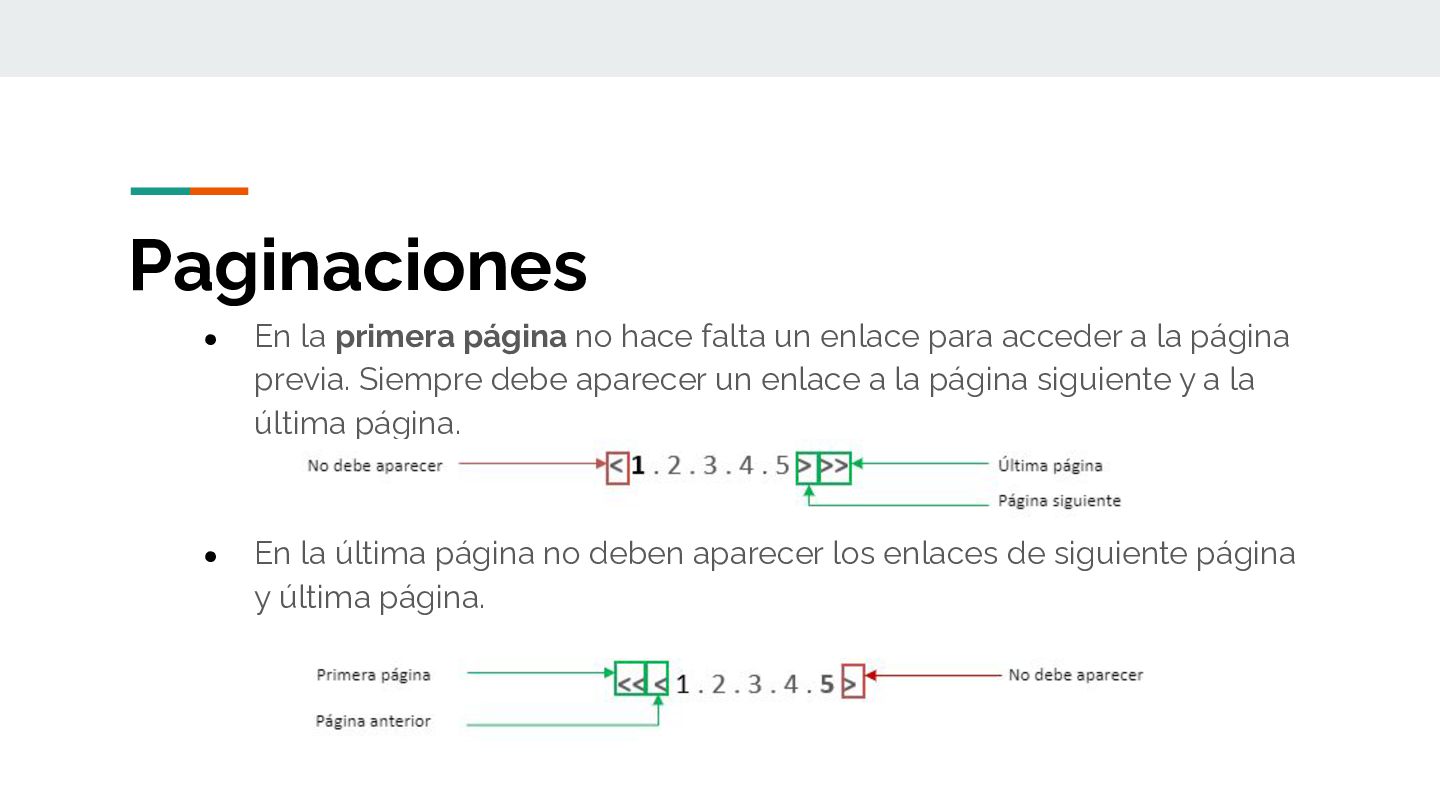
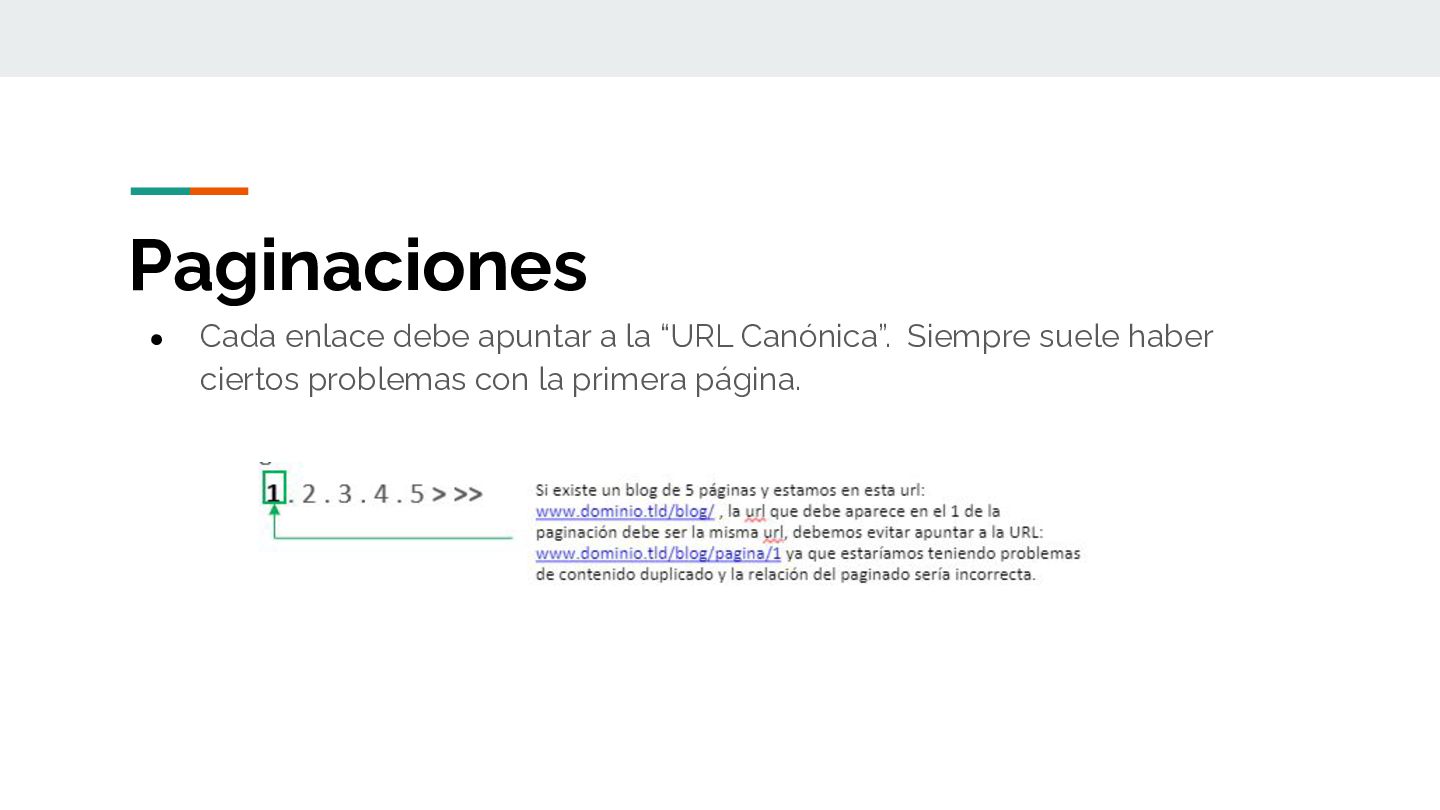
enlace para acceder a la página previa. Siempre debe aparecer un enlace a la página siguiente y a la última página. • En la última página no deben aparecer los enlaces de siguiente página y última página.
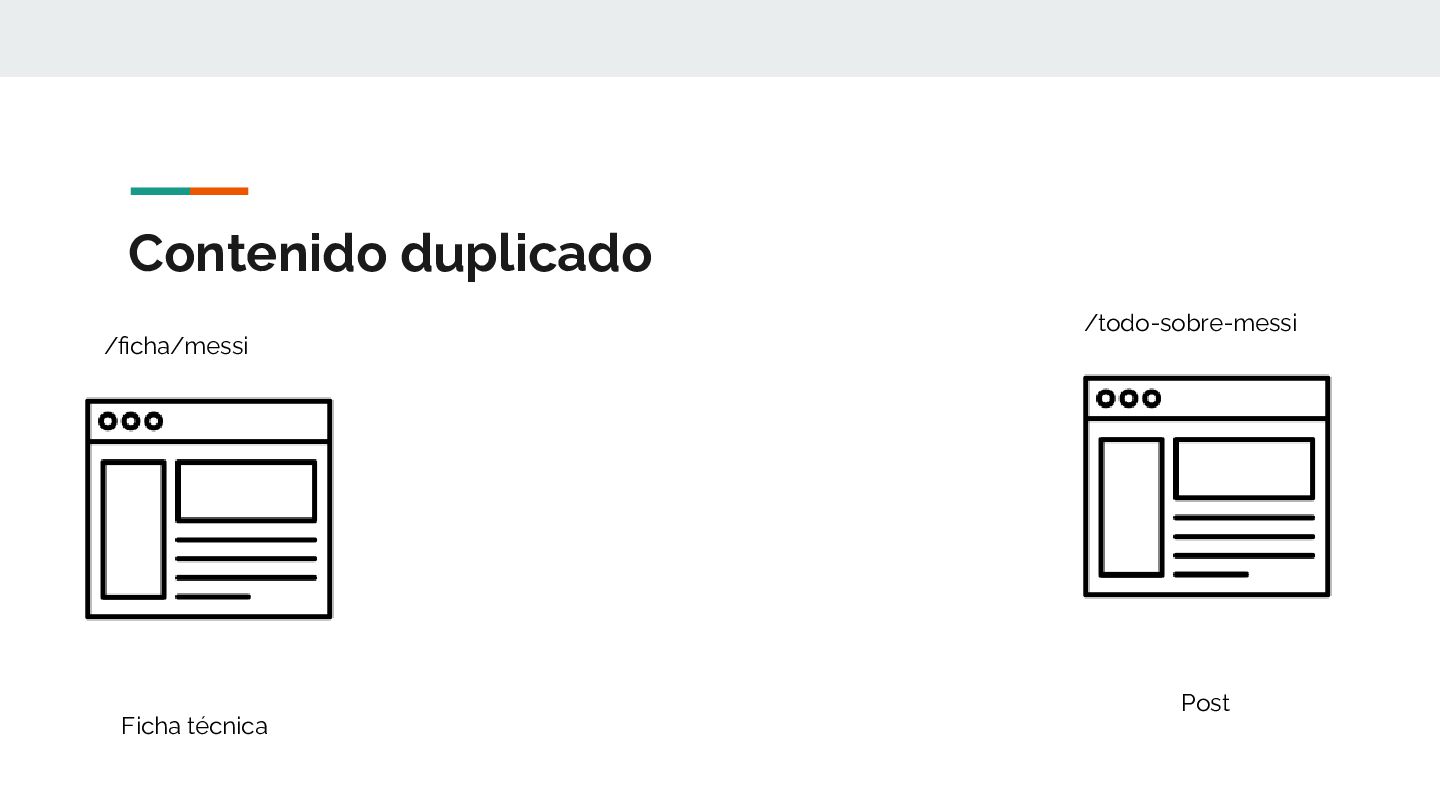
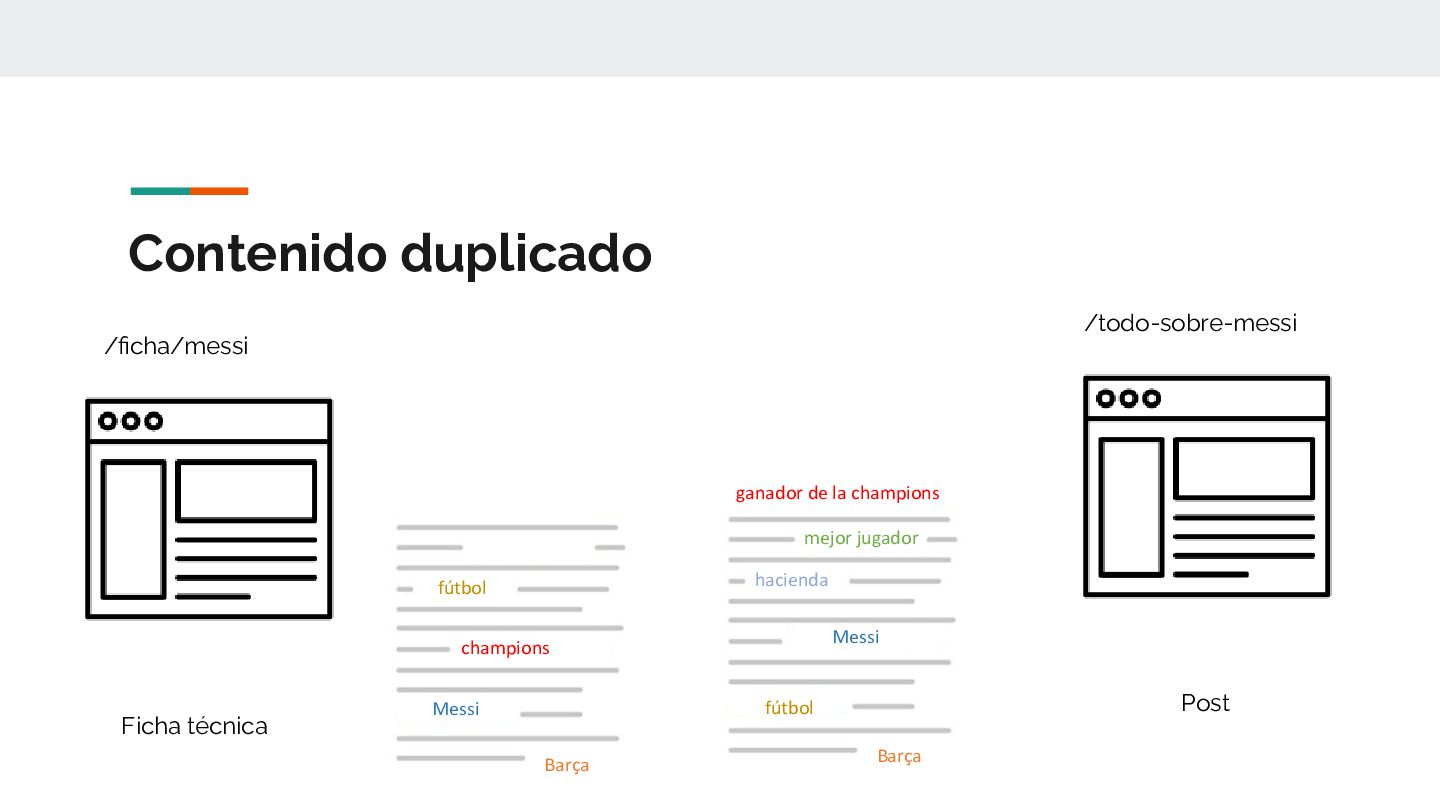
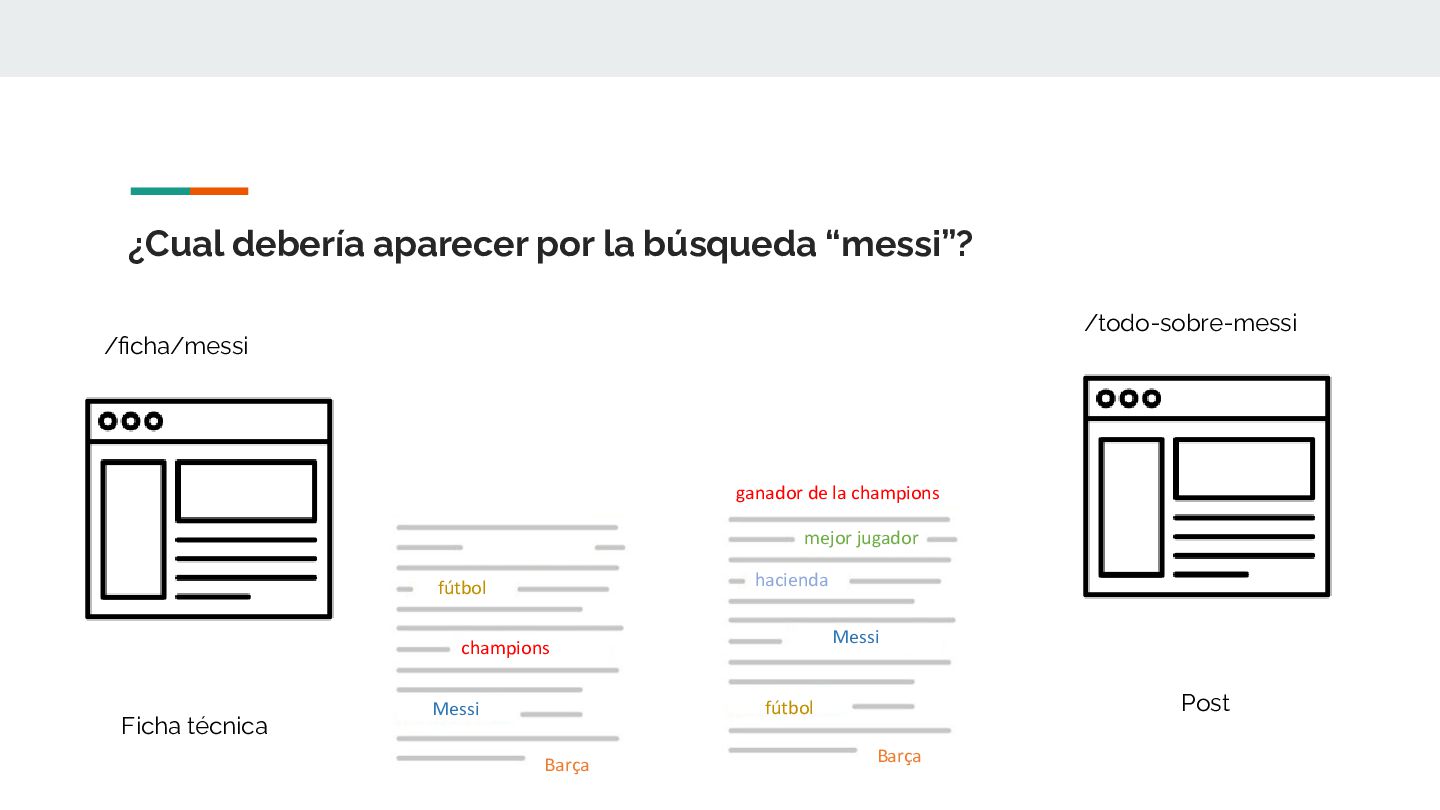
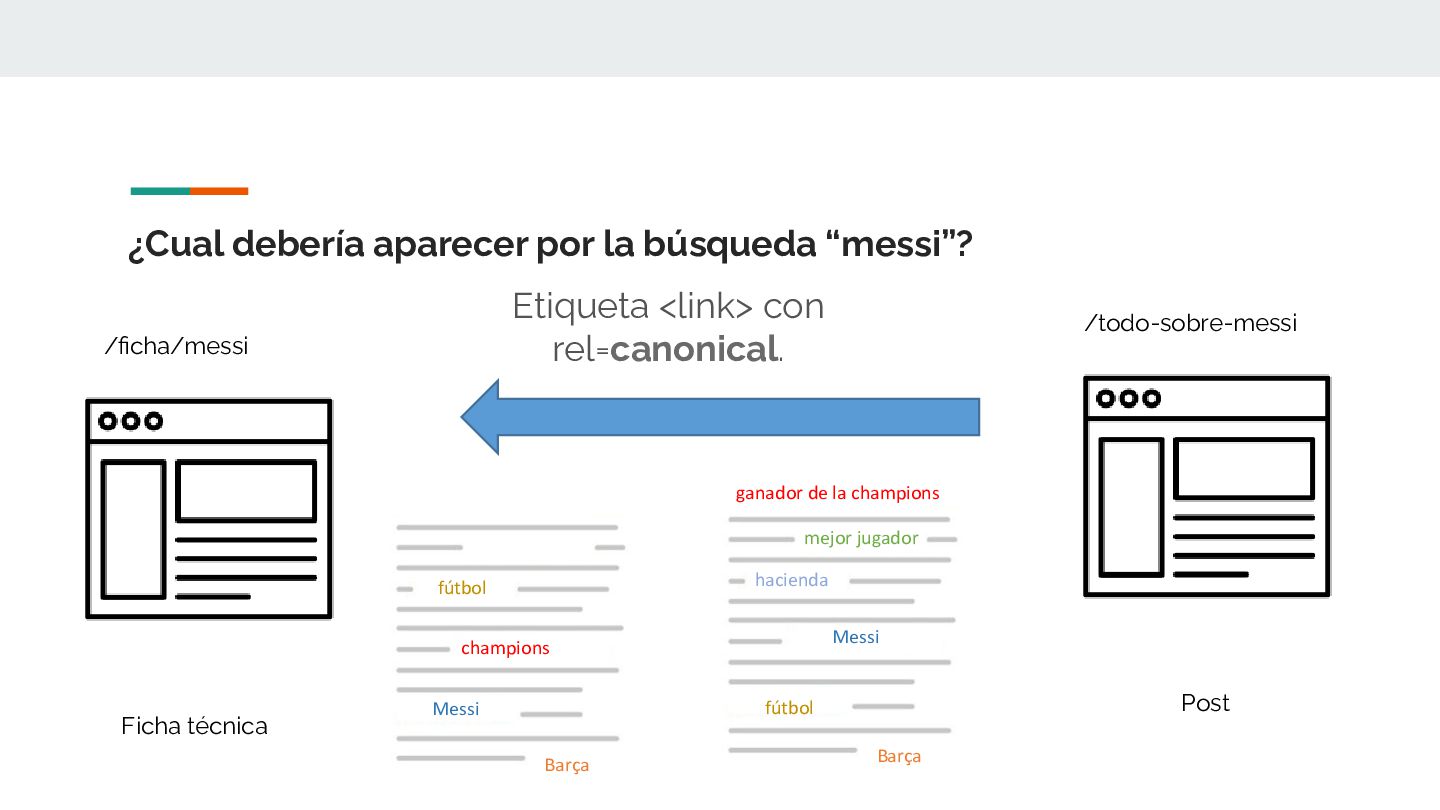
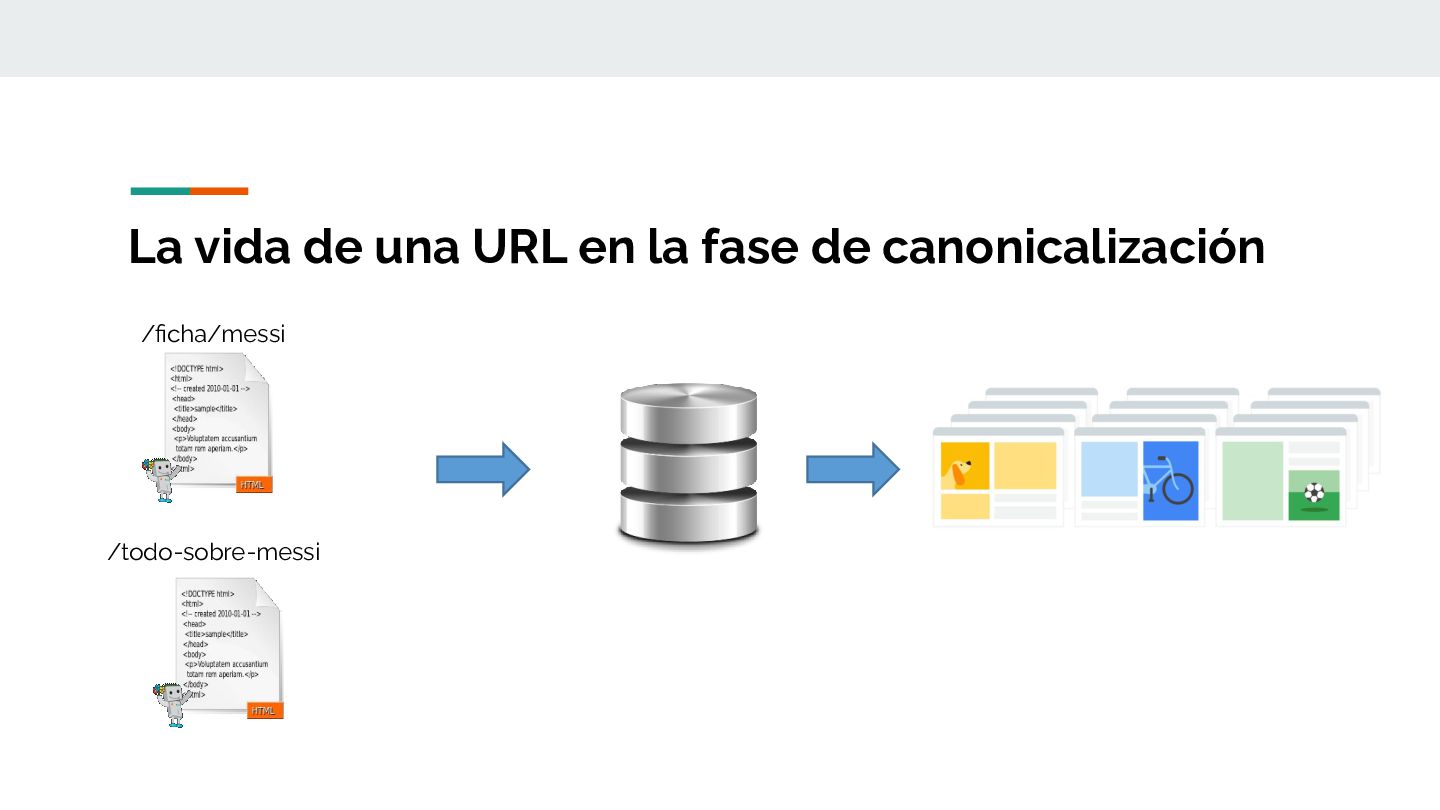
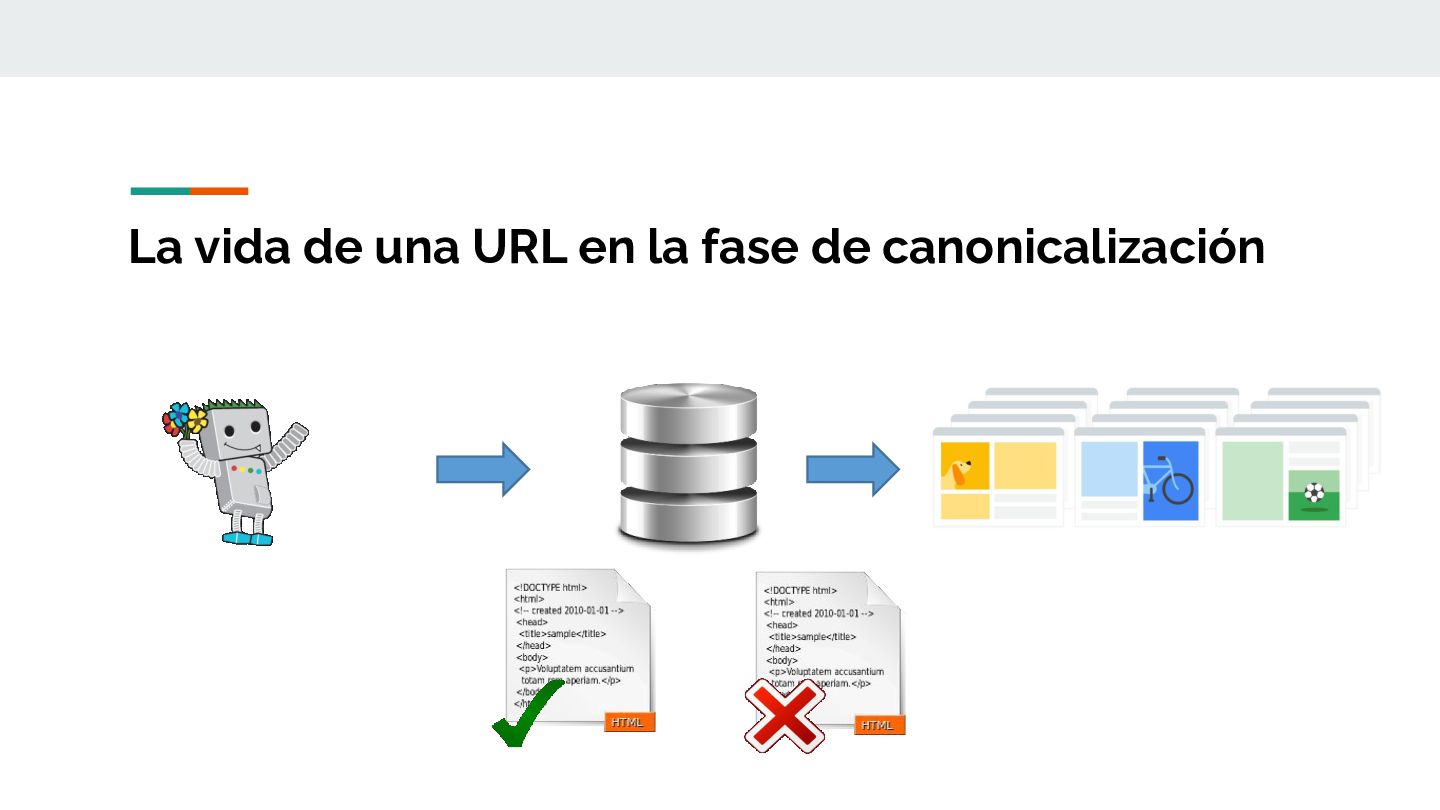
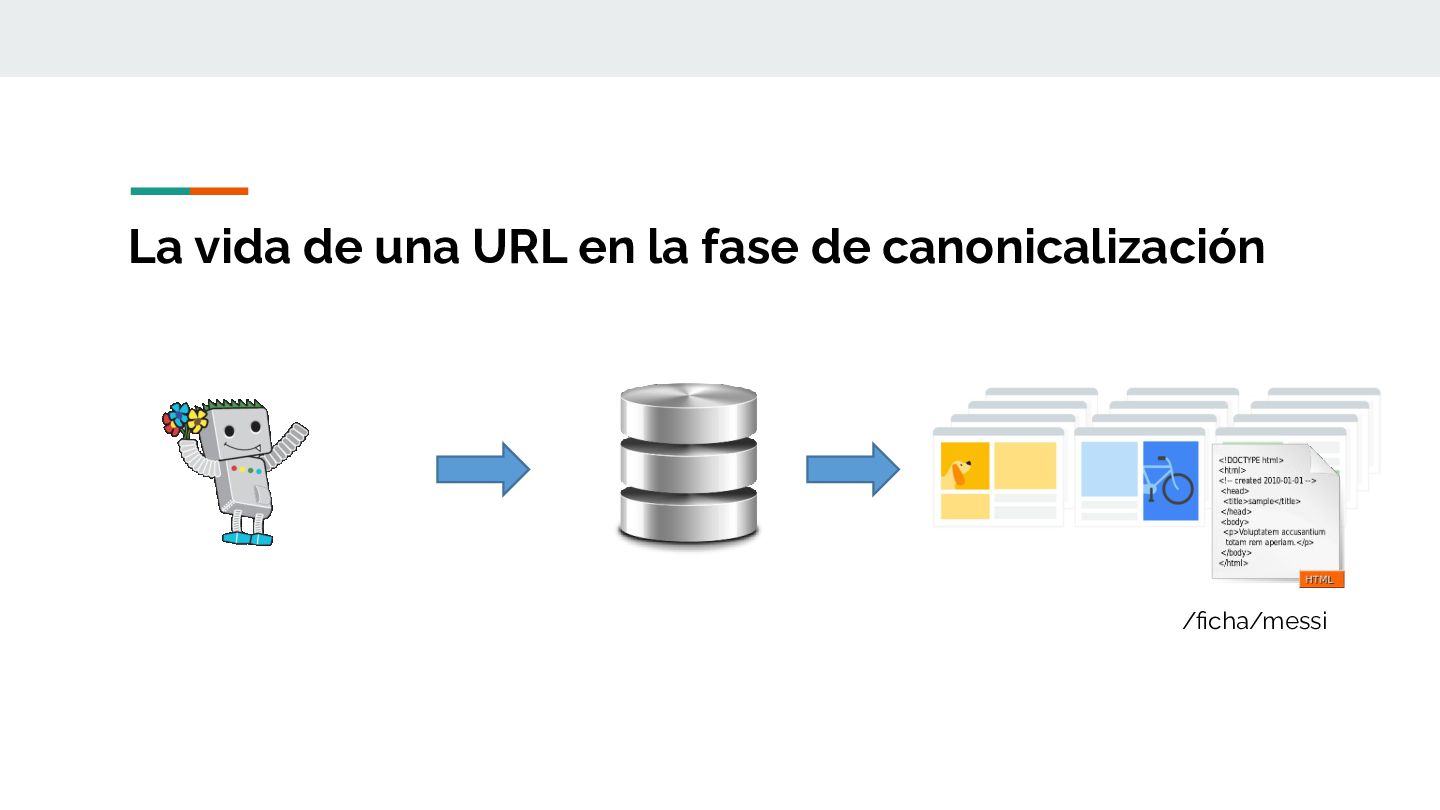
contenido pasa a compararlo con otras páginas para evitar mostrar el mismo contenido en los resultados de búsqueda. El contenido duplicado no penaliza, solo es filtrado. Elegirá una URL como versión canónica, que es la que rastreará, y considerará que las otras URL son duplicados
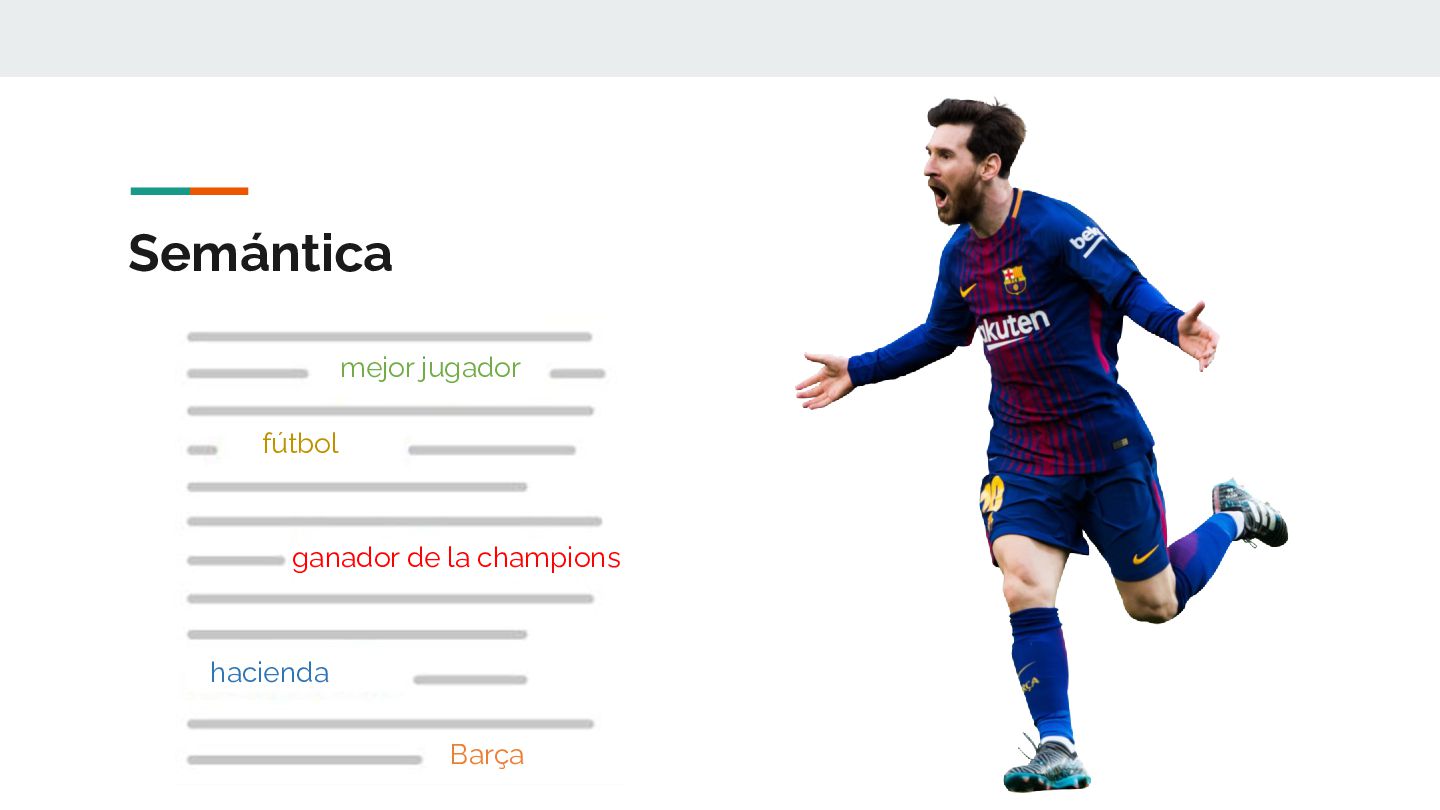
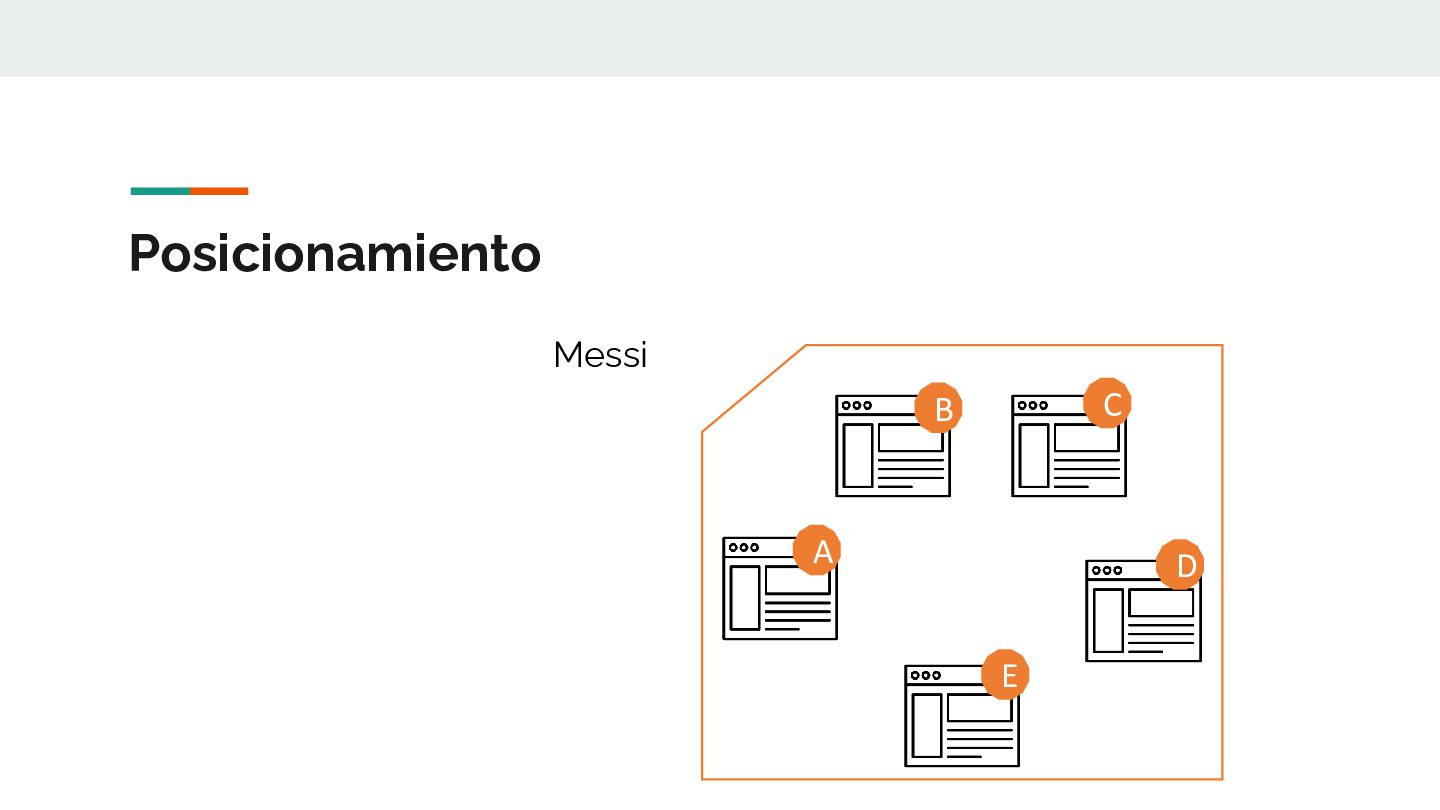
rel=canonical. /ficha/messi /todo-sobre-messi ganador de la champions mejor jugador hacienda fútbol Messi champions Ficha técnica Post fútbol Messi Barça Barça
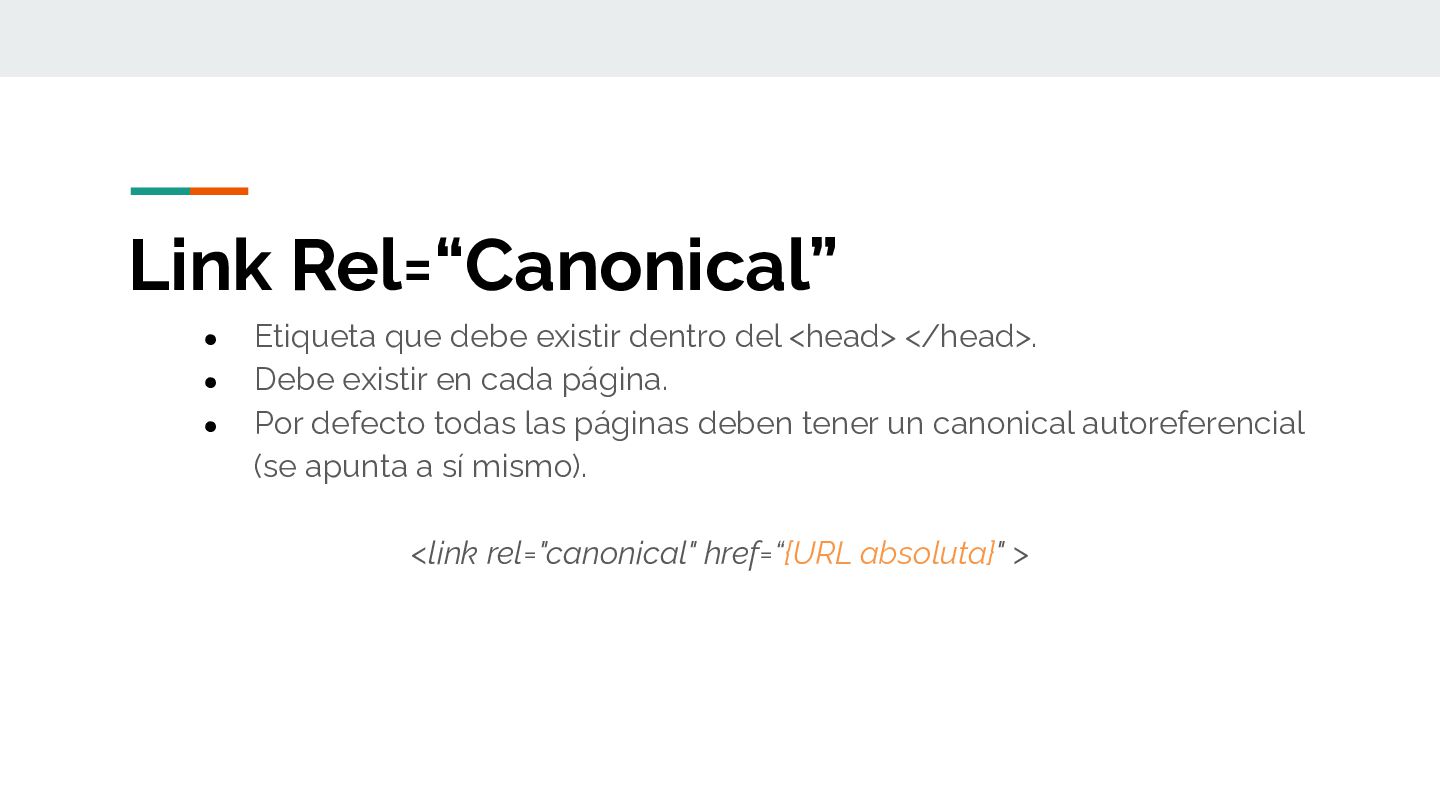
del <head> </head>. Debe existir en cada página. Por defecto todas las páginas deben tener un canonical autoreferencial (se apunta a sí mismo). <link rel="canonical" href=“{URL absoluta}" >
que quieres que se muestre en los resultados de búsqueda. • Para consolidar las señales de los enlaces de páginas similares o duplicadas. • Para simplificar las métricas de seguimiento de un mismo producto o tema. • Para gestionar el contenido sindicado • Para ahorrar tiempo de rastreo en páginas duplicadas
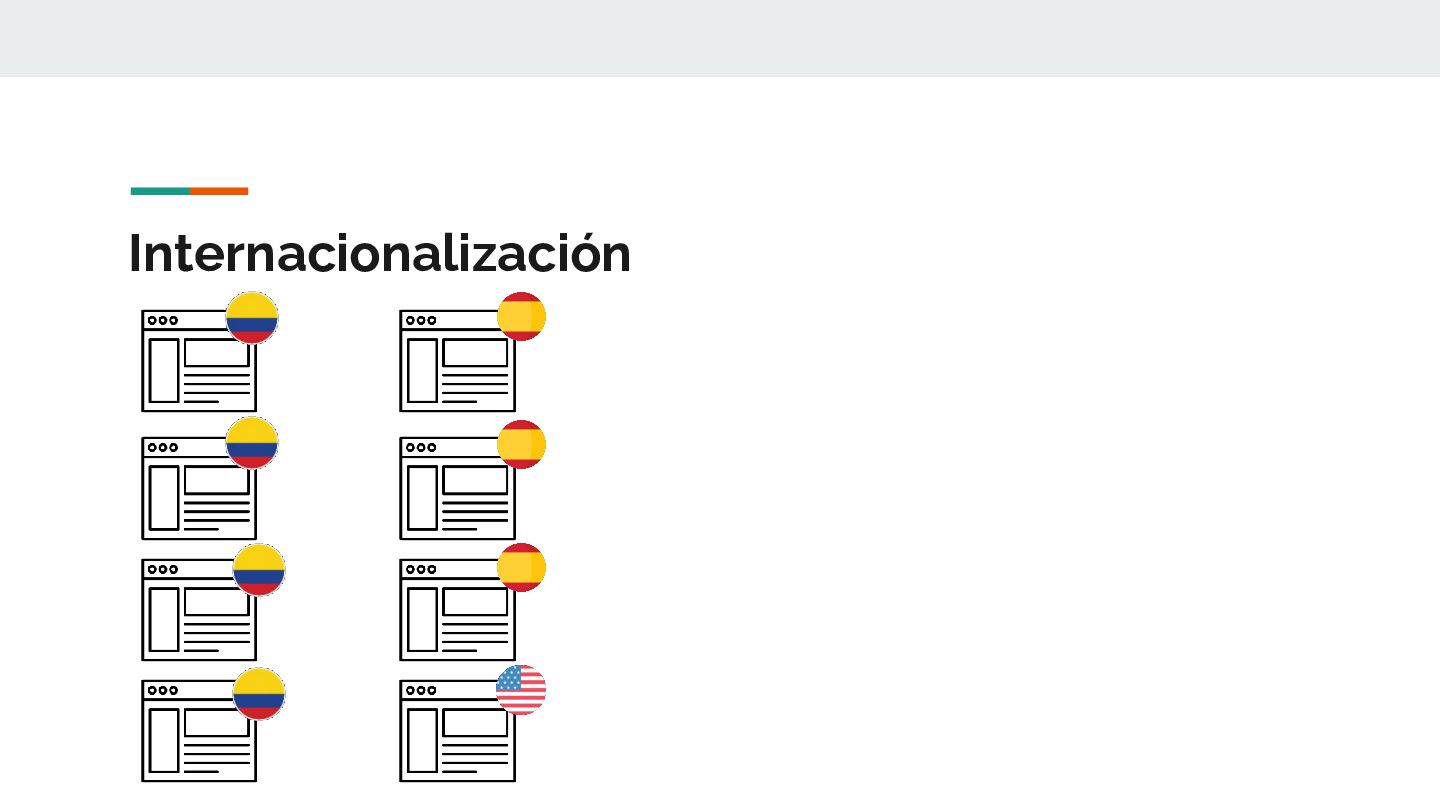
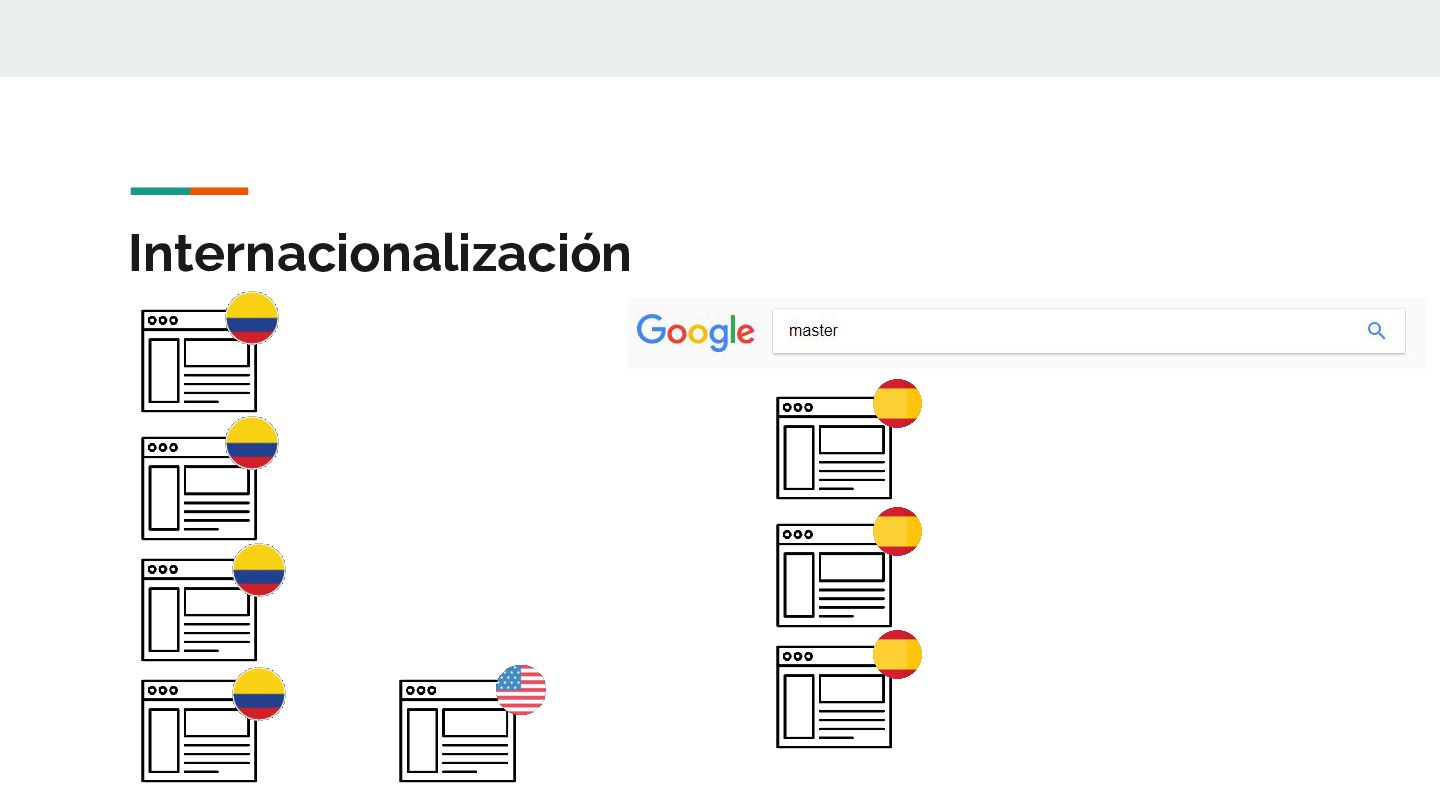
de la página según el contenido visible en ella. Esto quiere decir que si mi contenido está escrito en español, aparecerá en las búsquedas escritas en español.
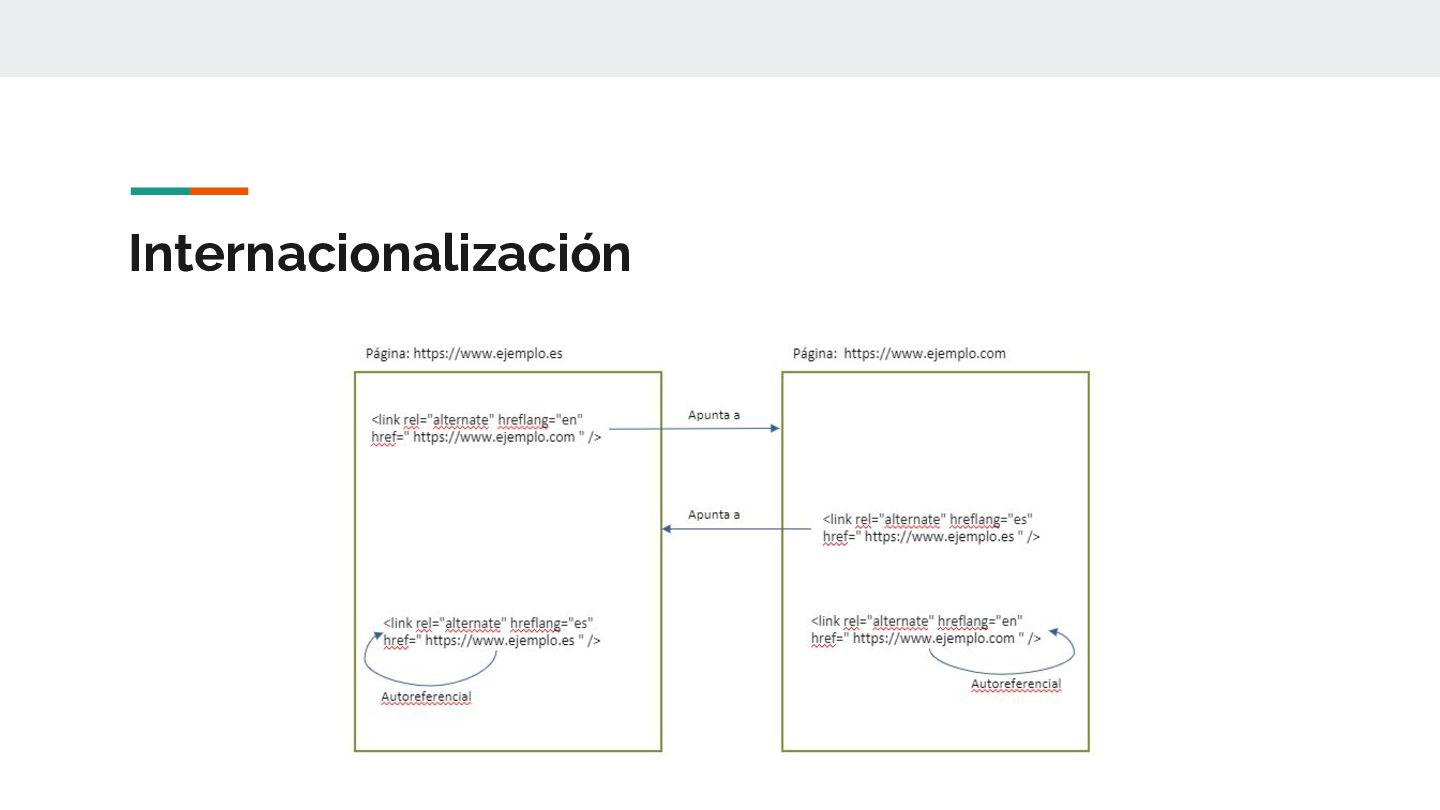
hreflang="x" para mostrar la URL de idioma o de región correcta en los resultados de búsqueda. En la sección <head> del HTML de la página hay que añadir un elemento de enlace link que dirija a la versión alternativa en otro idioma/región de esa página. En la misma sección debe haber otro elemento link apuntándose así mismo (a nivel de url) indicando en que idioma está la página. Todos los enlaces deben ser bidireccionales, si la página A enlaza con la página B, la página B tiene que volver a enlazar con la página A. Si no se cumple tal condición en todas las páginas que usen anotaciones "hreflang", es posible que no se interpreten correctamente.
el idioma en formato ISO 639-1 y, opcionalmente, la región en formato ISO 3166-1 Alpha 2 para una URL alternativa. La etiqueta es así: <link rel="alternate" hreflang=“idioma-región" href=“url" /> Es obligatorio indicar un idioma y opcional la región, al revés no se acepta.
habrá un titular Los subtitulares siempre estarán por debajo del titular Puede haber varios tipos de titulares (sub-subtitulares) El texto siempre tendrá una relación con el titular Usar el texto para enlazar a una de las categorías pertinentes (estructura de la información enfocada a mejorar el SEO On Page). Hay que cuidar el hecho de no sobreoptimizar, usando la misma palabra clave en muchos títulos . Vigilar cuando hay más de un porcentaje de repetición superior a la media de tu nicho. La premisa debe ser siempre la naturalidad. Cada página debe tener sus propios títulos H1 descriptivos del contenido de la página en concreto. Y, siempre que sea posible, que éstos contengan alguna de las palabras clave objetivo. La optimización de los headings debería centrarse en la ampliación de contenido semánticamente relevante.
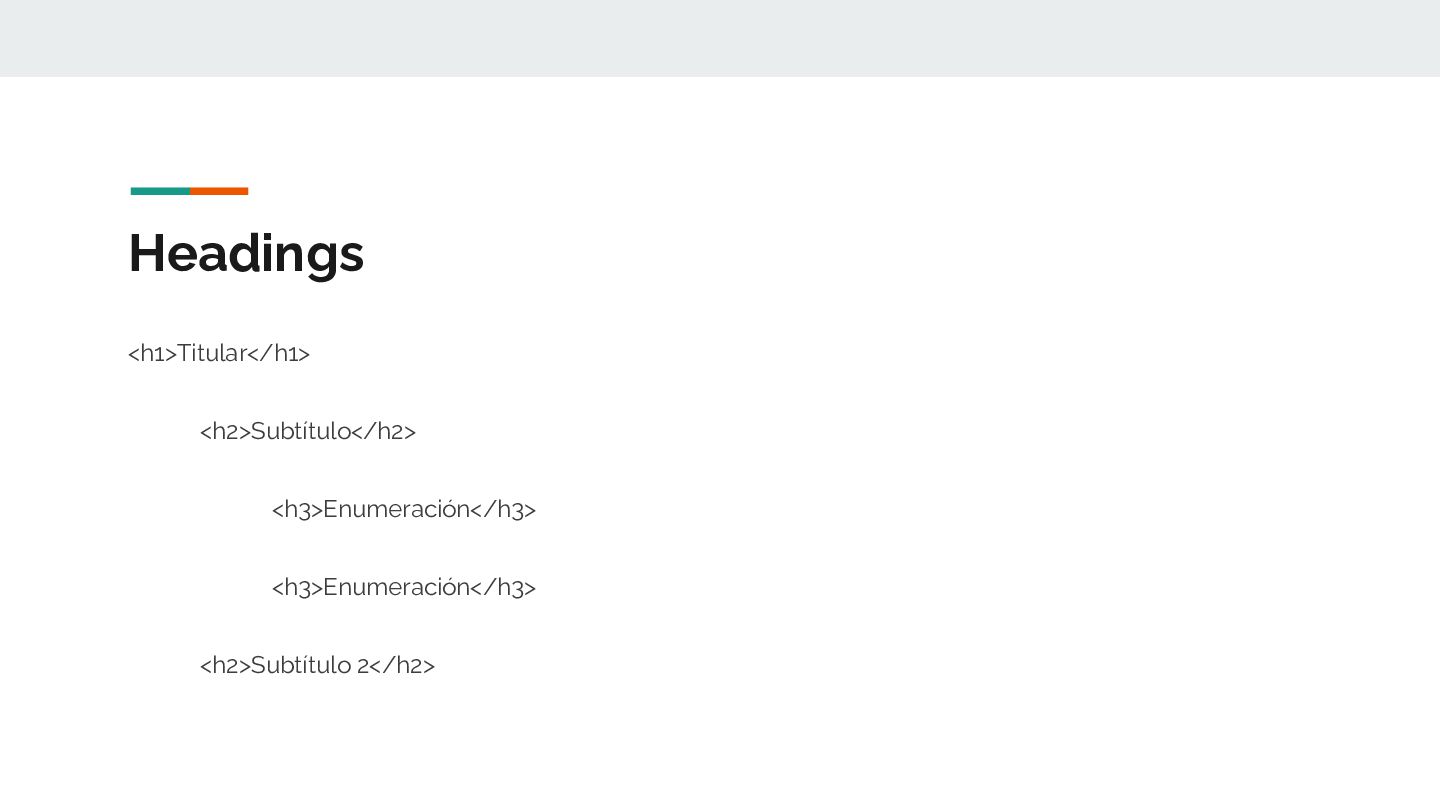
de una h1 y únicamente en casos de numeraciones muy definidas y jerarquizadas se usarán etiquetas menores a las ya usadas. • Es recomendable usar la keyword principal en el h1 y keywords relacionadas en los h2 y los h3 además de en el propio texto.
que estará en la URL de la imagen, el atributo ALT y el Title de la Imagen. El atributo ALT es el texto alternativo de una imagen. La función principal de este atributo es la de indicar a las personas ciegas de qué se trata esa imagen. Pese a que Google ya está empezando a reconocer ciertos elementos en una imagen aún necesita del atributo para entender de qué va la imagen.
así el usuario y el buscador sabrán lo que van a encontrar al hacer clic en el enlace. En las URL hemos de colocar las palabras clave que nos interesa posicionar, no hace falta que coincida con la misma Keyword que has puesto en el title. Deberías jugar con la semántica (importantísimo para el SEO On Page) y las palabras clave relacionadas de tu palabra clave principal.
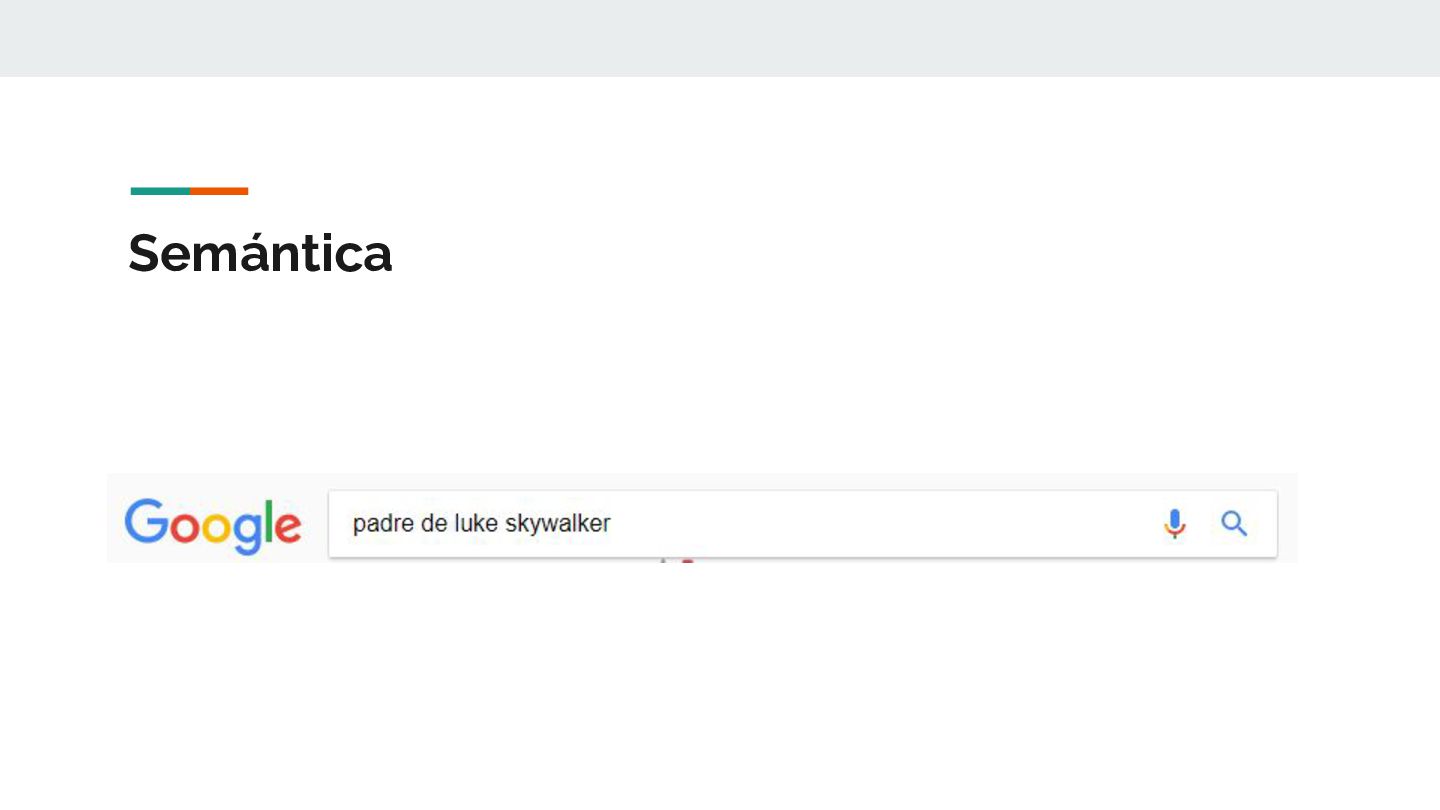
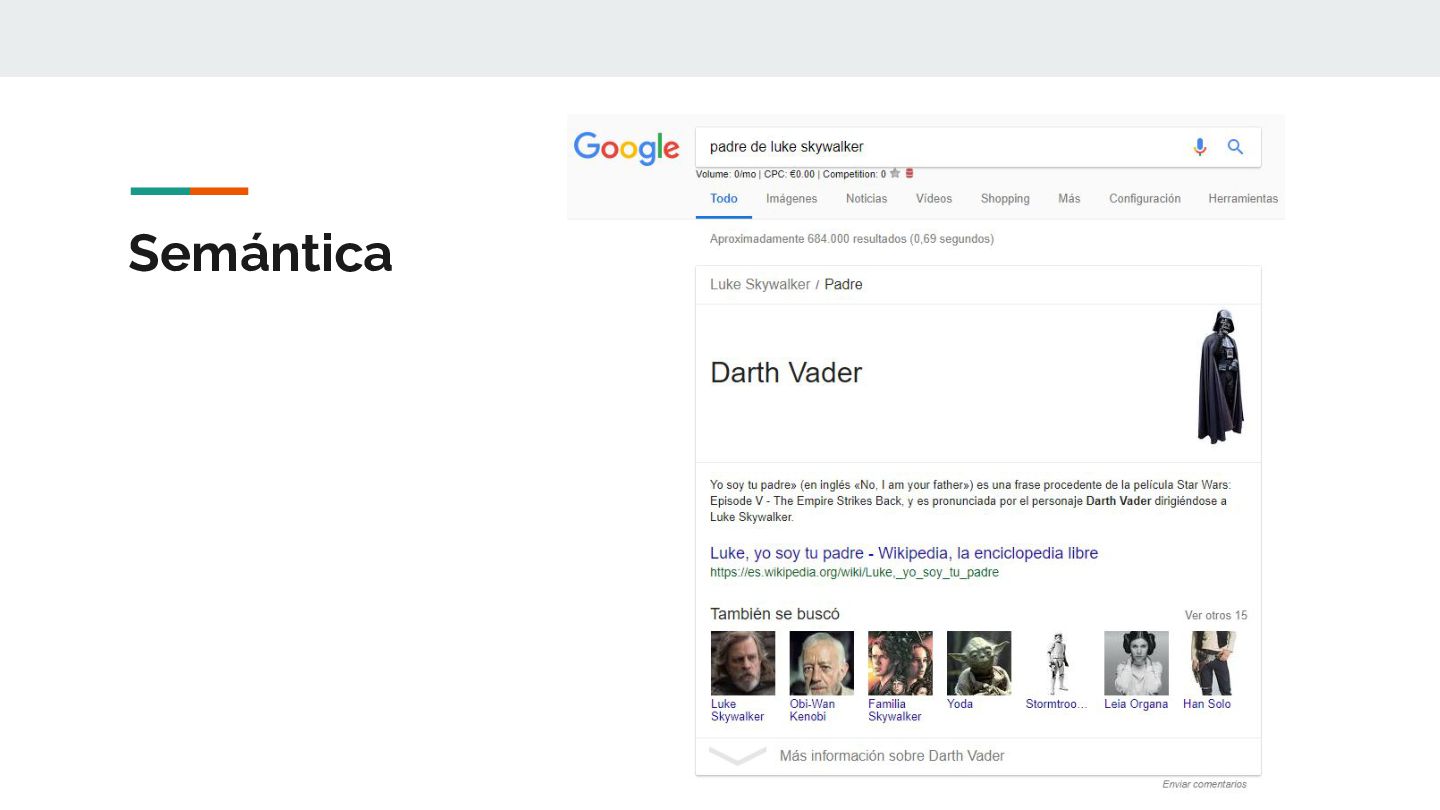
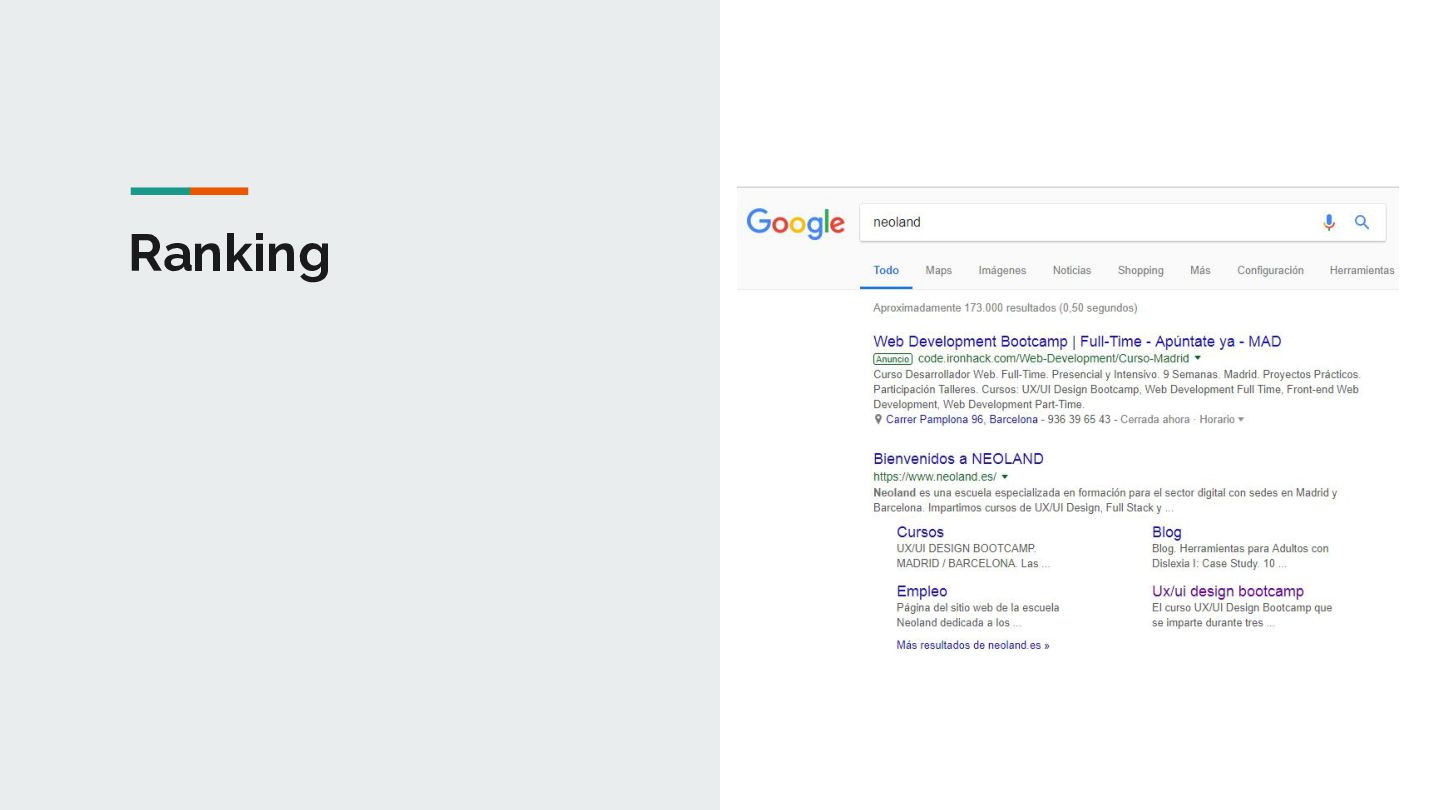
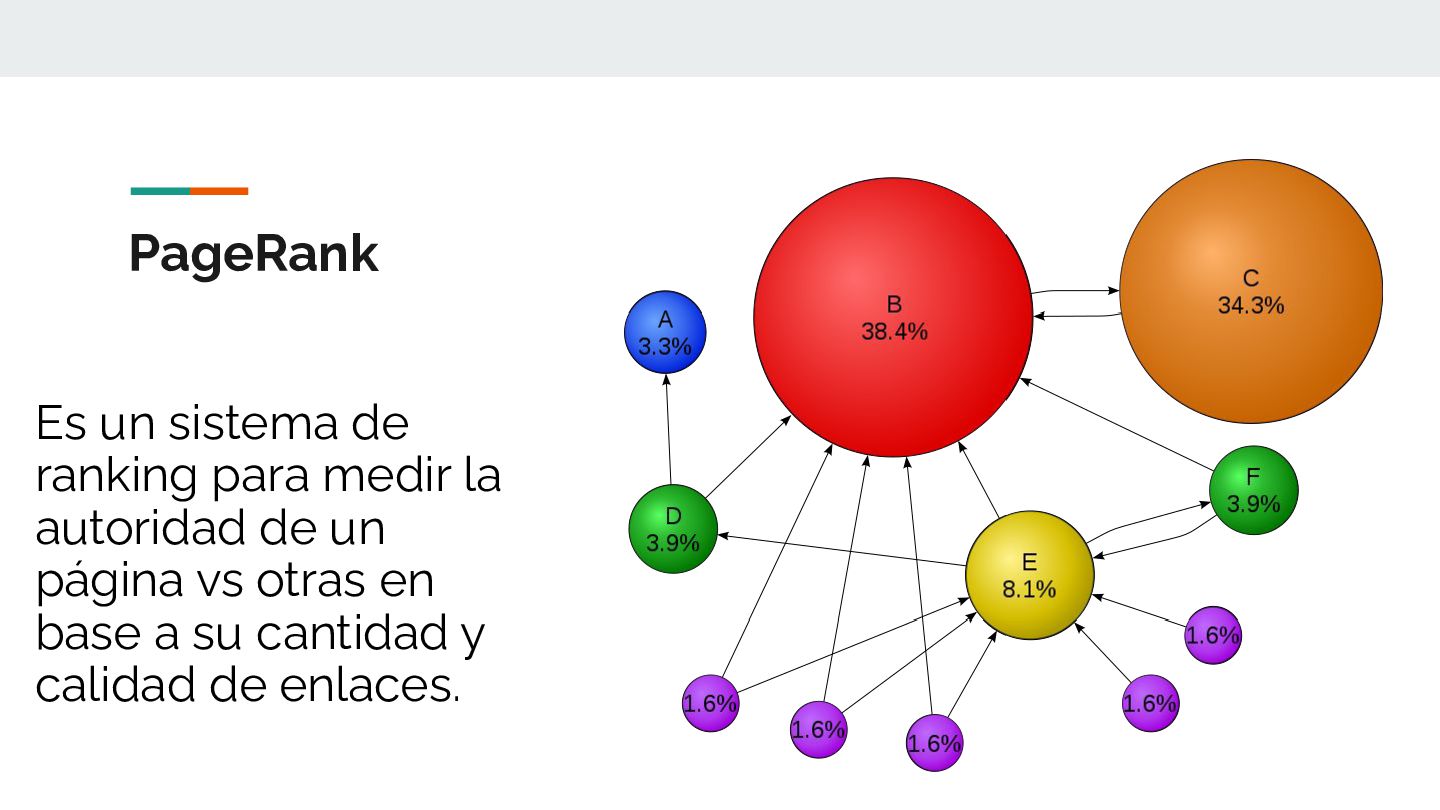
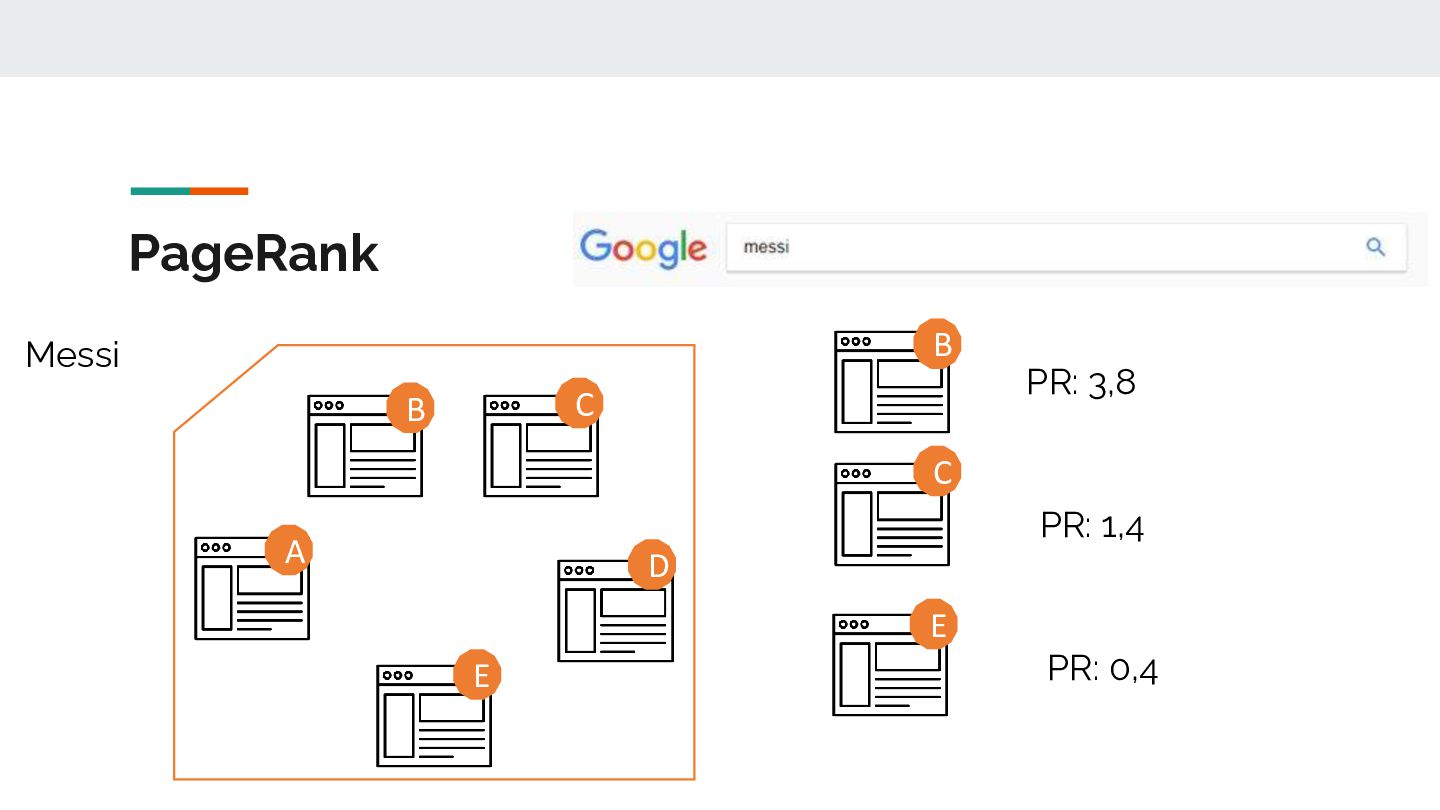
y para clasificarlas en el índice según la relevancia de sus contenidos. Pero el valor de Google reside en saber cuál de todos ellos es el mejor para la consulta del usuario.
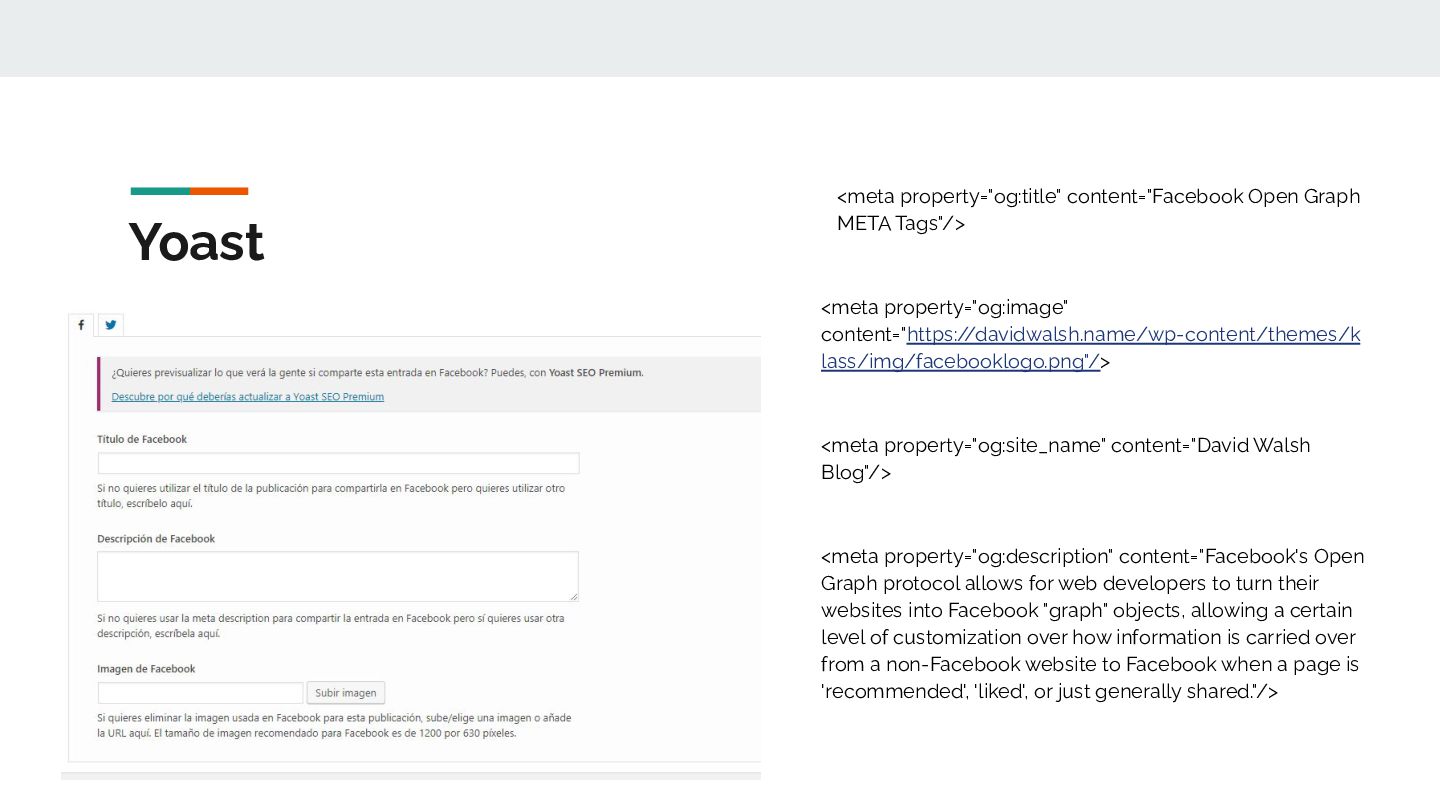
content="https://davidwalsh.name/wp-content/themes/k lass/img/facebooklogo.png"/> <meta property="og:site_name" content="David Walsh Blog"/> <meta property="og:description" content="Facebook's Open Graph protocol allows for web developers to turn their websites into Facebook "graph" objects, allowing a certain level of customization over how information is carried over from a non-Facebook website to Facebook when a page is 'recommended', 'liked', or just generally shared."/>


 nachomascort
 mkilby
 greggifford
 tamaranovitovic
 davidcarrasco
 cargoodrich
 wayneb77
 lynnandtonic
 stephenakadiri
 cassininazir
 akademiya2063
 brettharned