Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
解説: VisProg (CVPR2023 best paper)
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Naoto Inoue
July 23, 2023
Research
1k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
解説: VisProg (CVPR2023 best paper)
Naoto Inoue
July 23, 2023
More Decks by Naoto Inoue
See All by Naoto Inoue
Graphic design generation by multimodal models
naoto0804
6
1.2k
解説: Metadata Normalization
naoto0804
2
760
Other Decks in Research
See All in Research
論文読み会 SNLP2026 Tau2-Bench: Evaluating Conversational Agents in a Dual-Control Environment
s_mizuki_nlp
0
300
IA for theory
gpeyre
1
470
Les émissions de méthane entérique en élevage laitier : Enjeux et travaux menés en Afrique de l’Ouest et en France
institutdelelevage
PRO
0
120
XDPerf: A High-Performance Traffic Generator Built with WASM and eBPF
takehaya
1
330
OWASP AISVS - C7
shiell
2
830
大規模言語モデルは誰を覚えているか / Who Do Large Language Models Memorize?
upura
0
210
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance
kobayashi31
1
260
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
690
クラウド・AI 時代の研究開発 DX / R&D Digital Transformation
hariby
0
190
JPA2026_NetworkTutorial_JunKashihara
junkashihara
0
220
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
810
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
120
Featured
See All Featured
30 Presentation Tips
portentint
PRO
1
420
How to Think Like a Performance Engineer
csswizardry
28
2.9k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
46k
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
770
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
Git: the NoSQL Database
bkeepers
PRO
433
67k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
860
Transcript
Visual Programming: Compositional visual reasoning without training CVPR2023読み会 (前編) 2023/07/23
井上 直人
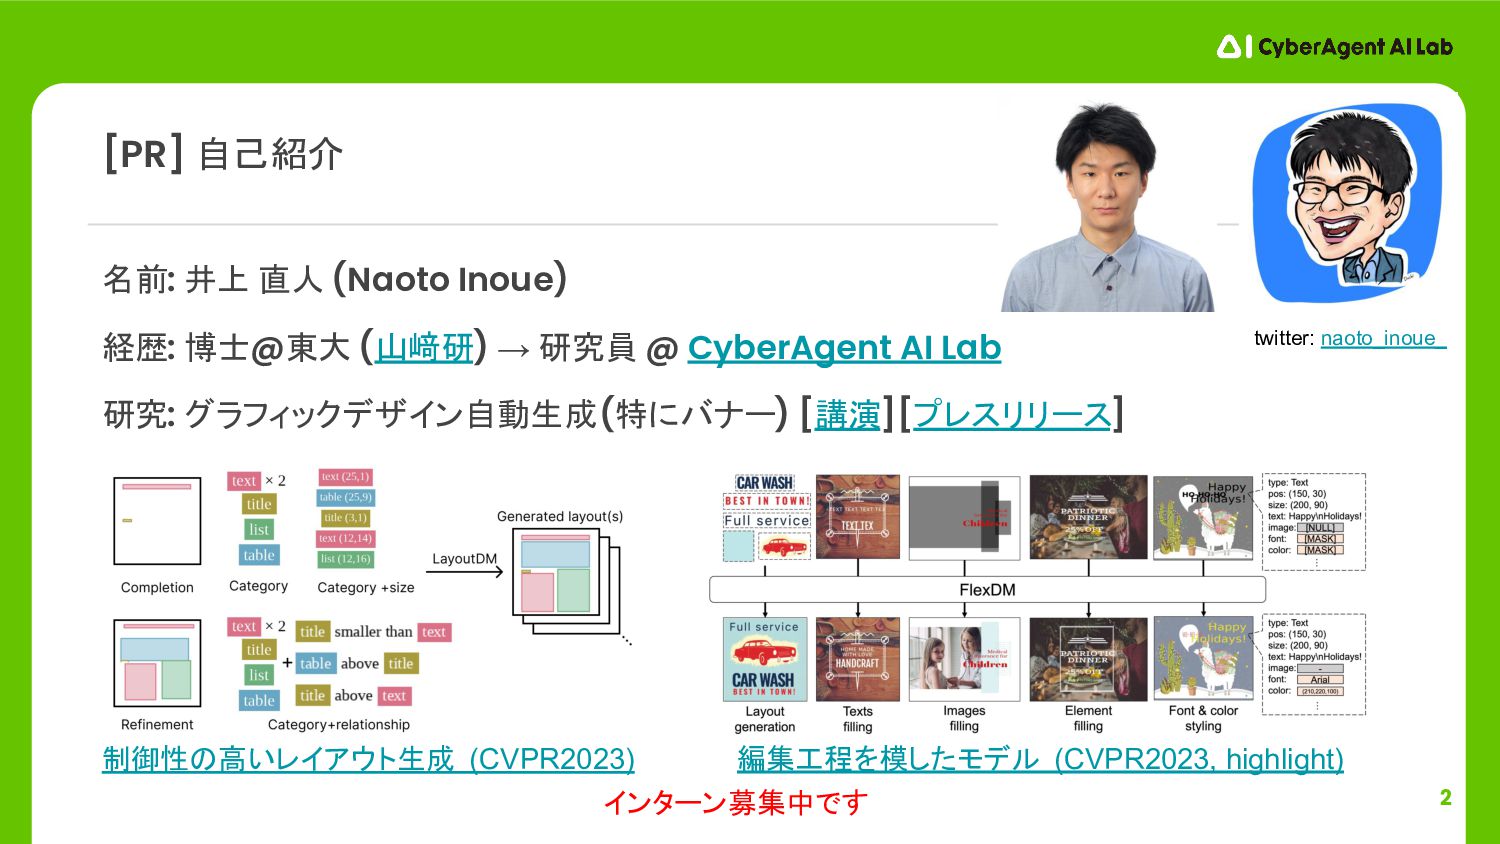
2 名前: 井上 直人 (Naoto Inoue) 経歴: 博士@東大 (山﨑研) →
研究員 @ CyberAgent AI Lab 研究: グラフィックデザイン自動生成 (特にバナー) [講演][プレスリリース] [PR] 自己紹介 制御性の高いレイアウト生成 (CVPR2023) 編集工程を模したモデル (CVPR2023, highlight) インターン募集中です twitter: naoto_inoue_
3 紹介する論文 Visual Programming: Compositional visual reasoning without training •
著者: Tanmay Gupta and Ani Kembhavi • project page / code / blog • Best paper (もう一本がUniAD)
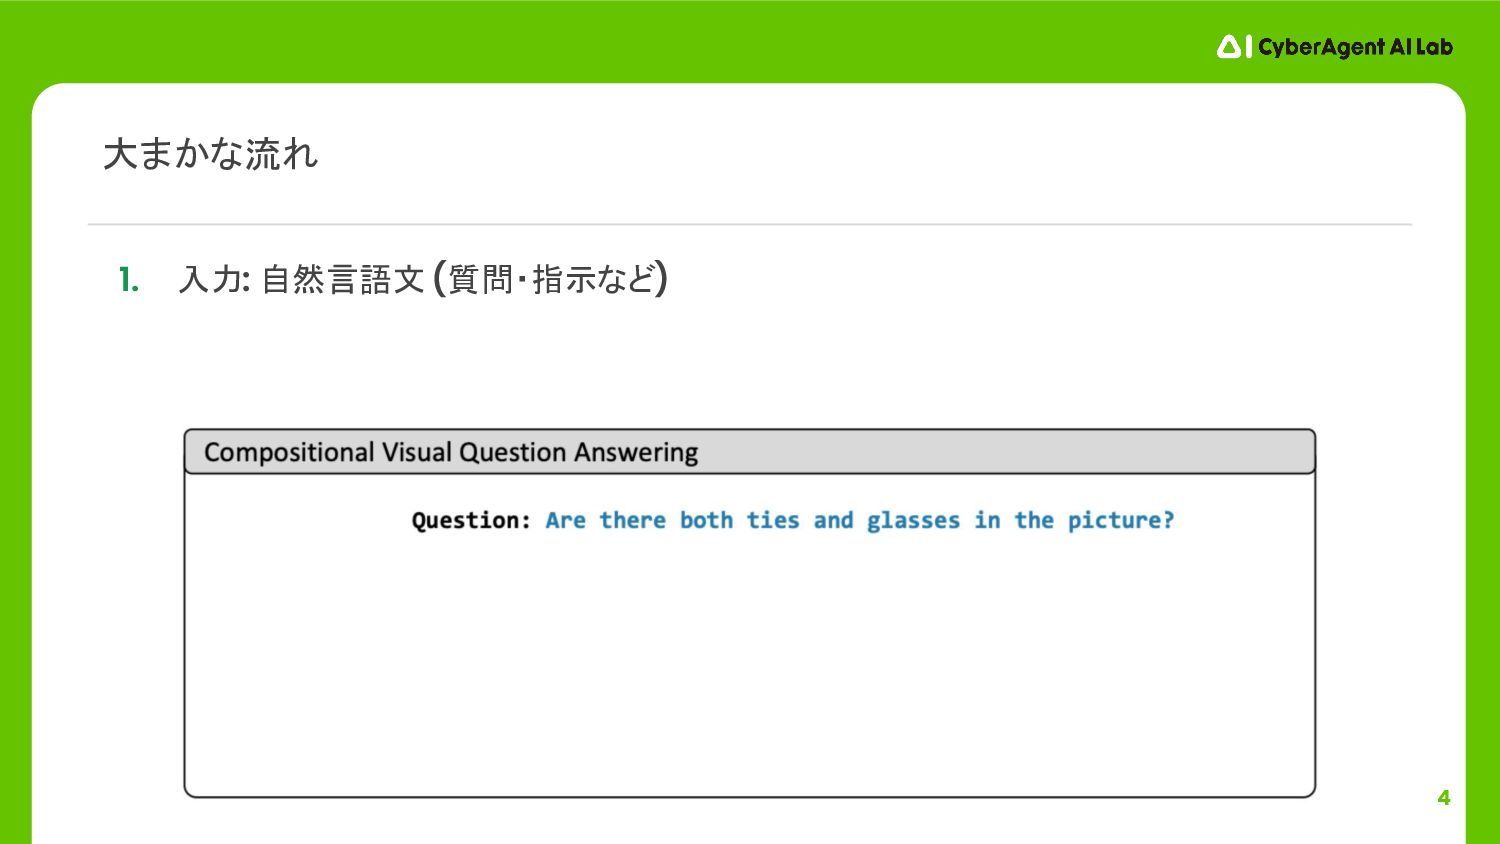
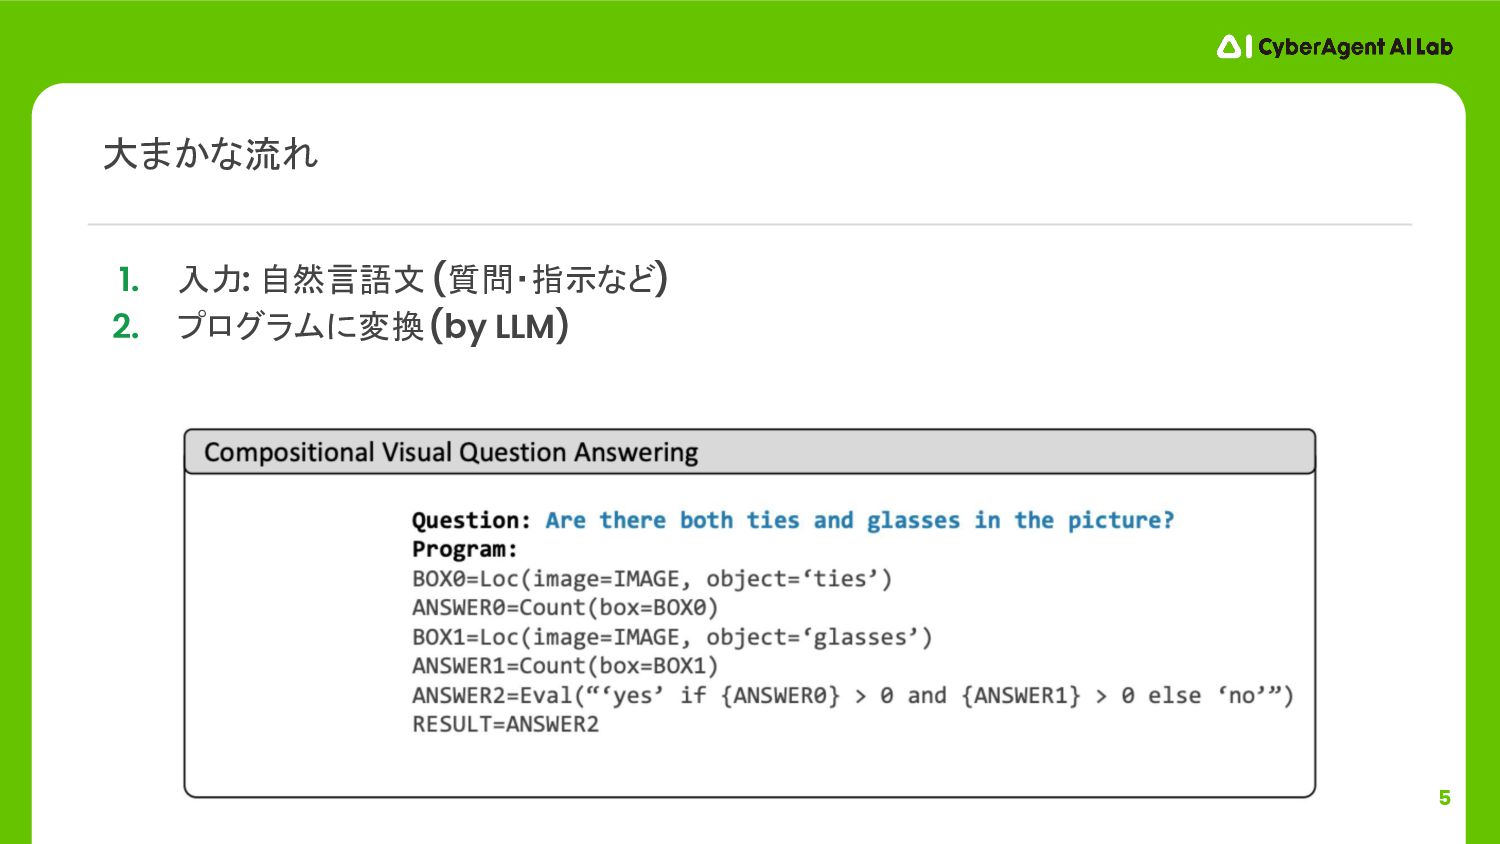
4 1. 入力: 自然言語文 (質問・指示など) 大まかな流れ
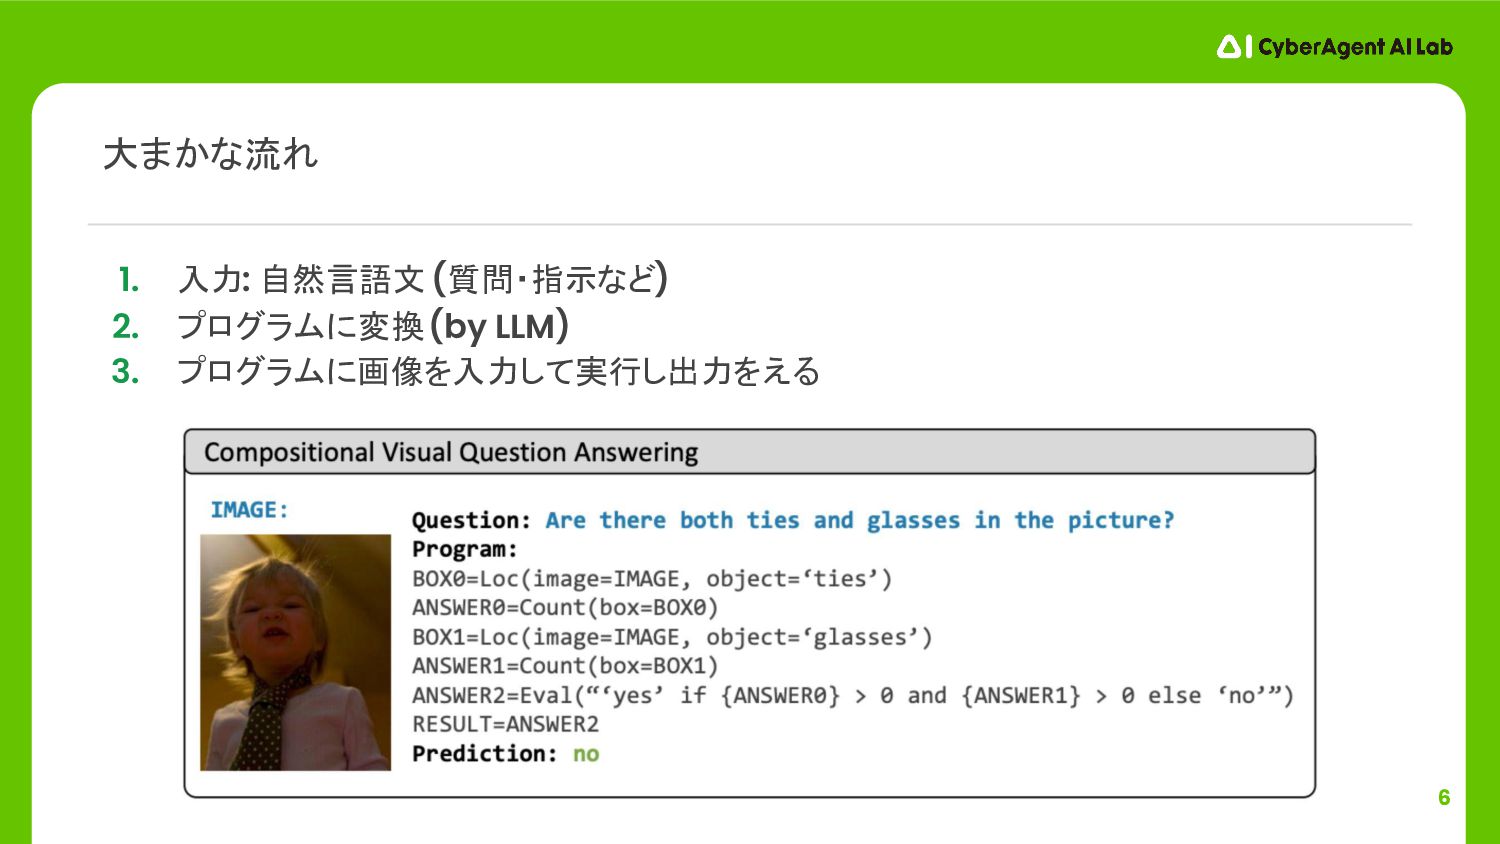
5 1. 入力: 自然言語文 (質問・指示など) 2. プログラムに変換 (by LLM) 大まかな流れ
6 1. 入力: 自然言語文 (質問・指示など) 2. プログラムに変換 (by LLM) 3.
プログラムに画像を入力して実行し出力をえる 大まかな流れ
7
8
9
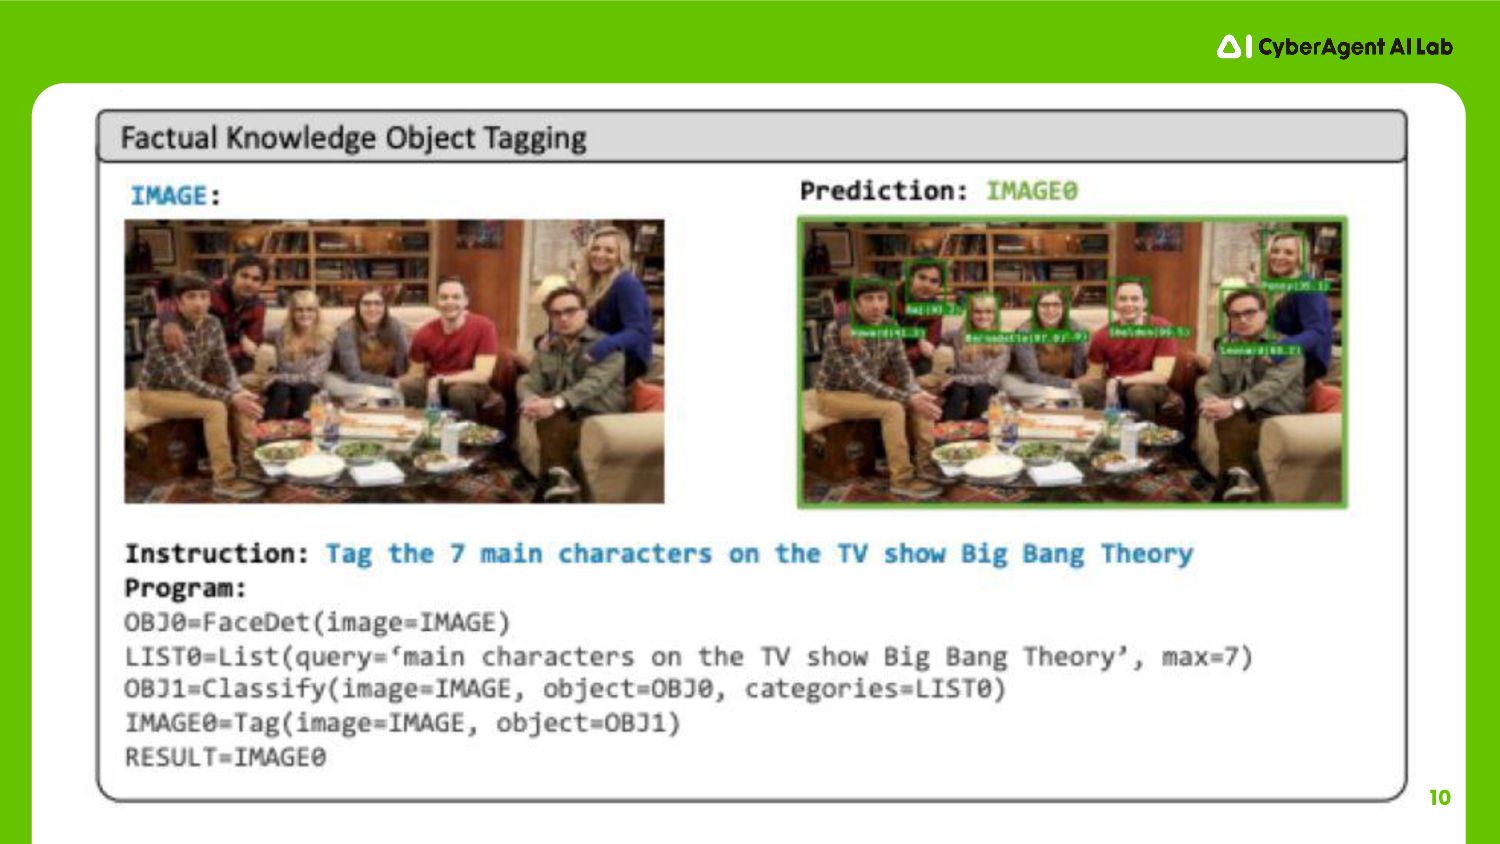
10
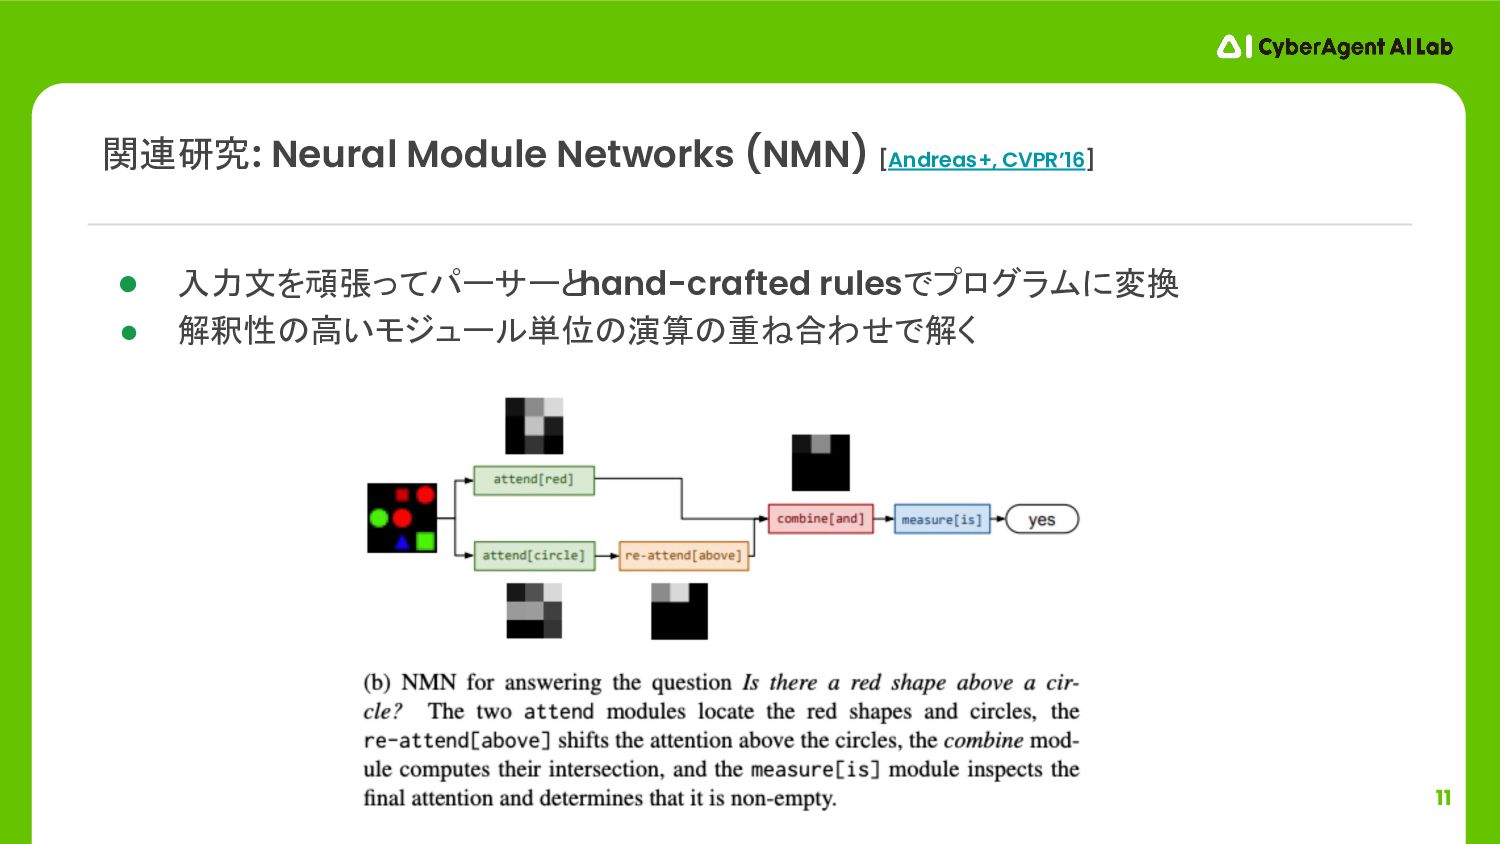
11 • 入力文を頑張ってパーサーとhand-crafted rulesでプログラムに変換 • 解釈性の高いモジュール単位の演算の重ね合わせで解く 関連研究: Neural Module Networks
(NMN) [Andreas+, CVPR’16]
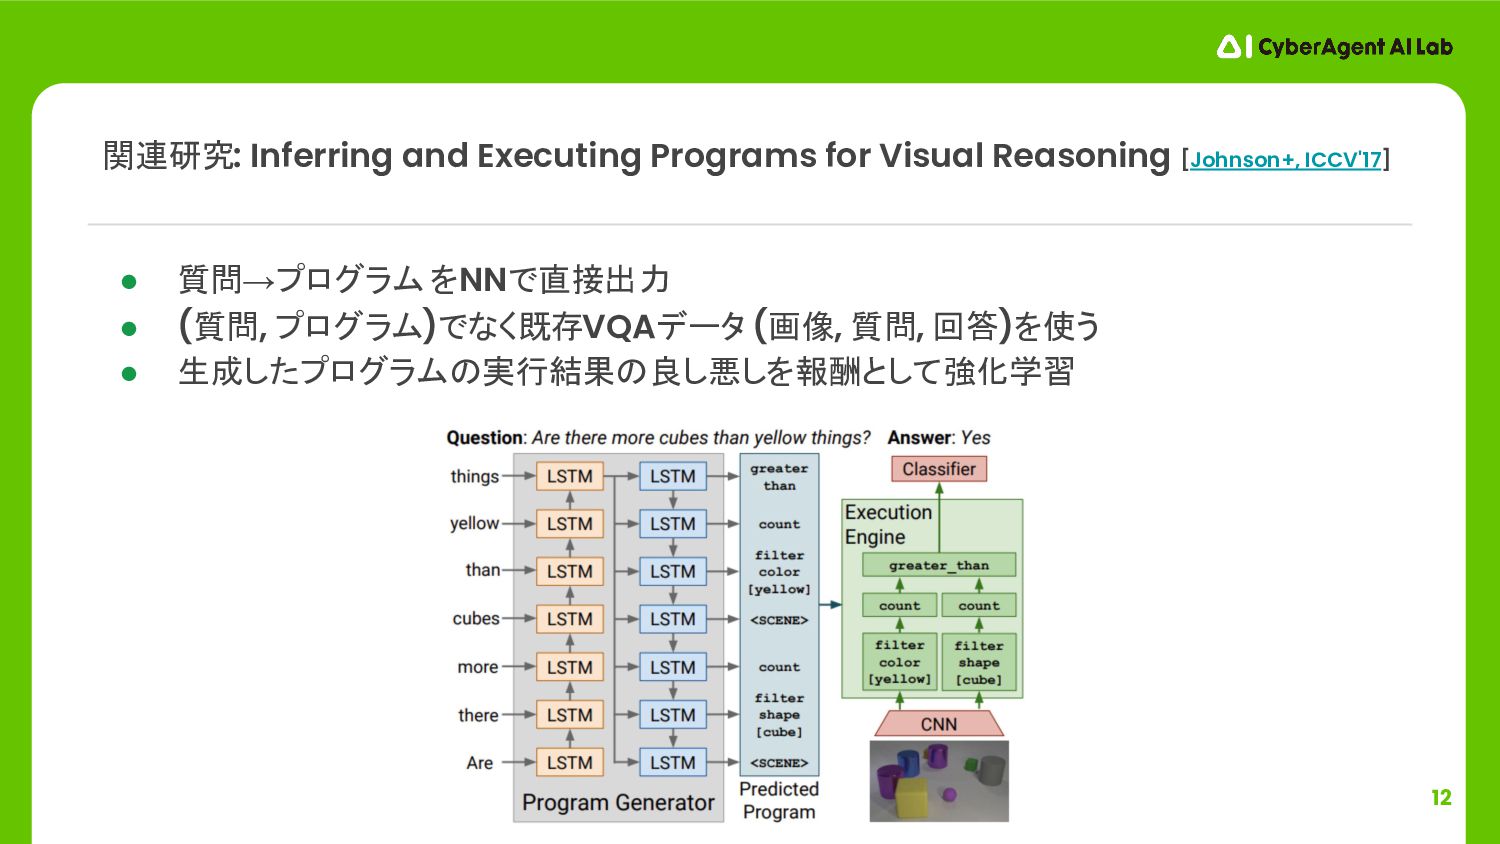
12 • 質問→プログラム をNNで直接出力 • (質問, プログラム)でなく既存VQAデータ (画像, 質問, 回答)を使う
• 生成したプログラムの実行結果の良し悪しを報酬として強化学習 関連研究: Inferring and Executing Programs for Visual Reasoning [Johnson+, ICCV'17]
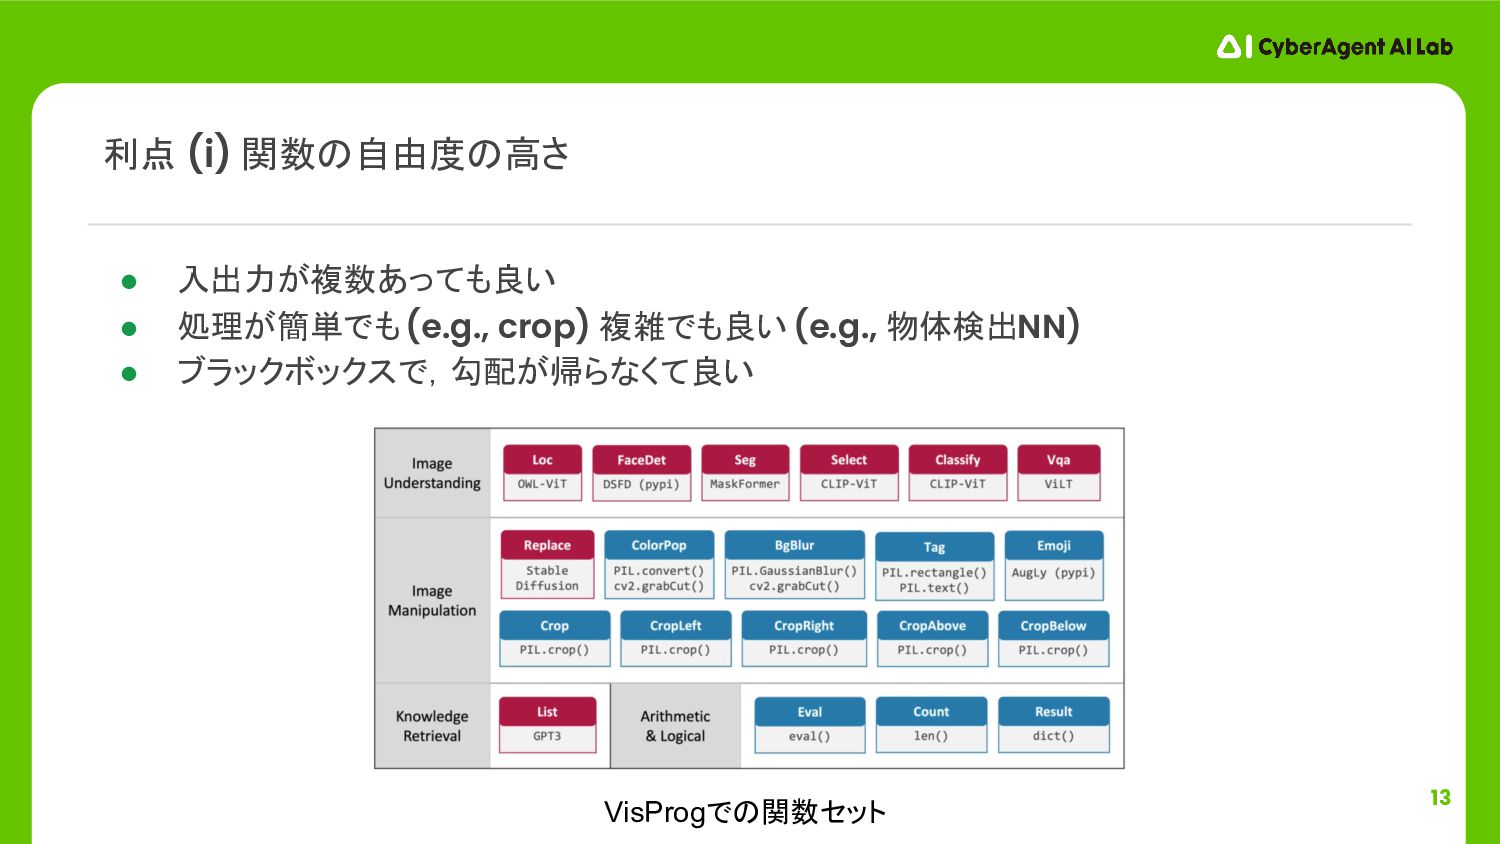
13 • 入出力が複数あっても良い • 処理が簡単でも (e.g., crop) 複雑でも良い (e.g., 物体検出NN)
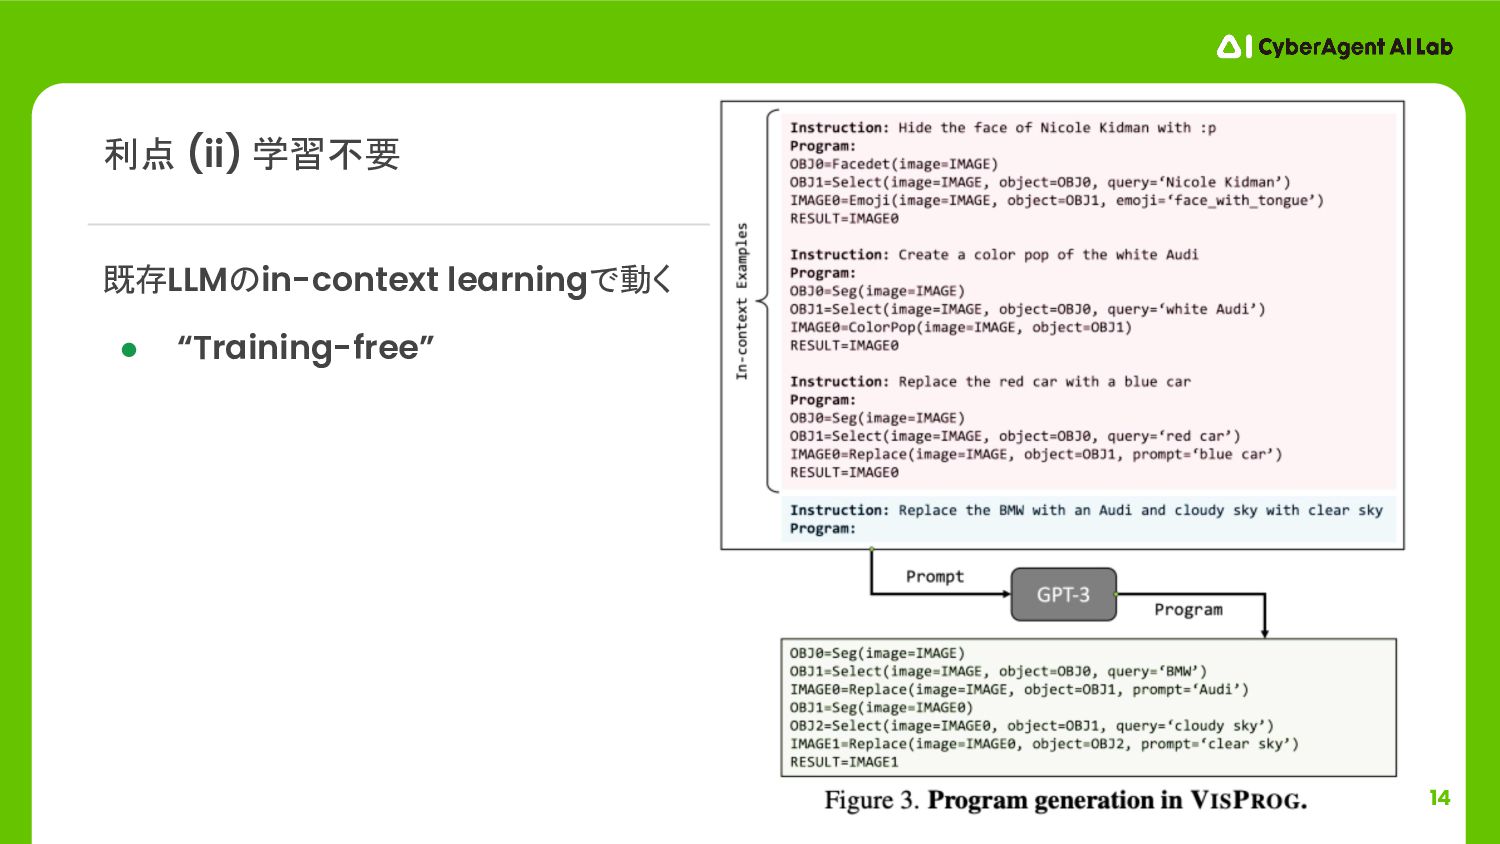
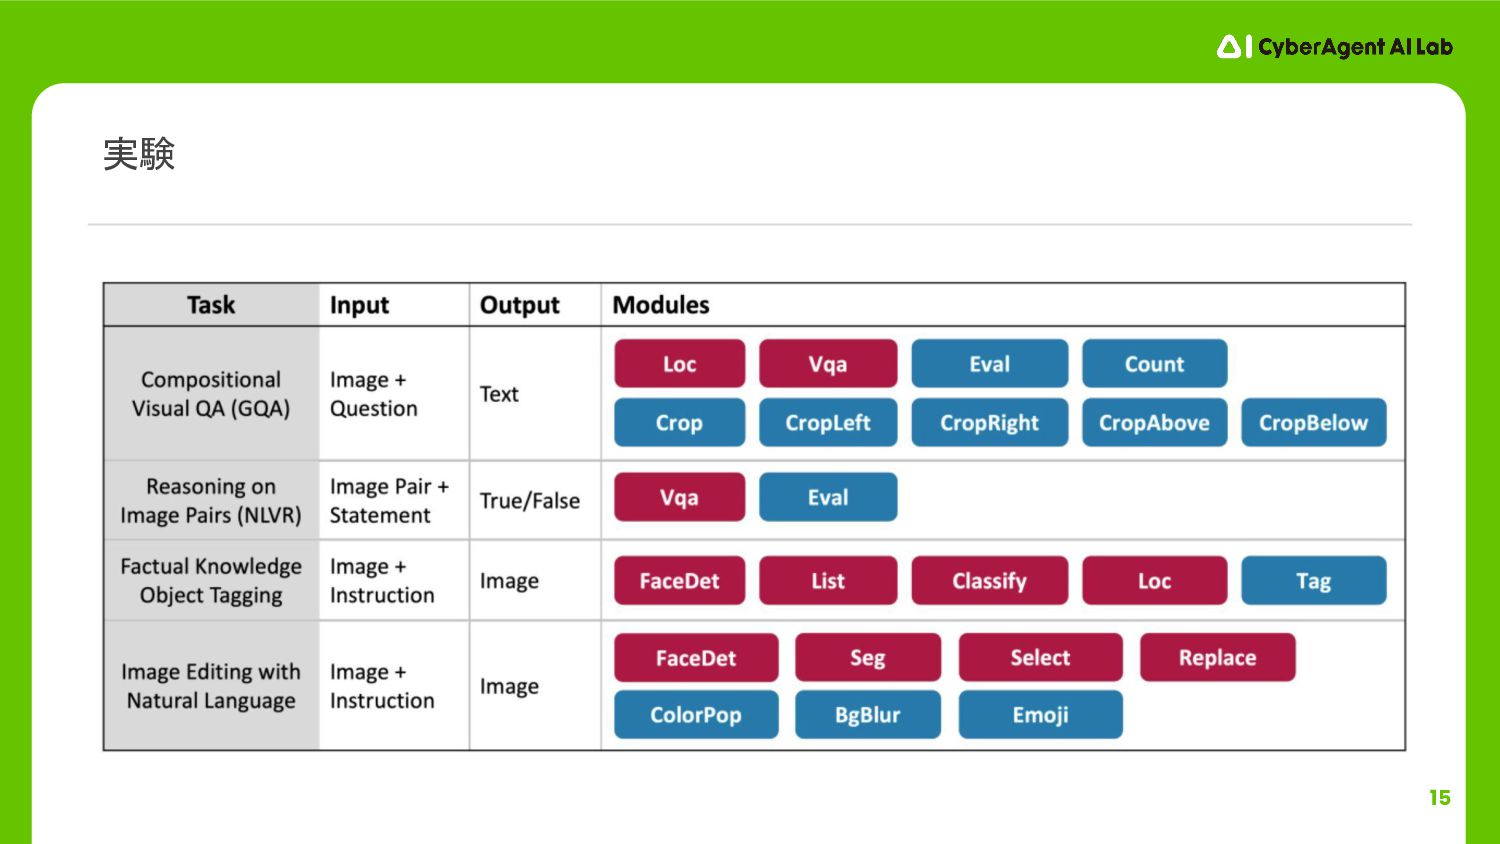
• ブラックボックスで,勾配が帰らなくて良い 利点 (i) 関数の自由度の高さ VisProgでの関数セット
14 既存LLMのin-context learningで動く • “Training-free” 利点 (ii) 学習不要
15 実験
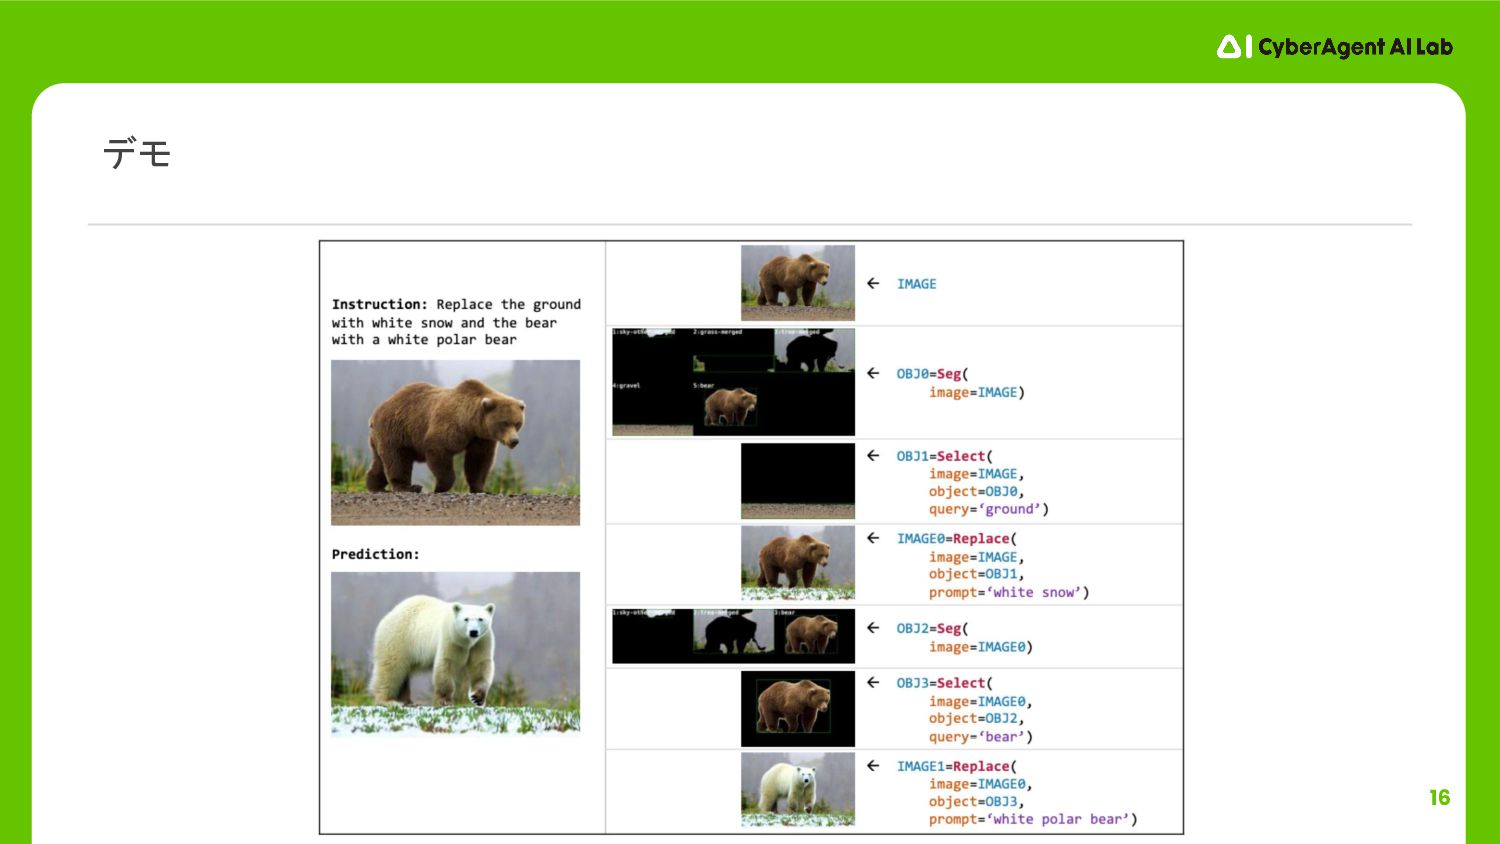
16 デモ
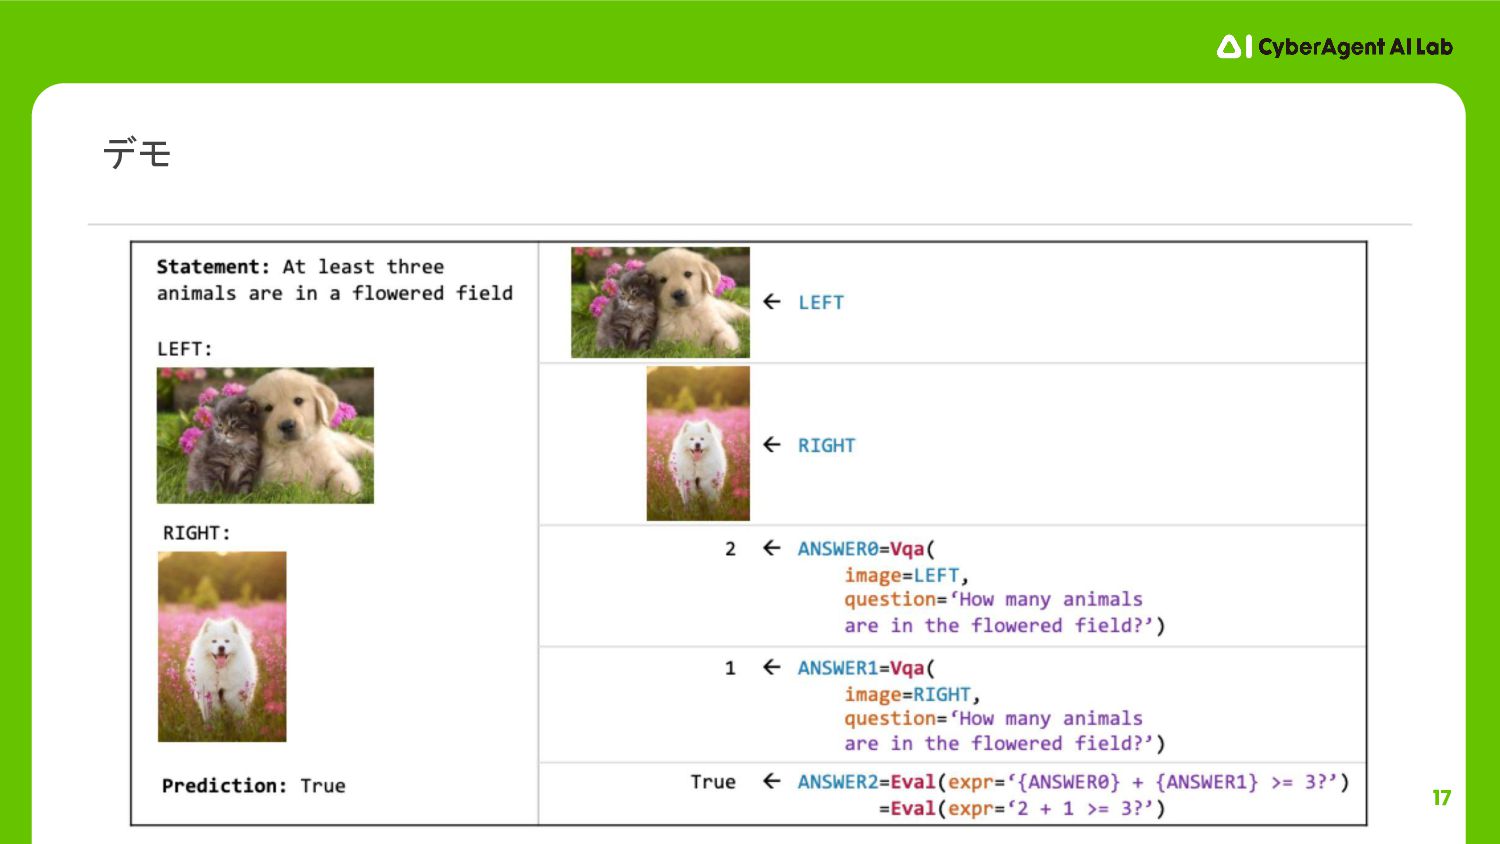
17 デモ
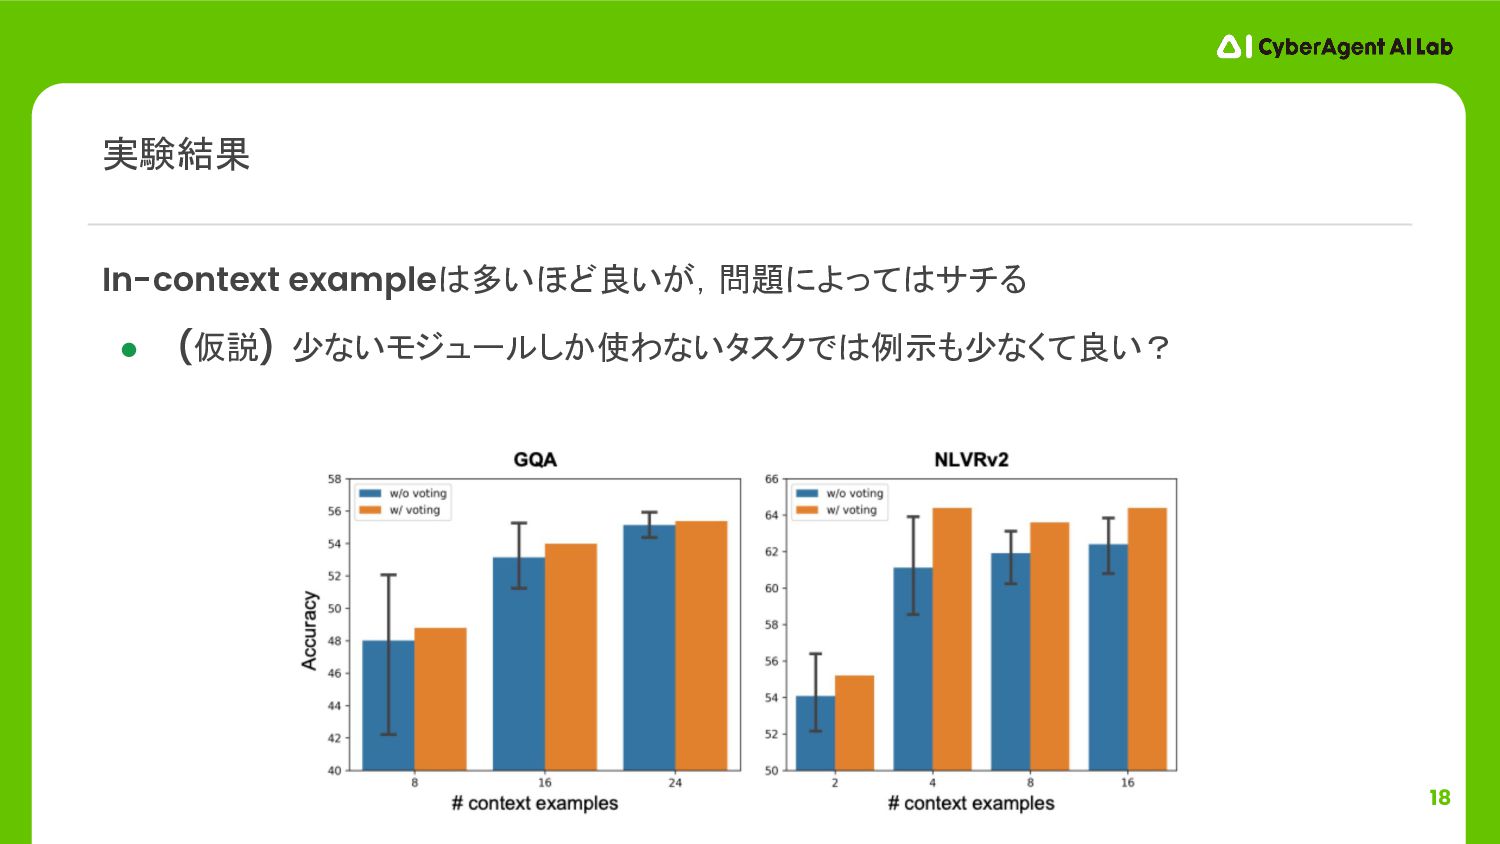
18 In-context exampleは多いほど良いが,問題によってはサチる • (仮説) 少ないモジュールしか使わないタスクでは例示も少なくて良い? 実験結果
19 汎用性に全振りしているので,特定のタスクにおいて強いかはケースバイケース • 勝敗は既存手法のモデルサイズや学習データセットサイズ次第 実験結果 実験結果 (reasoning on image pairs)
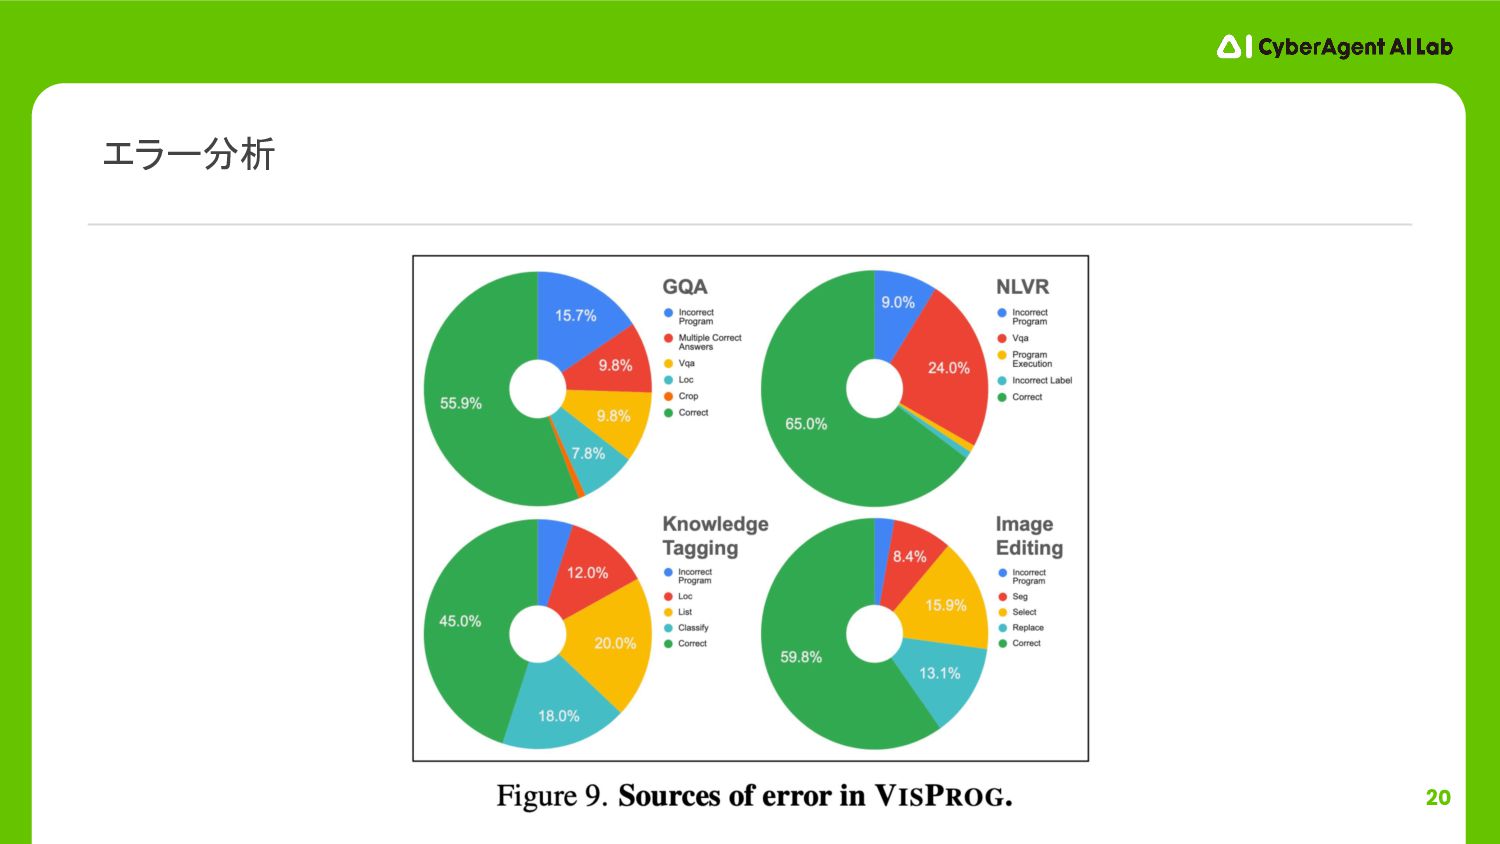
20 エラー分析
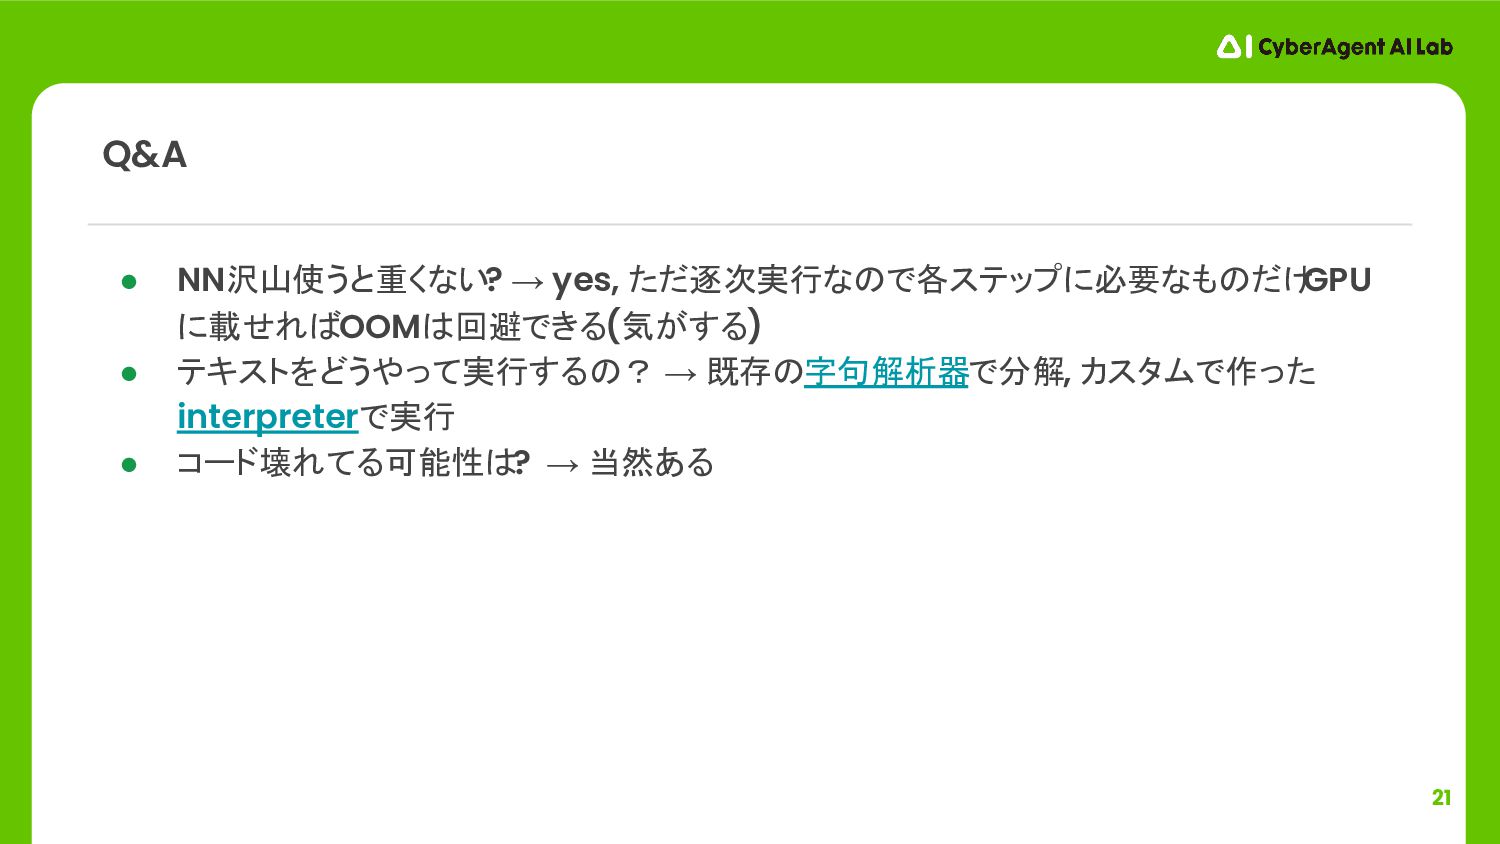
21 • NN沢山使うと重くない? → yes, ただ逐次実行なので各ステップに必要なものだけ GPU に載せればOOMは回避できる(気がする) • テキストをどうやって実行するの?
→ 既存の字句解析器で分解, カスタムで作った interpreterで実行 • コード壊れてる可能性は? → 当然ある Q&A
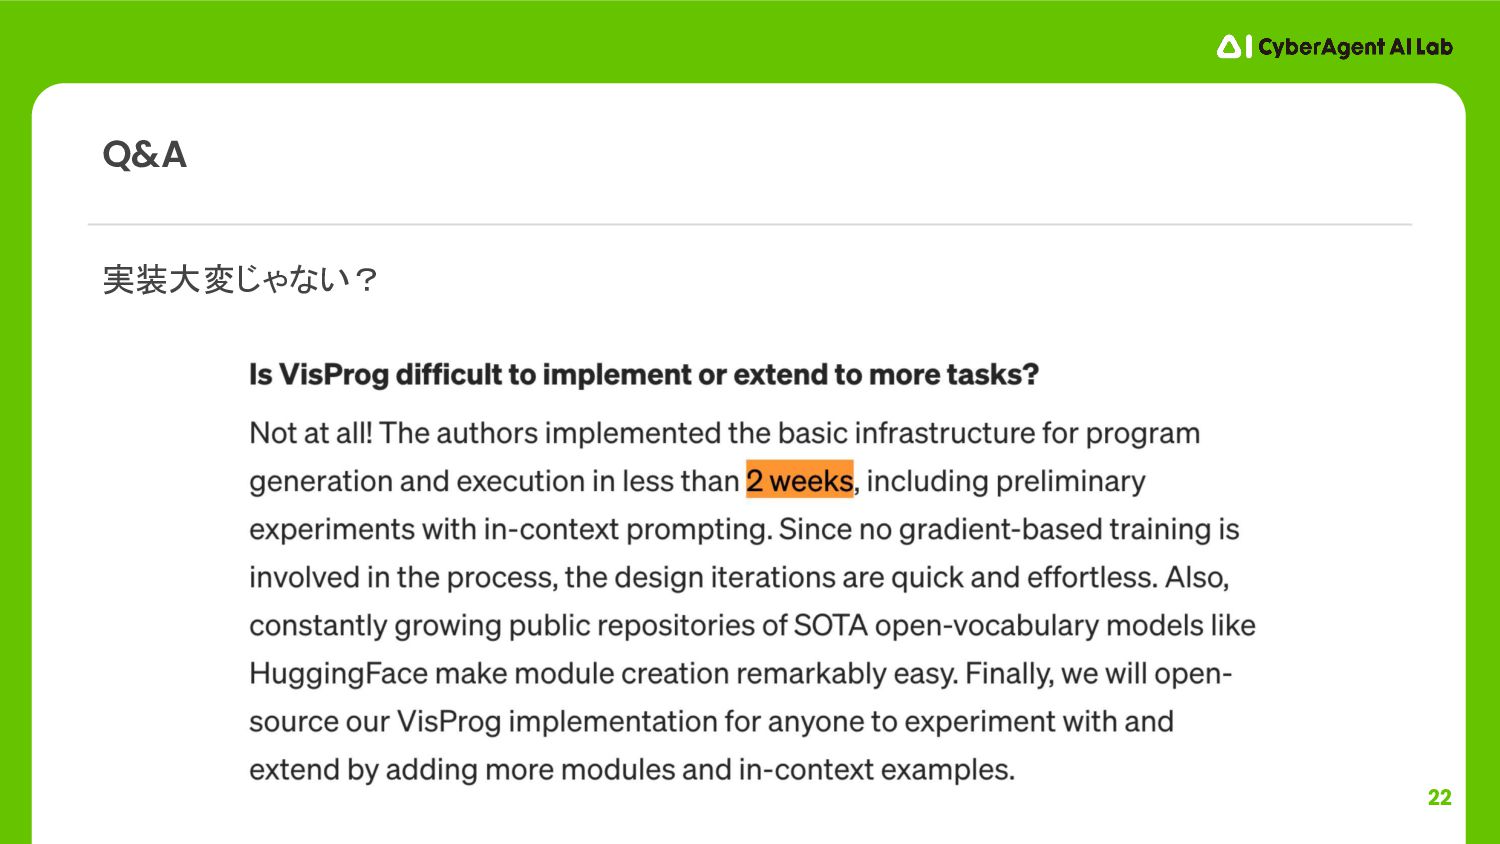
22 実装大変じゃない? Q&A
23 • 結局タスク数が増えるとin-context examplesの必要数増えて辛いのでは ◦ VQAはモジュール扱い,結果の信頼性がある限りはある程度汎用なモジュールが良い ◦ 結局各モジュールの改善は必須 • エラー訂正,
もしくは実行結果を見てのfeedbackは可能か 議論
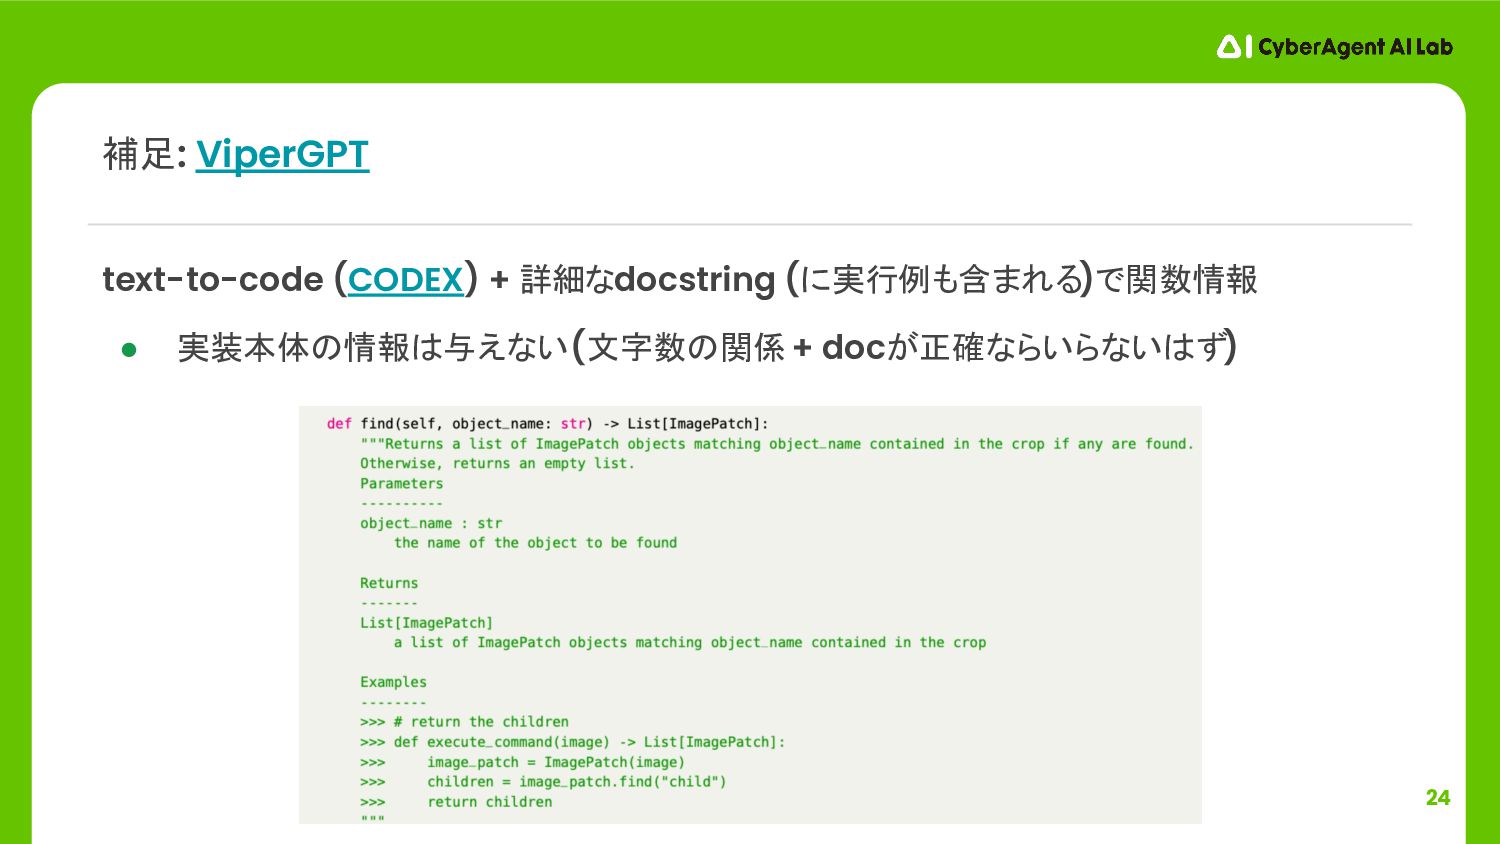
24 text-to-code (CODEX) + 詳細なdocstring (に実行例も含まれる)で関数情報 • 実装本体の情報は与えない (文字数の関係 +
docが正確ならいらないはず) 補足: ViperGPT
25 これも関数定義をpromptとして与えてLLMに使ってもらう試み 補足: Function Calling (OpenAI)
26 Ideas are cheap, execution is everything (≃ 素人発想玄人実行?) Revisiting
old ideas の典型例? • LLMが強くて思想にモデルが追いついてきた感じ • ここ5年くらいは,大規模データで V&L学習 → fine-tune が非常に多かった • Symbolic learningは Jiayuan Mao が地道に掘ってたけど有名とまでは言えない 雰囲気 アカデミアっぽい発想? • 企業だとlong-tailというよりはやっぱボリュームゾーンのタスクを教師あり学習で詰める のがやっぱり王道 所感
27 Scholars & Big Models: How Can Academics Adapt? •
Workshop in CVPR’23, スライドが全公開されている • 大規模モデル時代にどう戦うか?をテーマに大物がトーク ◦ 個人的なおすすめ: Jon Barron / Derek Hoiem 余談
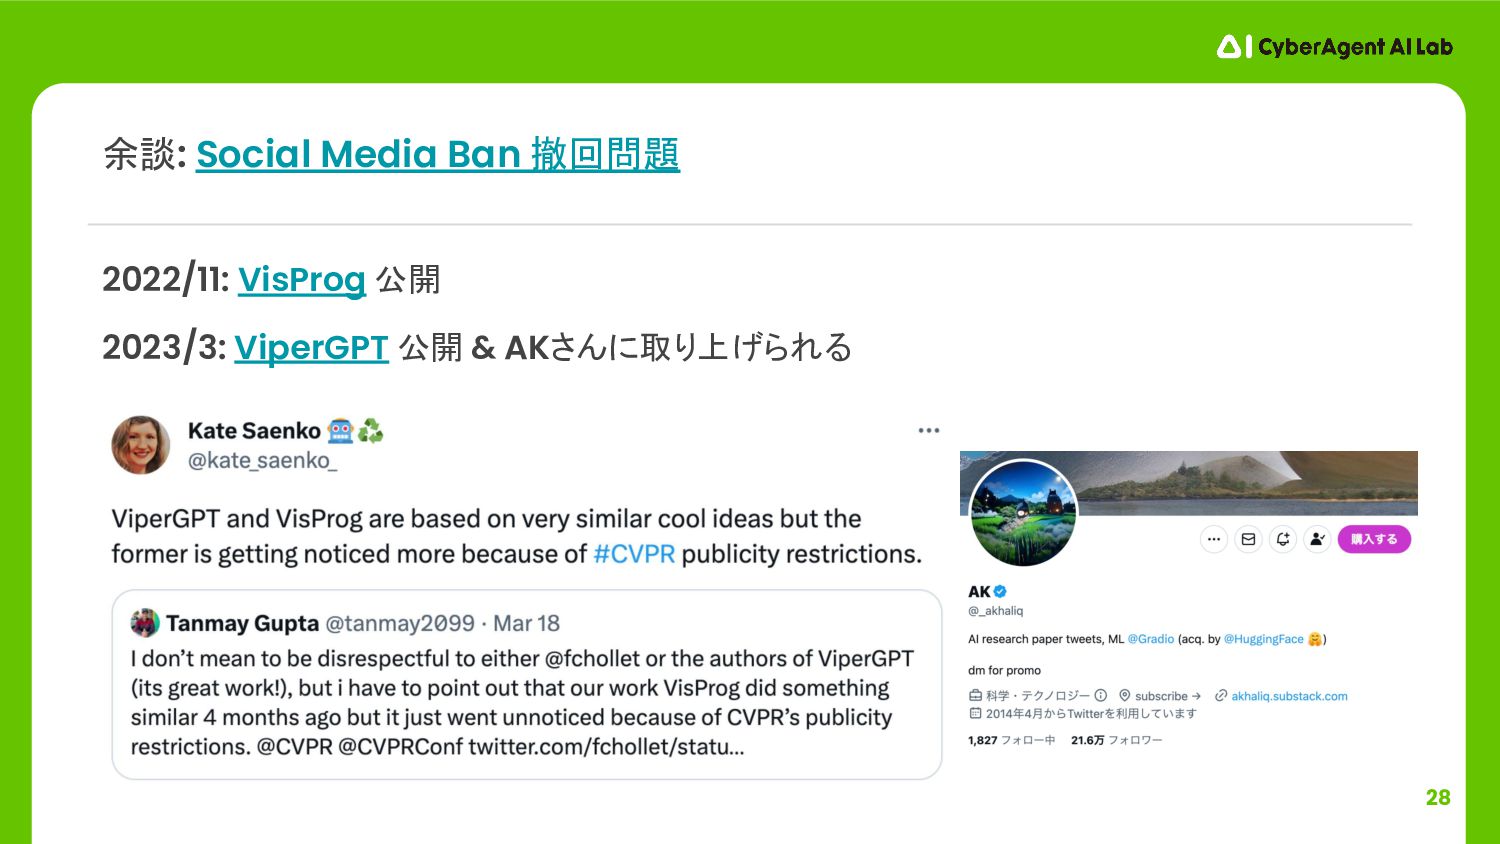
28 2022/11: VisProg 公開 2023/3: ViperGPT 公開 & AKさんに取り上げられる 余談:
Social Media Ban 撤回問題
29 主張 • 有名・大きなところほど同僚やインフルエンサーが宣伝するので結局無意味では 反論 • 宣伝を禁じるだけでarXivへのアップロード自体は禁じられていない • 査読を歪ませないのは大事 (参考:
Michael Black先生の趣旨説明) ただ,実際自分もViperGPT知っててVisProg知らなかったので難しいところ 余談: Social Media Ban 撤回問題
30 • 学習 (勾配降下) 不要で多種多様なタスクを解く • LLMのin-context learning能力をフル活用して,neuro-symbolic approachの アップデート
• ロングテール性・解釈性・拡張性などのメリット まとめ


 naoto0804
 s_mizuki_nlp
 gpeyre
 institutdelelevage
 takehaya
 shiell
 upura
 kobayashi31
 kogoro
 hariby
 junkashihara
 ontheslope
 satai
 portentint
 csswizardry
 mongodb
 aarron
 reverentgeek
 chriscoyier
 rkaga
 tammyeverts
 bkeepers
 jct
 cargoodrich