Upgrade to Pro — share decks privately, control downloads, hide ads and more …

データモデリングで、もっと使いやすい Looker

Avatar for Nicky Nicky
June 28, 2025
31

データモデリングで、もっと使いやすい Looker

2025-06-27 に開かれた「 Jagu'e'r データ利活用分科会 #25 あつまれ Looker の森 Part 3 」での発表資料です。

Avatar for Nicky

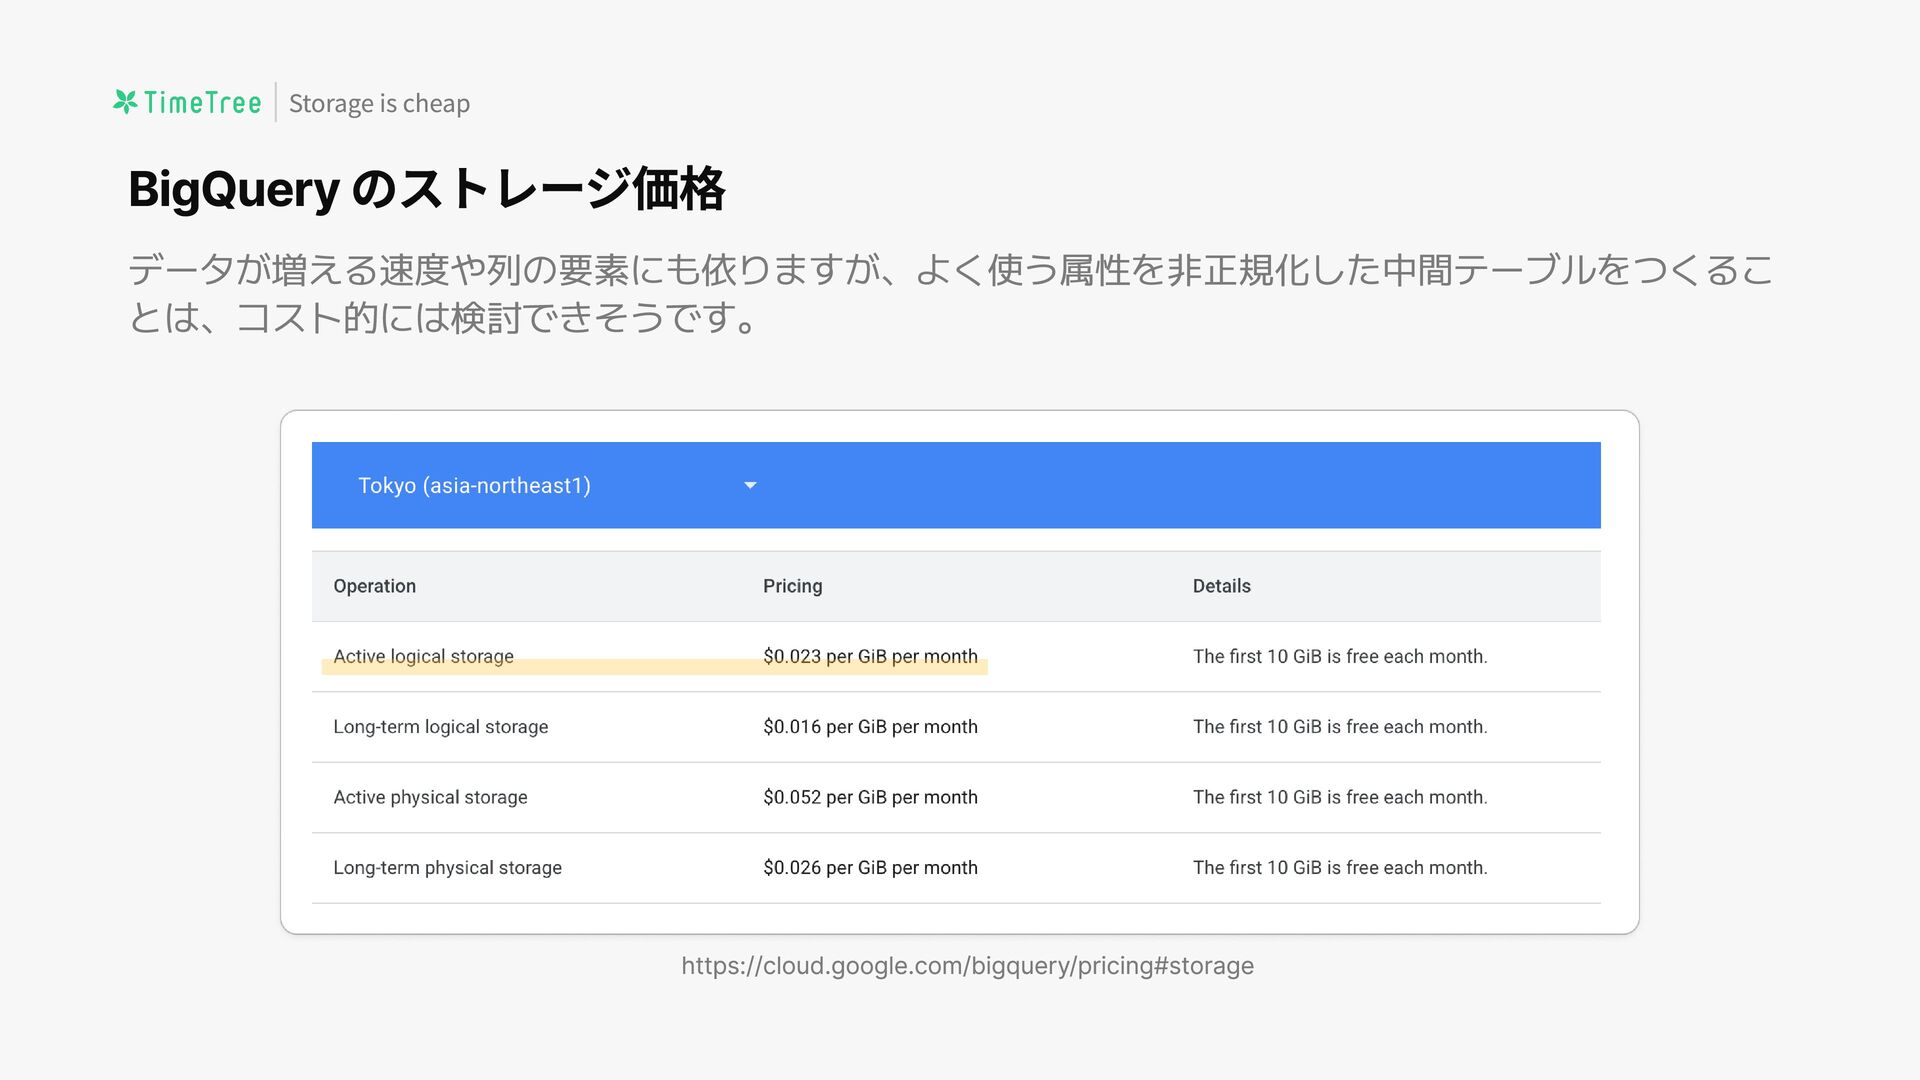
Nicky

June 28, 2025

Transcript

  1. Nicky 株式会社TimeTree CDO室 データアナリスト 経済学系の大学院を修了後、データ分析専門のコ ンサルティング会社を経て 2023 年に TimeTree へ入社しました。


    入社してからは新規事業チームのデータ分析を担 当し、いまは組織全体での BI 整備も担当していま す。 はじめに
  2. データモデリングとは? 「データの首尾一貫した構造を意図的に選択 すること」です。 データモデリングのアプローチはいくつかあ りますY F ディメンショナルモデリンR F One Big

    Table( OBT, 大福帳“ F Data Vault 分析以外の用途だと、第3正規形を考えて データモデリングされていることが多いと 思っています。 はじめに 参考:『データエンジニアリングの基礎  データプロジェクトで失敗しないために』 8.2 節。
  3. “Unlike in a traditional Kimball star schema though, in modern

    data warehousing — where storage is cheap and compute is expensive — we’ll happily borrow and add any and all data from other concepts that are relevant to answering questions about the mart’s core entity.” 『Marts: Business-defined entities』 https://docs.getdbt.com/best-practices/how-we-structure/4-marts はじめに ( 意訳 ) ” 伝統的な Kimball のスタースキーマと違って、現代的なデータウェ アハウス —— ストレージは安く計算が高くつく —— では、データマートの中 心的要素についての質問に答えられるなら、喜んで他のテーブルからあらゆる データを持ってきて追加します。”
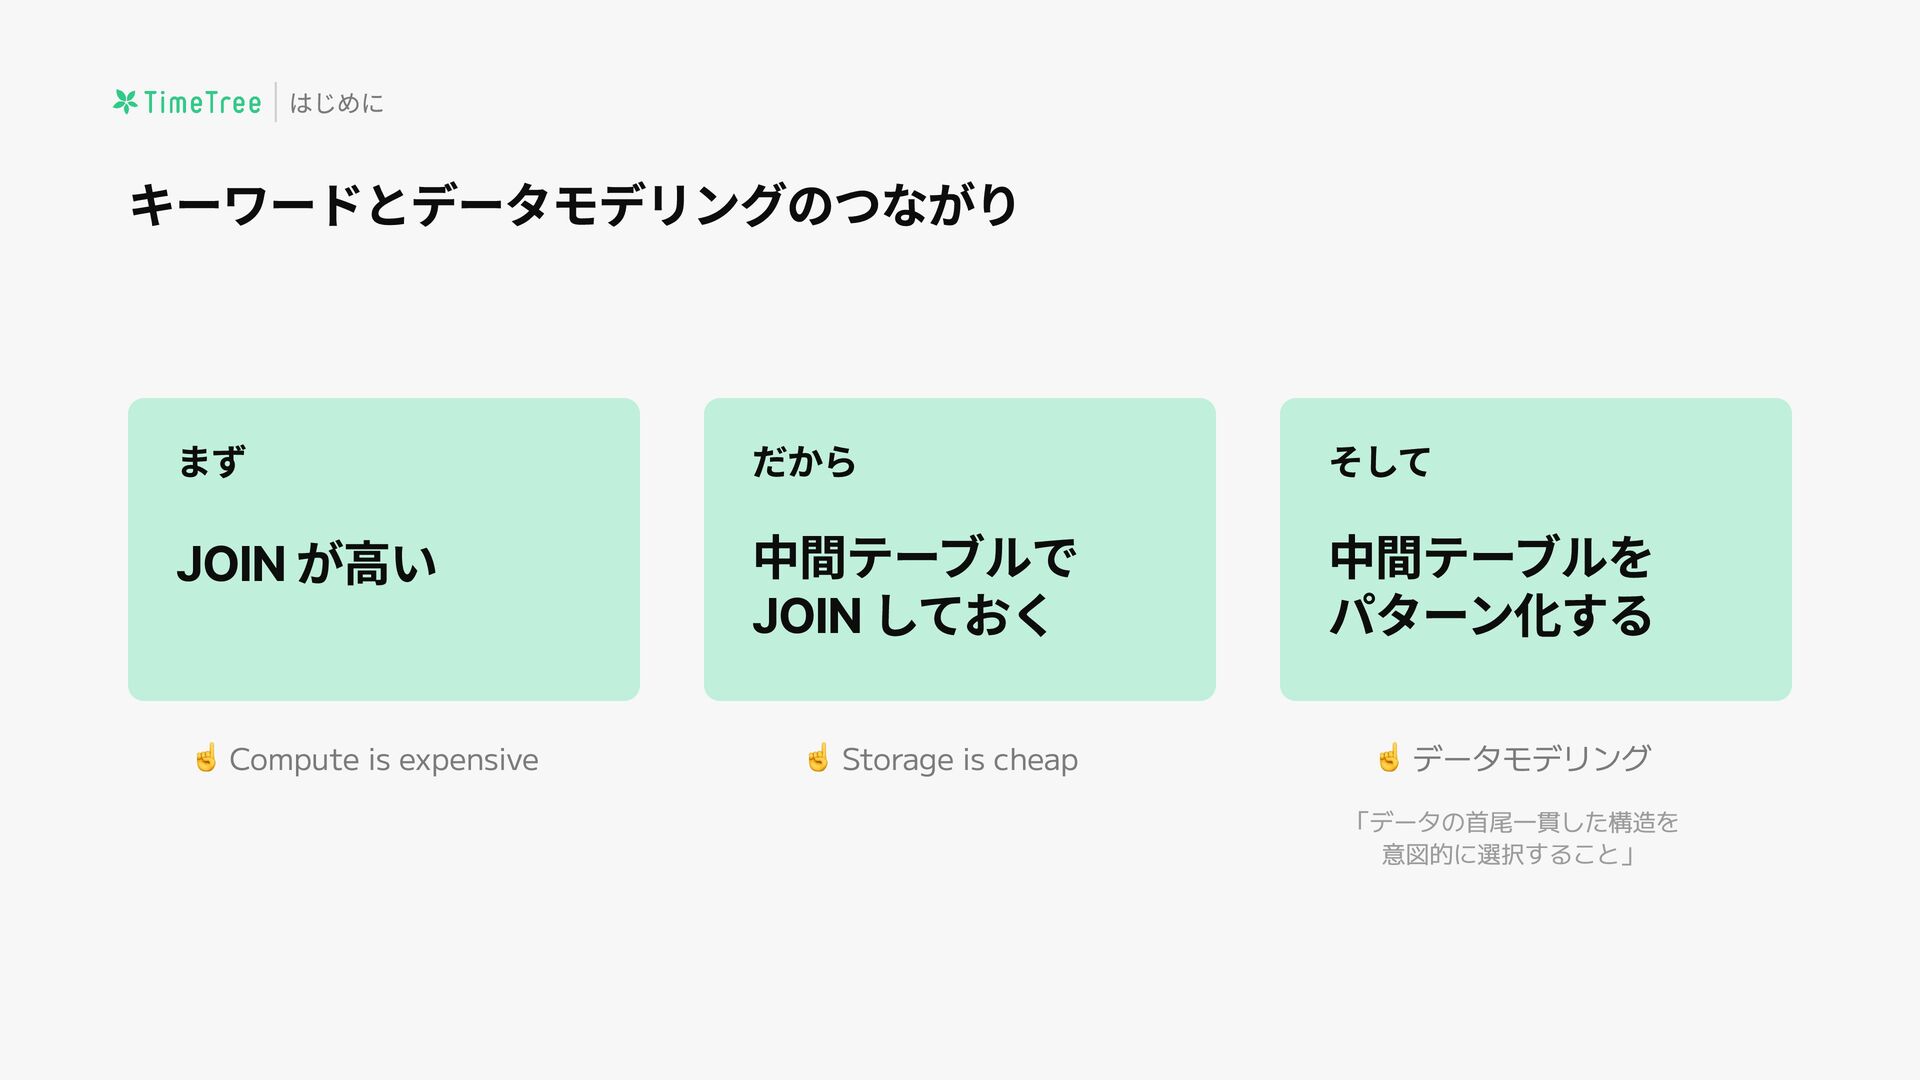
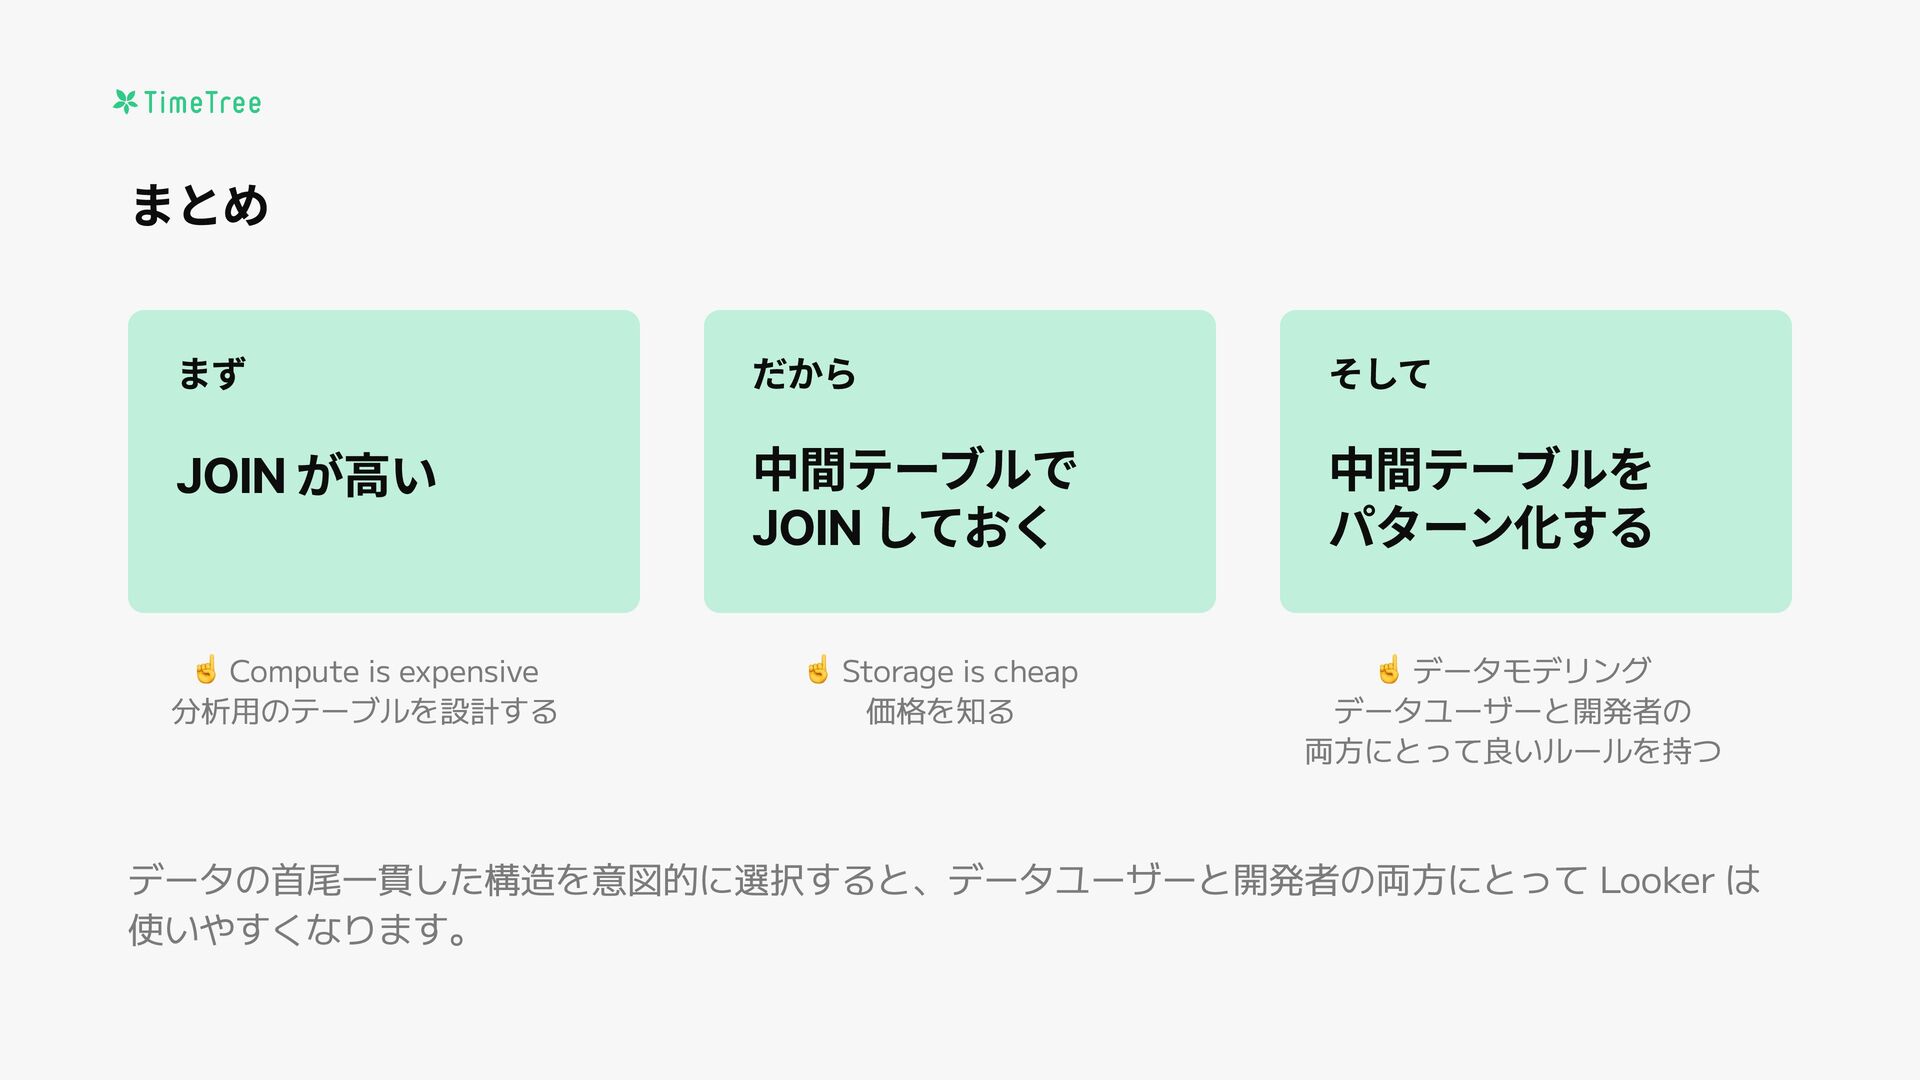
  4. キーワードとデータモデリングのつながり まず JOIN が高い だから 中間テーブルで JOIN しておく そして 中間テーブルを

    パターン化する Compute is expensive Storage is cheap データモデリング 「データの首尾一貫した構造を 意図的に選択すること」 はじめに
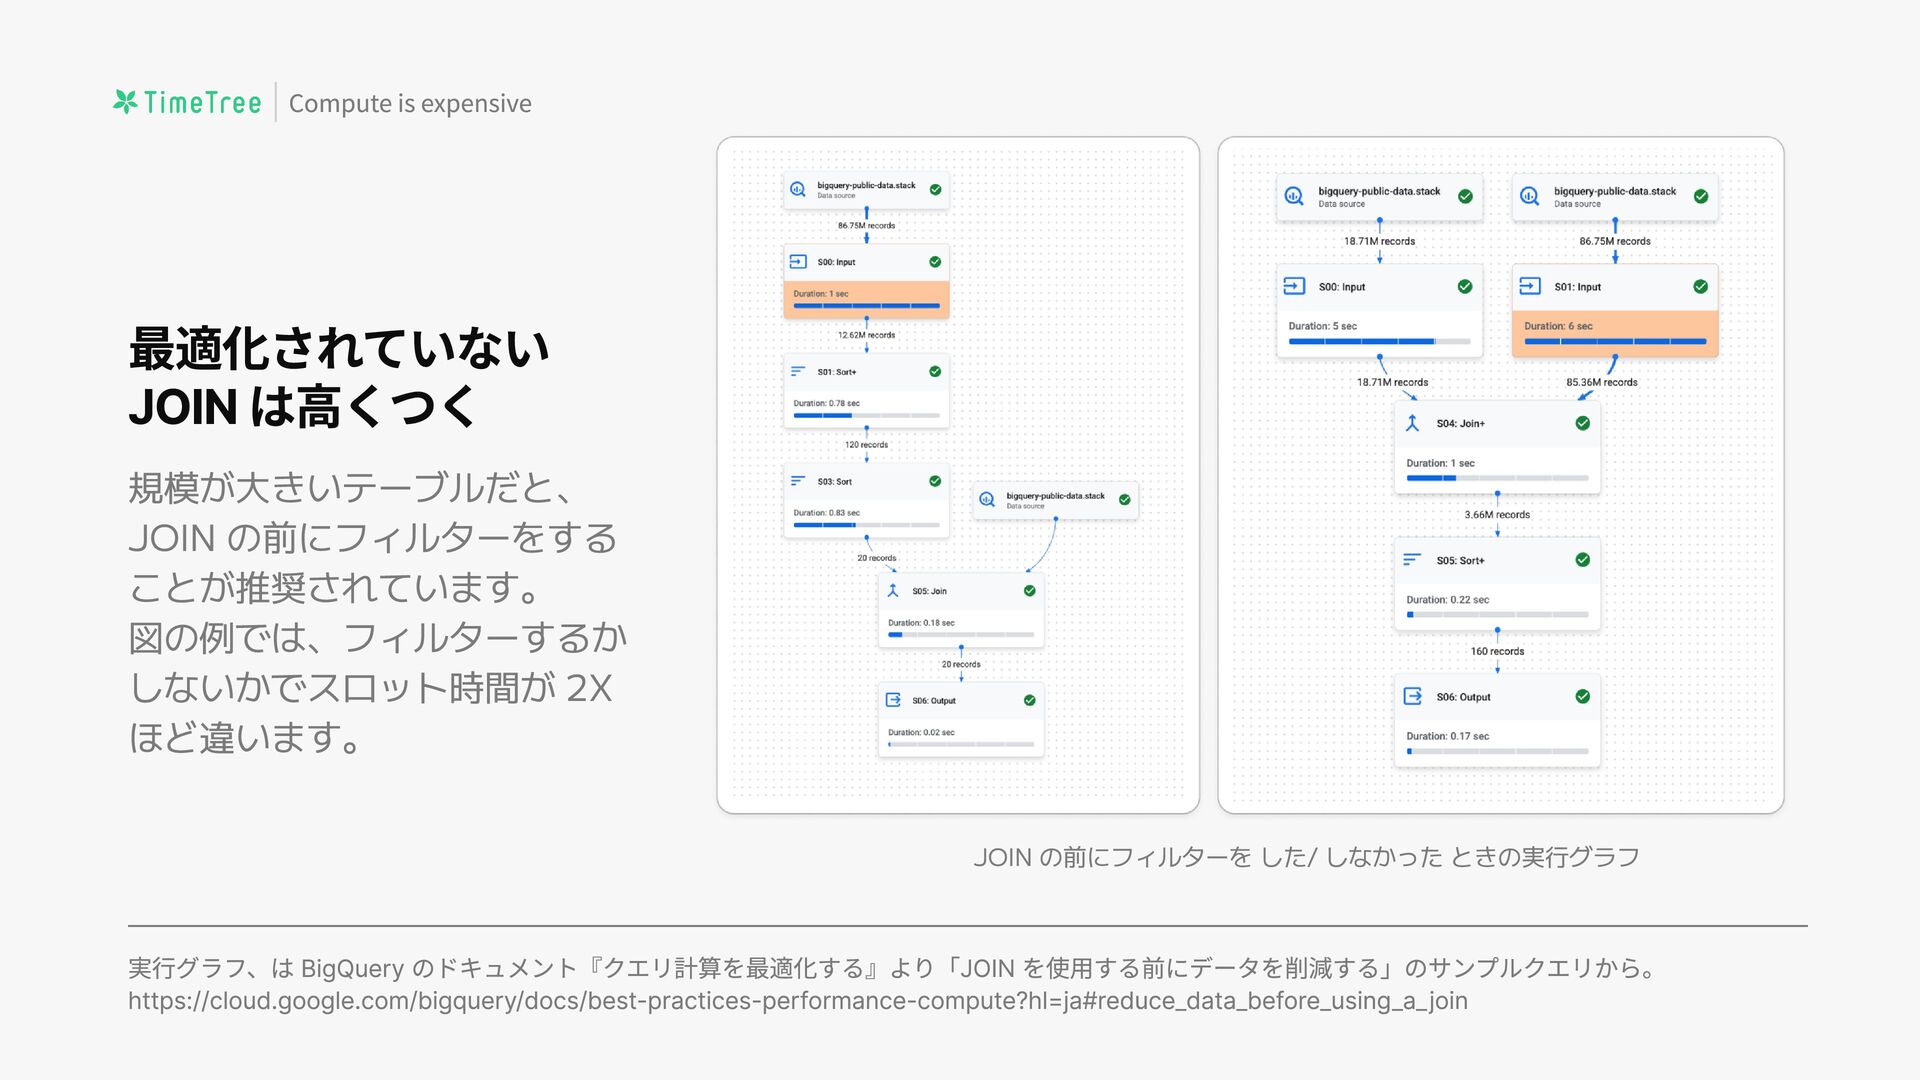
  5. 最適化されていない JOIN は高くつく 規模が大きいテーブルだと、 JOIN の前にフィルターをする ことが推奨されています。 図の例では、フィルターするか しないかでスロット時間が 2X

    ほど違います。 Compute is expensive JOIN の前にフィルターを した/ しなかった ときの実行グラフ 実行グラフ、は BigQuery のドキュメント『クエリ計算を最適化する』より「JOIN を使用する前にデータを削減する」のサンプルクエリから。 https://cloud.google.com/bigquery/docs/best-practices-performance-compute?hl=ja#reduce_data_before_using_a_join
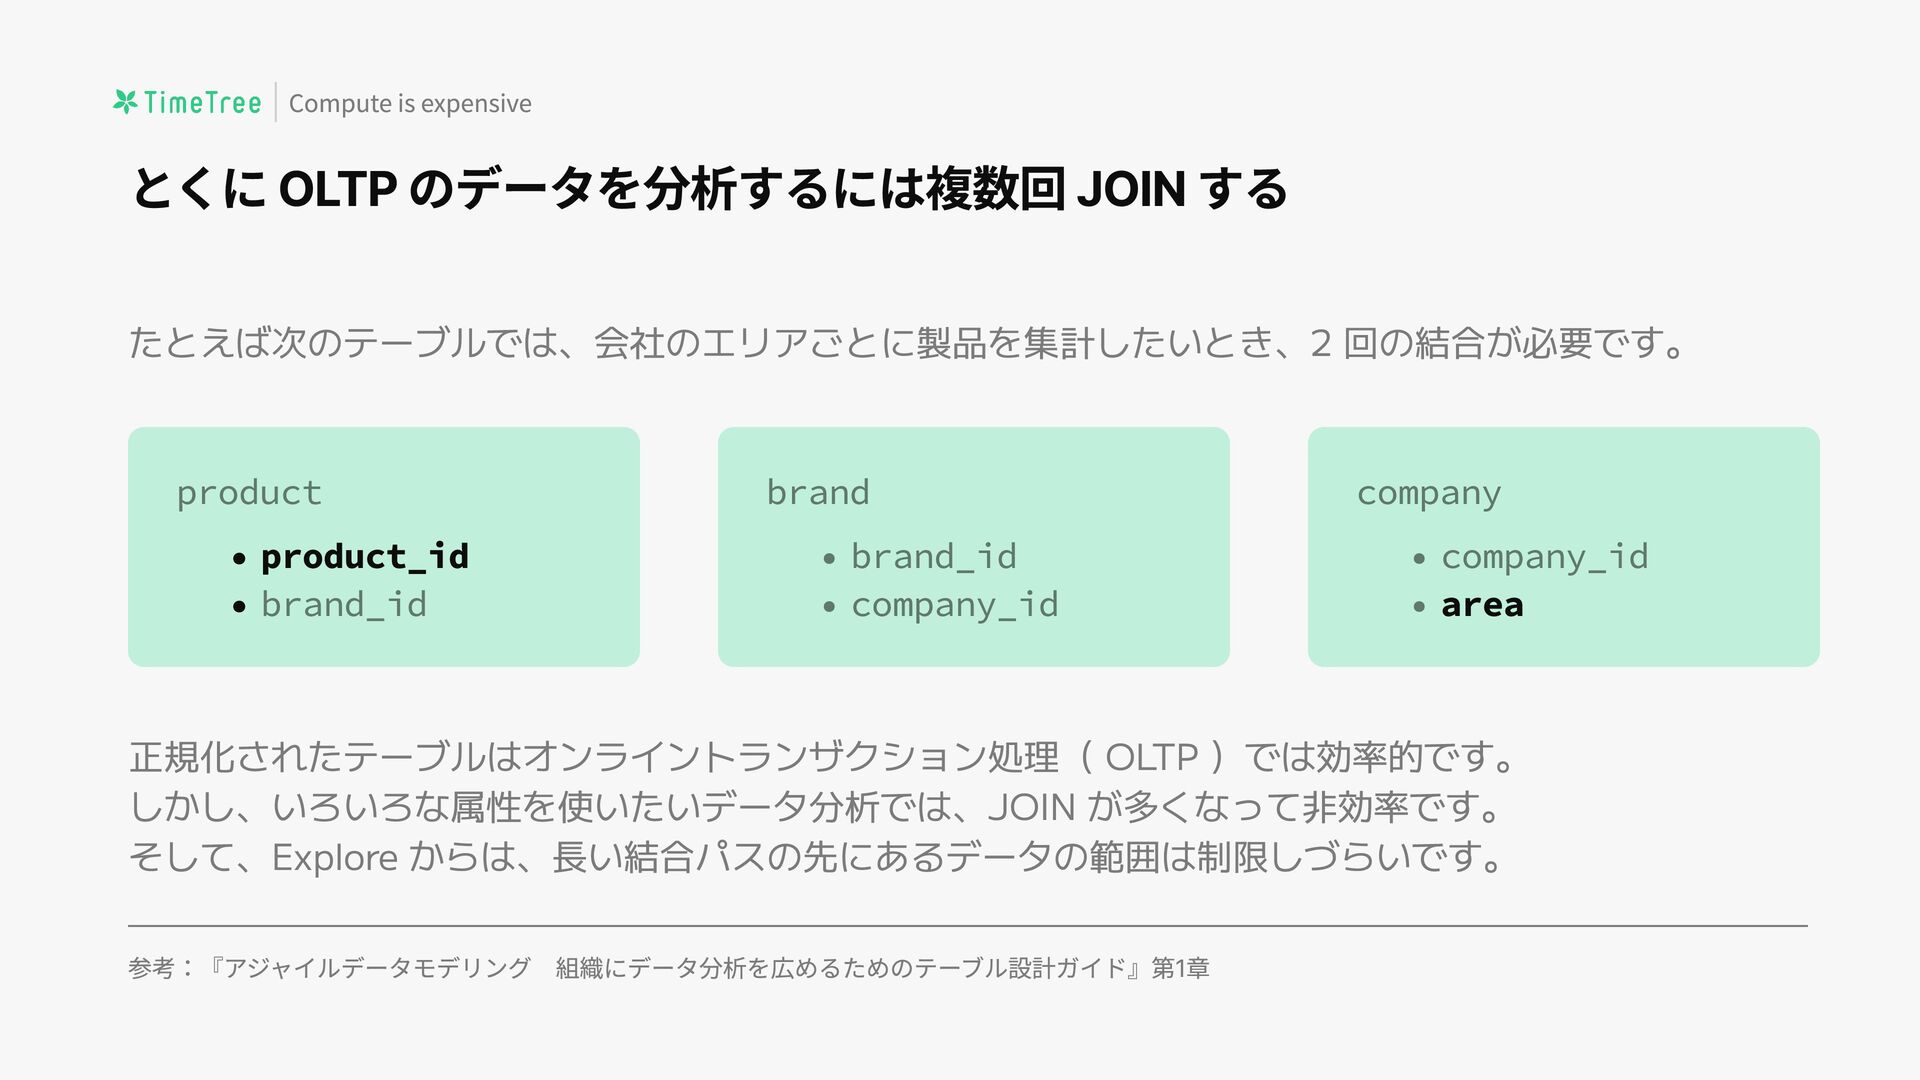
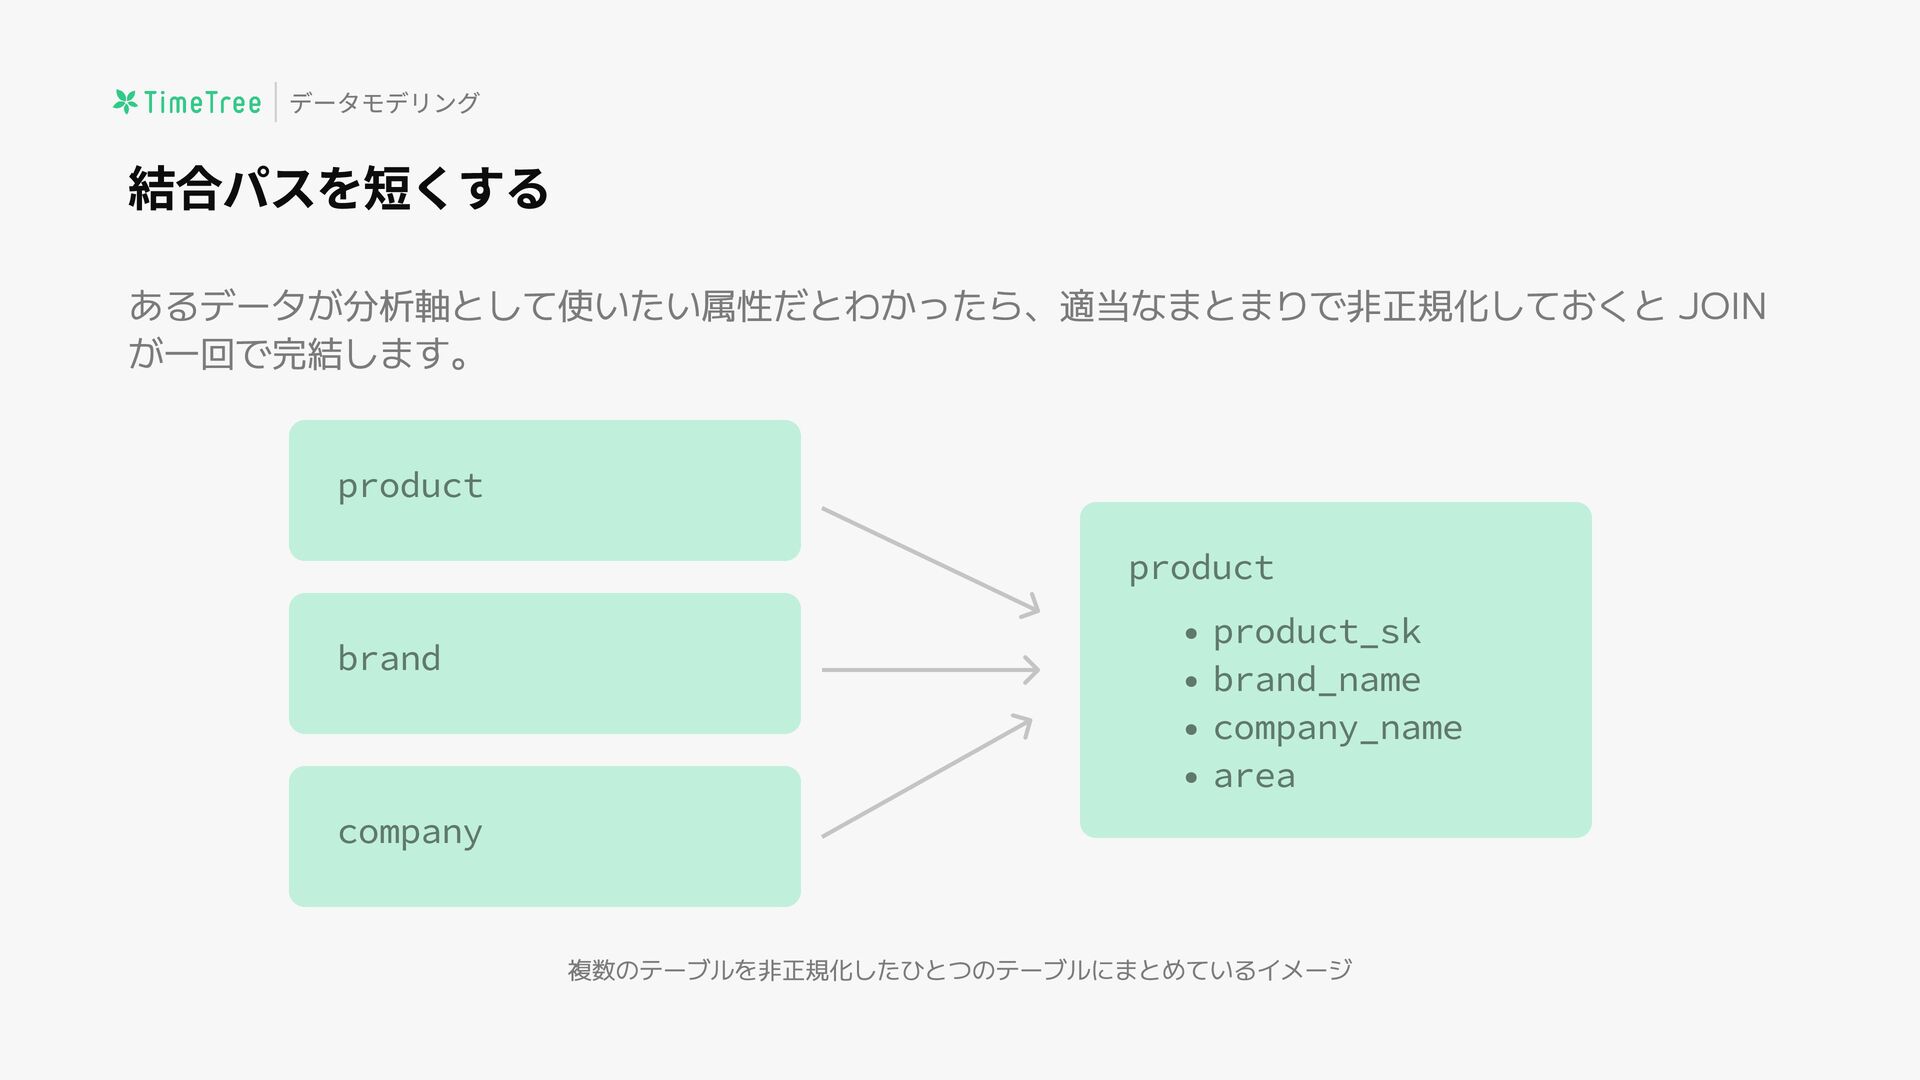
  6. とくに OLTP のデータを分析するには複数回 JOIN する 正規化されたテーブルはオンライントランザクション処理( OLTP )では効率的です。 しかし、いろいろな属性を使いたいデータ分析では、JOIN が多くなって非効率です。

    そして、Explore からは、長い結合パスの先にあるデータの範囲は制限しづらいです。 たとえば次のテーブルでは、会社のエリアごとに製品を集計したいとき、2 回の結合が必要です。 Compute is expensive product « product_i© « brand_id brand Ä brand_i¿ Ä company_id company Ä company_i¿ Ä area 参考:『アジャイルデータモデリング  組織にデータ分析を広めるためのテーブル設計ガイド』第1章
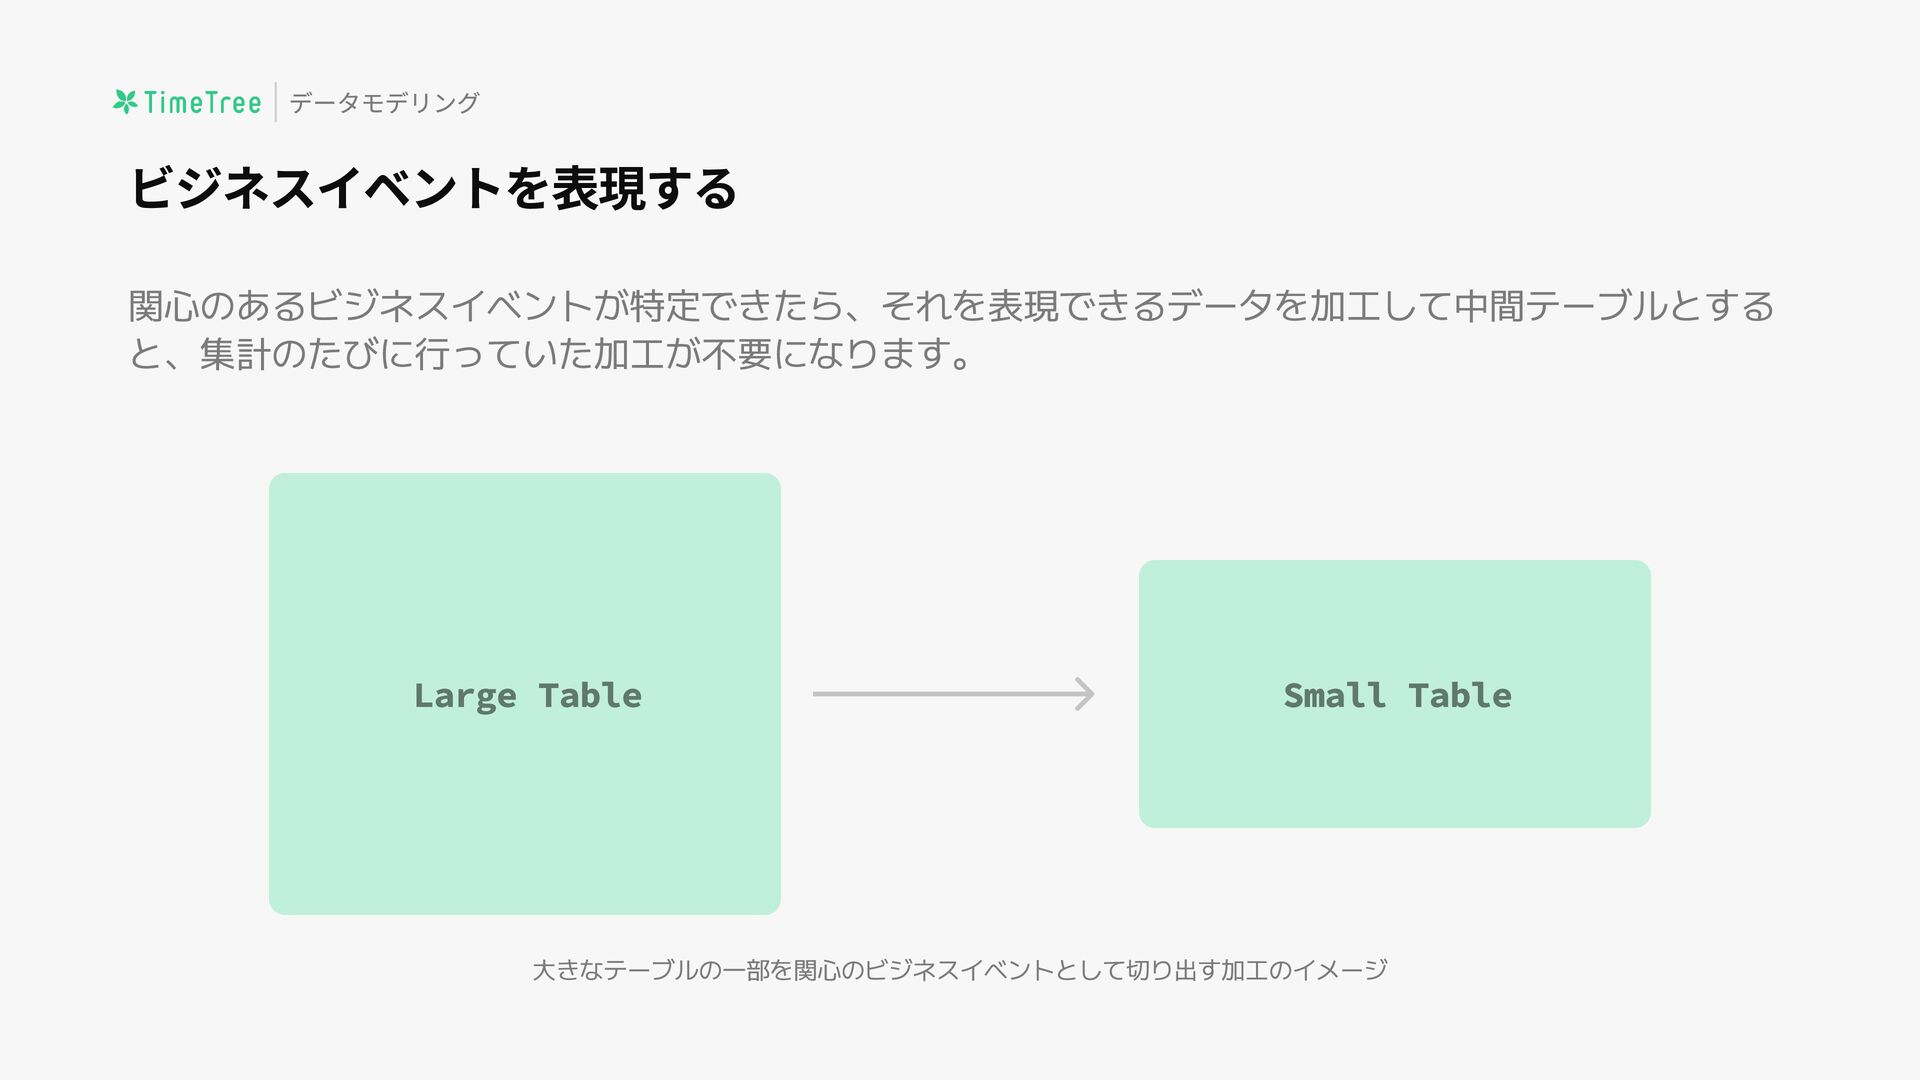
  7. 時は金 Looker の Explore では、少しだけ条件を変え た集計が何度も行われます。 条件を変えるたびに重い JOIN が必要だと、 計算リソースを使うだけでなく、意思決定の

    遅さにもつながります。 また、複雑な JOIN は人が理解するのにも時 間がかかります。 そのため、Looker の Explore 開発の遅さにも つながります。 Compute is expensive
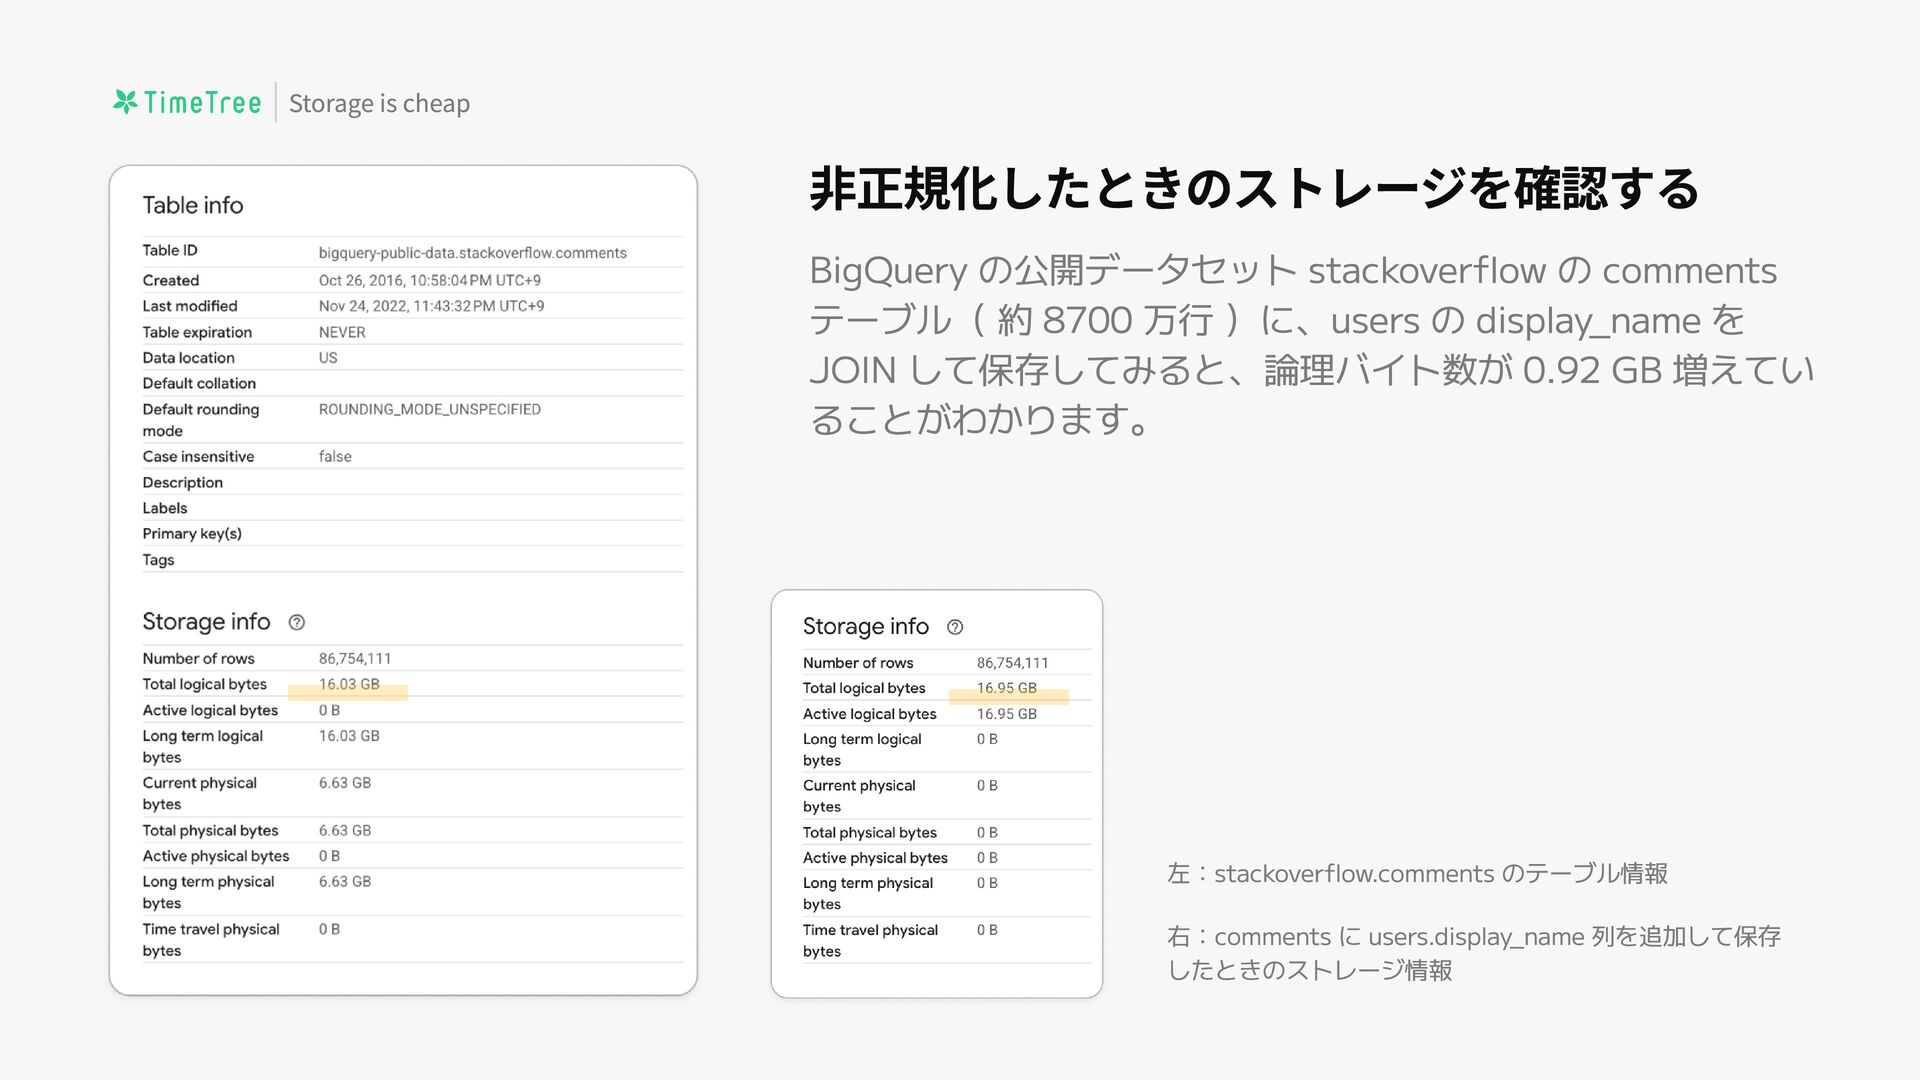
  8. Storage is cheap 右:comments に users.display_name 列を追加して保存 したときのストレージ情報 左:stackoverflow.comments のテーブル情報

    非正規化したときのストレージを確認する BigQuery の公開データセット stackoverflow の comments テーブル( 約 8700 万行 )に、users の display_name を JOIN して保存してみると、論理バイト数が 0.92 GB 増えてい ることがわかります。
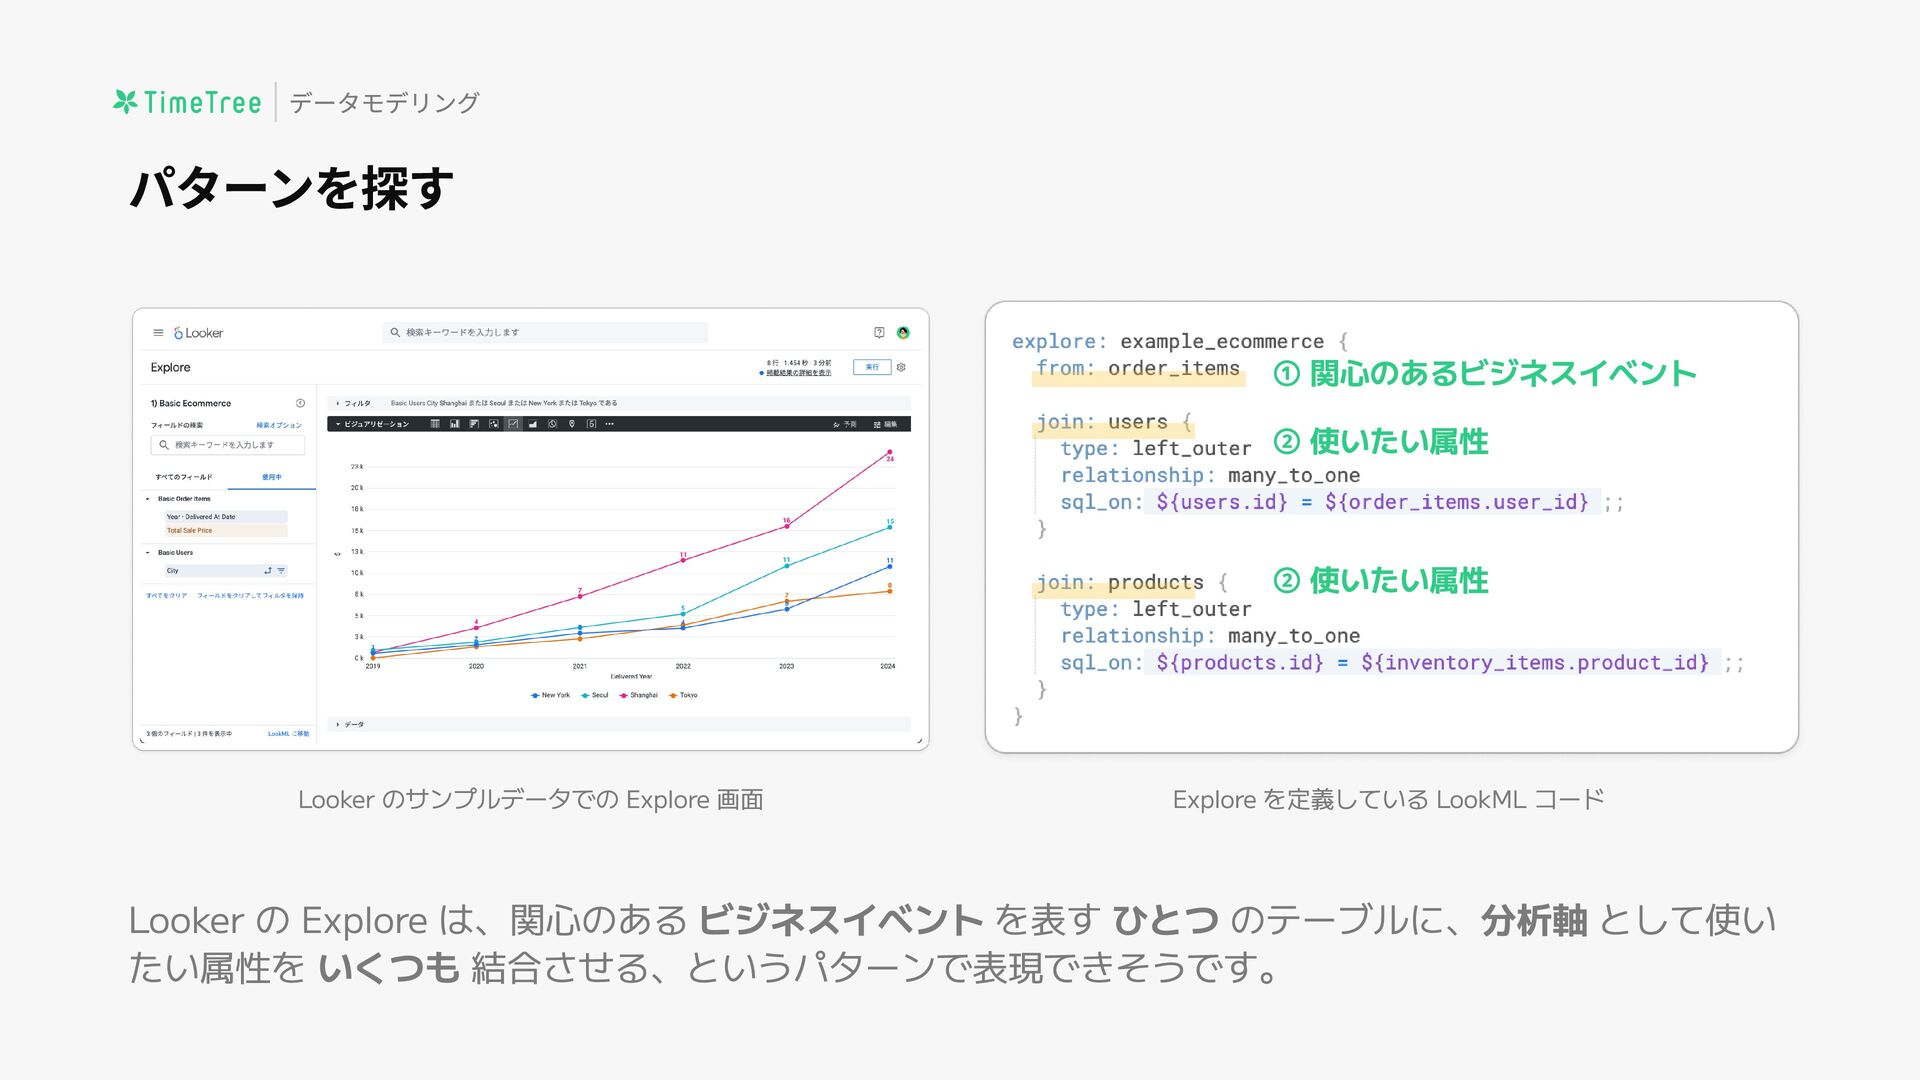
  9. パターンを探す Looker の Explore は、関心のある ビジネスイベント を表す ひとつ のテーブルに、分析軸 として使い

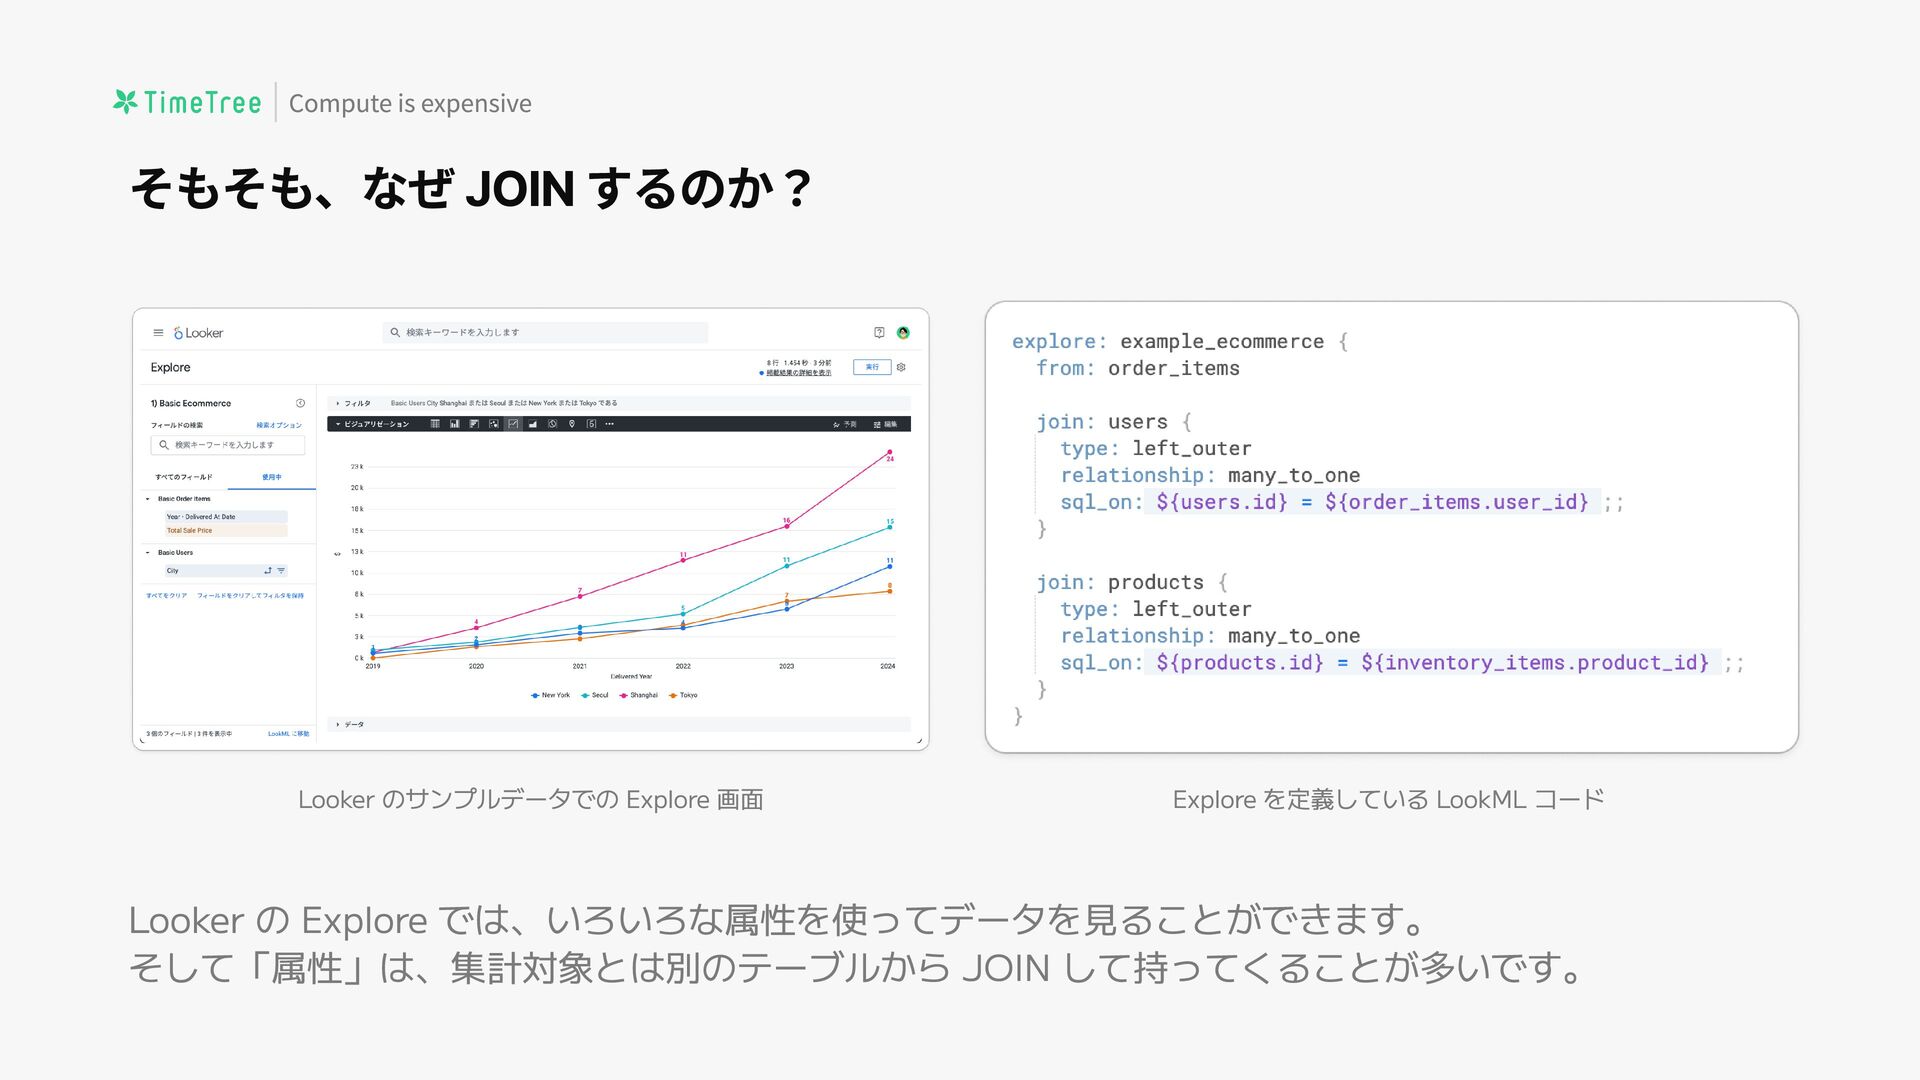
    たい属性を いくつも 結合させる、というパターンで表現できそうです。 ① 関心のあるビジネスイベント ② 使いたい属性 ② 使いたい属性 データモデリング Looker のサンプルデータでの Explore 画面 Explore を定義している LookML コード
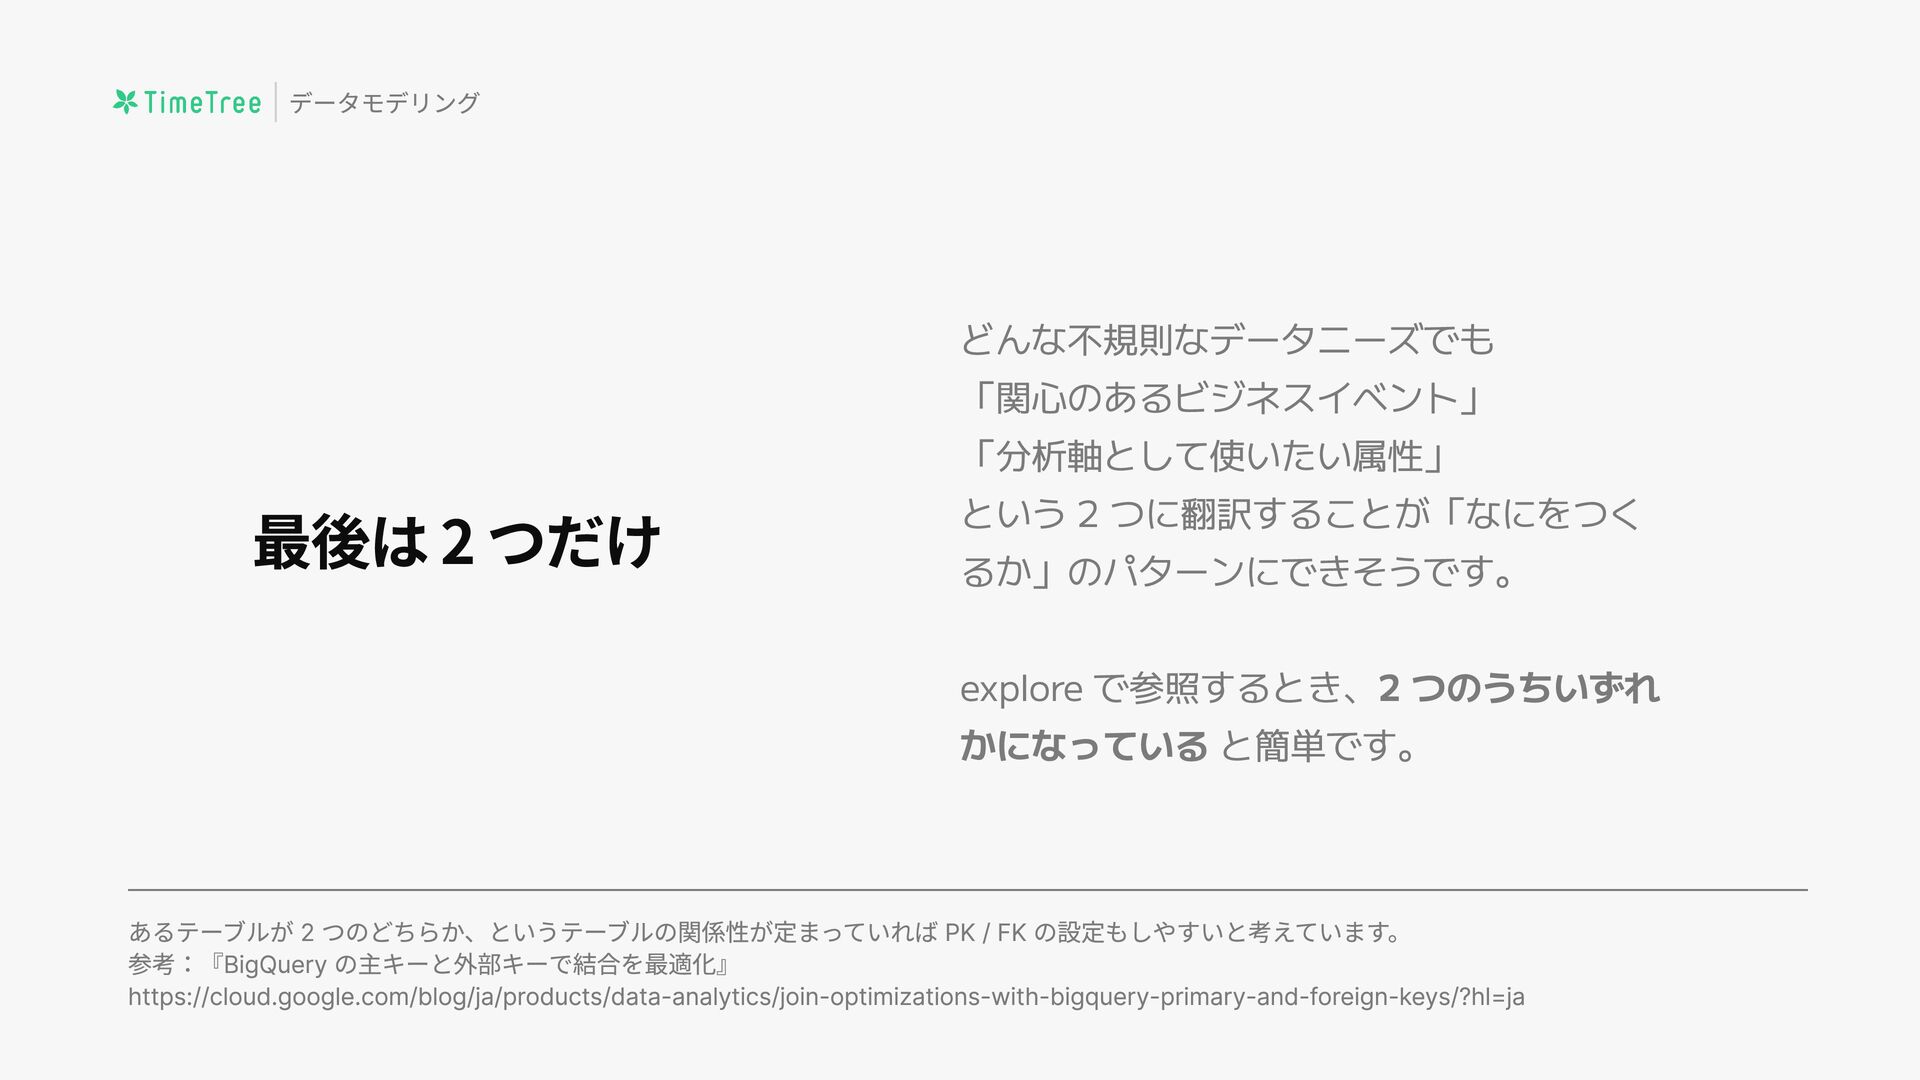
  10. 最後は 2 つだけ どんな不規則なデータニーズでも 「関心のあるビジネスイベント」 「分析軸として使いたい属性」 という 2 つに翻訳することが「なにをつく るか」のパターンにできそうです。

    explore で参照するとき、2 つのうちいずれ かになっている と簡単です。 データモデリング あるテーブルが 2 つのどちらか、というテーブルの関係性が定まっていれば PK / FK の設定もしやすいと考えています。 参考:『BigQuery の主キーと外部キーで結合を最適化』 https://cloud.google.com/blog/ja/products/data-analytics/join-optimizations-with-bigquery-primary-and-foreign-keys/?hl=ja
  11. “ The four key decisions made during the design of

    a dimensional model include # Select the business processA # Declare the grainA # Identify the dimensionsA # Identify the facts. “ 『Four-Step Dimensional Design Process』 https://www.kimballgroup.com/data-warehouse-business-intelligence- resources/kimball-techniques/dimensional-modeling-techniques/four-4- step-design-process/ データモデリング ( 意訳 ) ” ディメンショナルモデリングの設計でなされる 4 つの重要な判断 はs  ビジネスプロセスを選f  粒度を定義す˜  ディメンションをつき止め˜  ファクトをつき止める ”
  12. どうつくるのか? ここまでの話は、データモデリングのひと つである ディメンショナルモデリング につ いてです。 そのため、ディメンショナルモデリングの 開発の仕方が参考になります。 データモデリング たとえば

    Source, Staging, Intermediate, Mart というレイヤーに分けてテーブルを加工するなど。 参考:『Data modeling techniques for more modularity』 https://www.getdbt.com/blog/modular-data-modeling-techniques
  13. “ A general rule of thumb: go with your gut!

    If something feels like it should be a fact to meet your stakeholders' needs, then it’s a fact. If it feels like a dimension, it’s a dimension. The world is your oyster. If you find that you made the wrong decision down the road, (it’s usually) no big deal. You can remodel that data. Just remember: you’re not a surgeon. No one will die if you mess up (hopefully). So, just go with what feels right because you’re the expert on your data ” 『Guide to dimensional modeling』 https://www.getdbt.com/blog/guide-to-dimensional-modeling データモデリング ( 意訳 ) ” 汎用的な経験則:自分の直感を信じましょう! ステークホルダーのニーズを満たすためにファクトと して扱うべきだと感じれば、それはファクトです。ディメンションだと感じれば、それはディメンションです。世 界はあなたの思いのままです。もしも後で間違った判断だったとわかっても(だいたいは)ささいなことです。あ なたはもう一度モデリングできます。覚えておいてください:あなたは外科医ではありません。(おそらく)あな たが間違えても誰も亡くなりません。なので、自社のデータの専門家として、直感を信じましょう 。”
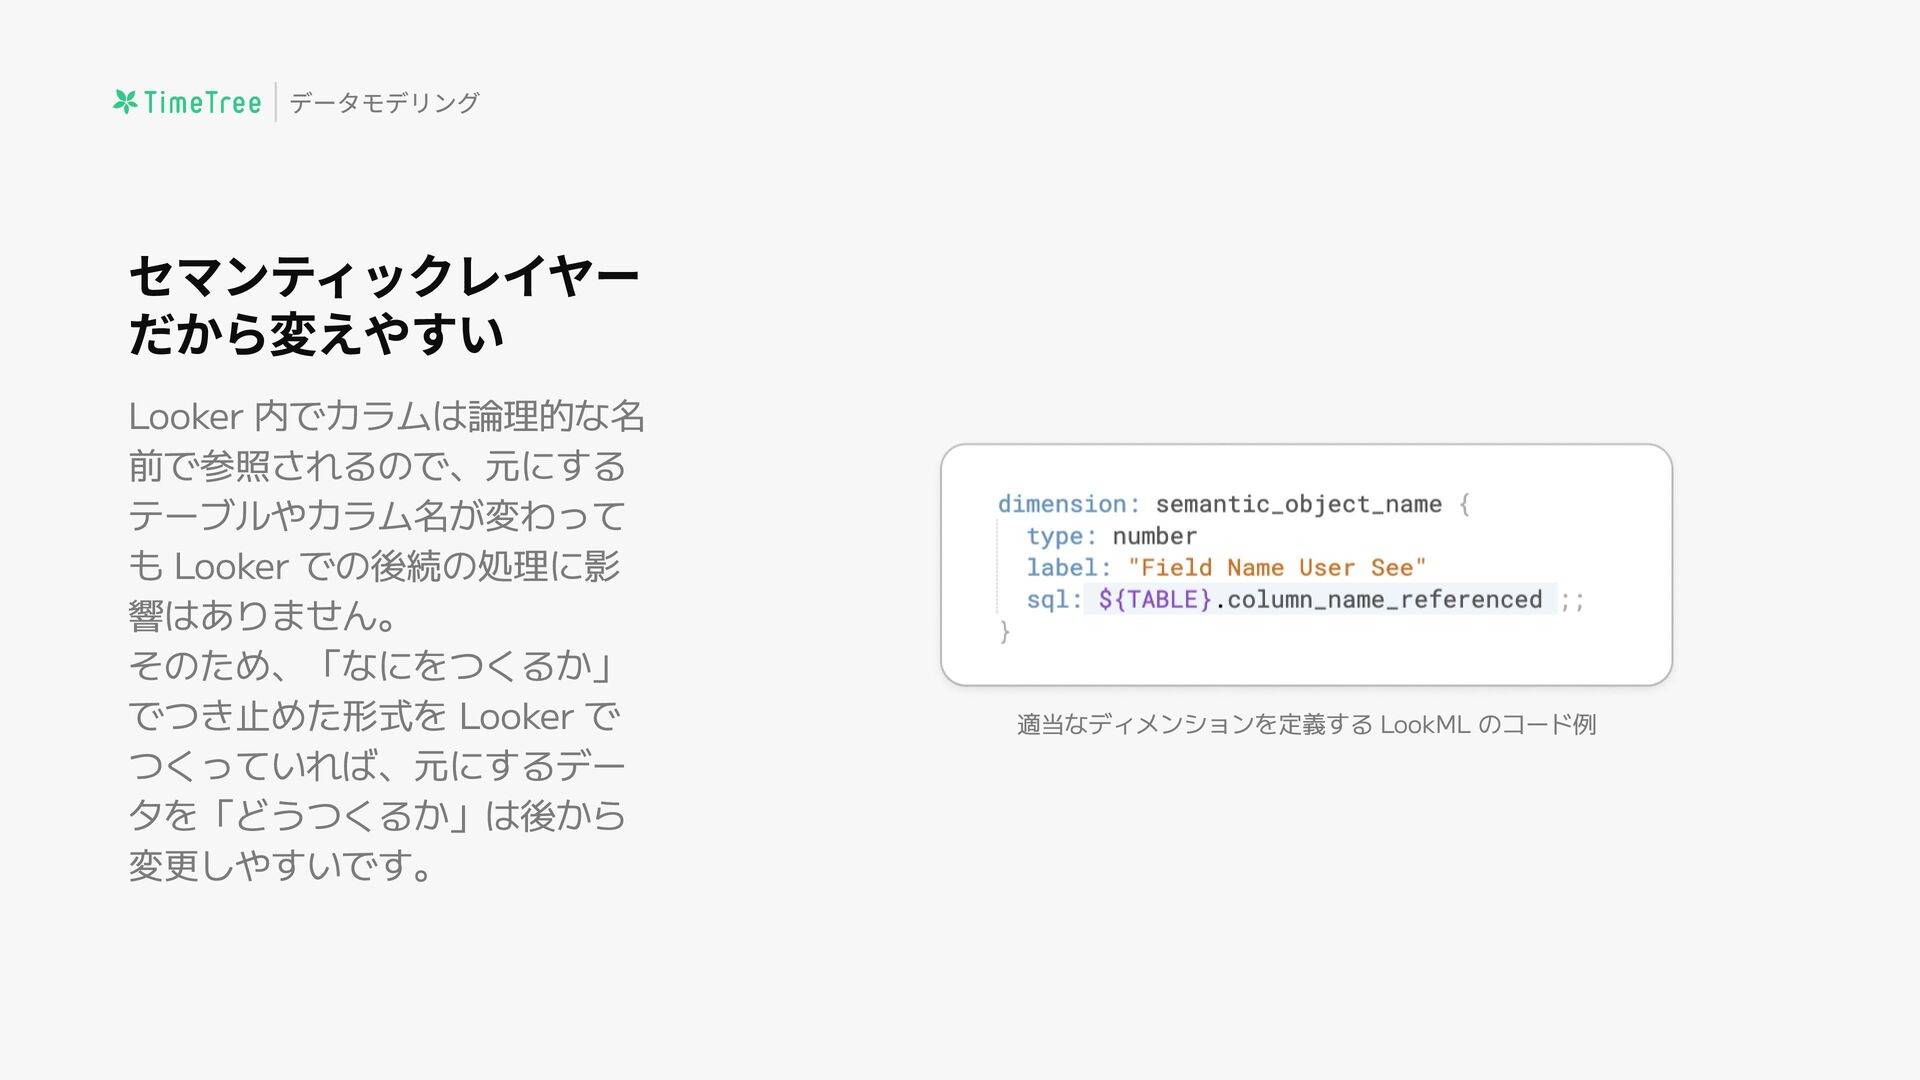
  14. セマンティックレイヤー だから変えやすい Looker 内でカラムは論理的な名 前で参照されるので、元にする テーブルやカラム名が変わって も Looker での後続の処理に影 響はありません。

    そのため、「なにをつくるか」 でつき止めた形式を Looker で つくっていれば、元にするデー タを「どうつくるか」は後から 変更しやすいです。 データモデリング 適当なディメンションを定義する LookML のコード例
  15. まとめ まず JOIN が高い だから 中間テーブルで JOIN しておく そして 中間テーブルを

    パターン化する Compute is expensive 分析用のテーブルを設計する Storage is cheap 価格を知る データモデリング データユーザーと開発者の 両方にとって良いルールを持つ データの首尾一貫した構造を意図的に選択すると、データユーザーと開発者の両方にとって Looker は 使いやすくなります。