Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Intro to Contextual Bandit and RL
Search
Akira
July 01, 2021
Technology
240
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Intro to Contextual Bandit and RL
Akira
July 01, 2021
Other Decks in Technology
See All in Technology
DGX Spark でどこまでハッキングができるのか?
kash1064
3
1.3k
[JAWS-UG彩の国埼玉#12]そろそろ準備する?re:Invent2026をやさしく解説 / reinvent2026-sainokuni
sh_fk2
1
340
PagerDuty Tech Hub-鳴らすけれど、人は動かない
ezaki
0
170
UniFi(ユニファイ)AIカメラの現場活用
ludicmind
1
440
JAWS-UGグッズ職人仕事の流儀
kentapapa
0
100
hackers_champloo_2026_tidb
makocchi
0
160
Webの常識が通じないHTMLメールのダークモード
teamlab
PRO
0
120
触りたくないデータに、どう触るか AI時代のRBACアクセスガバナンス
ivry_presentationmaterials
0
260
Classmethod Company Deck
satoshi7
1
680
継続的なAIコスト最適化
bgpat
1
340
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
130
Rust で関数型ドメインモデリング
takonda
0
140
Featured
See All Featured
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
500
The World Runs on Bad Software
bkeepers
PRO
72
12k
Paper Plane
katiecoart
PRO
5
54k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
330
Facilitating Awesome Meetings
lara
57
7.2k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Speed Design
sergeychernyshev
33
2.2k
Color Theory Basics | Prateek | Gurzu
gurzu
1
490
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
Transcript
Intro to Contextual Bandit and RL Akira Takezawa July 2nd,
2021
Highlights 1. Contextual Banditにおけるニュートン法 • テーラー展開とヘッセ⾏列、ラプラス近似 2. Reinforcement Rearningにおけるベルマン⽅程式 •
マルコフ決定過程(MDP) 3. Deep Q–learningにおけるTD誤差逆伝播法 • 微分の「連鎖律」
Contents 1. A/Bテストと確率的多腕バンディット 2. ⽂脈付きバンディットとPolicyベース・⽅策反復法・教師あり的強化学習 3. Q–LearningとValueベース・価値反復法・教師なし的強化学習 4. Deep Q–NetworksとFunction
Approximation(関数近似法)
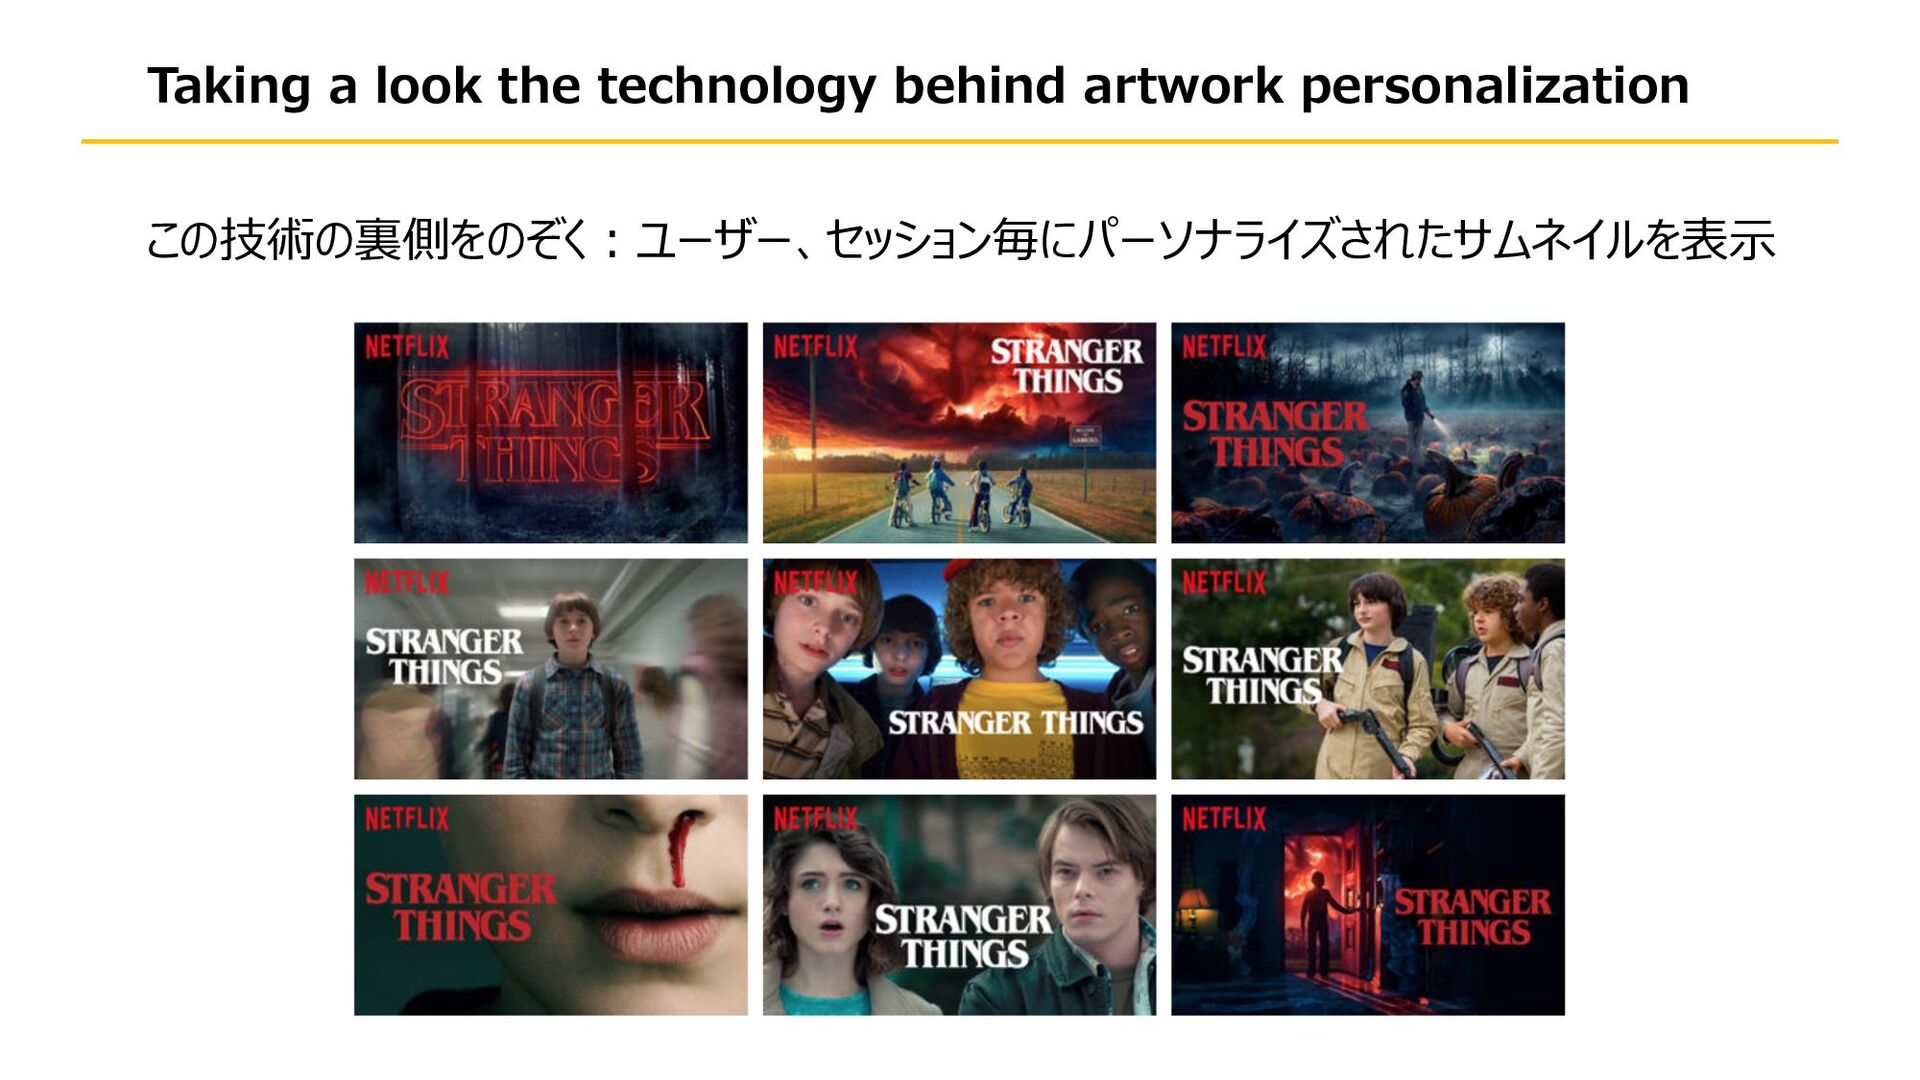
Taking a look the technology behind artwork personalization この技術の裏側をのぞく︓ユーザー、セッション毎にパーソナライズされたサムネイルを表⽰
References
Episode 1. Malti-armed Bandit
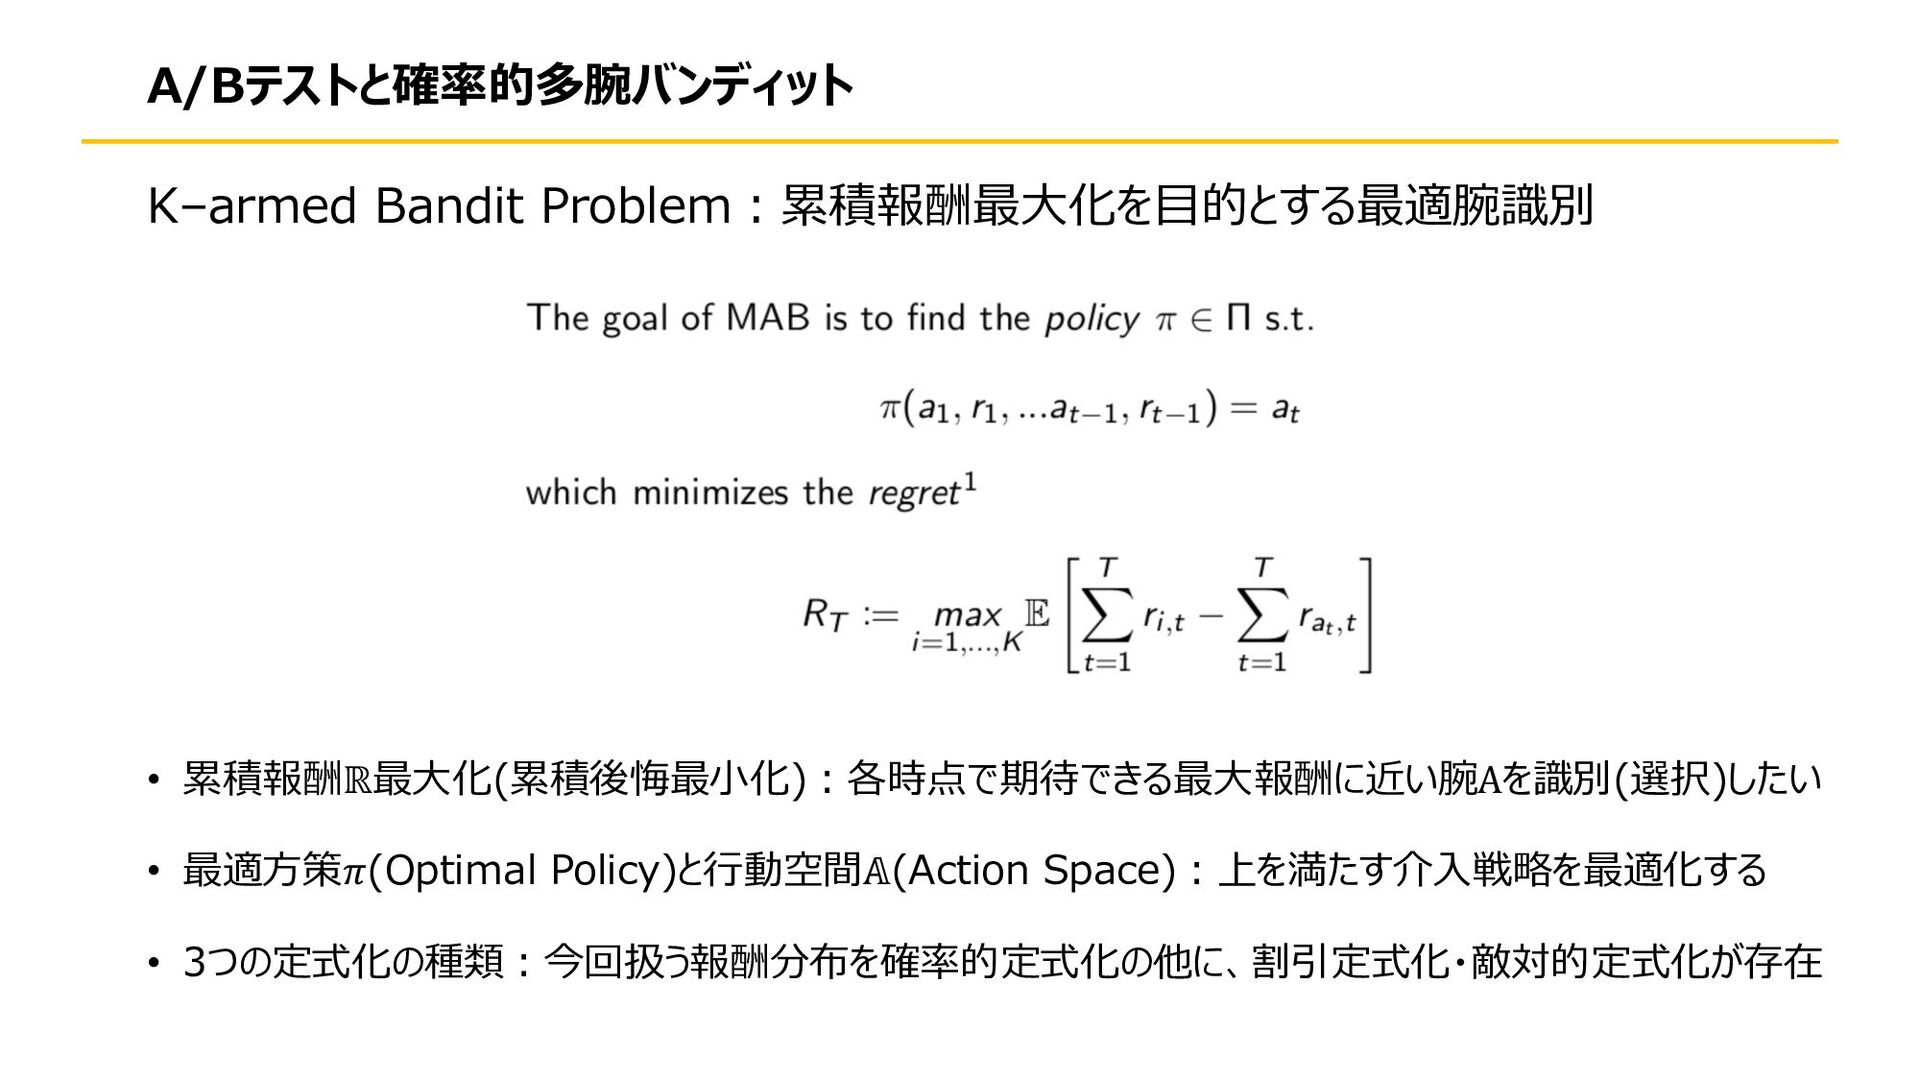
A/Bテストと確率的多腕バンディット K–armed Bandit Problem︓累積報酬最⼤化を⽬的とする最適腕識別 • 累積報酬ℝ最⼤化(累積後悔最⼩化)︓各時点で期待できる最⼤報酬に近い腕Aを識別(選択)したい • 最適⽅策𝜋(Optimal Policy)と⾏動空間𝔸(Action Space)︓上を満たす介⼊戦略を最適化する
• 3つの定式化の種類︓今回扱う報酬分布を確率的定式化の他に、割引定式化・敵対的定式化が存在
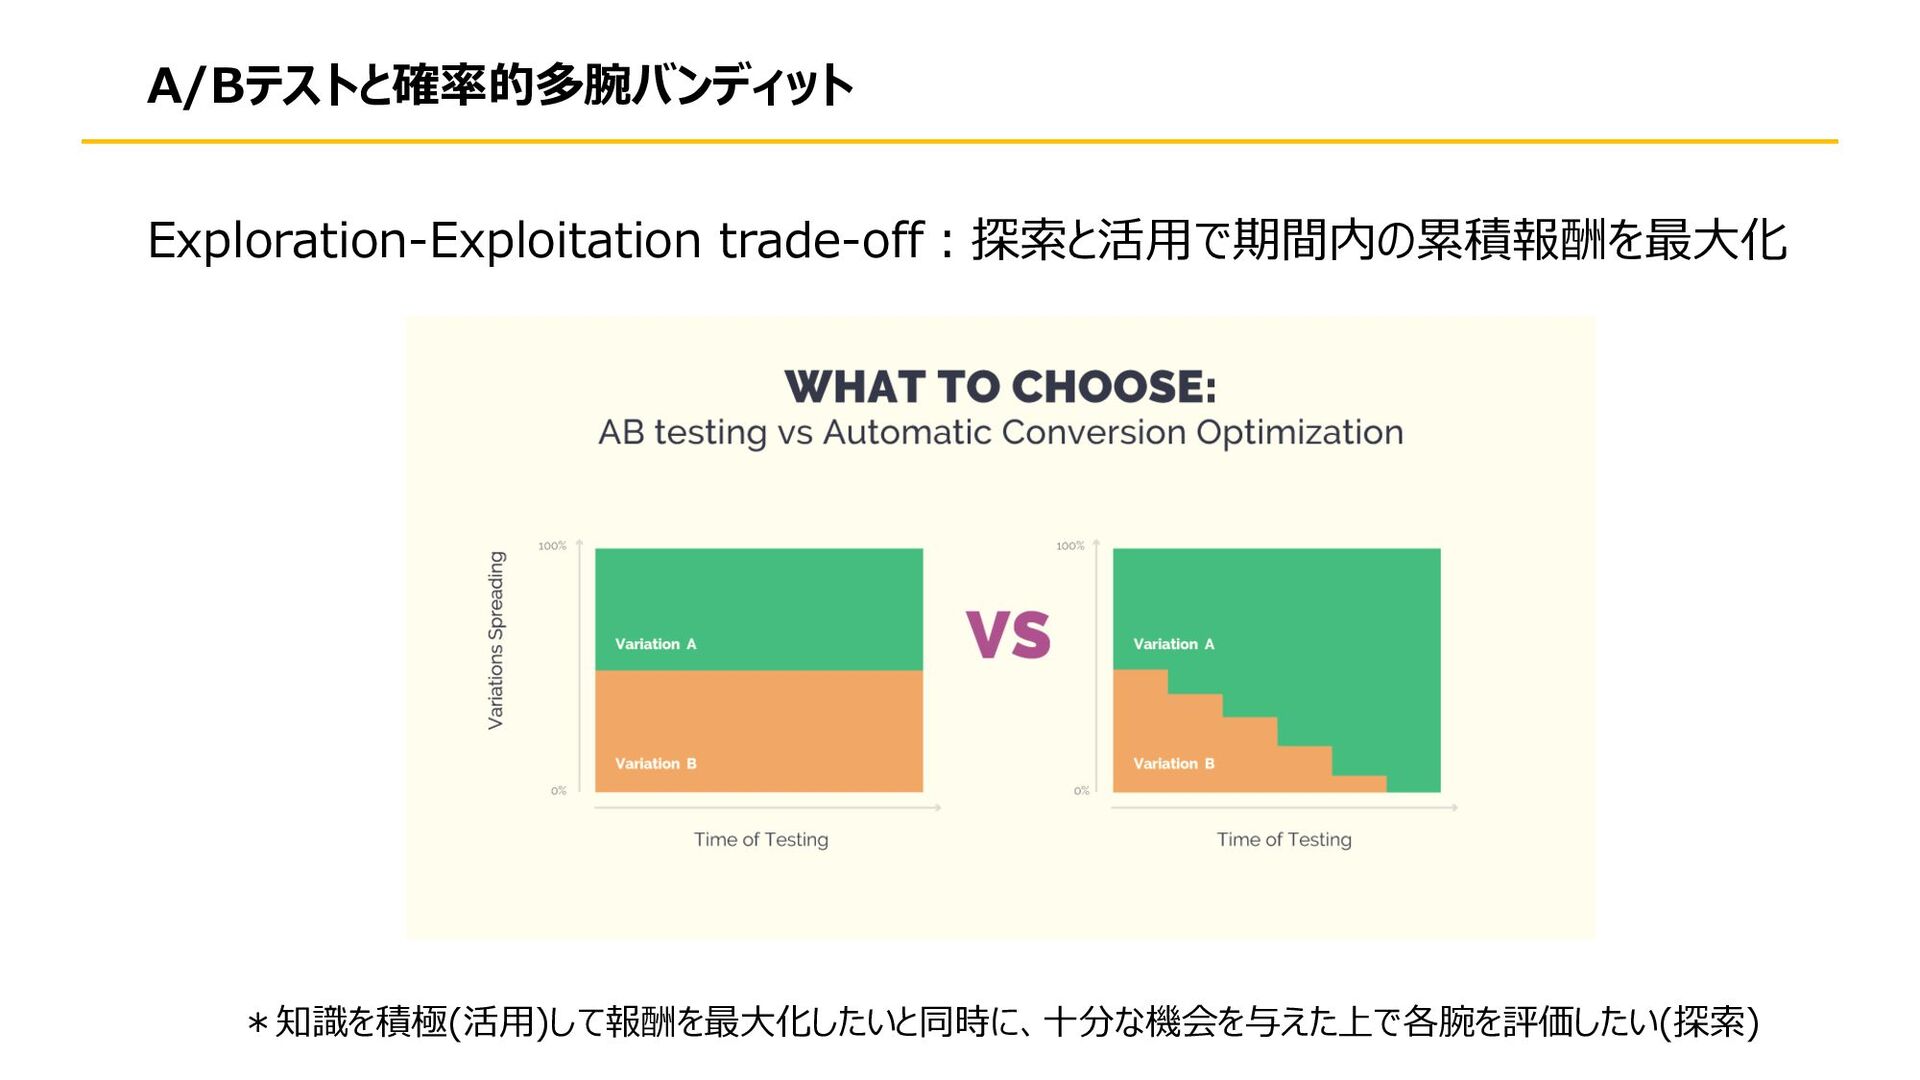
A/Bテストと確率的多腕バンディット Exploration-Exploitation trade-off︓探索と活⽤で期間内の累積報酬を最⼤化 *知識を積極(活⽤)して報酬を最⼤化したいと同時に、⼗分な機会を与えた上で各腕を評価したい(探索)
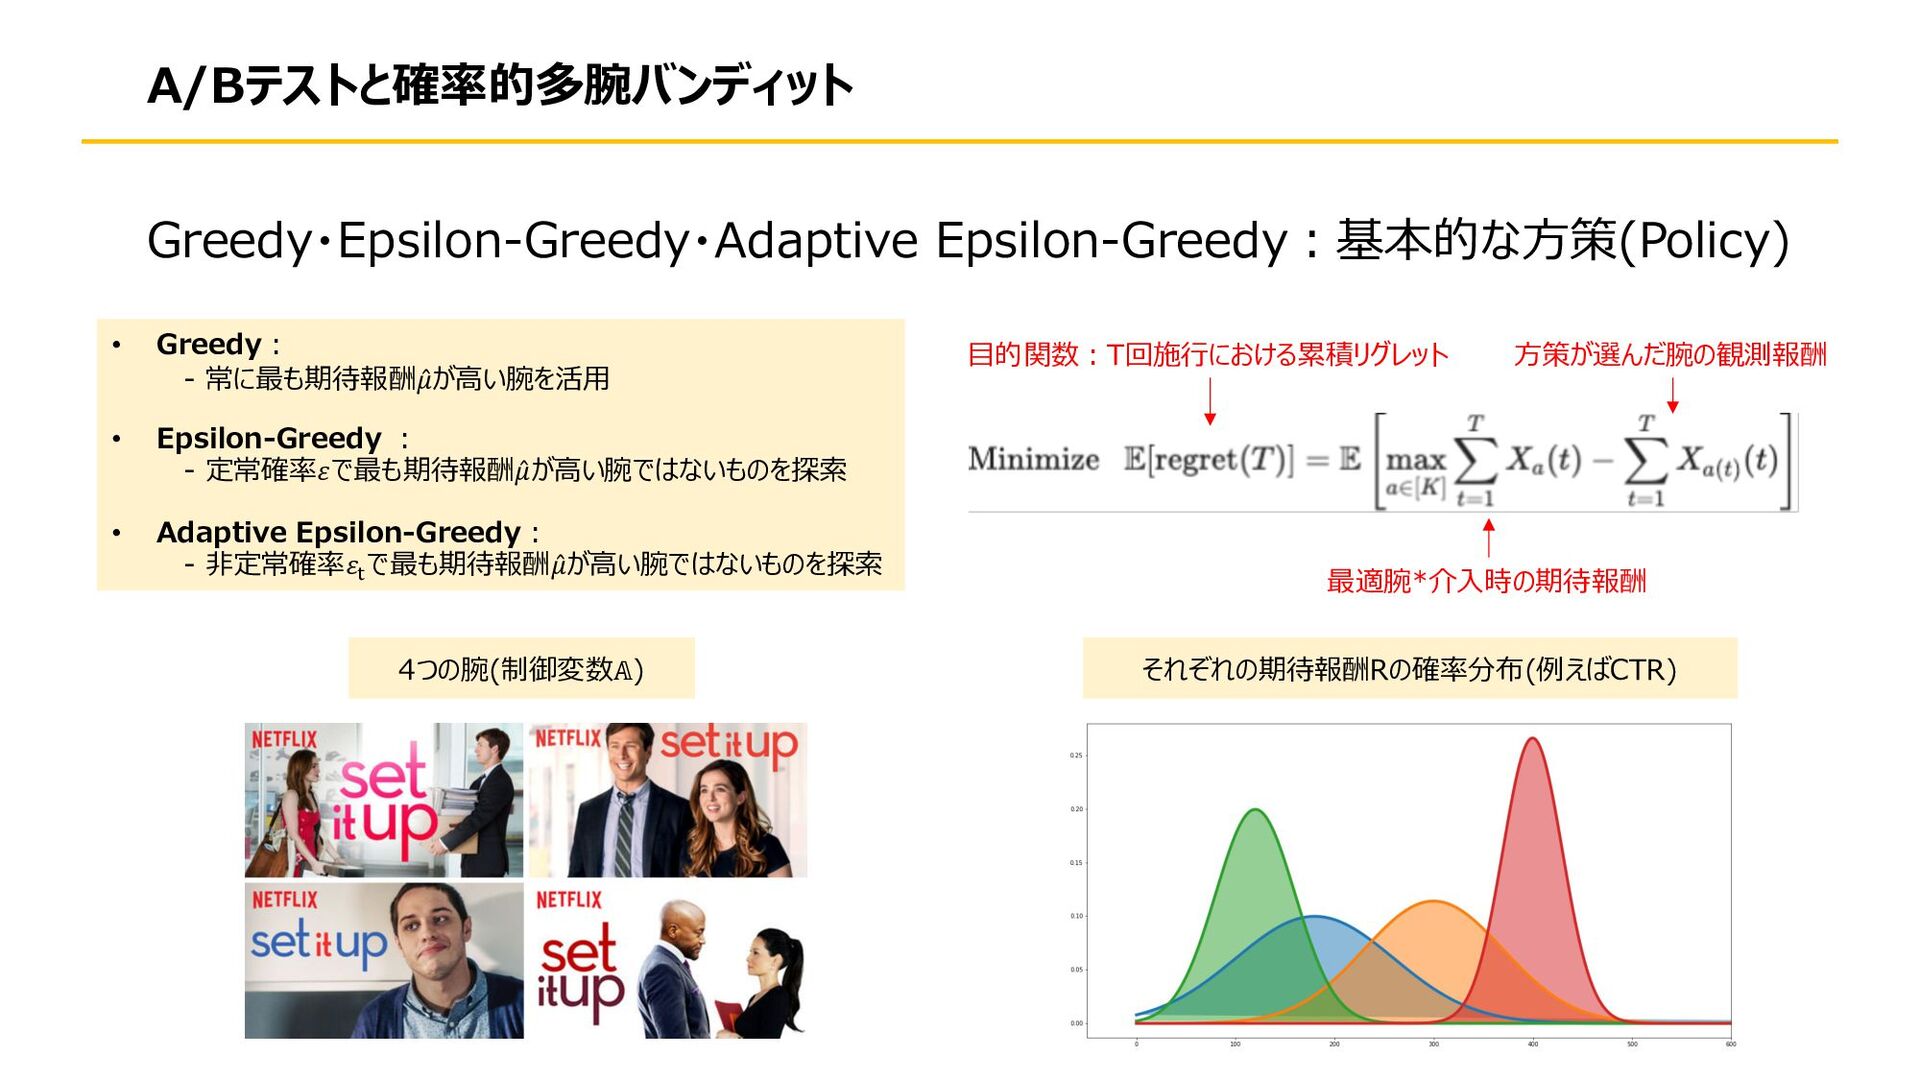
A/Bテストと確率的多腕バンディット Greedy・Epsilon-Greedy・Adaptive Epsilon-Greedy︓基本的な⽅策(Policy) • Greedy︓ - 常に最も期待報酬 ̂ 𝜇が⾼い腕を活⽤ •
Epsilon-Greedy ︓ - 定常確率𝜀で最も期待報酬 ̂ 𝜇が⾼い腕ではないものを探索 • Adaptive Epsilon-Greedy︓ - ⾮定常確率𝜀! で最も期待報酬 ̂ 𝜇が⾼い腕ではないものを探索 最適腕*介⼊時の期待報酬 ⽅策が選んだ腕の観測報酬 ⽬的関数︓T回施⾏における累積リグレット 4つの腕(制御変数𝔸) それぞれの期待報酬Rの確率分布(例えばCTR)
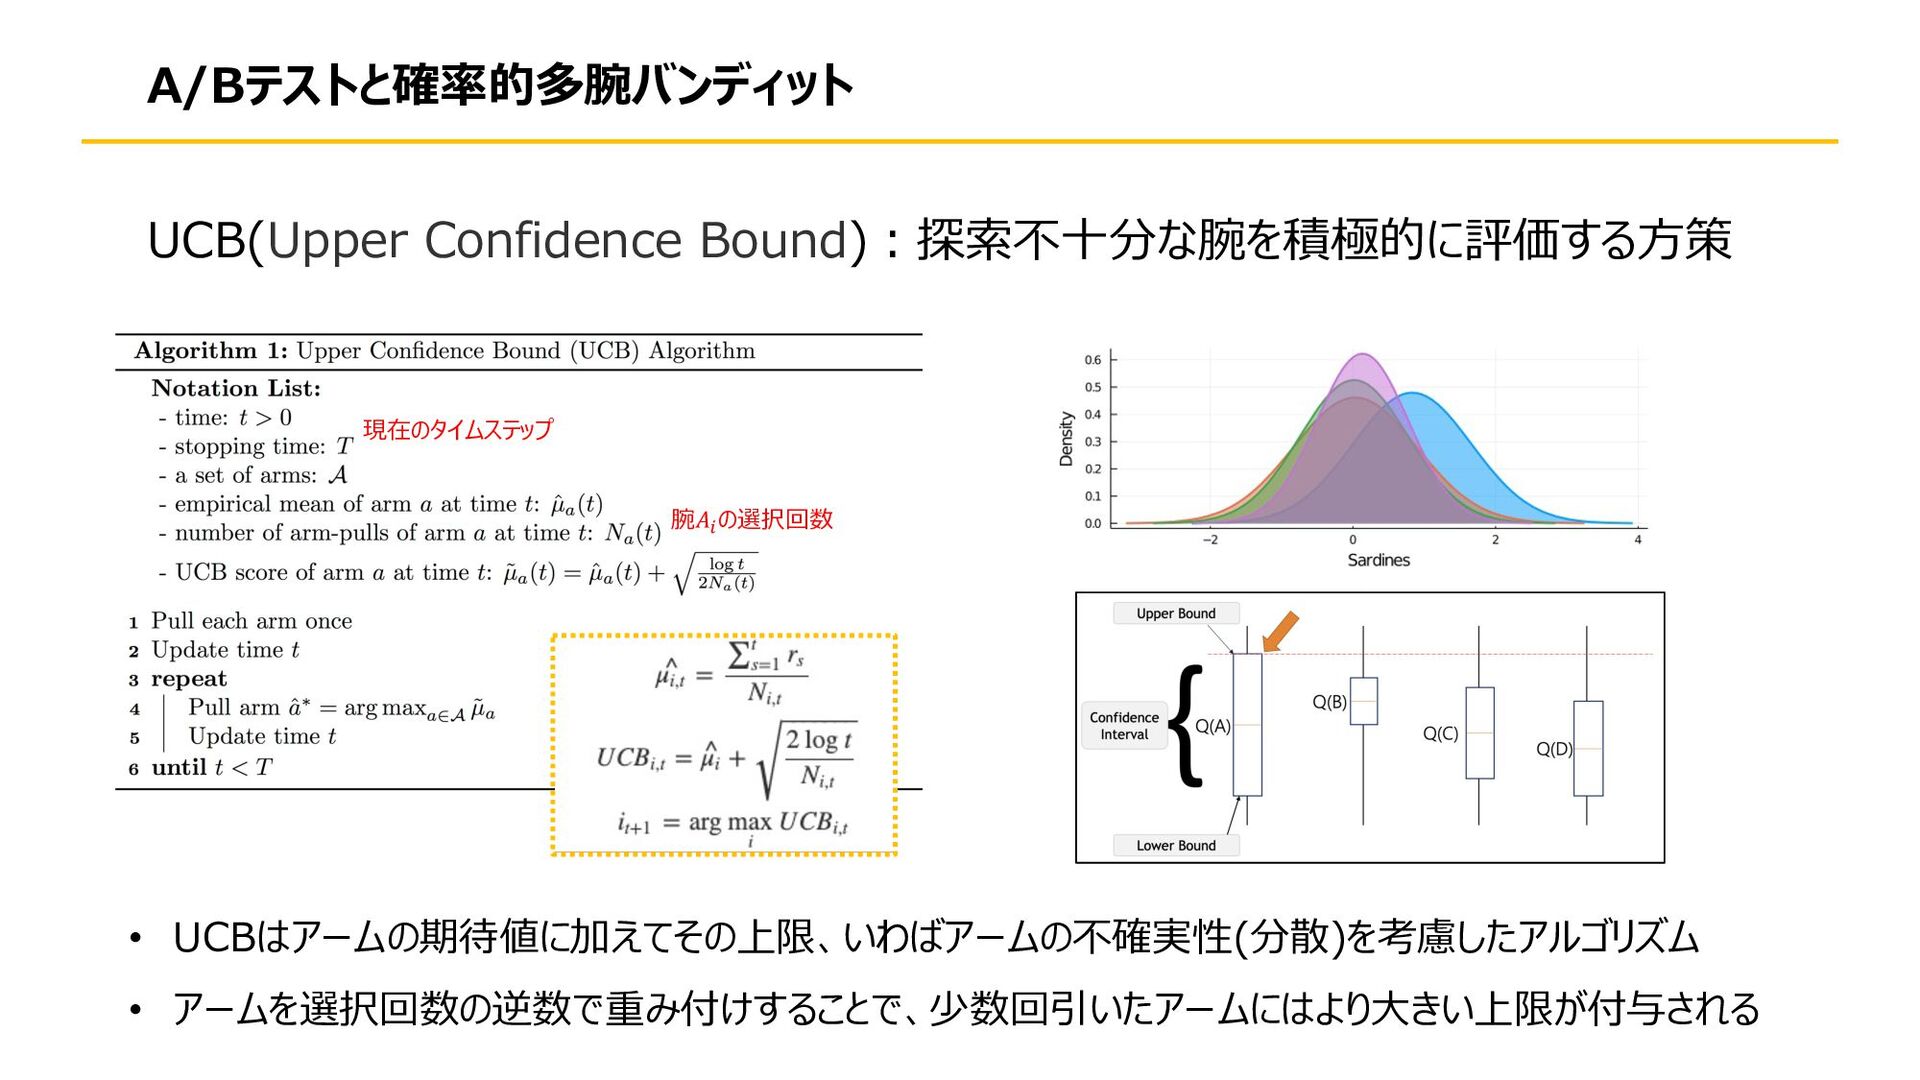
A/Bテストと確率的多腕バンディット UCB(Upper Confidence Bound)︓探索不⼗分な腕を積極的に評価する⽅策 • UCBはアームの期待値に加えてその上限、いわばアームの不確実性(分散)を考慮したアルゴリズム • アームを選択回数の逆数で重み付けすることで、少数回引いたアームにはより⼤きい上限が付与される 現在のタイムステップ 腕𝐴!
の選択回数
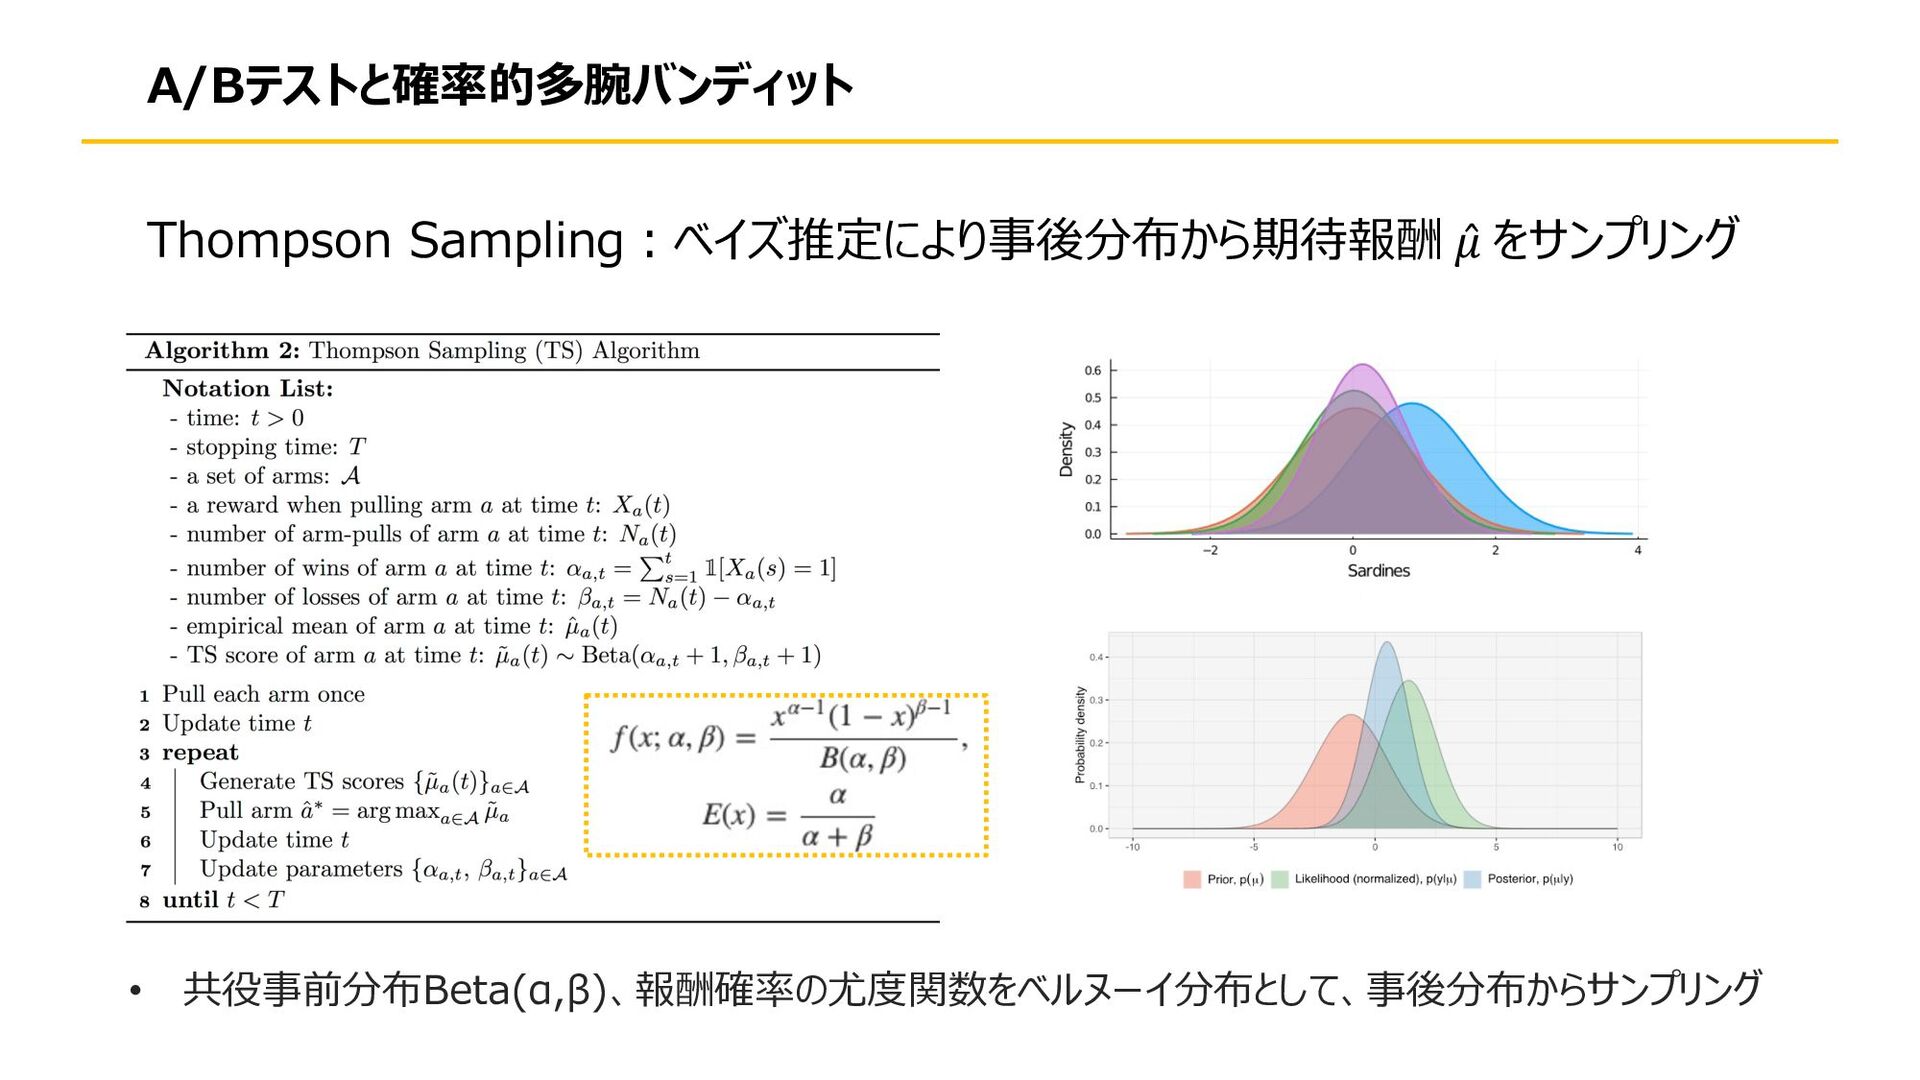
A/Bテストと確率的多腕バンディット Thompson Sampling︓ベイズ推定により事後分布から期待報酬 ̂ 𝜇 をサンプリング • 共役事前分布Beta(α,β)、報酬確率の尤度関数をベルヌーイ分布として、事後分布からサンプリング
Episode 2. Contextual Bandit
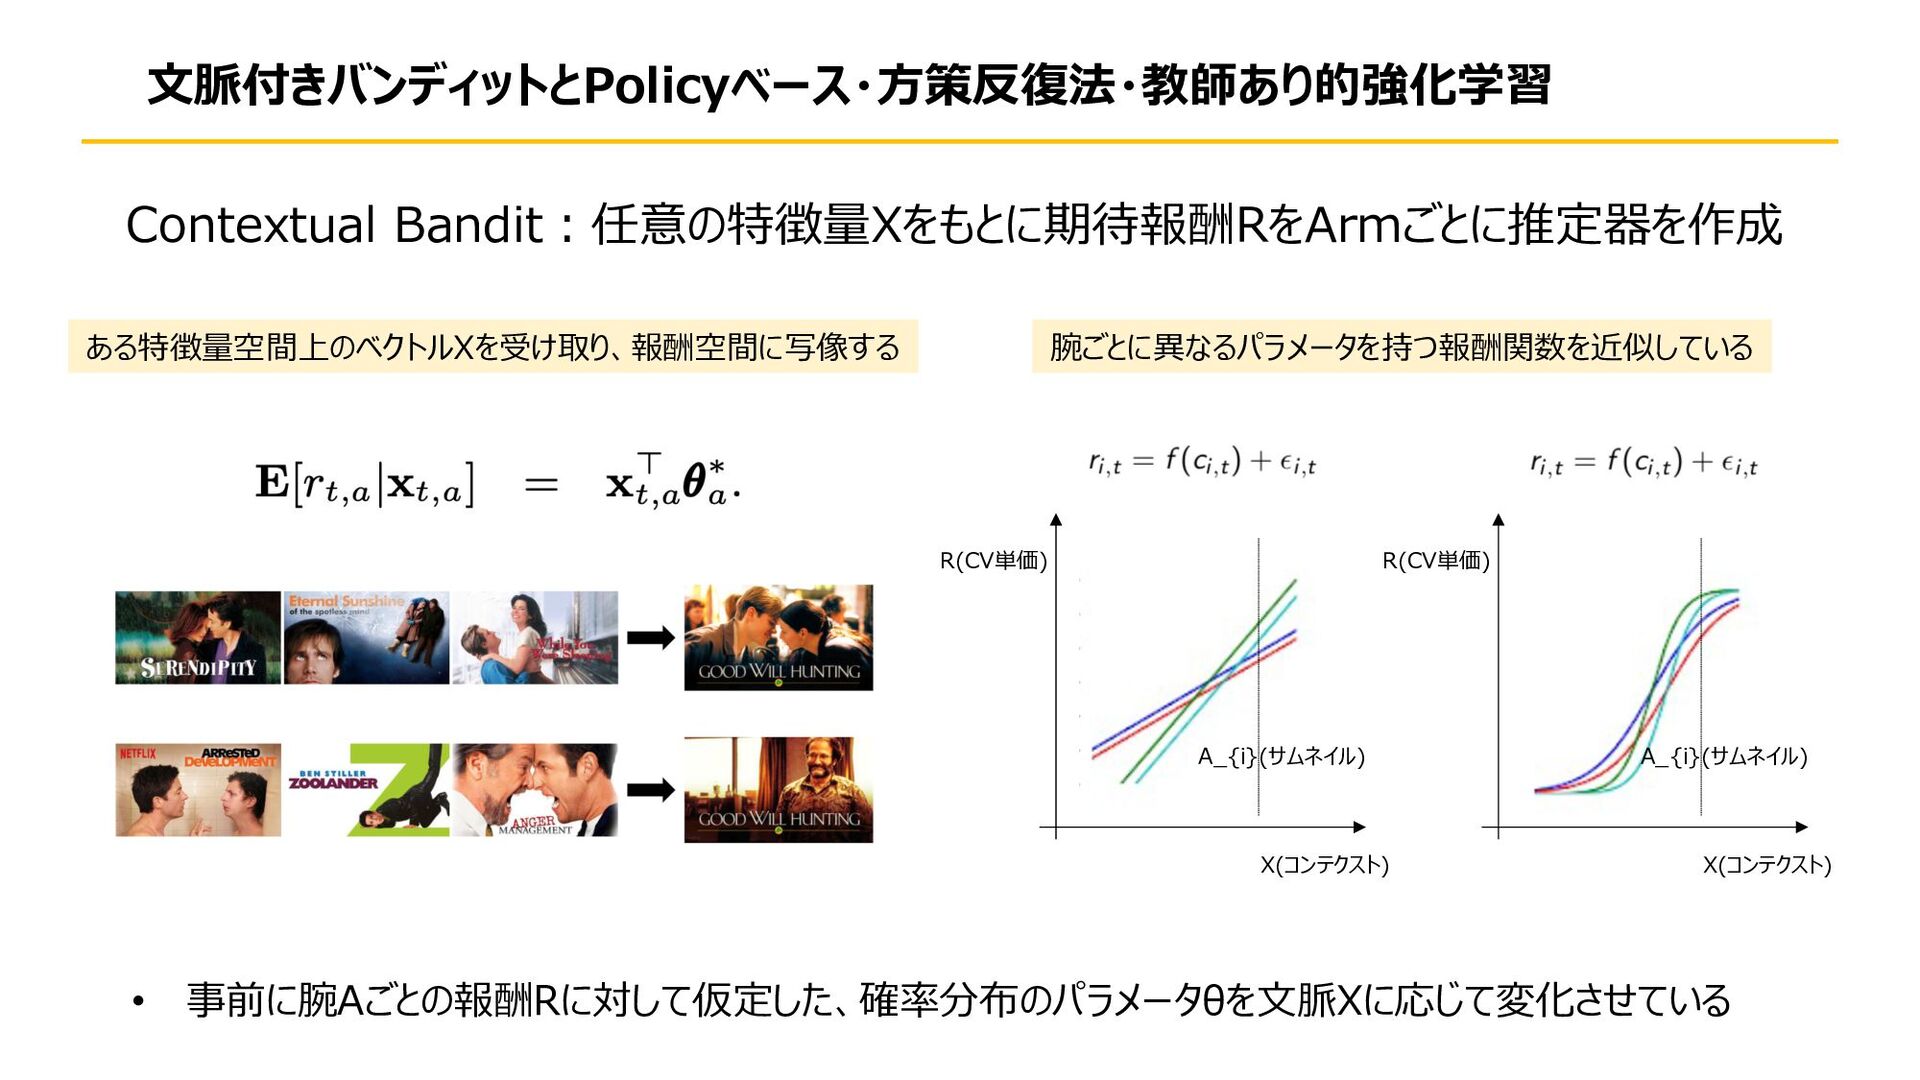
⽂脈付きバンディットとPolicyベース・⽅策反復法・教師あり的強化学習 Contextual Bandit︓任意の特徴量Xをもとに期待報酬RをArmごとに推定器を作成 R(CV単価) X(コンテクスト) A_{i}(サムネイル) R(CV単価) X(コンテクスト) A_{i}(サムネイル) 腕ごとに異なるパラメータを持つ報酬関数を近似している
ある特徴量空間上のベクトルXを受け取り、報酬空間に写像する • 事前に腕Aごとの報酬Rに対して仮定した、確率分布のパラメータθを⽂脈Xに応じて変化させている
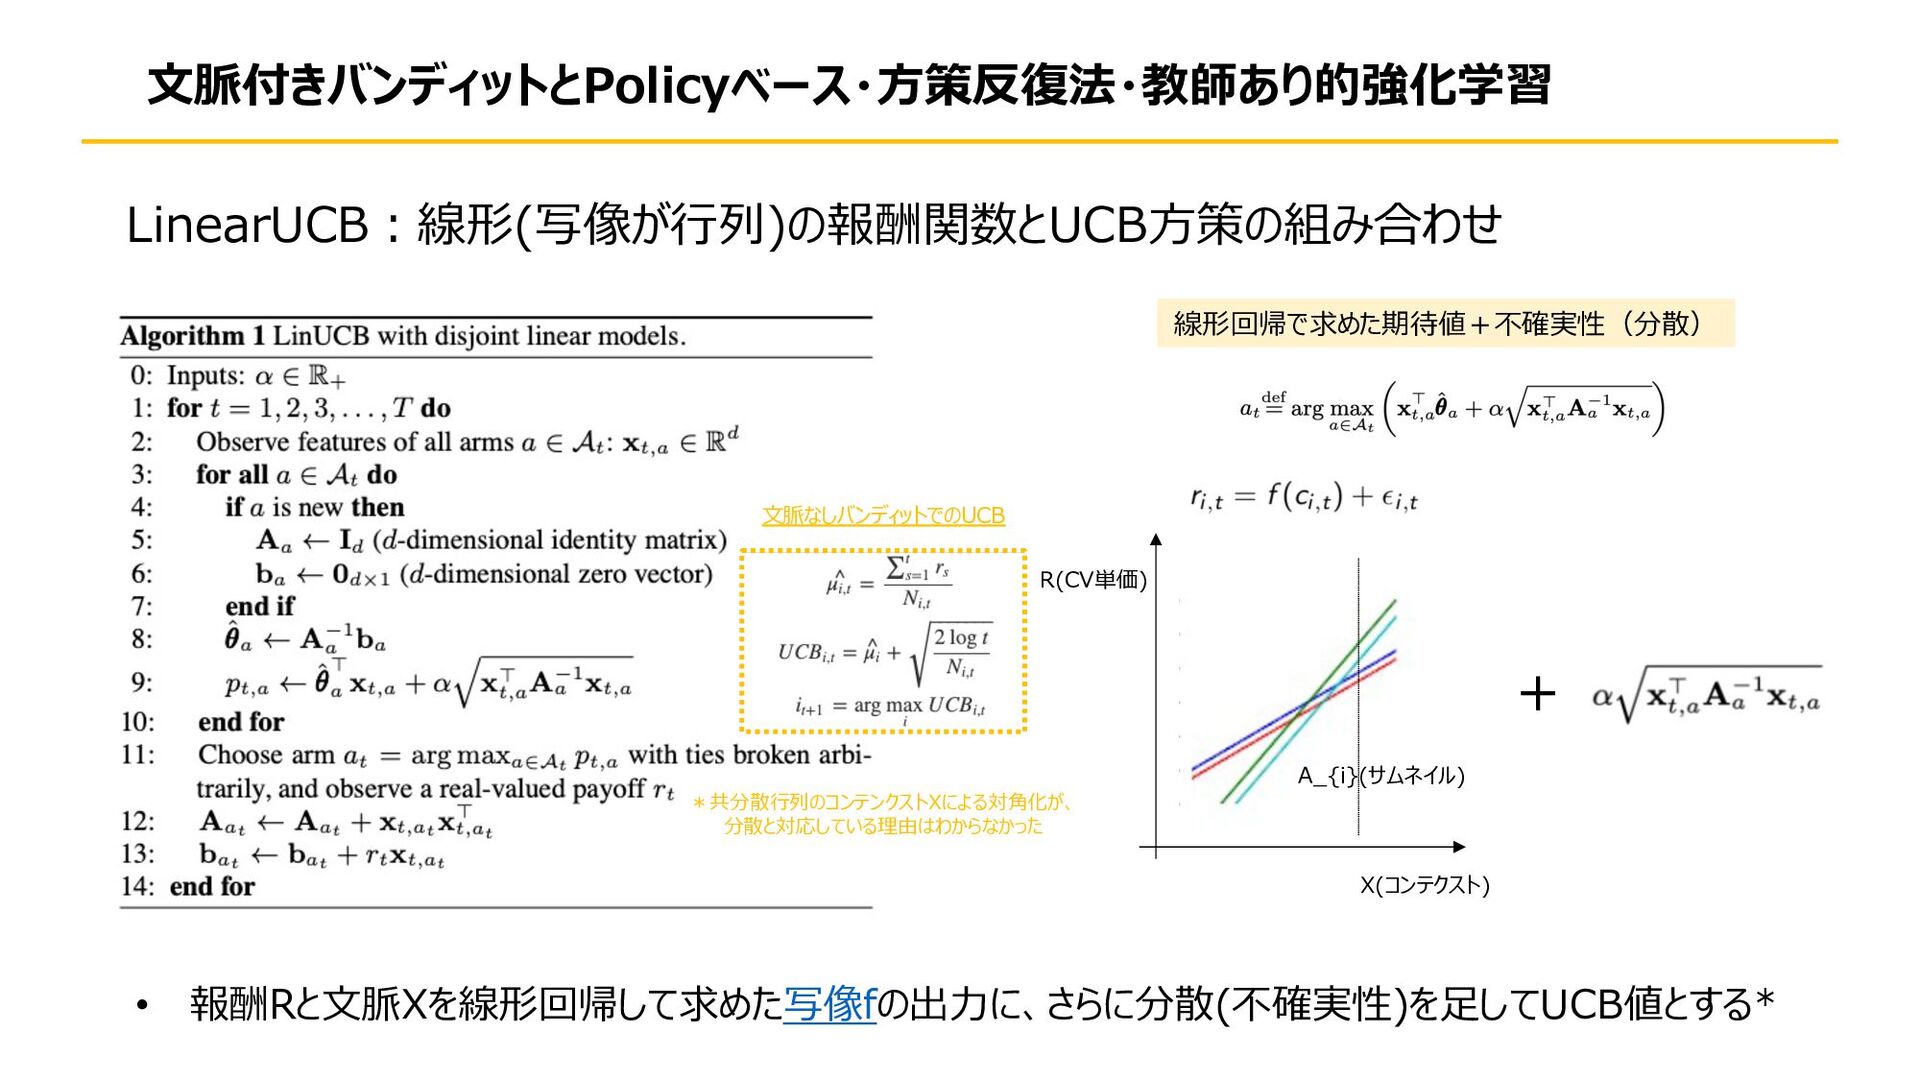
⽂脈付きバンディットとPolicyベース・⽅策反復法・教師あり的強化学習 LinearUCB︓線形(写像が⾏列)の報酬関数とUCB⽅策の組み合わせ *共分散⾏列のコンテンクストXによる対⾓化が、 分散と対応している理由はわからなかった R(CV単価) X(コンテクスト) A_{i}(サムネイル) 線形回帰で求めた期待値+不確実性(分散) + •
報酬Rと⽂脈Xを線形回帰して求めた写像fの出⼒に、さらに分散(不確実性)を⾜してUCB値とする* ⽂脈なしバンディットでのUCB
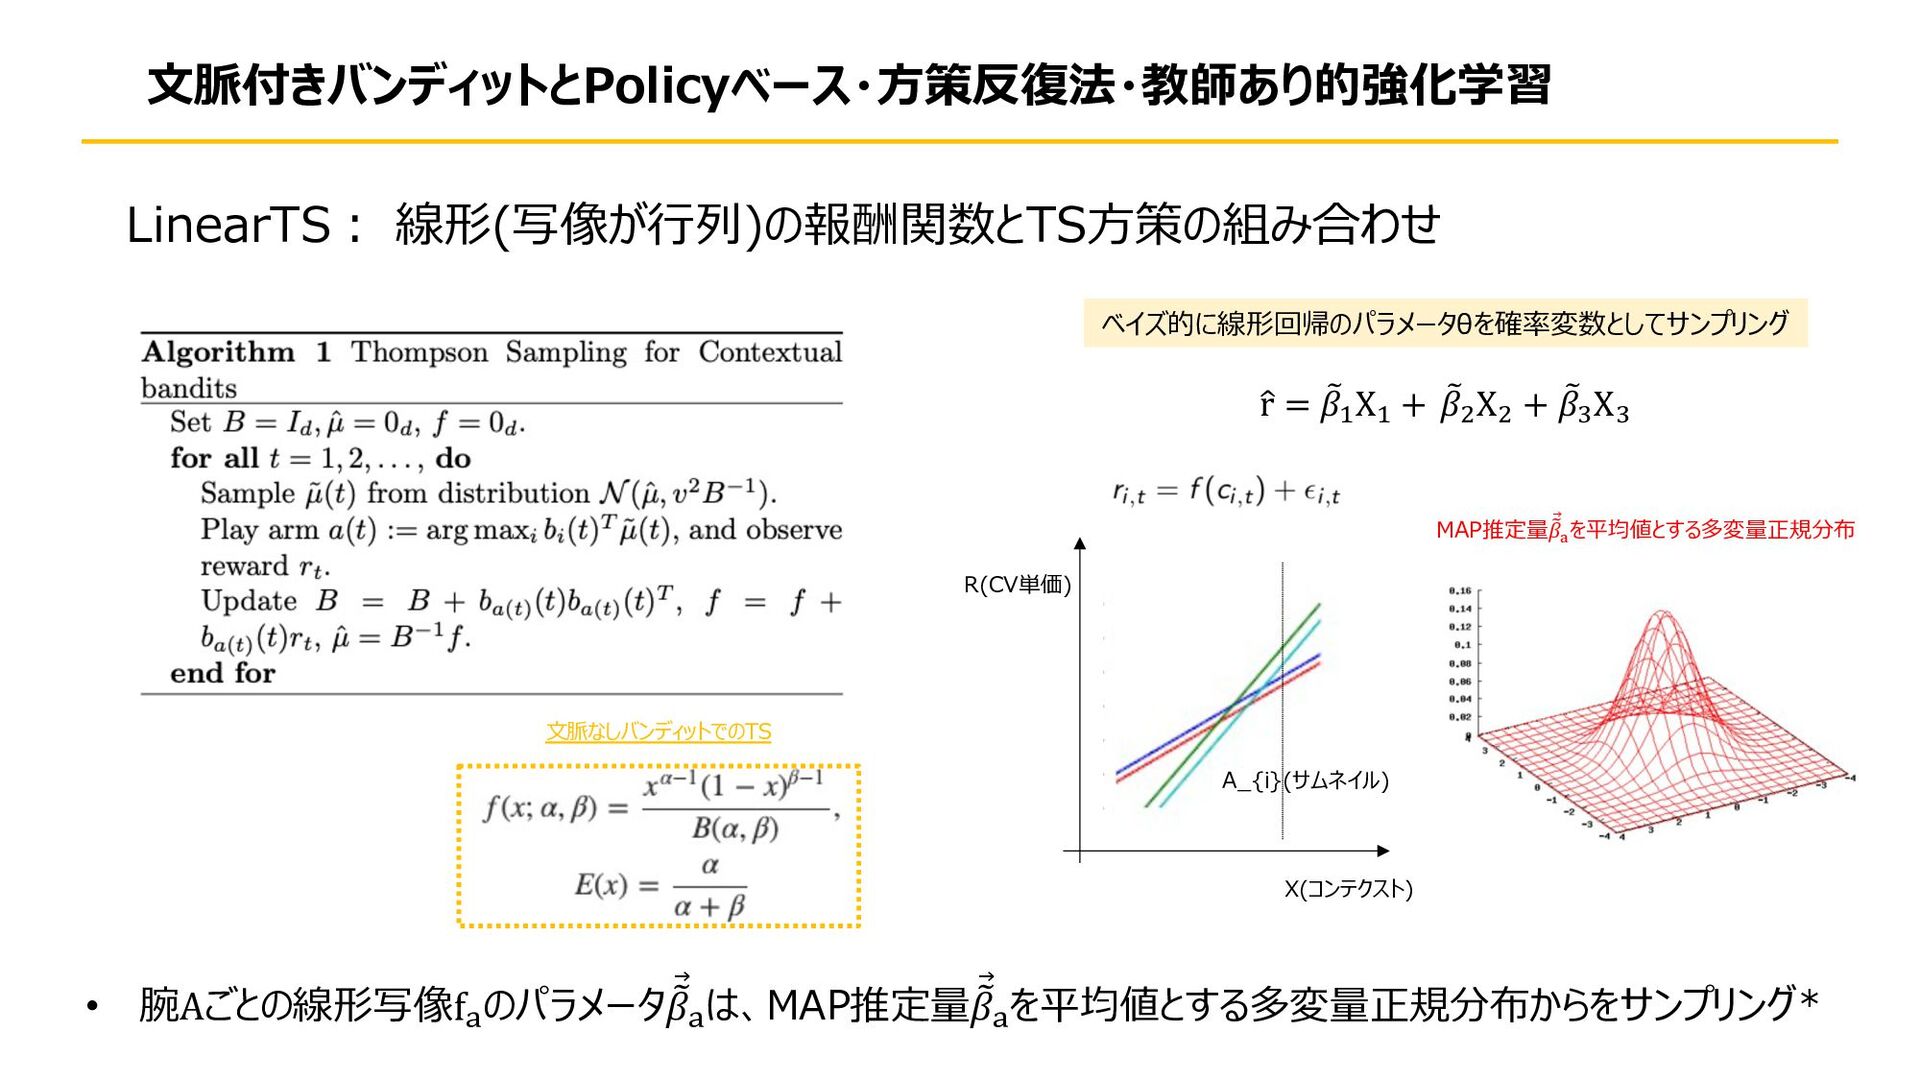
⽂脈付きバンディットとPolicyベース・⽅策反復法・教師あり的強化学習 LinearTS︓ 線形(写像が⾏列)の報酬関数とTS⽅策の組み合わせ R(CV単価) X(コンテクスト) A_{i}(サムネイル) ! r = $
𝛽! Χ! + $ 𝛽" Χ" + $ 𝛽# Χ# • 腕Aごとの線形写像f! のパラメータ ⃗ ' 𝛽! は、MAP推定量 ⃗ ' 𝛽! を平均値とする多変量正規分布からをサンプリング* ベイズ的に線形回帰のパラメータθを確率変数としてサンプリング ⽂脈なしバンディットでのTS MAP推定量 ⃗ " 𝛽! を平均値とする多変量正規分布
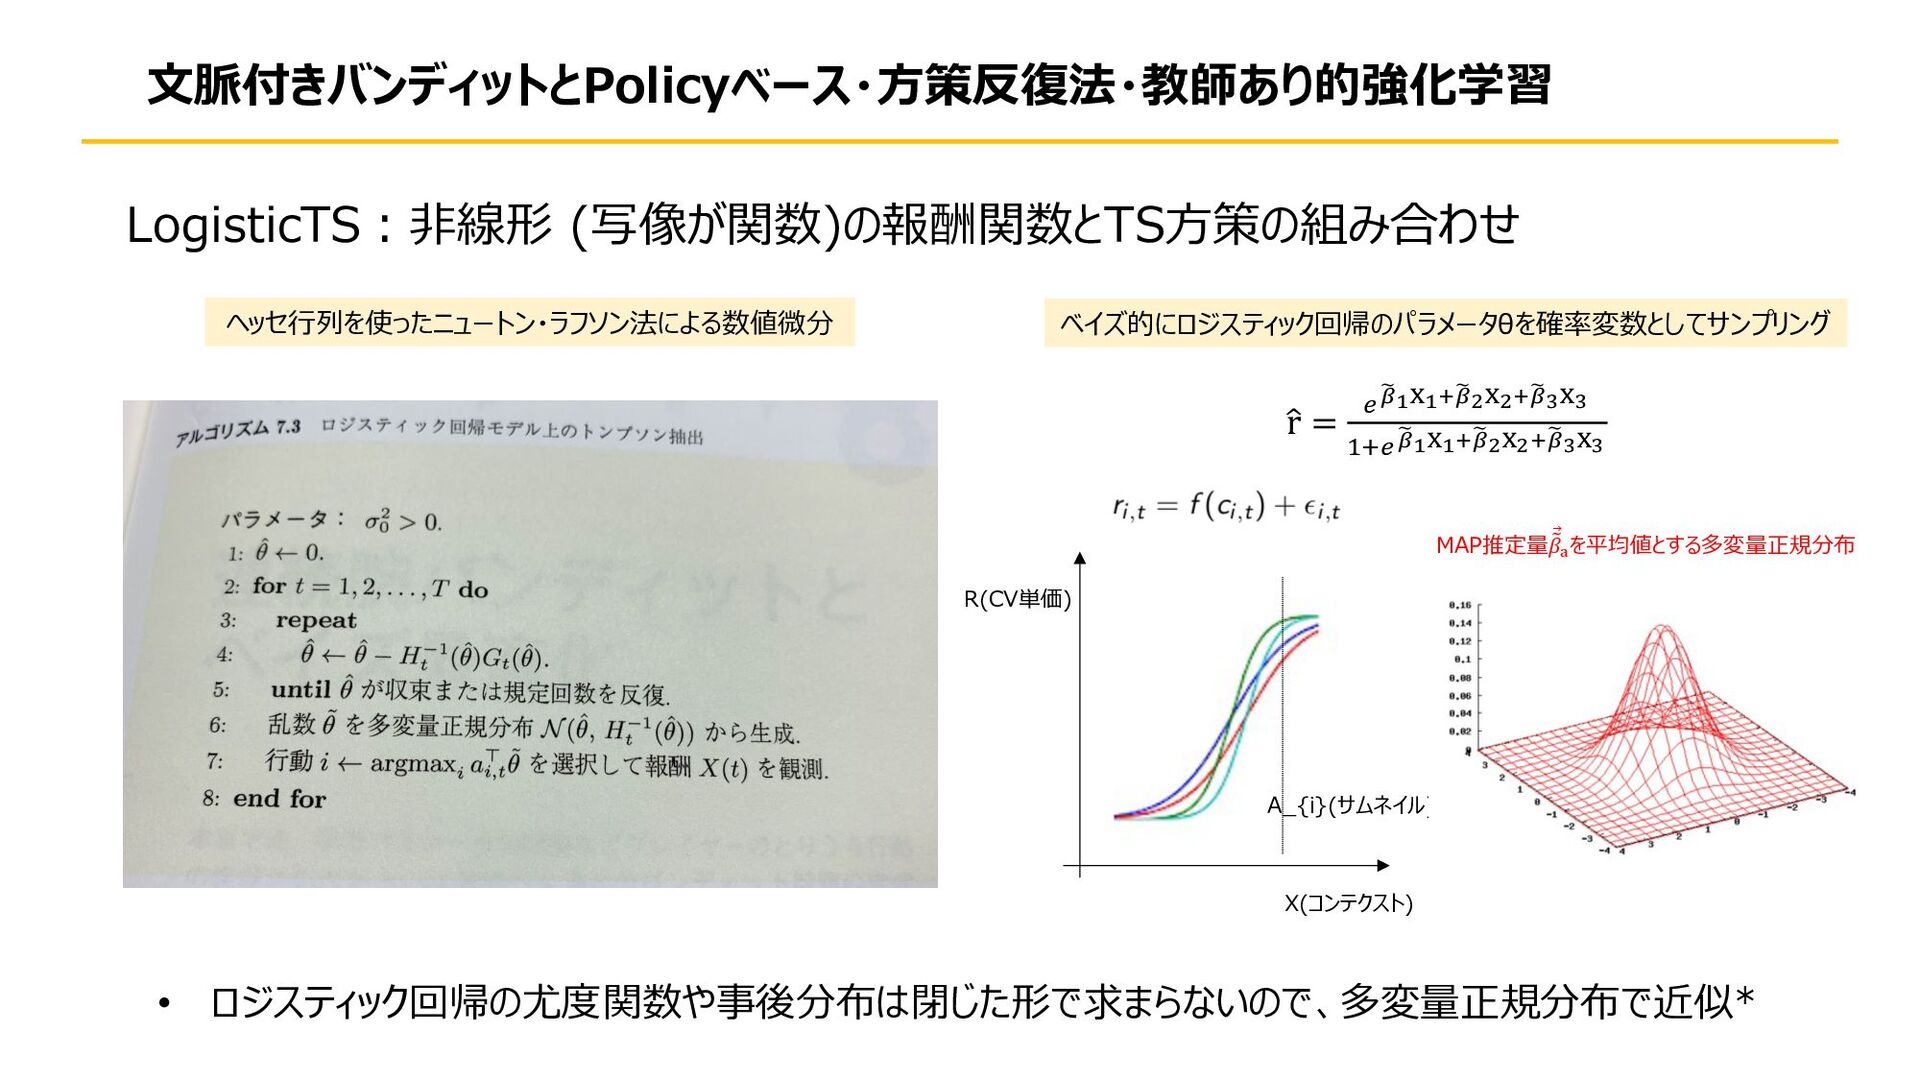
⽂脈付きバンディットとPolicyベース・⽅策反復法・教師あり的強化学習 LogisticTS︓⾮線形 (写像が関数)の報酬関数とTS⽅策の組み合わせ R(CV単価) X(コンテクスト) A_{i}(サムネイル) ! r = $$
%&'&($ %)')($ %*'* !%$$ %&'&($ %)')($ %*'* • ロジスティック回帰の尤度関数や事後分布は閉じた形で求まらないので、多変量正規分布で近似* MAP推定量 ⃗ " 𝛽! を平均値とする多変量正規分布 ヘッセ⾏列を使ったニュートン・ラフソン法による数値微分 ベイズ的にロジスティック回帰のパラメータθを確率変数としてサンプリング
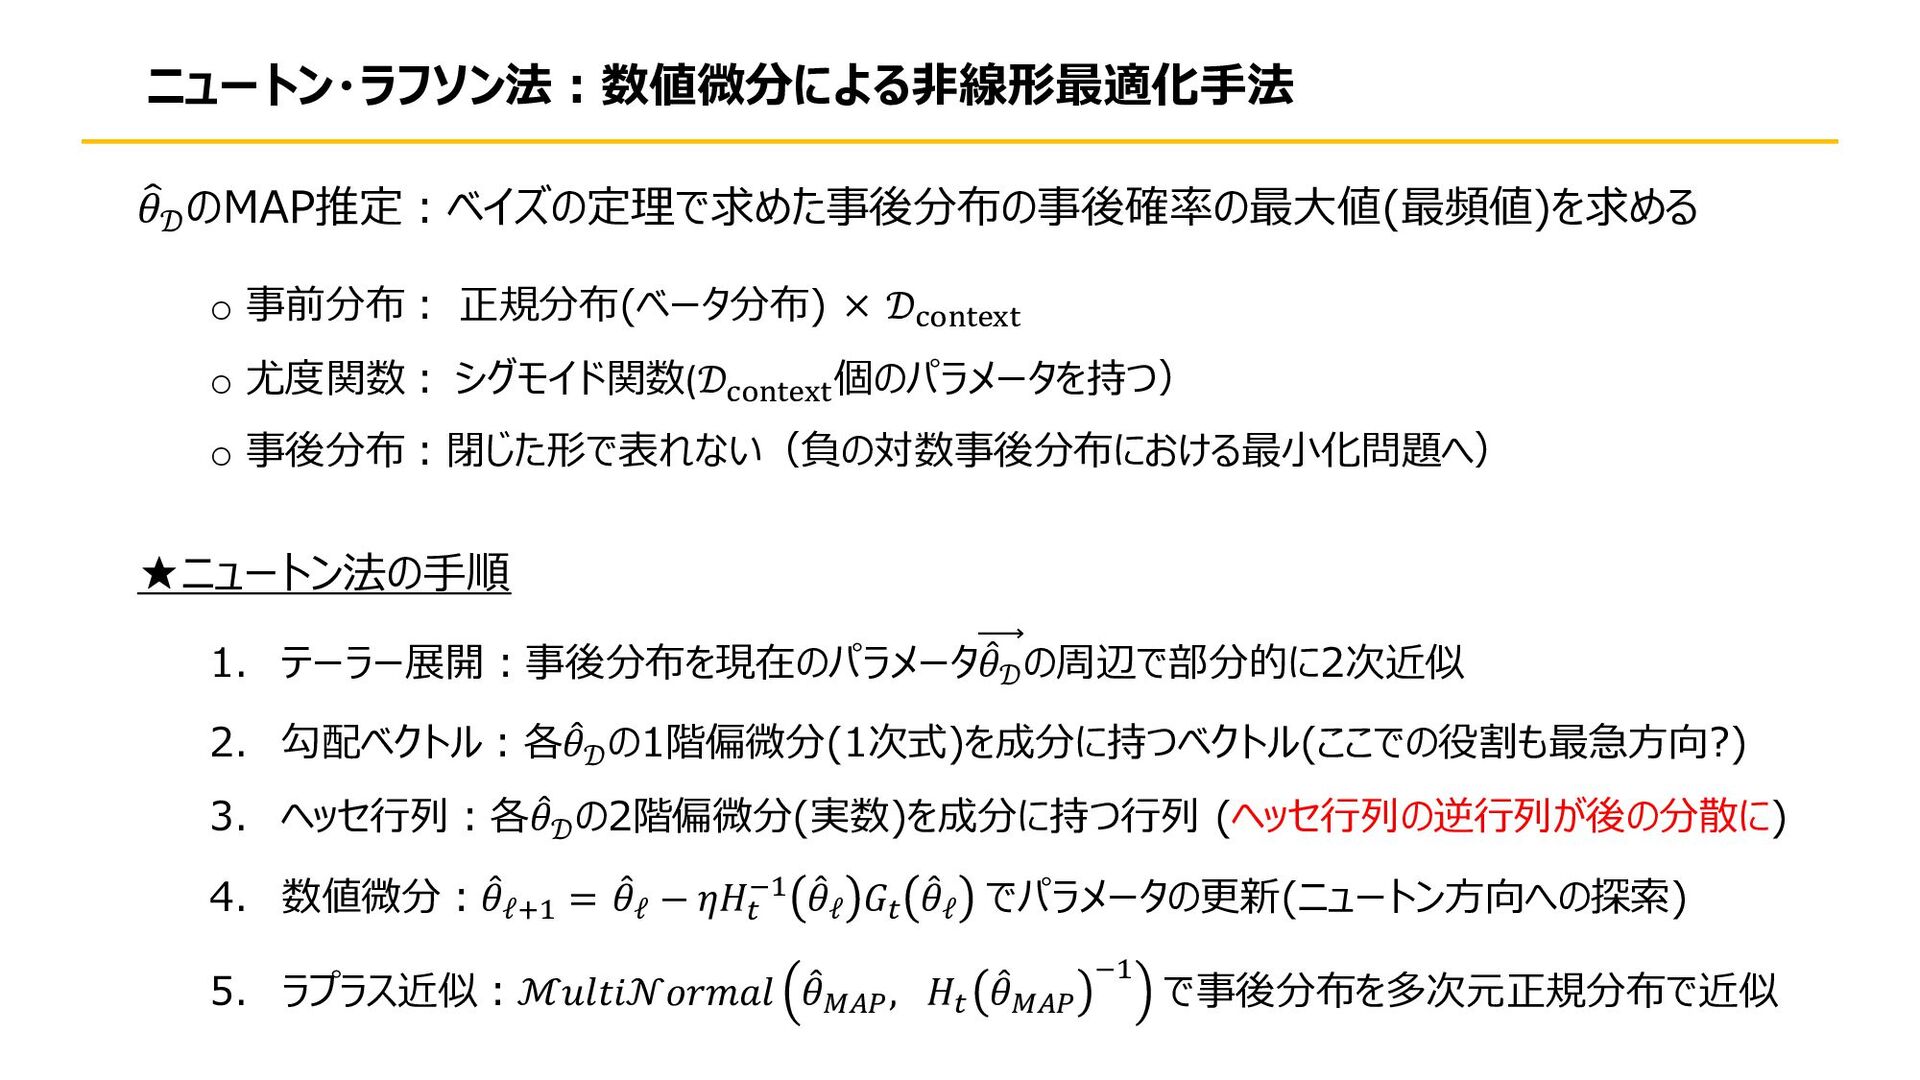
ニュートン・ラフソン法︓数値微分による⾮線形最適化⼿法 ! 𝜃𝒟 のMAP推定︓ベイズの定理で求めた事後分布の事後確率の最⼤値(最頻値)を求める o 事前分布︓ 正規分布(ベータ分布) × 𝒟"#$%&'% o
尤度関数︓ シグモイド関数(𝒟"#$%&'% 個のパラメータを持つ) o 事後分布︓閉じた形で表れない(負の対数事後分布における最⼩化問題へ) ★ニュートン法の⼿順 1. テーラー展開︓事後分布を現在のパラメータ * 𝜃𝒟 の周辺で部分的に2次近似 2. 勾配ベクトル︓各 * 𝜃𝒟 の1階偏微分(1次式)を成分に持つベクトル(ここでの役割も最急⽅向?) 3. ヘッセ⾏列︓各 * 𝜃𝒟 の2階偏微分(実数)を成分に持つ⾏列 (ヘッセ⾏列の逆⾏列が後の分散に) 4. 数値微分︓ * 𝜃ℓ*+ = * 𝜃ℓ − 𝜂𝐻, -+ * 𝜃ℓ 𝐺, * 𝜃ℓ でパラメータの更新(ニュートン⽅向への探索) 5. ラプラス近似︓ℳ𝑢𝑙𝑡𝑖𝒩𝑜𝑟𝑚𝑎𝑙 * 𝜃./0, 𝐻, * 𝜃./0 -+ で事後分布を多次元正規分布で近似
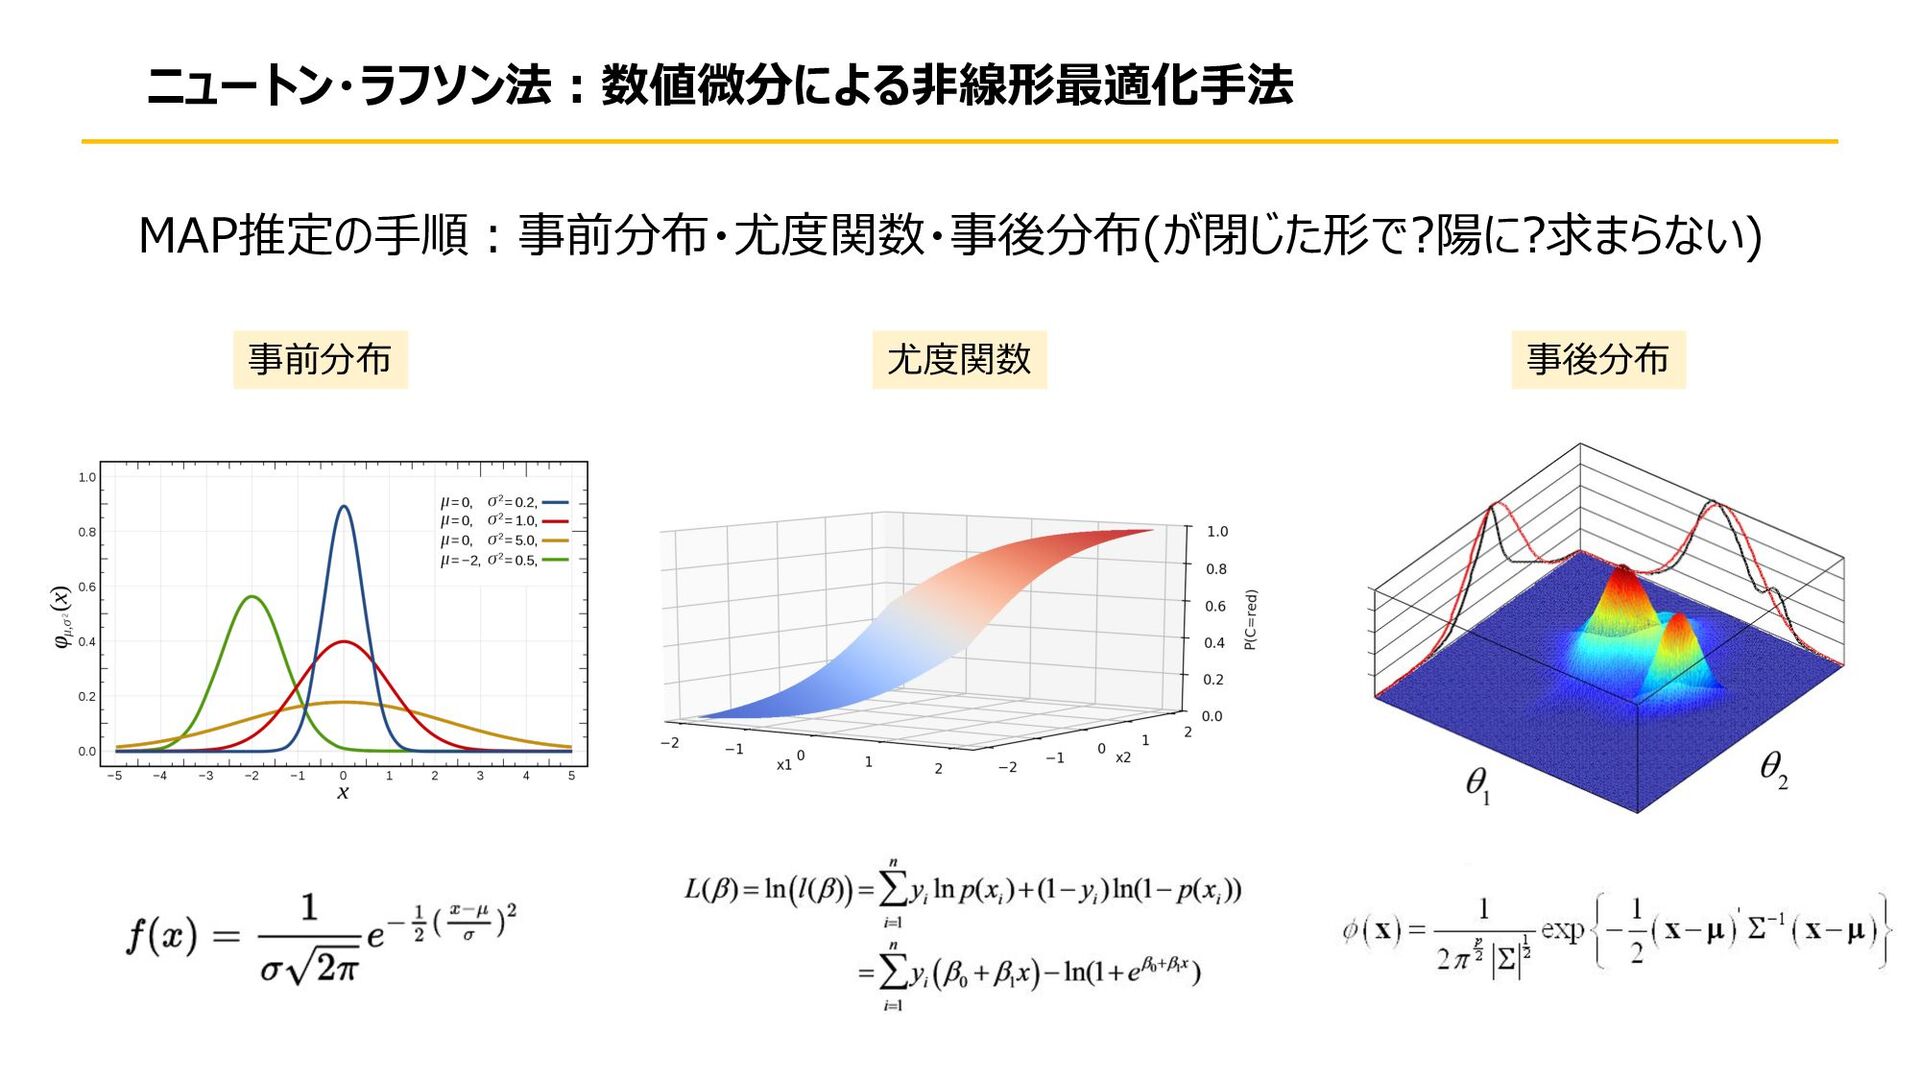
ニュートン・ラフソン法︓数値微分による⾮線形最適化⼿法 MAP推定の⼿順︓事前分布・尤度関数・事後分布(が閉じた形で?陽に?求まらない) 事前分布 尤度関数 事後分布
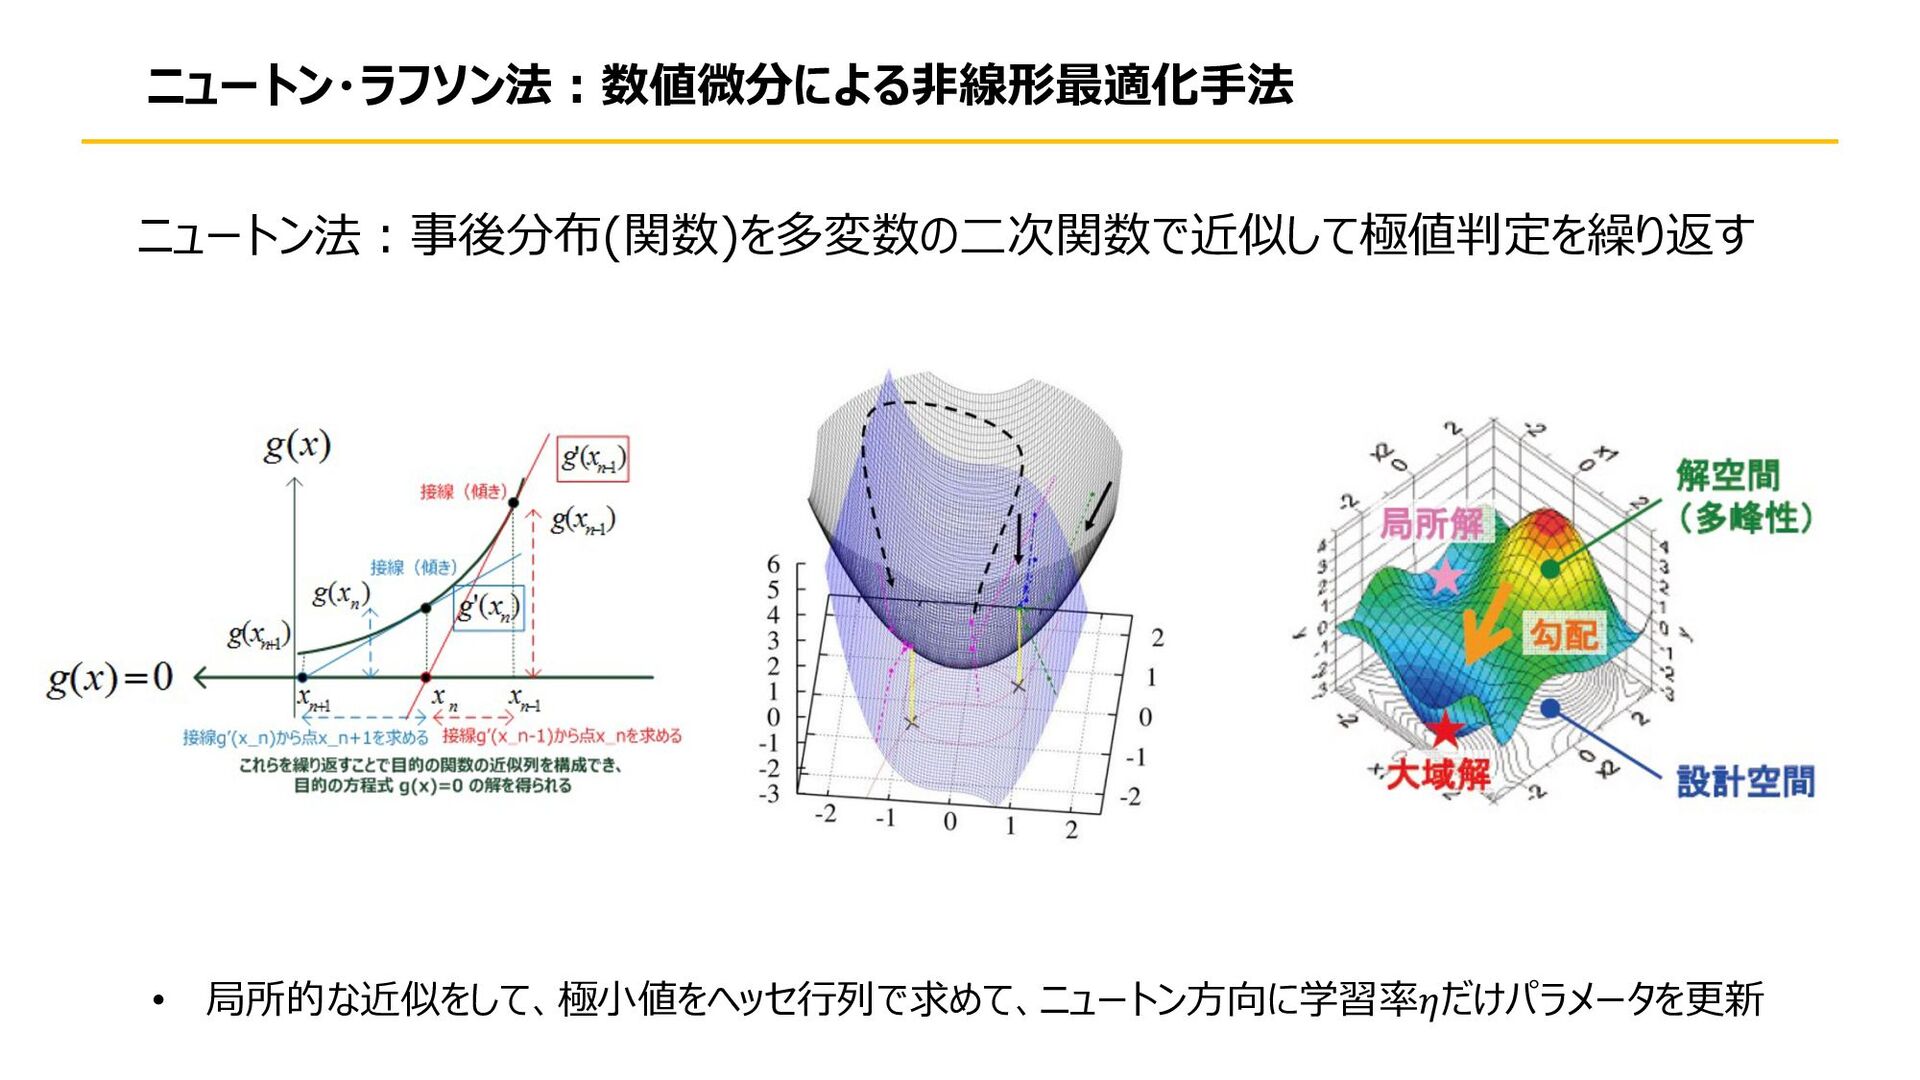
ニュートン・ラフソン法︓数値微分による⾮線形最適化⼿法 ニュートン法︓事後分布(関数)を多変数の⼆次関数で近似して極値判定を繰り返す • 局所的な近似をして、極⼩値をヘッセ⾏列で求めて、ニュートン⽅向に学習率𝜂だけパラメータを更新
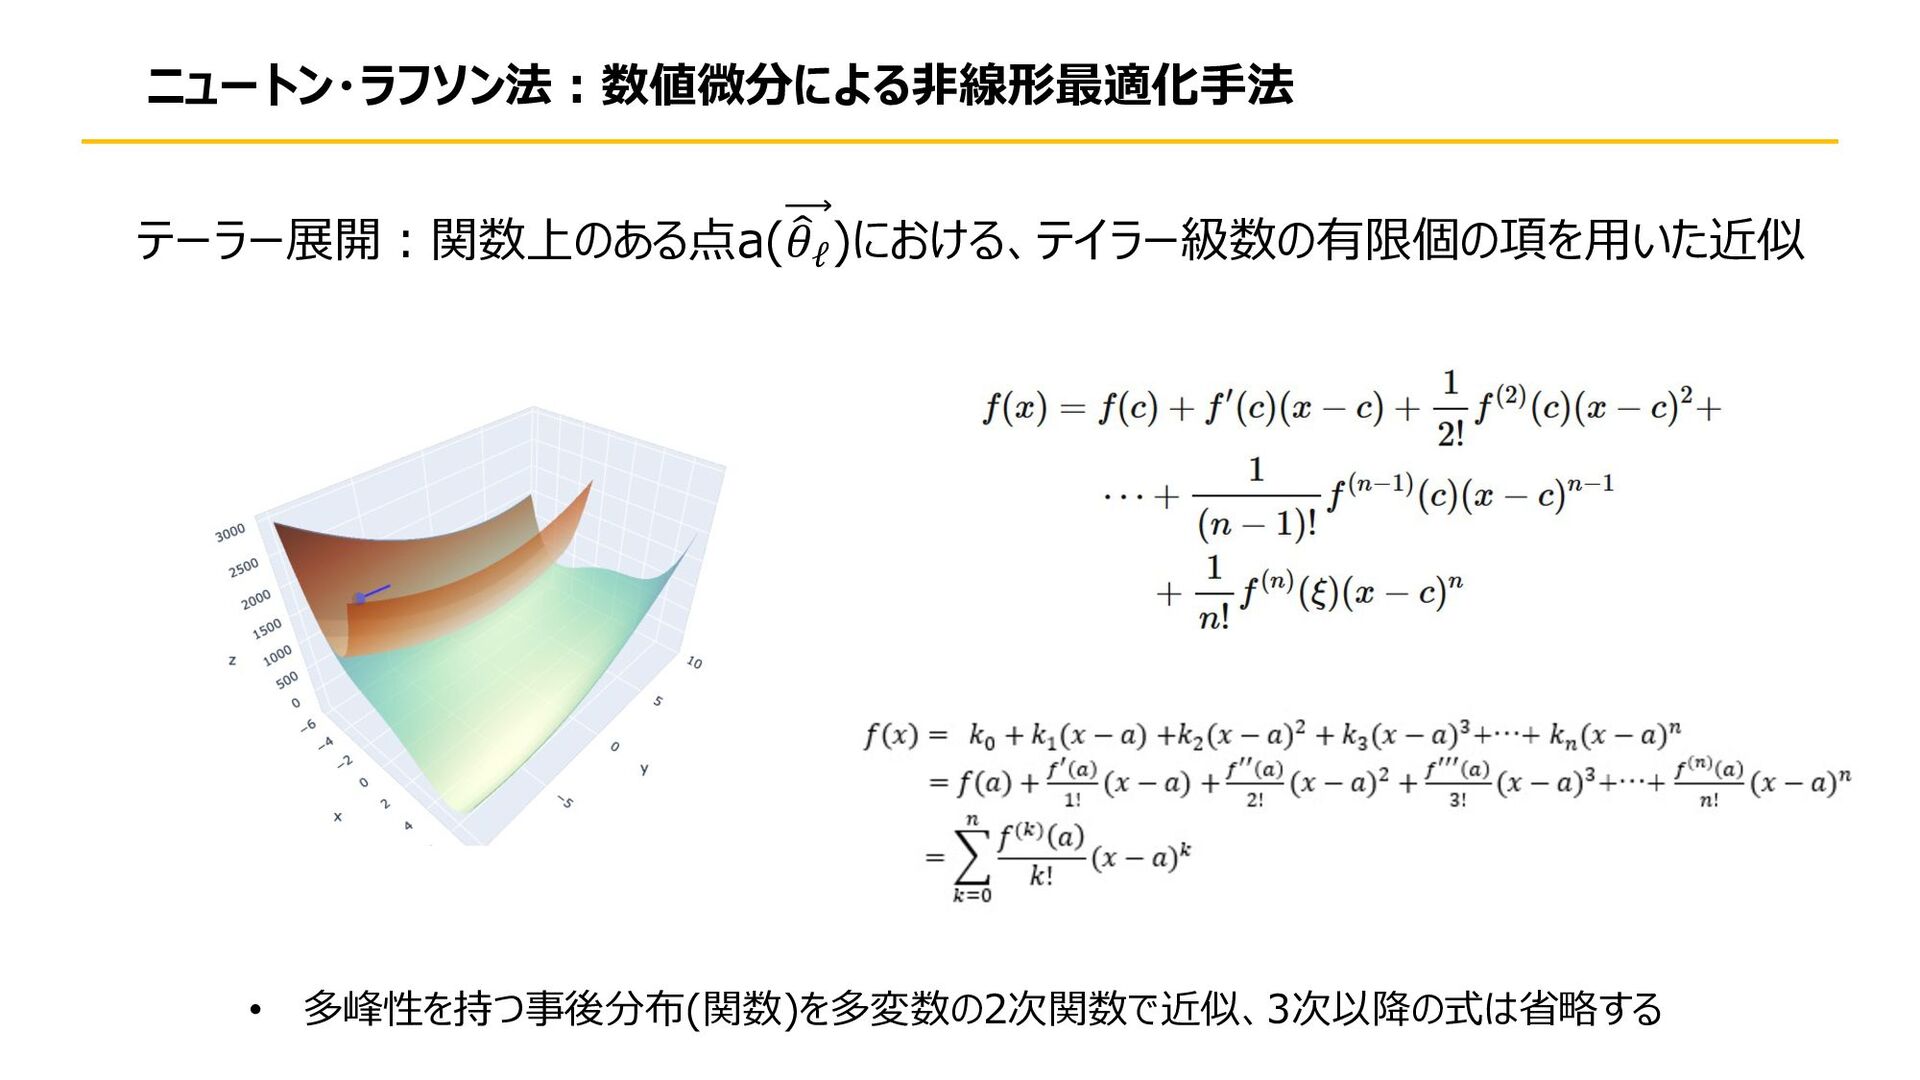
ニュートン・ラフソン法︓数値微分による⾮線形最適化⼿法 テーラー展開︓関数上のある点a( # 𝜃ℓ )における、テイラー級数の有限個の項を⽤いた近似 • 多峰性を持つ事後分布(関数)を多変数の2次関数で近似、3次以降の式は省略する
Episode 3. Deep Q-Network
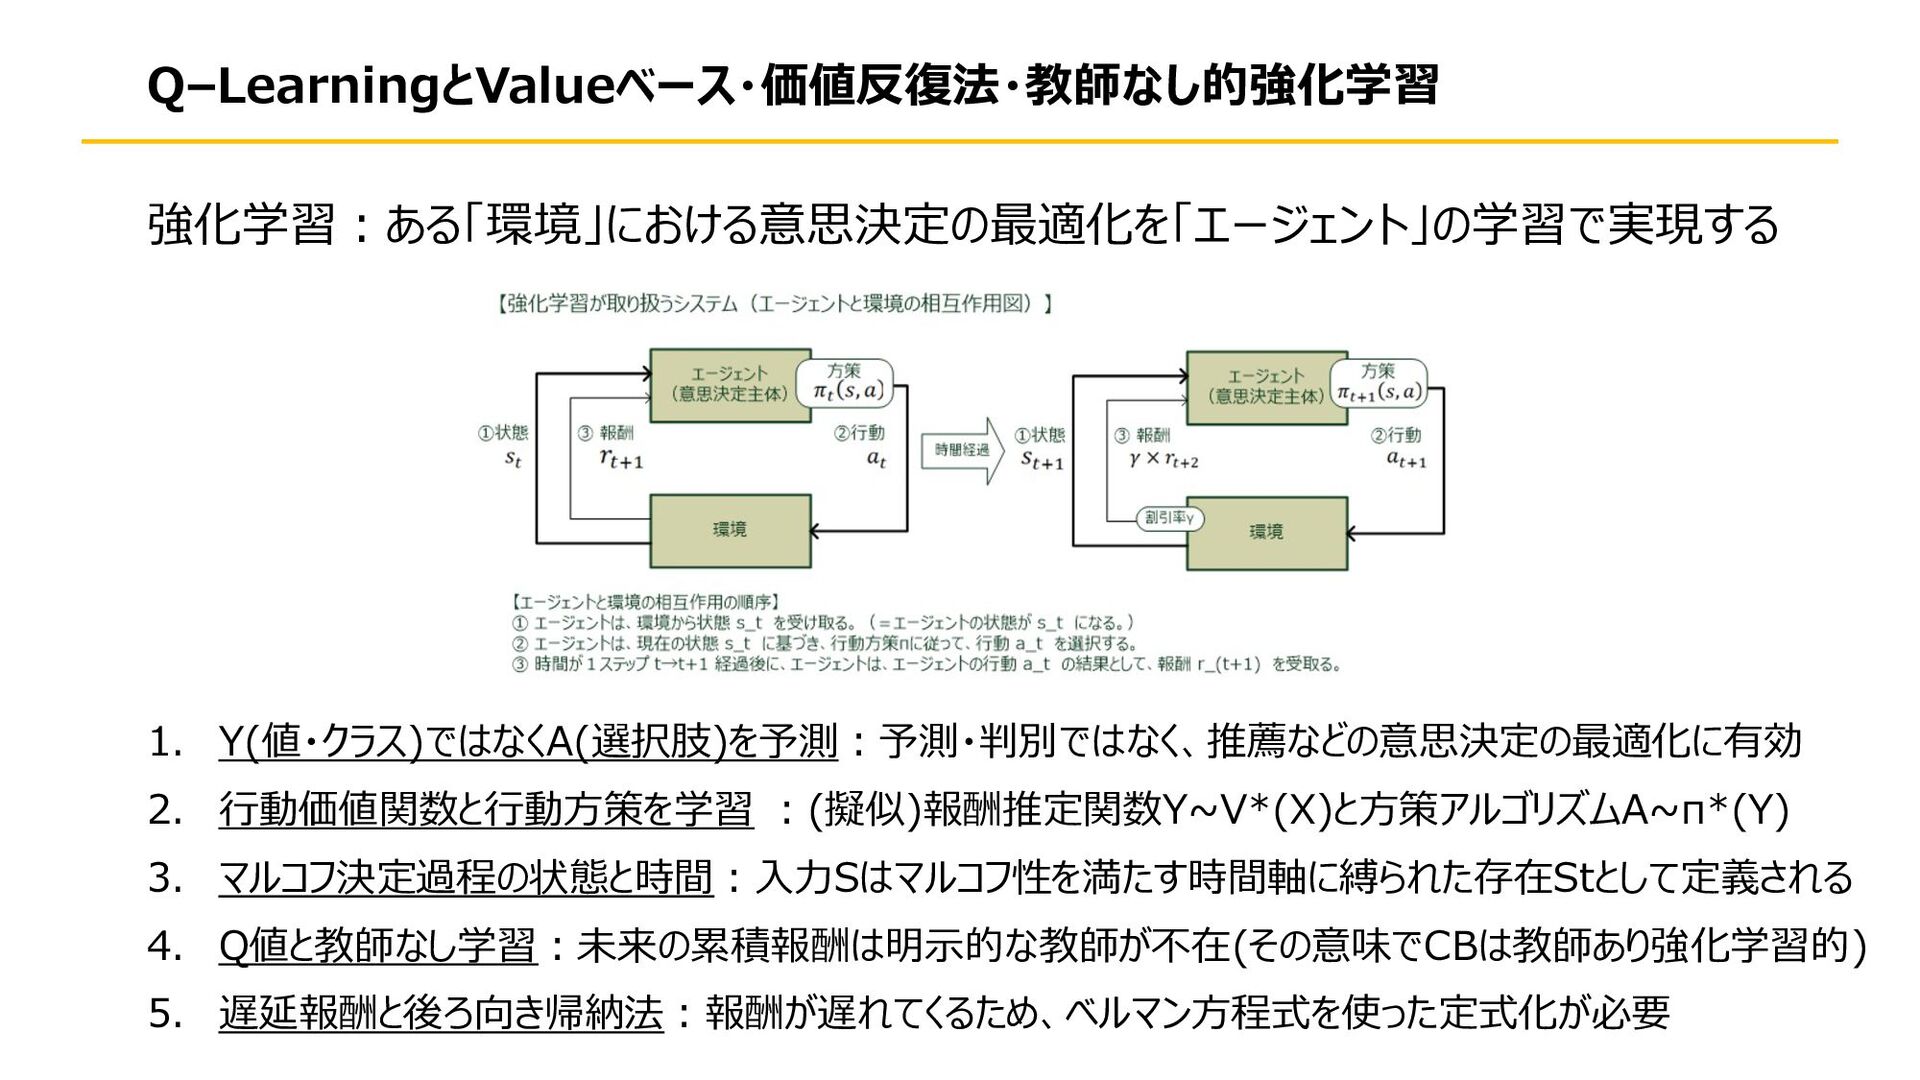
Q–LearningとValueベース・価値反復法・教師なし的強化学習 強化学習︓ある「環境」における意思決定の最適化を「エージェント」の学習で実現する 1. Y(値・クラス)ではなくA(選択肢)を予測︓予測・判別ではなく、推薦などの意思決定の最適化に有効 2. ⾏動価値関数と⾏動⽅策を学習 ︓(擬似)報酬推定関数Y~V*(X)と⽅策アルゴリズムA~π*(Y) 3. マルコフ決定過程の状態と時間︓⼊⼒Sはマルコフ性を満たす時間軸に縛られた存在Stとして定義される 4.
Q値と教師なし学習︓未来の累積報酬は明⽰的な教師が不在(その意味でCBは教師あり強化学習的) 5. 遅延報酬と後ろ向き帰納法︓報酬が遅れてくるため、ベルマン⽅程式を使った定式化が必要
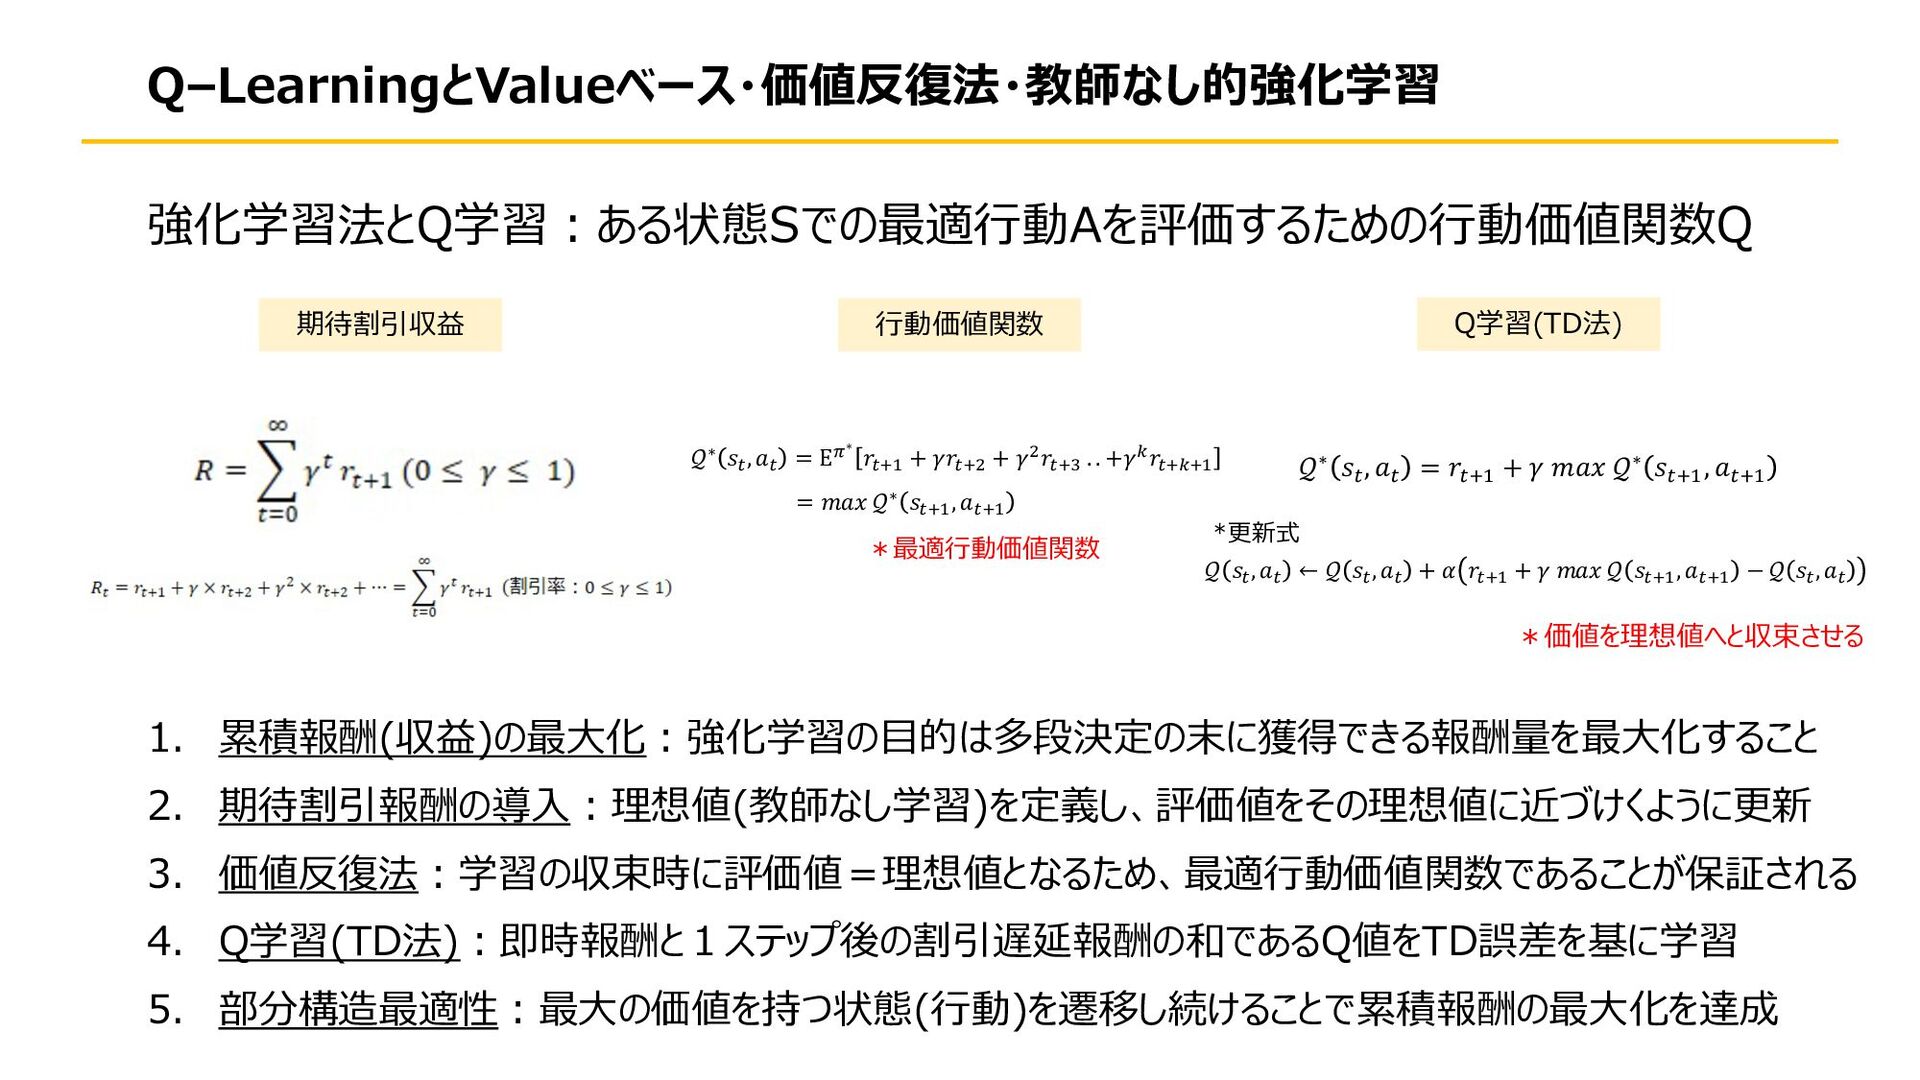
Q–LearningとValueベース・価値反復法・教師なし的強化学習 強化学習法とQ学習︓ある状態Sでの最適⾏動Aを評価するための⾏動価値関数Q 1. 累積報酬(収益)の最⼤化︓強化学習の⽬的は多段決定の末に獲得できる報酬量を最⼤化すること 2. 期待割引報酬の導⼊︓理想値(教師なし学習)を定義し、評価値をその理想値に近づけくように更新 3. 価値反復法︓学習の収束時に評価値=理想値となるため、最適⾏動価値関数であることが保証される 4. Q学習(TD法)︓即時報酬と1ステップ後の割引遅延報酬の和であるQ値をTD誤差を基に学習
5. 部分構造最適性︓最⼤の価値を持つ状態(⾏動)を遷移し続けることで累積報酬の最⼤化を達成 期待割引収益 Q学習(TD法) ⾏動価値関数 𝒬∗ 𝑠# , 𝑎# = 𝑟#$% + 𝛾 𝑚𝑎𝑥 𝒬∗ 𝑠#$% , 𝑎#$% *更新式 𝒬 𝑠", 𝑎" ← 𝒬 𝑠", 𝑎" + 𝛼 𝑟"#$ + 𝛾 𝑚𝑎𝑥 𝒬 𝑠"#$, 𝑎"#$ − 𝒬 𝑠", 𝑎" 𝒬∗ 𝑠", 𝑎" = Ε&∗ 𝑟"#$ + 𝛾𝑟"#' + 𝛾'𝑟"#( . . +𝛾)𝑟"#)#$ = 𝑚𝑎𝑥 𝒬∗ 𝑠"#$, 𝑎"#$ *価値を理想値へと収束させる *最適⾏動価値関数
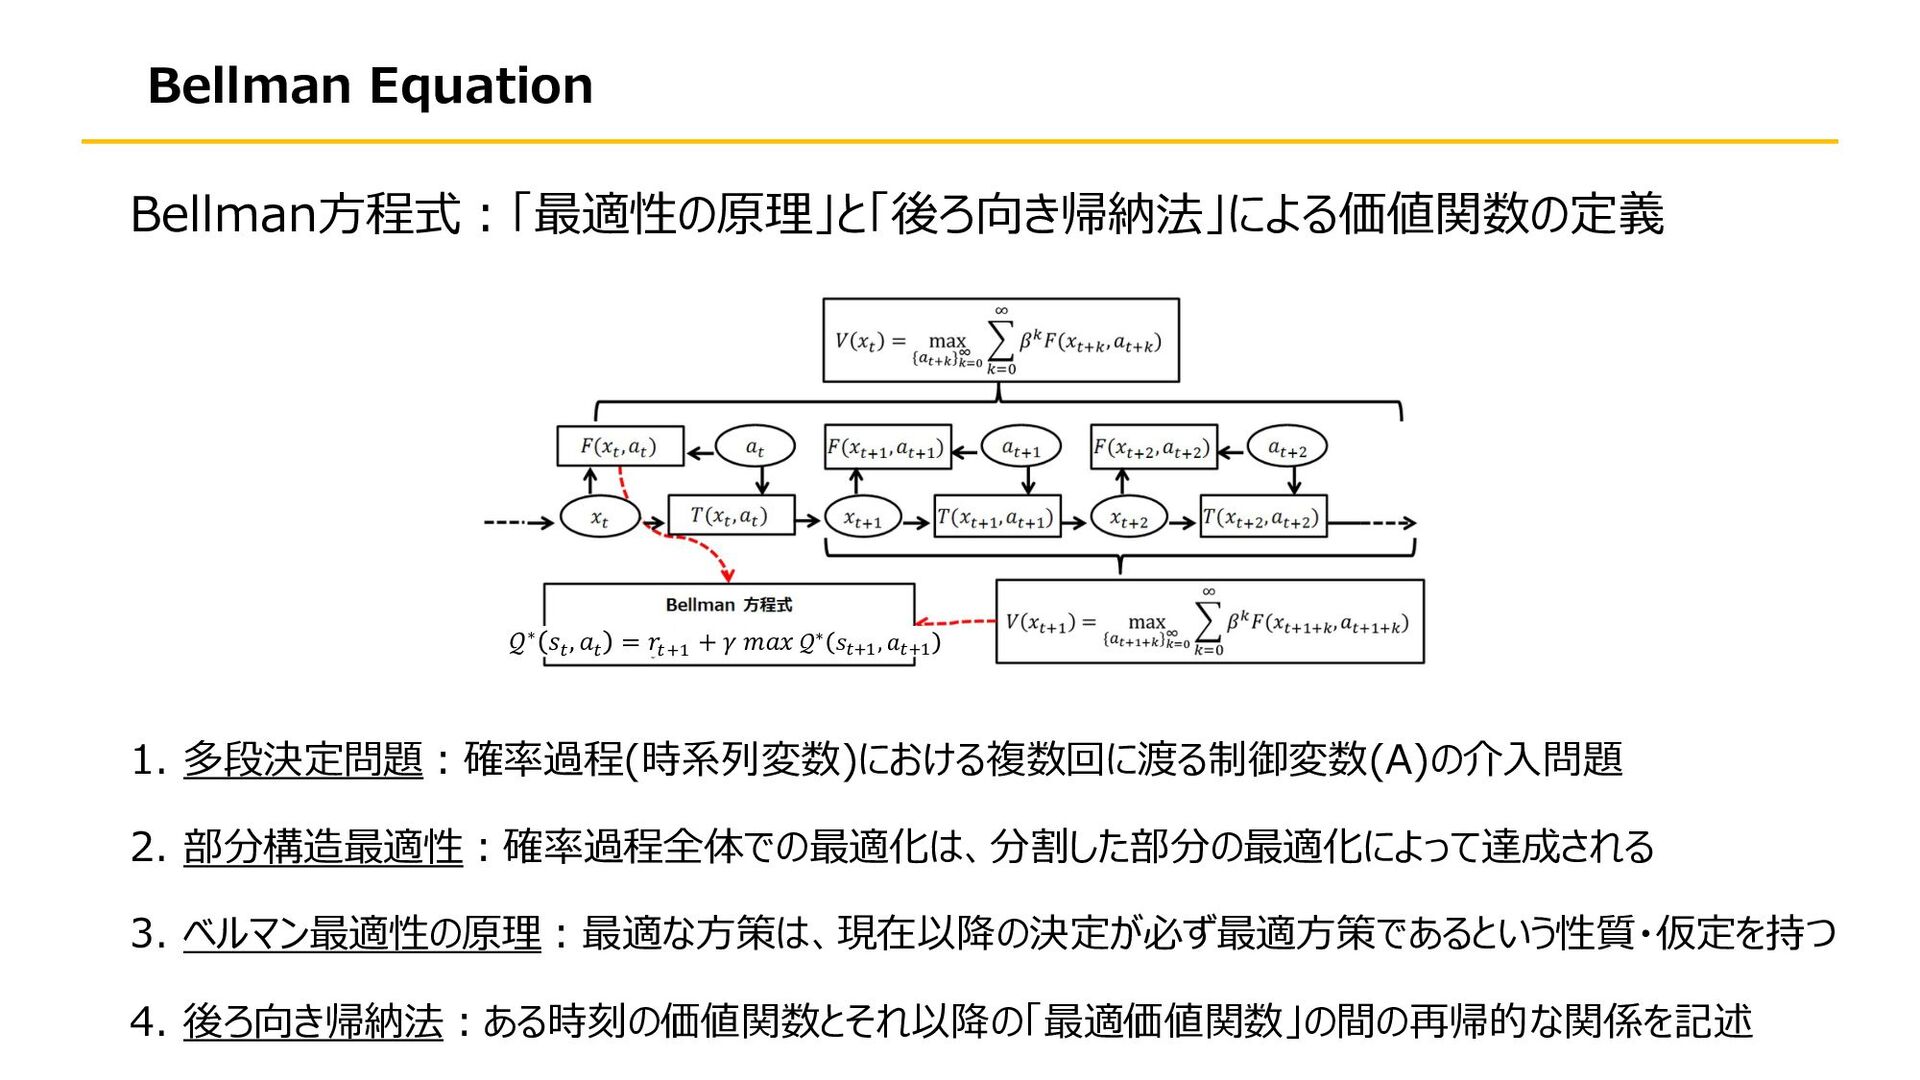
Bellman Equation Bellman⽅程式︓「最適性の原理」と「後ろ向き帰納法」による価値関数の定義 1. 多段決定問題︓確率過程(時系列変数)における複数回に渡る制御変数(A)の介⼊問題 2. 部分構造最適性︓確率過程全体での最適化は、分割した部分の最適化によって達成される 3. ベルマン最適性の原理︓最適な⽅策は、現在以降の決定が必ず最適⽅策であるという性質・仮定を持つ 4.
後ろ向き帰納法︓ある時刻の価値関数とそれ以降の「最適価値関数」の間の再帰的な関係を記述 𝒬∗ 𝑠" , 𝑎" = 𝑟"#$ + 𝛾 𝑚𝑎𝑥 𝒬∗ 𝑠"#$, 𝑎"#$
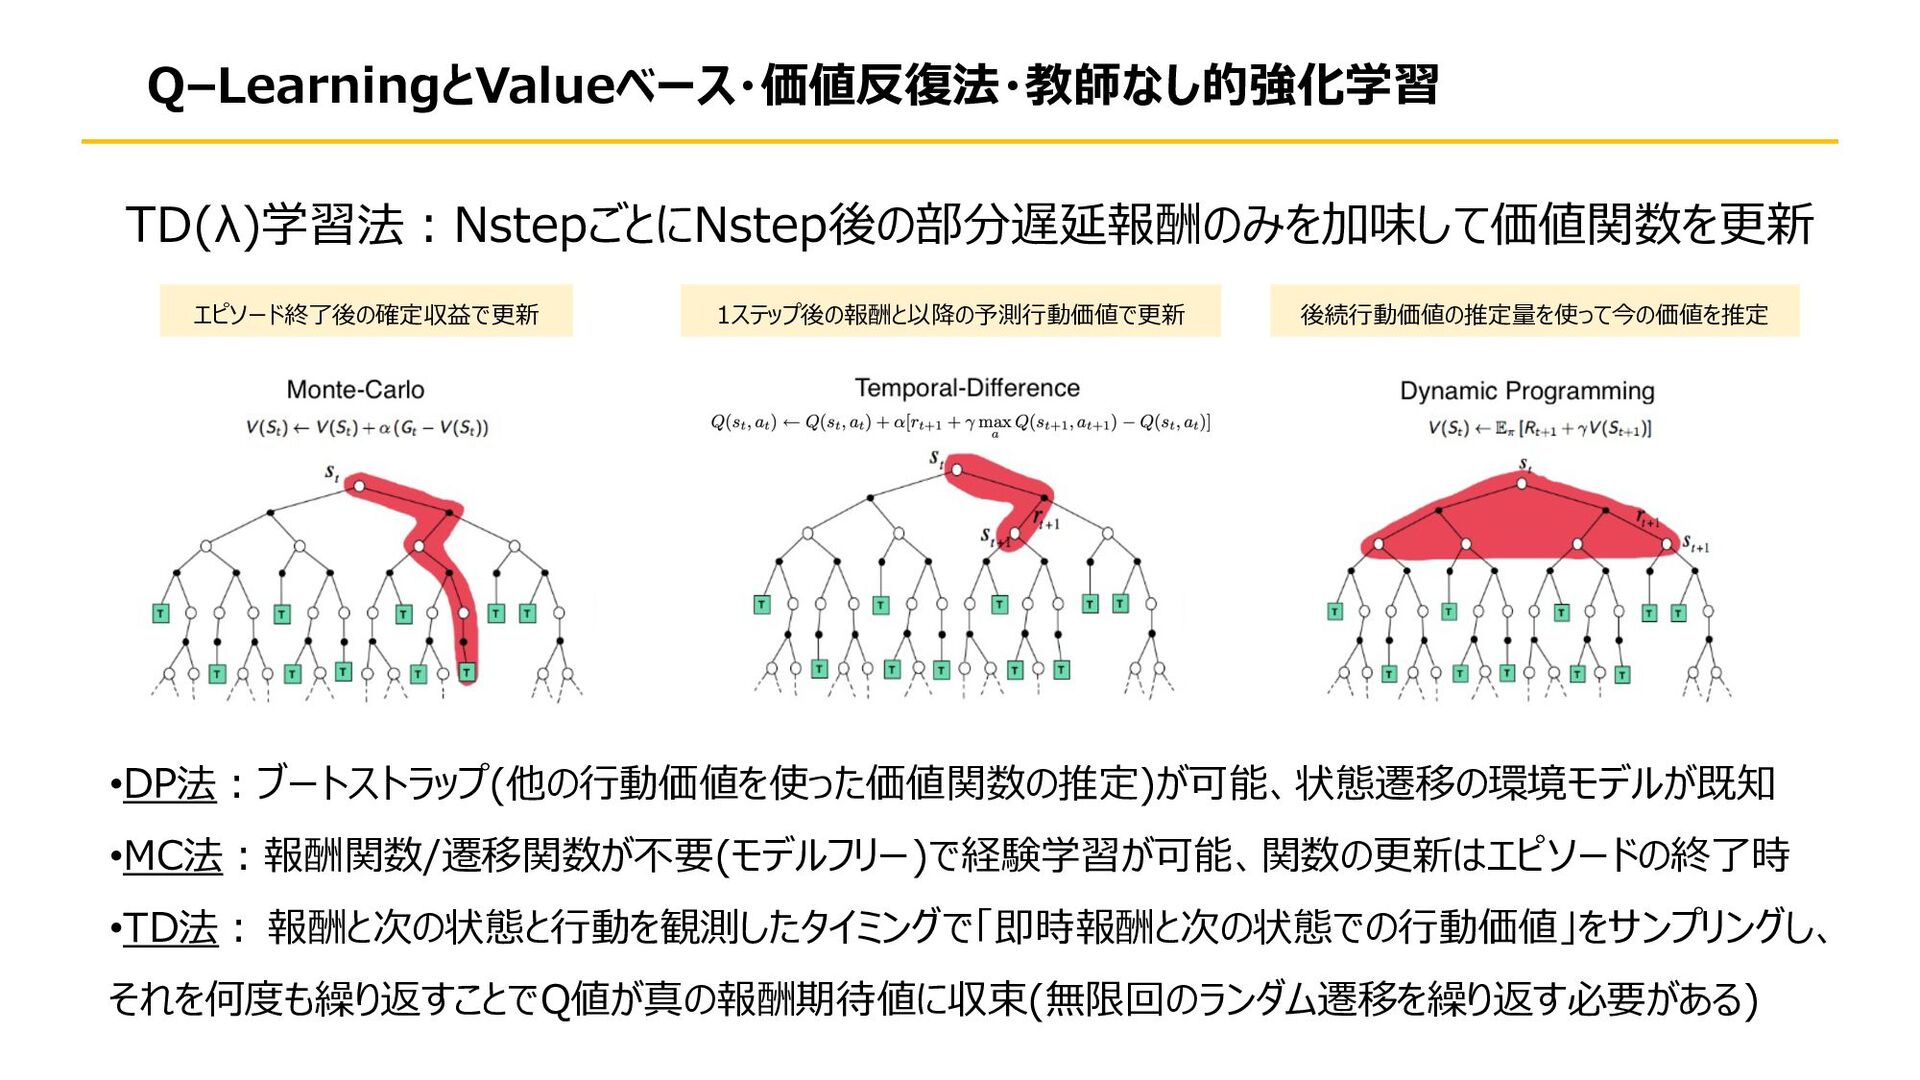
Q–LearningとValueベース・価値反復法・教師なし的強化学習 TD(λ)学習法︓NstepごとにNstep後の部分遅延報酬のみを加味して価値関数を更新 エピソード終了後の確定収益で更新 1ステップ後の報酬と以降の予測⾏動価値で更新 後続⾏動価値の推定量を使って今の価値を推定 •DP法︓ブートストラップ(他の⾏動価値を使った価値関数の推定)が可能、状態遷移の環境モデルが既知 •MC法︓報酬関数/遷移関数が不要(モデルフリー)で経験学習が可能、関数の更新はエピソードの終了時 •TD法︓ 報酬と次の状態と⾏動を観測したタイミングで「即時報酬と次の状態での⾏動価値」をサンプリングし、 それを何度も繰り返すことでQ値が真の報酬期待値に収束(無限回のランダム遷移を繰り返す必要がある)
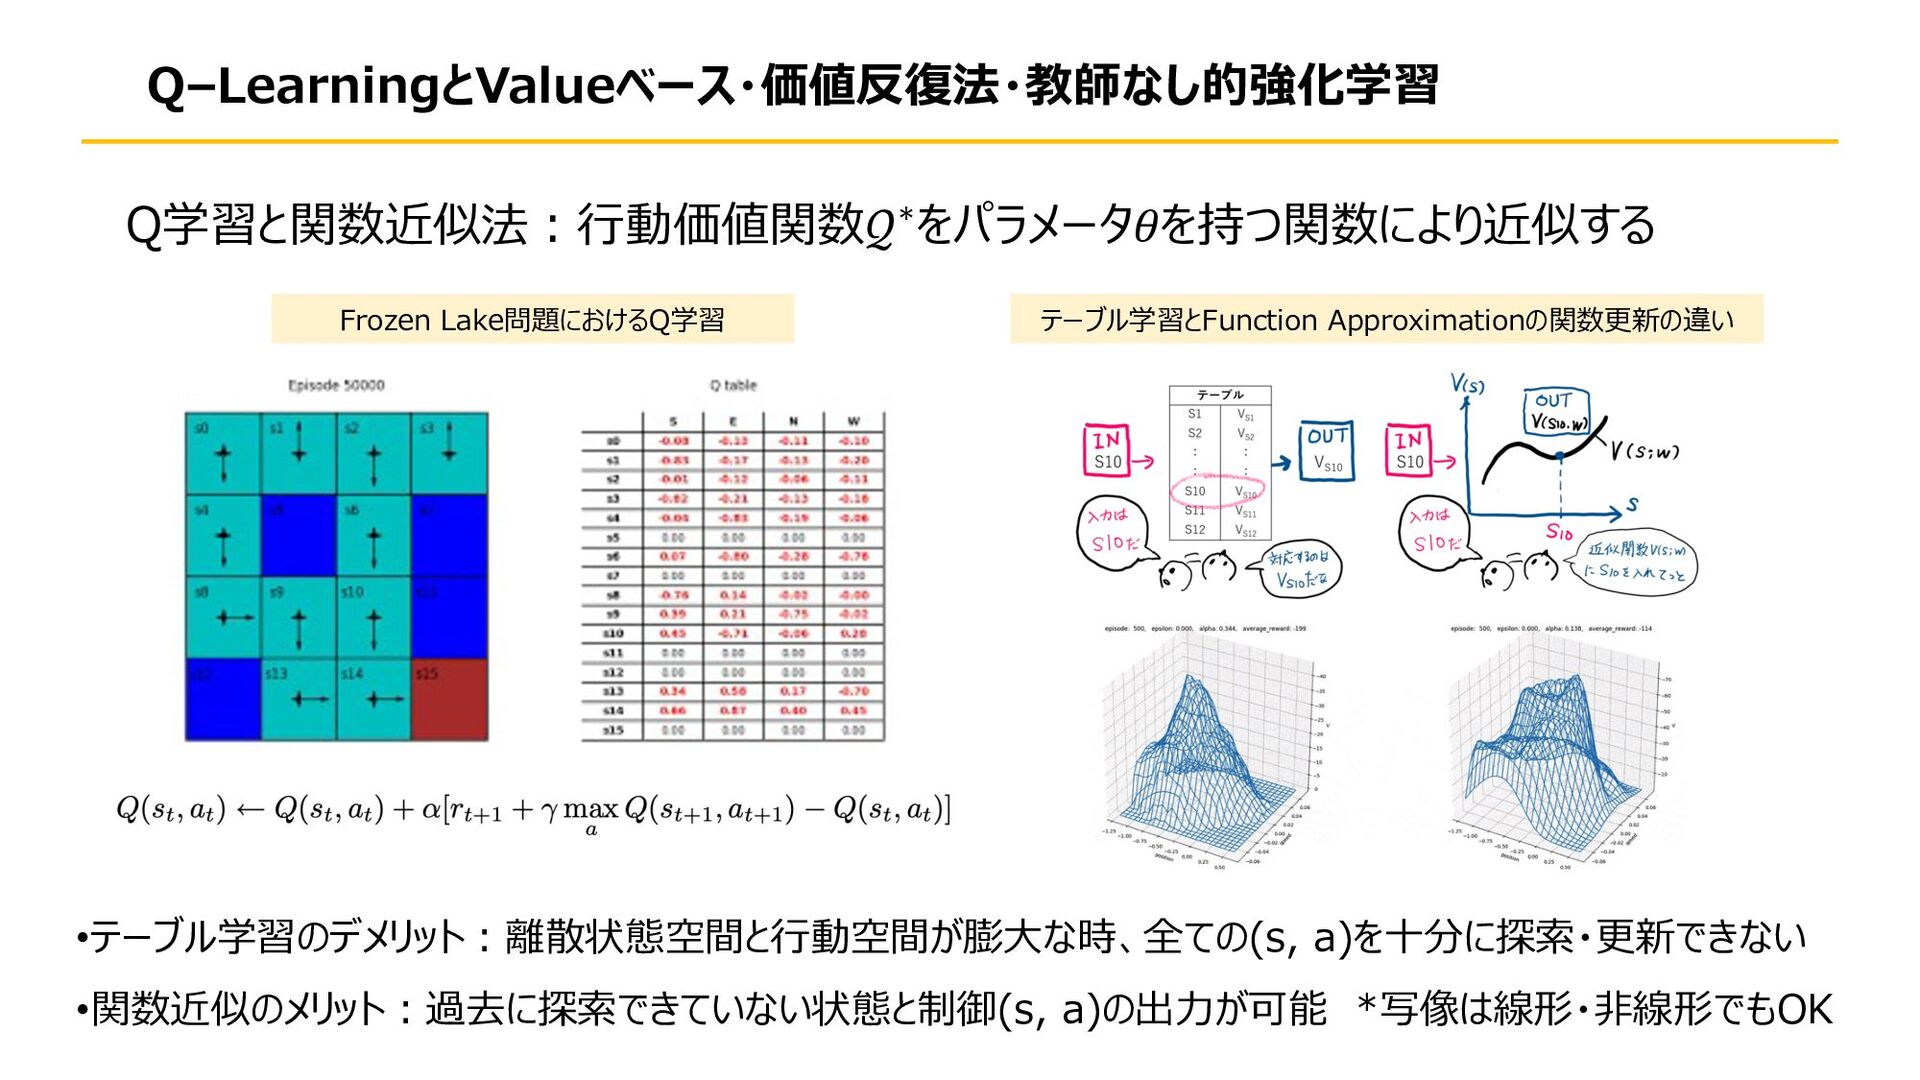
Q–LearningとValueベース・価値反復法・教師なし的強化学習 Q学習と関数近似法︓⾏動価値関数𝒬∗をパラメータ𝜃を持つ関数により近似する •テーブル学習のデメリット︓離散状態空間と⾏動空間が膨⼤な時、全ての(s, a)を⼗分に探索・更新できない •関数近似のメリット︓過去に探索できていない状態と制御(s, a)の出⼒が可能 *写像は線形・⾮線形でもOK Frozen Lake問題におけるQ学習 テーブル学習とFunction
Approximationの関数更新の違い
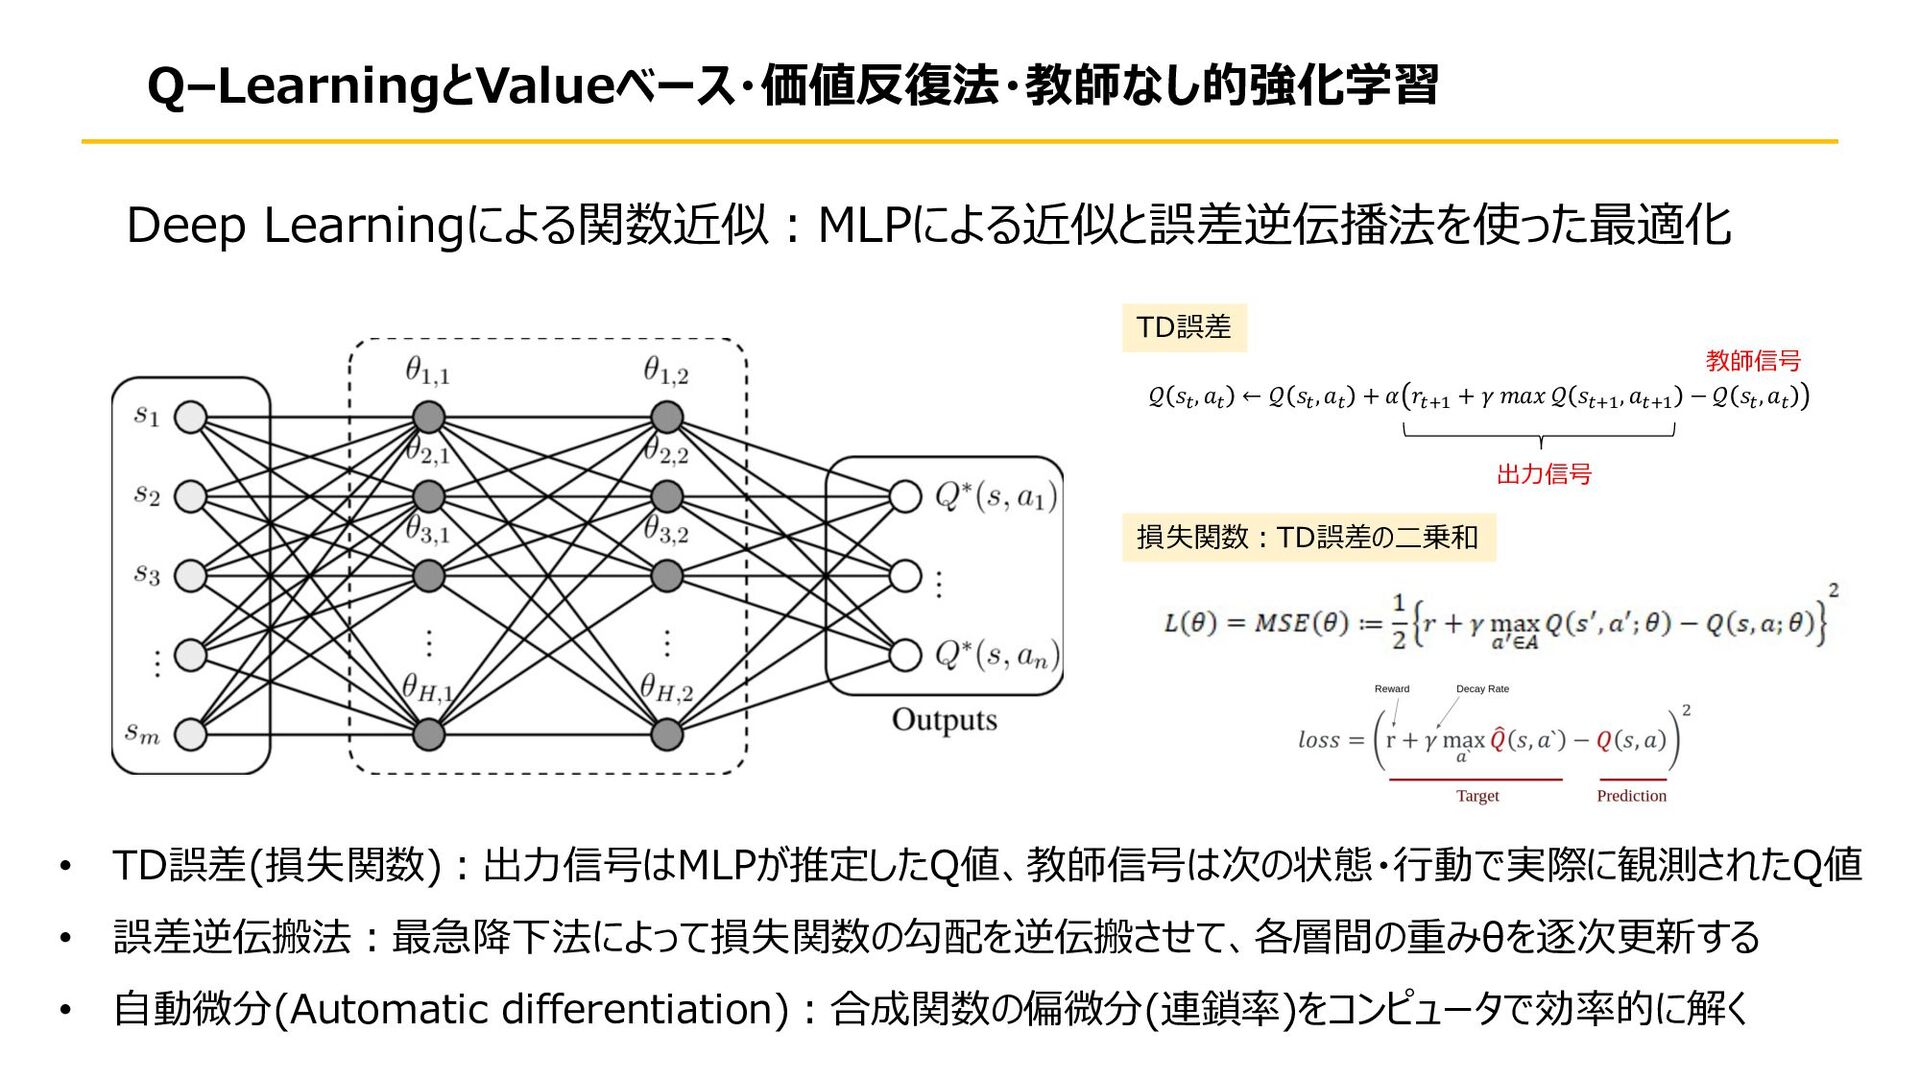
Q–LearningとValueベース・価値反復法・教師なし的強化学習 Deep Learningによる関数近似︓MLPによる近似と誤差逆伝播法を使った最適化 • TD誤差(損失関数)︓出⼒信号はMLPが推定したQ値、教師信号は次の状態・⾏動で実際に観測されたQ値 • 誤差逆伝搬法︓最急降下法によって損失関数の勾配を逆伝搬させて、各層間の重みθを逐次更新する • ⾃動微分(Automatic differentiation)︓合成関数の偏微分(連鎖率)をコンピュータで効率的に解く
𝒬 𝑠", 𝑎" ← 𝒬 𝑠", 𝑎" + 𝛼 𝑟"#$ + 𝛾 𝑚𝑎𝑥 𝒬 𝑠"#$, 𝑎"#$ − 𝒬 𝑠", 𝑎" TD誤差 損失関数︓TD誤差の⼆乗和 教師信号 出⼒信号
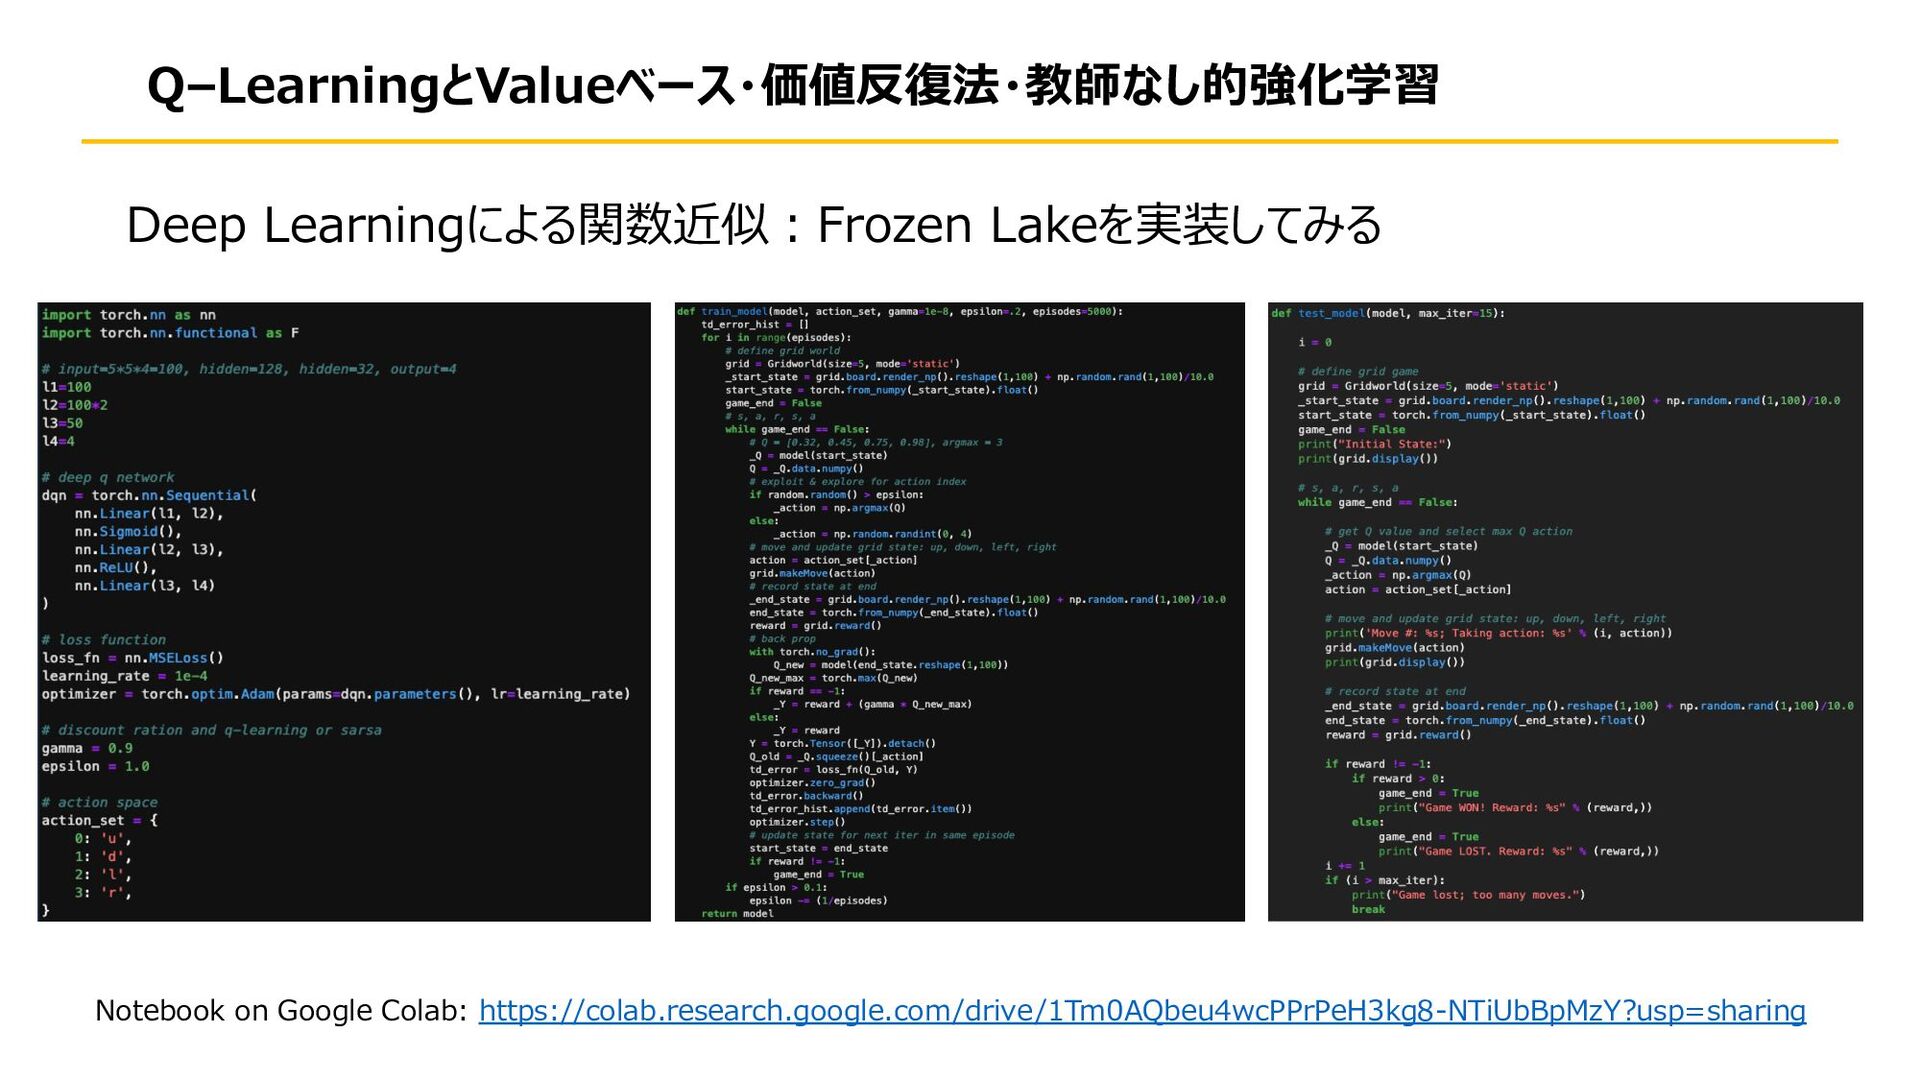
Q–LearningとValueベース・価値反復法・教師なし的強化学習 Deep Learningによる関数近似︓Frozen Lakeを実装してみる Notebook on Google Colab: https://colab.research.google.com/drive/1Tm0AQbeu4wcPPrPeH3kg8-NTiUbBpMzY?usp=sharing
References • https://livebook.manning.com/book/deep-reinforcement-learning-in-action/chapter-3/ • https://research.miidas.jp/author/tsutsumi-jintaro/ • https://qiita.com/sconeman/items/2432e8a1d1fb11c1111b • https://www.slideshare.net/pfi/nlp2018-introduction-of-deep-reinforcement-learning •
https://livebook.manning.com/book/deep-reinforcement-learning-in-action/chapter-3/37 • UCL: https://www.davidsilver.uk/teaching/ • https://hkashima.github.io/3-1.pdf • https://www.slideshare.net/devkato/prml-at-4431-452 • https://www.slideshare.net/yukimatsubara9847/prml44 • https://qiita.com/usaito/items/e727dcac7325b50d4d4c • https://kamino.hatenablog.com/entry/lm_method • https://speakerdeck.com/hkaneko/niyutonfa-niyutonrahusonfa-f-x-equals-0falsejie-woshu-zhi-de-niqiu-meru


 kash1064
 sh_fk2
 ezaki
 ludicmind
 kentapapa
 makocchi
 teamlab
 ivry_presentationmaterials
 satoshi7
 bgpat
 pfn
 takonda
 kimpetersen
 bkeepers
 katiecoart
 samlambert
 katarinadahlin
 gurzu
 lara
 aleyda
 sergeychernyshev
 codingconduct
 tammyeverts