Upgrade to Pro — share decks privately, control downloads, hide ads and more …

GeBDA: Building Damage Assessment as Text-Based...

GeBDA: Building Damage Assessment as Text-Based Sequence Prediction

本資料はSatAI.challengeのサーベイメンバーと共に作成したものです。
SatAI.challengeは、リモートセンシング技術にAIを適用した論文の調査や、より俯瞰した技術トレンドの調査や国際学会のメタサーベイを行う研究グループです。speakerdeckではSatAI.challenge内での勉強会で使用した資料をWeb上で共有しています。
https://x.com/sataichallenge

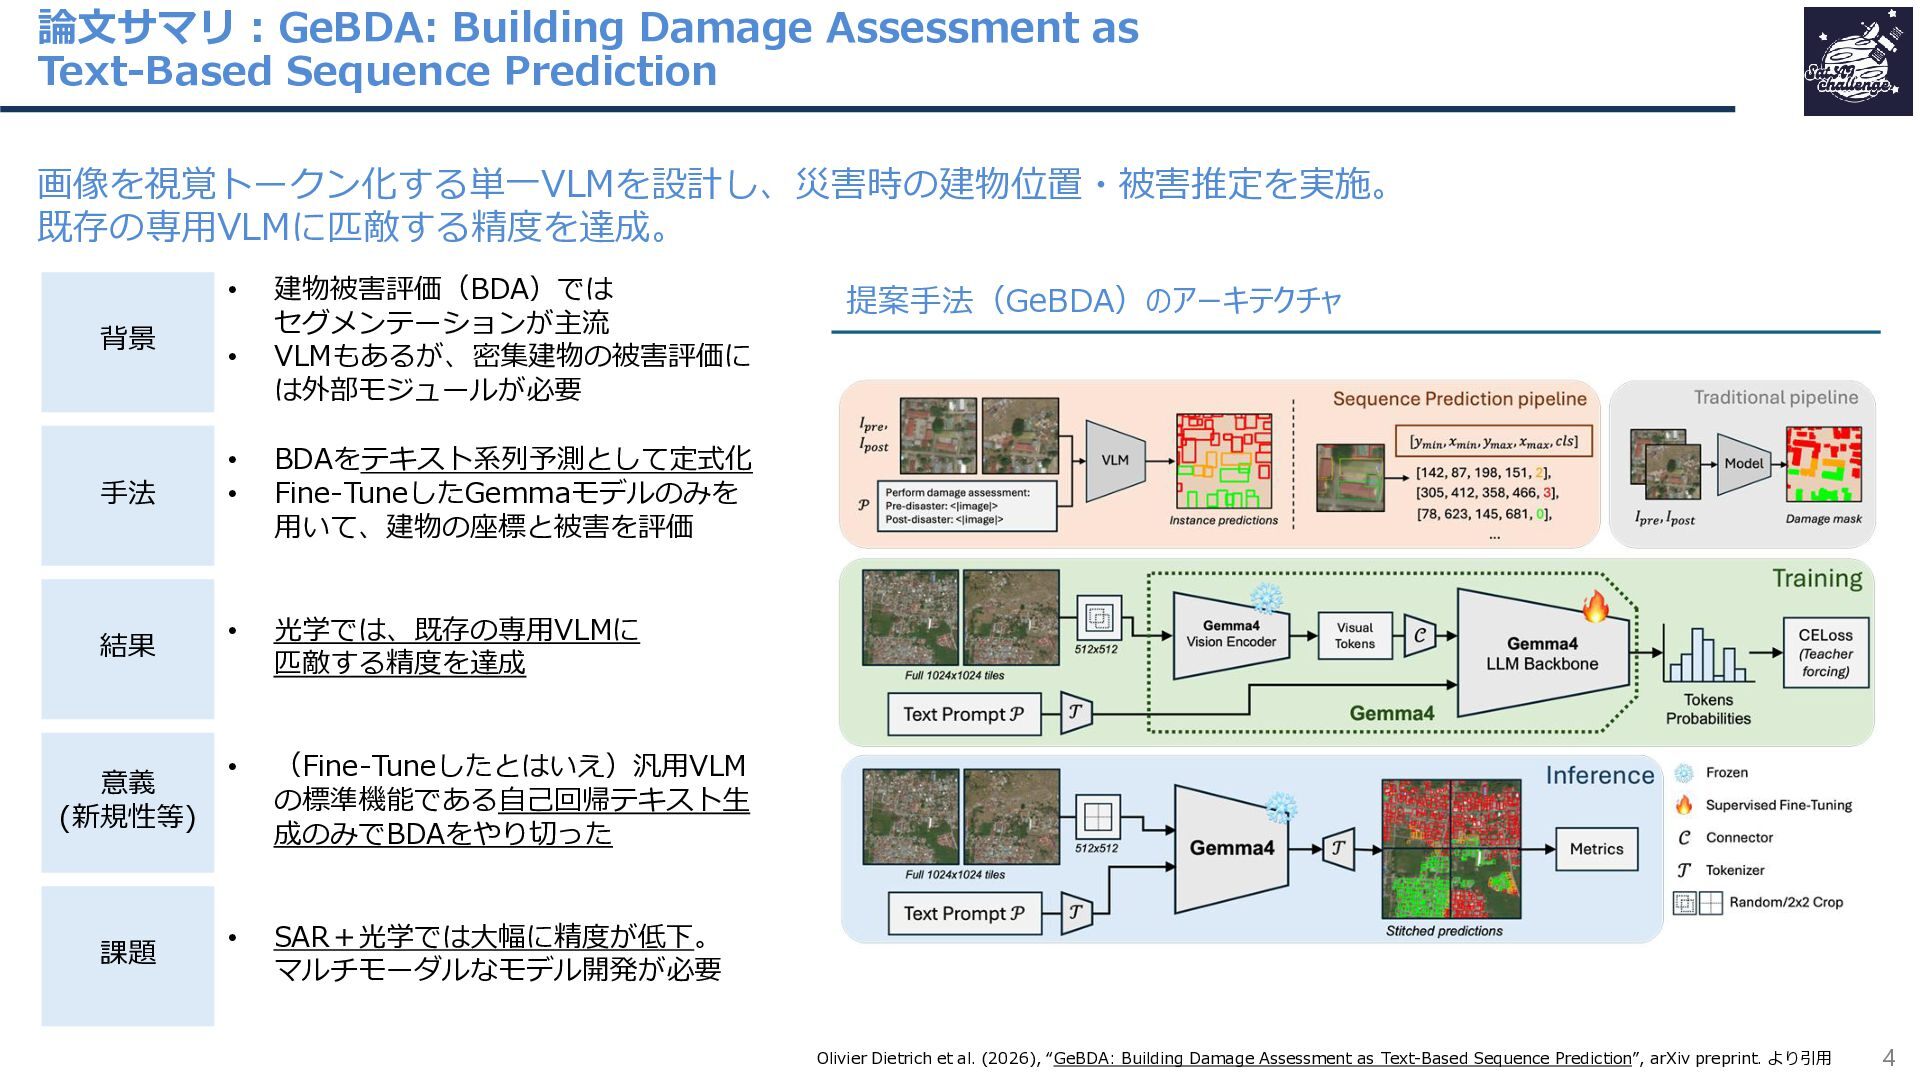
紹介する論文は、「GeBDA: Building Damage Assessment as Text-Based Sequence Prediction」です。本研究では、災害前後の衛星画像から、建物の座標と被害クラスを並べたテキスト系列を予測する形で建物被害評価(BDA)を定式化し、単一のVision-Language Model(VLM)のみで建物の位置特定と被害分類を行うGeBDAを提案しています。従来のセグメンテーションモデルは柔軟性に乏しく、既存のVLMも密集した建物に対応するために外部モジュールやタスクの単純化に頼ることが課題でした。本手法では、Gemma 4の視覚エンコーダを凍結してLLM部分のみをファインチューニングし、512×512画素に分割した画像から各建物のバウンディングボックスと被害クラスを自己回帰的に生成します。発災前後とも光学画像のxBDでは既存手法に迫る精度を示した一方、発災後がSAR画像のBRIGHTでは被害分類の精度が大きく低下しました。本研究は、汎用VLMの標準的なテキスト生成機能のみで建物被害評価を実現できる可能性を示しています。

Avatar for SatAI.challenge

SatAI.challenge

October 16, 2026

More Decks by SatAI.challenge

Other Decks in Research

Transcript

  1. 目次 • • • • • • • 自己紹介 論文サマリ

    研究の背景 手法 データセット 結果 感想 2 2
  2. 自己紹介 豊島 拓(てしま たく) 経歴 • 2020~2021:東京大学 航空宇宙工学専攻(修士) • 2022~:日系シンクタンク所属

    ✓ ALOS-2強度画像を用いた土砂災害検出 のためのパターンマッチング、を研究 ✓ 企業・官公庁向けに、事業戦略立案/政策立案・遂行を支援 ✓ 専門領域は、リモートセンシング、 決済・ポイントサービス、不動産・鉄道 専門・興味・関心 • • SARを使ったインフラモニタリング・災害観測 リモセン技術をどうやって社会実装していくか(≒シンク タンク目線で、実装に向けた機運・モメンタムをどう形成 していくか)に関心 3
  3. 論文サマリ:GeBDA: Building Damage Assessment as Text-Based Sequence Prediction 画像を視覚トークン化する単一VLMを設計し、災害時の建物位置・被害推定を実施。 既存の専用VLMに匹敵する精度を達成。

    • 背景 • 建物被害評価(BDA)では セグメンテーションが主流 VLMもあるが、密集建物の被害評価に は外部モジュールが必要 手法 • • BDAをテキスト系列予測として定式化 Fine-TuneしたGemmaモデルのみを 用いて、建物の座標と被害を評価 結果 • 光学では、既存の専用VLMに 匹敵する精度を達成 意義 (新規性等) • (Fine-Tuneしたとはいえ)汎用VLM の標準機能である自己回帰テキスト生 成のみでBDAをやり切った 課題 • SAR+光学では大幅に精度が低下。 マルチモーダルなモデル開発が必要 提案手法(GeBDA)のアーキテクチャ Olivier Dietrich et al. (2026), “GeBDA: Building Damage Assessment as Text-Based Sequence Prediction”, arXiv preprint. より引用 4
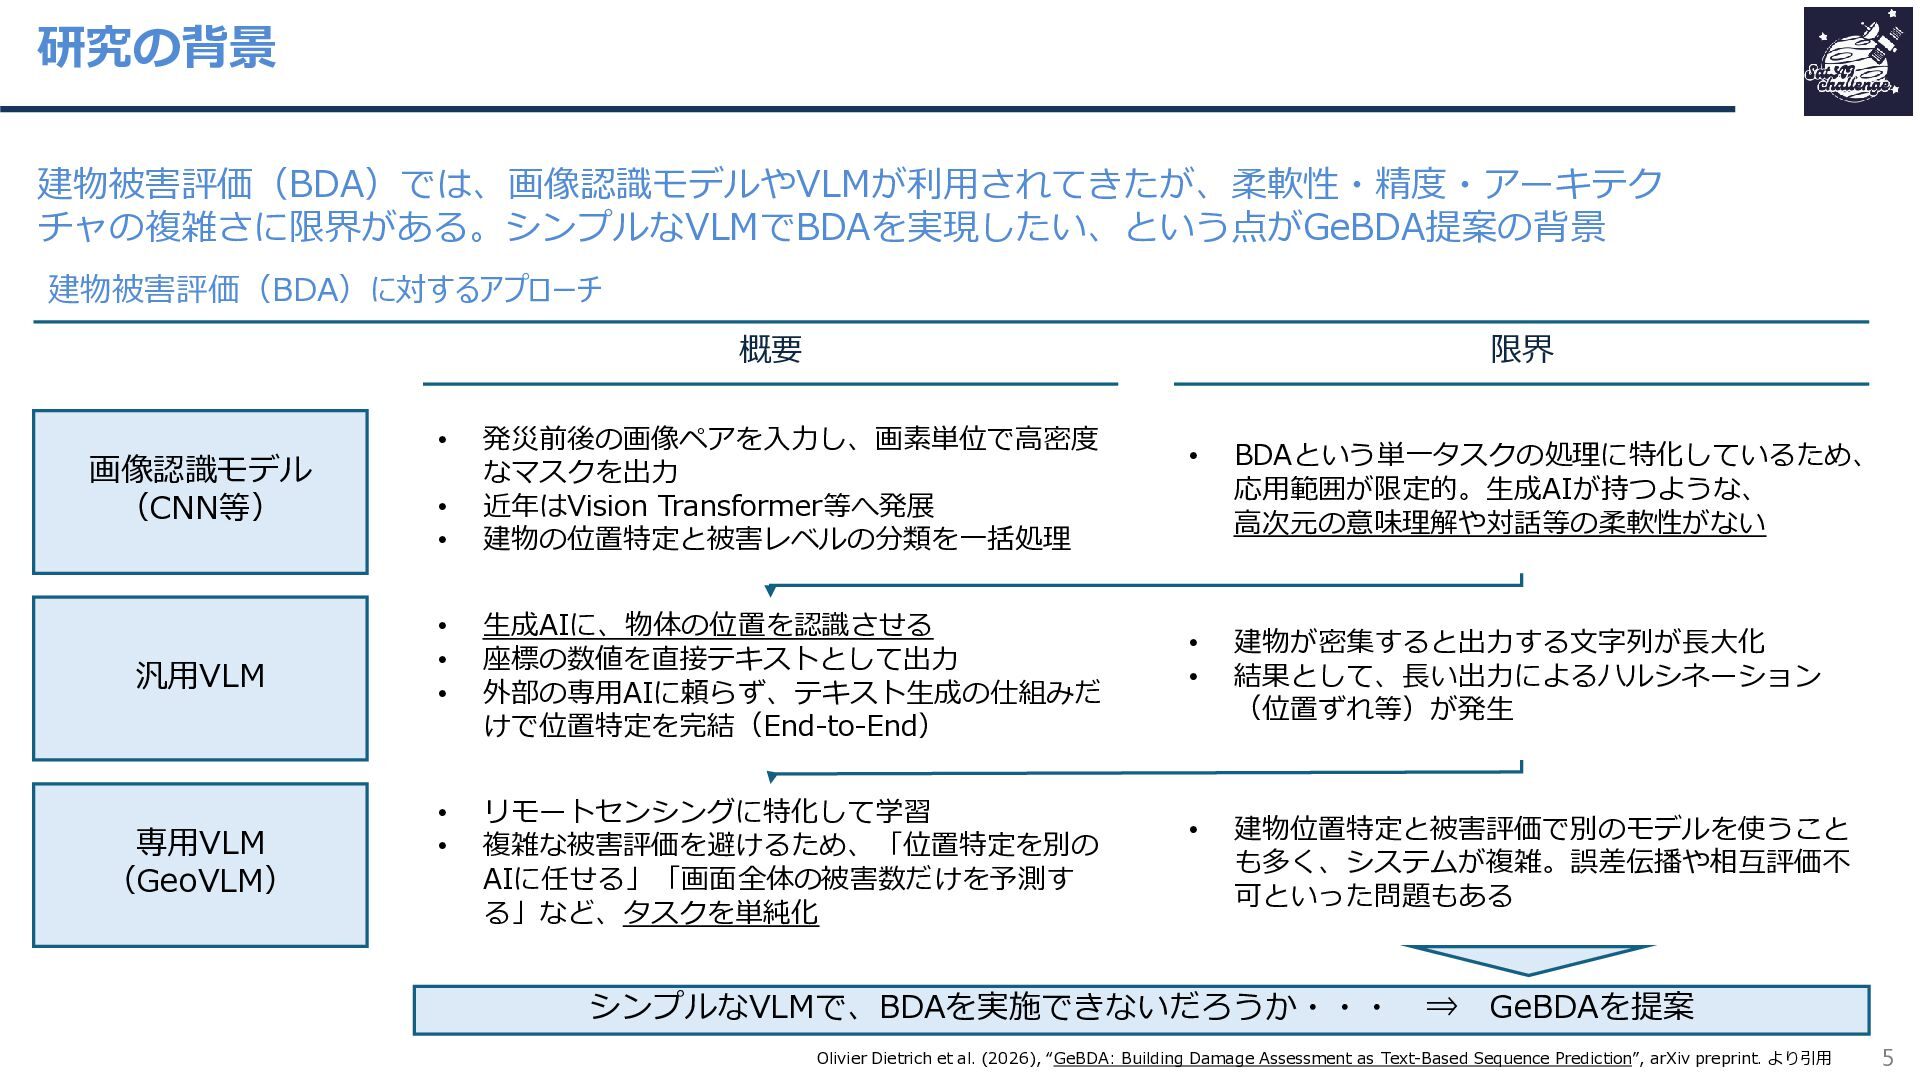
  4. 研究の背景 建物被害評価(BDA)では、画像認識モデルやVLMが利用されてきたが、柔軟性・精度・アーキテク チャの複雑さに限界がある。シンプルなVLMでBDAを実現したい、という点がGeBDA提案の背景 建物被害評価(BDA)に対するアプローチ 概要 画像認識モデル (CNN等) 汎用VLM 専用VLM (GeoVLM)

    • • • 限界 発災前後の画像ペアを入力し、画素単位で高密度 なマスクを出力 近年はVision Transformer等へ発展 建物の位置特定と被害レベルの分類を一括処理 • • • 生成AIに、物体の位置を認識させる 座標の数値を直接テキストとして出力 外部の専用AIに頼らず、テキスト生成の仕組みだ けで位置特定を完結(End-to-End) • • リモートセンシングに特化して学習 複雑な被害評価を避けるため、「位置特定を別の AIに任せる」「画面全体の被害数だけを予測す る」など、タスクを単純化 • BDAという単一タスクの処理に特化しているため、 応用範囲が限定的。生成AIが持つような、 高次元の意味理解や対話等の柔軟性がない • • 建物が密集すると出力する文字列が長大化 結果として、長い出力によるハルシネーション (位置ずれ等)が発生 • 建物位置特定と被害評価で別のモデルを使うこと も多く、システムが複雑。誤差伝播や相互評価不 可といった問題もある シンプルなVLMで、BDAを実施できないだろうか・・・ ⇒ GeBDAを提案 Olivier Dietrich et al. (2026), “GeBDA: Building Damage Assessment as Text-Based Sequence Prediction”, arXiv preprint. より引用 5
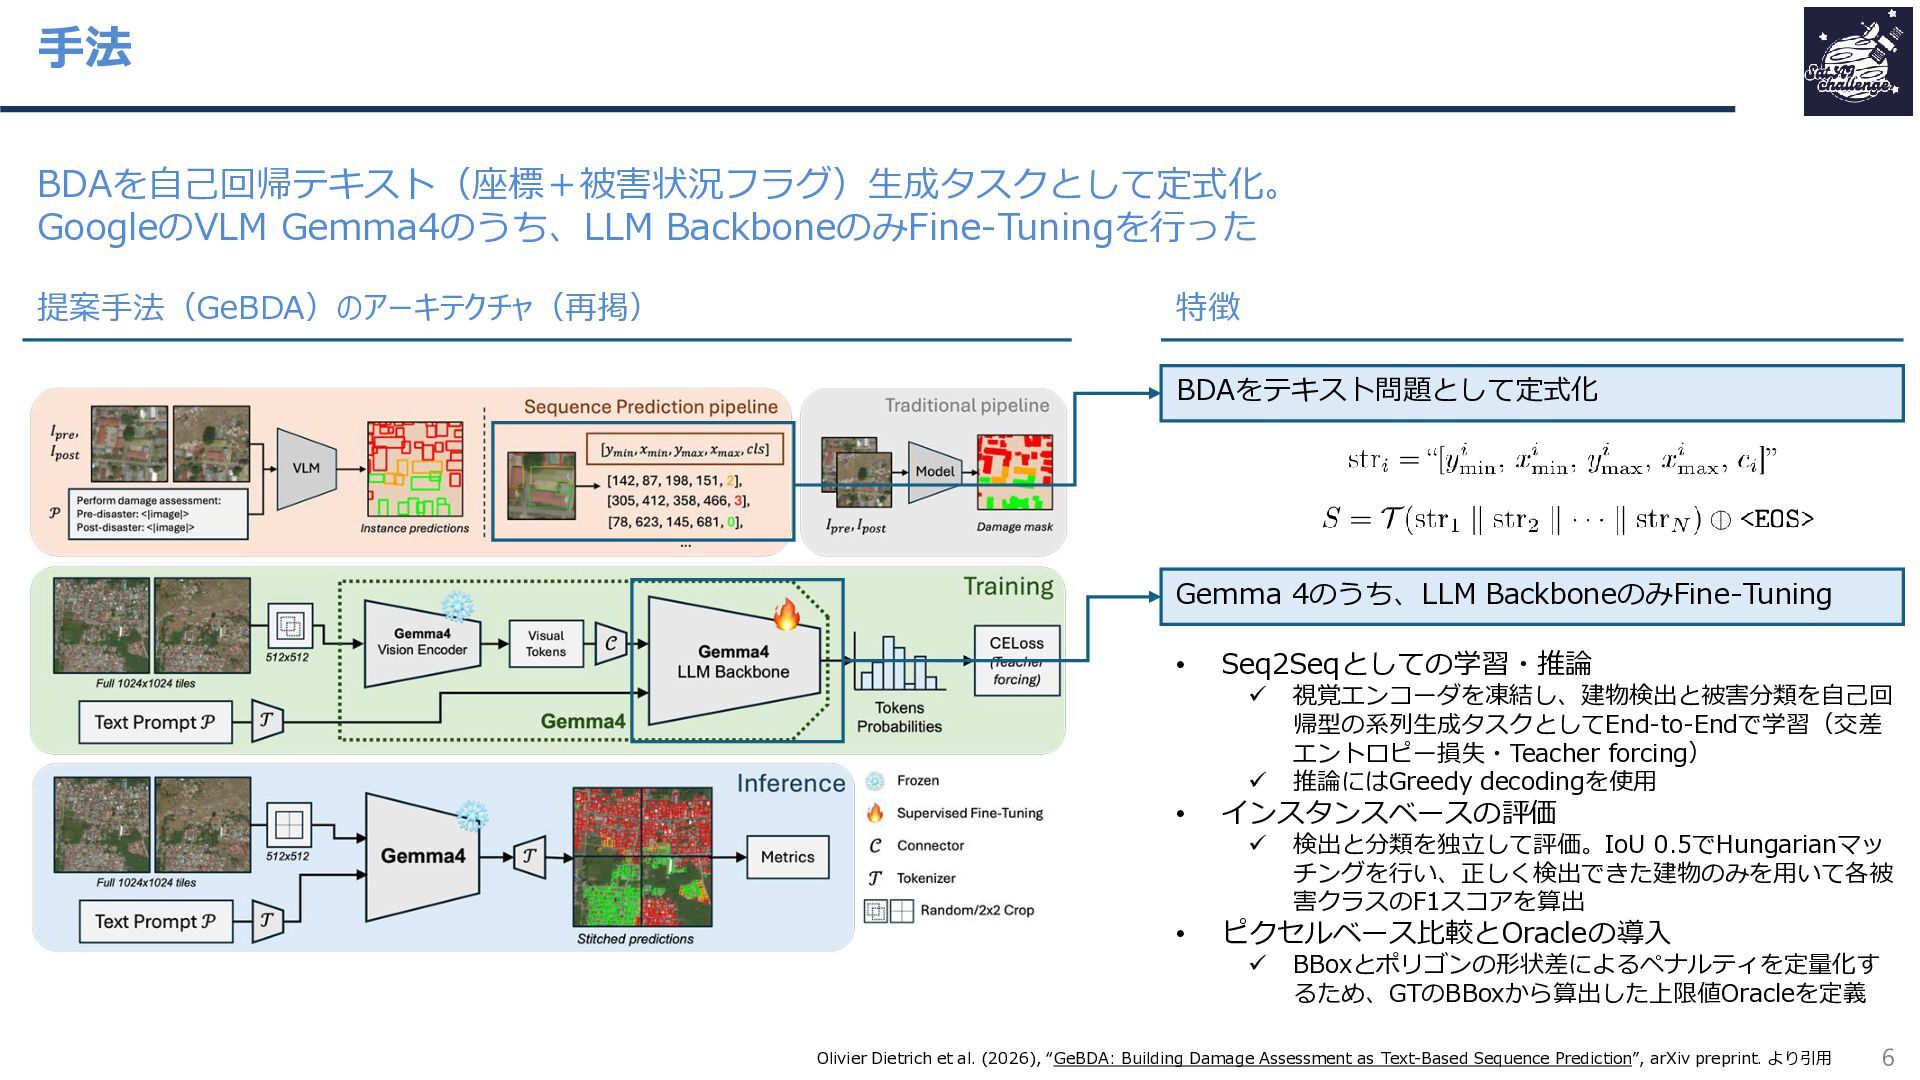
  5. 手法 BDAを自己回帰テキスト(座標+被害状況フラグ)生成タスクとして定式化。 GoogleのVLM Gemma4のうち、LLM BackboneのみFine-Tuningを行った 提案手法(GeBDA)のアーキテクチャ(再掲) 特徴 BDAをテキスト問題として定式化 Gemma 4のうち、LLM

    BackboneのみFine-Tuning • Seq2Seqとしての学習・推論 ✓ ✓ • インスタンスベースの評価 ✓ • 視覚エンコーダを凍結し、建物検出と被害分類を自己回 帰型の系列生成タスクとしてEnd-to-Endで学習(交差 エントロピー損失・Teacher forcing) 推論にはGreedy decodingを使用 検出と分類を独立して評価。IoU 0.5でHungarianマッ チングを行い、正しく検出できた建物のみを用いて各被 害クラスのF1スコアを算出 ピクセルベース比較とOracleの導入 ✓ BBoxとポリゴンの形状差によるペナルティを定量化す るため、GTのBBoxから算出した上限値Oracleを定義 Olivier Dietrich et al. (2026), “GeBDA: Building Damage Assessment as Text-Based Sequence Prediction”, arXiv preprint. より引用 6
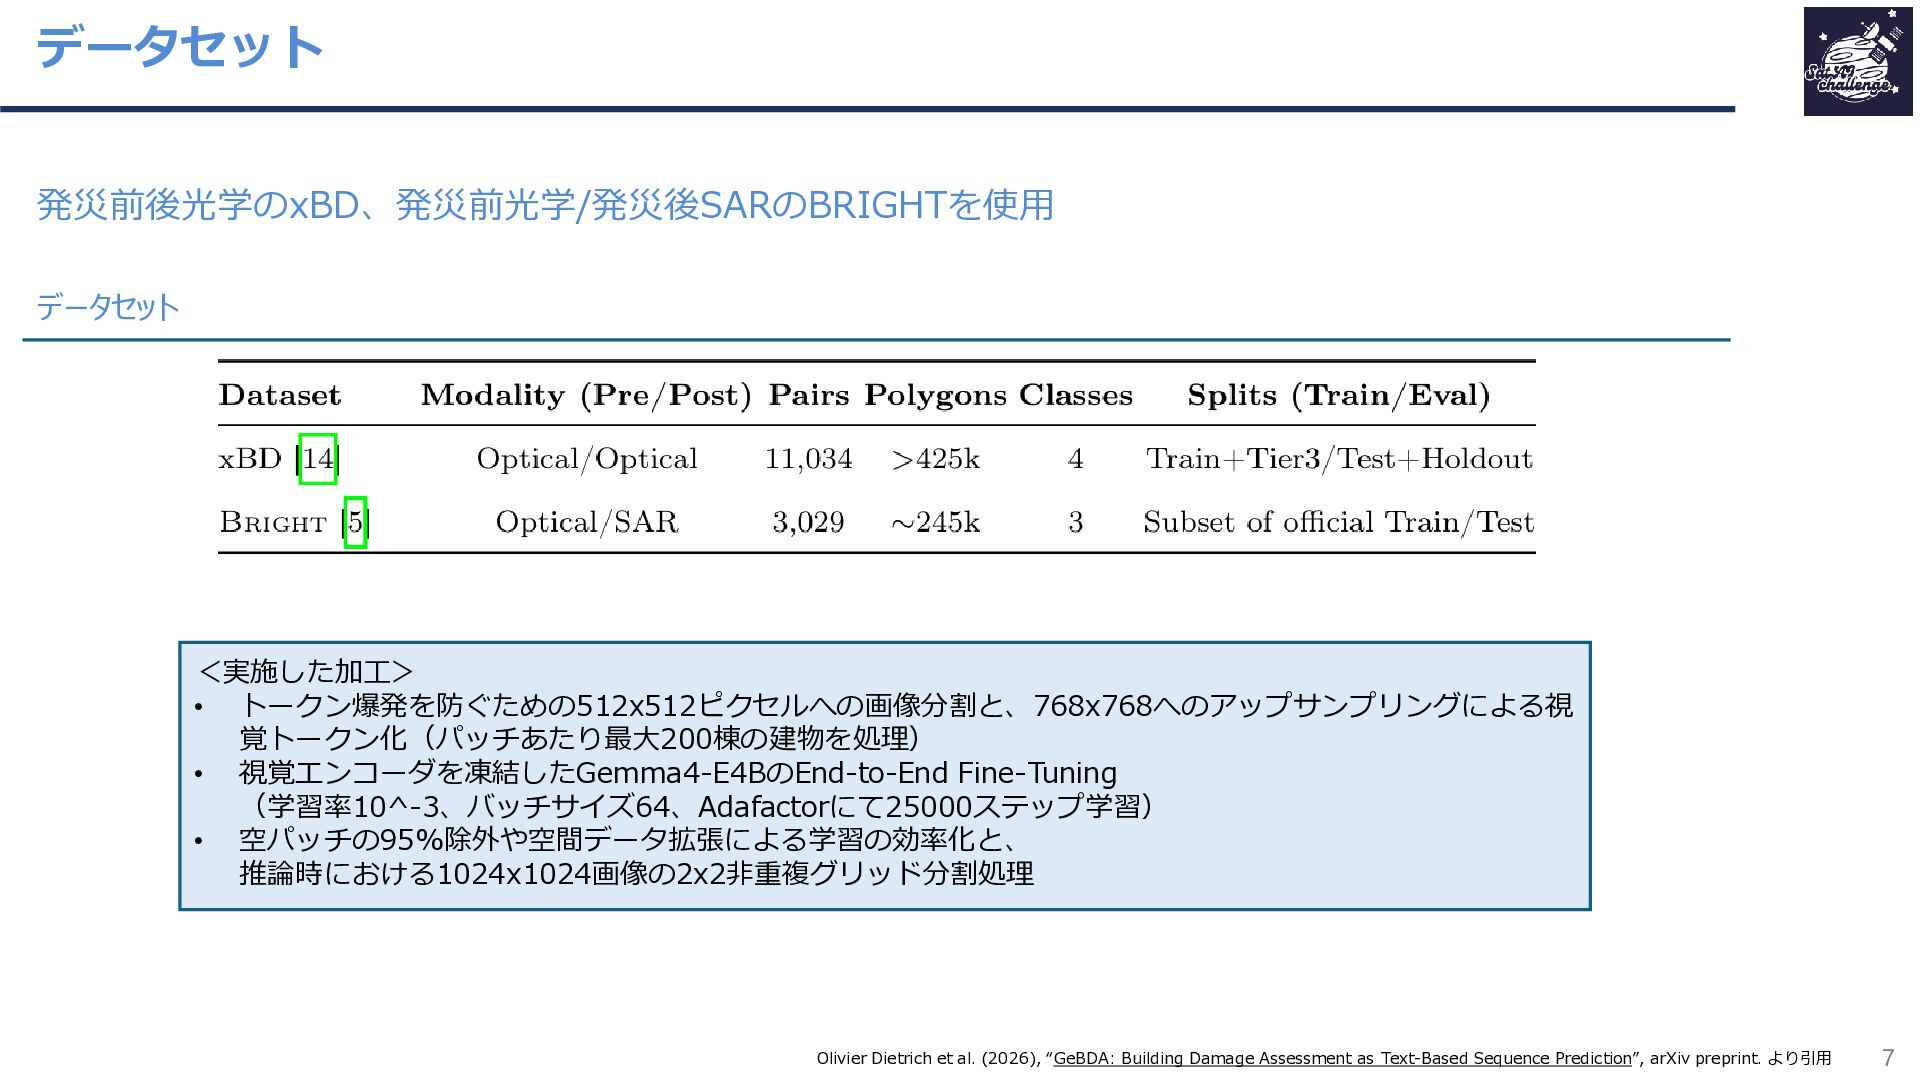
  6. データセット 発災前後光学のxBD、発災前光学/発災後SARのBRIGHTを使用 データセット <実施した加工> • トークン爆発を防ぐための512x512ピクセルへの画像分割と、768x768へのアップサンプリングによる視 覚トークン化(パッチあたり最大200棟の建物を処理) • 視覚エンコーダを凍結したGemma4-E4BのEnd-to-End Fine-Tuning

    (学習率10^-3、バッチサイズ64、Adafactorにて25000ステップ学習) • 空パッチの95%除外や空間データ拡張による学習の効率化と、 推論時における1024x1024画像の2x2非重複グリッド分割処理 Olivier Dietrich et al. (2026), “GeBDA: Building Damage Assessment as Text-Based Sequence Prediction”, arXiv preprint. より引用 7
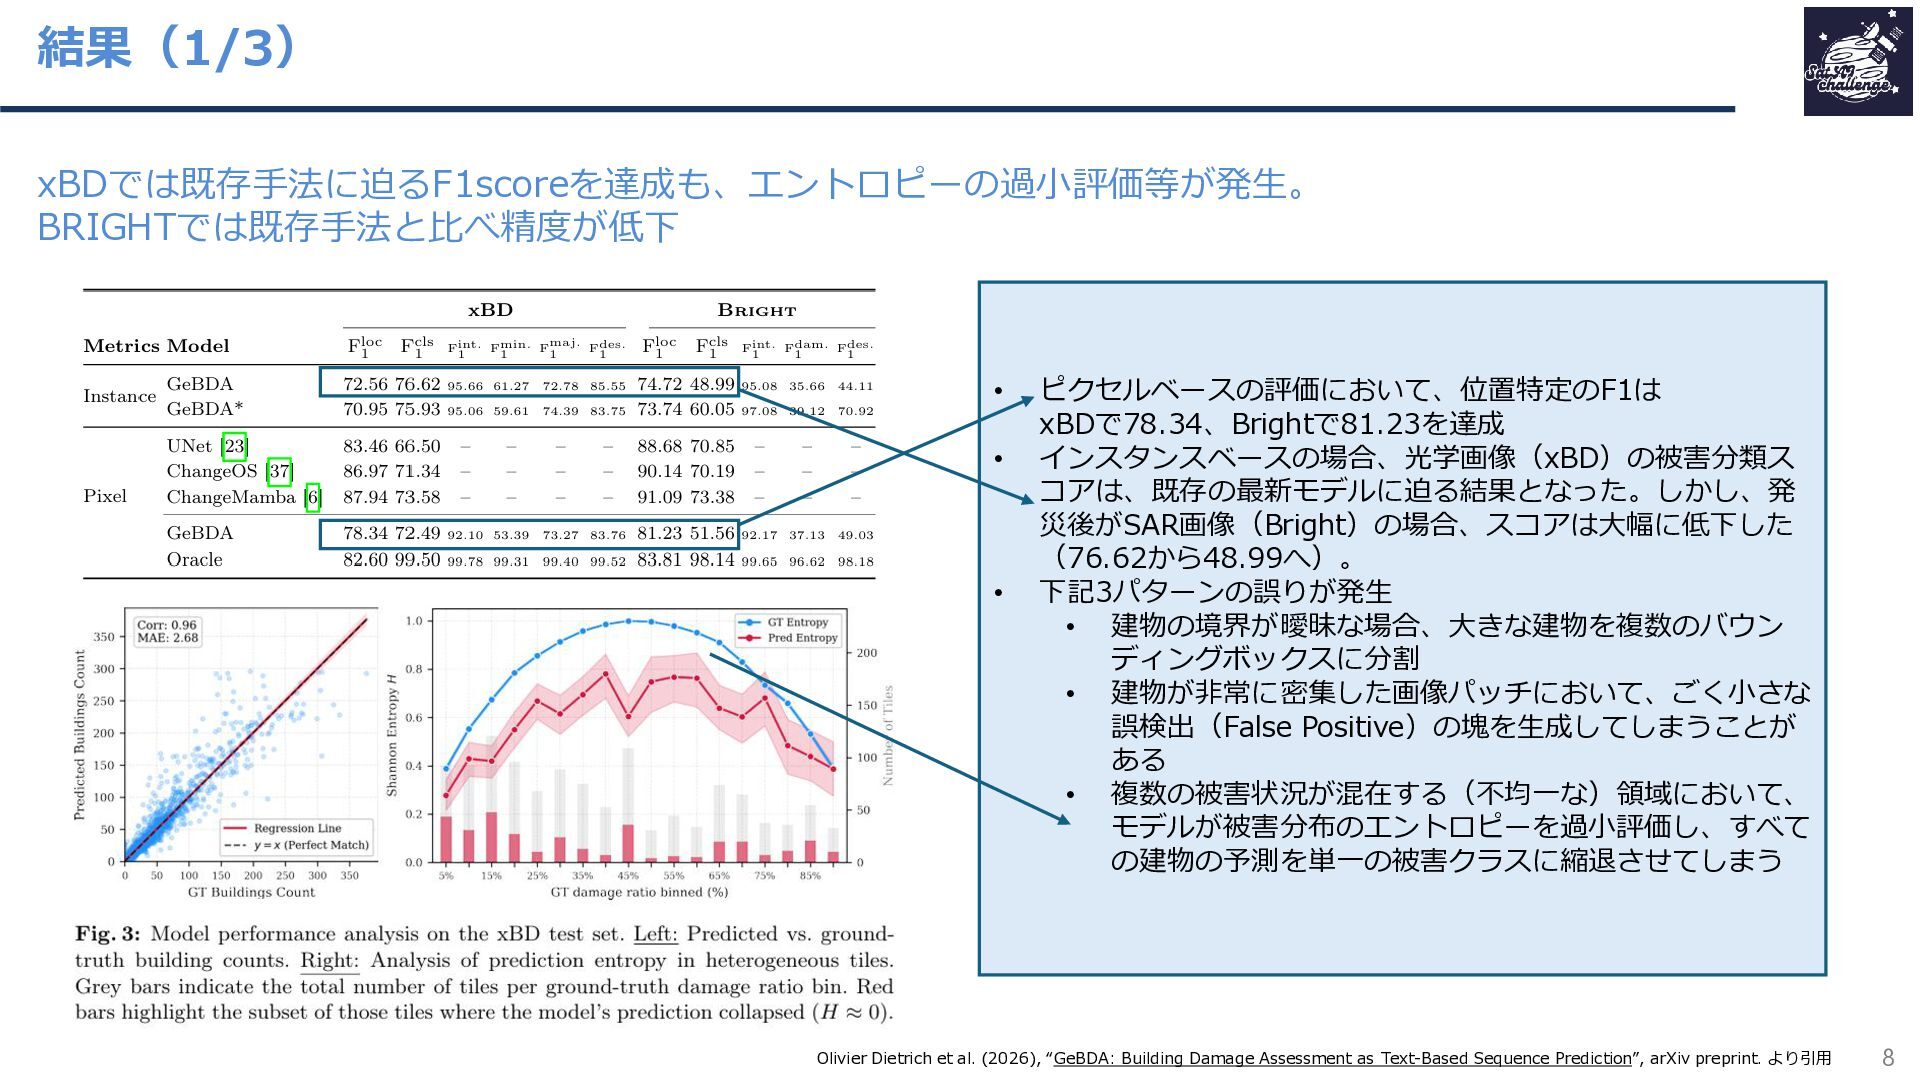
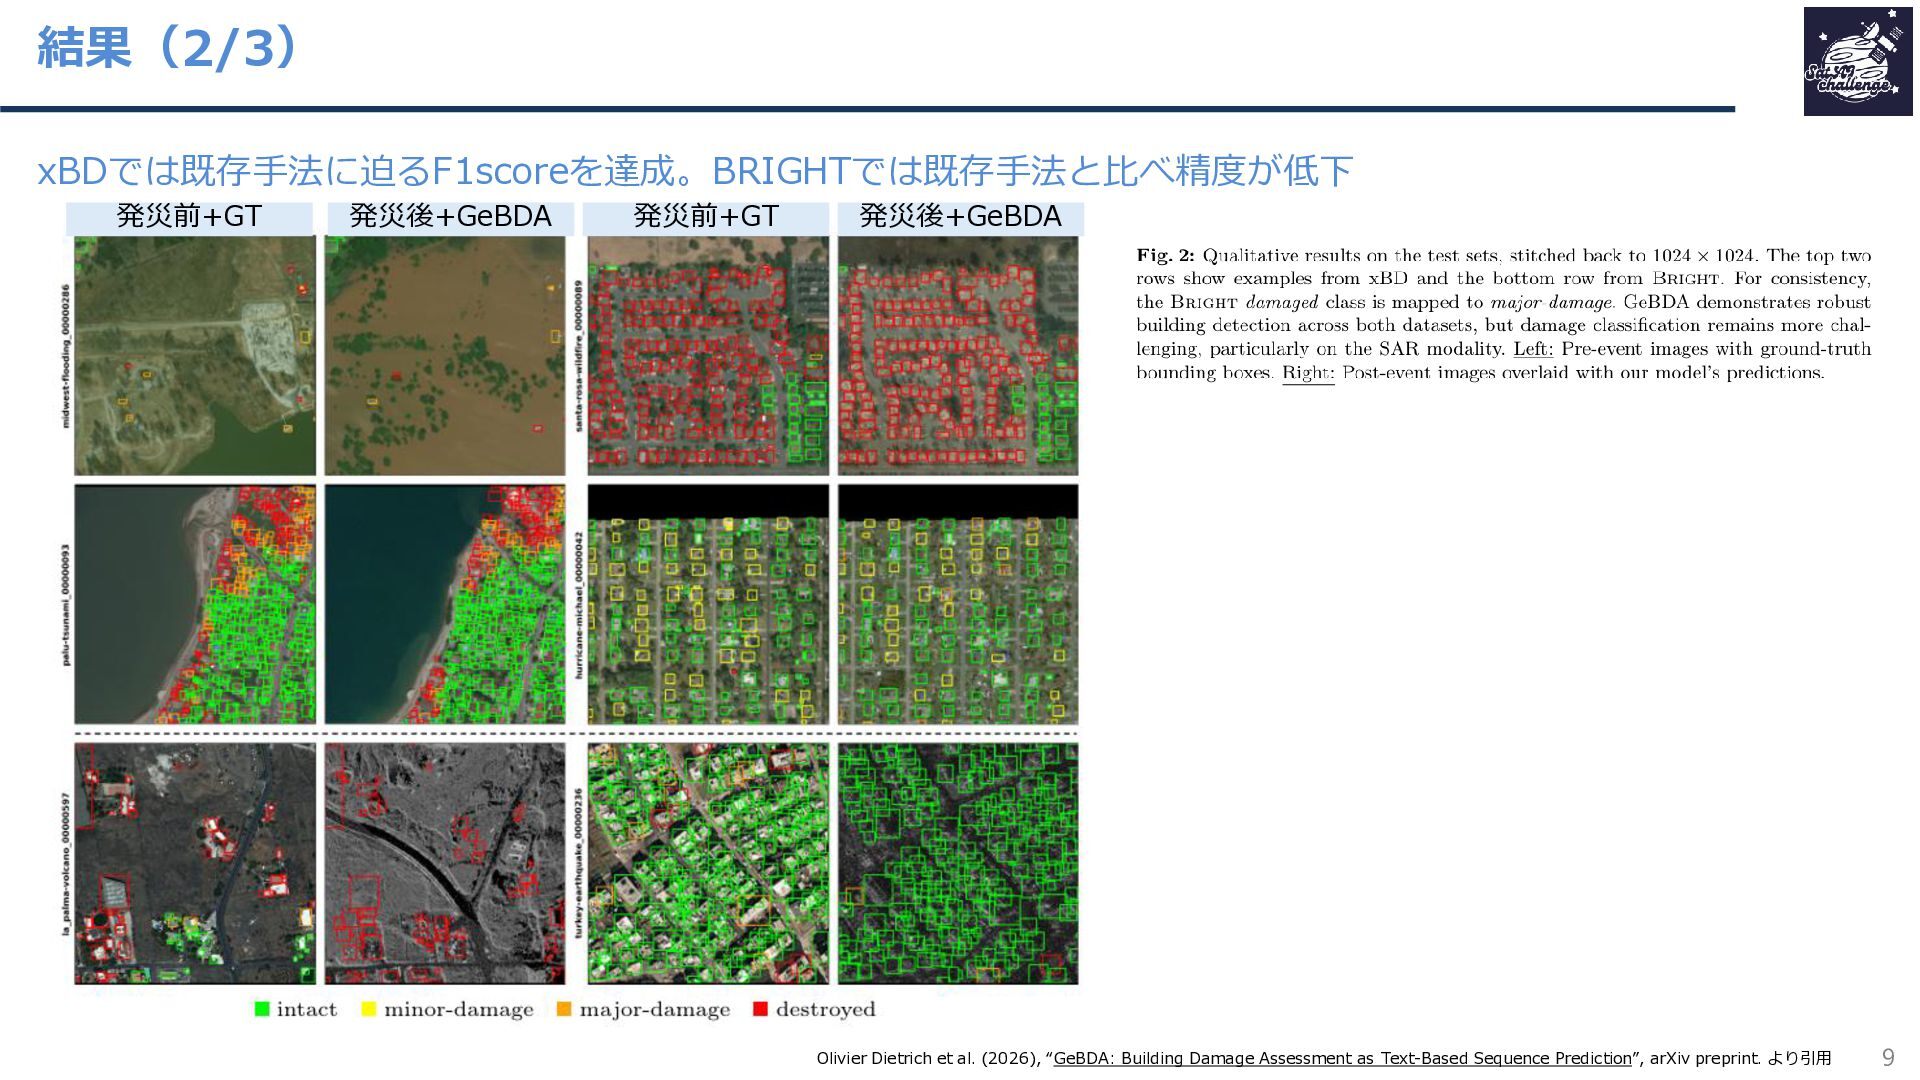
  7. 結果(1/3) xBDでは既存手法に迫るF1scoreを達成も、エントロピーの過小評価等が発生。 BRIGHTでは既存手法と比べ精度が低下 • • • ピクセルベースの評価において、位置特定のF1は xBDで78.34、Brightで81.23を達成 インスタンスベースの場合、光学画像(xBD)の被害分類ス コアは、既存の最新モデルに迫る結果となった。しかし、発

    災後がSAR画像(Bright)の場合、スコアは大幅に低下した (76.62から48.99へ)。 下記3パターンの誤りが発生 • 建物の境界が曖昧な場合、大きな建物を複数のバウン ディングボックスに分割 • 建物が非常に密集した画像パッチにおいて、ごく小さな 誤検出(False Positive)の塊を生成してしまうことが ある • 複数の被害状況が混在する(不均一な)領域において、 モデルが被害分布のエントロピーを過小評価し、すべて の建物の予測を単一の被害クラスに縮退させてしまう Olivier Dietrich et al. (2026), “GeBDA: Building Damage Assessment as Text-Based Sequence Prediction”, arXiv preprint. より引用 8
  8. 本論文を通しての気づき • 画像の分類をテキストとして扱う、というアプローチは興味深い • 一方で、テキスト自己回帰として扱うからこそ、不均一な被害の検出が難しい点は納得感がある • 次の単語を予測する仕組みのはず • 細かいが、光学画像でTrainされたGemma4を使えば、SARの精度向上は難しくのではないか? •

    性能差もほぼないとすると、現実的には、タスクを分割・単純化して 複数のモデルをつなげる、既存のGeoVLMが主流になっていくのではないか? • では、GoogleがGeBDAを提案した意図は何か?(より柔軟なGeoAgent? そこまでの柔軟性は必要なのか?)★要議論 11