Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
PyData.Fukuoka#6_LT_slide
Search
shinpsan
November 22, 2019
Programming
530
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
PyData.Fukuoka#6_LT_slide
前処理するとき便利だからよく
pandas.DataFrame.apply(lambda)
使っちゃうけど遅いから本当は
pandas.Series.map()
使った方がいいと思う
shinpsan
November 22, 2019
More Decks by shinpsan
See All by shinpsan
20251212_LT忘年会_データサイエンス枠_新川.pdf
shinpsan
0
330
CDLE_Fukuoka_20230523
shinpsan
0
220
LT_コンサル完全に理解したらミドルDSになった_ちゅらNOB合同勉強会
shinpsan
0
470
LT_統計学ユーザーでいいんです_みんなのPython勉強会#70
shinpsan
1
750
"Momochihama Store" on TNC has a wonderful "Udon MAP" section.
shinpsan
0
280
Other Decks in Programming
See All in Programming
AIで開発が速くなった先で、開発チームは何を目指すか
shihochan
1
1.6k
SalesForceを内製化!? ~ HR事業を支える顧客管理基盤のインフラを大公開 ~
oku053
0
180
R8 の設定見直しでアプリサイズ削減
andpad
0
220
現場と育てるRailsモデリング 〜Spreadsheetから始めたモデル設計〜
siroemk
2
630
PumaからFalconに移行したRailsアプリケーションでの実践
falcon8823
0
180
Agents on Rails - Rails at Scale 2026
irinanazarova
0
570
Herb in Rails 8.2: Your ERB views, now HTML-aware @ Kaigi on Rails 2026, Tokyo, Japan
marcoroth
2
270
Event is what happens
moro
2
860
機械に任せるテスト、人が見るテスト ⽣成AIで引き直した、運⽤保守フェーズの線引き
dske104
0
190
RAG の “R” を Swift で覗いてみる 〜「意味から探す」検索の仕組み〜
nao_randd
0
170
[2026-10-14](C)Re:ゼロから始める異世界生活〜始まりの終わりと終わりの始まり〜
tosite
0
100
Verilogで学ぶCPU自作入門
uyuki234
8
4.1k
Featured
See All Featured
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.4k
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
290
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
940
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
Marketing to machines
jonoalderson
1
5.9k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
Writing Fast Ruby
sferik
630
63k
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
300
How GitHub (no longer) Works
holman
316
150k
Transcript
前処理するとき便利だからよく pandas.DataFrame.apply(lambda) 使っちゃうけど遅いから本当は pandas.Series.map() 使った方がいいと思う PyData.Fukuoka #6 LT @shinpsan
自己紹介 下積みの父@shinpsan 小売業のデータサイエンティスト(12月まで。年明け転職します) MENSA会員 合同会社ocojoで副業 twitter : 仕事
: 特技: 趣味:
話すこと タイトルに書いたことが全てです。 pandasの基本的なところなのでみんな知ってる内容かも。 知ってる方はヒマだと思うので、心の中で 「シカ」って10回言った後、 「サンタクロースが乗っているのは?」に答えてて下さい
背景 クソみたいなデータ渡されたと文句言いながら、 いつもクソみたいなコード書いてることを反省。
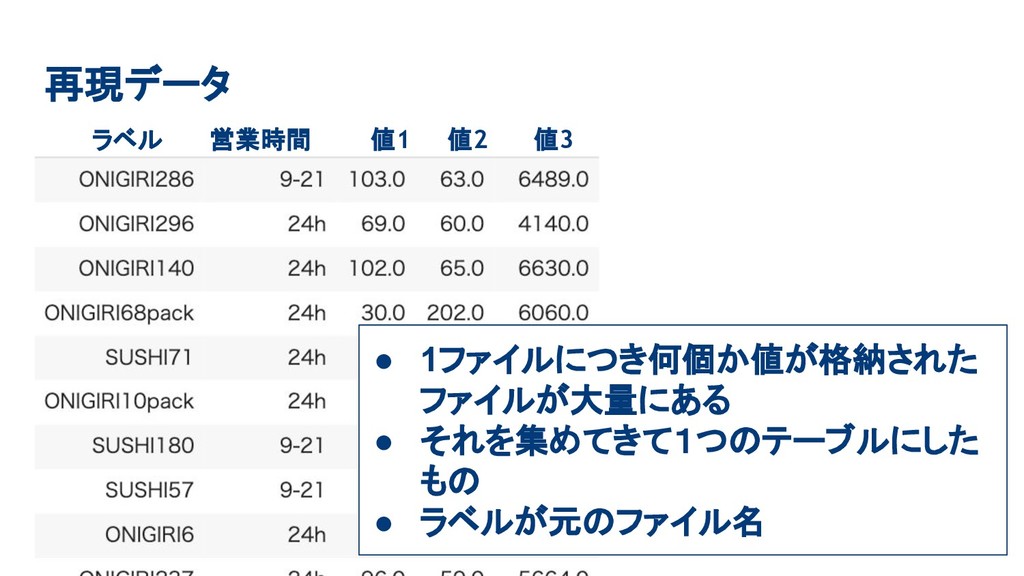
再現データ ラベル 営業時間 値1 値2 値3 • 1ファイルにつき何個か値が格納された ファイルが大量にある •
それを集めてきて1つのテーブルにした もの • ラベルが元のファイル名
やりたいこと(持っていきたい方向) 店舗の営業時間体系ごとの • 三角おにぎり • パックおにぎり • 寿司 のラベルをつけて集計とか 可視化とかいろいろ
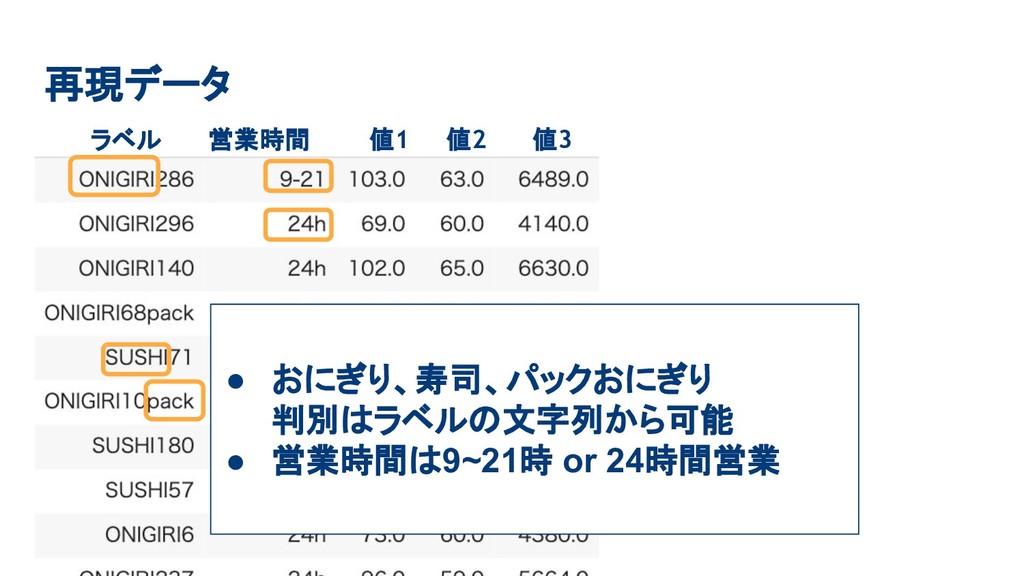
再現データ ラベル 営業時間 値1 値2 値3 • おにぎり、寿司、パックおにぎり 判別はラベルの文字列から可能
• 営業時間は9~21時 or 24時間営業
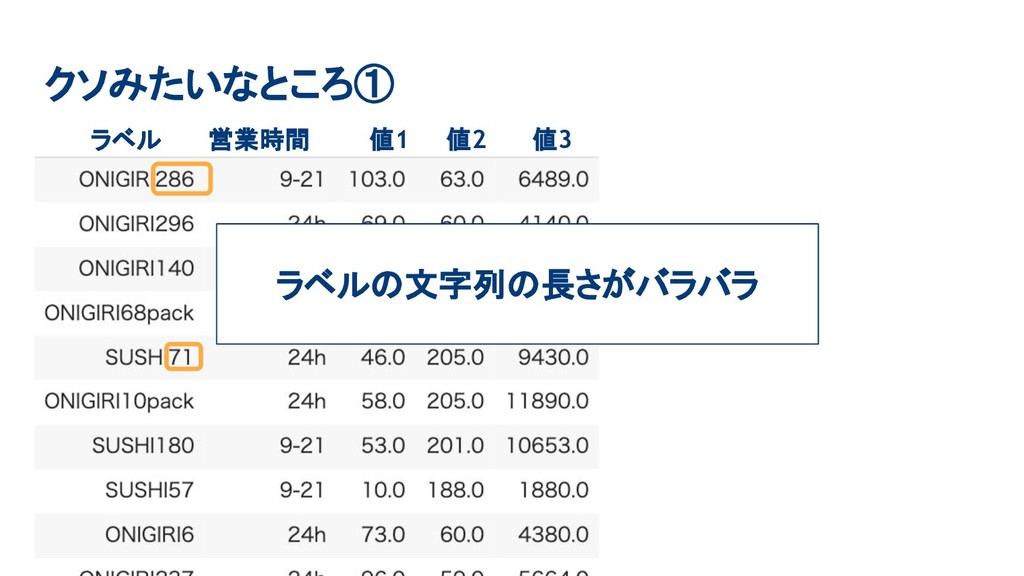
クソみたいなところ① ラベル 営業時間 値1 値2 値3 ラベルの文字列の長さがバラバラ
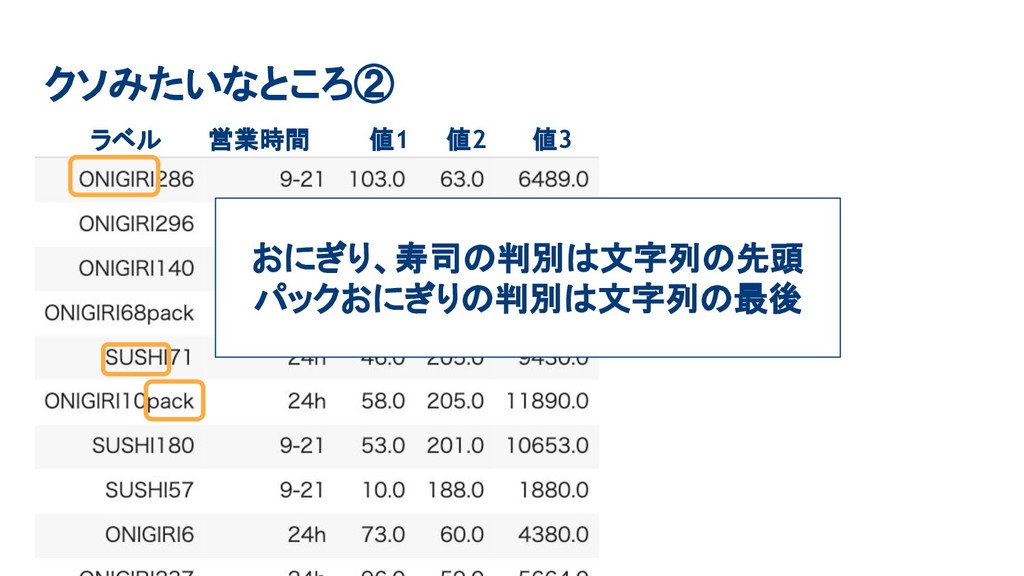
クソみたいなところ② ラベル 営業時間 値1 値2 値3 おにぎり、寿司の判別は文字列の先頭 パックおにぎりの判別は文字列の最後
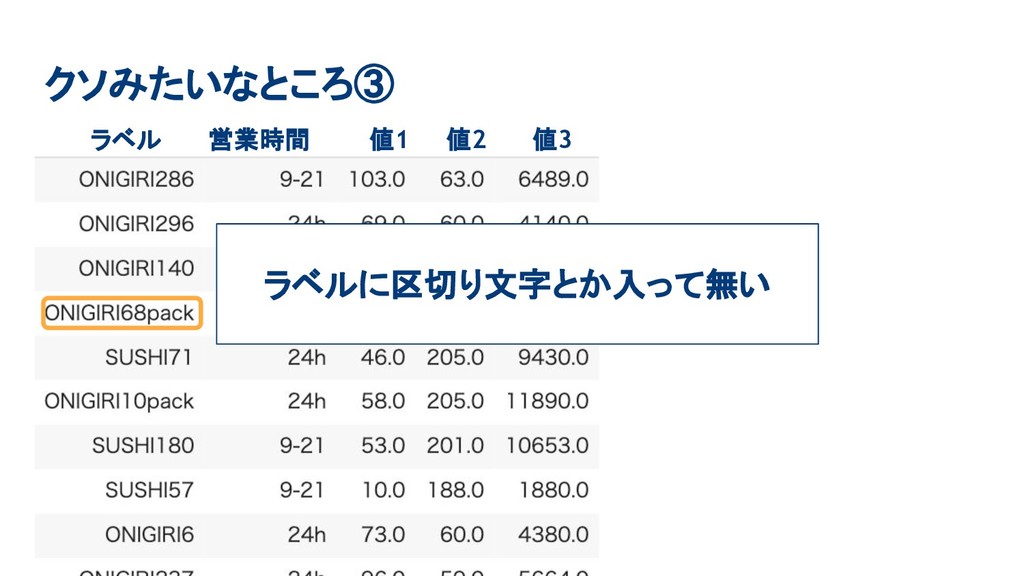
クソみたいなところ③ ラベル 営業時間 値1 値2 値3 ラベルに区切り文字とか入って無い
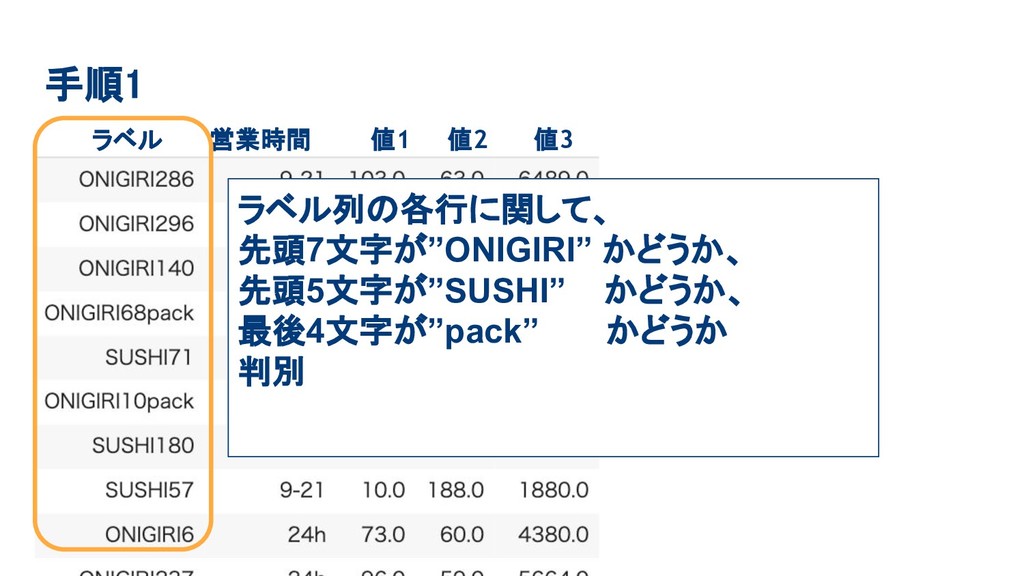
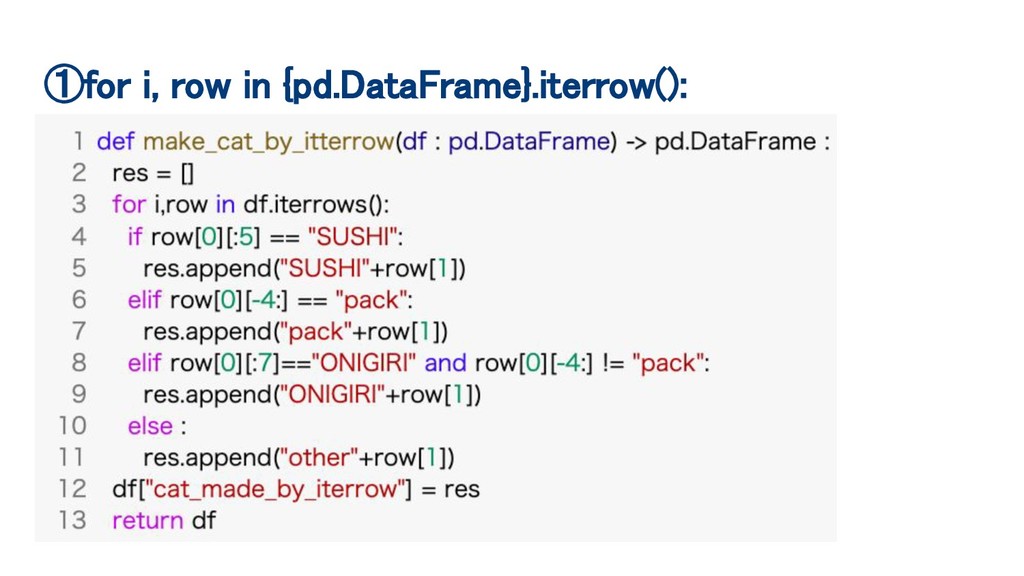
手順1 ラベル 営業時間 値1 値2 値3 ラベル列の各行に関して、 先頭7文字が”ONIGIRI” かどうか、 先頭5文字が”SUSHI”
かどうか、 最後4文字が”pack” かどうか 判別
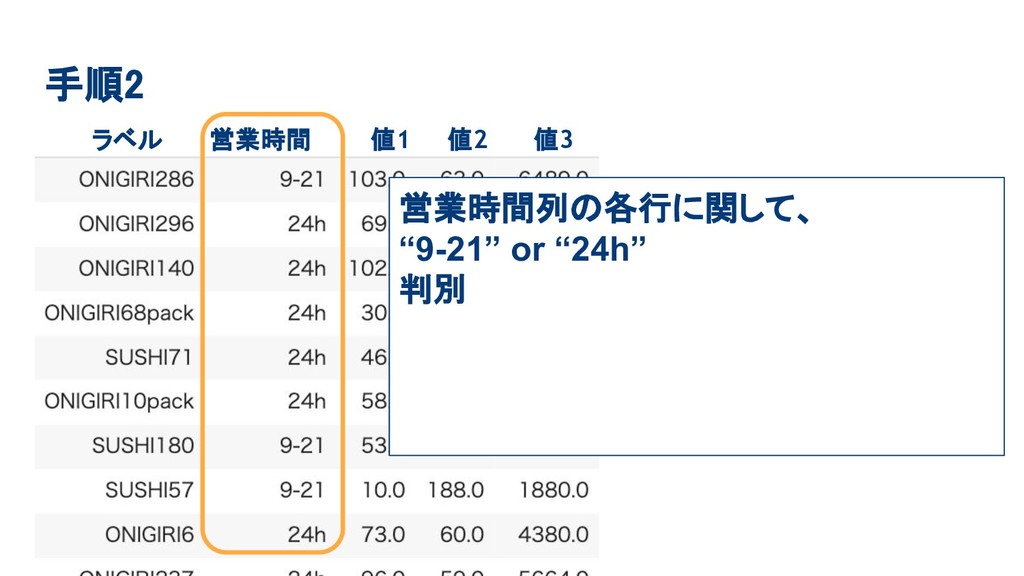
手順2 ラベル 営業時間 値1 値2 値3 営業時間列の各行に関して、 “9-21” or “24h”
判別
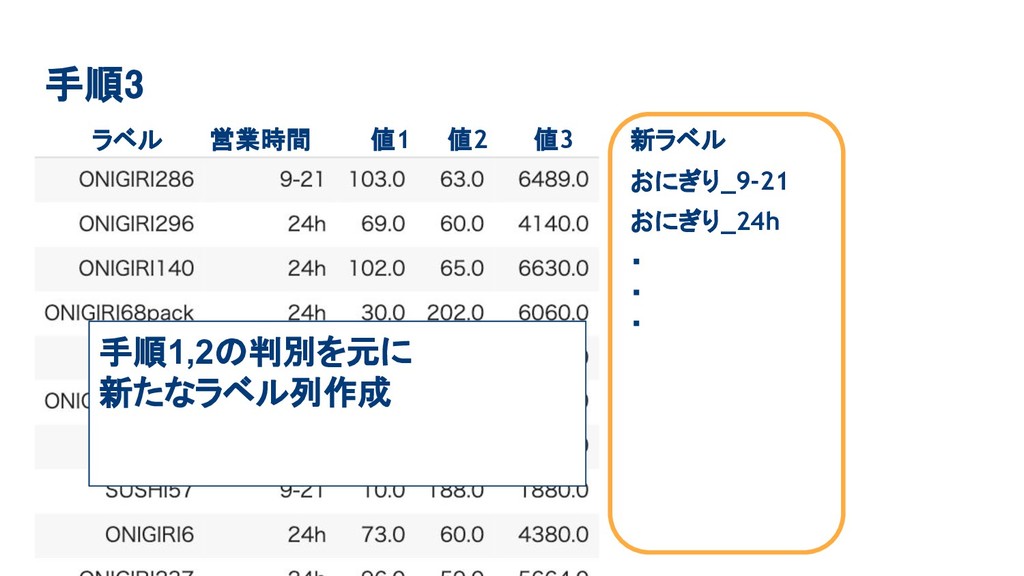
手順3 ラベル 営業時間 値1 値2 値3 手順1,2の判別を元に 新たなラベル列作成 新ラベル おにぎり_9-21
おにぎり_24h ・ ・ ・
ここで本題 どんな処理書く? • for + iterrows() • df.apply() • Series.map()
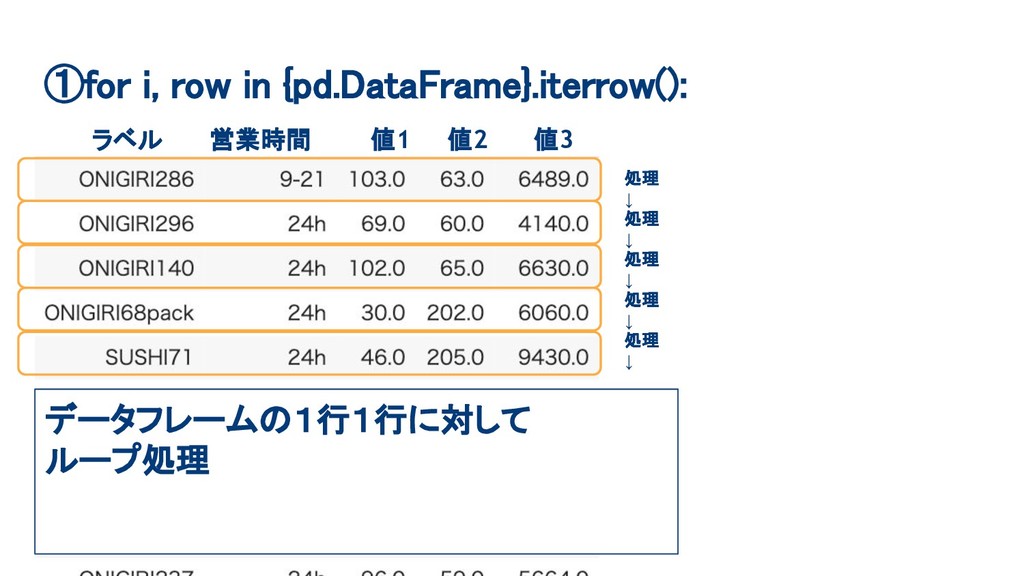
①for i, row in {pd.DataFrame}.iterrow(): ラベル 営業時間 値1 値2 値3
データフレームの1行1行に対して ループ処理 処理 ↓ 処理 ↓ 処理 ↓ 処理 ↓ 処理 ↓
①for i, row in {pd.DataFrame}.iterrow():
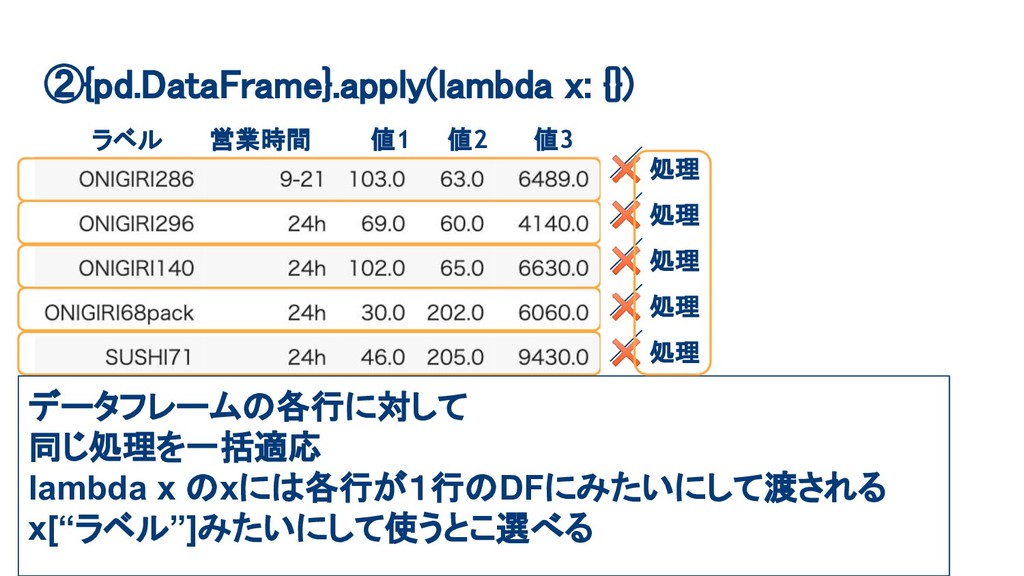
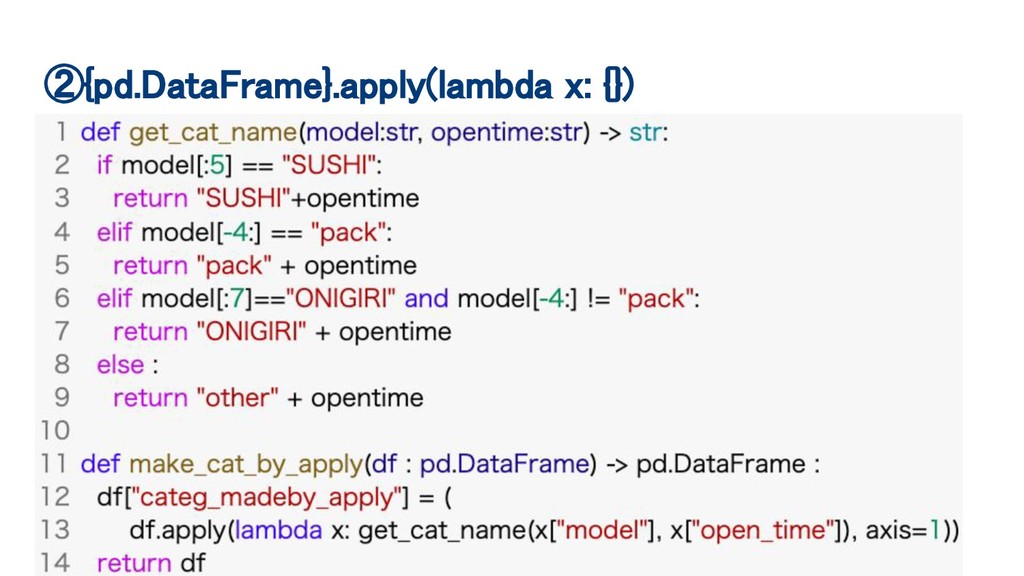
②{pd.DataFrame}.apply(lambda x: {}) ラベル 営業時間 値1 値2 値3 データフレームの各行に対して 同じ処理を一括適応
lambda x のxには各行が1行のDFにみたいにして渡される x[“ラベル”]みたいにして使うとこ選べる ✖ 処理 ✖ 処理 ✖ 処理 ✖ 処理 ✖ 処理
②{pd.DataFrame}.apply(lambda x: {})
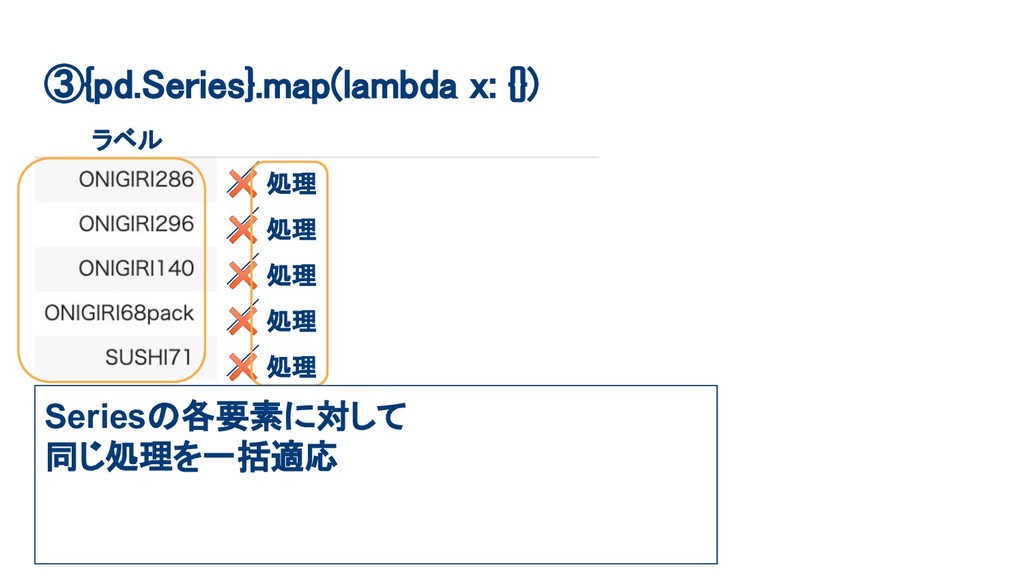
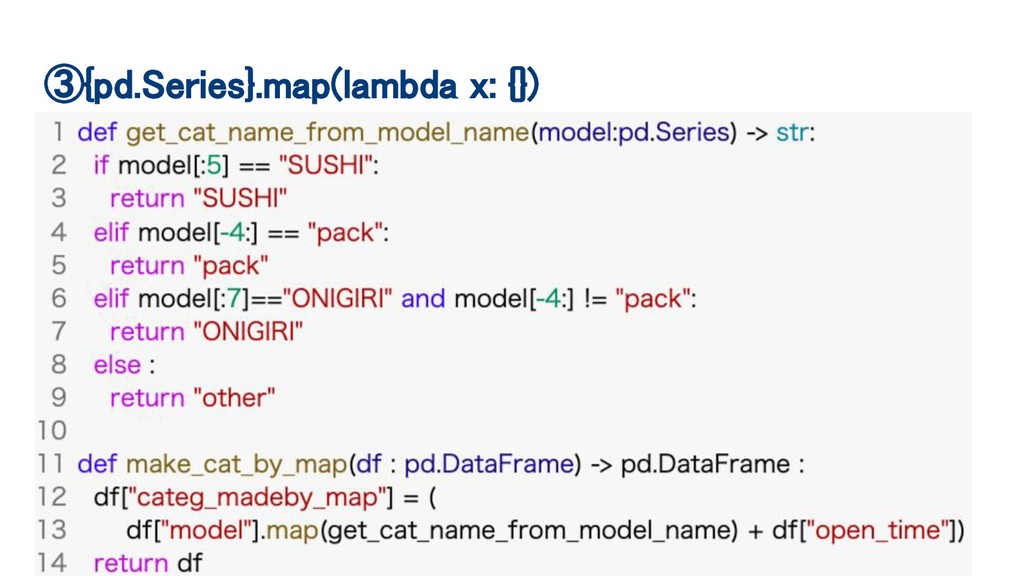
③{pd.Series}.map(lambda x: {}) ラベル ✖ 処理 ✖ 処理 ✖ 処理
✖ 処理 ✖ 処理 Seriesの各要素に対して 同じ処理を一括適応
③{pd.Series}.map(lambda x: {})
None
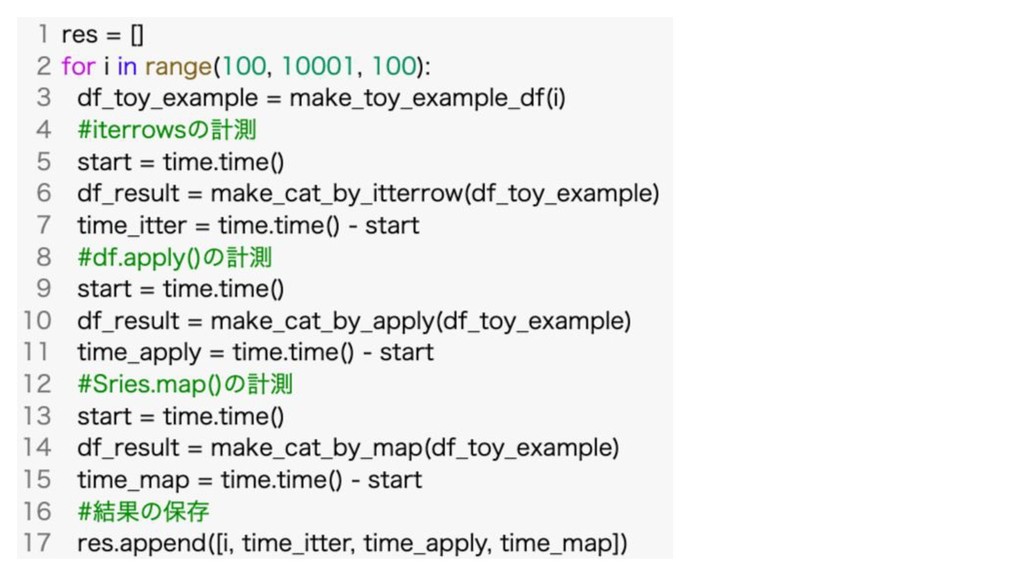
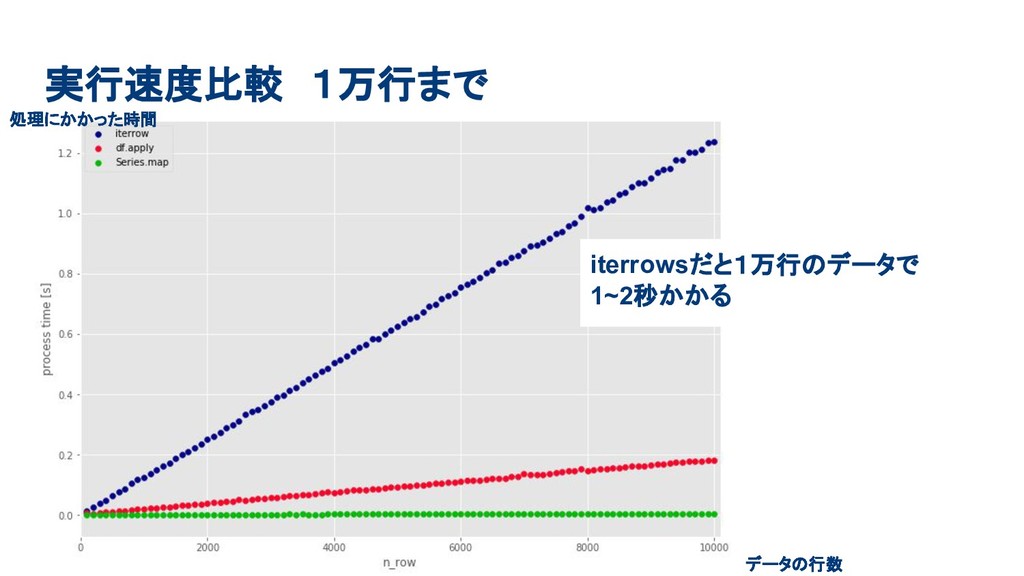
実行速度比較 1万行まで iterrowsだと1万行のデータで 1~2秒かかる データの行数 処理にかかった時間
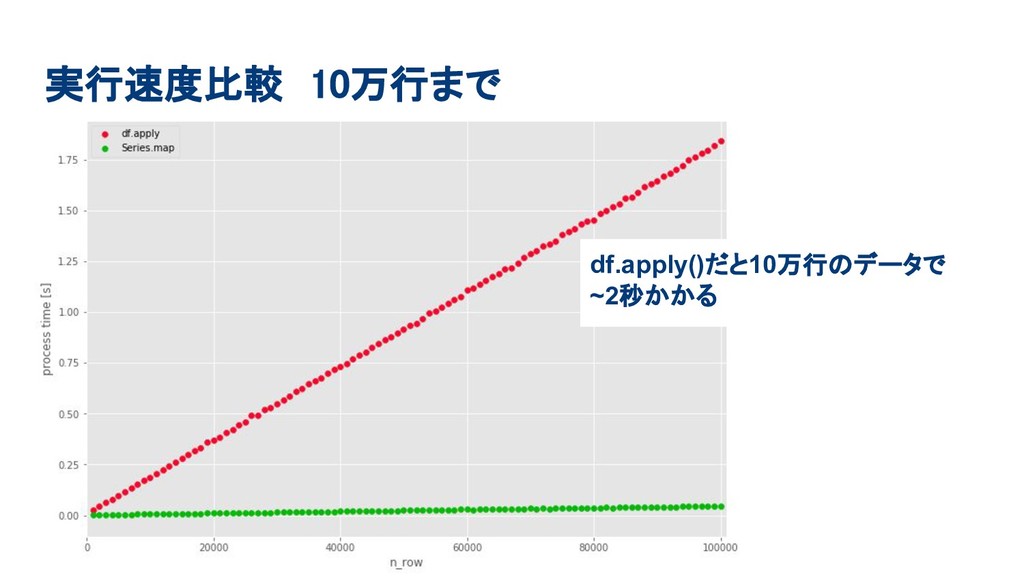
実行速度比較 10万行まで df.apply()だと10万行のデータで ~2秒かかる
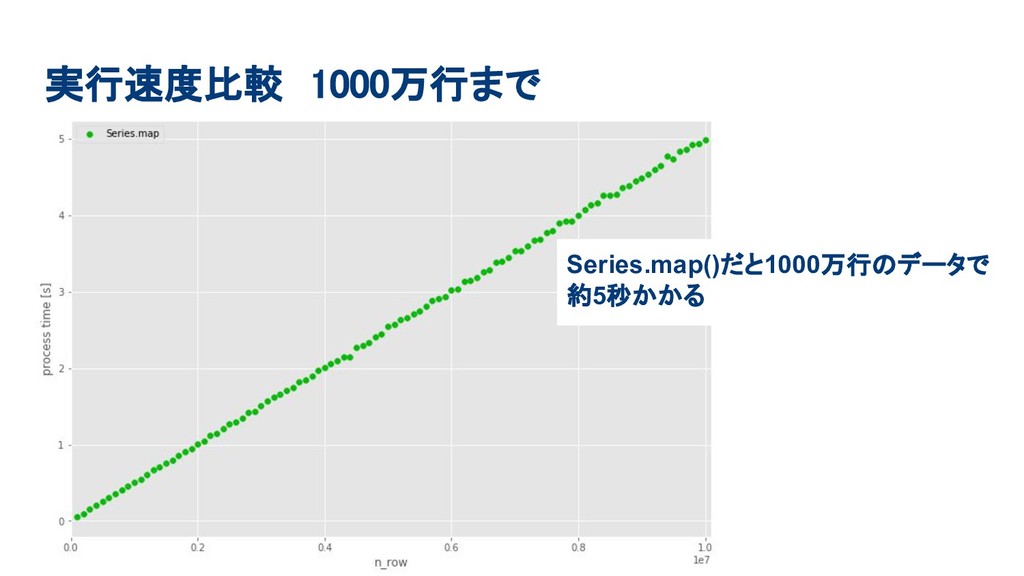
実行速度比較 1000万行まで Series.map()だと1000万行のデータで 約5秒かかる
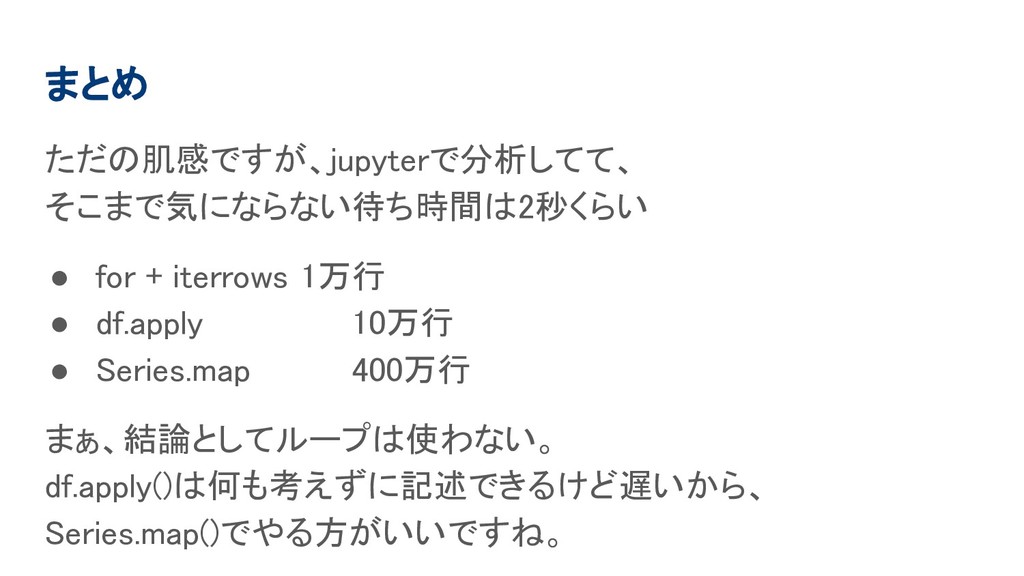
まとめ ただの肌感ですが、jupyterで分析してて、 そこまで気にならない待ち時間は2秒くらい • for + iterrows 1万行 • df.apply
10万行 • Series.map 400万行 まぁ、結論としてループは使わない。 df.apply()は何も考えずに記述できるけど遅いから、 Series.map()でやる方がいいですね。
enjoy! 答え:そり(トナカイには乗っていない)


 shinpsan
 shihochan
 oku053
 andpad
 siroemk
 falcon8823
 irinanazarova
 marcoroth
 moro
 dske104
 nao_randd
 tosite
 uyuki234
 jeffersonlam
 afnizarnur
 szymonslowik
 kimpetersen
 tammyeverts
 chrisshort
 tanoku
 jonoalderson
 jct
 sferik
 sarafernandez
 holman