Upgrade to Pro — share decks privately, control downloads, hide ads and more …

SLOを阻む不安

Avatar for sraku sraku
October 30, 2026

 SLOを阻む不安

SLO導入にはステークホルダー達の説得が必要になります。
本スライドは自分が以前導入に失敗した経験を振り返って、SLO導入の前にやるべき事の一つとしてSLOでは測れない大きな損失があることと、その対応についてのお話になります。

Avatar for sraku

sraku

October 30, 2026

Other Decks in Technology

Transcript

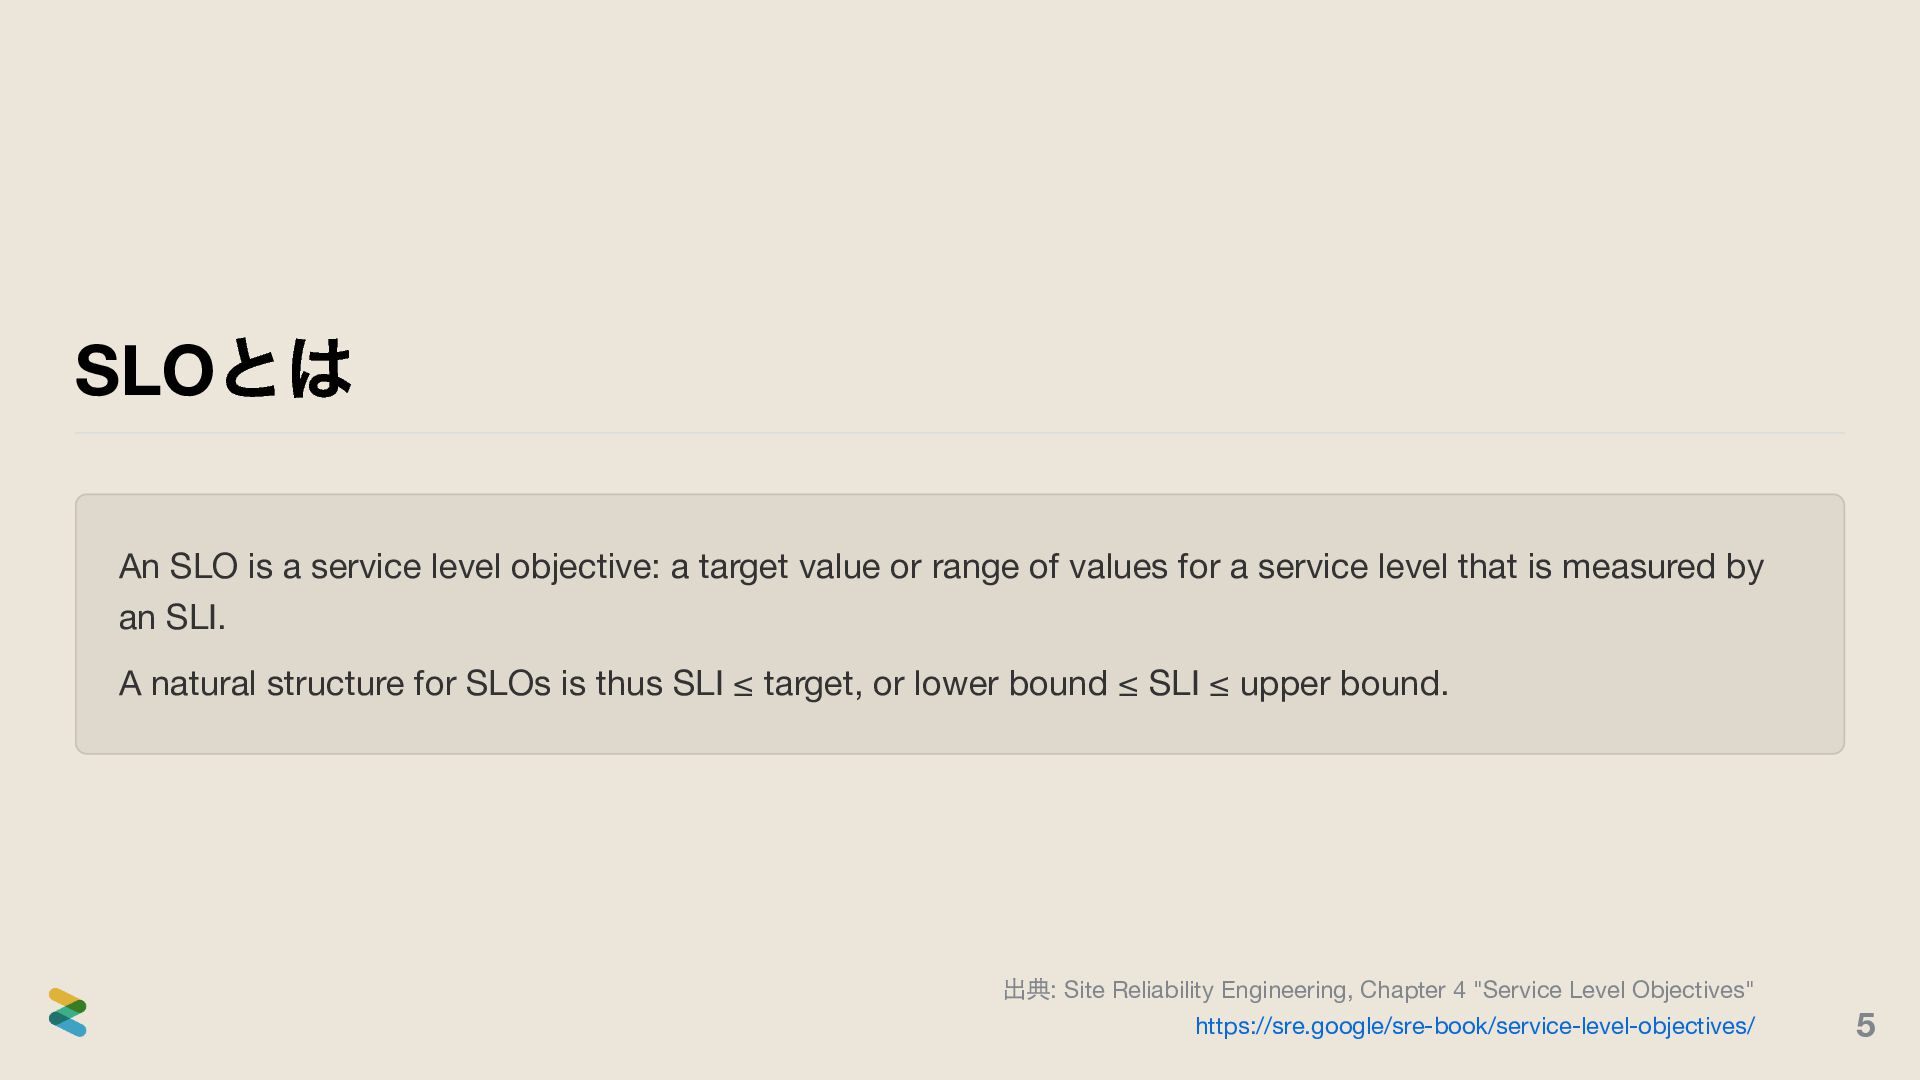
  1. とは SLO An SLO is a service level objective: a

    target value or range of values for a service level that is measured by an SLI. A natural structure for SLOs is thus SLI ≤ target, or lower bound ≤ SLI ≤ upper bound. 出典: Site Reliability Engineering, Chapter 4 "Service Level Objectives" https://sre.google/sre-book/service-level-objectives/ 5
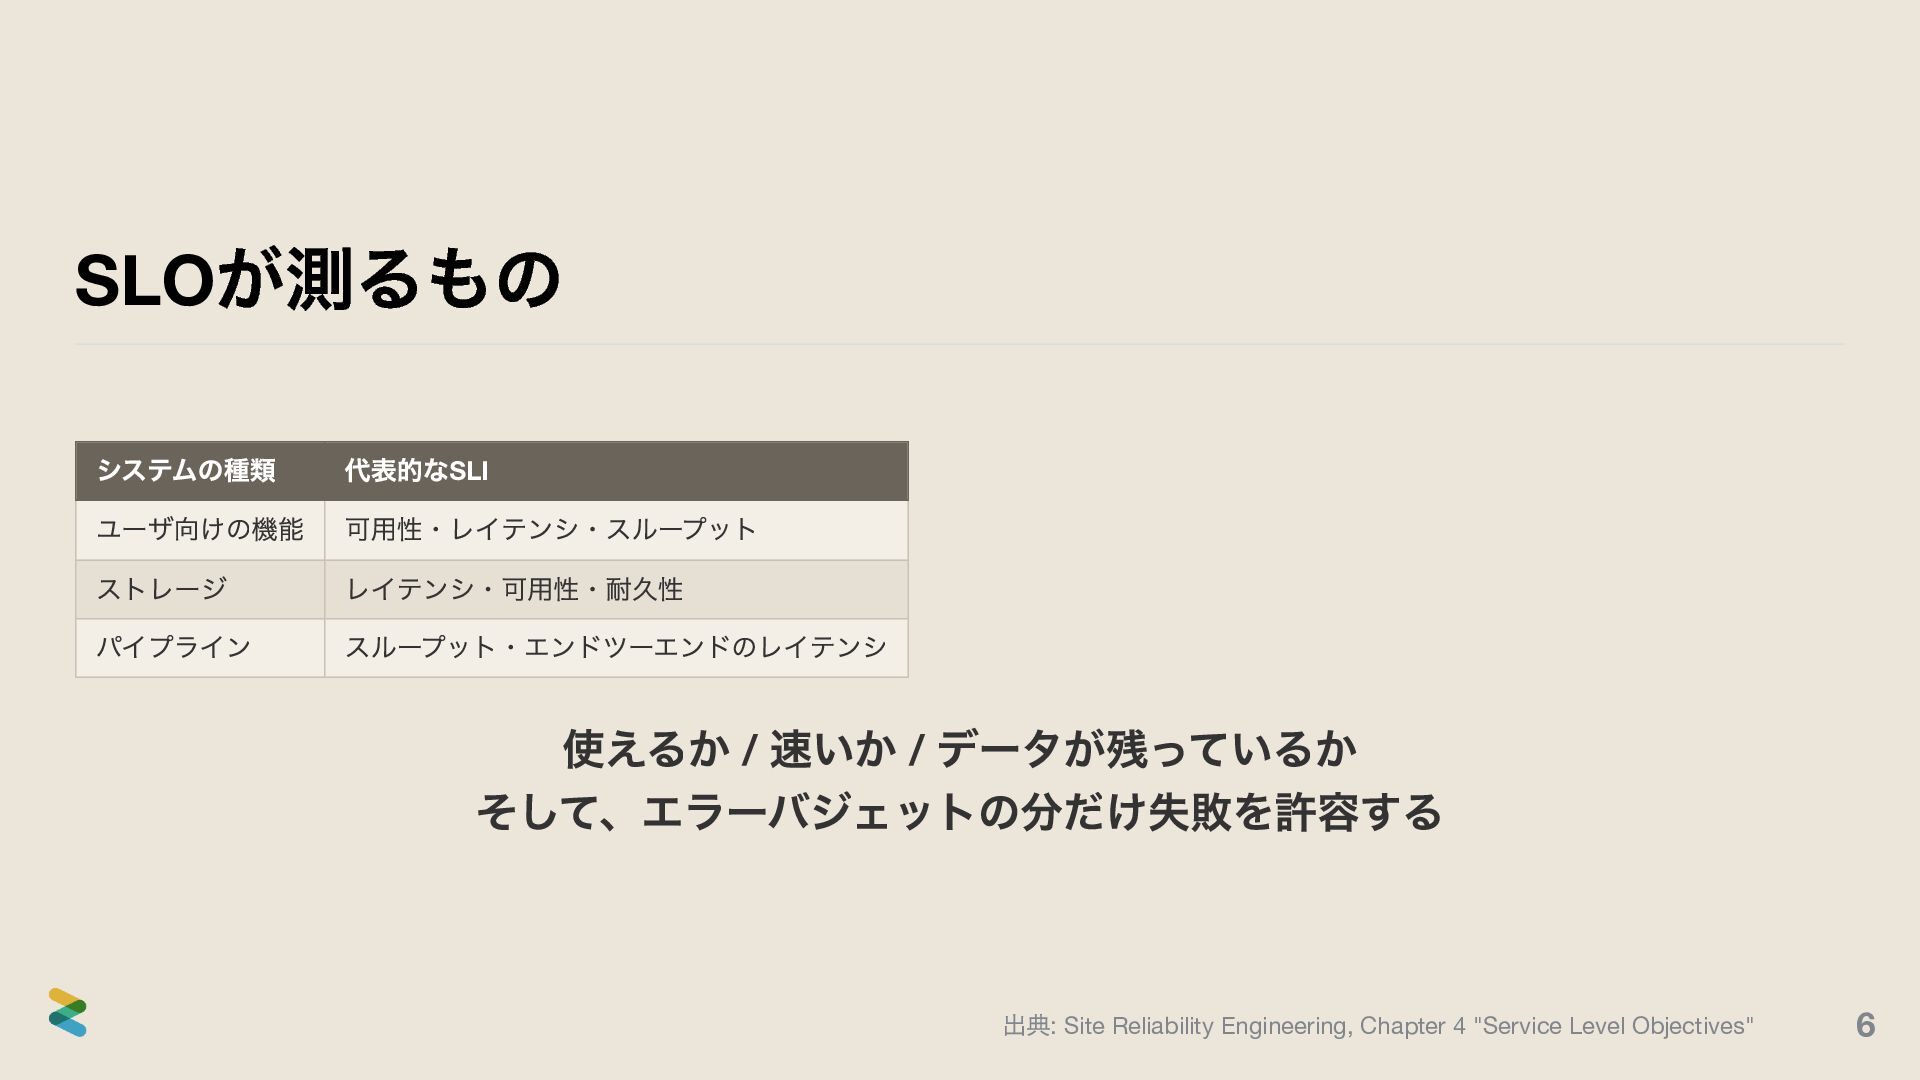
  2. が測るもの SLO システムの種類 ユーザ向けの機能 ストレージ パイプライン 代表的なSLI 可用性・レイテンシ・スループット レイテンシ・可用性・耐久性 スループット・エンドツーエンドのレイテンシ

    使えるか / 速いか / データが残っているか そして、エラーバジェットの分だけ失敗を許容する 出典: Site Reliability Engineering, Chapter 4 "Service Level Objectives" 6
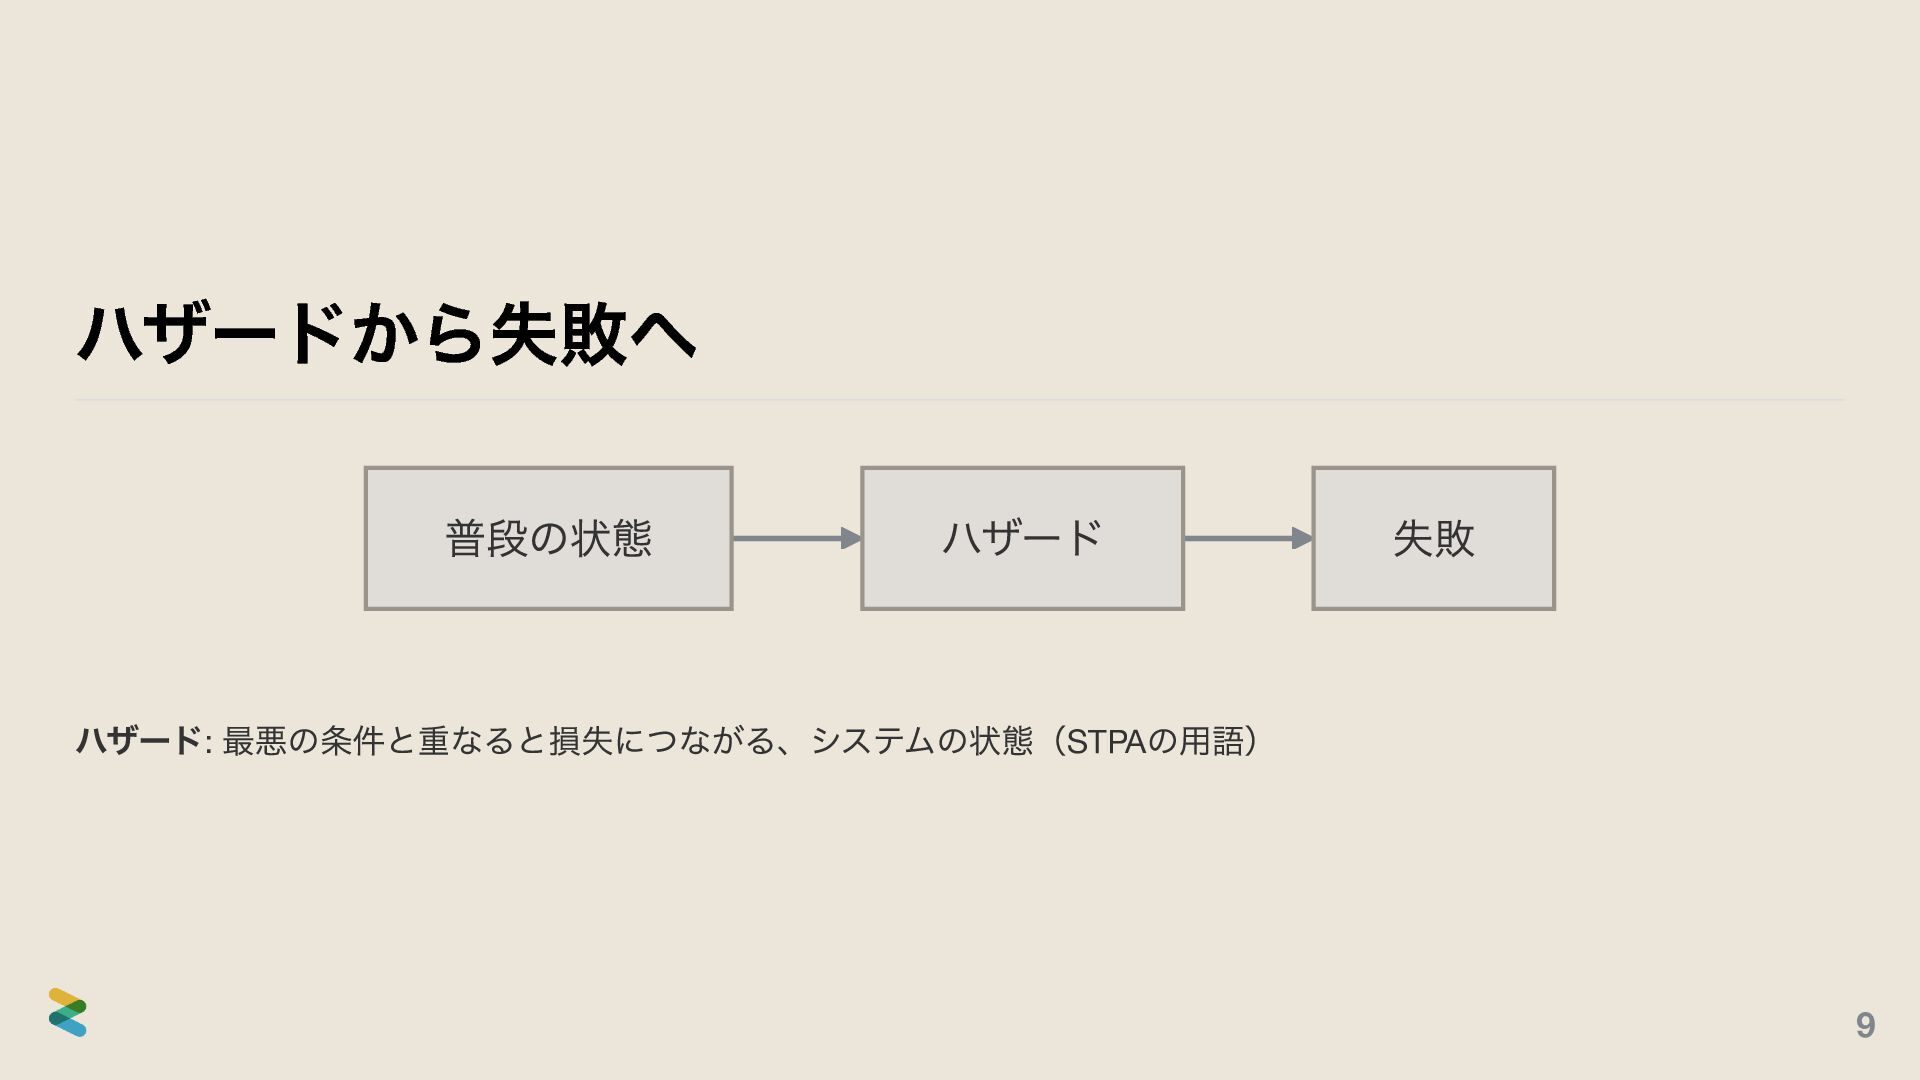
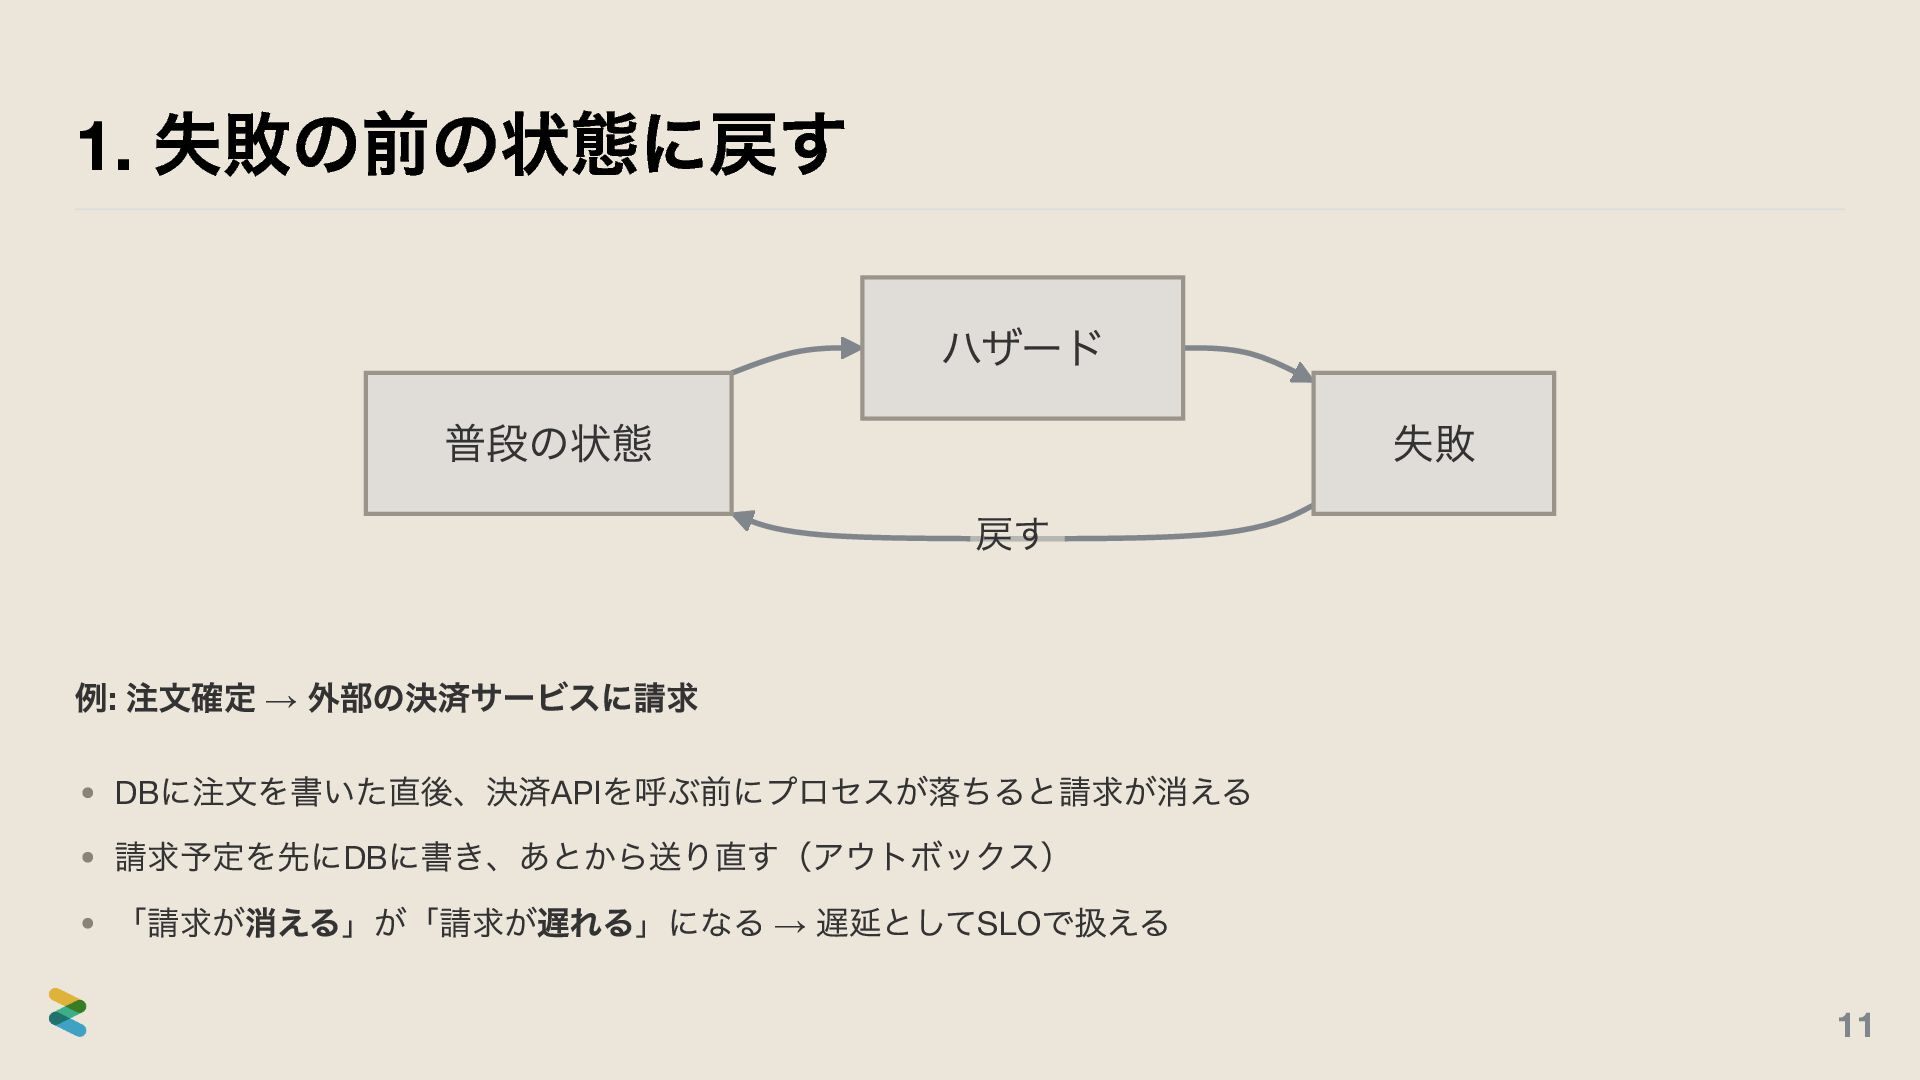
  3. 1. 失敗の前の状態に戻す 普段の状態 ハザード 戻す 失敗 例: 注文確定 → 外部の決済サービスに請求

    DBに注文を書いた直後、決済APIを呼ぶ前にプロセスが落ちると請求が消える 請求予定を先にDBに書き、あとから送り直す(アウトボックス) 「請求が消える」が「請求が遅れる」になる → 遅延としてSLOで扱える 11
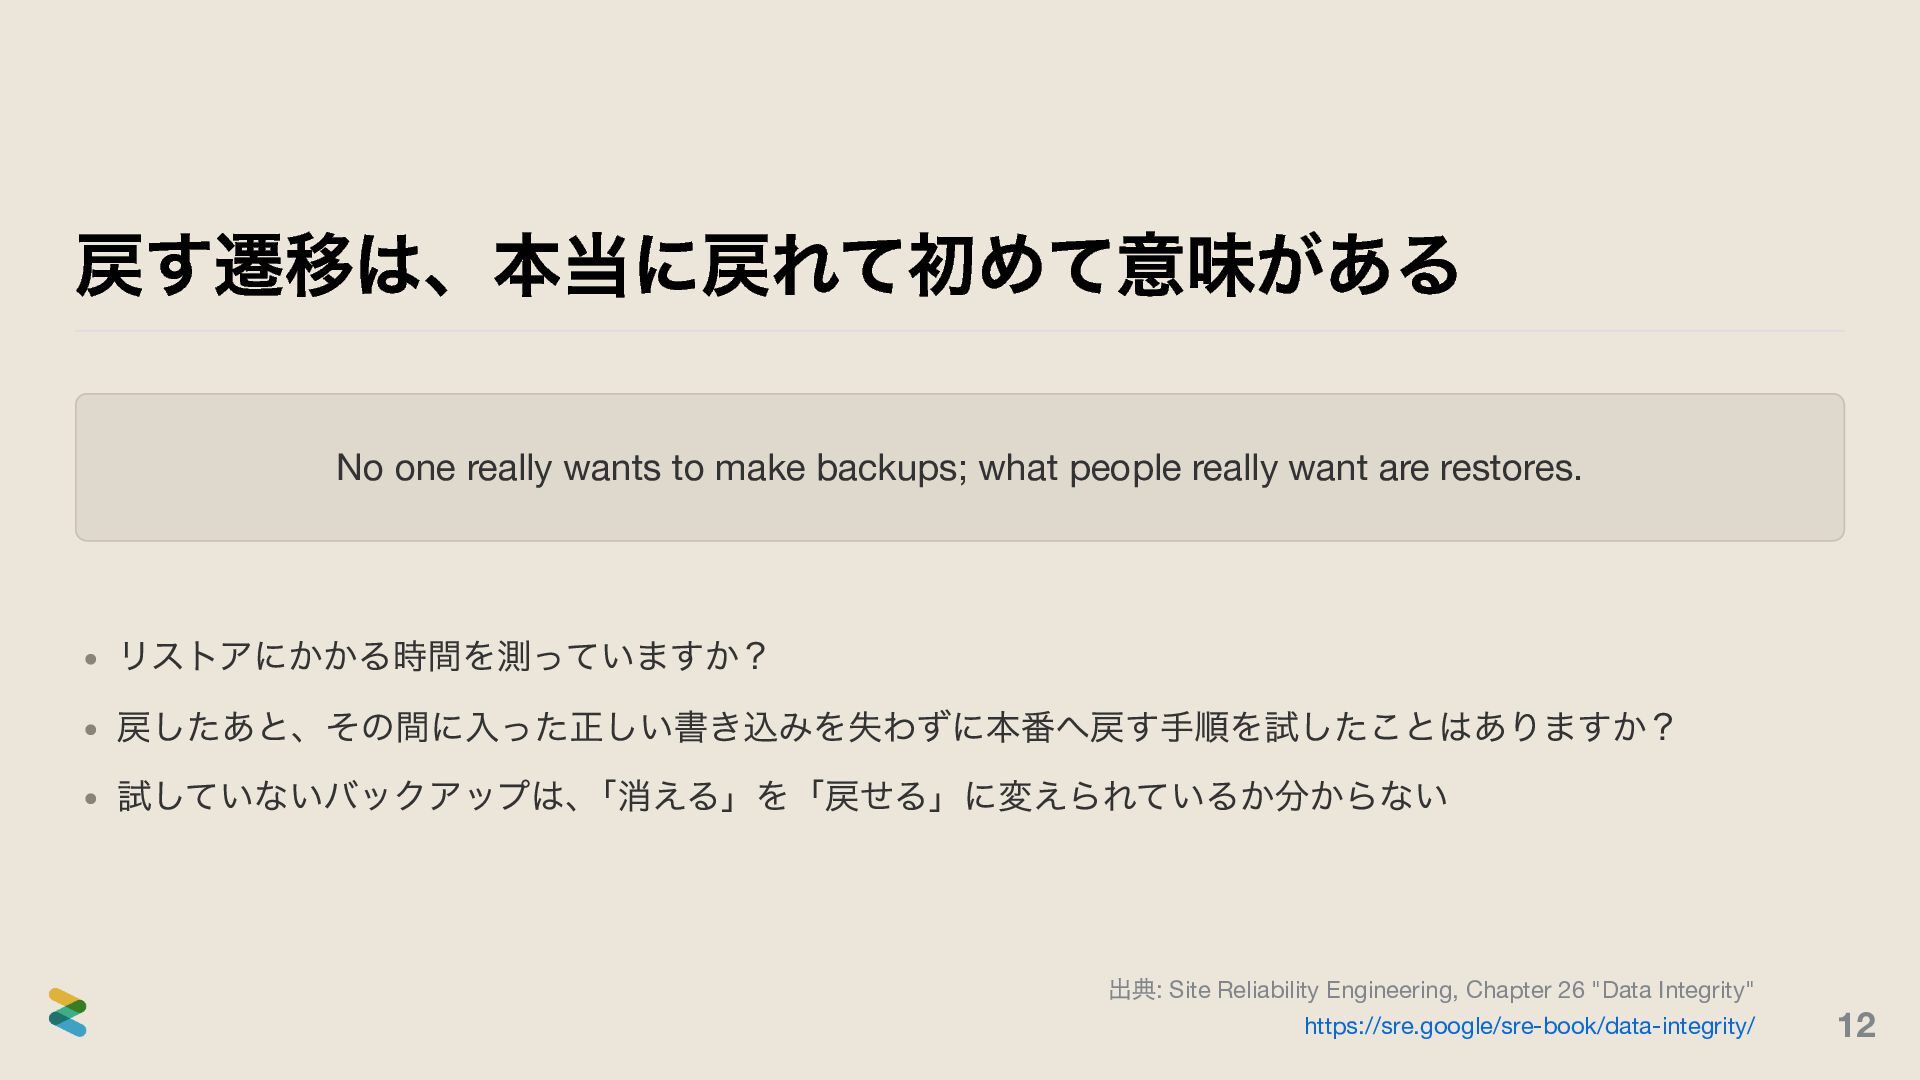
  4. 戻す遷移は、本当に戻れて初めて意味がある No one really wants to make backups; what people

    really want are restores. リストアにかかる時間を測っていますか? 戻したあと、その間に入った正しい書き込みを失わずに本番へ戻す手順を試したことはありますか? 試していないバックアップは、「消える」を「戻せる」に変えられているか分からない 出典: Site Reliability Engineering, Chapter 26 "Data Integrity" https://sre.google/sre-book/data-integrity/ 12
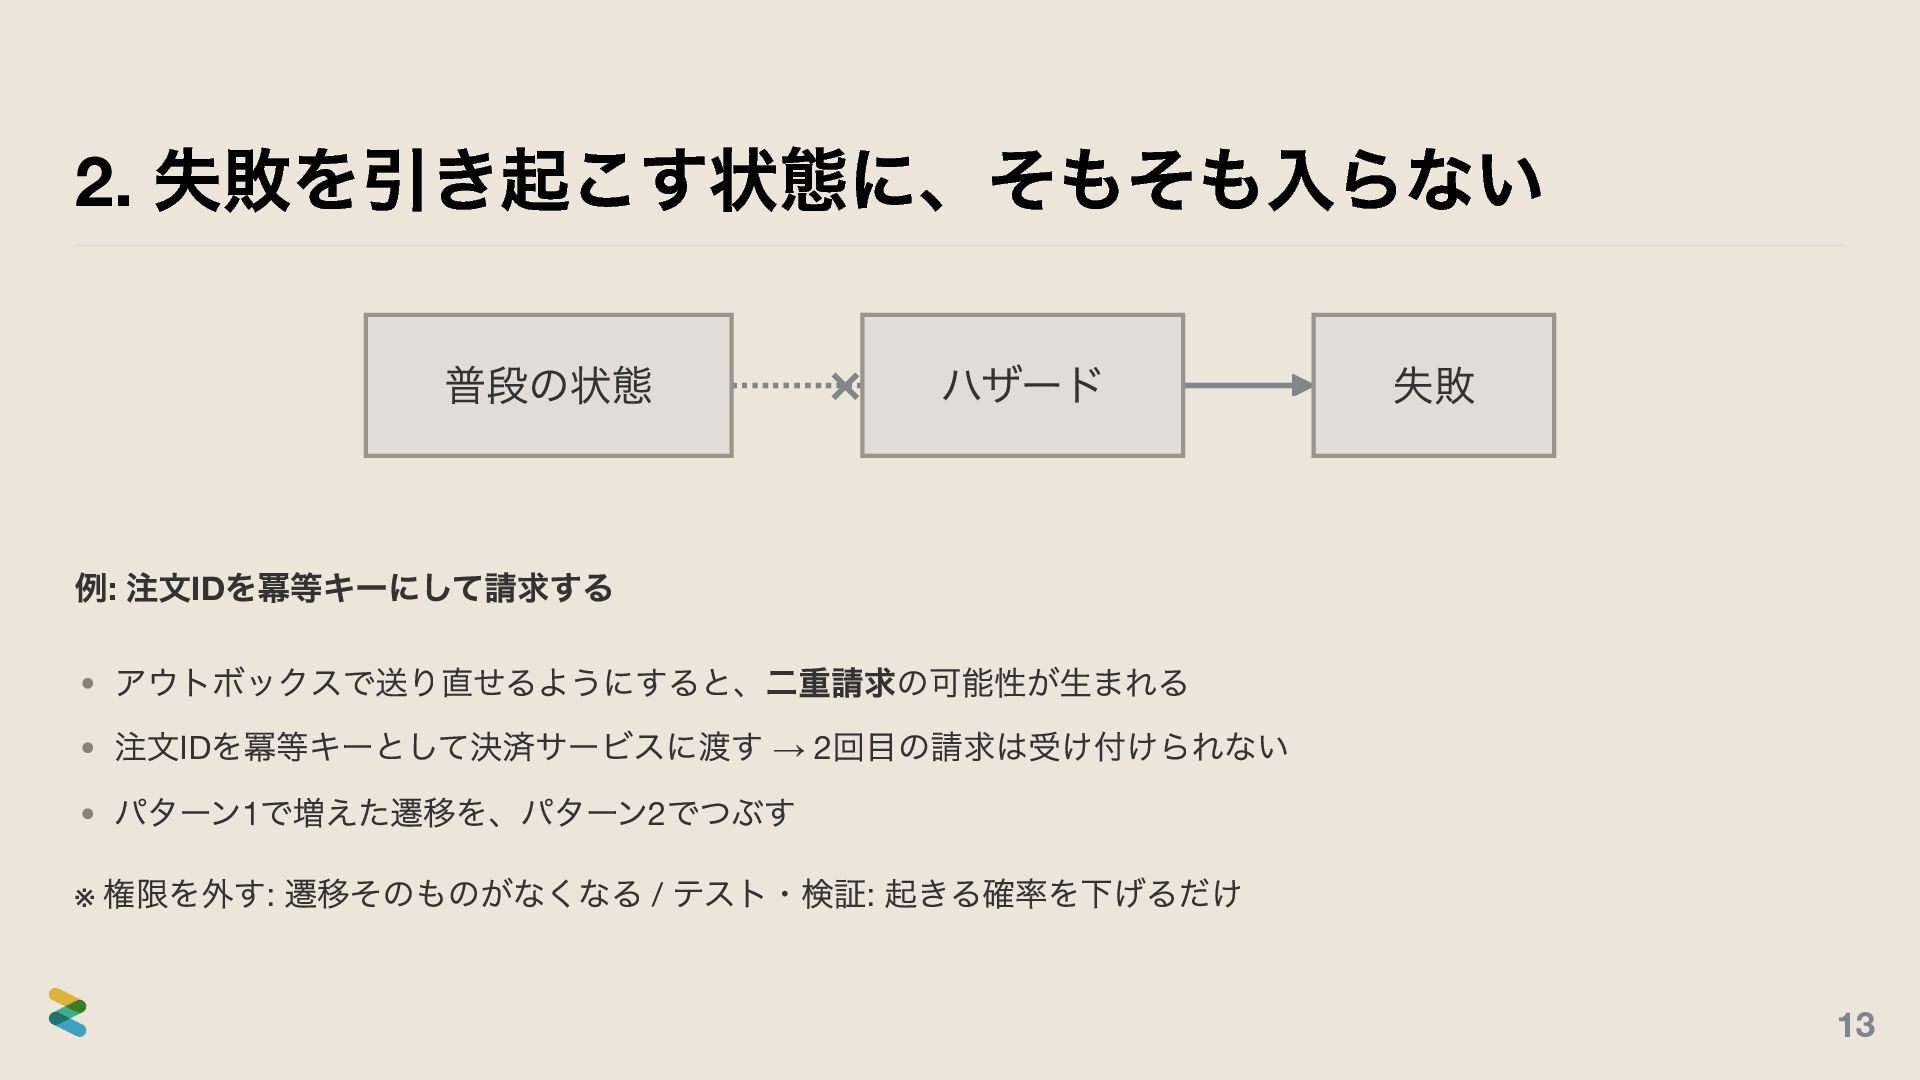
  5. 2. 失敗を引き起こす状態に、そもそも入らない 普段の状態 ハザード 失敗 例: 注文IDを冪等キーにして請求する アウトボックスで送り直せるようにすると、二重請求の可能性が生まれる 注文IDを冪等キーとして決済サービスに渡す →

    2回目の請求は受け付けられない パターン1で増えた遷移を、パターン2でつぶす ※ 権限を外す: 遷移そのものがなくなる / テスト・検証: 起きる確率を下げるだけ 13
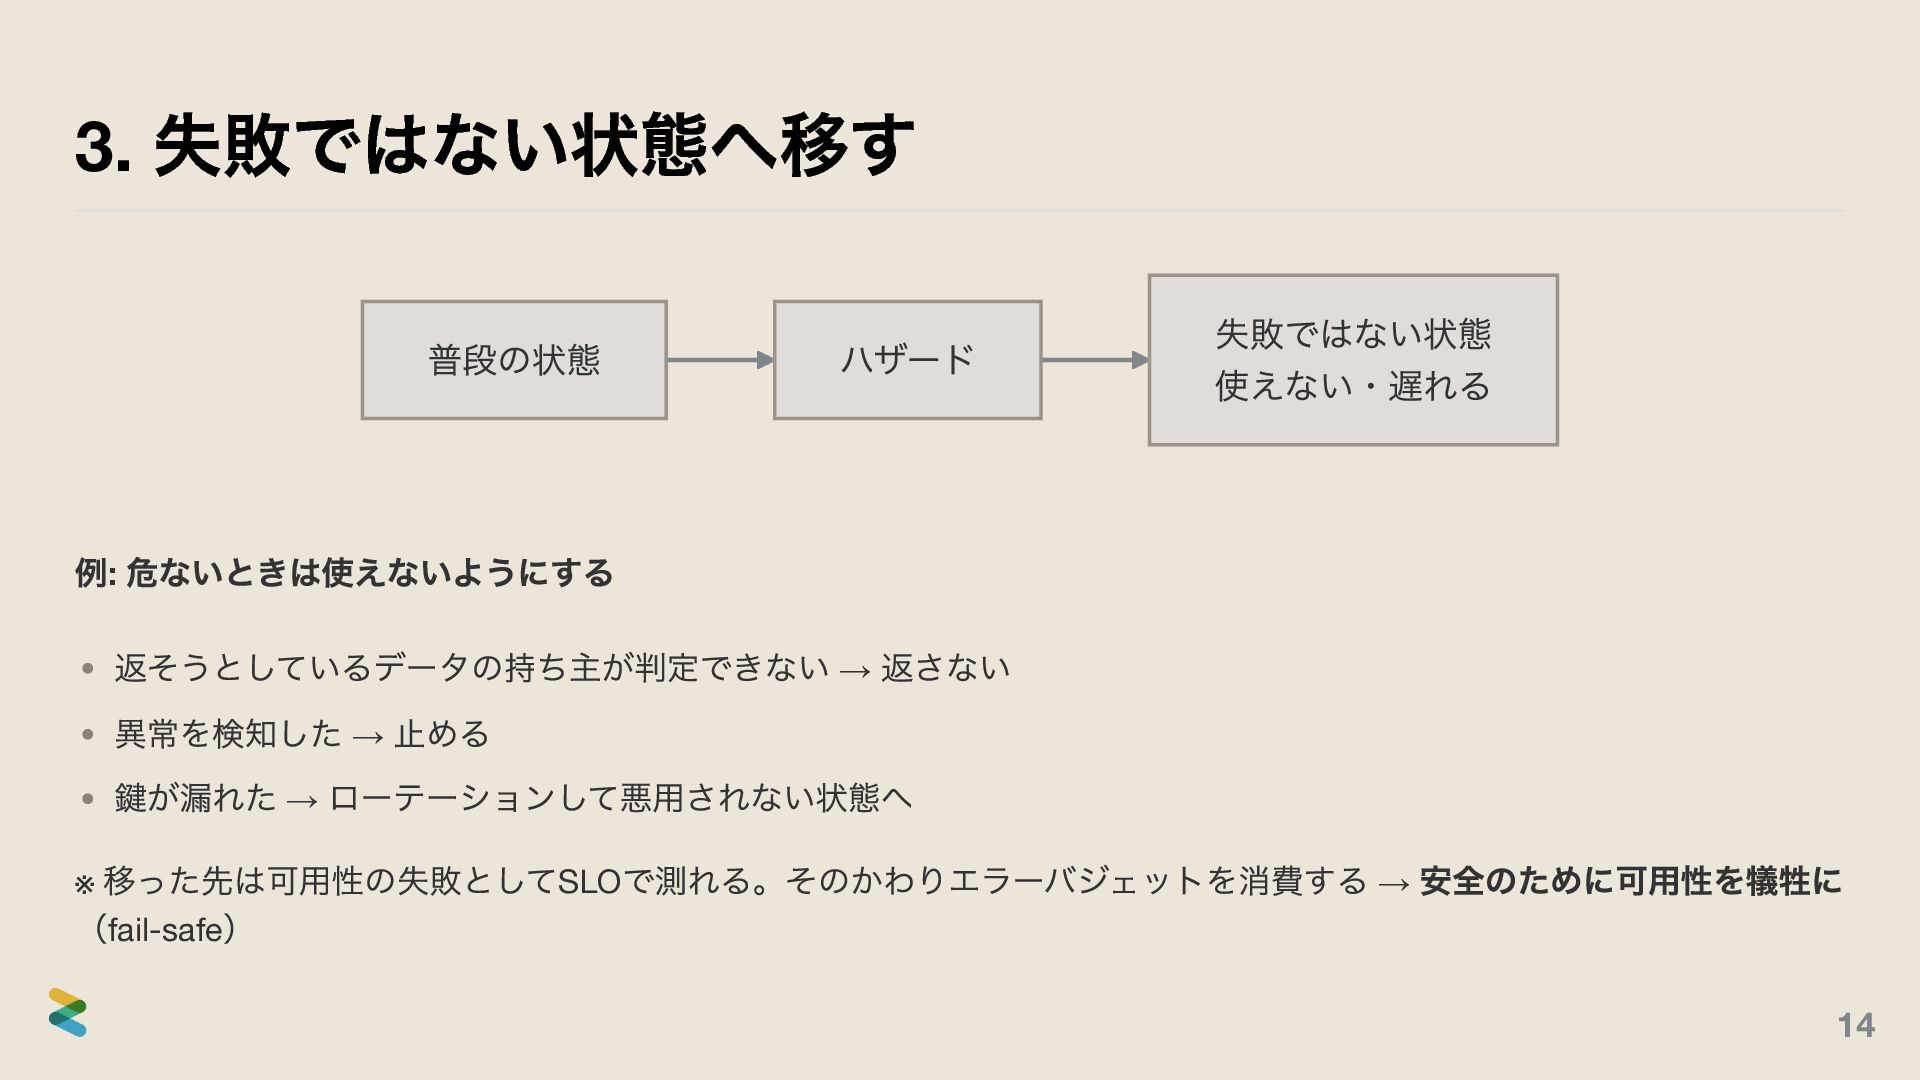
  6. 3. 失敗ではない状態へ移す 普段の状態 ハザード 失敗ではない状態 使えない・遅れる 例: 危ないときは使えないようにする 返そうとしているデータの持ち主が判定できない →

    返さない 異常を検知した → 止める 鍵が漏れた → ローテーションして悪用されない状態へ ※ 移った先は可用性の失敗としてSLOで測れる。そのかわりエラーバジェットを消費する → 安全のために可用性を犠牲に (fail-safe) 14
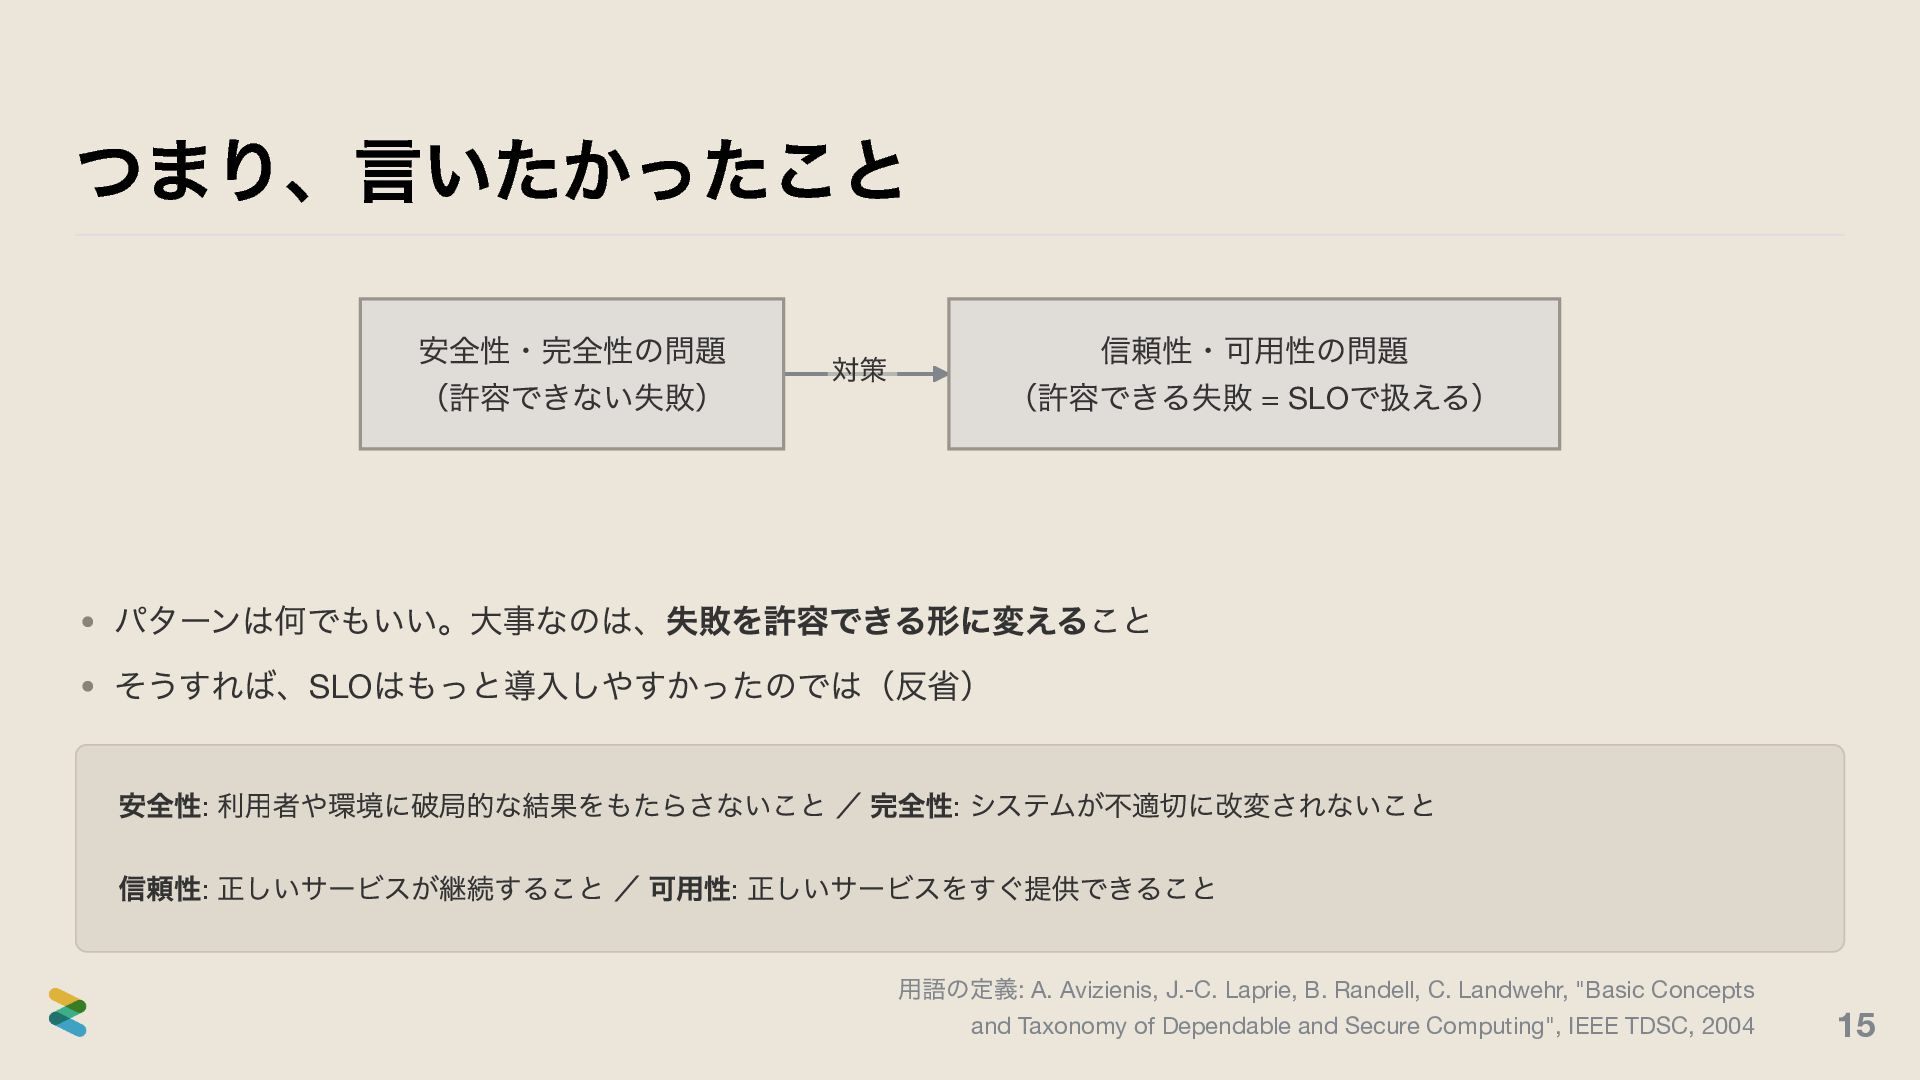
  7. つまり、言いたかったこと 安全性・完全性の問題 (許容できない失敗) 対策 信頼性・可用性の問題 (許容できる失敗 = SLOで扱える) パターンは何でもいい。大事なのは、失敗を許容できる形に変えること そうすれば、SLOはもっと導入しやすかったのでは(反省)

    安全性: 利用者や環境に破局的な結果をもたらさないこと / 完全性: システムが不適切に改変されないこと 信頼性: 正しいサービスが継続すること / 可用性: 正しいサービスをすぐ提供できること 用語の定義: A. Avizienis, J.-C. Laprie, B. Randell, C. Landwehr, "Basic Concepts and Taxonomy of Dependable and Secure Computing", IEEE TDSC, 2004 15
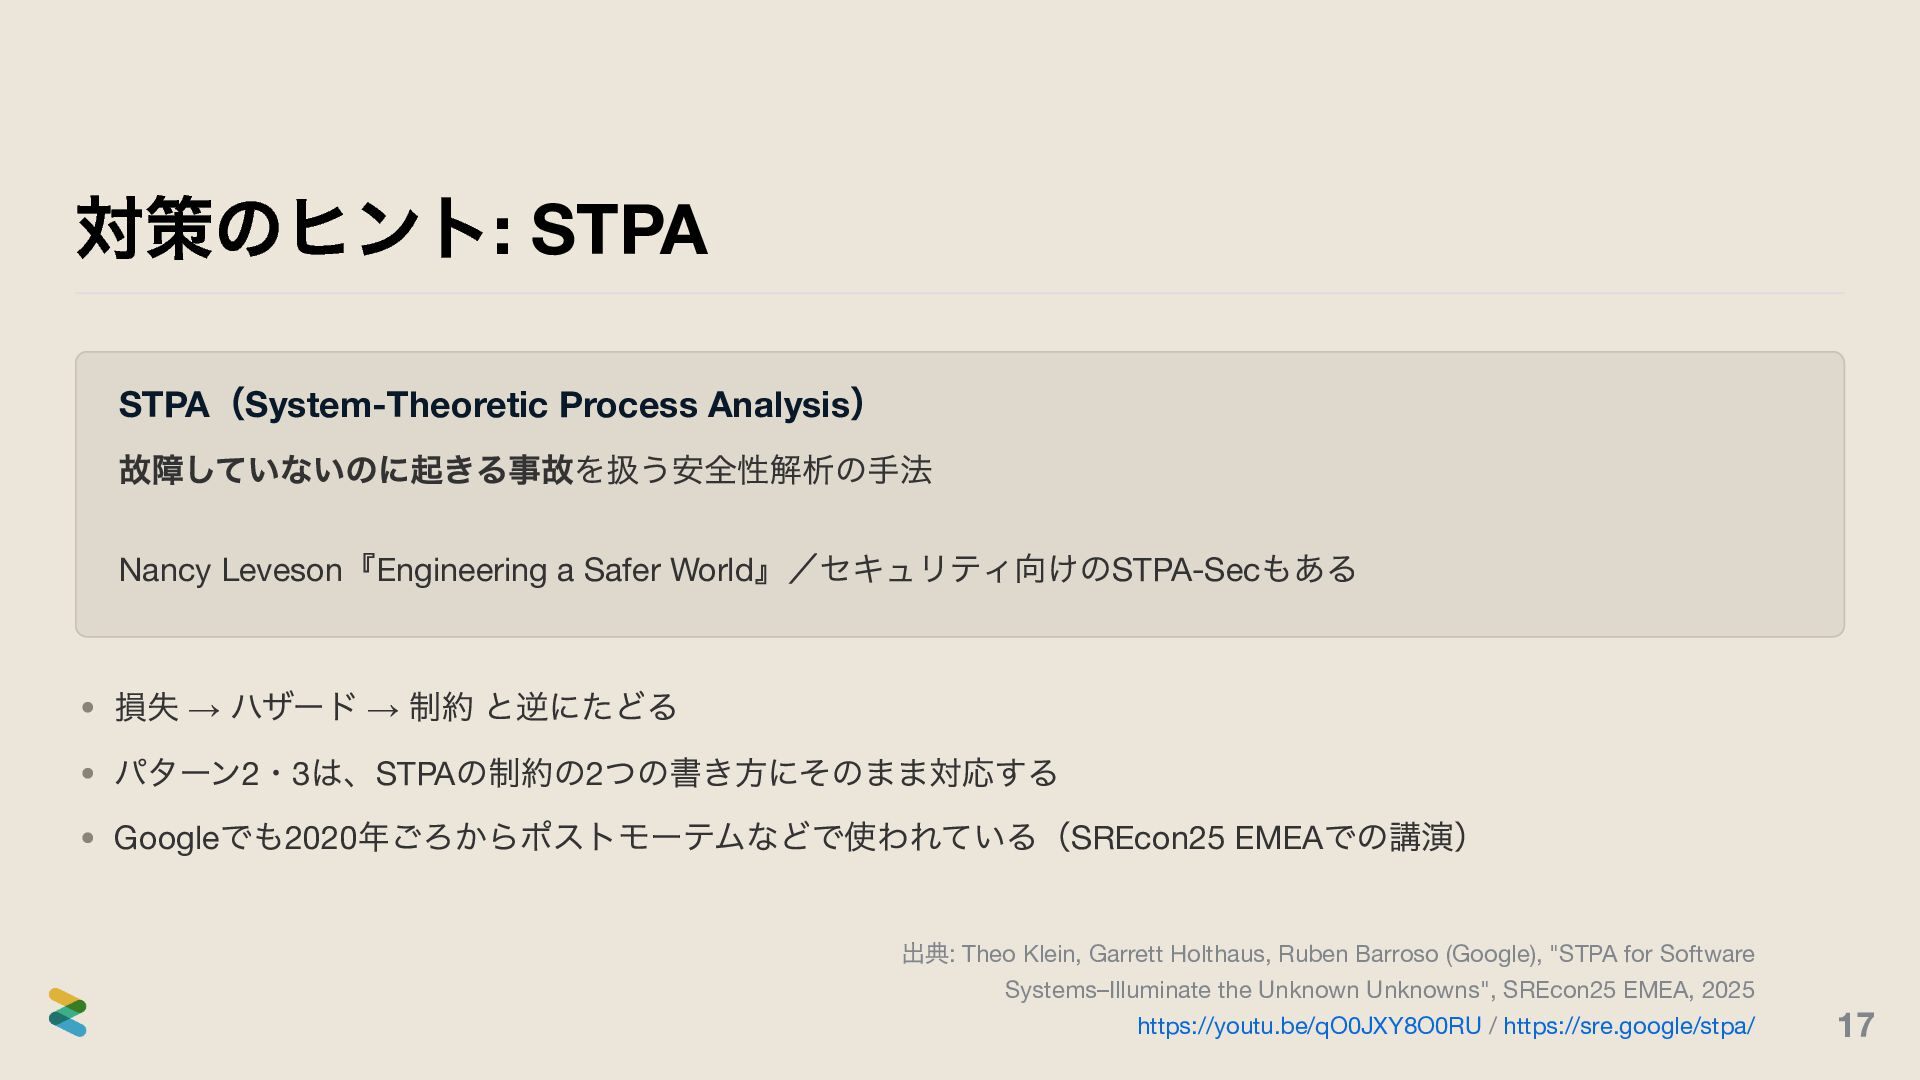
  8. 対策のヒント: STPA ( ) STPA System-Theoretic Process Analysis 故障していないのに起きる事故を扱う安全性解析の手法 『

    』/セキュリティ向けのSTPA-Secもある Nancy Leveson Engineering a Safer World 損失 → ハザード → 制約 と逆にたどる パターン2・3は、STPAの制約の2つの書き方にそのまま対応する Googleでも2020年ごろからポストモーテムなどで使われている(SREcon25 EMEAでの講演) 出典: Theo Klein, Garrett Holthaus, Ruben Barroso (Google), "STPA for Software Systems–Illuminate the Unknown Unknowns", SREcon25 EMEA, 2025 https://youtu.be/qO0JXY8O0RU / https://sre.google/stpa/ 17
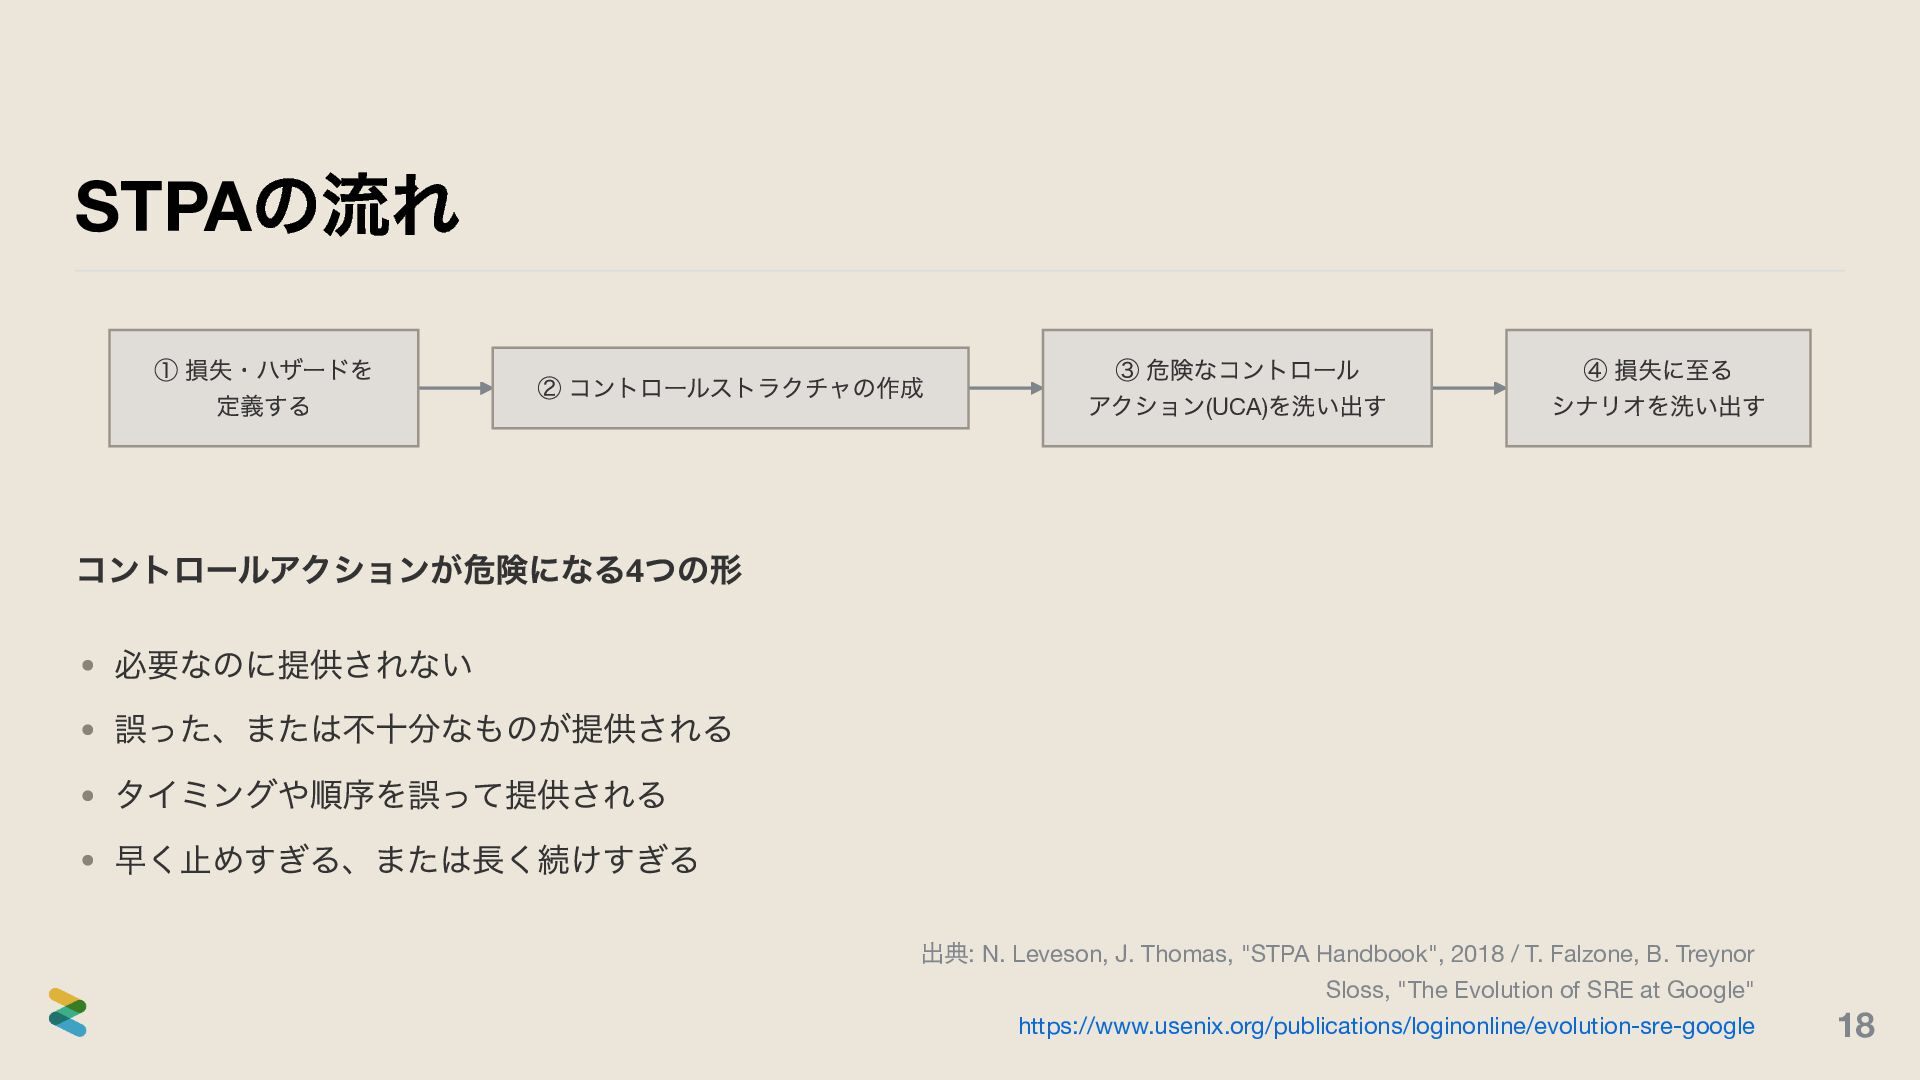
  9. の流れ STPA ① 損失・ハザードを 定義する ② コントロールストラクチャの作成 ③ 危険なコントロール アクション(UCA)を洗い出す

    ④ 損失に至る シナリオを洗い出す コントロールアクションが危険になる4つの形 必要なのに提供されない 誤った、または不十分なものが提供される タイミングや順序を誤って提供される 早く止めすぎる、または長く続けすぎる 出典: N. Leveson, J. Thomas, "STPA Handbook", 2018 / T. Falzone, B. Treynor Sloss, "The Evolution of SRE at Google" https://www.usenix.org/publications/loginonline/evolution-sre-google 18