Upgrade to Pro — share decks privately, control downloads, hide ads and more …

現代AI入門: 大規模言語モデルから思考するシステムへ — Test-Time Scaling...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

現代AI入門: 大規模言語モデルから思考するシステムへ — Test-Time Scaling, Loop, Harness, RSI

基盤モデルを中心に発展してきた「現代AI」を構成するトピックの中から、比較的新しく、かつ重要と思われる観点について「歴史・流れ・気持ち」を大事にしながら概観をします。

IBIS 2026 でのチュートリアルセッションでの発表資料を加筆修正した内容となります。
https://ibisml.org/ibis2026/tutorial/#session3

--

コーディングエージェントをはじめとするAIの能力は飛躍的に向上し、連日、様々な分野で目覚ましい成果をあげている。GPT(2018)から8年、ChatGPT(2022)から4年、o1(2024)から2年、Claude Code(2025)から1年。AIの進展は減速するどころか加速する一方のようにも感じられる。この急速な能力の向上は何によるものだろうか?

実際には、この性能向上は単一の技術の進展が成し得たものではなく、プロセッサが2次元から3次元に集積を移したように、幾つもの壁に突き当たりながらパラダイムを模索し続けた産物である。その結果、現代のAIはもはや単体の言語モデルではなく、モデルを部品の一つとする「思考するシステム」の様相を呈している。

本チュートリアルでは、ChatGPTで華々しく広まった言語モデル型のAIが、様々な技術革新を経て「思考するシステム」となり、数学の未解決問題を解くに至るまでの歴史・物語を概観する。なかでも、比較的新しく、かつ現代AIの理解において重要な技術トピック4つ(Test-Time Scaling、Loop、Harness、RSI)について、講演者の研究グループの仕事も交えながら、現象と方式、理論と解釈、実用の3観点から解説を試みる。

Avatar for Masafumi Oyamada

Masafumi Oyamada PRO

October 27, 2026

More Decks by Masafumi Oyamada

Other Decks in Science

Transcript

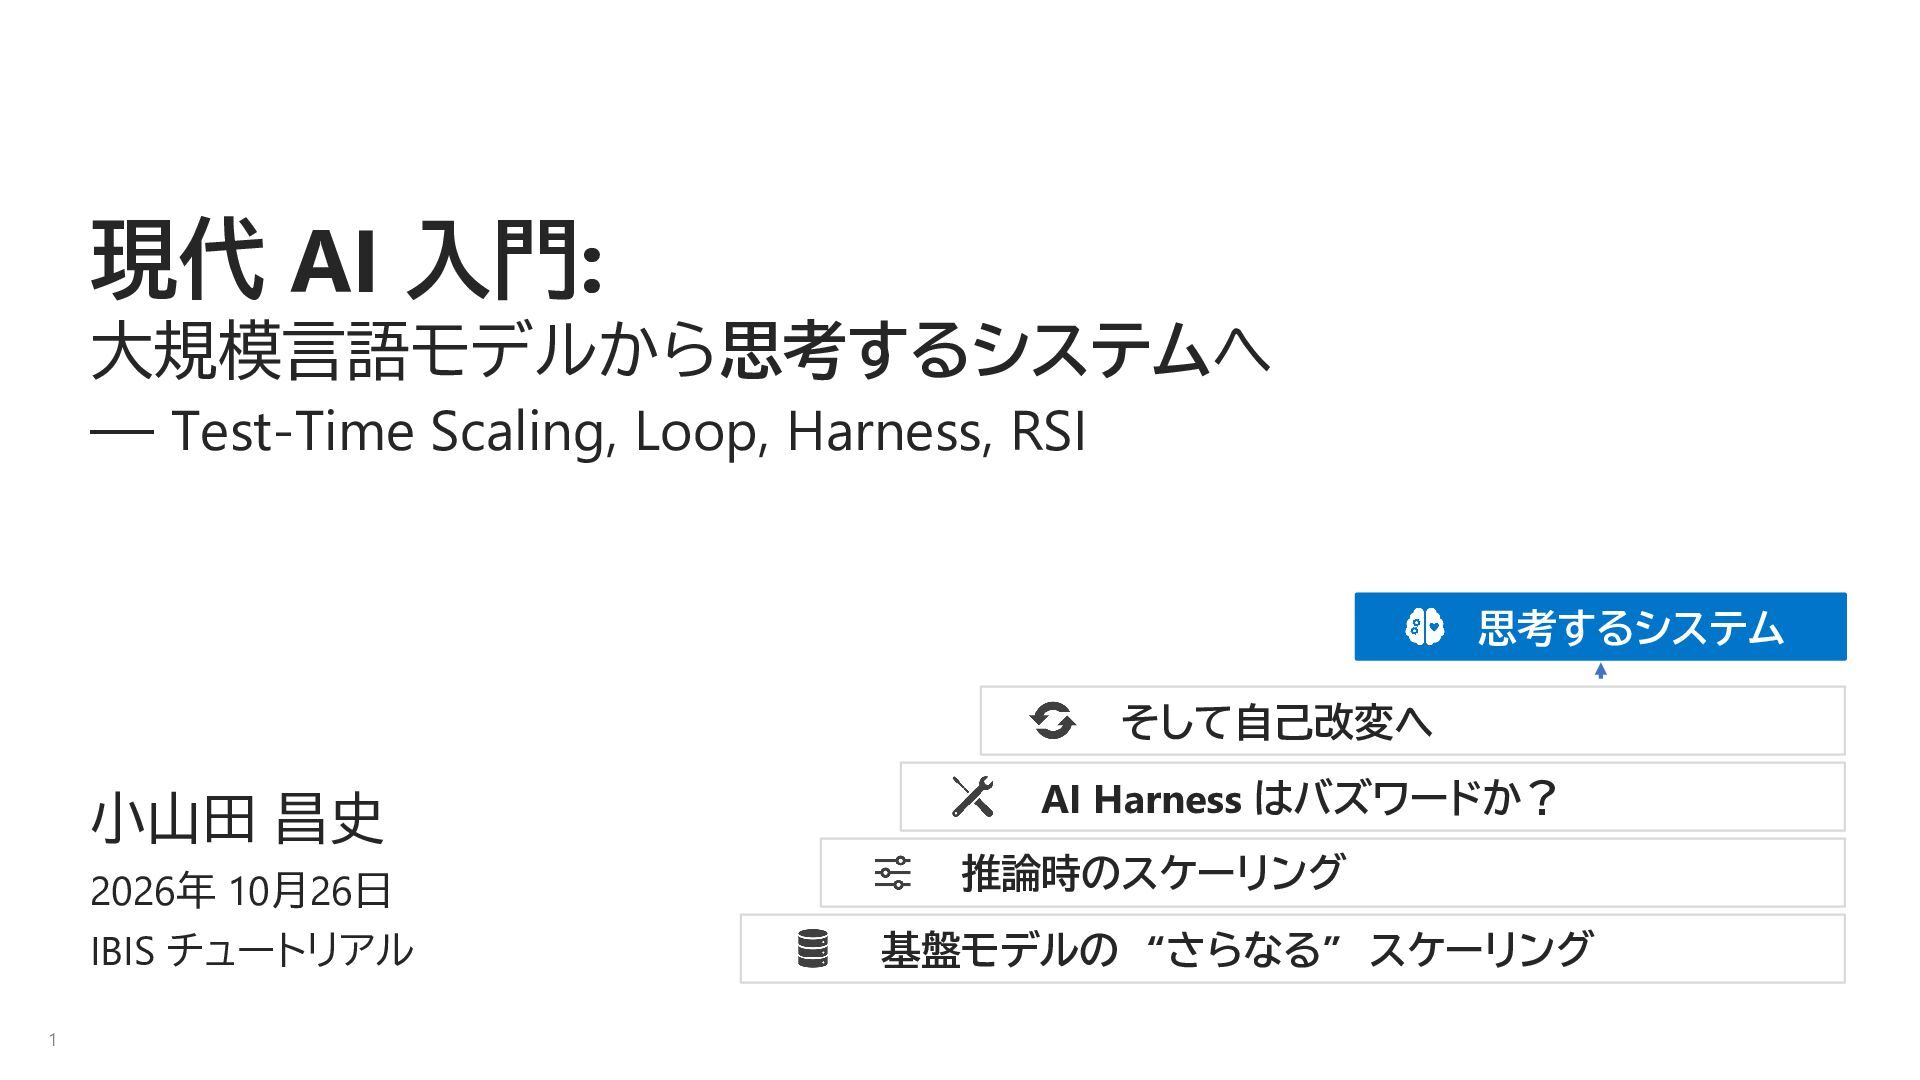
  1. 現代 AI 入門: 大規模言語モデルから思考するシステムへ — Test-Time Scaling, Loop, Harness, RSI

    思考するシステム そして自己改変へ 小山田 昌史 2026年 10月26日 IBIS チュートリアル 1 AI Harness はバズワードか? 推論時のスケーリング 基盤モデルの “さらなる” スケーリング
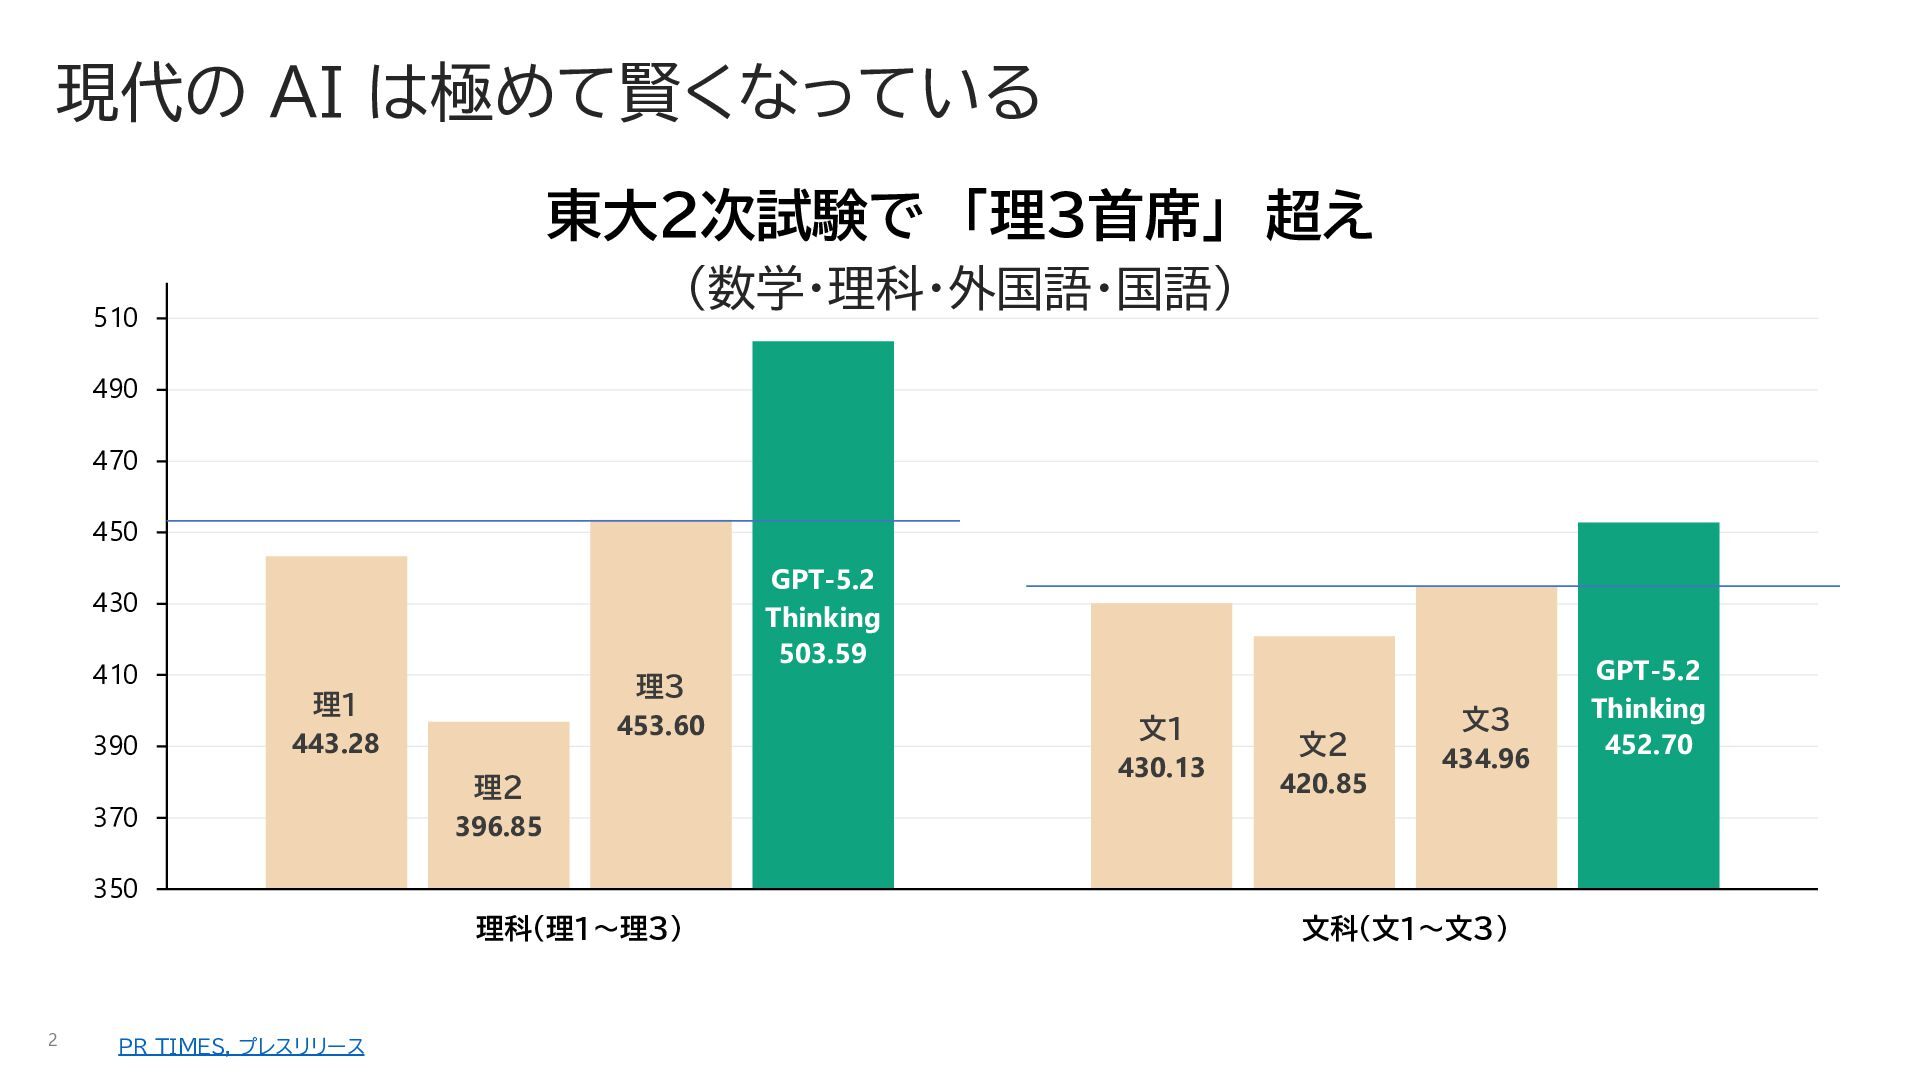
  2. 現代の AI は極めて賢くなっている 東大2次試験で 「理3首席」 超え (数学・理科・外国語・国語) 510 490 470

    450 GPT-5.2 Thinking 503.59 430 410 390 理3 453.60 理1 443.28 370 理2 396.85 文1 430.13 文2 420.85 文3 434.96 350 理科(理1~理3) 2 PR TIMES, プレスリリース 文科(文1~文3) GPT-5.2 Thinking 452.70
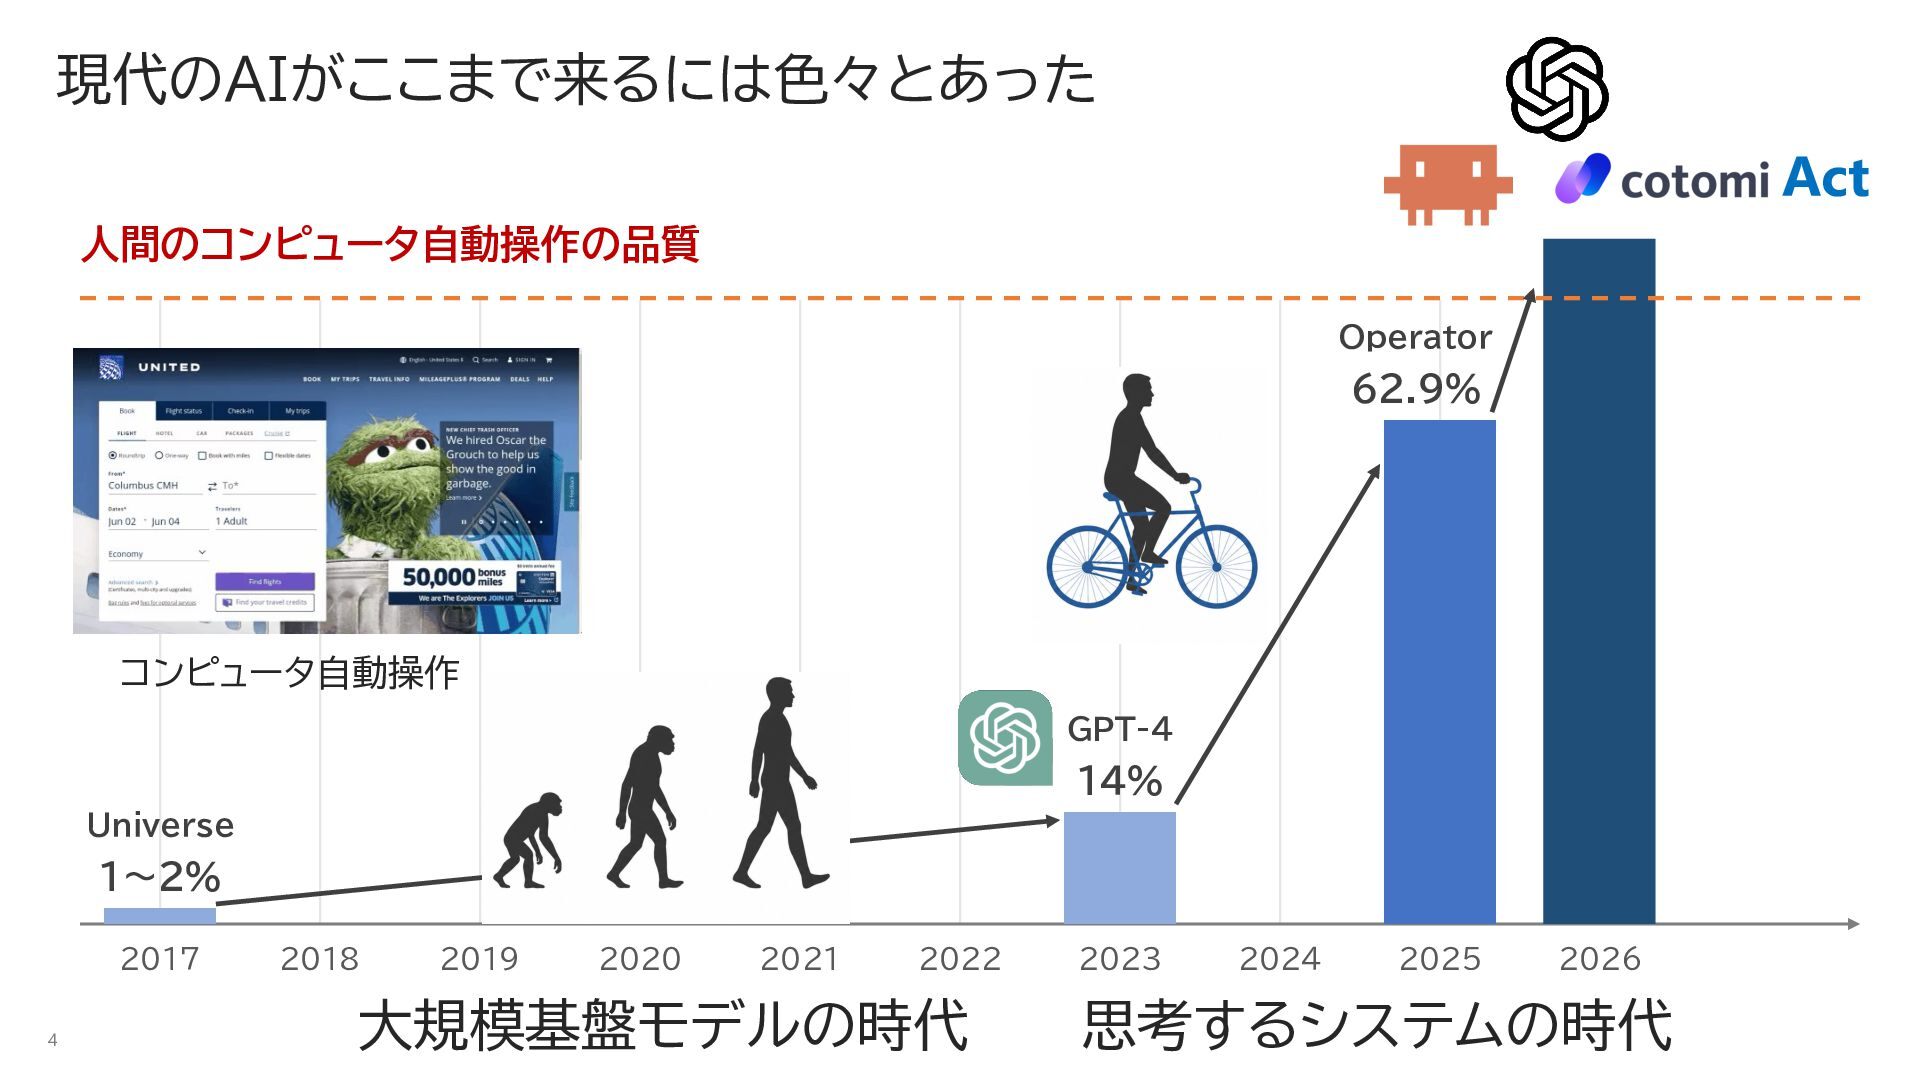
  3. 現代のAIがここまで来るには色々とあった Act 人間のコンピュータ自動操作の品質 Operator 62.9% コンピュータ自動操作 GPT-4 14% Universe 1〜2%

    2017 4 2018 2019 2020 2021 2022 大規模基盤モデルの時代 2023 2024 2025 2026 思考するシステムの時代
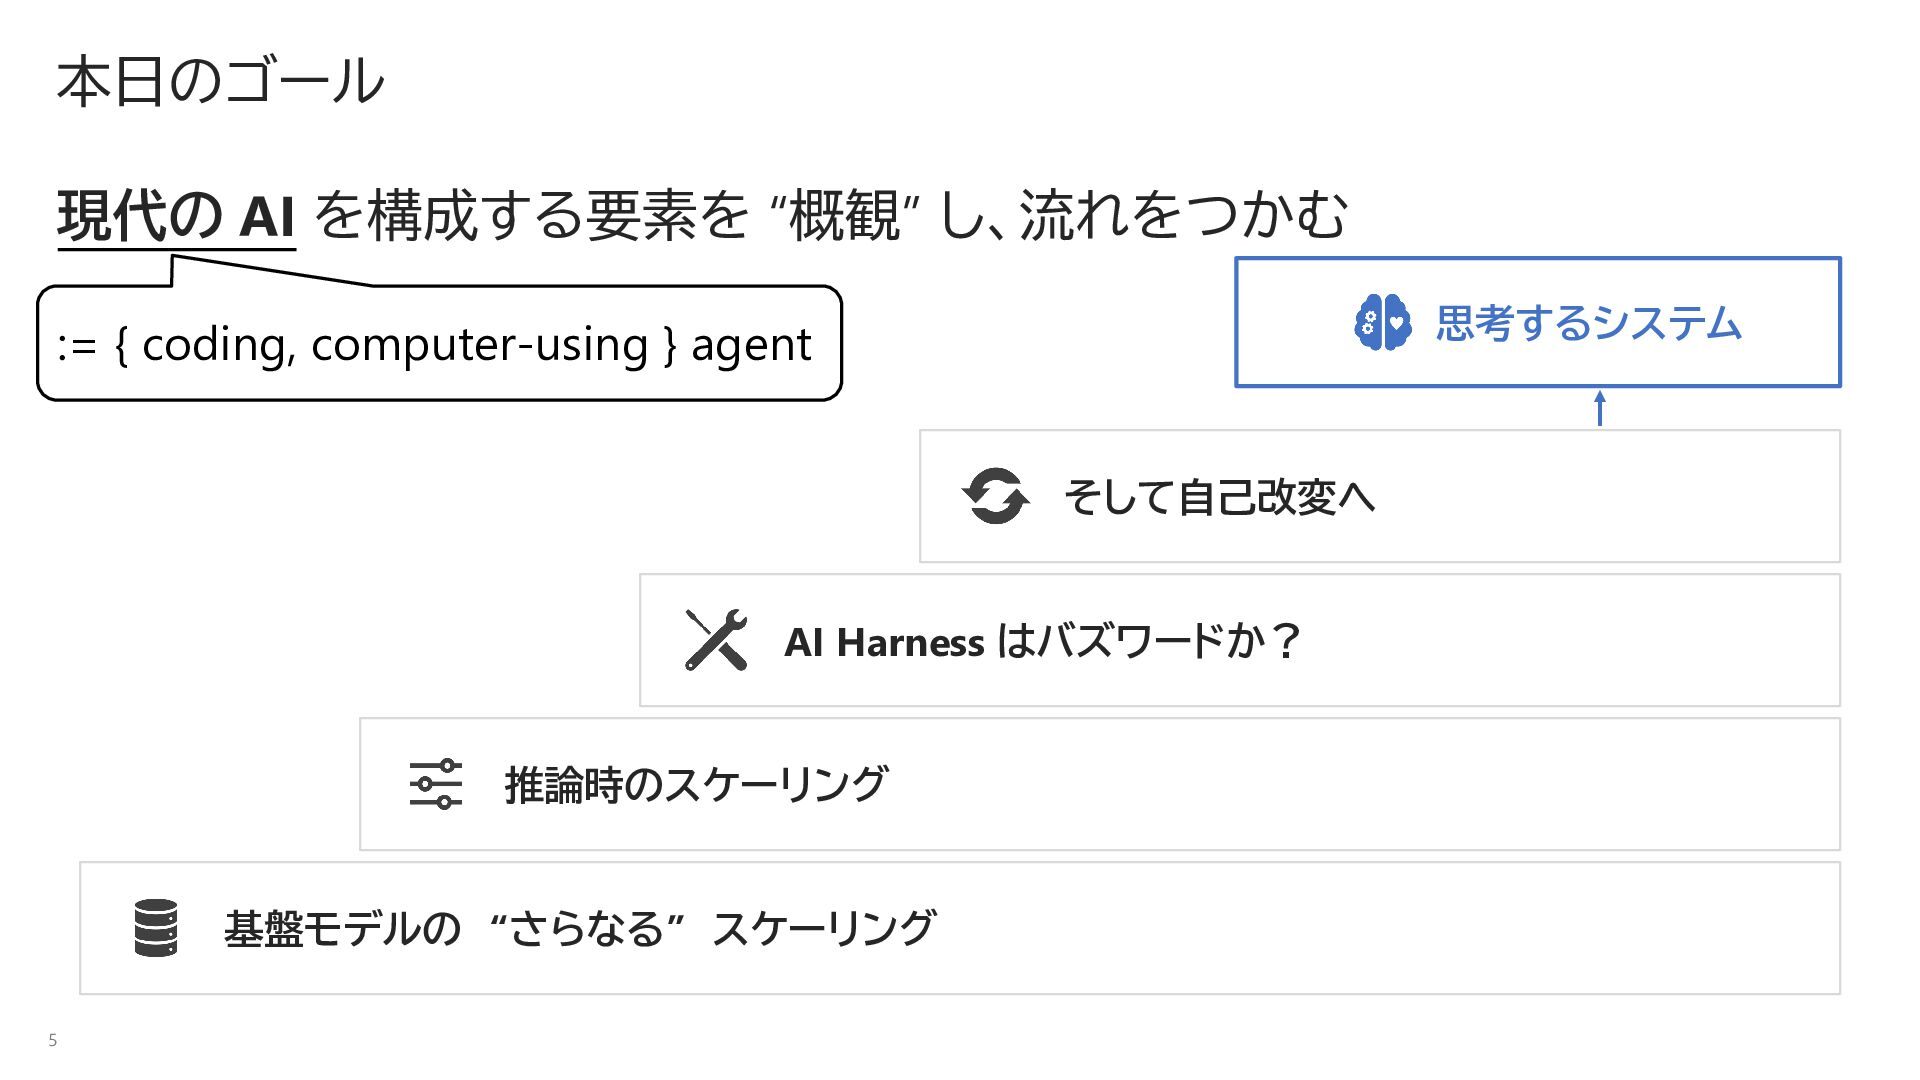
  4. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 思考するシステム := { coding,

    computer-using } agent そして自己改変へ AI Harness はバズワードか? 推論時のスケーリング 基盤モデルの “さらなる” スケーリング 5
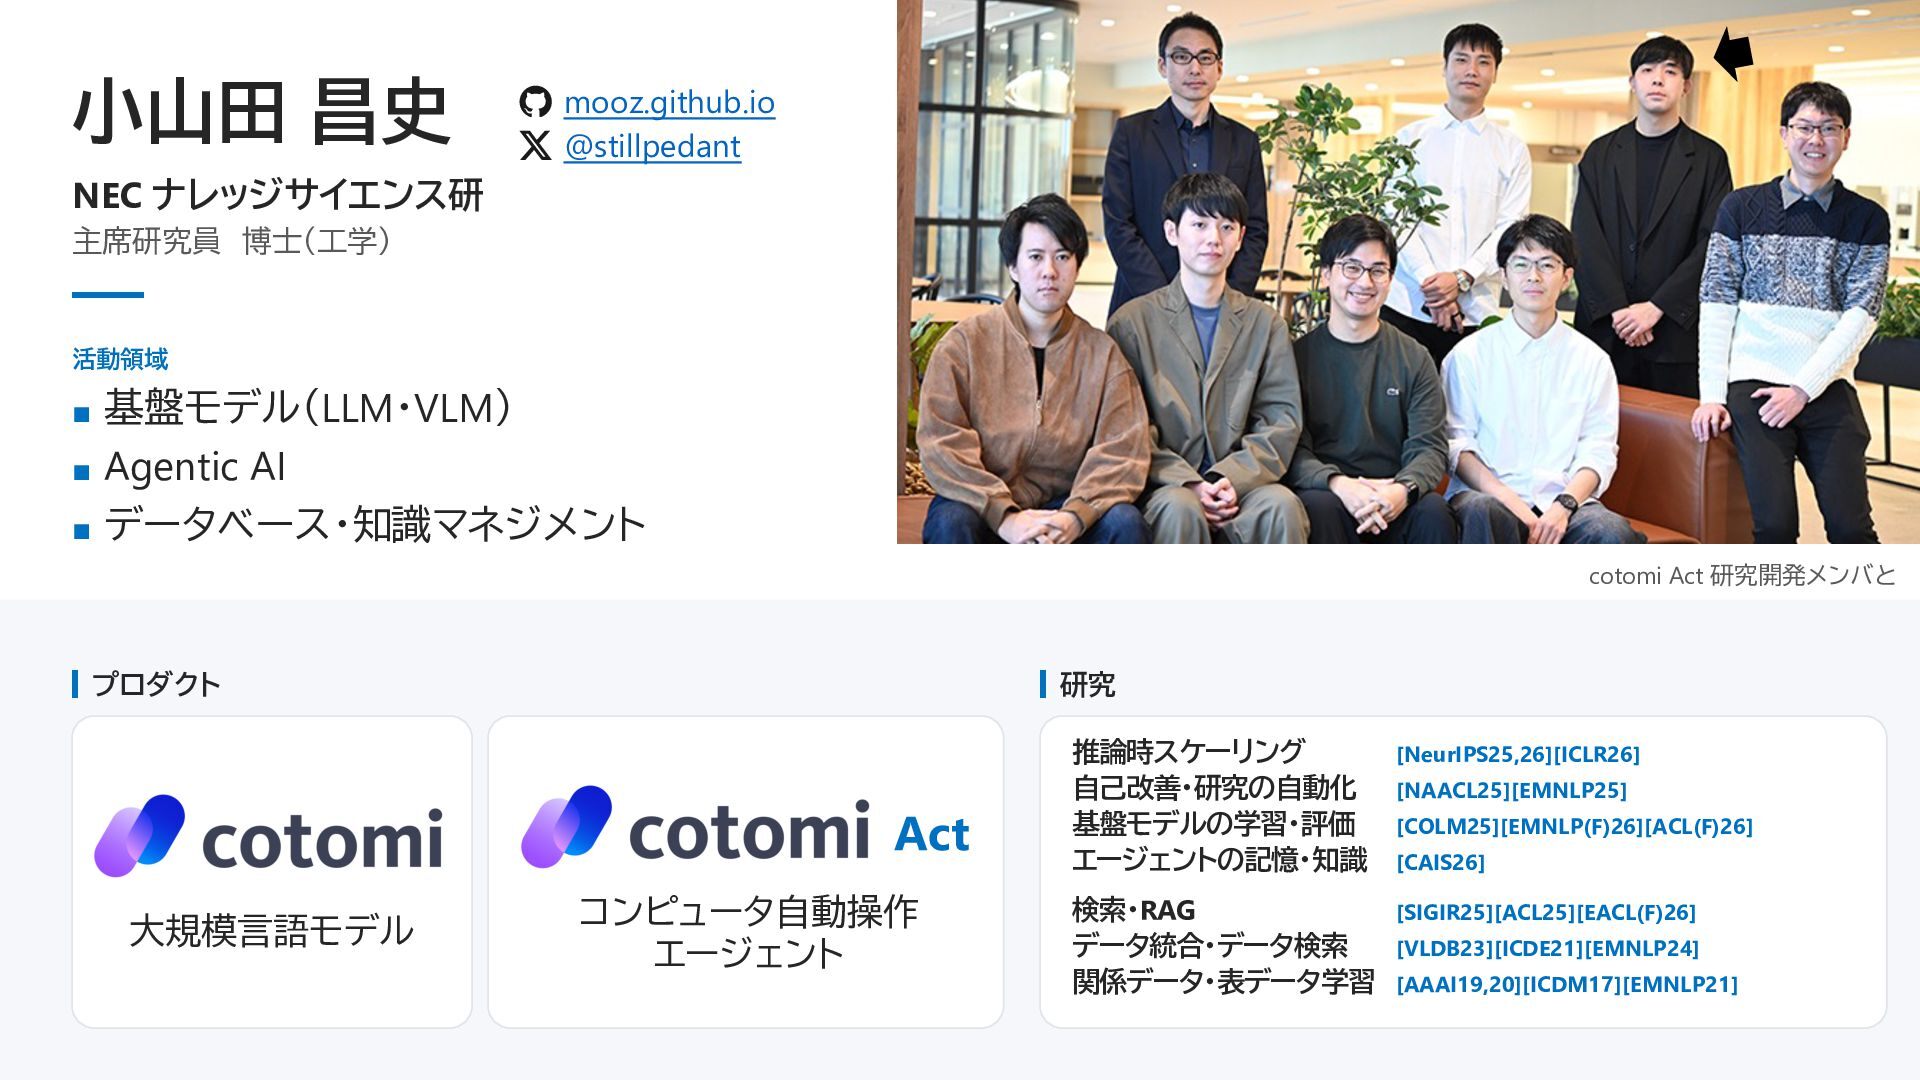
  5. 小山田 昌史 mooz.github.io @stillpedant NEC ナレッジサイエンス研 主席研究員 博士(工学) 活動領域 ▪

    基盤モデル(LLM・VLM) ▪ Agentic AI ▪ データベース・知識マネジメント cotomi Act 研究開発メンバと プロダクト 研究 Act 大規模言語モデル 6 コンピュータ自動操作 エージェント 推論時スケーリング 自己改善・研究の自動化 基盤モデルの学習・評価 エージェントの記憶・知識 [NeurIPS25,26][ICLR26] 検索・RAG データ統合・データ検索 関係データ・表データ学習 [SIGIR25][ACL25][EACL(F)26] [NAACL25][EMNLP25] [COLM25][EMNLP(F)26][ACL(F)26] [CAIS26] [VLDB23][ICDE21][EMNLP24] [AAAI19,20][ICDM17][EMNLP21]
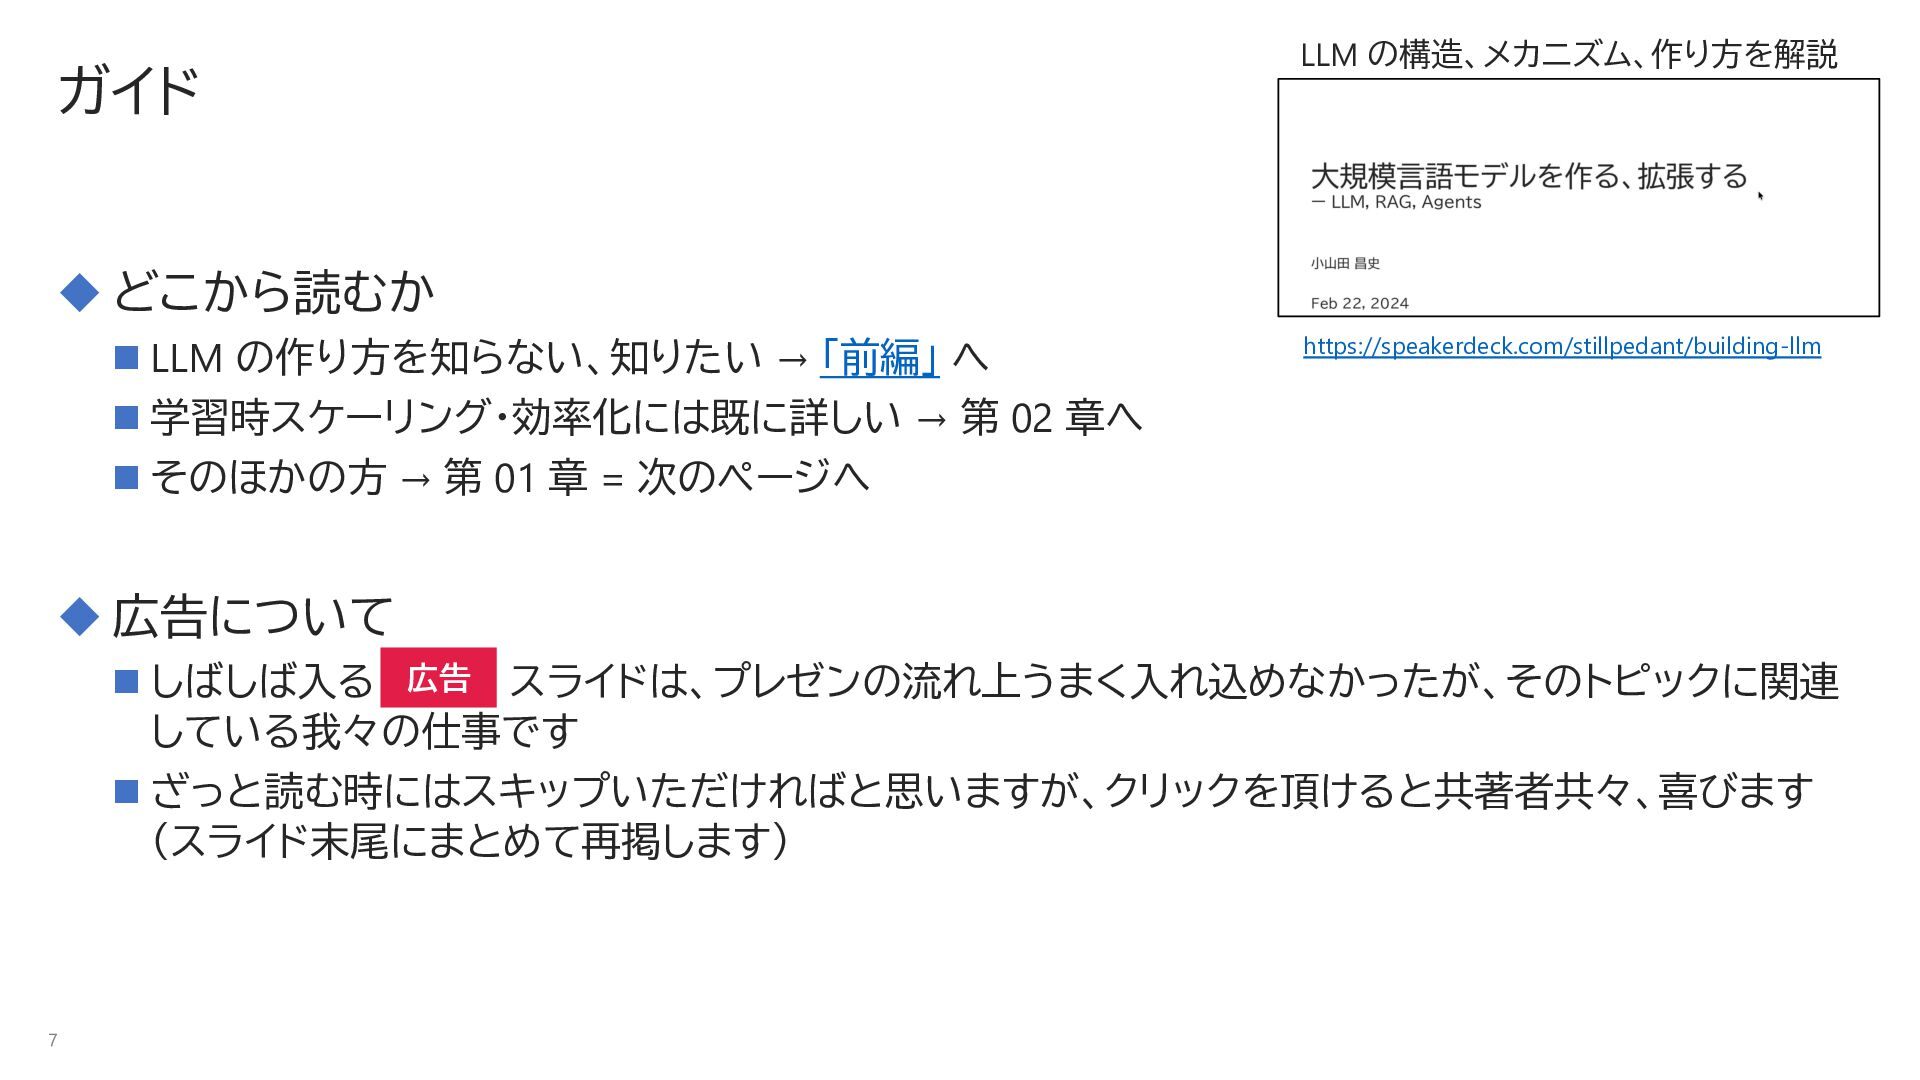
  6. ガイド LLM の構造、メカニズム、作り方を解説 u どこから読むか n LLM の作り方を知らない、知りたい → 「前編」

    へ https://speakerdeck.com/stillpedant/building-llm n 学習時スケーリング・効率化には既に詳しい → 第 02 章へ n そのほかの方 → 第 01 章 = 次のページへ u 広告について n しばしば入る 広告 スライドは、プレゼンの流れ上うまく入れ込めなかったが、そのトピックに関連 している我々の仕事です n ざっと読む時にはスキップいただければと思いますが、クリックを頂けると共著者共々、喜びます (スライド末尾にまとめて再掲します) 7
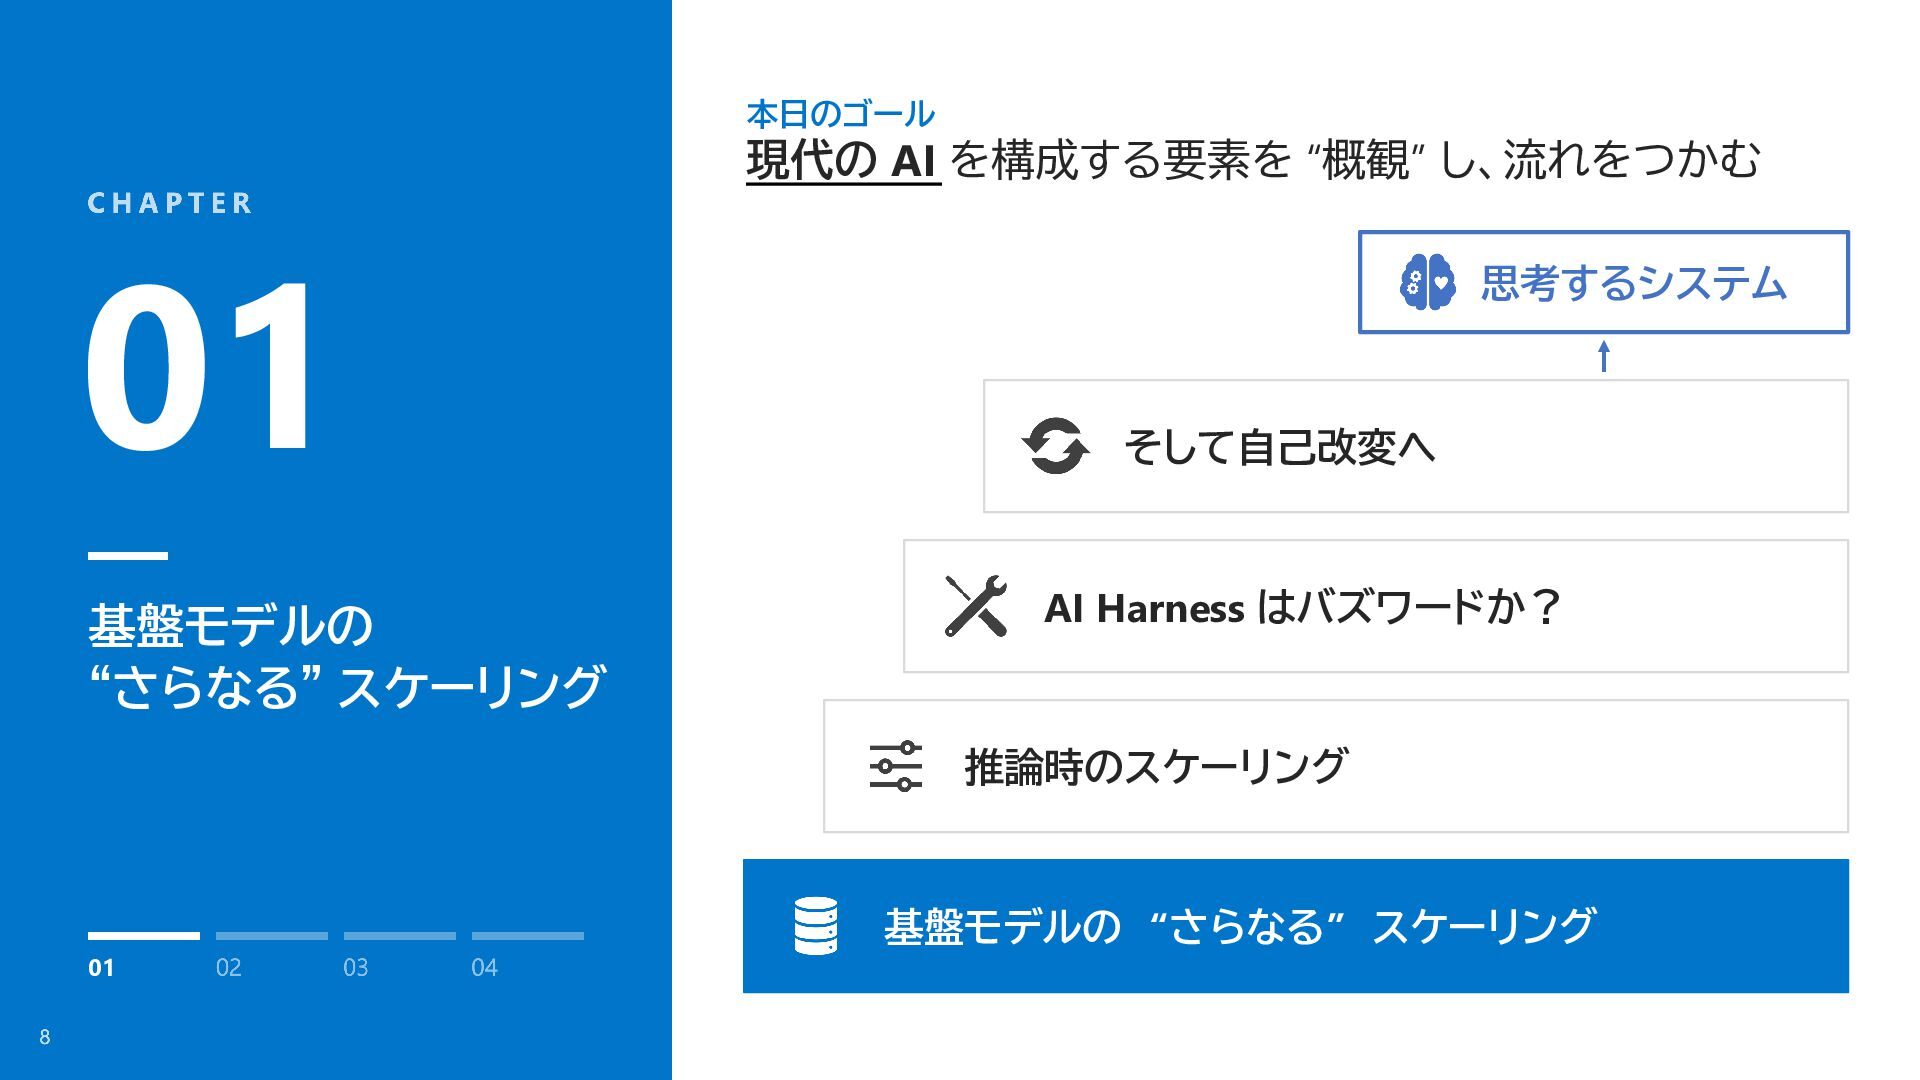
  7. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 01 基盤モデルの “さらなる” スケーリング

    思考するシステム そして自己改変へ AI Harness はバズワードか? 推論時のスケーリング 01 8 基盤モデルの “さらなる” スケーリング
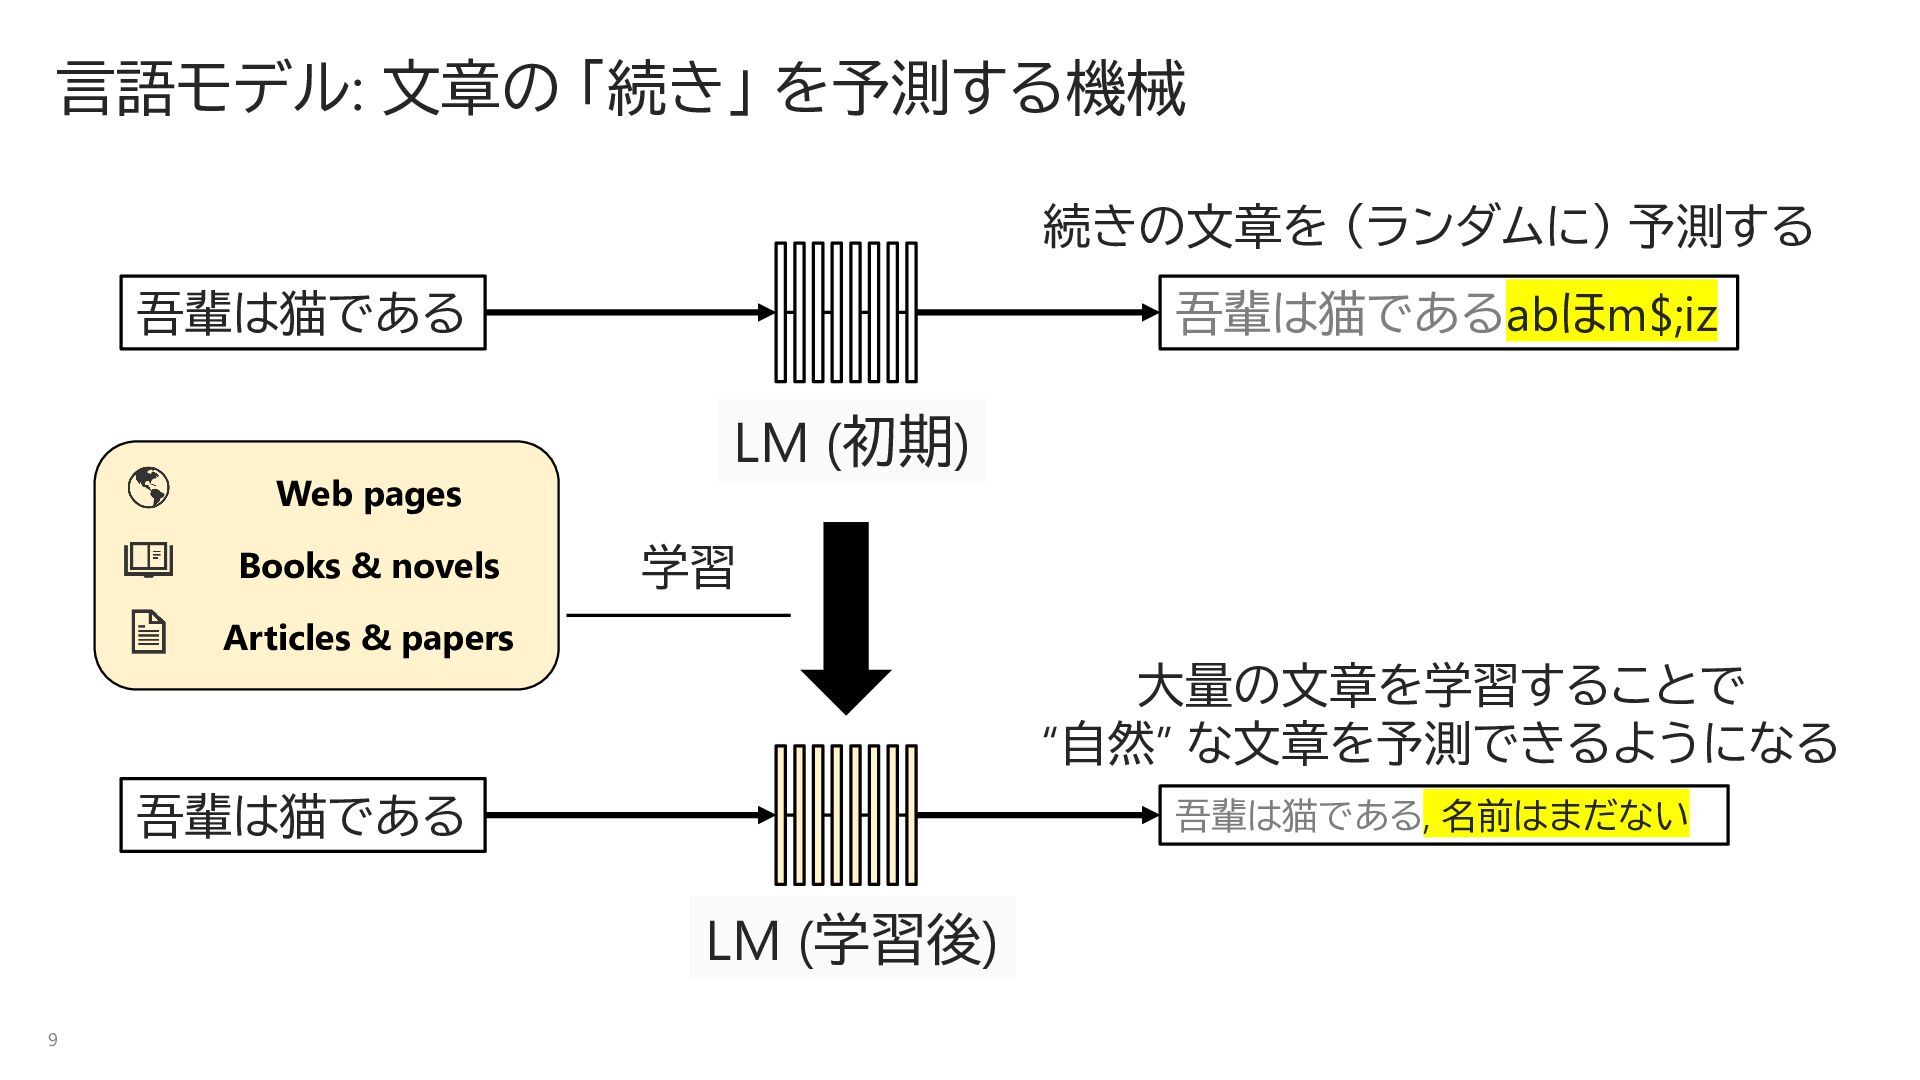
  8. 言語モデル: 文章の 「続き」 を予測する機械 続きの文章を (ランダムに) 予測する 吾輩は猫である Web pages

    Books & novels 吾輩は猫であるabほm$;iz LM (初期) 学習 Articles & papers 大量の文章を学習することで “自然” な文章を予測できるようになる 吾輩は猫である 吾輩は猫である, 名前はまだない LM (学習後) 9
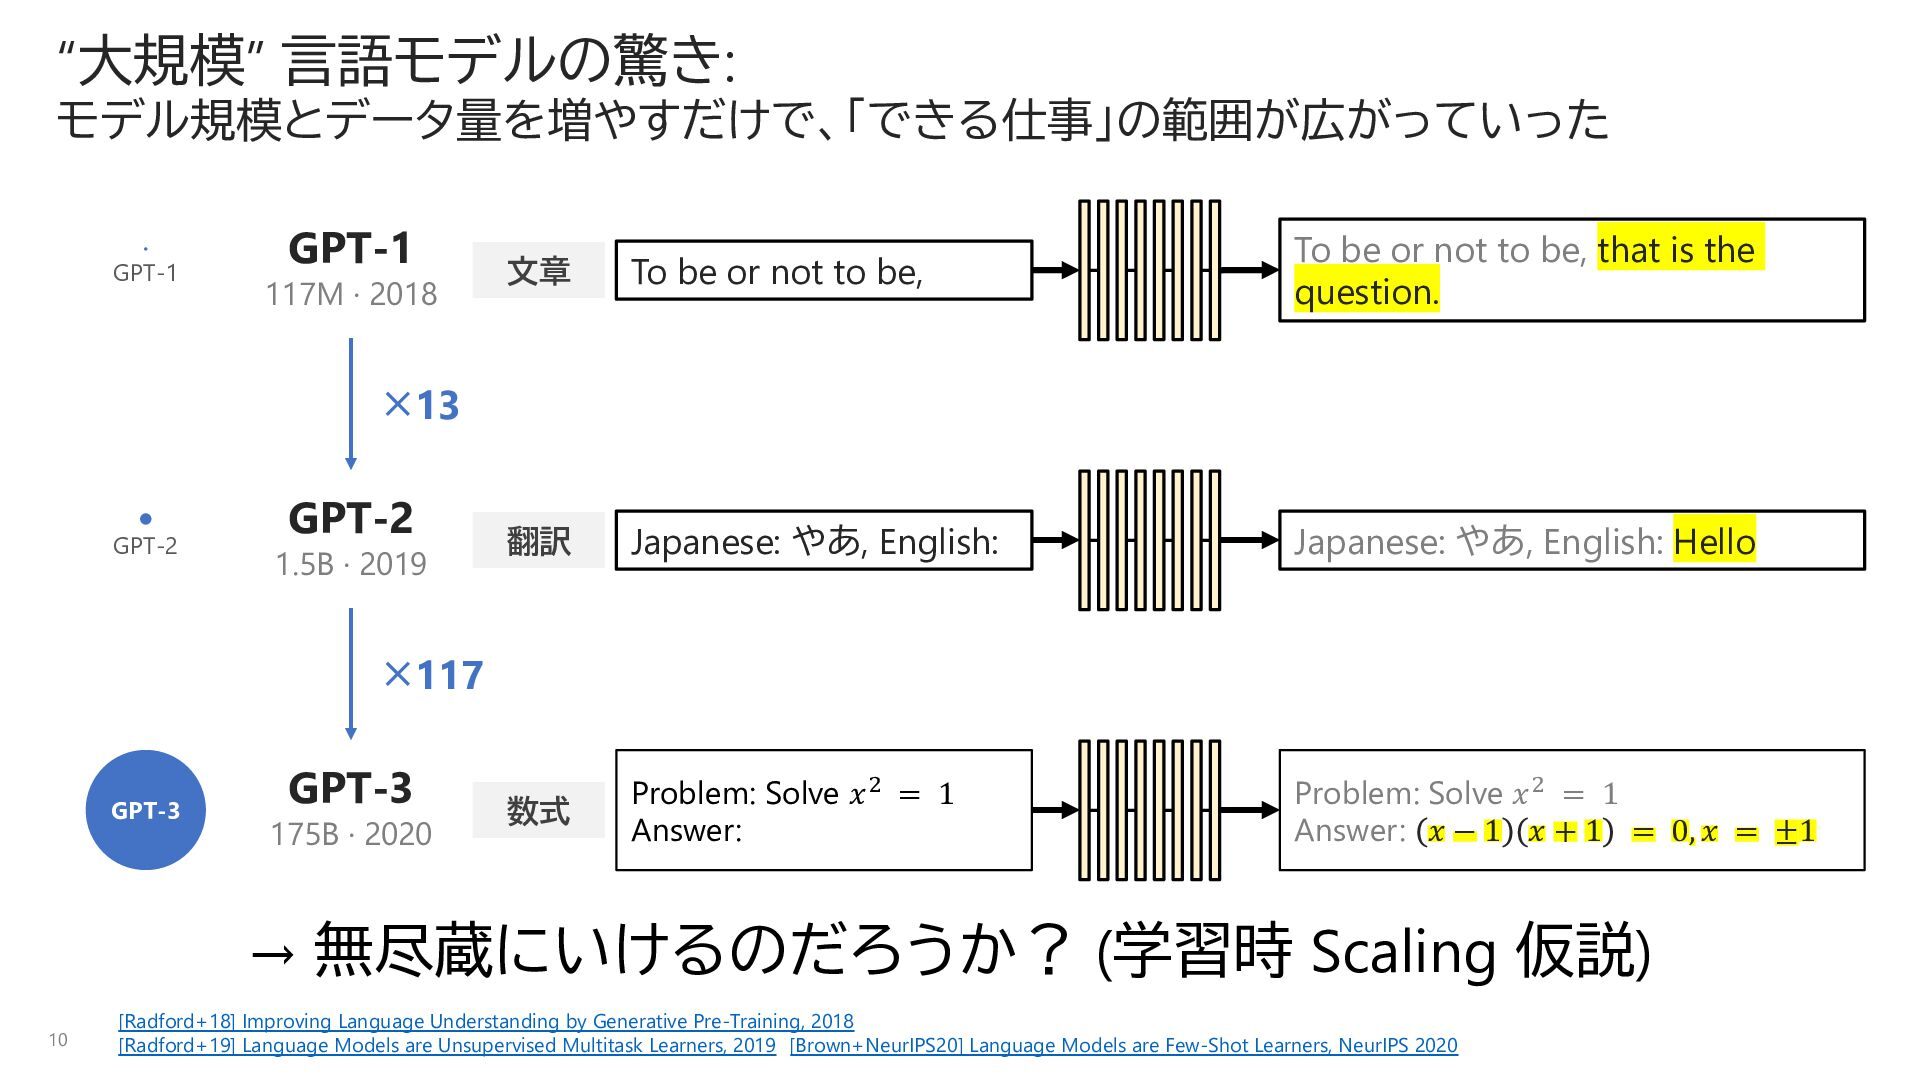
  9. “大規模” 言語モデルの驚き: モデル規模とデータ量を増やすだけで、「できる仕事」の範囲が広がっていった GPT-1 GPT-1 117M · 2018 文章 To

    be or not to be, To be or not to be, that is the question. 翻訳 Japanese: やあ, English: Japanese: やあ, English: Hello 数式 Problem: Solve 𝑥 ! = 1 Answer: Problem: Solve 𝑥 ! = 1 Answer: 𝑥 − 1 𝑥 + 1 = 0, 𝑥 = ±1 ×13 GPT-2 GPT-2 1.5B · 2019 ×117 GPT-3 GPT-3 175B · 2020 → 無尽蔵にいけるのだろうか? (学習時 Scaling 仮説) 10 [Radford+18] Improving Language Understanding by Generative Pre-Training, 2018 [Radford+19] Language Models are Unsupervised Multitask Learners, 2019 [Brown+NeurIPS20] Language Models are Few-Shot Learners, NeurIPS 2020
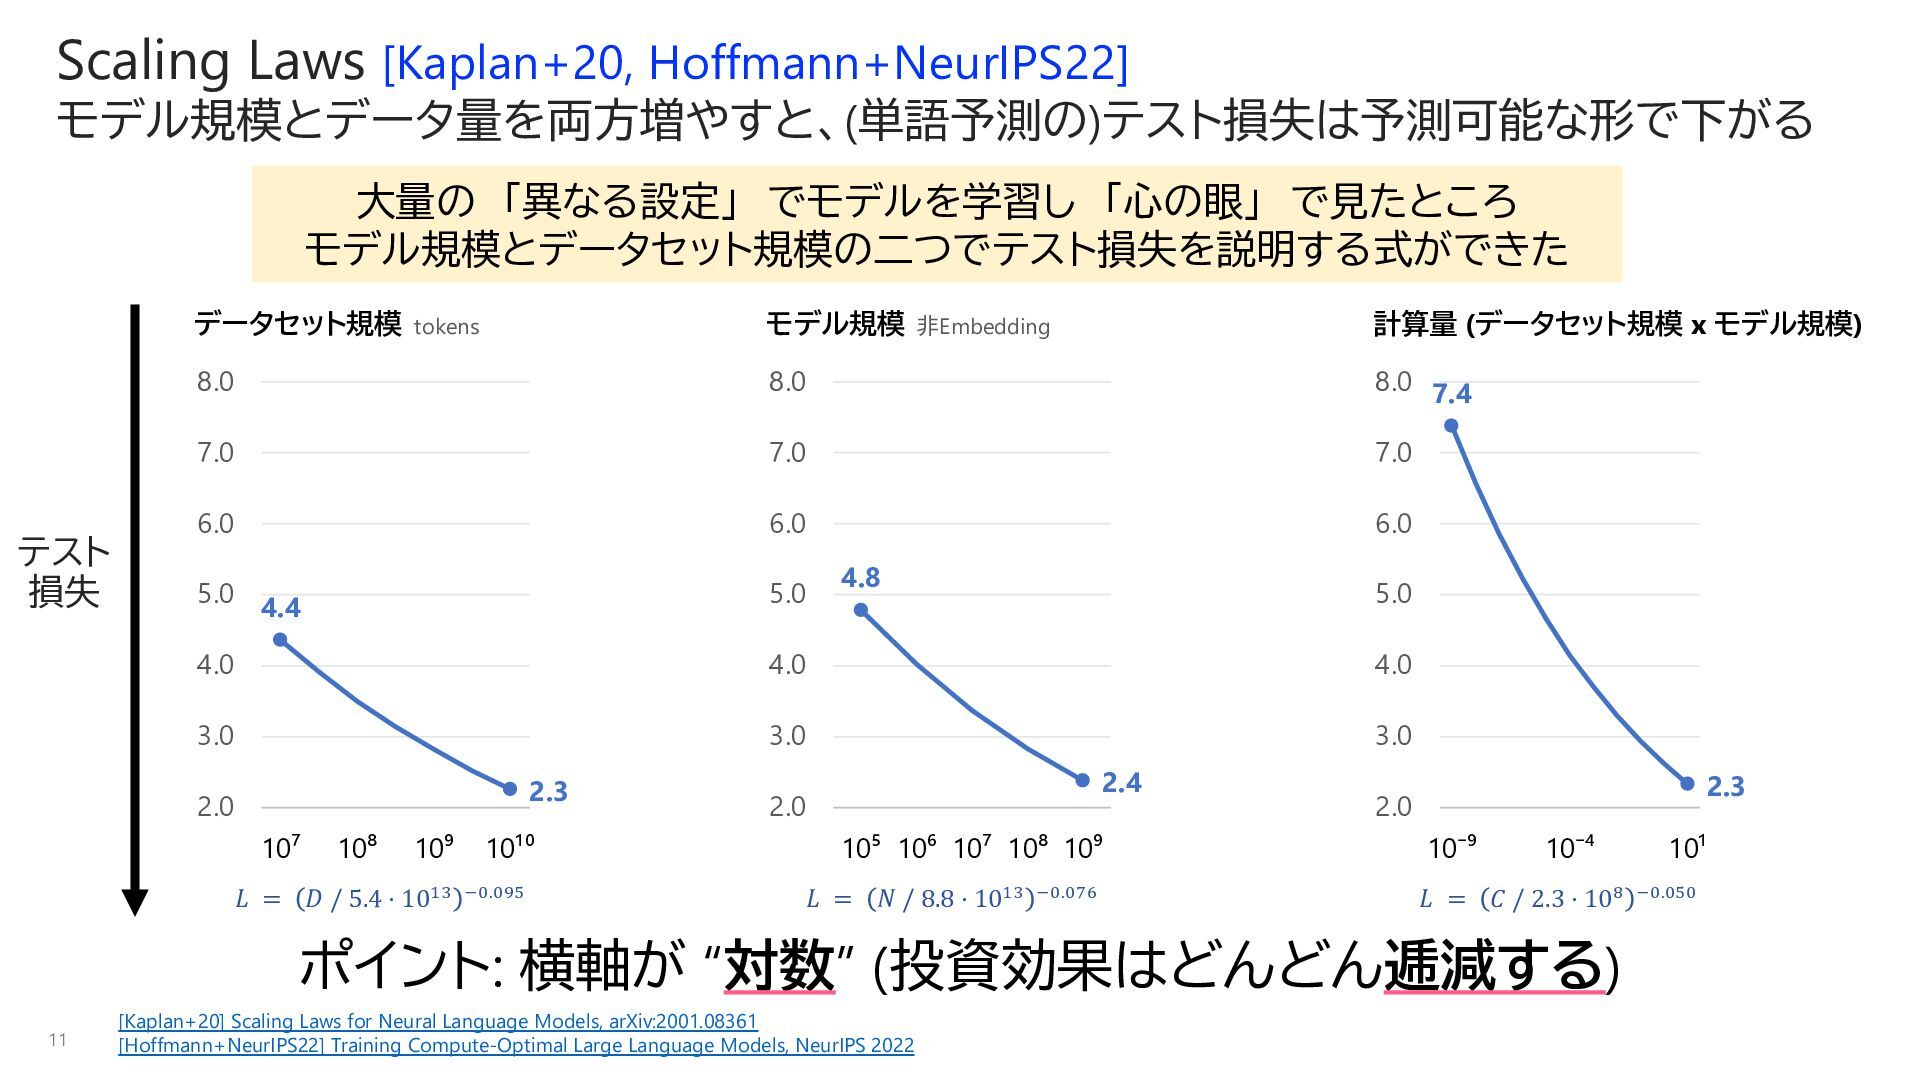
  10. Scaling Laws [Kaplan+20, Hoffmann+NeurIPS22] モデル規模とデータ量を両方増やすと、(単語予測の)テスト損失は予測可能な形で下がる 大量の 「異なる設定」 でモデルを学習し 「心の眼」 で見たところ

    モデル規模とデータセット規模の二つでテスト損失を説明する式ができた テスト 損失 データセット規模 tokens モデル規模 非Embedding 計算量 (データセット規模 x モデル規模) 8.0 8.0 8.0 7.4 7.0 7.0 7.0 6.0 6.0 6.0 5.0 4.4 5.0 4.0 4.0 4.0 3.0 3.0 3.0 2.3 2.0 10⁷ 10⁸ 10⁹ 4.8 5.0 2.4 2.0 10¹⁰ 10⁵ 10⁶ 10⁷ 10⁸ 10⁹ 𝐿 = 𝐷 / 5.4 · 10&' "#.#(% 𝐿 = 𝑁 / 8.8 · 10&' "#.#)* 2.3 2.0 10⁻⁹ 10⁻⁴ 𝐿 = 𝐶 / 2.3 · 10! "#.#%# ポイント: 横軸が “対数” (投資効果はどんどん逓減する) 11 [Kaplan+20] Scaling Laws for Neural Language Models, arXiv:2001.08361 [Hoffmann+NeurIPS22] Training Compute-Optimal Large Language Models, NeurIPS 2022 10¹
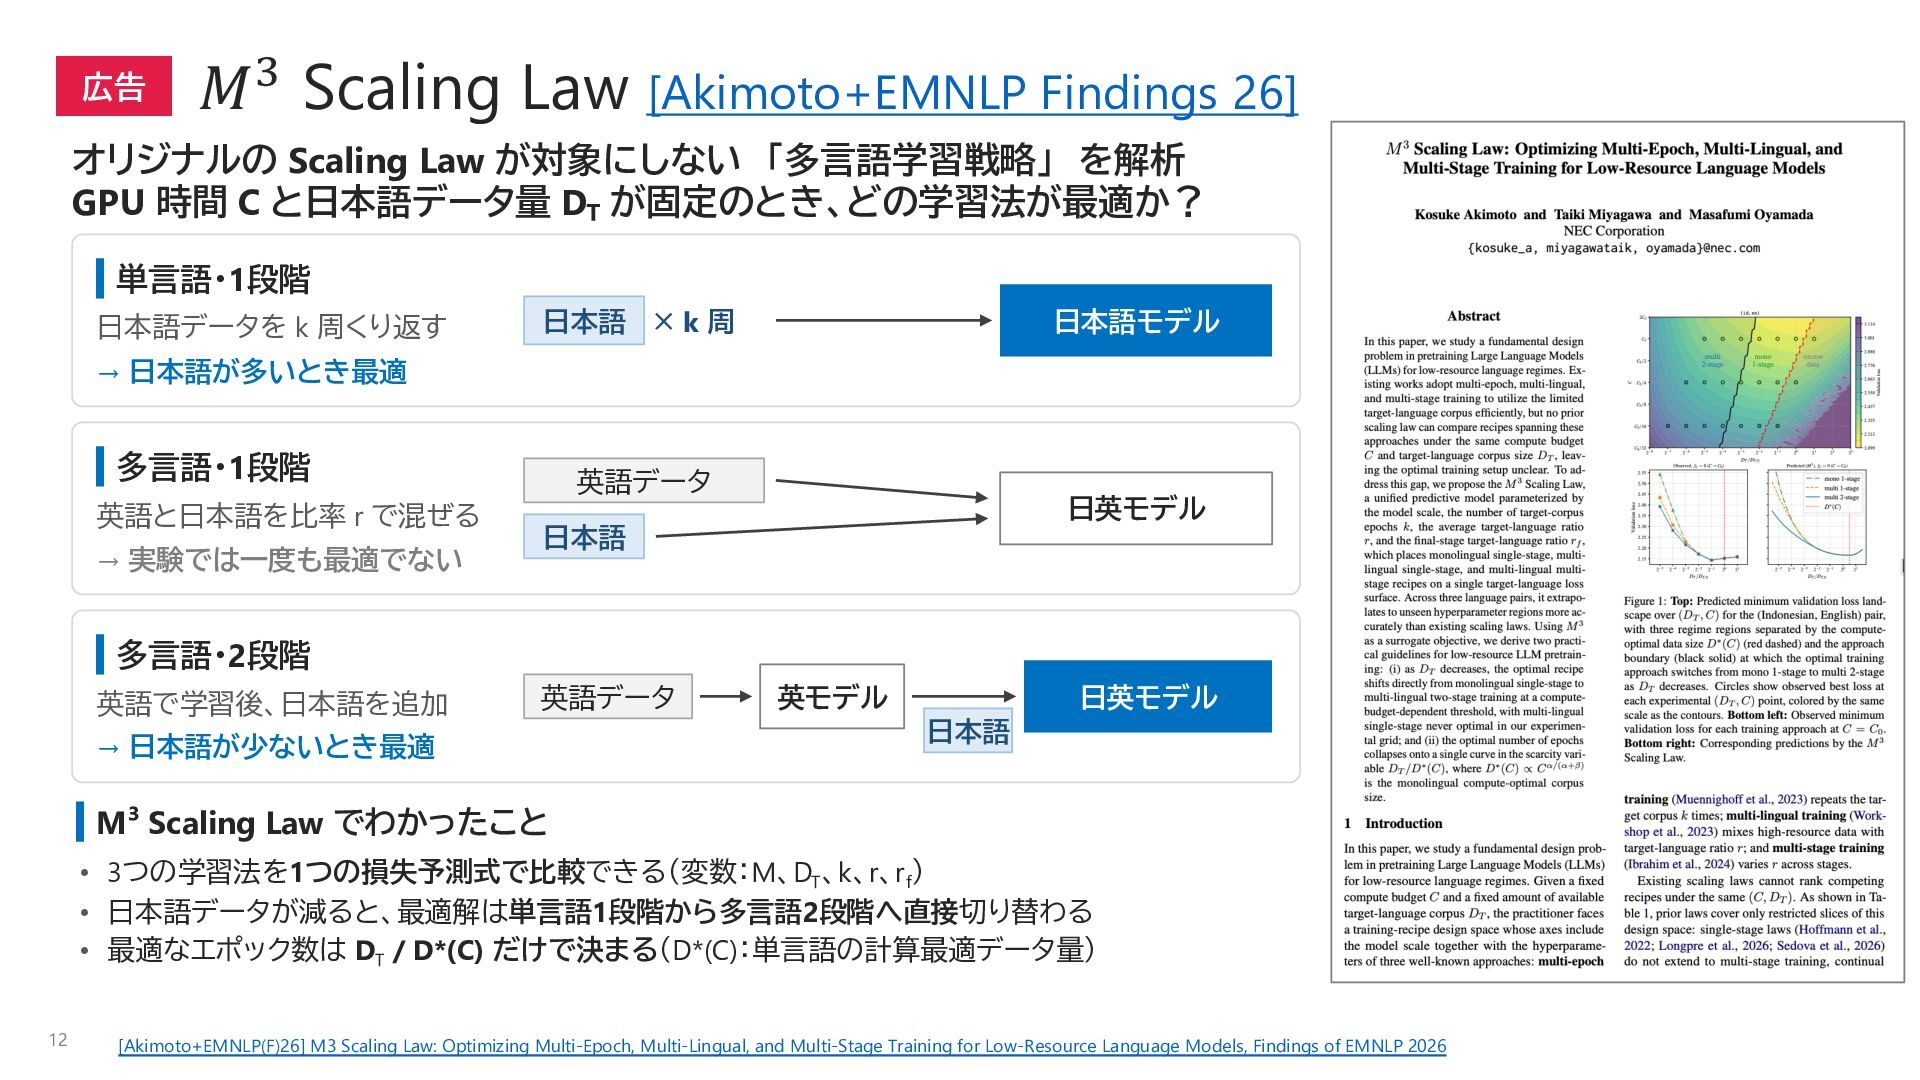
  11. 広告 𝑀! Scaling Law [Akimoto+EMNLP Findings 26] オリジナルの Scaling Law

    が対象にしない 「多言語学習戦略」 を解析 GPU 時間 C と日本語データ量 DT が固定のとき、どの学習法が最適か? 単言語・1段階 日本語データを k 周くり返す 日本語 × k 周 日本語モデル → 日本語が多いとき最適 多言語・1段階 英語と日本語を比率 r で混ぜる → 実験では一度も最適でない 英語データ 日英モデル 日本語 多言語・2段階 英語で学習後、日本語を追加 英語データ → 日本語が少ないとき最適 英モデル 日英モデル 日本語 M³ Scaling Law でわかったこと • 3つの学習法を1つの損失予測式で比較できる(変数:M、DT、k、r、rf) • 日本語データが減ると、最適解は単言語1段階から多言語2段階へ直接切り替わる • 最適なエポック数は DT / D*(C) だけで決まる(D*(C):単言語の計算最適データ量) 12 [Akimoto+EMNLP(F)26] M3 Scaling Law: Optimizing Multi-Epoch, Multi-Lingual, and Multi-Stage Training for Low-Resource Language Models, Findings of EMNLP 2026
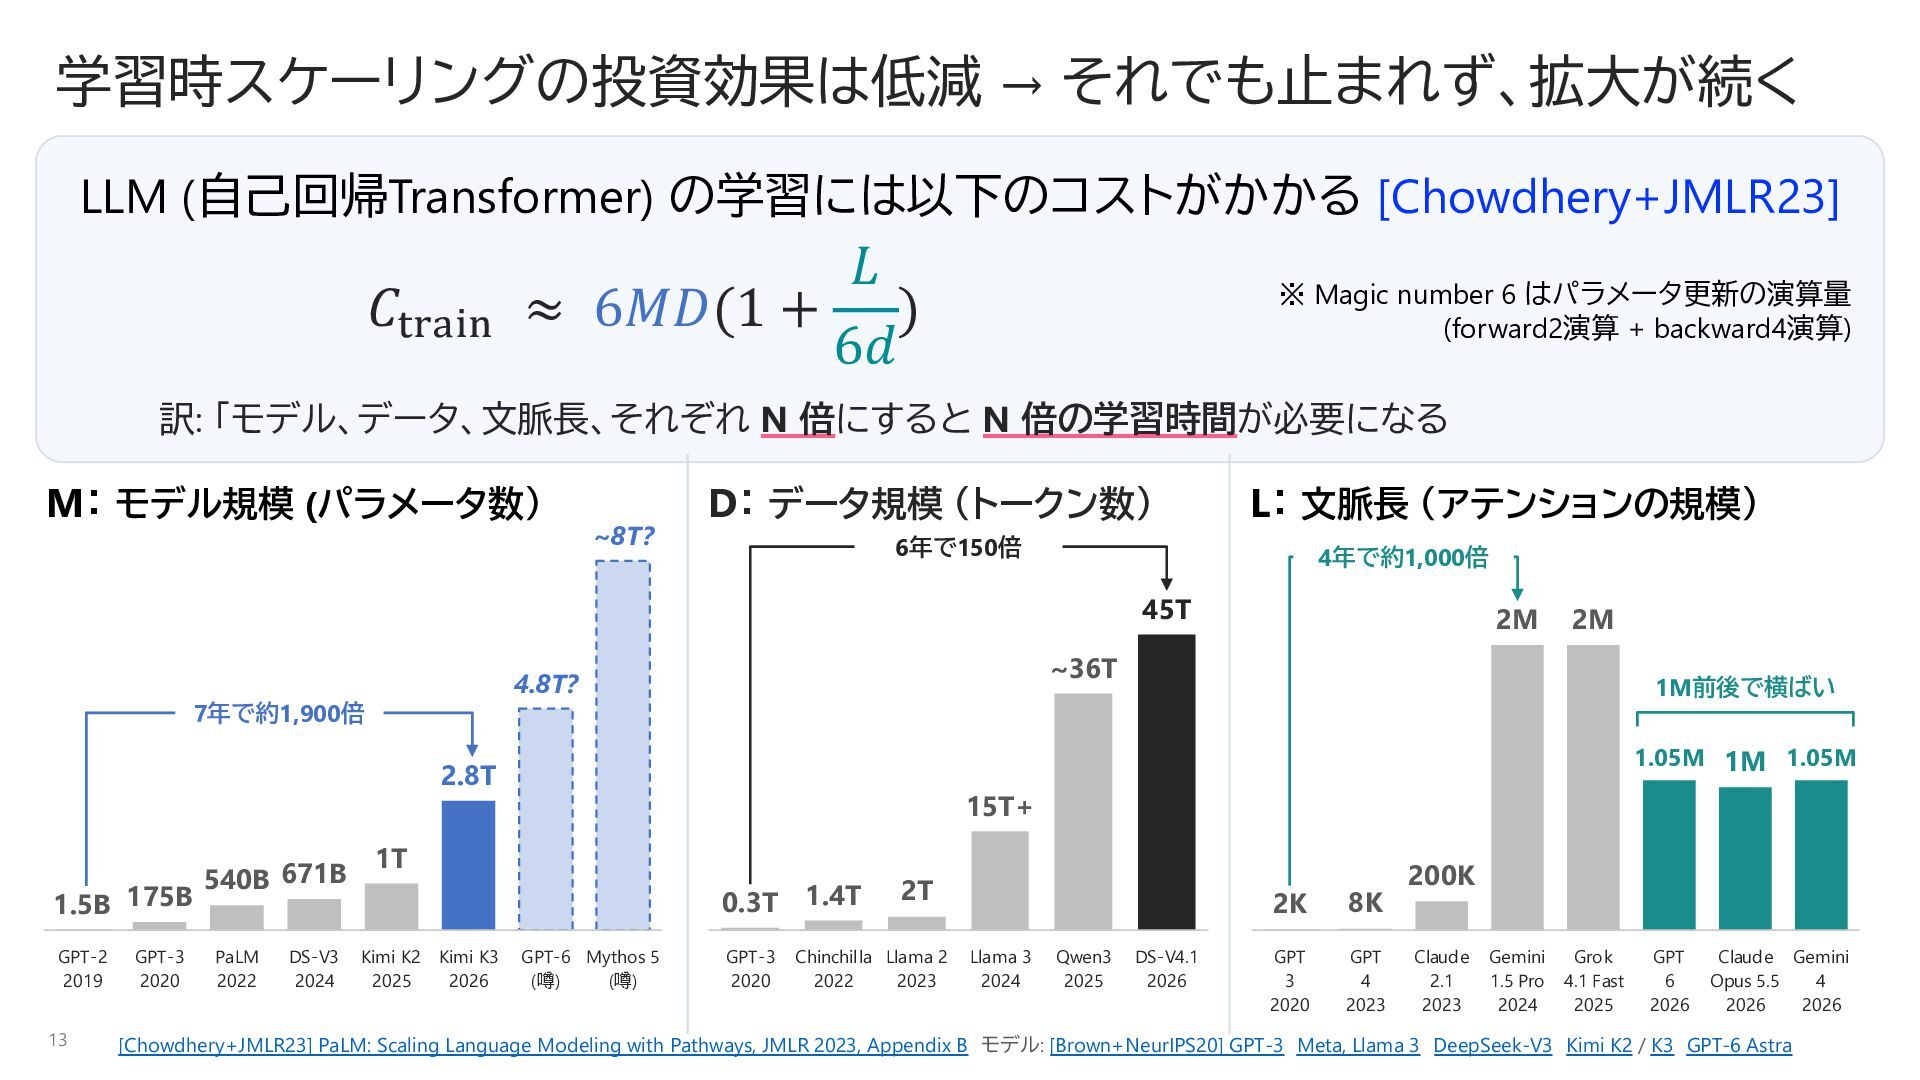
  12. 学習時スケーリングの投資効果は低減 → それでも止まれず、拡大が続く LLM (自己回帰Transformer) の学習には以下のコストがかかる [Chowdhery+JMLR23] 𝐿 𝐶!"#$% ≈

    6𝑀𝐷(1 + ) 6𝑑 ※ Magic number 6 はパラメータ更新の演算量 (forward2演算 + backward4演算) 訳: 「モデル、データ、文脈長、それぞれ N 倍にすると N 倍の学習時間が必要になる M: モデル規模 (パラメータ数) ~8T? D: データ規模 (トークン数) L: 文脈長 (アテンションの規模) 6年で150倍 4年で約1,000倍 45T 1.5B 175B GPT-2 2019 13 GPT-3 2020 PaLM 2022 DS-V3 2024 15T+ 1T Kimi K2 Kimi K3 2025 2026 1M前後で横ばい 1.05M 1M 1.05M 2.8T 540B 671B 2M ~36T 4.8T? 7年で約1,900倍 2M 0.3T 1.4T GPT-6 Mythos 5 (噂) (噂) GPT-3 2020 2T Chinchilla Llama 2 2022 2023 Llama 3 2024 Qwen3 2025 DS-V4.1 2026 2K 8K GPT 3 2020 GPT 4 2023 200K Claude 2.1 2023 Gemini Grok 1.5 Pro 4.1 Fast 2024 2025 GPT 6 2026 Claude Gemini Opus 5.5 4 2026 2026 [Chowdhery+JMLR23] PaLM: Scaling Language Modeling with Pathways, JMLR 2023, Appendix B モデル: [Brown+NeurIPS20] GPT-3 Meta, Llama 3 DeepSeek-V3 Kimi K2 / K3 GPT-6 Astra
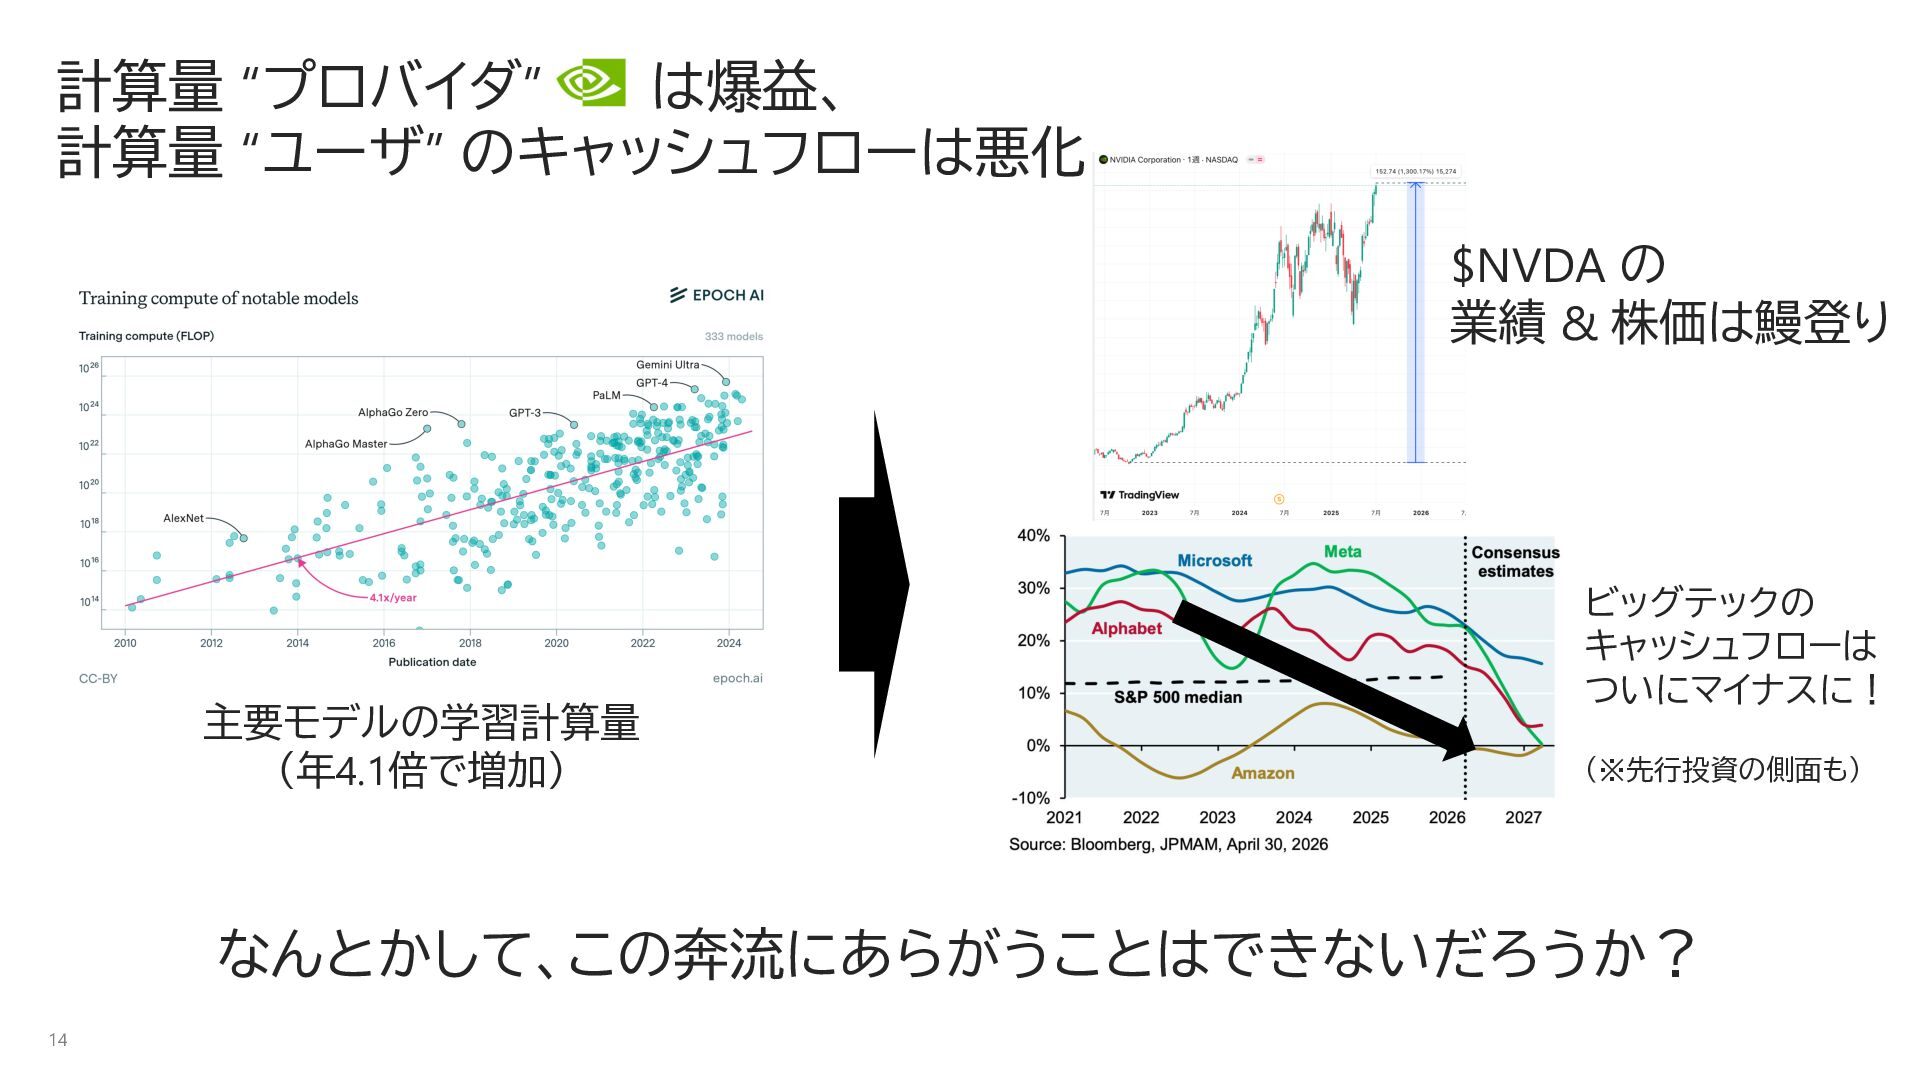
  13. 計算量 “プロバイダ” は爆益、 計算量 “ユーザ” のキャッシュフローは悪化 $NVDA の 業績 &

    株価は鰻登り 主要モデルの学習計算量 (年4.1倍で増加) ビッグテックの キャッシュフローは ついにマイナスに! (※先行投資の側面も) なんとかして、この奔流にあらがうことはできないだろうか? 14
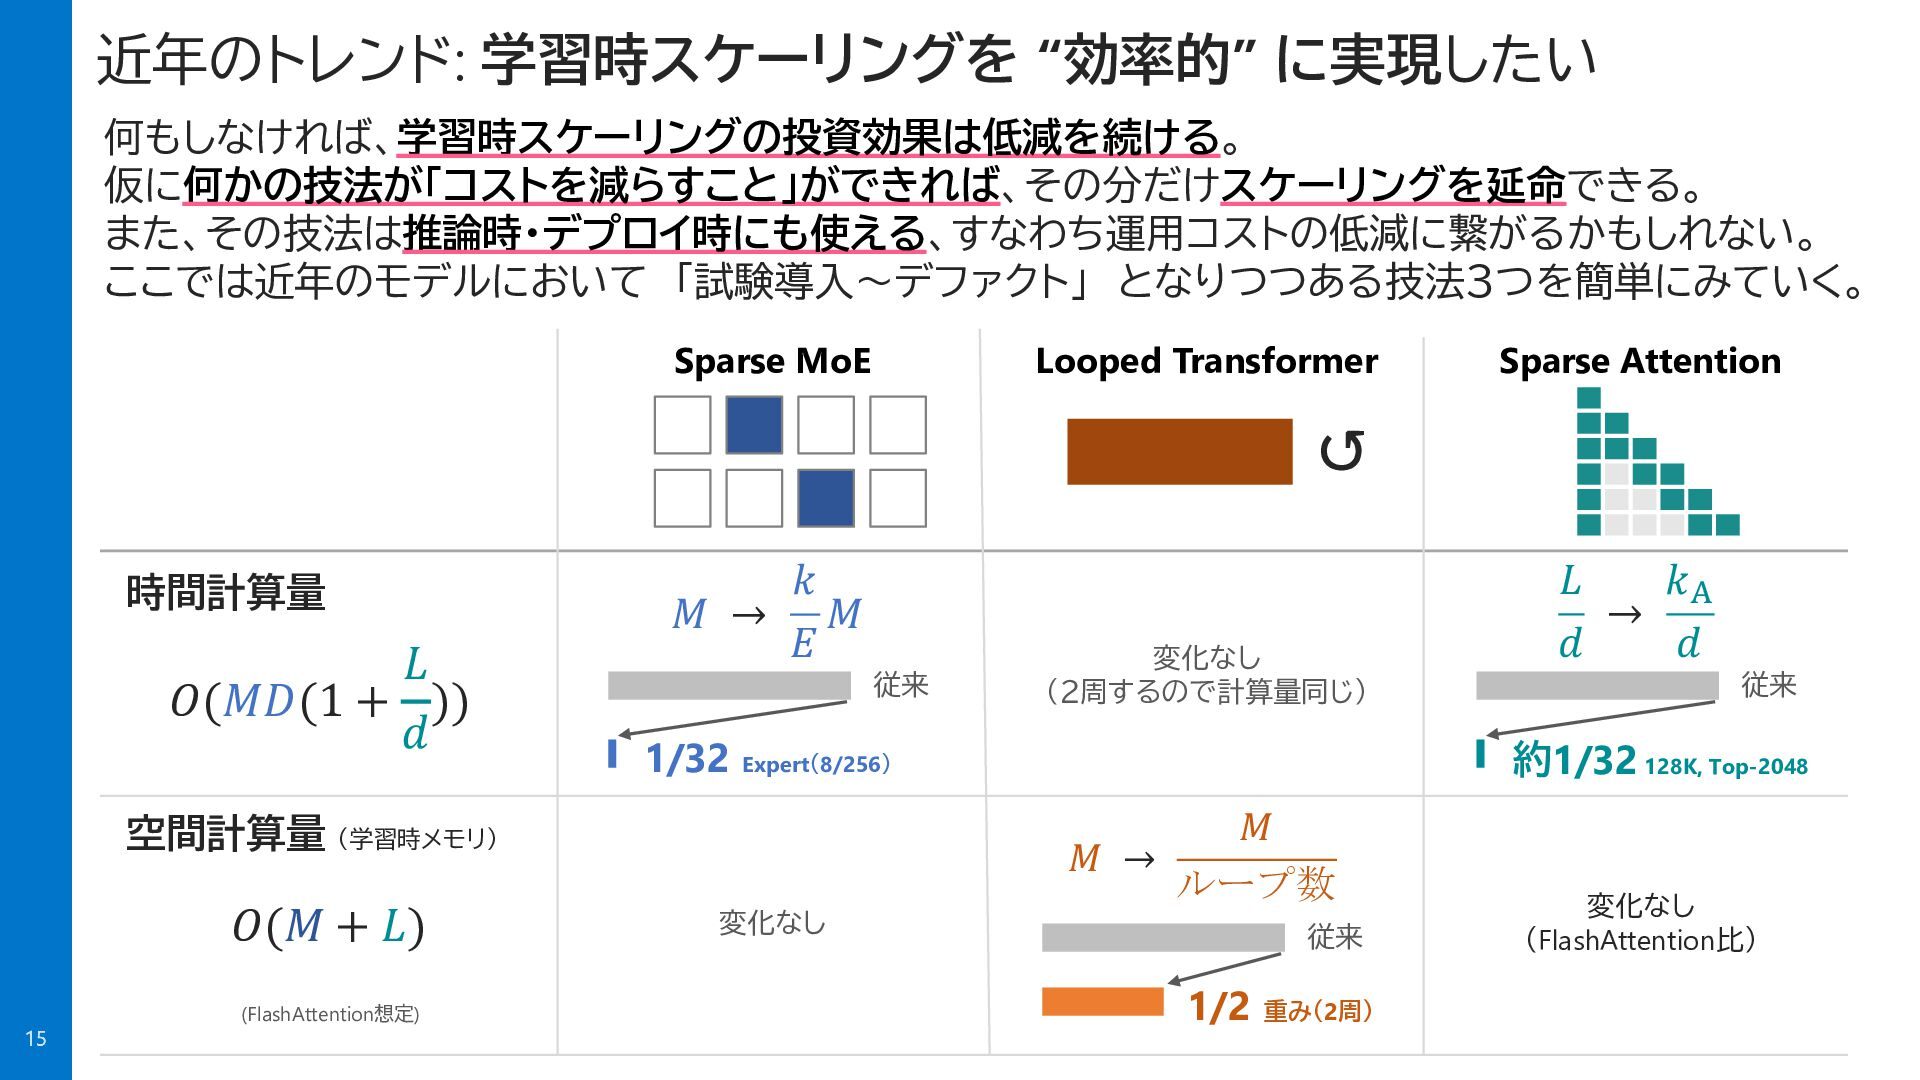
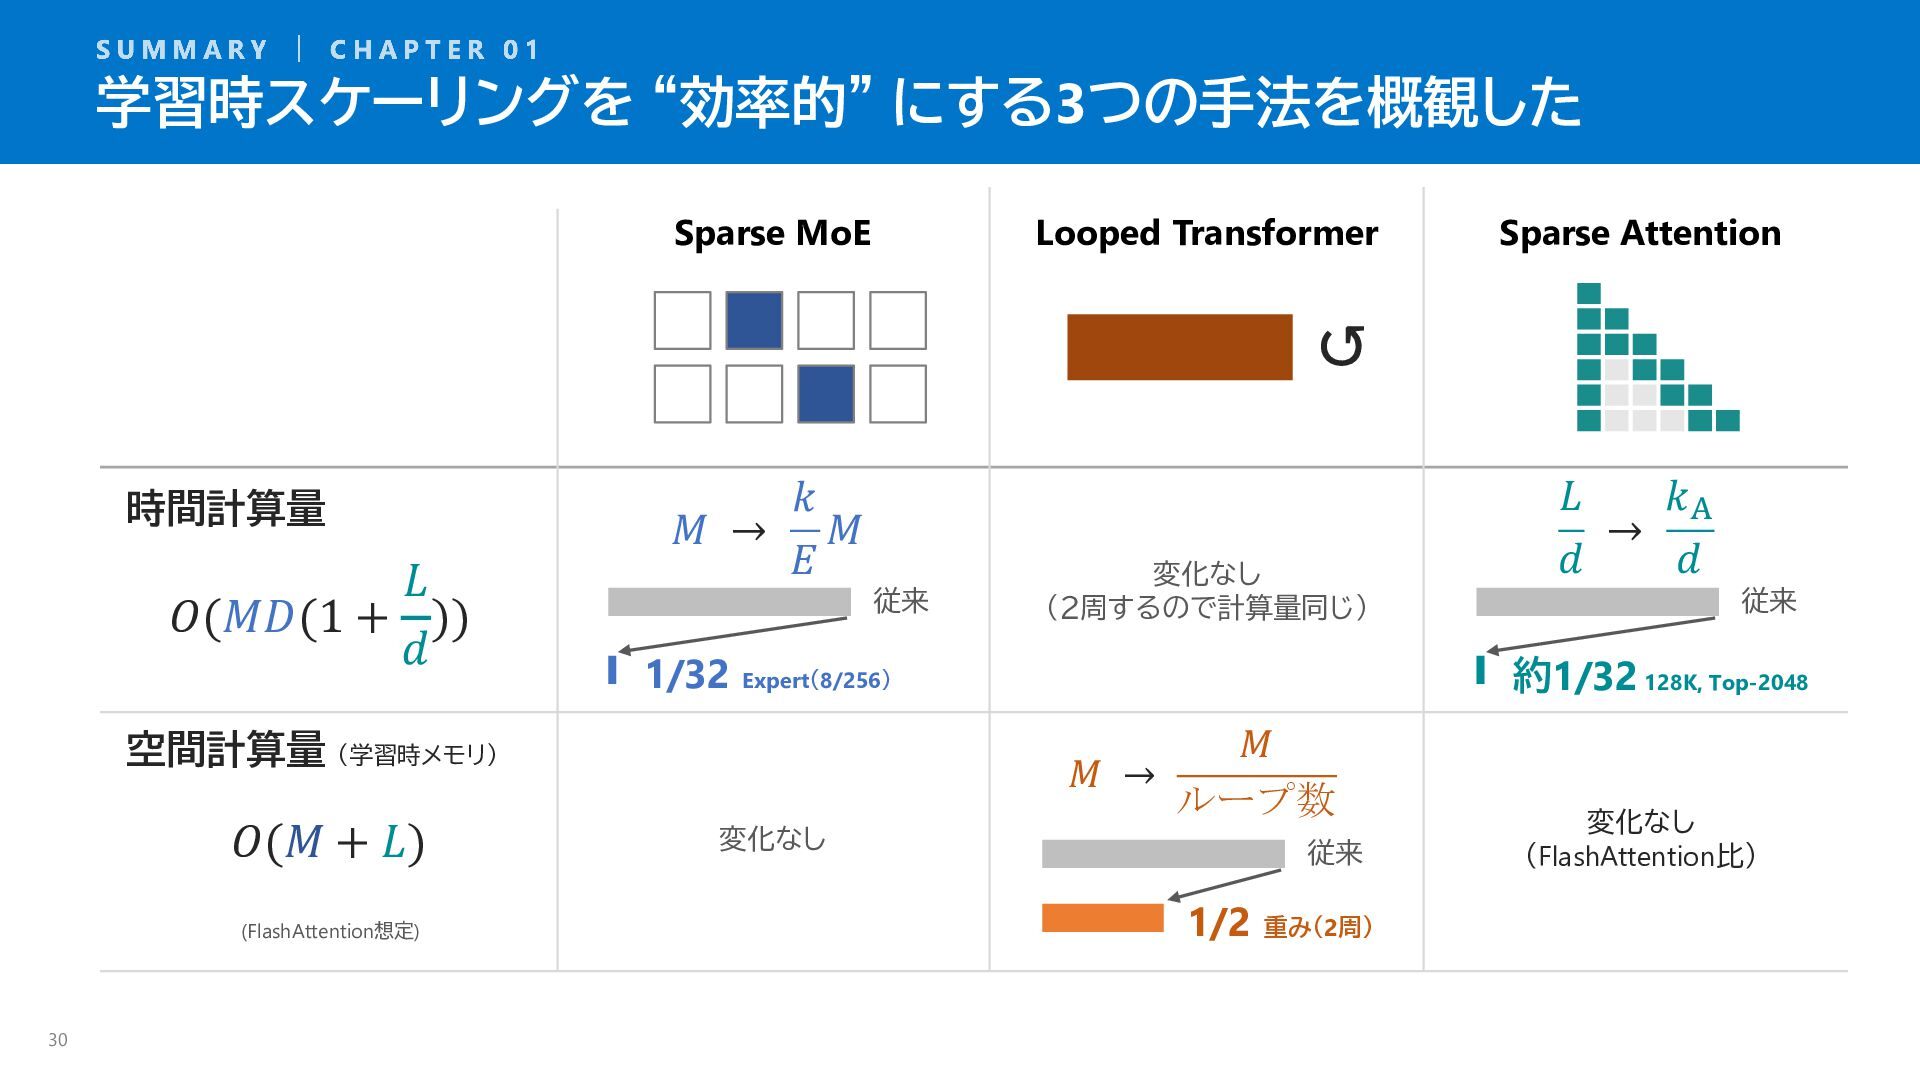
  14. 近年のトレンド: 学習時スケーリングを “効率的” に実現したい 何もしなければ、学習時スケーリングの投資効果は低減を続ける。 仮に何かの技法が「コストを減らすこと」ができれば、その分だけスケーリングを延命できる。 また、その技法は推論時・デプロイ時にも使える、すなわち運用コストの低減に繋がるかもしれない。 ここでは近年のモデルにおいて 「試験導入〜デファクト」 となりつつある技法3つを簡単にみていく。

    Sparse MoE Looped Transformer Sparse Attention ↺ 時間計算量 𝐿 𝑂(𝑀𝐷(1 + )) 𝑑 𝑘 𝑀 → 𝑀 𝐸 従来 1/32 Expert(8/256) 空間計算量 (学習時メモリ) 𝑂(𝑀 + 𝐿) (FlashAttention想定) 15 変化なし (2周するので計算量同じ) 従来 約1/32 128K, Top-2048 𝑀 → 変化なし 𝐿 𝑘* → 𝑑 𝑑 𝑀 ループ数 従来 1/2 重み(2周) 変化なし (FlashAttention比)
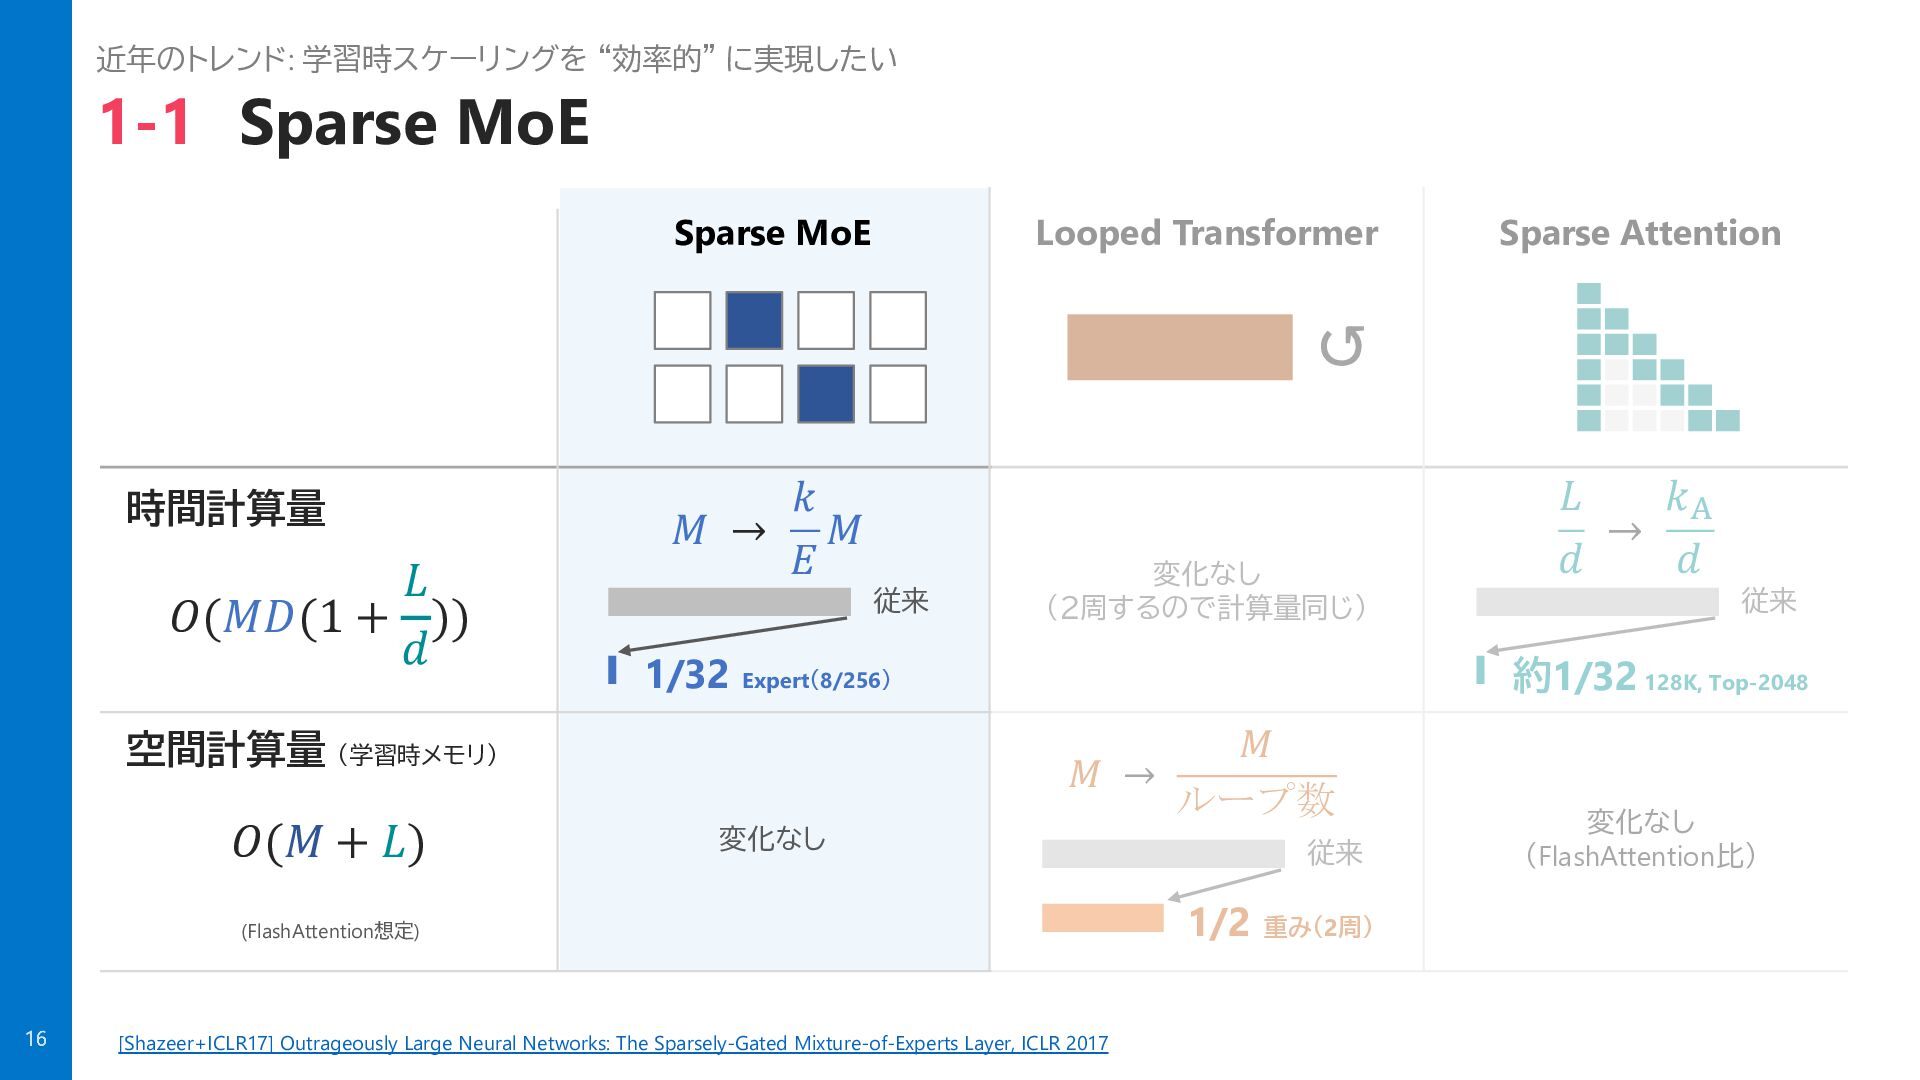
  15. 近年のトレンド: 学習時スケーリングを “効率的” に実現したい 1-1 Sparse MoE Sparse MoE Looped

    Transformer Sparse Attention ↺ 時間計算量 𝐿 𝑂(𝑀𝐷(1 + )) 𝑑 𝑘 𝑀 → 𝑀 𝐸 従来 1/32 Expert(8/256) 変化なし (FlashAttention想定) 16 従来 約1/32 128K, Top-2048 𝑀 𝑀 → ループ数 空間計算量 (学習時メモリ) 𝑂(𝑀 + 𝐿) 変化なし (2周するので計算量同じ) 𝐿 𝑘* → 𝑑 𝑑 [Shazeer+ICLR17] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, ICLR 2017 従来 1/2 重み(2周) 変化なし (FlashAttention比)
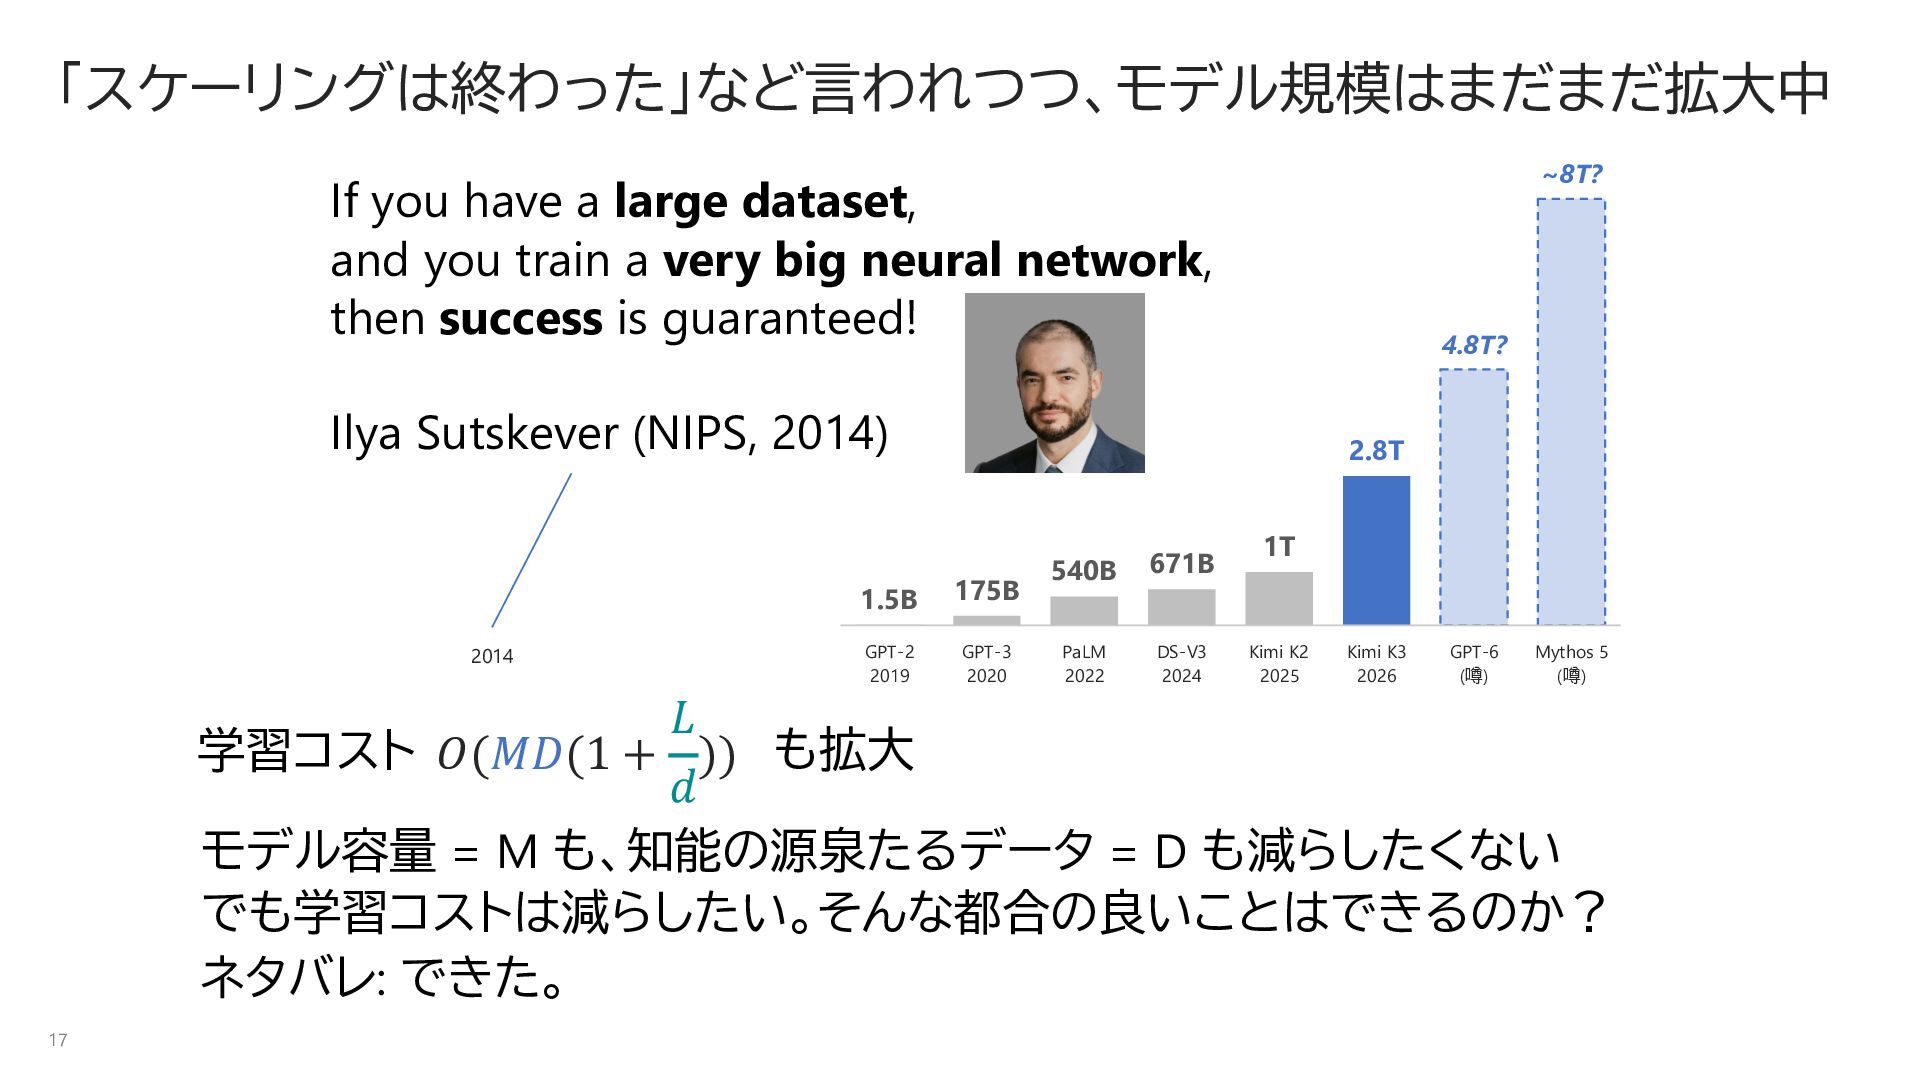
  16. 「スケーリングは終わった」など言われつつ、モデル規模はまだまだ拡大中 ~8T? If you have a large dataset, and you

    train a very big neural network, then success is guaranteed! 4.8T? Ilya Sutskever (NIPS, 2014) 1.5B 2014 GPT-2 2019 2.8T 175B GPT-3 2020 540B 671B PaLM 2022 DS-V3 2024 1T Kimi K2 2025 Kimi K3 2026 GPT-6 (噂) Mythos 5 (噂) 𝐿 学習コスト 𝑂(𝑀𝐷(1 + )) も拡大 𝑑 モデル容量 = M も、知能の源泉たるデータ = D も減らしたくない でも学習コストは減らしたい。そんな都合の良いことはできるのか? ネタバレ: できた。 17
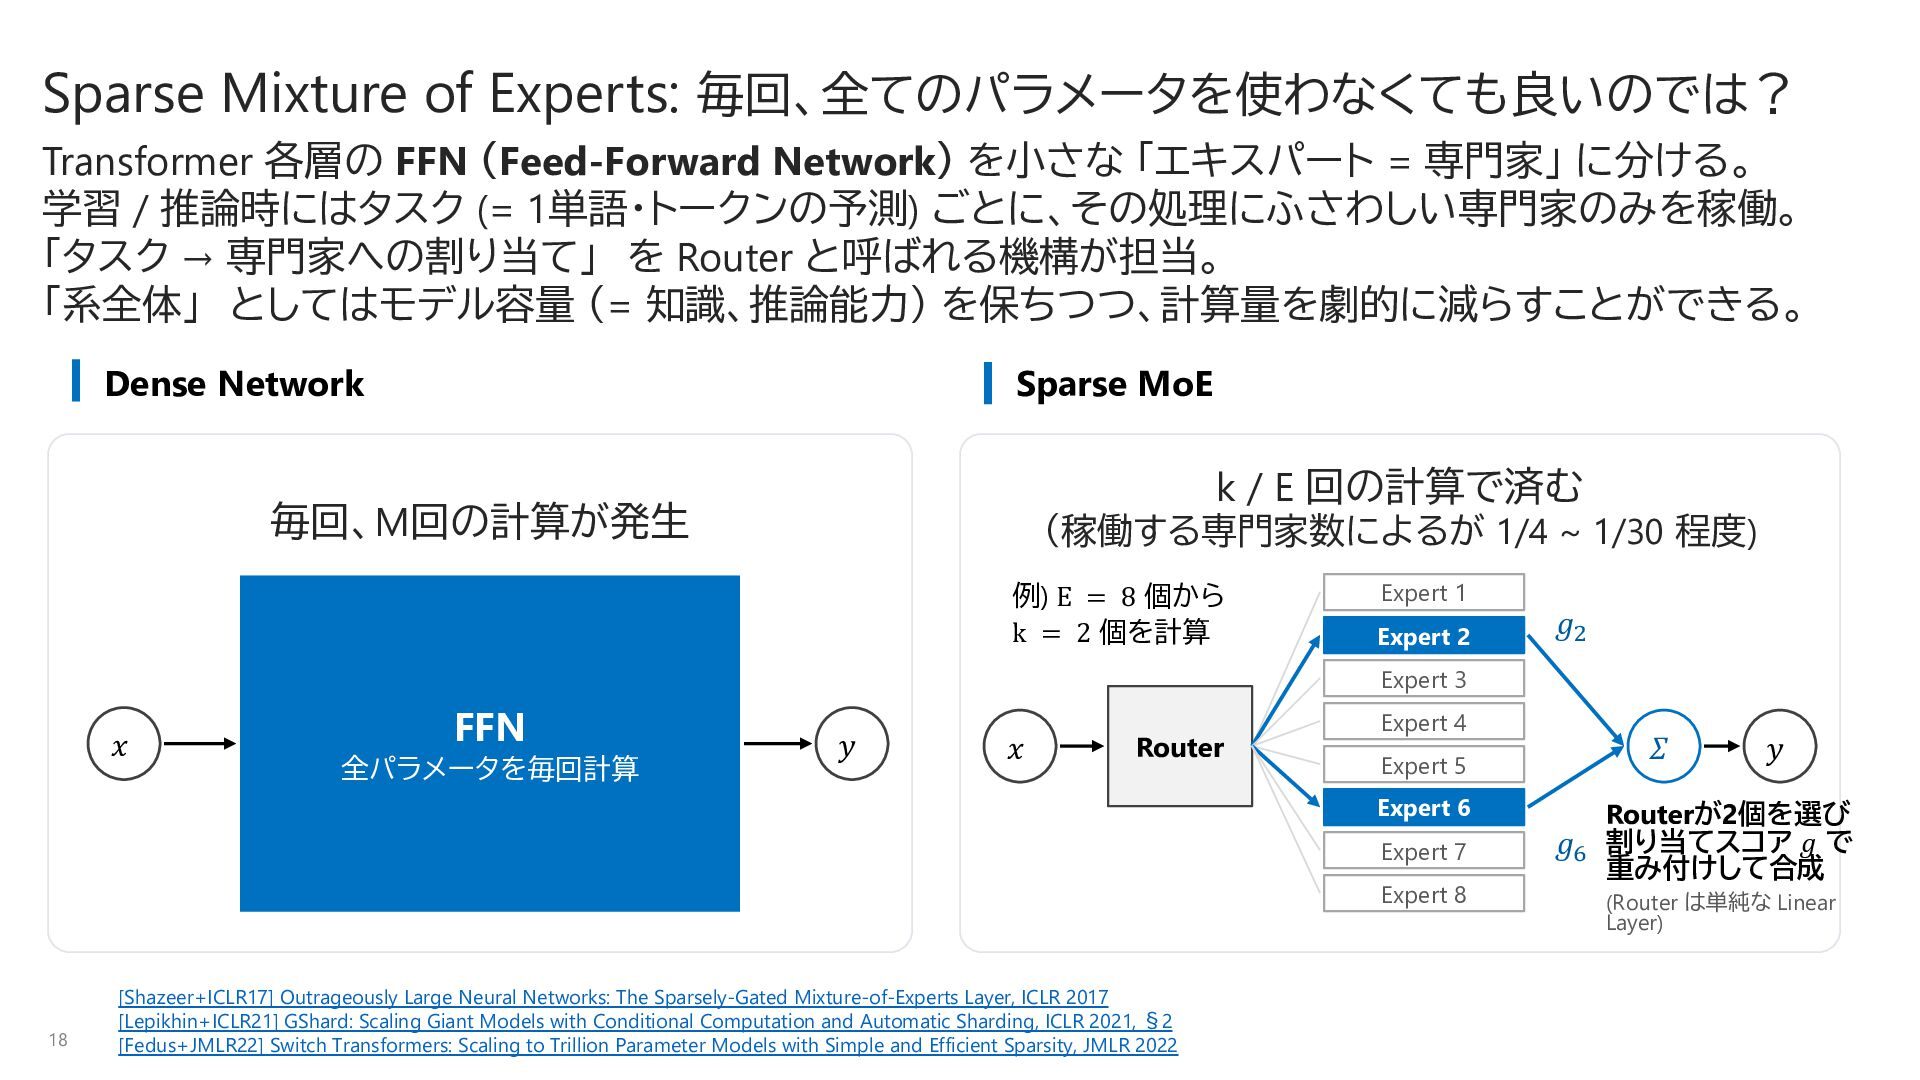
  17. Sparse Mixture of Experts: 毎回、全てのパラメータを使わなくても良いのでは? Transformer 各層の FFN (Feed-Forward Network)

    を小さな 「エキスパート = 専門家」 に分ける。 学習 / 推論時にはタスク (= 1単語・トークンの予測) ごとに、その処理にふさわしい専門家のみを稼働。 「タスク → 専門家への割り当て」 を Router と呼ばれる機構が担当。 「系全体」 としてはモデル容量 (= 知識、推論能力) を保ちつつ、計算量を劇的に減らすことができる。 Dense Network Sparse MoE k / E 回の計算で済む 毎回、M回の計算が発生 (稼働する専門家数によるが 1/4 ~ 1/30 程度) 例) E = 8 個から k = 2 個を計算 Expert 1 Expert 2 𝑔! Expert 3 𝑥 FFN 全パラメータを毎回計算 𝑦 𝑥 Router Expert 4 Expert 5 Expert 6 Expert 7 Expert 8 18 [Shazeer+ICLR17] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, ICLR 2017 [Lepikhin+ICLR21] GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, ICLR 2021, §2 [Fedus+JMLR22] Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, JMLR 2022 𝛴 𝑦 Routerが2個を選び 𝑔" 割り当てスコア 𝑔 で 重み付けして合成 (Router は単純な Linear Layer)
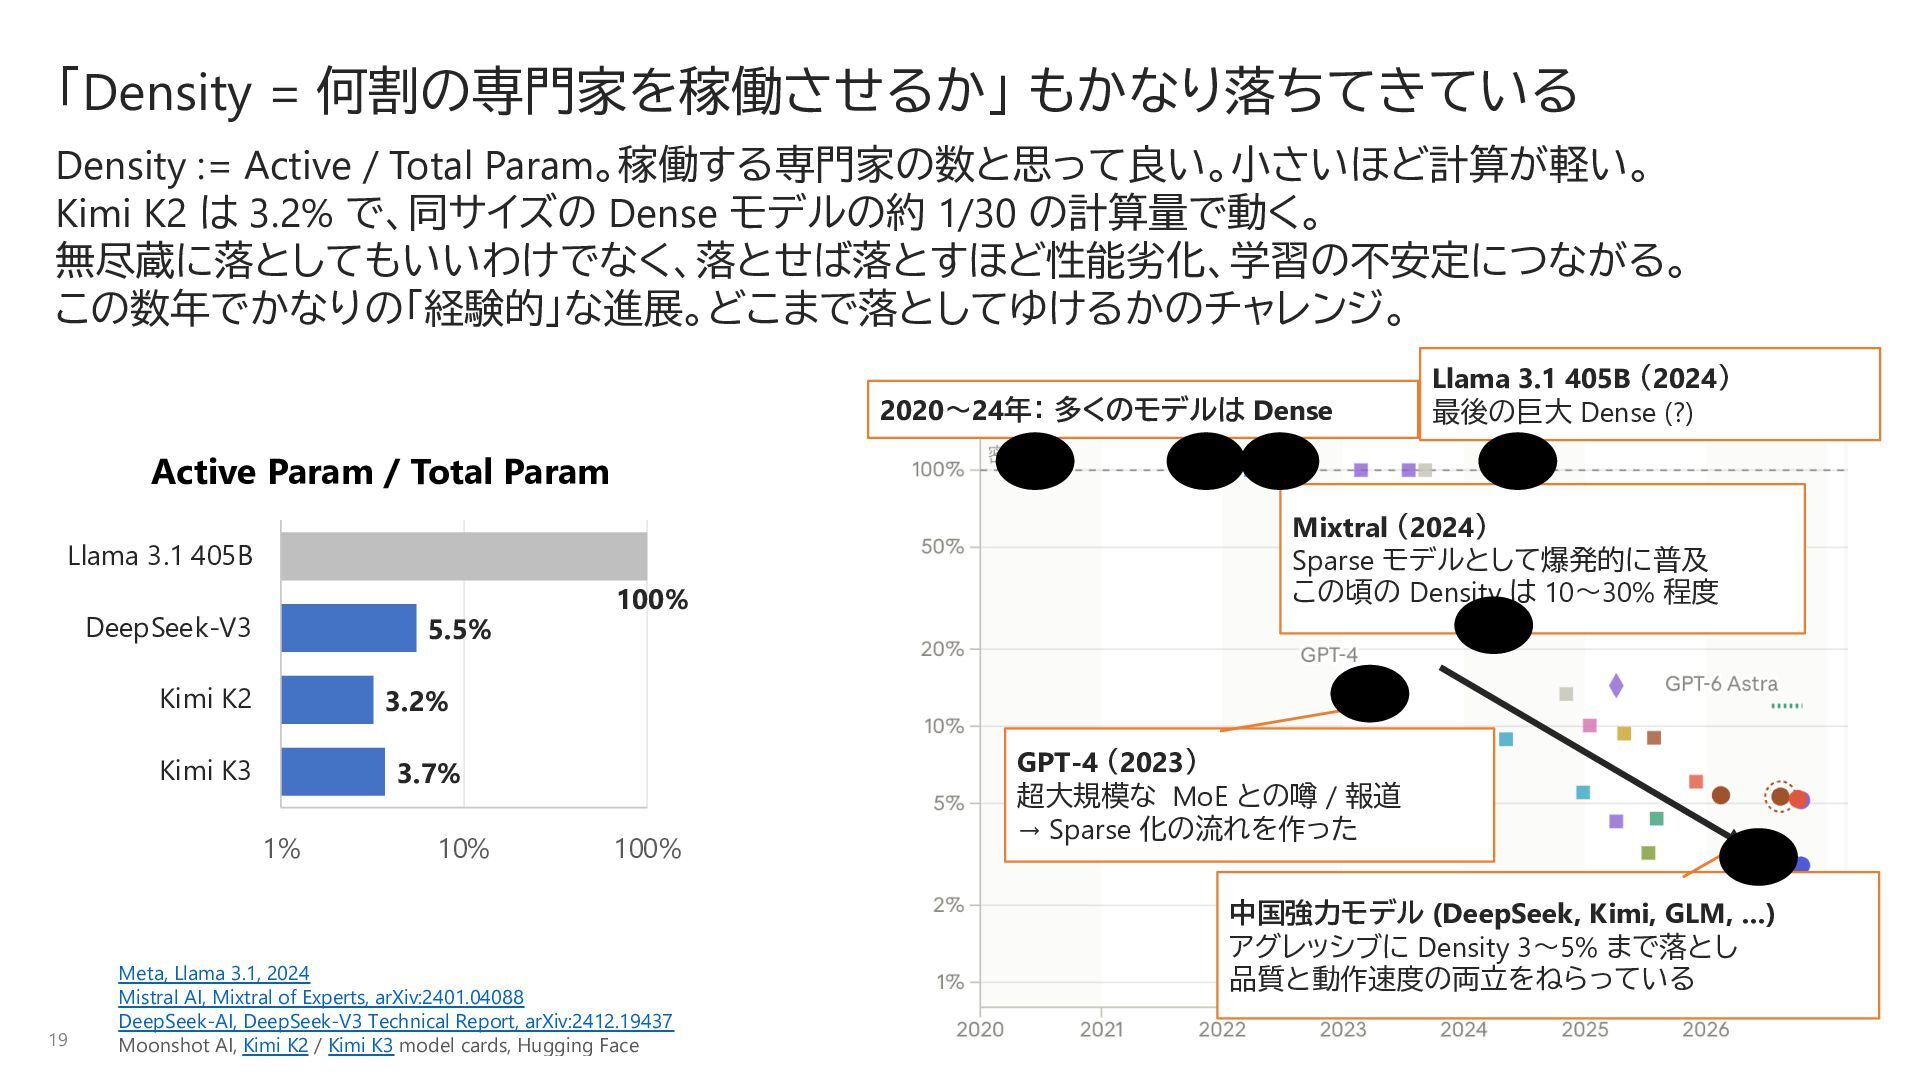
  18. 「Density = 何割の専門家を稼働させるか」 もかなり落ちてきている Density := Active / Total Param。稼働する専門家の数と思って良い。小さいほど計算が軽い。

    Kimi K2 は 3.2% で、同サイズの Dense モデルの約 1/30 の計算量で動く。 無尽蔵に落としてもいいわけでなく、落とせば落とすほど性能劣化、学習の不安定につながる。 この数年でかなりの「経験的」な進展。どこまで落としてゆけるかのチャレンジ。 2020〜24年: 多くのモデルは Dense Llama 3.1 405B (2024) 最後の巨大 Dense (?) Active Param / Total Param Llama 3.1 405B DeepSeek-V3 5.5% Kimi K2 3.2% Kimi K3 3.7% 1% 19 10% 100% 100% Meta, Llama 3.1, 2024 Mistral AI, Mixtral of Experts, arXiv:2401.04088 DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437 Moonshot AI, Kimi K2 / Kimi K3 model cards, Hugging Face Mixtral (2024) Sparse モデルとして爆発的に普及 この頃の Density は 10〜30% 程度 GPT-4 (2023) 超大規模な MoE との噂 / 報道 → Sparse 化の流れを作った 中国強力モデル (DeepSeek, Kimi, GLM, …) アグレッシブに Density 3〜5% まで落とし 品質と動作速度の両立をねらっている
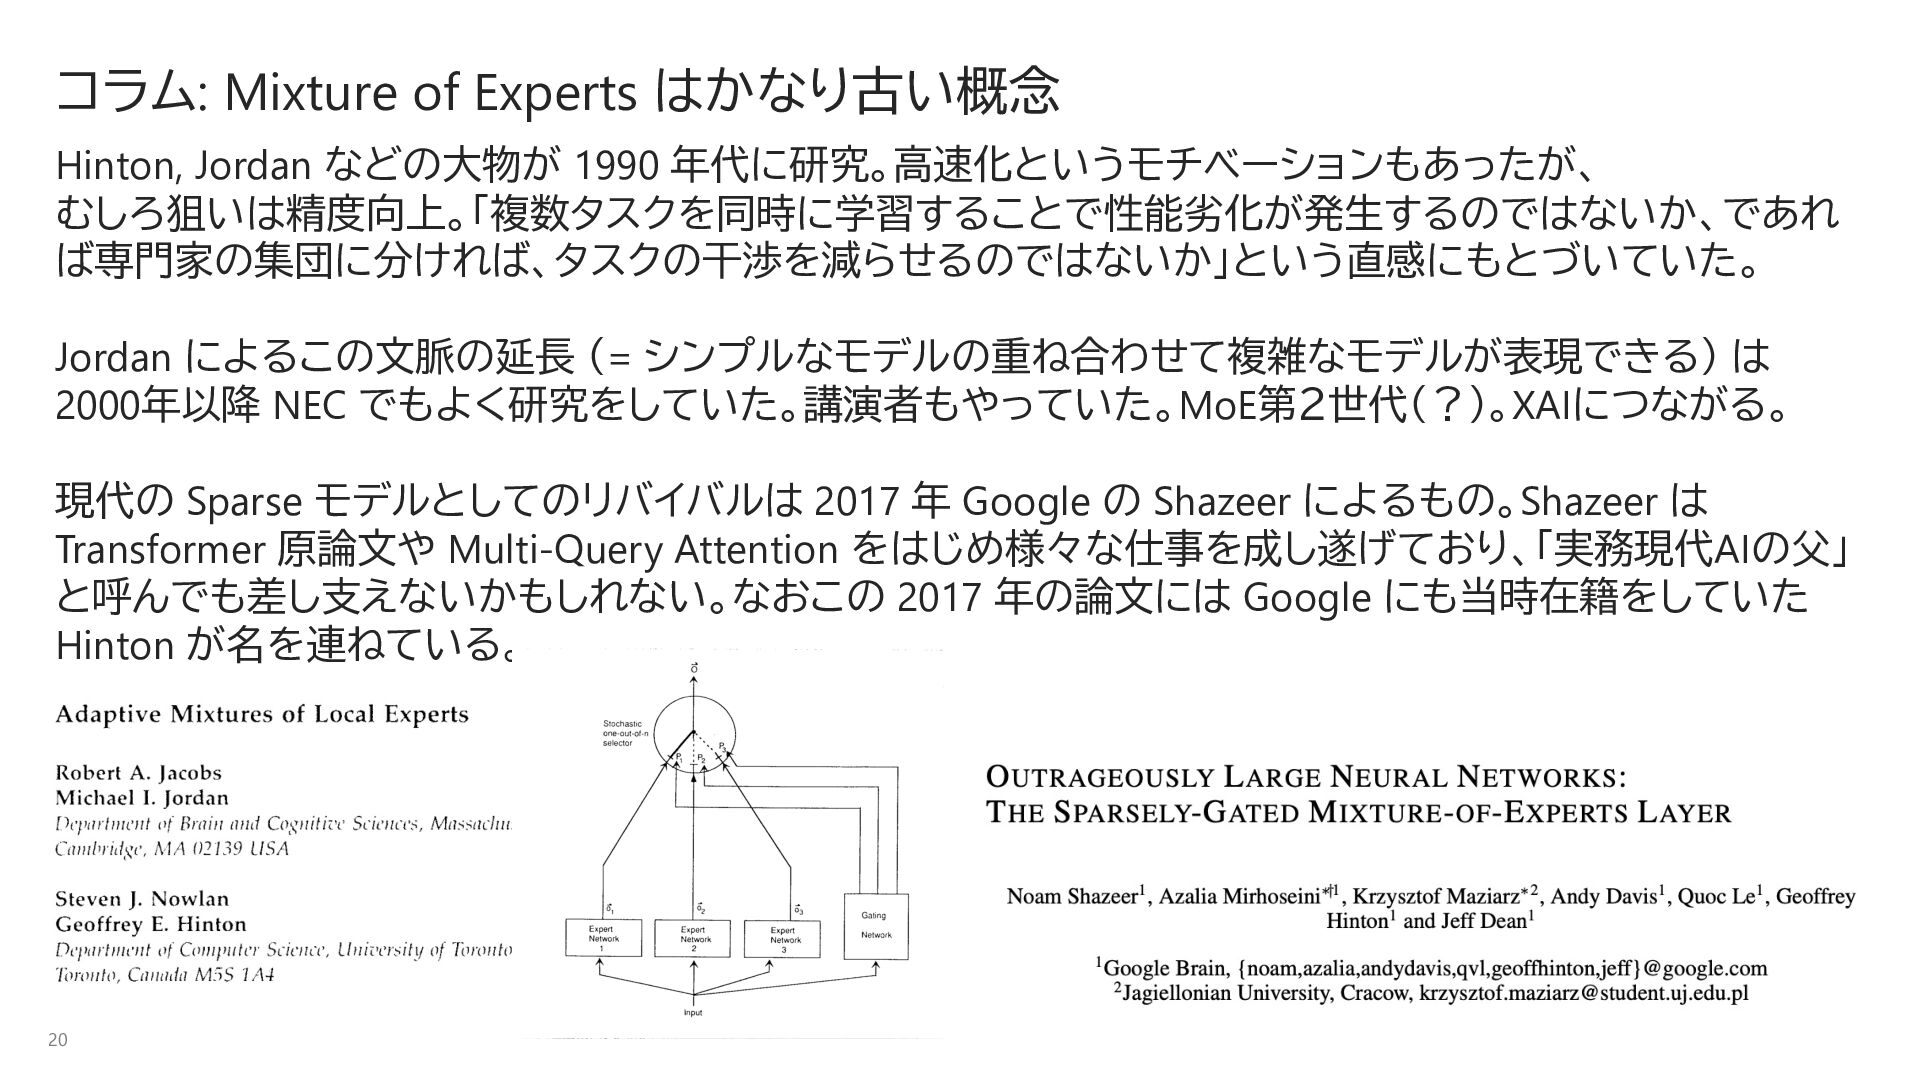
  19. コラム: Mixture of Experts はかなり古い概念 Hinton, Jordan などの大物が 1990 年代に研究。高速化というモチベーションもあったが、

    むしろ狙いは精度向上。「複数タスクを同時に学習することで性能劣化が発生するのではないか、であれ ば専門家の集団に分ければ、タスクの干渉を減らせるのではないか」という直感にもとづいていた。 Jordan によるこの文脈の延長 (= シンプルなモデルの重ね合わせて複雑なモデルが表現できる) は 2000年以降 NEC でもよく研究をしていた。講演者もやっていた。MoE第2世代(?)。XAIにつながる。 現代の Sparse モデルとしてのリバイバルは 2017 年 Google の Shazeer によるもの。Shazeer は Transformer 原論文や Multi-Query Attention をはじめ様々な仕事を成し遂げており、「実務現代AIの父」 と呼んでも差し支えないかもしれない。なおこの 2017 年の論文には Google にも当時在籍をしていた Hinton が名を連ねている。 20
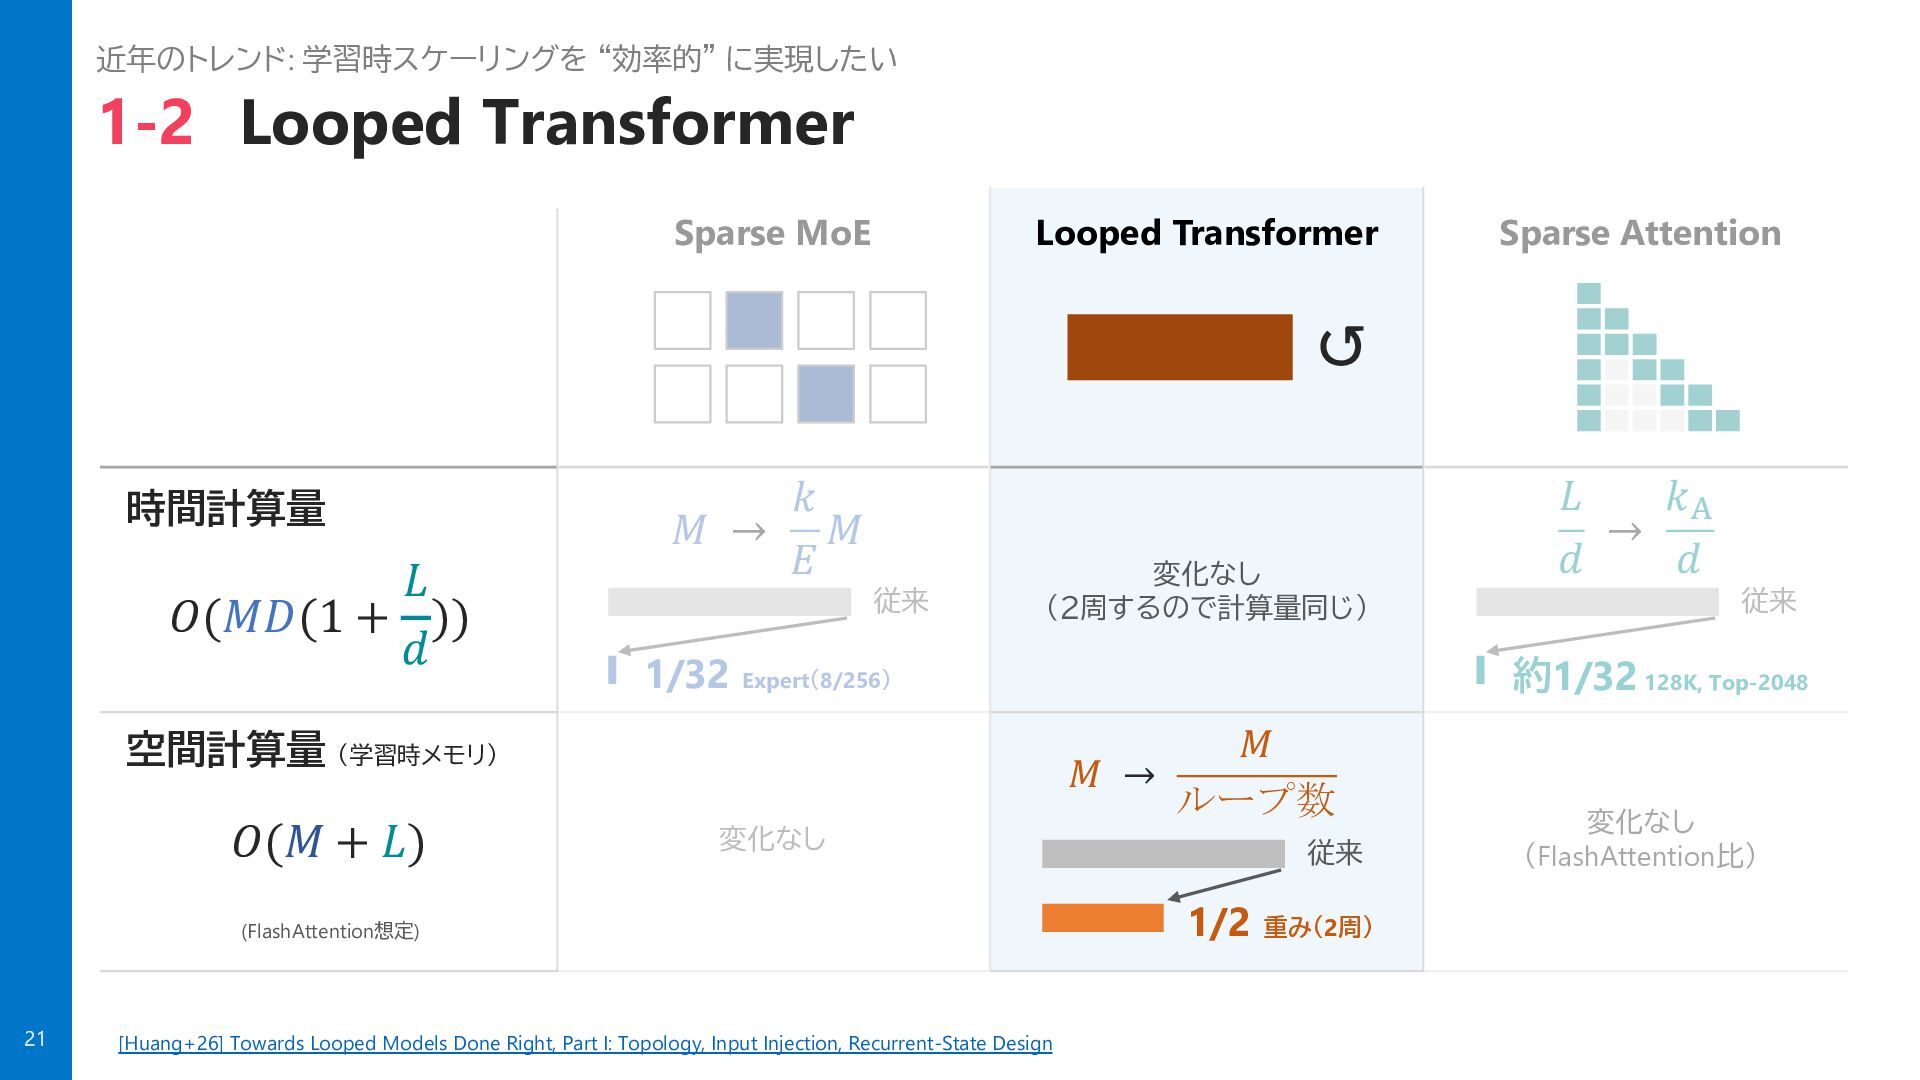
  20. 近年のトレンド: 学習時スケーリングを “効率的” に実現したい 1-2 Looped Transformer Sparse MoE Looped

    Transformer Sparse Attention ↺ 時間計算量 𝐿 𝑂(𝑀𝐷(1 + )) 𝑑 𝑘 𝑀 → 𝑀 𝐸 従来 変化なし (2周するので計算量同じ) 1/32 Expert(8/256) 𝑂(𝑀 + 𝐿) 変化なし (FlashAttention想定) 21 [Huang+26] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design 従来 約1/32 128K, Top-2048 𝑀 𝑀 → ループ数 空間計算量 (学習時メモリ) 𝐿 𝑘* → 𝑑 𝑑 従来 1/2 重み(2周) 変化なし (FlashAttention比)
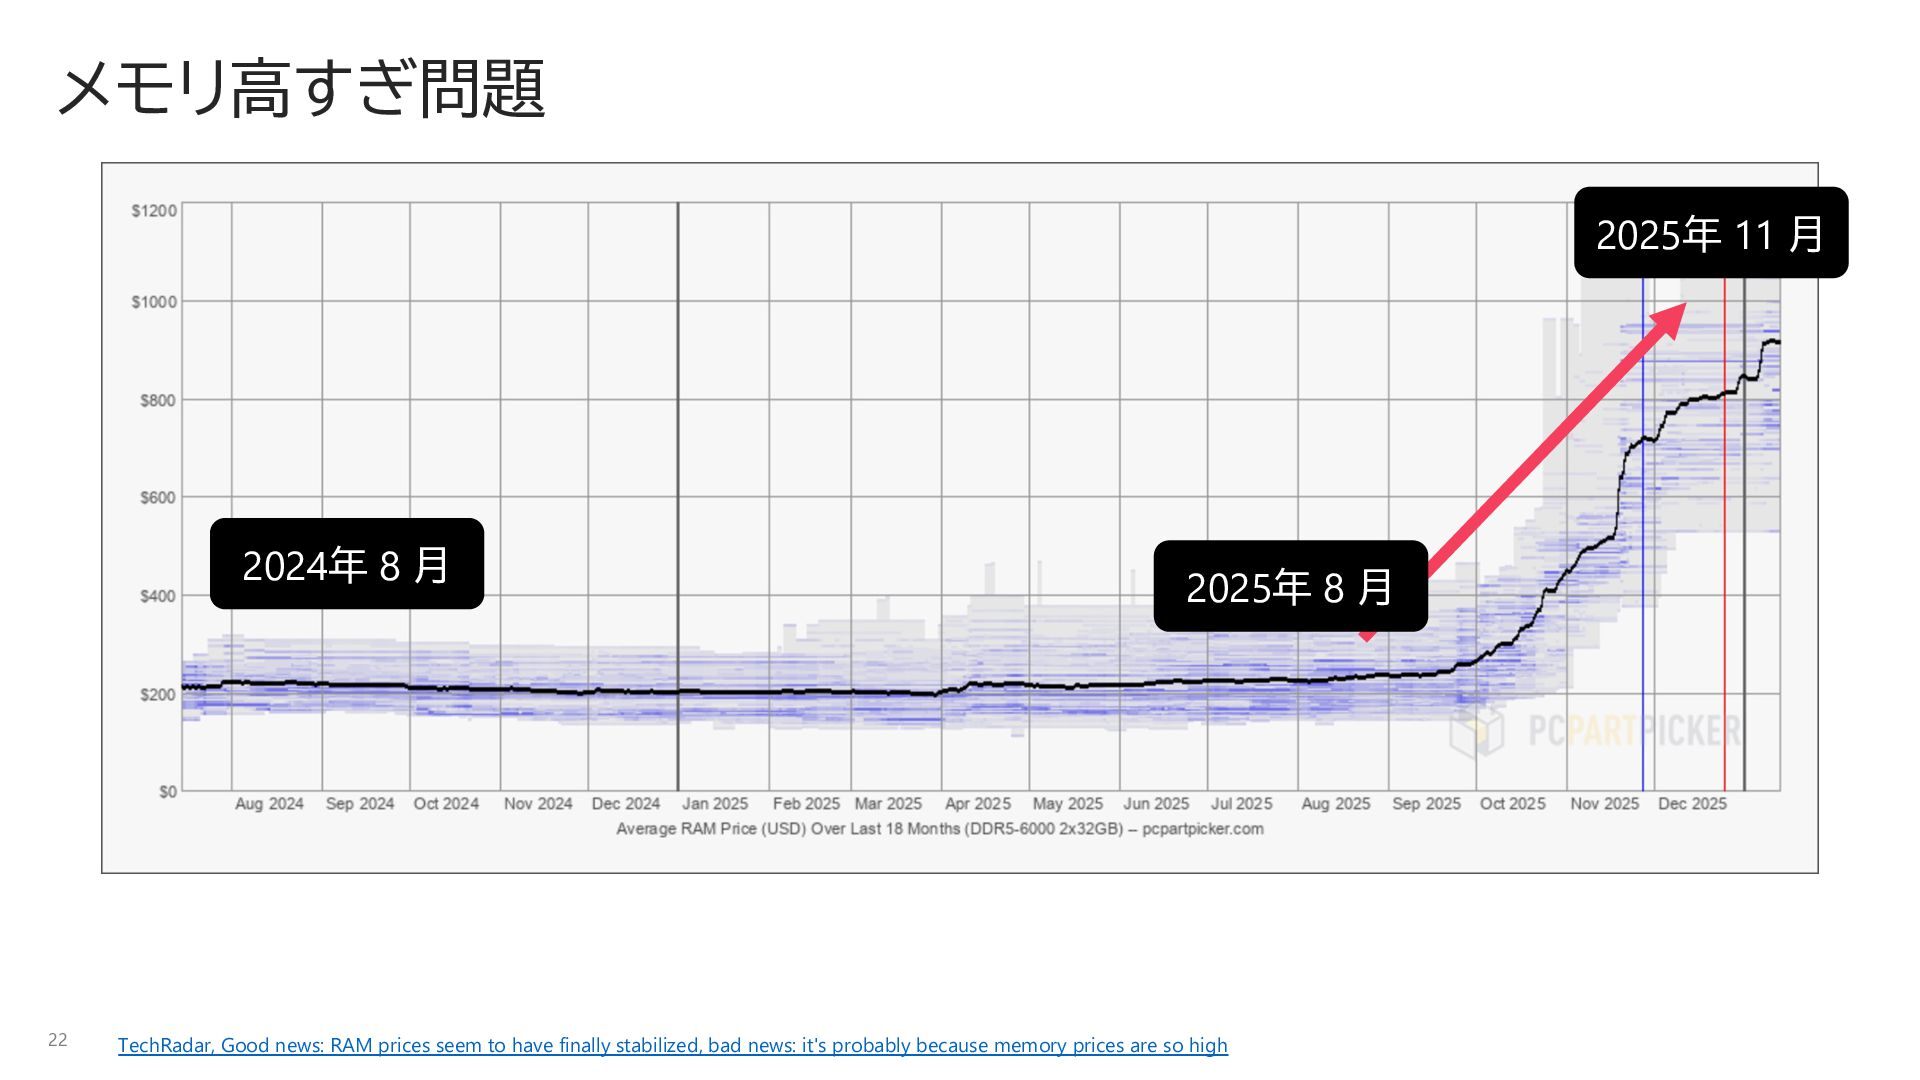
  21. メモリ高すぎ問題 2025年 11 月 2024年 8 月 22 2025年 8

    月 TechRadar, Good news: RAM prices seem to have finally stabilized, bad news: it's probably because memory prices are so high
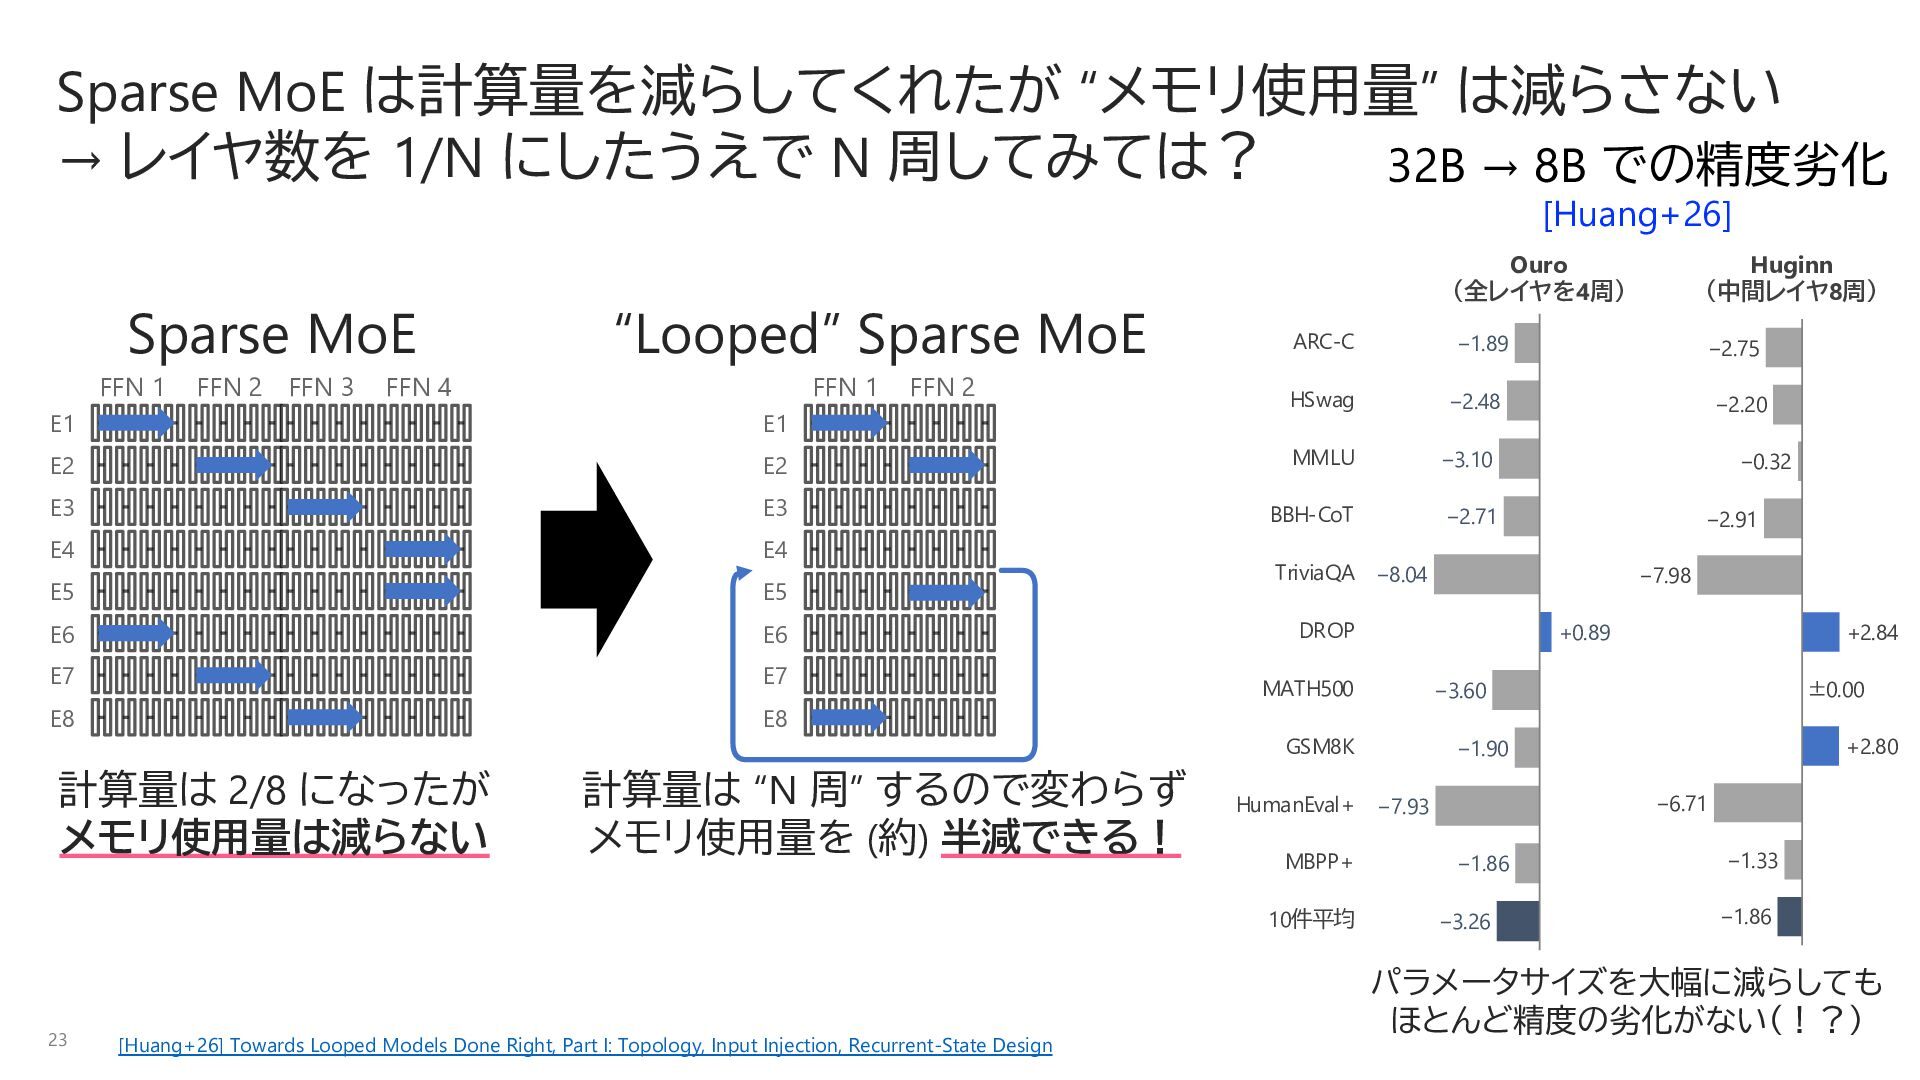
  22. Sparse MoE は計算量を減らしてくれたが “メモリ使用量” は減らさない → レイヤ数を 1/N にしたうえで N

    周してみては? 32B → 8B での精度劣化 [Huang+26] Sparse MoE FFN 1 FFN 2 FFN 3 “Looped” Sparse MoE FFN 4 FFN 1 FFN 2 Ouro (全レイヤを4周) Huginn (中間レイヤ8周) ARC-C −1.89 −2.75 HSwag −2.48 −2.20 E1 E1 E2 E2 MMLU −3.10 E3 E3 BBH-CoT −2.71 E4 E4 E5 E5 E6 E6 E7 E7 E8 E8 計算量は 2/8 になったが メモリ使用量は減らない 計算量は “N 周” するので変わらず メモリ使用量を (約) 半減できる! [Huang+26] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design −2.91 TriviaQA −8.04 −7.98 DROP +0.89 MATH500 ±0.00 +2.80 −1.90 −6.71 HumanEval+ −7.93 MBPP+ +2.84 −3.60 GSM8K 10件平均 23 −0.32 −1.86 −3.26 −1.33 −1.86 パラメータサイズを大幅に減らしても ほとんど精度の劣化がない(!?)
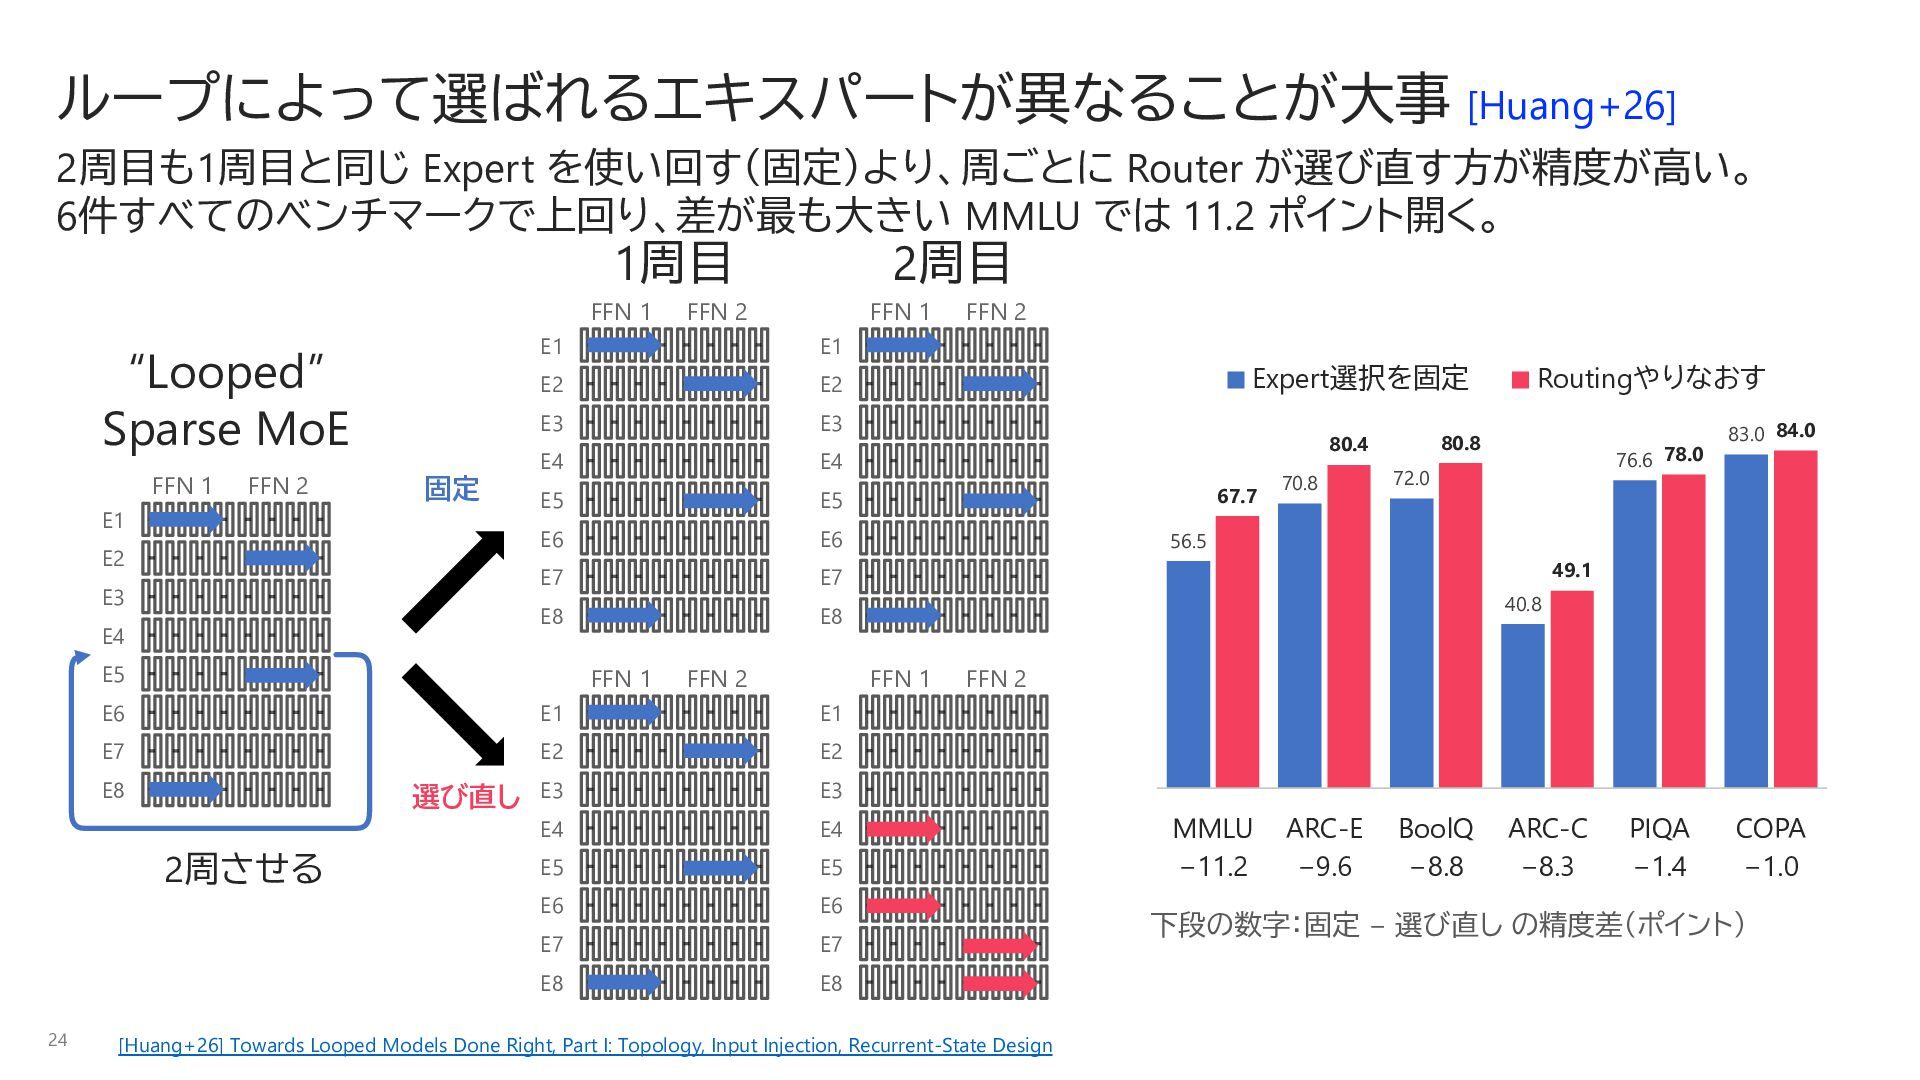
  23. ループによって選ばれるエキスパートが異なることが大事 [Huang+26] 2周目も1周目と同じ Expert を使い回す(固定)より、周ごとに Router が選び直す方が精度が高い。 6件すべてのベンチマークで上回り、差が最も大きい MMLU では

    11.2 ポイント開く。 1周目 FFN 1 “Looped” Sparse MoE FFN 1 FFN 2 固定 E1 E2 E3 E4 FFN 2 FFN 1 E1 E1 E2 E2 E3 E3 E4 E4 E5 E5 E6 E6 E7 E7 E8 E8 E5 FFN 1 FFN 2 E1 E1 E7 E2 E2 E3 E3 E4 E4 E5 E5 E6 E6 E7 E7 E8 E8 選び直し 2周させる FFN 2 Expert選択を固定 67.7 70.8 Routingやりなおす 80.8 80.4 76.6 78.0 72.0 83.0 84.0 56.5 49.1 40.8 FFN 1 E6 E8 24 2周目 FFN 2 [Huang+26] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design MMLU −11.2 ARC-E −9.6 BoolQ −8.8 ARC-C −8.3 PIQA −1.4 COPA −1.0 下段の数字:固定 − 選び直し の精度差(ポイント)
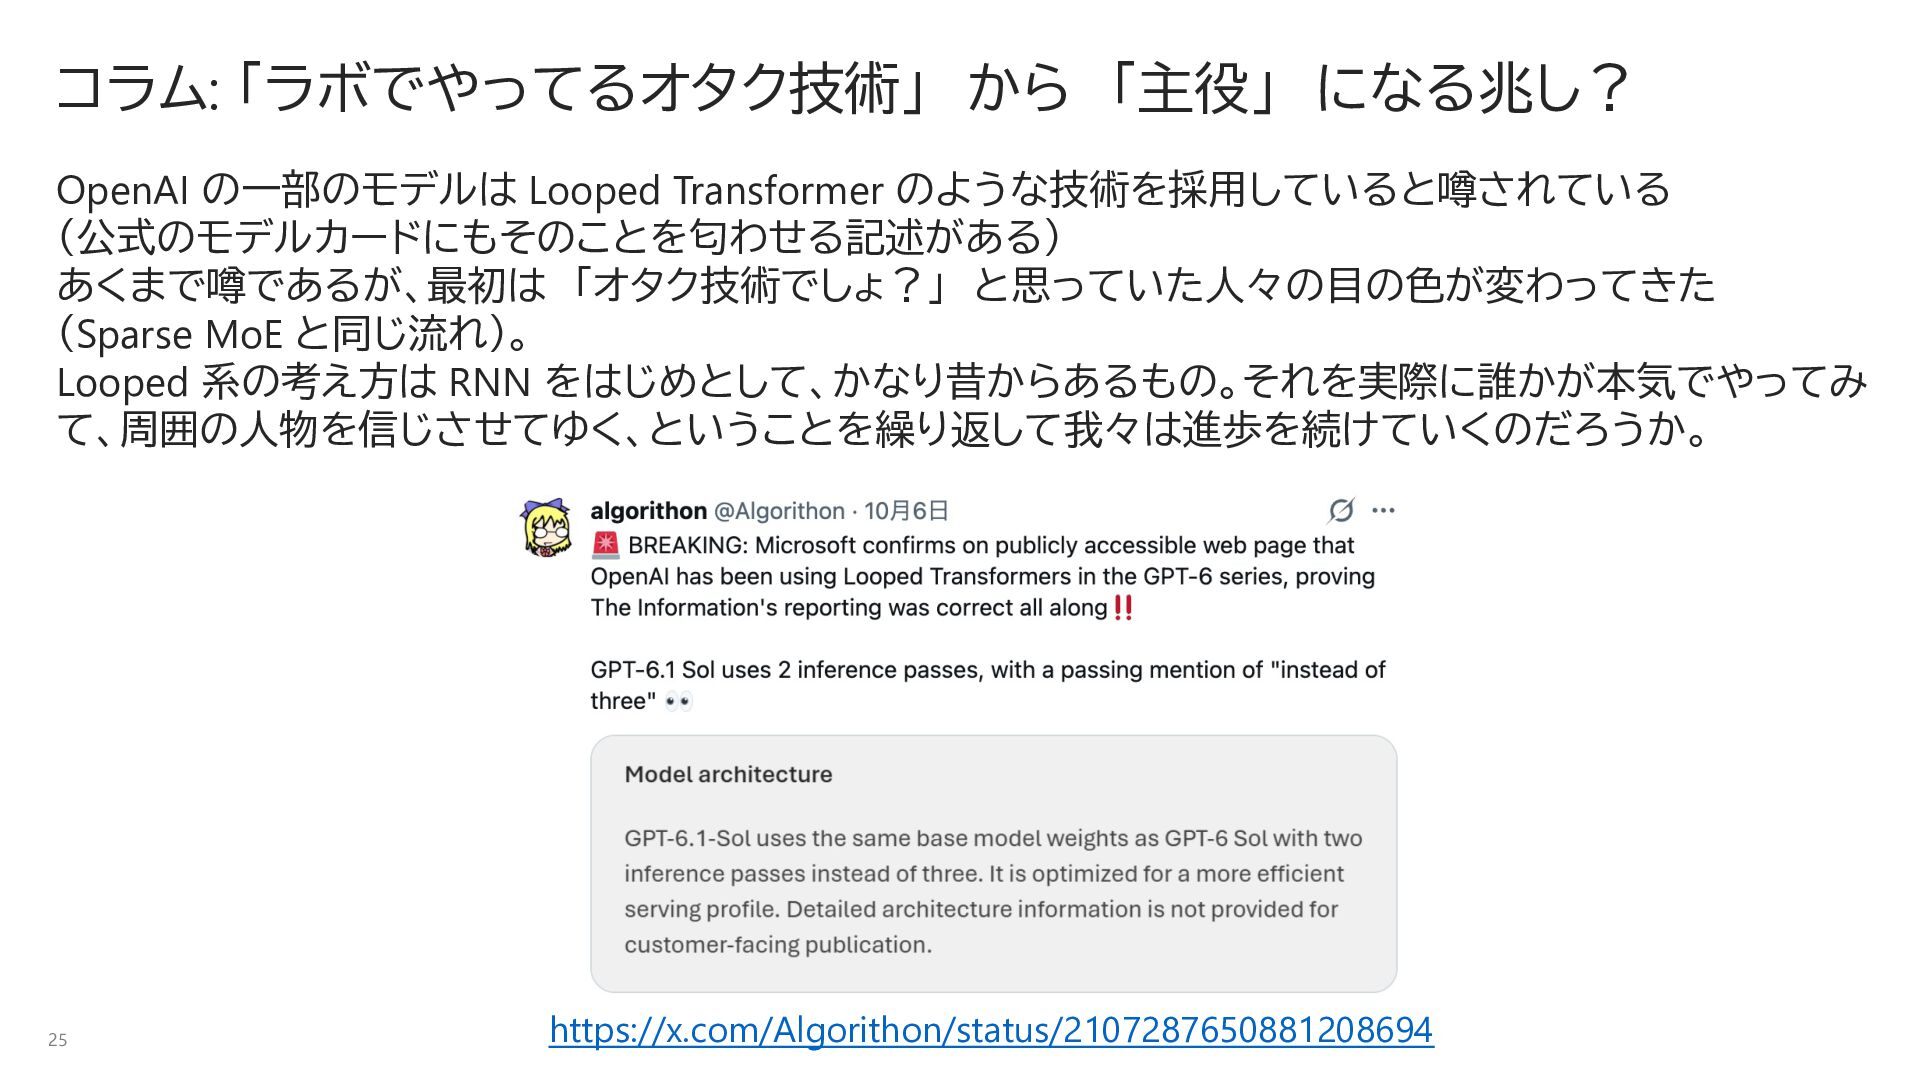
  24. コラム: 「ラボでやってるオタク技術」 から 「主役」 になる兆し? OpenAI の一部のモデルは Looped Transformer のような技術を採用していると噂されている

    (公式のモデルカードにもそのことを匂わせる記述がある) あくまで噂であるが、最初は 「オタク技術でしょ?」 と思っていた人々の目の色が変わってきた (Sparse MoE と同じ流れ)。 Looped 系の考え方は RNN をはじめとして、かなり昔からあるもの。それを実際に誰かが本気でやってみ て、周囲の人物を信じさせてゆく、ということを繰り返して我々は進歩を続けていくのだろうか。 25 https://x.com/Algorithon/status/2107287650881208694
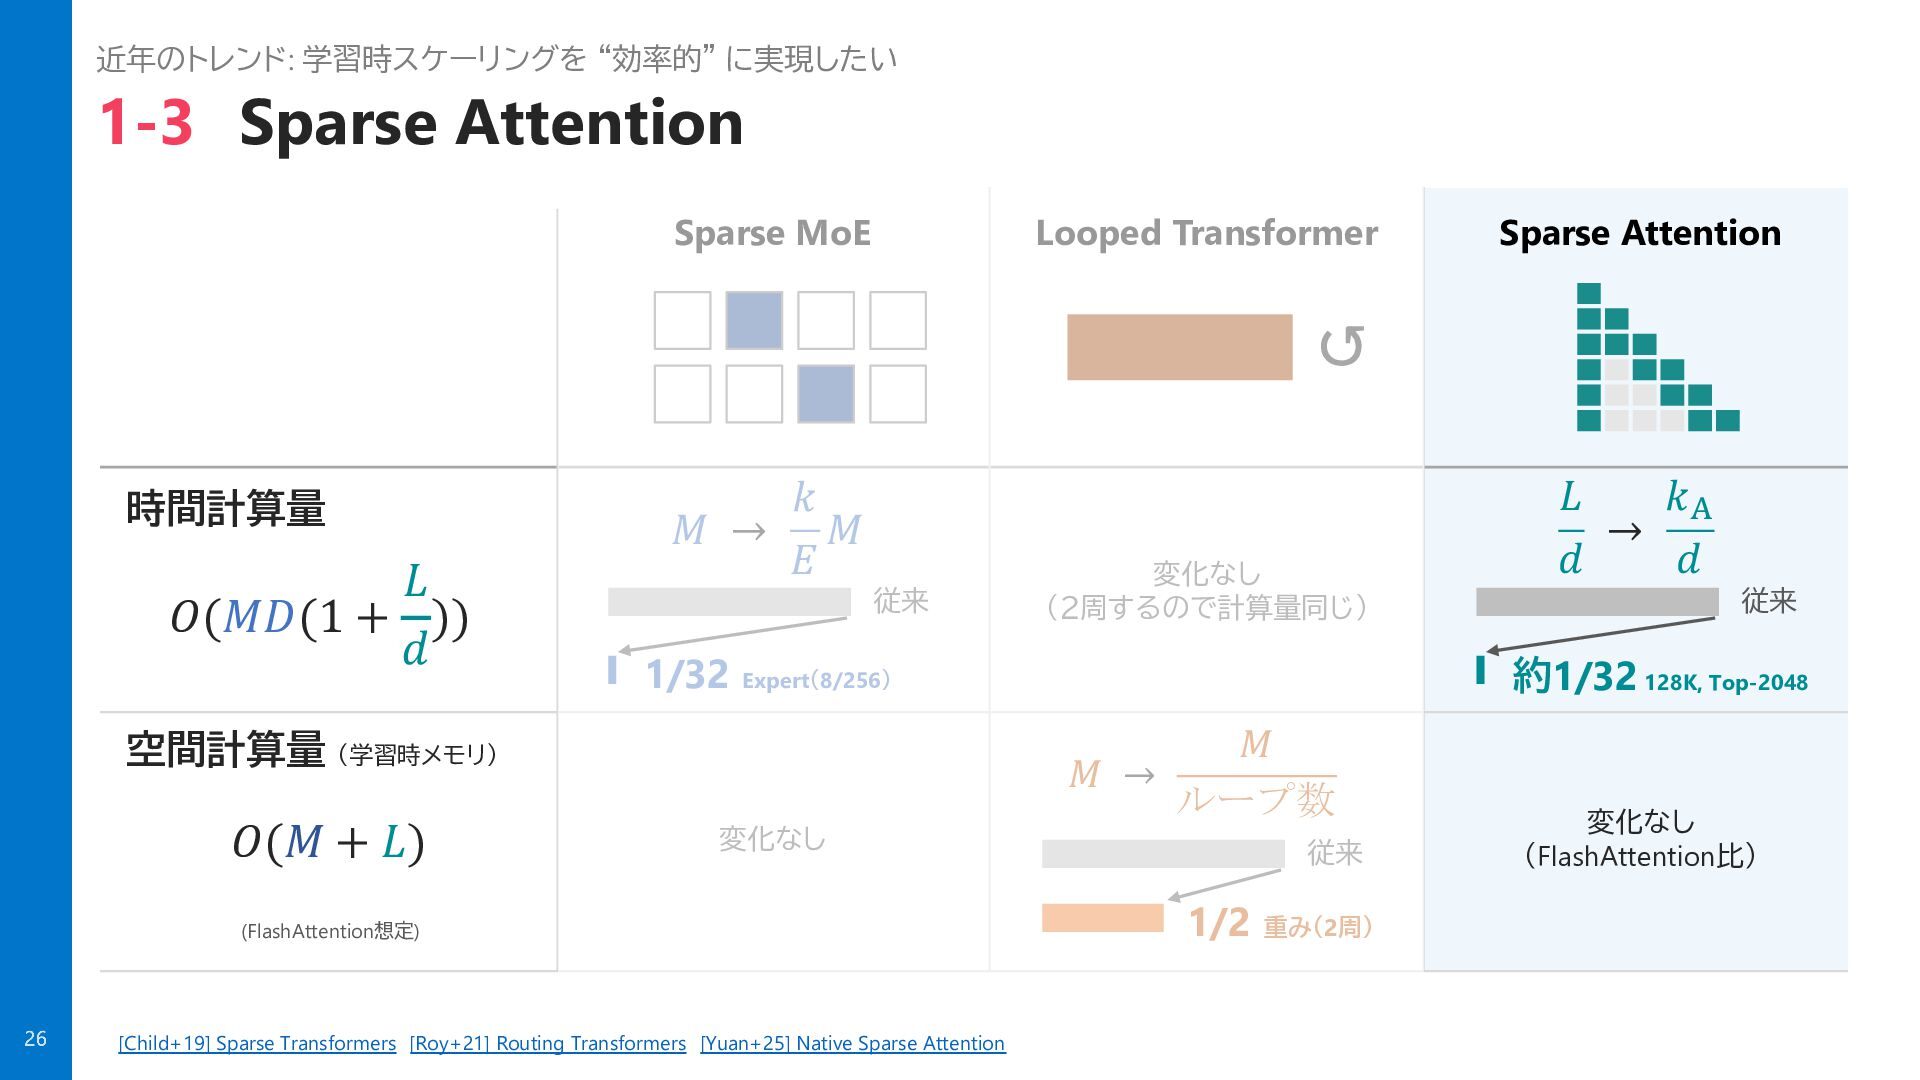
  25. 近年のトレンド: 学習時スケーリングを “効率的” に実現したい 1-3 Sparse Attention Sparse MoE Looped

    Transformer Sparse Attention ↺ 時間計算量 𝐿 𝑂(𝑀𝐷(1 + )) 𝑑 𝑘 𝑀 → 𝑀 𝐸 従来 1/32 Expert(8/256) 変化なし (FlashAttention想定) 26 [Child+19] Sparse Transformers [Roy+21] Routing Transformers [Yuan+25] Native Sparse Attention 従来 約1/32 128K, Top-2048 𝑀 𝑀 → ループ数 空間計算量 (学習時メモリ) 𝑂(𝑀 + 𝐿) 変化なし (2周するので計算量同じ) 𝐿 𝑘* → 𝑑 𝑑 従来 1/2 重み(2周) 変化なし (FlashAttention比)
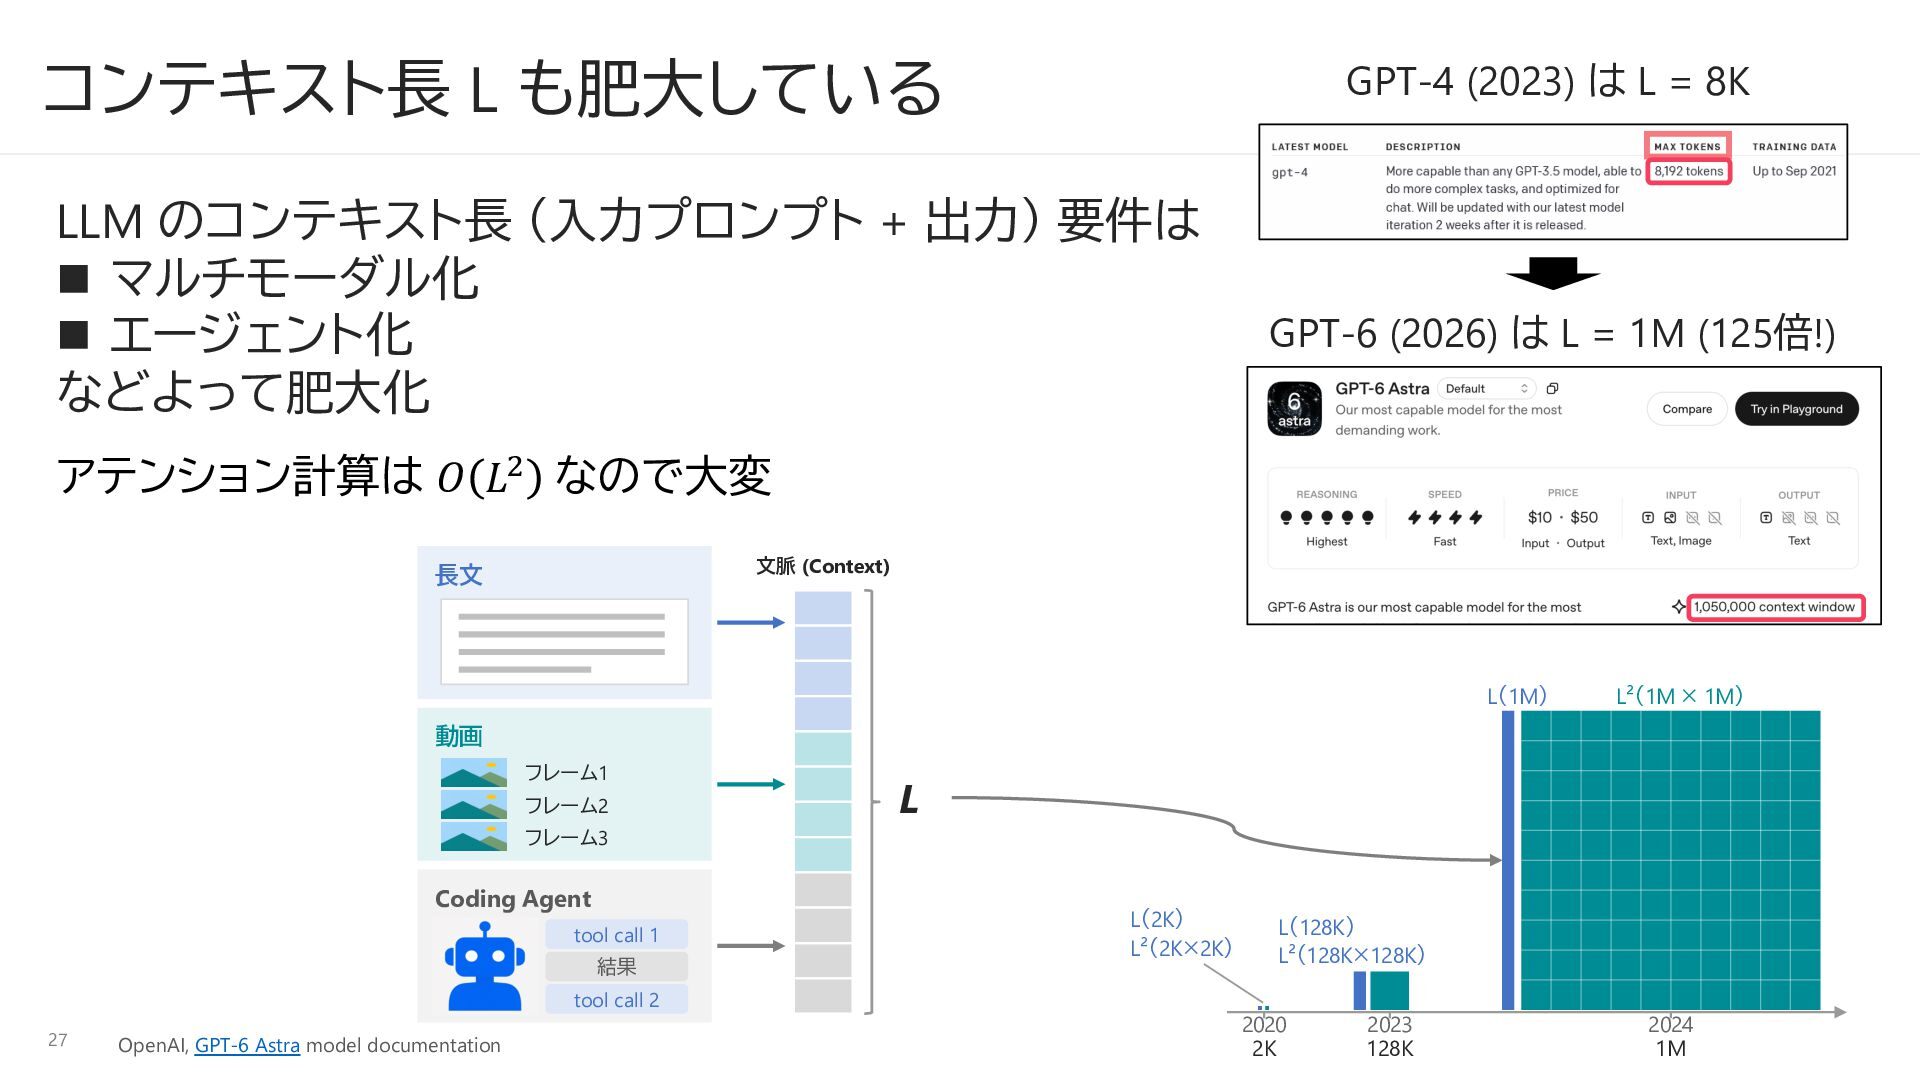
  26. コンテキスト長 L も肥大している GPT-4 (2023) は L = 8K LLM

    のコンテキスト長 (入力プロンプト + 出力) 要件は n マルチモーダル化 n エージェント化 などよって肥大化 GPT-6 (2026) は L = 1M (125倍!) アテンション計算は 𝑂 𝐿. なので大変 文脈 (Context) 長文 L(1M) L²(1M × 1M) 動画 フレーム1 フレーム2 L フレーム3 Coding Agent tool call 1 結果 tool call 2 27 OpenAI, GPT-6 Astra model documentation L(2K) L²(2K×2K) L(128K) L²(128K×128K) 2020 2K 2023 128K 2024 1M
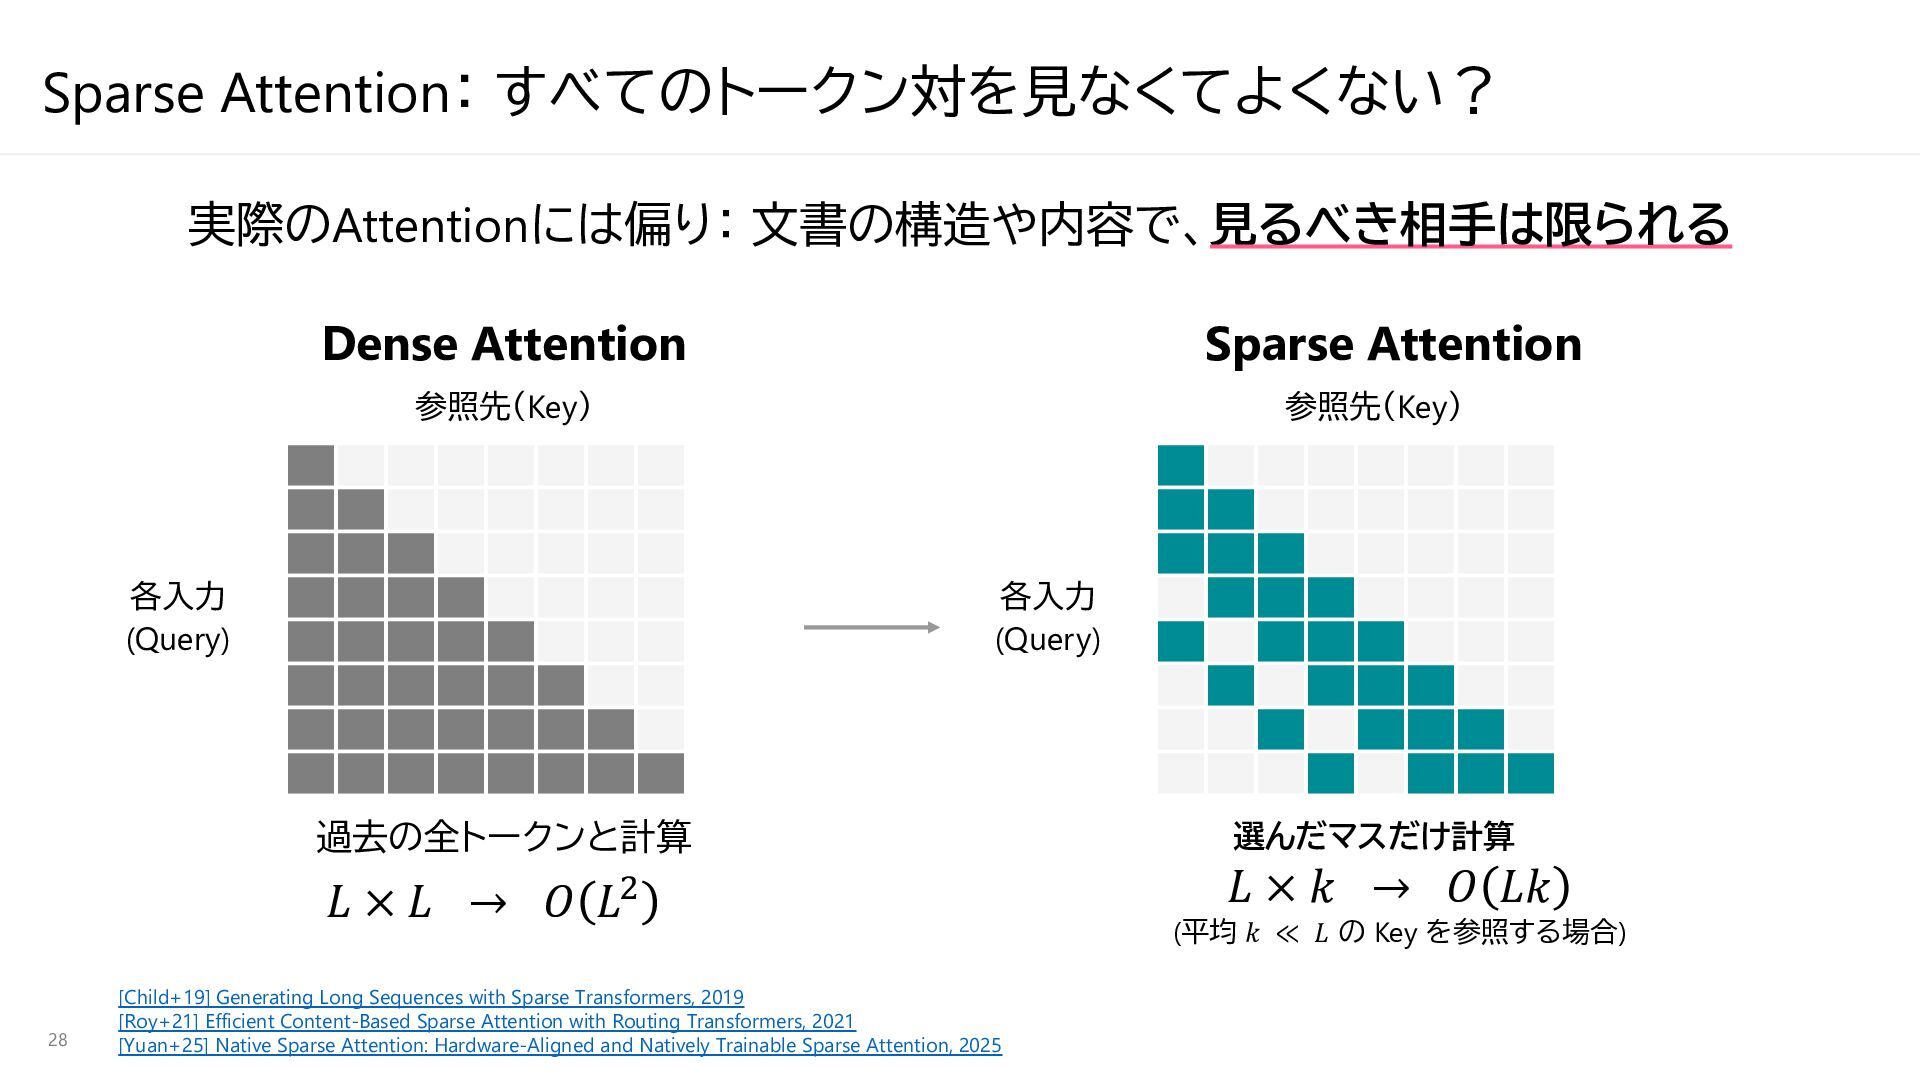
  27. Sparse Attention: すべてのトークン対を見なくてよくない? 実際のAttentionには偏り: 文書の構造や内容で、見るべき相手は限られる Dense Attention Sparse Attention 参照先(Key)

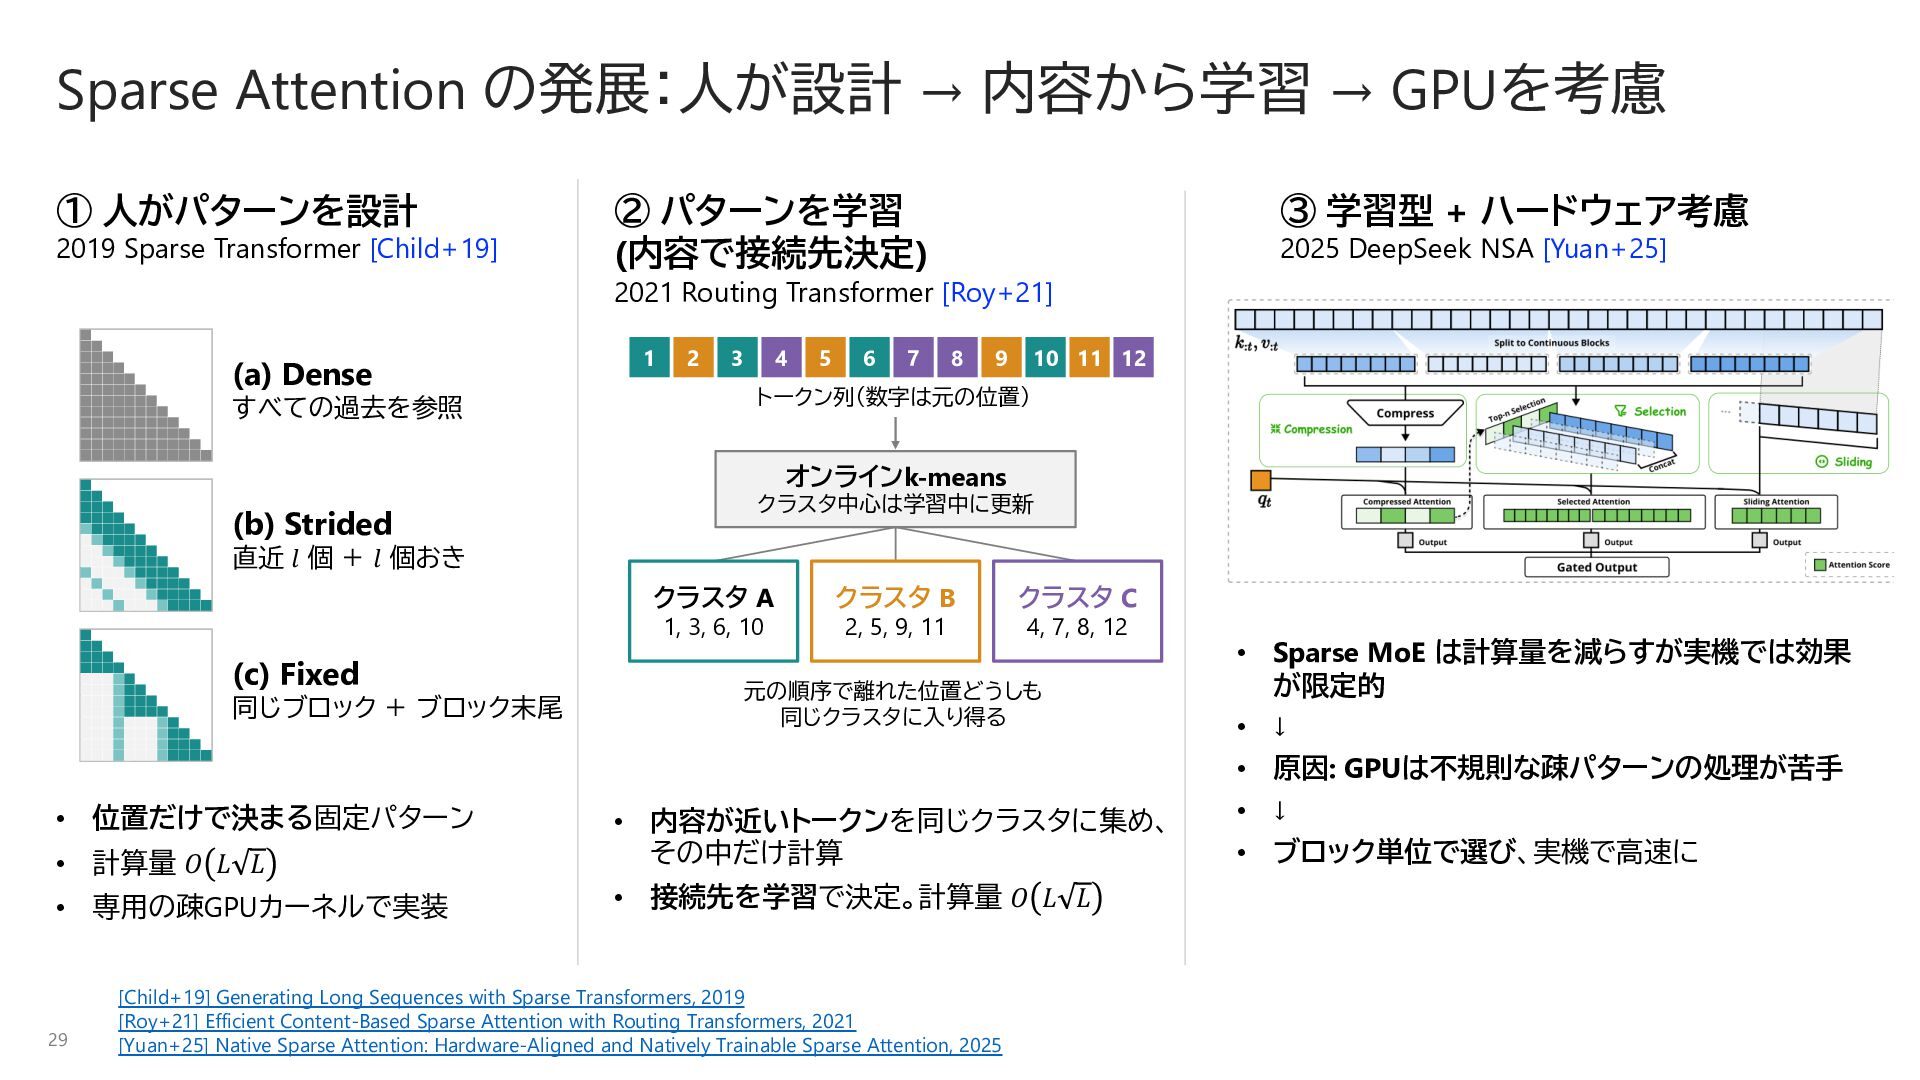
    参照先(Key) 各入力 (Query) 各入力 (Query) 過去の全トークンと計算 𝐿 × 𝐿 → 𝑂 𝐿! 28 [Child+19] Generating Long Sequences with Sparse Transformers, 2019 [Roy+21] Efficient Content-Based Sparse Attention with Routing Transformers, 2021 [Yuan+25] Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention, 2025 選んだマスだけ計算 𝐿 × 𝑘 → 𝑂 𝐿𝑘 (平均 𝑘 ≪ 𝐿 の Key を参照する場合)
  28. Sparse Attention の発展:人が設計 → 内容から学習 → GPUを考慮 ① 人がパターンを設計 2019

    Sparse Transformer [Child+19] ③ 学習型 + ハードウェア考慮 ② パターンを学習 (内容で接続先決定) 2025 DeepSeek NSA [Yuan+25] 2021 Routing Transformer [Roy+21] (a) Dense すべての過去を参照 1 2 3 4 5 6 7 8 9 10 11 12 トークン列(数字は元の位置) オンラインk-means (b) Strided クラスタ中心は学習中に更新 直近 𝑙 個 + 𝑙 個おき クラスタ A 1, 3, 6, 10 (c) Fixed 同じブロック + ブロック末尾 • 位置だけで決まる固定パターン クラスタ B 2, 5, 9, 11 クラスタ C 4, 7, 8, 12 元の順序で離れた位置どうしも 同じクラスタに入り得る • 計算量 𝑂 𝐿 𝐿 • 内容が近いトークンを同じクラスタに集め、 その中だけ計算 • 専用の疎GPUカーネルで実装 • 接続先を学習で決定。計算量 𝑂 𝐿 𝐿 29 [Child+19] Generating Long Sequences with Sparse Transformers, 2019 [Roy+21] Efficient Content-Based Sparse Attention with Routing Transformers, 2021 [Yuan+25] Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention, 2025 • Sparse MoE は計算量を減らすが実機では効果 が限定的 • ↓ • 原因: GPUは不規則な疎パターンの処理が苦手 • ↓ • ブロック単位で選び、実機で高速に
  29. 学習時スケーリングを “効率的” にする3つの手法を概観した Sparse MoE Looped Transformer Sparse Attention ↺

    時間計算量 𝐿 𝑂(𝑀𝐷(1 + )) 𝑑 𝑘 𝑀 → 𝑀 𝐸 従来 1/32 Expert(8/256) (FlashAttention想定) 30 変化なし 従来 約1/32 128K, Top-2048 𝑀 𝑀 → ループ数 空間計算量 (学習時メモリ) 𝑂(𝑀 + 𝐿) 変化なし (2周するので計算量同じ) 𝐿 𝑘* → 𝑑 𝑑 従来 1/2 重み(2周) 変化なし (FlashAttention比)
  30. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 02 推論時の スケーリング 思考するシステム

    そして自己改変へ AI Harness はバズワードか? 推論時のスケーリング 02 31 基盤モデルの “さらなる” スケーリング
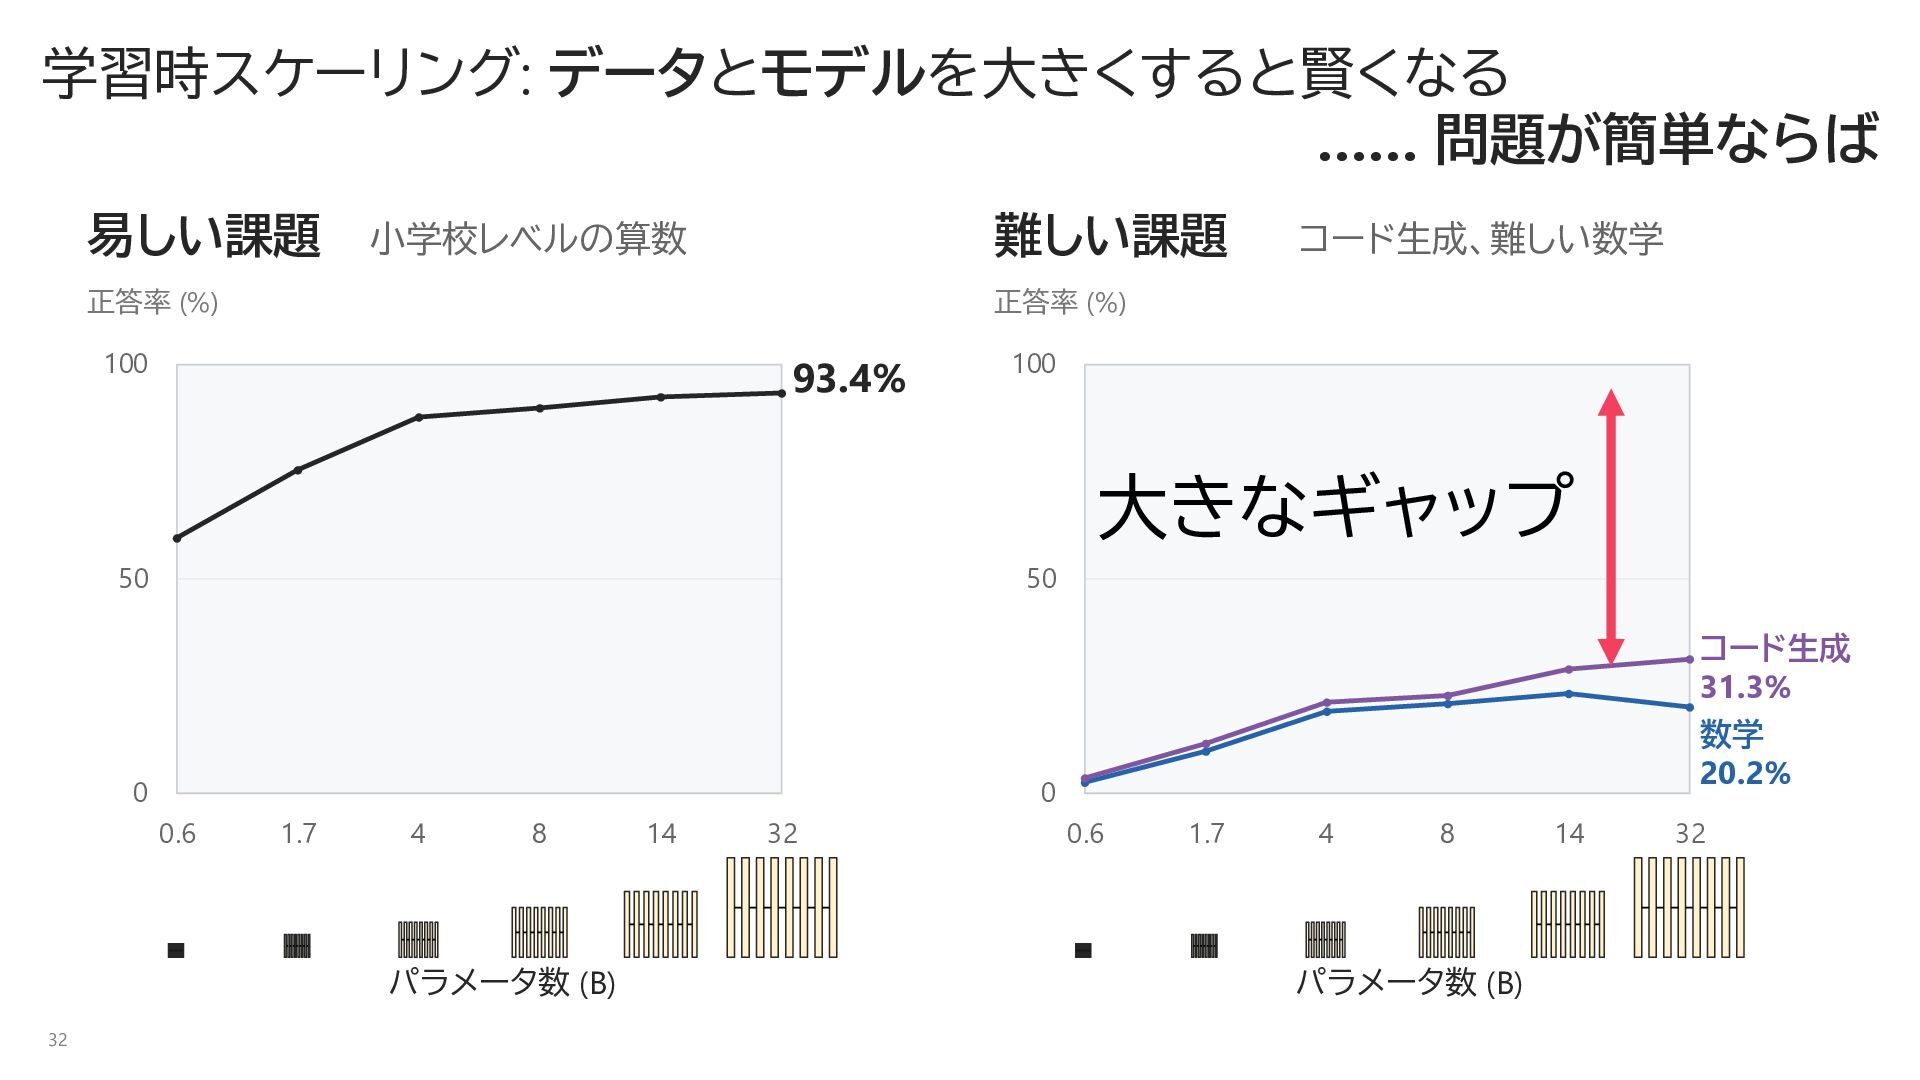
  31. 学習時スケーリング: データとモデルを大きくすると賢くなる …… 問題が簡単ならば 易しい課題 難しい課題 小学校レベルの算数 正答率 (%) コード生成、難しい数学

    正答率 (%) 100 93.4% 100 大きなギャップ 50 50 コード生成 31.3% 0 0 0.6 1.7 4 8 パラメータ数 (B) 32 数学 20.2% 14 32 0.6 1.7 4 8 パラメータ数 (B) 14 32
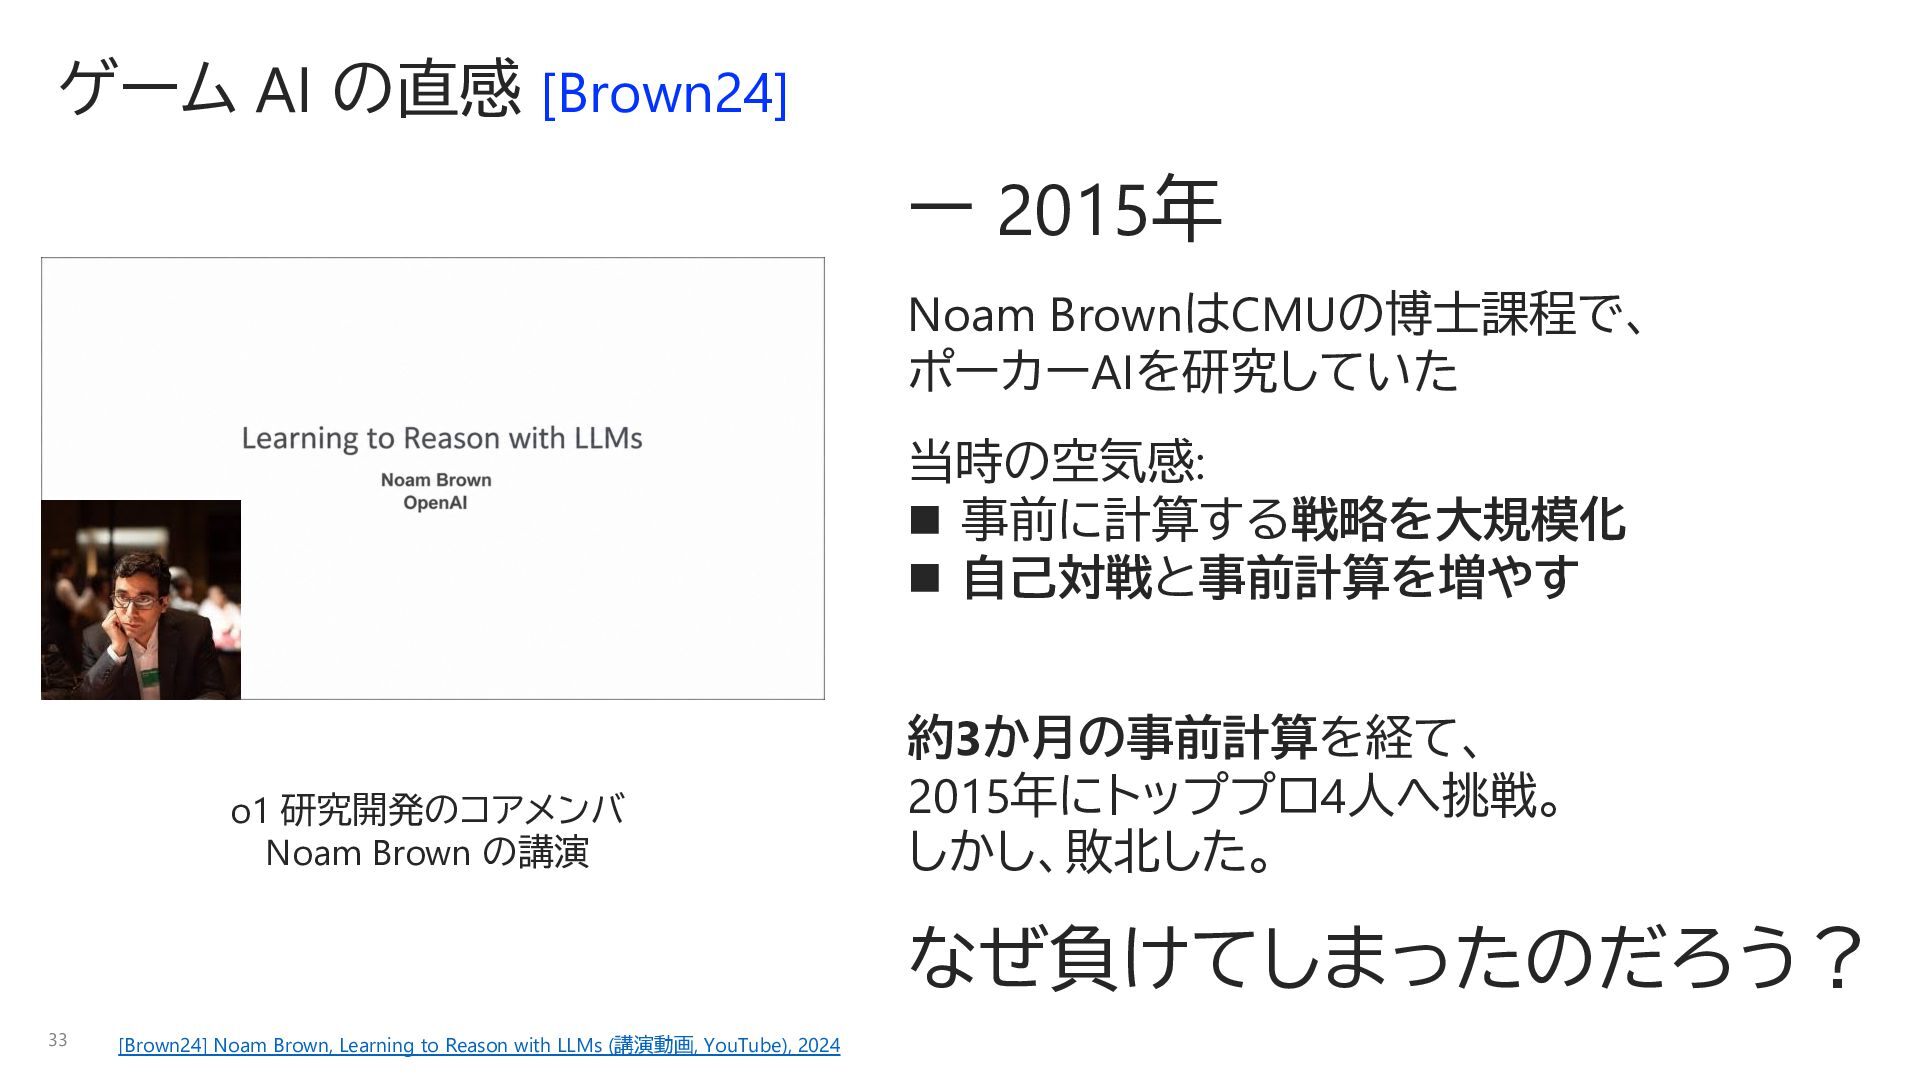
  32. ゲーム AI の直感 [Brown24] ー 2015年 Noam BrownはCMUの博士課程で、 ポーカーAIを研究していた 当時の空気感:

    n 事前に計算する戦略を大規模化 n 自己対戦と事前計算を増やす o1 研究開発のコアメンバ Noam Brown の講演 約3か月の事前計算を経て、 2015年にトッププロ4人へ挑戦。 しかし、敗北した。 なぜ負けてしまったのだろう? 33 [Brown24] Noam Brown, Learning to Reason with LLMs (講演動画, YouTube), 2024
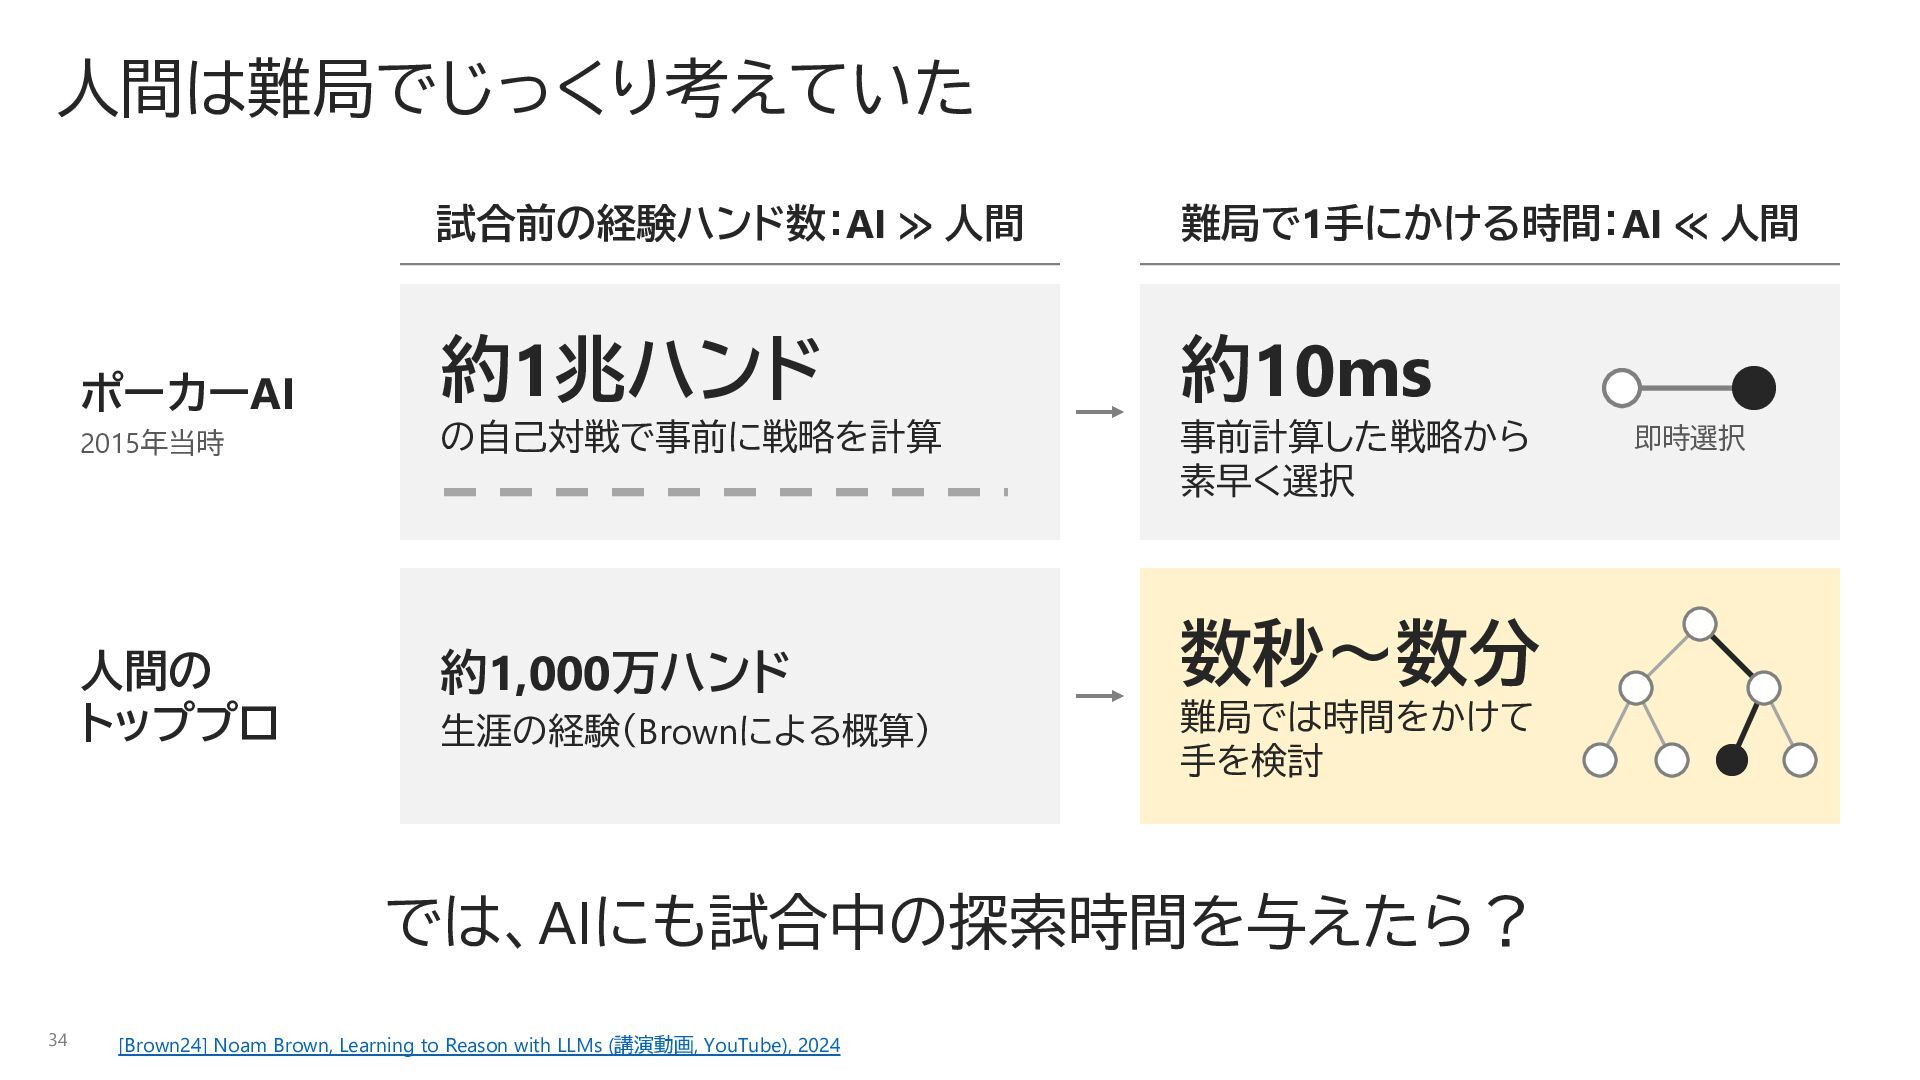
  33. 人間は難局でじっくり考えていた 試合前の経験ハンド数:AI ≫ 人間 難局で1手にかける時間:AI ≪ 人間 ポーカーAI 約1兆ハンド 約10ms

    2015年当時 の自己対戦で事前に戦略を計算 事前計算した戦略から 素早く選択 人間の トッププロ 約1,000万ハンド 生涯の経験(Brownによる概算) 数秒〜数分 難局では時間をかけて 手を検討 では、AIにも試合中の探索時間を与えたら? 34 [Brown24] Noam Brown, Learning to Reason with LLMs (講演動画, YouTube), 2024 即時選択
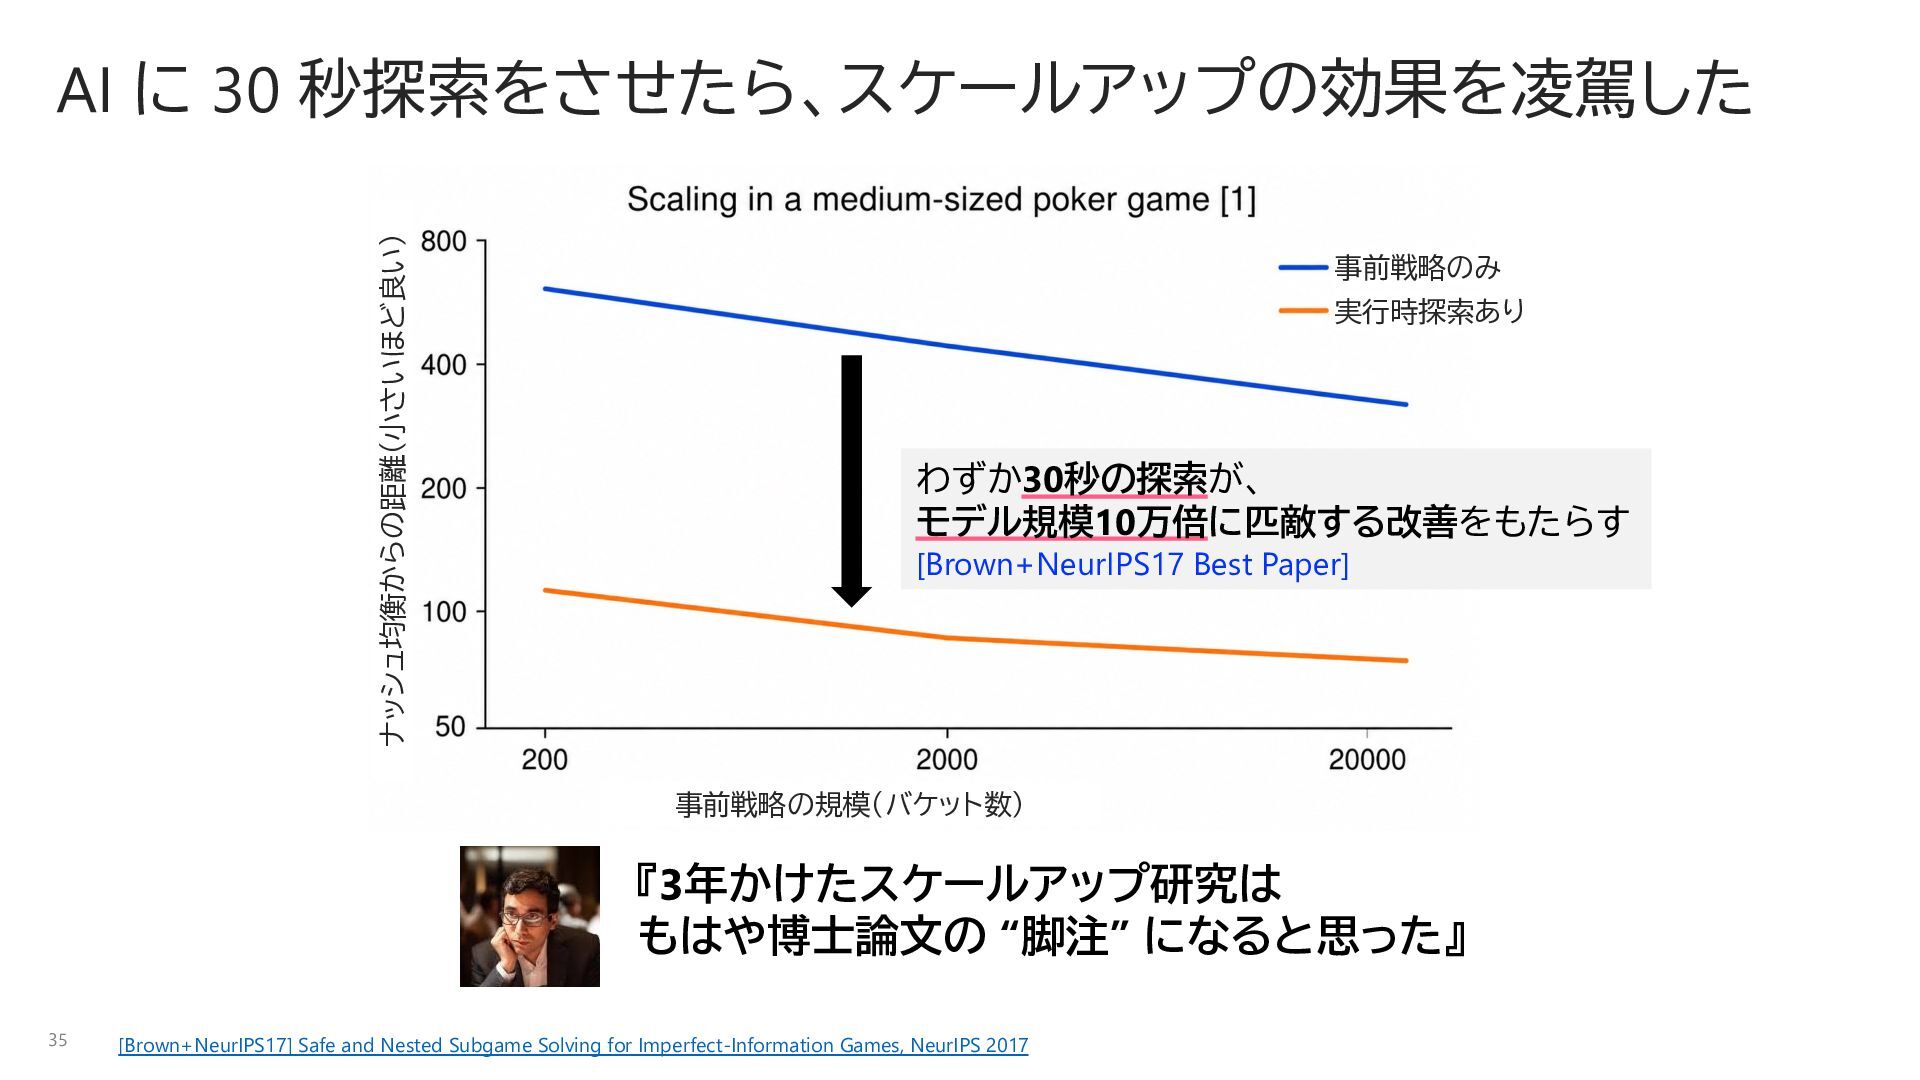
  34. ナッシュ均衡からの距離(小さいほど良い) AI に 30 秒探索をさせたら、スケールアップの効果を凌駕した 事前戦略のみ 実行時探索あり わずか30秒の探索が、 モデル規模10万倍に匹敵する改善をもたらす [Brown+NeurIPS17

    Best Paper] 事前戦略の規模(バケット数) 『3年かけたスケールアップ研究は もはや博士論文の “脚注” になると思った』 35 [Brown+NeurIPS17] Safe and Nested Subgame Solving for Imperfect-Information Games, NeurIPS 2017
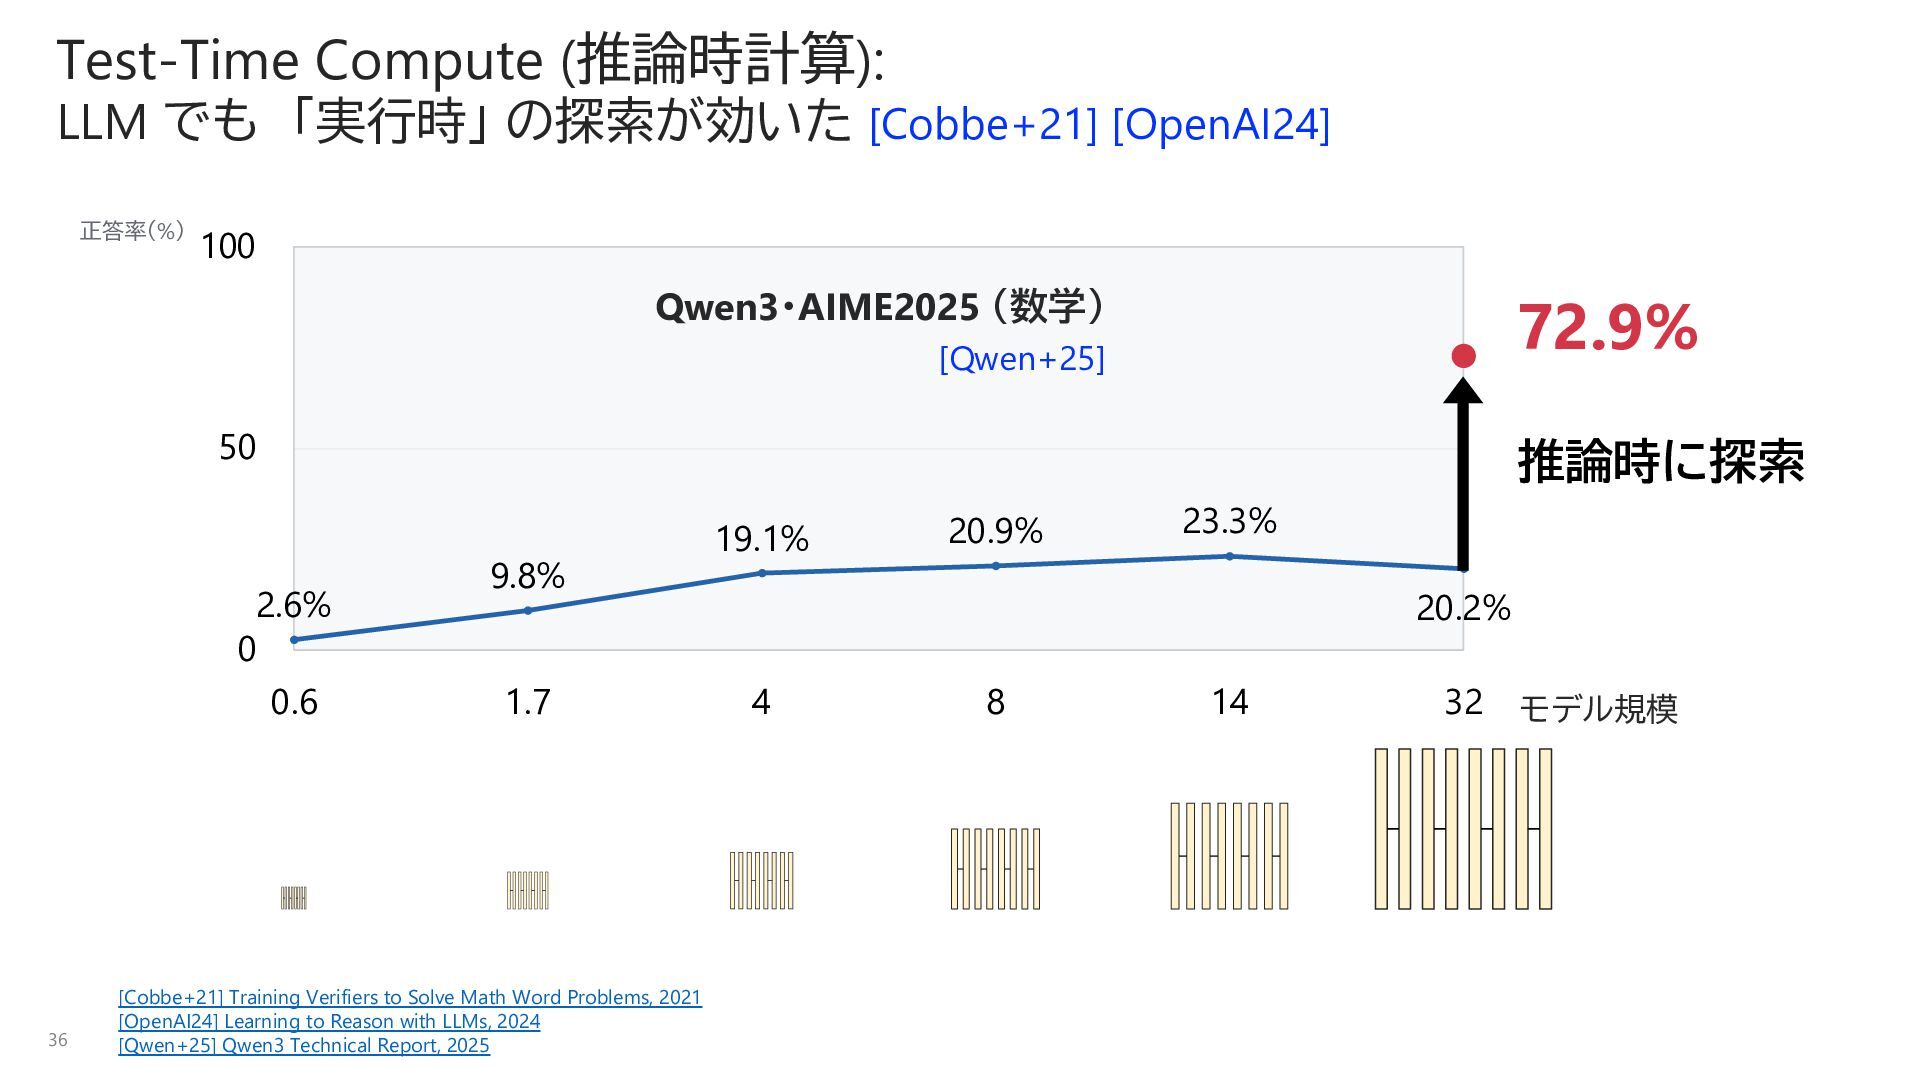
  35. Test-Time Compute (推論時計算): LLM でも 「実行時」 の探索が効いた [Cobbe+21] [OpenAI24] 正答率(%)

    100 Qwen3・AIME2025 (数学) 72.9% [Qwen+25] 50 2.6% 0 0.6 36 推論時に探索 9.8% 1.7 [Cobbe+21] Training Verifiers to Solve Math Word Problems, 2021 [OpenAI24] Learning to Reason with LLMs, 2024 [Qwen+25] Qwen3 Technical Report, 2025 19.1% 20.9% 23.3% 20.2% 4 8 14 32 モデル規模
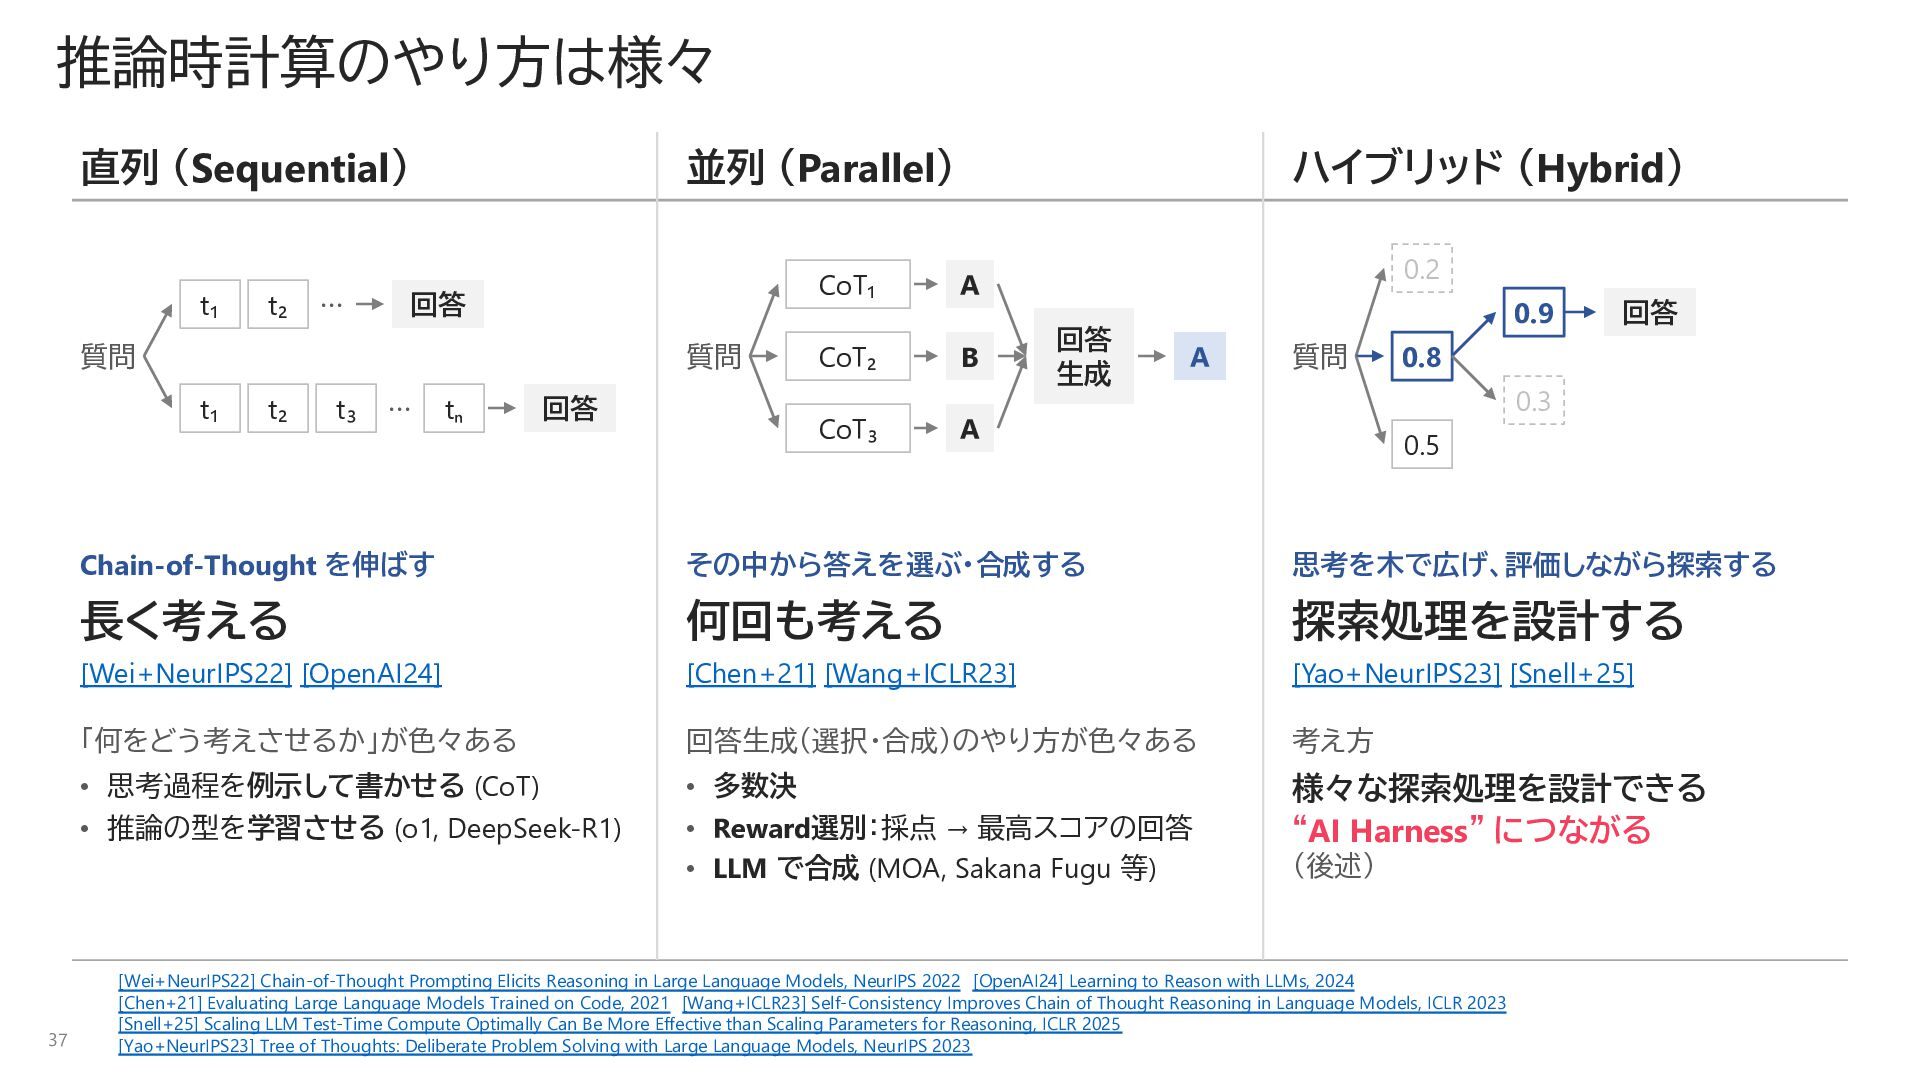
  36. 推論時計算のやり方は様々 直列 (Sequential) t₁ t₂ ⋯ 並列 (Parallel) CoT₁ 回答

    質問 質問 t₁ 37 t₂ t₃ ⋯ tₙ 回答 ハイブリッド (Hybrid) 0.2 A CoT₂ B CoT₃ A 回答 生成 0.9 A 質問 回答 0.8 0.3 0.5 Chain-of-Thought を伸ばす その中から答えを選ぶ・合成する 思考を木で広げ、評価しながら探索する 長く考える 何回も考える 探索処理を設計する [Wei+NeurIPS22] [OpenAI24] [Chen+21] [Wang+ICLR23] [Yao+NeurIPS23] [Snell+25] 「何をどう考えさせるか」が色々ある 回答生成(選択・合成)のやり方が色々ある 考え方 • 思考過程を例示して書かせる (CoT) • 多数決 • 推論の型を学習させる (o1, DeepSeek-R1) • Reward選別:採点 → 最高スコアの回答 • LLM で合成 (MOA, Sakana Fugu 等) 様々な探索処理を設計できる “AI Harness” につながる (後述) [Wei+NeurIPS22] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, NeurIPS 2022 [OpenAI24] Learning to Reason with LLMs, 2024 [Chen+21] Evaluating Large Language Models Trained on Code, 2021 [Wang+ICLR23] Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023 [Snell+25] Scaling LLM Test-Time Compute Optimally Can Be More Effective than Scaling Parameters for Reasoning, ICLR 2025 [Yao+NeurIPS23] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, NeurIPS 2023
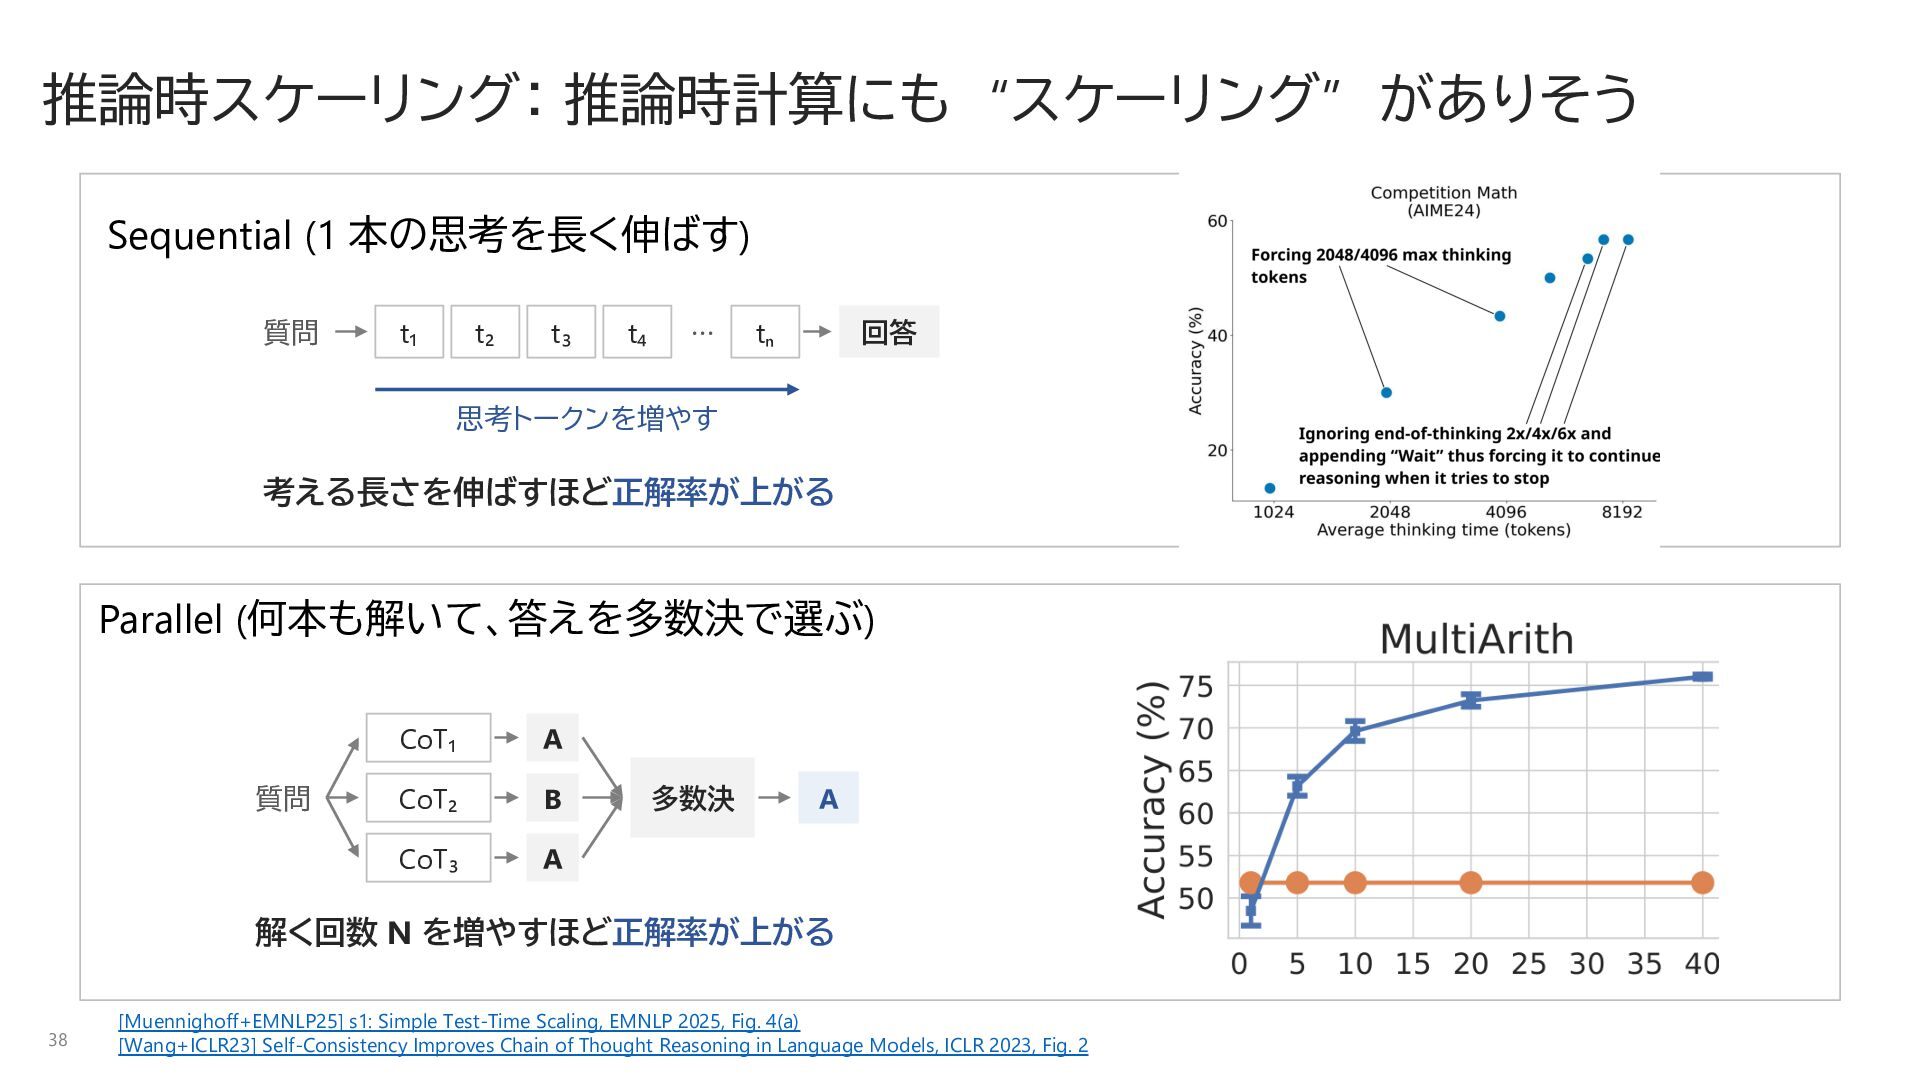
  37. 推論時スケーリング: 推論時計算にも “スケーリング” がありそう Sequential (1 本の思考を長く伸ばす) 質問 t₁ t₂

    t₃ t₄ ⋯ tₙ 回答 思考トークンを増やす 考える長さを伸ばすほど正解率が上がる Parallel (何本も解いて、答えを多数決で選ぶ) 質問 CoT₁ A CoT₂ B CoT₃ A 多数決 A 解く回数 N を増やすほど正解率が上がる 38 [Muennighoff+EMNLP25] s1: Simple Test-Time Scaling, EMNLP 2025, Fig. 4(a) [Wang+ICLR23] Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023, Fig. 2
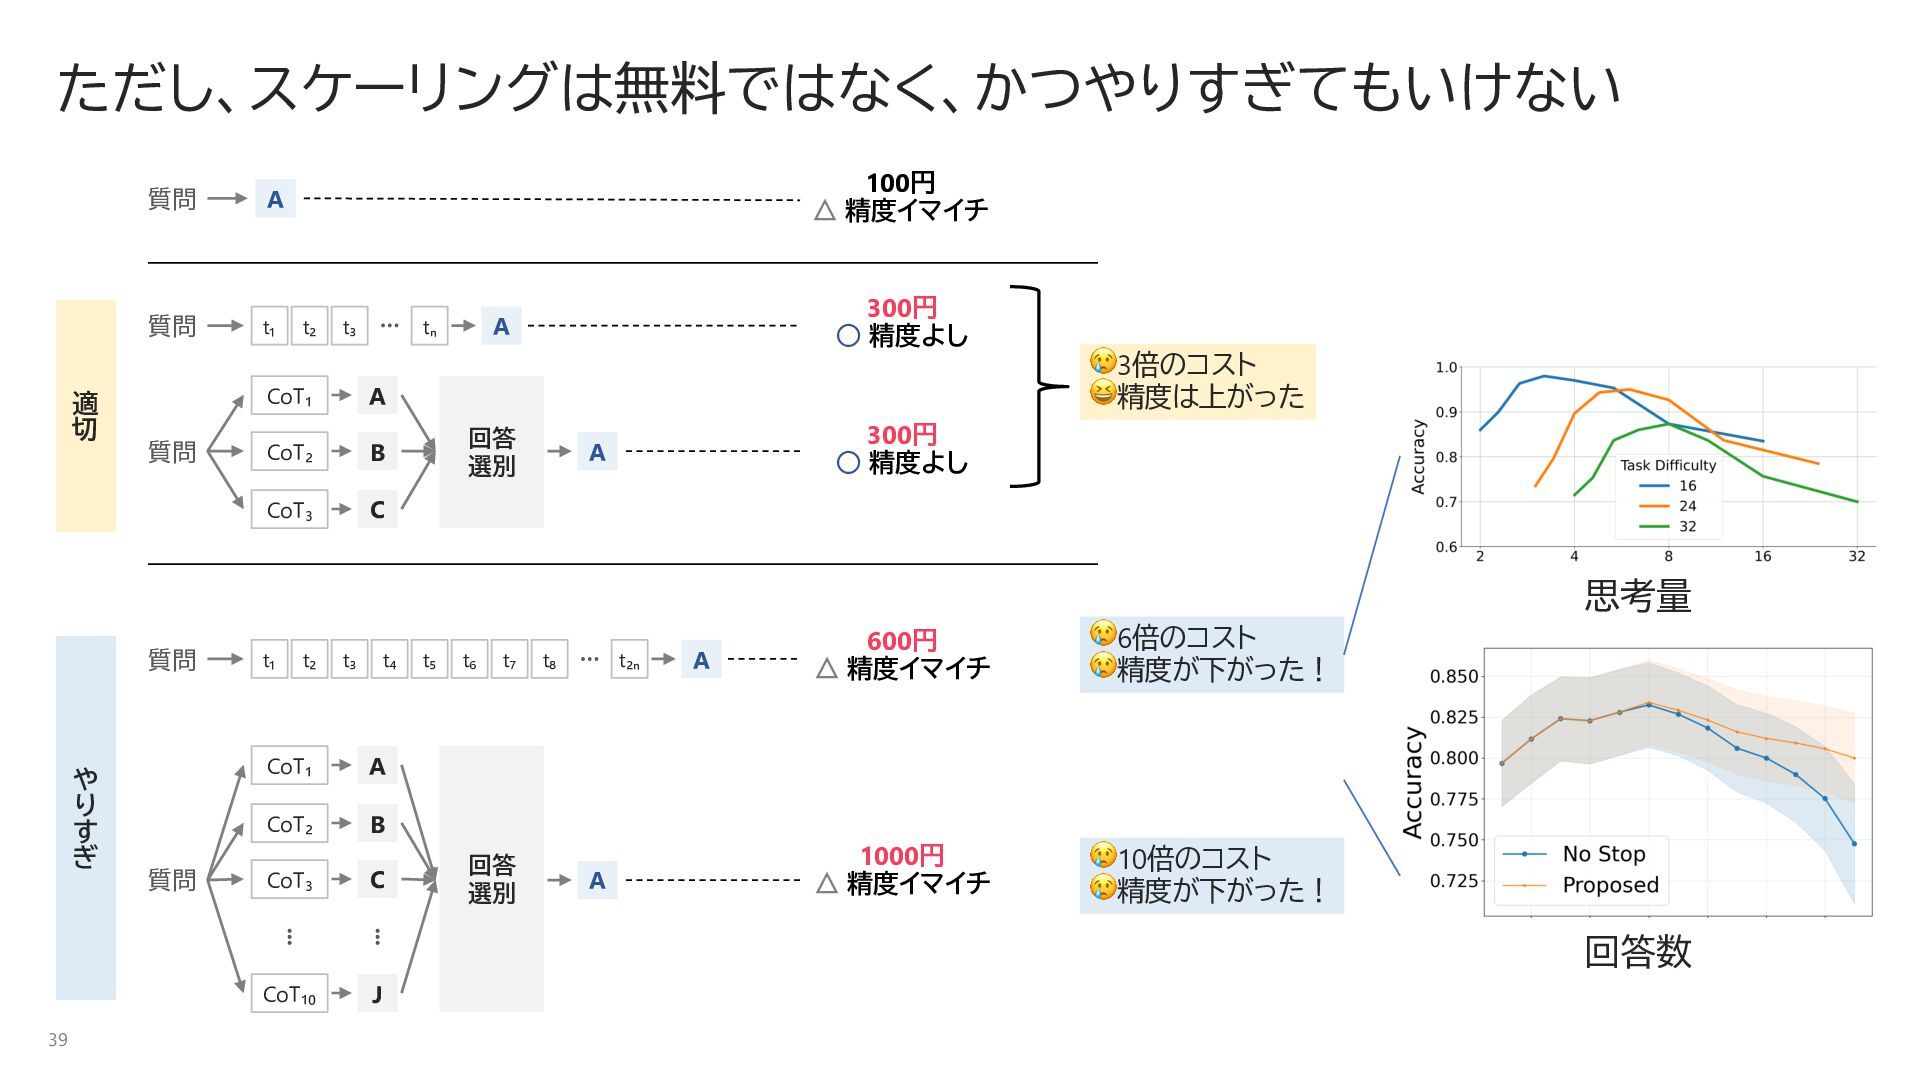
  38. ただし、スケーリングは無料ではなく、かつやりすぎてもいけない 適 切 質問 A 質問 t₁ 質問 100円 △

    精度イマイチ t₂ t₃ ⋯ CoT₁ A CoT₂ B CoT₃ C 300円 ◦ 精度よし A tₙ 回答 選別 😢3倍のコスト 😆精度は上がった 300円 ◦ 精度よし A 思考量 質問 や り す ぎ 39 質問 t₁ t₂ t₃ t₄ CoT₁ A CoT₂ B CoT₃ C ⋮ ⋮ CoT₁₀ J t₅ t₆ t₇ 回答 選別 t₈ ⋯ t₂ₙ A A 600円 △ 精度イマイチ 😢6倍のコスト 😢精度が下がった! 1000円 △ 精度イマイチ 😢10倍のコスト 😢精度が下がった! 回答数
  39. “適切なタイミングで止める” ができれば 「うまい」「早い」 が実現できる 直列(Sequential) 並列(Parallel) ここで停止 質問 t₁ t₂

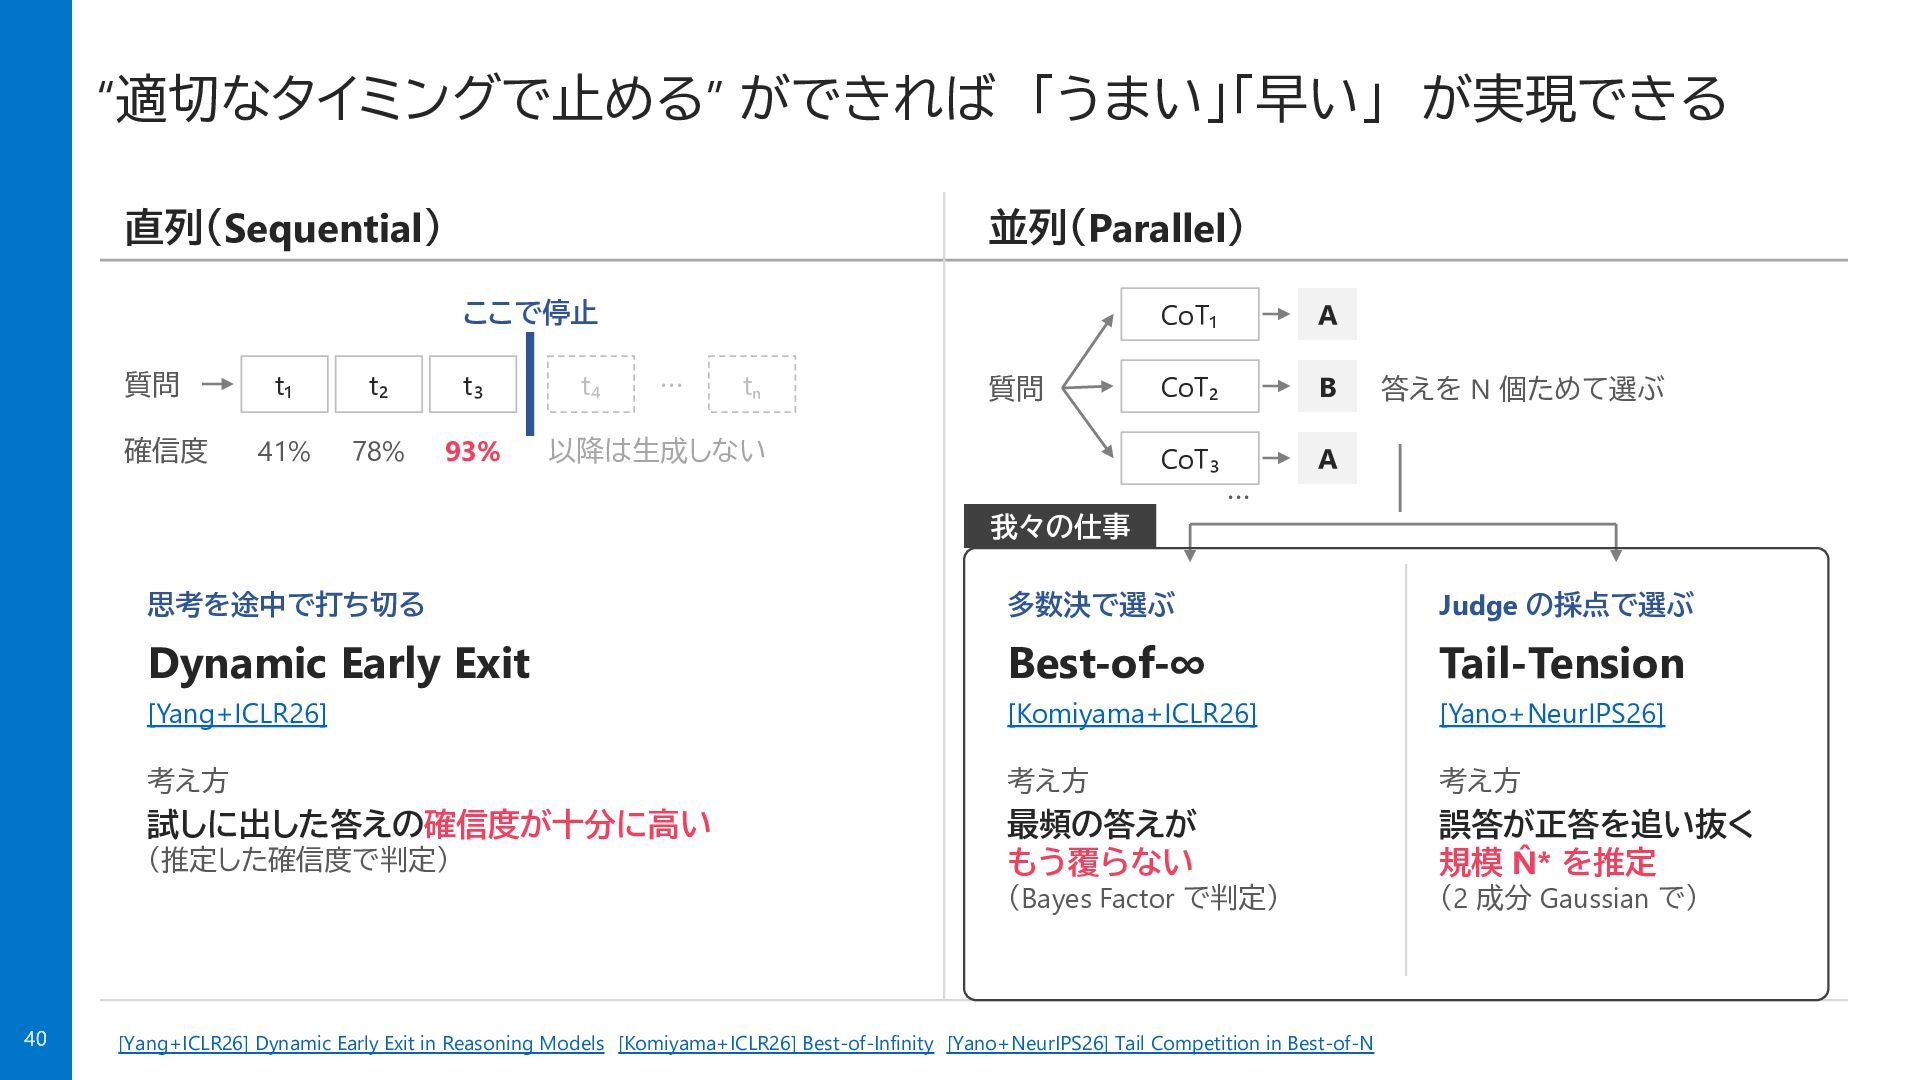
    t₃ 確信度 41% 78% 93% t₄ ⋯ tₙ 質問 以降は生成しない CoT₁ A CoT₂ B CoT₃ A 答えを N 個ためて選ぶ ⋯ 我々の仕事 思考を途中で打ち切る 多数決で選ぶ Judge の採点で選ぶ Dynamic Early Exit Best-of-∞ Tail-Tension [Yang+ICLR26] [Komiyama+ICLR26] [Yano+NeurIPS26] 考え方 考え方 考え方 試しに出した答えの確信度が十分に高い 最頻の答えが もう覆らない 誤答が正答を追い抜く 規模 N̂* を推定 (推定した確信度で判定) (Bayes Factor で判定) 40 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models [Komiyama+ICLR26] Best-of-Infinity [Yano+NeurIPS26] Tail Competition in Best-of-N (2 成分 Gaussian で)
  40. “適切なタイミングで止める” ができれば 「うまい」「早い」 が実現できる 2-1 Dynamic Early Exit 直列(Sequential) 並列(Parallel)

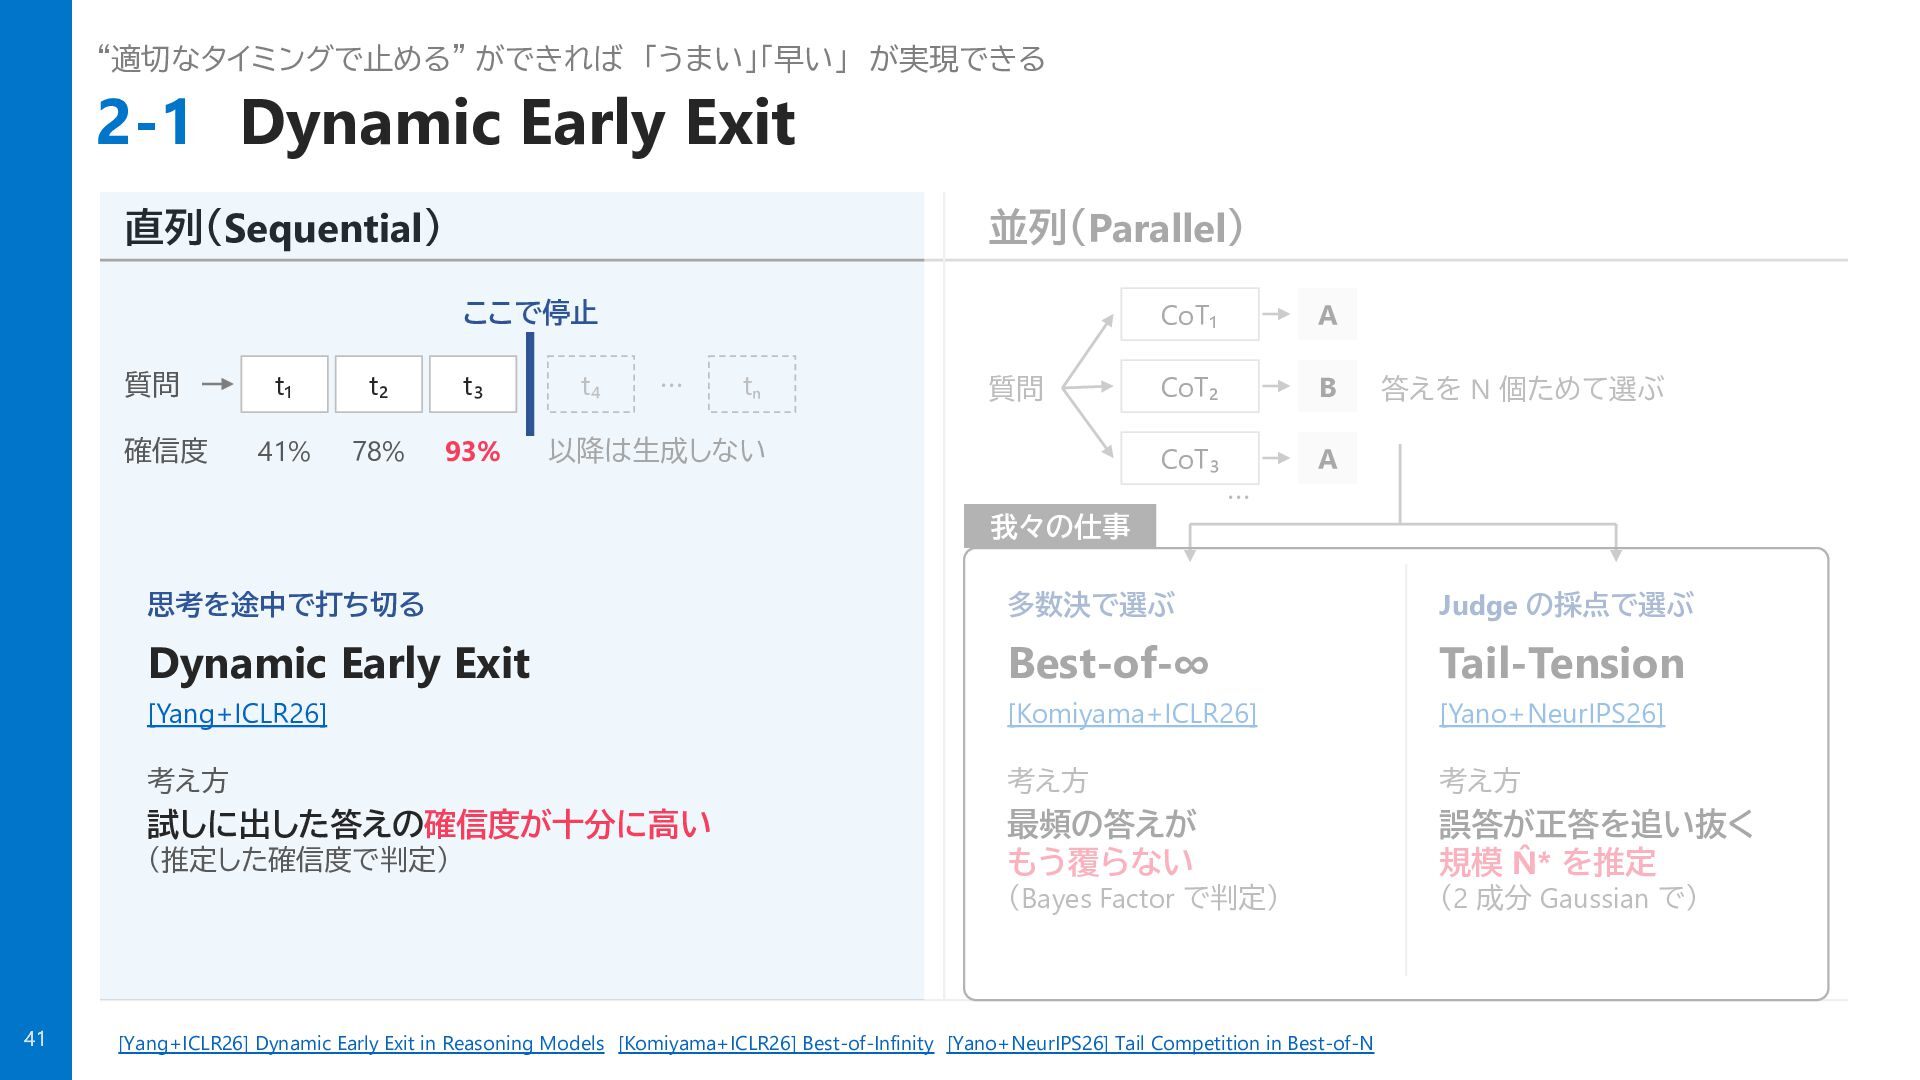
    ここで停止 質問 t₁ t₂ t₃ 確信度 41% 78% 93% t₄ ⋯ tₙ 質問 以降は生成しない CoT₁ A CoT₂ B CoT₃ A 答えを N 個ためて選ぶ ⋯ 我々の仕事 思考を途中で打ち切る 多数決で選ぶ Judge の採点で選ぶ Dynamic Early Exit Best-of-∞ Tail-Tension [Yang+ICLR26] [Komiyama+ICLR26] [Yano+NeurIPS26] 考え方 考え方 考え方 試しに出した答えの確信度が十分に高い 最頻の答えが もう覆らない 誤答が正答を追い抜く 規模 N̂* を推定 (推定した確信度で判定) (Bayes Factor で判定) 41 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models [Komiyama+ICLR26] Best-of-Infinity [Yano+NeurIPS26] Tail Competition in Best-of-N (2 成分 Gaussian で)
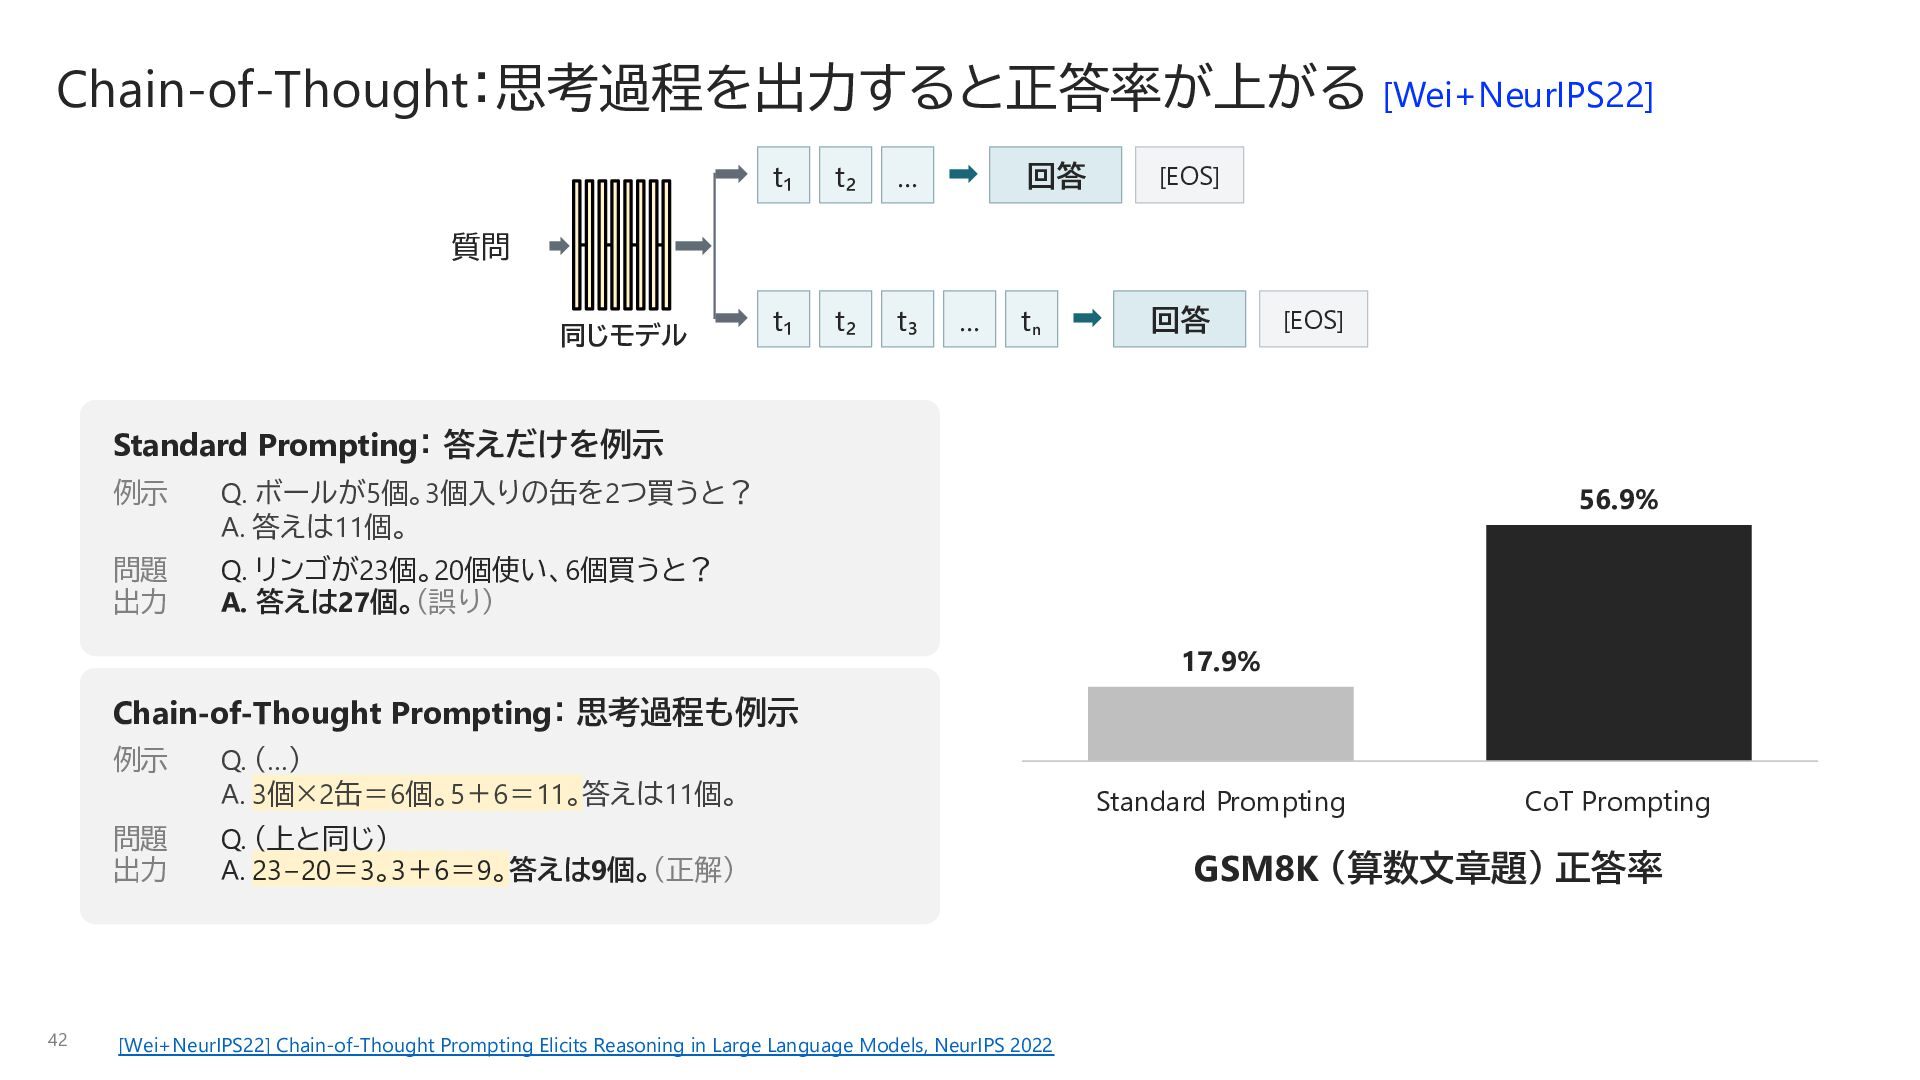
  41. Chain-of-Thought:思考過程を出力すると正答率が上がる [Wei+NeurIPS22] t₁ t₂ … t₁ t₂ t₃ 回答 [EOS]

    tₙ 回答 質問 同じモデル … [EOS] Standard Prompting: 答えだけを例示 例示 Q. ボールが5個。3個入りの缶を2つ買うと? A. 答えは11個。 問題 出力 Q. リンゴが23個。20個使い、6個買うと? A. 答えは27個。(誤り) 56.9% 17.9% Chain-of-Thought Prompting: 思考過程も例示 例示 問題 出力 42 Q. (…) A. 3個×2缶=6個。5+6=11。答えは11個。 Q. (上と同じ) A. 23−20=3。3+6=9。答えは9個。(正解) [Wei+NeurIPS22] Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, NeurIPS 2022 Standard Prompting CoT Prompting GSM8K (算数文章題) 正答率
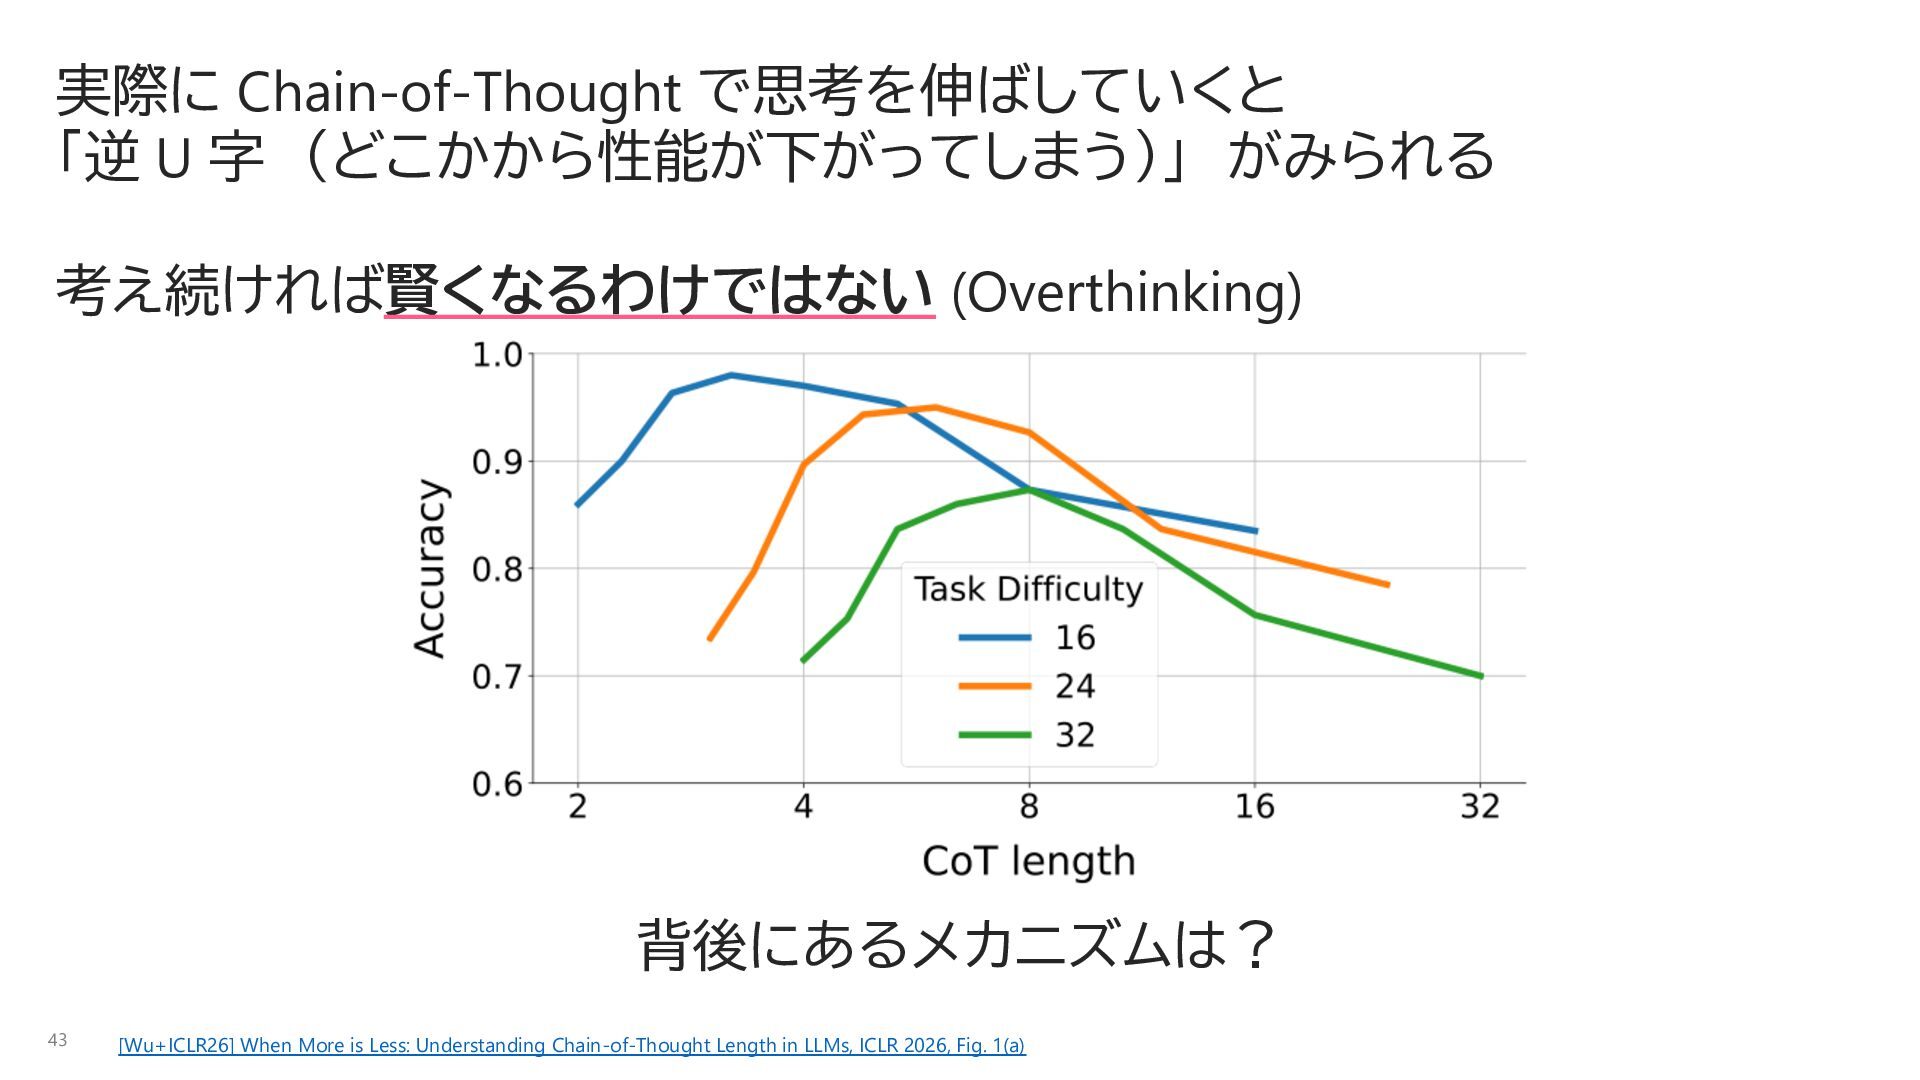
  42. 実際に Chain-of-Thought で思考を伸ばしていくと 「逆 U 字 (どこかから性能が下がってしまう)」 がみられる 考え続ければ賢くなるわけではない (Overthinking)

    背後にあるメカニズムは? 43 [Wu+ICLR26] When More is Less: Understanding Chain-of-Thought Length in LLMs, ICLR 2026, Fig. 1(a)
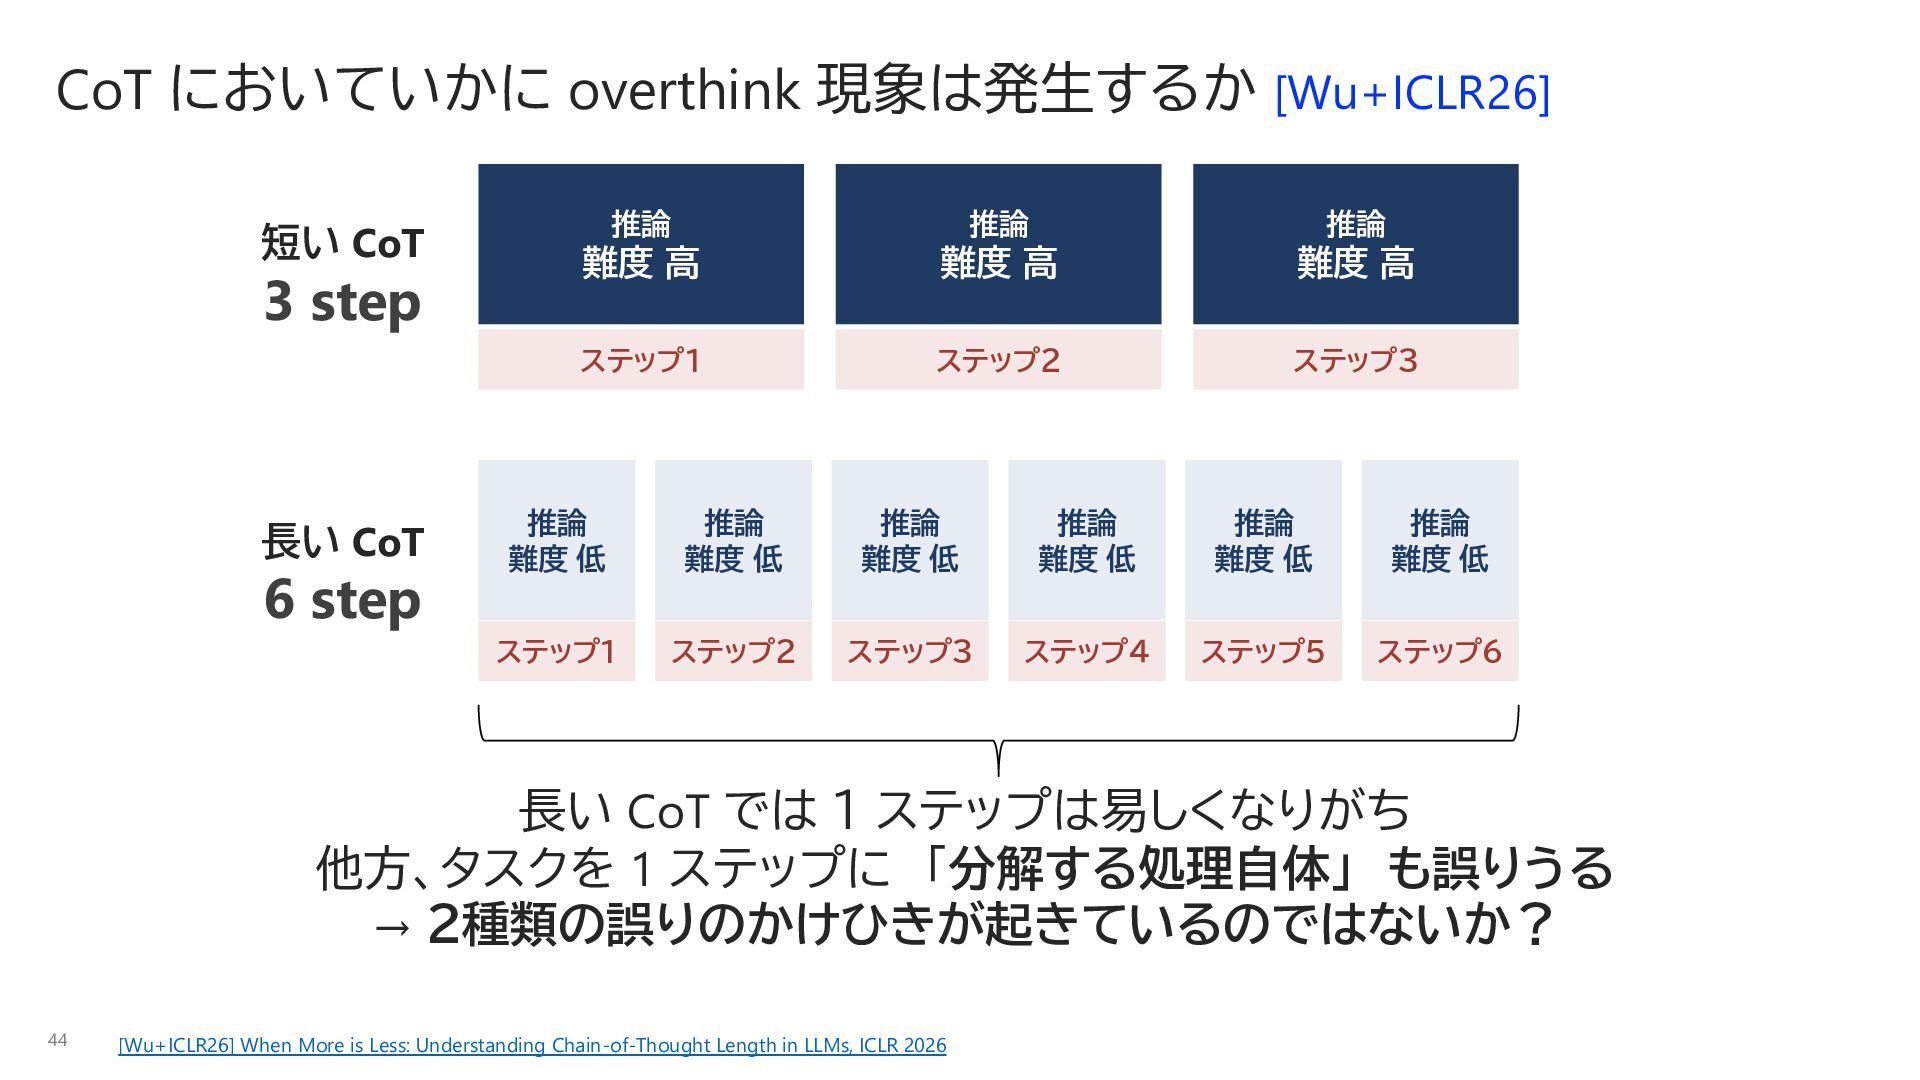
  43. CoT においていかに overthink 現象は発生するか [Wu+ICLR26] 短い CoT 3 step 長い

    CoT 6 step 推論 推論 推論 難度 高 難度 高 難度 高 ステップ1 ステップ2 ステップ3 推論 難度 低 推論 難度 低 推論 難度 低 推論 難度 低 推論 難度 低 推論 難度 低 ステップ1 ステップ2 ステップ3 ステップ4 ステップ5 ステップ6 長い CoT では 1 ステップは易しくなりがち 他方、タスクを 1 ステップに 「分解する処理自体」 も誤りうる → 2種類の誤りのかけひきが起きているのではないか? 44 [Wu+ICLR26] When More is Less: Understanding Chain-of-Thought Length in LLMs, ICLR 2026
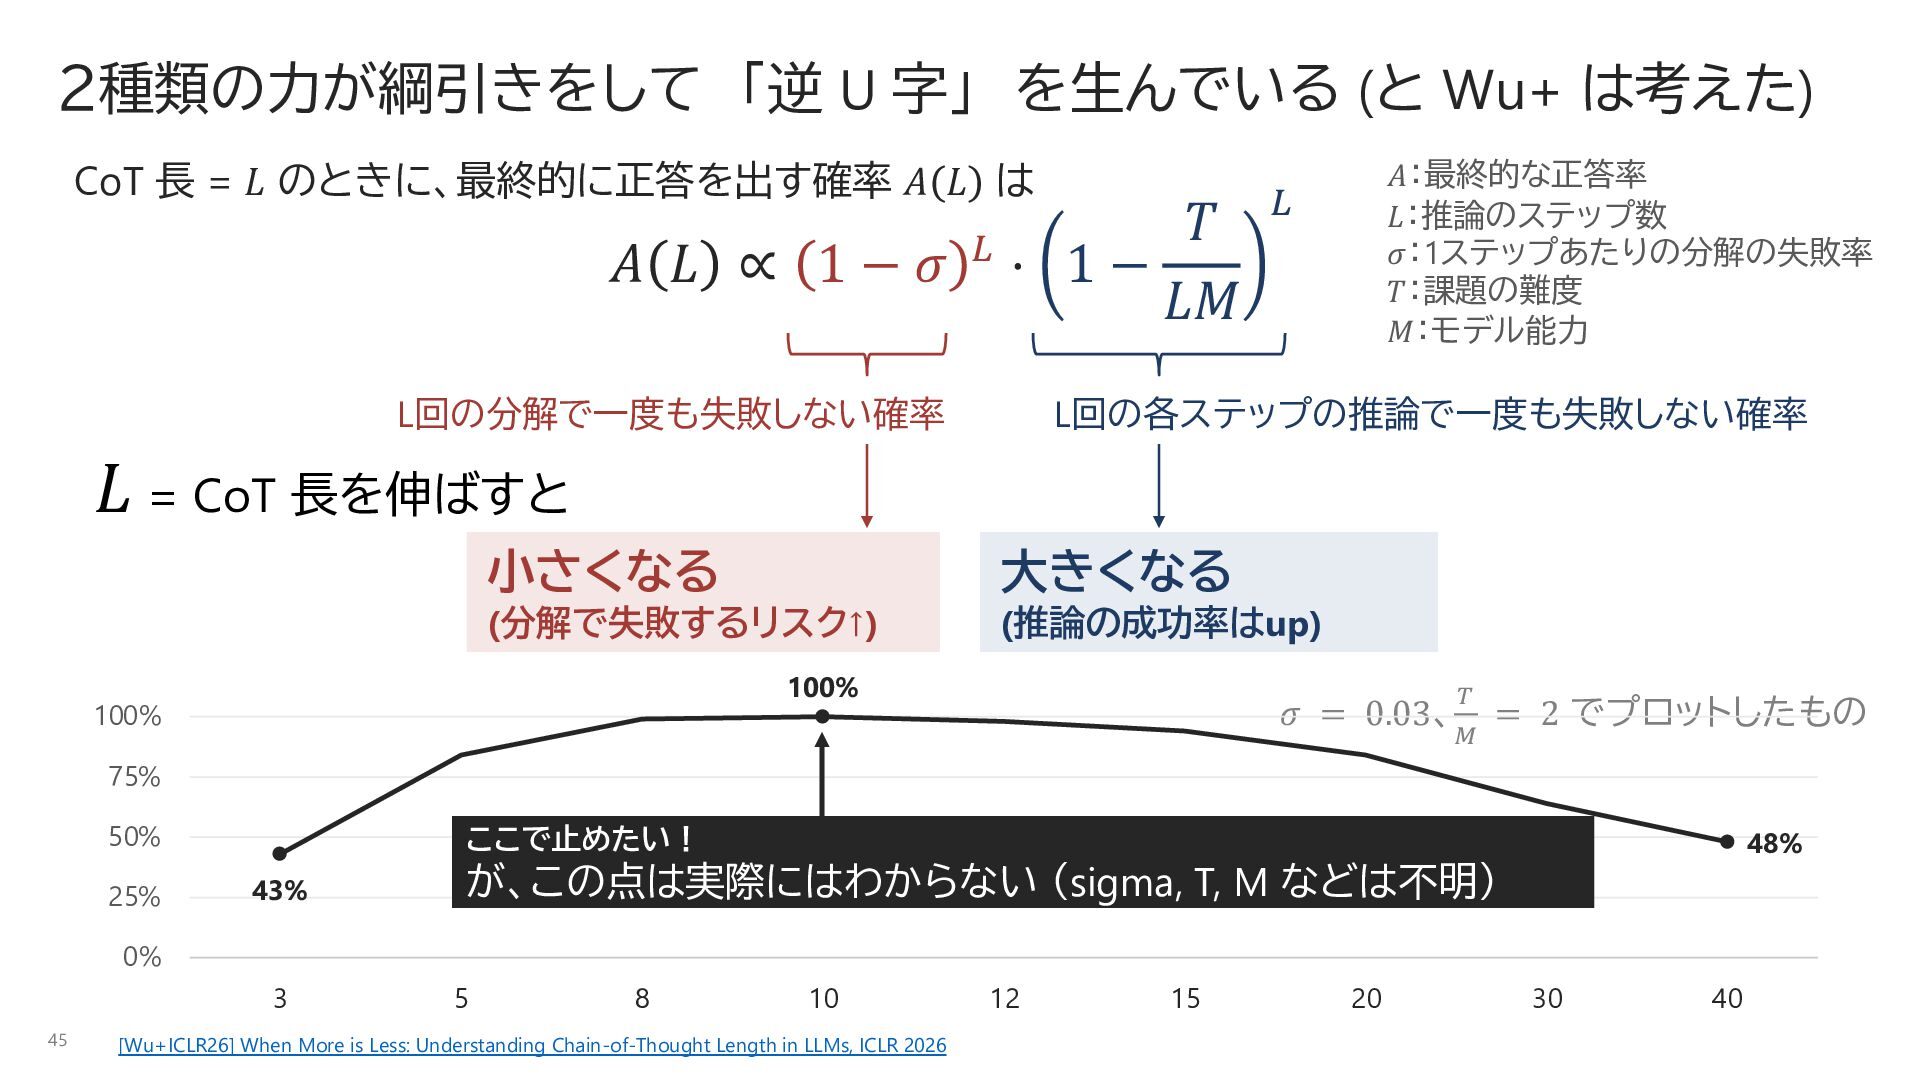
  44. 2種類の力が綱引きをして 「逆 U 字」 を生んでいる (と Wu+ は考えた) CoT 長

    = 𝐿 のときに、最終的に正答を出す確率 𝐴 𝐿 は 𝐴 𝐿 ∝ 1−𝜎 * 𝑇 ⋅ 1− 𝐿𝑀 L回の分解で一度も失敗しない確率 𝐴:最終的な正答率 𝐿:推論のステップ数 𝜎:1ステップあたりの分解の失敗率 𝑇:課題の難度 𝑀:モデル能力 * L回の各ステップの推論で一度も失敗しない確率 𝐿 = CoT 長を伸ばすと 小さくなる 大きくなる (分解で失敗するリスク↑) (推論の成功率はup) 100% 100% 𝜎 = 0.03、 ! " = 2 でプロットしたもの 75% 50% 25% 48% ここで止めたい! 43% が、この点は実際にはわからない (sigma, T, M などは不明) 0% 3 45 5 8 10 [Wu+ICLR26] When More is Less: Understanding Chain-of-Thought Length in LLMs, ICLR 2026 12 15 20 30 40
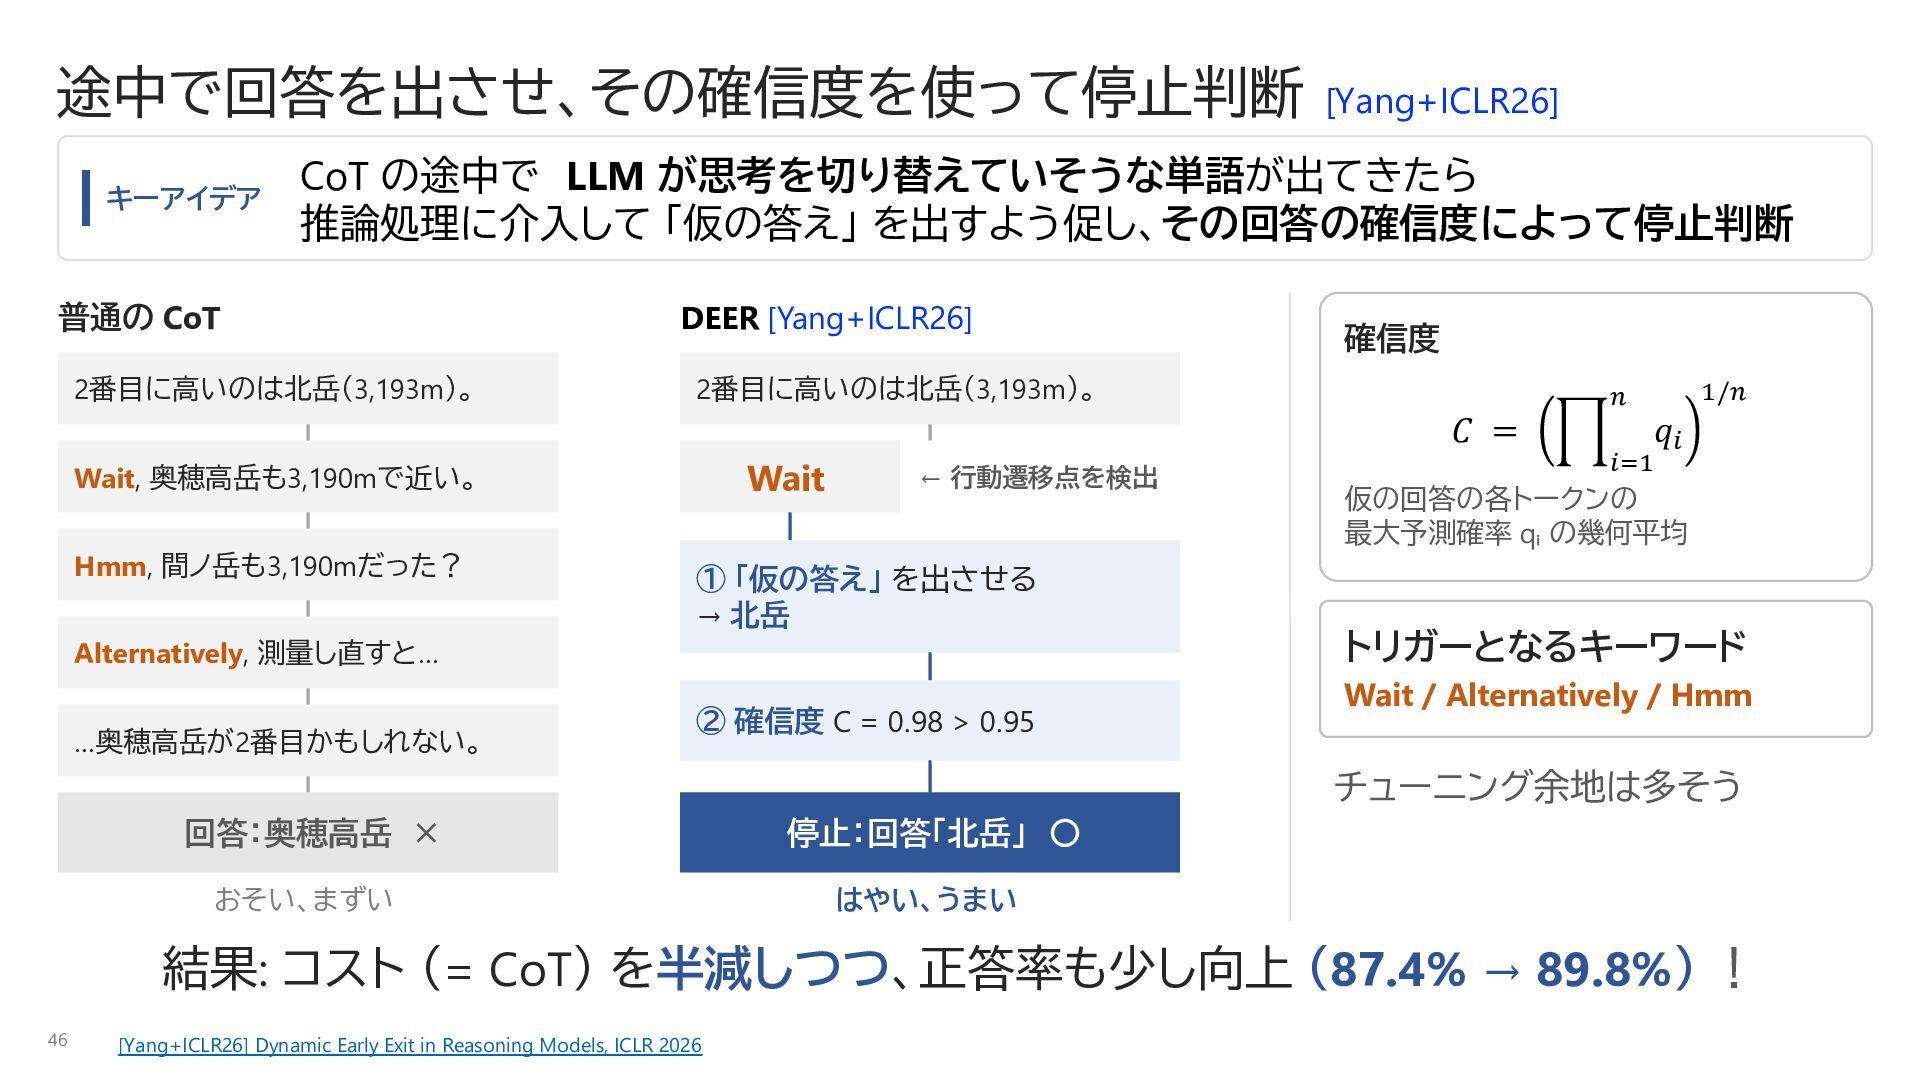
  45. 途中で回答を出させ、その確信度を使って停止判断 [Yang+ICLR26] キーアイデア CoT の途中で LLM が思考を切り替えていそうな単語が出てきたら 推論処理に介入して 「仮の答え」 を出すよう促し、その回答の確信度によって停止判断

    普通の CoT DEER [Yang+ICLR26] 2番目に高いのは北岳(3,193m)。 2番目に高いのは北岳(3,193m)。 確信度 & 𝐶 = * Wait Wait, 奥穂高岳も3,190mで近い。 Hmm, 間ノ岳も3,190mだった? Alternatively, 測量し直すと… …奥穂高岳が2番目かもしれない。 ← 行動遷移点を検出 ① 「仮の答え」 を出させる → 北岳 ② 確信度 C = 0.98 > 0.95 #$% %/& 𝑞# 仮の回答の各トークンの 最大予測確率 qᵢ の幾何平均 トリガーとなるキーワード Wait / Alternatively / Hmm チューニング余地は多そう 回答:奥穂高岳 × 停止:回答「北岳」 〇 おそい、まずい はやい、うまい 結果: コスト (= CoT) を半減しつつ、正答率も少し向上 (87.4% → 89.8%) ! 46 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models, ICLR 2026
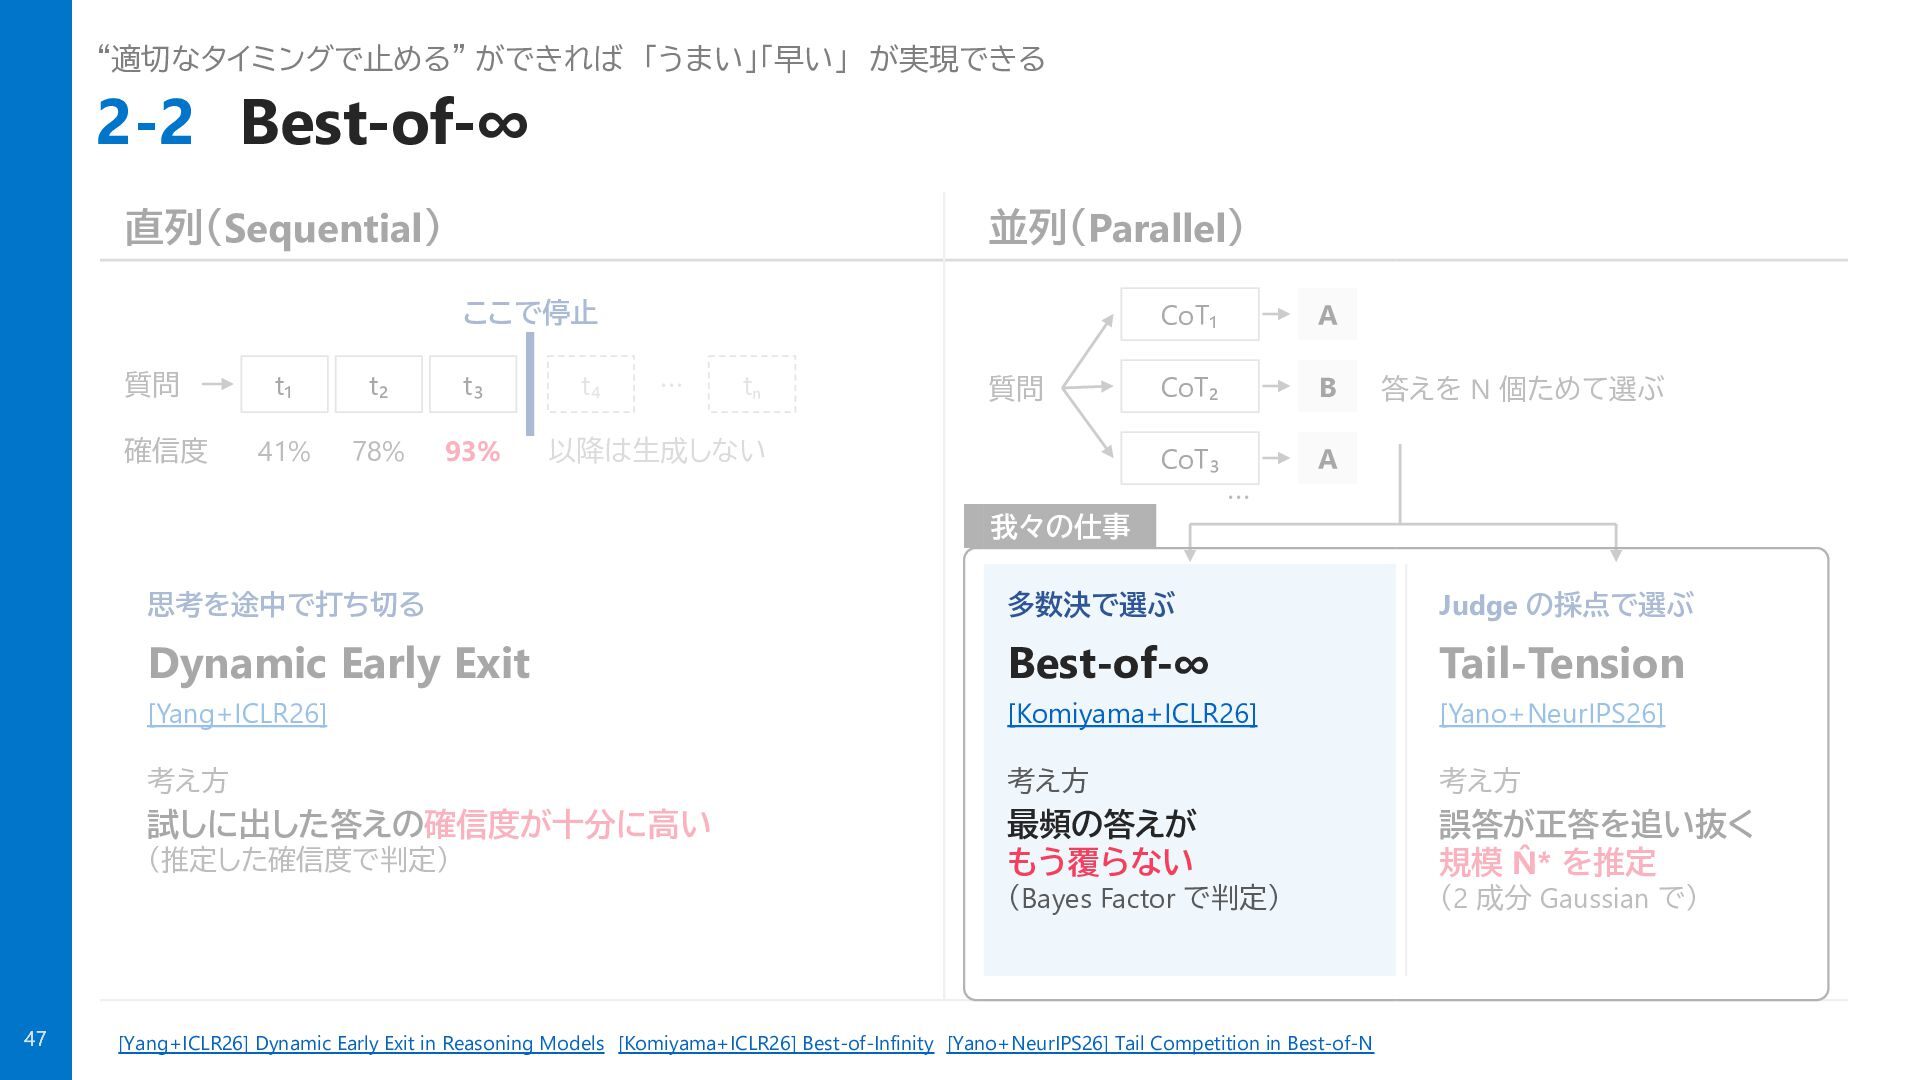
  46. “適切なタイミングで止める” ができれば 「うまい」「早い」 が実現できる 2-2 Best-of-∞ 直列(Sequential) 並列(Parallel) ここで停止 質問

    t₁ t₂ t₃ 確信度 41% 78% 93% t₄ ⋯ tₙ 質問 以降は生成しない CoT₁ A CoT₂ B CoT₃ A 答えを N 個ためて選ぶ ⋯ 我々の仕事 思考を途中で打ち切る 多数決で選ぶ Judge の採点で選ぶ Dynamic Early Exit Best-of-∞ Tail-Tension [Yang+ICLR26] [Komiyama+ICLR26] [Yano+NeurIPS26] 考え方 考え方 考え方 試しに出した答えの確信度が十分に高い 最頻の答えが もう覆らない 誤答が正答を追い抜く 規模 N̂* を推定 (推定した確信度で判定) (Bayes Factor で判定) 47 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models [Komiyama+ICLR26] Best-of-Infinity [Yano+NeurIPS26] Tail Competition in Best-of-N (2 成分 Gaussian で)
  47. シンプルな 「多数決」 はかなり強い [Wang+ICLR23] 問題 𝑥 Chain-of-Thoughts (CoT) 最終回答 思考経路

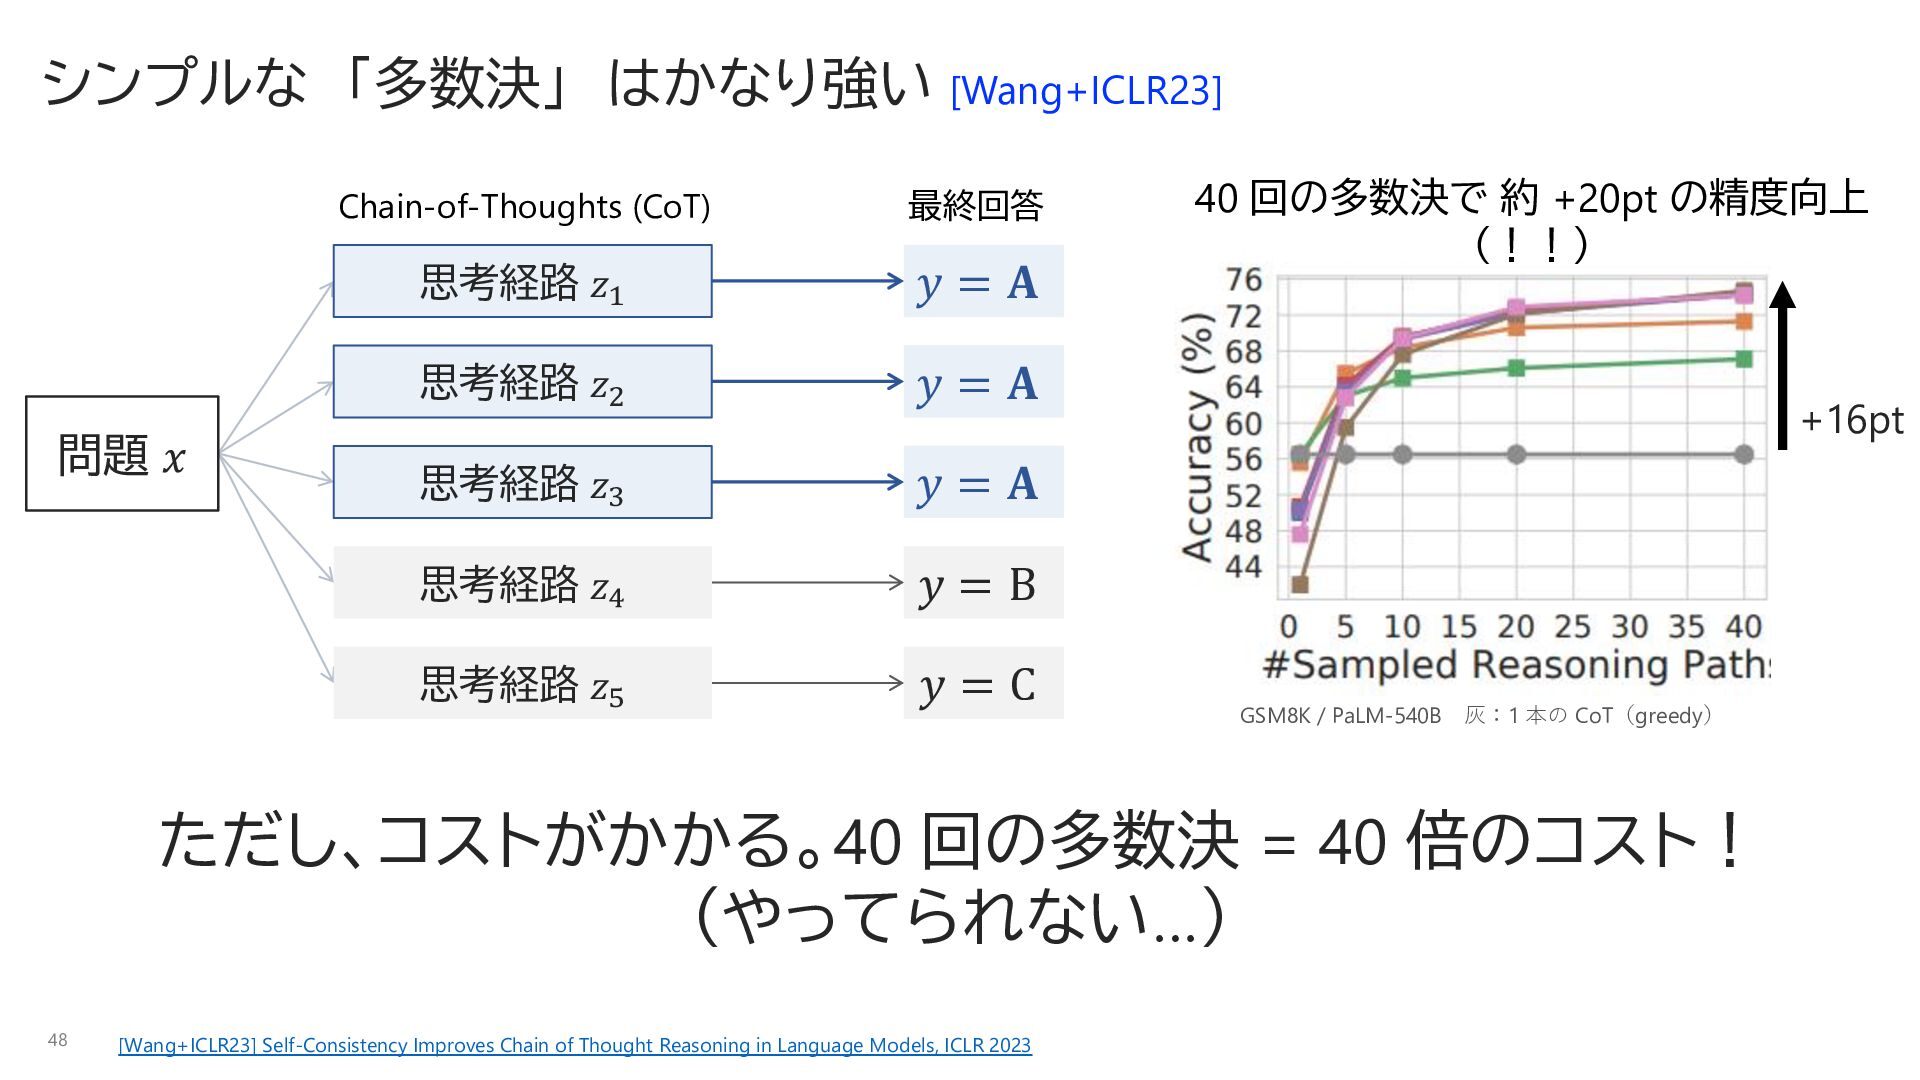
    𝑧! 𝑦=𝐀 思考経路 𝑧" 𝑦=𝐀 思考経路 𝑧# 𝑦=𝐀 思考経路 𝑧$ 𝑦=B 思考経路 𝑧% 𝑦=C 40 回の多数決で 約 +20pt の精度向上 (!!) +16pt GSM8K / PaLM-540B 灰:1 本の CoT(greedy) ただし、コストがかかる。40 回の多数決 = 40 倍のコスト! (やってられない…) 48 [Wang+ICLR23] Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023
  48. 多数決にかかるコストを (統計的に妥当に) 減らしたい [Komiyama+ICLR26] 観察: 10回、回答を生成してみると、問題によって、回答分布が異なる 問題1では A が9票と圧勝 10

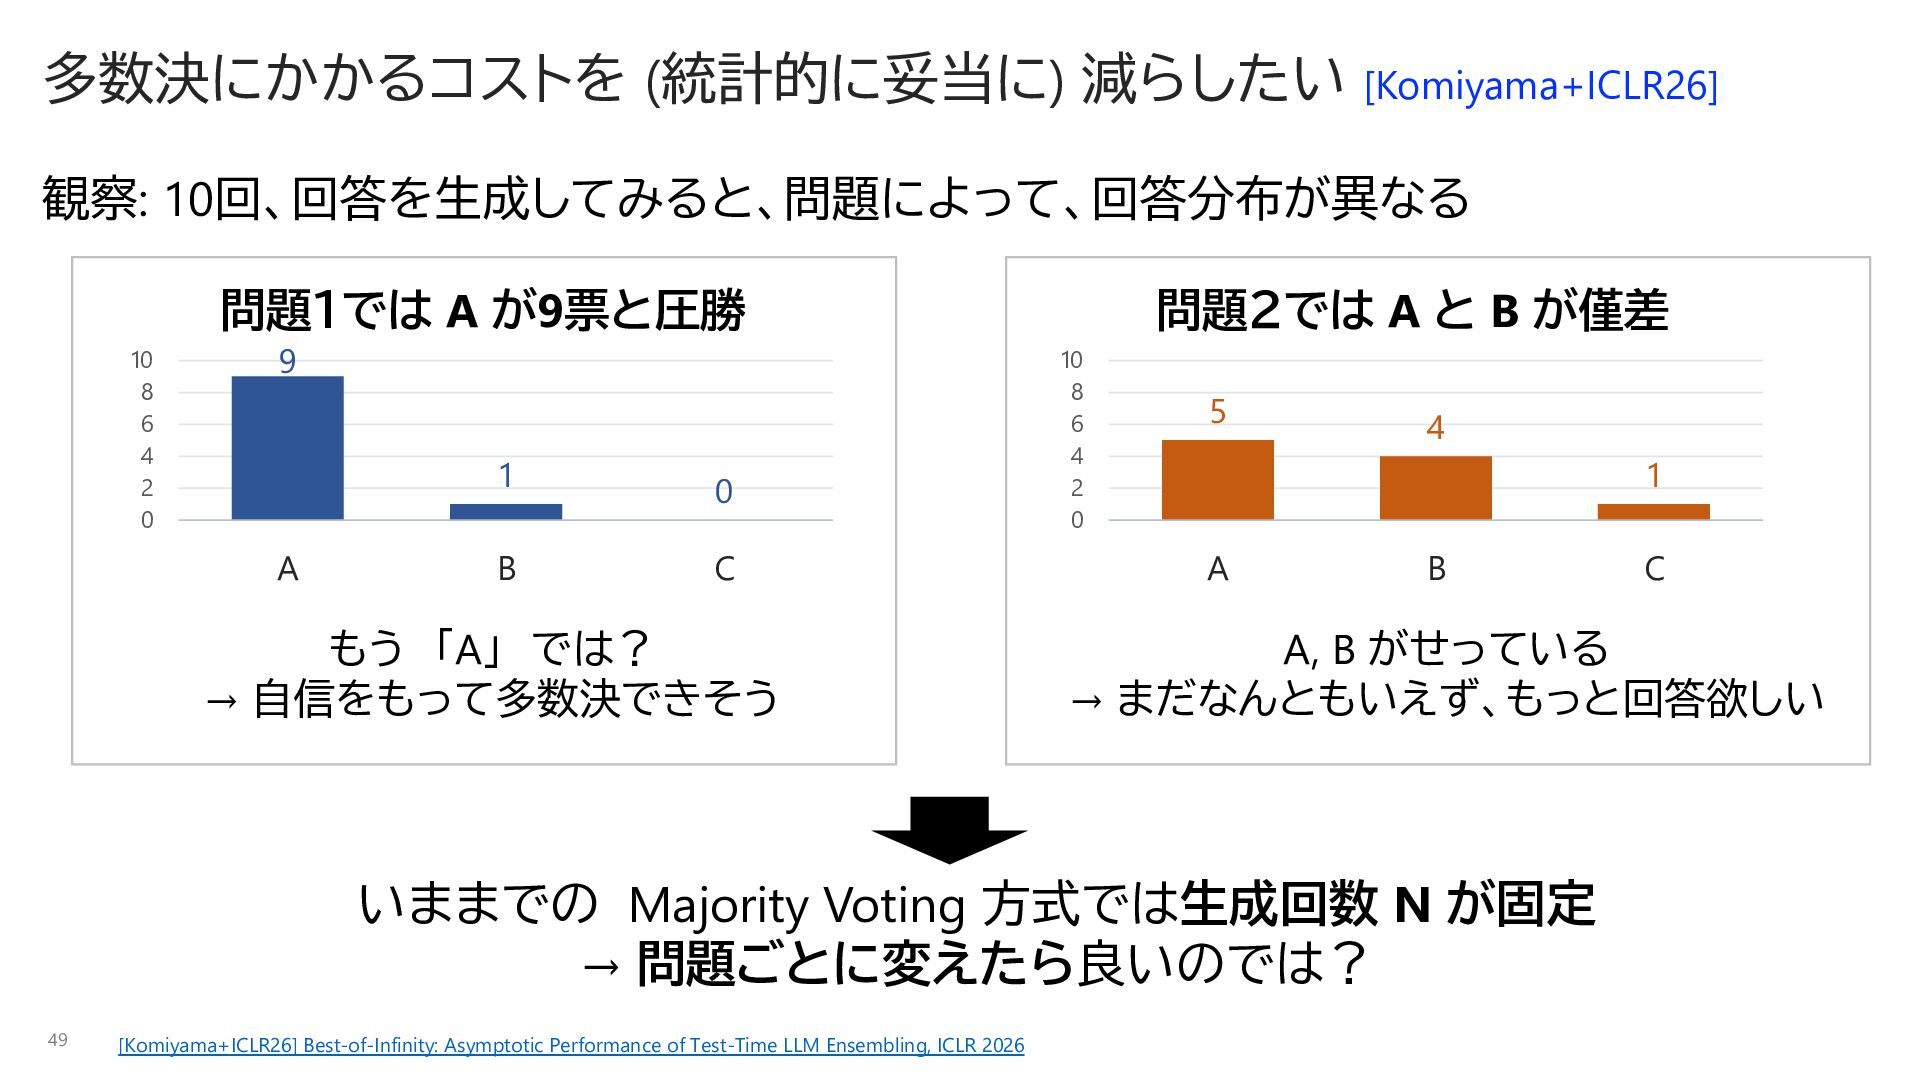
    8 6 4 2 0 9 A 1 0 B C もう 「A」 では? → 自信をもって多数決できそう 問題2では A と B が僅差 10 8 6 4 2 0 5 4 1 A B A, B がせっている → まだなんともいえず、もっと回答欲しい いままでの Majority Voting 方式では生成回数 N が固定 → 問題ごとに変えたら良いのでは? 49 [Komiyama+ICLR26] Best-of-Infinity: Asymptotic Performance of Test-Time LLM Ensembling, ICLR 2026 C
  49. 逐次的に回答を入手し、選挙速報的に多数決を打ち切る Bayes Factor (ベイズ的な仮説比較の仕組み) で これまでの推論結果が∞回後も最頻値になる「度合い」を算出 閾値 (validation set で調節)

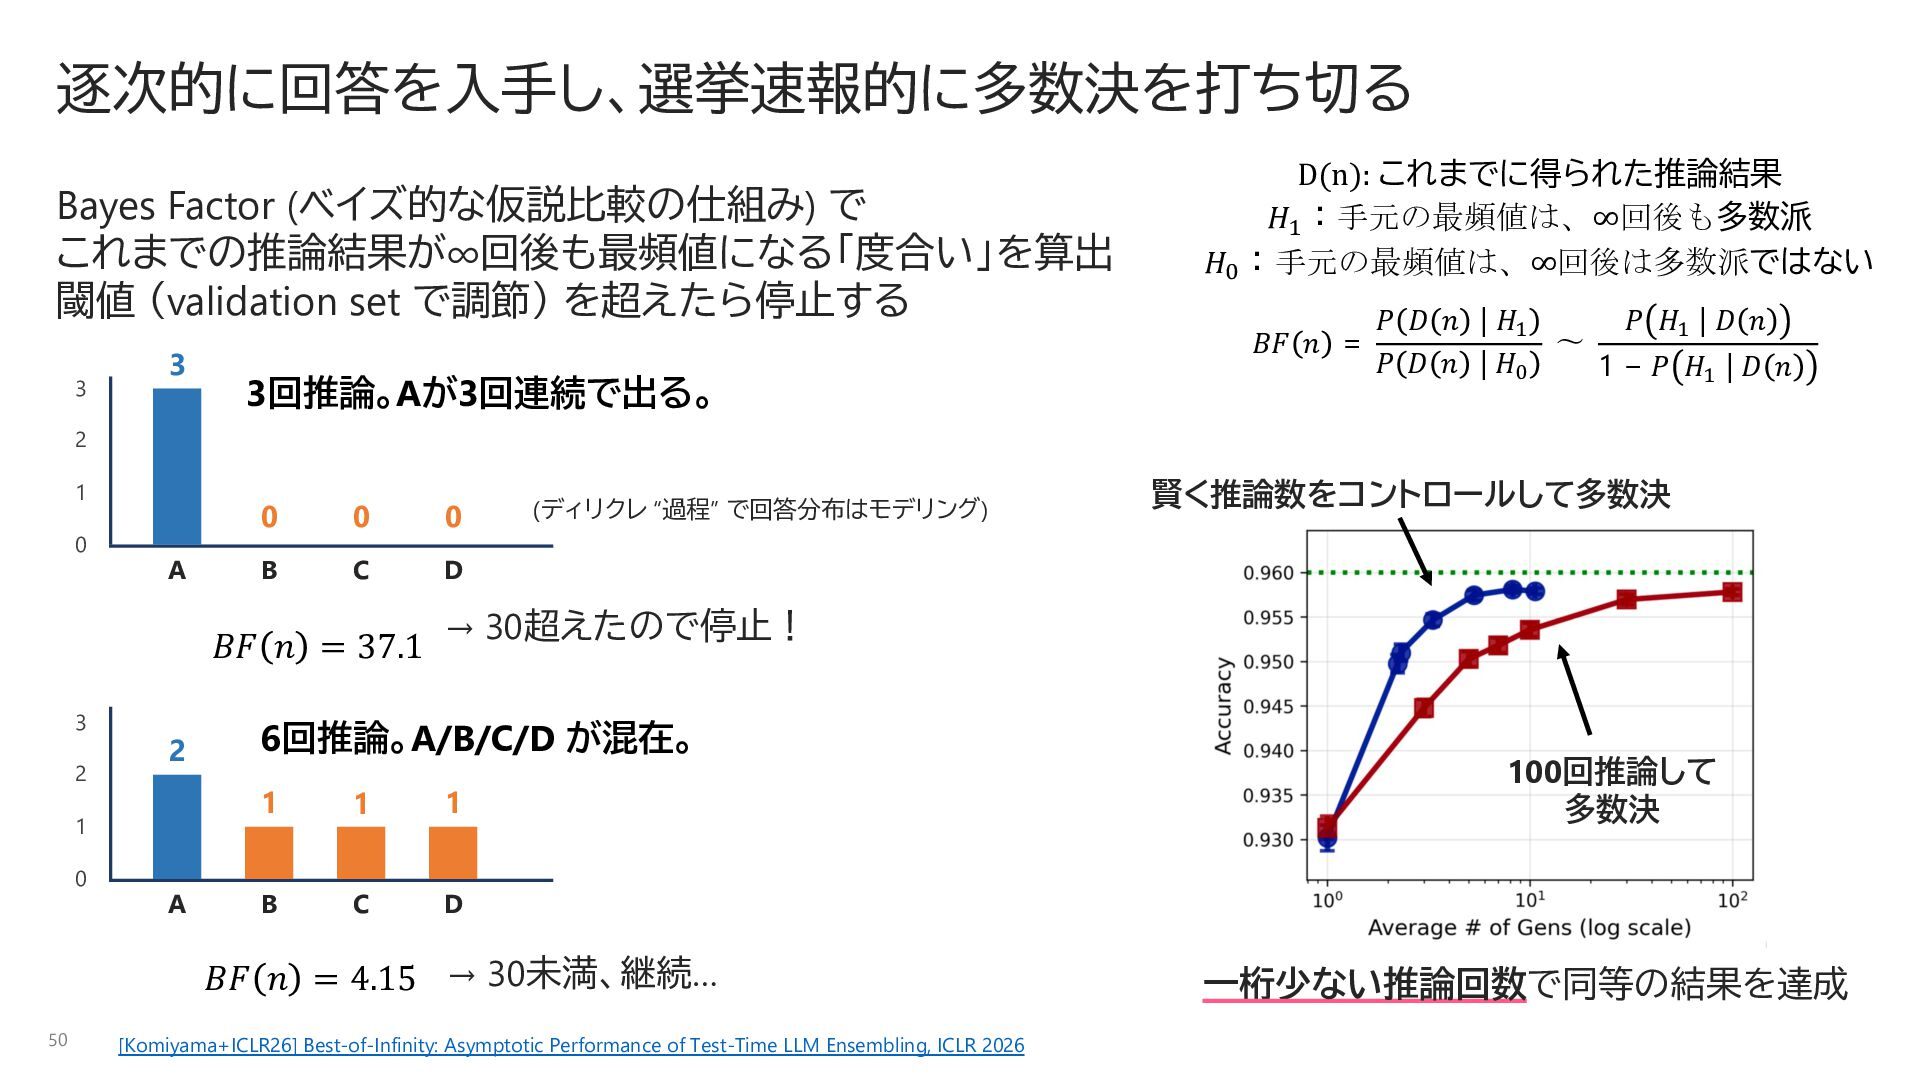
    を超えたら停止する 3 3 3回推論。Aが3回連続で出る。 D(n): これまでに得られた推論結果 𝐻! : 手元の最頻値は、∞回後も多数派 𝐻" : 手元の最頻値は、∞回後は多数派ではない 𝐵𝐹 𝑛 = 𝑃 𝐷 𝑛 | 𝐻" 𝑃 𝐻" | 𝐷 𝑛 〜 𝑃 𝐷 𝑛 | 𝐻# 1 − 𝑃 𝐻" | 𝐷 𝑛 2 1 0 A 0 0 0 B C D 𝐵𝐹 𝑛 = 37.1 3 2 2 1 0 A (ディリクレ “過程” で回答分布はモデリング) → 30超えたので停止! 6回推論。A/B/C/D が混在。 1 1 1 B C D 𝐵𝐹 𝑛 = 4.15 → 30未満、継続… 50 賢く推論数をコントロールして多数決 [Komiyama+ICLR26] Best-of-Infinity: Asymptotic Performance of Test-Time LLM Ensembling, ICLR 2026 100回推論して 多数決 一桁少ない推論回数で同等の結果を達成
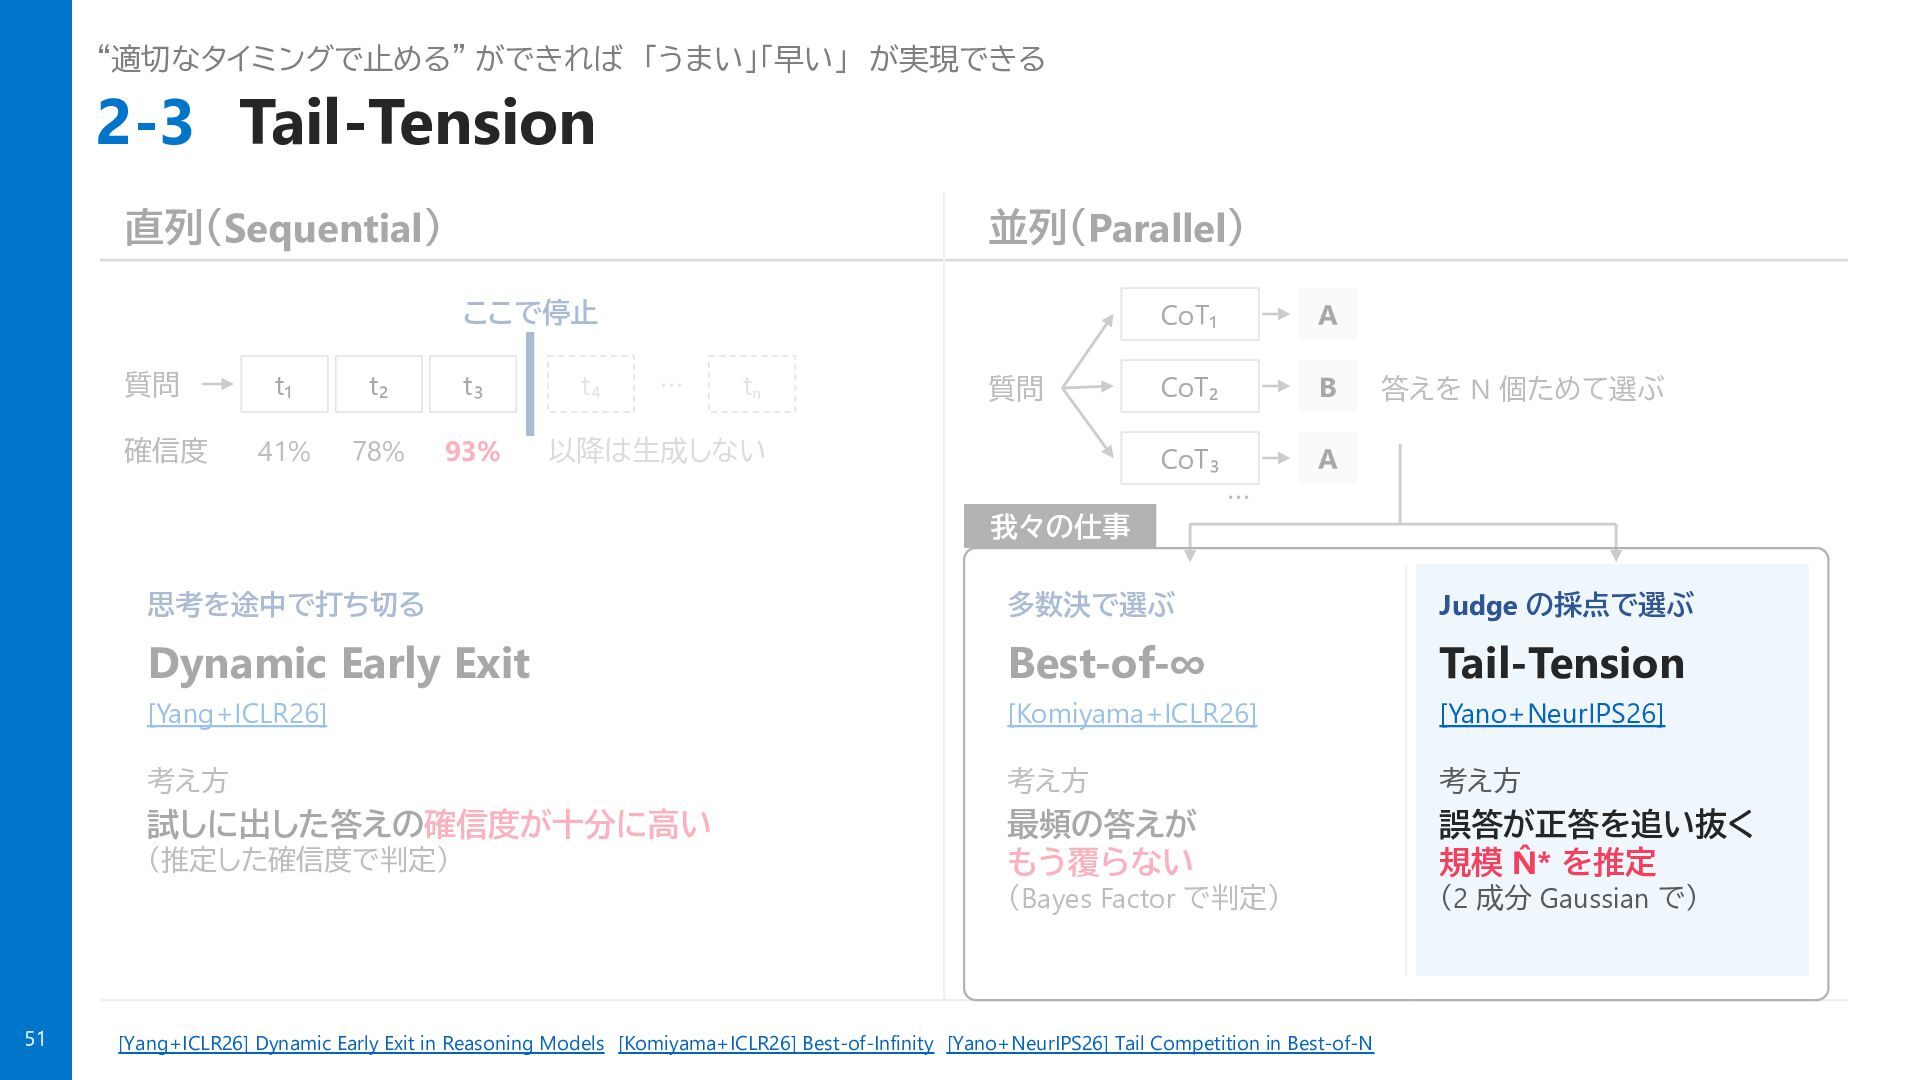
  50. “適切なタイミングで止める” ができれば 「うまい」「早い」 が実現できる 2-3 Tail-Tension 直列(Sequential) 並列(Parallel) ここで停止 質問

    t₁ t₂ t₃ 確信度 41% 78% 93% t₄ ⋯ tₙ 質問 以降は生成しない CoT₁ A CoT₂ B CoT₃ A 答えを N 個ためて選ぶ ⋯ 我々の仕事 思考を途中で打ち切る 多数決で選ぶ Judge の採点で選ぶ Dynamic Early Exit Best-of-∞ Tail-Tension [Yang+ICLR26] [Komiyama+ICLR26] [Yano+NeurIPS26] 考え方 考え方 考え方 試しに出した答えの確信度が十分に高い 最頻の答えが もう覆らない 誤答が正答を追い抜く 規模 N̂* を推定 (推定した確信度で判定) (Bayes Factor で判定) 51 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models [Komiyama+ICLR26] Best-of-Infinity [Yano+NeurIPS26] Tail Competition in Best-of-N (2 成分 Gaussian で)
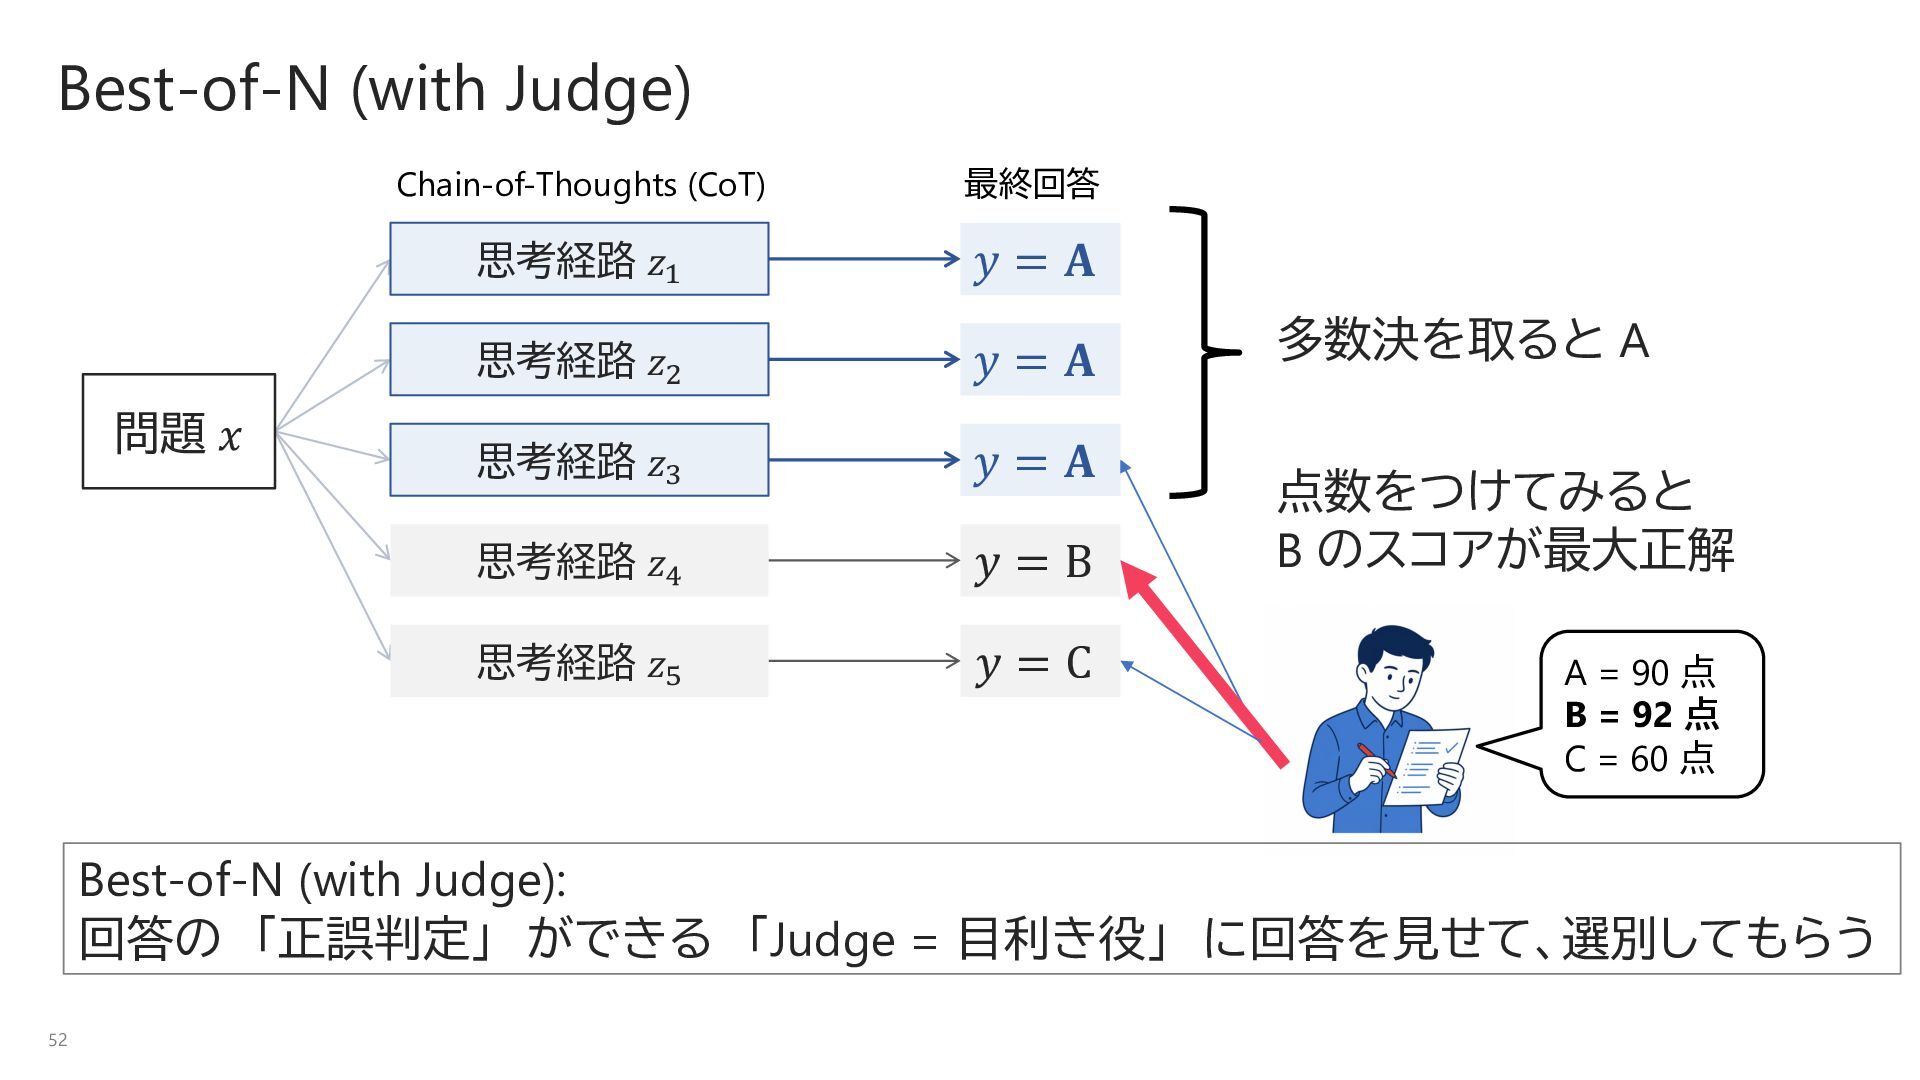
  51. Best-of-N (with Judge) 問題 𝑥 Chain-of-Thoughts (CoT) 最終回答 思考経路 𝑧!

    𝑦=𝐀 思考経路 𝑧" 𝑦=𝐀 思考経路 𝑧# 𝑦=𝐀 思考経路 𝑧$ 𝑦=B 思考経路 𝑧% 𝑦=C 多数決を取ると A 点数をつけてみると B のスコアが最大正解 A = 90 点 B = 92 点 C = 60 点 Best-of-N (with Judge): 回答の 「正誤判定」 ができる 「Judge = 目利き役」 に回答を見せて、選別してもらう 52
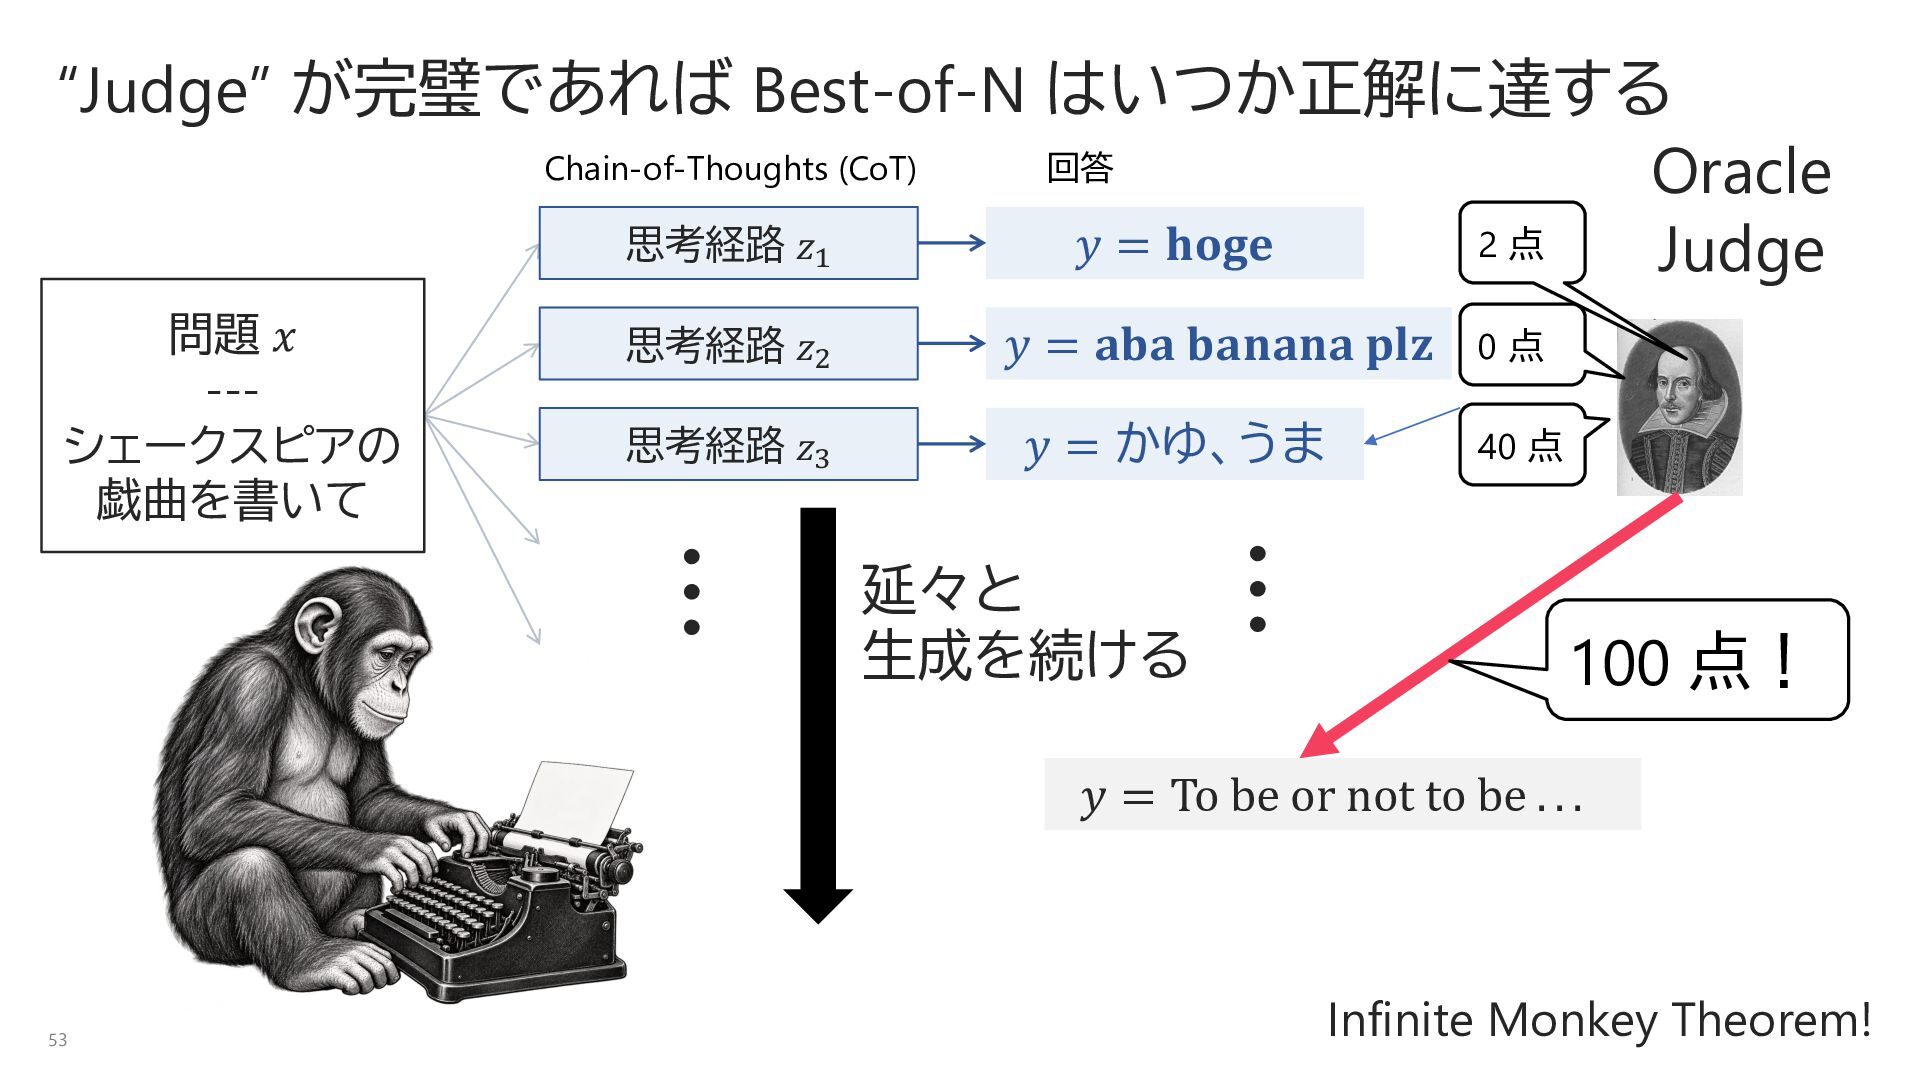
  52. “Judge” が完璧であれば Best-of-N はいつか正解に達する Chain-of-Thoughts (CoT) 回答 Oracle 2点 思考経路

    𝑧! 𝑦 = 𝐡𝐨𝐠𝐞 Judge 問題 𝑥 --シェークスピアの 戯曲を書いて 思考経路 𝑧" 𝑦 = 𝐚𝐛𝐚 𝐛𝐚𝐧𝐚𝐧𝐚 𝐩𝐥𝐳 0点 思考経路 𝑧# 𝑦 = かゆ、うま 40 点 … … 延々と 生成を続ける 100 点! 𝑦 = To be or not to be . . . 53 Infinite Monkey Theorem!
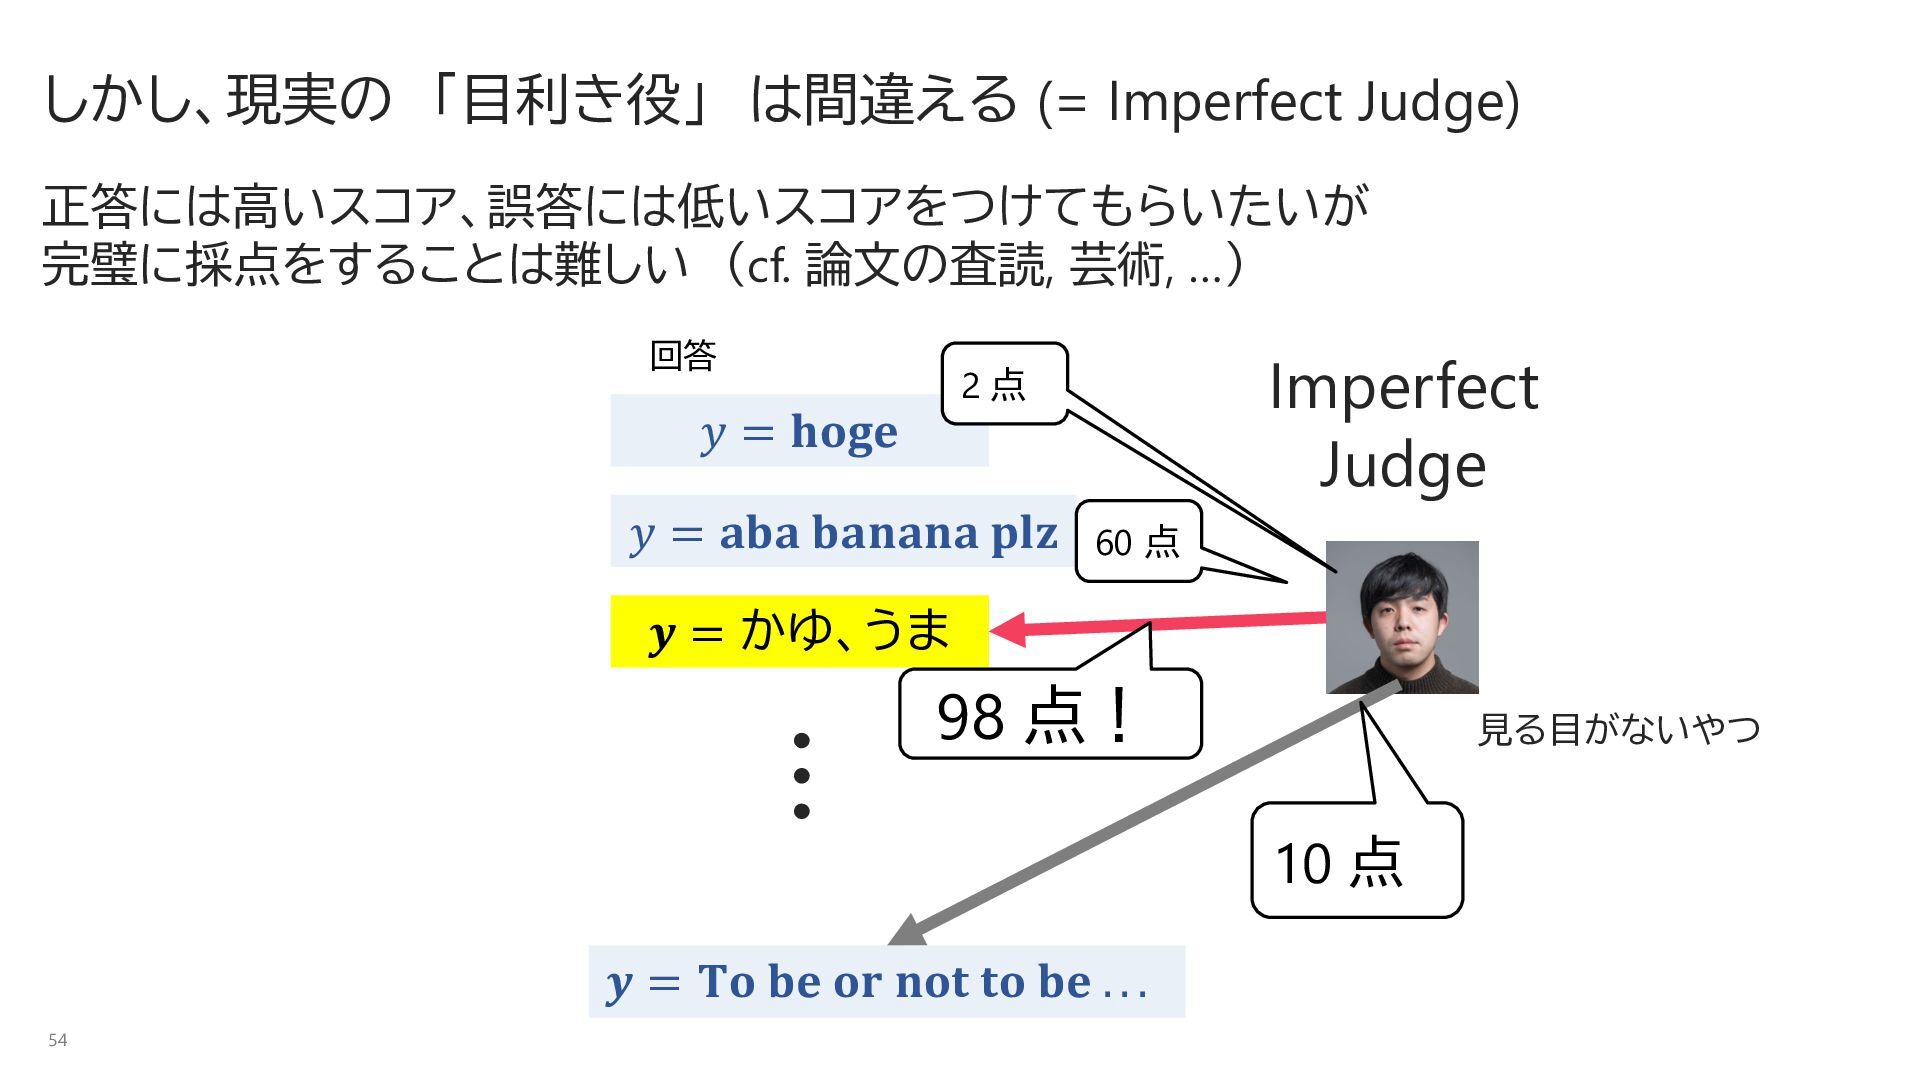
  53. しかし、現実の 「目利き役」 は間違える (= Imperfect Judge) 正答には高いスコア、誤答には低いスコアをつけてもらいたいが 完璧に採点をすることは難しい (cf. 論文の査読,
    芸術, …) 回答 Imperfect Judge 2点 𝑦 = 𝐡𝐨𝐠𝐞 𝑦 = 𝐚𝐛𝐚 𝐛𝐚𝐧𝐚𝐧𝐚 𝐩𝐥𝐳 60 点 𝒚 = かゆ、うま … 98 点! 𝒚 = 𝐓𝐨 𝐛𝐞 𝐨𝐫 𝐧𝐨𝐭 𝐭𝐨 𝐛𝐞 . . . 54 見る目がないやつ 10 点
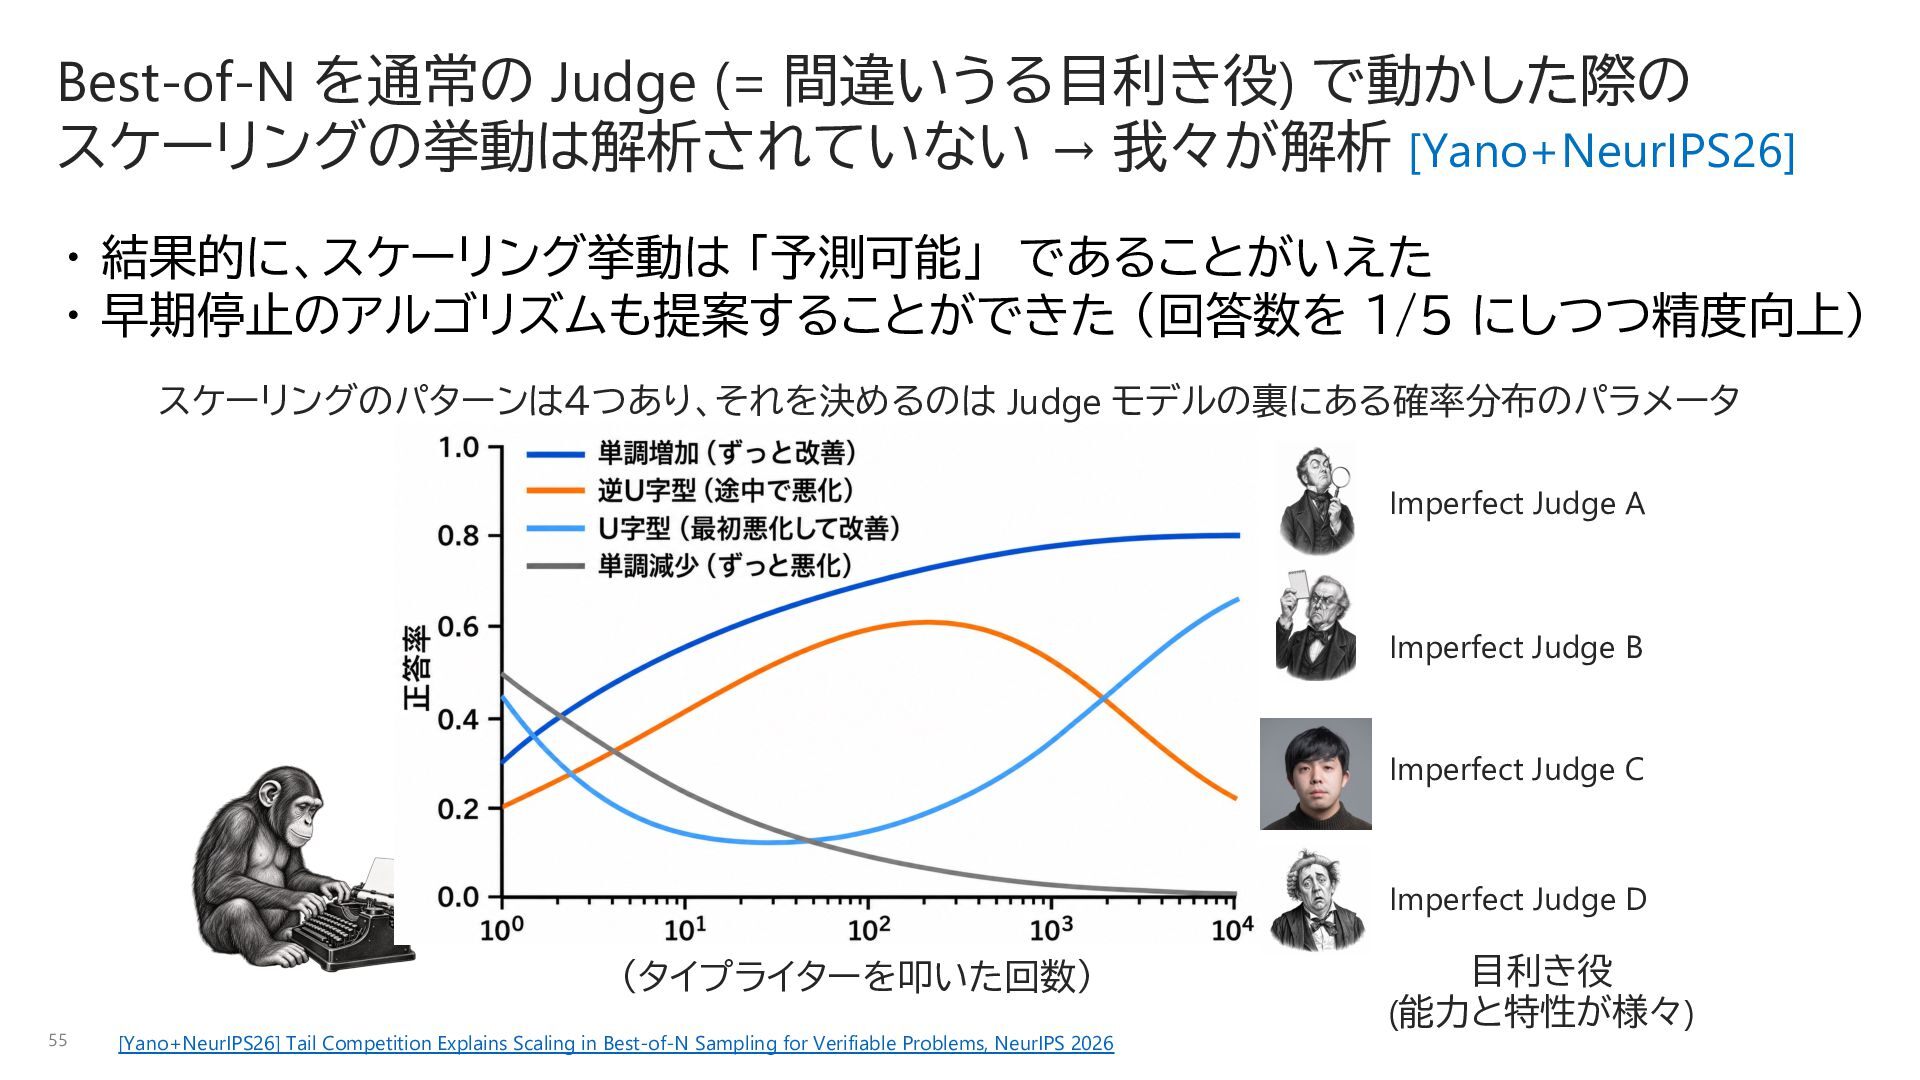
  54. Best-of-N を通常の Judge (= 間違いうる目利き役) で動かした際の スケーリングの挙動は解析されていない → 我々が解析 [Yano+NeurIPS26]

    ・ 結果的に、スケーリング挙動は 「予測可能」 であることがいえた ・ 早期停止のアルゴリズムも提案することができた (回答数を 1/5 にしつつ精度向上) スケーリングのパターンは4つあり、それを決めるのは Judge モデルの裏にある確率分布のパラメータ Imperfect Judge A Imperfect Judge B Imperfect Judge C Imperfect Judge D (タイプライターを叩いた回数) 55 [Yano+NeurIPS26] Tail Competition Explains Scaling in Best-of-N Sampling for Verifiable Problems, NeurIPS 2026 目利き役 (能力と特性が様々)
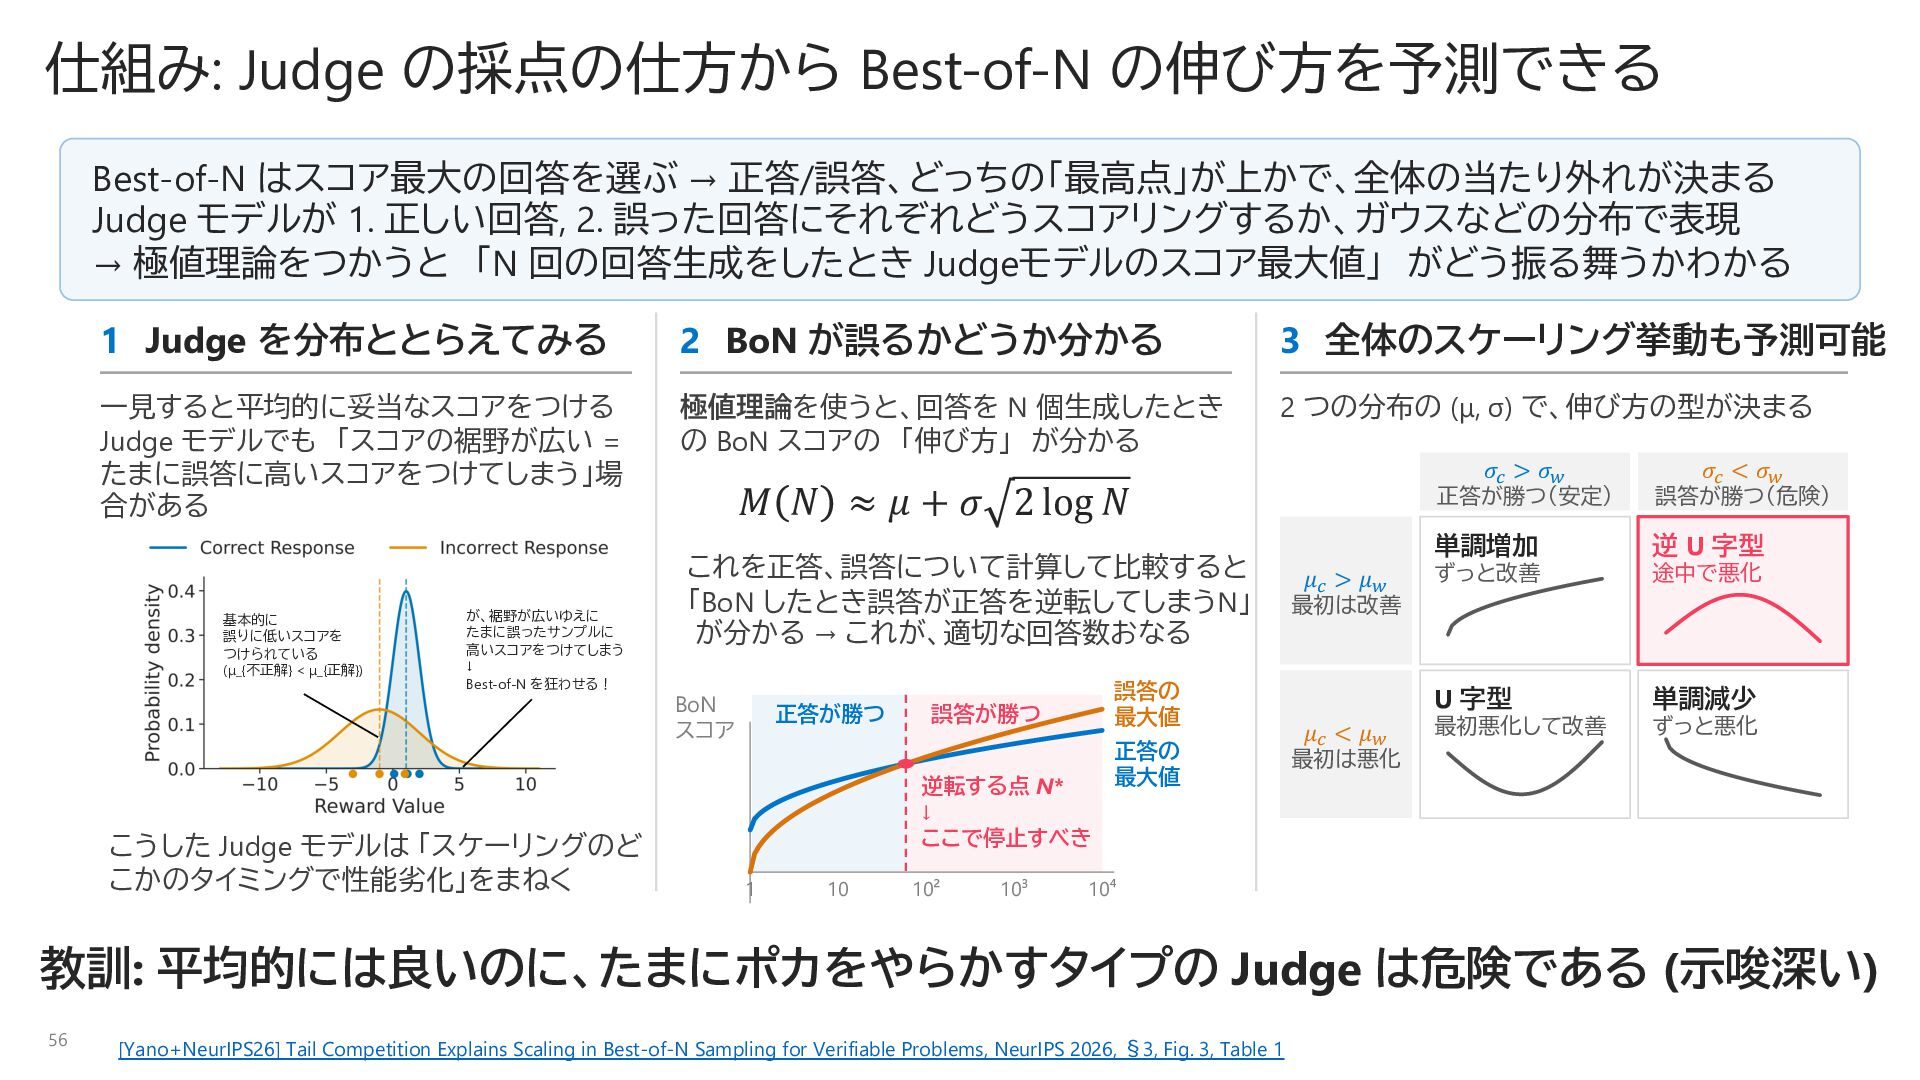
  55. 仕組み: Judge の採点の仕方から Best-of-N の伸び方を予測できる Best-of-N はスコア最大の回答を選ぶ → 正答/誤答、どっちの「最高点」が上かで、全体の当たり外れが決まる Judge

    モデルが 1. 正しい回答, 2. 誤った回答にそれぞれどうスコアリングするか、ガウスなどの分布で表現 → 極値理論をつかうと 「N 回の回答生成をしたとき Judgeモデルのスコア最大値」 がどう振る舞うかわかる 1 Judge を分布ととらえてみる 2 BoN が誤るかどうか分かる 3 全体のスケーリング挙動も予測可能 一見すると平均的に妥当なスコアをつける Judge モデルでも 「スコアの裾野が広い = たまに誤答に高いスコアをつけてしまう」場 合がある 極値理論を使うと、回答を N 個生成したとき の BoN スコアの 「伸び方」 が分かる 2 つの分布の (μ, σ) で、伸び方の型が決まる 基本的に 誤りに低いスコアを つけられている (μ_{不正解} < μ_{正解}) が、裾野が広いゆえに たまに誤ったサンプルに 高いスコアをつけてしまう ↓ Best-of-N を狂わせる! こうした Judge モデルは 「スケーリングのど こかのタイミングで性能劣化」をまねく 𝜎+ > 𝜎, 𝑀 𝑁 ≈ 𝜇 + 𝜎 2 log 𝑁 これを正答、誤答について計算して比較すると 「BoN したとき誤答が正答を逆転してしまうN」 が分かる → これが、適切な回答数おなる BoN スコア 正答が勝つ 誤答の 最大値 誤答が勝つ 逆転する点 N* ↓ ここで停止すべき 1 10 10² 10³ 正答の 最大値 𝜇+ > 𝜇, 𝜎+ < 𝜎, 正答が勝つ(安定) 誤答が勝つ(危険) 単調増加 逆 U 字型 ずっと改善 途中で悪化 U 字型 単調減少 最初悪化して改善 ずっと悪化 最初は改善 𝜇+ < 𝜇, 最初は悪化 10⁴ 教訓: 平均的には良いのに、たまにポカをやらかすタイプの Judge は危険である (示唆深い) 56 [Yano+NeurIPS26] Tail Competition Explains Scaling in Best-of-N Sampling for Verifiable Problems, NeurIPS 2026, §3, Fig. 3, Table 1
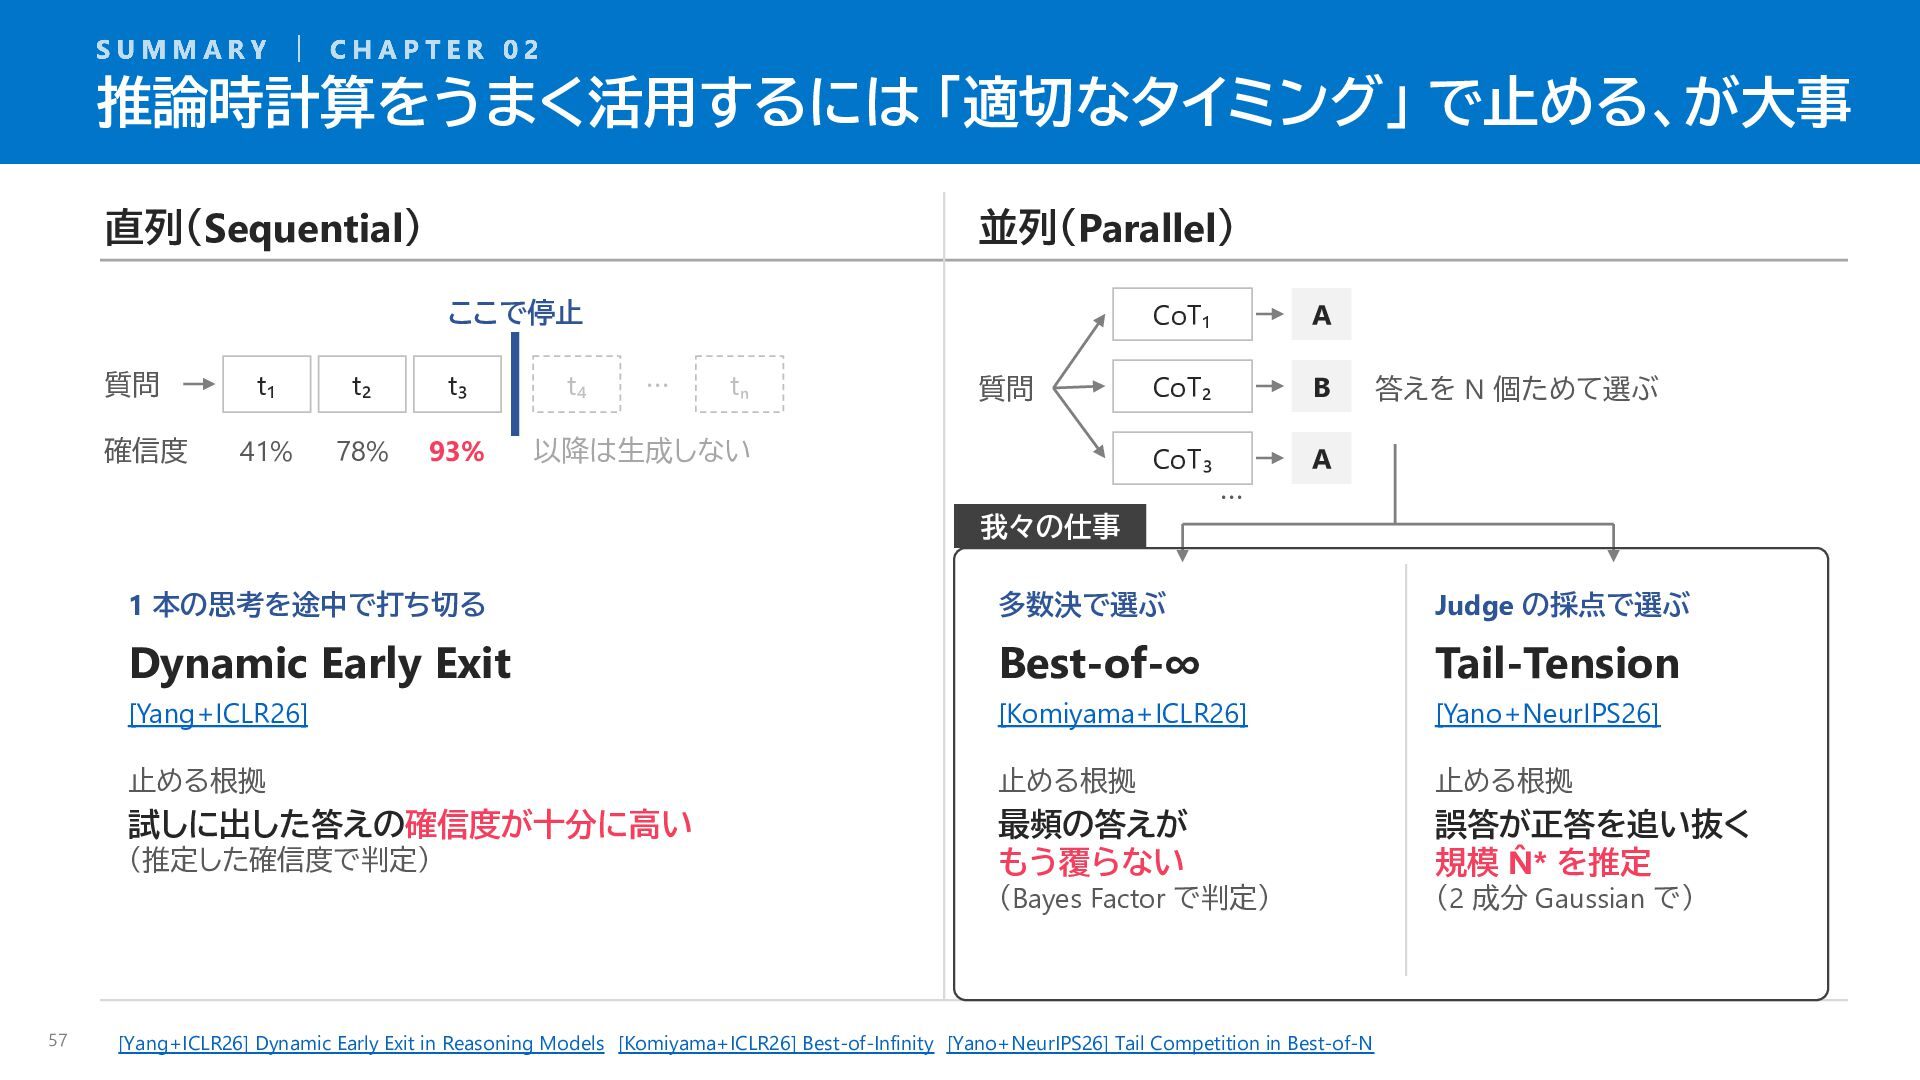
  56. 推論時計算をうまく活用するには 「適切なタイミング」 で止める、が大事 直列(Sequential) 並列(Parallel) ここで停止 質問 t₁ t₂ t₃

    確信度 41% 78% 93% t₄ ⋯ tₙ 質問 以降は生成しない CoT₁ A CoT₂ B CoT₃ A 答えを N 個ためて選ぶ ⋯ 我々の仕事 1 本の思考を途中で打ち切る 多数決で選ぶ Judge の採点で選ぶ Dynamic Early Exit Best-of-∞ Tail-Tension [Yang+ICLR26] [Komiyama+ICLR26] [Yano+NeurIPS26] 止める根拠 止める根拠 止める根拠 試しに出した答えの確信度が十分に高い 最頻の答えが もう覆らない 誤答が正答を追い抜く 規模 N̂* を推定 (推定した確信度で判定) (Bayes Factor で判定) 57 [Yang+ICLR26] Dynamic Early Exit in Reasoning Models [Komiyama+ICLR26] Best-of-Infinity [Yano+NeurIPS26] Tail Competition in Best-of-N (2 成分 Gaussian で)
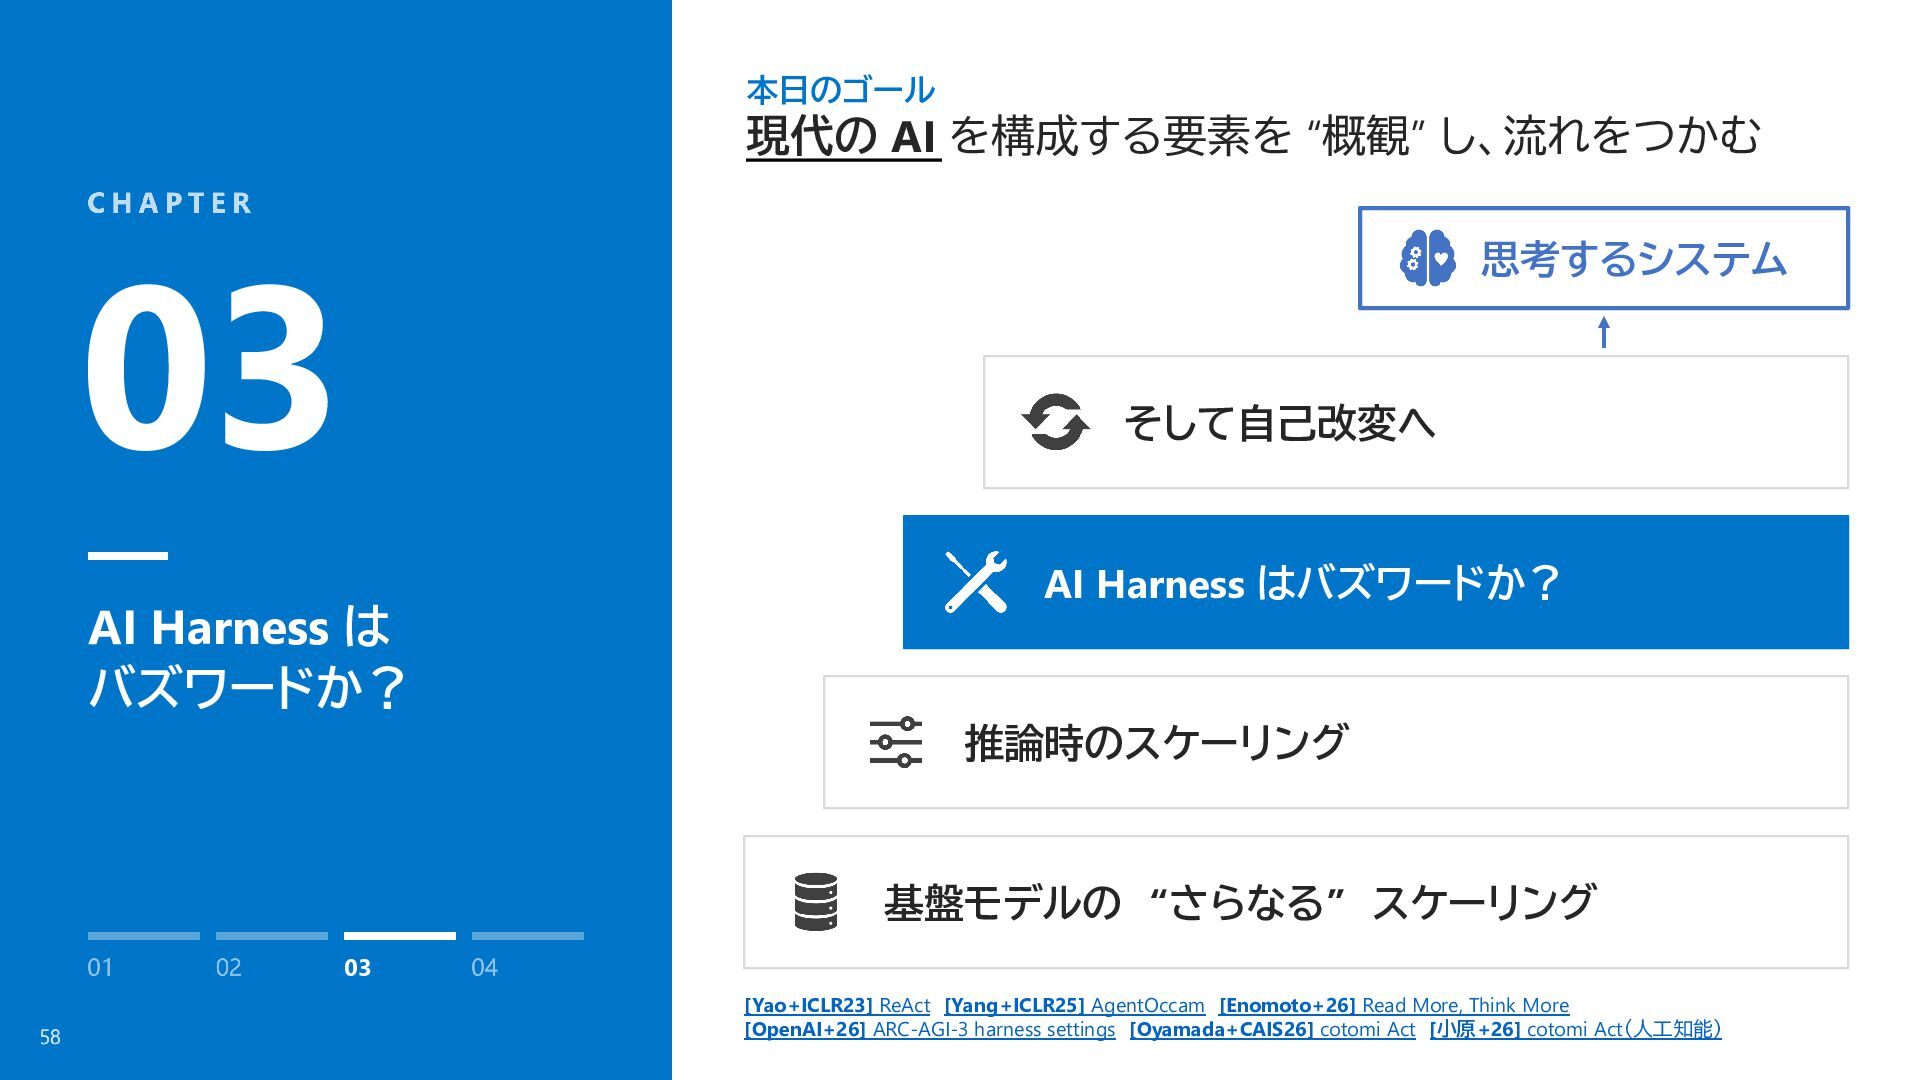
  57. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 03 AI Harness は

    バズワードか? 思考するシステム そして自己改変へ AI Harness はバズワードか? 推論時のスケーリング 基盤モデルの “さらなる” スケーリング 03 58 [Yao+ICLR23] ReAct [Yang+ICLR25] AgentOccam [Enomoto+26] Read More, Think More [OpenAI+26] ARC-AGI-3 harness settings [Oyamada+CAIS26] cotomi Act [小原+26] cotomi Act(人工知能)
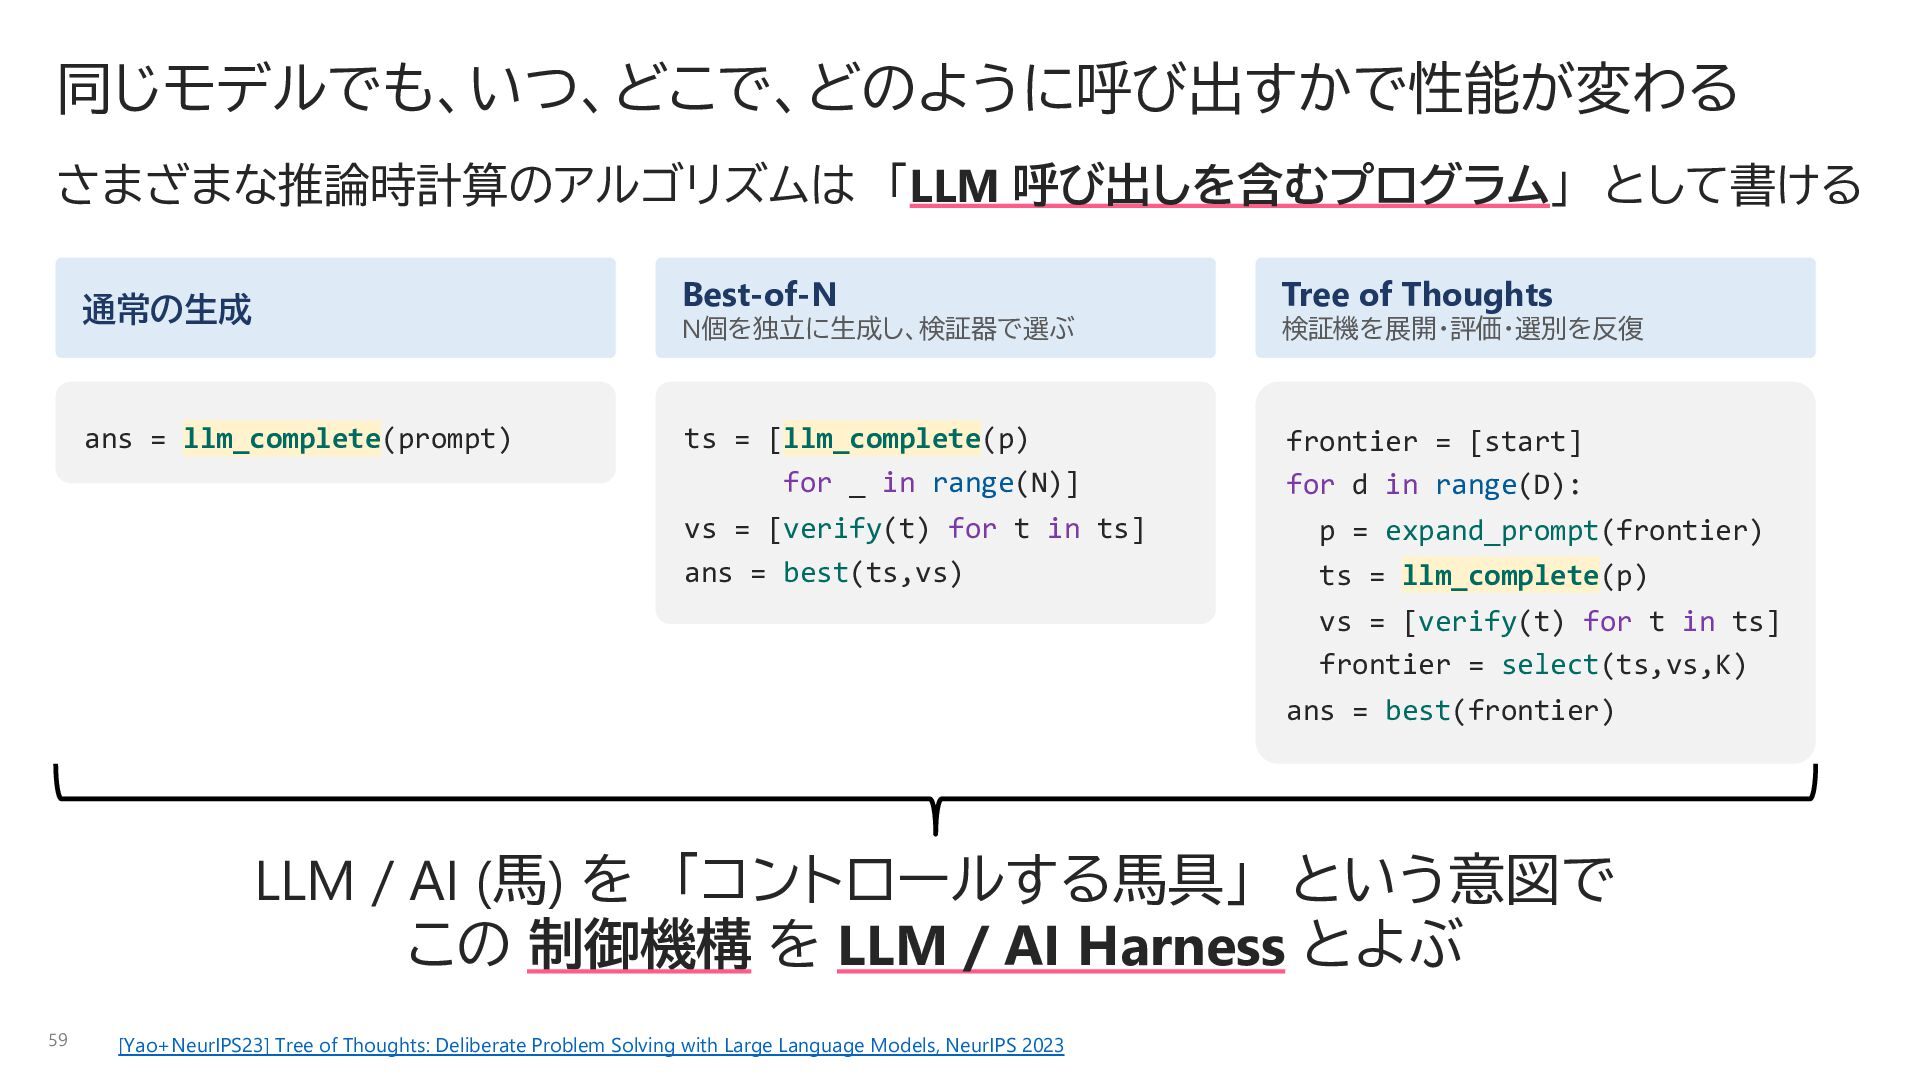
  58. 同じモデルでも、いつ、どこで、どのように呼び出すかで性能が変わる さまざまな推論時計算のアルゴリズムは 「LLM 呼び出しを含むプログラム」 として書ける Best-of-N 通常の生成 N個を独立に生成し、検証器で選ぶ ans =

    llm_complete(prompt) ts = [llm_complete(p) for _ in range(N)] vs = [verify(t) for t in ts] ans = best(ts,vs) Tree of Thoughts 検証機を展開・評価・選別を反復 frontier = [start] for d in range(D): p = expand_prompt(frontier) ts = llm_complete(p) vs = [verify(t) for t in ts] frontier = select(ts,vs,K) ans = best(frontier) LLM / AI (馬) を 「コントロールする馬具」 という意図で この 制御機構 を LLM / AI Harness とよぶ 59 [Yao+NeurIPS23] Tree of Thoughts: Deliberate Problem Solving with Large Language Models, NeurIPS 2023
  59. ReAct [Yao+ICLR23]: LLM を “ツール” 呼び出しによって外界に繋ぐ system 指示 履歴 行動

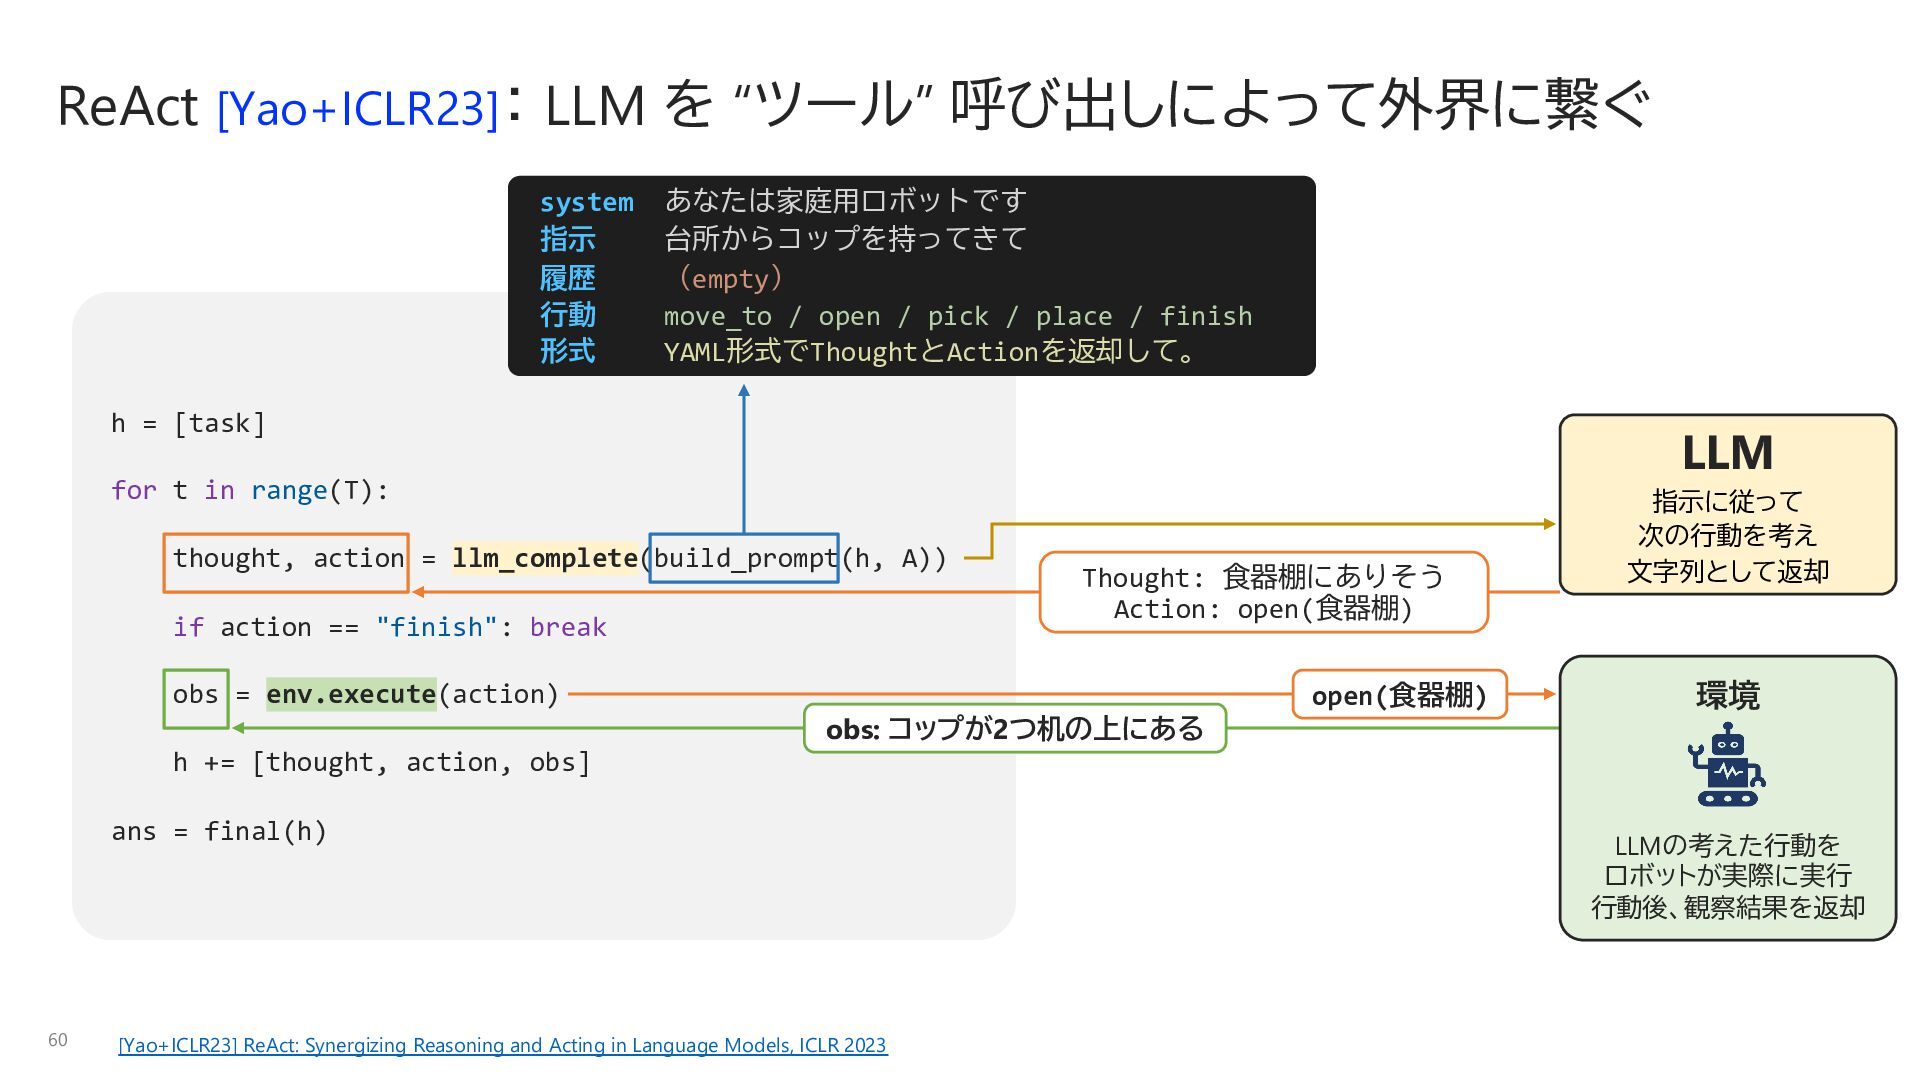
    形式 あなたは家庭用ロボットです 台所からコップを持ってきて (empty) move_to / open / pick / place / finish YAML形式でThoughtとActionを返却して。 h = [task] LLM for t in range(T): thought, action = llm_complete(build_prompt(h, A)) if action == "finish": break obs = env.execute(action) Thought: 食器棚にありそう Action: open(食器棚) obs: コップが2つ机の上にある open(食器棚) 指示に従って 次の行動を考え 文字列として返却 環境 h += [thought, action, obs] ans = final(h) 60 [Yao+ICLR23] ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023 LLMの考えた行動を ロボットが実際に実行 行動後、観察結果を返却
  60. 現代の AI (Agent) の多くは、本質的には ReAct にもとづいている AI Harness (ReAct++) $

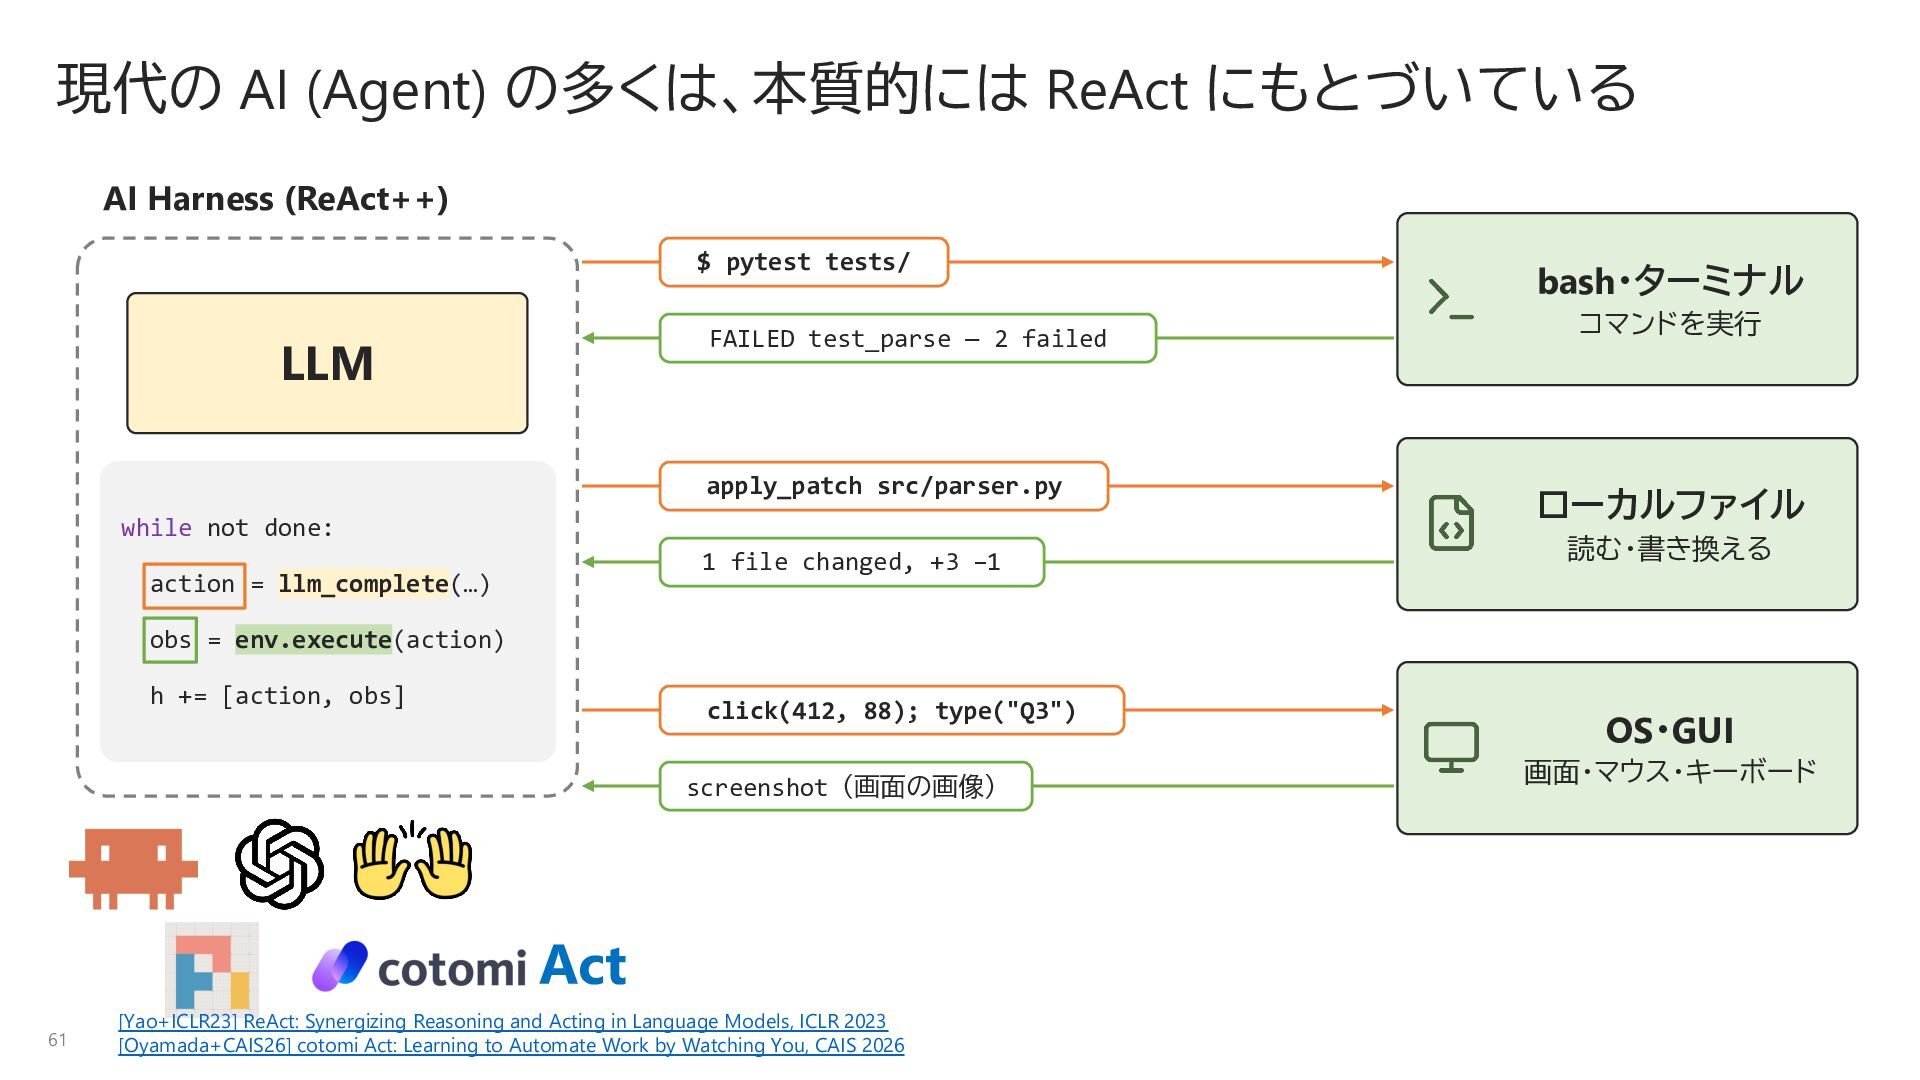
    pytest tests/ FAILED test_parse — 2 failed LLM apply_patch src/parser.py while not done: 1 file changed, +3 −1 action = llm_complete(…) bash・ターミナル コマンドを実行 ローカルファイル 読む・書き換える obs = env.execute(action) h += [action, obs] click(412, 88); type("Q3") screenshot(画面の画像) Act 61 [Yao+ICLR23] ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023 [Oyamada+CAIS26] cotomi Act: Learning to Automate Work by Watching You, CAIS 2026 OS・GUI 画面・マウス・キーボード
  61. “本質” は。 Parallel Execution モデル呼び出し Model Fallback Streaming Planning /

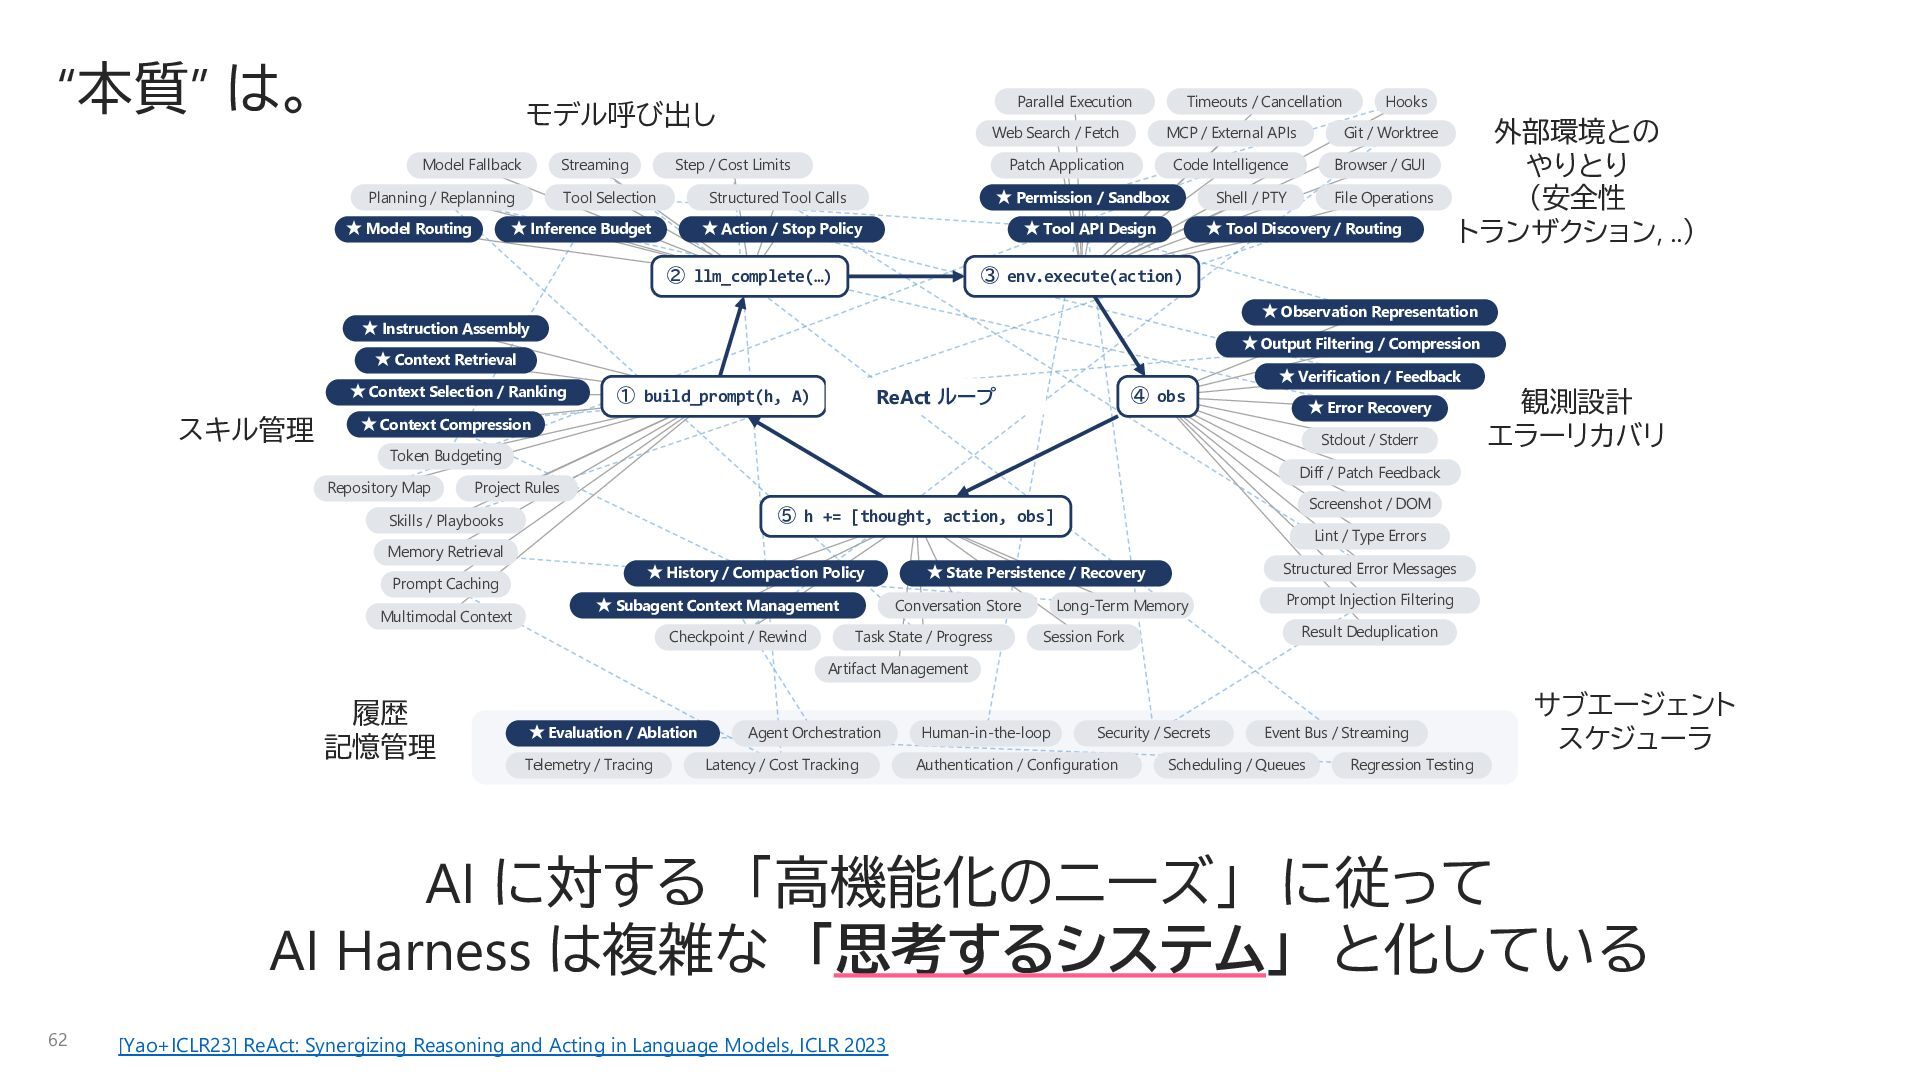
    Replanning ★ Model Routing ★ Inference Budget MCP / External APIs Git / Worktree Patch Application Code Intelligence Browser / GUI Shell / PTY File Operations Structured Tool Calls ★ Permission / Sandbox ★ Action / Stop Policy ★ Tool API Design ② llm_complete(…) ★ Tool Discovery / Routing ★ Observation Representation ★ Output Filtering / Compression ★ Context Retrieval スキル管理 ★ Verification / Feedback ReAct ループ ① build_prompt(h, A) ④ obs ★ Error Recovery ★ Context Compression Stdout / Stderr Token Budgeting Repository Map Multimodal Context Screenshot / DOM ⑤ h += [thought, action, obs] Skills / Playbooks Prompt Caching 観測設計 エラーリカバリ Diff / Patch Feedback Project Rules Memory Retrieval 外部環境との やりとり (安全性 トランザクション, ..) ③ env.execute(action) ★ Instruction Assembly ★ Context Selection / Ranking Hooks Web Search / Fetch Step / Cost Limits Tool Selection Timeouts / Cancellation ★ History / Compaction Policy ★ Subagent Context Management Checkpoint / Rewind Lint / Type Errors Structured Error Messages ★ State Persistence / Recovery Conversation Store Task State / Progress Long-Term Memory Prompt Injection Filtering Result Deduplication Session Fork Artifact Management 履歴 記憶管理 ★ Evaluation / Ablation Telemetry / Tracing Agent Orchestration Latency / Cost Tracking Human-in-the-loop Security / Secrets Authentication / Configuration Event Bus / Streaming Scheduling / Queues サブエージェント スケジューラ Regression Testing AI に対する 「高機能化のニーズ」 に従って AI Harness は複雑な 「思考するシステム」 と化している 62 [Yao+ICLR23] ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023
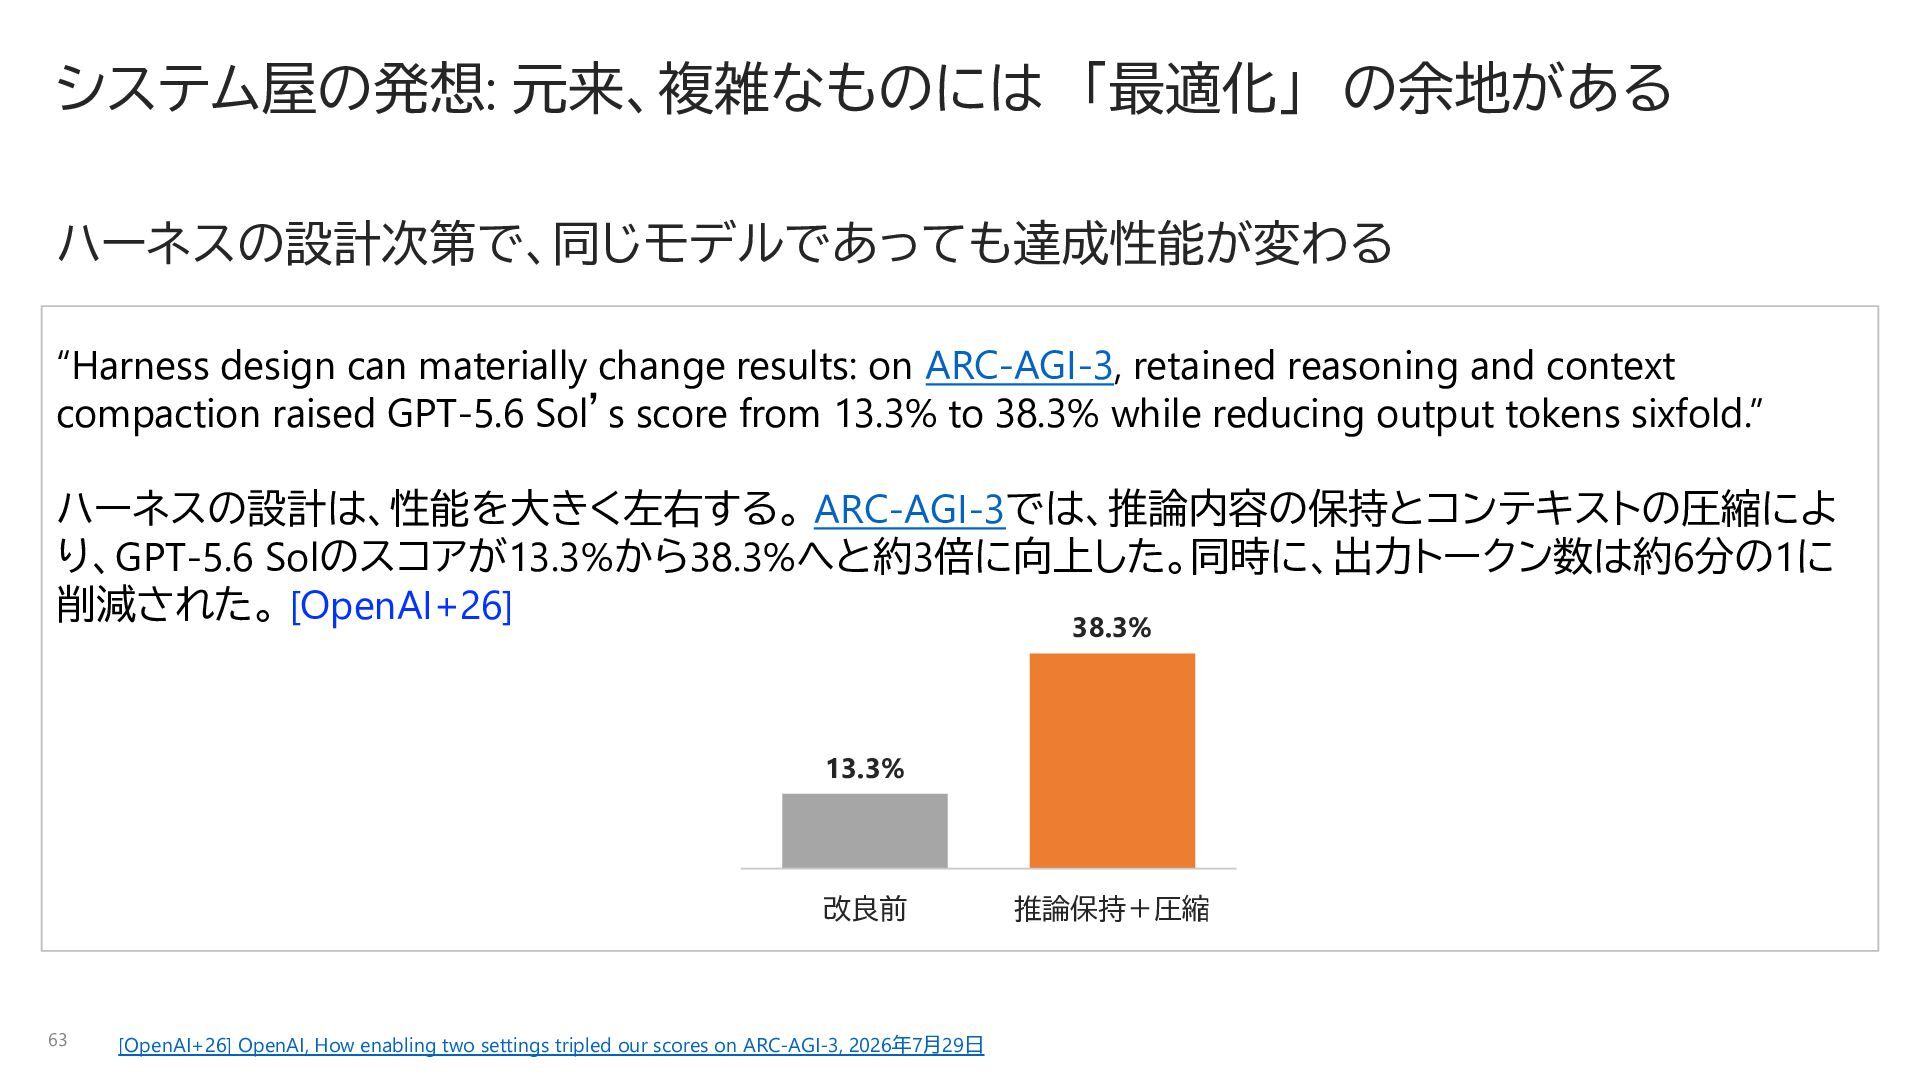
  62. システム屋の発想: 元来、複雑なものには 「最適化」 の余地がある ハーネスの設計次第で、同じモデルであっても達成性能が変わる “Harness design can materially change

    results: on ARC-AGI-3, retained reasoning and context compaction raised GPT-5.6 Sol’s score from 13.3% to 38.3% while reducing output tokens sixfold.” ハーネスの設計は、性能を大きく左右する。 ARC-AGI-3では、推論内容の保持とコンテキストの圧縮によ り、GPT-5.6 Solのスコアが13.3%から38.3%へと約3倍に向上した。同時に、出力トークン数は約6分の1に 削減された。 [OpenAI+26] 38.3% 13.3% 改良前 63 [OpenAI+26] OpenAI, How enabling two settings tripled our scores on ARC-AGI-3, 2026年7月29日 推論保持+圧縮
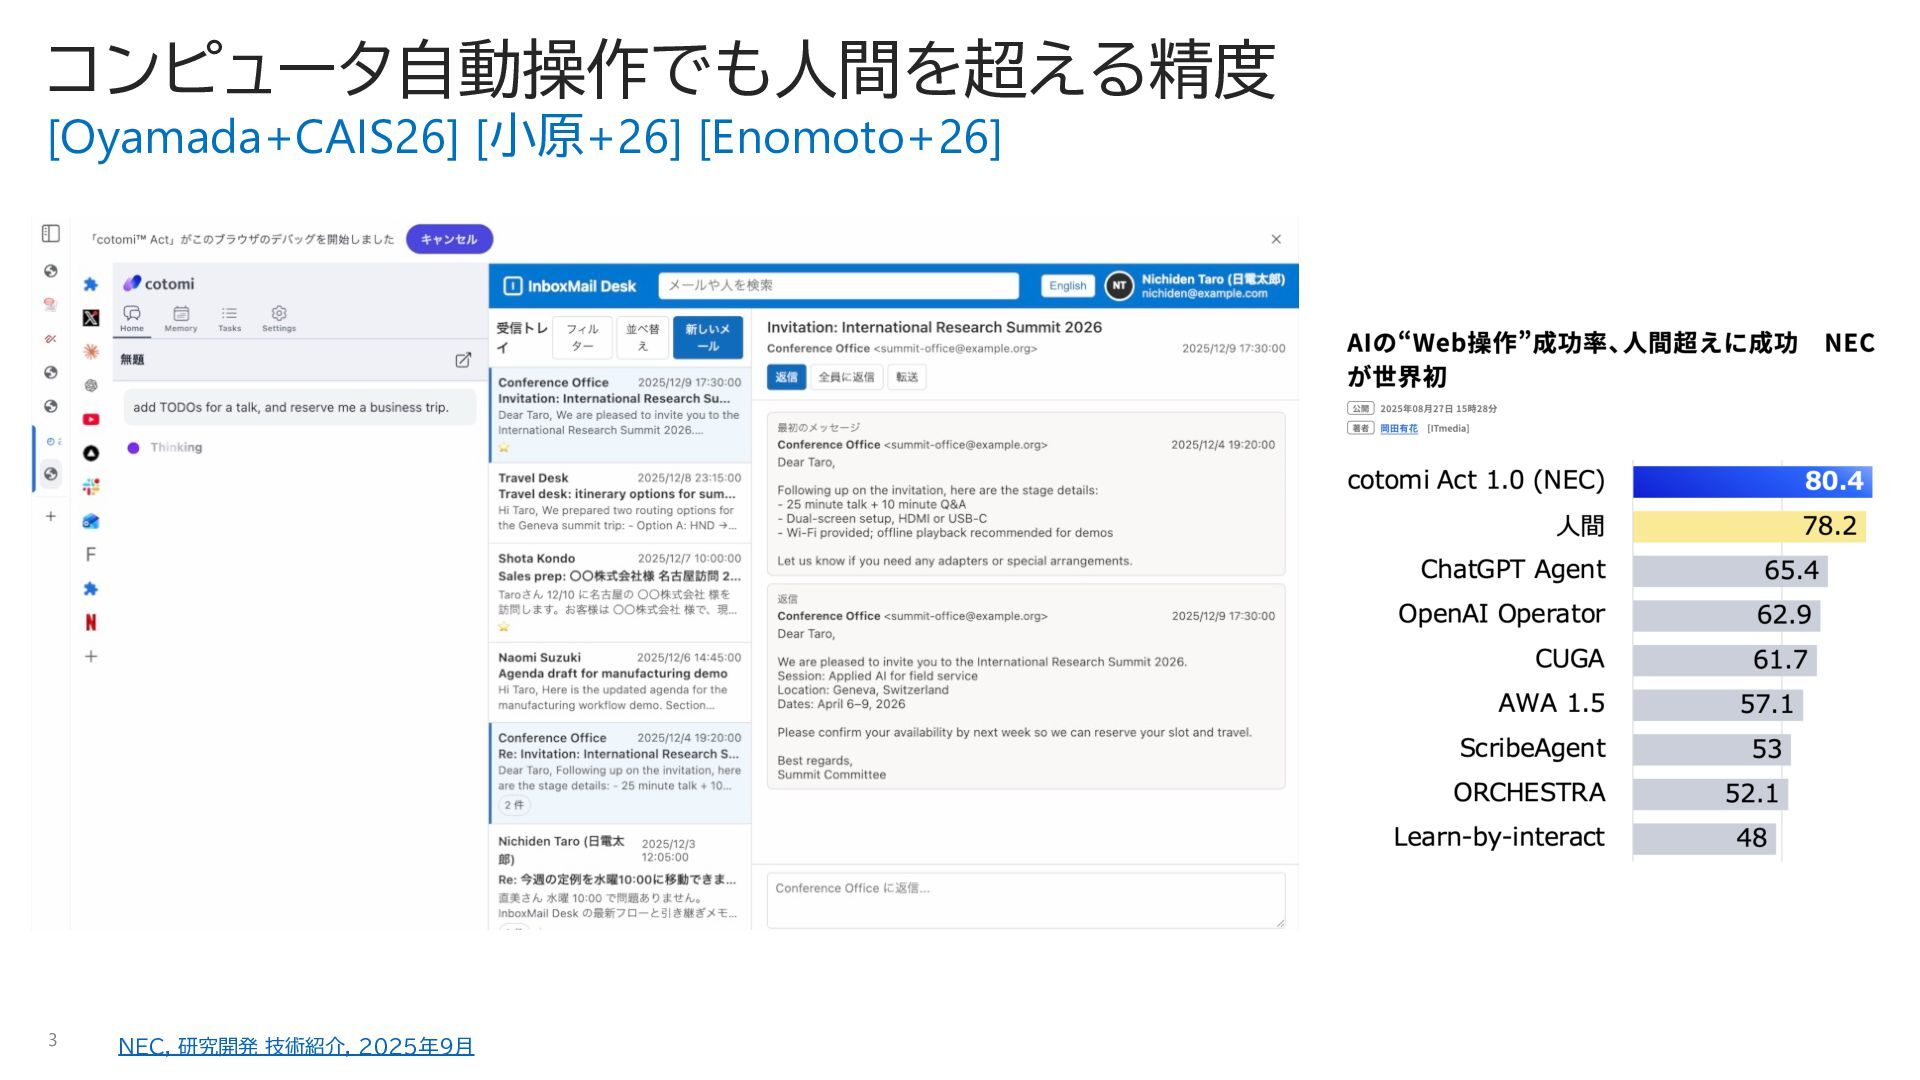
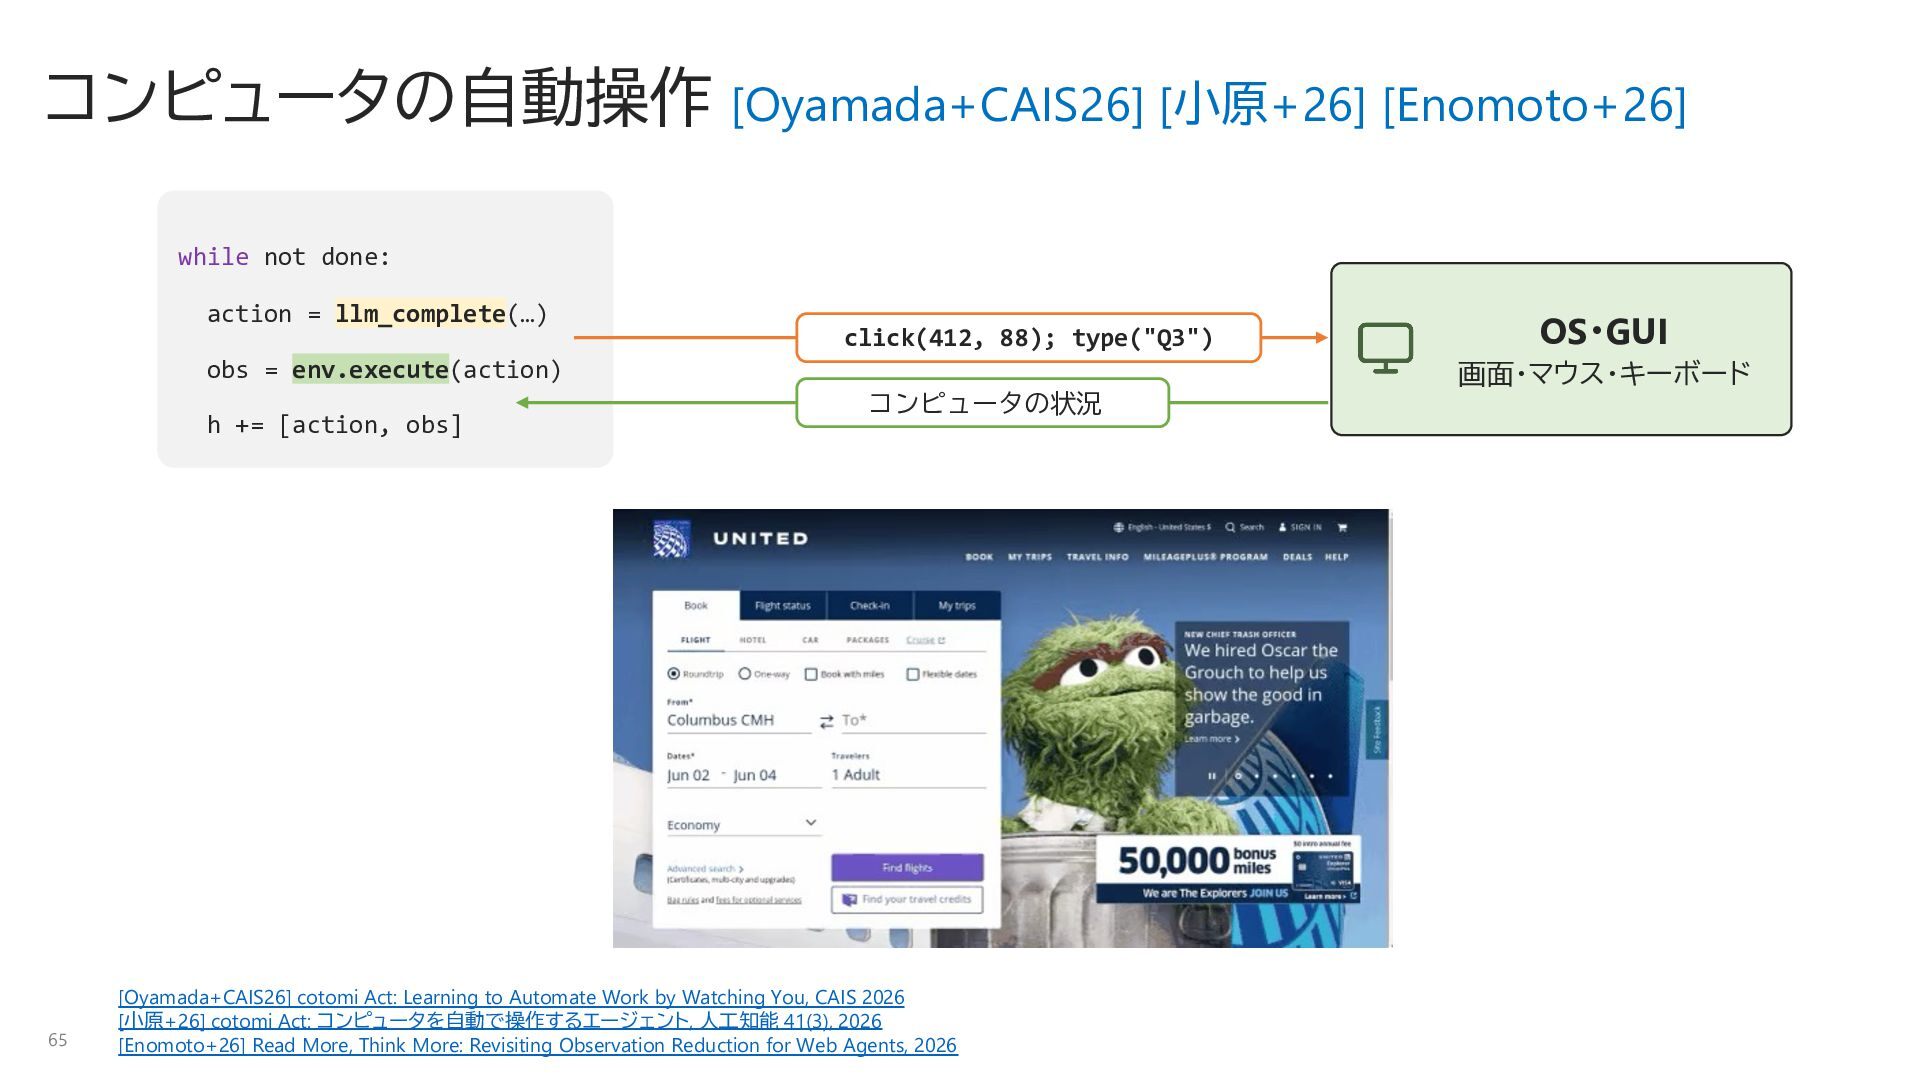
  63. コンピュータの自動操作 [Oyamada+CAIS26] [小原+26] [Enomoto+26] while not done: action = llm_complete(…)

    click(412, 88); type("Q3") obs = env.execute(action) h += [action, obs] 65 OS・GUI 画面・マウス・キーボード コンピュータの状況 [Oyamada+CAIS26] cotomi Act: Learning to Automate Work by Watching You, CAIS 2026 [小原+26] cotomi Act: コンピュータを自動で操作するエージェント, 人工知能 41(3), 2026 [Enomoto+26] Read More, Think More: Revisiting Observation Reduction for Web Agents, 2026
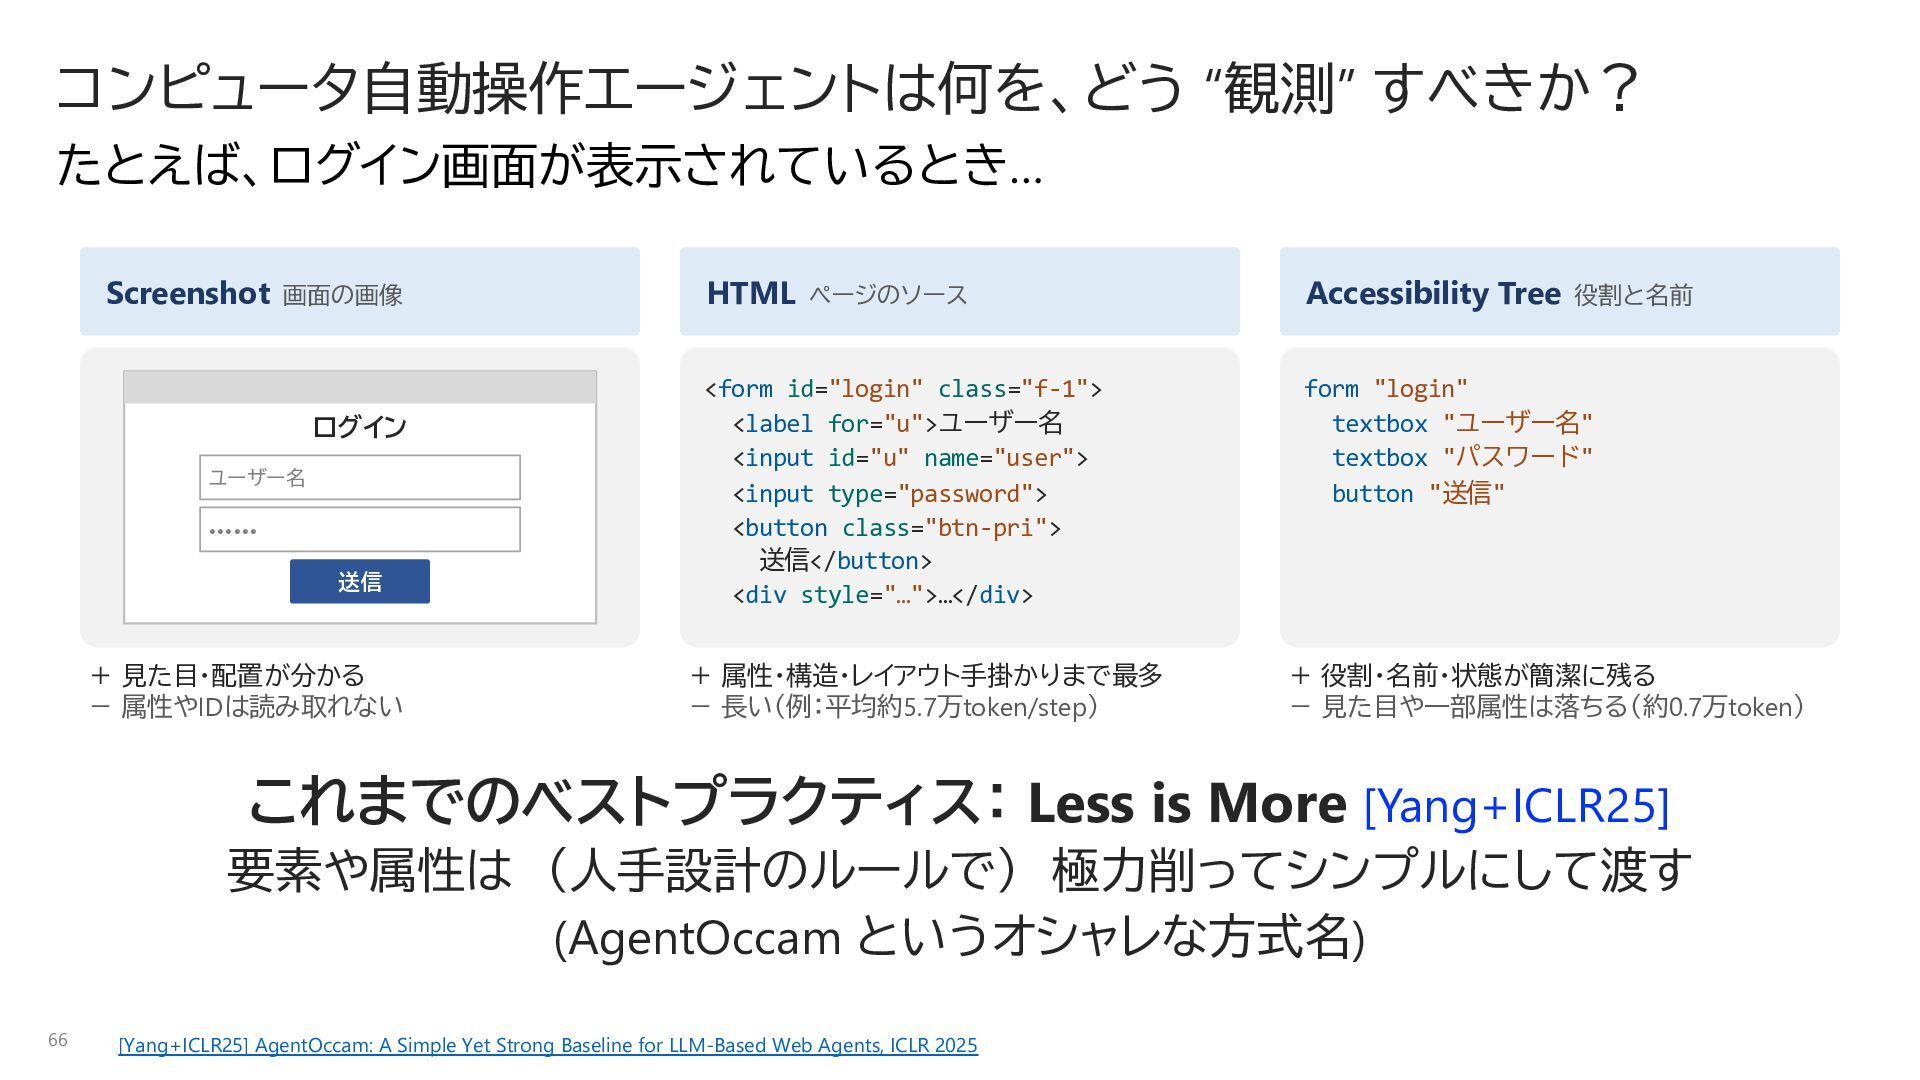
  64. コンピュータ自動操作エージェントは何を、どう “観測” すべきか? たとえば、ログイン画面が表示されているとき… Screenshot 画面の画像 ログイン ユーザー名 •••••• 送信

    + 見た目・配置が分かる - 属性やIDは読み取れない HTML ページのソース Accessibility Tree 役割と名前 <form id="login" class="f-1"> <label for="u">ユーザー名 <input id="u" name="user"> <input type="password"> <button class="btn-pri"> 送信</button> <div style="…">…</div> form "login" textbox "ユーザー名" textbox "パスワード" button "送信" + 属性・構造・レイアウト手掛かりまで最多 - 長い(例:平均約5.7万token/step) + 役割・名前・状態が簡潔に残る - 見た目や一部属性は落ちる(約0.7万token) これまでのベストプラクティス: Less is More [Yang+ICLR25] 要素や属性は (人手設計のルールで) 極力削ってシンプルにして渡す (AgentOccam というオシャレな方式名) 66 [Yang+ICLR25] AgentOccam: A Simple Yet Strong Baseline for LLM-Based Web Agents, ICLR 2025
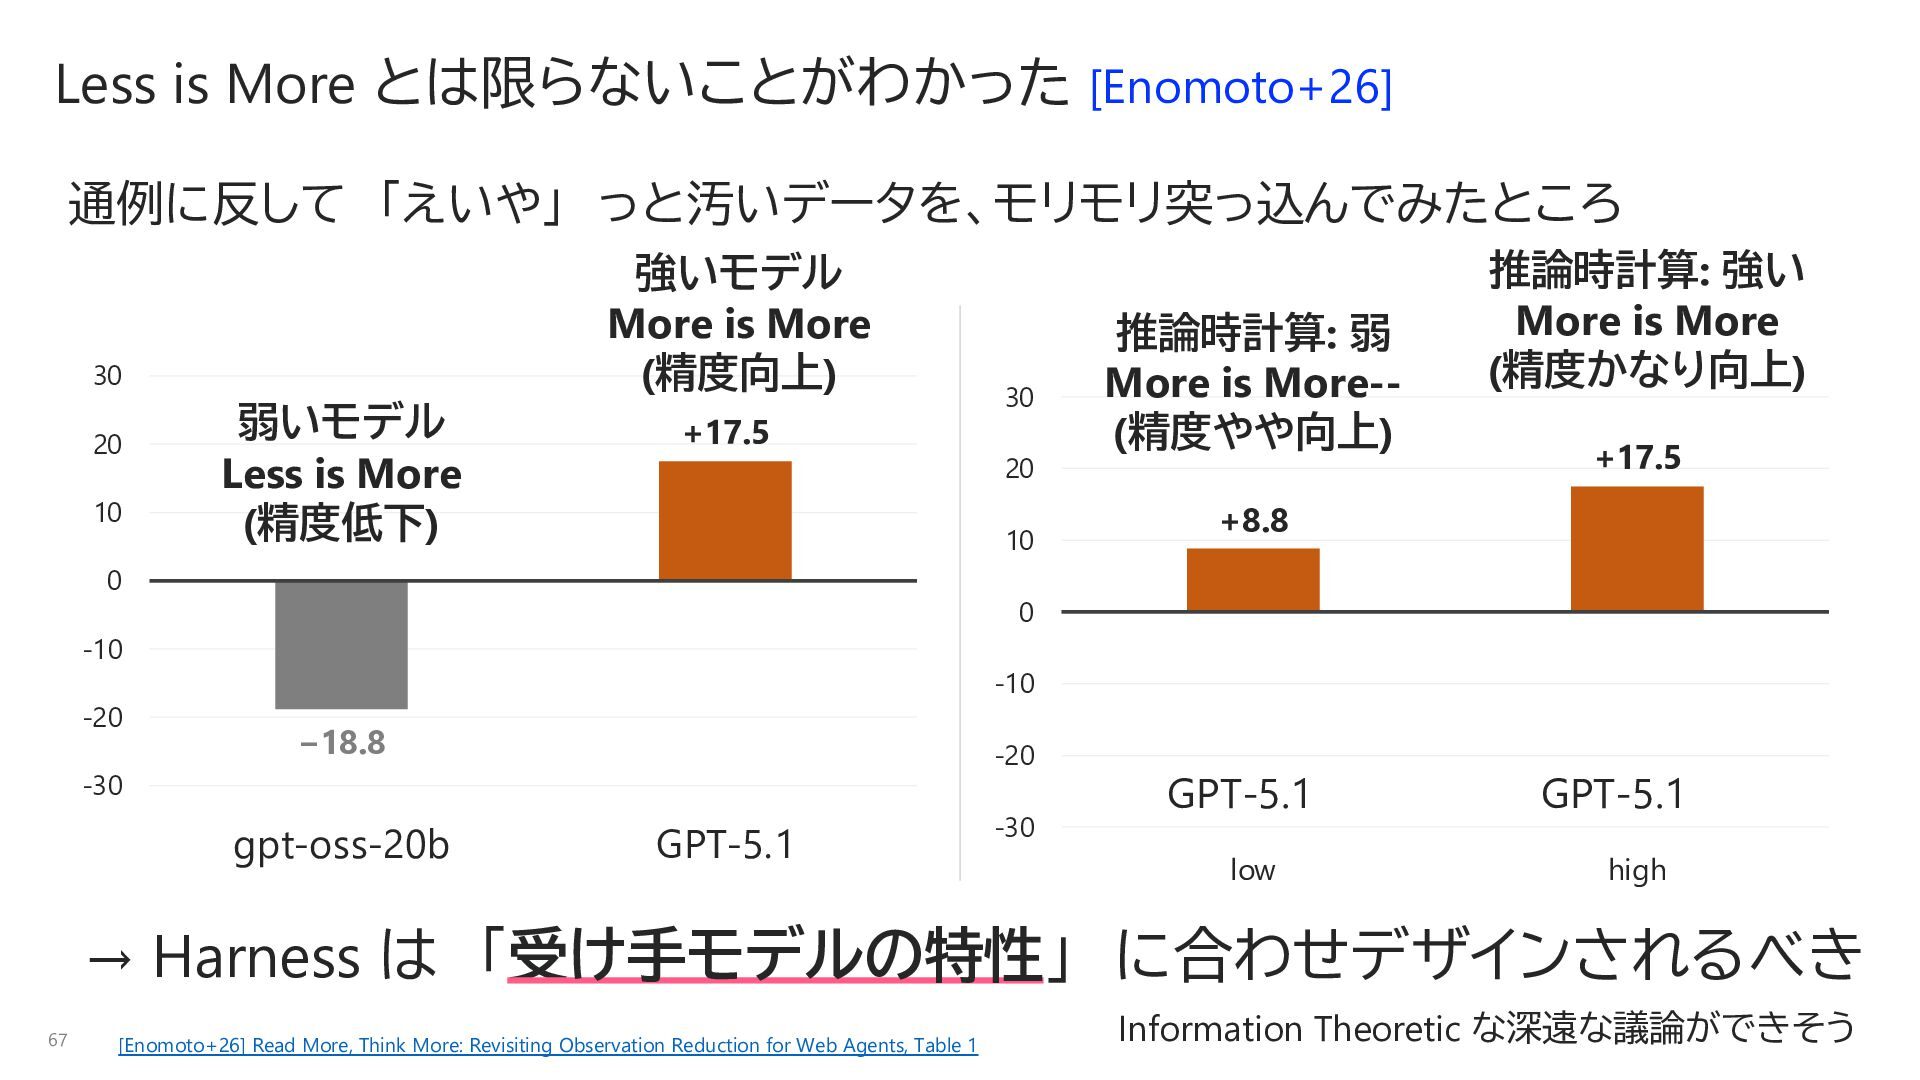
  65. Less is More とは限らないことがわかった [Enomoto+26] 通例に反して 「えいや」 っと汚いデータを、モリモリ突っ込んでみたところ 強いモデル More

    is More (精度向上) 30 20 10 弱いモデル Less is More (精度低下) +17.5 20 10 0 +17.5 +8.8 0 -10 -20 30 推論時計算: 弱 More is More-(精度やや向上) 推論時計算: 強い More is More (精度かなり向上) -10 −18.8 -20 -30 gpt-oss-20b GPT-5.1 -30 GPT-5.1 low GPT-5.1 high → Harness は 「受け手モデルの特性」 に合わせデザインされるべき 67 [Enomoto+26] Read More, Think More: Revisiting Observation Reduction for Web Agents, Table 1 Information Theoretic な深遠な議論ができそう
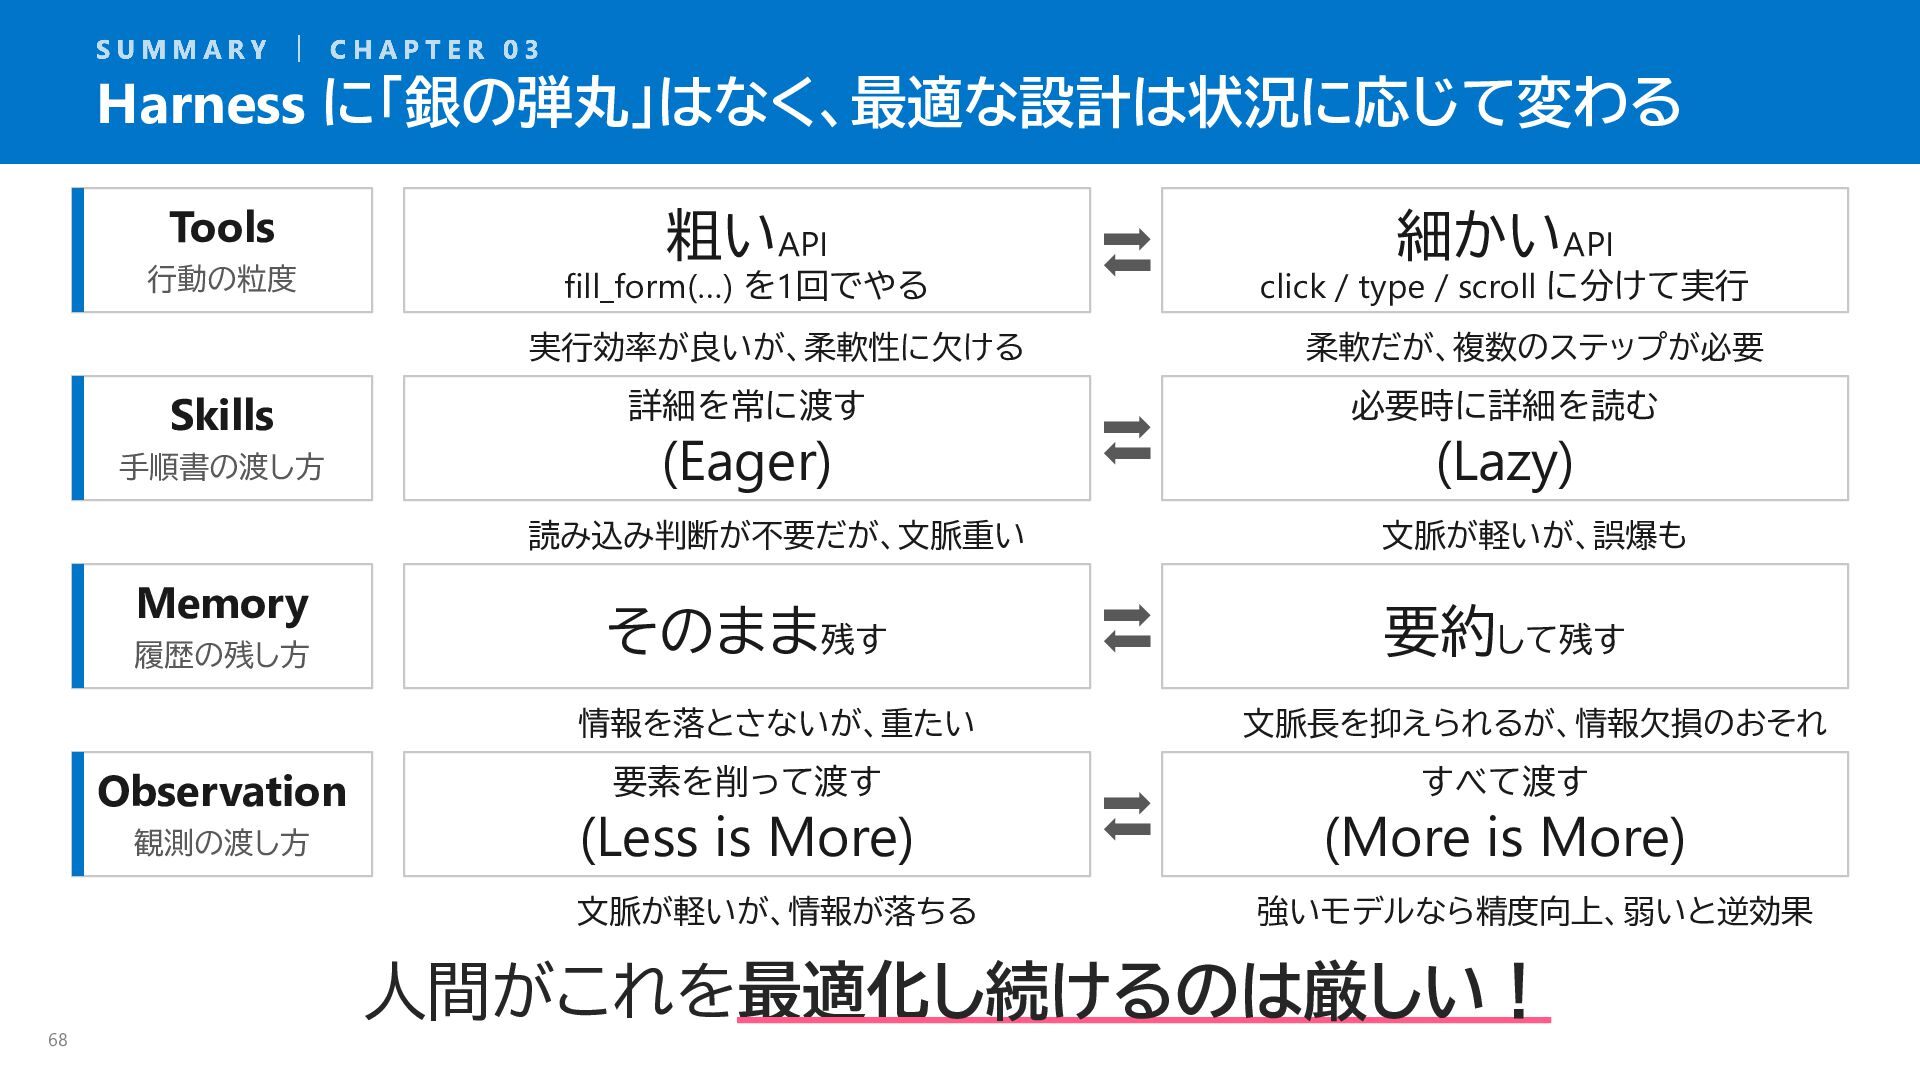
  66. Harness に「銀の弾丸」はなく、最適な設計は状況に応じて変わる Tools 行動の粒度 粗いAPI fill_form(…) を1回でやる 実行効率が良いが、柔軟性に欠ける Skills 手順書の渡し方

    詳細を常に渡す (Eager) 読み込み判断が不要だが、文脈重い Memory 履歴の残し方 そのまま残す 情報を落とさないが、重たい Observation 観測の渡し方 要素を削って渡す (Less is More) 文脈が軽いが、情報が落ちる 細かいAPI click / type / scroll に分けて実行 柔軟だが、複数のステップが必要 必要時に詳細を読む (Lazy) 文脈が軽いが、誤爆も 要約して残す 文脈長を抑えられるが、情報欠損のおそれ すべて渡す (More is More) 強いモデルなら精度向上、弱いと逆効果 人間がこれを最適化し続けるのは厳しい! 68
  67. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 04 思考するシステム そして自己改変へ AI

    Harness はバズワードか? そして 自己改変へ 推論時のスケーリング 04 69 基盤モデルの “さらなる” スケーリング
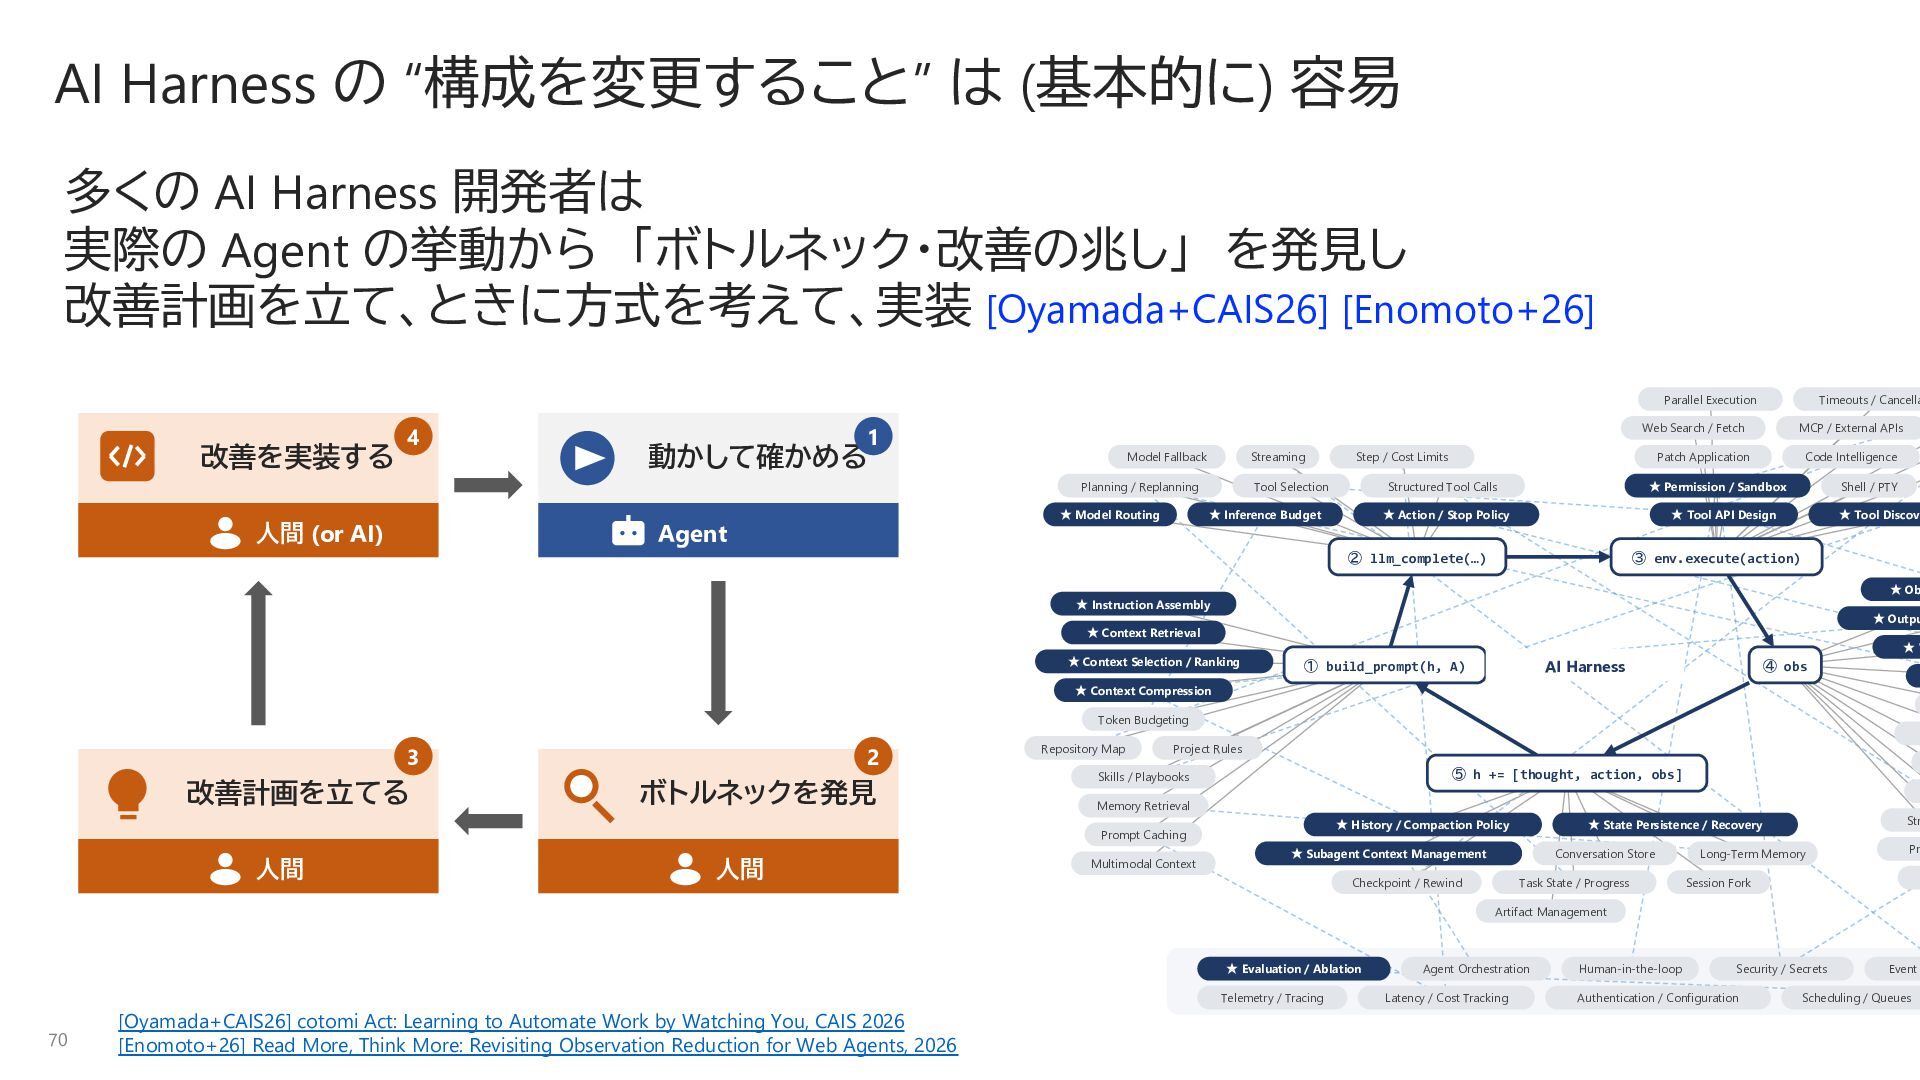
  68. AI Harness の “構成を変更すること” は (基本的に) 容易 多くの AI Harness

    開発者は 実際の Agent の挙動から 「ボトルネック・改善の兆し」 を発見し 改善計画を立て、ときに方式を考えて、実装 [Oyamada+CAIS26] [Enomoto+26] Parallel Execution 改善を実装する 4 1 動かして確かめる Model Fallback Streaming Planning / Replanning 人間 (or AI) ★ Model Routing Agent Web Search / Fetch MCP / External APIs Patch Application Code Intelligence Step / Cost Limits Tool Selection ★ Inference Budget Timeouts / Cancella Structured Tool Calls ★ Permission / Sandbox ★ Action / Stop Policy ★ Tool API Design ② llm_complete(…) Shell / PTY ★ Tool Discove ③ env.execute(action) ★ Ob ★ Instruction Assembly ★ Outpu ★ Context Retrieval ★ Context Selection / Ranking ★V AI Harness ① build_prompt(h, A) ④ obs ★ Context Compression Token Budgeting 3 2 改善計画を立てる ボトルネックを発見 Repository Map Project Rules ⑤ h += [thought, action, obs] Skills / Playbooks Memory Retrieval ★ History / Compaction Policy Prompt Caching 人間 人間 Multimodal Context ★ Subagent Context Management Conversation Store Checkpoint / Rewind Str ★ State Persistence / Recovery Task State / Progress Long-Term Memory Pr Session Fork Artifact Management ★ Evaluation / Ablation Telemetry / Tracing 70 [Oyamada+CAIS26] cotomi Act: Learning to Automate Work by Watching You, CAIS 2026 [Enomoto+26] Read More, Think More: Revisiting Observation Reduction for Web Agents, 2026 Agent Orchestration Latency / Cost Tracking Human-in-the-loop Security / Secrets Authentication / Configuration Event Scheduling / Queues
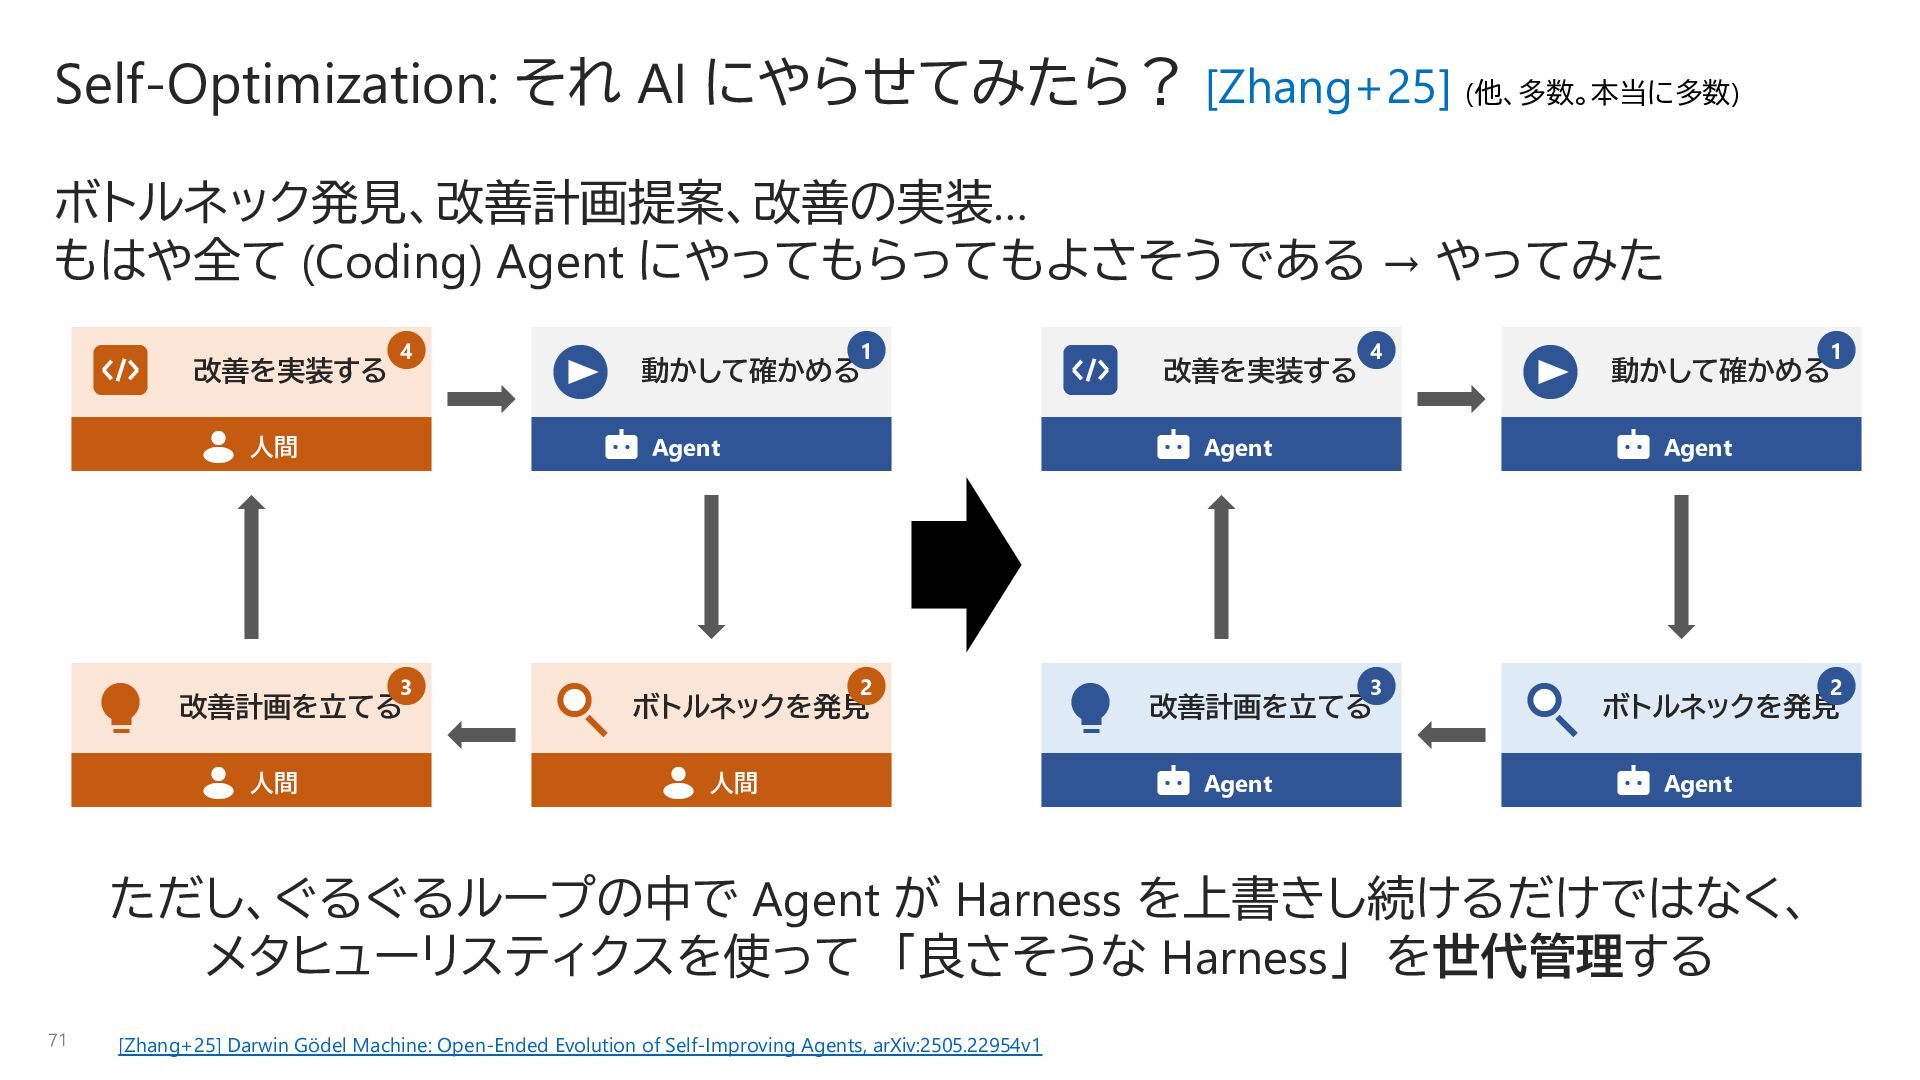
  69. Self-Optimization: それ AI にやらせてみたら? [Zhang+25] (他、多数。本当に多数) ボトルネック発見、改善計画提案、改善の実装… もはや全て (Coding) Agent

    にやってもらってもよさそうである → やってみた 改善を実装する 4 Agent 人間 3 改善計画を立てる 人間 1 動かして確かめる 改善を実装する 4 Agent 2 ボトルネックを発見 人間 Agent 3 改善計画を立てる Agent 1 動かして確かめる 2 ボトルネックを発見 Agent ただし、ぐるぐるループの中で Agent が Harness を上書きし続けるだけではなく、 メタヒューリスティクスを使って 「良さそうな Harness」 を世代管理する 71 [Zhang+25] Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, arXiv:2505.22954v1
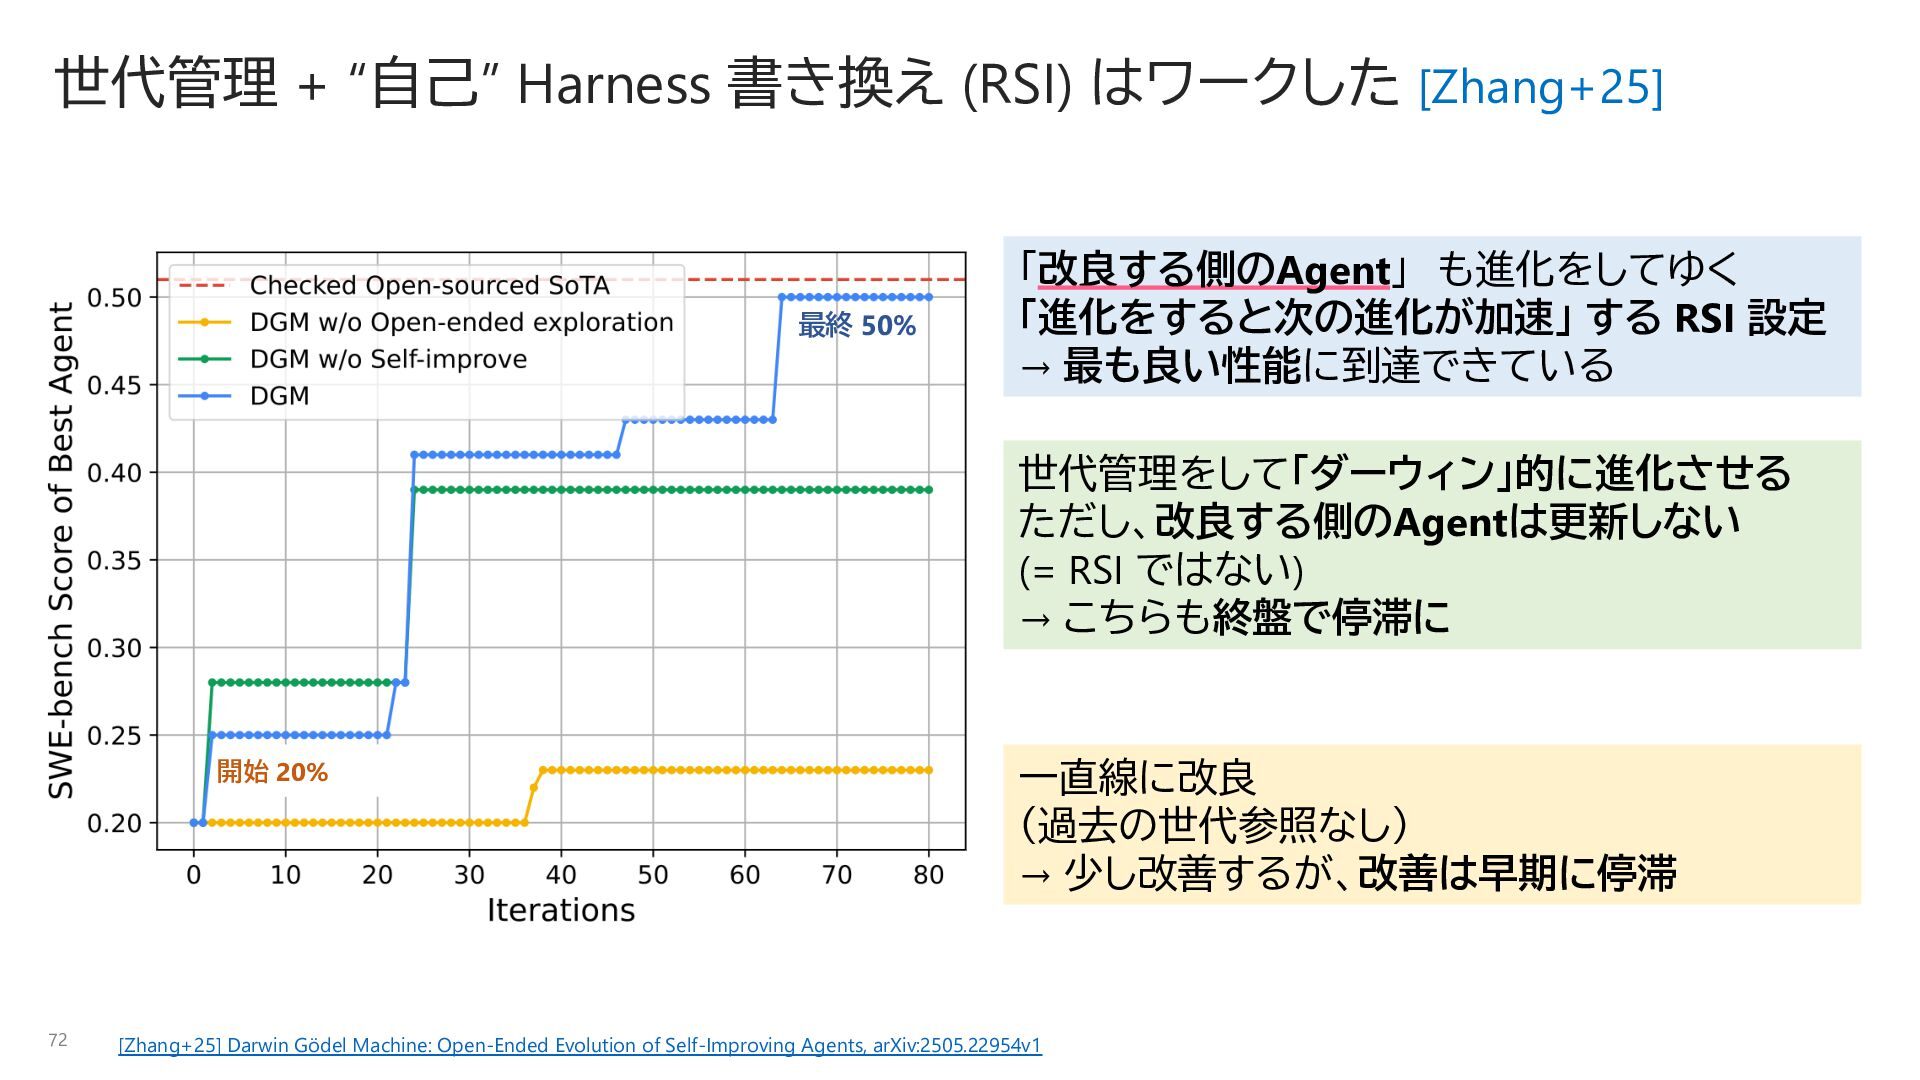
  70. 世代管理 + “自己” Harness 書き換え (RSI) はワークした [Zhang+25] 最終 50%

    「改良する側のAgent」 も進化をしてゆく 「進化をすると次の進化が加速」 する RSI 設定 → 最も良い性能に到達できている 世代管理をして「ダーウィン」的に進化させる ただし、改良する側のAgentは更新しない (= RSI ではない) → こちらも終盤で停滞に 開始 20% 72 一直線に改良 (過去の世代参照なし) → 少し改善するが、改善は早期に停滞 [Zhang+25] Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, arXiv:2505.22954v1
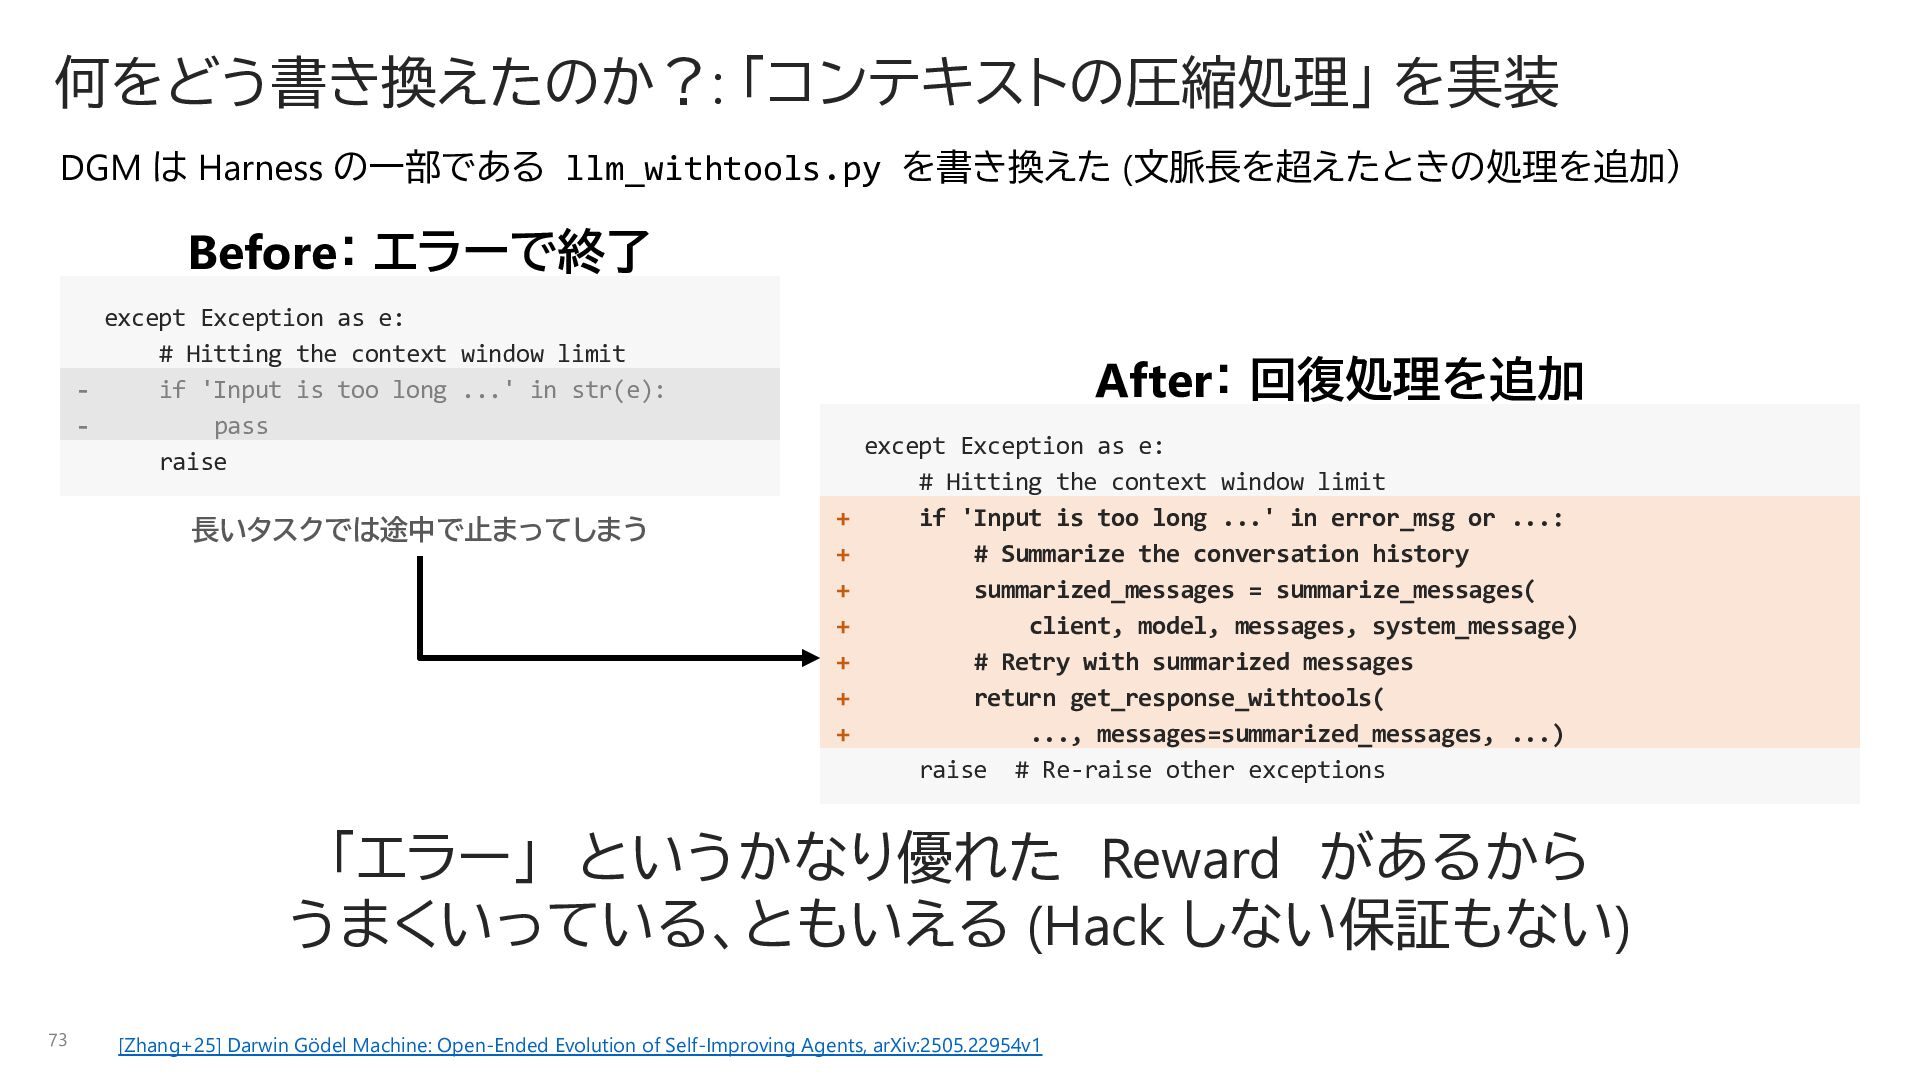
  71. 何をどう書き換えたのか?: 「コンテキストの圧縮処理」 を実装 DGM は Harness の一部である llm_withtools.py を書き換えた (文脈長を超えたときの処理を追加)

    Before: エラーで終了 except Exception as e: # Hitting the context window limit if 'Input is too long ...' in str(e): pass raise 長いタスクでは途中で止まってしまう After: 回復処理を追加 except Exception as e: # Hitting the context window limit + if 'Input is too long ...' in error_msg or ...: + # Summarize the conversation history + summarized_messages = summarize_messages( + client, model, messages, system_message) + # Retry with summarized messages + return get_response_withtools( + ..., messages=summarized_messages, ...) raise # Re-raise other exceptions 「エラー」 というかなり優れた Reward があるから うまくいっている、ともいえる (Hack しない保証もない) 73 [Zhang+25] Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, arXiv:2505.22954v1
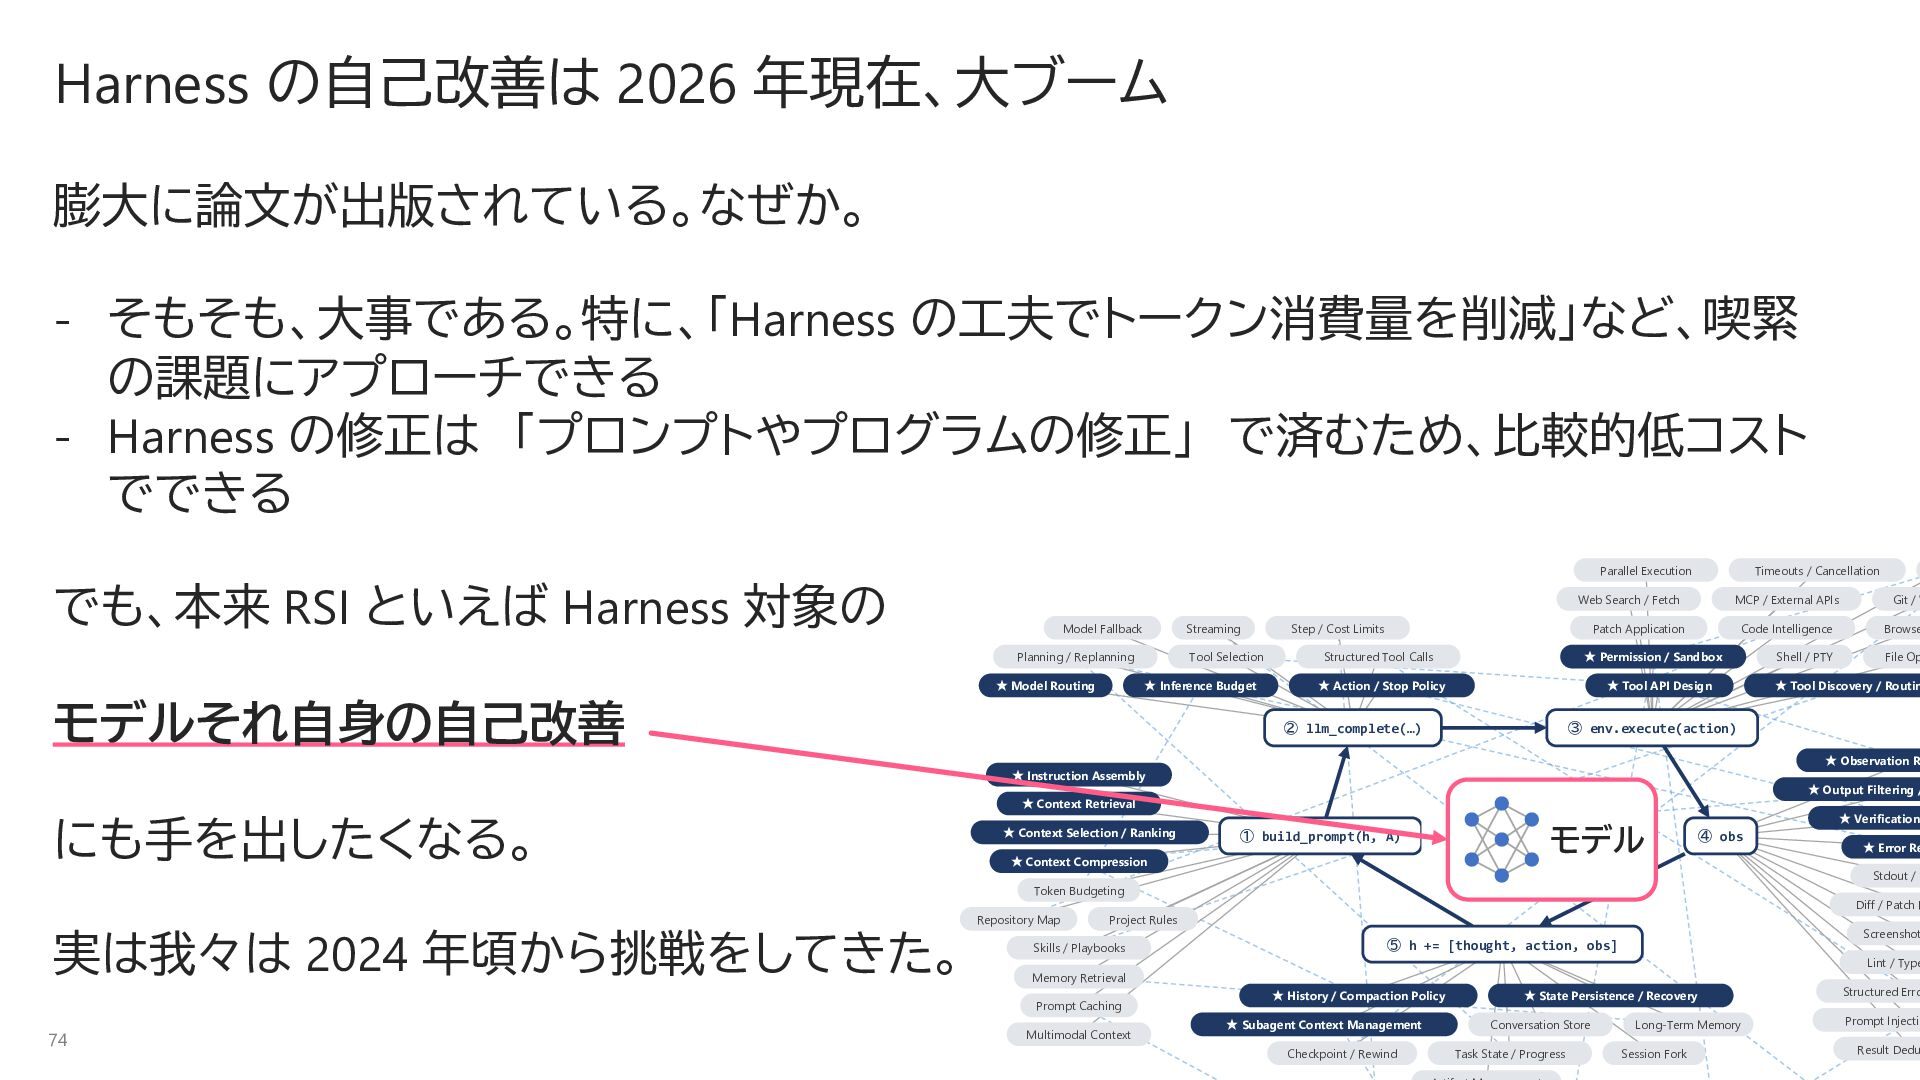
  72. Harness の自己改善は 2026 年現在、大ブーム 膨大に論文が出版されている。なぜか。 - そもそも、大事である。特に、「Harness の工夫でトークン消費量を削減」など、喫緊 の課題にアプローチできる -

    Harness の修正は 「プロンプトやプログラムの修正」 で済むため、比較的低コスト でできる Parallel Execution でも、本来 RSI といえば Harness 対象の Model Fallback Streaming Planning / Replanning ★ Model Routing Tool Selection ★ Inference Budget モデルそれ自身の自己改善 Timeouts / Cancellation Web Search / Fetch MCP / External APIs Git / W Patch Application Code Intelligence Browse Shell / PTY File Op Step / Cost Limits Structured Tool Calls ★ Permission / Sandbox ★ Action / Stop Policy ★ Tool API Design ② llm_complete(…) ③ env.execute(action) ★ Observation R ★ Instruction Assembly ★ Output Filtering / ★ Context Retrieval にも手を出したくなる。 ★ Context Selection / Ranking ① build_prompt(h, A) ★ Context Compression モデル AI Harness ★ Verification ④ obs 実は我々は 2024 年頃から挑戦をしてきた。 Screenshot ⑤ h += [thought, action, obs] Lint / Type Memory Retrieval Prompt Caching 74 Diff / Patch F Project Rules Skills / Playbooks Multimodal Context ★ Error Re Stdout / S Token Budgeting Repository Map ★ Tool Discovery / Routin ★ History / Compaction Policy ★ Subagent Context Management Checkpoint / Rewind ★ State Persistence / Recovery Conversation Store Task State / Progress Long-Term Memory Session Fork Structured Erro Prompt Injectio Result Dedu
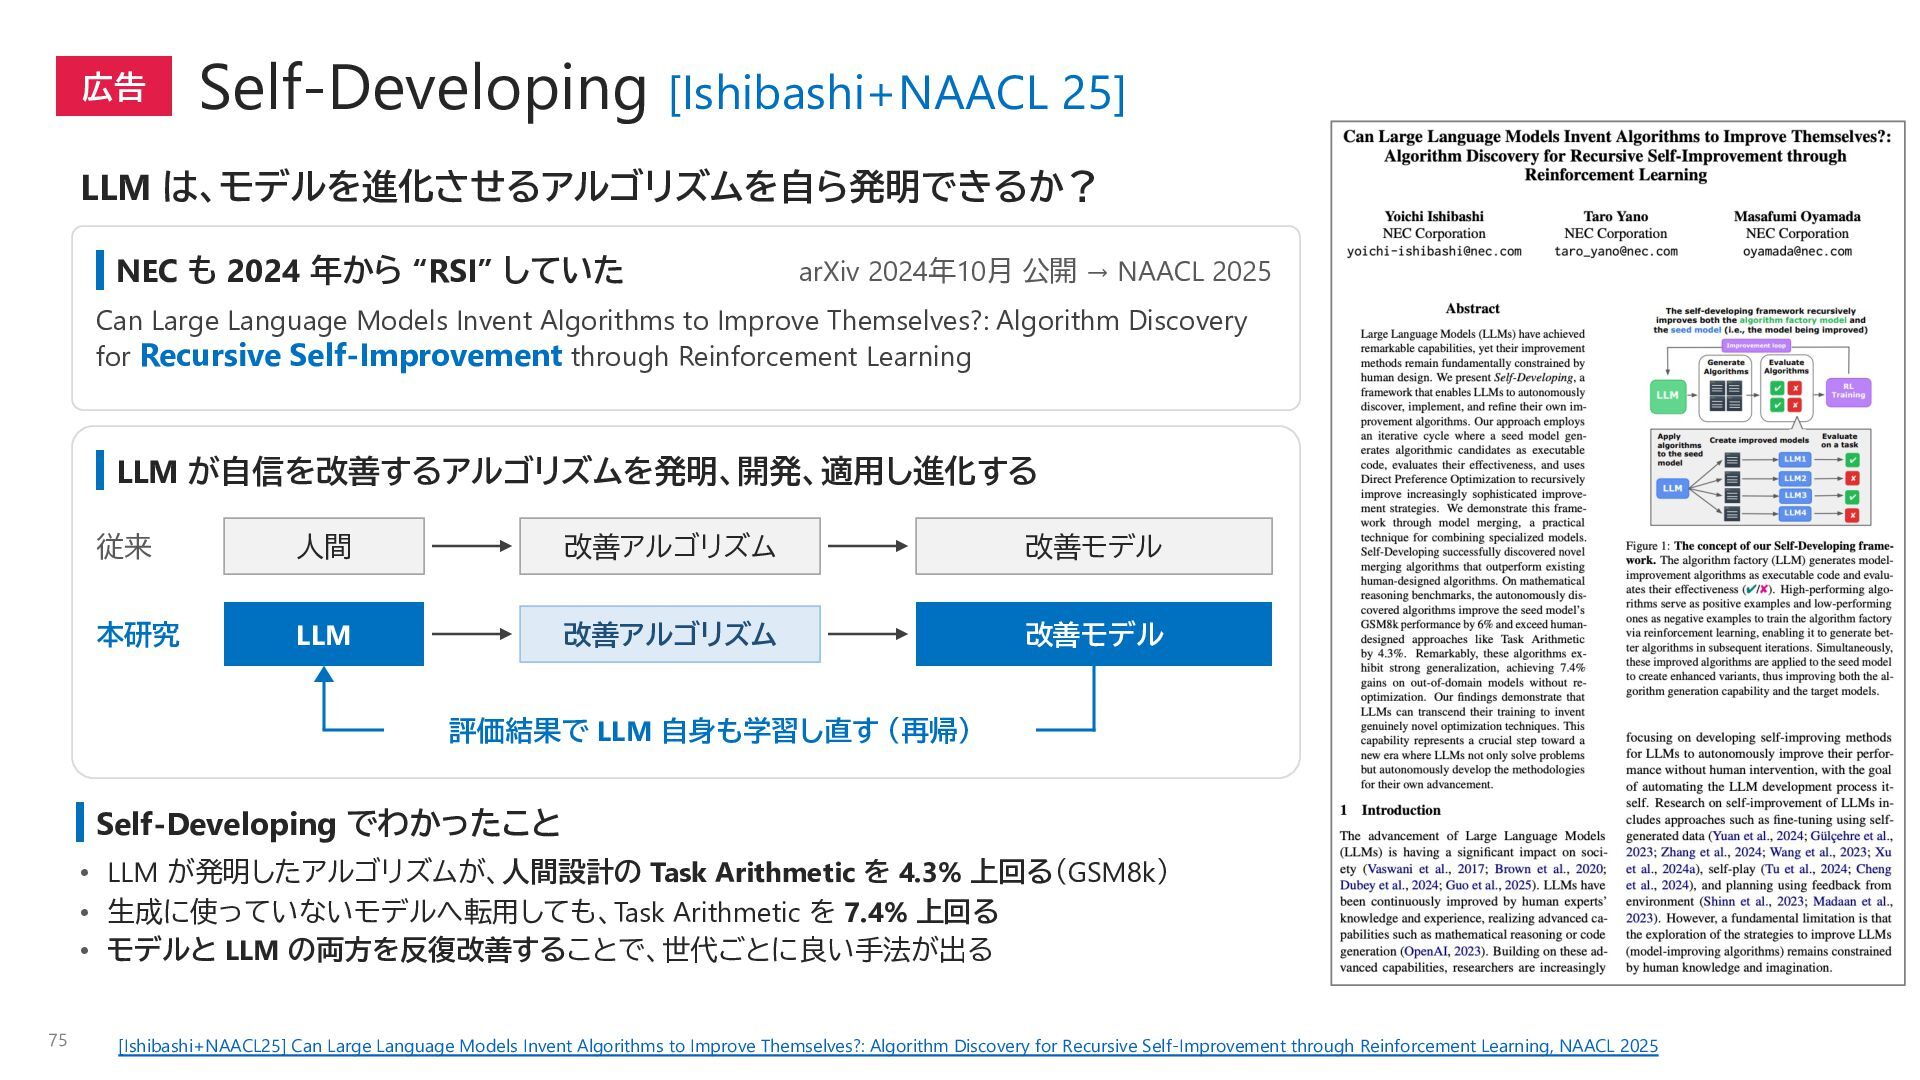
  73. 広告 Self-Developing [Ishibashi+NAACL 25] LLM は、モデルを進化させるアルゴリズムを自ら発明できるか? NEC も 2024 年から

    “RSI” していた arXiv 2024年10月 公開 → NAACL 2025 Can Large Language Models Invent Algorithms to Improve Themselves?: Algorithm Discovery for Recursive Self-Improvement through Reinforcement Learning LLM が自信を改善するアルゴリズムを発明、開発、適用し進化する 従来 人間 改善アルゴリズム 改善モデル 本研究 LLM 改善アルゴリズム 改善モデル 評価結果で LLM 自身も学習し直す (再帰) Self-Developing でわかったこと • LLM が発明したアルゴリズムが、人間設計の Task Arithmetic を 4.3% 上回る(GSM8k) • 生成に使っていないモデルへ転用しても、Task Arithmetic を 7.4% 上回る • モデルと LLM の両方を反復改善することで、世代ごとに良い手法が出る 75 [Ishibashi+NAACL25] Can Large Language Models Invent Algorithms to Improve Themselves?: Algorithm Discovery for Recursive Self-Improvement through Reinforcement Learning, NAACL 2025
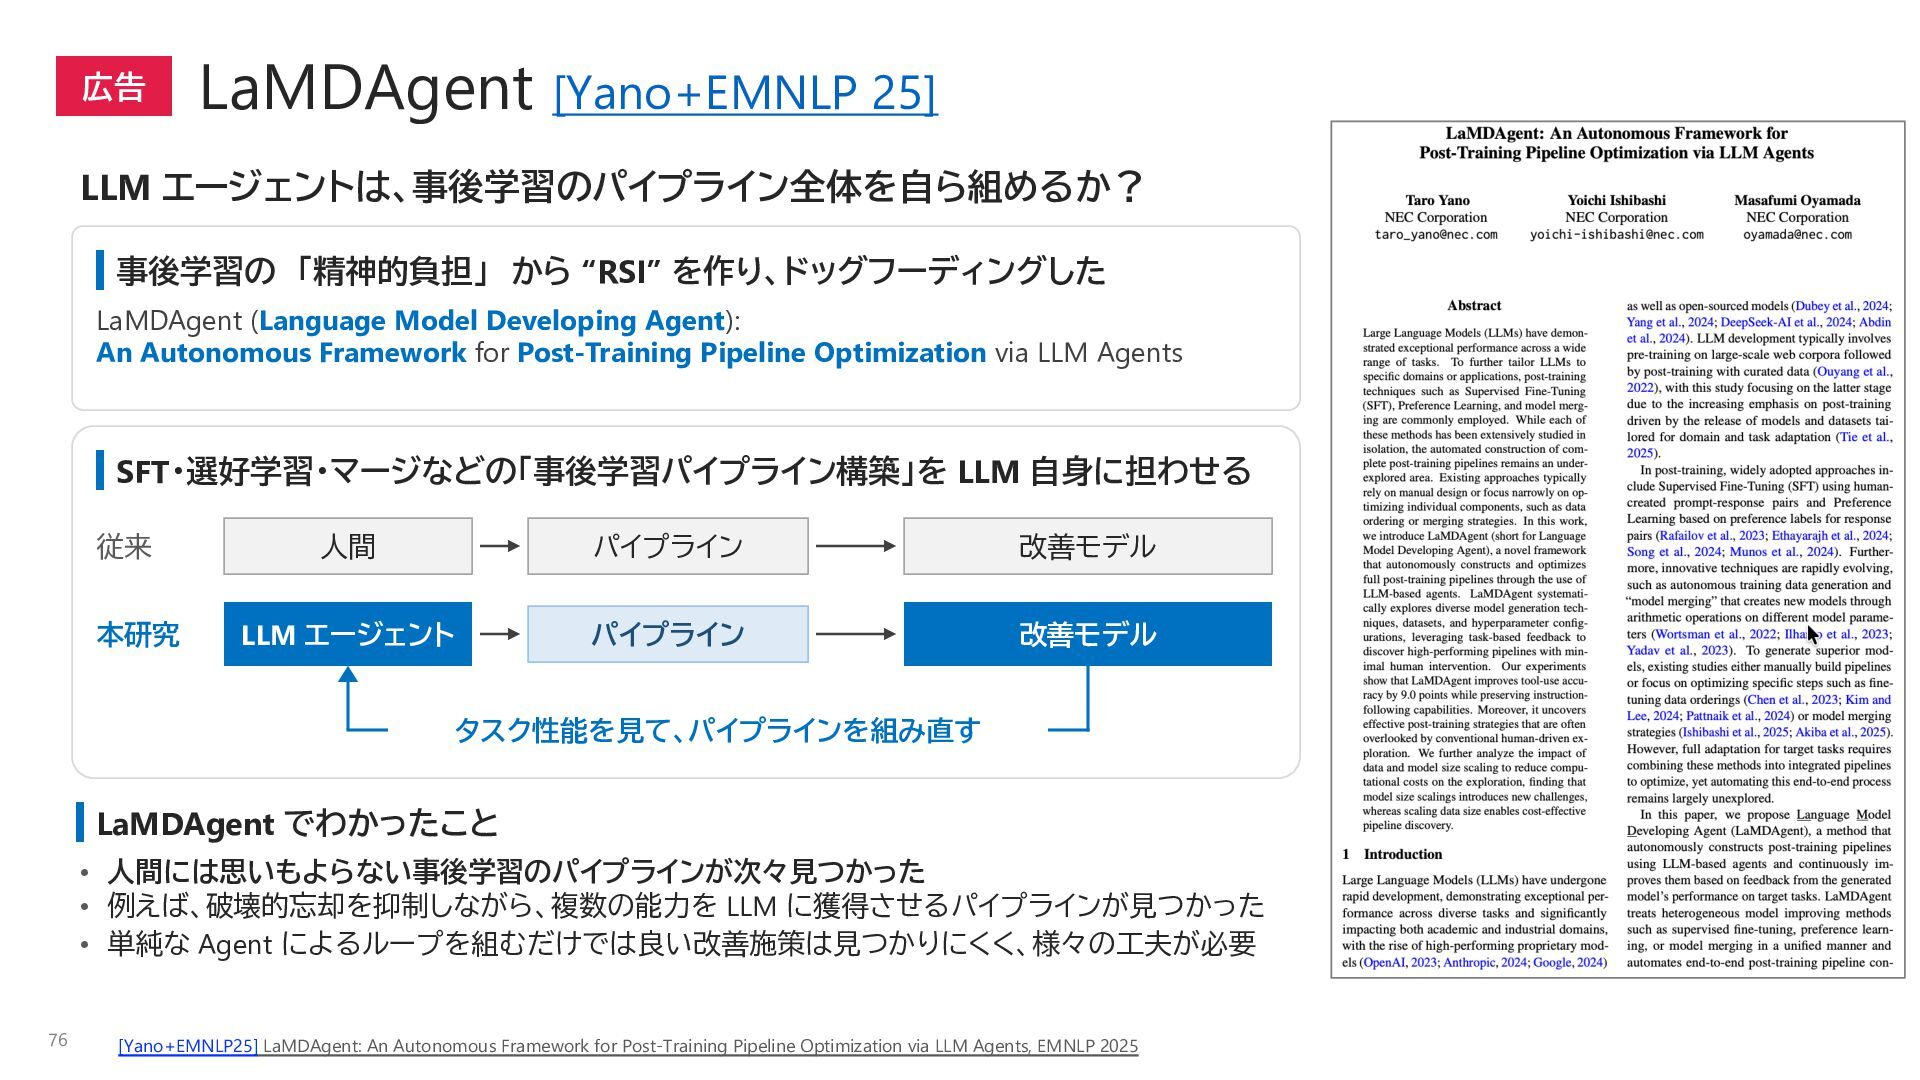
  74. 広告 LaMDAgent [Yano+EMNLP 25] LLM エージェントは、事後学習のパイプライン全体を自ら組めるか? 事後学習の 「精神的負担」 から “RSI”

    を作り、ドッグフーディングした LaMDAgent (Language Model Developing Agent): An Autonomous Framework for Post-Training Pipeline Optimization via LLM Agents SFT・選好学習・マージなどの「事後学習パイプライン構築」を LLM 自身に担わせる 従来 人間 パイプライン 改善モデル 本研究 LLM エージェント パイプライン 改善モデル タスク性能を見て、パイプラインを組み直す LaMDAgent でわかったこと • 人間には思いもよらない事後学習のパイプラインが次々見つかった • 例えば、破壊的忘却を抑制しながら、複数の能力を LLM に獲得させるパイプラインが見つかった • 単純な Agent によるループを組むだけでは良い改善施策は見つかりにくく、様々の工夫が必要 76 [Yano+EMNLP25] LaMDAgent: An Autonomous Framework for Post-Training Pipeline Optimization via LLM Agents, EMNLP 2025
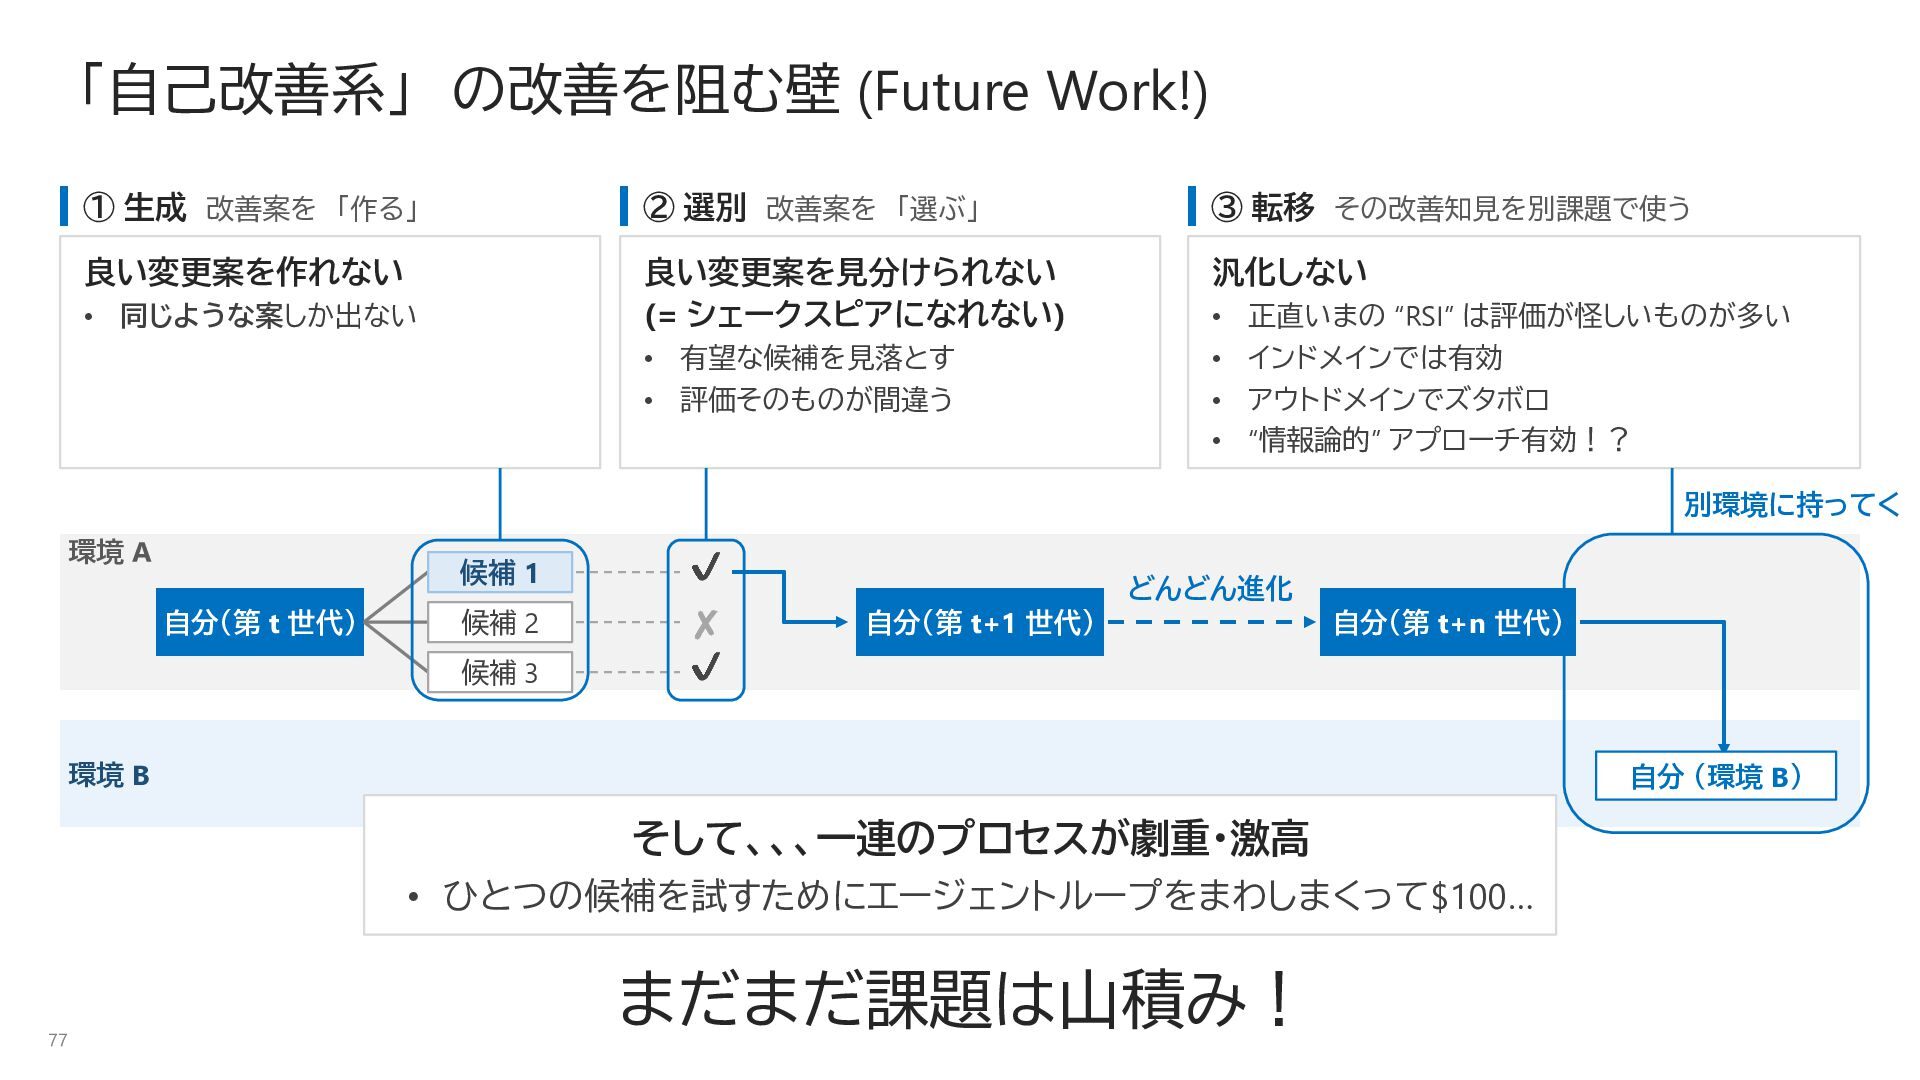
  75. 「自己改善系」 の改善を阻む壁 (Future Work!) ① 生成 改善案を 「作る」 ② 選別

    改善案を 「選ぶ」 ③ 転移 その改善知見を別課題で使う 良い変更案を作れない 良い変更案を見分けられない (= シェークスピアになれない) 汎化しない • 有望な候補を見落とす • 評価そのものが間違う • インドメインでは有効 • アウトドメインでズタボロ • “情報論的” アプローチ有効!? • 同じような案しか出ない • 正直いまの “RSI” は評価が怪しいものが多い 別環境に持ってく 環境 A 自分(第 t 世代) 候補 1 ✔ 候補 2 ✘ 候補 3 ✔ どんどん進化 自分(第 t+1 世代) 自分(第 t+n 世代) 環境 B 自分 (環境 B) そして、、、一連のプロセスが劇重・激高 • ひとつの候補を試すためにエージェントループをまわしまくって$100… 77 まだまだ課題は山積み!
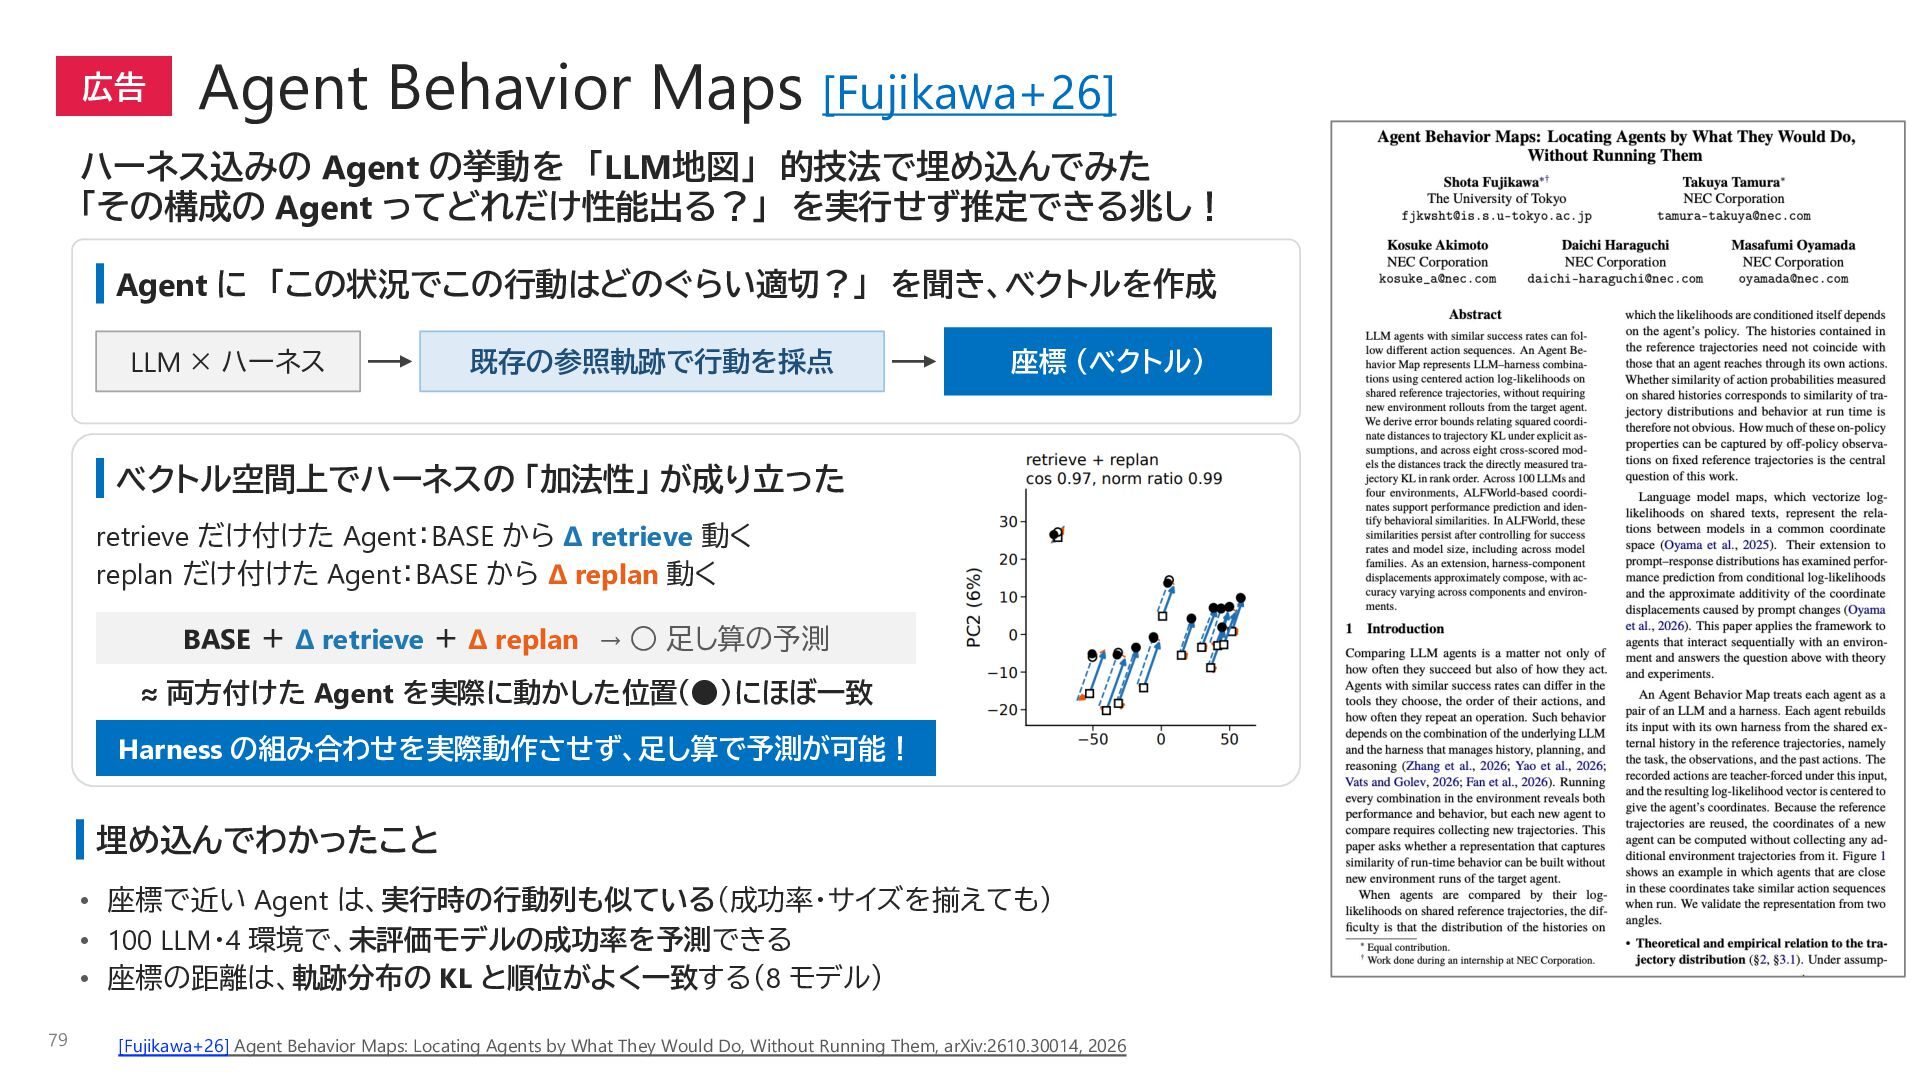
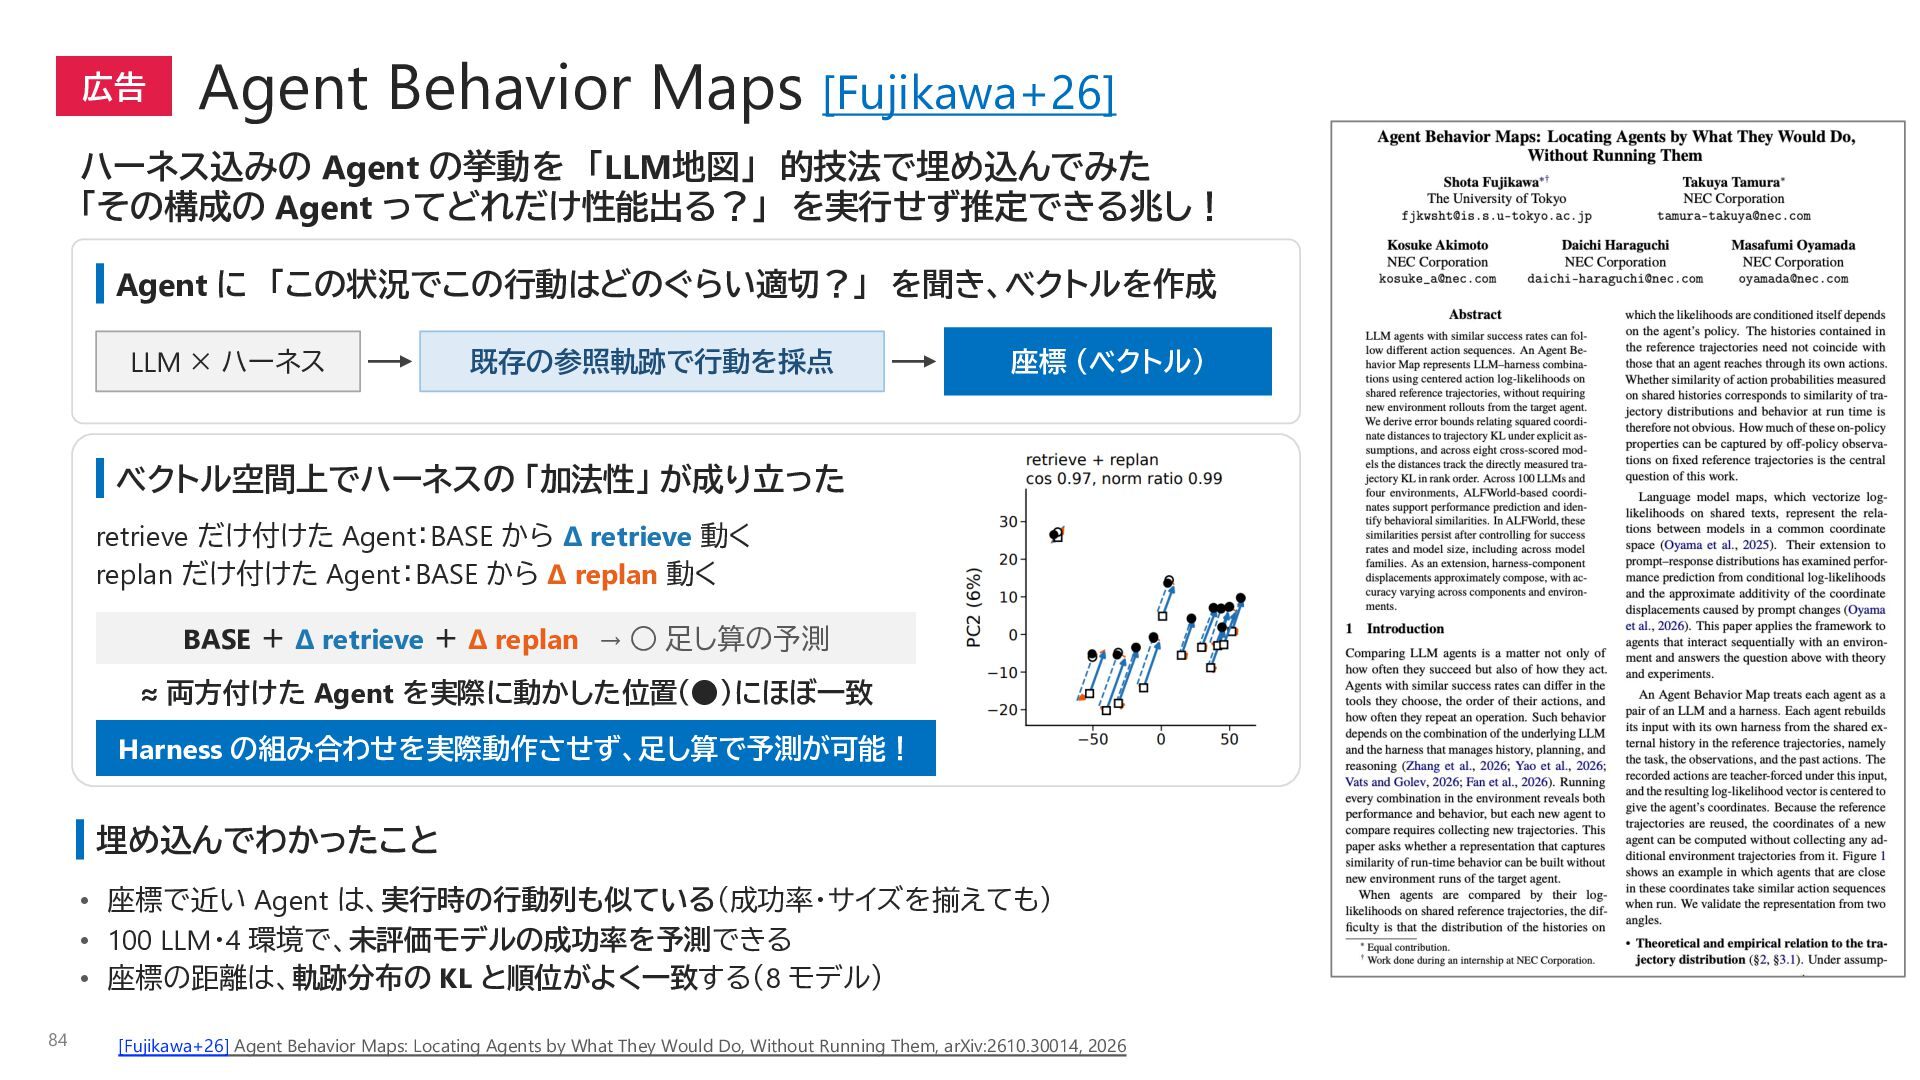
  76. 広告 Agent Behavior Maps [Fujikawa+26] ハーネス込みの Agent の挙動を 「LLM地図」 的技法で埋め込んでみた

    「その構成の Agent ってどれだけ性能出る?」 を実行せず推定できる兆し! Agent に 「この状況でこの行動はどのぐらい適切?」 を聞き、ベクトルを作成 LLM × ハーネス 既存の参照軌跡で行動を採点 座標 (ベクトル) ベクトル空間上でハーネスの 「加法性」 が成り立った retrieve だけ付けた Agent:BASE から Δ retrieve 動く replan だけ付けた Agent:BASE から Δ replan 動く BASE + Δ retrieve + Δ replan → ◦ 足し算の予測 ≈ 両方付けた Agent を実際に動かした位置(•)にほぼ一致 Harness の組み合わせを実際動作させず、足し算で予測が可能! 埋め込んでわかったこと • 座標で近い Agent は、実行時の行動列も似ている(成功率・サイズを揃えても) • 100 LLM・4 環境で、未評価モデルの成功率を予測できる • 座標の距離は、軌跡分布の KL と順位がよく一致する(8 モデル) 79 [Fujikawa+26] Agent Behavior Maps: Locating Agents by What They Would Do, Without Running Them, arXiv:2610.30014, 2026
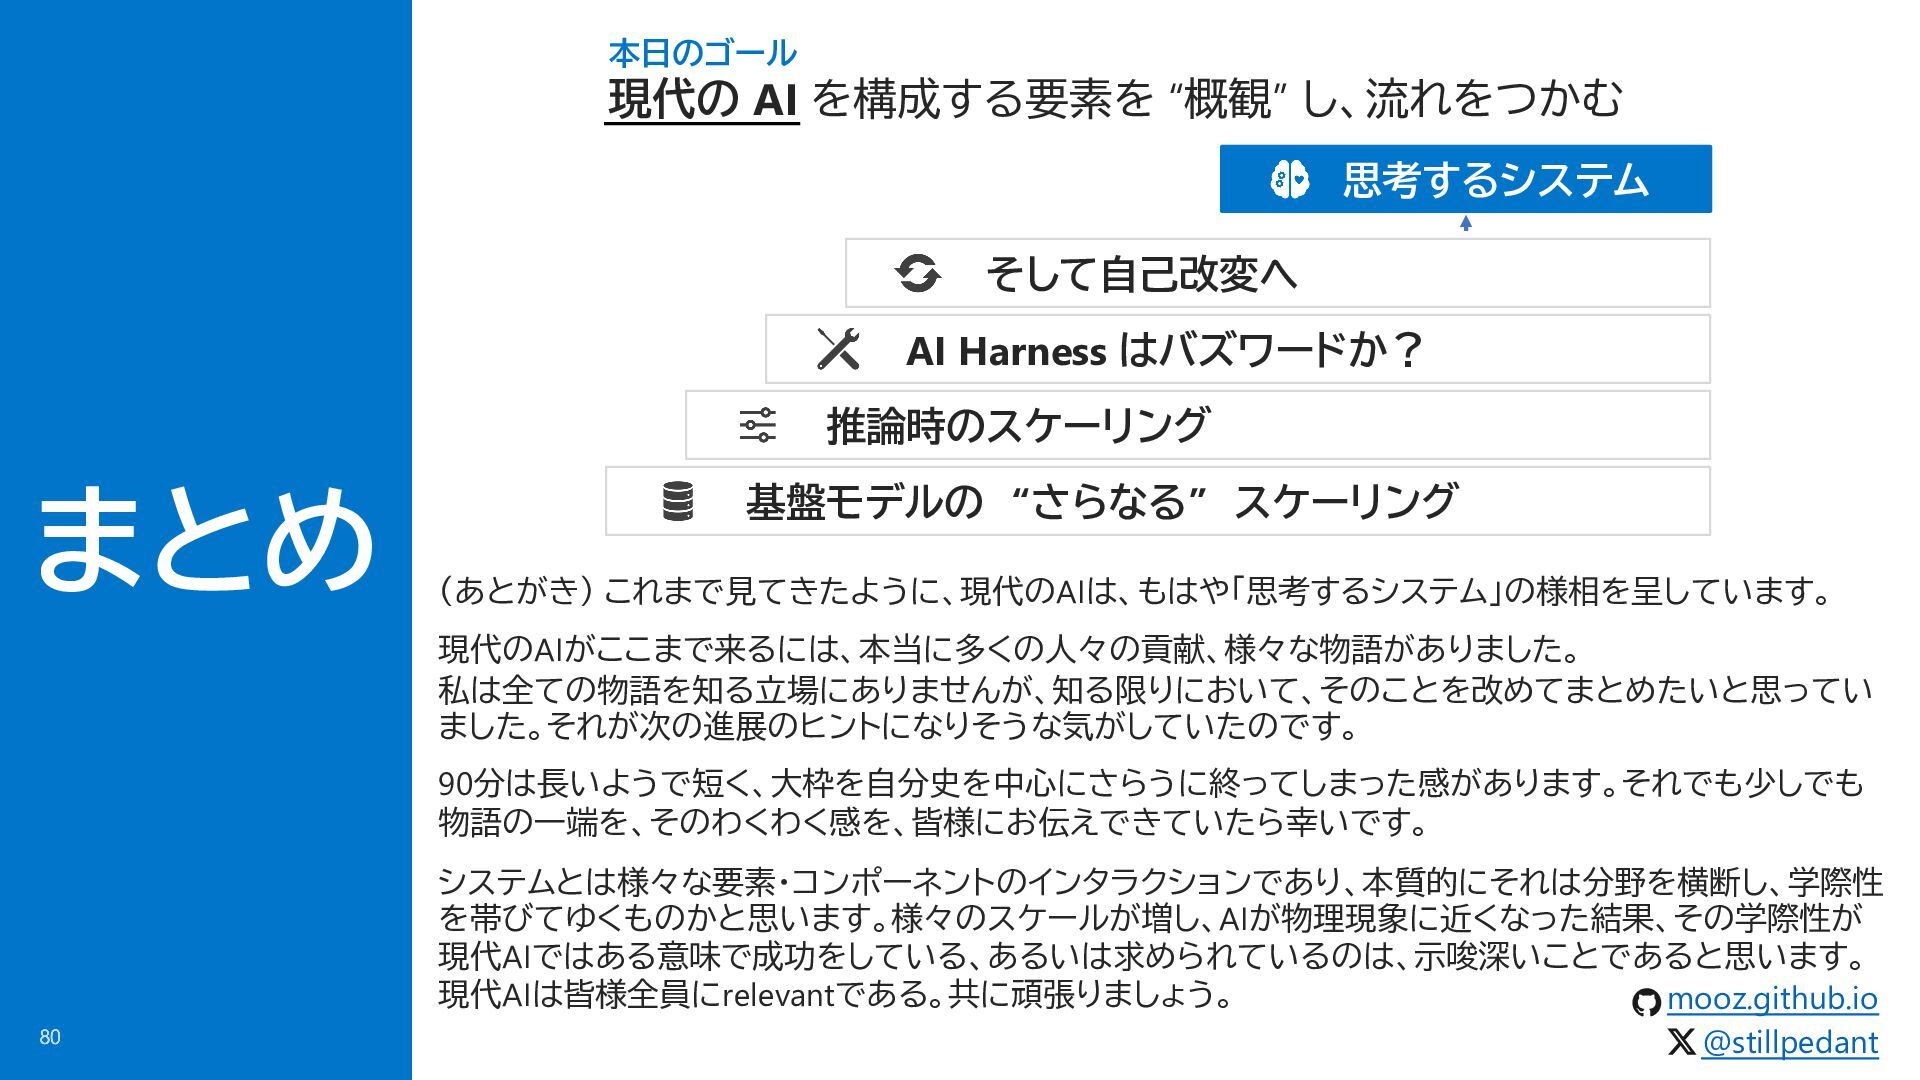
  77. 本日のゴール 現代の AI を構成する要素を “概観” し、流れをつかむ 思考するシステム そして自己改変へ AI Harness

    はバズワードか? 推論時のスケーリング まとめ 基盤モデルの “さらなる” スケーリング (あとがき) これまで見てきたように、現代のAIは、もはや「思考するシステム」の様相を呈しています。 現代のAIがここまで来るには、本当に多くの人々の貢献、様々な物語がありました。 私は全ての物語を知る立場にありませんが、知る限りにおいて、そのことを改めてまとめたいと思ってい ました。それが次の進展のヒントになりそうな気がしていたのです。 90分は長いようで短く、大枠を自分史を中心にさらうに終ってしまった感があります。それでも少しでも 物語の一端を、そのわくわく感を、皆様にお伝えできていたら幸いです。 80 システムとは様々な要素・コンポーネントのインタラクションであり、本質的にそれは分野を横断し、学際性 を帯びてゆくものかと思います。様々のスケールが増し、AIが物理現象に近くなった結果、その学際性が 現代AIではある意味で成功をしている、あるいは求められているのは、示唆深いことであると思います。 現代AIは皆様全員にrelevantである。共に頑張りましょう。 mooz.github.io @stillpedant
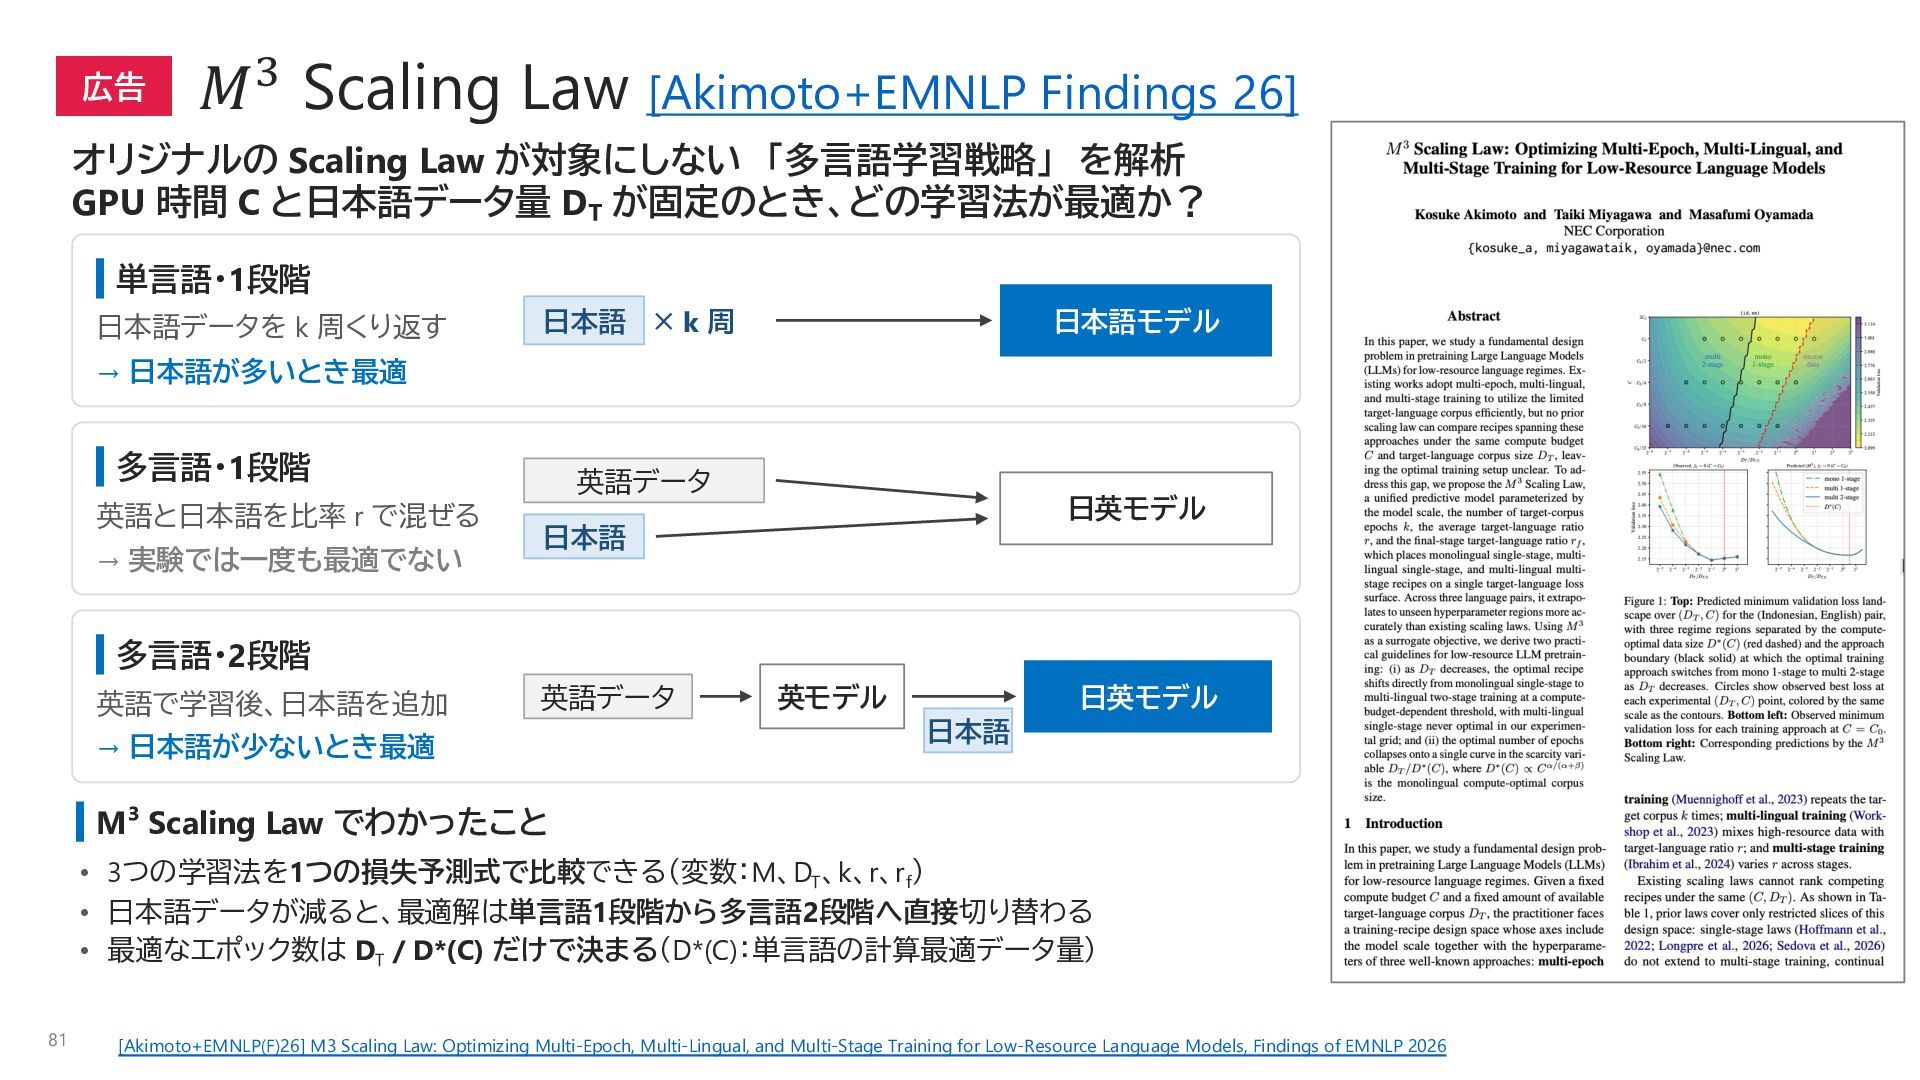
  78. 広告 𝑀! Scaling Law [Akimoto+EMNLP Findings 26] オリジナルの Scaling Law

    が対象にしない 「多言語学習戦略」 を解析 GPU 時間 C と日本語データ量 DT が固定のとき、どの学習法が最適か? 単言語・1段階 日本語データを k 周くり返す 日本語 × k 周 日本語モデル → 日本語が多いとき最適 多言語・1段階 英語と日本語を比率 r で混ぜる → 実験では一度も最適でない 英語データ 日英モデル 日本語 多言語・2段階 英語で学習後、日本語を追加 英語データ → 日本語が少ないとき最適 英モデル 日英モデル 日本語 M³ Scaling Law でわかったこと • 3つの学習法を1つの損失予測式で比較できる(変数:M、DT、k、r、rf) • 日本語データが減ると、最適解は単言語1段階から多言語2段階へ直接切り替わる • 最適なエポック数は DT / D*(C) だけで決まる(D*(C):単言語の計算最適データ量) 81 [Akimoto+EMNLP(F)26] M3 Scaling Law: Optimizing Multi-Epoch, Multi-Lingual, and Multi-Stage Training for Low-Resource Language Models, Findings of EMNLP 2026
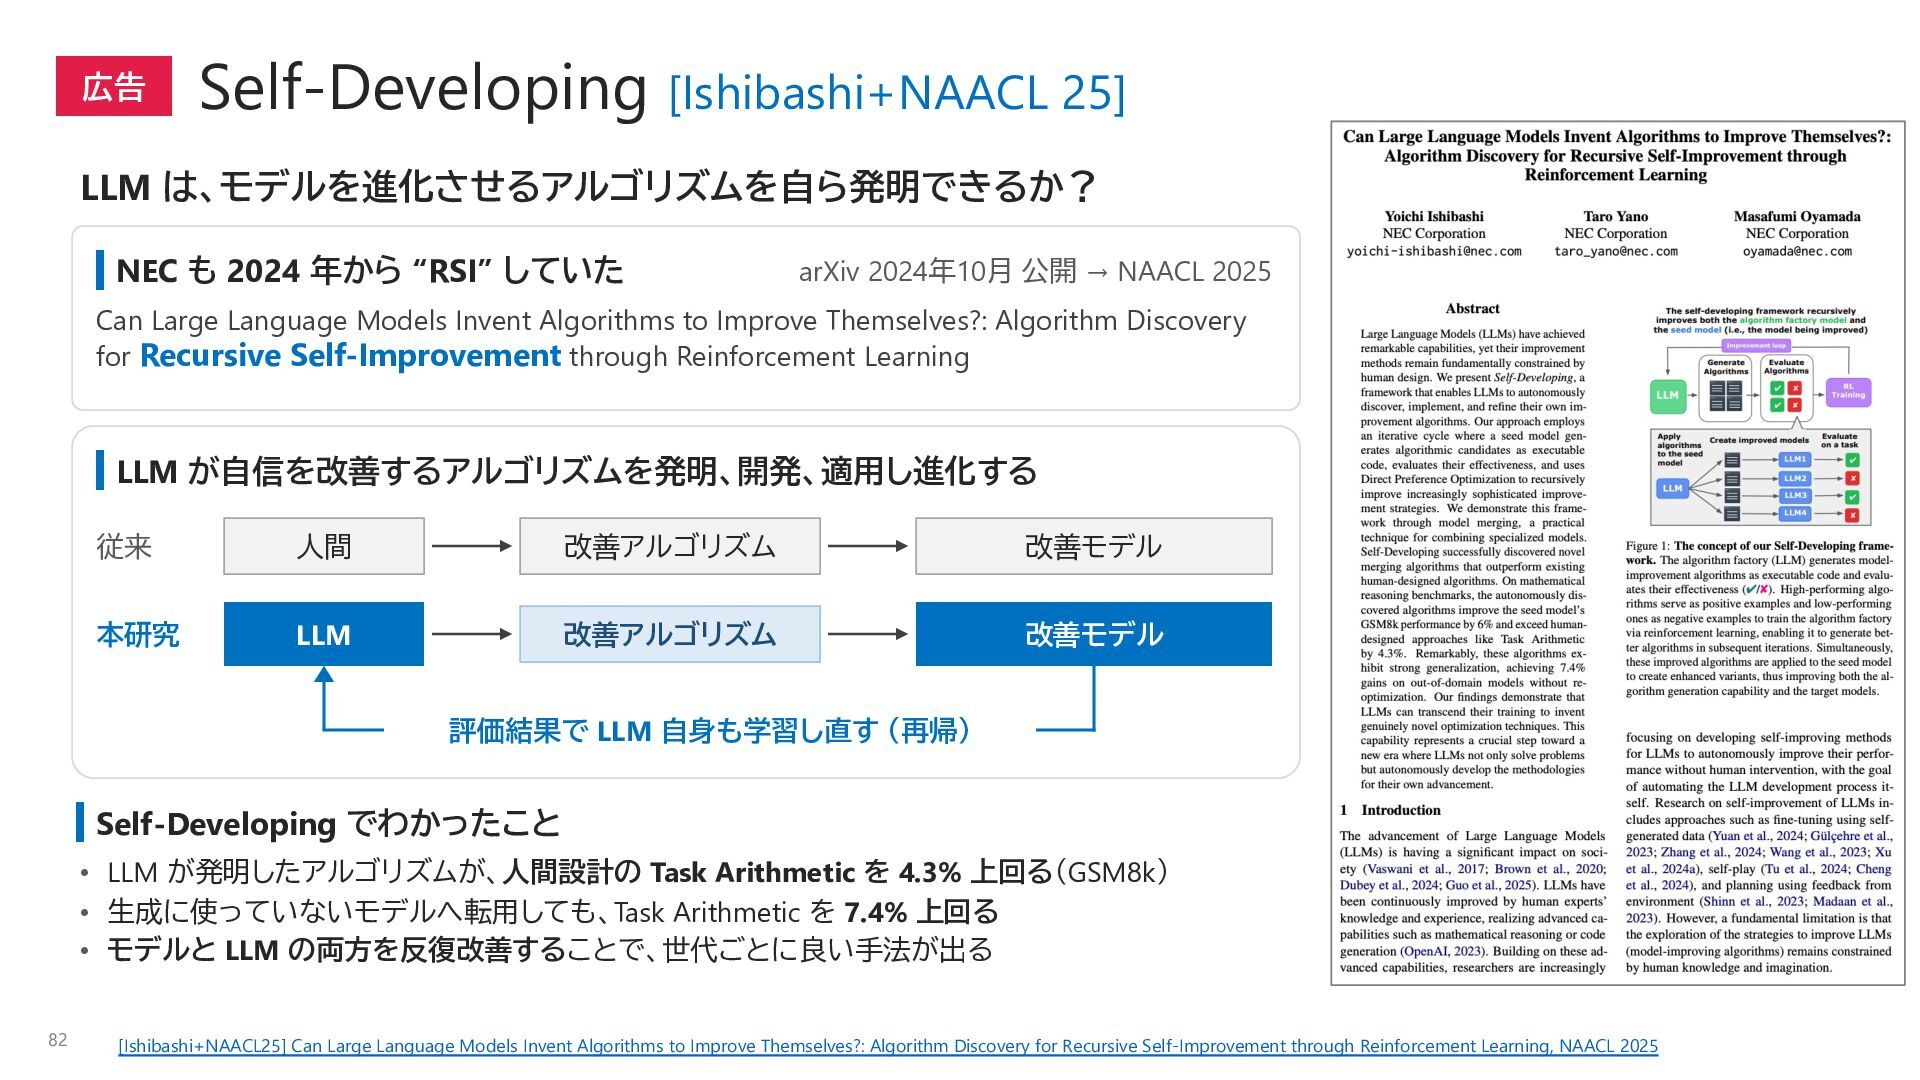
  79. 広告 Self-Developing [Ishibashi+NAACL 25] LLM は、モデルを進化させるアルゴリズムを自ら発明できるか? NEC も 2024 年から

    “RSI” していた arXiv 2024年10月 公開 → NAACL 2025 Can Large Language Models Invent Algorithms to Improve Themselves?: Algorithm Discovery for Recursive Self-Improvement through Reinforcement Learning LLM が自信を改善するアルゴリズムを発明、開発、適用し進化する 従来 人間 改善アルゴリズム 改善モデル 本研究 LLM 改善アルゴリズム 改善モデル 評価結果で LLM 自身も学習し直す (再帰) Self-Developing でわかったこと • LLM が発明したアルゴリズムが、人間設計の Task Arithmetic を 4.3% 上回る(GSM8k) • 生成に使っていないモデルへ転用しても、Task Arithmetic を 7.4% 上回る • モデルと LLM の両方を反復改善することで、世代ごとに良い手法が出る 82 [Ishibashi+NAACL25] Can Large Language Models Invent Algorithms to Improve Themselves?: Algorithm Discovery for Recursive Self-Improvement through Reinforcement Learning, NAACL 2025
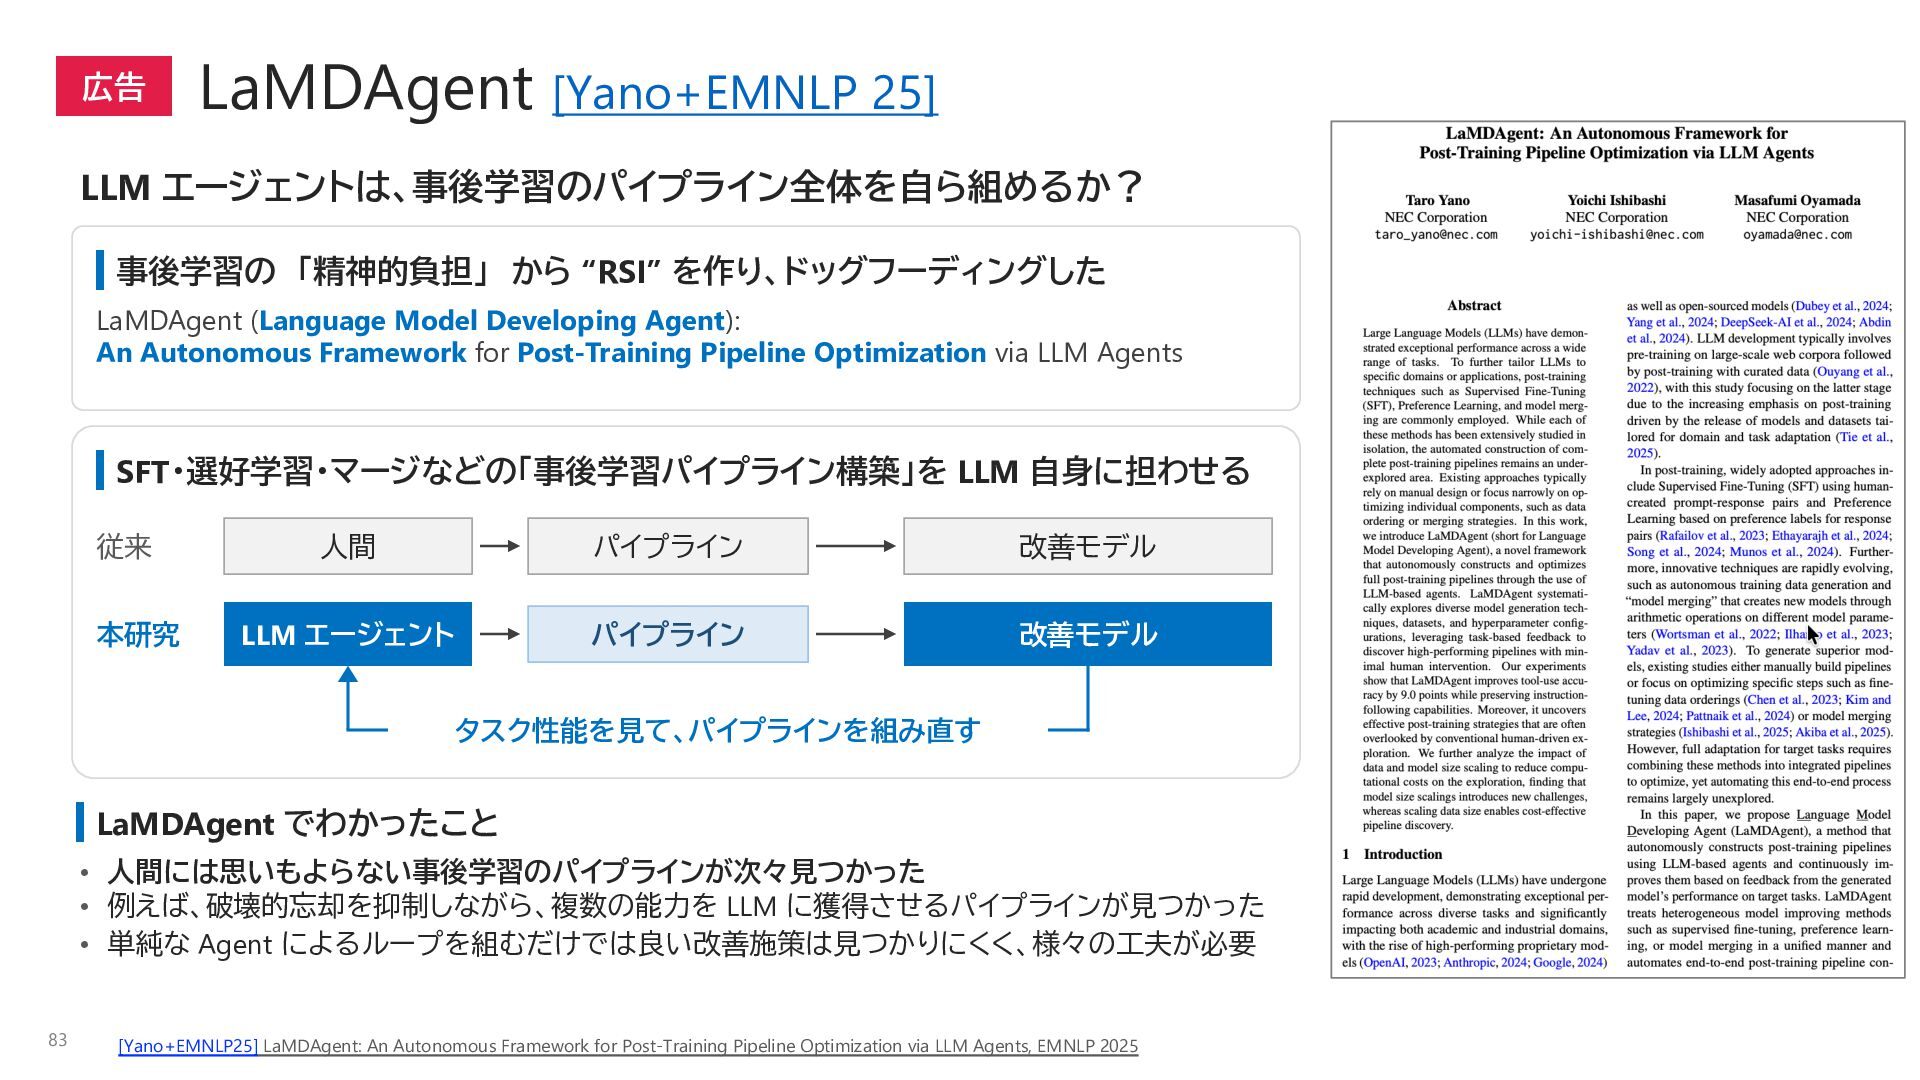
  80. 広告 LaMDAgent [Yano+EMNLP 25] LLM エージェントは、事後学習のパイプライン全体を自ら組めるか? 事後学習の 「精神的負担」 から “RSI”

    を作り、ドッグフーディングした LaMDAgent (Language Model Developing Agent): An Autonomous Framework for Post-Training Pipeline Optimization via LLM Agents SFT・選好学習・マージなどの「事後学習パイプライン構築」を LLM 自身に担わせる 従来 人間 パイプライン 改善モデル 本研究 LLM エージェント パイプライン 改善モデル タスク性能を見て、パイプラインを組み直す LaMDAgent でわかったこと • 人間には思いもよらない事後学習のパイプラインが次々見つかった • 例えば、破壊的忘却を抑制しながら、複数の能力を LLM に獲得させるパイプラインが見つかった • 単純な Agent によるループを組むだけでは良い改善施策は見つかりにくく、様々の工夫が必要 83 [Yano+EMNLP25] LaMDAgent: An Autonomous Framework for Post-Training Pipeline Optimization via LLM Agents, EMNLP 2025
  81. 広告 Agent Behavior Maps [Fujikawa+26] ハーネス込みの Agent の挙動を 「LLM地図」 的技法で埋め込んでみた

    「その構成の Agent ってどれだけ性能出る?」 を実行せず推定できる兆し! Agent に 「この状況でこの行動はどのぐらい適切?」 を聞き、ベクトルを作成 LLM × ハーネス 既存の参照軌跡で行動を採点 座標 (ベクトル) ベクトル空間上でハーネスの 「加法性」 が成り立った retrieve だけ付けた Agent:BASE から Δ retrieve 動く replan だけ付けた Agent:BASE から Δ replan 動く BASE + Δ retrieve + Δ replan → ◦ 足し算の予測 ≈ 両方付けた Agent を実際に動かした位置(•)にほぼ一致 Harness の組み合わせを実際動作させず、足し算で予測が可能! 埋め込んでわかったこと • 座標で近い Agent は、実行時の行動列も似ている(成功率・サイズを揃えても) • 100 LLM・4 環境で、未評価モデルの成功率を予測できる • 座標の距離は、軌跡分布の KL と順位がよく一致する(8 モデル) 84 [Fujikawa+26] Agent Behavior Maps: Locating Agents by What They Would Do, Without Running Them, arXiv:2610.30014, 2026