Share
Embed
作って理解するCoding Agent 〜フレームワークに頼らないピュア Python での実装〜
PyConJP 2026のDAY2の発表資料です。
https://2026.pycon.jp/ja/talks/CPFGDA
発表で利用したコードのリンク:https://github.com/takapy0210/takapy-code-pyconjp2026
Takanobu Nozawa
August 21, 2026
Transcript
59 slides
-
自己紹介 名前: 野澤 哲照(Nozawa Takanobu) 所属/役割: コネヒト株式会社 / CTO :
@takapy0210 / HN:たかぱい - ML Engineer / PdMなどをメインにデータ基盤整備などに従事 - 2026年4月からCTOに就任 - 猫とマンションとラーメンが好き - PyConJPは2021/2022/2024に登壇 PR:友人とPodcast配信してます wipfm 6 -
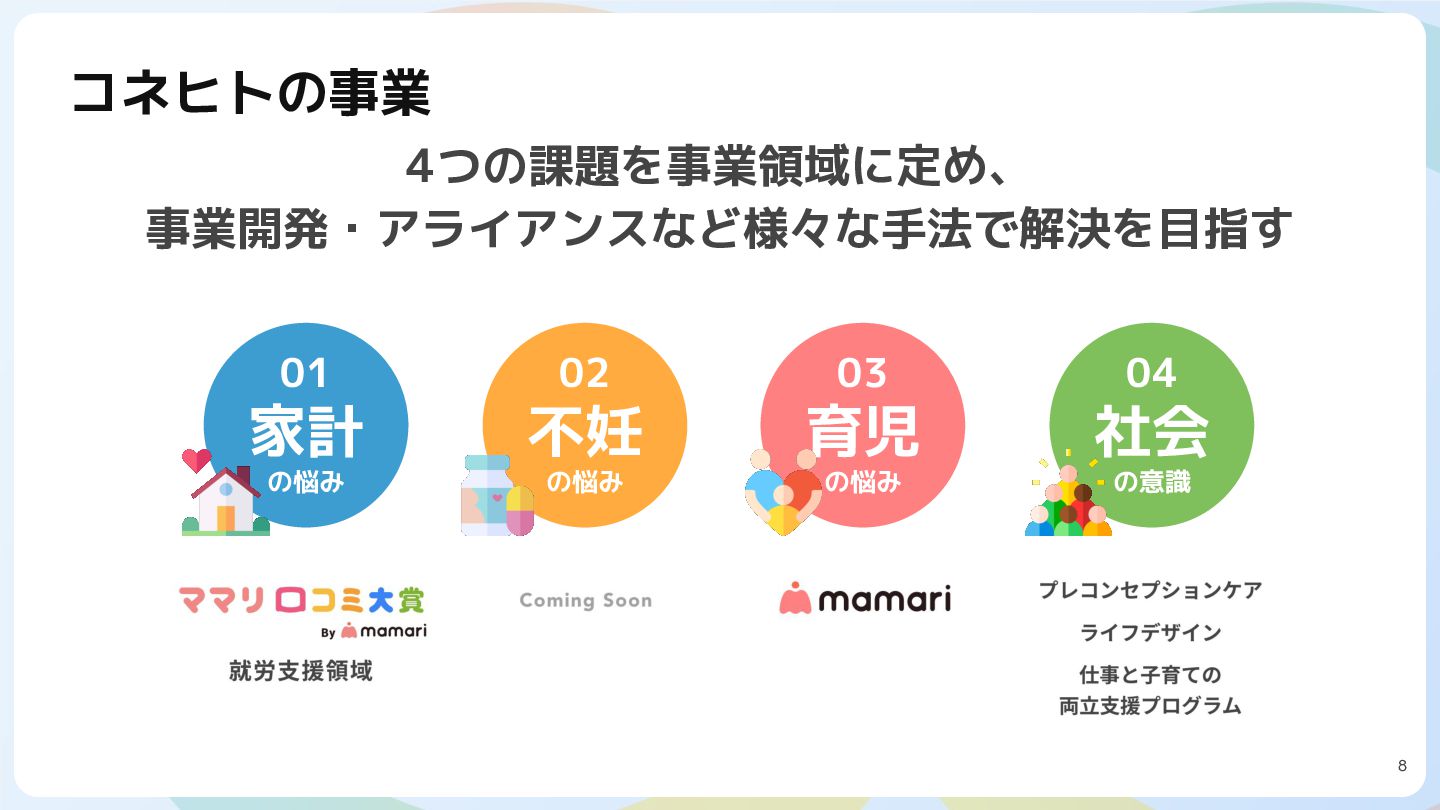
コネヒトの事業 4つの課題を事業領域に定め、 事業開発・アライアンスなど様々な手法で解決を目指す 01 02 03 04 家計 不妊 育児
社会 の悩み の悩み の悩み の意識 8 -
ママリについて Q&Aコミュニティ ユーザーが悩みを投稿、相談しあうQ&A機能 専門家による回答も期間限定で提供 メディア 妊娠・育児などの記事を毎日配信 専門家監修の記事も多数 SNS インスタのハッシュタグ #ママリ
の投稿数が 1000万件超 #ママ(約670万件)よりも投稿されている 9 -
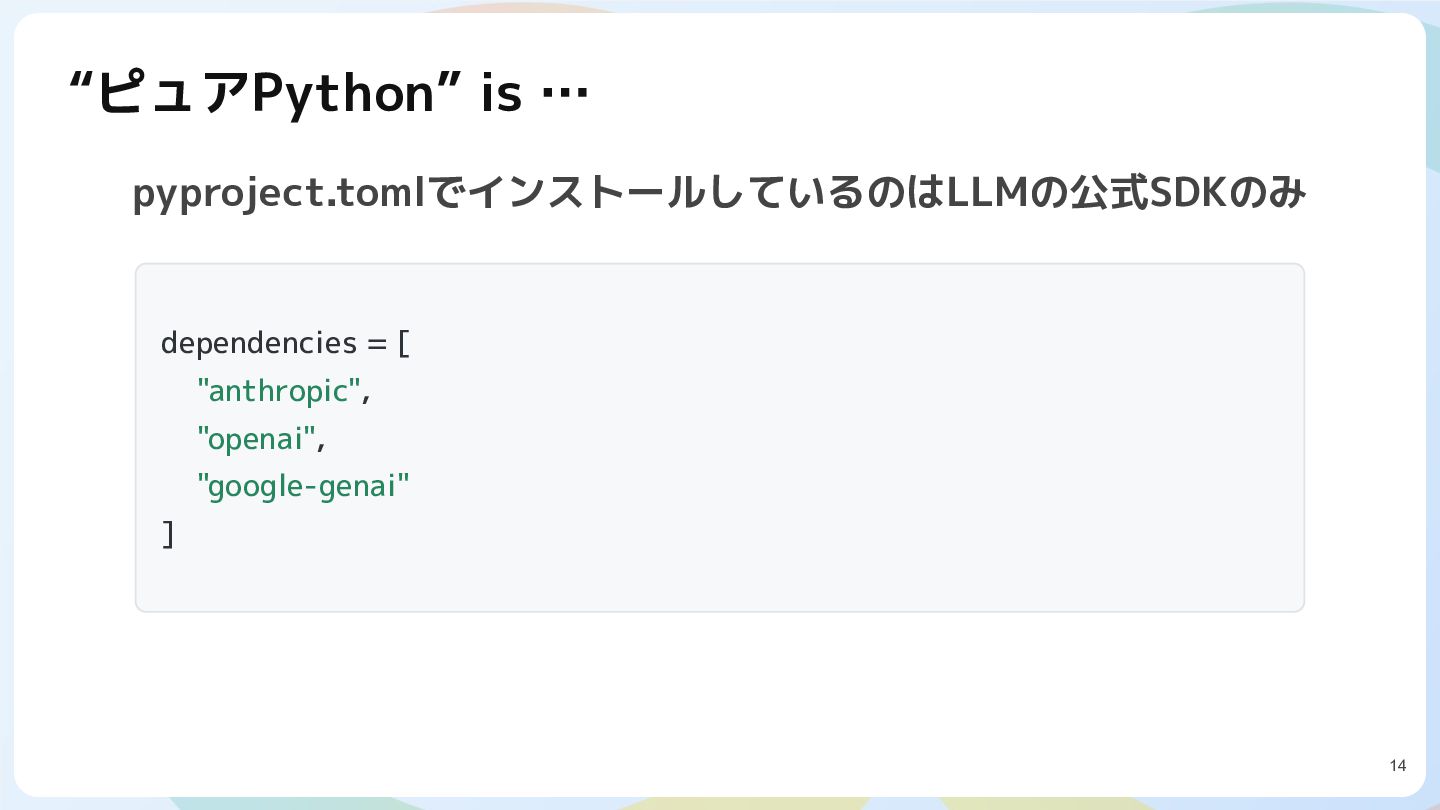
今回実装したCoding Agentの実装規模 約2,000 行 今回はOpenAI / Anthropic / Googleの3モデルに対応しているので 規模が少し大きくなっていますが、
1つのLLM SDKだけで骨格を組むなら 200〜300行で実装できます。 ボリュームは意外と少ない 13 -
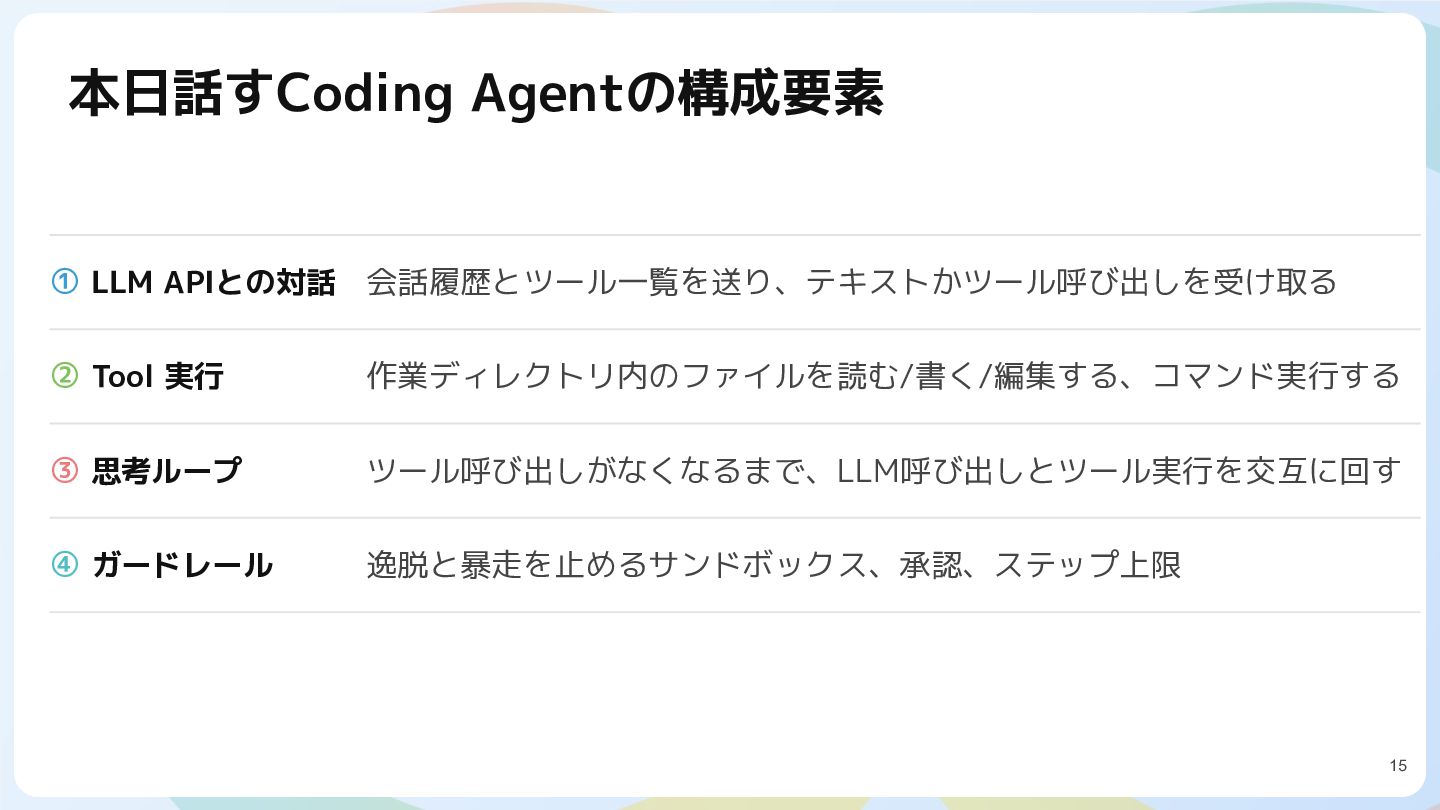
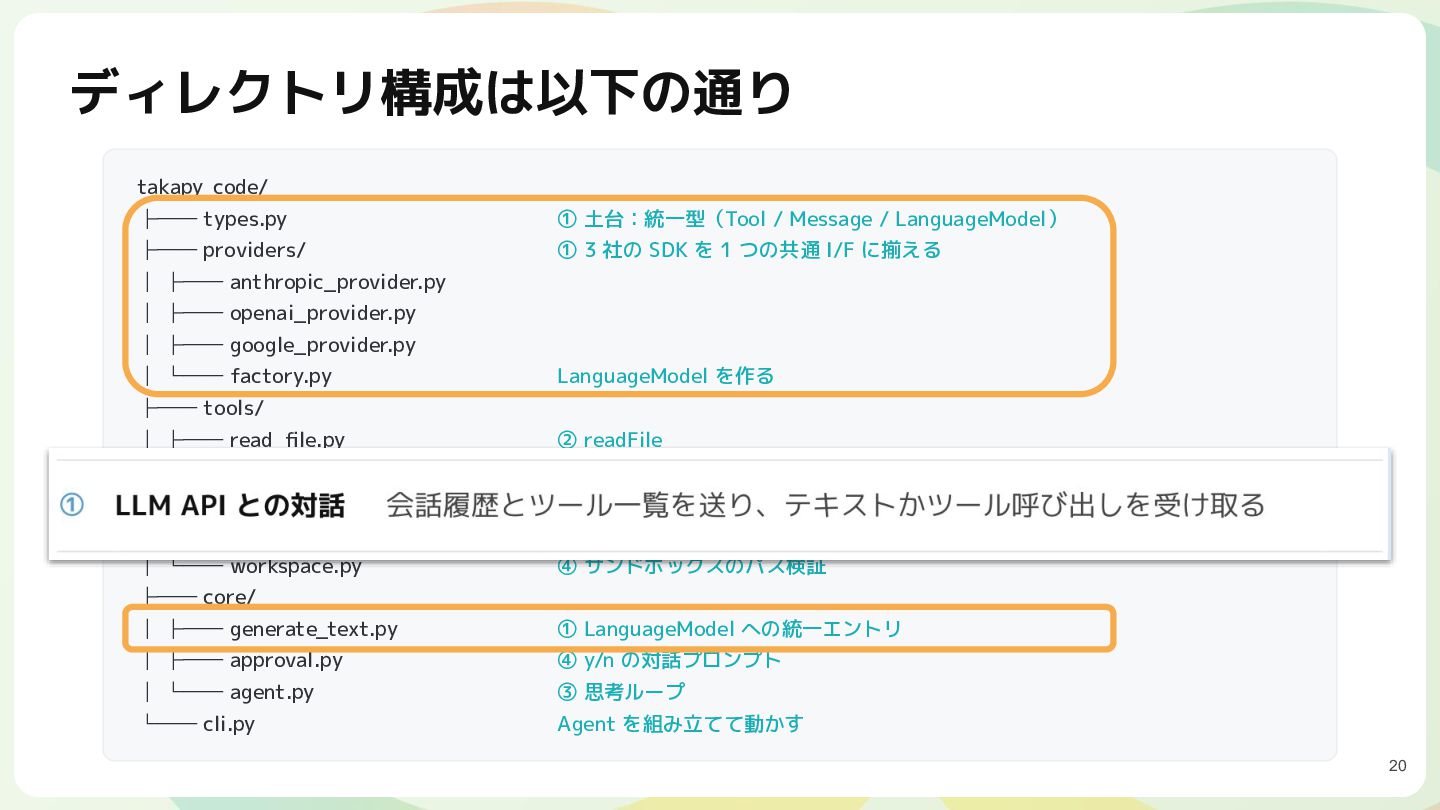
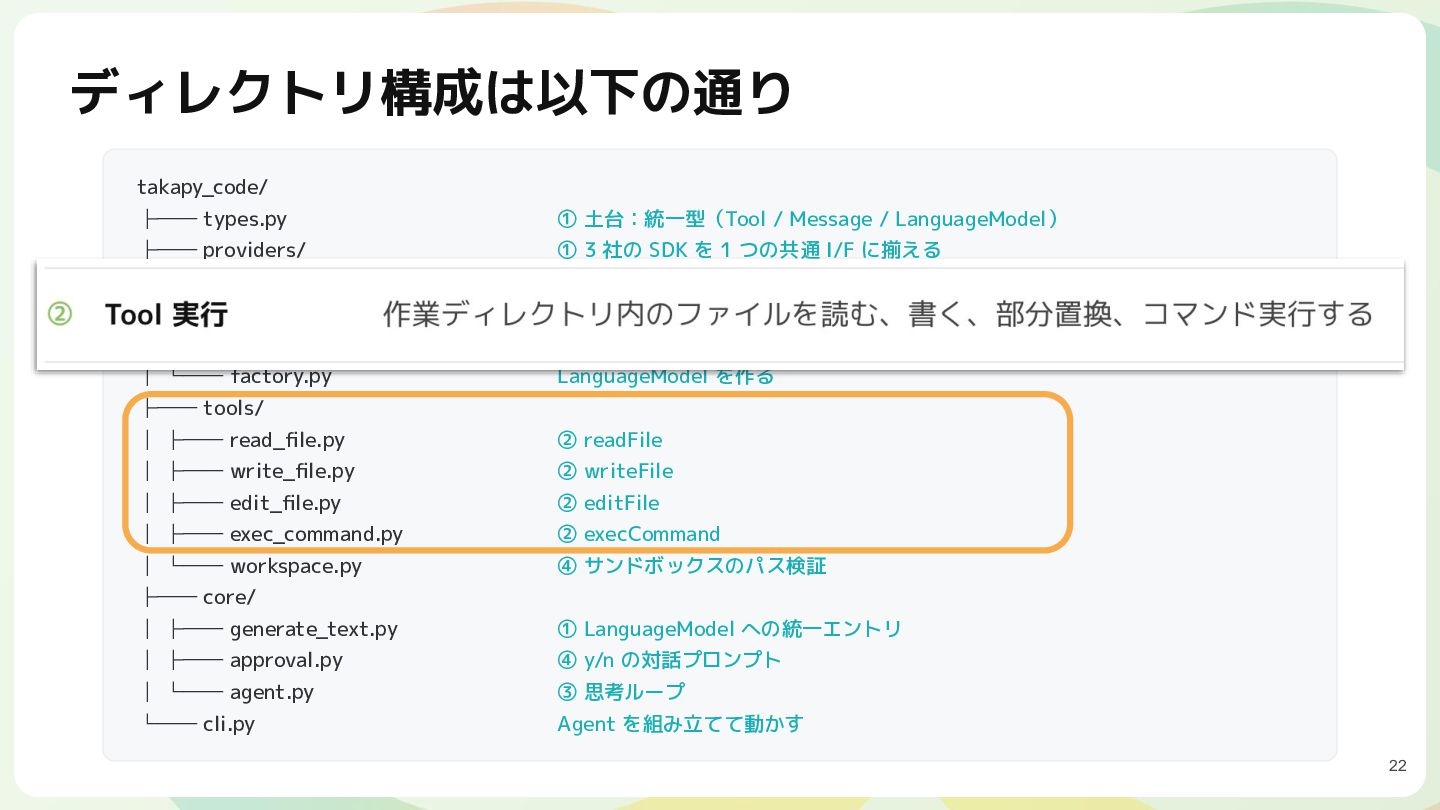
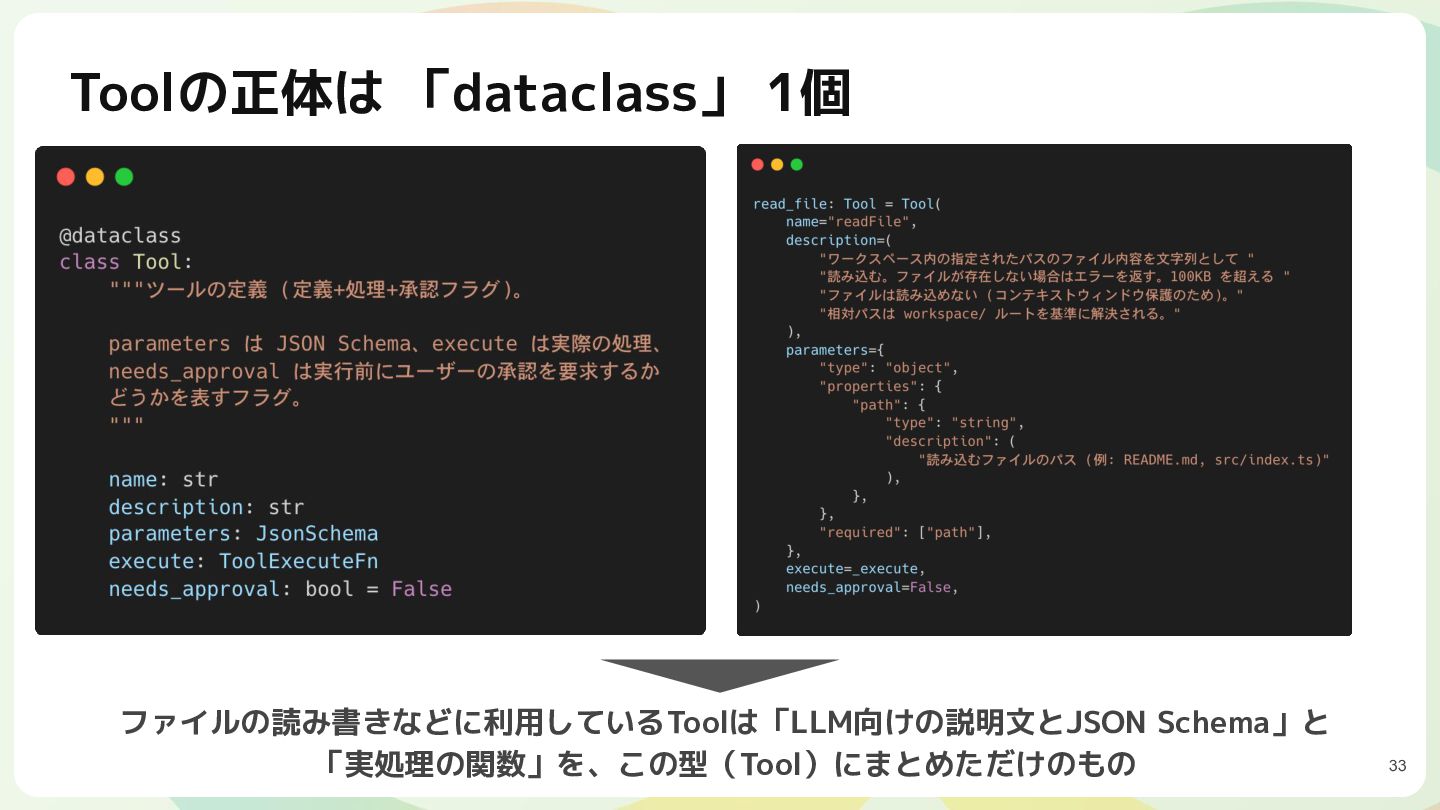
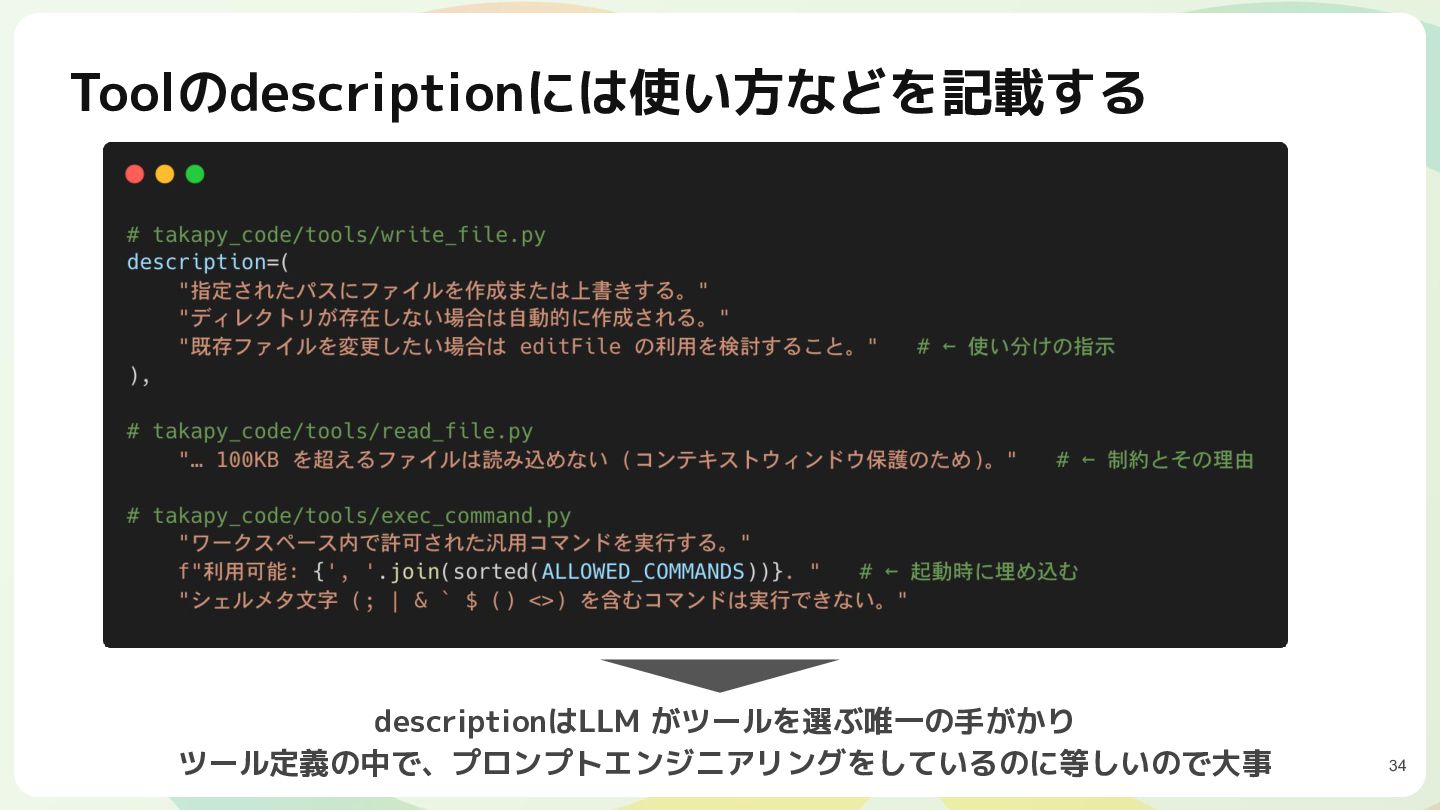
本日話すCoding Agentの構成要素 ① LLM APIとの対話 会話履歴とツール一覧を送り、テキストかツール呼び出しを受け取る ② Tool 実行 作業ディレクトリ内のファイルを読む/書く/編集する、コマンド実行する
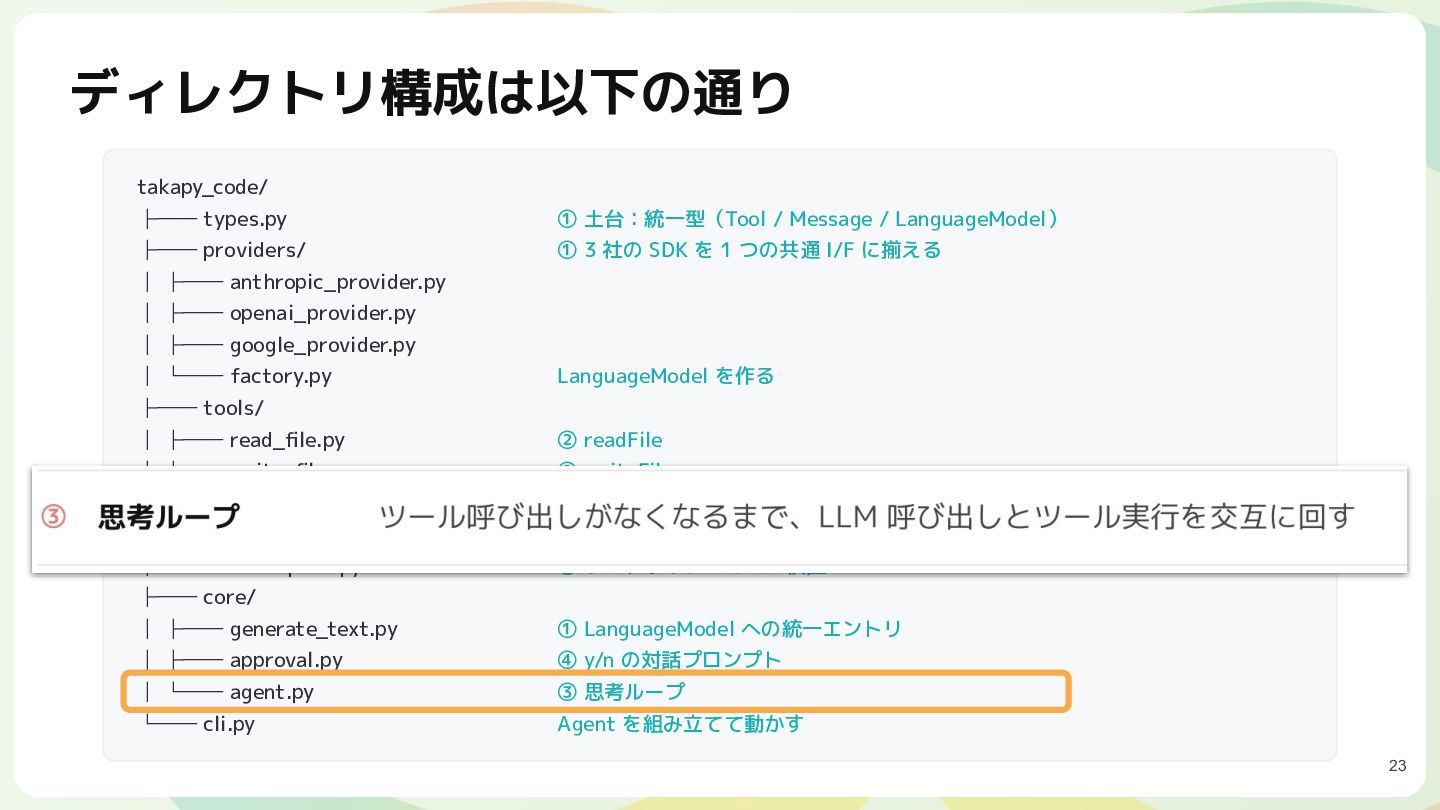
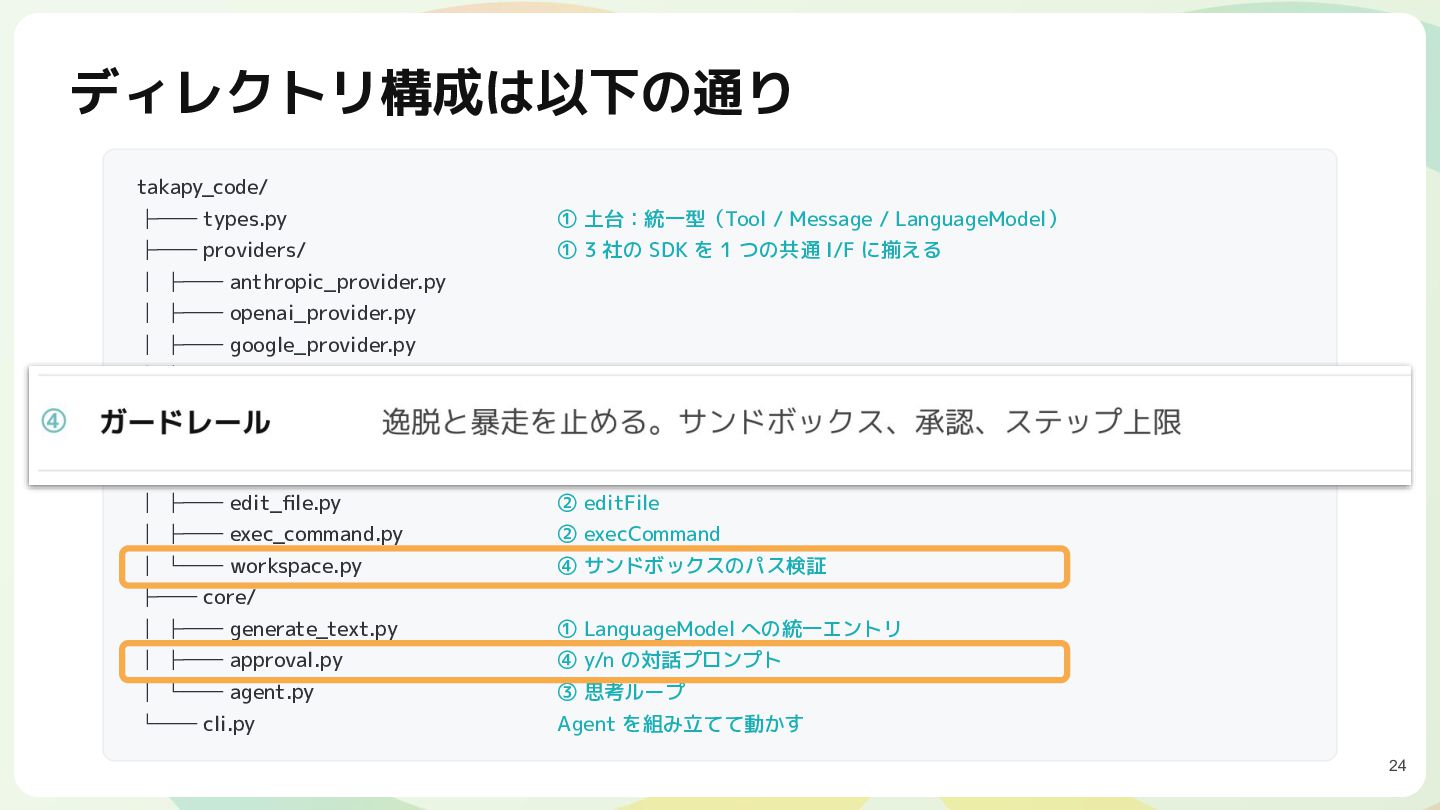
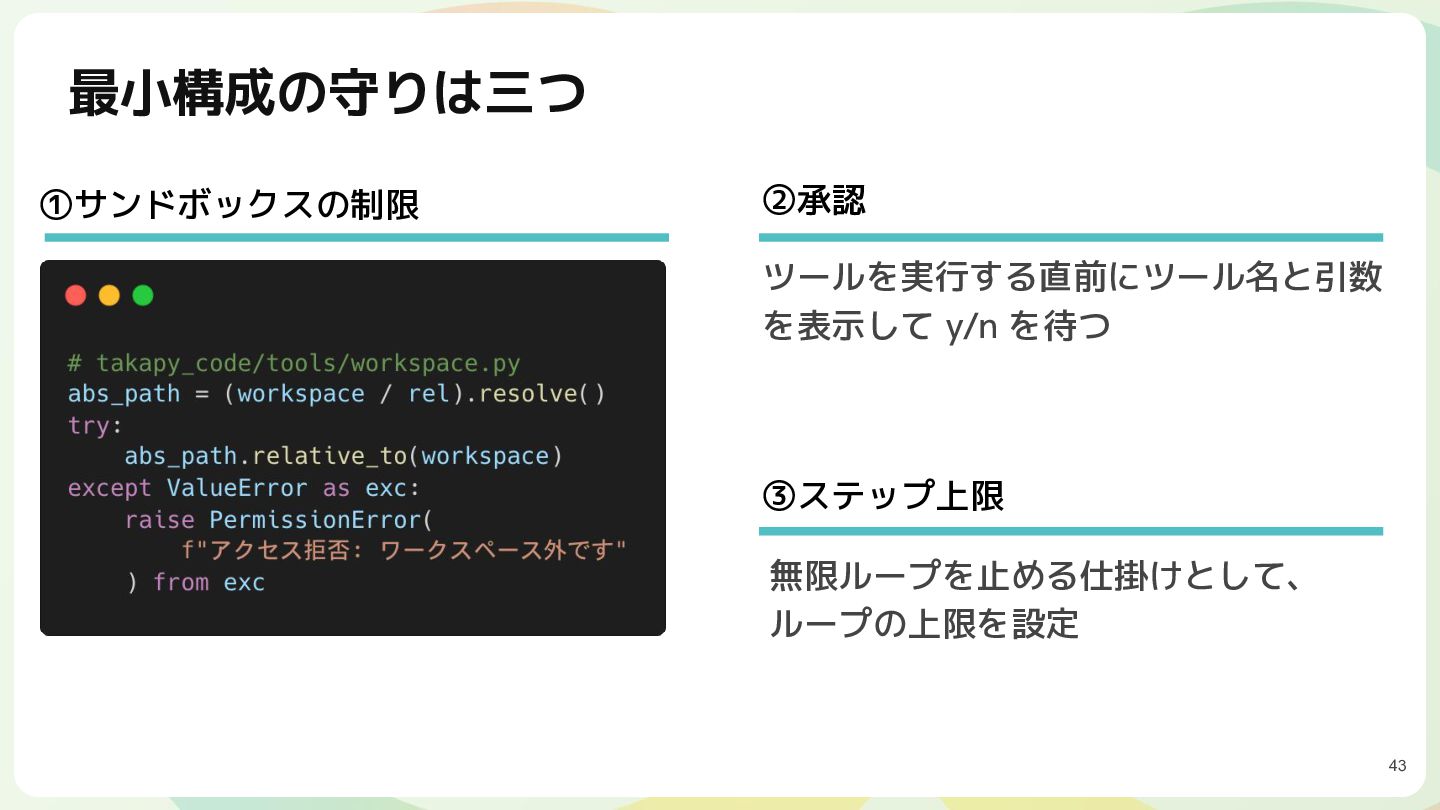
③ 思考ループ ツール呼び出しがなくなるまで、LLM呼び出しとツール実行を交互に回す ④ ガードレール 逸脱と暴走を止めるサンドボックス、承認、ステップ上限 15 -
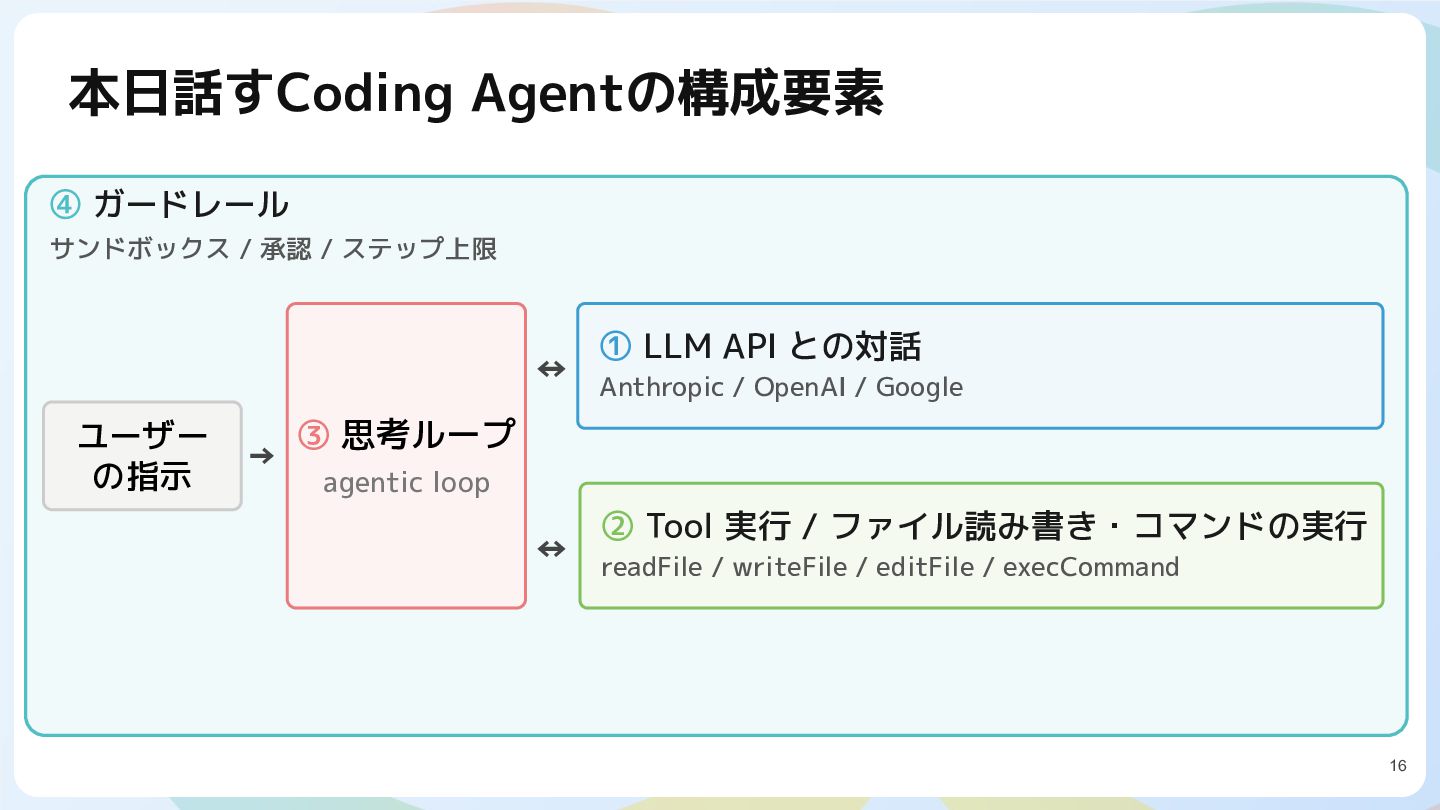
本日話すCoding Agentの構成要素 ④ ガードレール サンドボックス / 承認 / ステップ上限 ↔
ユーザー の指示 → ① LLM API との対話 Anthropic / OpenAI / Google ③ 思考ループ agentic loop ↔ ② Tool 実行 / ファイル読み書き・コマンドの実行 readFile / writeFile / editFile / execCommand 16 -
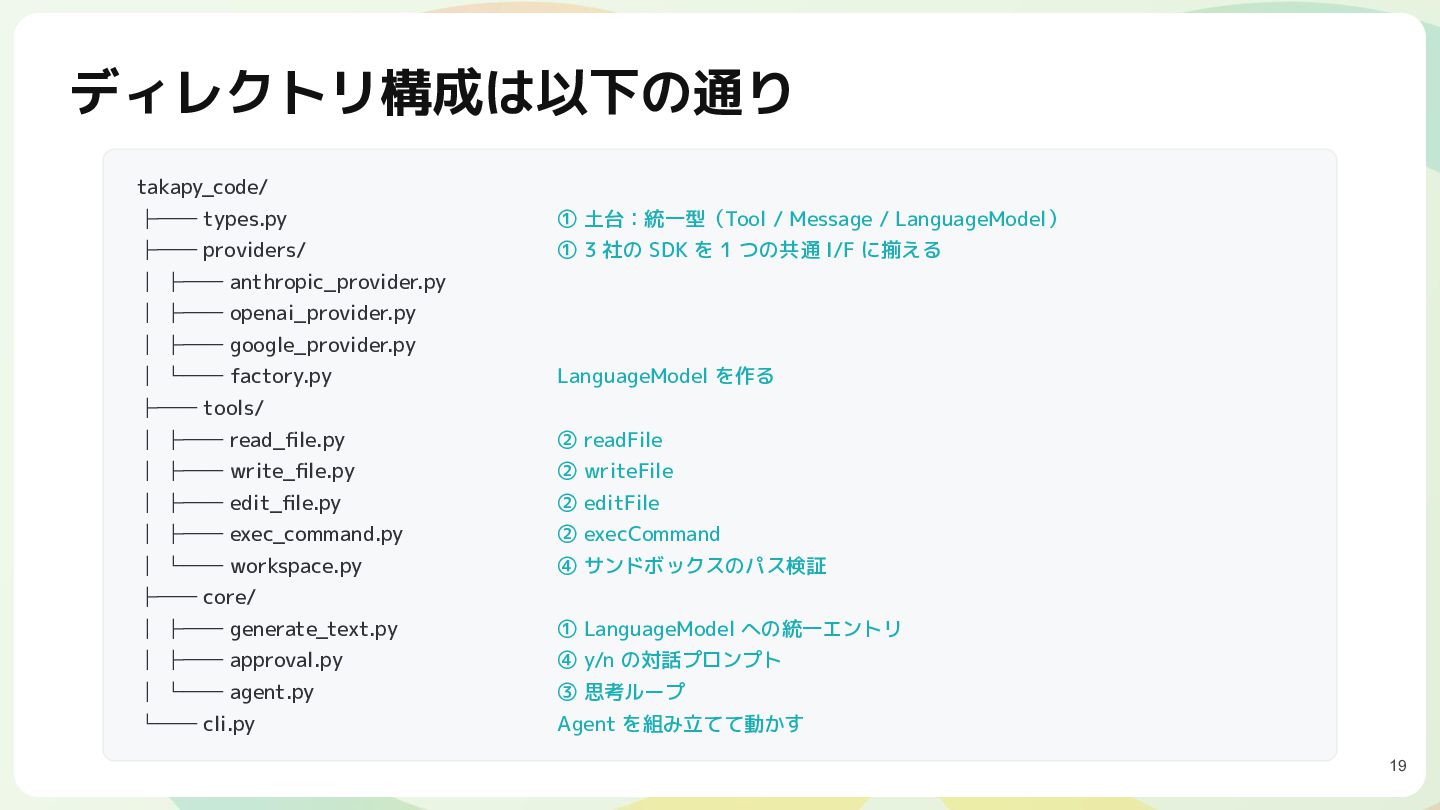
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py ② readFile │ ├── write_file.py ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 19 -
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py ② readFile │ ├── write_file.py ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 20 -
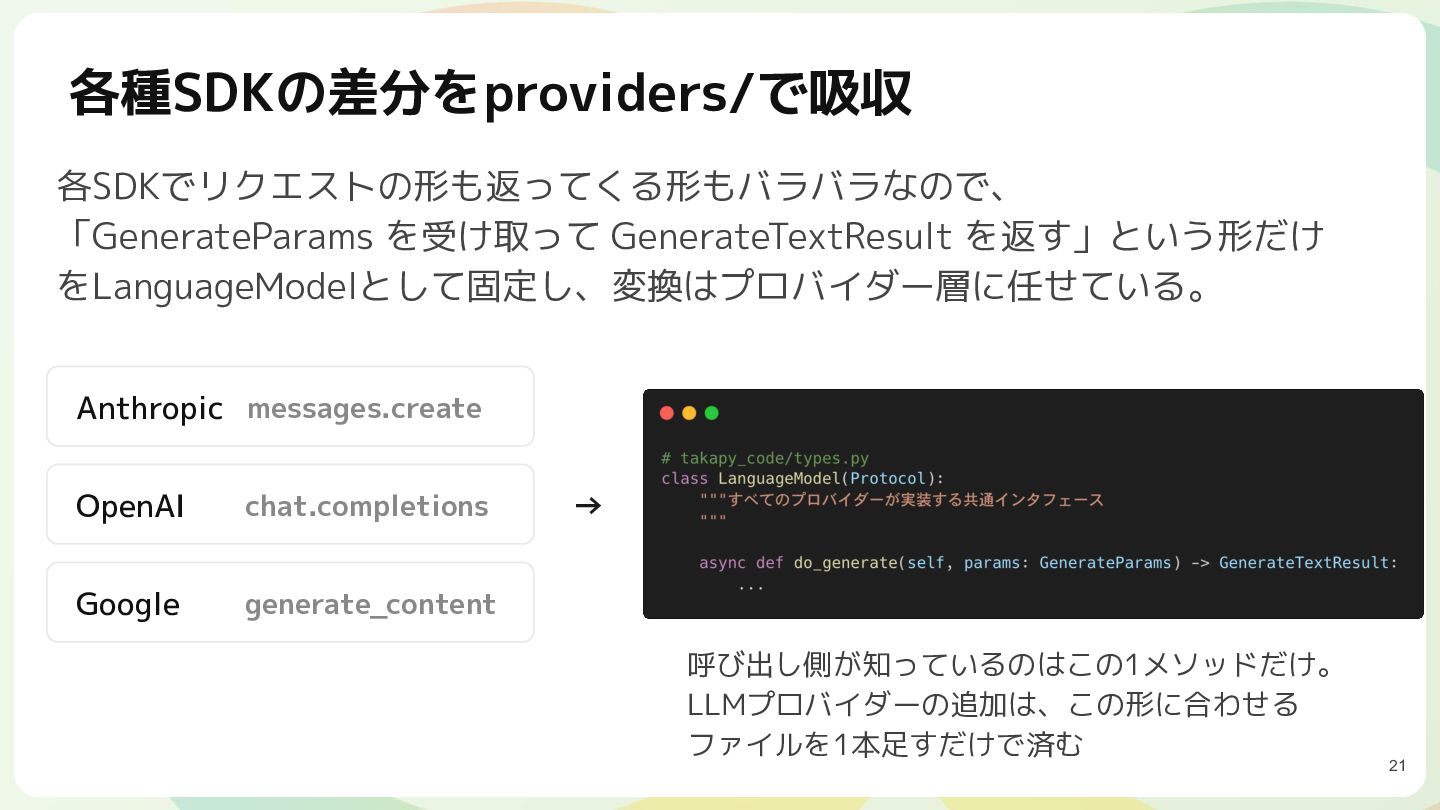
各種SDKの差分をproviders/で吸収 各SDKでリクエストの形も返ってくる形もバラバラなので、 「GenerateParams を受け取って GenerateTextResult を返す」という形だけ をLanguageModelとして固定し、変換はプロバイダー層に任せている。 Anthropic messages.create OpenAI
chat.completions Google generate_content → 呼び出し側が知っているのはこの1メソッドだけ。 LLMプロバイダーの追加は、この形に合わせる ファイルを1本足すだけで済む 21 -
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py ② readFile │ ├── write_file.py ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 22 -
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py ② readFile │ ├── write_file.py ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 23 -
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py ② readFile │ ├── write_file.py ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 24 -
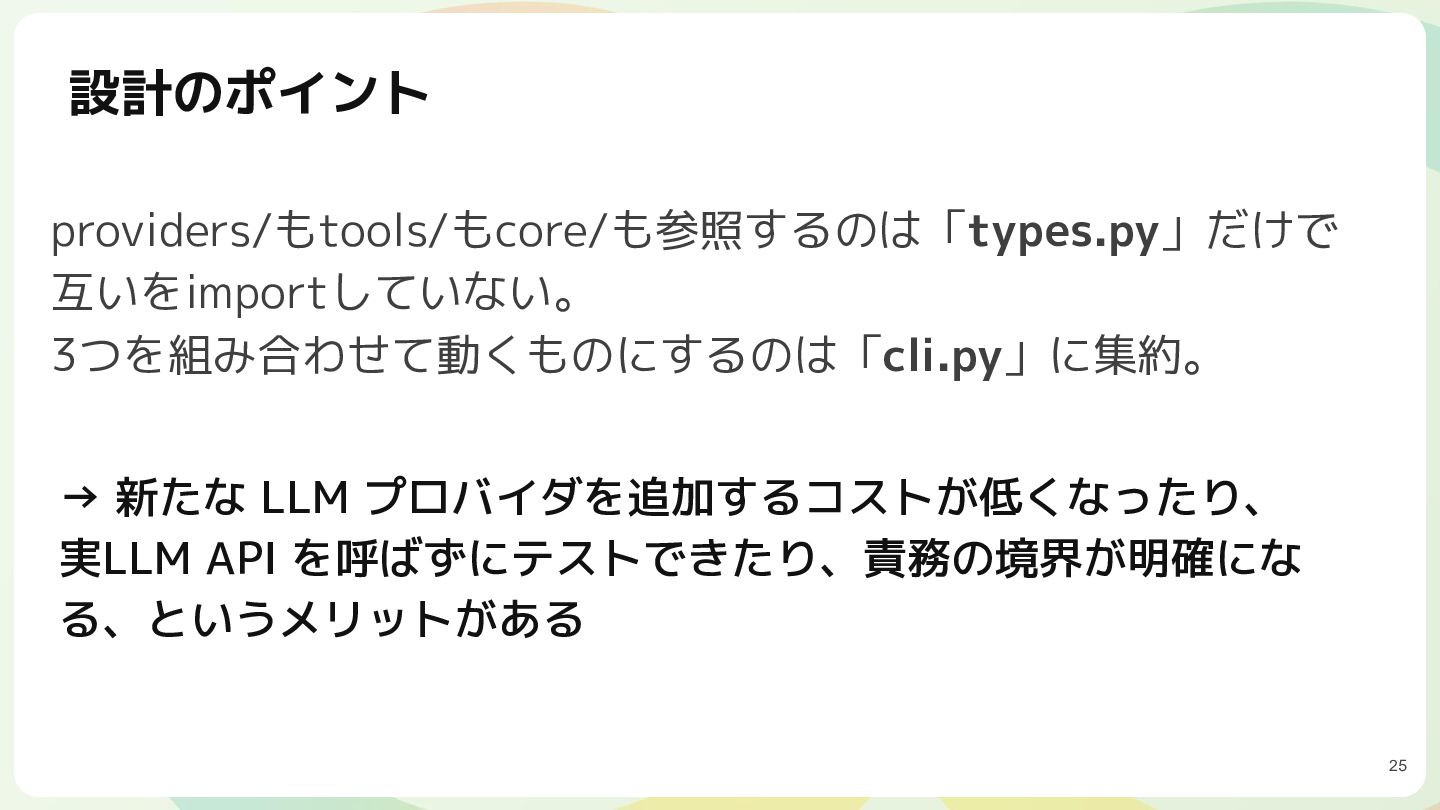
設計のポイント providers/もtools/もcore/も参照するのは「types.py」だけで 互いをimportしていない。 3つを組み合わせて動くものにするのは「cli.py」に集約。 → 新たな LLM プロバイダを追加するコストが低くなったり、 実LLM API
を呼ばずにテストできたり、責務の境界が明確にな る、というメリットがある 25 -
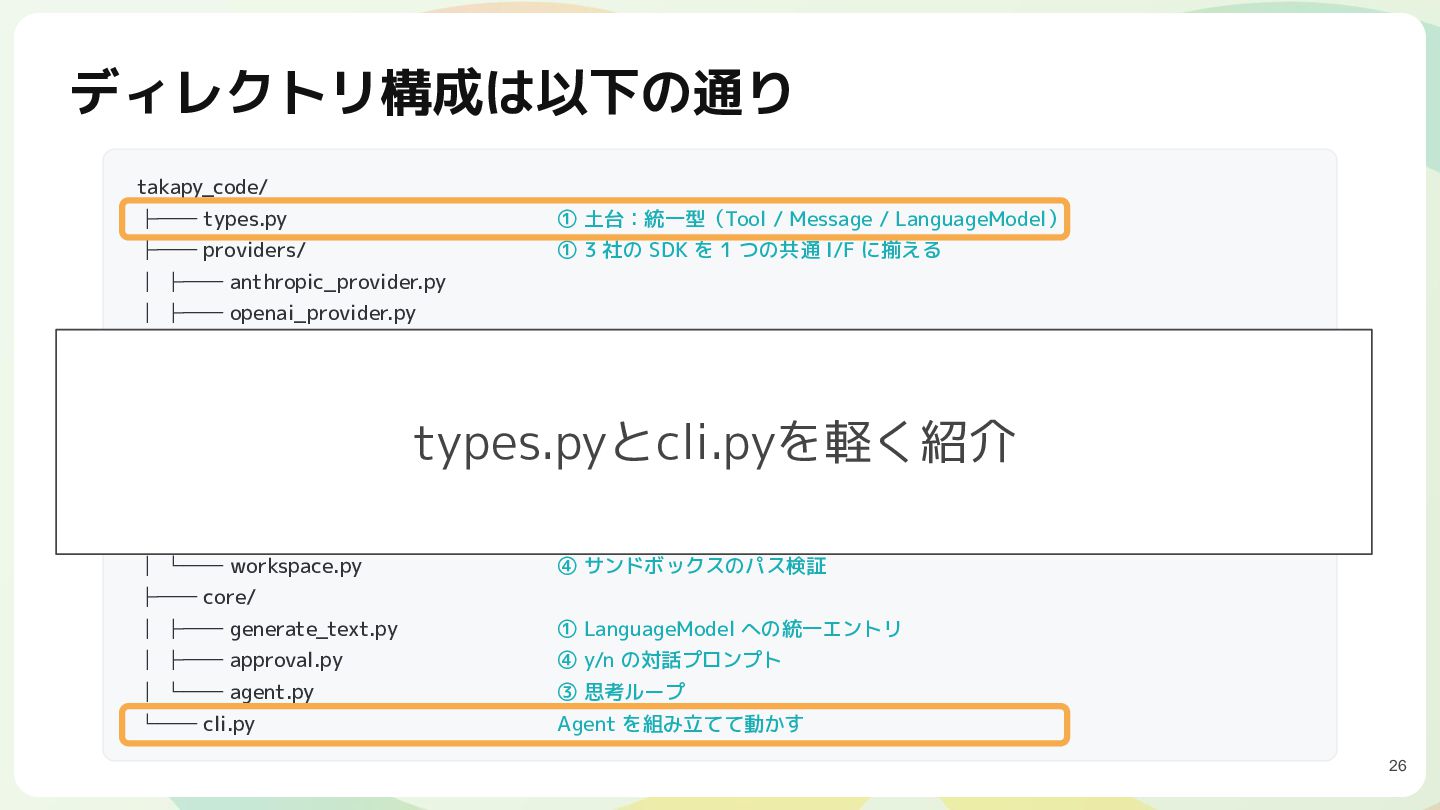
ディレクトリ構成は以下の通り takapy_code/ ├── types.py ① 土台:統一型(Tool / Message / LanguageModel)
├── providers/ ① 3 社の SDK を 1 つの共通 I/F に揃える │ ├── anthropic_provider.py │ ├── openai_provider.py │ ├── google_provider.py │ └── factory.py LanguageModel を作る ├── tools/ │ ├── read_file.py │ ├── write_file.py ② readFile types.pyとcli.pyを軽く紹介 ② writeFile │ ├── edit_file.py ② editFile │ ├── exec_command.py ② execCommand │ └── workspace.py ④ サンドボックスのパス検証 ├── core/ │ ├── generate_text.py ① LanguageModel への統一エントリ │ ├── approval.py ④ y/n の対話プロンプト │ └── agent.py ③ 思考ループ └── cli.py Agent を組み立てて動かす 26 -
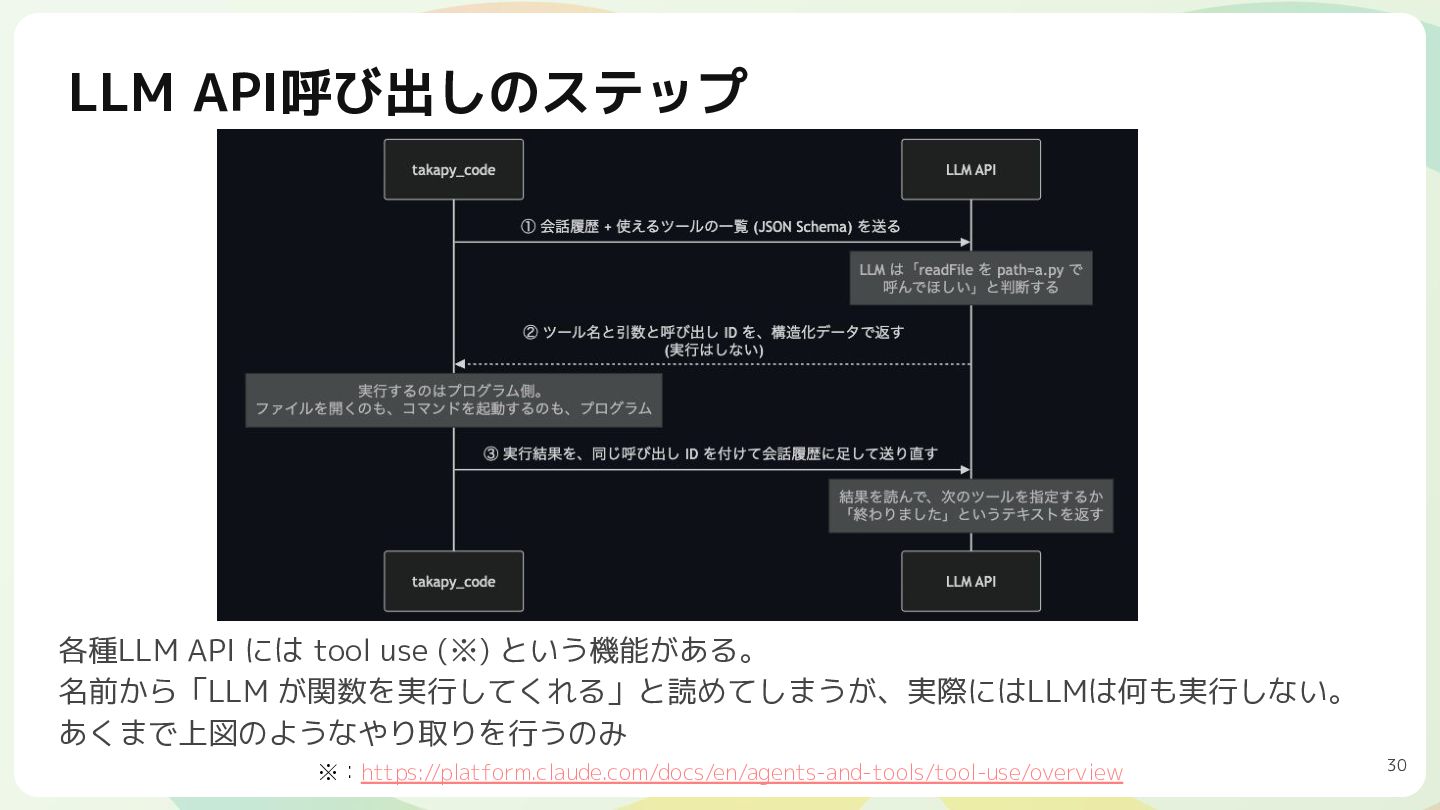
LLM API呼び出しのステップ 各種LLM API には tool use (※) という機能がある。 名前から「LLM
が関数を実行してくれる」と読めてしまうが、実際にはLLMは何も実行しない。 あくまで上図のようなやり取りを行うのみ ※:https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview 30 -
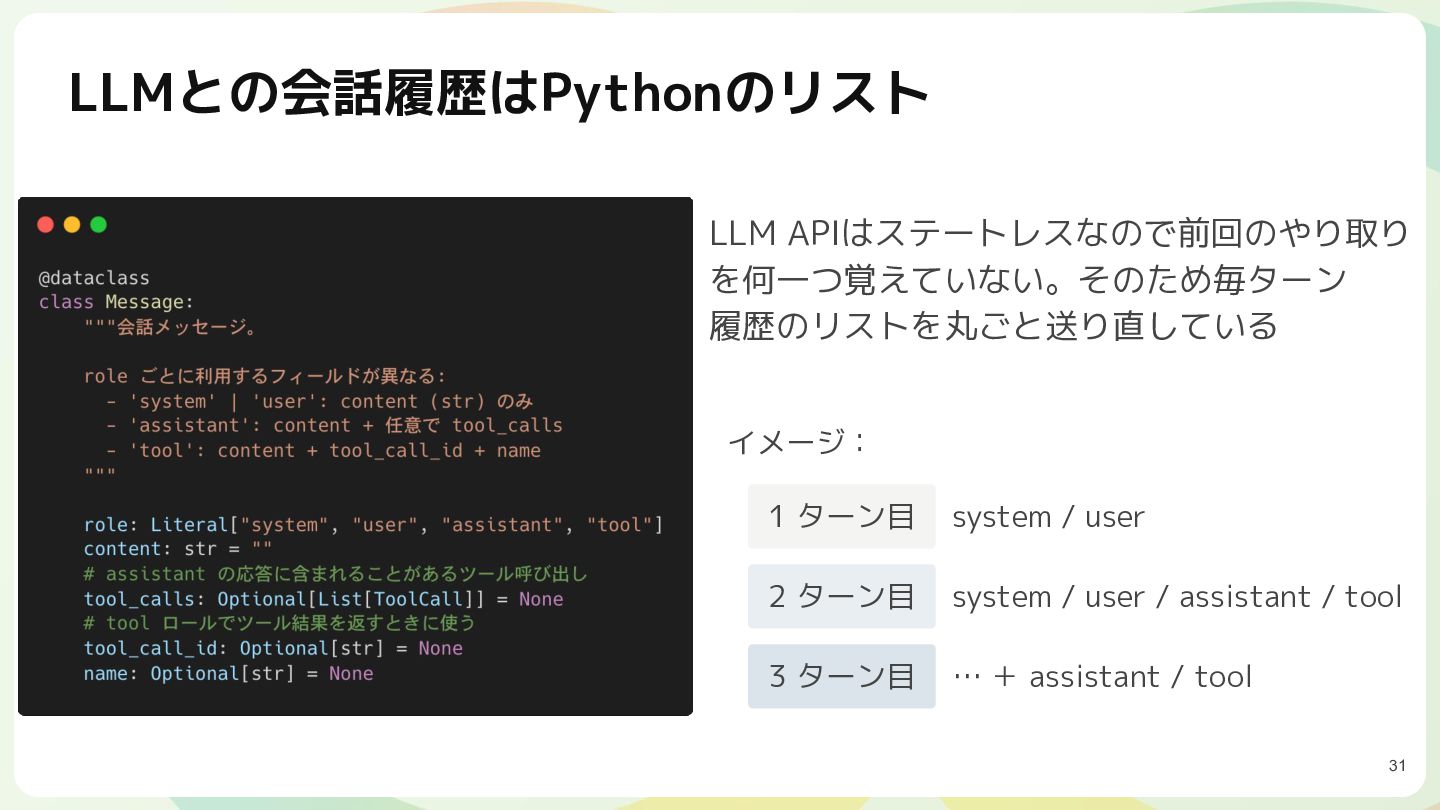
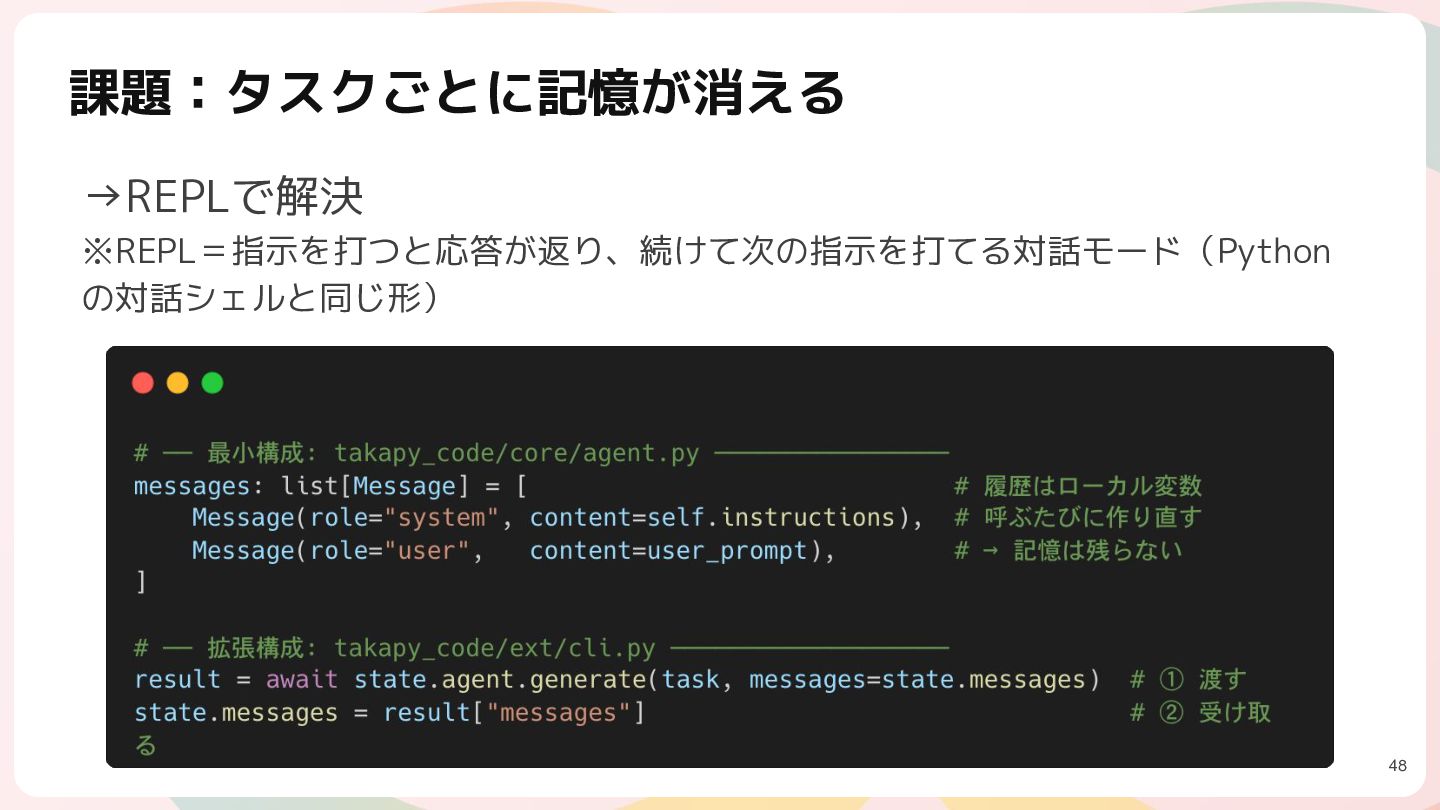
LLMとの会話履歴はPythonのリスト LLM APIはステートレスなので前回のやり取り を何一つ覚えていない。そのため毎ターン 履歴のリストを丸ごと送り直している イメージ: 1 ターン目 system /
user 2 ターン目 system / user / assistant / tool 3 ターン目 … + assistant / tool 31 -
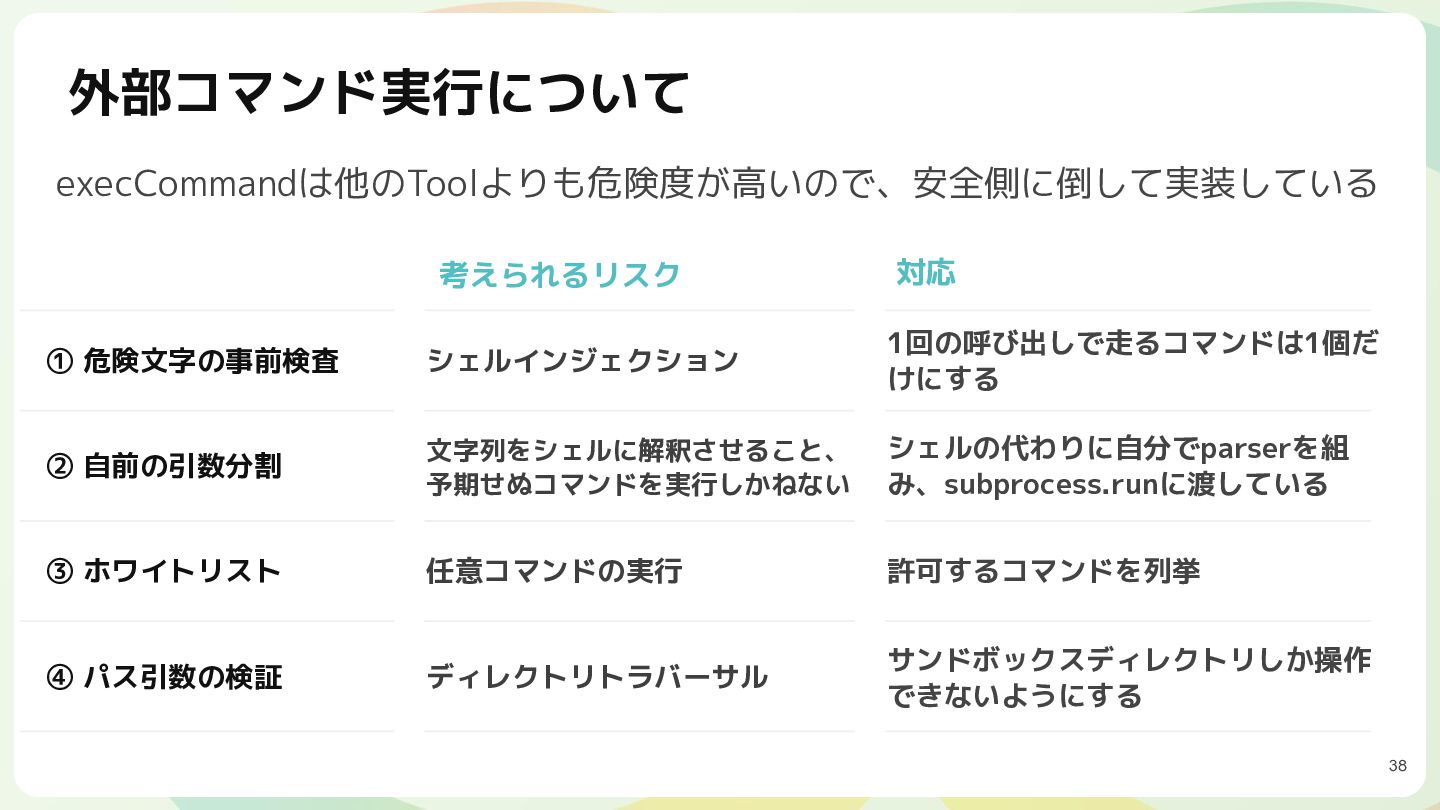
外部コマンド実行について execCommandは他のToolよりも危険度が高いので、安全側に倒して実装している 考えられるリスク 対応 ① 危険文字の事前検査 シェルインジェクション 1回の呼び出しで走るコマンドは1個だ けにする ②
自前の引数分割 文字列をシェルに解釈させること、 予期せぬコマンドを実行しかねない シェルの代わりに自分でparserを組 み、subprocess.runに渡している ③ ホワイトリスト 任意コマンドの実行 許可するコマンドを列挙 ④ パス引数の検証 ディレクトリトラバーサル サンドボックスディレクトリしか操作 できないようにする 38 -
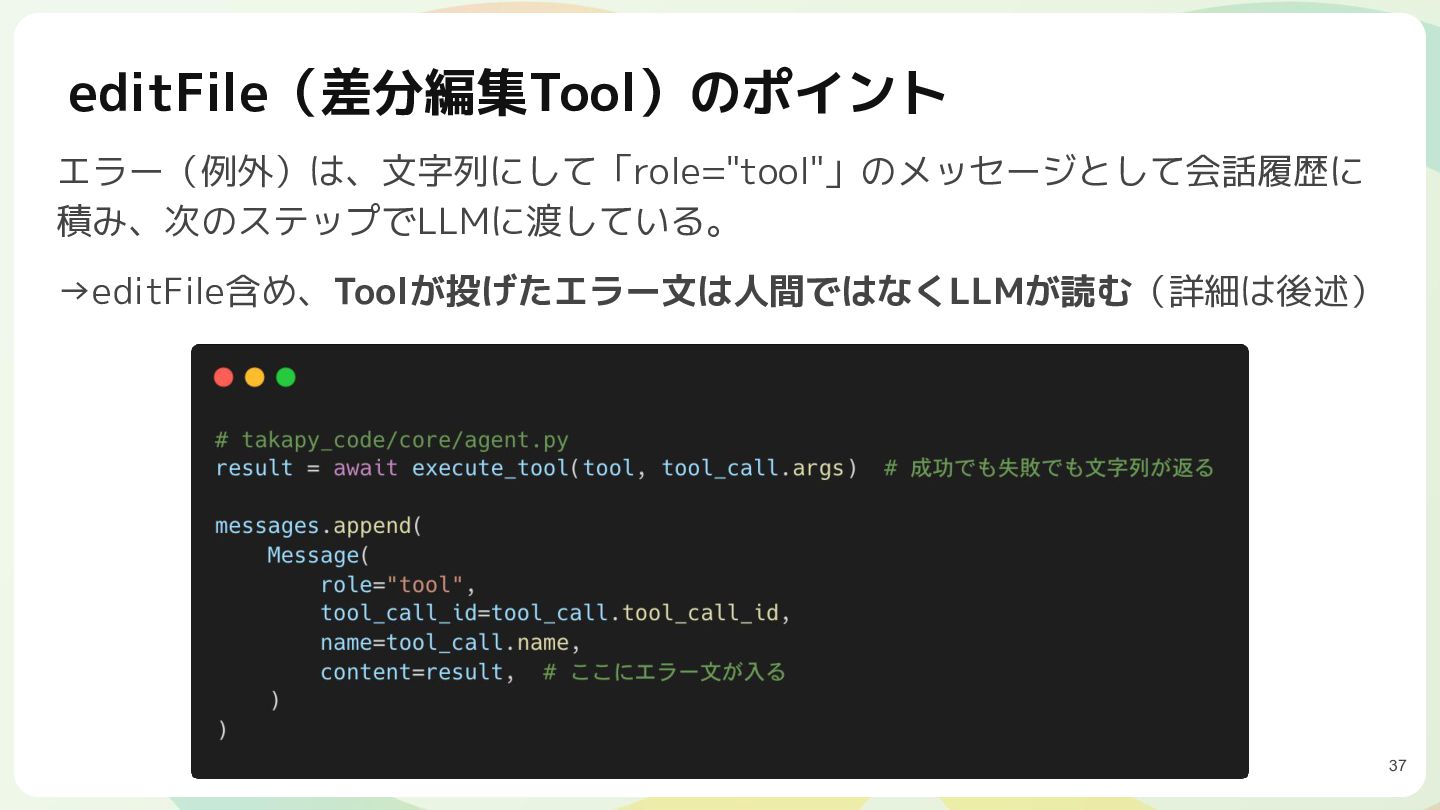
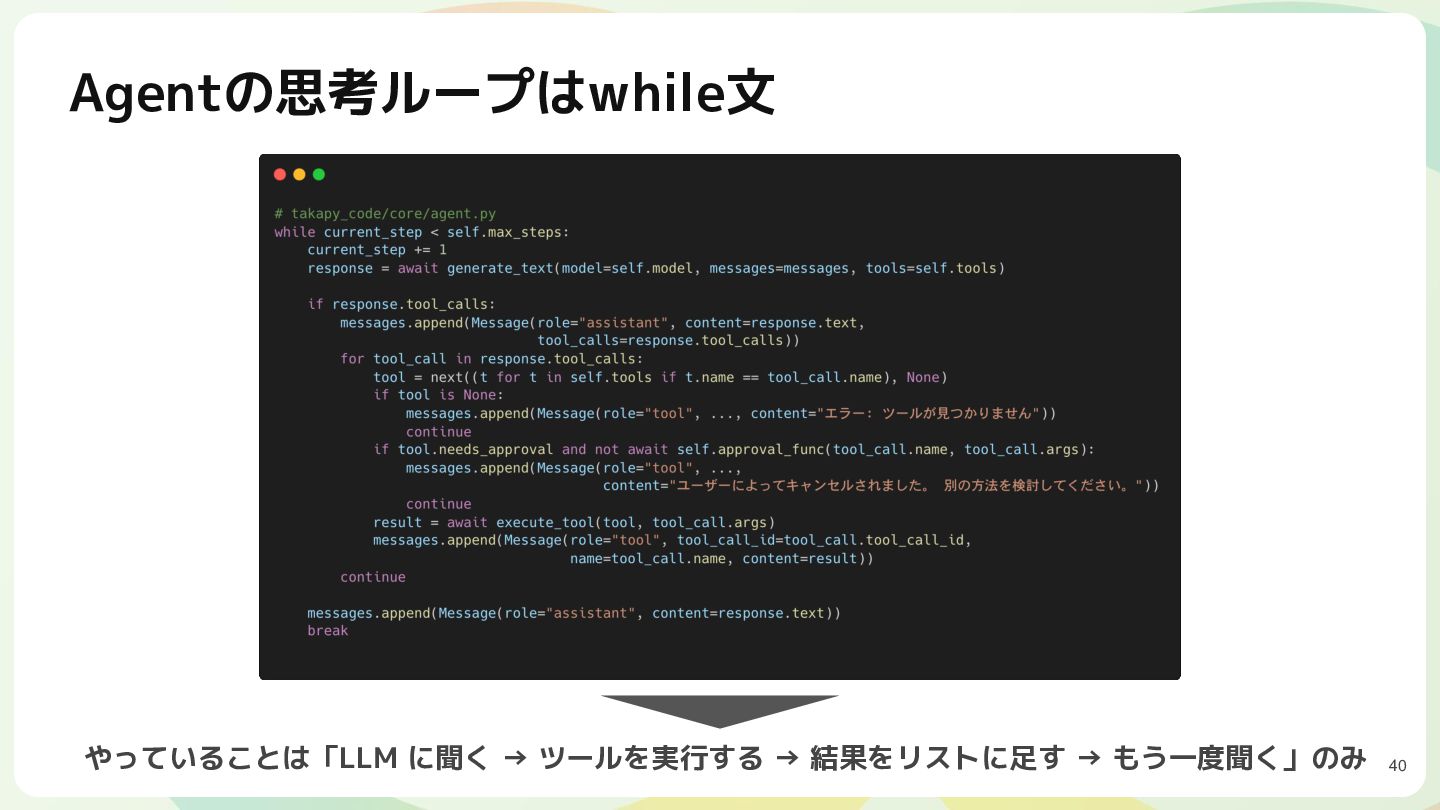
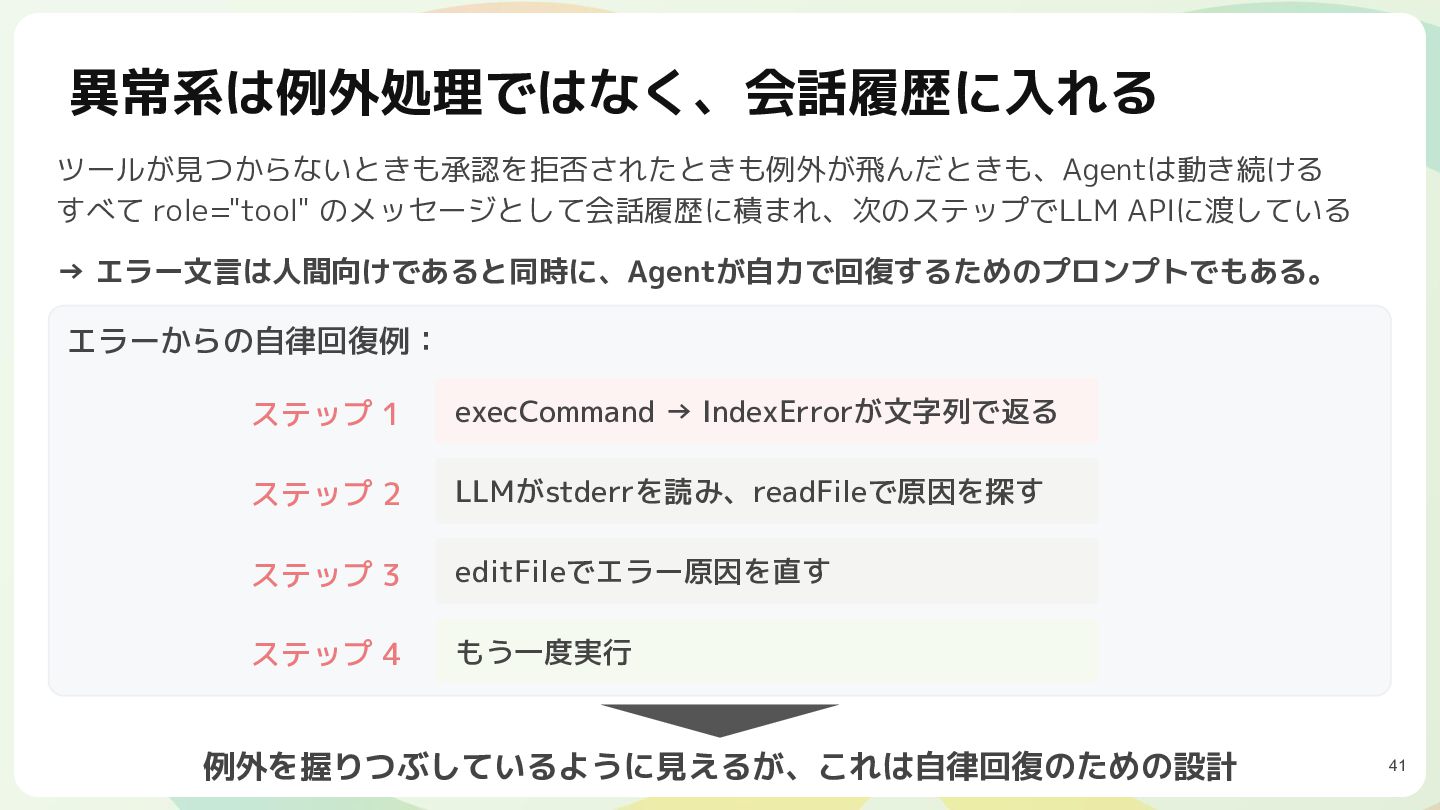
異常系は例外処理ではなく、会話履歴に入れる ツールが見つからないときも承認を拒否されたときも例外が飛んだときも、Agentは動き続ける すべて role="tool" のメッセージとして会話履歴に積まれ、次のステップでLLM APIに渡している → エラー文言は人間向けであると同時に、Agentが自力で回復するためのプロンプトでもある。 エラーからの自律回復例: ステップ
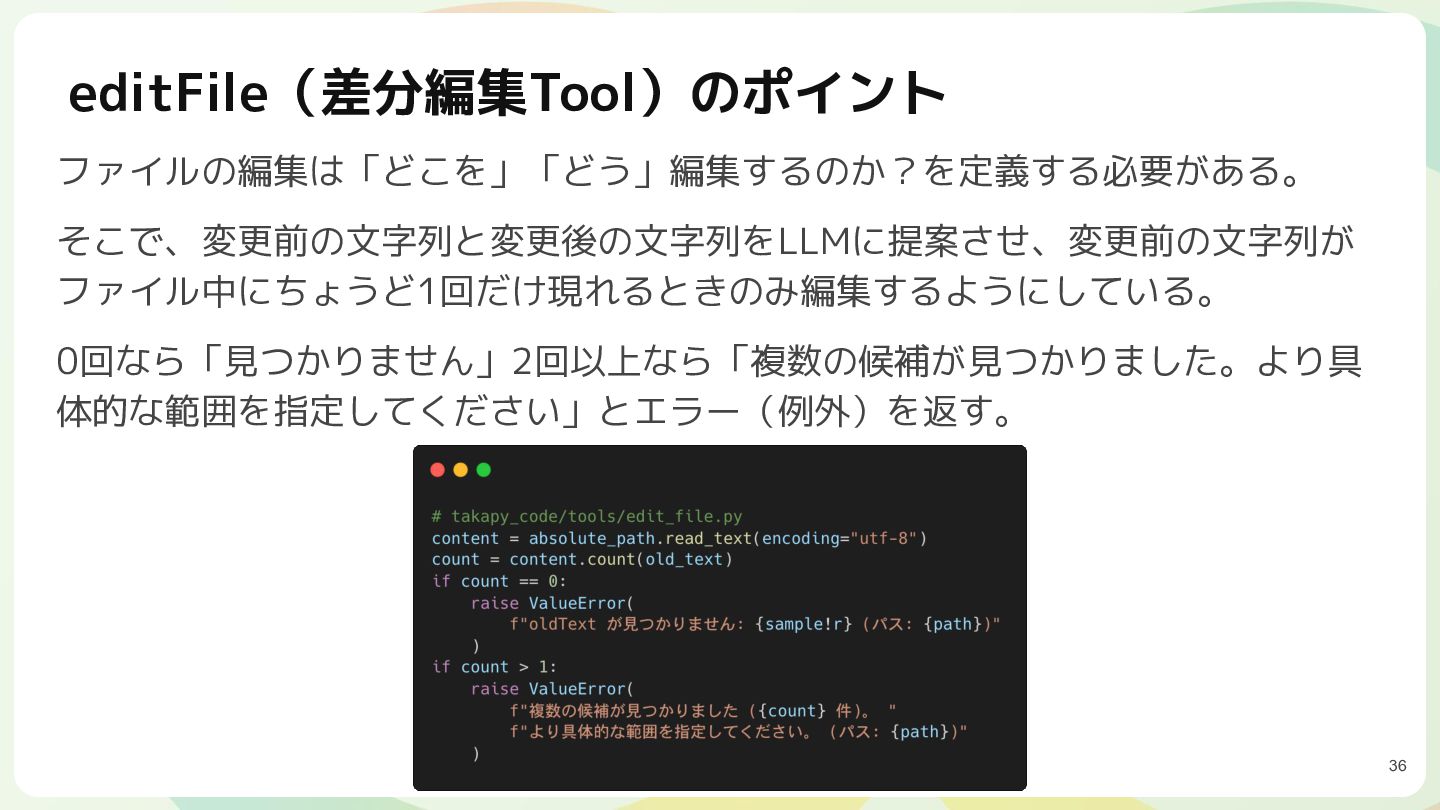
1 execCommand → IndexErrorが文字列で返る ステップ 2 LLMがstderrを読み、readFileで原因を探す ステップ 3 editFileでエラー原因を直す ステップ 4 もう一度実行 例外を握りつぶしているように見えるが、これは自律回復のための設計 41 -
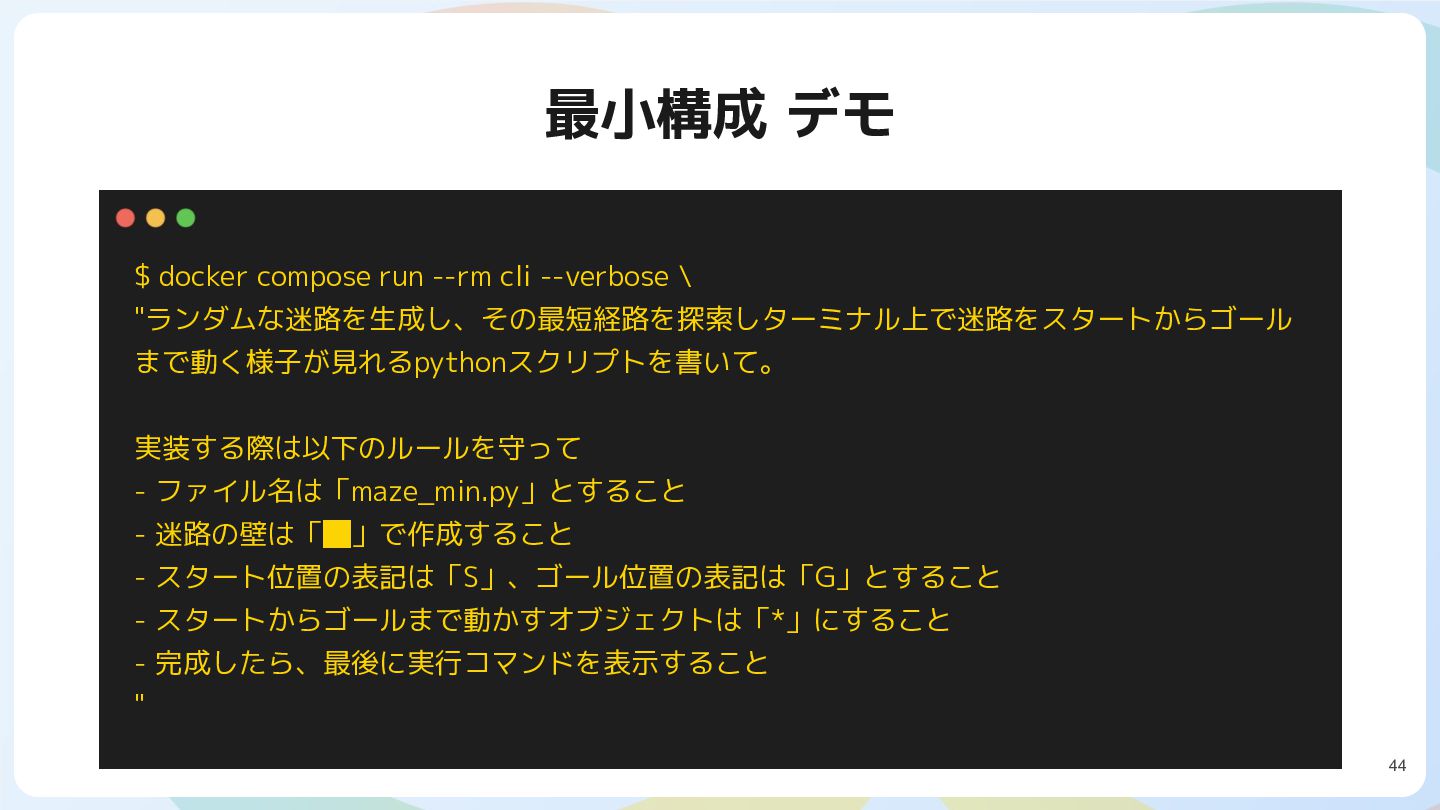
最小構成 デモ $ docker compose run --rm cli --verbose \
"ランダムな迷路を生成し、その最短経路を探索しターミナル上で迷路をスタートからゴール まで動く様子が見れるpythonスクリプトを書いて。 実装する際は以下のルールを守って - ファイル名は「maze_min.py」とすること - 迷路の壁は「█」で作成すること - スタート位置の表記は「S」、ゴール位置の表記は「G」とすること - スタートからゴールまで動かすオブジェクトは「*」にすること - 完成したら、最後に実行コマンドを表示すること " 44 -
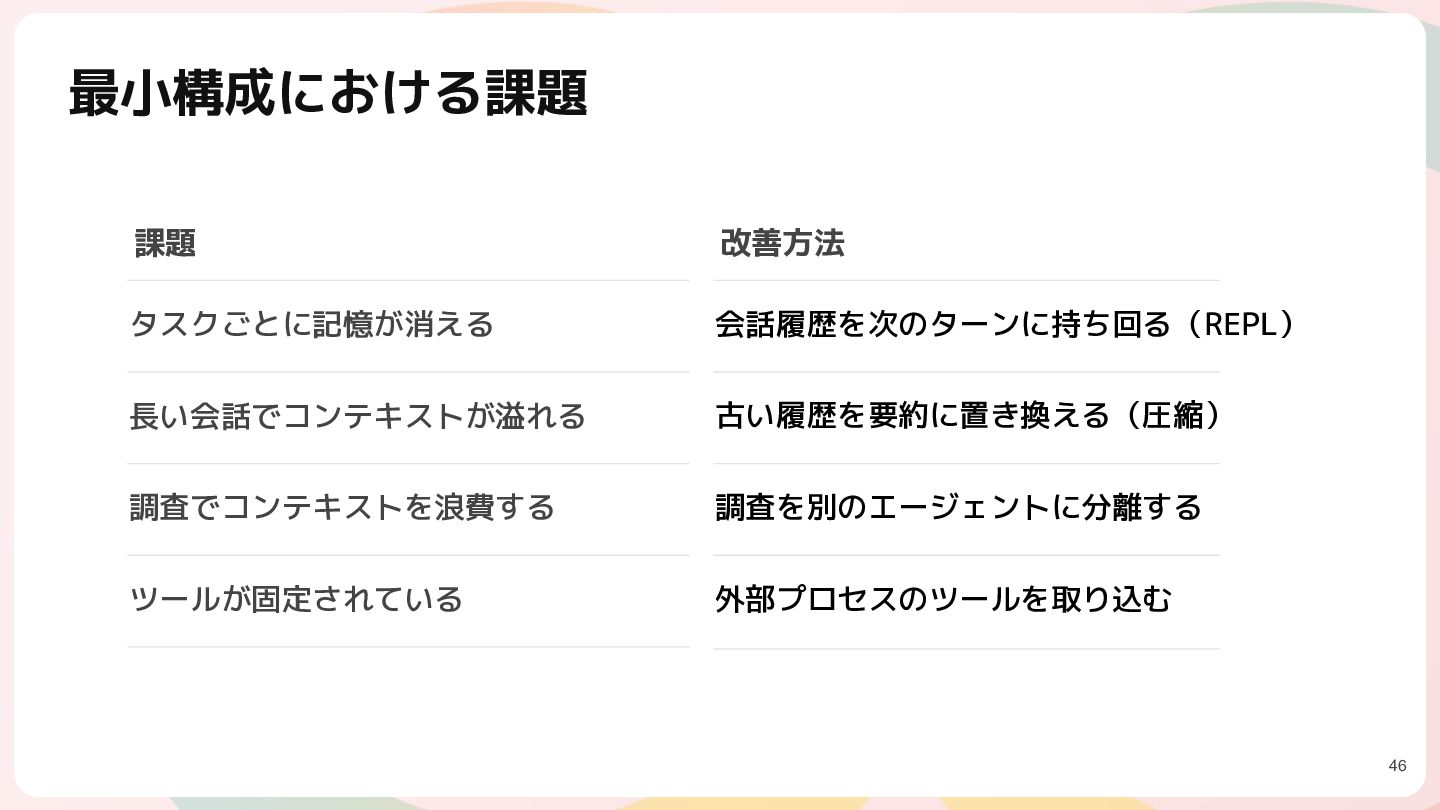
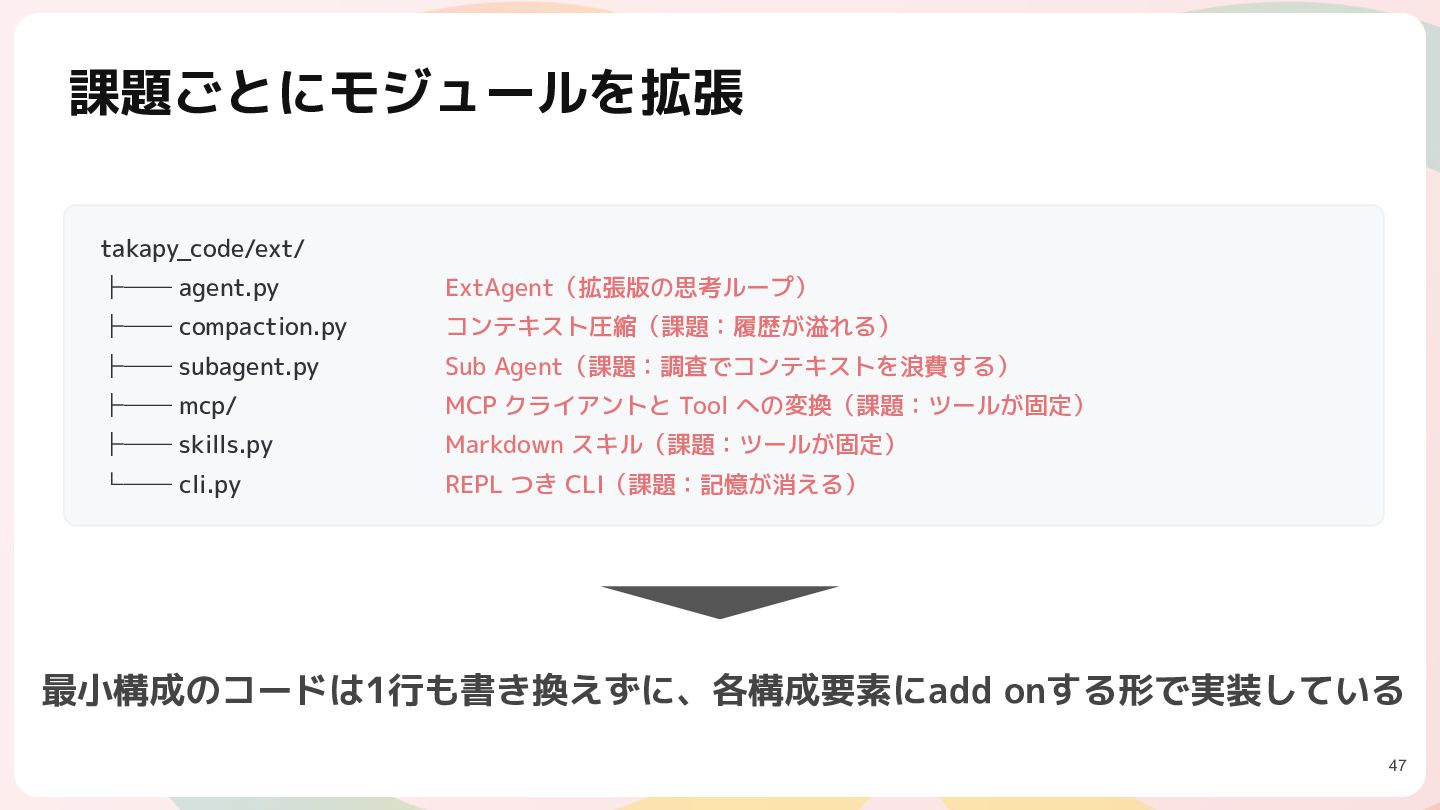
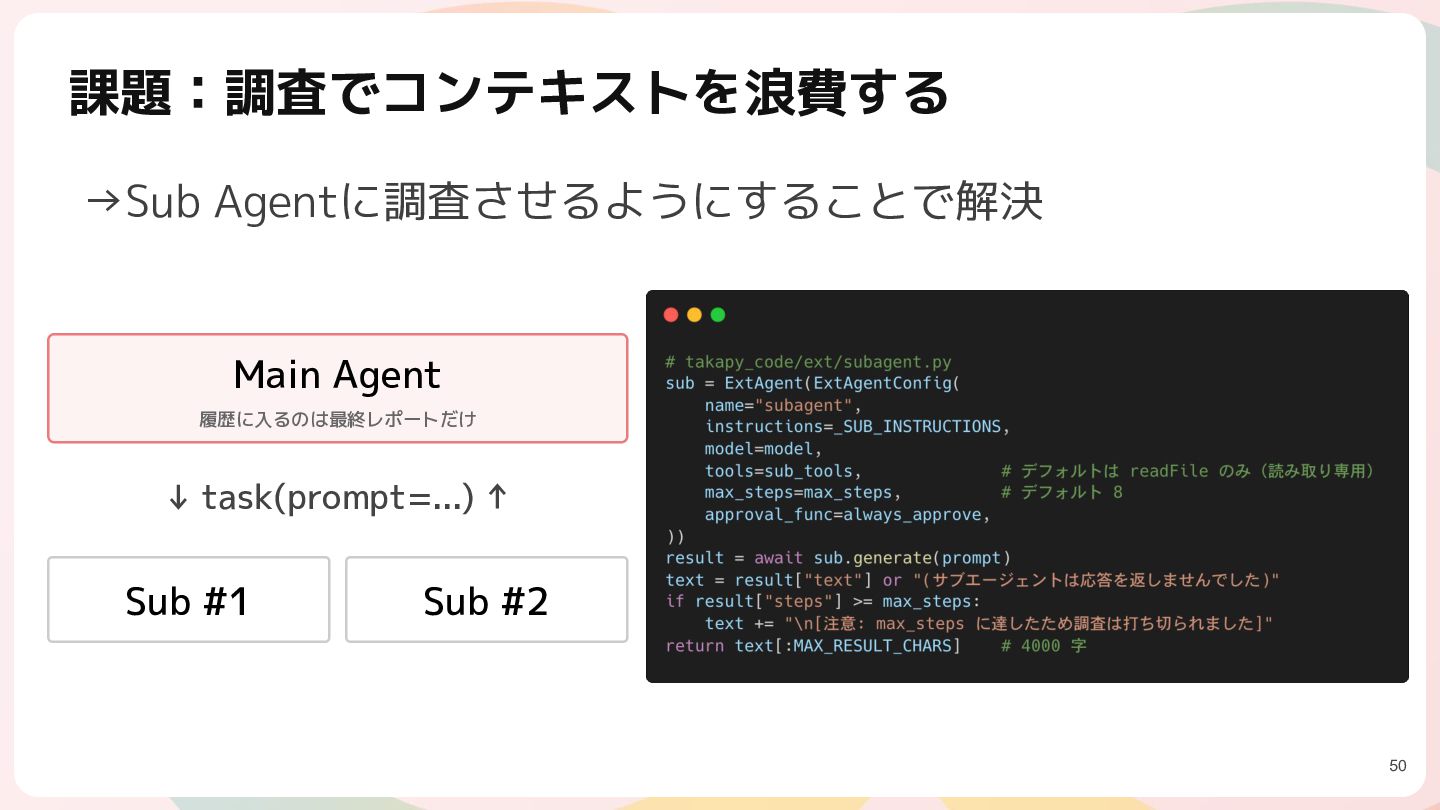
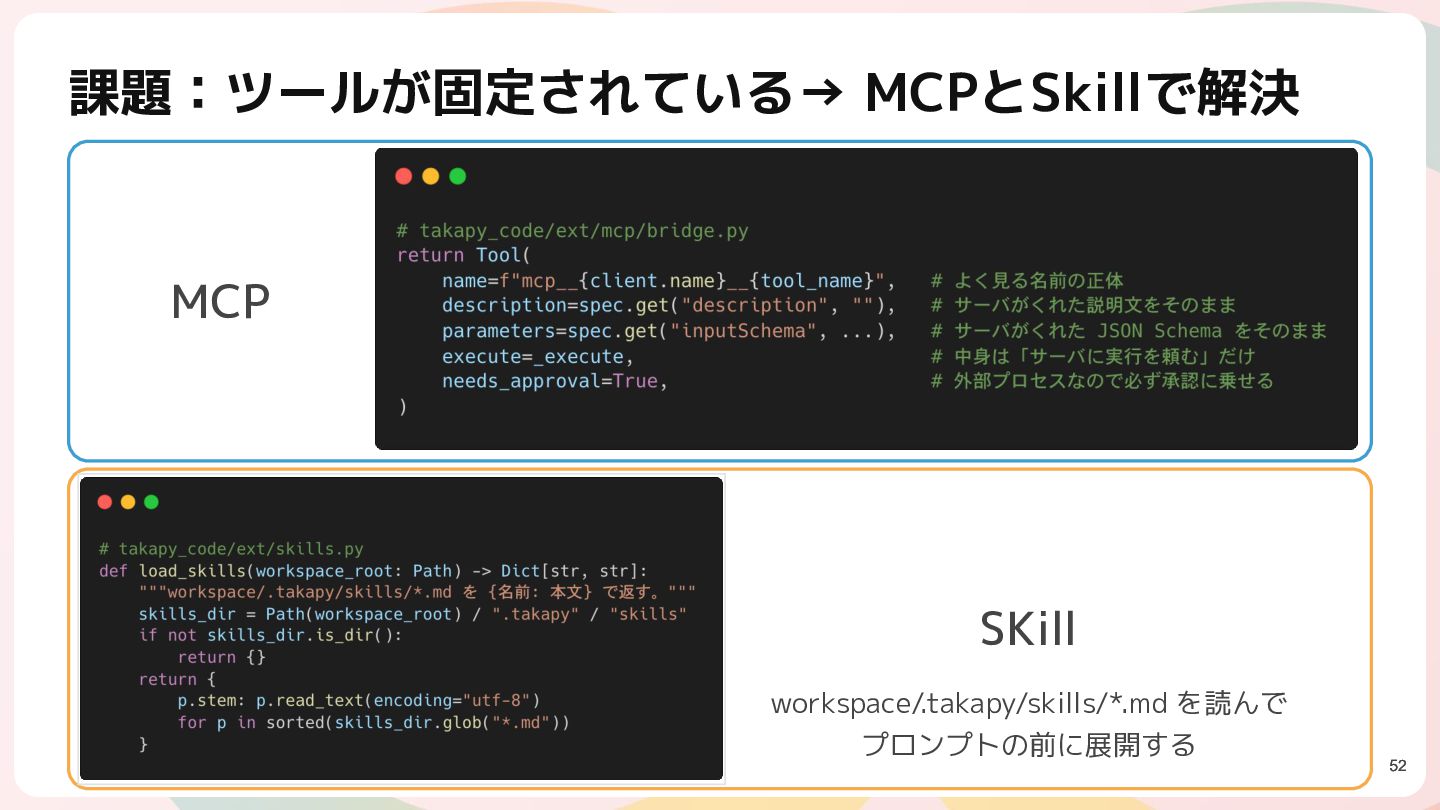
課題ごとにモジュールを拡張 takapy_code/ext/ ├── agent.py ExtAgent(拡張版の思考ループ) ├── compaction.py コンテキスト圧縮(課題:履歴が溢れる) ├── subagent.py
Sub Agent(課題:調査でコンテキストを浪費する) ├── mcp/ MCP クライアントと Tool への変換(課題:ツールが固定) ├── skills.py Markdown スキル(課題:ツールが固定) └── cli.py REPL つき CLI(課題:記憶が消える) 最小構成のコードは1行も書き換えずに、各構成要素にadd onする形で実装している 47 -
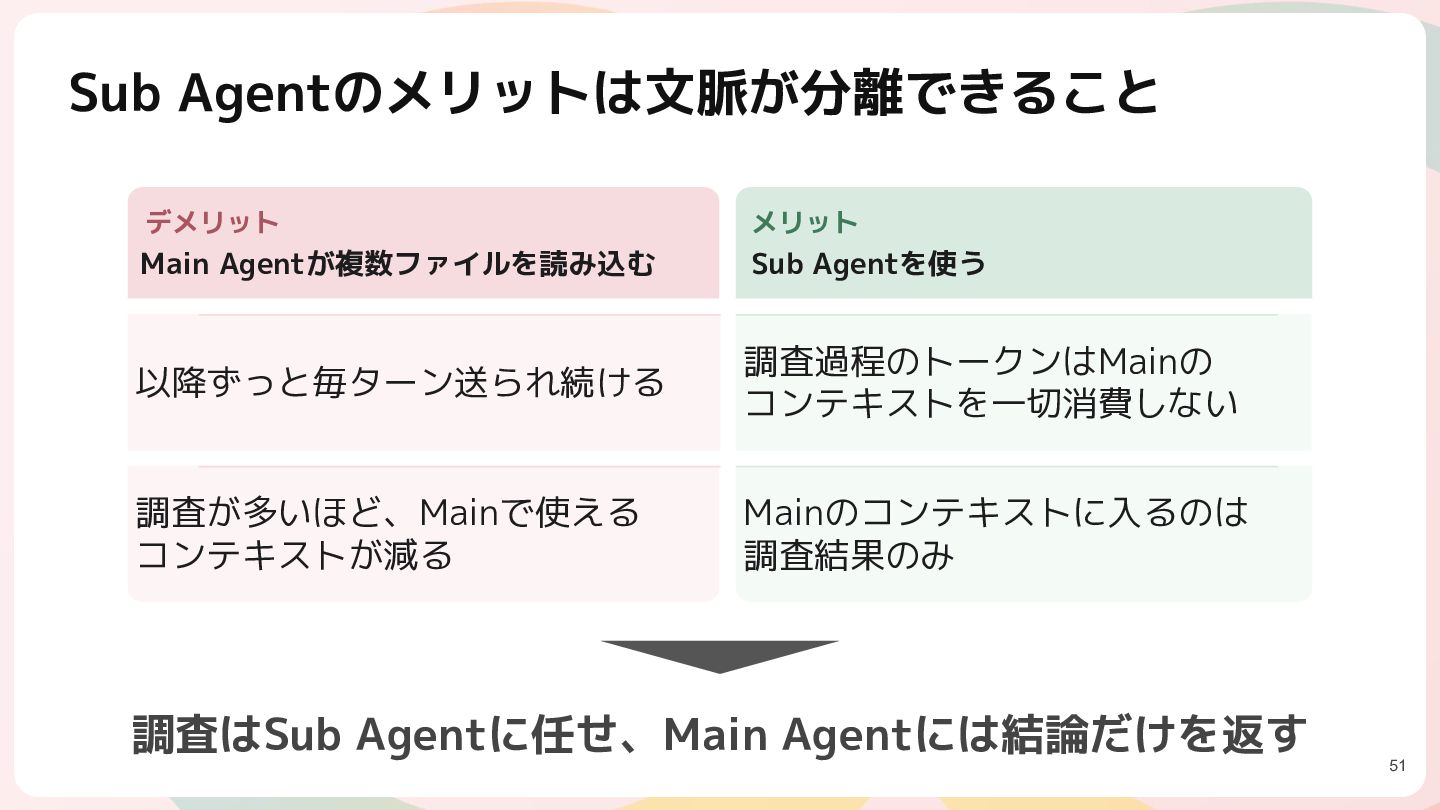
Sub Agentのメリットは文脈が分離できること デメリット メリット Main Agentが複数ファイルを読み込む Sub Agentを使う 以降ずっと毎ターン送られ続ける 調査過程のトークンはMainの
コンテキストを一切消費しない 調査が多いほど、Mainで使える コンテキストが減る Mainのコンテキストに入るのは 調査結果のみ 調査はSub Agentに任せ、Main Agentには結論だけを返す 51 -
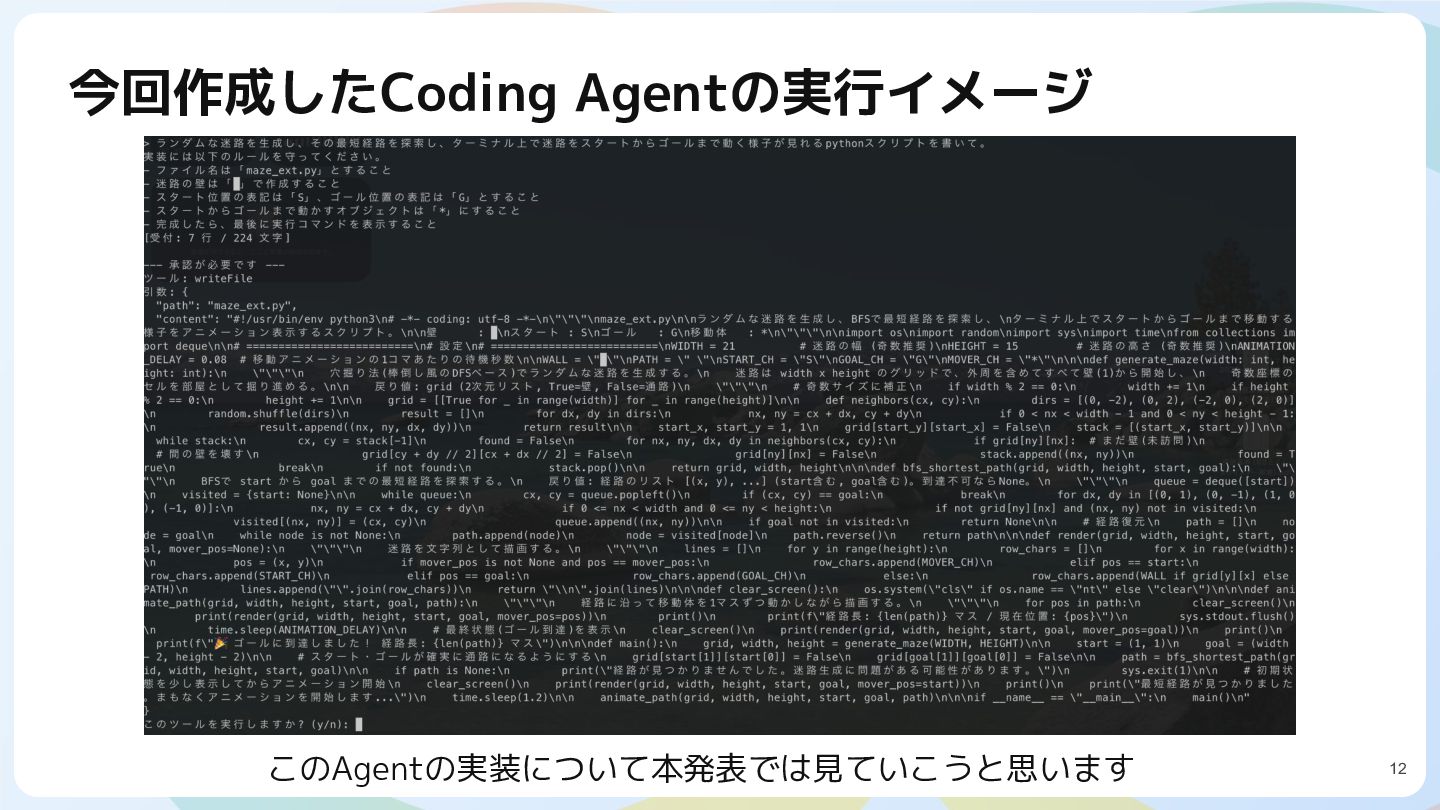
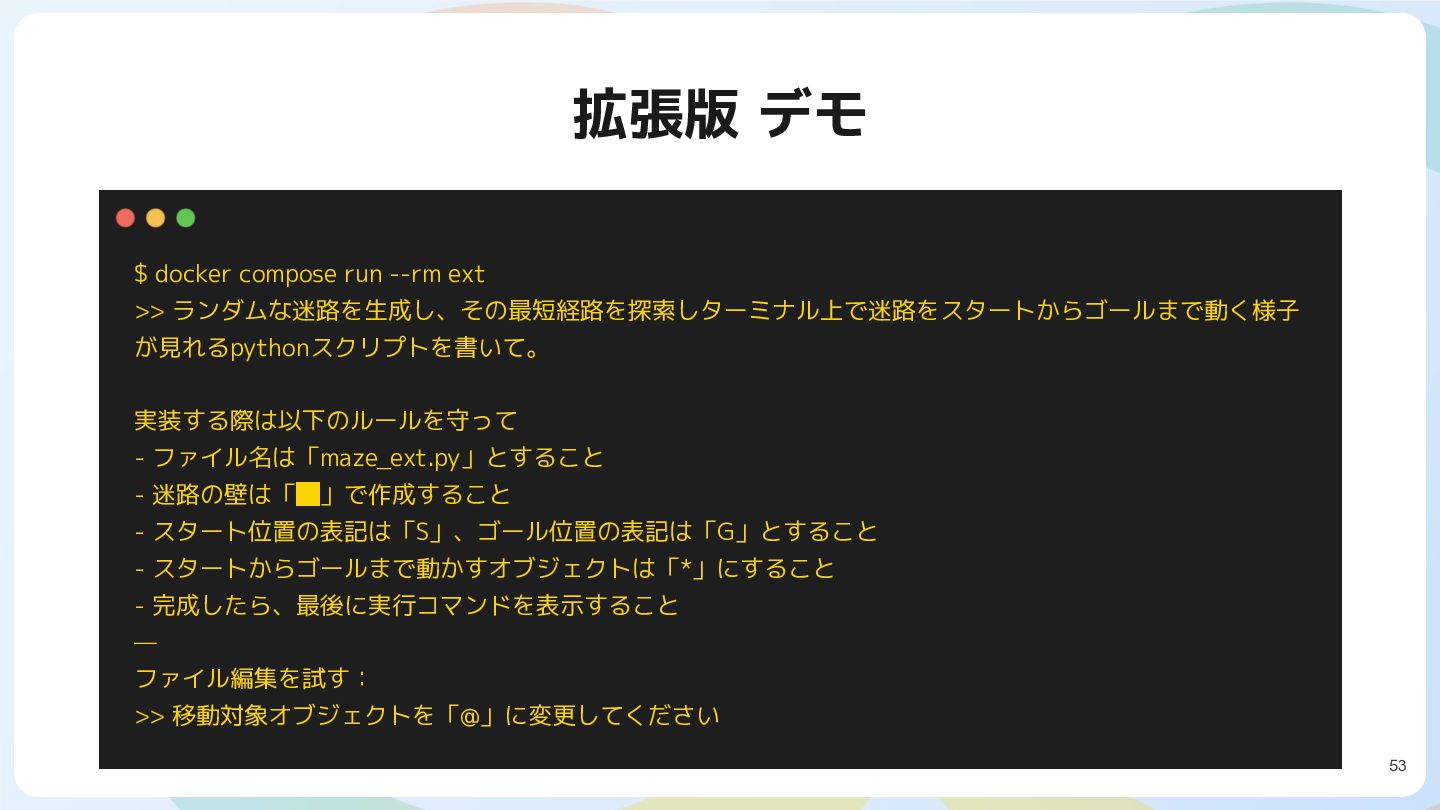
拡張版 デモ $ docker compose run --rm ext >> ランダムな迷路を生成し、その最短経路を探索しターミナル上で迷路をスタートからゴールまで動く様子
が見れるpythonスクリプトを書いて。 実装する際は以下のルールを守って - ファイル名は「maze_ext.py」とすること - 迷路の壁は「█」で作成すること - スタート位置の表記は「S」、ゴール位置の表記は「G」とすること - スタートからゴールまで動かすオブジェクトは「*」にすること - 完成したら、最後に実行コマンドを表示すること — ファイル編集を試す: >> 移動対象オブジェクトを「@」に変更してください 53 -
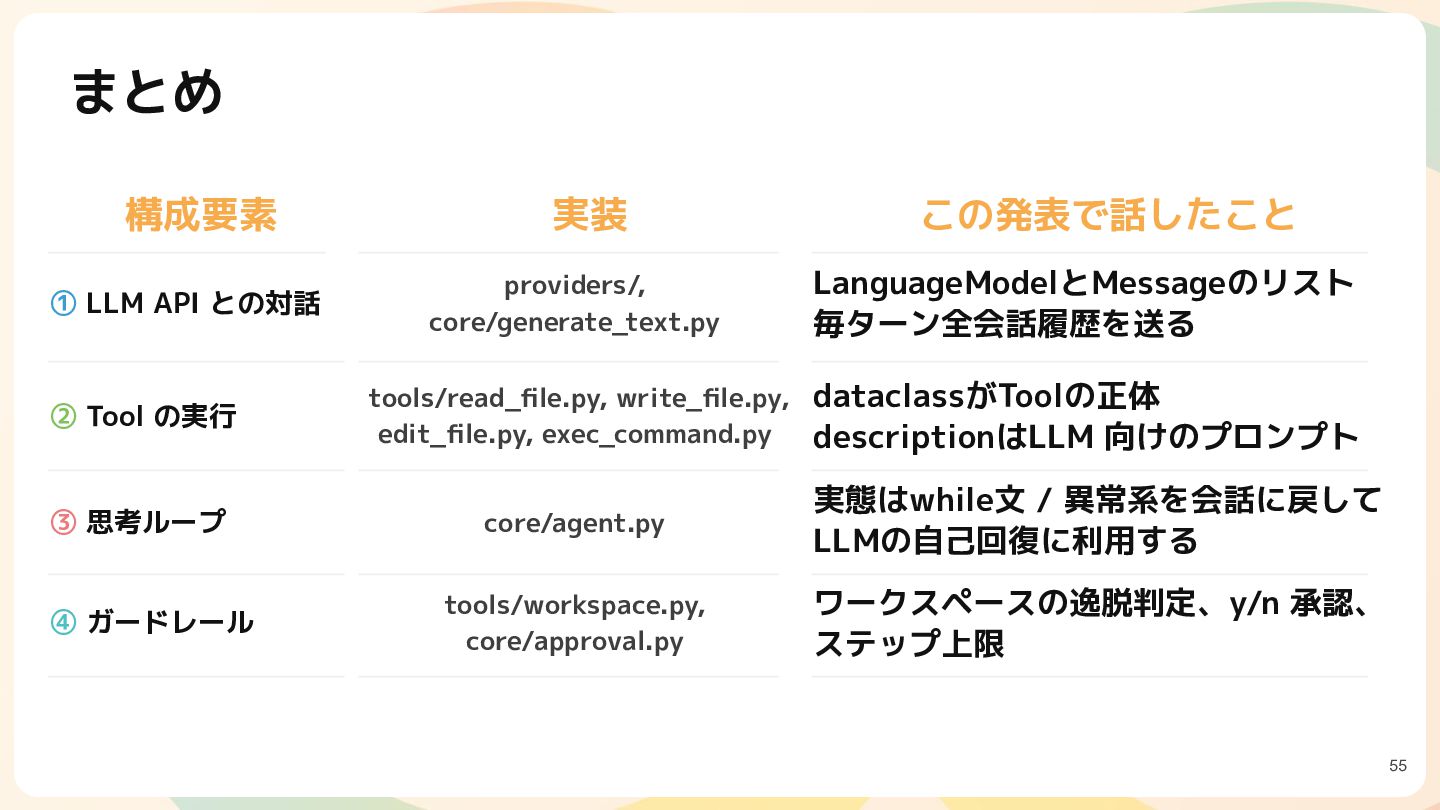
まとめ 構成要素 実装 この発表で話したこと ① LLM API との対話 providers/, core/generate_text.py
LanguageModelとMessageのリスト 毎ターン全会話履歴を送る ② Tool の実行 tools/read_file.py, write_file.py, edit_file.py, exec_command.py dataclassがToolの正体 descriptionはLLM 向けのプロンプト ③ 思考ループ core/agent.py 実態はwhile文 / 異常系を会話に戻して LLMの自己回復に利用する ④ ガードレール tools/workspace.py, core/approval.py ワークスペースの逸脱判定、y/n 承認、 ステップ上限 55 -
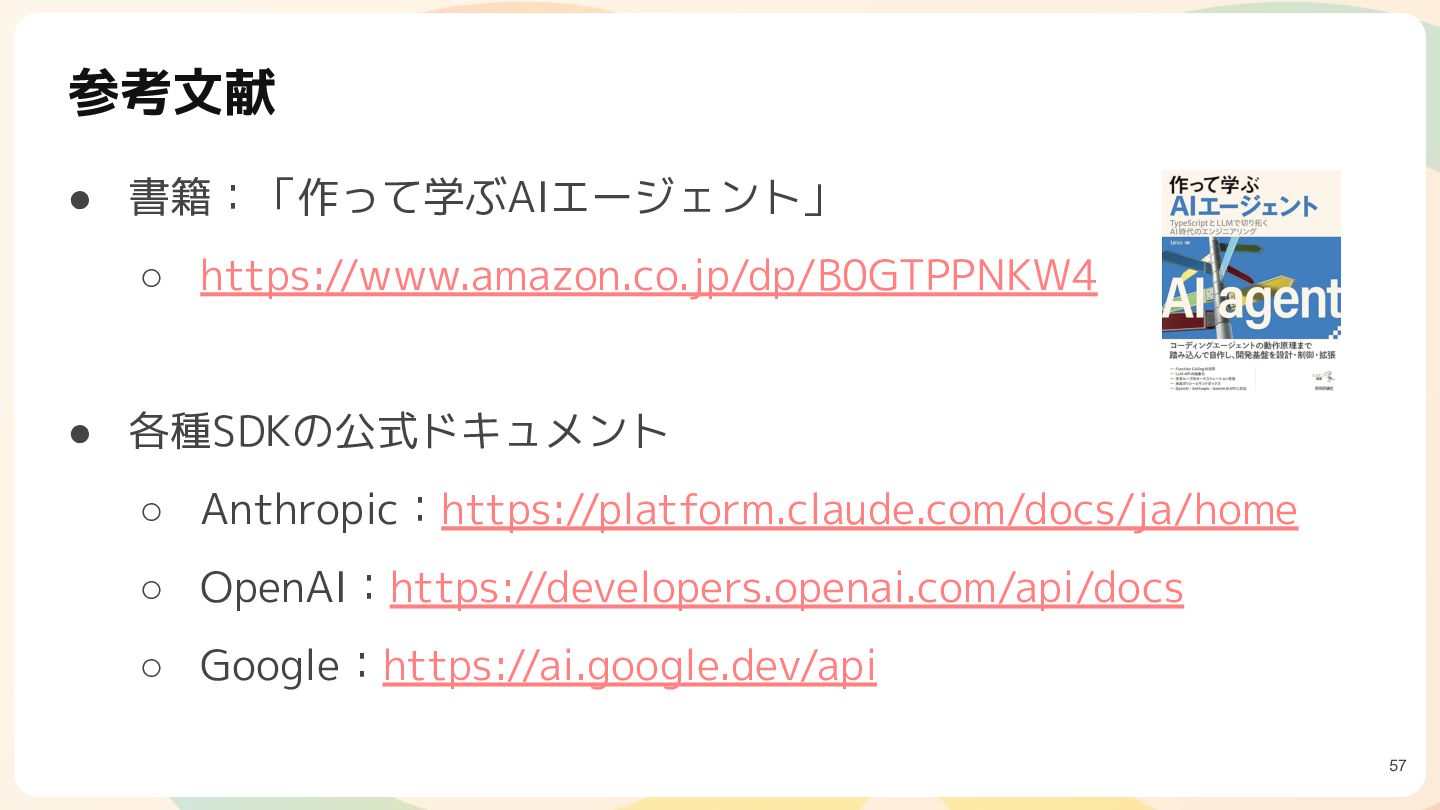
参考文献 • 書籍:「作って学ぶAIエージェント」 ◦ https://www.amazon.co.jp/dp/B0GTPPNKW4 • 各種SDKの公式ドキュメント ◦ Anthropic:https://platform.claude.com/docs/ja/home ◦
OpenAI:https://developers.openai.com/api/docs ◦ Google:https://ai.google.dev/api 57