Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
データエンジニアリング 4年前と変わったこと、 4年前と変わらないこと
Search
Sotaro Tanaka
July 18, 2025
Technology
1.2k
4
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
データエンジニアリング 4年前と変わったこと、 4年前と変わらないこと
Sotaro Tanaka
July 18, 2025
Transcript
25 slides
AbemaTV, Inc. All Rights Reserved 1 データエンジニアリング 4年前と変わったこと、 4年前と変わらないこと 2025/07/18
#DES 株式会社AbemaTV Sotaro Tanaka @__sotaron__
AbemaTV, Inc. All Rights Reserved Sotaro Tanaka 株式会社AbemaTV Development HQ
Data div. Data Enabling Team Mgr • 2023/04~ ABEMAでデータマネジメント • Data Management & BI • Data Engineering • Hobby: 🏂 / 🎮 / ⚽ / 小倉唯さん 2 Profile X(旧Twitter) @__sotaron__
AbemaTV, Inc. All Rights Reserved 3 ABEMAのご紹介
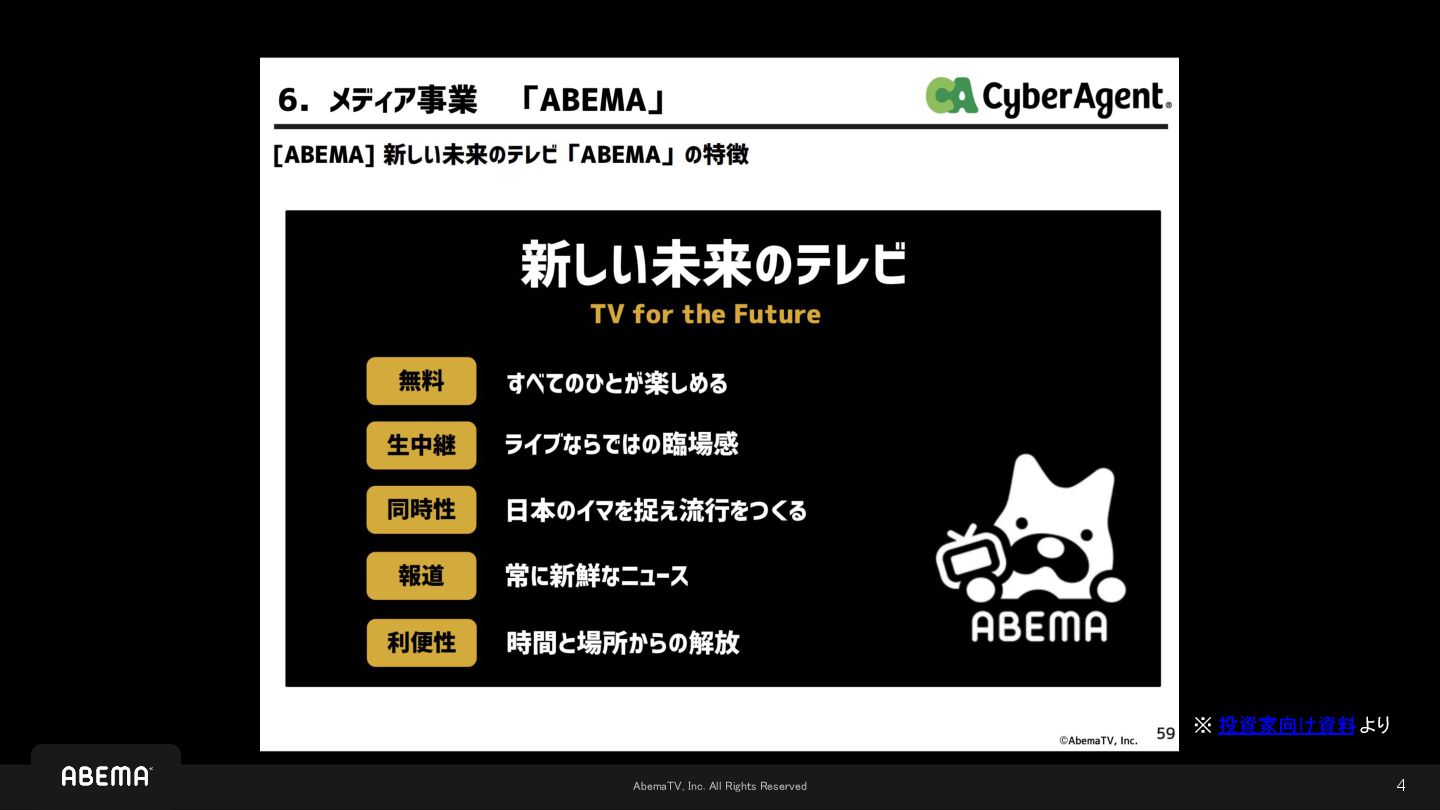
AbemaTV, Inc. All Rights Reserved 4 ※ 投資家向け資料 より
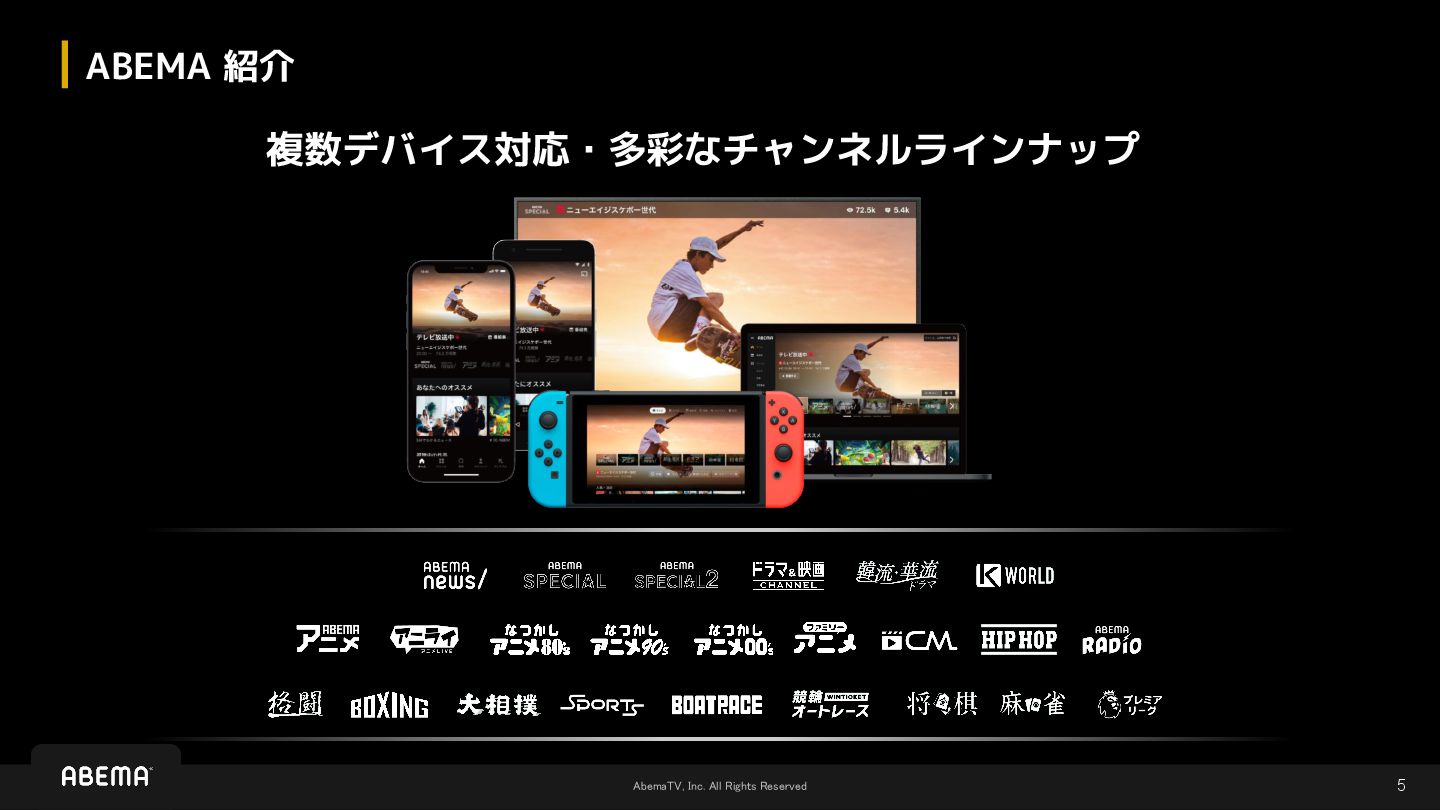
AbemaTV, Inc. All Rights Reserved ABEMA 紹介 5 複数デバイス対応・多彩なチャンネルラインナップ
AbemaTV, Inc. All Rights Reserved 今日お話すること 6 4年前、DES#11でdbtを活用したデータセット設計やモデリングについて、お話しました。 4年経ち、データエンジニアを取り巻く技術は大きく変わったものもあれば、変わらないものあります。 その中で、私個人が特に重要と思う「変わったこと・変わらないこと」についてお話しようと思います。
※ LTなので、網羅的な話題よりも、私自身が主観的に言及したい点や自身の考えについて話します。 ※ テキスト多めです。
AbemaTV, Inc. All Rights Reserved 7 4年前に話したこと
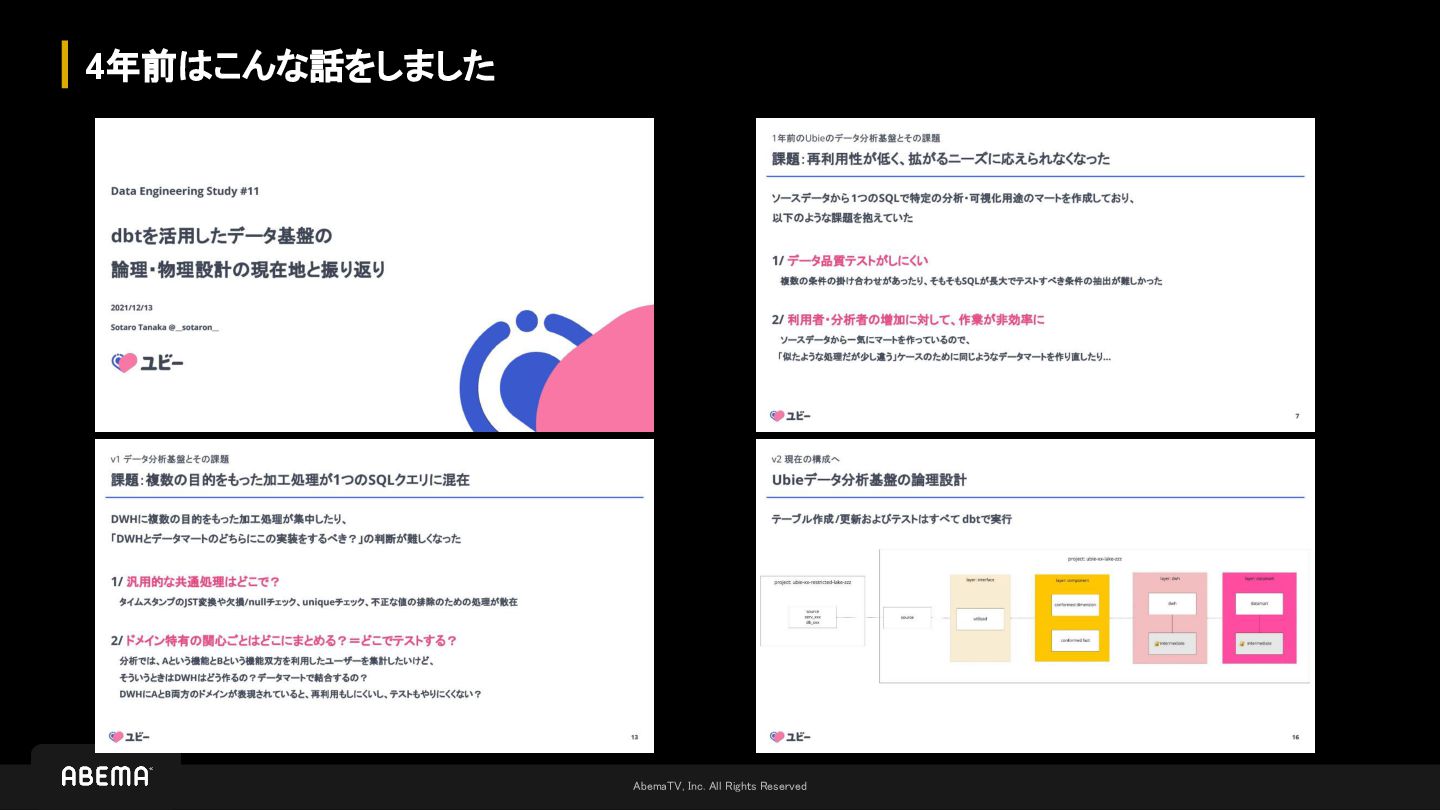
AbemaTV, Inc. All Rights Reserved 4年前はこんな話をしました
AbemaTV, Inc. All Rights Reserved 9 4年前と変わったこと
AbemaTV, Inc. All Rights Reserved 10 生成AI!!
AbemaTV, Inc. All Rights Reserved 11 とにかく 生成AI!!
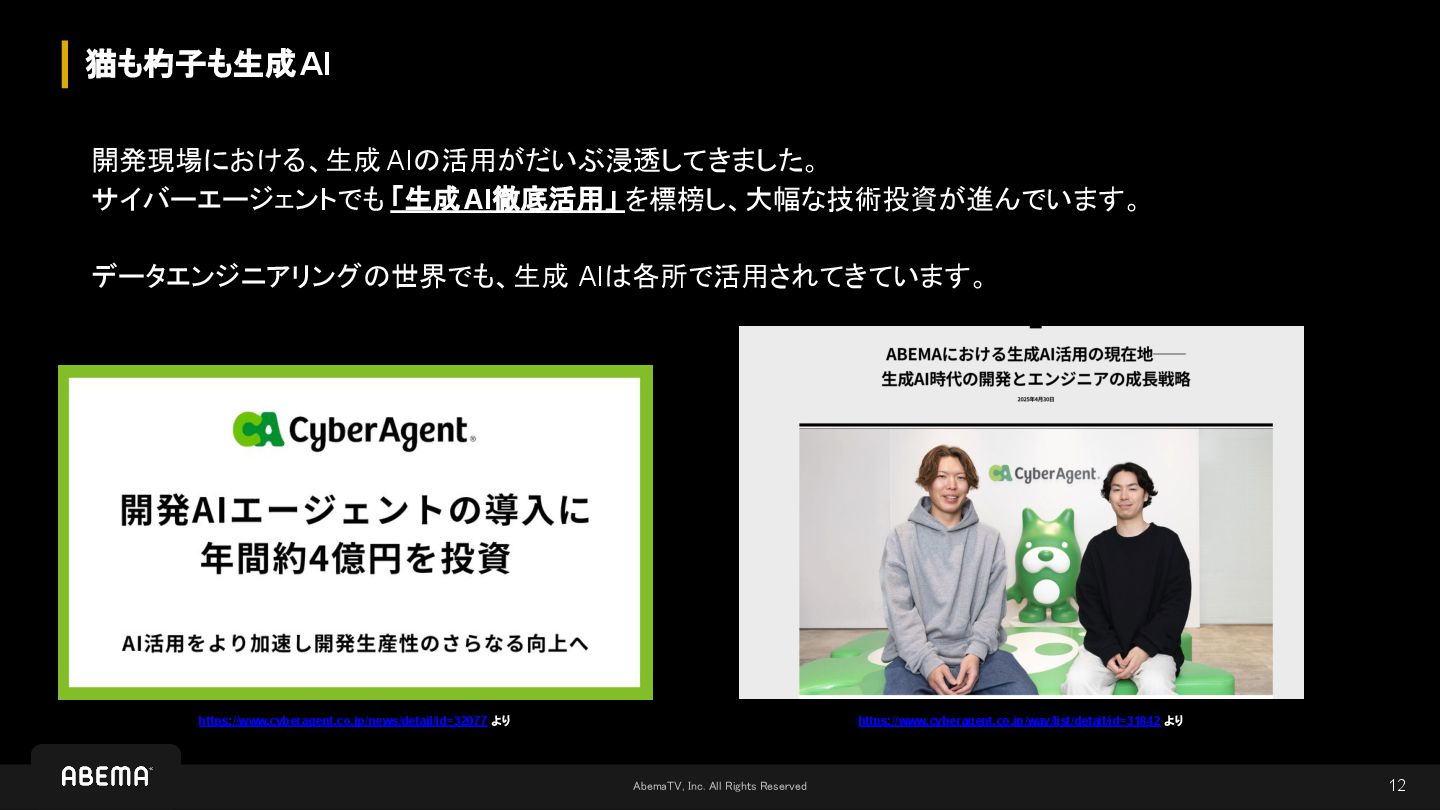
AbemaTV, Inc. All Rights Reserved 猫も杓子も生成AI 12 開発現場における、生成 AIの活用がだいぶ浸透してきました。 サイバーエージェントでも
「生成AI徹底活用」 を標榜し、大幅な技術投資が進んでいます。 データエンジニアリングの世界でも、生成 AIは各所で活用されてきています。 https://www.cyberagent.co.jp/news/detail/id=32077 より https://www.cyberagent.co.jp/way/list/detail/id=31842 より
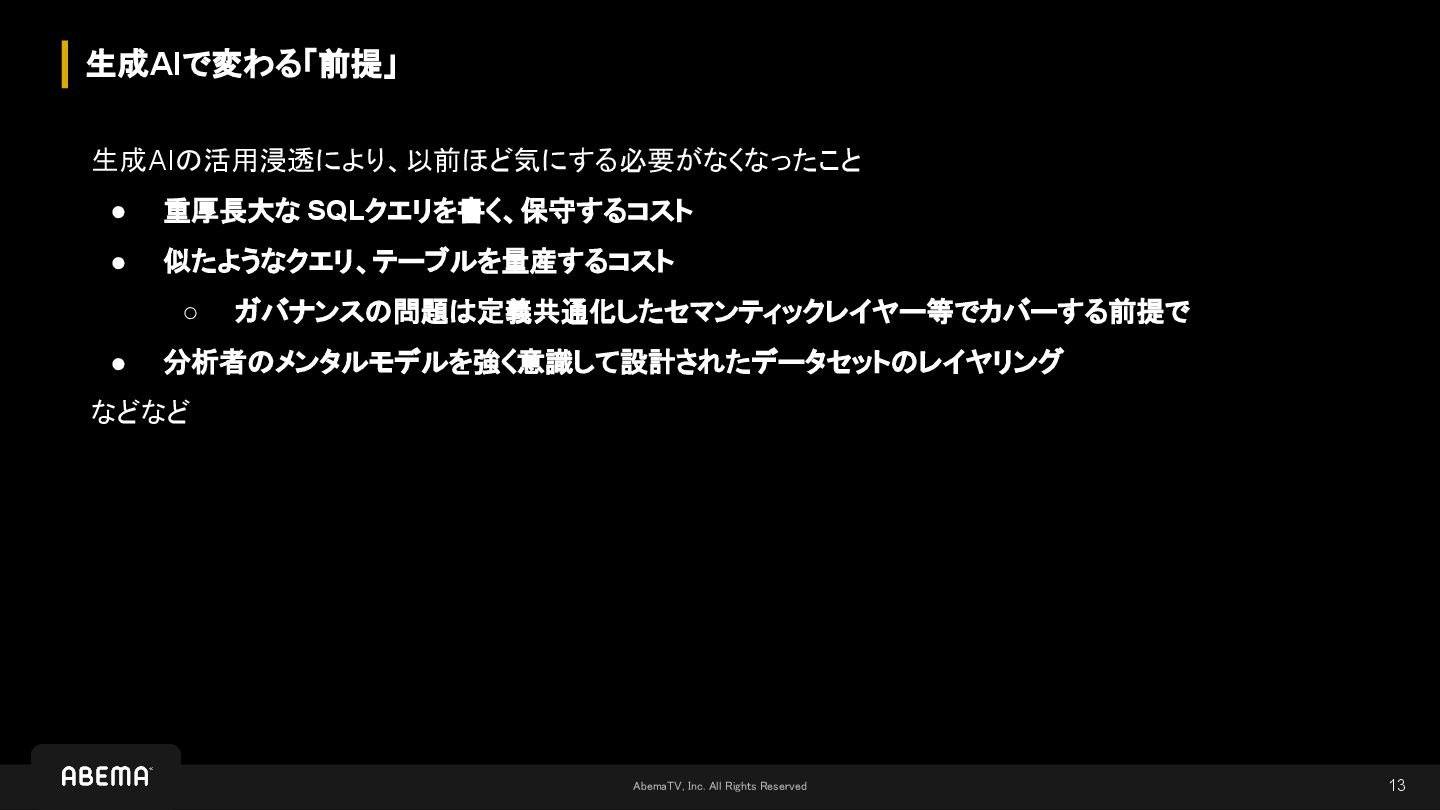
AbemaTV, Inc. All Rights Reserved 生成AIで変わる「前提」 13 生成AIの活用浸透により、以前ほど気にする必要がなくなったこと • 重厚長大な
SQLクエリを書く、保守するコスト • 似たようなクエリ、テーブルを量産するコスト ◦ ガバナンスの問題は定義共通化したセマンティックレイヤー等でカバーする前提で • 分析者のメンタルモデルを強く意識して設計されたデータセットのレイヤリング などなど
AbemaTV, Inc. All Rights Reserved 14 生成AI「前提」での データ基盤を考えていく時代に
AbemaTV, Inc. All Rights Reserved 15 4年前と変わらないこと
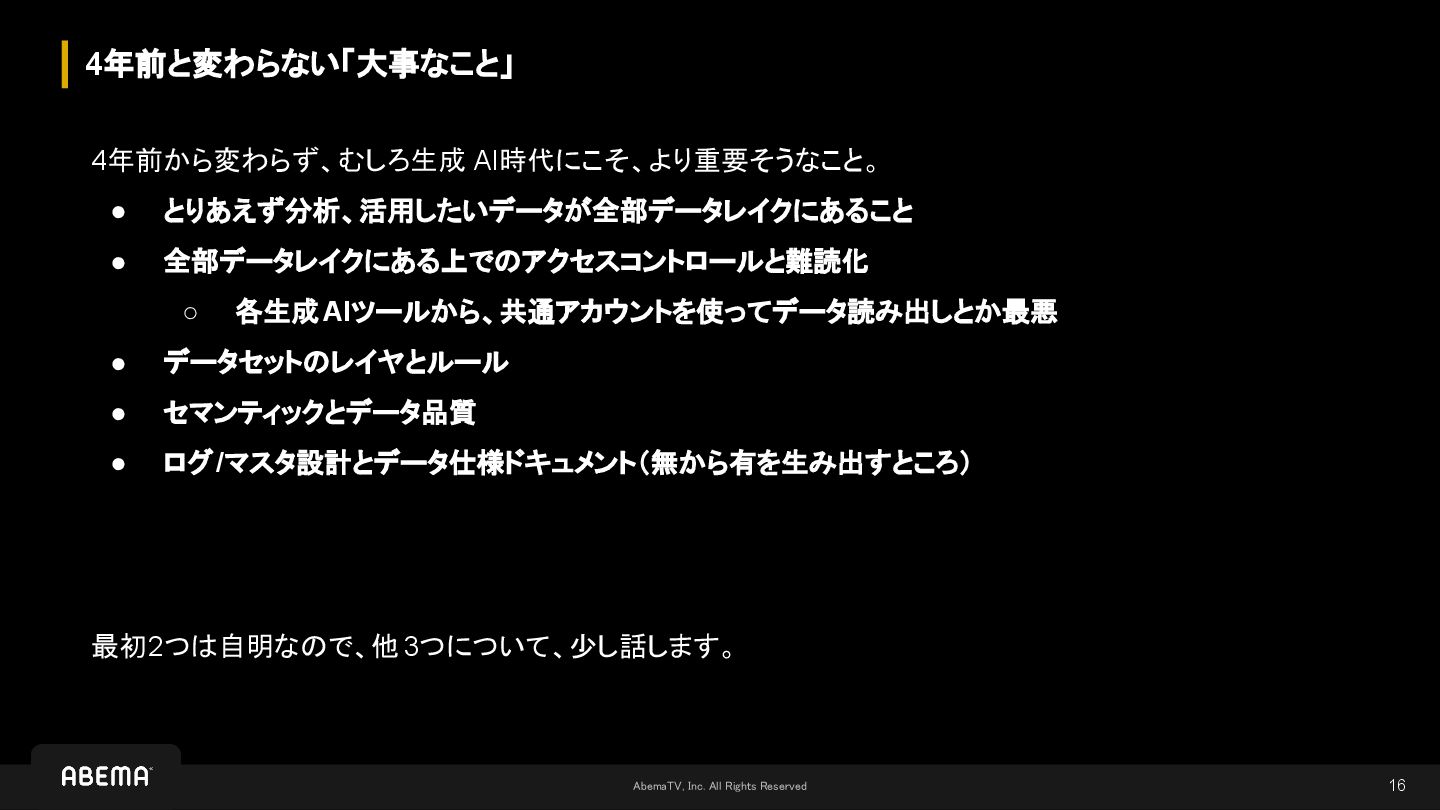
AbemaTV, Inc. All Rights Reserved 4年前と変わらない「大事なこと」 16 4年前から変わらず、むしろ生成 AI時代にこそ、より重要そうなこと。 •
とりあえず分析、活用したいデータが全部データレイクにあること • 全部データレイクにある上でのアクセスコントロールと難読化 ◦ 各生成AIツールから、共通アカウントを使ってデータ読み出しとか最悪 • データセットのレイヤとルール • セマンティックとデータ品質 • ログ/マスタ設計とデータ仕様ドキュメント(無から有を生み出すところ) 最初2つは自明なので、他 3つについて、少し話します。
AbemaTV, Inc. All Rights Reserved データセットのレイヤとルール 17 分析者や活用者のメンタルモデルを意識した過度なレイヤリングは必要なくなりましたが、 以下のようなことを考慮した処理ルールと、その前後のデータセットのレイヤ分けはより一層重要に。 •
ある権限ロールの人たちに開放するデータセットに施すべき難読化処理 • 入力値の値域の制限、異常値の除去 • 汎用共通処理 → この処理ルールとデータセットのレイヤを CursorやClaude Codeに開発ガイドラインとして 渡せば、分析や活用 readyなテーブル群を作ってもらえます。
AbemaTV, Inc. All Rights Reserved セマンティックとデータ品質 18 ABEMAは来年で10周年、そんな10年ものプロダクトともなると • 空の定義(
NULL、undefined、n/a、””)のブレなど、ドキュメント化しないと理解できないデータモ デル • 多態・多義なカラムや歴史的に情報量が変化しているカラム みたいなデータがいっぱいあります。皆さんはどうですか? このようなデータが存在する状態で、「とりあえず生成 AIだ!text2sqlやってみよう!」とか 上手くいくわけがありません。 これらのデータ特性を考慮した人間による事前処理や、事前処理の指示ドキュメントが必要です。
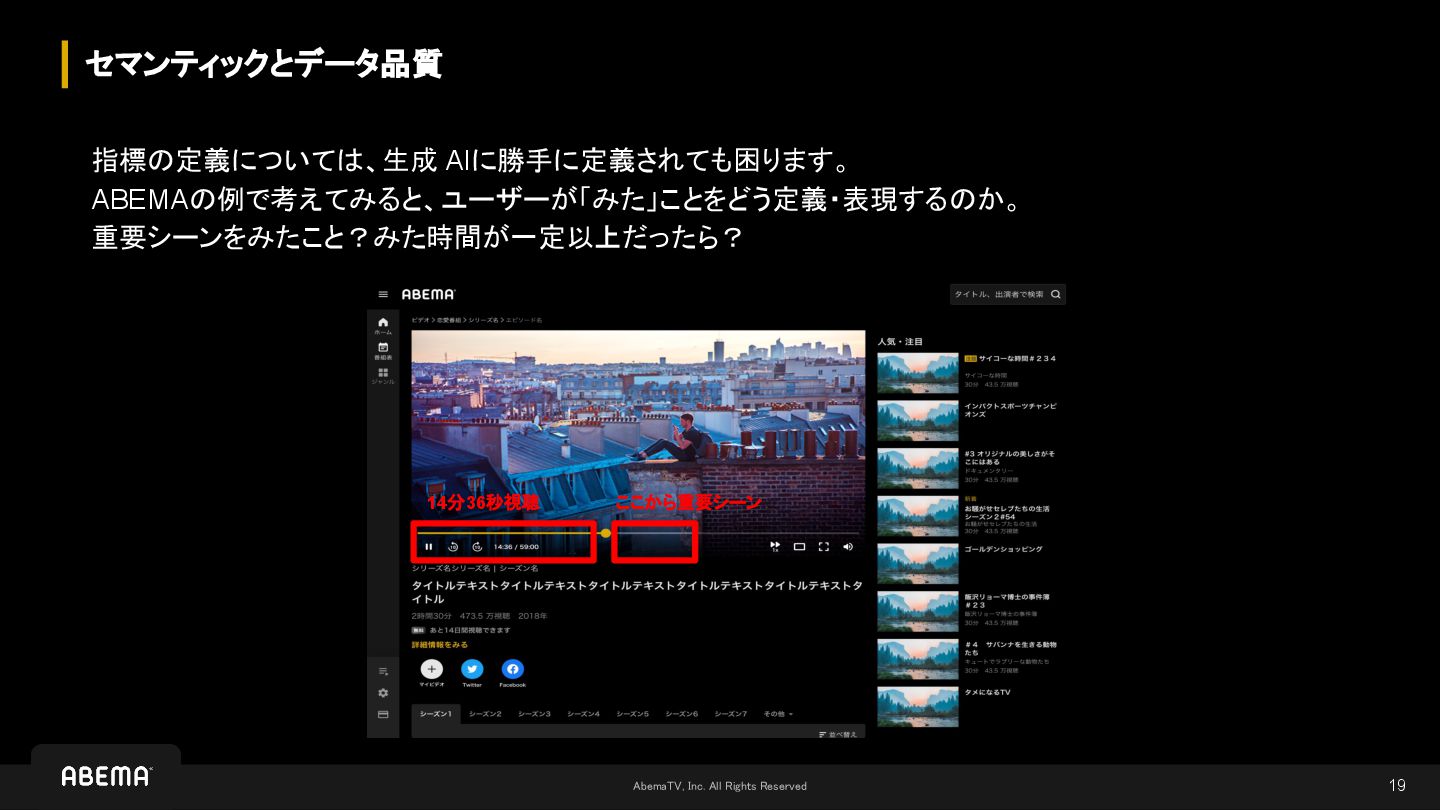
AbemaTV, Inc. All Rights Reserved セマンティックとデータ品質 19 指標の定義については、生成 AIに勝手に定義されても困ります。 ABEMAの例で考えてみると、ユーザーが「みた」ことをどう定義・表現するのか。
重要シーンをみたこと?みた時間が一定以上だったら? 遠藤航選手のプレミア初ゴールシーン ここから重要シーン 14分36秒視聴
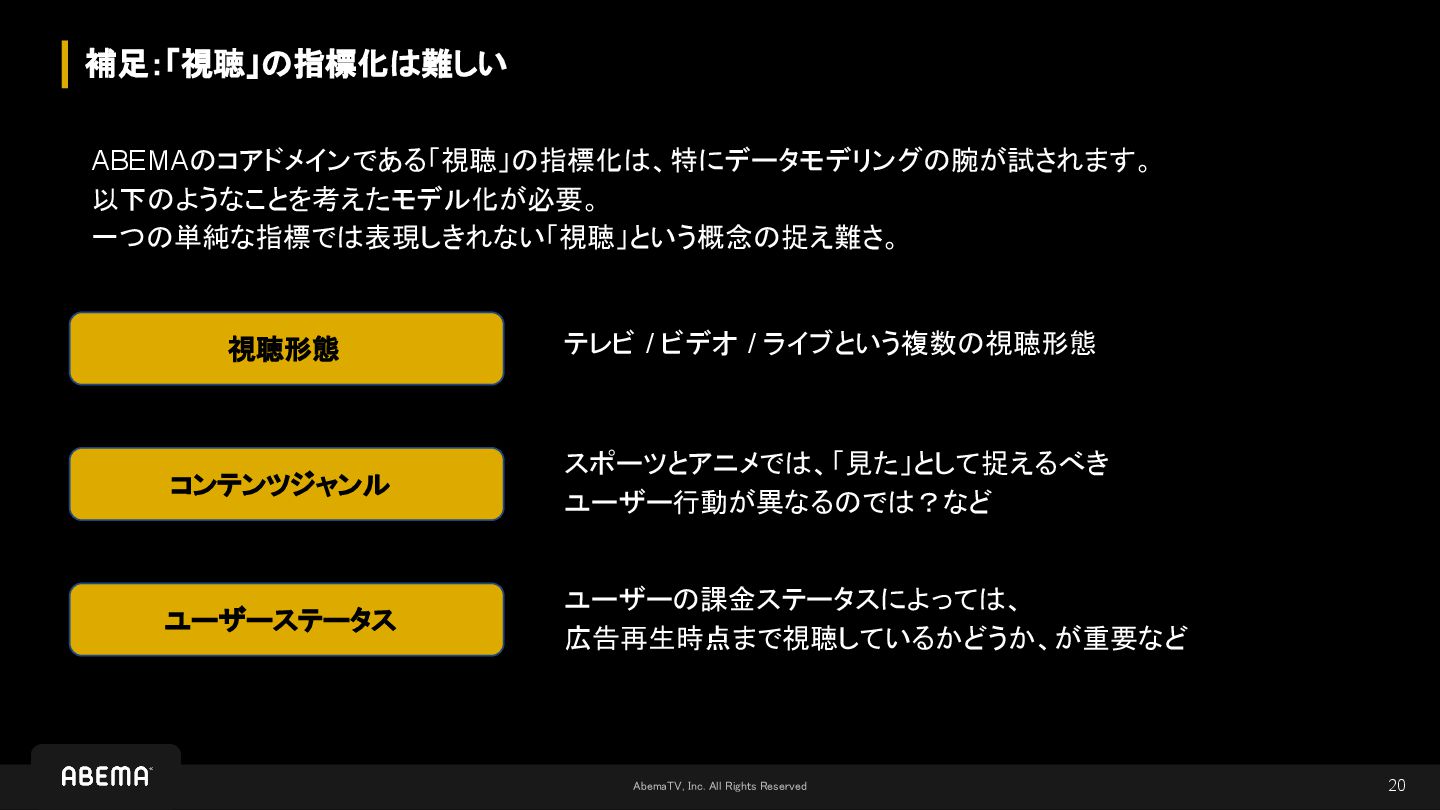
AbemaTV, Inc. All Rights Reserved 補足:「視聴」の指標化は難しい 20 ABEMAのコアドメインである「視聴」の指標化は、特にデータモデリングの腕が試されます。 以下のようなことを考えたモデル化が必要。 一つの単純な指標では表現しきれない「視聴」という概念の捉え難さ。
視聴形態 コンテンツジャンル ユーザーステータス テレビ / ビデオ / ライブという複数の視聴形態 スポーツとアニメでは、「見た」として捉えるべき ユーザー行動が異なるのでは?など ユーザーの課金ステータスによっては、 広告再生時点まで視聴しているかどうか、が重要など
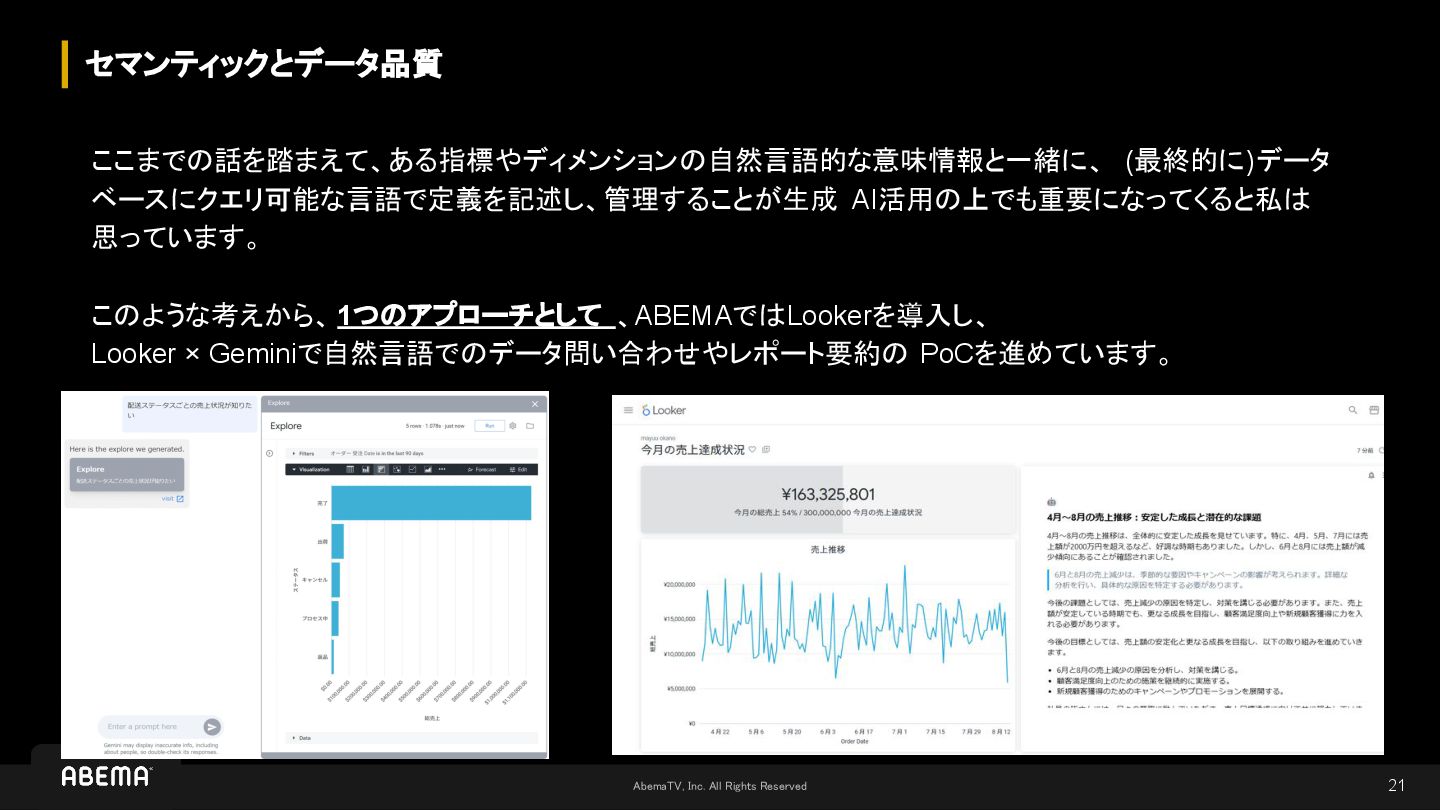
AbemaTV, Inc. All Rights Reserved セマンティックとデータ品質 21 ここまでの話を踏まえて、ある指標やディメンションの自然言語的な意味情報と一緒に、 (最終的に)データ ベースにクエリ可能な言語で定義を記述し、管理することが生成
AI活用の上でも重要になってくると私は 思っています。 このような考えから、 1つのアプローチとして 、ABEMAではLookerを導入し、 Looker × Geminiで自然言語でのデータ問い合わせやレポート要約の PoCを進めています。
AbemaTV, Inc. All Rights Reserved ログ/マスタ設計とデータ仕様ドキュメント 22 先述のように生成AIによるデータ集計や分析の支援、効率化を進める上で、ソースデータの品質は その成果を大きく左右すると考えています。 この「無から有を生み出す」最初のプロセスにおいて、
高い品質を維持しやすいデータモデル・型を設計することや仕様ドキュメントをしっかり書き残しておくこ とが今まで以上に重要になってきていると感じます。 結局、大事なことは4年前とあまり変わっていないような気がしますね。
AbemaTV, Inc. All Rights Reserved 結論 23 • 「猫も杓子も生成 AI」な時代でも結局、データ整備とドキュメント整備が大事
• データエンジニアは泥臭くがんばっていきましょう
AbemaTV, Inc. All Rights Reserved 『ABEMA』では 一緒に挑戦する仲間を募集中です! ✔オンラインでカジュアル面談実施中 ✔今すぐ転職を考えていなくてもOK!(興味ある方ぜひ声かけてください) 応募はこちら👉
カジュアル面談は こちらから👉
None
More Decks by Sotaro Tanaka
See All by Sotaro Tanaka
ABEMAはなぜセマンティックレイヤーに挑戦しているのか?
tanakarian
0
1.5k
データ基盤の○層構造を独り歩きさせない データモデリング設計 Data Ops Night #1
tanakarian
3
6.1k
dbtを活用したデータ基盤の 論理・物理設計の現在地と振り返り / data warehouse logic design by using dbt
tanakarian
8
16k
データ分析基盤の障害を未然に防ぐためのチェックリスト / checklist for preventing incidents of data management system
tanakarian
1
14k
データの価値を失わないためのData Reliability
tanakarian
7
12k
building-evolutionary-data-warehouse
tanakarian
2
11k
Other Decks in Technology
See All in Technology
Kiro を使うコツ (頼み方、覚えさせ方、任せ方) | 目指せ Kiro マスター 09
inariku
PRO
3
140
複数システムが同居した 15 年物の AWS アカウントを解体するための考古学
wa6sn
3
120
Active Directory と Entra ID のむむむな関係
murachiakira
PRO
4
1.8k
Kiro アップデート 2026 年 11 月号 (11 月 8 日時点) | 目指せ Kiro マスター アップデート編
inariku
PRO
2
100
生成AI時代のIAMのマニアックな話
takuros
6
3k
Kiro 入門 (1 つのエージェントを、どの画面からでも) | 目指せ Kiro マスター 01
inariku
PRO
6
1.5k
【dbts2026】AIエージェントの 判断と探索を変える、 データベース エンジニアリング― 既存DBの処理と依存関係から作る、オペレーショナルオントロジー ―
shisyu_gaku
0
280
JAWSコミュニティに 参加して1年経った結果
ssakita
0
120
Sizing, Benchmarking and Performance Tuning Apache Flink Clusters
rmetzger
0
150
Claude Codeで作ったアプリを安全に公開する/Built with Claude Japan 2026
yoshidashingo
0
230
[JAWS Festa 2026]一番いい仕事は、請求書に現れない / jawsfesta2026
sh_fk2
2
440
AIエージェントの監視、思考を見るか行動を見るか / Monitoring AI Agents: Thoughts or Actions
yusukeshimizu
2
180
Featured
See All Featured
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
470
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
430
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
660
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
20k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.6k
SEO for Brand Visibility & Recognition
aleyda
0
4.9k
Rebuilding a faster, lazier Slack
samanthasiow
85
9.8k
Navigating Team Friction
lara
192
16k
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.8k


 tanakarian
 inariku
 wa6sn
 murachiakira
 takuros
 shisyu_gaku
 ssakita
 rmetzger
 yoshidashingo
 sh_fk2
 yusukeshimizu
 jeffersonlam
 marketingsoph
 marcduiker
 panda_program
 reverentgeek
 marktimemedia
 morganepeng
 ivargrimstad
 aleyda
 samanthasiow
 lara
 signer