Share
Embed
深層学習による自然言語処理 輪読会#3 資料
機械学習プロフェッショナルシリーズの「深層学習による自然言語処理」の輪読会の第3回資料。
4章「言語処理特有の深層学習の発展」
https://learn-stats-ml.connpass.com/event/242216/
Natural Language Processing by Deep Learning
section04
Yoichi Tokita
March 24, 2022
Transcript
36 slides
-
⾃⼰紹介 • tokita(@yoichi_t) • 所属:株式会社Glia Computing (https://www.glia-computing.com/) • 2018年8⽉に設⽴(Co-Founder) •
機械学習/データ分析のPoC、導⼊⽀援、コンサル • 過去 • 広告会社で推薦システムの開発をやっていたり、警備会社で⼈物⾏動 の研究をしてました -
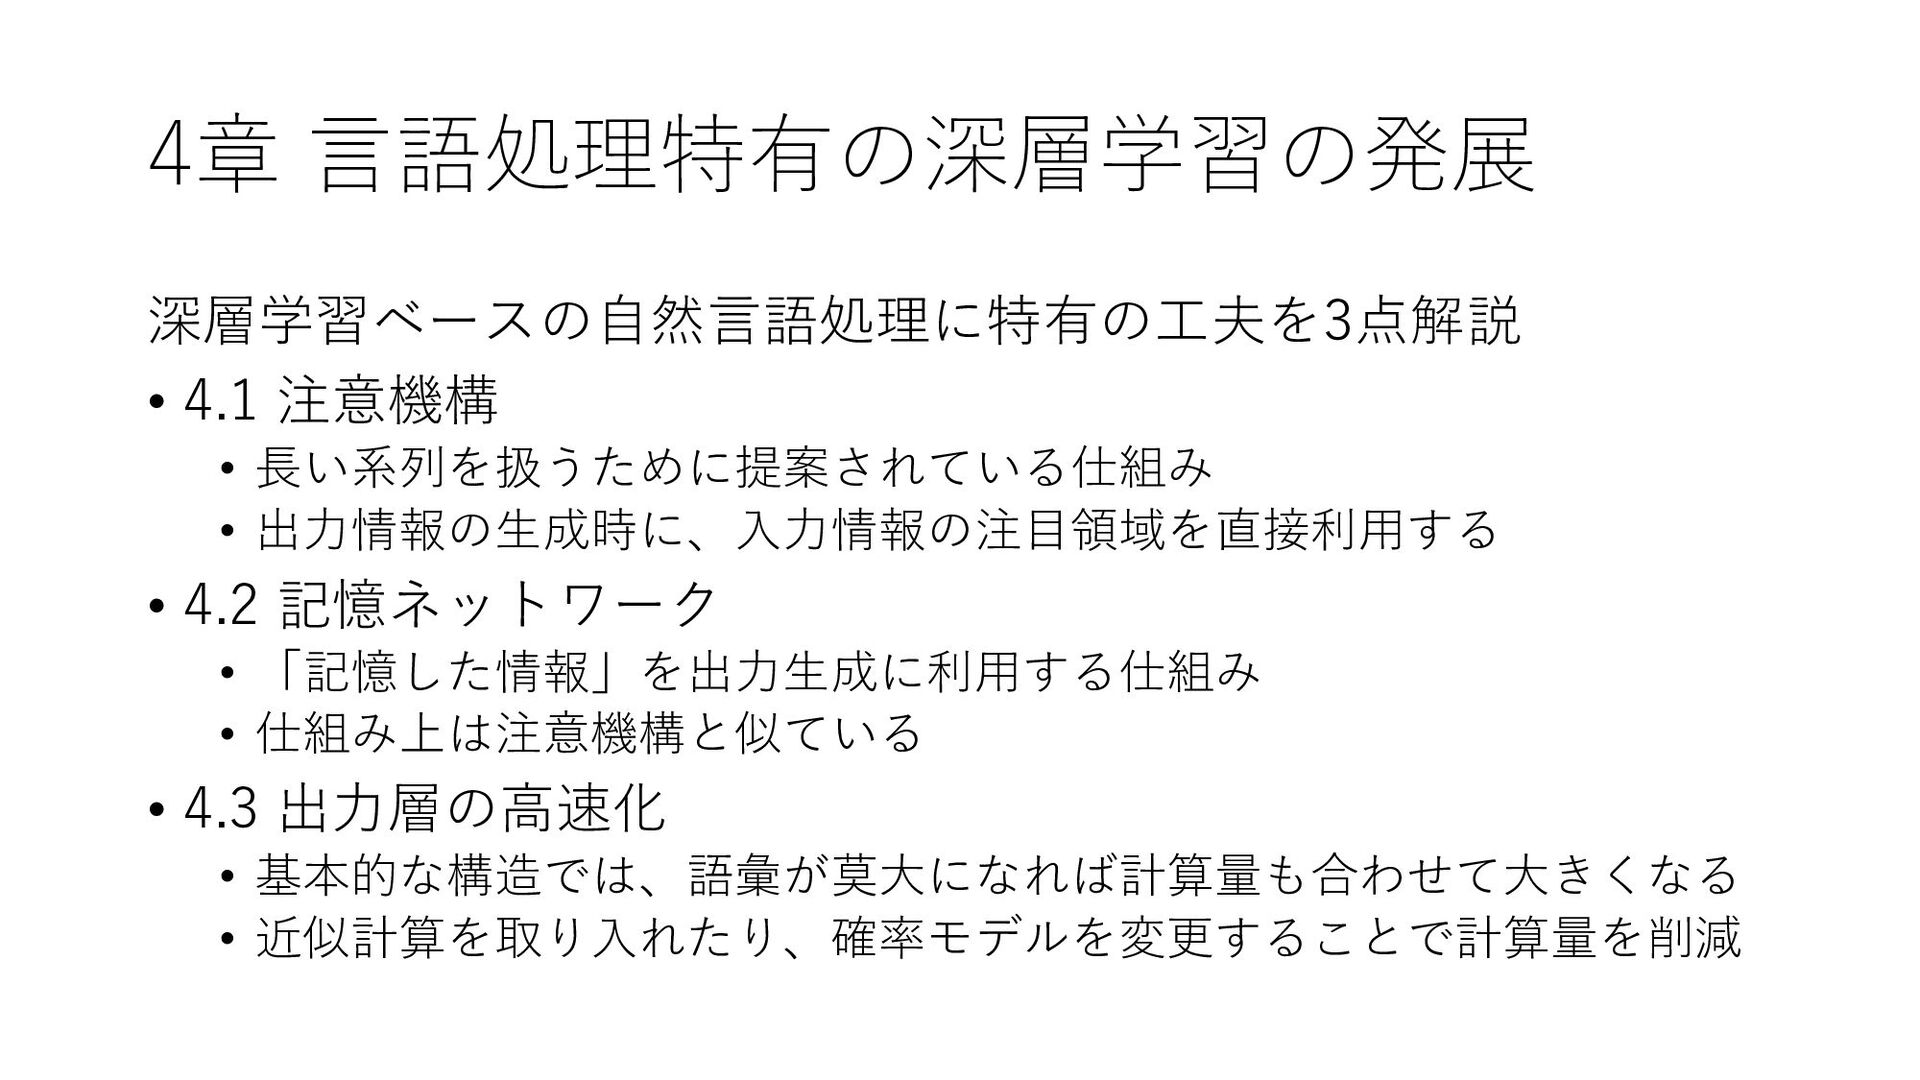
4章 ⾔語処理特有の深層学習の発展 深層学習ベースの⾃然⾔語処理に特有の⼯夫を3点解説 • 4.1 注意機構 • ⻑い系列を扱うために提案されている仕組み • 出⼒情報の⽣成時に、⼊⼒情報の注⽬領域を直接利⽤する
• 4.2 記憶ネットワーク • 「記憶した情報」を出⼒⽣成に利⽤する仕組み • 仕組み上は注意機構と似ている • 4.3 出⼒層の⾼速化 • 基本的な構造では、語彙が莫⼤になれば計算量も合わせて⼤きくなる • 近似計算を取り⼊れたり、確率モデルを変更することで計算量を削減 -
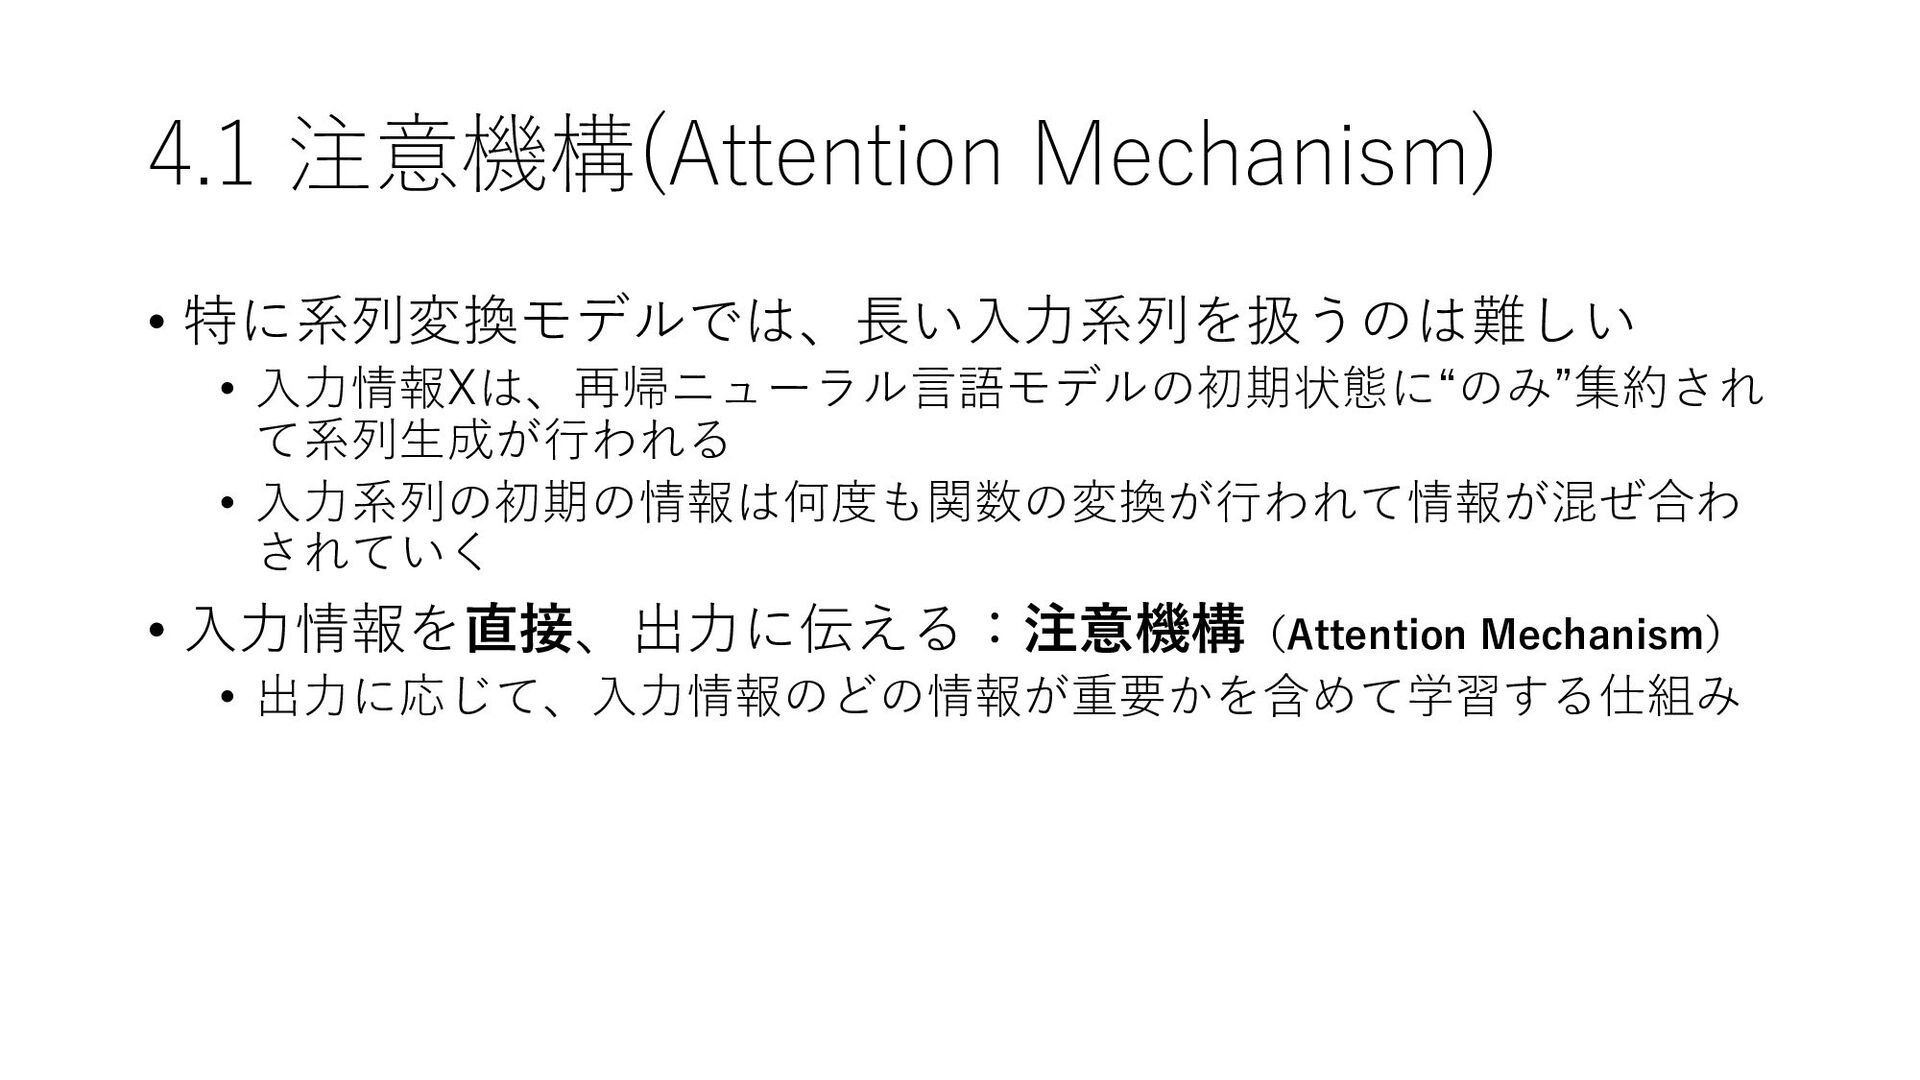
4.1 注意機構(Attention Mechanism) • 特に系列変換モデルでは、⻑い⼊⼒系列を扱うのは難しい • ⼊⼒情報Xは、再帰ニューラル⾔語モデルの初期状態に“のみ”集約され て系列⽣成が⾏われる • ⼊⼒系列の初期の情報は何度も関数の変換が⾏われて情報が混ぜ合わ
されていく • ⼊⼒情報を直接、出⼒に伝える:注意機構(Attention Mechanism) • 出⼒に応じて、⼊⼒情報のどの情報が重要かを含めて学習する仕組み -
系列変換モデル(課題) • 系列変換モデル(テキスト p.72, 3.4節) • 再帰ニューラル⾔語モデル の初期値を⼊⼒の再帰 ニューラル⾔語モデルで⽣ 成する
⼊⼒(Encoder) 出⼒(Decoder) -
系列変換モデル(課題) • 系列変換モデル(テキスト p.72, 3.4節) • 再帰ニューラル⾔語モデル の初期値を⼊⼒の再帰 ニューラル⾔語モデルで⽣ 成する
ここに⼊⼒情報が全て集約される LSTMやGRUでは情報のリセット を⾏う仕組み(リセットゲート) が備わっているので、全ての情報 をここに集約させるというのは難 しそう ⼊⼒(Encoder) 出⼒(Decoder) -
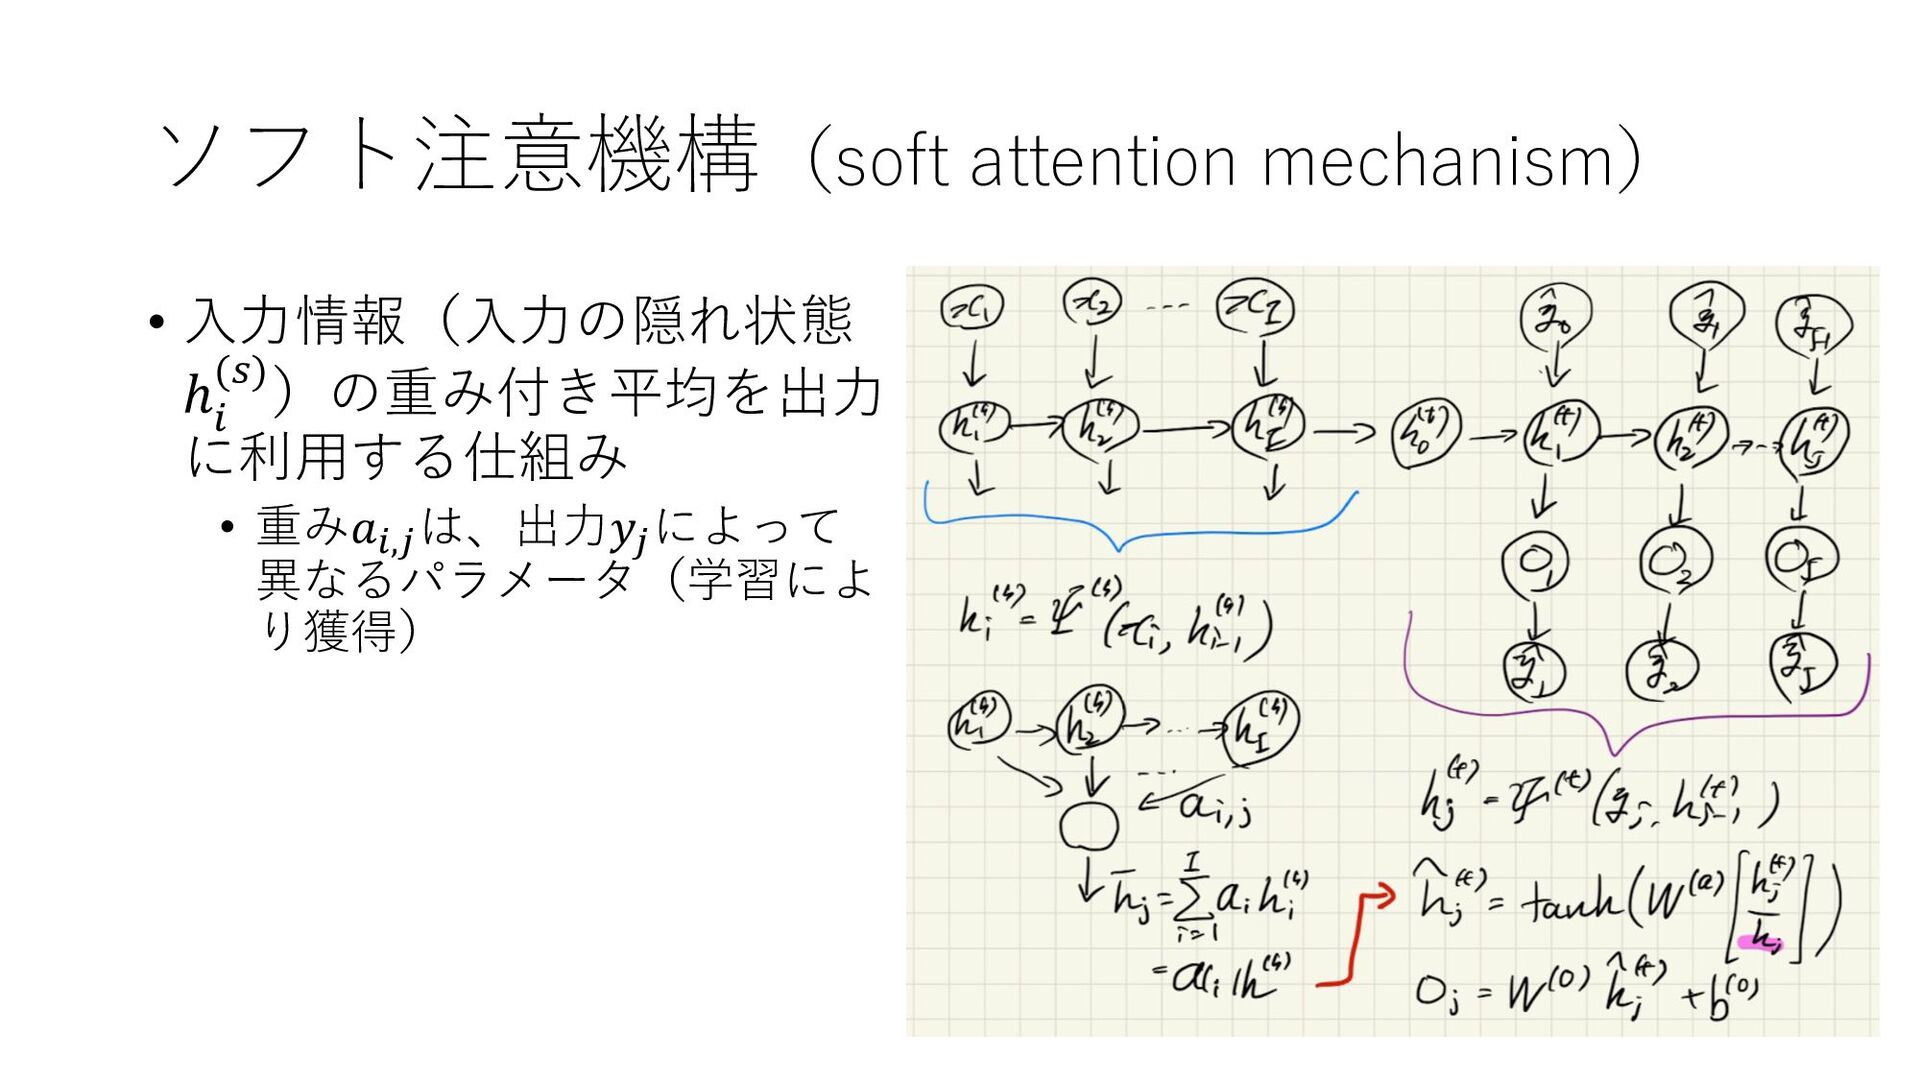
ソフト注意機構(soft attention mechanism) • ⼊⼒情報(⼊⼒の隠れ状態 ℎ ! (#))の重み付き平均を出⼒ に利⽤する仕組み •
重み𝑎!,# は、出⼒𝑦# によって 異なるパラメータ(学習によ り獲得) -
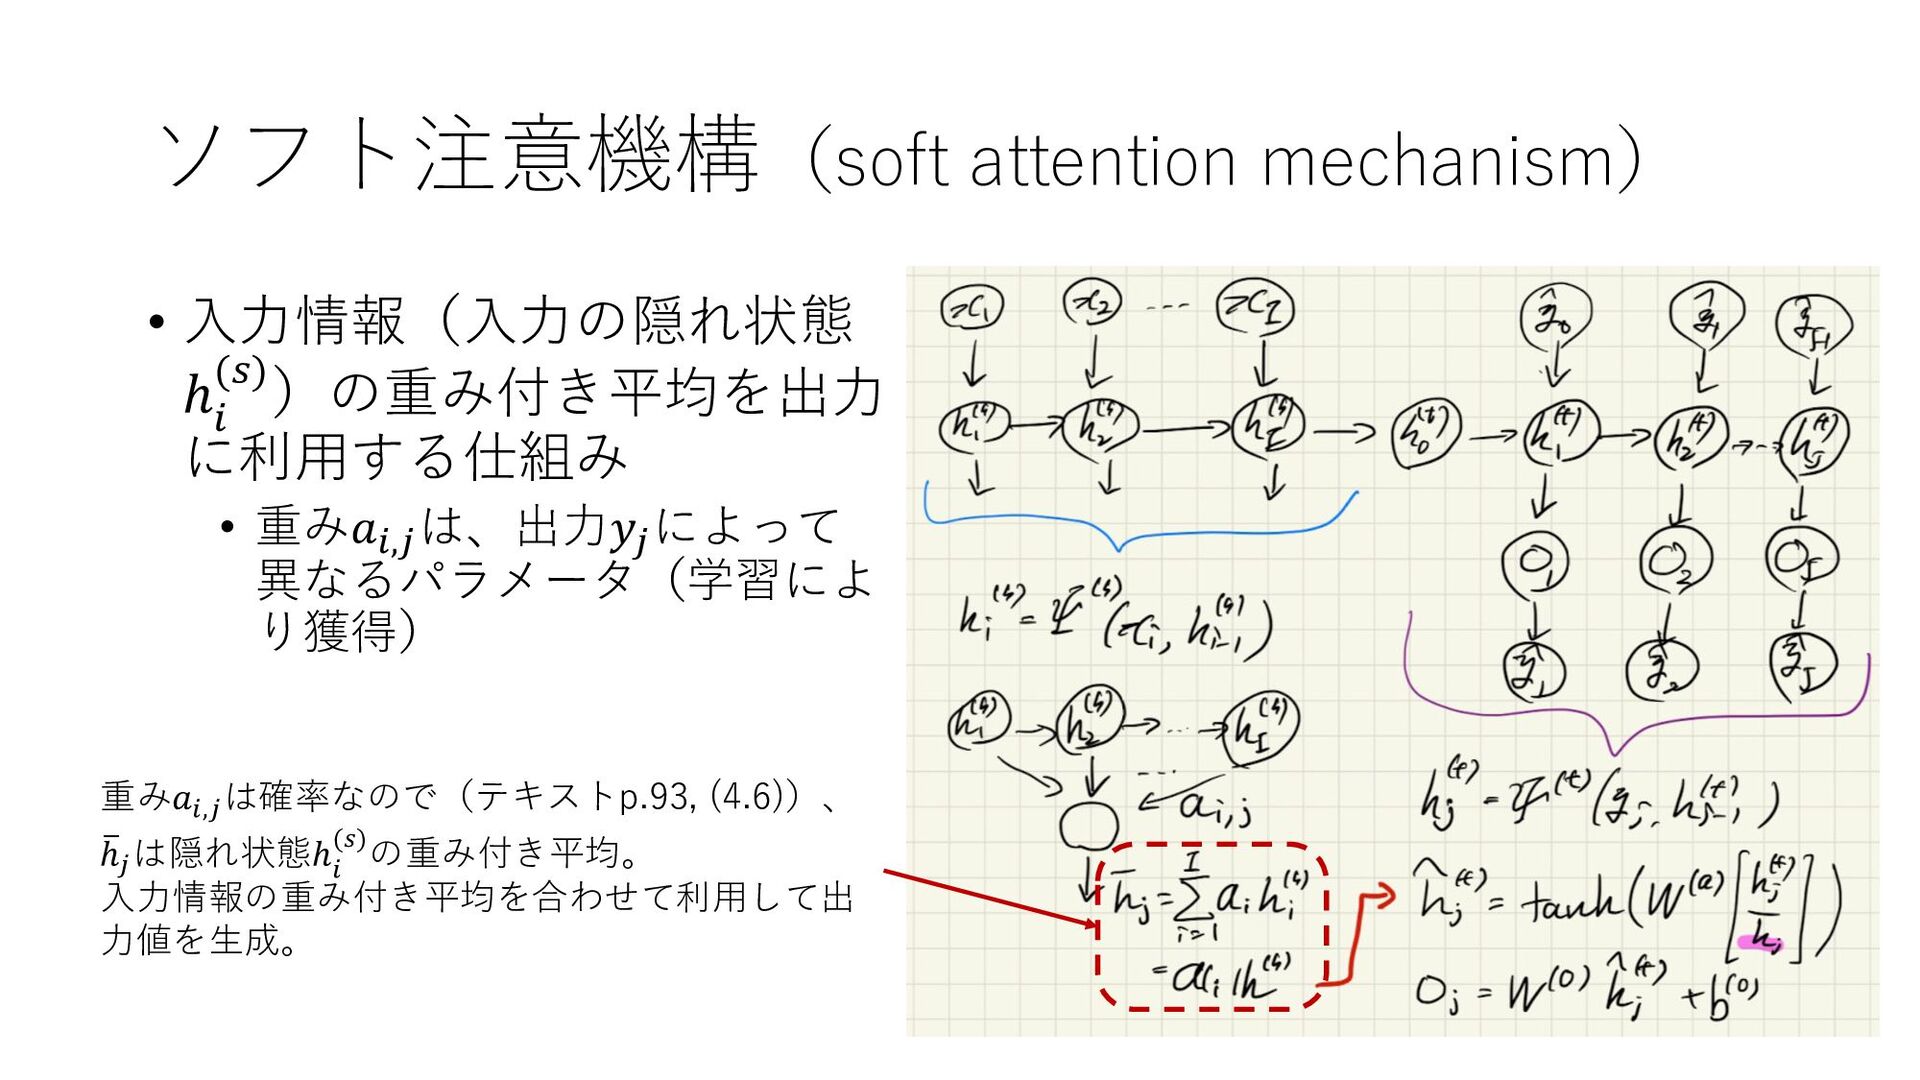
ソフト注意機構(soft attention mechanism) • ⼊⼒情報(⼊⼒の隠れ状態 ℎ ! (#))の重み付き平均を出⼒ に利⽤する仕組み •
重み𝑎!,# は、出⼒𝑦# によって 異なるパラメータ(学習によ り獲得) 重み𝑎!,# は確率なので(テキストp.93, (4.6))、 % ℎ# は隠れ状態ℎ ! (%)の重み付き平均。 ⼊⼒情報の重み付き平均を合わせて利⽤して出 ⼒値を⽣成。 -
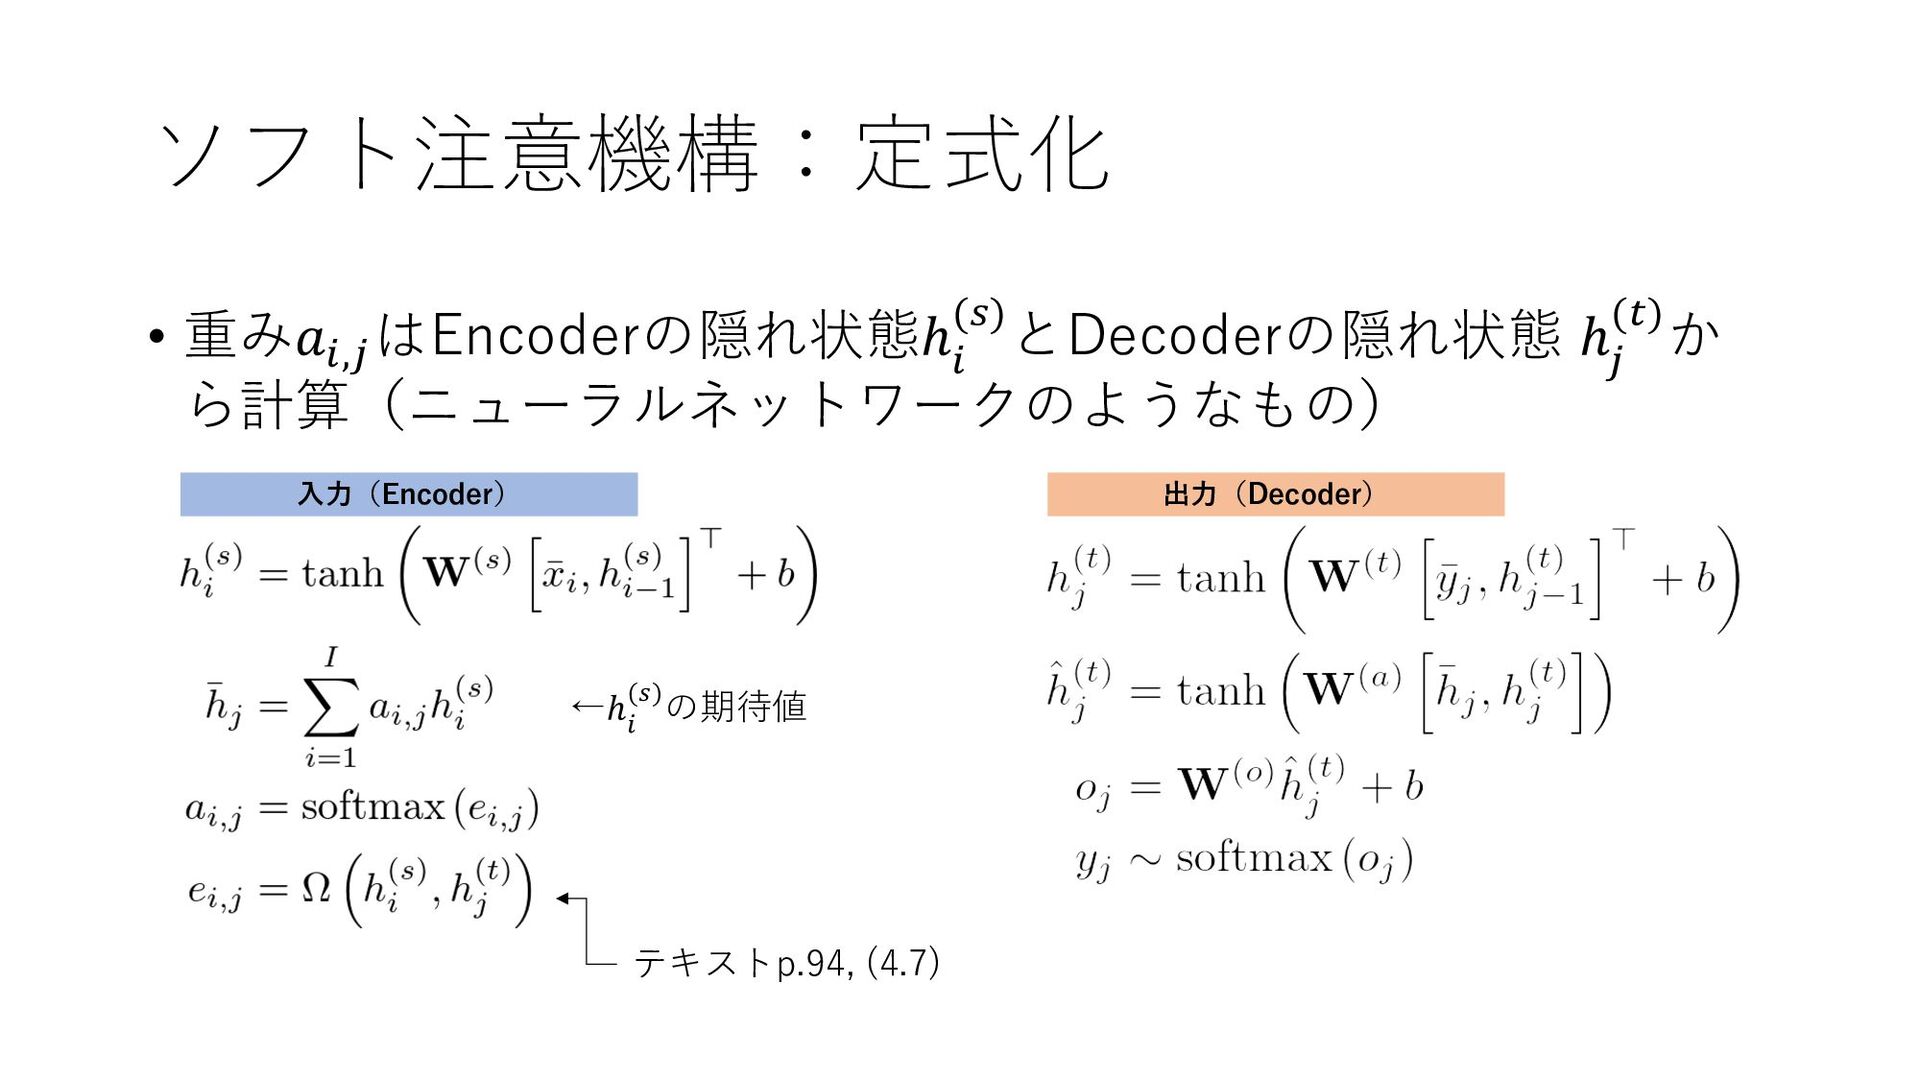
ソフト注意機構:定式化 • 重み𝑎!,& はEncoderの隠れ状態ℎ ! (#)とDecoderの隠れ状態 ℎ & (')か ら計算(ニューラルネットワークのようなもの)
⼊⼒(Encoder) 出⼒(Decoder) テキストp.94, (4.7) ←ℎ ! (%)の期待値 -
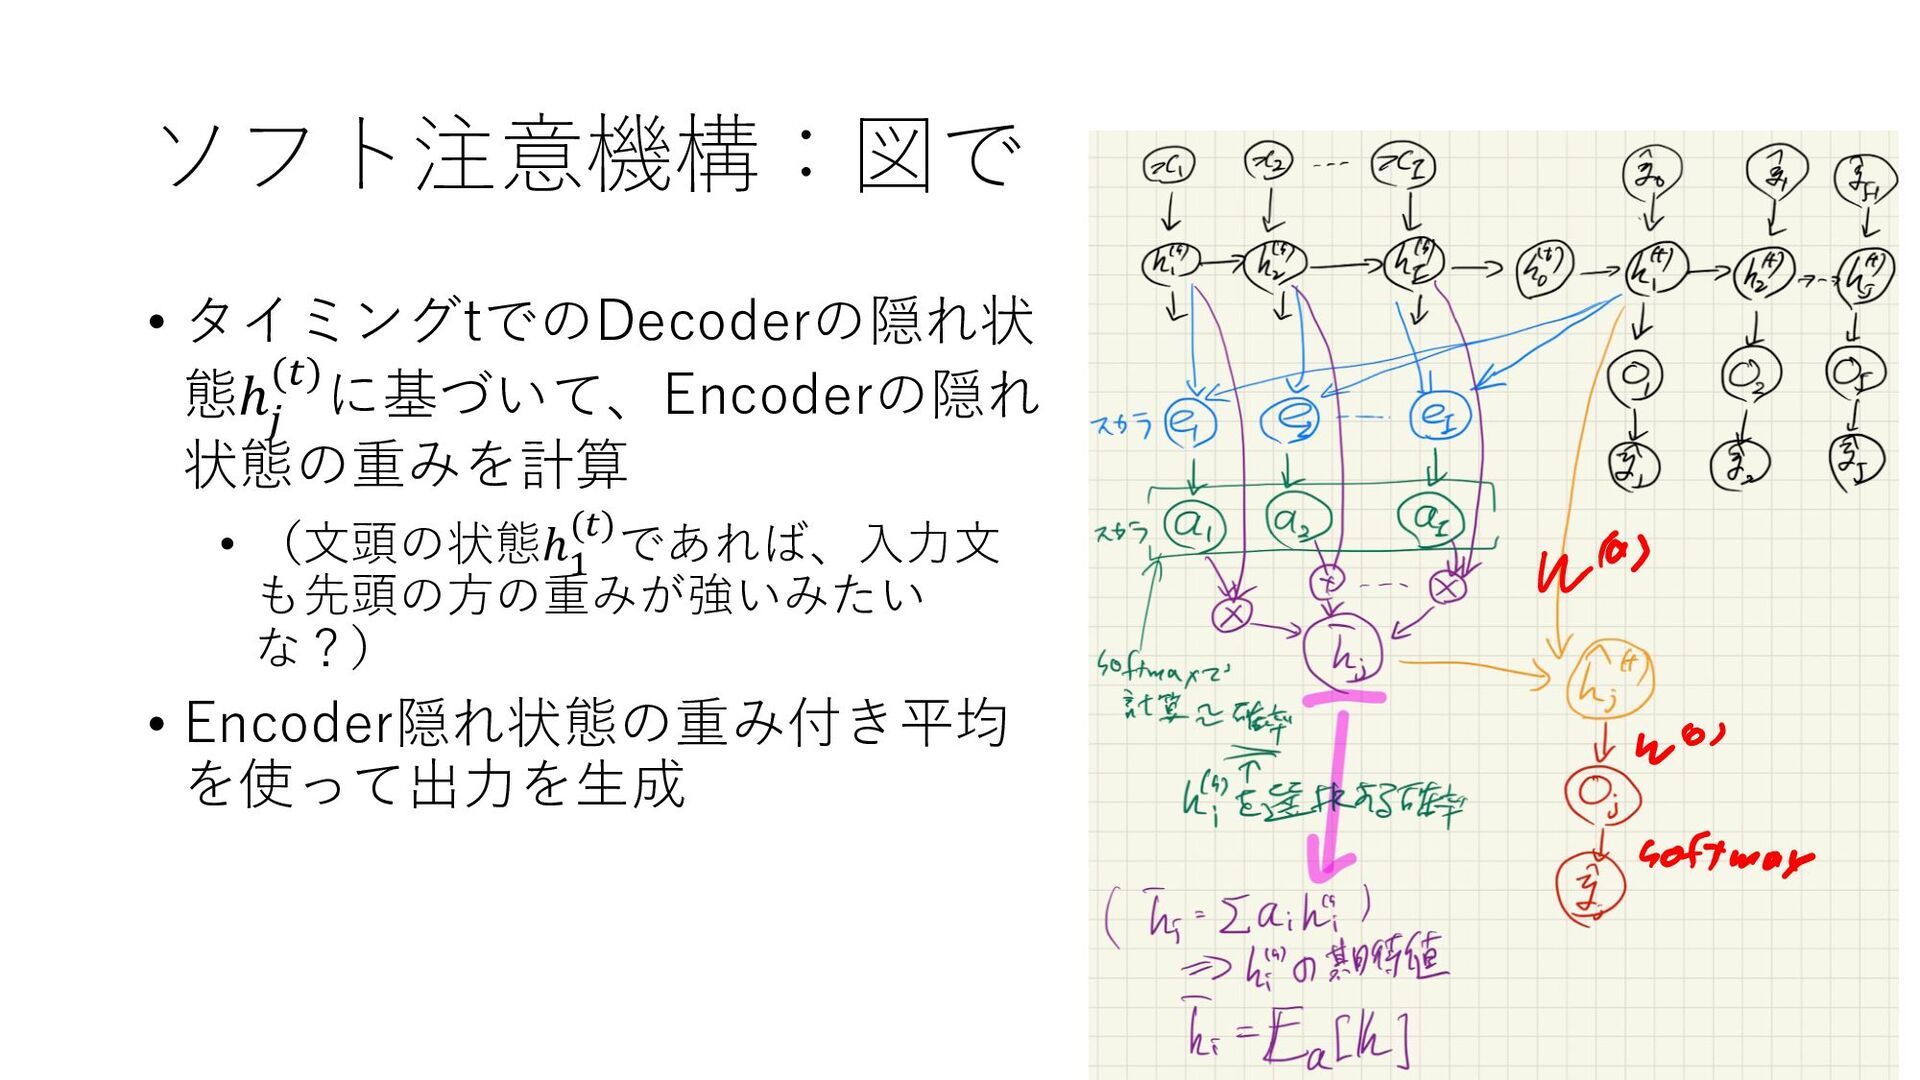
ソフト注意機構:図で • タイミングtでのDecoderの隠れ状 態ℎ & (')に基づいて、Encoderの隠れ 状態の重みを計算 • (⽂頭の状態ℎ' ())であれば、⼊⼒⽂
も先頭の⽅の重みが強いみたい な?) • Encoder隠れ状態の重み付き平均 を使って出⼒を⽣成 -
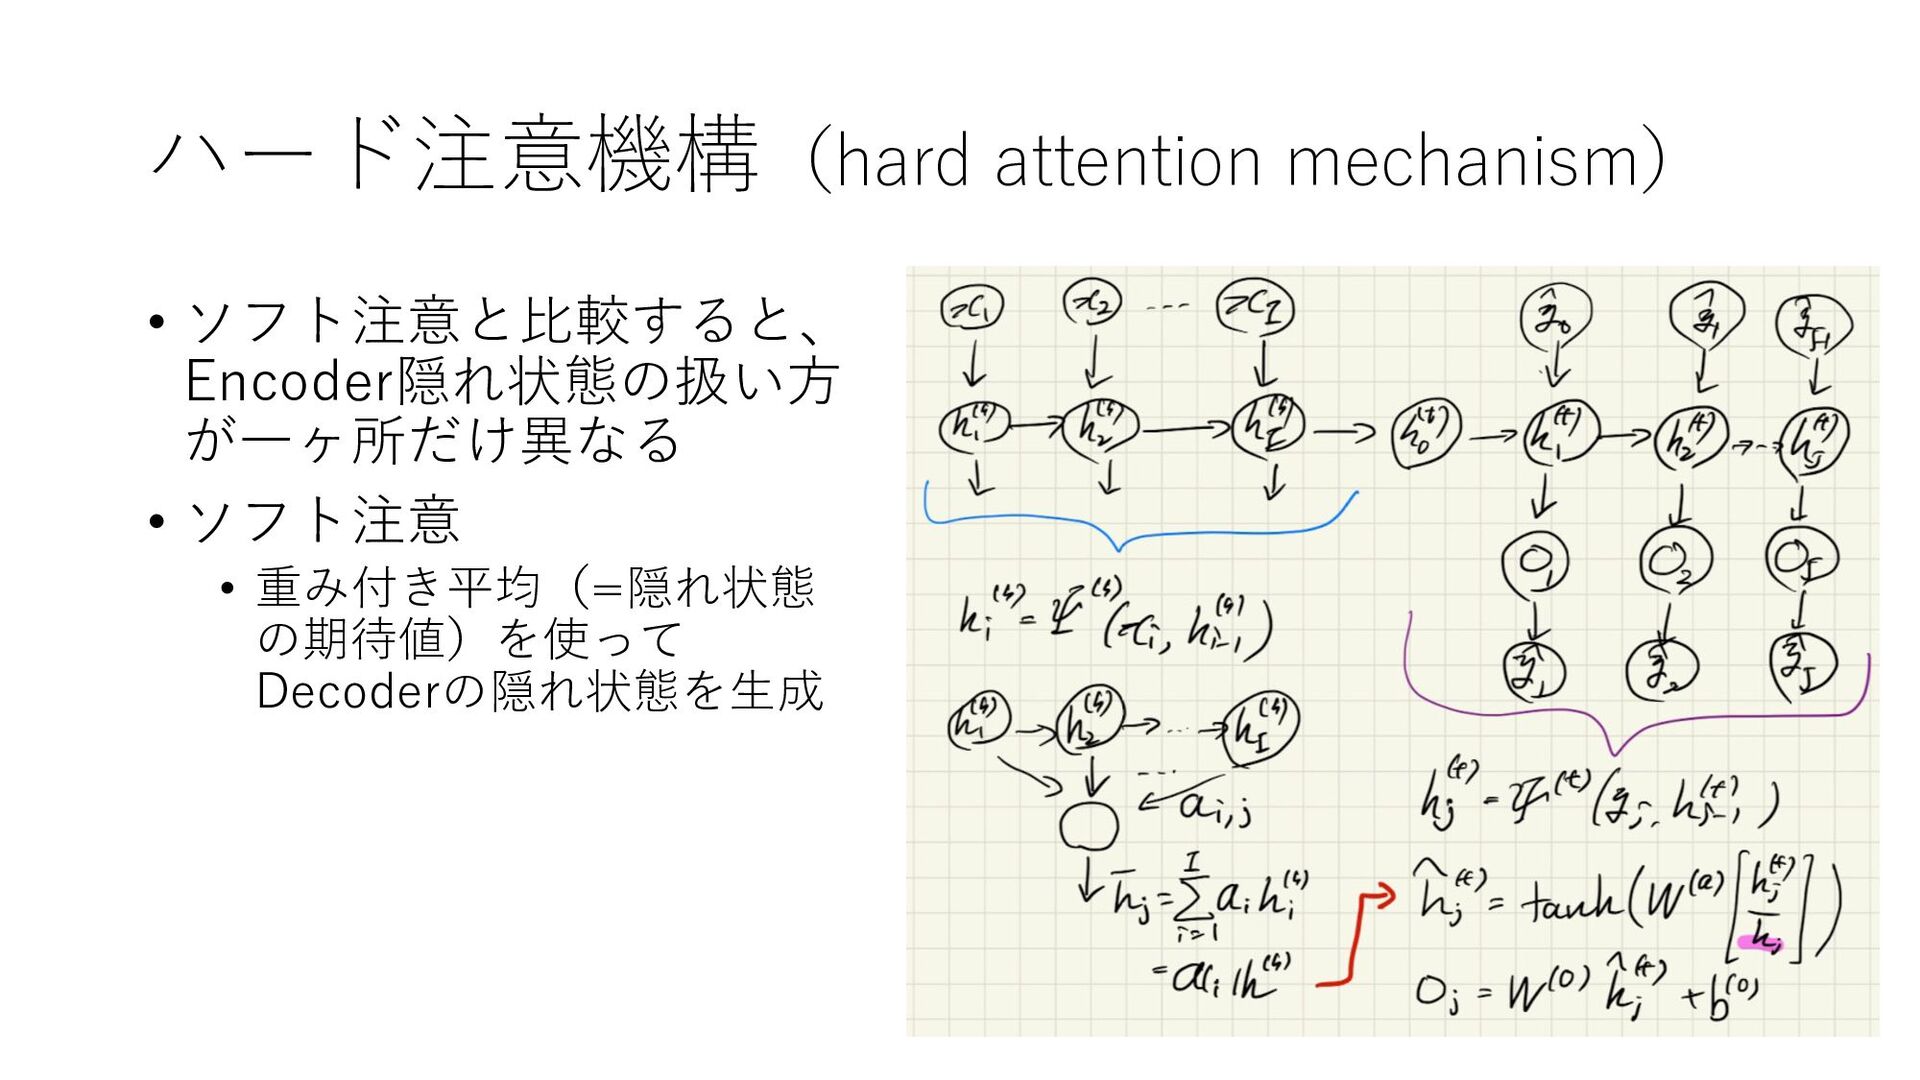
ハード注意機構(hard attention mechanism) • ソフト注意と⽐較すると、 Encoder隠れ状態の扱い⽅ が⼀ヶ所だけ異なる • ソフト注意 •
重み付き平均(=隠れ状態 の期待値)を使って Decoderの隠れ状態を⽣成 -
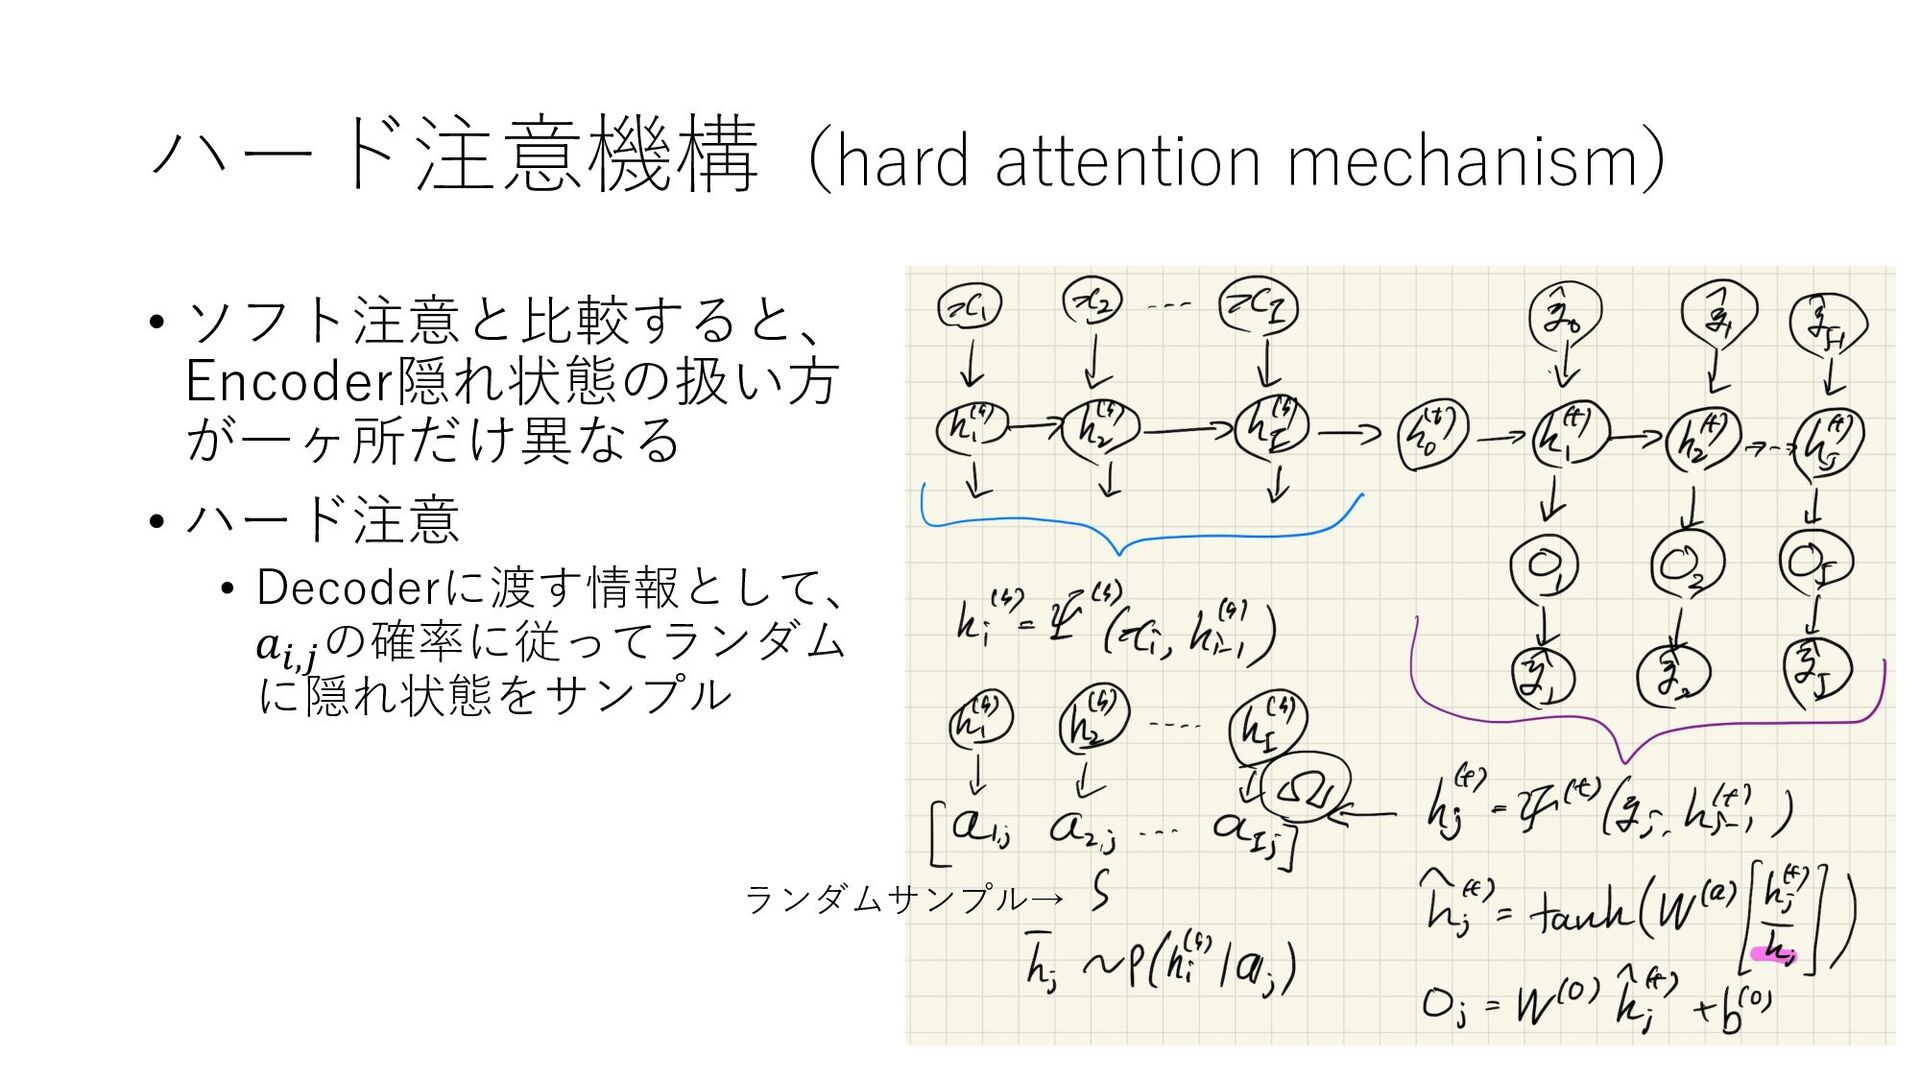
ハード注意機構(hard attention mechanism) • ソフト注意と⽐較すると、 Encoder隠れ状態の扱い⽅ が⼀ヶ所だけ異なる • ハード注意 •
Decoderに渡す情報として、 𝑎!,# の確率に従ってランダム に隠れ状態をサンプル ランダムサンプル→ -
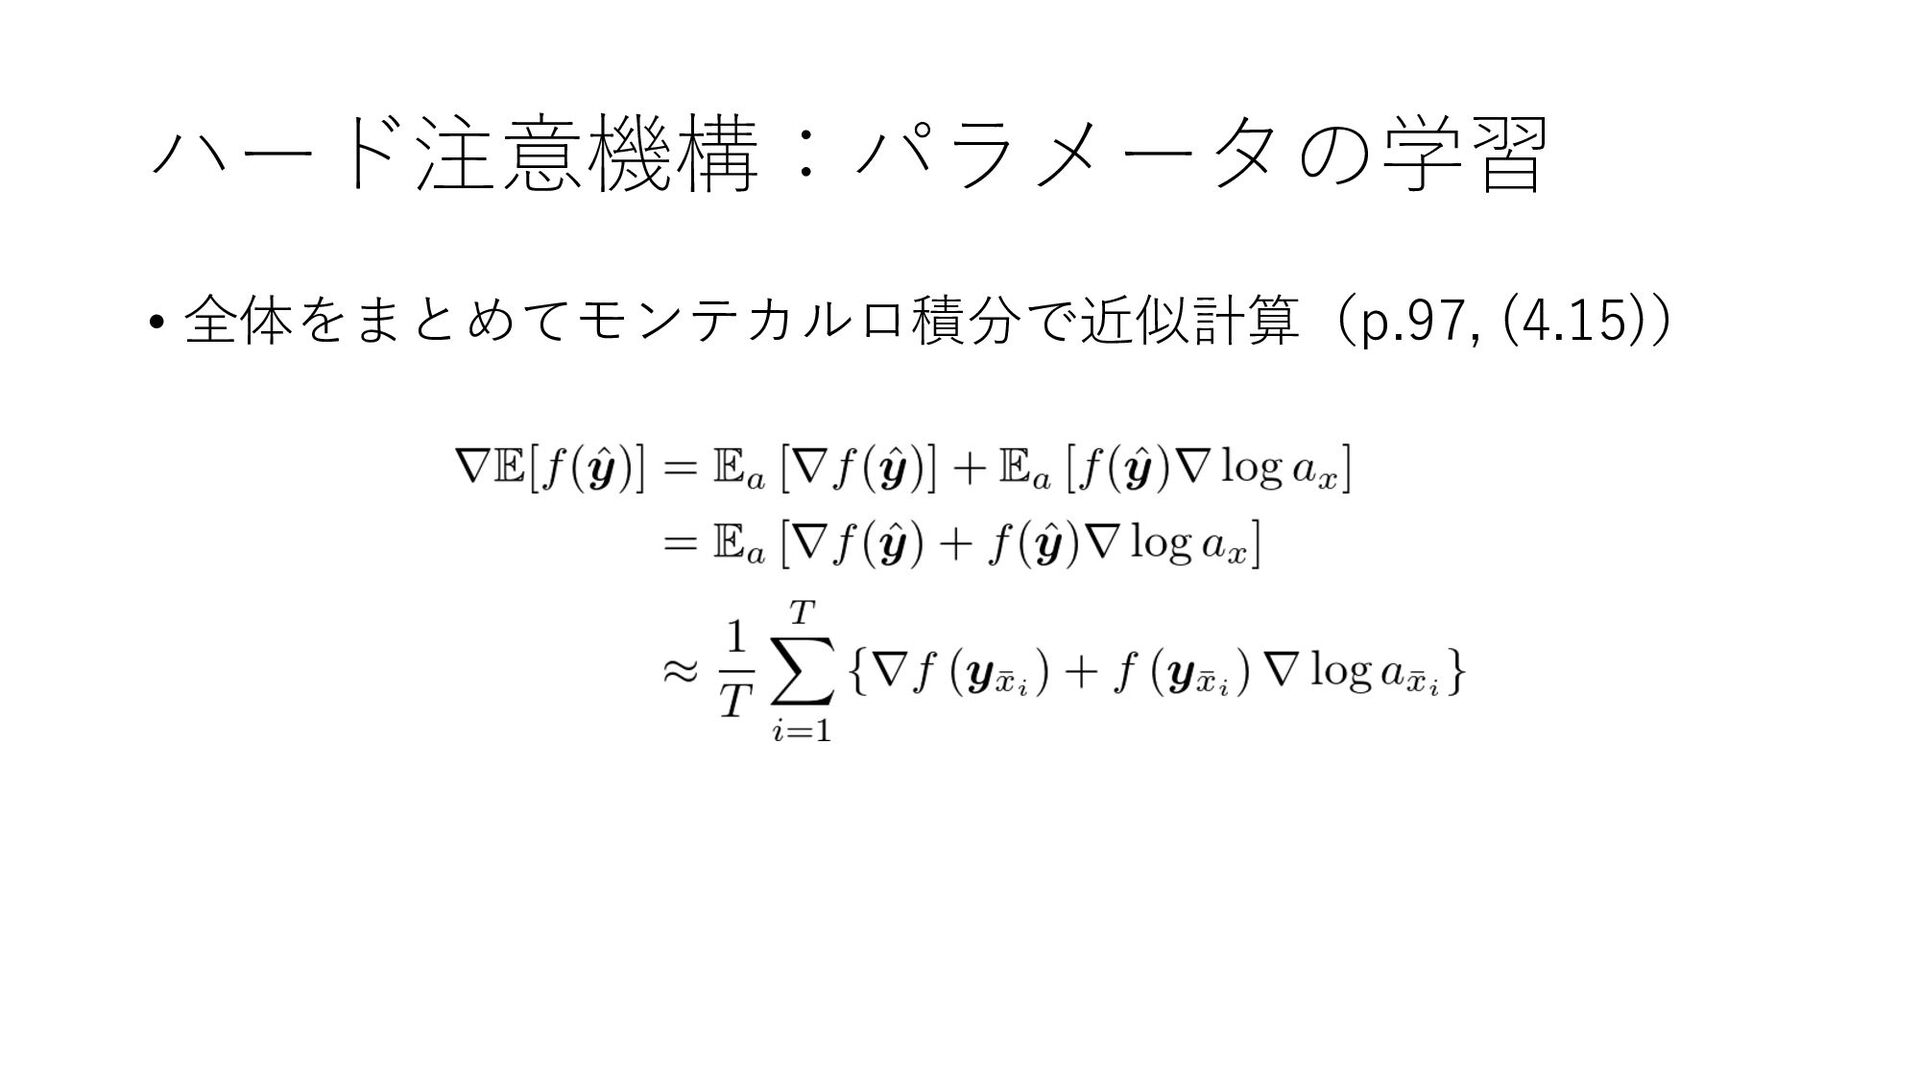
ハード注意機構:パラメータの学習 • 学習するパラメータ • ソフト注意機構と同じ • ランダムサンプルが仕組みに組み込まれているので、全体的に 確率的に振る舞う • 値が確定しないので、素直に⽬的関数の勾配を計算できない
• ⽬的関数𝑓(& 𝑦)の期待値𝔼 𝑓(& 𝑦) を最⼩化する テキストp.96~98では、この期待値𝔼 𝑓($ 𝑦) の最⼩化問題を扱うにあたって、 計算量を減らすための近似計算について解説があります。ハード注意を実装 するうえでは実⽤上必須の近似計算とは思いますが、仕組みの概要を理解す る上ではまずはここまで理解できれば良いと思います。 -
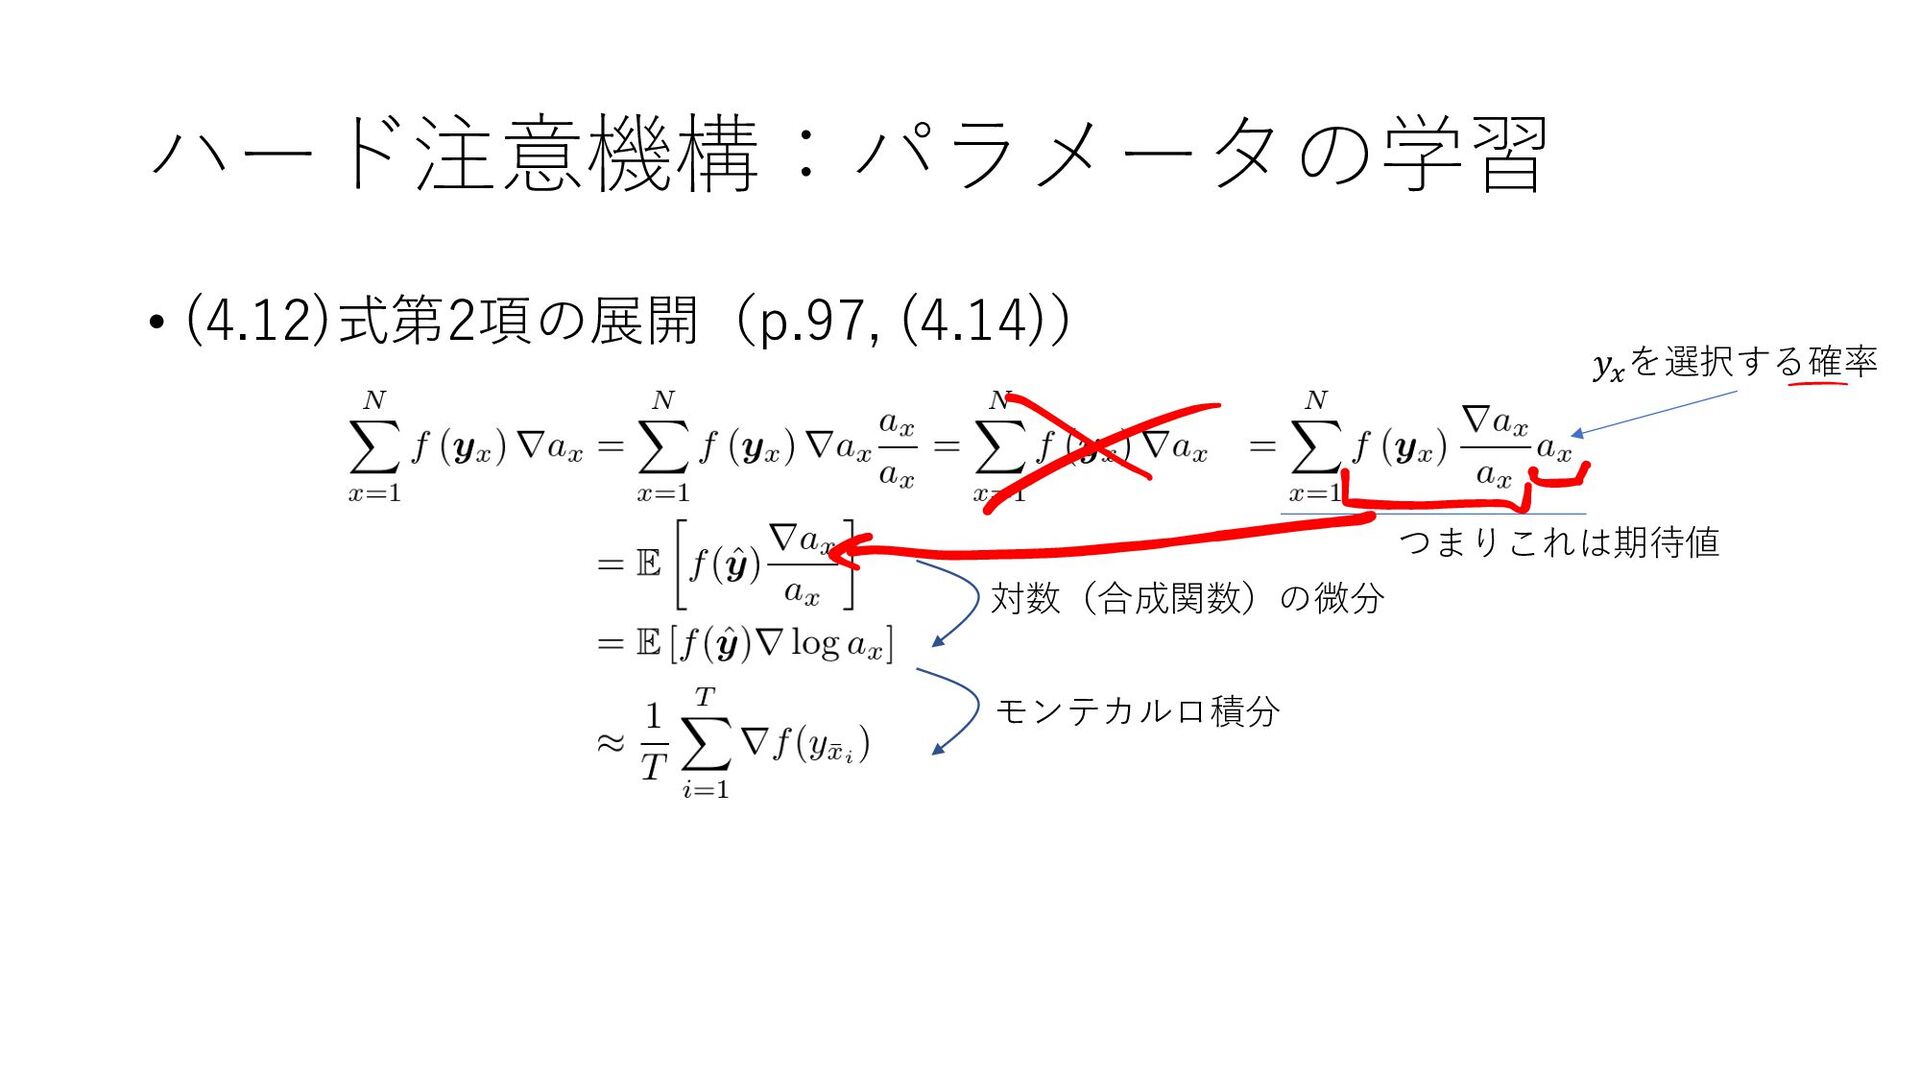
ハード注意機構:パラメータの学習 • ⽬的関数の期待値𝔼 𝑓(& 𝑦) の展開(p.96, (4.12)) 合成関数の微分 期待値の定義 モンテカルロ積分で期待値を近似計算
𝑦' を選択する確率 モンテカルロ積分できるように展開 N(語彙数)が莫⼤だと、𝑓($ 𝑦) を何度も計算する必要があり 重たい -
ハード注意機構:パラメータの学習 • モンテカルロ積分をするにあたって、サンプルの分散が⼤きく なると近似値の精度が問題になる場合がある • サンプルを⼤量に得れば良いがそれでは計算が軽くならない • 「ベースライン」というパラメータを導⼊(p.98, (4.16~18)) •
(4.18)から、ベースラインをf(y)の期待値にすれば、全体の絶対値が下 がるので分散が⼩さくなることが期待できる -
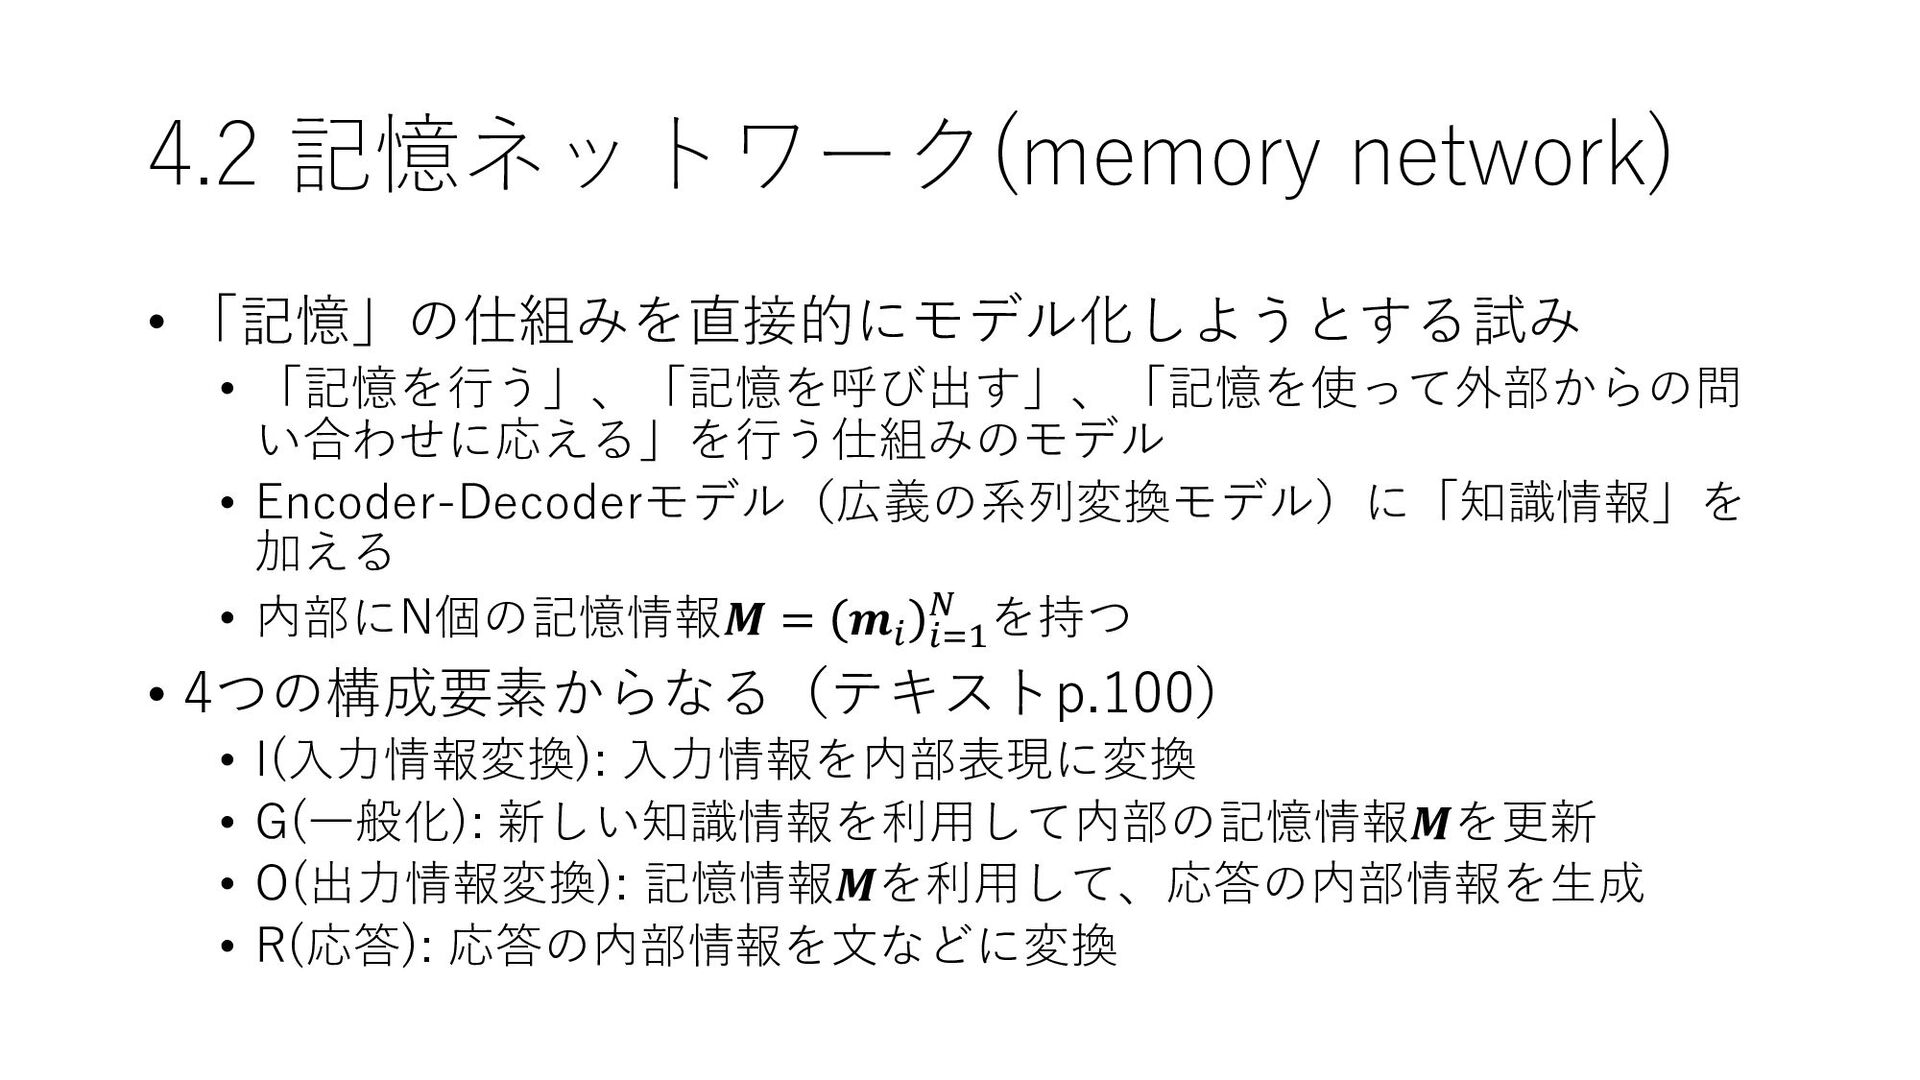
4.2 記憶ネットワーク(memory network) • 「記憶」の仕組みを直接的にモデル化しようとする試み • 「記憶を⾏う」、「記憶を呼び出す」、「記憶を使って外部からの問 い合わせに応える」を⾏う仕組みのモデル • Encoder-Decoderモデル(広義の系列変換モデル)に「知識情報」を
加える • 内部にN個の記憶情報𝑴 = 𝒎" "#$ % を持つ • 4つの構成要素からなる(テキストp.100) • I(⼊⼒情報変換): ⼊⼒情報を内部表現に変換 • G(⼀般化): 新しい知識情報を利⽤して内部の記憶情報𝑴を更新 • O(出⼒情報変換): 記憶情報𝑴を利⽤して、応答の内部情報を⽣成 • R(応答): 応答の内部情報を⽂などに変換 -
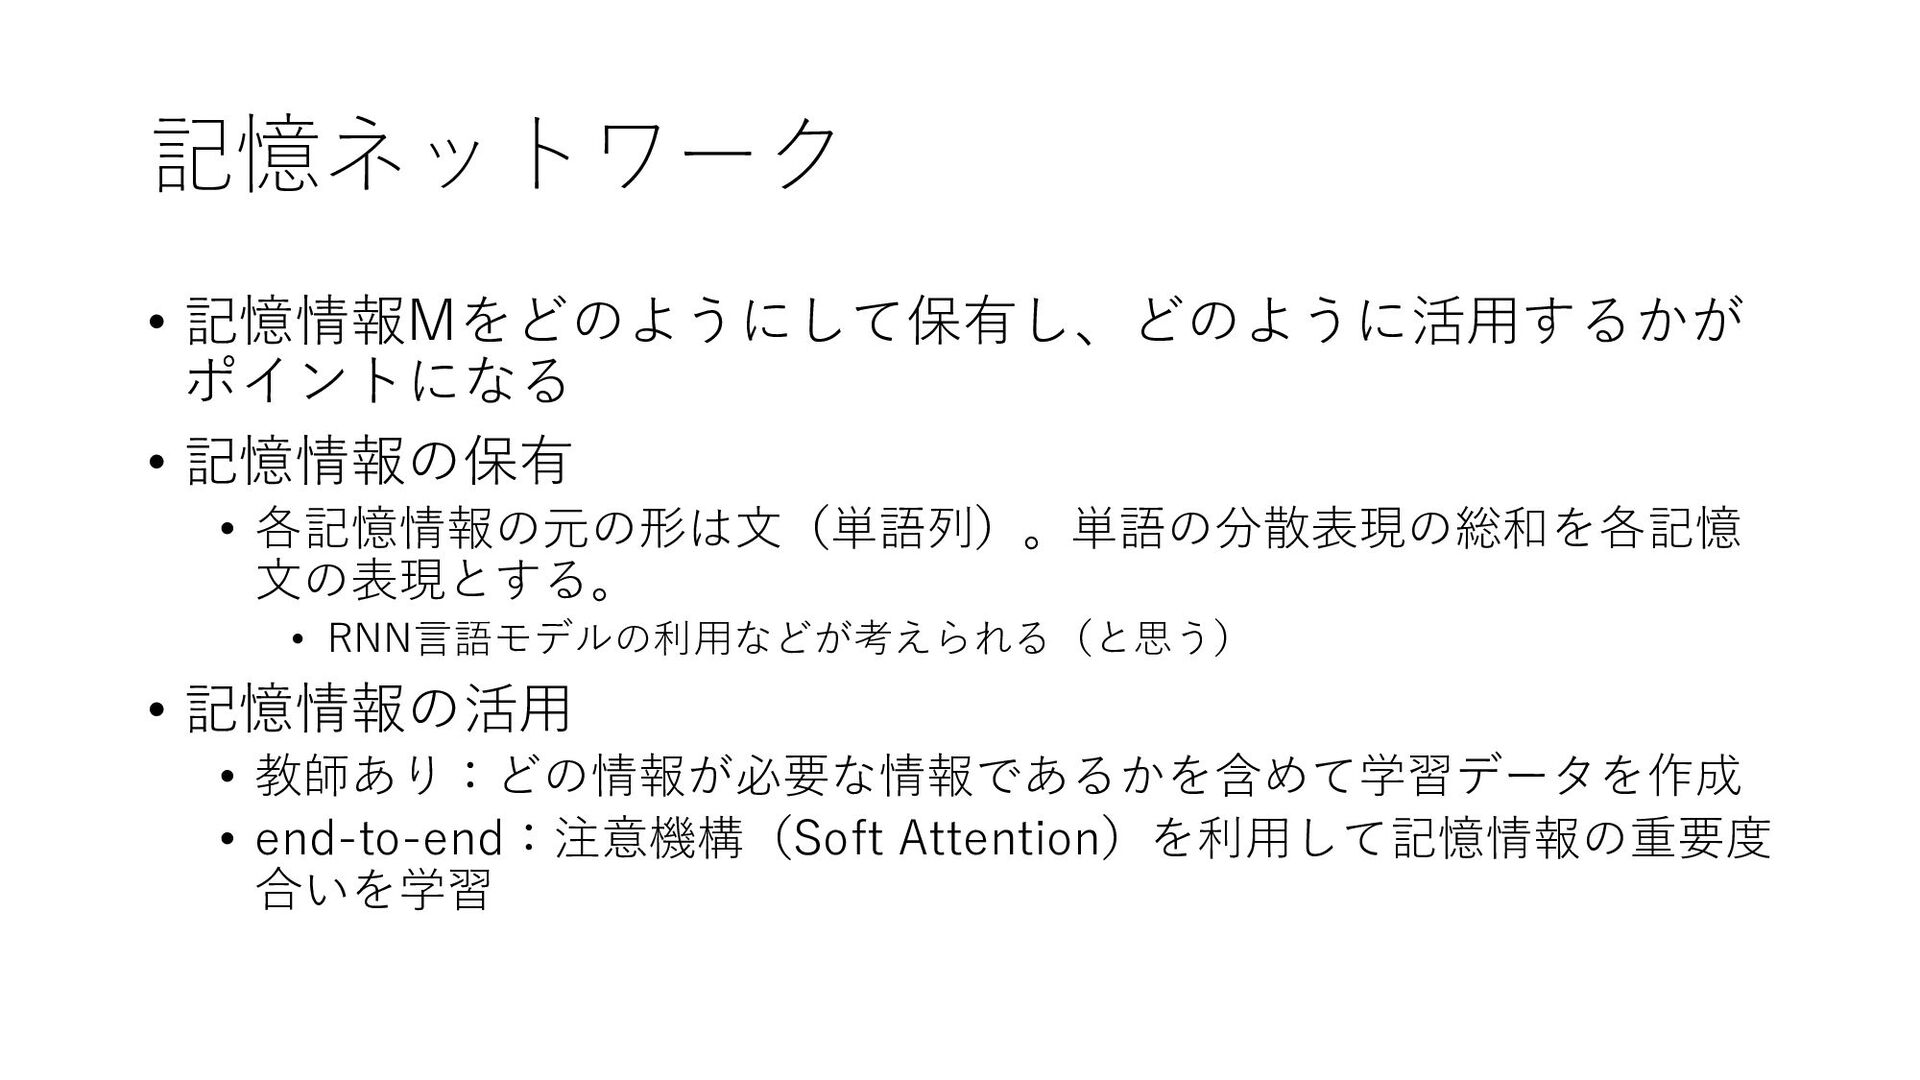
記憶ネットワーク • 記憶情報Mをどのようにして保有し、どのように活⽤するかが ポイントになる • 記憶情報の保有 • 各記憶情報の元の形は⽂(単語列)。単語の分散表現の総和を各記憶 ⽂の表現とする。 •
RNN⾔語モデルの利⽤などが考えられる(と思う) • 記憶情報の活⽤ • 教師あり:どの情報が必要な情報であるかを含めて学習データを作成 • end-to-end:注意機構(Soft Attention)を利⽤して記憶情報の重要度 合いを学習 -
記憶ネットワーク • 教師あり記憶ネットワークでは、どの記憶情報を参照すべきか という中間情報が既知であるとして学習 • ⾃然⽂には存在しない。1章で扱った部分問題の課題と同じ課題が現れ る。 • 注意機構(4.1節)では、⼊⼒系列のどの中間状態が重要かを学 習させて利⽤していた
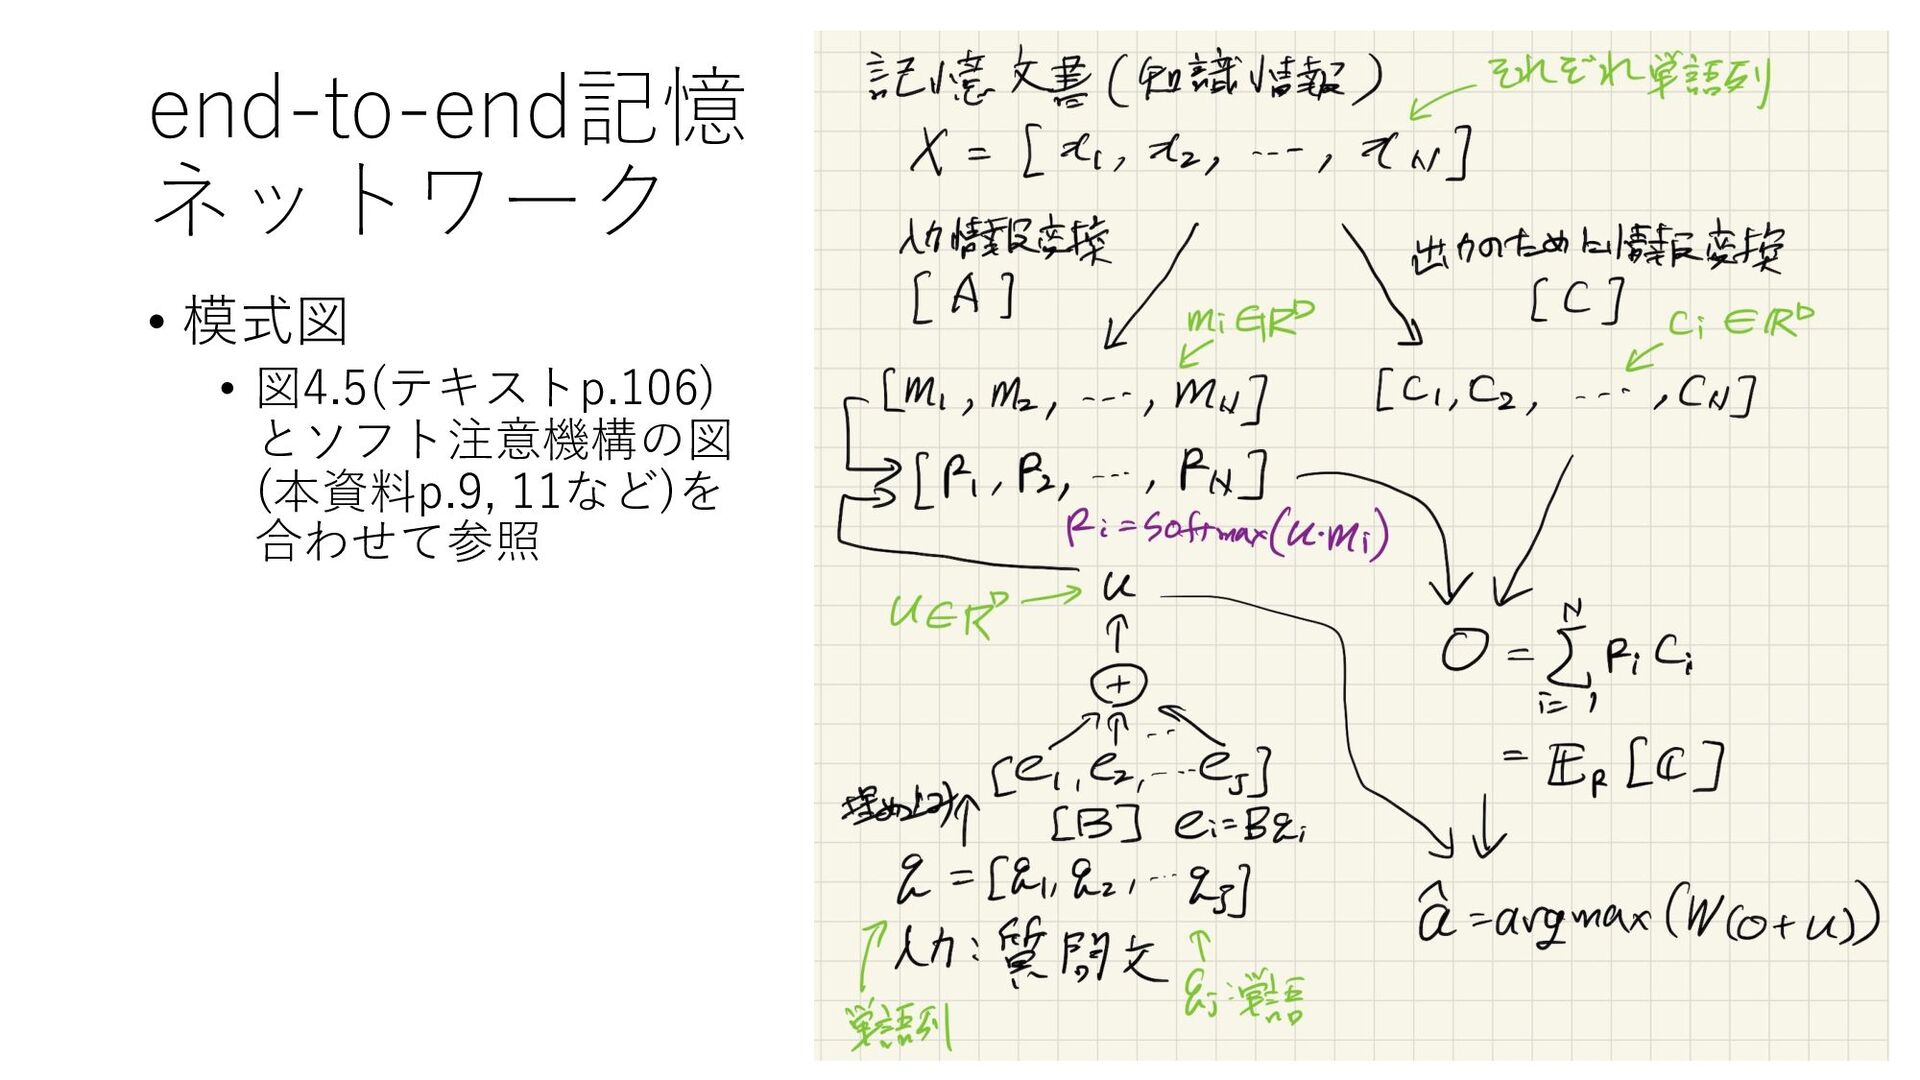
• この仕組みが使えそうと想像できる→end-to-end記憶ネットワーク end-to-end記憶ネットワークの構造を簡単に紹介 -
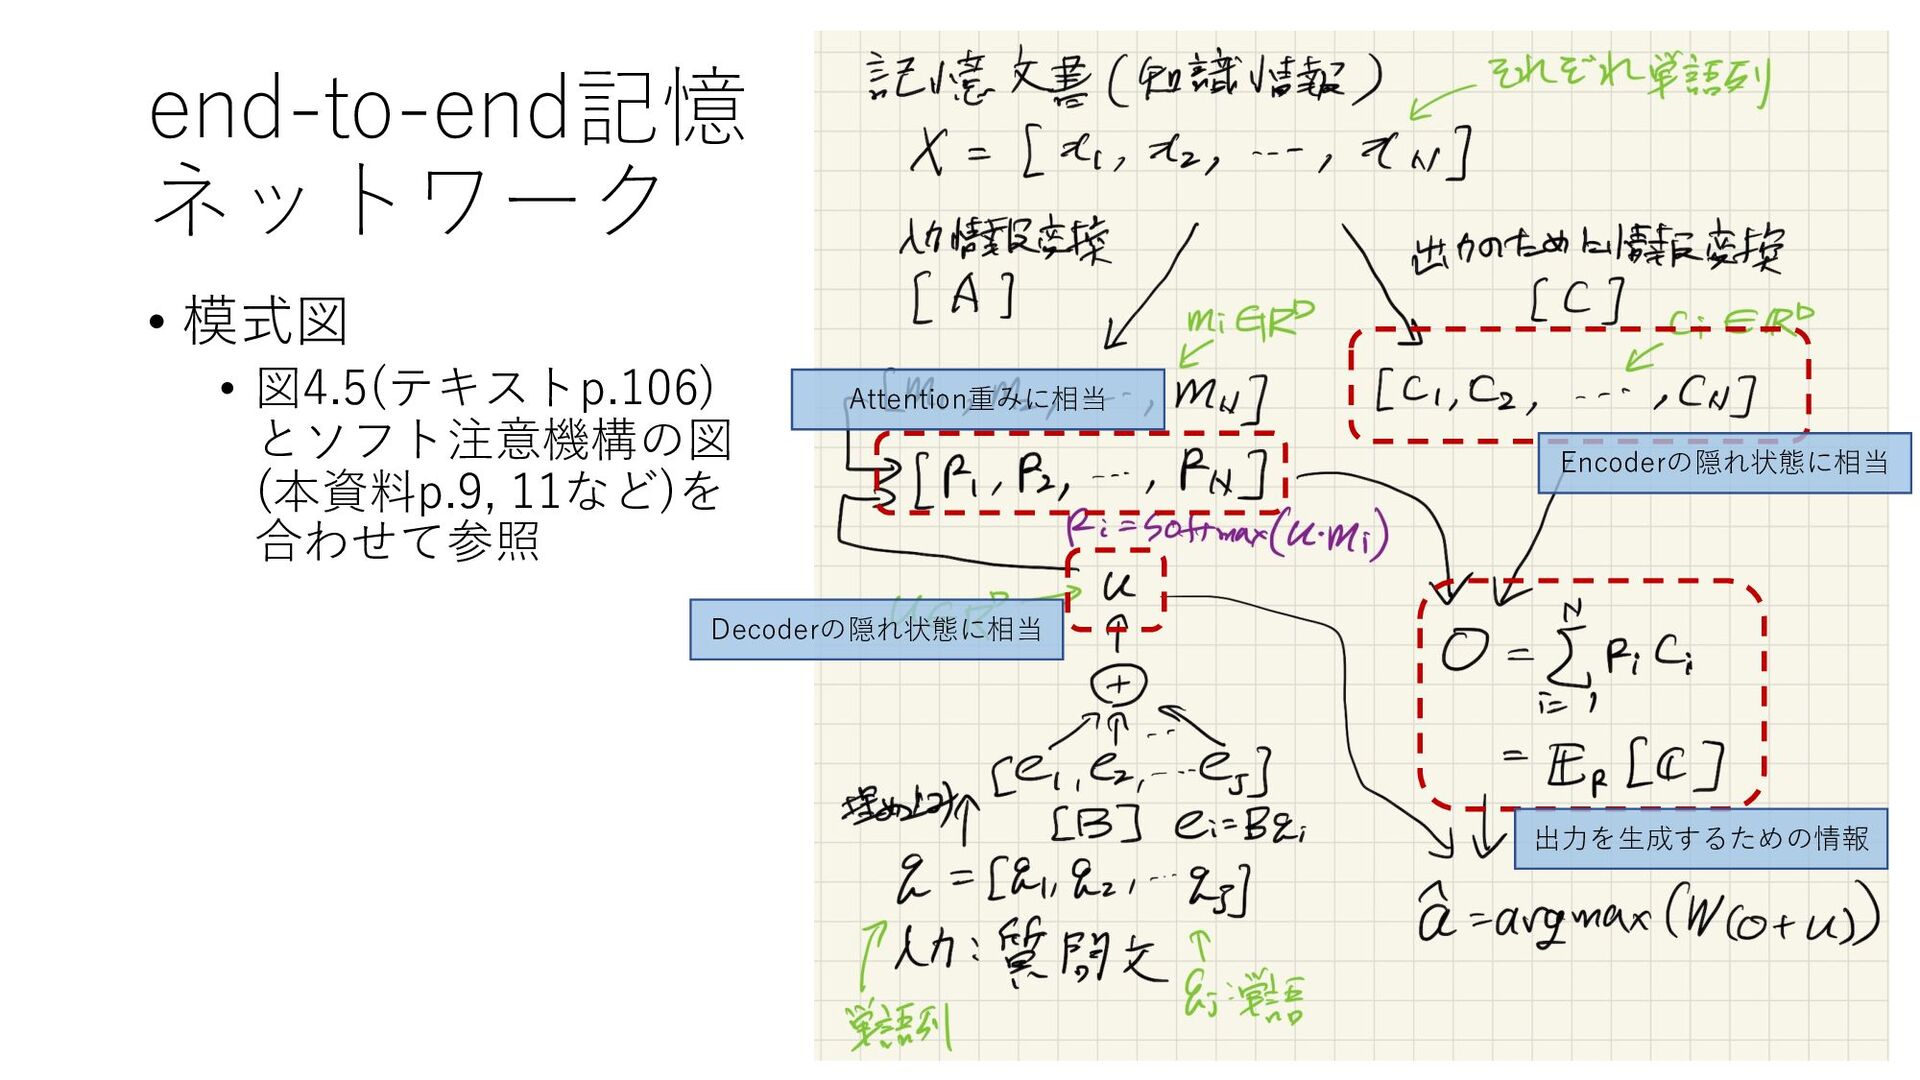
end-to-end記憶 ネットワーク • 模式図 • 図4.5(テキストp.106) とソフト注意機構の図 (本資料p.9, 11など)を 合わせて参照
Decoderの隠れ状態に相当 Encoderの隠れ状態に相当 Attention重みに相当 出⼒を⽣成するための情報 -
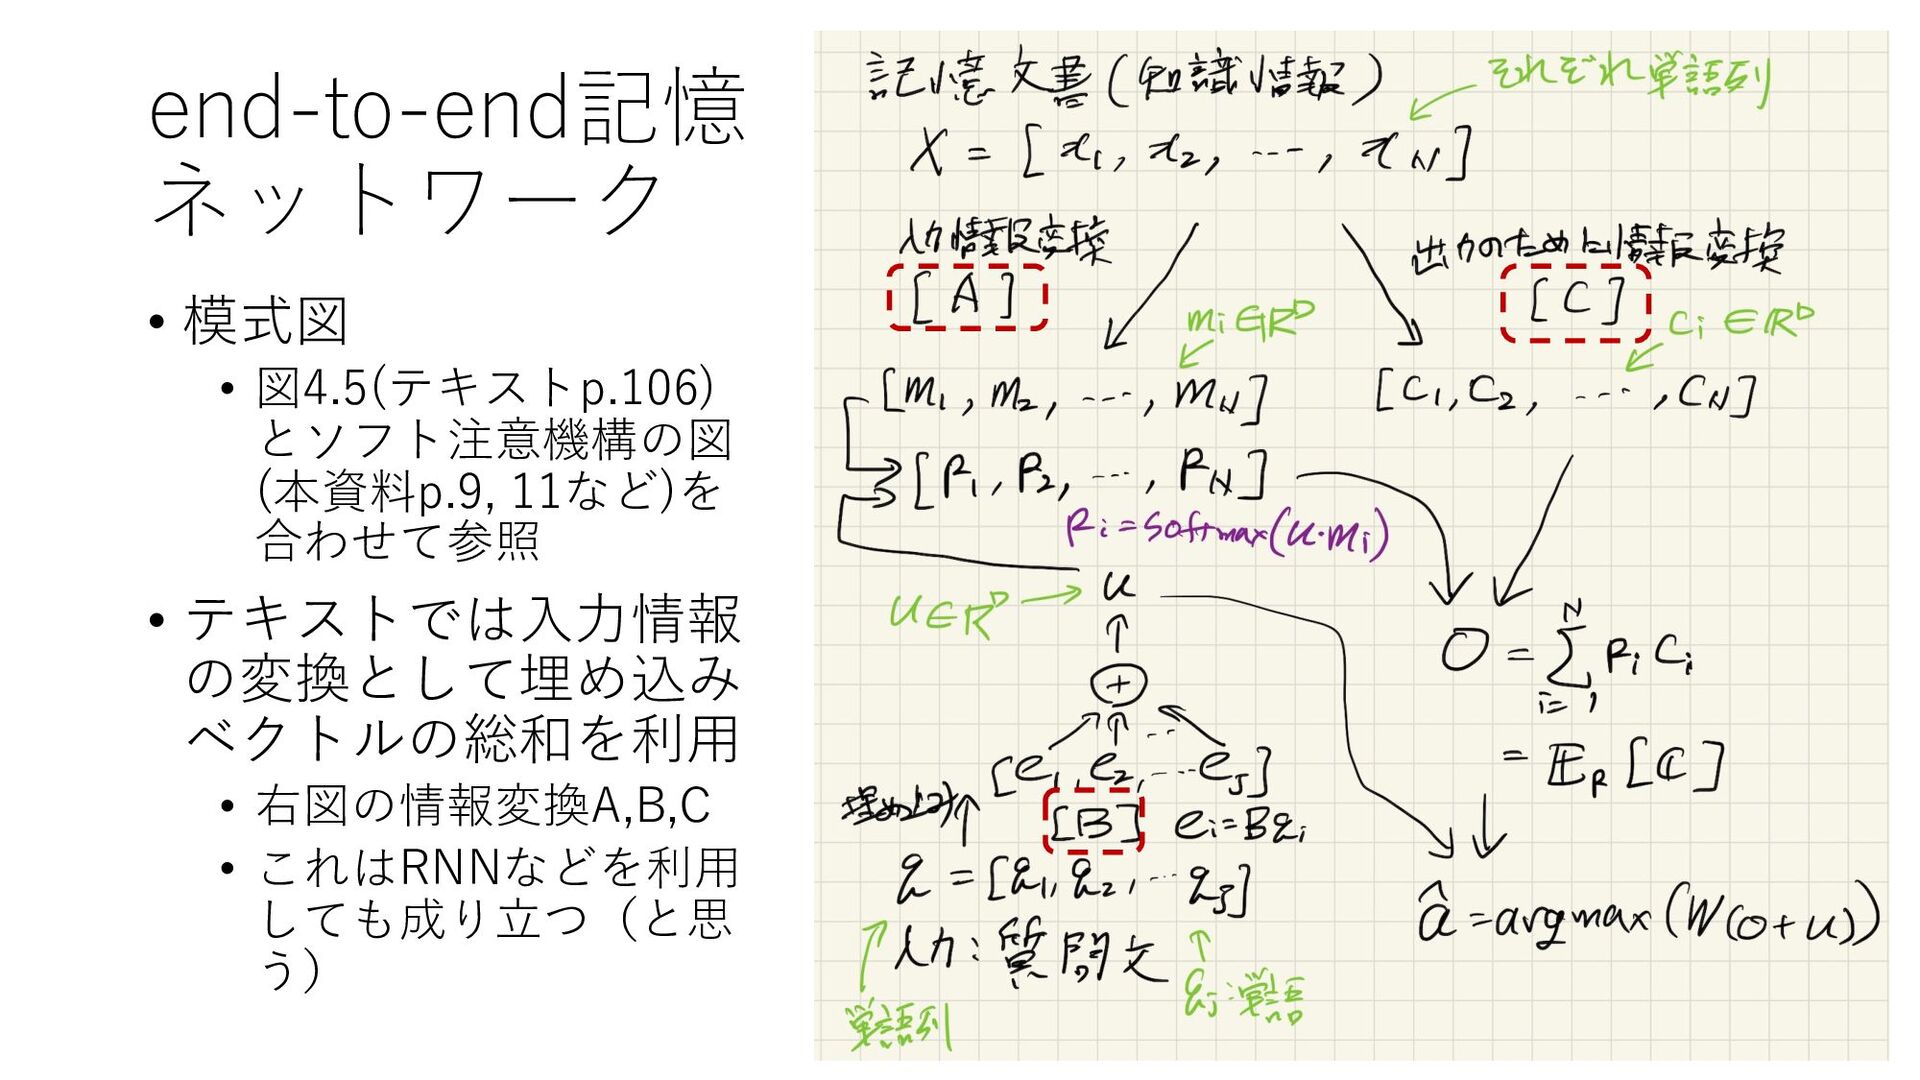
end-to-end記憶 ネットワーク • 模式図 • 図4.5(テキストp.106) とソフト注意機構の図 (本資料p.9, 11など)を 合わせて参照
• テキストでは⼊⼒情報 の変換として埋め込み ベクトルの総和を利⽤ • 右図の情報変換A,B,C • これはRNNなどを利⽤ しても成り⽴つ(と思 う) -
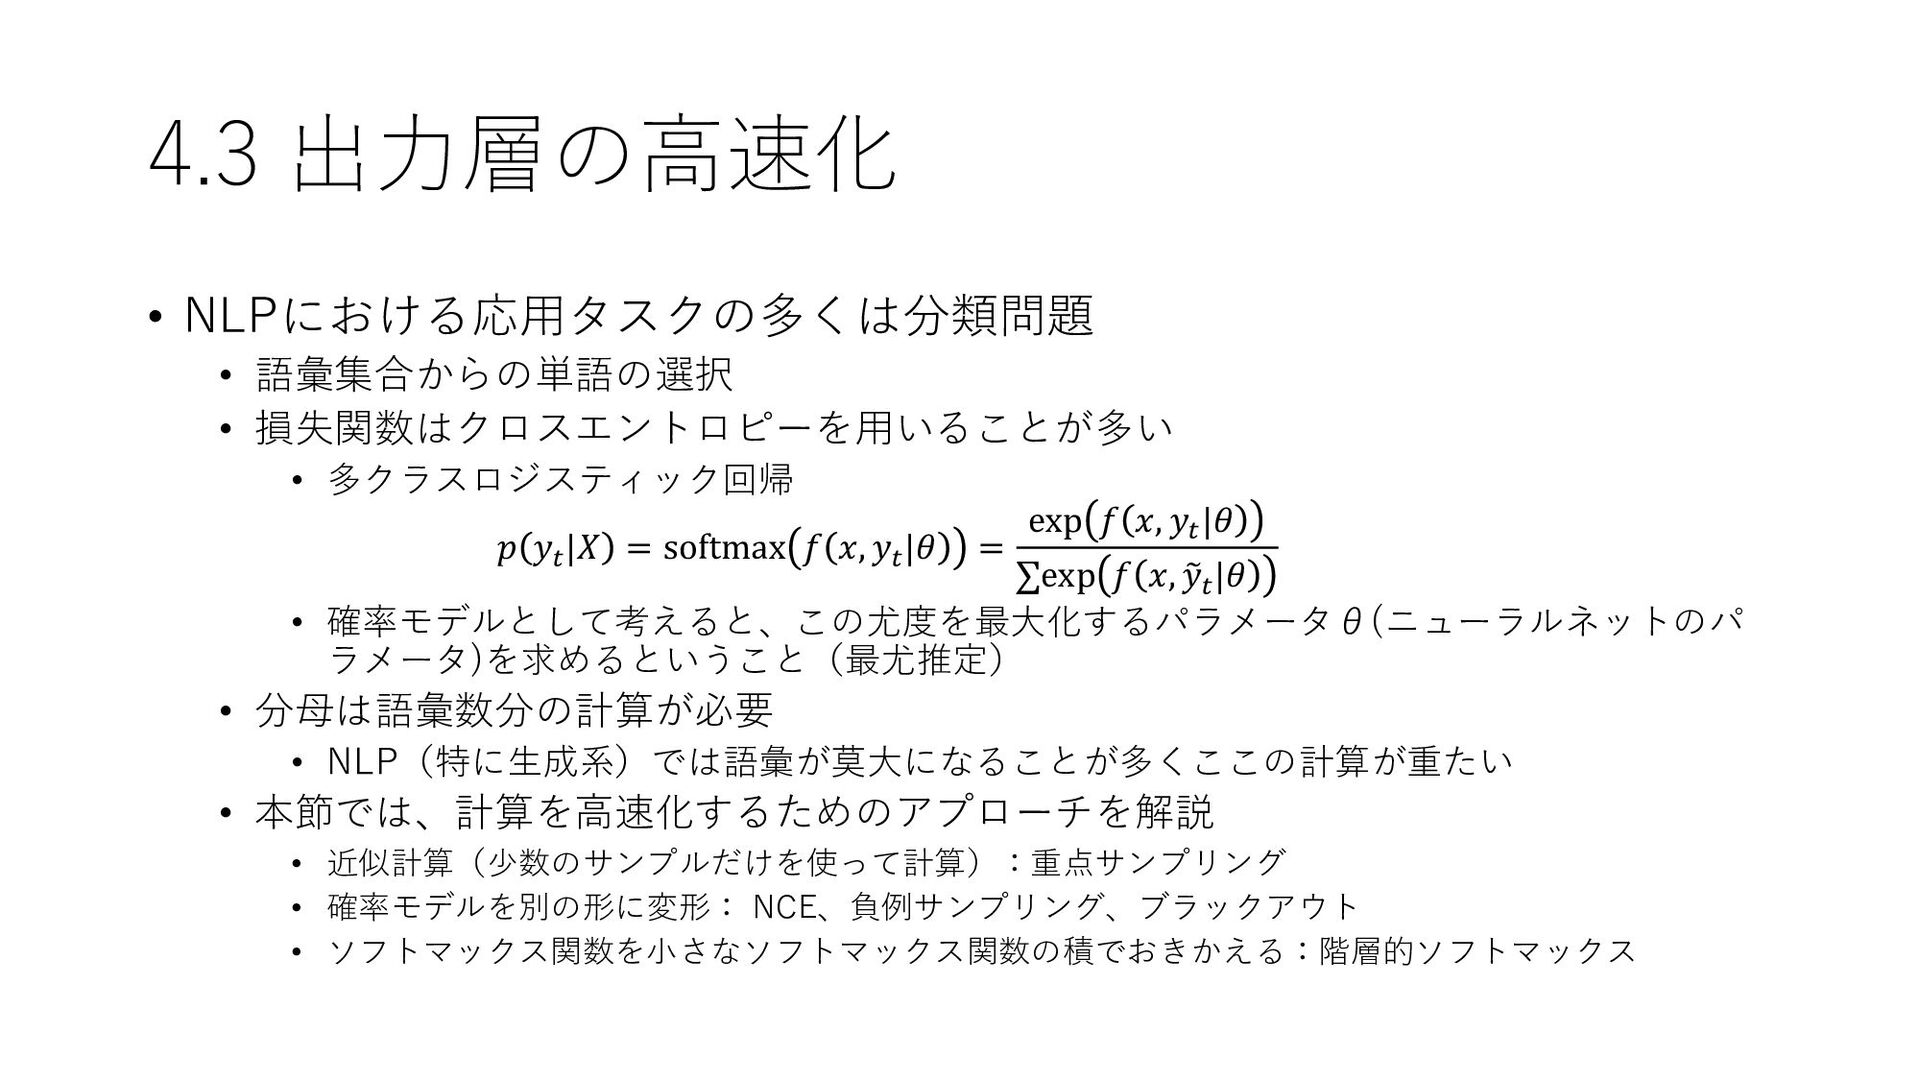
4.3 出⼒層の⾼速化 • NLPにおける応⽤タスクの多くは分類問題 • 語彙集合からの単語の選択 • 損失関数はクロスエントロピーを⽤いることが多い • 多クラスロジスティック回帰
𝑝 𝑦( |𝑋 = softmax 𝑓 𝑥, 𝑦( |𝜃 = exp 𝑓 𝑥, 𝑦( |𝜃 ∑exp 𝑓 𝑥, 8 𝑦( |𝜃 • 確率モデルとして考えると、この尤度を最⼤化するパラメータθ(ニューラルネットのパ ラメータ)を求めるということ(最尤推定) • 分⺟は語彙数分の計算が必要 • NLP(特に⽣成系)では語彙が莫⼤になることが多くここの計算が重たい • 本節では、計算を⾼速化するためのアプローチを解説 • 近似計算(少数のサンプルだけを使って計算):重点サンプリング • 確率モデルを別の形に変形: NCE、負例サンプリング、ブラックアウト • ソフトマックス関数を⼩さなソフトマックス関数の積でおきかえる:階層的ソフトマックス -
出⼒層の⾼速化:準備 • 課題を明らかにする 最適化の⽬的は負の対数尤度(損失関数)の最⼩化 ソフトマックス関数の分⺟をZとおく 最適化のために勾配を求める(勾配法) s(y)はyに対する関数の勾配(1回だけ) 対数の合成関数の微分と指数関数の合成関数の微分 𝑝 𝑦
= )*+ % , - . (前⾴参照)であるので p(y)は確率なので、離散変数(語彙数分)の期待値となる ここの計算を軽くしたい(近似計算) -
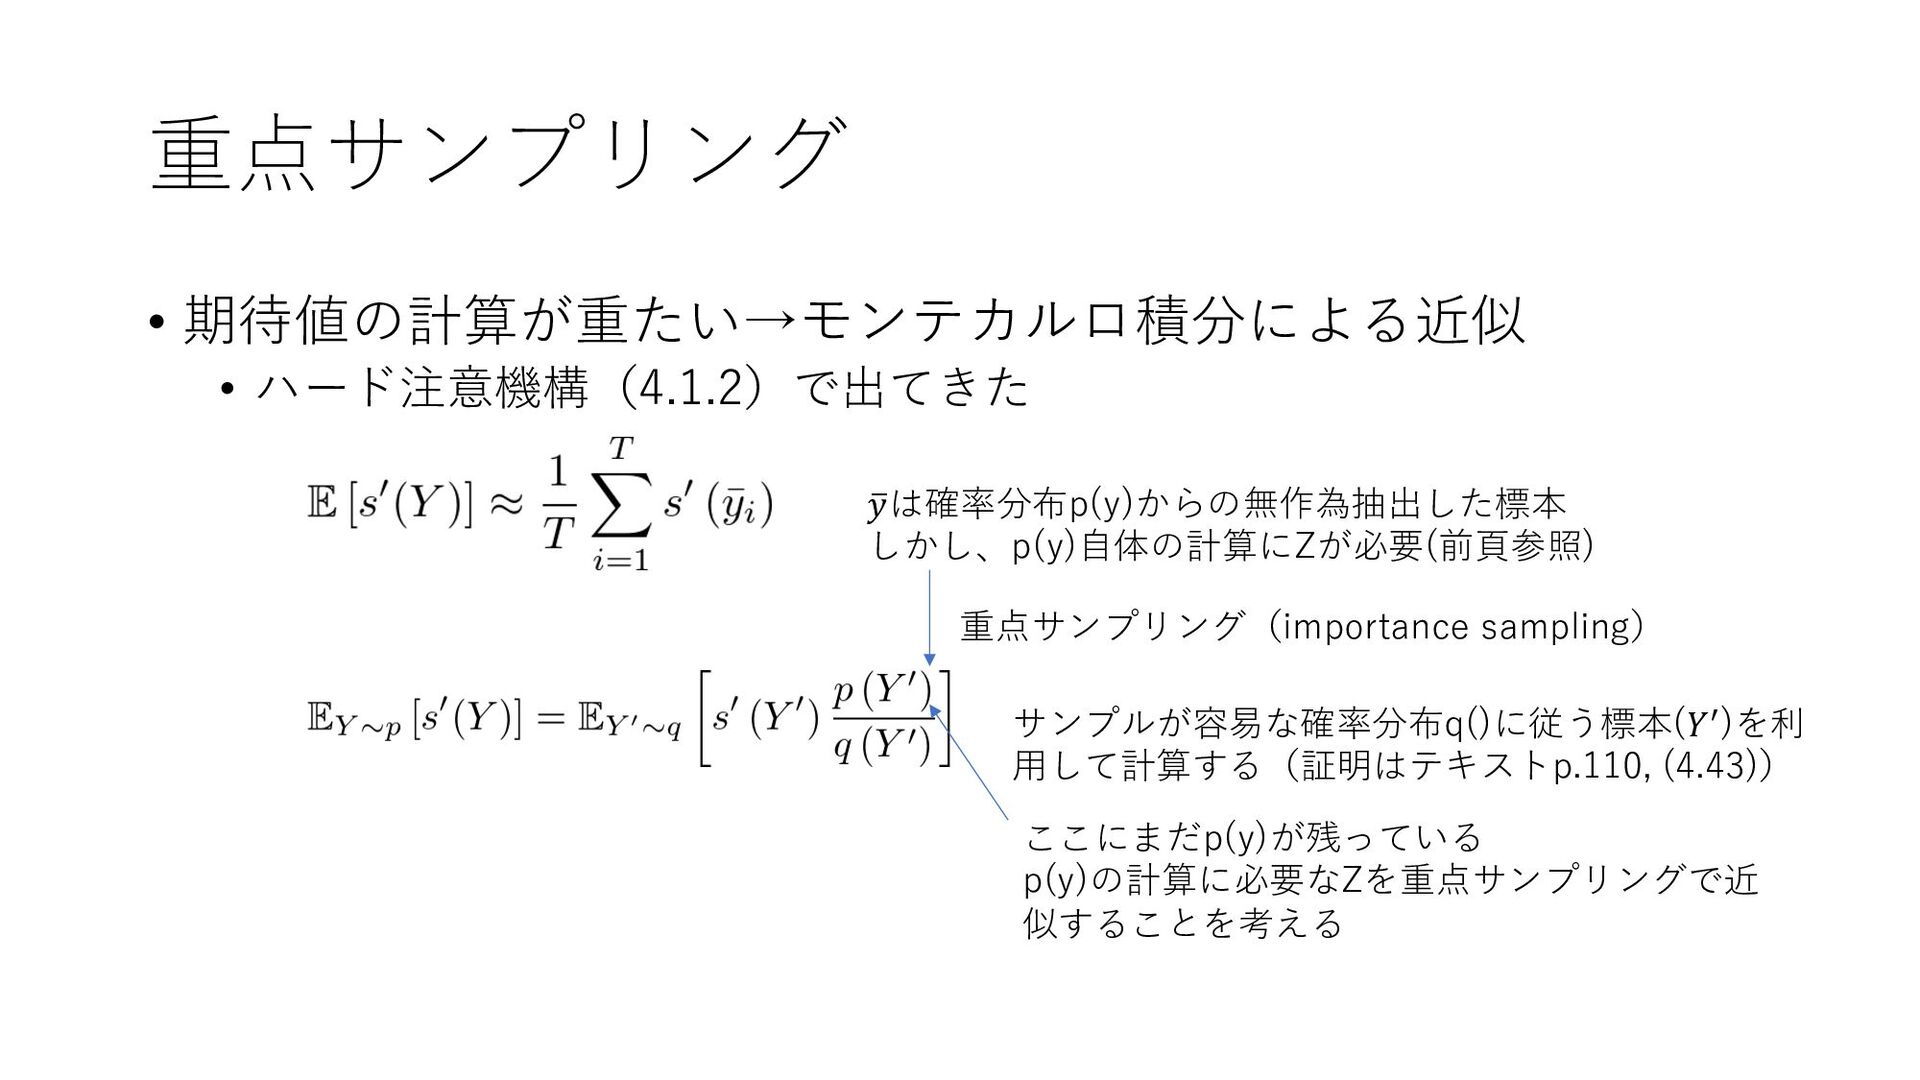
重点サンプリング • 期待値の計算が重たい→モンテカルロ積分による近似 • ハード注意機構(4.1.2)で出てきた 9 𝑦は確率分布p(y)からの無作為抽出した標本 しかし、p(y)⾃体の計算にZが必要(前⾴参照) 重点サンプリング(importance sampling)
サンプルが容易な確率分布q()に従う標本(𝑌/)を利 ⽤して計算する(証明はテキストp.110, (4.43)) ここにまだp(y)が残っている p(y)の計算に必要なZを重点サンプリングで近 似することを考える -
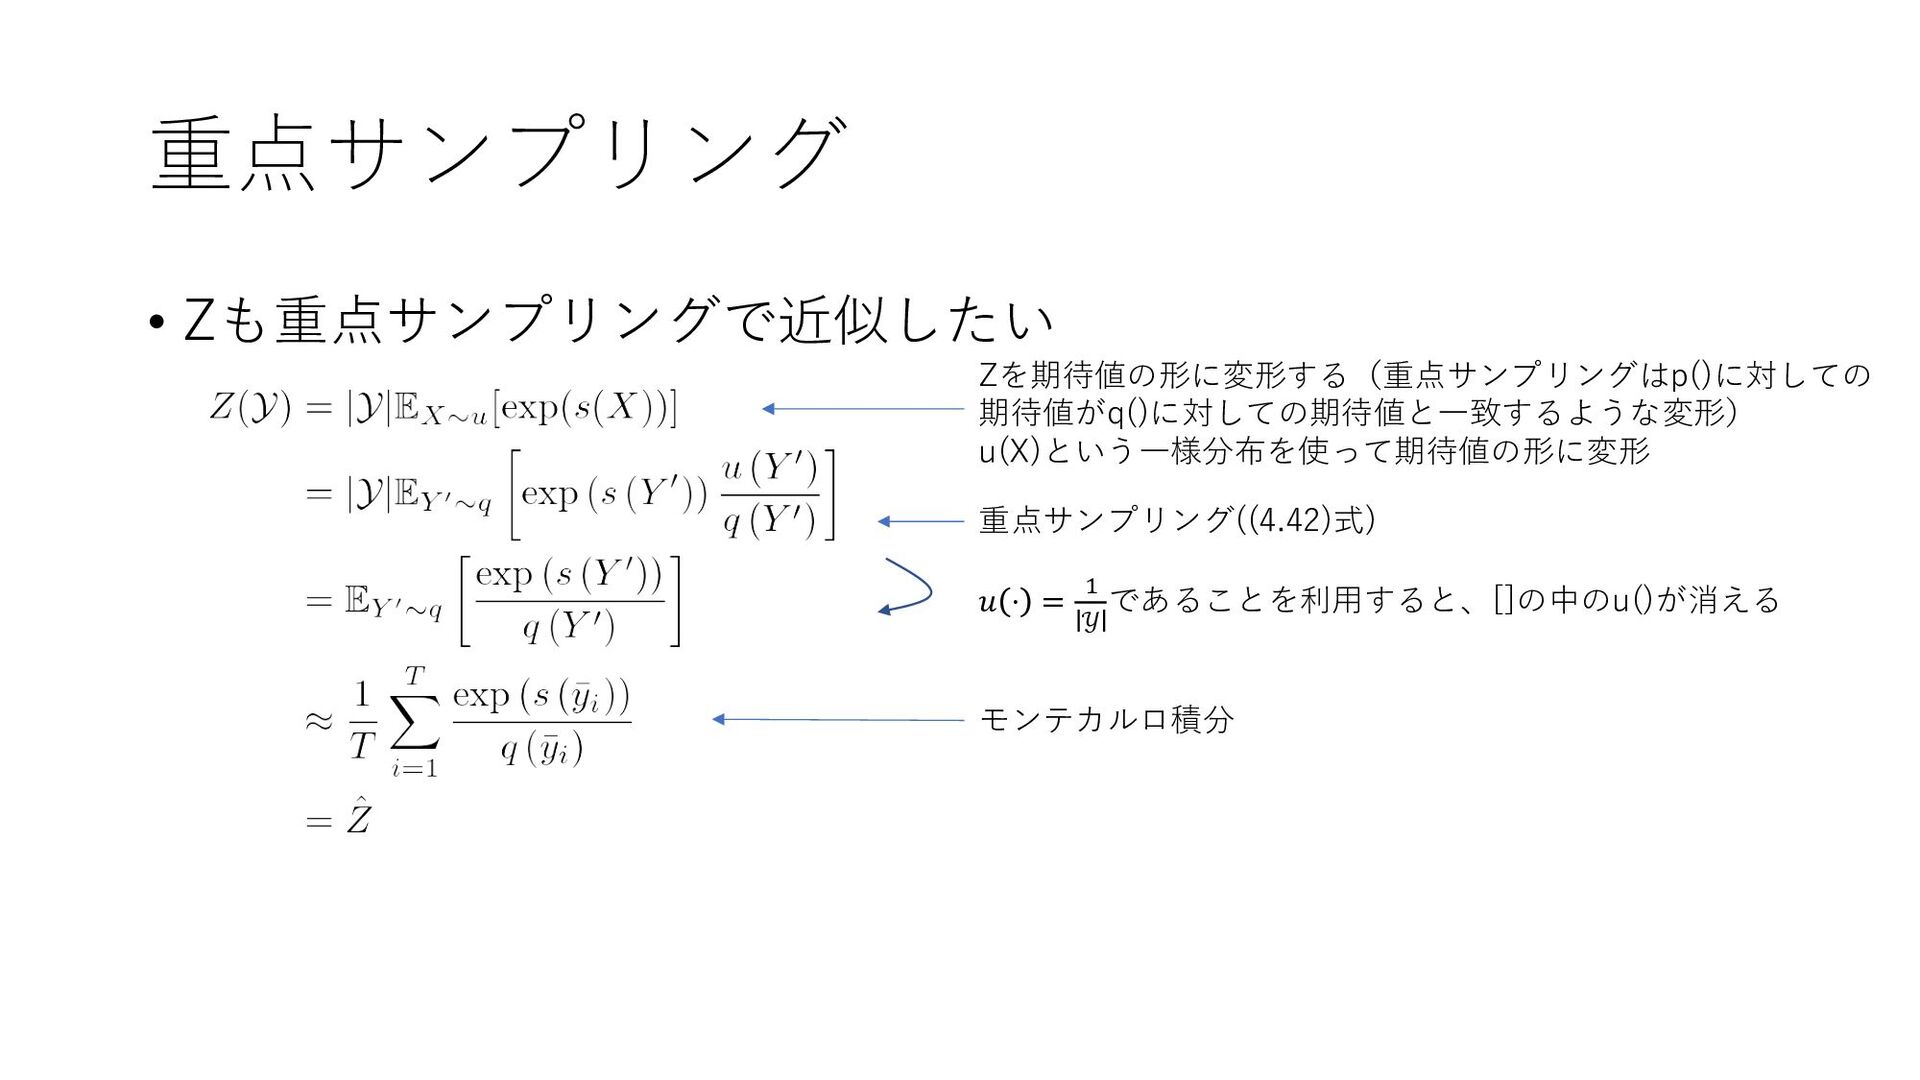
重点サンプリング • Zも重点サンプリングで近似したい Zを期待値の形に変形する(重点サンプリングはp()に対しての 期待値がq()に対しての期待値と⼀致するような変形) u(X)という⼀様分布を使って期待値の形に変形 重点サンプリング((4.42)式) 𝑢 ⋅ =
! 𝒴 であることを利⽤すると、[]の中のu()が消える モンテカルロ積分 -
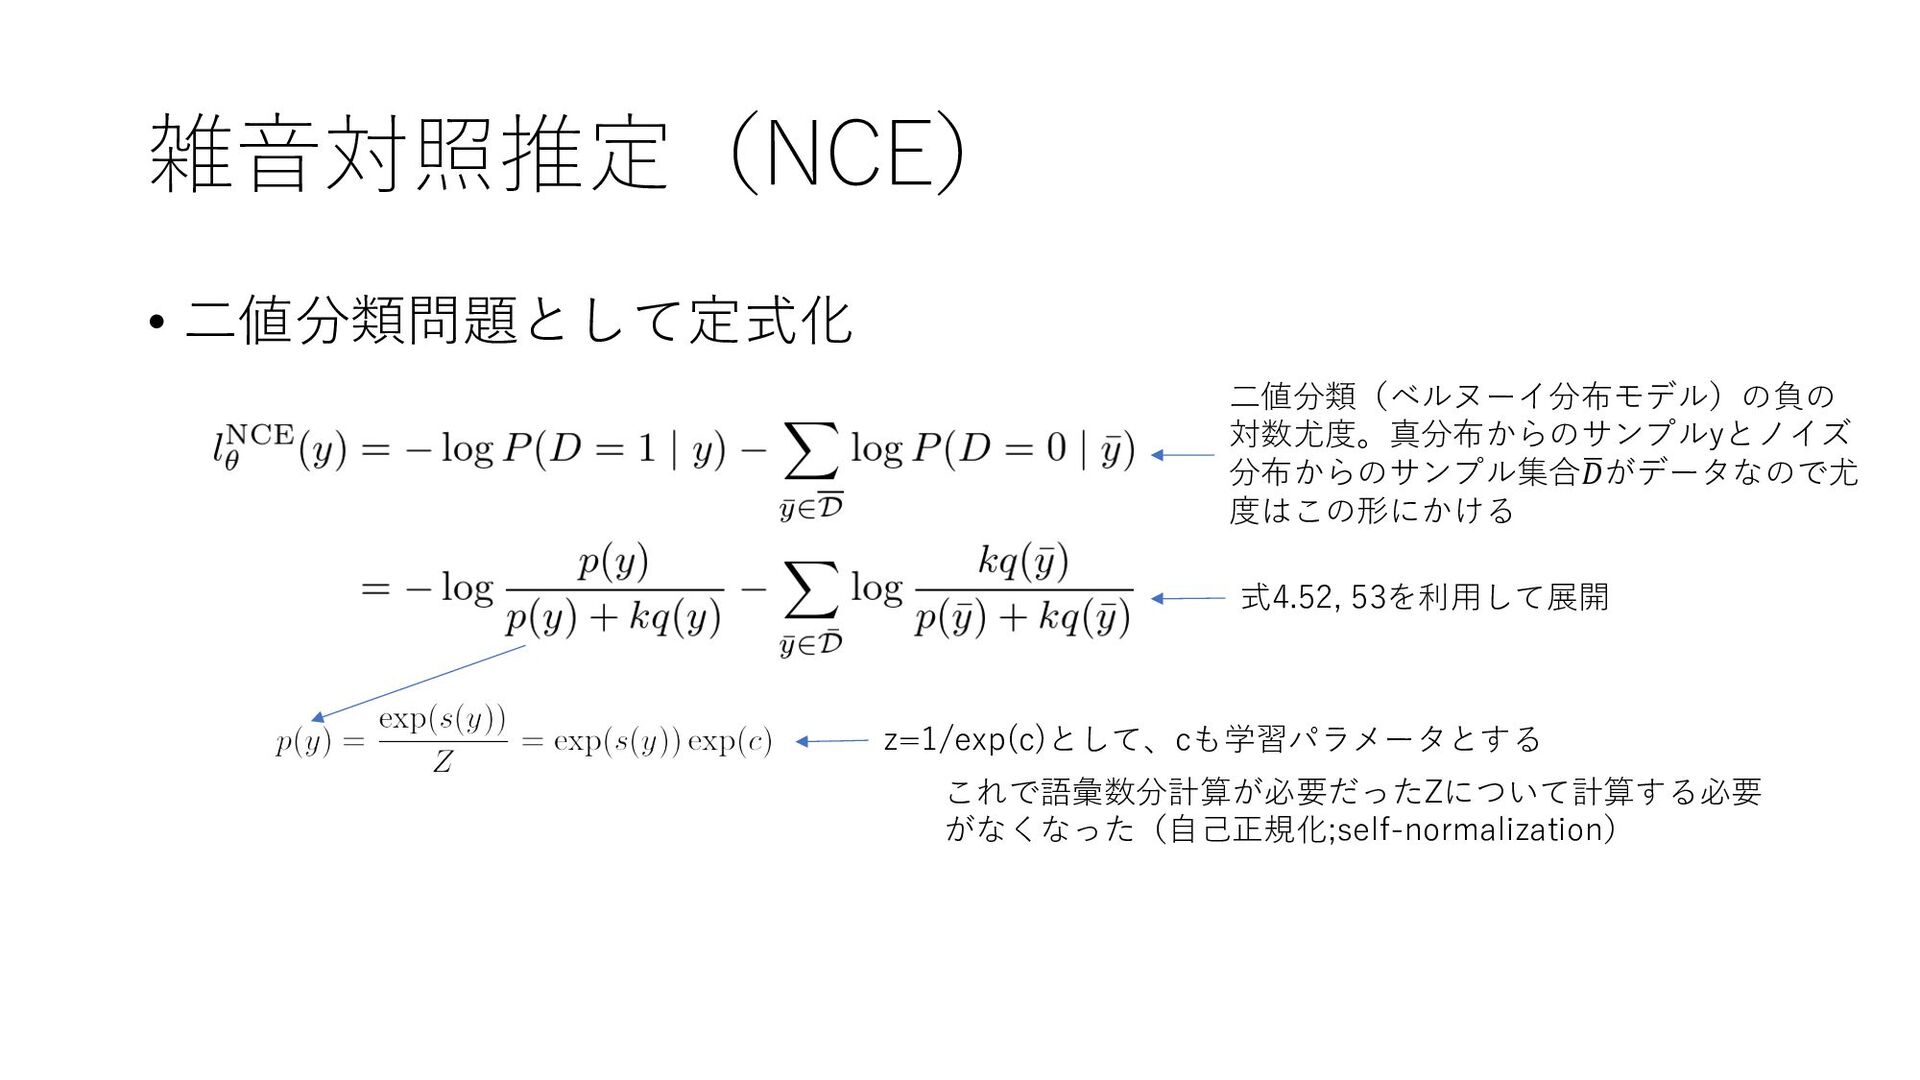
雑⾳対照推定(NCE) • 重点サンプリングは、元の⽬的関数を変えず、有限のサンプル を使ってモンテカルロ近似を利⽤して計算量を抑えていた • NCE、負例サンプリング、ブラックアウトは⽬的関数を変える • 3.3.3で負例サンプリングを扱ったがこれと考え⽅は同じ • 確率モデルの変更
• 語彙集合の中の単語の推定(多クラス分類)から、2クラス分類(真の 分布(D=1)かノイズ分布(D=0)か)に問題を変更して、Zも同時に推定 してやろうとするアプローチ 標本y(単語)が真の分布、ノイズ 分布それぞれからのサンプルとす る確率モデル(同時確率) -
雑⾳対照推定(NCE) • ⼆値分類問題として定式化 ⼆値分類(ベルヌーイ分布モデル)の負の 対数尤度。真分布からのサンプルyとノイズ 分布からのサンプル集合* 𝐷がデータなので尤 度はこの形にかける 式4.52, 53を利⽤して展開
z=1/exp(c)として、cも学習パラメータとする これで語彙数分計算が必要だったZについて計算する必要 がなくなった(⾃⼰正規化;self-normalization) -
階層的ソフトマックス • ⼆値分類器を連続させて最終的に⼀つに絞るようにモデルを⼤ きく変更 • ⽊構造で表現 • 通常のモデルは語彙数分の多クラス分類 • ⽊構造になるので、全語彙数の対数
程度の分類回数で済む テキストp.119, 図4.7 -
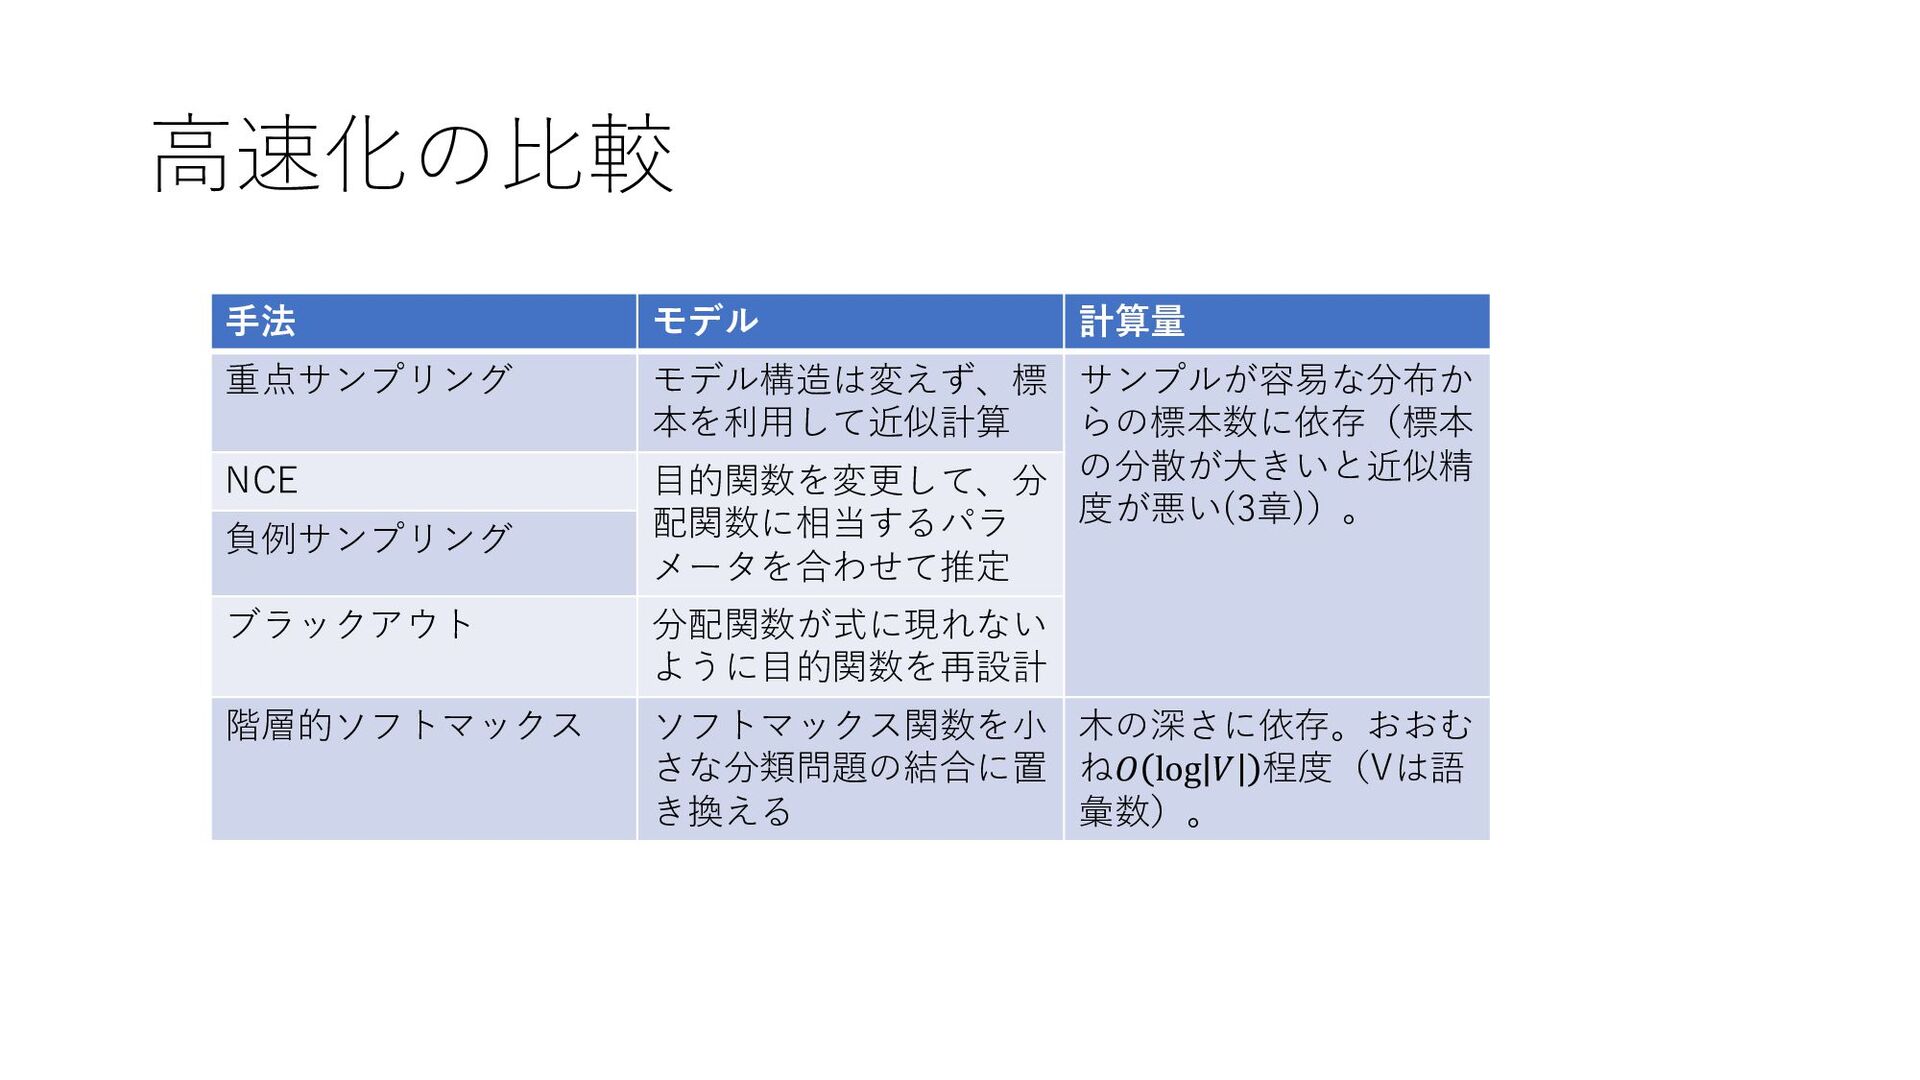
⾼速化の⽐較 ⼿法 モデル 計算量 重点サンプリング モデル構造は変えず、標 本を利⽤して近似計算 サンプルが容易な分布か らの標本数に依存(標本 の分散が⼤きいと近似精
度が悪い(3章))。 NCE ⽬的関数を変更して、分 配関数に相当するパラ メータを合わせて推定 負例サンプリング ブラックアウト 分配関数が式に現れない ように⽬的関数を再設計 階層的ソフトマックス ソフトマックス関数を⼩ さな分類問題の結合に置 き換える ⽊の深さに依存。おおむ ね𝑂 log 𝑉 程度(Vは語 彙数)。 -
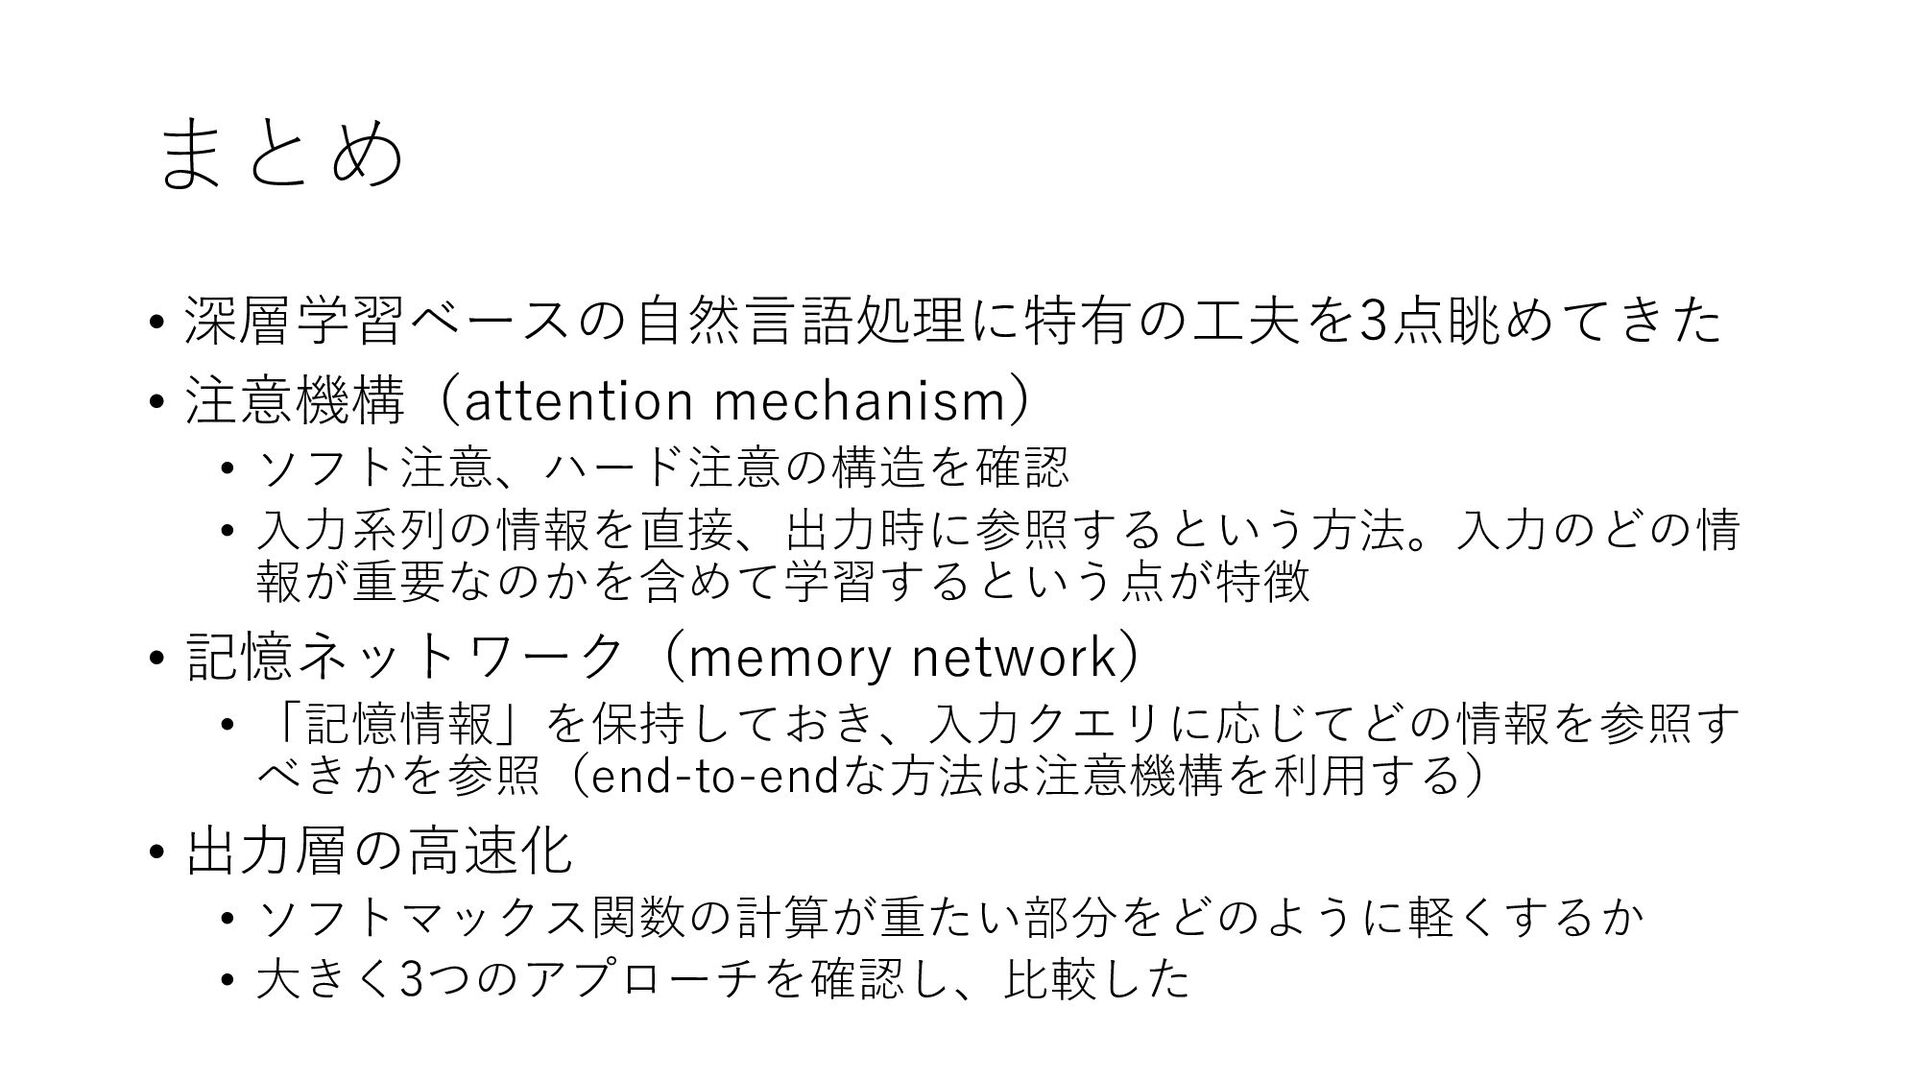
まとめ • 深層学習ベースの⾃然⾔語処理に特有の⼯夫を3点眺めてきた • 注意機構(attention mechanism) • ソフト注意、ハード注意の構造を確認 • ⼊⼒系列の情報を直接、出⼒時に参照するという⽅法。⼊⼒のどの情
報が重要なのかを含めて学習するという点が特徴 • 記憶ネットワーク(memory network) • 「記憶情報」を保持しておき、⼊⼒クエリに応じてどの情報を参照す べきかを参照(end-to-endな⽅法は注意機構を利⽤する) • 出⼒層の⾼速化 • ソフトマックス関数の計算が重たい部分をどのように軽くするか • ⼤きく3つのアプローチを確認し、⽐較した