Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
実践 時系列解析 輪読会#1
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Yoichi Tokita
October 28, 2021
Programming
470
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
実践 時系列解析 輪読会#1
https://reading-circle-beginners.connpass.com/event/227344/
オライリーから出版された「実践 時系列解析」の輪読会資料です。
Yoichi Tokita
October 28, 2021
More Decks by Yoichi Tokita
See All by Yoichi Tokita
深層学習による自然言語処理 輪読会#5 資料
tok41
0
510
深層学習による自然言語処理 輪読会#4 資料
tok41
0
3.2k
深層学習による自然言語処理 輪読会#3 資料
tok41
0
2.7k
深層学習による自然言語処理 輪読会#2 資料
tok41
0
3k
深層学習による自然言語処理 輪読会#1 資料
tok41
0
3k
実践 時系列解析 輪読会 Sec.11
tok41
0
190
実践 時系列解析 輪読会 Sec. 13-14
tok41
0
170
実践 時系列解析 輪読会 #6
tok41
0
530
実践 時系列解析 輪読会#5
tok41
0
430
Other Decks in Programming
See All in Programming
JPUG勉強会 OSSデータベースの内部構造を理解しよう(第2回)
oga5
0
280
テストを司るデーモンに会いに行く 〜隔離した仮想マシンでテストを通すまで〜
h1d3mun3
1
590
KiroのSpecで「五目並べ」を作ってみる
satoshi256kbyte
1
310
UPDATE をやめる — EF Core でマスタをバージョン管理する
panda728
PRO
0
1k
C#の現在地 進化の歴史と、AI時代の.NET Everywhere
neuecc
5
4.4k
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
350
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
5k
モバイル交通系ICへのチャージ実例から考える、クロスプラットフォーム開発におけるiOS実機テスト設計とCI運用
yusuga
1
560
AgentCore CLI で進化した AWS での AI エージェントの作り方 : 必要な機能を必要な時に
icoxfog417
PRO
4
390
Intent as Code
shoppingjaws
6
1.1k
GemmaをJevのように使ってみる / Use Gemma like Jev
kishida
4
190
Findy - エンジニア向け会社紹介/Findy Company Deck
findyinc
6
400k
Featured
See All Featured
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
270
Designing Powerful Visuals for Engaging Learning
tmiket
1
580
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
250
For a Future-Friendly Web
brad_frost
183
10k
Chasing Engaging Ingredients in Design
codingconduct
0
340
A Soul's Torment
seathinner
8
3.7k
Statistics for Hackers
jakevdp
799
230k
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
570
Joys of Absence: A Defence of Solitary Play
codingconduct
1
530
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
610
Marketing to machines
jonoalderson
1
5.8k
Transcript
「実践 時系列解析」 輪読会#1 2021/10/28 @yoichi_t
⾃⼰紹介 • tokita(@yoichi_t) • 所属:株式会社Glia Computing (https://www.glia-computing.com/) • 2018年8⽉に設⽴(Co-Founder) •
機械学習/データ分析のPoC、導⼊⽀援、コンサル • 過去 • 広告会社で推薦システムの開発をやっていたり、警備会社で⼈物⾏動 の研究をしてたりしてました
⾃⼰紹介 • tokita(@yoichi_t) • チョコボールの秘密を解明するために、⽇々データを収集&解析 チョコボール 統計
本書の構成 • 歴史 • 1. 時系列の概論と簡単な歴史 • データに関する全て • 2.
時系列データの⾒つけ⽅と前処理 • 3. 時系列の実践的データ解析 • 4. 時系列データのシミュレーション • 5. 時間データの保管 • 様々なモデルについて • 6. 時系列に使える統計モデル • 7. 時系列に使える状態空間モデル • 8. 特徴量の⽣成と選択 • 9. 機械学習による時系列解析 • 10. ディープラーニングによる時系列 解析 • モデリング後に考慮すべきこと • 11. 誤差の測定 • 12. 時系列モデルの当てはめ • 現実世界における活⽤事例 • 13. ヘルスケア分野への適⽤ • 14. ⾦融分野への適⽤ • 15. 政府機関が公表する時系列 • 最近の動向について • 16. 時系列パッケージ • 17. 予測に関する予測
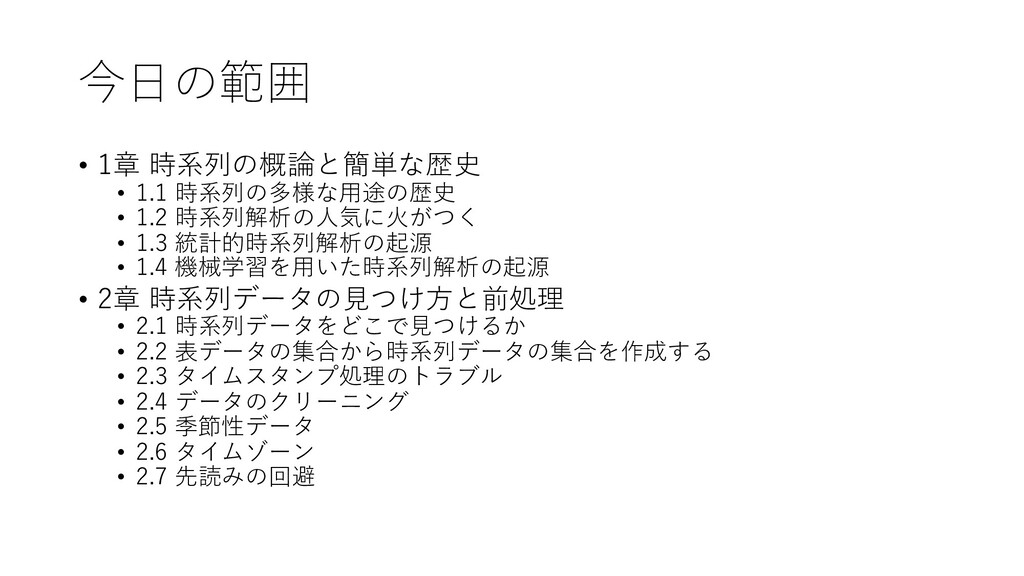
今⽇の範囲 • 1章 時系列の概論と簡単な歴史 • 1.1 時系列の多様な⽤途の歴史 • 1.2 時系列解析の⼈気に⽕がつく
• 1.3 統計的時系列解析の起源 • 1.4 機械学習を⽤いた時系列解析の起源 • 2章 時系列データの⾒つけ⽅と前処理 • 2.1 時系列データをどこで⾒つけるか • 2.2 表データの集合から時系列データの集合を作成する • 2.3 タイムスタンプ処理のトラブル • 2.4 データのクリーニング • 2.5 季節性データ • 2.6 タイムゾーン • 2.7 先読みの回避
1章 時系列の概論と簡単な歴史 • 1.1 時系列の多様な⽤途の歴史 • 1.2 時系列解析の⼈気に⽕がつく • 1.3
統計的時系列解析の起源 • 1.4 機械学習を⽤いた時系列解析の起源 「時系列データはどこにでもあり、間も無く何もかもが時系列 データ化するでしょう」(1.2)
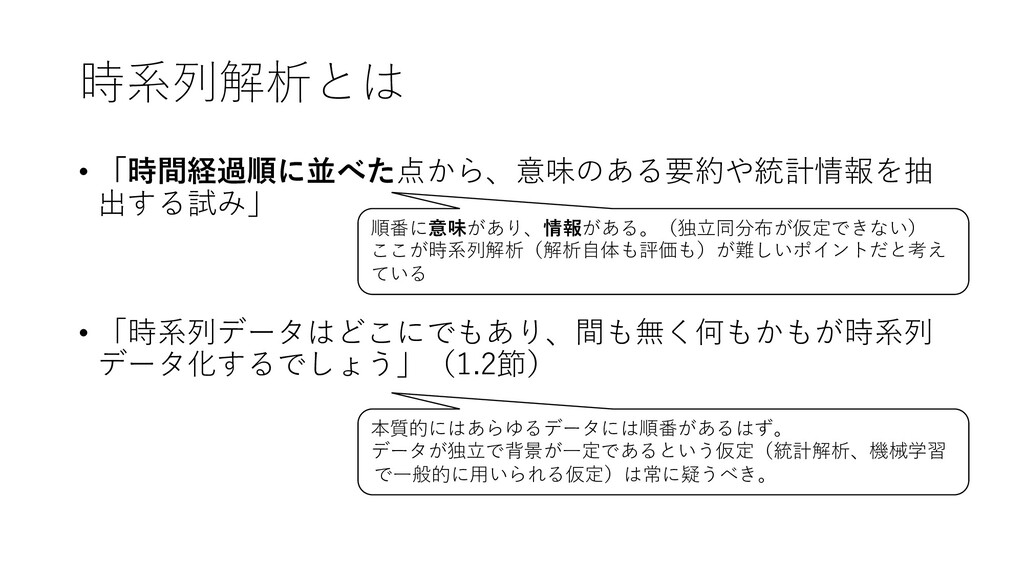
時系列解析とは • 「時間経過順に並べた点から、意味のある要約や統計情報を抽 出する試み」 • 「時系列データはどこにでもあり、間も無く何もかもが時系列 データ化するでしょう」(1.2節) 順番に意味があり、情報がある。(独⽴同分布が仮定できない) ここが時系列解析(解析⾃体も評価も)が難しいポイントだと考え ている
本質的にはあらゆるデータには順番があるはず。 データが独⽴で背景が⼀定であるという仮定(統計解析、機械学習 で⼀般的に⽤いられる仮定)は常に疑うべき。
1.1 時系列の多様な⽤途 • 医学 • 治療の経過はもちろん、医療機器で時系列データが使われる(⼼電、 脳波など) • ウェアラブル機器の普及で健康な⼈も⾃然に時系列データを⽣成 •
ビジネス的にも⼤きいインパクトが期待されている • 経済成⻑の予測 • 「ビジネス周期」の予測から始まった • 結局、「周期性」ないということがわかったらしい • 市場予測、需要予測などの場で利⽤されている
1.4 機械学習を⽤いた時系列解析の起源 • 「時系列解析と予測はまだ⻩⾦期に到達していません」「将来 予測が⼤きく発展するのは、これからです」 独⽴同分布を仮定できないということが機械学習を適⽤するハードルになっているのかな と思っています。 TransformerなどのAttention機構がブレイクスルーになるのかな?と感じています。
2章 時系列データの⾒つけ⽅と前処理 • 2.1 時系列データをどこで⾒つけるか • 2.2 表データの集合から時系列データの集合を作成する • 2.3
タイムスタンプ処理のトラブル • 2.4 データのクリーニング • 2.5 季節性データ • 2.6 タイムゾーン • 2.7 先読みの回避 「データのクリーニングと適切な処理は、タイムスタンプパイプライ ンの最も重要なステップです」 「データ理解の最終的な責任はあなたにあります」(2.3)
2章 時系列データの⾒つけ⽅と前処理 • データのクリーニングと適切な前処理は最も重要なステップ • 本章では、以下のポイントを解説 • 時系列データの種類 • 系列データの作成(実例)
• ⽋損値の補間 • 平滑化 • 季節性データ
系列データの種類 • データの⼊⼿ • コンペ(Kaggleなど)などのデータセット • ⽐較的扱いやすい • タイムスタンプ付きデータを系列データに加⼯ •
政府統計など多数のデータソースがある • 「時系列への変換」、「クリーニング」が必要 ←本章ではこれを解説 • 時系列データと系列データ • 時系列データ解析は「時間」が要件なのではなく、順番に意味がある というデータ構造のデータに対して適⽤できる • ワインのスペクトルなど • 複数系列が利⽤できることも(多変量時系列データ)
2.2 表データの集合から時系列データの 集合を作成する • 複数の表形式データを「時系列データへ変換」するプロセスの 実例 • jupyter notebook •
本章を通して以下のポイントが重要と感じています • データ分析で何をしたいか、⽬的を持ってデータの処理を設計する • ⽬的によって処理の内容が変わる • データに対する仮説を持ってデータを眺め、仮説を確認する • データの解釈が間違っているとその後の解析で致命的 • タイムスタンプの解釈を⾒落としがち
2.3 タイムスタンプ処理のトラブル • 「データ理解の最終的な責任はあなたにあります」 • データの理解 • どのようなイベントで⽣成されるデータなのか?(アプリケーションの理解) • どのタイミングで⽣成されるデータなのか?(サーバに到達した時間?)
• 誰が⽣成するデータなのか?(ユーザの能動的な⾏動?) • データ処理の設計 • 意味のある時間間隔 • 短ければ良いというものではない • ノイズの懸念
2.4 データのクリーニング • ⽋損値処理の種類 • 補完:データセット全体の観測に基づいて⽋損値を補完 • 補間:近傍のデータを⽤いて⽋損値を推定 • ⽋損期間の削除:⽋損期間のデータを使わない
←あまり良くない • ⽋損データの補完⽅法として3種類を実践(notebook) • 前⽅埋め • 移動平均 • 補間
2.4 データのクリーニング • データの平滑化の⽬的 • 外れ値/ノイズ処理 • 特徴量の⽣成 ←??データ圧縮? •
予測:ノイズ成分と状態を分離して、状態の先を予測する • 可視化
2.4 データのクリーニング • 指数平滑化 • 現在の状態に対して、直近のデータほど影響⼒が⼤きい • 𝑆! = 𝑑𝑆!"#
+ 1 − 𝑑 𝑥! • 𝑆! : 時刻tの状態の予測値 • 𝑥! : 時刻tの観測値 • 𝑑: 過去状態の影響⼒(減衰率、0 ≤ 𝑑 ≤ 1) • 𝑆! = 1 − 𝑑 𝑥! + 𝑑𝑥!"# + 𝑑$𝑥!"$ + 𝑑%𝑥!"% ⋯ • 他の平滑化法 • カルマンフィルタ:線形ガウス状態空間モデルを仮定した状態の予測 • LOESS:局所的に推定された散布図平滑化(ノンパラメトリックな⼿法) • 実装(notebook) 過去の影響は指数的 に減少
2.5 季節性データ • 安定した頻度で繰り返される挙動 • 時系列解析の⽬的の⼀つは、季節変動とトレンドを分離すること • トレンドを理解することで、系の状態を把握できる • 統計的な⼿法で分離するためのAPIが提供されている
• R: `stl`(書籍) • Python: Prophetなどの時系列ライブラリ • 繰り返しの挙動だが周期が変動する→循環性データ • 株式市場の好不況の循環など
2.7 先読みの回避 • 系列データの特徴は「順番」に意味があること • 平滑化や⽋損値補間で時間的に先のデータを利⽤して良いかはよく検 討が必要 • 運⽤時の制約を意識する •
モデルの評価は単純な交差検証ができない • 時間的に混合してしまうと本来知り得ない情報を使った予測が⾏われてしまう • 詳しくは11章
Appendix
輪読会の進め⽅ • タイムテーブル(⽬安) • 振り返り、(初参加者いらっしゃる場合)⾃⼰紹介(5〜10min) • 解説(50〜60min) • ディスカッション(30〜40min) •
進⾏ • 毎回の進⾏は主催者が実施します • 輪読スケジュールに従って、担当者に解説をお願いします • 解説中の質問/意⾒は積極的にお願いします • 解説終了後に全体通して議論の時間を設けます • (ご意⾒お願いします)
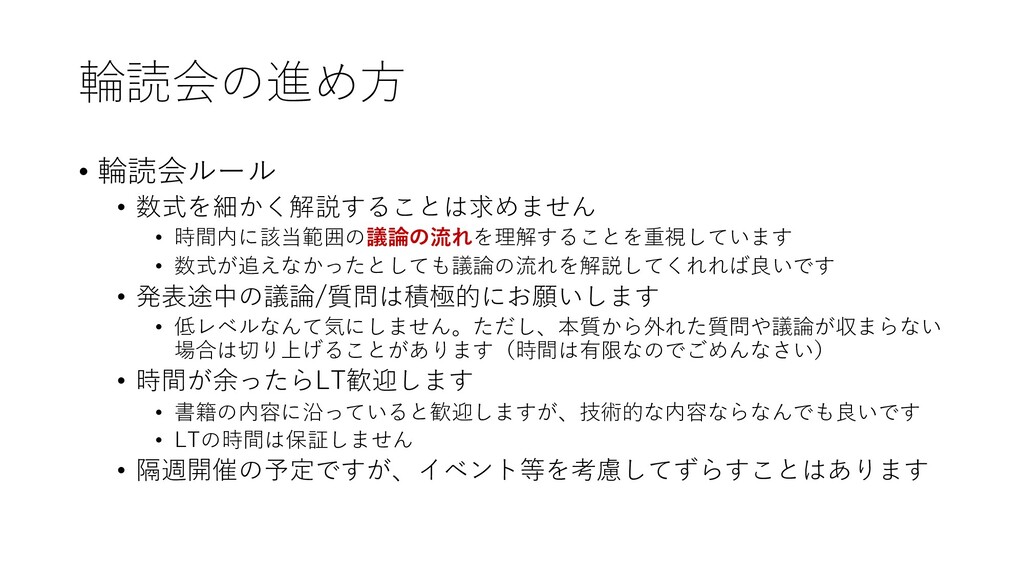
輪読会の進め⽅ • 輪読会ルール • 数式を細かく解説することは求めません • 時間内に該当範囲の議論の流れを理解することを重視しています • 数式が追えなかったとしても議論の流れを解説してくれれば良いです •
発表途中の議論/質問は積極的にお願いします • 低レベルなんて気にしません。ただし、本質から外れた質問や議論が収まらない 場合は切り上げることがあります(時間は有限なのでごめんなさい) • 時間が余ったらLT歓迎します • 書籍の内容に沿っていると歓迎しますが、技術的な内容ならなんでも良いです • LTの時間は保証しません • 隔週開催の予定ですが、イベント等を考慮してずらすことはあります
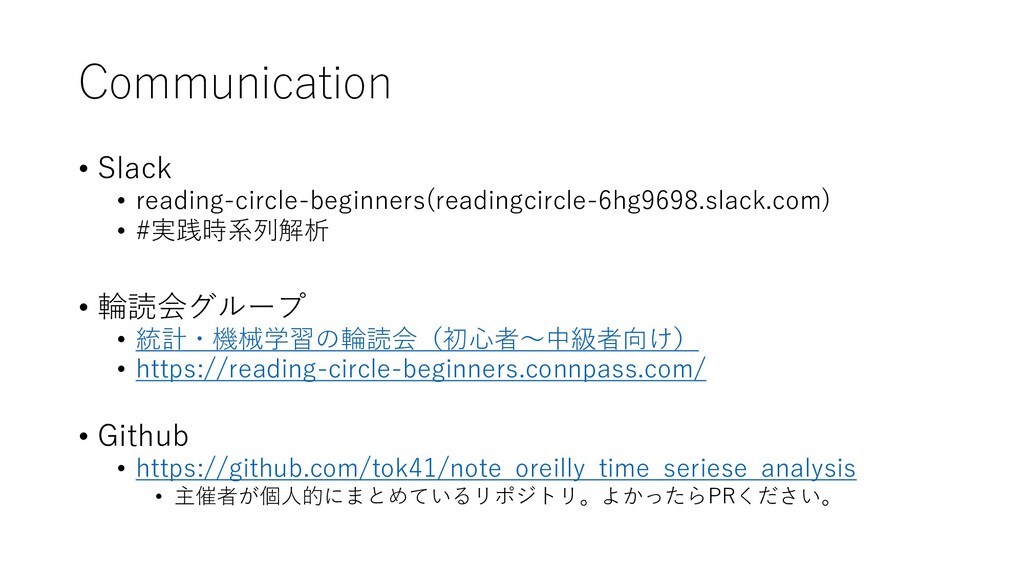
• Slack • reading-circle-beginners(readingcircle-6hg9698.slack.com) • #実践時系列解析 • 輪読会グループ • 統計・機械学習の輪読会(初⼼者〜中級者向け)
• https://reading-circle-beginners.connpass.com/ • Github • https://github.com/tok41/note_oreilly_time_seriese_analysis • 主催者が個⼈的にまとめているリポジトリ。よかったらPRください。 Communication


 tok41
 oga5
 h1d3mun3
 satoshi256kbyte
 panda728
 neuecc
 ivargrimstad
 po3rin
 yusuga
 icoxfog417
 shoppingjaws
 kishida
 findyinc
 sabderemane
 tmiket
 brad_frost
 codingconduct
 seathinner
 jakevdp
 pedronauck
 reverentgeek
 marktimemedia
 jonoalderson