Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
BlockNoteとDuckDB-WASMでつくる、ブラウザ内データ分析環境の設計
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
Ryotaro Tamura
April 01, 2026
Technology
160
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
BlockNoteとDuckDB-WASMでつくる、ブラウザ内データ分析環境の設計
さくらインターネット研究所 テックトーク2026春(
https://sakura-tokyo.connpass.com/event/383699/
) の発表で使用した資料です。
Ryotaro Tamura
April 01, 2026
More Decks by Ryotaro Tamura
See All by Ryotaro Tamura
Prometheus setup with long term storage
tokibi
7
6.1k
nanafshiを使って簡単に作るFUSEの動的ファイル
tokibi
0
630
monotips #3 - fzfる
tokibi
0
180
IAMロールはどこから来て、どこへ行くのか / Where do IAM rolls come from and where to go?
tokibi
2
2.7k
Other Decks in Technology
See All in Technology
【データ横丁主催】AI エージェント時代のTranslytical Data Platform
shisyu_gaku
0
270
Tofu-Controller lightning talk @ Containerday 2026
gionn
0
200
「Learning Outcome」を書きたくない私が、Learning Outcomeと折り合いをつけるまで
mhlyc
0
130
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
1
230
Claude for Google Workspaces ポン出し/claude-for-google-workspace-slide-conversion
emiki
0
350
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
240
dbt Semantic Layerで進めるenechainのデータ民主化
akizhou
1
240
その Valkey 使いこなしていますか?
onk
PRO
5
1.9k
CTO Night|NotionのAIエージェントとFDE
kzkhykw1991
0
310
生成AI時代、PMは事業責任者に進化するともっと面白い〜PMだからこそ事業構造を動かせる時代に〜
kakehashi
PRO
0
550
Let's Change Our World—Again
snoozer05
PRO
5
380
僕のハーネスを紹介します
watany
5
1.5k
Featured
See All Featured
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
20k
Why Mistakes Are the Best Teachers: Turning Failure into a Pathway for Growth
auna
0
330
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
330
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
760
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
320
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
Testing 201, or: Great Expectations
jmmastey
46
8.3k
Large-scale JavaScript Application Architecture
addyosmani
516
110k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
Transcript
BlockNote と DuckDB-WASM でつくる、 ブラウザ内データ分析環境の設計 さくらインターネット研究所 田村 龍太郎 (X: @_tokibi)
目次 1. 背景と目指す体験 2. 中核モデル 3. 設計・実装 4. まとめ
1. 背景と目指す体験
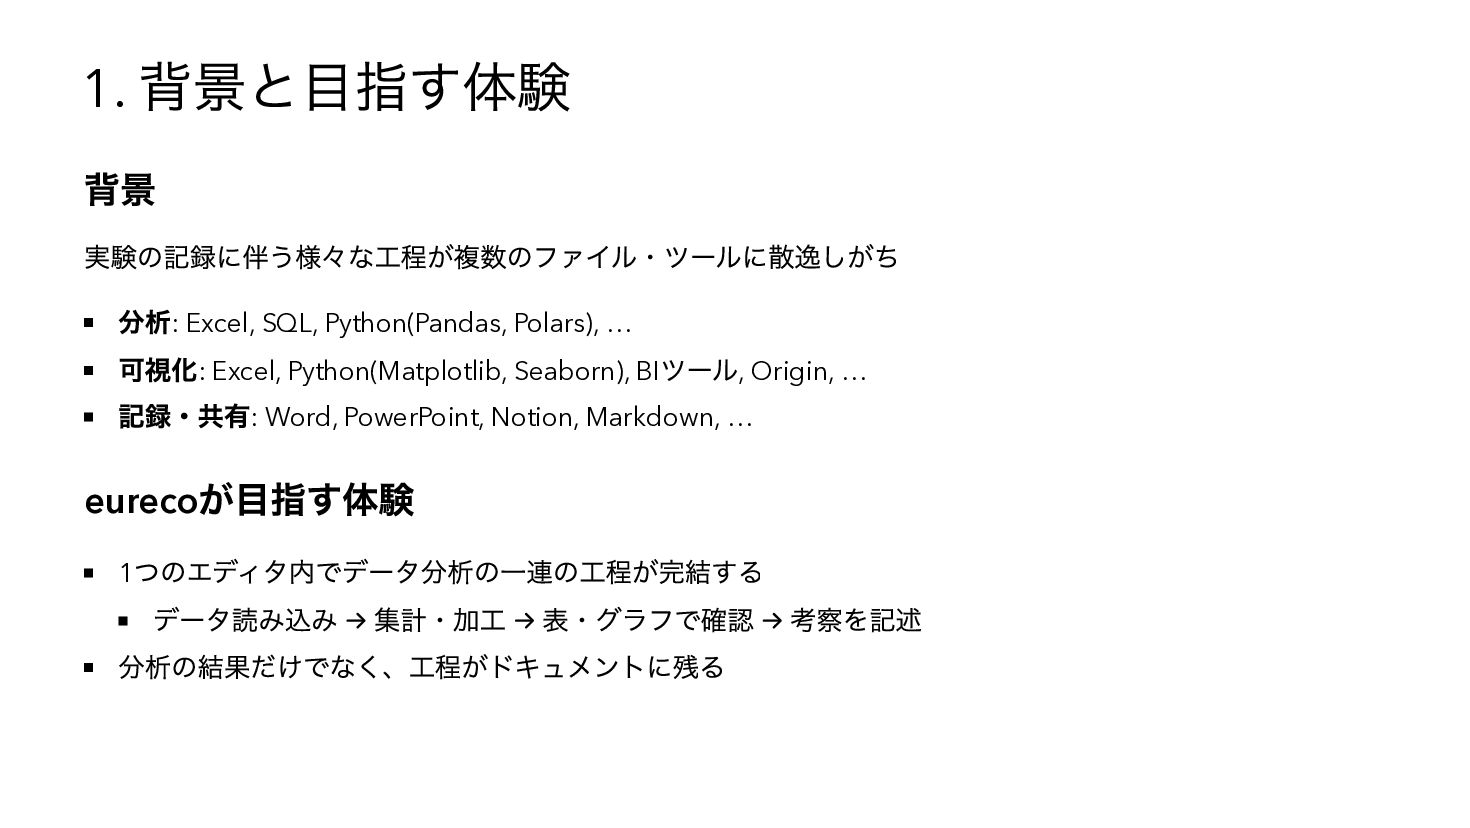
1. 背景と目指す体験 背景 実験の記録に伴う様々な工程が複数のファイル・ツールに散逸しがち 分析: Excel, SQL, Python(Pandas, Polars), …
可視化: Excel, Python(Matplotlib, Seaborn), BI ツール, Origin, … 記録・共有: Word, PowerPoint, Notion, Markdown, … eureco が目指す体験 1 つのエディタ内でデータ分析の一連の工程が完結する データ読み込み → 集計・加工 → 表・グラフで確認 → 考察を記述 分析の結果だけでなく、工程がドキュメントに残る
2. 中核モデル
2. 中核モデル ブロックエディタ(BlockNote) を記録と分析の共通インターフェースとして利用 分析・可視化用のカスタムブロックを追加 ブロック間の依存関係をドキュメント構造内に定義 分析用ブロックはブラウザ上で動作する DuckDB-WASM に同期 データの前処理や集計などの分析処理をDuckDB
上で実行
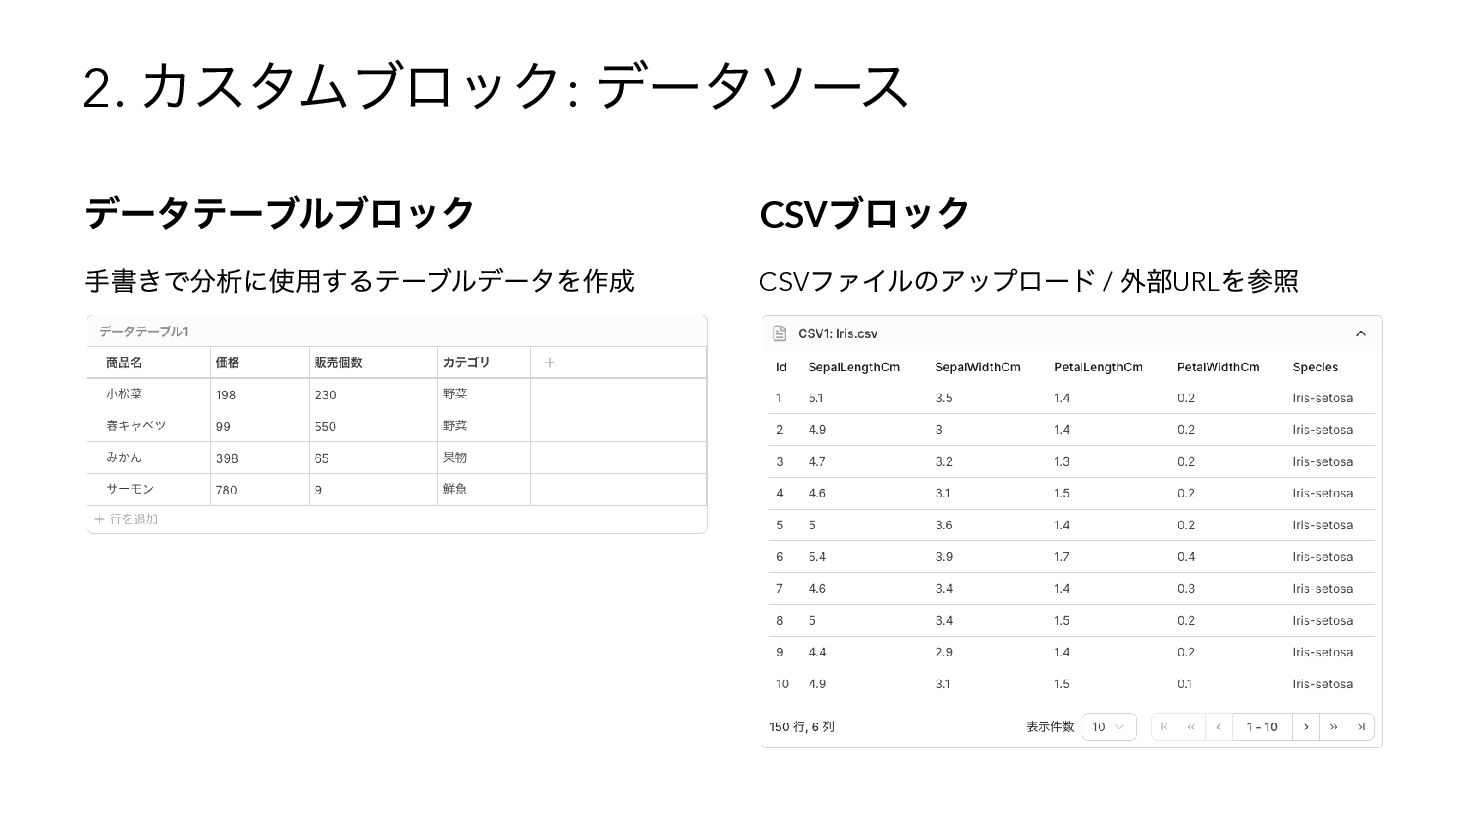
2. カスタムブロック: データソース データテーブルブロック 手書きで分析に使用するテーブルデータを作成 CSV ブロック CSV ファイルのアップロード /
外部URL を参照
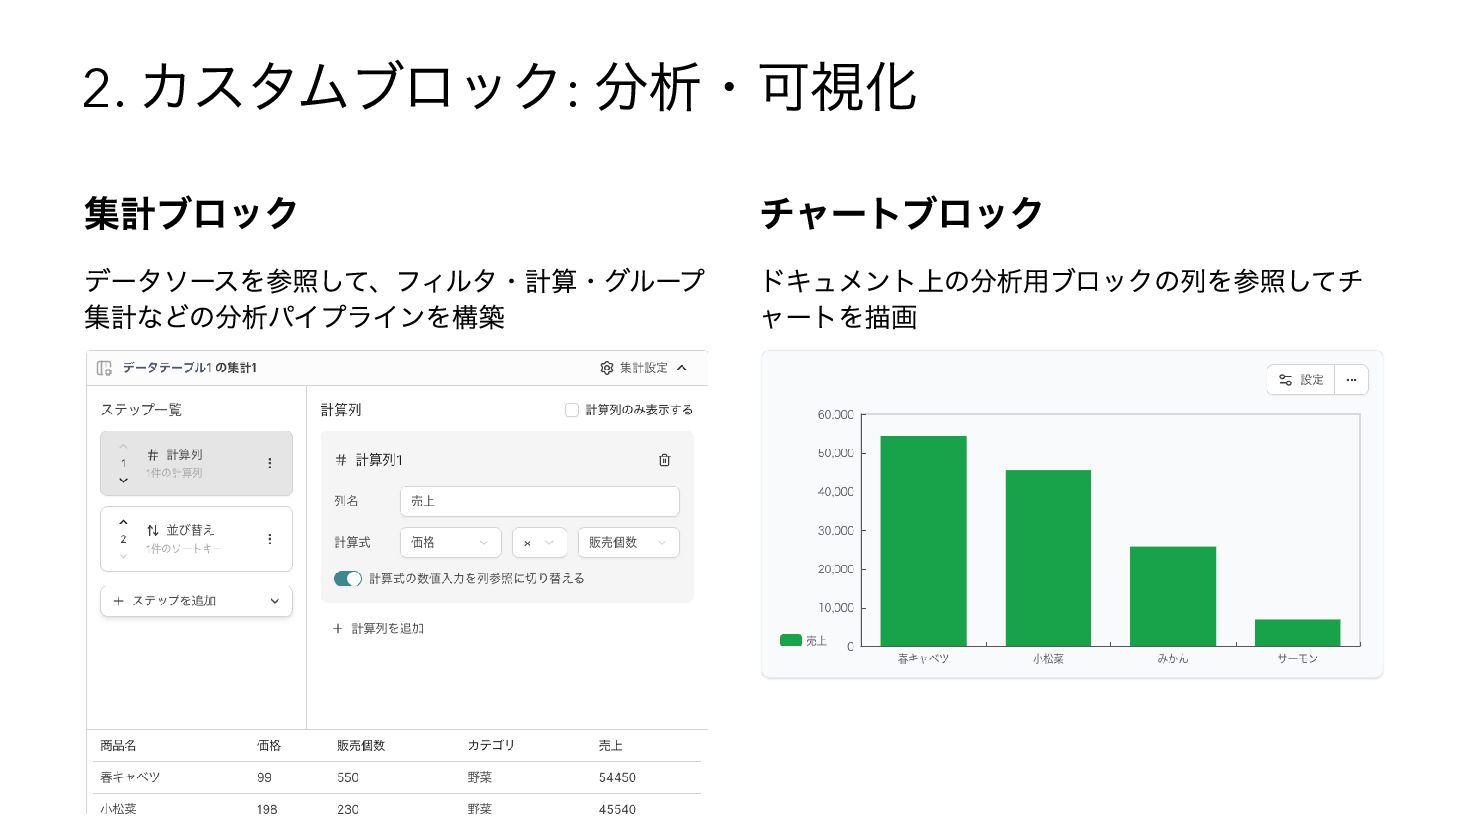
2. カスタムブロック: 分析・可視化 集計ブロック データソースを参照して、フィルタ・計算・グループ 集計などの分析パイプラインを構築 チャートブロック ドキュメント上の分析用ブロックの列を参照してチ ャートを描画
3. 設計・実装
3. 設計上の考慮事項 1. UI(BlockNote) と DuckDB-WASM の状態同期 BlockNote ドキュメントの状態変化をDuckDB にどう反映するか
DuckDB 上の状態変化をリアクティブにUI に反映させるには 2. 分析工程をドキュメントにどう記録するか
3-1. 状態同期
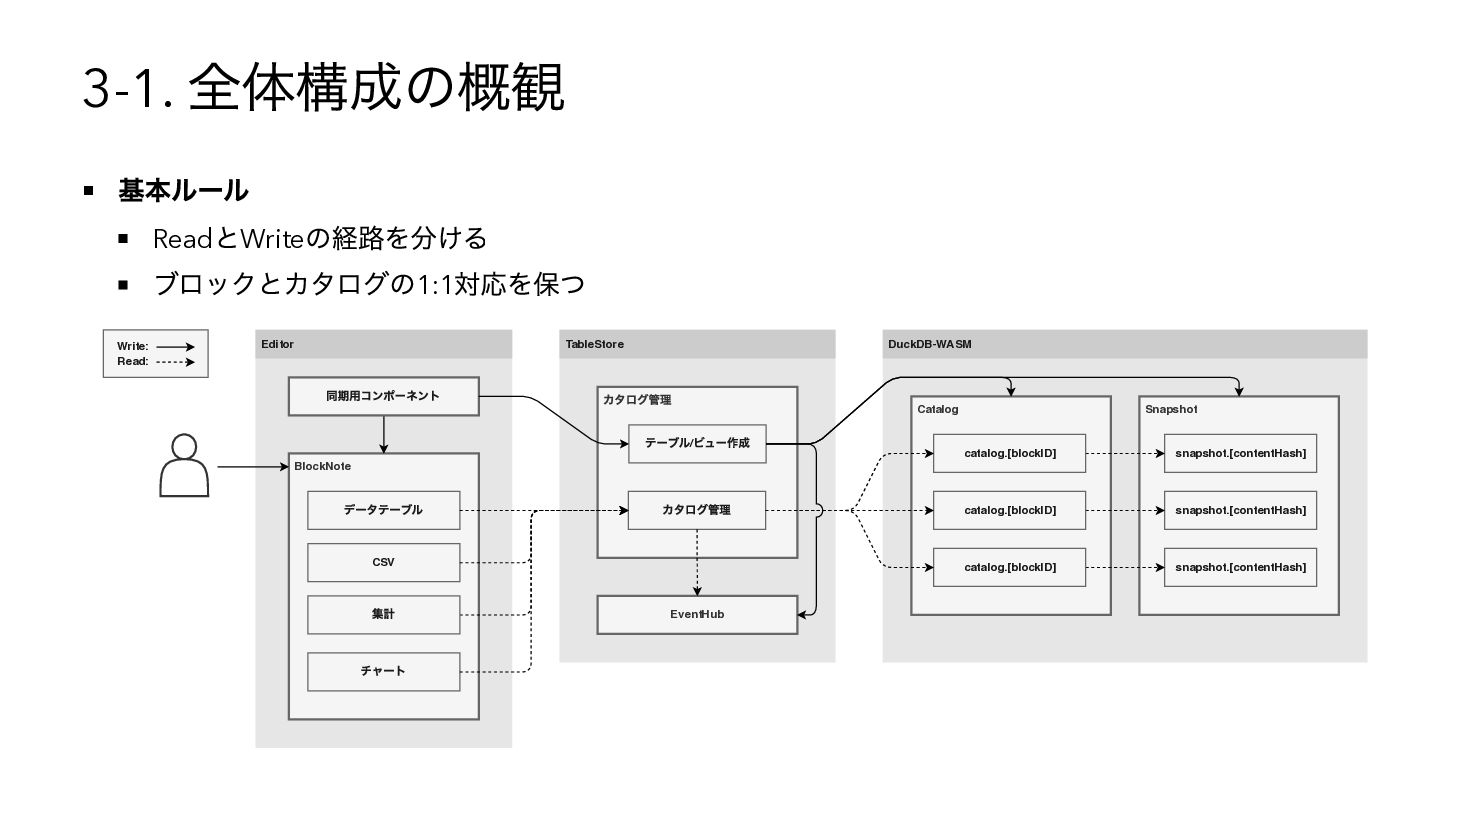
3-1. 全体構成の概観 基本ルール Read とWrite の経路を分ける ブロックとカタログの1:1 対応を保つ Editor TableStore
DuckDB-WASM BlockNote 同期⽤コンポーネント Catalog Snapshot snapshot.[contentHash] snapshot.[contentHash] snapshot.[contentHash] catalog.[blockID] catalog.[blockID] catalog.[blockID] データテーブル CSV 集計 チャート カタログ管理 カタログ管理 テーブル/ ビュー作成 EventHub Write: Read:
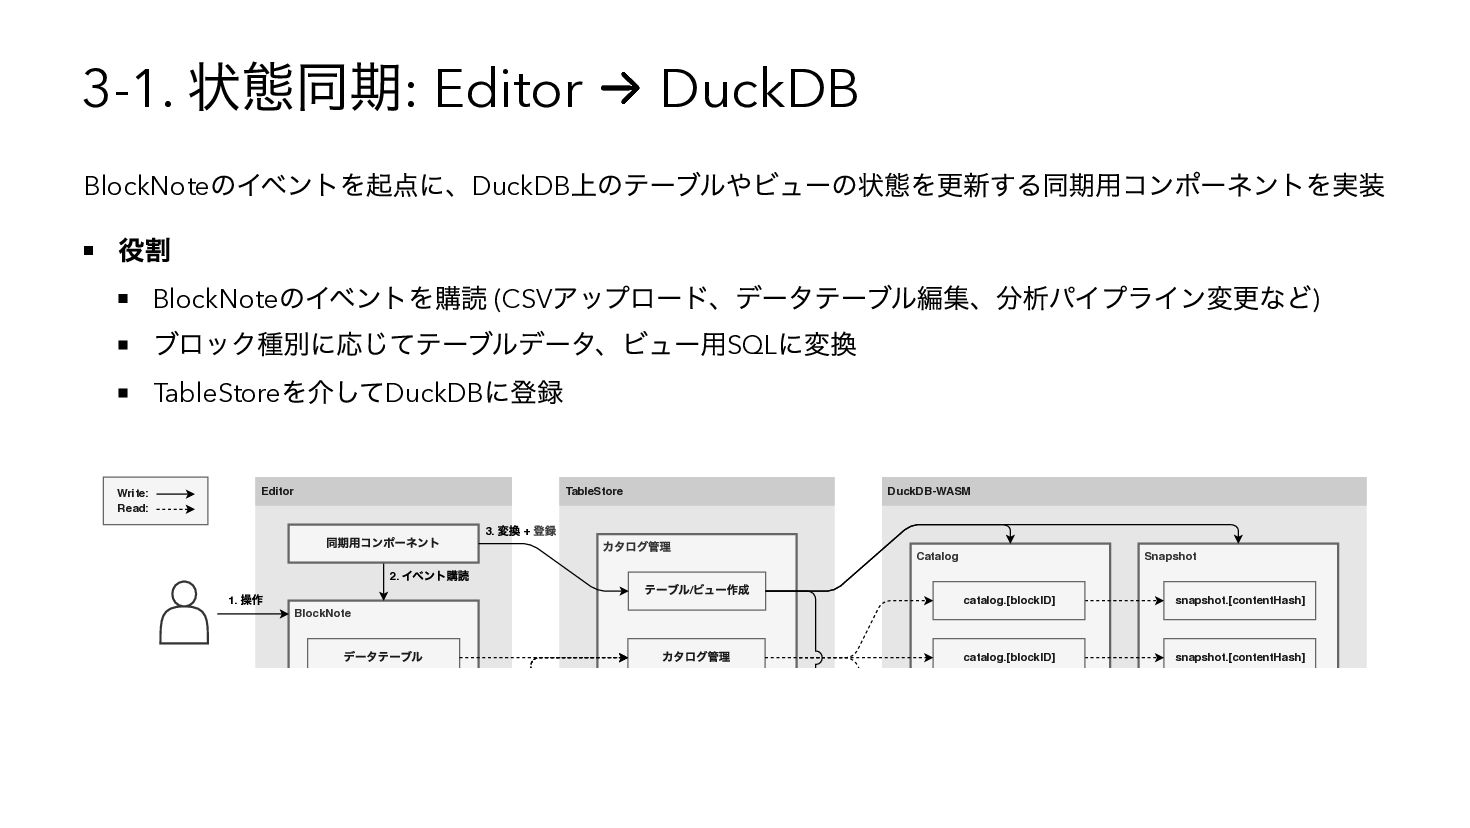
3-1. 状態同期: Editor → DuckDB BlockNote のイベントを起点に、DuckDB 上のテーブルやビューの状態を更新する同期用コンポーネントを実装 役割 BlockNote
のイベントを購読 (CSV アップロード、データテーブル編集、分析パイプライン変更など) ブロック種別に応じてテーブルデータ、ビュー用SQL に変換 TableStore を介してDuckDB に登録 Editor TableStore DuckDB-WASM BlockNote 同期⽤コンポーネント Catalog Snapshot snapshot.[contentHash] snapshot.[contentHash] catalog.[blockID] catalog.[blockID] データテーブル カタログ管理 カタログ管理 テーブル/ ビュー作成 Write: Read: 1. 操作 2. イベント購読 3. 変換 + 登録
3-1. 状態同期: DuckDB → Editor 自作のTableStore を中心に、DuckDB の状態をUI に反映する仕組みを構築 カタログ機能
ブロックID と、DuckDB 内のテーブル/ ビュー情報とのマッピングを管理するカタログ コンテンツハッシュを名前にしたスナップショットで実テーブルを保存 更新時は新スナップショット作成 → カタログの参照を切り替え ブロックからテーブル/ ビューへの安定参照に使用 イベントシステム カタログの更新時に各種イベントを発火 カタログ間の依存を見て、上流の変更で下流カタログの更新イベントも連鎖的に発火 最新のカタログ情報をUI コンポーネントに提供するためにReact フック内部で購読
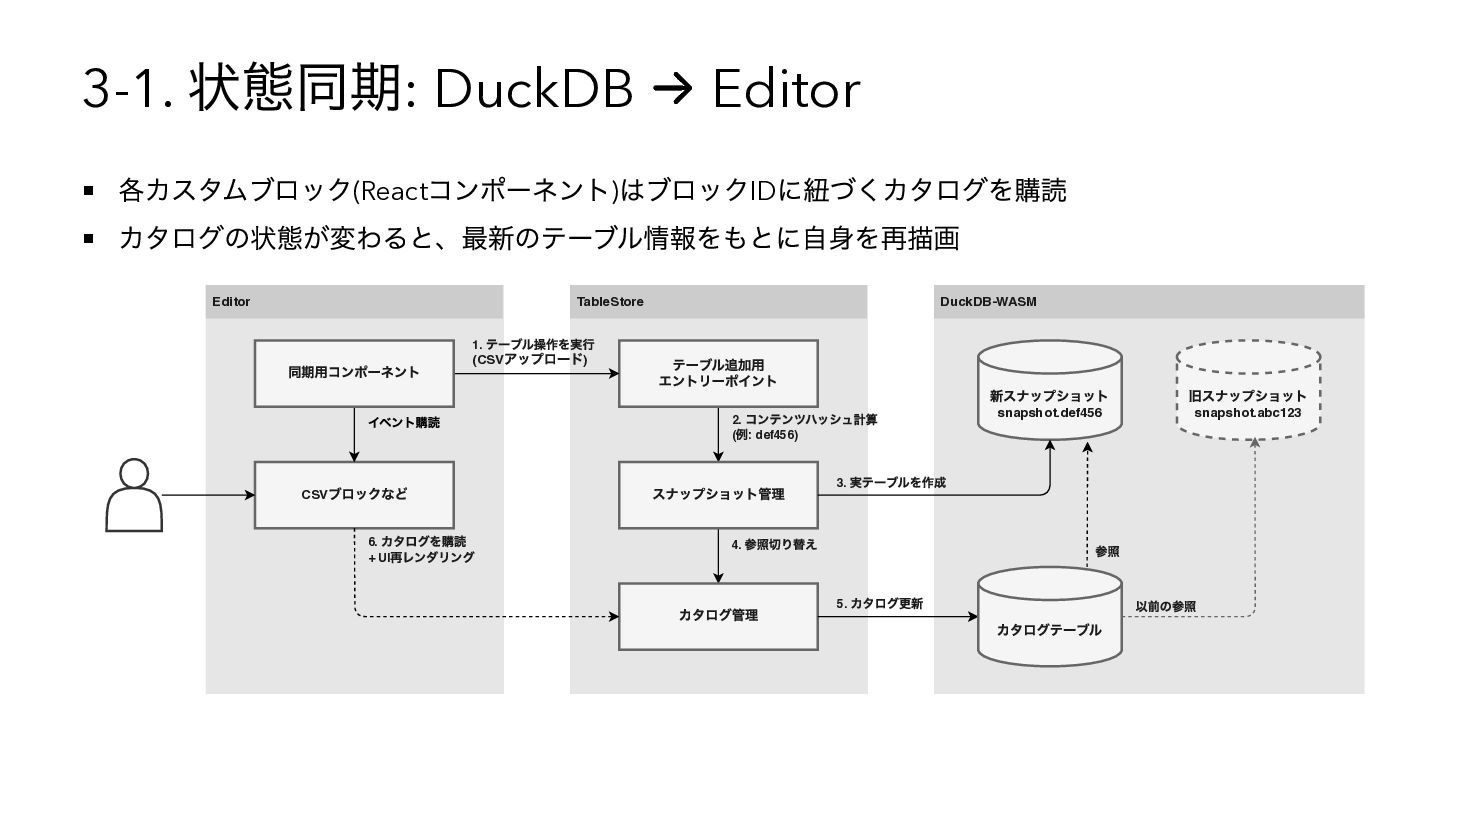
3-1. 状態同期: DuckDB → Editor 各カスタムブロック(React コンポーネント) はブロックID に紐づくカタログを購読 カタログの状態が変わると、最新のテーブル情報をもとに自身を再描画
Editor CSV ブロックなど TableStore 2. コンテンツハッシュ計算 ( 例: def456) テーブル追加⽤ エントリーポイント 1. テーブル操作を実⾏ (CSV アップロード) 4. 参照切り替え スナップショット管理 DuckDB-WASM 新スナップショット snapshot.def456 旧スナップショット snapshot.abc123 カタログ管理 5. カタログ更新 カタログテーブル 3. 実テーブルを作成 参照 以前の参照 6. カタログを購読 + UI 再レンダリング 同期⽤コンポーネント イベント購読
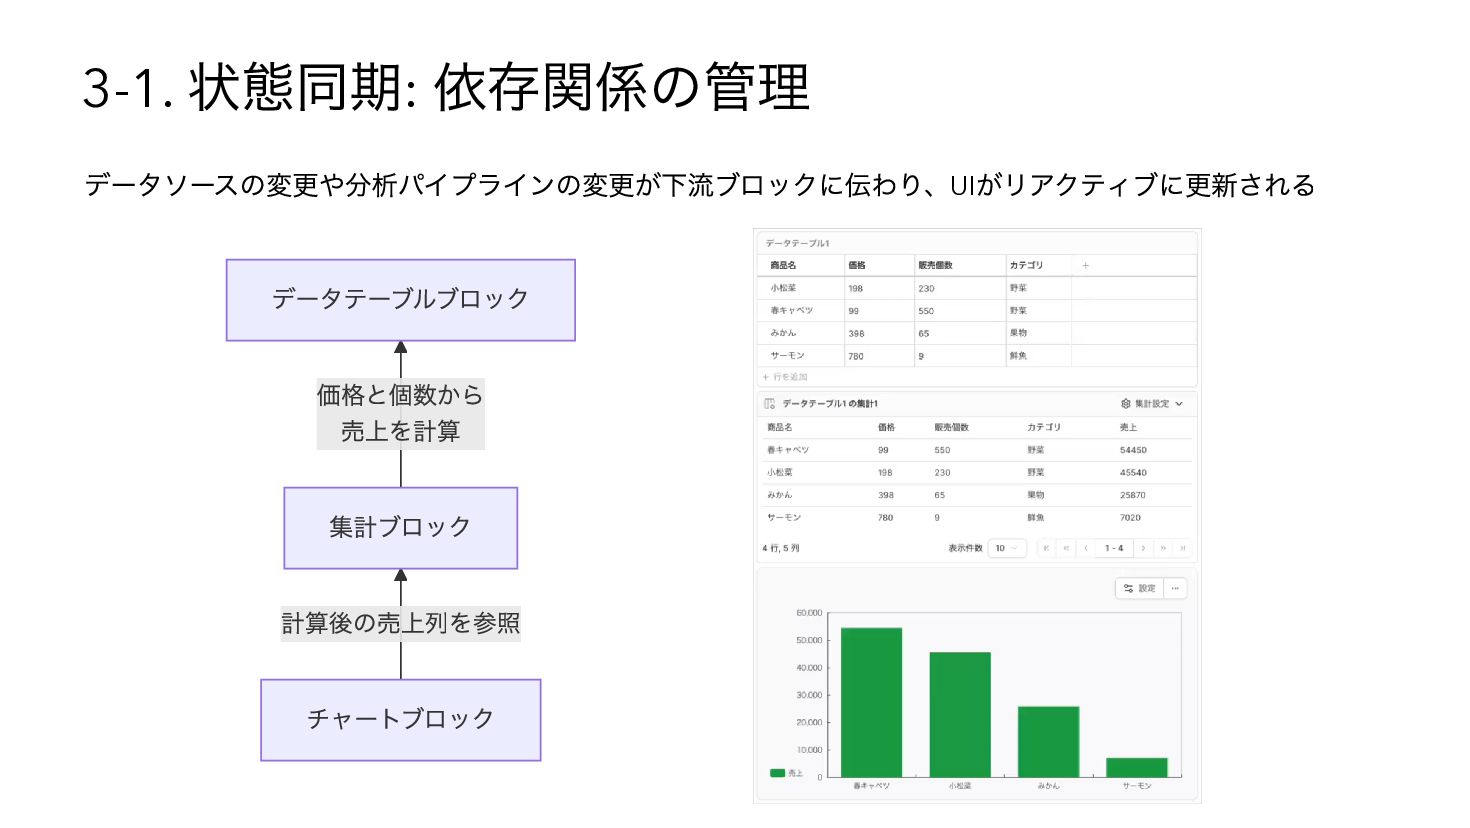
3-1. 状態同期: DuckDB → Editor TableStore 内で依存関係を持つテーブルの更新を検知して下流のカタログにも反映 カスタムブロックは常に自身に対応するカタログ情報を購読するだけ
3-1. 状態同期: 依存関係の管理 データソースの変更や分析パイプラインの変更が下流ブロックに伝わり、UI がリアクティブに更新される 計算後の売上列を参照 価格と個数から 売上を計算 データテーブルブロック 集計ブロック
チャートブロック
3-2. 分析工程の記録
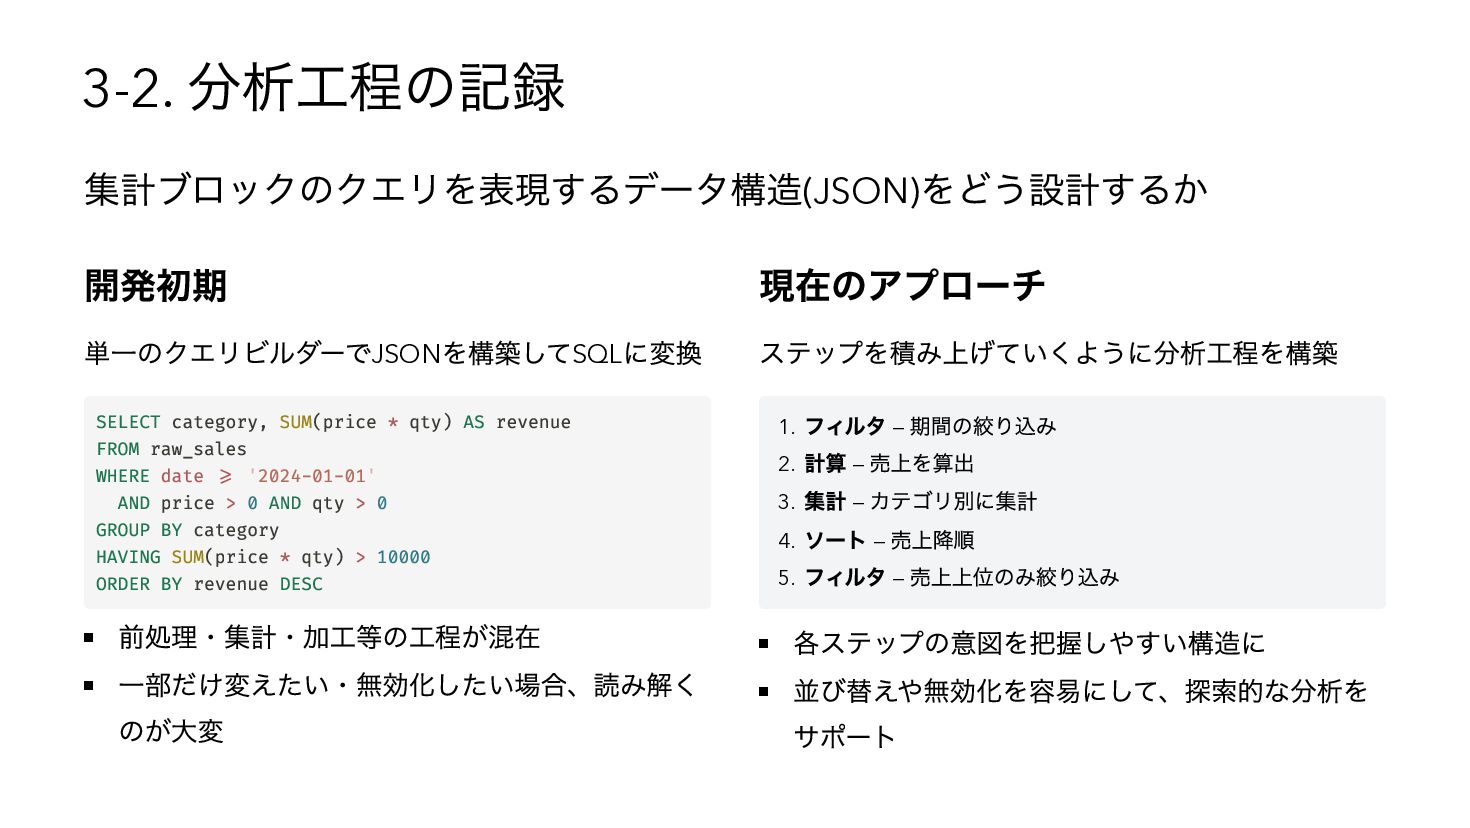
3-2. 分析工程の記録 集計ブロックのクエリを表現するデータ構造(JSON) をどう設計するか 開発初期 単一のクエリビルダーでJSON を構築してSQL に変換 前処理・集計・加工等の工程が混在 一部だけ変えたい・無効化したい場合、読み解く
のが大変 現在のアプローチ ステップを積み上げていくように分析工程を構築 1. フィルタ — 期間の絞り込み 2. 計算 — 売上を算出 3. 集計 — カテゴリ別に集計 4. ソート — 売上降順 5. フィルタ — 売上上位のみ絞り込み 各ステップの意図を把握しやすい構造に 並び替えや無効化を容易にして、探索的な分析を サポート SELECT category, SUM(price * qty) AS revenue FROM raw_sales WHERE date >= '2024-01-01' AND price > 0 AND qty > 0 GROUP BY category HAVING SUM(price * qty) > 10000 ORDER BY revenue DESC
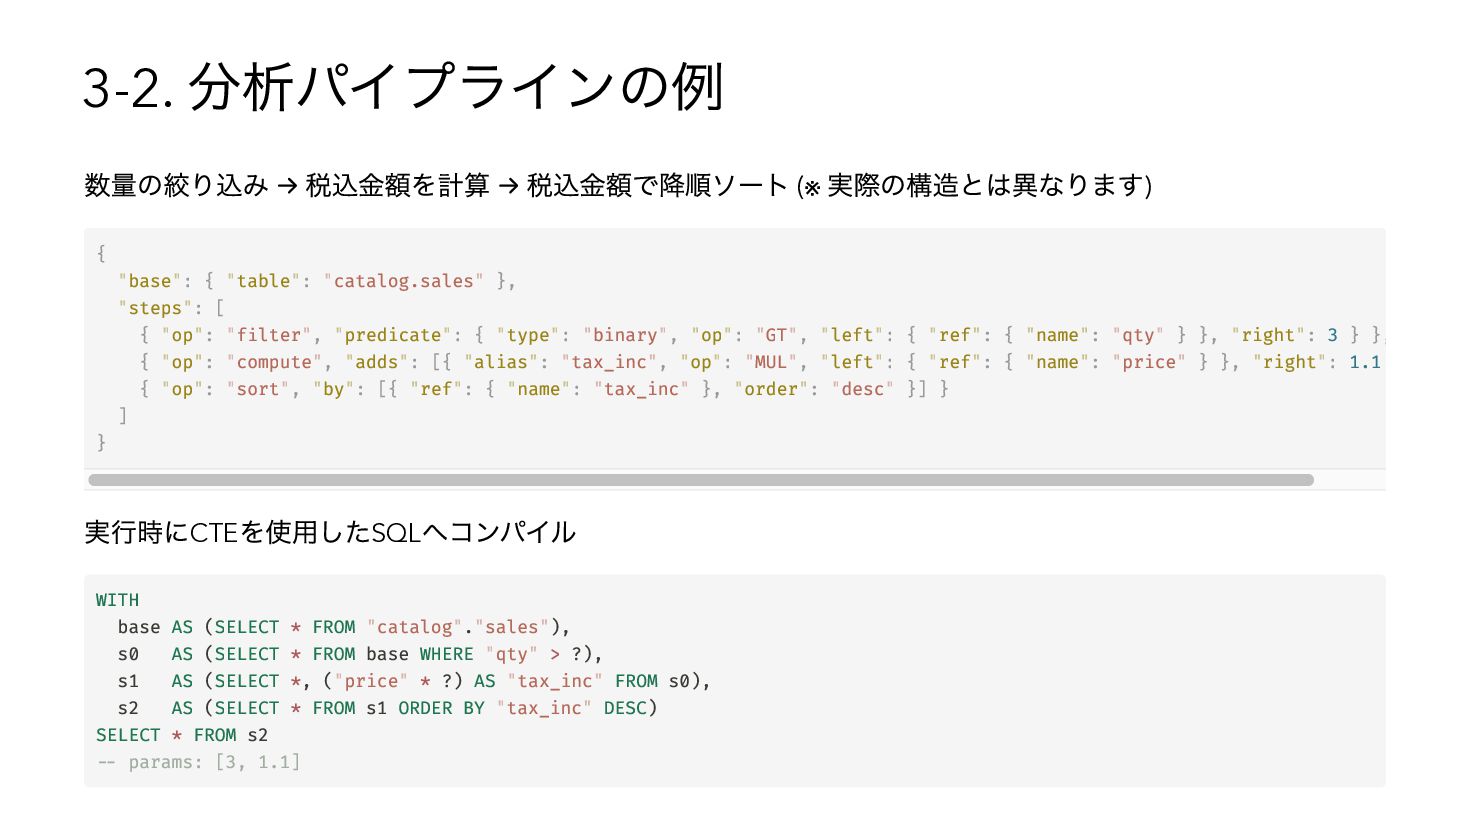
3-2. 分析パイプラインの例 数量の絞り込み → 税込金額を計算 → 税込金額で降順ソート (※ 実際の構造とは異なります) 実行時にCTE
を使用したSQL へコンパイル { "base": { "table": "catalog.sales" }, "steps": [ { "op": "filter", "predicate": { "type": "binary", "op": "GT", "left": { "ref": { "name": "qty" } }, "right": 3 } }, { "op": "compute", "adds": [{ "alias": "tax_inc", "op": "MUL", "left": { "ref": { "name": "price" } }, "right": 1.1 { "op": "sort", "by": [{ "ref": { "name": "tax_inc" }, "order": "desc" }] } ] } WITH base AS (SELECT * FROM "catalog"."sales"), s0 AS (SELECT * FROM base WHERE "qty" > ?), s1 AS (SELECT *, ("price" * ?) AS "tax_inc" FROM s0), s2 AS (SELECT * FROM s1 ORDER BY "tax_inc" DESC) SELECT * FROM s2 -- params: [3, 1.1]
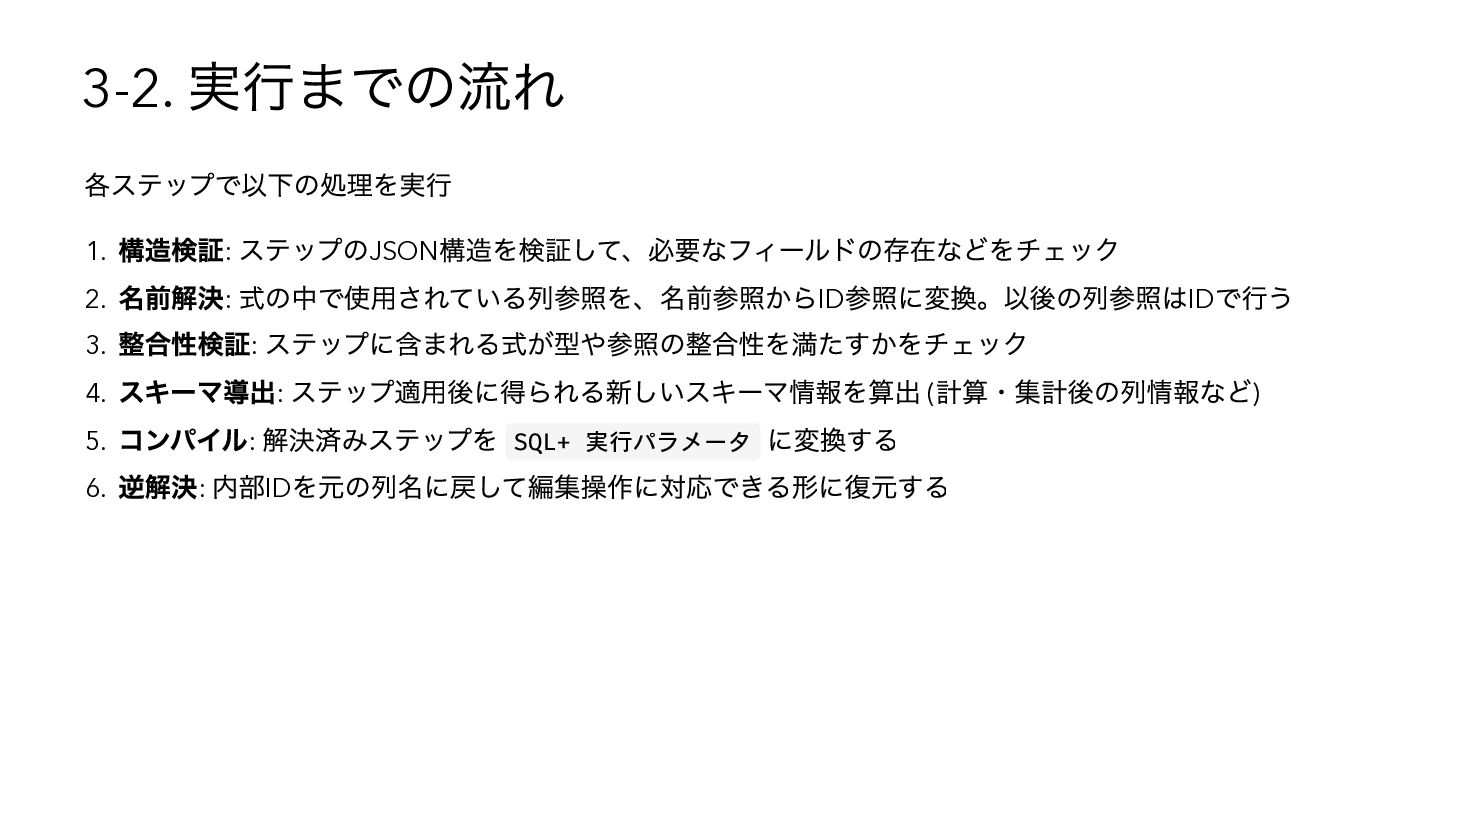
3-2. 実行までの流れ 各ステップで以下の処理を実行 1. 構造検証: ステップのJSON 構造を検証して、必要なフィールドの存在などをチェック 2. 名前解決: 式の中で使用されている列参照を、名前参照からID
参照に変換。以後の列参照はID で行う 3. 整合性検証: ステップに含まれる式が型や参照の整合性を満たすかをチェック 4. スキーマ導出: ステップ適用後に得られる新しいスキーマ情報を算出 ( 計算・集計後の列情報など) 5. コンパイル: 解決済みステップを SQL+ 実行パラメータ に変換する 6. 逆解決: 内部ID を元の列名に戻して編集操作に対応できる形に復元する
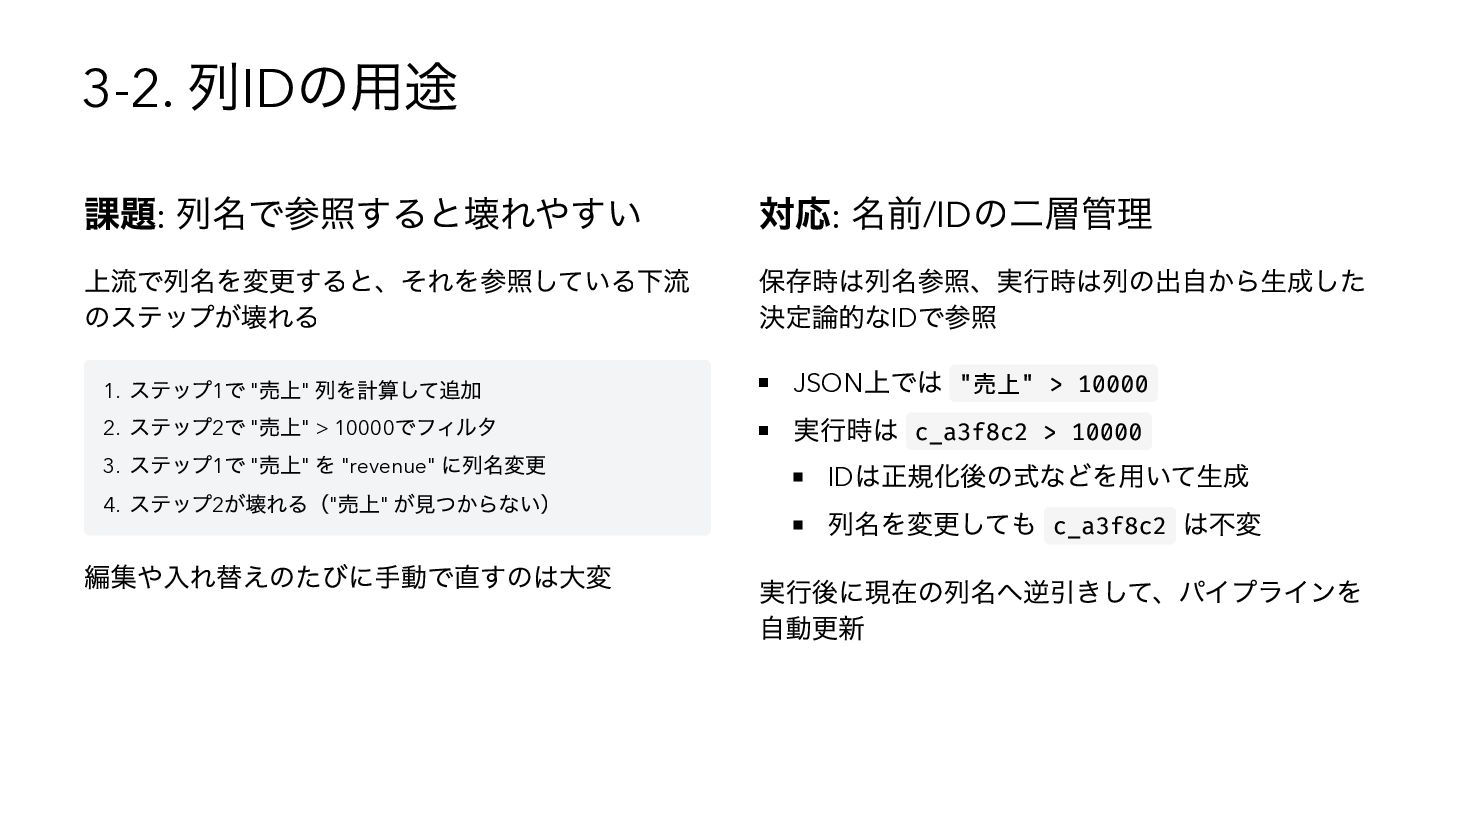
3-2. 列ID の用途 課題: 列名で参照すると壊れやすい 上流で列名を変更すると、それを参照している下流 のステップが壊れる 1. ステップ1 で
" 売上" 列を計算して追加 2. ステップ2 で " 売上" > 10000 でフィルタ 3. ステップ1 で " 売上" を "revenue" に列名変更 4. ステップ2 が壊れる(" 売上" が見つからない) 編集や入れ替えのたびに手動で直すのは大変 対応: 名前/ID の二層管理 保存時は列名参照、実行時は列の出自から生成した 決定論的なID で参照 JSON 上では "売上" > 10000 実行時は c_a3f8c2 > 10000 ID は正規化後の式などを用いて生成 列名を変更しても c_a3f8c2 は不変 実行後に現在の列名へ逆引きして、パイプラインを 自動更新
4. まとめ
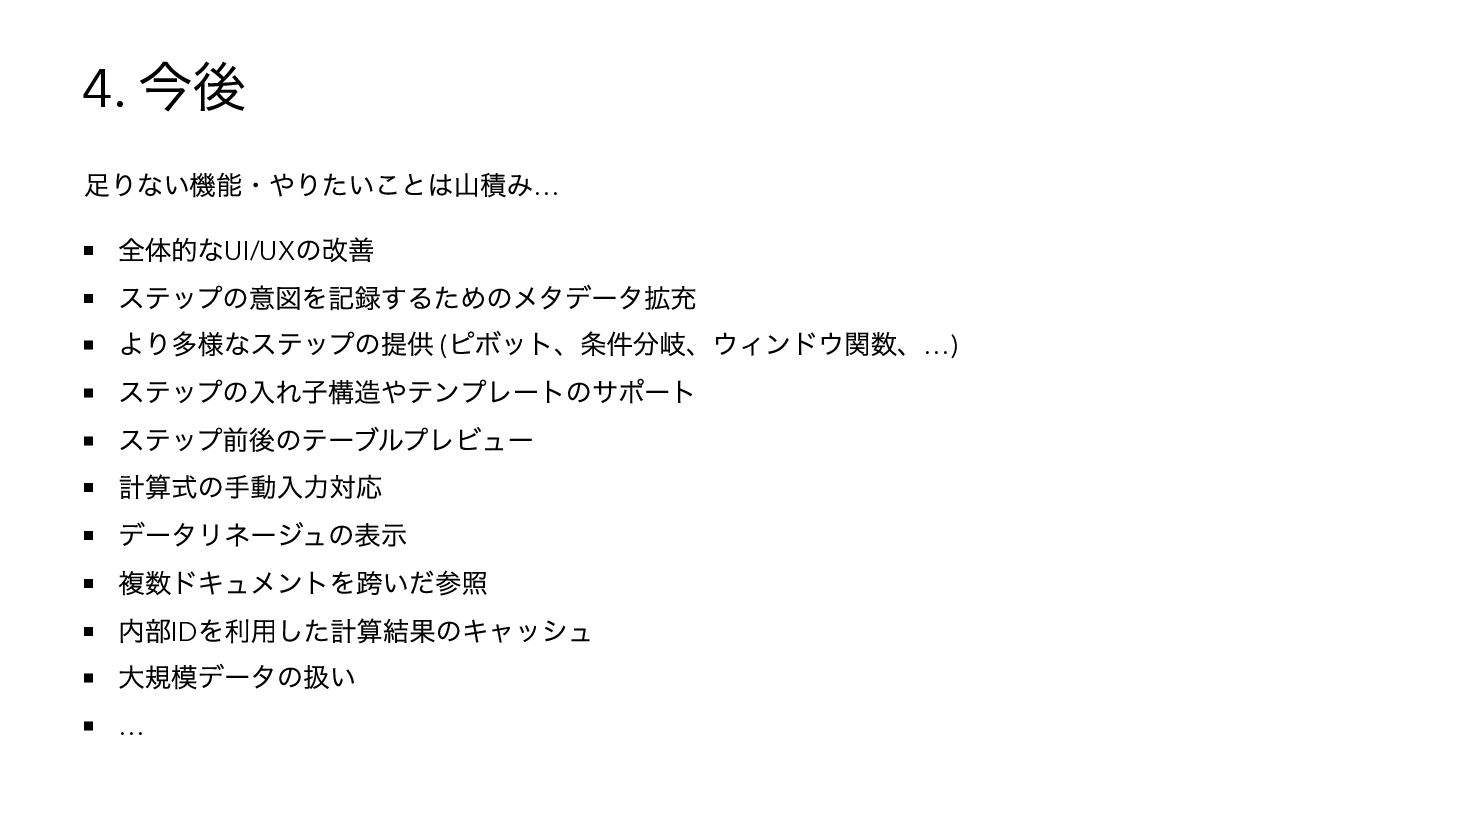
4. 今後 足りない機能・やりたいことは山積み… 全体的なUI/UX の改善 ステップの意図を記録するためのメタデータ拡充 より多様なステップの提供 ( ピボット、条件分岐、ウィンドウ関数、…) ステップの入れ子構造やテンプレートのサポート
ステップ前後のテーブルプレビュー 計算式の手動入力対応 データリネージュの表示 複数ドキュメントを跨いだ参照 内部ID を利用した計算結果のキャッシュ 大規模データの扱い …
4. まとめ ブロック = table / view の 1:1 対応を設計の軸に
同期レイヤ + カタログ機能 + イベント通知 でリアクティブにUI を更新 パイプラインJSON + CTE コンパイル で分析工程をドキュメントに記録

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 tokibi
 shisyu_gaku
 gionn
 mhlyc
 daidaidai
 emiki
 jtakeda
 akizhou
 onk
 kzkhykw1991
 kakehashi
 snoozer05
 watany
 morganepeng
 auna
 caitiem20
 gurzu
 sugarenia
 inesmontani
 mkilby
 aleyda
 scottboms
 jmmastey
 addyosmani
 smashingmag