Upgrade to Pro — share decks privately, control downloads, hide ads and more …

GlobalKTableで実現するマイクロサービス改革

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →

 GlobalKTableで実現するマイクロサービス改革

GlobalKTableで実現するマイクロサービス改革:REST APIで10,000 RPS、コスト95%削減

Avatar for Takuto Suzuki

Takuto Suzuki

March 05, 2026

Other Decks in Technology

Transcript

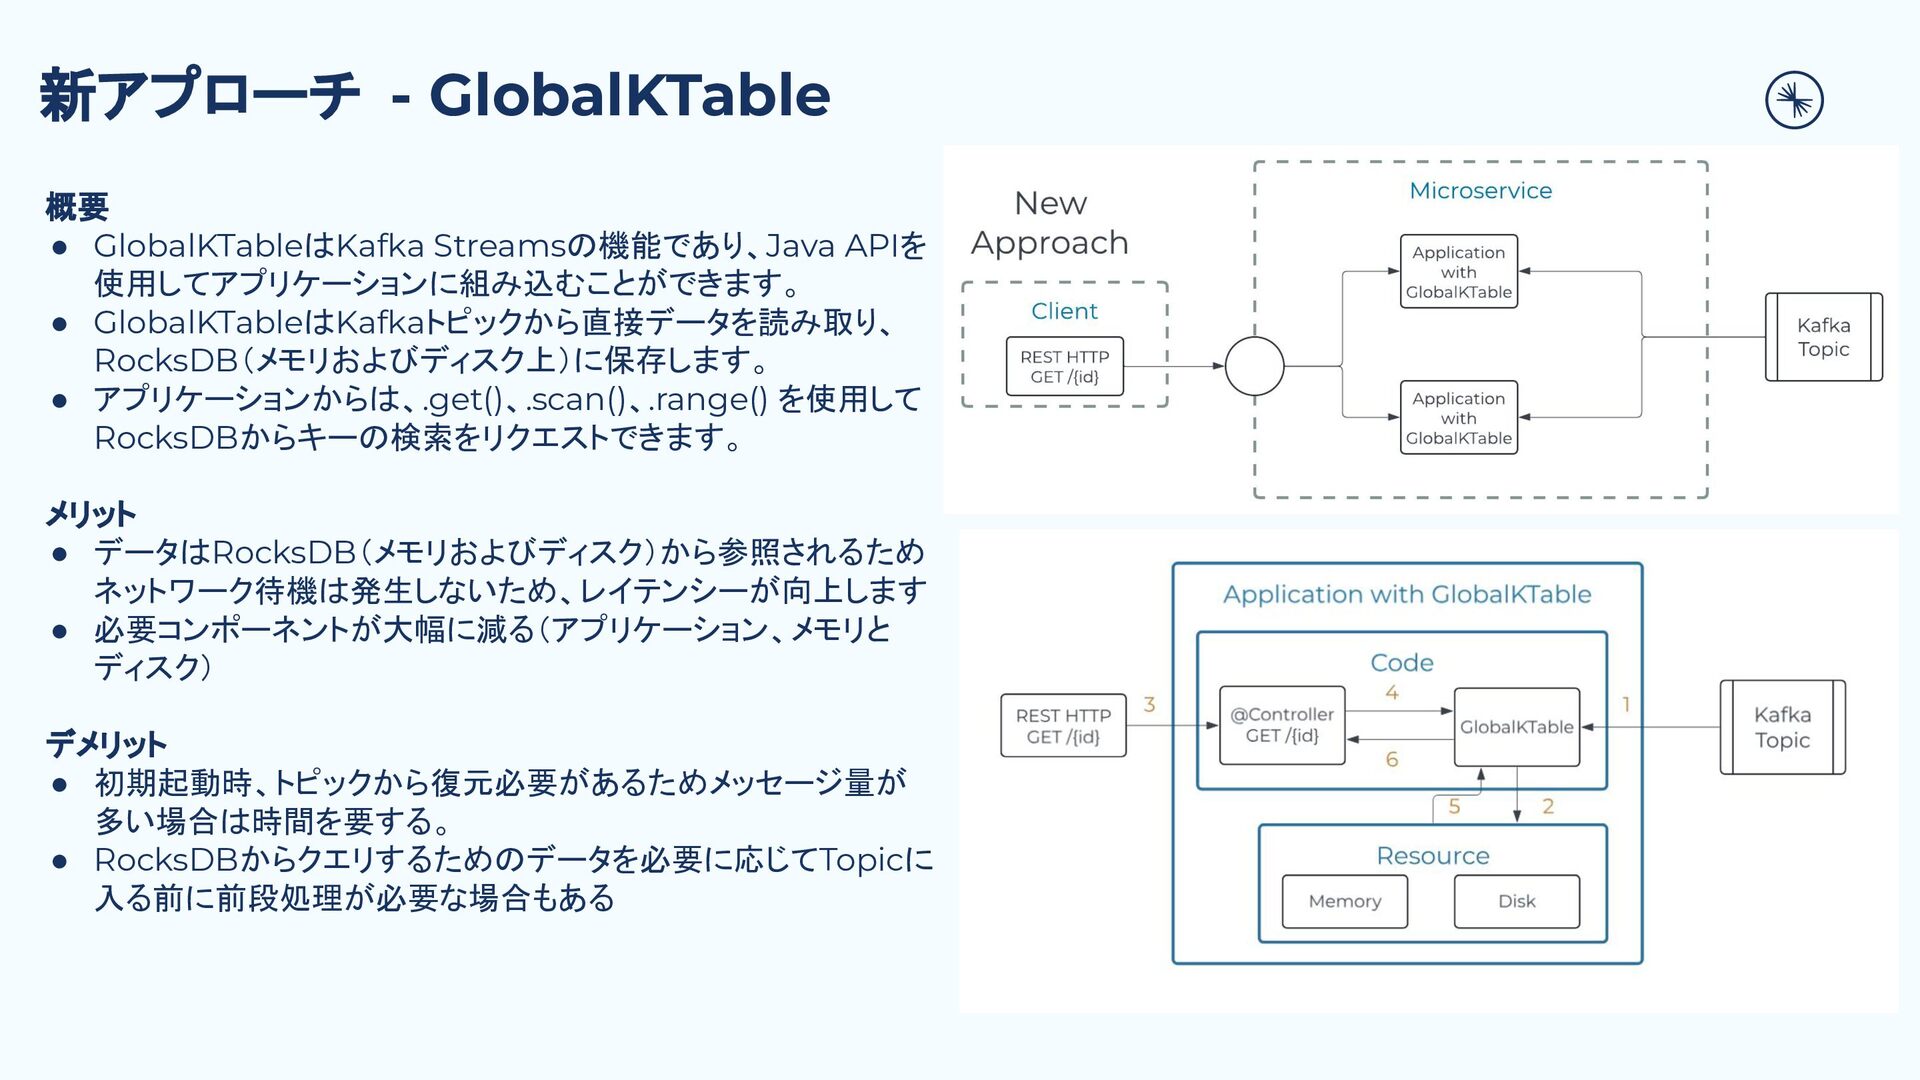
  1. 新アプローチ - GlobalKTable 概要 • GlobalKTableはKafka Streamsの機能であり、Java APIを 使用してアプリケーションに組み込むことができます。 •

    GlobalKTableはKafkaトピックから直接データを読み取り、 RocksDB(メモリおよびディスク上)に保存します。 • アプリケーションからは、.get()、.scan()、.range() を使用して RocksDBからキーの検索をリクエストできます。 メリット • データはRocksDB(メモリおよびディスク)から参照されるため ネットワーク待機は発生しないため、レイテンシーが向上します • 必要コンポーネントが大幅に減る(アプリケーション、メモリと ディスク) デメリット • 初期起動時、トピックから復元必要があるためメッセージ量が 多い場合は時間を要する。 • RocksDBからクエリするためのデータを必要に応じてTopicに 入る前に前段処理が必要な場合もある 4
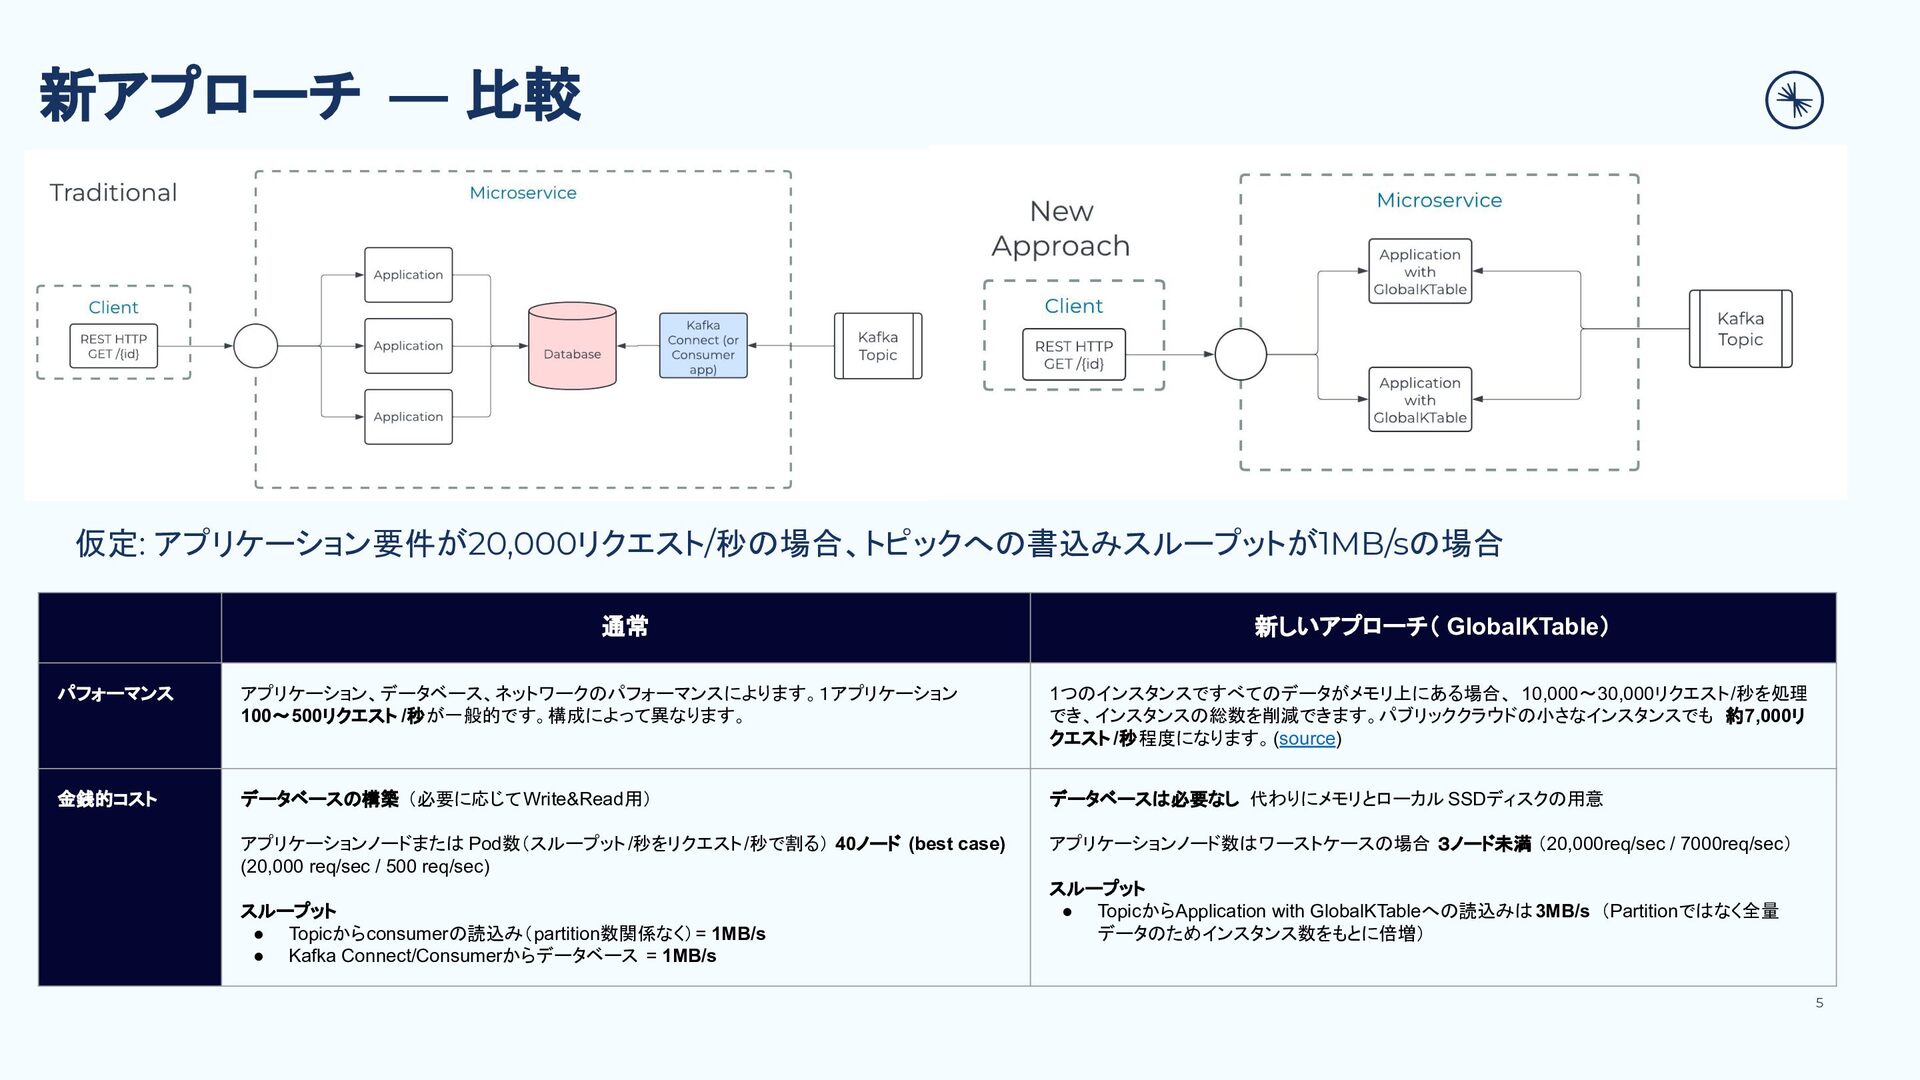
  2. 通常 新しいアプローチ( GlobalKTable) パフォーマンス アプリケーション、データベース、ネットワークのパフォーマンスによります。1アプリケーション 100〜500リクエスト /秒が一般的です。構成によって異なります。 1つのインスタンスですべてのデータがメモリ上にある場合、 10,000〜30,000リクエスト/秒を処理 でき、インスタンスの総数を削減できます。パブリッククラウドの小さなインスタンスでも

    約7,000リ クエスト /秒程度になります。(source) 金銭的コスト データベースの構築 (必要に応じてWrite&Read用) アプリケーションノードまたは Pod数(スループット/秒をリクエスト/秒で割る) 40ノード (best case) (20,000 req/sec / 500 req/sec) スループット • Topicからconsumerの読込み(partition数関係なく)= 1MB/s • Kafka Connect/Consumerからデータベース = 1MB/s データベースは必要なし 代わりにメモリとローカル SSDディスクの用意 アプリケーションノード数はワーストケースの場合 3ノード未満 (20,000req/sec / 7000req/sec) スループット • TopicからApplication with GlobalKTableへの読込みは3MB/s (Partitionではなく全量 データのためインスタンス数をもとに倍増) 5 新アプローチ — 比較 仮定: アプリケーション要件が20,000リクエスト/秒の場合、トピックへの書込みスループットが1MB/sの場合
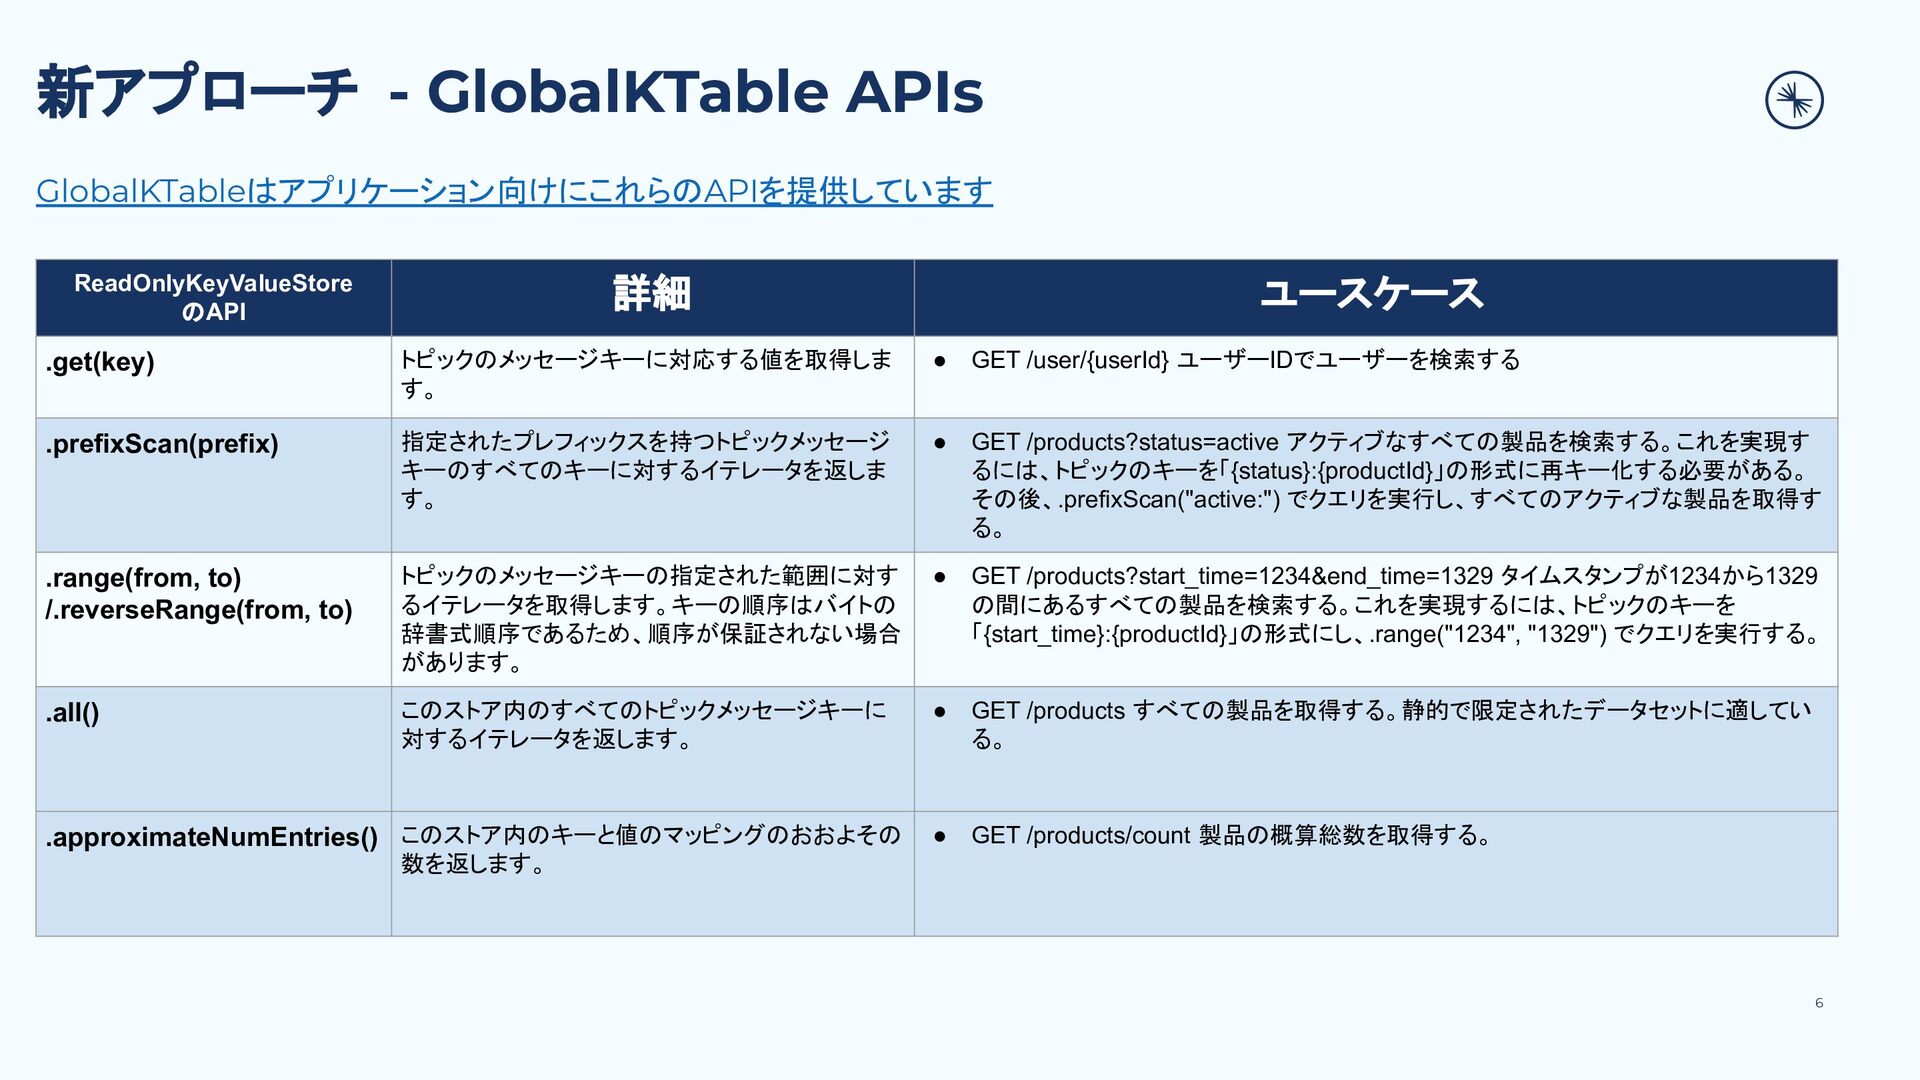
  3. 6 新アプローチ - GlobalKTable APIs 6 ReadOnlyKeyValueStore のAPI 詳細 ユースケース

    .get(key) トピックのメッセージキーに対応する値を取得しま す。 • GET /user/{userId} ユーザーIDでユーザーを検索する .prefixScan(prefix) 指定されたプレフィックスを持つトピックメッセージ キーのすべてのキーに対するイテレータを返しま す。 • GET /products?status=active アクティブなすべての製品を検索する。これを実現す るには、トピックのキーを「{status}:{productId}」の形式に再キー化する必要がある。 その後、.prefixScan("active:") でクエリを実行し、すべてのアクティブな製品を取得す る。 .range(from, to) /.reverseRange(from, to) トピックのメッセージキーの指定された範囲に対す るイテレータを取得します。キーの順序はバイトの 辞書式順序であるため、順序が保証されない場合 があります。 • GET /products?start_time=1234&end_time=1329 タイムスタンプが1234から1329 の間にあるすべての製品を検索する。これを実現するには、トピックのキーを 「{start_time}:{productId}」の形式にし、.range("1234", "1329") でクエリを実行する。 .all() このストア内のすべてのトピックメッセージキーに 対するイテレータを返します。 • GET /products すべての製品を取得する。静的で限定されたデータセットに適してい る。 .approximateNumEntries() このストア内のキーと値のマッピングのおおよその 数を返します。 • GET /products/count 製品の概算総数を取得する。 GlobalKTableはアプリケーション向けにこれらのAPIを提供しています
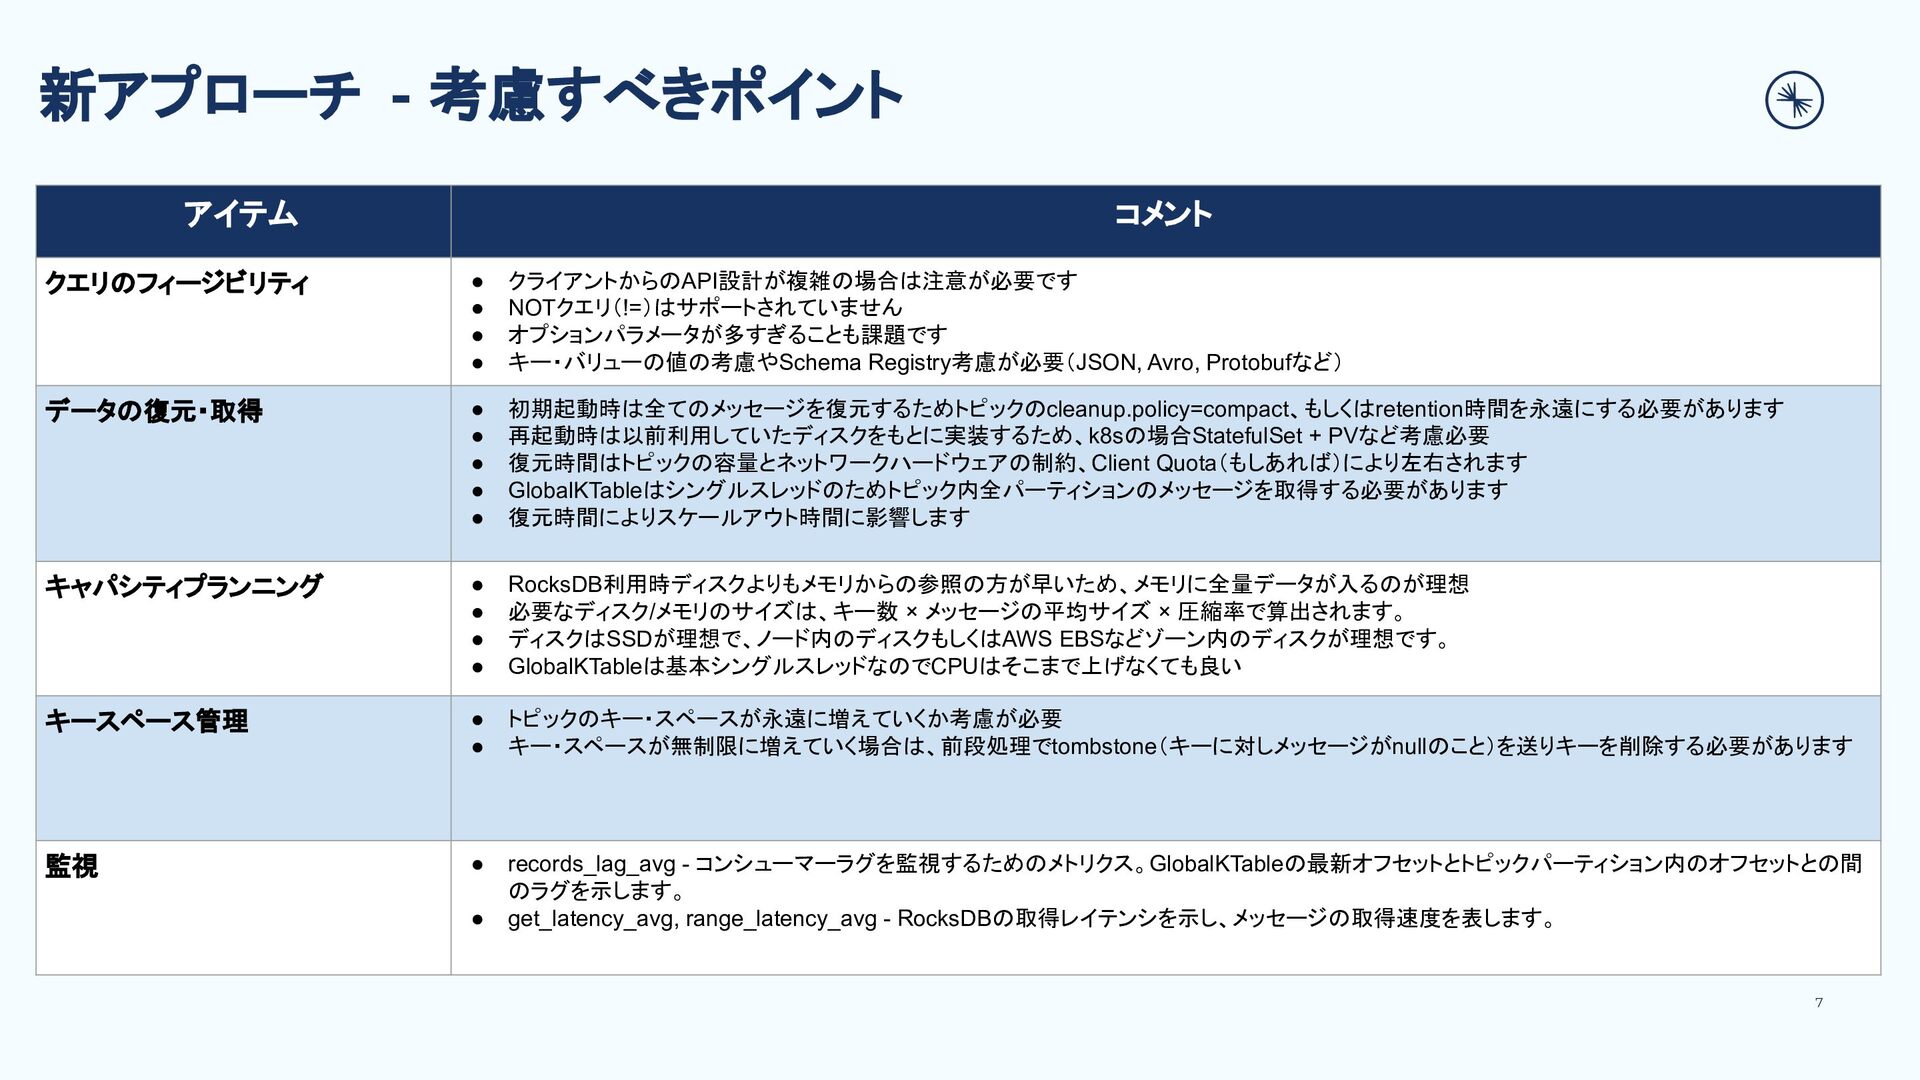
  4. 新アプローチ - 考慮すべきポイント 7 アイテム コメント クエリのフィージビリティ • クライアントからのAPI設計が複雑の場合は注意が必要です •

    NOTクエリ(!=)はサポートされていません • オプションパラメータが多すぎることも課題です • キー・バリューの値の考慮やSchema Registry考慮が必要(JSON, Avro, Protobufなど) データの復元・取得 • 初期起動時は全てのメッセージを復元するためトピックのcleanup.policy=compact、もしくはretention時間を永遠にする必要があります • 再起動時は以前利用していたディスクをもとに実装するため、k8sの場合StatefulSet + PVなど考慮必要 • 復元時間はトピックの容量とネットワークハードウェアの制約、Client Quota(もしあれば)により左右されます • GlobalKTableはシングルスレッドのためトピック内全パーティションのメッセージを取得する必要があります • 復元時間によりスケールアウト時間に影響します キャパシティプランニング • RocksDB利用時ディスクよりもメモリからの参照の方が早いため、メモリに全量データが入るのが理想 • 必要なディスク/メモリのサイズは、キー数 × メッセージの平均サイズ × 圧縮率で算出されます。 • ディスクはSSDが理想で、ノード内のディスクもしくはAWS EBSなどゾーン内のディスクが理想です。 • GlobalKTableは基本シングルスレッドなのでCPUはそこまで上げなくても良い キースペース管理 • トピックのキー・スペースが永遠に増えていくか考慮が必要 • キー・スペースが無制限に増えていく場合は、前段処理でtombstone(キーに対しメッセージがnullのこと)を送りキーを削除する必要があります 監視 • records_lag_avg - コンシューマーラグを監視するためのメトリクス。GlobalKTableの最新オフセットとトピックパーティション内のオフセットとの間 のラグを示します。 • get_latency_avg, range_latency_avg - RocksDBの取得レイテンシを示し、メッセージの取得速度を表します。
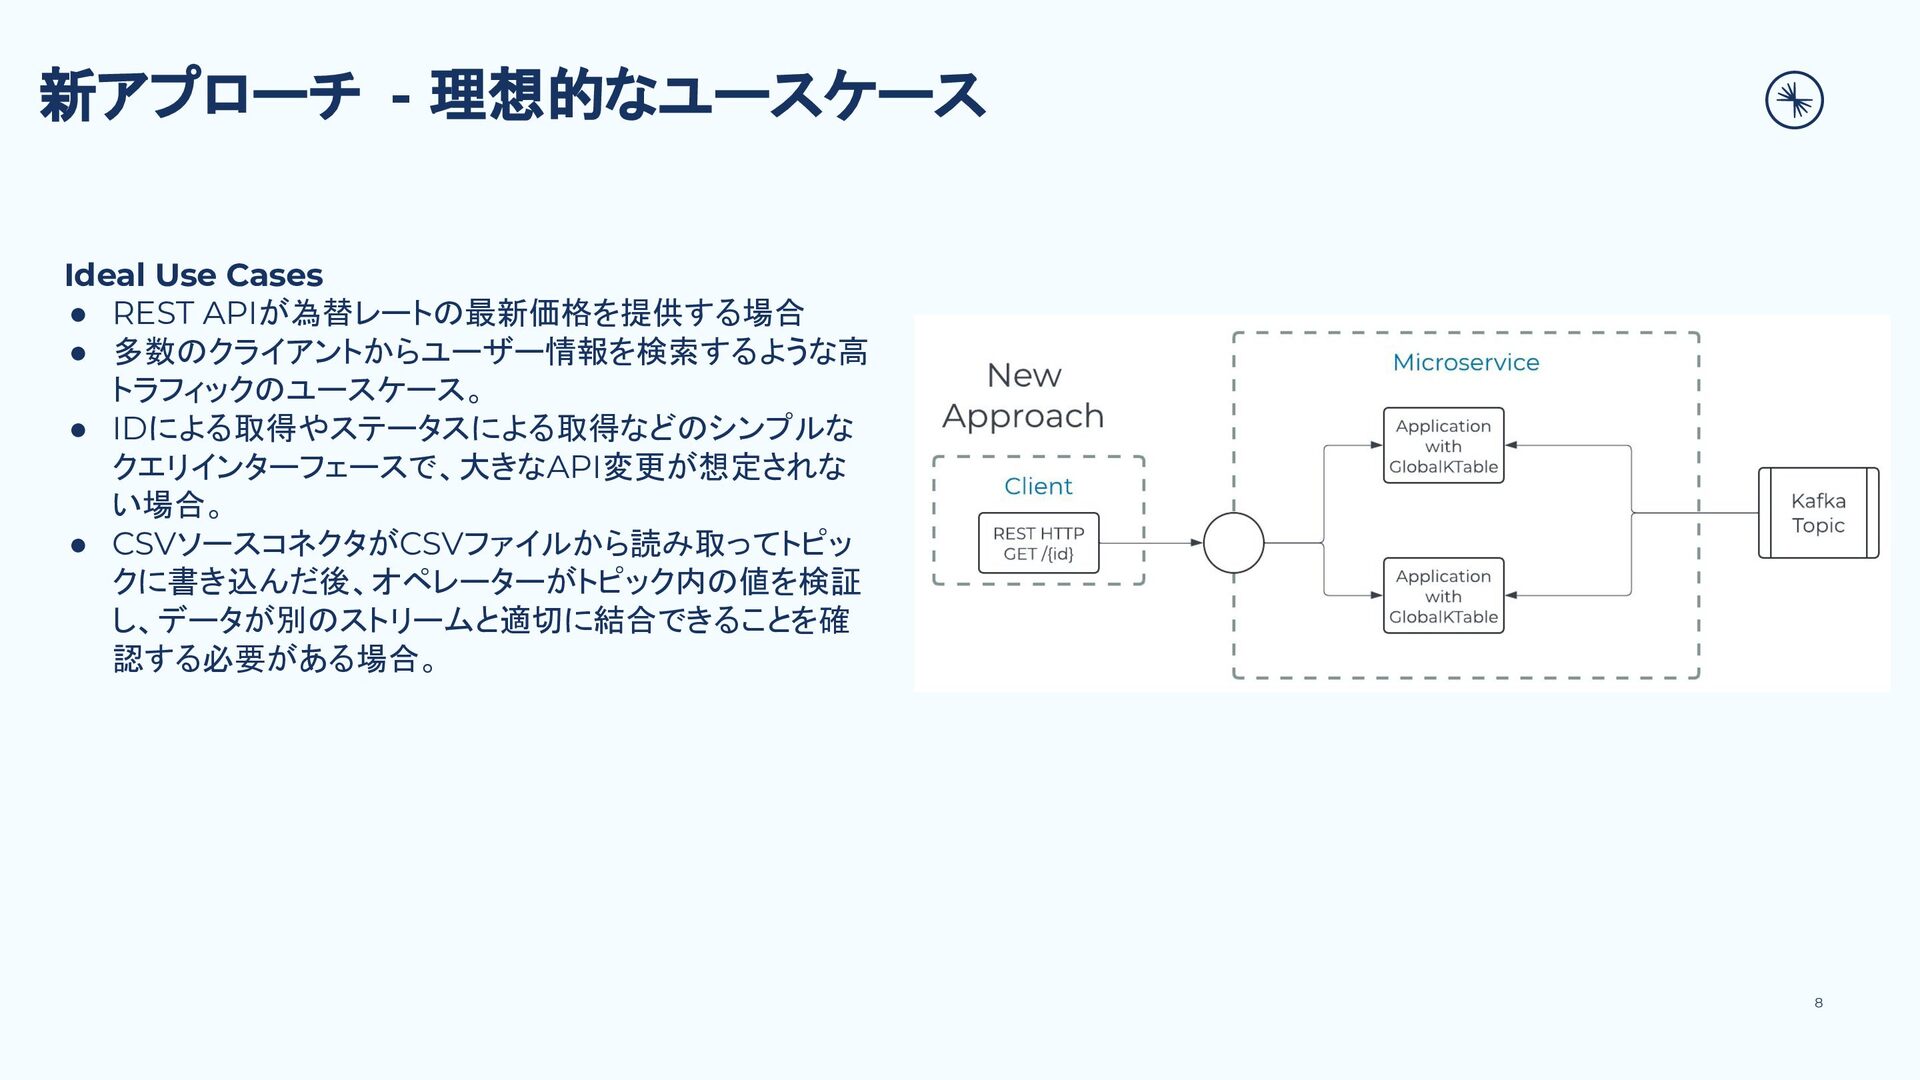
  5. 新アプローチ - 理想的なユースケース Ideal Use Cases • REST APIが為替レートの最新価格を提供する場合 •

    多数のクライアントからユーザー情報を検索するような高 トラフィックのユースケース。 • IDによる取得やステータスによる取得などのシンプルな クエリインターフェースで、大きなAPI変更が想定されな い場合。 • CSVソースコネクタがCSVファイルから読み取ってトピッ クに書き込んだ後、オペレーターがトピック内の値を検証 し、データが別のストリームと適切に結合できることを確 認する必要がある場合。 8
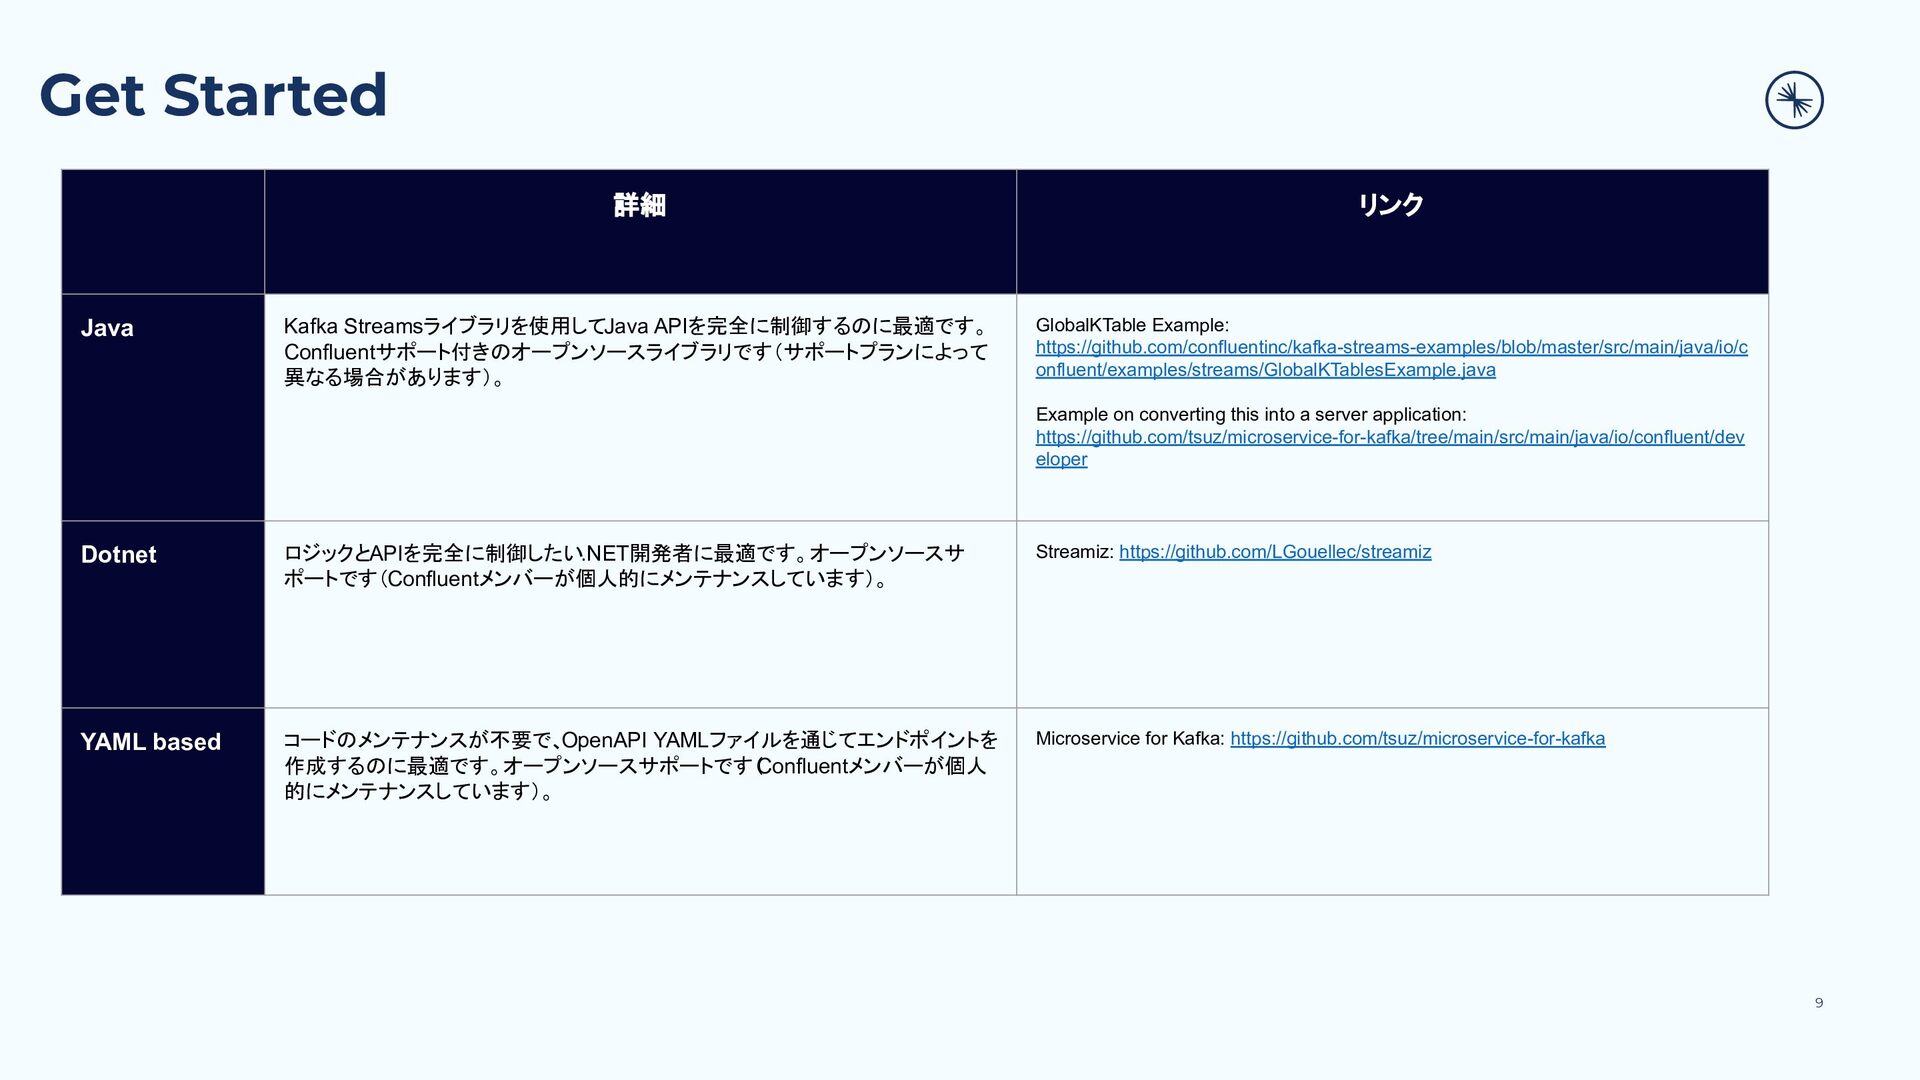
  6. Get Started 9 詳細 リンク Java Kafka Streamsライブラリを使用してJava APIを完全に制御するのに最適です。 Confluentサポート付きのオープンソースライブラリです(サポートプランによって

    異なる場合があります)。 GlobalKTable Example: https://github.com/confluentinc/kafka-streams-examples/blob/master/src/main/java/io/c onfluent/examples/streams/GlobalKTablesExample.java Example on converting this into a server application: https://github.com/tsuz/microservice-for-kafka/tree/main/src/main/java/io/confluent/dev eloper Dotnet ロジックとAPIを完全に制御したい.NET開発者に最適です。オープンソースサ ポートです(Confluentメンバーが個人的にメンテナンスしています)。 Streamiz: https://github.com/LGouellec/streamiz YAML based コードのメンテナンスが不要で、 OpenAPI YAMLファイルを通じてエンドポイントを 作成するのに最適です。オープンソースサポートです( Confluentメンバーが個人 的にメンテナンスしています)。 Microservice for Kafka: https://github.com/tsuz/microservice-for-kafka