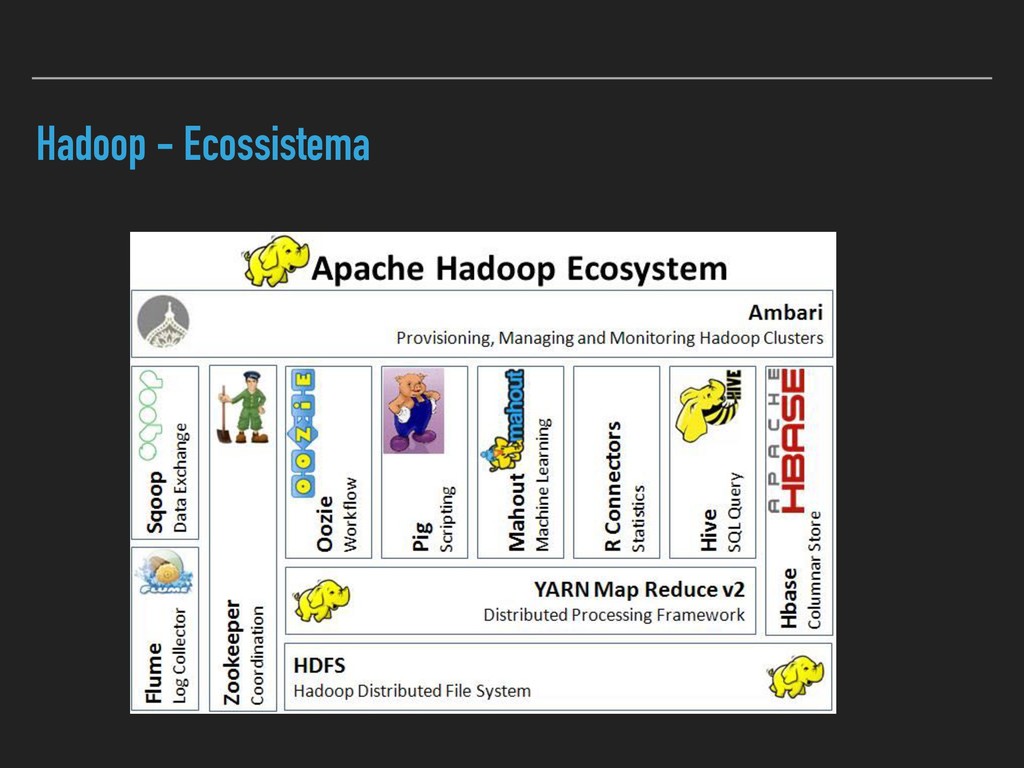
plataforma para desenvolvimento de aplicações distribuídas, com alta escalabilidade, confiabilidade e tolerância a falhas. Criado por Doug Cutting e Mike Cafarella em 2005.
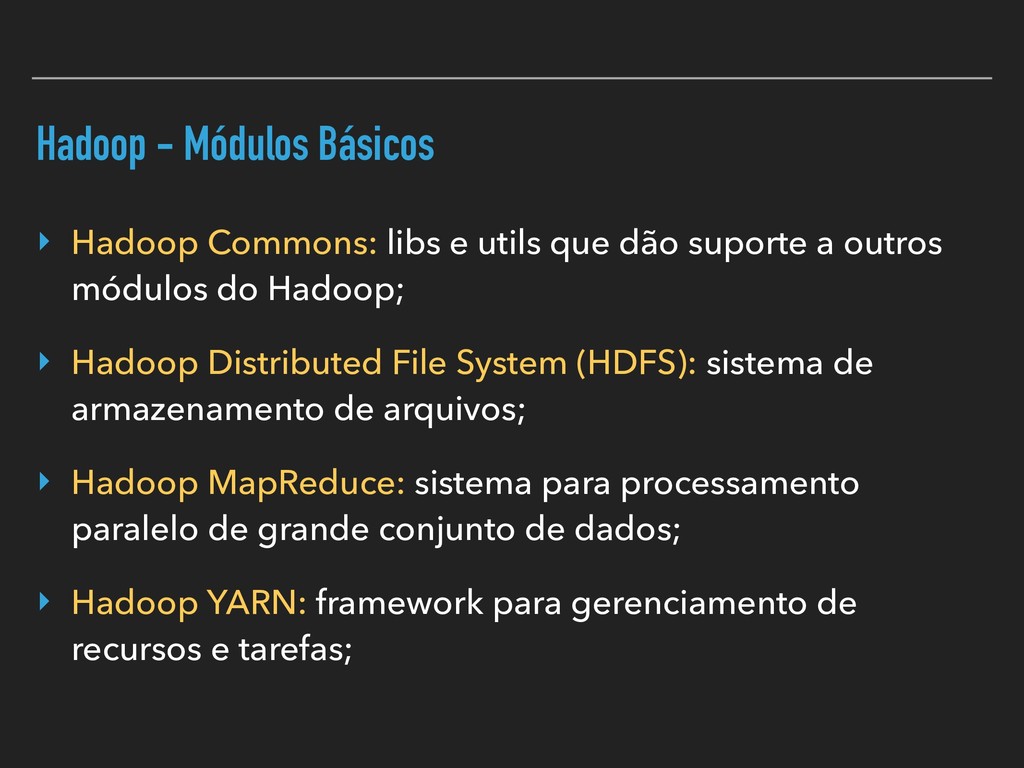
que dão suporte a outros módulos do Hadoop; ‣ Hadoop Distributed File System (HDFS): sistema de armazenamento de arquivos; ‣ Hadoop MapReduce: sistema para processamento paralelo de grande conjunto de dados; ‣ Hadoop YARN: framework para gerenciamento de recursos e tarefas;
uma engine unificada de análise para Big Data e Machine Learning. Maior projeto open source para o processamento de dados. Desenvolvido desde 2009 pela Universidade de Califórnia e em 2010 código aberto para fundação Apache.
Spark é 100x mais rápido comparado com Hadoop, para o processamento de dados em larga escala; ‣ Facilidade de uso: disponibiliza API (Application Programming Interface) para operar grandes datasets; ‣ Análises sofisticadas: inclui suporte a consulta SQL (Structured Query Language), data streaming, Machine Learning e processamento de grafos;
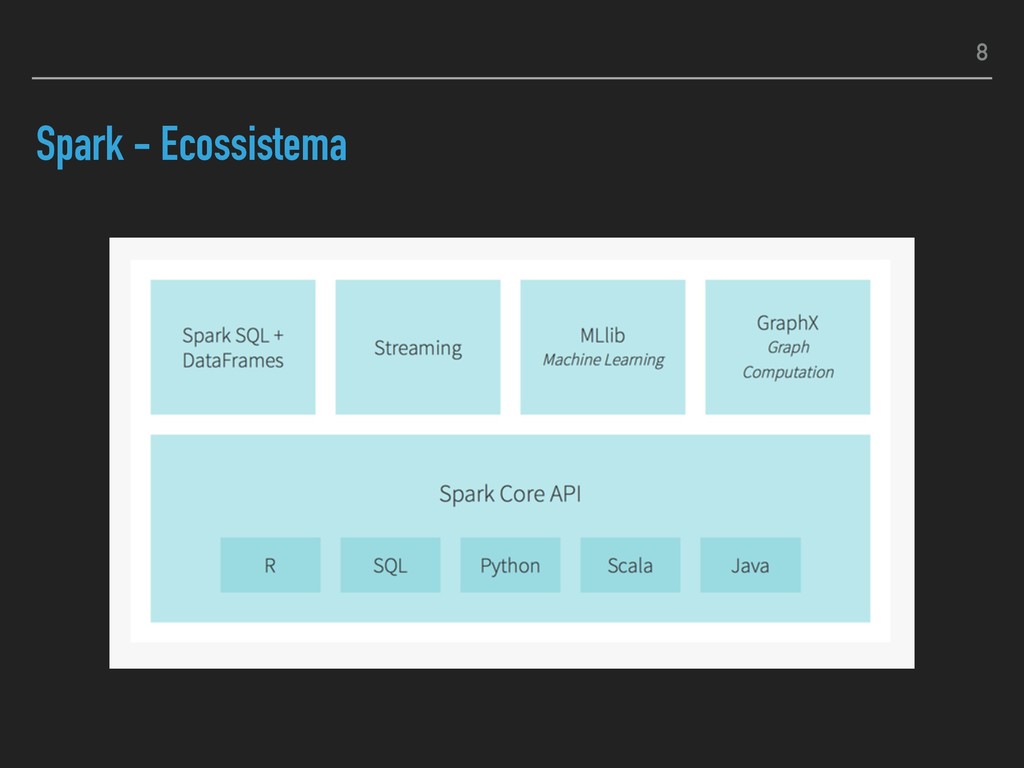
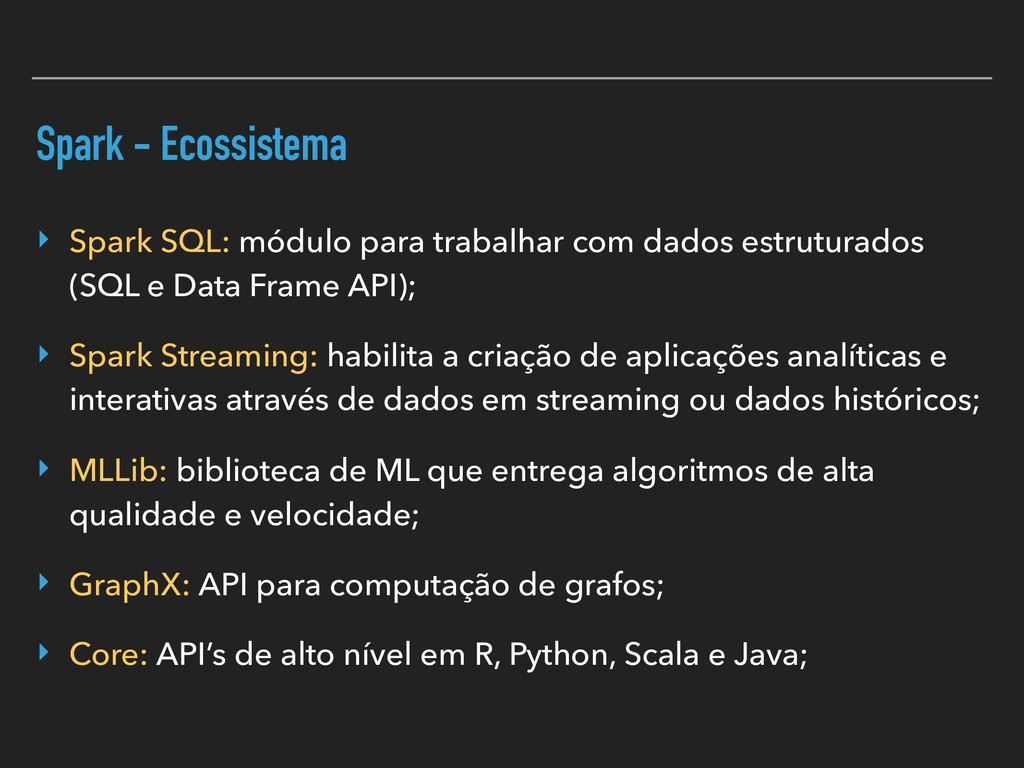
dados estruturados (SQL e Data Frame API); ‣ Spark Streaming: habilita a criação de aplicações analíticas e interativas através de dados em streaming ou dados históricos; ‣ MLLib: biblioteca de ML que entrega algoritmos de alta qualidade e velocidade; ‣ GraphX: API para computação de grafos; ‣ Core: API’s de alto nível em R, Python, Scala e Java;
volume de dados em cluster; ‣ Extrair dados diretamente de um cluster através de uma instância Spark configurada em alguma máquina; ‣ Criar Data Frames Pandas a partir do Spark;


 wagnerjgoncalves
 yahonda
 techtekt
 kaminashi
 maimyyym
 taketakekaho
 pfn
 tomokusaba
 shumei_ito
 prog893
 kakehashi
 grimoh
 camiha
 tammyeverts
 leimatthew05
 frankvandijk
 tomoyanonymous
 palkan
 wjessup
 helmedeiros
 jonoalderson
 axbom
 aleyda
 gurzu
 erikaheidi