Share
Embed
非同期推論システムによるコスト削減と信頼性向上
2024/04/23 第40回 MLOps 勉強会
# 非同期推論システムによるコスト削減と信頼性向上
CADDiでは同期的なリアルタイム推論WebAPIを用いてサービスを構築していました。事業の成長に伴い、よりスケーラブルで疎結合に推論を行うために非同期推論のシステムを開発しています。新システムにより、コスト削減・信頼性向上を実現できそうなので事例として紹介いたします。
Koki Nishihara
April 23, 2024
Transcript
26 slides
-
2024/04 第40回 MLOps勉強会 CADDi AI Team Lead Engineer Koki Nishihara
非同期推論システムによる コスト削減と信頼性向上 -
Koki Nishihara (github@nishikoh) CADDi AI Team, Lead Engineer • 一人目のMLOpsエンジニアとしてCADDiに入社
MLOpsの推進 • Python Working Group Lead • バックエンド・インフラが中心のキャリア • PyCon APAC 2023登壇 自己紹介 2 -
図面データ活用クラウドDrawerの図面解析チーム • 類似検索、図面OCR、記号認識など • Engineer (ML + MLOps) + PdM
技術スタック • Python ◦ Pants, PyTorch, Kubeflow Pipelines, Polars, pydantic, pytest, Ruff, mypy, uv…etc • Google Cloud, Terraform • GitHub/GitHub Actions CADDi AI Team 5 -
✅マネージドなVertex AI を中心に構築。開発者の考える領域と運用を削減 • Vertex AI Endpoints • Vertex AI
Model Registry • Vertex AI Pipelines AI TeamのML/MLOps 7 • Vertex AI Experiments • Vertex AI Tensor Board -
これまで同期処理 (WebAPI) で推論していたが時間がかかる処理が出てきた • 想定している負荷をさばけず大量のエラーが発生、安定稼働が難しい。 コンテナのサイズが大きいこともありスケールアウトが間に合わない。 • 推論時間を短くするための画像のリサイズやモデル側の改善を 試したが、精度的な観点で見送り •
min replica数を上げる or 強いGPUを使うと解決できるが 常時費用が発生する。費用対効果の面で見送り CADDiの同期推論システムの課題 12 -
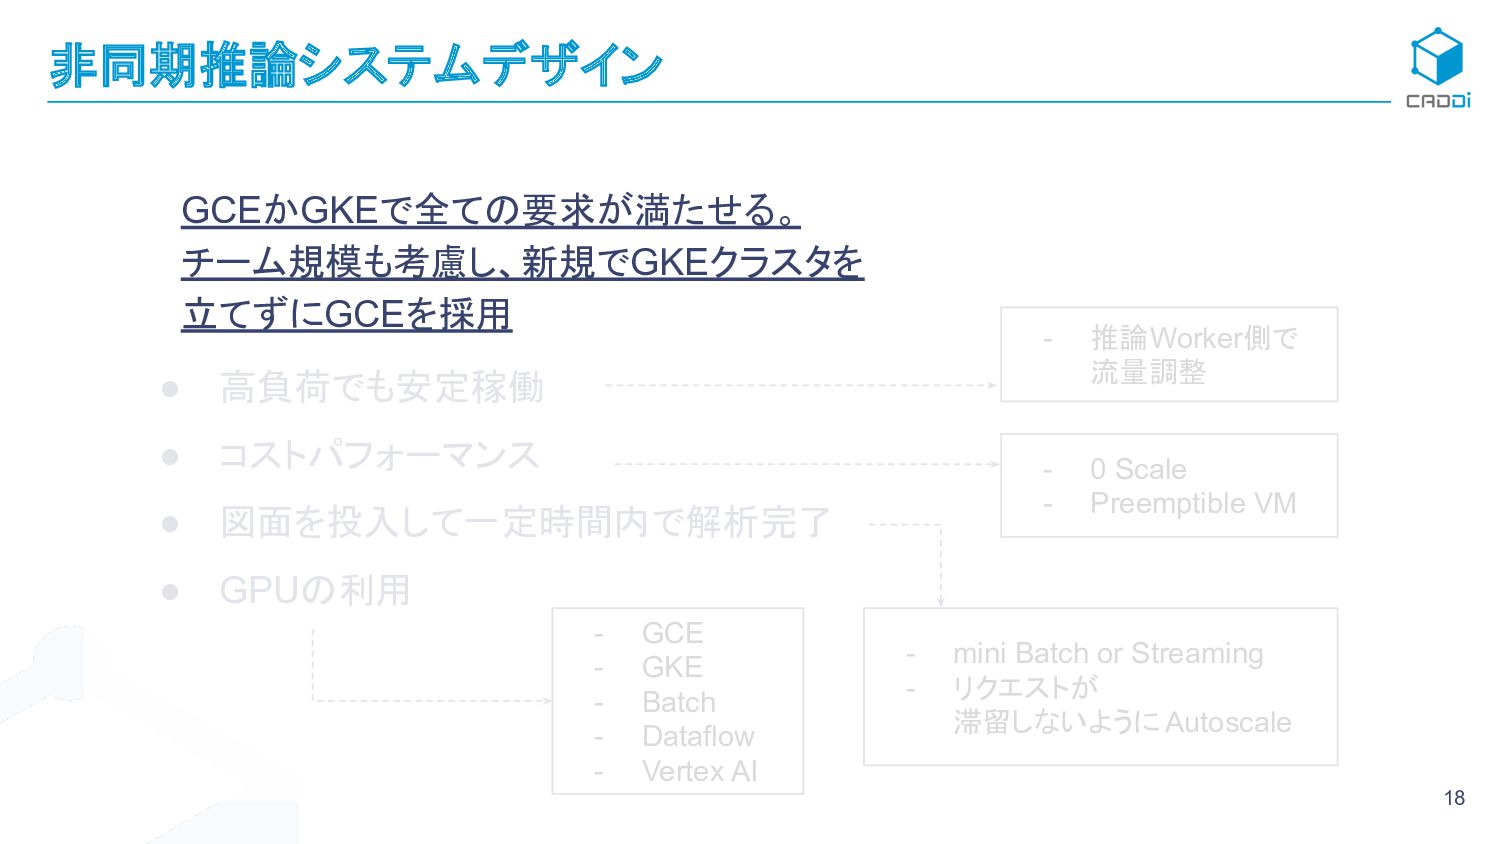
要求を満たせそうな技術的要素 • 高負荷でも安定稼働 • コストパフォーマンス • 図面を投入して一定時間内で解析完了 • GPUの利用 非同期推論システムデザイン
14 - 推論Worker側で 流量調整 - 0 Scale - Preemptible VM - mini Batch or Streaming - リクエストが 滞留しないようにAutoscale - GCE - GKE - Batch - Dataflow - Vertex AI -
- 推論Worker側で 流量調整 - mini Batch or Streaming - リクエストが滞留しないように
Autoscaleしてほしい - GCE - GKE - Batch - Dataflow - Vertex AI 新システムに求められるもの - GPUの利用 - 高負荷でも安定稼働 - コストパフォーマンス - 図面を投入して一定時間内で解析完了 非同期推論システムデザイン 15 Preemptible (Spot) Instance Google Cloudの余っているVMを割安で利用できる。VM が余ってない時は利用できない。 > プリエンプティブル VM インスタンスは、 標準 VM の料金よりもはるかに低価格 (60~91% 割引)で利用できます 。ただし、他の VM に割り当てるためにコン ピューティング容量を再利用する必要がある場合、 Compute Engine はこのイン スタンスを停止(プリエンプト)する可能性があります。プリエンプティブル インスタ ンスは、Compute Engine の余剰の容量を利用する機能であり、使用できるかど うかは利用状況に応じて変わります。 - 0 Scale - Preemptible VM -
- 推論Worker側で 流量調整 - mini Batch or Streaming - リクエストが滞留しないように
Autoscaleしてほしい - GCE - GKE - Batch - Dataflow - Vertex AI 新システムに求められるもの - GPUの利用 - 高負荷でも安定稼働 - コストパフォーマンス - 図面を投入して一定時間内で解析完了 非同期推論システムデザイン 16 これまでの同期処理アーキテクチャでは WebAPIごとに常に一台サーバーが起動していた。 リクエストがない時も費用がかかっていため、 この際に 0 Scaleアーキテクチャにしたい。 - 0 Scale - Preemptible VM -
要求を満たせそうな技術的要素 • 高負荷でも安定稼働 • コストパフォーマンス • 図面を投入して一定時間内で解析完了 • GPUの利用 非同期推論システムデザイン
17 - 推論Worker側で 流量調整 - 0 Scale - Preemptible VM - mini Batch or Streaming - リクエストが 滞留しないようにAutoscale - GCE - GKE - Batch - Dataflow - Vertex AI -
- 推論Worker側で 流量調整 - 0 Scale - Preemptible VM -
mini Batch or Streaming - リクエストが 滞留しないようにAutoscale - GCE - GKE - Batch - Dataflow - Vertex AI • 高負荷でも安定稼働 • コストパフォーマンス • 図面を投入して一定時間内で解析完了 • GPUの利用 非同期推論システムデザイン 18 GCEかGKEで全ての要求が満たせる。 チーム規模も考慮し、新規でGKEクラスタを 立てずにGCEを採用 -
19 システム構成 Clientからの解析リクエストを Queue(Pub/Sub)に一度溜める。 WorkerがQueueから取り出して推論 ✅ GPU推論 ✅ 高負荷でも安定稼働 推論Worker側で流量調整
✅ コストパフォーマンス Preemptible VM + 0 Scale ✅ 図面を投入して一定時間内で解析完了 図面投入後、少ない遅延で解析開始 + 滞留しないように Autoscale -
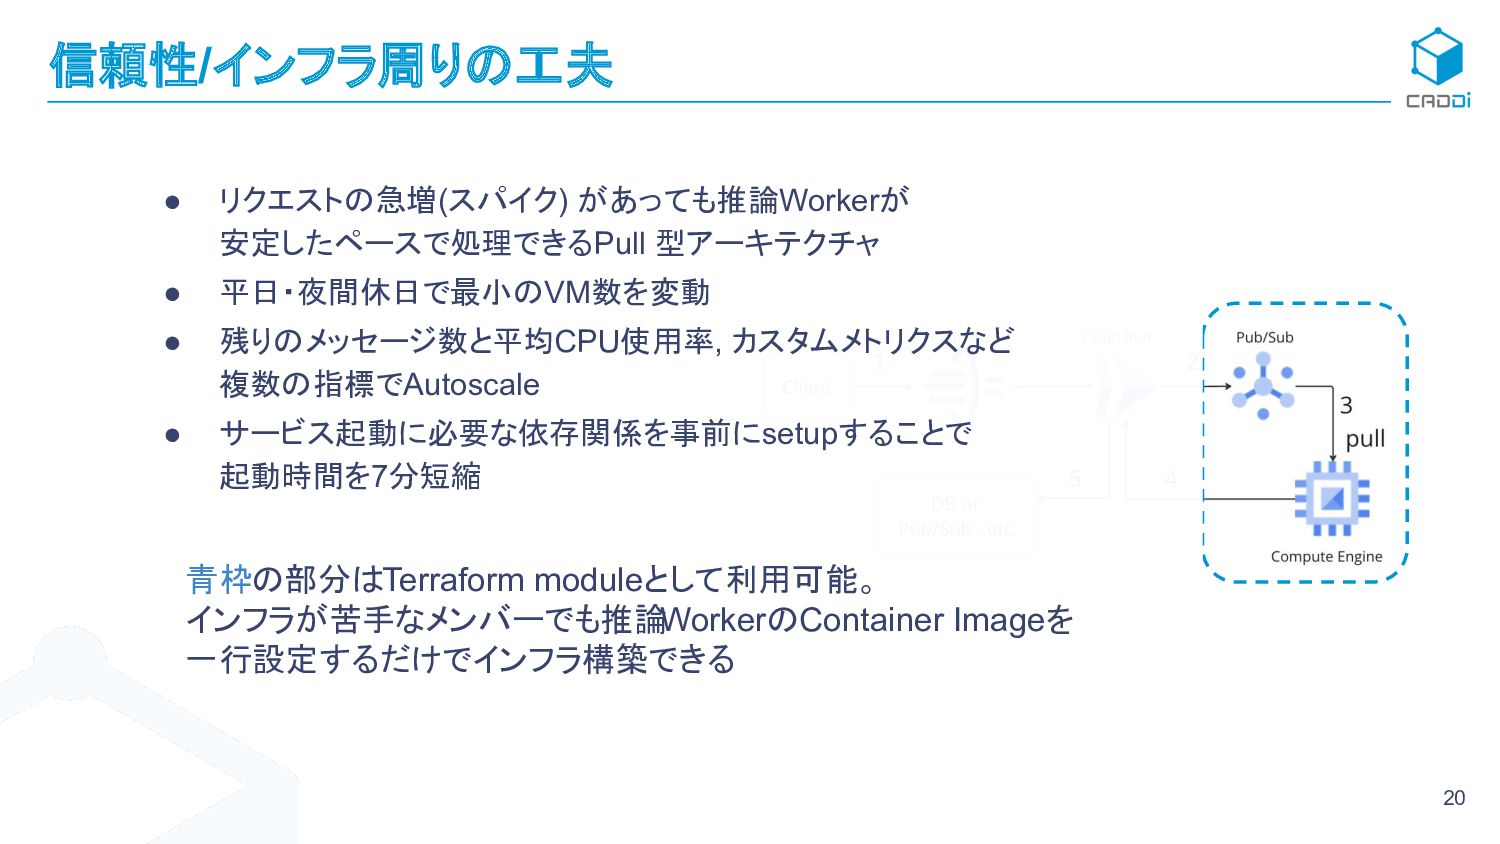
20 信頼性/インフラ周りの工夫 • リクエストの急増(スパイク) があっても推論Workerが 安定したペースで処理できるPull 型アーキテクチャ • 平日・夜間休日で最小のVM数を変動 •
残りのメッセージ数と平均CPU使用率, カスタムメトリクスなど 複数の指標でAutoscale • サービス起動に必要な依存関係を事前にsetupすることで 起動時間を7分短縮 青枠の部分はTerraform moduleとして利用可能。 インフラが苦手なメンバーでも推論 WorkerのContainer Imageを 一行設定するだけでインフラ構築できる -
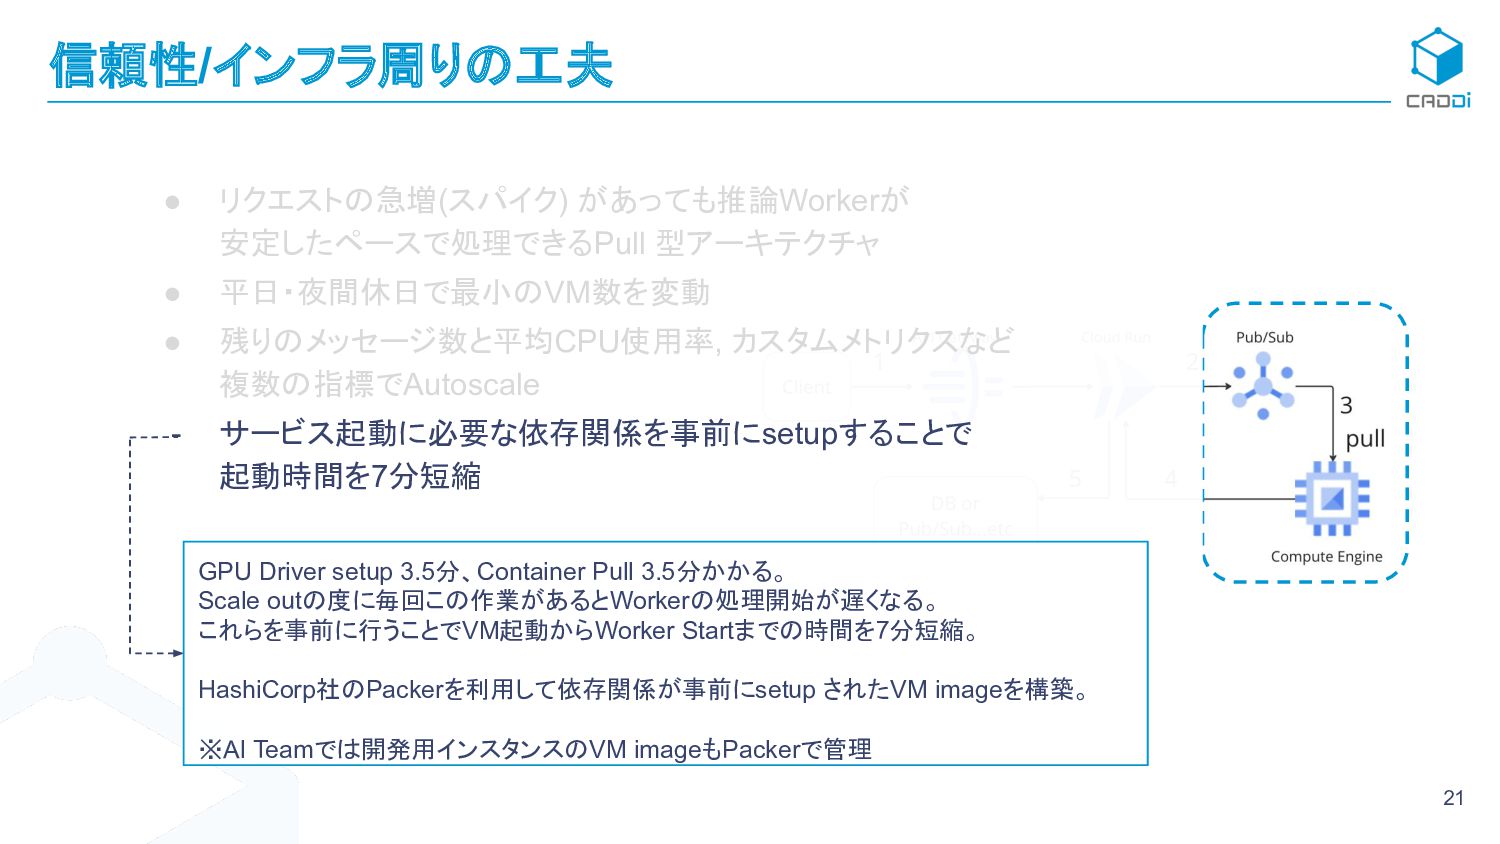
21 信頼性/インフラ周りの工夫 • リクエストの急増(スパイク) があっても推論Workerが 安定したペースで処理できるPull 型アーキテクチャ • 平日・夜間休日で最小のVM数を変動 •
残りのメッセージ数と平均CPU使用率, カスタムメトリクスなど 複数の指標でAutoscale - サービス起動に必要な依存関係を事前にsetupすることで 起動時間を7分短縮 GPU Driver setup 3.5分、Container Pull 3.5分かかる。 Scale outの度に毎回この作業があるとWorkerの処理開始が遅くなる。 これらを事前に行うことでVM起動からWorker Startまでの時間を7分短縮。 HashiCorp社のPackerを利用して依存関係が事前にsetup されたVM imageを構築。 ※AI Teamでは開発用インスタンスのVM imageもPackerで管理 -
22 信頼性/インフラ周りの工夫 • リクエストの急増(スパイク) があっても推論Workerが 安定したペースで処理できるPull 型アーキテクチャ • 平日・夜間休日で最小のVM数を変動 •
残りのメッセージ数と平均CPU使用率, カスタムメトリクスなど 複数の指標でAutoscale • サービス起動に必要な依存関係を事前にsetupすることで 起動時間を7分短縮 青枠の部分はTerraform moduleとして利用可能。 インフラが苦手なメンバーでも推論 WorkerのContainer Imageを 一行設定するだけでインフラ構築できる -
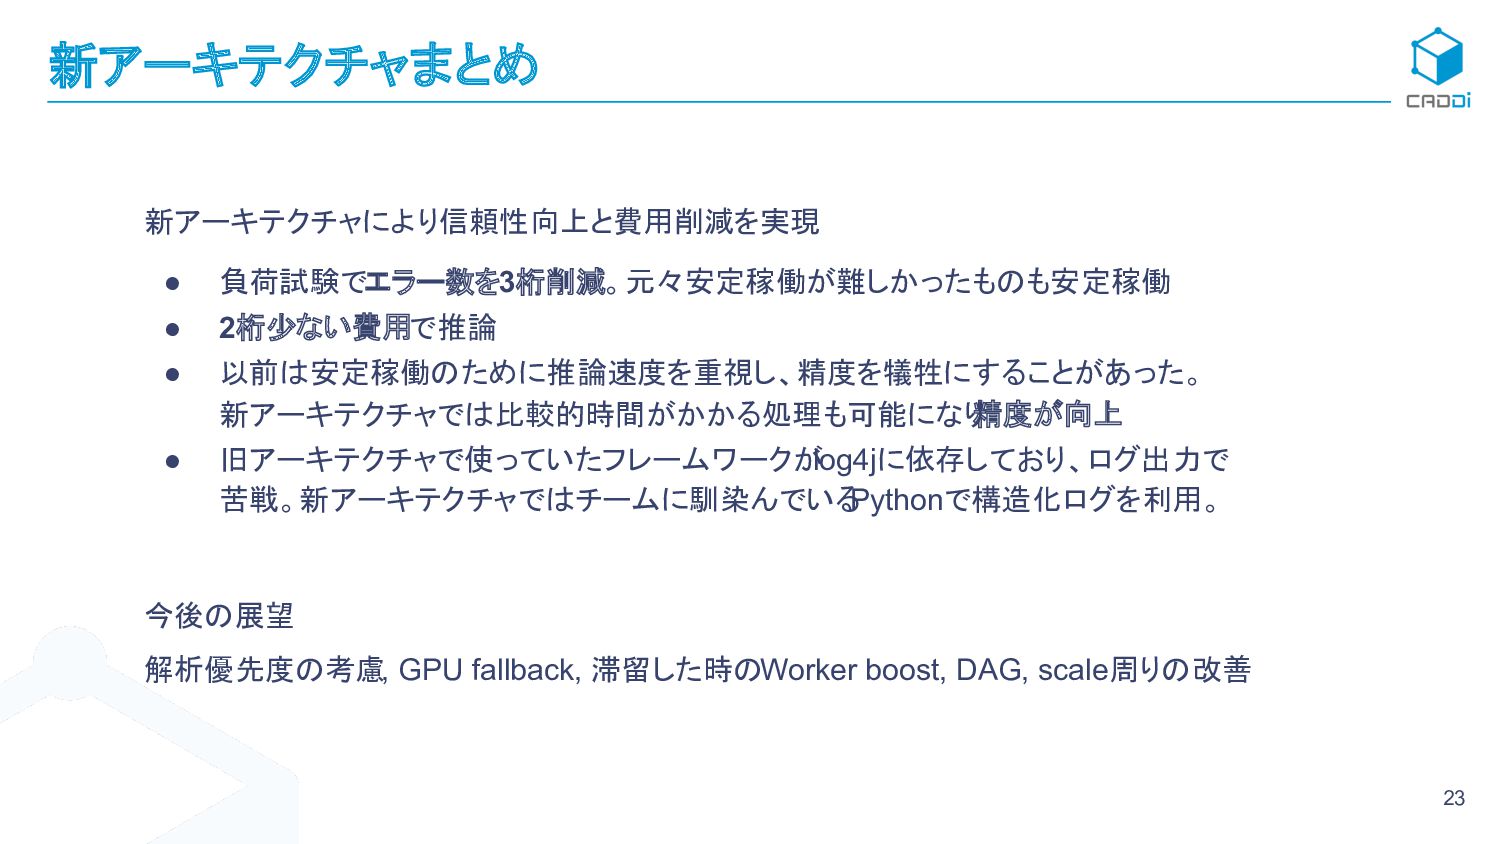
23 新アーキテクチャまとめ 新アーキテクチャにより信頼性向上と費用削減を実現 • 負荷試験でエラー数を3桁削減。元々安定稼働が難しかったものも安定稼働 • 2桁少ない費用で推論 • 以前は安定稼働のために推論速度を重視し、精度を犠牲にすることがあった。 新アーキテクチャでは比較的時間がかかる処理も可能になり
精度が向上 • 旧アーキテクチャで使っていたフレームワークが log4jに依存しており、ログ出力で 苦戦。新アーキテクチャではチームに馴染んでいる Pythonで構造化ログを利用。 今後の展望 解析優先度の考慮, GPU fallback, 滞留した時のWorker boost, DAG, scale周りの改善 -
• Vertex AI はインフラの準備がいらないので 「とりあえず試す」がしやすく、運用コストも低い • VM / Kubernetesは自由度が高く、マネージドサービスが カバーしてないユースケースにも対応可能
• 同期的な推論から非同期にすることでコスト削減と信頼性向上を実現 24 まとめ -
Thank you for your listening!!! 25 カジュアルにお話しましょう! カジュアル⾯談ページ エンジニア採⽤ポータル CADDi
Engineering We Are Hiring! • MLOps Engineer • Machine Learning Engineer • Site Reliability Engineer -
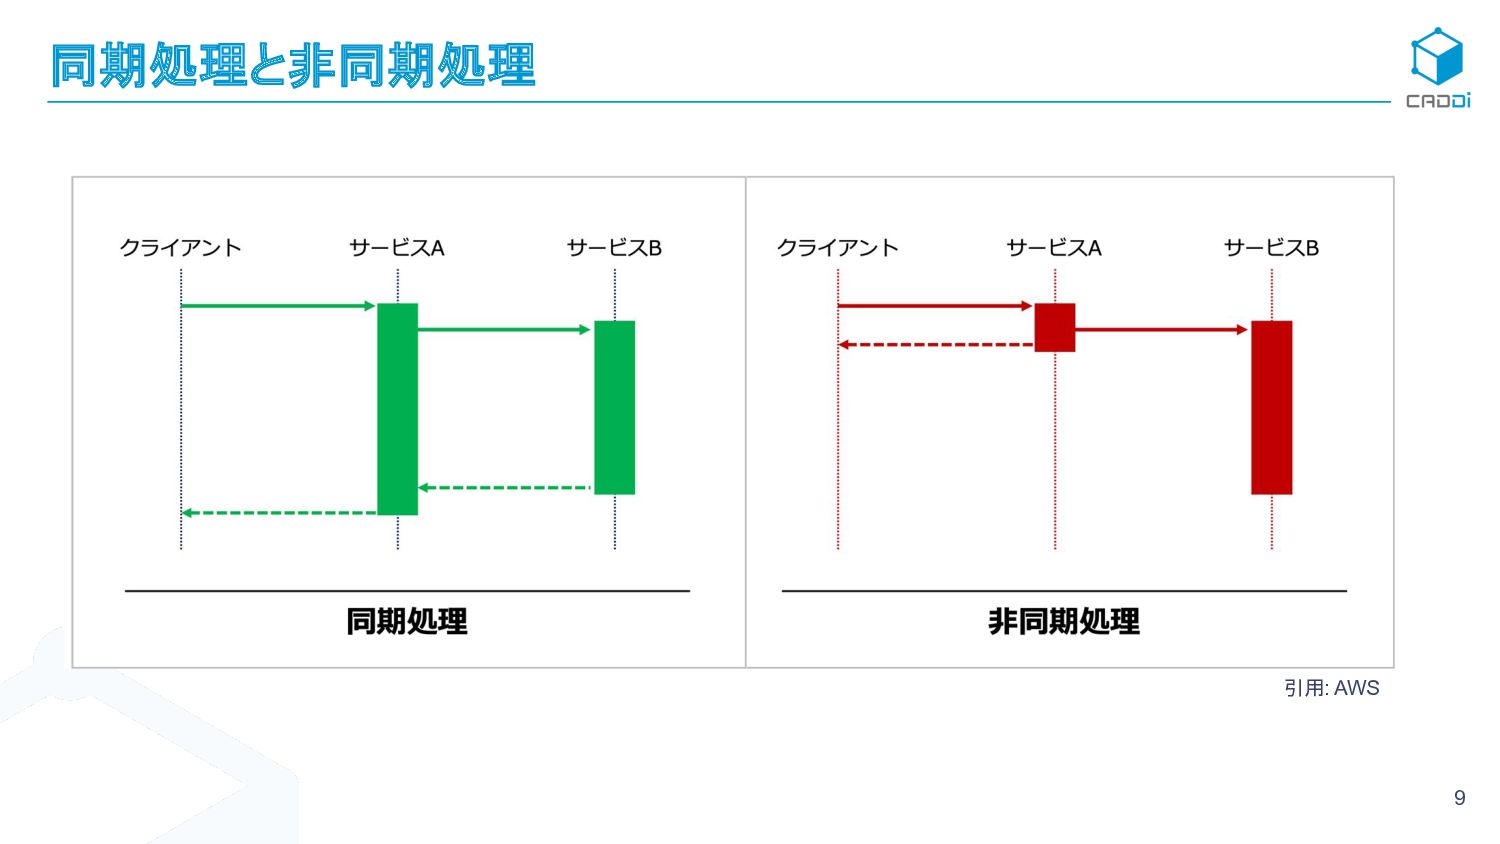
- 非同期処理を使いこなそう ! - 第 1 回 非同期処理ってなんだろう ? -
builders.flash☆ - 変化を求めるデベロッパーを応援するウェブマガジン | AWS 26 参考