Share
Embed
【SnowVillageデータマネジメント入門講座】第2回:データウェアハウスとデータレイクハウス
で利用した、データウェアハウスとデータレイクハウスの基礎についてのお話です。
Matsubara
May 28, 2026
Transcript
41 slides
-
2 Agenda Keyword, 概要について Data Warehouseについて - OLTP・OLAP
- Schema on Read ・ Schema on Write - Data Mart Data Lakeについて - Data Swamp Data Lakehouseについて - Open Table Format 各種サービスについて -
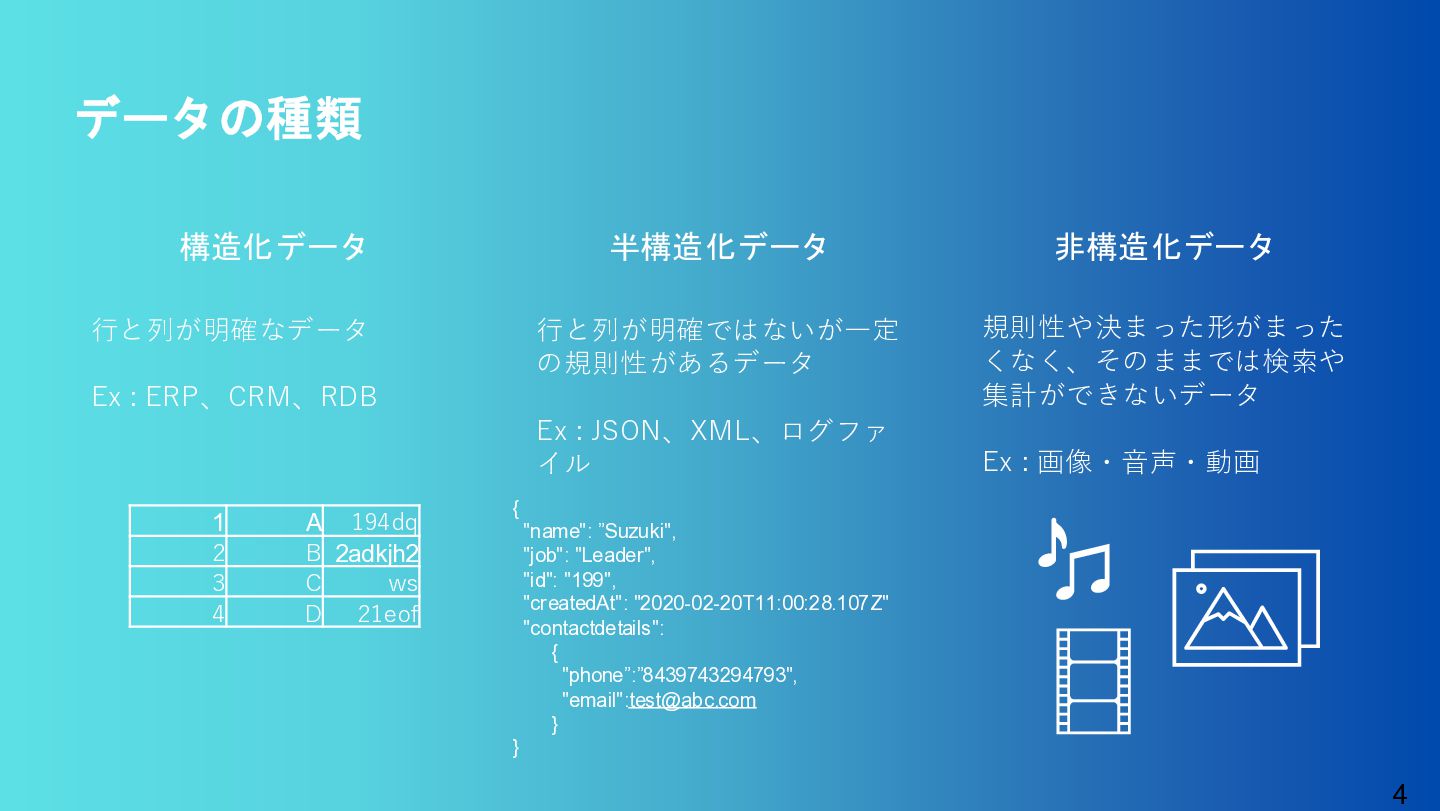
4 データの種類 行と列が明確なデータ Ex : ERP、CRM、RDB 構造化データ 半構造化データ 非構造化データ 行と列が明確ではないが一定
の規則性があるデータ Ex : JSON、XML、ログファ イル 1 A 194dq 2 B 2adkjh2 3 C ws 4 D 21eof { "name": ”Suzuki", "job": "Leader", "id": "199", "createdAt": "2020-02-20T11:00:28.107Z" "contactdetails": { "phone”:”8439743294793", "email":[email protected] } } 規則性や決まった形がまった くなく、そのままでは検索や 集計ができないデータ Ex : 画像・音声・動画 -
5 呼称 • Data Warehouse ◦ 略:DW or DWH 呼称:データウェアハウス
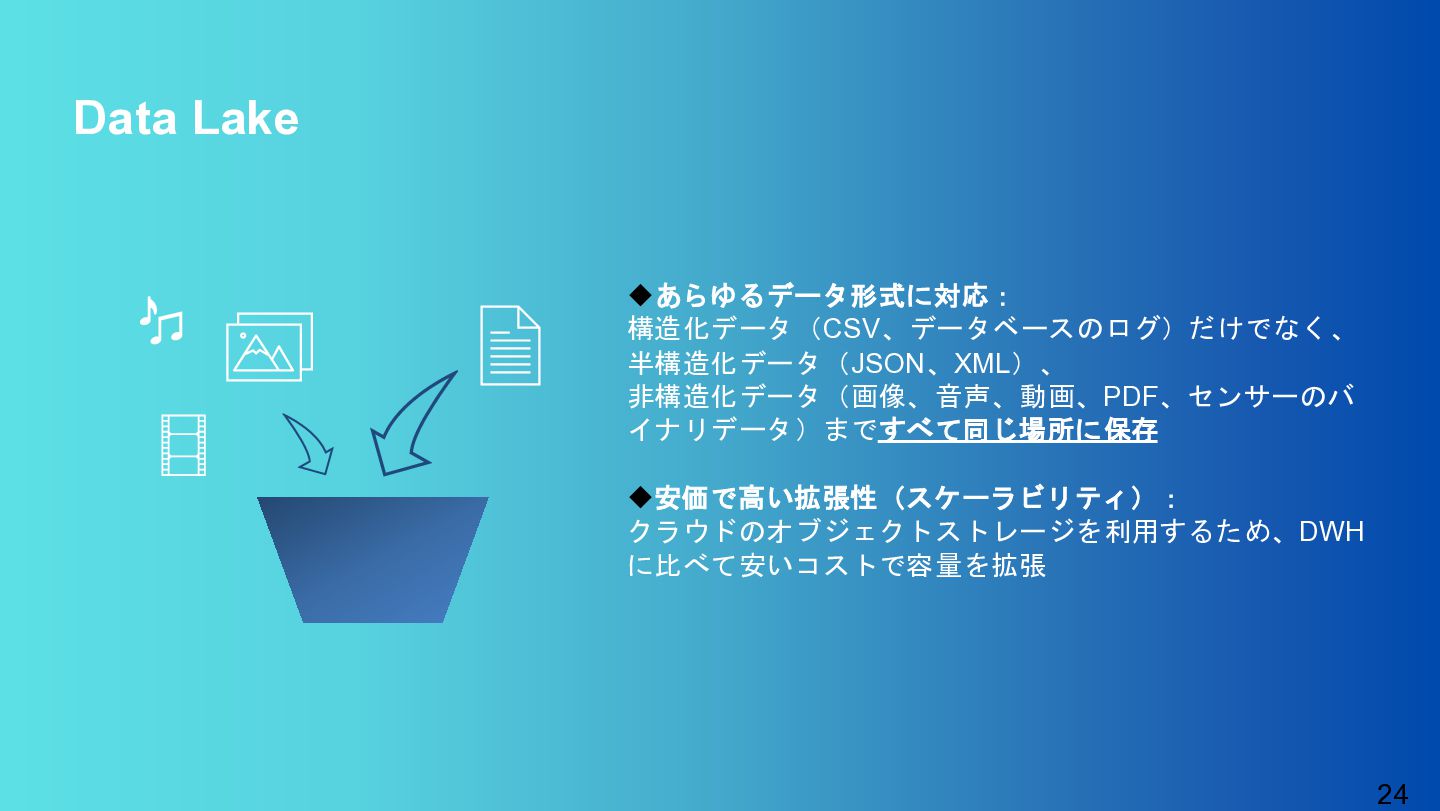
• Data Lake ◦ 略:DL ※あまり見ないかも 呼称:データレイク • Data Lakehouse ◦ 略:DLH ※あまり見ないかも 呼称:データレイクハウス -
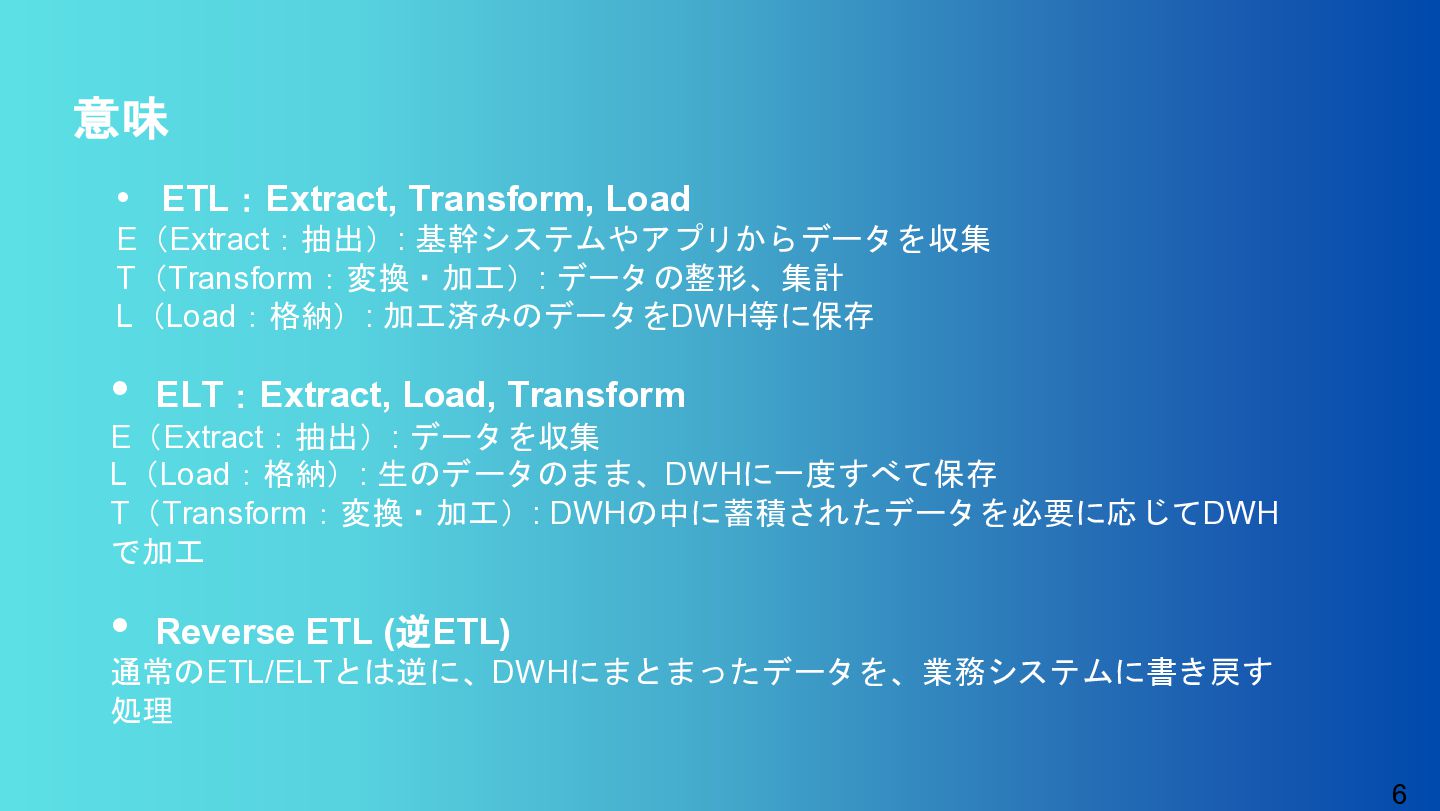
6 意味 • ETL:Extract, Transform, Load E(Extract:抽出): 基幹システムやアプリからデータを収集 T(Transform:変換・加工): データの整形、集計
L(Load:格納): 加工済みのデータをDWH等に保存 • ELT:Extract, Load, Transform E(Extract:抽出): データを収集 L(Load:格納): 生のデータのまま、DWHに一度すべて保存 T(Transform:変換・加工): DWHの中に蓄積されたデータを必要に応じてDWH で加工 • Reverse ETL (逆ETL) 通常のETL/ELTとは逆に、DWHにまとまったデータを、業務システムに書き戻す 処理 -
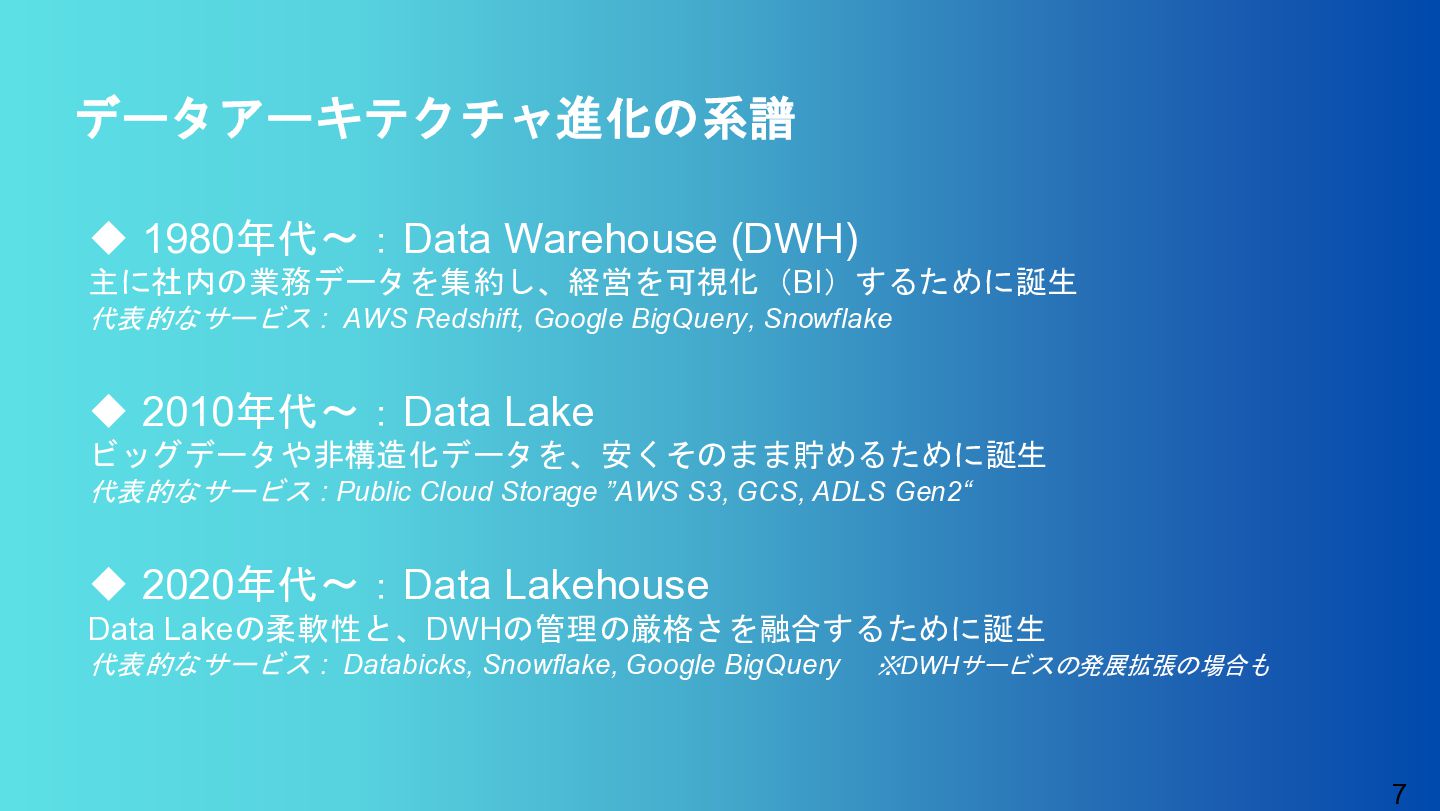
7 データアーキテクチャ進化の系譜 ◆ 1980年代〜:Data Warehouse (DWH) 主に社内の業務データを集約し、経営を可視化(BI)するために誕生 代表的なサービス : AWS
Redshift, Google BigQuery, Snowflake ◆ 2010年代〜:Data Lake ビッグデータや非構造化データを、安くそのまま貯めるために誕生 代表的なサービス : Public Cloud Storage ”AWS S3, GCS, ADLS Gen2“ ◆ 2020年代〜:Data Lakehouse Data Lakeの柔軟性と、DWHの管理の厳格さを融合するために誕生 代表的なサービス : Databicks, Snowflake, Google BigQuery ※DWHサービスの発展拡張の場合も -
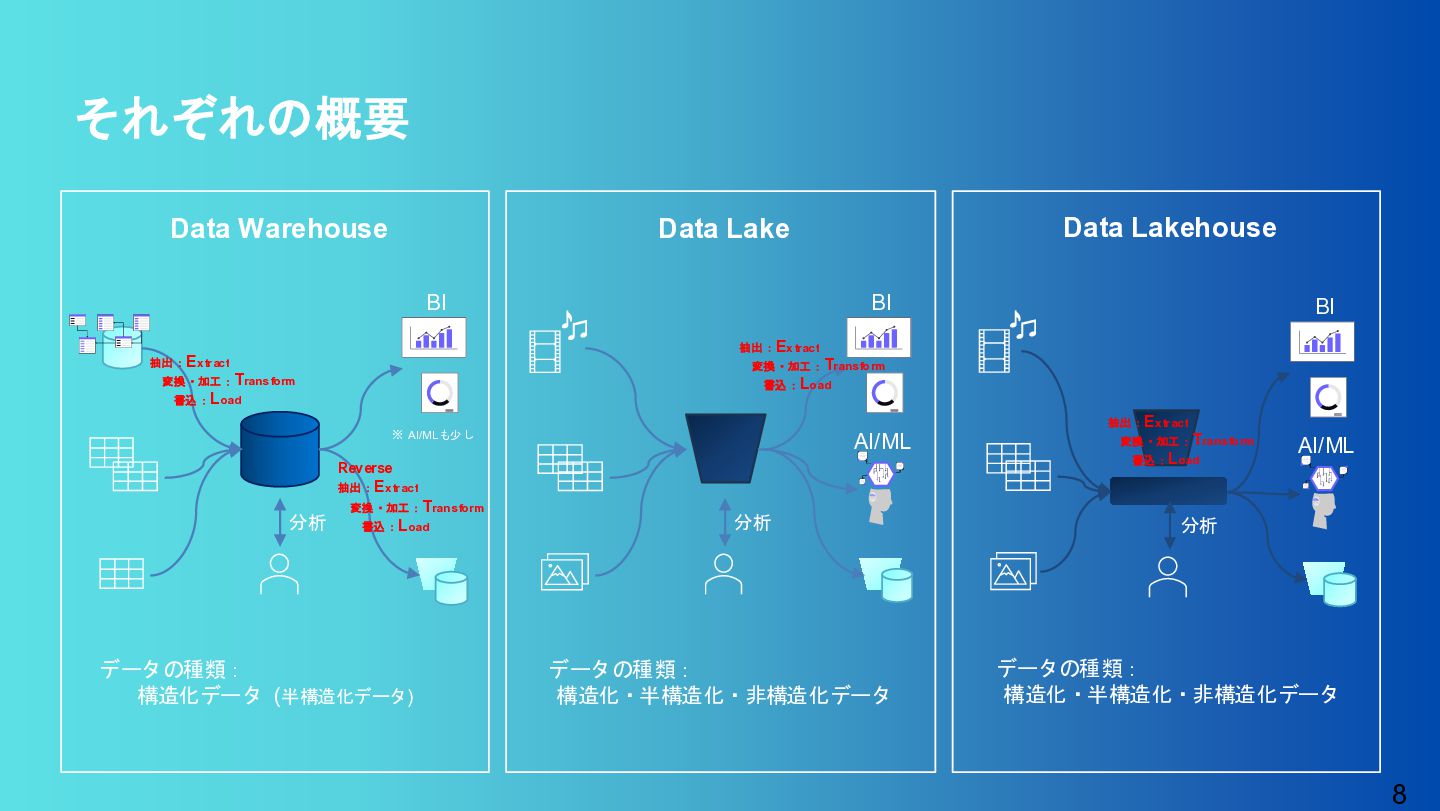
8 それぞれの概要 抽出:Extract 変換・加工:Transform 書込:Load BI Reverse 抽出:Extract 変換・加工:Transform 書込:Load
分析 ※ AI/MLも少し Data Warehouse データの種類: 構造化データ (半構造化データ) BI 分析 Data Lake データの種類: 構造化・半構造化・非構造化データ 抽出:Extract 変換・加工:Transform 書込:Load AI/ML 抽出:Extract 変換・加工:Transform 書込:Load BI AI/ML データの種類: 構造化・半構造化・非構造化データ Data Lakehouse 分析 -
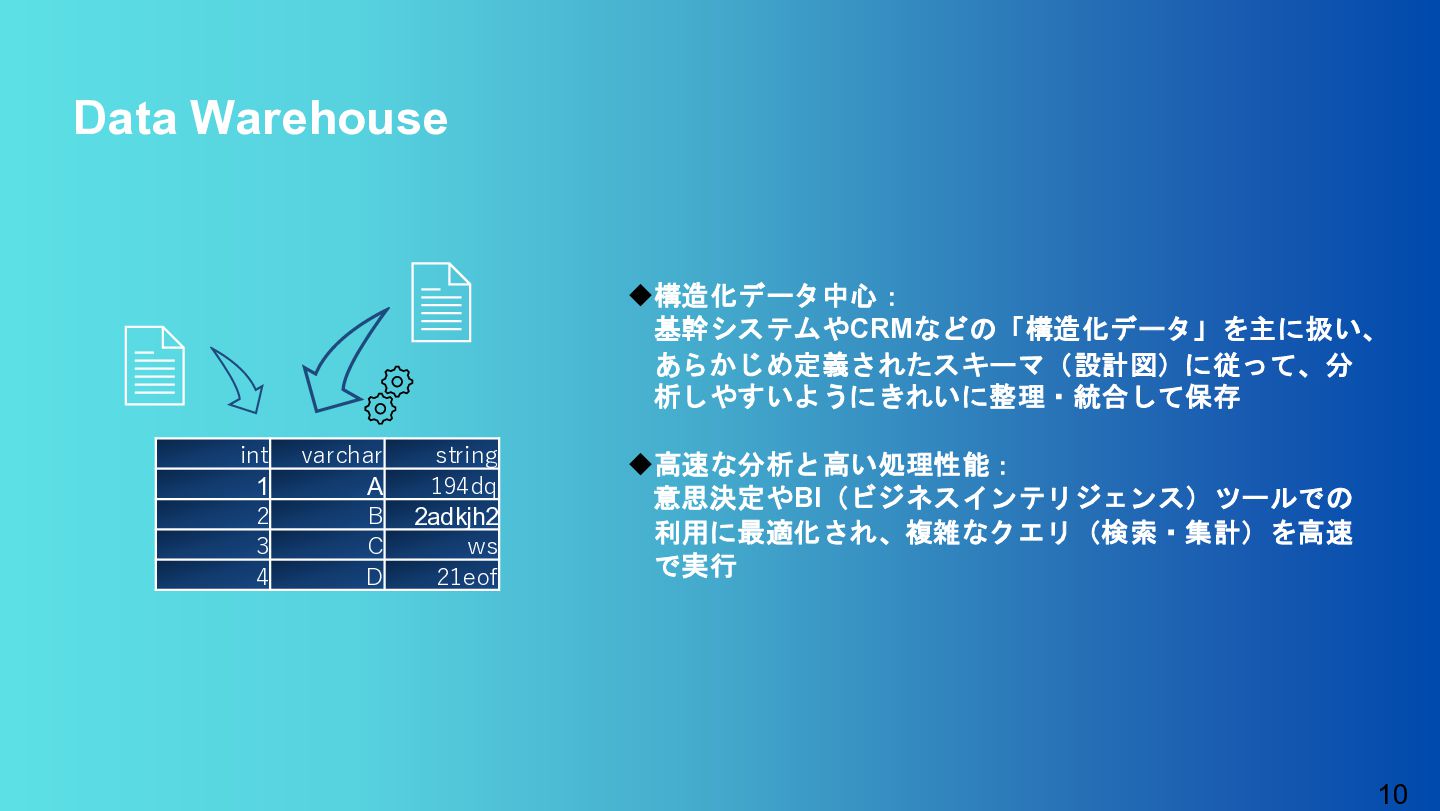
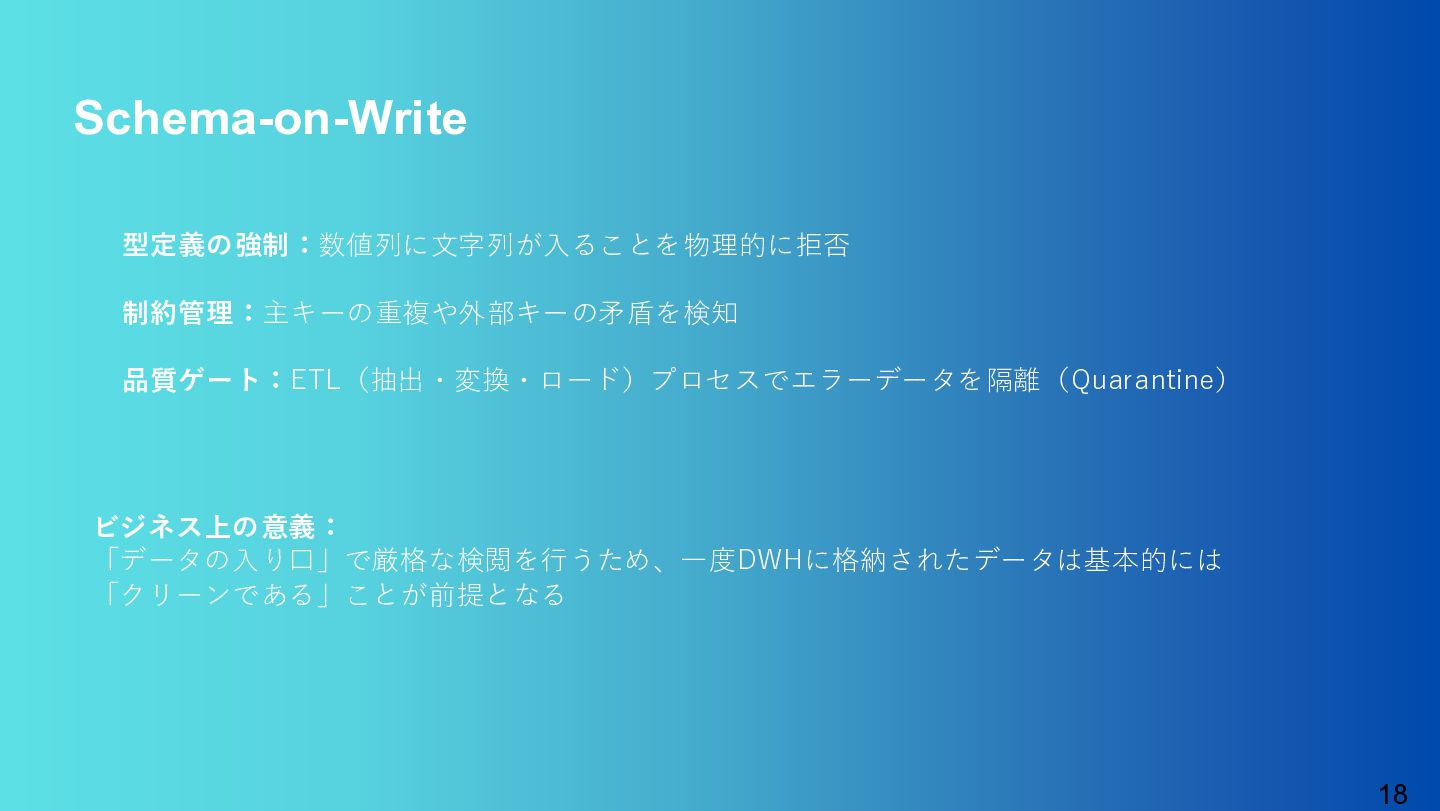
10 Data Warehouse ◆構造化データ中心: 基幹システムやCRMなどの「構造化データ」を主に扱い、 あらかじめ定義されたスキーマ(設計図)に従って、分 析しやすいようにきれいに整理・統合して保存 ◆高速な分析と高い処理性能: 意思決定やBI(ビジネスインテリジェンス)ツールでの 利用に最適化され、複雑なクエリ(検索・集計)を高速
で実行 int varchar string 1 A 194dq 2 B 2adkjh2 3 C ws 4 D 21eof -
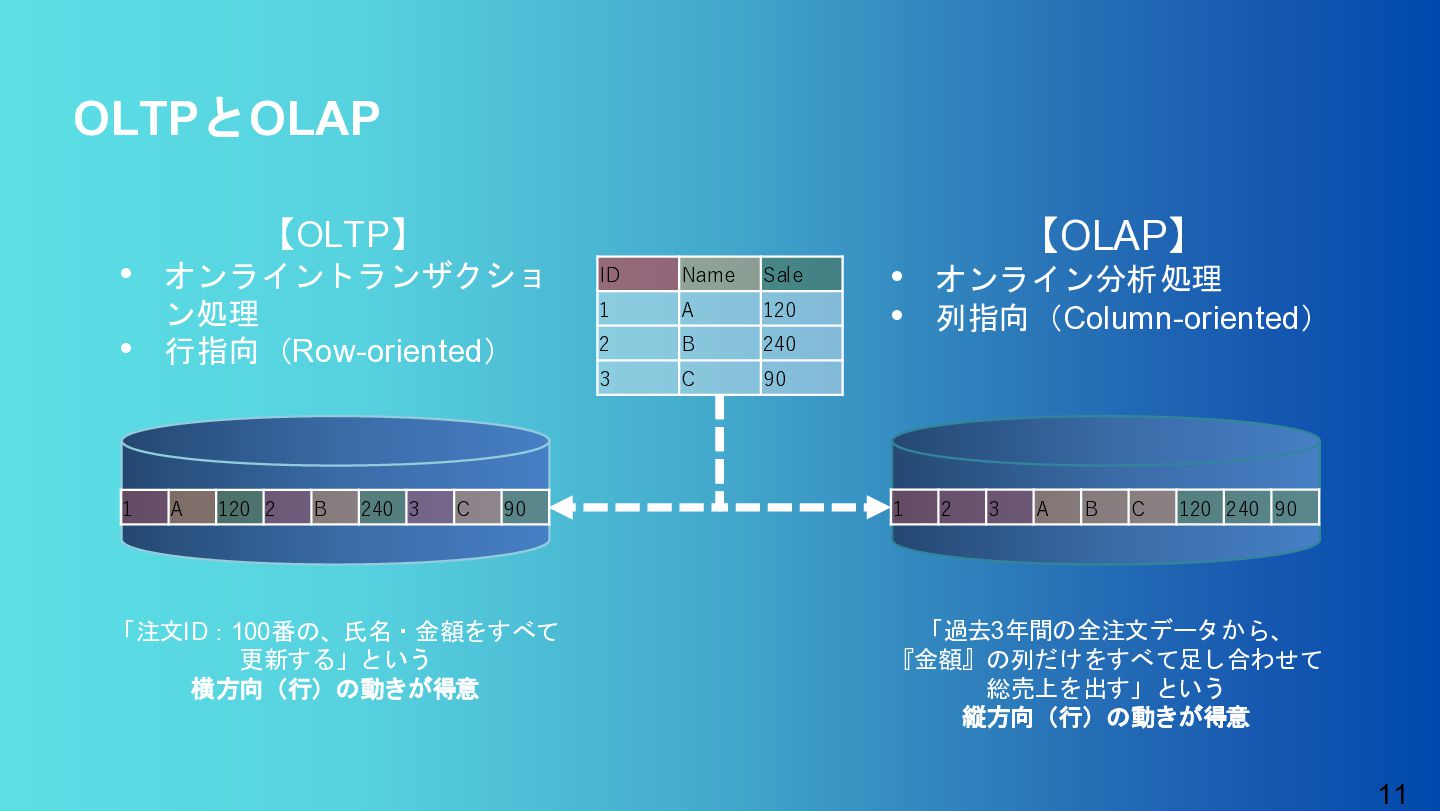
11 OLTPとOLAP 【OLTP】 • オンライントランザクショ ン処理 • 行指向(Row-oriented) 【OLAP】 •
オンライン分析処理 • 列指向(Column-oriented) 「注文ID:100番の、氏名・金額をすべて 更新する」という 横方向(行)の動きが得意 1 A 120 2 B 240 3 C 90 ID Name Sale 1 A 120 2 B 240 3 C 90 1 2 3 A B C 120 240 90 「過去3年間の全注文データから、 『金額』の列だけをすべて足し合わせて 総売上を出す」という 縦方向(行)の動きが得意 -
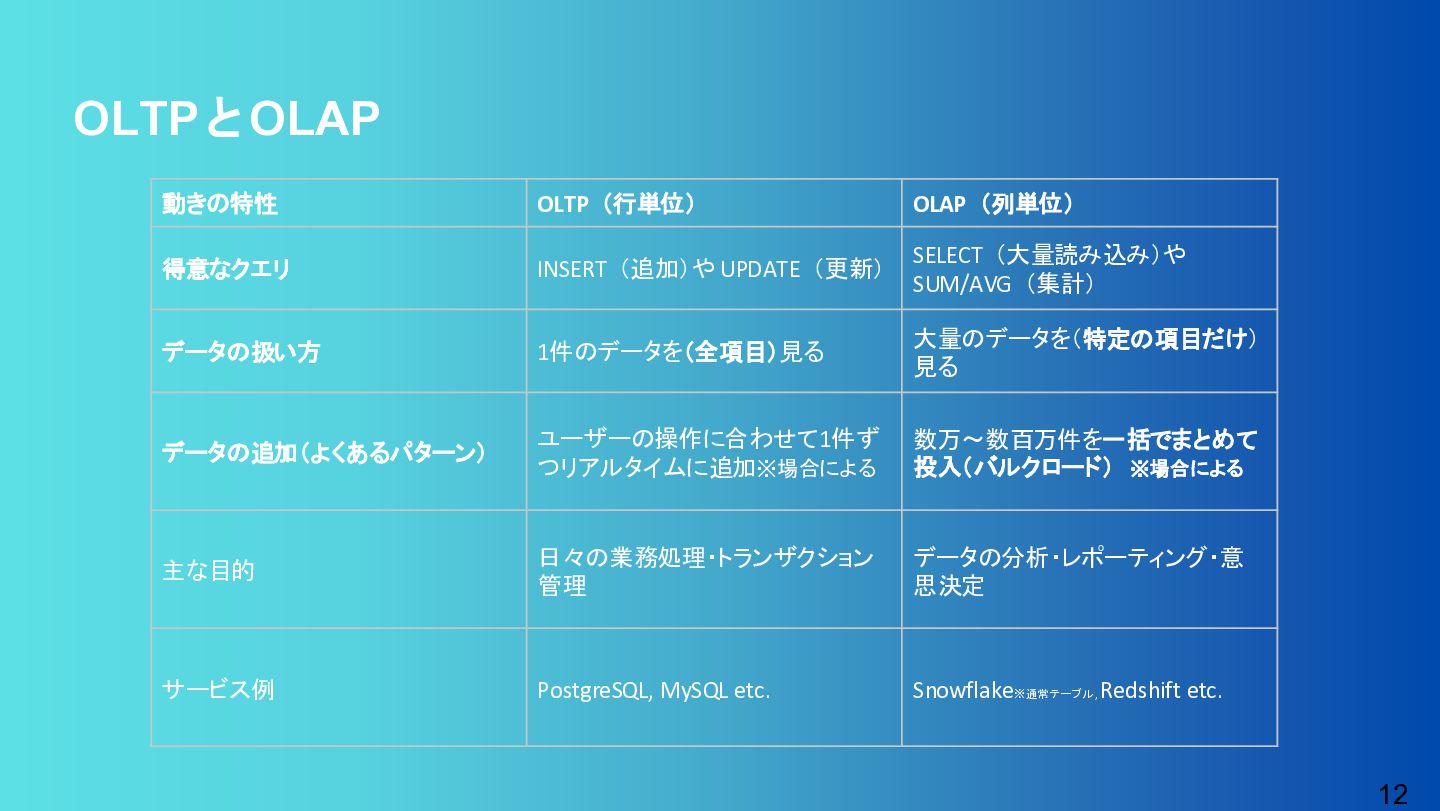
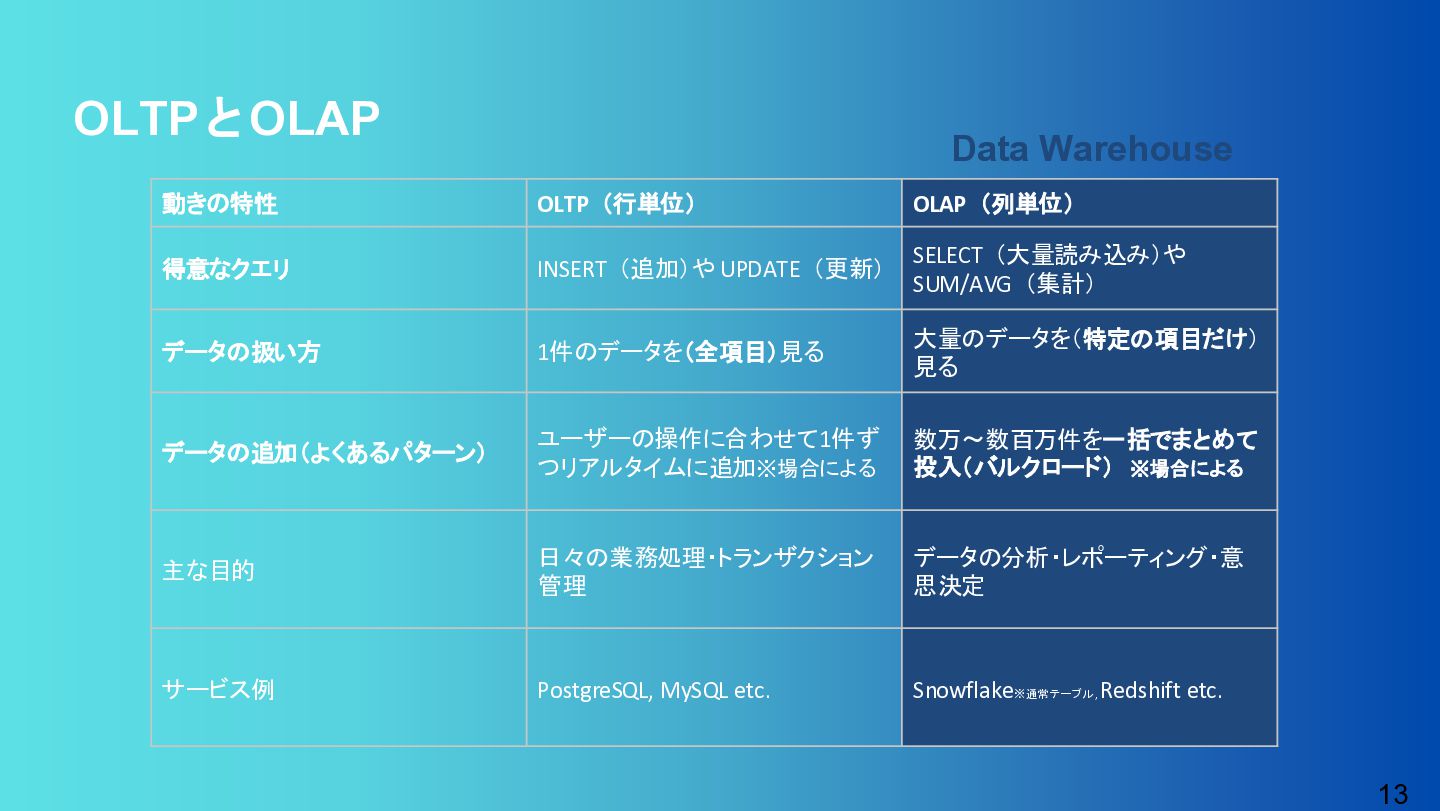
12 OLTPとOLAP 動きの特性 OLTP(行単位) OLAP(列単位) 得意なクエリ INSERT(追加)や UPDATE(更新) SELECT(大量読み込み)や SUM/AVG(集計)
データの扱い方 1件のデータを(全項目)見る 大量のデータを(特定の項目だけ) 見る データの追加(よくあるパターン) ユーザーの操作に合わせて1件ず つリアルタイムに追加※場合による 数万〜数百万件を一括でまとめて 投入(バルクロード) ※場合による 主な目的 日々の業務処理・トランザクション 管理 データの分析・レポーティング・意 思決定 サービス例 PostgreSQL, MySQL etc. Snowflake※通常テーブル, Redshift etc. -
13 OLTPとOLAP 動きの特性 OLTP(行単位) OLAP(列単位) 得意なクエリ INSERT(追加)や UPDATE(更新) SELECT(大量読み込み)や SUM/AVG(集計)
データの扱い方 1件のデータを(全項目)見る 大量のデータを(特定の項目だけ) 見る データの追加(よくあるパターン) ユーザーの操作に合わせて1件ず つリアルタイムに追加※場合による 数万〜数百万件を一括でまとめて 投入(バルクロード) ※場合による 主な目的 日々の業務処理・トランザクション 管理 データの分析・レポーティング・意 思決定 サービス例 PostgreSQL, MySQL etc. Snowflake※通常テーブル, Redshift etc. Data Warehouse -
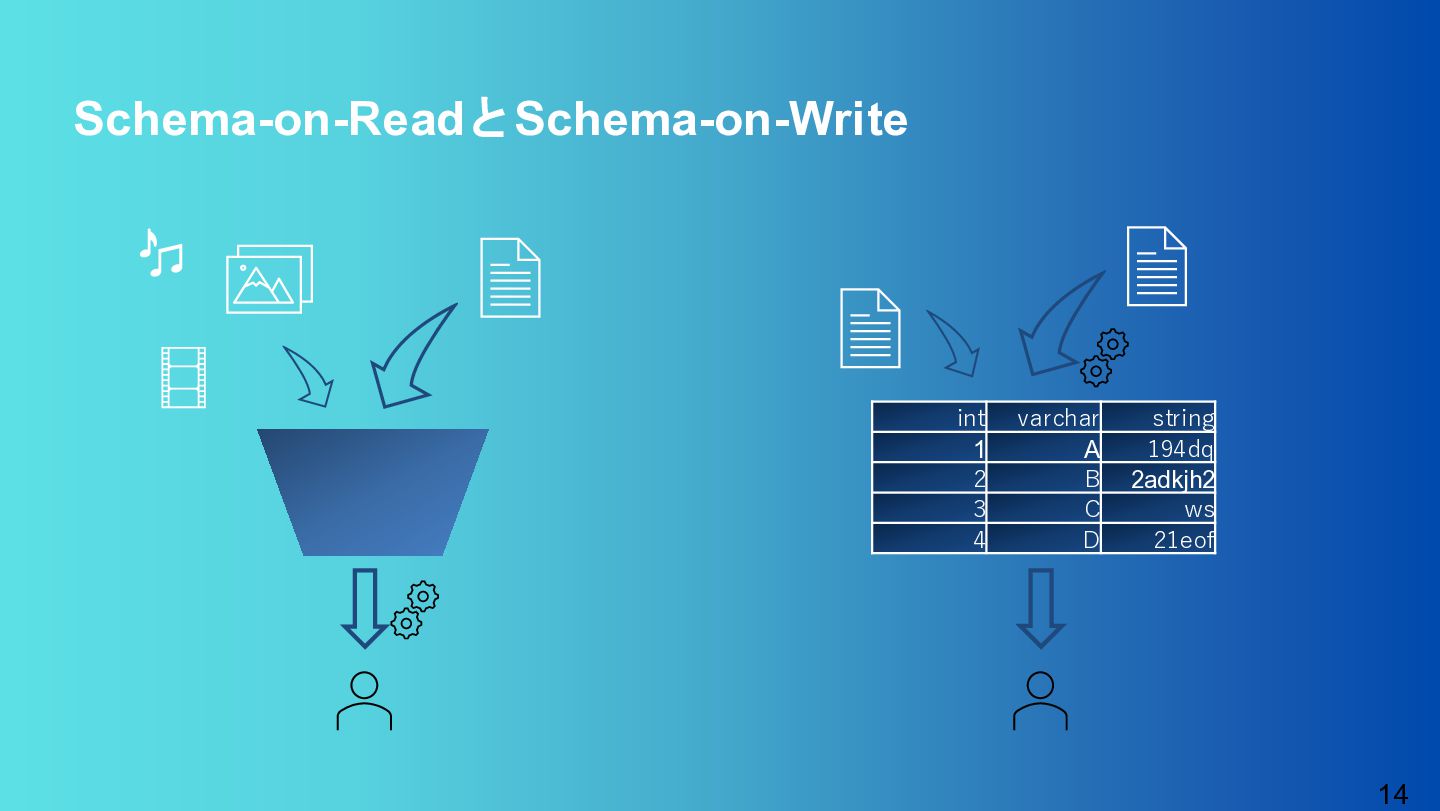
14 Schema-on-ReadとSchema-on-Write int varchar string 1 A 194dq 2 B
2adkjh2 3 C ws 4 D 21eof -
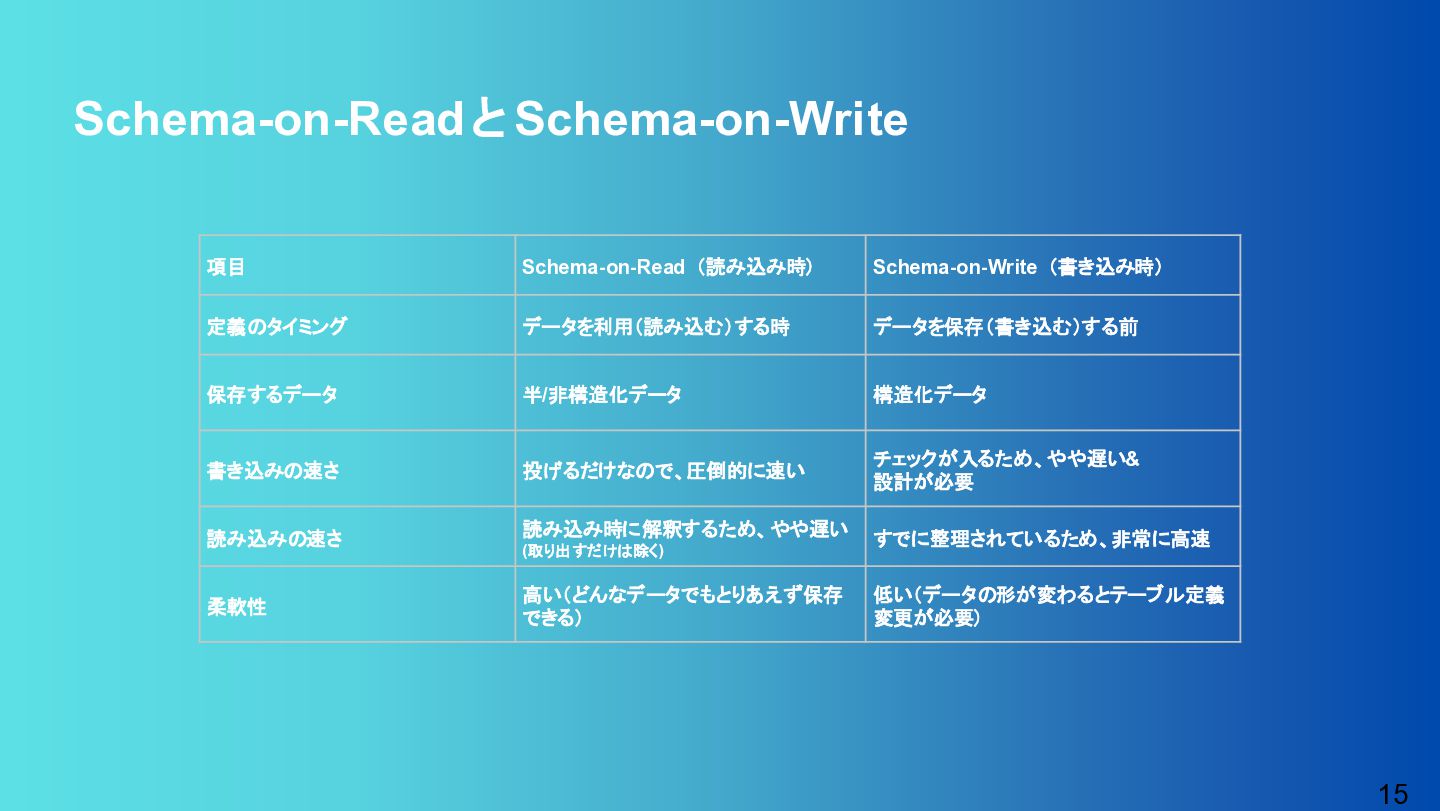
15 Schema-on-ReadとSchema-on-Write 項目 Schema-on-Read(読み込み時) Schema-on-Write(書き込み時) 定義のタイミング データを利用(読み込む)する時 データを保存(書き込む)する前 保存するデータ 半/非構造化データ
構造化データ 書き込みの速さ 投げるだけなので、圧倒的に速い チェックが入るため、やや遅い& 設計が必要 読み込みの速さ 読み込み時に解釈するため、やや遅い (取り出すだけは除く) すでに整理されているため、非常に高速 柔軟性 高い(どんなデータでもとりあえず保存 できる) 低い(データの形が変わるとテーブル定義 変更が必要) -
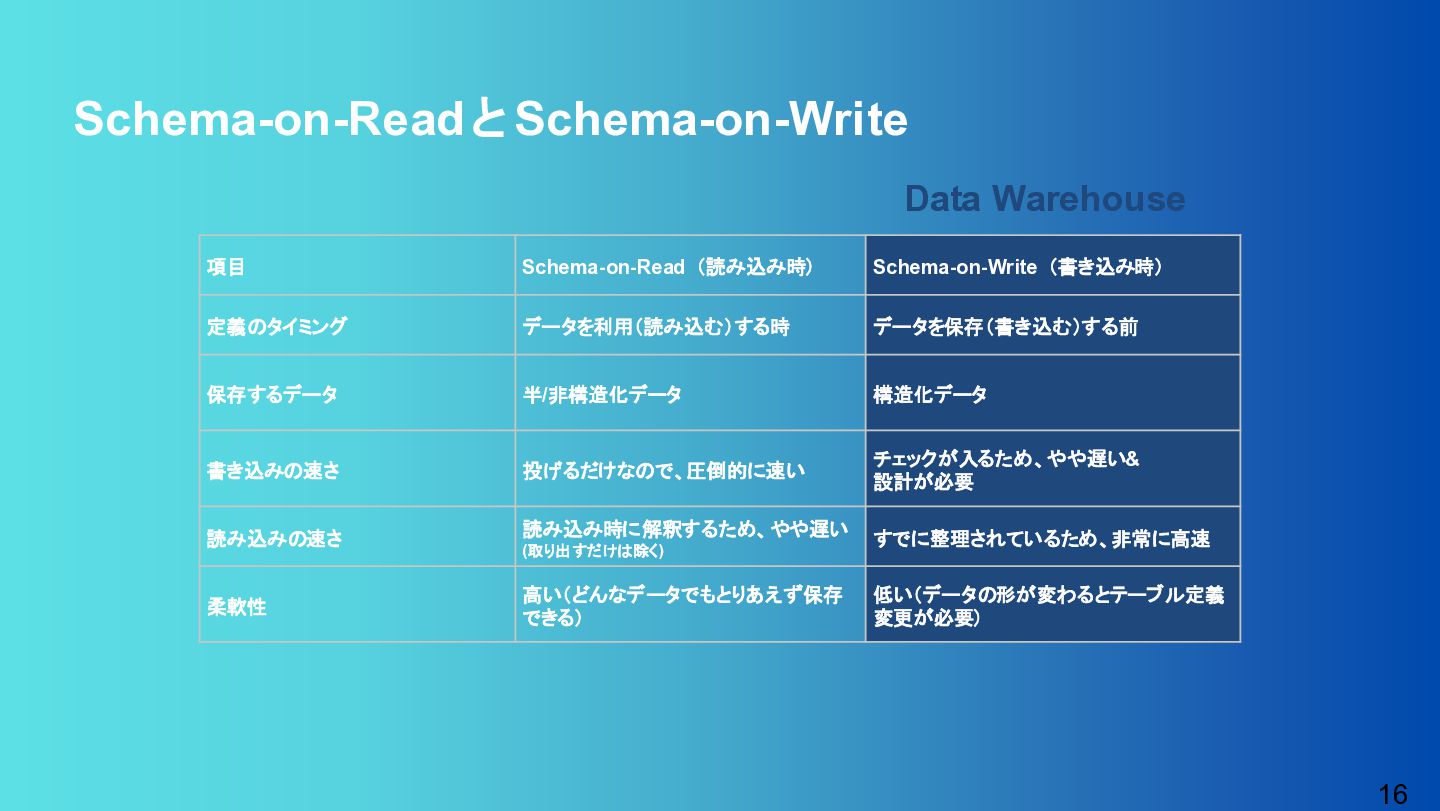
16 Schema-on-ReadとSchema-on-Write 項目 Schema-on-Read(読み込み時) Schema-on-Write(書き込み時) 定義のタイミング データを利用(読み込む)する時 データを保存(書き込む)する前 保存するデータ 半/非構造化データ
構造化データ 書き込みの速さ 投げるだけなので、圧倒的に速い チェックが入るため、やや遅い& 設計が必要 読み込みの速さ 読み込み時に解釈するため、やや遅い (取り出すだけは除く) すでに整理されているため、非常に高速 柔軟性 高い(どんなデータでもとりあえず保存 できる) 低い(データの形が変わるとテーブル定義 変更が必要) Data Warehouse -
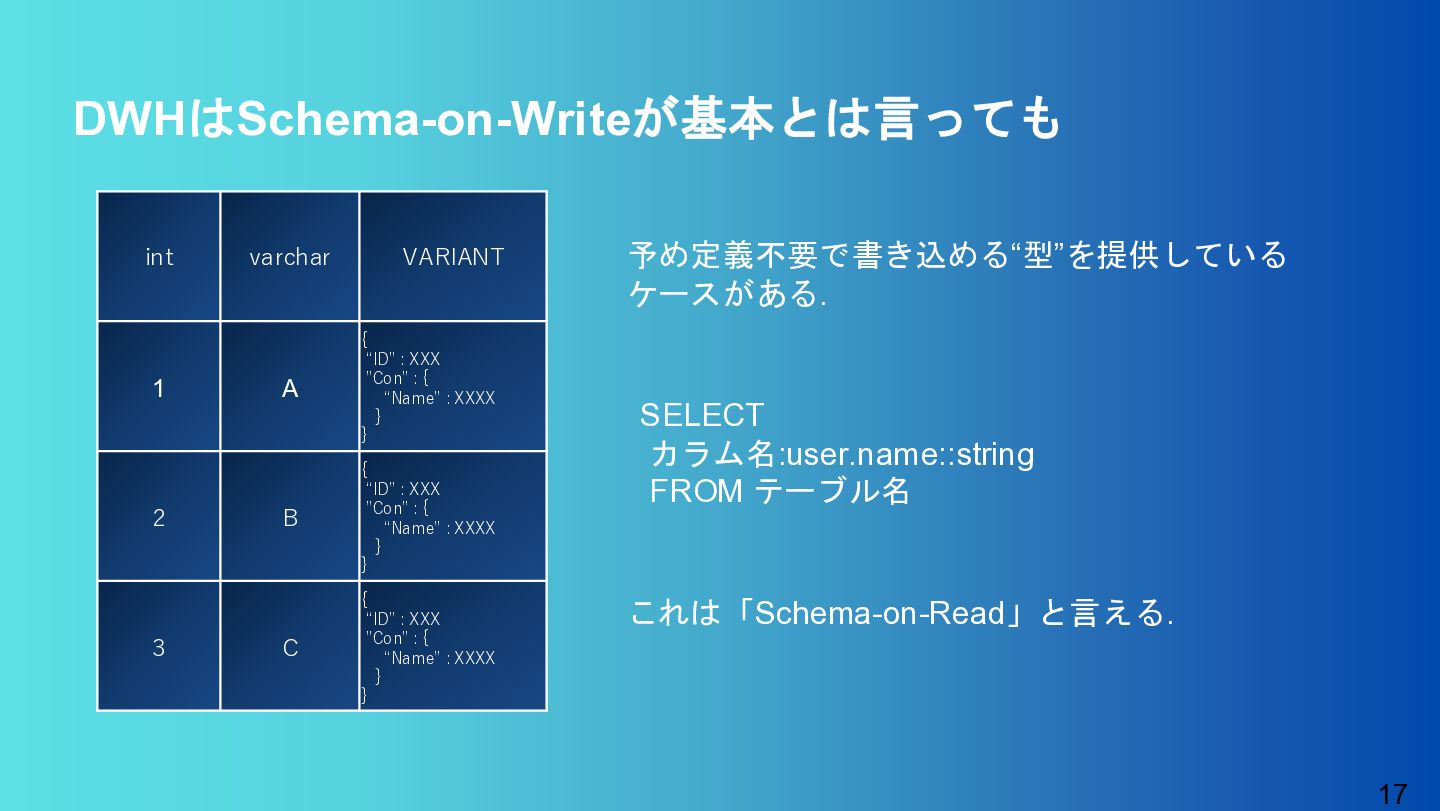
17 DWHはSchema-on-Writeが基本とは言っても int varchar VARIANT 1 A { “ID” :
XXX ”Con” : { “Name” : XXXX } } 2 B { “ID” : XXX ”Con” : { “Name” : XXXX } } 3 C { “ID” : XXX ”Con” : { “Name” : XXXX } } SELECT カラム名:user.name::string FROM テーブル名 予め定義不要で書き込める“型”を提供している ケースがある. これは「Schema-on-Read」と言える. -
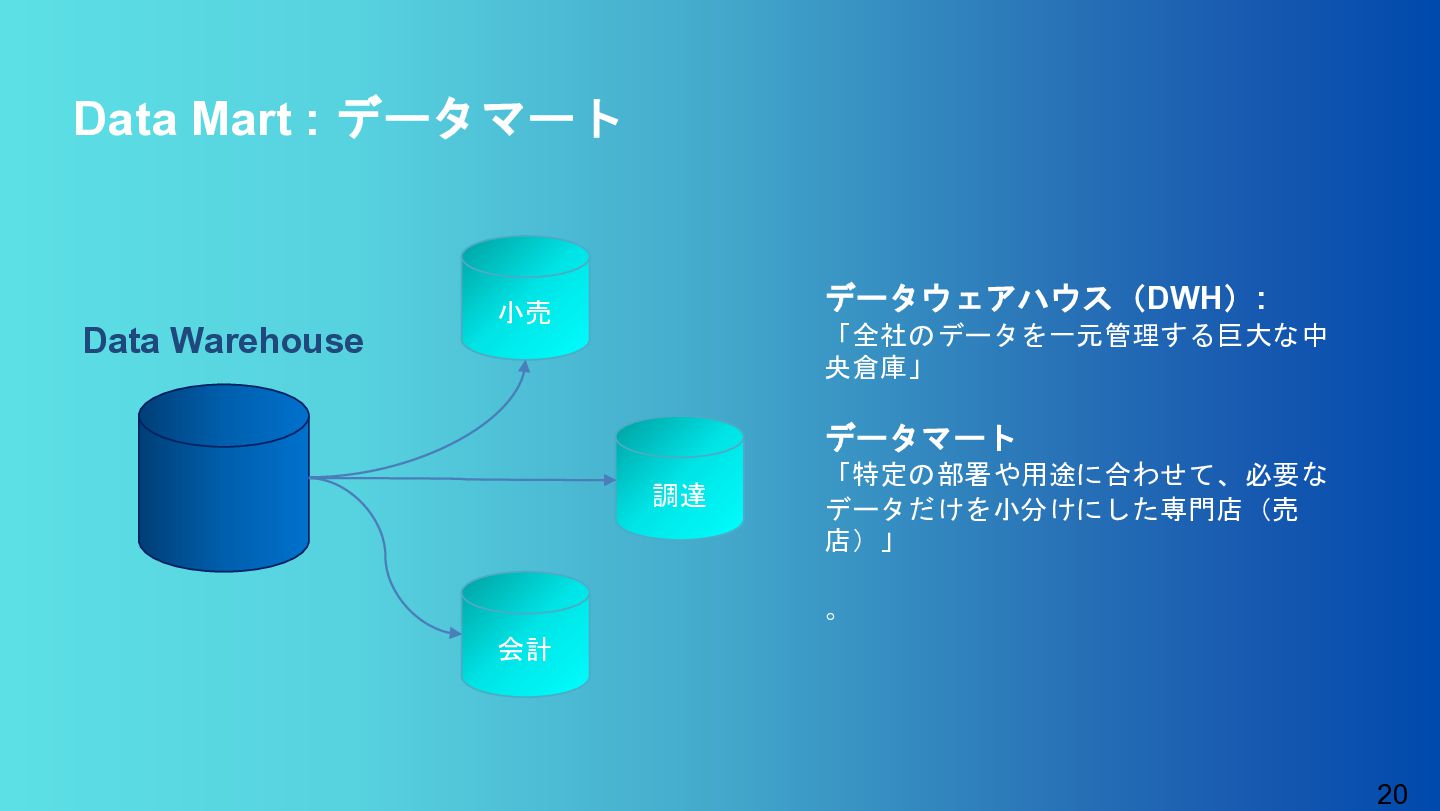
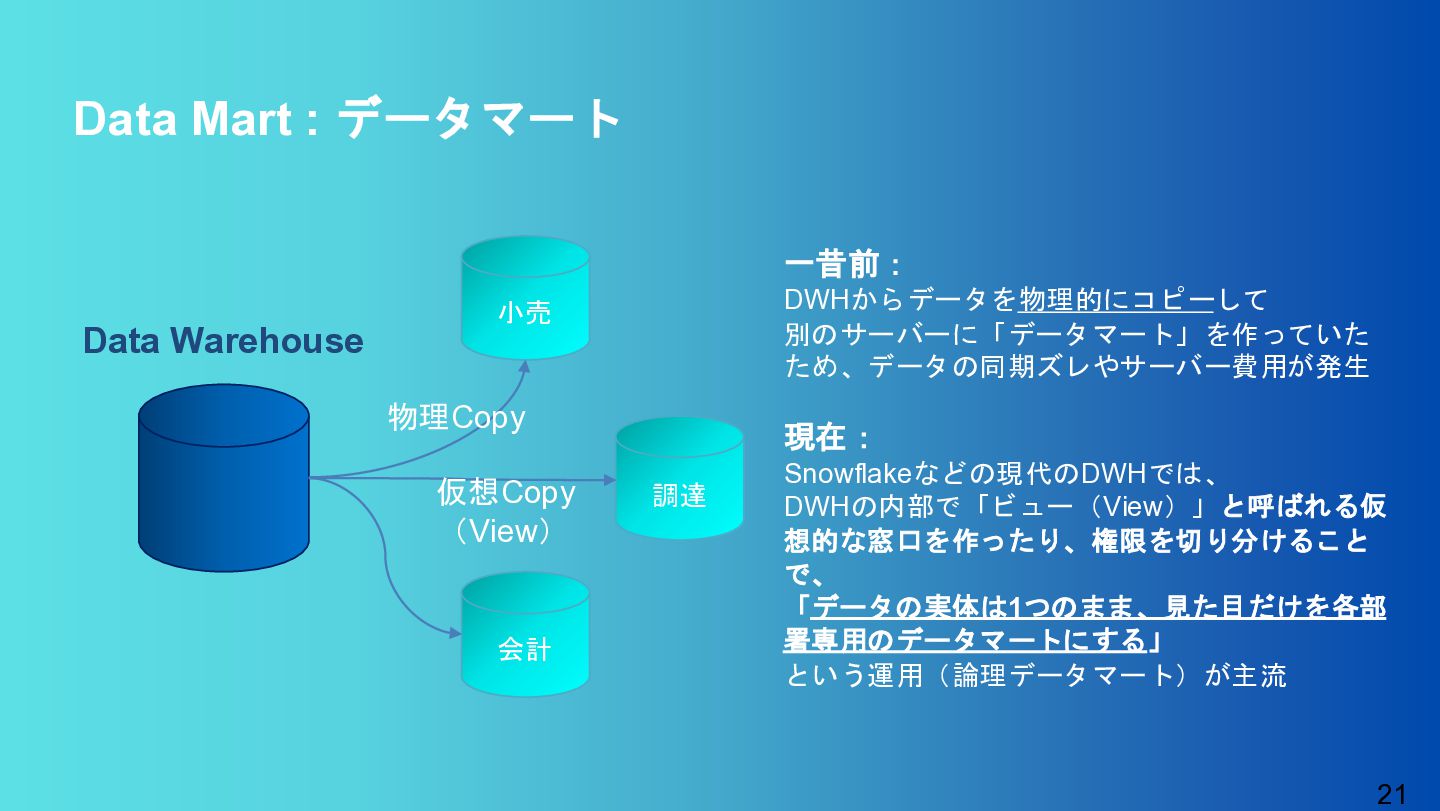
20 Data Mart : データマート データウェアハウス(DWH): 「全社のデータを一元管理する巨大な中 央倉庫」 データマート 「特定の部署や用途に合わせて、必要な
データだけを小分けにした専門店(売 店)」 。 Data Warehouse 小売 調達 会計 -
21 Data Mart : データマート Data Warehouse 小売 調達 会計
物理Copy 仮想Copy (View) 一昔前: DWHからデータを物理的にコピーして 別のサーバーに「データマート」を作っていた ため、データの同期ズレやサーバー費用が発生 現在: Snowflakeなどの現代のDWHでは、 DWHの内部で「ビュー(View)」と呼ばれる仮 想的な窓口を作ったり、権限を切り分けること で、 「データの実体は1つのまま、見た目だけを各部 署専用のデータマートにする」 という運用(論理データマート)が主流 -
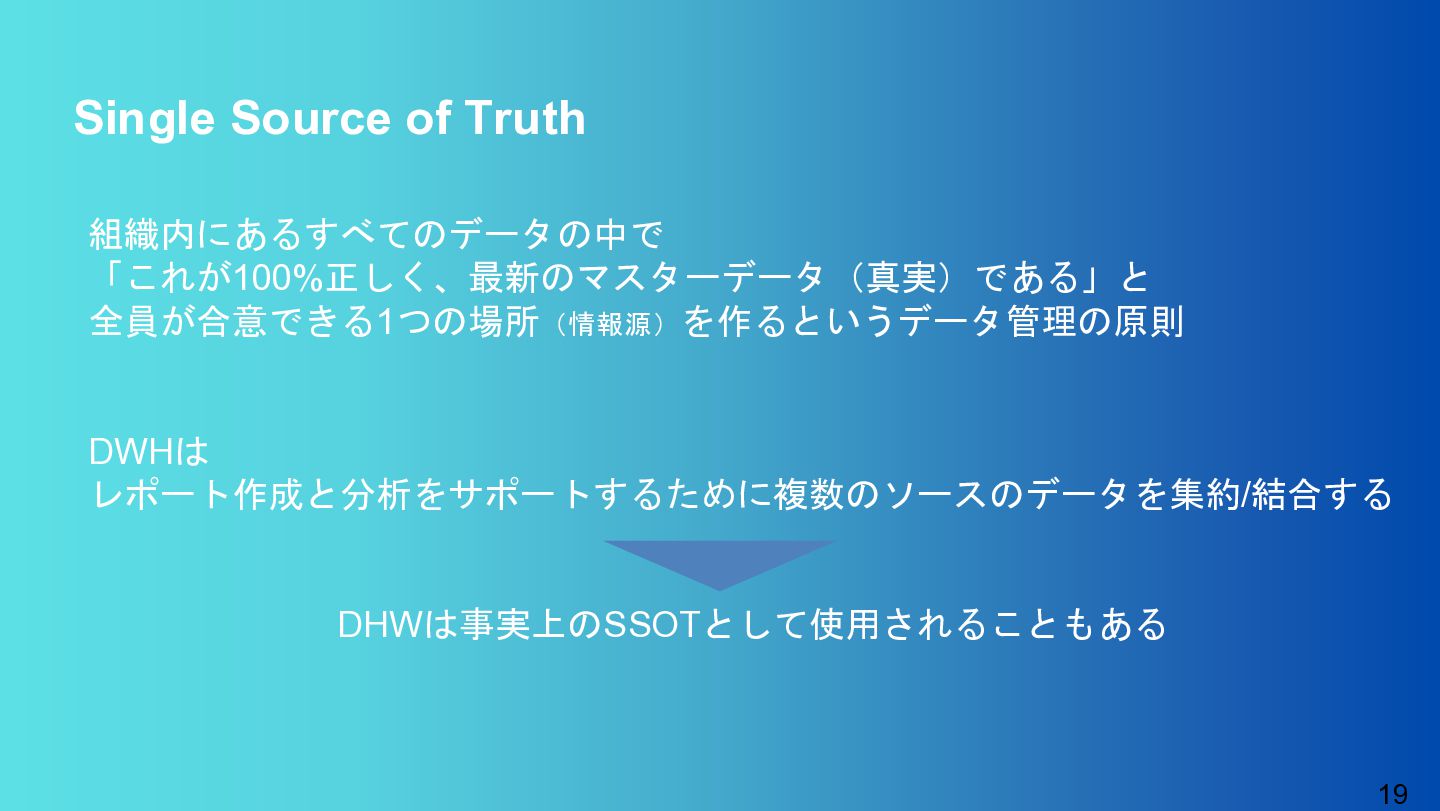
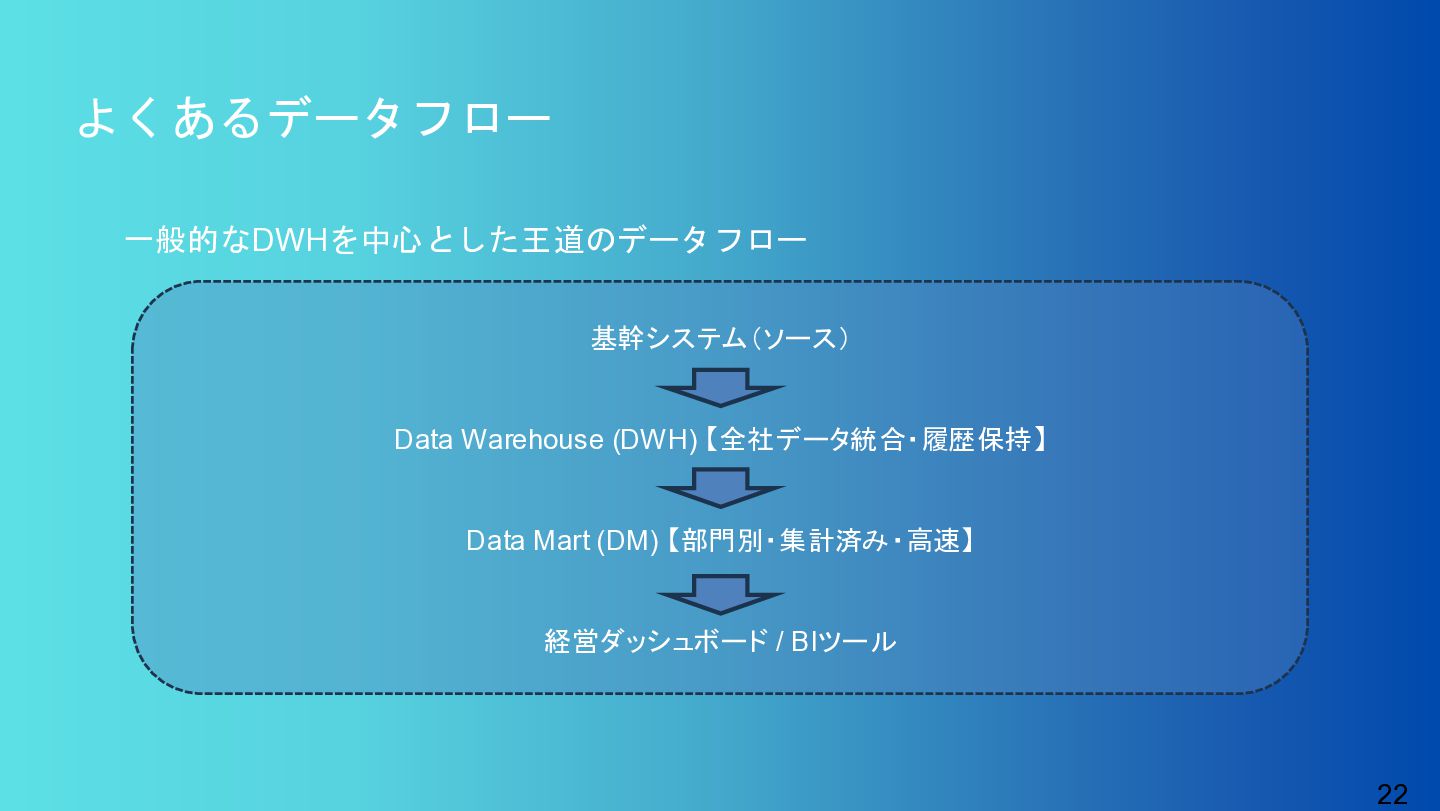
22 よくあるデータフロー 基幹システム(ソース) Data Warehouse (DWH) 【全社データ統合・履歴保持】 Data Mart (DM)
【部門別・集計済み・高速】 経営ダッシュボード / BIツール 一般的なDWHを中心とした王道のデータフロー -
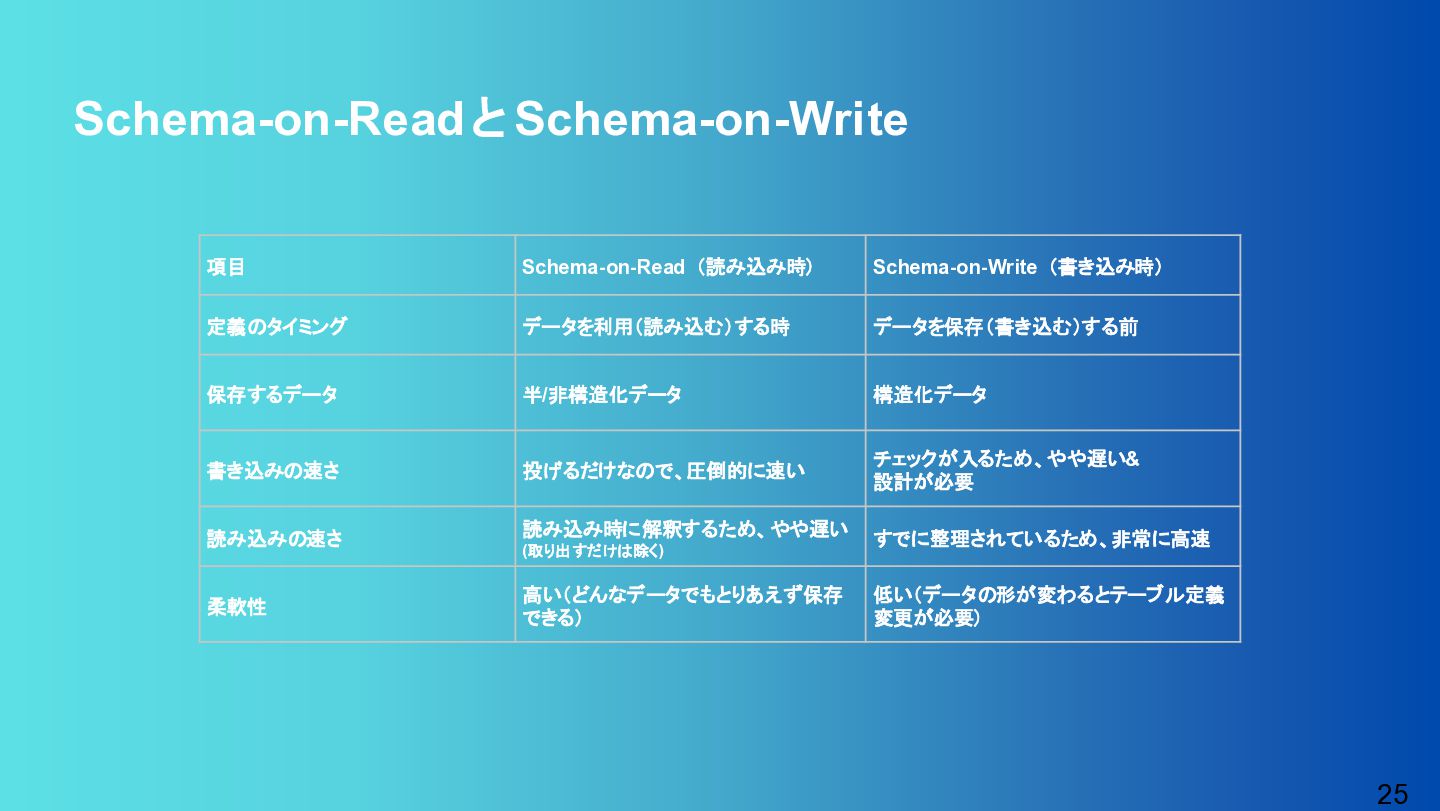
25 Schema-on-ReadとSchema-on-Write 項目 Schema-on-Read(読み込み時) Schema-on-Write(書き込み時) 定義のタイミング データを利用(読み込む)する時 データを保存(書き込む)する前 保存するデータ 半/非構造化データ
構造化データ 書き込みの速さ 投げるだけなので、圧倒的に速い チェックが入るため、やや遅い& 設計が必要 読み込みの速さ 読み込み時に解釈するため、やや遅い (取り出すだけは除く) すでに整理されているため、非常に高速 柔軟性 高い(どんなデータでもとりあえず保存 できる) 低い(データの形が変わるとテーブル定義 変更が必要) -
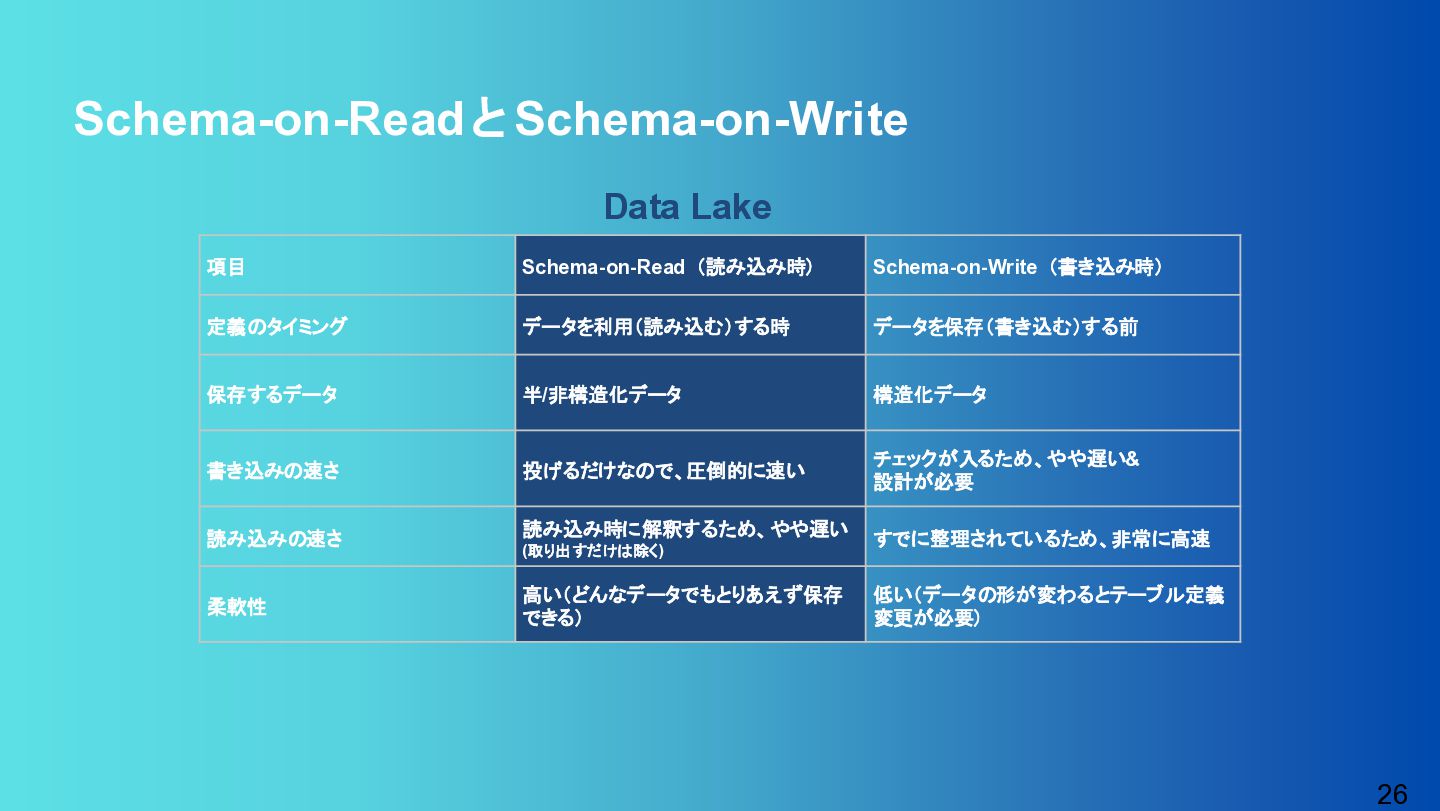
26 Schema-on-ReadとSchema-on-Write 項目 Schema-on-Read(読み込み時) Schema-on-Write(書き込み時) 定義のタイミング データを利用(読み込む)する時 データを保存(書き込む)する前 保存するデータ 半/非構造化データ
構造化データ 書き込みの速さ 投げるだけなので、圧倒的に速い チェックが入るため、やや遅い& 設計が必要 読み込みの速さ 読み込み時に解釈するため、やや遅い (取り出すだけは除く) すでに整理されているため、非常に高速 柔軟性 高い(どんなデータでもとりあえず保存 できる) 低い(データの形が変わるとテーブル定義 変更が必要) Data Lake -
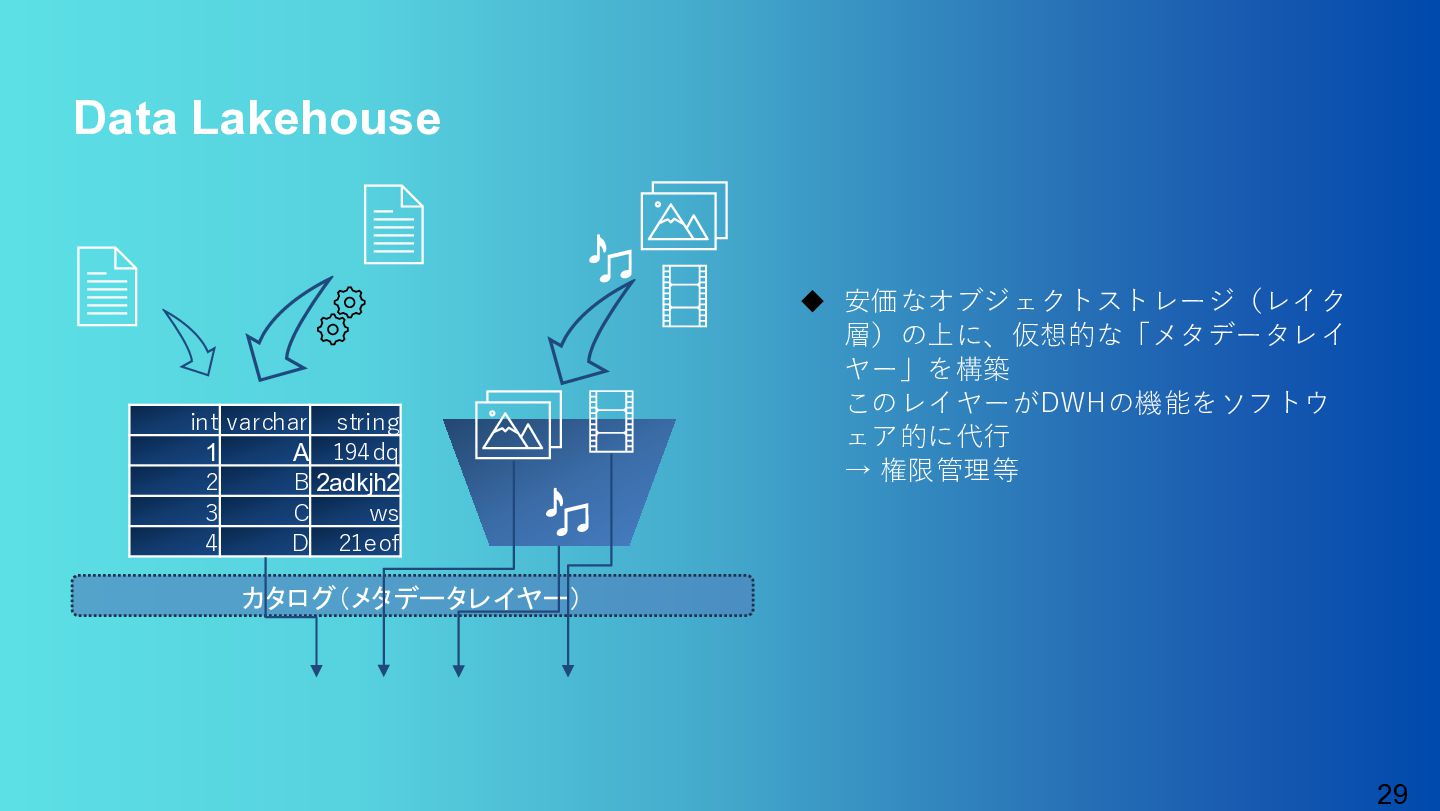
29 カタログ(メタデータレイヤー) Data Lakehouse int varchar string 1 A 194dq
2 B 2adkjh2 3 C ws 4 D 21eof ◆ 安価なオブジェクトストレージ(レイク 層)の上に、仮想的な「メタデータレイ ヤー」を構築 このレイヤーがDWHの機能をソフトウ ェア的に代行 → 権限管理等 -
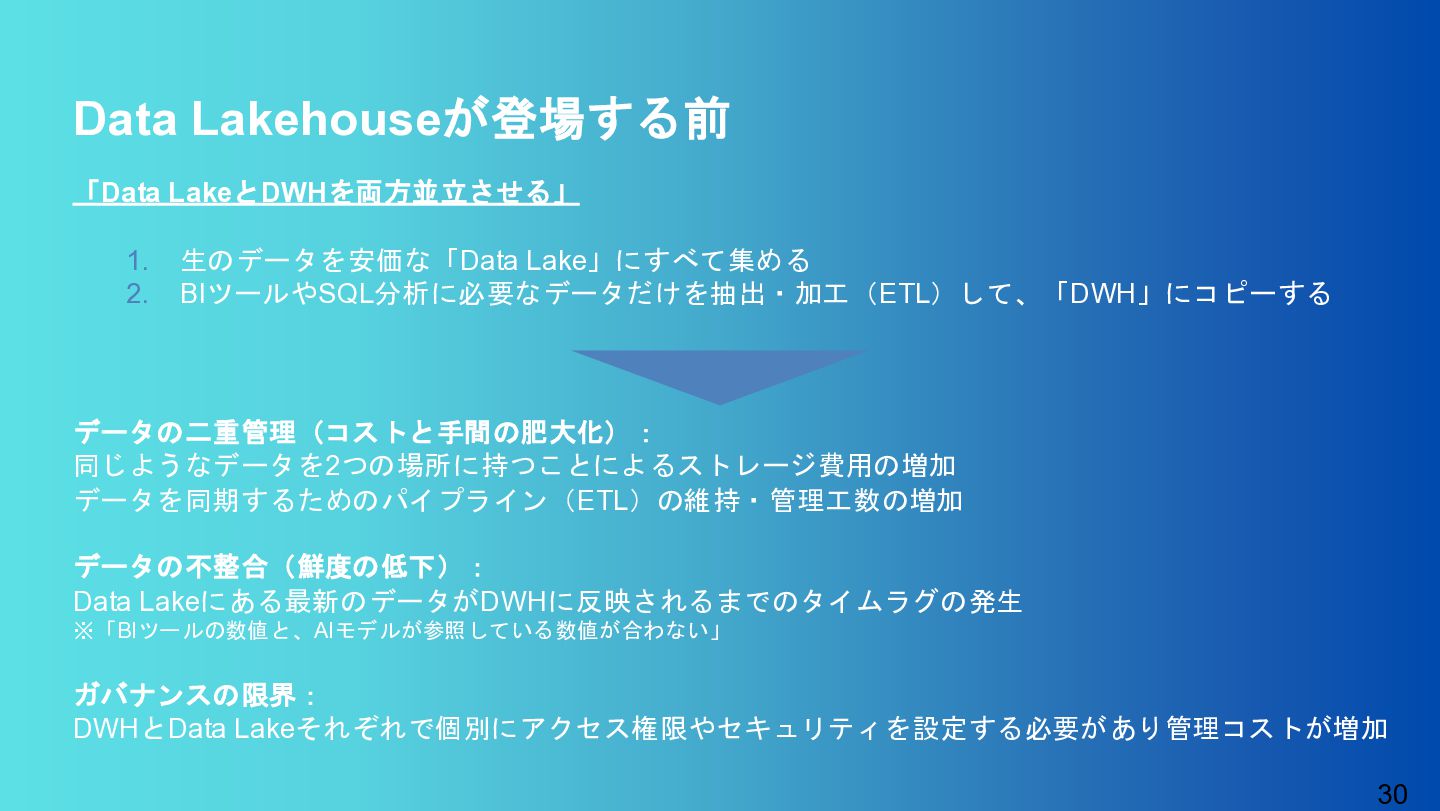
30 Data Lakehouseが登場する前 1. 生のデータを安価な「Data Lake」にすべて集める 2. BIツールやSQL分析に必要なデータだけを抽出・加工(ETL)して、「DWH」にコピーする データの二重管理(コストと手間の肥大化): 同じようなデータを2つの場所に持つことによるストレージ費用の増加
データを同期するためのパイプライン(ETL)の維持・管理工数の増加 データの不整合(鮮度の低下): Data Lakeにある最新のデータがDWHに反映されるまでのタイムラグの発生 ※「BIツールの数値と、AIモデルが参照している数値が合わない」 ガバナンスの限界: DWHとData Lakeそれぞれで個別にアクセス権限やセキュリティを設定する必要があり管理コストが増加 「Data LakeとDWHを両方並立させる」 -
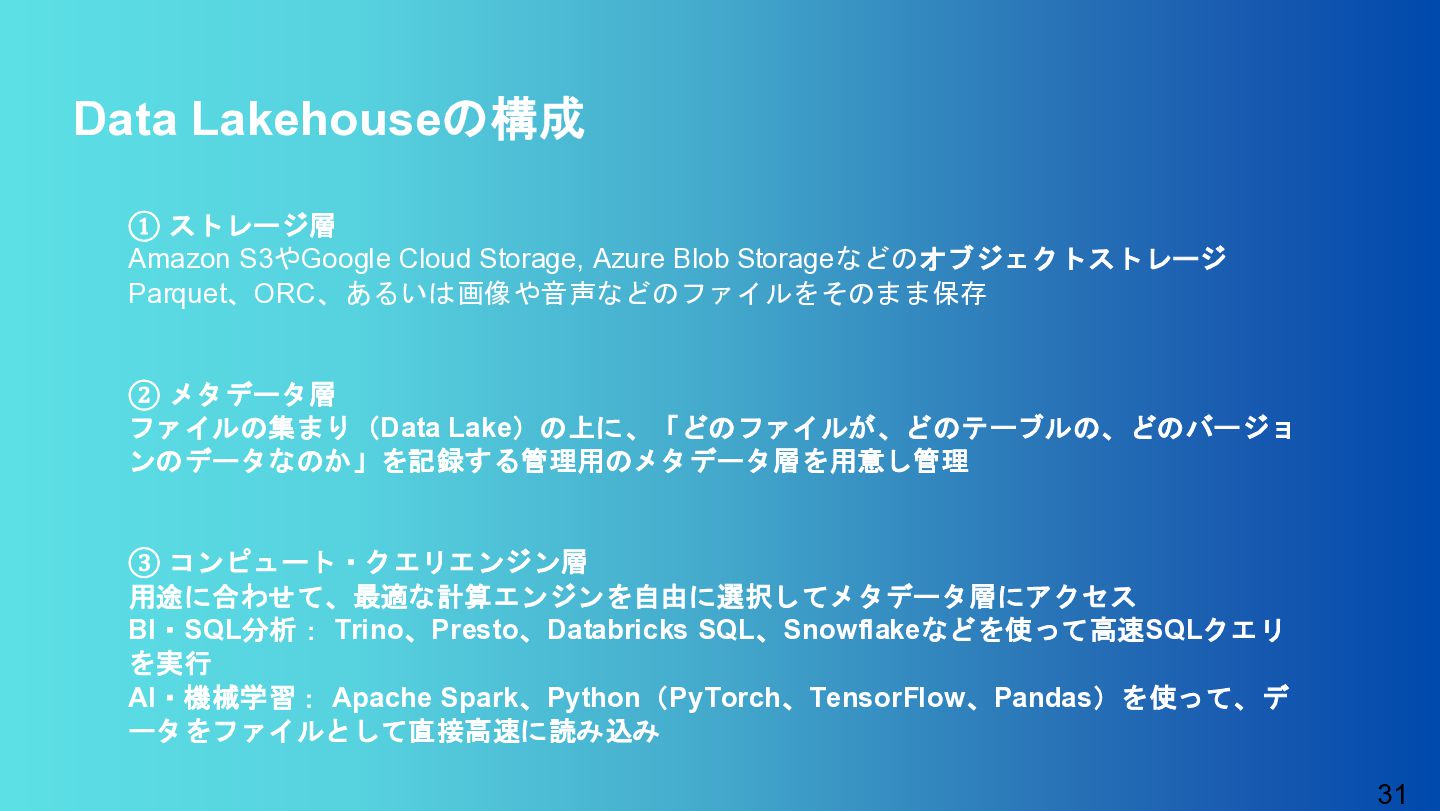
31 Data Lakehouseの構成 ① ストレージ層 Amazon S3やGoogle Cloud Storage, Azure
Blob Storageなどのオブジェクトストレージ Parquet、ORC、あるいは画像や音声などのファイルをそのまま保存 ② メタデータ層 ファイルの集まり(Data Lake)の上に、「どのファイルが、どのテーブルの、どのバージョ ンのデータなのか」を記録する管理用のメタデータ層を用意し管理 ③ コンピュート・クエリエンジン層 用途に合わせて、最適な計算エンジンを自由に選択してメタデータ層にアクセス BI・SQL分析: Trino、Presto、Databricks SQL、Snowflakeなどを使って高速SQLクエリ を実行 AI・機械学習: Apache Spark、Python(PyTorch、TensorFlow、Pandas)を使って、デ ータをファイルとして直接高速に読み込み -
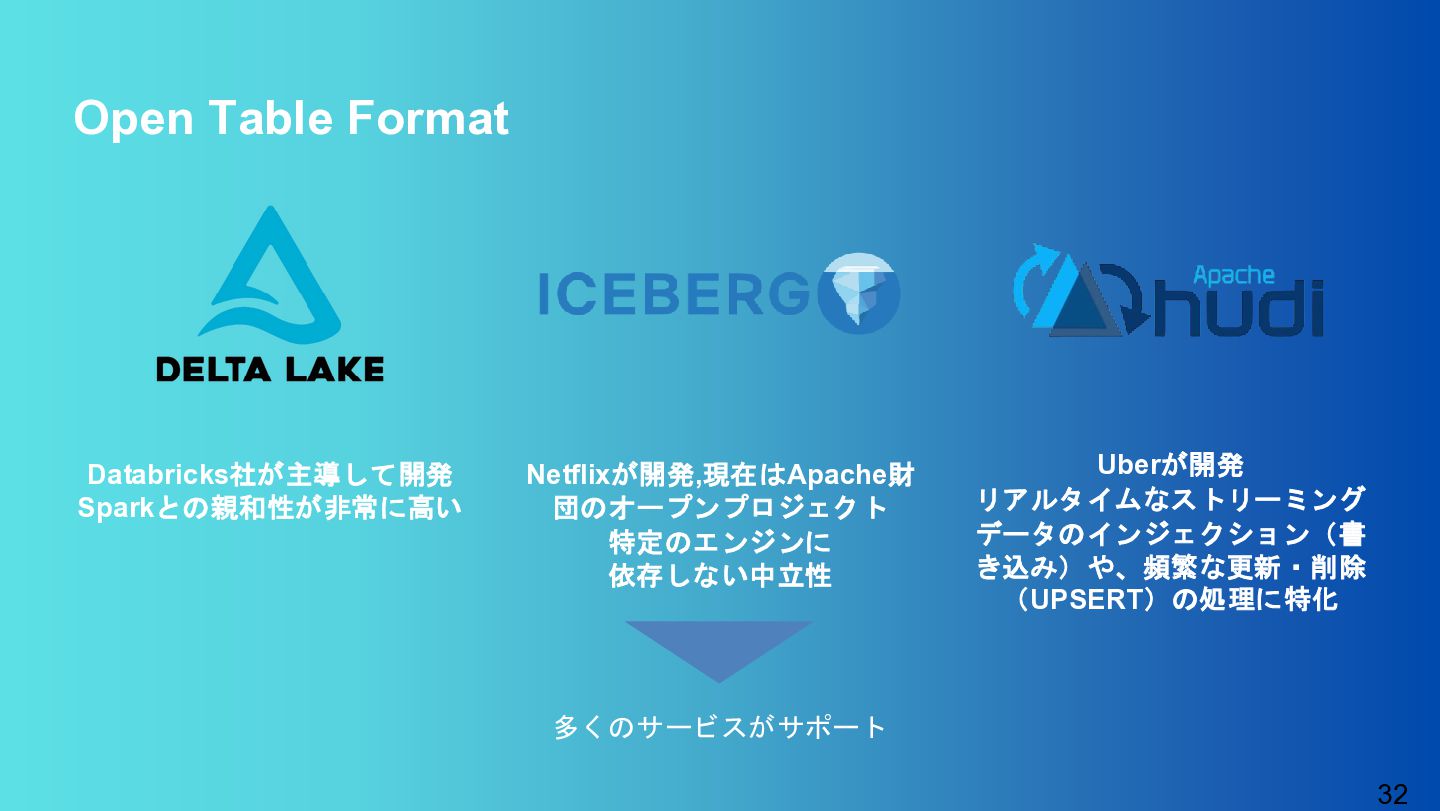
32 Open Table Format Databricks社が主導して開発 Sparkとの親和性が非常に高い Netflixが開発,現在はApache財 団のオープンプロジェクト 特定のエンジンに 依存しない中立性
Uberが開発 リアルタイムなストリーミング データのインジェクション(書 き込み)や、頻繁な更新・削除 (UPSERT)の処理に特化 多くのサービスがサポート -
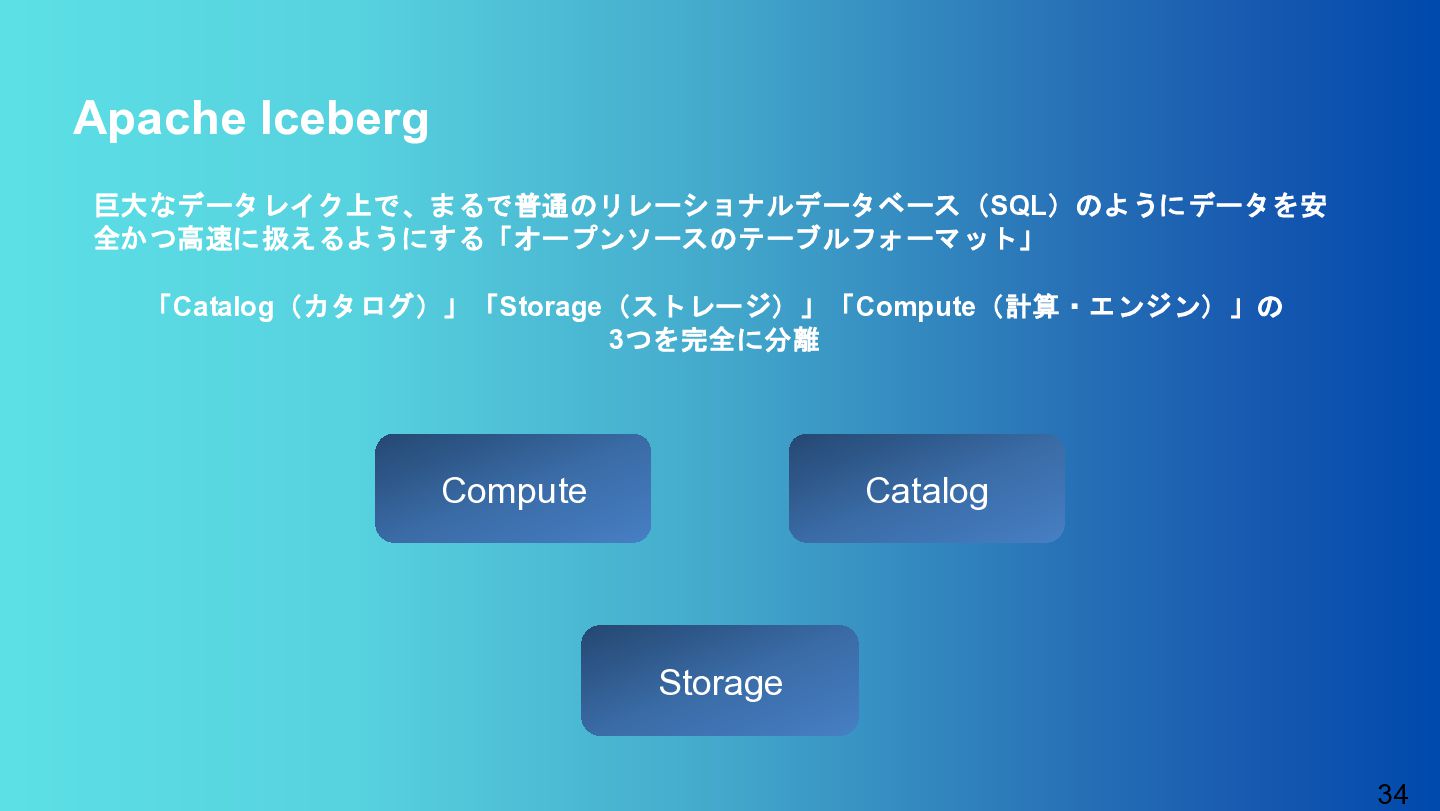
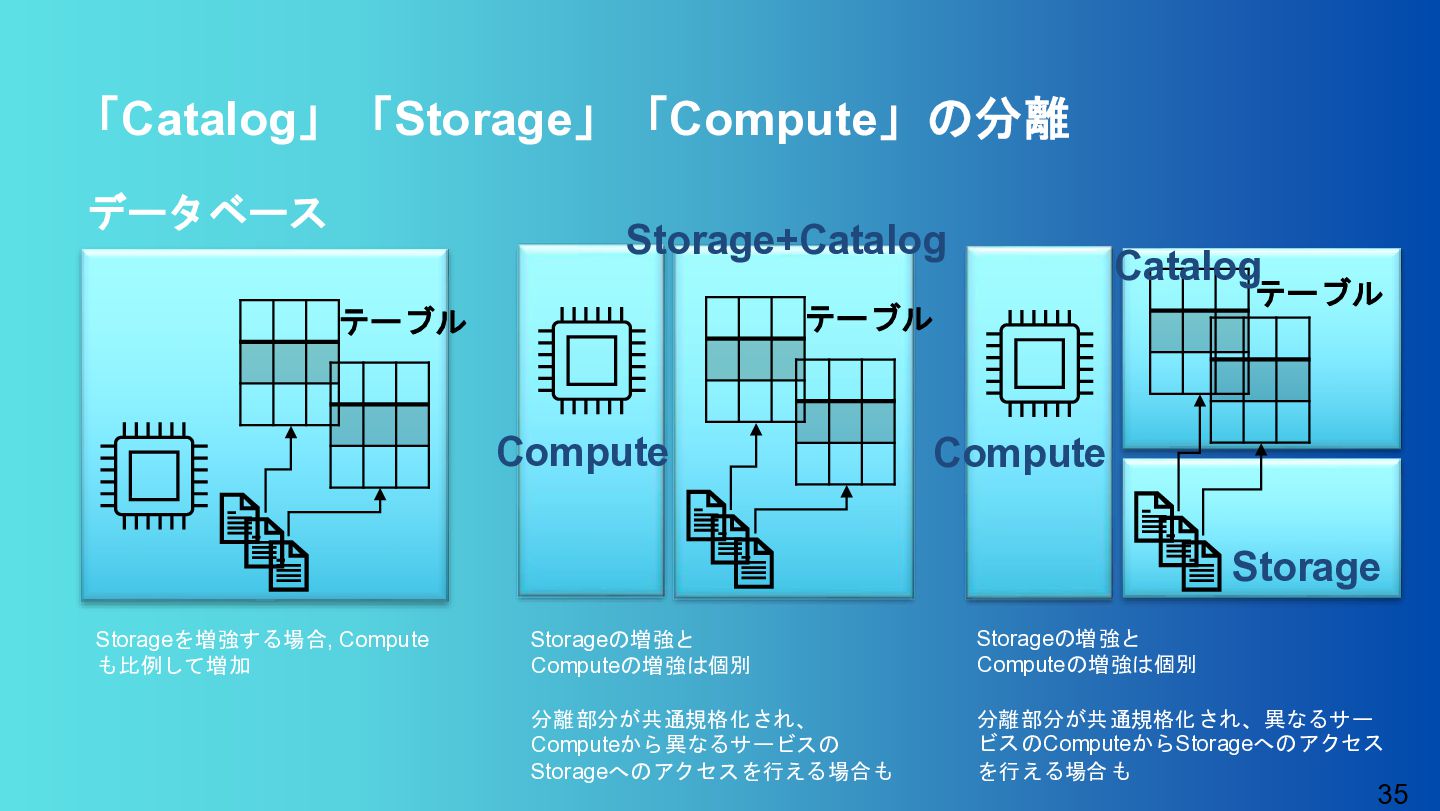
35 「Catalog」「Storage」「Compute」の分離 テーブル テーブル テーブル データベース Compute Storage+Catalog Catalog Storage
Compute Storageを増強する場合, Compute も比例して増加 Storageの増強と Computeの増強は個別 分離部分が共通規格化され、 Computeから異なるサービスの Storageへのアクセスを行える場合も Storageの増強と Computeの増強は個別 分離部分が共通規格化され、異なるサー ビスのComputeからStorageへのアクセス を行える場合も -
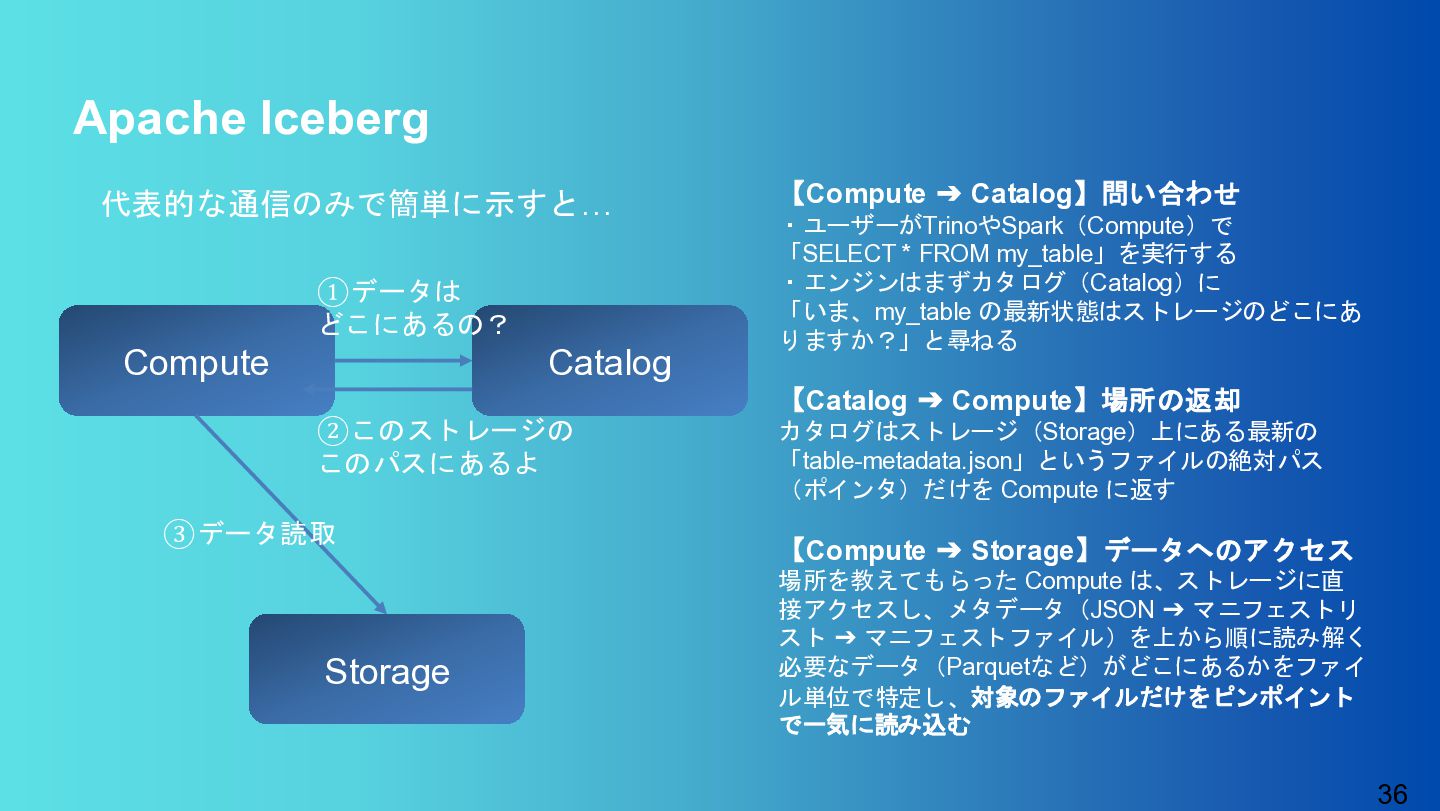
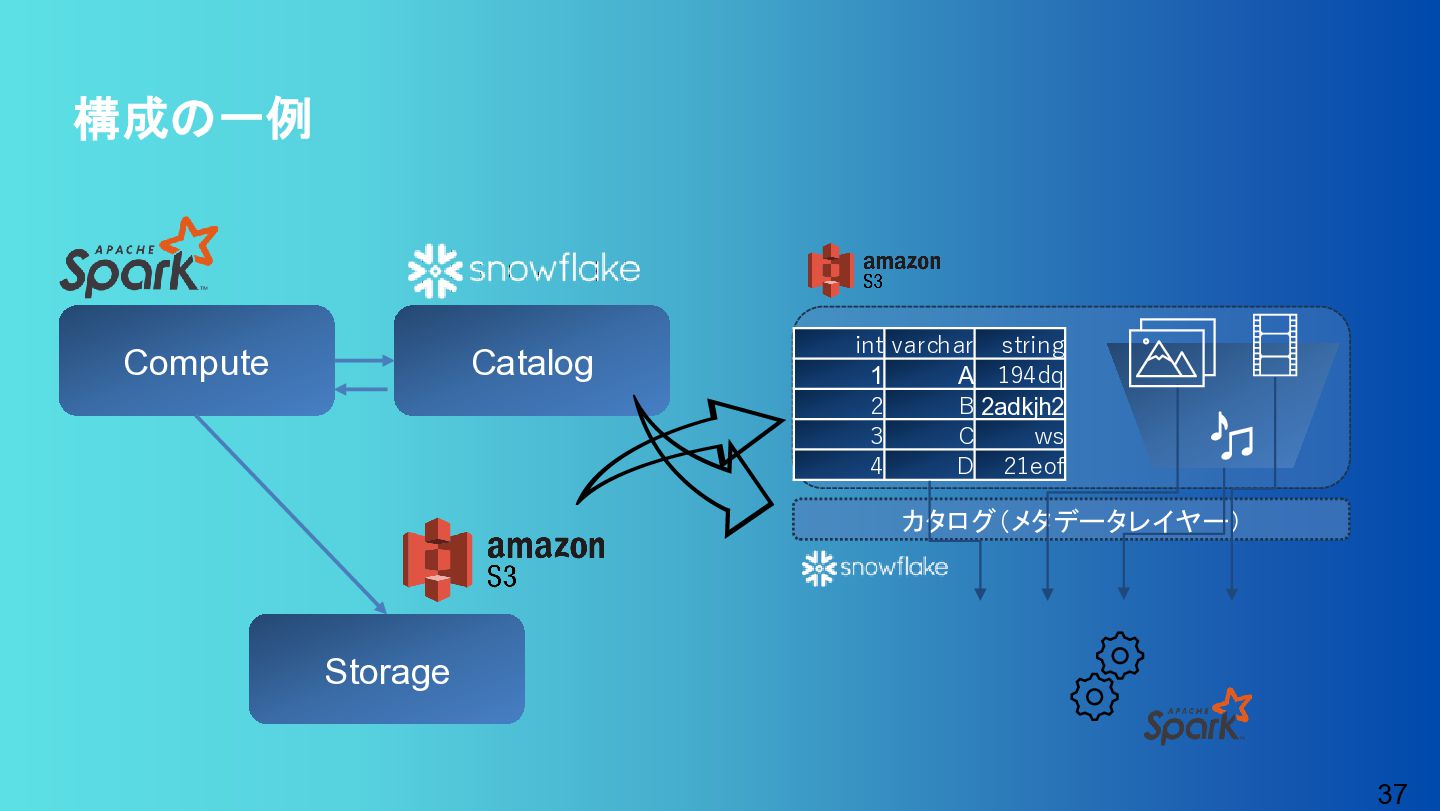
36 Apache Iceberg Catalog Compute Storage ①データは どこにあるの? ②このストレージの このパスにあるよ
③データ読取 代表的な通信のみで簡単に示すと… 【Compute ➔ Catalog】問い合わせ ・ユーザーがTrinoやSpark(Compute)で 「SELECT * FROM my_table」を実行する ・エンジンはまずカタログ(Catalog)に 「いま、my_table の最新状態はストレージのどこにあ りますか?」と尋ねる 【Catalog ➔ Compute】場所の返却 カタログはストレージ(Storage)上にある最新の 「table-metadata.json」というファイルの絶対パス (ポインタ)だけを Compute に返す 【Compute ➔ Storage】データへのアクセス 場所を教えてもらった Compute は、ストレージに直 接アクセスし、メタデータ(JSON ➔ マニフェストリ スト ➔ マニフェストファイル)を上から順に読み解く 必要なデータ(Parquetなど)がどこにあるかをファイ ル単位で特定し、対象のファイルだけをピンポイント で一気に読み込む -
37 構成の一例 Catalog Compute Storage カタログ(メタデータレイヤー) int varchar string 1
A 194dq 2 B 2adkjh2 3 C ws 4 D 21eof -
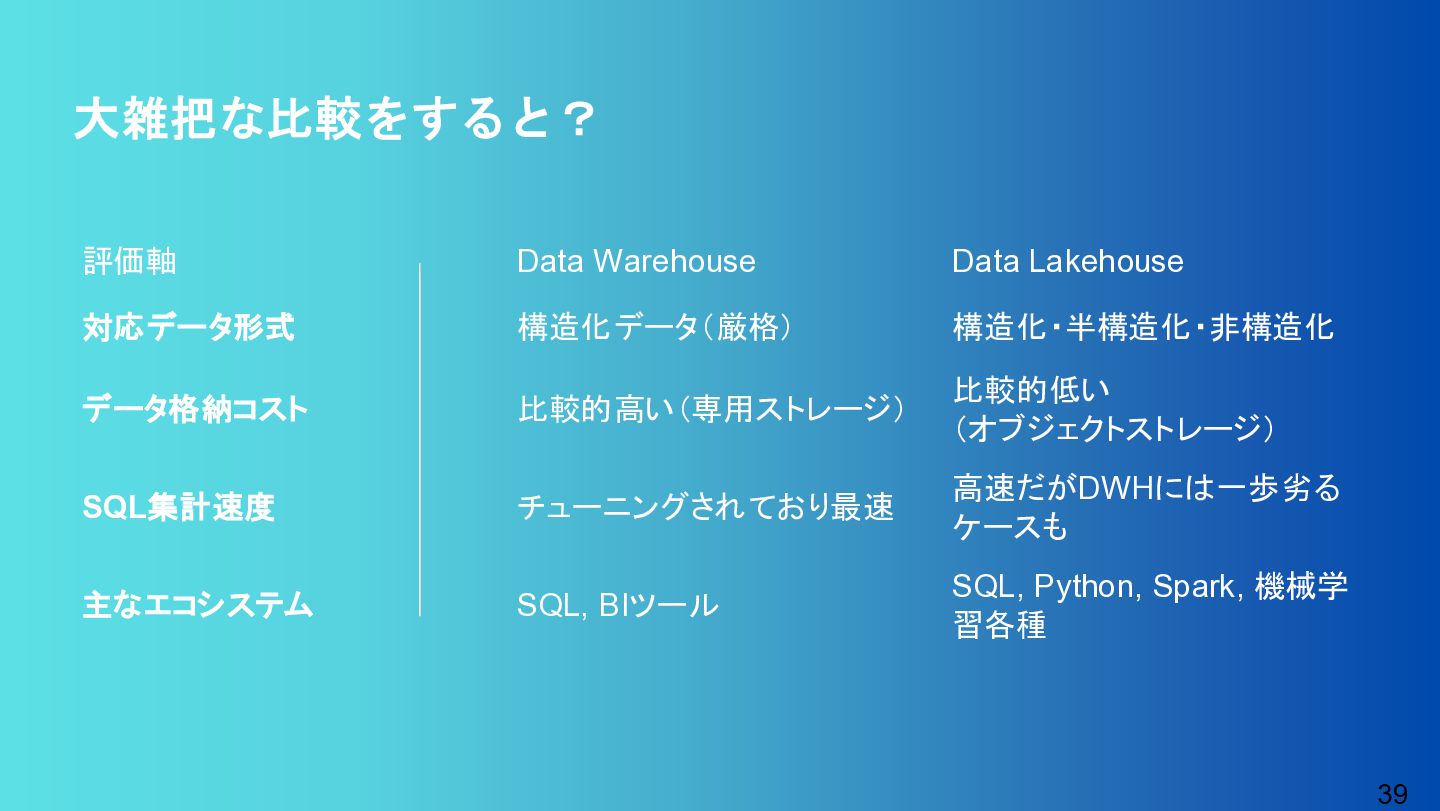
39 大雑把な比較をすると? 評価軸 Data Warehouse Data Lakehouse 対応データ形式 構造化データ(厳格) 構造化・半構造化・非構造化
データ格納コスト 比較的高い(専用ストレージ) 比較的低い (オブジェクトストレージ) SQL集計速度 チューニングされており最速 高速だがDWHには一歩劣る ケースも 主なエコシステム SQL, BIツール SQL, Python, Spark, 機械学 習各種 -
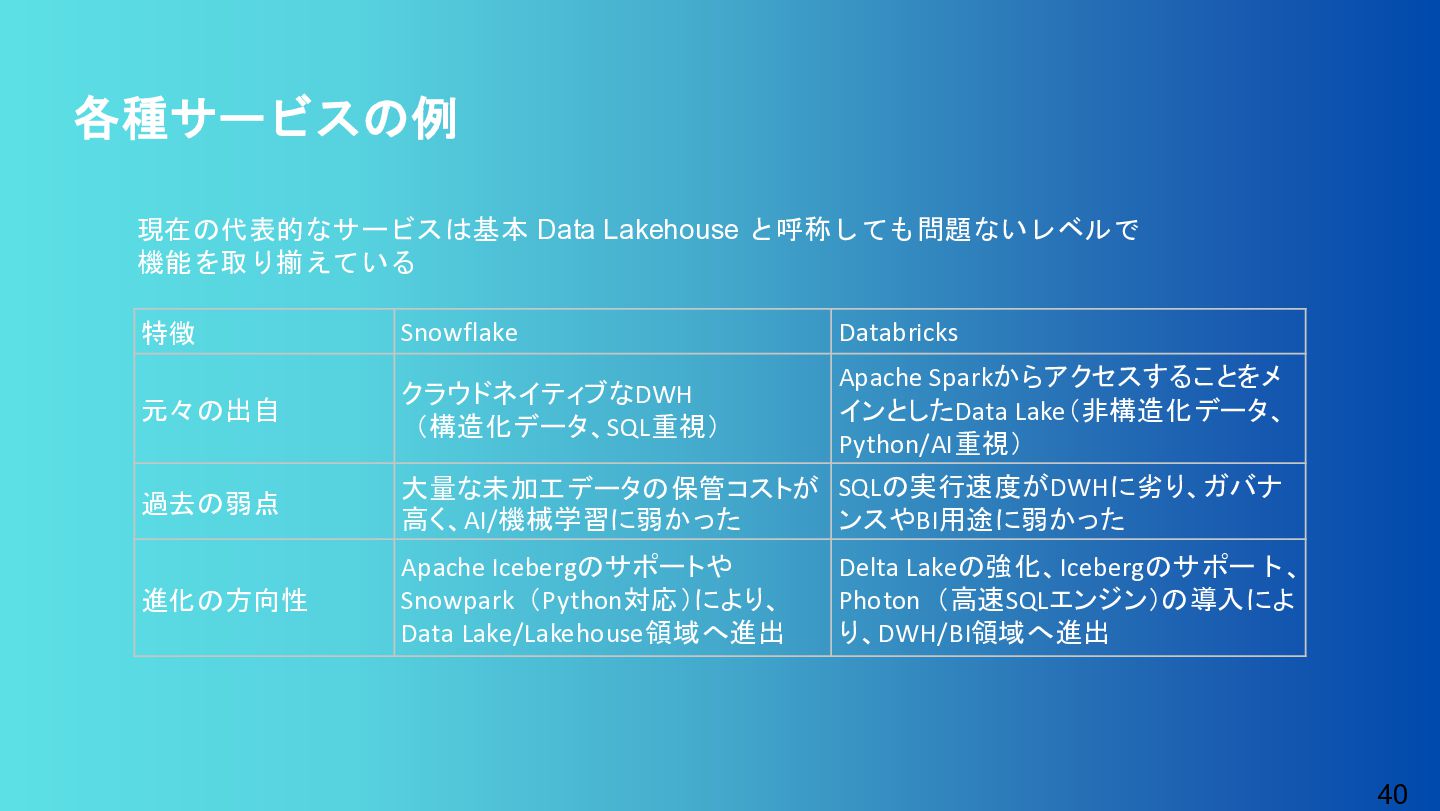
40 各種サービスの例 特徴 Snowflake Databricks 元々の出自 クラウドネイティブなDWH (構造化データ、SQL重視) Apache Sparkからアクセスすることをメ
インとしたData Lake(非構造化データ、 Python/AI重視) 過去の弱点 大量な未加工データの保管コストが 高く、AI/機械学習に弱かった SQLの実行速度がDWHに劣り、ガバナ ンスやBI用途に弱かった 進化の方向性 Apache Icebergのサポートや Snowpark(Python対応)により、 Data Lake/Lakehouse領域へ進出 Delta Lakeの強化、Icebergのサポート、 Photon(高速SQLエンジン)の導入によ り、DWH/BI領域へ進出 現在の代表的なサービスは基本 Data Lakehouse と呼称しても問題ないレベルで 機能を取り揃えている