Upgrade to Pro — share decks privately, control downloads, hide ads and more …

2024年度 数理・データサイエンス・AI入門 #3

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

2024年度 数理・データサイエンス・AI入門 #3

学部生がAI分野に興味を持ってもらうことを主眼とした授業の資料例です.

Avatar for Yoichi Hirose

Yoichi Hirose

January 09, 2025

More Decks by Yoichi Hirose

Other Decks in Technology

Transcript

  1. ⽬次 ⼤規模⾔語モデル 対話型AI, ⾔語モデル, Transformer, スケーリング則 few-shot learning, hallucination, ⽇本語学習モデル

    AutoML Black-box 最適化, HPO, NAS, アルゴリズムの最適化 画像⽣成モデル Diffusion models, 応⽤例の紹介 1
  2. 利⽤者のテキストや⾳声の⼊⼒に対して応答するAI 主にルールベース ⼊⼒に対してあらかじめ定めたルールに従って返答 Siri (Apple), Alexa (Amazon) 主に深層学習モデルの利⽤ ⼊⼒に対する応答を⾔語モデル(深層学習モデルの⼀種)が⽣成 GhatGPT

    (OpenAI), Copilot (Microsoft), Gemini (Google) 対話型AIの概要 https://www.apple.com/siri/ https://www.amazon.in/Echo-Studio/dp/B07NQH4Q45/ https://en.wikipedia.org/wiki/File:ChatGPT-Logo.png https://en.m.wikipedia.org/wiki/File:Microsoft_365_Copilot_Icon.svg https://en.m.wikipedia.org/wiki/File:Google_Gemini_logo.svg 3
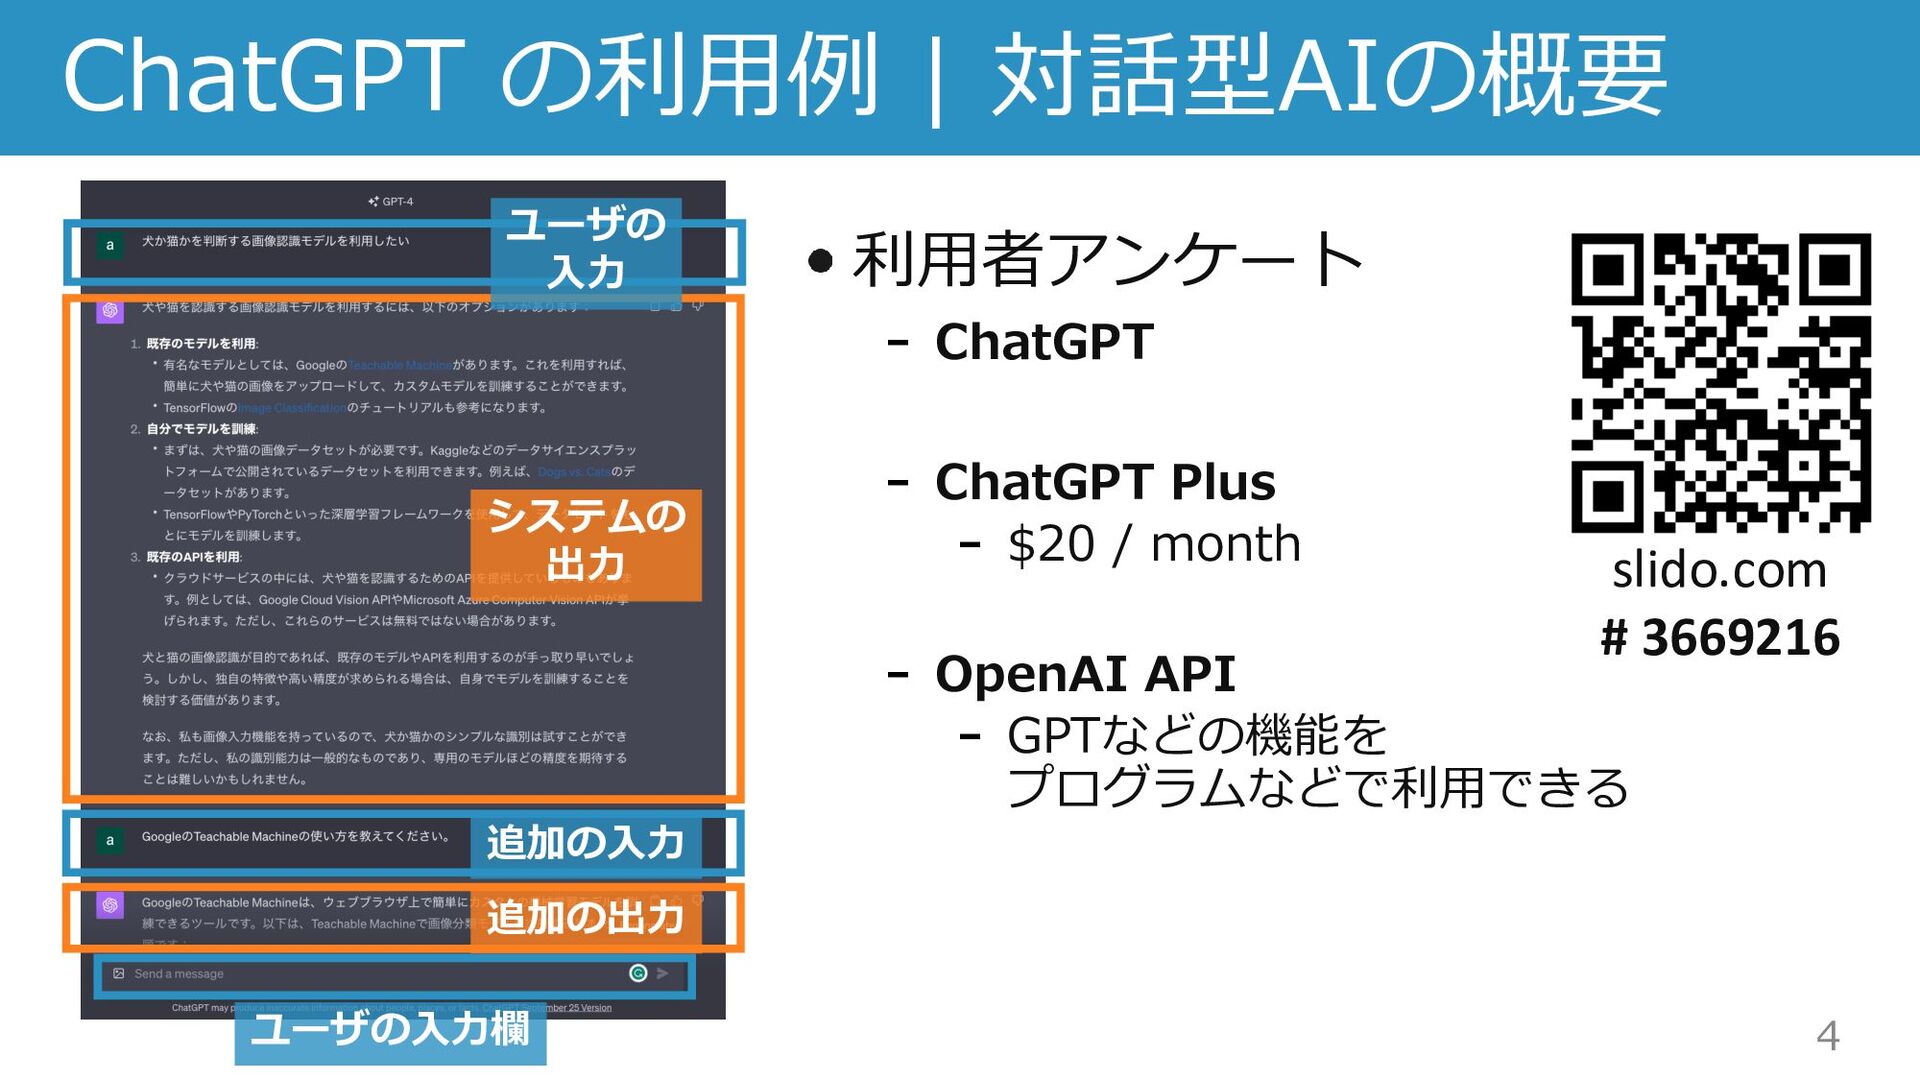
  3. 4 ChatGPT の利⽤例 | 対話型AIの概要 利⽤者アンケート ChatGPT ChatGPT Plus $20

    / month OpenAI API GPTなどの機能を プログラムなどで利⽤できる ユーザの ⼊⼒ システムの 出⼒ 追加の⼊⼒ 追加の出⼒ ユーザの⼊⼒欄 slido.com # 3669216
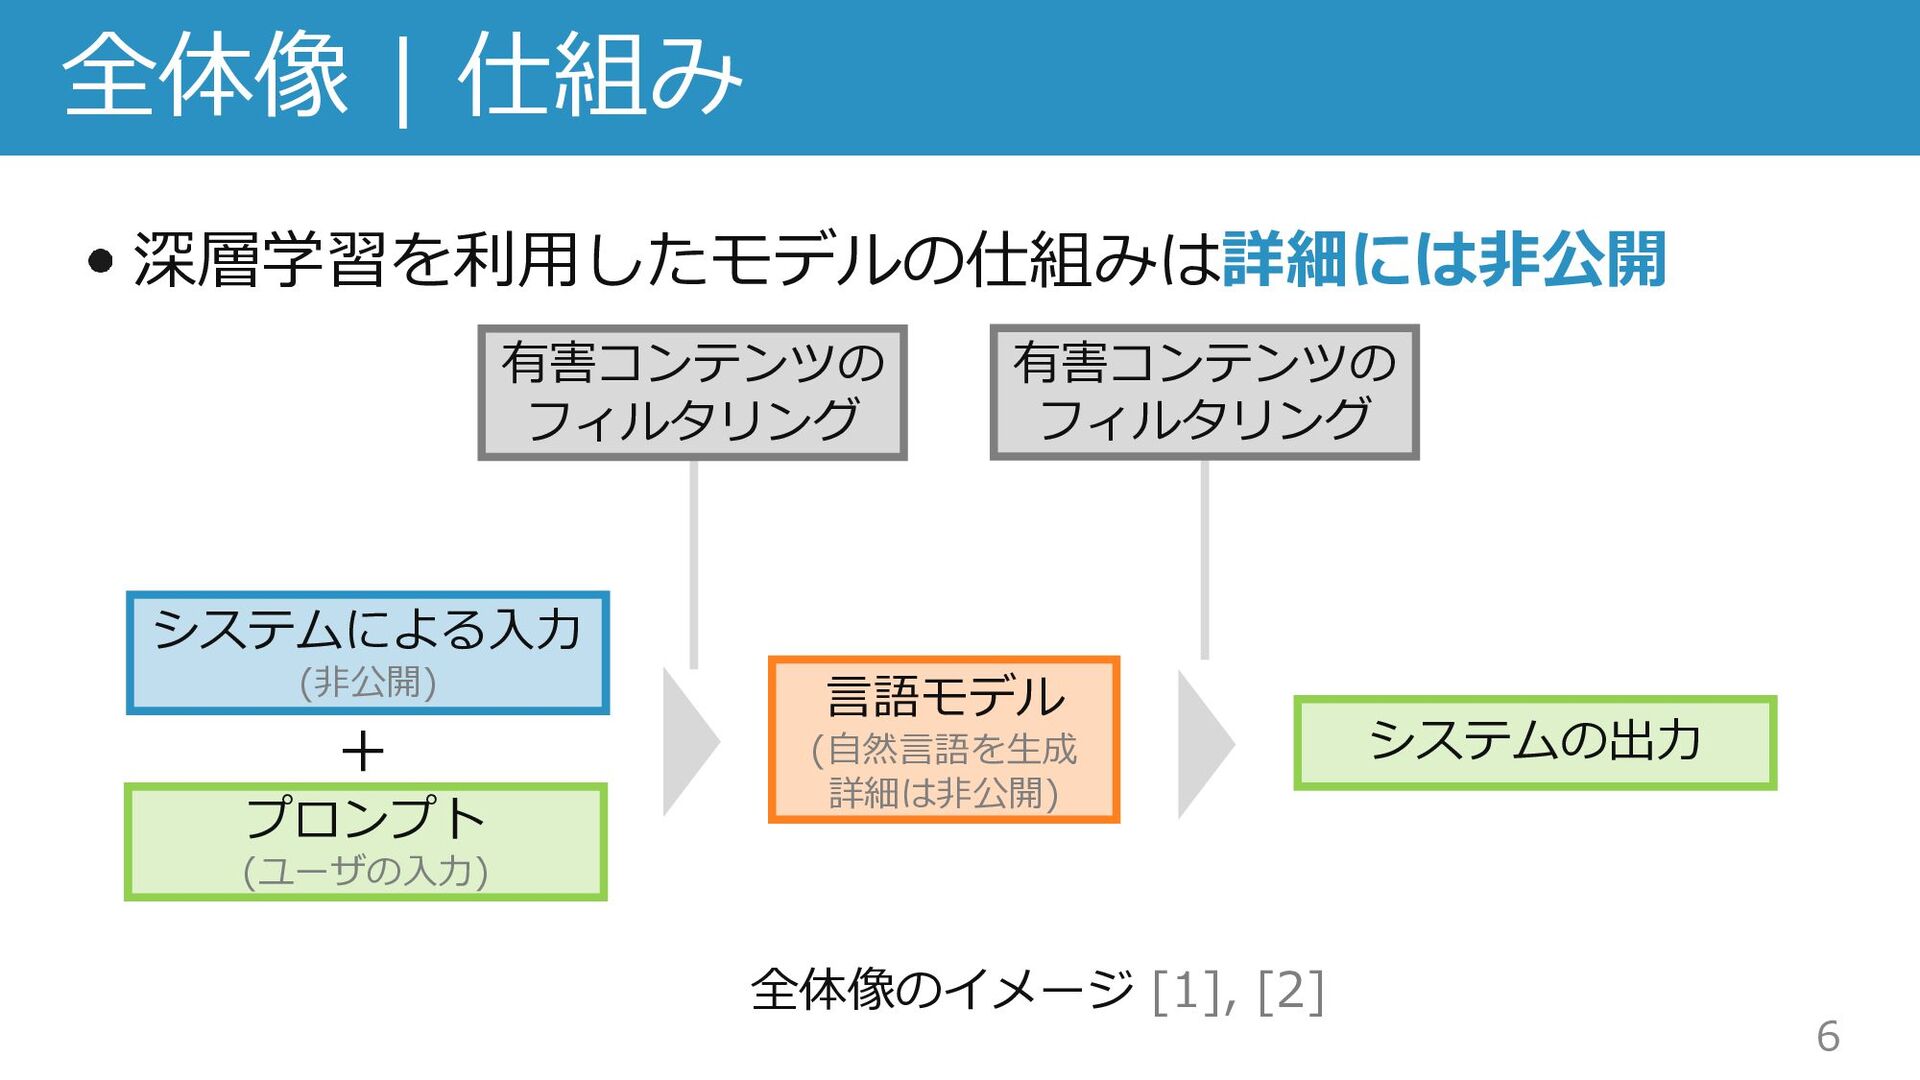
  4. 6 全体像 | 仕組み 深層学習を利⽤したモデルの仕組みは詳細には⾮公開 プロンプト (ユーザの⼊⼒) システムによる⼊⼒ (⾮公開) +

    有害コンテンツの フィルタリング ⾔語モデル (⾃然⾔語を⽣成 詳細は⾮公開) 有害コンテンツの フィルタリング システムの出⼒ 全体像のイメージ [1], [2]
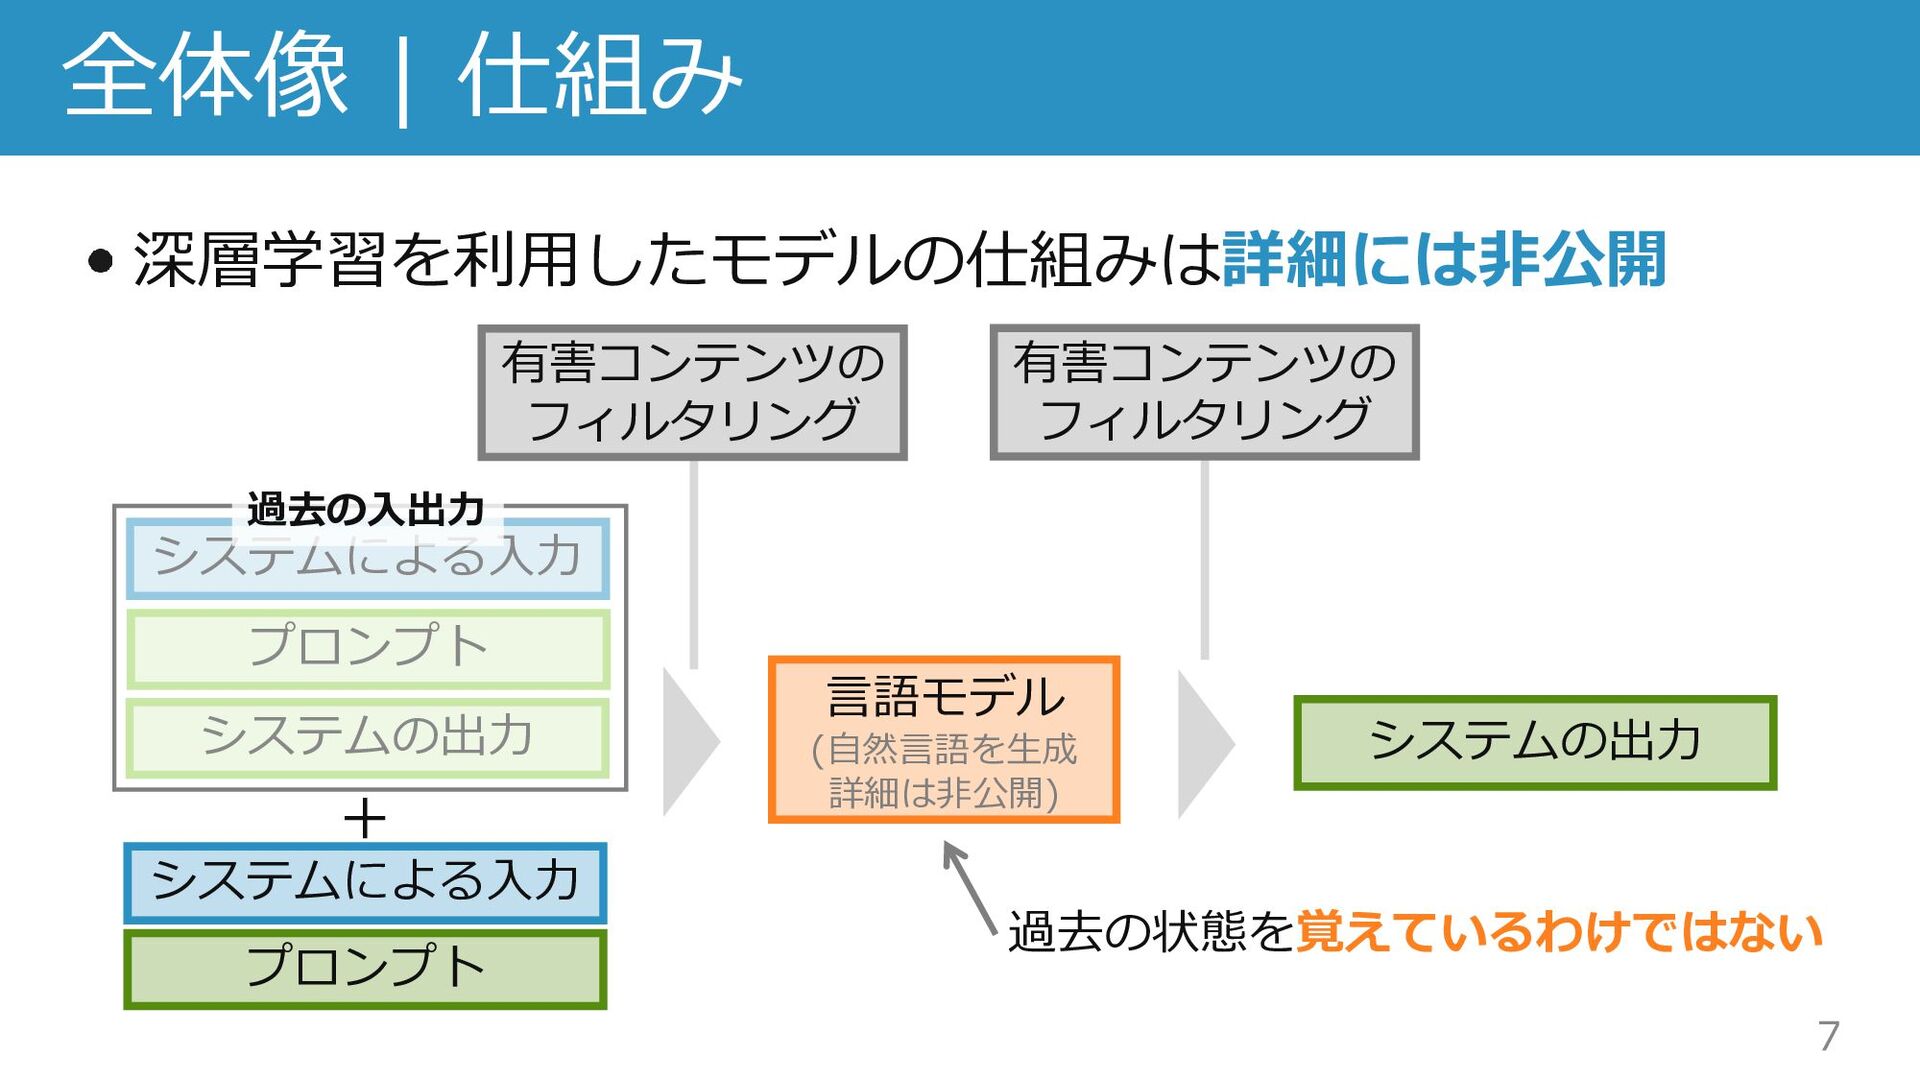
  5. 7 全体像 | 仕組み 深層学習を利⽤したモデルの仕組みは詳細には⾮公開 プロンプト システムによる⼊⼒ 有害コンテンツの フィルタリング ⾔語モデル

    (⾃然⾔語を⽣成 詳細は⾮公開) 有害コンテンツの フィルタリング システムの出⼒ プロンプト システムによる⼊⼒ 過去の⼊出⼒ + システムの出⼒ 過去の状態を覚えているわけではない
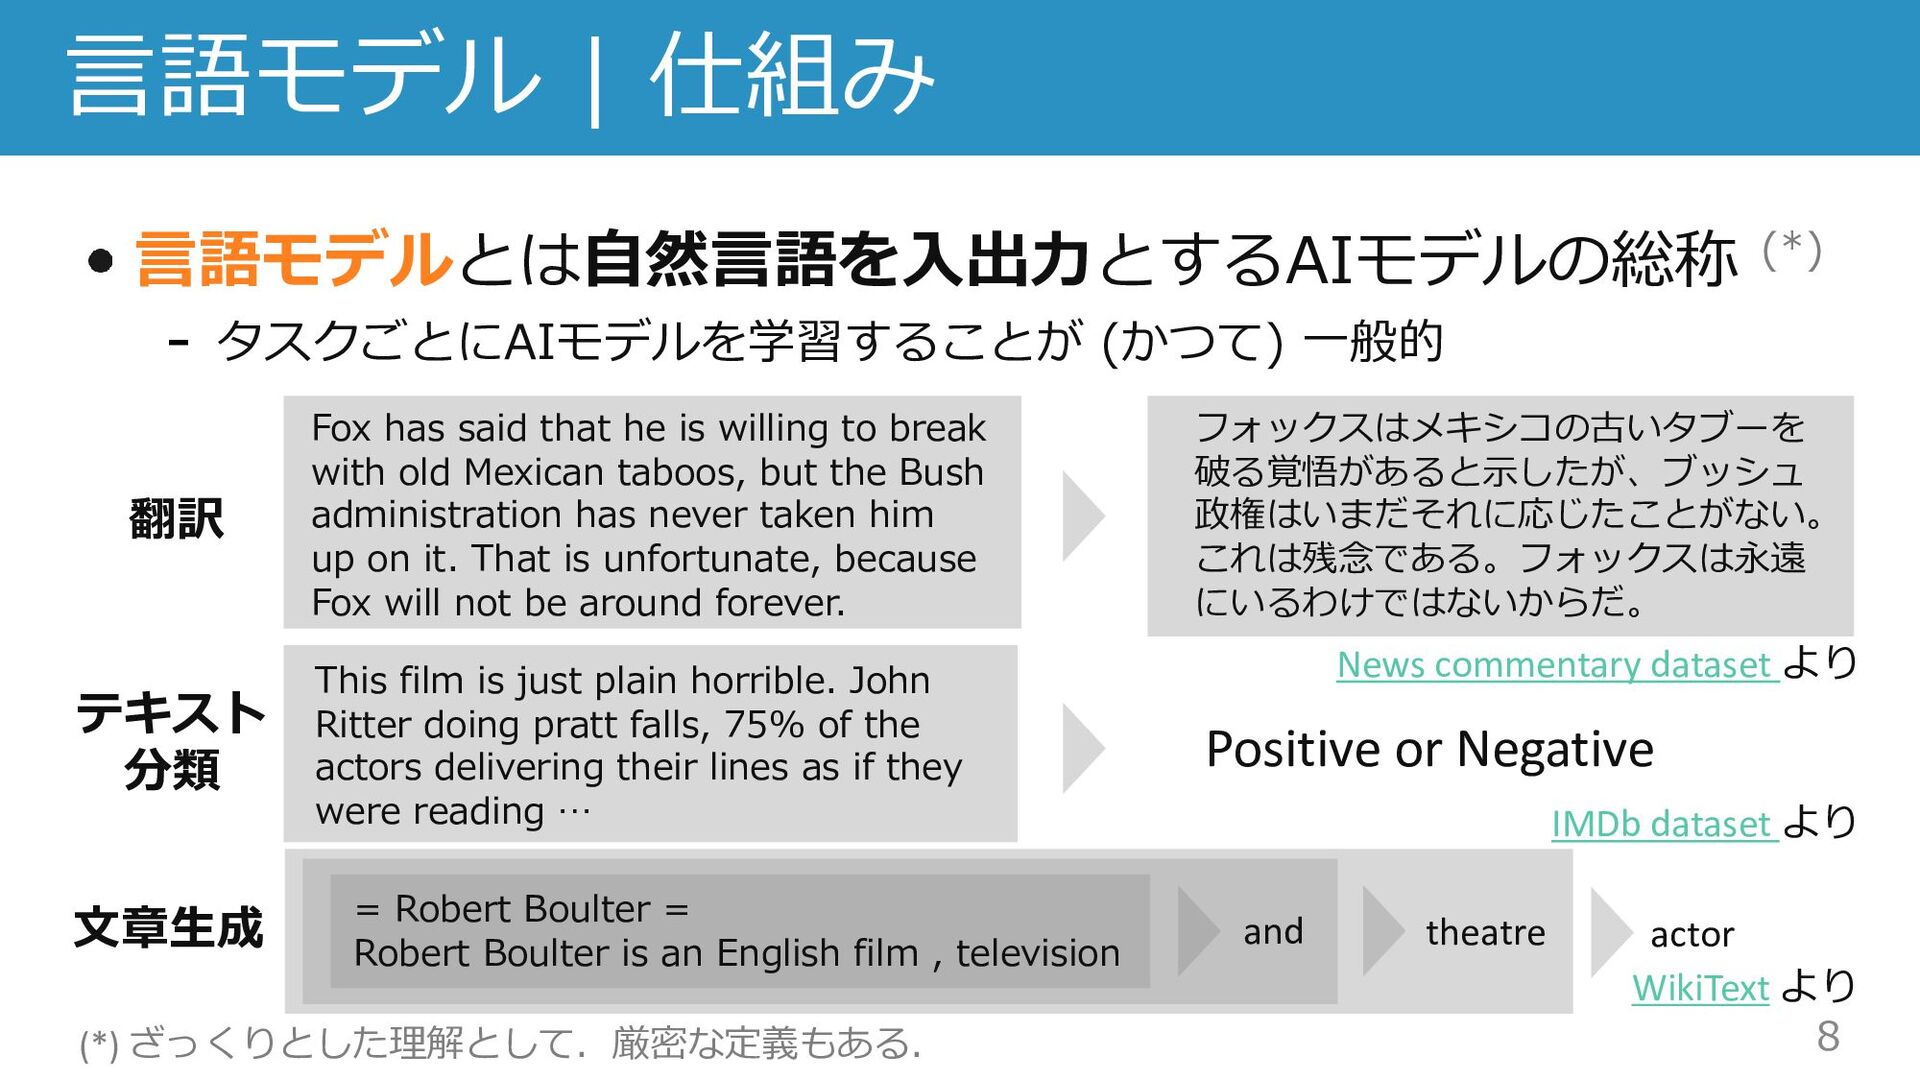
  6. actor theatre 8 ⾔語モデル | 仕組み ⾔語モデルとは⾃然⾔語を⼊出⼒とするAIモデルの総称 (*) タスクごとにAIモデルを学習することが (かつて)

    ⼀般的 Fox has said that he is willing to break with old Mexican taboos, but the Bush administration has never taken him up on it. That is unfortunate, because Fox will not be around forever. フォックスはメキシコの古いタブーを 破る覚悟があると⽰したが、ブッシュ 政権はいまだそれに応じたことがない。 これは残念である。フォックスは永遠 にいるわけではないからだ。 News commentary dataset より 翻訳 This film is just plain horrible. John Ritter doing pratt falls, 75% of the actors delivering their lines as if they were reading … Positive or Negative IMDb dataset より テキスト 分類 WikiText より = Robert Boulter = Robert Boulter is an English film , television and ⽂章⽣成 (*) ざっくりとした理解として.厳密な定義もある.
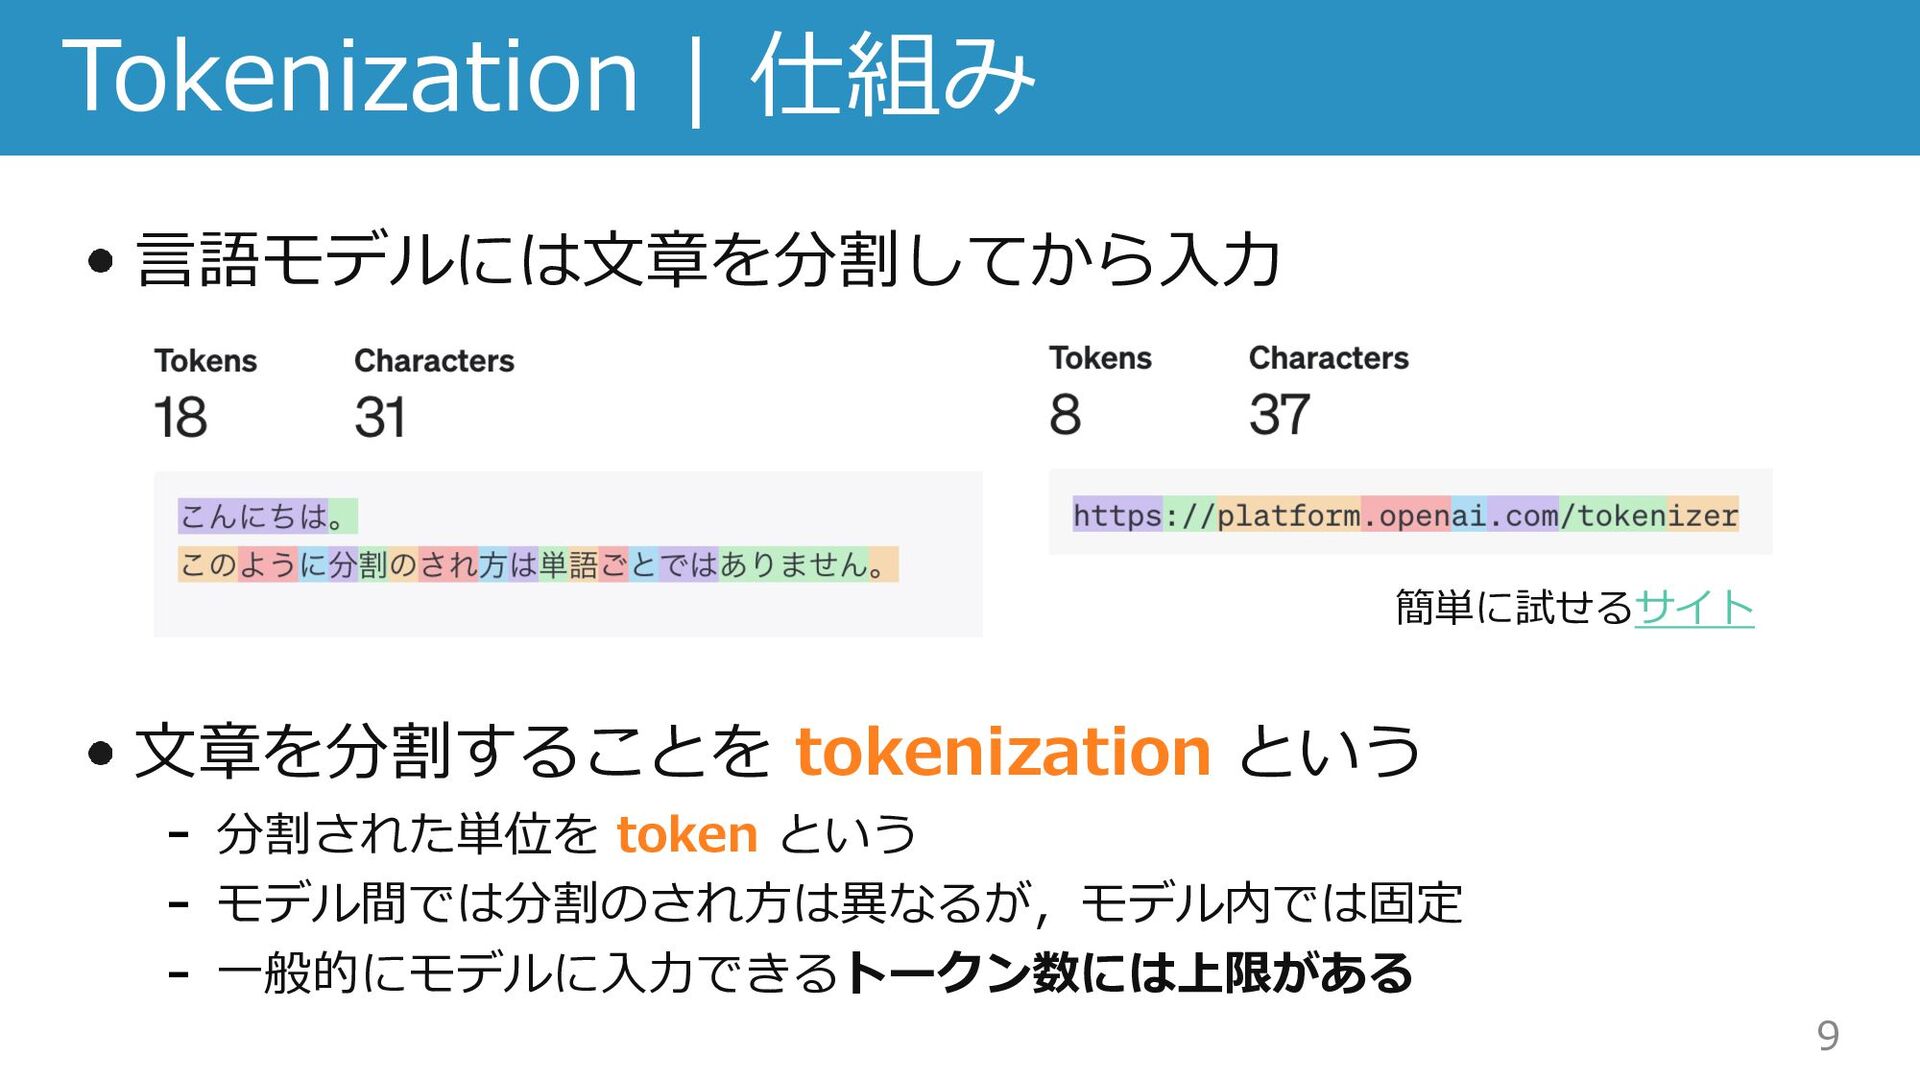
  7. 9 Tokenization | 仕組み ⾔語モデルには⽂章を分割してから⼊⼒ ⽂章を分割することを tokenization という 分割された単位を token

    という モデル間では分割のされ⽅は異なるが,モデル内では固定 ⼀般的にモデルに⼊⼒できるトークン数には上限がある 簡単に試せるサイト
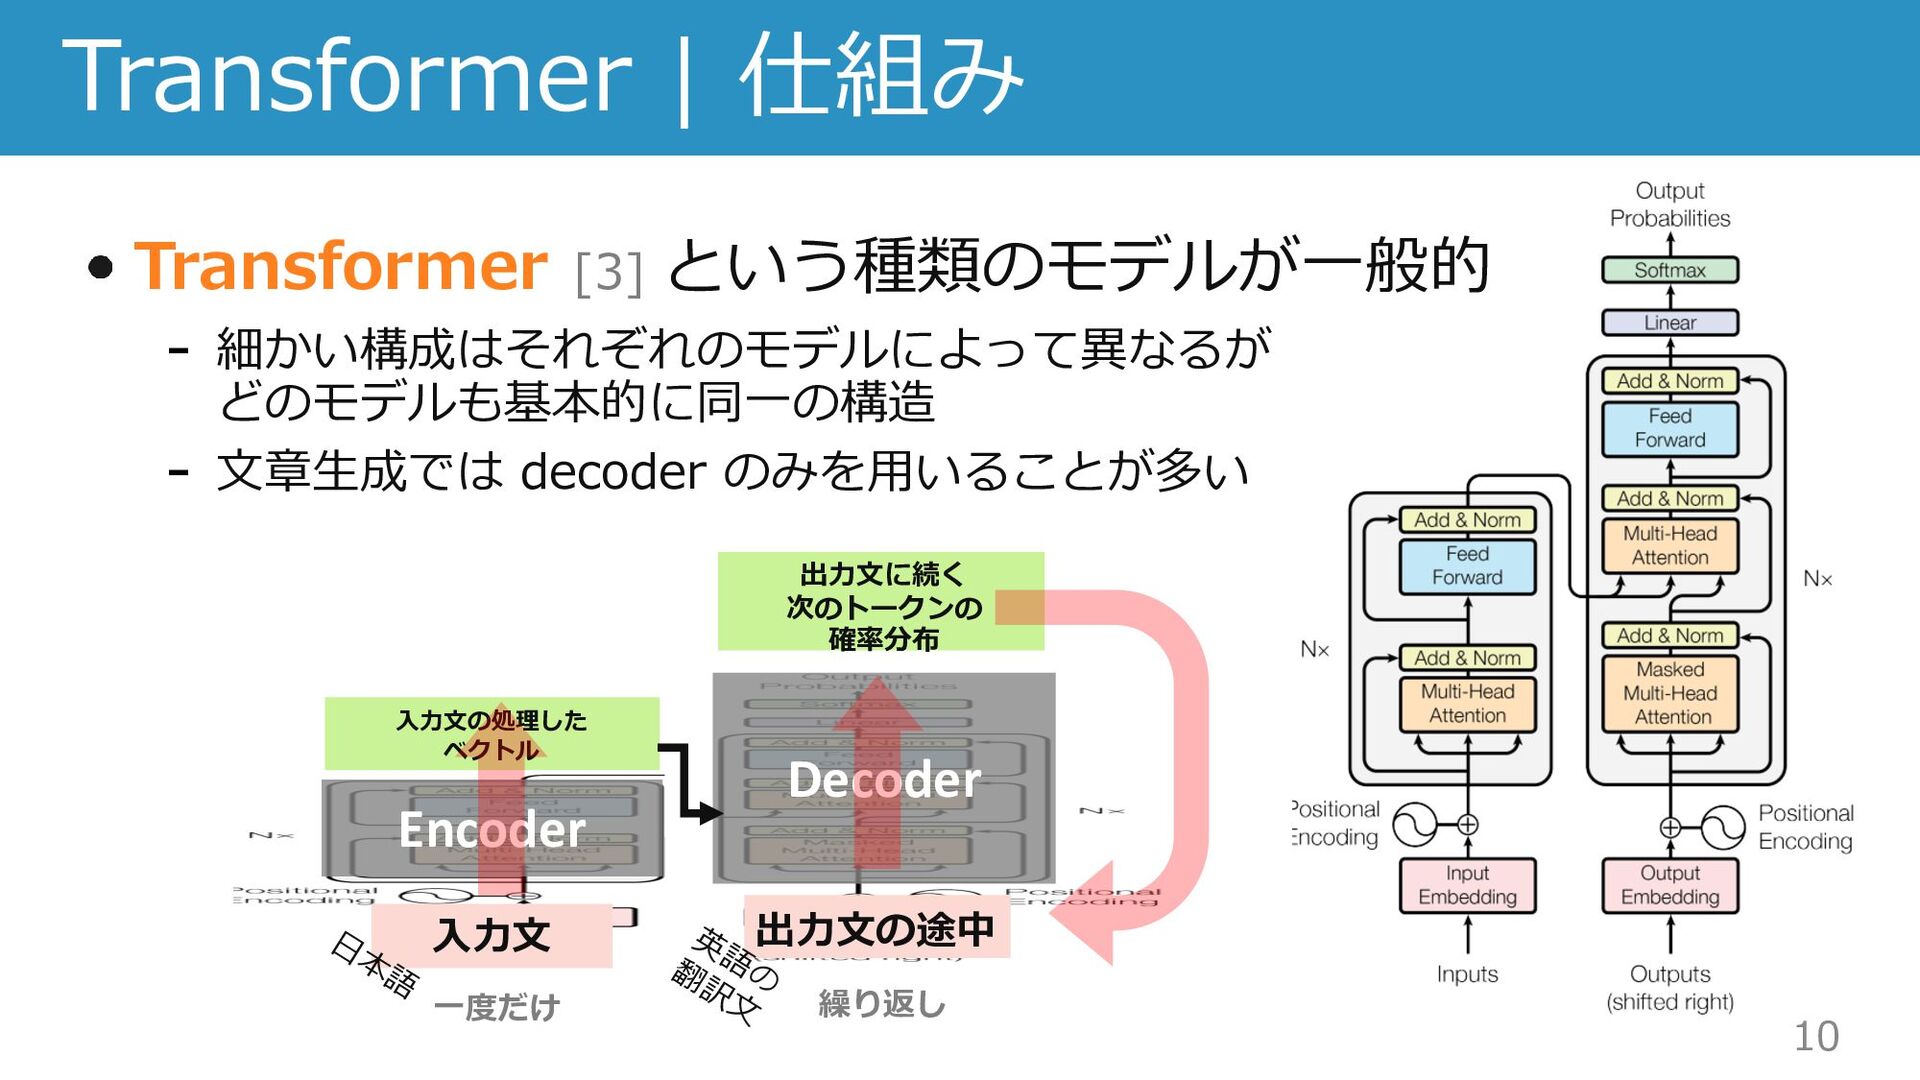
  8. Transformer [3] という種類のモデルが⼀般的 細かい構成はそれぞれのモデルによって異なるが どのモデルも基本的に同⼀の構造 ⽂章⽣成では decoder のみを⽤いることが多い 10 Transformer

    | 仕組み ⼊⼒⽂ 出⼒⽂の途中 Encoder Decoder 出⼒⽂に続く 次のトークンの 確率分布 ⼊⼒⽂の処理した ベクトル ⼀度だけ 繰り返し ⽇ 本 語 英 語 の 翻 訳 ⽂
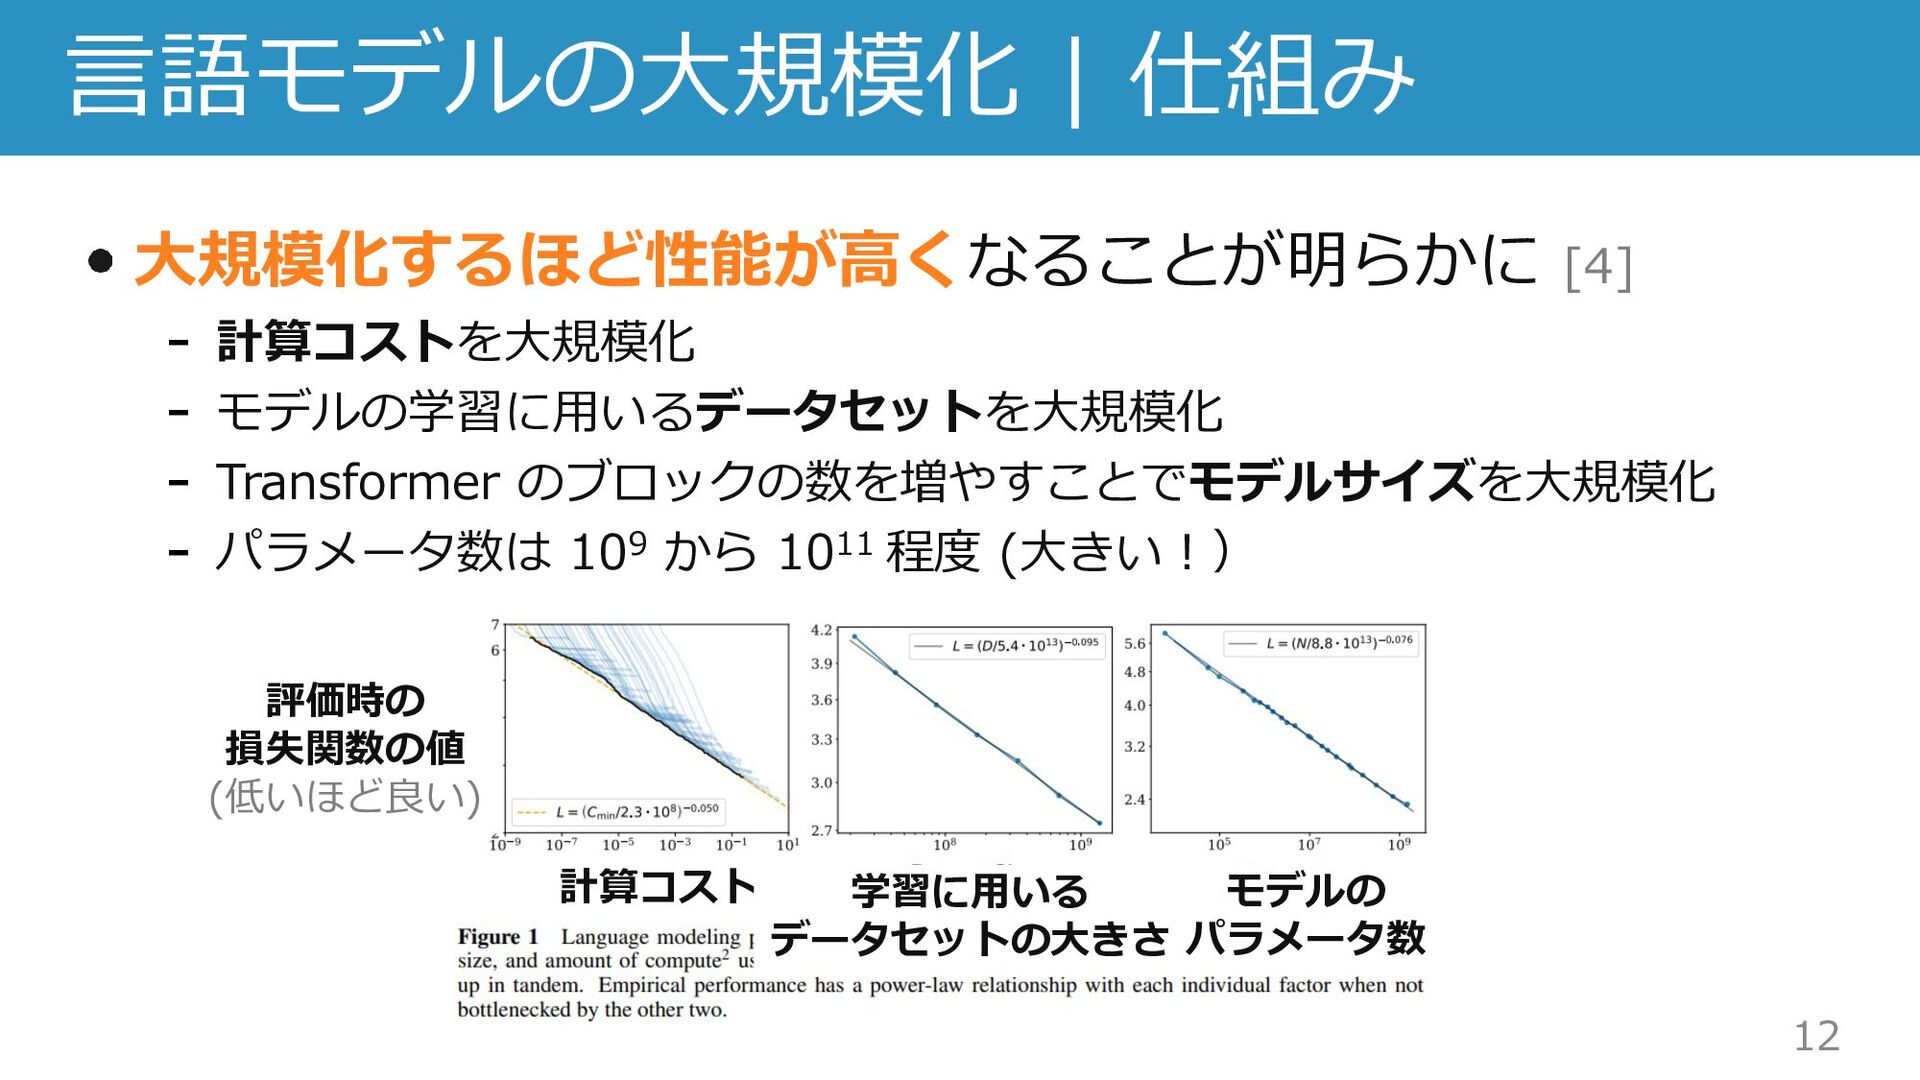
  9. 12 ⾔語モデルの⼤規模化 | 仕組み ⼤規模化するほど性能が⾼くなることが明らかに [4] 計算コストを⼤規模化 モデルの学習に⽤いるデータセットを⼤規模化 Transformer のブロックの数を増やすことでモデルサイズを⼤規模化

    パラメータ数は 109 から 1011 程度 (⼤きい︕) 計算コスト 学習に⽤いる データセットの⼤きさ モデルの パラメータ数 評価時の 損失関数の値 (低いほど良い)
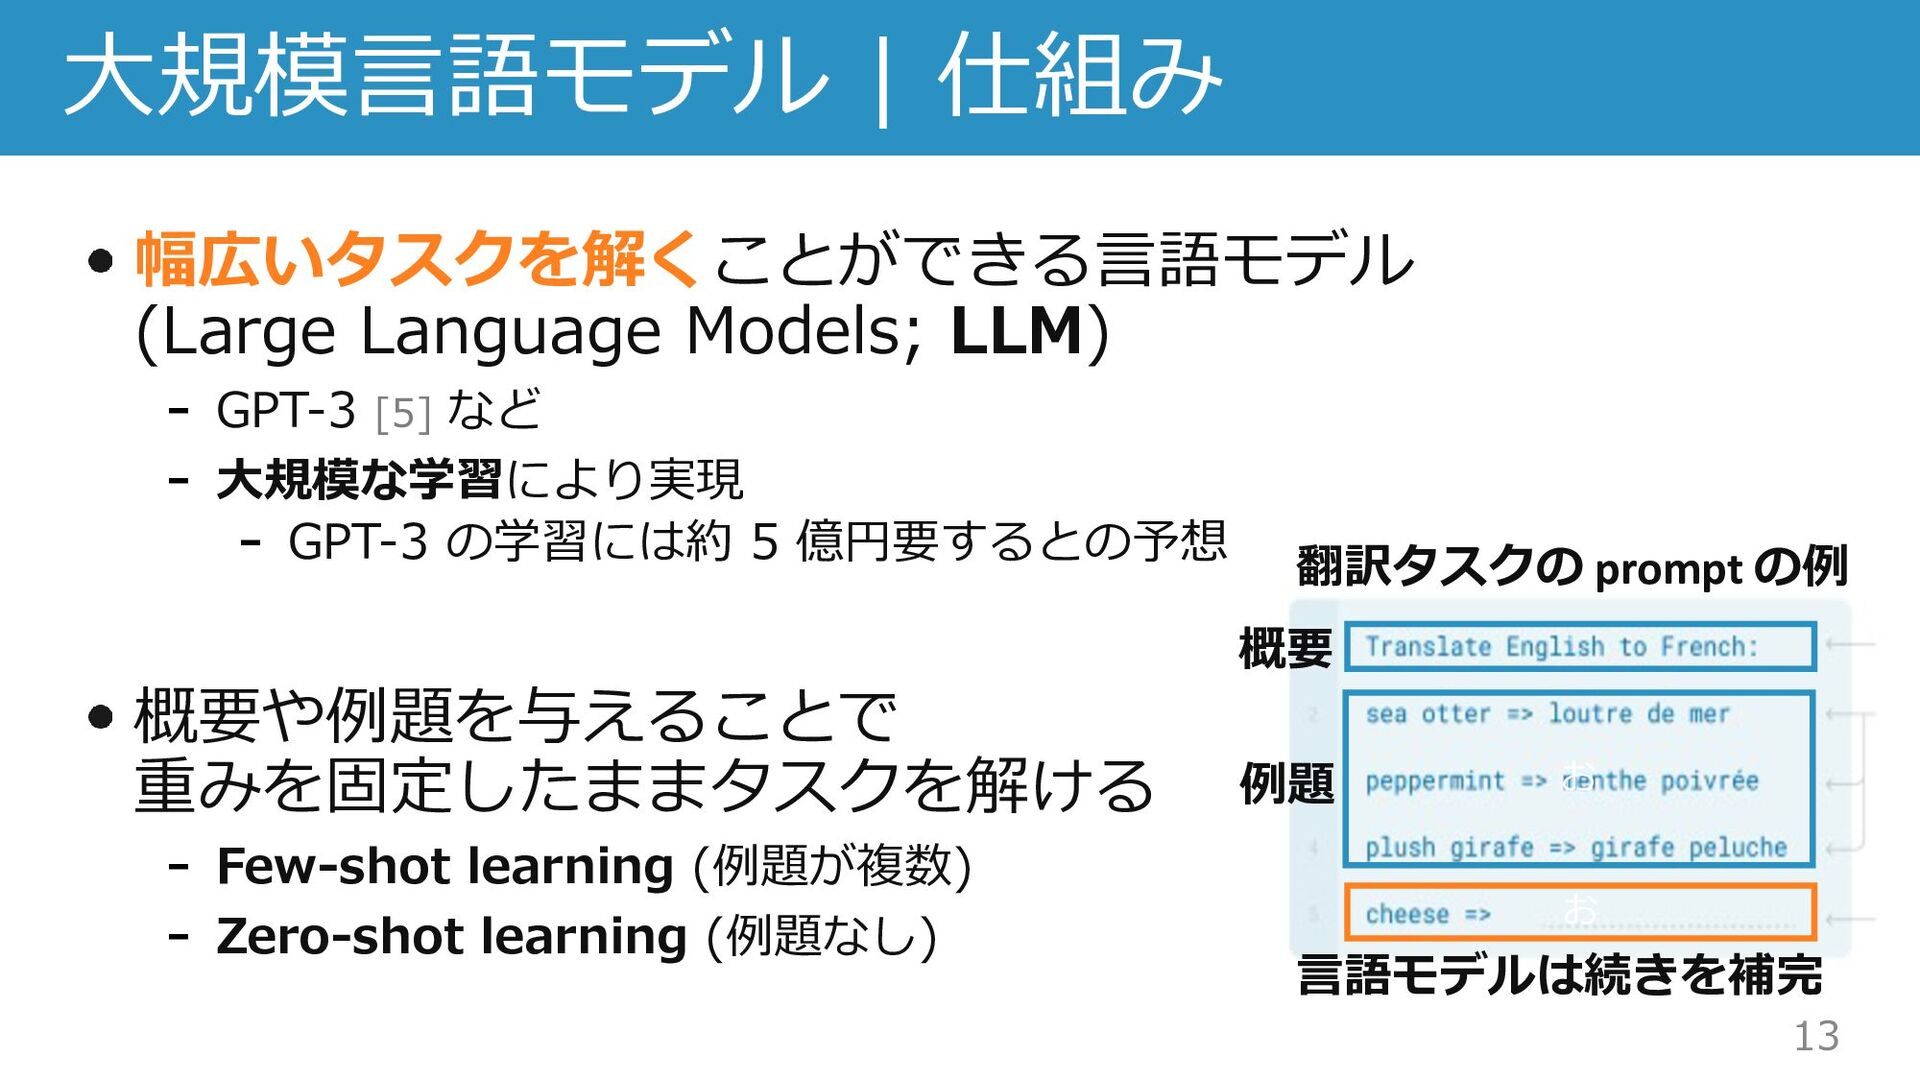
  10. 13 ⼤規模⾔語モデル | 仕組み 幅広いタスクを解くことができる⾔語モデル (Large Language Models; LLM) GPT-3

    [5] など ⼤規模な学習により実現 GPT-3 の学習には約 5 億円要するとの予想 概要や例題を与えることで 重みを固定したままタスクを解ける Few-shot learning (例題が複数) Zero-shot learning (例題なし) お 概要 例題 翻訳タスクの prompt の例 お ⾔語モデルは続きを補完
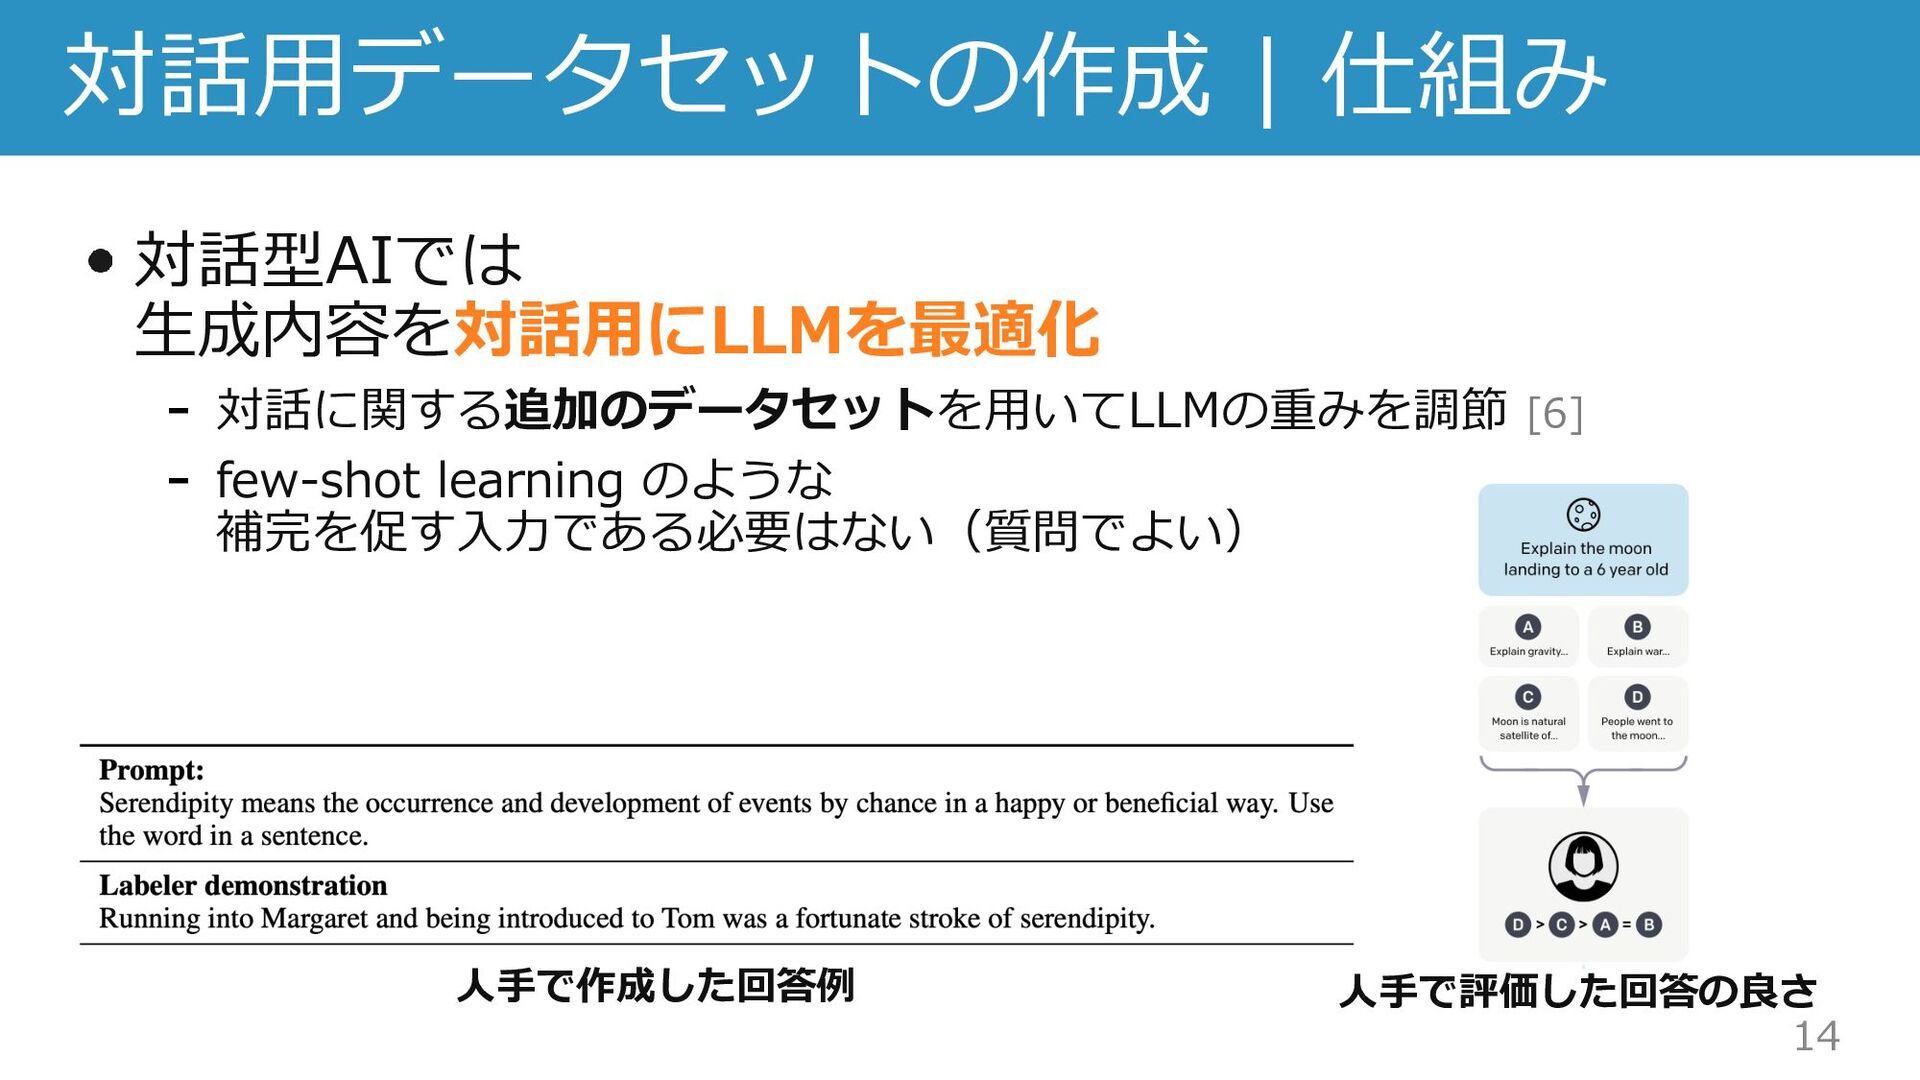
  11. 14 対話⽤データセットの作成 | 仕組み 対話型AIでは ⽣成内容を対話⽤にLLMを最適化 対話に関する追加のデータセットを⽤いてLLMの重みを調節 [6] few-shot learning

    のような 補完を促す⼊⼒である必要はない(質問でよい) ⼈⼿で作成した回答例 ⼈⼿で評価した回答の良さ
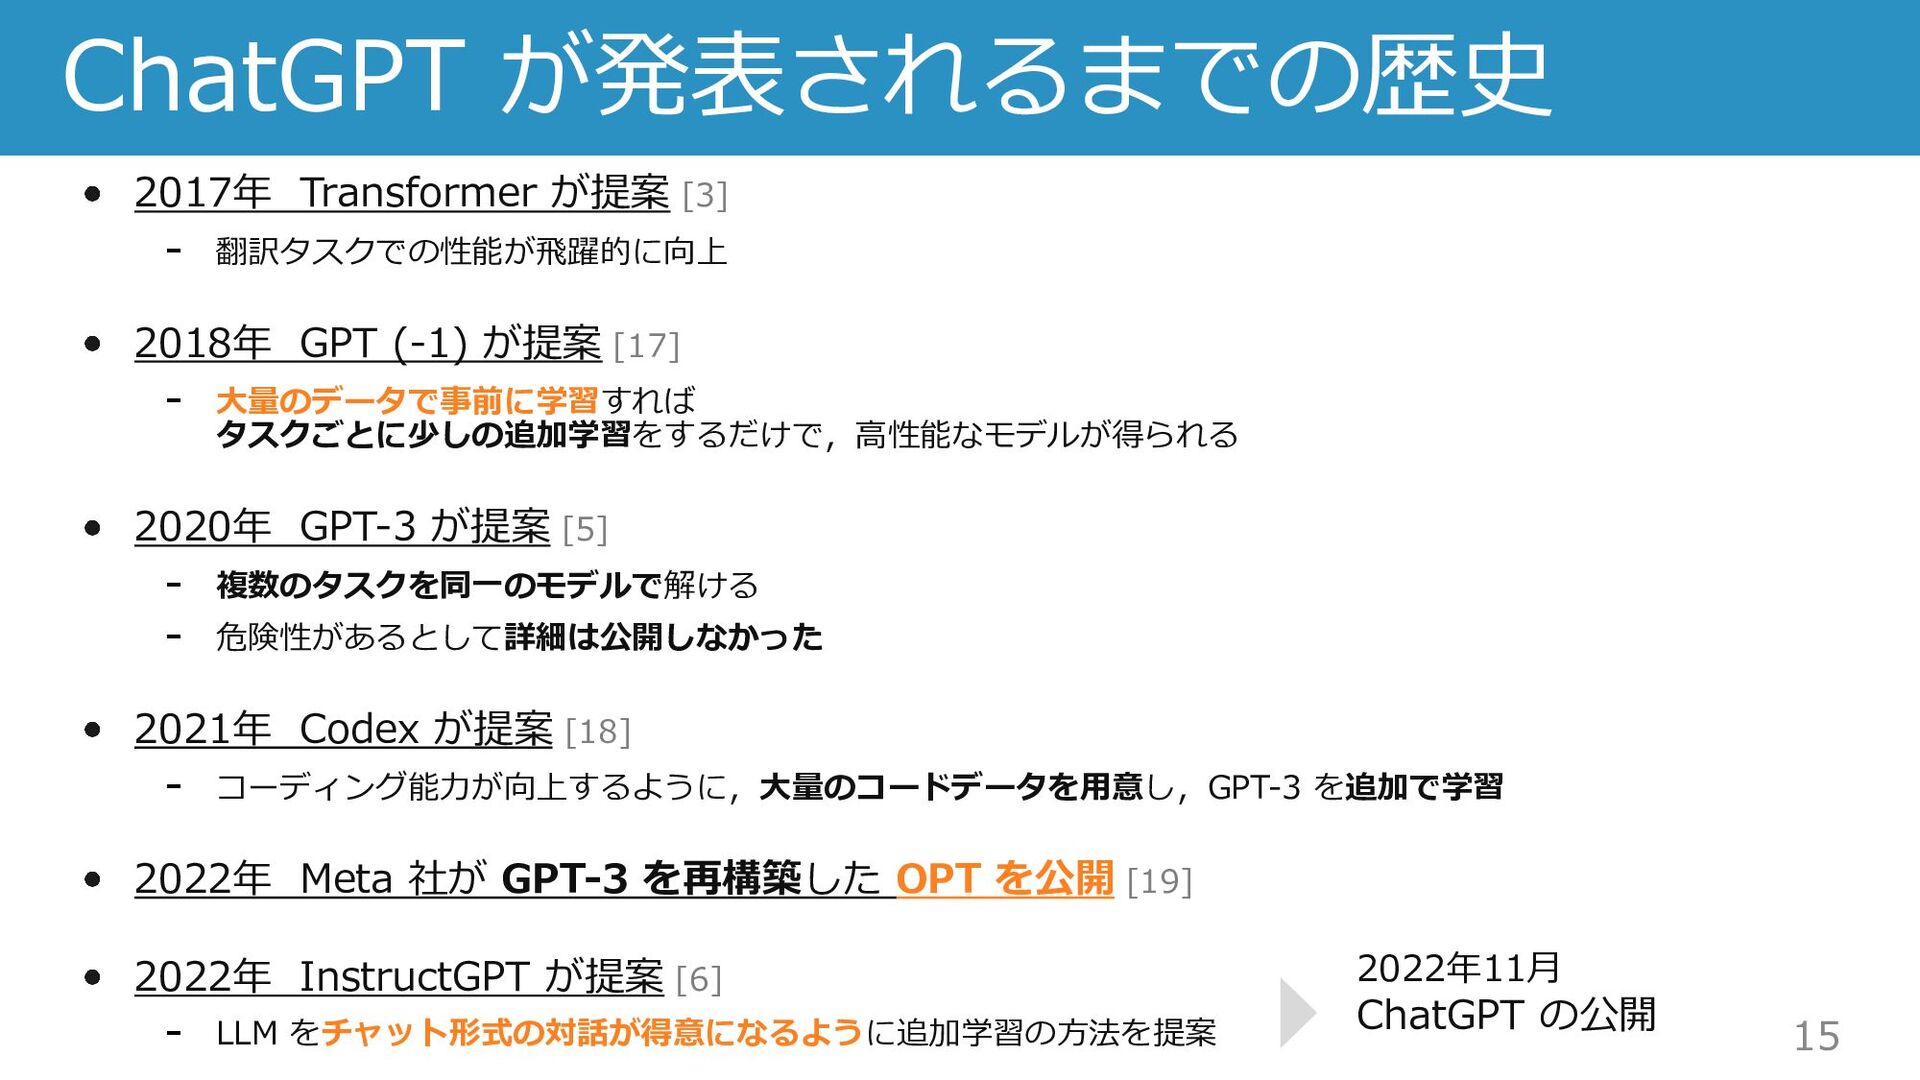
  12. 15 ChatGPT が発表されるまでの歴史 2017年 Transformer が提案 [3] 翻訳タスクでの性能が⾶躍的に向上 2018年 GPT

    (-1) が提案 [17] ⼤量のデータで事前に学習すれば タスクごとに少しの追加学習をするだけで,⾼性能なモデルが得られる 2020年 GPT-3 が提案 [5] 複数のタスクを同⼀のモデルで解ける 危険性があるとして詳細は公開しなかった 2021年 Codex が提案 [18] コーディング能⼒が向上するように,⼤量のコードデータを⽤意し,GPT-3 を追加で学習 2022年 Meta 社が GPT-3 を再構築した OPT を公開 [19] 2022年 InstructGPT が提案 [6] LLM をチャット形式の対話が得意になるように追加学習の⽅法を提案 2022年11⽉ ChatGPT の公開
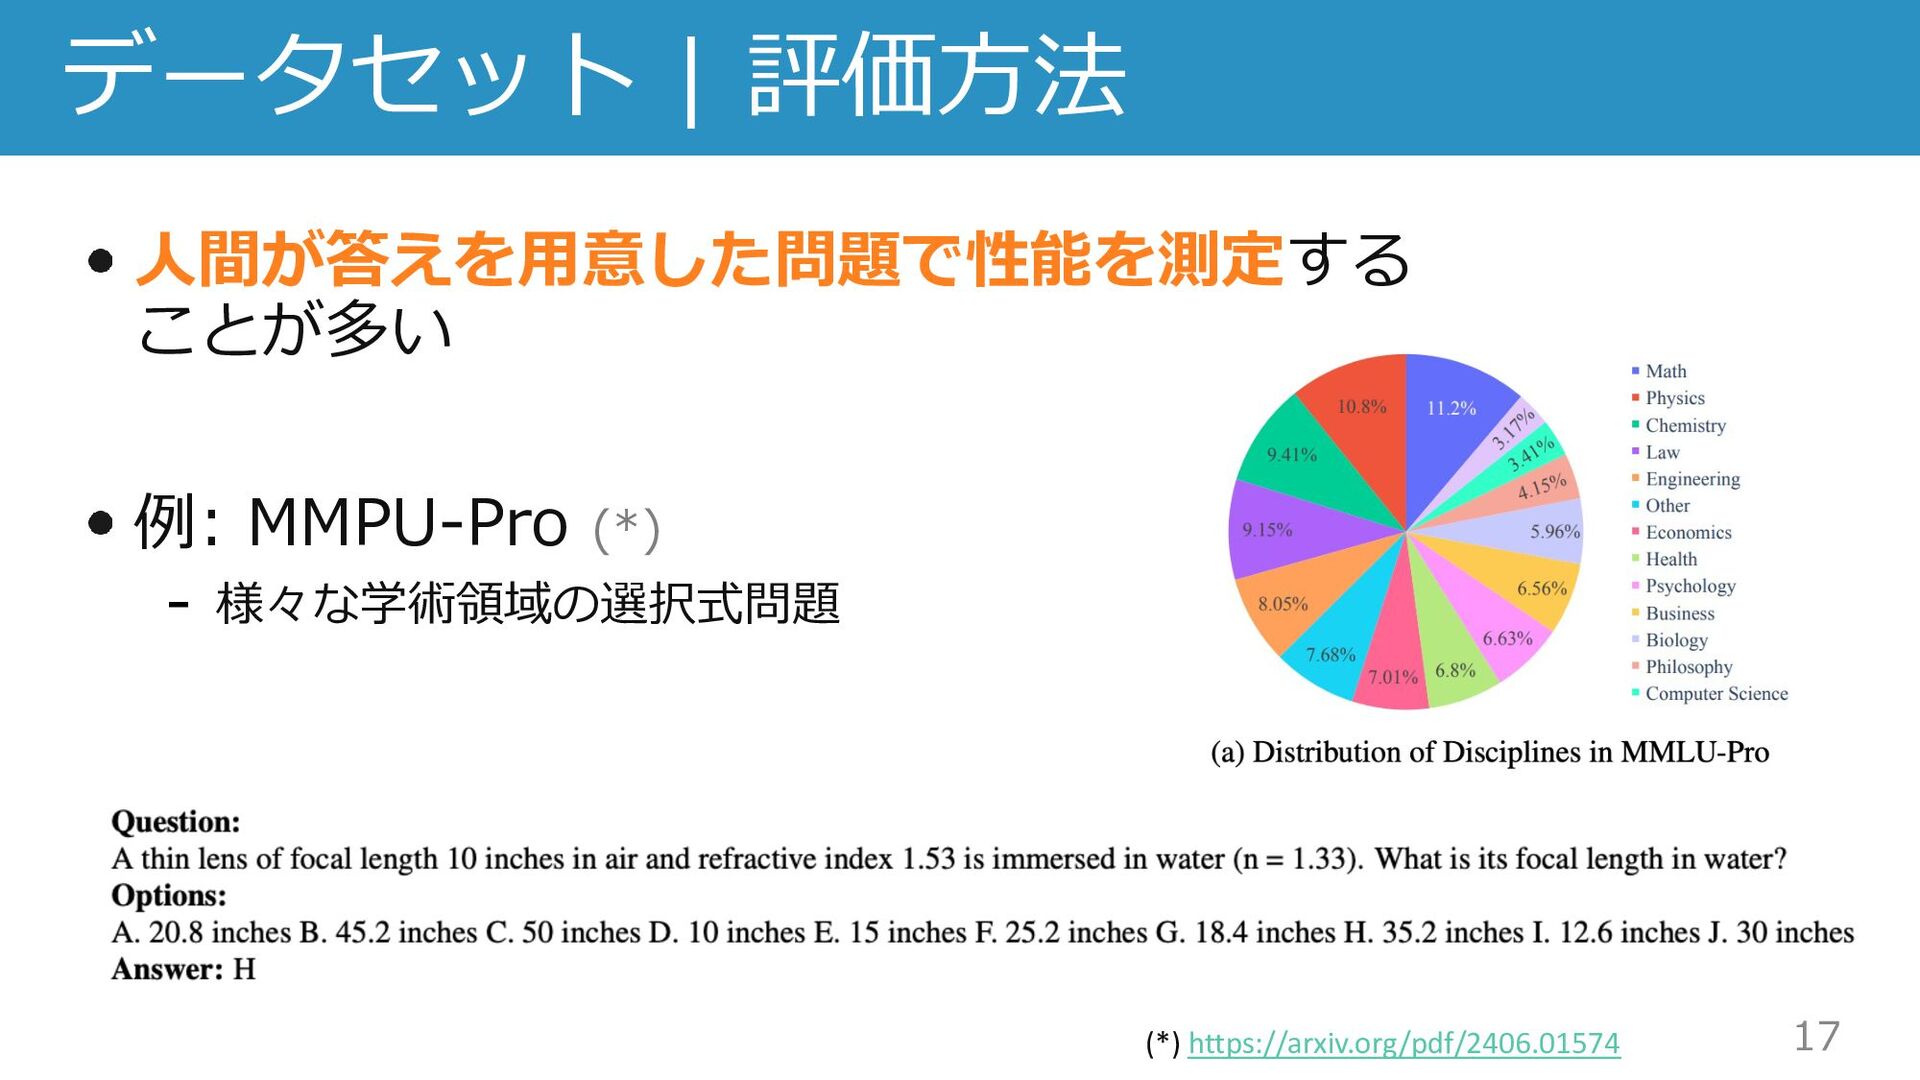
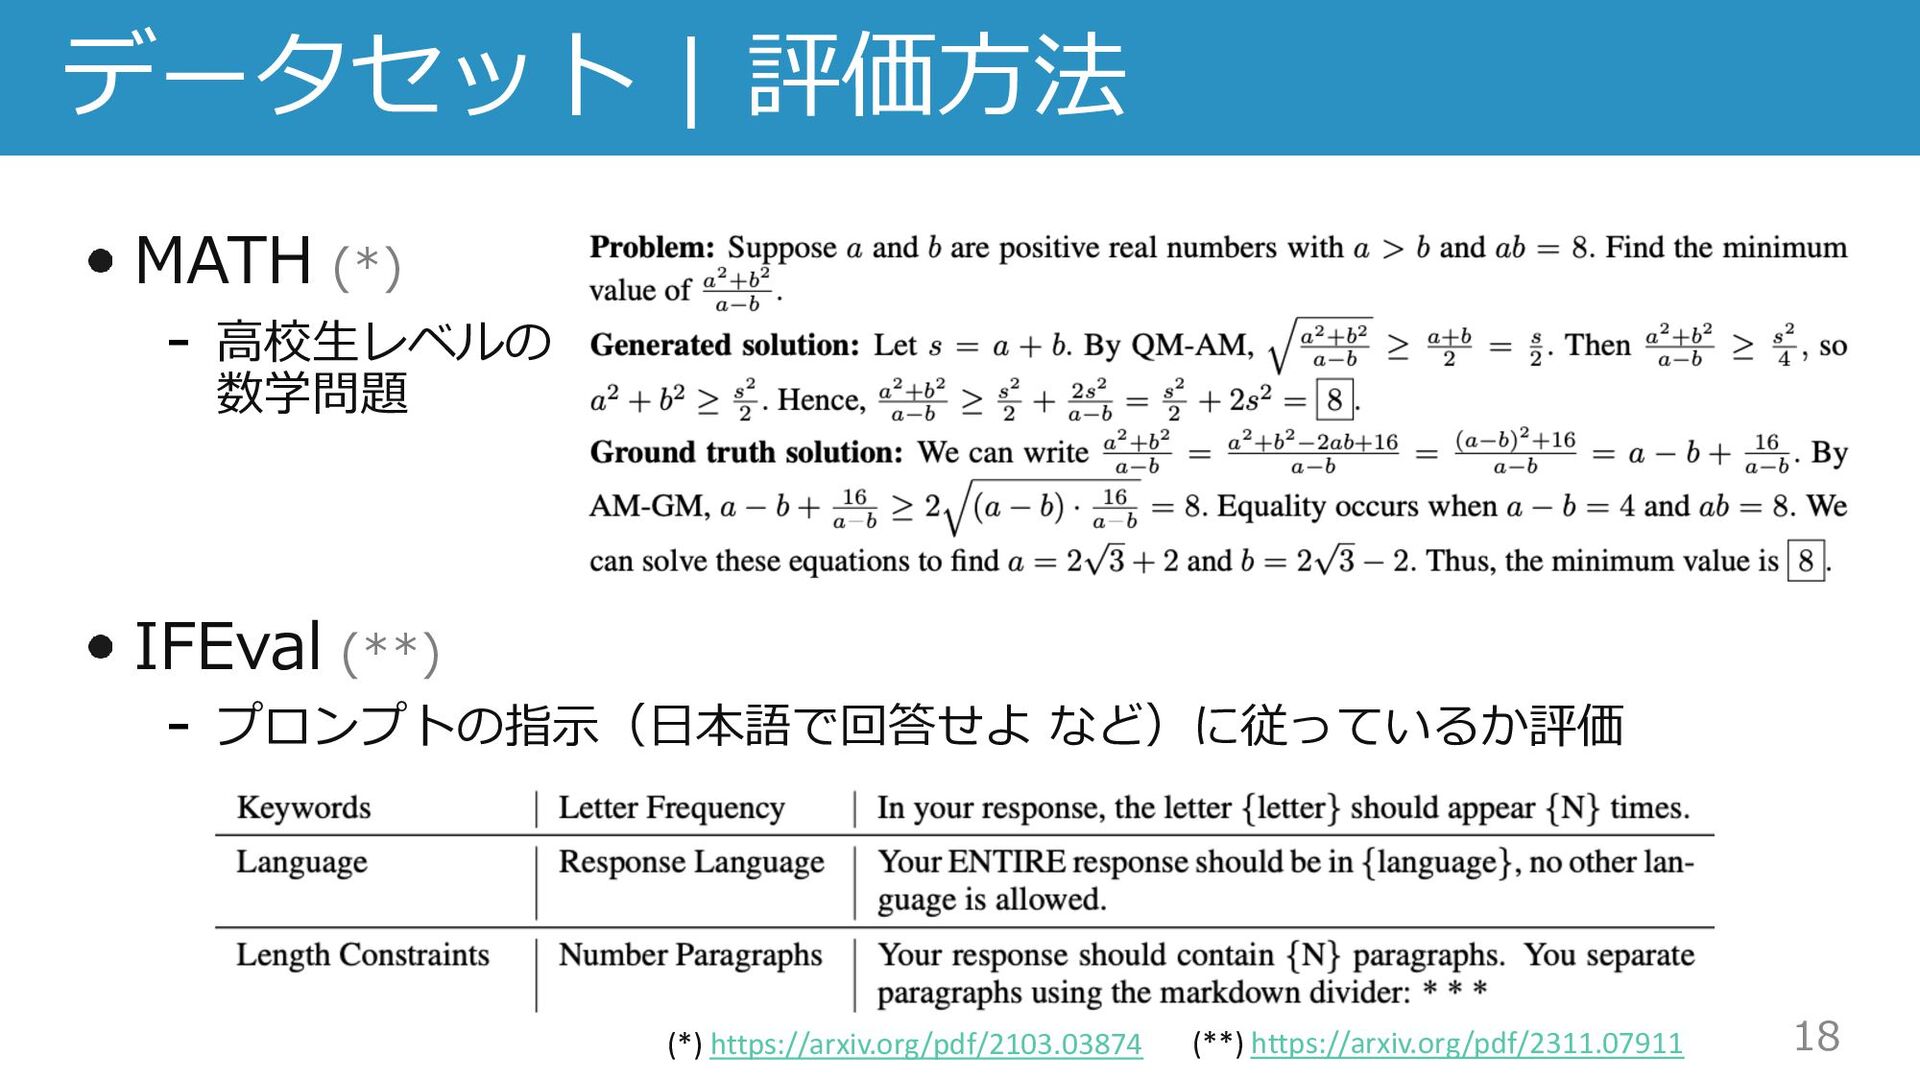
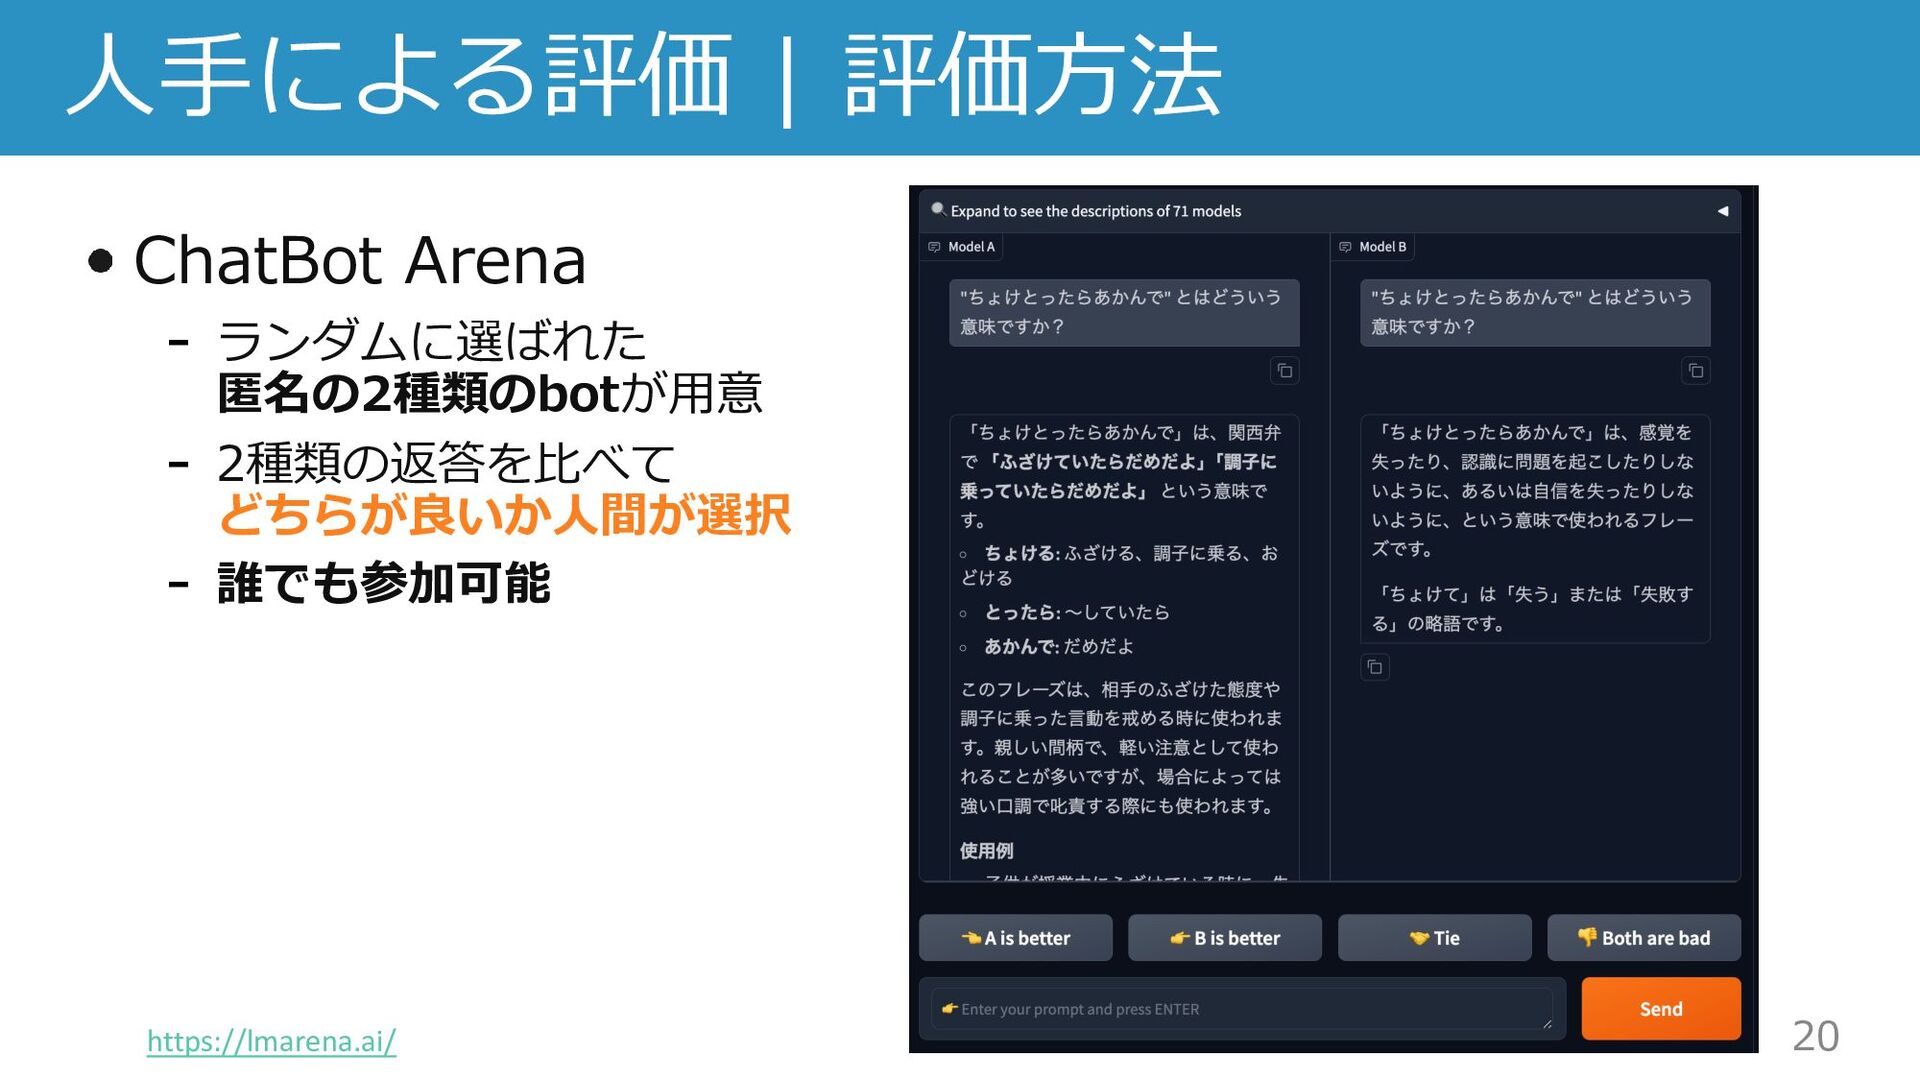
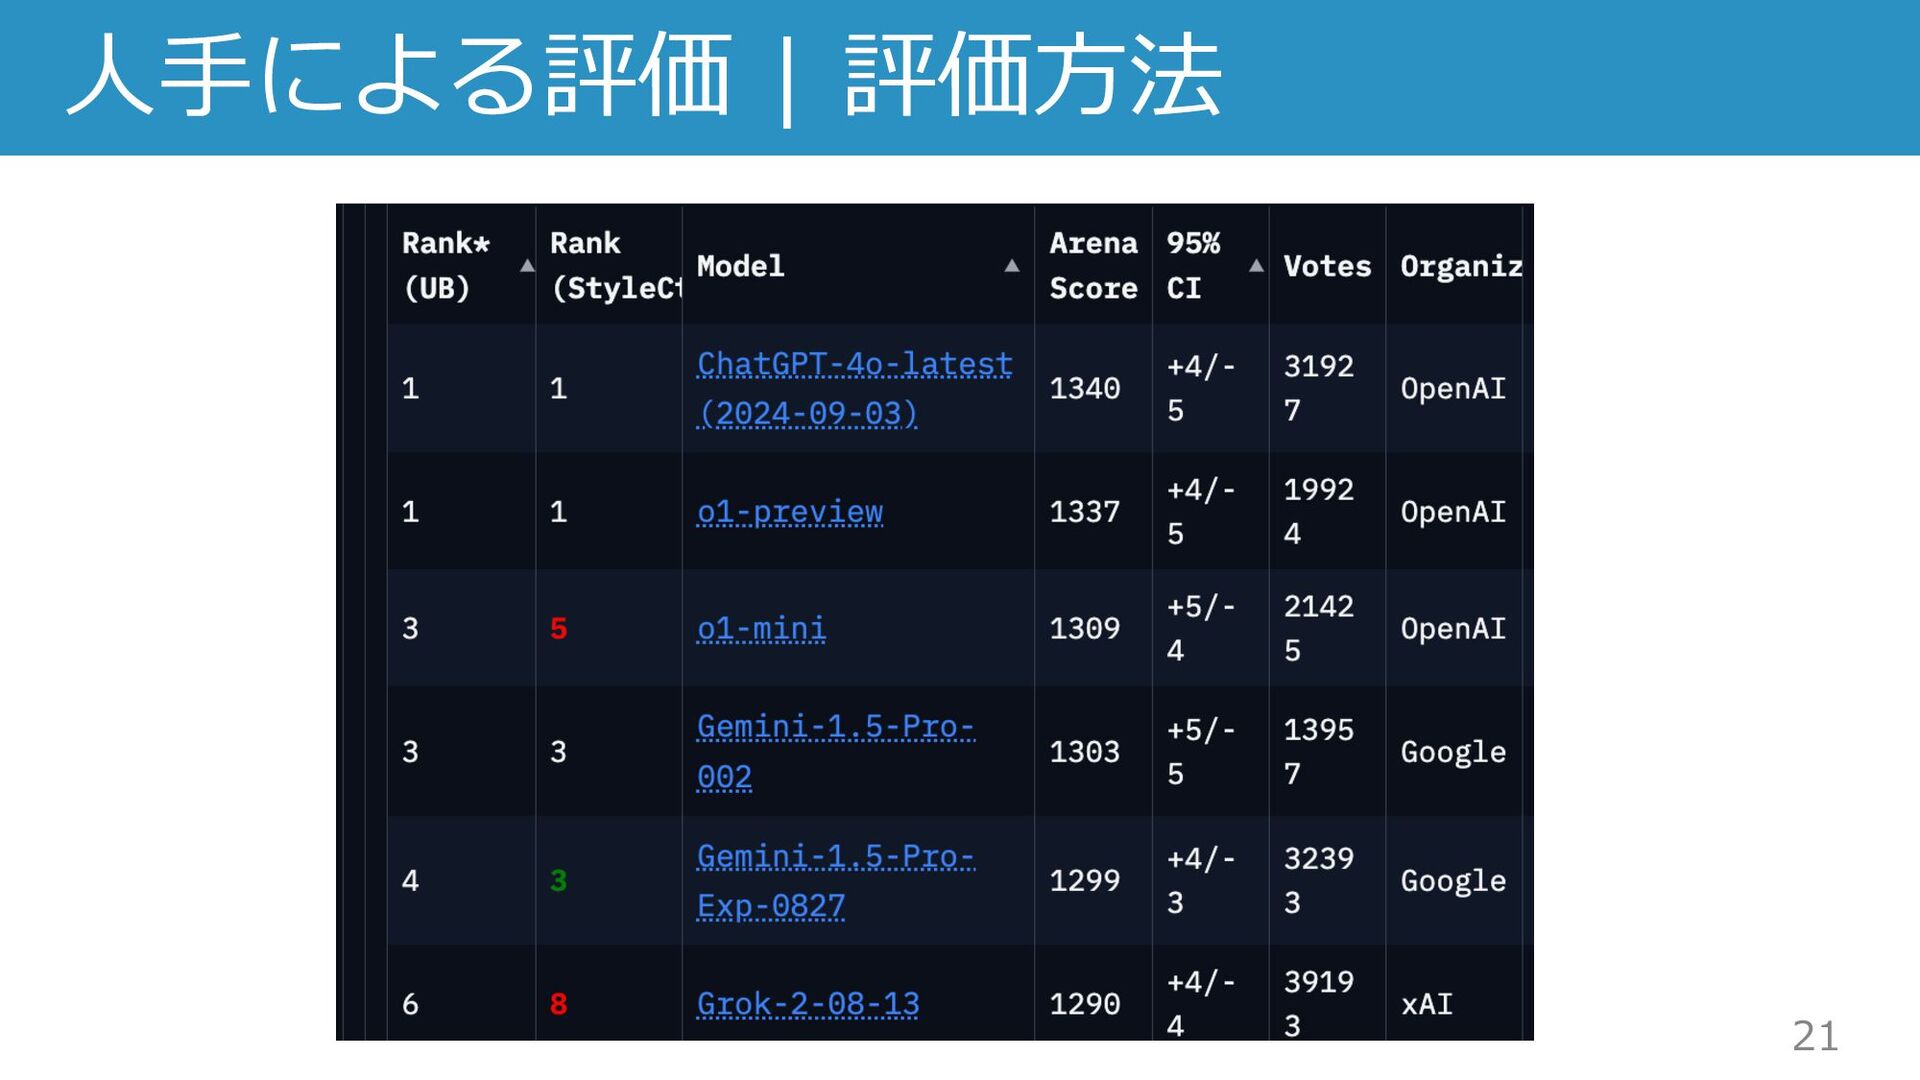
  13. 18 データセット | 評価⽅法 MATH (*) ⾼校⽣レベルの 数学問題 IFEval (**)

    プロンプトの指⽰(⽇本語で回答せよ など)に従っているか評価 (**) https://arxiv.org/pdf/2311.07911 (*) https://arxiv.org/pdf/2103.03874
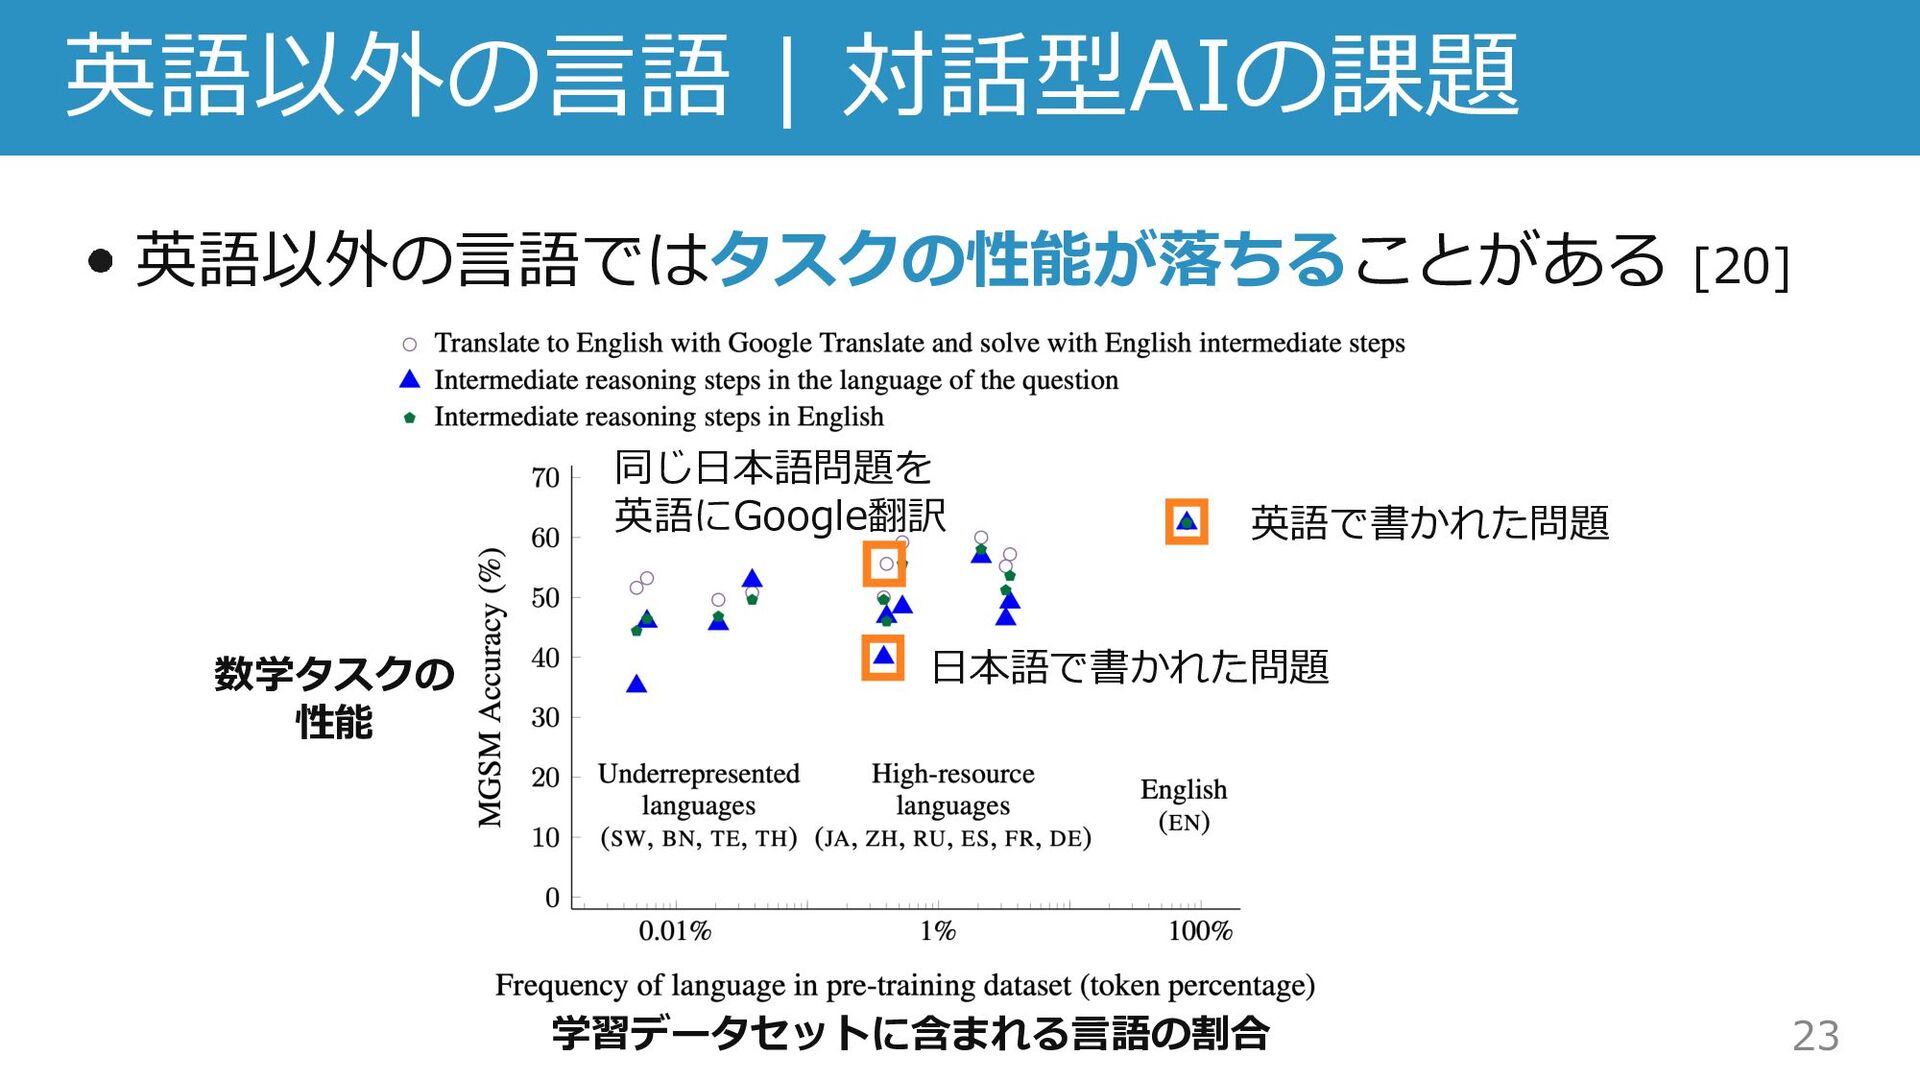
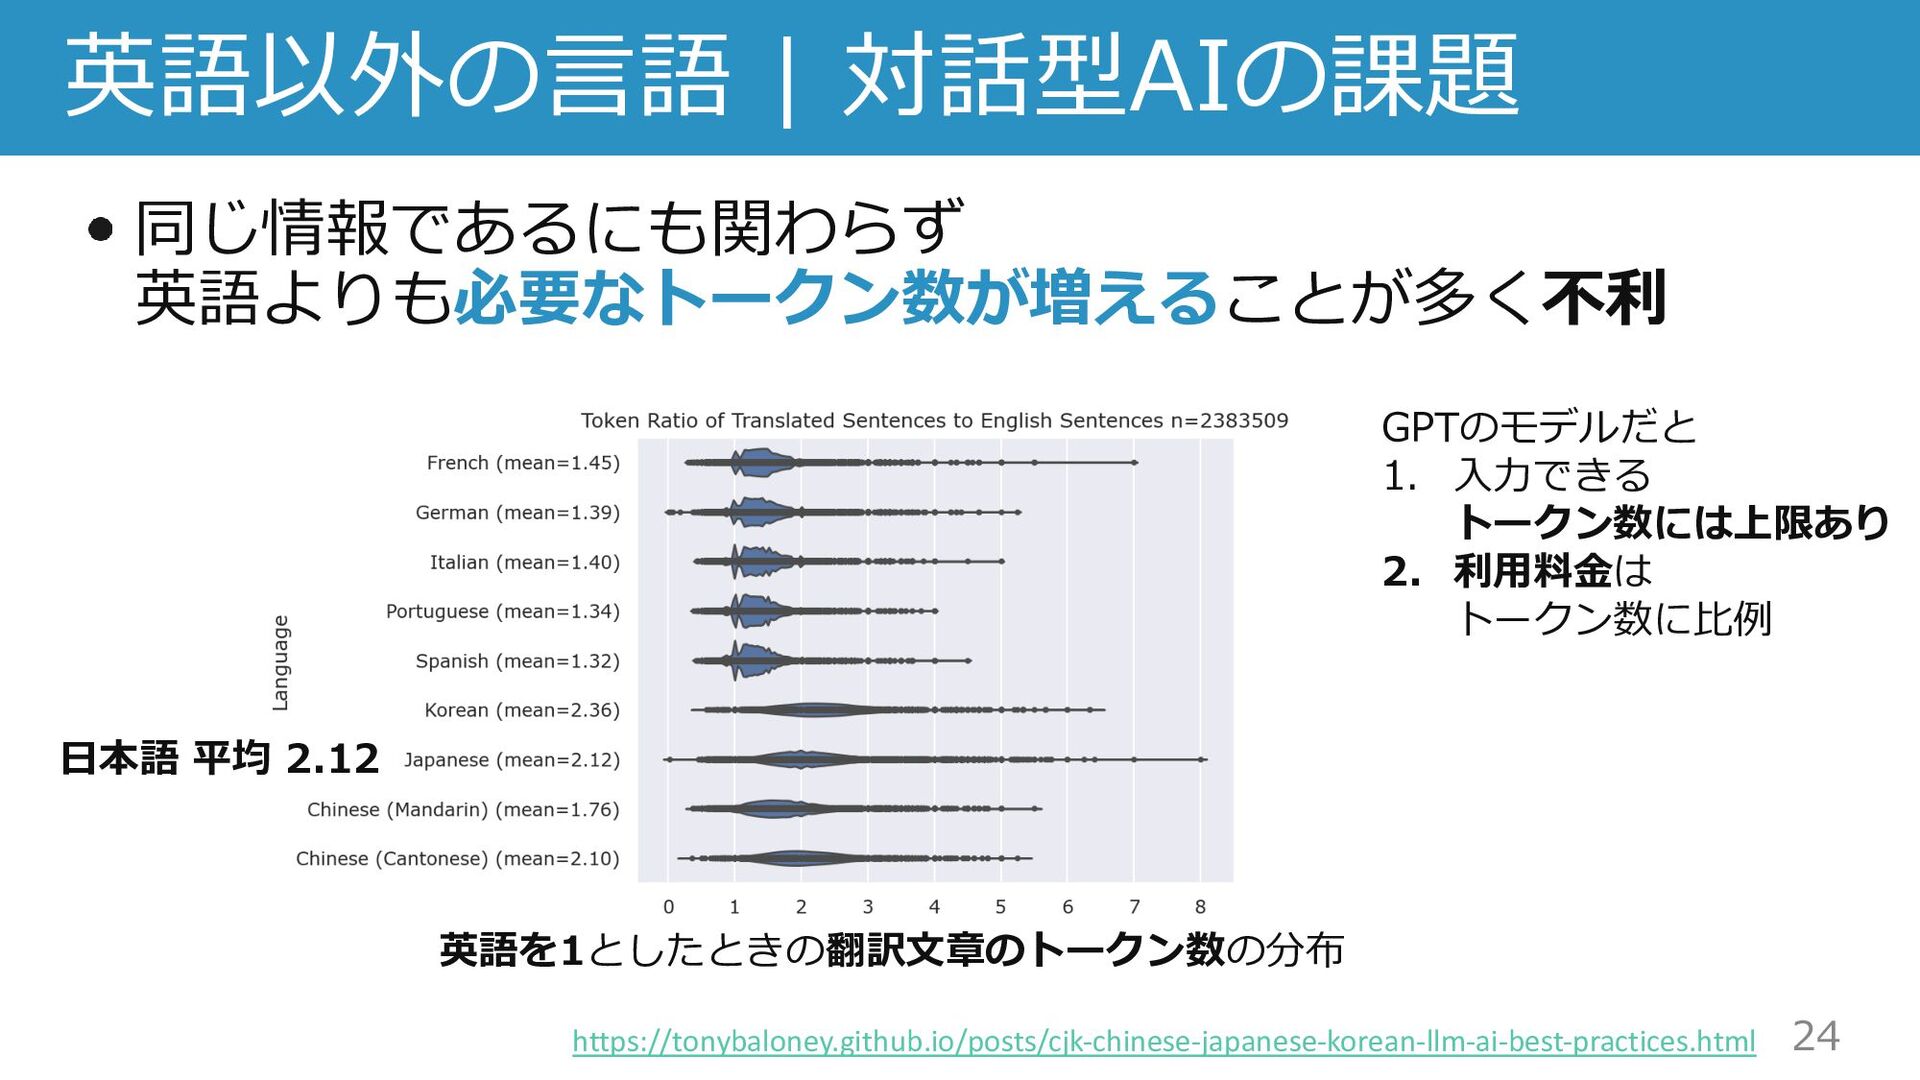
  14. 英語を1としたときの翻訳⽂章のトークン数の分布 ⽇本語 平均 2.12 24 英語以外の⾔語 | 対話型AIの課題 同じ情報であるにも関わらず 英語よりも必要なトークン数が増えることが多く不利

    https://tonybaloney.github.io/posts/cjk-chinese-japanese-korean-llm-ai-best-practices.html GPTのモデルだと 1. ⼊⼒できる トークン数には上限あり 2. 利⽤料⾦は トークン数に⽐例
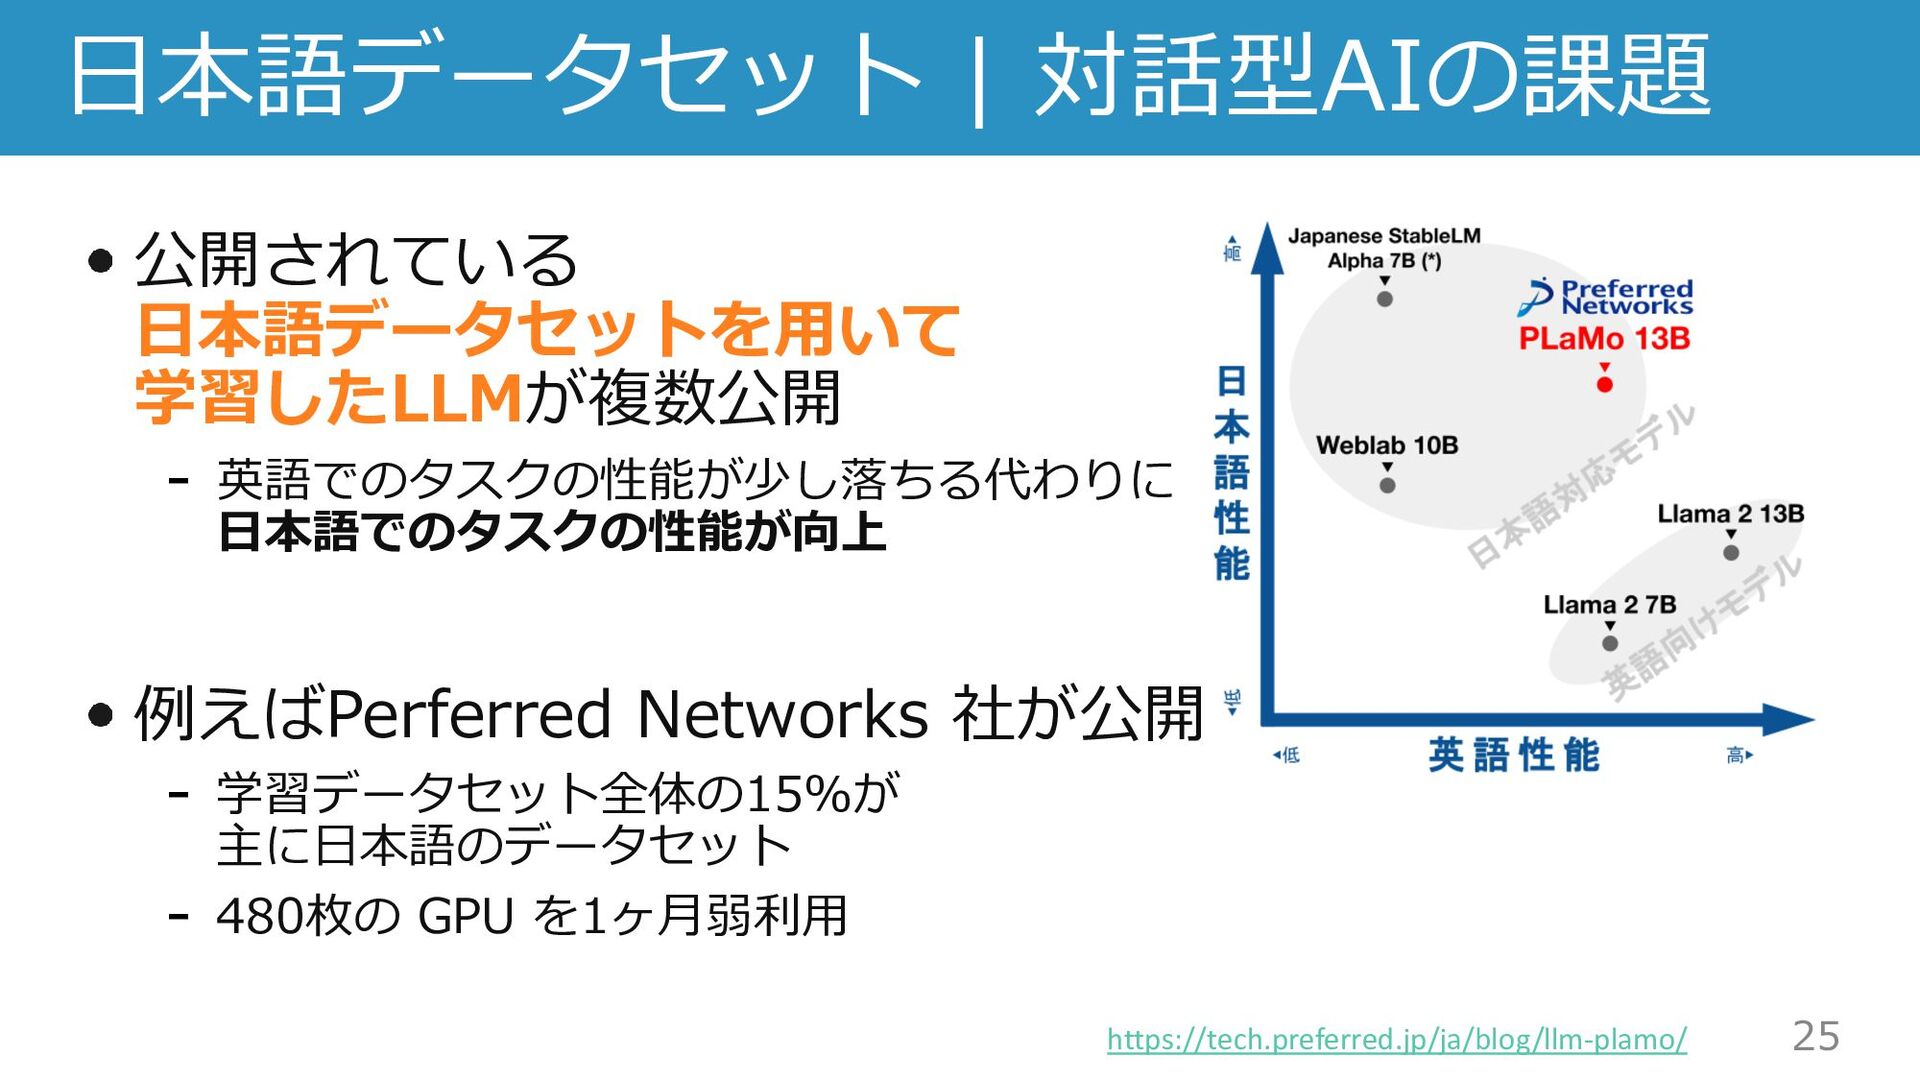
  15. 25 ⽇本語データセット | 対話型AIの課題 公開されている ⽇本語データセットを⽤いて 学習したLLMが複数公開 英語でのタスクの性能が少し落ちる代わりに ⽇本語でのタスクの性能が向上 例えばPerferred

    Networks 社が公開 学習データセット全体の15%が 主に⽇本語のデータセット 480枚の GPU を1ヶ⽉弱利⽤ https://tech.preferred.jp/ja/blog/llm-plamo/
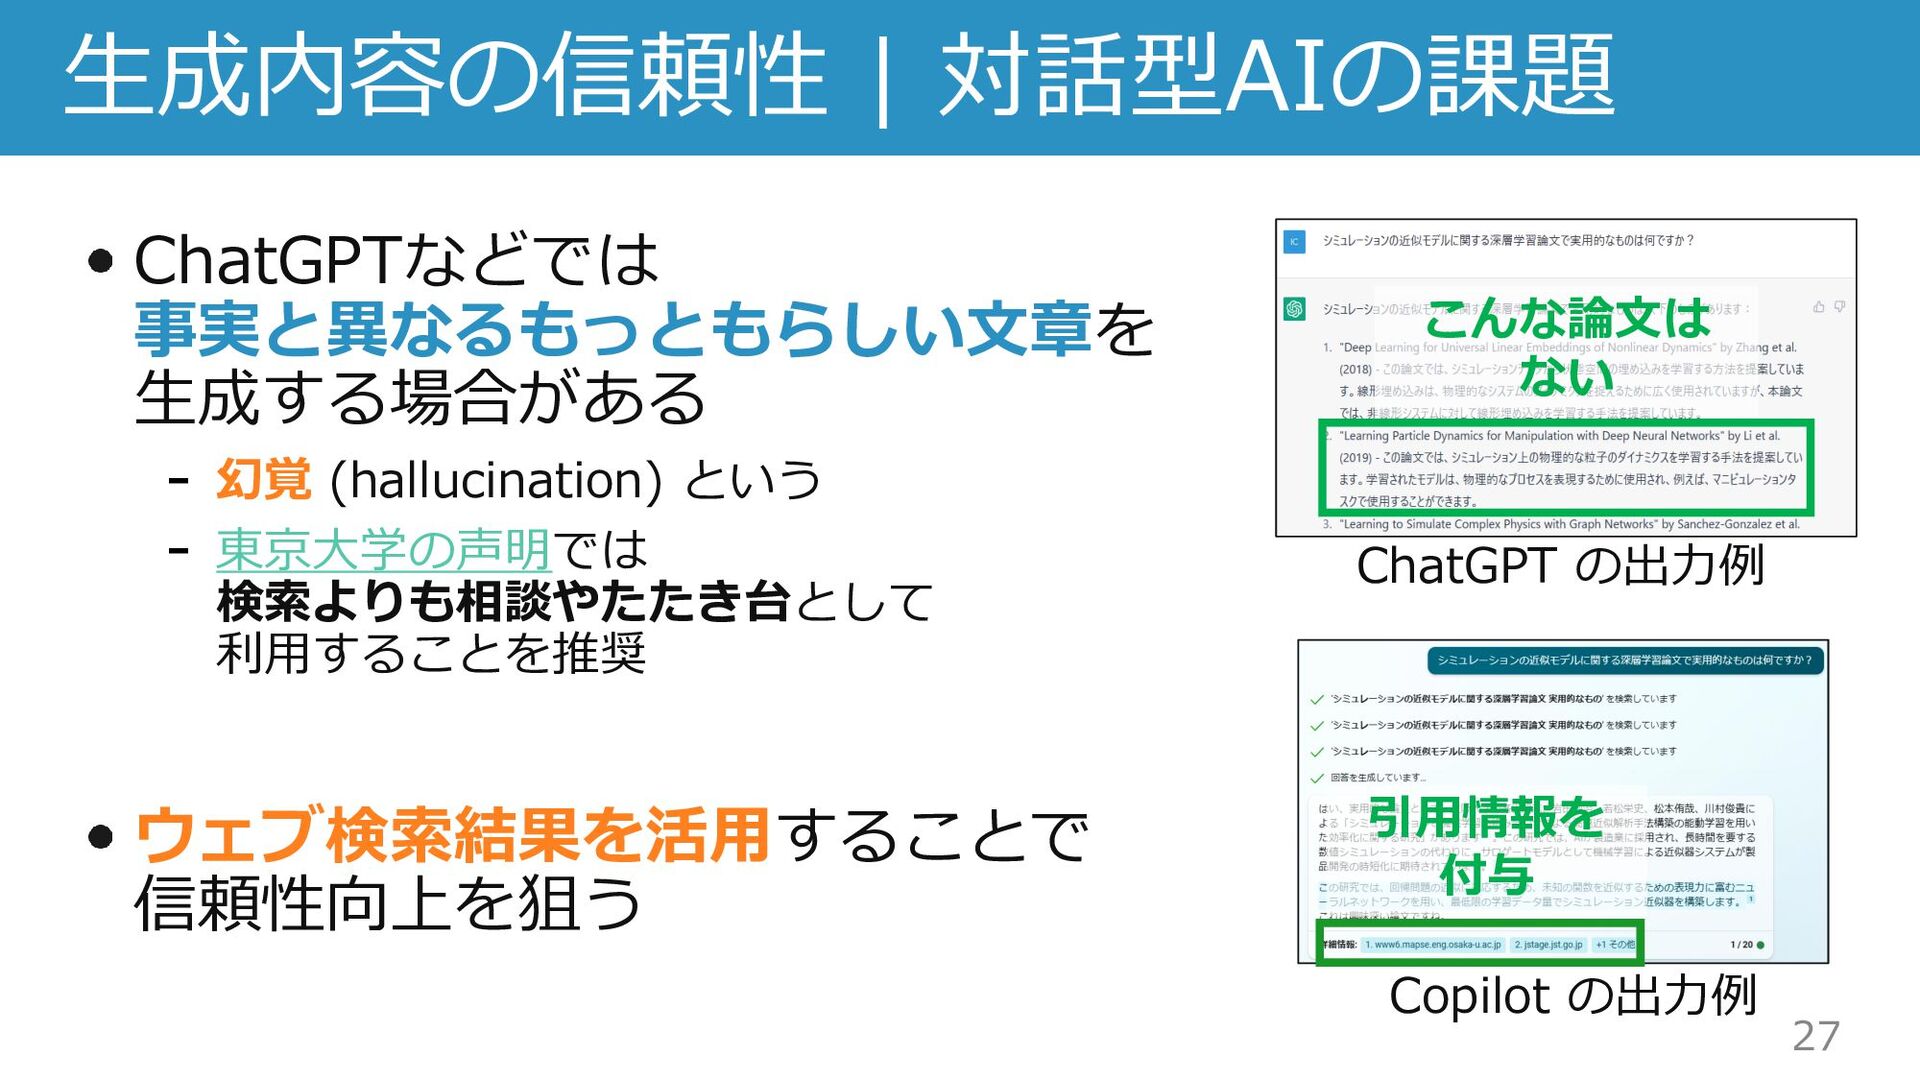
  16. 27 ⽣成内容の信頼性 | 対話型AIの課題 ChatGPTなどでは 事実と異なるもっともらしい⽂章を ⽣成する場合がある 幻覚 (hallucination) という

    東京⼤学の声明では 検索よりも相談やたたき台として 利⽤することを推奨 ウェブ検索結果を活⽤することで 信頼性向上を狙う こんな論⽂は ない ChatGPT の出⼒例 引⽤情報を 付与 Copilot の出⼒例
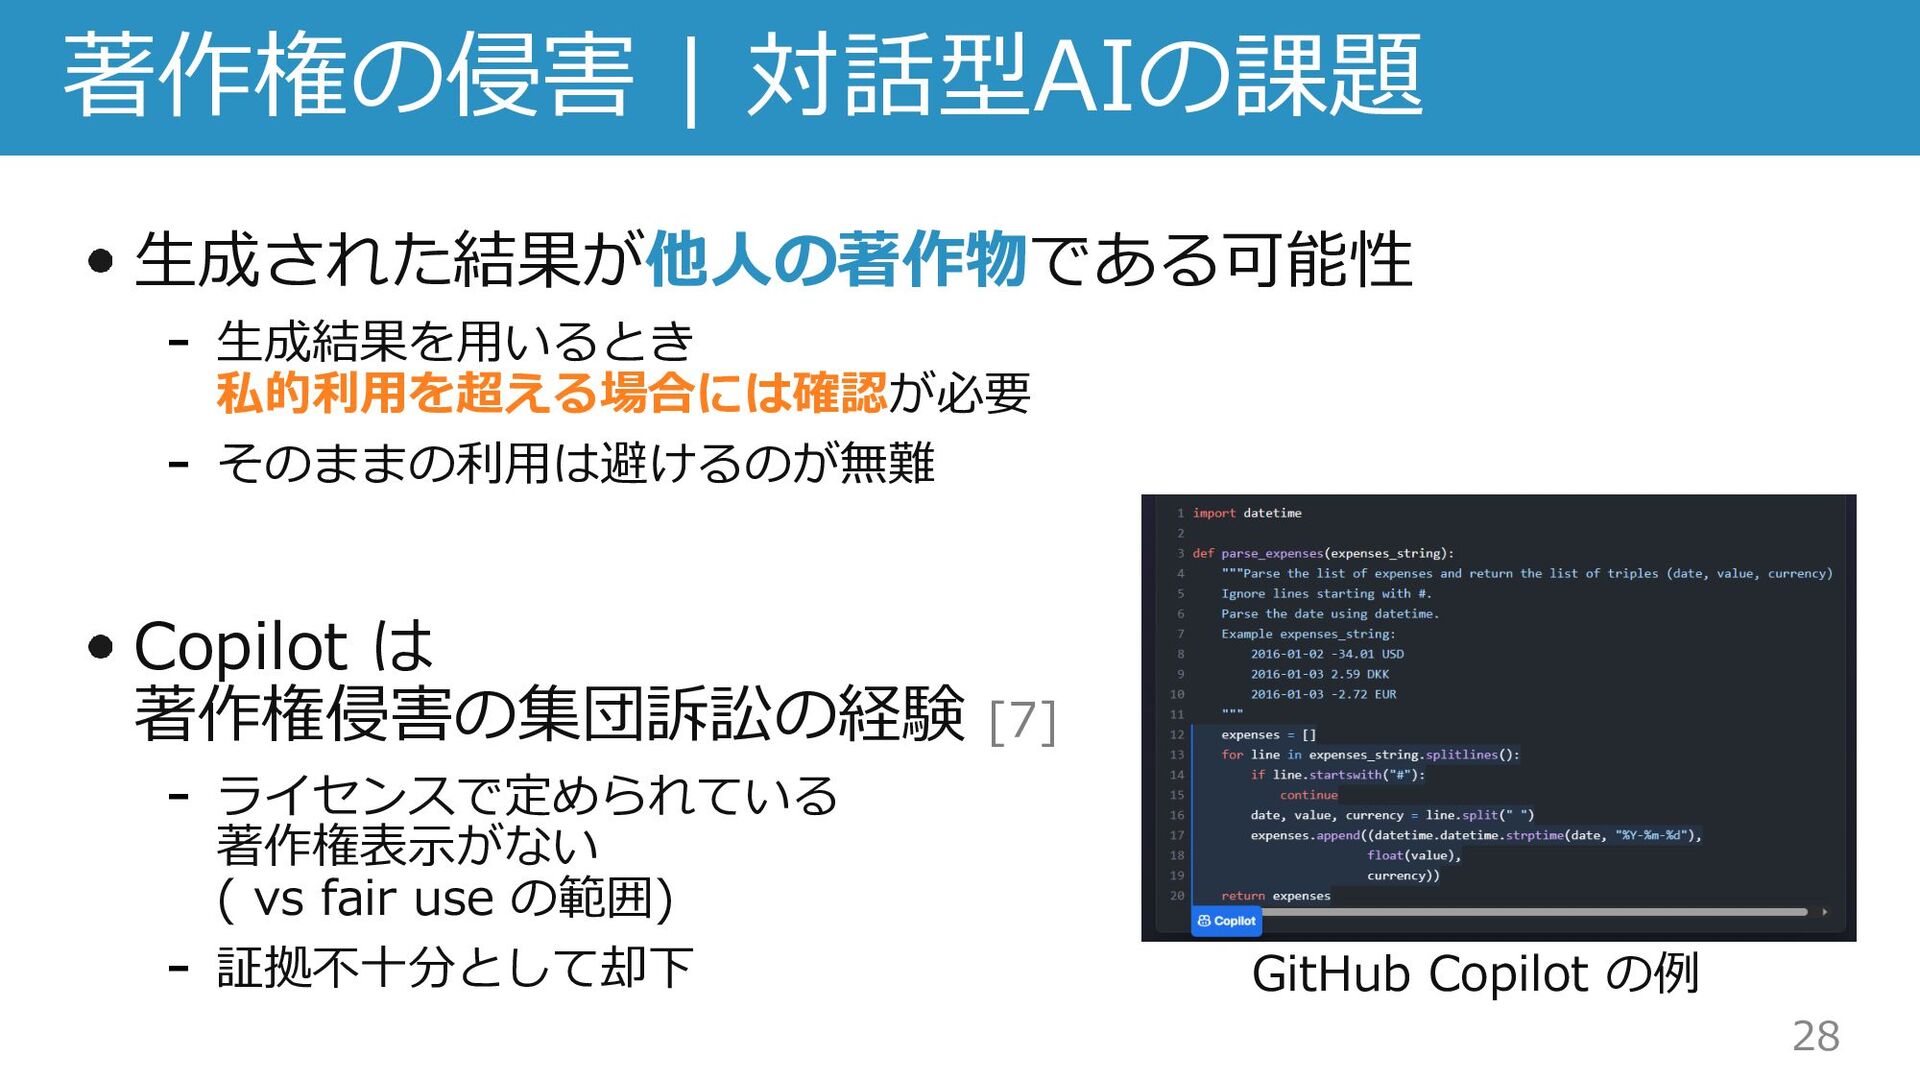
  17. 28 著作権の侵害 | 対話型AIの課題 ⽣成された結果が他⼈の著作物である可能性 ⽣成結果を⽤いるとき 私的利⽤を超える場合には確認が必要 そのままの利⽤は避けるのが無難 Copilot は

    著作権侵害の集団訴訟の経験 [7] ライセンスで定められている 著作権表⽰がない ( vs fair use の範囲) 証拠不⼗分として却下 GitHub Copilot の例
  18. ⽬次 ⼤規模⾔語モデル 対話型AI, ⾔語モデル, Transformer, スケーリング則 few-shot learning, hallucination, ⽇本語学習モデル

    AutoML Black-box 最適化, HPO, NAS, アルゴリズムの最適化 画像⽣成モデル Diffusion models, 応⽤例の紹介 29
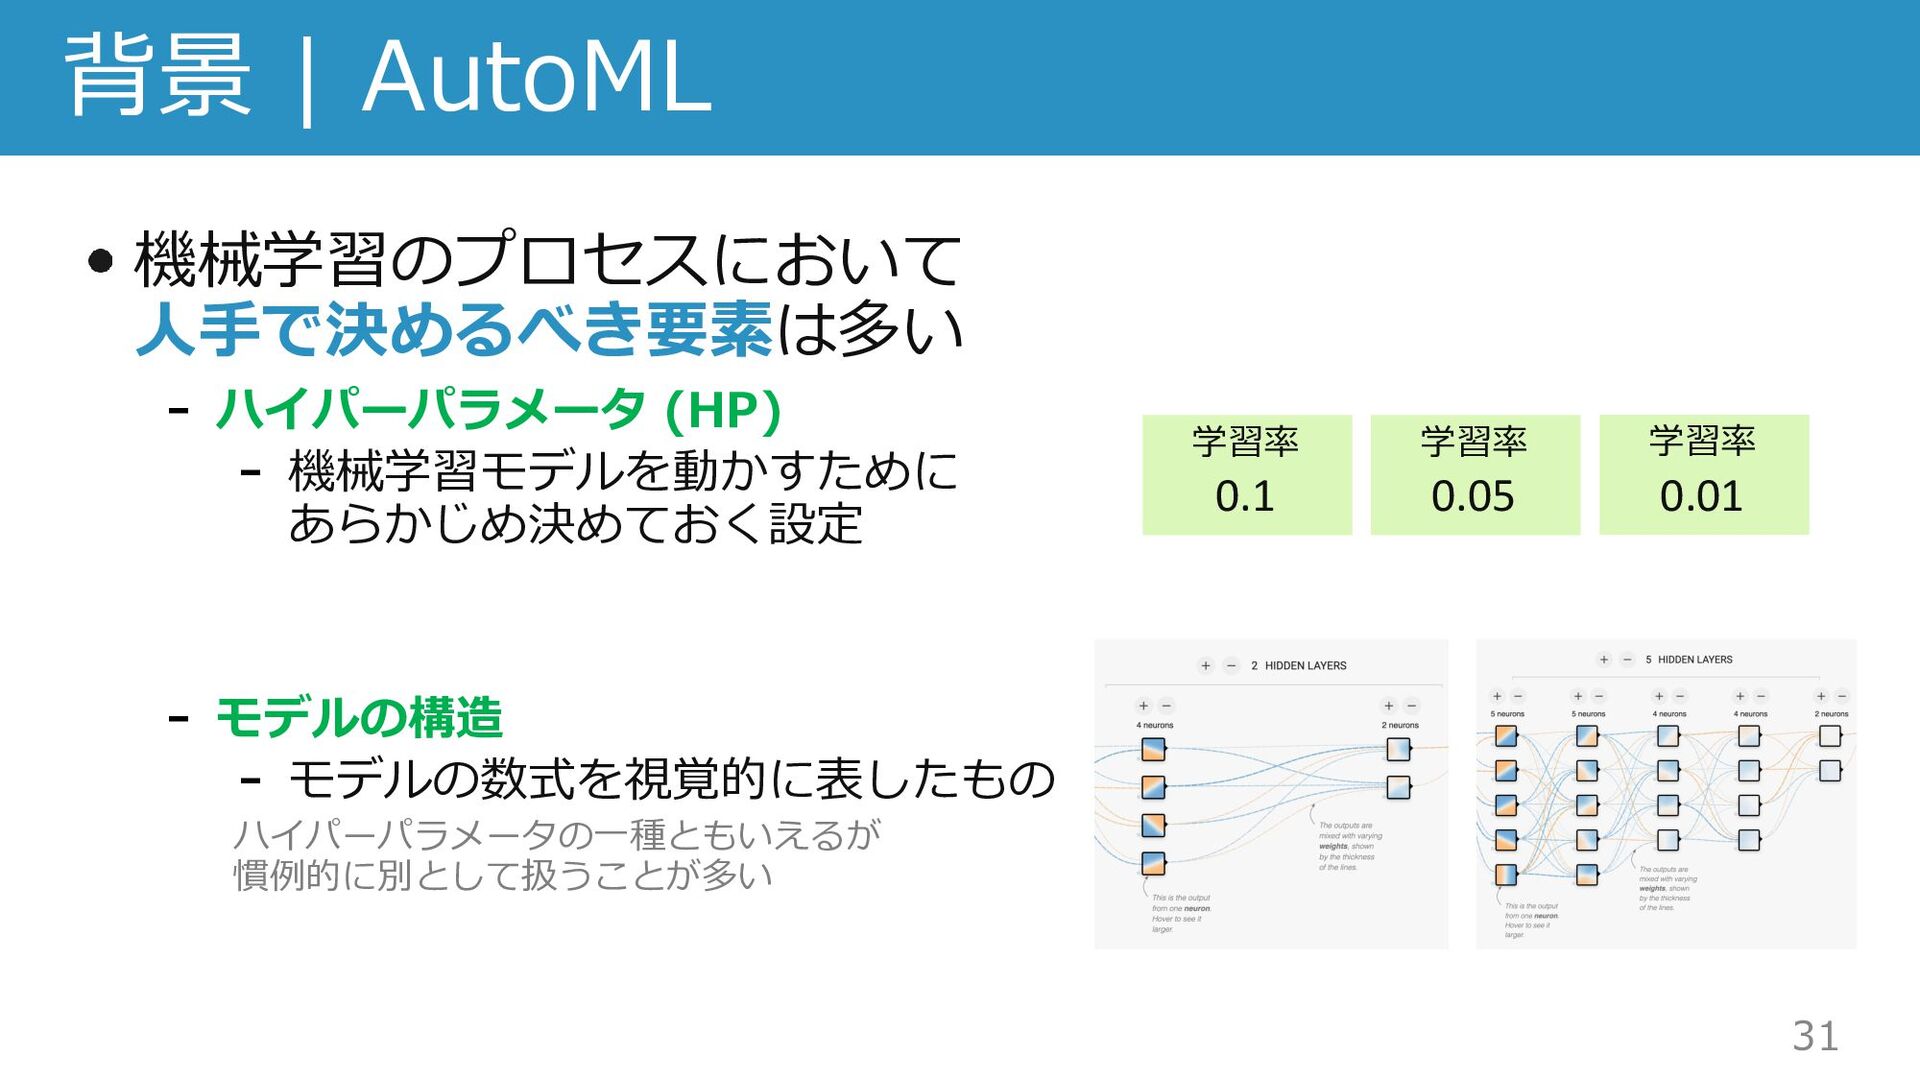
  19. 31 背景 | AutoML 機械学習のプロセスにおいて ⼈⼿で決めるべき要素は多い ハイパーパラメータ (HP) 機械学習モデルを動かすために あらかじめ決めておく設定

    モデルの構造 モデルの数式を視覚的に表したもの ハイパーパラメータの⼀種ともいえるが 慣例的に別として扱うことが多い 学習率 0.1 学習率 0.05 学習率 0.01
  20. 32 背景 | AutoML これらの要素を ⾃動的に最適化する技術を AutoML という Automated Machine

    Learning このような泥臭い調節を⾃動化することで 誰でもAIを利⽤できること(AIの⺠主化)を⽬指す
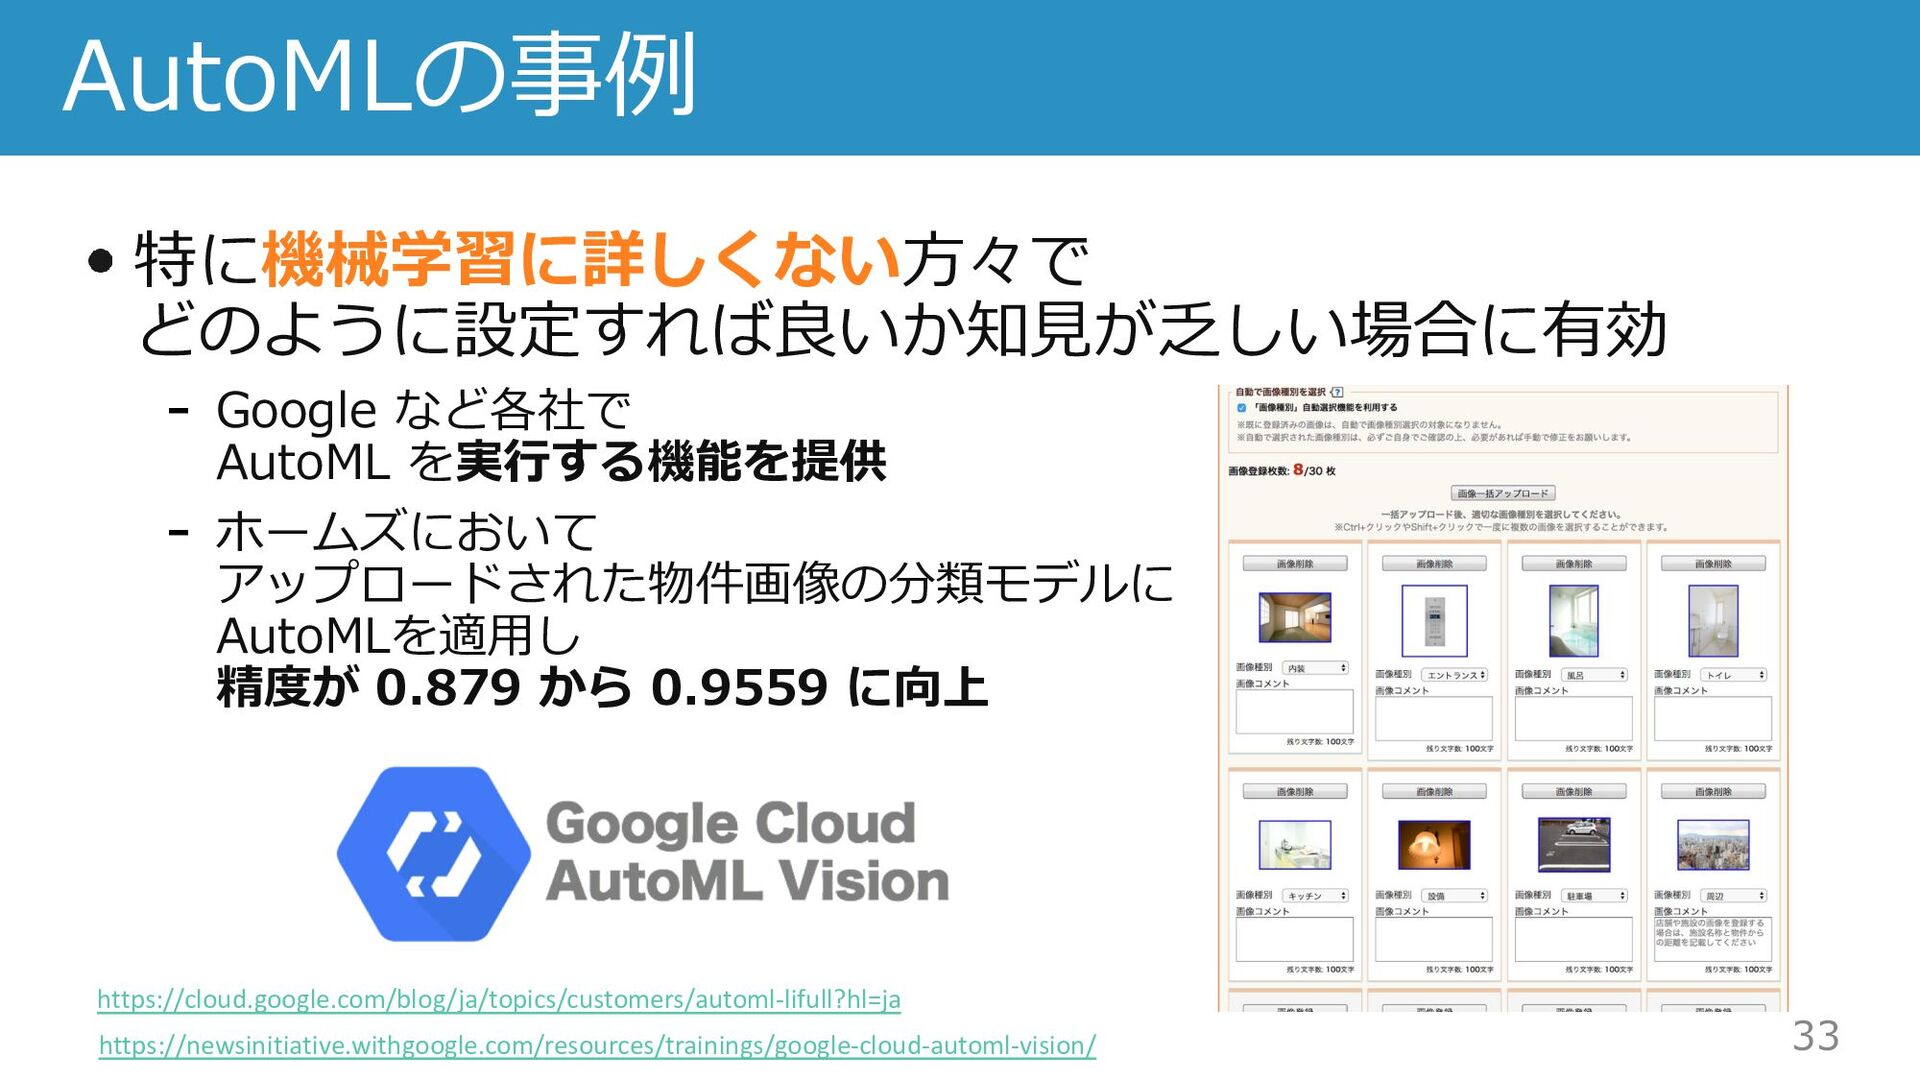
  21. 33 AutoMLの事例 特に機械学習に詳しくない⽅々で どのように設定すれば良いか知⾒が乏しい場合に有効 Google など各社で AutoML を実⾏する機能を提供 ホームズにおいて アップロードされた物件画像の分類モデルに

    AutoMLを適⽤し 精度が 0.879 から 0.9559 に向上 https://cloud.google.com/blog/ja/topics/customers/automl-lifull?hl=ja https://newsinitiative.withgoogle.com/resources/trainings/google-cloud-automl-vision/
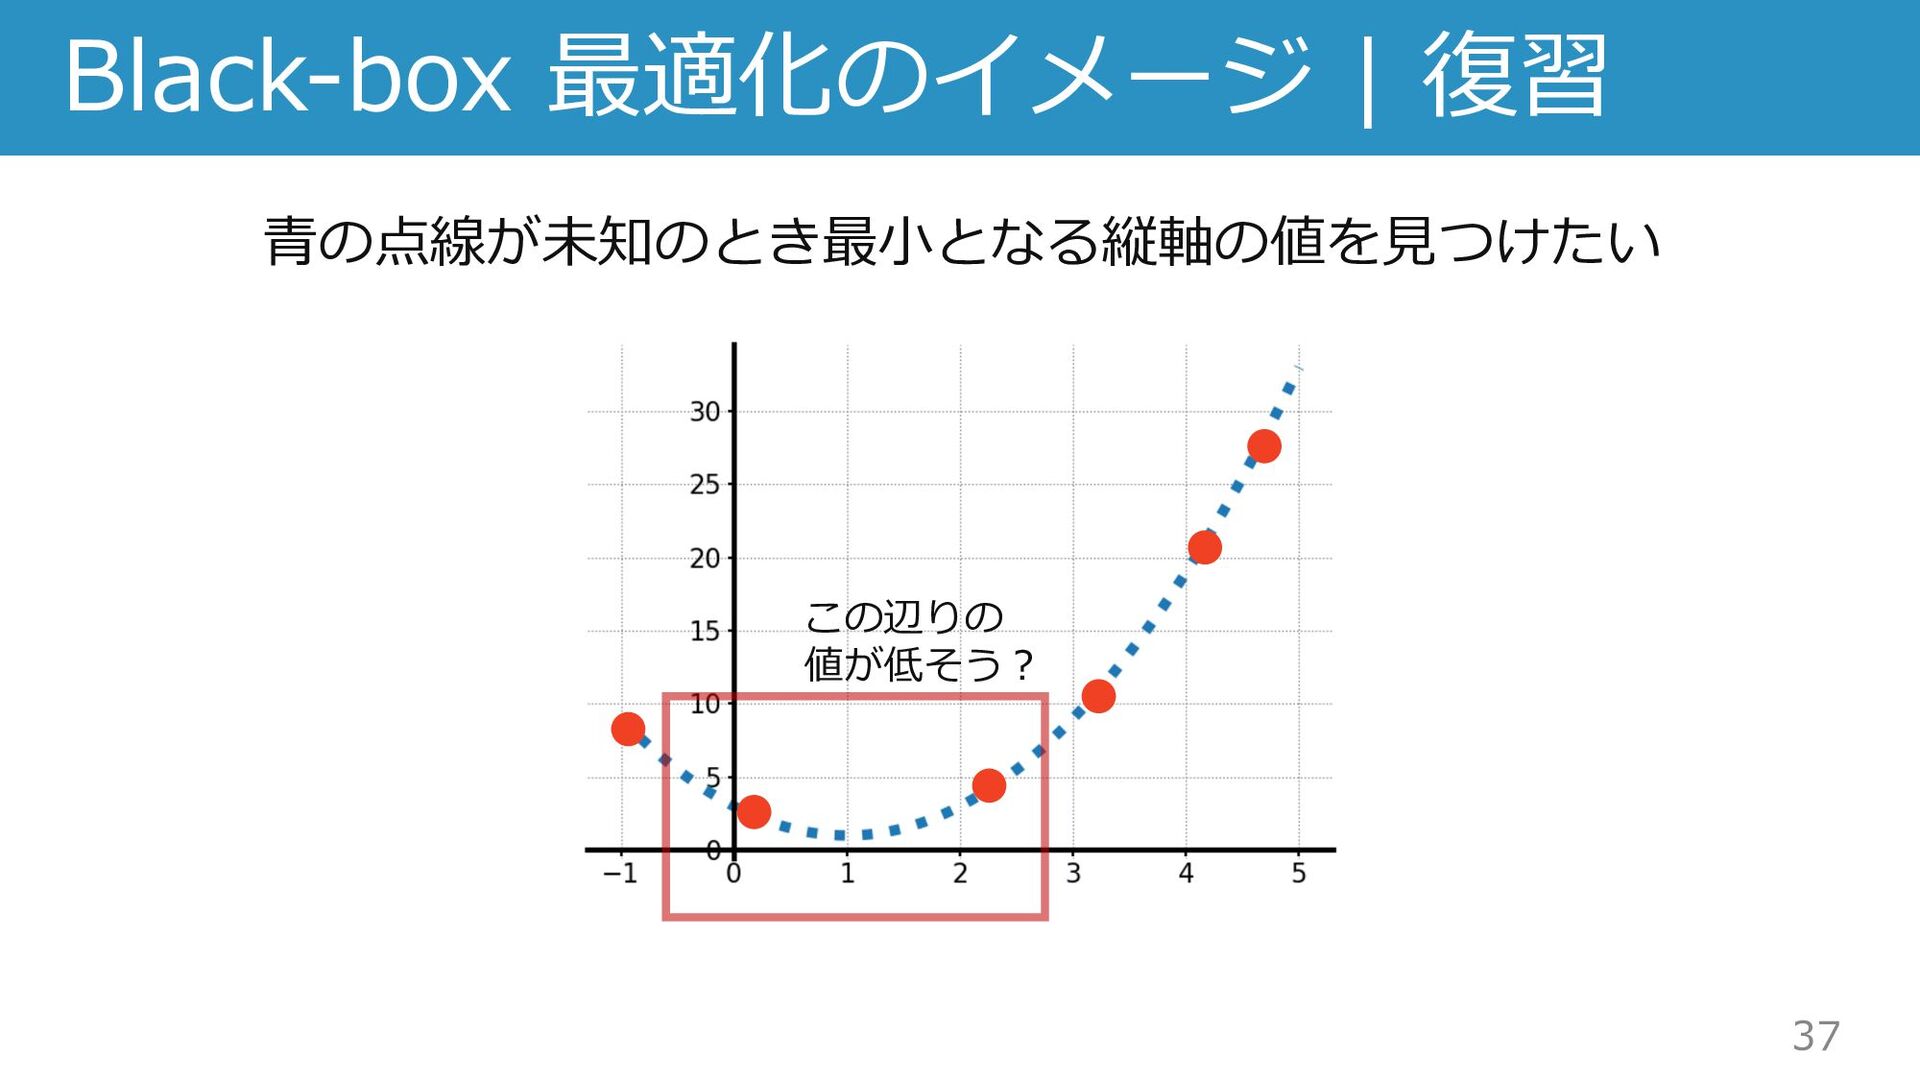
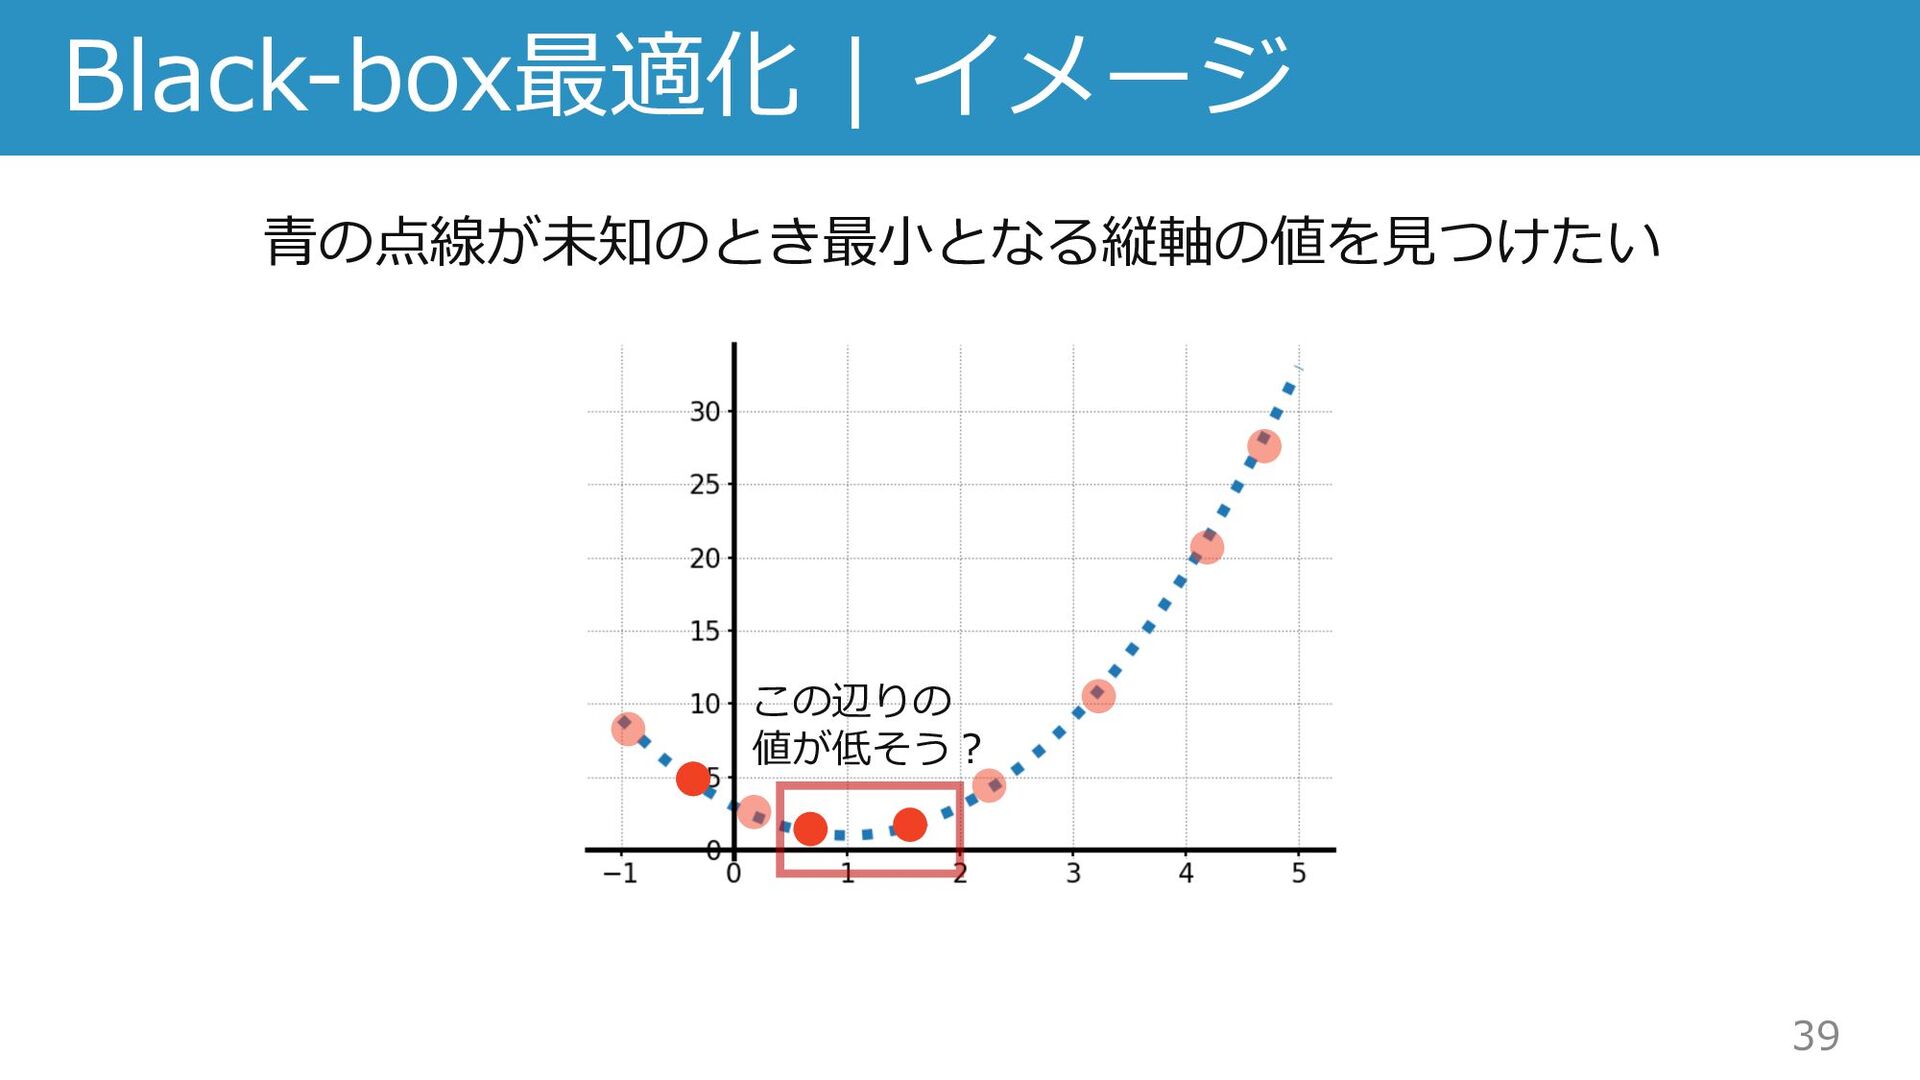
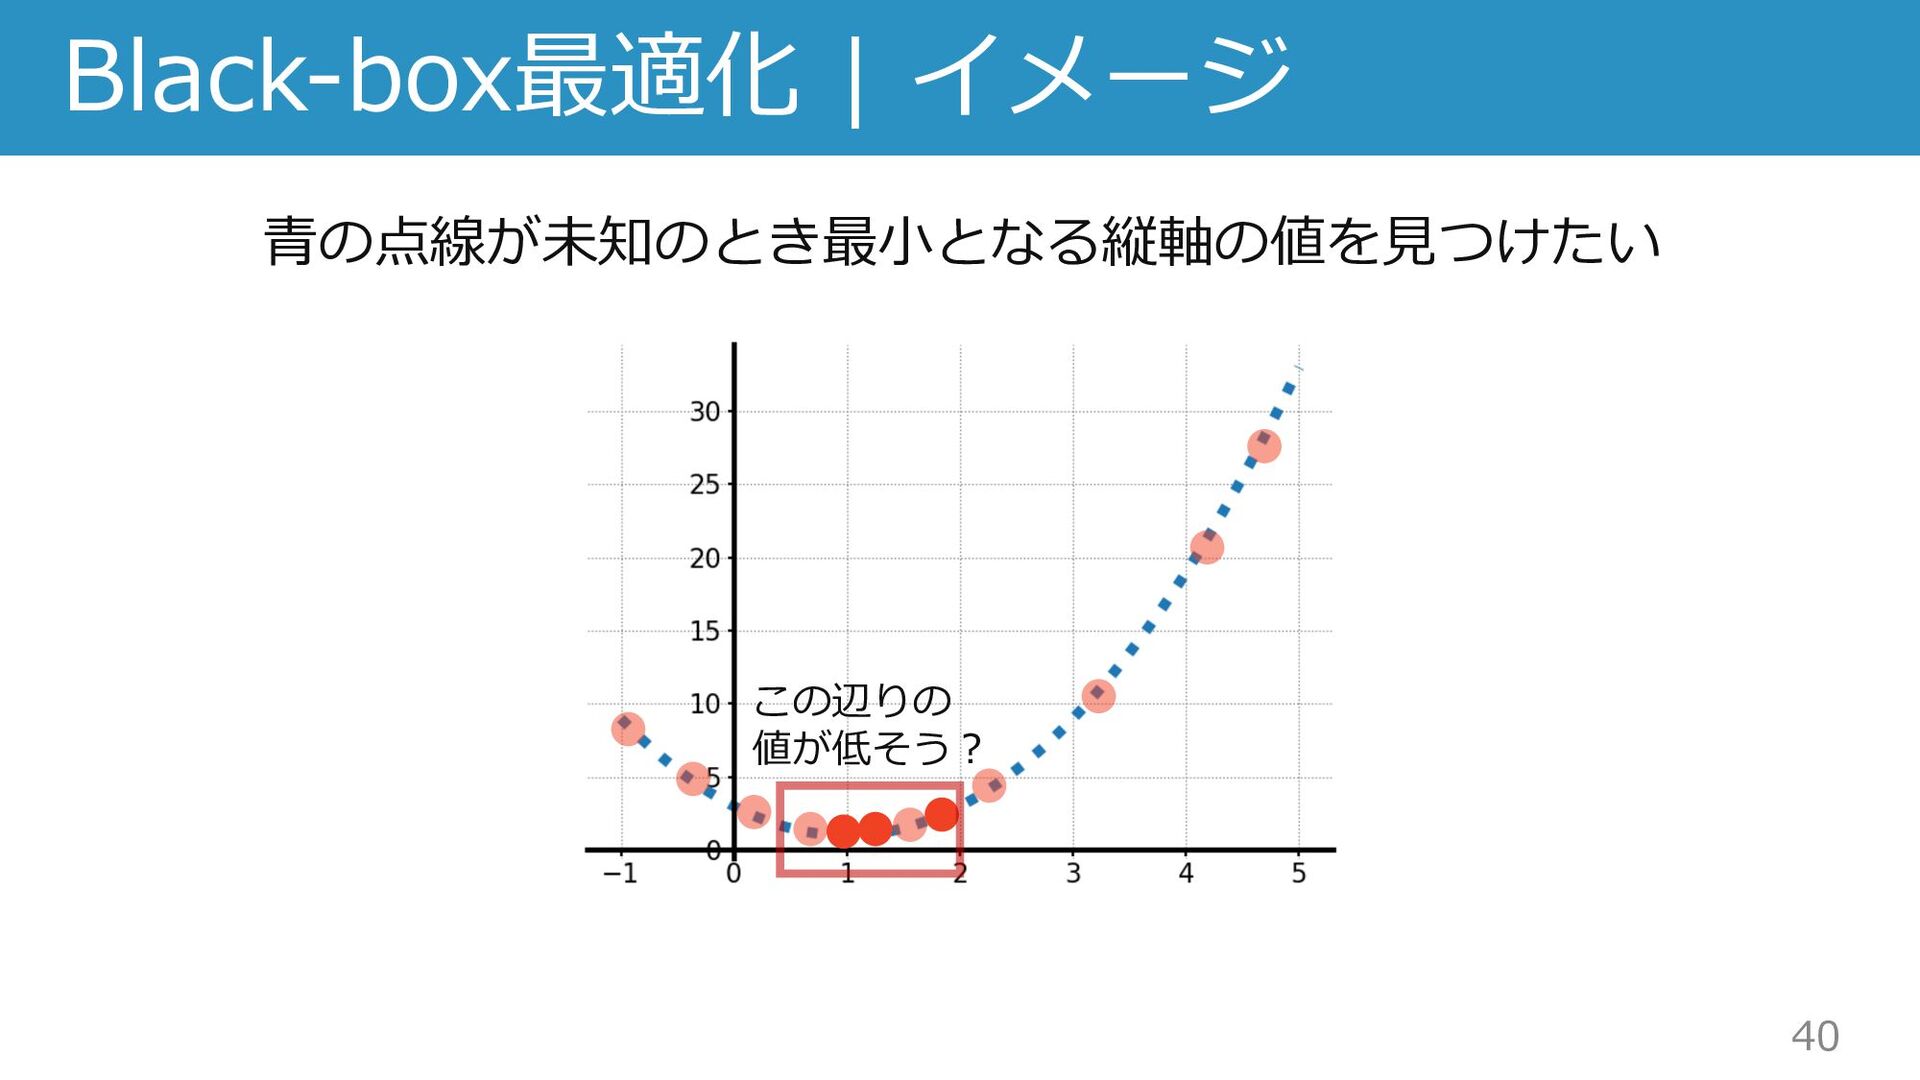
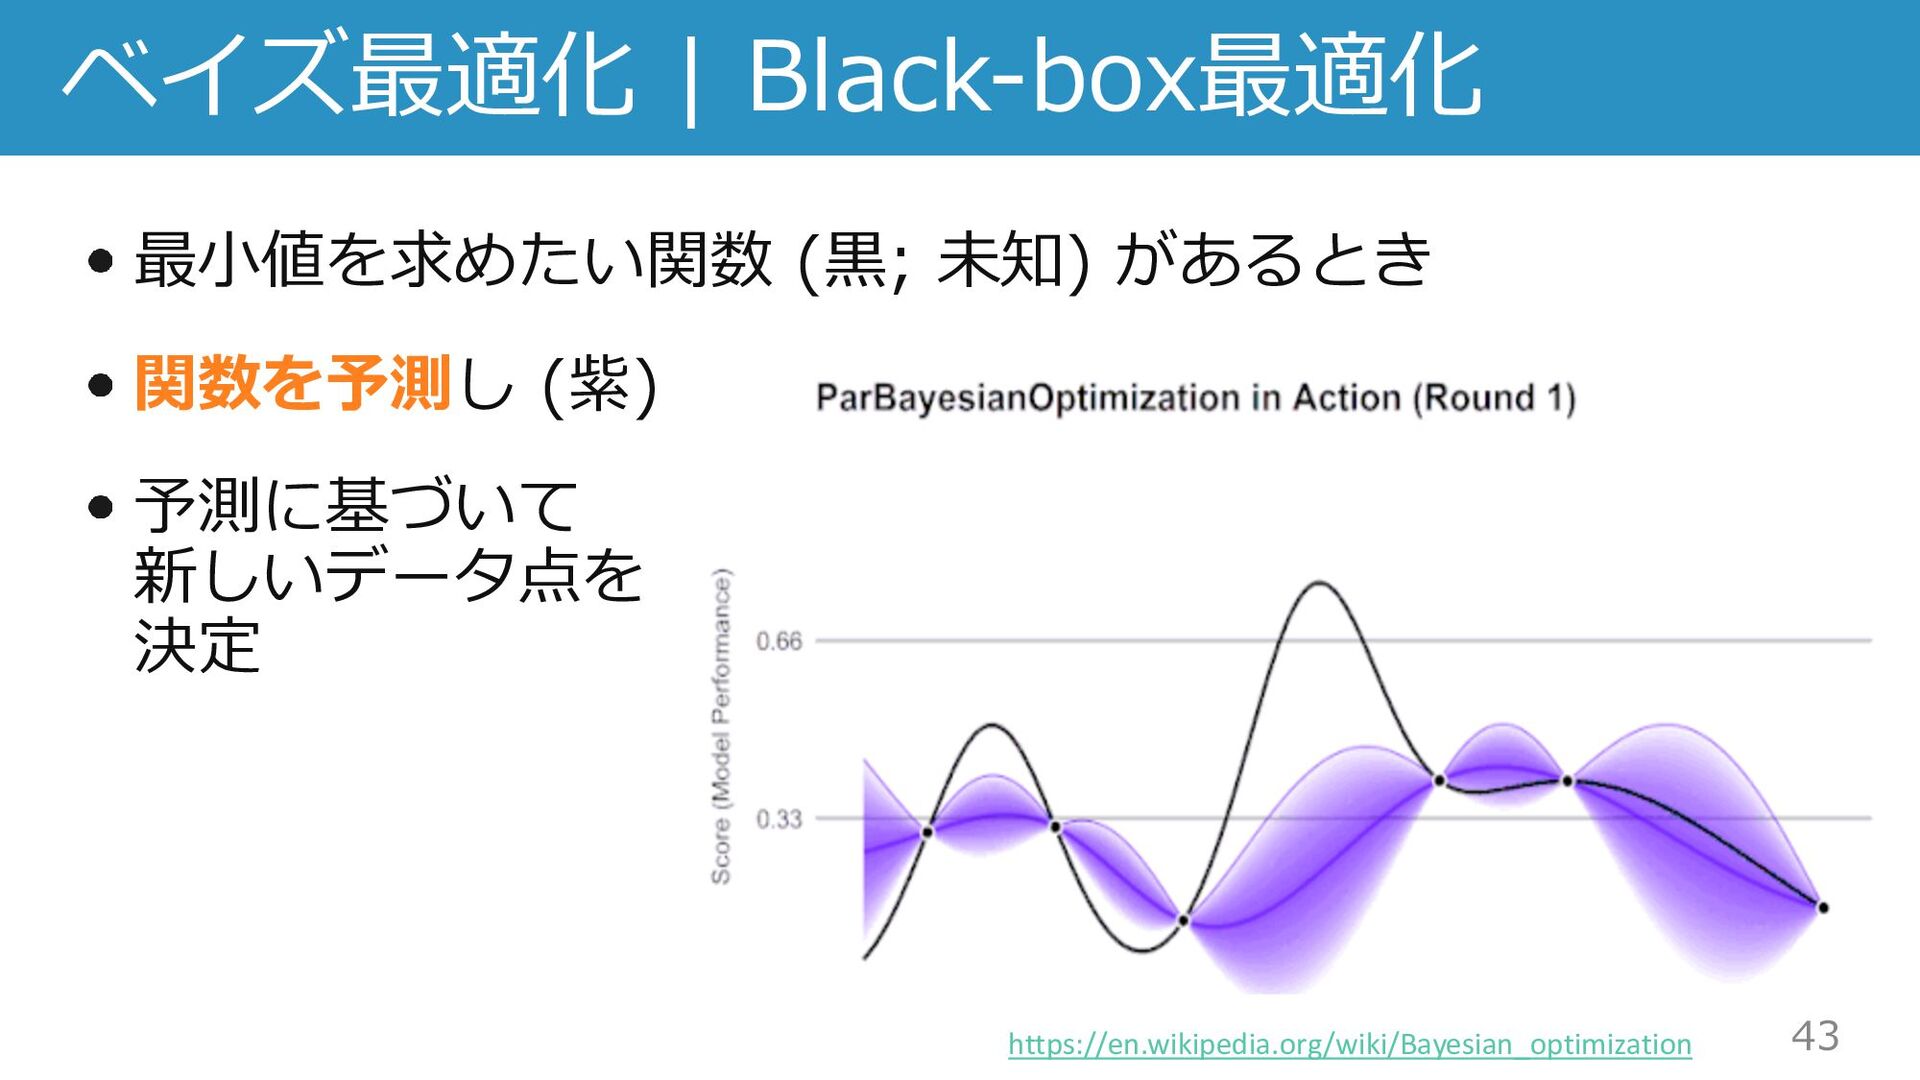
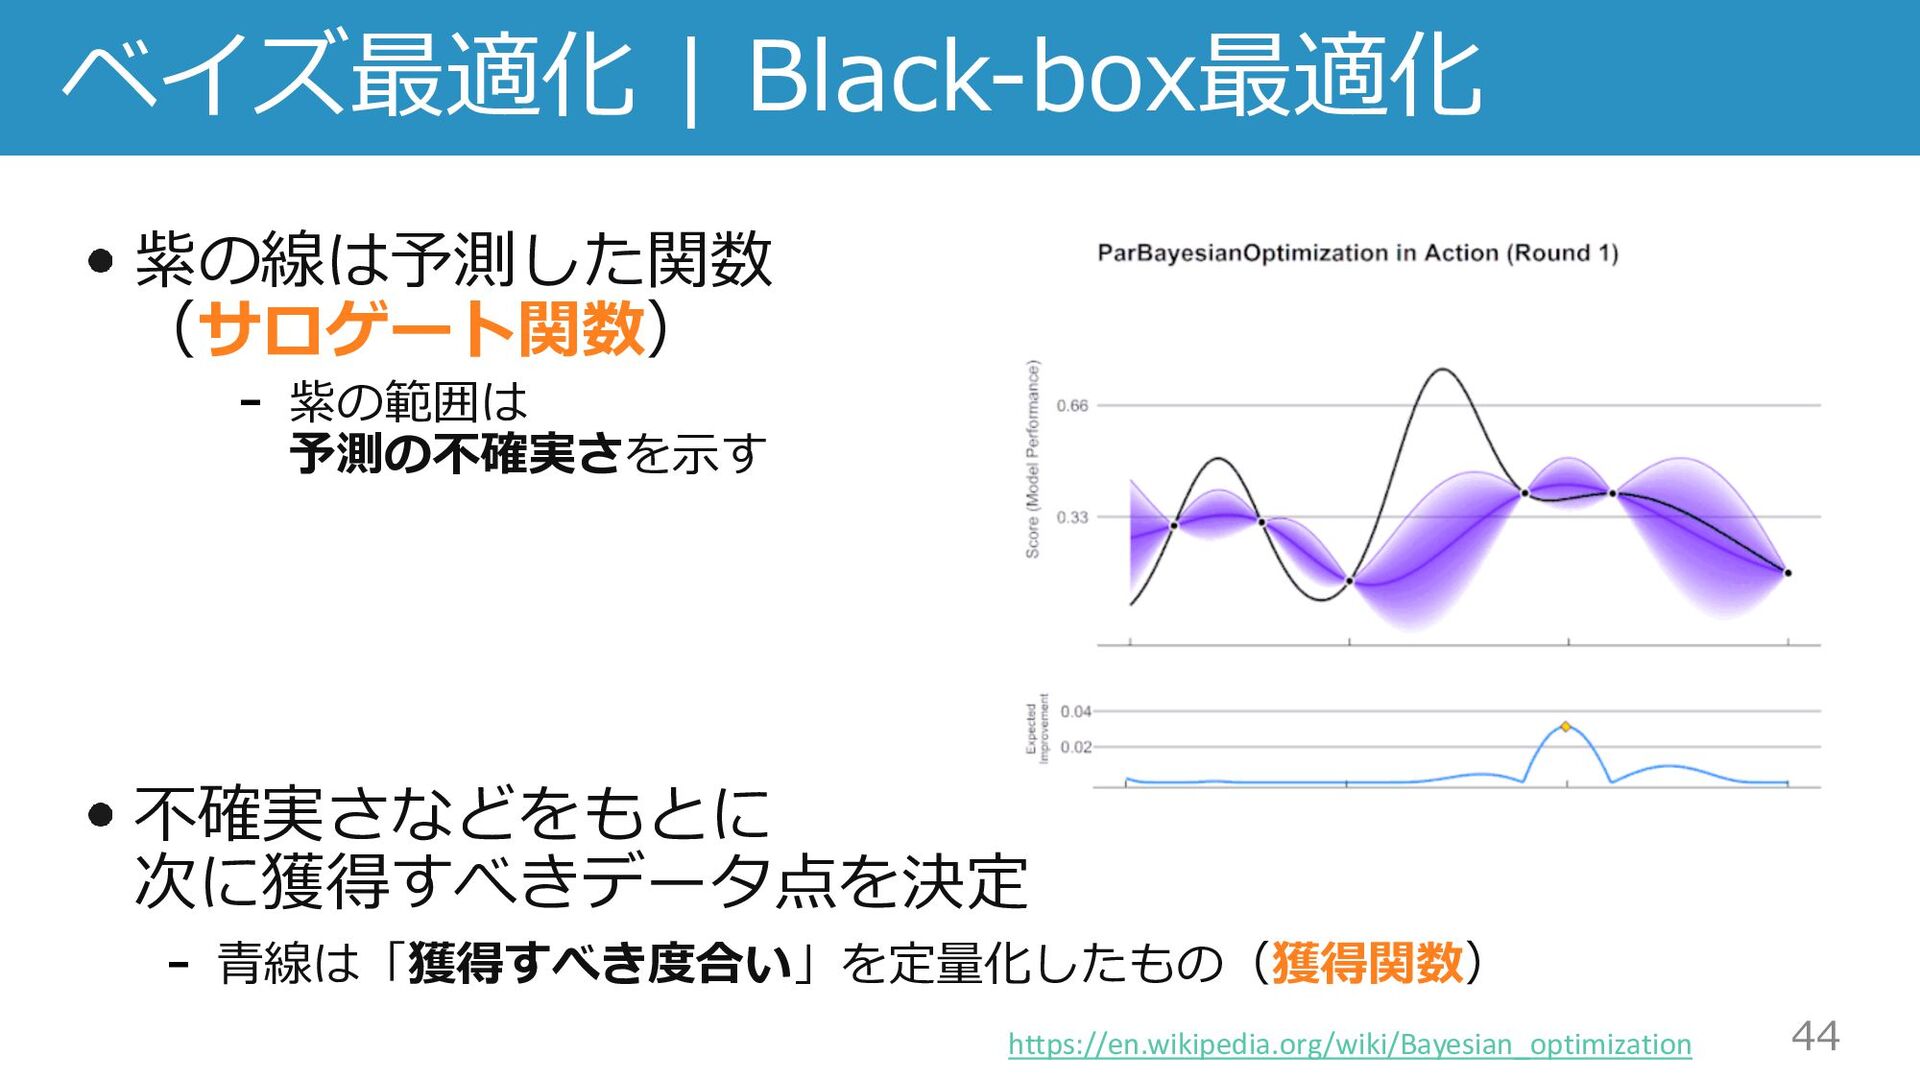
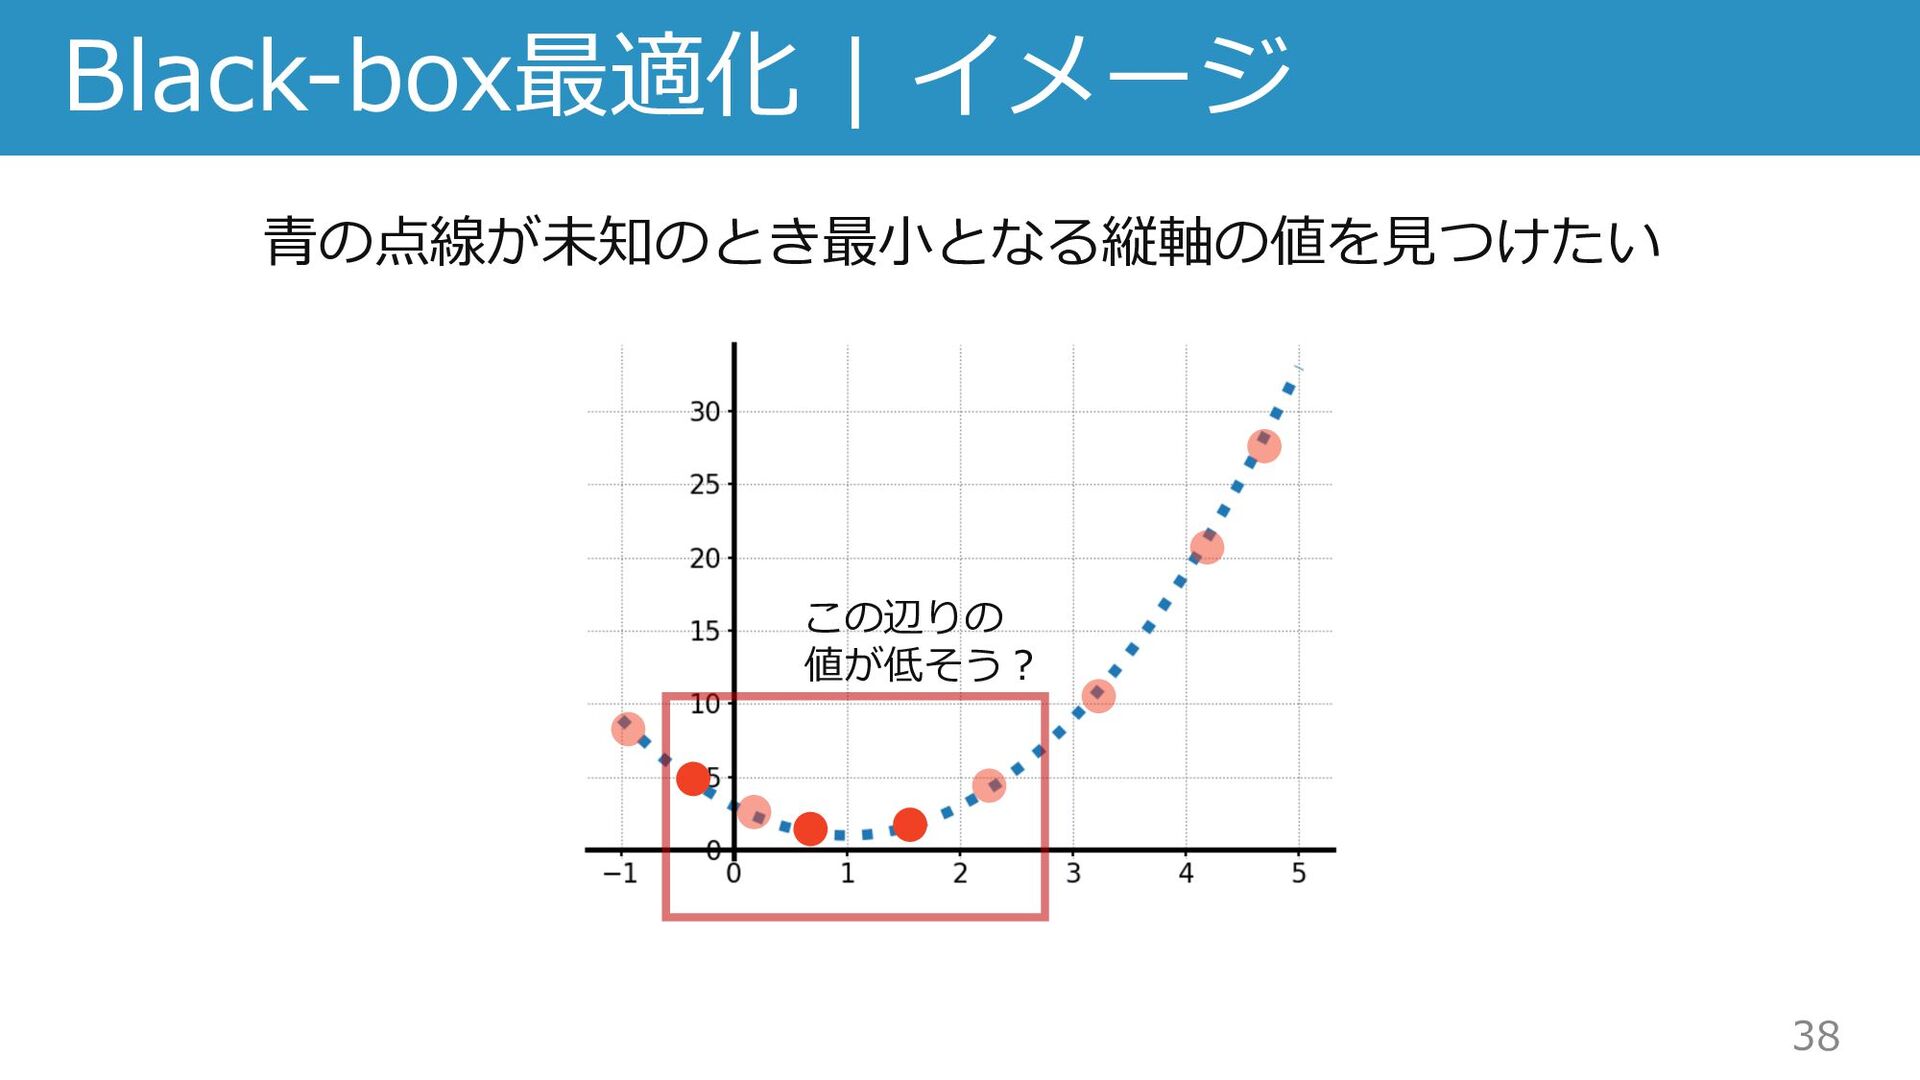
  22. 43 ベイズ最適化 | Black-box最適化 最⼩値を求めたい関数 (⿊; 未知) があるとき 関数を予測し (紫)

    予測に基づいて 新しいデータ点を 決定 https://en.wikipedia.org/wiki/Bayesian_optimization
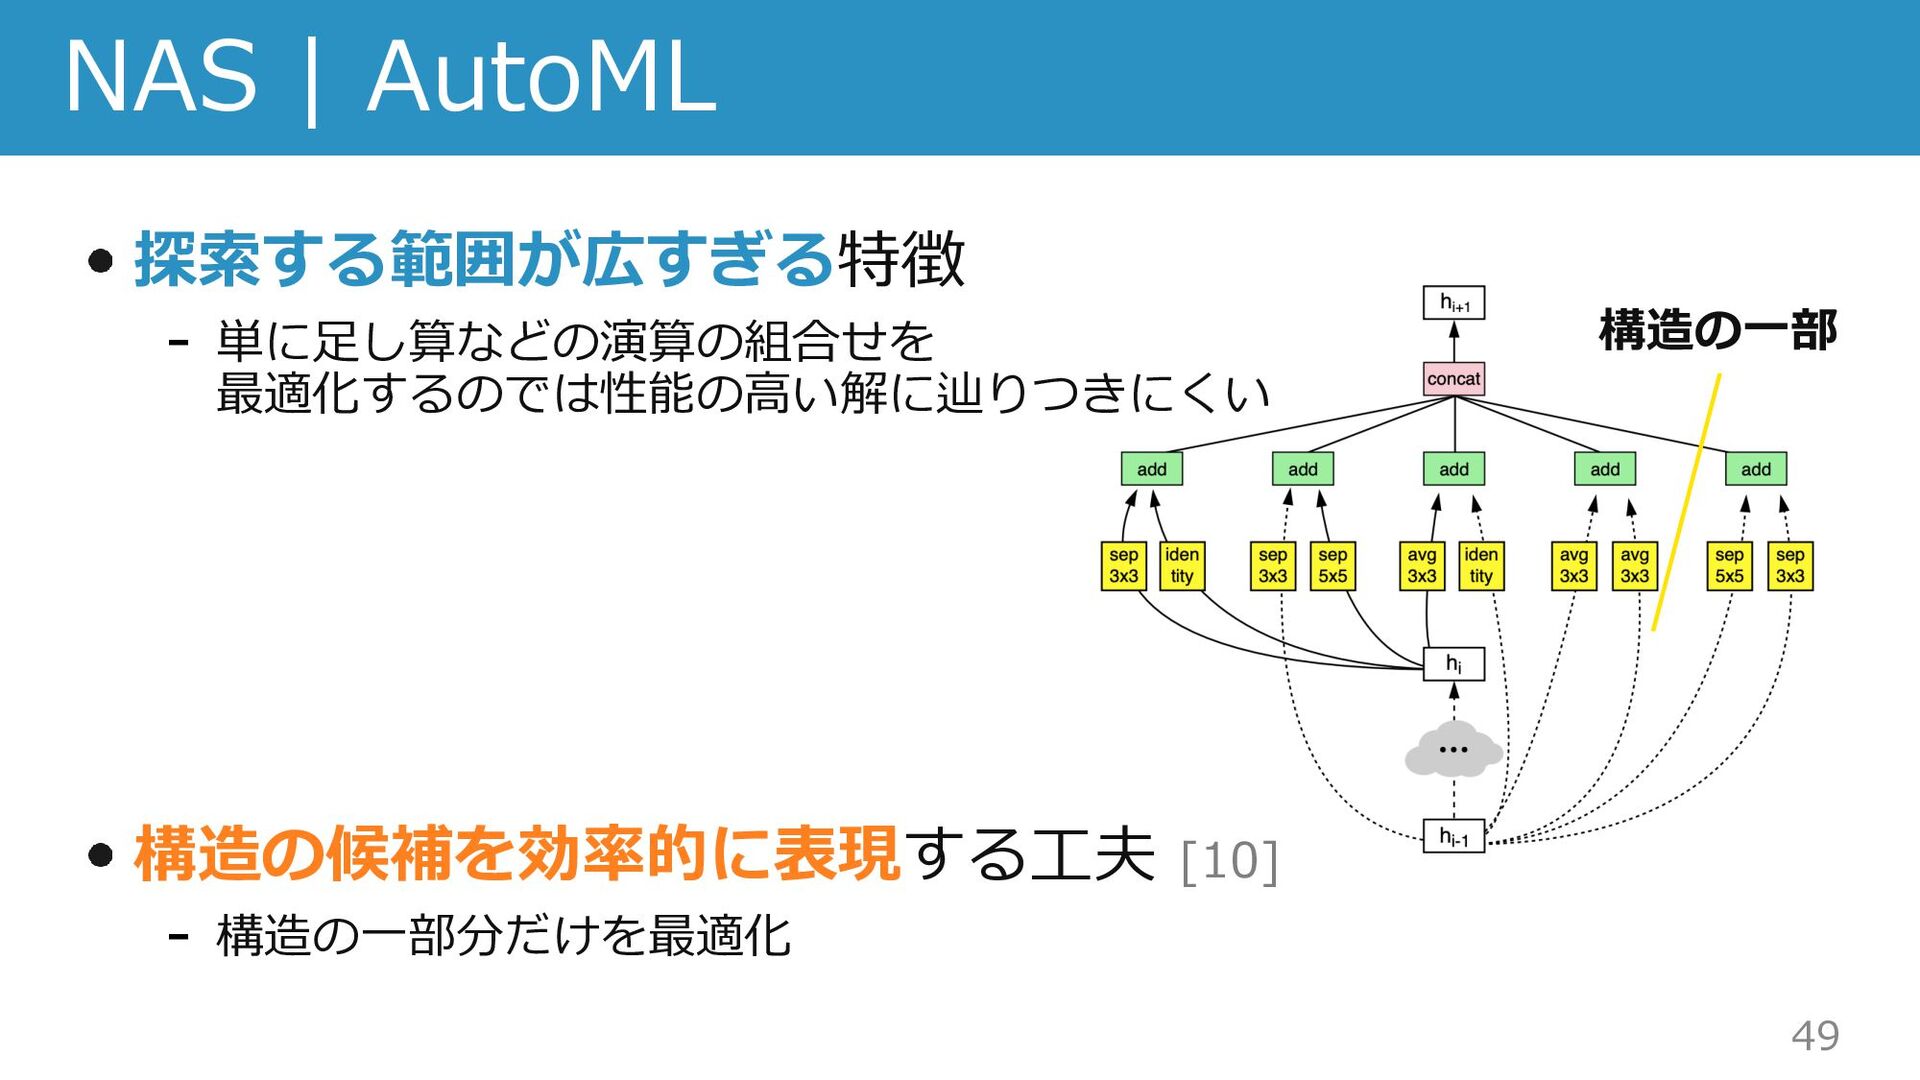
  23. AutoML の中でも扱う対象によって名称がある ハイパーパラメータを最適化︓ HPO モデルの構造を最適化︓ NAS Hyper-Parameter Optimization (HPO) 機械学習のハイパーパラメータ

    (HP) の最適化⼿法の総称 汎⽤的な black-box 最適化⼿法を もとに開発することが⼀般的 46 ハイパーパラメータ最適化 | AutoML
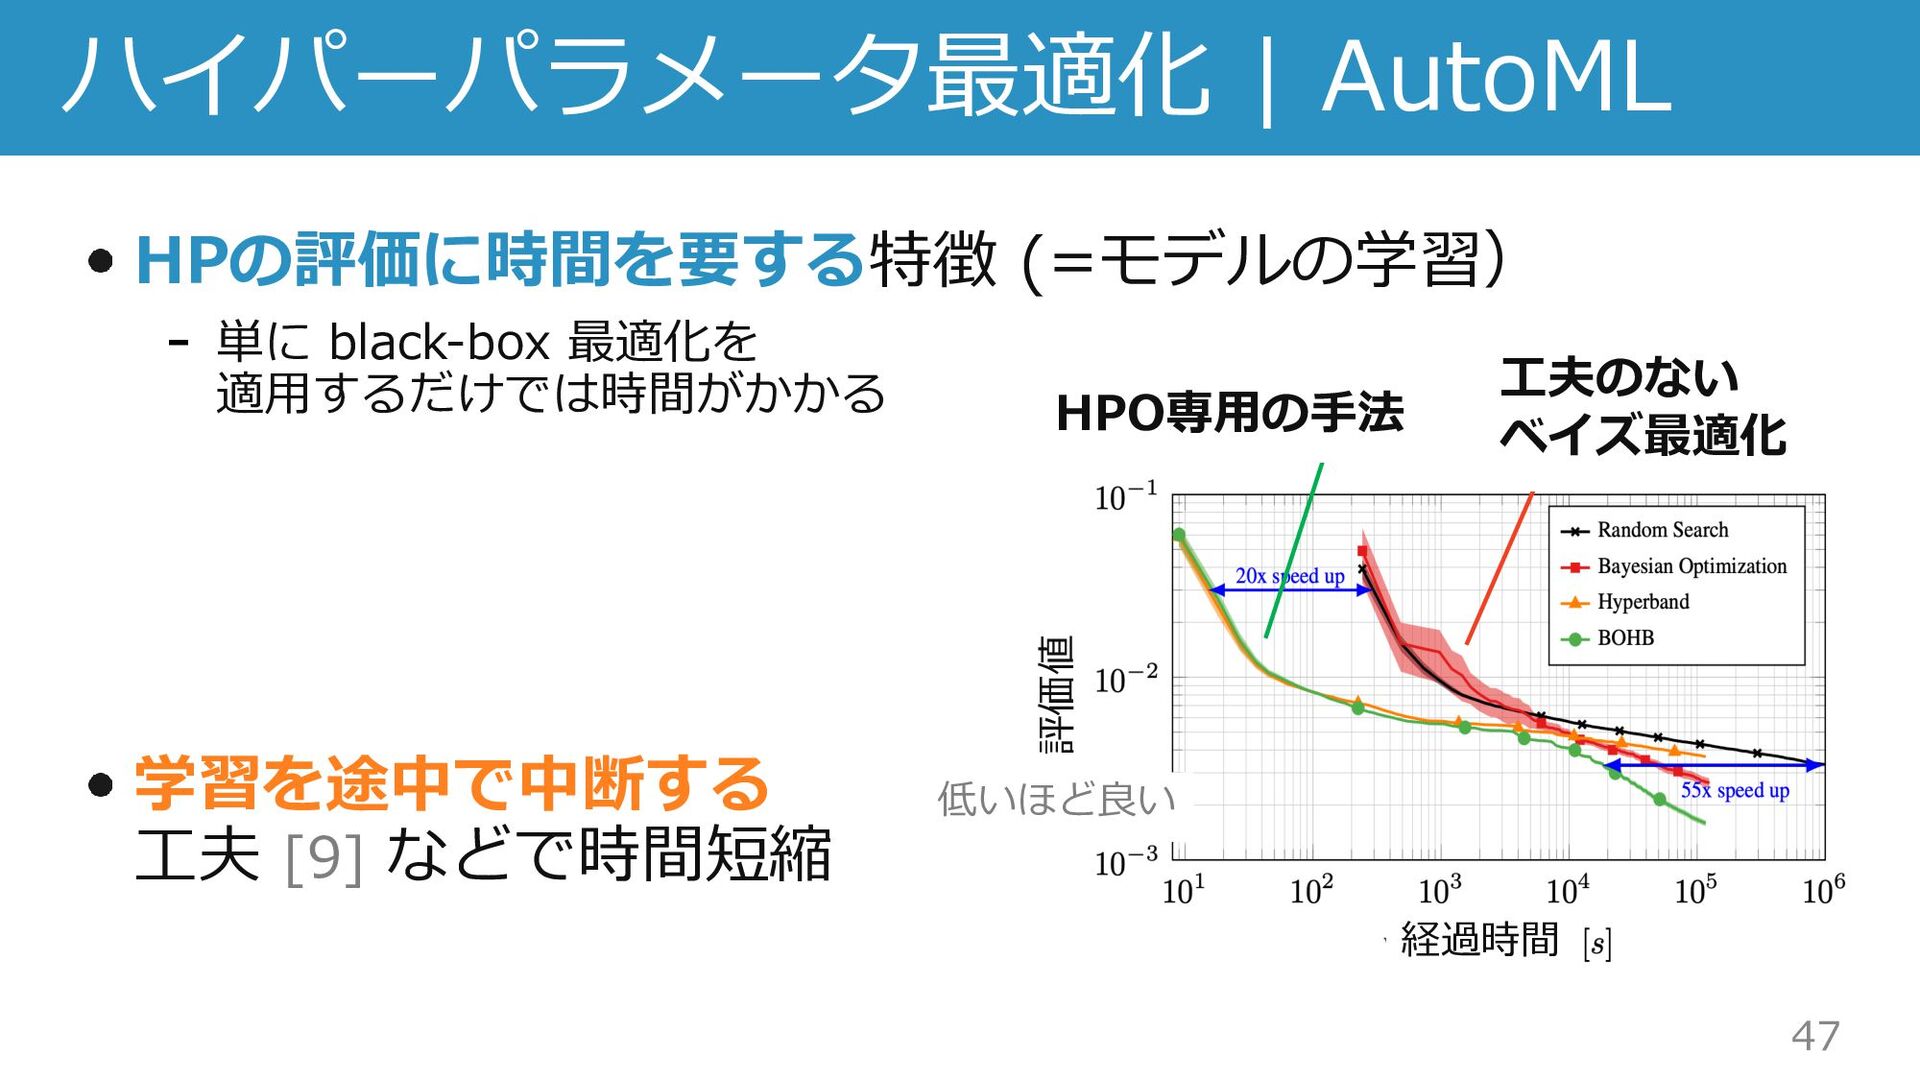
  24. HPの評価に時間を要する特徴 (=モデルの学習) 単に black-box 最適化を 適⽤するだけでは時間がかかる 学習を途中で中断する ⼯夫 [9] などで時間短縮

    47 ハイパーパラメータ最適化 | AutoML 経過時間 評価値 ⼯夫のない ベイズ最適化 HPO専⽤の⼿法 低いほど良い
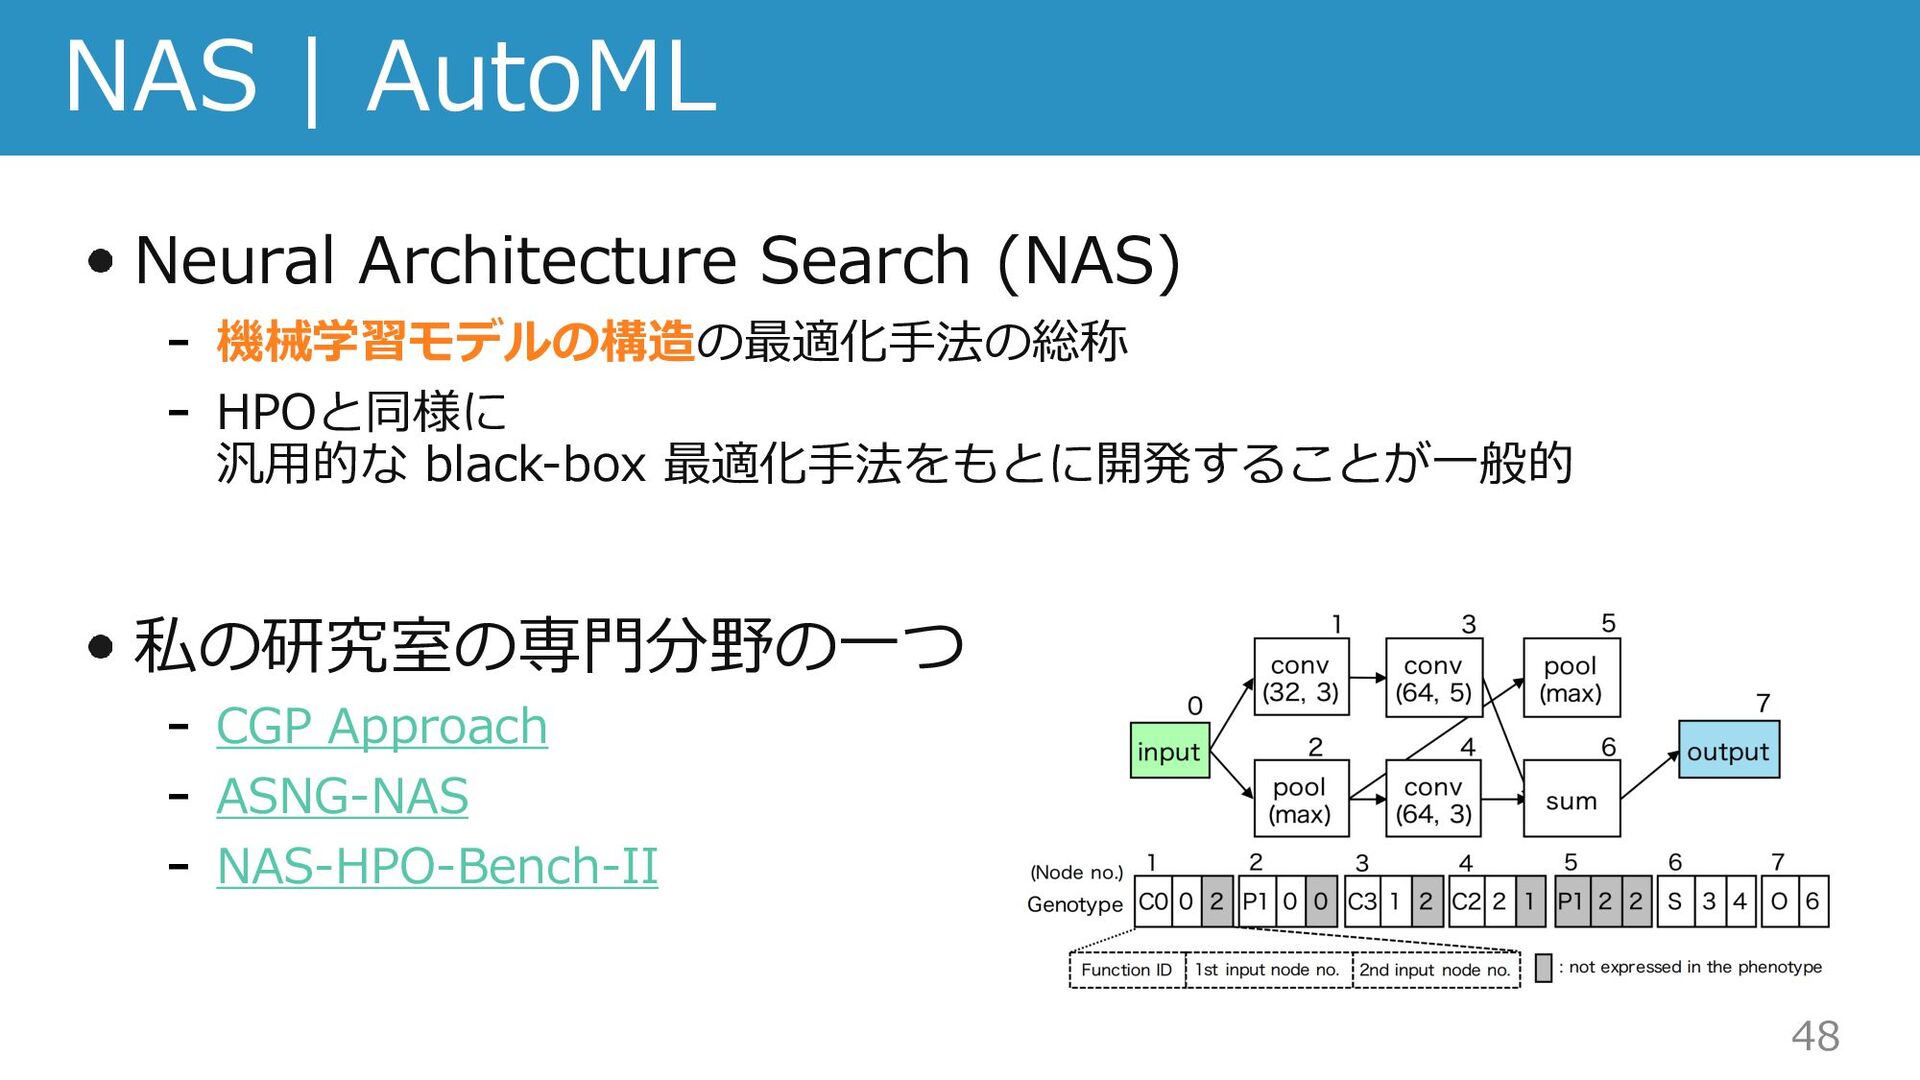
  25. 48 NAS | AutoML Neural Architecture Search (NAS) 機械学習モデルの構造の最適化⼿法の総称 HPOと同様に

    汎⽤的な black-box 最適化⼿法をもとに開発することが⼀般的 私の研究室の専⾨分野の⼀つ CGP Approach ASNG-NAS NAS-HPO-Bench-II
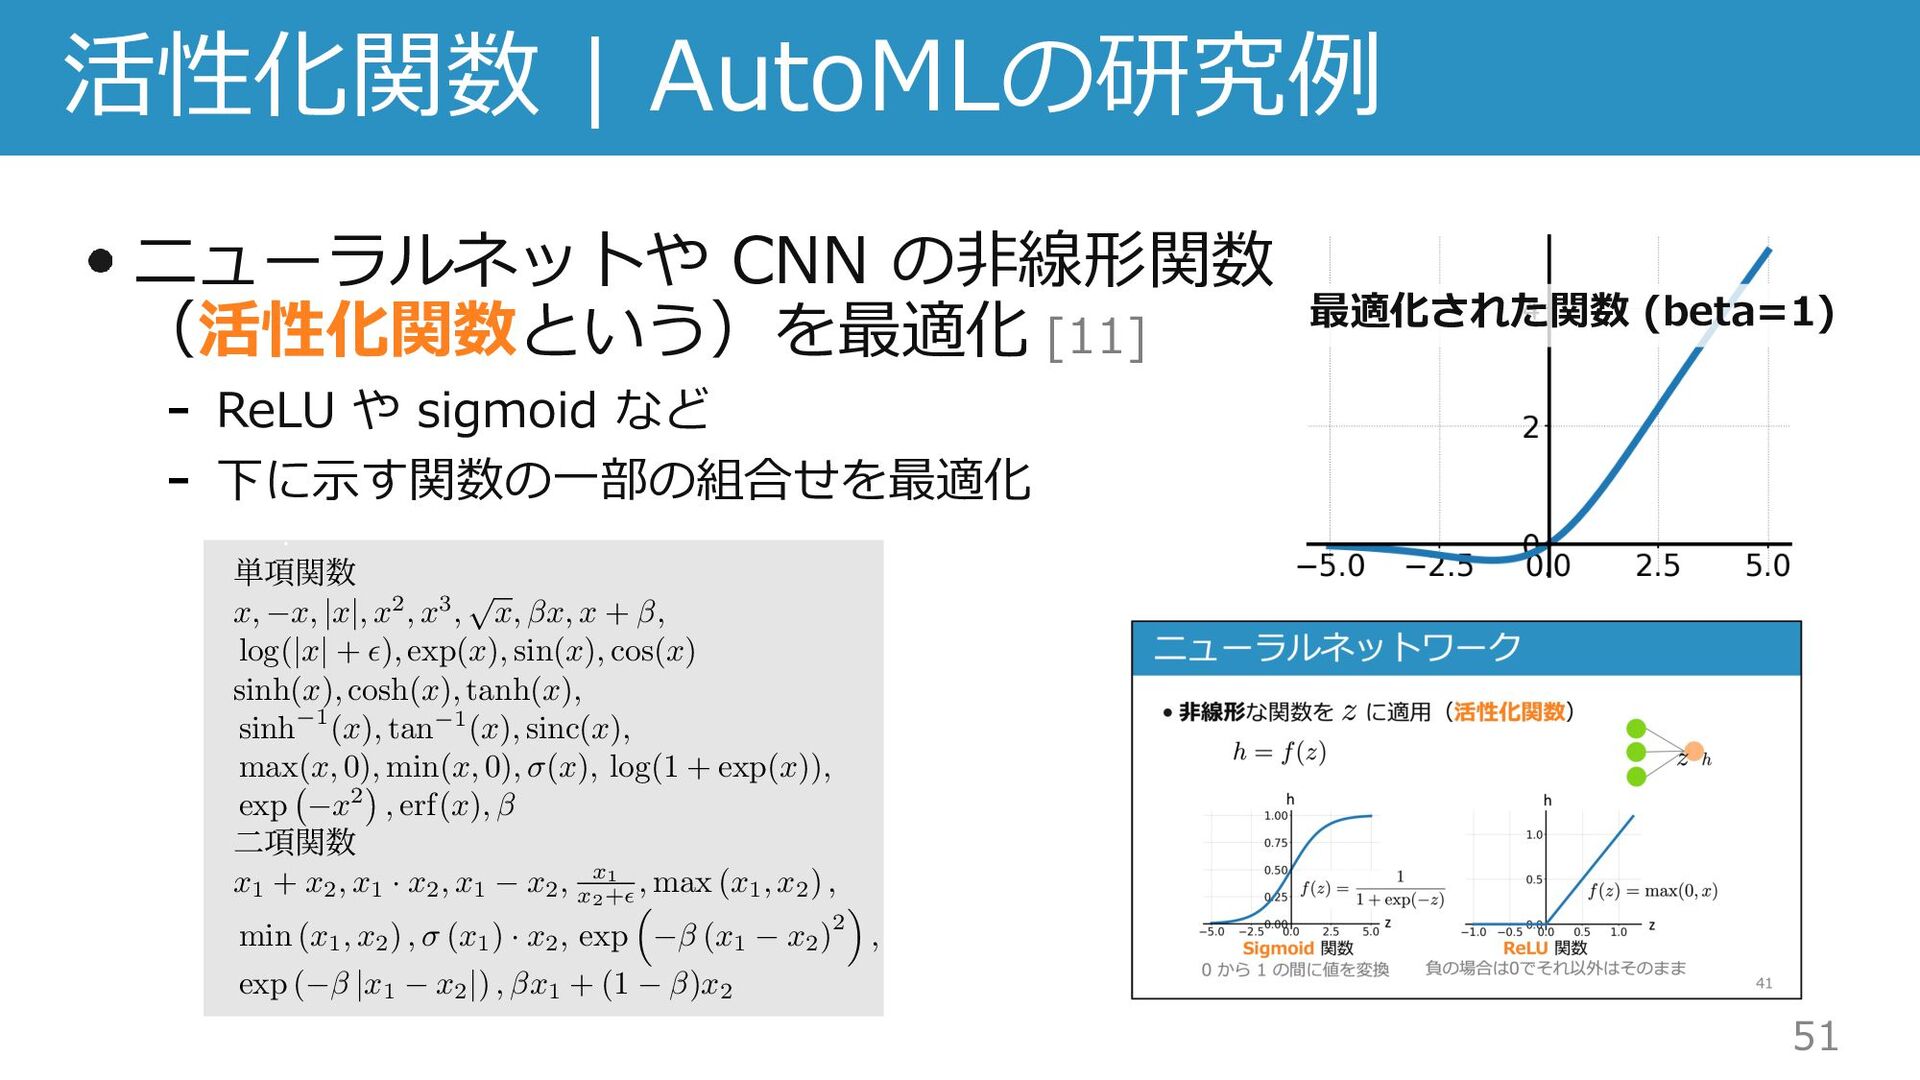
  26. 51 活性化関数 | AutoMLの研究例 ニューラルネットや CNN の⾮線形関数 (活性化関数という)を最適化 [11] ReLU

    や sigmoid など 下に⽰す関数の⼀部の組合せを最適化 最適化された関数 (beta=1) <latexit sha1_base64="4lUGr8LR6j9+e71FeRT6lLfSQe4=">AAAHiHiclVVLb9NAEJ4WQkp4tXDkYlEjtYJESUEUblW5cEKtoA+pTqP1epNY9Qvvuk3l5MgNiRMSZ65c4cfwb5hdbxw7TouwlN3JN9+8R7YdeS4X7fafpeUbN2u36iu3G3fu3rv/YHXt4SEPk5iyAxp6YXxsE848N2AHwhUeO45iRnzbY0f22VupPzpnMXfD4KO4jFjXJ4PA7buUCITCteWvYAGFEDz8xZDCBQzBBQEMJtBCnTWnt1EiiJyh3kSdZI7wTD8cf699+8EijVvQwHsEz6GpzjGeY7wNvE9hK5deKMkCDp/QP/pBdKIxG30LjGYoD/J8VkAzjoxjqewG+H9Dx5E8BhF6dZUugE3Nl9lGijnKMckK5jBZM88xM49l5vxhwWLKH855kXkGFTTLeeblFKtuQgfrrtpepQ2xCoYdI8iTkwlQ8hFJtV86x89i+sga6Wwk3s71fqEHZY30N1CW015I3Cx1vaM7XuxtOfJUJ60Y9DHrDbUZchcszF/GGCL67/ok2p+rbroTZmFK+Wa+/7JwM3sqa3lPt1Ei2ewdjCk0VtQ2C4isqq8ypGpre2pGqWZUN3CSdzqbQbETmfXzPOKijliFKf2v7WyGVcsyf1H9pq7XvHKOswlU/TcX5nXV3K/blkVRxtdEGS+MUHyrZDuwoexnms1Z5b3V9XarrR6jKnS0sA762eutLe1bTkgTnwWCeoTzk047Et2UxMKlHps0rISziNAzMmAnKAbEZ7ybqjf5xHiKiGP0wxh/gTAUWrRIic/5pW8j0ydiyOd1ElykO0lE/3U3dYMoESygWaB+4hkiNORnwXDcmFHhXaJAaOxirgYdkphQgR+PchRvECJh6JdLCUIWOF2pjThLsAOhUy42PSfxhetgfiU759yNuG7CSHehZGb7ExxCZ77lVeFwq9V51Xq5v7W+s6vHsQKP4Yka7zbswDvYgwOgtc+1n7Vftd/1Rr1d366/yajLS9rmEZSe+u5fjByZVA==</latexit> . ୯߲ؔ਺ x, x, |x|, x2, x3, p x, x, x + , log(|x| + ✏), exp(x), sin(x), cos(x) sinh(x), cosh(x), tanh(x), sinh 1(x), tan 1(x), sinc(x), max(x, 0), min(x, 0), (x), log(1 + exp(x)), exp x2 , erf(x), ೋ߲ؔ਺ x1 + x2, x1 · x2, x1 x2, x1 x2+✏ , max (x1, x2) , min (x1, x2) , (x1) · x2, exp ⇣ (x1 x2)2 ⌘ , exp ( |x1 x2 |) , x1 + (1 )x2
  27. ⽬次 ⼤規模⾔語モデル 対話型AI, ⾔語モデル, Transformer, スケーリング則 few-shot learning, hallucination, ⽇本語学習モデル

    AutoML Black-box 最適化, HPO, NAS, アルゴリズムの最適化 画像⽣成モデル Diffusion models, 応⽤例の紹介 53
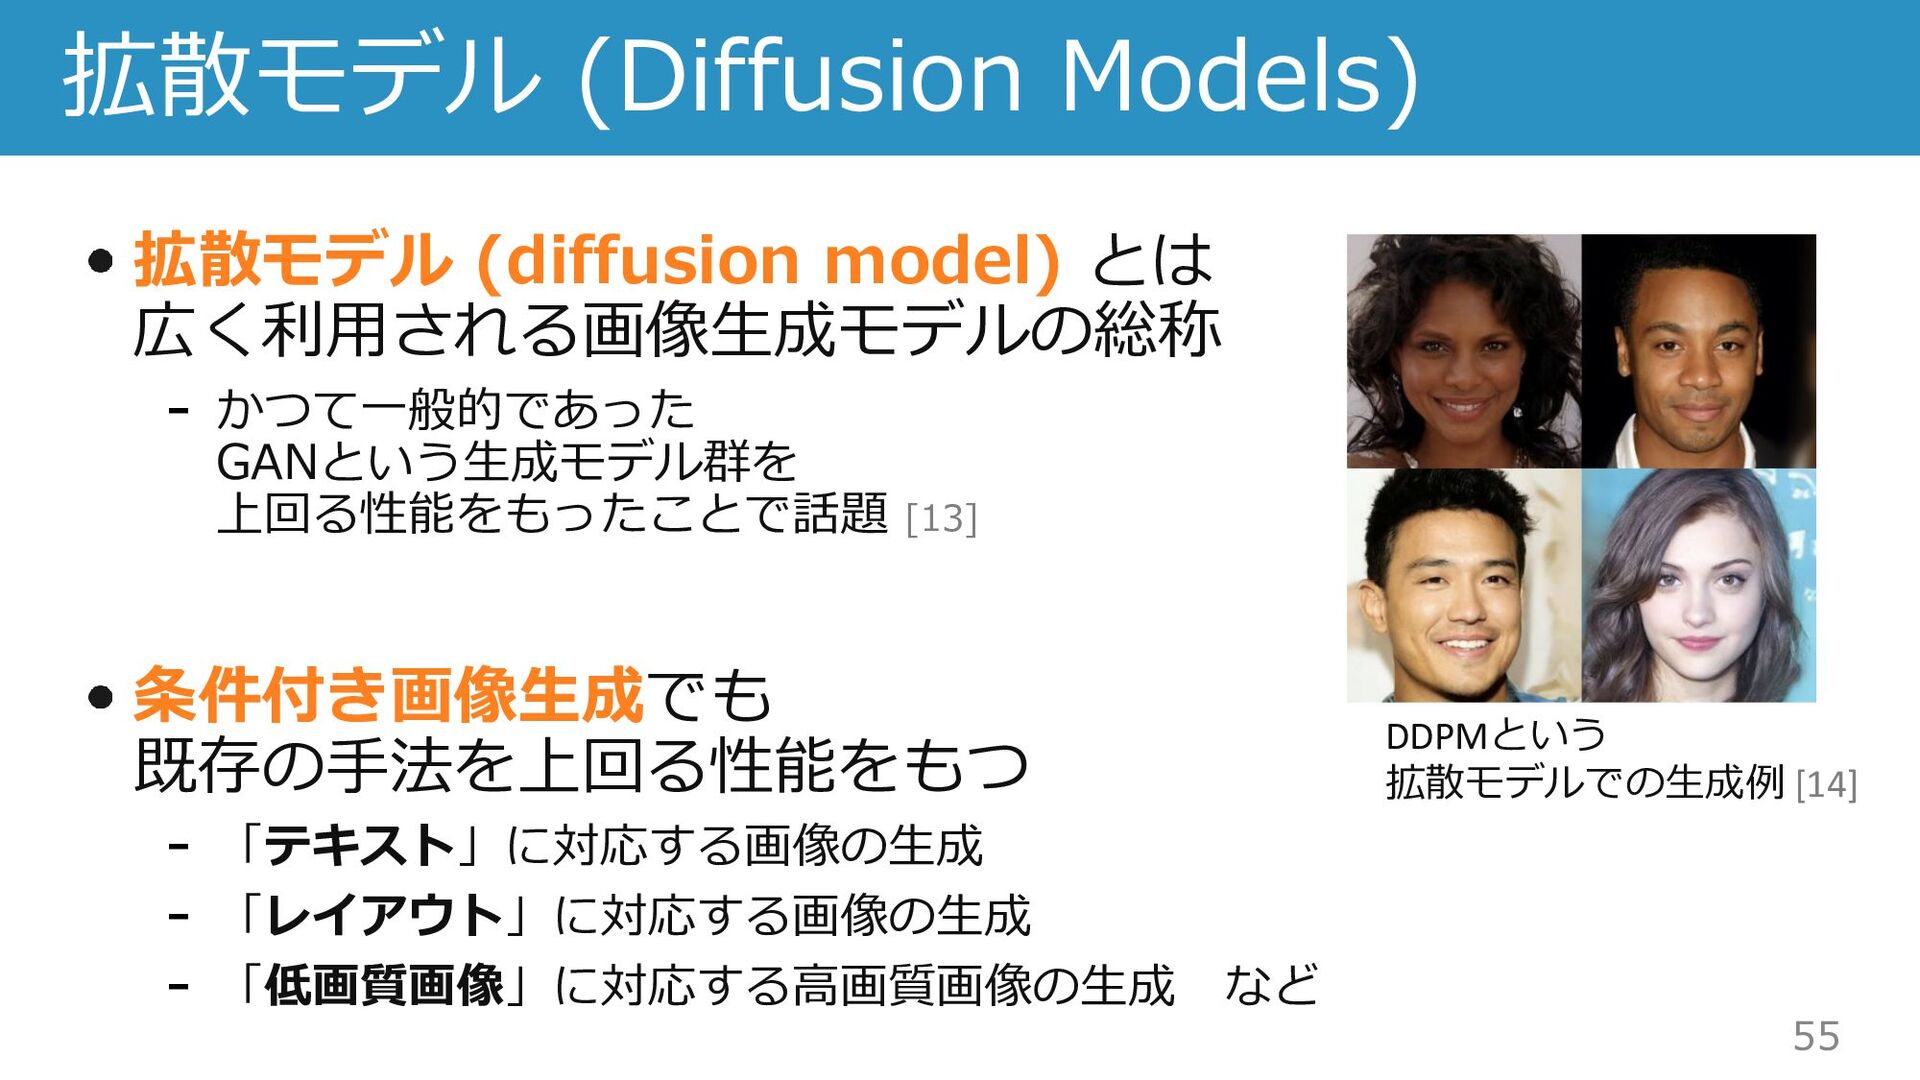
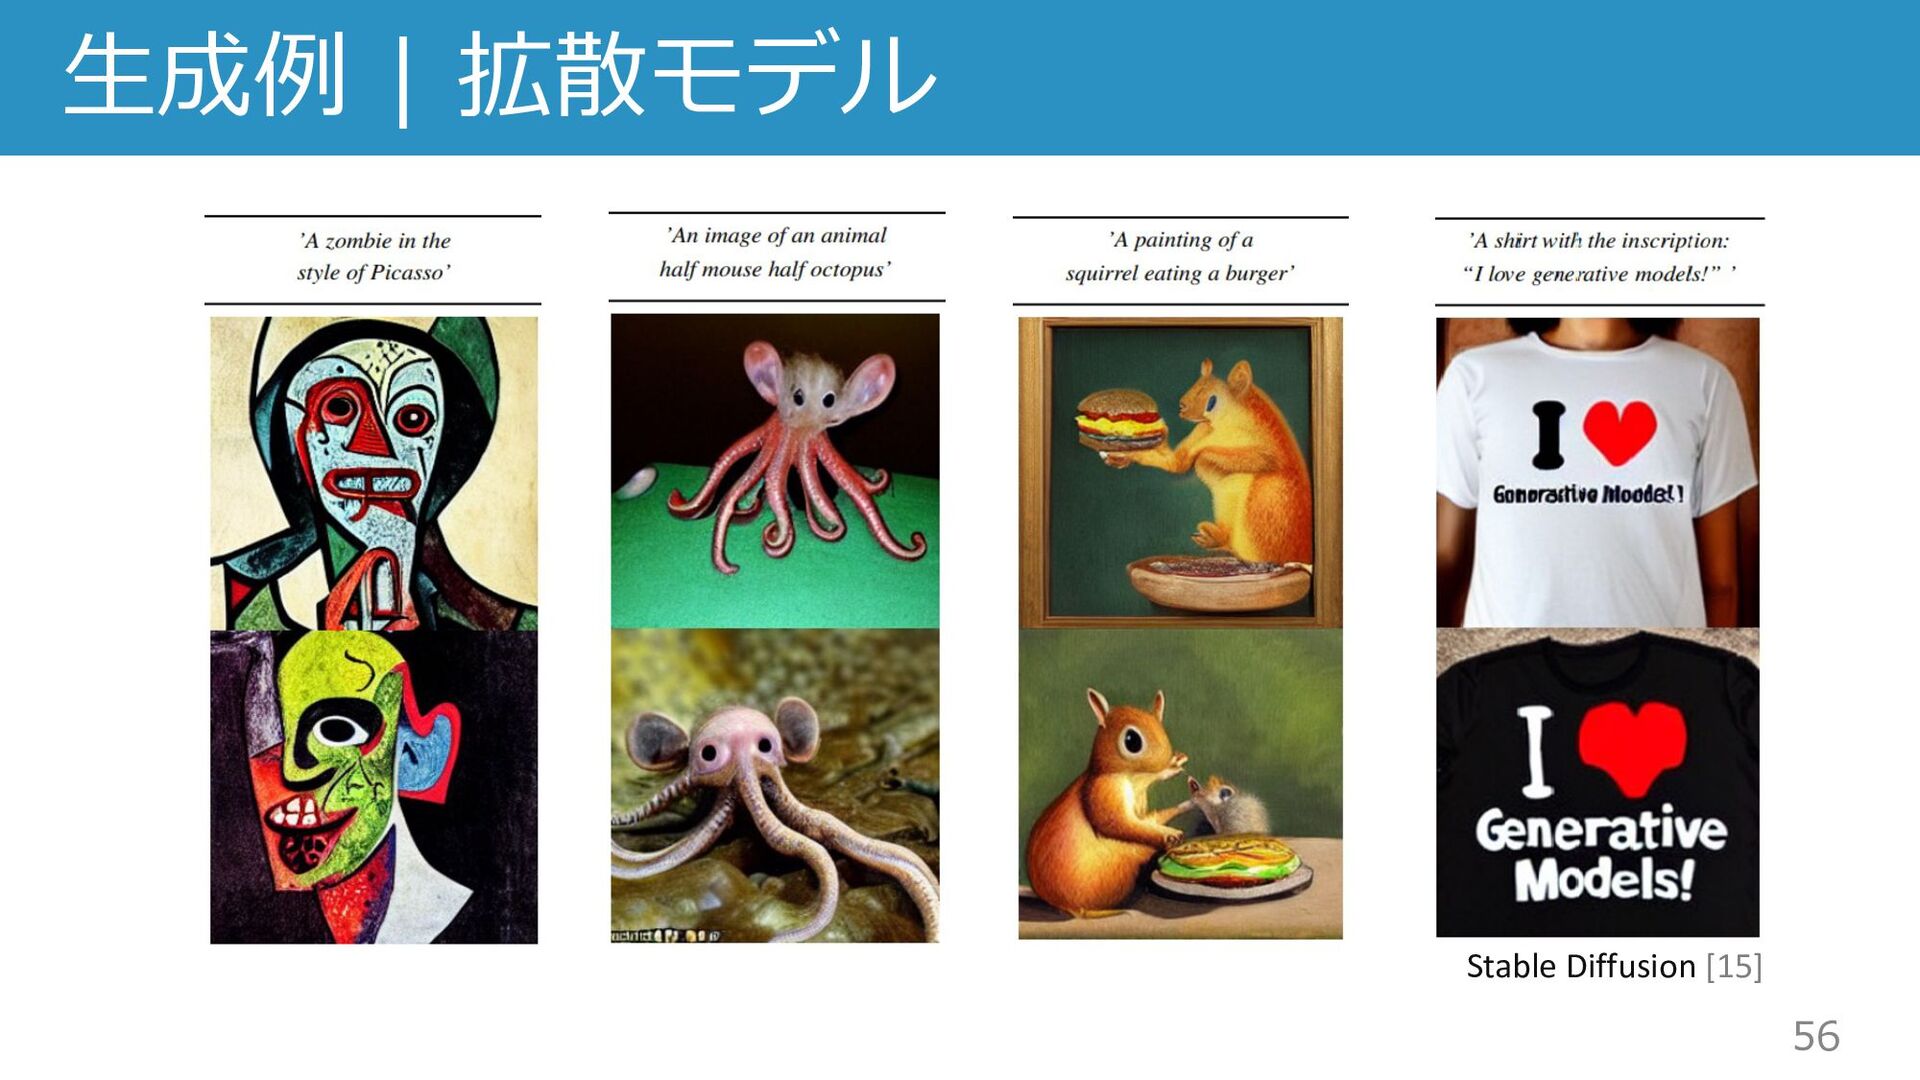
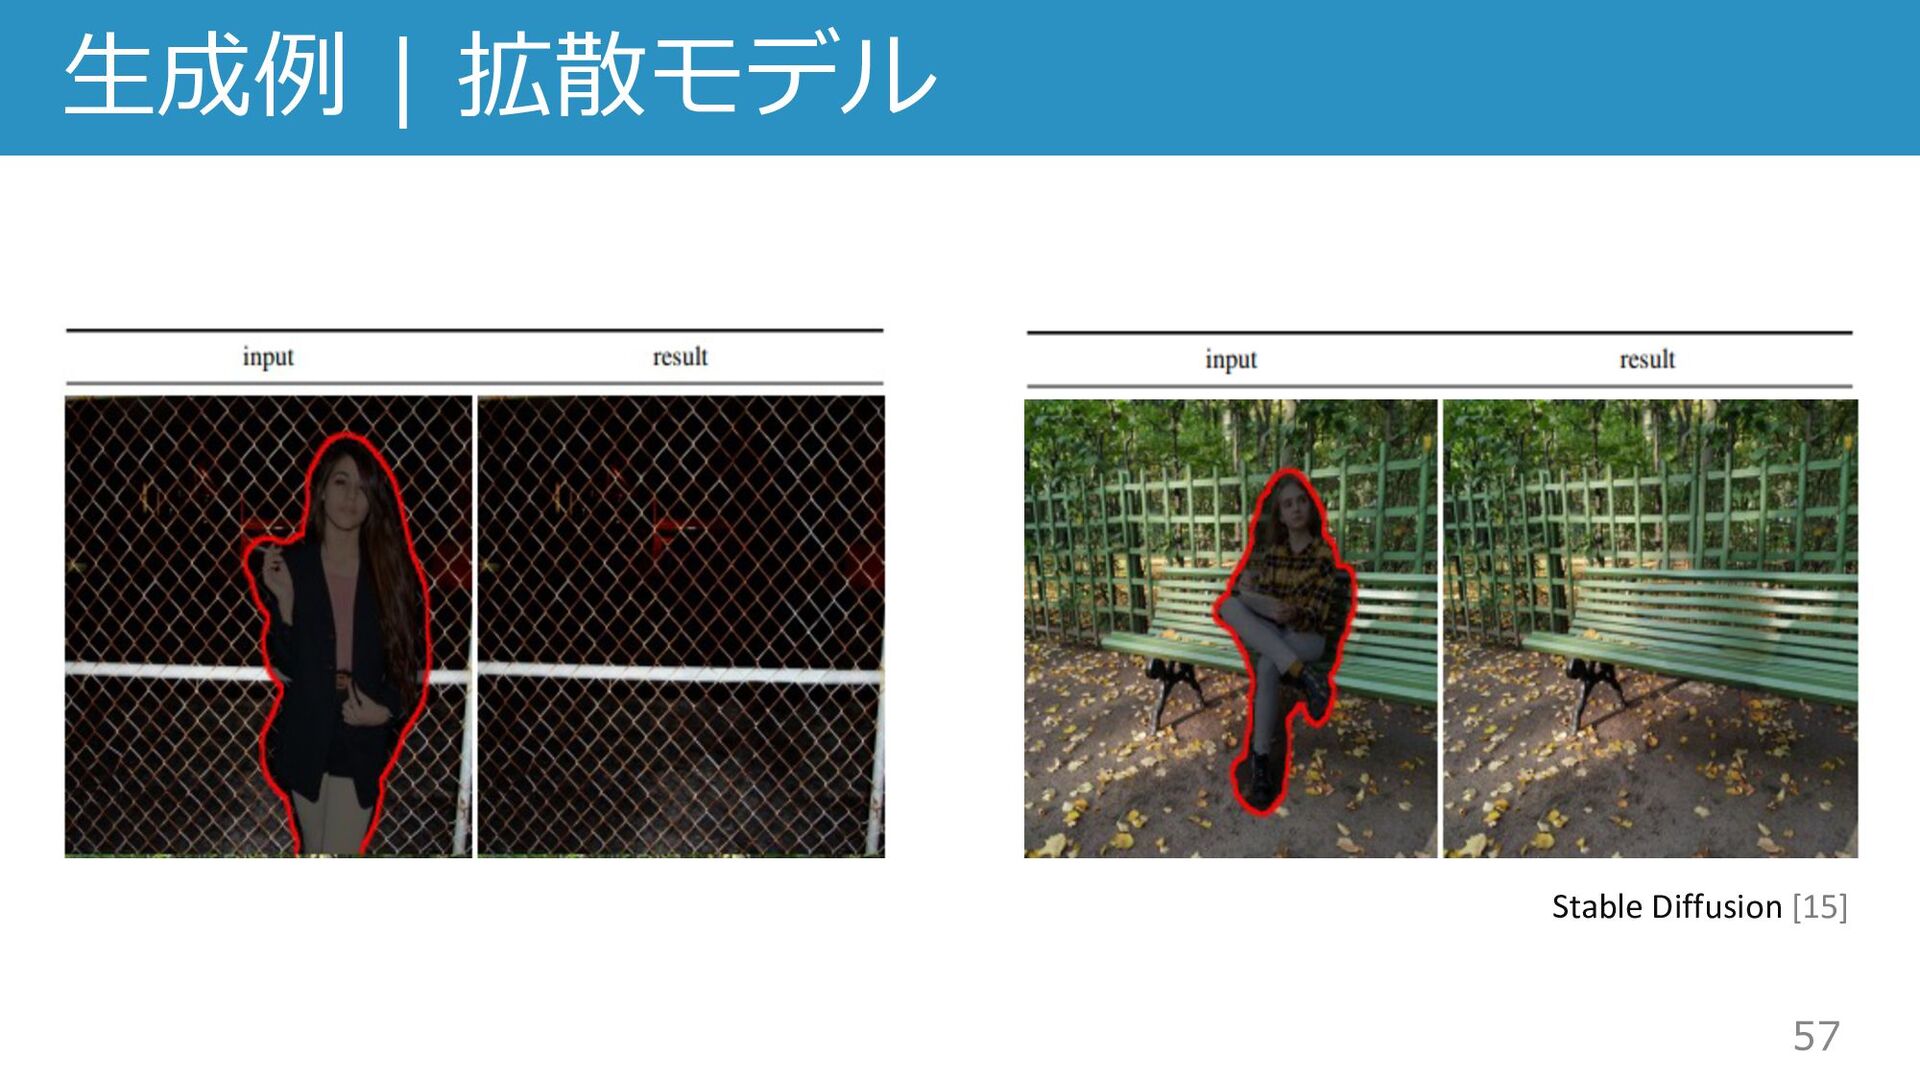
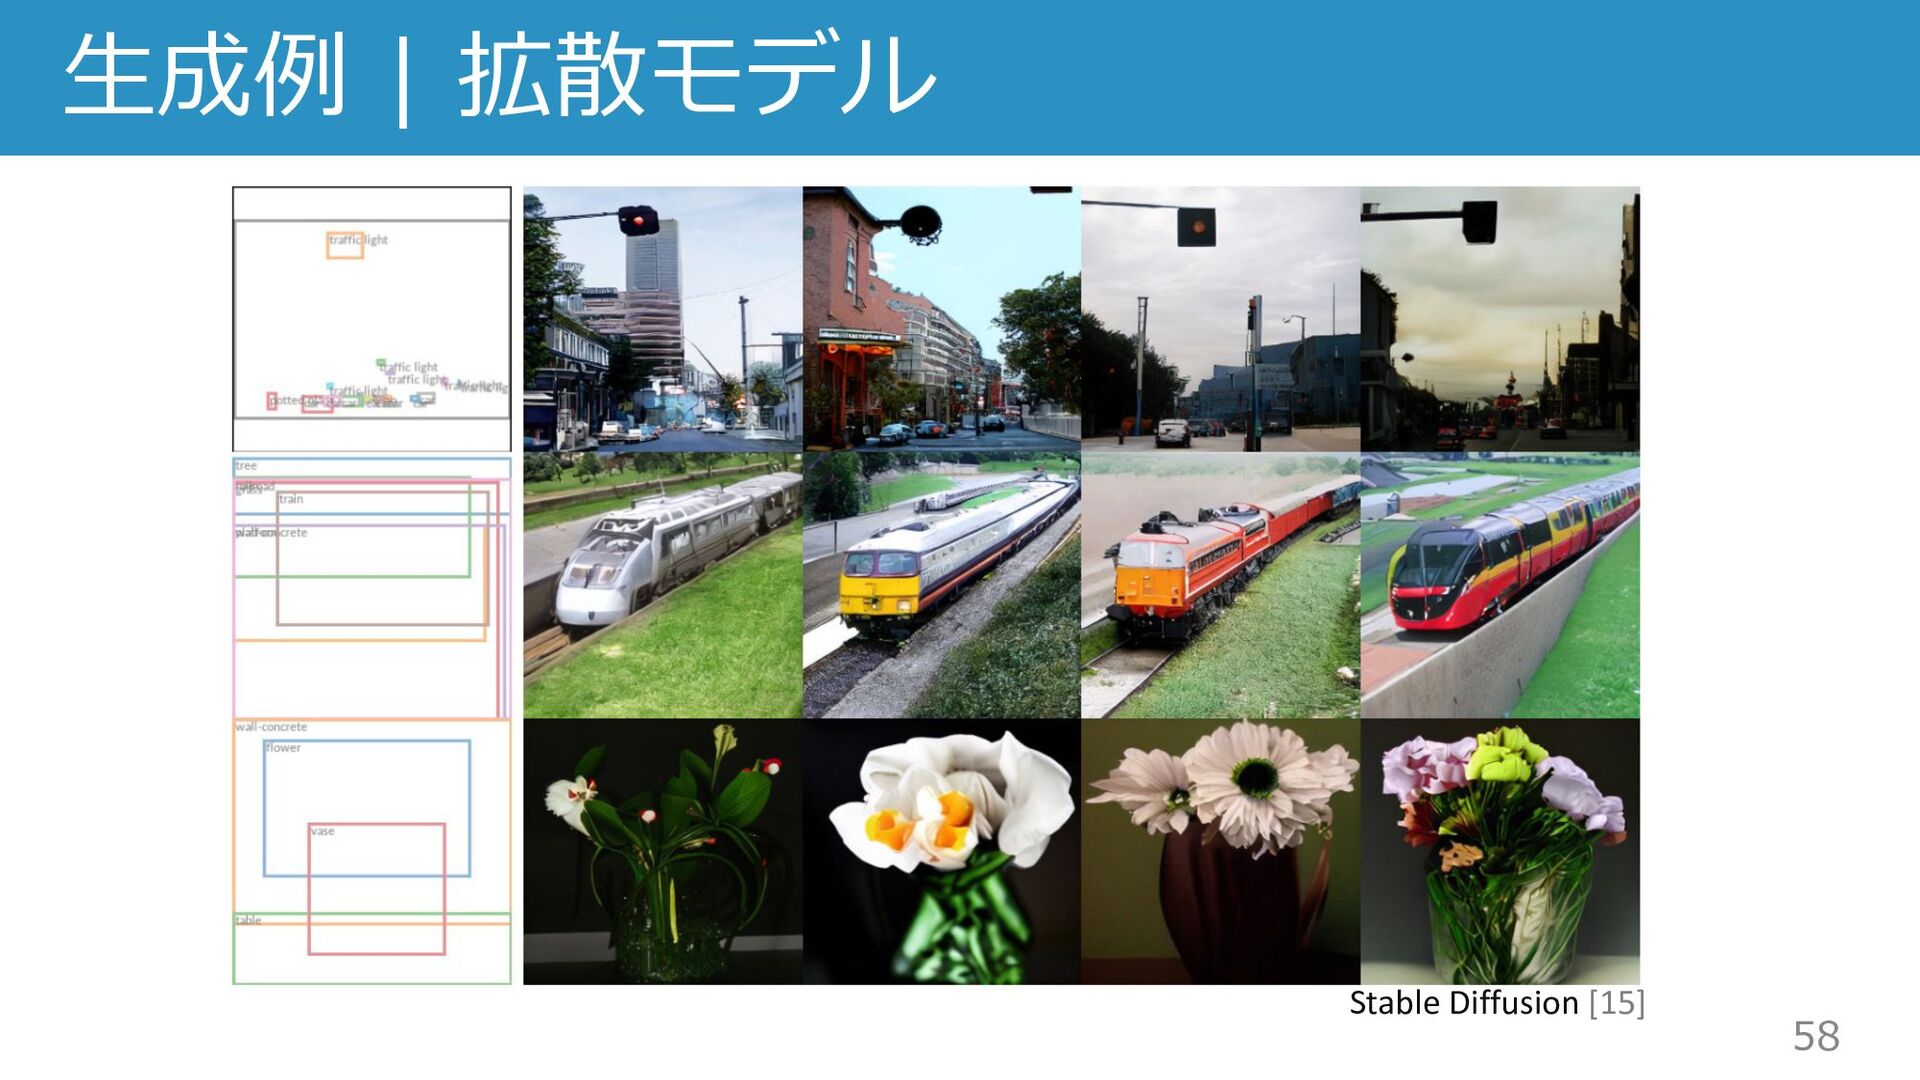
  28. 55 拡散モデル (Diffusion Models) 拡散モデル (diffusion model) とは 広く利⽤される画像⽣成モデルの総称 かつて⼀般的であった

    GANという⽣成モデル群を 上回る性能をもったことで話題 [13] 条件付き画像⽣成でも 既存の⼿法を上回る性能をもつ 「テキスト」に対応する画像の⽣成 「レイアウト」に対応する画像の⽣成 「低画質画像」に対応する⾼画質画像の⽣成 など DDPMという 拡散モデルでの⽣成例 [14]
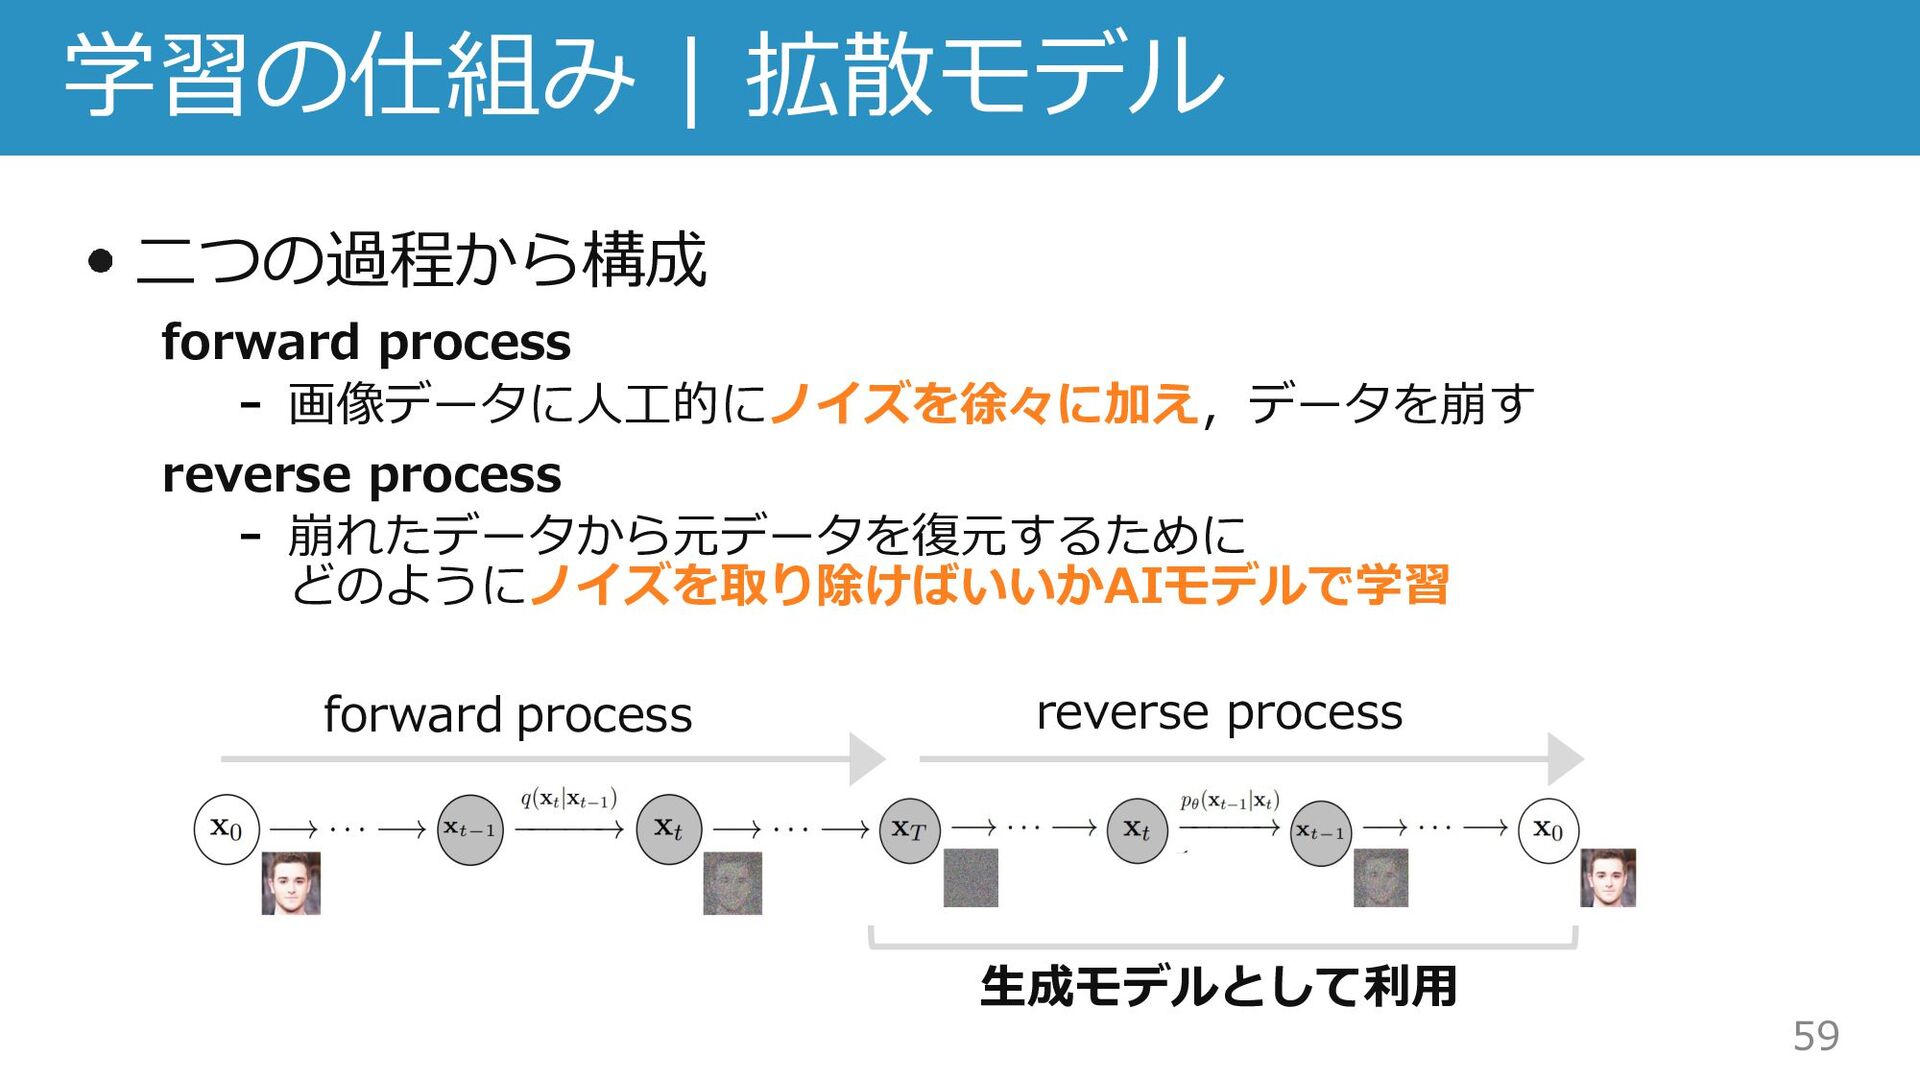
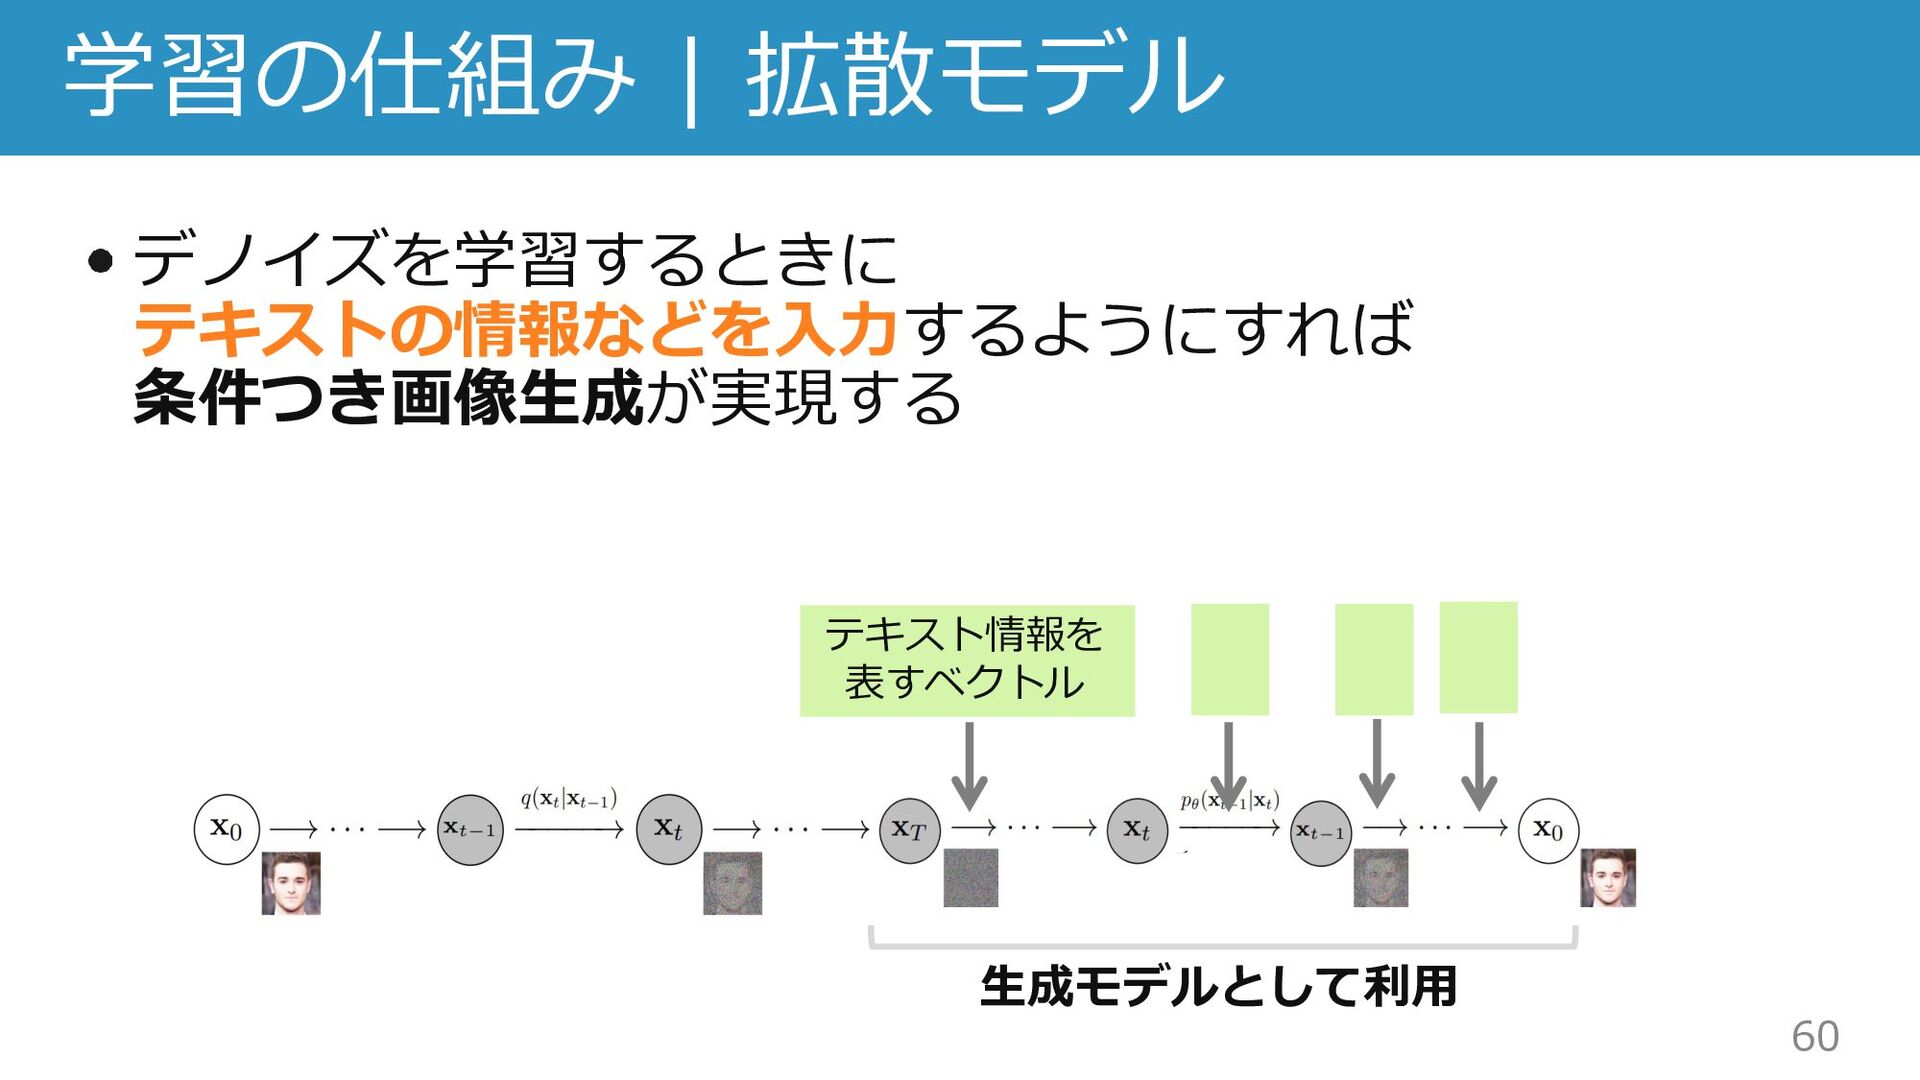
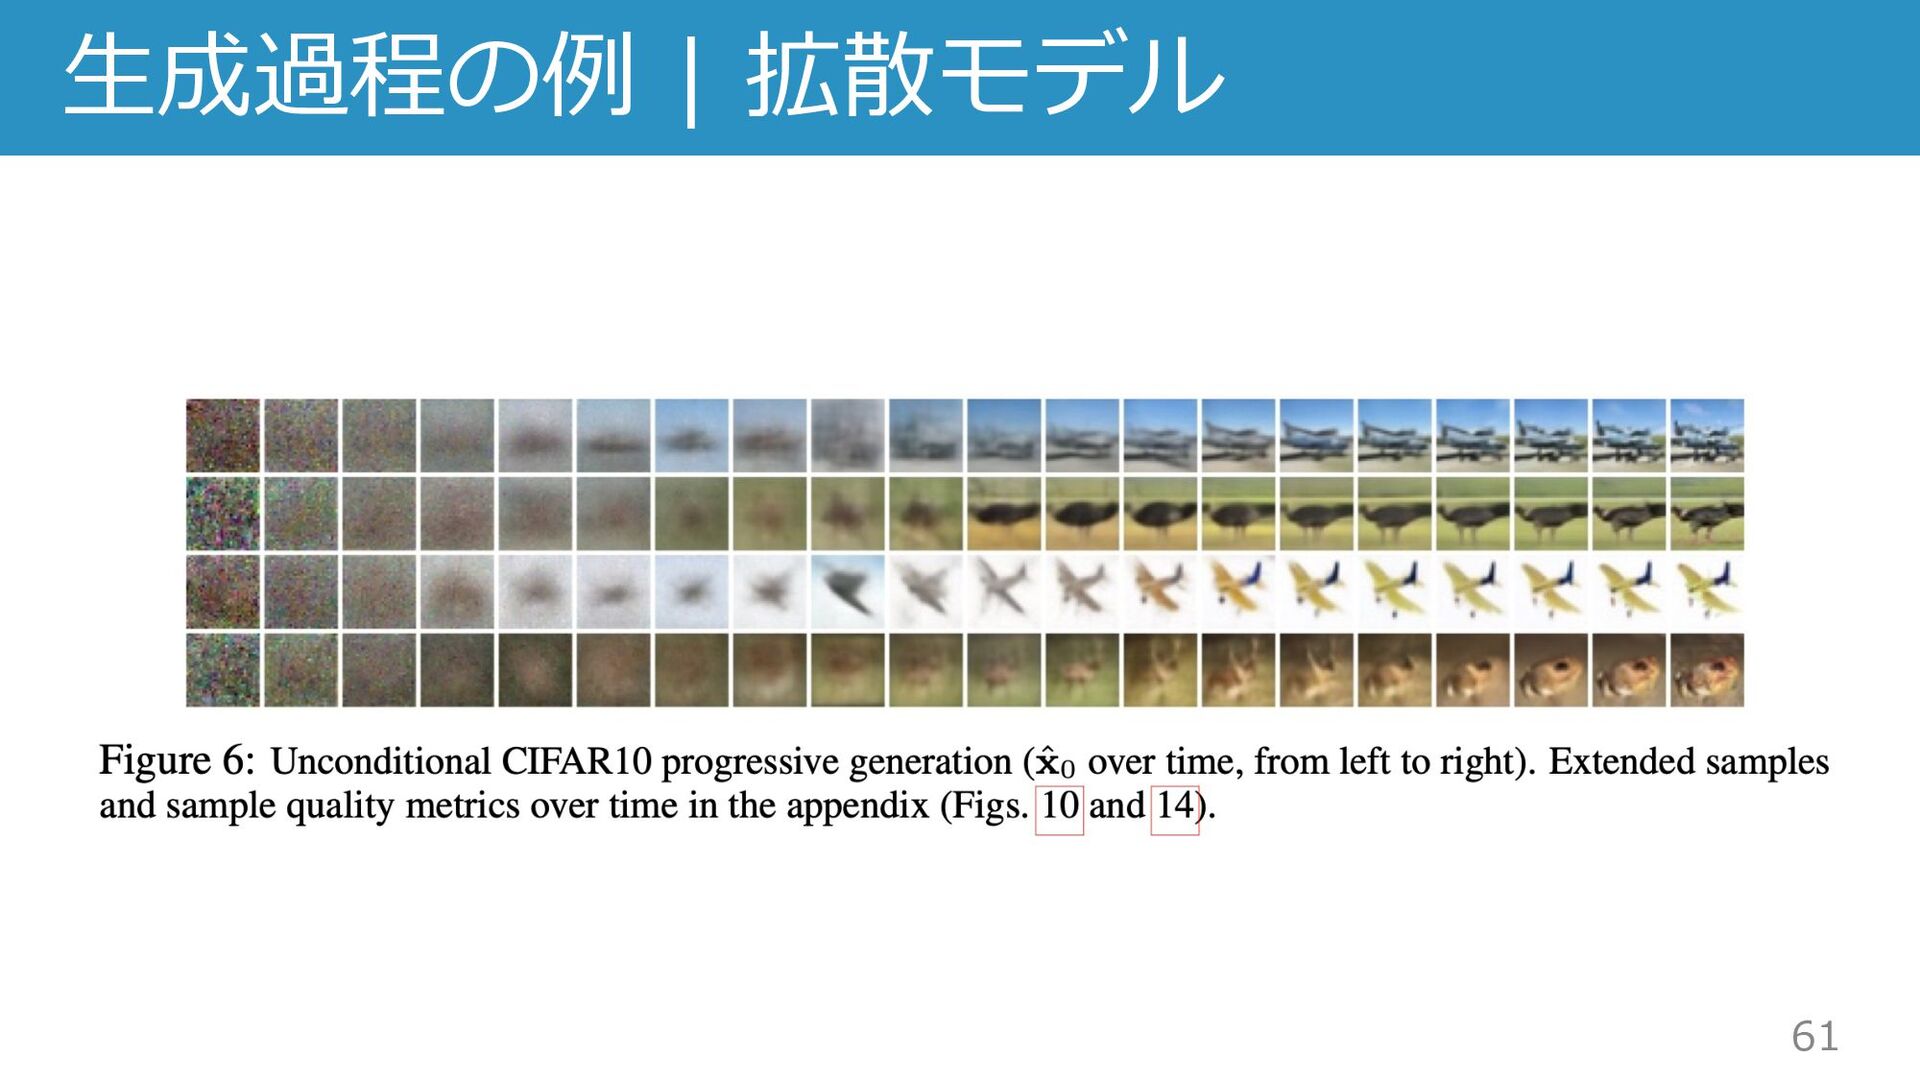
  29. 59 学習の仕組み | 拡散モデル ⼆つの過程から構成 forward process 画像データに⼈⼯的にノイズを徐々に加え,データを崩す reverse process
    崩れたデータから元データを復元するために どのようにノイズを取り除けばいいかAIモデルで学習 forward process reverse process ⽣成モデルとして利⽤
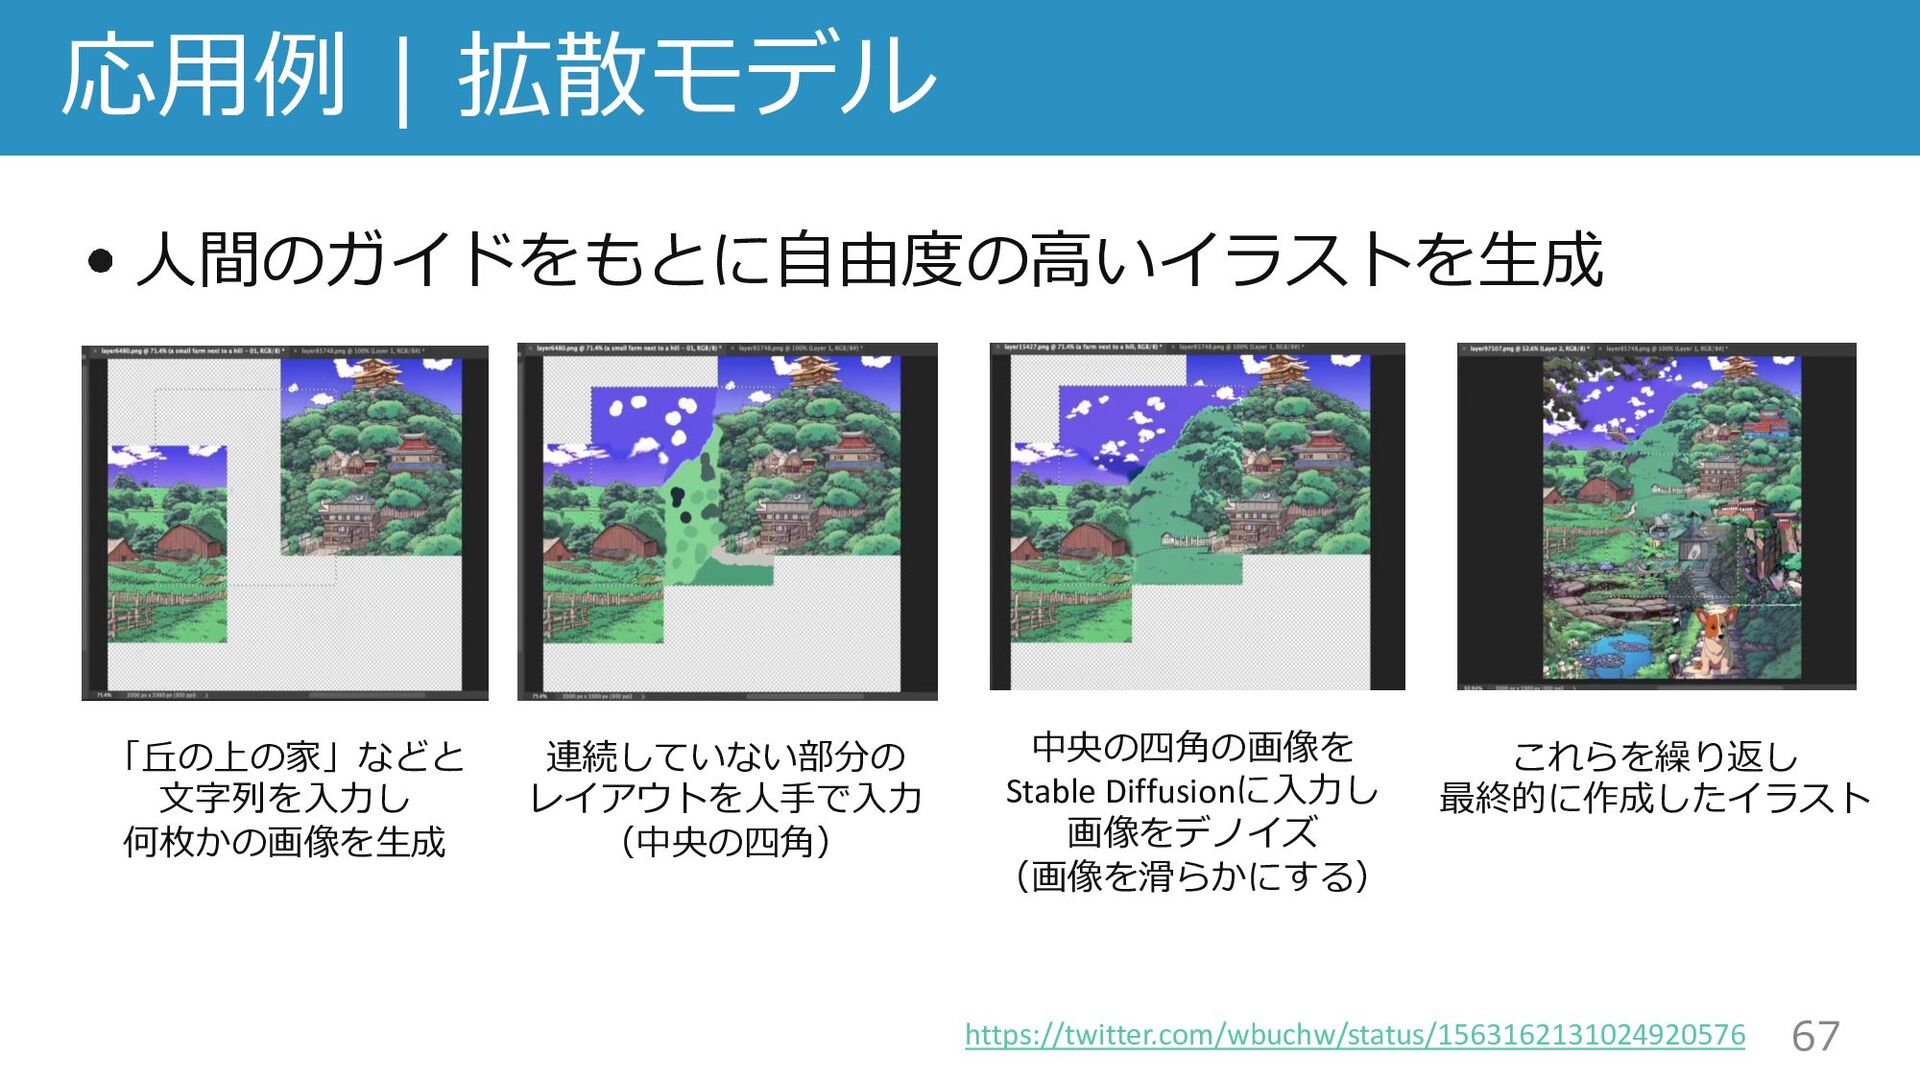
  30. 67 応⽤例 | 拡散モデル ⼈間のガイドをもとに⾃由度の⾼いイラストを⽣成 「丘の上の家」などと ⽂字列を⼊⼒し 何枚かの画像を⽣成 連続していない部分の レイアウトを⼈⼿で⼊⼒

    (中央の四⾓) 中央の四⾓の画像を Stable Diffusionに⼊⼒し 画像をデノイズ (画像を滑らかにする) これらを繰り返し 最終的に作成したイラスト https://twitter.com/wbuchw/status/1563162131024920576
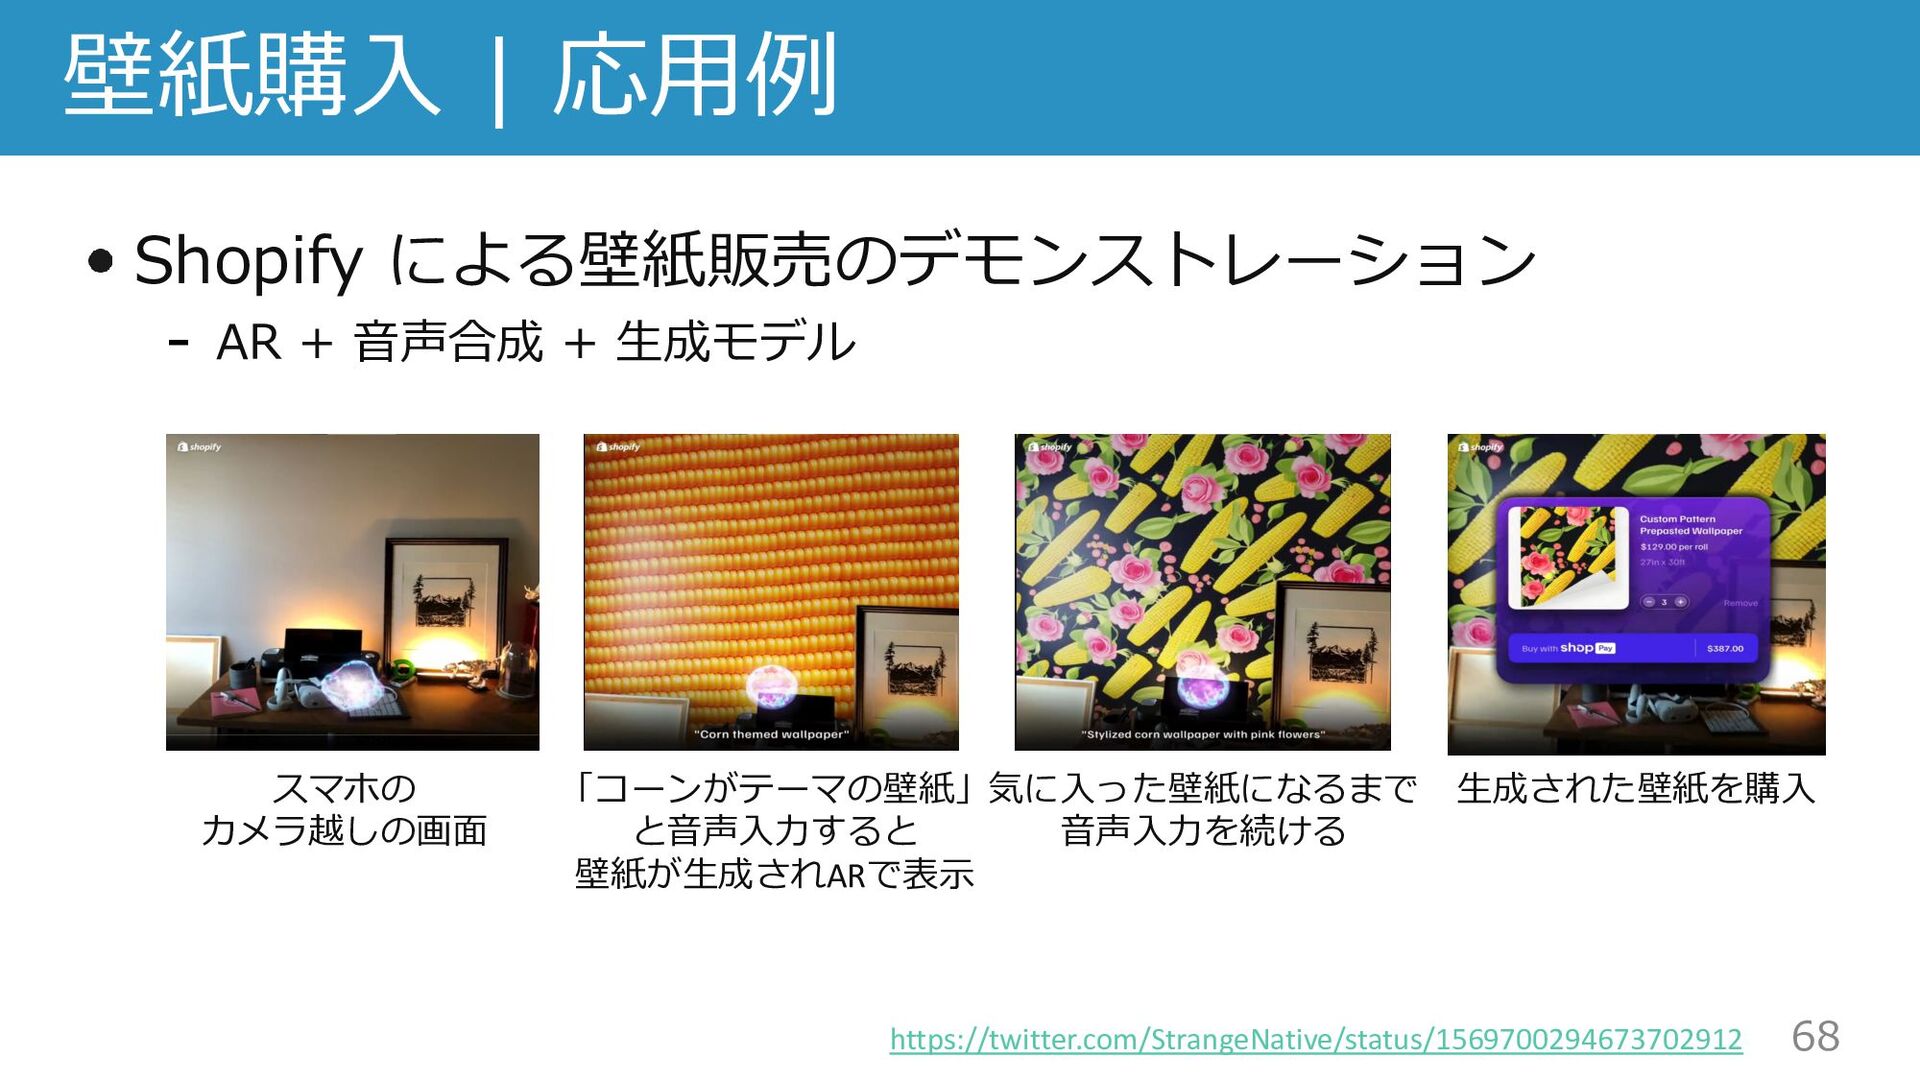
  31. 68 壁紙購⼊ | 応⽤例 Shopify による壁紙販売のデモンストレーション AR + ⾳声合成 +

    ⽣成モデル スマホの カメラ越しの画⾯ 「コーンがテーマの壁紙」 と⾳声⼊⼒すると 壁紙が⽣成されARで表⽰ 気に⼊った壁紙になるまで ⾳声⼊⼒を続ける ⽣成された壁紙を購⼊ https://twitter.com/StrangeNative/status/1569700294673702912
  32. ⽬次 ⼤規模⾔語モデル 対話型AI, ⾔語モデル, Transformer, スケーリング則 few-shot learning, hallucination, ⽇本語学習モデル

    AutoML Black-box 最適化, HPO, NAS, アルゴリズムの最適化 画像⽣成モデル Diffusion models, 応⽤例の紹介 69
  33. 71 参考⽂献 [1] OpenAI, Introducing ChatGPT. Available from https://openai.com/blog/chatgpt, 2023.

    [2] OpenAI, ChatGPT API Transition Guide. Available from https://help.openai.com/en/articles/7042661-chatgpt-api-transition-guide, 2023. [3] A. Vaswani et al., Attention Is All You Need. In NeurIPS 2017. [4] J. Kaplan et al., Scaling Laws for Neural Language models., In arXiv preprint arXiv:2001.08361, 2020. [5] T. Brown et al., Language Models are Few-shot Learner. In NeurIPS, 2020. [6] L. Ouyang et al., Training language models to follow instructions with human feedback. In NeurIPS, 2022. [7] Joseph Saveri Law Firm, GitHub and Copilot Intellectual Property Litigation. Available from https://www.saverilawfirm.com/our- cases/github-copilot-intellectual-property-litigation. [8] A. Ramesh et al., Hierarchical Text-Conditional Image Generation with CLIP Latents. In arXiv preprint arXiv:2204.06125, 2022. [9] S. Falkner et al., BOHB: Robust and Efficient Hyperparameter Optimization at Scale. In ICML Workshop, 2018. [10] B. Zoph et al., Learning Transferable Architectures for Scalable Image Recognition. In CVPR, 2018. [11] P. Ramachandran et al., Searching for Activation Function. In ICLR Workshop, 2018. [12] E. Real et al., AutoML-Zero: Evolving Machine Learning Algorithms From Scratc. In ICML, 2020. [13] P. Dhariwal and A. Nichol, Diffusion Models Beat GANs on Image Synthesis. In NeurIPS, 2021. [14] J. Ho et al., Denoising Diffusion Probabilistic Models. In NeurIPS, 2020. [15] R. Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models. In CVPR, 2022. [16] A. Hertz et al., Prompt-to-Prompt Image Editing with Cross Attention Control. In ICLR, 2023. [17] A. Radford et al., Improving Language Understanding by Generative Pre-Training. In OpenAI Blog. [18] M. Chen et al., Evaluating Large Language Models Trained on Code. In arXiv preprint arXiv:2107.03374, 2021. [19] S. Zhang et al., OPT: Open Pre-trained Transformer Language Models. In arXiv preprint arXiv:2205.01068, 2022. [20] F. Shi et al., Language models are multilingual chain-of-thought reasoners. In ICLR, 2023.