Upgrade to Pro — share decks privately, control downloads, hide ads and more …

GPUが使用するバス帯域の実際

Avatar for Yu-i Yu-i
October 06, 2026

 GPUが使用するバス帯域の実際

NVLinkがなく、PCI-Express間でGPUを共有する場合、GPU間の帯域使用状況はどのようになっているのかを調査した。

Avatar for Yu-i

Yu-i

October 06, 2026

More Decks by Yu-i

Other Decks in Technology

Transcript

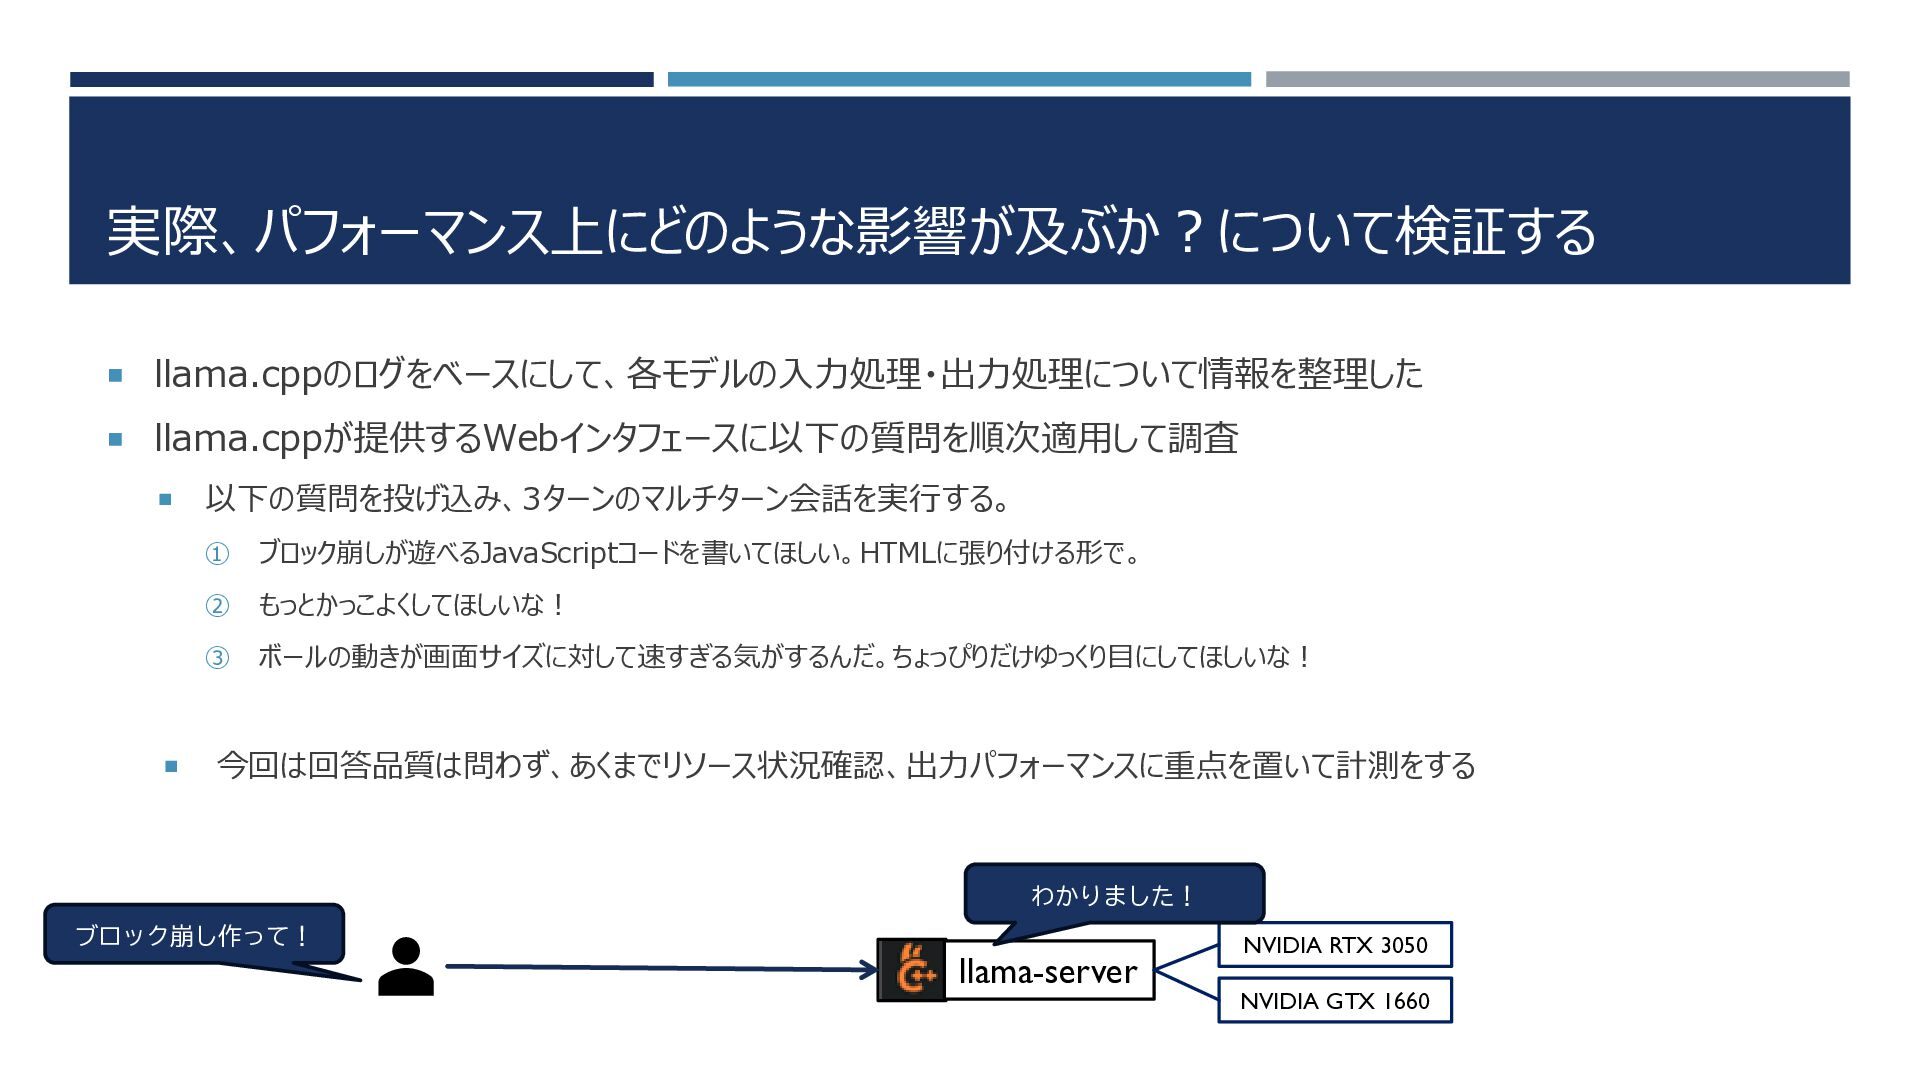
  1. 実際、パフォーマンス上にどのような影響が及ぶか?について検証する  llama.cppのログをベースにして、各モデルの入力処理・出力処理について情報を整理した  llama.cppが提供するWebインタフェースに以下の質問を順次適用して調査   以下の質問を投げ込み、3ターンのマルチターン会話を実行する。 ① ブロック崩しが遊べるJavaScriptコードを書いてほしい。HTMLに張り付ける形で。

    ② もっとかっこよくしてほしいな! ③ ボールの動きが画面サイズに対して速すぎる気がするんだ。ちょっぴりだけゆっくり目にしてほしいな! 今回は回答品質は問わず、あくまでリソース状況確認、出力パフォーマンスに重点を置いて計測をする わかりました! ブロック崩し作って! llama-server NVIDIA RTX 3050 NVIDIA GTX 1660
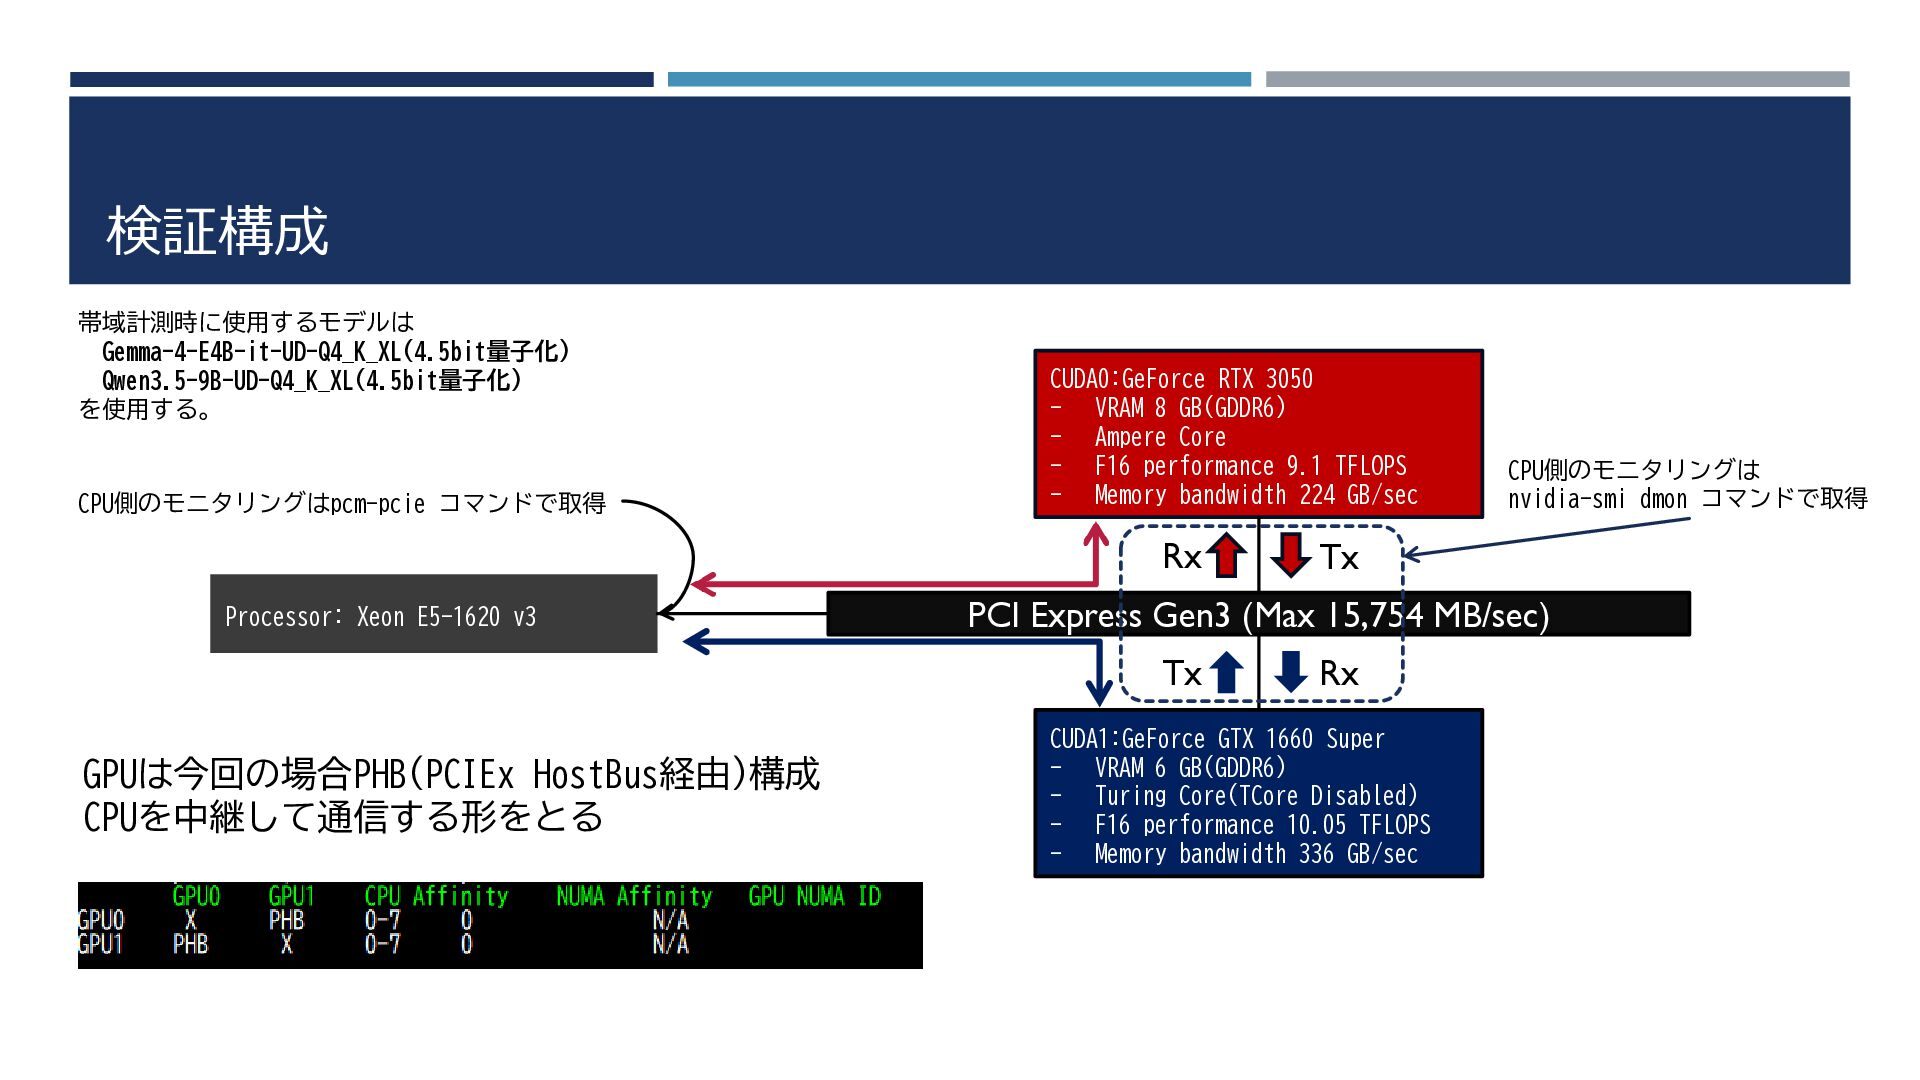
  2. 検証構成 帯域計測時に使用するモデルは Gemma-4-E4B-it-UD-Q4_K_XL(4.5bit量子化) Qwen3.5-9B-UD-Q4_K_XL(4.5bit量子化) を使用する。 CPU側のモニタリングはpcm-pcie コマンドで取得 CUDA0:GeForce RTX 3050

    - VRAM 8 GB(GDDR6) - Ampere Core - F16 performance 9.1 TFLOPS - Memory bandwidth 224 GB/sec Rx Processor: Xeon E5-1620 v3 Tx PCI Express Gen3 (Max 15,754 MB/sec) Tx GPUは今回の場合PHB(PCIEx HostBus経由)構成 CPUを中継して通信する形をとる CPU側のモニタリングは nvidia-smi dmon コマンドで取得 Rx CUDA1:GeForce GTX 1660 Super - VRAM 6 GB(GDDR6) - Turing Core(TCore Disabled) - F16 performance 10.05 TFLOPS - Memory bandwidth 336 GB/sec
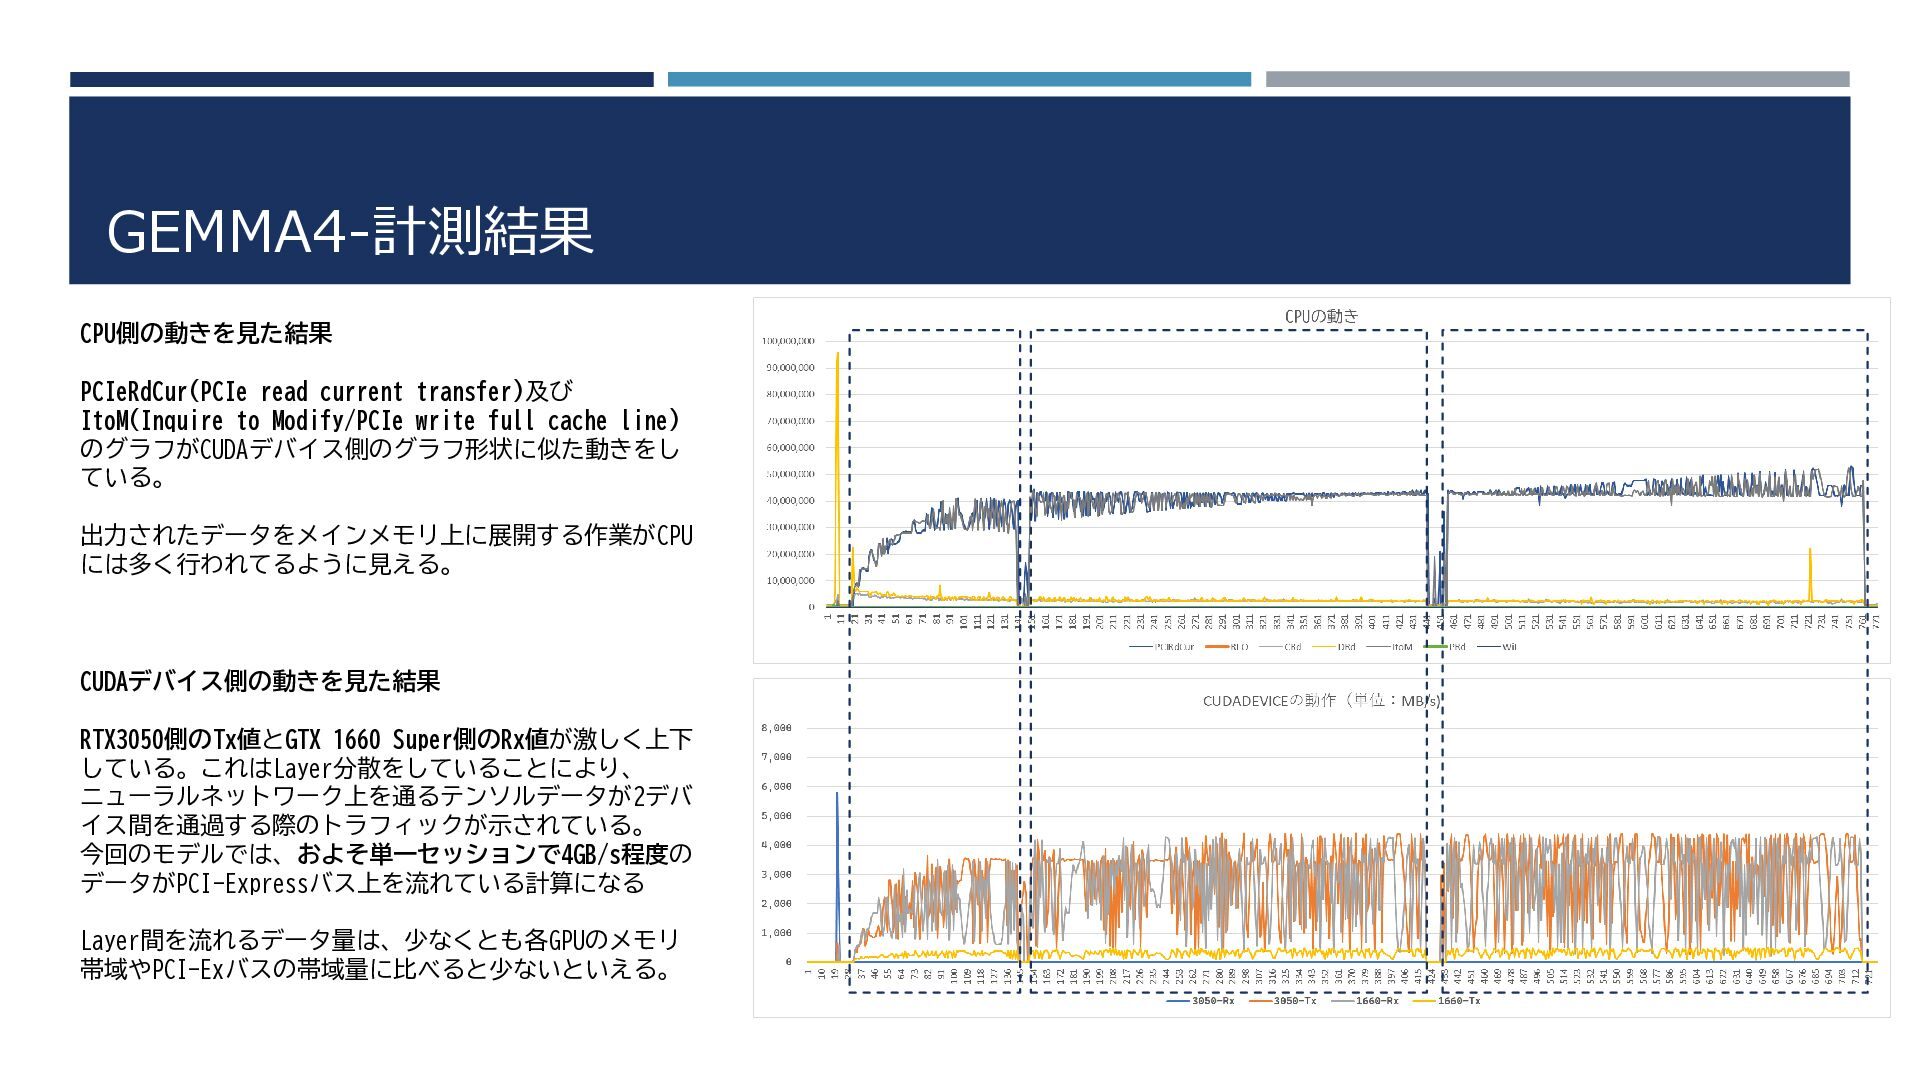
  3. GEMMA4-計測結果 CPU側の動きを見た結果 PCIeRdCur(PCIe read current transfer)及び ItoM(Inquire to Modify/PCIe write

    full cache line) のグラフがCUDAデバイス側のグラフ形状に似た動きをし ている。 出力されたデータをメインメモリ上に展開する作業がCPU には多く行われてるように見える。 CUDAデバイス側の動きを見た結果 RTX3050側のTx値とGTX 1660 Super側のRx値が激しく上下 している。これはLayer分散をしていることにより、 ニューラルネットワーク上を通るテンソルデータが2デバ イス間を通過する際のトラフィックが示されている。 今回のモデルでは、およそ単一セッションで4GB/s程度の データがPCI-Expressバス上を流れている計算になる Layer間を流れるデータ量は、少なくとも各GPUのメモリ 帯域やPCI-Exバスの帯域量に比べると少ないといえる。
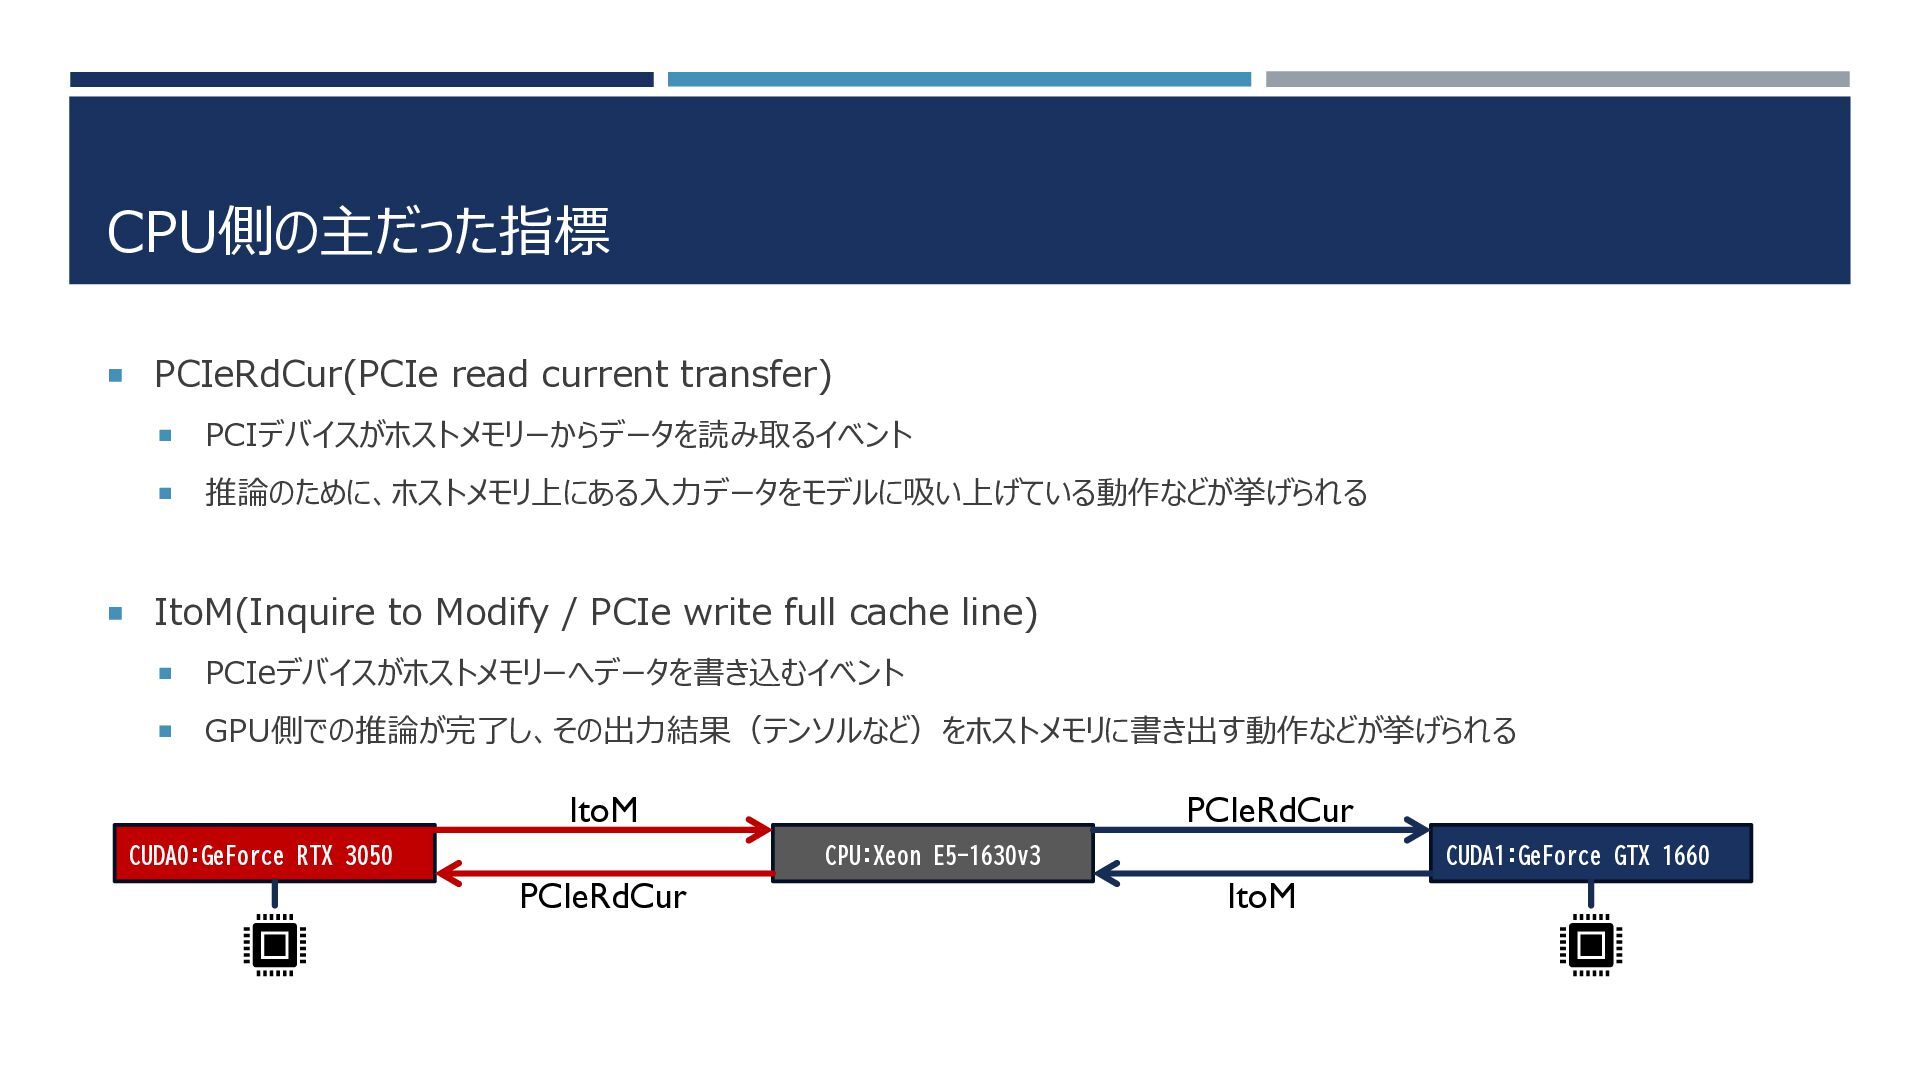
  4. CPU側の主だった指標  PCIeRdCur(PCIe read current transfer)  PCIデバイスがホストメモリーからデータを読み取るイベント  推論のために、ホストメモリ上にある入力データをモデルに吸い上げている動作などが挙げられる

     ItoM(Inquire to Modify / PCIe write full cache line)  PCIeデバイスがホストメモリーへデータを書き込むイベント  GPU側での推論が完了し、その出力結果(テンソルなど)をホストメモリに書き出す動作などが挙げられる ItoM CUDA0:GeForce RTX 3050 PCIeRdCur CPU:Xeon E5-1630v3 PCIeRdCur CUDA1:GeForce GTX 1660 ItoM
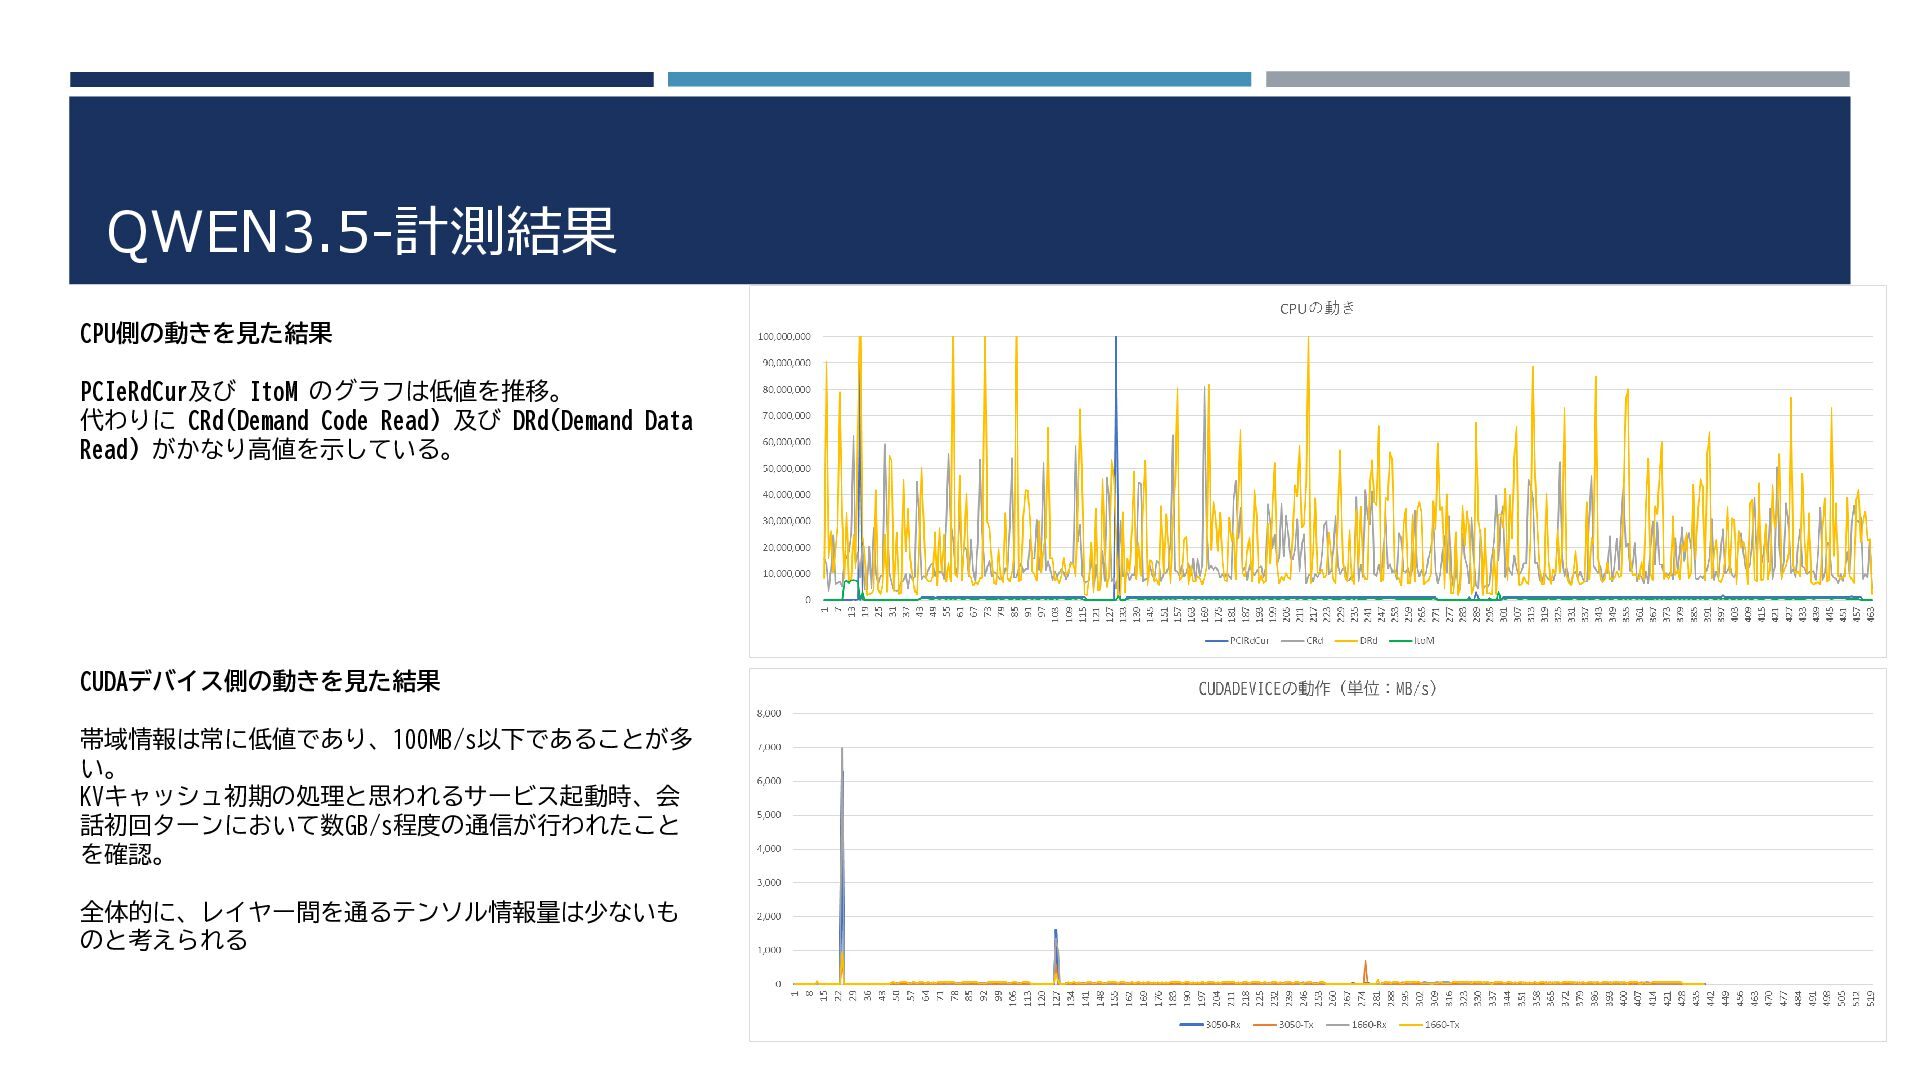
  5. QWEN3.5-計測結果 CPU側の動きを見た結果 PCIeRdCur及び ItoM のグラフは低値を推移。 代わりに CRd(Demand Code Read) 及び

    DRd(Demand Data Read) がかなり高値を示している。 CUDAデバイス側の動きを見た結果 帯域情報は常に低値であり、100MB/s以下であることが多 い。 KVキャッシュ初期の処理と思われるサービス起動時、会 話初回ターンにおいて数GB/s程度の通信が行われたこと を確認。 全体的に、レイヤー間を通るテンソル情報量は少ないも のと考えられる
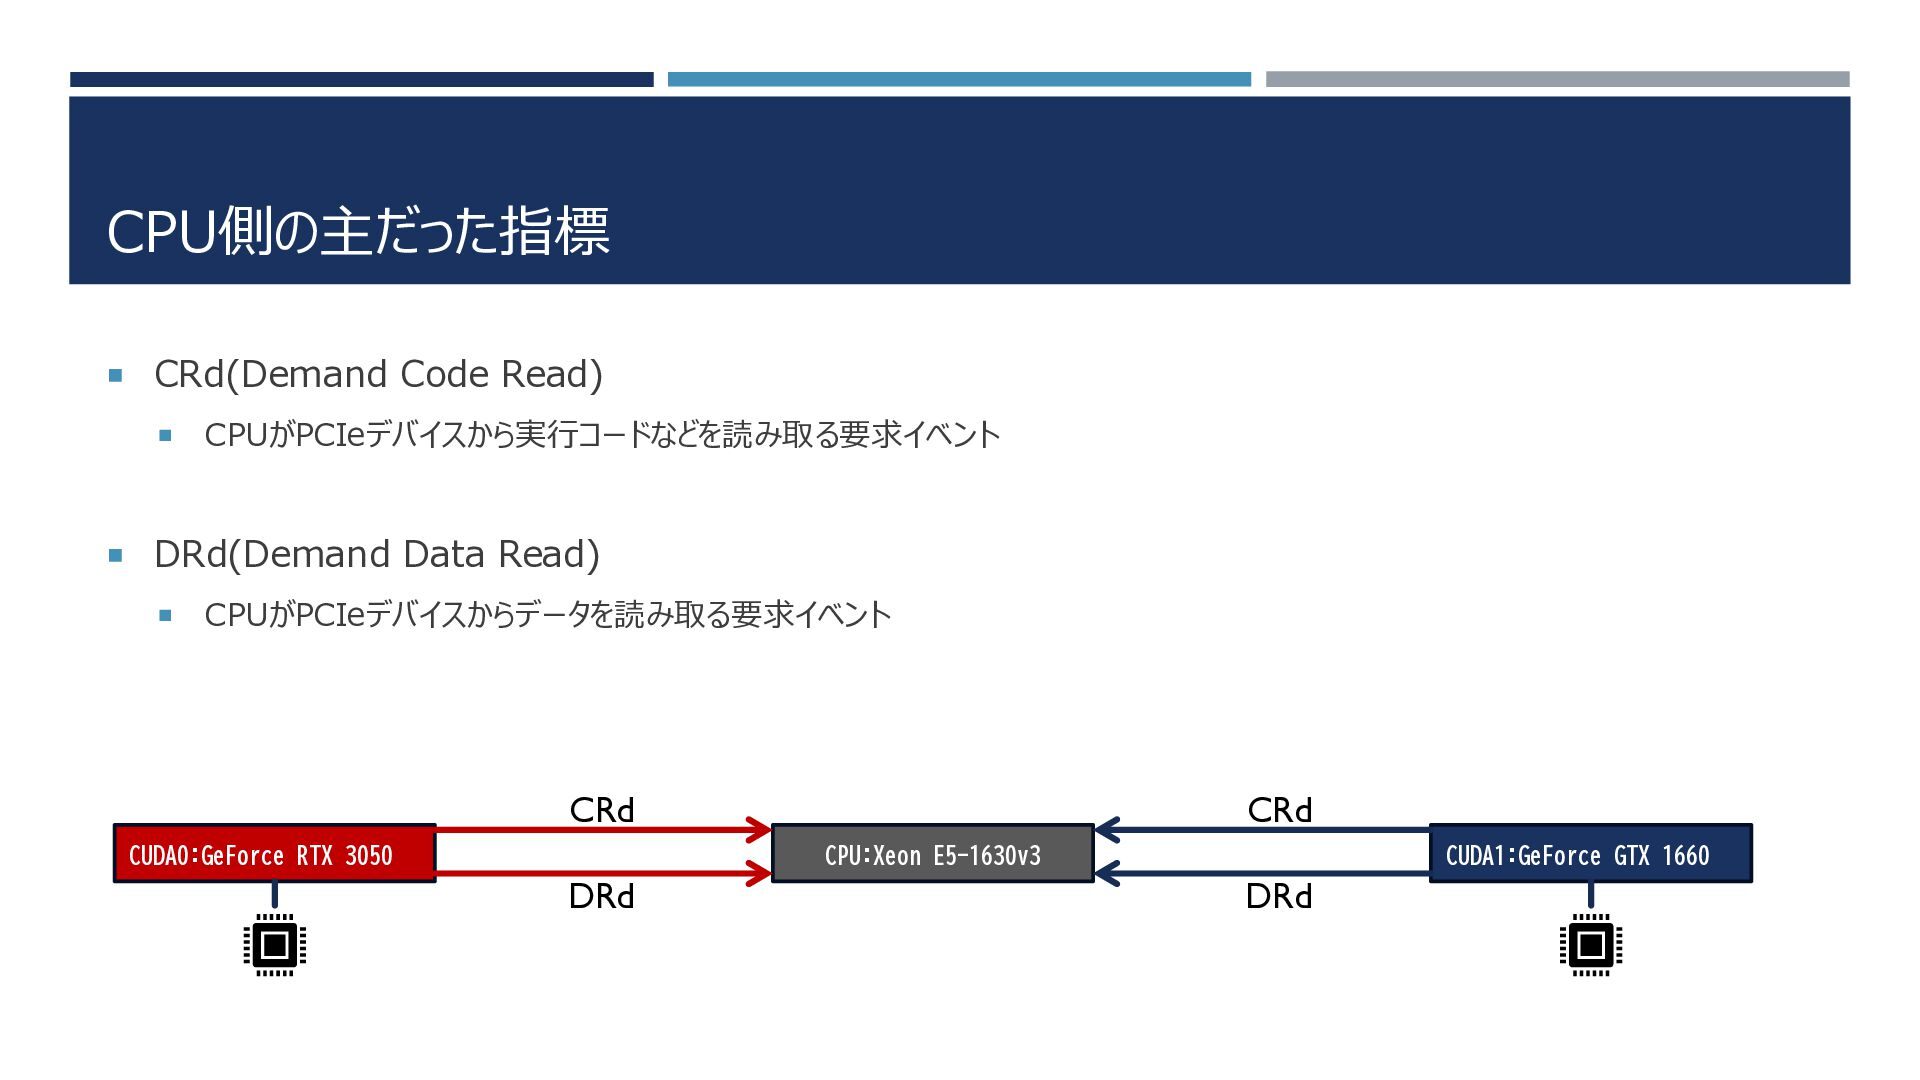
  6. CPU側の主だった指標  CRd(Demand Code Read)  CPUがPCIeデバイスから実行コードなどを読み取る要求イベント  DRd(Demand Data

    Read)  CPUがPCIeデバイスからデータを読み取る要求イベント CRd CUDA0:GeForce RTX 3050 CRd CPU:Xeon E5-1630v3 DRd CUDA1:GeForce GTX 1660 DRd
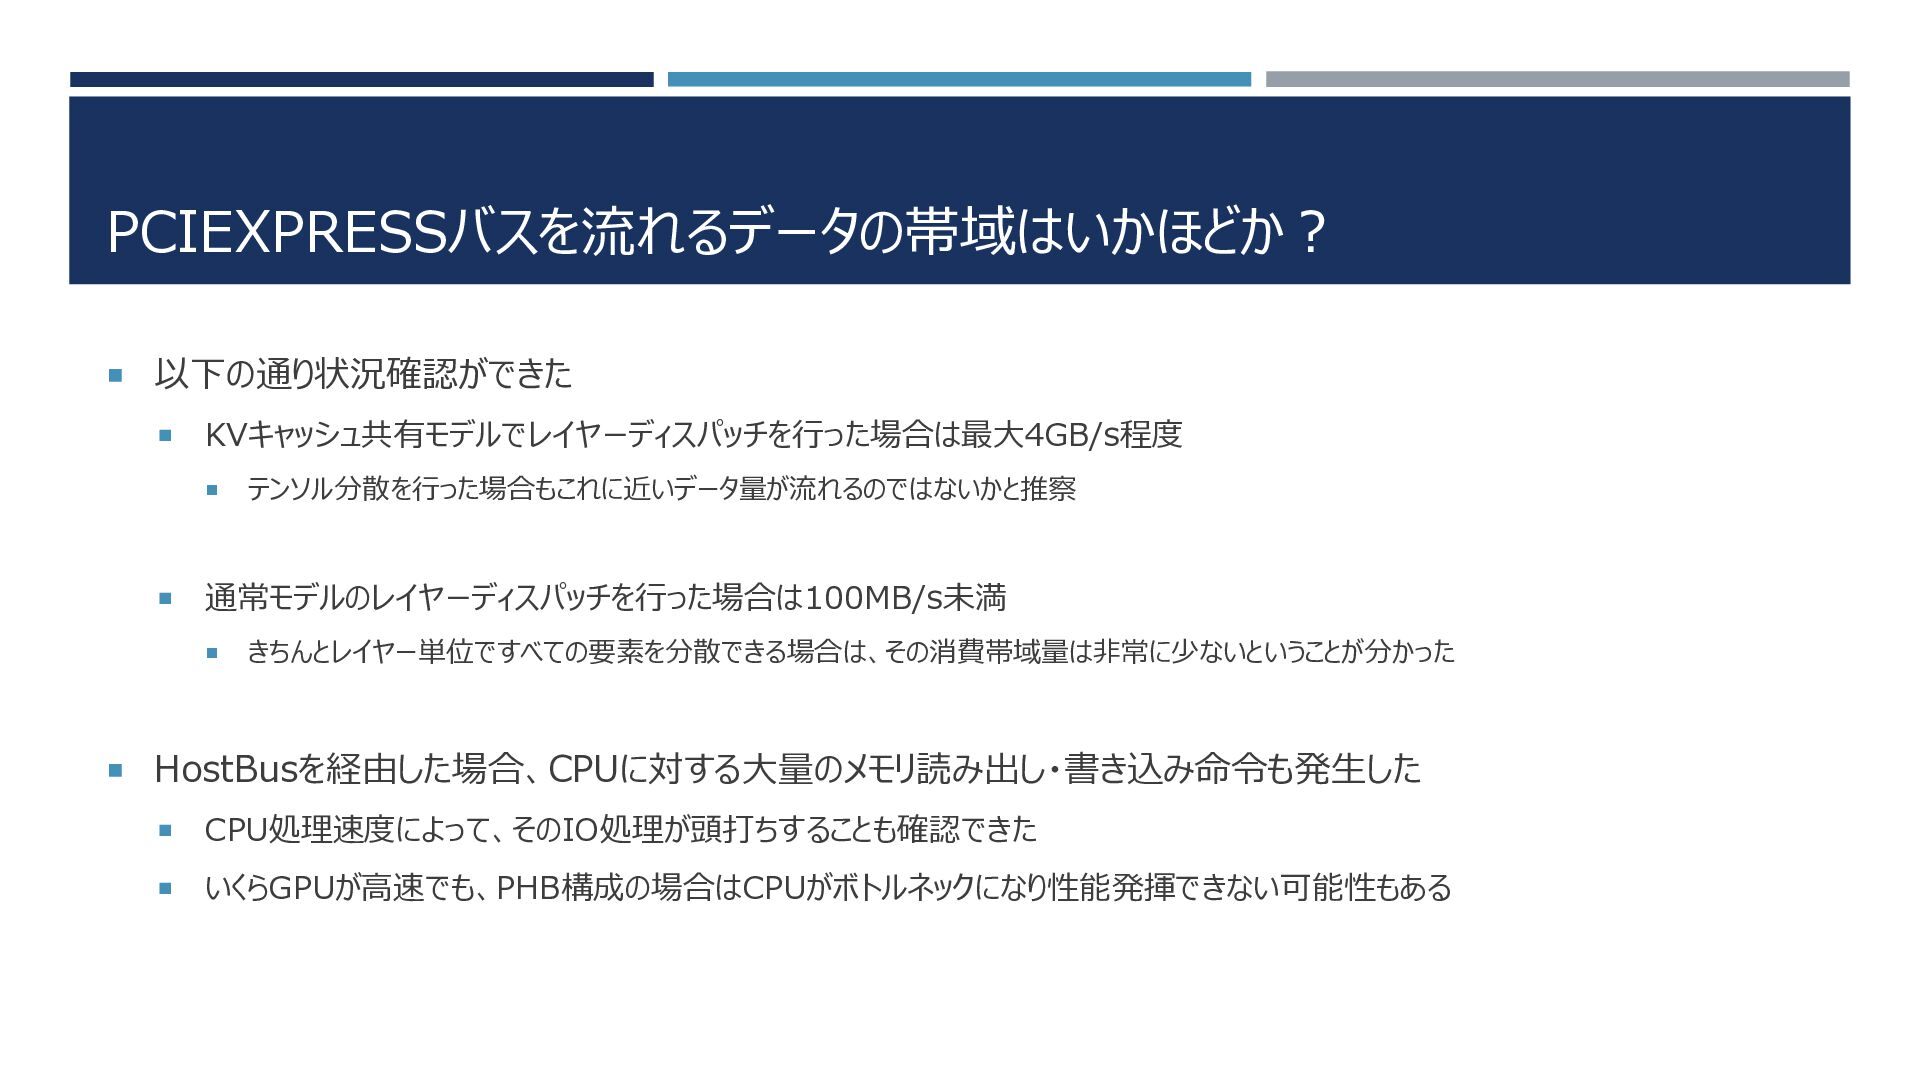
  7. PCIEXPRESSバスを流れるデータの帯域はいかほどか?  以下の通り状況確認ができた  KVキャッシュ共有モデルでレイヤーディスパッチを行った場合は最大4GB/s程度   テンソル分散を行った場合もこれに近いデータ量が流れるのではないかと推察 通常モデルのレイヤーディスパッチを行った場合は100MB/s未満 

    きちんとレイヤー単位ですべての要素を分散できる場合は、その消費帯域量は非常に少ないということが分かった  HostBusを経由した場合、CPUに対する大量のメモリ読み出し・書き込み命令も発生した  CPU処理速度によって、そのIO処理が頭打ちすることも確認できた  いくらGPUが高速でも、PHB構成の場合はCPUがボトルネックになり性能発揮できない可能性もある
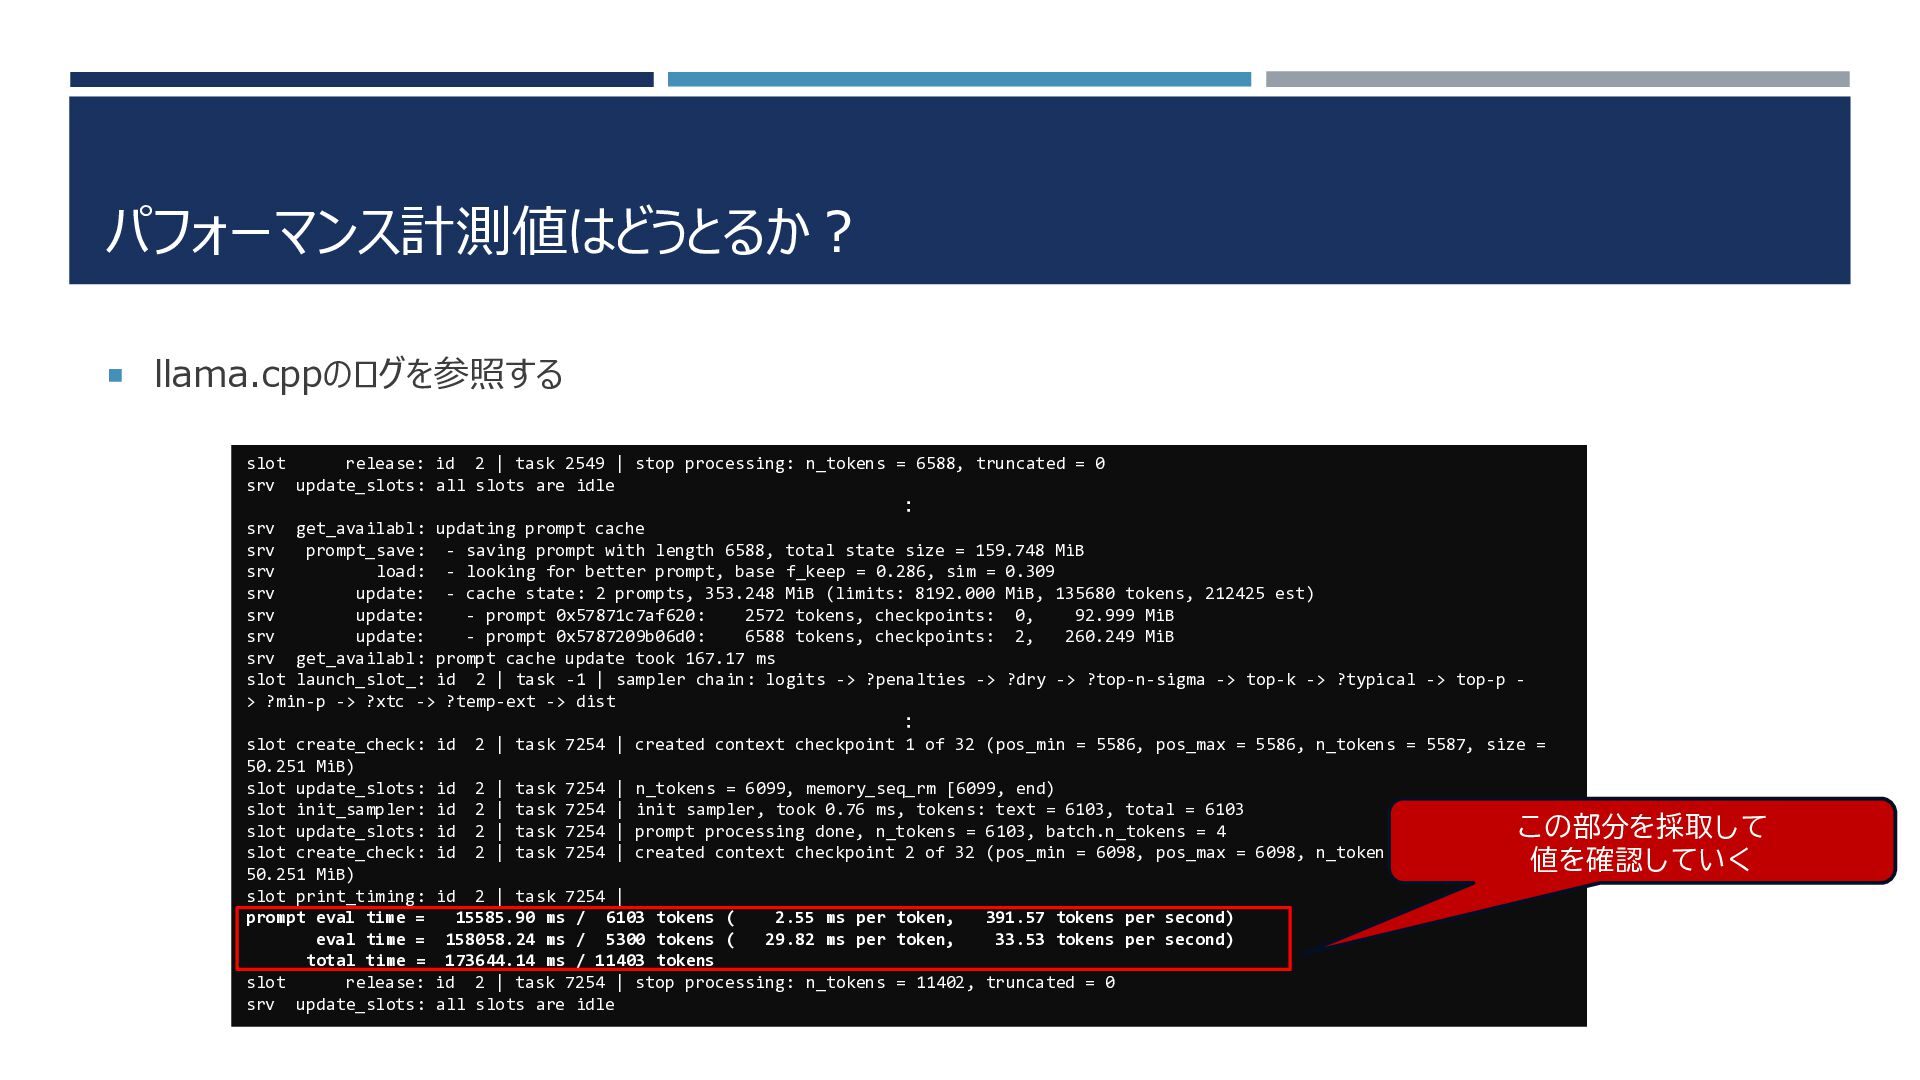
  8. パフォーマンス計測値はどうとるか?  llama.cppのログを参照する slot release: id 2 | task 2549

    | stop processing: n_tokens = 6588, truncated = 0 srv update_slots: all slots are idle : srv get_availabl: updating prompt cache srv prompt_save: - saving prompt with length 6588, total state size = 159.748 MiB srv load: - looking for better prompt, base f_keep = 0.286, sim = 0.309 srv update: - cache state: 2 prompts, 353.248 MiB (limits: 8192.000 MiB, 135680 tokens, 212425 est) srv update: - prompt 0x57871c7af620: 2572 tokens, checkpoints: 0, 92.999 MiB srv update: - prompt 0x5787209b06d0: 6588 tokens, checkpoints: 2, 260.249 MiB srv get_availabl: prompt cache update took 167.17 ms slot launch_slot_: id 2 | task -1 | sampler chain: logits -> ?penalties -> ?dry -> ?top-n-sigma -> top-k -> ?typical -> top-p > ?min-p -> ?xtc -> ?temp-ext -> dist : slot create_check: id 2 | task 7254 | created context checkpoint 1 of 32 (pos_min = 5586, pos_max = 5586, n_tokens = 5587, size = 50.251 MiB) slot update_slots: id 2 | task 7254 | n_tokens = 6099, memory_seq_rm [6099, end) slot init_sampler: id 2 | task 7254 | init sampler, took 0.76 ms, tokens: text = 6103, total = 6103 slot update_slots: id 2 | task 7254 | prompt processing done, n_tokens = 6103, batch.n_tokens = 4 この部分を採取して slot create_check: id 2 | task 7254 | created context checkpoint 2 of 32 (pos_min = 6098, pos_max = 6098, n_tokens = 6099, size = 値を確認していく 50.251 MiB) slot print_timing: id 2 | task 7254 | prompt eval time = 15585.90 ms / 6103 tokens ( 2.55 ms per token, 391.57 tokens per second) eval time = 158058.24 ms / 5300 tokens ( 29.82 ms per token, 33.53 tokens per second) total time = 173644.14 ms / 11403 tokens slot release: id 2 | task 7254 | stop processing: n_tokens = 11402, truncated = 0 srv update_slots: all slots are idle
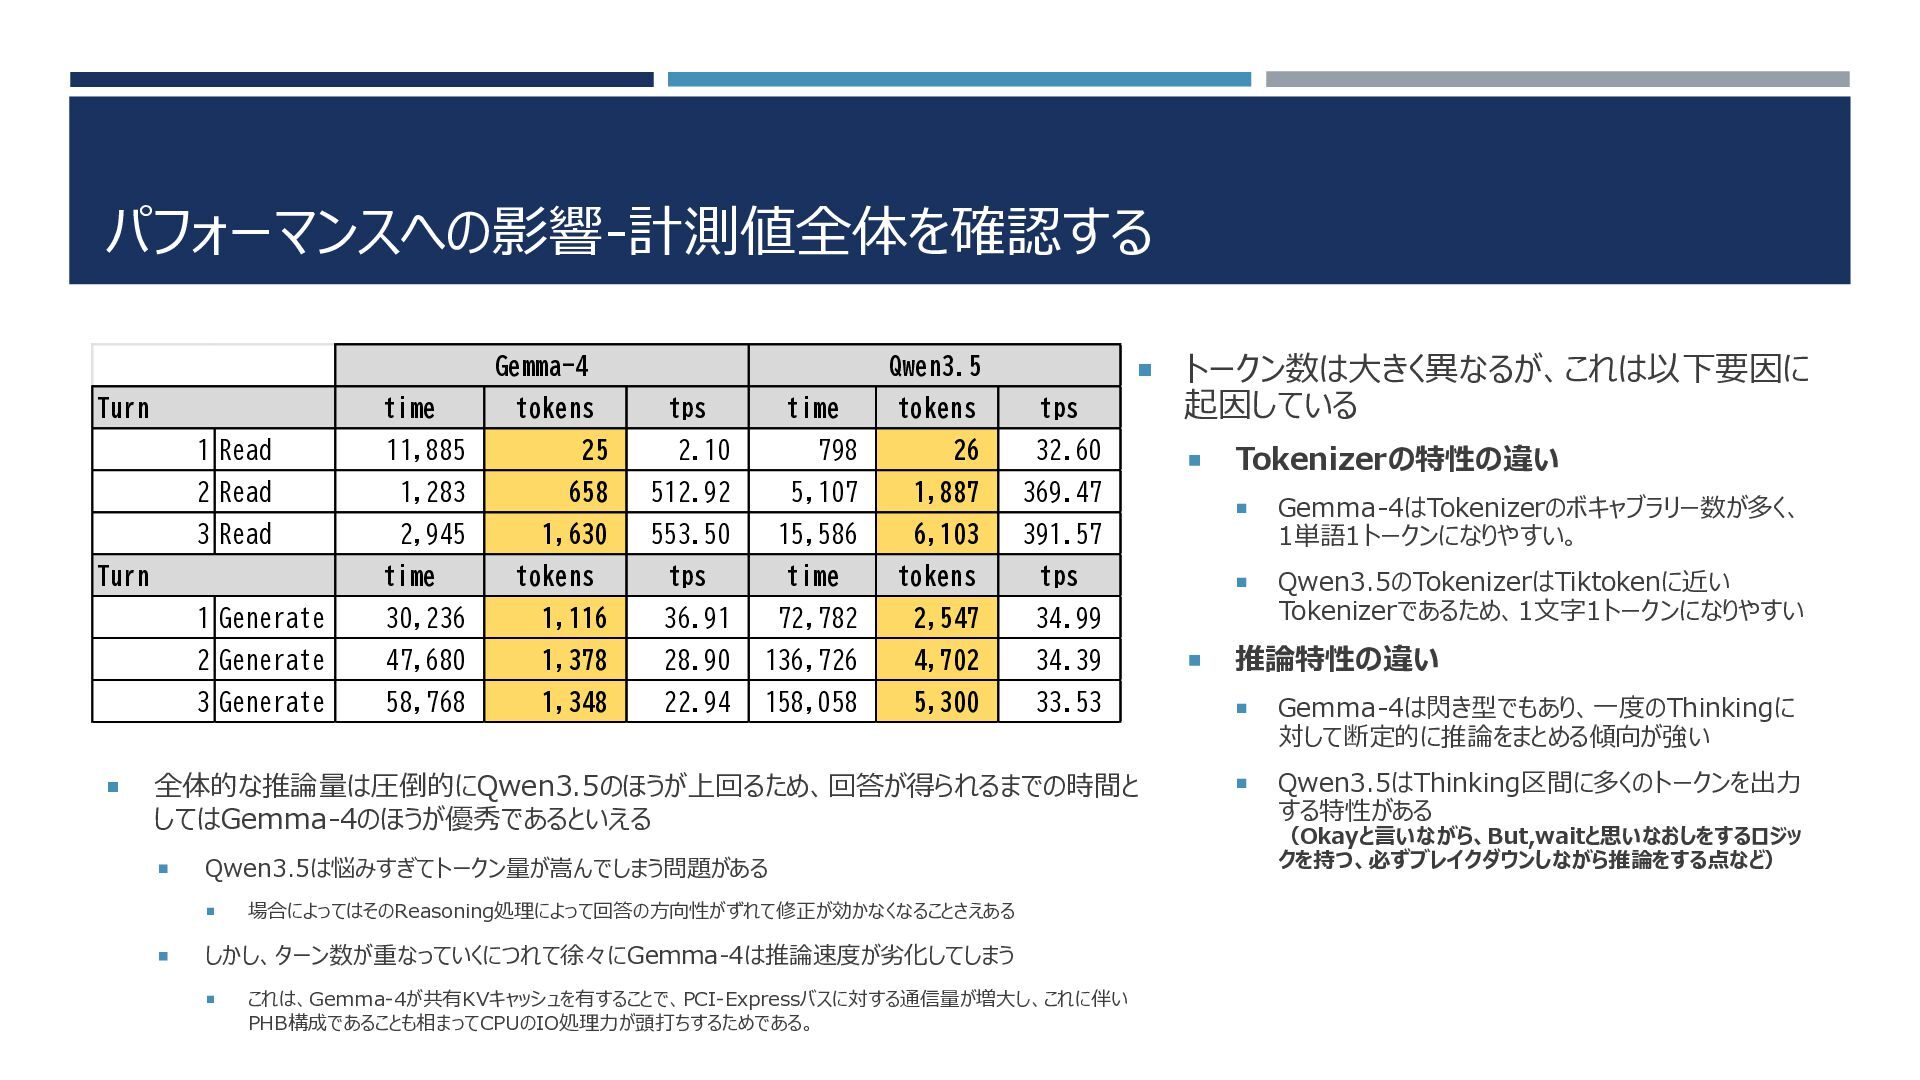
  9. パフォーマンスへの影響-計測値全体を確認する Gemma-4 Turn time tps time tokens tps 起因している 

    1 Read 11,885 25 2.10 798 26 32.60 2 Read 1,283 658 512.92 5,107 1,887 369.47 3 Read 2,945 1,630 553.50 15,586 6,103 391.57 tps time tokens tps Turn  tokens  トークン数は大きく異なるが、これは以下要因に Qwen3.5 time tokens 1 Generate 30,236 1,116 36.91 72,782 2,547 34.99 2 Generate 47,680 1,378 28.90 136,726 4,702 34.39 3 Generate 58,768 1,348 22.94 158,058 5,300 33.53 全体的な推論量は圧倒的にQwen3.5のほうが上回るため、回答が得られるまでの時間と してはGemma-4のほうが優秀であるといえる  Qwen3.5は悩みすぎてトークン量が嵩んでしまう問題がある   場合によってはそのReasoning処理によって回答の方向性がずれて修正が効かなくなることさえある しかし、ターン数が重なっていくにつれて徐々にGemma-4は推論速度が劣化してしまう  これは、Gemma-4が共有KVキャッシュを有することで、PCI-Expressバスに対する通信量が増大し、これに伴い PHB構成であることも相まってCPUのIO処理力が頭打ちするためである。  Tokenizerの特性の違い  Gemma-4はTokenizerのボキャブラリー数が多く、 1単語1トークンになりやすい。  Qwen3.5のTokenizerはTiktokenに近い Tokenizerであるため、1文字1トークンになりやすい 推論特性の違い  Gemma-4は閃き型でもあり、一度のThinkingに 対して断定的に推論をまとめる傾向が強い  Qwen3.5はThinking区間に多くのトークンを出力 する特性がある (Okayと言いながら、But,waitと思いなおしをするロジッ クを持つ、必ずブレイクダウンしながら推論をする点など)
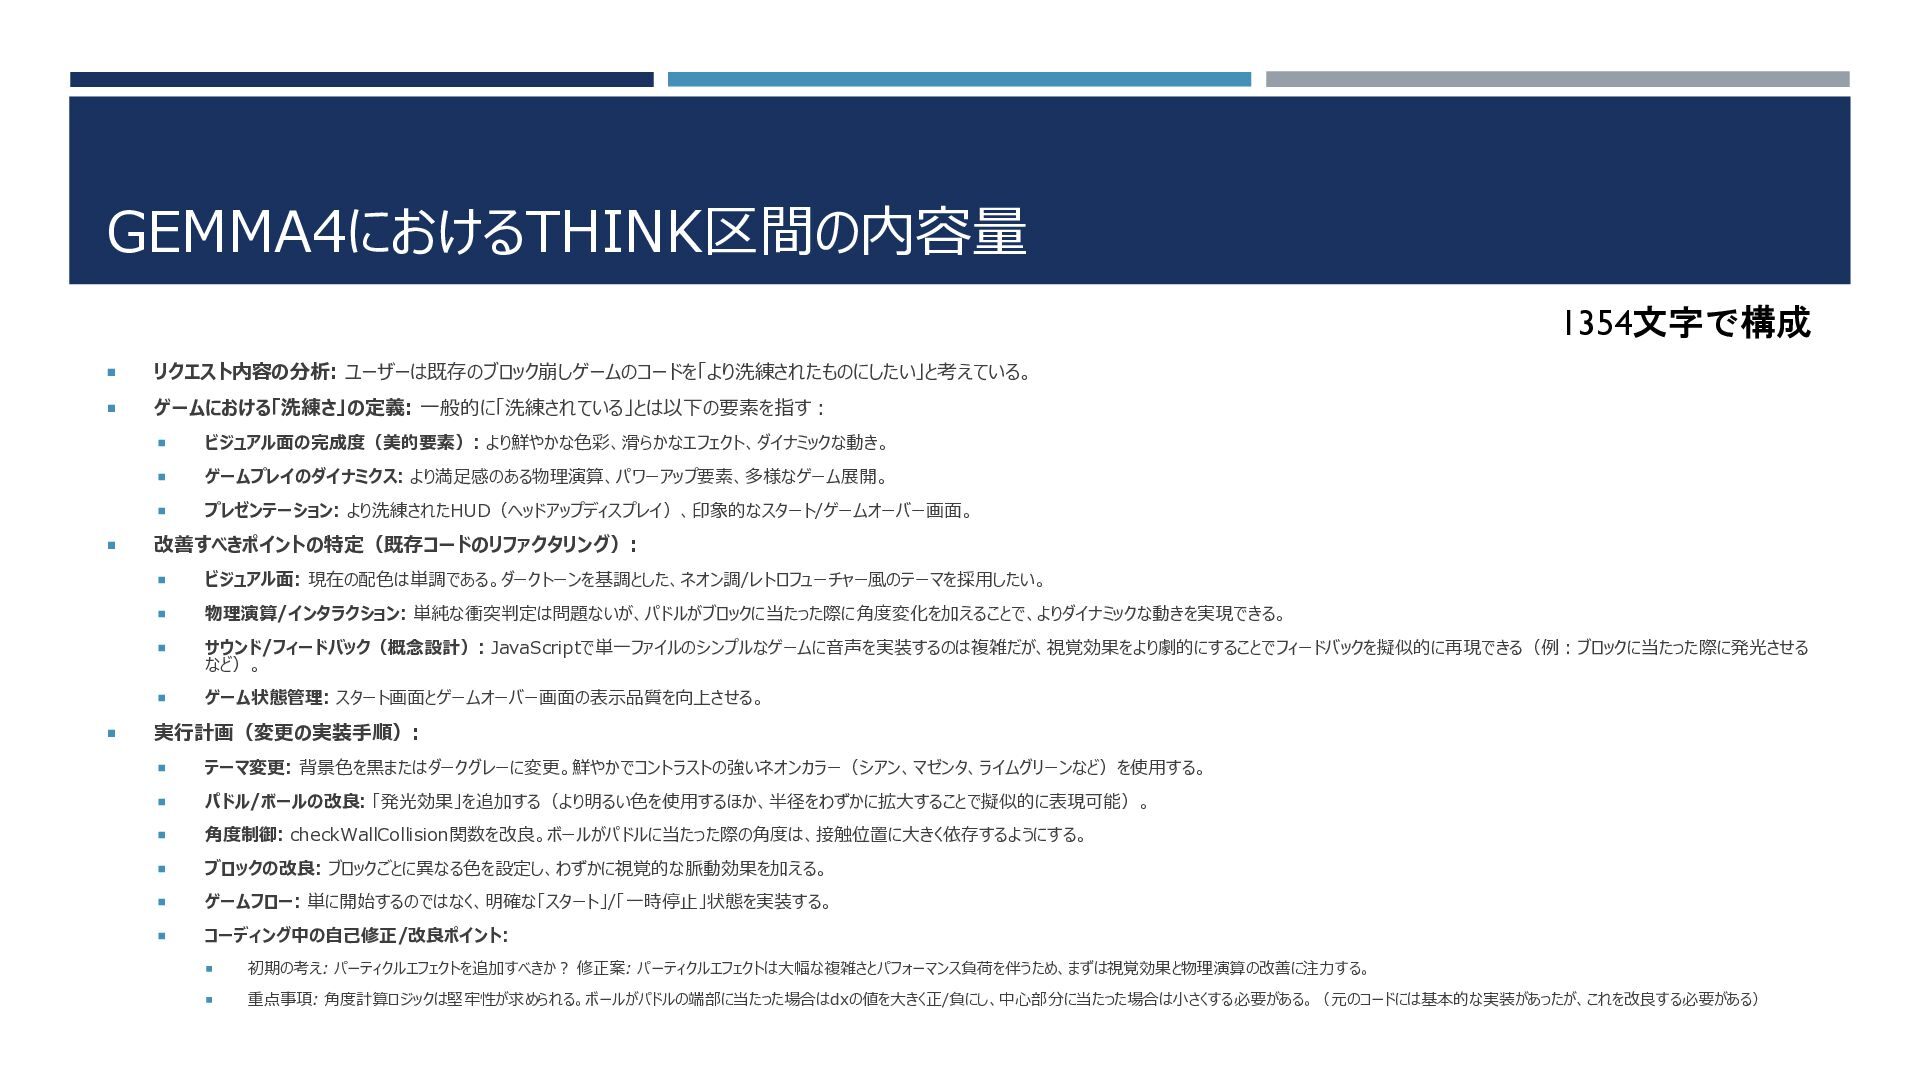
  10. GEMMA4におけるTHINK区間の内容量 1354文字で構成  リクエスト内容の分析: ユーザーは既存のブロック崩しゲームのコードを「より洗練されたものにしたい」と考えている。  ゲームにおける「洗練さ」の定義: 一般的に「洗練されている」とは以下の要素を指す:  

     ビジュアル面の完成度(美的要素): より鮮やかな色彩、滑らかなエフェクト、ダイナミックな動き。  ゲームプレイのダイナミクス: より満足感のある物理演算、パワーアップ要素、多様なゲーム展開。  プレゼンテーション: より洗練されたHUD(ヘッドアップディスプレイ)、印象的なスタート/ゲームオーバー画面。 改善すべきポイントの特定(既存コードのリファクタリング):  ビジュアル面: 現在の配色は単調である。ダークトーンを基調とした、ネオン調/レトロフューチャー風のテーマを採用したい。  物理演算/インタラクション: 単純な衝突判定は問題ないが、パドルがブロックに当たった際に角度変化を加えることで、よりダイナミックな動きを実現できる。  サウンド/フィードバック(概念設計): JavaScriptで単一ファイルのシンプルなゲームに音声を実装するのは複雑だが、視覚効果をより劇的にすることでフィードバックを擬似的に再現できる(例:ブロックに当たった際に発光させる など)。  ゲーム状態管理: スタート画面とゲームオーバー画面の表示品質を向上させる。 実行計画(変更の実装手順):  テーマ変更: 背景色を黒またはダークグレーに変更。鮮やかでコントラストの強いネオンカラー(シアン、マゼンタ、ライムグリーンなど)を使用する。  パドル/ボールの改良: 「発光効果」を追加する(より明るい色を使用するほか、半径をわずかに拡大することで擬似的に表現可能)。  角度制御: checkWallCollision関数を改良。ボールがパドルに当たった際の角度は、接触位置に大きく依存するようにする。  ブロックの改良: ブロックごとに異なる色を設定し、わずかに視覚的な脈動効果を加える。  ゲームフロー: 単に開始するのではなく、明確な「スタート」/「一時停止」状態を実装する。  コーディング中の自己修正/改良ポイント:  初期の考え: パーティクルエフェクトを追加すべきか? 修正案: パーティクルエフェクトは大幅な複雑さとパフォーマンス負荷を伴うため、まずは視覚効果と物理演算の改善に注力する。  重点事項: 角度計算ロジックは堅牢性が求められる。ボールがパドルの端部に当たった場合はdxの値を大きく正/負にし、中心部分に当たった場合は小さくする必要がある。(元のコードには基本的な実装があったが、これを改良する必要がある)
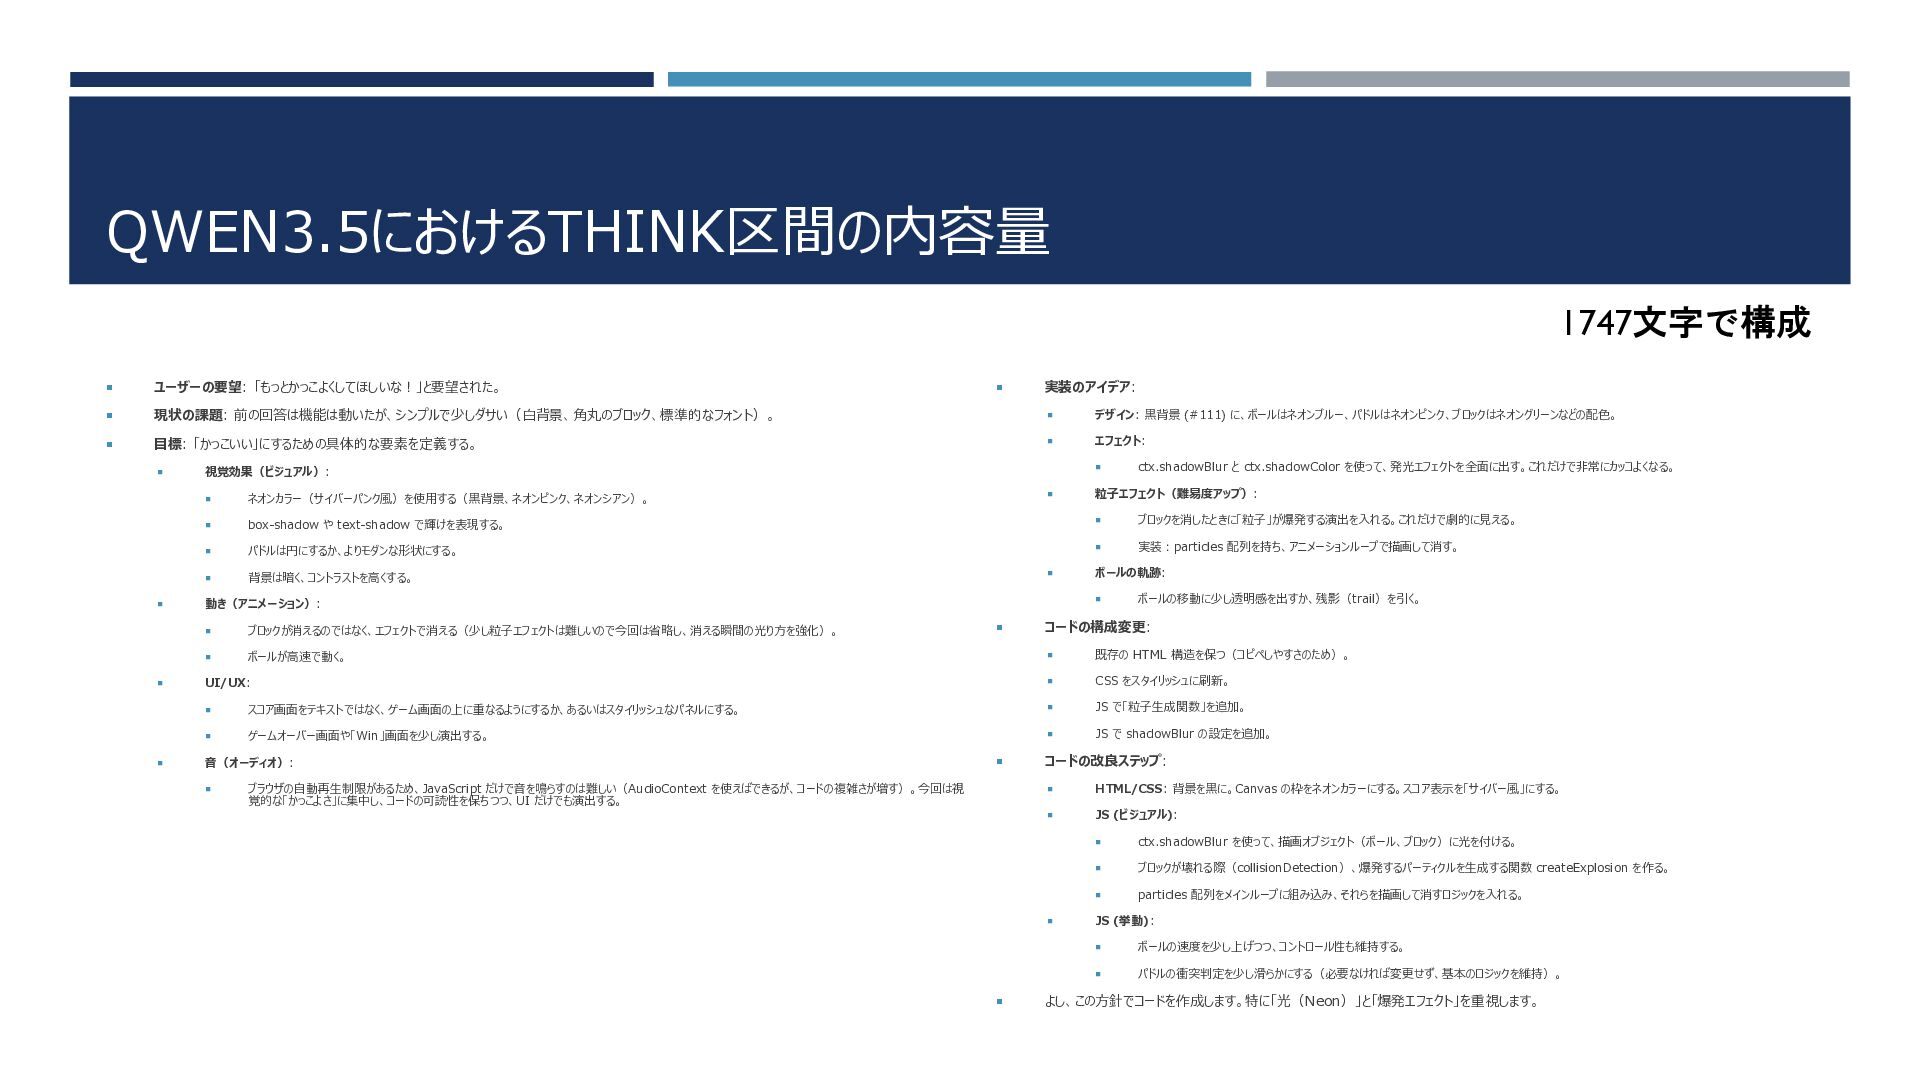
  11. QWEN3.5におけるTHINK区間の内容量 1747文字で構成  ユーザーの要望: 「もっとかっこよくしてほしいな!」と要望された。  現状の課題: 前の回答は機能は動いたが、シンプルで少しダサい(白背景、角丸のブロック、標準的なフォント)。  デザイン:

    黒背景 (#111) に、ボールはネオンブルー、パドルはネオンピンク、ブロックはネオングリーンなどの配色。  目標: 「かっこいい」にするための具体的な要素を定義する。  エフェクト:      実装のアイデア:  視覚効果(ビジュアル):  ctx.shadowBlur と ctx.shadowColor を使って、発光エフェクトを全面に出す。これだけで非常にカッコよくなる。 粒子エフェクト(難易度アップ):  ネオンカラー(サイバーパンク風)を使用する(黒背景、ネオンピンク、ネオンシアン)。  box-shadow や text-shadow で輝けを表現する。  ブロックを消したときに「粒子」が爆発する演出を入れる。これだけで劇的に見える。  パドルは円にするか、よりモダンな形状にする。  実装:particles 配列を持ち、アニメーションループで描画して消す。  背景は暗く、コントラストを高くする。   動き(アニメーション):  ブロックが消えるのではなく、エフェクトで消える(少し粒子エフェクトは難しいので今回は省略し、消える瞬間の光り方を強化)。  ボールが高速で動く。  UI/UX:  スコア画面をテキストではなく、ゲーム画面の上に重なるようにするか、あるいはスタイリッシュなパネルにする。  ゲームオーバー画面や「Win」画面を少し演出する。 音(オーディオ):  ボールの軌跡:  ブラウザの自動再生制限があるため、JavaScript だけで音を鳴らすのは難しい(AudioContext を使えばできるが、コードの複雑さが増す)。今回は視 覚的な「かっこよさ」に集中し、コードの可読性を保ちつつ、UI だけでも演出する。  既存の HTML 構造を保つ(コピペしやすさのため)。  CSS をスタイリッシュに刷新。  JS で「粒子生成関数」を追加。  JS で shadowBlur の設定を追加。 コードの改良ステップ:  HTML/CSS: 背景を黒に。Canvas の枠をネオンカラーにする。スコア表示を「サイバー風」にする。  JS (ビジュアル):   ボールの移動に少し透明感を出すか、残影(trail)を引く。 コードの構成変更:  ctx.shadowBlur を使って、描画オブジェクト(ボール、ブロック)に光を付ける。  ブロックが壊れる際(collisionDetection)、爆発するパーティクルを生成する関数 createExplosion を作る。  particles 配列をメインループに組み込み、それらを描画して消すロジックを入れる。 JS (挙動):  ボールの速度を少し上げつつ、コントロール性も維持する。  パドルの衝突判定を少し滑らかにする(必要なければ変更せず、基本のロジックを維持)。 よし、この方針でコードを作成します。特に「光(Neon)」と「爆発エフェクト」を重視します。
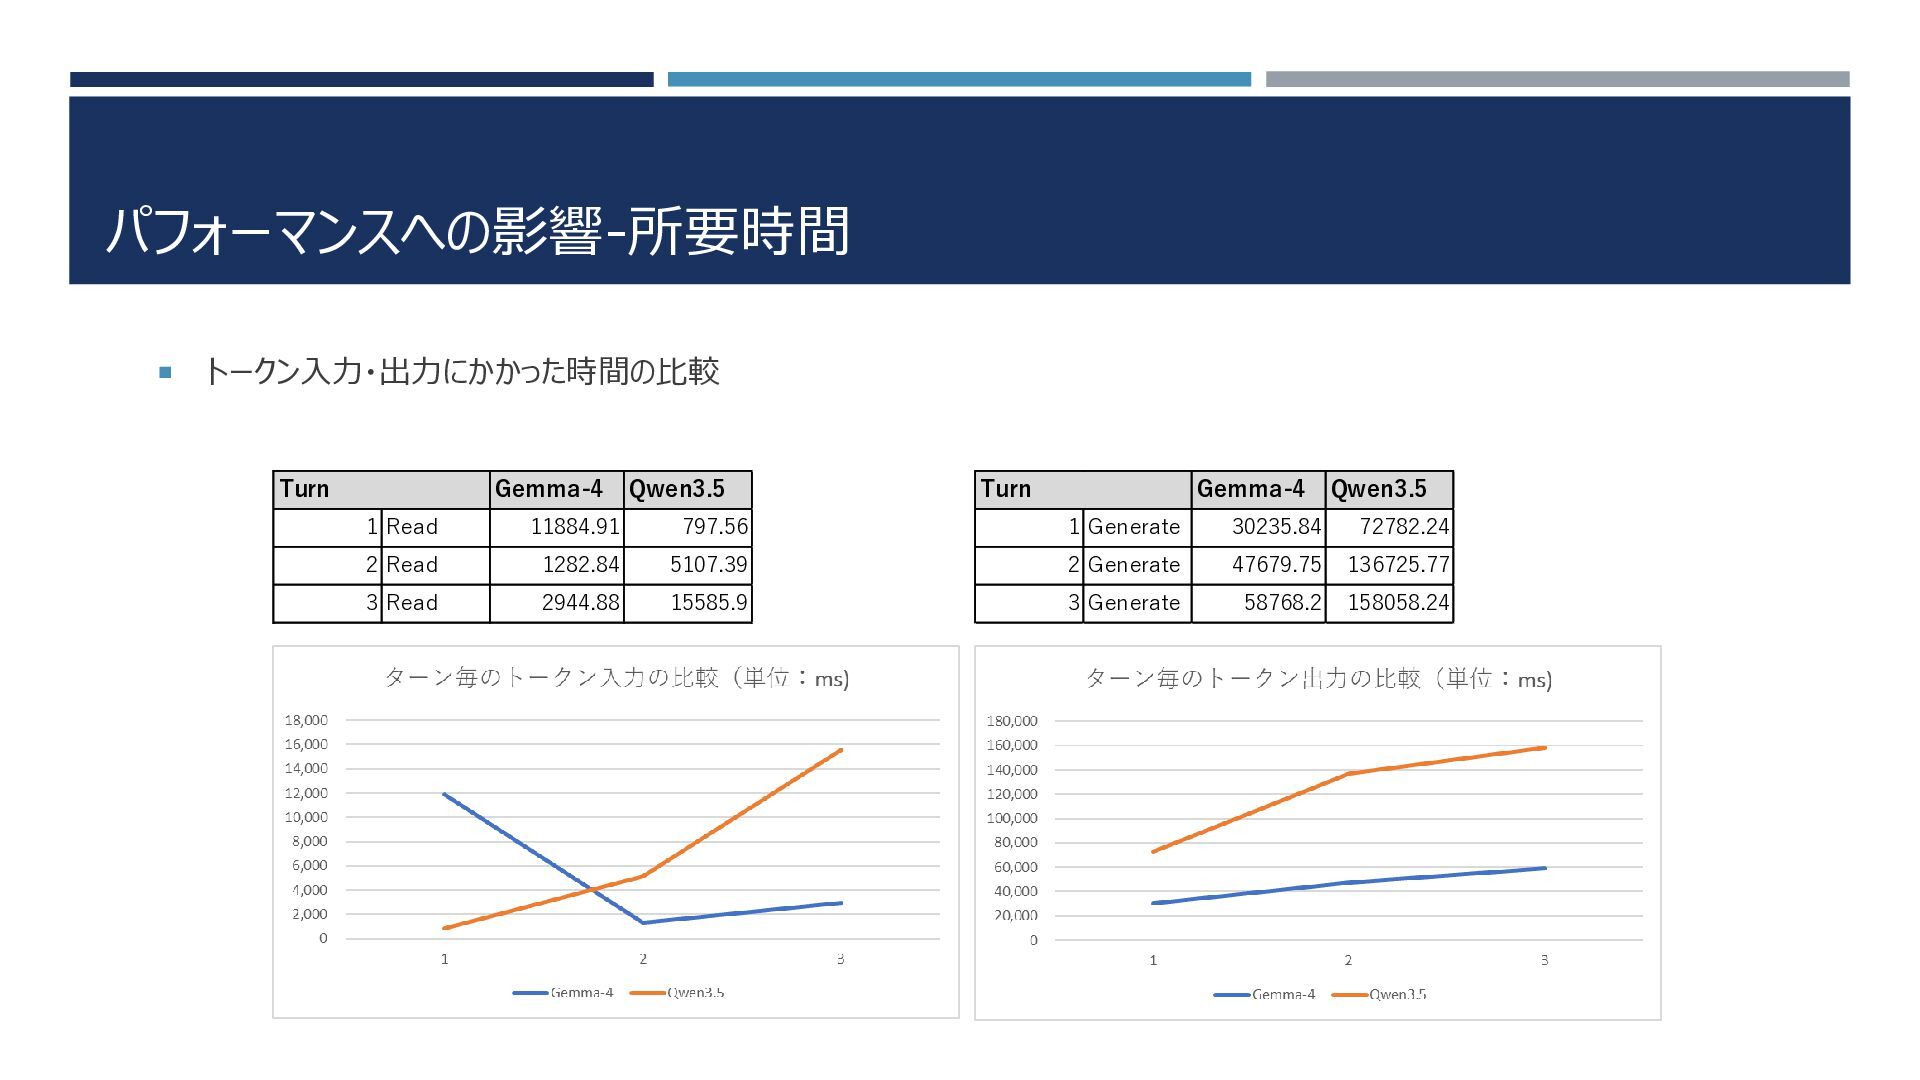
  12. パフォーマンスへの影響-所要時間  トークン入力・出力にかかった時間の比較 Turn Gemma-4 Qwen3.5 Turn Gemma-4 Qwen3.5 1

    Read 11884.91 797.56 1 Generate 30235.84 72782.24 2 Read 1282.84 5107.39 2 Generate 47679.75 136725.77 3 Read 2944.88 15585.9 3 Generate 58768.2 158058.24
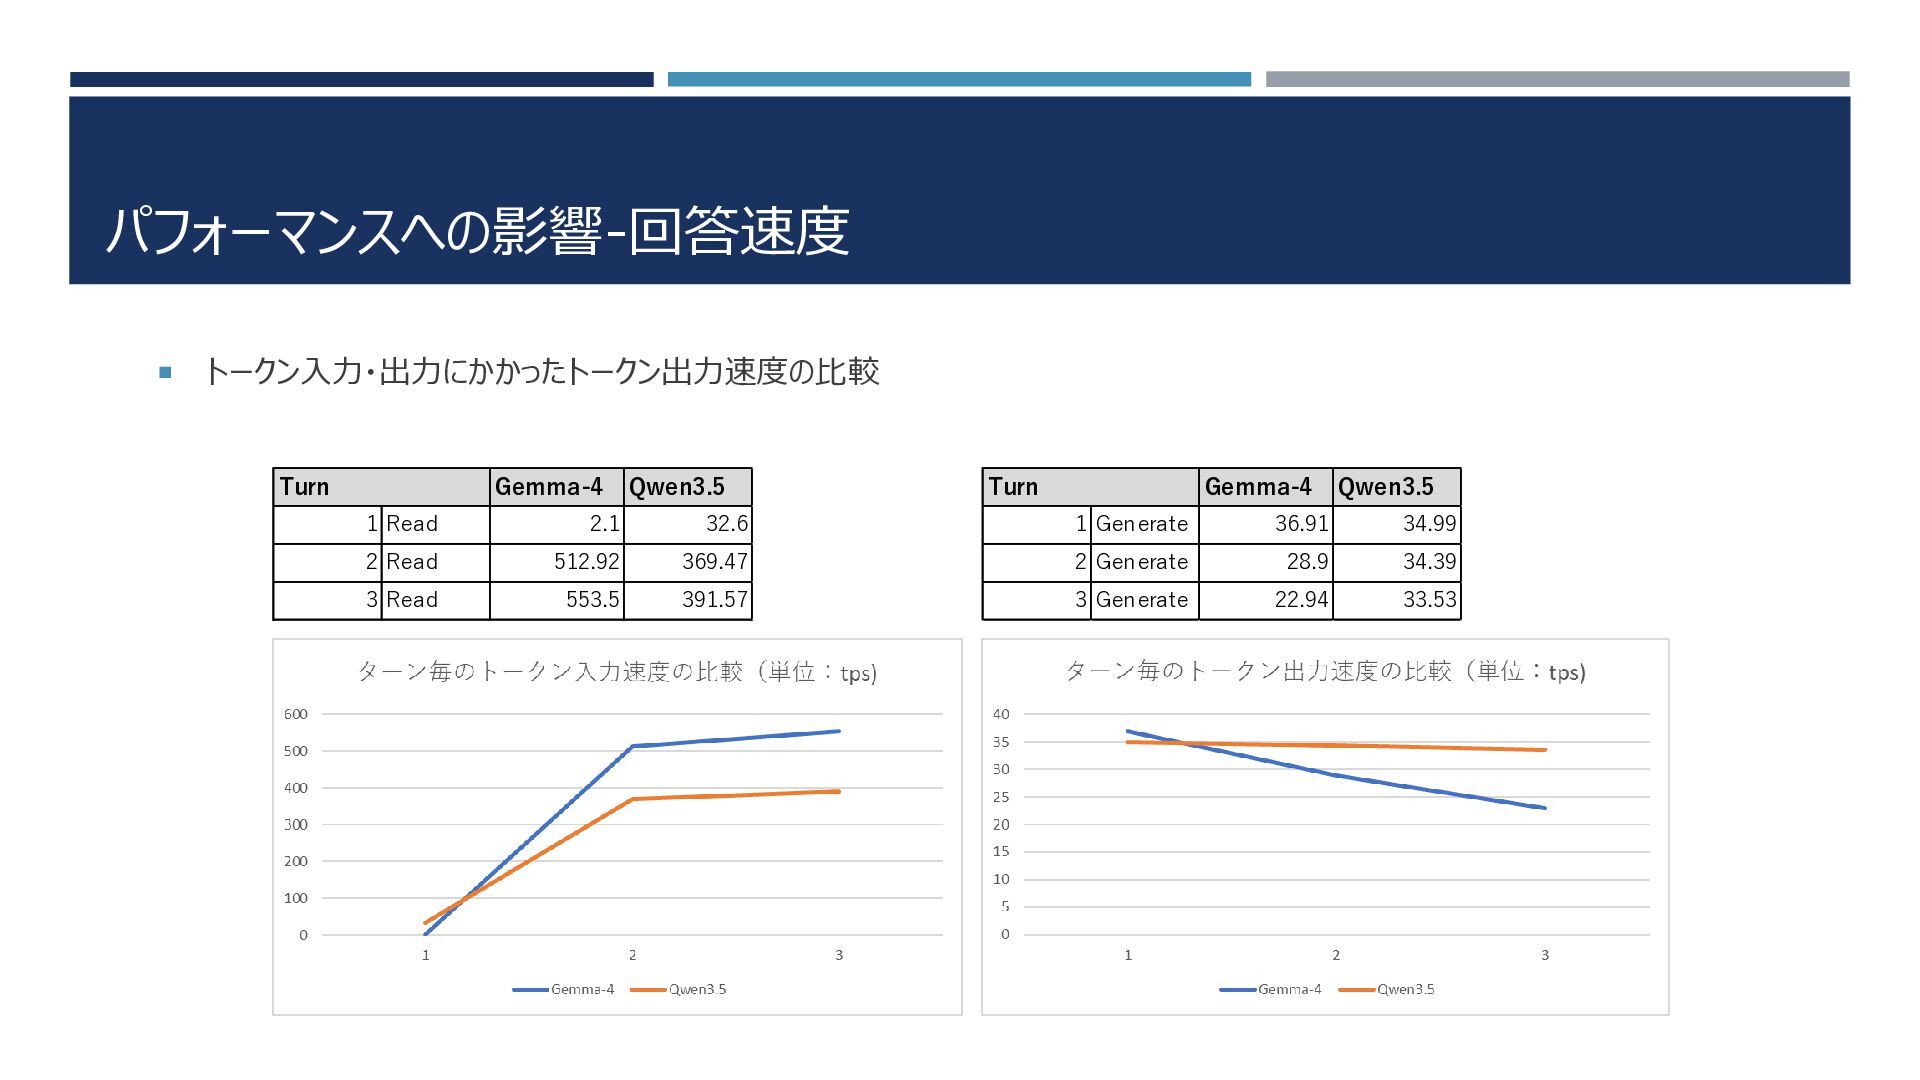
  13. パフォーマンスへの影響-回答速度  トークン入力・出力にかかったトークン出力速度の比較 Turn Gemma-4 Qwen3.5 Turn Gemma-4 Qwen3.5 1

    Read 2.1 32.6 1 Generate 36.91 34.99 2 Read 512.92 369.47 2 Generate 28.9 34.39 3 Read 553.5 391.57 3 Generate 22.94 33.53
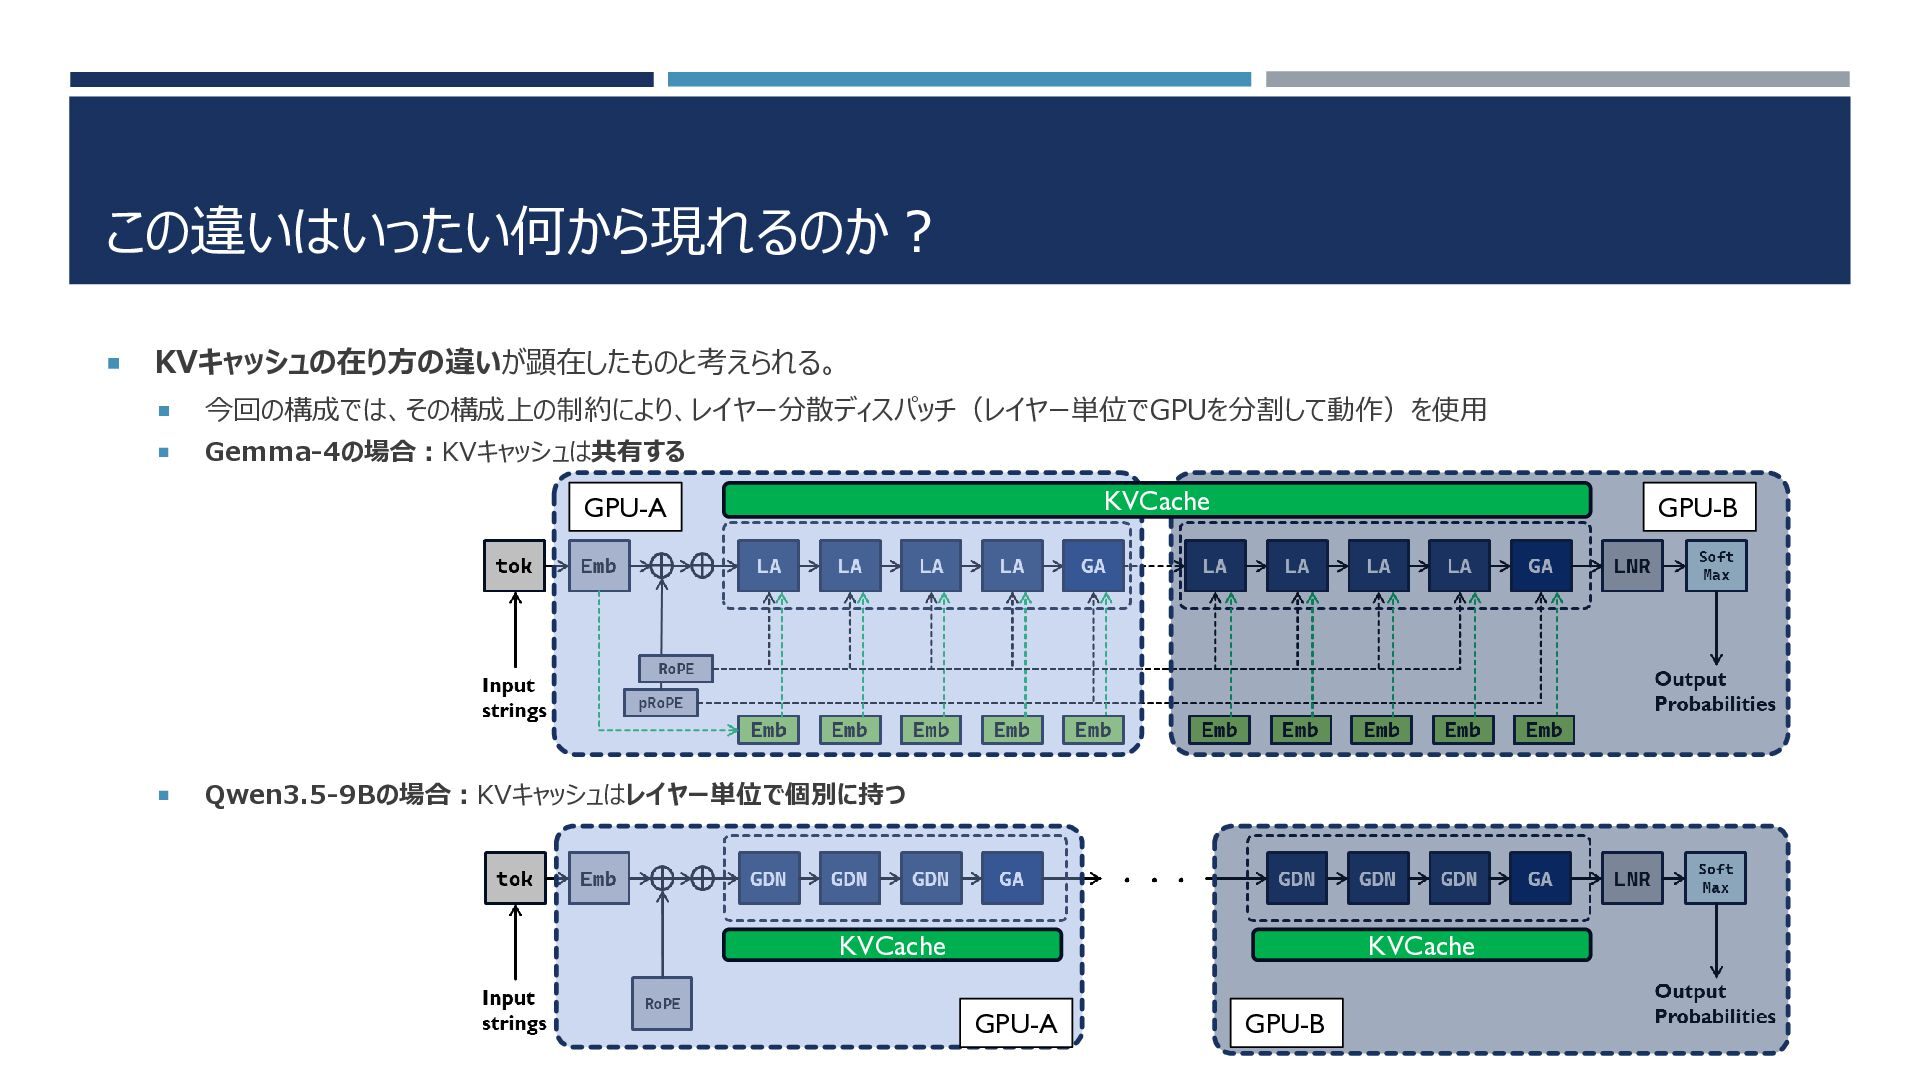
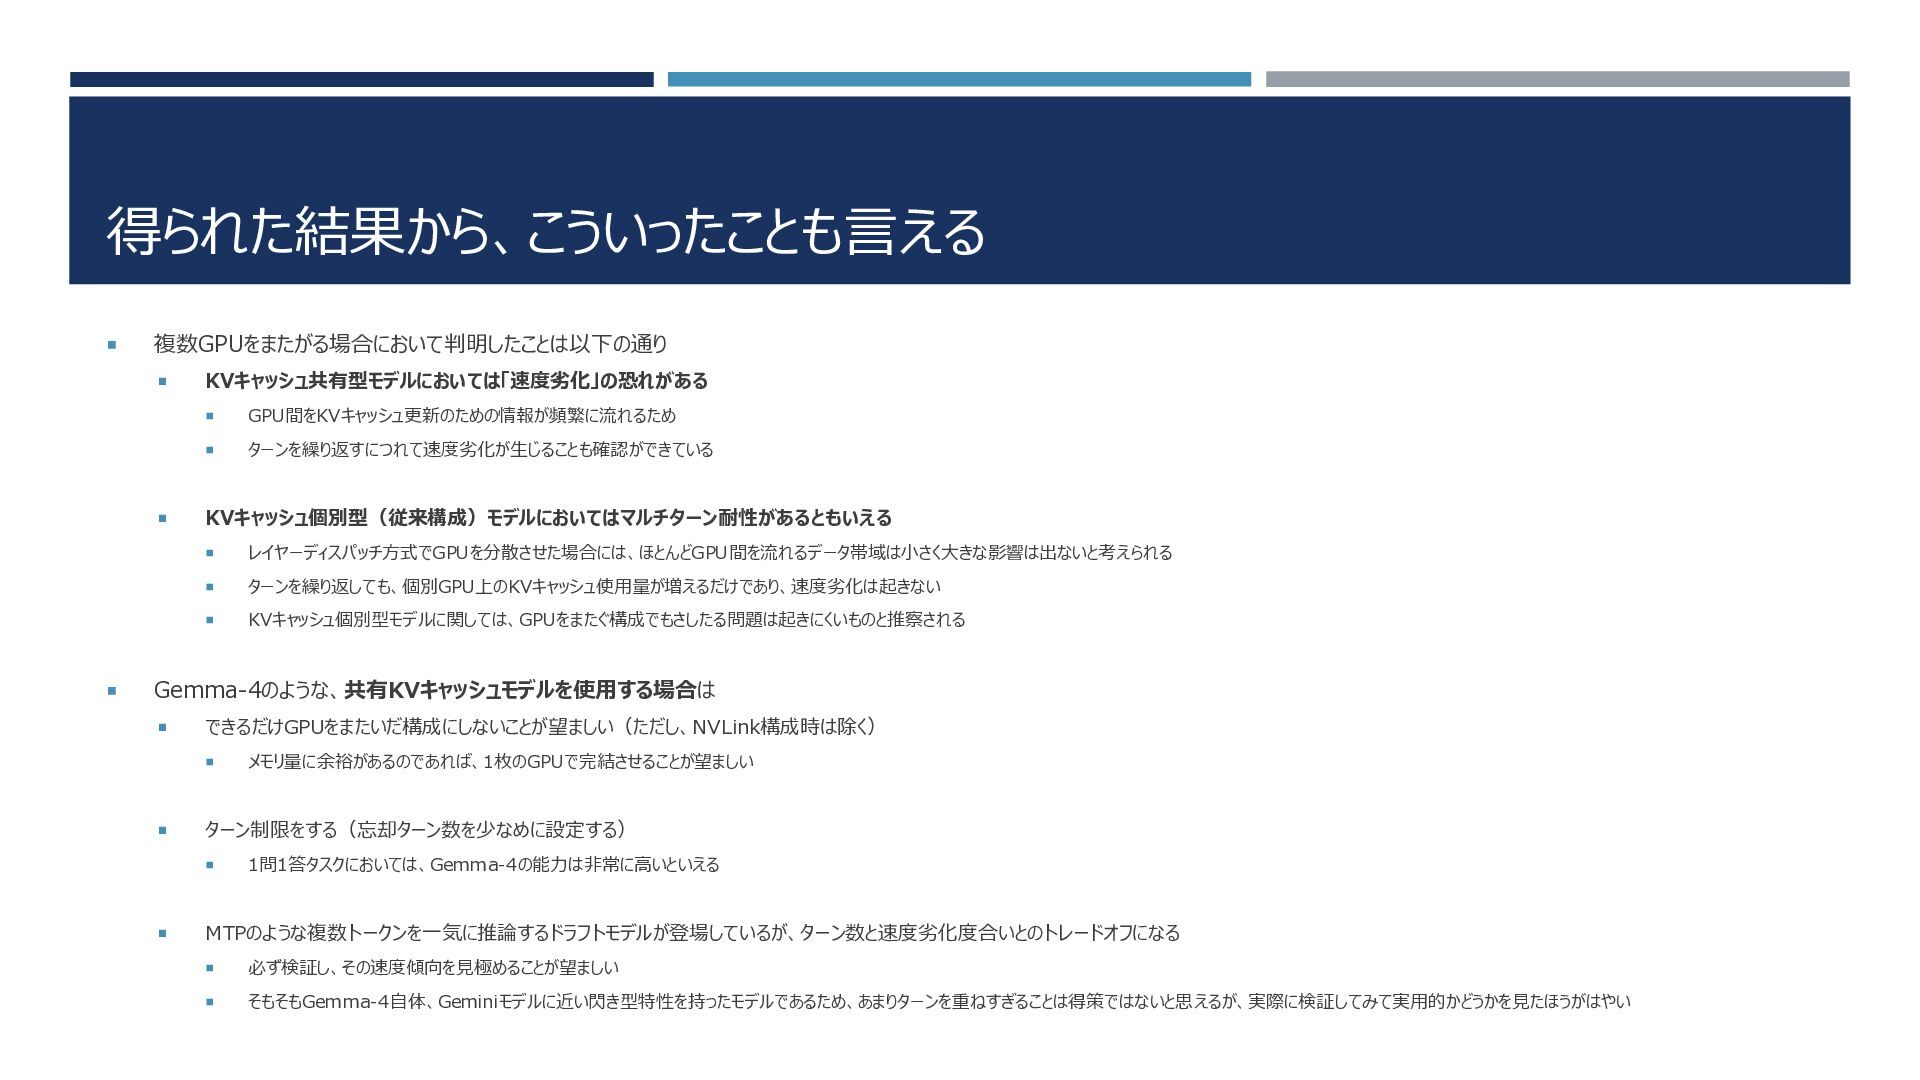
  14. 得られた結果から、こういったことも言える  複数GPUをまたがる場合において判明したことは以下の通り    KVキャッシュ共有型モデルにおいては「速度劣化」の恐れがある  GPU間をKVキャッシュ更新のための情報が頻繁に流れるため 

    ターンを繰り返すにつれて速度劣化が生じることも確認ができている KVキャッシュ個別型(従来構成)モデルにおいてはマルチターン耐性があるともいえる  レイヤーディスパッチ方式でGPUを分散させた場合には、ほとんどGPU間を流れるデータ帯域は小さく大きな影響は出ないと考えられる  ターンを繰り返しても、個別GPU上のKVキャッシュ使用量が増えるだけであり、速度劣化は起きない  KVキャッシュ個別型モデルに関しては、GPUをまたぐ構成でもさしたる問題は起きにくいものと推察される Gemma-4のような、共有KVキャッシュモデルを使用する場合は  できるだけGPUをまたいだ構成にしないことが望ましい(ただし、NVLink構成時は除く)   ターン制限をする(忘却ターン数を少なめに設定する)   メモリ量に余裕があるのであれば、1枚のGPUで完結させることが望ましい 1問1答タスクにおいては、Gemma-4の能力は非常に高いといえる MTPのような複数トークンを一気に推論するドラフトモデルが登場しているが、ターン数と速度劣化度合いとのトレードオフになる  必ず検証し、その速度傾向を見極めることが望ましい  そもそもGemma-4自体、Geminiモデルに近い閃き型特性を持ったモデルであるため、あまりターンを重ねすぎることは得策ではないと思えるが、実際に検証してみて実用的かどうかを見たほうがはやい